Cette étude examine la relation entre le lupus érythémateux disséminé et les pertes de grossesse répétées et identifie IFI27 comme un biomarqueur candidat pour des recherches futures.
Article de recherche
La randomisation mendélienne et la bio-informatique identifient IFI27 comme un biomarqueur candidat pour les pertes de grossesse récurrentes dans le lupus érythémateux systémique
* These authors contributed equally
Dans cet article
Résumé
Résumé
Le lupus érythémateux systémique (SLE) est associé à des issues indésirables de la grossesse, mais son lien de causalité avec la perte de grossesse récurrente (RPL) ainsi que leurs caractéristiques moléculaires partagées restent incertains. Cette étude a combiné des analyses bidirectionnelles de randomisation mendélienne (MR) à deux échantillons et des approches bioinformatiques transcriptomiques afin d'explorer cette relation et d'identifier des biomarqueurs candidats communs. FinnGen et le UK Biobank ont été sélectionnés car ils fournissent de grandes statistiques sommaires d'études d'association pangénomique (GWAS) d'ascendance européenne, non chevauchantes. Les gènes différentiellement exprimés (DEGs) ont été identifiés à partir des jeux de données GSE61635 (sang ; |log₂ du rapport d'expression| > 1) et GSE165004 (endomètre ; |log₂ du rapport d'expression| > 0,5) en utilisant un seuil de P ajusté < 0,05, suivis d'une analyse d'enrichissement fonctionnel, d'une analyse d'interaction protéine–protéine (PPI), d'un criblage de gènes centraux, d'une régression par l'opérateur de réduction et de sélection par la norme LASSO (least absolute shrinkage and selection operator), d'une validation externe à l'aide des jeux de données GSE50772 et GSE198700, d'une analyse de la courbe ROC (receiver operating characteristic) et d'une analyse d'enrichissement des ensembles de gènes par échantillon unique (ssGSEA). Le SLE prédit génétiquement était associé à une augmentation statistiquement significative mais modeste en valeur absolue des fausses couches spontanées (odds ratio [OR] pondéré par la variance inverse [IVW] = 1,01, intervalle de confiance [IC] à 95 % = 1,00–1,02 ; P < 0,001). La force des instruments était adéquate, et les analyses de sensibilité n'ont révélé aucune hétérogénéité notable, pléiotropie directionnelle ou variant unique influent. Cinquante-neuf DEGs partagés étaient enrichis dans des réponses immunitaires antivirales, l'adhésion cellulaire et des processus liés à l'apoptose. IFI27 était constamment surexprimé dans le sang des patients atteints de SLE, mais sous-exprimé dans l'endomètre et les villosités choriales des cas de RPL, tandis que CXCL11 n'a pas obtenu de validation externe cohérente. Des analyses rétrospectives ROC ont donné des aires sous la courbe (AUC) de 0,822 pour le SLE et de 0,872 pour la RPL. Les scores ssGSEA inférés par calcul montrent des corrélations entre l'expression d'IFI27 et plusieurs signatures de cellules immunitaires, notamment les cellules T auxiliaires de type 2 (Th2). Ces résultats identifient IFI27 comme un biomarqueur candidat commun au SLE et à la RPL ; toutefois, des études cliniques et expérimentales prospectives sont nécessaires pour valider sa signification biologique et clinique.
Introduction
Le lupus érythémateux disséminé (LED) est une maladie auto-immune complexe caractérisée par une atteinte multisystémique et une dysrégulation immunitaire chronique1. Les anomalies pathologiques observées dans le LED sont principalement attribuées à un dysfonctionnement des réponses immunitaires adaptatives et au dépôt de complexes antigène–anticorps, entraînant des lésions tissulaires auto-immunes et des dommages organiques2,3. L'incidence mondiale du LED est d'environ 5,14 (1,4–15,13) cas pour 100 000 personnes-années, avec une incidence estimée à 8,82 (2,4–25,99) cas pour 100 000 personnes-années chez les femmes4. Le LED affecte les individus de tout âge, mais survient principalement chez les femmes en âge de procréer5,6. Les patientes enceintes atteintes de LED présentent un risque accru de complications obstétricales, notamment des fausses couches répétées, des morts fœtales, des accouchements prématurés et une restriction de la croissance intra-utérine7,8. La perte de grossesse répétée (PGR) est définie comme deux fausses couches ou plus avant 20 à 24 semaines d'aménorrhée9. Sa prévalence rapportée est d'environ 2,6 %10, ce qui en fait une complication reproductive cliniquement significative. Environ 20 % des patientes enceintes atteintes de LED subissent une fausse couche11, et le LED est reconnu comme un facteur de risque important de PGR12. Les mécanismes proposés incluent des altérations hormonales et une dysrégulation immunitaire. Des biomarqueurs tels que les anticorps antiphospholipides et le lupus anticoagulant ont été étudiés comme prédicteurs potentiels de complications obstétricales chez les patientes atteintes de LED11. Ces auto-anticorps peuvent se lier aux cellules trophoblastiques placentaires, altérer la signalisation, la prolifération et l'invasion trophoblastiques, moduler la sécrétion d'hormones et de cytokines, et augmenter l'apoptose, contribuant ainsi à des issues de grossesse défavorables13. De plus, la bêta-2 glycoprotéine I (β2-GPI), un antigène majeur du syndrome des anticorps antiphospholipides, est exprimée dans le tissu placentaire. La liaison des anticorps anti-β2-GPI à la β2-GPI inhibe la croissance et la différenciation trophoblastiques, entraînant des anomalies placentaires. Cette interaction favorise également un environnement pro-inflammatoire marqué par une production destructrice de cytokines et une activation du complément, contribuant à la thrombose placentaire et aux fausses couches répétées14,15. Toutefois, les études antérieures ont souvent manqué d'analyses approfondies des tissus reproducteurs locaux, tels que le chorion, limitant ainsi la possibilité de corréler les biomarqueurs systémiques avec les modifications pathologiques locales. En outre, la prise en charge de la grossesse compliquée par le LED et la prévention des complications obstétricales restent difficiles. La prédisposition génétique contribue au développement du LED, et des variations génétiques ont également été impliquées dans la pathogenèse de la PGR16,17. Néanmoins, l'existence d'une relation causale entre le LED et la PGR, ainsi que les mécanismes moléculaires et les gènes partagés sous-jacents à leur coexistence, demeurent incertaines.
La randomisation mendélienne (RM) est une approche établie d'inférence causale qui utilise des variants génétiques comme variables instrumentales afin d'estimer les effets causaux des expositions sur les résultats liés aux maladies18. En exploitant la relation entre génotype et phénotype, la RM réduit les biais dus aux facteurs de confusion et à la causalité inverse par rapport aux études observationnelles classiques. Parallèlement, les progrès réalisés dans les plateformes de microarrays génomiques et le séquençage à haut débit ont permis à des analyses bioinformatiques d'identifier des biomarqueurs diagnostiques candidats et des cibles thérapeutiques grâce au profilage transcriptomique. L'intégration de ces approches complémentaires pourrait offrir une compréhension plus complète de la relation entre le lupus érythémateux systémique (LES) et les fausses couches à répétition (FCR), en combinant des preuves génétiques causales avec des profils d'expression génique associés à la maladie. Cette étude visait donc à explorer la relation causale potentielle entre le LES et les FCR, à identifier des biomarqueurs candidats et des voies biologiques partagées, et à hiérarchiser les cibles pour une validation ultérieure. Pour atteindre ces objectifs, le flux analytique a été prédéfini comme suit : une RM bidirectionnelle pour évaluer le sens causal ; des analyses indépendantes d'expression différentielle des gènes suivies d'une intégration transcriptomique ; une analyse du réseau d'interactions protéine-protéine (IPP) et une régression par l'opérateur de réduction et de sélection par la norme LASSO (LASSO) pour la priorisation des biomarqueurs ; une validation externe de l'expression et une analyse de la courbe ROC (caractéristique de fonctionnement du récepteur) ; et une analyse d'enrichissement des ensembles de gènes à l'échelle du seul échantillon (ssGSEA) afin d'évaluer les associations avec les signatures des cellules immunitaires. Ce flux de travail progressif est résumé dans Figure 1.
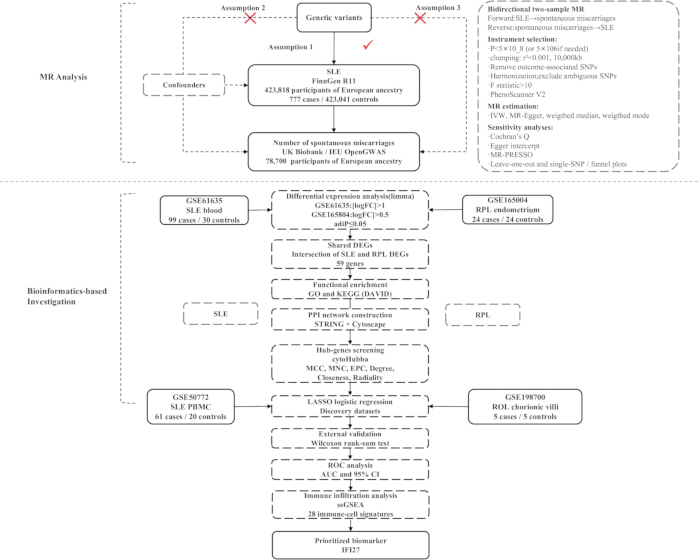
Figure 1. Schéma de l'étude et flux analytique.
Le panneau supérieur illustre l'analyse de randomisation mendélienne (MR) bidirectionnelle à deux échantillons évaluant l'association entre le lupus érythémateux systémique (SLE) et le nombre de fausses couches spontanées, à l'aide de statistiques sommaires d'études d'association pangénomique (GWAS). L'analyse résume la sélection des instruments, le regroupement par déséquilibre de liaison, les analyses de randomisation mendélienne (MR) et les analyses de sensibilité. Le panneau inférieur décrit le flux de travail en bioinformatique, comprenant l'analyse d'expression différentielle, l'identification des gènes différentiellement exprimés (DEGs) communs, l'analyse d'enrichissement fonctionnel, la construction du réseau d'interactions protéine-protéine (PPI), le criblage des gènes centraux, la régression par l'opérateur de réduction et de sélection par la norme absolue minimale (LASSO), une validation externe, l'analyse de la courbe ROC (receiver operating characteristic), l'analyse d'enrichissement des ensembles de gènes par échantillon unique (ssGSEA), et la priorisation du biomarqueur candidat IFI27. IVW, pondération inverse de la variance ; KEGG, Encyclopédie de Kyoto des gènes et des génomes ; GO, Ontologie des gènes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Protocole
Une approbation éthique n’était pas requise pour la présente étude, car celle-ci impliquait uniquement des analyses secondaires de statistiques sommaires d’études d’association pangénomique (GWAS) et de jeux de données transcriptomiques, tous publiquement accessibles et anonymisés. Aucun nouveau participant n’a été recruté, aucun échantillon biologique n’a été collecté, et aucune information identifiable au niveau individuel n’a été consultée. Les études initiales de FinnGen, du UK Biobank et du Gene Expression Omnibus ont indiqué qu’une approbation éthique et un consentement éclairé avaient été obtenus conformément aux exigences respectives de leurs institutions, de leurs pays et de leurs bases de données spécifiques. Tous les jeux de données utilisés dans la présente étude ont été consultés et analysés conformément aux politiques d’utilisation applicables des bases de données, aux conditions d’accès aux données et aux lignes directrices éthiques. Les auteurs n’ont pas tenté de réidentifier un participant quel qu’il soit. Un consentement éclairé écrit supplémentaire n’était donc pas requis pour cette analyse secondaire. Le contenu de cette étude comprend deux parties : l’analyse MR et l’analyse bioinformatique (Figure 1). Cette étude était entièrement computationnelle et utilisait des jeux de données sommaires de GWAS et transcriptomiques publiquement accessibles. Aucun réactif ni consommable de laboratoire humide n’a été utilisé.
Analyse MR
Sources de données, acquisition et prétraitement des statistiques sommaires de GWAS :
Les statistiques sommaires de GWAS pour le lupus érythémateux ont été obtenues à partir de FinnGen Release 11 (finngen_R11_L12_LUPUS ; RRID:SCR_022254), une cohorte finlandaise de population. Le phénotype a été défini à l’aide du code CIM-10 L93 et comprenait 423 818 participants, dont 777 cas et 423 041 témoins. Le fichier de statistiques sommaires de FinnGen a été téléchargé depuis le portail public de données de FinnGen au format tabulaire compressé, puis importé dans R à l’aide de la fonction read_exposure_data() ou read_outcome_data() du package TwoSampleMR, selon que le jeu de données était utilisé comme exposition ou comme critère de jugement. Les informations conservées étaient les suivantes : rsID, chromosome, position génomique, allèle d’effet, autre allèle, fréquence de l’allèle d’effet, coefficient bêta, erreur-type et valeur P d’association.
Des statistiques sommaires concernant le nombre de fausses couches spontanées ont été obtenues à partir de la biobanque du Royaume-Uni (UK Biobank) via la ressource IEU OpenGWAS (ukb-b-419 ; RRID : SCR_012815), comprenant 78 700 participants. Dans l'analyse directe, les associations entre les polymorphismes nucléotidiques simples (SNP) sélectionnés de FinnGen et le résultat ont été récupérées à l’aide de la fonction extract_outcome_data(outcomes = "ukb-b-419", proxies = FALSE). Dans l'analyse inverse, les SNP associés au lupus érythémateux ont été récupérés à l’aide de la fonction extract_instruments(outcomes = "finngen_R11_L12_LUPUS", clump = FALSE), après quoi les associations correspondantes des SNP ont été extraites du fichier de statistiques sommaires de l'UK Biobank. Les caractéristiques des jeux de données GWAS utilisés dans les analyses MR bidirectionnelles sont résumées dans Tableau 1.
| Trait | Taille de l'échantillon | Ancestralité | Consortium | Année | Identifiant du jeu de données GWAS |
| Lupus érythémateux | 4,23,818 | Européenne | FinnGen (RRID: SCR_022254) | 2024 | finngen_R11_L12_LUPUS |
| Nombre de fausses couches spontanées | 78,700 | Européenne | UK Biobank (RRID: SCR_012815) | 2018 | ukb-b-419 |
Tableau 1 : Statistiques sommaires des études d'association génomique (GWAS) utilisées pour l'analyse de randomisation mendélienne bidirectionnelle.
Le tableau résume les jeux de données issus d'études d'association génomique disponibles publiquement, utilisés comme sources d'exposition et de résultat pour les analyses de randomisation mendélienne directe et inverse, incluant la taille de l'échantillon, l'ascendance, la source des données, l'année de publication des données et l'identifiant du jeu de données.
FinnGen et UK Biobank ont été sélectionnés car ils fournissent de grands ensembles de données principalement d'ascendance européenne, accessibles au public et dérivés de populations sources non chevauchantes, avec une couverture suffisante des variants pour une analyse MR à deux échantillons. Aucun chevauchement entre les échantillons d'exposition et de résultat n'a été signalé. Étant donné que seules des données résumées ont été utilisées, aucune donnée génétique individuelle n'a été consultée, aucune normalisation supplémentaire au niveau des participants n'a été effectuée, et aucun participant n'a été exclu par les investigateurs présents. Nous nous sommes appuyés sur les procédures de contrôle qualité au niveau des échantillons et des variants mises en œuvre par les consortia GWAS d'origine. Au cours de l'analyse actuelle, un contrôle qualité supplémentaire a été réalisé au niveau des variants par filtrage selon la significativité, regroupement en déséquilibre de liaison, harmonisation des allèles, évaluation de la force de l'instrument et dépistage de la pléiotropie, comme décrit ci-dessous.
FinnGen Release 11 indique les positions génomiques selon GRCh38/hg38, tandis que les jeux de données harmonisés d'IEU OpenGWAS et la ressource de référence pour le déséquilibre de liaison utilisent des annotations de variants compatibles avec GRCh37. Par conséquent, les variants d'exposition et de résultat ont été appariés principalement par leurs rsID stables plutôt que par leurs coordonnées chromosomiques. Aucun appariement positionnel direct entre les versions de référence n’a été effectué. Les variants dépourvus d’un rsID non ambigu ou présentant des informations alléliques incohérentes entre les jeux de données ont été exclus avant l’analyse MR. Les statistiques sommaires de FinnGen Release 11 utilisent GRCh38, alors que les données OpenGWAS sont harmonisées selon la convention de séquence de référence utilisée pour Build 37. L’appariement par rsID est donc essentiel lors de la combinaison de ces deux ressources.
Conception de l'étude de randomisation mendélienne :
Nous avons strictement suivi les recommandations STROBE-MR (Fichier supplémentaire 1)19. Une conception de randomisation mendélienne bidirectionnelle à deux échantillons a été utilisée pour évaluer la relation entre le lupus érythémateux prédit génétiquement et le nombre de fausses couches spontanées. Dans l'analyse directe, le lupus érythémateux était considéré comme l'exposition et le nombre de fausses couches spontanées comme le résultat. Dans l'analyse inverse, l'exposition et le résultat ont été inversés, et l'ensemble du processus de sélection des instruments, d'élagage en fonction du déséquilibre de liaison, d'harmonisation des données, d'estimation causale et d'analyses de sensibilité a été répété. Des polymorphismes nucléotidiques simples (SNP) ont été utilisés comme variables instrumentales (VI). L'ensemble du processus a été réalisé dans l'ordre suivant : acquisition et mise en forme des statistiques sommaires des études d'association à l'échelle du génome (GWAS) ; sélection des SNP associés à l'exposition ; élimination des variants dupliqués ou incomplètement annotés ; élagage en fonction du déséquilibre de liaison ; extraction des associations correspondantes au résultat ; exclusion des SNP directement associés au résultat ; harmonisation des allèles de l'exposition et du résultat ; calcul de la puissance de l'instrument ; dépistage des phénotypes de confusion potentiels ; estimation des effets causaux ; évaluation de l'hétérogénéité et de la pléiotropie horizontale ; détection des valeurs aberrantes par la méthode Mendelian Randomization Pleiotropy RESidual Sum and Outlier (MR-PRESSO) ; et analyses de sensibilité par la méthode leave-one-out et analyse univariée par SNP. Toutes les analyses de randomisation mendélienne ont été réalisées à l'aide de R version 4.4.2 (RRID:SCR_001905), TwoSampleMR version 0.6.6 (RRID:SCR_019010), MRPRESSO version 1.0 (RRID:SCR_023697) et forestploter version 1.1.2. L'analyse de randomisation mendélienne reposait sur trois hypothèses fondamentales. Premièrement, selon l'hypothèse de pertinence, les SNP sélectionnés doivent être fortement associés à l'exposition. Deuxièmement, selon l'hypothèse d'indépendance, les SNP sélectionnés doivent être indépendants des facteurs qui confondent l'association entre l'exposition et le résultat. Troisièmement, selon l'hypothèse d'exclusion, les SNP sélectionnés ne doivent influencer le résultat qu'à travers l'exposition20 (Figure 1).
Méthodes de sélection des SNP :
La sélection des instruments a été effectuée selon l'ordre suivant : (1) sélectionner les SNP associés à l'exposition avec une valeur P < 5 × 10⁻⁸ ; lorsque le nombre d'instruments était insuffisant, utiliser P < 5 × 10⁻⁶ ; (2) utiliser la fonction clump_data() pour effectuer le regroupement par déséquilibre de liaison avec un seuil de R2 < 0,001 et une distance génétique de 10 000 kb, en assouplissant les critères à R2 < 0,01 dans une fenêtre de 5 000 kb uniquement si nécessaire pour conserver un ensemble d'instruments analysable ; (3) éliminer les SNP significativement associés au résultat à l’aide d’un seuil de P = 5 × 10⁻⁵ ; (4) utiliser la fonction harmonise_data() pour harmoniser les allèles d’exposition et de résultat, et exclure les variants palindromiques ou autrement ambigus ; (5) calculer la puissance de l’instrument selon la formule F = β2/SE2, et exclure les SNP pour lesquels F < 10 ; et (6) analyser les SNP conservés dans PhenoScanner V2 afin d’identifier les phénotypes pouvant introduire un biais de confusion dans la relation entre le lupus érythémateux systémique (LES) et la perte de grossesse21. Les anticorps antiphospholipides (aPL) pourraient constituer un facteur de risque commun au LES et au nombre de fausses couches spontanées. Chaque SNP individuel a été recherché dans PhenoScanner V2. Tous les SNP candidats ont été interrogés dans PhenoScanner V2 à l’aide du catalogue GWAS par défaut afin d’obtenir toutes les associations rapportées par des études d’association pangénomique (GWAS). Le seuil de significativité a été fixé à P < 1 × 10⁻5, et la version par défaut du génome de référence (GRCh37) a été utilisée. Étant donné que la population étudiée était d’ascendance européenne, la recherche de variants proxy a été activée en utilisant le panel de référence européen (proxies = "EUR"), avec un seuil de déséquilibre de liaison de R2 > 0,8 dans une fenêtre de 1 000 kb. Tous les autres paramètres de recherche ont été conservés à leurs valeurs par défaut. Les SNP présentant des associations significatives avec le facteur de confusion prédéfini, à savoir les anticorps antiphospholipides (aPL), ont été considérés comme potentiellement pléiotropes et ont été exclus de l’ensemble final de variables instrumentales afin de minimiser la violation de l’hypothèse d’exclusion en randomisation mendélienne. Les SNP instrumentaux conservés pour les analyses de randomisation mendélienne directe et inverse sont indiqués respectivement dans les tableaux supplémentaires 1 et 2.
Analyse statistique :
Après la sélection des instruments et l'harmonisation des allèles, les estimations causales ont été calculées à l'aide de la fonction mr() dans TwoSampleMR. Le flux de travail analytique a été réalisé dans l'ordre suivant. Premièrement, l'effet causal global a été estimé à l'aide de quatre méthodes MR : la pondération par la variance inverse (IVW), la régression MR-Egger, la médiane pondérée et le mode pondéré. Les estimations d'effet concernant le nombre de fausses couches spontanées et le lupus érythémateux systémique ont été exprimées sous forme de rapports de cotes avec les intervalles de confiance à 95 % correspondants et les valeurs P. La méthode IVW a été choisie comme analyse principale car elle offre une puissance statistique élevée lorsque tous les SNP inclus sont des variables instrumentales valides et qu'aucune pléiotropie horizontale n'est présente. Toutefois, l'estimation IVW peut être biaisée en cas de pléiotropie horizontale22. La régression MR-Egger a été principalement utilisée pour évaluer les inférences causales en présence d'une pléiotropie horizontale potentielle23. L'approche par médiane pondérée exige qu'au moins 50 % du poids analytique provienne de variables instrumentales valides. Cette méthode est optimale en présence d'hétérogénéité mais en l'absence de pléiotropie horizontale24. Le mode pondéré identifie des groupes de variables instrumentales ayant des effets causaux similaires et estime l'effet à partir du plus grand groupe25. Les estimations d'effet obtenues à l'aide des quatre méthodes MR sont présentées dans la Figure 2. Deuxièmement, l'hétérogénéité entre les estimations causales spécifiques aux SNP a été évaluée à l'aide du test Q de Cochran, mis en œuvre via la fonction mr_heterogeneity(). La statistique Q représente la somme pondérée des carrés des écarts des estimations individuelles par SNP par rapport à l'estimation causale globale. Une valeur P du test Q < 0,05 a été considérée comme une indication d'hétérogénéité, auquel cas un modèle IVW à effets aléatoires a été appliqué. En l'absence d'hétérogénéité significative, un modèle IVW à effets fixes a été utilisé26. Troisièmement, la pléiotropie horizontale directionnelle a été évaluée à l'aide du test d'ordonnée à l'origine MR-Egger, mis en œuvre avec la fonction mr_pleiotropy_test(). Une ordonnée à l'origine significativement différente de zéro à P < 0,05 a été considérée comme une preuve de pléiotropie horizontale directionnelle. Quatrièmement, la procédure MR-PRESSO a été réalisée à l'aide de la fonction mr_presso() dans le package MRPRESSO (RRID:SCR_023697) afin de détecter les SNP présentant des effets pléiotropiques atypiques27. Lorsque des valeurs aberrantes ont été détectées, elles ont été supprimées et l'analyse causale a été répétée à l'aide des instruments restants. Le test global MR-PRESSO a été utilisé pour évaluer la pléiotropie horizontale globale, et le test de distorsion a été pris en compte pour déterminer si la suppression des valeurs aberrantes modifiait substantiellement l'estimation causale. Cinquièmement, une analyse de sensibilité « leave-one-out » a été effectuée à l'aide de la fonction mr_leaveoneout(). Dans cette analyse, chaque SNP a été exclu séquentiellement, et l'estimation causale regroupée a été recalculée à l'aide des SNP restants. Les résultats ont été visualisés à l'aide de mr_leaveoneout_plot() afin de déterminer si l'association globale était excessivement influencée par un seul instrument. Sixièmement, des estimations individuelles spécifiques à chaque SNP ont été générées à l'aide de la fonction mr_singlesnp(). Ces estimations ont permis de construire des graphiques en embout de flèche (funnel plots) avec mr_funnel_plot(), afin d'évaluer visuellement une éventuelle asymétrie pouvant être attribuée à une pléiotropie horizontale directionnelle. Des graphiques en forêt sommaires ont été générés à l'aide de forestploter (version 1.1.2) pour afficher les estimations d'effet et les intervalles de confiance obtenus à partir des différentes méthodes MR. Le graphique de dispersion MR direct, le graphique en forêt spécifique aux SNP, l'analyse « leave-one-out » et le graphique en embout de flèche sont présentés respectivement dans les Figures supplémentaires 1–4.
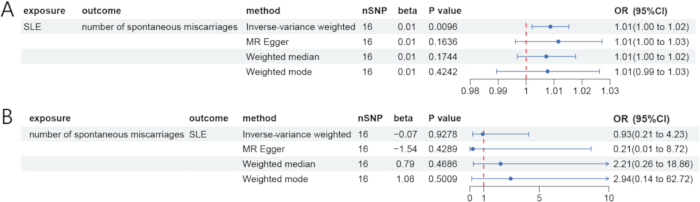
Figure 2. Résultats de l'analyse de randomisation mendélienne bidirectionnelle.
(A) Graphique en forêt de l'analyse de randomisation mendélienne (MR) directe avec le lupus érythémateux systémique (SLE) comme exposition et le nombre de fausses couches spontanées comme résultat. (B) Graphique en forêt de l'analyse MR inverse avec le nombre de fausses couches spontanées comme exposition et le SLE comme résultat. Les estimations d'effet sont présentées sous forme de rapports de cotes (OR) avec des intervalles de confiance à 95 % (IC) pour les méthodes pondérées par l'inverse de la variance, MR-Egger, médiane pondérée et mode pondéré. SNP, polymorphisme nucléotidique unique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Une association causale était considérée comme étayée lorsque l'estimation IVW était statistiquement significative avec P < 0,05, que les estimations obtenues par MR-Egger, la médiane pondérée et le mode pondéré montraient des directions concordantes avec celle de l'estimation IVW, et que les résultats n'étaient pas sensiblement modifiés par l'hétérogénéité, la pléiotropie, l'analyse MR-PRESSO ou les analyses de sensibilité de type « leave-one-out ». Tous les tests statistiques étaient bilatéraux.
Analyse bioinformatique
Données de puces à ADN :
Les jeux de données transcriptomiques ont été obtenus à partir de la base de données Gene Expression Omnibus (GEO ; RRID:SCR_005012)28. Les fichiers matriciels de série traités, les métadonnées des échantillons et les fichiers d'annotation de plateforme ont été téléchargés pour les enregistrements GSE61635, GSE165004, GSE50772 et GSE198700. La plateforme, la source tissulaire, la taille de l'échantillon et la catégorie d'analyse de chaque jeu de données sont résumées dans le tableau 2. Étant donné que les jeux de données ont été générés à partir de tissus et de plateformes de puces à ADN différents, chaque jeu de données a été prétraité et analysé indépendamment. Les matrices d'expression provenant de différents jeux de données n'ont pas été fusionnées directement, et aucune correction de lot inter-plateforme n'a été appliquée. L'intégration entre jeux de données a été effectuée uniquement au niveau du symbole génique, après avoir terminé l'analyse d'expression différentielle indépendamment dans chaque jeu de données de découverte.
| Jeu de données GEO | Maladie | Plateforme | Tissu (Homo sapiens) | Cas | Témoins | Type d'expérience | Contributeur | Catégorie du jeu de données |
| GSE61635 | Lupus érythémateux systémique (SLE) | GPL570 | Sang total | 99 | 30 | Microarray d'expression | Greidinger EL | Jeu de données de découverte |
| GSE165004 | Perte de grossesse récurrente (RPL) | GPL16699 | Endomètre | 24 | 24 | Microarray d'expression | Keleş ID29 | Jeu de données de découverte |
| GSE50772 | Lupus érythémateux systémique (SLE) | GPL570 | Cellules mononucléées du sang périphérique (PBMCs) | 61 | 20 | Microarray d'expression | Kennedy WP30 | Jeu de données de validation |
| GSE198700 | Perte de grossesse récurrente (RPL) | GPL13534 | Villosités choriales | 5 | 5 | Microarray d'expression | Li Y31 | Jeu de données de validation |
Tableau 2 : Ensembles de données transcriptomiques utilisés pour les analyses de bioinformatique.
Le tableau résume les ensembles de données transcriptomiques du Gene Expression Omnibus (GEO) inclus dans les analyses de découverte et de validation, incluant la maladie, la plateforme de puces à ADN, la source du tissu, la taille de l'échantillon, le type d'expérience, le contributeur initial de l'étude et la catégorie de l'ensemble de données.
La série GSE61635 a été générée à l'aide de la plateforme Affymetrix Human Genome U133 Plus 2.0 Array (GPL570) et comprenait 99 puces à ADN provenant d'échantillons de sang total de patients atteints de lupus érythémateux systémique (LES), y compris des visites répétées pour certains patients, ainsi que 30 puces provenant de témoins sains indépendants. La matrice d'expression déposée avait déjà subi une correction de fond par la méthode robuste d'average multiarray, une normalisation par quantiles, une synthèse des jeux de sondes et une transformation logarithmique en base 2 (log2) par les investigateurs initiaux. Par conséquent, aucune correction de fond ni normalisation par quantiles supplémentaire n'a été effectuée. Les identifiants des patients ont été extraits des métadonnées de GEO et conservés afin de permettre la modélisation de mesures répétées.
Le jeu de données GSE165004 a été généré à l'aide de la plateforme de puces à ADN Agilent SurePrint G3 Human Gene Expression v2 8×60K (GPL16699). L'ensemble complet des données comprenait 24 témoins fertiles, 24 patients atteints de fausses couches à répétition (RPL) et 24 patients souffrant d'infertilité inexpliquée. Seuls les échantillons provenant des 24 patients RPL et des 24 témoins fertiles prélevés entre les jours 19 et 21 du cycle menstruel ont été inclus ; les 24 échantillons d'infertilité inexpliquée ont été exclus car ils ne correspondaient pas à la comparaison prédéfinie29. La matrice d'expression normalisée par le déposant a été utilisée, et aucune normalisation supplémentaire entre les puces n'a été appliquée, après vérification de la comparabilité des distributions des échantillons à l'aide de diagrammes en boîte et de graphiques de densité.
GSE50772 a été utilisé comme jeu de données indépendant de validation pour le lupus érythémateux systémique (LES) et comprenait des échantillons de cellules mononucléées du sang périphérique provenant de 61 patients atteints de LES et de 20 témoins sains, générés à l’aide de GPL57030. GSE198700 a été généré à l’aide de GPL13534 et contient des échantillons de villosités choriales provenant de cinq patients présentant des avortements à répétition (RPL) et de cinq témoins ayant bénéficié d’un avortement électif31. La matrice d’expression déposée a été importée intégralement et transformée une seule fois à l’aide de log2(x + 1), car les valeurs d’expression déposées étaient fournies sur une échelle non logarithmique. Cette transformation a été appliquée à l’ensemble de la matrice d’expression avant le contrôle qualité au niveau des échantillons, l’annotation des sondes, la synthèse au niveau des gènes, la validation des gènes candidats, l’analyse d’expression différentielle, les tests de comparaison entre groupes et l’analyse ROC. Les gènes candidats n’ont pas été transformés séparément, et aucune transformation logarithmique supplémentaire n’a été effectuée lors des analyses de validation ultérieures. Pour tous les jeux de données, les identités des échantillons, le statut pathologique, l’origine tissulaire et les étiquettes des groupes ont été vérifiés croisés par rapport aux métadonnées GEO correspondantes avant l’analyse. Le contrôle qualité comprenait l’évaluation des tailles des bibliothèques ou des distributions d’expression, des boîtes à moustaches par échantillon, une analyse en composantes principales, un regroupement hiérarchique et des cartes thermiques de distance entre échantillons. Aucun échantillon supplémentaire n’a été exclu suite à l’évaluation du contrôle qualité.
Analyse de l'expression différentielle :
Des analyses d'expression différentielle ont été réalisées indépendamment pour GSE61635 et GSE165004 à l'aide de limma version 3.60.6 (RRID:SCR_010943). Toutes les matrices d'expression ont été organisées avec les gènes en lignes et les échantillons en colonnes. Le seuil d'expression différentielle a été fixé à |log₂ du rapport d'expression| > 1 pour GSE61635 et |log₂ du rapport d'expression| > 0,5 pour GSE165004, avec une valeur P ajustée selon Benjamini–Hochberg (BH) < 0,05. Les diagrammes en volcan ont été générés à l'aide de ggplot2 version 3.5.1 (RRID:SCR_014601). Les cartes thermiques des 50 gènes différentiellement exprimés (GDE) les plus significatifs, classés par valeur P ajustée, ont été produites à l'aide de pheatmap version 1.0.12 (RRID:SCR_016418). Les GDE communs ont été identifiés en croisant les symboles génétiques officiels des listes significatives de GDE pour SLE et RPL à l'aide de la fonction intersect() de base R, puis visualisés à l'aide de ggvenn version 0.1.16 (RRID:SCR_025300). Les cartes thermiques d'expression différentielle, les diagrammes en volcan et l'intersection des listes de GDE pour SLE et RPL sont présentés dans Figure 3.
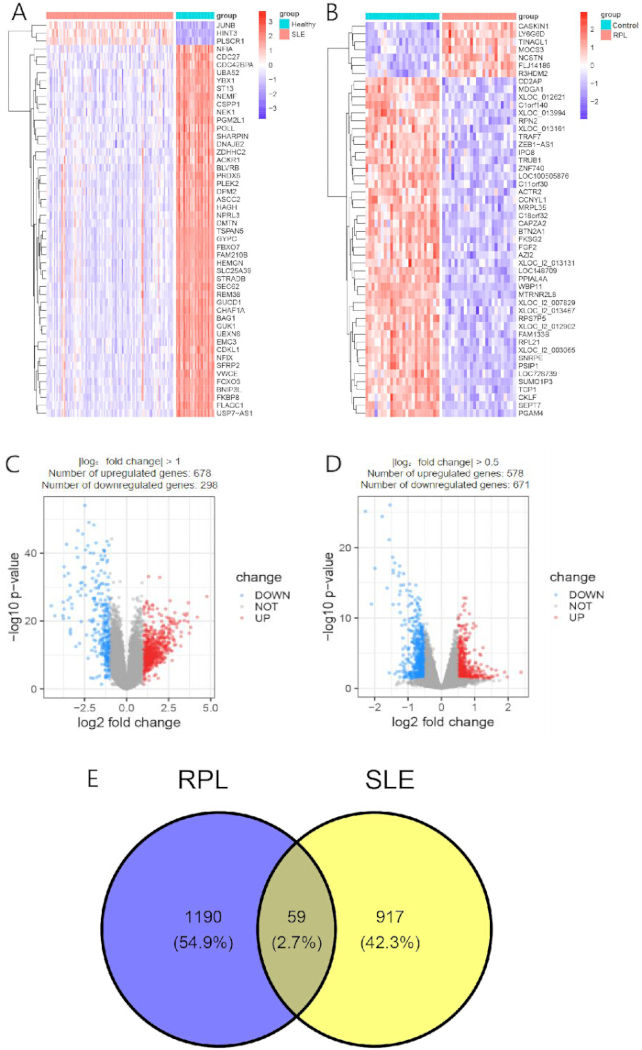
Figure 3. Gènes différentiellement exprimés dans le lupus érythémateux systémique et les pertes de grossesse répétées.
(A) Carte thermique des 50 gènes différentiellement exprimés (DEG) les plus significatifs entre les patients atteints de lupus érythémateux systémique (SLE) et les témoins sains dans GSE61635. (B) Carte thermique des 50 DEG les plus significatifs entre les patients présentant des pertes de grossesse répétées (RPL) et les témoins fertiles dans GSE165004. (C) Graphique en volcan de l'expression différentielle des gènes dans GSE61635. (D) Graphique en volcan de l'expression différentielle des gènes dans GSE165004. (E) Diagramme de Venn montrant la superposition entre les listes significatives de DEG issues des jeux de données de découverte SLE et RPL. DEGs, gènes différentiellement exprimés. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Analyse d'enrichissement fonctionnel des DEG d'intersection :
Pour l'analyse au niveau moléculaire des fonctions des DEG, l'outil en ligne DAVID (version 2021 ; RRID:SCR_001881)32 a été utilisé pour effectuer des analyses d'enrichissement fonctionnel selon l'Ontologie Génétique (GO) et des voies métaboliques selon la Kyoto Encyclopedia of Genes and Genomes (KEGG). Les symboles officiels des gènes humains ont été téléchargés comme type d'identifiant, et Homo sapiens a été sélectionné comme espèce. La population de référence personnalisée comprenait l'intersection de tous les gènes ayant passé l'annotation des sondes et le contrôle qualité, et qui étaient mesurables à la fois dans GSE61635 et GSE165004. Le seuil minimal de nombre de gènes a été fixé à 2, et le score EASE maximal, représentant la valeur P unilatérale de Fisher modifiée par DAVID, a été fixé à 0,05. La correction pour comparaisons multiples a été effectuée selon la procédure de Benjamini–Hochberg indiquée dans la colonne « Benjamini » de DAVID. Les termes fonctionnels ont été considérés statistiquement significatifs lorsque le score EASE était < 0,05 et que la valeur P ajustée selon Benjamini était < 0,05. L'ensemble des résultats DAVID, incluant les noms des termes, les nombres de gènes, les scores EASE, les valeurs P ajustées selon Benjamini, les affectations des gènes d'entrée et des gènes de référence, a été exporté sous forme de fichier séparé par des tabulations. Le site web CNSknowall a été utilisé pour visualiser les résultats DAVID filtrés. Les résultats d'enrichissement GO et KEGG sont présentés dans Figure 4A.
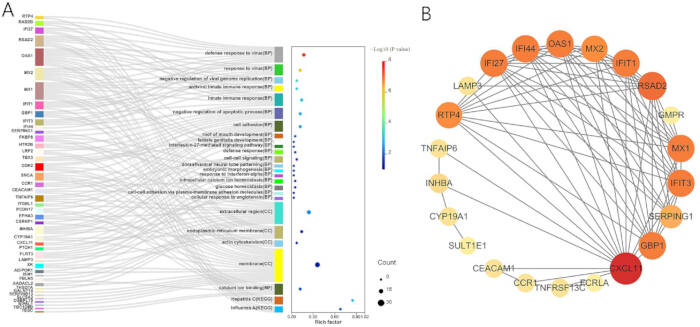
Figure 4. Analyse d'enrichissement fonctionnel et réseau d'interactions protéine-protéine des gènes différentiellement exprimés communs.
(A) Analyses d'enrichissement Gene Ontology (GO) et Kyoto Encyclopedia of Genes and Genomes (KEGG) des 59 gènes différentiellement exprimés (DEG) communs. Le diagramme de Sankey illustre les relations entre les gènes et les termes GO enrichis, et le graphique en bulles associé résume les termes GO et KEGG enrichis selon le facteur d'enrichissement, le nombre de gènes et la signification statistique. (B) Réseau d'interactions protéine-protéine (PPI) construit à partir des 59 DEG communs à l'aide de STRING et visualisé dans Cytoscape. La taille et la couleur des nœuds reflètent la connectivité du réseau, et les arêtes indiquent des associations protéine-protéine prédites. BP, processus biologique ; CC, composant cellulaire ; MF, fonction moléculaire. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Réseau PPI et identification des gènes centraux :
Les gènes différentiellement exprimés (DEG) communs ont été téléchargés vers STRING version 11.0 (RRID:SCR_005223)33, avec Homo sapiens sélectionné comme organisme (identifiant taxonomique : 9606). Le réseau STRING complet a été utilisé, autorisant à la fois les associations protéiques fonctionnelles et physiques. Tous les canaux de preuves disponibles ont été activés, y compris les preuves expérimentales, les bases de données curatées, la co-expression, l'exploration de texte, le voisinage génique, la fusion génique et la co-occurrence génique.
Le score d'interaction minimum requis a été fixé à 0,400, ce qui correspond à une confiance moyenne. Aucun interfacteur supplémentaire de première ou deuxième couche n'a été ajouté ; par conséquent, le réseau ne contenait que les protéines codées par les DEG partagés soumis. Les arêtes du réseau ont été affichées en mode confiance et exportées sous forme de fichier de valeurs séparées par des tabulations contenant les protéines interagissantes et les scores STRING combinés. Les scores de confiance STRING représentent le niveau de confiance dans l'existence d'une association, et non l'ampleur ou la force de liaison de l'interaction.
Le fichier de réseau STRING a été importé dans Cytoscape version 3.10.0 (RRID:SCR_003032)34. Les nœuds n'ayant aucune interaction avec une autre protéine soumise ont été supprimés avant l'analyse de la topologie du réseau35. Le réseau restant a été traité comme un réseau non orienté. Les scores combinés de STRING ont été conservés en tant qu'attributs des arêtes pour la visualisation, tandis que les classements cytoHubba ont été générés à l'aide des définitions topologiques par défaut non pondérées. Le réseau d'interactions protéine-protéine (PPI) obtenu est présenté dans Figure 4B.
Les gènes centraux ont été classés à l'aide de cytoHubba version 0.1 (RRID:SCR_017677) selon six algorithmes : centralité de la clique maximale (MCC), composante maximale du voisinage (MNC), composante par percolation des arêtes (EPC), degré, proximité et radialité36. Pour chaque algorithme, les gènes ont été classés par ordre décroissant, et les 10 premiers gènes ont été conservés. Les candidats gènes centraux ont été définis à partir de l'intersection stricte des six listes des 10 premiers. Ainsi, un gène n'était conservé comme gène central que s'il figurait parmi les 10 premiers gènes identifiés par chacun des six algorithmes. Les classements et la procédure d'intersection ont été exportés et archivés. Les 10 premiers gènes identifiés par chaque algorithme cytoHubba sont présentés dans Tableau 3.
| Rang | Centralité maximale de la clique (MCC) | Composante maximale du voisinage (MNC) | Composante de percolation des arêtes (EPC) | Degré | Proximité | Radialité |
| 1 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 |
| 2 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 |
| 3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 |
| 4 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 |
| 5 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 |
| 6 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 |
| 7 | MX1 | MX1 | MX1 | MX1 | MX1 | MX1 |
| 8 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 |
| 9 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 |
| 10 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 |
Tableau 3 : Les 10 principaux gènes centraux identifiés par six algorithmes de classement cytoHubba.
Les gènes différentiellement exprimés partagés ont été classés à l'aide de six algorithmes de topologie de réseau implémentés dans le plugin cytoHubba de Cytoscape. Les 10 gènes les mieux classés générés par chaque algorithme sont présentés pour comparaison entre la centralité de la clique maximale (MCC), la composante du voisinage maximale (MNC), la composante de percolation des arêtes (EPC), le degré, la proximité et la radialité.
Régression LASSO pour l'identification des gènes centraux :
Une régression logistique LASSO a été réalisée indépendamment sur les jeux de données de découverte du lupus érythémateux systémique (SLE) et de la thrombophlébite veineuse profonde récidivante (RPL) à l’aide du package glmnet version 4.1-8 (RRID:SCR_015505). La matrice de prédicteurs comprenait les valeurs d’expression normalisées des candidats gènes centraux du réseau, avec les échantillons en lignes et les gènes en colonnes. Le statut malade était codé par 1 et le statut témoin par 0. Un modèle linéaire généralisé binomial avec une pénalité pure LASSO a été ajusté en utilisant family = "binomial" et alpha = 1. Les variables prédictives ont été standardisées automatiquement à l’aide de standardize = TRUE, et un terme constant a été inclus. Des attributions stratifiées par classe en 10 parties ont été générées séparément pour les jeux de données SLE et RPL à l’aide d’un code R personnalisé. Au sein de chaque strate définie par le statut pathologique, les indices des échantillons ont été permutés aléatoirement puis répartis aussi uniformément que possible entre les 10 parties à l’aide de sample(rep(seq_len(10), length.out = n)). Une graine aléatoire (random seed) de 123 a été fixée avant la génération des attributions de parties pour chaque jeu de données afin d’assurer la reproductibilité. Étant donné que chaque groupe défini par le statut pathologique comprenait plus de 10 échantillons, chaque partie de validation croisée incluait à la fois des cas et des témoins. Les vecteurs d’entiers obtenus (foldid_sle et foldid_rpl) ont été fournis à l’argument foldid de la fonction cv.glmnet(), et les mêmes attributions de parties ont été utilisées pour toutes les valeurs de λ évaluées au sein du jeu de données correspondant.
Les modèles ont été ajustés à l'aide des paramètres suivants : family = « binomial », alpha = 1, nfolds = 10, type.measure = « deviance », standardize = TRUE, intercept = TRUE, nlambda = 100, thresh = 1 × 10⁻7 et maxit = 100000. Le paramètre de pénalité a été sélectionné à l’aide de lambda.min, défini comme la valeur de lambda produisant la déviance binomiale moyenne minimale lors de la validation croisée. La valeur plus conservatrice lambda.1se, définie comme la plus grande valeur de lambda située à moins d’un écart-type de l’erreur minimale de validation croisée, a été enregistrée comme résultat de sensibilité. La procédure LASSO a été appliquée séparément aux jeux de données GSE61635 et GSE165004. Les gènes présentant des coefficients non nuls dans les deux modèles spécifiques à la maladie ont été définis comme des gènes candidats partagés sélectionnés par LASSO. En introduisant le terme de régularisation L1, la méthode réduit efficacement à zéro les coefficients des gènes moins informatifs, réalisant ainsi une sélection de caractéristiques37. Les profils de coefficients et les courbes de validation croisée à 10 plis pour les jeux de données de découverte SLE et RPL sont présentés dans la Figure 5.
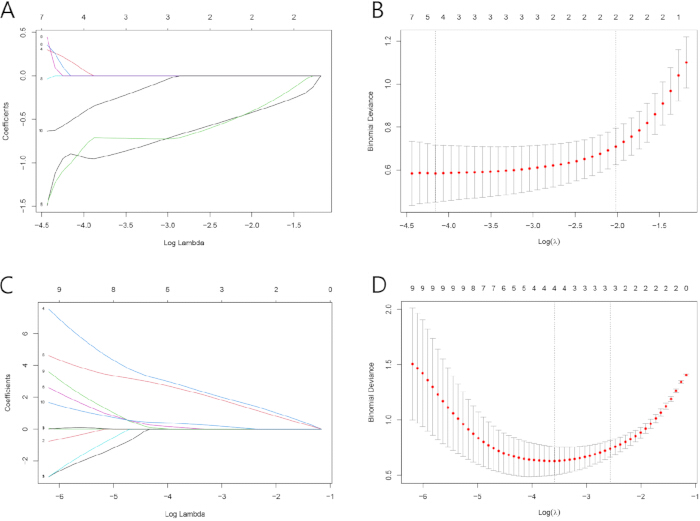
Figure 5. Analyse de régression par la méthode du cadrage absolu le moins élevé et de la sélection d'opérateur (LASSO) des gènes centraux du réseau.
(A) Profils de coefficients générés par régression logistique LASSO pour le jeu de données de découverte de lupus érythémateux systémique (LES) (GSE61635). (B) Courbe de validation croisée à dix plis utilisée pour déterminer le paramètre de pénalité optimal (λ) pour le modèle de LES. (C) Profils de coefficients générés par régression logistique LASSO pour le jeu de données de découverte de la perte de grossesse récurrente (RPL) (GSE165004). (D) Courbe de validation croisée à dix plis utilisée pour déterminer le paramètre de pénalité optimal (λ) pour le modèle de RPL. Les nombres indiqués sur l'axe des abscisses supérieur indiquent le nombre de coefficients de régression non nuls à chaque valeur de λ. Les lignes verticales en pointillés indiquent λ_min et λ_1se. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Validation de la valeur diagnostique des gènes principaux :
Les profils d'expression des gènes candidats sélectionnés par LASSO ont été évalués dans le jeu de données indépendant de lupus érythémateux systémique (SLE) GSE50772 et dans le jeu de données indépendant de RPL GSE198700. Les jeux de données externes ont été utilisés uniquement après que la sélection des gènes candidats a été terminée dans GSE61635 et GSE165004. Aucune sélection supplémentaire de caractéristiques ni aucun ajustement de modèle n’a été effectué sur les jeux de données de validation. L’expression des gènes candidats a été comparée entre les cas et les témoins à l’aide du test de somme des rangs de Wilcoxon bilatéral. Lorsque plus d’un gène candidat a été testé au sein d’un même jeu de données, les valeurs P obtenues ont été corrigées selon la procédure de Benjamini–Hochberg. Un gène candidat était considéré comme répliqué externement lorsque son expression différait de manière significative entre les cas et les témoins après correction pour tests multiples, et lorsque son sens d’expression était cohérent avec celui du jeu de données de découverte correspondant. Les profils d’expression des gènes candidats dans les jeux de données de découverte et de validation sont présentés dans la Figure 6.
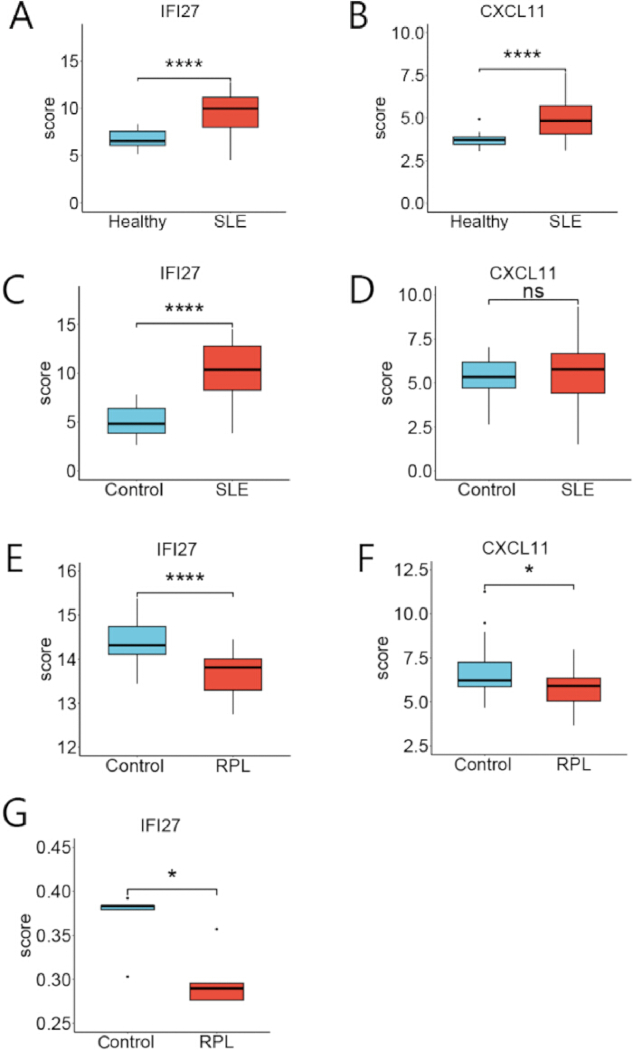
Figure 6. Expression de IFI27 et de CXCL11 dans les jeux de données de découverte et de validation.
(A,B) Expression de IFI27 et de CXCL11, respectivement, dans le jeu de données de découverte de lupus érythémateux systémique (LES) (GSE61635). (C,D) Expression de IFI27 et de CXCL11, respectivement, dans le jeu de données de validation indépendant de LES (GSE50772). (E,F) Expression de IFI27 et de CXCL11, respectivement, dans le jeu de données de découverte de fausses couches répétées (FCR) (GSE165004). (G) Expression de IFI27 dans le jeu de données de validation indépendant de FCR (GSE198700). L'expression génique a été comparée entre les groupes à l'aide du test de Wilcoxon-Mann-Whitney bilatéral. Les valeurs P ont été ajustées selon la méthode de Benjamini–Hochberg lorsqu'多个 gènes candidats ont été testés au sein du même jeu de données. P < 0,05 ; **** P < 0,0001 ; ns, non significatif. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Des analyses de caractéristique de fonctionnement du récepteur (ROC) ont été réalisées à l'aide de la version 1.18.5 de pROC (RRID:SCR_024286)38. Des courbes ROC distinctes ont été générées pour chaque gène candidat dans chaque jeu de données de découverte. La surface sous la courbe ROC (AUC) et son intervalle de confiance bilatéral à 95 % ont été calculées selon la méthode de DeLong. Le seuil diagnostique exploratoire a été déterminé à l'aide de l'indice de Youden maximal. Les intervalles de confiance pour le seuil, la sensibilité et la spécificité ont été calculés à partir de 2 000 réplicats bootstrap stratifiés, avec une graine aléatoire fixée à 123. L'AUC a été utilisée comme mesure indépendante du seuil de la capacité de discrimination39. Étant donné que les jeux de données étaient rétrospectifs et avaient été générés à partir de tissus, de plateformes et de procédures de normalisation différents, les seuils dérivés de l'indice de Youden ont été calculés séparément pour chaque jeu de données et ont été considérés comme des seuils exploratoires spécifiques à chaque jeu. Ces seuils n'ont pas été considérés comme des seuils cliniques standardisés et n'ont pas été directement transférés d'une plateforme à l'autre. Les résultats ROC externes représentent une validation transcriptomique et non une validation clinique prospective. pROC prend en charge les intervalles de confiance de DeLong pour les AUC et l'optimisation par l'indice de Youden via coords(), tandis que les intervalles de confiance pour les coordonnées ROC peuvent être estimés par rééchantillonnage bootstrap stratifié. Les courbes ROC et les résumés de la discrimination des gènes candidats dans les jeux de données de découverte SLE et RPL sont présentés dans Figure 7.
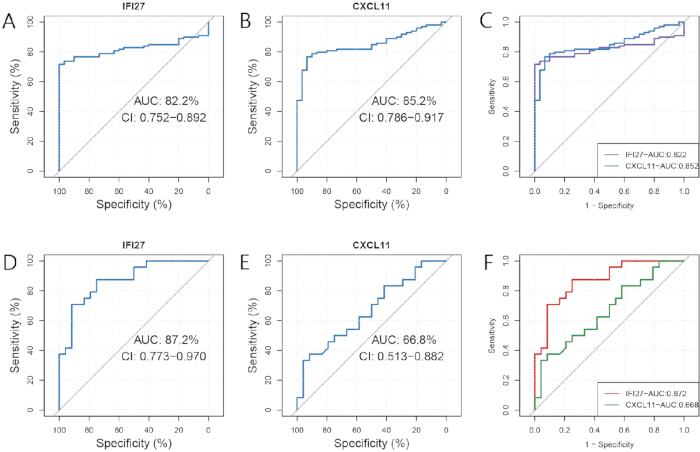
Figure 7. Analyse de la caractéristique de fonctionnement du récepteur des gènes candidats.
(A) Courbe de la caractéristique de fonctionnement du récepteur (ROC) pour IFI27 dans le jeu de données de découverte du lupus érythémateux systémique (LES). (B) Courbe ROC pour CXCL11 dans le jeu de données de découverte du LES. (C) Résumé des performances diagnostiques d'IFI27 et de CXCL11 dans le jeu de données de découverte du LES. (D) Courbe ROC pour IFI27 dans le jeu de données de découverte de la perte de grossesse récurrente (PGR). (E) Courbe ROC pour CXCL11 dans le jeu de données de découverte de la PGR. (F) Résumé des performances diagnostiques d'IFI27 et de CXCL11 dans le jeu de données de découverte de la PGR. Les valeurs de la surface sous la courbe (AUC) sont présentées avec des intervalles de confiance à 95 % (IC). Veuillez cliquer ici pour consulter une version agrandie de cette figure.
Infiltration immunitaire par ssGSEA :
Compte tenu du rôle de la dysrégulation des cellules immunitaires dans la pathogenèse du lupus érythémateux disséminé (SLE) et de la fausse couche à répétition (RPL)40,41, l'enrichissement en cellules immunitaires a été inféré par calcul dans les jeux de données de découverte GSE61635 et GSE165004. L'analyse a été effectuée séparément pour chaque jeu de données, sans fusion des deux. La collection de signatures génétiques des cellules immunitaires comprenait les jeux de gènes marqueurs pour 28 populations de cellules immunitaires décrites par Charoentong et al.42. Le tableau original des signatures génétiques en annexe a été converti en une liste de jeux de gènes nommés à l’aide des symboles génétiques humains officiels. Les symboles en double au sein de chaque jeu de gènes ont été supprimés. Les gènes absents de la matrice d'expression correspondante ont été écartés, et les jeux de gènes contenant moins de cinq gènes appariés après le mappage des identifiants ont été exclus de ce jeu de données. Une analyse d'enrichissement de l'ensemble de gènes à échantillon unique (ssGSEA) a été réalisée à l’aide de GSVA version 1.52.3 (RRID:SCR_021058) et de GSEABase version 1.66.0. Dans la version 1.52.3 de GSVA, un objet de paramètres spécifique à la méthode est requis. Les paramètres suivants ont été utilisés : minSize = 5, maxSize = 500, alpha = 0,25, normalize = TRUE, et checkNA = "yes."
Le paramètre alpha a été fixé à 0,25, et la normalisation finale des scores ssGSEA a été activée. Les ensembles de gènes ont été restreints à 5–500 gènes après appariement à la matrice d'expression. Une exécution monothread a été utilisée afin d'assurer un calcul cohérent sur l'ensemble des systèmes. Le paramètre kcdf n'a pas été utilisé car il ne fait pas partie des paramètres de la procédure ssgseaParam() dans la version 1.52.3 de GSVA. La ssGSEA produit des scores d'enrichissement d'ensembles de gènes au niveau des échantillons, relatifs, plutôt que des décomptes cellulaires immunitaires mesurés expérimentalement ou des fractions cellulaires absolues43. Le flux de travail GSVA 1.52.3 nécessite un objet de paramètres spécifique à la méthode, et les paramètres de la ssGSEA incluent alpha, la normalisation des scores et les limites de taille des ensembles de gènes.
Pour chaque signature de cellule immunitaire, les scores ssGSEA ont été comparés entre les groupes malades et les groupes témoins à l'aide du test de somme des rangs de Wilcoxon bilatéral. Les valeurs P pour les 28 comparaisons de types cellulaires ont été corrigées séparément au sein de chaque jeu de données en utilisant la méthode de Benjamini–Hochberg. Les signatures de cellules immunitaires présentant une valeur P ajustée < 0,05 ont été considérées comme différemment enrichies.
Des corrélations de rang de Spearman ont été calculées entre l'expression des gènes candidats et le score ssGSEA de chaque signature de cellule immunitaire au sein de chaque jeu de données. Les valeurs P de corrélation ont été ajustées à l'aide de la méthode de Benjamini–Hochberg pour l'ensemble des combinaisons gène candidat–cellule immunitaire au sein de ce jeu de données. Les corrélations ont été considérées comme statistiquement significatives pour une valeur P ajustée < 0,05. Les matrices de corrélation ont été visualisées à l'aide de ggcorrplot version 0.1.4.1, et les graphiques de comparaison de groupes ont été générés à l'aide de ggplot2 version 3.5.1.
Les scores ssGSEA bruts normalisés ont été utilisés pour tous les tests statistiques. Les cartes thermiques et les visualisations empilées ont été utilisées uniquement à des fins descriptives. Les scores n'ont pas été décrits comme des proportions directes de cellules immunitaires, et les associations observées ont été interprétées comme des corrélations computationnelles plutôt que comme des interactions cellules-gènes démontrées expérimentalement. Les profils d'enrichissement des signatures des cellules immunitaires, les comparaisons entre groupes et les corrélations avec l'expression des gènes candidats sont présentés dans la Figure 8.
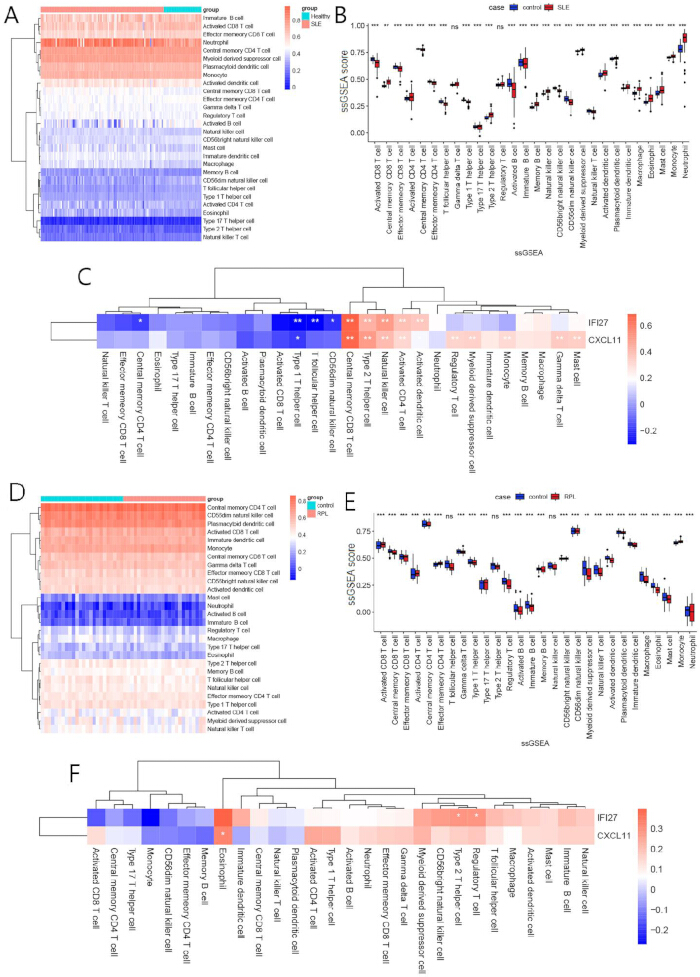
Figure 8. Enrichissement des signatures de cellules immunitaires et corrélations avec les gènes candidats partagés dans le lupus érythémateux systémique et la perte de grossesse récurrente.
(A) Carte thermique de clustering hiérarchique des scores d'analyse d'enrichissement de jeux de gènes à échantillon unique (ssGSEA) pour 28 signatures de cellules immunitaires dans le jeu de données de découverte du lupus érythémateux systémique (SLE). (B) Comparaison des scores ssGSEA des signatures de cellules immunitaires entre les patients atteints de SLE et les témoins sains. (C) Carte thermique de corrélation de Spearman montrant les associations entre l'expression de IFI27 et de CXCL11 et les scores ssGSEA des 28 signatures de cellules immunitaires dans le jeu de données de découverte du SLE. (D) Carte thermique de clustering hiérarchique des scores ssGSEA pour 28 signatures de cellules immunitaires dans le jeu de données de découverte de la perte de grossesse récurrente (RPL). (E) Comparaison des scores ssGSEA des signatures de cellules immunitaires entre les patients atteints de RPL et les témoins fertiles. (F) Carte thermique de corrélation de Spearman montrant les associations entre l'expression de IFI27 et de CXCL11 et les scores ssGSEA des 28 signatures de cellules immunitaires dans le jeu de données de découverte du RPL. Les corrélations ont été calculées à l'aide du coefficient de corrélation de rang de Spearman, et les valeurs P ont été ajustées selon la méthode de Benjamini–Hochberg. P < 0,05 ; ** P < 0,01 ; *** P < 0,001 ; ns, non significatif. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Résultats
Analyse MR
Après la sélection des instruments et l'harmonisation des données, 16 SNP ont été retenus pour l'analyse MR directe, dans laquelle le lupus érythémateux systémique (LES) était considéré comme l'exposition et le nombre de fausses couches spontanées comme le critère de jugement. Des informations détaillées sur les variables instrumentales sont fournies dans le Tableau supplémentaire 1. Tous les SNP retenus présentaient des statistiques F supérieures à 10, indiquant qu’un biais dû à un instrument faible était improbable. Chaque SNP retenu a également été analysé à l’aide de PhenoScanner V2, et aucun SNP associé aux anticorps antiphospholipides (aPL) n’a été identifié. L’analyse MR-PRESSO n’a détecté aucun point aberrant. Le test Q de Cochran n’a révélé aucune hétérogénéité significative entre les estimations spécifiques aux SNP (Q = 16,12, P = 0,31) ; par conséquent, un modèle IVW à effets fixes a été appliqué. Le test de l’ordonnée à l’origine MR-Egger n’a pas indiqué de pléiotropie horizontale directionnelle (P = 0,69). L’analyse IVW a montré une association positive statistiquement significative mais modeste sur le plan quantitatif entre le lupus érythémateux systémique prédit génétiquement et le nombre de fausses couches spontanées (rapport de cotes [OR] = 1,01, intervalle de confiance à 95 % [IC] = 1,00–1,02, P < 0,01 ; Figure 2A). Les estimations d’effet obtenues à l’aide de la régression MR-Egger (OR = 1,01, IC 95 % = 1,00–1,03, P = 0,16), de la méthode de la médiane pondérée (OR = 1,01, IC 95 % = 1,00–1,02, P = 0,17) et de la méthode du mode pondéré (OR = 1,01, IC 95 % = 0,99–1,03, P = 0,42) étaient concordantes en direction avec l’estimation IVW, bien qu’elles n’aient pas individuellement atteint la signification statistique. L’analyse d’exclusion d’un seul SNP à la fois a montré que l’élimination d’un seul SNP n’altérait pas de manière notable l’estimation agrégée, et le graphique en embouchure approximativement symétrique n’a fourni aucune preuve visuelle que le résultat était dû à une pléiotropie directionnelle marquée. Le graphique de dispersion correspondant, le graphique en forêt spécifique aux SNP, l’analyse d’exclusion d’un seul SNP à la fois et le graphique en embouchure sont présentés dans les Figures supplémentaires 1–4.
Dans l'analyse MR inverse, 16 SNP ont été conservés après la sélection des instruments, et tous présentaient des statistiques F supérieures à 10 (Tableau supplémentaire 2). L'analyse MR-PRESSO n'a identifié aucun valeur aberrante. Le test Q de Cochran n'a révélé aucune hétérogénéité significative (Q = 13,41, P = 0,50), et le test d'interception MR-Egger n'a fourni aucune preuve de pléiotropie horizontale directionnelle (P = 0,41). L'estimation IVW ne soutenait pas d'association entre le nombre prédit génétiquement de fausses couches spontanées et le risque de lupus érythémateux systémique (SLE) (OR = 0,93, IC à 95 % = 0,21–4,23, P = 0,93 ; Figure 2B). Dans leur ensemble, les résultats de MR soutiennent une association modeste dans le sens direct, du SLE prédit génétiquement vers le nombre de fausses couches spontanées, tandis que l'analyse inverse ne soutenait pas d'association allant du nombre prédit génétiquement de fausses couches spontanées vers le risque de SLE.
Analyse bioinformatique
Analyse de l'expression différentielle :
L'analyse de l'expression différentielle de GSE61635 a identifié 976 gènes différentiellement exprimés (DEG) entre les groupes lupus érythémateux systémique (SLE) et témoins sains, dont 678 gènes surexprimés et 298 gènes sous-exprimés (Figure 3C). L'analyse de GSE165004 a révélé 1 249 DEG entre les groupes RPL et témoins, incluant 578 gènes surexprimés et 671 gènes sous-exprimés (Figure 3D). Des cartes thermiques représentant les 50 DEG les plus significatifs dans les deux jeux de données de découverte sont présentées dans Figure 3A et Figure 3B. De plus, 59 DEG communs ont été identifiés entre les deux jeux de données (Figure 3E). Ces DEG communs ont constitué le jeu de gènes utilisé pour les analyses fonctionnelles d'enrichissement et les analyses de réseau ultérieures.
Analyse d'enrichissement fonctionnel des DEG communs :
Les 59 DEG partagés ont été soumis à des analyses d'enrichissement des voies GO et KEGG à l'aide de DAVID. Dans la catégorie processus biologique, les DEG partagés étaient enrichis en réponse de défense contre les virus, réponse aux virus, régulation négative de la réplication du génome viral, réponse immunitaire innée antivirale, régulation négative du processus apoptotique et adhésion cellulaire. Les termes enrichis relatifs aux composants cellulaires comprenaient la région extracellulaire, la membrane du réticulum endoplasmique, le cytosquelette d'actine et la membrane. La liaison des ions calcium a été identifiée parmi les termes enrichis relatifs aux fonctions moléculaires. L'analyse KEGG a révélé un enrichissement dans des voies liées à l'hépatite C et à la grippe A (Figure 4A). Ces résultats indiquent que les DEG partagés étaient principalement associés à des processus biologiques liés à l'antiviral et à l'immunité, fournissant un contexte fonctionnel aux gènes communs aux jeux de données de découverte de lupus érythémateux systémique (LES) et de fausses couches à répétition (FCR).
Réseau PPI et identification des gènes centraux
Les 59 DEG communs ont été téléchargés dans STRING afin de construire un réseau d'interactions protéine-protéine (PPI) en utilisant un score de confiance d'interaction minimal de 0,400. Le réseau obtenu comprenait 59 nœuds et 80 arêtes. Ce réseau a été importé dans Cytoscape version 3.10.0 pour visualisation, et les nœuds isolés ont été supprimés avant l'analyse topologique (Figure 4B). Le classement des gènes centraux a été effectué à l'aide du plugin cytoHubba. Six algorithmes ont été appliqués : centralité du clique maximal (MCC), composante voisine maximale (MNC), composante d'arêtes percolées (EPC), degré, proximité (Closeness) et radialité (Radiality). Les mêmes 10 gènes ont été identifiés parmi les gènes les mieux classés selon les six algorithmes : RSAD2, RTP4, IFIT3, IFI27, IFI44, GBP1, MX1, OAS1, IFIT1 et CXCL11 (Tableau 3). Ces gènes ont donc été retenus comme candidats gènes centraux pour la régression LASSO ultérieure.
La régression LASSO a identifié IFI27 et CXCL11 comme gènes candidats partagés
Les 10 gènes centraux candidats ont été soumis à une analyse de régression LASSO dans les jeux de données de découverte du lupus érythémateux systémique (LES) et de la lithiase rénale (LR). Dans le jeu de données du LES, quatre gènes ont conservé des coefficients non nuls à la valeur lambda sélectionnée : IFIT3, IFI27, IFI44 et CXCL11, avec des coefficients respectifs de 2,575, 0,057, 2,359 et 0,307 (Figure 5A,B). Dans le jeu de données de la LR, quatre gènes ont conservé des coefficients non nuls : IFI27, GBP1, OAS1 et CXCL11, avec des coefficients respectifs de −0,897, 0,167, −1,007 et −0,519 (Figure 5C,D). La comparaison des gènes sélectionnés par les deux modèles spécifiques aux maladies a identifié IFI27 et CXCL11 comme gènes candidats partagés sélectionnés par LASSO. Ces deux gènes ont ensuite été évalués dans les jeux de données de découverte et de validation externe.
Validation externe de l'expression de IFI27 et de CXCL11
Les profils d'expression des deux gènes candidats ont été évalués à l'aide des jeux de données de validation indépendants GSE50772 et GSE198700 obtenus à partir de la base de données GEO. Dans GSE61635, IFI27 et CXCL11 étaient tous deux significativement surexprimés dans le groupe lupus érythémateux systémique (SLE) par rapport aux témoins sains (Figure 6A,B). Dans le jeu de données de validation SLE indépendant (GSE50772), IFI27 restait significativement surexprimé (Figure 6C), tandis que CXCL11 ne présentait pas de différence significative entre les groupes (Figure 6D). Dans le jeu de données de découverte RPL (GSE165004), IFI27 et CXCL11 étaient tous deux significativement sous-exprimés dans le groupe RPL par rapport aux témoins (Figure 6E,F). Dans le jeu de données de validation RPL indépendant (GSE198700), IFI27 restait significativement sous-exprimé dans le groupe RPL (Figure 6G), tandis que CXCL11 n'a pas été détecté. Dans l'ensemble, IFI27 a montré une expression différentielle cohérente dans les jeux de données de découverte et de validation pour le SLE et le RPL. En revanche, CXCL11 n'a pas été reproduit de manière cohérente dans les jeux de données de validation externe. Par conséquent, IFI27 a été retenu comme biomarqueur candidat commun pour les analyses ultérieures.
Évaluation exploratoire de la discrimination diagnostique
Une analyse de la courbe ROC (receiver operating characteristic) a été réalisée afin d'évaluer la capacité des expressions d'IFI27 et de CXCL11 à distinguer les échantillons pathologiques des témoins dans les jeux de données transcriptomiques rétrospectifs analysés. Pour le lupus érythémateux systémique (LES), IFI27 a donné une aire sous la courbe ROC (AUC) de 0,822 (IC à 95 % = 0,752–0,892 ; Figure 7A), tandis que CXCL11 a donné une AUC de 0,852 (IC à 95 % = 0,786–0,917 ; Figure 7B). Une comparaison des courbes ROC des deux gènes candidats dans le jeu de données du LES est présentée dans la Figure 7C. Pour le RPL, IFI27 a donné une AUC de 0,872 (IC à 95 % = 0,773–0,970 ; Figure 7D), tandis que CXCL11 a donné une AUC de 0,668 (IC à 95 % = 0,513–0,882 ; Figure 7E). Une comparaison des courbes ROC des deux gènes candidats dans le jeu de données du RPL est présentée dans la Figure 7F. IFI27 a présenté des valeurs d'AUC supérieures à 0,80 dans les deux jeux de données pathologiques et a montré une validation externe plus cohérente que CXCL11 à travers les jeux de données d'expression. Ces résultats soutiennent IFI27 comme biomarqueur candidat nécessitant une évaluation supplémentaire. Toutefois, étant donné que les analyses ROC ont été effectuées à l'aide de jeux de données transcriptomiques publiques rétrospectives, les résultats doivent être interprétés comme une preuve exploratoire de discrimination transcriptomique plutôt que comme une validation diagnostique clinique prospective.
Évaluation computationnelle de l'infiltration immunitaire
Une analyse par ssGSEA a été réalisée afin d'évaluer l'enrichissement de 28 signatures de cellules immunitaires dans les jeux de données de découverte GSE61635 et GSE165004. Les cartes thermiques d'enrichissement des cellules immunitaires pour les jeux de données SLE et RPL sont présentées respectivement dans la Figure 8A,D, tandis que les comparaisons de groupes correspondantes des scores ssGSEA sont illustrées dans la Figure 8B,E. Dans le jeu de données SLE, plusieurs signatures de cellules immunitaires différaient significativement entre les patients atteints de SLE et les témoins sains, notamment celles représentant les cellules T CD8+, les cellules T CD4+, les cellules B, les cellules dendritiques, les cellules T auxiliaires de type 1 (Th1), les cellules T auxiliaires de type 2 (Th2), les cellules T auxiliaires de type 17 (Th17), les cellules natural killer (NK), les macrophages, les éosinophiles, les mastocytes, les monocytes et les neutrophiles (Figure 8B). Dans le jeu de données RPL, les scores ssGSEA des cellules T CD8+ activées, des cellules T CD4+ activées, des cellules T CD4+ mémoire effectrices, des cellules Th17 et des monocytes étaient plus élevés dans le groupe RPL que dans le groupe témoin. En revanche, les scores ssGSEA des cellules T régulatrices (Treg) et des macrophages étaient plus faibles dans le groupe RPL que dans le groupe témoin (Figure 8E). Une analyse de corrélation a montré que, dans le jeu de données SLE, l'expression d'IFI27 et de CXCL11 était positivement corrélée aux scores ssGSEA des cellules T CD4+ activées, des cellules NK, des cellules Th2 et des cellules T CD8+ mémoire centrales, et négativement corrélée au score ssGSEA des cellules Th1 (Figure 8C). Dans le jeu de données RPL, l'expression d'IFI27 était positivement corrélée aux scores ssGSEA des cellules Treg et des cellules Th2, tandis que l'expression de CXCL11 était positivement corrélée au score ssGSEA des éosinophiles (Figure 8F).
Disponibilité des données :
Aucune nouvelle donnée primaire provenant de participants humains n’a été générée dans cette étude. Toutes les analyses étaient basées exclusivement sur des statistiques sommaires d’études d’association pangénomique (GWAS) et des jeux de données transcriptomiques accessibles au public. Les statistiques sommaires GWAS pour le lupus érythémateux systémique (SLE) ont été obtenues auprès de FinnGen, version 11 (numéro d’accès : finngen_R11_L12_LUPUS). Les statistiques sommaires concernant le nombre de fausses couches spontanées ont été obtenues à partir de la ressource IEU OpenGWAS (numéro d’accès : ukb-b-419), qui repose sur des données du UK Biobank. Les jeux de données transcriptomiques ont été obtenus auprès du Gene Expression Omnibus (GEO) du National Center for Biotechnology Information sous les numéros d’accès GSE61635, GSE165004, GSE50772 et GSE198700. Les jeux de données accessibles au public peuvent être consultés dans les dépôts suivants :
-- FinnGen Release 11 : https://r11.finngen.fi/
-- IEU OpenGWAS : https://gwas.mrcieu.ac.uk/
-- Gene Expression Omnibus (GEO) : https://www.ncbi.nlm.nih.gov/geo/
Les données traitées qui soutiennent les résultats de cette étude sont incluses dans l'article et ses Matériaux Supplémentaires. Aucune donnée individuelle ou permettant d'identifier un participant n'a été consultée ou conservée. Le flux de travail analytique a été réalisé à l'aide de logiciels et de packages accessibles au public, comme décrit dans le Protocole.
Fichier supplémentaire 1. Liste de contrôle STROBE-MR complétée.
Liste de contrôle Strengthening the Reporting of Observational Studies in Epidemiology Using Mendelian Randomization (STROBE-MR) complétée, indiquant où chaque élément recommandé de rapportage est abordé dans le manuscrit. Veuillez cliquer ici pour télécharger ce fichier.
Figure suplémentaire 1. Nuage de points de l'analyse de randomisation mendélienne directe.
Nuage de points montrant les associations entre les effets génétiques des polymorphismes nucléotidiques simples (SNP) instrumentaux sur le lupus érythémateux systémique (LES) et le nombre de fausses couches spontanées. Chaque point représente un SNP, les barres d'erreur horizontales et verticales indiquant les erreurs-types des estimations de l'effet du SNP. Les droites de régression correspondent aux méthodes de randomisation mendélienne par pondération inverse de la variance, MR-Egger, médiane pondérée et mode pondéré. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 2. Estimations causales spécifiques aux polymorphismes mononucléotidiques issues de l'analyse de randomisation mendélienne directe.
Graphique en forêt montrant l'estimation de l'effet causal pour chaque polymorphisme mononucléotidique (SNP) instrumental sur l'association entre le lupus érythémateux systémique (SLE) et le nombre de fausses couches spontanées. Les points noirs représentent les estimations d'effet spécifiques à chaque SNP avec des intervalles de confiance à 95 %. Les points rouges représentent les estimations globales de l'effet causal obtenues à l'aide des méthodes pondérées par l'inverse de la variance et MR-Egger. La ligne pointillée verticale indique l'absence d'effet. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 3. Analyse de sensibilité en laissant un individu de côté dans l'analyse de randomisation mendélienne directe.
Graphique en forêt montrant les résultats de l'analyse de sensibilité en laissant un individu de côté, évaluant l'association entre le lupus érythémateux systémique (SLE) et le nombre de fausses couches spontanées. Chaque point noir représente l'estimation globale de l'effet causal pondérée par l'inverse de la variance après exclusion séquentielle d'un polymorphisme mononucléotidique (SNP) instrumental, les lignes horizontales indiquant les intervalles de confiance à 95 % correspondants. Le point rouge représente l'estimation globale pondérée par l'inverse de la variance obtenue en utilisant tous les SNPs instrumentaux. La ligne pointillée verticale indique l'absence d'effet. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 4. Graphique en entonnoir de l'analyse de randomisation mendélienne directe.
Graphique en entonnoir montrant la distribution des estimations d'effet causal spécifiques aux SNP pour l'association entre le lupus érythémateux systémique (LES) et le nombre de fausses couches spontanées. Chaque point représente un polymorphisme nucléotidique unique (SNP) utilisé comme variable instrumentale. Les lignes verticales indiquent les estimations globales de l'effet causal obtenues à l'aide des méthodes pondérées par l'inverse de la variance et MR-Egger. L'axe des ordonnées représente l'inverse de l'erreur-type (1/SE). Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 1. Polymorphismes de nucléotide unique instrumentaux sélectionnés pour l'analyse de randomisation mendélienne directe.
Le tableau énumère les polymorphismes de nucléotide unique (SNP) instrumentaux utilisés pour l'analyse de randomisation mendélienne directe du lupus érythémateux systémique et du nombre de fausses couches spontanées, y compris le gène annoté le plus proche, le chromosome, la position génomique, l'allèle d'effet, la fréquence de l'allèle d'effet, l'effet (bêta), l'erreur-type (ET), la valeur P et la statistique F. Les positions chromosomiques sont basées sur l'assemblage du génome source utilisé dans l'étude d'association pangénomique. La statistique F a été calculée selon la formule Beta2/ET2. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2. Polymorphismes de nucléotide unique instrumentaux sélectionnés pour l'analyse de randomisation mendélienne inverse.
Le tableau énumère les polymorphismes de nucléotide unique (SNP) instrumentaux utilisés pour l'analyse de randomisation mendélienne inverse, dans laquelle le nombre de fausses couches spontanées est la variable d'exposition et le lupus érythémateux systémique l'issue, incluant le gène annoté le plus proche, le chromosome, la position génomique, l'allèle d'effet, la fréquence de l'allèle d'effet, l'effet (bêta), l'erreur-type (ET), la valeur P et la statistique F. Les positions chromosomiques sont basées sur l'assemblage du génome de référence utilisé dans l'étude d'association pangénomique. La statistique F a été calculée selon la formule Beta2/SE2. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Grâce à une analyse de randomisation mendélienne bidirectionnelle combinée à des analyses bioinformatiques multidimensionnelles, cette étude a identifié une association causale positive entre le lupus érythémateux systémique (LES) et les fausses couches à répétition (FCR), tout en recherchant systématiquement des biomarqueurs transcriptomiques partagés. À notre connaissance, il s'agit de la première étude à intégrer une randomisation mendélienne bidirectionnelle, des analyses transcriptomiques et des analyses d'infiltration immunitaire afin d'explorer cette relation. Bien que l'effet observé en termes de taille d'effet en randomisation mendélienne ait été modeste (OR IVW = 1,01), l'association a été constamment soutenue par plusieurs méthodes complémentaires de randomisation mendélienne et analyses de sensibilité, sans preuve d'hétérogénéité importante, de pléiotropie horizontale ou de valeurs aberrantes influentes, suggérant que la relation observée est statistiquement robuste mais faible en amplitude. Par conséquent, les résultats actuels doivent être interprétés comme une preuve en faveur d'une contribution génétique modeste du LES à la susceptibilité aux FCR, plutôt qu'un effet clinique important. En intégrant une inférence causale, une validation transcriptomique et des analyses d'infiltration immunitaire, cette étude fournit un cadre reproductible permettant de hiérarchiser les biomarqueurs candidats pour les troubles reproducteurs complexes médiés par le système immunitaire. Une étude menée en Égypte entre 2007 et 2021, incluant 123 femmes atteintes de LES et un total de 201 grossesses, a rapporté que 20,4 % des grossesses chez les femmes atteintes de LES se sont soldées par une perte fœtale44. D'autres études antérieures ont également suggéré que le LES constitue un facteur de risque important pour les FCR, car une régulation immunitaire altérée pourrait augmenter la probabilité de pertes de grossesse12.
Les analyses de bioinformatique ont révélé que les 59 gènes différentiellement exprimés (DEG) partagés étaient principalement enrichis dans des voies liées aux réponses immunitaires antivirales, à l'adhésion cellulaire et à la régulation de l'apoptose. L'infection virale pourrait contribuer à la pathogenèse du lupus érythémateux systémique (LES). Les patients atteints de LES présentent souvent un dysfonctionnement des réponses immunitaires innée et adaptative45,46, ce qui les rend plus sensibles aux infections virales. Cette susceptibilité accrue pourrait contribuer à la perte de grossesse par des mécanismes tels que l'inflammation placentaire et les lésions des cellules placentaires47. En tant que composant essentiel du placenta, des altérations de l'autophagie et du comportement biologique des cellules trophoblastiques ont également été associées à l'apparition de fausses couches à répétition (FCR)48,49. Prises ensemble, ces observations suggèrent que le déséquilibre immunitaire associé au LES pourrait influencer les issues de la grossesse en affectant la fonction des cellules trophoblastiques. Des analyses supplémentaires ont identifié IFI27 et CXCL11 comme gènes centraux candidats partagés par le LES et la FCR. Toutefois, IFI27 a été priorisé pour les analyses ultérieures car il présentait une plus grande cohérence biologique à travers des jeux de données indépendants. Bien que les deux gènes aient été sélectionnés par le modèle LASSO, seul IFI27 a montré une expression différentielle cohérente dans les jeux de données de découverte et de validation externe, tandis que CXCL11 n'a pas été reproduit de manière constante dans les jeux de données de validation. De plus, IFI27 présentait une meilleure capacité discriminante diagnostique pour la FCR et est resté significativement régulé de manière anormale à travers les jeux de données sanguins et tissulaires reproductifs. Collectivement, ces résultats soutiennent IFI27 comme un biomarqueur candidat plus robuste que CXCL11, bien qu'une validation expérimentale supplémentaire soit nécessaire. La validation à l'aide du jeu de données du LES GSE50772 et du jeu de données de la FCR GSE198700 a démontré que l'expression d'IFI27 restait constamment altérée dans les jeux de données de validation. Notamment, IFI27 était surexprimé dans les échantillons sanguins de patients atteints de LES, en accord avec des études antérieures50, mais était sous-régulé dans les échantillons d'endomètre et de villosités choriales de patients atteints de FCR. Ce profil contrasté pourrait refléter des différences entre le déséquilibre immunitaire systémique et l'environnement immunitaire local à l'interface mère-fœtus dans le LES compliqué de FCR.
IFI27 est un gène stimulé par l'interféron impliqué dans l'immunité antivirale, la signalisation par l'interféron et les réponses immunitaires de l'hôte après une infection virale51,52. Lors d'une grossesse normale, l'expression de IFI27 est fortement augmentée dans les cellules trophoblastiques53, suggérant un rôle physiologique important dans le maintien de la fonction trophoblastique. En revanche, nos analyses ont montré une diminution de l'expression de IFI27 dans l'endomètre et les villosités choriales des patientes atteintes de fausses couches à répétition (RPL). Bien que cette observation diffère de certains rapports antérieurs54, elle doit être interprétée avec prudence, car la présente étude a intégré des jeux de données transcriptomiques provenant de tissus différents plutôt que d'échantillons appariés mère-fœtus. Une explication possible est qu'une activation chronique systémique de type I de l'interféron dans le lupus érythémateux systémique (SLE) induit une signalisation persistante par l'interféron dans les cellules immunitaires circulantes tout en favorisant simultanément une désensibilisation des récepteurs, une épuisement immunitaire ou des mécanismes de rétroaction négative compensatoires au niveau de l'interface mère-fœtus. Une autre possibilité est que la régulation épigénétique spécifique aux tissus ou des différences dans la composition cellulaire entre le sang périphérique et les tissus reproducteurs puissent supprimer l'expression locale de IFI27 malgré l'activation systémique de l'interféron. Ces hypothèses restent spéculatives et nécessitent une validation mécanistique à l'aide d'échantillons appariés de sang maternel, de tissu endométrial et de trophoblastes, idéalement au niveau monocellulaire, afin de distinguer les mécanismes régulateurs spécifiques aux tissus et aux types cellulaires55.
L'analyse de l'infiltration immunitaire a révélé des différences significatives dans les signatures des cellules immunitaires dans le lupus érythémateux systémique (SLE) et les avortements à répétition (RPL), caractérisées principalement par des altérations des populations liées aux cellules T CD4+. L'expression de IFI27 était positivement corrélée à l'enrichissement des cellules Th2 dans les deux maladies ; toutefois, ces résultats représentent des corrélations computationnelles dérivées de l'analyse ssGSEA plutôt que des interactions biologiques vérifiées expérimentalement. Des études antérieures ont montré que le sang périphérique des patients atteints de SLE contient des proportions réduites de cellules Th1 et Treg, mais des proportions accrues de cellules Th256,57, ce qui est conforme à nos résultats. Pendant une grossesse normale, l'équilibre immunitaire Th1/Th2 à l'interface mère-fœtus s'oriente vers un état dominant en Th258. Ainsi, une expression réduite de IFI27 dans les tissus reproducteurs pourrait refléter des altérations de l'homéostasie immunitaire locale associées à une tolérance mère-fœtus altérée, bien qu'il reste à déterminer expérimentalement si IFI27 régule directement ce processus.
Plusieurs limites doivent être reconnues. Premièrement, bien que les analyses de randomisation mendélienne aient soutenu une association causale, l'effet génétique estimé était relativement faible, suggérant que le lupus érythémateux systémique ne représente qu'un composant parmi la pathogenèse multifactorielle de l'insuffisance répétée de la grossesse. Deuxièmement, l'intégration transcriptomique incluait des jeux de données générés à partir de tissus différents (sang périphérique, endomètre et villosités choriales), de plates-formes de puces à ADN et de cohortes indépendantes, ce qui pourrait introduire une hétérogénéité biologique et technique, malgré la validation cohérente de IFI27. Troisièmement, la cohorte de validation externe pour les villosités choriales comprenait un nombre limité d'échantillons, ce qui aurait pu réduire la puissance statistique et la généralisabilité. Quatrièmement, comme les jeux de données accessibles publiquement contenaient des informations cliniques limitées, des facteurs importants, tels que l'activité de la maladie, le statut des anticorps antiphospholipides, l'exposition aux médicaments, le stade de la grossesse et d'autres covariables cliniques, n'ont pas pu être entièrement évalués. Enfin, bien que le criblage par PhenoScanner ait minimisé les biais de confusion pleiotropes potentiels dans les analyses de randomisation mendélienne, un biais résiduel ne peut être complètement exclu.
Du point de vue translationnel, IFI27 devrait actuellement être considéré comme un biomarqueur candidat plutôt qu’un marqueur diagnostique validé sur le plan clinique. Avant toute mise en œuvre clinique, des études prospectives multicentriques sont nécessaires afin de valider sa performance diagnostique dans des populations variées, d’établir des plateformes d’analyse standardisées et des seuils diagnostiques, et de déterminer l’influence du stade de la grossesse, de l’activité de la maladie et du traitement immunosuppresseur sur l’expression d’IFI27. Des expériences fonctionnelles, associées à des analyses de transcriptomique spatiale et de transcriptomique unicellulaire, seront également essentielles pour préciser si IFI27 contribue activement à la régulation immunitaire materno-fœtale ou s’il reflète simplement une activation immunitaire induite par l’interféron.
Déclarations de divulgation
Conflit d'intérêts :
Les auteurs déclarent ne pas avoir d'intérêts financiers ou non-financiers concurrents.
Remerciements
Ce travail a été soutenu par le projet clé intégré de médecine traditionnelle chinoise et de médecine occidentale sur les maladies graves du Bureau municipal de médecine traditionnelle chinoise de Pékin (2023BJSZDYNJBXTGG-003), le Fonds national de recherche scientifique d'intérêt public pour les activités de base de recherche fondamentale des instituts (ZZ16-XRZ-038) et le Projet de promotion des hôpitaux chinois de haut niveau (HLCMHPP2023087). Les sources de financement n'ont joué aucun rôle dans la conception de l'étude, la collecte des données, l'analyse des données, l'interprétation des données, la rédaction du manuscrit ou la décision de soumettre le manuscrit à publication. Les auteurs remercient les investigateurs et les participants de l'étude FinnGen, du Biobanque du Royaume-Uni (UK Biobank) et du Gene Expression Omnibus (GEO) du Centre national d'information biotechnologique pour avoir rendu leurs ensembles de données accessibles au public. Les auteurs remercient également le consortium FinnGen, qui intègre des échantillons provenant de biobanques finlandaises avec des données issues de registres de santé nationaux par le biais de collaborations entre des organismes de recherche finlandais, des biobanques et des partenaires internationaux.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Collection de 28 signatures génétiques de cellules immunitaires | Ressource complémentaire publiée sur les signatures géniques | Liste supplémentaire de gènes marqueurs de cellules immunitaires décrite par Charoentong et al. (référence 42) | Non applicable RRID : Non disponible Objectif / notes : Signatures de cellules immunitaires utilisés pour la ssGSEA. |
| CNSknowall | plateforme web CNSknowall | Fichiers de sortie de DAVID | Non applicable RRID : Non disponible Objectif / notes : Visualisation des résultats filtrés d'enrichissement fonctionnel. |
| Poste de travail informatique | Environnement informatique institutionnel | Non applicable | Non applicable RRID : Non applicable Objectif / notes : Analyses computationnelles. |
| Consommables | Non applicable | Non applicable | Non applicable RRID : Non applicable Objectif / notes : Aucun consommable de laboratoire humide n'a été utilisé. |
| Cytoscape | Consortium Cytoscape | Non applicable | 3.10.0 RRID : SCR_003032 Objectif / notes : Protéine–visualisation et analyse topologique d'un réseau d'interactions protéiques |
| cytoHubba | Boutique d'applications Cytoscape | Non applicable | 0.1 RRID : SCR_017677 Objectif / remarques : Classement des gènes centraux selon MCC, MNC, EPC, degré, centralité de proximité et radialité. |
| Outil d'annotation fonctionnelle DAVID | Instituts nationaux de la santé / Institut national du cancer | Listes de gènes différentiellement exprimés (DEG) et de gènes de fond partagées téléchargées | 2021 RRID : SCR_001881 Objectif / notes : Analyse d'enrichissement des voies de la base Gene Ontology et KEGG |
| Panel de référence européen pour le déséquilibre de liaison | Projet 1000 génomes / IEU OpenGWAS | Panel européen de phase 3 (variants compatibles avec GRCh37) | Phase 3 RRID : Non indiqué Objectif / notes : Élagage en déséquilibre de liaison via le flux de travail OpenGWAS/TwoSampleMR. |
| FinnGen | Consortium FinnGen | finngen_R11_L12_LUPUS | Version 11 RRID : SCR_022254 Objectif / remarques : Statistiques sommaires des études d'association génome entier pour le lupus érythémateux. |
| forestploter | CRAN | Non applicable | 1.1.2 RRID : Non disponible Objectif / notes : Visualisation sous forme de forêt des estimations de la randomisation mendélienne. |
| Gene Expression Omnibus (GEO) | Centre national d'information biotechnologique | GSE61635 ; GSE165004 ; GSE50772 ; GSE198700 | Non applicable RRID : SCR_005012 Objectif / notes : Source des jeux de données transcriptomiques de découverte et de validation. |
| Ontologie génique | Consortium pour l'ontologie génétique | Termes GO accessibles via DAVID | Annotations DAVID 2021 RRID : SCR_002811 Objectif / notes : Annotation des processus biologiques, des composants cellulaires et des fonctions moléculaires. |
| ggcorrplot | CRAN | Non applicable | 0.1.4.1 RRID : Non disponible Objectif / notes : Visualisation du gène candidat–matrices de corrélation des cellules immunitaires |
| ggplot2 | CRAN | Non applicable | 3.5.1 RRID : SCR_014601 Objectif / remarques : Graphiques en volcan, boîtes à moustaches et autres graphiques statistiques. |
| ggvenn | CRAN | Non applicable | 0.1.16 RRID : SCR_025300 Objectif / notes : Visualisation des gènes différentiellement exprimés communs. |
| glmnet | CRAN | Non applicable | 4.1-8 RRID : SCR_015505 Objectif / remarques : Régression logistique LASSO et validation croisée. |
| GSE165004 | NCBI GEO | GSE165004 / GPL16699 | Matrice de série traitée RRID : SCR_005012 Objectif / notes : Jeu de données de découverte de l'endomètre RPL |
| GSE198700 | NCBI GEO | GSE198700 / GPL13534 | Matrice de série traitée RRID : SCR_005012 Objectif / notes : Jeu de données indépendant de validation des villosités choriales par RPL |
| GSE50772 | NCBI GEO | GSE50772 / GPL570 | Matrice de série traitée RRID : SCR_005012 Objectif / notes : Jeu de données indépendant de validation de cellules mononucléées du sang périphérique de patients atteints de lupus érythémateux systémique. |
| GSE61635 | NCBI GEO | GSE61635 / GPL570 | Matrice de série traitée RRID : SCR_005012 Objectif / notes : Série de données découverte sur le sang total de patients atteints de lupus érythémateux systémique |
| GSEABase | Bioconductor | Non applicable | 1.66.0 RRID : Non disponible Objectif / notes : Gestion des ensembles de gènes de cellules immunitaires pour la ssGSEA. |
| GSVA | Bioconductor | Non applicable | 1.52.3 RRID : SCR_021058 Objectif / notes : Analyse d'enrichissement de gènes à partir d'un échantillon unique (ssGSEA). |
| IEU OpenGWAS | Unité d'épidémiologie intégrative du MRC | ukb-b-419 ; finngen_R11_L12_LUPUS | Non applicable RRID : Non indiqué Objectif / notes : Récupération des statistiques sommaires des études d'association génome entier (GWAS) et des données harmonisées d'association génétique. |
| Encyclopédie de Kyoto des gènes et des génomes (KEGG) | Kanehisa Laboratories | Voies métaboliques KEGG accessibles via DAVID | Annotations DAVID 2021 RRID : SCR_012773 Objectif / notes : Annotation de l'enrichissement des voies métaboliques |
| limma | Bioconductor | Non applicable | 3.60.6 RRID : SCR_010943 Objectif / notes : Analyse de l'expression différentielle. |
| MRPRESSO | Verbanck et al. | Non applicable | 1 RRID : SCR_023697 Objectif / notes : Détection de la pléiotropie horizontale et des variables instrumentales aberrantes. |
| pheatmap | CRAN | Non applicable | 1.0.12 RRID : SCR_016418 Objectif / notes : Cartes thermiques d'expression. |
| PhenoScanner V2 | Consortium PhenoScanner | Requêtes phénotypiques au niveau des SNP | Version 2 RRID : Non disponible Objectif / notes : Analyse de criblage des SNP conservés en vue de détecter d'éventuelles associations avec des phénotypes de confusion. |
| pROC | CRAN | Non applicable | 1.18.5 RRID : SCR_024286 Objectif / notes : Courbes ROC, AUC, intervalles de confiance de DeLong, seuils de cutoff de l'indice de Youden et intervalles de confiance bootstrap. |
| R | Fondation R pour l'informatique statistique | Non applicable | 4.4.2 RRID : SCR_001905 Objectif / notes : Environnement de calcul statistique |
| Réactifs | Non applicable | Non applicable | Non applicable RRID : Non applicable Objectif / notes : Aucun réactif de laboratoire humide n'a été utilisé. |
| STRING | Consortium STRING | Homo sapiens (taxon 9606) ; score d'interaction minimum 0,400 | 11 RRID : SCR_005223 Objectif / notes : Protéine–construction d'un réseau d'interactions protéiques |
| TwoSampleMR | Unité d'épidémiologie intégrative MRC | Non applicable | 0.6.6 RRID : SCR_019010 Objectif / notes : Randomisation mendélienne bidirectionnelle à deux échantillons, extraction des données, harmonisation, estimation causale et analyses de sensibilité. |
| UK Biobank | UK Biobank | ukb-b-419 | Jeu de données récapitulatif de 2018 RRID : SCR_012815 Objectif / notes : Statistiques sommaires de l'étude d'association pangénomique (GWAS) concernant le nombre de fausses couches spontanées. |
Références
- Petri M. Pregnancy and systemic lupus erythematosus. Best Pract Res Clin Obstet Gynaecol. 2020;64:24-30.
- Zhao X, et al. Advances in drug therapy for systemic lupus erythematosus. Curr Med Chem. 2021;28(7):1251-1268.
- Stanescu II, et al. Salivary biomarkers of inflammation in systemic lupus erythematosus. Ann Anat. 2018;219:89-93.
- Tian J, Zhang D, Yao X, Huang Y, Lu Q. Global epidemiology of systemic lupus erythematosus: A comprehensive systematic analysis and modelling study. Ann Rheum Dis. 2023;82(3):351-356.
- Palma Dos Reis CR, et al. Prediction of adverse pregnancy outcomes in women with systemic lupus erythematosus. Clin Rev Allergy Immunol. 2020;59(2):287-294.
- Venne K, Scott S, Bernatsky S, Vinet E. Induced abortions in women with systemic lupus erythematosus. Lupus. 2021;30(4):484-488.
- Kim JW, et al. Lupus low disease activity state achievement is important for reducing adverse outcomes in pregnant patients with systemic lupus erythematosus. J Rheumatol. 2021;48(5):707-716.
- Braga A, et al. Systemic lupus erythematosus and pregnancy: A Portuguese case-control study. Clin Rev Allergy Immunol. 2022;62(2):324-332.
- Dimitriadis E, Menkhorst E, Saito S, Kutteh WH, Brosens JJ. Recurrent pregnancy loss. Nat Rev Dis Primers. 2020;6(1):98.
- Quenby S, et al. Miscarriage matters: The epidemiological, physical, psychological, and economic costs of early pregnancy loss. Lancet. 2021;397(10285):1658-1667.
- Valeff NJ, Ventimiglia MS, Diao L, Jensen F. Lupus and recurrent pregnancy loss: The role of female sex hormones and B cells. Front Endocrinol (Lausanne). 2023;14:1233883.
- Gao R, Zeng X, Qin L. Systemic autoimmune diseases and recurrent pregnancy loss: Research progress in diagnosis and treatment. Chin Med J (Engl). 2021;134(17):2140-2142.
- Pantham P, Abrahams VM, Chamley LW. The role of anti-phospholipid antibodies in autoimmune reproductive failure. Reproduction. 2016;151(5):R79-R90.
- Meroni PL, et al. Updating on the pathogenic mechanisms of antiphospholipid antibody-associated pregnancy loss. Clin Rev Allergy Immunol. 2008;34(3):332-337.
- Blank M, Shoenfeld Y. Antiphospholipid antibody-mediated reproductive failure in antiphospholipid syndrome. Clin Rev Allergy Immunol. 2010;38(2–3):141-147.
- Babker A, et al. Frequency of ACE I/D and PAI-1 4G/5G polymorphisms in women with recurrent pregnancy loss in Sudan. Biomed Pharmacol J. 2025;18(3):1953-1961.
- Babker AM, et al. Detection of human platelet antigen polymorphisms (HPA-1 and HPA-3) and factor XIII mutation in Sudanese women with recurrent pregnancy loss. BMC Res Notes. 2024;17(1):66.
- Grover S, Del Greco MF, Stein CM, Ziegler A. Mendelian randomization. Methods Mol Biol. 2017;1666:581-628.
- Skrivankova VM, et al. Strengthening the reporting of observational studies in epidemiology using Mendelian randomization: The STROBE-MR statement. JAMA. 2021;326(16):1614-1621.
- Emdin CA, Khera AV, Kathiresan S. Mendelian randomization. JAMA. 2017;318(19):1925-1926.
- Burgess S, Thompson SG, CRP CHD Genetics Collaboration. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40(3):755-764.
- Hemani G, et al. The MR-Base platform supports systematic causal inference across the human phenome. eLife. 2018;7:e34408.
- Bowden J, Davey Smith G, Burgess S. Mendelian randomization with invalid instruments: Effect estimation and bias detection through Egger regression. Int J Epidemiol. 2015;44(2):512-525.
- Bowden J, Davey Smith G, Haycock PC, Burgess S. Consistent estimation in Mendelian randomization with some invalid instruments using a weighted median estimator. Genet Epidemiol. 2016;40(4):304-314.
- Hartwig FP, Davey Smith G, Bowden J. Robust inference in summary data Mendelian randomization via the zero modal pleiotropy assumption. Int J Epidemiol. 2017;46(6):1985-1998.
- Burgess S, Butterworth A, Thompson SG. Mendelian randomization analysis with multiple genetic variants using summarized data. Genet Epidemiol. 2013;37(7):658-665.
- Verbanck M, Chen CY, Neale B, Do R. Detection of widespread horizontal pleiotropy in causal relationships inferred from Mendelian randomization between complex traits and diseases. Nat Genet. 2018;50(5):693-698.
- Barrett T, et al. NCBI GEO: Archive for functional genomics data sets—update. Nucleic Acids Res. 2013;41(Database issue):D991-D995.
- Keleş İD, et al. Gene pathway analysis of the endometrium at the start of the window of implantation in women with unexplained infertility and unexplained recurrent pregnancy loss: Is unexplained recurrent pregnancy loss a subset of unexplained infertility? Hum Fertil (Camb). 2023;26(5):1129-1141.
- Kennedy WP, et al. Association of the interferon signature metric with serological disease manifestations but not global activity scores in multiple cohorts of patients with SLE. Lupus Sci Med. 2015;2(1):e000080.
- Matsumoto Y, et al. Characteristic DNA methylation profiles of chorionic villi in recurrent miscarriage. Sci Rep. 2022;12(1):11673.
- Sherman BT, Lempicki RA. Systematic and integrative analysis of large gene lists using DAVID bioinformatics resources. Nat Protoc. 2009;4(1):44-57.
- Szklarczyk D, et al. STRING v11: Protein–protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607-D613.
- Shannon P, et al. Cytoscape: A software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504.
- Jia P, Zheng S, Long J, Zheng W, Zhao Z. dmGWAS: Dense module searching for genome-wide association studies in protein–protein interaction networks. Bioinformatics. 2011;27(1):95-102.
- Chin CH, et al. cytoHubba: Identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11.
- Mohammadi M. A projection neural network for the generalized Lasso. IEEE Trans Neural Netw Learn Syst. 2020;31(6):2217-2221.
- Kumar R, Indrayan A. Receiver operating characteristic (ROC) curve for medical researchers. Indian Pediatr. 2011;48(4):277-287.
- de Hond AAH, Steyerberg EW, van Calster B. Interpreting area under the receiver operating characteristic curve. Lancet Digit Health. 2022;4(12):e853-e855.
- Xu H, et al. Single-cell transcriptomics reveals CCL3+ classical monocyte subset linked to autoimmune pathogenesis. J Inflamm Res. 2025;18:16273-16291.
- Zych M, et al. Surface immune checkpoints as potential biomarkers in physiological pregnancy and recurrent pregnancy loss. Int J Mol Sci. 2024;25(17):9378.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-262.
- Liu J, Lu J, Wang G, Gu L, Li W. Prognostic characteristics of a six-gene signature based on ssGSEA in sarcoma. Aging (Albany NY). 2024;16(2):1536-1554.
- Mokbel A, et al. Pregnancy outcomes among Egyptian women with systemic lupus erythematosus: A prospective cohort study. Lupus. 2023;32(4):521-530.
- Illescas-Montes R, Corona-Castro CC, Melguizo-Rodríguez L, Ruiz C, Costela-Ruiz VJ. Infectious processes and systemic lupus erythematosus. Immunology. 2019;158(3):153-160.
- Banko A, et al. Epstein-Barr virus infection as a potential indicator of the occurrence and clinical presentation of systemic lupus erythematosus. Front Immunol. 2023;14:1307589.
- Nigro G, et al. Role of infections in recurrent spontaneous abortion. J Matern Fetal Neonatal Med. 2011;24(8):983-989.
- Yang D, et al. YY1-PVT1 affects trophoblast invasion and adhesion by regulating mTOR pathway-mediated autophagy. J Cell Physiol. 2020;235(10):6637-6646.
- Guan D, et al. Immunologic insights in recurrent spontaneous abortion: Molecular mechanisms and therapeutic interventions. Biomed Pharmacother. 2024;177:117082.
- Zhao X, et al. Identification of key biomarkers and immune infiltration in systemic lupus erythematosus by integrated bioinformatics analysis. J Transl Med. 2021;19(1):35.
- Villamayor L, et al. The IFN-stimulated gene IFI27 counteracts innate immune responses after viral infections by interfering with RIG-I signaling. Front Microbiol. 2023;14:1176177.
- Lim FY, et al. High-frequency home self-collection of capillary blood correlates IFI27 expression kinetics with SARS-CoV-2 viral clearance. J Clin Invest. 2023;133(23):e173715.
- Apps R, et al. Genome-wide expression profile of first-trimester villous and extravillous human trophoblast cells. Placenta. 2011;32(1):33-43.
- Li Y, et al. RNA sequencing of decidua reveals differentially expressed genes in recurrent pregnancy loss. Reprod Sci. 2021;28(8):2261-2269.
- Dankers W, et al. Failing maternal-fetal tolerance in SLE (FaMaLE): A prospective cohort study for finding the molecular mechanisms behind pregnancy complications. Lupus Sci Med. 2025;12(1):e001668.
- Xiang S, et al. Imbalance of helper T cell type 1, helper T cell type 2, and associated cytokines in patients with systemic lupus erythematosus: A meta-analysis. Front Pharmacol. 2022;13:988512.
- Tu J, et al. UC-BSC exosomes regulate Th17/Treg balance in patients with systemic lupus erythematosus via miR-19b/KLF13. Cells. 2022;11(24):4123.
- Wang W, et al. T helper (Th) cell profiles in pregnancy and recurrent pregnancy loss: Th1/Th2/Th9/Th17/Th22/Tfh cells. Front Immunol. 2020;11:2025.