Cette étude identifie huit gènes pronostiques liés à la catastrophe mitotique (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B) dans l'adénocarcinome pulmonaire, établit un modèle de risque doté d'une performance prédictive acceptable et révèle des caractéristiques distinctes du microenvironnement immunitaire entre les groupes à risque.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Identification de gènes pronostiques liés à la catastrophe mitotique dans l'adénocarcinome pulmonaire via l'analyse du transcriptome
Dans cet article
Résumé
Résumé
Le carcinome adénocarcinomateux du poumon (LUAD), le sous-type de cancer du poumon le plus fréquent, présente un pronostic défavorable. Bien que la catastrophe mitotique puisse être induite dans le LUAD, entraînant la mort cellulaire, la signification pronostique et biologique des gènes liés à la catastrophe mitotique (MCRGs) dans cette maladie reste incertaine. Des gènes différentiellement exprimés (DEGs) associés au LUAD ont été criblés à partir de la cohorte TCGA-LUAD, et les gènes communs ont été définis par l'intersection des DEGs avec les MCRGs. Des gènes pronostiques candidats ont été sélectionnés par apprentissage automatique, puis un modèle pronostique multigénique a été construit. Une signature pronostique à huit gènes candidats composée de PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2 et S100B a été établie, démontrant une fiabilité prédictive acceptable lors de l'entraînement, avec des aires sous la courbe (AUC) à 2, 3 et 5 ans de 0,723, 0,715 et 0,625 respectivement dans le jeu d'entraînement (C-index corrigé par bootstrap : 0,699, IC 95 % : 0,657-0,742) et une validation cohérente dans GSE31210 (AUCs : 0,812, 0,766 et 0,814). Les patients à faible risque présentaient des résultats de survie significativement meilleurs, une infiltration immunitaire accrue, des scores immunitaires et stromaux plus élevés, des immunophénoscores augmentés et des cycles d'immunité anticancéreuse plus actifs. Des différences significatives de charge mutationnelle tumorale et de sensibilité aux médicaments ont été observées entre les groupes à haut et à faible risque. La réaction de polymérisation en chaîne par transcription inverse (qPCR) a validé les profils transcriptomiques de six gènes candidats liés au pronostic dans des échantillons cliniques. Un nomogramme intégrant le score de risque et le stade clinique a montré une bonne performance prédictive. Ces résultats démontrent que les huit gènes candidats liés aux MCRGs ont un fort potentiel pour prédire les résultats chez les patients et stratifier le risque dans le LUAD, avec des caractéristiques distinctes du microenvironnement immunitaire entre les groupes à risque.
Introduction
Le cancer du poumon reste l'un des cancers les plus répandus et les plus mortels dans le monde entier1,2. Le cancer du poumon non à petites cellules (NSCLC) est dominé par l'adénocarcinome pulmonaire (LUAD), qui représente environ 40 % de tous les cas de cancer du poumon3,4. Bien que des progrès significatifs aient été accomplis dans les procédures chirurgicales, les thérapies ciblées moléculairement, les inhibiteurs de points de contrôle immunitaires et les régimes combinés, le pronostic clinique des patients atteints de LUAD reste défavorable5,6. Bien que les approches diagnostiques fondées sur l'analyse histopathologique et l'imagerie soient largement utilisées dans le LUAD, elles présentent des limites inhérentes pour capturer l'hétérogénéité tumorale et les caractéristiques moléculaires. En revanche, l'analyse moléculaire des tissus tumoraux basée sur des biomarqueurs peut fournir des informations plus complètes sur la biologie tumorale et contribuer à l'évaluation pronostique ainsi qu'aux stratégies de traitement individualisées7. Par conséquent, l'identification de biomarqueurs moléculaires fiables reste essentielle pour améliorer la prédiction du pronostic et la compréhension biologique du LUAD.
La mitose, un mécanisme essentiel de la réplication cellulaire, assure le partage fidèle des chromosomes répliqués entre deux cellules filles8. Une régulation altérée des processus mitotiques peut favoriser une prolifération cellulaire incontrôlée, une instabilité génomique et la progression tumorale. La catastrophe mitotique (MC) désigne une voie de mort cellulaire déclenchée par l'échec de l'achèvement de la mitose, résultant généralement d'un dommage au fuseau mitotique ou de points de contrôle du cycle cellulaire défectueux9. Au niveau morphologique, la MC se manifeste par des anomalies cellulaires telles qu'une multinucléation, la présence de micronoyaux, des configurations multipolaires du fuseau et une polyploïdisation10. En tant que mécanisme d'élimination des cellules présentant de graves défauts mitotiques, la MC pourrait contribuer à la suppression de la progression tumorale9. La délétion de p53 dans les cellules A549 de CUPA peut induire une catastrophe mitotique et, en fin de compte, la mort cellulaire11, suggérant un lien potentiel entre la MC et les processus cellulaires liés au CUPA. Toutefois, la signification pronostique et les fonctions biologiques des gènes associés à la catastrophe mitotique (MCRGs) dans le CUPA restent mal élucidées.
Dans cette étude, l'importance pronostique et la pertinence biologique potentielle des gènes liés au métabolisme du cholestérol (MCRGs) dans le carcinome pulmonaire à petites cellules (LUAD) ont été systématiquement analysées à l'aide de données provenant de TCGA et de GEO. Les MCRGs candidats ont d'abord été identifiés par des analyses d'expression différentielle et d'intersection. Plusieurs approches d'apprentissage automatique ont permis de sélectionner les gènes candidats et d'établir une signature pronostique de risque, ultérieurement validée de manière externe. Un nomogramme intégrant le score de risque ainsi que des caractéristiques cliniques a ensuite été élaboré afin d'améliorer la prédiction de la survie. En outre, la caractérisation du microenvironnement immunitaire, l'évaluation des mutations somatiques et l'analyse de la chimiosensibilité ont été réalisées afin d'examiner les implications biologiques et l'utilité clinique des gènes identifiés. Dans leur ensemble, ces résultats démontrent le potentiel pronostique des MCRGs dans le LUAD et pourraient guider le développement de biomarqueurs ainsi que la prise en charge individualisée.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
L'étude a été menée conformément à la Déclaration d'Helsinki, et le protocole a été approuvé par le Comité d'éthique de l'Hôpital thoracique d'Anhui (K2025-007) le 22 avril 2025. Le consentement éclairé a été obtenu de tous les sujets ayant participé à l'étude.
Extraction et normalisation des données
Les profils transcriptomiques et les jeux de données cliniques correspondants pour le CUPA ont été obtenus à partir des cohortes TCGA et GEO. Le jeu de données TCGA-CUPA a été désigné comme ensemble d'apprentissage, tandis que GSE72094, GSE31210 et GSE26939 ont servi de cohortes pour la validation externe (Tableau 1). De plus, 900 gènes liés au MCR ont été recueillis à partir d'une étude précédente12 (Tableau supplémentaire 1). Les données transcriptomiques ont été annotées à l'aide de GENCODE v36 ou des fichiers d'annotation GPL correspondants. Les identifiants de sondes ont été convertis en symboles géniques, les gènes en double ont été fusionnés à l'aide de la fonction avereps, et seuls les gènes codant pour des protéines ont été conservés afin de générer des matrices d'expression au niveau génique. Pour l'ensemble d'apprentissage TCGA-CUPA, les gènes dont les Fragments par kilobase du modèle d'exon par million de fragments cartographiés (FPKM) étaient < 1 dans plus de 50 % des échantillons ont été éliminés, et les valeurs d'expression restantes ont été transformées en log2 (log2[FPKM+1]). Pour les cohortes de validation GEO, les données d'expression brutes ont été téléchargées, les identifiants de sondes ont été associés aux symboles géniques à l'aide des fichiers d'annotation propres à chaque plateforme, et les sondes multiples correspondant au même gène ont été regroupées en faisant la moyenne de leurs valeurs d'expression. Ces jeux de données ont été transformés en log2 si nécessaire. Aucune correction d'effet de lot inter-plateformes n'a été appliquée entre TCGA et GEO, car nous avons adopté une stratégie de standardisation par cohorte afin d'assurer une comparabilité relative. Plus précisément, pour les cohortes d'apprentissage et de validation, les valeurs d'expression génique ont été centrées et normalisées (transformation en score z) à l'aide de la moyenne et de l'écart-type de chaque jeu de données individuellement. Les mêmes coefficients de régression de Cox dérivés de l'ensemble d'apprentissage ont ensuite été utilisés pour calculer les scores de risque pour toutes les cohortes. Afin de préserver l'applicabilité clinique et d'éviter un surajustement à l'une quelconque des cohortes de validation, la médiane du score de risque de la cohorte d'apprentissage a été utilisée comme seuil fixe pour répartir les patients en groupes à haut et à faible risque à travers toutes les cohortes de validation externe. Les informations cliniques, incluant l'âge, le sexe, le stade pathologique, le stade Tumeur-Node-Métastase (TNM), le type histologique, la durée de survie, le statut de survie et le type de tissu, ont été extraites lorsque disponibles. Le critère de jugement était la survie globale (SG). Les échantillons présentant des informations de survie incomplètes ou une durée de survie < 30 jours ont été exclus. La durée de survie a été convertie en années, et le statut de survie a été codé 0 pour vivant et 1 pour décédé.
Identification et analyses fonctionnelles de gènes candidats
Le package Limma a identifié les gènes différentiellement exprimés (DEGs) entre les échantillons tumoraux et normaux de LUAD dans le jeu d'apprentissage13. Les critères suivants ont défini les DEGs : |log2FC| > 0,5 et valeur p ajustée < 0,05. Par la suite, l'algorithme de clustering flou mfuzz du package R ClusterGVis a été utilisé pour répartir les DEGs en clusters d'expression distincts. Une analyse de l'ontologie génique – processus biologique (GO-BP) a été réalisée sur les cinq gènes les plus représentatifs de chaque cluster, en fonction de leurs scores d'appartenance. Un ensemble de gènes communs a été obtenu en prenant l'intersection des DEGs avec les MCRGs. Une analyse d'enrichissement fonctionnel utilisant l'ontologie génique/encyclopédie de Kyoto des gènes et des génomes (GO/KEGG) a évalué la pertinence biologique des gènes en chevauchement. Les réseaux d'interactions protéine-protéine (PPI) provenaient de la base de données STRING14. Seules les interactions ayant des scores de confiance > 0,7 ont été conservées afin d'améliorer la fiabilité du réseau.
Recherche de gènes pronostiques
Le package Survival a été utilisé pour réaliser une analyse de régression de Cox univariée afin d'identifier les gènes probablement associés au taux de survie global dans le LUAD15. Les gènes ayant une valeur p < 0,05 ont été considérés comme des indicateurs pronostiques potentiels. La cohorte d'apprentissage TCGA-LUAD comprenait 500 patients disposant de données complètes sur la survie, parmi lesquels 216 (43,2 %) avaient présenté un décès pendant le suivi. Le rapport entre le nombre de gènes candidats (n = 108) et le nombre d'événements (n = 216) était d'environ 1:2, ce qui est acceptable pour une analyse de régression de Cox. Ensuite, une analyse de régression par sélection et réduction absolue minimale (LASSO) ainsi qu'un modèle Extreme Gradient Boosting (XGBoost) ont permis une sélection supplémentaire de caractéristiques. Des modèles de risques proportionnels de Cox ont été construits avec family = "cox" à l'aide de la fonction cv.glmnet du package glmnet. Le paramètre de régularisation optimal a été déterminé par une validation croisée en 10 parties, la valeur λ.min représentant l'erreur minimale de validation croisée, choisie comme valeur optimale de λ. Les gènes présentant des coefficients de régression non nuls ont été extraits comme caractéristiques candidates. Pour le modèle XGBoost, le temps de survie et le statut de survie ont été combinés en une seule variable réponse, des valeurs positives étant attribuées aux décès et des valeurs négatives aux cas censurés. Les paramètres ont été définis comme objective = "survival: cox" et eval_metric = "cox-nloglik", avec 100 itérations et un taux d'apprentissage de 0,1. Après l'entraînement du modèle, les scores d'importance des gènes ont été calculés à partir des gains des caractéristiques. Les 20 gènes les plus importants ont été conservés après tri des scores d'importance par ordre décroissant, afin de réduire la dimensionnalité des caractéristiques et la complexité du modèle. Les gènes communs aux résultats de LASSO et de XGBoost ont été identifiés comme des gènes pronostiques candidats.
Construction et évaluation d'un modèle pronostique
Un modèle pronostique a été développé à l'aide d'une analyse de régression de Cox multivariée portant sur les gènes candidats identifiés. Les scores de risque ont été calculés individuellement comme suit :
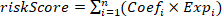 .
où Coefi désigne le coefficient pour le gène i, et Expi indique la valeur d'expression génique respective. Les individus ont ensuite été répartis en deux groupes : à haut risque et à faible risque, en utilisant le score médian de risque comme seuil de division. Ensuite, des courbes caractéristiques de fonctionnement du récepteur (ROC) dépendant du temps ont été établies. Afin d'évaluer le risque de surajustement, une validation interne par rééchantillonnage bootstrap comprenant 1 000 itérations a été réalisée afin de calculer l'indice C corrigé du biais et les AUC dépendant du temps, avec des intervalles de confiance à 95 %. Des courbes de calibration ont été générées pour évaluer la concordance entre les probabilités de survie prédites et observées à 2, 3 et 5 ans. De plus, une analyse de courbe décisionnelle (DCA) a été effectuée à l'aide du package ggDCA dans R afin d'évaluer le bénéfice net clinique du modèle aux points temporels de 2, 3 et 5 ans, quantifiant ainsi la valeur potentielle du score de risque dans la prise de décision clinique selon différentes probabilités seuils. Les différences de survie entre les groupes stratifiés par risque et selon d'autres catégories cliniques ont été comparées à l'aide de courbes de survie de Kaplan-Meier (KM) avec un test du log-rank. En outre, l'analyse Shapley Additive exPlanations (SHAP) a été utilisée afin d'élucider la contribution individuelle des gènes à la performance du modèle, permettant une interprétation explicative a posteriori.
Développement et validation externe d'un nomogramme
Les relations entre les scores de risque calculés et diverses caractéristiques cliniques (y compris le sexe, l'âge et le stade TNM) ont été examinées à l'aide de tests de Wilcoxon ou de Kruskal-Wallis afin d'évaluer l'applicabilité clinique du modèle. Pour déterminer si le score de risque constituait un facteur pronostique indépendant, les variables cliniques ainsi que le score de risque ont été intégrées dans un modèle de régression de Cox multivariée. Ensuite, un nomogramme pronostique combinant les facteurs de risque cliniques indépendants (par exemple, le stade) et le score de risque génétique a été construit à l'aide du package R regplot afin de personnaliser les prédictions de probabilité de survie. Des courbes de calibration ont été utilisées pour évaluer la concordance entre la probabilité de survie prédite par le nomogramme et les résultats de survie réels. Enfin, la capacité prédictive finale et la généralisabilité du système de nomogramme intégré ont été rigoureusement validées à l'aide de courbes ROC dépendantes du temps et d'analyses exhaustives de sous-groupes cliniques KM à travers les cohortes.
Analyses de l'infiltration immunitaire et des sous-types immunitaires
CIBERSORT, en utilisant la matrice de signatures des gènes des leucocytes (LM22), a été utilisé pour estimer les proportions relatives des 22 types de cellules immunitaires afin d'évaluer l'infiltration des cellules immunitaires chez les patients atteints de LUAD. Les relations entre les niveaux d'expression des gènes pronostiques et l'infiltration immunologique ont été évaluées par une analyse de corrélation de Spearman. Les scores immunitaire, stromal, de pureté tumorale et d'estimation ont été obtenus à l'aide de l'algorithme ESTIMATE, et le test de Wilcoxon a été utilisé pour évaluer les différences entre les groupes à risque. Les patients atteints de LUAD ont été répartis en six sous-types immunitaires à l'aide du package ImmuneSubtypeClassifier16. Le test de Wilcoxon a également été utilisé pour comparer les répartitions des sous-types immunitaires entre les groupes à risque.
Analyses des points de contrôle immunitaires, du score d'immunophénotype et du cycle de l'immunité anticancéreuse
Dans cette étude, le test de Wilcoxon à deux échantillons indépendants a été utilisé pour évaluer 21 gènes de points de contrôle immunitaire17 dans des groupes stratifiés selon le risque, dans le but de caractériser le paysage immunitaire du carcinome pulmonaire à petites cellules (LUAD). Une corrélation de Spearman a permis d'associer les gènes pronostiques candidats aux gènes de points de contrôle immunitaire. Afin d'évaluer les différences de réponse aux inhibiteurs de points de contrôle immunitaires (ICIs) chez les patients atteints de LUAD selon différents niveaux de risque, les données de score immunophénotypique (IPS) pour les traitements anti-PD-1 et anti-CTLA-4 ont été obtenues à partir de The Cancer Immunome Atlas (TCIA)18, et la base de données Tracking Tumor Immunophenotype (TIP)19 a été utilisée pour évaluer l'activité du cycle cancer-immunité, en comparant les scores correspondants entre les groupes à risque.
Analyse des mutations somatiques et de la sensibilité aux médicaments
L'outil de mutations TCGA a extrait les profils de mutations somatiques pour les cas TCGA-LUAD afin d'étudier la variation des motifs de mutation entre les groupes à risque. Le package maftools a permis le traitement et la visualisation des données de mutation. La charge mutationnelle tumorale (TMB) a été déterminée pour chaque échantillon et comparée entre les deux catégories de risque. Une analyse de sensibilité pharmacogénomique a été réalisée à l'aide du package pRRophetic selon la base de données Genomics of Drug Sensitivity in Cancer (GDSC)20. Les concentrations inhibitrices demi-maximales (IC50) pour les médicaments anticancéreux ont été prédites pour chaque patient atteint de LUAD, et les différences entre les groupes de risque ont été quantifiées à l'aide du test de Wilcoxon-Mann-Whitney.
Évaluation des niveaux d'expression de gènes pronostiques
Chaque jeu de données a permis d'évaluer les niveaux de transcrits de gènes candidats sélectionnés liés au résultat. Afin de relier l'expression génique au pronostic des patients, des seuils optimaux ont été déterminés à l'aide de la fonction surv_cutpoint du package R survminer. Sur la base de ces seuils, les cas de CPCA ont été classés en sous-groupes à expression élevée et faible pour les analyses de survie ultérieures.
De plus, cinq paires de tumeurs de carcinome pulmonaire à cellules adénoïdes (LUAD) et tissus normaux adjacents appariés ont été obtenues à l'hôpital thoracique d'Anhui, et une validation par RT-PCR quantitative a ensuite été réalisée. Chaque participant a fourni un consentement éclairé écrit. Six gènes pronostiques candidats (PDGFB, LDHA, ZEB2, FKBP4, DMD et S100B) ont été sélectionnés pour la validation par RT-PCR quantitative. L'ARN a été extrait à partir d'échantillons de tissus homogénéisés à l'aide d'un réactif d'extraction d'ARN, suivi d'une extraction au chloroforme et d'une précipitation à l'isopropanol. Un spectrophotomètre a permis la mesure de la concentration et de la pureté de l'ARN. La validation par RT-PCR quantitative des six gènes pronostiques candidats a été effectuée à l'aide d'un mélange maître PCR basé sur le SYBR Green sur un système de PCR en temps réel : une dénaturation initiale à 95 °C pendant 30 s, suivie de 40 cycles de 95 °C pendant 20 s, 55 °C pendant 20 s et 72 °C pendant 20 s. L'expression relative a été calculée et normalisée par rapport à la Glyceraldehyde-3-Phosphate Dehydrogenase (GAPDH) selon la méthode 2-ΔΔCt. Les détails de tous les réactifs et instruments sont fournis dans le Tableau des Matériaux.
Analyse statistique
Les analyses statistiques ont été réalisées à l'aide d'un logiciel de calcul et de représentation graphique statistiques. Le réseau d'interactions protéine-protéine a été visualisé à l'aide d'un logiciel d'analyse de réseaux. Après évaluation de la normalité, le test t de Student a été utilisé pour les variables continues normalement distribuées, et le test de Mann-Whitney U pour celles ne suivant pas une distribution normale.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Identification des gènes candidats et analyse fonctionnelle
Un total de 4 915 GDE a été détecté, dont 2 485 GDE surexprimés et 2 430 GDE sous-exprimés (Figure 1A). L'analyse de regroupement par modules fonctionnels a classé ces GDE en six modules d'expression (C1-C6), parmi lesquels les modules C1, C2, C3 et C5 présentaient une expression relativement plus élevée dans les échantillons tumoraux (Figure 1B). L'annotatio...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Le CUPA fait partie des formes les plus fréquentes de cancer du poumon et continue de représenter un fardeau important pour la santé publique21. La MC est un processus lié à la mort cellulaire qui pourrait contribuer à l'élimination des cellules présentant de graves anomalies mitotiques et à la suppression de la progression tumorale22. Par conséquent, explorer le rôle potentiel des gènes liés à la MC dans le CUPA pourrait aider à identifier des biomarqueurs pronostiques et ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir de conflits d'intérêts.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| ClusterGVis | CRAN | version 0.1.2 | Regroupement et visualisation de l'expression génique |
| Cytoscape | Cytoscape Consortium | version 3.9.1 | Visualisation des réseaux d'interactions protéiques RRID:SCR_003032 |
| CFX384 Real-Time Quantitative Fluorescent PCR System | Bio-Rad | CFX384 Touch | réactif de qPCR |
| DMD-primer | Tsingke | N/A | Sens : 5’-GCTCAACCATCGATTTGCAGCC-3’ Anti-sens : 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| FKBP4-primer | Tsingke | N/A | Sens : 5’-TGACTCCAGTCTGGATCGCAAG-3’ Anti-sens : 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | Outil en ligne | Obtention du jeu de données de validation externe LUAD RRID:SCR_005012 |
| GAPDH-primer | Tsingke | N/A | Sens : 5’-GTCTCCTCTGACTTCAACAGCG-3’ Anti-sens : 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | version 4.1-8 | Sélection de caractéristiques en régression LASSO RRID:SCR_015505 |
| LDHA-primer | Tsingke | N/A | Sens : 5’-GGATCTCCAACATGGCAGCCTT-3’ Anti-sens : 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | version 3.60.6 | Recherche de gènes différentiellement exprimés RRID:SCR_010943 |
| maftools | Bioconductor | version 2.20.0 | Visualisation des données de mutations somatiques RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | Prédiction des valeurs d'IC50 des médicaments RRID:SCR_024417 |
| PDGFB-primer | Tsingke | N/A | Sens : 5’-GAGATGCTGAGTGACCACTCGA-3’ Anti-sens : 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| qPCR SYBR Green Master Mix | Vazyme | Q111-02 | réactif de qPCR |
| R software | R Foundation | version 4.2.2 | Analyse bioinformatique |
| regplot | CRAN | version 1.1 | Création de graphiques linéaires |
| survival | CRAN | version 3.8-3 | Analyse de survie et régression de Cox RRID:SCR_021137 |
| STRING | STRING Consortium | Outil en ligne | Analyse du réseau d'interactions protéiques RRID:SCR_005223 |
| S100B-primer | Tsingke | N/A | Sens : 5’-GAAGAAATCCGAACTGAAGGAGC-3’ Anti-sens : 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | version 0.5.0 | Tracé et optimisation des courbes de survie RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | réactif de qPCR |
| TCGA | NCI | Outil en ligne | Acquisition des données transcriptomiques et cliniques de LUAD RRID:SCR_003193 |
| ZEB2-primer | Tsingke | N/A | Sens : 5’-AATGCACAGAGTGTGGCAAGGC-3’ Anti-sens : 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
Références
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Réimpressions et autorisations
Cet article a été publié
Vidéo bientôt disponible