Ce protocole fournit un questionnaire reproductible et un flux de travail de modélisation structurelle partielle des moindres carrés pour évaluer les voies d’association entre l’expérience d’apprentissage en ligne, les besoins psychologiques fondamentaux et l’engagement dans l’apprentissage chez les étudiants universitaires, y compris l’adaptation par questionnaire, le dépistage, l’évaluation de mesures, les tests d’association indirecte, les vérifications de robustesse et les enregistrements de reproductibilité.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Une enquête et un protocole pour évaluer l’expérience d’apprentissage en ligne, les besoins psychologiques fondamentaux et l’engagement dans l’apprentissage chez les étudiants universitaires
Dans cet article
Résumé
Résumé
L’apprentissage en ligne est intégré dans l’enseignement supérieur, mais les évaluations reposent souvent sur des indicateurs d’accès, de satisfaction ou de réussite qui ne permettent pas d’identifier les problèmes d’engagement. Cet article présente une enquête reproductible en anglais et un protocole de modélisation structurelle des moindres carrés partiels pour évaluer les voies d’association entre l’expérience d’apprentissage en ligne, les besoins psychologiques fondamentaux et l’engagement à l’apprentissage chez les étudiants universitaires. L’expérience d’apprentissage en ligne se mesure à travers l’utilisabilité de la plateforme, le soutien pédagogique, la qualité de l’interaction et la flexibilité d’apprentissage ; les besoins psychologiques fondamentaux par l’autonomie, la compétence et la relation ; et l’engagement d’apprentissage par l’engagement comportemental, cognitif et émotionnel. Le flux de travail spécifie la cartographie source-élément, l’adaptation au questionnaire, la revue d’experts, les tests pilotes, le consentement électronique, le contrôle d’éligibilité, les contrôles de qualité des réponses, la notation des constructs, le diagnostic des biais de méthode courante, l’estimation des constructs d’ordre supérieur, l’évaluation des modèles de mesure, les tests des voies structurelles, l’analyse indirecte des associations, l’analyse de sensibilité des besoins psychologiques, les vérifications de robustesse basées sur la régression et le verrouillage de fichiers de reproductibilité. Les résultats représentatifs de 386 réponses valides démontrent une fiabilité acceptable, des corrélations modérées entre les constructs, une qualité de mesure conservée, une association indirecte soutenue par des besoins psychologiques fondamentaux, des chemins de contrôle non significatifs et des scores dimensionnels inégals. Le protocole soutient un diagnostic transparent de la manière dont l’expérience d’apprentissage en ligne est associée à la satisfaction et à l’engagement des besoins psychologiques, tout en évitant l’interprétation causale à partir des données d’enquête transversales.
Introduction
L’apprentissage en ligne est devenu une partie intégrante de l’enseignement supérieur de routine grâce à des systèmes de gestion de l’apprentissage, des plateformes vidéo, des supports enregistrés, des sessions synchrones et des conceptions de cours hybrides. Cependant, de nombreuses évaluations reposent encore sur des journaux d’accès, des notes de satisfaction ou des indicateurs de réussite, qui indiquent si les étudiants ont utilisé un cours en ligne sans préciser si une baisse d’engagement est liée à l’utilisabilité de la plateforme, au soutien pédagogique, à la qualité de l’interaction, à la flexibilité d’apprentissage, à la satisfaction des besoins psychologiques ou à une dimension spécifique de l’engagement1. L’expérience d’apprentissage en ligne ne devrait donc pas être réduite à un seul score de satisfaction. Les recherches antérieures sur l’engagement en ligne mettent l’accent sur l’interaction entre apprenant, apprenant-enseignant et apprentissage comme éléments importants de l’expérience d’apprentissage en lignedes étudiants 2. Le protocole actuel mesure l’expérience d’apprentissage en ligne à travers l’utilisabilité de la plateforme, le soutien pédagogique, la qualité de l’interaction et la flexibilité de l’apprentissage.
L’engagement dans l’apprentissage est également multidimensionnel. Cela inclut la participation comportementale, l’investissement cognitif et l’implication émotionnelle. Les instruments d’engagement des cours en ligne montrent que l’engagement ne peut pas être pleinement représenté uniquement par la participation visible ou l’accomplissement des tâches3. Des recherches plus larges sur les technologies éducatives montrent également que l’engagement comportemental est souvent plus facile à observer que l’engagement cognitif ouaffectif 4. Pour cette raison, le protocole mesure l’engagement de l’apprentissage à travers un engagement comportemental, cognitif et émotionnel, plutôt que de réduire l’engagement en un seul score non différencié.
La théorie de l’autodétermination fournit la base théorique pour lier l’expérience d’apprentissage en ligne à l’engagement dans l’apprentissage. La théorie des besoins psychologiques fondamentaux identifie l’autonomie, la compétence et la relation comme des conditions centrales de motivation etd’ajustement 5. Dans l’apprentissage en ligne, l’autonomie fait référence au choix et au contrôle perçus, de la compétence à la capacité perçue à accomplir des tâches d’apprentissage, et à la relation avec la connexion ressentie avec les enseignants et les camarades. Des études antérieures d’apprentissage en ligne utilisant la théorie de l’autodétermination ont lié le soutien contextuel, la satisfaction des besoins, la motivation et l’engagement 6,7. Ces résultats soutiennent l’examen des besoins psychologiques fondamentaux comme un construct d’association indirecte entre l’expérience d’apprentissage en ligne et l’engagement dans l’apprentissage, tout en évitant l’interprétation causale car les données sont transversales.
Un problème méthodologique dans la recherche sur l’engagement en ligne est l’absence d’une structure opérationnelle cohérente. Les études varient dans la manière dont elles définissent les conditions d’apprentissage, mesurent l’engagement et relient l’environnement d’apprentissage à l’expérience psychologique desélèves 8. Les enquêtes auto-déclarées sont également vulnérables à des réponses négligentes, des réponses structurées, des exclusions post hoc, des décisions liées à des données manquantes et à un biais de méthodecourant 9. Par conséquent, ce protocole fixe la structure du questionnaire en anglais, la cartographie source-item, les règles de notation, la procédure de consentement électronique, le filtrage d’éligibilité, la règle de contrôle d’attention, le seuil de temps d’achèvement, le critère de ligne droite, la vérification de réponse à longue chaîne, la gestion des données manquantes, la spécification du modèle et la procédure de verrouillage des ensembles de données avant le début de l’analyse structurelle.
Le cadre conceptuel spécifie l’expérience d’apprentissage en ligne comme le construct indépendant, les besoins psychologiques fondamentaux comme le construct d’association indirecte, et l’engagement de l’apprentissage comme le construct du résultat. La voie principale teste si l’expérience d’apprentissage en ligne est associée à des besoins psychologiques fondamentaux, si les besoins psychologiques fondamentaux sont associés à l’engagement à l’apprentissage, et si l’expérience d’apprentissage en ligne reste directement liée à l’engagement après avoir pris en compte les besoins psychologiques fondamentaux. Le protocole repose sur quatre questions de recherche : le protocole d’enquête structurée peut-il mesurer les trois constructions avec une qualité de réponse acceptable et une fiabilité du bâtiment ; si l’expérience d’apprentissage en ligne est positivement associée à des besoins psychologiques fondamentaux et à l’engagement dans l’apprentissage ; si l’association entre l’expérience d’apprentissage en ligne et l’engagement à l’apprentissage se fait en partie par des besoins psychologiques fondamentaux en tant qu’association indirecte ; et si les analyses de sous-dimension psychologiques et les vérifications de robustesse basées sur la régression soutiennent la même interprétation que le flux de travail principal PLS-SEM.
Cet article est présenté comme une contribution axée sur la méthode plutôt que comme une étude transversale explicative conventionnelle. Le protocole offre un flux de travail reproductible pour l’adaptation du questionnaire, la revue d’experts, les tests pilotes, l’administration d’enquêtes, le criblage des réponses, la notation des constructs, l’évaluation des modèles de mesure, les tests des voies structurales, l’analyse indirecte, l’analyse de sensibilité, la vérification de robustesse et le verrouillage de fichiers de reproductibilité. Des flux de travail transparents en recherche éducative exigent que les décisions analytiques soient documentées avant l’interprétation finale dumodèle 10. La modélisation structurelle par moindres carrés partiels est utilisée car elle permet d’examiner les composantes de mesure et structurelles dans un seul flux de travail, avec des constructions réfléchissantes du premier ordre et des scores analytiques dérivés de constructs d’ordre supérieur via une approche disjointe endeux étapes 11. Des travaux antérieurs sur l’engagement des étudiants en ligne, la présence sociale, le soutien aux apprenants et la fidélisation montrent que la communication, le soutien, la connexion et la conception inclusive des cours comptent au-delà de l’accès simple ou de laflexibilité 12,13. Les revues systématiques indiquent également que l’engagement comportemental, cognitif et émotionnel peut répondre différemment aux conditions d’apprentissageen ligne 14. Les résultats représentatifs sont donc utilisés uniquement pour démontrer le résultat du protocole, et non pour revendiquer des effets causaux à partir de données d’enquêtetransversales 15.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Le protocole de l’étude a été examiné et approuvé par le Comité d’éthique de la recherche (non médicale) de l’Université de Malaisie sous le numéro d’approbation UM. TNC (P&I)/UMREC_4892 le 7 août 2025. Mener toutes les procédures conformément aux directives institutionnelles pour la recherche impliquant des participants humains. Obtenez un consentement éclairé électronique avant d’administrer le questionnaire. Utilisez des codes de participants anonymes lors du recrutement, du sélection, du notage, de l’analyse et du stockage des fichiers. Les outils et logiciels de recherche sont listés dans le tableau des matériaux.
1. Définir la conception de l’étude et le cadre analytique
- Utilisez un questionnaire quantitatif transversal pour évaluer les parcours d’association entre l’expérience d’apprentissage en ligne, les besoins psychologiques fondamentaux et l’engagement à l’apprentissage chez les étudiants universitaires.
- Définissez l’expérience d’apprentissage en ligne comme le construct latent indépendant, les besoins psychologiques fondamentaux comme le construct latent à association indirecte, et l’engagement à l’apprentissage comme le construct latent résultat.
- Spécifiez les trois constructions multidimensionnelles avant la collecte des données. Représenter l’expérience d’apprentissage en ligne par l’ergonomie de la plateforme, le soutien pédagogique, la qualité de l’interaction et la flexibilité de l’apprentissage ; besoins psychologiques fondamentaux par le besoin d’autonomie, le besoin de compétence et le besoin de relation ; et l’engagement de l’apprentissage par l’engagement comportemental, cognitif et émotionnel.
- Utilisez la modélisation structurelle des moindres carrés partiels comme méthode analytique principale pour évaluer la qualité de la mesure, les scores des constructs d’ordre supérieur, les trajectoires structurelles et la voie indirecte prédéfinie.
- Précisez le parcours principal avant l’analyse : expérience d’apprentissage en ligne → besoins psychologiques fondamentaux, besoins psychologiques fondamentaux → engagement à l’apprentissage, et expérience d’apprentissage en ligne → engagement en apprentissage.
- Considérez tous les chemins structurels comme des estimations d’association. N’interprétez aucune voie comme causale car toutes les variables sont mesurées à un seul moment. Effectuez une vérification préalable de la taille de l’échantillon et de la puissance avant le recrutement. Utilisez au moins 380 réponses valides comme échantillon cible et 350 réponses valides comme échantillon minimum acceptable après le dépistage.
- Présentez le flux de travail du protocole à la Figure 1, incluant le recrutement, le consentement, l’administration du questionnaire, la revue d’experts, les tests pilotes, le criblage des réponses, le verrouillage des ensembles de données, l’évaluation des mesures, les tests structurels, l’analyse indirecte, la vérification de la robustesse et la préparation des fichiers de reproductibilité.
REMARQUE : Maintenir le modèle conceptuel et les parcours structurels inchangés, de la construction du questionnaire jusqu’à l’analyse finale.
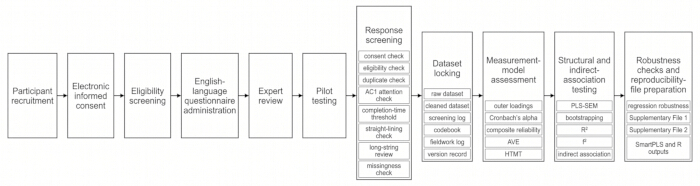
Figure 1 : Flux de travail opérationnel pour évaluer l’expérience d’apprentissage en ligne, les besoins psychologiques fondamentaux et l’engagement dans l’apprentissage. La figure montre le flux de travail du protocole, du recrutement, du consentement, de l’administration du questionnaire, de la revue d’experts, des tests pilotes, du criblage des réponses et du verrouillage des ensembles de données jusqu’à l’évaluation des mesures, les tests structurels, l’analyse indirecte des associations, la vérification de la robustesse et la préparation des fichiers de reproductibilité. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
2. Recruter des participants éligibles
- Recrutez des étudiants universitaires ayant suivi au moins un cours en ligne ou mixte au cours du semestre académique en cours ou le plus récent.
- Incluez les participants âgés de 18 ans ou plus, actuellement inscrits en licence ou en master, exposés à l’apprentissage en ligne ou hybride, capables de lire le questionnaire en anglais et prêts à fournir leur consentement éclairé électroniquement.
- Excluez les réponses lorsque le consentement n’est pas confirmé, que les critères d’éligibilité ne sont pas remplis, que l’élément de vérification d’attention est échoué, qu’une soumission en double est détectée, que le délai de complétion est inférieur au seuil prédéfini, que le contournement est détecté, ou qu’une incohérence d’éligibilité non résolue est présente.
- Recrutez des participants via des plateformes d’apprentissage universitaires, des groupes de communication de cours, des listes d’emails étudiantes et des canaux institutionnels pour les étudiants.
- Ne collectez pas d’identifiants directs, y compris les noms, numéros d’identification étudiants, numéros de téléphone, adresses e-mail privées, adresses résidentielles exactes, adresses IP, identifiants d’appareils ou identifiants de compte.
- Consignez les dates de recrutement, les canaux de recrutement, les réponses soumises, le nombre d’exclusions par catégorie, les réponses conservées, ainsi que la taille finale valide de l’échantillon dans le journal de travail de terrain et le journal de sélection.
POINT DE PAUSE : Vérifiez l’avancement du recrutement chaque semaine. Examinez uniquement le nombre de réponses, la couverture des chaînes de recrutement et le taux d’exclusion préliminaire. N’inspectez pas les scores de construction, les corrélations ou les estimations de parcours lors du recrutement.
3. Construire le questionnaire
- Préparez un questionnaire structuré en anglais avec consentement éclairé électronique, un contrôle d’éligibilité, des informations de fond des participants, des items sur l’échelle substantielle et un item de contrôle d’attention basé sur l’instruction.
- Utilisez une échelle de réponse de Likert à 5 points pour tous les éléments substantiels : 1 = fortement en désaccord, 2 = désaccord, 3 = neutre, 4 = d’accord et 5 = fortement d’accord.
- Adapter les éléments d’expérience d’apprentissage en ligne à partir de mesures antérieures de perception de l’apprentissage en ligne, du soutien pédagogique, de la qualité de l’interaction, de l’ergonomie de la plateforme et de la flexibilité d’apprentissage. Adapter les besoins psychologiques de base à partir des mesures établies d’autonomie, de compétence et de relation. Adapter les items d’engagement d’apprentissage à partir de mesures comportementales, cognitives et émotionnelles établies.
- Corrigez uniquement la formulation des items pour qu’elle corresponde aux contextes universitaires en ligne et à l’apprentissage mixte. Utilisez des formulations claires, non suggestives, et évitez celles qui impliquent une grande satisfaction, un besoin psychologique élevé ou un engagement élevé attendu.
- Préparez une table de cartographie source-items avant les essais pilotes. Consignez le code d’item, la construction, la dimension, la formulation adaptée, la base de la source, la note d’adaptation, le texte du questionnaire et la direction de notation pour chaque élément substantiel.
- Utilisez 33 items substantiels de l’échelle Likert : 12 pour l’expérience d’apprentissage en ligne, neuf pour les besoins psychologiques de base et 12 pour l’engagement à l’apprentissage. Utilisez trois éléments pour chaque dimension de l’expérience d’apprentissage en ligne, trois éléments pour chaque dimension des besoins psychologiques de base, et quatre éléments pour chaque dimension d’engagement apprenant.
- Placez un élément de contrôle d’attention basé sur l’enseignement après le blocage des besoins psychologiques de base. Utilisez cet élément uniquement pour le criblage de la qualité de la réponse et excluez-le du notation des constructs, de l’analyse de fiabilité, de l’analyse de validité, de l’estimation PLS-SEM, des tests d’association indirecte et de l’analyse de robustesse.
- Limitez le temps de remplissage prévu du questionnaire entre 8 et 12 minutes pendant les essais pilotes. Utilisez le tableau 1 pour documenter les domaines de construction, les dimensions, les codes d’items, le nombre d’items, l’échelle de réponse, la direction de notation et la base d’adaptation. Utilisez le Fichier Supplémentaire 1 pour fournir le questionnaire complet, la correspondance item-source, le codage variable et les règles de notation.
REMARQUE : Gardez conceptuellement distincts les éléments prédicteurs, d’associations indirectes et de résultats.
Tableau 1 : Construire les domaines, les dimensions, la structure du questionnaire et les règles de notation. Ce tableau résume la structure du questionnaire, incluant les domaines et dimensions des constructs, les codes et numéros d’items, les items d’exemple, la base d’adaptation, l’échelle de réponse et les règles de notation. L’élément de contrôle d’attention est identifié comme un élément uniquement de filtrage. Veuillez cliquer ici pour télécharger ce tableau.
4. Effectuer des examens d’experts et des essais pilotes
- Invitez trois à cinq experts en psychologie de l’éducation, apprentissage en ligne, méthodologie quantitative, recherche en enseignement supérieur ou conception d’enquêtes à examiner le questionnaire.
- Demandez aux experts d’évaluer la clarté des items, de construire leur pertinence, la redondance de formulation, la charge de réponse, l’adéquation culturelle, la clarté linguistique et l’alignement entre chaque élément et sa dimension attribuée.
- Consignez les résultats des revues d’experts dans un journal de révision des éléments, y compris la formulation originale, la préoccupation du réviseur, la décision de révision, la formulation finale et la raison de la conservation, de la révision ou de la suppression.
- Révisez les éléments ambigus, à double barreau, trop similaires, culturellement inappropriés, faiblement alignés avec la dimension cible, ou incompatibles avec le contexte de l’enquête anglophone.
- Réaliser un test pilote avec 30 à 50 étudiants universitaires remplissant les mêmes critères d’éligibilité que l’étude principale. Demandez aux participants pilotes d’identifier des formulations peu claires, des problèmes techniques d’affichage, une longueur excessive, des formulations répétitives ou un inconfort causé par un élément du questionnaire.
- Enregistrez le temps de fin de pilote pour chaque participant. Définir le seuil minimum de temps d’achèvement de l’étude formelle comme la valeur la plus grande comprise entre 3 minutes et un tiers du temps médian de complétion du pilote.
- Calculez la cohérence interne préliminaire pour chaque construction et inspectez les corrélations entre le total d’items après les tests pilotes. Révisez ou retirez les éléments faibles uniquement lorsque la suppression améliore la qualité des mesures et n’affaiblit pas la couverture des constructs.
- Finaliser et verrouiller le questionnaire, le codebook, la cartographie source-items, le journal d’évaluation expert, le dossier du test pilote, le seuil de temps d’achèvement, la règle de vérification d’attention, la règle de détection des doublons et les critères d’exclusion avant le recrutement formel.
POINT DE PAUSE : Ne commencez pas le recrutement formel tant que tous les questionnaires, fichiers de sélection et de codage n’ont pas été verrouillés.
5. Administrer le questionnaire en ligne
- Intégrez le questionnaire dans un système d’enquête en ligne qui supporte la participation anonyme, la confirmation de consentement, le filtrage d’éligibilité, les paramètres de réponse requise, l’enregistrement du temps de réponse, la restriction des soumissions non identifiantes, le placement par vérification d’attention et l’exportation des tableurs.
- Placez le consentement éclairé électronique avant les questions de sélection et de questionnaire. Permettre aux participants de poursuivre uniquement après confirmation de leur participation volontaire et présenter l’objectif de l’étude dans un langage neutre. Déclarez que l’étude examine la perception des élèves concernant l’apprentissage en ligne, la satisfaction des besoins psychologiques et l’engagement dans l’apprentissage.
- Définissez les questions de consentement, d’éligibilité et les 33 éléments substantiels de l’échelle Likert comme champs obligatoires. Désactivez les champs pour les informations d’identification directe. Ne demandez pas de noms, numéros d’étudiants, numéros de téléphone, adresses e-mail privées, adresses résidentielles exactes, adresses IP, identifiants d’appareil ou identifiants de compte.
- Permettre aux participants de quitter le questionnaire avant la soumission finale sans pénalité. Limitez les soumissions répétées uniquement via des paramètres non identifiants de la plateforme d’enquête lorsque disponibles. Gardez le questionnaire ouvert pendant 4 à 6 semaines. Surveillez les décomptes de réponses deux fois par semaine et documentez l’avancement du recrutement dans le journal de travail de terrain.
REMARQUE : Ne fournissez pas de retour personnel sur votre score après la soumission du questionnaire.
6. Exporter et protéger les données brutes
- Exportez toutes les réponses soumises en formats .xlsx et .csv immédiatement après la clôture du recrutement.
- Sauvegardez un fichier .xlsx non modifié en tant que RawData_OnlineLearning_BPN_Engagement_YYYYMMDD.xlsx et un fichier .csv non modifié en tant que RawData_OnlineLearning_BPN_Engagement_YYYYMMDD.csv.
- Créez une copie fonctionnelle pour le filtrage, le codage et l’analyse. Nommez-la WorkingData_OnlineLearning_BPN_Engagement_YYYYMMDD.xlsx. Attribuez à chaque réponse soumise un code participant anonyme au format P001, P002, P003, etc.
- Stockez le jeu de données brut dans un dossier en lecture seule et créez une somme de contrôle, un enregistrement de version du fichier ou un historique des versions institutionnel avant le début du filtrage.
- Conservez les métadonnées brutes d’archives d’archives et de dépistage des dossiers soumis non identifiées dans le dossier de vérification institutionnel protégé. N’incluez pas les documents bruts exclus, les informations directement identifiables ou les données brutes au niveau des participants dans le manuscrit ou les fichiers complémentaires soumis pour publication.
POINT DE PAUSE : Ne commencez pas à filtrer tant que le fichier brut .xlsx , le fichier brut .csv, le journal de travail sur le terrain, l’enregistrement de version des données brutes et le dossier de données brutes protégées n’ont pas été sauvegardés.
7. Filtrer les réponses et appliquer les règles d’exclusion
- Appliquer toutes les règles d’exclusion avant d’examiner les corrélations des constructs, la sortie des modèles de mesure, les chemins structurels ou les estimations d’associations indirectes. Supprimer les réponses sans confirmation de consentement ou sans âge, inscription, exposition à l’apprentissage en ligne ou éligibilité au questionnaire linguistique.
- Supprimez les réponses en double selon la règle de détection des doublons prédéfinie. Identifier les doublons possibles uniquement par des drapeaux de doublons non identifiants de la plateforme d’enquête et des informations anonymes sur les schémas de réponse. Conserver la réponse complète la plus précoce lorsque des réponses en double sont identifiées.
- Supprimez les réponses qui échouent à l’élément de vérification d’attention basé sur l’instruction ou qui sont complétées en dessous du seuil minimal de temps d’achèvement de l’étude formelle. Définissez la ligne droite comme sélectionnant la même option de réponse pour au moins 90 % des 33 éléments substantiels de l’échelle Likert. Supprimez les réponses qui répondent à ce critère.
- Signalez les motifs de réponse à longues chaînes lorsque la même option de réponse est sélectionnée pourr 20 ou plus d’éléments substantiels consécutifs à l’échelle Likert. Supprimer les réponses signalées uniquement lorsqu’elles montrent également un temps d’achèvement improbablement court, un échec à la vérification d’attention, un alignement ou une autre violation de qualité prédéfinie.
- Signalez des réponses de fond incohérentes lorsque le participant déclare ne pas avoir d’exposition à l’apprentissage en ligne ou à l’apprentissage mixte mais signale des heures d’apprentissage hebdomadaires en ligne supérieures à zéro. Supprimez les réponses avec des incohérences d’éligibilité non résolues.
- Consignez chaque cas exclu dans un registre de dépistage désidentifié avec un code de participant anonyme, une catégorie d’exclusion, un motif d’exclusion, une date de dépistage et une décision de dépistage.
- Utilisez le tableau 2 pour documenter les réponses soumises, les catégories d’exclusion, le nombre d’exclusions, les réponses conservées et la taille finale valide de l’échantillon. Si les comptages bruts d’exclusions ne peuvent pas être reconstruits pour le jeu de données représentatif, énoncéez-le explicitement.
REMARQUE : Excluez les cas uniquement selon des règles prédéfinies de consentement, d’éligibilité, de doublon, de contrôle d’attention, de temps de complétude, de schéma de réponse, de manque ou de cohérence. Ne commencez pas à coder tant que le jeu de données brut, le jeu de données nettoyé, le journal de filtrage, le fichier de règles d’exclusion, le journal de travail de terrain et l’enregistrement de version de l’ensemble de données n’ont pas été sauvegardés séparément et verrouillés.
Tableau 2 : Filtrage des réponses, règles d’exclusion et décisions de gestion des données. Ce tableau résume les règles de sélection prédéfinies et les décisions de gestion des données concernant le consentement, l’éligibilité, les réponses dupliquées, la vérification de l’attention, le temps d’achèvement, les vérifications des schémas de réponse, l’absence et le verrouillage des ensembles de données. Des règles d’exclusion sont appliquées avant d’examiner les corrélations construct, la sortie des modèles de mesure, les chemins structurels ou les estimations d’associations indirectes. Chaque réponse exclue est enregistrée dans un registre de dépistage désidentifié en utilisant le code du participant anonyme, la catégorie d’exclusion, le motif d’exclusion, la date de dépistage et la décision de prévision. Veuillez cliquer ici pour télécharger ce tableau.
8. Gérer les données manquantes
- Évitez l’absence de valeurs dans les questions de consentement, d’éligibilité et les 33 éléments substantiels de l’échelle de Likert en définissant ces champs comme requis dans le système d’enquête. Inspectez le jeu de données nettoyé pour détecter des valeurs manquantes après le filtrage.
- Considérez les valeurs manquantes dans les variables d’arrière-plan optionnelles comme « non déclarées ». N’intervenez pas de variables démographiques ou de contexte optionnelles.
- Excluez une variable de fond de l’analyse des covariables si son taux de manque dépasse 10 %. Conservez une variable de fond comme covariée seulement lorsque son taux manquant est de 10 % ou moins et que la variable est théoriquement pertinente.
- Ne pas imputer les valeurs manquantes dans les 33 items substantiels de l’échelle de Likert. Si une absence substantielle d’élément est détectée malgré les paramètres de réponse requise, identifiez si le problème est causé par l’exportation d’enquête, la logique de l’enquête ou une gestion incomplète des soumissions avant de finaliser le jeu de données nettoyé.
REMARQUE : Enregistrez la vérification des données manquantes. Rapportez le nombre de valeurs manquantes et le taux manquant pour le code des participants, les variables de fond, les éléments substantiels de l’échelle Likert, les scores dimensionnels et les scores globaux des constructs.
9. Coder les variables et calculer les scores
- Codez tous les éléments substantiels de l’échelle de Likert de 1 à 5 : 1 = fortement en désaccord, 2 = désaccord, 3 = neutre, 4 = d’accord, et 5 = fortement d’accord. Code genre, niveau académique, année d’études, catégorie disciplinaire, heures hebdomadaires d’apprentissage en ligne et expériences d’apprentissage en ligne antérieures selon le code verrouillé.
- Inspectez toutes les variables pour détecter des valeurs hors plage avant de calculer les scores dimensionnels ou globaux des constructs.
- Calculez les scores de dimension de l’expérience d’apprentissage en ligne comme moyens d’éléments : utilisabilité de plateforme = moyenne(OLE_PU1–OLE_PU3), support pédagogique = moyenne(OLE_IS1–OLE_IS3), qualité d’interaction = moyenne(OLE_IQ1–OLE_IQ3), et flexibilité d’apprentissage = moyenne(OLE_LF1–OLE_LF3).
- Calculez les scores de dimension des besoins psychologiques de base comme des moyens d’ítems : besoin d’autonomie = moyenne(BPN_AU1–BPN_AU3), besoin de compétence = moyen(BPN_CO1–BPN_CO3), et besoin de parenté = moyen(BPN_RE1–BPN_RE3).
- Calculez les scores de la dimension d’engagement d’apprentissage comme moyens d’items : engagement comportemental = moyenne(LE_BE1–LE_BE4), engagement cognitif = moyen(LE_CE1–LE_CE4), et engagement émotionnel = moyen(LE_EE1–LE_EE4).
- Calculer les scores globaux des constructs comme moyennes dimensionnelles : expérience d’apprentissage en ligne = moyenne (utilisabilité de la plateforme, soutien pédagogique, qualité d’interaction, flexibilité d’apprentissage) ; Besoins psychologiques de base = Moyen (besoin d’autonomie, besoin de compétence, besoin de relation) ; et engagement dans l’apprentissage = moyenne (engagement comportemental, engagement cognitif, engagement émotionnel).
- Conserver les données au niveau des items pour l’évaluation des modèles de mesure, les scores dimensionnels pour l’estimation des constructs d’ordre supérieur et l’analyse des sous-dimensions, ainsi que les scores globaux des constructs pour les statistiques descriptives, l’analyse de corrélation, la vérification des modèles structurels et l’analyse de robustesse basée sur la régression.
REMARQUE : N’incluez pas l’élément de vérification d’attention dans aucun score, analyse de fiabilité, analyse de validité, estimation PLS-SEM, analyse d’association indirecte ou analyse de robustesse. Ne standardisez pas les scores originaux de 1 à 5 avant l’analyse descriptive.
10. Contrôler et évaluer le biais de méthode courant
- Appliquer des contrôles procéduraux avant analyse en utilisant des réponses anonymes, une formulation neutre, des blocs constructs séparés, un élément de vérification d’attention basé sur des instructions, des paramètres de réponse requise et un accès restreint aux données brutes.
- Après le criblage des réponses, utilisez le test à facteur unique de Harman pour examiner si un facteur non roté représente une part dominante de la variance des items. Considérez le résultat comme acceptable lorsque le premier facteur non roté représente moins de 50 % de la variance totale.
- Calculez les valeurs complètes du facteur d’inflation de variance de collinéarité pour les constructions focales. Considérez les valeurs inférieures à 3,30 comme indiquant qu’un biais de méthode courant sévère est peu probable. Notez le biais de méthode commune comme limitation si le premier facteur non roté représente 50 % ou plus de la variance totale ou si tout facteur d’inflation de la variance de collinéarité est de 3,30 ou plus.
REMARQUE : Ne dites pas que le biais courant de méthode est absent. Indiquez seulement si les diagnostics indiquent une preuve sévère d’un facteur de méthode commun dominant.
11. Effectuer des vérifications descriptives et préliminaires
- Utilisez R 4.4.1 pour les statistiques descriptives, les contrôles de distribution, l’analyse de corrélation et l’analyse de robustesse basée sur la régression. Calculez les fréquences et pourcentages pour les caractéristiques catégoriques des participants.
- Calculez la moyenne, l’écart-type, le minimum, le maximum, l’asietrie et la kurtose pour les éléments substantiels, les scores dimensionnels et les scores globaux des constructions.
- Inspectez les distributions des items et des scores pour les effets de plancher, les effets de plafond et la non-normalité sévère. Définissez un effet potentiel de plancher ou de plafond comme plus de 20 % des participants choisissant l’option de réponse la plus faible ou la plus élevée pour un élément substantiel.
- Calculez les corrélations de Pearson entre les constructs globaux et les scores dimensionnels. Considérez les corrélations comme des preuves descriptives préliminaires uniquement et ne les utilisez pas comme substitut au modèle structurel prédéfini.
REMARQUE : Enregistrer les effets de plancher ou de plafond comme caractéristiques de données. Ne supprimez pas les cas pour des raisons de distribution, sauf s’ils enfreignent également les règles prédéfinies de qualité de réponse.
12. Estimation du modèle de mesure d’ordre supérieur
- Utilisez Smart PLS 4.1 pour l’analyse PLS-SEM primaire et importez le jeu de données nettoyé au niveau des items. Spécifiez l’ergonomie de la plateforme, le soutien pédagogique, la qualité de l’interaction, la flexibilité d’apprentissage, le besoin d’autonomie, le besoin de compétences, le besoin de lien, l’engagement comportemental, l’engagement cognitif et l’engagement émotionnel comme des concepts réflexifs de premier ordre.
- Utilisez l’approche disjointe en deux étapes. Lors de la première étape, estimez les constructions réfléchissantes du premier ordre et enregistrez leurs scores en variables latentes.
- Dans la deuxième étape, utiliser des scores variables latents tels que l’utilisabilité de la plateforme, le soutien pédagogique, la qualité de l’interaction et la flexibilité d’apprentissage pour représenter l’expérience d’apprentissage en ligne ; les scores variables latentes de besoin d’autonomie, besoin de compétence et de relation doivent représenter des besoins psychologiques fondamentaux ; et les scores variables latentes tels que l’engagement comportemental, l’engagement cognitif et l’engagement émotionnel représentent l’engagement dans l’apprentissage.
- Considérer les scores de constructs d’ordre supérieur comme des représentations analytiques de constructions multidimensionnelles. Ne les décrivez pas comme formatifs à moins qu’un modèle formatif ne soit explicitement spécifié et justifié. Enregistrez les paramètres de la première étape, des paramètres de la deuxième étape, les scores de variables latentes et les fichiers de sortie modèle dans le dossier de vérification.
REMARQUE : Utilisez la même procédure de construction d’ordre supérieur dans le modèle structurel principal, l’analyse des sous-dimensions des besoins psychologiques et l’analyse de robustesse basée sur la régression.
13. Évaluer le modèle de mesure
- Évaluez le modèle de mesure avant d’interpréter le modèle structurel. Examinez les charges extérieures standardisées pour tous les indicateurs conservés. Conserver des indicateurs avec des charges d’au moins 0,70 lorsque possible.
- Examinez les indicateurs avec des charges comprises entre 0,40 et 0,70. Supprimer un indicateur uniquement lorsque la suppression améliore la fiabilité ou la validité convergente et n’affaiblit pas la couverture du contenu. Supprimez les indicateurs inférieurs à 0,40 sauf si une raison théorique documentée soutient la rétention.
- Évaluer la cohérence interne en utilisant la fiabilité alpha et composite de Cronbach. Considérez des valeurs comprises entre 0,70 et 0,95 comme acceptables. Évaluer la validité convergente en utilisant la variance moyenne extraite. Considérez des valeurs d’au moins 0,50 comme acceptables.
- Évaluer la validité discriminante à l’aide du ratio hétérotrait-monotrait. Utilisez 0,85 comme seuil conservatif et 0,90 comme seuil maximal acceptable pour les constructions théoriquement adjacentes.
- Indicateurs de conservation des enregistrements, charges externes standardisées, alpha de Cronbach, fiabilité composite, variance moyenne extraite, valeurs hétérotrait-monotrait, et toute décision de suppression d’éléments dans la sortie du modèle de mesure verrouillé.
REMARQUE : Ne supprimez pas les éléments uniquement pour améliorer les valeurs statistiques. Supprimer un élément uniquement lorsque la faiblesse statistique et la redondance conceptuelle sont toutes deux documentées.
POINT DE PAUSE : Ne commencez pas les tests structurels tant que les indicateurs conservés, les valeurs de chargement, les valeurs de fiabilité, la validité convergente, la validité discriminante, les entrées du codebook et les valeurs de sortie de mesure n’ont pas été vérifiés par rapport aux fichiers d’analyse verrouillés.
14. Tester le modèle structurel et la voie de médiation
- Spécifiez trois parcours structurels : l’expérience d’apprentissage en ligne → besoins psychologiques fondamentaux, les besoins psychologiques fondamentaux → l’engagement à l’apprentissage, et l’expérience d’apprentissage en ligne → l’engagement à l’apprentissage.
- Inclure les heures d’apprentissage en ligne hebdomadaires et l’expérience préalable en ligne comme variables de contrôle prédéfinies. Considérez le genre, le niveau académique, l’année d’études et la catégorie disciplinaire comme des variables descriptives, sauf si cela inclut dans un modèle de sensibilité prédéfini.
- Examinez la collinéarité des modèles structurels avant d’interpréter les coefficients de chemin. Considérer les valeurs du facteur d’inflation de la variance inférieures à 3,30 comme indiquant qu’une colinéarité nuisible est peu probable.
- Estimez les coefficients de chemin standardisés, les valeurs t , les valeurs p et les intervalles de confiance à 95 % en utilisant 5 000 rééchantillonnages bootstrap avec des tests à deux queues. Utilisez des intervalles de confiance corrigés en biais lorsque disponibles.
- Estimez le parcours indirect allant de l’expérience d’apprentissage en ligne à l’engagement dans l’apprentissage en passant par les besoins psychologiques fondamentaux. Considérer la voie d’association indirecte comme supportée lorsque l’intervalle de confiance bootstrap pour l’effet indirect n’inclut pas zéro.
- Notez l’effet direct, l’effet indirect, l’effet total, les valeurs de R2 , les valeurs ajustées de R2 , les tailles d’effet f2 , les valeurs du facteur d’inflation de variance du modèle structurel, et les chemins des variables témoins dans la sortie du modèle structurel verrouillé. Interprétez toutes les estimations structurelles comme des voies basées sur l’association plutôt que comme des effets causals.
REMARQUE : Ne retirez pas un chemin prédéfini car il n’est pas significatif. Conservez le modèle prédéfini sauf si une erreur de codage ou d’erreur de spécification du modèle est identifiée.
15. Examiner les sous-dimensions des besoins psychologiques
- Remplacer la construction globale des besoins psychologiques fondamentaux par le besoin d’autonomie, le besoin de compétence et le besoin de relation par des constructions parallèles d’association indirecte. Estimez séparément les parcours indirects allant de l’expérience d’apprentissage en ligne à l’engagement dans l’apprentissage via le besoin d’autonomie, le besoin de compétences et le besoin de connexion.
- Utilisez 5 000 rééchantillons bootstrap pour chaque voie de sous-dimension. Comparez la direction, la magnitude et l’intervalle de confiance de chaque voie indirecte de sous-dimension. Considérez cette analyse comme une analyse de sensibilité plutôt que comme le modèle principal.
REMARQUE : Ne réinterprétez pas l’analyse de sensibilité aux sous-dimensions comme un nouveau modèle primaire.
16. Réaliser une analyse de robustesse basée sur la régression
- Exportez le jeu de données construct-score nettoyé et enregistrez-le en ConstructScores_OnlineLearning_BPN_Engagement_YYYYMMDD.csv. Utilisez R 4.4.1 pour régresser les besoins psychologiques fondamentaux mondiaux concernant l’expérience mondiale d’apprentissage en ligne, les heures d’apprentissage hebdomadaires en ligne et l’expérience d’apprentissage en ligne antérieure.
- Régressez l’engagement mondial de l’apprentissage sur l’expérience mondiale d’apprentissage en ligne, les besoins psychologiques fondamentaux mondiaux, les heures hebdomadaires d’apprentissage en ligne et les expériences d’apprentissage en ligne antérieures. Estimez la voie indirecte à l’aide de 5 000 rééchantillonnages bootstrap.
- Comparez la voie indirecte basée sur la régression avec la voie indirecte PLS-SEM. Classez la voie comme robuste seulement lorsque la direction reste constante et que l’interprétation substantielle ne change pas. Sauvegardez le script R, les paramètres de démarrage et la robustesse dans le dossier de vérification.
POINT DE PAUSE : Ne commencez pas le verrouillage final du fichier tant que le modèle structurel, l’analyse de sous-dimension et l’analyse de robustesse basée sur la régression n’ont pas été vérifiés.
17. Gérer des résultats analytiques sous-optimaux
- Si la fiabilité alpha ou composite de Cronbach est inférieure à 0,70, inspectez les corrélations entre le total d’items et les charges externes standardisées. Si la variance moyenne extraite est inférieure à 0,50, on inspecte les indicateurs conservés et on identifie si un ou plusieurs indicateurs affaiblissent la validité convergente.
- Si les valeurs d’hétérotraits-monotraits dépassent le seuil prédéfini, on examine le libellé des items pour détecter un chevauchement sémantique entre des constructions théoriquement proches. Supprimez un élément faible seulement lorsqu’il est statistiquement faible et conceptuellement redondant. Garder les constructions théoriquement adjacentes séparées lors de leur fusion réduirait la clarté conceptuelle.
- Si la voie indirecte n’est pas prise en charge, il faut enregistrer le résultat comme une association indirecte non supportée. Si les variables témoins présentent des associations non significatives, notez les résultats sans surinterpréter.
REMARQUE : Ne révisez pas le modèle théorique après analyse pour renforcer un soutien.
18. Verrouiller les fichiers de sortie logicielle et de reproductibilité
- Créez un dossier final de vérification institutionnelle nommé Verification_OnlineLearning_BPN_Engagement_YYYYMMDD.
- Sauvegardez l’archive brute du jeu de données, le jeu de données nettoyé, le jeu de données construct-score, le codebook, le questionnaire, la table de cartographie objet-source, le journal d’experts-revues, le dossier du test pilote, le journal de terrain, le journal de présélection, le fichier de règles d’exclusion, l’enregistrement seuil du temps d’achèvement, les sorties Smart PLS, les scripts R, les tables de sortie R, l’enregistrement des versions logicielles et le journal des modifications de version dans le dossier de vérification.
- Sauvegardez les fichiers de projet Smart PLS 4.1 et les sorties exportées des modèles de mesure, du modèle structurel, du bootstrap et des sorties hétérotrait-monotraits dans un sous-dossier nommé SmartPLS_Output. Sauvegardez les scripts R et les tables de sortie R dans un sous-dossier nommé R_Output. Sauvegardez le questionnaire, la correspondance source-item, le codage des variables et les règles de notation sous forme de fichier supplémentaire 1.
- Sauvegarder la vérification finale du jeu de données analytiques, le résumé de dépistage, l’enregistrement des données manquantes, les diagnostics de biais de méthode commune, les résultats des modèles de mesure, les résultats du modèle structurel, les résultats des associations indirectes, l’analyse de sous-dimensions, l’enregistrement de robustesse basé sur la régression, les paramètres logiciels et l’enregistrement de version sous forme de fichier supplémentaire 2.
- N’incluez pas d’informations directement identifiables, de documents bruts exclus ou de données brutes au niveau des participants dans le manuscrit ou les fichiers complémentaires soumis pour publication. Verrouillez le dossier de vérification final après vérification de cohérence. Enregistrez les corrections ultérieures comme des versions nouvelles et datées et documentez la raison dans le journal des modifications de version.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Ensemble de données analytiques finales et caractéristiques des participants
Le jeu de données analytique final comprenait 386 étudiants universitaires. Le recrutement formel a eu lieu du 18 août 2025 au 26 septembre 2025 via des plateformes d’apprentissage universitaires, des groupes de communication de cours, des listes de diffusion étudiante et des canaux institutionnels pour les étudiants. Un total de 432 réponses soumises ont été examinée...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Ce protocole offre un flux de travail méthodologique reproductible pour évaluer les voies d’association entre l’expérience d’apprentissage en ligne, les besoins psychologiques fondamentaux et l’engagement à l’apprentissage chez les étudiants universitaires. Plutôt que de traiter l’apprentissage en ligne comme une condition unique, le protocole sépare l’environnement d’apprentissage perçu en utilisabilité de plateforme, soutien pédagogique, qualité d’interaction et flexibilité d’apprentis...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs affirment qu’ils n’ont aucune relation financière ou personnelle qui aurait pu influencer le travail rapporté dans cet article.
Remerciements
Nous remercions sincèrement tous les étudiants participants pour leur temps, leur coopération et leurs réponses précieuses. Nous remercions également le personnel académique et administratif concerné pour leur soutien tout au long du processus d’enquête.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Qualtrics online survey platform | Qualtrics | Institutional account; version not applicable | Used to administer the anonymous English-language questionnaire, including consent confirmation, eligibility screening, required-response settings, AC1 attention-check item, response-time recording, and data export. |
| Microsoft Excel for Microsoft 365 | Microsoft Corporation | Microsoft 365 institutional version | Used to store the raw exported dataset, cleaned dataset, codebook, screening log, construct-score file, and verification records in .xlsx and .csv formats. |
| G*Power | Heinrich Heine University Düsseldorf | G*Power 3.1.9.7 | Used for a priori sample-size and power checking before recruitment. |
| SmartPLS | SmartPLS GmbH | SmartPLS 4.1 Professional | Used for the primary PLS-SEM workflow, including disjoint two-stage higher-order construct estimation, measurement-model assessment, structural-pathway testing, bootstrapping, R², f², and model-output export. |
| R statistical software | R Foundation / CRAN | R 4.4.1 | Used for descriptive statistics, Pearson correlations, common method bias diagnostics, and regression-based robustness analysis. |
| R package: psych | CRAN | psych 2.4.6 | Used for descriptive statistics, reliability checks, and psychometric summaries. |
| R package: boot | CRAN | boot 1.3-30 | Used for bootstrap-based regression robustness checks. |
| R package: semPlot | CRAN | semPlot 1.1.6 | Used only for optional path-diagram cross-checking when R-based visual verification is needed. |
| OneDrive for Business or SharePoint version history | Microsoft Corporation | Microsoft 365 institutional account | Used to store the verification folder and preserve version history for raw data, cleaned data, codebook, screening log, SmartPLS outputs, R scripts, and supplementary files. |
| Questionnaire and coding file | Author-prepared study file | Supplementary File 1 | Contains the final questionnaire, item-source mapping, variable names, coding rules, dimension-score formulas, global construct-score formulas, and data-handling rules. |
| Screening and reproducibility record | Author-prepared study file | Supplementary File 2 | Contains final dataset verification, screening checks, missing-data record, reliability results, common method bias diagnostics, measurement-model output, structural-model output, indirect-association results, sensitivity analysis, robustness record, and final consistency checklist. |
| Figure-preparation software | Adobe Illustrator or equivalent vector-editing software | Institutional version | Used to prepare publication-ready workflow and structural-model figures. |
Références
- Organization for Economic Co-operation and Development. OECD digital education outlook 2021: pushing the frontiers with artificial intelligence, blockchain and robots. Paris: OECD Publishing; 2021. doi:10.1787/589b283f-en.
- Martin F, Bolliger DU. Engagement matters: student perceptions on the importance of engagement strategies in the online learning environment. Online Learn. 2018;22(1):205-222. doi:10.24059/olj.v22i1.1092.
- Dixson MD. Measuring student engagement in the online course: the Online Student Engagement scale (OSE). Online Learn. 2015;19(4). doi:10.24059/olj.v19i4.561.
- Bond M, Buntins K, Bedenlier S, Zawacki-Richter O, Kerres M. Mapping research in student engagement and educational technology in higher education: a systematic evidence map. Int J Educ Technol High Educ. 2020;17(1):2. doi:10.1186/s41239-019-0176-8.
- Vansteenkiste M, Ryan RM, Soenens B. Basic psychological need theory: advancements, critical themes, and future directions. Motiv Emot. 2020;44(1):1-31. doi:10.1007/s11031-019-09818-1.
- Chen KC, Jang SJ. Motivation in online learning: testing a model of self-determination theory. Comput Human Behav. 2010;26(4):741-752. doi:10.1016/j.chb.2010.01.011.
- Chiu TKF. Applying the self-determination theory to explain student engagement in online learning during the COVID-19 pandemic. J Res Technol Educ. 2022;54(sup1):S14-S30. doi:10.1080/15391523.2021.1891998.
- Bedenlier S, Bond M, Buntins K, Zawacki-Richter O, Kerres M. Facilitating student engagement through educational technology in higher education: a systematic review in the field of arts and humanities. Australas J Educ Technol. 2020;36(4):126-150. doi:10.14742/ajet.5477.
- Ward MK, Meade AW. Dealing with careless responding in survey data: prevention, identification, and recommended best practices. Annu Rev Psychol. 2023;74:577-596. doi:10.1146/annurev-psych-040422-045007.
- Zawacki-Richter O, Kerres M, Bedenlier S, Bond M, Buntins K, editors. Systematic reviews in educational research: methodology, perspectives and application. Wiesbaden: Springer VS; 2020. doi:10.1007/978-3-658-27602-7.
- Hair JF, Hult GTM, Ringle CM, Sarstedt M. A primer on partial least squares structural equation modeling. 3rd ed. Thousand Oaks: Sage Publications; 2022.
- Wut TM, Ng PML, Low MP. Engaging university students in online learning: a regional comparative study from the perspective of social presence theory. J Comput Educ. 2024;11(3):763-789. doi:10.1007/s40692-023-00278-8.
- Stone C, O’Shea S. Older, online and first: recommendations for retention and success. Australas J Educ Technol. 2019;35(1):57-69. doi:10.14742/ajet.3913.
- Salas-Pilco SZ, Yang Y, Zhang Z. Student engagement in online learning in Latin American higher education during the COVID-19 pandemic: a systematic review. Br J Educ Technol. 2022;53(3):593-619. doi:10.1111/bjet.13190.
- Maxwell SE, Cole DA. Bias in cross-sectional analyses of longitudinal mediation. Psychol Methods. 2007;12(1):23-44. doi:10.1037/1082-989X.12.1.23.
- Richardson JC, Maeda Y, Lv J, Caskurlu S. Social presence in relation to students’ satisfaction and learning in the online environment: a meta-analysis. Comput Human Behav. 2017;71:402-417. doi:10.1016/j.chb.2017.02.001.
- Meade AW, Craig SB. Identifying careless responses in survey data. Psychol Methods. 2012;17(3):437-455. doi:10.1037/a0028085.
- Deci EL, Ryan RM. The “what” and “why” of goal pursuits: human needs and the self-determination of behavior. Psychol Inq. 2000;11(4):227-268. doi:10.1207/S15327965PLI1104_01.
- Fredricks JA, Blumenfeld PC, Paris AH. School engagement: potential of the concept, state of the evidence. Rev Educ Res. 2004;74(1):59-109. doi:10.3102/00346543074001059.
- Garrison DR, Anderson T, Archer W. Critical inquiry in a text-based environment: computer conferencing in higher education. Internet High Educ. 2000;2(2-3):87-105. doi:10.1016/S1096-7516(00)00016-6.
- Cole DA, Maxwell SE. Testing mediational models with longitudinal data: questions and tips in the use of structural equation modeling. J Abnorm Psychol. 2003;112(4):558-577. doi:10.1037/0021-843X.112.4.558.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903. doi:10.1037/0021-9010.88.5.879.
- Gašević D, Dawson S, Siemens G. Let’s not forget: learning analytics are about learning. TechTrends. 2015;59(1):64-71. doi:10.1007/s11528-014-0822-x.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Réimpressions et autorisations
Cet article a été publié
Vidéo bientôt disponible