Ce protocole décrit comment construire, entraîner et évaluer un cadre multiview Vision Mamba U-Shaped Network pour la segmentation médicale d’images, permettant la segmentation reproductible des lésions cutanées et des organes abdominaux grâce à la préparation standardisée de jeux de données, à la mise en œuvre de modèles et à l’évaluation des performances.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Cadre de réseau en forme de U Mamba Vision Multi-View pour la segmentation d’images médicales
Dans cet article
Résumé
Résumé
La segmentation d’images médicales nécessite des méthodes informatiques qui capturent avec précision le contexte global, les frontières locales et les structures anatomiques à plusieurs échelles tout en restant reproductibles à travers différentes applications. Cet article présente un protocole pour construire, entraîner et évaluer un cadre Multi-view Vision Mamba U-Shaped Network pour la segmentation d’images médicales en deux dimensions. Le protocole offre un flux de travail reproductible incluant l’acquisition de jeux de données publics, le prétraitement d’images et de masques, la construction de réseau, l’entraînement de modèles, la sélection de points de contrôle, ainsi qu’une évaluation quantitative et qualitative de la performance. Le cadre intègre le balayage multi-vues des caractéristiques pour capturer des informations complémentaires spatiales, de contours, d’échelle et de frontières, et applique la fusion des caractéristiques multi-étapes au sein d’une architecture encodeur-décodeur en U afin d’améliorer l’intégration des caractéristiques lors de la segmentation. Le protocole est démontré à l’aide de jeux de données de segmentation des lésions cutanées et des organes abdominaux accessibles publiquement. Dans le cadre du flux de travail décrit, le cadre atteint une performance de segmentation compétitive à l’aide de métriques d’évaluation standard. En suivant les procédures présentées dans ce protocole, les chercheurs peuvent reproduire l’implémentation du modèle, entraîner le réseau en utilisant des paramètres expérimentaux définis, évaluer la performance de segmentation et adapter le flux de travail pour les tâches de segmentation d’images médicales liées nécessitant une analyse reproductible basée sur un apprentissage profond.
Introduction
La segmentation d’images médicales est une tâche fondamentale dans les domaines de la vision par ordinateur et de l’analyse d’imagesmédicales 1,2,3. Il consiste à partitionner une image en plusieurs régions ou objets pour une analyse et un traitement ultérieurs. Cette technologie est particulièrement importante en imagerie médicale car elle aide les cliniciens à identifier et localiser les régions pathologiques, améliorant ainsi la précision diagnostique et la planification du traitement. Avec l’avancement des technologies d’imagerie médicale, telles que l’imagerie par résonance magnétique (IRM), la tomodensitométrie (CT) et la tomographie par émission de positons (TEP), la demande pour des techniques précises de segmentation médicale d’images n’a cessé d’augmenter. Les méthodes actuelles pour la segmentation d’images médicales peuvent être globalement catégorisées en trois approches principales : méthodes basées sur réseaux neuronauxconvolutionnels (CNN) 4, méthodes basées surTransformer 5, et méthodes basées sur le modèle d’espace d’états (SSM) 6,7. Les méthodes basées sur CNN utilisent généralement des architectures réseau en forme de U pour la segmentation d’images médicales. L’architecture la plus utilisée dans cette catégorie estU-Net 8, qui a démontré l’efficacité d’une architecture encodeur-décodeur en forme de U pour la segmentation d’images biomédicales. U-Net3+ combine des connexions de saut denses de UNet++9 avec des connexions de saut à grande échelle pour améliorer l’agrégation de caractéristiques multiéchelle. Cependant, les méthodes basées sur CNN ont une capacité limitée à capturer des dépendances à longue portée et, par conséquent, peuvent ne pas modéliser efficacement les informations contextuelles à longue portée.
Les méthodes basées sur les transformateurs capturent efficacement les dépendances à longue portée grâce au mécanisme d’auto-attention, qui permet le calcul parallèle et attribue différents poids d’attention à différentes régions d’intérêt. UNETR++10 introduit le module Attention Pairée Efficace (EPA) pour réduire le nombre de paramètres et le coût de calcul. nnFormer11 combine des opérations convolutionnelles entrelacées et d’auto-attention, et introduit un mécanisme d’auto-attention local–global basé sur le volume pour apprendre les représentations volumétriques dans la segmentation d’images médicales tridimensionnelle (3D). H2Former12 propose un transformateur de vision hybride hiérarchique efficace qui combine des mécanismes d’attention avec l’extraction de caractéristiques basée sur CNN dans l’encodeur. Cependant, les méthodes basées sur les transformateurs présentent une complexité de calcul quadratique avec l’augmentation de la longueur de la séquence, ce qui entraîne un coût computationnel nettement plus élevé. La Figure 1 illustre la motivation de MVM-UNet et compare la stratégie proposée de balayage multiview avec les cadres de segmentation existants basés sur le SSM.
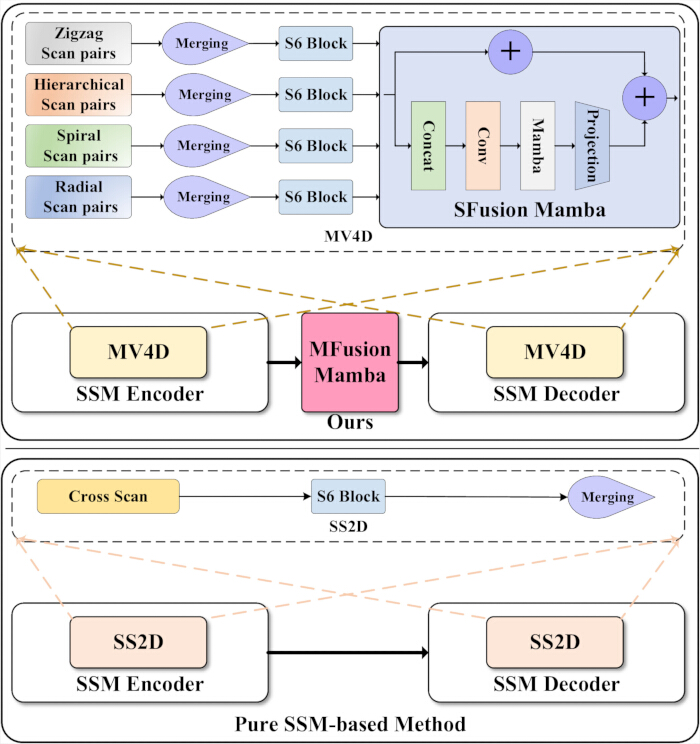
Figure 1. Comparaison de MVM-UNet avec les architectures de segmentation existantes basées sur des modèles purement d’espace d’états (SSM). Comparaison entre un cadre de segmentation conventionnel basé sur un modèle d’espace d’états pur (SSM) et l’architecture proposée Multi-View Mamba U-Net (MVM-UNet). Le panneau supérieur illustre MVM-UNet, dans lequel le module Multi-View 4-Directional (MV4D) extrait des caractéristiques complémentaires à l’aide de paires de balayage en zigzag, hiérarchique, spirale et radiale intégrées par Spatial Fusion Mamba (SFusion Mamba), tandis que Multi-stage Fusion Mamba (MFusion Mamba) agrège des caractéristiques d’encodeurs multi-échelle avant le décodage. Le panneau inférieur présente une architecture représentative basée uniquement sur le SSM utilisant des modules à balayage sélectif 2-dimensionnel (SS2D) avec balayage croisé. La figure met en lumière les différences architecturales entre les réseaux de segmentation conventionnels basés sur le SSM et le MVM-UNet proposé. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
Les méthodes basées sur SSM combinent la capacité de modélisation globale des Transformers avec une complexité computationnelle linéaire. L’architecture Mamba traite sélectivement les informations d’entrée à l’aide d’un modèle sélectif d’espace d’états (Selective-SSM), permettant au modèle d’ajuster dynamiquement ses paramètres selon l’entrée tout en filtrant les informations non pertinentes et en mettant l’accent sur les caractéristiques informatives. Vim13 et VMamba14 adaptent l’architecture Mamba aux tâches de vision par ordinateur. U-Mamba15 utilise une architecture hybride CNN–SSM pour explorer l’application des SSM dans la segmentation d’images médicales, tandis que Mamba-UNet16 adopte une architecture encodeur-décodeur entièrement basée sur SSM pour la segmentation d’images médicales. Ces méthodes permettent d’obtenir des performances compétitives tout en utilisant beaucoup moins de paramètres. Cependant, les méthodes actuelles basées sur SSM/Mamba extraient principalement les caractéristiques d’image à l’aide de patches simples et de stratégies de balayage SS2D, ce qui présente plusieurs limites pour la segmentation médicale de l’image. Premièrement, les techniques SS2D et basées sur les correctifs sont principalement conçues pour des tâches générales de vision par ordinateur. Local Mamba17 et MotionMamba 18 ont suggéré que la stratégie de balayage SS2D est insuffisante pour toutes les tâches visuelles car différentes stratégies de balayage capturent différents types d’informations visuelles. Deuxièmement, la stratégie de balayage SS2D est relativement simple, ne reposant que sur les directions de balayage horizontales et verticales. Par conséquent, il peut ne pas capturer adéquatement des relations spatiales complexes et des détails structurels fins. La segmentation médicale de l’image nécessite une modélisation simultanée à la fois du contexte spatial global et des caractéristiques anatomiques locales précises. De plus, les méthodes actuelles basées sur SSM/Mamba offrent une fusion limitée des fonctionnalités entre l’encodeur et le décodeur. Des architectures telles que UNet++ et FATNet améliorent la précision de segmentation grâce à une fusion de fonctionnalités renforcée, soulignant l’importance d’une intégration efficace des fonctionnalités pour la segmentation d’images médicales.
Pour remédier à ces limitations, cet article propose un nouveau cadre de segmentation d’images médicales basé sur Mamba, appelé MVM-UNet. Comme montré à la Figure 1, le module Multi-View Four-Directional (MV4D) proposé sert de composant central d’extraction de caractéristiques de MVM-UNet et est spécifiquement conçu pour la segmentation d’images médicales en intégrant des informations issues de quatre stratégies de balayage distinctes. Chaque stratégie de balayage extrait des caractéristiques d’image complémentaires et représente une vue différente de l’image d’entrée. Le balayageen zigzag 19 alterne la direction de parcours à la fin de chaque ligne ou colonne, équilibrant ainsi les informations spatiales locales et globales. En revanche, les schémas de balayage en spirale et radial20 offrent une couverture complète en s’étendant soit vers l’extérieur depuis le centre, soit vers l’intérieur depuis la périphérie. Le balayagehiérarchique 18 capture à la fois des caractéristiques locales et globales à plusieurs échelles. Pour améliorer la robustesse de chaque stratégie de balayage, les paires de balayage sont fusionnées avant d’être saisies dans le bloc S6. Le module Scan-view Fusion Mamba (SFusion Mamba) intègre ensuite les fonctionnalités extraites des quatre modalités de balayage. Pour exploiter efficacement les caractéristiques des encodeurs multiéchelle, cet article propose également un module de fusion Mamba multi-échelle (MFusion Mamba), qui accumule et fusionne les sorties de chaque étage d’encodeur avant de transmettre les caractéristiques fusionnées au décodeur. MVM-UNet a été évalué sur les ensembles de données ISIC 2017, ISIC 2018 et Synapse. Les résultats expérimentaux démontrent que MVM-UNet atteint des performances de segmentation compétitives sur les ensembles de données ISIC 2017, ISIC 2018 et Synapse.
Les architectures de segmentation représentative ont encore fait progresser la segmentation d’images médicales. U-Net a également été appliqué avec succès à des tâches d’analyse d’images biomédicales telles que le comptage cellulaire, la détection et la morphométrie21. Les architectures CNN à assistance améliorée, telles queCA-Net 22, améliorent la représentation des caractéristiques grâce à des mécanismes d’attention complets. Des cadres de segmentation représentatifs basés sur Transformers, dont TransUNet23, Pyramid MedicalTransformer 24, SwinU-Net 25,TransAttUNet 26 etTransCUNet 27, démontrent également l’efficacité de la modélisation globale des caractéristiques basée sur l’attention pour la segmentation d’images médicales.
La conception de MVM-UNet est motivée par deux limitations des méthodes de segmentation existantes basées sur SSM/Mamba. Tout d’abord, de nombreux modèles actuels de Vision Mamba reposent sur des stratégies de balayage bidimensionnelle simples, qui peuvent être insuffisantes pour des images médicales présentant des limites irrégulières de lésions, de petites régions cibles et des structures anatomiques multi-échelles. Deuxièmement, les architectures conventionnelles encodeur-décodeur en U transfèrent principalement des caractéristiques via des connexions de saut correspondantes, limitant l’utilisation directe des informations des encodeurs multi-étages lors du décodage. Par conséquent, MVM-UNet introduit MV4D pour améliorer la modélisation spatiale multiview et MFusion Mamba pour agréger explicitement les caractéristiques de l’encodeur multi-étages. Cette conception vise à adapter la modélisation à longue portée basée sur Mamba aux exigences spécifiques de la segmentation d’images médicales.
Bien que MVM-UNet soit construit sur le paradigme général encodeur-décodeur et la modélisation de séquences basée sur Mamba, sa nouveauté réside dans l’adaptation et l’intégration de ces composants pour la segmentation d’images médicales. Plutôt que d’incorporer simplement un bloc Mamba standard dans un réseau en forme de U, le cadre proposé redessine le processus de modélisation spatiale à travers plusieurs branches de paires de balayage orientées tâche, introduit SFusion Mamba pour intégrer des représentations spécifiques au balayage, améliore le bloc MVV avec des voies résiduelles et de projection, et insère MFusion Mamba entre l’encodeur et le décodeur pour agréger les fonctionnalités de l’encodeur multi-étages avant le décodage. Cette conception au niveau architectural vise à traiter les limites irrégulières, les petites régions cibles et les structures anatomiques multi-échelle couramment observées dans les images médicales.
Ce protocole est particulièrement adapté aux tâches de segmentation nécessitant la modélisation simultanée d’informations contextuelles à longue portée, de frontières irrégulières d’objets et de structures anatomiques multi-échelle dans des images médicales bidimensionnelles. Comparé aux méthodes de segmentation basées sur CNN, la conception encodeur-décodeur basée sur Mamba offre un mécanisme efficace de modélisation contextuelle tout en conservant un flux de travail en U familier aux chercheurs en segmentation d’images médicales. Comparé aux méthodes basées sur Transformer, le cadre proposé évite l’utilisation directe de l’auto-attention quadratique et s’adresse aux chercheurs recherchant une modélisation contextuelle globale utilisant un mécanisme de modélisation de séquences relativement efficace. En conséquence, ce protocole convient à la segmentation des lésions cutanées, à la segmentation des organes abdominaux et à d’autres tâches bidimensionnelles de segmentation d’images médicales bidimensionnelles où l’information structurelle globale et les détails locaux des limites sont importants.
Ce protocole présente également des limites à prendre en compte avant utilisation. Il peut ne pas être nécessaire pour des tâches de segmentation relativement simples dans lesquelles un CNN léger offre déjà des performances suffisantes. De plus, il n’est pas directement conçu pour une segmentation volumétrique complète en trois dimensions sans adaptation architecturale. Les chercheurs disposant de données annotées très limitées, de ressources limitées en unités de traitement graphique (GPU) ou d’un besoin de modèles classiques hautement interprétables devraient également prendre en compte ces contraintes avant d’appliquer le protocole. Dans l’ensemble, cette méthode est destinée aux chercheurs cherchant à reproduire et évaluer un cadre de segmentation en forme de U basé sur Mamba, qui équilibre modélisation contextuelle à long terme, représentation des frontières locales et fusion de caractéristiques à plusieurs étages.
Les contributions clés sont les suivantes :
1. Cet article présente un nouveau cadre de segmentation d’images médicales basé sur Mamba, appelé MVM-UNet. Contrairement aux approches qui intègrent directement des blocs Mamba existants basés sur SS2D ou standards, MVM-UNet introduit MV4D pour modéliser les caractéristiques d’images médicales à partir de quatre vues complémentaires de paires de balayage, incluant le balayage en zigzag, hiérarchique, spiral et radial.
2. Cet article conçoit SFusion Mamba et le bloc MVV pour intégrer des représentations spécifiques au balayage et améliorer la transformation des caractéristiques. SFusion Mamba fusionne les caractéristiques extraites de différentes branches de paires de balayage, tandis que les branches résiduelles et de projection haut-bas au sein du bloc MVV fournissent des voies complémentaires qui stabilisent et enrichissent les représentations des caractéristiques.
3. Cet article présente MFusion Mamba comme module de fusion multi-étage intermédiaire entre l’encodeur et le décodeur. Contrairement aux connexions de saut conventionnelles qui transfèrent principalement des caractéristiques correspondantes, MFusion Mamba agrège explicitement les caractéristiques des encodeurs multi-étages par fusion grossière-fine-fine et fournit des informations enrichies pour le décodage.
4. Des résultats expérimentaux étendus démontrent que le MVM-UNet proposé atteint des performances de segmentation compétitive sur les ensembles de données ISIC 2017 et ISIC 2018 ainsi que de fortes performances sur le jeu de données de segmentation multiorgane Synapse. De plus, des études d’ablation complètes valident la contribution de chaque composant au sein du MVM-UNet.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude n’a utilisé que des ensembles de données d’images médicales publiques et désidentifiées, notamment ISIC 2017, ISIC 2018 et Synapse. Aucun nouveau participant humain, sujet animal ou dossier médical privé identifiable n’a été collecté dans cette étude. L’ensemble de données ISIC 2017 utilisé dans cette étude était le jeu de données ISIC 2017 Challenge Skin Injury Segmentation Segmentation, obtenu à partir du dépôt officiel de données de défis de l’International Imaging Imaging Collaboration (https://challenge.isic-archive.com/data/#2017). La version du jeu de données utilisée dans cette étude correspond à la tâche de segmentation des lésions ISIC 2017, incluant les partitions officielles d’entraînement, de validation et de test. Le jeu de données a été téléchargé le 15 mars 2024. L’ensemble de données ISIC 2018 utilisé dans cette étude était le jeu de données de segmentation des limites de lésions de la Challenge Task 1 ISIC 2018, obtenu à partir du dépôt officiel de données de défis de l’International Imaging Imaging Collaboration (https://challenge.isic-archive.com/data/#2018). La version du jeu de données utilisée dans cette étude correspond à la Tâche 1 ISIC 2018 : Segmentation des limites des lésions. Le jeu de données a été téléchargé le 8 juillet 2024.
Le jeu de données Synapse utilisé dans cette étude était le multi-atlas Labeling Beyond the Cranial Vault abdominal CT, obtenu à partir du dépôt Synapse sous l’identifiant d’accession syn3193805 (https://www.synapse.org/Synapse:syn3193805). Le jeu de données utilisé dans cette étude correspond au jeu de données de segmentation multiorganiques par scanner abdominal de 30 cas couramment utilisé. L’archive téléchargée était Abdomen/RawData.zip, disponible sous accession syn 3193805. Aucun numéro de version, étiquette de sortie ou tag de sortie datée n’a été fourni par le dépôt au moment du téléchargement. Suite à la répartition standard adoptée dans les études précédentes, 18 cas ont été utilisés pour la formation et 12 cas pour les tests. La répartition des données a suivi la liste des cas utilisée par TransUNet23. Plus précisément, les cas de formation étaient cas 0031, cas 0007, cas 0009, cas 0005, cas 0026, cas 0039, cas 0024, cas 0034, cas 0033, cas 0030, cas 0023, cas 0040, cas 0010, cas 0021, cas 0006, cas 0027, cas 0028 et cas 0037, tandis que les cas test étaient cas 0008, cas 0022, cas 0038, cas 0036, cas 0032, cas 0002, cas 0002, cas 0003, cas 0003, cas 000 10 10 cas (cas 0004, cas 0025 et cas 0035). Le jeu de données a été téléchargé le 9 juillet 2024. Comme cette étude utilisait uniquement des ensembles de données publiques et désidentifiés et ne concernait pas la collecte de nouvelles données humaines ou d’informations privées identifiables, l’approbation du comité d’examen institutionnel n’était pas requise pour les expériences computationnelles décrites dans ce protocole. Aucune détermination écrite formelle d’exemption institutionnelle n’a été obtenue. Si la politique institutionnelle locale l’exige, les chercheurs devraient obtenir une détermination d’exemption institutionnelle avant de réaliser des analyses secondaires de jeux de données publiques. Aucun numéro de référence d’exemption éthique institutionnelle ni document d’exemption formel n’était disponible pour cette étude.
1. Préparation de jeux de données
- Téléchargez le jeu de données ISIC 2017 sur la segmentation des lésions cutanées depuis le dépôt officiel de la Collaboration internationale d’imagerie cutanée. Utilisez les partitions officielles de formation, validation et test. Vérifiez que le jeu de données contient 2 000 images d’entraînement, 150 images de validation et 600 images de test.
- Téléchargez le jeu de données ISIC 2018 sur la segmentation des lésions cutanées depuis le dépôt officiel de la Collaboration internationale d’imagerie cutanée. Utilisez les partitions officielles de formation, validation et test. Vérifiez que le jeu de données de segmentation contient 2 594 images d’entraînement, 100 images de validation et 1 000 images de test.
- Téléchargez le jeu de données de segmentation multiorgane Synapse. Utilisez la répartition standard composée de 18 caisses (2 212 tranches axiales) pour l’entraînement et 12 caisses (1 567 tranches axiales) pour les tests. N’introduisez pas un ensemble de validation séparé.
- Réservez les 12 cas de test exclusivement pour l’évaluation finale. N’utilisez pas les cas de test pour l’entraînement du modèle, l’ajustement des hyperparamètres ou la sélection du modèle. La tâche de segmentation comprend huit organes abdominaux : aorte, vésicule biliaire, rate, rein gauche, rein droit, foie, pancréas et estomac.
- Utilisez la répartition suivante des ensembles de données Synapse. Les 18 cas de formation étaient case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 et case0037. Les 12 cas testés étaient cas 0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 et case0035.
- Organisez chaque jeu de données en dossiers d’images et de masques séparés. Assurez-vous que chaque image possède un masque de segmentation correspondant avec le même identifiant de cas.
- Convertir chaque masque de lésion cutanée en une carte binaire de segmentation avant-arrière-plan. Conserver les étiquettes d’organes multiclasses originales pour le jeu de données Synapse.
- Pour les ensembles de données ISIC 2017 et ISIC 2018, attribuez une valeur d’étiquette de 0 aux pixels de fond et 1 aux pixels de lésion (au premier plan) après conversion de masque binaire. Les pixels dont les valeurs de masque d’origine sont supérieures à 0 sont traités comme au premier plan et convertis en 1, tandis que les pixels dont les valeurs de masque d’origine sont égales à 0 sont traités comme arrière-plan et conservés comme 0. Pour le jeu de données Synapse, conservez les valeurs originales d’étiquettes entières, 0 représentant la classe de fond et 1–8 représentant les huit classes d’orgues au premier plan.
- Redimensionnez les images et masques ISIC 2017 et ISIC 2018 à 256 × 256 pixels sans préserver le format d’image original. N’appliquez pas de recadre ni de rembourrage.
- Redimensionnez chaque tranche Synapse CT et chaque map d’étiquette correspondante à 224 × 224 pixels. Utilisez l’interpolation bilinéaire pour les images RVB, l’interpolation spline du troisième ordre pour les tranches CT, et l’interpolation du plus proche voisin pour les masques de segmentation.
- Redimensionnez les images en Python.
- Pour les ensembles de données ISIC 2017 et ISIC 2018, utilisez la transformation personnalisée myResize implémentée dans utils.py, qui appelle torchvision.transforms.functional.resize pour redimensionner à la fois les tenseurs d’image et de masque à 256 × 256 pixels. Ne spécifiez pas un mode d’interpolation explicite ou un argument d’anticrénelage dans cette transformation.
- Pour le jeu de données Synapse, utilisez scipy.ndimage.zoom dans les ensembles de données/dataset.py. Redimensionner les tranches d’image CT à 224 × 224 pixels en utilisant l’interpolation spline du troisième ordre (ordre = 3), et redimensionner les cartes d’étiquettes en utilisant l’interpolation du voisin le plus proche (ordre = 0). N’appliquez pas d’opération d’anticrénelage séparée ni de réglage anti_aliasing=Vrai lors du redimensionnement.
- Normalisez chaque image RVB ISIC avant conversion tensorielle en utilisant la moyenne et l’écart-type (DE) spécifiques à chaque ensemble de données en utilisant l’équation 1 comme suit :
 (1)
Ensuite, redimensionnez l’image normalisée à la plage de 0 à 255 en utilisant la normalisation min–max.- Utilisez μ = 159,922 et σ = 28,871 pour l’ensemble d’entraînement ISIC 2017 et μ = 148,429 et σ = 25,748 pour les ensembles de validation et de test ISIC 2017. Utilisez μ = 157,561 et σ = 26,706 pour l’ensemble d’entraînement ISIC 2018 et μ = 149,034 et σ = 32,022 pour les ensembles de validation et de test ISIC 2018.
- Convertissez chaque image normalisée en un tenseur de forme 3 × 256 × 256. Convertir chaque masque binaire en un tenseur de forme 1 × 256 × 256.
- Effectuer la normalisation min–max indépendamment pour chaque image après normalisation de la moyenne et de l’écart-type spécifique à chaque ensemble de données. Plus précisément, soustrayez la moyenne spécifique à chaque ensemble de données de chaque image et divisez par l’écart-type correspondant.
- Calculez les valeurs d’intensité minimale et maximale à partir de l’image normalisée et redimensionnez l’image à la plage 0–255 en utilisant ces valeurs minimales et maximales par image. N’utilisez pas les valeurs minimales et maximales à l’échelle du jeu de données pour cette étape de remise à l’échelle min–max.
- Préparez chaque tranche Synapse CT sous forme d’image bidimensionnelle en niveaux de gris. Convertissez chaque tranche CT en float32 et ajoutez une dimension de canal singleton pour obtenir un tenseur d’entrée avec la forme 1 × 224 × 224.
- Conservez chaque map d’étiquettes Synapse comme un masque entier à canal unique avec la forme 224 × 224. N’appliquez pas de normalisation moyenne SD-SD supplémentaire au niveau du jeu de données dans le chargeur de données.
- Utilisez les fichiers Synapse prétraités fournis au format .npz pour les tranches d’entraînement et au format .npy.h5 pour tester les volumes. Chargez les tableaux d’image et d’étiquettes directement depuis chaque fichier .npz pendant l’entraînement et directement depuis chaque fichier .npy.h5 pendant les tests. N’appliquez pas de découpage d’intensité supplémentaire, de fenêtrage CT, de normalisation au niveau du jeu de données ou de rééchantillonnage en volume brut dans le chargeur de données publié.
- Lors de l’entraînement du modèle, convertissez chaque tranche bidimensionnelle chargée en float32, redimensionnez-la à la taille spatiale cible en utilisant scipy.ndimage.zoom avec ordre = 3 pour les tranches d’image et ordre = 0 pour les cartes d’étiquettes, puis convertissez les tableaux redimensionnés en tenseurs avec une dimension de canal unique.
- Appliquez l’augmentation de données uniquement à l’ensemble d’entraînement. Pour ISIC 2017 et ISIC 2018, appliquez un retournement horizontal aléatoire (p = 0,5), un retournement vertical aléatoire (p = 0,5) et une rotation aléatoire (p = 0,5) avec un angle échantillonné de 0° à 360°.
- Appliquez la même transformation géométrique à chaque paire image-masque. Lors de la validation et des tests, appliquez uniquement le redimensionnement, la normalisation et la conversion tensorielle.
- Pour le jeu de données Synapse, appliquez une rotation aléatoire et des basculements aléatoires pendant l’entraînement. Faites pivoter aléatoirement chaque paire image-étiquette de k × 90°, où k ∈ {0,1,2,3}, inversez aléatoirement la paire image-étiquette le long d’un axe spatial, ou faites pivoter aléatoirement la paire image-étiquette d’un angle échantillonné de −20° à 20°.
- N’appliquez pas d’augmentation stochastique lors des tests.
- Appliquez l’augmentation des données au jeu de données Synapse en utilisant les branches mutuellement exclusives implémentées dans la transformation RandomGenerator.
- Pour chaque échantillon d’entraînement, il faut d’abord évaluer la condition random.random() > 0,5. Si cette condition est satisfaite, appliquer random_rot_flip, consistant en une rotation aléatoire de 90° (k = 0, 1, 2 ou 3) suivie d’un basculement aléatoire le long d’un axe spatial.
- Si la première branche n’est pas sélectionnée, évaluer une seconde condition, random.random() > 0,5. Si cette condition est satisfaite, on applique random_rotate en utilisant un angle de rotation choisi au hasard entre −20° et 20°. Si aucune des deux conditions n’est satisfaite, ne pas appliquer d’augmentation stochastique à l’échantillon.
- Appliquez la même transformation à la fois à l’image d’entrée et à la carte d’étiquettes correspondante.
- Définissez la graine aléatoire avant le chargement du jeu de données, le prétraitement et l’entraînement. Utilisez les graines aléatoires 1, 52 et 100 pour les principales expériences de comparaison et utilisez la graine 100 pour les études d’ablation, sauf indication contraire.
- Initialiser les générateurs aléatoires Python, NumPy, CPU PyTorch, CUDA PyTorch et cuDNN avant de construire le chargeur de données. Gardez les partitions de jeux de données, les procédures de prétraitement, les paramètres d’augmentation, les paramètres de normalisation, la stratégie de redimensionnement et le prétraitement d’évaluation inchangés sur toutes les exécutions de seed.
- Fixer num_workers = 0 pour les expériences ISIC et Synapse afin d’effectuer le chargement des données dans le processus principal. Avant de construire le jeu de données et de créer le DataLoader, initialisez la graine aléatoire globale en utilisant la fonction set_seed pour semer les générateurs de nombres aléatoires Python, NumPy, CPU PyTorch, CUDA PyTorch et cuDNN. Ne définissez pas de générateur aléatoire worker_init_fn séparé ou spécifique à DataLoader, car ceux-ci ne sont pas utilisés dans l’implémentation publiée.
2. Construction de l’architecture MVM-UNet
- Construisez le projet Multi-view Vision Mamba UNet (MVM-UNet) en utilisant une architecture encodeur-décodeur en forme de U.
- Réglez la dimension d’entrée de l’image à H × W × 3. Faites passer l’image d’entrée à travers la couche d’intégration du patch.
- Implémentez la couche d’embedding de patch en utilisant une convolution 2D avec une taille de noyau de 4 × 4, une foulée de 4, trois canaux d’entrée et 96 canaux de sortie.
- Transformez la carte des caractéristiques d’entrée en une résolution spatiale de H/4 × W/4 avec C = 96 canaux de sortie.
- Construisons quatre étapes d’encodeur et quatre étapes de décodeur. Réduisez la résolution spatiale de moitié et doublez la dimension du canal après chaque étape de l’encodeur.
- Utilisez une configuration encodeur-décodeur symétrique. Réglez le nombre de blocs MVV dans l’encodeur et le décodeur à {2, 2, 2, 2}.
- Placez deux blocs MVV dans chaque étage d’encodeur et deux blocs MVV dans chaque étage de décodeur.
- Insérer un bloc MVV dans chaque encodeur et chaque étape du décodeur. Utilisez le module MV4D comme module principal d’extraction de caractéristiques à l’intérieur de chaque bloc MVV.
- Insérez le module MFusion Mamba entre l’encodeur et le décodeur. Utilisez ce module pour fusionner les caractéristiques de l’encodeur multi-étages avant de décoder.
- Configurez le flux de travail global MVM-UNet. Utilisez MV4D pour l’extraction des caractéristiques dans tout l’encodeur.
- Conservez les sorties des encodeurs comme connexions de saut. Passer les sorties encodeurs aux étapes correspondantes.
- Passez les fonctionnalités de l’encodeur à MFusion Mamba avant de décoder. On suréchantillonne progressivement la représentation fusionnée via le décodeur et on génère la carte de segmentation finale à l’aide de la tête de segmentation.
- Passez l’image d’entrée I ∈ RB×H×W×3 à travers la couche d’intégration de patch pour obtenir
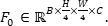 Ici, C = 96.
- Générer des cartes de caractéristiques de l’encodeur : E1 ∈ RB×H/4×W/4×C, E 2 ∈ RB×H/8×W/8×2C, E 3 ∈ RB×H/16×W/16×4C, et E4 ∈ RB×H/32×W/32×8C. Utilisez des blocs MVV contenant MV4D à chaque étape de l’encodeur.
- Conservez toutes les fonctionnalités de l’encodeur pour la connexion de saut correspondante. Passez toutes les fonctionnalités de l’encodeur à MFusion Mamba pour la fusion multi-étages.
- Aligner les caractéristiques de l’encodeur à un espace de caractéristiques commun avant la fusion grossière et fine au sein de MFusion Mamba. Passez la représentation fusionnée au décodeur.
- On rééchantillonne progressivement la représentation du décodeur. Fusionner les caractéristiques du décodeur avec E3 à H/16 × W/16, E2 à H/8 × W/8, et E1 à H/4 × W/4.
- Upséchantillon la fonction finale du décodeur à la résolution d’image d’origine. Générez l’application
 de prédiction ∈ RB×H×W×K. Ici, K = 1 pour la segmentation binaire des lésions et K = 8 pour la segmentation multiorgane par synapse.
- Voir la Figure 2 pour l’architecture réseau globale et le Tableau Supplémentaire 1 pour la spécification complète de l’architecture couche par couche, incluant les opérations, les paramètres principaux et les dimensions des caractéristiques de sortie pour chaque étage
- Couches de transition encodeur-décodeur
- Downsampling fonctionnalités de l’encodeur utilisant des couches de transition patch-merging. Pour chaque transition, échantillonnez quatre groupes de caractéristiques spatialement entrelacés d’un voisinage 2 × 2, concaténez-les selon la dimension du canal, appliquez la normalisation de couche (LayerNorm), et projetez la caractéristique résultante de dimension 4C sur des canaux 2C en utilisant une couche linéaire sans biais. Cette opération réduit la résolution spatiale d’un facteur 2 tout en doublant la dimension du canal.
- Upsampling des fonctionnalités du décodeur en utilisant des couches de transition à expansion de patch. Appliquez une projection linéaire sans biais, réarrangez les caractéristiques étendues spatialement pour augmenter la résolution d’un facteur 2, puis appliquez LayerNorm après expansion spatiale. Répétez cette opération pour reconstruire progressivement les cartes de caractéristiques de H/32 × W/32 à H/16 × W/16, H/8 × W/8 et H/4 × W/4.
- Alignez les caractéristiques de l’encodeur au sein du module MFusion Mamba en les redimensionnant à la résolution spatiale cible en utilisant une interpolation bilinéaire (align_corners = Faux), puis en appliquant une projection linéaire par canal apprenable avant la fusion des caractéristiques.
- Tête de segmentation
- Upéchantillon de la carte de caractéristiques finale du décodeur de H/4 × W/4 à la résolution d’image d’origine (H × W) en utilisant la couche finale d’extension du patch. Appliquez la projection linéaire, effectuez un réarrangement spatial avec un facteur d’expansion de 4, puis appliquez LayerNorm.
- Projetez la carte de caractéristiques reconstruite sur K canaux de sortie en utilisant une convolution 1 × 1 après avoir converti le tenseur en format canal d’abord.
- Générez la prédiction finale lors de l’évaluation en appliquant une fonction d’activation sigmoïde pour la segmentation binaire des lésions ou une activation softmax suivie d’argmax pour la segmentation multiorganique Synapse. N’appliquez pas de fonction d’activation directement dans la tête de segmentation.
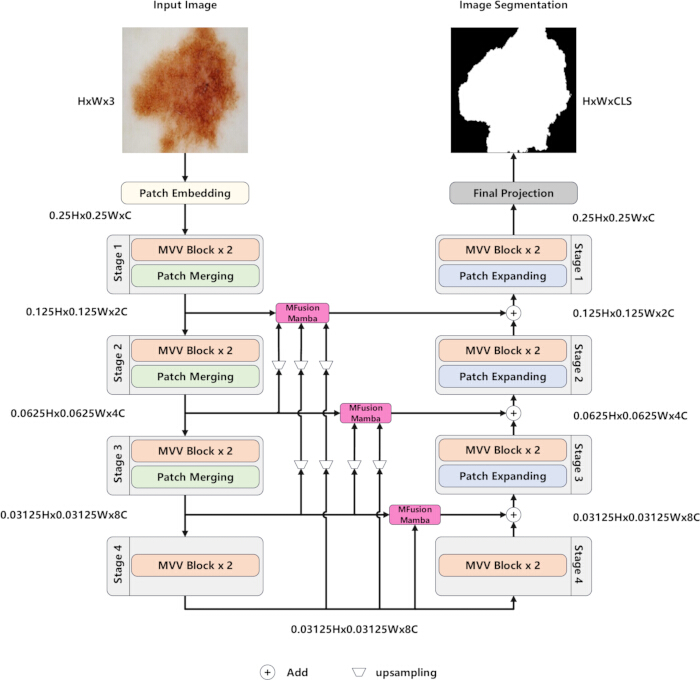
Figure 2. Architecture globale de Multi-View Mamba U-Net (MVM-UNet). Aperçu de l’architecture proposée Multi-View Mamba U-Net (MVM-UNet). L’image d’entrée est convertie en embeddings de patch et traitée à travers quatre étapes d’encodeur composées de blocs Multi-View Vision (MVV) séparés par des opérations de fusion de patchs. Les caractéristiques de l’encodeur sont agrégées par Multi-stage Fusion Mamba (MFusion Mamba) et propagées vers le décodeur via des connexions à saut. Le décodeur restaure progressivement la résolution spatiale grâce à des opérations d’expansion de patch et génère la carte de segmentation finale via la couche de projection. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
3. Construction du module MV4D
- Utilisez le module MV4D comme unité d’extraction de caractéristiques de base dans le bloc MVV. Alimentez les correctifs de fonctionnalités d’entrée en quatre branches de paires de balayage. Voir l’Algorithme 1, Fichier Supplémentaire 1 pour le pseudocode complet de l’aplatissement spatial, de la construction d’index par paires de balayage, de la collecte de séquences, du traitement S6/Mamba, du réorganisation spatiale inverse, de la fusion par paires de balayage, de la fusion SFusion Mamba, de la projection et du remodelage de la sortie.
- Utilisez exactement les procédures de génération d’index de balayage en zigzag, hiérarchique, spirale et radiale implémentées dans les modèles/mvmunet/core.py. Pour chaque stratégie de balayage, utilisez l’ordre de balayage avant et son ordre inverse comme une paire de balayage bidirectionnelle.
- Construis la paire de balayage en zigzag. Parcourez les éléments de l’image en alternance à la fin de chaque ligne ou colonne. Utilisez ce schéma de balayage pour équilibrer les informations spatiales locales et globales.
- Construis la paire de balayage hiérarchique. Capturez des caractéristiques à plusieurs échelles spatiales. Utilisez ce schéma de balayage pour renforcer l’extraction des représentations locales et globales.
- Construisons la paire de balayage en spirale. Scannez les caractéristiques de l’image du centre vers la frontière ou de la frontière vers le centre. Utilisez ce schéma de balayage pour améliorer l’extraction des informations globales sur les contours.
- Construis la paire de balayage radial. Balayez les caractéristiques de l’image dans plusieurs directions radiales. Utilisez ce schéma de balayage pour améliorer l’extraction des détails locaux des limites et des bords.
- Fusionner chaque paire de balayage avant d’introduire la séquence fusionnée dans le bloc S6. Utilisez la conception en paire pour améliorer la robustesse de chaque stratégie de balayage tout en préservant l’efficacité de calcul.
- Alimentez la séquence de sortie de chaque branche de paires de balayage dans un bloc S6. Obtenez quatre représentations de caractéristiques correspondant aux vues en zigzag, hiérarchique, spirale et radiale.
- Fusionner les quatre représentations de caractéristiques extraites à l’aide du module SFusion Mamba. Utilisez deux voies de fusion parallèles. Dans le premier chemin, intégrez les quatre caractéristiques par addition élément par élément.
- Dans la deuxième voie SFusion Mamba, concaténez les quatre caractéristiques. Traitez la représentation concaténée en utilisant Conv1d et Mamba. Réduisez la dimension du canal en utilisant une couche de projection pour correspondre à la dimension de sortie du bloc S6.
- Configurez le bloc S6/Mamba en utilisant la dimension de caractéristique C comme dimension du modèle. Utilisez une couche de projection pour mapper chaque élément de paire de balayage fusionné vers la dimension du canal C avant la fusion.
- Dans SFusion Mamba, effectuez l’addition élément par élément dans le premier chemin. Concatéter les quatre caractéristiques de la vue de balayage dans le second chemin avant Conv1d, Mamba et la projection linéaire. Utilisez les opérations de normalisation, projection linéaire, convolution séparable en profondeur et activation autour de MV4D comme décrit à l’étape 4.
- Ajoutez les sorties des deux voies de fusion pour obtenir la sortie finale du module MV4D.
- Construisez quatre branches complémentaires de paires de balayage au lieu d’utiliser uniquement des directions de balayage horizontales et verticales. Utilisez le balayage en zigzag pour mettre l’accent sur la traversée spatiale continue, le balayage hiérarchique pour renforcer la représentation multiéchelle, le balayage en spirale pour capturer des informations du centre à la frontière, et le balayage radial pour améliorer l’extraction locale des détails orientés frontières.
- Traiter chaque branche de paire de balayage indépendamment. Fusionner les fonctionnalités résultantes à l’aide de SFusion Mamba. Cartographiez chaque séquence traitée à son ordre spatial initial avant la fusion.
- Étant donné une application de caractéristiques d’entrée X ∈ RB×H×W×C, aplatissez-la en Xseq ∈ RB×L×C, où L = H × W.
- Réorganisez la séquence aplatie selon les indices de balayage pour chaque branche de paire de balayage. Traiter chaque séquence réorganisée en utilisant le bloc S6. Restaurez la séquence traitée à l’ordre spatial original.
- Fusionner les quatre caractéristiques de la vue de balayage via la voie additive et la voie SFusion Mamba pour obtenir la sortie finale MV4D. Voir la Figure 3 pour l’architecture MV4D et l’Algorithme 1, Fichier Supplémentaire 1 pour le flux complet d’implémentation au niveau du tensor.
- Utilisez l’implémentation logicielle complète dans les modèles/mvmunet/core.py. Ce fichier contient les générateurs d’index de balayage, PairwiseScanMamba, SequenceS6, SFusion Mampa et le module enveloppeur MV4D.
- Générer des indices de balayage multiview
- Générez les indices de balayage en suivant l’implémentation publiée dans models/mvmunet/core.py. Pour une carte de caractéristiques d’entrée de taille spatiale H × W, aplatir chaque emplacement de pixel en un index unidimensionnel en utilisant : indice = r × W + c, où r et c désignent respectivement les coordonnées ligne et colonne.
- Générez le balayage en zigzag en parcourant des diagonales d’image avec r + c constant. Collectez les indices de pixels valides pour chaque diagonale et alternez la direction de traversée en inversant l’ordre de chaque diagonale paire.
- Générez le balayage hiérarchique en divisant récursivement l’image en quatre quadrants. Visitez les quadrants en haut à gauche, en haut à droite, en bas à gauche et en bas à droite de manière séquentielle jusqu’à ce que la hauteur ou la largeur de la sous-région ne dépasse pas 2 pixels, puis parcourez les pixels restants dans l’ordre des rangs majeurs.
- Générez le balayage en spirale en parcourant la limite extérieure de l’image de gauche à droite le long de la rangée supérieure, vers le bas le long de la colonne de droite, de droite à gauche le long de la rangée inférieure, et vers le haut le long de la colonne de gauche tout en rétrécissant progressivement la frontière vers le centre de l’image.
- Générez le balayage radial en triant chaque pixel selon sa distance au carré du centre de l’image, puis selon son angle polaire calculé à l’aide de la fonction atan2.
- Générez le balayage inverse pour chaque stratégie de balayage en inversant l’ordre correspondant du balayage direct. Combinez les séquences de balayage avant et arrière pour former une paire de balayage pour chaque stratégie de balayage avant de passer les paires de balayage au module MV4D.
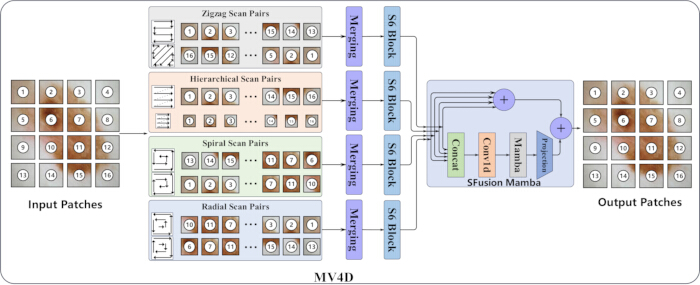
Figure 3. Architecture du module Multi-View 4-Directional (MV4D). Structure du module d’extraction de caractéristiques Multi-View 4-Directional (MV4D). Les patches d’entrée sont traités à travers quatre branches complémentaires de paires de balayage, incluant le balayage en zigzag, hiérarchique, spiral et radial. Les caractéristiques extraites des quatre branches sont fusionnées, traitées à l’aide de blocs d’espace d’états, puis intégrées par Spatial Fusion Mamba (SFusion Mamba) pour générer la représentation des caractéristiques de sortie. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
4. Construction du bloc MVV
- Construisez le bloc MVV en utilisant une branche principale et deux branches auxiliaires. Utilisez la structure générale présentée à la Figure 4.
- Appliquez la normalisation des couches à la fonction d’entrée dans la branche principale. Alimentez la caractéristique normalisée dans une couche linéaire. Passez la caractéristique transformée à la convolution séparable en profondeur.
- Traitez la caractéristique transformée en utilisant la convolution séparable en profondeur. Appliquez la fonction d’activation GELU. Faites entrer la fonctionnalité activée dans le module MV4D.
- Construisons la première branche auxiliaire comme une connexion résiduelle d’identité. Connecte la fonction d’entrée directement à la sortie finale. Utilisez cette branche pour préserver la représentation originale et stabiliser l’entraînement.
- Construisons la seconde branche auxiliaire comme une branche de projection descendante-ascendante. Compressez la fonction d’entrée à l’aide d’une couche de projection descendante. Restaurez la dimension des caractéristiques à l’aide d’une couche de projection montante.
- Fusionner les sorties de la branche principale et des deux branches auxiliaires. Obtenez la sortie finale du bloc MVV. Voir la Figure 4 pour l’architecture complète.
- Fixez la dimension cachée de la branche principale égale à la dimension du canal d’entrée Cs. Appliquez CoucheNorm(Cs) avant la projection linéaire principale et utilisez une couche linéaire de dimensions Cs→Cs. Utilisez une convolution séparable en profondeur consistant en une convolution 3×3 en profondeur avec un bourrage 1, des groupes = Cs, et sans biais, suivie d’une convolution 1×1 point par point sans biais.
- Appliquez la fonction d’activation GELU après la convolution séparable en profondeur. Alimentez la caractéristique activée dans MV4D et appliquez une projection linéaire de sortie avec des dimensions C s→Cs. Configurez la branche projection descendante-ascendante en utilisant LayerNorm(Cs), un ratio de projection de 4, une projection descendanteC s→Cs/4, une activation GLU, et une projection ascendante Cs/4→Cs.
- Combinez la branche identité, la branche projection vers le bas et la branche principale traitée par chemin de dépôt en utilisant l’addition élément par élément pour obtenir la sortie finale du bloc MVV.
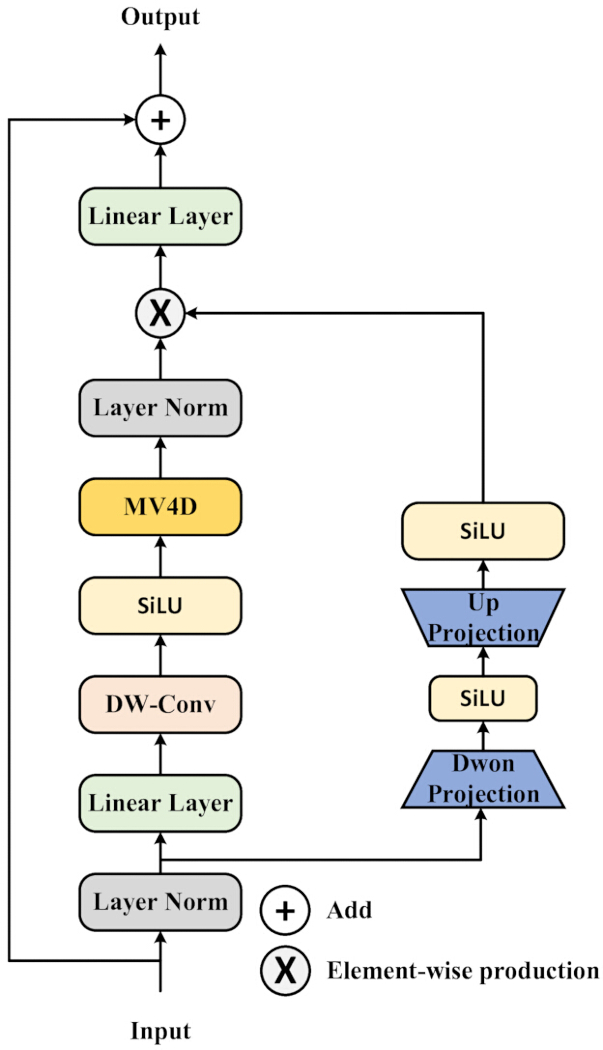
Figure 4. Architecture du bloc Multi-View Vision (MVV). Structure du bloc Multi-View Vision (MVV). Le bloc consiste en une branche principale d’extraction de caractéristiques contenant le module Multi-View 4-Directional (MV4D) ainsi que des couches de convolution en profondeur, de normalisation et de projection linéaire. Une branche auxiliaire de projection haut-bas fournit une modulation de caractéristiques par bloc par multiplication élément par élément avant l’addition résiduelle pour générer la représentation des caractéristiques de sortie. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
5. Construction de MFusion Mamba
- Collectez les feature maps de tous les niveaux de l’encodeur. Alignez les caractéristiques de l’encodeur à un espace de représentation unifié en les redimensionnant ou en les projetant lorsque nécessaire. Voir l’Algorithme 2, Fichier Supplémentaire 1 pour le flux de travail complet de mise en œuvre au niveau du tensor.
- Redimensionner les caractéristiques de l’encodeur à la résolution spatiale cible lorsque cela est nécessaire. Des fonctionnalités de projet avec différentes dimensions de canal dans la même dimension de canal. Alignez toutes les caractéristiques de l’encodeur avant la fusion multi-étages.
- Alimentez les caractéristiques de l’encodeur aligné dans le composant Fusion grossière. Effectuez la fusion grossière en utilisant le produit de Hadamard. Générez la représentation grossière fusionnée.
- Introduisez la représentation grossière fusionnée dans la composante de fusion fine. Construisons deux voies parallèles de fusion fine. Traitez les deux voies indépendamment.
- Traiter la première voie de fusion fine à l’aide d’une couche linéaire. Traiter la seconde voie de fusion fine en utilisant la projection vers le haut, Conv1d, Mamba et projection descendante. Restaurez la dimension des caractéristiques après projection descendante.
- Fusionner les sorties des deux voies de fusion fine en utilisant le produit de Hadamard. Appliquez la couche linéaire finale. Obtenez la sortie MFusion Mamba.
- Alimentez la sortie MFusion Mamba dans le décodeur. Décodez la représentation multi-étages fusionnée avec les caractéristiques de saut encodeur-décodeur. Générez la carte de segmentation finale.
- Aligner les caractéristiques des encodeurs de différents stades dans un espace de caractéristiques unifié avant la fusion grossière. Traiter les représentations des caractéristiques alignées en utilisant les étapes de fusion grossière et fine. Voir la Figure 5 pour l’architecture MFusion Mamba et l’Algorithme Supplémentaire 2 pour le flux de travail complet de mise en œuvre au niveau du tensor.
- Utilisez les paramètres d’implémentation de MFusion Mamba comme suit. Pour chaque caractéristique d’encodeur Ei, projetez la dimension du canal de Ci à Ct. Redimensionner les caractéristiques projetées à la taille spatiale cible en utilisant une interpolation bilinéaire avec align_corners=Faux lorsque nécessaire.
- Appliquer le produit de Hadamard pour effectuer la fusion grossière à travers les caractéristiques de l’encodeur aligné. Configurez la première voie de fusion fine en utilisant une couche linéaire de dimensions Ct → Ct. Configurez la seconde voie de fusion fine en utilisant une projection ascendante Ct → 2Ct, Conv1d, un bloc Mamba/S6 avec dimension modèle 2Ct, une direction de balayage, dimension d’état 16, et une projection descendante 2Ct → Ct.
- Fusionner les sorties des voies de fusion fine à l’aide du produit de Hadamard. Appliquez une projection linéaire finale avec des dimensions Ct à Ct. Faites entrer la représentation multi-étages fusionnée dans le décodeur.
- Fonctions de l’encodeur multiétage fusible utilisant MFusion Mamba
- Collectez les fonctionnalités de l’encodeur des quatre étages de l’encodeur (E1, E2, E3 et E4) et utilisez-les comme entrée du module MFusion Mamba. Ne sélectionnez pas uniquement la fonction encodeur à l’étage correspondant pour la fusion du décodeur.
- Aligner toutes les caractéristiques de l’encodeur à la résolution spatiale requise pour l’étape actuelle du décodeur. Redimensionnez les caractéristiques de l’encodeur à la résolution cible et projetez-les à la dimension du canal requise avant la fusion des caractéristiques.
- Répétez la procédure d’alignement des caractéristiques pour chaque étape du décodeur. Lorsque le décodeur fonctionne à H/16 × W/16, H/8 × W/8 et H/4 × W/4, redimensionnez et projetez E1, E2,E 3 et E4 dans l’espace de caractéristiques cible correspondant.
- Fusionner les caractéristiques de l’encodeur multi-étage alignées à l’aide des opérations de fusion grossière et de fusion fine du module MFusion Mamba, et combiner la représentation fusionnée avec les caractéristiques du décodeur à l’échelle correspondante.
- Effectuez les opérations de projection de caractéristiques, de redimensionnement et de fusion selon l’implémentation publiée dans Models/mvmunet/core.py.
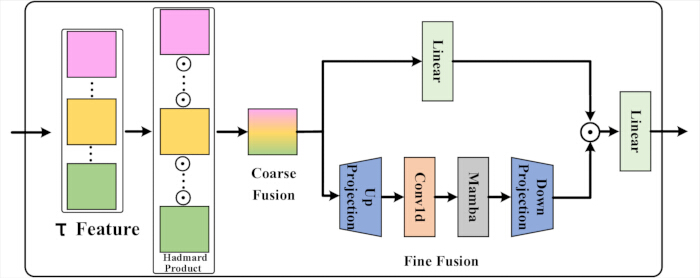
Figure 5. Architecture du module Multi-stage Fusion Mamba (MFusion Mamba). Structure du module Multi-stage Fusion Mamba (MFusion Mamba). Les caractéristiques de l’encodeur multi-échelle sont d’abord combinées par fusion grossière, puis affinées via le module Fine Fusion composé de projection linéaire, de convolution unidimensionnelle (Conv1d), d’un bloc Mamba et de couches de projection de caractéristiques avant la génération de la représentation des caractéristiques fusionnées utilisée par le décodeur. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
6. Entraînement par modèle
- Entraînez MVM-UNet sur Ubuntu 22.04.1 avec le noyau Linux version 6.8.0. Utilisez une station de travail équipée d’un processeur Intel Core i9-13900K de 13e génération et d’un GPU NVIDIA A800. Utilisez la même configuration matérielle tout au long de la formation et de l’évaluation.
- Implémentez et entraînez le modèle en utilisant PyTorch 2.0.1 avec CUDA 11.8. Installez toutes les dépendances logicielles nécessaires avant la formation.
- Utilisez l’optimiseur AdamW avec un taux d’apprentissage initial de 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸, et une décroissance pondérative de 0,01. Réglez la taille du lot à 32 sauf indication contraire.
- Entraînez chaque modèle pendant 300 époques. Utilisez un rythme d’apprentissage par recuit cosinus avec ηmin = 1 × 10⁻⁵. Réglez la taille de l’image d’entrée à 256 × 256 pour ISIC 2017 et ISIC 2018, et à 224 × 224 pour Synapse.
- Utilisez trois graines aléatoires indépendantes (1, 52 et 100) pour les principales expériences de comparaison. Répétez la procédure complète d’entraînement et d’évaluation pour chaque graine. Rapportez les résultats quantitatifs finaux en moyenne ± SD sur les trois séries.
- Utilisez une graine aléatoire fixe de 100 pour toutes les études d’ablation sauf indication contraire. Gardez les partitions de jeux de données, la stratégie de prétraitement, l’architecture réseau, l’optimiseur, le taux d’apprentissage, la taille du lot et le nombre d’époques d’entraînement inchangés dans toutes les expériences d’ablation.
- Utilisez la perte BCE-Dice pour la segmentation binaire des lésions sur ISIC 2017 et ISIC 2018. Fixez les poids de perte BCE et de dés à 1,0. Utilisez la perte CE-Dice pour Synapse et fixez à la fois les poids de la cross-entropie et de la perte de dés à 1,0.
- Redimensionnez, normalisez et augmentez les images d’entraînement ISIC 2017 et ISIC 2018 en utilisant la procédure de prétraitement décrite à l’étape 1. Appliquez le redimensionnement, la rotation aléatoire et le basculement aléatoire aux images d’entraînement Synapse comme décrit à l’étape 1. Utilisez les mêmes réglages de prétraitement lors de toutes les sessions d’entraînement.
- Sélectionnez les points de contrôle du modèle selon le protocole de validation spécifique à chaque ensemble de données. Sauvegardez le point de contrôle avec les meilleures performances de validation pour ISIC 2017 et ISIC 2018, et effectuez la validation toutes les 30 époques. Entraînez Synapse pendant 300 époques sans ensemble de validation et utilisez le point de contrôle final pour les tests.
- Utilisez uniquement le jeu de validation officiel pour la sélection des modèles ISIC 2017 et ISIC 2018. N’utilisez pas le jeu de test Synapse pour l’entraînement, l’ajustement des hyperparamètres ou la sélection de points de contrôle. Réservez toutes les données de test exclusivement pour l’évaluation finale.
- Utilisez les paramètres d’entraînement suivants pour la reproductibilité. Fixez la taille du lot à 32 pour tous les jeux de données. Utilisez AdamW avec un taux d’apprentissage initial de 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸, et une décroissance en poids de 1 × 10⁻².
- Configurez l’ordonnanceur de taux d’apprentissage du recuit cosinus avec Tmax = 50 et ηmin = 1×10⁻⁵ pour ISIC 2017 et ISIC 2018. Configurez l’ordonnanceur avec Tmax = 100 et ηmin = 1×10⁻⁵ pour Synapse. Gardez la configuration du planificateur inchangée pour toutes les expériences répétées.
- Entraînez tous les modèles en utilisant l’arithmétique FP32 en pleine précision. Désactivez l’entraînement automatique à précision mixte. N’appliquez pas de dégradé pendant l’optimisation.
- Gardez les réglages de précision, la stratégie de mise à jour du gradient, la configuration des optimiseurs, le calendrier du taux d’apprentissage et le protocole de graine aléatoire inchangés dans toutes les expériences de comparaison, études d’ablation et exécutions de reproductibilité.
- Sélectionnez le meilleur point de contrôle modèle
- Évaluer le modèle sur l’ensemble de validation après chaque période d’entraînement pour les ensembles de données ISIC 2017 et ISIC 2018.
- Calculez la perte binaire de dés croisés (BCE) pour chaque lot de validation et calculez la perte moyenne de validation sur l’ensemble de l’ensemble des validations.
- Sauvegardez le modèle actuel comme meilleur point de contrôle lorsque la perte moyenne de validation est inférieure à la perte minimale de validation précédemment enregistrée.
- Enregistrez la moyenne d’intersection sur Union (mIoU), le coefficient de similarité des dés (DSC), la précision (Acc), la spécificité (Spe) et la sensibilité (Sen) lors de la validation uniquement pour la surveillance des performances. N’utilisez pas ces indicateurs comme critère de sélection du point de contrôle.
7. Évaluation du modèle
- Évaluez le modèle entraîné en utilisant l’ensemble de tests officiel pour chaque jeu de données. Utilisez le jeu de tests uniquement pour l’évaluation finale des performances.
- Pour ISIC 2017 et ISIC 2018, calculez les mIoU, DSC, Acc, Sen et Spe. Utilisez les vrais positifs (TP) au niveau des pixels, les faux positifs (FP), les vrais négatifs (TN) et les faux négatifs (FN) pour tous les calculs.
- Appliquez une fonction d’activation sigmoïde à la sortie du modèle pour ISIC 2017 et ISIC 2018. Convertir la carte de probabilité en masque de segmentation binaire en utilisant un seuil de 0,5. Calculez les indicateurs d’évaluation à l’aide des équations 2 à 6 :
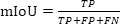 (2)
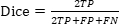 (3)
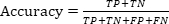 (4)
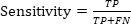 (5)
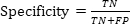 (6)
- Pour Synapse, appliquez la fonction d’activation softmax à la sortie du modèle. Assignez chaque pixel ou voxel à la classe ayant la plus forte probabilité en utilisant l’opération argmax. Calculez la DSC et la distance de Hausdorff du 95e percentile (HD95) pour chaque organe au premier plan et rapportez les valeurs moyennes pour tous les cas testés.
- Comparez MVM-UNet avec des méthodes de segmentation représentatives basées sur CNN, Transformer et modèles d’espace d’états (SSM). Utilisez des partitions de jeux de données identiques, des procédures de prétraitement, des résolutions d’entrée et des métriques d’évaluation pour toutes les méthodes.
- Utilisez les partitions officielles de formation, validation et tests pour ISIC 2017 et ISIC 2018. Utilisez la répartition standard de 18 cas d’entraînement et 12 cas de test pour Synapse. Réglez la résolution d’entrée sur pour les ensembles de données ISIC et pour Synapse.
- Reproduire les méthodes de base en utilisant leurs implémentations officielles dès que possible. Rapporter les résultats en moyenne ± DS sur plusieurs reprises. Conserver les valeurs rapportées par la littérature telles qu’elles ont été publiées à l’origine et les distinguer dans les notes de tableau correspondantes.
- Réalisez des études d’ablation en utilisant la graine aléatoire fixe de 100, sauf indication contraire. Gardez les partitions de jeux de données, la procédure de prétraitement, la résolution des entrées, l’optimiseur, le calendrier du taux d’apprentissage, la taille du lot, le nombre d’époques, la fonction de perte et les métriques d’évaluation inchangés dans toutes les expériences d’ablation.
- Évaluer les contributions de MV4D, SFusion Mamba, la branche Up-Down Projection dans le bloc MVV, MFusion Mamba, la taille de l’image d’entrée, la valeur de dropout et la configuration des couches encodeur-décodeur. Modifiez uniquement la composante ou le paramètre cible dans chaque expérience d’ablation.
- Effectuer le test de rang signé de Wilcoxon en utilisant des résultats par image appariés pour ISIC 2017 et ISIC 2018 ainsi que des résultats par cas par cas pour Synapse. Considérons une valeur p inférieure à 0,05 pour indiquer une signification statistique.
- Évaluer l’efficacité de calcul en utilisant le même environnement matériel et la même résolution d’entrée pour toutes les méthodes. Mesurez le temps d’entraînement par époque, le temps d’inférence par image, l’utilisation maximale de la mémoire GPU pendant l’entraînement, le nombre de paramètres du modèle et les opérations en virgule flottante (FLOP). Calculez les FLOPs à l’aide d’une seule passe avant.
- Sélectionnez des exemples qualitatifs représentatifs uniquement dans l’ensemble de tests après avoir terminé l’évaluation du modèle. Comparez l’image originale, le masque de la vérité du terrain et le masque prédit en utilisant des cas de test identiques pour toutes les méthodes. Sélectionnez des exemples représentatifs incluant de petites cibles, des frontières irrégulières, des frontières ambiguës et des structures multiorganiques représentatives.
- Calculer les métriques d’évaluation et effectuer une analyse statistique
- Calculez les métriques de segmentation des ensembles de données ISIC 2017 et ISIC 2018 en Python à l’aide de NumPy et sklearn.metrics.confusion_matrix. Seuillez la carte de probabilité prédite à 0,5, obtenez les TP, FP, TN et FN au niveau des pixels, et calculez le mIoU, DSC, Acc, Sen et Spe à partir de ces valeurs.
- Calculez le DSC et le HD95 pour l’ensemble de données Synapse en utilisant respectivement medpy.metric.binary.dc et medpy.metric.binary.hd95. Appliquez softmax suivi d’argmax à la sortie du modèle avant de calculer les métriques d’évaluation.
- Calculez le nombre de FLOPs et de paramètres entraînables à l’aide de thop.profile avec une seule passe avant.
- Effectuez le test de rang signé Wilcoxon en Python en utilisant scipy.stats.wilcoxon. Utilisez des valeurs de métriques par image appariées pour les ensembles de données ISIC 2017 et ISIC 2018 ainsi que des valeurs métriques par cas pour le jeu de données Synapse.
8. Définition de la fonction de perte
- Utilisez la perte standard de Cross-Entropy (CE) pour la segmentation multiclasse et la perte BCE standard pour la segmentation binaire. Utilisez la formulation standard de perte de dés pour la segmentation. Les équations 7 à 11 définissent les fonctions de perte utilisées dans ce protocole.
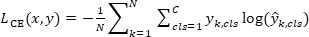 (7)
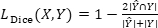 (8)
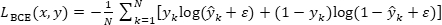 (9)
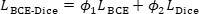 (10)
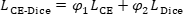 (11)
- Fixez les poids de perte BCE et de Dé à 1,0 pour ISIC 2017 et ISIC 2018, de sorte que
 1 = 1,0 et 2 = 1,0. Fixez les poids de perte CE et Dice à 1,0 pour Synapse, φ1 = 1,0 et φ2 = 1,0.
- Implémentez les fonctions de perte dans utils.py. Utilise nn. BCELoss pour le terme BCE et nn. CrossEntropyLoss pour le terme CE. Calculez la perte binaire de dés en aplatissant chaque masque prédit et masque de vérité de base, en calculant la perte de dé pour chaque échantillon, et en moyennant la perte sur le lot. Calculez la perte de dé multiclasse en convertissant la carte d’étiquettes cible en format one-hot, en appliquant softmax à la sortie du modèle, en calculant la perte de dés pour chaque classe, et en faisant la moyenne de la perte pour toutes les classes.
- Fixez la constante de lissage à 1 pour la perte binaire de Dé et à 1×10⁻⁵ pour la perte de dé multiclassé. Implémentez la perte BCE-Dice en utilisant la classe BceDiceLoss avec wb = 1 et wd = 1. Mettre en œuvre la perte CE-Dice en utilisant la classe CeDiceLoss avec loss_weight = [1, 1]. Gardez les constantes de lissage, la stratégie de réduction et l’implémentation logicielle inchangées pour tous les ensembles de données, graines aléatoires et expériences.
- Configurez la réduction des pertes
- Instancier nn. BCELoss() et nn. CrossEntropyLoss() sans spécifier explicitement l’argument de réduction.
- Utilisez le réglage par défaut de réduction des pertes de PyTorch (réduction = « moyenne ») pour les deux fonctions de perte. N’utilisez pas réduction = « somme » ou une sortie de perte non réduite.
9. Réglages de reproductibilité et exécution
- Téléchargez l’implémentation publiée depuis https://github.com/LIXUEGUANG002/MVM-UNet. Utilisez le dépôt avec les logiciels de travail, les jeux de données, les spécifications matérielles et les ressources informatiques listées dans le tableau des matériaux.
- Clonez le dépôt et entrez dans le répertoire du projet en exécutant git clone https://github.com/LIXUEGUANG002/MVM-UNet.git, suivi de cd MVM-Unet.
- Configurez l’expérience ISIC 2017 ou ISIC 2018 en définissant le nom du jeu de données, le chemin du jeu de données, la taille de l’entrée, la taille du lot, le nombre d’époques, la fonction de perte, l’optimiseur, l’ordonnanceur de taux d’apprentissage et la graine aléatoire dans les configurations/config_setting.py. Exécutez le script d’entraînement depuis la racine du dépôt en utilisant train.py Python.
- Configurez l’expérience Synapse en définissant le nom du jeu de données, le chemin des données d’entraînement, le chemin du volume de test, le répertoire de liste, la taille des entrées, le nombre de classes, la taille du lot, le nombre d’époques, la fonction de perte, l’optimiseur, l’ordonnanceur de taux d’apprentissage et la graine aléatoire dans les configurations/config_setting_synapse.py. Exécutez le script d’entraînement depuis la racine du dépôt en utilisant train_synapse.py Python.
- Effectuer une évaluation uniquement par inférence en définissant only_test_and_save_figs = Vrai, best_ckpt_path au point de contrôle entraîné, et img_save_path au répertoire de sortie dans le fichier de configuration correspondant. Exécutez des train.py Python pour ISIC 2017 ou ISIC 2018, ou exécutez train_synapse.py Python pour Synapse afin de générer des résultats de prédiction et des chiffres qualitatifs.
- Utilisez la version publiée en code source
- Clonez le dépôt GitHub publié et consultez le commit ee891b42c2f083c4990eed72f1d4463adc5e103e sur la branche maîtresse avant de configurer les ensembles de données, scripts d’entraînement et paramètres d’évaluation.
- Utilisez cet engagement pour reproduire les expériences rapportées dans cette étude. Aucune version de publication balisée n’était disponible pour le dépôt au moment de la révision du manuscrit.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Résultats attendus et interprétation
Lorsque ce protocole est correctement implémenté, le modèle entraîné MVM-UNet devrait produire une performance de segmentation stable sur des exécutions répétées, avec seulement de faibles variations entre différentes graines aléatoires pour la plupart des métriques d’évaluation. Pour ISIC 2017 et ISIC 2018, les résultats positifs se reflètent par des valeurs élevées de DSC, mIoU, Acc, Sen et Spe, ainsi que des masques de lésion pr...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Ce protocole décrit MVM-UNet, un cadre de segmentation d’images médicales basé sur Mamba. La méthode a été conçue pour répondre à deux limites des modèles de segmentation existants. Premièrement, les méthodes conventionnelles basées sur CNN ont une capacité limitée à modéliser les dépendances à longue portée et les informations contextuelles hiérarchiques dans des images médicalescomplexes 43. Deuxièmement, les méthodes basées sur Transformer peuvent modéliser le ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont pas d’intérêts financiers concurrents.
Remerciements
Cette recherche n’a reçu aucun financement externe.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 with Linux kernel 6.8.0; Intel Core i9-13900K CPU; NVIDIA A800 GPU; 128 GB RAM; 512 GB local storage. | Computational platform for training, validation, testing, ablation, and inference-only experiments. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | NVIDIA A800 GPU (80 GB memory). | GPU-accelerated model training and inference. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | 13th Gen Intel Core i9-13900K CPU. | Host processor for data loading, preprocessing, and experiment execution. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB system RAM | Memory for dataset loading, preprocessing, and training. |
| Hardware - Storage | Institutional computing platform / local workstation | 2 TB NVMe solid-state drive. | Storage for datasets, checkpoints, logs, and generated prediction figures. |
| Software environment - Operating system | Canonical Ltd. | Recommended: Ubuntu 22.04.1 LTS | Operating system for the computational environment. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Environment name: mvmunet | Python environment used to install and isolate dependencies. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Programming language used for implementation and experiment execution. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | GPU computing backend required by PyTorch and Mamba-related packages. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | GPU-accelerated deep-learning primitives used through PyTorch. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Deep-learning framework for model training, loss calculation, optimization, and inference. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Image transform utilities used in preprocessing and augmentation. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Installed with the recommended PyTorch environment. |
| Python package - timm | timm developers | timm == 0.4.12 | Model-component or utility dependency listed in the repository environment instructions. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | Dependency used by GPU-accelerated sequence modeling components. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Efficient causal convolution dependency required by the Mamba implementation. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | State-space sequence modeling package used for Mamba/S6-related components. |
| Python package - NumPy | NumPy developers | NumPy version 1.24.3. | Numerical computation and array operations. |
| Python package - SciPy | SciPy developers | SciPy version 1.10.1. | Scientific computation; scipy.ndimage.zoom is imported in utils.py. |
| Python package - SimpleITK | Insight Software Consortium | SimpleITK version 2.2.1. | Medical image input/output and preprocessing utility imported in utils.py. |
| Python package - MedPy | MedPy developers | MedPy version 0.4.0. | Medical image metric calculation package imported in utils.py. |
| Python package - scikit-image | scikit-image developers | scikit-image version 0.21.0. | Image-processing dependency listed in README. |
| Python package - scikit-learn | scikit-learn developers | scikit-learn version 1.3.2. | Machine-learning utility package listed in README. |
| Python package - matplotlib | Matplotlib developers | Matplotlib version 3.7.2. | Used for saving qualitative visualization figures. |
| Python package - h5py | h5py developers | h5py version 3.9.0. | HDF5 file support for Synapse test volumes. |
| Python package - thop | THOP developers | THOP version 0.1.1.post2209072238. | Used when calculating FLOPs and parameter-related computational cost. |
| Python package - packaging | Python Packaging Authority | packaging version 23.1. | Dependency listed in README. |
| Python package - pytest | pytest developers | pytest version 7.4.0. | Dependency listed in README. |
| Python package - chardet | chardet developers | chardet version 5.2.0. | Dependency listed in README. |
| Python package - yacs | YACS developers | yacs version 0.1.8. | Configuration utility dependency listed in README. |
| Python package - termcolor | termcolor developers | termcolor version 2.3.0. | Logging/terminal utility dependency listed in README. |
| Python package - submitit | submitit developers | submitit version 1.4.5. | Experiment/job utility dependency listed in README. |
| Python package - tensorboardX | tensorboardX developers | tensorboardX version 2.6.2.2. | Training log visualization utility listed in README. |
| Python package - ml-collections | ml_collections developers | ml-collections version 0.1.1. | Imported by configs/config_setting_synapse.py. |
| Dataset - ISIC 2017 Challenge dataset | International Skin Imaging Collaboration | ISIC 2017 skin lesion segmentation dataset | Public de-identified dermoscopic skin lesion images and masks used for binary segmentation. |
| Dataset - ISIC 2018 Challenge Task 1 dataset | International Skin Imaging Collaboration | ISIC 2018 Task 1: Lesion Boundary Segmentation | Public de-identified dermoscopic skin lesion images and masks used for binary segmentation. |
| Dataset - Synapse Multi-Atlas Labeling Beyond the Cranial Vault dataset | Synapse / Sage Bionetworks | Accession identifier: syn3193805 | Public abdominal CT multi-organ segmentation dataset. |
| Data organization - ISIC 2017 data folder | Authors / repository layout | data/isic2017/ | Expected local folder containing train and validation images/masks. |
| Data organization - ISIC 2018 data folder | Authors / repository layout | data/isic2018/ | Expected local folder containing train and validation images/masks. |
| Data organization - Synapse data folder | Authors / repository layout | data/Synapse/ | Expected local folder for Synapse lists, train_npz, and test_vol_h5. |
| Source code - MVM-UNet source-code repository | Authors / GitHub | Branch: master;Git commit hash: ee891b42c2f083c4990eed72f1d4463adc5e103e. | Complete source-code implementation of the protocol. |
| Source code - ISIC configuration file | Authors | configs/config_setting.py | Configuration file for ISIC-style binary segmentation. |
| Source code - Synapse configuration file | Authors | configs/config_setting_synapse.py | Configuration file for Synapse multi-organ segmentation. |
| Source code - ISIC training script | Authors | train.py | Training and validation entry point for ISIC-style binary segmentation. |
| Source code - Synapse training script | Authors | train_synapse.py | Training and validation entry point for Synapse multi-class segmentation. |
| Source code - |
Références
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.