Cette enquête transversale a examiné les associations entre l'utilisation de l'intelligence artificielle générative, le style d'enseignement, la littératie numérique, la motivation, l'anxiété et la créativité chez des étudiants saoudiens de premier cycle apprenant l'anglais comme langue étrangère, identifiant la motivation comme un médiateur important des relations observées.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
L'intelligence artificielle générative, la motivation, l'anxiété et la créativité dans les salles de classe d'anglais langue étrangère en Arabie saoudite : une enquête transversale
Dans cet article
Résumé
Résumé
Les outils d'intelligence artificielle (IA), tels que ChatGPT, sont de plus en plus intégrés à l'enseignement de l'anglais langue étrangère (ALE) ; toutefois, peu de données sont disponibles sur la manière dont leur utilisation est liée au style d'enseignement, à l'alphabétisation numérique, à la motivation, à l'anxiété en classe de langue étrangère (ALE) et à la créativité dans le contexte saoudien. Cette étude a examiné les associations entre ces variables et analysé le rôle médiateur de la motivation dans un cadre conceptuel unifié. Une enquête quantitative transversale a été menée auprès de 280 étudiants universitaires inscrits dans une université publique d'Arabie saoudite, à l'aide d'instruments de questionnaire validés. Les relations proposées ont été analysées à l'aide d'une modélisation par équations structurelles aux moindres carrés partiels (PLS-SEM). Les résultats ont indiqué que l'utilisation de ChatGPT, le style d'enseignement et l'alphabétisation numérique étaient positivement associés à la motivation des étudiants. Une motivation plus élevée était associée à des niveaux plus faibles d'ALE et à des niveaux plus élevés de créativité. La motivation a également médié les associations entre l'utilisation de ChatGPT, le style d'enseignement, l'alphabétisation numérique et l'ALE. Ces résultats suggèrent que les expériences motivationnelles des étudiants sont étroitement liées aux relations entre les pratiques pédagogiques, l'utilisation des technologies et les résultats d'apprentissage des langues. L'étude fournit des preuves appuyant l'intégration de stratégies d'enseignement appropriées, d'outils d'IA générative et d'activités visant l'alphabétisation numérique dans l'enseignement de la langue anglaise, tout en soulignant l'importance de prendre en compte les expériences motivationnelles et émotionnelles des étudiants lors de la mise en œuvre d'environnements d'apprentissage soutenus par la technologie.
Introduction
Le Royaume d'Arabie saoudite est en train de mettre en œuvre un programme de réforme éducative transformatrice dans le cadre de la Vision 2030, qui accorde la priorité au développement des compétences du XXIe siècle, à la maîtrise du numérique et à l'adoption d'approches pédagogiques innovantes à tous les niveaux de l'enseignement.1Dans ce contexte national, l'enseignement de l'anglais langue étrangère (ALE) continue de faire face à des difficultés persistantes, notamment une culture axée sur les examens qui privilégie l'apprentissage par cœur et la performance aux tests au détriment de la compétence communicative.2,3. Des possibilités limitées d'interactions authentiques en langue anglaise en dehors de la salle de classe, combinées à des niveaux élevés d'anxiété en situation d'apprentissage d'une langue étrangère (ALSE), restreignent davantage la volonté des étudiants de communiquer et de s'engager de manière significative dans la langue cible4Ces défis ont incité les éducateurs et les décideurs à explorer des approches innovantes permettant de remédier aux déficits de motivation, aux obstacles émotionnels et à l'utilisation créative de la langue. L'intelligence artificielle (IA) s'est imposée comme une piste prometteuse pour soutenir l'apprentissage des langues et transformer les pratiques pédagogiques.5Parmi les applications de l'intelligence artificielle (IA) dans l'enseignement de la langue anglaise (ELT), ChatGPT, un modèle d'IA générative conversationnel, a retenu considérablement l'attention pour son aptitude à offrir une pratique interactive de la langue et des retours personnalisés immédiats dans des contextes conversationnels en temps réel.6Ces caractéristiques sont particulièrement pertinentes dans les salles de classe saoudiennes d'anglais langue étrangère, où l'enseignement centré sur l'enseignant et l'interaction limitée entre élèves continuent de restreindre la production linguistique créative.7ChatGPT pourrait aider à surmonter ces limitations en offrant des opportunités de pratique linguistique authentique et peu anxiogène avec un interlocuteur IA8.
De récentes réformes éducatives en Arabie saoudite ont encouragé une transition vers une pédagogie centrée sur l'apprenant, créant ainsi des opportunités d'intégrer des technologies d'intelligence artificielle favorisant la participation active, la pensée critique et l'apprentissage autonome9,10. Lorsqu'il est mis en œuvre de manière appropriée, ChatGPT peut soutenir cette transition en prolongeant la pratique linguistique au-delà des activités traditionnelles en classe11. Toutefois, l'efficacité de l'intégration de l'IA dépend en partie de la littératie numérique des étudiants, définie comme leur capacité à évaluer, utiliser et interagir efficacement avec les technologies numériques à des fins d'apprentissage12. La littératie numérique permet aux apprenants d'utiliser de manière productive les outils d'IA tout en minimisant les risques potentiels, tels que la dépendance excessive et la désinformation13. Cette compétence est particulièrement importante dans l'enseignement supérieur saoudien, où la transformation numérique s'est accélérée dans le cadre de la Vision 203014.
Bien que des recherches antérieures aient examiné séparément les outils d'intelligence artificielle, le style d'enseignement, la littératie numérique, la motivation, l'anxiété et la créativité, peu de données ont étudié la manière dont ces facteurs interagissent au sein d'un cadre unifié dans des contextes anglophones non occidentaux, comme celui de l'Arabie saoudite. La motivation a été régulièrement identifiée comme un mécanisme important reliant les pratiques pédagogiques aux résultats d'apprentissage, notamment une anxiété réduite, une créativité accrue et un engagement soutenu15. Toutefois, les relations entre l'utilisation de ChatGPT, le style d'enseignement, la littératie numérique, la motivation, l'anxiété en contexte de langue étrangère (FLCA) et la créativité n'ont pas été exhaustivement étudiées dans le contexte saoudien d'apprentissage de l'anglais langue étrangère (EFL)16. Combler cette lacune pourrait fournir des éclairages théoriques et pratiques utiles à la conception d'environnements d'apprentissage des langues enrichis par les technologies, capables de soutenir le développement motivationnel, émotionnel et créatif des étudiants. Cette étude examine donc les relations entre l'utilisation de ChatGPT, le style d'enseignement, la littératie numérique, la motivation, l'FLCA et la créativité chez des étudiants saoudiens anglophones. Plus précisément, elle analyse (1) les relations entre l'utilisation de ChatGPT, le style d'enseignement et la littératie numérique, d'une part, et la motivation des étudiants, d'autre part ; (2) les relations entre la motivation, l'FLCA et la créativité ; et (3) le rôle médiateur de la motivation dans les relations entre l'utilisation de ChatGPT, le style d'enseignement, la littératie numérique, et les variables de résultat que sont l'anxiété et la créativité.
Cette étude contribue à l'enseignement des langues étrangères et à l'apprentissage assisté par les technologies en intégrant l'utilisation d'outils d'intelligence artificielle dans les modèles existants de motivation et d'apprentissage linguistique, élargissant ainsi la compréhension de l'apprentissage des langues soutenu par les technologies dans les contextes éducatifs contemporains. Elle fournit également des éléments probants susceptibles d'aider les enseignants, les concepteurs de programmes et les décideurs souhaitant intégrer des outils d'intelligence artificielle dans l'enseignement des langues étrangères en Arabie saoudite. En examinant la motivation comme un facteur médiateur reliant l'utilisation des technologies et les pratiques pédagogiques à l'anxiété envers l'apprentissage des langues étrangères (FLCA) et à la créativité, cette étude apporte des preuves contextuelles pour soutenir le développement d'un enseignement des langues centré sur l'apprenant, en alignement avec les objectifs de réforme éducative de l'Arabie saoudite.
La théorie de l'autodétermination (Self-Determination Theory, SDT) fournit un cadre théorique permettant de comprendre la relation entre les pratiques d'enseignement et la motivation des étudiants dans les contextes éducatifs17. Selon la SDT, la motivation intrinsèque et les formes autonomes de motivation extrinsèque sont favorisées lorsque les trois besoins psychologiques fondamentaux des apprenants — l'autonomie, la compétence et l'interrelation — sont satisfaits dans l'environnement d'apprentissage18. Le style d'enseignement constitue donc un facteur contextuel clé influant sur la motivation et l'engagement des étudiants19. Les pratiques pédagogiques favorisant l'autonomie, qui offrent des choix significatifs, tiennent compte du point de vue des étudiants et expliquent les activités d'apprentissage, renforcent la motivation intrinsèque et un engagement autodéterminé20. Dans les contextes d'apprentissage d'une langue étrangère (EFL), les approches centrées sur l'apprenant, incluant les styles d'enseignement de facilitateur et de délégateur, ont été associées à un engagement, une participation et un intérêt plus grands des étudiants pour l'apprentissage linguistique21,22. En revanche, un enseignement centré sur l'enseignant peut réduire la motivation en limitant la participation et l'autonomie des étudiants, tout en privilégiant les récompenses extrinsèques au détriment de l'intérêt intrinsèque23,24. Dans le contexte saoudien d'apprentissage d'une langue étrangère, où l'enseignement traditionnel a historiquement mis l'accent sur la mémorisation et la transmission par l'enseignant25, l'adoption d'approches pédagogiques davantage centrées sur l'apprenant pourrait soutenir la motivation des étudiants26. Sur la base de cette fondation théorique et empirique, l'hypothèse suivante est proposée : H1 : Le style d'enseignement influence positivement la motivation des étudiants en EFL.
La relation entre la technologie éducative et la motivation des apprenants a été largement étudiée27,28. Le modèle d'acceptation de la technologie (TAM) suggère que la motivation des apprenants à utiliser une technologie éducative dépend de l'utilité perçue et de la facilité d'utilisation perçue, qui influencent les intentions comportementales et l'utilisation de la technologie29. Appliqué à ChatGPT, ce cadre théorique indique que les étudiants qui perçoivent l'outil comme utile et facile à utiliser sont plus enclins à l'adopter pour l'apprentissage des langues30. Des études empiriques ont rapporté des associations positives entre l'apprentissage des langues assisté par l'intelligence artificielle et la motivation des étudiants, les fonctionnalités interactives, les retours immédiats et les exercices personnalisés contribuant à un engagement soutenu31,32. ChatGPT pourrait également réduire les obstacles liés à l'anxiété linguistique en offrant des possibilités de pratique dans un contexte peu stressant, ce qui pourrait encourager une utilisation prolongée de la langue33. Ce potentiel est particulièrement pertinent dans le contexte saoudien, où l'anxiété en classe de langue étrangère (FLCA) a été identifiée comme un obstacle important à la motivation et à la réussite linguistique34. À partir de ces résultats théoriques et empiriques, l'hypothèse suivante est formulée : H2 : L'utilisation de ChatGPT influence positivement la motivation des étudiants en apprentissage d'une langue étrangère (EFL).
La maîtrise du numérique est devenue un déterminant important de la motivation des étudiants dans les environnements d'apprentissage actuels de l'anglais langue étrangère35. Elle désigne la capacité à rechercher, évaluer et utiliser efficacement les technologies et les médias numériques à des fins d'apprentissage36. Dans les contextes d'apprentissage de l'anglais langue étrangère, la maîtrise du numérique permet aux apprenants d'utiliser efficacement des ressources numériques, notamment ChatGPT, les systèmes de gestion de l'apprentissage et les outils multimédias, afin de soutenir l'apprentissage des langues et la motivation37. Les étudiants possédant un niveau plus élevé de maîtrise du numérique sont plus enclins à utiliser les technologies d'apprentissage avec confiance, renforçant ainsi leur compétence et leur autonomie, facteurs associés à la motivation intrinsèque38. Ils sont également mieux préparés à utiliser les outils numériques pour s'exercer de manière autonome à la langue, obtenir des retours et maintenir un engagement soutenu dans l'apprentissage39. À partir de ces travaux, l'hypothèse suivante est proposée : H3 : La maîtrise du numérique des étudiants en anglais langue étrangère influence positivement leur motivation.
L'anxiété en situation de langue étrangère (FLCA) et la créativité sont des concepts étroitement liés dans l'enseignement des langues étrangères (EFL), bien que leur relation demeure complexe40. L'anxiété peut limiter la performance des apprenants dans des tâches exigeant de la créativité, de la flexibilité cognitive, une pensée divergente et une expression de soi41. La FLCA reflète la peur des apprenants de commettre des erreurs, leur crainte d'une évaluation négative et leur faible confiance en eux, éléments qui peuvent tous entraver la production linguistique créative42. La créativité est toutefois une compétence essentielle dans l'apprentissage d'une langue étrangère, car elle favorise une utilisation linguistique innovante et adaptée au contexte31. Des études antérieures ont montré que les apprenants plus anxieux participent moins volontiers aux activités d'écriture créative et de communication orale43,44. À partir de ces travaux, les hypothèses suivantes sont formulées : 1) H4 : La motivation des étudiants en EFL est en relation négative avec leur anxiété, et 2) H5 : L'anxiété des étudiants en EFL exerce une influence négative sur leur créativité.
La motivation fournit un mécanisme théorique par lequel le style d'enseignement, l'utilisation de ChatGPT et la littératie numérique peuvent être liés à l'anxiété en contexte d'apprentissage d'une langue étrangère (FLCA)45. Les apprenants motivés ont plus de chances de participer activement, de persévérer face aux difficultés et d'éprouver un niveau moindre d'anxiété en communication46. Des pratiques pédagogiques bienveillantes, l'apprentissage des langues assisté par l'intelligence artificielle et une meilleure maîtrise du numérique ont chacune été associées à une motivation accrue et à une anxiété réduite dans les contextes d'apprentissage d'une langue étrangère (EFL)47,48,49. Des recherches antérieures suggèrent également qu'une motivation plus élevée est associée à une anxiété moindre en classe et à une créativité accrue, ce qui appuie l'idée que la motivation pourrait jouer un rôle de médiateur entre les pratiques pédagogiques, l'utilisation des technologies et les résultats d'apprentissage50,51,52. Sur la base de cette littérature, les hypothèses suivantes sont formulées : 1) H6 : La motivation joue un rôle de médiateur dans la relation entre le style d'enseignement et l'anxiété des étudiants en EFL ; 2) H7 : La motivation joue un rôle de médiateur dans la relation entre l'utilisation de ChatGPT et l'anxiété des étudiants en EFL ; et 3) H8 : La motivation joue un rôle de médiateur dans la relation entre la littératie numérique des étudiants en EFL et leur anxiété. Figure 1 illustre le modèle hypothétique dans lequel le style d'enseignement, l'utilisation de ChatGPT et la littératie numérique sont associés à la motivation des étudiants en EFL, laquelle, à son tour, médie leurs relations avec l'anxiété en contexte d'apprentissage d'une langue étrangère (FLCA) et la créativité.
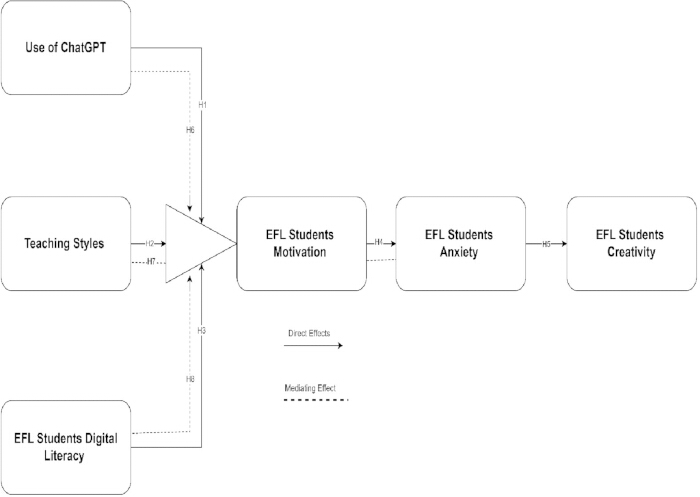
Figure 1. Modèle de recherche hypothétique. Ce modèle illustre les relations hypothétiques entre l'utilisation de ChatGPT, le style d'enseignement, la littératie numérique, la motivation, l'anxiété en classe de langue étrangère et la créativité chez les étudiants apprenant l'anglais comme langue étrangère (EFL). Les lignes continues représentent des relations directes hypothétiques, tandis que les lignes en pointillés représentent des relations médiatrices, telles qu'indiquées sur la figure. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Bien que l'étude n'ait pas nécessité d'approbation éthique formelle d'un comité d'évaluation institutionnel en raison de son design de sondage anonyme non expérimental, ne comportant aucune intervention physique, manipulation ou tromperie des participants, toutes les procédures ont été menées conformément aux principes éthiques de la Déclaration d'Helsinki et aux lignes directrices de l'American Psychological Association pour la recherche impliquant des participants humains. Un consentement éclairé a été obtenu de tous les participants avant la collecte des données. L'institution n'exigeait ni n'a délivré d'approbation éthique formelle ni d'exemption pour ce type d'étude. Tous les répondants ont été expressément informés de l'objectif de la recherche, de la nature volontaire de leur participation, de leur droit de se retirer à tout moment sans conséquence, ainsi que des mesures strictes de confidentialité appliquées à leurs données. Aucune information permettant d'identifier les personnes n'a été collectée ni rapportée, et toutes les données ont été utilisées exclusivement pour une analyse académique agrégée. Une attention particulière a été portée au choix d'un libellé non intrusif et respectueux afin de garantir que le questionnaire n'interfère pas avec les activités académiques ou le bien-être psychologique des participants. Pour le formulaire de consentement éclairé, voir Fichier Supplémentaire 1. Par ailleurs, les matériaux utilisés dans cette étude sont répertoriés dans le Tableau des Matériaux.
Conception de la recherche
Cette section décrit la conception de la recherche, les procédures de collecte des données et les détails de l'échantillon utilisés dans l'étude afin d'analyser les relations entre le style d'enseignement, l'utilisation de ChatGPT, la littératie numérique, la motivation, l'anxiété et la créativité chez les étudiants en anglais langue étrangère (EFL). L'étude a adopté une conception de recherche quantitative transversale afin d'examiner le rôle médiateur de la motivation dans les relations entre le style d'enseignement, l'utilisation de ChatGPT, la littératie numérique et l'anxiété chez les étudiants EFL, ainsi que la manière dont ces variables sont globalement liées à la créativité. Une méthodologie d'enquête structurée a été utilisée pour recueillir les données primaires, garantissant une standardisation et une fiabilité dans la mesure des variables étudiées. L'étude a utilisé des échelles validées pour évaluer toutes les variables, notamment le style d'enseignement, l'utilisation de ChatGPT, la littératie numérique, la motivation, l'anxiété en contexte de langue étrangère (FLCA) et la créativité.
Données et échantillon
Les données de cette étude ont été recueillies auprès d'étudiants en anglais langue étrangère inscrits à l'Université de Djeddah, une université du secteur public en Arabie saoudite reconnue pour son accent mis sur l'enseignement des langues et l'intégration des technologies dans l'enseignement. Les participants ont été sélectionnés selon une méthode d'échantillonnage raisonné, jugée appropriée pour cette étude étant donné les critères d'inclusion spécifiques exigeant que les participants aient une expérience active d'outils d'intelligence artificielle tels que ChatGPT dans leur environnement d'apprentissage. Cette approche d'échantillonnage non probabiliste s'est avérée nécessaire car les questions de recherche de l'étude portaient sur une population précise d'étudiants en anglais langue étrangère ayant été exposés à la fois à des méthodes d'apprentissage traditionnelles et assistées par technologie, et un échantillonnage aléatoire n'aurait pas garanti l'inclusion de participants répondant à ces critères. Bien que l'échantillonnage raisonné limite la généralisation des résultats à l'ensemble de la population, il était justifié pour cette investigation exploratoire afin de s'assurer que les participants possédaient les expériences et les points de vue pertinents nécessaires pour atteindre les objectifs de recherche. Afin d'atténuer les limites de l'échantillonnage raisonné, des efforts ont été faits pour inclure des participants aux parcours universitaires variés et aux niveaux de compétence technologique différents, renforçant ainsi la représentativité de l'échantillon au sein de la population cible. L'échantillon final comprenait 280 étudiants de premier cycle en anglais langue étrangère, une taille jugée suffisante pour les techniques statistiques utilisées.
La détermination de l'adéquation de la taille de l'échantillon s'est fondée sur des directives établies pour la modélisation par équations structurelles (MES). Les chercheurs recommandent un ratio minimal de 10 sujets par paramètre estimé en MES, des directives plus conservatrices préconisant 20 sujets par paramètre pour la MES aux moindres carrés partiels (MES-MCP). Le modèle de mesure comprenait 29 items pour l'alphabétisation numérique, 25 items pour le style d'enseignement et 32 items pour l'anxiété envers la langue étrangère (FLCA), ainsi que des items supplémentaires relatifs à l'utilisation de ChatGPT, à la motivation et à la créativité. Les directives pour la MES-MCP recommandent également une taille d'échantillon minimale égale à 10 fois le nombre maximal d'indicateurs formatifs ou le nombre maximal de chemins structurels dirigés vers une construction donnée ; ainsi, l'échantillon de 280 participants dépassait ces exigences minimales. De plus, une analyse de puissance a posteriori réalisée à l'aide de G*Power53 a indiqué qu'un échantillon de 280 participants offrait une puissance statistique supérieure à 0,95 pour détecter des effets de taille moyenne (f2 = 0,15) avec α = 0,05, dépassant ainsi le seuil couramment recommandé de 0,80. Cette taille d'échantillon permet d'obtenir des estimations de paramètres fiables et une puissance statistique suffisante pour détecter des relations significatives entre les variables de l'étude, tout en tenant compte de la complexité des modèles de mesure et structurels proposés.
Participants et procédure
Les participants étaient des étudiants apprenant l'anglais comme langue étrangère âgés de 18 à 25 ans, la majorité étant des étudiants de première ou de deuxième année inscrits à des cours de langue anglaise. L'enquête a été menée entre septembre et octobre 2025, durant laquelle les étudiants ont été invités à participer de manière volontaire. Le processus de recrutement a impliqué une diffusion via les canaux officiels de l'université, notamment par courriels et annonces en classe. Les participants étaient des étudiants EFL âgés de 18 à 25 ans inscrits en première ou deuxième année de licence dans des cours de langue anglaise. L'éligibilité était déterminée selon des critères d'inclusion et d'exclusion prédéfinis. Les participants étaient éligibles s'ils (a) étaient officiellement inscrits à des cours de langue anglaise de premier cycle à l'Université de Djeddah, (b) avaient entre 18 et 25 ans, et (c) étaient inscrits comme étudiants de première ou deuxième année. Les étudiants étaient exclus s'ils (a) étaient des étudiants diplômés ou des étudiants de niveau supérieur extérieurs à la séquence de cours fondamentaux, (b) se situaient en dehors de la tranche d'âge précisée, ou (c) avaient participé à la phase de prétest du questionnaire. Afin d'assurer le consentement éclairé, les participants ont été informés de l'objectif de l'étude, du caractère volontaire de leur participation et de la confidentialité de leurs réponses. L'instrument de collecte des données était un questionnaire structuré auto-administré, distribué physiquement et électroniquement au moyen d'une plateforme en ligne sécurisée. Des échelles validées ont été adaptées pour mesurer le style d'enseignement, l'utilisation de ChatGPT, l'alphabétisation numérique, la motivation des étudiants, l'anxiété en contexte de langue étrangère (FLCA) et la créativité. Les participants ont été invités à évaluer leurs réponses selon une échelle de Likert à 5 points, allant de 1 (Totalement en désaccord) à 5 (Totalement d'accord). Un prétest du questionnaire a été réalisé auprès d'un petit groupe de 30 étudiants afin d'en assurer la clarté et la fiabilité. Sur la base des résultats du prétest, des ajustements mineurs ont été apportés au libellé des items pour améliorer leur compréhension, et aucun problème majeur concernant la fiabilité ou la validité des échelles n'a été identifié. Afin de préserver l'intégrité des données et encourager des réponses honnêtes, l'anonymat a été garanti, et les participants ont été assurés que leurs données seraient utilisées uniquement à des fins de recherche. Sur les 300 réponses initialement recueillies, 280 ont été jugées valides après vérification des données incomplètes ou incohérentes, ce qui correspond à un taux de rétention de 93 %. Les procédures de contrôle des données comprenaient l'analyse des profils de réponse pour détecter les réponses linéaires systématiques, les données manquantes excessives (plus de 10 %) et les valeurs aberrantes multivariées à l'aide de la distance de Mahalanobis. Cette approche méthodologique fournit une base solide pour analyser les relations entre les variables de l'étude et offre des perspectives précieuses sur le rôle du style d'enseignement, des outils d'intelligence artificielle et de l'alphabétisation numérique dans la motivation, l'anxiété et la créativité des étudiants EFL.
Après la collecte des données, 20 réponses ont été exclues du lot initial de 300 selon des critères prédéfinis : 12 réponses ont été retirées en raison d'un nombre excessif de données manquantes dépassant 10 % des items du questionnaire, 5 ont été éliminées pour avoir présenté des profils de réponse linéaires (réponses uniformes sur tous les items, indiquant un manque d'engagement), et 3 ont été identifiées comme des valeurs aberrantes multivariées à l'aide de la distance de Mahalanobis (p < 0,001), puis supprimées afin d'éviter de fausser les résultats de la modélisation par équations structurelles (SEM). Les valeurs manquantes pour les cas conservés ont été traitées par imputation de la moyenne lorsque les données manquantes étaient minimes (moins de 5 % par cas), car cette méthode est acceptable pour de faibles proportions de données manquantes dans les études par sondage à grande échelle. Le taux de rétention final de 93 % (280 réponses valides sur 300 questionnaires collectés) représente la proportion de réponses exploitables conservées parmi l'ensemble des questionnaires recueillis ; toutefois, ce chiffre ne doit pas être interprété comme un taux de réponse réel, car le nombre exact de participants invités n'a pas pu être calculé, les méthodes combinées de distribution physique et électronique via les canaux officiels de l'université ne permettant pas un suivi précis du nombre total d'invitations envoyées. Cette limite est reconnue, et la valeur de 93 % est donc indiquée comme la proportion de réponses valides conservées parmi les questionnaires collectés, et non comme un taux de réponse par rapport à l'ensemble de la population invitée.
Outils et mesures
Cette étude a utilisé des échelles bien établies et validées, soigneusement adaptées au contexte de l'enseignement de l'anglais langue étrangère (EFL), afin de mesurer les concepts fondamentaux suivants : style d'enseignement, littératie numérique, utilisation de ChatGPT, anxiété en classe de langue étrangère (FLCA), motivation et créativité. Chaque échelle a été sélectionnée en fonction de sa pertinence et de son exhaustivité pour rendre compte des dimensions respectives des variables étudiées. La littératie numérique a été mesurée à l’aide d’une échelle adaptée de Rodríguez-de-Dios et al.54, comprenant six dimensions et 29 items. Ces dimensions incluaient la Compétence technologique, la Compétence en sécurité personnelle, la Compétence critique, la Compétence en sécurité des appareils, la Compétence informationnelle et la Compétence en communication, permettant ainsi une évaluation complète de la maîtrise des étudiants en compétences numériques essentielles dans les contextes éducatifs contemporains. L’utilisation de ChatGPT a été évaluée à l’aide d’une échelle de 8 items, adaptée de Abbas et al.55, centrée sur l’interaction des étudiants avec l’outil d’intelligence artificielle dans des tâches d’apprentissage linguistique. Le style d’enseignement a été évalué à l’aide d’une version adaptée de l’Inventaire des styles d’enseignement de Grasha56. Cet instrument mesure cinq dimensions des styles d’enseignement : Autorité, Expert, Modèle personnel, Facilitateur et Délégué. Ces dimensions reflètent diverses approches pédagogiques influant sur l’expérience d’apprentissage des étudiants en EFL. L’anxiété en classe de langue étrangère (FLCA) a été mesurée à l’aide d’une échelle adaptée de Briesmaster et Briesmaster57. Cet instrument examine l’anxiété selon trois dimensions : l’Appréhension en communication (10 items), l’Anxiété liée aux examens (10 items) et la Peur de l’évaluation négative (7 items). La motivation des étudiants a été évaluée à l’aide d’une échelle adaptée de Kanoksilapatham et al.58, mesurant trois dimensions : Promotion et prévention instrumentales, Ethnocentrisme et intégration, et Attitude envers l’apprentissage de l’anglais. L’échelle comprenait au total 20 items. La créativité des étudiants en EFL a été mesurée à l’aide d’une échelle adaptée de Govindasamy et al.59, qui évalue quatre dimensions : Originalité, Souplesse, Fluidité et Élaboration. Chaque dimension a été mesurée à l’aide de trois items. Afin de garantir l’adéquation culturelle et contextuelle des instruments au cadre EFL, une procédure systématique d’adaptation a été appliquée. Étant donné que les échelles d’origine étaient rédigées en anglais, deux experts bilingues en EFL ont relu et simplifié le langage afin d’en améliorer la clarté pour des étudiants universitaires de niveau intermédiaire, tout en préservant le sens original de chaque concept. Les versions adaptées ont ensuite été retrotraduites dans la langue maternelle des participants par un traducteur indépendant afin de vérifier l’équivalence linguistique et conceptuelle, et toute divergence a été résolue par discussion au sein de l’équipe de recherche. Par la suite, trois enseignants expérimentés en EFL ont évalué les instruments adaptés en termes de pertinence du contenu, d’appropriation culturelle et de clarté des items, ce qui a conduit à de légères révisions de formulation et au remplacement d’exemples culturellement peu familiers le cas échéant. Enfin, les instruments révisés ont été testés en avant-première auprès de 30 étudiants (voir la section Procédure), et les retours des participants ont été utilisés pour effectuer des ajustements mineurs supplémentaires afin d’améliorer la compréhensibilité. Ce processus en plusieurs étapes a permis de s’assurer que les instruments adaptés conservaient leurs propriétés psychométriques d’origine tout en étant adaptés à la population cible d’étudiants en EFL. Pour consulter le questionnaire entièrement adapté, voir le Fichier supplémentaire 2.
Méthodes d'analyse des données
Les données recueillies pour cette étude ont été analysées à l'aide du logiciel Statistical Package for the Social Sciences (SPSS 26) et de SmartPLS 4, en utilisant la méthode des moindres carrés partiels avec modélisation par équations structurelles (PLS-SEM). Cette approche fondée sur deux méthodes a permis une analyse complète des données, traitant à la fois les aspects descriptifs et inférentiels, tout en testant les relations hypothétisées et les effets de médiation dans le modèle de recherche. Dans un premier temps, SPSS a été utilisé pour effectuer une analyse préliminaire des données, incluant le nettoyage des données, les statistiques descriptives et les tests de fiabilité. L'examen des données comprenait la vérification des valeurs manquantes, des valeurs aberrantes et de la normalité afin de garantir la qualité et l'intégrité du jeu de données. Des statistiques descriptives, notamment la moyenne, l'écart type et les distributions de fréquences, ont été calculées pour résumer les caractéristiques de l'échantillon. L'analyse principale a été réalisée à l'aide de SmartPLS 4. La méthode PLS-SEM a été choisie en raison de son adéquation à l'analyse de modèles complexes comportant de multiples construits, ainsi que de sa robustesse pour des échantillons de taille petite à moyenne. L'analyse a été menée en deux étapes : l'évaluation du modèle de mesure et l'évaluation du modèle structurel. Lors de l'évaluation du modèle de mesure, la fiabilité des indicateurs, la fiabilité de cohérence interne (à l'aide de la fiabilité composite [CR]), la validité convergente (à l'aide de la variance moyenne extraite [AVE]) et la validité discriminante (à l'aide du ratio hétérotrait–monotrait [HTMT]) ont été examinées.
Après la validation du modèle de mesure, le modèle structurel a été évalué afin d'analyser les relations hypothétiques entre le style d'enseignement, l'utilisation de ChatGPT, la littératie numérique, la motivation, l'anxiété et la créativité. Les coefficients de chemin ont été analysés pour déterminer l'intensité et la significativité des effets directs et indirects, la significativité étant évaluée par un bootstrap avec 5 000 rééchantillonnages. Pour évaluer la significativité des effets directs, indirects et de médiation, des intervalles de confiance bootstrap corrigés du biais (BC) ont été construits à l'aide de 5 000 rééchantillonnages bootstrap avec un niveau de confiance de 95 %. Les effets de médiation de la motivation sur les relations entre le style d'enseignement, l'utilisation de ChatGPT, la littératie numérique et l'anxiété ont également été évalués à l'aide d'intervalles de confiance bootstrap. L'ajustement du modèle et sa puissance prédictive ont été évalués à l'aide du coefficient de détermination (R2), de la pertinence prédictive (Q2) et du résidu quadratique moyen standardisé (SRMR).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Statistiques descriptives
Les statistiques descriptives offrent un aperçu des caractéristiques de l'échantillon ainsi que de la distribution, de la tendance centrale et de la variabilité des variables étudiées. Dans cette étude, des analyses descriptives ont été réalisées afin de caractériser l'échantillon de participants et de résumer les variables clés avant d'effectuer les analyses structurelles.
Tableau 1 résume les caractéristi...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Cette étude a examiné les relations entre le style d'enseignement, l'utilisation de ChatGPT, la littératie numérique, la motivation, l'anxiété envers l'apprentissage d'une langue étrangère (FLCA) et la créativité chez des étudiants saoudiens universitaires apprenant l'anglais comme langue étrangère (EFL), en accordant une attention particulière au rôle médiateur de la motivation. Les résultats apportent des éléments probants sur les relations entre les pratiques pédagogiques, l'utilisation des technologies et les caracté...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Conflit d'intérêts :
L'auteur déclare ne pas avoir de conflits d'intérêts.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Échelle d'utilisation de ChatGPT (adaptée) | Auteurs ; adapté de Abbas et al. | N/A | Questionnaire à huit items évaluant l'utilisation par les étudiants de ChatGPT pour l'apprentissage des langues. |
| Échelle de créativité (adaptée) | Auteurs ; adapté de Govindasamy et al. | N/A | Questionnaire à douze items évaluant l'originalité, la flexibilité, la fluidité et l'élaboration. |
| Échelle de littératie numérique (adaptée) | Auteurs ; adapté de Rodríguez-de-Dios et al. | N/A | Questionnaire à vingt-neuf items mesurant six dimensions de la littératie numérique. |
| Échelle d'anxiété en classe de langue étrangère (FLCA) (adaptée) | Auteurs ; adapté de Briesmaster & Briesmaster | N/A | Questionnaire à vingt-sept items mesurant l'appréhension en communication, l'anxiété liée aux examens et la peur de l'évaluation négative. |
| G*Power | Université Heinrich Heine de Düsseldorf | Version 3.1.9.7 ; RRID : SCR_013726 | Logiciel utilisé pour l'analyse post hoc de la puissance statistique. |
| IBM SPSS Statistics | IBM Corp. | Version 26 ; RRID : SCR_002865 | Logiciel statistique utilisé pour le nettoyage des données, les statistiques descriptives, les analyses de fiabilité et les analyses préliminaires. |
| Analyse de la distance de Mahalanobis | IBM SPSS Statistics | Version 26 ; RRID : SCR_002865 | Procédure statistique mise en œuvre dans IBM SPSS Statistics pour identifier les valeurs aberrantes multivariées. |
| Échelle de motivation (adaptée) | Auteurs ; adapté de Kanoksilapatham et al. | N/A | Questionnaire à vingt items évaluant la motivation de l'apprenant. |
| Questionnaire papier | Auteurs | N/A | Version imprimée du questionnaire auto-administré structuré utilisé pour la collecte de données en présentiel. |
| Plateforme sécurisée de sondage en ligne | Google LLC | N/A | Plateforme Google Forms utilisée pour la diffusion électronique du questionnaire. |
| SmartPLS | SmartPLS GmbH | Version 4 ; RRID : SCR_036419 | Logiciel utilisé pour la modélisation par équations structurelles aux moindres carrés partiels (PLS-SEM), incluant l'évaluation du modèle de mesure, l'analyse du modèle structurel, le bootstrap (5 000 rééchantillonnages) et l'analyse de médiation. |
| Questionnaire auto-administré structuré | Auteurs | N/A | Questionnaire administré sous format papier et électronique à l'aide d'une échelle de Likert à 5 points (1 = Tout à fait en désaccord à 5 = Tout à fait d'accord). |
| Inventaire des styles d'enseignement (adapté) | Auteurs ; adapté de l'Inventaire des styles d'enseignement de Grasha | N/A | Questionnaire mesurant les styles d'enseignement Autorité, Expert, Modèle personnel, Facilitateur et Délégué. |
| Canaux de communication universitaires | Université de Djeddah | N/A | Messages officiels par courrier électronique et annonces en classe utilisés pour le recrutement des participants. |
Références
- Ansa H. Exploring the role of artificial intelligence (AI) in enhancing EFL education in Saudi Arabia: A review of opportunities, obstacles, and future directions. Educ Sci. 2026;16(6):981.
- Alshehri A, Aldossary S, Jamshed M, Banu S. Incorporating ChatGPT in Saudi EFL classrooms: Oscillating between expectations and anxiety. J Lang Teach Res. 2025;16(5):1673-81.
- Alzubi AA, Alelaiwi AS. Exploring EFL university teachers’ perceptions of AI-generative tools in Saudi Arabia: A mixed-methods study. Discov Comput. 2025;28(1):282.
- Alzubi AA, Nazim M, Alyami N. Do AI-generative tools kill or nurture creativity in EFL teaching and learning? Educ Inf Technol. 2025;30(11):15147-84.
- Allehyani FS, Albedah F, Jamshed M, Warda WU. Exploring Saudi EFL learners’ engagement with AI generative tools in educational settings: Perceptions, practices, and pedagogical outcomes. Theory Pract Lang Stud. 2025;15(6):1959-66.
- Almusharraf A, Bailey D. Generative AI use among Saudi and Korean language learners in higher education: Examination through a modified TAM framework. SAGE Open. 2025;15(4):21582440251387804.
- Alharbi MA, Hassan Al-Ahdal AA. Exploring Saudi EFL learners’ engagement with ChatGPT: A mixed-methods study of perceptions, attitudes, and intentions. SAGE Open. 2025;15(4):21582440251392080.
- Khoso AK, Honggang W, Darazi MA. Empowering creativity and engagement: The impact of generative artificial intelligence usage on Chinese EFL students’ language learning experience. Comput Hum Behav Rep. 2025;18:100627.
- Alalwi FS, Alqahtani N, Jamshed M, Ahmmed MF. AI-driven feedback for pedagogical innovation: Assessing ChatGPT’s impact on Saudi EFL learners’ writing proficiency. World. 2026;16(5).
- Alshehri N. Speaking with AI: Exploring EFL learners’ attitudes, engagement, and satisfaction through ChatGPT conversations. 2026. 10.2139/ssrn.6595190
- Metwally AA, Bin-Hady WR. Probing the necessity and advantages of AI integration training for EFL educators in Saudi Arabia. Cogent Educ. 2025;12(1):2472462.
- Elmahdi OE, et al. AI-Driven Vocabulary Acquisition in EFL Higher Education: Interdisciplinary Insights into Technological Innovation, Ethical Challenges, and Equitable Access. Forum Linguist Stud. 2025;7(4):477–491.
- Al-Nofaie H, Alwerthan TA. Appreciative inquiry into implementing artificial intelligence for the development of language student teachers. Sustainability (Basel). 2024;16(21):9361.
- Alshayban A. Exploring EFL learners’ use of AI outside the classroom. J Lang Teach Res. 2026;17(1).
- Abdelhalim SM, Alsehibany RA. Integrating AI-powered tools in EFL pronunciation instruction: Effects on accuracy and L2 motivation. Comput Assist Lang Learn. 2025;38:1-25.
- Khoso AK, Honggang W, Darazi MA. Trust and attitude towards AI as pathways to creativity: A TAM model study of EFL students’ digital literacy and AI acceptance. Humanit Soc Sci Commun. 2025;13(1):69.
- Xiong X. Influence of teaching styles of higher education teachers on students’ engagement in learning: The mediating role of learning motivation. Educ Chem Eng. 2025;51:87-102.
- Bartholomew KJ, et al. Beware of your teaching style: A school-year-long investigation of controlling teaching and student motivational experiences. Learn Instr. 2018;53:50-63.
- Wiangga IA. The impact of educators’ teaching styles on secondary school learners’ motivation in English. J Educ Manag Strategy. 2024;3(2):136-44.
- Sheikh A, Mahmood N. Effect of different teaching styles on students’ motivation towards English language learning at secondary level. Sci Int (Lahore). 2014;26:825-30.
- Marina I, Natalia M, Tatiana K, Nataliya S. The influence of the teaching style of communication on the motivation of students to learn foreign languages. J Lang Educ. 2019;5(2):67-77.
- Zalukhu FS, Laoli A, Zebua EP, Daeli H. The influence of teacher teaching styles on English learning motivation of eighth-grade students at SMP Negeri 1 Afulu. J Pembelajaran Bahasa dan Sastra. 2026;5(2):1545-54.
- Yue X, Hou X, Zhang J, Li M. The impact of controlling teaching style on student engagement and academic achievement: Differences across varied motivation profiles. Teach Teach Educ. 2026;176:105479.
- Idhaufi NL, Ashari ZM. Relationship between motivation and teachers’ teaching style among secondary school students in Kulai. Man India. 2017;97(12):299-307.
- Zolfaghari M, Janghorbanian Z, Krevan Brojerdi K, Aghaziarati A. Investigation of the role of teaching styles and student-teacher interaction in students’ academic achievement motivation. Educ Strateg Med Sci. 2020;13(3):220-8.
- Avecilla PA, Capiña XE, Javier AY. Teachers’ teaching style as perceived by students and its influence on students’ level of self-regulation and motivation in learning psychology. Technium Soc Sci J. 2023;43:213-24.
- Khoso AK, et al. The dual forces of AI: How generative AI and perceived AI dependency influence fear of missing out (FoMO) and EFL students’ vocabulary acquisition. J Vis Exp. 2025;(226):e69637.
- Ali JK, Shamsan MA, Hezam TA, Mohammed AA. Impact of ChatGPT on learning motivation: Teachers’ and students’ voices. J Engl Stud Arabia Felix. 2023;2(1):41-9.
- Song C, Song Y. Enhancing academic writing skills and motivation: Assessing the efficacy of ChatGPT in AI-assisted language learning for EFL students. Front Psychol. 2023;14:1260843.
- Khoso AK, et al. Integrating Sustainable Development Goals (SDGs) and generative AI to enhance language digital literacy and creativity in EFL learning environments. J Vis Exp. 2026;(228):e69445.
- Balcı Ö. The role of ChatGPT in English as a foreign language (EFL) learning and teaching: A systematic review. Int J Curr Educ Stud. 2024;3(1):66-82.
- Yamaoka K. ChatGPT’s motivational effects on Japanese university EFL learners: A qualitative analysis. Int J TESOL Stud. 2024;6(3).
- Afkarin MY, Asmara CH. Investigating the implementation of ChatGPT in English language education: Effects on student motivation and performance levels. Journey J Engl Lang Pedagogy. 2024;7(1):57-66.
- Alrabai F. The influence of teachers’ anxiety-reducing strategies on learners’ foreign language anxiety. Innov Lang Learn Teach. 2015;9(2):163-90.
- Kang S, Kim Y. Examining the quality of mobile-assisted video-making task outcomes: The role of proficiency, narrative ability, digital literacy, and motivation. Lang Teach Res. 2024;28(6):2326-53.
- Honggang W, Khoso AK, Althubyani AR. Technostress, digital fatigue, and AI dependency as antecedents of burnout and SDG-4 achievement in EFL classrooms. Sci Rep. 2026;16:15412.
- Sari AA, Ningsih SK. The influence of digital literacy in social media use on high school students’ intrinsic motivation in EFL learning. IDEAS J Engl Lang Teach Learn Linguist Lit. 2025;13(2):6634-51.
- Zhang Y. Impact of digital literacy on college students’ English proficiency: The mediating role of learning motivation and the moderating effect of technological self-efficacy. Acta Psychol (Amst). 2025;259:105452.
- Bender SM. Awareness of artificial intelligence as an essential digital literacy: ChatGPT and Gen-AI in the classroom. Changing Engl. 2024;31(2):161-74.
- Khoso AK, et al. The impact of ESL teachers’ emotional intelligence on ESL students’ academic engagement, reading and writing proficiency: Mediating role of ESL students’ motivation. Int J Early Child Spec Educ. 2022;14:3267-80.
- He M, Abbasi BN, He J. AI-driven language learning in higher education: An empirical study on self-reflection, creativity, anxiety, and emotional resilience in EFL learners. Humanit Soc Sci Commun. 2025;12(1):1-20.
- Wang HC. Exploring the relationships of achievement motivation and state anxiety to creative writing performance in English as a foreign language. Think Skills Creat. 2021;42:100948.
- Khan MA, Mahjabeen AN, Hussain F, Ur Rehman M. Investigating the correlation between writing anxiety and English creativity in Pakistani ESL students. Russ Law J. 2021;9(1):214-24.
- McDonough K, Crawford WJ, Mackey A. Creativity and EFL students’ language use during a group problem-solving task. TESOL Q. 2015;49(1):188-99.
- Rubino C, Luksyte A, Perry SJ, Volpone SD. How do stressors lead to burnout? The mediating role of motivation. J Occup Health Psychol. 2009;14(3):289-304.
- Halbesleben JRB, Bowler WM. Emotional exhaustion and job performance: The mediating role of motivation. J Appl Psychol. 2007;92(1):93-106.
- van Emmerik IJH, et al. The route to employability: Examining resources and the mediating role of motivation. Career Dev Int. 2012;17(2):104-19.
- Dana LP, et al. The impact of entrepreneurial education on technology-based enterprise development: The mediating role of motivation. Adm Sci (Basel). 2021;11(4):105.
- Kholifah N, Nurtanto M, Mutohhari F, et al. The mediating role of motivation and professional development in determining teacher performance in vocational schools. Cogent Educ. 2024;11(1):2421094.
- Güngör P. The relationship between reward management system and employee performance with the mediating role of motivation: A quantitative study on global banks. Procedia Soc Behav Sci. 2011;24:1510-20.
- Danish RQ, Khan MK, Shahid AU, et al. Effect of intrinsic rewards on task performance of employees: Mediating role of motivation. Int J Organ Leadersh. 2015;4:33-46.
- Mavhungu D, Bussin MH. The mediation role of motivation between leadership and public sector performance. SA J Hum Resour Manag. 2017;15(1):1-11.
- Faul F, Erdfelder E, Buchner A, Lang AG. Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behav Res Methods. 2009;41(4):1149-60.
- Rodríguez-de-Dios I, Igartua JJ, González-Vázquez A. Development and validation of a digital literacy scale for teenagers. In: Proceedings of the Fourth International Conference on Technological Ecosystems for Enhancing Multiculturality; 2016. p. 1067-72.
- Abbas M, Jam FA, Khan TI. Is it harmful or helpful? Examining the causes and consequences of generative AI usage among university students. Int J Educ Technol High Educ. 2024;21(1):10.
- Grasha AF. Teaching with style: The integration of teaching and learning styles in the classroom. Alliance Publishers; Pittsburgh (PA); 1996.
- Briesmaster M, Briesmaster-Paredes J. The relationship between teaching styles and NNPSETs’ anxiety levels. System. 2015;49:145-56.
- Kanoksilapatham B, et al. Motivation of Thai university students from two disciplinary backgrounds using a hybrid questionnaire. LEARN J Lang Educ Acquis Res Netw. 2021;14(1):455-91.
- Govindasamy P, Cumming TM, Abdullah N. Validity and reliability of a needs analysis questionnaire for the development of a creativity module. J Res Spec Educ Needs. 2024;24(3):637-52.
- Hair JF, Risher JJ, Sarstedt M, Ringle CM. When to use and how to report the results of PLS-SEM. Eur Bus Rev. 2019;31(1):2-24.
- Zhang R, et al. Mediating effect of learning motivation and engagement on the relationship between generative artificial intelligence implementation and English as a foreign language proficiency. 2026. https://doi.org/10.21203/rs.3.rs-9075280/v1.
- Almira NF, Almira ZF, Vircavani C, Agustina E. A systematic review of teachers’ teaching styles and their impact on EFL student learning outcomes. J Appl Linguist Engl Educ. 2025;3(1):1-5.
- Reeve J. Teachers as facilitators: What autonomy-supportive teachers do and why their students benefit. Elem Sch J. 2006;106(3):225-36.
- Huang S, Dong L, Wang W, et al. Language is not all you need: Aligning perception with language models. In: Advances in Neural Information Processing Systems. 2023;36:72096-109.
- Liu L. An international graduate student’s ESL learning experience beyond the classroom. TESL Can J. 2011;29(1):77-92.
- van Laar E, van Deursen AJAM, van Dijk JAGM, De Haan J. The relation between 21st-century skills and digital skills: A systematic literature review. Comput Hum Behav. 2017;72:577-88.
- Al-Kahtani N. A survey assessing health science students’ perceptions of online learning at a Saudi higher education institution during the COVID-19 pandemic. Heliyon. 2022;8(9):e10688.
- Dewaele JM, Chen X, Padilla AM, Lake J. The flowering of positive psychology in foreign language teaching and acquisition research. Front Psychol. 2019;10:2128.
- Liu W, Li Y. A qualitative study of question-posing anxiety in Chinese postgraduates in UK TESOL programs. Sci Rep. 2025;16(1):2081.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.