Cet article présente un cadre explicatif basé sur un CNN pour la classification des lésions cutanées, combinant une haute précision diagnostique avec une interprétabilité du modèle. Il classifie les images de lésions et génère des explications visuelles pour ses prédictions. Les résultats démontrent des performances élevées et une transparence améliorée, soutenant la prise de décision clinique et aidant les dermatologues dans la détection précoce des maladies de la peau.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Un cadre informatique explicable pour la classification des lésions cutanées utilisant l'apprentissage profond
Dans cet article
Résumé
Résumé
L'utilisation de réseaux neuronaux convolutifs profonds en vue du diagnostic de maladies cutanées s'est révélée, dans différentes études, produire des niveaux de précision comparables à ceux obtenus par des dermatologues. Néanmoins, de nombreux défis persistent, notamment une performance insuffisante et une faible généralisation dans certains cas, ainsi qu'une interprétabilité limitée liée à l'utilisation de modèles boîte noire. Cela crée d'importantes difficultés pour la mise en œuvre pratique, car il est nécessaire d'obtenir non seulement un diagnostic précis, mais aussi une explication des résultats, rendant indispensable la recherche d'une solution. Pour surmonter les difficultés mentionnées, un cadre d'apprentissage profond explicatif pour la classification des lésions cutanées (EDLF-SLC) est développé dans cette étude. Ce cadre utilise diverses approches d'apprentissage automatique et d'intelligence artificielle explicative (XAI) afin d'améliorer à la fois la précision et l'interprétabilité, selon un processus en trois étapes. Dans la première étape, des représentations profondes extraites de plusieurs architectures de CNN pré-entraînés sont fusionnées afin de préserver l'information discriminante complémentaire apprise par différentes architectures de réseaux, avant la classification à l'aide d'un SVM doté d'un noyau à fonction de base radiale. Ensuite, des classificateurs à vecteurs de support (SVM) munis d'un noyau à fonction de base radiale sont utilisés pour classifier les caractéristiques obtenues. Enfin, les prédictions du modèle sont interprétées au moyen d'explications locales modèles-agnostiques interprétables (LIME). Les résultats expérimentaux montrent que l'EDLF-SLC atteint une précision de 88,0 %, une exactitude de 89,0 %, un rappel de 87,0 % et un score F1 de 88,0 %, démontrant ainsi une performance compétitive par rapport à plusieurs méthodes récemment publiées dans les conditions expérimentales considérées dans cette étude.
Introduction
Les lésions cutanées constituent un problème majeur en dermatologie et en oncologie, car elles vont de simples anomalies bénignes à des cancers malignes tels que le mélanome, la forme la plus mortelle du cancer de la peau. En 2020, le mélanome représentait environ 325 000 nouveaux cas et plus de 57 000 décès dans le monde entier1. Bien que les progrès dans le dépistage et le traitement aient amélioré l'évolution de la maladie chez les patients, un diagnostic tardif et un accès limité aux soins de santé continuent d'entraîner une forte mortalité et une perte importante d'années de vie, en particulier chez les populations plus jeunes2,3.
Le diagnostic traditionnel repose principalement sur l'examen visuel et la dermoscopie, ce qui rend le processus dépendant de l'expertise des cliniciens et sujet à la subjectivité, à la variabilité inter-observateur, aux biopsies inutiles et à des temps d'examen prolongés4,5,6. Pour pallier ces limites, l'apprentissage profond, en particulier les CNN, s'est imposé comme une solution efficace pour la classification automatisée des lésions cutanées. Les modèles basés sur les CNN, notamment DDCNN-F7, YOLOv7-XAI8 et plusieurs autres architectures9,10,11,12,13, ont démontré une grande précision diagnostique en apprenant automatiquement des caractéristiques discriminantes des images. Malgré leurs succès, la plupart des modèles d'apprentissage profond fonctionnent comme des « boîtes noires », ce qui limite la confiance des cliniciens et freine leur adoption en pratique médicale courante. Des techniques d'intelligence artificielle explicables ont donc été introduites afin d'améliorer la transparence des modèles en fournissant des explications visuelles des prédictions. Parmi ces méthodes, les explications locales interprétables indépendantes du modèle (LIME) génèrent des interprétations locales en identifiant les régions de l'image qui influencent le plus les décisions du modèle14.
La classification des lésions cutanées a évolué depuis l'évaluation clinique traditionnelle jusqu'aux systèmes diagnostiques avancés basés sur l'intelligence artificielle, en réponse au besoin de détection précise, fiable et précoce du cancer de la peau. Cette évolution s'est déroulée en cinq grandes étapes — méthodes diagnostiques traditionnelles, diagnostic assisté par ordinateur (CAD), apprentissage automatique (ML), apprentissage profond (DL), et plus récemment, explication de l'intelligence artificielle (XAI) et apprentissage fédéré (FL) — reflétant des efforts continus pour améliorer la précision, la cohérence, l'évolutivité et la fiabilité clinique du diagnostic, tout en surmontant les limites de l'examen conventionnel. Les premières méthodes computationnelles tentaient d'imiter le raisonnement clinique à l'aide de descripteurs d'image conçus manuellement dérivés de la règle ABCD, incluant l'asymétrie, l'irrégularité des bords, la variation de couleur et le diamètre de la lésion. Ces caractéristiques étaient combinées à des réseaux bayésiens, des arbres de décision, des systèmes experts et des modèles d'inférence floue afin d'aider au diagnostic du mélanome, plusieurs études rapportant des précisions de classification dépassant 90 %15,16,17. Bien qu'ayant fourni une base importante pour le diagnostic assisté par ordinateur, ces méthodes dépendaient entièrement de caractéristiques conçues manuellement et de règles diagnostiques prédéfinies. Par conséquent, elles présentaient une robustesse limitée face aux variations de qualité d'image, de morphologie des lésions, d'éclairage et de conditions d'acquisition.
Pour remédier à ces limites, les systèmes classiques d'aide au diagnostic assisté par ordinateur (CAD) sont apparus comme une étape intermédiaire entre l'analyse d'image conventionnelle et les cadres modernes basés sur l'intelligence artificielle. Les systèmes CAD combinaient l'extraction manuelle de caractéristiques avec des classificateurs conventionnels afin d'améliorer la cohérence du diagnostic et d'aider à la prise de décision clinique. Plusieurs approches hybrides ont intégré le regroupement hiérarchique avec des réseaux neuronaux récurrents et des architectures à mémoire à long court terme, atteignant des précisions de classification proches de 99,5 %18. D'autres cadres basés sur le CAD ont intégré des classificateurs par boosting de gradient avec des explications fondées sur SHAP, démontrant une précision diagnostique compétitive tout en améliorant la transparence du modèle19. Bien que ces systèmes représentent une amélioration significative par rapport aux approches purement basées sur des règles, ils continuaient de dépendre fortement de l'extraction manuelle de caractéristiques, de prétraitements intensifs, de jeux de données soigneusement annotés et de pipelines de traitement multiphases.
Les techniques d'apprentissage automatique ont encore amélioré la classification automatisée des lésions cutanées en permettant un apprentissage basé sur les données plutôt qu'une conception explicite de règles. Des cadres hybrides combinant des réseaux neuronaux convolutifs avec des classificateurs d'apprentissage automatique classiques, notamment la régression logistique et les k-plus-proches voisins, ont démontré de solides performances de classification sur des ensembles de données de référence, atteignant des précisions supérieures à 95 %9. L'apprentissage multimodal auto-supervisé a encore amélioré la représentation des caractéristiques en exploitant conjointement des images dermoscopiques et cliniques, réduisant ainsi la dépendance à l'égard d'annotations manuelles exhaustives tout en améliorant les performances de classification20. D'autres études ont combiné des réseaux CNN avec une analyse discriminante généralisée, des descripteurs SURF et des algorithmes d'optimisation afin d'améliorer la discrimination des caractéristiques et la précision de la classification21. Des techniques de sélection automatique de caractéristiques utilisant DenseNet-201, InceptionV3 et des algorithmes d'optimisation par arbre binaire ont encore renforcé la représentation des caractéristiques tout en maintenant des performances diagnostiques compétitives22. Des approches d'apprentissage par transfert utilisant des architectures pré-entraînées telles qu'AlexNet et GoogLeNet ont également montré des capacités prometteuses de classification, malgré un volume limité de données d'entraînement23. Néanmoins, la plupart des méthodes d'apprentissage automatique continuaient de dépendre de procédures de prétraitement soigneusement conçues, de stratégies d'optimisation manuelles, de jeux de données équilibrés et d'un réglage hyperparamétrique poussé. Leur validation externe limitée et leur sensibilité au déséquilibre des classes ont encore restreint leur applicabilité pratique dans des contextes cliniques variés.
L'introduction de l'apprentissage profond (DL) a transformé fondamentalement la classification automatisée des lésions cutanées en permettant un apprentissage de bout en bout directement à partir de données d'images brutes. Les réseaux neuronaux convolutifs (CNN) ont éliminé le besoin d'ingénierie manuelle des caractéristiques tout en améliorant sensiblement les performances diagnostiques sur plusieurs ensembles de données de référence. La plupart des approches basées sur les CNN ont démontré des améliorations significatives dans la classification des lésions grâce à des architectures de plus en plus sophistiquées. Les modèles de CNN prenant en compte la symétrie ont exploré des caractéristiques de lésions cliniquement pertinentes, mais n'ont atteint qu'une précision équilibrée modérée24. D'autres ont intégré des architectures EfficientNet avec des explications LIME et SHAP afin d'améliorer l'interprétabilité tout en introduisant des mesures quantitatives de fiabilité25. Des systèmes hybrides d'apprentissage profond combinant segmentation des lésions, apprentissage ensembliste et CNN ont obtenu d'excellentes performances sur plusieurs jeux de données ISIC, mais sont restés sensibles à la qualité de la segmentation et au déséquilibre des classes26.
Plus récemment, des architectures hybrides de plus en plus sophistiquées ont encore amélioré la précision de classification en intégrant des techniques complémentaires d'apprentissage profond. Des réseaux antagonistes génératifs conditionnels combinés à YOLOv5 et à une analyse en composantes indépendantes ont atteint des précisions de classification dépassant 99 %, bien que leur complexité computationnelle ait limité leur déploiement pratique 27. De même, les architectures hybrides LSTM–ResNet ont efficacement appris des représentations spatio-temporelles, mais nécessitaient des ressources computationnelles nettement plus importantes28. Les modèles basés sur des transformeurs, notamment Sap-Former, ont exploité l'information contextuelle globale afin d'améliorer la représentation des caractéristiques, mais exigeaient un prétraitement approfondi, des ensembles de données annotées à grande échelle et une puissance de calcul importante29. Des alternatives légères telles que S-MobileNet ont cherché à équilibrer efficacité computationnelle et précision diagnostique30, tandis que les méthodes d'adaptation de domaine non supervisées ont amélioré la généralisation inter-domaines, malgré une efficacité réduite lorsque seuls de rares échantillons d'entraînement étaient disponibles31. Des réseaux hybrides améliorés par l'attention, intégrant des modules d'attention convolutionnels modifiés et un apprentissage par ensemble instantané (snapshot ensemble learning), ont également montré des performances prometteuses pour la classification des lésions cutanées dues à la variole du singe, bien que des défis liés au déséquilibre des classes, à la diversité des images et au manque d'explicabilité restent non résolus32. Des architectures résiduelles personnalisées, utilisant des conceptions de réseaux plus profondes et des fonctions de perte hybrides, ont encore accru la précision de classification au-delà de 99 %, mais au prix d'une surcharge computationnelle et d'un temps d'entraînement considérablement plus élevés33. Des études de synthèse approfondies ont systématiquement conclu que l'apprentissage profond surpasse largement les approches traditionnelles basées sur des caractéristiques manuelles en apprenant automatiquement des représentations discriminantes des images, tout en mettant simultanément en évidence des défis persistants liés aux artefacts d'imagerie, aux variations d'éclairage, à la complexité computationnelle et à la généralisation clinique limitée34.
Bien que l'apprentissage profond (DL) ait considérablement amélioré la précision diagnostique, les préoccupations relatives à la transparence des modèles, à l'estimation de l'incertitude et au déploiement clinique fiable ont suscité un intérêt croissant pour l'IA explicable (XAI) et l'apprentissage fédéré. Plusieurs études ont examiné des techniques de quantification de l'incertitude, notamment la prédiction conforme, le dropout de Monte Carlo et l'apprentissage profond fondé sur des preuves, démontrant que l'estimation fiable de la confiance peut améliorer sensiblement l'aide à la décision, malgré des contraintes supplémentaires en matière de calcul et de données35. Des cadres d'apprentissage mutuel basés sur des transformeurs ont également été proposés afin de corriger le déséquilibre des classes tout en améliorant l'efficacité de l'apprentissage des caractéristiques36. D'autres approches ont combiné des réseaux de neurones convolutifs (CNN) à pleine résolution avec des techniques d'optimisation basées sur des graphes pour améliorer la segmentation et la classification des lésions37, tandis que des cadres hybrides d'apprentissage profond intégrant plusieurs représentations complémentaires de caractéristiques ont atteint des précisions de classification proches de 99,5 %, bien qu'ils nécessitent un prétraitement intensif38.
De récentes recherches se sont de plus en plus concentrées sur l'intégration de l'explicabilité directement dans les cadres d'apprentissage profond (DL) afin de renforcer la confiance des cliniciens et de faciliter l'adoption clinique pratique. Des systèmes explicables utilisant plusieurs architectures de réseaux neuronaux convolutifs combinés à Grad-CAM et Score-CAM ont localisé avec succès les régions lésionnelles diagnostiquement pertinentes tout en maintenant des performances de classification compétitives sur des jeux de données internes et externes39. Des cadres hybrides CNN–Transformeur combinant des images dermoscopiques avec des métadonnées cliniques ont encore amélioré les performances prédictives, tout en utilisant SHAP et Grad-CAM pour générer des explications visuelles cliniquement significatives40. D'autres architectures hybrides basées sur des transformeurs, intégrant EfficientNetV2S, des transformeurs Swin, des réseaux Xception modifiés et des mécanismes d'attention sur graphes, ont efficacement capturé des caractéristiques lésionnelles complémentaires globales et locales, bien que leur nombre élevé de paramètres et leurs performances limitées sur les classes minoritaires restreignent leur déploiement pratique41. De même, des cadres hybrides YOLOv8–Transformeur visuel ont démontré une meilleure localisation des lésions, une classification multiclasses améliorée et une interprétabilité visuelle grâce à une augmentation adaptative combinée à des explications SHAP et Grad-CAM ; toutefois, ces méthodes continuent de reposer principalement sur des jeux de données de référence et montrent une robustesse limitée pour les catégories de lésions minoritaires42. Plusieurs articles de synthèse ont résumé ces avancées, soulignant à la fois les progrès remarquables réalisés par les techniques modernes d'apprentissage profond et les défis persistants liés à l'efficacité computationnelle, à l'explicabilité, à la dépendance aux jeux de données et à la validation clinique43,44,45. Tableau 1 résume certains travaux récemment publiés utilisant des algorithmes d'apprentissage profond pour la classification des lésions cutanées.
Malgré les progrès remarquables réalisés par les méthodes récentes d'apprentissage profond (DL) dans la classification des lésions cutanées, la plupart des approches existantes restent limitées par une complexité computationnelle élevée, une dépendance à de grands ensembles de données annotées, une interprétabilité des modèles limitée et une validation insuffisante dans divers contextes cliniques du monde réel. Pour surmonter ces limitations, cet article propose le cadre EDLF-SLC, qui intègre des caractéristiques complémentaires extraites de plusieurs architectures de CNN avec un classificateur SVM afin d'obtenir une classification robuste et précise. Le cadre utilise en outre un prétraitement amélioré pour améliorer la qualité des images et corriger le déséquilibre des classes, tout en incorporant la technique LIME pour fournir des explications visuelles des prédictions individuelles, renforçant ainsi la transparence du modèle et sa crédibilité clinique.
Les contributions de cette étude sont triples. Premièrement, les auteurs proposent un cadre robuste, EDLF-SLC, qui intègre des réseaux neuronaux convolutifs avancés (CNN) avec un classificateur à vecteurs de support (SVM) afin d'obtenir une classification précise et fiable des lésions cutanées. Deuxièmement, les auteurs mettent en œuvre des techniques de prétraitement améliorées pour remédier au déséquilibre des classes et réduire le bruit dans les images, améliorant ainsi la qualité des images d'entrée et les performances globales du modèle de classification. Troisièmement, les auteurs intègrent la méthode Local Interpretable Model-agnostic Explanations (LIME) afin de visualiser et interpréter les prédictions individuelles du modèle en mettant en évidence les régions des images qui influencent le plus fortement les décisions de classification, améliorant ainsi la transparence et l'interprétabilité du cadre proposé.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude n'a pas impliqué le recrutement de participants humains ni la collecte de données patient identifiables. Toutes les expériences ont été réalisées à l'aide du jeu de données public sur les lésions cutanées ISIC 2020, obtenu à partir du dépôt Kaggle ; par conséquent, aucune approbation par un comité d'éthique institutionnel ni consentement éclairé n'était requise. Tous les matériaux utilisés dans cette étude figurent dans le tableau des matériaux.
Extraction et fusion de caractéristiques
Les images de lésions cutanées ont été traitées à l'aide de plusieurs modèles de CNN préentraînés. Les vecteurs de caractéristiques profondes extraits des architectures de CNN préentraînés sélectionnées sont concaténés afin de construire une représentation unifiée des caractéristiques pour chaque image de lésion cutanée. La stratégie de fusion adoptée préserve les informations visuelles complémentaires apprises par différentes architectures de CNN, permettant au classificateur SVM ultérieur d'exploiter à la fois les caractéristiques texturales de bas niveau et les représentations sémantiques de niveau supérieur. Bien que des techniques de réduction de dimensionnalité telles que l'analyse en composantes principales ou la sélection de caractéristiques basée sur l'information mutuelle puissent réduire la dimension des caractéristiques, la représentation fusionnée complète a été délibérément conservée, car l'espace de caractéristiques fusionné reste informatiquement traitable pour le classificateur RBF-SVM utilisé, tout en préservant les informations diagnostiques complémentaires extraites des squelettes hétérogènes de CNN.
Classification
Les vecteurs de caractéristiques fusionnés ont été utilisés pour entraîner un classificateur SVM avec un noyau RBF. Des techniques d'optimisation des hyperparamètres ont été employées pour déterminer les paramètres optimaux de classification. Le classificateur a ensuite catégorisé les lésions cutanées selon leurs classes respectives.
Interprétabilité
Afin d'améliorer l'interprétabilité, la méthode LIME a été appliquée pour générer des explications visuelles mettant en évidence les régions de l'image qui contribuent le plus significativement aux résultats de classification. Ces explications aideraient les cliniciens à comprendre et à valider les décisions du modèle.
Plan d'évaluation
Le cadre proposé a été évalué à l'aide d'un jeu de données de référence sur les lésions cutanées. Les performances ont été évaluées à l'aide de l'exactitude, de la précision, du rappel et du score F1. Des expériences comparatives ont été menées par rapport à des approches existantes d'apprentissage machine et d'apprentissage profond afin de démontrer l'efficacité du cadre proposé.
Résultats attendus
L'étude devait produire un système de classification précis et interprétable des lésions cutanées. Les résultats expérimentaux préliminaires indiquent que EDLF-SLC atteint une exactitude de 88,0 %, une précision de 89,0 %, un rappel de 87,0 % et un score F1 de 88,0 %, surpassant plusieurs méthodes concurrentes. On s'attendait à ce que l'intégration d'explications LIME améliore la fiabilité et facilite l'adoption de systèmes diagnostiques assistés par l'intelligence artificielle en pratique clinique.
Signification
Cette recherche contribue au domaine en plein essor de l'intelligence artificielle médicale explicative en abordant à la fois les défis liés aux performances et à la transparence dans le diagnostic des lésions cutanées. Le cadre proposé pourrait aider les dermatologues à prendre des décisions diagnostiques plus fiables et interprétables, améliorant ainsi la prise en charge des patients. De plus, dans cette section, les auteurs fournissent des informations sur les matériaux et la méthodologie appliqués dans cette étude. Plus précisément, les auteurs commencent par décrire le jeu de données utilisé pour les expériences, puis passent à une discussion détaillée du cadre d'apprentissage profond explicatif pour la classification des lésions cutanées.
Jeu de données
Les travaux présentés s'appuient sur le jeu de données ISIC 2020 (International Skin Imaging Collaboration) disponible publiquement, auquel on peut accéder sur le site web Kaggle (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). Le référentiel ISIC est reconnu comme l'une des meilleures ressources dans le domaine de l'imagerie dermatologique, car il fournit une grande variété d'images dermoscopiques de différents types de lésions cutanées, comme illustré dans la Figure 1. Importamment, le jeu de données inclut des images de lésions bénignes et malignes, ce qui le rend utile pour effectuer des tâches de classification binaire appliquées au cancer de la peau 46. Le jeu de données actuel contient 3 297 images, dont 1 800 sont bénignes et 1 497 malignes. Pour mener des expériences plus efficaces, les données ont dû être divisées en un ensemble d'apprentissage et un ensemble de test. En particulier, l'ensemble d'apprentissage comprend 2 637 images, dont 1 440 bénignes et 1 197 malignes, tandis que l'ensemble de test se compose de 660 images, parmi lesquelles 360 sont bénignes et 300 malignes. Un résumé du jeu de données est présenté dans le Tableau 2.
Le modèle EDLF-SLC proposé
Dans cet article, une solution efficace et compréhensible pour classer les lésions cutanées en catégories bénignes et malignes est proposée, en utilisant une nouvelle technique d'apprentissage profond explicative fondée sur une approche hybride combinant les avantages de plusieurs modèles de réseaux neuronaux convolutifs pré-entraînés. Les réseaux neuronaux convolutifs se sont révélés très efficaces pour extraire des caractéristiques sémantiques de haut niveau à partir d'images médicales. En exploitant cette capacité, le cadre d'apprentissage profond explicatif proposé pour la classification des lésions cutanées (EDLF-SLC) utilise plusieurs modèles CNN pré-entraînés afin d'atteindre des performances supérieures. Afin d'assurer la transparence nécessaire au processus de décision médicale, la méthode LIME a été adoptée dans l'approche proposée pour générer des explications locales compréhensibles par l'humain pour les résultats obtenus. L'ensemble du cadre peut être divisé en trois étapes principales, illustrées dans la Figure 2, à savoir : (1) le prétraitement des données, (2) l'extraction de caractéristiques et la classification, et (3) l'interprétabilité.
Architecture du modèle et intégration
Comme étape préliminaire, sept modèles populaires d'apprentissage profond (MobileNetV2, ResNet50, EfficientNetB0, Xception, InceptionResNetV2, NASNetLarge et MobileNet) ont été sélectionnés et évalués séparément sur le jeu de données de validation, et les quatre modèles les plus performants (ResNet50, EfficientNetB0, MobileNet et Xception) ont été retenus pour l'étape d'extraction de caractéristiques. Dans le cadre proposé, chaque image d'entrée x est transmise indépendamment à travers les modèles préentraînés sélectionnés. La dernière couche entièrement connectée a été supprimée de chacun de ces modèles, et des vecteurs de caractéristiques ont été extraits des couches précédentes. fResNet50(x), fEfficientNetB0(x), fMobileNet(x) et fXception(x) désignent les vecteurs de caractéristiques en sortie de chacun des modèles mentionnés ci-dessus. En concaténant ces vecteurs de caractéristiques, un nouveau vecteur de caractéristiques agrégé F(xi) est obtenu :
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
Ensuite, F(xi) a été transmis à un classificateur SVM avec un noyau de fonction de base radiale (RBF) afin d'obtenir le résultat de classification. L'algorithme complet du cadre proposé est présenté dans le Supplementary File 1.
Le cadre proposé adopte une fusion au niveau des caractéristiques car chaque architecture de CNN préentraînée capture des caractéristiques discriminantes différentes des lésions cutanées grâce à son architecture de réseau distincte et à sa hiérarchie de caractéristiques apprises. Par conséquent, la concaténation de ces représentations hétérogènes de caractéristiques préserve des informations complémentaires qui contribuent à une caractérisation plus complète des lésions avant la classification. Bien que des techniques de réduction de dimensionnalité telles que l'analyse en composantes principales (PCA) ou la sélection de caractéristiques basée sur l'information mutuelle puissent réduire la dimension de la représentation fusionnée, le vecteur complet de caractéristiques fusionnées a été délibérément conservé, car sa dimension reste gérable sur le plan computationnel pour le classifieur RBF-SVM adopté, tout en préservant les informations diagnostiques complémentaires extraites par les différentes architectures de base de CNN. Cette conception privilégie donc la conservation de représentations profondes complémentaires plutôt que l'élimination de caractéristiques potentiellement informatives avant la classification.
Préparation des données
La préparation des données a inclus le prétraitement et la division du jeu de données en ensembles d'apprentissage et de test. Le prétraitement vise à améliorer la qualité des données en éliminant les incohérences, en supprimant les éléments en double, en formatant les images d'entrée et en effectuant une mise à l'échelle des caractéristiques pour un apprentissage stable d'un bon modèle. Toutes les images ont été normalisées dans la plage [−1, 1] à l'aide de la normalisation Z-score :
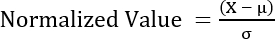 (2)
où µ et σ représentent respectivement la valeur moyenne et l'écart type de l'image correspondante. L'ensemble de données a été divisé en deux sous-ensembles, à savoir un ensemble d'apprentissage (70,0 %) et un ensemble de test (30,0 %).
Augmentation des données
Afin d'éviter le surapprentissage et d'améliorer la capacité de généralisation du modèle, certaines augmentations ont été appliquées à l'ensemble d'apprentissage. Les augmentations d'images consistent à modifier les images afin d'agrandir artificiellement le jeu de données sans altérer les caractéristiques essentielles des affections médicales. Le pipeline d'augmentation a été construit à l'aide de l'API Séquentielle de Keras. Des transformations telles que le retournement horizontal aléatoire, la rotation selon un petit angle, le redimensionnement, la mise à l'échelle, l'ajustement de la luminosité et du contraste, le zoom et certains légers déplacements ont été utilisées. Des exemples représentatifs d'images augmentées sont illustrés dans la Figure 3.
Modèles préentraînés
Plusieurs modèles d'apprentissage profond préentraînés ont été adoptés dans le cadre proposé afin d'extraire des caractéristiques à partir des images d'entrée. Ces modèles incluent MobileNet, ResNet50, EfficientNetB0, Xception, NASNetLarge, Inception-ResNet-v2 et MobileNetV2. MobileNet et MobileNetV2 sont des modèles d'apprentissage profond légers permettant des calculs efficaces grâce aux convolutions séparables par profondeur. ResNet50 utilise le mécanisme des connexions résiduelles pour entraîner le modèle, évitant ainsi le problème des gradients qui s'annulent durant l'entraînement. EfficientNetB0 établit un équilibre entre efficacité et précision grâce à une approche de mise à l'échelle composée. Xception étend le réseau Inception en utilisant des convolutions séparables par profondeur. NASNetLarge implique l'utilisation d'une recherche d'architecture neuronale pour construire des structures de réseaux neuronaux profonds optimales, tandis qu'Inception-ResNet-v2 combine un modèle Inception avec le mécanisme de connexions résiduelles. Les vecteurs de caractéristiques extraits de ResNet50 (1 024 caractéristiques), EfficientNetB0 (1 280 caractéristiques), MobileNet (1 024 caractéristiques) et Xception (2 048 caractéristiques) sont concaténés pour produire une représentation unifiée de 5 376 dimensions. Cette stratégie de fusion a été choisie afin de préserver les représentations complémentaires apprises par les différentes architectures de CNN, plutôt que de réduire la représentation avant la classification. Le vecteur de caractéristiques résultant est ensuite transmis au classifieur RBF-SVM, qui détermine la frontière de décision non linéaire optimale au sein de l'espace de caractéristiques fusionné.
Modèle d'intelligence artificielle explicatif (LIME)
Afin d'assurer une certaine interprétabilité locale des prédictions du modèle, les auteurs utilisent une méthode permettant de générer des explications localisées et lisibles par l'humain pour chaque prédiction particulière du modèle, appelée LIME47. Pour toute image d'entrée, LIME la partitionne d'abord en unités plus petites appelées superpixels. Des perturbations sont ensuite générées à partir de l'image initiale, et les prédictions du modèle neuronal profond sont estimées pour chacune de ces perturbations. Ensuite, un modèle linéaire pondéré est ajusté sur les perturbations, en utilisant des poids dépendant de leur proximité avec l'instance d'entrée initiale. Après l'ajustement du modèle linéaire, des scores d'importance des caractéristiques sont estimés, indiquant le rôle de chaque superpixel dans la prédiction de l'étiquette finale. Ces scores d'importance sont mis en évidence visuellement sur l'image d'explication finale. L'algorithme LIME est présenté dans le Fichier supplémentaire 2.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
L'évaluation des performances du cadre de classification développé repose sur des mesures traditionnelles issues de la matrice de confusion. Une matrice de confusion permet de comprendre complètement les performances du classifieur en représentant le nombre de classifications correctes et incorrectes effectuées pour chaque classe définie. De cette manière, tous les types d'erreurs peuvent être analysés. Par exemple, les faux positifs et les faux négatifs sont particulièrement importants dans le diagnostic des maladies. D...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Le cadre d'apprentissage profond explicatif proposé pour la classification des lésions cutanées (EDLF-SLC) montre que la combinaison de représentations complémentaires de caractéristiques profondes avec une intelligence artificielle explicative peut améliorer à la fois les performances de classification et la transparence du modèle. En intégrant plusieurs architectures de CNN préentraînés (ResNet50, EfficientNetB0, MobileNet et Xception) pour l'extraction de caractéristiques et en utilisant une machine à vecteurs de supp...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs déclarent qu'il n'existe aucun conflit d'intérêts.
Remerciements
Les auteurs tiennent à exprimer leur profonde gratitude à l'Université de Taif pour avoir fourni l'environnement de recherche et le soutien institutionnel qui ont permis la réalisation de ce travail.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Ensemble de données sur les lésions cutanées ISIC 2020 | Collaboration internationale pour l'imagerie cutanée (ISIC) | Ensemble de données du défi ISIC 2020 | Ensemble d'images dermoscopiques utilisé pour le développement et l'évaluation du modèle. |
| Keras | Équipe Keras | Intégré à TensorFlow | Construction et entraînement de modèles d'apprentissage profond. |
| LIME (explications locales interprétables indépendantes du modèle) | Ribeiro et al. | Package Python | Génération d'explications visuelles locales pour les prédictions du modèle. |
| Matplotlib | Développeurs de Matplotlib | Dernière version compatible | Visualisation des courbes d'apprentissage, des matrices de confusion et des graphiques d'évaluation. |
| NumPy | Développeurs de NumPy | Dernière version compatible | Calcul numérique et manipulation de tableaux. |
| GPU NVIDIA Tesla T4 | Société NVIDIA | 16 Go de mémoire vidéo (VRAM) | Accélération de l'entraînement et de l'inférence du modèle. |
| Pandas | Équipe de développement de Pandas | Dernière version compatible | Traitement des données et gestion des résultats expérimentaux. |
| Modèles CNN préentraînés | Applications TensorFlow/Keras | ResNet50, EfficientNetB0, MobileNet, Xception | Extraction de caractéristiques profondes à partir d'images dermoscopiques. |
| Python | Fondation logicielle Python | Version 3.9 | Langage de programmation utilisé pour l'implémentation. |
| PyTorch | Fondation PyTorch | Version 2.3.1 | Infrastructure d'apprentissage profond utilisée pour l'extraction de caractéristiques et l'implémentation du modèle. |
| Scikit-learn | Développeurs de Scikit-learn | Dernière version compatible | Machines à vecteurs de support (SVM), métriques d'évaluation et prétraitement des données. |
| Machine à vecteurs de support (noyau RBF) | Scikit-learn | SVC | Classification des représentations de caractéristiques profondes fusionnées. |
| TensorFlow | Google LLC | Version 2.x | Infrastructure d'apprentissage profond pour l'entraînement et l'inférence du modèle. |
| Système d'exploitation Ubuntu | Canonical Ltd. | Ubuntu 20.04 | Environnement expérimental de fonctionnement. |
Références
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.