Cette étude intègre la pharmacologie des réseaux, l'alignement moléculaire validé et des expériences in vitro afin d'évaluer les relations candidates entre composés et cibles entre les constituants du Cordyceps sinensis et les processus liés à la glomérulonéphrite chronique. Le β-sitostérol a été sélectionné pour la validation au niveau du composé et s'est révélé atténuer l'activation inflammatoire et profibrotique dans des modèles de cellules mésangiales.
Article de méthode
Évaluation guidée par réseau du β-sitostérol dans des modèles de cellules mésangiales inflammatoires et profibrotiques pertinents pour la glomérulonéphrite chronique
* These authors contributed equally
Dans cet article
Résumé
Résumé
La glomérulonéphrite chronique (GNC) se caractérise par une lésion inflammatoire persistante et un remodelage fibrotique progressif, mais les relations composé-cible sous-jacentes aux interventions basées sur des produits naturels restent incomplètement définies. Cette étude a combiné la pharmacologie en réseau, un dockage moléculaire validé et des expériences in vitro afin d'évaluer les constituants candidats du Cordyceps sinensis (C. sinensis) dans les processus pathologiques liés à la GNC. Les constituants candidats du C. sinensis ont été sélectionnés, et les cibles associées aux composés provenant de la base de données et plateforme d'analyse de la pharmacologie systémique de la médecine traditionnelle chinoise ont été croisées avec les gènes associés à la GNC. Des analyses d'enrichissement fonctionnel et d'interaction protéine-protéine ont permis de hiérarchiser les processus biologiques et les cibles centrales. Le gène PTGS2 a été identifié comme une cible centrale commune. Un dockage moléculaire a été réalisé à l'aide d'une structure de COX-2 liée au célécoxib. Le redockage du ligand cocrystallisé, le célécoxib, a reproduit la conformation cristallographique avec une RMSD de 0,876 Å, validant ainsi le protocole de dockage. Le β-sitostérol et l'acétate de linoléyle ont montré une compatibilité prévue avec la région de dockage de la COX-2, avec des affinités de liaison respectives de −7,2 et −7,5 kcal/mol. Le β-sitostérol a été sélectionné pour une validation au niveau du composé dans des cellules mésangiales glomérulaires de rat HBZY-1. À des concentrations de 0,5 à 10 µM, le β-sitostérol n'a pas notablement réduit la viabilité cellulaire. Dans des cellules stimulées par le lipopolysaccharide (LPS), le β-sitostérol a réduit l'expression de Tnf, Il6 et Ptgs2, diminué la production de prostaglandine E2 (PGE2) et abaissé l'abondance protéique de la cyclooxygénase-2 (COX-2). Dans des cellules traitées par le facteur de croissance transformant β1 (TGF-β1), le β-sitostérol a réduit l'expression de Col1a1 et Acta2 et diminué l'abondance protéique de l'actine alpha lisse (α-SMA). Ces résultats fournissent des éléments suggérant que le β-sitostérol module l'activation inflammatoire et profibrotique dans des modèles de cellules mésangiales, sans toutefois établir une inhibition enzymatique directe de la COX-2 ou une efficacité thérapeutique dans la GNC.
Introduction
La glomérulonéphrite chronique (CGN) regroupe un ensemble hétérogène de troubles glomérulaires pouvant évoluer vers une maladie rénale chronique et une insuffisance rénale terminale1. Elle se caractérise par une lésion glomérulaire persistante, une activation inflammatoire et une remodélisation fibreuse progressive2,3. Bien que les corticostéroïdes et les agents immunosuppresseurs soient utilisés chez certains patients, un contrôle durable de la maladie reste difficile dans de nombreux cas, et les effets indésirables liés au traitement sont fréquents1,4,5. L'évolution de la CGN implique des processus pathologiques interconnectés, notamment l'activation immunitaire, une dysfonction endothéliale, un stress oxydatif et l'accumulation de la matrice extracellulaire3,6,7. Par conséquent, l'identification de nœuds moléculaires reliant les réponses inflammatoires et profibrotiques pourrait permettre d'élaborer des hypothèses testables concernant des stratégies thérapeutiques pertinentes pour la maladie.
Cordyceps sinensis (C. sinensis) a été utilisé dans des contextes cliniques et expérimentaux liés aux reins et s'est révélé exercer des effets anti-inflammatoires, anti-apoptotiques et cytoprotecteurs dans plusieurs modèles de maladies8,9,10. Toutefois, la base moléculaire selon laquelle ses constituants candidats pourraient interagir avec des cibles pertinentes pour la glomérulonéphrite reste insuffisamment définie11. Compte tenu de la nature multi-composants de C. sinensis et de l'hétérogénéité mécanistique de la NGC, la pharmacologie en réseau fournit un cadre utile pour hiérarchiser les relations composés candidats-cibles-voies12,13.
Dans cette étude, le criblage de composés, la récupération de cibles, l'analyse d'intersection gène-maladie, l'enrichissement fonctionnel, l'analyse du réseau d'interactions protéine-protéine, le dockage moléculaire et une validation in vitro ont été combinés afin d'explorer les relations moléculaires potentielles entre les constituants candidats de C. sinensis et les processus pathologiques liés à la CGN. La prostaglandine-endoperoxyde synthase 2 (PTGS2) a été identifiée comme une cible centrale dans le réseau composé-maladie et a été évaluée par dockage moléculaire à l'aide d'une structure de la cyclooxygénase-2 (COX-2) liée au célécoxib, avec une validation par redockage. Sur la base des résultats du réseau, de l'analyse de dockage et des données antérieures concernant l'activité anti-inflammatoire et anti-fibrosante, le β-sitostérol a été sélectionné comme composé candidat représentatif pour la validation en aval14,15,16. Des cellules mésangiales stimulées par le lipopolysaccharide (LPS) ont été utilisées pour évaluer l'activation inflammatoire et la réponse associée à la COX-2/prostaglandine E2 (PGE2), tandis qu'un modèle induit par le facteur de croissance transformant β1 (TGF-β1) a été inclus pour évaluer l'expression des marqueurs profibrosants.
Protocole
Les analyses de pharmacologie en réseau et de bio-informatique étaient basées sur des bases de données publiquement accessibles et n'ont pas impliqué de participants humains ni d'animaux. Les expériences in vitro ont été réalisées à l'aide d'une lignée cellulaire établie et n'ont pas nécessité d'approbation éthique selon les exigences institutionnelles.
Recherche de constituants candidats et récupération de cibles
Les constituants candidats et leurs cibles correspondantes ont été récupérés à partir de la base de données et plateforme d'analyse Pharmacologie des Systèmes de la Médecine Traditionnelle Chinoise (TCMSP) en utilisant le terme de recherche « dongchongxiacao » le 13 juillet 2025. Les composés présentant une biodisponibilité orale prédite d'au moins 30 % et une similarité aux médicaments d'au moins 0,18 ont été retenus. Sept constituants candidats ont satisfait aux deux critères de sélection. Le poids moléculaire, la biodisponibilité orale, la similarité aux médicaments et d'autres descripteurs pharmacocinétiques disponibles ont été enregistrés à partir de TCMSP pour une comparaison descriptive.
Les informations composé-cible associées aux constituants conservés ont été téléchargées directement à partir de TCMSP. Les entrées cibles en double ont été supprimées manuellement lors de la construction du jeu de cibles non redondant, tandis que les relations originales composé-cible ont été conservées pour la construction ultérieure du réseau. Étant donné que TCMSP fournissait les noms des cibles sous leur forme complète plutôt que sous forme de symboles génétiques normalisés, chaque cible a été recherchée dans la base de données UniProt (consultée le 14 juillet 2025). L'entrée humaine correspondante a été sélectionnée, et le nom de la cible a été converti en son symbole génétique officiel. Le jeu de données composé-cible normalisé a été utilisé pour l'analyse de l'intersection cible-maladie et du réseau composé-cible.
Collecte de gènes associés à la glomérulonéphrite et intersection des cibles
Les gènes associés à la maladie ont été extraits de GeneCards, DisGeNET, PharmGKB et de la Therapeutic Target Database en utilisant le terme de recherche « glomerulonephritis » le 14 juillet 2025. Pour GeneCards, seules les entrées dont le score de pertinence était supérieur au score médian de 10 ont été conservées. Les entrées admissibles provenant des autres bases de données ont été incluses selon leurs annotations curatées entre maladie et cible. Les noms des gènes ont été normalisés selon les symboles officiels des gènes humains, et les doublons ont été supprimés. Cette procédure a permis d'obtenir 1 134 gènes uniques associés à la glomérulonéphrite. Étant donné que la recherche utilisait le terme plus général « glomerulonephritis », l'ensemble de données obtenu a été considéré comme pertinent pour les processus moléculaires associés à la glomérulonéphrite chronique, plutôt que spécifique à un seul sous-type histopathologique.
Les cibles associées aux composés dérivés de TCMSP ont été croisées avec le jeu de gènes associés à la maladie à l'aide de R. Vingt-trois cibles communes ont été identifiées. Les diagrammes de Venn ont été générés à l'aide du package R venn, et le réseau cible commun-composé a été construit et visualisé à l'aide de Cytoscape. Les relations entre les constituants candidats et les cibles communes sont résumées dans Tableau 1.
Analyses d'enrichissement fonctionnel et d'interactions entre protéines
Des analyses d'enrichissement de la Gene Ontology (GO) et de la Kyoto Encyclopedia of Genes and Genomes (KEGG) ont été réalisées dans R à l'aide des packages clusterProfiler et org.Hs.eg.db. Les termes de la Gene Ontology ont été analysés selon les catégories processus biologique, composant cellulaire et fonction moléculaire. Les valeurs de p ont été ajustées pour les tests multiples selon la méthode de Benjamini-Hochberg, et les termes ou voies présentant des valeurs de p ajustées inférieures à 0,05 ont été conservés. Les termes et voies enrichis ont été représentés à l'aide de graphiques en barres et de diagrammes en points générés indépendamment.
Les 23 cibles chevauchantes ont été soumises à STRING, avec Homo sapiens sélectionné comme organisme et un score d'interaction minimal supérieur à 0,4. Le réseau d'interactions protéine-protéine résultant a été importé dans Cytoscape. La topologie du réseau a été évaluée à l'aide de CytoNCA selon les paramètres suivants : degré, centralité d'intermédiarité, centralité de proximité, centralité vectorielle, connectivité moyenne locale et centralité du réseau. Les cibles centrales ont été définies comme les nœuds dont les valeurs de degré, de centralité d'intermédiarité, de centralité de proximité, de centralité vectorielle, de connectivité moyenne locale et de centralité du réseau étaient toutes supérieures aux valeurs médianes correspondantes du réseau. Cette analyse a permis de hiérarchiser neuf cibles centrales pour l'interprétation ultérieure.
Validation du dockage moléculaire et du redockage
Le dockage moléculaire a été réalisé à l'aide de la structure de la cyclooxygénase-2 liée au célécoxib, d'identifiant PDB 3LN1. La chaîne A et son groupe hème associé ont été conservées comme récepteur, tandis que les molécules d'eau cristallographiques et le ligand célécoxib co-cristallisé ont été supprimés lors de la préparation du récepteur. La conformation native du célécoxib a été extraite séparément de la chaîne A afin de valider le redockage. Des atomes d'hydrogène polaires et des charges de Gasteiger ont été ajoutés à l'aide d'AutoDockTools, puis le récepteur a été enregistré au format PDBQT. L'identifiant PDB 3LN1 correspond à une structure de COX-2 murin liée au célécoxib, résolue à 2,40 Å. Les structures du β-sitostérol et de l'acétate de linoléyle ont été obtenues à partir de PubChem et préparées à l'aide d'Open Babel. Des atomes d'hydrogène et des charges partielles de Gasteiger ont été ajoutés, les liaisons rotatables ont été définies, puis chaque ligand a été converti au format PDBQT. Le célécoxib, le β-sitostérol et l'acétate de linoléyle ont été dockés à l'aide d'AutoDock Vina en utilisant le même récepteur et les mêmes paramètres de recherche.
La boîte de docking a été centrée sur la région native de fixation de la célécoxib en utilisant les coordonnées suivantes : center_x = 30,9886, center_y = -22,2836, center_z = -16,5072, size_x = 26 Å, size_y = 26 Å, size_z = 26 Å. La valeur d'exhaustivité a été fixée à 16, le nombre de modes de sortie à 10, et la plage d'énergie à 3 kcal/mol. La pose classée en tête, basée sur l'énergie de liaison prédite la plus faible, a été conservée pour la visualisation. Pour la validation du protocole, la célécoxib native a été redockée dans les mêmes conditions, et l'écart quadratique moyen des atomes lourds entre les poses cristallographique et redockée a été calculé à l'aide de PyMOL. Un écart quadratique moyen inférieur à 2 Å a été considéré comme une reproduction acceptable de la pose de référence. Les résidus situés à moins de 4 Å de chaque ligand docké ont été identifiés dans PyMOL. Les scores de docking et les poses ont été interprétés comme des estimations de la compatibilité structurale et non comme une preuve directe de liaison à la cible ou d'inhibition enzymatique.
Culture cellulaire et préparation des composés
Les cellules mésangiales glomérulaires de rat HBZY-1 ont été cultivées dans un milieu de Dulbecco modifié (DMEM) à haute teneur en glucose, complété avec 10 % de sérum de veau fœtal et 1 % de pénicilline-streptomycine, à 37 °C dans des conditions humidifiées avec 5 % de CO₂. Les cellules aux passages 2 à 7 ont été utilisées pour toutes les expériences, et l'absence de mycoplasmes a été vérifiée avant utilisation. Le β-sitostérol et la célécoxib ont été utilisés comme composés chimiquement définis. Le β-sitostérol a été dissous dans de l'éthanol absolu afin d'obtenir une solution mère de 10 mM (environ 4,15 mg/mL). Si nécessaire, une sonication brève et un réchauffage à 50–60 °C ont été effectués pour obtenir une solution limpide à l'œil nu. La célécoxib a été dissoute dans du diméthylsulfoxyde (DMSO) pour préparer une solution mère de 10 mM (environ 3,81 mg/mL). Les solutions mères ont été aliquotées et stockées à −20 °C. Avant traitement, les solutions mères ont été diluées directement dans le milieu de culture préchauffé et immédiatement mélangées.
Les concentrations de véhicule ont été appariées au sein de chaque expérience. Dans le test de viabilité cellulaire, la concentration finale d'éthanol a été ajustée à 0,2 % (v/v) dans tous les groupes, car la concentration la plus élevée de β-sitostérol testée était de 20 µM. Dans l'expérience inflammatoire induite par le LPS, les concentrations finales d'éthanol et de diméthylsulfoxyde ont été ajustées respectivement à 0,1 % et 0,01 % (v/v) dans tous les groupes. Dans l'expérience profibrotique induite par le TGF-β1, la concentration finale d'éthanol a été ajustée à 0,1 % (v/v) dans tous les groupes. Des volumes équivalents des véhicules correspondants ont été ajoutés aux groupes Témoin, LPS et TGF-β1.
Dosage de la viabilité cellulaire
Les cellules ont été ensemencées dans des plaques de 96 puits à une densité de 5 × 10³ cellules par puits dans 100 µL de milieu complet et ont été laissées à s’adhérer pendant 24 h. Pour évaluer la gamme de concentrations du β-sitostérol, les cellules ont été incubées avec 0,5, 1, 5, 10 ou 20 µM de β-sitostérol pendant 24 h. Pour le test de viabilité cellulaire lié au LPS, les cellules ont été prétraitées avec du β-sitostérol à 1, 5 ou 10 µM pendant 2 h, puis exposées à 1 µg/mL de lipopolysaccharide pendant 24 h supplémentaires.
Les groupes de traitement étaient les suivants : témoin, β-sitostérol à 0,5 µM, β-sitostérol à 1 µM, β-sitostérol à 5 µM, β-sitostérol à 10 µM, β-sitostérol à 20 µM, LPS, LPS plus β-sitostérol à 1 µM, LPS plus β-sitostérol à 5 µM, et LPS plus β-sitostérol à 10 µM. Le réactif du kit de comptage cellulaire Cell Counting Kit-8 a été ajouté à raison de 10 µL par puits, puis les plaques ont été incubées pendant 2 h. L'absorbance a ensuite été mesurée à 450 nm. La viabilité cellulaire a été déterminée après soustraction du témoin sans cellules et exprimée par rapport au groupe témoin. Chaque condition comprenait six puits techniques pour chacune des six expériences biologiques indépendantes. Les valeurs des puits techniques de chaque expérience ont été moyennées afin d'obtenir une valeur par réplicat biologique pour l'analyse statistique.
Activation inflammatoire induite par le LPS
Pour les expériences d'activation inflammatoire, les cellules HBZY-1 ont été cultivées dans des plaques de 6 puits à une densité de 2 × 10⁵ cellules par puits et traitées après avoir atteint une confluence d'environ 70 à 80 %. Les cellules ont été maintenues dans un milieu supplémenté avec 1 % de sérum de veau fœtal pendant 12 heures avant le traitement. Le β-sitostérol ou la célécoxib ont été administrés 2 heures avant la stimulation par le LPS. Par la suite, les cellules ont été exposées à 1 µg/mL de LPS pendant 24 heures.
Les groupes expérimentaux étaient les suivants : contrôle, β-sitostérol à 10 µM, LPS, LPS plus β-sitostérol à 1 µM, LPS plus β-sitostérol à 5 µM, LPS plus β-sitostérol à 10 µM, et LPS plus célécoxib à 1 µM. Le célécoxib a été inclus comme témoin positif fonctionnel d'inhibition de la production de prostaglandines dépendante de la COX-2. À la fin du traitement, les surnageants de culture ont été recueillis pour la mesure du PGE2. Les cellules ont été recueillies séparément pour une analyse par PCR quantitative en temps réel des gènes Tnf, Il6 et Ptgs2, ainsi que pour une analyse par immunoblotting de la COX-2.
Activation profibrotique induite par le TGF-β1
Un modèle distinct induit par le TGF-β1 a été utilisé pour évaluer l'activation profibrotique. Les cellules HBZY-1 ont été ensemencées dans des plaques de 6 puits à une densité de 2 × 10⁵ cellules par puits et maintenues dans un milieu supplémenté avec 1 % de sérum de veau fœtal pendant 12 h avant le traitement. Les cellules ont été prétraitées avec du β-sitostérol pendant 2 h, puis stimulées avec 10 ng/mL de TGF-β1 recombinant pendant 48 h.
Les groupes de traitement comprenaient le témoin, le β-sitostérol (10 µM), le TGF-β1, le TGF-β1 + β-sitostérol (5 µM) et le TGF-β1 + β-sitostérol (10 µM). À la fin de la période de traitement, les cellules ont été récoltées pour une analyse par PCR quantitative en temps réel de Col1a1 et de Acta2, ainsi que pour une analyse par immunobuvardage de l'actine alpha du muscle lisse (α-SMA).
PCR quantitative en temps réel
L'ARN total a été isolé à partir de cellules traitées à l'aide d'un réactif d'extraction de l'ARN à base de phénol-guanidinium, selon le protocole du fabricant. La concentration et la pureté de l'ARN ont été déterminées à l'aide d'un spectrophotomètre. Seuls les échantillons présentant un rapport A260/A280 compris entre 1,8 et 2,0 ont été utilisés pour la transcription inverse. Pour chaque échantillon, 1 µg d'ARN total a été transcrit en ADN complémentaire dans un volume réactionnel final de 20 µL. L'ADN complémentaire obtenu a été dilué au cinquième avec de l'eau sans nucléase avant la PCR quantitative. La PCR quantitative a été réalisée dans un volume total de 20 µL contenant 10 µL de mix maître SYBR Green 2×, 0,4 µL de chacun des amorces avant et arrière à 10 µM, 2 µL d'ADN complémentaire dilué et 7,2 µL d'eau sans nucléase. Les conditions d'amplification comprenaient une étape initiale de dénaturation à 95 °C pendant 30 s, suivie de 40 cycles de dénaturation à 95 °C pendant 5 s et d'hybridation-élongation à 60 °C pendant 30 s. Une analyse de la courbe de fusion a ensuite été réalisée de 65 °C à 95 °C afin de vérifier la spécificité de l'amplification.
Les gènes mesurés étaient Tnf, Il6, Ptgs2, Col1a1, Acta2 et Gapdh. Le gène Gapdh a servi de gène de référence interne. L'expression relative des gènes a été déterminée à l'aide de la méthode 2−ΔΔCt, le groupe témoin étant utilisé comme calibrateur. Les séquences des amorces sont indiquées dans le Tableau supplémentaire 1. Chaque échantillon a été analysé en triplets techniques, et six expériences biologiques indépendantes ont été réalisées. Les valeurs obtenues à partir des réplicats techniques ont été moyennées avant l'analyse statistique.
Mesure du PGE2 par dosage immunoenzymatique
Les surnageants de culture ont été recueillis après 24 h de stimulation par le LPS et centrifugés à 1 000 ×g pendant 10 min à 4 °C pour éliminer les débris cellulaires. Les concentrations de PGE2 ont été déterminées à l’aide d’un kit de dosage immunoenzymatique disponible commercialement, conformément aux instructions du fabricant.
Les étalons et les échantillons ont été chargés en double sur la plaque d'analyse. Après la liaison des anticorps et les étapes de développement de la couleur, l'absorbance a été mesurée à 450 nm à l'aide d'un lecteur de microplaques. Les concentrations de PGE2 ont été déterminées à partir d'une courbe standard logistique à quatre paramètres et exprimées en pg/mL. Les surnageants de six expériences cellulaires indépendantes ont été analysés. Les mesures en double de chaque échantillon biologique ont été moyennées avant l'analyse statistique.
Immunotransfert
Les cellules traitées ont été lysées dans un tampon d'essai d'immunoprécipitation radio-immunologique complété par un mélange d'inhibiteurs de protéases. Les lysats ont été incubés sur de la glace pendant 30 min et centrifugés à 12 000 × g pendant 15 min à 4 °C. Les concentrations protéiques dans les surnageants ont été déterminées à l'aide d'un dosage protéique à l'acide bicinchoninique. Des quantités équivalentes de protéines (30 µg par puits) ont été mélangées au tampon de charge et dénaturées à 95 °C pendant 5 min. Les protéines provenant des expériences avec le LPS ont été séparées sur des gels de polyacrylamide à 10 % contenant du dodécylsulfate de sodium, tandis que celles des expériences avec le TGF-β1 ont été séparées sur des gels à 12 %. Les protéines séparées ont ensuite été transférées sur des membranes de fluorure de polyvinylidène.
Les membranes ont été bloquées avec du lait écrémé à 5 % dans une solution saline tamponnée au Tris contenant 0,1 % de Tween 20 pendant 1 h à température ambiante, puis incubées toute la nuit à 4 °C avec des anticorps primaires dirigés contre COX-2 (1:1000), α-SMA (1:1000) et GAPDH (1:5000). L'analyse de COX-2 a été réalisée sur des échantillons provenant de l'expérience avec le LPS, tandis que celle de α-SMA a été effectuée sur des échantillons issus de l'expérience avec le TGF-β1. Après lavage, les membranes ont été incubées avec des anticorps secondaires conjugués à la peroxydase de raifort (1:5000) pendant 1 h à température ambiante. Les bandes protéiques ont été visualisées à l'aide d'un substrat de chimiluminescence amplifiée et capturées à l'aide d'un système d'imagerie par chimiluminescence. Les temps d'exposition étaient d'environ 10 s pour COX-2, 10 s pour α-SMA et 2 s pour GAPDH.
Les intensités des bandes ont été quantifiées à l'aide d'ImageJ. Les signaux de COX-2 et d'α-SMA ont été normalisés par rapport au signal correspondant de GAPDH. Le western blot a été réalisé à partir d'échantillons protéiques obtenus lors de six expériences indépendantes de culture cellulaire et de traitement.
Analyse statistique
Les analyses statistiques ont été réalisées à l'aide de GraphPad Prism. Les données sont présentées sous la forme de la moyenne ± l'écart type. Six expériences indépendantes de culture cellulaire et de traitement ont été effectuées pour chaque analyse quantitative, chaque expérience indépendante représentant un réplicat biologique. Les mesures issues des réplicats techniques obtenus à partir de la même expérience biologique ont été moyennées avant l'analyse statistique et n'ont pas été considérées comme des observations indépendantes.
Pour le test de viabilité cellulaire, chaque expérience biologique comprenait six puits techniques par condition. Les réactions de PCR quantitative ont été réalisées en triple technique pour chaque échantillon biologique, et les mesures de PGE2 ont été effectuées en double. La quantification par immunotransfert était basée sur six échantillons protéiques préparés indépendamment. Ainsi, chaque barre quantitative contient six valeurs issues de réplicats biologiques individuels.
Les différences entre plusieurs groupes ont été analysées à l'aide d'une analyse de la variance à un facteur suivie du test de comparaison multiple de Tukey. Une valeur P bilatérale < 0,05 a été considérée comme statistiquement significative. Les valeurs individuelles des réplicats biologiques ont été représentées conjointement avec la moyenne et l'écart type.
Résultats
Écranage des constituants candidats, récupération des cibles et intersection des cibles
Le flux de travail pour l'identification des cibles communes aux composés candidats et aux maladies est résumé dans la Figure 1A. Sept composés candidats de C. sinensis ont satisfait aux critères prédéfinis de criblage, soit une biodisponibilité orale (OB) ≥30 % et une similarité de structure (DL) ≥0,18, notamment l'acide arachidonique, l'acétate de linoléyle, le β-sitostérol, le peroxyergostérol, le cérévistérol, le palmitate de cholestérol et le CLR (Tableau 2). Parallèlement, 1 134 gènes associés à la glomérulonéphrite ont été extraits des bases de données GeneCards, DisGeNET, PharmGKB et TTD, et leur répartition entre ces quatre bases est illustrée dans la Figure 1B. Une analyse d'intersection entre l'ensemble des cibles associées aux composés et l'ensemble des gènes associés à la maladie a permis d'identifier 23 cibles communes (Tableau 1, Figure 1C). Le réseau correspondant entre les composés candidats et les cibles communes est présenté dans la Figure 1D, illustrant les relations entre les composés candidats représentatifs, les cibles communes et la CGN. Ces cibles communes incluent plusieurs gènes liés à la régulation de l'inflammation, à l'apoptose et aux voies de signalisation vasculaire, tels que PTGS2, CASP3, MAPK1, PPARG, TNFRSF1A et NOS3.
Analyses d'enrichissement fonctionnel et d'interactions protéine-protéine
Afin d'étudier la signification biologique des 23 cibles communes, des analyses d'enrichissement des voies GO et KEGG ont été réalisées. Les résultats ont révélé que ces cibles sont significativement enrichies dans plusieurs voies liées à l'inflammation et au métabolisme.
L'analyse GO a classé les cibles en fonction des catégories processus biologique (BP), composant cellulaire (CC) et fonction moléculaire (MF). Les termes BP les plus significativement enrichis comprenaient la réponse au lipopolysaccharide, la réponse aux molécules d'origine bactérienne et la régulation des processus du système musculaire. Au niveau cellulaire, les cibles étaient enrichies dans les radeaux membranaires, les cavéoles et les compartiments des granules alpha des plaquettes, tandis que les termes MF tels que l'activité d'oxydoréductase et la liaison aux récepteurs nucléaires suggéraient davantage de rôles dans le stress oxydatif et la régulation transcriptionnelle (Figure 2A).
L'analyse KEGG a révélé que la voie métabolique des lipides et de l'athérosclérose (hsa05417) était la plus significativement enrichie (valeur q <1 × 10⁻⁶), ainsi que des voies telles que la signalisation AGE–RAGE dans les complications du diabète, la signalisation de TNF, la signalisation de IL-17 et la signalisation de HIF-1 (Figure 2B). Notamment, la voie des lipides et de l'athérosclérose impliquait 10 des 23 cibles, notamment CASP3, MAPK1, PPARG, NOS3 et TNFRSF1A.
Dans leur ensemble, ces résultats d'enrichissement indiquent que les cibles chevauchantes sont fonctionnellement associées à des processus biologiques liés à l'inflammation, à la réponse au stress et à l'endothélium, pertinents pour la NCG.
Analyse du réseau d'interactions protéine-protéine
Un réseau d'interactions protéine-protéine (IPP) a été construit pour les 23 cibles communes à l'aide de STRING, produisant un réseau composé de 23 nœuds et de 102 arêtes (Figure 3A). Une analyse topologique réalisée avec CytoNCA a identifié neuf cibles centrales fortement connectées : PTGS2, MAPK1, PPARG, CASP3, EGF, JUN, PECAM1, BCL2 et PRKCA (Figure 3B). Parmi ces cibles, PTGS2 présentait une centralité importante dans le réseau et a donc été sélectionée pour l'analyse ultérieure de docking moléculaire. Ces résultats mettent en évidence un sous-ensemble de régulateurs candidats prioritaires issus du réseau, potentiellement pertinents pour l'intersection composé-maladie.
Validation du Docking Moléculaire et du Redocking
Afin d'évaluer davantage la plausibilité structurale des relations candidates associées à PTGS2 identifiées par l'analyse de réseau, un ancrage moléculaire a été réalisé en utilisant une structure de COX-2 liée au célécoxib. La structure cristalline d'identifiant PDB 3LN1 a été choisie car elle contient du célécoxib lié au site actif de la COX-2, fournissant ainsi une poche de liaison au ligand définie expérimentalement pour la validation de l'ancrage. Le ligand célécoxib co-cristallisé a d'abord été extrait puis réancré dans la même poche de liaison. La pose du célécoxib réancré reproduit fidèlement la pose cristallographique, avec un écart quadratique moyen (RMSD) de redocking de 0,876 Å et une affinité de liaison prédite de -12,3 kcal/mol (Figure 4A). Ce résultat indique que le protocole d'ancrage était capable de reproduire la pose de liaison du ligand connu dans les conditions d'ancrage sélectionnées.
En utilisant le même récepteur, la même boîte de grille et les mêmes paramètres de docking, le β-sitostérol a été positionné dans la région de liaison de la COX-2 définie par le célécoxib. Le β-sitostérol a montré une affinité de liaison prédite de -7,2 kcal/mol (Figure 4B). La conformation obtenue se situait dans la région prédéfinie de docking de la COX-2, et les résidus entourant cette conformation du β-sitostérol comprenaient ASN567, ASP333, GLN178, GLN336, GLY340, HIS337, HIS80, PRO500, THR79 et TYR341.
L'acétate de linoléyle a également été évalué comme candidat secondaire par calcul informatique, car il a été conservé dans la liste des constituants candidats et lié à PTGS2 dans l'analyse du réseau. Dans les mêmes conditions de docking, l'acétate de linoléyle a montré une affinité de liaison prédite de -7,5 kcal/mol, légèrement plus favorable que celle du β-sitostérol (Figure 4C). Sa position prédite se situe près du ligand de référence, la célécoxib, dans la région de docking. Les résidus entourant l'acétate de linoléyle comprennent ALA502, ALA513, ARG106, ARG499, GLN178, GLY512, HIS75, ILE503, LEU338, LEU345, LEU517, MET508, PHE504, SER339, SER516, TRP373, TYR371, VAL102, VAL335 et VAL509.
Viabilité cellulaire, activation inflammatoire et activation profibrotique
Le β-sitostérol a été sélectionné pour la validation au niveau du composé car il avait été identifié comme un candidat associé à PTGS2 lors de l'analyse du réseau et bénéficiait déjà d'un soutien expérimental pour son activité anti-inflammatoire et anti-fibrosante. La viabilité cellulaire a d'abord été évaluée afin de déterminer la gamme de concentrations appropriée pour les expériences ultérieures. Un traitement par le β-sitostérol à 0,5, 1, 5 et 10 µM n'a pas nettement réduit la viabilité cellulaire par rapport au groupe témoin, tandis que 20 µM de β-sitostérol ont provoqué une légère diminution. L'exposition au LPS a réduit la viabilité cellulaire, et un traitement concomitant avec le β-sitostérol a partiellement amélioré la viabilité cellulaire sous stimulation par le LPS, l'effet le plus marqué étant observé à 10 µM (Figure 5A). Sur la base de ces résultats, les concentrations de 1, 5 et 10 µM de β-sitostérol ont été utilisées pour les expériences suivantes d'activation inflammatoire induite par le LPS.
La stimulation par le LPS a fortement augmenté l'expression des ARNm des gènes inflammatoires dans les cellules HBZY-1. Par rapport au groupe témoin, le groupe traité au LPS présentait des niveaux d'expression plus élevés de Tnf, Il6 et Ptgs2 (Figure 5B-D). Le traitement par le β-sitostérol a réduit la surexpression induite par le LPS de ces gènes de manière dépendante de la concentration. La tendance à l'inhibition était la plus marquée dans le groupe LPS plus 10 µM de β-sitostérol. Le célécoxib, inclus comme contrôle fonctionnel d'un inhibiteur de la COX-2, a également réduit dans une certaine mesure l'expression des gènes inflammatoires, bien que son effet soit moins prononcé que celui observé avec 10 µM de β-sitostérol pour plusieurs marqueurs transcriptionnels (Figure 5B-D).
Étant donné que Ptgs2 code pour la COX-2 et que le PGE2 est un principal produit prostaglandine en aval de l'activité de la COX-2, la sécrétion de PGE2 a été mesurée par ELISA. Le traitement par le LPS a augmenté la concentration de PGE2 dans le surnageant de culture par rapport au groupe témoin. Le β-sitostérol a diminué la production de PGE2 induite par le LPS d'une manière dépendante de la concentration. La célécoxib a également réduit la production de PGE2 et a servi de contrôle positif pour l'inhibition fonctionnelle de l'axe COX-2/PGE2 (Figure 5E). Une analyse par immunoblotting a en outre montré que le LPS augmentait l'abondance protéique de la COX-2. Le traitement par le β-sitostérol a réduit les niveaux protéiques de COX-2 en conditions de stimulation par le LPS, avec une réduction plus marquée observée à la concentration plus élevée. En revanche, la célécoxib a réduit la production de PGE2 mais a montré un effet plus limité sur l'abondance protéique de la COX-2 (Figure 5F).
Afin de compléter le modèle inflammatoire induit par le LPS, un modèle d'activation profibrotique induite par le TGF-β1 a été utilisé pour évaluer si le β-sitostérol affectait l'expression des marqueurs fibrotiques dans les cellules mésangiales. Le TGF-β1 a fortement augmenté l'expression des ARNm de Col1a1 et Acta2 par rapport au groupe témoin (Figure 6A,B). Le β-sitostérol a réduit l'augmentation induite par le TGF-β1 pour les deux marqueurs, et cette réduction était plus marquée à 10 µM qu'à 5 µM (Figure 6A,B). Une analyse par immunoblotting a montré une augmentation correspondante de l'expression protéique de l'α-SMA après stimulation par le TGF-β1, tandis que le traitement par le β-sitostérol a diminué l'abondance de la protéine α-SMA dans les cellules traitées au TGF-β1 (Figure 6C).
DISPONIBILITÉ DES DONNÉES :
Les données brutes et traitées à l'appui de cette étude ont été déposées dans Zenodo sous le DOI : https://zenodo.org/records/21649482. Les images en balayage complet du bolt western sont fournies dans le fichier supplémentaire 1.
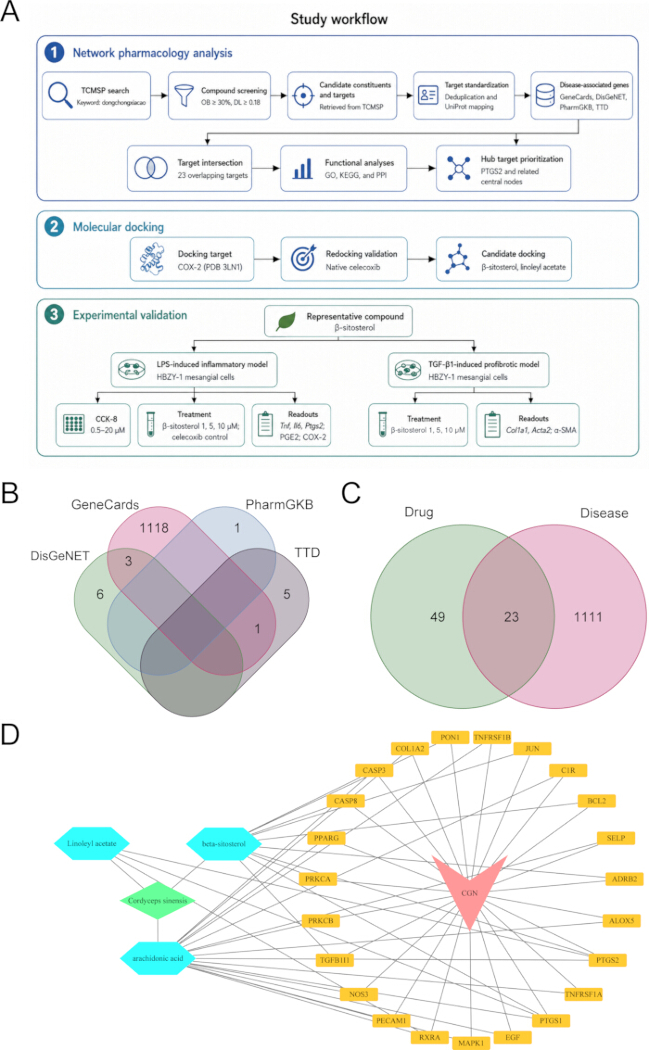
Figure 1. Flux de travail et identification basée sur les réseaux des cibles communes candidats aux composés et maladies liés à C. sinensis dans la glomérulonéphrite. (A) Schéma du flux de travail montrant l'identification des composés candidats, la récupération et la normalisation des cibles associées aux composés, la récupération des gènes associés à la glomérulonéphrite, l'analyse d'intersection et la construction du réseau composé–cible commune. (B) Diagramme de Venn illustrant la répartition des gènes associés à la glomérulonéphrite extraits de GeneCards, DisGeNET, PharmGKB et TTD. (C) Diagramme de Venn montrant l'intersection entre les cibles associées aux composés provenant de TCMSP et les gènes associés à la maladie, donnant lieu à 23 cibles communes. (D) Réseau composé–cible commune. Le losange vert représente C. sinensis, les hexagones bleus indiquent les composés candidats, les cercles jaunes indiquent les cibles communes, et le triangle rose représente la CGN. Les arêtes indiquent les relations correspondantes entre composé–cible ou maladie–cible. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
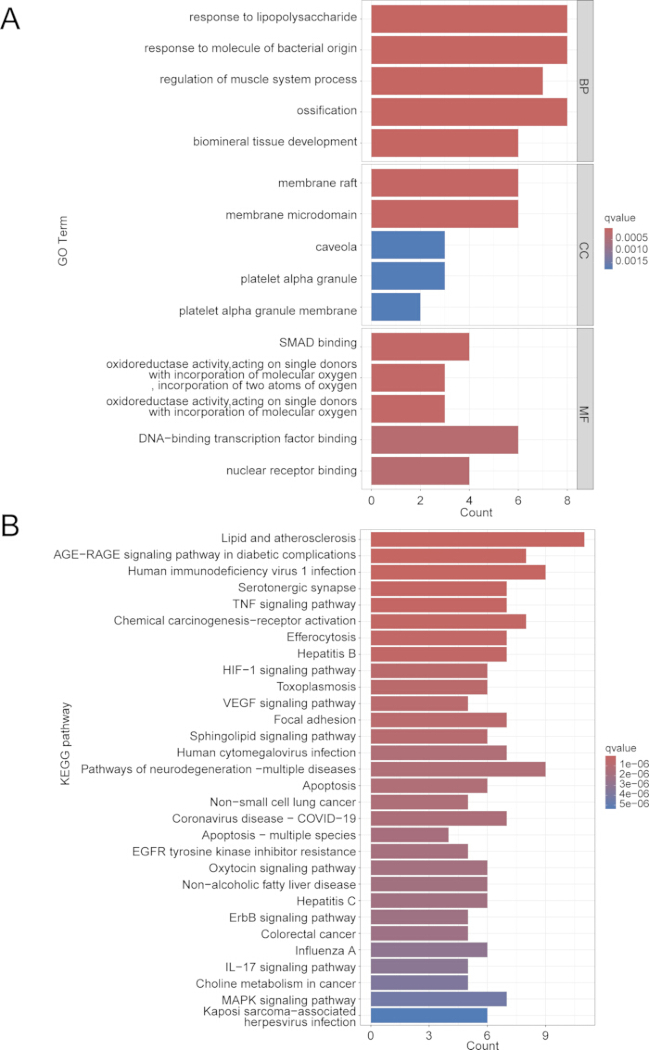
Figure 2. Analyse d'enrichissement fonctionnel des cibles communes. (A) Analyse d'enrichissement GO des 23 cibles communes. Les termes BP, CC et MF les plus significatifs ont été identifiés. La longueur des barres indique le nombre de gènes ; le dégradé de couleur représente la valeur q. (B) Analyse d'enrichissement KEGG des 23 cibles communes. Les voies sont classées selon le nombre de gènes et la significativité statistique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
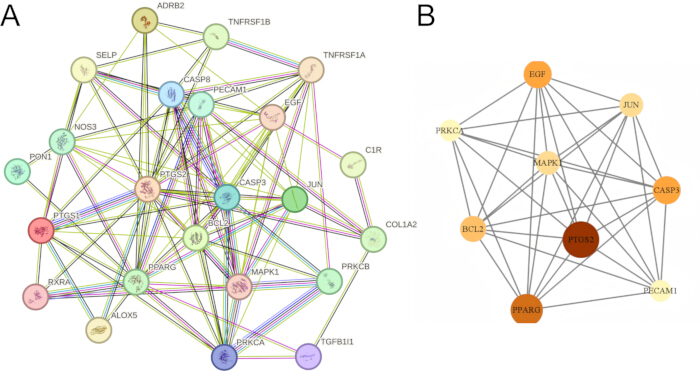
Figure 3. Réseau d'interactions protéine-protéine et hiérarchisation des cibles centrales parmi les cibles communes. (A) Réseau d'interactions protéine-protéine construit à partir des 23 cibles communes à l'aide de STRING, avec un seuil de score d'interaction >0,4. (B) Les neuf principales cibles centrales ont été hiérarchisées par une analyse topologique du réseau basée sur CytoNCA. PTGS2 a montré une centralité réseau importante et a été sélectionée pour l'analyse ultérieure de docking moléculaire. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
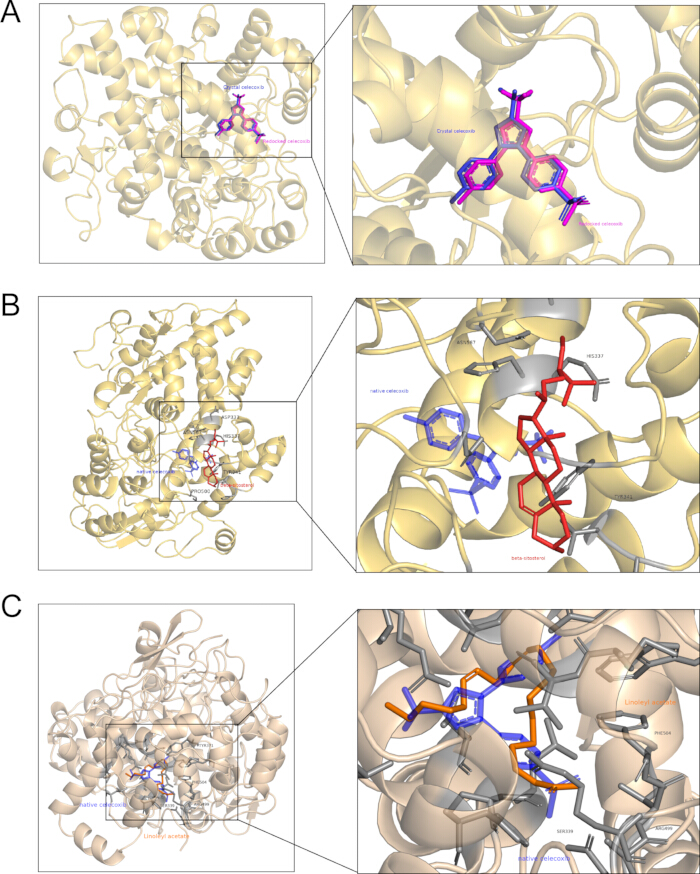
Figure 4. Validation par docking moléculaire et redocking de composés candidats sélectionnés avec la COX-2. (A) Superposition de la pose cristallographique de la célécoxib et de la pose redockée la mieux classée dans la structure murine de la COX-2 liée à la célécoxib (ID PDB 3LN1). Le redocking a reproduit l'orientation expérimentale du liaisonnement. (B) Pose de docking la mieux classée du β-sitostérol dans la région de docking de la COX-2 définie par la célécoxib. La pose cristallographique de la célécoxib est incluse comme référence spatiale. (C) Pose de docking la mieux classée de l'acétate de linoléyle dans la même région de docking. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
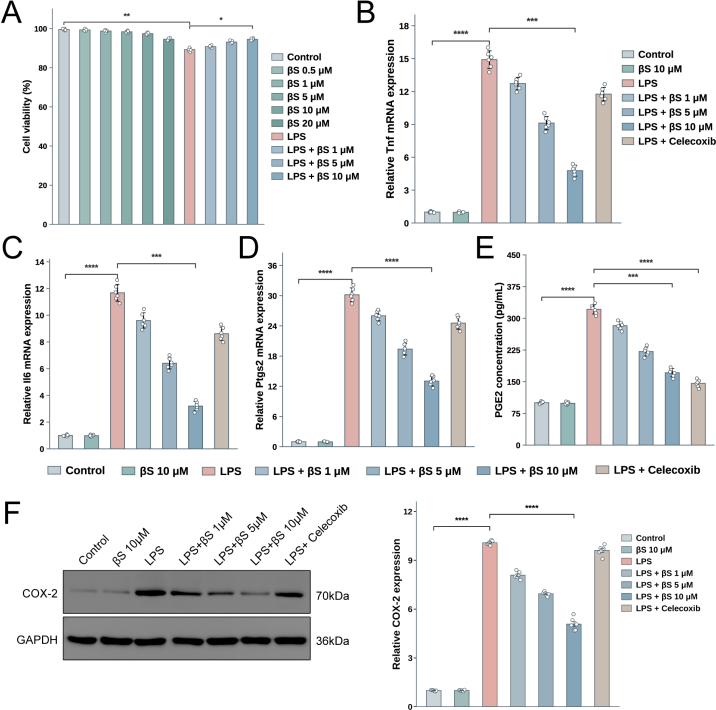
Figure 5. Le β-sitostérol atténue l'activation inflammatoire induite par le LPS et la production de PGE2 dans les cellules mésangiales HBZY-1. (A) La viabilité cellulaire a été mesurée à l’aide du test Cell Counting Kit-8. Les cellules ont été traitées avec du β-sitostérol à 0,5, 1, 5, 10 ou 20 µM pendant 24 h. Dans les groupes stimulés au LPS, les cellules ont été prétraitées avec du β-sitostérol à 1, 5 ou 10 µM pendant 2 h avant d’être exposées à 1 µg/mL de LPS pendant 24 h. La viabilité cellulaire est exprimée par rapport au groupe témoin. (B–D) Analyse par PCR quantitative en temps réel de l’expression des ARNm de Tnf (B), Il6 (C) et Ptgs2 (D). L’expression génique a été normalisée à Gapdh et exprimée par rapport au groupe témoin. (E) Concentrations de PGE2 dans les surnageants de culture mesurées par dosage immunoenzymatique (ELISA). Le célécoxib a été inclus comme témoin positif fonctionnel de la suppression de la production de prostaglandines dépendante de la COX-2. (F) Images représentatives de western blot de COX-2 et de GAPDH dans les groupes de traitement indiqués. Les données sont présentées comme moyenne ± écart-type à partir de six expériences biologiques indépendantes, les valeurs individuelles des réplicats biologiques étant indiquées. Les valeurs des réplicats techniques ont été moyennées avant analyse. Les comparaisons ont été effectuées par ANOVA à un facteur suivie du test de comparaison multiple de Tukey. La significativité est indiquée par des crochets dans les différents panneaux : *P < 0,05, **P < 0,01, ***P < 0,001 et ****P < 0,0001. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
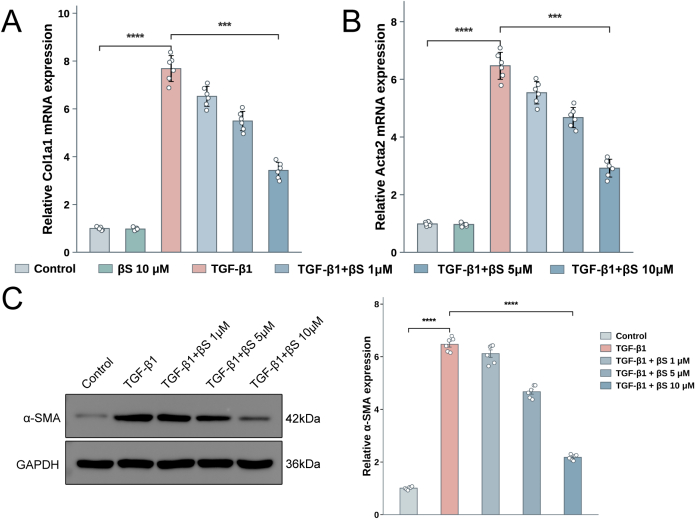
Figure 6. Le β-sitostérol réduit l'expression des marqueurs profibrotiques induite par le TGF-β1 dans les cellules mésangiales HBZY-1. (A–B) Analyse par PCR quantitative en temps réel de l'expression des ARNm de Col1a1 (A) et de Acta2 (B). L'expression génique a été normalisée à Gapdh et exprimée par rapport au groupe témoin. (C) Images représentatives de western blot de l'α-SMA et de la GAPDH dans les groupes de traitement indiqués. Les données sont présentées comme moyenne ± ÉT de six expériences biologiques indépendantes, les valeurs individuelles des réplicats biologiques étant indiquées. Les valeurs des réplicats techniques ont été moyennées avant l'analyse. Les comparaisons ont été effectuées par ANOVA à un facteur suivie du test de comparaisons multiples de Tukey. La significativité est indiquée par des crochets dans les panneaux individuels : *P < 0,05, **P < 0,01, ***P < 0,001 et ****P < 0,0001. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
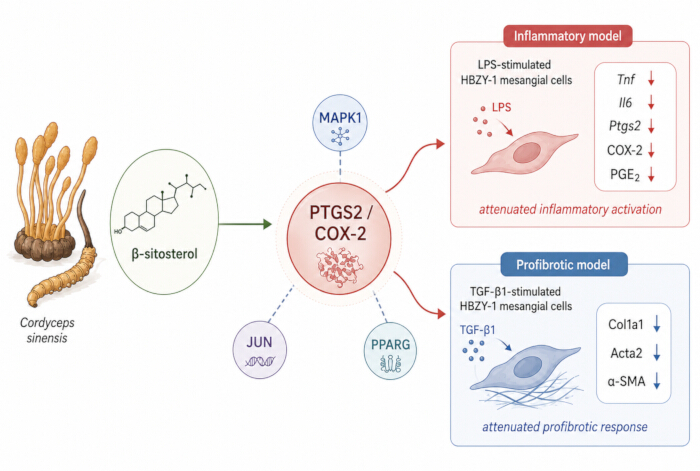
Figure 7. Interprétation intégrée des réponses inflammatoires et profibrotiques associées au β-sitostérol dans les cellules HBZY-1. Les analyses de réseau et de docking ont mis en évidence PTGS2/COX-2 dans un contexte plus large incluant MAPK1, JUN et PPARG. Le traitement par le β-sitostérol a été associé à une réduction de l'expression de Tnf, Il6 et Ptgs2 induite par le LPS, à une diminution de l'abondance protéique de COX-2 et de la production de PGE2, ainsi qu'à une réduction de l'expression de Col1a1, Acta2 et de l'α-SMA induite par le TGF-β1. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| No. | Cible chevauchante | Composé(s) candidat(s) associé(s) à la cible |
| 1 | PTGS1 | β-sitosterol; linoleyl acetate; arachidonic acid |
| 2 | PTGS2 | β-sitosterol; linoleyl acetate; arachidonic acid |
| 3 | CASP3 | β-sitosterol; arachidonic acid |
| 4 | CASP8 | β-sitosterol |
| 5 | BCL2 | β-sitosterol |
| 6 | JUN | β-sitosterol |
| 7 | PON1 | β-sitosterol |
| 8 | PRKCA | β-sitosterol |
| 9 | TGFB1I1 | β-sitosterol |
| 10 | ADRB2 | β-sitosterol |
| 11 | RXRA | linoleyl acetate; arachidonic acid |
| 12 | TNFRSF1A | arachidonic acid |
| 13 | TNFRSF1B | arachidonic acid |
| 14 | ALOX5 | arachidonic acid |
| 15 | SELP | arachidonic acid |
| 16 | C1R | arachidonic acid |
| 17 | COL1A2 | arachidonic acid |
| 18 | PPARG | arachidonic acid |
| 19 | PRKCB | arachidonic acid |
| 20 | NOS3 | arachidonic acid |
| 21 | PECAM1 | arachidonic acid |
| 22 | MAPK1 | arachidonic acid |
| 23 | EGF | arachidonic acid |
Tableau 1 : Cibles communes entre les cibles associées aux composés issus de TCMSP et les gènes associés à la glomérulonéphrite. Les enregistrements composé-cible ont été extraits de TCMSP, dédupliqués manuellement et normalisés selon les symboles génétiques humains officiels à l’aide d’UniProt.
| Nom de la molécule | MW | AlogP | OB (%) | Caco-2 | BBB | DL | FASA | HL |
| Acide arachidonique | 304.52 | 6.41 | 45.57 | 1.2 | 0.58 | 0.2 | 0.28 | 4.39 |
| Acétate de linoléyle | 308.56 | 6.85 | 42.1 | 1.36 | 1.08 | 0.2 | 0.21 | 7.48 |
| β-sitostérol | 414.79 | 8.08 | 36.91 | 1.32 | 0.99 | 0.75 | 0.23 | 5.36 |
| Péroxyergostérol | 428.72 | 6.73 | 44.39 | 0.86 | -0.29 | 0.82 | 0.24 | 4.06 |
| Cérévistérol | 432.76 | 5.26 | 39.52 | 0.35 | -0.29 | 0.77 | 0.22 | 5.08 |
| Palmitate de cholestéryle | 625.19 | 14.35 | 31.05 | 1.45 | 0.68 | 0.45 | 0.18 | 7.93 |
| Cholestérol (CLR) | 386.73 | 7.38 | 37.87 | 1.43 | 1.13 | 0.68 | 0.2 | 4.52 |
Tableau 2 : Constituants candidats de C. sinensis extraits de TCMSP à l’aide de critères de criblage basés sur la biodisponibilité orale et la similarité aux médicaments. Les composés présentant une biodisponibilité orale d’au moins 30 % et une similarité aux médicaments d’au moins 0,18 ont été retenus. MW, masse moléculaire ; ALogP, coefficient de partition octanol-eau prédit ; OB, biodisponibilité orale ; Caco-2, perméabilité prédite à Caco-2 ; BBB, pénétration de la barrière hémato-encéphalique ; DL, similarité aux médicaments ; FASA, surface accessible négative fractionnaire ; HL, demi-vie.
Tableau supplémentaire 1. Séquences des amorces utilisées pour la PCR quantitative en temps réel dans les cellules mésangiales glomérulaires de rat HBZY-1. Toutes les séquences sont indiquées dans le sens 5′ à 3′.Veuillez cliquer ici pour télécharger ce fichier.
Fichier supplémentaire 1. Images de numérisation complète pour le Western blot.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Cette étude a combiné la pharmacologie en réseau, le dockage moléculaire validé par ligand de référence et des expériences au niveau des composés afin d'évaluer une hypothèse associée à PTGS2, dérivée de constituants candidats de C. sinensis. Sept constituants ont satisfait aux critères prédéfinis de criblage TCMSP, et 23 cibles présentaient un recoupement avec le jeu de gènes associés à la glomérulonéphrite. L'analyse d'interaction protéique a permis de hiérarchiser neuf cibles centrales, parmi lesquelles PTGS2 a été sélectionnée pour le dockage et l'évaluation expérimentale. Le redockage du célécoxib a reproduit sa conformation cristallographique, tandis que le β-sitostérol et l'acétate de linoléyle ont montré une compatibilité modérée prédite avec la région de dockage de la COX-2. Dans les cellules mésangiales HBZY-1, le β-sitostérol a réduit l'expression génique inflammatoire induite par le LPS, l'abondance de COX-2 et la production de PGE2, ainsi que l'expression induite par le TGF-β1 de marqueurs profibrotiques. Ces résultats établissent un lien entre la hiérarchisation computationnelle et les phénotypes cellulaires, mais ils soutiennent une relation régulatoire candidate plutôt qu'un mécanisme thérapeutique défini.
Les résultats d'enrichissement ont placé les cibles chevauchantes au sein de processus biologiques liés à la stimulation inflammatoire, au stress cellulaire, à la régulation des lipides, à la fonction vasculaire et au remodelage tissulaire. L'enrichissement des réponses au lipopolysaccharide et aux produits bactériens était conforme au modèle inflammatoire utilisé pour la validation expérimentale. Les voies liées à TNF, IL-17, AGE-RAGE et HIF-1 ont également fourni un contexte fonctionnel plausible pour l'inflammation glomérulaire et le remodelage maladaptatif6,17,18,19. Toutefois, l'enrichissement de voies reflète une concentration statistique de gènes annotés et n'établit pas l'activation ou l'inhibition d'une voie par le β-sitostérol12. L'annotation marquée relative aux lipides et à l'athérosclérose doit donc être interprétée comme une biologie inflammatoire, apoptotique et vasculaire commune, plutôt que comme une preuve que l'athérosclérose représente le mécanisme principal de la maladie dans la GNCG. De même, les données issues de TCMSP concernant la biodisponibilité orale, le profil de médicament et les cibles ont été utilisées pour hiérarchiser les candidats.
PTGS2 s'est révélé comme un nœud pertinent car il était présent dans l'intersection maladie-composé, présentait une forte centralité dans le réseau et était lié expérimentalement à des modifications de la transcription de Ptgs2, de l'abondance protéique de la COX-2 et de la production de PGE2. Cet accord entre les niveaux computationnel et cellulaire renforce la justification pour examiner la réponse associée à PTGS2. Cela n'implique toutefois pas que PTGS2 soit uniformément pathogène dans le rein. Les prostanoides dérivés de la COX participent au débit sanguin rénal, à la gestion du sel et à l'homéostasie adaptative, et peuvent exercer des effets protecteurs ou délétères selon le type cellulaire, la distribution des récepteurs, la phase de la maladie et la concentration locale20,21. Dans une néphrite expérimentale, le célécoxib a réduit la production liée au PGE2, tandis que le PGE2 lui-même influençait l'expression des récepteurs des prostaglandines dans les cellules mésangiales22. Ces observations montrent que les conséquences biologiques de la COX-2 et du PGE2 vont au-delà d'une simple voie linéaire pro-inflammatoire20,23. La comparaison avec le célécoxib aide à distinguer l'expression de la cible de la fonction enzymatique. Le célécoxib a produit la réduction la plus nette du PGE2, en accord avec son rôle d'inhibiteur fonctionnel de la COX-2, mais a eu un effet plus limité sur l'expression de Ptgs2 et l'abondance de la protéine COX-222. Le β-sitostérol a montré un profil plus large incluant une diminution de Tnf, Il6, Ptgs2, de la COX-2 et du PGE2. Cette différence n'indique pas une puissance inhibitrice supérieure sur la COX-2. Elle suggère plutôt que le β-sitostérol pourrait modifier l'état inflammatoire dans lequel PTGS2 est induit, tandis que le célécoxib limite principalement la synthèse des prostaglandines par inhibition de l'activité catalytique. Des dosages enzymatiques directs, des études d'engagement de la cible et des perturbations de PTGS2 seraient nécessaires pour déterminer si le β-sitostérol interagit également fonctionnellement avec la COX-2.
Les résultats du réseau suggèrent également que PTGS2 ne doit pas être interprété comme un nœud moléculaire isolé. MAPK1, JUN et PPARG ont été co-priorisés dans le réseau d'interactions protéiques, plaçant ainsi la synthèse des prostanoides dans un contexte plus large de signalisation et de régulation transcriptionnelle. Dans les cellules mésangiales rénales, la sphingosine 1-phosphate augmente l'expression de la COX-2 et la formation de PGE2 via une signalisation p42/p44 MAPK dépendante du récepteur S1P2, fournissant une preuve directe que l'activité MAPK peut se situer en amont de la réponse COX-2/PGE2 dans ce type cellulaire24. Étant donné que JUN est un composant principal du complexe transcriptionnel AP-1, AP-1 pourrait constituer une interface entre l'activation de MAPK et la transcription de PTGS2. En accord avec cette hypothèse, la 15-désoxy-Δ12,14-prostaglandine J2 supprime l'expression induite de COX-2 par l'IL-1β ainsi que l'activité d'AP-1 dans des cellules mésangiales en culture25. Dans des modèles cellulaires non rénaux, le β-sitostérol réduit l'activation d'ERK et de p38, la signalisation NF-κB, l'expression de COX-2 et la production de cytokines inflammatoires après exposition au LPS14,15. Ces observations offrent un contexte plausible aux réductions coordonnées de Tnf, Il6, Ptgs2, COX-2 et PGE2 observées dans la présente étude. Toutefois, les études citées sur le β-sitostérol ont été menées sur des cellules microgliales ou endothéliales, et non sur des cellules mésangiales rénales, et la phosphorylation de MAPK1 ainsi que l'activité de JUN n'ont pas été mesurées ici. Les résultats actuels ne permettent donc pas d'établir un mécanisme de régulation de PTGS2 par le β-sitostérol dépendant de MAPK1 ou de JUN. PPARG pourrait interagir avec le réseau centré sur PTGS2 par le biais d'une régulation transcriptionnelle sensible aux lipides et d'une modulation du phénotype profibrotique des cellules mésangiales, plutôt que comme un effecteur linéaire simple en aval de PTGS2. Dans les cellules mésangiales glomérulaires, des ligands naturels et synthétiques de PPARγ inhibent l'expression de la fibronectine induite par le TGF-β1, tandis que d'autres travaux ont montré que les agonistes de PPARγ réduisent l'activation des cellules mésangiales induite par le TGF-β, l'expression de l'α-SMA et l'accumulation de collagène IV en atténuant la signalisation PKA et CREB26,27. Des travaux plus récents chez des souris diabétiques et dans des cellules mésangiales glomérulaires stimulées par une concentration élevée de glucose ont placé les axes régulateurs NF-κB/COX-2 et PPARγ/UCP2 sur des voies parallèles associées à l'inflammation et à la fibrose rénales, suggérant une convergence fonctionnelle potentielle sans toutefois démontrer un couplage direct entre PTGS2 et PPARG28. Ces résultats fournissent un contexte biologiquement plausible aux réductions observées pour Col1a1, Acta2 et l'α-SMA dans le modèle actuel de TGF-β1. Cependant, l'expression de PPARG, son activité transcriptionnelle et sa liaison à des ligands n'ont pas été évaluées. Les données actuelles ne permettent donc pas d'attribuer la réponse profibrotique observée à une activation de PPARG ni de définir une voie de signalisation séquentielle MAPK1-PTGS2-PPARG. Il est important de noter que MAPK1 et PPARG ont été priorisés au niveau du réseau intégré composé-maladie et ne doivent pas être interprétés comme des cibles directes du β-sitostérol selon l'analyse actuelle.
L'analyse de docking doit être interprétée dans les mêmes limites probantes. Un RMSD de redocking de 0,876 Å indique que le protocole de docking sélectionné est capable de reproduire l'orientation connue du célécoxib dans la structure 3LN1. Les affinités prédites nettement moins favorables du β-sitostérol et de l'acétate de linoléyle par rapport au célécoxib soutiennent une accommodation spatiale au sein de la région prédéfinie, mais pas une force de liaison ou une action pharmacologique équivalente29,30. La différence de 0,3 kcal/mol entre l'acétate de linoléyle et le β-sitostérol est trop faible pour justifier un classement biologique en isolation. Le β-sitostérol a été sélectionné pour les tests ultérieurs car son association au réseau s'accompagne d'une littérature expérimentale plus vaste relative à l'inflammation et à la fibrose14,15,16. Des études antérieures ont rapporté des réductions de TNF-α, d'IL-6 et de COX-2 dans des cellules microgliales et endothéliales exposées au LPS, ainsi que des modifications de la signalisation MAPK et NF-κB14,15. L'acide arachidonique nécessite une interprétation différente car il s'agit d'un substrat endogène de la COX21. Sa présence dans le réseau issu de TCMSP n'indique pas une action inhibitrice anti-inflammatoire et illustre le fait que les relations cibles-composés basées sur des bases de données ne définissent pas la directionnalité. Les réductions liées à la concentration des marqueurs inflammatoires observées dans les cellules HBZY-1 sont cohérentes avec ces résultats cellulaires antérieurs, tout en étendant les preuves à un contexte mésangial glomérulaire14,15. Le modèle TGF-β1 aborde un aspect distinct du processus pathologique31. Le β-sitostérol a réduit la transcription de Col1a1 et de Acta2 et diminué l'abondance de l'α-SMA après stimulation par le TGF-β1. Des travaux antérieurs menés sur des cellules épithéliales alvéolaires humaines ont également montré que le β-sitostérol réduit l'expression du collagène, de la fibronectine et de l'α-SMA induite par le TGF-β1, bien que cette étude ait impliqué un tissu et un processus cellulaire différents16. Les résultats actuels soutiennent donc une activité contre un phénotype profibrotique dans les cellules mésangiales, mais n'établissent pas l'inhibition d'un récepteur spécifique du TGF-β ou d'un mécanisme dépendant des SMAD31.
Plusieurs limites définissent la portée de l'interprétation. Le jeu de gènes associés à la maladie a été établi à l'aide du terme général glomérulonéphrite et n'est pas spécifique à un sous-type clinique ou histologique de GNC. L'analyse computationnelle a utilisé des annotations humaines, la modélisation moléculaire s'est appuyée sur une structure murine de la COX-2, et les expériences ont été réalisées sur des cellules HBZY-1 de rat. Les relations d'orthologie permettent des comparaisons, mais des différences dépendant de l'espèce dans la régulation et la reconnaissance des ligands restent possibles. Une seule lignée cellulaire mésangiale immortalisée ne peut pas représenter les interactions entre les cellules mésangiales, les podocytes, les cellules endothéliales, les cellules immunitaires infiltrantes et le compartiment tubulo-interstitiel. L'étude n'a pas non plus évalué la liaison directe, l'activité enzymatique de la COX-2, la dépendance vis-à-vis de PTGS2, des cellules rénales humaines primaires, l'efficacité in vivo, la pharmacocinétique ou l'exposition rénale. Enfin, l'utilisation d'une préparation définie de β-sitostérol résout l'incohérence antérieure entre les constituants prédits et un extrait non caractérisé, mais ne démontre pas que le β-sitostérol soit responsable des effets du C. sinensis entier ni que les autres constituants soient inactifs.
Ensemble, les résultats issus des analyses de réseau, des études de docking et des expériences cellulaires soutiennent que le β-sitostérol constitue un candidat représentatif associé à une réduction de l'activation inflammatoire et profibrotique dans les cellules HBZY-1. Ces résultats sont compatibles avec une modulation d'une réponse liée à PTGS2/COX-2/PGE2, mais n'établissent pas une liaison directe avec COX-2, une causalité dépendante de PTGS2 ou une efficacité thérapeutique dans la NCG. Des études supplémentaires sur l'engagement de la cible, les perturbations génétiques, les cellules primaires et des expériences in vivo sont nécessaires (Figure 7).
Déclarations de divulgation
Les auteurs déclarent ne pas avoir d'intérêts concurrents. Des outils basés sur l'intelligence artificielle (ChatGPT, OpenAI) ont été utilisés pour aider à la révision linguistique et à la conception préliminaire de schémas. Une intelligence artificielle générative a été utilisée pour aider à la préparation de brouillons graphiques préliminaires des figures 1A et 7, qui ont ensuite été examinés et révisés par les auteurs afin d'assurer leur cohérence avec les méthodes et résultats rapportés. Toutes les productions assistées par l'IA ont été évaluées de manière critique et approuvées par les auteurs. Les auteurs ont vérifié le contenu final des figures et assument l'entière responsabilité de l'intégrité et de l'exactitude du manuscrit.
Remerciements
Cette étude a été soutenue par la spécialité caractéristique en néphropathie intégrant la médecine traditionnelle chinoise et la médecine occidentale (ZYTSZK2-3) et par l'étude sur la stratégie d'intervention de la médecine traditionnelle chinoise dans la maladie rénale chronique du point de vue de la gestion des maladies chroniques (202240169).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Éthanol absolu | Sigma-Aldrich/Merck | E7023 | Éthanol non dénaturé de qualité biologie moléculaire à 200 degrés, solvant pour la solution mère de β-sitostérol. |
| AutoDock Vina | Scripps Research | Version 1.1.2 | Simulation de docking moléculaire |
| Enceinte de sécurité biologique | Thermo Fisher Scientific | 1300 Series A2 | Opérations stériles de culture cellulaire |
| Célécoxib | MedChemExpress | HY-14398 | Inhibiteur sélectif de la COX-2 utilisé comme contrôle positif ; solution mère à 10 mM dans le DMSO. |
| Kit de comptage cellulaire-8 | Dojindo Molecular Technologies, Inc. | CK04 | Dosage colorimétrique WST-8 pour la viabilité cellulaire ; mesure de l'absorbance à 450 nm. |
| Système d'imagerie par chimiluminescence | Bio-Rad Laboratories | ChemiDoc MP | Acquisition d'images de western blot |
| Pack R clusterProfiler | Bioconductor | Version 4.10.0 | Analyse d'enrichissement GO et KEGG |
| Incubateur de culture cellulaire au CO2 | Thermo Fisher Scientific | Forma Series II 3111 | Incubation des cultures cellulaires à 37 °C et 5 % de CO2 |
| Anticorps monoclonal de lapin COX-2 (D5H5) | Cell Signaling Technology | 12282 | Validé par western blot pour la COX-2 humaine, murine et rat ; utilisé à une dilution de 1:1 000. |
| Module complémentaire CytoNCA | Boutique d'applications Cytoscape | Version 2.1.6 | Analyse topologique des cibles centrales |
| Logiciel Cytoscape | Consortium Cytoscape | Version 3.8.0 | Visualisation et analyse de réseaux |
| Diméthylsulfoxyde | Sigma-Aldrich/Merck | D2650 | Réactif biologique filtré stérile, ≥99,7 % ; solvant pour la solution mère de célécoxib. |
| Base de données DisGeNET | Groupe d'informatique biomédicale intégrative | Non applicable | Extraction de gènes associés à la glomérulonéphrite |
| Milieu de culture de Dulbecco modifié (DMEM) | Gibco/Thermo Fisher Scientific | C11995500BT | Milieu de base pour la culture cellulaire HBZY-1 |
| Substrat chimiluminescent amélioré | Beyotime Biotechnology | P0018S | Visualisation des bandes de western blot |
| Sérum de veau fœtal | Gibco/Thermo Fisher Scientific | 10099-141C | Complément sérique pour la culture cellulaire |
| Anticorps monoclonal de lapin GAPDH (D16H11) | Cell Signaling Technology | 5174 | Témoin de chargement en western blot ; réactif avec le GAPDH humain, murin et rat ; utilisé à une dilution de 1:5 000 après optimisation interne. |
| Base de données GeneCards | Institut Weizmann des sciences | NA | Extraction de gènes associés à la glomérulonéphrite |
| GraphPad Prism | GraphPad Software | Version 9.0.0.121 | Analyse statistique des données expérimentales in vitro |
| Anticorps secondaire IgG de chèvre anti-lapin conjugué à la HRP | Proteintech Group | SA00001-2 | Anticorps secondaire pour les anticorps primaires de lapin |
| Logiciel ImageJ | National Institutes of Health | Version 1.54 | Analyse densitométrique de western blot |
| Microscope inversé à contraste de phase | Olympus | CKX53 | Observation de la morphologie cellulaire |
| Pack R org.Hs.eg.db | Bioconductor | Version 3.18.0 | Annotation des gènes humains pour l'analyse d'enrichissement |
| Solution de pénicilline-streptomycine | Gibco/Thermo Fisher Scientific | 15140122 | Complément antibiotique pour la culture cellulaire |
| Kit de dosage du paramètre PGE2 | R&D Systems, une marque Bio-Techne | KGE004B | ELISA compétitif multi-espèces pour les surnageants de culture cellulaire ; plage de dosage de 39–2 500 pg/mL ; détection colorimétrique à 450 nm. |
| Base de données PharmGKB | Pharmacogenomics Knowledgebase | NA | Extraction de cibles liées à la maladie |
| Base de données PubChem | Centre national d'information biotechnologique | NA | Extraction des structures des ligands |
| Mébrane PVDF | Millipore/Merck | IPVH00010 | Mébrane de transfert protéique pour le western blot |
| Système graphique moléculaire PyMOL | Schrödinger, LLC | Version 2.6.2 | Visualisation des poses de docking |
| Logiciel R | Fondation R pour l'informatique statistique | Version 4.3.2 | Analyse d'intersection et d'enrichissement des cibles |
| Ligne cellulaire de cellules mésangiales glomérulaires de rat (HBZY-1) | Procell Life Science & Technology Co., Ltd. | CL-0117 | Modèle de validation in vitro des cellules mésangiales |
| Base de données RCSB Protein Data Bank | Collaboratoire de recherche en bioinformatique structurale | PDB ID : 3LN1 | Extraction de la structure cristalline de PTGS2/COX2 |
| Protéine recombinante humaine TGF-β1 | PeproTech, une marque Thermo Fisher Scientific | 100-21-10UG | TGF-β1 humain recombinant dérivé de HEK293 ; stimulation profibrotique à 10 ng/mL. |
| Système d'électrophorèse SDS-PAGE | Bio-Rad Laboratories | Mini-PROTEAN Tetra | Séparation des protéines par SDS-PAGE |
| Base de données STRING | ELIXIR/Consortium STRING | Version 12.0 | Construction de réseau d'interactions protéine-protéine |
| Base de données TCMSP | Base de données de pharmacologie systémique de la médecine traditionnelle chinoise | NA | Présélection des composés candidats de Cordyceps sinensis |
| Base de données des cibles thérapeutiques | Groupe de recherche sur les médicaments innovants et l'informatique biomédicale | NA | Extraction de cibles thérapeutiques |
| Anticorps primaire α-SMA | Proteintech Group | 14395-1-AP | Détection de l'expression protéique de α-SMA |
| β-Sitostérol (pureté >98 %) | MedChemExpress | HY-N0171A | CAS 83-46-5 ; composé défini utilisé pour le traitement cellulaire ; solution mère à 10 mM dans l'éthanol absolu. |
Références
- Kidney Disease: Improving Global Outcomes Glomerular Diseases Work G. KDIGO 2021 Clinical Practice Guideline for the Management of Glomerular Diseases. Kidney Int. 2021;100(4S):S1–S276.
- Roccatello D. et al. From inflammation to renal fibrosis: A one-way road in autoimmunity? Autoimmun Rev. 2024;23(4):103466.
- Reiss AB. et al. Fibrosis in Chronic Kidney Disease: Pathophysiology and Therapeutic Targets. J Clin Med. 2024;13(7).
- Kant S, Kronbichler A, Geetha D. Principles of Immunosuppression in the Management of Kidney Disease: Core Curriculum 2022. Am J Kidney Dis. 2022;80(3):393–405.
- El Karoui K, Fervenza FC, De Vriese AS. Treatment of IgA Nephropathy: A Rapidly Evolving Field. J Am Soc Nephrol. 2024;35(1):103–16.
- Stenvinkel P. et al. Chronic Inflammation in Chronic Kidney Disease Progression: Role of Nrf2. Kidney Int Rep. 2021;6(7):1775–87.
- Tanaka S, Portilla D, Okusa MD. Role of perivascular cells in kidney homeostasis, inflammation, repair and fibrosis. Nat Rev Nephrol. 2023;19(11):721–32.
- Liu W. et al. Mechanism of Cordyceps sinensis and its Extracts in the Treatment of Diabetic Kidney Disease: A Review. Front Pharmacol. 2022;13:881835.
- Yan G. et al. The effects of Ophiocordyceps sinensis combined with ACEI/ARB on diabetic kidney disease: A systematic review and meta-analysis. Phytomedicine. 2023;108:154531.
- Li S, Pang W, Wang Y, Zhang Y. Cordyceps sinensis extract protects against acute kidney injury by inhibiting perforin expression in NK cells via the STING/IRF3 pathway. Aging (Albany NY). 2024;16(7):5887–904.
- Zhang Y, Li K, Zhang C, Liao H, Li R. Research Progress of Cordyceps sinensis and Its Fermented Mycelium Products on Ameliorating Renal Fibrosis by Reducing Epithelial-to-Mesenchymal Transition. J Inflamm Res. 2023;16:2817–30.
- Zhao L. et al. Network pharmacology, a promising approach to reveal the pharmacology mechanism of Chinese medicine formula. J Ethnopharmacol. 2023;309:116306.
- Ru J. et al. TCMSP: a database of systems pharmacology for drug discovery from herbal medicines. J Cheminform. 2014;6:13.
- Bi Y. et al. beta-Sitosterol Suppresses LPS-Induced Cytokine Production in Human Umbilical Vein Endothelial Cells via MAPKs and NF-kappaB Signaling Pathway. Evid Based Complement Alternat Med. 2023;2023:9241090.
- Sun Y, Gao L, Hou W, Wu J. beta-Sitosterol Alleviates Inflammatory Response via Inhibiting the Activation of ERK/p38 and NF-kappaB Pathways in LPS-Exposed BV2 Cells. Biomed Res Int. 2020;2020:7532306.
- Park YJ. et al. Effects of beta-Sitosterol from Corn Silk on TGF-beta1-Induced Epithelial-Mesenchymal Transition in Lung Alveolar Epithelial Cells. J Agric Food Chem. 2019;67(35):9789–95.
- Li DD. et al. RTEC-intrinsic IL-17-driven inflammatory circuit amplifies antibody-induced glomerulonephritis and is constrained by Regnase-1. JCI Insight. 2021;6(13).
- Martin-Carro B. et al. Role of Klotho and AGE/RAGE-Wnt/beta-Catenin Signalling Pathway on the Development of Cardiac and Renal Fibrosis in Diabetes. Int J Mol Sci. 2023;24(6).
- Naas S, Schiffer M, Schodel J. Hypoxia and renal fibrosis. Am J Physiol Cell Physiol. 2023;325(4):C999–C1016.
- Harris RC, Breyer MD. Physiological regulation of cyclooxygenase-2 in the kidney. Am J Physiol Renal Physiol. 2001;281(1):F1–11.
- Calder PC. Eicosanoids. Essays Biochem. 2020;64(3):423–41.
- Waldner C, Heise G, Schror K, Heering P. COX-2 inhibition and prostaglandin receptors in experimental nephritis. Eur J Clin Invest. 2003;33(11):969–75.
- Pan Y. et al. Myeloid cyclooxygenase-2/prostaglandin E2/E-type prostanoid receptor 4 promotes transcription factor MafB-dependent inflammatory resolution in acute kidney injury. Kidney Int. 2022;101(1):79–91.
- Volzke A, Koch A, Meyer Zu Heringdorf D, Huwiler A, Pfeilschifter J. Sphingosine 1-phosphate (S1P) induces COX-2 expression and PGE2 formation via S1P receptor 2 in renal mesangial cells. Biochim Biophys Acta. 2014;1841(1):11–21.
- Sawano H. et al. 15-Deoxy-Delta12,14-prostaglandin J2 inhibits IL-1beta-induced cyclooxygenase-2 expression in mesangial cells. Kidney Int. 2002;61(6):1957–67.
- Guo B. et al. Peroxisome proliferator-activated receptor-gamma ligands inhibit TGF-beta 1-induced fibronectin expression in glomerular mesangial cells. Diabetes. 2004;53(1):200–8.
- Zou R. et al. PPARgamma agonists inhibit TGF-beta-PKA signaling in glomerulosclerosis. Acta Pharmacol Sin. 2010;31(1):43–50.
- Wei J. et al. PP2 Ameliorates Renal Fibrosis by Regulating the NF-kappaB/COX-2 and PPARgamma/UCP2 Pathway in Diabetic Mice. Oxid Med Cell Longev. 2021;2021:7394344.
- Yang C, Chen EA, Zhang Y. Protein-Ligand Docking in the Machine-Learning Era. Molecules. 2022;27(14).
- Quiroga R, Villarreal MA. Developing Generalizable Scoring Functions for Molecular Docking: Challenges and Perspectives. Curr Med Chem. 2025;32(28):5960–72.
- Li J. et al. TGF-beta/Smad signaling in chronic kidney disease: Exploring post-translational regulatory perspectives (Review). Mol Med Rep. 2024;30(2).