Cette analyse transversale de profils latents menée auprès de 1 420 étudiants chinois a identifié quatre profils de sommeil distincts à l'aide du PSQI. Les profils de sommeil plus sains étaient significativement associés à des niveaux plus élevés d'activité physique modérée à vigoureuse, suggérant des cibles spécifiques aux profils de sommeil pour la promotion de la santé sur les campus.
Article de recherche
Analyse de profil latent des modes de sommeil et leur association avec les niveaux d'activité physique chez des étudiants universitaires chinois
* These authors contributed equally
Dans cet article
Résumé
Résumé
Cette étude transversale visait à identifier les profils latents des habitudes de sommeil chez les étudiants universitaires et à examiner leurs associations avec les niveaux d'activité physique (AP), fournissant ainsi des preuves empiriques pour des interventions sanitaires ciblées dans les établissements universitaires. Un total de 1 420 étudiants universitaires ont été recrutés selon un échantillonnage aléatoire stratifié en grappes à plusieurs stades dans trois universités complètes du sud de la Chine. La qualité du sommeil et l'AP ont été évaluées à l'aide de l'Index de qualité du sommeil de Pittsburgh (PSQI) et du Questionnaire international d'activité physique – version courte (IPAQ-SF), respectivement. Une analyse de profils latents (APL), des tests du chi-deux et des analyses de régression logistique multinomiale ont été réalisées à l'aide d'un logiciel statistique approprié. Quatre profils latents de sommeil ont été identifiés sur la base des probabilités de classes estimées par le modèle : sommeil sain (44,7 %), sommeil insuffisant (24,8 %), mauvaise qualité du sommeil (20,3 %) et troubles sévères du sommeil (10,2 %) ; les proportions observées correspondantes basées sur l'attribution de classe la plus probable étaient de 45,0 %, 25,0 %, 20,0 % et 10,0 % (n = 639, 355, 284 et 142, respectivement). Le sexe et le niveau d'AP différaient significativement selon les profils. Par rapport aux étudiants du groupe présentant des troubles sévères du sommeil, ceux du groupe au sommeil sain étaient plus susceptibles de déclarer une activité physique modérée (rapport de cotes (RC) = 4,69, intervalle de confiance (IC) à 95 % : 2,92–7,51) et une activité physique élevée (RC = 7,55, IC 95 % : 4,41–12,91). Les étudiants du groupe au sommeil insuffisant étaient également plus susceptibles de déclarer une activité physique modérée (RC = 2,98, IC 95 % : 1,83–4,86) et une activité physique élevée (RC = 5,02, IC 95 % : 2,84–8,87). Les habitudes de sommeil des étudiants universitaires présentaient une hétérogénéité marquée. Des habitudes de sommeil favorables étaient associées à des niveaux d'AP plus élevés. En raison de la conception transversale, aucune relation causale ne peut être déduite. Des stratégies d'intervention différenciées devraient être élaborées en fonction des caractéristiques spécifiques au sommeil de chaque sous-groupe, et la promotion de l'AP pourrait être envisagée comme cible comportementale potentielle pour les étudiants souffrant d'un sommeil de mauvaise qualité.
Introduction
Le sommeil est essentiel non seulement pour maintenir les fonctions physiologiques de base, mais aussi pour soutenir la santé physique et mentale, le développement cognitif et la régulation émotionnelle1,2. Dans les sociétés contemporaines aux rythmes accélérés, les troubles du sommeil sont toutefois devenus un problème de santé publique mondial. Les problèmes de sommeil sont particulièrement fréquents chez les étudiants universitaires, qui éprouvent souvent une surveillance parentale réduite après leur entrée à l’université et font face à des pressions académiques, à l’ajustement interpersonnel et à une utilisation excessive des appareils électroniques3. Des études épidémiologiques ont montré qu’environ 25 % à 60 % des étudiants universitaires dans le monde signalent des degrés variés de mauvaise qualité du sommeil ou de privation de sommeil4,5. Des problèmes de sommeil persistants peuvent altérer la fonction du système nerveux central, entraînant une inattention et un déclin de la mémoire ; ils peuvent également augmenter le risque de troubles mentaux internalisés, tels que la dépression et l’anxiété6,7, ainsi que le risque futur de maladies cardiovasculaires et de syndrome métabolique8.
Les études antérieures sur le sommeil ont principalement adopté une approche analytique centrée sur les variables, évaluant le statut du sommeil au niveau du groupe à l’aide de scores totaux provenant d’échelles normalisées telles que l’Indice de qualité du sommeil de Pittsburgh (PSQI) ou des scores moyens de dimensions spécifiques9. Bien que cette approche fournisse une estimation intuitive de la gravité globale du sommeil, elle suppose implicitement que la population étudiée est homogène. En réalité, le sommeil est un processus physiologique multidimensionnel impliquant la durée du sommeil, la latence du sommeil, l’efficacité du sommeil, les réveils nocturnes et le dysfonctionnement diurne10. Des individus présentant le même score total au PSQI peuvent afficher des combinaisons de symptômes très différentes ; par exemple, un étudiant peut principalement éprouver des difficultés à s’endormir, tandis qu’un autre peut connaître des réveils précoces et une somnolence diurne. Ces dernières années, les approches centrées sur la personne ont suscité un intérêt croissant. L’analyse en profils latents (LPA) permet d’identifier des sous-groupes hétérogènes non observés dans les données en maximisant les différences entre profils et en minimisant les différences au sein de chaque profil11,12. Grâce à la LPA, les chercheurs peuvent caractériser plus précisément les profils de sommeil spécifiques chez les étudiants universitaires13, offrant ainsi des cibles d’intervention plus ciblées.
L'activité physique (AP) est largement recommandée par l'Organisation mondiale de la Santé et d'autres lignes directrices de santé publique comme un pilier de la promotion de la santé tout au long de la vie14,15. Des études empiriques et des méta-analyses ont montré qu'une activité physique régulière d'intensité modérée à vigoureuse peut améliorer la condition cardiorespiratoire et réduire la mortalité16,17, tout en aidant à soulager le stress psychologique et à améliorer les fonctions cognitives18,19. L'activité physique est également considérée comme une intervention non pharmacologique efficace contre les troubles du sommeil20,21. Des associations positives entre l'activité physique et la qualité du sommeil ont été rapportées dans des études de cohorte utilisant des dispositifs objectifs tels que des accéléromètres22,23,24 ainsi que dans des études transversales fondées sur des questionnaires auto-rapportés25,26. De plus, l'exercice et le sommeil semblent entretenir une relation bidirectionnelle : un sommeil adéquat peut renforcer la motivation et l'endurance pour l'activité physique, tandis que la dépense énergétique diurne peut favoriser le sommeil lent profond pendant la nuit27,28.
Bien qu'il existe un large consensus sur les bienfaits de l'activité physique pour la qualité globale du sommeil, la littérature actuelle présente plusieurs limites. La plupart des études ont considéré l'activité physique comme une variable indépendante permettant de prédire un score unique de sommeil, négligeant ainsi la possibilité que différents profils de sommeil puissent correspondre à des combinaisons distinctes de caractéristiques liées au mode de vie29,30. On comprend encore insuffisamment si les niveaux d'activité physique varient selon les profils latents de sommeil chez les étudiants universitaires.
Dans ce contexte, cette étude avait pour objectifs : (1) d'identifier des profils latents basés sur des indicateurs multidimensionnels de la qualité du sommeil chez des étudiants chinois à l'université à l'aide de l'analyse de profils latents (LPA) ; et (2) d'examiner les associations entre les profils de sommeil et les niveaux d'activité physique (faible, modéré et élevé) après ajustement sur les variables démographiques. Nous avons émis l'hypothèse que plusieurs profils de sommeil hétérogènes seraient présents parmi les étudiants universitaires et que les étudiants présentant un schéma de sommeil sain auraient plus de chances d'atteindre des niveaux d'activité physique modérés à vigoureux que ceux souffrant de troubles sévères du sommeil.
Protocole
Cette étude a été approuvée par le Comité d'éthique biomédicale de l'Université Jishou (Numéro d'approbation : JSDX-2023-0034). Tous les participants étaient des étudiants de licence à temps plein âgés de 18 à 25 ans et ont donné leur consentement éclairé par écrit avant de participer. L'autorisation a été obtenue auprès des universités participantes. Les données de l'enquête ont été utilisées uniquement à des fins de recherche académique et ont été analysées de manière anonyme. L'étude a été menée conformément à la Déclaration d'Helsinki et aux exigences institutionnelles locales.
Recrutement des participants et plan d'échantillonnage
Une enquête transversale a été menée auprès d'étudiants de premier cycle de trois universités complètes du sud de la Chine entre septembre et décembre 2025, selon un plan d'échantillonnage aléatoire en grappes stratifié à plusieurs degrés. Dans un premier temps, trois universités complètes ont été sélectionnées à partir d'une liste d'universités publiques complètes du sud de la Chine par échantillonnage aléatoire stratifié, les strates étant définies par région administrative provinciale afin d'assurer une représentation géographique. Dans un deuxième temps, au sein de chaque université sélectionnée, deux à trois classes complètes de chaque niveau d'année (de la première à la quatrième année) ont été choisies aléatoirement comme unités d'échantillonnage en grappes à l'aide de nombres aléatoires générés par ordinateur, ce qui a donné un total de 28 classes réparties entre les trois universités. Tous les étudiants des classes sélectionnées ont été invités à participer, comme indiqué dans Figure 1. Les critères d'inclusion étaient les suivants : (1) statut d'étudiant de premier cycle à temps plein ; (2) âge compris entre 18 et 25 ans ; et (3) participation volontaire accompagnée d'un consentement éclairé écrit. Les critères d'exclusion étaient : (1) maladie physique grave récente ou contre-indications à l'exercice, telles qu'une fracture ou une maladie cardiaque sévère ; (2) utilisation actuelle de médicaments psychiatriques, comme traitement pour une dépression sévère ou une schizophrénie ; et (3) temps de complétion du questionnaire inférieur à 180 secondes ou incohérences logiques manifestes, telles que la sélection de la même option pour tous les items. Un total de 1 500 questionnaires ont été distribués. Parmi les 80 questionnaires invalides exclus lors du nettoyage des données, 24 ont été exclus en raison d'un temps de complétion inférieur à 180 secondes, 20 en raison d'incohérences logiques (par exemple, des réponses identiques pour tous les items ou des réponses contradictoires), 18 en raison d'un âge en dehors de la fourchette 18–25 ans, 11 en raison de données manquantes excessives (plus de 20 % des items), et 7 en raison d'une maladie physique grave déclarée ou d'une utilisation actuelle de médicaments psychiatriques. Cela a laissé 1 420 questionnaires valides pour l'analyse, avec un taux de réponse effectif de 94,67 %.
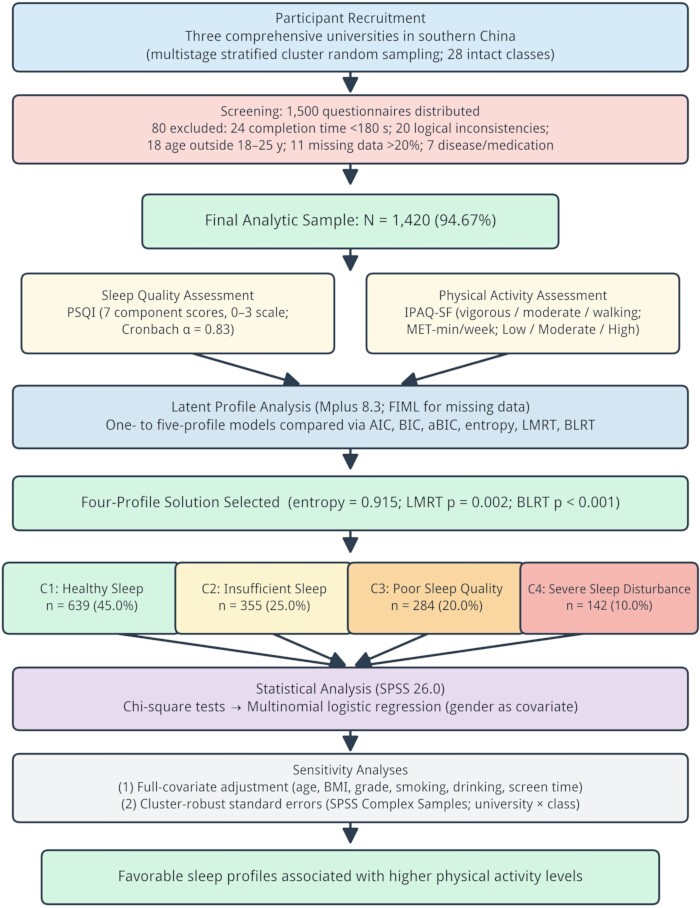
Figure 1 : Conception de l'étude et flux analytique. Vue schématique du recrutement et du dépistage des participants (1 500 questionnaires distribués ; 80 exclus ; N = 1 420 inclus), évaluation à l'aide du PSQI et de l'IPAQ-SF, analyse de profils latents (modèles de un à cinq profils comparés à l'aide de l'AIC, du BIC, de l'aBIC, de l'entropie, du LMRT et du BLRT), affectation à quatre profils de sommeil, tests du khi-deux bivariés, régression logistique multinomiale avec le sexe comme covariable, et analyses de sensibilité (ajustement complet aux covariables et erreurs standards robustes par grappes). Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Évaluation démographique et du mode de vie
Un questionnaire auto-conçu a été utilisé pour recueillir les caractéristiques démographiques et sociologiques, notamment le sexe (masculin/féminin), l'âge (en années), le niveau d'études (première, deuxième, troisième ou quatrième année), le lieu d'origine (urbain/rural), l'indice de masse corporelle (IMC), les antécédents de tabagisme, les antécédents de consommation d'alcool et le temps d'écran moyen quotidien. L'IMC a été calculé comme le poids corporel en kilogrammes divisé par le carré de la taille en mètres (IMC = poids [kg] / taille [m]²).2). La taille et le poids autodéclarés ont été vérifiés afin d'identifier les valeurs invraisemblables avant l'analyse ; les cas présentant une taille <140 cm ou >200 cm, poids <30 kg ou >150 kg, ou IMC <12 kg/m2 ou >40 kg/m2 ont été signalées et vérifiées par rapport aux dossiers d'origine, les valeurs aberrantes confirmées ayant été exclues. Le statut tabagique a été catégorisé comme jamais, occasionnel (fumer certains jours mais pas quotidiennement) ou régulier (fumer quotidiennement), selon le comportement déclaré par les participants au cours du mois précédent. La consommation d'alcool a été catégorisée comme jamais, occasionnelle (consommer moins d'une fois par semaine) ou régulière (consommer au moins une fois par semaine), sur la base du mois précédent. Le temps d'écran moyen quotidien a été évalué en demandant aux participants de déclarer le nombre total d'heures par jour passées sur les smartphones, ordinateurs, tablettes et télévision au cours du mois précédent, cette donnée étant enregistrée comme une variable continue. Le questionnaire a fait l'objet d'un test pilote auprès de 30 étudiants de premier cycle avant le début officiel de la collecte des données, afin d'évaluer la clarté des items et la durée de complétion ; des ajustements mineurs du libellé ont été effectués en fonction des retours du test pilote. Des études antérieures ont suggéré que ces variables pourraient être des facteurs de confusion dans l'association entre le sommeil et l'activité physique30,31. Tous les instruments, logiciels et matériaux utilisés dans cette étude sont répertoriés dans le Table des matériels.
Évaluation de la qualité du sommeil
Le PSQI, développé par Buysse et al.9, a été utilisé pour évaluer la qualité du sommeil des participants au cours du mois précédent. Cette échelle comprend 19 items auto-évalués qui se répartissent en sept composantes : qualité subjective du sommeil, latence d'endormissement, durée du sommeil, efficacité habituelle du sommeil, troubles du sommeil, utilisation de médicaments hypnotiques et dysfonctionnement diurne. Chaque composante est notée de 0 (aucune difficulté) à 3 (difficulté sévère). Les scores de ces sept composantes continues ont été utilisés comme indicateurs observés pour l'ALC. Le PSQI a démontré une bonne fiabilité et une bonne validité auprès de populations d'étudiants universitaires en Chine et à l'international.30Dans la présente étude, l'alpha de Cronbach pour l'échelle était de 0,83.
Évaluation de l'activité physique
Le questionnaire IPAQ-SF, développé par Craig et al.32, a été utilisé pour évaluer l'activité physique des participants au cours des sept jours précédents. Le questionnaire enregistre la fréquence (jours/semaine) et la durée (minutes/jour) des activités physiques intenses, des activités physiques d'intensité modérée et des marches. Les valeurs d'équivalent métabolique de la tâche (MET) ont été calculées selon le protocole de cotation de l'IPAQ : MET-min/semaine pour la marche = 3,3 × durée × fréquence ; MET-min/semaine pour l'activité d'intensité modérée = 4,0 × durée × fréquence ; et MET-min/semaine pour l'activité d'intensité élevée = 8,0 × durée × fréquence. Les valeurs MET pour les trois types d'activité ont été additionnées afin d'obtenir l'activité physique totale. Les participants ont été classés en activité physique élevée, modérée ou faible selon les critères de cotation de l'IPAQ-SF validés chez les étudiants universitaires33. Une activité physique élevée était définie par une activité intense pratiquée au moins trois jours par semaine avec un niveau d'activité physique total d'au moins 1 500 MET-min/semaine, ou par toute combinaison de marche, d'activité d'intensité modérée ou d'activité intense pratiquée sept jours ou plus par semaine avec un niveau d'activité physique total d'au moins 3 000 MET-min/semaine. Une activité physique modérée était définie par une activité intense pratiquée au moins trois jours par semaine pendant au moins 20 minutes par jour, ou une activité d'intensité modérée et/ou de marche pratiquée au moins cinq jours par semaine pendant au moins 30 minutes par jour, ou toute combinaison d'activités atteignant au moins 600 MET-min/semaine. Une activité physique faible était définie par l'absence de satisfaction des critères d'activité modérée ou élevée. Le nettoyage des données a suivi le protocole officiel de cotation de l'IPAQ : les participants déclarant plus de 16 h d'activité totale par jour ont été exclus ; les durées quotidiennes par catégorie ont été tronquées à 180 min avant le calcul des MET-minutes ; et les cas présentant des réponses logiquement incohérentes ont été supprimés lors du nettoyage des données.
Analyse statistique
Tout d'abord, réalisez une analyse de profils latents (LPA) à l'aide d'un logiciel de modélisation de profils latents (voir Tableau du matériel)34. Parmi les 1 420 participants, 33 (2,3 %) présentaient des données manquantes partielles sur l'ISQF, avec 69 réponses manquantes sur les 9 940 réponses aux composantes (0,69 % ; c'est-à-dire 1 420 participants × sept scores composantes de l'ISQF). La méthode du maximum de vraisemblance avec information complète (FIML) a été utilisée pour traiter ces valeurs manquantes sous l'hypothèse de données manquantes au hasard. Des modèles comportant de un à cinq profils ont été estimés séquentiellement. L'ajustement des modèles a été évalué à l'aide du critère d'information d'Akaike (AIC), du critère d'information bayésien (BIC), du BIC ajusté à la taille de l'échantillon (aBIC), de l'entropie, du test du rapport de vraisemblance de Lo-Mendell-Rubin (LMRT) et du test du rapport de vraisemblance par bootstrap (BLRT). Des valeurs plus faibles d'AIC, de BIC et d'aBIC indiquent un meilleur ajustement relatif, tandis que des valeurs d'entropie proches de 1 indiquent une meilleure précision de classification. Le LMRT et le BLRT ont été utilisés pour déterminer si un modèle à k profils s'ajustait significativement mieux qu'un modèle à k − 1 profils. La solution optimale de profils a été choisie en tenant compte conjointement des indices statistiques d'ajustement, de l'entropie, de la taille des classes (aucun profil ne contenant moins de 5 % de l'échantillon) et de l'interprétabilité substantielle, conformément aux recommandations établies pour l'analyse de profils latents11,35. Une fois la solution optimale de profils sélectionnée, l'appartenance la plus probable des individus aux classes a été exportée vers un logiciel d'analyse statistique (voir Tableau du matériel) pour les analyses ultérieures. Des tests du chi-deux de Pearson ont été utilisés pour examiner les différences de caractéristiques démographiques et de niveaux d'activité physique selon les profils de sommeil. Les tests du chi-deux bivariés ont montré que seul le sexe et le niveau d'activité physique différaient significativement entre les quatre profils de sommeil (les deux p < 0,001), tandis que l'âge, le niveau scolaire, l'IMC, le tabagisme, la consommation d'alcool et le temps d'écran n'étaient pas significativement différents (tous p > 0,05 ; voir Tableau supplémentaire 1). Par conséquent, seul le sexe a été inclus comme covariable dans le modèle de régression logistique multinomiale, conformément au principe de parcimonie. Une analyse de sensibilité ajustée sur toutes les covariables recueillies a donné un patron et une significativité des résultats identiques (Tableau supplémentaire 2). Une régression logistique multinomiale a été réalisée avec le niveau d'activité physique comme variable dépendante (faible AP = 0, AP modérée = 1, forte AP = 2) et le profil de sommeil comme variable indépendante principale. Les rapports de cotes (OR) et les intervalles de confiance à 95 % (IC) ont été calculés. Tous les tests étaient bilatéraux, et la significativité statistique a été fixée à p < 0,05. Étant donné que les participants ont été recrutés par classes entières imbriquées dans des universités, nous avons réalisé une analyse de sensibilité à l'aide du module d'échantillons complexes du logiciel statistique (voir Tableau du matériel), en spécifiant l'université et la classe comme variables de regroupement, afin d'obtenir des erreurs-types ajustées au plan d'échantillonnage. Les résultats étaient cohérents avec ceux obtenus par la régression logistique multinomiale standard (Tableau supplémentaire 3). Le jeu de données brut anonymisé, avec les libellés des variables en anglais et un codebook, est fourni sous forme de Fichier supplémentaire 1.
Résultats
Des modèles comportant de un à cinq profils latents ont été extraits. Comme indiqué dans le Tableau 1, l'AIC, le BIC et l'aBIC ont diminué à mesure que le nombre de profils augmentait. Le modèle à quatre profils présentait la valeur d'entropie la plus élevée (0,915), et les tests LMRT et BLRT étaient tous deux significatifs (p < 0,001). En revanche, le LMRT pour le modèle à cinq profils n'était pas significatif (p = 0,085), et l'entropie a diminué jusqu'à 0,880. Par conséquent, bien que le modèle à cinq profils affiche des critères d'information plus faibles, le modèle à quatre profils a été retenu car il offrait un meilleur équilibre entre la précision de la classification, la parcimonie du modèle, la taille des classes et l'interprétabilité substantielle. Les étiquettes des profils ont été attribuées en fonction des moyennes conditionnelles des sept scores composants du PSQI entre les classes (Figure 2), conformément aux pratiques recommandées pour la présentation des analyses de profils latents11.
Tableau 1 : Indices d'ajustement du modèle pour l'analyse de profils latents des habitudes de sommeil des étudiants universitaires. AIC, critère d'information d'Akaike ; BIC, critère d'information bayésien ; aBIC, BIC ajusté à la taille de l'échantillon ; LMRT, test du rapport de vraisemblance de Lo-Mendell-Rubin ; BLRT, test du rapport de vraisemblance avec bootstrap. Veuillez cliquer ici pour télécharger ce tableau.
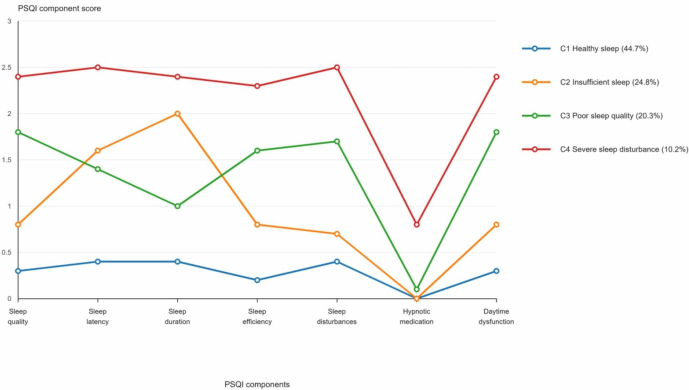
Figure 2 : APL des profils de sommeil : solution à quatre profils. Le graphique en courbes montre les scores des composantes de l'IPQI à travers les quatre profils latents de sommeil : sommeil sain, sommeil insuffisant, mauvaise qualité de sommeil et perturbation sévère du sommeil. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Sur la base des caractéristiques des scores des composantes du PSQI, les quatre profils ont été désignés comme le groupe au sommeil sain (C1), le groupe au sommeil insuffisant (C2), le groupe à la mauvaise qualité de sommeil (C3) et le groupe aux troubles sévères du sommeil (C4). Les probabilités estimées par le modèle pour chaque classe étaient respectivement de 0,447, 0,248, 0,203 et 0,102. Selon l'attribution à la classe la plus probable, les effectifs observés étaient de 639 (45,0 %), 355 (25,0 %), 284 (20,0 %) et 142 (10,0 %) pour C1 à C4, respectivement. Des tests du chi-deux ont révélé des différences significatives selon le sexe et les niveaux d'activité physique entre les profils (p < 0,001 ; Tableau 2). La solution à quatre profils offrait le meilleur équilibre entre l'ajustement du modèle et l'interprétabilité théorique, avec une précision élevée de classification (entropie = 0,915).
Groupe au sommeil sain (C1, 45,0 %) : les étudiants de ce groupe présentaient des scores faibles pour les sept composantes du PSQI, indiquant un sommeil relativement régulier et une meilleure qualité de sommeil. Groupe au sommeil insuffisant (C2, 25,0 %) : ce groupe se caractérisait par des scores relativement élevés en matière de durée de sommeil et de latence du sommeil, tandis que la dysfonction diurne n'était pas marquée. Groupe à la mauvaise qualité de sommeil (C3, 20,0 %) : les étudiants de ce groupe présentaient des scores relativement élevés pour la qualité subjective du sommeil, les troubles du sommeil et la dysfonction diurne, ainsi qu'une efficacité du sommeil relativement faible. Groupe avec troubles sévères du sommeil (C4, 10,0 %) : ce sous-groupe présentait des scores élevés pour la plupart des composantes du PSQI et déclarait des scores plus élevés en matière de médicaments hypnotiques que les autres profils, suggérant un risque accru de troubles du sommeil cliniquement pertinents, sans toutefois correspondre à un diagnostic clinique confirmé.
Les moyennes conditionnelles exactes et les écarts types des sept scores des composantes du PSQI pour chaque profil sont indiqués dans le Tableau supplémentaire 4.
Tableau 2 : Répartition des caractéristiques démographiques et des niveaux d'activité physique selon les profils de sommeil. C1, groupe au sommeil sain ; C2, groupe au sommeil insuffisant ; C3, groupe à qualité de sommeil médiocre ; C4, groupe à perturbation sévère du sommeil. Veuillez cliquer ici pour télécharger ce tableau.
Le niveau d'activité physique a été saisi comme variable dépendante, avec un faible niveau d'AP comme catégorie de référence. Le profil de sommeil a été saisi comme variable indépendante, le groupe présentant des troubles du sommeil sévères servant de catégorie de référence, et le sexe a été contrôlé. Comme indiqué dans Tableau 3, les étudiants des groupes ayant un sommeil sain et un sommeil insuffisant étaient significativement plus susceptibles de déclarer une activité physique modérée ou élevée que ceux du groupe présentant des troubles du sommeil sévères. Ces résultats soutiennent une association entre des profils de sommeil favorables et des niveaux plus élevés d'activité physique, mais la conception transversale ne permet pas d'établir une inférence causale.
Tableau 3 : Régression logistique multinomiale des profils de sommeil et des niveaux d'activité physique chez les étudiants universitaires. L'activité physique faible constituait la catégorie de référence pour l'issue, et le groupe présentant des troubles du sommeil sévères constituait la catégorie de référence pour le profil de sommeil. Veuillez cliquer ici pour télécharger ce tableau.
DISPONIBILITÉ DES DONNÉES :
Les données brutes anonymisées et le code d'analyse soutenant les résultats de cette étude sont accessibles librement sur Figshare à l'adresse https://doi.org/10.6084/m9.figshare.33340908.
Fichier supplémentaire 1 : Jeu de données brutes anonymisées (Sleep_LPA_Raw_Data_N1420.xlsx) avec des libellés de variables en anglais et un codebook.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 1 : Tests bivariés des différences des covariables selon les profils de sommeil.
Remarque : Les variables catégorielles ont été analysées à l’aide de tests du chi-deux de Pearson ; les variables continues, à l’aide d’une ANOVA à un facteur. Seul le sexe présentait des différences significatives selon les profils (p < 0,001). Les répartitions détaillées par catégories pour le niveau scolaire, l’origine, le tabagisme, la consommation d’alcool et la spécialité sont omises par souci de concision, mais sont accessibles à partir des données brutes.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2 : Régression logistique multinomiale ajustée sur tous les covariables (analyse de sensibilité).
Remarque : La catégorie de référence pour l'activité physique (AP) : faible AP ; la catégorie de référence pour le profil de sommeil : C4 (trouble sévère). Le modèle est ajusté sur le sexe, l'âge, l'IMC, le temps d'écran, le niveau scolaire, le lieu d'origine, le tabagisme, la consommation d'alcool et la filière principale. Le sens et la significativité de toutes les associations sont cohérents avec l'analyse principale (Tableau 3), qui était ajustée uniquement sur le sexe.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 3 : Régression logistique multinomiale avec erreurs standards robustes aux effets de grappes (SPSS Complex Samples).
Remarque : Les erreurs standard ont été ajustées pour tenir compte du regroupement par université et par classe (équivalent SPSS Complex Samples ; N = 1 420, grappes = 3 universités × classes complètes). Les coefficients B sont identiques à ceux de l'analyse principale (Tableau 3) ; seules les erreurs standard et les valeurs p diffèrent. C1 et C2 restent significativement associés à une activité physique modérée et élevée ; C3 reste non significatif.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 4 : Moyennes et écarts-types des scores des composantes du PSQI selon le profil de sommeil.
Remarque : Les valeurs sont des moyennes conditionnelles (écarts-types) basées sur l'attribution à la classe la plus probable. Les sept composantes du PSQI ainsi que le score total différaient de manière significative selon les profils (ANOVA unidirectionnelle, toutes les valeurs de p < 0,001). C1 = sommeil sain ; C2 = sommeil insuffisant ; C3 = mauvaise qualité du sommeil ; C4 = troubles sévères du sommeil.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
À l’aide d’un échantillon transversal relativement vaste, cette étude a appliqué une approche centrée sur la personne par analyse de profil latent (LPA) afin d’identifier quatre profils de sommeil hétérogènes parmi les étudiants chinois du supérieur, puis a examiné plus en détail les associations entre ces profils et différents niveaux d’activité physique. Les résultats offrent une perspective utile pour comprendre le regroupement des comportements liés à la santé concernant le sommeil et l’exercice physique chez les étudiants universitaires, et proposent des cibles plus précises pour les interventions de santé publique dans les établissements universitaires.
Cette étude a classé les habitudes de sommeil des étudiants universitaires en quatre profils : sommeil sain, sommeil insuffisant, mauvaise qualité du sommeil et troubles sévères du sommeil. Bien que le groupe au sommeil sain représente la proportion la plus élevée (45,0 %), plus de la moitié des étudiants (55,0 %) ont été classés dans des profils caractérisés par un sommeil déficient. Ce résultat est conforme aux données internationales indiquant une forte prévalence des troubles du sommeil chez les adolescents et les jeunes adultes3,4. En particulier, la proportion d'étudiantes dans le groupe des troubles sévères du sommeil était nettement plus élevée que celle des étudiants masculins (68,3 % contre 31,7 %), ce qui est en accord avec les résultats antérieurs sur les différences liées au sexe en matière de sommeil. Les fluctuations des niveaux hormonaux féminins au cours du cycle menstruel, notamment les variations cycliques des œstrogènes et de la progestérone, pourraient accroître la vulnérabilité aux troubles du sommeil10. Du point de vue psychologique, les étudiantes pourraient également être plus sensibles au stress académique et interpersonnel et plus enclines à internaliser les émotions négatives. Ce type de rumination pourrait prolonger la latence du sommeil et réduire sa profondeur7. En outre, 25,0 % des étudiants appartenaient au groupe du sommeil insuffisant. D'après la littérature antérieure, ce profil pourrait être partiellement attribuable à un temps prolongé passé devant les écrans avant le coucher et à l'exposition à la lumière bleue émise par les appareils mobiles, ainsi qu'à des compétences relativement faibles en gestion du temps30 ; toutefois, ces facteurs n'ont pas été évalués directement dans la présente étude et devraient faire l'objet d'analyses dans des recherches futures.
Cette étude a révélé des différences importantes et progressives des niveaux d'activité physique selon les profils de sommeil. Une régression logistique multinomiale a montré que, par rapport aux étudiants du groupe présentant une perturbation sévère du sommeil, ceux du groupe ayant un sommeil sain avaient des probabilités nettement plus élevées d'atteindre une activité physique élevée (OR = 7,55). Ces résultats sont cohérents avec le concept de regroupement des comportements de santé en médecine du mode de vie, suggérant que des schémas de sommeil favorables et une activité physique régulière peuvent coexister chez les mêmes individus.
L'association observée entre les profils de sommeil et l'activité physique (AP) peut s'expliquer par plusieurs voies physiologiques et psychologiques possibles, bien que ces mécanismes n'aient pas été directement évalués dans la présente étude transversale. Premièrement, il est possible que l'activité physique régulière facilite le sommeil. Une activité physique d'intensité modérée à vigoureuse peut provoquer une augmentation aiguë de la température corporelle, suivie d'une baisse compensatoire post-exercice qui pourrait favoriser l'endormissement et augmenter la proportion de sommeil lent profond17. L'activité physique régulière pourrait également réguler le système nerveux autonome en renforçant le tonus vagal et en réduisant l'hyperactivation sympathique. De plus, les endorphines liées à l'exercice et le facteur neurotrophique dérivé du cerveau pourraient contribuer à atténuer la dépression et l'anxiété, réduisant ainsi les facteurs psychologiques favorisant l'insomnie36,37. Une activité en plein air pendant la journée pourrait en outre augmenter l'exposition lumineuse rétinienne, aidant à calibrer les rythmes circadiens et à stabiliser la sécrétion de mélatonine38. Deuxièmement, il est également plausible qu'un sommeil de mauvaise qualité limite l'AP diurne. Les étudiants du groupe présentant des troubles du sommeil sévères peuvent éprouver de la fatigue et de la somnolence diurnes en raison d'une récupération nocturne insuffisante, comme en témoignent les scores élevés de dysfonctionnement diurne au PSQI. Cette perte d'énergie peut réduire l'auto-efficacité et la motivation à fournir un effort physique20,28. Des données expérimentales et des analyses de synthèse suggèrent que le sommeil et l'exercice peuvent s'influencer mutuellement par des voies liées à la récupération, à la fatigue, aux états émotionnels et aux rythmes circadiens28,39. Par conséquent, les étudiants souffrant de troubles du sommeil sévères pourraient être plus enclins à adopter un mode de vie sédentaire. Ces voies bidirectionnelles proposées restent spéculatives et devraient être confirmées par des études de cohorte longitudinales et des essais contrôlés randomisés.
Cette étude présente les avantages d'un échantillon relativement important et d'une approche analytique centrée sur la personne ; toutefois, plusieurs limites doivent être reconnues. Premièrement, comme l'étude utilisait un plan transversal, il est impossible d'inférer des relations causales entre les habitudes de sommeil et l'activité physique. Des études longitudinales futures ou des essais contrôlés randomisés sont nécessaires pour évaluer les effets d'interventions d'exercice sur des profils de sommeil spécifiques39. Deuxièmement, le sommeil et l'activité physique ont tous deux été évalués à l'aide d'échelles d'auto-évaluation, qui peuvent être influencées par des biais de mémoire et de désirabilité sociale. Les recherches futures devraient intégrer la polysomnographie, des accéléromètres ou des dispositifs portables afin d'obtenir des données physiologiques et comportementales plus objectives22,24. Troisièmement, l'échantillon était limité à des étudiants universitaires du sud de la Chine ; par conséquent, le contexte culturel et les conditions climatiques pourraient limiter la généralisabilité des résultats. Les études futures devraient inclure des participants provenant de régions géographiques plus vastes et de groupes professionnels variés. Quatrièmement, bien que l'analyse de sensibilité pour échantillons complexes, ajustée pour le regroupement par université et par classe, ait produit des résultats cohérents, les tests du chi-deux n'ont pas explicitement tenu compte de la corrélation intraclasse introduite par l'échantillonnage en grappes. Les futures études impliquant un plus grand nombre de grappes devraient envisager une analyse en profils latents multiniveaux ou une régression multiniveaux dès la phase de conception. Cinquièmement, la régression logistique multinomiale a utilisé l'appartenance la plus probable à une classe, issue du modèle de profils latents, ce qui ne tient pas pleinement compte de l'incertitude de classification. Bien que l'entropie élevée (0,915) et les probabilités postérieures moyennes supérieures à 0,80 pour toutes les classes suggèrent une grande précision de classification, les études futures devraient employer des approches fondées sur des modèles, telles que la procédure en trois étapes de Bolck-Croon-Hagenaars (BCH), afin de propager plus adéquatement l'incertitude de classification dans les analyses auxiliaires.
Les habitudes de sommeil des étudiants universitaires ne sont pas homogènes, mais présentent une hétérogénéité marquée entre les groupes. Dans cette étude, ils ont été classés en quatre profils latents : sommeil sain, sommeil insuffisant, mauvaise qualité du sommeil et troubles sévères du sommeil. Les habitudes de sommeil favorables étaient associées positivement à des niveaux modérés et élevés d'activité physique. Ces résultats suggèrent que les enseignants universitaires et les décideurs en santé publique devraient éviter les approches « unique pour tous » lorsqu'ils promeuvent la santé mentale et la condition physique des étudiants. Pour les étudiants du groupe au sommeil insuffisant, les interventions pourraient cibler la gestion du temps et les comportements avant le coucher. Pour les étudiants du groupe aux troubles sévères du sommeil, un soutien psychologique professionnel, notamment une thérapie cognitivo-comportementale pour l'insomnie (CBT-I), pourrait être envisagé selon les indications cliniques40. Le niveau d'activité physique pourrait servir de marqueur comportemental utile pour identifier les étudiants à risque de mauvais sommeil, mais des études longitudinales et des études d'intervention sont nécessaires pour déterminer si l'augmentation de l'activité physique peut améliorer des profils de sommeil spécifiques.
Déclarations de divulgation
Les auteurs déclarent que ce travail a été réalisé en l'absence de toute relation commerciale ou financière pouvant être perçue comme un conflit d'intérêts potentiel.
Remerciements
Nous remercions sincèrement les universités participantes et tous les étudiants qui ont répondu au questionnaire. Ce travail a été soutenu par le projet de recherche en sciences humaines et sociales pour jeunes chercheurs du ministère de l'Éducation (subvention no 23YJC890059) ; et par le projet de recherche sur la réforme de l'enseignement et de l'éducation de la province du Hunan (subvention no 202502000069).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Questionnaire sur les données démographiques et le mode de vie | Conçu par l'équipe de l'étude | N/A | Utilisé pour recueillir le sexe, l'âge, le niveau scolaire, le lieu d'origine, l'indice de masse corporelle, les antécédents de tabagisme, les antécédents de consommation d'alcool et le temps d'écran quotidien moyen. |
| Indice de qualité du sommeil de Pittsburgh (PSQI) | Buysse et al., 1989 | DOI: 10.1016/0165-1781(89)90047-4 | Utilisé pour évaluer la qualité du sommeil au cours du mois précédent. Sept scores composants ont été utilisés comme indicateurs observés pour l'analyse de profils latents. |
| Questionnaire international d'activité physique - version courte (IPAQ-SF) | Craig et al., 2003 | DOI: 10.1249/01.MSS.0000078924.61453 .FB | Utilisé pour évaluer la marche, l'activité physique d'intensité modérée et l'activité physique vigoureuse au cours des sept derniers jours. |
| Formulaire de consentement éclairé écrit | Équipe de l'étude et universités participantes | Numéro d'approbation éthique : JSDX-2023-0034 | Utilisé pour documenter la participation volontaire d'étudiants de premier cycle âgés de 18 à 25 ans. |
| Procédure de collecte des données par questionnaire | Universités participantes du sud de la Chine | N/A | Utilisée pour un échantillonnage aléatoire stratifié en grappes à plusieurs stades et pour la passation des questionnaires entre septembre et décembre 2025. |
| Mplus | Muthen & Muthen | Version 8.3 | Utilisé pour réaliser une analyse de profils latents à partir des sept scores composants du PSQI. |
| IBM SPSS Statistics | IBM | Version 26.0 | Utilisé pour effectuer des tests du khi-deux et des analyses de régression logistique multinomiale. |
| Microsoft Excel | Microsoft | N/A | Utilisé pour préparer des fichiers de tableaux JoVE séparés à téléverser. |
Références
- Chaput JP, et al. Sleeping hours: What is the ideal number and how does age impact this? Nat Sci Sleep. 2018;10:421–430.
- Li J, et al. Sleep in normal aging. Sleep Med Clin. 2018;13(1):1–11.
- Becker SP, et al. Sleep in a large, multi-university sample of college students: Sleep problem prevalence, sex differences, and mental health correlates. Sleep Health. 2018;4(2):174–181.
- Lund HG, et al. Sleep patterns and predictors of disturbed sleep in a large population of college students. J Adolesc Health. 2010;46(2):124–132.
- Chen X, et al. Sleep characteristics and health-related quality of life among a national sample of American young adults. Sleep. 2014;37(4):793–799.
- Steptoe A, et al. Sleep duration and health in young adults. Arch Intern Med. 2006;166(16):1689–1692.
- Zhai L, et al. Sleep duration and depression among adults: A meta-analysis of prospective studies. Depress Anxiety. 2015;32(9):664–670.
- Grandner MA, et al. Sleep: Important considerations for the prevention of cardiovascular disease. Curr Opin Cardiol. 2016;31(5):551–565.
- Buysse DJ, et al. The Pittsburgh Sleep Quality Index: A new instrument for psychiatric practice and research. Psychiatry Res. 1989;28(2):193–213.
- Hirshkowitz M, et al. National Sleep Foundation’s sleep time duration recommendations: Methodology and results summary. Sleep Health. 2015;1(1):40–43.
- Nylund-Gibson K, et al. Ten frequently asked questions about latent class analysis. Transl Issues Psychol Sci. 2018;4(4):440–461.
- Nylund KL, et al. Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Struct Equ Modeling. 2007;14(4):535–569.
- Lanza ST, et al. Latent class analysis: An alternative perspective on subgroup analysis in prevention and treatment. Prev Sci. 2013;14(2):157–168.
- Bull FC, et al. World Health Organization 2020 guidelines on physical activity and sedentary behaviour. Br J Sports Med. 2020;54(24):1451–1462.
- U.S. Department of Health and Human Services. Physical Activity Guidelines for Americans. 2nd ed. U.S. Department of Health and Human Services; Washington, DC; 2018.
- Stamatakis E, et al. Sitting time, physical activity, and risk of mortality in adults. J Am Coll Cardiol. 2019;73(16):2062–2072.
- Nystoriak MA, et al. Cardiovascular effects and benefits of exercise. Front Cardiovasc Med. 2018;5:135.
- Biddle SJH, et al. A systematic review of physical activity and health in emerging adults. J Sci Med Sport. 2015;18(6):633–638.
- Lubans D, et al. Physical activity for cognitive and mental health in youth: A systematic review of mechanisms. Pediatrics. 2016;138(3):e20161642.
- Kredlow MA, et al. The effects of physical activity on sleep: A meta-analytic review. J Behav Med. 2015;38(3):427–449.
- Wang F, et al. The effect of physical activity on sleep quality: A systematic review. Eur J Physiother. 2021;23(1):11–18.
- Buman MP, et al. Objectively measured physical activity and sleep in older men. J Sleep Res. 2014;23(2):164–171.
- Loprinzi PD, et al. Association between objectively-measured physical activity and sleep, NHANES 2005–2006. Ment Health Phys Act. 2011;4(2):65–69.
- Vandelanotte C, et al. Associations between objective sleep characteristics and physical activity and sedentary behaviours. J Sci Med Sport. 2019;22(5):565–570.
- Pedisic Z, et al. State of health in Australian adults: Does physical activity mitigate the negative impact of poor sleep? J Sci Med Sport. 2014;17(1):60–65.
- Memon AR, et al. Sleep and physical activity in university students: A systematic review and meta-analysis. Sleep Med Rev. 2021;58:101482.
- Kline CE. The bidirectional relationship between exercise and sleep: Implications for exercise adherence and sleep improvement. Am J Lifestyle Med. 2014;8(6):375–379.
- Dolezal BA, et al. Interrelationship between sleep and exercise: A systematic review. Adv Prev Med. 2017;2017:1364387.
- Gerber M, et al. Fitness and exercise as correlates of sleep complaints: Is it all in our minds? Med Sci Sports Exerc. 2010;42(5):893–901.
- Wu X, et al. Low physical activity and high screen time can increase the risks of mental health problems and poor sleep quality among Chinese college students. PLoS One. 2015;10(3):e0119607.
- Carter B, et al. Association between portable screen-based media device access or use and sleep outcomes: A systematic review and meta-analysis. JAMA Pediatr. 2016;170(12):1202–1208.
- Craig CL, et al. International Physical Activity Questionnaire: 12-country reliability and validity. Med Sci Sports Exerc. 2003;35(8):1381–1395.
- Dinger MK, et al. Validity and reliability of the International Physical Activity Questionnaire in college students. Am J Health Educ. 2006;37(6):337–343.
- Muthén LK, Muthén BO. Mplus User’s Guide. 8th ed. Muthén & Muthén; Los Angeles, CA; 1998–2017.
- Spurk D, et al. Latent profile analysis: A review and “how to” guide of its application within vocational behavior research. J Vocat Behav. 2020;120:103445.
- Rebar AL, et al. A meta-meta-analysis of the effect of physical activity on depression and anxiety in non-clinical adult populations. Health Psychol Rev. 2015;9(3):366–378.
- Yang PY, et al. Exercise training improves sleep quality in middle-aged and older adults with sleep problems: A systematic review. J Physiother. 2012;58(3):157–163.
- Irish LA, et al. The role of sleep hygiene in promoting public health: A review of empirical evidence. Sleep Med Rev. 2015;22:23–36.
- Driver HS, et al. Exercise and sleep. Sleep Med Rev. 2000;4(4):387–402.
- Morin CM, et al. Chronic insomnia. Lancet. 2012;379(9821):1129–1141.