Ici, nous présentons un protocole permettant d'enrichir l'ADN mitochondrial à partir d'ovocytes humains uniques à l'aide de l'Exonuclease V et de préparer des bibliothèques de séquençage duplex pour une détection hautement précise des variants de l'ADN mitochondrial en utilisant des plates-formes de séquençage compatibles avec Illumina.
Article de méthode
Protocole de séquençage duplex de l'ADN mitochondrial dans des ovocytes humains uniques
Dans cet article
Résumé
Résumé
Les ovocytes sont densément peuplés de mitochondries, des organites producteurs d'énergie qui contiennent leur propre génome, l'ADN mitochondrial (ADNmt). Chaque cellule contient plusieurs copies d'ADNmt, le nombre de copies variant selon les types de tissus. Les ovocytes possèdent le nombre le plus élevé de copies d'ADNmt, avec des centaines de milliers de molécules d'ADNmt par cellule. Étant donné que les mitochondries sont transmises exclusivement par la lignée maternelle, une détection précise des variants d'ADNmt est essentielle pour les études sur l'hérédité, le vieillissement et les maladies. La présence de multiples copies d'ADNmt permet à des molécules de type sauvage et mutantes de coexister au sein d'une même cellule, une condition appelée hétéroplasmie, dans laquelle des variants de faible fréquence ou de novo peuvent apparaître à des fréquences inférieures à 1 %. Le séquençage conventionnel de nouvelle génération (NGS) ne possède pas une précision suffisante pour distinguer de façon fiable ces variants rares des erreurs introduites lors de la préparation des bibliothèques et du séquençage. Ici, nous présentons un protocole permettant d'enrichir l'ADNmt à partir d'ovocytes humains isolés en utilisant l'exonucléase V pour éliminer l'ADN linéaire, suivi d'une préparation de bibliothèque de séquençage en duplex pour une analyse hautement précise de l'ADNmt. Ce flux de travail permet un séquençage corrigé des erreurs à partir d'ovocytes individuels, facilitant la détection fiable de variants d'ADNmt à faible fréquence ainsi que l'analyse de l'hétéroplasmie et de la mutagenèse de novo. Ce protocole offre une approche reproductible pour étudier la variation du génome mitochondrial dans des ovocytes isolés à l'aide de plates-formes de séquençage compatibles avec Illumina.
Introduction
Les mitochondries jouent un rôle fondamental dans des processus cellulaires essentiels, notamment la production d'énergie, l'apoptose, la signalisation et l'homéostasie du calcium1. Elles possèdent leur propre génome, l'ADN mitochondrial (ADNmt), une molécule circulaire bicaténaire d'environ 16,6 kb de longueur chez les mammifères. Bien que la majorité des gènes mitochondriaux ancestraux ait été transférée vers le génome nucléaire durant l'endosymbiose, l'ADNmt conserve 37 gènes codant pour 13 polypeptides de la phosphorylation oxydative (OXPHOS), 22 ARN de transfert (ARNt) et deux ARN ribosomaux (ARNr)2. Des mutations dans l'ADNmt peuvent altérer l'expression génique et la fonction mitochondriales, et peuvent entraîner des troubles graves3. Étant donné que les mitochondries sont transmises exclusivement par la lignée maternelle, l'ADNmt de l'ovocyte joue un rôle crucial dans la fécondation, le développement embryonnaire et la santé de la descendance4. Par conséquent, la détection et la caractérisation des mutations de l'ADNmt ainsi que de leurs fréquences suscitent un grand intérêt. Par exemple, comprendre la mutagénèse germinale associée au vieillissement et aux maladies constitue une étape essentielle pour élaborer des stratégies thérapeutiques contre l'infertilité féminine.
Contrairement à l'ADN nucléaire, l'ADN mitochondrial (ADNmt) est présent en plusieurs copies par cellule, allant de centaines à plusieurs milliers de copies dans les cellules somatiques selon le type de tissu, et dépassant 100 000 copies dans les ovocytes matures4. Ce nombre élevé de copies d'ADNmt rend les ovocytes particulièrement adaptés à l'étude de la mutagenèse mitochondriale au niveau de la cellule unique. Toutefois, la détection des mutations de novo de l'ADNmt, notamment celles présentes à des fréquences très faibles, demeure difficile, car les taux d'erreur du séquençage conventionnel de nouvelle génération (NGS) dépassent les fréquences de nombreuses variantes réelles5. Des méthodes de séquençage corrigées en erreur sont donc nécessaires pour distinguer les véritables mutations des artefacts introduits lors de la préparation des bibliothèques, de l'amplification et du séquençage. L'une de ces approches est le séquençage en duplex (DS)6,7. Dans le DS, des fragments d'ADN sont ligaturés à des adaptateurs contenant des marqueurs moléculaires aléatoires double brin de 12 nucléotides avant amplification. Ces identifiants moléculaires uniques étiquettent chaque molécule d'ADN d'origine aux deux extrémités, permettant de regrouper les lectures de séquençage issues du même brin matrice en familles fondées sur la séquence de marqueur partagée. Une séquence consensus de brin simple (SSCS) est générée à partir de chaque famille de lectures, puis les SSCS complémentaires dérivées du duplex d'ADN initial sont combinées pour produire une séquence consensus en duplex (DCS). Seules les variantes détectées dans la majorité des lectures au sein des deux SSCS complémentaires et confirmées dans la DCS résultante sont considérées comme de véritables mutations, permettant ainsi des taux d'erreur inférieurs de plusieurs ordres de grandeur à ceux des approches NGS conventionnelles8. Cette stratégie est particulièrement avantageuse pour détecter les variants mitochondriaux à faible fréquence et l'hétéroplasmie au niveau de la cellule unique.
Une limitation majeure de la plupart des protocoles publiés de séquençage en duplex est la nécessité de quantités relativement importantes d'ADN d'entrée lors de la préparation de la banque, ce qui rend ces méthodes inadaptées aux applications à cellule unique6,7,9. L'objectif global de ce protocole est de permettre un séquençage en duplex hautement précis de l'ADNmt à partir d'ovocytes humains isolés, grâce à un flux de travail optimisé pour l'enrichissement de l'ADNmt, la préparation de la banque et le séquençage. Afin de minimiser le séquençage des segments nucléaires d'ADN mitochondrial (NUMTs) et d'améliorer l'efficacité du séquençage, ce protocole inclut une étape d'enrichissement basée sur l'Exonucléase V, qui dégrade sélectivement l'ADN linéaire tout en préservant l'ADNmt circulaire. Le flux de travail résultant offre une approche pratique pour la détection précise de variants de l'ADNmt dans des ovocytes isolés, et convient aux études portant sur l'hétéroplasmie, la mutagenèse de novo, le vieillissement et les maladies mitochondriales.
Protocole
La collecte et le traitement des ovocytes humains ont été approuvés par la Commission d'éthique de l'Université Johannes Kepler de Linz (numéro d'approbation : 1293/2020). Réalisez toutes les procédures conformément aux directives institutionnelles, y compris le consentement éclairé, l'anonymisation des échantillons et toutes les réglementations applicables relatives à l'utilisation de tissus humains.
REMARQUE : Bien que ce protocole soit décrit pour des ovocytes humains, adaptez les amorces spécifiques à l'espèce afin d'appliquer le flux de travail à d'autres espèces. Utilisez des consommables à faible rétention d'ADN (par exemple, tubes et embouts de pipette) tout au long du protocole afin de minimiser la perte d'échantillon. Effectuez toutes les étapes jusqu'à la première purification dans le tube initial de collecte des ovocytes à faible rétention. N'agitez pas les échantillons par vortex, car cette manipulation pourrait endommager les brins d'ADN. Mélangez plutôt les composants de la réaction par pipetage doux ou par de légers tapotements sur le tube, suivis d'une courte centrifugation. Dans la mesure du possible, effectuez l'isolement de l'ADN, la préparation du mélange maître et la mise en place des réactions dans des postes de travail dédiés à la réaction en chaîne par polymérase (PCR) ou dans des zones de laboratoire physiquement séparées afin de minimiser les contaminations.
1. Préparation des tampons et des réactifs
- Préparer le tampon de lyse des ovocytes (OLB), le tampon Tris-HCl 10 mM, le tampon TE, le tampon TElow et le tampon Tris-NaCl 10 mM selon le Tableau 1 en combinant les volumes indiqués des solutions mères et en ajustant chaque solution au volume final désigné avec de l’eau de qualité pour biologie moléculaire. Répartir 1 mL des tampons préparés en aliquots, conserver les aliquots à 4 °C et les utiliser dans l’année suivant leur préparation.
Tableau 1 : Composition des tampons utilisés tout au long du protocole. Compositions des tampons et concentrations finales pour la préparation du Tris-HCl 10 mM, du tampon TE, du tampon TElow, du Tris-NaCl 10 mM et du tampon de lyse d'ovocyte (OLB). Préparer tous les tampons à l'aide d'eau de qualité biologie moléculaire. Ajuster le pH des solutions mères de Tris-HCl et de EDTA avant la préparation des tampons, si nécessaire, conformément aux recommandations du fabricant. L'OLB est supplémenté en protéinase K thermolabile juste avant la lyse des échantillons, comme décrit dans le protocole. Veuillez cliquer ici pour télécharger ce fichier.
2. Prélèvement individuel d'ovocyte
REMARQUE : Les ovocytes humains utilisés dans ce protocole ont été collectés auprès de patientes programmées pour une injection intracytoplasmique de spermatozoïdes (ICSI) au centre de fertilité Kinderwunsch Zentrum de l'hôpital universitaire Kepler, Linz, Autriche. Les protocoles de stimulation ovarienne étaient basés sur la réponse ovarienne prévue de la patiente, et les doses étaient ajustées selon les caractéristiques individuelles, notamment l'âge, les taux d'hormone anti-Müllerienne (AMH) et le poids corporel, conformément aux recommandations de la Société européenne de la reproduction humaine et de l'embryologie (ESHRE)10. La suppression hypophysaire a été obtenue à l’aide de protocoles utilisant un agoniste ou un antagoniste de l'hormone de libération des gonadotrophines (GnRH), combinés à une stimulation par gonadotrophines afin de favoriser la maturation folliculaire. La croissance folliculaire a été surveillée régulièrement par échographie transvaginale avant le déclenchement de l'ovulation. Les ovocytes ont ensuite été récupérés par ponction folliculaire transvaginale, et le liquide folliculaire contenant les complexes cumulus–ovocyte (COC) a été collecté11. Seuls les ovocytes immatures ou non fécondés, qui ne pouvaient pas être utilisés pour le traitement ICSI de la patiente et qui auraient sinon été écartés, étaient disponibles pour la recherche, après obtention d'un consentement éclairé. Les patientes présentant un nombre plus élevé de follicules antraux (AFC) ont été prioritairement sollicitées pour le don d'ovocytes, car elles avaient plus de chances de produire des ovocytes immatures ou non fécondés adaptés à la recherche. Toutes les procédures effectuées avant la sélection des ovocytes à des fins de recherche doivent respecter la réglementation nationale relative à la fécondation in vitro et à l'utilisation de tissus humains. Manipuler tous les matériaux en conditions stériles sous une hotte à flux laminaire. S'assurer que tous les matériaux et milieux de culture certifiés CE entrant en contact direct avec les ovocytes sont stériles, préalablement réchauffés à 37 °C, et maintenus à un pH compris entre 7,20 et 7,40.
- Prélèver les complexes oocyte-cumulus (COC) à partir du liquide folliculaire et les transférer dans 750 µL de milieu de culture GM501 sous huile minérale stérile après une hyperstimulation ovarienne contrôlée et une récupération transvaginale des ovocytes.
- Éliminer les cellules du cumulus entourant la zone pellucide (ZP) par digestion enzymatique à l'hyaluronidase. Incuber les ovocytes dans 500 µL de GM501 contenant de l'hyaluronidase (80 U/mL) pendant 30 à 60 secondes à 37 °C, puis effectuer trois lavages dans 750 µL de milieu de culture GM501. Retirer soigneusement les cellules du cumulus restantes par une méthode mécanique à l’aide de pipettes de dénucléation.
- Pour les ovocytes en télophase I (TI) ou en métaphase II (MII), ouvrir la ZP à l’aide d’une série d’impulsions laser adjacentes au globule polaire et retirer le premier globule polaire à l’aide de micromanipulateurs. Ajuster les paramètres du laser en fonction de l’épaisseur de la ZP (1 à 3 impulsions ; durée de l’impulsion, 1,5 à 2,6 ms ; diamètre du spot, 16 à 20 µm). Utiliser le laser pour éliminer les cellules du cumulus résiduelles, réduisant ainsi au minimum la contamination de l’ovocyte par l’ADN de cellules somatiques.
- Transférer chaque ovocyte individuellement dans 2 à 3 µL de solution saline tamponnée au phosphate (PBS) 1× dans un tube de 200 µL à faible liaison. Congeler immédiatement le tube à −20 °C. Pour un stockage à long terme, transférer les ovocytes congelés à −80 °C.
NOTE : Après décongélation, poursuivre le protocole restant sans interruption jusqu’à la fin de la première étape d’amplification. - Pour surveiller d’éventuelles contaminations par de l’ADN environnemental au cours du protocole, inclure un témoin négatif composé de 2 µL de PBS 1× sans ovocyte lors de la préparation de la banque (à partir de l’étape 4). Traiter ce témoin négatif de la même manière que tous les échantillons d’ovocytes. Aucun ADN détectable ne devrait être observé dans le témoin négatif à aucune étape du protocole.
Synthèse des adaptateurs
REMARQUE : Préparer les adaptateurs avant de commencer la préparation de la banque. Conserver les adaptateurs synthétisés à −80 °C pendant un maximum de 3 mois. Préparer des aliquotes afin d'éviter des cycles de congélation-décongélation répétés et ne pas recongeler les adaptateurs après décongélation. Toutes les séquences d'oligonucléotides utilisées dans ce protocole sont indiquées dans Tableau 2.
Tableau 2 : Oligonucléotides et amorces utilisés tout au long du protocole. Le tableau répertorie tous les oligonucléotides utilisés pour la synthèse des adaptateurs, l'amplification des bibliothèques, la réaction de polymérisation en chaîne quantitative (qPCR), la quantification des bibliothèques et l'estimation de l'enrichissement de l'ADN mitochondrial (ADNmt), ainsi que leurs séquences, méthodes de purification, quantités fournies ou concentrations stock recommandées, et le fabricant. La séquence de l'oligonucléotide porteur indiquée correspond à la séquence exemple utilisée dans ce protocole. L'astérisque (*) dans les séquences des amorces désigne une liaison phosphorothioate. Les nucléotides aléatoires (N) dans l'adaptateur mws55 représentent l'identifiant moléculaire unique (UMI), tandis que Y désigne la base pyrimidique dégénérée (C ou T). Sauf indication contraire, les oligonucléotides ont été synthétisés par purification standard par désalinisation. Veuillez cliquer ici pour télécharger ce fichier.
- Préparer un aliquot d'éthanol à 96 % (EtOH) et le conserver à −20 °C pour les étapes de purification ultérieures. Préparer de l'EtOH à 80 % frais immédiatement avant utilisation.
- Mélanger 20,5 µL de chacun des oligonucléotides mws51_short à 100 µM et mws55 à 100 µM dans un tube bas de liaison de 200 µL pour obtenir un volume total de 41 µL (2 000 pmol de chaque oligonucléotide).
- Incuver les oligonucléotides combinés à 95 °C pendant 5 min dans un thermocycleur dont la température du couvercle est réglée à 110 °C. Démarrer le minuteur une fois que l'échantillon atteint 95 °C, éteindre le thermocycleur après 5 min, puis laisser les tubes à l'intérieur du thermocycleur pendant 1 h afin de permettre un refroidissement lent jusqu'à la température ambiante (TA) et l'hybridation (« adaptateur hybridé »).
- Préparer un mélange maître d'extension en combinant 1× tampon NEB Buffer 2 (5,6 µL de solution mère 10×), des triphosphates de désoxynucléotides (dNTP) à 3,5 mM (5,6 µL de solution mère 10 mM), 11,5 U de fragment de Klenow (2,3 µL de solution mère 5 U/µL) et 2,5 µL d'eau de qualité pour biologie moléculaire, pour un volume final de 16 µL.
- Prélever 1 µL de l'adaptateur hybridé préparé à l'étape 3.3, le diluer 1:20 dans du tampon TElow, étiqueter cet aliquot « hybridé » et le conserver à 4 °C pour électrophorèse sur gel d'agarose.
- Ajouter 16 µL du mélange maître d'extension aux 40 µL restants d'oligonucléotides hybridés et bien mélanger.
- Incuver la réaction à 37 °C pendant 1 h avec la température du couvercle du thermocycleur réglée à 47 °C.
- Purifier les oligonucléotides étendus par précipitation à l'EtOH. Ajouter 28 µL d'acétate d'ammonium (NH4OAc) au mélange réactionnel de 56 µL et bien mélanger.
- Transférer l'ensemble de la réaction dans un tube bas de liaison de 1,5 mL et ajouter 168 µL d'EtOH à 96 % refroidi sur glace.
- Inverser le tube plusieurs fois et incuber à −20 °C pendant 30 min afin de précipiter l'ADN.
- Préparer 1 mL d'EtOH à 80 % frais et le refroidir à −20 °C. Pré-refroidir la centrifugeuse à 4 °C.
- Centrifuger à 14 000 × g pendant 30 min.
- Retirer soigneusement le surnageant sans perturber le culot. Ajouter 1 mL d'EtOH à 80 % refroidi sur glace sans mélanger ni inverser le tube.
- Centrifuger à 14 000 × g pendant 5 min.
- Éliminer tout l'EtOH résiduel et sécher le culot d'ADN à l'air pendant 10 à 15 min, jusqu'à disparition complète du liquide visible et apparition d'un culot transparent. Ne pas sur-sécher les oligonucléotides.
- Reprendre le culot dans 41 µL d'eau de qualité pour biologie moléculaire.
- Prélever 1 µL, le diluer 1:20 dans du tampon TElow, étiqueter cet aliquot « étendu » et le conserver à 4 °C.
- Préparer un mélange maître de restriction en combinant 47 µL d'eau de qualité pour biologie moléculaire, 1× tampon CutSmart (10 µL de solution mère 10×) et 15 U de HpyCH4III (3 µL de solution mère 5 U/µL), pour un volume final de 60 µL.
- Ajouter 60 µL du mélange maître de restriction à 40 µL d'oligonucléotides purifiés et bien mélanger.
- Incuver la réaction à 37 °C pendant 16 h avec la température du couvercle du thermocycleur réglée à 47 °C.
- Préparer 6,5 mL d'EtOH à 80 % frais et le refroidir à −20 °C. Pré-refroidir la centrifugeuse à 4 °C.
- Transférer les adaptateurs digérés dans un tube bas de liaison de 1,5 mL et ajouter 900 µL d'eau de qualité pour biologie moléculaire.
- Ajouter 500 µL de NH4OAc et bien mélanger.
- Répartir la solution en six aliquots de 250 µL dans des tubes bas de liaison de 1,5 mL. Ajouter 500 µL d'EtOH à 96 % refroidi sur glace à chaque tube.
- Inverser les tubes plusieurs fois et incuber à −20 °C pendant 30 min afin de précipiter l'ADN.
- Centrifuger à 14 000 × g pendant 30 min. Retirer soigneusement le surnageant sans perturber le culot. Ajouter 1 mL d'EtOH à 80 % refroidi sur glace à chaque tube sans mélanger ni inverser. Centrifuger à 14 000 × g pendant 5 min.
- Éliminer tout l'EtOH résiduel et sécher les culots d'adaptateurs à l'air.
- Reprendre chaque culot dans 6,7 µL de tampon Tris-NaCl et regrouper les six suspensions pour obtenir un volume final de 41 µL. Prélever 1 µL, le diluer 1:10 dans du tampon TElow, étiqueter cet aliquot « coupé » et le conserver à 4 °C.
- Préparer des aliquots du stock d'adaptateur et les conserver à −80 °C. Mesurer la concentration en adaptateur et déterminer les rapports d'absorbance A260/280 et A260/230 de l'aliquot « coupé » à l'aide d'un spectrophotomètre. La concentration attendue en adaptateur est de 30 à 50 µM, avec un rapport A260/280 de >1,7 et un rapport A260/230 de >1,9.
- Faire migrer les aliquots « hybridé », « étendu » et « coupé » sur un gel d'agarose à 2 % à 125 V pendant 45 min afin de vérifier la formation de l'adaptateur et la digestion complète par restriction (Figure 1).
NOTE : L'aliquot « hybridé » doit contenir deux bandes représentant les fractions hybridée et non hybridée. L'adaptateur hybridé doit migrer à environ 90 pb et se compose d'une région double brin de 13 pb avec un dépassement simple brin de 68 nt, tandis que les oligonucléotides non hybridés migrent à environ 60 pb. Après extension, l'adaptateur se compose d'une région double brin de 37 pb avec un dépassement en forme de Y de 44 nt et doit migrer à environ 110 pb. Après digestion par restriction, un fragment de 8 pb est éliminé de l'adaptateur. Trois bandes doivent être visibles : une bande principale à environ 100 pb (adaptateur final), et deux bandes faibles à environ 60 pb (oligonucléotides restants non hybridés) et 8 pb (fragment de restriction).
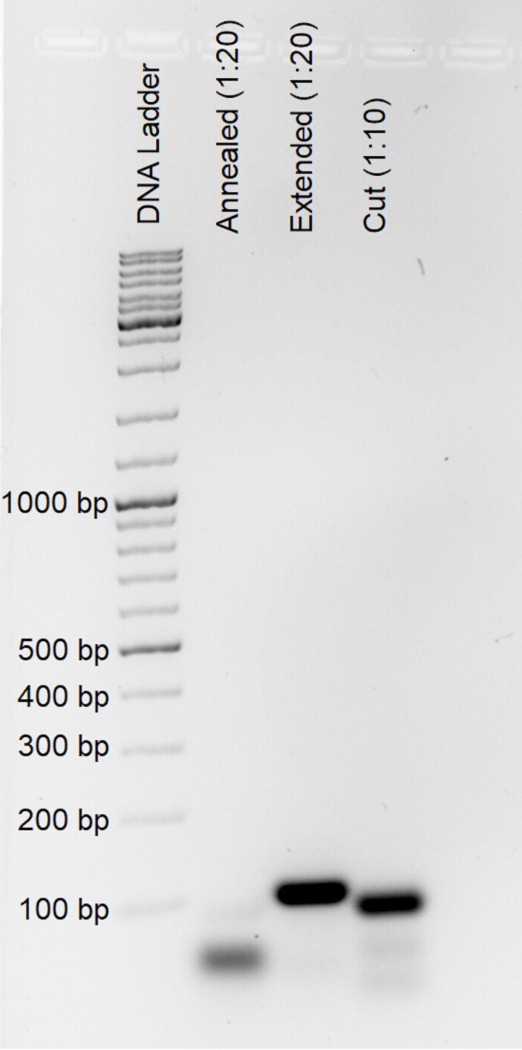
Figure 1. Analyse représentative de la taille des fragments des produits intermédiaires et des adaptateurs duplex de séquençage finaux. Des aliquotes prélevées au cours de la synthèse des adaptateurs, après hybridation des oligonucléotides (« hybridés », dilués 1:20), extension par remplissage (« étendus », dilués 1:20) et digestion par l'enzyme de restriction HpyCH4III (« coupés », dilués 1:10), ont été analysées par électrophorèse sur gel d'agarose à 2 % afin de vérifier la formation correcte des adaptateurs duplex de séquençage. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
4. Lysis individuelle des ovocytes
- Préparer le tampon OLB supplémenté en protéinase K thermolabile (OLB+) en ajoutant 1 µL de protéinase K thermolabile (0,120 U/µL) à 99 µL d'OLB afin d'obtenir une concentration finale de protéinase K de 0,0012 U/µL.
- Dégeler les ovocytes à température ambiante. Ajouter immédiatement 4 µL d'OLB+ à chaque ovocyte. Rincer plusieurs fois les parois du tube avec le tampon de lyse afin de garantir un transfert complet de l'ovocyte dans le tampon et d'empêcher l'adhérence de l'échantillon aux parois du tube.
- Mélanger soigneusement l'échantillon, centrifuger brièvement pour rassembler le contenu au fond du tube, puis incuber à 37°C pendant 16 h dans un thermocycleur dont la température du couvercle est réglée à 47°C.
REMARQUE : Aucune évaluation indépendante de la lyse des ovocytes n'est effectuée avant la fragmentation. Une incubation de 16 h dans les conditions de lyse spécifiées est généralement suffisante pour assurer la lyse complète d'un seul ovocyte. La quantité d'ADN récupérée peut toutefois varier en raison de pertes d'échantillon lors de la manipulation et des différences du nombre de copies d'ADNmt entre les ovocytes. - Inactiver la protéinase K thermolabile en incubant les échantillons à 55°C pendant 15 min dans un thermocycleur dont la température du couvercle est réglée à 75°C.
REMARQUE : Terminer le protocole suivant sans interruption après la lyse et l'inactivation de la protéinase K, sauf indication explicite d'un point d'arrêt à une étape ultérieure du protocole.
5. Digestion par l'exonucléase V
- Laisser les échantillons s'équilibrer à température ambiante (TA) avant de poursuivre.
- Préparer un mélange maître d'Exonuclease V en combinant 4 µL de chlorure de magnésium (MgCl₂) 25 mM, 1 µL de Tris-HCl 10 mM, 1 µL d'adénosine triphosphate (ATP) 10 mM et 1 µL d'Exonuclease V (stock à 10 U/µL) pour obtenir un volume final de 7 µL.
- Préparer une solution de travail de ribonucléase A (RNase A) à 1 mg/mL en diluant 1 µL de solution mère de RNase A à 10 mg/mL avec 99 µL d'eau de qualité pour biologie moléculaire. Ajouter environ 0,1 µL de la solution de RNase A diluée à chaque échantillon d'ovocyte lysé.
NOTE : Utiliser une pipette adaptée pour cette étape. Lors du traitement simultané de plusieurs échantillons, une pipette multicanal appropriée peut être utilisée, à condition de prendre des précautions pour éviter toute contamination croisée entre les échantillons. Étant donné que la précision de la pipette peut diminuer lors de la distribution de tels petits volumes avec une pipette multicanal, inspecter soigneusement tous les canaux. En alternative, plonger brièvement la pointe de la pipette dans la solution de RNase A diluée suffit à transférer environ 0,1 µL. De légères variations par rapport à ce volume n'affectent pas l'efficacité du protocole. Vérifier au préalable le volume approximatif transféré à l'aide d'une pipette monocanal. - Ajouter 7 µL du mélange maître d'Exonuclease V à chaque échantillon d'ovocyte lysé et mélanger soigneusement. Incuber les échantillons à 37°C pendant 1 h dans un thermocycleur dont la température du couvercle est réglée à 47°C.
- Ajouter 38 µL de tampon TE à chaque échantillon afin d'obtenir un volume réactionnel final d'environ 51 µL. Inactiver les enzymes par chauffage en incubant les échantillons à 70°C pendant 30 min dans un thermocycleur dont la température du couvercle est réglée à 75°C.
- Passer immédiatement à la préparation de la banque d'ADN.
6. Fragmentation
- Réduisez en fragments l'ADN à une taille moyenne d'environ 550 paires de bases (pb) par sonication.
NOTE : Ce protocole décrit la fragmentation de l'ADN à l'aide d'un appareil de sonication ultrasonique focalisée Covaris M220, appelé par la suite le sonicateur ; toutefois, des systèmes équivalents peuvent également être utilisés. Étant donné que les échantillons contiennent des débris cellulaires en plus de l'ADN après la lyse, optimisez les conditions de fragmentation selon l'instrument spécifique et le type d'échantillon afin d'obtenir une distribution relativement étroite des tailles de fragments centrée autour de la taille cible. - Transférez le volume total de l'échantillon (environ 51 µL) dans un tube de 50 µL destiné à la sonication focalisée.
- Fragmentez l'ADN pendant 70 s en utilisant un facteur de cycle de 10 %, une puissance incidente maximale de 75 W et 200 cycles par salve à 20 °C.
- Transférez immédiatement chaque échantillon fragmenté (environ 50 µL) du tube de fragmentation vers un tube bas de 200 µL, car les tubes de sonication ne sont pas bas. Le tube d'origine utilisé pour la collecte des ovocytes peut être réutilisé à cet effet. Vérifiez le couvercle du tube de sonication pour détecter tout résidu liquide et récupérez tout échantillon restant afin de maximiser le rendement.
- Passez immédiatement à la réparation des extrémités et à l'ajout de la queue A.
7. Réparation des extrémités et ajout d'une queue A
- Préparez un mélange maître de réparation des extrémités/ajout d'une queue A contenant 7 µL de tampon de réaction End Prep et 3 µL de mélange enzymatique End Prep.
- Ajoutez 10 µL du mélange maître de réparation des extrémités/ajout d'une queue A à chaque échantillon afin d'obtenir un volume réactionnel final de 60 µL. Mélangez soigneusement en aspirant et en expulsant 10 fois à l’aide d’une pipette.
- Incubez les échantillons à 20°C pendant 30 min avec le couvercle du thermocycleur éteint, puis incubez-les à 65°C pendant 30 min avec la température du couvercle réglée à 75°C.
- Procédez immédiatement à la ligature des adaptateurs.
8. Ligation d'adaptateurs
- Préparez un mélange maître de ligature contenant 30 µL de mélange de ligature et 1 µL d'activateur de ligature.
- Décongelez un aliquot de l'adaptateur synthétisé et diluez-le 1:4000 dans un tampon Tris-NaCl.
- Ajoutez 1,5 µL de l'adaptateur dilué à chaque échantillon d'ADN ayant subi une réparation des extrémités et une addition de résidu A. Ajoutez 31 µL du mélange maître de ligature et mélangez soigneusement.
- Incubez les échantillons à 20°C pendant 15 min. Ajoutez 1 µL de l'adaptateur dilué à chaque échantillon afin d'obtenir un volume réactionnel final de 93,5 µL. Mélangez soigneusement puis incubez à 4°C pendant 16 h.
- Procédez immédiatement à la purification.
9. Purification de l'ADN ligaturé à l'adaptateur
- Laisser les billes magnétiques et le tampon TElow s'équilibrer à température ambiante (TA) pendant au moins 30 min. Pendant ce temps, préparer de l'éthanol (EtOH) à 80 % frais. Préparer une solution d'oligonucléotide porteur en ajoutant 1 µL de l'oligonucléotide porteur (séquence absente du génome humain ; voir Tableau 2) à 99 µL de tampon TElow afin d'obtenir une concentration finale de 1 nM.
- Transférer 74,8 µL de billes magnétiques, correspondant à un rapport bille-échantillon de 0,8×, dans un tube de 1,5 mL à faible rétention. Ajouter l'intégralité du volume de 93,5 µL d'ADN ligaturé avec l'adaptateur et mélanger soigneusement.
- Incuber le mélange bille-échantillon à température ambiante pendant 15 min. Après 7,5 min, mélanger doucement la suspension et centrifuger brièvement le tube.
- Centrifuger brièvement le tube, le placer sur un support magnétique et l'incuber pendant 5 min afin de permettre une séparation complète des billes. Retirer et jeter soigneusement le surnageant clair, puis refermer immédiatement le tube.
- Ajouter 400 µL d'EtOH à 80 %, incuber pendant 30 s, puis retirer l'EtOH. Ajouter 200 µL d'EtOH à 80 %, incuber pendant 30 s, puis retirer l'EtOH.
- Retirer le tube du support magnétique et le centrifuger brièvement. Replacer le tube sur le support magnétique, éliminer tout reste d'EtOH et laisser sécher les billes à l'air pendant moins de 5 min.
- Ajouter 50 µL de tampon TElow supplémenté d'oligonucléotides porteurs. Retirer le tube du support magnétique et resuspendre complètement les billes par pipetage.
- Incuber la suspension à température ambiante pendant 5 min, en mélangeant occasionnellement. Centrifuger brièvement le tube, le replacer sur le support magnétique et incuber encore 5 min.
- Pendant les 5 dernières minutes de la première séparation magnétique, préparer un nouveau tube de 1,5 mL à faible rétention contenant 40 µL de billes magnétiques. Transférer 50 µL de l'éluate dans le tube préparé pour effectuer une deuxième purification selon un rapport bille-échantillon de 0,8×.
- Mélanger soigneusement et incuber à température ambiante pendant 15 min. Après 7,5 min, mélanger doucement la suspension et centrifuger brièvement le tube.
- Placer le tube sur le support magnétique et l'incuber pendant 5 min afin de permettre une séparation complète des billes. Retirer et jeter soigneusement le surnageant clair, puis refermer immédiatement le tube.
- Ajouter 400 µL d'EtOH à 80 %, incuber pendant 30 s, puis retirer l'EtOH. Ajouter 200 µL d'EtOH à 80 %, incuber pendant 30 s, puis retirer l'EtOH.
- Retirer le tube du support magnétique et le centrifuger brièvement. Replacer le tube sur le support magnétique, éliminer tout reste d'EtOH et laisser sécher les billes à l'air pendant moins de 5 min.
- Ajouter 15,5 µL de Tris-HCl à chaque échantillon. Retirer le tube du support magnétique et resuspendre complètement les billes par pipetage.
- Incuber la suspension à température ambiante pendant 5 min, en mélangeant occasionnellement. Centrifuger brièvement le tube, le replacer sur le support magnétique et incuber encore 5 min.
- Transférer 15 µL de l'éluate dans un nouveau tube de 200 µL à faible rétention. Prélever 1 µL de l'éluate et le diluer 1:10 dans du Tris-HCl pour des analyses par PCR quantitative en attomoles (qPCR) et par qPCR d'enrichissement de l'ADN mitochondrial (ADNmt).
10. Estimation à l'attomole
REMARQUE : Déterminez la quantité approximative d'ADN ligaturé aux adaptateurs afin d'ajuster la quantité d'ADN en entrée et le nombre de cycles utilisés dans les PCR d'amplification et d'indexation ultérieures. Étant donné que la quantité d'échantillon est limitée, les mesures directes de concentration peuvent ne pas être fiables ; par conséquent, estimez la quantité d'ADN par qPCR. Analysez les produits d'amplification par électrophorèse sur gel d'agarose pour évaluer la distribution des tailles de fragments et détecter les dimères résiduels d'adaptateurs. Les valeurs de Cq peuvent varier selon les réactifs et l'appareil de PCR en temps réel utilisés. Les ajustements des valeurs de Cq fondés sur la détection des dimères d'adaptateurs, ainsi que les quantités d'ADN en aval et les nombres de cycles de PCR, reposent principalement sur des observations empiriques et peuvent nécessiter une optimisation pour chaque préparation de bibliothèque.
- Préparez un mélange maître de PCR q attomolaire contenant, par réaction, 5 µL de mélange de réaction KAPA HiFi HotStart 2× (désormais appelé mélange PCR haute fidélité 2×), 1 µL du Dual-NEBNext Universal PCR Primer pour Illumina (10 µM ; ci-après appelé amorce universelle de bibliothèque), 1 µL de l'amorce mws20 (10 µM), 0,5 µL d'EvaGreen 20× et 0,5 µL d'eau de qualité biologie moléculaire.
- Ajoutez 8 µL du mélange maître dans chaque puits désigné d'une plaque 96 puits compatible avec la PCR en temps réel. Ajoutez 2 µL de l'échantillon dilué au 1/10 pour obtenir un volume de réaction final de 10 µL.
- Fermez hermétiquement la plaque et centrifugez-la brièvement avant de l'introduire dans l'appareil de PCR en temps réel.
- Réalisez la PCR q en utilisant les conditions cycliques suivantes : 45 s à 98 °C, suivis de 45 cycles de 15 s à 98 °C, 30 s à 65 °C et 45 s à 72 °C.
- Déterminez le cycle de quantification (Cq) en fixant le seuil de fluorescence à 1 000 unités de fluorescence relative (UFR).
NOTE : Choisissez un seuil de fluorescence compatible avec l'appareil de PCR en temps réel et utilisez le même seuil dans toutes les expériences afin de permettre la comparaison des valeurs de Cq. - Séparez les produits d'amplification de la PCR q sur un gel d'agarose à 1,5 % à 125 V pendant 40 min.
- Examinez le gel à la recherche de dimères d'adaptateurs résiduels. Les dimères d'adaptateurs migrent à environ 130 pb (Figure 2).
- Si des dimères d'adaptateurs sont visibles, ajustez la valeur de Cq à l'aide du facteur de correction Cq attomolaire (ACF) approprié indiqué dans la Figure 2. Sélectionnez l'ACF en fonction de l'intensité de la bande de dimère d'adaptateur observée sur le gel d'agarose, en vous référant aux exemples représentatifs de la Figure 2. Une valeur de Cq attomolaire corrigée par ACF comprise entre 22 et 26 est optimale ; toutefois, des valeurs <29 sont généralement acceptables.
NOTE : Plutôt que de corriger la valeur de Cq, une purification supplémentaire peut être effectuée si nécessaire ; cependant, cela peut entraîner une perte importante de bibliothèque. Les échantillons présentant des bandes fortes de dimères d'adaptateurs sont généralement associés à des valeurs élevées de Cq en PCR q attomolaire, indiquant une quantité faible d'ADN en entrée. Les échantillons dont les valeurs de Cq sont ≥29 produisent généralement des tailles de familles importantes et des profondeurs de séquençage de l'ADN mitochondrial faibles (<100×) et peuvent donc être exclus du séquençage. Étant donné que les valeurs de Cq dépendent de l'appareil de PCR en temps réel et des conditions de dosage, établissez des valeurs seuils spécifiques au laboratoire lors de la mise en œuvre de ce protocole.
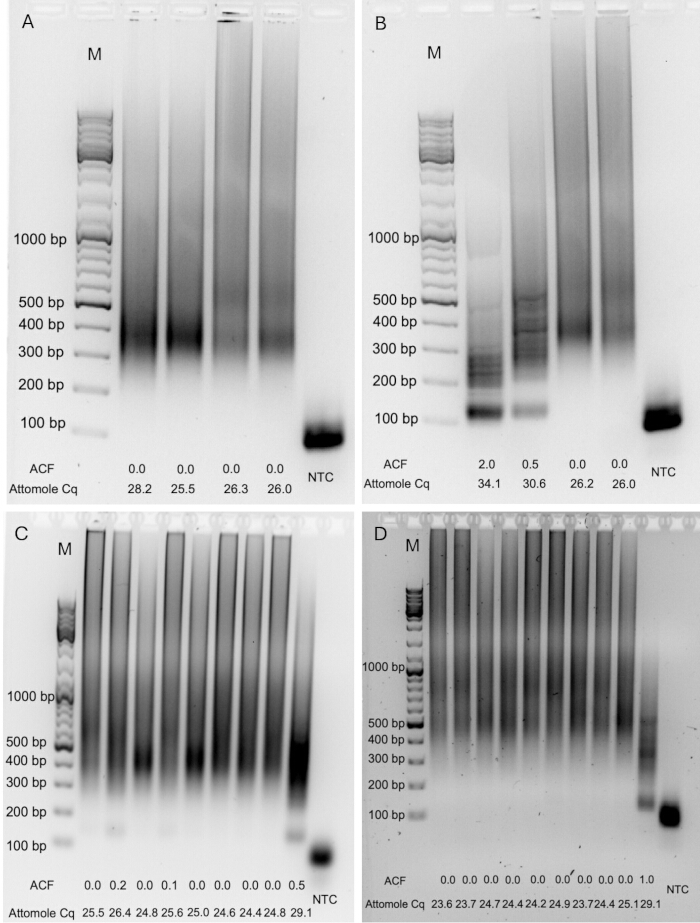
Figure 2. Produits représentatifs de la PCR quantitative attomolaire (qPCR) utilisés pour estimer la quantité d'entrée d'ADN dans la banque et identifier les dimères d'adaptateur/amorce. Les produits amplifiés par qPCR attomolaire ont été analysés par électrophorèse sur gel d'agarose à 1,5 % afin d'évaluer la distribution des tailles de fragments et de détecter la présence de dimères résiduels d'adaptateur/amorce. (A–D) Exemples représentatifs illustrant des banques contenant différentes quantités d'ADN ligaturé à l'adaptateur et des niveaux variables de dimères d'adaptateur/amorce. Le facteur de correction attomolaire (ACF) et le cycle de quantification (Cq) correspondant non corrigé sont indiqués pour chaque échantillon. M, marqueur de taille d'ADN ; NTC, témoin négatif sans matrice. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
11. Estimation de l'enrichissement de l'ADN mitochondrial (facultatif)
REMARQUE : Estimez l'enrichissement en ADN mitochondrial (ADNmt) par qPCR en utilisant des amorces ciblant le gène mitochondrial ND6 et les éléments nucléaires Alu. Calculez la différence des valeurs Cq entre les cibles nucléaires et mitochondriales pour estimer l'enrichissement en ADNmt. Utilisez la valeur Cq absolue de la cible mitochondriale pour estimer la quantité d'ADNmt présente dans l'échantillon. Les valeurs Cq peuvent varier selon les réactifs, les consommables et l'instrument de PCR en temps réel utilisés. Ajustez les séquences des amorces en fonction des espèces. Reportez-vous aux publications antérieures pour les amorces spécifiques à la souris et au macaque12,13. Cette étape est facultative et fournit une estimation approximative de l'enrichissement en ADNmt avant le séquençage.
- Préparez des mélanges maîtres séparés pour les cibles mitochondriales et nucléaires. Pour chaque réaction, combinez 5 µL de mélange PowerUp SYBR Green 2×, 0,4 µL de chaque amorces du couple d'amorces respectif (10 µM chacune) et 2,1 µL d'eau de qualité biologie moléculaire.
- Ajoutez 8 µL du mélange maître approprié dans chaque puits désigné d'une plaque 96 puits compatible avec la qPCR. Ajoutez 2 µL de l'échantillon dilué au 1/10 pour obtenir un volume final de réaction de 10 µL.
- Fermez hermétiquement la plaque et centrifugez-la brièvement avant de la placer dans l'appareil de PCR en temps réel.
- Réalisez la qPCR en utilisant les conditions de cyclage thermique suivantes : 2 min à 95°C, suivis de 45 cycles de 15 s à 95°C, 20 s à 56°C et 30 s à 72°C.
- Déterminez le Cq en fixant le seuil de fluorescence à 100 unités de fluorescence relative (RFU).
NOTE : Choisissez un seuil de fluorescence compatible avec l'appareil de PCR en temps réel et utilisez le même seuil dans toutes les expériences afin de permettre la comparaison des valeurs de Cq. Corréléez les valeurs de Cq avec les rendements d'enrichissement obtenus par séquençage après séquençage, et utilisez ces valeurs comme références pour les préparations de bibliothèques ultérieures. - Calculez le ΔCq associé à l'enrichissement en soustrayant le Cq de la cible nucléaire du Cq de la cible mitochondriale (CqmtDNA − CqnDNA). Une fois les données initiales de séquençage disponibles, établissez une courbe standard propre au laboratoire pour estimer la proportion de lectures de séquençage issues de l'ADNmt.
NOTE : Si les données de séquençage ne sont pas encore disponibles, l'équation 1 peut être utilisée pour obtenir une estimation approximative du pourcentage attendu de lectures de séquençage issues de l'ADNmt, en utilisant une courbe standard d'exemple générée à partir de sept bibliothèques d'ovocytes (ΔCq = −0,8, 16,83 % ; ΔCq = −2,1, 33,62 % ; ΔCq = −3,0, 45,57 % ; ΔCq = −3,9, 60,34 % ; ΔCq = −5,0, 77,98 % ; ΔCq = −6,2, 89,25 % ; ΔCq = −8,4, 95,09 %). Une valeur de ΔCq <−1 doit être atteinte pour assurer une élimination efficace de l'ADN nucléaire. Des rendements d'enrichissement plus faibles peuvent être compensés en attribuant des lectures de séquençage supplémentaires pour obtenir une profondeur de séquençage suffisante de l'ADNmt ; toutefois, cela peut augmenter la contamination par les segments nucléaires d'ADN mitochondrial (NUMT). Étant donné que la relation entre le ΔCq et la teneur en ADNmt dépend des réactifs, des consommables, de l'instrumentation et des conditions expérimentales, l'équation 1 doit être considérée comme un exemple d'étalonnage, et des courbes standard spécifiques au laboratoire doivent être établies chaque fois que possible.
ADNmt estimé (%) = −11,006 × ΔCq + 13,776 (1)
12. Amplification de la banque
REMARQUE : Réalisez la première amplification en deux étapes PCR consécutives. Effectuez la première PCR à l'aide d'un seul amorcette pour obtenir une amplification linéaire. Ajoutez ensuite la seconde amorcette afin de permettre une amplification exponentielle durant la seconde PCR.
- Déterminer la quantité d'ADN à utiliser pour la première PCR d'amplification à l'aide des résultats de la qPCR en attomoles.
- Pour les bibliothèques issues d'un seul ovocyte, utiliser des échantillons dont la valeur Cq en qPCR attomolaire est généralement supérieure à 22. Si un échantillon présente une valeur Cq inférieure, le diluer jusqu'à une valeur Cq d'environ 22 selon le Tableau 3. Les bibliothèques dont les valeurs Cq sont ≥29 produisent généralement de grandes tailles de familles et des profondeurs de séquençage de l'ADNmt peu élevées, et ne sont donc pas recommandées pour la poursuite de la préparation ou du séquençage des bibliothèques.
- Préparer un mélange maître d'amplification contenant, par réaction, 20 µL de mélange PCR haute fidélité 2× et 4 µL de l'amorce mws20 (10 µM).
- Ajouter 24 µL du mélange maître d'amplification à 14 µL de l'échantillon dilué.
- Réaliser la PCR d'amplification linéaire selon les conditions de cyclage thermique suivantes : 45 s à 98°C, suivis de 12 cycles de 15 s à 98°C, 30 s à 60°C et 45 s à 72°C, puis une étape finale de 2 min à 72°C.
- Ajouter 4 µL de l'amorce universelle de bibliothèque (10 µM) et mélanger soigneusement.
- Réaliser la PCR d'amplification exponentielle selon les conditions de cyclage thermique suivantes : 45 s à 98°C, suivis de 9 cycles de 15 s à 98°C, 30 s à 65°C et 45 s à 72°C, puis une extension de 2 min à 72°C.
NOTE : Après la fin de la première amplification, les échantillons peuvent être conservés à 4°C et le protocole peut être repris ultérieurement si nécessaire. Effectuer toutes les étapes précédentes, de la lyse de l'ovocyte jusqu'à la première amplification, sans interruption. - Ajouter 10 µL d'eau de qualité biologie moléculaire à chaque échantillon.
- Purifier l'ADN amplifié à l'aide de 40 µL de billes magnétiques (0,8× le volume de l'échantillon), en suivant la deuxième procédure de purification par billes magnétiques décrite aux étapes 9.9–9.15. Laver les billes deux fois avec 200 µL d'EtOH à 80 %, éluer l'ADN dans 15,5 µL de Tris-HCl, puis transférer 15 µL de l'éluat dans un nouveau tube bas-reliure de 200 µL.
NOTE : Ce point constitue une étape d'arrêt appropriée. Conserver l'ADN purifié à 4°C ou passer immédiatement à l'indexation.
Tableau 3 : Facteurs de dilution et facteurs de correction correspondants du cycle de quantification par réaction en chaîne par polymérase quantitative (qPCR, Cq) utilisés pour normaliser la quantité d’ADN en entrée lors de la première amplification par PCR pour la construction de bibliothèques. Les échantillons dont les valeurs de Cq en attomole étaient inférieures à la valeur cible ont été dilués avec de l’eau de qualité moléculaire avant la première PCR d’amplification. La valeur de Cq corrigée a été obtenue en ajoutant au Cq mesuré expérimentalement le facteur de correction de dilution approprié, puis a été utilisée ultérieurement pour déterminer le nombre de cycles de PCR d’indexation et la profondeur de séquençage cible (tableau 4). Les volumes d’échantillon et d’eau permettent d’obtenir un volume final d’entrée de 14 µL pour la première PCR d’amplification. L’astérisque (*) indique que le facteur de correction de dilution indiqué doit être ajouté à la valeur de Cq en attomole mesurée expérimentalement afin d’obtenir la valeur de Cq corrigée. Les facteurs de correction ont été déterminés empiriquement pour ce protocole. Veuillez cliquer ici pour télécharger ce fichier.
13. Indexation
- Déterminer le nombre de cycles de PCR d'indexation à l'aide de la valeur de Cq qPCR en attomoles corrigée pour les dimères et les dilutions selon le Tableau 4.
- Préparer un mélange maître d'indexation contenant 25 µL de mélange de PCR haute fidélité 2× et 10 µL d'une paire de primers d'indexation double unique à 10 µM pour chaque échantillon.
- Ajouter 35 µL du mélange maître d'indexation à 15 µL de chaque échantillon amplifié.
- Effectuer la PCR d'indexation en utilisant les conditions de cyclage thermique suivantes : 45 s à 98 °C, puis le nombre approprié de cycles composés de 15 s à 98 °C, 30 s à 65 °C et 45 s à 72 °C, suivis d'une extension finale à 72 °C pendant 2 min.
- Purifier les bibliothèques indexées à l'aide de 40 µL de billes magnétiques (volume égal à 0,8× le volume de l'échantillon). Laver les billes deux fois avec de l'ÉtOH à 80 % et éluer l'ADN dans 21 µL de tampon TElow.
- Transférer l'éluate dans un tube faible liaison pour ADN.
- Mesurer la concentration d'ADN à l'aide d'un dosage ADN High Sensitivity Qubit ou d'un dosage fluorométrique équivalent.
- Conserver les bibliothèques à 4 °C avant le séquençage ou à −80 °C pour un stockage à long terme.
REMARQUE : Ce point constitue une étape de pause sûre.
Tableau 4 : Nombre de cycles de réaction en chaîne par polymérase (PCR) d'indexation et profondeur cible de séquençage déterminés à partir du cycle de quantification (Cq) corrigé de la PCR quantitative (qPCR) en attomole. La valeur Cq corrigée intègre le Cq expérimental mesuré en attomole par qPCR ainsi que le facteur de correction éventuel pour les dimères d'adaptateurs (Figure 2) et le facteur de correction pour dilution (Tableau 3). La valeur Cq corrigée a été utilisée pour déterminer à la fois le nombre de cycles de PCR d'indexation et le nombre recommandé de lectures en séquençage apparié attribué à chaque banque avant regroupement. Les attributions cibles de lectures de séquençage servent de recommandation initiale et peuvent nécessiter une optimisation propre au laboratoire en fonction de l'appareil de PCR en temps réel, de la plateforme de séquençage, de la stratégie de multiplexage et des exigences expérimentales. Veuillez cliquer ici pour télécharger ce fichier.
14. Contrôle de qualité
- Évaluer la qualité de la bibliothèque, la distribution des tailles de fragments et la présence de dimères résiduels d'adaptateur ou d'amorces à l'aide d'un Bioanalyzer, d'un TapeStation ou d'un instrument équivalent d'analyse de fragments d'acides nucléiques. Les tailles de fragments doivent se situer approximativement entre 300 et 1 000 pb. De petits pics résiduels (<5 % de l'intensité de fluorescence de l'échantillon [RFU] sur l'électrophérogramme du Bioanalyzer) étaient généralement acceptables (Figure 3A–D). Les dimères résiduels d'adaptateur ou d'amorces apparaissent comme des pics distincts aux alentours de 70–150 pb (Figure 3E–H). La concentration finale de la bibliothèque doit être d'au moins 5 ng/µL. Se référer au Fichier supplémentaire 1 (Guide de dépannage) si l'un de ces critères de qualité n'est pas respecté.
- (Facultatif) Si des dimères d'adaptateur ou d'amorces sont détectés (Figure 3E–H), ajuster le volume de la bibliothèque à 50 µL avec de l'eau de qualité biologie moléculaire, ajouter 40 µL de billes magnétiques (0,8× le volume de l'échantillon), puis effectuer une purification supplémentaire. Laver les billes deux fois avec de l'EtOH à 80 % et éluer la bibliothèque purifiée dans 21,5 µL de tampon TElow.
- (Facultatif) Répéter l'analyse de contrôle qualité (Étape 14.1) afin de confirmer l'élimination complète des dimères d'adaptateur et d'amorces.
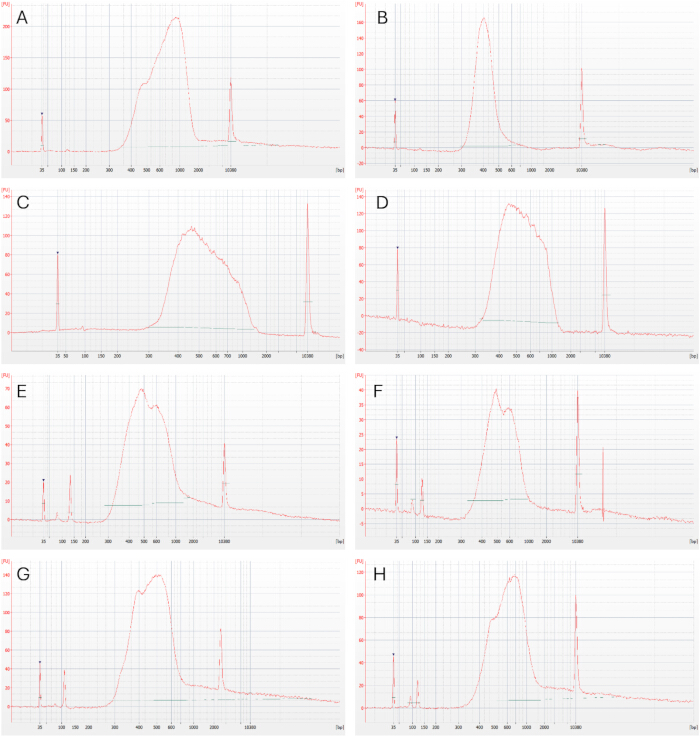
Figure 3. Analyse représentative de fragments de bibliothèques de séquençage indexées. Électrophérogrammes représentatifs obtenus par analyse de fragments sur Bioanalyzer, illustrant la qualité des bibliothèques après la PCR d'indexation. (A–D) Bibliothèques présentant une distribution de taille de fragment attendue (environ 300-1000 pb) et sans dimères d'adaptateur/amorce détectables, appropriées pour le séquençage sans purification supplémentaire. (E–H) Bibliothèques contenant des dimères résiduels d'adaptateur et/ou d'amorce nécessitant une purification supplémentaire par billes magnétiques avant le séquençage. Les pics situés à environ 35 pb et 10 380 pb correspondent respectivement aux marqueurs internes inférieur et supérieur. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
15. Regroupement et séquençage
- Mesurez la concentration de chaque bibliothèque indexée à l’aide d’un dosage de quantification de bibliothèque basé sur la qPCR, compatible avec les bibliothèques préparées pour Illumina, tel que le Collibri Library Quantification Kit, conformément au protocole du fabricant. Diluez chaque bibliothèque au 1:100 000 dans le tampon de dilution fourni et analysez chaque échantillon en au moins double ; des mesures en triple sont recommandées. Analysez les étalons en triple.
- Calculez la valeur moyenne du cycle de quantification (Cq) pour chaque échantillon et chaque étalon. Établissez une courbe d’étalonnage à partir des valeurs moyennes de Cq des étalons et calculez la concentration de chaque bibliothèque conformément aux instructions du fabricant.
- Constituez un pool des bibliothèques selon le nombre prévu de lectures en lecture appariée déterminé à partir de la valeur de Cq en attomoles corrigée pour les dimères d’adaptateurs et la dilution obtenue à l’étape 10 et selon les répartitions indiquées dans Tableau 4.
REMARQUE : Le ratio de regroupement dépend de la valeur de Cq corrigée de chaque bibliothèque d’ovocyte et du nombre cible correspondant de lectures en lecture appariée. Les valeurs du Tableau 4 sont approximatives et peuvent varier selon les instruments de PCR en temps réel. Établissez des valeurs spécifiques à votre laboratoire pour des performances optimales. - Calculez la fraction relative de regroupement pour chaque bibliothèque en divisant son nombre cible de lectures en lecture appariée par la somme des lectures cibles attribuées à toutes les bibliothèques. Déterminez la quantité nécessaire de chaque bibliothèque en multipliant cette fraction par la quantité molaire totale du pool final, puis calculez le volume correspondant de la bibliothèque à partir de sa concentration molaire mesurée. Mélangez les volumes calculés pour obtenir le pool final.
- Séquençez les bibliothèques regroupées à l’aide d’une plateforme de séquençage Illumina ou d’une autre plateforme compatible avec les séquences d’adaptateurs Illumina. Utilisez une configuration en lecture appariée avec une longueur minimale de lecture de 2 × 150 pb. Des lectures plus longues, telles que 2 × 250 ou 2 × 300 pb, sont recommandées car elles améliorent la capacité à identifier et à filtrer les lectures provenant de segments nucléaires d’ADN mitochondrial plus courts (NUMTs).
- Séquençez les bibliothèques regroupées, par exemple sur une plateforme Illumina NovaSeq 6000, en utilisant une chimie de séquençage par synthèse à deux canaux avec un kit de réactifs SP v1.5 (500 cycles) et une configuration en lecture appariée de 2 × 250 pb, incluant un ajout de 5 % de PhiX. Chargez la bibliothèque et effectuez le séquençage conformément aux instructions du fabricant. Les performances typiques de séquençage devraient atteindre ≥75 % des bases avec un score de qualité ≥Q30 et ≥60 % des clusters passant le filtre.
16. Analyse bioinformatique
REMARQUE : Le flux de travail suivant décrit l'analyse des données dans Galaxy à l'aide des outils d'analyse Du Novo8,14,15. L'analyse peut également être réalisée à l'aide d'une installation locale de Du Novo ou d'autres logiciels développés pour les données de séquençage duplex.
- Transférez les fichiers FASTQ appariés démultiplexés, générés à l’aide de BCL Convert ou d’un outil de démultiplexage équivalent, vers une installation locale de Galaxy ou vers une instance Galaxy publiquement accessible14.
- Évaluez la qualité des lectures de séquençage à l’aide de FastQC (version Galaxy 0.72+galaxy1). Examinez, au minimum, les modules Per Base Sequence Quality, Per Sequence GC Content et Adapter Content.
- Générez des séquences de consensus monocaténaires (SSCS) et des DCS à partir des fichiers FASTQ appariés démultiplexés en utilisant le pipeline Du Novo (version Galaxy 3.0.2). Utilisez une taille minimale de famille de trois lectures pour la formation des SSCS et déterminez un nucléotide de consensus lorsqu’il est présent dans au moins 70 % des lectures15. Activez la correction d’erreurs des codes-barres avec jusqu’à trois incompatibilités. Reportez-vous au tutoriel Du Novo du Galaxy Training Network pour des instructions détaillées sur l’utilisation du pipeline16.
- Utilisez Sequence Content Trimmer (version Galaxy 0.2.3) pour supprimer les bases représentées par « NRYSWKMBDHV » et éliminer les lectures de moins de 10 pb.
- Supprimez les 10 premiers nucléotides de l’extrémité 5′ de chaque DCS à l’aide de FASTQ Trimmer (version Galaxy 1.1.5) afin de réduire les biais associés à la réparation des extrémités. Alignez les lectures DCS tronquées sur le génome de référence humain, tel que GRCh38.p14 contenant la séquence de référence de Cambridge révisée (rCRS ; NC_012920.1), à l’aide de BWA-MEM (version Galaxy 0.7.17.1).
NOTE : D'autres assemblages du génome humain, notamment T2T-CHM13v2.0 ou des assemblages plus récents, peuvent être utilisés. - Filtrez les fichiers BAM à l’aide de BAMTools Filter BAM datasets selon divers attributs (version Galaxy 2.5.2+galaxy1). Conservez les lectures ayant une qualité d’alignement >20, qui s’alignent sur chrM, qui représentent des alignements primaires, qui sont appariées, correctement appariées, et dont le partenaire est aligné. Ces critères permettent de réduire les alignements potentiellement issus de NUMT17.
- Alignez les lectures à gauche à l’aide de Bam Left Align (version Galaxy 1.3.1). Supprimez les régions chevauchantes des lectures DCS appariées à l’aide de BAMUtil clipOverlap (version Galaxy 1.0.15+galaxy1).
- Détectez les variants nucléotidiques simples (SNV) et les insertions/suppressions (indels) à l’aide de Call variants with LoFreq (version Galaxy 2.1.5+galaxy2) avec les paramètres par défaut.
- Excluez les lectures DCS appariées contenant plus de deux variants, le cas échéant, afin de réduire une contamination potentielle par des NUMT. Les échantillons avec un enrichissement efficace de l’ADNmt sont généralement exempts de lectures issues de NUMT détectables ; toutefois, une déplétion insuffisante de l’ADN nucléaire peut entraîner la présence de séquences issues de NUMT.
- Examinez chaque bibliothèque à la recherche de contaminations croisées potentielles à l’aide des différences de séquence mtDNA spécifiques au donneur, y compris les variants fixes et les hétéroplasmies à fréquence élevée. Si une contamination croisée est détectée, appliquez les précautions décrites dans le Fichier supplémentaire 1 (Guide de dépannage). Si la distribution de la taille des fragments dépasse la plage recommandée ou si la taille moyenne des fragments est >900 pb, effectuez une purification double avec sélection de taille comme décrite précédemment18.
- Effectuez les analyses en aval des variants détectés selon les objectifs de l’étude.
- N’incluez que les échantillons ayant une profondeur moyenne de séquençage mitochondrial DCS ≥100× pour les analyses en aval. Aucun seuil minimal fixe n’a été appliqué pour le nombre de lectures appariées ou pour le rendement en SSCS ou en DCS.
Résultats
Des bibliothèques de séquençage en duplex ont été préparées à partir d'ovocytes humains représentant différents stades de maturation, notamment les ovocytes à vésicule germinative (GV), en métaphase I (MI), en MII, au stade pronucléaire (0PN) et en TI. Les bibliothèques correctement préparées ont été séquencées sur une plateforme Illumina NovaSeq 6000 à l'aide d'une cellule d'écoulement SP avec des lectures appariées en 2 × 250 pb. L'analyse des données a été réalisée dans Galaxy en utilisant le pipeline Du Novo pour le regroupement des familles de lectures et la génération de lectures consensus8,14,15. Les métriques de séquençage représentatives pour les bibliothèques correctement traitées sont résumées dans le Tableau supplémentaire 1, tandis que les échantillons ayant donné des résultats sous-optimaux lors de la préparation des bibliothèques et exclus du séquençage sont résumés dans le Tableau supplémentaire 2.
Plusieurs étapes de contrôle qualité ont été effectuées tout au long de la préparation des bibliothèques afin d'évaluer la quantité d'ADN ligaturé aux adaptateurs, l'enrichissement en ADN mitochondrial, la concentration de la bibliothèque et la distribution de la taille des fragments. La première étape de contrôle qualité a été le test qPCR en attomole, utilisé pour estimer la quantité d'ADN ligaturé aux adaptateurs (Figure 4A,B). La valeur de cycle de quantification (Cq) calculée était ajustée lorsqu'on détectait des dimères d'adaptateurs ou d'amorces par électrophorèse sur gel d'agarose des produits d'amplification qPCR (Figure 2A–D). Les dimères d'adaptateurs ou d'amorces étaient généralement observés dans les échantillons présentant des valeurs Cq plus élevées, indiquant une quantité moindre d'ADN ligaturé aux adaptateurs. À l'aide des conditions décrites dans ce protocole, une valeur moyenne ajustée de Cq en qPCR attomolaire de 25,8 a été obtenue (Tableau supplémentaire 1). En fonction de la valeur Cq corrigée, la quantité d'ADN utilisée en entrée pour la première PCR d'amplification a été ajustée selon le schéma de dilution indiqué dans le Tableau 3. Les échantillons ayant des valeurs Cq corrigées ≥22 ont été utilisés sans dilution, tandis que ceux ayant des valeurs Cq corrigées <22 ont été dilués avant l'amplification. Cet ajustement a été réalisé afin d'optimiser la taille des familles de lectures et de réduire le nombre de lectures de séquençage nécessaires. Les échantillons ayant des valeurs Cq corrigées >28 produisaient généralement des familles de lectures plus grandes (taille moyenne de la famille, 21,8), entraînant moins de DCS et une profondeur moyenne de séquençage de l'ADNmt de <200× (Tableau supplémentaire 1). Ajuster la valeur Cq corrigée à une plage de 22–28 a conduit à une taille moyenne de famille de 7,91, proche de la taille de famille d'environ six précédemment rapportée comme optimale pour le séquençage duplex6,7. Toutefois, des tailles de famille plus grandes peuvent être avantageuses pour des échantillons à très faible quantité d'ADN, comme les ovocytes uniques, car elles peuvent augmenter la profondeur de séquençage.
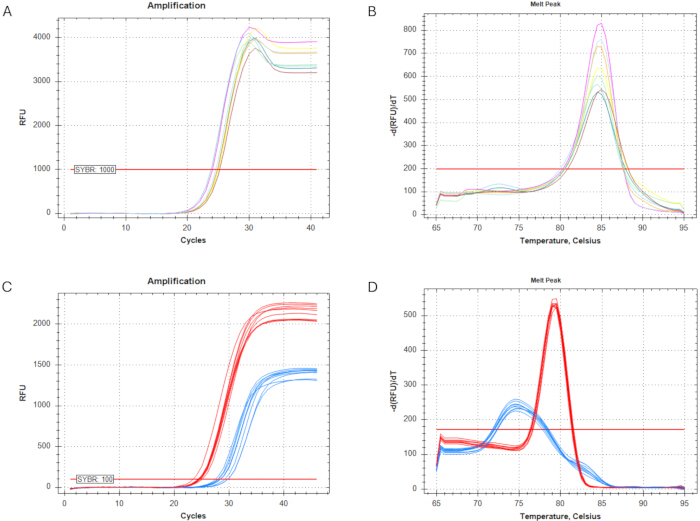
Figure 4. Dosages par PCR quantitative (qPCR) utilisés pour la quantification des bibliothèques et l'estimation de l'enrichissement en ADN mitochondrial (ADNmt). L'ADN ligaturé aux adaptateurs purifié a été dilué au 1/10 avant analyse par qPCR. (A) Courbes d'amplification issues du dosage qPCR en attomole, utilisé pour estimer la quantité d'ADN ligaturé aux adaptateurs. Le seuil de fluorescence a été fixé à 1 000 unités de fluorescence relative (UFR). (B) Analyse des courbes de fusion du dosage qPCR en attomole. (C) Courbes d'amplification du dosage qPCR d'estimation de l'enrichissement en ADNmt. Le seuil de fluorescence a été fixé à 100 UFR. L'amplification de la cible mitochondriale, la sous-unité 6 de la NADH déshydrogénase (ND6), est indiquée en rouge, et l'amplification de la cible nucléaire, l'élément répétitif Alu, est indiquée en bleu. (D) Analyse des courbes de fusion des produits qPCR mitochondriaux et nucléaires. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Avant la mise en commun des bibliothèques, chacune d'entre elles a été analysée à l'aide d'un Bioanalyzer ou d'un TapeStation afin d'évaluer la distribution des tailles de fragments et de détecter la présence éventuelle de dimères d'adaptateur ou d'amorces résiduels. Des exemples représentatifs de bibliothèques optimales et de bibliothèques contenant des dimères d'adaptateur ou d'amorces résiduels sont présentés dans la figure 3A–H. Les dimères d'adaptateur ou d'amorces apparaissaient sous forme de pics situés approximativement entre 70 et 150 pb (figure 3E–H) ; lorsqu'ils étaient détectés, les échantillons faisaient l'objet d'une purification supplémentaire par billes magnétiques avant le séquençage. Étant donné que la sélection de taille avait été délibérément omise afin de minimiser la perte d'échantillon, les bibliothèques séquencées présentaient une taille médiane d'insert de 275 pb (tableau supplémentaire 1).
L'enrichissement de l'ADNmt a été estimé par qPCR en utilisant des loci cibles mitochondriaux et nucléaires, permettant de prédire la proportion de lectures de séquençage devant être cartographiées sur le génome mitochondrial (Figure 4C,D). Les valeurs moyennes de Cq étaient de 25,2 pour la cible mitochondriale et de 29,7 pour la cible nucléaire (Tableau supplémentaire 1), correspondant à un ΔCq moyen (CqADNmt − CqADNn) de −4,5. En moyenne, 67,5 % des lectures de séquençage en paires ont été cartographiées sur le génome de référence mitochondrial. Lors du regroupement des banques, on a pris en compte à la fois l'estimation de l'enrichissement de l'ADNmt et la valeur corrigée de Cq en attomoles obtenue par qPCR. Les banques présentant des valeurs corrigées de Cq plus élevées et un enrichissement plus efficace de l'ADNmt se sont vu attribuer proportionnellement moins de lectures de séquençage selon le schéma d'allocation de séquençage indiqué dans le Tableau 4, afin de favoriser une production équilibrée de séquençage entre les échantillons.
Sur la base des valeurs corrigées de Cq en qPCR attomolaire, une répartition moyenne cible de 4 millions de lectures appariées par bibliothèque a été attribuée (Tableau 4). En raison d'une génération inefficace de clusters, une moyenne de 1,3 million de lectures appariées par bibliothèque a été obtenue après séquençage ; toutefois, ce rendement de séquençage s'est révélé suffisant pour l'analyse en aval du séquençage en duplex (Tableau supplémentaire 1). Le positionnement des DCS sur le génome de référence mitochondrial a donné une profondeur médiane de séquençage de 567× sur l'ensemble du génome mitochondrial (Figure 5A,B,D ; Tableau supplémentaire 1). En moyenne, 344 554 SSCS et 96 322 DCS ont été générés par bibliothèque (Tableau supplémentaire 1). Les bibliothèques obtenues présentaient une taille moyenne de famille de lectures de 8,32, des tailles de famille plus grandes étant généralement observées dans les bibliothèques ayant des valeurs corrigées de Cq en qPCR attomolaire plus élevées (Figure 5C,E ; Tableau supplémentaire 1). Ces résultats sont cohérents avec ceux obtenus dans une étude précédente réalisée à densité optimale de clusters, où une profondeur médiane de séquençage de l'ADNmt de 1 440× avait été atteinte19.
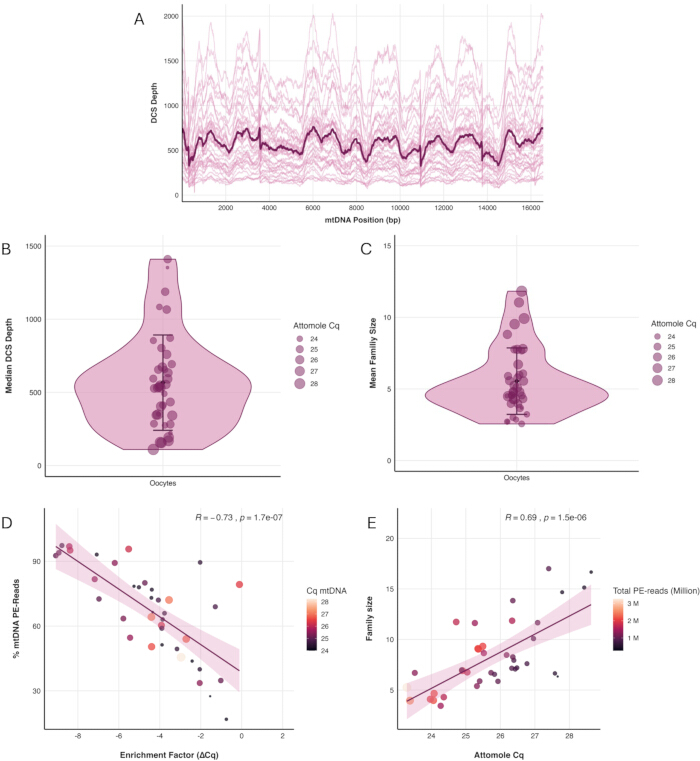
Figure 5. Performances de séquençage de bibliothèques de séquençage duplex issues d'un seul ovocyte. (A) Profondeur de la séquence consensus duplex (DCS) à travers le génome mitochondrial. Les lignes fines représentent des bibliothèques individuelles, et la ligne épaisse représente la profondeur moyenne pour l'ensemble des bibliothèques. (B) Répartition de la profondeur médiane DCS pour chaque bibliothèque. (C) Répartition de la taille moyenne des familles DCS pour chaque bibliothèque. Dans (B) et (C), chaque point représente une bibliothèque, et la couleur du point indique le cycle de quantification (Cq) par qPCR attomole. (D) Corrélation de Pearson entre l'estimation de l'enrichissement en ADNmt (ΔCq) et la proportion de lectures de séquençage alignées sur le génome de référence mitochondrial. (E) Corrélation de Pearson entre la valeur Cq de la qPCR attomole et la taille moyenne des familles DCS. Dans (D) et (E), chaque point représente une bibliothèque ; la couleur du point indique la valeur Cq de la qPCR attomole, et la taille du point représente le nombre total de lectures appariées obtenues pour cette bibliothèque. n = 39 bibliothèques. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Tableau supplémentaire 1. Métriques de séquençage et de qualité des bibliothèques pour le séquençage duplex optimal d'ovocytes humains. Ce tableau résume les métriques de qualité des bibliothèques avant le séquençage, les mesures de réaction en chaîne par polymérase quantitative (qPCR), les performances de séquençage et les résultats d'analyse de séquençage duplex pour les bibliothèques ayant passé les contrôles qualité et ayant été incluses dans les analyses ultérieures. Les paramètres rapportés incluent le stade de développement de l'ovocyte, les résultats de qPCR d'enrichissement de l'ADN mitochondrial (ADNmt), les mesures de qPCR en attomoles, le facteur de correction des dimères d'adaptateurs (ACF), le nombre de cycles de PCR d'indexation, la profondeur de séquençage apparié prévue, la concentration de la bibliothèque, le rendement de séquençage, l'enrichissement de l'ADNmt, les nombres de lectures de séquences de consensus monocaténaires (SSCS) et de séquences de consensus duplex (DCS), les statistiques de taille des familles, la profondeur de séquençage et les distributions de tailles d'insert. Les identifiants des échantillons ont été anonymisés avant l'analyse. Les nombres prévus de lectures appariées ont été attribués selon la valeur corrigée du cycle de quantification (Cq) de la qPCR en attomoles (tableau 4). Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2. Métriques de qualité pré-séquençage pour les bibliothèques d'ovocytes humains suboptimales exclues des analyses de séquençage duplex en aval. Ce tableau résume les résultats du contrôle de qualité pré-séquençage pour les bibliothèques qui n'ont pas satisfait aux critères d'inclusion dans les analyses de séquençage en aval. Les paramètres rapportés comprennent l'identifiant de l'échantillon, le stade de développement de l'ovocyte, les résultats de la réaction en chaîne par polymérase (qPCR) quantitative d'enrichissement en ADN mitochondrial (ADNmt), le facteur de correction des dimères d'adaptateurs (ACF), le cycle de quantification qPCR corrigé en attomoles (Cq), le nombre de cycles de la réaction en chaîne par polymérase (PCR) d'indexation et la concentration de la bibliothèque mesurée à l'aide du test Qubit High Sensitivity DNA Assay. Les bibliothèques ont été exclues selon les critères de contrôle qualité décrits dans le protocole. Veuillez cliquer ici pour télécharger ce fichier.
Fichier supplémentaire 1. Guide de dépannage pour la préparation de bibliothèques d'ADN mitochondrial à partir d'un seul ovocyte par séquençage en duplex. Ce fichier supplémentaire fournit des recommandations de dépannage pour les étapes critiques du protocole, notamment la prévention de la perte d'échantillons, la préparation et l'évaluation de la qualité des adaptateurs, la purification par billes magnétiques, le contrôle qualité des bibliothèques, la performance du séquençage, la contamination croisée entre échantillons et la contamination par des segments nucléaires d'ADN mitochondrial (NUMT). Ce guide complète le protocole principal et doit être consulté lorsque les indicateurs de qualité des bibliothèques ou la performance du séquençage sortent des plages recommandées. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Les variants d'ADNmt identifiés dans les ovocytes reflètent une combinaison de mutagenèse de novo, de modifications de l'hétéroplasmie au fil des générations, et des effets du vieillissement et des maladies sur la lignée germinale féminine. Ce protocole décrit une méthode permettant d'enrichir l'ADNmt à partir d'ovocytes uniques, suivie de la préparation d'une bibliothèque de séquençage duplex et du séquençage, ce qui permet une détection et une analyse hautement précises des mutations de l'ADNmt. Malgré le nombre élevé de copies d'ADNmt présentes dans les ovocytes, ce protocole exige la préparation complète d'une bibliothèque de séquençage à partir d'une seule cellule. Par conséquent, une manipulation soigneuse des échantillons est essentielle tout au long de la procédure, comme indiqué en détail dans le fichier supplémentaire 1 (Guide de dépannage). Malgré une manipulation attentive des échantillons, environ 5 % des préparations de bibliothèque peuvent échouer en raison de la perte d'ovocytes lors des premières étapes de manipulation ou de la perte d'échantillons durant la préparation de la bibliothèque.
Le contrôle qualité tout au long et après la préparation de la bibliothèque est essentiel pour vérifier la ligature réussie des adaptateurs, évaluer l'enrichissement en ADN mitochondrial, optimiser la quantité d'ADN en entrée pour l'amplification, détecter la présence d'adaptateurs résiduels ou de dimères d'amorces, et déterminer si des étapes supplémentaires de purification ou d'amplification sont nécessaires. L'utilisation du même appareil de PCR en temps réel pour toutes les préparations de bibliothèque assure des conditions de réaction constantes et améliore la comparabilité, la reproductibilité et la fiabilité des mesures utilisées pour le contrôle qualité en aval et l'optimisation du protocole. Les nombres de cycles de PCR pour l'amplification et l'indexation des bibliothèques décrits dans ce protocole peuvent nécessiter des ajustements selon les instruments, enzymes ou réactifs utilisés. L'étape initiale d'amplification est divisée en une phase d'amplification linéaire utilisant une seule amorce, suivie d'une amplification exponentielle après ajout de la seconde amorce. Cette stratégie minimise la probabilité que des erreurs introduites lors du premier cycle d'amplification soient amplifiées à des niveaux rendant difficile leur distinction avec les mutations réelles de l'ADN. Les nombres de cycles recommandés ont été choisis pour obtenir une taille optimale de famille de lectures pour l'analyse de séquençage en duplex ; toutefois, ils peuvent nécessiter une optimisation selon la quantité et la qualité de l'ADN en entrée. Les échantillons avec une quantité d'ADN en entrée plus faible peuvent nécessiter des cycles d'amplification supplémentaires, tandis que ceux avec une quantité d'ADN plus élevée peuvent nécessiter moins de cycles afin d'éviter une suramplification et préserver la complexité de la bibliothèque.
Bien que ce protocole soit démontré à l’aide d’ovocytes humains isolés, le flux opératoire n’est pas limité aux échantillons humains. Nous avons précédemment appliqué la même approche pour étudier la mutagenèse germinale chez la souris et le macaque12,13, ce qui indique que la préparation de bibliothèques pour le séquençage en duplex peut s’appliquer aux ovocytes de multiples espèces après optimisation des séquences d’amorces spécifiques à chaque espèce et, le cas échéant, d’autres paramètres expérimentaux. Malgré l’applicabilité étendue du séquençage en duplex, le protocole d’enrichissement de l’ADNmt et de préparation de bibliothèques décrit ici n’est pas facilement transposable à des cellules somatiques uniques, car leur nombre de copies d’ADNmt est généralement inférieur de plusieurs ordres de grandeur à celui des ovocytes, ce qui limite la quantité d’ADN disponible en entrée pour la préparation de la bibliothèque. Néanmoins, des bibliothèques de séquençage en duplex peuvent être produites à partir d’échantillons massifs de cellules somatiques lorsqu’elles sont associées à un enrichissement optimisé de l’ADNmt avant la préparation de la bibliothèque. Une autre limitation du séquençage en duplex réside dans la nécessité de fragmenter l’ADN, ce qui peut introduire des erreurs artéfactuelles, en particulier près des extrémités des fragments. Par conséquent, les bases situées aux extrémités des fragments sont généralement exclues des analyses en aval, et la détection ainsi que la caractérisation des insertions et des délétions peuvent également être affectées par le processus de fragmentation. Les récents progrès des technologies de séquençage en lecture longue, notamment celles développées par Oxford Nanopore Technologies, pourraient éventuellement permettre un séquençage hautement précis de molécules entières d’ADN mitochondrial sans fragmentation. Toutefois, l’obtention de la précision requise pour une détection fiable des mutations dépend actuellement de l’analyse de molécules d’ADN natif non amplifié. Étant donné que la quantité d’ADN présente dans un seul ovocyte est insuffisante pour ces approches, leur application à ce type d’échantillon est actuellement peu pratique.
Par rapport aux approches utilisées dans des études antérieures, notamment la PCR à longue distance et le séquençage massivement parallèle conventionnel20,21,22, ce protocole présente plusieurs avantages. Chaque étape d'amplification comporte un risque d'introduire des mutations artéfactuelles pouvant entraver la détection de variants à faible fréquence, nécessitant souvent des seuils de fréquence allélique mineure d'au moins 1 %. En revanche, le taux d'erreur nettement plus faible obtenu par le séquençage en duplex améliore la précision de l'identification des mutations et dépasse celui des approches de séquençage conventionnelles5. Par conséquent, cette méthode fournit un cadre plus fiable pour la détection et la quantification de mutations rares de l'ADN mitochondrial. À l'aide de ce flux de travail, nous avons précédemment montré que, contrairement à la plupart des tissus somatiques, les ovocytes échappent largement à l'accumulation liée à l'âge des mutations de l'ADN mitochondrial19. On ignore encore si cet effet protecteur apparent persiste dans les états pathologiques altérant le microenvironnement ovarien, tels que l'endométriose, et compromettant la qualité des ovocytes, ce qui justifie des investigations supplémentaires.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir de conflits d'intérêts.
Remerciements
Nous remercions sincèrement l'équipe du Centre de fécondation in vitro de l'Hôpital universitaire Kepler de Linz pour leur soutien dans la collecte des ovocytes. Nous remercions également N. Stoler et A. Nekrutenko pour avoir mis en place l'instance d'analyse de séquençage duplex sur Galaxy et pour avoir fourni des conseils sur l'analyse des données. Ce travail a été financé par la bourse Schrödinger du Fonds autrichien pour la science (FWF) (DOI : 10.55776/J4096 ; BA) et par le projet autonome FWF (DOI : 10.55776/P36928 ; BA). KDM a bénéficié, en partie, d'une subvention des National Institutes of Health R01GM116044 et du fonds de dotation Willaman Chair de la faculté des sciences Eberly de l'Université d'État de Pennsylvanie.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| 96 paires uniques d'amorces à double indexation | New England Biolabs | E6440S/L | Paires uniques d'amorces doublement indexées pour l'indexation en PCR |
| Éthanol absolu, de grade biologie moléculaire, 96 % | Fisher BioReagents | 15518181 | Préparer de l'éthanol à 80 % frais avec de l'eau de qualité pour biologie moléculaire |
| Agarose, faible électroendosmose | Biozym | 840000 | Pour la préparation de gels d'agarose à 1,5 % et 2 % |
| Solution d'acétate d'ammonium, 5 M | Thermo Fisher Scientific | J60688.AD | Utilisé pour la précipitation à l'éthanol |
| ATP, 10 mM | New England Biolabs | P0756S/L | Utilisé pour la digestion par l'endonucléase V |
| Instrument d'électrophorèse automatisé | Agilent Technologies | G2992AA | L'Agilent 2100 Bioanalyzer, désormais discontinué, a été utilisé ; un 4150 TapeStation ou un instrument équivalent d'analyse de fragments d'acides nucléiques peut être utilisé. |
| Kit d'ADN à haute sensibilité pour Bioanalyzer | Agilent Technologies | 5067-4626 | Pour l'évaluation de la distribution de taille de la bibliothèque et des dimères d'adaptateur/amorce |
| Oligonucléotide porteur | Integrated DNA Technologies (IDT) | Synthèse sur mesure | Séquence non complémentaire au génome humain. Un exemple de séquence est fourni dans le tableau 2. Préparez une solution mère à 100 nM et diluez-la à une concentration finale de 1 nM. |
| Système de détection de PCR en temps réel CFX96 Touch | Bio-Rad | 12011319 | L'instrument utilisé dans cette étude n'est plus commercialisé ; un instrument de PCR en temps réel de type CFX Opus 96 ou équivalent peut être utilisé, bien que les valeurs de Cq puissent varier. |
| Kit de quantification Collibri Library | Invitrogen | A38524100 | Pour la quantification des bibliothèques indexées avant regroupement |
| Milieu de retrait des cellules du cumulus contenant de l'hyaluronidase (80 U/mL) | Gynemed | 4 HY 0010 | GM501 Hyaluronidase |
| tube PCR à faible liaison d'ADN, 200 µL | Corning | PCR-02-L-C | Axygen tube Maximum Recovery |
| Tube à faible liaison pour ADN, 0,5 mL | Biozym | 710136 | |
| tube à faible liaison d'ADN, 1,5 mL | Biozym | 710176 | |
| ADN polymérase I, fragment large (Klenow) (5 U/µL) | New England Biolabs | M0210S/L | Utilisé lors de l'extension de l'adaptateur |
| mélange de dNTP (dATP, dCTP, dGTP et dTTP en quantités équimolaires), 10 mM | New England Biolabs | N0447S/L | Utilisé lors de l'extension de l'adaptateur |
| EDTA, 0,5 M (pH 8,0) | Fisher BioReagents | 10628203 | Composant des tampons TE et TElow |
| teinture EvaGreen, 20× | Biotium | 31077-T | Utilisé en qPCR attomolaire |
| Exonucléase V (RecBCD), 10 U/µL | New England Biolabs | M0345S/L | Utilisé pour la digestion de l'ADN linéaire |
| Peigne à hauteur fixe | Bio-Rad | 1704446EDU | Pour l'électrophorèse sur gel d'agarose |
| Appareil d'ultrasonication focalisée | Covaris | 500295 | M220 ultrasonicateur focalisé |
| tube d'ultrasonication focalisée 50 µL | Covaris | 520166 | microTUBE-50 AFA à visser |
| Colorant de charge d'électrophorèse, 6× | Thermo Fisher Scientific | R1161 | TriTrack DNA Loading Dye |
| GM501 Huile minérale | Gynemed | 4 MO 0100 | Utilisé pour recouvrir le milieu de collecte des ovocytes afin d'éviter l'évaporation et de maintenir des conditions de culture stériles stables, incluant la température, l'osmolarité et le pH, durant la manipulation des ovocytes |
| Mix de PCR haute fidélité, 2× | KAPA Biosystems | KK2602 | KAPA HiFi HotStart ReadyMix |
| Kit d'analyse d'ADN fluorométrique à haute sensibilité | Invitrogen | Q32854 | Kit d'évaluation Qubit ADN bicaténaire Haute Sensibilité |
| enzyme de restriction HpyCH4III (5 U/µL) | New England Biolabs | R0618S/L | Utilisé pour la digestion de restriction des adaptateurs |
| Centrifugeuse de laboratoire, réfrigérée | Eppendorf | 5406000313 | Doit supporter 14 000 × g à 4 °C |
| Système laser pour l'ouverture de la zone pellucide | Vitrolife | 19310/0146 | Utilisé pour le retrait du globule polaire |
| Kit de préparation de bibliothèque | New England Biolabs | E7645S/L | Kit de préparation de bibliothèques d'ADN NEBNext Ultra II ; comprend des réactifs pour la réparation des extrémités, l'ajout d'une queue poly-A et la ligation |
| Solution de chlorure de magnésium, 25 mM | New England Biolabs | B9021S/L | Utilisé pour la digestion par l'endonucléase V |
| Réactif de purification par billes magnétiques | Beckman Coulter | A63881 | AMPure XP billes magnétiques |
| Support magnétique | Invitrogen | 12-321-D | Pour la séparation par billes magnétiques |
| Micromanipulateur | Luigs & Neumann GmbH | SM II/2 | Utilisé pour le retrait du corps polaire |
| Microscope | Olympus | IX51 | Utilisé pour le retrait du globule polaire |
| Eau de qualité biologie moléculaire | Thermo Fisher Scientific | 327290010 | Utilisé pour la préparation des réactifs et les dilutions |
| Milieu de culture des ovocytes | Gynemed | 4 GM 501H-20 | Milieu de culture GM501 |
| plaque PCR, 96 puits | Biozym | AF4TI-0960-C | Puits transparents, cadre transparent, profil bas, bord surélevé |
| scellé de plaque PCR | Bio-Rad | MSB1001B | Compatible avec l'appareil de PCR en temps réel |
| Solution saline tamponnée au phosphate (PBS), 20× | Cell Signaling Technology | 9808S | Diluer à 1× avec de l'eau de qualité biologie moléculaire |
| Pipettes pour la manipulation et le transfert des cumulus–complexes ovocytaires (COC) et ovocytes | CooperSurgical | MXL3-150 (150 µm) | Utilisé pour le retrait mécanique des cellules du cumulus et le transfert des COC et des ovocytes. Se référer au site web du fabricant pour d'autres tailles de pipettes. |
| Alimentation électrique pour l'électrophorèse sur gel | Bio-Rad | 1645050 | Alimentation électrique PowerPac Basic |
| PowerUp SYBR Green Master Mix, 2× | Applied Biosystems | 15350929 | Utilisé pour les tests de qPCR mitochondriale et nucléaire |
| Fluoromètre Qubit | Invitrogen | Q33238 | Le fluoromètre Qubit 1, désormais discontinué, a été utilisé ; une version plus récente ou un instrument équivalent de quantification fluorométrique des acides nucléiques peut être employé. |
| RNase A, 10 mg/mL | Thermo Fisher Scientific | 10753721 | Diluer à 1 mg/mL avant utilisation |
| Spectrophotomètre | Thermo Fisher Scientific | NDULTRAGL | L'instrument NanoDrop OneC, désormais discontinué, a été utilisé ; une version plus récente ou un spectrophotomètre microvolume équivalent peut être utilisé. |
| Colorant pour gel d'ADN SYBR Safe | Invitrogen | S33102 | Pour l'électrophorèse sur gel d'agarose |
| Thermostat de PCR | Bio-Rad | 1861096 | Thermocycleur T100 |
| Protéinase K thermolabile (0,120 U/µL) | New England Biolabs | P8111S/L | Utilisé pour la lyse d'un seul ovocyte |
| Tampon Tris-acétate-EDTA (TAE), 50× | Fisher Scientific | BP1332-1 | Diluer jusqu'à 1× pour l'électrophorèse sur gel d'agarose |
| Tris-HCl (pH 8,0), 1 M | Fisher BioReagents | 10336763 | Utilisé pour la préparation des réactifs et les dilutions |
| Tween 20 | Fisher BioReagents | 11417160 | Composant du tampon de lyse des ovocytes |
| Échelle universelle d'ADN | Thermo Fisher Scientific | SM0333 | GeneRuler Échelle d'ADN prête à l'emploi (100–1 000 pb |
| Wide Mini-Sub Cell GT Cell | Bio-Rad | 1704468EDU | Pour l'électrophorèse sur gel d'agarose |
| Plateau de gel transparent aux UV Wide Mini-Sub Cell GT (15 × 7 cm | Bio-Rad | 1704426 | Pour l'électrophorèse sur gel d'agarose |
Références
- Dyall SD, Brown MT, Johnson PJ. Ancient invasions: from endosymbionts to organelles. Science. 2004;304:253-257. doi:10.1126/science.1094884.
- Pakendorf B, Stoneking M. Mitochondrial DNA and human evolution. Annu Rev Genomics Hum Genet. 2005;6:165-183. doi:10.1146/annurev.genom.6.080604.162249.
- Ng YS, Turnbull DM. Mitochondrial disease: genetics and management. J Neurol. 2016;263:179-191. doi:10.1007/s00415-015-7884-3.
- Shoubridge EA, Wai T. Mitochondrial DNA and the mammalian oocyte. In: St John JC, editor. Current Topics in Developmental Biology. Vol. 77: The Mitochondrion in the Germline and Early Development. San Diego (CA): Academic Press; 2007. p. 87-111. doi:10.1016/S0070-2153(06)77004-1.
- Fox EJ, Reid-Bayliss KS, Emond MJ, Loeb LA. Accuracy of next generation sequencing platforms. Next Gener Seq Appl. 2014;1:1000106. doi:10.4172/jngsa.1000106.
- Kennedy SR, et al. Detecting ultralow-frequency mutations by Duplex Sequencing. Nat Protoc. 2014;9:2586-2606. doi:10.1038/nprot.2014.170.
- Schmitt MW, et al. Detection of ultra-rare mutations by next-generation sequencing. Proc Natl Acad Sci U S A. 2012;109:14508-14513. doi:10.1073/pnas.1208715109.
- Stoler N, et al. Family reunion via error correction: an efficient analysis of duplex sequencing data. BMC Bioinformatics. 2020;21:96. doi:10.1186/s12859-020-3419-8.
- Abascal F, et al. Somatic mutation landscapes at single-molecule resolution. Nature. 2021;593:405-410. doi:10.1038/s41586-021-03477-4.
- The ESHRE Guideline Group on Ovarian Stimulation, Ata B, Bosch E, Broer S, Griesinger G, Grynberg M, et al. ESHRE guideline: ovarian stimulation for IVF/ICSI: an update in 2025. Hum Reprod. 2026;41:498-514. doi:10.1093/humrep/deag018.
- The ESHRE Working Group on Ultrasound in ART, et al. Recommendations for good practice in ultrasound: oocyte pick up. Hum Reprod Open. 2019;2019:hoz025. doi:10.1093/hropen/hoz025.
- Arbeithuber B, et al. Age-related accumulation of de novo mitochondrial mutations in mammalian oocytes and somatic tissues. PLoS Biol. 2020;18:e3000745. doi:10.1371/journal.pbio.3000745.
- Arbeithuber B, et al. Advanced age increases frequencies of de novo mitochondrial mutations in macaque oocytes and somatic tissues. Proc Natl Acad Sci U S A. 2022;119:e2118740119. doi:10.1073/pnas.2118740119.
- The Galaxy Community. The Galaxy platform for accessible, reproducible, and collaborative data analyses: 2024 update. Nucleic Acids Res. 2024;52:W83-W94. doi:10.1093/nar/gkae410.
- Stoler N, Arbeithuber B, Guiblet W, Makova KD, Nekrutenko A. Streamlined analysis of duplex sequencing data with Du Novo. Genome Biol. 2016;17:180. doi:10.1186/s13059-016-1039-4.
- Nekrutenko A, Stoler N. Calling very rare variants. Galaxy Training Network. Available from: https://training.galaxyproject.org/training-material/topics/variant-analysis/tutorials/dunovo/tutorial.html. Accessed July 25, 2026.
- Barnett DW, et al. BamTools: a C++ API and toolkit for analyzing and managing BAM files. Bioinformatics. 2011;27:1691-1692. doi:10.1093/bioinformatics/btr174.
- Illumina. Double sided size selection and bead clean up. Illumina Knowledge Base. Available from: https://knowledge.illumina.com/library-preparation/general-library-prep/library-preparation-general-library-prep-reference_material-list/000006157. Accessed July 25, 2026.
- Arbeithuber B, et al. Allele frequency selection and no age-related increase in human oocyte mitochondrial mutations. Sci Adv. 2025;11:eadw4954. doi:10.1126/sciadv.adw4954.
- Mertens J, et al. Mitochondrial DNA variants segregate during human preimplantation development into genetically different cell lineages that are maintained postnatally. Hum Mol Genet. 2022;31:3629-3642. doi:10.1093/hmg/ddac059.
- Mertens J, et al. Children born after assisted reproduction more commonly carry a mitochondrial genotype associating with low birthweight. Nat Commun. 2024;15:1232. doi:10.1038/s41467-024-45446-1.
- Van Der Kelen A, et al. The interplay between mitochondrial DNA genotypes, female infertility, ovarian response, and mutagenesis in oocytes. Hum Reprod Open. 2025;2025:hoae074. doi:10.1093/hropen/hoae074.
Réimpressions et autorisations
Cet article a été publié
Vidéo bientôt disponible