Cette étude combine une expérience scénaristique et des électroencéphalogrammes afin d'examiner comment le cadrage des rôles d'expert et de compagnon est associé à la confiance dans différents contextes de tâches médicales.
Article de méthode
Cadrage du rôle et confiance dans l'IA médicale : preuves issues d'une expérience scénarisée et de l'EEG
Dans cet article
Résumé
Résumé
L'intelligence artificielle médicale en ligne a évolué à partir d'outils analytiques en arrière-plan vers des interfaces de service destinées aux patients, ce qui fait du niveau de confiance calibré un problème croissant de conception et de gouvernance. En s'appuyant sur la théorie de la congruence des rôles, cette étude a examiné la manière dont le cadrage du rôle d'expert ou de compagnon est associé à la confiance dans différents contextes de tâches médicales. L'étude 1 a utilisé un scénario expérimental en plan factoriel 2 (rôle : expert contre compagnon) × 2 (tâche : consultation pour maladie contre consultation pour santé) (N = 300). Le cadrage en tant qu'expert augmentait la perception du professionnalisme, tandis que le cadrage en tant que compagnon renforçait la présence sociale ; ces deux perceptions étaient indépendamment associées à la confiance globale lorsqu'elles étaient introduites simultanément. L'association indirecte par l'intermédiaire du professionnalisme dépendait du contexte de la tâche, mais une comparaison directe par rééchantillonnage bootstrap n'a pas montré de différence significative entre les deux indices de médiation modérée pour la confiance globale. Les analyses de mesure ont révélé une forte superposition entre le professionnalisme perçu et la confiance cognitive, ainsi qu'entre la présence sociale et la confiance affective, ce qui impose une interprétation prudente. L'étude 2 a comparé des énoncés cadrés comme émanant d'un expert ou d'un compagnon à l'aide de l'EEG, sur 39 observations appariées. Le cadrage en tant qu'expert était associé à une ERS thêta plus élevée en région frontale médiane et à un ΔPLV thêta FCz-F6 moins négatif après correction de la ligne de base, tandis que les comportements au niveau des conditions ne montraient aucune différence fiable concernant le taux de confiance, le temps de réponse ou le taux de non-réponse. Ces résultats d'EEG constituent des corrélats exploratoires au niveau des processus, et non une validation neuronale du modèle d'effet indirect conditionnel. Dans l'ensemble, les indices de rôle semblent façonner des évaluations non exclusives orientées vers la compétence et vers la relation. La conception du rôle devrait favoriser une dépendance calibrée par des limites de compétences, la communication de l'incertitude, des avertissements fondés sur les risques et une escalade appropriée, plutôt que de chercher simplement à maximiser la confiance.
Introduction
L'intelligence artificielle médicale couvre désormais des applications internes telles que la reconnaissance d'images, l'analyse de données pathologiques et la découverte de médicaments, ainsi que des interfaces de service destinées directement aux patients. Des analyses sectorielles prévoient une croissance continue du marché de l'IA en santé jusqu'en 20331. Les grands modèles linguistiques permettent aux systèmes d'IA médicale de répondre à des questions de santé, d'interpréter des résultats d'analyses, de résumer des informations et de formuler des recommandations en langage naturel2. Ce changement modifie la relation entre l'utilisateur et la technologie. Un outil analytique interne est évalué par des cliniciens et des organisations, tandis qu'une interface destinée aux patients doit communiquer clairement son rôle, les preuves à l'appui, les incertitudes et ses limites. L'IA médicale peut se présenter comme un assistant diagnostique, une interface de médecin traitant ou un compagnon de gestion de la santé, chacune de ces formes influençant la manière dont les utilisateurs perçoivent l'identité du service fourni par le système. Alors que ces systèmes participent de plus en plus aux consultations sur les maladies et à la gestion quotidienne de la santé, la confiance devient plus qu'une simple attitude envers la technologie. Elle détermine si les utilisateurs divulguent des informations, jugent les recommandations crédibles, interagissent avec le système ou suivent les conseils de santé. La confiance est donc une préoccupation centrale en matière de conception et de gouvernance des plateformes de santé numérique.
La seule compétence technique ne détermine pas si les utilisateurs considèrent l'IA médicale comme crédible et acceptable. Les analyses des agents conversationnels en santé montrent que leur mise en œuvre dépend de la qualité de l'interaction, de la pertinence clinique, de la transparence et des conditions de déploiement3. Des travaux récents sur les preuves crédibles en matière d'IA médicale affirment également que la performance du modèle est insuffisante à moins que les affirmations soient étayées par des preuves adaptées à l'usage prévu4. La transparence est essentielle, car les patients doivent pouvoir identifier les limites des capacités, les incertitudes et la base d'une recommandation, plutôt que d'évaluer la fiabilité uniquement à partir de la fluidité du langage5. La recherche en systèmes d'information aborde de la même manière l'adoption du diagnostic assisté par l'IA comme un problème de configuration de la confiance, dans lequel l'interprétabilité, la protection de la vie privée et les indices fournis par l'interface façonnent conjointement l'acceptation6. Ces considérations sont importantes pour les interfaces basées sur des modèles de langage. La fluidité peut rendre une réponse facile à comprendre tout en laissant sans réponse les questions suivantes : le système possède-t-il des connaissances cliniques ? Sa recommandation s'applique-t-elle au contexte de l'utilisateur ? Et quand faut-il faire intervenir un clinicien qualifié ? La question pertinente n'est pas seulement de savoir si l'IA médicale peut produire une réponse, mais si les utilisateurs peuvent l'évaluer avec un niveau de confiance approprié.
La confiance dans l'IA médicale est sensible au contexte de la tâche. Les recherches sur la résistance à l'IA médicale montrent que les utilisateurs peuvent rejeter les recommandations algorithmiques dans les décisions à enjeux élevés, car ils estiment qu'un algorithme ne peut pas tenir compte de leur singularité7. Cette résistance n'est pas universelle. Les études sur l'appréciation des algorithmes indiquent que les personnes peuvent préférer le jugement algorithmique lorsque les tâches sont objectives et que les règles sont plus claires8. Dans les consultations de santé en ligne, la personnalisation et le soin apporté aux conseils générés par l'IA influencent la confiance et l'adoption9. Des études de choix discret comparant des consultations classiques, numériques et basées sur l'IA révèlent également que les préférences et les attentes en matière de confiance varient selon les formats10. Le travail en équipe humain-IA peut également réduire la résistance grâce à un transfert de confiance de l'expertise humaine vers un dispositif de service assisté par IA11. La confiance dans l'IA médicale se développe donc à travers l'interaction entre le risque perçu, les exigences de la tâche, le style de communication et l'évaluation du système. La consultation pour une maladie met en évidence l'incertitude, la perte possible, les conséquences diagnostiques et le coût des erreurs. En revanche, la consultation en matière de santé concerne plus souvent l'alimentation, l'exercice physique, le sommeil, l'observance thérapeutique et la gestion préventive, domaines dans lesquels une interaction soutenue et une accessibilité relationnelle peuvent revêtir une importance plus grande. Par conséquent, un même indice d'interface peut être interprété différemment selon que l'utilisateur cherche de l'aide pour une maladie potentielle ou pour une gestion de santé à long terme.
Le cadrage du rôle est une caractéristique d'interface permettant de communiquer ces attentes. L'intelligence artificielle médicale peut être présentée comme un expert mettant l'accent sur l'autorité professionnelle, le raisonnement structuré, les limites cliniques et les preuves de compétence, ou comme un compagnon soulignant l'empathie, la rassurance, le soutien social et la continuité. Cette distinction se rapporte à la compétence et à la chaleur, les deux dimensions de la perception sociale, mais ne se résume pas à un simple choix entre un système compétent et un système chaleureux12. Le style de communication et le cadrage de l'agent influencent les évaluations des agents conversationnels13. Dans les applications médicales mobiles, les indices sociaux et les préoccupations liées à la confidentialité affectent conjointement la confiance et l'intention comportementale14. Les indices anthropomorphiques dans les agents conversationnels de santé peuvent accroître la présence sociale, la confiance et l'acceptabilité, bien qu'ils puissent aussi susciter des attentes dépassant les capacités du système15. Les recherches sur les équipes humain-IA montrent en outre que la chaleur et la compétence prédisent différentes formes de réceptivité16. Dans les tâches à haut risque, la confiance dépend de l'adéquation entre le rôle au sein de l'équipe, le contexte de la tâche et la violation de performance17. La cohérence entre le rôle social d'un chatbot et sa performance influence également l'établissement et la restauration de la confiance18. Les indices d'expert et de compagnon rendent donc saillants des critères d'évaluation différents, plutôt que de simplement modifier le ton de la conversation.
Deux lacunes subsistent. Premièrement, la recherche n’a pas expliqué comment la pertinence des indices orientés vers la compétence et la relation évolue selon les exigences des tâches médicales. Les revues sur la confiance humaine envers l’IA soulignent la dépendance au contexte, mais ne précisent pas comment les indices d’expert et de compagnon fonctionnent dans les consultations liées à la maladie et à la santé19. Deuxièmement, les études sur la confiance dans l’IA médicale s’appuient sur des déclarations subjectives, offrant des preuves limitées concernant le traitement associé à l’évaluation encadrée par le rôle. La confidentialité, la transparence, la responsabilité et les biais limitent également l’interprétation des indices de rôle en interface20,21. Pour combler ces lacunes, cette étude s’appuie sur la théorie de la congruence des rôles, qui explique l’évaluation par l’alignement entre les indices de rôle et les exigences saillantes du contexte22. L’étude 1 utilise une expérience aléatoire selon un plan factoriel 2 (rôle : expert contre compagnon) × 2 (tâche : consultation pour maladie contre consultation pour santé) (N = 300) afin d’examiner le cadrage du rôle, le contexte de la tâche, ainsi que les associations indirectes parallèles à travers la perception du professionnalisme et de la présence sociale. L’étude 2 utilise une expérience distincte d’EEG en mesures répétées (N = 39) pour comparer l’activité dans la bande thêta en réponse à des énoncés encadrés selon l’expert ou le compagnon. L’étude 1 évalue les associations comportementales et la modulation contextuelle ; l’étude 2 fournit une comparaison exploratoire au niveau des processus, plutôt qu’une validation neuronale du modèle indirect conditionnel.
Cadre théorique et élaboration de l'hypothèse
Cadrage du rôle dans l'IA médicale
L'intelligence artificielle médicale opère dans des contextes à enjeux élevés impliquant le risque de maladie, les recommandations de traitement, la responsabilité et les limites éthiques23. Le cadrage du rôle est donc important, car le langage utilisé à l'interface peut rendre plus ou moins évidentes les limites des capacités, des preuves et des responsabilités aux yeux des utilisateurs. Les recherches sur la transparence insistent également sur le fait que les systèmes d'intelligence artificielle médicale devraient communiquer clairement leurs limites de fonctionnalité et leurs bases factuelles5. Les réponses de style expert transmettent la compétence par l'usage d'un vocabulaire formel, un raisonnement structuré, des énoncés de limites et des recommandations d'action, tandis que les réponses de style compagnon expriment un soutien relationnel par l'empathie, la réassurance et un langage collaboratif. Ces indices ne sont pas de simples éléments de décoration d'interface : ils façonnent les critères que les utilisateurs appliquent lorsqu'ils évaluent un système24,25. L'anthropomorphisation peut susciter des réactions sociales, mais risque aussi de créer des attentes irréalistes et d'atténuer les frontières de responsabilité26,27. Les études sur les équipes humain-IA et les chatbots indiquent en outre que la chaleur humaine, la compétence, l'adéquation du rôle au contexte et la cohérence entre le rôle social et la performance influencent l'acceptation et la confiance16,17,18. Dans cette étude, la congruence de rôle désigne l'alignement entre les indices transmis par une réponse d'IA et les exigences d'évaluation mises en évidence par la tâche de consultation22.
Double voie de confiance : professionnalisme perçu et présence sociale
La congruence des rôles est déduite de l'interaction observée entre le rôle et la tâche, plutôt que mesurée comme une construction subjective distincte. L'interprétation est donc liée à l'interaction expérimentale et n'implique pas que les participants aient rapporté consciemment un sentiment d'adéquation au rôle. La confiance implique des jugements cognitifs concernant la compétence et la fiabilité, ainsi que des jugements affectifs relatifs à la sécurité relationnelle et au confort28,29,30. Dans l'utilisation de l'IA en médecine, les utilisateurs évaluent à la fois si le système peut soutenir une décision de santé et si l'interaction avec celui-ci leur paraît suffisamment sécurisante et accessible. Le cadrage par l'expert devrait rendre l'évaluation axée sur la compétence plus saillant. Des travaux sur l'aide à la décision clinique indiquent que les explications et les informations sur le raisonnement du système influencent la confiance et la dépendance à celui-ci31. Dans les consultations de santé en ligne, la personnalisation et l'attention portée au patient sont également associées à la confiance et à l'acceptation9. La professionnalité perçue reflète une évaluation orientée vers la compétence, pertinente pour la confiance25. Des recherches sur les consultations de santé en ligne identifient également la crédibilité de la source comme un facteur pertinent pour l'acceptation par les utilisateurs des recommandations de santé32. La présente étude teste donc si le cadrage par l'expert est associé à une professionnalité perçue plus élevée.
H1 : Les rôles d'accompagnement génèrent une perception moindre du professionnalisme comparativement aux intelligences artificielles médicales de type expert.
Le cadrage comparatif devrait rendre l'évaluation relationnelle plus saillante. La présence sociale fait référence à la qualité interpersonnelle perçue d'une interaction médiatisée, plutôt qu'à la croyance que le système est humain33. Elle est associée à la qualité de l'interaction, à la confiance et à l'acceptabilité dans les services en ligne et les agents conversationnels de santé15,34.
La présence sociale peut réduire le coût psychologique de la divulgation de soi et favoriser l'échange d'informations lors d'une consultation en ligne32. La présente étude teste donc si le cadrage par compagnonnage est associé à une présence sociale plus élevée.
H2 : Les rôles d'expert génèrent une présence sociale moindre par rapport aux IA médicales de type compagnon.
Le professionnalisme perçu et la présence sociale sont considérés comme des associations parallèles et non exclusives de la confiance. Une utilisation appropriée de l'automatisation à enjeux élevés dépend des capacités du système, de ses limites et des exigences de la tâche, plutôt que de la maximisation de la confiance seule35.
H3 : Le professionnalisme perçu et la présence sociale prédisent chacun positivement la confiance lorsqu’ils sont modélisés simultanément.
Effet modérateur du contexte de la tâche
Les mêmes indices de rôle peuvent avoir un poids psychologique différent selon les tâches médicales. L'adéquation tâche-technologie fournit un cadre contextuel pour examiner si les indices de rôle correspondent aux exigences de la tâche36. La consultation pour une maladie implique une incertitude plus grande, un risque de perte accru et des coûts liés aux erreurs, ce qui rend particulièrement saillants le professionnalisme, la précision et des limites claires7,37. Les indices d'expertise devraient donc être davantage alignés sur ces exigences que les indices de compagnonnage. La consultation en matière de santé se concentre sur la gestion à long terme de la santé, la persévérance comportementale et la continuité des interactions. Les revues portant sur les systèmes d'aide à la décision clinique fondés sur l'intelligence artificielle et les agents conversationnels en santé soulignent l'importance des informations contextuelles, de l'actionnabilité, de l'interaction et des conditions de mise en œuvre3,38,39.
Cette étude prévoit que la différence entre experts et accompagnants concernant le professionnalisme perçu sera plus marquée lors d'une consultation pour une maladie que lors d'une consultation pour la santé. Elle ne considère pas une interaction non significative sur la présence sociale comme une preuve d'invariance. L'hypothèse est formulée comme suit :
H4 : Le contexte de la tâche module significativement l'impact des rôles d'expert sur la perception du professionnalisme. Cet impact est plus marqué lors d'une consultation pour une maladie que lors d'une consultation pour la santé.
Protocole
Aperçu de la recherche
L'étude a été menée conformément à la Déclaration d'Helsinki et a été approuvée par le Comité d'éthique de l'Université Huaqiao (M2025021), qui couvrait à la fois l'expérience en ligne et l'expérience EEG. Tous les participants ont donné leur consentement éclairé et ont reçu une compensation à l'issue de l'étude.
Cet article comprend deux études complémentaires (voir Figure 1). L'étude 1 est une expérience aléatoire en plan factoriel 2 × 2 qui estime les effets du cadrage du rôle et du contexte de la tâche, évalue la structure de mesure et teste des associations indirectes conditionnelles parallèles à travers la perception du professionnalisme et de la présence sociale. L'étude 2 est une expérience d'EEG à mesures répétées qui compare l'activité dans la bande thêta lors de déclarations formulées selon un cadrage d'expert ou de compagnon, interprétée comme une comparaison exploratoire au niveau des processus. Les études fournissent des preuves comportementales et neuronales à différents niveaux ; elles ne sont pas considérées comme un mécanisme unique et progressif.
Étude 1 : Expérience en scénario
Participants et conception
L'étude 1 a utilisé un plan expérimental entre sujets équilibré de type 2 × 2, avec le cadrage du rôle (expert contre compagnon) et le contexte de la tâche (consultation pour une maladie contre consultation pour la santé). Le calcul initial effectué avec G*Power supposait un effet global de taille moyenne pour une ANOVA (f = 0,25), α = 0,05 et une puissance = 0,80, indiquant un minimum de 128 participants40. Étant donné que ce calcul n'était pas adapté aux effets indirects conditionnels, il est rapporté comme base initiale de recrutement plutôt que comme preuve de puissance pour une médiation modérée. Avec N = 300 et quatre groupes équilibrés, une analyse de sensibilité a montré une puissance de 80 % pour détecter une interaction d'effet f = 0,162 (η2 partiel = 0,026) au seuil α = 0,05.
Nous avons en outre effectué une analyse de puissance basée sur des simulations a posteriori pour les indices de modération-médiation en utilisant le jeu de données du questionnaire SPSS comprenant 300 cas. La simulation a généré 1 000 échantillons équilibrés de type 2 × 2 à partir du modèle à médiateurs parallèles ajusté, par rééchantillonnage des résidus empiriques ; chaque jeu de données simulé a utilisé 500 intervalles de confiance bootstrap percentiles obtenus par rééchantillonnage des cas. Les probabilités estimées que l'intervalle de confiance excluait zéro étaient de 0,698 pour l'indice de professionnalisme, de 0,157 pour l'indice de présence sociale et de 0,279 pour la différence directe entre les deux indices. Cette analyse est conditionnelle aux coefficients observés, aux distributions des résidus et à la spécification du modèle, et ne constitue pas une justification a priori de la taille de l'échantillon. L'analyse complète de puissance basée sur des simulations a posteriori est présentée dans le Tableau supplémentaire S1.
Trois cents participants ont été recrutés via Credamo et répartis aléatoirement en quatre conditions (n = 75 par groupe). L'échantillon comprenait 109 hommes (36,3 %) et 191 femmes (63,7 %) ; 43,7 % avaient entre 21 et 30 ans, 41,3 % avaient entre 31 et 40 ans, et 69,7 % détenaient un diplôme de licence. Tous les items requis du questionnaire ont été complétés. Aucun item spécifique de contrôle d'attention ni critère d'exclusion préenregistré basé sur le temps de complétion n'a été utilisé, et aucun participant n'a été exclu. Le temps médian de complétion était de 268 s (intervalle = 67-1 894 s). Une analyse de robustesse a posteriori, excluant les réponses situées en dessous du cinquième centile du temps de complétion (<125 s ; n conservé = 285), a été menée afin d'évaluer la sensibilité aux réponses inhabituellement rapides. Les statistiques détaillées des contrôles de manipulation et les analyses de sensibilité relatives au temps de complétion sont indiquées dans le Tableau supplémentaire S2.
Stimuli expérimentaux et protocole
Les matériaux de stimulation comprenaient une introduction à un scénario de tâche et une réponse en dialogue avec un médecin IA, formant quatre séries expérimentales complètes. Le scénario de consultation médicale demandait aux participants d’imaginer une oppression thoracique et des palpitations nocturnes récurrentes, ainsi que la préoccupation quant à la nécessité de soins hospitaliers immédiats. Le scénario de consultation de santé demandait aux participants d’imaginer être en bonne santé générale et de rechercher un plan personnalisé d’alimentation et d’exercice physique. Chaque catégorie de tâche était représentée par un scénario ; les conclusions sont donc limitées à ces deux scénarios et ne peuvent être généralisées à l’ensemble des consultations médicales ou de santé.
Les quatre captures d'écran du questionnaire utilisaient la même icône et affichaient le nom du système, Medical AI (DiagnosPro), maintenant ainsi l'identité affichée constante entre les conditions. Les réponses formulées selon le cadre d'expertise utilisaient une analyse structurée, des énoncés sur les risques ou les preuves, un langage directif et des recommandations d'action explicites. Les réponses formulées selon le cadre d'accompagnement faisaient appel à l'empathie, à la rassurance, à un vocabulaire collaboratif et à des suggestions flexibles. La manipulation représentait donc un ensemble de signaux communicationnels et informationnels conformes au rôle ; elle ne permettait pas d'isoler le cadrage du rôle de la spécificité, de l'actionnabilité, de la certitude, des détails médicaux ou du soutien émotionnel. Le nom partagé DiagnosPro pouvait également transmettre un indice d'expertise dans toutes les conditions. L'ensemble complet des stimuli est fourni dans le fichier supplémentaire 1.
Les participants ont d'abord lu le formulaire de consentement éclairé, puis ont été assignés aléatoirement à l'une des quatre conditions expérimentales. Après avoir lu le scénario et le stimulus dialogué, ils ont rempli le questionnaire en fonction de leurs réponses. Le questionnaire commençait par des vérifications de manipulation, suivies d'évaluations de la perception du professionnalisme, de la présence sociale, de la confiance et des données démographiques. La procédure a duré environ 15 min.
Toutes les échelles utilisaient une notation de type Likert à 7 points, où 1 correspondait à « fortement en désaccord » et 7 à « fortement d'accord ». La professionnalisme perçu a été mesuré à l’aide de trois items : « Cet IA médical est capable de fournir des conseils médicaux », « Cet IA médical semble très professionnel » et « Cet IA médical est un expert dans le domaine médical » (α = .883)41. La présence sociale a été mesurée par trois items : « Lors de l’interaction avec cet IA médical, j’ai ressenti une touche humaine », « L’interaction avec cet IA médical m’a donné une sensation de proximité » et « Cet IA médical m’a semblé sociable durant l’interaction » (α = .932)42. La confiance cognitive comprenait trois items : « Je peux compter sur cet IA médical car il possède les compétences nécessaires pour donner des conseils », « Je fais confiance à l’exactitude des conseils fournis par cet IA médical » et « Cet IA médical dispose de capacités suffisantes pour gérer mon problème de santé » (α = .837). La confiance affective comprenait trois items : « Cet IA médical me procure une sensation de chaleur et d’attention », « Le fait de compter sur cet IA médical me donne un sentiment de sécurité car il semble se soucier de ma santé » et « Je crois que cet IA médical ne ferait intentionnellement rien qui puisse me nuire » (α = .700). La confiance globale correspondait à la moyenne des six items relatifs à la confiance (α = .784). Ces mesures ont été analysées comme des résultats orientés vers la compétence, les relations interpersonnelles, la confiance cognitive, la confiance affective et la confiance globale, plutôt que comme des constructions mutuellement exclusives.
L'analyse a été menée en quatre étapes. Premièrement, une analyse factorielle confirmatoire a comparé le modèle à quatre facteurs proposé à des alternatives à deux facteurs et à un facteur ; la fiabilité composite, la variance moyenne extraite, les corrélations latentes et les rapports hétérotrait-monotrait ont été examinés. Deuxièmement, des modèles factoriels complets 2 × 2 ont permis d'estimer les effets principaux et les effets d'interaction concernant le professionnalisme perçu, la présence sociale, la confiance cognitive, la confiance affective et la confiance globale, avec les moyennes des cellules, les intervalles de confiance et les η2 partiels. Les moyennes marginales estimées et les intervalles de confiance à 95 % sont présentés dans la Figure 2. Troisièmement, le modèle 7 de PROCESS 4.2 bêta a intégré simultanément le professionnalisme perçu et la présence sociale comme médiateurs parallèles, à l'aide de 5 000 échantillons bootstrap percentiles43. Le cadrage du rôle a été codé 1 = expert et 2 = compagnon, et le contexte de tâche a été codé 1 = consultation pour une maladie et 2 = consultation pour la santé. Un bootstrap à rééchantillonnage commun a directement comparé les deux indices de médiation modérée. Quatrièmement, la confiance cognitive et la confiance affective ont été analysées séparément comme résultats exploratoires. Étant donné que les médiateurs et les résultats ont été mesurés simultanément, les estimations sont interprétées comme des associations indirectes compatibles avec une médiation, plutôt que comme des mécanismes psychologiques causaux.
Étude 2 : Expérience de EEG
Participants
L'étude 2 a recruté 40 participants. Un participant a été exclu car les essais contaminés par des artefacts dépassaient 30 % dans au moins une condition expérimentale, laissant 39 participants pour les analyses finales de l'EEG. Ce critère garantissait que chaque participant retenu contribuait à au moins 70 % des essais dans chaque condition. Tous les participants ont donné leur consentement éclairé par écrit et ont reçu une compensation après l'expérience. Les informations démographiques n'ont pas pu être associées à tous les enregistrements d'EEG conservés et ne sont donc pas résumées pour l'échantillon final d'EEG.
Stimuli expérimentaux et protocole
L'expérience a été menée dans un laboratoire EEG standard selon un plan expérimental intra-sujets, les stimuli étant présentés à l'aide d'E-Prime 2.1. Les participants ont reçu pour consigne d'imaginer interagir avec un système d'intelligence artificielle médicale et d'évaluer leur niveau de confiance dans ce système pour chaque scénario de consultation médicale. L'expérience a manipulé le rôle perçu du système d'intelligence artificielle médicale, en incluant des variantes de type expert et de type compagnon.
Un total de 40 stimuli constitués de phrases chinoises a été élaboré. La condition de type expert comprenait 20 stimuli commençant par « Expert en IA médicale », tandis que la condition de type compagnon comprenait 20 stimuli parallèles commençant par « Compagnon en IA médicale ». Les scénarios médicaux couvraient à la fois des fonctions diagnostiques professionnelles, telles que poser des questions sur les antécédents médicaux, analyser des rapports d'examens, évaluer des données de fréquence cardiaque, interpréter des tests génétiques, juger du risque de maladie et recommander des plans de traitement, et des fonctions de gestion du bien-être à caractère plus soutenu, telles que manifester de l'intérêt pour l'état physique, s'enquérir de la qualité du sommeil, atténuer l'anxiété, enregistrer des données de santé, encourager l'adhésion au traitement et fournir des conseils quotidiens pour la santé. Les conditions différaient donc également par leur contenu sémantique et leur complexité ; aucune mise en correspondance indépendante des stimuli ni aucun prétest n'étaient disponibles.
Avant l'expérience formelle, les participants ont effectué un court bloc d'entraînement. Chaque essai commençait par une croix de fixation de 500 ms, suivie d'un intervalle vide aléatoire de 300 à 500 ms et d'un énoncé d'IA médicale présenté pendant 1 600 ms. Les participants formulaient ensuite un jugement binaire de confiance à leur propre rythme en appuyant sur la touche F pour indiquer qu'ils faisaient confiance ou sur la touche J pour indiquer qu'ils n'y faisaient pas confiance (voir Figure 3). Les énoncés formulés selon le cadre de l'expert et selon le cadre du compagnon étaient présentés dans un ordre aléatoire. Les journaux de tâche E-Prime indiquaient 80 essais formels par enregistrement de tâche : 40 essais avec l'expert et 40 essais avec le compagnon, chaque énoncé unique par rôle étant présenté deux fois.
Données de la tâche comportementale
Les données des tâches comportementales étaient exploitables pour 38 des 39 participants de l'échantillon final d'EEG ; l'enregistrement de la tâche E-Prime d'un participant était inutilisable. Les analyses comportementales ont donc utilisé un échantillon N = 38. Les résultats comportementaux détaillés et le décompte de l'échantillon sont fournis dans le Tableau S3 supplémentaire. La confiance a été codée comme une réponse sur la touche F ; les réponses sur la touche J indiquaient l'absence de confiance. Les réponses vides ou un temps de réponse enregistré de 0 ms ont été codés comme manquants. Le taux de confiance a été calculé parmi les essais répondus, et le temps de réponse a été résumé sur les essais répondus. Les données neuronales disponibles pour l'analyse contenaient des mesures agrégées par condition, mais aucun indice d'EEG au niveau des essais ni identifiant vérifié permettant de relier chaque enregistrement comportemental à son enregistrement d'EEG ; par conséquent, aucun modèle mixte au niveau des essais associant EEG et jugements de confiance n'a été estimé.
Enregistrement et analyse de l'EEG
Un gel électrolytique conducteur Quik-Gel a été utilisé pour maintenir l'impédance électrode-peau en dessous de 5 kOhm. FCz constituait la référence en ligne par défaut de l'appareil, et la fréquence d'échantillonnage était de 1 000 Hz. La re-référenciation hors ligne par rapport à la moyenne des mastoïdes bilatéraux a été effectuée à l'aide de la fonction de re-référenciation intégrée de CURRY ; FCz a été conservé et automatiquement reconstruit par rapport à la nouvelle référence, aucune commande ou script de reconstruction personnalisé n'ayant été utilisé. Le traitement ultérieur hors ligne a été réalisé sous MATLAB R2020b à l'aide de EEGLAB44 et ICLabel45. Les données ont été sous-échantillonnées à 500 Hz et filtrées par bande passante de 0,1 à 40 Hz. Les mauvais canaux et les segments de données fortement contaminés ont été identifiés et supprimés par inspection visuelle ; aucune interpolation automatisée ni seuil de rejet automatisé des segments n'a été appliqué. L'implémentation par défaut de runica dans EEGLAB (ICA Infomax) a ensuite été utilisée, et les composantes ont été supprimées lorsque ICLabel attribuait une probabilité d'au moins 0,70 à une classe d'artéfact (par exemple, activité oculaire, musculaire, cardiaque, de bruit de ligne ou de bruit de canal). Les participants présentant plus de 30 % d'essais contaminés par des artéfacts dans l'une ou l'autre condition ont été exclus, garantissant ainsi une rétention d'au moins 70 % des essais dans chaque condition. Les époques s'étendaient de −1 000 à 1 996 ms. Pour l'analyse de connectivité fonctionnelle, les données prétraitées ont été davantage sous-échantillonnées à 250 Hz, et les électrodes périphériques, notamment P7, P8, F7 et F8, ont été exclues avant l'estimation de la synchronie de phase.
On a associé l'activité thêta enregistrée au niveau des sites frontaux médians du cuir chevelu à des calculs engagés par des exigences de contrôle cognitif46. La synchronisation de phase dans la bande thêta entre les sites électrodes frontaux médians et latéraux a également été associée à la coordination durant le traitement lié au contrôle47. En particulier, une synchronisation de phase accrue dans la bande thêta entre des sites tels que FCz et F6 a été observée après la détection d'un conflit ou d'une erreur48. Étant donné que ces mesures du cuir chevelu ne sont pas spécifiques de manière unique au contrôle cognitif, elles sont considérées ici comme des indicateurs convergents de processus plutôt que comme des lectures directes d'un mécanisme cognitif unique.
Premièrement, la synchronisation évoquée par événement (ERS) dans la bande thêta fronto-médiane a été quantifiée dans la bande de fréquence 4–8 Hz, dans la fenêtre post-stimulus de 800 à 1 000 ms. L'ERS a été calculée à l'aide d'une analyse temps-fréquence, la variation de puissance relative étant déterminée par rapport à la période de référence préstimulus allant de −500 à −200 ms. Des valeurs positives indiquent un renforcement de la puissance (synchronisation), tandis que des valeurs négatives indiquent une suppression de la puissance (désynchronisation). Deuxièmement, la connectivité fonctionnelle a été estimée après un sous-échantillonnage supplémentaire des données prétraitées à 250 Hz et l'exclusion des électrodes périphériques, notamment P7, P8, F7 et F8. Une transformation de Fourier à court terme (STFT) a été appliquée avant de calculer la valeur de verrouillage de phase dans la bande thêta entre FCz et F6. La variation du PLV corrigée par rapport à la ligne de base (ΔPLV) a été calculée par rapport à la période de référence préstimulus allant de −600 à −200 ms. Le PLV brut est compris entre 0 et 1 ; par conséquent, des valeurs négatives de ΔPLV indiquent une diminution par rapport à la ligne de base, et non un verrouillage de phase négatif. Ces mesures au niveau du scalp sont interprétées comme des profils exploratoires associés au traitement lié au contrôle et à la coordination préfrontale ; elles n'identifient pas directement un processus cognitif ou une source neuronale spécifique.
Résultats
Étude 1 : Résultats de l'expérience-scénario
Modèle de mesure. Le modèle à quatre facteurs s'ajustait mieux que les alternatives à deux et à un facteur, mais l'ajustement absolu était mitigé : χ2(48) = 223,93, p < ,001 ; CFI = ,935 ; TLI = ,911 ; RMSEA = ,111 ; SRMR = ,140. Les saturations standardisées variaient de ,382 à ,937. La fiabilité composite était de ,886 pour le professionnalisme perçu, ,932 pour la présence sociale, ,840 pour la confiance cognitive et ,709 pour la confiance affective ; les valeurs correspondantes de AVE étaient ,722, ,821, ,636 et ,474. La validité discriminante était limitée : les valeurs HTMT étaient de ,935 entre le professionnalisme perçu et la confiance cognitive, et de ,926 entre la présence sociale et la confiance affective. Les résultats de l'analyse conditionnelle du processus doivent donc être interprétés avec prudence, et les analyses de la confiance spécifiques aux dimensions sont exploratoires (Tableau 1).
Vérifications de manipulation. Les participants du groupe « expert » (n = 150, M = 5,57, SD = 1,18) ont jugé l'IA médicale plus proche d'un expert que les participants du groupe « compagnon » (n = 150, M = 3,21, SD = 1,76). Comme les variances différaient, F = 47,42, p < ,001, un test de Welch a été utilisé, t(259,90) = 13,63, p < ,001, différence moyenne = 2,36, IC 95 % [2,02 ; 2,70]. Les participants du groupe « maladie » (n = 150, M = 2,51, SD = 1,53) ont attribué des notes plus faibles en orientation vers la santé préventive que les participants du groupe « santé » (n = 150, M = 5,98, SD = 1,22), F = 10,96, p = ,001 ; t de Welch (284,11) = −21,70, p < ,001, différence moyenne = −3,47, IC 95 % [−3,79 ; −3,16]. Les degrés de liberté de Welch ne sont pas égaux à N − 2 lorsque les variances sont inégales ; toutes les analyses ont utilisé N = 300.
Statistiques descriptives par condition expérimentale. Pour le cadrage en tant qu'expert, les moyennes de professionnalisme perçu étaient de 5,69 (ET = 0,83) et de 5,85 (ET = 0,63), les moyennes de présence sociale de 4,28 (ET = 1,54) et de 4,25 (ET = 1,64), et les moyennes de confiance globale de 5,45 (ET = 0,86) et de 5,28 (ET = 0,87), respectivement, dans les contextes de maladie et de consultation de santé. Pour le cadrage en tant que compagnon, les moyennes correspondantes pour la maladie et la santé étaient de 4,52 (ET = 1,47) et de 5,25 (ET = 0,94) pour le professionnalisme perçu, de 5,68 (ET = 1,07) et de 5,93 (ET = 0,74) pour la présence sociale, et de 5,30 (ET = 1,02) et de 5,61 (ET = 0,64) pour la confiance globale. Tableau 2 présente tous les intervalles de confiance spécifiques aux conditions ainsi que les tests factoriels complets.
Résultats factoriels complets. La perception du professionnalisme a révélé un effet principal de la définition du rôle, F(1, 296) = 56,92, p < ,001, η2 partiel = ,161, un effet principal du contexte de la tâche, F(1, 296) = 14,37, p < ,001, η2 partiel = ,046, ainsi qu'une interaction rôle × tâche, F(1, 296) = 5,89, p = ,016, η2 partiel = ,020. La présence sociale a montré un effet principal de la définition du rôle, F(1, 296) = 105,57, p < ,001, η2 partiel = ,263, mais ni l'effet principal de la tâche, F(1, 296) = 0,59, p = ,442, ni l'interaction, F(1, 296) = 0,84, p = ,359, n'étaient significatifs. Ce dernier résultat indique qu'aucune modulation n'a été détectée ; il n'établit pas une équivalence entre les tâches. Pour la confiance cognitive, l'interaction rôle × tâche était significative, F(1, 296) = 5,60, p = ,019, η2 partiel = ,019 ; l'interaction correspondante n'était pas significative pour la confiance affective, F(1, 296) = 3,48, p = ,063, η2 partiel = ,012. La confiance globale n'a montré ni effet principal de la définition du rôle, F(1, 296) = 0,81, p = ,369, ni effet principal de la tâche, F(1, 296) = 0,55, p = ,459, mais l'interaction rôle × tâche était significative, F(1, 296) = 5,78, p = ,017, η2 partiel = ,019. Dans le cadre d'une consultation pour une maladie, la confiance globale ne différait pas entre la présentation en tant que compagnon et celle en tant qu'expert, différence moyenne = −0,15, EE = 0,14, t(296) = −1,06, p = ,288, IC à 95 % [−0,42, 0,13]. Lors d'une consultation de santé, la confiance globale était plus élevée avec la présentation en tant que compagnon, différence moyenne = 0,33, EE = 0,14, t(296) = 2,34, p = ,020, IC à 95 % [0,05, 0,60].
Associations indirectes conditionnelles parallèles. Lorsque le professionnalisme perçu et la présence sociale ont été saisis simultanément, les deux étaient positivement associés à la confiance globale : b = 0,4872, SE = 0,0258, p < ,001, IC 95 % [0,4294 ; 0,5460] et b = 0,3293, SE = 0,0208, p < ,001, IC 95 % [0,2762 ; 0,3829], respectivement. L'association directe liée au cadrage du rôle n'était pas significative, b = 0,0119, SE = 0,0680, p = ,861, IC 95 % [−0,1071 ; 0,1361]. Les associations indirectes liées au professionnalisme étaient de −0,5695 dans le contexte de consultation pour une maladie, IC bootstrap 95 % [−0,7687 ; −0,3851], et de −0,2923 dans le contexte de consultation pour la santé, IC bootstrap 95 % [−0,4288 ; −0,1634]. Les associations indirectes liées à la présence sociale étaient de 0,4625 dans le contexte de consultation pour une maladie, IC bootstrap 95 % [0,3165 ; 0,6091], et de 0,5532 dans le contexte de consultation pour la santé, IC bootstrap 95 % [0,3855 ; 0,7383] (Tableau 3). L'indice de médiation modérée par le professionnalisme perçu était de 0,2772, IC bootstrap 95 % [0,0594 ; 0,5035], tandis que l'indice par la présence sociale était de 0,0907, IC bootstrap 95 % [−0,0984 ; 0,3008]. La comparaison directe bootstrap entre les indices n'était pas significative, différence = 0,1864, IC bootstrap 95 % [−0,0856 ; 0,4447]. Les résultats soutiennent donc une modulation contextuelle de l'association indirecte avec le professionnalisme, mais ne permettent pas d'établir une modulation contextuelle statistiquement différente entre les deux associations.
Analyses exploratoires des dimensions de la confiance. Pour la confiance cognitive, le contraste entre les indices de modulation-médiation de la professionnalisme et de la présence sociale était positif, différence = 0,3707, IC à 95 % par bootstrap [0,0493, 0,6996]. Pour la confiance affective, le contraste correspondant n'était pas soutenu, différence = 0,0022, IC à 95 % par bootstrap [−0,3421, 0,3127]. Les deux médiateurs conservaient des associations positives avec les deux dimensions de la confiance, indiquant des effets croisés plutôt qu'exclusifs. Étant donné les valeurs élevées de HTMT, ces résultats ne doivent pas être interprétés comme une séparation définitive des mécanismes cognitifs et affectifs.
Puissance de la médiation modérée a posteriori. Selon le modèle ajusté et les hypothèses de rééchantillonnage des résidus, la probabilité estimée que l'intervalle de confiance au percentile exclue zéro était de 0,698 pour l'indice de professionnalisme, de 0,157 pour l'indice de présence sociale et de 0,279 pour leur différence directe (1 000 simulations ; 500 rééchantillonnages bootstrap par simulation). Ces estimations basées sur le plan d'expérience observé expliquent pourquoi l'indice de professionnalisme soutenu et le contraste direct non significatif ne doivent pas être interprétés comme une preuve concluante d'une modulation contextuelle différente.
Robustesse du temps de complétion. En excluant les 15 réponses inférieures à 125 s, 285 cas sont restés. L'interaction confiance globale est restée significative, p = .029 ; l'indice de professionnalisme est resté soutenu, IC bootstrap à 95 % [0,0242, 0,4827] ; et le contraste entre les indices de médiation modérée est resté non significatif, IC bootstrap à 95 % [−0,1027, 0,4506]. Les conclusions principales ne dépendaient pas des 5 % de réponses les plus rapides.
Étude 2 : Résultats de l'EEG
ERS thêta fronto-médiane. Dans l'échantillon analytique final (N = 39), l'ERS thêta dans la fenêtre 4–8 Hz, 800–1 000 ms était plus élevée dans la condition de cadrage par l'expert (M = 0,2948, SD = 0,8218) que dans la condition de cadrage par le compagnon (M = −0,0422, SD = 1,2155), différence moyenne = 0,3369, IC à 95 % [0,0125, 0,6614], t(38) = 2,10, p = ,042, dz de Cohen = 0,337, η2 partiel = ,104. La valeur de p ajustée selon Holm pour les deux résultats appariés de l'EEG rapportés était de ,042. Cette différence indique un traitement différentiel dans la bande thêta durant cette fenêtre de tâche ; l'ERS thêta seule ne permet pas d'identifier un processus psychologique spécifique.
Changement du PLV thêta corrigé de la ligne de base en FCz-F6 (ΔPLV). Dans l'échantillon analytique final (N = 39), le ΔPLV thêta était moins négatif dans le cadre d'un encadrement par des experts (M = −0.0111, SD = 0.0546) que dans celui d'un encadrement par des compagnons (M = −0.0350, SD = 0.0473), différence moyenne = 0,0239, IC 95 % [0,0058, 0,0420], t(38) = 2,68, p = ,011, dz de Cohen = 0,429, η2 partiel = ,159. La valeur de p ajustée selon Holm pour les deux résultats appariés de l'EEG rapportés était de ,022. Ce profil correspond à une diminution moindre de la cohérence de phase thêta par rapport à la ligne de base lors d'un encadrement par des experts ; cela n'établit pas en soi un contrôle préfrontal plus fort ou un mécanisme cognitif spécifique (voir Figure 4 et Tableau 4).
Résultats de la tâche comportementale. Sur les 38 enregistrements de tâche analysés, le taux de réponse de confiance était de 83,1 % (SD = 15,8 %) dans le cadre d'expert et de 82,4 % (SD = 17,5 %) dans le cadre de compagnon, différence moyenne = 0,7 point de pourcentage, IC 95 % [−0,9 ; 2,4], t(37) = 0,91, p = ,371, dz = 0,147. Les temps de réponse moyens étaient respectivement de 828,7 ms (SD = 204,6) et de 826,1 ms (SD = 208,9), différence moyenne = 2,5 ms, IC 95 % [−14,0 ; 19,1], t(37) = 0,31, p = ,758, dz = 0,050. Les taux de non-réponse étaient respectivement de 6,3 % (SD = 7,4 %) et de 5,2 % (SD = 6,3 %), différence moyenne = 1,1 point de pourcentage, IC 95 % [−1,0 ; 3,1], t(37) = 1,05, p = ,302, dz = 0,170.
Déclaration relative à la disponibilité des données :
Les données anonymisées du questionnaire de l'étude 1, les fichiers EEG prétraités et les fichiers de sortie EEG agrégés soutenant l'étude 2 sont accessibles publiquement sur le Open Science Framework (OSF) à l'adresse https://doi.org/10.17605/OSF.IO/JKSP7. Les matériaux supplémentaires comprennent les stimuli expérimentaux complets (Fichier supplémentaire 1), les vérifications de manipulation, des analyses comportementales supplémentaires, des analyses de puissance a posteriori et des informations méthodologiques complémentaires.
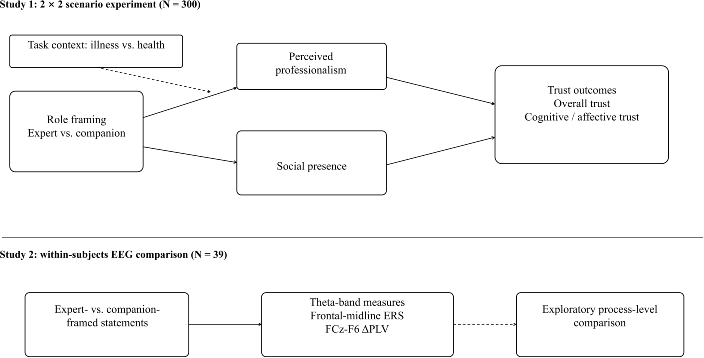
Figure 1. Cadre de recherche. L'étude 1 est une expérience en scénarios 2 × 2 (N = 300) examinant le cadrage du rôle, le contexte de la tâche et les associations indirectes parallèles à travers la perception du professionnalisme et de la présence sociale. L'étude 2 propose une comparaison exploratoire d'électroencéphalogrammes entre des énoncés formulés selon une perspective d'expertise ou de compagnonnage (N = 39) ; elle ne teste pas directement le modèle indirect conditionnel. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
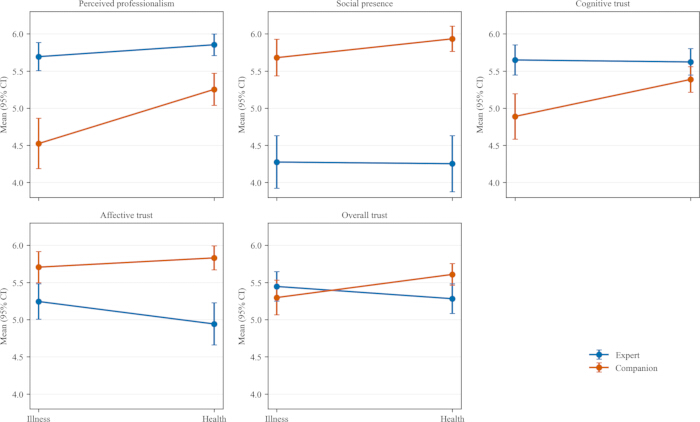
Figure 2. Graphiques rôle-perçu × contexte de tâche pour le professionnalisme perçu, la présence sociale, la confiance cognitive, la confiance affective et la confiance globale. Les points représentent les moyennes des cellules, et les barres d'erreur indiquent les intervalles de confiance à 95 % (n = 75 par cellule). Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
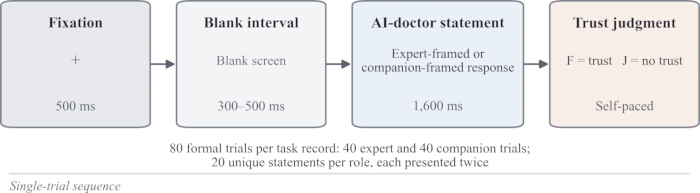
Figure 3. Séquence d'un essai unique dans l'Étude 2. Chaque essai comprenait une fixation de 500 ms, un intervalle vide avec variation aléatoire de 300 à 500 ms, une déclaration du médecin IA formulée selon le cadre expert ou compagnon pendant 1 600 ms, puis un jugement binaire de confiance effectué à son propre rythme. Les journaux de tâche E-Prime indiquaient 80 essais formels par enregistrement de tâche, avec 40 essais par condition de cadrage du rôle et deux présentations de chacune des 20 déclarations uniques par condition. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
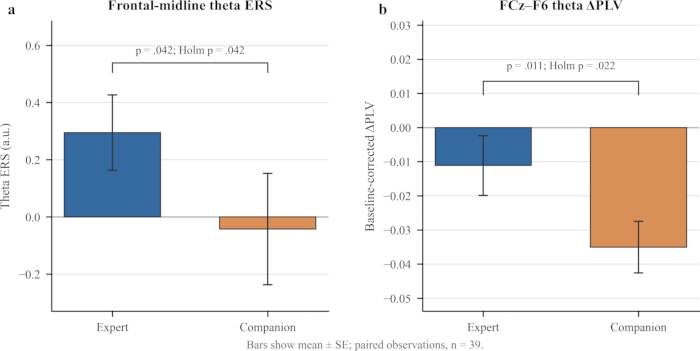
Figure 4. Effets du cadrage du rôle de l'IA médicale sur la synchronisation évoquée par le thêta fronto-médian et la valeur de verrouillage de phase thêta FCz-F6. (A) Synchronisation évoquée par le thêta fronto-médian. (B) Variation de la valeur de verrouillage de phase thêta FCz-F6 corrigée du niveau de base (ΔVVP) ; les valeurs négatives indiquent une diminution par rapport à la ligne de base pré-stimulus. Les barres représentent la moyenne ± erreur standard pour n = 39. Les tests t appariés ont donné p = .042 pour la SER thêta et p = .011 pour le ΔVVP ; les valeurs de p ajustées selon Holm pour ces deux résultats rapportés étaient respectivement de .042 et .022. Abréviations : Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Tableau 1 : Diagnostics du modèle de mesure pour l'étude 1. Le tableau indique les saturations standardisées, l'alpha de Cronbach, la fiabilité composite, la variance moyenne extraite, les corrélations latentes et les valeurs HTMT pour la professionnalisme perçu, la présence sociale, la confiance cognitive et la confiance affective. N = 300. Le modèle à quatre facteurs s'ajustait mieux que les alternatives, mais l'RMSEA et le SRMR indiquaient un ajustement absolu faible, et deux valeurs HTMT dépassaient 0,90. Abréviations : CR = fiabilité composite ; AVE = variance moyenne extraite ; HTMT = rapport hétérotrait-monotrait. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 2 : Statistiques descriptives à quatre conditions et tests factoriels complets 2 × 2 pour l'étude 1. Les cellules indiquent n, la moyenne, l'écart type et l'intervalle de confiance à 95 % ; les tests factoriels indiquent F, p et η2 partiel. N = 300 ; n = 75 par cellule. Le cadrage du rôle a été codé 1 = expert et 2 = compagnon ; le contexte de la tâche a été codé 1 = maladie et 2 = consultation de santé. Les coefficients et les intervalles de confiance sont non standardisés. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 3 : Associations indirectes conditionnelles parallèles dans l'étude 1. N = 300. Le cadrage du rôle a été codé 1 = expert et 2 = compagnon ; le contexte de la tâche a été codé 1 = consultation pour une maladie et 2 = consultation pour la santé. La professionnalisme perçu et la présence sociale ont été introduits simultanément. Les estimations sont non standardisées, et les intervalles de confiance au percentile par rééchantillonnage bootstrap ont utilisé 5 000 répétitions. Le tableau inclut les associations indirectes conditionnelles, les deux indices de médiation modérée, ainsi que leur contraste direct par bootstrap. Le contraste direct entre les deux indices de médiation modérée pour la confiance globale était de 0,1864, IC 95 % [-0,0856 ; 0,4447]. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 4 : Résultats appariés de l'EEG dans l'étude 2. N = 39 observations appariées dans l'échantillon analytique final. Le tableau présente les moyennes selon les conditions, les différences moyennes appariées, les intervalles de confiance à 95 %, appariés t tests, dz de Cohen, η partiel2et valeurs de p ajustées selon Holm pour l'ERS thêta fronto-médiane et le ΔPLV thêta de FCz-F6 corrigé par rapport à la ligne de base. La correction de Holm concerne uniquement les deux résultats EEG appariés rapportés et ne tient pas compte d'une recherche plus étendue non documentée sur les électrodes, les bandes de fréquence ou les fenêtres temporelles. Veuillez cliquer ici pour télécharger ce tableau.
Fichier supplémentaire 1 : Stimuli expérimentaux utilisés dans l'étude 1. Ce fichier contient le texte complet des réponses de l'IA médicale formulées selon le cadre de l'expert et selon le cadre du compagnon, utilisées dans les scénarios de consultation pour une maladie et de consultation pour la santé. Le texte original en chinois ainsi que sa traduction en anglais sont fournis.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S1. Analyse de puissance post hoc basée sur des simulations pour le modèle de médiation modérée. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S2. Statistiques de vérification de la manipulation et analyses de sensibilité du temps de complétion pour l'étude 1. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S3. Résultats des tâches comportementales, répartition des échantillons et statistiques descriptives pour l'étude 2. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Implications théoriques
Les deux études fournissent des preuves à différents niveaux. L'étude 1 identifie des associations rôle-par-tâche et des associations indirectes parallèles dans une expérience aléatoire par scénarios, tandis que l'étude 2 propose une comparaison exploratoire au niveau des processus par EEG. Par conséquent, ces études soutiennent une interprétation limitée de l'évaluation encadrée par le rôle, plutôt qu'un mécanisme unique et progressif. Les résultats étendent la théorie de la congruence de rôle à l'intelligence artificielle médicale en considérant la congruence comme l'alignement entre les indices de rôle et les exigences évaluatives saillantes pour la tâche22. Cette interprétation se distingue du contenu compétence-chaleur et de l'adéquation tâche-technologie. Les observations d'aversion envers les algorithmes et d'appréciation des algorithmes peuvent être comprises comme des évaluations sensibles au contexte de la compatibilité entre les indices de rôle, les capacités et la tâche49,50.
Les résultats soutiennent également des associations parallèles et non exclusives entre le cadrage du rôle, le professionnalisme perçu, la présence sociale et la confiance. Étant donné que le professionnalisme chevauche la confiance cognitive et que la présence sociale chevauche la confiance affective, les données appuient une teneur évaluative différenciée, mais pas deux mécanismes clairement distincts. L'interaction rôle-par-tâche sur le professionnalisme perçu est conforme au modèle proposé de congruence des rôles. Les preuves soutiennent une modulation contextuelle de l'association avec le professionnalisme, mais n'établissent pas de mécanismes contextuels statistiquement asymétriques ni d'invariance dans le chemin de la présence sociale.
Les résultats de l'EEG offrent une perspective exploratoire au niveau des processus. Des énoncés formulés par des experts étaient associés à des profils distincts dans la bande thêta, mais les conditions différaient également par leur contenu sémantique et leur complexité, et le comportement au niveau des conditions ne montrait aucune différence fiable en matière de confiance. Les mesures d'EEG n'établissent donc pas un mécanisme distinct de contrôle cognitif ou de confiance. Les résultats neuronaux doivent être considérés comme générateurs d'hypothèses. L'étude 2 n'a pas manipulé le contexte de la tâche, ni mesuré la perception du professionnalisme ou de la présence sociale, ni associé les indices d'EEG au niveau des essais aux jugements de confiance ; les résultats d'EEG complètent donc le modèle indirect conditionnel sans toutefois le valider.
Les résultats sont compatibles avec une dépendance appropriée plutôt qu'optimale. La dépendance vis-à-vis des systèmes automatisés devrait être calibrée en fonction des capacités, des limites et des exigences de la tâche35. Des travaux connexes décrivent des mécanismes cognitifs adaptatifs qui pourraient soutenir une confiance et une dépendance calibrées51. La perspective NeuroIS soutient l'utilisation de mesures neuronales comme compléments aux données comportementales lors de l'examen de processus résolus dans le temps52. Des études antérieures en IRMf montrent également que l'activité neuronale durant les jugements de confiance en ligne varie selon les cibles et les contextes53.
Implications pour la gestion
Pour les plateformes médicales en ligne, l'implication pratique consiste à établir une confiance calibrée plutôt qu'à maximiser simplement la confiance. Les indices de rôle doivent être adaptés aux exigences de la tâche et combinés à une communication sur l'incertitude, à des limites explicites des capacités, à des avertissements fondés sur les risques et à une transmission aux cliniciens qualifiés.
Dans les modules à haut risque impliquant le diagnostic, l'interprétation de résultats anormaux, les conseils médicaux ou le triage, des indices axés sur les compétences peuvent aider les utilisateurs à reconnaître les limites des preuves et des actions sans conférer une autorité injustifiée. Dans les modules de moindre urgence, tels que l'alimentation, l'exercice physique, le sommeil, l'observance thérapeutique et le soutien émotionnel, des indices axés sur la relation peuvent favoriser l'engagement sans créer de fausse assurance ou un anthropomorphisme inapproprié.
La conception des rôles devrait être modulaire et basée sur des scénarios, plutôt que fondée sur un réglage de personnalité fixe. La configuration des rôles doit être intégrée à des explications, des alertes relatives à la confidentialité, des étiquettes de risque et des mécanismes d'escalade. Les recherches en gouvernance soulignent que la transparence, la responsabilité, la gestion des biais et la protection de la vie privée doivent être conçues conjointement, afin que des indices de rôle crédibles en interface ne masquent pas des risques en aval6,20,21.
Limites de la recherche et orientations futures
L'étude 1 est une expérience de scénario plutôt qu'une consultation réelle. Les conditions n'ont pas été prétestées indépendamment quant à leur longueur, fréquence des mots, lisibilité, exactitude, applicabilité, valence émotionnelle, niveau d'activation, risque, familiarité ou complexité. Les études futures devraient utiliser plusieurs scénarios, des noms de système neutres, des stimuli appariés en contenu, une manipulation indépendante ou des mesures temporellement séparées, ainsi que des effets aléatoires au niveau des participants et des stimuli.
L'étude 2 a fourni des preuves au niveau des processus par EEG, mais le lien démographique final comprenant 39 personnes était incomplet, les énoncés EEG n'ont pas été appariés indépendamment ni prétestés selon la longueur des phrases, la fréquence des mots, la lisibilité, la valence émotionnelle, l'activation, le risque perçu, la familiarité et la complexité, et l'utilisation d'étiquettes de rôle explicites aurait pu induire des caractéristiques de demande. La présente étude a utilisé la valeur de verrouillage de phase corrigée par rapport à la ligne de base (ΔPLV) comme mesure prédéfinie de connectivité fonctionnelle. Bien que l'indice pondéré de décalage de phase (wPLI) soit moins sensible à la conduction en volume, il n'a pas été inclus dans le pipeline d'analyse initial. Les études futures devraient examiner si les résultats actuels se reproduisent avec le wPLI ou d'autres mesures complémentaires de connectivité. Les sorties neuronales disponibles sont agrégées par condition et ne peuvent pas être associées à des jugements de confiance au niveau des essais ; un modèle mixte EEG-comportement au niveau des essais n'a donc pas été estimé. Le PLV au niveau du cuir chevelu est également sensible aux effets de référence commune et de conduction en volume. Ces limites impliquent que les résultats neuronaux doivent rester exploratoires et ne doivent pas être interprétés comme une preuve en faveur d'un mécanisme cognitif de contrôle ou de confiance unique.
Déclarations de divulgation
Les auteurs n'ont aucun conflit d'intérêts à déclarer.
Durant la préparation de ce travail, les auteurs ont utilisé ChatGPT pour améliorer la langue. Après avoir utilisé cet outil/service, les auteurs ont relu et modifié le contenu selon les besoins et assument l'entière responsabilité du contenu de la publication.
Remerciements
Ce projet de recherche a été soutenu par les projets généraux financés par le Fonds national des sciences sociales, RPC (subvention no 22BGL006).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Plateforme en ligne de sondage Credamo | Credamo (Jianshu), Chine | Non applicable | Plateforme en ligne utilisée dans l'étude 1 pour les questionnaires, l'attribution aléatoire et le recrutement des participants. |
| Fonction de recréage de référence CURRY | Compumedics Neuroscan, États-Unis | Version non précisée | Recréage de référence hors ligne intégré, passant de la référence en ligne FCz à la moyenne des mastoïdes bilatérales ; le FCz a été automatiquement reconstruit par rapport à la nouvelle référence. |
| Capteur d'électrodes EEG, 64 canaux | Compumedics Neuroscan (Compumedics Limited), Australie | Modèle ou numéro de catalogue non précisé | Capteur d'électrodes Ag/AgCl à 64 canaux utilisé pour l'enregistrement continu de l'EEG. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, États-Unis | Version 2023.0 | Boîte à outils MATLAB utilisée pour le prétraitement de l'EEG et l'analyse en composantes indépendantes. |
| E-Prime | Psychology Software Tools, Inc., États-Unis | Version 2.1 | Présentation des stimuli et collecte des réponses dans l'étude 2. |
| G*Power | Heinrich Heine University Dusseldorf, Allemagne | Version 3.1.9.7 | Calcul initial de la taille de l'échantillon, analyse de sensibilité à l'interaction et analyse de puissance a posteriori fondée sur un modèle pour l'étude 1. |
| IBM SPSS Statistics | IBM Corp., États-Unis | Version 27 | Environnement statistique utilisé pour exécuter la macro PROCESS. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, États-Unis | Version 1.7 | Greffon EEGLAB utilisé pour classifier les composantes indépendantes artéfactuelles. |
| MATLAB | The MathWorks, Inc., États-Unis | Version R2020b | Environnement informatique utilisé pour le traitement et l'analyse de l'EEG. |
| Macro PROCESS pour SPSS | Andrew F. Hayes, Canada | Version 4.2 bêta | Modèle 7 avec le professionnalisme perçu et la présence sociale entrés simultanément comme médiateurs parallèles, utilisant 5 000 échantillons bootstrap par centiles dans l'étude 1. |
| Gel électrolytique conducteur Quik-Gel | Compumedics Neuroscan (Compumedics Limited), Australie | Numéro de catalogue non précisé ; 32 oz | Gel conducteur utilisé pour réduire l'impédance électrode-peau pendant l'enregistrement de l'EEG. |
| Amplificateur EEG SynAmps2 | Compumedics Neuroscan (Compumedics Limited), Australie | SynAmps2 ; numéro de catalogue non précisé | Amplificateur EEG à 64-256 canaux configuré pour un enregistrement à 64 canaux. |
Références
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.