Cette étude computationnelle présente un flux de travail tenant compte des compartiments pour l'évaluation de transcriptomes publics de virus respiratoires, démontrant que les réponses de l'hôte dans le nez et le sang montrent une concordance limitée au niveau des gènes, mais produisent toutefois des modules spécifiques à chaque compartiment, reproductibles et biologiquement interprétables, à travers des jeux de données indépendants, des comparaisons cliniques, des analyses de récupération longitudinales et des analyses de robustesse.
Article de recherche
Analyse comparative des transcriptomes de virus respiratoires tenant compte des compartiments pour les modules de réponse de l'hôte dans le nez et le sang : une étude computationnelle
Dans cet article
Résumé
Résumé
Les transcriptomes publics des virus respiratoires sont précieux pour étudier les réponses de l'hôte, mais les différences concernant la source tissulaire, la définition des témoins et la conception de l'étude peuvent compliquer les analyses regroupées. Nous avons mis au point un flux de travail computationnel tenant compte des compartiments afin de déterminer si une activité de réponse de l'hôte reproductible peut être identifiée tout en préservant le contexte biologique nasal et sanguin. La cohorte pédiatrique appariée GSE117827 a servi de jeu de données de référence, comprenant des transcriptomes de prélèvements nasaux et de sang total provenant d'infections symptomatiques par le picornavirus, d'infections symptomatiques par le virus respiratoire syncytial, de détections asymptomatiques du picornavirus et de témoins négatifs pour les virus. Après un filtrage selon le Comité d'appellation génétique HUGO (HGNC), 27 685 gènes ont été analysés. Des modules nasaux et sanguins distincts de 50 gènes codant des protéines ont été définis à partir des réponses positives les plus marquées, puis figés avant évaluation externe. Les effets au niveau des gènes dans le nez et le sang étaient presque indépendants (coefficient de corrélation de Pearson r = 0,015), et les modules partageaient six gènes communs identifiés de manière exploratoire (indice de Jaccard = 0,064). Néanmoins, le module nasal a permis de distinguer l'infection des témoins dans des cohortes indépendantes des voies respiratoires supérieures, avec des aires sous la courbe caractéristique de fonctionnement du récepteur (AUROC) de 0,749, 0,693 et 0,609, tandis que le module sanguin a atteint des AUROC de 0,832, 0,924 et 0,870 dans des cohortes sanguines externes. Dans des données longitudinales d'infection naturelle, les scores appariés ont diminué de la phase aiguë à la sortie, avec des variations appariées (deltas) de 0,436 pour les échantillons nasaux et de 0,330 pour le sang. Trois jeux de données supplémentaires de référence, comprenant 666 échantillons externes, ainsi que des gènes aléatoires servant de nuls, des analyses de taille de module, une stabilité par rééchantillonnage bootstrap, des corrélations avec des programmes de marqueurs et une partition de la variance, ont permis de définir la robustesse et les limites du flux de travail. Le jeu de 33 ARN messagers (mRNA) de Pandya restait plus performant pour discriminer les infections virales des bactériennes, tandis que le module sanguin augmentait également lors de pneumonies bactériennes. Ces résultats soutiennent l'utilisation de modules spécifiques aux compartiments comme scores d'activité de réponse de l'hôte réutilisables pour la comparaison de cohortes et le suivi de la récupération, plutôt que comme biomarqueurs universels valables pour tous les tissus ou comme classificateurs de pathogènes autonomes.
Introduction
Les signatures transcriptomiques de l'hôte sont largement utilisées pour classer les syndromes infectieux et comparer les réponses immunitaires entre différents pathogènes1,2,3,4,5. Les virus respiratoires activent souvent des gènes stimulés par l'interféron (ISG), des médiateurs inflammatoires et des voies de présentation de l'antigène qui se chevauchent6,7,8,9,10. Des études récentes appariées et longitudinales montrent également que les réponses locales dans les voies respiratoires et les réponses systémiques peuvent différer par leur chronologie, leur composition cellulaire et leur ampleur11. Ce phénomène s'étend au-delà de la grippe, du virus respiratoire syncytial (VRS), du rhinovirus et du SARS-CoV-2. Le métapneumovirus humain reste une cause importante de maladies respiratoires, bien que la littérature sur la réponse de l'hôte et les interventions thérapeutiques soit encore en développement12,13. Ces observations réalisées lors d'infections par des virus respiratoires soulignent davantage les différences entre les réponses de l'hôte au niveau des voies respiratoires locales et au niveau systémique14. Pour les études computationnelles sur l'hôte et les virus, la question pratique n'est donc pas seulement de savoir si une réponse existe. Elle porte sur la possibilité de réutiliser des données publiques au moyen d'un flux de travail transparent qui préserve le contexte tissulaire et permet d'obtenir des scores reproductibles de la réponse de l'hôte.
La plupart des jeux de données transcriptomiques publics sur les virus respiratoires n'ont pas été conçus pour permettre des inférences claires entre virus ou entre tissus. La source tissulaire, le moment, la gravité, l'âge, la définition du témoin et la plateforme varient souvent conjointement. Les jeux de données d'expression à haut débit sont également sensibles aux variations techniques indésirables et aux variations propres à chaque étude15,16. Une analyse regroupée peut ainsi révéler une signature forte d'interféron ou inflammatoire tout en masquant son origine. Les échantillons nasaux reflètent la biologie immunitaire épithéliale et muqueuse, tandis que le sang total traduit les réponses systémiques des leucocytes. Traiter ces compartiments comme interchangeables facilite le calcul d'un score, mais rend son interprétation difficile.
Nous avons conçu l'analyse autour de GSE117827, une cohorte appariée nez-sang provenant d'une même étude, plutôt que d'utiliser la plus vaste collection de découverte disponible17. La cohorte est petite, mais elle réduit les facteurs de confusion inter-études lors de la comparaison des tailles d'effet dans le nez et le sang. Elle comprend des infections symptomatiques par le picornavirus, des infections symptomatiques par le VRS, des détections asymptomatiques du picornavirus et des témoins négatifs pour les virus. Nous l'avons donc utilisée uniquement comme ancre pour des modules spécifiques à chaque compartiment. L'appartenance aux modules a été figée avant les tests externes. La stabilité de la sélection basée sur la petite cohorte a été évaluée par un rééchantillonnage bootstrap stratifié, des modèles nuls avec des gènes aléatoires et des analyses de sensibilité à la taille des modules.
Nous avons ajouté une couche de référence comprenant des comparateurs bactériens et non infectieux. GSE63990 contient des échantillons de sang total provenant de patients atteints de maladies respiratoires aiguës, étiquetés comme viraux, bactériens ou non infectieux18. GSE40012 contient des cas de pneumonie communautaire sévère, de syndrome de réponse inflammatoire systémique (SIRS) et des témoins sains19. Ces cohortes permettent de tester si un module reflète une activité générale de la réponse de l'hôte ou une spécificité liée à la classe de pathogène. GSE53543 a été analysé séparément comme une référence ex vivo de perturbation par le rhinovirus sur des cellules mononucléées du sang périphérique (PBMC). Cette étude mesure la réactivité des leucocytes sous un stimulus contrôlé, mais ne correspond pas à une infection naturelle.
Notre hypothèse est délibérément conservatrice. Nous n'essayons pas de démontrer une signature antivirale universelle à partir de données publiques hétérogènes. Au lieu de cela, nous nous demandons si un flux de travail tenant compte des compartiments peut produire des scores de module qui restent utiles après un test externe. L'utilisation visée est complémentaire aux classificateurs diagnostiques tels que le Pandya 33-mRNA. Ces modules évaluent l'activité de la réponse hôte dans le nez et le sang à travers différentes cohortes, gradients de rétablissement et de symptômes. Ils ne sont pas conçus pour attribuer une classe de pathogène.
Protocole
La présente étude a reanalysé des données anonymisées et accessibles publiquement et n'a impliqué aucun nouveau recrutement, intervention ni prélèvement d'échantillons. Par conséquent, une approbation éthique institutionnelle et un nouveau consentement éclairé n'étaient pas requis pour cette analyse secondaire. L'approbation éthique et le consentement éclairé pour les études initiales ont été rapportés par les producteurs de données respectifs.
Conception de l'étude et logique du flux de travail
Nous avons mené une étude bioinformatique rétrospective utilisant des données publiques déposées dans le Gene Expression Omnibus20,21. Aucun nouvel échantillon de patient, expérience de culture cellulaire, modèle animal ou validation en laboratoire n’a été généré. Le flux de travail a adopté une conception basée sur un ancrage préalable. La série GSE117827 a été utilisée pour l’estimation de l’ampleur de l’effet, la construction de modules, l’analyse de concordance entre compartiments et l’analyse du gradient des symptômes. Des jeux de données indépendants n’ont été introduits qu’après la fixation de l’appartenance aux modules. Le flux de travail comprenait un ancrage par paires de compartiments, un mappage HGNC et un filtrage des gènes codant pour des protéines, la construction séparée de modules nasaux et sanguins, une validation sur tissus appariés et longitudinale, un étalonnage clinique, ainsi que des analyses de robustesse. Les analyses confirmatoires comprenaient des tests verrouillés sur tissus appariés et longitudinaux. Les analyses d’overlap des gènes, de gradient des symptômes, de programmes marqueurs et de variance étaient exploratoires ou descriptives.
Cohorte d'ancrage et contraste principal
GSE117827 contient des profils d'expression provenant de prélèvements nasaux et de sang total de 26 enfants : 9 cas symptomatiques de picornavirus, 5 détections asymptomatiques de picornavirus, 6 cas symptomatiques de VRS et 6 témoins asymptomatiques négatifs pour les virus17. Deux cas de VRS ne disposaient pas d'échantillons sanguins. Le plan expérimental complet d'ancrage comprenait donc 50 échantillons, et le contraste principal entre infectés et témoins comprenait 40 échantillons après exclusion des détections asymptomatiques de picornavirus de la construction des modules. Pour le contraste principal, les échantillons symptomatiques de picornavirus et les échantillons symptomatiques de VRS ont été étiquetés comme infectés, tandis que les échantillons asymptomatiques négatifs pour les virus ont été étiquetés comme témoins. Les détections asymptomatiques de picornavirus n'ont pas été considérées comme des témoins, car la détection virale en l'absence de symptômes est biologiquement distincte de la santé sans présence virale. Ces échantillons ont été exclus de la construction des modules et utilisés ultérieurement pour une analyse du gradient de symptômes.
Cartographie et prétraitement des sondes
GSE117827 a été profilé sur GPL23126. Les identifiants de regroupement des transcrits ont été associés aux symboles génétiques à l'aide du fichier d'annotation Clariom D Human na36, hg38 distribué via la plateforme GEO GPL24539. Seuls les symboles approuvés par HGNC ont été conservés.22. Les sondes témoins, les sondes ERCC, les groupes de transcrits non cartographiés et les symboles non approuvés ont été supprimés. Les multiples groupes de transcrits associés à un même symbole approuvé ont été regroupés par expression médiane. Après filtration et regroupement, 27 685 gènes étaient disponibles pour l'analyse d'ancrage. Un log₂La transformation (x + 1) a été appliquée uniquement lorsque le 95e percentile de la matrice d'expression dépassait 50, indiquant une échelle d'intensité non logarithmique. Les gènes présentant plus de 20 % de valeurs manquantes ont été supprimés ; les valeurs manquantes restantes ont été remplacées par la médiane intra-gène. Chaque gène a ensuite été standardisé sur l'ensemble des échantillons de ce jeu de données en tant que z = (x − moyenne)/écart type de l'échantillon (ddof = 1). Les gènes de variance nulle se sont vu attribuer une valeur standardisée de 0. La construction des modules a été restreinte aux entrées classées comme gènes codant des protéines dans le jeu de données complet de l'HGNC.
Analyse de la taille de l'effet et construction des modules
Les compartiments nasaux et sanguins ont été analysés séparément. Les échantillons viraux symptomatiques ont été comparés aux témoins négatifs pour le virus à l’aide de différences moyennes standardisées de Hedges g et de tests de Welch bilatéraux23. Hedges g a été calculé comme la différence moyenne entre infectés et témoins divisée par l’écart-type regroupé, puis multiplié par la correction pour petits échantillons 1 − 3/(4df − 1), où df = ninfected + ncontrol − 2. Les tests de Welch ont été appliqués en tenant compte de variances inégales. Les taux de faux positifs (FDR) de Benjamini–Hochberg ont été calculés pour l’ensemble des gènes testés dans chaque compartiment24. Aucun gène codant pour une protéine n’ayant satisfait dans la petite cohorte d’ancrage à la combinaison stricte préétablie de FDR < 0,05 et Hedges g > 0,8, les gènes à effet positif ont été classés d’abord par valeur de P de Welch bilatérale croissante, puis par Hedges g décroissant, le symbole du gène servant de critère de départage déterministe en cas d’égalité. Les 50 gènes en tête formaient chaque module principal. Un nombre de 50 gènes a été choisi a priori comme taille modérée de module permettant de conserver une largeur biologique tout en limitant la perte de gènes manquants entre différentes plates-formes. Cette taille de module n’a pas été ajustée selon l’AUROC externe. Des analyses de sensibilité utilisant 10, 25, 50, 100 et 200 gènes ont donné le même résultat qualitatif de séparation de la cohorte d’ancrage. L’objectif visait la reproductibilité au niveau du module, et non la découverte de gènes individuels.
Concordance entre compartiments
Les estimations de Hedges g au niveau nasal et sanguin ont été appariées par gène et comparées à l'aide de corrélations de Pearson et de Spearman. Le chevauchement entre les 50 premiers modules nasaux et les 50 premiers modules sanguins a été résumé par le nombre de correspondances et par l'indice de Jaccard. Les gènes en chevauchement ont été interprétés comme des candidats exploratoires de chevauchement de classement entre compartiments, plutôt que comme des biomarqueurs conservés validés.
Validation externe appariée aux tissus
La validation par score de module a utilisé des jeux de données publiques indépendants dotés de groupes sources interprétables. La validation des voies respiratoires supérieures comprenait les échantillons de lavage nasal RSV du jeu GSE41374 et les jeux de données SARS-CoV-2 GSE152075 et GSE156063. La validation sanguine comprenait GSE171110 et deux unités du jeu GSE38900 normalisées séparément : GPL10558 (36 échantillons ; 28 RSV et 8 témoins) et GPL6884 (138 échantillons ; 107 RSV et 31 témoins). Pour chaque jeu de données externe, les sondes ont été associées aux symboles HGNC, et les symboles en double ont été regroupés par expression médiane. La même transformation, le même filtrage des valeurs manquantes, l'imputation médiane et les règles de standardisation z par gène appliquées au jeu de données d'ancrage ont été utilisées dans chaque jeu de données. Un score de module a été calculé comme la moyenne non pondérée des valeurs d'expression standardisées des gènes du module représenté. L'AUC-ROC, la précision moyenne et la FDR du test de Welch ont été rapportées comme des métriques de portabilité, et non comme des estimations de la performance diagnostique clinique.
Grands ensembles de données cliniques de référence et de perturbation ex vivo
Deux ensembles de données provenant de sang total ont été utilisés comme cohortes de référence clinique plutôt que comme cohortes de découverte. Dans GSE63990, les échantillons ont été attribués selon les métadonnées d'état d'infection déposées à une infection respiratoire virale (n = 117), une infection respiratoire bactérienne (n = 73) ou une maladie non infectieuse (n = 90) ; les échantillons ne portant pas l'un de ces libellés sans ambiguïté ont été exclus18. Dans GSE40012, les champs de diagnostic déposés ont été regroupés en pneumonie à influenza A (n = 39), pneumonie bactérienne sans influenza (n = 61), SIRS sans pneumonie (n = 40), témoins sains (n = 36) ou pneumonie mixte bactérienne/influenza (n = 14)19. Les échantillons de pneumonie mixte bactérienne/influenza ont été décrits mais exclus des comparaisons binaires de référence.
GSE53543 contient 196 profils de PBMC ex vivo provenant de 98 individus. Chaque individu a fourni un échantillon avec milieu seul et un échantillon exposé au rhinovirus 16 pendant 24 h ; les identifiants des sujets ont confirmé l'existence de 98 paires complètes. Le critère principal évalué était l'AUROC parmi les 98 échantillons stimulés et les 98 échantillons non stimulés, car l'AUROC est une métrique de séparation par rang. L'appariement des sujets a été conservé dans les métadonnées et utilisé dans une analyse de sensibilité appariée des différences de scores. Cette expérience a été analysée séparément des infections cliniques naturelles et n'a pas été utilisée pour étayer des affirmations diagnostiques cliniques.
Les matrices brutes des séries GEO ont été téléchargées pour GSE63990, GSE40012 et GSE53543. La plateforme GPL571 a été utilisée pour GSE63990, GPL6947 pour GSE40012 et GPL10558 pour GSE53543. Les sondes ont été associées aux symboles approuvés par HGNC, et les doublons ont été regroupés par expression médiane. Les matrices normalisées déposées ont été utilisées. La règle générale du 95e centile a déclenché le log₂(x + 1) transformation uniquement pour les matrices sur une échelle non logarithmique. GSE53543 était déjà en échelle logarithmique₂-transformés, normalisés selon le rang et ajustés en fonction du jour de traitement par les investigateurs initiaux, aucune transformation logarithmique supplémentaire n'a donc été appliquée. Après élimination des gènes présentant plus de 20 % de valeurs manquantes et imputation par la médiane des valeurs manquantes restantes, chaque gène a été z-normalisée pour tous les échantillons au sein de son jeu de données. La couche de référence comprenait 470 échantillons cliniques de sang total et 196 échantillons de PBMC ex vivo.
Évaluation comparative des signatures de référence
Les modules nasaux et sanguins d'ancrage ont été évalués par rapport à trois ensembles de référence non pondérés. L'ensemble officiel de 33 ARNm de Pandya a été transcrit à partir du tableau supplémentaire 1 du rapport original du classificateur5. Le comparateur Andres-Terre comprenait 33 gènes orientés vers l'interféron, sélectionnés à partir de la signature multivirus rapportée3. Le comparateur Hallmark comprenait un sous-ensemble de 33 gènes constituant le noyau de la réponse à l'interféron-alpha, associé à l'ensemble MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE25,26. Les listes complètes des gènes pour les trois ensembles de référence sont fournies dans les données supplémentaires 1. Ces scores de référence ne reproduisent pas les classificateurs pondérés d'origine. Pour chaque jeu de données, un score a été calculé comme la moyenne non pondérée des scores z par gène disponibles ; au moins trois gènes représentés étaient requis, et le nombre de gènes représentés a été indiqué. Les comparaisons d'évaluation comprenaient virus contre bactéries, virus contre non infectieux, virus contre bactéries-ou-non-infectieux, virus contre sain/témoin, et bactéries contre sain/témoin, lorsque les groupes requis étaient disponibles. L'AUC-ROC et la précision moyenne ont été interprétées comme des métriques d'évaluation comparative. Les valeurs P du test de Welch ont été ajustées selon la procédure de Benjamini–Hochberg pour toutes les combinaisons valides jeu de données-comparaison-module dans le tableau d'évaluation comparative.
Validation longitudinale indépendante
Les jeux de données appariés aigu par rapport au congé GSE97741 et GSE97742 ont été utilisés uniquement pour la validation longitudinale27. Les échantillons étiquetés comme infection simple par le VRS (RSVsi) ou rhinovirus (hRV) dans les métadonnées déposées ont constitué l'analyse principale ; les co-infections par le VRS (RSVco) ont été conservées uniquement dans les résultats supplémentaires. Les étiquettes aiguës et de congé ont été extraites des titres des échantillons. Les échantillons ont été appariés par jeu de données, compartiment, groupe viral et identifiant du sujet, et seuls les sujets possédant les deux points temporels ont été conservés. Le groupe combiné principal comprenait 38 paires RSVsi et 30 paires hRV (68 paires par compartiment).
Aucune sélection de gènes, affinement de module ou réglage de seuil n'a été utilisé pour GSE97741 ou GSE97742. Ces jeux de données ont été réservés à la validation externe. Les identifiants de sondes ont été associés aux symboles HGNC approuvés, et les symboles en double ont été regroupés par expression médiane. La même règle de transformation logarithmique au 95e percentile, le même filtre des valeurs manquantes, l'imputation médiane et les procédures de standardisation par gène au sein de chaque jeu de données selon le score z ont été appliquées avant le calcul des scores de module fixes de GSE117827.
Pour chaque tissu et module, les scores aigus et de sortie ont été appariés par sujet et groupe viral. La différence entre aigu et sortie a été calculée pour chaque paire. Le dz de Cohen a été calculé comme la moyenne des différences appariées divisée par son écart-type échantillonnal. Des tests t appariés bilatéraux et des tests de Wilcoxon des rangs signés bilatéraux ont été rapportés, accompagnés de l’AUC-ROC pour la séparation des scores aigus et de sortie. Les valeurs de FDR de Benjamini–Hochberg ont été calculées sur l’ensemble des 20 tests t appariés valides dans la sortie longitudinale complète (deux jeux de données, deux sources de modules et cinq résumés de groupes viraux prédéfinis).
Analyse du gradient des symptômes et analyse a posteriori
Une fois l'appartenance aux modules fixée, les détections de picornavirus asymptomatiques exclues de GSE117827 ont été utilisées uniquement pour l'analyse du gradient des symptômes. Le score clinique ordinal était de 0 pour les témoins négatifs au virus, de 1 pour les détections asymptomatiques de picornavirus et de 2 pour les infections symptomatiques. La corrélation de Spearman a évalué la tendance ordinale, tandis que le test de Kruskal-Wallis a évalué les différences globales entre les trois groupes. Des tests a posteriori de Mann-Whitney U bilatéraux ont comparé les trois paires de groupes. Une correction de Benjamini-Hochberg a été appliquée séparément à l'intérieur de chaque compartiment à sa famille de trois comparaisons par paires.
Enrichissement fonctionnel
Les gènes des modules nasaux et sanguins ont été analysés avec Enrichr à l'aide de gseapy, en utilisant les bibliothèques MSigDB Hallmark 2020, Reactome 2022 et GO Biological Process 2023.25,26,28,29,30,31. Enrichr a utilisé son cadre standard de sur-représentation basé sur le test exact de Fisher. Valeurs corrigées par la méthode de Benjamini-Hochberg telles que rapportées par la bibliothèque P valeurs < 0,05 ont été considérés comme significatifs. Les huit termes les plus significatifs par module parmi les trois bibliothèques interrogées ont été classés par valeur ajustée P valeur. Les résultats d'enrichissement ont été utilisés uniquement à des fins d'interprétation.
Analyses de robustesse, de programme de marqueurs et de variance
Les analyses de robustesse ont vérifié si les résultats dépendaient de la taille des modules ou d'une sélection aléatoire. Des tailles de modules de 10, 25, 50, 100 et 200 gènes ont été évaluées. Pour l'analyse nulle basée sur des gènes aléatoires, l'univers éligible comprenait les gènes codant des protéines selon HGNC présents dans la matrice GSE117827 traitée. Cinq cents ensembles de 50 gènes ont été échantillonnés sans remise en utilisant une graine aléatoire NumPy de 20260622. La réélection par rééchantillonnage a été restreinte aux 1 000 gènes codant des protéines ayant un effet positif et classés aux premiers rangs dans l'analyse d'ancrage initiale pour chaque compartiment. À chaque rééchantillonnage, les gènes codant des protéines positifs ont été classés par valeur P de Welch bilatérale croissante, puis par différence moyenne décroissante. Les 50 gènes situés en tête ont été sélectionnés. La stabilité des gènes a été calculée comme le nombre de sélections divisé par 100. Les 20 gènes ayant la fréquence de sélection la plus élevée dans chaque compartiment ont été affichés.
Les scores des programmes de marqueurs ont été utilisés comme aides descriptives plutôt que comme estimations des fractions cellulaires. Six programmes soigneusement sélectionnés ont été évalués : épithélial (EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1), monocyte/macrophage (LYZ, LST1, S100A8, S100A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS), neutrophile (S100A8, S100A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8), T/NK (CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R), B/plasmocyte (MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1) et myéloïde interféron (SIGLEC1, IFI27, IFI44L, ISG15, MX1, OAS1, RSAD2, IFIT3). Chaque score de programme a été calculé comme la moyenne des z-scores par gène disponibles, au moins trois gènes devant être représentés. Les valeurs de P de Spearman ont été ajustées à l’aide de la procédure de Benjamini–Hochberg sur l’ensemble des corrélations entre jeu de données, module et programme. L’eta-carré unidirectionnel a été calculé comme le rapport de la somme des carrés intergroupes divisée par la somme totale des carrés pour chaque paire module-facteur. Les lignes manquantes pour le facteur pertinent ont été exclues de ce calcul. Cette analyse était descriptive et n’a pas corrigé les facteurs mutuellement corrélés.
Reproductibilité
Toutes les analyses ont été réalisées à l'aide de workflows scriptés en Python 3.12.13, les versions des packages logiciels étant indiquées dans le Tableau des matériaux. Les procédures randomisées ont utilisé une graine fixe de 20260622. Les matrices d'expression publiques de GEO ont été traitées selon une structure de projet cohérente, séparant les données brutes, les données traitées, les résultats statistiques, les tableaux et les figures. Les définitions des modules, les registres de curation des échantillons, les estimations des tailles d'effet, les statistiques de validation, les résultats d'enrichissement, les analyses de robustesse et les données sources des figures ont été conservées afin de permettre une vérification indépendante. Le code d'analyse, les spécifications des dépendances et les données dérivées associées sont disponibles conformément à la déclaration sur la disponibilité des données.
Résultats
L'évaluation par étape d'ancrage a séparé les effets géniques spécifiques à un tissu des effets géniques pan-tissulaires
La matrice d'ancrage curatée GSE117827 contenait 27 685 gènes approuvés par HGNC. Le contraste nasal principal comprenait 15 échantillons infectés symptomatiques et 6 échantillons témoins négatifs au virus ; le contraste sanguin comprenait 13 échantillons infectés symptomatiques et 6 témoins (Tableau 1). Étant donné que cette petite cohorte ne permet pas une découverte stable au niveau des gènes individuels, elle a été utilisée comme ancrage apparié par compartiment. La stabilité a été évaluée au niveau des modules par rééchantillonnage bootstrap, tests nuls aléatoires sur les gènes, validation externe et analyses de sensibilité à la taille des modules.
| Source | Groupe | Condition | Contraste principal | n |
| Sang | RSV | Infected | Oui | 4 |
| Sang | Picornavirus asymptomatique | Secondaire | Non | 5 |
| Sang | Picornavirus symptomatique | Infected | Oui | 9 |
| Sang | Témoin négatif pour le virus | Témoin | Oui | 6 |
| Nasal | RSV | Infected | Oui | 6 |
| Nasal | Picornavirus asymptomatique | Secondaire | Non | 5 |
| Nasal | Picornavirus symptomatique | Infected | Oui | 9 |
| Nasal | Témoin négatif pour le virus | Témoin | Oui | 6 |
Tableau 1 : Conception de l'ancrage pour GSE117827 après curation du contraste principal. Répartition des échantillons entre les compartiments sanguin et nasal dans le jeu de données à ancrage apparié après curation du contraste principal. Les échantillons de virus respiratoire syncytial (VRS) symptomatiques et les échantillons de picornavirus symptomatiques ont été classés comme infectés et inclus dans le contraste principal, tandis que les témoins négatifs pour les virus ont été classés comme témoins et inclus dans le contraste principal. Les échantillons de picornavirus asymptomatiques ont été désignés comme secondaires et exclus de la construction des modules ; ils ont été utilisés uniquement dans l'analyse exploratoire du gradient de symptômes. Deux cas de VRS ne disposaient pas d'échantillons sanguins, ce qui donne un total de quatre échantillons sanguins et six échantillons nasaux de VRS.
Parmi les 27 685 gènes partagés, les estimations de Hedges g pour le nez et le sang étaient presque non corrélées (Pearson r = 0,015 ; Figure 1). Ce résultat provient d'une seule étude et est moins exposé aux différences entre études qu'une comparaison groupée transversale entre cohortes. Le nuage dense central montre que la plupart des gènes ne se sont pas déplacés de manière similaire dans les deux compartiments. Les gènes de recouvrement mis en évidence constituaient des exceptions situées en haut des deux listes de classement. Ce schéma soutient la construction séparée de modules nasaux et sanguins.
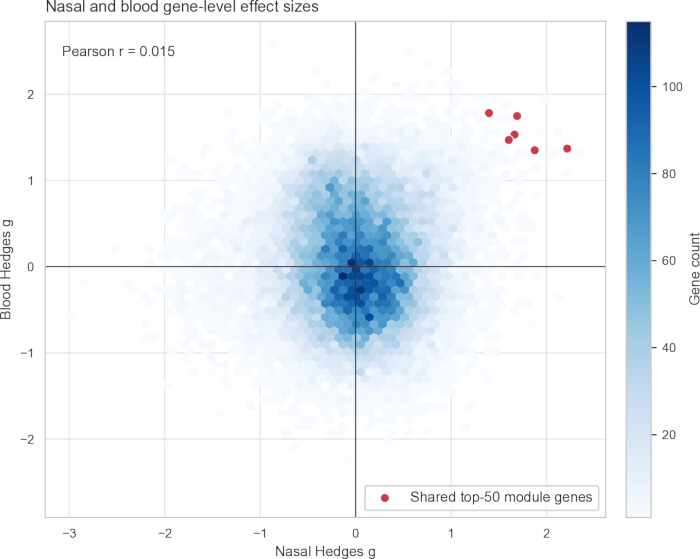
Figure 1. Tailles d'effet au niveau des gènes dans le nez et le sang dans la cohorte ancre appariée GSE117827. Les valeurs de Hedges g comparent l'infection symptomatique à des contrôles négatifs au virus pour 27 685 gènes. Les estimations nasales (15 infectés, 6 contrôles) sont indiquées sur l'axe des abscisses, et les estimations sanguines (13 infectés, 6 contrôles) sur l'axe des ordonnées. La teinte des hexagones indique le nombre de gènes par bin. Les points rouges indiquent les six gènes partagés entre les modules nasaux et sanguins du top 50. Pearson r = 0,015. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
La construction des modules a produit un petit chevauchement centré sur l'interféron
Les 50 premiers modules nasaux et sanguins partageaient six gènes : ISG15, ACRBP, IFIT1, RSAD2, CCRL2 et XAF1 (indice de Jaccard = 0,064 ; Tableau 2 ; Figure 2). ISG15, IFIT1, RSAD2 et XAF1 sont compatibles avec une biologie antivirale liée à l'interféron32,33,34. CCRL2 s'interprète mieux dans le contexte de la migration des leucocytes inflammatoires35. ACRBP n'a aucun rôle antiviral établi. Les six gènes sont indiqués par souci de transparence, mais aucun n'est revendiqué comme biomarqueur validé traversant les tissus. Leurs valeurs de FDR au niveau individuel n'étaient pas significatives dans le petit groupe témoin. L'inférence principale repose donc sur la validation au niveau des modules verrouillés, et non sur la liste des chevauchements.
| Gène | Hedges nasal g | FDR nasal | Hedges sanguin g | FDR sanguin | Interprétation |
| ISG15 | 2.215 | 0.213 | 1.369 | 0.442 | Gène antiviral induit par l'interféron ; chevauchement exploratoire |
| ACRBP | 1.69 | 0.205 | 1.748 | 0.429 | Aucun rôle antiviral établi ; conservé par transparence |
| IFIT1 | 1.875 | 0.213 | 1.35 | 0.442 | Gène antiviral induit par l'interféron ; chevauchement exploratoire |
| RSAD2 | 1.663 | 0.213 | 1.532 | 0.442 | Gène antiviral induit par l'interféron ; chevauchement exploratoire |
| CCRL2 | 1.396 | 0.217 | 1.782 | 0.442 | Contexte de migration des leucocytes inflammatoires ; non spécifique aux virus |
| XAF1 | 1.603 | 0.226 | 1.47 | 0.442 | Facteur d'apoptose lié à l'interféron ; chevauchement exploratoire |
Tableau 2 : Chevauchement exploratoire complet entre les modules nasaux et sanguins les mieux classés. Les six gènes partagés sont indiqués avec les valeurs de Hedges g nasales et sanguines ainsi que les valeurs de FDR par gène. Les six gènes sont considérés comme des candidats exploratoires de chevauchement de classement, car les valeurs de FDR par gène n'étaient pas significatives dans le petit groupe témoin. Le gène ACRBP est conservé par transparence, malgré l'absence de rôle antiviral établi. Aucun des six gènes n'est présenté comme un biomarqueur universel validé ; les preuves principales reposent sur une validation externe au niveau du module.
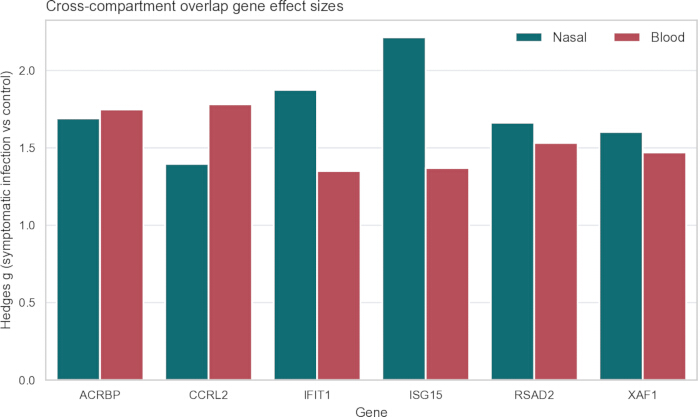
Figure 2. Tailles d'effet des six gènes exploratoires présentant un chevauchement entre nez et sang. Les estimations de Hedges g dans les échantillons nasaux et sanguins sont présentées pour ACRBP, CCRL2, IFIT1, ISG15, RSAD2 et XAF1 dans GSE117827. Des valeurs positives indiquent une expression plus élevée lors d'une infection symptomatique par rapport aux témoins négatifs au virus. Le chevauchement complet est montré à des fins de transparence ; les valeurs de FDR au niveau du gène unique n'étaient pas significatives, et ces gènes ne sont pas présentés comme des biomarqueurs universels validés. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
L'enrichissement fonctionnel a fourni un contrôle biologique sur le contenu des modules
Les deux modules étaient enrichis pour les voies de l'interféron et antivirales, bien que la composition génique et l'intensité d'enrichissement diffèrent (Figure 3). Les huit termes les plus significatifs par module sont affichés. Pour le module nasal, la réponse Hallmark à l'interféron-gamma (ajusté P = 2,23 × 10⁻24), la réponse Hallmark à l'interféron-alpha (ajusté P = 1,40 × 10⁻22), la signalisation Reactome de l'interféron-alpha/bêta (ajusté P = 3,64 × 10⁻19) et la réponse à la défense contre les virus selon GO (ajusté P = 5,47 × 10⁻15) figuraient parmi les termes principaux. Le module sanguin présentait la même biologie générale, mais avec une intensité d'enrichissement moindre : réponse à l'interféron-alpha (ajusté P = 3,87 × 10⁻6), signalisation Reactome de l'interféron-alpha/bêta (ajusté P = 5,70 × 10⁻6), réponse à l'interféron-gamma (ajusté P = 8,89 × 10⁻6) et réponse à la défense contre les virus (ajusté P = 1,07 × 10⁻4). Ces résultats confirment la cohérence biologique sans impliquer une hiérarchisation identique des gènes selon les compartiments.
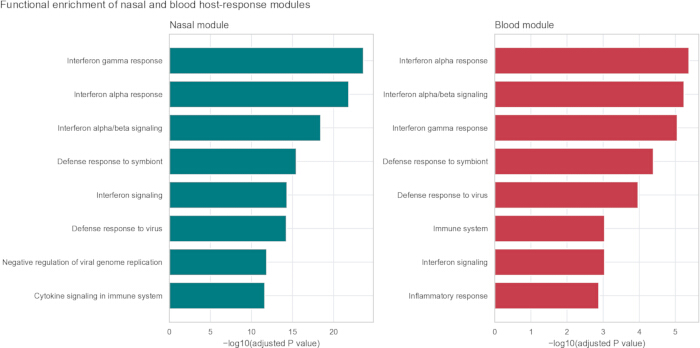
Figure 3. Termes d'enrichissement sélectionnés pour les modules nasaux et sanguins. Une analyse de sur-représentation a été réalisée à l'aide d'Enrichr avec Hallmark 2020, Reactome 2022 et GO Biological Process 2023. Les huit termes présentant les valeurs de P ajustées selon Benjamini–Hochberg les plus faibles pour chaque module sont indiqués. La longueur des barres représente −log10(valeur de P ajustée). Les panneaux gauche et droit montrent respectivement les modules nasaux et sanguins. Les termes sont affichés en casse de phrase. L'analyse d'enrichissement n'a pas modifié l'appartenance aux modules. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Les modules verrouillés ont été testés lors d'une validation externe appariée aux tissus
Le module nasal verrouillé a atteint des AUC-ROC de 0,749 dans GSE41374, 0,693 dans GSE152075 et 0,609 dans GSE156063 (Tableau 3 ; Figure 4). Le module sanguin verrouillé a atteint des AUC-ROC de 0,832 dans GSE171110, 0,924 dans l'unité GSE38900 GPL10558 et 0,870 dans l'unité GPL6884. Les performances internes des ancres ne sont pas indiquées car elles sont biaisées de manière optimiste par construction. Les AUC-ROC externes sont considérées comme des résumés de portabilité. Elles n'établissent pas la sensibilité clinique, la spécificité ou l'aptitude au diagnostic.
| Cohorte | Échantillon/virus | Module | n positif | n négatif | Gènes représentés | AUROC | Précision moyenne | FDR du test de Welch |
| GSE152075 | SARS-CoV-2 voies respiratoires supérieures | Nasal | 430 | 54 | 50 | 0.693 | 0.935 | 2.20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 voies respiratoires supérieures | Nasal | 93 | 100 | 49 | 0.609 | 0.551 | 1.38 × 10⁻² |
| GSE171110 | SARS-CoV-2 sang total | Sang | 44 | 10 | 50 | 0.832 | 0.959 | 7.94 × 10⁻⁴ |
| GSE38900-GPL10558 | RSV sang total | Sang | 28 | 8 | 50 | 0.924 | 0.979 | 7.94 × 10⁻⁴ |
| GSE38900-GPL6884 | RSV sang total | Sang | 107 | 31 | 49 | 0.87 | 0.962 | 3.47 × 10⁻¹⁵ |
| GSE41374 | Lavage nasal RSV | Nasal | 76 | 10 | 50 | 0.749 | 0.951 | 2.63 × 10⁻² |
Tableau 3 : Validation externe des scores de modules appariés aux tissus. Le module nasal verrouillé a été testé dans les séries GSE41374, GSE152075 et GSE156063, et le module sanguin verrouillé a été testé dans les unités de plateforme GSE171110 et GSE38900, GPL10558 et GPL6884. Le tableau indique les nombres d'échantillons positifs et négatifs, les gènes du module représentés, l'AUROC, la précision moyenne et la FDR du test de Welch. Les performances des ancres internes sont omises. L'AUROC et la précision moyenne sont indiquées comme résumés de portabilité et non comme des estimations de la performance diagnostique clinique.
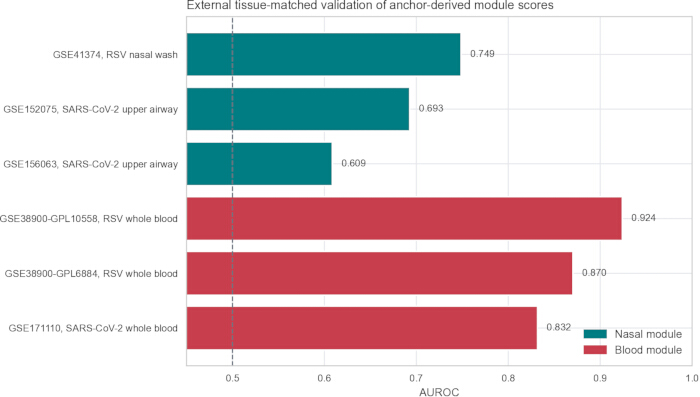
Figure 4. Transférabilité des scores de module appariés aux tissus externes. Les AUROC sont présentés pour le module nasal dans GSE41374 (76 RSV, 10 témoins), GSE152075 (430 SARS-CoV-2, 54 témoins) et GSE156063 (93 SARS-CoV-2, 100 témoins), ainsi que pour le module sanguin dans GSE171110 (44 SARS-CoV-2, 10 témoins), GSE38900-GPL10558 (28 RSV, 8 témoins) et GSE38900-GPL6884 (107 RSV, 31 témoins). Les scores correspondent aux moyennes non pondérées des valeurs z par gène représentées. La ligne en pointillés indique un AUROC = 0,5. Les valeurs constituent des résumés de transférabilité, et non des estimations diagnostiques cliniques. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
La validation longitudinale a testé si les scores diminuent pendant la récupération
Les jeux de données complémentaires GSE97741/GSE97742 ont fourni un cadre de validation indépendant basé sur une infection naturelle, comprenant des échantillons prélevés en phase aiguë et au moment de la sortie chez des enfants hospitalisés27. Ces échantillons n'ont pas été utilisés comme données de découverte de contrôles sains. Ils ont servi à évaluer si les scores des modules dérivés des ancres diminuaient entre la phase aiguë de la maladie et la sortie hospitalière.
Pour le groupe combiné prédéfini d'infection unique par le VRS et le rhinovirus, 68 sujets appariés ont été analysés pour chaque tissu (Tableau 4 ; Figure 5). Le module sanguin a diminué de la phase aiguë à la sortie pour le sang (delta moyen = 0,330 ; Cohen dz = 0,740 ; FDR du test apparié = 1,98 × 10⁻7 ; AUROC = 0,765). Le module nasal a également diminué dans les échantillons nasopharyngés (delta moyen = 0,436 ; Cohen dz = 0,477 ; FDR du test apparié = 3,06 × 10⁻4 ; AUROC = 0,679). Les trajectoires appariées et leurs erreurs standard montrent que la baisse au niveau du groupe n'était pas due à quelques valeurs extrêmes non appariées.
| Jeu de données | Source de l'échantillon | Module | Tissu apparié | Nombre de paires | Delta moyen aigu-décharge | Cohen dz | AUROC | FDR du test apparié |
| GSE97741 | Sang | Sang | Oui | 68 | 0,330 | 0,740 | 0,765 | 1,98 × 10⁻⁷ |
| GSE97741 | Sang | Nasal | Non | 68 | 0,479 | 0,721 | 0,755 | 3,19 × 10⁻⁷ |
| GSE97742 | Nasopharyngé | Sang | Non | 68 | 0,361 | 0,914 | 0,845 | 9,42 × 10⁻¹⁰ |
| GSE97742 | Nasopharyngé | Nasal | Oui | 68 | 0,436 | 0,477 | 0,679 | 3,06 × 10⁻⁴ |
Tableau 4 : Validation longitudinale indépendante aiguë par rapport au moment du congé. Le tableau indique le nombre de paires complètes, la différence moyenne entre les scores aigu et au congé, le dz de Cohen, l'AUROC et la FDR du test apparié pour les modules fixes dans les jeux de données GSE97741 et GSE97742. Un delta positif indique un score de module plus élevé durant la phase aiguë de la maladie. Les valeurs de FDR du test apparié correspondent à des P valeurs ajustées selon Benjamini–Hochberg pour des tests t appariés bilatéraux, calculées sur l'ensemble des 20 tests t appariés valides présents dans la sortie longitudinale complète.
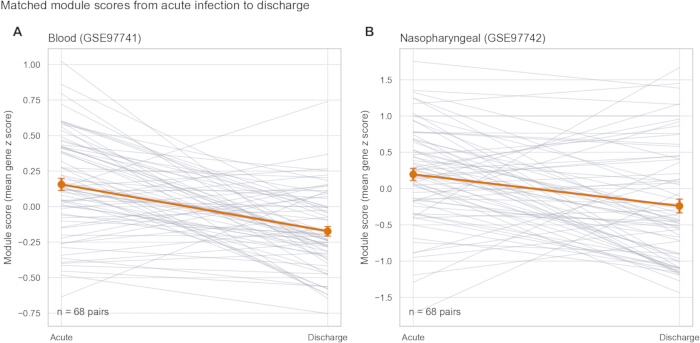
Figure 5. Évolution appariée des scores des modules de la maladie aiguë au congé. (A) Scores des modules sanguins dans le sang total (GSE97741). (B) Scores des modules nasaux dans les échantillons nasopharyngés (GSE97742). Chaque graphique comprend 68 paires complètes de sujets : 38 infections simples à VRS et 30 infections à rhinovirus. Des lignes fines relient les mesures appariées par sujet. Les points orange indiquent les moyennes du groupe, et les barres d'erreur oranges indiquent l'erreur-type de la moyenne. Des tests t appariés bilatéraux et des tests de Wilcoxon pour échantillons appariés ont été réalisés ; une correction FDR de Benjamini–Hochberg a été appliquée sur l'ensemble des 20 tests t appariés longitudinaux valides. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Les tests intercompartiments ont révélé une nuance utile. Le module sanguin appliqué aux échantillons nasopharyngés a donné une AUC-ROC de 0,845, bien que les effets individuels du nez et du sang aient été faiblement concordants dans l'élément de référence. L'analyse des trajectoires appariées a montré une diminution constante des scores, plutôt qu'une distribution inversée des étiquettes. Ainsi, ce résultat ne constitue pas une preuve que les mêmes gènes individuels dominent dans les deux tissus. Il indique plutôt qu'un programme coordonné d'interféron/inflammation peut être résumé par des ensembles de gènes différents mais partiellement redondants. La spécificité par compartiment est la plus marquée au niveau du classement des gènes et n'est pas absolue au niveau des voies ou des scores.
Les détections asymptomatiques exclues ont été testées pour évaluer le comportement selon le gradient des symptômes
Les détections asymptomatiques de picornavirus dans GSE117827 ont été exclues de la construction du module afin d'éviter leur inclusion dans le groupe témoin principal. Ce groupe exclu a ensuite servi de contrôle biologique. Dans les deux compartiments, les scores des modules ont augmenté progressivement à travers les groupes ordonnés suivants : contrôles négatifs au virus, détections asymptomatiques de picornavirus et infections symptomatiques (Figure 6A,B).
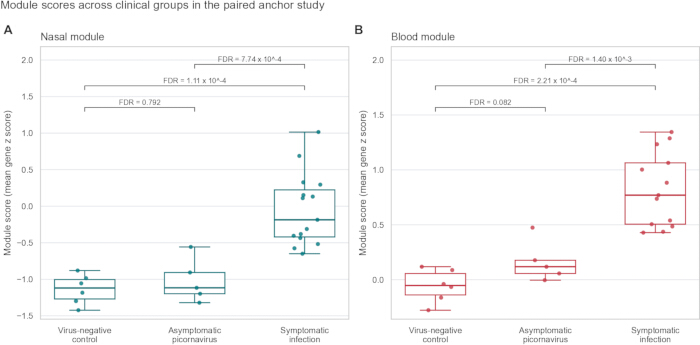
Figure 6. Scores des modules selon le gradient de symptômes conservé. (A) Module nasal : 6 témoins négatifs pour les virus, 5 détections asymptomatiques de picornavirus et 15 infections symptomatiques. (B) Module sanguin : 6 témoins négatifs pour les virus, 5 détections asymptomatiques de picornavirus et 13 infections symptomatiques. Les points représentent des échantillons individuels. Les lignes centrales indiquent les médianes ; les boîtes s'étendent du 25e au 75e centile ; les moustaches vont jusqu'aux valeurs les plus extrêmes dans un intervalle de 1,5 fois l'écart interquartile. Les étiquettes indiquent les comparaisons a posteriori bilatérales de Mann-Whitney U avec correction de Benjamini-Hochberg pour les trois comparaisons par compartiment. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Le module nasal était corrélé au score ordinal des symptômes (rho de Spearman = 0,818, P = 3,28 × 10⁻7 ; Kruskal-Wallis P = 1,57 × 10⁻4). Le module sanguin présentait un gradient similaire (rho = 0,861, P = 6,89 × 10⁻8 ; Kruskal-Wallis P = 1,92 × 10⁻4). Après correction au sein de chaque famille de trois comparaisons, l'infection symptomatique différait des témoins et des détections asymptomatiques dans les deux compartiments. Les détections asymptomatiques ne différaient pas des témoins négatifs au virus (FDR nasal = 0,792 ; FDR sanguin = 0,082). Les modules reflétaient donc l'activité de la réponse hôte symptomatique de manière plus nette que la détection virale seule.
Des critères cliniques ont défini la limite entre la réponse de l'hôte et la spécificité du pathogène
Les critères cliniques ont établi la distinction entre l'activité de la réponse de l'hôte et la classification des pathogènes (Tableau 5 ; Figure 7). Dans GSE63990, le module nasal a donné des AUC-ROC de 0,782 pour la distinction maladie virale/maladie bactérienne et de 0,791 pour maladie virale/maladie non infectieuse. Le module sanguin a donné respectivement des AUC-ROC de 0,678 et 0,753. Le comparateur à 33 ARNm de Pandya a donné de meilleurs résultats, avec des AUC-ROC respectives de 0,867 et 0,852. Ce résultat était attendu pour un ensemble conçu pour discriminer les infections virales des non virales, et montre que les modules d'ancrage ne doivent pas être présentés comme des classificateurs diagnostiques de remplacement.
| Jeu de données | Contraste | Repère nasal | Repère sanguin | ARNm Pandya 33 | ISG Andres-Terre | Interféron-alpha caractéristique |
| GSE63990 | Viral contre bactérien | 0,782 | 0,678 | 0,867 | 0,833 | 0,831 |
| GSE63990 | Viral contre non infectieux | 0,791 | 0,753 | 0,852 | 0,851 | 0,848 |
| GSE40012 | Pneumonie virale contre pneumonie bactérienne | 0,755 | 0,789 | 0,893 | 0,867 | 0,872 |
| GSE40012 | Pneumonie virale contre SIRS | 0,897 | 0,907 | 0,985 | 0,965 | 0,956 |
| GSE40012 | Pneumonie virale contre état sain | 0,804 | 0,986 | 0,923 | 0,906 | 0,891 |
| GSE40012 | Pneumonie bactérienne contre état sain | 0,476 | 0,917 | 0,465 | 0,391 | 0,378 |
| GSE53543 | GBMC stimulés ex vivo par le rhinovirus contre non stimulés | 1 | 0,957 | 1 | 1 | 1 |
Tableau 5 : Référence AUROC pour les modules d'ancrage et les jeux de référence de la réponse hôte. GSE63990 et GSE40012 sont des cohortes cliniques de sang total. GSE53543 est une expérience de perturbation ex vivo sur des PBMC impliquant 98 sujets appariés et est rapportée séparément des cohortes cliniques naturelles. Les jeux de référence ont été notés selon la moyenne non pondérée des gènes plutôt que selon leurs classificateurs pondérés d'origine. Les valeurs AUROC sont indiquées comme métriques de référence et non comme estimations de la performance diagnostique clinique.
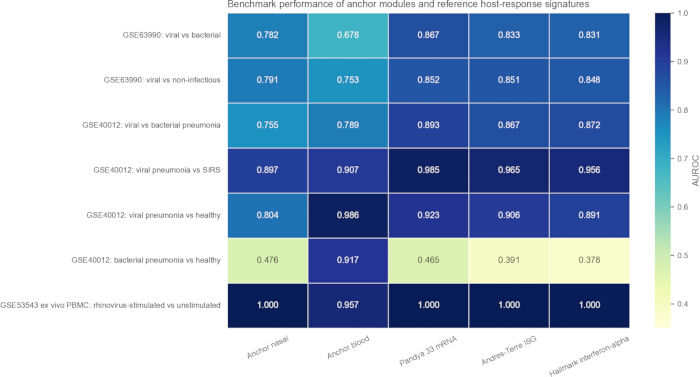
Figure 7. Évaluation comparative par AUROC des modules d'ancrage et des jeux de référence de la réponse hôte. Les lignes représentent des comparaisons prédéfinies dans les jeux de données GSE63990, GSE40012 et GSE53543 ; les colonnes représentent les deux modules d'ancrage et les trois jeux de référence non pondérés. Le jeu GSE53543 est étiqueté comme cellules mononucléées du sang périphérique (PBMC) stimulées ex vivo par le rhinovirus par rapport aux PBMC non stimulées, et est présenté séparément des cohortes cliniques naturelles. Le comparateur Hallmark est étiqueté Hallmark interféron-alpha. Les valeurs dans les cellules indiquent les AUROC utilisées pour l'évaluation comparative des méthodes et ne doivent pas être interprétées comme des estimations de la performance diagnostique clinique. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
GSE40012 a précisé cette limite. Le comparateur Pandya a atteint des AUROC de 0,893 pour la pneumonie virale contre bactérienne et de 0,985 pour la pneumonie virale contre le SIRS. Le module sanguin a distingué la pneumonie à influenza A des témoins sains (AUROC = 0,986) et du SIRS (AUROC = 0,907), mais il a également différencié la pneumonie bactérienne des témoins sains (AUROC = 0,917). Le module sanguin mesure donc une activité inflammatoire systémique générale et associée à l'interféron. Il n'est pas spécifique aux virus, et un score élevé ne permet pas d'attribuer une classe de pathogène.
Dans le test témoin ex vivo GSE53543 distinct, le module nasal et les comparateurs d'interféron ont atteint une AUROC de 1,000 pour les PBMC stimulés par le rhinovirus par rapport aux PBMC traités au milieu seul ; le module sanguin a atteint une AUROC de 0,957. Les 98 sujets ont tous fourni des conditions appariées. Ce résultat contrôlé soutient la réactivité des programmes évalués à la stimulation par le rhinovirus. Il n'estime pas la performance diagnostique clinique.
Des vérifications de robustesse ont testé la taille des modules, les alternatives aléatoires et la stabilité de la sélection
La séparation des ancres est restée inchangée pour les 10, 25, 50, 100 et 200 gènes les mieux classés (Figure 8A). Ces AUC-ROC internes ne constituent pas une validation externe, mais montrent que le résultat qualitatif ne dépendait pas du choix exact de 50 gènes. Dans 500 ensembles aléatoires de 50 gènes, les médianes d’AUC-ROC sous l’hypothèse nulle étaient de 0,489 pour le tissu nasal et de 0,705 pour le sang ; les 99e percentiles correspondants étaient respectivement de 0,722 et 0,872 (Figure 8B). Les modules observés dépassaient ces distributions nulles. Les fréquences de sélection par rééchantillonnage bootstrap étaient réparties plutôt que concentrées dans une liste unique invariante (Figure 8C). Cette observation reflète directement la petite taille de l’échantillon d’ancrage. Elle soutient l’existence d’un signal agrégé stable, tout en mettant en garde contre le fait de considérer chaque gène sélectionné comme fixe.
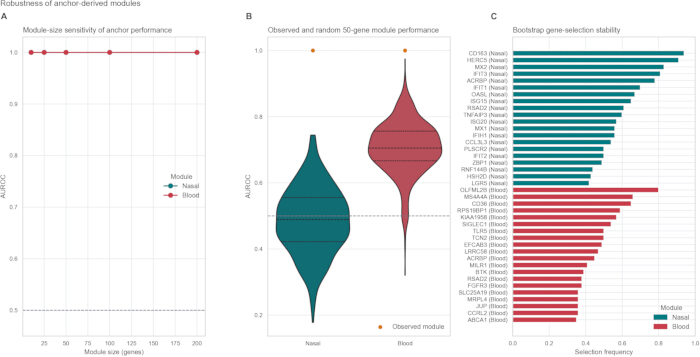
Figure 8. Analyses de robustesse de la taille du module, des gènes aléatoires et du bootstrap. (A) AUROC d'ancrage selon différentes tailles de module : 10, 25, 50, 100 et 200 gènes ; ces valeurs représentent des contrôles internes de sensibilité. (B) Distributions de l'AUROC obtenues à partir de 500 ensembles aléatoires de 50 gènes codant des protéines, échantillonnés sans remise parmi les gènes présents dans GSE117827 (graine = 20260622). Les points orange indiquent les AUROC observés pour les modules. Les lignes horizontales à l'intérieur de chaque tracé en violon indiquent le 25e percentile, la médiane et le 75e percentile. (C) Le rééchantillonnage par bootstrap a été restreint aux 1 000 gènes codant des protéines ayant un effet positif, classés comme les mieux placés dans l'analyse d'ancrage initiale pour chaque compartiment. Les barres montrent les 20 gènes ayant la fréquence de sélection la plus élevée par compartiment ; la fréquence de sélection a été calculée comme le nombre de sélections divisé par 100. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Les analyses des programmes marqueurs et de la variance ont précisé ce que mesurent les scores
Dans les jeux de données GSE40012, GSE53543 et GSE63990, les deux modules étaient le plus régulièrement corrélés au programme interféron myéloïde (Figure 9A). Les corrélations pour le module nasal étaient de 0,812, 0,878 et 0,882 ; celles du module sanguin étaient de 0,517, 0,843 et 0,774. La partition de la variance était descriptive (Tableau 6 ; Figure 9B). Pour le module sanguin, la condition et le groupe détaillé expliquaient davantage de variance (éta² = 0,282 et 0,250, respectivement) que le jeu de données (0,066), le type d'échantillon (0,026) ou le groupe d'origine (0,025). Pour le module nasal, le groupe détaillé et la condition expliquaient également plus de variance que le jeu de données, le type d'échantillon ou le groupe d'origine. La condition biologique et le groupe détaillé expliquaient donc des fractions plus importantes de la variance des scores des modules que le jeu de données ou le type d'échantillon, bien que des effets non nuls liés au jeu de données et à la composition restent une limite à la réutilisation de données publiques en bulk.
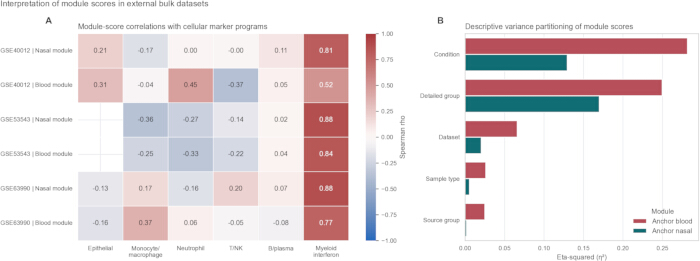
Figure 9. Corrélations entre les programmes marqueurs et partition descriptive de la variance. (A) Corrélations de Spearman entre les scores de module et les six scores de programme marqueur dans GSE40012, GSE53543 et GSE63990. Les programmes nécessitaient au moins trois gènes représentés. Les valeurs P ont été ajustées pour l'ensemble des corrélations jeu de données-module-programme. Les cellules vides indiquent des combinaisons non disponibles ou non estimables après application des critères relatifs aux gènes et aux échantillons. (B) Éta-carré unidirectionnel (η2 ; somme des carrés intergroupes / somme totale des carrés) pour la condition, le groupe détaillé, le jeu de données, le type d'échantillon et le groupe d'origine. L'analyse a inclus 934 scores de module sanguin et 1 469 scores de module nasal et est descriptive, non causale. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Module | Facteur | Éta-carré | n échantillons |
| Anchor blood | Condition | 0.282 | 934 |
| Anchor blood | Groupe détaillé | 0.25 | 934 |
| Anchor blood | Jeu de données | 0.066 | 934 |
| Anchor blood | Type d'échantillon | 0.026 | 934 |
| Anchor blood | Groupe source | 0.025 | 934 |
| Anchor nasal | Groupe détaillé | 0.17 | 1469 |
| Anchor nasal | Condition | 0.13 | 1469 |
| Anchor nasal | Jeu de données | 0.021 | 1469 |
| Anchor nasal | Type d'échantillon | 0.006 | 1469 |
| Anchor nasal | Groupe source | 0.002 | 1469 |
Tableau 6 : Partition descriptive de la variance des scores des modules. Une ligne est fournie pour chaque paire module-facteur, avec la valeur d'êta-carré correspondante et la taille de l'échantillon. L'êta-carré a été calculé comme le rapport de la somme des carrés intergroupes divisée par la somme totale des carrés, après exclusion des lignes manquantes le score du module ou du facteur concerné. Les facteurs ont été évalués individuellement ; par conséquent, l'analyse est descriptive, n'ajuste pas pour les facteurs mutuellement corrélés et ne doit pas être interprétée de manière causale.
Disponibilité des données :
Tous les jeux de données transcriptomiques analysés dans cette étude sont accessibles publiquement à partir de Gene Expression Omnibus sous les numéros d'accès GSE117827, GSE41374, GSE152075, GSE156063, GSE171110, GSE38900, GSE97741, GSE97742, GSE63990, GSE40012 et GSE53543. Les données issues des analyses qui sous-tendent les principales figures et tableaux, ainsi que le code d'analyse, sont disponibles auprès de l'auteur correspondant sur demande raisonnable. Aucune donnée individuelle restreinte ou nouvellement générée n'a été utilisée dans cette étude.
Discussion
La leçon principale est opérationnelle : commencer par le compartiment échantillonné, plutôt que par la matrice groupée la plus vaste. GSE117827 est petit, mais sa conception appariée permet une comparaison directe nez-sang au sein d'une même étude. La corrélation quasi nulle au niveau des effets géniques montre qu'une liste de classement pancorps groupée masquerait une structure compartimentée importante. Des modules séparés constituaient donc une conception plus justifiable. Leurs performances externe et longitudinale soutiennent une activité de réponse de l'hôte reproductible au niveau des modules, et non une liste universelle de gènes.
La portabilité au niveau des gènes et au niveau des modules est différente. Le module sanguin a bien performé sur des échantillons longitudinaux du nasopharynx (AUROC 0,845), malgré une faible concordance entre les tailles d'effet individuelles du nez et du sang. Les trajectoires appariées n'ont pas montré d'inversion d'étiquette. Une explication plus probable est la redondance des voies métaboliques : l'activité coordonnée de l'interféron et de l'inflammation peut être résumée par différents sous-ensembles de gènes dans différents compartiments6,7,8,9,10,11,32,33,34. C'est pourquoi nous décrivons les modules comme étant sensibles au compartiment plutôt que strictement exclusifs à un compartiment. Les classements exacts diffèrent, mais une composante partagée au niveau des voies métaboliques reste détectable. Les profils en bloc mélangent également les variations d'expression avec les changements de composition cellulaire. Les corrélations entre marqueurs et programmes peuvent signaler ce problème, mais elles ne permettent pas d'obtenir des mécanismes résolus au niveau cellulaire36,37.
Les critères cliniques définissent une seconde limite. Les comparateurs basés sur les 33 ARNm de Pandya et sur l'interféron se sont révélés plus performants pour la discrimination entre infection virale et bactérienne. Les modules d'ancrage répondent à une question différente : dans quelle mesure un échantillon exprime-t-il un programme de réponse hôte aiguë ? Le module sanguin augmentait également lors de pneumonie bactérienne. Il doit donc être interprété comme un score d'activité inflammatoire systémique ou interféronique large, et non comme un classificateur spécifique aux virus. Un score élevé peut appuyer la comparaison entre cohortes, le suivi de la réponse ou la description d'un état inflammatoire, mais il ne permet pas d'identifier le pathogène. L'importance clinique croissante de virus tels que le métapneumovirus humain plaide davantage en faveur d'une validation prenant en compte une diversité de pathogènes et adaptée aux tissus concernés, plutôt qu'une extrapolation à partir d'un ensemble restreint de virus12,13.
Les six gènes chevauchants sont exploratoires. ISG15, IFIT1, RSAD2 et XAF1 ont des rôles plausibles liés à l'interféron32,33,34 ; CCRL2 est associé à la migration des leucocytes inflammatoires35 ; ACRBP n'a aucune interprétation antivirale établie. La petite taille de la cohorte et les valeurs de FDR non significatives au niveau des gènes empêchent des conclusions plus fortes. L'innovation méthodologique réside ailleurs : un ancrage apparié dans la même étude, des modules spécifiques à des compartiments verrouillés, des tests externes appariés selon le tissu, une analyse appariée de la récupération, un étalonnage comparatif clinique, ainsi que des vérifications explicites aléatoires, de taille, de bootstrap, de marqueurs et de variance. Cette hiérarchie de preuves fournit un cadre conservateur pour l'interprétation des résultats.
Plusieurs limites persistent. Le groupe témoin comprend uniquement 15 échantillons nasaux infectés et 6 échantillons témoins, ainsi que 13 échantillons sanguins infectés et 6 échantillons témoins. Les résultats du bootstrap confirment que l'appartenance individuelle des gènes n'est pas entièrement stable. Les cas symptomatiques de VRS et de picornavirus ont été regroupés, de sorte que les effets du groupe témoin ne sont pas spécifiques à un virus. Les groupes externes diffèrent par l'âge, la plateforme, la gravité, le moment du prélèvement et la définition des témoins. GSE53543 est une étude de perturbation appariée ex vivo. GSE63990 et GSE40012 fournissent des comparateurs cliniques utiles, mais aucun prélèvement apparié nasal-sang. La charge virale, la durée des symptômes, le besoin en oxygène et la gravité n'étaient pas systématiquement disponibles. Un dispositif prospectif plus rigoureux consisterait à prélever des écouvillons nasaux et du sang chez les mêmes participants à des temps appariés, avec des mesures de charge virale et de symptômes, des comparateurs bactériens et des virus symptomatiques négatifs, ainsi qu'une validation à résolution cellulaire11,14,36,37.
En conclusion, les transcriptomes publics actuels soutiennent des modules d'activité de la réponse hôte reproductibles dans le nez et le sang lorsque le contexte tissulaire est préservé. Ils ne soutiennent pas une signature génique pan-tissulaire interchangeable. L'ancrage apparié a montré peu de concordance au niveau des gènes, tandis que les scores de module verrouillés se sont transférés au sein des tissus appariés et ont diminué durant la récupération. La réponse du module sanguin dans la pneumonie bactérienne et la performance supérieure d'un classificateur établi pour distinguer les infections virales des infections bactériennes définissent l'utilisation prévue : ces modules décrivent l'activité de la réponse hôte et permettent un étalonnage transparent des cohortes ; ils ne constituent pas des classificateurs de pathogènes autonomes. Le code d'analyse et les données dérivées sont disponibles comme décrit dans l'énoncé de disponibilité des données afin de permettre la vérification indépendante et la réutilisation du flux de travail.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir de conflits d'intérêts financiers ou non financiers liés à ce travail.
Remerciements
Les auteurs remercient les investigateurs et les participants des études GEO publiques réanalysées dans ce travail. Aucun individu supplémentaire ne remplissait les critères pour l'auteur. Cette recherche n'a reçu aucune subvention spécifique d'un organisme de financement public, commercial ou à but non lucratif.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Ensemble de gènes stimulés par l'interféron multi-virus d'Andres-Terre | Andres-Terre et al. | Comparateur à 33 gènes ; Données supplémentaires 1 | Comparateur non pondéré orienté interféron, curé à partir de la signature multi-virus rapportée ; la liste complète des gènes est fournie dans les Données supplémentaires 1. |
| Enrichr | Ma'ayan Laboratory | Consulté le 18 août 2026 ; RRID : SCR_001575 | Ressource d'analyse d'hyperreprésentation d'ensembles de gènes accessible via gseapy. |
| Gene Expression Omnibus | Centre national d'information sur la biotechnologie (NCBI) | GEO ; RRID : SCR_005012 | Référentiel public de transcriptomes utilisé pour accéder aux jeux de données analysés. |
| Ontologie génétique | Consortium de l'ontologie génétique (Gene Ontology Consortium) | Processus biologique GO 2023 ; RRID : SCR_002811 | Bibliothèque d'annotations fonctionnelles utilisée via Enrichr. |
| GPL10558 | NCBI GEO | GPL10558 | Plateforme pour GSE53543 et l'unité de validation GSE38900 de 36 échantillons. |
| GPL23126 | NCBI GEO | GPL23126 | Plateforme d'expression pour GSE117827. |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | Annotation Clariom D Humain na36, hg38 utilisée pour le mappage des groupes de transcrits de GSE117827. |
| GPL571 | NCBI GEO | GPL571 | Annotation de plateforme appliquée à GSE63990. |
| GPL6884 | NCBI GEO | GPL6884 | Plateforme pour l'unité de validation RSV à sang total de 138 échantillons de GSE38900. |
| GPL6947 | NCBI GEO | GPL6947 | Annotation de plateforme appliquée à GSE40012. |
| GSE117827 | NCBI GEO | GSE117827 | Jeu de données principal apparié de prélèvements nasaux et de sang total servant de référence. |
| GSE152075 | NCBI GEO | GSE152075 | Jeu de données externe de validation des voies respiratoires supérieures pour SARS-CoV-2. |
| GSE156063 | NCBI GEO | GSE156063 | Jeu de données externe de validation des voies respiratoires supérieures pour SARS-CoV-2. |
| GSE171110 | NCBI GEO | GSE171110 | Jeu de données externe de validation à sang total pour SARS-CoV-2. |
| GSE38900 | NCBI GEO | GSE38900 ; GPL10558 et GPL6884 | Validation externe RSV à sang total analysée comme deux unités de plateforme distinctes normalisées, de 36 et 138 échantillons. |
| GSE40012 | NCBI GEO | GSE40012 | Référence clinique pour pneumonie à influenza A, pneumonie bactérienne, SIRS et témoins sains. |
| GSE41374 | NCBI GEO | GSE41374 | Jeu de données externe de validation par lavage nasal pour RSV. |
| GSE53543 | NCBI GEO | GSE53543 | Référence appariée de perturbation ex vivo des PBMC par le rhinovirus impliquant 98 sujets et 196 échantillons. |
| GSE63990 | NCBI GEO | GSE63990 | Référence clinique à sang total pour infections virales, bactériennes et non infectieuses. |
| GSE97741 | NCBI GEO | GSE97741 | Jeu de données de validation longitudinal à sang total comparant phase aiguë et phase de sortie. |
| GSE97742 | NCBI GEO | GSE97742 | Jeu de données de validation longitudinal au niveau nasopharyngé comparant phase aiguë et phase de sortie. |
| gseapy | Développeurs de gseapy | Version 1.3.1 | Interface Python utilisée pour interroger Enrichr. |
| Ressource de symboles génétiques HGNC | Comité d'appellation génétique HUGO (HUGO Gene Nomenclature Committee) | Consulté le 18 août 2026 ; RRID : SCR_002827 | Ressource normalisée de symboles génétiques approuvés et de classification des gènes codant pour des protéines. |
| Matplotlib | Équipe de développement de Matplotlib | Version 3.11.1 | Génération de figures. |
| Ensembles de gènes caractéristiques MSigDB | Institut Broad (Broad Institute) | Caractéristiques 2020 ; RRID : SCR_016863 | Bibliothèque d'enrichissement « Hallmark » accessible via Enrichr. |
| Ensemble de gènes de réponse à l'interféron-alpha MSigDB Hallmark | Institut Broad (Broad Institute) | HALLMARK_INTERFERON_ALPHA_ RESPONSE ; sous-ensemble principal de 33 gènes dans les Données supplémentaires 1 | Comparateur non pondéré de réponse à l'interféron-alpha ; le sous-ensemble exact est fourni dans les Données supplémentaires 1. |
| NumPy | Développeurs de NumPy | Version 2.5.2 | Calcul numérique et échantillonnage aléatoire contrôlé. |
| pandas | Équipe de développement de pandas | Version 3.0.5 | Traitement de données tabulaires. |
| Ensemble de 33 ARNm de réponse hôte de Pandya | Pandya et al. | Tableau supplémentaire 1 ; Données supplémentaires 1 | Ensemble officiel de 33 gènes évalué comme comparateur non pondéré. |
| Python | Fondation Python Software Foundation | Version 3.12.13 | Environnement d'analyse computationnelle. |
| Reactome | Reactome | Reactome 2022 ; RRID : SCR_003485 | Bibliothèque d'enrichissement de voies métaboliques accessible via Enrichr. |
| scikit-learn | Développeurs de scikit-learn | Version 1.9.0 | Calculs de AUROC et de précision moyenne. |
| SciPy | Développeurs de SciPy | Version 1.18.0 | Tests de Welch, t apparié, Wilcoxon, Mann–Whitney et tests de corrélation. |
| Seaborn | Équipe de développement de Seaborn | Version 0.13.2 | Graphiques statistiques. |
| statsmodels | Développeurs de statsmodels | Version 0.14.6 | Utilitaires statistiques. |
Références
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.