Ce travail de recherche a présenté une approche, FusionNetX, en enrichissant la capacité de fusion de caractéristiques de DenseNet121 et d'EfficientNetB7 pour la classification des tumeurs cérébrales sur cinq ensembles de données publiquement disponibles, avec augmentation des données, prétraitement et personnalisation de modèle hybride (fusion intermédiaire), obtenant des résultats compris entre 98,77 % et 99,89 %, surpassant plusieurs paramètres d'évaluation.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
FusionNetX : un modèle de fusion de caractéristiques profondes exploitant l'IRM et l'apprentissage profond pour une détection améliorée des tumeurs cérébrales
Dans cet article
Résumé
Résumé
Les tumeurs cérébrales sont considérées comme l'une des maladies les plus mortelles au monde, et leur mauvais diagnostic met en danger la vie des patients et réduit le taux de survie. L'imagerie par résonance magnétique (IRM) combinée à des techniques basées sur l'apprentissage profond, en particulier les réseaux neuronaux convolutifs, joue un rôle crucial pour surmonter cet obstacle, car elle permet un examen plus détaillé de la structure interne du cerveau et offre des capacités exceptionnelles d'apprentissage et de prédiction. Le besoin d'un diagnostic précis de la tumeur cérébrale reste important. Par conséquent, un modèle d'apprentissage profond amélioré basé sur la fusion de caractéristiques (FusionNetX) est proposé, exploitant les forces de deux modèles préentraînés, DenseNet121 et EfficientNetB7, à l'aide de paramètres d'ajustement fin personnalisés, incluant des couches entraînables et non entraînables. Le modèle proposé FusionNetX a été appliqué à cinq ensembles de données publics sur les tumeurs cérébrales : Br35H, Figshare, Sartaj, Masoud et Balanced Brain Tumor. Certaines étapes de prétraitement ont été appliquées afin d'améliorer la qualité des images et de lutter contre le surapprentissage par redimensionnement et augmentation des données. À l'aide de diverses métriques d'évaluation des performances, telles que la précision, la perte, la valeur prédictive positive, la valeur prédictive négative, le taux de vrais positifs, le taux de vrais négatifs, le score F1, le taux de faux négatifs et le taux de faux positifs, le modèle proposé FusionNetX a atteint une précision de 99,33 % pour Br35H, 99,13 % pour Figshare, 99,89 % pour Masoud, 99,19 % pour BBT-Dataset et 98,77 % pour Sartaj. De plus, les cinq ensembles de données sur les tumeurs cérébrales ont été évalués à l'aide de la fusion tardive et de la fusion basée sur l'attention afin de démontrer l'importance du modèle FusionNetX proposé, et les résultats ont été nettement meilleurs, avec des gains allant de 0,3 % à 1,9 % sur tous les ensembles de données. En outre, la courbe caractéristique de fonctionnement du récepteur (ROC) a été calculée, et les résultats issus des différentes métriques d'évaluation des performances indiquent que le modèle proposé FusionNetX peut détecter et prédire avec précision les tumeurs cérébrales et aider les professionnels de santé à prendre des décisions en temps opportun.
Introduction
Le cancer est la maladie la plus mortelle du corps humain de nos jours en raison de sa gravité et de son taux de progression croissant, tandis que de nombreuses affections cancéreuses, telles que les tumeurs cérébrales, le cancer du sein, les nodules pulmonaires, le cancer du rein et d'autres, sont présentes dans l'organisme humain, entraînant une augmentation du taux de mortalité. Le cancer se développe lorsque des cellules ou des tissus dans le corps d'une personne se multiplient de manière anormale. Lorsque le cancer métastase, il peut endommager d'autres organes humains et devenir plus dangereux1. Étant donné que le cerveau contrôle toutes les fonctions corporelles, toute lésion de celui-ci peut avoir des conséquences étendues sur l'ensemble du corps. C'est pourquoi les tumeurs cérébrales ou les cancers cérébraux sont si mortels pour l'humain2. De plus, les tumeurs cérébrales se divisent principalement en deux catégories : bénignes et malignes. « Bénin » signifie fondamentalement non cancéreux ; il s'agit simplement d'un problème cérébral qui peut être corrigé en modifiant l'environnement local. Mais dans le cas d'une tumeur maligne, celle-ci est considérée comme dangereuse en raison de sa nature métastatique, qui permet aux cellules ou tissus anormaux de se déplacer vers d'autres parties du corps ou d'elles-mêmes, perturbant également d'autres organes et augmentant ainsi la probabilité de propagation du cancer dans l'organisme3.
De plus, selon l'American Brain Tumor Association et l'Organisation mondiale de la Santé (OMS), les tumeurs pituitaires, les méningiomes et les gliomes constituent les trois principales catégories de cancers du cerveau4. Les gliomes prennent naissance dans les cellules gliales, qui nourrissent les neurones du cerveau. Les tumeurs pituitaires se développent dans l'hypophyse, située à la base du cerveau et responsable de diverses fonctions corporelles ; quant aux méningiomes, ils apparaissent dans les méninges, qui forment les membranes protectrices entourant le cerveau et la moelle épinière. Par ailleurs, plusieurs modalités d'imagerie médicale sont couramment utilisées à des fins diagnostiques pour examiner les parties internes du corps, notamment les rayons X, la tomodensitométrie (scanner CT) et l'imagerie par résonance magnétique (IRM)5,6. Chaque modalité d'imagerie présente ses propres avantages et inconvénients. L'IRM est une technique d'imagerie qui fournit des images détaillées des tissus mous et des cellules du corps, en particulier du cerveau. Le cancer implique la présence de tissus ou de cellules anormaux dans l'organisme, et l'IRM permet d'obtenir des images précises de ces anomalies, ce qui en fait une modalité d'imagerie particulièrement utile pour diagnostiquer les tumeurs cérébrales ou les cancers. En outre, l'IRM est plus sûre que les autres modalités d'imagerie, car elle ne produit pas de rayonnement nocif lors de l'examen de l'anatomie interne du corps.
En outre, de nombreuses méthodologies computationnelles sont également utilisées pour relever les défis diagnostiques associés aux tumeurs cérébrales, notamment l'apprentissage automatique (ML), le traitement d'images (IP) et l'apprentissage profond (DL), et chaque approche est appliquée à des images obtenues par des modalités d'imagerie afin de diagnostiquer le cancer7. Ces approches apprennent les motifs et structures cachés des différents objets présents dans les images afin de diagnostiquer le cancer en identifiant les motifs dans la région affectée. Chaque méthode computationnelle présente ses propres avantages et inconvénients dans le processus de diagnostic. Les approches basées sur le ML et l'IP extraient des caractéristiques conçues manuellement, ce qui conduit souvent à des prédictions inexactes et à des erreurs de diagnostic, en particulier sur de grands ensembles de données8. Pour surmonter les difficultés liées à l'extraction de caractéristiques manuelles, les chercheurs se tournent vers des modèles basés sur l'apprentissage profond, couramment appelés modèles basés sur les réseaux neuronaux convolutifs (CNN), capables d'apprendre et d'extraire automatiquement les meilleures caractéristiques à partir des images afin de diagnostiquer précisément les tumeurs. Les approches fondées sur le DL sont désormais couramment utilisées en imagerie médicale pour diagnostiquer des maladies dans le corps humain, notamment pour la détection précoce et précise des tumeurs cérébrales, du cancer du sein, du cancer du poumon et d'autres affections, en raison de leur capacité à apprendre et à extraire des motifs complexes dans des données à grande échelle en produisant des résultats plus précis9. Le principal problème rencontré avec un modèle DL est la consommation importante de ressources et d'échantillons de données, un obstacle surmonté par une autre approche basée sur l'apprentissage profond appelée apprentissage par transfert10 (TL), dans laquelle des modèles pré-entraînés sont utilisés pour diagnostiquer la maladie, ce qui permet d'économiser du temps et des ressources. Le diagnostic précoce et précis des problèmes de santé est rendu possible grâce à des modèles pré-entraînés, qui ont déjà acquis des caractéristiques fondamentales liées à la texture, à la couleur, aux contours, et à d'autres éléments à partir d'un vaste ensemble de données. Ces modèles peuvent ensuite être transférés vers un nouvel ensemble de données jamais vu auparavant, en exploitant le modèle existant et en ajoutant des hyperparamètres ainsi que des couches entraînables et non entraînables11. Un nombre important de recherches a été mené sur la classification des tumeurs cérébrales, et Tableau 112,13,14,15,16,17,18,19,20,21,22,23 présente les détails de ces travaux, incluant les approches, les ensembles de données et les résultats. Toutefois, aucune étude n'a encore utilisé une méthodologie combinant deux modèles d'apprentissage par transfert pour une extraction robuste des caractéristiques et ajustant les techniques de régularisation afin d'assurer un entraînement et des tests fluides. Une évaluation approfondie de la méthodologie proposée fournit des informations sur les performances du modèle à travers différentes caractéristiques des tumeurs cérébrales.
| Réf | Approche | Échantillons de données | Résultats | Limitations |
| 12 | CNN personnalisé | Br35H | Précision = 97,45 %, | Des améliorations restent nécessaires dans les résultats ; plutôt que d'utiliser un CNN conçu sur mesure, il est préférable d'utiliser un modèle CNN préexistant modifié. |
| Perte = 0,1141 %, | ||||
| Rappel = 98,09 %, | ||||
| Score F1 = 97,69 %, | ||||
| Précision = 97,29 %, | ||||
| Br35H augmenté | Précision = 98,99 %, | |||
| Précision = 98,90 %, | ||||
| Perte = 0,0570 %, | ||||
| Rappel = 98,91 %, | ||||
| Score F1 = 99,04 % | ||||
| 13 | Modèle DNN à fusion de caractéristiques | Br35H | Précision = 98,22 %, | Des améliorations restent nécessaires dans les résultats, et plutôt que d'utiliser un modèle personnalisé, il est encore nécessaire d'utiliser un modèle préexistant pour la fusion de caractéristiques. |
| FNR = 1,77 %, | ||||
| Sensibilité = 98,2 %, | ||||
| Score F1 = 98 %, | ||||
| Spécificité = 98 %, | ||||
| Figshare | Précision = 98,01 %, | |||
| Sensibilité = 96,03 %, | ||||
| Score F1 = 96 %, | ||||
| Spécificité = 98,67 %, | ||||
| FNR = 3,96 % | ||||
| 14 | AlexNet avec SGD | Br35H | Précision = 98,79 %, | Des améliorations restent nécessaires dans les résultats, et nous devons également tester certains modèles avancés basés sur CNN sur différents échantillons de données. |
| MCR = 1,20 %, | ||||
| Sensibilité = 98,98 %, | ||||
| Spécificité = 98,58 %, | ||||
| Score F1 = 98,82 % | ||||
| 15 | InceptionV3 | Figshare | Précision = 98,89 %, | Les auteurs ont utilisé le jeu de données Figshare, qui comporte trois classes de tumeurs ; au lieu de les classifier, ils classifient la présence ou l'absence de tumeur, et des améliorations restent nécessaires dans les résultats ainsi que dans la catégorisation des classes de tumeurs. |
| SensibilitéB = 95,28 %, | ||||
| SensibilitéM = 94,47 % | ||||
| 16 | ResNet50 optimisé | Figshare | Précision = 99,03 %, | D'autres paramètres d'évaluation des performances devraient être calculés, avec davantage d'améliorations des résultats. |
| Rappel = 99 %, | ||||
| Score F1 = 99 % | ||||
| 17 | Res-BRNet | Br35H | Précision = 98,22 %, | Des améliorations restent nécessaires dans les résultats. |
| Sensibilité = 98,11 %, | ||||
| Précision = 98,22 %, | ||||
| Figshare | Score F1 = 98,41 % | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Précision = 99,18 %, | Il y a une légère amélioration des résultats, mais il est nécessaire de tester davantage de jeux de données liés aux tumeurs cérébrales. |
| Rappel = 99,11 %, | ||||
| Score F1 = 99,08, | ||||
| Précision = 99,07 %, | ||||
| Sartaj | Précision = 97,24 %, | |||
| Rappel = 97,58 %, | ||||
| Score F1 = 97,28 %, | ||||
| Précision = 97,06 %, | ||||
| 19 | CNN-SVM | Brats | Précision = 98,02 %, | Il est nécessaire d'appliquer certains modèles préexistants avec SVM, et des améliorations restent nécessaires dans les résultats. |
| Score F1 = 98,31 %, | ||||
| Précision = 98,09 %, | ||||
| Sensibilité = 98,53 %, | ||||
| Spécificité = 97,30 %, | ||||
| Sartaj | Précision = 96,83 %, | |||
| Précision = 95,36 %, | ||||
| Sensibilité = 94,73 %, | ||||
| Spécificité = 97,56 %, | ||||
| Score F1 = 95 % | ||||
| 20 | EfficientNetB3 finement ajusté | Figshare | Précision = 98,70 % | Il est nécessaire d'utiliser les variantes susmentionnées d'EfficientNetB3 pour améliorer les résultats. |
| Sartaj | Précision = 97,50 % | |||
| 21 | InceptionV4 | Masoud | Précision = 98,7 %, | Des améliorations des résultats sont requises en utilisant davantage de jeux de données. |
| Précision = 99 %, | ||||
| Sensibilité = 98 %, | ||||
| Spécificité = 99 %, | ||||
| Score F1 = 99,1 % | ||||
| 22 | VGG16 | Masoud | Précision = 98 % | Des améliorations des résultats sont nécessaires en testant davantage de modèles de réseaux neuronaux profonds. |
| 23 | MFR-CNN | Masoud | Précision = 94 %, | Une architecture complexe est utilisée dans cette solution proposée. |
| Rappel = 96 %, | ||||
| Score F1 = 96 %, | ||||
| Précision = 96 %, |
Tableau 1 : Examen comparatif des travaux de recherche les plus récents. Ce tableau résume les recherches existantes, ainsi que leurs approches, échantillons de données, résultats et limites. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 1 passe en revue les approches existantes, soulignant leurs limites quant à l'amélioration des résultats et la nécessité d'utiliser des modèles d'apprentissage profond préexistants tout en évaluant leurs performances par rapport à divers paramètres statistiques, le tout dans un cadre efficace qui offre de meilleures performances sur différents ensembles de données de tumeurs cérébrales.
Objectifs de l'étude et énoncé du problème
L'interprétation manuelle est longue et souffre d'une variabilité inter-observateur ; par conséquent, une catégorisation rapide et précise des types de tumeurs cérébrales à partir de l'IRM est essentielle pour la prise de décision clinique. La plupart des approches d'apprentissage profond (DL) actuelles pour la classification automatisée des tumeurs cérébrales reposent sur un réseau unique ou sur une simple fusion au niveau décisionnel, ce qui n'exploite pas pleinement les représentations de caractéristiques complémentaires issues de plusieurs architectures pré-entraînées, et sont souvent validées uniquement sur un seul jeu de données, ce qui limite la confiance dans leur généralisabilité.
Ce projet de recherche vise à élaborer et à fournir une méthode complète et précise pour diagnostiquer les cancers du cerveau chez l'humain à l'aide d'un cadre d'apprentissage profond à double structure (EfficientNetB7 et DenseNet121) qui exploite des représentations de caractéristiques complémentaires afin de permettre une classification robuste des tumeurs cérébrales à partir d'IRM. Il évalue également la robustesse de ce cadre sur plusieurs jeux de données publics indépendants. Cette approche peut aider les radiologues et les paramédicaux à diagnostiquer rapidement et efficacement les tumeurs cérébrales, sauvant ainsi des vies en permettant la reconnaissance et la classification.
Pour résoudre un problème de recherche particulier et atteindre les objectifs de ce projet de recherche, voici les questions de recherche et les contributions apportées pour répondre à ces questions : 1) La fusion au niveau des caractéristiques (intermédiaire) de deux réseaux profonds pré-entraînés est-elle meilleure que les techniques de fusion au niveau de la décision (tardive) et basées sur l'attention pour la classification des tumeurs cérébrales ? 2) Le système proposé fournira-t-il des performances de classification cohérentes sur de nombreuses bases de données d'IRM de tumeurs cérébrales acquises indépendamment ?
La portée de cette étude se limite à la classification au niveau des images (coupes IRM 2D), à l'aide de cinq ensembles de données IRM de tumeurs cérébrales disponibles publiquement (Br35H, Figshare, Sartaj, Masoud et BBT-Dataset) ; évalués indépendamment, sans comparaison entre jeux de données ; et en utilisant l'architecture spécifique, le pipeline de prétraitement et la configuration expérimentale décrits dans la section méthodologie. L'étude n'inclut pas de validation au niveau du patient ni de tests dans un cadre de déploiement clinique.
Les principales contributions de ce travail de recherche sont les suivantes : 1) La contribution principale de ce travail de recherche consiste à utiliser des modèles préentraînés doubles pour une meilleure extraction de caractéristiques, notamment DenseNet121 et EfficientNetb7 avec des hyperparamètres optimisés. 2) Une architecture de modèle innovante intégrant une technique de régularisation avancée appliquée aux caractéristiques concaténées provenant d'un modèle doublement préentraîné, assurant ainsi une performance robuste. 3) Une stratégie efficace d'augmentation des données est appliquée afin d'accroître la diversité des échantillons d'apprentissage, permettant d'apprendre des caractéristiques plus génériques et spécifiques, tout en surmontant les problèmes de surapprentissage. 4) La performance du modèle proposé a été évaluée sur cinq jeux de données publics distincts de tumeurs cérébrales, en se concentrant sur divers paramètres statistiques d'évaluation, notamment la précision, le taux de mauvaise classification, la justesse, la valeur prédictive négative, la sensibilité, la spécificité, le score F1, le taux de faux négatifs et le taux de faux positifs.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
La maladie la plus menaçante au monde est la tumeur cérébrale. Un diagnostic précis peut être bénéfique pour la survie des patients. Toutefois, il existe un besoin urgent d’un système diagnostique précis capable de détecter les tumeurs cérébrales à un stade précoce. Pour résoudre ce problème, une technique plus fiable permettant de détecter avec précision les tumeurs cérébrales à un stade précoce a été proposée, en utilisant un mécanisme hybride de double apprentissage profond avec des hyperparamètres optimisés et des couches ajustées finement, basé sur les modèles DenseNet121 et EfficientNetB7. L'approche proposée prend en entrée des images IRM 2D et fournit en sortie une prédiction indiquant la présence ou l'absence de tumeur pour le jeu de données de classification binaire Br35H, ainsi qu'une catégorisation des tumeurs pour quatre autres jeux de données de classification multiclasse. Ainsi, cette section décrit les principales étapes de l'approche proposée, du recueil des données jusqu'à l'obtention du résultat final, incluant l'acquisition des données, le prétraitement des données, la séparation des données, la sélection du modèle, l'extraction des caractéristiques, la prédiction de la tumeur et l'évaluation du modèle proposé, comme illustré dans Figure 1.
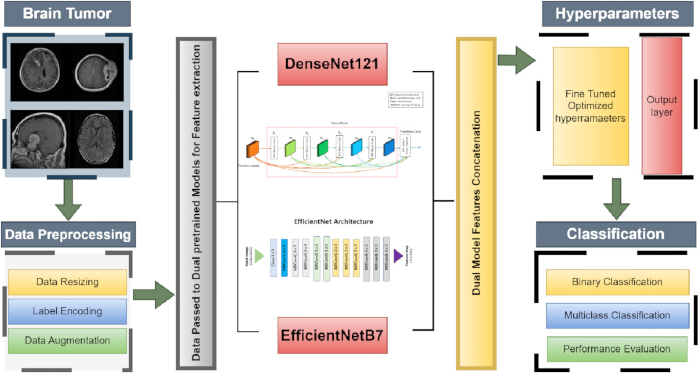
Figure 1 : Flux de travail de la méthodologie proposée. Ce diagramme présente l'architecture générale du modèle proposé, incluant l'acquisition et le prétraitement des données, deux modèles préentraînés pour l'extraction de caractéristiques, la concaténation de leurs caractéristiques, ainsi que l'ajustement fin des hyperparamètres pour la classification et le typage des tumeurs. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Acquisition des données
Dans toute recherche expérimentale, la première étape consiste à acquérir des données. À cet effet, cinq ensembles de données différents et accessibles publiquement ont été sélectionnés, notamment Br35H24, Figshare25, Sartaj26, Masoud27 et un ensemble d'images IRM de tumeurs cérébrales provenant de la bibliothèque open source Kaggle28, déjà utilisés par de nombreux chercheurs pour le diagnostic de la détection des tumeurs cérébrales. L'ensemble de données Br35H contient 3 000 images réparties en deux classes : images cérébrales saines et non saines (tumorales), avec 1 500 images dans chaque classe, tandis que l'ensemble de données Figshare comprend 3 064 images, réparties en trois groupes selon le type de tumeur : 1 426 images de gliome, 708 images de méningiome et 930 images de tumeurs hypophysaires. L'ensemble de données Sartaj contient 3 264 images classées en quatre catégories de tumeurs : gliomes (926 images), méningiomes (937 images), tumeurs hypophysaires (901 images) et absence de tumeur ou cerveau sain (500 images). De plus, l'ensemble de données Masoud comprend également quatre classes différentes de tumeurs, dont les images ont été extraites des trois ensembles de données mentionnés ci-dessus, pour un total de 7 023 images, réparties en gliome (1 621 images), méningiome (1 645 images), hypophyse (1 757 images) et absence de tumeur ou cerveau sain (2 000 images). Le dernier ensemble de données choisi est un ensemble basé sur des images IRM, qui comprend également quatre classes pour un total de 5 248 images, réparties en types de tumeurs : 1 312 images de gliome, 1 312 images de méningiome, 1 312 images de tumeur hypophysaire et 1 312 images saines ou sans tumeur, déjà réparties de manière égale selon les types de tumeurs et considérées comme un ensemble de données équilibré.
Prétraitement des données
Après l'acquisition des données, l'étape suivante est le prétraitement, qui est essentiel pour obtenir de meilleurs résultats et s'avère plus utile pour les approches computationnelles afin d'extraire et d'apprendre les meilleures caractéristiques à partir des données, produisant ainsi des résultats plus précis. La première étape appliquée a été le redimensionnement des images. Cinq jeux de données accessibles publiquement, comportant différentes classes et tailles d'images, même au sein d'un même jeu de données selon les classes de tumeurs, ont été sélectionnés et uniformément redimensionnés à 224 x 224 pour améliorer l'interprétation et l'apprentissage par le modèle. En outre, une augmentation des données a été appliquée à tous les jeux de données en générant des échantillons supplémentaires sous différents angles, améliorant ainsi l'extraction et l'apprentissage des caractéristiques par les modèles d'apprentissage profond (DL). Pour cela, une plage de rotation de 7 % a été appliquée à toutes les images, les faisant pivoter jusqu'à 7 degrés. Par ailleurs, un décalage aléatoire de 5 % a été appliqué à toutes les images horizontalement et verticalement, avec un décalage de 5 % en hauteur et en largeur par rapport aux images d'origine. Ensuite, les images ont été agrandies de 10 % par rapport aux images d'origine, et enfin, toutes les images ont été retournées horizontalement et verticalement. La principale raison de réaliser l'augmentation des données29 est de surmonter le surapprentissage (overfitting) et d'améliorer la généralisation des modèles en les entraînant sur diverses versions transformées des échantillons de données d'origine. Avant de diviser les jeux de données en ensembles d'entraînement et de validation, un encodage des étiquettes a été appliqué, ce qui facilite le calcul de la perte (loss) pendant l'entraînement et la validation, tout en rendant les échantillons de données plus pertinents pour que les modèles traitent correctement les étiquettes. De plus, le jeu de données a été réparti en ensembles d'entraînement et de validation selon un ratio de 80 % à 20 %30 pour chacun, et Tableau 2 présente la répartition globale des échantillons de données ainsi que leurs ratios d'entraînement et de validation.
| Jeu de données | Classes de tumeurs | Images totales | Images d'apprentissage | Images de validation |
| Br35H | Sain | 1500 | 1200 | 300 |
| Tumeur | 1500 | 1200 | 300 | |
| Images totales | 3000 | 2400 | 600 | |
| Figshare | Gliome | 1426 | 1141 | 285 |
| Méningiome | 708 | 566 | 142 | |
| Pituitaire | 930 | 744 | 186 | |
| Images totales | 3064 | 2451 | 613 | |
| Sartaj | Gliome | 926 | 741 | 185 |
| Méningiome | 937 | 749 | 188 | |
| Absence de tumeur | 500 | 400 | 100 | |
| Pituitaire | 901 | 721 | 180 | |
| Images totales | 3264 | 2611 | 653 | |
| Masoud | Gliome | 1621 | 1297 | 324 |
| Méningiome | 1645 | 1316 | 329 | |
| Absence de tumeur | 2000 | 1600 | 400 | |
| Pituitaire | 1757 | 1405 | 352 | |
| Images totales | 7023 | 5618 | 1405 | |
| Jeu de données équilibré de tumeurs cérébrales (BBT-Dataset) | Gliome | 1312 | 1050 | 262 |
| Méningiome | 1312 | 1050 | 262 | |
| Absence de tumeur | 1312 | 1050 | 262 | |
| Pituitaire | 1312 | 1050 | 262 | |
| Images totales | 5248 | 4200 | 1048 |
Tableau 2 : Répartition du jeu de données. Le tableau présente des statistiques par classe concernant le nombre total d'images, ainsi que les nombres d'images d'entraînement et de validation dans les jeux de données de tumeurs cérébrales.
Le jeu de données Br35H comprend 3000 images, dont 2400 ont été sélectionnées pour l'entraînement et 600 pour la validation. Le jeu de données Figshare comprend 3064 images. Sur l'ensemble des images, 2451 ont été sélectionnées pour l'entraînement, et les 613 restantes pour la validation. Le jeu de données Sartaj compte au total 3264 images, dont 2611 ont été utilisées pour l'entraînement et les 653 restantes pour la validation. Le jeu de données Masoud comprend au total 7023 images ; parmi celles-ci, 5618 ont été utilisées pour l'entraînement, et les 1405 restantes pour la validation. Le jeu de données BBT compte au total 5248 images. Sur l'ensemble des images, 4200 ont été retenues à des fins d'entraînement, tandis que les 1048 images restantes ont été considérées à des fins de validation. De plus, la Figure 2 ci-dessous illustre diverses images de tumeurs cérébrales.
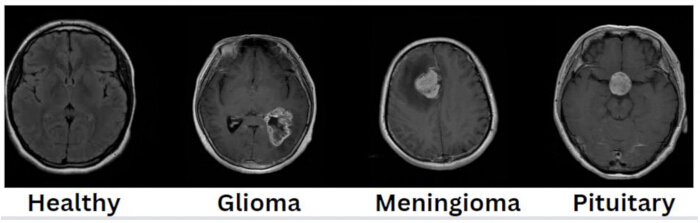
Figure 2 : Images de tumeurs cérébrales, incluant les types de tumeurs. Le jeu de données contient quatre images de tissu cérébral sain et trois images tumorales : gliome, méningiome et tumeur hypophysaire. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Modèle proposé
Après l'étape de prétraitement, la prochaine étape consiste à proposer un modèle d'apprentissage efficace uniquement pour la classification des tumeurs cérébrales. À cet effet, un modèle efficace d'entraînement a été proposé, spécifiquement conçu pour classifier les tumeurs cérébrales. Pour ce faire, un nouveau modèle hybride préentraîné, fondé sur la fusion efficace de caractéristiques, est proposé, combinant DenseNet12131,32 et EfficientNetB733, utilisés pour extraire les caractéristiques des images. Ensuite, ces caractéristiques extraites sont concaténées puis transmises à différents hyperparamètres ajustés finement, incluant des couches entraînables et non entraînables, afin de diagnostiquer précisément les tumeurs cérébrales. Ce modèle a été mis en œuvre sur cinq jeux de données différents disponibles publiquement, qui ont été abordés dans les sections précédentes. Par ailleurs, le modèle DenseNet121 a été développé par Gao Huang et ses collaborateurs en 2017 et comprend 121 couches. L'objectif principal de ce modèle était de maximiser la réutilisation des caractéristiques et d'éviter le problème du gradient évanescent34. Les couches de ce modèle sont organisées en blocs denses, chacun contenant plusieurs couches de convolution chargées d'extraire et d'apprendre des caractéristiques. Chaque couche prend la carte de caractéristiques de toutes les couches précédentes comme entrée, et sa sortie est reliée aux sorties de ces couches, puis transmise comme entrée aux couches suivantes du même bloc selon un mode avant. De plus, des couches de transition sont ajoutées entre les blocs denses, chacune composée d'une couche de convolution 1 × 1, d'une couche de normalisation par lots (BatchNormalization) et de couches de moyennage 2 × 2, qui réduisent la carte de caractéristiques afin de contrôler la complexité du modèle. Enfin, une couche terminale dotée d'une fonction d'activation SoftMax (AF) est ajoutée avant une couche de moyennage global pour la classification. La structure fondamentale du modèle DenseNet121 est illustrée dans Figure 334 ci-dessous.
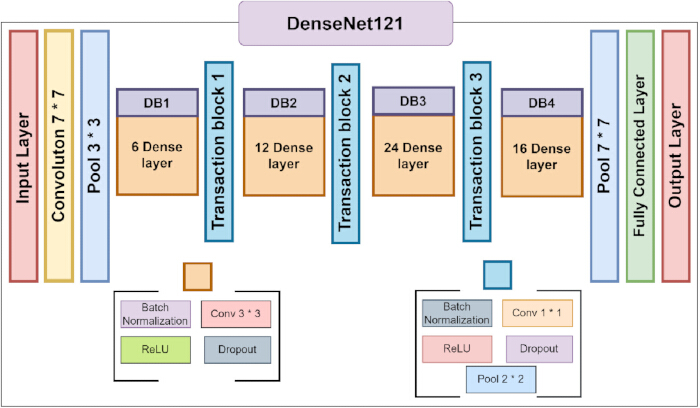
Figure 3 : Détail de l'architecture DenseNet12134. Cette figure présente le détail architectural du modèle DenseNet121, incluant tous les blocs denses et de transition. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
De plus, le modèle EfficientNetB7 a été conçu par Tan et Lee en 2019. Il appartient à la famille EfficientNet, qui comprend des variantes allant de B0 à B7, et son objectif principal est de surpasser les autres modèles tout en utilisant moins de paramètres et une puissance de calcul réduite. La largeur du modèle (nombre de canaux par couche), la profondeur (nombre de couches) et la résolution peuvent toutes être ajustées grâce à une mise à l'échelle composée, qui constitue la caractéristique fondamentale du modèle. Ce modèle comprend par ailleurs des blocs MBConv (convolution à goulot d'étranglement inversé mobile), qui intègrent une couche d'expansion convolutive 1 × 1 chargée d'augmenter le nombre de canaux, une convolution séparable par profondeur responsable de l'application de la convolution à chaque canal séparément, et une couche de projection convolutive 1 × 1 qui réduit le nombre de canaux à leur valeur initiale. Chaque bloc MBConv intègre également des blocs Squeeze and Excitation (SE)35, qui recalibrent les caractéristiques par canal, aidant ainsi le réseau à se concentrer sur les plus importantes. Au lieu de la fonction sigmoïde ou de toute autre fonction d'activation (AF), la fonction Swish est utilisée, car elle offre de meilleures performances que ReLU en autorisant des valeurs négatives, ce qui facilite la circulation du gradient. En outre, une couche de sortie finale équipée d'une fonction d'activation SoftMax est ajoutée avant une couche de moyennage global (global average pooling) pour la classification. Figure 435 illustre la structure de base du modèle EfficientNetB7, tandis que Figure 5 présente l'architecture recommandée du modèle.
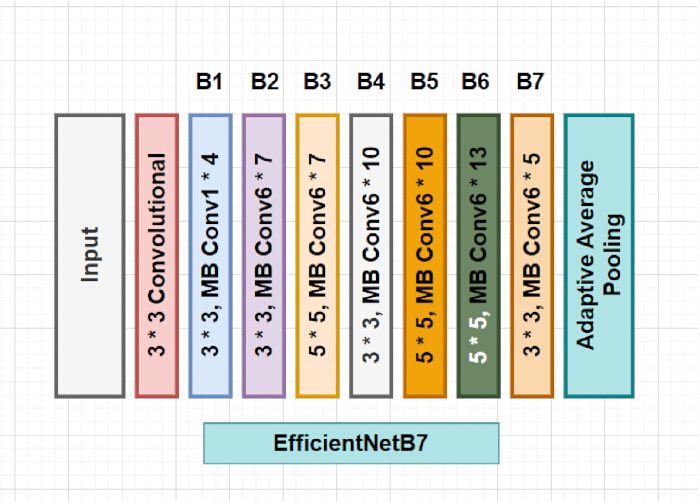
Figure 4 : Détail de l'architecture EfficientNetB735. Cette figure présente le détail architectural du modèle EfficientNetB7, incluant tous les blocs de convolution à goulot d'étranglement inversé mobiles. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
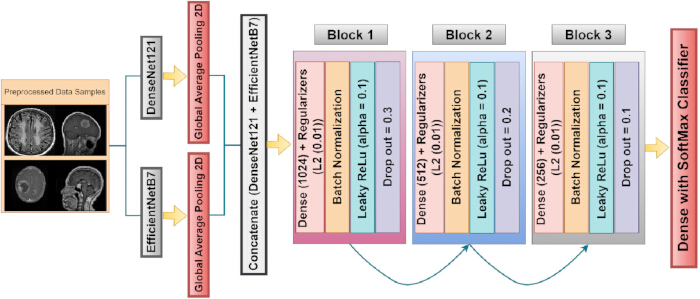
Figure 5 : Architecture proposée d'un modèle hybride fusionné. L'architecture proposée illustre comment les images prétraitées sont transmises à l'extracteur de caractéristiques, composé de trois blocs personnalisés aux hyperparamètres différents, suivis d'une couche de sortie. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
De plus, des caractéristiques initiales ont été extraites des modèles pré-entraînés DenseNet121 et EfficientNetB7. Les poids mis à jour des modèles pré-entraînés ont été chargés dans les modèles entraînés, et les couches de base non entraînables des modèles ont été figées afin d'empêcher un nouvel entraînement du modèle. Cela devrait permettre au modèle de conserver ses meilleures connaissances acquises précédemment, de les adapter à la lumière de nouveaux échantillons de données pour améliorer la convergence, et de se concentrer sur les couches supplémentaires à entraîner afin d'extraire des caractéristiques avancées. Les équations 1 et 2 ci-dessous illustrent le fonctionnement des modèles DenseNet121 et EfficientNetB7.
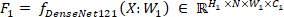 (1)
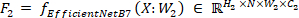 (2)
Les équations ci-dessus 1 et 2 illustrent le fonctionnement du modèle préentraîné en matière d'extraction de caractéristiques ; F1 désigne les cartes de caractéristiques en sortie produites par le modèle DenseNet121 préentraîné et F2 désigne les cartes de caractéristiques en sortie produites par le modèle EfficientNetB7 préentraîné après traitement des images d'entrée, représentées par X. Par ailleurs, W1 et W2 sont les paramètres ajustables ou poids associés respectivement aux premiers blocs et couches des modèles DenseNet121 et EfficientNetB7. En outre, ∈ RN ×H1×W1×C1 et ∈ RN ×H2×W2×C2 représentent la dimensionnalité des cartes de caractéristiques en sortie des modèles DenseNet121 et EfficientNetB7, respectivement, avec des dimensions de H1 ×N×W1×C1 et H2 ×N×W2×C2, où N représente la taille du lot d'images, fixée à 16. De plus, H1×W1 indique respectivement la hauteur et la largeur des images pour le modèle DenseNet121, et H2×W2 indique la hauteur et la largeur des images pour le modèle EfficientNetB7, choisies avec des dimensions de 224 × 224. C1 et C2 représentent respectivement le canal de couleur pour les modèles DenseNet121 et EfficientNetB7. Après obtention des cartes de caractéristiques en sortie du modèle, soit 2560 canaux pour EfficientNetB7 et 1024 pour DenseNet121, une couche de moyennage global 2D36 est appliquée aux cartes de caractéristiques afin de réduire la dimension spatiale en prenant la moyenne de toutes les dimensions spatiales pour former un unique vecteur, ce qui facilite la transmission à la couche suivante et améliore l'extraction de caractéristiques et la reconnaissance de motifs en termes de caractéristiques interprétables.
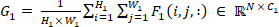 (3)
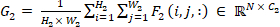 (4)
Les équations ci-dessus 3 et 4 illustrent le fonctionnement de la couche de moyennage global 2D appliquée aux modèles DenseNet121 et EfficientNetB7, respectivement, où  et
 montrent la procédure de normalisation de la somme en divisant par le nombre total de positions spatiales pour les deux modèles, afin de s'assurer que la sortie agrégée correspond à une moyenne plutôt qu'à une somme simple.
 et
 représentent la sommation effectuée sur les dimensions spatiales des cartes de caractéristiques, tandis que i et j servent uniquement à itérer respectivement sur la hauteur et la largeur, afin de sommer les cartes de caractéristiques pour les deux modèles. De plus, F1(i, j, :) et F2(i, j, :) représentent les valeurs des cartes de caractéristiques à des positions spatiales spécifiques (i, j) à travers tous les canaux, respectivement pour les modèles DenseNet121 et EfficientNetB7. Cette opération de regroupement agrège l'information spatiale en une représentation plus compacte et plus précise, tout en préservant les caractéristiques les plus importantes de chaque image. En outre, les sorties des couches de moyennage global sont concaténées pour produire un unique vecteur de caractéristiques par échantillon, ce qui est souvent utilisé pour fusionner des caractéristiques provenant de différents modèles afin d'améliorer les performances en exploitant les forces de chacun ; l'équation 5 montre comment cela fonctionne.
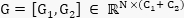 (5)
L'équation ci-dessus 5 illustre la procédure de concaténation de deux vecteurs de caractéristiques de modèles différents [G1, G2], où G1 représente le vecteur de caractéristiques du modèle DenseNet121 et G2 représente le vecteur de caractéristiques du modèle EfficientNetB7, tandis que la forme du vecteur de caractéristiques concaténé est représentée par RN ×(C1+ C2), où N est la taille du lot, qui indique le nombre d'échantillons traités en parallèle, et (C1+ C2) correspond au nombre total de caractéristiques extraites respectivement des modèles 1 et 2, soit environ 3584, qui sont traitées en parallèle, et le vecteur de caractéristiques de sortie concaténé est noté G. En outre, trois blocs distincts ont été ajoutés afin de modifier le modèle fusionné pour extraire des caractéristiques plus complexes, améliorer la généralisation et éviter le surapprentissage, dans le seul but d'obtenir des résultats plus précis et plus efficaces. Chaque bloc est composé d'une couche dense comportant un nombre différent de neurones : le premier bloc comprend 1024 neurones dans sa couche dense, ce qui lui permet de capturer un large éventail de caractéristiques et des motifs plus génériques dans les données, tandis que le second bloc dispose de 512 neurones dans sa couche dense, ce qui affine spécifiquement les caractéristiques en réduisant la dimensionnalité et en se concentrant sur des motifs plus précis. Le troisième bloc contient 256 neurones dans sa couche dense, qui distillent davantage les caractéristiques afin de garantir que seules les caractéristiques et les motifs les plus pertinents soient transmis à la couche de sortie pour accomplir une tâche plus ciblée. De plus, des méthodes de régularisation L237 sont appliquées à chaque couche dense de chaque bloc afin d'éviter le surapprentissage en pénalisant les poids élevés, ce qui contribue également à augmenter la complexité du modèle. Une couche de dropout38 est également introduite après chaque bloc pour ignorer aléatoirement 30 %, 20 % et 10 % des neurones respectivement pour les blocs 1, 2 et 3, ce qui oblige les réseaux à développer des caractéristiques plus robustes, non dépendantes d'un seul neurone. Par ailleurs, afin de stabiliser le processus d'apprentissage, une couche de normalisation par lot (BatchNormalization)39 est appliquée après chaque couche dense, ce qui garantit que les activations restent dans une plage stable et aide également le modèle à éviter des problèmes tels que les gradients nuls ou explosifs durant la phase d'apprentissage. En outre, cette couche de BatchNormalization accélère également le processus d'apprentissage, permettant au modèle de converger plus rapidement en lissant le paysage de la fonction de perte, ce qui facilite l'atteinte des minima globaux par les optimiseurs. Enfin, dans chaque bloc, une fonction d'activation de type ReLU fuyante (leaky ReLU)40 est utilisée afin de produire une non-linéarité, ce qui permet au modèle d'apprendre des motifs complexes. La ReLU fuyante présente des avantages par rapport à d'autres fonctions d'activation, notamment celui de garantir que le neurone ne devienne pas inactif en autorisant un petit gradient non nul pour les entrées négatives. Enfin, l'équation ci-dessous 6 illustre le fonctionnement des différents blocs intégrés au modèle hybride fusionné.
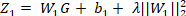 (6)
Après obtention du vecteur concaténé, G est transmis à la couche dense du bloc 1 (entièrement connectée) comportant 1024 neurones, où la matrice de poids W1 transforme le vecteur d'entrée G en un vecteur de sortie à 1024 dimensions, chaque élément du vecteur de sortie étant une combinaison linéaire des caractéristiques d'entrée. Ensuite, le vecteur de biais b1 est ajouté à chacun des 1024 éléments du vecteur de sortie, ce qui permet au modèle de décaler indépendamment la sortie des caractéristiques d'entrée. De plus, le terme de régularisation L2 : λ||W1||22 pénalise les poids élevés, ce qui dissuade le modèle de dépendre excessivement d'un seul neurone et contribue ainsi à éviter le surapprentissage. Ici, la matrice de poids d'une couche donnée est notée W1 dans le réseau de neurones, tandis que ||W1||22 désigne la norme L2 au carré de la matrice de poids W1 et λ représente le paramètre de régularisation qui contrôle l'intensité de la régularisation appliquée, fixé à 0,1 dans tous les blocs. Z1 devient la nouvelle représentation des caractéristiques après application de la couche dense ainsi que de la régularisation L2 sur l'entrée provenant du vecteur concaténé G, comme indiqué dans l'équation 6.
Après avoir obtenu la sortie de la couche dense du bloc 1 sous la forme de Z1, la couche de normalisation par lots a été appliquée afin d'accélérer le processus d'apprentissage, et l'équation 7 ci-dessous illustre son fonctionnement.
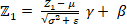 (7)
σ2 représente la variance de la sortie de la dernière couche Z1 sur l'ensemble du lot, tandis que μ est la moyenne de la sortie Z1, calculée séparément pour chaque neurone, qui était de 1024 dans la première couche dense. Quant à ε, il s'agit d'une petite constante intégrée afin d'assurer la stabilité numérique et d'éviter la division par zéro. La sortie normalisée peut être ajustée par le modèle grâce au paramètre d'échelle apprenable γ, tandis que la sortie normalisée peut être décalée par le paramètre de translation apprenable β. Enfin, après l'application de la couche de normalisation par lot (BatchNormalization) à la sortie de la couche dense, la sortie normalisée Z1 garantit que les activations ont une distribution cohérente à travers les différentes couches, ce qui contribue à stabiliser et accélérer l'apprentissage. Après la normalisation par lot, la sortie normalisée Z1 passe par la fonction d'activation ReLU fuyante (leaky ReLU), qui introduit une non-linéarité dans le réseau et permet ainsi d'apprendre des motifs complexes dans les données. Plutôt que de choisir ReLU ou une autre fonction d'activation, on a opté pour la ReLU fuyante, une version modifiée de la fonction ReLU qui prend en compte également les petites valeurs négatives au lieu de les ramener à 0 comme le fait la fonction d'activation ReLU, permettant ainsi de surmonter le problème du « ReLU mourant » (dying ReLU). L'équation 8 ci-dessous montre son fonctionnement.
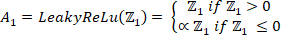 (8)
Où Z1 appartient à la sortie de la couche de normalisation par lots (BatchNormalization), qui est transmise à Leaky ReLU comme entrée pour appliquer la non-linéarité, tandis que ∝ est une constante faible utilisée pour déterminer la pente de la partie négative de la fonction. En outre, A1 représente la sortie obtenue après l'application de la non-linéarité. Enfin, une couche de dropout est appliquée à la sortie A1 reçue en entrée depuis l'activation Leaky ReLU, comme indiqué dans l'équation 9.
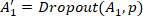 (9)
Où A1 est la sortie initiale de la fonction d'activation reçue de la dernière fonction d'activation ReLu, et où p est le taux de dropout, variant entre 0 et 1, choisi respectivement à 0,3, 0,2 et 0,1 pour trois couches de blocs, simplement pour supprimer une fraction des neurones. De plus, A1′ indique la sortie modifiée après l'application de la couche de dropout, dans laquelle certains neurones ont été fixés à 0. Le principal avantage de son utilisation est de prévenir les problèmes de surapprentissage ainsi que de réduire la co-adaptation. Ensuite, la sortie du bloc1 A1′ est transmise au bloc suivant afin d'extraire à nouveau des caractéristiques plus abstraites, en appliquant les mêmes paramètres que dans le bloc 1, à l'exception de 512 neurones dans la couche dense au lieu de 1024 et d'un taux de dropout de 0,2 au lieu de 0,3, les autres séquences opérationnelles restant identiques, comme décrit dans les équations 10 à 13 ci-dessous.
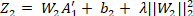 (10)
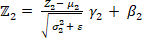 (11)
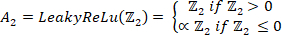 (12)
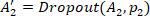 (13)
Après avoir obtenu la sortie du bloc 1, notée A1′, celle-ci est transmise à la couche dense (entièrement connectée) du bloc 2 composée de 512 neurones, où la matrice de poids W2 transforme le vecteur d'entrée A1′ en un vecteur de sortie à 512 dimensions, chaque élément du vecteur de sortie étant une combinaison linéaire des caractéristiques d'entrée. Ensuite, le vecteur de biais b2 est ajouté à chacun des 512 éléments du vecteur de sortie, ce qui permet au modèle de décaler indépendamment la sortie des caractéristiques d'entrée. De plus, une régularisation L2 est également appliquée, où λ||W2||22 pénalise les poids élevés, ce qui permet d'atténuer le surajustement en empêchant le modèle de trop dépendre d'un neurone particulier dans ce bloc spécifique. Ici, W2 représente la matrice de poids d'une couche donnée du réseau de neurones, tandis que λ est le paramètre de régularisation qui contrôle l'intensité de la régularisation appliquée, fixé ici à 0,1. Z2 devient la nouvelle représentation des caractéristiques après application de la couche dense ainsi que de la régularisation L2 sur l'entrée provenant du bloc 1, comme indiqué dans l'équation 10.
En outre, la couche de normalisation par lots a été appliquée à la nouvelle caractéristique Z2, ce qui permet d'accélérer le processus d'apprentissage ; σ22 représente la variance sur l'ensemble du lot, tandis que μ2 est la moyenne de la sortie Z2. Bien que ε soit une petite constante intégrée afin d'assurer la stabilité numérique, γ est un paramètre d'échelle ajustable qui permet au modèle de modifier la sortie normalisée, et β est un paramètre de décalage ajustable qui permet au modèle de décaler la sortie normalisée. Enfin, après avoir appliqué la couche de normalisation par lots, comme indiqué dans l'équation 11, la sortie normalisée Z2 passe par la fonction d'activation ReLU fuiteuse, ce qui introduit une non-linéarité dans le réseau, comme illustré dans l'équation 12. Ici, Z2 correspond à la sortie de la couche de normalisation par lots, qui est transmise comme entrée à la ReLU fuiteuse afin d'introduire la non-linéarité. Tandis que A2 indique la sortie obtenue après l'application de la non-linéarité.
Enfin, une couche de dropout est appliquée à la sortie A2 reçue en entrée depuis l'activation Leaky ReLU, comme indiqué dans l'équation 13. Ici, A2 correspond à la sortie provenant de la dernière fonction d'activation ReLU, et p2 représente le taux de dropout, choisi à 0,2 pour ce bloc, afin simplement d'annuler une fraction des neurones. Par ailleurs, A2′ indique la sortie modifiée après application de la couche de dropout, dans laquelle certains neurones ont été fixés à 0. Ensuite, la sortie du bloc 2, A2′, est transmise au troisième bloc afin d'extraire à nouveau des caractéristiques plus abstraites, en appliquant les mêmes paramètres que dans le bloc 2, à l'exception de 256 neurones dans la couche dense au lieu de 512 et d'un taux de dropout de 0,1 au lieu de 0,2 ; les autres séquences opérationnelles restent identiques, comme décrit dans les équations 14 à 17 ci-dessous.
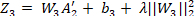 (14)
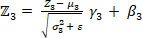 (15)
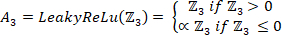 (16)
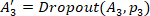 (17)
Après avoir obtenu la sortie du bloc 2, notée A2′, celle-ci est transmise à la couche dense (entièrement connectée) du bloc 3 composée de 256 neurones, où la matrice de poids W3 transforme le vecteur d'entrée A2′ en un vecteur de sortie à 256 dimensions, chaque élément du vecteur de sortie étant une combinaison linéaire des caractéristiques d'entrée. Ensuite, le vecteur de biais b3 est ajouté à chacun des 256 éléments du vecteur de sortie, ce qui permet au modèle de décaler indépendamment la sortie des caractéristiques d'entrée. Par ailleurs, une régularisation L2 est également appliquée, où λ||W3||22 pénalise les poids élevés, ce qui dissuade le modèle de dépendre excessivement d'un seul neurone et contribue ainsi à éviter le surapprentissage. Ici, W3 représente la matrice de poids d'une couche particulière du réseau de neurones, tandis que le degré de régularisation utilisé est contrôlé par le paramètre de régularisation λ, fixé à 0,01. Z3 devient la nouvelle représentation des caractéristiques après application de la couche dense ainsi que de la régularisation L2 sur l'entrée provenant du bloc 3, comme indiqué dans l'équation 14.
En outre, la couche de normalisation par lots a été appliquée à la nouvelle caractéristique Z3, ce qui permet d'accélérer le processus d'apprentissage ; σ32 représente la variance sur l'ensemble du lot, tandis que μ3 est la moyenne de la sortie Z3. Quant à ε, il s'agit d'une petite constante ajoutée pour assurer la stabilité numérique. La sortie normalisée peut être ajustée par le modèle à l'aide du paramètre d'échelle apprenable γ3, puis décalée à l'aide du paramètre de translation apprenable β3. Enfin, après l'application de la couche de normalisation par lots, illustrée dans l'équation 15, la sortie normalisée Z3 traverse la fonction d'activation ReLU fuyante, qui introduit une non-linéarité dans le réseau, comme indiqué dans l'équation 16. Ici, Z3 correspond à la sortie de la couche de normalisation par lots, qui est transmise comme entrée à la ReLU fuyante afin d'appliquer la non-linéarité. Quant à A3, elle représente la sortie obtenue après l'application de la non-linéarité.
Enfin, une couche de dropout est appliquée à la sortie A3 reçue en entrée depuis l'activation Leaky ReLU, comme indiqué dans l'équation 17. Où A3 correspond à la sortie provenant de la dernière fonction d'activation ReLU, et où p3 est le taux de dropout, choisi à 0,1 pour ce bloc, afin simplement d'annuler une fraction des neurones. Par ailleurs, A3′ représente la sortie modifiée après application de la couche de dropout, dans laquelle certains neurones ont été fixés à 0.
En outre, la sortie du bloc 3 A3′ traverse la dernière couche dense à des fins de classification, avec un nombre K de neurones représentant le nombre réel de classes dans le jeu de données, comme décrit dans l'équation 18 ci-dessous.
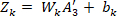 (18)
La matrice de poids associée à la couche dense est Wk, qui est chargée de transformer le vecteur à 256 dimensions A3′ en un vecteur à k dimensions, représentant les caractéristiques apprises à partir du bloc précédent et fournies en sortie. De plus, bk représente le vecteur de biais qui ajuste la prédiction afin de garantir que la fonction d'activation produise une sortie non nulle lorsque l'entrée est nulle, et Zk est la sortie de la couche finale avant l'application de la fonction d'activation ; elle génère les logits pour chaque classe. Enfin, un classificateur SoftMax41 est appliqué, qui convertit le logit Zk en probabilités pour chaque classe, comme indiqué dans les équations 19 et 20.
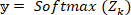 (19)
 (20)
La probabilité prédite de la classe ième est représentée par yi, K est le nombre de classes, tandis que Zk, i est le logit pour la classe ième, et eZk, i est l'exponentielle du logit de la classe ième. y indique la distribution de probabilité de toutes les classes possibles et garantit que la somme des probabilités est égale à 1. Tableau 3 ci-dessous fournit les détails des hyperparamètres utilisés pour entraîner le modèle hybride proposé, y compris les détails architecturaux adoptés afin d'améliorer la reproductibilité et les performances.
| Paramètres hyper | Modèle proposé (FusionNetX) |
| Taille de l'image | 224 × 224 |
| Architecture du réseau de base | EfficientNetB7 et DenseNet121 préentraînés respectivement utilisés comme BBA1 et BBA2 |
| Augmentation des données | Plage de rotation = 7, |
| Décalage en largeur/hauteur jusqu'à 0,05, | |
| Plage de zoom jusqu'à 0,01, | |
| Retournement horizontal/vertical | |
| Ratio de division des données | 80 % pour l'entraînement et 20 % pour la validation, avec un échantillonnage stratifié et un état aléatoire fixe = 42 |
| Extraction et fusion des caractéristiques | Un regroupement par moyenne globale est appliqué sur la sortie de chaque réseau de base : 2560 pour BBA1 et 1024 pour BBA2, puis fusionnés pour obtenir 3584 vecteurs de caractéristiques conjointes. |
| Composition du bloc entièrement connecté | 3 blocs entièrement connectés avec 1 couche de sortie. Chaque bloc contient une régularisation L2 (λ=0,01), une normalisation par lot, une fonction LeakyReLU (α=0,01), une désactivation (0,3, 0,2 et 0,1) et une dimension cachée (1024, 512, 256) respectivement. Aucune connexion de saut supplémentaire n'est introduite dans la tête de fusion. |
| Fonction d'activation | Leaky ReLU & SoftMax |
| Optimiseur et taux d'apprentissage | Adam avec un taux fixe de 0,00001, sans planificateur de taux d'apprentissage. |
| Fonction de perte | sparse_categorical_crossentropy |
| Taille du lot | 16 |
| Époques | 100 époques fixes pour chaque jeu de données |
| Plateforme utilisée | Carnet Kaggle équipé d'un GPU P100 et de 16 Go de mémoire vidéo, avec les plateformes TensorFlow et Keras. |
Tableau 3 : Hyperparamètres utilisés pour entraîner le modèle proposé et détails architecturaux proposés. Ce tableau fournit les détails structurels et architecturaux du modèle proposé, ainsi que les paramètres finement ajustés et l'environnement d'implémentation.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Cette partie détaille les résultats des tests du modèle de fusion de caractéristiques double proposé sur cinq ensembles de données open source concernant les cancers du cerveau, notamment les ensembles Br35H, Figshare, Sartaj, Masoud et Balanced Brain Tumor, et évalue leurs performances selon différents paramètres statistiques d'évaluation, notamment la précision42,43,44, le taux de mauvaise classification (MCR)
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Comme indiqué, le modèle proposé fonctionnait comme suit : premièrement, la taille de l'image a été fixée à 224 × 224, une taille modérée permettant à tout modèle d'apprentissage profond d'extraire et d'apprendre des caractéristiques adaptées à partir des échantillons de données tout en conservant toutes les informations importantes. Ensuite, une augmentation des données a été effectuée, ce qui est particulièrement avantageux pour diversifier les échantillons selon plusieurs directions, jouant ainsi un rôle clé dans l'ex...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n'ont rien à divulguer et n'ont aucun conflit d'intérêt. En outre, aucun outil d'intelligence artificielle n'a été utilisé pour rédiger le manuscrit ni pour produire les figures.
Remerciements
Les auteurs tiennent à remercier le projet de soutien aux chercheurs de l'Université Princesse Nourah bint Abdulrahman (PNURSP2026R192), Université Princesse Nourah bint Abdulrahman, Riyad, Arabie saoudite, pour le soutien apporté. Les auteurs remercient également les participants à l'étude et les institutions ayant contribué à cette recherche.
Financement :
Ce travail a été soutenu par une subvention du National Research Foundation of Korea (NRF) financée par le gouvernement coréen (MSIT) (n° RS-2023-00218176) et par le fonds de recherche de l'université Soonchunhyang. Projet de soutien aux chercheurs de l'université Princess Nourah bint Abdulrahman (PNURSP2026R192), université Princess Nourah bint Abdulrahman, Riyad, Arabie saoudite.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Jeu de données sur les tumeurs cérébrales Br35H | Kaggle (contributeur du jeu de données) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | Jeu de données public ; classification binaire (tumeur / pas de tumeur) 300 images IRM |
| Jeu de données sur les tumeurs cérébrales Figshare | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | Jeu de données public ; multiclasse (gliome, méningiome, tumeur hypophysaire) 3064 images IRM |
| Jeu de données IRM de classification des tumeurs cérébrales Sartaj | Kaggle (jeu de données par Sartaj Bhuvaji) | https://doi.org/10.34740/kaggle/dsv/12745533 | Jeu de données public ; multiclasse (gliome, méningiome, pas de tumeur, tumeur hypophysaire) 3264 images IRM |
| Jeu de données IRM sur les tumeurs cérébrales Masoud | Kaggle (jeu de données par Masoud Nickparvar) | https://doi.org/10.34740/kaggle/dsv/14832123 | Jeu de données public ; multiclasse (gliome, méningiome, pas de tumeur, tumeur hypophysaire) 7023 images IRM |
| BBT-Dataset (Jeu de données sur les tumeurs cérébrales) | Kaggle (contributeur du jeu de données) | https://doi.org/10.34740/kaggle/dsv/6758053 | Jeu de données public ; tumeur cérébrale multiclasse équilibrée, 5248 images IRM |
| Python | Fondation Python | https://www.python.org | Langage de programmation, version 3.10.13 |
| TensorFlow / Keras | Google / développeurs TensorFlow | https://www.tensorflow.org | Framework d'apprentissage profond ; construction, entraînement et évaluation de modèles, version 2.15.0 |
| EfficientNetB7 (pré-entraîné) | Google / Applications Keras | https://keras.io/api/applications/efficientnet/ | Backbone pré-entraîné sur ImageNet ; extraction de caractéristiques |
| DenseNet121 (pré-entraîné) | Applications Keras | https://keras.io/api/applications/densenet/ | Backbone pré-entraîné sur ImageNet ; extraction de caractéristiques |
| scikit-learn | Développeurs scikit-learn (NumFOCUS) | https://scikit-learn.org | Encodage des étiquettes, division entraînement-test, métriques d'évaluation (rapport de classification, matrice de confusion, ROC/AUC) |
| OpenCV (cv2) | Équipe OpenCV | https://opencv.org | Chargement et redimensionnement d'images |
| NumPy | Développeurs NumPy (NumFOCUS) | https://numpy.org | Calcul numérique et opérations sur tableaux |
| pandas | Équipe de développement pandas (NumFOCUS) | https://pandas.pydata.org | Organisation des données et présentation des métriques sous forme de tableau |
Références
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.