Cet article présente un flux de travail computationnel supervisé par des humains pour examiner les représentations récurrentes des femmes dans 433 peintures chinoises d'époque Qing destinées à l'exportation. Sept catégories de référence humaines et des indices visuels récurrents caractérisent les motifs présents dans le corpus, tandis que les résultats restent limités aux images échantillonnées et ne mesurent ni la réalité sociale ni la réception historique de l'époque Qing.
Article de recherche
Identité féminine et imaginaire de classe dans les peintures d'exportation chinoises de la dynastie Qing : une étude assistée par l'intelligence artificielle sur l'interprétation transculturelle
Dans cet article
Résumé
Résumé
Cette étude a examiné les représentations récurrentes de l'identité féminine et des indices visuels liés à la classe sociale dans un corpus de 433 peintures chinoises de la dynastie Qing destinées à l'exportation, datées de 1757 à 1911. Le flux de travail combinait CLIP ViT-B/32 pour l'étiquetage préliminaire, le modèle de segmentation universel (Segment Anything Model, SAM) pour l'assistance à la localisation, une réduction de dimensionnalité et un regroupement en clusters, ainsi qu'un codage iconographique manuel réalisé par deux codeurs indépendants. Les étiquettes CLIP ont été utilisées pour l'organisation préliminaire, SAM a servi d'aide à la localisation, et le codage humain validé a fourni les catégories de référence. Les résultats globaux ont identifié sept catégories de référence humaine : élite/belle (n = 112), travail (n = 72), domestique (n = 64), servante (n = 58), rituel/mariage (n = 45), marché (n = 43) et spectacle (n = 39). Les étiquettes computationnelles préliminaires correspondaient aux étiquettes de référence humaine pour 356 des 433 peintures (82,2 %), le rappel au niveau des catégories variant de 73,3 % à 88,4 %. Des combinaisons récurrentes de vêtements, de cadre spatial, d'objets, de posture et de relations sociales représentées ont été utilisées pour caractériser les profils visuels de ces catégories. L'évaluation des 433 paires d'étiquettes IA–humain au cas par cas a permis d'obtenir des scores complets de précision, de rappel et de F1 au niveau des catégories, ainsi qu'une matrice de confusion détaillant les schémas de classification. La validation des clusters a confirmé la solution de regroupement choisie et a démontré une correspondance entre les clusters obtenus et les catégories de référence définies par l'humain. Dans l'ensemble, les combinaisons récurrentes de vêtements, de cadre spatial, d'objets, de posture et de relations sociales indiquent des typologies picturales structurées au sein du corpus échantillonné. Ces résultats caractérisent la représentation visuelle dans les peintures chinoises de la dynastie Qing destinées à l'exportation, mais ne doivent pas être interprétés comme des mesures directes du statut juridique, de l'expérience vécue, de la demande du marché ou de la réception historique par les étrangers.
Introduction
Les peintures chinoises d'exportation de la dynastie Qing faisaient partie des réseaux commerciaux et culturels reliant Canton et d'autres centres de collection à des acheteurs euro-américains à partir de la fin du dix-huitième siècle1,2,3,4,5. Des marchands, voyageurs, diplomates, missionnaires et collectionneurs acquéraient ces peintures comme biens portables, souvenirs, sources d'informations visuelles et représentations de lieux, de professions, de modes de production, de coutumes et de types sociaux. Leur circulation reflétait donc à la fois les pratiques des ateliers chinois et les attentes des marchés extérieurs.
La demande étrangère favorisait des sujets reconnaissables, des formats en série, des motifs répétés et des scènes pouvant être collectionnées et comparées. Les ateliers adaptaient les médiums, les dimensions, la composition et les sujets en vue de la vente, tandis que les acheteurs privilégiaient souvent des représentations aisément identifiables des métiers, des cérémonies, des intérieurs, des jardins, des rues et des types sociaux pittoresques. Les versions répétées de scènes d’ateliers cantonais illustrent davantage la manière dont les artistes et leurs assistants adaptaient l’iconographie et les procédés picturaux occidentaux pour les clients outre-mer1,2,3,4,5. Bien que la demande du marché ait pu influencer ce qui était produit et préservé, le corpus actuel ne mesure pas directement les préférences ou les réactions individuelles des acheteurs.
Ces peintures doivent donc être considérées comme des sources sélectives et médiatisées, plutôt que comme des documents exhaustifs de la vie quotidienne. Leurs scènes peuvent idéaliser, simplifier, normaliser ou adapter les pratiques sociales à travers les conventions des ateliers, la sélection du marché, l'acquisition par les musées, le catalogage et la numérisation1,2,3,4,5. L'interprétation historique doit distinguer les caractéristiques directement observables dans les peintures des inférences concernant les individus représentés, les conditions de production et les significations que des observateurs ultérieurs ont attribuées aux œuvres.
Les représentations féminines offrent un moyen ciblé d'examiner cette distinction. Les vêtements, la coiffure, la posture, le cadre spatial, les objets, les activités et les relations avec d'autres personnages peuvent organiser les femmes en rôles visuellement récurrents, notamment les catégories beauté/élite, domestique, servante, travailleuse, marchande, artiste de spectacle, et rituelle/mariage. Ces catégories constituent des descriptions analytiques de motifs picturaux et n'établissent pas, en tant que telles, le rang juridique, la richesse, la profession, l'ethnie, l'appartenance à une Banner ou à un groupe Han, le caractère moral ou l'identité vécue.
L'histoire de l'art numérique et la vision par ordinateur peuvent faciliter des comparaisons à grande échelle de collections visuelles numérisées tout en permettant un examen critique des hypothèses intégrées aux modèles computationnels6,7. Les modèles vision-langage peuvent aider à identifier et organiser des motifs visuels récurrents, bien que les biais culturels constituent une limitation importante lorsque les vocabulaires contemporains des modèles sont appliqués à des images historiques non occidentales8. Des recherches computationnelles connexes sur la peinture traditionnelle chinoise démontrent de même l'intérêt de combiner la détection quantitative de motifs avec une interprétation éclairée par l'histoire9.
Cette étude aborde trois questions : (1) Quelles catégories d'identité féminine codées par des humains et validées par arbitrage sont représentées dans le corpus ? (2) Quelles combinaisons de vêtements, de cadre spatial, d'objets, de posture et de relations sociales caractérisent ces catégories ? (3) Comment la précision globale par correspondance exacte et le rappel au niveau des catégories varient-ils selon les sept catégories ? Le flux de travail s'appuie sur des approches computationnelles appliquées à la peinture chinoise traditionnelle9, tout en limitant ses affirmations historiques aux images échantillonnées et aux analyses documentées.
La contribution visée est à la fois historiographique et technique. Une comparaison à l'échelle d'un corpus peut identifier des formules picturales récurrentes qui pourront ensuite être contextualisées au moyen d'une analyse historique approfondie. Cette approche peut éclairer la recherche sur le genre, la hiérarchie, les représentations de la vie quotidienne et les rencontres interculturelles, sans traiter la fréquence des images comme une preuve de prévalence sociale ni la similarité visuelle comme une preuve d'identité historique.
Protocole
Conception de l'étude et unité d'analyse
Chaque tableau ou notice de catalogue a été considéré comme une unité d'analyse. Une conception observationnelle fondée sur un corpus a été utilisée, combinant l'examen des métadonnées, une organisation computationnelle préliminaire, un codage manuel indépendant et une interprétation de nature historico-artistique. La période d'étude s'est étendue de 1757 à 1911, et des critères d'inclusion et d'exclusion ont été appliqués dans cet intervalle. Des œuvres d'art historiques ainsi que leurs métadonnées cataloguées associées ont été analysées. Lorsque des distributions sur des intervalles de temps inégaux ont été comparées, les effectifs ont été normalisés par la durée des intervalles, tout en tenant compte, dans l'interprétation, des biais potentiels liés à la conservation et à l'acquisition.
Construction et sélection du corpus
Les notices candidates ont été extraites des catalogues de musées cités, des archives numériques et des catalogues publiés. Pour chaque notice candidate, l'institution, le titre, la date ou la période, le support, le numéro d'inventaire ou de catalogue, l'URL stable de la source, la date de consultation et l'avis sur les droits ont été conservés. Les liens sources ont été préservés même lorsque le fichier image correspondant ne pouvait pas être redistribué légalement. La procédure de tri signalée a débuté avec 612 images candidates. Parmi celles-ci, 85 ont été exclues car elles se situaient en dehors de la période 1757–1911 ou en dehors de la tradition des peintures d'exportation, 58 ont été exclues car il s'agissait de reproductions modernes, de notices floues ou de sujets incorrects, 29 ont été exclues car elles ne présentaient pas de figure féminine identifiable ou une résolution d'image insuffisante, et 7 ont été exclues en raison de métadonnées insuffisantes. Le corpus analytique final comprenait 433 notices.
Standardisation des métadonnées et prétraitement des images
Chaque tableau du corpus analytique final s'est vu attribuer un identifiant QEP stable, allant de QEP_001 à QEP_433. Les métadonnées muséales associées ont été conservées, notamment l'institution, le numéro d'inventaire, le titre, la date, la technique ou les matériaux, le lieu d'origine, le lien source et la description cataloguée disponible. Pour l'analyse visuelle, l'étiquette préliminaire générée par l'IA, la catégorie humaine validée, le nombre de figures féminines, le groupe d'âge, la posture, les vêtements, le cadre spatial, les objets associés et les relations sociales ont été enregistrés. Chaque tableau a été classé dans l'une des sept catégories principales suivantes : élite/belle, domestique, servante, travail, marché, spectacle ou rituel/mariage. Pour les scènes comportant plusieurs figures féminines, la figure centrale a été identifiée en fonction de sa prééminence visuelle et de son importance narrative. Lorsqu'aucune figure féminine n'était dominante, la catégorie principale a été attribuée en fonction de l'activité principale représentée et du contexte général de la scène. Les catégories superposées ont été tranchées en privilégiant l'activité représentée et le contexte de la scène plutôt que les seuls vêtements ou l'apparence. Les cas ambigus ont été examinés indépendamment par les deux codeurs et résolus par consensus. Les images sources ont été sauvegardées au format JPEG ou PNG. Seuls les bordures de page web, les cadres de catalogue ou les marges non liées à l'image ont été rognés. Le contenu pictural n'a pas été reconstruit, recolorié, amélioré ou restauré.
Étiquetage préliminaire basé sur CLIP
L'encodeur d'image CLIP ViT-B/32 a été utilisé pour l'analyse préliminaire de similarité image-texte9. Les termes d'identité candidats comprenaient femme élitée, femme domestique, servante, femme active, femme du marché, femme artiste, mariée et femme rituelle. Les termes relatifs à la scène comprenaient intérieur chinois, jardin, marché de rue, atelier, production de thé, travail textile et scène cérémonielle. L'ensemble complet des modèles de prompts, leur ordre, tout regroupement de prompts, les procédures de normalisation du texte, les règles de décision, les scores de confiance et les ex-aequo ont été conservés pour chaque image.
La liste complète de prompts a été appliquée de manière uniforme à toutes les images à l’aide du modèle OpenAI CLIP ViT-B/32 implémenté en Python 3.10 avec PyTorch 2.0.1 et le package OpenAI CLIP. L’inférence a été réalisée sur un GPU compatible CUDA avec une taille de lot de 32, en utilisant une précision FP32. Chaque image a été redimensionnée puis rognée au centre à 224 × 224 pixels, et les canaux RVB ont été normalisés à l’aide de la transformation de prétraitement associée au modèle ViT-B/32. Les prompts textuels ont été construits à partir descripteurs d’identité et de scène définis précédemment, puis encodés à l’aide de l’encodeur de texte CLIP. La similarité cosinus a été calculée entre les intégrations textuelles et images normalisées, et le prompt présentant le score de similarité le plus élevé a été attribué comme étiquette préliminaire générée par l’IA. Les scores de similarité pour toutes les étiquettes candidates ont été conservés en vue d’un examen ultérieur par un humain. Une graine aléatoire fixe de 42 a été utilisée, et des procédures de prétraitement, des modèles de prompts et des règles de décision identiques ont été appliqués à l’ensemble des 433 peintures.
Localisation assistée par SAM
Le modèle Segment Anything (SAM) a été strictement utilisé pour localiser des figures, des vêtements, des meubles, des outils, des objets rituels et des régions architecturales destinées à l'inspection visuelle humaine. Il convient de souligner que SAM n'a pas participé au pipeline de classification ; ses masques, recadrages et caractéristiques dérivées ont été isolés des processus d'étiquetage et de regroupement par CLIP, garantissant ainsi que l'application de SAM fournisse des aides à la localisation sans influencer ni amplifier les performances de classification.
Des points manuels ou des cadres englobants ont été appliqués selon les besoins afin d'affiner la localisation des éléments visuels. Des masques SAM ont été générés pour les figures féminines, les vêtements, les meubles, les outils, les objets rituels et les éléments architecturaux, et chaque résultat de segmentation a été inspecté visuellement afin de s'assurer d'une couverture régionale adéquate. Les masques obtenus ont permis l'identification et l'examen des caractéristiques iconographiques pertinentes, mais n'ont pas été utilisés pour l'étiquetage CLIP ou l'attribution de catégories.
Réduction de la dimensionnalité et regroupement en clusters
Les intégrations d'images CLIP ont été calculées, et l'UMAP avec distance cosinus a été utilisée pour la visualisation en deux dimensions10. La représentation utilisée pour le regroupement en clusters, ainsi que sa procédure de prétraitement, sa dimensionnalité et la définition de la distance, ont été enregistrées.
Les méthodes des K-moyennes et de regroupement hiérarchique ont été appliquées aux représentations des caractéristiques d'image afin d'identifier des regroupements visuels récurrents au sein du corpus11. Les solutions candidates des K-moyennes pour k = 5–9 ont été évaluées à l'aide du coefficient de silhouette et de l'indice de Davies–Bouldin. L'initialisation K-moyennes++ a été utilisée avec n_init = 10, max_iter = 300, tol = 1 × 10⁻4, et random_state = 42. Le regroupement hiérarchique a été réalisé à l'aide d'un regroupement agglomératif avec une liaison moyenne et une distance cosinus. Les solutions candidates ont été comparées à l'aide d'indices de validation quantitative, de la stabilité des groupes et de l'interprétabilité du point de vue de l'histoire de l'art, et la solution finale de regroupement a été retenue pour sa représentation la plus cohérente des motifs visuels récurrents. L'attribution finale des groupes pour chacune des 433 peintures a été conservée afin d'être comparée ultérieurement aux catégories codées par l'humain.
Codage manuel, formation et arbitrage
Deux codeurs ont examiné indépendamment les 433 images à l’aide d’un manuel de codage versionné couvrant la catégorie principale, le nombre de personnages, le groupe d’âge, la posture, les vêtements, le cadre spatial, les objets et les relations sociales. Les enregistrements propres à chaque codeur ont été conservés avant l’arbitrage. Les codeurs possédaient des formations pertinentes en histoire de l’art et en analyse visuelle, et ont été formés à l’aide du manuel de codage normalisé ainsi qu’à partir d’exemples représentatifs du corpus de peintures. Avant le codage formel, ils ont réalisé un exercice d’étalonnage portant sur 30 peintures afin de favoriser une interprétation cohérente des sept catégories d’identité et des cinq dimensions des indices visuels.
Lors du codage formel, les deux codeurs ont évalué indépendamment toutes les peintures éligibles en étant aveugles aux décisions de codage de l'autre, aux étiquettes préliminaires de l'IA et aux attributions de groupes. La fiabilité entre codeurs a été évaluée à l'aide du kappa de Cohen. La valeur de kappa observée pour la catégorie d'identité principale était de 0,88, et les variables catégorielles des indices visuels variaient entre 0,79 et 0,92, démontrant un fort accord entre les codeurs. Les désaccords ont été résolus par discussion et consensus, et les codes catégoriels et des indices visuels arbitrés ont été enregistrés pour les analyses ultérieures12. Les étiquettes préalables à l'arbitrage ont été conservées.
Concordance entre l'IA et les humains et estimation des performances
La catégorie humaine arbitrée a été utilisée comme référence pour une comparaison descriptive avec une étiquette préliminaire de l'IA par tableau. La précision globale par correspondance exacte a été calculée à 356/433 (82,2 %). Le rappel par catégorie a été déterminé en divisant le nombre de correspondances exactes entre l'IA et les humains par le nombre d'éléments de référence humaine pour chaque catégorie. Le soutien par catégorie, les correspondances exactes, les discordances et les dénominateurs correspondants ont été indiqués explicitement.
À partir des 433 étiquettes appariées au niveau des cas, issues de l'IA et humaines, les faux positifs de la classe cible, ainsi que la précision, le rappel et les scores F1 par catégorie ont été calculés. Une matrice de confusion complète a été établie afin d'analyser les schémas de classification hors diagonale, ce qui a ensuite guidé l'examen des incohérences, la documentation de la taxonomie des erreurs et les règles d'arbitrage.
Paquet de reproductibilité et matériaux
Le flux de travail computationnel et les matériaux de recherche associés ont été organisés dans un dépôt soumis à un contrôle de version. Le paquet de reproductibilité a été conçu pour inclure des scripts destinés au prétraitement, à l'analyse CLIP, à la localisation SAM, à l'UMAP, au regroupement en clusters, à l'analyse d'accord inter-observateurs, et à la génération de figures, ainsi que le cahier des charges du codage manuel, les fichiers de configuration, les informations sur les dépendances, les résultats dérivés au niveau des cas, et un inventaire lisible par machine des sources d'images et des informations sur les droits. Un identifiant persistant a été attribué aux matériaux de recherche archivés afin de faciliter la reproductibilité et la réutilisation.
Microsoft Excel 2021 a été utilisé pour organiser et gérer les métadonnées. Les analyses computationnelles ont utilisé CLIP ViT-B/32 pour l'étiquetage préliminaire vision-langage, SAM pour la localisation des éléments visuels, UMAP avec distance cosinus pour la réduction de dimensionnalité, et les méthodes des k-moyennes et de regroupement hiérarchique pour l'analyse exploratoire de motifs. Les solutions de regroupement ont été évaluées à l'aide du coefficient de silhouette et de l'indice de Davies-Bouldin, et l'accord entre codeurs a été évalué à l'aide du kappa de Cohen. L'environnement logiciel, les configurations des modèles, les paramètres computationnels et les graines aléatoires utilisés tout au long du flux de travail ont été documentés afin d'assurer la reproductibilité.
Résultats
Construction du corpus et composition descriptive
Figure 1 présente un aperçu en quatre parties du corpus. Figure 1A montre le processus de sélection signalé, allant de 612 références candidates à 433 références conservées. Figure 1B affiche des exemples représentatifs de médias et de formats. Figure 1C présente les effectifs répartis selon quatre intervalles de dates, et Figure 1D résume la composition du corpus selon les sources et les médiums. Étant donné que les intervalles de dates couvrent des périodes inégales, ces effectifs décrivent la composition du corpus échantillonné et ne doivent pas être interprétés comme des taux de production historiques.
Tableau 1 résume les caractéristiques globales du corpus. Les collections de musées représentaient 302 entrées, les archives numériques 81 et les catalogues publiés 50. Les supports ont été classés en aquarelle d'exportation (n = 176), peinture sur papier de pith (n = 112), feuille d'album d'exportation (n = 83), peinture de figures (n = 41) et autre format (n = 21). Les métadonnées ont été classées comme complètes (n = 288), partielles (n = 118) ou minimales (n = 27). Les figures féminines ont été classées comme principales (n = 214), secondaires (n = 102) ou multiples (n = 117). Chaque groupe de classification comprenait l'ensemble des 433 enregistrements.
Étiquettes préliminaires générées par IA et catégories de référence humaine
Le Tableau 2 résume l'accord global entre les étiquettes préliminaires générées par IA et les catégories de référence humaine pour l'ensemble des 433 peintures, tandis que le Tableau supplémentaire 1 fournit, au niveau individuel, les étiquettes préliminaires de l'IA, les classifications des codeurs, les catégories de référence humaine arbitées, le statut de correspondance et les affectations aux groupes. Dans l'ensemble, les étiquettes de l'IA et celles de référence humaine correspondaient pour 356 peintures, ce qui correspond à une précision par correspondance exacte de 82,2 %. Le rappel au niveau des catégories a été calculé comme la proportion de correspondances exactes entre l'IA et l'humain par rapport au nombre d'occurrences dans chaque catégorie selon la référence humaine.
Le rappel au niveau des catégories variait de 73,3 % pour les scènes rituelles/mariages (33/45) à 88,4 % pour les élites/beauté (99/112). Le rappel était de 84,7 % pour le travail (61/72), de 82,1 % pour la performance (32/39), de 79,7 % pour le cadre domestique (51/64), de 79,3 % pour les domestiques (46/58) et de 79,1 % pour le marché (34/43). Dans l'ensemble, l'accord exact était de 356/433 (82,2 %). L'évaluation des paires au niveau des cas a permis de calculer la précision et les scores F1 pour l'ensemble des sept catégories, avec des valeurs allant de 74,5 % à 89,2 % pour la précision, et de 0,75 à 0,88 pour les scores F1. Une matrice de confusion détaillée, indiquant les faux positifs par classe cible et les motifs hors diagonale, est fournie dans la figure supplémentaire 1.
Résumés des motifs computationnels rapportés
Figure 2 présente quatre affichages d'analyses computationnelles rapportées. Figure 2A montre une galerie de neuf peintures avec des superpositions de segmentation colorées utilisées pour la localisation visuelle et l'examen. Figure 2B montre un nuage de points UMAP des intégrations d'images CLIP rapportées, avec des contours de densité étiquetés C1–C7. Figure 2C compare le nombre de peintures rapportées (points pleins) avec le rappel au niveau des catégories (cercles ouverts), et Figure 2D présente une galerie de peintures représentatives regroupées selon les mêmes étiquettes. La validation des groupes a soutenu la solution de regroupement sélectionnée, qui a donné un score de silhouette de 0,54 et un indice de Davies–Bouldin de 0,92. La correspondance entre les groupes et les catégories humaines a montré un fort alignement, chaque groupe dérivé correspondant principalement à une catégorie de référence humaine distincte.
Tableau 3 présente sept profils computationnels rapportés avec des tailles d'échantillon correspondant aux sept catégories de référence humaine. Le tableau de contingence regroupant les clusters par catégorie est fourni dans le Tableau supplémentaire 2 et illustre la répartition des sept catégories de référence humaine attribuées par consensus parmi les clusters C1–C7. L'analyse de ces attributions de clusters au niveau des cas a démontré que le regroupement computationnel a permis de retrouver des structures visuelles correspondant étroitement aux sept catégories de référence humaine.
Associations liées aux indices visuels et synthèse interprétative
Le tableau 4 résume les profils qualitatifs d'indices visuels utilisés pour caractériser les sept catégories codées par des humains. Ces profils décrivent les associations récurrentes entre vêtements, cadre spatial, posture, objets et relations sociales. Ils n'ont pas été établis à partir d'une table de contingence quantitative et ne permettent donc pas d'établir le statut juridique, l'ethnicité, la causalité sociale ou la réception par le public.
Figure 3 associe des résumés quantitatifs descriptifs des caractéristiques visuelles codées à un modèle conceptuel interprétatif. Figure 3A présente les sept catégories humaines de référence validées ainsi que leurs tailles d'échantillon. Figure 3B montre les associations relatives entre ces catégories et les marqueurs visuels codés selon cinq dimensions : vêtements, cadre spatial, objets, posture et relations sociales. Les intensités d'association affichées ont été calculées à partir des annotations au niveau des cas dans chaque catégorie de référence humaine. Figure 3C résume les relations entre les catégories de référence humaine, les dimensions de marquage visuel et les archétypes d'implication de classe, à l’aide de flux pondérés dérivés des observations codées. Ces relations quantitatives caractérisent des schémas de représentation récurrents au sein des peintures échantillonnées et ne doivent pas être interprétées comme des estimations de répartitions démographiques ou sociales historiques. Figure 3D présente un modèle interprétatif conceptuel transculturel et doit être compris comme un cadre interprétatif éclairé par l’histoire, plutôt que comme un chemin causal éprouvé empiriquement.
Interprétation intégrée des motifs visuels
Dans l'ensemble du corpus, les sept catégories d'identité féminine étaient caractérisées par des combinaisons récurrentes de vêtements, de cadre spatial, d'objets, de postures et de relations sociales. Ces combinaisons fournissaient des preuves descriptives de conventions visuelles structurées au sein des peintures échantillonnées. Les interprétations historiques relatives au genre, à la hiérarchie et à la médiation interculturelle demeuraient inférentielles.
Dans leur ensemble, les résultats agrégés ont identifié sept catégories d'identité féminine de référence humaine et cinq dimensions récurrentes utilisées pour les caractériser : les vêtements, le cadre spatial, les objets, la posture et les relations sociales. Les étiquettes préliminaires de l'IA correspondaient aux catégories humaines validées pour 356 des 433 peintures (82,2 %), le taux de rappel le plus faible au niveau des catégories étant observé pour les scènes rituelles ou de mariage (73,3 %). Ces résultats ont soutenu l'organisation descriptive et la comparaison du corpus. Les étiquettes cas par cas issues de l'IA et des annotateurs humains ont permis d'estimer la précision et le score F1 au niveau des catégories. Par ailleurs, l'analyse de regroupement a mis en évidence des structures correspondant aux sept catégories de référence humaine. Néanmoins, ces résultats computationnels décrivent des conventions de représentation visuelle plutôt qu'ils n'établissent de liens de causalité concernant la réalité sociale historique ou la réception par le public.
DISPONIBILITÉ DES DONNÉES :
Les données soutenant cette étude, y compris les métadonnées, les informations sur les sources et les enregistrements de criblage, sont disponibles via Zenodo à l'adresse suivante : https://doi.org/10.5281/zenodo.21130291.
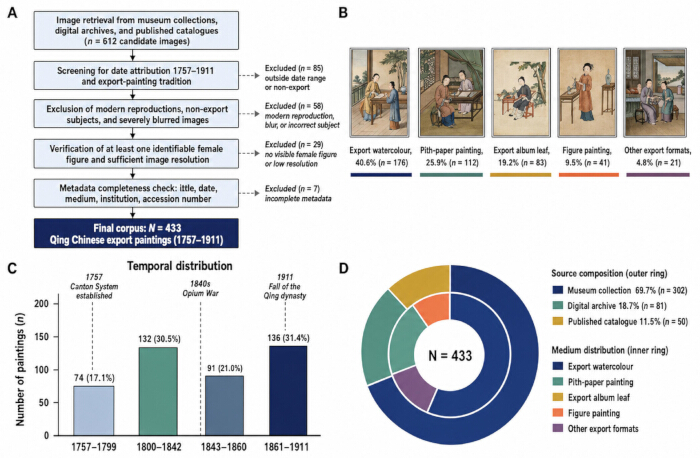
Figure 1 : Construction du corpus et composition descriptive de l'échantillon de 433 peintures. (A) Analyse séquentielle de 612 images candidates, aboutissant à 433 peintures éligibles. Les exclusions comprenaient des peintures en dehors de la période d'étude ou de la tradition des peintures d'exportation (n = 85), des reproductions modernes, des images floues ou des sujets incorrects (n = 58), des images sans figure féminine identifiable ou avec une résolution insuffisante (n = 29), ainsi que des enregistrements comportant des métadonnées insuffisantes (n = 7). (B) Exemples représentatifs de cinq médias et formats : aquarelle d'exportation (40,6 %, n = 176), peinture sur papier de pith (25,9 %, n = 112), feuille d'album d'exportation (19,2 %, n = 83), peinture de figures (9,5 %, n = 41) et autres formats d'exportation (4,8 %, n = 21). (C) Répartition des peintures échantillonnées selon quatre intervalles chronologiques. (D) Répartition des sources de collection (anneau extérieur) et des médias/formats (anneau intérieur). Les pourcentages sont calculés sur l'ensemble de l'échantillon (N = 433) et arrondis à une décimale. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
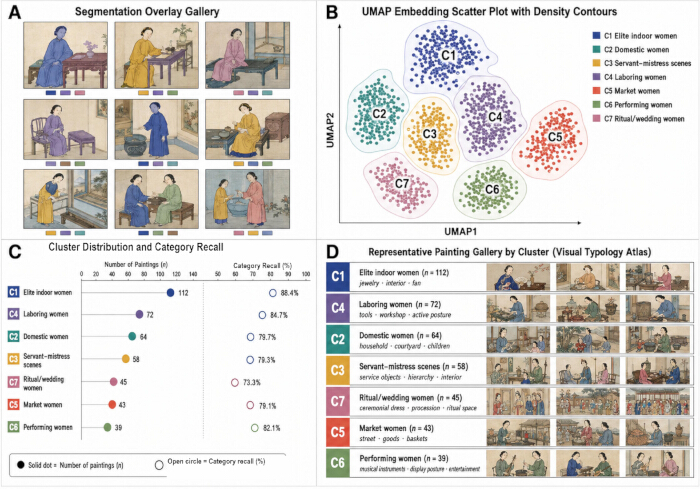
Figure 2 : Segmentation signalée, visualisation par intégration, distribution des groupes, rappel des catégories et peintures représentatives. (A) Galerie de neuf peintures avec superpositions colorées de segmentation utilisées pour localiser les figures ou éléments visuels à examiner. (B) Graphique de dispersion UMAP des intégrations d'images CLIP signalées, avec des contours de densité et les étiquettes C1–C7. (C) Nombre signalé de peintures (points pleins, axe supérieur) et rappel des catégories (cercles vides, axe inférieur) ; le rappel des catégories correspond au nombre de correspondances exactes divisé par le soutien de référence humaine. Aucun intervalle de confiance ni barre d'erreur n'est indiqué. (D) Galerie de peintures représentatives regroupées selon les étiquettes C1–C7, avec des images sélectionnées en fonction de leur proximité respective aux centroïdes des groupes. Abréviations : IA = intelligence artificielle ; CLIP = pré-entraînement contrastif langage-image ; SAM = modèle de segmentation universel ; UMAP = approximation et projection uniforme des variétés ; C1–C7 = étiquettes signalées 1–7. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
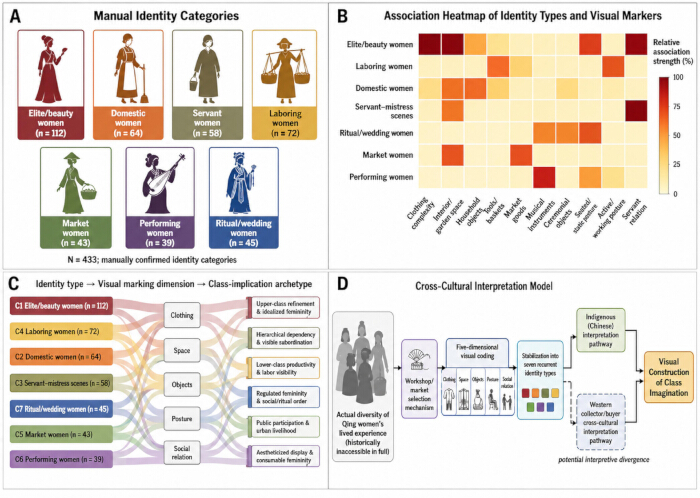
Figure 3 : Cadre visuel des associations et modèle interprétatif interculturel. (A) Sept catégories d'identité féminine de référence humaine validées et leurs effectifs au sein du corpus de 433 tableaux. (B) Carte thermique d'association montrant l'intensité relative des liens entre les sept catégories de référence humaine et les marqueurs visuels codés portant sur les vêtements, le cadre spatial, les objets, la posture et les relations sociales. Les intensités d'association ont été déduites des annotations au niveau des cas dans chaque catégorie. (C) Représentation en flux superposés résumant les relations pondérées entre les catégories de référence humaine, les dimensions de marquage visuel et les archétypes d'implication de classe, basées sur les observations codées. (D) Modèle conceptuel d'interprétation interculturelle reliant les activités représentées, la sélection d'atelier et de marché, le codage visuel à cinq dimensions, les types d'identité récurrents et les voies interprétatives possibles. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Tableau 1 : Caractéristiques du corpus et exhaustivité des métadonnées (N = 433). Les effectifs et pourcentages résument six blocs distincts : intervalle de dates, source, support ou format, exhaustivité des métadonnées, représentation des figures féminines et type de scène. Chaque bloc utilise N = 433 comme dénominateur et totalise 433 ; les pourcentages correspondent à des proportions du corpus par bloc, arrondies à une décimale. Veuillez cliquer ici pour télécharger ce fichier.
Tableau 2 : Étiquettes préliminaires de l'IA et catégories de référence humaine (N = 433). Le support représente le nombre de peintures attribuées à chaque catégorie de référence humaine. Les correspondances exactes indiquent les peintures pour lesquelles l'étiquette préliminaire générée par l'IA correspondait à la catégorie de référence humaine. Le rappel au niveau des catégories est calculé comme le nombre de correspondances exactes divisé par le nombre de supports de référence humaine. Veuillez cliquer ici pour télécharger ce fichier.
Tableau 3 : Résumé du profil computationnel rapporté. Les profils C1 à C7 reproduisent les tailles validées et les libellés dominants. L'intégration des attributions de clusters au niveau des cas et du tableau de contingence cluster-par-catégorie confirme que le regroupement non supervisé a efficacement capturé les structures visuelles correspondant aux sept catégories de référence humaine. Veuillez cliquer ici pour télécharger ce fichier.
Tableau 4 : Profils qualitatifs des catégories d'identité féminine et indices visuels liés à la classe sociale. Les effectifs et pourcentages résument les catégories de référence humaine, tandis que les vêtements, l'espace, les objets, la posture et les relations sociales caractérisent les profils visuels récurrents associés à chaque catégorie. Les interprétations liées à la classe représentent des lectures iconographiques de motifs picturaux plutôt que des mesures directes du statut social historique. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 1 : Matrice de confusion comparant les étiquettes préliminaires de l'IA aux catégories de référence humaine validées pour le corpus de 433 peintures. Les lignes représentent les catégories de référence humaine validées (étiquettes réelles), et les colonnes représentent les catégories préliminaires générées par CLIP (étiquettes prédites). Les valeurs des cellules indiquent le nombre de peintures pour chaque combinaison d'étiquettes IA–humain. Les cellules diagonales représentent les correspondances exactes entre l'IA et l'humain, la sensibilité (rappel) au niveau de chaque catégorie étant indiquée en pourcentage. Les cellules hors diagonale représentent les inadéquations entre la classification préliminaire de l'IA et la catégorie de référence humaine validée. La précision globale par correspondance exacte était de 82,2 % (356/433). Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 1 : Comparaison au niveau des cas entre les étiquettes préliminaires de l'IA, les catégories de référence humaine consensuelles et les attributions de clusters UMAP. Chaque ligne représente l'une des 433 peintures chinoises d'exportation Qing incluses dans le corpus analytique. Le tableau indique l'identifiant d'image QEP stable, l'étiquette préliminaire de CLIP ViT-B/32, les classifications indépendantes des codeurs humains 1 et 2, la catégorie de référence humaine consensuelle, le statut de concordance entre l'IA et l'humain, ainsi que l'attribution au cluster UMAP. « Concordance exacte » indique un accord entre l'étiquette préliminaire de l'IA et la catégorie de référence humaine consensuelle ; « Discordance » indique un désaccord. La catégorie humaine consensuelle a servi de classification de référence pour les analyses de concordance entre l'IA et l'humain. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2 : Tableau de contingence des catégories de référence humaine et des attributions de grappes computationnelles. Les lignes représentent les sept catégories de référence humaine validées par consensus, et les colonnes représentent les grappes C1–C7 obtenues à partir de l'analyse de regroupement computationnel. Les valeurs des cellules indiquent le nombre de peintures attribuées à chaque combinaison catégorie-grappe. Le soutien total représente le nombre de peintures appartenant à chaque catégorie de référence humaine. La concentration des observations selon les combinaisons catégorie-grappe fournit une évaluation descriptive de la concordance entre les grappes computationnelles déterminées indépendamment et les catégories de référence humaine validées par consensus. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Parmi les résumés agrégés fournis, 433 enregistrements ont été classés en sept catégories de référence humaine et décrits à l’aide de cinq familles de signaux visuels. La catégorie élite/beauté était la plus importante (112/433), et 356 étiquettes préliminaires correspondaient à la référence humaine rapportée (82,2 %). Il s’agit d’observations issues du corpus. Elles permettent d’étudier des formules picturales récurrentes, mais pas d’affirmer plus fortement que ces formules reproduisent fidèlement la société qing ou ont provoqué une réaction particulière auprès des publics étrangers13.
Le discours prescriptif sur le genre, la position dans le foyer, le travail et la loi Qing ont façonné la vie des femmes sans la déterminer de manière uniforme. Les recherches sur les femmes de la Haute période Qing attestent de leur participation au travail, à l'écriture, aux rituels, à la religion et aux loisirs, parallèlement aux régimes familiaux et de chasteté prescrits. Les Huit Bannières formaient un groupe statutaire héréditaire et multiethnique défini par la loi et par la pratique administrative ; l'appartenance aux Bannières ne doit donc pas être automatiquement assimilée à une appartenance ethnique mandchoue14,15,16,17. Dans cette étude, les vêtements, la posture, les objets et le cadre constituent des indices picturaux plutôt que des preuves de rang juridique, d'affiliation Bannières/Han, d'ethnicité, de conformité morale ou d'identité vécue. Des preuves archivistiques et juridiques seraient nécessaires pour étayer de telles affirmations.
Les résultats informatiques exigent également une retenue culturelle et technique. Il ne faut pas supposer que les modèles généraux de vision et de langage sont culturellement neutres. Les résultats publiés de CulturalVQA montrent des performances inégales selon les régions et les aspects culturels, mais cette référence n’a évalué ni CLIP ViT-B/32 ni l’art historique d’Asie orientale8,18,19. Elle justifie donc la création, plutôt que de se substituer à, une référence adaptée à ce corpus. En l’absence d’une telle expérience, CLIP constitue un outil préliminaire d’organisation, mais non une autorité sur l’identité ou la hiérarchie qing. Le flux de traitement informatique a confirmé que SAM a fonctionné strictement comme preuve auxiliaire de localisation ; aucune masque ni caractéristique dérivée de masque n’a été utilisée comme entrée pour l’étiquetage ou le regroupement, garantissant ainsi que la catégorisation visuelle reposait uniquement sur les intégrations sémantiques globales des images non segmentées. La recherche en patrimoine numérique insiste également sur la sensibilité culturelle, la supervision interdisciplinaire, l’accessibilité, la protection des données et des flux de travail transparents20.
Historiquement, la pertinence de ces motifs réside dans le commerce des peintures d'exportation : des ateliers chinois et une demande étrangère ont sélectionné et normalisé des sujets transportables, lisibles et collectables ; la répétition des images dans les ateliers montre également une copie avec variation plutôt qu'une duplication purement mécanique1,2,3,4,5. Le corpus peut donc contribuer aux études sur l'histoire du genre, des hiérarchies, des représentations de la vie quotidienne et des rencontres interculturelles en révélant quels schémas se répètent à grande échelle. Cela ne signifie toutefois pas que ces images constituent des documents ethnographiques exhaustifs. La comparaison computationnelle peut orienter une lecture approfondie et une contextualisation interculturelle21, tandis que les registres de production, les historiques d'achat et les témoignages de réception doivent étayer les interprétations concernant les intentions du marché ou la signification pour le public.
La réponse affective et cognitive reste une direction de recherche complémentaire plutôt qu'un résultat de la présente étude. Shi et ses collègues ont combiné des évaluations de préférence, une analyse en dimensions latentes et un suivi oculaire afin de distinguer les voies émotionnelles, formelles-esthétiques et cognitives dans les réponses aux images de lanternes de Xiashi22. Un dispositif comparable pourrait permettre de tester si les spectateurs portent une attention différente aux vêtements, aux objets, à la posture ou à la hiérarchie dans les peintures d'exportation. Étant donné que cette étude n'a recueilli ni évaluations, ni suivi oculaire, ni aucune autre donnée provenant du public, elle ne peut pas déduire l'excitation émotionnelle, la saillance visuelle ou la réception à partir du seul contenu de l'image.
Les limites sont théoriques, méthodologiques et pratiques. Sur le plan théorique, les catégories fondées sur les indices matériels simplifient le genre, les relations domestiques, la hiérarchie juridique, l’ethnicité et l’expérience vécue. Sur le plan méthodologique, les inférences sont limitées par la préservation, la collecte, la numérisation, les métadonnées, les modèles zero-shot, le codage et les biais liés à la disparité des périodes. Bien que le pipeline analytique démontre une détection robuste des motifs, ces biais structurels soulignent la nécessité de considérer les résultats computationnels comme des analyses de conventions picturales plutôt que comme des fenêtres transparentes sur la réalité sociale de l’époque Qing. Sur le plan pratique, les droits d’image restreignent la redistribution, et les résultats pourraient ne pas être généralisables à d’autres institutions, périodes, supports ou environnements computationnels. Sous réserve de ces limites, l’étude propose un cadre supervisé par l’humain permettant de transformer des observations visuelles répétées en questions historiques testables, plutôt qu’en conclusions automatisées. En tant qu’étude interprétative et non interventionnelle, elle n’a pas évalué les progrès vers un Objectif de développement durable (ODD) ou indicateur quelconque. Son sujet est toutefois pertinent par rapport à l’Objectif 5, et sa documentation respectueuse des droits ainsi que son cadre éducatif interculturel sont conceptuellement alignés sur les cibles 11.4 et 4.7 ; aucun résultat lié à un ODD n’a été mesuré. Le jeu de données fourni en vue de la reproductibilité aligne l’étude sur les récentes demandes de flux de travail numériques transparents dans le domaine du patrimoine, ainsi que sur les exigences FAIR concernant les identifiants persistants, les métadonnées riches, les licences, la provenance et les données, algorithmes, outils et flux de travail réutilisables20,23.
Déclarations de divulgation
Les auteurs n'ont rien à divulguer.
Remerciements
Les auteurs remercient le Victoria and Albert Museum, le British Museum, le Metropolitan Museum of Art, le Smithsonian National Museum of Asian Art, le Peabody Essex Museum, le Hong Kong Museum of Art, la British Library, le Getty Research Institute et d'autres institutions dépositaires ainsi que les équipes de catalogage dont les notices en ligne ont permis la découverte du corpus. L'accès à une notice en ligne n'implique pas l'autorisation de redistribuer son image ; les droits au niveau des panneaux et les liens sources sont donc documentés séparément. Les auteurs remercient également les communautés de recherche ouverte qui soutiennent CLIP et SAM, ainsi que le soutien administratif fourni par la City University of Macau et la Guangdong Polytechnic Normal University.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | Modèle vision-langage utilisé pour l'analyse préliminaire de similarité image–texte et l'attribution de labels préliminaires par IA. |
| Station de travail informatique | Station de travail informatique des auteurs’ | GPU compatible CUDA ; la configuration matérielle exacte doit être indiquée | Station utilisée pour l'inférence avec CLIP et SAM et pour les analyses informatiques ; les spécifications du GPU, du CPU, de la mémoire vive (RAM), du système d'exploitation et de CUDA doivent être rapportées à partir de l'environnement d'exécution d'origine. |
| Matplotlib | Équipe de développement de Matplotlib | Package Python ; la version exacte doit être indiquée | Utilisé pour la visualisation informatique et la génération de figures et de graphiques d'analyse. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | Utilisé pour l'organisation des métadonnées, les enregistrements de triage et la gestion des données d'étude sous forme tabulaire. |
| NumPy | Développeurs de NumPy | Package Python ; la version exacte doit être indiquée | Utilisé pour le calcul numérique et la manipulation de tableaux d'images et de caractéristiques analytiques. |
| pandas | Équipe de développement de pandas | Package Python ; la version exacte doit être indiquée | Utilisé pour la gestion de données structurées, le traitement des métadonnées et l'organisation des résultats analytiques au niveau des cas. |
| Python 3.10 | Fondation Python Software | Python 3.10 | Environnement de programmation utilisé pour implémenter le flux de travail d'analyse d'images par calcul informatique. |
| PyTorch 2.0.1 | Fondation PyTorch | PyTorch 2.0.1 | Framework d'apprentissage profond utilisé pour l'encodage d'images et de textes basé sur CLIP et pour l'inférence sur GPU. |
| scikit-learn | Développeurs de scikit-learn | Package Python ; la version exacte doit être indiquée | Utilisé pour les calculs de regroupement par K-moyennes, de regroupement hiérarchique, du coefficient de silhouette, de l'indice de Davies–Bouldin et de la kappa de Cohen’. |
| Modèle de segmentation universel (SAM) | Meta AI Research | SAM | Modèle de segmentation utilisé pour localiser les figures féminines, les vêtements, les meubles, les outils, les objets rituels et les zones architecturales à des fins d'inspection visuelle. |
| umap-learn | McInnes et al. | Implémentation Python d'UMAP | Utilisé pour la réduction de dimensionnalité et la visualisation en deux dimensions des intégrations d'images CLIP avec la distance cosinus. |
Références
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.