Ce protocole intègre des enregistrements comportementaux multimodaux afin d'évaluer les corrélats observables de l'effort cognitif et l'efficacité fonctionnelle de la révision dans la traduction écrite anglais-chinois ainsi que dans l'interprétation simultanée. Il combine l'enregistrement des frappes au clavier, la capture d'écran, l'analyse audio, un codage fondé sur les transcriptions et une évaluation de qualité normalisée.
Article de méthode
Un protocole comportemental pour évaluer l'effort cognitif et la révision stratégique dans des tâches de traduction anglais-chinois et d'interprétation à vue
Dans cet article
Résumé
Résumé
Cet article présente un protocole comportemental multimodal permettant d'examiner les corrélats observables de l'effort cognitif et de la révision stratégique lors de traductions écrites et d'interprétations simultanées du chinois vers l'anglais. Des journaux de frappe et des enregistrements d'écran sont synchronisés pour la traduction écrite, tandis que des enregistrements audio et des transcriptions littérales sont utilisés pour l'interprétation simultanée. Les épisodes de révision et d'autocorrection sont codés selon leur type et leur résultat fonctionnel (efficace, neutre ou nuisible), indépendamment des évaluations globales de la qualité du produit final. Dans une étude de démonstration impliquant 62 participants répartis en deux groupes (novices et formés), les deux groupes ont réalisé les deux conditions de tâche dans un ordre contrebalancé. Les participants formés ont obtenu des scores moyens plus élevés en matière de qualité du produit final dans la traduction écrite (20,1 ± 2,1 contre 16,8 ± 2,3) et dans l'interprétation simultanée (18,9 ± 2,4 contre 15,4 ± 2,6), ainsi qu'une proportion plus importante de révisions ou d'autocorrections efficaces. Étant donné que les pauses, les suppressions, la latence d'apparition et la densité de révision sont des indicateurs indirects et sensibles à la tâche, ils sont interprétés comme des corrélats comportementaux nécessitant une triangulation, plutôt que comme des mesures directes d'une construction unitaire. Ce protocole est conçu pour des textes explicatifs contrôlés et peut être adapté à d'autres couples linguistiques après recalibrage de la gestion des méthodes de saisie, des seuils de pause, de la comparabilité des textes et des procédures de notation.
Introduction
La traduction écrite et l'interprétation simultanée anglais-chinois exigent une compréhension du texte source, un transfert interlinguistique et une formulation dans la langue cible, mais elles imposent des conditions de tâche différentes. La traduction écrite permet une lecture récursive et une correction différée, tandis que l'interprétation simultanée exige une production orale soumise à des contraintes temporelles plus strictes. La charge cognitive, la difficulté de traitement et l'effort cognitif sont des concepts connexes mais non interchangeables : la charge concerne les exigences de la tâche, tandis que l'effort concerne les ressources que le participant mobilise face à ces exigences. L'effort cognitif est latent et multidimensionnel ; par conséquent, la latence, les pauses, les suppressions et la densité de révision sont considérées ici comme des corrélats comportementaux pouvant refléter des processus de planification, de contrôle, moteurs ou des difficultés, et doivent être interprétées conjointement plutôt que comme des mesures directes de l'effort1,2,3,4,5,6,7,8.
La recherche orientée vers les processus combine les évaluations des produits avec des enregistrements comportementaux alignés sur le temps afin d'identifier quand et comment se produisent les décisions de traduction. L'enregistrement des frappes au clavier est utile pour analyser les séquences de production et de révision, mais la méthode de saisie chinoise peut dissocier les événements physiques des touches enfoncées des caractères effectivement saisis ; un enregistrement d'écran synchronisé est donc nécessaire pour reconstituer l'état du texte visible9,10,11. Les seuils de pause sont des choix analytiques et non des frontières cognitives universelles, et des seuils plus courts peuvent modifier sensiblement les conclusions basées sur les pauses8,12. Le protocole exige par conséquent des vérifications explicites de synchronisation, des analyses de sensibilité aux seuils et une distinction entre les mesures spécifiques à la tâche et les mesures partagées.
La fréquence des révisions à elle seule n'indique pas si la surveillance améliore un résultat. Les révisions écrites et les autocalques verbaux peuvent viser le choix lexical, la syntaxe, le sens ou le style, mais leur résultat fonctionnel doit être évalué par rapport au sens source et au segment cible qui le précède immédiatement. Des études sur l'interprétation visuelle dans le traitement anglais-chinois et chinois-anglais montrent que la formation, la directionnalité, la coordination œil-voix et les déclencheurs de problèmes spécifiques à la langue peuvent modifier les profils de performance13,14,15,16. Pour cette raison, le type d'épisode, l'issue de l'épisode, la qualité du produit final et les comportements liés à la restitution sont codés comme des variables distinctes.
Le protocole est conçu pour des apprenants adultes ou des traducteurs-interprètes formés travaillant sur des textes expositifs courts et non spécialisés lors de séances contrôlées assistées par ordinateur. Il est particulièrement adapté lorsque les frappes au clavier et les enregistrements d'écran peuvent être capturés pour la production écrite, et qu'un enregistrement audio de haute qualité peut être réalisé pour la production orale. Le cadre peut être adapté à d'autres paires linguistiques, mais la correspondance des textes, la segmentation en unités d'information, le comportement du clavier ou du mode de saisie, les seuils de pause et les références d'évaluation doivent être réétalonnés pour chaque paire linguistique et chaque système d'écriture17. La démonstration compare les conditions de tâche plutôt que d'attribuer toutes les différences à la modalité seule, car la longueur des textes, les limites de temps, le mode de sortie et les possibilités de révision diffèrent également.
Protocole
Toutes les méthodes impliquant l'utilisation de sujets humains ont été réalisées conformément aux directives institutionnelles et ont reçu l'approbation explicite du Comité d'éthique pour la recherche sur les êtres humains de l'Institut d'information et de technologie de Guilin (Numéro d'approbation : UYHAJ2025899). Un consentement éclairé écrit a été obtenu de tous les participants avant leur participation. Veuillez vous référer au Tableau du matériel pour obtenir une liste complète du matériel et des logiciels utilisés dans cette étude.
1. Recrutement des participants et répartition en groupes
- Recruter 62 participants, comprenant des étudiants en anglais ou en traduction et des stagiaires interprètes professionnels. Vérifier que tous les participants sont des locuteurs natifs chinois possédant une vision et une audition normales ou corrigées à la normale.
- Assigner les participants ayant moins de 12 mois de formation structurée en traduction au groupe des débutants, et ceux ayant au moins 12 mois de formation au groupe des formés. Indiquer séparément pour tous les participants leur expérience antérieure en traduction écrite et en interprétation simultanée.
- Exclure les participants avant l'attribution des tâches s'ils ont déjà été exposés aux textes sources, s'ils présentent un déficit sensoriel non corrigé ou s'ils sont incapables d'utiliser la méthode normalisée de saisie chinoise.
- Exclure les tâches après l'enregistrement uniquement pour des raisons prédéfinies, telles que l'utilisation d'outils externes interdits, une exécution incomplète, des fichiers corrompus ou un enregistrement audio inutilisable.
- Tenir un registre des exclusions de tâches sans informations permettant l'identification personnelle. Indiquer l'échantillon final analysé de manière cohérente dans le texte et dans la Figure 1A–D.
2. Sélection des matériaux et évaluation pilote
- Sélectionnez des textes expositifs anglais courts provenant de domaines académiques généraux, éducatifs, sociaux ou de communication publique. Utilisez des textes destinés à la traduction écrite d’environ 180 à 220 mots et des textes destinés à l’interprétation simultanée d’environ 120 à 160 mots.
- Appariez ou ajustez statistiquement la longueur des textes, la difficulté lexicale, la complexité syntaxique, la densité d’information et la familiarité du sujet entre les différentes conditions de tâche.
- Demander à trois experts bilingues d’évaluer indépendamment la difficulté lexicale, la complexité syntaxique, la densité d’information, la familiarité du sujet et l’adéquation à la traduction sur une échelle de 1 à 5 (1 = très faible, 5 = très élevée).
- Calculez un coefficient de corrélation intraclasse (CCI) à effets aléatoires bidirectionnel avec un intervalle de confiance à 95 % pour les évaluations moyennées. Révisez les éléments présentant un faible accord (CCI < 0,75).
- Conservez uniquement les paires de textes pour lesquelles les variables appariées normalisées se situent dans une marge de tolérance de ±10 %.
- Définissez une unité d’information comme la plus petite proposition du texte source exprimant une idée, une relation ou un événement évaluable indépendamment. Résolvez les désaccords concernant les limites avant la mise en œuvre de la tâche.
- Effectuez un essai pilote des instructions, du mode de saisie, de la synchronisation, de la qualité sonore et des limites de temps auprès de participants qui ne seront pas inclus dans l’analyse principale. Enregistrez les distributions des temps de réalisation et la proportion de participants atteignant chaque limite de temps.
- Modifiez un texte ou une limite de temps lorsque les participants du pilote présentent une performance au plafond ou au plancher, une ambiguïté persistante ou une instabilité de l’enregistrement. Documentez chaque modification avant le lancement de l’étude principale.
3. Administration de la tâche et configuration de l'enregistrement
- Tester les participants individuellement dans une pièce calme et insonorisée, en utilisant des configurations standardisées de matériel et de logiciels.
- Lire un script d'instructions standardisé et autoriser un seul essai hors expérience. Interdire l'utilisation de dictionnaires, de moteurs de recherche, d'intelligence artificielle générative, de traduction automatique et de corpus externes.
- Contrebalancer les deux ordres de tâches (traduction écrite en premier contre interprétation simultanée en premier) au sein de chaque groupe de formation, et prévoir un intervalle de repos de 5 minutes.
- Préparer la liste d'affectation avant la fin du recrutement et masquer l'attribution jusqu'à ce que l'éligibilité soit confirmée. Si plusieurs textes sources sont utilisés, contrebalancer l'identité des textes indépendamment de l'ordre des tâches, et conserver une variable d'identification du texte pour l'analyse.
- Présenter le texte source en anglais de manière continue et demander au participant de produire une traduction chinoise exacte et naturelle dans le champ de saisie désigné. Autoriser une édition libre, mais interdire strictement le collage de texte externe.
- Appliquer le plafond de 20 minutes établi lors de l'étude pilote sans afficher de compte à rebours, et noter si ce plafond est atteint.
- Capturer en continu l'intégralité du processus de traduction écrite, en utilisant un logiciel d'enregistrement des frappes synchronisé avec un enregistrement continu de l'écran. Conserver les traductions finales ainsi que les fichiers journaux horodatés pour une extraction comportementale ultérieure.
- Présenter le texte source pour l'interprétation simultanée à l'écran et demander au participant de commencer une restitution orale en chinois sans prendre de notes écrites.
- Appliquer systématiquement le plafond de 6 minutes et noter si ce plafond est atteint. Différencier une observation limitée dans le temps d'une observation normalement terminée.
- Enregistrer la production orale à l'aide d'un logiciel de capture audio numérique. Élaborer des transcriptions rigoureusement fidèles à partir de ces enregistrements afin de faciliter le codage ultérieur.
4. Extraction d'indicateurs du processus comportemental
- Extraire des fichiers journaux les corrélats comportementaux liés à la tâche écrite, en définissant la latence initiale comme l'intervalle entre le début du stimulus et le premier caractère chinois saisi.
- Extraire le temps total de la tâche, le nombre et la durée des pauses, le taux de suppressions, la densité de révisions et le taux de production. Conserver les horodatages bruts ainsi que le dénominateur exact utilisé pour chaque mesure normalisée.
- Utiliser 2 s comme seuil opérationnel de pause à l'écrit. Indiquer si les pauses survenues pendant la navigation avec le curseur, la sélection de texte ou le choix des candidats dans la méthode de saisie sont incluses.
- Extraire des corrélats comportementaux liés à la tâche orale à partir de l'onde sonore et de la transcription validée, en définissant la latence d'amorçage comme l'intervalle entre la présentation du stimulus et la première énonciation significative dans la langue cible.
- Exclure de la latence d'amorçage les inspirations, les raclages de gorge et les sons non lexicaux abandonnés. Extraire le temps total d'interprétation, les pauses silencieuses, les pauses remplies, les répétitions, les faux départs, les auto-corrections et le débit de parole.
- Définir une pause silencieuse orale comme un silence d'au moins 1,0 s au sein d'un énoncé. Examiner les limites des pauses à l'aide de l'onde sonore et de la transcription validée, et exclure les silences initiaux et finaux des comptages de pauses internes à l'énoncé.
- Réaliser une fiche de contrôle qualité pour chaque tâche administrée. Indiquer si le fichier de procédure correspondant est lisible et complet, si la transcription a été validée, et si le codage a été terminé ou arbitré. Préserver l'enregistrement d'origine et consigner toute correction dans la piste d'audit.
5. Codage de la révision stratégique et de l'auto-correction orale
- Reconstruire chaque révision écrite en alignant le journal des frappes au clavier, la vidéo de l'écran et le texte final.
- Considérer un épisode comme une séquence continue d'actions d'édition portant sur le même segment cible, et clore l'épisode lorsque la production reprend ailleurs pendant au moins 2 s ou qu'un segment différent est modifié.
NOTE : Pour la saisie chinoise, distinguer les modifications de composition avant validation des suppressions du texte cible après validation, et coder uniquement ces dernières comme révisions textuelles. - Attribuer un type de révision principal selon les changements sémantiques, syntaxiques, lexicaux ou stylistiques. Autoriser une étiquette secondaire pour les cas superposés, mais utiliser l'étiquette principale pour les décomptes mutuellement exclusifs. Appliquer les exemples traités fournis dans le Fichier supplémentaire 1.
- Produire une transcription verbale chronométrée avant de coder l'autocorrection orale. Demander au premier transcripteur de marquer le contenu lexical, les pauses remplies, les répétitions, les faux départs, les interruptions et les segments inintelligibles.
- Faire vérifier la transcription par un deuxième relecteur formé, qui la confrontera à l'audio et résoudra les divergences tout en préservant les horodatages audio d'origine.
- Définir une autocorrection orale comme une reformulation explicite qui remplace, complète ou corrige un segment immédiatement précédent dans la langue cible. Ne pas déduire une surveillance implicite du silence seul. Appliquer les mêmes règles décisionnelles lexicales, syntaxiques, sémantiques et stylistiques à l'autocorrection orale.
- Coder une répétition exacte sans changement correctif comme une disfluence, un début abandonné suivi d'une nouvelle construction comme un faux départ plus une correction, et une omission ou une erreur de traduction sans reformulation explicite comme une erreur de production.
- Lorsque l'audio est peu clair ou que deux catégories restent également plausibles, marquer l'épisode comme ambigu. Conserver les étiquettes provisoires pour les épisodes ambigus et les trancher avant l'analyse de fiabilité.
- Évaluer le résultat fonctionnel en comparant les segments cibles avant et après l'épisode avec l'unité d'information source et le contexte cible local. Porter ce jugement avant de révéler le score global final. Ne pas utiliser un changement du score global comme définition de l'efficacité.
- Coder en double au moins 20 % des productions sélectionnées parmi les deux groupes et les ordres de tâche, et calculer la fiabilité à partir des codages indépendants avant arbitrage.
- Reformer et recoder si l'accord entre évaluateurs tombe en dessous d'un kappa de Cohen de 0,80. Documenter précisément ce seuil et toutes les mesures correctives prises.
6. Évaluation de la qualité et modélisation statistique
- Évaluer chaque traduction écrite finale et chaque prestation d'interprétation simultanée à l'aide de la grille analytique de 25 points fournie dans le fichier supplémentaire 1.
- Noter l'exactitude, l'exhaustivité, l'adéquation lexicale, la cohérence et le caractère naturel dans la langue cible de 0 à 5 selon les repères indiqués. Ne pas interpoler les critères d'évaluation après avoir examiné l'appartenance aux groupes.
- Demander aux évaluateurs d'utiliser à la fois l'audio et la transcription validée pour les dimensions liées à l'interprétation simultanée. Analyser les pauses et les mesures de dysfluidité séparément des notes attribuées par la grille.
- Former deux évaluateurs indépendants à l’aide du codebook et d’au moins 10 productions d’entraînement, en veillant à ce que les évaluateurs soient aveugles quant au groupe des participants et à l’ordre des tâches.
- Après évaluation indépendante et codage des épisodes, calculer la fiabilité avant toute discussion. Résoudre les désaccords par consensus et consulter un troisième évaluateur uniquement si un consensus ne peut être atteint.
- Indiquer un coefficient de corrélation intraclasse à deux facteurs aléatoires et accord absolu pour les scores de qualité continus moyennés. Indiquer le kappa de Cohen pour le code catégoriel principal de révision et un kappa distinct pour le code de résultat effectif/neutre/défavorable. Préciser le nombre exact et le pourcentage d'épisodes codés en double.
- Vérifier que chaque fichier de processus est lisible et complet avant l'analyse, aligner les journaux des tâches écrites avec les enregistrements d'écran correspondants, et confronter les transcriptions à l'audio.
- Enregistrer les échecs d'alignement, les problèmes d'intelligibilité et les mesures correctives dans un registre de contrôle qualité. Normaliser les mesures de fréquence en utilisant 100 unités d'information du texte source pour la fréquence des pauses et 100 caractères chinois produits pour la densité de révision écrite.
- Coder l'issue fonctionnelle indépendamment de la note globale de qualité finale. Considérer un épisode comme effectif lorsqu’il améliore le texte après révision sans introduire de nouveaux problèmes, comme neutre lorsqu’il ne produit aucun changement significatif, et comme défavorable lorsqu’il introduit une erreur.
- Calculer le taux d’efficacité comme le rapport entre les épisodes effectifs et l’ensemble des épisodes classifiables, en excluant les épisodes ambigus du dénominateur.
- Analyser la démonstration comme un jeu de données exploratoire à mesures répétées. Spécifier le modèle à effets fixes pour prédire le score total de qualité en utilisant la condition de la tâche, le groupe de formation, les indicateurs de pause, la densité de révision, le taux d’efficacité, le fardeau de dysfluidité et la vitesse de parole.
- Inclure un effet aléatoire d’interception par participant, et inclure des effets aléatoires liés au texte source uniquement si le plan expérimental comporte suffisamment de textes échantillonnés indépendamment.
- Centrer les prédicteurs continus, examiner les résidus et vérifier la colinéarité. Indiquer la méthode d’estimation, la version du logiciel, les valeurs de β, l’ER, l’IC à 95 %, les p-values exactes, les composantes de variance, l’AIC, le BIC, ainsi que les R2 marginaux et conditionnels. Décrire l’analyse comme exploratoire et éviter les affirmations causales confirmatoires.
- Exporter un ensemble d’analyse reproductible comprenant les données anonymisées, le dictionnaire, le codebook, la grille d’évaluation, les détails du logiciel, les scripts et les résultats. Confirmer que chaque valeur des figures et tableaux peut être retracée jusqu’à une variable et une étape d’analyse nommées avant publication.
Résultats
Caractéristiques de base des participants et disponibilité des données
Le questionnaire comprenait 62 participants (31 novices et 31 formés), et la feuille de tâches contenait 124 enregistrements, indiquant deux tâches accomplies par participant (Tableau 1). Le groupe novice avait moins de 12 mois de formation structurée en traduction (maximum observé : 8,6 mois), tandis que le groupe formé en avait au moins 12 (minimum observé : 13,3 mois). Les répartitions selon l’âge, le sexe, la durée d’apprentissage de l’anglais, le niveau de compétence et l’ordre des tâches étaient similaires entre les groupes. Figure 1 présente l’échantillon final analysé et distingue correctement les données spécifiques à chaque tâche : les journaux de frappe et les enregistrements d’écran concernent la traduction écrite, les enregistrements audio et les transcriptions littérales concernent l’interprétation simultanée, et les évaluations de qualité s’appliquent aux deux.
Profils comportementaux selon les conditions de la tâche
Les profils comportementaux différaient entre les deux conditions de tâche et entre les groupes d'entraînement (Tableau 2 ; Figure 2A–E). La traduction écrite présentait des durées de complétion plus longues et des pauses moyennes plus prolongées, tandis que l'interprétation simultanée comportait davantage de pauses par 100 unités d'information sous le seuil rapporté. Pour chaque condition de tâche, le groupe entraîné accomplissait les tâches plus rapidement et obtenait des scores moyens de production plus élevés. Ces contrastes ne doivent pas être interprétés comme des effets purs de modalité, car la longueur du texte, la limite de temps, le mode de production et la possibilité de révision différaient également. Les pauses ne sont pas toutes également perturbatrices : une pause peut refléter une difficulté non résolue, une planification réussie, une activité de contrôle ou une action liée au mode de saisie ; par conséquent, les mesures de pauses sont interprétées conjointement avec celles des révisions, de la restitution et de la qualité.
Révision stratégique, auto-réparation et modélisation prédictive
Le cadre de codage a séparé le type d'épisode de l'issue fonctionnelle (Tableau 3 ; Figure 3A–D). Les participants formés ont produit davantage d'épisodes de révision écrite que les novices (12,4 ± 3,7 contre 8,9 ± 3,0 par tâche), tandis que le nombre total d'auto-corrections orales ne différait pas significativement entre les groupes (4,9 ± 1,6 contre 4,4 ± 1,5 par tâche). Néanmoins, le groupe formé présentait une proportion plus élevée d'épisodes efficaces dans les deux tâches. Le résumé mixte à effets mixtes indiqué dans le Tableau 4 présente des associations plutôt que des relations causales ; Figure 3E affiche donc les estimations des effets fixes rapportées et leurs intervalles de confiance, plutôt qu'un diagramme causal.
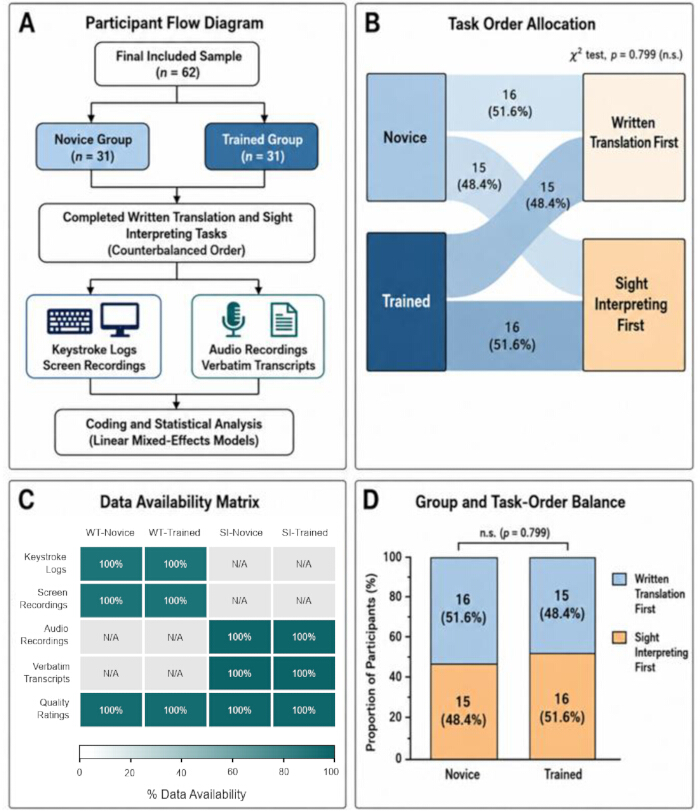
Figure 1 : Flux des participants, répartition par ordre des tâches et disponibilité des données spécifiques aux tâches. (A) Échantillon final analysé de 62 participants et 124 enregistrements de tâches. (B) Répartition contrebalancée de l'ordre des tâches au sein des groupes novices et entraînés. (C) Matrice de disponibilité dans laquelle les journaux de frappe et les enregistrements d'écran s'appliquent uniquement à la traduction écrite, les enregistrements audio et les transcriptions littérales uniquement à l'interprétation visuelle, et les évaluations de qualité aux deux tâches. (D) Équilibre entre groupe et ordre (test du chi-deux, p = 0,799). n = 62 participants (31 par groupe). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
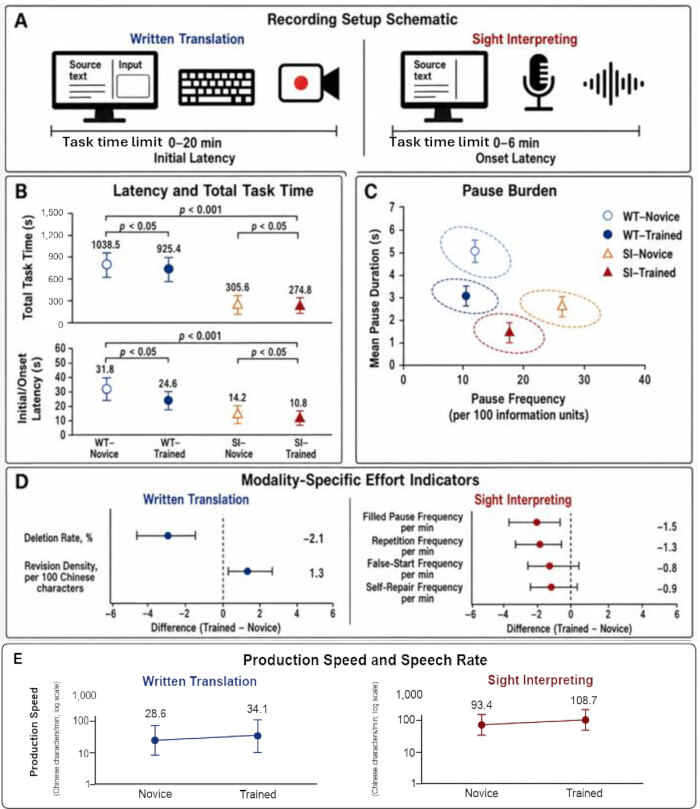
Figure 2 : Profils comportementaux lors des tâches de traduction écrite et d'interprétation simultanée. (A) Dispositif d'enregistrement spécifique à chaque tâche. (B) Latence initiale/d'activation et durée totale de la tâche. (C) Distribution conjointe de la fréquence des pauses et de la durée moyenne des pauses. (D) Indicateurs spécifiques à chaque tâche concernant les suppressions, les révisions et les disfluences orales. (E) Vitesse de production écrite et vitesse de parole orale. Dans les panneaux B, C et E, les points et les barres d'erreur représentent les moyennes du groupe ± écart-type (SD) ; dans le panneau D, les points indiquent les différences moyennes (expérimentés moins novices) et les barres d'erreur montrent les intervalles de confiance à 95 %. n = 31 participants par groupe. Dans le panneau E, l'axe des y est représenté sur une échelle logarithmique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
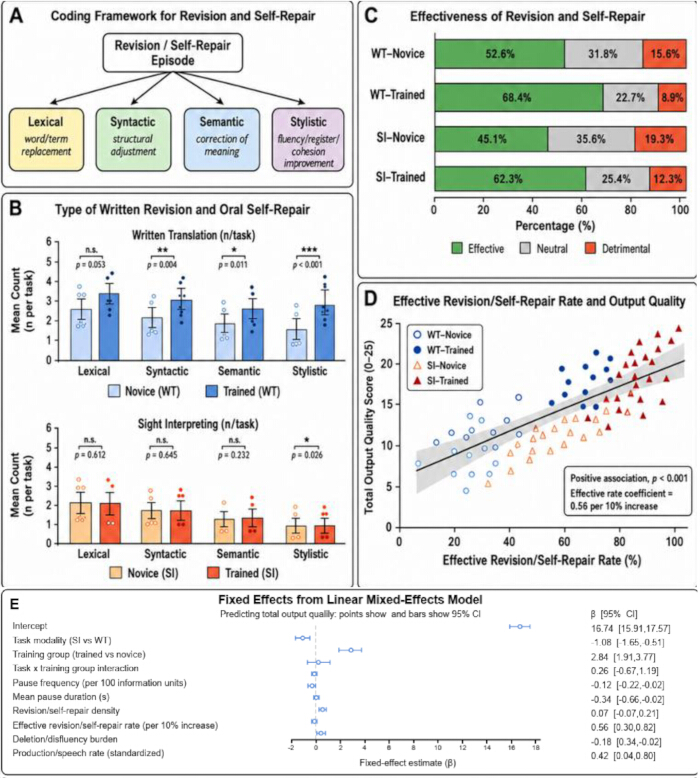
Figure 3 : Révision/autoréparation du codage, résultats fonctionnels et associations avec la qualité des sorties. (A) Cadre décisionnel pour attribuer indépendamment le type d'épisode et le résultat fonctionnel. (B) Nombre moyen d'épisodes lexicaux, syntaxiques, sémantiques et stylistiques dans chaque condition de tâche. (C) Proportions moyennes d'épisodes efficaces, neutres et néfastes. (D) Association descriptive entre le taux d'épisodes efficaces et le score total de qualité des sorties. (E) Graphique en forêt affichant les effets fixes issus d'un modèle linéaire à effets mixtes avec des intervalles de confiance à 95 % (détailés dans le Tableau 4) ; ce graphique illustre une association et ne représente pas un modèle causal. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Variables | Groupe novice (n = 31) | Groupe entraîné (n = 31) | Valeur p |
| Âge, années | 21,9 ± 1,7 | 22,4 ± 1,9 | 0,279 |
| Femmes, n (%) | 22 (71,0) | 21 (67,7) | 0,779 |
| Durée d'apprentissage de l'anglais, années | 12,4 ± 2,1 | 12,9 ± 2,2 | 0,36 |
| Score de compétence en anglais | 548,6 ± 41,3 | 562,4 ± 45,8 | 0,216 |
| Durée de la formation à la traduction, mois | 5,6 ± 3,0 | 18,7 ± 5,4 | <0,001 |
| Durée de la formation à l'interprétation, mois | 2,3 ± 2,1 | 13,9 ± 5,7 | <0,001 |
| Pratique antérieure de traduction écrite ≥5 tâches, n (%) | 9 (29,0) | 24 (77,4) | <0,001 |
| Pratique antérieure d'interprétation simultanée ≥5 tâches, n (%) | 5 (16,1) | 20 (64,5) | <0,001 |
| Traduction écrite en premier, n (%) | 16 (51,6) | 15 (48,4) | 0,799 |
| Interprétation simultanée en premier, n (%) | 15 (48,4) | 16 (51,6) | 0,799 |
Tableau 1 : Caractéristiques des participants et profils initiaux de formation linguistique par groupe. Les variables sont présentées sous forme de moyenne ± écart-type pour les données continues et de nombres (pourcentages) pour les données catégorielles. Les valeurs de p rapportées reflètent des comparaisons entre groupes afin de vérifier l'équilibre démographique initial et de confirmer les différences prévues en durée de formation.
| Variables | Traduction écrite Novice (n = 31) | Traduction écrite Formé (n = 31) | Interprétation simultanée Novice (n = 31) | Interprétation simultanée Formé (n = 31) | Effet de la tâche p | Effet du groupe p |
| Latence initiale/d'apparition, s | 31,8 ± 12,4 | 24,6 ± 9,7 | 14,2 ± 5,6 | 10,8 ± 4,2 | <0,001 | 0,003 |
| Durée totale de la tâche, s | 1038,5 ± 168,2 | 925,4 ± 151,6 | 305,6 ± 59,3 | 274,8 ± 50,7 | <0,001 | 0,004 |
| Fréquence des pauses, par 100 unités d'information | 18,6 ± 6,1 | 14,2 ± 5,0 | 24,8 ± 7,4 | 19,6 ± 6,3 | <0,001 | 0,001 |
| Durée moyenne des pauses, s | 4,1 ± 1,2 | 3,3 ± 1,0 | 2,7 ± 0,8 | 2,3 ± 0,7 | 0,012 | 0,002 |
| Taux de production/parole, caractères chinois/min | 28,6 ± 6,7 | 34,1 ± 7,5 | 93,4 ± 18,9 | 108,7 ± 20,4 | 0,001 | |
| Taux de suppressions, % | 8,9 ± 3,4 | 6,8 ± 2,7 | 0,009 | |||
| Densité de révision, par 100 caractères chinois | 7,6 ± 2,8 | 8,9 ± 3,1 | 0,087 | |||
| Fréquence des pauses remplies, par min | 5,7 ± 1,9 | 4,2 ± 1,6 | 0,002 | |||
| Fréquence des répétitions, par min | 4,9 ± 1,8 | 3,6 ± 1,4 | 0,004 | |||
| Fréquence des faux départs, par min | 2,8 ± 1,1 | 2,0 ± 0,9 | 0,006 | |||
| Fréquence des auto-corrections, par min | 4,8 ± 1,7 | 3,9 ± 1,4 | 0,031 | |||
| Note globale de qualité, 0–25 | 16,8 ± 2,3 | 20,1 ± 2,1 | 15,4 ± 2,6 | 18,9 ± 2,4 | 0,002 | <0,001 |
| Exactitude, 0–5 | 3,4 ± 0,7 | 4,1 ± 0,6 | 3,1 ± 0,8 | 3,8 ± 0,7 | 0,004 | <0,001 |
| Complétude, 0–5 | 3,3 ± 0,8 | 4,0 ± 0,6 | 3,0 ± 0,8 | 3,7 ± 0,7 | 0,006 | <0,001 |
| Adéquation lexicale, 0–5 | 3,2 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,041 | <0,001 |
| Cohérence, 0–5 | 3,5 ± 0,6 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,003 | <0,001 |
| Naturalité dans la langue cible, 0–5 | 3,4 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,7 | 0,007 | <0,001 |
Tableau 2 : Indicateurs du processus comportemental et qualité des résultats selon les conditions de tâche et les groupes. Les valeurs sont exprimées en moyenne ± écart type. Les valeurs de p indiquent les effets principaux de la modalité de la tâche (traduction écrite par rapport à l'interprétation simultanée) et du niveau de formation (novice par rapport à formé) sur chaque variable de processus et de qualité.
| Variables | Traduction écrite Novice | Traduction écrite Formé | p valeur | Interprétation visuelle Novice | Interprétation visuelle Formé | p valeur |
| Révision lexicale/autocorrection, n/tâche | 3,4 ± 1,5 | 4,2 ± 1,7 | 0,053 | 1,8 ± 0,8 | 1,7 ± 0,7 | 0,612 |
| Révision syntaxique/autocorrection, n/tâche | 2,1 ± 1,1 | 3,0 ± 1,2 | 0,004 | 1,1 ± 0,7 | 1,2 ± 0,8 | 0,645 |
| Révision sémantique/autocorrection, n/tâche | 1,8 ± 1,0 | 2,5 ± 1,1 | 0,011 | 0,9 ± 0,6 | 1,1 ± 0,7 | 0,232 |
| Révision stylistique/autocorrection, n/tâche | 1,6 ± 0,9 | 2,7 ± 1,2 | <0,001 | 0,6 ± 0,4 | 0,9 ± 0,6 | 0,026 |
| Nombre total d'épisodes de révision/autocorrection, n/tâche | 8,9 ± 3,0 | 12,4 ± 3,7 | <0,001 | 4,4 ± 1,5 | 4,9 ± 1,6 | 0,209 |
| Épisodes efficaces, % | 52,6 ± 13,5 | 68,4 ± 12,1 | <0,001 | 45,1 ± 14,2 | 62,3 ± 13,0 | <0,001 |
| Épisodes neutres, % | 31,8 ± 10,4 | 22,7 ± 8,8 | 0,001 | 35,6 ± 11,7 | 25,4 ± 9,6 | 0,001 |
| Épisodes nuisibles, % | 15,6 ± 7,1 | 8,9 ± 5,6 | <0,001 | 19,3 ± 8,6 | 12,3 ± 6,8 | 0,001 |
Tableau 3 : Type et efficacité des révisions écrites et des auto-corrections orales selon les conditions de la tâche. Les types d'épisodes sont indiqués en moyennes de nombre par tâche (± écart type), et les résultats fonctionnels sont exprimés en pourcentages moyens (± écart type). Les valeurs p indiquent la significativité des différences entre groupes au sein de chaque modalité de tâche.
| Effets fixes | β | SE | IC à 95 % | p valeur |
| Constante | 16,74 | 0,42 | 15,91 à 17,57 | <0,001 |
| Modalité de tâche : interprétation simultanée vs traduction écrite | -1,08 | 0,29 | -1,65 à -0,51 | <0,001 |
| Groupe d'entraînement : entraîné vs novice | 2,84 | 0,47 | 1,91 à 3,77 | <0,001 |
| Interaction modalité de tâche × groupe d'entraînement | 0,26 | 0,47 | -0,67 à 1,19 | 0,581 |
| Fréquence des pauses, par 100 unités d'information | -0,12 | 0,05 | -0,22 à -0,02 | 0,018 |
| Durée moyenne des pauses, s | -0,34 | 0,16 | -0,66 à -0,02 | 0,041 |
| Densité de révision/autocorrection | 0,07 | 0,07 | -0,07 à 0,21 | 0,334 |
| Taux effectif de révision/autocorrection, par augmentation de 10 % | 0,56 | 0,13 | 0,30 à 0,82 | <0,001 |
| Charge de suppression/disfluence | -0,18 | 0,08 | -0,34 à -0,02 | 0,027 |
| Taux de production/élocution, standardisé | 0,42 | 0,19 | 0,04 à 0,80 | 0,032 |
Tableau 4 : Effets fixes rapportés par le modèle linéaire à effets mixtes prédisant la qualité totale de la production. Le résumé présente les coefficients non standardisés (β), les erreurs standards (SE), les intervalles de confiance à 95 % (IC) et les valeurs p exactes pour tous les prédicteurs comportementaux et relatifs à la tâche spécifiés.
Discussion
Cette étude présente un protocole multimodal permettant de mesurer des indicateurs observables de processus et de coder la révision stratégique dans la traduction écrite et l'interprétation simultanée anglais-chinois. Ce protocole ne mesure pas directement une variable unitaire d'effort cognitif. Plutôt, la latence, les pauses, les suppressions et les schémas de révision sont interprétés comme des corrélats comportementaux sensibles à la tâche, dont la signification dépend d'une triangulation avec des enregistrements synchronisés et des preuves de qualité du produit final1,2,3,4,5,6,7,8. Les deux tâches diffèrent également par les matériaux utilisés, le chronométrage, le mode de production et les possibilités de révision ; les contrastes représentatifs décrivent donc des différences liées aux conditions de la tâche plutôt que des effets isolés de modalité. La principale contribution analytique réside dans la distinction entre la fréquence des révisions et leur résultat fonctionnel. Dans les résumés rapportés, les participants formés ont effectué davantage de révisions écrites, et non moins, tandis que le nombre total d'autocorrections orales ne différait pas significativement entre les groupes. Leur proportion plus élevée d'épisodes efficaces suggère que le contrôle de la qualité pourrait être plus informatif que la fréquence brute, mais cette interprétation dépend de règles de décision transparentes, d'un codage indépendant des résultats et de la fiabilité rapportée. Le manuel de codage et les exemples détaillés fournis dans le fichier supplémentaire 1 visent à rendre cette distinction reproductible plutôt que promotionnelle.
Les étapes critiques sont l'alignement entre enregistrements, la qualité audio, la vérification de la transcription et la cohérence du codage. Les horodatages disponibles et les indices liés aux limites des tâches doivent être vérifiés lors de l'alignement des journaux et des enregistrements. L'audio doit être examiné pour détecter les saturations et l'intelligibilité avant la transcription, et les limites de pauses proposées doivent être vérifiées par rapport au signal acoustique et à la transcription. Pour une saisie chinoise, les frappes au clavier ne doivent pas être assimilées aux révisions de caractères validés. Ces vérifications et actions correctives doivent être consignées dans un journal de contrôle qualité.
Plusieurs limites restreignent l'interprétation. La démonstration utilise des cohortes d'étudiants et de stagiaires, des textes explicatifs généraux courts, des tâches de longueurs et de durées limites variables, ainsi qu'un échantillon basé sur la disponibilité. Les conditions de la tâche diffèrent également selon le mode de production et les possibilités de révision, et le jeu de données ne contient pas d'identifiants de texte source échantillonnés indépendamment permettant d'estimer la variation au niveau du texte. De plus, les seuils de pause sont des choix opérationnels, et les pauses plus longues peuvent refléter à la fois une planification productive et des difficultés non résolues. Une généralisation aux professionnels, aux domaines spécialisés, à d'autres paires linguistiques ou à d'autres systèmes d'écriture nécessite une nouvelle validation des matériaux, de la gestion des méthodes de saisie, des seuils et des critères de notation.
Des travaux futurs pourraient combiner les enregistrements comportementaux avec un suivi oculaire, une pupillométrie ou des mesures subjectives de charge mentale afin de tester quels arrêts et révisions correspondent à l'attention, à l'effort perçu ou à une planification réussie5,6,13,14,15,16. Shreve et al. ont utilisé le suivi oculaire en traduction simultanée visuelle et ne doivent pas être cités comme une étude de pupillométrie18 ; la pupillométrie est abordée directement par Seeber5. Ces extensions multimodales devraient conserver la distinction entre la demande de la tâche, l'effort investi, le comportement observé et la performance. Le présent protocole est donc préférablement utilisé comme un cadre d'évaluation de processus transparent, dont les indicateurs soutiennent, mais n'établissent pas à eux seuls, des affirmations concernant l'effort cognitif latent.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir de conflits d'intérêts commerciaux ou financiers. En ce qui concerne l'utilisation de l'intelligence artificielle, les auteurs indiquent que OpenAI Codex a été utilisé au cours du processus de révision uniquement pour aider à la correction linguistique, aux vérifications de cohérence, à la préparation des modifications suivies et à la régénération des agencements des figures à partir de données fournies par les auteurs. Les auteurs ont minutieusement examiné toutes les sorties assistées par l'IA et assument l'entière responsabilité de l'exactitude, de l'intégrité et de l'originalité du manuscrit final. Le classeur structuré à la base des résumés rapportés est publiquement accessible sur Zenodo (https://doi.org/10.5281/zenodo.21189434). Le fichier supplémentaire 1 contient le manuel de codage et la grille de qualité ancrée.
Remerciements
L'auteur remercie l'Institut d'information et de technologie de Guilin pour le soutien en laboratoire, les experts bilingues qui ont évalué les textes sources, les évaluateurs indépendants et les participants. Cette recherche n'a reçu aucune subvention spécifique d'un organisme de financement public, commercial ou à but non lucratif.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Logiciel d'analyse acoustique (Praat) | Paul Boersma et David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| Ordinateur de bureau | Dell | OptiPlex | |
| Logiciel d'enregistrement audio numérique (Audacity) | Équipe Audacity | https://www.audacityteam.org/ | |
| Logiciel de journalisation des frappes au clavier (Inputlog) | Université d'Anvers | https://www.inputlog.net/ | |
| Logiciel d'enregistrement d'écran (OBS Studio) | Projet OBS | https://democreator.wondershare.com/ | |
| Logiciel d'analyse statistique (SPSS) | IBM | Version 27 |
Références
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
Réimpressions et autorisations
Cet article a été publié
Vidéo bientôt disponible