Cet article présente un flux de travail bioinformatique reproductible intégrant des jeux de données transcriptomiques publics, l'apprentissage automatique, une validation externe, la PCR quantitative en temps réel, le criblage de la carte de connectivité (Connectivity Map) et le dockage moléculaire afin d'identifier des biomarqueurs de l'hypertension pulmonaire et des composés thérapeutiques candidats.
Article de recherche
Identification par bioinformatique et apprentissage automatique de biomarqueurs de l'hypertension pulmonaire et de composés thérapeutiques candidats
Dans cet article
Résumé
Résumé
Cette étude visait à identifier des biomarqueurs moléculaires associés à l'hypertension pulmonaire (PH) ainsi que des composés candidats de petite molécule en utilisant des données transcriptomiques publiques et des ressources de validation indépendantes. Trois jeux de données du Gene Expression Omnibus (GSE22356, GSE33463 et GSE48149) ont été intégrés après normalisation, annotation des sondes et correction des effets de lot par ComBat. Une analyse différentielle d'expression, une analyse de réseau de co-expression génique pondérée, une analyse d'enrichissement fonctionnel, une analyse de réseau d'interactions protéine-protéine et trois algorithmes d'apprentissage automatique ont été utilisés pour identifier les gènes caractéristiques centraux. La performance diagnostique a été évaluée à l'aide de courbes ROC (caractéristique de fonctionnement du récepteur). La validation externe a inclus une cohorte indépendante de tissus pulmonaires (GSE117261), un jeu de données de séquençage de l'ARN monocellulaire de l'artère pulmonaire (GSE210248) et une validation par PCR en temps réel quantitative sur des échantillons pulmonaires indépendants. Le répositionnement de médicaments basé sur Connectivity Map et la modélisation moléculaire ont été utilisés pour cribler les composés candidats. Soixante-dix-huit gènes différentiellement exprimés ont été identifiés, et CXCL10, JUN, IFIH1, MX1 et TLR7 ont été sélectionnés comme gènes caractéristiques centraux. Dans la cohorte indépendante de tissus pulmonaires GSE117261, JUN a montré le soutien externe le plus fort, tandis que la réplication des autres gènes était variable. La PCR en temps réel quantitative réalisée sur 20 échantillons biologiquement indépendants d'hypertension artérielle pulmonaire et 20 échantillons témoins a confirmé la surexpression des cinq gènes. Le modèle apparent de qRT-PCR à cinq gènes et les 100 analyses de validation croisée stratifiée en cinq parties répétées ont tous deux donné une aire sous la courbe de 1,000, bien que la petite taille de la cohorte impose une interprétation prudente et une validation prospective indépendante. L'analyse monocellulaire de GSE210248 a soutenu une communication altérée entre les cellules immunitaires et les cellules structurelles ainsi qu'un changement phénotypique des cellules musculaires lisses. BRD-K91900765/VX-745 a obtenu le classement le plus élevé lors du criblage Connectivity Map. MAPK14/p38α, sa cible pharmacologique établie, a été inclus comme protéine de référence positive, tandis que la modélisation moléculaire contre les cinq protéines associées aux biomarqueurs a été considérée comme exploratoire. Ces résultats soutiennent l'idée que ces cinq gènes sont des biomarqueurs candidats pour la PH et que VX-745 constitue une hypothèse de répositionnement thérapeutique computationnel nécessitant une validation expérimentale.
Introduction
L'hypertension pulmonaire (HP) est un syndrome cardio-pulmonaire progressif caractérisé par une pression artérielle pulmonaire élevée de manière persistante, une résistance vasculaire pulmonaire accrue et, à terme, une insuffisance ventriculaire droite. Les critères hémodynamiques actuels définissent l'HP comme une pression artérielle pulmonaire moyenne au repos supérieure ou égale à >20 mmHg, mesuré par cathétérisme cardiaque droit1Parmi les différents sous-types cliniques, l'hypertension artérielle pulmonaire (HAP) est l'une des formes les plus sévères et se caractérise par un remodelage progressif des vaisseaux pulmonaires. Ses caractéristiques pathologiques incluent une dysfonction endothéliale, une prolifération et une migration anormales des cellules musculaires lisses des artères pulmonaires, une activation des fibroblastes de l'adventice, un dépôt de matrice extracellulaire, une infiltration de cellules inflammatoires, ainsi qu'un rétrécissement ou une oblitération des artères pulmonaires distales.2Ces modifications indiquent que l'HP/APH n'est pas seulement un trouble de la vasoconstriction, mais également une maladie complexe de remodelage vasculaire induite par des mécanismes moléculaires, cellulaires et immuno-inflammatoires coordonnés.
Les traitements actuels de l'HTAP ciblent principalement les voies de la prostacycline, de l'endothéline, de l'oxyde nitrique–guanylate cyclase soluble et de la phosphodiestérase de type 53˒4. Bien que ces traitements améliorent les symptômes, la capacité à l'exercice et les paramètres hémodynamiques, leurs effets restent largement vasodilatateurs et hémodynamiques. Leur capacité à inverser le remodelage vasculaire pulmonaire installé est limitée, et de nombreux patients continuent de présenter une progression de la maladie malgré un traitement combiné. Par conséquent, l'identification de nouveaux biomarqueurs moléculaires et de candidats thérapeutiques reflétant le processus de remodelage constitue un besoin médical important encore insatisfait. En particulier, l'activation immuno-inflammatoire, les voies de signalisation liées à l'interféron, les voies des récepteurs de type Toll, le recrutement immunitaire médié par les chimioattractants et la transition phénotypique des cellules musculaires lisses se sont révélés comme des facteurs potentiels contribuant à la progression de l'HP/HTAP5˒6.
Les jeux de données transcriptomiques à haut débit fournissent des ressources précieuses pour l'identification de signatures moléculaires associées aux maladies dans l'HP/APH. Toutefois, les études fondées sur un seul jeu de données sont souvent limitées par des tailles d'échantillon réduites, des effets de lot, une hétérogénéité des plateformes et une validation insuffisante. L'analyse d'expression différentielle permet d'identifier des gènes dont l'expression est modifiée, mais elle risque de ne pas rendre pleinement compte des modules de co-expression liés à la maladie ou des interactions au niveau du réseau. L'analyse de réseau de co-expression génique pondéré (WGCNA) peut identifier des modules de gènes associés à des caractères pathologiques, tandis que l'analyse du réseau d'interactions protéine-protéine (PPI) peut révéler des gènes fortement connectés au sein de réseaux biologiques. Les méthodes d'apprentissage automatique peuvent également hiérarchiser les gènes ayant une valeur diagnostique ou de classification. Cependant, le recours à un seul algorithme peut introduire un biais propre au modèle. L'intégration de l'analyse d'expression différentielle, de la WGCNA, de l'analyse du réseau PPI et de plusieurs algorithmes d'apprentissage automatique pourrait donc améliorer la robustesse de la découverte de biomarqueurs.
Un autre défi majeur dans les études de biomarqueurs transcriptomiques est l'interprétation biologique. Les signaux provenant de tissus bruts peuvent refléter des changements d'expression génique au sein des cellules vasculaires résidentes, une infiltration de cellules immunitaires ou des proportions modifiées de plusieurs populations cellulaires. Le séquençage de l'ARN au niveau de la cellule unique offre la possibilité de situer les gènes candidats issus des analyses en masse dans un contexte cellulaire. Dans l'hypertension pulmonaire (HP/APH), le remodelage vasculaire pulmonaire implique les cellules endothéliales, les cellules musculaires lisses, les fibroblastes, les monocytes/macrophages, les lymphocytes et d'autres cellules immunitaires ou structurelles. La progression de la maladie est également associée à une communication altérée entre les cellules et à un basculement phénotypique des cellules musculaires lisses. Ainsi, la combinaison d'un criblage transcriptomique en masse avec une validation à la cellule unique peut aider à déterminer si les biomarqueurs candidats sont associés à une activation immunitaire, à un remodelage structurel vasculaire ou à un déséquilibre dans la communication multicellulaire.
En plus de la découverte de biomarqueurs, les signatures transcriptomiques peuvent être utilisées pour le repositionnement computationnel de médicaments. La carte de connectivité (Connectivity Map, CMap) relie les profils d'expression génique associés aux maladies à des petites molécules susceptibles d'inverser ou de moduler ces signatures7. Lorsqu'elle est combinée à la curation de composés et au dockage moléculaire, cette stratégie peut générer des hypothèses thérapeutiques pouvant être testées expérimentalement. Bien que la prédiction par CMap et le dockage moléculaire ne puissent pas établir l'efficacité d'un médicament, elles permettent de hiérarchiser les composés candidats pour des essais futurs d'interaction avec la cible, des expériences cellulaires et une validation dans des modèles animaux.
Un flux de travail intégré et reproductible a été mis au point pour identifier des biomarqueurs de l'hypertension pulmonaire (HP)/l'hypertension artérielle pulmonaire (HAP) ainsi que des composés thérapeutiques candidats. Trois jeux de données transcriptomiques publics du Gene Expression Omnibus ont été intégrés après normalisation et correction des effets de lot. Une analyse d'expression différentielle, une analyse WGCNA, une analyse d'enrichissement fonctionnel, une analyse du réseau d'interactions protéine-protéine (PPI) et trois algorithmes d'apprentissage automatique ont été utilisés pour sélectionner des gènes caractéristiques robustes. Une analyse de la courbe ROC (receiver operating characteristic), une cohorte de validation indépendante sur tissu pulmonaire, des données de séquençage de l'ARN à la cellule unique provenant de l'artère pulmonaire et une validation par PCR quantitative en temps réel sur des échantillons indépendants ont été utilisées pour évaluer davantage les gènes sélectionnés. Enfin, un répositionnement de médicaments basé sur CMap et un dockage moléculaire ont été appliqués pour identifier des composés candidats. L'originalité de l'étude réside dans son cadre de validation multicouche, qui relie la découverte transcriptomique à partir d'échantillons massifs, la priorisation par apprentissage automatique, la validation indépendante, la confirmation expérimentale par PCR quantitative en temps réel, l'interprétation mécanistique à la cellule unique et le criblage computationnel de composés. L'hypothèse de l'étude était que l'HP/l'HAP est induite par un programme coordonné d'inflammation immunitaire et de remodelage vasculaire, et que des gènes robustes appartenant à ce programme pourraient servir de biomarqueurs candidats et offrir des opportunités de répositionnement thérapeutique.
Protocole
Les ensembles de données publiques du Gene Expression Omnibus (GEO) analysés dans cette étude contenaient des données transcriptomiques dé-identifiées provenant d'études précédemment publiées et n'ont pas nécessité d'approbation éthique supplémentaire. Le comité d'éthique de l'Université Huaihua a approuvé l'étude indépendante de validation par transcription inverse quantitative en temps réel (qRT-PCR) sur des tissus pulmonaires humains (numéro d'approbation : 2024(A05112)). Un consentement éclairé écrit a été obtenu auprès de tous les participants ou de leurs représentants légalement habilités avant le prélèvement des échantillons. Les procédures d'approbation et de consentement se sont appliquées à l'ensemble des 20 échantillons de tissus pulmonaires provenant de patients atteints d'hypertension artérielle pulmonaire (PAH) et des 20 échantillons témoins inclus dans la validation par qRT-PCR. Les outils de recherche utilisés pour ce protocole sont répertoriés dans le Tableau des matériaux.
1. Collecte et prétraitement des jeux de données transcriptomiques publics
Les jeux de données de puces à ADN liés à l'hypertension pulmonaire (PH) GSE22356, GSE33463 et GSE48149 ont été obtenus à partir de la base de données GEO. Les échantillons de PH/hypertension artérielle pulmonaire (PAH) et les échantillons témoins ont été extraits selon les annotations phénotypiques d'origine. Les matrices d'expression et les fichiers d'annotation de la plateforme ont été téléchargés à l'aide de scripts R reproductibles et du package GEOquery.
L'annotation des sondes et la correspondance des symboles génétiques ont été effectuées de manière cohérente pour l'ensemble des jeux de données. Lorsque plusieurs sondes correspondaient au même gène, la valeur moyenne d'expression a été calculée. Une normalisation par quantiles a été appliquée, et les gènes présentant une faible expression ou une faible variance ont été éliminés. Les jeux de données ont été fusionnés, et les effets de lot ont été corrigés à l'aide de l'algorithme ComBat du package sva8. La correction a été évaluée à l'aide de boîtes à moustaches et d'une analyse en composantes principales.
2. Identification des gènes différentiellement exprimés
Le package limma a été utilisé pour comparer les niveaux d'expression entre les échantillons de PH et les échantillons témoins dans la matrice d'expression corrigée par lot9Un modèle linéaire a été ajusté et des statistiques de Bayes empirique ont été appliquées. Les gènes différentiellement exprimés ont été définis à l'aide d'une valeur seuil ajustée P valeur <0,05 et un changement de l'expression différentielle absolu en échelle log2 > 0,585. Les résultats ont été visualisés à l'aide de diagrammes en volcan et de cartes thermiques.
3. Construction d'un réseau de co-expression génique pondéré
Un réseau de co-expression génique pondéré a été construit à l'aide du package WGCNA10. Un regroupement des échantillons a été effectué afin de détecter les valeurs aberrantes. La puissance de seuil doux a été choisie en fonction de l'indice d'ajustement à la topologie sans échelle. Les modules géniques ont été identifiés à l'aide de l'algorithme de découpage dynamique de l'arbre. Les eigengènes des modules ont été corrélés au phénotype HP, et le module associé à la maladie présentant la corrélation la plus forte a été sélectionné. Les gènes du module clé ont été croisés avec les gènes différentiellement exprimés afin d'obtenir les gènes consensus.
4. Analyse d'enrichissement fonctionnel
Les catégories biologiques du Gene Ontology, concernant le processus biologique, le composant cellulaire et la fonction moléculaire, ont été analysées à l'aide de clusterProfiler11. Une analyse d'enrichissement des voies du Kyoto Encyclopedia of Genes and Genomes a été réalisée afin d'identifier les voies de signalisation12. Une valeur de P < 0,05 et une valeur de q < 0,2 ont été utilisées comme seuils d'enrichissement, et les termes enrichis ont été visualisés à l'aide de graphiques en bulles11.
5. Construction du réseau d'interactions protéine-protéine et identification des gènes centraux
La liste de gènes consensus a été soumise à la base de données STRING, avec Homo sapiens sélectionné comme espèce et un seuil de confiance d'interaction > 0,413. Le fichier d'interactions a été importé dans Cytoscape, et le plug-in CytoHubba a été utilisé pour classer les gènes selon leur degré de nœud. Les gènes fortement connectés ont été définis comme des gènes centraux.
6. Sélection de gènes caractéristiques diagnostiques à l'aide de l'apprentissage automatique
Trois algorithmes indépendants de sélection de caractéristiques ont été appliqués. Premièrement, une régression logistique utilisant l'opérateur de sélection et de réduction absolue minimale a été effectuée à l'aide du package glmnet et d'une validation croisée en 10 folds afin d'identifier les gènes possédant des coefficients non nuls14. Deuxièmement, une élimination récursive de caractéristiques par machines à vecteurs de support a été appliquée pour supprimer les caractéristiques redondantes et sélectionner le sous-ensemble de caractéristiques offrant la plus grande précision en validation croisée15. Troisièmement, un modèle de forêt aléatoire a été construit, et les caractéristiques ont été classées selon la diminution moyenne de l'impureté de Gini16. L'intersection des ensembles de gènes obtenus à partir des trois algorithmes a été utilisée pour définir l'ensemble final des gènes caractéristiques principaux. Le package pROC a été utilisé pour générer les courbes caractéristiques de fonctionnement du récepteur et calculer les valeurs de la surface sous la courbe17.
7. Validation des gènes centraux à l'aide de jeux de données indépendants en masse et en cellule unique
GSE117261 a été utilisé comme cohorte externe indépendante de validation sur tissu pulmonaire, comprenant 58 échantillons de HAP et 25 échantillons témoins de donneurs décédés18. Cet ensemble de données n’a pas été utilisé dans l’analyse de découverte de l’expression différentielle, la construction du réseau de co-expression génique pondéré ou la sélection des caractéristiques par apprentissage automatique. La matrice d’expression a été normalisée et annotée, et l’expression différentielle a été analysée à l’aide de limma v3.68.0. Une correction du taux de fausses découvertes de Benjamini-Hochberg a été appliquée à l’ensemble du transcrit annoté. Des courbes caractéristiques de fonctionnement du récepteur (ROC) pour un gène unique ont été calculées à l’aide de pROC v1.19.0.1, d’intervalles de confiance à 95 % de DeLong et de seuils basés sur l’indice de Youden. Un modèle exploratoire de régression logistique à cinq gènes a été ajusté dans GSE117261, et ses performances internes ont été évaluées supplémentairement par une validation croisée imbriquée répétée.
GSE210248 (Tableau 1) a été utilisé comme jeu de données de validation à l'échelle cellulaire unique provenant de l'artère pulmonaire, comprenant des échantillons de trois patients atteints d'hypertension artérielle pulmonaire (PAH) et de trois donneurs sains19. Les données ont été traitées à l'aide de Seurat v5.5.1 pour le contrôle de qualité, la normalisation, la réduction de la dimensionnalité, le regroupement en clusters et l'annotation cellulaire20. Les principales populations cellulaires, notamment les cellules endothéliales, les cellules musculaires lisses, les fibroblastes, les monocytes/macrophages et les cellules T/cellules tueuses naturelles, ont été identifiées. La communication intercellulaire a été analysée à l'aide de CellChat v2.1.2 et de la base de données de ligands-récepteurs CellChatDB.human21. Un objet CellChat a été créé à partir de la matrice d'expression normalisée de Seurat et des métadonnées relatives aux types cellulaires. Les gènes surexprimés ainsi que les interactions ligand-récepteur ont été identifiés ; les probabilités de communication ont été calculées ; les interactions impliquant des groupes cellulaires comportant moins de 10 cellules ont été éliminées ; et les réseaux de communication au niveau des voies ont été inférés et agrégés. Ce jeu de données a été utilisé uniquement pour une validation mécanistique externe et non pour l'entraînement du modèle.
| Élément | Description |
| Ensemble de données | GSE210248 |
| Type de données | Séquençage RNA unicellulaire basé sur les gouttelettes 10x Genomics ; profilage transcriptomique à haut débit |
| Échantillons humains | Trois échantillons d'artère pulmonaire de patients atteints de HAP et trois échantillons d'artère pulmonaire de donneurs sains |
| Origine du tissu | Tissu artériel pulmonaire ex vivo, reflétant principalement l'écologie cellulaire de la paroi vasculaire pulmonaire et le processus de remodelage vasculaire |
| Objectif principal de l'analyse | Localisation des types cellulaires, transition phénotypique des cellules musculaires lisses, communication entre cellules immunitaires et structurelles, et validation de la cohérence mécanistique des gènes candidats |
Tableau 1 : Informations de base pour le jeu de données de validation unique-cellule GSE210248. Le tableau résume l'identifiant du jeu de données, la plateforme de séquençage, la source tissulaire, la composition de l'échantillon et l'objectif analytique de l'analyse de validation de l'artère pulmonaire à l'échelle unique-cellule.
8. Validation de l'expression génique par qRT-PCR
La validation par qRT-PCR a inclus 20 échantillons de tissu pulmonaire atteint de MAP, biologiquement indépendants, provenant de patients présentant une HP/MAP et 20 échantillons de tissu pulmonaire contrôles, biologiquement indépendants. L'ARN total a été extrait à l'aide du kit d'extraction d'ARN total. La concentration et la pureté de l'ARN ont été évaluées à l'aide d'un spectrophotomètre, et l'intégrité de l'ARN a été analysée par électrophorèse sur gel d'agarose. Seuls les échantillons d'ARN dont les valeurs A260/280 se situaient entre 1,8 et 2,1 et ne présentaient aucune dégradation visible ont été retenus.
Des quantités équivalentes d'ARN ont été rétrotranscrites en ADN complémentaire à l'aide du kit Solarbio Universal RT-PCR (AMV ; n° de catalogue RP1200). Une PCR quantitative pour CXCL10, JUN, IFIH1, MX1 et TLR7 a été réalisée à l'aide du mélange maître SYBR Green PCR sur un système de PCR en temps réel. Chaque échantillon biologique a été analysé en trois réplicats techniques, accompagné de témoins sans matrice et sans rétrotranscription. La valeur moyenne de Ct des trois réplicats techniques a été utilisée pour les analyses ultérieures ; les réplicats techniques n'ont pas été considérés comme des observations indépendantes. Des amorces chevauchant les jonctions exon-exon et produisant des amplicons de 80 à 200 pb ont été utilisées (Tableau 2). La spécificité des amorces a été vérifiée à l'aide de NCBI Primer-BLAST et d'une analyse de la courbe de fusion22.
β-actine (ACTB) a été utilisée comme gène de référence interne pour normaliser les niveaux d'expression des gènes cibles. L'expression relative a été calculée en utilisant la méthode 2-ΔΔCt méthode23Des tests de Mann-Whitney U bilatéraux ont été utilisés pour les comparaisons entre groupes en fonction de la distribution des données, et une correction du taux de fausses découvertes selon Benjamini-Hochberg a été appliquée pour les cinq gènes. Des courbes ROC pour chaque gène ont été générées avec des intervalles de confiance à 95 % selon la méthode de DeLong, et les seuils optimaux ont été déterminés à l'aide de l'indice de Youden. Le modèle de régression logistique à cinq gènes a d'abord été ajusté et évalué sur les mêmes 40 échantillons biologiques ; cette estimation a donc été définie comme la performance apparente dans l'échantillon. Afin d'évaluer un éventuel surajustement, 100 répétitions de validation croisée stratifiée en cinq parties ont été réalisées à l'aide d'un modèle de régression logistique régularisé L2, et la performance moyenne ROC hors pli a été calculée.
| Gène | Numéro d'accès RefSeq | Amorce sens (5′–3′) | Amorce antisens (5′–3′) | Taille du produit (pb) | Tm (°C) | Enjambement d'introns |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | Oui |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | Oui |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | Oui |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | Oui |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | Oui |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | Oui |
Tableau 2 : Séquences des amorces utilisées pour la PCR quantitative par transcription inverse. Le tableau recense les gènes cibles, les numéros d'accès RefSeq, les séquences des amorces sens et antisens, les tailles des produits, les températures de fusion et le statut relatif au franchissement d'introns des amorces utilisées pour la qRT-PCR.
9. Analyse de criblage des composés candidats et docking moléculaire
Les signatures des gènes centraux surexprimés et sous-exprimés ont été soumises à la base de données Connectivity Map afin d'identifier les petites molécules susceptibles d'inverser le profil d'expression associé à l'HTAP7. Les candidats ont été classés selon leur score Logit et leur probabilité de prédiction.
La structure tridimensionnelle du BRD-K91900765/VX-745 a été obtenue à partir de PubChem sous le CID 303852524. Les informations pharmacologiques relatives au composé ont été recueillies à partir de bases de données publiques sur les médicaments, et les descripteurs structuraux ont été calculés à l’aide de DrugBank et de SwissADME25,26. Les structures protéiques ont été obtenues à partir de la base de données RCSB Protein Data Bank en utilisant les identifiants PDB suivants : CXCL10, 1LV9 ; JUN, 1JUN ; IFIH1, 3B6E ; MX1, 5GTM ; TLR7, 7CYN ; et MAPK14/p38α, 1OUK27. La détection aveugle de cavités et le dockage moléculaire ont été réalisés à l’aide de CB-Dock2 v2.0 avec le moteur de scoring AutoDock Vina v1.2.028,29. Les fichiers protéiques et ligand ont été téléchargés sur CB-Dock2, les cavités candidates ont été automatiquement détectées, et le dockage a été effectué dans les boîtes spécifiques aux cavités générées par le serveur. Pour chaque protéine, l’identifiant de la cavité, le score Vina, le volume de la cavité, le centre de la boîte de dockage, les dimensions de la boîte de dockage et le fichier du complexe protéine-ligand ont été enregistrés. La conformation présentant le score Vina le plus négatif a été sélectionnée comme la pose prédite la mieux classée. MAPK14/p38α a été inclus comme cible pharmacologique établie et protéine de référence positive pour le dockage de VX-745. Le dockage contre CXCL10, JUN, IFIH1, MX1 et TLR7 était exploratoire et n’a pas été interprété comme une preuve de ciblage pharmacologique direct, de liaison, d’inhibition ou d’efficacité.
10. Analyse statistique et contrôle de la reproductibilité
Toutes les analyses statistiques ont été effectuées avec R, sauf indication contraire. Les valeurs de P bilatérales < 0,05 ont été considérées comme statistiquement significatives. Une correction pour tests multiples a été appliquée aux analyses d'expression différentielle, d'enrichissement, de validation externe et de qRT-PCR, comme précisé ci-dessus. Une validation croisée a été utilisée pour évaluer la stabilité des modèles d'apprentissage automatique et combinés de qRT-PCR.
Résultats
Prétraitement des données transcriptomiques publiques et identification des gènes différentiellement exprimés
L'intégration et la correction par ComBat des jeux de données GSE22356, GSE33463 et GSE48149 ont réduit les différences systématiques entre ces derniers. Les boîtes à moustaches ont montré que les distributions d'expression des échantillons sont devenues plus cohérentes après correction. L'analyse en composantes principales a indiqué que les échantillons s'agrégeaient principalement selon la source du jeu de données avant la correction, mais qu'ils étaient davantage mélangés après correction, ce qui indique une réduction efficace des effets de lot (Figure 1).
En utilisant des seuils de changement de l'expression de log2 en valeur absolue >0,585 et une valeur de P ajustée < 0,05, 78 gènes différentiellement exprimés ont été identifiés, dont 44 gènes surexprimés et 34 gènes sous-exprimés (Figure 2A). La carte thermique a montré que les gènes liés à l'interféron, notamment XAF1, MX1, IFI44L, EPSTI1, PARP9, IFIH1, CXCL10, GBP1, STAT1, SAMHD1, TNFSF10 et TLR7, étaient généralement surexprimés dans les échantillons associés à l'HP. En revanche, les gènes liés aux érythroïdes, notamment HBG1, HBD, ALAS2, CA1 et SLC4A1, avaient tendance à être sous-exprimés (Figure 2B).
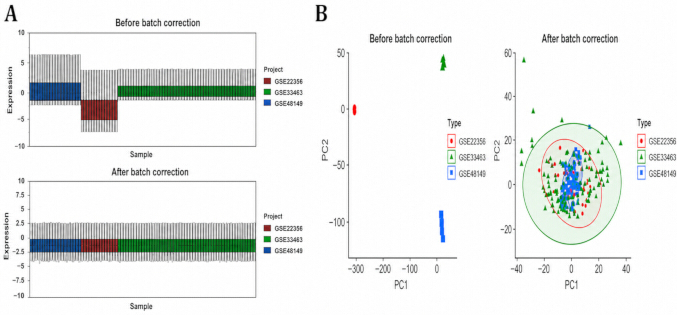
Figure 1 : Correction des effets de lot. (A) Boîtes à moustaches de la matrice d'expression fusionnée avant et après correction par ComBat. (B) Graphiques d'analyse en composantes principales montrant la répartition des échantillons avant et après correction des effets de lot. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
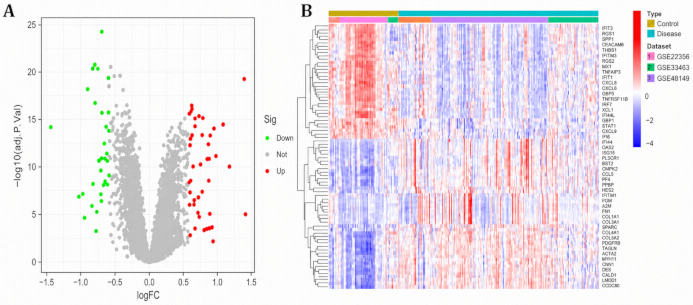
Figure 2 : Gènes différentiellement exprimés. (A) Graphique volcan montrant les gènes surexprimés et sous-exprimés dans les échantillons liés à l'HTP. (B) Carte thermique montrant les gènes différentiellement exprimés entre les groupes témoin et malade. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Construction d'un réseau de co-expression génique pondéré et enrichissement fonctionnel
Le regroupement des échantillons a révélé un regroupement global stable, sans valeurs aberrantes évidentes (Figure 3A). L'indice d'ajustement à la topologie sans échelle s'est approché de 0,8 pour une puissance de 9, et β = 9 a été choisi pour la construction du réseau (Figure 3B). Le regroupement des gènes et l'identification dynamique des modules ont produit plusieurs modules de coexpression (Figure 3C). Le module bleu présentait la plus forte association avec le statut HP (r = 0,55, P = 1 × 10⁻¹⁹), tandis que les modules turquoises et gris présentaient également des corrélations avec l'HP (Figure 3D).
Les gènes consensus obtenus en croisant les gènes clés du module d'analyse de réseau de co-expression génique pondéré avec les gènes différentiellement exprimés étaient enrichis dans la défense immunitaire antivirale, la régulation de NF-κB et de JAK-STAT, les réponses aux facteurs inflammatoires, la liaison aux récepteurs de cytokines et de chimioquines, ainsi que la régulation transcriptionnelle (Figure 4A). L'analyse d'enrichissement de Kyoto Encyclopedia of Genes and Genomes a révélé des interactions cytokines-récepteurs de cytokines, la signalisation des chimioquines, la signalisation des récepteurs de type NOD, la signalisation des récepteurs de type Toll, la signalisation du facteur de nécrose tumorale et la signalisation de l'interleukine-17 (Figure 4B), soutenant ainsi un déséquilibre immuno-inflammatoire comme base moléculaire du remodelage vasculaire pulmonaire.
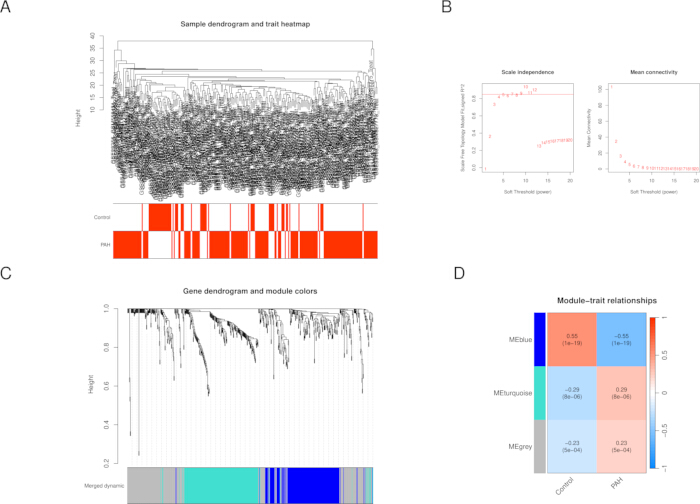
Figure 3 : Analyse du réseau de co-expression génique pondéré. (A) Arbre de regroupement des échantillons et carte thermique des caractères. (B) Graphique de sélection du seuil doux. (C) Dendrogramme des gènes et couleurs des modules. (D) Carte thermique des relations entre modules et caractères. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
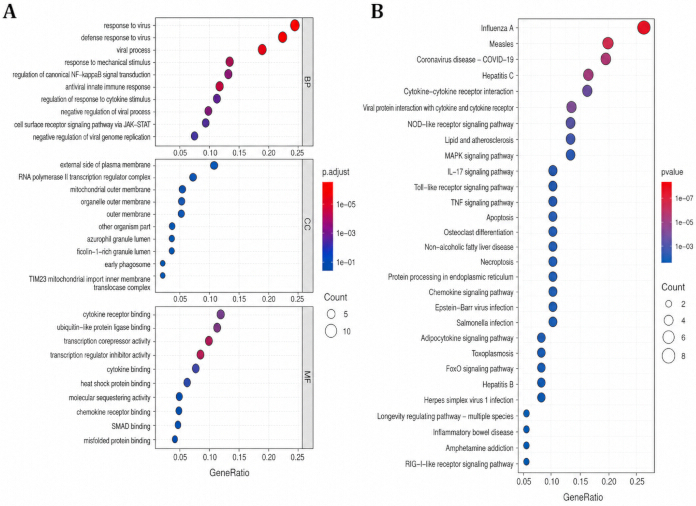
Figure 4 : Analyse d'enrichissement fonctionnel. (A) Résultats de l'enrichissement de l'ontologie génique pour les gènes consensus. (B) Résultats de l'enrichissement des voies de la Kyoto Encyclopedia of Genes and Genomes pour les gènes consensus. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Réseau d'interactions protéine-protéine et criblage des gènes centraux
Le réseau d'interactions protéine-protéine STRING construit à partir des gènes consensus a révélé un réseau immuno-inflammatoire interconnecté (Figure 5A). Le classement CytoHubba basé sur le degré a montré que FN1, CD44, JUN, TGFB1, CXCL8 et BCL2 présentaient une forte connectivité (Figure 5B). Ces gènes centraux pourraient participer à la signalisation inflammatoire, à l'adhésion cellulaire, au remodelage de la matrice extracellulaire et au remodelage structural des vaisseaux pulmonaires.
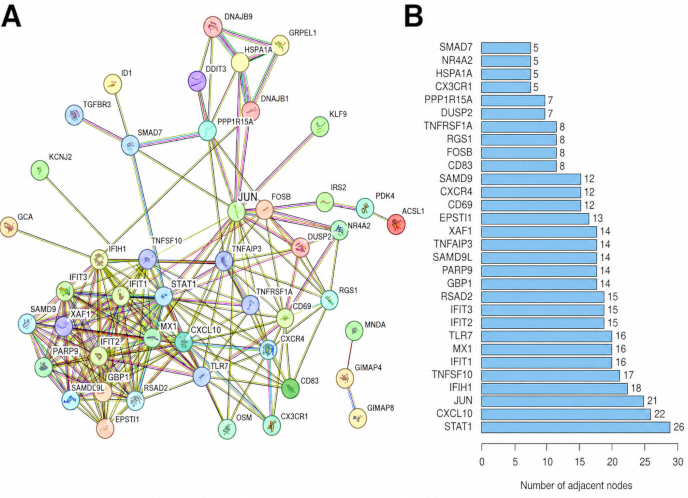
Figure 5 : Réseau d'interactions protéine-protéine et gènes centraux. (A) Réseau d'interactions protéine-protéine des gènes consensus provenant de STRING. (B) Gènes centraux classés par degré d'interaction, identifiés à l'aide de CytoHubba. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Sélection des caractéristiques par apprentissage automatique et performance diagnostique
La régression par l'opérateur de réduction et de sélection des moindres valeurs absolues a identifié six gènes candidats présentant des coefficients non nuls après validation croisée (Figure 6A, B). La machine à vecteurs de support avec élimination récursive des caractéristiques a conservé huit gènes et a donné une exactitude de validation croisée de 0,883 et une erreur de 0,117 (Figure 7A). L'erreur « out-of-bag » de la forêt aléatoire s'est stabilisée lorsque le nombre d'arbres était ≥100, et IFIH1, JUN et TLR7 figuraient parmi les gènes les plus importants selon le score d'importance (Figure 7B).
L'intersection des résultats obtenus par l'opérateur de réduction et de sélection par contrainte de valeur absolue minimale, la machine à vecteurs de support avec élimination récursive des caractéristiques et la forêt aléatoire a identifié cinq gènes centraux : CXCL10, JUN, IFIH1, MX1 et TLR7 (Figure 8A). Une analyse de la courbe ROC monocritère a montré une discrimination diagnostique modérée à bonne, avec des valeurs de la surface sous la courbe de 0,842 pour IFIH1, 0,833 pour JUN, 0,827 pour TLR7, 0,814 pour CXCL10 et 0,759 pour MX1 (Figure 8B).
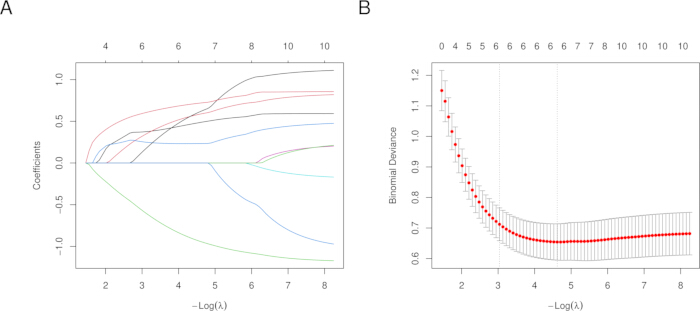
Figure 6 : Analyse de régression par l'opérateur de réduction et de sélection par norme L1. (A) Courbe des coefficients obtenue par la régression par l'opérateur de réduction et de sélection par norme L1. (B) Graphique de l'erreur de validation croisée. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
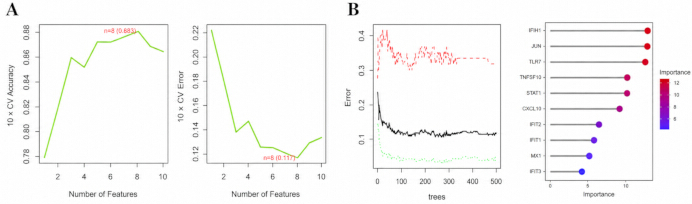
Figure 7 : Analyses par machine à vecteurs de support avec élimination récursive des caractéristiques et par forêt aléatoire. (A) Graphique de sélection des caractéristiques par la méthode d'élimination récursive avec machine à vecteurs de support. (B) Modèle de forêt aléatoire et classement d'importance des gènes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
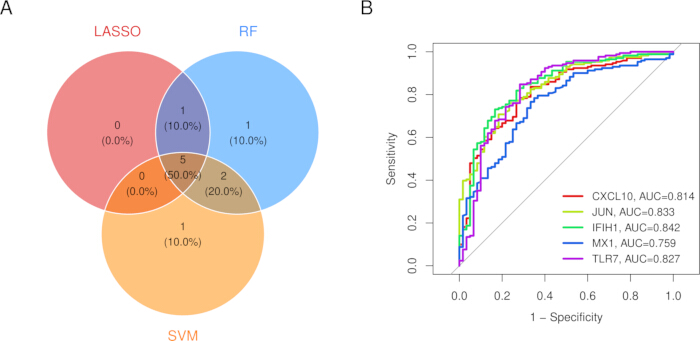
Figure 8 : Résumé du machine learning. (A) Diagramme de Venn montrant l'intersection des trois algorithmes de sélection de caractéristiques. (B) Courbes caractéristiques de fonctionnement du récepteur pour les cinq gènes centraux. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Validation externe dans GSE117261
GSE117261 a été utilisé comme cohorte indépendante de validation sur tissu pulmonaire et n’a pas été inclus dans le criblage de l’expression différentielle, la construction du réseau de co-expression génique pondéré ou la sélection des caractéristiques par apprentissage automatique (Tableau 3). Les résultats de validation complets ont montré une réplication hétérogène parmi les cinq gènes (Tableau 4). CXCL10 était augmenté (changement du rapport log₂ = 0,677 ; P = 0,0410 ; FDR = 0,144) et a donné une AUC de 0,639 (IC à 95 %, 0,491–0,786), avec un seuil de 6,245, une sensibilité de 0,724 et une spécificité de 0,600. JUN était augmenté (changement du rapport log₂ = 0,463 ; P = 0,00248 ; FDR = 0,0194) et a donné une AUC de 0,714 (IC à 95 %, 0,593–0,835), avec un seuil de 8,708, une sensibilité de 0,707 et une spécificité de 0,720.
IFIH1 (changement de l'expression log2 = 0,107 ; P = 0,371 ; FDR = 0,591 ; AUC = 0,543, IC à 95 %, 0,398–0,687), MX1 (changement de l'expression log2 = 0,109 ; P = 0,488 ; FDR = 0,690 ; AUC = 0,475, IC à 95 %, 0,337–0,614) et TLR7 (changement de l'expression log2 = -0,050 ; P = 0,543 ; FDR = 0,733 ; AUC = 0,546, IC à 95 %, 0,414–0,679) n'ont pas satisfait aux critères préétablis de soutien externe. TLR7 présentait également une direction opposée à celle observée dans les résultats de la qRT-PCR. Le modèle exploratoire à cinq gènes ajusté et évalué dans GSE117261 a donné un AUC apparent de 0,740, tandis qu'une validation croisée imbriquée répétée a donné un AUC de 0,656. Ainsi, JUN a reçu le soutien indépendant le plus fort, CXCL10 a montré des preuves limitées mais cohérentes en termes de direction, et la réplication pour IFIH1, MX1 et TLR7 s'est révélée faible ou discordante.
| Élément | Description |
| Numéro d'accès au jeu de données | GSE117261 |
| Source des données | Gene Expression Omnibus (GEO) |
| Type d'échantillon | Données de puces transcriptomiques de tissu pulmonaire humain |
| Taille de l'échantillon | 58 échantillons de HAP et 25 échantillons témoins de donneurs décédés |
| Plateforme | GPL6244 / Affymetrix Human Gene 1.0 ST Array |
| Objectif de validation | Différences d'expression, analyse ROC monocritère et modélisation ROC exploratoire combinée à cinq gènes pour CXCL10, JUN, IFIH1, MX1 et TLR7 |
| Rôle dans cette étude | Jeu de données de validation externe indépendant ; non inclus dans les analyses initiales d'apprentissage, de WGCNA ou de sélection de caractéristiques |
Tableau 3 : Informations de base concernant le jeu de données externe de validation indépendante GSE117261. Le tableau résume la source du jeu de données, le type d'échantillon, la taille de l'échantillon, la plateforme, les objectifs de validation et le rôle de GSE117261 dans l'étude.
| Gène/modèle | PAH n | Témoin n | Changement d'expression log2 | Valeur P | FDR | AUC | IC 95 % de l'AUC | Seuil de Youden | Sensibilité | Spécificité |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| Modèle à cinq gènes (apparente/échantillon) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| Modèle à cinq gènes (CV imbriquée répétée) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
Tableau 4 : Résultats réels de différence d'expression et de validation ROC pour GSE117261. Le tableau indique les effectifs des échantillons PAH et témoins, les variations d'expression exprimées en log₂, les valeurs P, les valeurs ajustées selon le taux de fausses découvertes, les AUC, les intervalles de confiance à 95 %, les seuils déterminés par l'indice de Youden, les sensibilités, les spécificités, ainsi que les interprétations pour les cinq gènes et les modèles combinés exploratoires.
Validation par PCR quantitative en temps réel avec transcription inverse
La validation par PCR quantitative de transcription inverse comprenait 20 échantillons biologiques indépendants de tissu pulmonaire de patients atteints de HAP et 20 échantillons biologiques indépendants témoins, avec trois réplicats techniques moyennés pour chaque échantillon biologique. CXCL10, JUN, IFIH1, MX1 et TLR7 étaient significativement surexprimés dans la HAP (Tableau 5 ; Figure 9A). Les valeurs moyennes d'expression relative étaient d'environ 3,470 pour CXCL10, 2,560 pour JUN, 2,760 pour IFIH1, 2,650 pour MX1 et 2,580 pour TLR7. Les valeurs de P et les valeurs FDR correspondantes étaient respectivement de 1,43 × 10⁻7/7,15 × 10⁻7, 4,17 × 10⁻5/4,17 × 10⁻5, 1,10 × 10⁻5/1,38 × 10⁻5, 1,58 × 10⁻6/2,63 × 10⁻6 et 1,37 × 10⁻6/2,63 × 10⁻6.
L'analyse ROC basée sur l'expression par qRT-PCR d'un seul gène a montré des AUC de 0,988 pour CXCL10 (IC 95 %, 0,961–1,000), 0,880 pour JUN (IC 95 %, 0,758–1,000), 0,908 pour IFIH1 (IC 95 %, 0,820–0,995), 0,945 pour MX1 (IC 95 %, 0,874–1,000) et 0,948 pour TLR7 (IC 95 %, 0,886–1,000) (Figure 9B ; Tableau 5). Le modèle de régression logistique à cinq gènes a atteint une AUC apparente de 1,000 (IC 95 % de DeLong : 1,000–1,000), avec une sensibilité et une spécificité de 1,000 (Figure 9C). La cohérence de la direction d'expression entre la validation par PCR en temps réel avec transcription inverse quantitative et GSE117261 a été visualisée à l'aide d'une carte thermique (Figure 9D). Étant donné que les mêmes 40 échantillons ont été utilisés à la fois pour l'ajustement et l'évaluation, cela reflète la performance apparente dans l'échantillon. Dans 100 répétitions de validation croisée stratifiée en cinq parties utilisant un modèle de régression logistique régularisé L2, l'AUC moyenne hors pli est également restée à 1,000 (IC 95 %, 1,000–1,000), et chaque répétition a donné une AUC de 1,000. Malgré cette stabilité interne, la cohorte était petite et une validation prospective indépendante reste nécessaire. La comparaison directionnelle avec GSE117261 a montré des augmentations concordantes pour CXCL10, JUN, IFIH1 et MX1, mais une direction discordante pour TLR7 (Figure 9D).
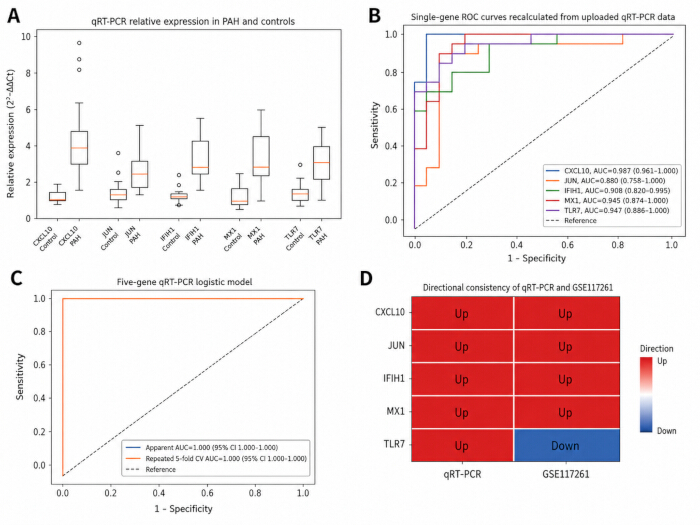
Figure 9 : Validation par PCR quantitative en temps réel après transcription inverse. (A) Diagrammes en boîte montrant l'expression relative de CXCL10, JUN, IFIH1, MX1 et TLR7 dans 20 échantillons biologiques indépendants de tissu pulmonaire de patients atteints de HAP et 20 échantillons témoins biologiquement indépendants. Chaque échantillon biologique a été mesuré en trois réplicats techniques, et la valeur moyenne de Ct a été utilisée pour l'analyse. Pour chaque diagramme en boîte, la ligne centrale représente la médiane, la boîte représente l'intervalle interquartile, les moustaches s'étendent jusqu'à 1,5 fois l'intervalle interquartile, et les points individuels au-delà des moustaches représentent des valeurs aberrantes. (B) Courbes ROC à gène unique basées sur les valeurs d'expression en qRT-PCR ; les AUC et les intervalles de confiance à 95 % selon la méthode de DeLong sont indiqués. (C) Courbes ROC pour le modèle de régression logistique à cinq gènes, montrant à la fois les performances apparentes/intrachantillonnées et les performances agrégées hors-pli issues de 100 analyses de validation croisée stratifiée en cinq plis répétées. (D) Carte thermique montrant la cohérence de la direction d'expression entre la qRT-PCR et GSE117261 ; CXCL10, JUN, IFIH1 et MX1 étaient concordamment augmentés, tandis que TLR7 était discordant. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Gène/modèle | PAH n | Témoin n | Témoin 2^-ΔΔCt, moyenne ± ÉT | PAH 2^-ΔΔCt, moyenne ± ÉT | Sens | Valeur p | FDR | AUC | IC 95 % de l'AUC | Seuil de Youden | Sensi- bilité | Spéci- ficité | Type de validation | ||||
| CXCL10 | 20 | 20 | 1.099 ± 0.502 | 3.470 ± 1.043 | Surexprimé | 1.43E-07 | 7.15E-07 | 0.987 | 0.961–1.000 | 2.028 | 1 | 0.95 | Analyse par qRT-PCR à gène unique | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | Surexprimé | 4.17E-05 | 4.17E-05 | 0.88 | 0.758–1.000 | 1.423 | 0.85 | 0.9 | Analyse par qRT-PCR à gène unique | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | Surexprimé | 1.10E-05 | 1.38E-05 | 0.908 | 0.820–0.995 | 1.579 | 0.8 | 0.85 | Analyse par qRT-PCR à gène unique | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | Surexprimé | 1.58E-06 | 2.63E-06 | 0.945 | 0.874–1.000 | 1.779 | 0.9 | 0.9 | Analyse par qRT-PCR à gène unique | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.444 | 2.580 ± 1.284 | Surexprimé | 1.37E-06 | 2.63E-06 | 0.947 | 0.886–1.000 | 1.764 | 0.85 | 0.9 | Analyse par qRT-PCR à gène unique | ||||
| Modèle à cinq gènes (apparent/in-sample) | 20 | 20 | Non appli- cable | Non appli- cable | Non applicable | / | / | 1 | 1.000–1.000 | 0.998 | 1 | 1 | Mêmes 40 échantillons biologiques utilisés pour l'ajustement et l'évaluation du modèle | ||||
| Modèle à cinq gènes (CV interne répétée 100× à 5 plis) | 20 | 20 | Non appli- cable | Non appli- cable | Non applicable | / | / | 1 | 1.000–1.000 | 0.716 | 1 | 1 | Validation croisée interne par régression logistique régularisée L2 | ||||
Tableau 5 : Résultats complets d'expression en qRT-PCR et de ROC pour CXCL10, JUN, IFIH1, MX1 et TLR7, incluant les analyses du modèle combiné à cinq gènes. Le tableau indique les effectifs des échantillons PAH et témoins, les valeurs d'expression relative, les sens d'expression, les valeurs P, les valeurs ajustées selon le taux de fausses découvertes, les AUC, les intervalles de confiance à 95 %, les seuils déterminés par l'indice de Youden, les sensibilités, les spécificités et les types de validation pour les gènes individuels et les modèles combinés.
Validation transcriptomique à l'échelle cellulaire unique dans GSE210248
GSE210248 a fourni un appui mécanistique au niveau cellulaire en montrant que le remodelage artériel pulmonaire dans l'HTAP s'accompagnait d'une communication altérée entre les cellules immunitaires et les cellules structurelles vasculaires. Cette observation était conforme à l'enrichissement transcriptomique global des réponses inflammatoires, de la signalisation des chimioattractants, de la signalisation des récepteurs de type Toll et de la signalisation du facteur de nécrose tumorale.
Des preuves issues de l'analyse unicellulaire ont suggéré que le réseau de signalisation des artères pulmonaires associé aux HPAP s'est orienté vers les cellules structurelles, notamment les cellules musculaires lisses et les fibroblastes. Les cellules musculaires lisses présentaient plusieurs états, notamment des états proches des cellules à fonction de capteur d'oxygène/de péricytes, contractiles, synthétiques et proches des fibroblastes. Ces résultats appuient un modèle de maladie dans lequel l'activation immuno-inflammatoire et la remodélisation des cellules structurelles vasculaires contribuent conjointement à la progression de l'HP/HPAP.
Écranage des composés candidats et docking moléculaire
Le criblage de la carte de connectivité a identifié BRD-K91900765 comme le composé candidat le mieux classé parmi les 10 meilleurs résultats, avec un score Logit de 10,13 et une probabilité prédite de 0,085 (Figure 10). La curation du composé a révélé que BRD-K91900765 correspond à VX-745/neflamapimod, un inhibiteur sélectif de p38α/MAPK14 possédant un identifiant de composé PubChem de 3038525 et une masse moléculaire de 436,27 g/mol (Tableau 6).
L'analyse préliminaire de l'ancrage de la molécule BRD-K91900765/VX-745 avec les cinq protéines associées aux biomarqueurs a donné des scores Vina maximaux de -7,5 kcal/mol pour CXCL10, -7,6 kcal/mol pour JUN, -7,5 kcal/mol pour IFIH1, -8,7 kcal/mol pour MX1 et -8,1 kcal/mol pour TLR7 (Tableaux 7–11 ; Figure 11A–E). Ces résultats indiquaient une compatibilité structurale prédite, sans toutefois établir que les cinq protéines étaient des cibles pharmacologiques directes. Des prédictions préliminaires concernant l'absorption, la distribution, le métabolisme, l'excrétion et la toxicité suggéraient que le composé possédait plusieurs propriétés caractéristiques d'un médicament, bien que le cLogP calculé relativement élevé nécessite une évaluation complémentaire (Tableau 12). Un ancrage contre la cible établie de VX-745, MAPK14/p38α (ID PDB : 1OUK), a été inclus comme analyse de référence positive. La cavité principale de MAPK14, C1, a donné un score Vina de -7,9 kcal/mol, un volume de cavité de 3560 Å3, un centre de boîte d'ancrage de (2, 22, 34) et des dimensions de (22, 31, 31) (Tableau 13 ; Figure 11F).
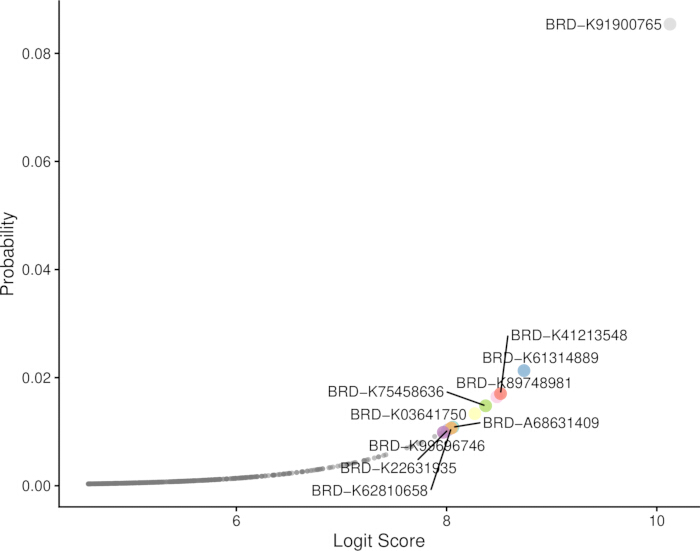
Figure 10 : Classement des composés candidats de la carte de connectivité. Classement des composés candidats identifiés par criblage de la carte de connectivité. BRD-K91900765 était le composé le mieux classé, avec un score Logit de 10,13 et une probabilité prédite de 0,085. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
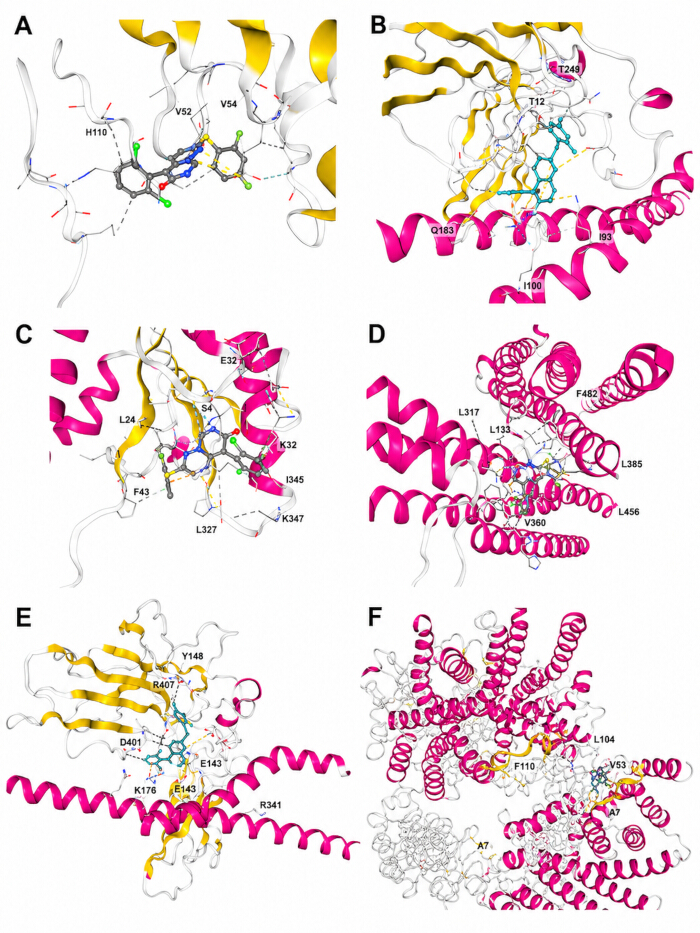
Figure 11 : Diagrammes tridimensionnels de docking moléculaire pour BRD-K91900765/VX-745. (A) Docking exploratoire avec CXCL10. (B) Docking exploratoire avec JUN. (C) Docking exploratoire avec IFIH1. (D) Docking exploratoire avec MX1. (E) Docking exploratoire avec TLR7. (F) Docking de référence positif avec la cible pharmacologique établie MAPK14/p38α (ID PDB : 1OUK). Les panneaux A–E indiquent une compatibilité structurale prédite et n'établissent pas de ciblage pharmacologique direct. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Élément | Description |
| CMap/Broad ID | BRD-K91900765 (format de lot courant : BRD-K91900765-001-xx-x) |
| Nom courant/synonymes | VX-745; neflamapimod; VRT-031745; VD-31745 |
| Nom chimique | 5-(2,6-dichlorophényl)-2-(2,4-difluorophényl)sulfanylpyrimido[1,6-b]pyridazin-6-one |
| PubChem CID | 3038525 |
| Numéro CAS | 209410-46-8 |
| Formule moléculaire / masse moléculaire relative | C19H9Cl2F2N3OS ; 436,27 g/mol |
| SMILES canonique | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| Cible pharmacologique majeure établie | MAPK14/p38α ; une inhibition de p38β a également été rapportée, mais avec une sélectivité moindre que pour p38α |
Tableau 6 : Informations chimiques et pharmacologiques concernant le BRD-K91900765/VX-745. Le tableau résume les identifiants du composé, les synonymes, le nom chimique, la formule moléculaire, la masse moléculaire, les descripteurs structuraux et la cible pharmacologique établie du BRD-K91900765/VX-745.
| ID de CurPocket | Score Vina (kcal/mol) | Volume de la cavité (ų) | Centre (x, y, z) | Taille du docking (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 33, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 22, 22, 22 |
| C3 | -6 | 208 | 34, 15, 9 | 22, 22, 22 |
| C2 | -5.8 | 465 | 45, -6, 19 | 22, 22, 22 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 22, 22 |
Tableau 7 : Poches de docking prédites pour BRD-K91900765/VX-745 avec CXCL10 (ID PDB : 1LV9). Le tableau indique les identifiants de cavité classés par ordre, les scores Vina, les volumes des cavités, les centres des boîtes de docking et les dimensions des boîtes de docking générés par CB-Dock2.
| ID de CurPocket | Score Vina (kcal/mol) | Volume de la cavité (ų) | Centre (x, y, z) | Taille du docking (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
Tableau 8 : Poches de docking prédites pour BRD-K91900765/VX-745 avec JUN (ID PDB : 1JUN). Le tableau indique les identifiants de cavité classés par ordre, les scores Vina, les volumes des cavités, les centres des boîtes de docking et les dimensions des boîtes de docking générés par CB-Dock2.
| ID de CurPocket | Score Vina (kcal/mol) | Volume de la cavité (ų) | Centre (x, y, z) | Taille du docking (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
Tableau 9 : Poches de docking prédites pour BRD-K91900765/VX-745 avec IFIH1 (ID PDB : 3B6E). Le tableau indique les identifiants de cavité classés par ordre, les scores Vina, les volumes des cavités, les centres des boîtes de docking et les dimensions des boîtes de docking générés par CB-Dock2.
| ID de CurPocket | Score Vina (kcal/mol) | Volume de la cavité (ų) | Centre (x, y, z) | Taille du docking (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 22, 22, 22 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 22 |
| C3 | -7 | 306 | 12, 12, -7 | 22, 22, 22 |
| C2 | -6.9 | 408 | -3, 1, -12 | 22, 22, 22 |
| C5 | -6.2 | 179 | 24, 25, 13 | 22, 22, 22 |
Tableau 10 : Poches de docking prédites pour BRD-K91900765/VX-745 avec MX1 (ID PDB : 5GTM). Le tableau indique les identifiants de cavité classés par ordre, les scores Vina, les volumes des cavités, les centres des boîtes de docking et les dimensions des boîtes de docking générés par CB-Dock2.
| ID de CurPocket | Score Vina (kcal/mol) | Volume de la cavité (ų) | Centre (x, y, z) | Taille du docking (x, y, z) |
| C2 | -8.1 | 7347 | 112, 137, 148 | 33, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 22, 22 |
| C1 | -8 | 7676 | 137, 112, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 117, 157, 88 | 22, 22, 22 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 22, 22, 22 |
Tableau 11 : Poches de docking prédites pour BRD-K91900765/VX-745 avec TLR7 (ID PDB : 7CYN). Le tableau indique les identifiants de cavité classés par ordre, les scores Vina, les volumes des cavités, les centres des boîtes de docking et les dimensions des boîtes de docking générés par CB-Dock2.
| Propriété physicochimique | Paramètre | Résultat | Interprétation |
| Propriété physicochimique | Masse moléculaire | 436,27 g/mol | Inférieure à 500 Da, satisfaisant au seuil de masse moléculaire de Lipinski |
| Propriété physicochimique | cLogP | Environ 5,49 | Légèrement supérieur à 5, suggérant une lipophilie élevée et la nécessité de prendre en compte la solubilité et les liaisons non spécifiques |
| Propriété physicochimique | TPSA | Environ 47,26 Ų | Faible surface polaire, compatible avec une perméabilité membranaire potentiellement favorable |
| Apparence de médicament | Accepteurs/donneurs de liaisons hydrogène (HBA/HBD) | 00 mai | Respecte les seuils de Lipinski pour les accepteurs et donneurs de liaisons hydrogène |
| Apparence de médicament | Liaisons rotatables | 3 | Faible flexibilité conformationnelle, favorable à des conformations de liaison stables |
| Alertes structurales | Alertes PAINS/Brenk | Non détecté | Aucune alerte structurale courante d'interférence pan-test ou de réactivité détectée |
| Prédiction de toxicité | Mutagénicité d'Ames | Prédit non toxique selon Ames | Suggère un risque mutagène prédit faible ; une validation expérimentale reste nécessaire |
| Prédiction de toxicité | Cancérogénicité | Prédit non cancérigène | Suggère un risque cancérigène à long terme relativement faible ; une validation expérimentale reste nécessaire |
| Note pharmacocinétique | Disponibilité orale/pénétration cérébrale | La littérature et les bases de données indiquent une petite molécule disponible par voie orale et pénétrant dans le cerveau | Compatible avec son historique de développement en tant qu'inhibiteur de p38α ; une réévaluation reste nécessaire pour les indications PH |
Tableau 12 : Prédictions préliminaires des propriétés physicochimiques, de l'aptitude au médicament, des paramètres ADMET et de la toxicité pour le BRD-K91900765/VX-745. Le tableau résume les propriétés physicochimiques prédites, les indicateurs d'aptitude au médicament, les alertes structurales, les paramètres de toxicité et les caractéristiques pharmacocinétiques. Ces prédictions informatiques sont préliminaires et ne remplacent pas une validation expérimentale pharmacocinétique ou toxicologique.
| ID de CurPocket | Score Vina (kcal/mol) | Volume de la cavité (ų) | Centre (x, y, z) | Taille du docking (x, y, z) |
| C1 | -7.9 | 3560 | 2, 22, 34 | 22, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 22, 22, 22 |
| C3 | -7.4 | 351 | 12, 7, 37 | 22, 22, 22 |
| C2 | -6.3 | 827 | 18, 5, 28 | 22, 22, 22 |
| C4 | -6.3 | 334 | -16, 17, 38 | 22, 22, 22 |
Tableau 13 : Poches de docking prédites pour BRD-K91900765/VX-745 avec sa cible pharmacologique établie MAPK14/p38α (ID PDB : 1OUK), inclus comme analyse de référence positive. Le tableau indique les identifiants de cavité classés par ordre, les scores Vina, les volumes des cavités, les centres des boîtes de docking et les dimensions des boîtes de docking générés à l’aide du même protocole de docking appliqué aux cinq protéines associées aux biomarqueurs.
Dans leur ensemble, les analyses de découverte et les résultats de RT-qPCR soutiennent CXCL10, JUN, IFIH1, MX1 et TLR7 comme biomarqueurs candidats de l'HTAP/APH associés à une dysrégulation immuno-inflammatoire et à un remodelage vasculaire pulmonaire, bien que la réplication indépendante dans GSE117261 ait été la plus forte pour JUN et variable pour les autres gènes. BRD-K91900765/VX-745 est un candidat prioritaire de repositionnement thérapeutique identifié par calcul, doté d'un mécanisme plausible d'inhibition de MAPK14/p38α ; une validation de la liaison à la cible, des effets cellulaires, de la pharmacocinétique, de la toxicité et des modèles animaux est requise avant toute interprétation thérapeutique.
DISPONIBILITÉ DES DONNÉES :
Tous les jeux de données transcriptomiques publics utilisés dans cette étude sont disponibles dans la base de données Gene Expression Omnibus sous les numéros d'accès GSE22356, GSE33463, GSE48149, GSE117261 et GSE210248. Tous les fichiers de code, jeux de données traités, données brutes et analysées de qRT-PCR dé-identifiées, résultats des modèles, ainsi que les fichiers d'entrée et de sortie du dockage moléculaire ont été regroupés dans un dépôt structuré sur Zenodo. Le dépôt inclut un fichier LISEZ-MOI décrivant chaque fichier, les versions des logiciels et des packages, l'ordre d'exécution des scripts, et les étapes complètes de reproduction — https://zenodo.org/records/21682282
Discussion
Un flux de travail intégré et reproductible a été mis au point pour identifier des biomarqueurs moléculaires associés à l'HTAP/AAPH et des composés thérapeutiques candidats, en combinant des données transcriptomiques publiques, une analyse de réseau de coexpression génique pondérée, un enrichissement fonctionnel, une analyse de réseau d'interactions protéine-protéine, trois algorithmes d'apprentissage automatique, une validation externe, une interprétation transcriptomique unicellulaire, une confirmation par PCR quantitative en temps réel, un criblage de la carte de connectivité (Connectivity Map) et un dockage moléculaire. CXCL10, JUN, IFIH1, MX1 et TLR7 ont été systématiquement classés comme des gènes caractéristiques centraux et regroupés ensemble au sein d'un axe moléculaire impliquant une inflammation immunitaire et des voies liées à l'interféron. Ces résultats appuient l'idée que l'HTAP/AAPH n'est pas seulement un trouble hémodynamique, mais également une maladie complexe de remodelage vasculaire impliquant une activation immunitaire, des signaux inflammatoires, une détection innée des acides nucléiques, ainsi que des modifications phénotypiques cellulaires et structurales2,5,6.
Le potentiel diagnostique des cinq gènes était soutenu par une sélection de caractéristiques multi-algorithmes et par une analyse ROC sur le lot de découverte. La validation indépendante dans GSE117261 s'est révélée hétérogène plutôt qu'uniforme : JUN a satisfait aux critères préspecifiés de FDR et d'AUC, CXCL10 a montré une augmentation nominale directionnellement cohérente sans atteindre la signification de FDR à l'échelle du transcriptome, IFIH1 et MX1 ont montré une réplication limitée, et TLR7 a présenté une direction discordante. Ces résultats ne soutiennent pas l'affirmation selon laquelle les cinq gènes ont été validés indépendamment et indiquent des effets possibles liés à la composition du lot, à l'hétérogénéité tissulaire, aux différences de plateforme et à la gravité de la maladie. En revanche, la qRT-PCR réalisée sur 20 échantillons de tissu pulmonaire de patients atteints de HAP et 20 échantillons témoins a confirmé une surexpression significative des cinq gènes ainsi qu'une bonne performance individuelle au test ROC.
Le modèle logistique de qRT-PCR à cinq gènes a atteint une AUC apparente de 1,000 (IC à 95 %, 1,000–1,000), et son AUC groupée hors pli est restée à 1,000 lors de 100 analyses de validation croisée stratifiée en cinq parties répétées. Toutefois, le modèle a été élaboré à partir de seulement 40 échantillons biologiques, et une séparation complète dans un petit échantillon rétrospectif peut produire des estimations de performance optimistes et instables. Le panel doit donc être considéré comme une signature moléculaire exploratoire plutôt qu'un outil diagnostique cliniquement validé. Des cohortes plus vastes et multicentriques, des coefficients de modèle fixes prédéfinis, une validation au niveau protéique, une immunohistochimie et des tests prospectifs sont nécessaires avant toute application clinique.
Parmi les cinq gènes principaux, CXCL10 pourrait favoriser le recrutement des cellules immunitaires et l'amplification locale de l'inflammation au sein du microenvironnement vasculaire pulmonaire. IFIH1 et TLR7 participent à la détection innée des acides nucléiques et pourraient refléter l'activation de voies inflammatoires de type antiviral. MX1 est un gène classiquement induit par l'interféron et pourrait représenter un marqueur en aval de l'activation de la voie des interférons de type I. JUN est un facteur de transcription sensible au stress qui relie la stimulation inflammatoire à la prolifération cellulaire, à l'apoptose et au remodelage tissulaire. Ensemble, ces gènes suggèrent un modèle biologiquement cohérent dans lequel l'activation de l'immunité innée et les signaux liés à l'interféron interagissent avec les processus de remodelage vasculaire dans l'HP/APH. Cette interprétation est compatible avec des données antérieures indiquant que l'inflammation, l'immunité et les voies liées à l'interféron contribuent à la pathobiologie de l'APH2,5,6.
La validation au niveau cellulaire unique a fourni un contexte mécanistique aux découvertes issues des analyses globales. La série d'expression génique GSE210248 a suggéré que le remodelage artériel pulmonaire dans l'HTAP s'accompagnait d'une communication altérée entre les cellules immunitaires et les cellules structurelles vasculaires, notamment les cellules musculaires lisses, les fibroblastes, les cellules endothéliales et les monocytes/macrophages. La présence de plusieurs états phénotypiques des cellules musculaires lisses, notamment contractile, synthétique, sensible à l'oxygène/de type péricyte et de type fibroblaste, soutient un modèle de maladie dans lequel l'activation immunitaire et le remodelage structural des cellules se produisent simultanément. Ces preuves cellulaires sont importantes car les signaux transcriptomiques globaux peuvent résulter de modifications des proportions cellulaires, d'une infiltration de cellules immunitaires ou de changements transcriptionnels dans les cellules vasculaires résidentes. L'analyse au niveau cellulaire unique situe ainsi CXCL10, JUN, IFIH1, MX1 et TLR7 dans un écosystème multicellulaire de remodelage vasculaire pulmonaire, plutôt que dans un processus restreint à un seul type cellulaire18,19,20,21.
L'analyse de repositionnement de médicaments a identifié BRD-K91900765, correspondant à VX-745/neflamapimod, comme le candidat computationnel le mieux classé. VX-745 est un inhibiteur sélectif de p38α/MAPK14, et son lien avec les voies de stress inflammatoire rend mécanistiquement plausible son implication dans le contexte de l'inflammation associée à l'HP/APH30. Un docking contre MAPK14/p38α a donc été inclus comme analyse de référence positive mécaniquement pertinente. En revanche, le docking contre CXCL10, JUN, IFIH1, MX1 et TLR7 était exploratoire et indiquait uniquement une compatibilité structurale prédite ; il n'a pas démontré que ces protéines associées à des biomarqueurs sont des cibles directes de VX-745, ni établi une liaison directe, une inhibition de la cible ou une efficacité thérapeutique. Une hypothèse plus biologiquement plausible est que VX-745 pourrait moduler indirectement la signature transcriptionnelle immuno-inflammatoire et liée à l'interféron identifiée en inhibant MAPK14. Les prédictions de la carte de connectivité, les scores de docking et les estimations ADMET restent des preuves computationnelles. Des travaux supplémentaires devraient inclure des tests biochimiques d'interaction avec la cible, des expériences sur des cellules endothéliales et musculaires lisses artérielles pulmonaires, des modèles de stimulation inflammatoire, des évaluations pharmacocinétiques et toxicologiques, ainsi que la validation dans des modèles animaux.
De récentes études expérimentales sur l'hypertension pulmonaire hypoxique ont également mis en évidence l'importance de la communication entre les neutrophiles et les cellules vasculaires pulmonaires. Des interactions médiées par HCK entre les neutrophiles et les cellules musculaires lisses artérielles pulmonaires, ainsi que des interactions médiées par SERPINB3 entre les neutrophiles et les cellules endothéliales, ont été décrites comme des facteurs contribuant au remodelage vasculaire pulmonaire31˒32. L'axe SERPINB3–STAT1/3 est particulièrement pertinent par rapport aux résultats actuels, car des signaux liés à l'interféron, à STAT1 et à la voie JAK–STAT ont été identifiés lors des analyses transcriptomiques. Dans leur ensemble, ces observations appuient l'interprétation selon laquelle l'activation des cellules immunitaires et leur communication avec les cellules structurelles vasculaires pourraient contribuer à la progression de l'HP/APH.
L'étude présente plusieurs forces. Plusieurs jeux de données publics et une correction des effets de lot ont été utilisés pour réduire les biais spécifiques aux jeux de données. L'analyse d'expression différentielle, l'analyse de réseau de co-expression pondérée des gènes, l'analyse des interactions protéine-protéine et trois algorithmes d'apprentissage automatique ont été combinés afin d'améliorer la robustesse des caractéristiques. Une validation indépendante en bulk, une confirmation par qRT-PCR et des preuves issues de l'analyse unicellulaire ont fourni des couches complémentaires mais non identiques de preuves. Les résultats hétérogènes du jeu de données GSE117261 et la petite cohorte utilisée pour la qRT-PCR soulignent également des limites importantes, notamment une réplication externe incomplète, des effets potentiels liés au tissu ou à la plateforme, ainsi que le risque de surajustement. La découverte de biomarqueurs a également été étendue à un criblage de composés candidats, mais les analyses de docking restent génératrices d'hypothèses. De futures études devraient valider les cinq gènes dans de plus grandes cohortes indépendantes à l'aide de la transcriptomique spatiale, de la protéomique, de l'immunohistochimie et de modèles d'organoïdes ou de puces vasculaires. Dans l'ensemble, CXCL10, JUN, IFIH1, MX1 et TLR7 restent des biomarqueurs candidats pour l'HP/APH liés au remodelage vasculaire inflammatoire-immunitaire et aux interférons, tandis que BRD-K91900765/VX-745 constitue un candidat computationnel au répositionnement médicamenteux dont la pertinence thérapeutique nécessite une validation expérimentale.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun intérêt concurrentiel.
Remerciements
Cette étude a été soutenue par le projet de construction de la province innovante du Hunan (n° 2022JJ30465).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| 2× SYBR Green PCR Mastermix | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. SR1110 | Amplification PCR en temps réel quantitative basée sur un colorant et détection de fluorescence |
| AI21.msvmRFE.R et e1071 | Script R personnalisé avec le package CRAN e1071 | AI21.msvmRFE.R ; e1071 v1.7-17 | Élimination récursive de caractéristiques par machine à vecteurs de support |
| Agarose | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. A8201 ; CAS 9012-36-6 | Évaluation de l'intégrité de l'ARN total par électrophorèse sur gel d'agarose |
| Appareil d'électrophorèse sur gel d'agarose | Beijing Liuyi Biotechnology Co., Ltd. | Modèle DYCZ-24DN | Évaluation électrophorétique de l'intégrité de l'ARN |
| Moteur de scoring AutoDock Vina | Center for Computational Structural Biology, Scripps Research | v1.2.0 ; RRID : SCR_011958 | Évaluation des poses ligand-protéine dans le cadre de flux CB-Dock2 |
| CB-Dock2 | Laboratoire Cao, serveur web CB-Dock2 | v2.0 ; accédé en juillet 2026 | Détection aveugle de cavités et docking moléculaire de VX-745 avec les structures protéiques sélectionnées |
| CellChat | Package R CellChat | v2.1.2 | Inférence et visualisation des communications intercellulaires à partir de la matrice d'expression unicellulaire |
| CellChatDB.human | Distribué avec le package R CellChat | CellChatDB.human ; sous-ensemble Signaling Secreted ; seuil minimal de cellules = 10 | Base de données d'interactions ligand-récepteur humaines pour CellChat |
| clusterProfiler | Package R Bioconductor | v4.20.0 ; version Bioconductor 3.23 | Analyses d'enrichissement Gene Ontology et Kyoto Encyclopedia of Genes and Genomes |
| Connectivity Map (CMap/CLUE) | Broad Institute | Ressource L1000/CLUE ; RRID : SCR_016204 ; accédée en juillet 2026 | Analyse computationnelle de réaffectation thérapeutique |
| Amorces oligonucléotidiques personnalisées | Beijing Solarbio Science & Technology Co., Ltd. | Synthétisées sur mesure ; séquences des amorces fournies dans le tableau 2 | Amplification de ACTB, CXCL10, JUN, IFIH1, MX1 et TLR7 |
| cytoHubba | Boutique d'applications Cytoscape | v0.1 | Classement des gènes centraux (hub genes) basé sur le degré dans le réseau d'interactions protéine-protéine |
| Cytoscape | Consortium Cytoscape | v3.10.4 ; RRID : SCR_003032 | Visualisation et analyse du réseau d'interactions protéine-protéine |
| DrugBank | Base de connaissances DrugBank | v6.0 ; RRID : SCR_002700 | Curation de l'identité des composés et des informations pharmacologiques |
| Système de documentation des gels | Beijing Liuyi Biotechnology Co., Ltd. | Modèle WO-9413B | Visualisation et enregistrement des résultats d'intégrité de l'ARN sur gel d'agarose |
| Gene Expression Omnibus (GEO) | National Center for Biotechnology Information | GSE22356, GSE33463, GSE48149, GSE117261 et GSE210248 ; RRID : SCR_005012 | Récupération de jeux de données transcriptomiques en masse et unicellulaires |
| GEOquery | Package R Bioconductor | v2.80.0 ; version Bioconductor 3.23 | Téléchargement et importation programmés des données d'expression et de phénotype de GEO |
| glmnet | Package R CRAN | v5.0 | Régression logistique avec opérateur de sélection et de réduction absolue (LASSO) et modélisation logistique régularisée |
| limma | Package R Bioconductor | v3.68.0 ; version Bioconductor 3.23 ; RRID : SCR_010943 | Analyse d'expression différentielle et statistiques bayésiennes empiriques |
| Spectrophotomètre NanoDrop | Thermo Fisher Scientific | NanoDrop ND-1000 ; logiciel v3.8 | Mesure de la concentration en ARN et des rapports de pureté A260/280 et A260/230 |
| NCBI Primer-BLAST | National Center for Biotechnology Information | Outil web ; RRID : SCR_003095 ; accédé en juillet 2026 | Vérification de la spécificité des amorces |
| pROC | Package R CRAN | v1.19.0.1 ; RRID : SCR_024286 | Analyse de la courbe ROC, intervalles de confiance de DeLong et seuils basés sur l'indice de Youden |
| Protein Data Bank (PDB) | RCSB Protein Data Bank | CXCL10 : 1LV9 ; JUN : 1JUN ; IFIH1 : 3B6E ; MX1 : 5GTM ; TLR7 : 7CYN ; MAPK14/p38α : 1OUK ; RRID : SCR_012820 | Récupération de structures protéiques déterminées expérimentalement pour le docking moléculaire |
| PubChem | National Center for Biotechnology Information | PubChem CID 3038525 ; RRID : SCR_004284 | Récupération de la structure tridimensionnelle et des identifiants chimiques de BRD-K91900765/VX-745 |
| R | R Foundation for Statistical Computing | v4.6.1 ; RRID : SCR_001905 | Calcul statistique, traitement des données, apprentissage automatique et visualisation |
| randomForest | Package R CRAN | v4.7-1.2 | Sélection de caractéristiques par forêt aléatoire et classement de l'importance des variables |
| Système PCR en temps réel | Stratagene, maintenant Agilent Technologies | Système Mx3000P Real-Time PCR | Amplification qRT-PCR, acquisition de fluorescence, analyse de courbe de fusion et exportation des valeurs Ct |
| Seurat | Package R CRAN ; Laboratoire Satija | v5.5.1 ; RRID : SCR_016341 | Contrôle qualité, normalisation, réduction de dimensionnalité, regroupement et annotation en séquençage d'ARN unicellulaire |
| STRING | Consortium STRING | v12.0 ; RRID : SCR_005223 | Construction du réseau d'interactions protéine-protéine |
| sva (ComBat) | Package R Bioconductor | v3.60.0 ; version Bioconductor 3.23 | Correction des effets de lot entre jeux de données |
| SwissADME | Institut suisse de bioinformatique | Serveur web ; accédé en juillet 2026 | Présélection de la similitude avec un médicament, des propriétés physico-chimiques et des paramètres ADME |
| Kit d'extraction d'ARN total | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. R1200 | Extraction et purification de l'ARN total à partir d'échantillons de tissu pulmonaire |
| Kit RT-PCR universel (AMV) | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. RP1200 | Transcription inverse de l'ARN total en ADN complémentaire |
| WGCNA | Package R CRAN | v1.74 | Construction de réseaux de co-expression génique pondérés et analyse module-trait |
Références
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.