Cette étude identifie cinq biomarqueurs liés à la cuproptose et à la ferroptose dans la rectocolite ulcéreuse grâce à une approche intégrée combinant apprentissage automatique, séquençage de l'ARN au niveau cellulaire unique et validation expérimentale, offrant ainsi des perspectives pour le diagnostic clinique et l'immunothérapie ciblée.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Ciblage de la ferroptose et de la cuproptose dans la rectocolite hémorragique : résultats issus d'une bio-informatique complète et d'une validation expérimentale
Dans cet article
Résumé
Résumé
La colite ulcéreuse (CU) est un trouble intestinal persistant dont la pathogenèse n'est pas entièrement définie et dont la prévalence ainsi que les taux d'hospitalisation augmentent dans les pays récemment industrialisés. Dans la CU, la mort excessive des cellules épithéliales intestinales perturbe la barrière muqueuse et déclenche des réponses inflammatoires. La ferroptose et la cuproptose sont deux formes récemment décrites de mort cellulaire régulée. La plupart des études sur la CU ont examiné ces processus séparément ; toutefois, leurs rôles combinés dans la progression de la CU restent insuffisamment caractérisés. Afin d'étudier leurs rôles synergiques dans la pathogenèse de la CU, nous avons utilisé une approche progressive combinant un profilage transcriptomique à grande échelle pour identifier des cibles candidates, suivie d'une validation dans des modèles in vitro. Les gènes différentiellement exprimés (DEG) ont été croisés avec les gènes associés à la ferroptose (FRG) et les gènes associés à la cuproptose (CRG). Les cibles communes ont été priorisées à l'aide d'un consensus d'algorithmes d'apprentissage automatique et d'une analyse de réseau de co-expression génique pondérée (WGCNA). Cinq biomarqueurs — LCN2, IDO1, CXCL2, NOS2 et CD274 — se sont révélés fortement surexprimés dans la CU. Une analyse unicellulaire a caractérisé leur expression à travers différents types cellulaires, montrant que LCN2 et NOS2 étaient principalement enrichis dans les cellules épithéliales. La pertinence mécanistique de ces marqueurs a été évaluée davantage par des tests in vitro. Le traitement par des inhibiteurs de la ferroptose ou de la cuproptose a atténué l'inflammation associée à la CU et modulé l'expression des biomarqueurs dans des modèles cellulaires Caco-2. Ces résultats identifient cinq biomarqueurs associés à la progression de la CU et fournissent des preuves expérimentales appuyant leur potentiel d'application en diagnostic clinique et en intervention thérapeutique.
Introduction
La colite ulcéreuse (CU) est une maladie inflammatoire chronique de l'intestin à évolution récidivante, associée à un fardeau mondial croissant et à des coûts de traitement à long terme importants1,2. Bien que les aminosalicylates, les corticostéroïdes, les traitements biologiques et les petites molécules aient élargi les options thérapeutiques, l'obtention d'une rémission durable reste difficile pour de nombreux patients3,4. Ce besoin clinique non satisfait souligne l'importance d'identifier des marqueurs moléculaires reproductibles et des mécanismes accessibles susceptibles de favoriser un diagnostic précoce et une thérapie guidée par les mécanismes5.
La ferroptose est une forme dépendante du fer de mort cellulaire régulée, induite par la peroxydation lipidique, l'épuisement du glutathion et l'altération de l'activité de la GPX46. Des niveaux élevés de fer et de malondialdéhyde dans la rectocolite ulcéreuse sont compatibles avec une lésion épithéliale ferroptotique, tandis que l'activation expérimentale de l'axe SLC7A11–GSH–GPX4 ou l'inhibition directe de la ferroptose peut protéger la barrière intestinale7,8.
La cuproptose, décrite en 2022, est déclenchée lorsque le cuivre se lie à des protéines mitochondriales lipoylées, entraînant une agrégation des protéines et un stress protéotoxique9. Étant donné que l'intestin joue un rôle central dans la régulation du cuivre, la perturbation de cette voie pourrait amplifier les lésions épithéliales oxydatives et inflammatoires dans la rectocolite ulcéreuse10.
La ferroptose et la cuproptose pourraient converger par le biais d'un déséquilibre des ions métalliques, du métabolisme mitochondrial, de l'appauvrissement en glutathion et du stress oxydatif11. Cependant, on ignore encore si cette interaction produit une signature moléculaire reproductible dans la colite ulcéreuse et si une telle signature répond à une inhibition spécifique des voies impliquées.
L'hypothèse de l'étude était que la communication désordonnée entre la ferroptose et la cuproptose dans la CU converge vers une signature reproductible de biomarqueurs pouvant être priorisée à partir de jeux de données transcriptomiques en masse et unicellulaires, et atténuée par une inhibition spécifique des voies dans un modèle de lésion de l'épithélium intestinal. En conséquence, des analyses bioinformatiques multicohortes, un apprentissage automatique, une analyse unicellulaire et des expériences ciblées sur des cellules Caco-2 ont été combinées afin d'identifier et d'évaluer fonctionnellement des biomarqueurs candidats (Figure 1).
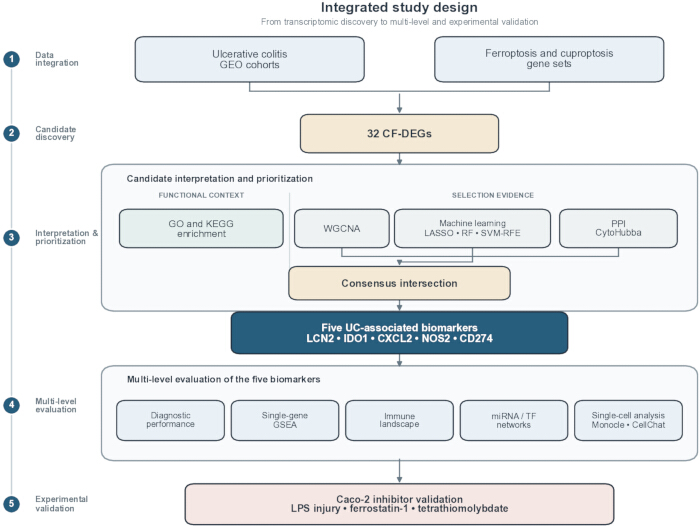
Figure 1 : Flux de travail de l'étude. Flux de travail intégré pour le criblage transcriptomique multicohorte, la priorisation de biomarqueurs basée sur l'apprentissage automatique et les réseaux, la localisation au niveau cellulaire unique et la validation par inhibiteurs dans les cellules Caco-2. RC : rectocolite ulcéreuse ; GEO : Gene Expression Omnibus ; WGCNA : analyse de réseau de co-expression génique pondérée ; PPI : interaction protéine-protéine ; ROC : caractéristique de fonctionnement du récepteur ; GSEA : analyse d'enrichissement des ensembles de gènes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude a utilisé des ensembles de données accessibles au public et des lignées cellulaires humaines disponibles commercialement. Aucun participant humain, tissu humain nouvellement collecté ou animal vertébré n'a été impliqué ; par conséquent, aucune approbation par un comité d'éthique institutionnel n'était requise. Les outils de recherche, logiciels et ressources en ligne utilisés dans le protocole sont répertoriés dans le Tableau des matériaux.
1. Traitement des données pour l'analyse d'expression différentielle
Pour établir les cohortes de découverte et de validation transcriptomiques, la base de données Gene Expression Omnibus (GEO) a été interrogée à l’aide du terme « ulcerative colitis ». Quatre jeux de données — GSE87466, GSE92415, GSE107499 et GSE75214 — ont été utilisés comme ensemble d’apprentissage, tandis que GSE47908 a été réservé à la validation externe. Les jeux de données d’apprentissage ont été normalisés et corrigés par lot à l’aide de ComBat dans Sangerbox 3.0, tandis que le jeu de données de validation a été traité indépendamment.
Un total de 583 gènes liés à la ferroptose (FRG) a été obtenu à partir de FerrDB et complété par des gènes rapportés dans la littérature afin de réduire le biais d'une source unique12. Un ensemble de 96 gènes liés à la cuproptose (CRG) a été compilé à partir d'études publiées12,13,14. L'expression différentielle a été analysée à l'aide de limma avec des seuils de |variation du log₂| > 1 et une valeur P ajustée selon Benjamini–Hochberg < 0,05. Les graphiques diagnostiques de la normalisation, de la correction par lot, de l'expression différentielle et du regroupement sont fournis dans la figure supplémentaire 1. La composition des échantillons, les plateformes et les attributions des cohortes sont indiquées dans le tableau supplémentaire 1.
2. Identification des gènes différentiellement exprimés dans la FC au cours de la RC
Une analyse de corrélation de Pearson a été réalisée en utilisant des seuils de |r| > 0,5 et P < 0,05 afin d'identifier les gènes liés à la ferroptose (FRGs) et les gènes liés au cuproptose (CRGs) coexprimés. L'ensemble génique obtenu a été croisé avec les gènes différentiellement exprimés (DEGs) afin d'identifier les gènes différentiellement exprimés coexprimés impliqués dans le cuproptose–ferroptose (CF-DEGs).
3. Analyse d'enrichissement
Des analyses d'enrichissement de l'ontologie génique (GO) et de l'Encyclopédie de Kyoto des gènes et des génomes (KEGG) ont été réalisées à l'aide de clusterProfiler et de la plateforme Bioinformatics.com.cn. Un seuil de significativité défini par une valeur P ajustée selon Benjamini–Hochberg < 0,05 a été utilisé. Les graphiques d'enrichissement sont fournis dans la Figure supplémentaire 2.
4. Analyse de réseau de co-expression génique pondéré (WGCNA)
La structure modulaire sous-jacente aux profils d'expression génique a été analysée à l'aide de l'analyse de réseau de co-expression génique pondérée (WGCNA). Des échantillons anormaux ont été identifiés et exclus par regroupement hiérarchique combiné à la fonction goodSamplesGenes. Une puissance de seuil doux (β) appropriée a ensuite été déterminée afin de satisfaire le critère de topologie sans échelle pour la construction du réseau.
Les données d'expression traitées ont été utilisées pour construire une matrice de superposition topologique (TOM) destinée à l'analyse de la co-expression génique. À l'aide de l'approche de découpage dynamique de l'arbre, les gènes présentant des profils d'expression fortement cohérents ont été regroupés en modules géniques, chacun contenant au moins 100 gènes. Les associations entre les eigengènes des modules (ME) et les phénotypes ont été analysées afin d'identifier les modules liés au processus de la maladie et d'extraire les jeux de gènes correspondants. Les diagnostics de dépistage WGCNA sont fournis dans la figure supplémentaire 3.
5. Sélection des biomarqueurs
Pour hiérarchiser les candidats en vue d'un suivi expérimental, trois algorithmes d'apprentissage automatique ont été appliqués en parallèle¹⁵. Une régression par l'opérateur de sélection et de réduction absolue (LASSO) a été utilisée pour la sélection des caractéristiques, une forêt aléatoire avec ntree = 500 a permis de classer l'importance des gènes, et une machine à vecteurs de support avec élimination récursive des caractéristiques (SVM-RFE) a été employée pour identifier le sous-ensemble de caractéristiques présentant l'erreur de validation croisée la plus faible. Le diagnostic complet du criblage est fourni dans la figure supplémentaire 5.
L'importance des gènes a été évaluée en fonction de la contribution de chaque gène à la précision de la classification, et les gènes les mieux classés ont été regroupés afin de constituer un ensemble préliminaire de gènes¹⁶. L'algorithme SVM-RFE a effectué un criblage des caractéristiques et une optimisation du modèle par élimination itérative des caractéristiques, permettant ainsi d'identifier le sous-ensemble optimal de caractéristiques pour la classification¹⁷. Les gènes communs aux trois algorithmes ont été considérés comme des biomarqueurs candidats identifiés par apprentissage automatique.
Les gènes différentiellement exprimés associés à la CF ont été utilisés pour construire un réseau d'interactions protéine–protéine (PPI), et CytoHubba a permis de classer les nœuds centraux. L'intersection des modules clés de WGCNA, des trois sorties d'apprentissage automatique et de l'ensemble central du réseau PPI a permis d'identifier cinq biomarqueurs candidats intégrés : LCN2, IDO1, CXCL2, NOS2 et CD274. Ces gènes ont été classés comme des candidats diagnostiques associés à la colite ulcéreuse. Des expériences ultérieures avec des inhibiteurs ont ensuite classé LCN2, IDO1, CXCL2 et NOS2 comme des marqueurs sensibles à l'inhibition de la ferroptose, et CD274 comme un marqueur sensible à l'inhibition de la cuproptose. Ces gènes n'ont pas été considérés comme des régulateurs en amont prouvés de l'une ou l'autre voie.
6. Développement du modèle prédictif et évaluation multiméthode
Afin d'évaluer le potentiel clinique de translation de la signature génique identifiée, un nomogramme a été construit à l'aide du package rms pour évaluer la performance diagnostique. La performance du modèle a été évaluée à l'aide d'une courbe de calibration, du test de Hosmer–Lemeshow (HL) et de l'indice de concordance de Harrell (C-index).
L'étalonnage du modèle a été évalué à l'aide du test de Hosmer-Lemeshow (HL) et de l'erreur absolue moyenne (MAE). Une valeur P > 0,05 et une MAE < 0,1 ont été établies comme seuils pour un ajustement et une précision du modèle acceptables, respectivement. Des courbes caractéristiques de fonctionnement du récepteur (ROC) ont été générées, et l'aire sous la courbe (AUC) a été calculée afin d'évaluer les performances prédictives du nomogramme pour la CU. Un jeu de données indépendant a été utilisé pour évaluer la généralisabilité et la stabilité du modèle.
7. Analyse d'enrichissement de l'ensemble de gènes (GSEA)
Dans le jeu d'apprentissage, une analyse de corrélation de Spearman a été réalisée entre chaque biomarqueur et tous les autres gènes. Les résultats de corrélation ont été classés afin de générer un ensemble de gènes ordonné. Une analyse d'enrichissement des ensembles de gènes (GSEA) a été effectuée en utilisant l'ensemble de gènes c2.cp.kegg_medicus.v2025.1.Hs.symbols de la base de données Molecular Signatures Database (MSigDB) comme référence. Les voies biologiques ayant une valeur P < 0,05 ont été considérées comme significativement enrichies.
8. Analyse du paysage immunitaire
L'outil CIBERSORT et la matrice de signature LM22 ont été utilisés pour effectuer une analyse de déconvolution des données d'expression et estimer les proportions des 22 sous-types de cellules immunitaires. Une analyse de corrélation de Spearman a ensuite été réalisée pour évaluer les associations entre les cinq biomarqueurs et les sous-types de cellules immunitaires.
9. Analyse du réseau régulatoire
Les informations relatives à la régulation des gènes par les facteurs de transcription (TF) et les microARN (miARN) ont été obtenues à partir des bases de données intégrées ChEA3 et TarBase 9.0 via la plateforme NetworkAnalyst. Les miARN associés à au moins deux nœuds ont été inclus dans le réseau régulateur.
10. Séquençage ARN unicellulaire
Les jeux de données unicellulaires de la maladie de Crohn GSE116222, comprenant trois échantillons sains et trois échantillons atteints de la maladie de Crohn, et GSE214695, comprenant six échantillons sains et six échantillons atteints de la maladie de Crohn, ont été intégrés. Les cellules ont été conservées si elles contenaient entre 200 et 5 000 gènes détectés, >1 000 identifiants moléculaires uniques, < 30 % des transcrits mitochondriaux, < 3 % de transcrits d'hémoglobine, et < 50 % des transcrits ribosomaux. La fonction NormalizeData a été utilisée pour la normalisation, et Harmony a été utilisée pour la correction par lot avant le regroupement et l'annotation.
Après filtration, les données ont été normalisées à l'aide de la fonction NormalizeData. Harmony a été utilisée pour minimiser les effets de lot entre les échantillons. L'approximation uniforme des variétés et la projection (UMAP) ainsi que l'embedding stochastique t-distribué des voisins les plus proches (t-SNE) ont été utilisées pour la réduction de dimensionnalité et le regroupement cellulaire afin de caractériser les structures locales et globales au sein de la population cellulaire. Un total de 31 712 cellules de haute qualité a été conservé pour des analyses supplémentaires. Les types cellulaires ont été annotés selon les gènes marqueurs canoniques des cellules.
Une analyse de pseudotemporel a été réalisée à l'aide de Monocle 2 afin d'étudier les changements dans les états des cellules épithéliales et myéloïdes provenant de tissus atteints de rectocolite ulcéreuse. Les trajectoires développementales cellulaires et les différences entre groupes ont été évaluées, et les profils d'expression des biomarqueurs le long de la trajectoire pseudotemporelle ont été visualisés.
CellChat a été utilisé pour évaluer la communication cellule-cellule entre les sous-populations épithéliales et myéloïdes. Les profils d'expression spécifiques aux sous-populations ont été intégrés afin d'inférer les probabilités d'interaction et les principales voies de signalisation entre les cellules épithéliales et myéloïdes, et de caractériser leurs réseaux régulateurs intercellulaires potentiels.
11. Expériences sur les cellules
Les cellules humaines de carcinome colorectal Caco-2 ont été cultivées dans un milieu de Dulbecco modifié (Eagle) contenant 10 % de sérum bovin fœtal, 100 U/mL de pénicilline et 100 µg/mL de streptomycine, à 37 °C en atmosphère à 5 % de CO₂. Les cellules Caco-2 ont été choisies comme modèle reproductible de monolame épithéliale pour les tests de barrière intestinale et de lésion inflammatoire ; toutefois, leur origine cancéreuse limite l’extrapolation directe à l’épithélium colique non cancéreux. Les informations concernant les passages cellulaires n’étaient pas disponibles dans les dossiers expérimentaux archivés.
Un modèle in vitro d'inflammation-lésion a été établi en exposant les cellules à 1 µg/mL de lipopolysaccharide (LPS) pendant 24 h. Les cellules ont été réparties entre un groupe témoin recevant le véhicule diméthylsulfoxyde, un groupe LPS seul, un groupe LPS + 4 µM de ferrostatine-1 ou un groupe LPS + 40 µM de tétrathiomolybdate, avec des concentrations finales de solvant appariées. Le groupe LPS seul a servi de témoin positif de lésion/modèle pour les comparaisons de récupération par inhibition.
- Viabilité cellulaire
La viabilité cellulaire a été évaluée à l’aide d’un test de viabilité cellulaire conformément aux instructions du fabricant. Après une incubation à 37 °C pendant environ 2 h, l’absorbance à 450 nm a été mesurée à l’aide d’un lecteur de microplaques. - Mesure des niveaux de MDA et de Fe²⁺
Les niveaux intracellulaires de malondialdéhyde (MDA) et de Fe2⁺ ont été mesurés à l’aide des kits d’analyse correspondants, conformément aux instructions des fabricants. La quantité totale de protéines a été déterminée par un dosage à l’acide bichinconinique, et chaque résultat a été normalisé par rapport à la teneur en protéines de l’échantillon correspondant. - Dosage au moyen d’une sonde fluorescente spécifique des ions cuivre
Après élimination du milieu de culture, une sonde fluorescente spécifique du Cu2⁺ a été ajoutée à une concentration finale de 1 µM et incubée pendant 30 min à 37 °C. Les images ont été acquises immédiatement sans lavage à l’aide d’un microscope à fluorescence inversé, avec des longueurs d’onde d’excitation et d’émission de 510 et 578 nm, respectivement. Les paramètres d’acquisition ont été maintenus constants entre les groupes, et l’échelle de la barre de mesure des images a été calibrée à 50 µm. - RT-qPCR
L’ARN total a été isolé à l’aide d’un réactif d’extraction d’ARN à base de phénol–guanidinium. L’ADN complémentaire a été synthétisé à partir de 1 µg d’ARN à l’aide d’un kit de synthèse du brin complémentaire, et des réactifs basés sur le vert SYBR ont été utilisés pour la PCR en temps réel. Chaque réaction a été réalisée en triple exemplaire technique. Les séquences des amorces sont indiquées dans le Tableau 2 supplémentaire, et l’abondance relative des ARN messagers a été calculée selon la méthode 2⁻ΔΔCt.
12. Analyse statistique
La normalité et l'homogénéité des variances ont été évaluées à l'aide des tests de Shapiro–Wilk et de Levene centré sur la médiane, respectivement. Les données satisfaisant aux deux hypothèses ont été analysées à l'aide d'un test t non apparié bilatéral ou d'une analyse de la variance à un facteur suivie du test de différence honnêtement significative de Tukey. Lorsqu'une des hypothèses n'était pas respectée, le test t de Welch ou l'analyse de la variance de Welch suivie de comparaisons de Games–Howell a été utilisé.
Les résultats sont présentés sous forme de moyenne ± écart type. Les nombres réels de réplicats biologiques, les valeurs P exactes bilatérales et les vérifications des hypothèses sont indiqués dans le Tableau supplémentaire 3. La feuille source archivée de la Figure 13 contient moins de réplicats témoins pour les panneaux A (n = 4), C (n = 4) et F (n = 2), tandis que toutes les autres combinaisons de panneaux/groupes contiennent n = 6.
Les analyses computationnelles ont été réalisées à l'aide de R et des pipelines limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC, rms, Seurat v4, Harmony, Monocle 2, CellChat, et Cytoscape/CytoHubba. Les ressources en ligne comprenaient FerrDB, GEO, STRING, ChEA3, TarBase 9.0, NetworkAnalyst, CIBERSORT/LM22, MSigDB, Bioinformatics.com.cn et Sangerbox 3.0.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Identification et annotation fonctionnelle des gènes coexprimés dans la cuproptose et la ferroptose
Quatre jeux de données d'entraînement comprenant 421 échantillons de CU et 97 contrôles sains ont été intégrés. Un total de 551 gènes différentiellement exprimés, dont 362 surexprimés et 189 sous-exprimés, ont été identifiés. L'analyse de corrélation a révélé 444 gènes corrélés à la ferroptose et à la cuproptose, et l'intersection avec les gènes différentiellement exprimés a pro...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Cette étude a combiné des analyses transcriptomiques globales, l'apprentissage automatique, des analyses unicellulaires et des expériences ciblées sur des cellules afin d'examiner les interactions entre la ferroptose et la cuproptose dans la rectocolite ulcéreuse (UC). Cinq candidats diagnostiques associés à l'UC se sont révélés reproductibles dans les cohortes de découverte et de validation, étaient principalement localisés dans les compartiments épithélial et myéloïde, et présentaient une expression sensible à l'inhibi...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n'ont rien à divulguer.
Remerciements
Ce travail a été soutenu par le projet Young Qihuang Scholar de l'Administration nationale de la médecine traditionnelle chinoise (subvention no 2022256). Nous remercions tous les membres des équipes de recherche de l'Université de médecine traditionnelle chinoise du Liaoning et du Troisième hôpital affilié de l'Université de médecine traditionnelle chinoise du Liaoning pour leur soutien technique ainsi que pour leurs contributions à la gestion des données et à l'analyse bioinformatique.
OpenAI Codex (OpenAI) a été utilisé lors de la révision uniquement pour aider à la correction en anglais, au formatage du document et à la vérification de la qualité des figures. Tout le contenu scientifique, les analyses, les citations et la présentation finale ont été examinés et vérifiés par les auteurs, qui assument l'entière responsabilité du manuscrit.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Kits d'analyse des protéines BCA | Institut de biotechnologie Beyotime | P0010 | Quantification des protéines pour la normalisation. |
| Bioinformatics.com.cn | Bioinformatics.com.cn | Plateforme en ligne ; consultée en 2026 | Plateforme de visualisation et d'analyse GO/KEGG. |
| Ligne cellulaire Caco-2 | ATCC | HTB-37 | Ligne cellulaire d'adénocarcinome colorectal humain utilisée pour le modèle de lésion épithéliale. |
| Kits Cell Counting Kit-8 | GLPBio | GK10001 | Dosage de viabilité cellulaire mesuré à 450 nm. |
| CIBERSORT avec signature LM22 | Développeurs de CIBERSORT | LM22 | Déconvolution de 22 fractions de cellules immunitaires. |
| ChEA3 | Laboratoire Ma'ayan | Plateforme en ligne ; consultée en 2026 | Enrichissement des facteurs de transcription et prédiction de réseaux régulateurs. |
| Incubateur CO2 | Non enregistré | N/A | Incubateur humidifié utilisé pour la culture à 37 °C et 5 % de CO2. |
| Sonde fluorescente Cu2+ | BIOFOUNT | CAS 98907-26-7 | Détection de fluorescence intracellulaire du Cu2+ . |
| Cytoscape avec CytoHubba | Consortium Cytoscape | Version non enregistrée | Visualisation des interactions protéine-protéine et classement des nœuds centraux. |
| Milieu de culture Eagle modifié de Dulbecco | Gibco | 11965092 | Milieu de culture des cellules Caco-2. |
| Diméthylsulfoxyde | Non enregistré | N/A | Témoin véhicule. |
| Sérum de veau fœtal | Non enregistré | N/A | Supplément du milieu à 10 %. |
| Kits d'analyse du Fe2+ | Abcam | ab83366 | Mesure du Fe2+ intracellulaire. |
| FerrDB | Développeurs de FerrDB | Base de données en ligne ; consultée en 2026 | Source de gènes liés à la ferroptose. |
| Ferrostatine-1 | Sigma-Aldrich | SML0583 | Inhibiteur de la ferroptose ; concentration finale de 4 µM. |
| Harmony | Institut Broad/communauté | Version non enregistrée | Correction par lots pour les données unicellulaires. |
| Microscope à fluorescence inversé | Olympus | IX71 | Imagerie de fluorescence du Cu2+ avec excitation/émission à 510/578 nm. |
| Lipopolysaccharide | Non enregistré | N/A | Stimulus de lésion inflammatoire à 1 µg/mL pendant 24 h. |
| Kits d'analyse du malondialdéhyde | Institut de biotechnologie Beyotime | S0131S | Mesure de la peroxydation lipidique. |
| Lecteur de microplaques | Non enregistré | N/A | Mesure de l'absorbance à 450 nm. |
| Monocle | Bioconductor/communauté | Version 2 | Analyse de pseudotemps unicellulaire. |
| Base de données Molecular Signatures Database | Institut Broad | c2.cp.kegg_medicus.v2025.1.Hs | Jeu de gènes de référence pour l'analyse GSEA. |
| NetworkAnalyst | Développeurs de NetworkAnalyst | Plateforme en ligne ; consultée en 2026 | Intégration des réseaux de facteurs de transcription et de miARN. |
| Pénicilline–streptomycine | Non enregistré | N/A | 100 U/mL de pénicilline et 100 µg/mL de streptomycine. |
| R | Fondation R pour l'informatique statistique | Version non enregistrée | Environnement d'analyse bioinformatique. |
| Ensemble de packages R | CRAN/Bioconductor | Builds des packages non enregistrés | Flux de travail avec limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC et rms. |
| Système de PCR en temps réel | Non enregistré | N/A | Appareil de RT-PCR en temps réel utilisant le SYBR Green. |
| Kits de synthèse d'ADN complémentaire de premier brin RevertAid | Thermo Fisher Scientific | K1622 | Synthèse d'ADN complémentaire de premier brin à partir de 1 µg d'ARN. |
| Sangerbox | Développeurs de Sangerbox | 3.0 | Normalisation et correction par lots avec ComBat. |
| Seurat | Laboratoire Satija/communauté | Version 4 | Contrôle qualité, normalisation, regroupement et visualisation des données unicellulaires. |
| Logiciel d'analyse statistique | Non enregistré | N/A | Analyse statistique des expériences cellulaires initiales. |
| STRING | Consortium STRING | Base de données en ligne ; consultée en 2026 | Construction de réseaux d'interactions protéine–protéine. |
| Réactifs de PCR en temps réel au SYBR Green | Takara | RR820A | PCR quantitative en temps réel. |
| TarBase | Outils DIANA | 9.0 | Interactions miARN–gène validées expérimentalement. |
| Tétrathiomolybdate | Sigma-Aldrich | 323446 | Chélateur du cuivre ; concentration finale de 40 µM. |
| Réactif TRIzol | Takara | 9108 | Extraction d'ARN total. |
Références
- Fu M, Wang QW, Liu YR, Chen SJ. The role of the three major intestinal barriers in ulcerative colitis in the elderly. Ageing Res Rev. 2025;108:102752. https://doi.org/10.1016/j.arr.2025.102752.
- Le Berre C, Honap S, Peyrin-Biroulet L. Ulcerative colitis. Lancet. 2023;402:571–584.
- Wangchuk P, Yeshi K, Loukas A. Ulcerative colitis: Clinical biomarkers, therapeutic targets, and emerging treatments. Trends Pharmacol Sci. 2024;45:892–903.
- Kobayashi T, et al. Ulcerative colitis (primer). Nat Rev Dis Primers. 2020;6:74. https://doi.org/10.1038/s41572-020-0205-x.
- Huang J, et al. Comprehensive analysis of cuproptosis-related genes in immune infiltration and diagnosis in ulcerative colitis. Front Immunol. 2022;13:1008146. https://doi.org/10.3389/fimmu.2022.1008146.
- Liu Y, et al. Development and experimental validation of machine learning-based disulfidptosis-related ferroptosis biomarkers in inflammatory bowel disease. Genes. 2025;16:496. https://doi.org/10.3390/genes16050496.
- Hu W, et al. HIF-1α alleviates ferroptosis in ulcerative colitis by regulation of GPX4. Cell Death Dis. 2025;16:542. https://doi.org/10.1038/s41419-025-07883-8.
- Zhao C, et al. FXR acts as a therapeutic target for ulcerative colitis via suppressing ferroptosis. Mol Med. 2025;31:258. https://doi.org/10.1186/s10020-025-01305-3.
- Tsvetkov P, et al. Copper induces cell death by targeting lipoylated TCA cycle proteins. Science. 2022;375:1254–1261.
- Liu J, et al. Unveiling the cuproptosis in colitis and colitis-related carcinogenesis: A multifaceted player and immune moderator. Research (Wash D C). 2025;8:0698. https://doi.org/10.34133/research.0698.
- Liu N, Chen M. Crosstalk between ferroptosis and cuproptosis: From mechanism to potential clinical application. Biomed Pharmacother. 2024;171:116115. https://doi.org/10.1016/j.biopha.2023.116115.
- Hao S, et al. Development of prognostic model incorporating a ferroptosis/cuproptosis-related signature and mutational landscape analysis in muscle-invasive bladder cancer. BMC Cancer. 2024;24:958. https://doi.org/10.1186/s12885-024-12716-1.
- Wang Z, et al. Exosomes secreted by macrophages upon copper ion stimulation can promote angiogenesis. Mater Sci Eng C Mater Biol Appl. 2021;123:111981. https://doi.org/10.1016/j.msec.2021.111981.
- Zou M, Zhang W, Zhu Y, Xu Y. Identification of 6 cuproptosis-related genes for active ulcerative colitis with both diagnostic and therapeutic values. Medicine (Baltimore). 2023;102:e35503. https://doi.org/10.1097/MD.0000000000035503.
- Chen W, Miao J, Chen J, Chen J. Development of machine learning models for diagnostic biomarker identification and immune cell infiltration analysis in PCOS. J Ovarian Res. 2025;18:1. https://doi.org/10.1186/s13048-024-01582-8.
- Lv JH, et al. WGCNA combined with machine learning to find potential biomarkers of liver cancer. Medicine (Baltimore). 2023;102:e36536. https://doi.org/10.1097/MD.0000000000036536.
- Wu Q, Yang C, Huang C, Lin Z. Screening key genes for intracranial aneurysm rupture using LASSO regression and the SVM-RFE algorithm. Front Med. 2025;11:1487224. https://doi.org/10.3389/fmed.2024.1487224.
- Tang D, Pu B, Liu S, Li H. Identification of cuproptosis-associated subtypes and signature genes for diagnosis and risk prediction of ulcerative colitis based on machine learning. Front Immunol. 2023;14:1142215. https://doi.org/10.3389/fimmu.2023.1142215.
- Yang C, et al. Identification of cuproptosis hub genes contributing to the immune microenvironment in ulcerative colitis using bioinformatic analysis and experimental verification. Front Immunol. 2023;14:1113385. https://doi.org/10.3389/fimmu.2023.1113385.
- Yadav SK, et al. Fecal Lcn-2 level is a sensitive biological indicator for gut dysbiosis and intestinal inflammation in multiple sclerosis. Front Immunol. 2022;13:1015372. https://doi.org/10.3389/fimmu.2022.1015372.
- Luo Q, et al. Bioinformatics analysis reveals potential crosstalk genes and molecular mechanisms between ulcerative colitis and psoriasis. Arch Dermatol Res. 2024;317:118. https://doi.org/10.1007/s00403-024-02856-1.
- Nielsen OH, et al. Rectal dialysate and fecal concentrations of neutrophil gelatinase-associated lipocalin, interleukin-8, and tumor necrosis factor-alpha in ulcerative colitis. Am J Gastroenterol. 1999;94:2923–2928.
- Sun Y, et al. Natural polyphenol rutin inhibits ferroptosis in ulcerative colitis by regulating lipid metabolism via blocking the LCN2-ALOX15 axis. Food Funct. 2025;16:7169–7186.
- Sofia MA, et al. Tryptophan metabolism through the kynurenine pathway is associated with endoscopic inflammation in ulcerative colitis. Inflamm Bowel Dis. 2018;24:1471–1480.
- Shon WJ, et al. Severity of DSS-induced colitis is reduced in Ido1-deficient mice with down-regulation of TLR-MyD88-NF-kB transcriptional networks. Sci Rep. 2015;5:17305. https://doi.org/10.1038/srep17305.
- Zeng T, et al. Indoleamine 2, 3-dioxygenase 1 enhances hepatocytes ferroptosis in acute immune hepatitis associated with excess nitrative stress. Free Radic Biol Med. 2020;152:668–679.
- Pavlidis P, et al. Interleukin-22 regulates neutrophil recruitment in ulcerative colitis and is associated with resistance to ustekinumab therapy. Nat Commun. 2022;13:5820. https://doi.org/10.1038/s41467-022-33333-3.
- Urzua U, et al. The ovarian transcriptome of reproductively aged multiparous mice: Candidate genes for ovarian cancer protection. Biomolecules. 2020;10:113. https://doi.org/10.3390/biom10010113.
- Zahn A, et al. Transcript levels of different cytokines and chemokines correlate with clinical and endoscopic activity in ulcerative colitis. BMC Gastroenterol. 2009;9:13. https://doi.org/10.1186/1471-230X-9-13.
- Yi Q, et al. Application of genomic selection and experimental techniques to predict cell death and immunotherapeutic efficacy of ferroptosis-related CXCL2 in hepatocellular carcinoma. Front Oncol. 2022;12:998736. https://doi.org/10.3389/fonc.2022.998736.
- Kolios G, Valatas V, Ward SG. Nitric oxide in inflammatory bowel disease: A universal messenger in an unsolved puzzle. Immunology. 2004;113:427–437.
- Cheng F, et al. Identification of differential intestinal mucosa transcriptomic biomarkers for ulcerative colitis by bioinformatics analysis. Dis Markers. 2020;2020:8876565. https://doi.org/10.1155/2020/8876565.
- Tratensek A, et al. Oxidative stress-related biomarkers as promising indicators of inflammatory bowel disease activity: A systematic review and meta-analysis. Redox Biol. 2024;77:103380. https://doi.org/10.1016/j.redox.2024.103380.
- Zhang JL, et al. Jatrorrhizine alleviates ulcerative colitis via regulating gut microbiota and NOS2 expression. Gut Pathog. 2022;14:41. https://doi.org/10.1186/s13099-022-00516-7.
- Li H, et al. Development of a prognostic model based on ferroptosis-related genes for colorectal cancer patients and exploration of the biological functions of NOS2 in vivo and in vitro. Front Oncol. 2023;13:1133946. https://doi.org/10.3389/fonc.2023.1133946.
- Seibt TM, Proneth B, Conrad M. Role of GPX4 in ferroptosis and its pharmacological implication. Free Radic Biol Med. 2019;133:144–152.
- Holland T, Mattner J. Intestinal eosinophils: Characterization of elusive granulocytes as anti-bacterial and immunomodulatory effector cells in colitis. Signal Transduct Target Ther. 2023;8:321. https://doi.org/10.1038/s41392-023-01588-4.
- Nguyen J, et al. Overexpression of programmed death ligand 1 in refractory inflammatory bowel disease. Hum Pathol. 2022;126:19–27.
- Shen Z, et al. Exploration of a screening model for intrahepatic cholangiocarcinoma patients prone to cuproptosis and mechanisms of the susceptibility of CD274-knockdown intrahepatic cholangiocarcinoma cells to cuproptosis. Cancer Gene Ther. 2023;30:1663–1678.
- Niu Y, et al. Platelet activation stimulates macrophages to enhance ulcerative colitis through PF4/CXCR3 signaling. Int J Mol Med. 2025;55:78. https://doi.org/10.3892/ijmm.2025.5499.
- Qu F, et al. The role of macrophage polarization in ulcerative colitis and its treatment. Microb Pathog. 2025;199:107227. https://doi.org/10.1016/j.micpath.2025.107227.
- Danne C, Skerniskyte J, Marteyn B, Sokol H. Neutrophils: From IBD to the gut microbiota. Nat Rev Gastroenterol Hepatol. 2024;21:184–197.
- Zhao Q, et al. CD4+ T cell activation and concomitant mTOR metabolic inhibition can ablate microbiota-specific memory cells and prevent colitis. Sci Immunol. 2020;5:eabc6373. https://doi.org/10.1126/sciimmunol.abc6373.
- Chen E, et al. Inflamed ulcerative colitis regions associated with MRGPRX2-mediated mast cell degranulation and cell activation modules, defining a new therapeutic target. Gastroenterology. 2021;160:1709–1724.
- Xu H, Wu C, Wang D, Wang H. Alleviating effect of Nexrutine on mucosal inflammation in mice with ulcerative colitis: Involvement of the RELA suppression. Immun Inflamm Dis. 2024;12:e1147. https://doi.org/10.1002/iid3.1147.
- Luo Y, et al. Rab27A promotes cellular apoptosis and ROS production by regulating the miRNA-124-3p/STAT3/RelA signalling pathway in ulcerative colitis. J Cell Mol Med. 2020;24:11330–11342.
- Pace F, Watnick PI. The interplay of sex steroids, the immune response, and the intestinal microbiota. Trends Microbiol. 2021;29:849–859.
- Rodriguez J, Olivares M, Delzenne NM. Implication of the gut microbiota in metabolic inflammation associated with nutritional disorders and obesity. Mol Nutr Food Res. 2021;65:e1900481. https://doi.org/10.1002/mnfr.201900481.
- Ojha R, et al. Emerging role of circulating microRNA in the diagnosis of human infectious diseases. J Cell Physiol. 2019;234:1030–1043.
- Tian Y, et al. LncRNA CDKN2B-AS1 relieved inflammation of ulcerative colitis via sponging miR-16 and miR-195. Int Immunopharmacol. 2020;88:106970. https://doi.org/10.1016/j.intimp.2020.106970.
- Kulkarni N, Pathak M, Lal G. Role of chemokine receptors and intestinal epithelial cells in the mucosal inflammation and tolerance. J Leukoc Biol. 2017;101:377–394.
- Stadnyk AW. Intestinal epithelial cells as a source of inflammatory cytokines and chemokines. Can J Gastroenterol. 2002;16:241–246.
- Xu Y, Chen N. DUOX2-mediated innate immune hyperactivation drives macrophage M1 polarization via the APP-CD74 axis in inflammatory bowel disease. Presented at: 19th Congress of the European Crohn’s and Colitis Organisation (ECCO 2026); Stockholm, Sweden; 2026. https://academic.oup.com/ecco-jcc/article/20/Supplement_1/jjaf231.232/8432779.
- Shi CL, et al. Single-nucleus transcriptome unveils the role of ferroptosis in ischemic stroke. Heliyon. 2024;10:e32727. https://doi.org/10.1016/j.heliyon.2024.e32727.
- Tu H, et al. Integrated single-cell analysis with experimental validation reveals ANXA2 as a therapeutic target for ferroptosis in inflammatory bowel disease. Am J Transl Res. 2026;18:91–111.
- Yan C, et al. Exploring the anti-ferroptosis mechanism of Kai-Xin-San against Alzheimer's disease through integrating network pharmacology, bioinformatics, and experimental validation strategy in vivo and in vitro. J Ethnopharmacol. 2024;326:117915. https://doi.org/10.1016/j.jep.2024.117915.
- Shaik JP, Ahmad A. Pharmacological mechanism of cinnamic acid in the treatment of prostate cancer by network pharmacology. Archives of Medical Reports. 2024;1(2):1–6. https://doi.org/10.26524/amr.2024.2.1.
- Nimmagadda S, Patel S, MR Vishwathika. Targeting ferroptosis: A novel therapeutic avenue in osteoarthritis and bone degeneration. Archives of Medical Reports. 2025;2(5):6–9. https://doi.org/10.26524/amr.2025.5.2.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.