La pharmacologie des réseaux et la modélisation moléculaire ont révélé que le Rhizoma Drynariae agit sur plusieurs cibles et voies pour soulager les lésions de la coiffe des rotateurs par des effets anti-inflammatoires, anti-apoptotiques et pro-angiogéniques.
Article de recherche
La pharmacologie en réseau et le docking moléculaire révèlent le mécanisme d'action du Rhizoma Drynariae contre les lésions de la coiffe des rotateurs
Dans cet article
Résumé
Résumé
La lésion de la coiffe des rotateurs (RCI) est un trouble musculosquelettique réfractaire caractérisé par une inflammation chronique, une apoptose des ténocytes, un angiogenèse altérée et une dysrégulation de la matrice extracellulaire (ECM), avec peu de traitements cliniques disponibles. Cette étude a utilisé la pharmacologie en réseau et le dockage moléculaire pour analyser systématiquement les composants actifs, les cibles principales et les voies de signalisation du Rhizoma Drynariae (RD) contre la RCI. Dix-huit ingrédients actifs du RD et 213 cibles non redondantes ont été identifiés dans les bases TCMSP, ETCM et SymMap, tandis que 870 cibles associées à la RCI ont été extraites des bases GeneCards et OMIM, permettant d'obtenir 71 cibles candidates communes. L'analyse du réseau d'interactions protéine-protéine et le criblage par cytoHubba ont révélé dix gènes centraux, notamment TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3 et HMOX1. L'enrichissement en termes de Gene Ontology a mis en évidence la réponse inflammatoire, le stress oxydatif, l'angiogenèse, la prolifération cellulaire et l'organisation de la matrice extracellulaire, tandis que l'analyse des voies KEGG a impliqué les voies de signalisation TNF, PI3K-Akt, MAPK et HIF-1. Le dockage moléculaire a confirmé une liaison stable et à haute affinité de l'ériodictyol, de la lutéoline, de la catéchine, de la naringénine et de l'aureusidine avec ces protéines centrales. Dans leur ensemble, le RD exerce des effets anti-RCI via un réseau multi-composants, multi-cibles et multi-voies, pouvant atténuer la RCI en supprimant l'inflammation et l'apoptose, en favorisant l'angiogenèse et en améliorant la réparation de la matrice extracellulaire, fournissant ainsi une base théorique pour son application clinique et sa validation expérimentale.
Introduction
La lésion de la coiffe des rotateurs (LCR) est l'un des troubles de l'épaule les plus fréquents en orthopédie et en médecine du sport, touchant environ 20 % des adultes de plus de 20 ans et jusqu'à 54 % de ceux de plus de 60 ans1,2. La LCR se caractérise pathologiquement par une dégénérescence du tendon, une infiltration de cellules inflammatoires, un excès d'apoptose des ténocytes, une néovascularisation insuffisante et une synthèse désordonnée de la matrice extracellulaire, entraînant des douleurs chroniques de l'épaule, une mobilité limitée, une atrophie musculaire et même une instabilité articulaire3. Si elle n'est pas traitée, la LCR peut gravement réduire la qualité de vie et imposer un fardeau socio-économique important4. Les stratégies thérapeutiques actuelles pour la LCR comprennent le traitement conservateur et la réparation chirurgicale5. Les anti-inflammatoires non stéroïdiens (AINS) et les injections de corticostéroïdes soulagent la douleur, mais comportent des risques de lésions gastro-intestinales, de dysfonctionnement rénal, de dégénérescence du cartilage et d'ostéoporose6,7. La réparation chirurgicale améliore la fonction à court terme, mais est limitée par des taux élevés de rupture récidivante, des adhérences postopératoires et une qualité médiocre de cicatrisation à long terme8,9. Par conséquent, le développement de traitements sûrs, efficaces et agissant sur plusieurs cibles pour la LCR est urgent.
La médecine traditionnelle chinoise (MTC) possède une longue histoire dans le traitement des maladies musculosquelettiques, offrant des avantages tels qu'une composition multi-constituants, une action multi-cibles et une faible toxicité10. Rhizoma Drynariae (RD), le rhizome séché de Drynaria fortunei (Kunze) J. Sm., est une plante médicinale emblématique pour le renforcement osseux, favorisant la circulation sanguine, éliminant les stagnations sanguines et accélérant la réparation des tendons et des os11,12. La pharmacologie moderne a confirmé que les flavonoïdes constituent les principes actifs principaux du RD, exerçant des effets anti-inflammatoires, antioxydants, ostéogéniques et chondroprotecteurs13. Le RD est largement utilisé dans le traitement de l'ostéoporose, de l'arthrose, de la nécrose de la tête fémorale et de la dégénérescence des disques intervertébraux14,15,16. Toutefois, aucune étude systématique n’a encore exploré l'efficacité et le mécanisme d'action du RD contre les lésions coronariennes ischémiques (RCI). La pharmacologie en réseau est une approche interdisciplinaire émergente qui intègre la bio-informatique, la biologie des systèmes et la pharmacologie, particulièrement adaptée à l'élucidation du mécanisme global de la MTC17,18. Elle permet la construction systématique d’un réseau régulateur « médicament–composant–cible–voie–maladie » ainsi que la prédiction à haut débit de cibles thérapeutiques potentielles19. Dans cette étude, la pharmacologie en réseau combinée au dockage moléculaire a été utilisée afin d'identifier les composants actifs, les gènes centraux et les voies de signalisation clés du RD dans le traitement des RCI, dans le but de fournir une base théorique pour son application clinique et pour des recherches expérimentales ultérieures.
Protocole
Cette étude a utilisé uniquement des bases de données bioinformatiques publiques anonymisées et n'a pas impliqué d'expériences sur des êtres humains ou des animaux. Conformément à l'article 32 des règlements nationaux chinois sur l'examen éthique et à la Déclaration d'Helsinki, l'approbation éthique et le consentement éclairé ont été dispensés. Tous les matériaux utilisés dans cette étude sont répertoriés dans le Tableau des matériaux.
Conception de l'étude et schéma du flux opérationnel
L'ensemble du flux de travail de cette étude de pharmacologie en réseau, incluant le criblage des ingrédients, l'acquisition des cibles, la construction du réseau, l'analyse d'enrichissement et la vérification par docking moléculaire, a été réalisé en suivant des normes bioinformatiques unifiées à chaque étape afin d'assurer la reproductibilité de toutes les données prédites (Figure 1).
Recherche d'ingrédients actifs dans le RD
La base de données et plateforme d'analyse en pharmacologie systémique de la médecine traditionnelle chinoise (TCMSP, https://old.tcmsp-e.com/tcmsp.php) était une plateforme en ligne conçue selon les principes de la pharmacologie systémique des plantes médicinales20. Elle a recensé de manière exhaustive les paramètres pharmacocinétiques des composés naturels, notamment la biodisponibilité orale (OB), la similitude aux médicaments (DL), la barrière hémato-encéphalique ainsi que les informations cibles correspondantes. Les auteurs ont saisi le mot-clé « Rhizoma Drynariae » afin de rechercher tous les ingrédients chimiques de RD stockés dans la base de données TCMSP, puis ont sélectionné les ingrédients actifs pertinents selon les indices d'absorption, de distribution, de métabolisme et d'élimination (ADME), avec une valeur d'OB ≥ 30 % et une valeur de DL ≥ 0,18. Les composés répondant à ces deux critères ont été conservés comme ingrédients actifs candidats pour explorer le mécanisme thérapeutique de RD contre l'IRC. Date d'accès à la base de données : TCMSP V2.3 [2025-12-08]. Les champs exportés comprenaient le nom du composé, la valeur d'OB, la valeur de DL et les entrées des protéines cibles correspondantes. Les doublons d'ingrédients composés ont été supprimés manuellement.
Recueil des cibles potentielles de RD
Les chercheurs ont extrait les cibles d'action de la RD à partir de trois bases de données indépendantes : TCMSP, l'Encyclopédie de la médecine traditionnelle chinoise (ETCM, http://www.tcmip.cn/ETCM/)21 et SymMap (http://www.symmap.org/)22. TCMSP a servi de plateforme spécialisée en pharmacologie systémique des plantes médicinales, enregistrant les interrelations entre les médicaments à base de plantes, les composés de petite taille, les cibles protéiques et les maladies humaines. ETCM a intégré des informations normalisées sur les herbes médicinales chinoises courantes et leurs formules, en recensant les données relatives aux ingrédients végétaux, aux gènes cibles, aux voies métaboliques et aux maladies. SymMap a combiné les théories de la MTC et la médecine moderne à travers les mécanismes moléculaires et la cartographie des symptômes. Lors de l'extraction des cibles médicamenteuses, l'espèce a été uniformément définie comme Homo sapiens. Après obtention des séquences brutes des protéines cibles, la base de données UniProt (https://www.uniprot.org/)23 a converti toutes les entrées cibles en symboles génétiques normalisés et standardisés. Les gènes cibles en double ont été éliminés, et l'ensemble des cibles dédupliqué de la RD a été conservé pour une analyse croisée avec les cibles de la maladie. Dates d'accès aux bases de données : ETCM V2.0 [2025-12-10], SymMap V2.0 [2025-12-11], version d'UniProt [2025-12-12]. Les auteurs ont exporté les entrées brutes des protéines cibles depuis TCMSP, ETCM et SymMap. UniProt a été utilisée pour associer les identifiants protéiques aux symboles génétiques humains officiels (HUGO). Les doublons de cibles provenant de plusieurs bases de données ont été supprimés, ne conservant qu'un seul symbole génétique unique par cible.
Rechercher des cibles potentielles pour le RCI
Deux bases de données fiables ont été utilisées pour sélectionner les gènes humains associés à la lésion de la coiffe des rotateurs (RCI) à l’aide du mot-clé de recherche « rotator cuff injury ». GeneCards (https://www.genecards.org/) regroupe des données multi-omiques provenant de plus de 150 plateformes génétiques et fournit une annotation fonctionnelle des gènes24. L'Online Mendelian Inheritance in Man (OMIM, https://omim.org/) recense les maladies héréditaires humaines et révèle les corrélations entre les variations génétiques et les phénotypes cliniques25. Toutes les entrées géniques associées à la RCI, incluant les noms et identifiants des gènes, ont été extraites. Les données provenant des deux bases ont été fusionnées puis dédoublonnées afin d'obtenir un ensemble complet de gènes pathogènes destiné à l'analyse d'intersection de Venn. Dates d'accès aux bases de données : GeneCards [2025-12-15], OMIM [2025-12-21]. Terme de recherche : « rotator cuff injury ». Les champs exportés comprenaient les noms des gènes humains liés à la maladie et leurs identifiants génétiques. Les doublons d'entrées géniques entre les deux bases de données ont été supprimés après fusion. Le filtre d'espèce a été défini sur Homo sapiens.
Construction du réseau d'interactions protéine-protéine (PPI)
L'ensemble de données des gènes cibles de RD criblés et l'ensemble de données des gènes pathogènes RCI ont été téléchargés sur la plateforme en ligne Venny (https://bioinfogp.cnb.csic.es/tools/venny/) afin de générer un diagramme de Venn et d'identifier les gènes communs partagés. Les gènes en intersection ont été importés dans STRING v11.5 (https://cn.string-db.org/) pour la construction du réseau d'interactions protéine-protéine26. STRING a extrait des interactions protéiques vérifiées et prédites, couvrant plus de 24 millions de protéines provenant de plus de 5000 espèces. L'espèce sélectionnée était Homo sapiens, et le seuil de score de confiance a été fixé à 0,7 pour filtrer les paires d'interactions de faible crédibilité. Les fichiers d'interactions protéine-protéine exportés ont été importés dans Cytoscape 3.8.0 pour la visualisation et l'analyse topologique27. Venny 2.0 a été consulté le [2025-12-24] pour le calcul du diagramme de Venn. Date d'accès à STRING v11.5 : [2025-12-28]. Les auteurs ont exporté le tableau complet des interactions protéine-protéine au format TSV, incluant les identifiants des protéines, les symboles des gènes et les scores combinés de confiance des interactions.
Analyse des gènes centraux
Le plugin cytoHubba intégré à Cytoscape 3.8.0 a analysé les caractéristiques topologiques de chaque nœud du réseau. Les 10 principaux gènes centraux présentant les scores de centralité de la clique maximale (MCC) les plus élevés ont été sélectionnés. Le MCC est l'un des algorithmes de classement intégrés à cytoHubba ; des scores MCC plus élevés indiquent des positions topologiques plus critiques au sein du réseau d'interactions protéine-protéine (PPI). Ces gènes exercent des effets régulateurs centraux dans l'ensemble du réseau.
Analyse d'enrichissement des voies de l'Ontologie génique (GO) et de l'Encyclopédie de Kyoto des gènes et des génomes (KEGG)
Toutes les cibles thérapeutiques chevauchantes de RD contre RCI ont été importées dans le logiciel R x64 4.0.3, avec l'espèce définie comme Homo sapiens. Le package Bioconductor clusterProfiler a effectué les analyses d'enrichissement GO et KEGG. L'analyse GO comprenait trois modules : processus biologique (BP), composant cellulaire (CC) et fonction moléculaire (MF), permettant d'annoter respectivement les comportements biologiques, la localisation subcellulaire et les fonctions biochimiques des protéines cibles28. L'analyse KEGG a permis de mapper les gènes sur des cascades de signalisation intracellulaires afin d'observer la répartition des cibles dans diverses voies biologiques29. Les termes BP, CC, MF significativement enrichis ainsi que les voies centrales liées à l'intervention de RD sur RCI ont été extraits, et tous les résultats d'enrichissement ont été exportés pour la réalisation de graphiques, avec un seuil de significativité de p < 0,05.
Simulation de docking moléculaire
Les gènes centraux sélectionnés par l'analyse PPI ont été définis comme des récepteurs protéiques, et les ingrédients actifs de RD ont été considérés comme des ligands de petite taille. Une simulation de docking moléculaire a été réalisée afin d'explorer les interactions naturelles de liaison entre les protéines centrales et les ingrédients correspondants. Les structures tridimensionnelles des ligands ont été téléchargées à partir de PubChem (https://pubchem.ncbi.nlm.nih.gov/)30, et les structures cristallines des récepteurs ont été obtenues à partir de RCSB PDB (https://www.rcsb.org/)31. Les structures des récepteurs ont été prétraitées dans AutoDock 432, incluant l'élimination des molécules d'eau redondantes et l'ajout d'hydrogènes polaires. Le calcul de docking en lot a été effectué à l'aide d'AutoDock Vina, en combinaison avec le logiciel Open Babel. Les complexes présentant une énergie libre de liaison ≤ −7,0 kcal/mol ont été définis comme des structures de liaison stables représentant les complexes de docking les mieux classés. Les complexes ayant une énergie libre de liaison ≤ −7,0 kcal/mol ont été considérés comme des structures stables présentant une forte affinité intermoléculaire. Ce seuil empirique est couramment utilisé dans les études in silico basées sur AutoDock-Vina concernant les composés bioactifs d'origine végétale, bien qu'il ne remplace pas la validation expérimentale des interactions protéine-ligand33. Les 20 complexes de docking présentant l'affinité optimale ont été importés dans PyMOL pour générer des diagrammes de conformation tridimensionnelle de la liaison34. Date d'accès à PubChem : [2026-02-10] ; date d'accès à RCSB-PDB : [2026-02-03]. Les structures des petites molécules ont été récupérées par le nom du composé ; les structures des récepteurs protéiques ont été récupérées par les identifiants d'accès PDB correspondant aux gènes.
Analyse statistique
R x64 4.0.3, Cytoscape 3.8.0 et PyMOL ont été utilisés pour effectuer toutes les analyses statistiques et les cartographies bioinformatiques. Une valeur de p < 0,05 indiquait une différence statistiquement significative pour tous les éléments enrichis.
Résultats
Les ingrédients actifs du RD
Un total de 71 ingrédients chimiques bruts ont été extraits de TCMSP en utilisant « Rhizoma Drynariae » comme mot-clé. Un criblage secondaire a été effectué selon les critères ADME (OB ≥ 30 %, DL ≥ 0,18), permettant d'obtenir finalement 18 ingrédients bioactifs présentant une bonne absorption orale et une aptitude au développement thérapeutique. Tableau 1 résume les informations de base détaillées relatives à ces 18 ingrédients actifs. Ces 18 composés constituent la base matérielle multiconstituante de RD contre RCI.
Cibles géniques pertinentes de RD
Les bases de données TCMSP, ETCM et SymMap ont été consultées pour rechercher des gènes cibles correspondant aux ingrédients actifs du RD, et un total de 327 entrées cibles initiales a été recueilli. Après l'intégration des données et la suppression des symboles de gènes redondants, 213 gènes cibles potentiels non redondants du RD ont été obtenus pour l'analyse d'intersection ultérieure.
Cibles géniques pertinentes pour la RCI
Les bases de données Genecards et OMIM ont été consultées à l'aide du mot-clé « rotator cuff injury », et 989 entrées brutes de gènes liées aux lésions de la coiffe des rotateurs ont été obtenues. Après intégration des données et suppression des doublons, 870 gènes pathogènes humains uniques étroitement associés à la progression des lésions de la coiffe des rotateurs ont été identifiés.
Construction du réseau d'interactions protéine-protéine
L'analyse d'intersection entre 213 gènes cibles de la RD et 870 gènes pathogènes de la RCI a identifié 71 gènes communs, définis comme des cibles thérapeutiques potentielles de la RD pour le traitement de la RCI. Un diagramme de Venn illustrant la relation d'intersection a été généré à l'aide du logiciel Venny 2.0 (Figure 2). Les 71 cibles communes ont été importées dans STRING afin de construire le réseau PPI de la RD intervenant dans la RCI (Figure 3). L'ensemble des données PPI a été importé dans Cytoscape, et cytoHubba a sélectionné les 10 gènes centraux présentant les scores MCC les plus élevés : TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3, HMOX1. Leurs informations topologiques selon le score MCC ont été résumées dans le Tableau 2 et visualisées dans la Figure 4. Les 71 gènes intersectants représentaient les cibles centrales médiant l'effet thérapeutique de la RD contre la RCI.
Analyse d'enrichissement GO et KEGG
Afin d'explorer le mécanisme moléculaire des cibles candidates de RD dans le traitement de la RCI, le package clusterProfiler a effectué une analyse d'enrichissement GO et KEGG sur les cibles thérapeutiques communes. Des statistiques d'enrichissement GO distinctes ont été réalisées pour les processus biologiques (BP), les composants cellulaires (CC) et les fonctions moléculaires (MF). Les Figures 5A–B, 6A–B et 7A–B illustrent les 10 entrées les plus significativement enrichies pour BP, CC et MF, tandis que le sous-graphique B de chaque figure présente la répartition des gènes pour chaque terme fonctionnel. Une analyse d'enrichissement KEGG a été réalisée en outre afin d'identifier les voies centrales impliquées dans l'intervention de RD sur la RCI, et les 30 voies les plus enrichies ont été visualisées dans la Figure 8.
Simulation de docking moléculaire
Les 10 principaux gènes centraux ont été définis comme des récepteurs protéiques, et les 18 ingrédients actifs de RD ont été utilisés comme ligands pour le calcul d'ancrage via AutoDock Vina et Open Babel. PyMOL a permis de visualiser les conformations de liaison entre les ligands et les récepteurs. Les résultats du docking ont montré que la majorité des protéines cibles centrales formaient des structures de liaison stables avec les ingrédients actifs de RD. Tableau 3 et Figure 9 présentent les paramètres complets de docking ainsi que les diagrammes tridimensionnels des 20 complexes présentant la meilleure affinité de liaison.
Dans la présente analyse de pharmacologie en réseau, 18 ingrédients bioactifs de RD et 213 cibles thérapeutiques non redondantes associées aux médicaments ont été identifiés. Après intersection avec 870 gènes associés à la RCI, 71 cibles thérapeutiques candidates communes ont été obtenues. La construction du réseau PPI et le criblage cytoHubba-MCC ont permis d'identifier dix gènes centraux : TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3 et HMOX1. L'enrichissement GO a couvert les processus biologiques (BP), les composants cellulaires (CC) et les fonctions moléculaires (MF), tandis que l'enrichissement KEGG a révélé plusieurs voies de signalisation enrichies. La simulation de docking moléculaire a confirmé une affinité de liaison favorable entre les principaux constituants actifs de RD et ces protéines cibles centrales.
DISPONIBILITÉ DES DONNÉES :
Toutes les données brutes et traitées générées dans cette étude, y compris les listes de cibles, les fichiers de réseau d'interactions protéiques (PPI), les résultats d'enrichissement GO et KEGG, ainsi que la matrice de docking moléculaire, sont déposées dans la banque de données Science Data Bank. Le lien d'accès aux données brutes est https://www.scidb.cn/anonymous/alVOVlJu.
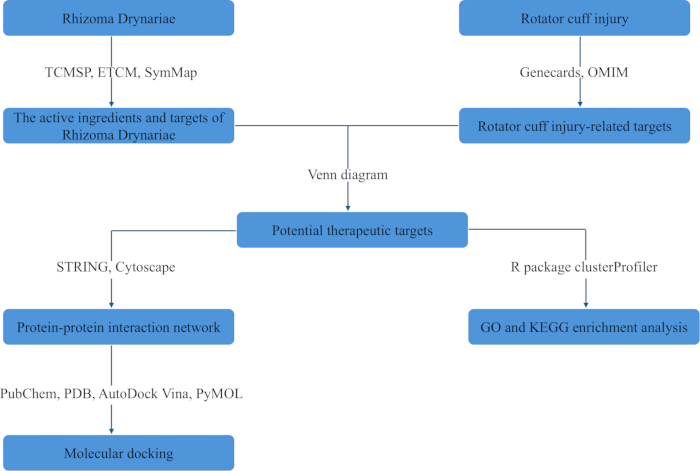
Figure 1 : Schéma du flux de travail décrivant le pipeline bioinformatique appliqué dans cette étude. En partant de la gauche, les composés bioactifs candidats et leurs cibles RD correspondantes ont été extraits des bases de données TCMSP, ETCM et SymMap. À droite, les gènes associés aux lésions de la coiffe des rotateurs (RCI) ont été récupérés à partir des bases de données GeneCards et OMIM. Les gènes cibles communs à ces deux jeux de données ont été identifiés à l’aide d’un diagramme de Venn et définis comme des cibles thérapeutiques potentielles. Les cibles partagées ont ensuite été traitées selon deux voies distinctes : l’une a permis de construire un réseau d’interactions protéine-protéine à l’aide de STRING et de Cytoscape ; l’autre a réalisé des analyses d’enrichissement en GO et KEGG à l’aide du package R clusterProfiler. Les gènes centraux extraits du réseau PPI ont ensuite été validés par docking moléculaire, la préparation structurale et la simulation ayant été effectuées à l’aide de PubChem, PDB, AutoDock Vina et PyMOL. Abréviations : RD = Rhizoma Drynariae, RCI = lésion de la coiffe des rotateurs, TCMSP = The Traditional Chinese Medicine Systems Pharmacology Database and Analysis Platform, ETCM = The Encyclopedia of Traditional Chinese Medicine, OMIM = The Online Mendelian Inheritance in Man, GO = ontologie génique, KEGG = encyclopédie de Kyoto des gènes et des génomes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
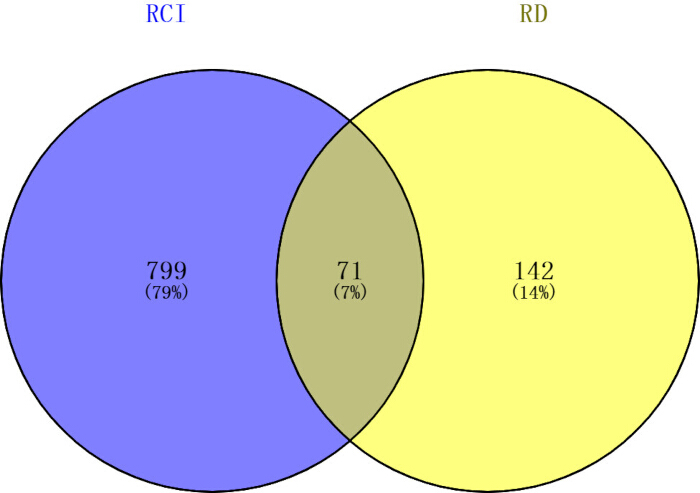
Figure 2 : Diagramme de Venn des cibles communes entre le RD et le RCI. Le cercle bleu représente les cibles associées au RCI. Le cercle jaune représente les cibles thérapeutiques potentielles du RD. La région commune, de couleur vert olive, indique les cibles partagées entre le RD et le RCI. Les nombres et pourcentages à l’intérieur de chaque région indiquent le nombre et la proportion de cibles uniques ou partagées. Abréviations : RD = Rhizoma Drynariae, RCI = lésion de la coiffe des rotateurs. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
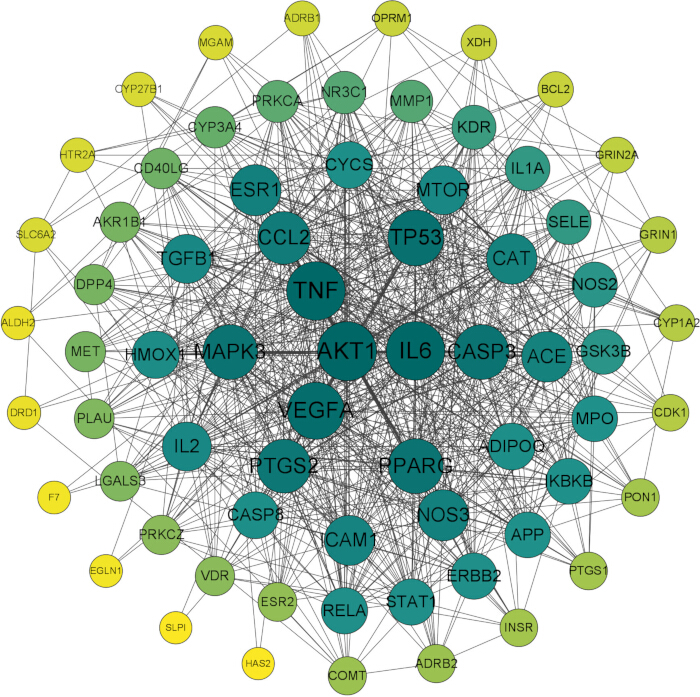
Figure 3 : Réseau d'interactions protéine-protéine (PPI) généré à partir des 71 gènes cibles communs reliant le RD et le RCI. Chaque cercle du réseau représente un gène cible, étiqueté avec son symbole génétique officiel. Les lignes reliant deux cercles illustrent les associations protéine-protéine extraites de bases de données bioinformatiques publiques. La taille des nœuds et l'intensité de la couleur reflètent la signification topologique des gènes individuels au sein du réseau. Les gènes représentés par des cercles plus grands et des teintes vertes plus intenses obtiennent des scores topologiques plus élevés et occupent des positions plus centrales ; les cercles plus petits et jaunes pâles indiquent des gènes ayant une importance topologique moindre. Abréviations : RD = Rhizoma Drynariae, RCI = lésion de la coiffe des rotateurs, PPI = interaction protéine-protéine. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
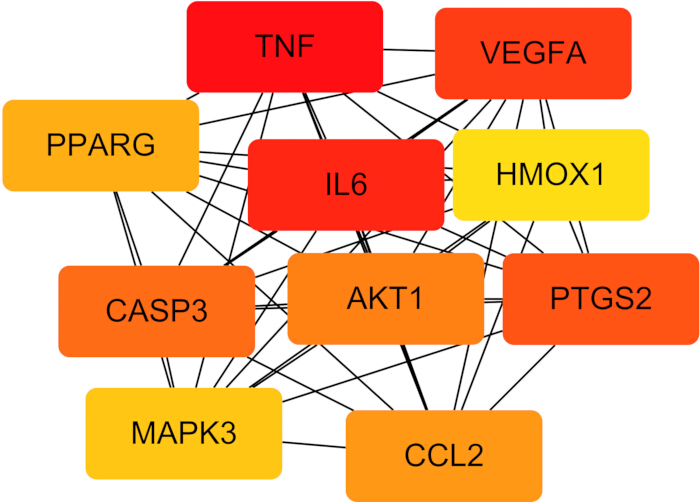
Figure 4 : Les 10 principaux gènes centraux identifiés à partir du réseau PPI à l'aide du plugin cytoHubba. Les rectangles représentent les gènes centraux, chacun étant étiqueté par son symbole génique officiel. Les lignes noires reliant les rectangles illustrent les interactions protéiques entre ces cibles principales. Le dégradé de couleur, allant du rouge vif à l'orange puis au jaune, illustre le classement des gènes centraux selon les scores MCC calculés par le plugin cytoHubba ; les rectangles rouges vifs indiquent les gènes ayant les scores MCC les plus élevés et l'importance maximale dans le réseau, tandis que les rectangles jaunes désignent les gènes ayant des scores relativement plus faibles. Abréviations : PPI = interaction protéine-protéine, MCC = centralité de la clique maximale.Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
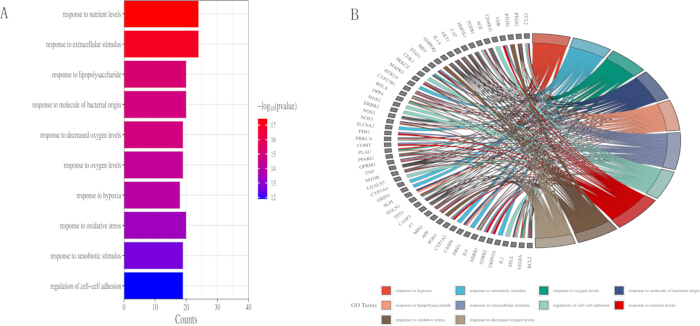
Figure 5 : Analyse d'enrichissement BP des 71 gènes cibles partagés de RD par rapport à RCI. (A) Analyse d'enrichissement GO des cibles thérapeutiques potentielles pour le BP. Il s'agit d'un diagramme en barres horizontales montrant les 10 premiers termes du processus biologique GO significativement enrichis. L'axe horizontal X représente le nombre de gènes, correspondant au nombre de gènes cibles annotés à chaque terme GO. L'axe vertical Y énumère les termes GO enrichis individuels. La barre de couleur continue située à droite code la valeur -log10(p-value) ; les teintes rouges plus chaudes indiquent une valeur -log10(p-value) plus élevée et une signification statistique plus forte, tandis que les teintes violettes et bleues plus froides indiquent une signification moindre. (B) Relation entre les cibles thérapeutiques potentielles et le BP. Le panneau B est un diagramme en cordes illustrant les associations par paires entre les termes GO enrichis et leurs gènes cibles correspondants. Les segments circulaires extérieurs sont divisés en deux catégories : les blocs colorés représentent des termes distincts du processus biologique GO, et les graduations rectangulaires grises indiquent les symboles individuels des gènes cibles. Des rubans courbes à l'intérieur du cercle relient les termes GO à leurs gènes cibles associés, chaque ruban reliant un gène au terme GO auquel il participe. La couleur de chaque ruban reprend la teinte de son terme GO correspondant provenant de l'anneau extérieur. Une légende en bas relie chaque couleur à son terme GO respectif. Abréviations : RD = Rhizoma Drynariae, RCI = lésion de la coiffe des rotateurs, BP = processus biologique, GO = ontologie génique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
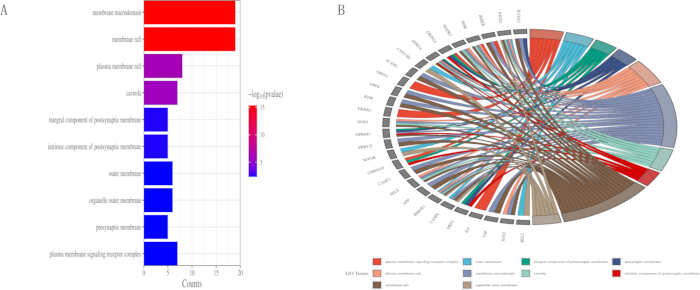
Figure 6 : Termes GO-CC dérivés des 71 cibles candidates de RD dans le traitement des LCR. (A) Analyse d'enrichissement GO des cibles thérapeutiques potentielles pour le CC. (B) Relation entre les cibles thérapeutiques potentielles et le CC. Le panneau A est un graphique à barres horizontales affichant les 10 premières entrées significativement enrichies de la composante cellulaire GO. L'axe horizontal X quantifie le nombre de gènes cibles attribués à chaque terme GO, désigné par « Counts ». Les descriptions enrichies des composantes cellulaires GO sont disposées le long de l'axe vertical Y. La barre de couleur à droite associe les variations de couleur aux valeurs de -log10(pvalue) ; le rouge vif correspond à des valeurs plus élevées de -log10(pvalue) et à une signification statistique plus forte, tandis que les nuances bleues représentent des niveaux de signification plus faibles. Le panneau B présente un diagramme en cordes visualisant les connexions entre les termes enrichis de la composante cellulaire GO et leurs gènes cibles associés. Les segments situés sur l'anneau extérieur sont divisés en deux groupes : les blocs colorés représentent des termes distincts de la composante cellulaire GO, et les traits gris indiquent les symboles individuels des gènes cibles. Des rubans courbes à l'intérieur du cercle relient chaque gène à son terme GO correspondant, chaque ruban reprenant la couleur de son terme GO correspondant sur l'anneau extérieur. Une légende en bas précise le code couleur pour toutes les catégories de composantes cellulaires GO. Abréviations : RD = Rhizoma Drynariae, LCR = lésion de la coiffe des rotateurs, CC = composante cellulaire, GO = ontologie génique Veuillez cliquer ici pour consulter une version agrandie de cette figure.
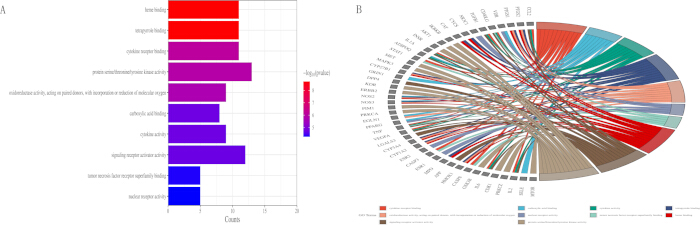
Figure 7 : Analyse d'enrichissement en MF réalisée sur les 71 gènes cibles communs à l'ICR pour l'intervention au RD. (A) Analyse d'enrichissement en ontologie génique (GO) des cibles thérapeutiques potentielles pour la MF. (B) Relation entre les cibles thérapeutiques potentielles et la MF. Le panneau A est un graphique en barres horizontales classant les 10 premiers termes significativement enrichis de fonction moléculaire (GO). Les valeurs sur l'axe horizontal X représentent le nombre de gènes, correspondant au nombre total de gènes cibles annotés pour chaque entrée de fonction moléculaire. L'axe vertical Y énumère les descriptions individuelles des fonctions moléculaires (GO). La barre de dégradé de couleur à droite traduit la variation de couleur en valeurs de -log10(pvalue) ; le rouge vif correspond à des valeurs plus élevées de -log10(pvalue) et à une signification statistique plus forte, tandis que les teintes bleues indiquent une signification plus faible. Le panneau B est un diagramme en cordes représentant les relations entre les catégories enrichies de fonction moléculaire (GO) et leurs gènes cibles associés. Les segments situés sur l'anneau extérieur contiennent deux types d'étiquettes : les blocs colorés indiquent des termes distincts de fonction moléculaire (GO), et les petits traits rectangulaires gris marquent les symboles individuels des gènes cibles. Des rubans courbes partant de l'anneau extérieur relient chaque gène à son terme fonctionnel correspondant, et chaque ruban reprend la couleur attribuée à son terme GO associé. Une légende en bas définit le code couleur pour toutes les catégories de fonction moléculaire (GO) représentées sur le graphique. Abréviation : RD = Rhizoma Drynariae, ICR = lésion de la coiffe des rotateurs, MF = fonction moléculaire, GO = ontologie génique Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
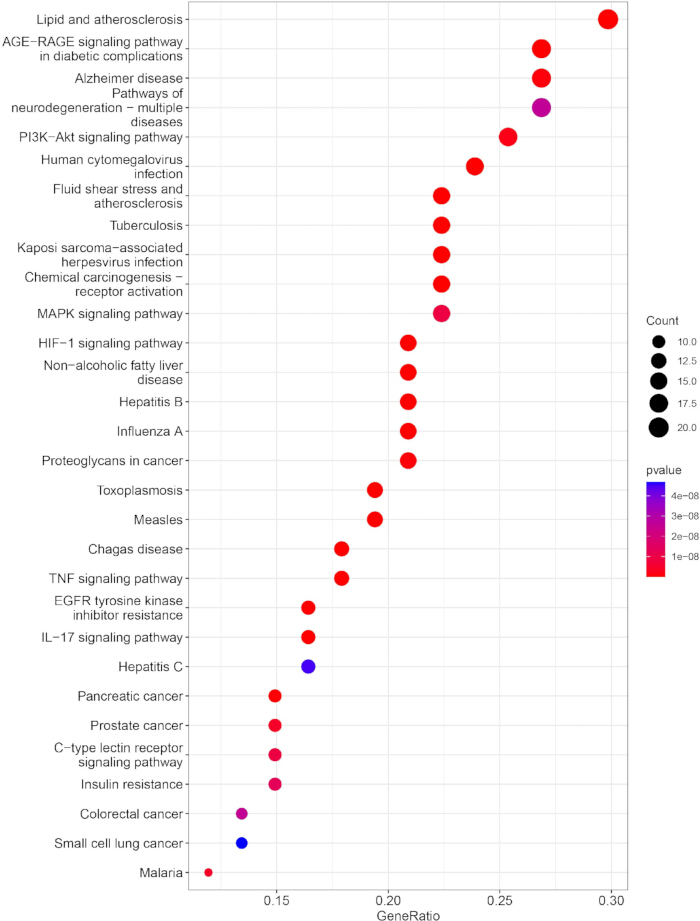
Figure 8 : Analyse d'enrichissement des voies KEGG des 71 gènes cibles partagés du RD par rapport à la LCR. Ce diagramme en points illustre les voies KEGG les plus enrichies. L'axe vertical Y indique les noms des voies enrichies individuelles. L'axe horizontal X représente le GeneRatio, défini comme le rapport entre le nombre de gènes cibles associés à une voie et le nombre total de gènes dans cette voie. Chaque point circulaire correspond à une voie enrichie. La taille du point est proportionnelle au nombre de gènes, les cercles plus grands indiquant un plus grand nombre de gènes cibles annotés à la voie. La couleur du point reflète la valeur de p : le rouge indique des valeurs de p plus faibles et une signification statistique plus forte, tandis que le bleu foncé indique des valeurs de p plus élevées et une signification statistique plus faible. Deux légendes latérales définissent séparément l'échelle du nombre de gènes et la correspondance des couleurs pour la valeur de p. Abréviations : RD = Rhizoma Drynariae, LCR = lésion de la coiffe des rotateurs, KEGG = encyclopédie de Kyoto des gènes et des génomes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
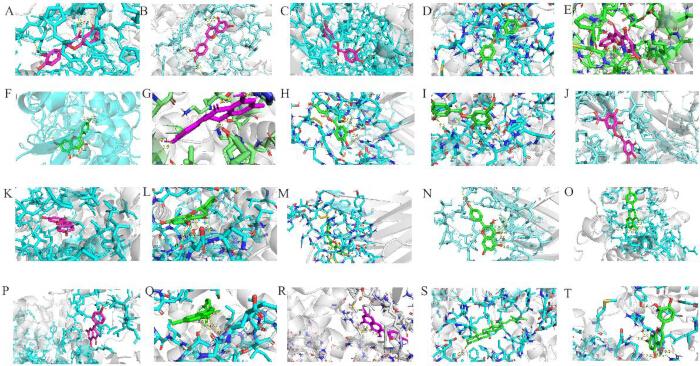
Figure 9 : Les complexes de docking les mieux classés. (A) (PTGS2, ériodictyol, -9,7 kcal/mol). (B) (PTGS2, lutéoline, -9,6 kcal/mol). (C) (PTGS2, catéchine, -9,5 kcal/mol). (D) (PTGS2, naringénine, -9,5 kcal/mol). (E) (PTGS2, auréusidine, -9,4 kcal/mol). (F) (PTGS2, kaempférol, -9,2 kcal/mol). (G) (PTGS2, chromane, -9,1 kcal/mol). (H) (TNF, catéchine, -9,1 kcal/mol). (I) (PTGS2, digallate, -9 kcal/mol). (J) (TNF, digallate, -9 kcal/mol). (K) (PPARG, chromane, -8,9 kcal/mol). (L) (PPARG, naringénine, -8,9 kcal/mol). (M) (TNF, auréusidine, -8,9 kcal/mol). (N) (TNF, kaempférol, -8,8 kcal/mol). (O) (MAPK3, chromane, -8,7 kcal/mol). (P) (MAPK3, naringénine, -8,7 kcal/mol). (Q) (PPARG, auréusidine, -8,7 kcal/mol). (R) (PPARG, kaempférol, -8,7 kcal/mol). (S) (PTGS2, 22_Stigmasten_3_one, -8,7 kcal/mol). (T) (MAPK3, lutéoline, -8,6 kcal/mol). Les panneaux A à T illustrent séparément la géométrie de liaison calculée de composés individuels de petite taille au sein de la cavité de liaison des protéines cibles correspondantes. Les modèles en bâtonnets cyan représentent les résidus d'acides aminés bordant la cavité de liaison de la protéine. Les ligands de petite taille sont représentés en bâtonnets magenta ou verts afin de distinguer différentes structures chimiques. Les lignes pointillées jaunes indiquent les liaisons hydrogène intermoléculaires entre les ligands et les résidus du site, les annotations numériques précisant les distances des liaisons hydrogène en angströms (Å). La surface blanche translucide délimite la topologie tridimensionnelle globale de chaque récepteur protéique. Tous les calculs de pose de liaison ont été effectués par docking moléculaire avec récepteur rigide à l'aide du logiciel AutoDock Vina. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
| ID de la molécule | Nom de la molécule | Bio disponibilité orale (OB) (%) | Caractère médicamenteux (DL) |
| MOL001040 | (2R)-5,7-dihydroxy-2-(4-hydroxyphényl)chroman-4-one | 42,36 | 0,21 |
| MOL001978 | Auréusidine | 53,42 | 0,24 |
| MOL002914 | Ériodictiol (flavanone) | 41,35 | 0,24 |
| MOL000449 | Stigmastérol | 43,83 | 0,76 |
| MOL000358 | bêta-sitostérol | 36,91 | 0,75 |
| MOL000422 | kaempférol | 41,88 | 0,24 |
| MOL004328 | naringénine | 59,29 | 0,21 |
| MOL000492 | (+)-catéchine | 54,83 | 0,24 |
| MOL005190 | ériodictyol | 71,79 | 0,24 |
| MOL000569 | digallate | 61,85 | 0,26 |
| MOL000006 | lutéoline | 36,16 | 0,25 |
| MOL009061 | 22-Stigmastén-3-one | 39,25 | 0,76 |
| MOL009063 | Acétate de cyclolaudénol | 41,66 | 0,79 |
| MOL009075 | cycloartenone | 40,57 | 0,79 |
| MOL009076 | cyclolaudénol | 39,05 | 0,79 |
| MOL009078 | davallioside A_qt | 62,65 | 0,51 |
| MOL009087 | marioside_qt | 70,79 | 0,19 |
| MOL009091 | xanthogalénol | 41,08 | 0,32 |
Tableau 1 : Profils pharmacocinétiques des dix-huit constituants bioactifs candidats dérivés du RD. Les composés ont été extraits de la base de données TCMSP et filtrés selon deux seuils liés à l'ADME : BV ≥ 30 % et DL ≥ 0,18. Les colonnes indiquent le numéro d'accès TCMSP (ID Mol), le nom du composé, la valeur de BV calculée (%) et le score DL pour chaque constituant sélectionné. Abréviations : RD = Rhizoma Drynariae, RCI = lésion de la coiffe des rotateurs, ADME = absorption, distribution, métabolisme, élimination, TCMSP = The Traditional Chinese Medicine Systems Pharmacology Database and Analysis Platform, BV = biodisponibilité orale, DL = caractère médicamenteux.
| Rang | Gène | Nom | Score |
| 1 | TNF | facteur de nécrose tumorale | 328291218366500 |
| 2 | IL6 | interleukine 6 | 328291215913592 |
| 3 | VEGFA | facteur de croissance endothélial vasculaire A | 328291215896284 |
| 4 | PTGS2 | synthase 2 des prostaglandines-endoperoxydes | 328288656326402 |
| 5 | CASP3 | Caspase 3 | 328288180323600 |
| 6 | AKT1 | kinase 1 de la sérine/thréonine AKT | 328287745700516 |
| 7 | CCL2 | ligand 2 du chimioattractant contenant le motif C-C | 328161521686320 |
| 8 | PPARG | récepteur gamma activé par la prolifération des peroxysomes | 325302724852296 |
| 9 | MAPK3 | kinase 3 des protéines activées par un mitogène | 308779166166218 |
| 10 | HMOX1 | hème oxygénase 1 | 299171945318400 |
Tableau 2 : Les 10 principaux gènes centraux identifiés à partir du réseau PPI. Les gènes ont été classés selon les scores MCC calculés par le plugin cytoHubba dans Cytoscape. Le MCC est une métrique topologique de cytoHubba pour laquelle des valeurs numériques plus élevées reflètent une importance topologique plus grande au sein du réseau. Les colonnes indiquent l'ordre de classement, le symbole officiel du gène, le nom complet du gène et le score MCC brut correspondant pour chaque gène central. Abréviations : PPI = interaction protéine-protéine, MCC = centralité de la clique maximale.
| Récepteurs | Ligands | Énergie libre (kcal/mol) | Numéros de série correspondants dans la Figure 9 |
| PTGS2 | eriodictyol | -9.7 | A |
| PTGS2 | luteolin | -9.6 | B |
| PTGS2 | catechin | -9.5 | C |
| PTGS2 | naringenin | -9.5 | D |
| PTGS2 | Aureusidin | -9.4 | E |
| PTGS2 | kaempferol | -9.2 | F |
| PTGS2 | chroman | -9.1 | G |
| TNF | catechin | -9.1 | H |
| PTGS2 | digallate | -9 | I |
| TNF | digallate | -9 | J |
| PPARG | chroman | -8.9 | K |
| PPARG | naringenin | -8.9 | L |
| TNF | Aureusidin | -8.9 | M |
| TNF | kaempferol | -8.8 | N |
| MAPK3 | chroman | -8.7 | O |
| MAPK3 | naringenin | -8.7 | P |
| PPARG | Aureusidin | -8.7 | Q |
| PPARG | kaempferol | -8.7 | R |
| PTGS2 | 22_Stigmasten_3_one | -8.7 | S |
| MAPK3 | luteolin | -8.6 | T |
Tableau 3 : Résultats d'affinité de liaison en docking moléculaire pour les 20 complexes récepteur-ligand sélectionnés. Chaque ligne indique la protéine réceptrice, le ligand de petite molécule, l'énergie libre de liaison calculée (kcal/mol) et l'étiquette du sous-graphique correspondant dans la Figure 9. Des valeurs d'énergie libre plus négatives correspondent à une stabilité de liaison plus forte entre la poche protéique et le composé ligand. Abréviations : PTGS2 = prostaglandine-endoperoxyde synthase 2, TNF = facteur de nécrose tumorale, PPARG = récepteur gamma activé par la prolifération des peroxysomes, MAPK3 = kinase 3 des protéines activées par un mitogène.
Discussion
L'IRC est un trouble musculosquelettique complexe impliquant une inflammation chronique, un taux excessif d'apoptose des ténocytes, une angiogenèse altérée et un remodelage insuffisant de la matrice extracellulaire, dont les modifications pathologiques combinées entraînent une mauvaise cicatrisation du tendon à l'os et un pronostic clinique sous-optimal35. Cette maladie provient souvent d'un traumatisme aigu ou d'une surutilisation prolongée de l'épaule, et une inflammation persistante perturbe l'équilibre métabolique de la matrice extracellulaire du tendon36. Cliniquement, les traitements actuels ne parviennent pas à cibler simultanément plusieurs maillons pathologiques, ce qui entraîne une efficacité limitée et un taux de récidive élevé37. Le RD est une plante médicinale classique de la MTC qui renforce les os, active la circulation sanguine et favorise la réparation tissulaire, et qui est depuis longtemps utilisée cliniquement pour traiter les lésions osseuses et tendineuses38. Toutefois, le mécanisme moléculaire régulateur précis du RD contre l'IRC n'a pas été systématiquement analysé dans les études existantes.
Sur la base des recherches susmentionnées, cette étude révèle de manière systématique le mécanisme multi-composants, multi-cibles et multi-pathways de la RD contre les lésions chroniques des tendons (RCI) à l’aide de la pharmacologie en réseau et du dockage moléculaire. Des études phytochimiques et pharmacologiques antérieures ont pleinement confirmé que les flavonoïdes extraits de la RD possèdent des activités biologiques importantes anti-inflammatoires, antioxydantes, anti-apoptotiques et pro-angiogéniques, qui constituent la base matérielle essentielle de sa fonction de réparation tissulaire39. Conformément aux résultats des études précédentes, un total de 18 composants actifs ont été identifiés dans la RD, parmi lesquels l’ériodictyol, la lutéoline, la catéchine, la naringénine et l’aureusidine ont été reconnus comme des composants centraux. Un grand nombre d’études phytochimiques ont démontré que les flavonoïdes constituent les principales substances pharmacodynamiques de la RD40. Ces composés de petite taille peuvent franchir les barrières tissulaires et exercer des effets régulateurs complets sur le microenvironnement de réparation des tendons lésés41. Leurs propriétés favorables en termes d’ADME assurent une bonne biodisponibilité (OB) et une conformité aux critères de médicament, soutenant ainsi leur potentiel en tant qu’agents thérapeutiques naturels contre les RCI. Contrairement aux médicaments chimiques synthétiques à cible unique, ces flavonoïdes naturels peuvent simultanément intervenir dans l’inflammation, les lésions oxydatives, la survie cellulaire et l’angiogenèse, offrant ainsi des avantages uniques dans le traitement des lésions tendineuses dégénératives chroniques42.
Des études accumulées ont confirmé que l'apparition et le développement de la RCI sont étroitement liés à l'expression anormale de multiples gènes fonctionnels, et divers gènes centraux se sont révélés participer aux processus pathologiques d'inflammation tendineuse, d'apoptose et de remodelage tissulaire43. Sur la base du mécanisme régulateur génique reconnu de la RCI, cette étude a approfondi l'exploration des cibles thérapeutiques de la RD. Soixante et onze cibles communes ont été identifiées comme des cibles thérapeutiques potentielles de la RD contre la RCI. L'analyse du réseau PPI a permis de sélectionner 10 gènes centraux : TNF, IL6, VEGFA, PTGS2, CASP3, AKT1, CCL2, PPARG, MAPK3 et HMOX1. Parmi eux, TNF et IL6 sont des cytokines pro-inflammatoires essentielles qui déclenchent des cascades inflammatoires, inhibent la prolifération des ténocytes et suppriment la synthèse de la matrice extracellulaire, aggravant ainsi les lésions tendineuses44. La libération massive de ces deux cytokines recrute des cellules immunitaires, amplifie la réaction inflammatoire et freine la prolifération des cellules souches tendineuses45. VEGFA favorise la néovascularisation au site de la lésion, améliore l'irrigation sanguine locale et renforce la résistance mécanique du tissu en cours de cicatrisation46. L'interface tendon-os est naturellement peu vascularisée, et un apport insuffisant en nouveaux vaisseaux constitue un facteur majeur de qualité médiocre de la cicatrisation après une lésion47. PTGS2 intervient dans la douleur inflammatoire et la production de prostaglandines, tandis que CASP3 est un effecteur clé de l'apoptose des ténocytes48,49. La surexpression de PTGS2 aggrave l'œdème et la douleur inflammatoires, tandis qu'une activation élevée de CASP3 induit une perte continue de ténocytes fonctionnels50,51. AKT1 et MAPK3 sont des kinases centrales régulant la survie, la prolifération et la différenciation cellulaires, essentielles à la régénération tendineuse52,53. Une activation modérée de ces deux kinases peut maintenir la vitalité des cellules de réparation et accélérer le dépôt de la matrice extracellulaire54. CCL2 recrute les cellules inflammatoires, tandis que PPARG et HMOX1 exercent des effets anti-inflammatoires et antioxydants55,56,57. Ces deux gènes peuvent atténuer le stress oxydatif et réduire l'infiltration inflammatoire excessive dans les tissus tendineux locaux58. Collectivement, ces gènes centraux forment un réseau régulateur fondamental qui module l'inflammation, l'apoptose, l'angiogenèse et le remodelage tissulaire dans la RCI.
Des études pathologiques existantes ont montré que la progression pathologique de la LCR est principalement induite par une réponse inflammatoire, un stress oxydatif, une prolifération cellulaire anormale et une organisation désordonnée de la matrice extracellulaire, qui constituent les principaux mécanismes pathologiques impliqués dans l'apparition et la réparation de la LCR.59. Sur cette base, une analyse d'enrichissement en ontologies génétiques (GO) a été réalisée dans la présente étude afin d'explorer le mécanisme biologique potentiel de l'intervention de RD dans l'IRC. Ces processus biologiques correspondent précisément aux principaux maillons pathologiques de l'IRC tout au long de la survenue de la lésion et de sa réparation, suggérant que RD peut cibler simultanément plusieurs processus pathologiques.60Un grand nombre d'études mécanistiques antérieures ont confirmé que la voie de signalisation du TNF, la voie de signalisation PI3K-Akt, la voie de signalisation MAPK et la voie de signalisation HIF-1 sont des voies de signalisation clés régulant l'inflammation tendineuse, la réparation cellulaire et la reconstruction tissulaire.61,62,63,64. Afin d'explorer davantage le mécanisme de signalisation potentiel de RD dans le traitement de la RCI, cette étude a réalisé une analyse d'enrichissement des voies métaboliques KEGG sur la base des recherches précédentes. Les résultats ont révélé que l'action de RD contre la RCI implique principalement les quatre voies susmentionnées. La voie de signalisation du TNF favorise la réponse inflammatoire et l'apoptose des ténocytes, jouant ainsi le rôle de facteur initiateur en amont de la dégénérescence inflammatoire du tendon.65La voie PI3K-Akt favorise la survie cellulaire et l'angiogenèse, deux processus bénéfiques pour la cicatrisation des tendons, et elle peut coordonner plusieurs facteurs de croissance afin de faciliter la sécrétion de collagène par les fibroblastes.66,67La voie de signalisation MAPK régule la prolifération cellulaire, la différenciation et la synthèse de la matrice extracellulaire, participant ainsi à l'ensemble du processus de reconstruction du tendon.68La voie de signalisation de HIF‑1 répond à l'hypoxie et favorise la régénération vasculaire, ce qui améliore efficacement le microenvironnement hypoxique des tendons lésés.69Ces voies communiquent entre elles et forment un réseau régulateur complexe, incarnant pleinement les caractéristiques multi-voies de la RD dans le traitement des ICR.
La modélisation moléculaire est devenue une méthode courante et complémentaire de vérification en recherche de pharmacologie en réseau, permettant de caractériser directement l'activité de liaison entre les principes actifs et les cibles principales. Ainsi, cette étude a utilisé la modélisation moléculaire afin de valider les résultats prédictifs de la pharmacologie en réseau70. Les résultats ont montré que les composants flavonoïdes principaux du RD peuvent se lier de manière stable aux poches actives des protéines centrales, ce qui confirme davantage la fiabilité des prédictions issues de la pharmacologie en réseau. Ces modes de liaison stables suggèrent que le RD pourrait agir directement sur des cibles clés pour exercer ses effets thérapeutiques. La liaison étroite entre les ligands flavonoïdes et les sites actifs des protéines centrales fournit une preuve intuitive des interactions moléculaires, tout en offrant des composés candidats pour des expériences ultérieures de validation fonctionnelle cellulaire.
Cette étude présente plusieurs limites. Premièrement, les prédictions reposent sur des analyses bioinformatiques de bases de données publiques, ce qui peut introduire un biais d'annotation en faveur des protéines bien étudiées. L'expression génique spécifique aux tendons de la coiffe des rotateurs et les isoformes protéiques n'ont pas été prises en compte, et le réseau d'interactions protéine-protéine (PPI) non orienté dérivé de STRING ne peut pas entièrement reproduire la biologie spécifique au tendon. Les voies enrichies telles que TNF, PI3K-Akt et MAPK représentent des cascades inflammatoires communes plutôt que des signatures exclusives à la RD. Les ressources omiques publiques ne peuvent pas reproduire les changements pathologiques dynamiques in vivo ni les différences individuelles observées dans les tissus humains de la coiffe des rotateurs. De futures recherches pourraient intégrer des jeux de données de séquençage ARN à l'échelle unique cellule afin d'affiner l'interprétation mécanistique. Deuxièmement, le criblage de composés a utilisé des seuils empiriques ADME (BO ≥ 30 %, DL ≥ 0,18), ce qui peut éliminer des composés bioactifs ayant une faible biodisponibilité orale. Le dockage moléculaire a été réalisé selon un modèle de récepteur rigide, ignorant la flexibilité protéique et les molécules d'eau structurales, sans validation biophysique (par exemple, SPR, ITC). Aucun contrôle positif médicamenteux, analyse de sensibilité, évaluation de la toxicité ni profil pharmacocinétique complet n'ont été réalisés. Tous les résultats sont des prédictions informatiques ; des expériences cellulaires in vitro et animales in vivo sont nécessaires pour valider les fonctions des voies cibles et les relations régulatrices entre les ingrédients et les gènes centraux. Troisièmement, les interactions synergiques entre plusieurs composants de la RD et leurs comportements pharmacocinétiques in vivo restent inexplorés. Un travail expérimental systématique est requis pour élucider les interactions entre ingrédients et les profils métaboliques de ce médicament à base de plantes. Cette étude révèle de manière systématique que la RD traite la IRC par un réseau régulateur multi-composant, multi-cible et multi-voie. La RD pourrait exercer ses effets thérapeutiques en inhibant l'inflammation, en réduisant l'apoptose des ténocytes, en favorisant l'angiogenèse et en améliorant la réparation de la matrice extracellulaire via les voies de signalisation TNF, PI3K-Akt, MAPK et HIF-1. Ces résultats fournissent une base théorique solide pour l'application clinique et la recherche mécanistique de la RD dans le traitement de la IRC.
Déclarations de divulgation
Les auteurs déclarent que la recherche a été menée en l'absence de toute relation commerciale ou financière pouvant être perçue comme un conflit d'intérêts potentiel.
Remerciements
Les auteurs remercient les développeurs et mainteneurs des ressources bioinformatiques publiques utilisées dans ce travail, notamment TCMSP, ETCM, SymMap, GeneCards, OMIM, STRING, UniProt, PubChem et RCSB‑PDB. Ces bases de données en accès libre ont fourni des ensembles de données publiquement disponibles qui ont soutenu les analyses computationnelles décrites dans cette étude. Cette recherche n'a reçu aucun financement externe.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| AutoDock Vina | Institut de recherche Scripps | V1.2.0 | Logiciel de docking moléculaire pour la simulation de la liaison protéine-ligand ; RRID : Non disponible. URL : https://github.com/ccsb-scripps/AutoDock-Vina |
| clusterProfiler | Bioconductor | V3.2.14 | Package R pour l'analyse d'enrichissement GO et KEGG ; compatible avec R 4.0.3 ; RRID : SCR_016884. URL : https://bioconductor.org/packages/release/bioc/html/clusterProfiler.html |
| cytoHubba | Université nationale de Taïwan (plugin Cytoscape) | V0.1 | Plugin Cytoscape pour le criblage des gènes centraux par métriques topologiques ; RRID : SCR_006556. URL : https://apps.cytoscape.org/apps/cytohubba |
| Cytoscape | Institut de biologie des systèmes | V3.8.0 | Logiciel de visualisation et d'analyse de réseaux ; RRID : SCR_003032. URL : https://cytoscape.org/ |
| ETCM (Encyclopédie de la médecine traditionnelle chinoise) | Institut de matière médicale chinoise, Académie chinoise des sciences médicales chinoises | V2.0 | Base de données annotée sur les ingrédients, cibles et formules de la MTC ; RRID : Non disponible. URL : http://www.tcmip.cn/ETCM2/front/#/ |
| GeneCards | Institut Weizmann des sciences | — | Base de données intégrative sur les gènes humains avec des versions majeures publiées périodiquement et des mises à jour incrémentielles ; données récupérées le 2025-12-15 ; RRID : Non disponible. URL : https://www.genecards.org |
| Open Babel | Équipe de développement d'Open Babel | — | Outil chimioinformatique open source pour la conversion de fichiers moléculaires ; données récupérées le 2025-12-21 ; RRID : Non disponible. URL : https://openbabel.org/ |
| OMIM (Héritage mendélien en ligne chez l'homme) | Université Johns Hopkins | — | Base de données actualisée quotidiennement sur les gènes et les phénotypes, sans version globale de publication ; données récupérées le 2026-02-16 ; RRID : Non disponible. URL : https://omim.org |
| PubChem | Centre national d'information sur la biotechnologie (NCBI) | — | Base de données chimiques publique mise à jour en continu, sans version fixe globale ; données sur les composés récupérées le 2026-02-10 ; RRID : Non disponible. URL : https://pubchem.ncbi.nlm.nih.gov |
| PyMOL | Schrödinger, LLC | V2.5 | Logiciel de visualisation et de rendu des structures protéine-ligand ; RRID : SCR_000305. URL : https://pymol.org |
| Logiciel R | Fondation R pour l'informatique statistique | V4.0.3 | Environnement de calcul et de graphisme statistiques ; RRID : SCR_001905. URL : https://cran.r-project.org |
| RCSB PDB | Banque de données des protéines RCSB | — | Archive publique de structures protéiques tridimensionnelles ; chaque entrée PDB possède sa propre version ; fichiers de structure récupérés le 2026-02-03 ; RRID : SCR_012820. URL : https://www.rcsb.org |
| STRING | ELIXIR | V11.5 | Base de données d'interactions protéine-protéine connues et prédites ; RRID : SCR_005223. URL : https://string-db.org |
| SymMap | Académie chinoise des sciences médicales chinoises | V2.0 | Base de données intégrée reliant les médicaments à base de plantes, leurs ingrédients, cibles et symptômes ; RRID : Non disponible. URL : http://www.symmap.org |
| TCMSP | Université Northwest A&F | V2.3 | Base de données de pharmacologie des systèmes de la MTC contenant des ingrédients, cibles et propriétés ADME ; RRID : Non disponible. URL : https://old.tcmsp-e.com/tcmsp.php |
| UniProt | Institut européen de bioinformatique (EMBL-EBI) | — | Base de données complète sur les séquences et annotations des protéines, avec des publications planifiées et des mises à jour continues ; données récupérées le 2025-12-12 ; RRID : SCR_002380. URL : https://www.uniprot.org |
| Venny | BioinfoGP, Centre national espagnol de biotechnologie | V2.0 | Outil en ligne pour la génération de diagrammes de Venn et l'analyse d'ensembles de gènes superposés ; RRID : SCR_016561. URL : https://bioinfogp.cnb.csic.es/tools/venny/index2.0.2.html |
Références
- Desmeules F, et al. Rotator cuff tendinopathy diagnosis, nonsurgical medical care, and rehabilitation: a clinical practice guideline. J Orthop Sports Phys Ther. 2025;55(4):235-274.
- Yoshida M, et al. Post-operative rotator cuff integrity, based on Sugaya's classification, can reflect abduction muscle strength of the shoulder. Knee Surg Sports Traumatol Arthrosc. 2018;26(1):161-168.
- Aydın A, et al. The effects of N-acetylcysteine and adipose-derived stem cells on tendon healing in chronic rotator cuff tears: a rabbit model study. BMC Musculoskelet Disord. 2025;26(1):1014.
- Bolam SM, et al. Ethnicity, sex, and socioeconomic disparities in the treatment of traumatic rotator cuff injuries in Aotearoa/New Zealand. J Shoulder Elbow Surg. 2023;32(1):121-132.
- Patel HP, Patel S, Zalin M, Agrawal DK. Calcified vs. non-calcified tendinopathy of the rotator cuff: clinical presentations, prognostic implications, and emerging therapeutic strategies. J Orthop Sports Med. 2025;7(3):379-391.
- Sewpaul Y, et al. Non-steroidal anti-inflammatory drugs and cyclooxygenase-2 inhibitors do not affect healing after rotator cuff repair: a systematic review and meta-analysis. Arthroscopy. 2024;40(3):930-940.e1.
- Hopewell S, et al. Progressive exercise compared with best practice advice, with or without corticosteroid injection, for the treatment of patients with rotator cuff disorders (GRASP): a multicentre, pragmatic, 2 × 2 factorial, randomised controlled trial. Lancet. 2021;398(10298):416-428.
- Kandikattu S, Aavula M, Pisarski T, Parvizi D, Agrawal DK. Effect of metabolic syndrome in the incidence of rotator cuff injury and recovery following surgical repair. J Surg Res (Houst). 2025;8(1):202-210.
- Longo UG, et al. Retear rates after rotator cuff surgery: a systematic review and meta-analysis. BMC Musculoskelet Disord. 2021;22(1):749.
- Siu WS, Ma H, Cheng W, Shum WT, Leung PC. Traditional Chinese medicine for topical treatment of skeletal muscle injury. Pharmaceuticals (Basel). 2023;16(8):1144.
- Jingying G, et al. A comprehensive review of Drynariae rhizoma: botany, traditional applications, and active flavonoid components. J Pharm Pharmacol. 2025;77(10):1319-1337.
- Chen GY, et al. Prediction of Rhizoma Drynariae targets in the treatment of osteoarthritis based on network pharmacology and experimental verification. Evid Based Complement Alternat Med. 2021;2021:5233462.
- Yang G, et al. Total flavonoids of Rhizoma Drynariae enhance bone marrow mesenchymal stem cell-mediated tendon-bone healing by promoting tissue regeneration, angiogenesis, and modulation of cytokine expression. Biology (Basel). 2025;14(11):1593.
- Shen J, et al. Rhizoma Drynariae-derived EV-like particles alleviate osteoporosis by promoting osteogenic differentiation in BMSCs through the activation of the hsa_circ_0001275/miR-422a pathway. Bone. 2025;196:117489.
- Cai L, et al. Hydrogel microspheres loaded with sinomenine and Drynaria rhizome enhance the treatment of rheumatoid arthritis via immune regulation and promoting bone repair. J Nanobiotechnology. 2026;24(1):174.
- Chen GY, et al. Network pharmacology analysis and experimental validation to investigate the mechanism of total flavonoids of Rhizoma Drynariae in treating rheumatoid arthritis. Drug Des Devel Ther. 2022;16:1743-1766.
- Chen GY, et al. Mechanisms of total glucosides of paeony in alleviating methotrexate-induced liver injury. Drug Des Devel Ther. 2025;19:3407-3423.
- Zhang P, et al. Network pharmacology: towards the artificial intelligence-based precision traditional Chinese medicine. Brief Bioinform. 2024;25(1):bbad518.
- Zhao L, et al. Network pharmacology, a promising approach to reveal the pharmacology mechanism of Chinese medicine formula. J Ethnopharmacol. 2023;309:116306.
- Ru J, et al. TCMSP: a database of systems pharmacology for drug discovery from herbal medicines. J Cheminform. 2014;6:13.
- Xu HY, et al. ETCM: an encyclopaedia of traditional Chinese medicine. Nucleic Acids Res. 2019;47(D1):D976-D982.
- Wu Y, et al. SymMap: an integrative database of traditional Chinese medicine enhanced by symptom mapping. Nucleic Acids Res. 2019;47(D1):D1110-D1117.
- UniProt Consortium. UniProt: the universal protein knowledgebase. Nucleic Acids Res. 2018;46(5):2699.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Amberger JS, Hamosh A. Searching Online Mendelian Inheritance in Man (OMIM): a knowledgebase of human genes and genetic phenotypes. Curr Protoc Bioinformatics. 2017;58:1.2.1-1.2.12.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-D646.
- Otasek D, Morris JH, Bouças J, Pico AR, Demchak B. Cytoscape Automation: empowering workflow-based network analysis. Genome Biol. 2019;20(1):185.
- Pitarch B, Chagoyen M, Ranea JAG, Pazos F. A review on Gene Ontology evaluations. Database (Oxford). 2025;2025:baaf058.
- Kanehisa M, Furumichi M, Sato Y, Kawashima M, Ishiguro-Watanabe M. KEGG for taxonomy-based analysis of pathways and genomes. Nucleic Acids Res. 2023;51(D1):D587-D592.
- Kim S, et al. PubChem in 2021: new data content and improved web interfaces. Nucleic Acids Res. 2021;49(D1):D1388-D1395.
- Burley SK, et al. RCSB Protein Data Bank: celebrating 50 years of the PDB with new tools for understanding and visualizing biological macromolecules in 3D. Protein Sci. 2022;31(1):187-208.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891-3898.
- Li QR, Han YX, Bian YT, Lan MQ, Chen GY. Unveiling the mechanism of Cibotium barometz in the treatment of rheumatoid arthritis: a study based on network pharmacology and experimental validation. Curr Med Chem. 2026. Online ahead of print.
- Seeliger D, de Groot BL. Ligand docking and binding site analysis with PyMOL and Autodock/Vina. J Comput Aided Mol Des. 2010;24(5):417-422.
- Wang Y, Xu B, Ma C, Huang D, Zhou L. Association between inflammatory proteins and rotator cuff tears: a bidirectional Mendelian randomization study. Sci Rep. 2025;15(1):26987.
- Wang KC, et al. The influence of age on cellular senescence in injured versus healthy muscle and its implications on rotator cuff injuries. J Shoulder Elbow Surg. 2025;34(6 Suppl):S117-S126.
- Wellington IJ, et al. Management of failed rotator cuff repairs: a review. Orthop Clin North Am. 2022;53(4):473-482.
- Han L, Wang C, Wang T, Hu Y, Wang H. Total flavonoids of Rhizoma Drynariae improves tendon-bone healing for anterior cruciate ligament reconstruction in mice and promotes the osteogenic differentiation of bone mesenchymal stem cells by the ERR1/2-Gga1-TGF-β/MAPK pathway. Environ Toxicol. 2024;39(1):106-119.
- Chai S, et al. Luteolin rescues postmenopausal osteoporosis elicited by OVX through alleviating osteoblast pyroptosis via activating PI3K-AKT signaling. Phytomedicine. 2024;128:155516.
- Li W, et al. Effects of total flavonoids of Rhizoma Drynariae on biochemical indicators of bone metabolism: a systematic review and meta-analysis. Front Pharmacol. 2024;15:1443235.
- Wang Z, Cao L, Wang X. Total flavonoids of Rhizoma Drynariae ameliorate tendon-bone healing following anterior cruciate ligament reconstruction in rats by activating the FSP1/CoQ10 pathway to inhibit osteoblast mitochondrial dysfunction and ferroptosis. Appl Biochem Biotechnol. 2026;198(8):5916-5938.
- Kim JG, et al. Therapeutic potential of quercetin as an antioxidant for bone-muscle-tendon regeneration and aging. Aging Dis. 2024;16(3):1414-1437.
- Worsfold SI, et al. Rotator cuff tendinopathy: pathways of apoptosis. Sports Med Arthrosc Rev. 2024;32(1):12-16.
- Chen L, et al. AMPK signaling in osteoarthritis: from mechanisms to targeted therapeutics. Front Pharmacol. 2025;16:1681610.
- Li Y, et al. Leptin enhances M1 macrophage polarization and impairs tendon-bone healing in rotator cuff repair: a rat model. Clin Orthop Relat Res. 2025;483(5):939-951.
- Yang Y, et al. Celastrol suppresses neovascularization in rat aortic vascular endothelial cells stimulated by inflammatory tenocytes via modulating the NLRP3 pathway. Open Med (Wars). 2025;20(1):20241121.
- Li Y, et al. Prevascularized bone marrow-derived mesenchymal stem cell sheets promote tendon-bone integration in rotator cuff repair. J Bone Joint Surg Am. 2026;108(17):1389-1398.
- Zhao MJ, et al. Eupatorin as a promising natural compound against knee osteoarthritis: from network pharmacology to experimental validation. Front Biosci (Landmark Ed). 2025;30(12):46747.
- Cho W, et al. Valdecoxib ameliorates apoptosis and ferroptosis in tenocytes via the SIRT6/NRF2-mediated suppression of oxidative stress. Arch Med Res. 2025;56(6):103231.
- Cheng Y, et al. Amentoflavone alleviated cartilage injury and inflammatory response of knee osteoarthritis through PTGS2. Naunyn Schmiedebergs Arch Pharmacol. 2024;397(11):8903-8916.
- Cho W, et al. Therapeutic potential of ginsenoside compound K in managing tenocyte apoptosis and extracellular matrix damage in diabetic tendinopathy. Tissue Cell. 2024;86:102275.
- Cheng P, et al. High-purity magnesium screws modulate macrophage polarization during the tendon-bone healing process in the anterior cruciate ligament reconstruction rabbit model. Regen Biomater. 2022;9:rbac067.
- Zhou L, et al. Regorafenib attenuates osteoclasts differentiation by inhibiting the NF-κB, NFAT, ERK, and p38 signaling pathways. ACS Omega. 2024;9(31):33574-33593.
- Cho MH, Jin H, Ha J, Chu S, An S. An integrated systems pharmacology approach combining bioinformatics, untargeted metabolomics and molecular dynamics to unveil the anti-aging mechanisms of Tephroseris flammea. Biomolecules. 2025;15(12):1740.
- Wang L, et al. IL-33/ST2 drives inflammatory pain via CCL2 signaling and activation of TRPV1 and TRPM8. Commun Biol. 2025;8(1):724.
- Zhang P, Xu X, Wang H, Zhang Y. Anti-inflammatory activity and potential anti-inflammatory mechanisms of Artemisia scoparia essential oil. J Pharm Pharmacol. 2026;78(2):rgag004.
- Wang Z, et al. Engineered mesenchymal stem cells with endogenous trehalose expression activate the NRF2-HMOX1 pathway to enhance antioxidant stress and wound healing capacity. Adv Wound Care (New Rochelle). 2026. Online ahead of print.
- Lu Y, et al. Dual-PPARα/δ agonist H11 alleviates tendinopathy via modulating the Nrf2/HO-1/GPX4 pathway. Free Radic Biol Med. 2026;242:333-344.
- Chung SW, Yoon JP, Park SJ. Inhibiting muscle degeneration in rotator cuff tears: integrative biologic approaches targeting regeneration, fibrosis, and metabolism. Stem Cells Transl Med. 2026;15(6):szag023.
- Feuerriegel GC, et al. Assessment of the rotator cuff muscles: state-of-the-art MRI and clinical implications. Radiology. 2025;315(2):e242131.
- He Y, et al. SHED-derived exosome-mimetics promotes rotator cuff tendon-bone healing via macrophage immunomodulation through NF-κB suppression and autophagy activation. Mater Today Bio. 2025;34:102146.
- Zhang Z, et al. Curcumin improves functional recovery of ruptured tendon by promoting tenogenesis via PI3K/Akt signaling. Stem Cells Transl Med. 2024;13(5):477-489.
- Chen C, et al. CTHRC1 attenuates tendinopathy via enhancing EGFR/MAPK signaling pathway. Adv Sci (Weinh). 2024;11(47):e2406611.
- Zulkifli A, et al. The potential mechanism of hypoxia-induced tenogenic differentiation of mesenchymal stem cell for tendon regeneration. Tissue Cell. 2023;82:102075.
- Xiang L, Deng H, Zhou S. Effects of TNF-α on behaviour and inflammation in rats with rotator cuff injury through NGF. Discov Med. 2024;36(185):1241-1249.
- Liu H, et al. RNA-sequencing-based elucidation of the mechanism underlying aFGF mediated regulation of BMSCs via the PI3K-AKT pathway and its implications for rotator cuff injury repair. J Orthop Surg Res. 2025;20(1):997.
- Chen GY, et al. Total flavonoids of Rhizoma Drynariae restore the MMP/TIMP balance in models of osteoarthritis by inhibiting the activation of the NF-κB and PI3K/AKT pathways. Evid Based Complement Alternat Med. 2021;2021:6634837.
- Wang Y, Gu X, Tu J, Xu B. MCP-1 exacerbates diabetic rotator cuff tear by driving synovial inflammation via MAPK/ERK-mediated macrophage polarization. J Shoulder Elbow Surg. 2026. Online ahead of print.
- Lin J, et al. Hypobaric hypoxia ameliorates impaired regeneration after diabetic skeletal muscle injury by promoting HIF-1α signaling. Int J Mol Sci. 2026;27(2):648.
- Tian M, Wang K, Chen D. Efficacy and mechanisms of Xiangsha Liujunzi Decoction for gastroesophageal reflux disease: a study integrating meta-analysis, network pharmacology and molecular docking. Phytomedicine. 2026;151:157766.