Ce protocole intègre la désidentification, la normalisation de la terminologie, la vérification des sources et la visualisation reproductible afin de produire des résultats agrégés vérifiables à partir de dossiers de patients externes réels en médecine traditionnelle chinoise.
Article de méthode
Extraction et visualisation auditées à la source de dossiers de cas réels de médecine traditionnelle chinoise utilisant la formule Hegan Jianpi
* These authors contributed equally
Dans cet article
Résumé
Résumé
Les dossiers de consultations externes de médecine traditionnelle chinoise (MTC) en conditions réelles contiennent des informations longitudinales sur les diagnostics, les éléments syndromiques, les descriptions des symptômes et les prescriptions individualisées, mais leur format semi-structuré complique une analyse reproductible. Cet article présente un protocole validé par vérification des sources permettant de convertir des dossiers de cas anonymisés en tableaux agrégés traçables et des visualisations prêtes à la publication. Le flux de travail définit des critères d'éligibilité et des unités d'analyse, préserve les correspondances entre la terminologie originale et normalisée, vérifie tous les numérateurs et dénominateurs rapportés, et régénère les figures à partir de tableaux sources versionnés. Appliqué aux dossiers couvrant la période de janvier 2015 à juin 2024, le protocole a identifié 555 consultations de prescription éligibles provenant de 396 patients. Le jeu de données final comprenait 324 désignations normalisées de plantes médicinales et 9 339 occurrences d'utilisation de plantes. Le flux de travail a produit des spectres parallèles de maladies en médecine occidentale et en MTC, un spectre explicite des éléments syndromiques et une matrice de co-occurrence, des profils de fréquence des plantes et de la pharmacopée, un spectre de symptômes dérivé de l'anamnèse composé de 37 termes, 15 règles d'association orientées, un regroupement hiérarchique et des cartes thermiques d'utilisation des plantes stratifiées par diagnostic. Au moins un mot-clé prédéfini de l'anamnèse a été détecté dans 474 consultations (85,41 %). Lorsque les politiques institutionnelles le permettent, une option utilisant une intelligence artificielle (IA) supervisée par un humain peut aider à la vérification terminologique, à l'examen de la cohérence entre fichiers et à l'alignement des légendes avec les figures. Toute utilisation d'IA doit être documentée dans un registre d'audit distinct et ne doit en aucun cas remplacer l'examen des données sources. En intégrant gouvernance, normalisation, calcul, interprétation clinique et sortie visuelle au sein d'un flux de travail unique et reproductible, cette méthode transforme une documentation clinique dispersée en une ressource de recherche examinable. Le protocole peut être adapté à d'autres jeux de données issus de pratiques expertes, à des projets multicentriques de terminologie et à des plateformes de données cliniques prospectives.
Introduction
Les dossiers de consultations externes de la médecine traditionnelle chinoise (MTC) dans le monde réel conservent un raisonnement clinique longitudinal à travers des symptômes narratifs, des systèmes diagnostiques parallèles, des descriptions de syndromes et des prescriptions individualisées. Les premiers travaux de découverte de connaissances ont reconnu que les dossiers de cas constituent des données expérientielles complexes nécessitant des méthodes informatiques dédiées avant que leurs motifs puissent être étudiés de manière fiable1. Des recherches ultérieures ont montré que les expressions synonymes des symptômes, les entités fines et les termes diagnostiques documentés localement doivent être normalisés sans effacer les formulations d'origine2,3,4,5,6. Les données des dossiers de santé électroniques (DSE) peuvent également soutenir la recherche computationnelle sur les prescriptions et l'utilisation d'outils analytiques réutilisables lorsque le contexte clinique et la traçabilité des données restent visibles7,8. Des références autorisées en matière de pharmacopée sont donc nécessaires pour normaliser les noms des plantes médicinales, leurs formes de préparation, leurs propriétés, leurs saveurs et leurs attributions aux méridiens9,10. Au niveau de la restitution, les déclarations RECORD et STROBE exigent des descriptions transparentes des sources de données, des critères d'éligibilité, des variables et des décisions analytiques, tandis que les principes FAIR mettent l'accent sur des objets de recherche traçables et réutilisables11,12,13. Ces considérations sont particulièrement importantes lorsque les dossiers contiennent des visites répétées, des champs manquants, des terminologies chevauchantes et du texte libre. L'évaluation de l'adéquation à l'usage doit aborder les aspects de complétude, de conformité, de plausibilité et d'accord entre sources14,15. La désidentification des textes libres exige également des procédures explicites et une vérification humaine, car les méthodes automatisées peuvent préserver un contenu clinique utile tout en laissant des risques résiduels pour la vie privée16,17,18.
Une fois les aspects de gouvernance et de terminologie établis, le profilage de fréquence, l'extraction de règles d'association et le regroupement hiérarchique peuvent offrir des perspectives complémentaires de la structure des prescriptions19,20,21. Les méthodes issues des réseaux et de la cartographie scientifique montrent davantage comment des représentations visuelles coordonnées peuvent révéler des relations que ne saurait capturer une simple liste classée22,23,24,25. Des études récentes portant sur la polyarthrite rhumatoïde associée à la dépression, les inhibiteurs de la kinase Janus dans la colite ulcéreuse, et la polyarthrite rhumatoïde associée à la fibromyalgie illustrent l'intérêt de critères de récupération figés par version, de réseaux de co-occurrence, de regroupement, d'interprétation temporelle et de déclarations explicites des limites analytiques26,27,28. La présente étude adapte ces principes de conception transférables à l'exploration de dossiers cliniques plutôt qu'à la bibliométrie de la littérature. Dans les dossiers sources, Hegan Jianpi Formula désigne une formule empirique associée à la pratique du professeur Nai-li Yao29,30. Des publications connexes décrivent son approche clinique plus large d'harmonisation foie-rate et rate-estomac29,30. Dans cet article méthodologique, le nom de la formule identifie uniquement le contexte du dossier source et n'établit ni composition fixe, ni posologie, ni indication thérapeutique, ni affirmation d'efficacité. Le flux de travail computationnel utilise des règles déterministes et des méthodes statistiques générales. Une pratique computationnelle reproductible exige en outre la conservation des entrées, la documentation des paramètres, les transformations automatisées par script et des sorties vérifiables31,32. Une option d'intelligence artificielle (IA) supervisée par un humain peut aider aux vérifications terminologiques, aux examens de cohérence entre fichiers et au contrôle visuel de qualité, à condition que son utilisation soit documentée. L'expertise clinique, les mesures de protection de la vie privée et la prise de décision humaine responsable doivent rester primordiales (Tableau supplémentaire 1)33,34. L'objectif global de cette méthode est de transformer des dossiers de cas de médecine traditionnelle chinoise dé-identifiés en une chaîne validée par la source, produisant des résultats stratifiés selon la maladie, le syndrome, les symptômes, l'utilisation des plantes, les associations, le regroupement et le diagnostic. L'exemple traité utilise 555 consultations éligibles provenant de 396 patients afin de montrer comment gouvernance, normalisation, calcul, interprétation clinique et diffusion visuelle peuvent être intégrées sans divulguer les données au niveau patient, les détails exacts des formulations, les rapports posologiques ou les instructions prescriptives.
Protocole
Cette analyse rétrospective de dossiers cliniques anonymisés a été examinée et approuvée par le Comité d'éthique médicale de l'hôpital Guang'anmen, Académie des sciences médicales chinoises de Chine (n° d'approbation 2026-108-KY ; 13 juillet 2026). L'exigence de consentement éclairé a été levée par le Comité.
1. Établir l'éthique, la gouvernance et la sécurité des données
- Attribuez un responsable des données, un analyste des données sources, un examinateur de la terminologie clinique, un examinateur quantitatif et un chercheur autorisé à approuver la diffusion des données agrégées. Enregistrez chaque rôle dans le journal du projet.
- Élaborez un plan de gestion des données précisant le système source autorisé, la période d'étude, les champs, l'emplacement de stockage, les autorisations d'accès, la procédure de sauvegarde, la durée de conservation et les restrictions relatives aux clés de liaison.
- Exportez uniquement les variables minimales nécessaires à l'analyse prédéfinie. Incluez un identifiant local du patient, la date de la visite, l'âge ou la date de naissance lorsque cela est autorisé, le sexe, le diagnostic occidental, le nom de la maladie en médecine traditionnelle chinoise, le texte du dossier médical anonymisé, la description de la langue, celle du pouls, celle du syndrome, ainsi que les champs relatifs à l'ordonnance et aux plantes médicinales.
- Supprimez les noms, les numéros d'identification nationaux, les numéros de téléphone, les adresses détaillées, les identifiants d'assurance, les coordonnées et tout autre identifiant direct au sein de l'environnement institutionnel contrôlé. Remplacez chaque numéro de dossier médical par un identifiant patient spécifique au projet.
- Parcourez les champs de texte libre à la recherche d'identifiants résiduels et masquez chaque élément détecté. Stockez toute clé de liaison séparément du jeu de données analytique et excluez-la des dossiers de travail, de collaboration et de soumission.
- Conservez l'export initial anonymisé sous forme d'une image source en lecture seule. Enregistrez son nom de fichier, sa date de création, son nombre de lignes, son nombre de colonnes, sa taille et sa somme de contrôle dans un manifeste des sources.
- Créez des répertoires distincts pour les fichiers sources, les fichiers de travail, les dictionnaires, les tableaux agrégés, les figures, les scripts et les enregistrements d'audit.
- Limitez les documents diffusés ou partagés aux tableaux agrégés, aux dictionnaires anonymisés approuvés, aux scripts et aux figures destinées à la publication. Ne téléversez pas de données identifiables ou potentiellement réidentifiables vers des systèmes d'intelligence artificielle générative publics, des services cloud non approuvés ou des dépôts publics.
NOTE : Lorsque la politique institutionnelle autorise une assistance par intelligence artificielle supervisée par un humain, fournissez uniquement des extraits de texte anonymisés ou des tableaux agrégés. Enregistrez dans le journal d'audit la finalité, le résultat examiné, la correction acceptée, l'examinateur et la date.
2. Définir la règle d'identification des enregistrements et les unités d'analyse
- Définir l'établissement, le cadre ambulatoire, l'équipe clinique responsable, le système de dossier médical électronique et la période source avant le dépistage. Pour l'exemple traité, utiliser les dossiers datés de janvier 2015 à juin 2024.
- Stocker la règle d'identification de la cohorte dans un fichier restreint et sous contrôle de version avant d'examiner les résultats analytiques. Enregistrer les variantes terminologiques acceptées ainsi que toutes les conditions d'inclusion et d'exclusion, sans divulguer dans le manuscrit les détails confidentiels de la formulation.
- Appliquer la règle d'identification des dossiers verrouillée en version au niveau de la consultation-prescription, après la normalisation des noms d'herbes. Finaliser les fichiers sources, les dictionnaires, la règle de cohorte et les paramètres d'analyse en un seul jeu publié.
- Créer une nouvelle version et régénérer toutes les sorties dépendantes chaque fois qu'un composant verrouillé en version est modifié. Ne pas modifier la règle d'identification de la cohorte après avoir examiné les distributions de maladies, les fréquences d'herbes, les règles d'association ou les regroupements.
- Inclure une consultation ambulatoire lorsqu'elle se situe dans la période d'étude verrouillée en version, qu'elle correspond à un identifiant patient de projet valide, qu'elle contient un enregistrement de prescription interprétable et qu'elle satisfait à la règle d'identification des dossiers restreinte.
- Exclure les exports en double exact, les dossiers hors période d'étude, les dossiers sans prescription interprétable, et les lignes ne satisfaisant pas à la règle d'identification verrouillée en version. Attribuer une raison d'exclusion principale à chaque ligne exclue.
- Distinguer les exports répétés des consultations de suivi réelles. Supprimer uniquement les doublons exacts du système ou des exports, et conserver les consultations répétées authentiques.
- Attribuer des identifiants stables aux patients et aux consultations-prescriptions. Créer un manifeste de cohorte contenant la version source, la version de la règle, le statut de dépistage, la raison d'inclusion ou d'exclusion, l'identifiant du patient, l'identifiant de la consultation et le statut du vérificateur.
- Utiliser un seul enregistrement par patient unique pour les résumés démographiques fixes, incluant l'âge et le sexe. Utiliser la consultation-prescription comme unité d'analyse pour les analyses de maladie, de syndrome, de mot-clé d'antécédents, de langue, de pouls, d'herbe, de règles d'association et de regroupement.
- Différencier l'éligibilité de la cohorte de la disponibilité des variables. Conserver une consultation autrement éligible lorsqu'un champ spécifique à une variable est manquant, et indiquer le dénominateur analysable pour chaque analyse.
- Figurer le manifeste de cohorte avant l'analyse descriptive. Enregistrer le nombre de consultations-prescriptions éligibles et de patients uniques, et régénérer toutes les sorties dépendantes si une décision d'éligibilité est modifiée.
3. Normaliser la terminologie et préserver la traçabilité
- Créer des dictionnaires distincts soumis au contrôle de version pour les herbes, les diagnostics occidentaux, les noms de maladies de la médecine traditionnelle chinoise (MTC), les éléments du syndrome, les mots-clés de l’anamnèse, les termes relatifs à la langue, les termes relatifs au pouls et les attributs de la matière médicale.
- Inclure dans chaque dictionnaire le terme d'origine, le terme normalisé, la catégorie du terme, le champ source, la règle, la source de référence, la version du dictionnaire, le réviseur, la date de révision et les commentaires. Conserver chaque terme d'origine après la normalisation.
- Normaliser les noms des matériaux médicinaux chinois (CMM) en utilisant des références auctoriées en matière de nomenclature9,10. Corriger les variantes orthographiques et les abréviations systématiques tout en préservant les formes de préparation cliniquement significatives.
- Conserver les qualificatifs de préparation, notamment « sauté », « préparé au vinaigre », « frit au miel », « préparé au gingembre », « préparé au vin », « calciné » et « cru », comme des étiquettes distinctes.
- Conserver séparément les herbes orthographiquement ou cliniquement distinctes. Ne pas fusionner Bai Shao avec Bai Zhu, ni déduire une herbe à partir d'une abréviation ambiguë sans examen de la source.
- Conserver la dose et l'unité d'origine dans des champs distincts lorsqu'elles sont disponibles. Supprimer le texte relatif à la dose uniquement lors de la construction de variables indiquant la présence d'herbes au niveau de la consultation.
- Ne pas interpréter la fréquence d'apparition comme une dose cumulative ou une intensité de traitement.
- Normaliser indépendamment les noms de maladies occidentales et ceux de la MTC. Préserver le système diagnostique et le statut de diagnostic principal, et ne pas traduire un libellé de maladie en MTC par un diagnostic occidental, sauf si les deux sont explicitement enregistrés.
- Définir un libellé de maladie en MTC translittéré lors de sa première utilisation, si nécessaire pour l'orientation du lecteur. Conserver le libellé source d'origine.
- Scinder les textes explicites de syndrome à valeurs multiples à l’aide de délimiteurs verrouillés par version, et associer les expressions sources aux éléments de syndrome normalisés. Supprimer les doublons pour chaque élément normalisé au sein d'une même consultation.
- Conserver séparément les textes explicites de syndrome et les colonnes d'indicateurs hérités ou dérivés de scores.
- Conserver les champs d'origine relatifs à la langue, au pouls, aux symptômes structurés et à l’anamnèse dépersonnalisée comme produits de données distincts. Ne pas considérer une correspondance avec un mot-clé d’anamnèse comme équivalente à un symptôme structuré saisi par un clinicien.
- Faire proposer chaque association ambiguë ou de type « un-à-plusieurs » par un réviseur, puis faire vérifier celle-ci par un second réviseur clinicien. Exclure des analyses publiées les associations incertaines jusqu’à ce qu’un examen de la source les résolve.
- Vérifier l’absence d’étiquettes normalisées vides, d’associations « un-à-plusieurs », d’associations « plusieurs-à-un », d’entrées de dictionnaire en double, de termes non révisés et de pertes accidentelles d’étiquettes de préparation. Verrouiller les versions des dictionnaires avant de générer les tableaux agrégés.
4. Vérifier les champs sources et verrouiller les sorties déclarables
- Créer un registre des preuves avec une ligne pour chaque affirmation du manuscrit, tableau et panneau de figure. Enregistrer l'unité d'analyse, le champ source, la version source, la version du dictionnaire, la version du script, le numérateur, le dénominateur, le fichier de sortie, le réviseur et la formulation approuvée.
- Recalculer directement à partir des fichiers verrouillés les nombres de visites éligibles et de patients uniques, les résumés démographiques, les nombres de cas de maladie, les nombres de syndromes explicites, les nombres d'occurrences de mots-clés d'antécédents, les fréquences d'herbes fusionnées et les totaux d'utilisation d'herbes.
- Comparer chaque valeur recalculée avec la valeur correspondante dans le manuscrit, le tableur ou la figure. Corriger le manuscrit et régénérer les sorties dépendantes chaque fois qu'une divergence est confirmée.
- Résoudre chaque divergence au niveau du champ source. Enregistrer la raison, la correction, le réviseur et la date dans le registre des preuves avant de diffuser le résultat concerné.
- Vérifier que chaque tableau agrégé contient l'étiquette normalisée, le numérateur, le dénominateur, la définition du pourcentage, l'unité d'analyse et l'identifiant source nécessaires pour reproduire l'énoncé correspondant.
- Vérifier le dénominateur utilisé pour chaque pourcentage. Utiliser les patients uniques pour les caractéristiques démographiques fixes et les consultations de prescription pour les variables cliniques et prescriptives dynamiques.
- Comparer les étiquettes, valeurs, ordres et définitions des panneaux des figures avec leurs tableaux agrégés verrouillés. Régénérer chaque figure après une correction du tableau plutôt que de modifier manuellement les valeurs tracées.
- Demander à un réviseur clinique de vérifier les correspondances terminologiques. Demander à un réviseur quantitatif de vérifier les décomptes, taux, métriques des règles et dénominateurs des cartes thermiques.
- Verrouiller le registre des preuves, les tableaux agrégés et les sources des figures sous un même identifiant de version avant l'assemblage du manuscrit.
5. Générer des spectres descriptifs et des sorties de co-occurrence
- Générer des résumés par patient concernant l'âge et le sexe à partir d'une ligne par patient unique. Conserver et indiquer explicitement les catégories inconnues.
- Générer séparément les spectres de maladies occidentales et de médecine traditionnelle chinoise au niveau de la consultation-prescription. Préserver le système diagnostique d'origine et calculer les libellés normalisés principaux en utilisant un dénominateur commun de consultations.
- Générer le spectre des éléments du syndrome à partir du champ textuel du syndrome normalisé explicite. Fractionner les termes à l’aide de délimiteurs verrouillés par version, éliminer les doublons de chaque terme au sein d’une même consultation et calculer les fréquences par consultation.
- Construire la matrice de co-occurrence des syndromes à partir des mêmes ensembles de tokens présents dans une même consultation. Encoder la taille des nœuds selon la fréquence des consultations et l’épaisseur des arêtes ou l’intensité de la carte thermique selon le nombre de co-occurrences par paire.
- Prédéfinir un dictionnaire exact de mots-clés d’antécédents lorsque les informations symptomatiques sont principalement narratives. Analyser uniquement le champ d’antécédents désidentifié et comptabiliser chaque concept au plus une fois par consultation.
- Calculer la proportion de consultations éligibles contenant au moins un mot-clé d’antécédents et classer tous les décomptes de mots-clés. Exporter le tableau complet ainsi que le sous-ensemble représenté graphiquement.
- Générer les fréquences des herbes combinées à partir des données de prescription normalisées. Compter chaque libellé d’herbe normalisé au plus une fois par consultation, et conserver les formes de préparation cliniquement pertinentes comme libellés distincts.
- Générer les profils des Quatre-Qi, des cinq saveurs et de l’affinité des méridiens à partir du dictionnaire verrouillé par version de la matière médicale. Considérer les Quatre-Qi comme une catégorie à valeur unique pour chaque occurrence d’herbe codée par propriété.
- Considérer les cinq saveurs et l’affinité des méridiens comme des attributs multicatégoriels. Préciser le dénominateur des propriétés codées et préserver l’unité d’analyse distincte.
- Exporter un tableau agrégé lisible par machine pour chaque domaine descriptif avant de générer les figures finales.
6. Réaliser des analyses de règles d'association et de regroupement hiérarchique
- Construire une matrice binaire visite-ordonnance-par-plante à partir de la table normalisée d'ordonnances verrouillée en version. Utiliser une ligne par visite éligible et une colonne par libellé normalisé de plante.
- Calculer le support, la confiance et le lift pour les règles d'association à une seule plante orientées19. Conserver le sens de chaque règle car la confiance dépend de l'antécédent.
- Appliquer les seuils prédéfinis de support ≥ 0,30, de confiance ≥ 0,70 et de lift > 1,0. Exporter chaque règle conservée avec son nombre de co-occurrence et ses trois métriques.
- Représenter l'ensemble complet des règles conservées sous forme d'un réseau bipartite orienté et d'un profil ordonné de force des règles. Coder l'épaisseur des arêtes du réseau par le support et la couleur des arêtes par le lift.
- Coder la taille des points par le support et annoter la confiance dans le profil ordonné.
- Vérifier que les deux représentations des règles contiennent le même ensemble de règles conservées et préservent le sens des règles. Corriger chaque discordance en comparant avec la table de règles exportée avant publication.
- Sélectionner les 20 variables de présence de plantes ayant la fréquence la plus élevée pour un regroupement hiérarchique. Calculer les distances de Jaccard par paires et appliquer un regroupement par liaison moyenne.
- Étiqueter le dendrogramme avec les noms normalisés des plantes. Interpréter la proximité des branches uniquement comme une similarité dans les profils d'occurrence au niveau des visites.
- Exporter la spécification de la matrice binaire, la table des règles, la liste des arêtes du réseau, l'ordre d'entrée pour le regroupement, la matrice des distances et la matrice de liaison avant la génération des figures.
- Demander à un relecteur quantitatif de recalculer manuellement une métrique de règle. Comparer chaque arête du réseau avec la table des règles.
- Relancer l'ensemble du flux de travail relatif aux règles et au regroupement chaque fois que la cohorte, le dictionnaire de terminologie ou la matrice de présence des plantes change.
- Pour l'exemple traité, effectuer une analyse de sensibilité déterministe d'une visite par patient en conservant l'enregistrement le plus ancien selon l'ordre source pour chaque patient. Comparer les 12 règles obtenues avec les 15 règles issues de l'analyse au niveau des visites.
- Présenter cette différence comme un résultat descriptif de robustesse plutôt qu'une validation au niveau des patients. Utiliser le recalcul déterministe fourni dans Supplementary File 1.
7. Générer des profils stratifiés selon le diagnostic et le cadre d'interprétation clinique
- Sélectionnez d'abord des strates principales de diagnostic occidental cliniquement pertinentes avant d'examiner les distributions d'herbes spécifiques à chaque diagnostic.
- Comptez chaque étiquette d'herbe normalisée au plus une fois par visite au sein de chaque strate de diagnostic. Calculez la prévalence comme étant le nombre de visites contenant l'étiquette divisé par le nombre total de visites éligibles dans cette strate.
- Utilisez le même ensemble d'herbes affiché et une échelle de couleurs fixe de 0 % à 100 % pour toutes les strates de diagnostic. Affichez les valeurs des cellules afin de préserver une interprétation exacte.
- Signalez le numérateur et le dénominateur pour chaque cellule affichée dans un tableau agrégé indépendant.
- Construisez un panneau d'interprétation clinique distinct après avoir terminé la carte thermique descriptive. Gardez les résultats calculés et l'interprétation experte clairement séparés sur le plan visuel.
- Remplissez la couche d'indices uniquement avec des termes traçables jusqu'au tableau des mots-clés historiques verrouillés par version ou jusqu'au texte normalisé explicite du syndrome.
- Demander à deux évaluateurs cliniques de s'entendre sur des interprétations contextuelles concises des indices sélectionnés. Enregistrez les noms des évaluateurs et la formulation finale dans le registre de preuves.
- Liez chaque interprétation contextuelle à une utilisation en recherche, telle que la sélection de variables, la validation prospective ou la génération d'hypothèses.
- Utilisez des connecteurs en pointillés et non directionnels pour la couche d'interprétation. Omettez tout contenu relatif à la dose, à la composition fixe ou aux recommandations thérapeutiques.
- Examinez conjointement la carte thermique et le panneau d'interprétation. Assurez-vous que la prévalence calculée, le contexte expert et l'utilisation future en recherche restent clairement distincts.
8. Assembler et vérifier le package de reproductibilité
- Exporter le manifeste source, le manifeste de cohorte, les versions du dictionnaire, le registre des preuves, les scripts d'analyse, les tableaux agrégés, les sources des figures et les figures finales dans des répertoires séparés.
- Donner à chaque fichier un nom basé sur un numéro stable de figure ou de tableau et sur la date de version. Conserver une version courante officielle et archiver séparément les versions remplacées.
- Générer chaque figure sous la forme d'un seul fichier image multipanneau. Exporter un PDF haute résolution et un PNG à 300 ppp pour relecture.
- Placer les légendes des figures dans le manuscrit et ne pas les inclure dans les fichiers image. Décrire chaque panneau, l'unité d'analyse, le dénominateur et le codage visuel.
- Préparer un fichier XLSX indépendant pour chaque tableau.
- Demander à un relecteur indépendant de comparer les chiffres du manuscrit avec les tableaux agrégés, ainsi que les pourcentages avec leurs numérateurs et dénominateurs.
- Comparer les bords des règles avec le tableau des règles et les cellules de la carte thermique avec la matrice source.
- Exécuter des vérifications automatisées portant sur la cohérence des noms de fichiers, la présence des sections obligatoires, les dimensions des figures, le nombre de tableaux, le nombre de références, les vestiges de modèle et l'emploi de formulations interdites.
- Demander à l'équipe d'auteurs cliniciens de vérifier la terminologie, l'interprétation, les limites liées à la propriété intellectuelle, les coordonnées des auteurs, l'ordre de financement, la formulation relative à l'éthique et le jeu complet des figures finales.
- Supprimer du jeu de soumission les fichiers au niveau patient, les clés de liaison, les textes libres non restreints, les correspondances internes et les artefacts temporaires de relecture.
- Figurer le jeu publié et enregistrer sa version, sa date, sa somme de contrôle, la version du manuscrit et le statut d'approbation par les auteurs. Créer une nouvelle version et un journal des modifications pour chaque correction ultérieure.
Résultats
L'application réussie du protocole a produit une chaîne traçable reliant l'instantané source désidentifié, le manifeste de la cohorte, les dictionnaires de terminologie, les tableaux agrégés, les scripts et les figures finales. La procédure de sélection verrouillée par version a identifié 555 consultations pour prescriptions éligibles provenant de 396 patients uniques. Figure 1 résume les trois étapes coordonnées de la méthode : gouvernance, normalisation de la terminologie et analyse avec examen clinique. La documentation correspondante assurant la transparence et la traçabilité, incluant la limite d'utilisation des données agrégées uniquement pour l'examen assisté par intelligence artificielle, est fournie dans le tableau supplémentaire 1.
La cohorte finale comprenait 555 consultations de prescription éligibles, réalisées par 396 patients distincts (Figure 2 et Tableau 1). Les visites répétées réelles ont été conservées pour les variables cliniques et de prescription dynamiques, tandis que l’âge et le sexe ont été résumés après dédoublonnage au niveau patient. L’âge des patients variait de 13 à 94 ans, avec une moyenne de 47,11 ans et un écart type de 14,88 ans. La cohorte comprenait 228 patientes (57,58 %), 167 patients de sexe masculin (42,17 %) et 1 patient dont le sexe était inconnu (0,25 %). Cette distinction des unités d’analyse a permis de préserver les consultations longitudinales sans gonfler le dénominateur démographique.
Les spectres des maladies occidentales et de la médecine traditionnelle chinoise sont résumés dans la Figure 3. Les diagnostics occidentaux étaient concentrés sur les troubles gastro-intestinaux, hépatobiliaires et pancréatiques. Le regroupement hiérarchique a attribué 271 consultations à des troubles gastro-intestinaux, 222 à des troubles hépatobiliaires ou pancréatiques, et 62 à d'autres systèmes (Figure 3A). Les diagnostics individuels les plus fréquents étaient la gastrite chronique lors de 133 consultations (23,96 %), la stéatose hépatique lors de 77 consultations (13,87 %) et la cirrhose du foie lors de 46 consultations (8,29 %), suivis par la gastrite chronique atrophique, la douleur abdominale, l'hépatite chronique B, la dyspepsie, l'œsophagite de reflux, la gastrite chronique superficielle et la pancréatite chronique (Figure 3C et Tableau 2).
Le spectre correspondant des noms de maladies de la médecine traditionnelle chinoise (MTC) a organisé les mêmes visites selon un système diagnostique parallèle. Les noms de maladies du spleen-estomac ou de l'intestin ont représenté 280 visites, ceux des maladies du foie-vésicule biliaire 223, les troubles du qi-sang-liquides 26, les troubles de l'esprit-thorax-tête 12, les troubles des méridiens ou des membres 5, les troubles gynécologiques 4, et d'autres catégories 5 visites (Figure 3B). Le « Wei pi », une étiquette diagnostique conservée en MTC pour désigner une plénitude ou un inconfort épigastrique, a été enregistré lors de 163 visites (29,37 %). Le « Ji » (accumulation), le « Gan zhuo » (littéralement, fixation du foie ; une ancienne étiquette diagnostique classique en MTC), le « Bi » (maladie d'obstruction) et le « Xiao ke » (amaigrissement avec soif) ont été conservés comme étiquettes diagnostiques originelles en MTC et n'ont pas été convertis en diagnostics biomédicaux modernes. Le « Gan pi », une étiquette diagnostique en MTC utilisée dans le consensus chinois contemporain pour les troubles du foie gras, a été noté lors de 77 visites (13,87 %)35. Les champs diagnostiques occidentaux et ceux de la MTC sont restés indépendants et n'ont pas été substitués l'un à l'autre (Figure 3D et Table 3). Le « Xie xie » (selles molles ou aqueuses) et le « Fu xie » (diarrhée) étaient deux étiquettes diagnostiques initiales distinctes en MTC, enregistrées respectivement 6 et 2 fois, et aucune n'a été assimilée à un diagnostic biomédical moderne. La présentation côte à côte des deux spectres a permis de préserver la logique propre à chaque système diagnostique tout en illustrant l'étendue clinique des données d'origine.
Le champ de texte de syndrome normalisé explicite contenait 555 lignes de consultations éligibles. Après déduplication au sein de chaque consultation, les éléments principaux étaient la rate dans 362 consultations (65,23 %), le foie dans 304 (54,77 %), la déficience du qi dans 295 (53,15 %), l'estomac dans 171 (30,81 %), l'humidité dans 151 (27,21 %) et la stagnation du qi dans 109 (19,64 % ; Figure 4A et Tableau 4). La chaleur, la rétention d'eau, le sang, la stase sanguine, les méridiens, le rein, le cœur et la déficience du yin constituaient le reste du spectre affiché. Les pourcentages n'étaient pas exclusifs, car plusieurs éléments de syndrome pouvaient survenir au cours d'une même consultation.
Le réseau et la matrice de comptage ont été générés à partir des mêmes ensembles de jetons au niveau de la visite (Figure 4B,C). Les enregistrements fréquents en co-occurrence portaient principalement sur la rate, le foie et la déficience du qi, avec des connexions supplémentaires vers l'estomac, l'humidité, la stagnation du qi, la chaleur et la rétention d'eau. L'utilisation d'une matrice verrouillée à une version unique pour le tracé de fréquence, le réseau et la carte thermique a permis de s'assurer que les trois panneaux représentaient la même preuve sous-jacente à différents niveaux de détail. L'audit récupéré a identifié 0 correspondance exacte entre syndrome-texte et indicateur parmi 555 lignes, avec une similarité moyenne de Jaccard texte-indicateur de 0,1806. Les colonnes d'indicateurs ont donc été exclues de la présentation principale. Les matériaux conservés ne contenaient pas de vecteurs de distribution reconstructibles avant nettoyage ; par conséquent, la stabilité distributionnelle inter-version n'a pas été estimée. L'analyse de sensibilité basée sur une seule visite par patient a plutôt évalué l'effet des visites répétées. Les résultats de l'audit source et de la qualité des données sont résumés dans le Tableau supplémentaire 2.
Après la normalisation terminologique et la conservation des formes de traitement cliniquement significatives, les 555 visites comprenaient 324 étiquettes d'herbes fusionnées distinctes et 9 339 occurrences d'utilisation d'herbes. Bai Shao a été enregistré dans 531 visites (95,68 %), suivi par Fu Ling dans 520 (93,69 %), Dang Gui dans 510 (91,89 %), Chi Shao dans 467 (84,14 %) et Bai Zhu stir-fried dans 361 (65,05 % ; Figure 5A et Tableau 5). La courbe rang-fréquence des 36 principales étiquettes présentait un segment élevé et à forte fréquence, suivi d'une queue progressivement plus large (Figure 5B), offrant ainsi une représentation synthétique des composantes de fond commun et des prescriptions individualisées. Les correspondances entre les termes sources et les termes normalisés, les descripteurs de traitement, les noms normalisés de MTC, les espèces sources et les limites probantes sous-jacentes à la nomenclature des herbes sont documentés dans le Tableau supplémentaire 3.
Le dictionnaire auxiliaire de matière médicale contenait 9 115 occurrences d'utilisation de plantes codées par propriété. Les catégories principales des Quatre Qi étaient celles de chaud (2 588, 28,39 %), légèrement froid (2 339, 25,66 %), neutre (2 330, 25,56 %) et froid (1 221, 13,40 % ; Figure 5C). Après normalisation de la terminologie des saveurs des composés d'origine, les cinq catégories principales de saveurs étaient amère (4 488, 49,24 %), douce (4 377, 48,02 %) et piquante (2 893, 31,74 % ; Figure 5D). Le codage de la tropie méridienne était dominé par la rate (5 541, 60,79 %), le foie (4 801, 52,67 %), le poumon (3 358, 36,84 %), l'estomac (2 988, 32,78 %) et le cœur (2 702, 29,64 % ; Figure 5E). La Figure 5F présente les unités d'analyse distinctes par niveau de consultation et codées par propriété, ainsi que leur lien de reproductibilité. Ensemble, ces graphiques montrent comment la fréquence des prescriptions et les descripteurs normalisés de matière médicale peuvent être résumées sans fusionner la terminologie spécifique aux procédés de transformation.
Le dictionnaire d'antécédents préspecifié contenait 37 concepts exacts de symptômes. Au moins un concept a été détecté lors de 474 des 555 consultations éligibles (85,41 %). Les termes les plus fréquents étaient la sécheresse de la gorge dans 178 consultations (32,07 %), la fatigue dans 151 (27,21 %), le mauvais sommeil dans 139 (25,05 %), la distension abdominale dans 115 (20,72 %), le reflux acide dans 100 (18,02 %), le goût amer dans 99 (17,84 %), les brûlures d'estomac dans 90 (16,22 %), les hoquets dans 87 (15,68 %), les éructations dans 87 (15,68 %) et les selles molles dans 77 (13,87 % ; Figure 6A,B et Tableau 6).
La courbe complète de rang-fréquence affichait la distribution complète des 37 termes, tandis que la ligne cumulative résumait la concentration de toutes les détections de mots-clés à travers les rangs (Figure 6C). Figure 6D enregistre la séquence reproductible utilisée pour générer le spectre : verrouiller le dictionnaire, analyser le texte historique désidentifié, dédupliquer les concepts au sein de chaque visite, puis exporter les comptages agrégés et les taux.
L'exploration de règles d'association a utilisé la matrice de présence d'herbes par visite et prescription, verrouillée à 555 lignes. Quinze règles à base d'une seule herbe ont satisfait aux seuils suivants : support ≥ 0,30, confiance ≥ 0,70 et lift > 1,0 (Figure 7A,B et Tableau 7). Les valeurs de support conservées variaient de 0,3009 à 0,7892, celles de la confiance de 0,7302 à 0,9748, et celles du lift de 1,0010 à 1,1226.
La paire dirigée la plus fréquemment enregistrée simultanément était Chi Shao > Fu Ling, fondée sur 438 visites, avec un support de 0,7892, une confiance de 0,9379 et un lift de 1,0010. La règle inverse avait le même support et une confiance de 0,8423, ce qui illustre pourquoi le sens de la règle doit être conservé. L'analyse de sensibilité aux seuils a conservé 18, 11, 21, 14, 7 et 4 règles selon des seuils de support ≥ 0,25 ou ≥ 0,35, de confiance ≥ 0,65 ou ≥ 0,75, ou de lift > 1,02 ou > 1,05, respectivement. Dans l'analyse d'une seule visite par patient, la même paire est apparue dans 316 visites, avec un support de 0,7980, une confiance de 0,9489 et un lift de 0,9994 ; par conséquent, elle n'a pas été conservée selon le critère de lift > 1,0. Les résultats des perturbations de seuil et de la sensibilité aux visites répétées sont fournis dans le Supplementary Table 4, et le recalcul déterministe est fourni dans le Supplementary File 1. Ainsi, un fort support au niveau des visites ne doit pas être interprété comme une validation au niveau des patients.
Les valeurs de lift les plus élevées ont été observées pour Gan Cao > Bai Zhu torréfié (1,1226) et Gan Cao > Chi Shao (1,1200). Figure 7A intègre les 15 règles retenues dans un réseau bipartite orienté, la largeur des arêtes représentant le support et la couleur des arêtes le lift. Figure 7B classe ces mêmes règles par lift, dimensionne chaque point selon le support et indique la confiance. Les deux panneaux distinguent ainsi la topologie du réseau de la force quantitative des règles, plutôt que de dupliquer la même représentation visuelle.
Le regroupement hiérarchique des 20 variables d'herbes les plus fréquentes a utilisé la distance de Jaccard et le lien moyen (Figure 7C). Le dendrogramme fournit une représentation globale des similitudes dans les profils de présence au niveau des visites, ce qui complète l'information directionnelle locale fournie par les règles d'association. Ensemble, les panneaux montrent comment des points de vue analytiques complémentaires peuvent être alignés sur une même matrice binaire verrouillée à une version.
La prévalence stratifiée par diagnostic a été calculée pour la stéatose hépatique (77 consultations), la cirrhose du foie (46 consultations) et la gastrite chronique (133 consultations ; Figure 8A et Tableau 8). Bai Shao, Fu Ling et Dang Gui présentaient une prévalence élevée dans les trois strates. Les consultations pour cirrhose hépatique ont montré une documentation importante de Dan Shen (95,65 %), d’E Zhu préparé au vinaigre (86,96 %), de Bie Jia préparé au vinaigre (84,78 %) et de Sheng Huang Qi (60,87 %). Les consultations pour stéatose hépatique ont révélé une prévalence plus élevée de Yin Chen (41,56 %) et de Ze Xie (31,17 %) par rapport aux autres strates, tandis que les consultations pour gastrite chronique ont montré une récurrence de Huang Lian (44,36 %), de Mu Xiang (34,59 %) et de Chai Hu (36,09 %). La carte thermique fournit donc une comparaison descriptive synthétique des profils de prescription agrégés selon les principaux contextes cliniques.
Figure 8B distingue le calcul de l'interprétation. Les indices historiques vérifiés sont associés à des contextes experts concis, puis aux utilisations en recherche, notamment la contextualisation des éléments du syndrome, la comparaison de profils stratifiés par diagnostic, la sélection de variables pour une validation prospective et la formulation de questions complémentaires. Ce dernier panneau montre comment l'expertise clinique peut enrichir les résultats analytiques tout en restant clairement distincte de la prévalence calculée.
Figure 8C résume la reproductibilité et les limites de diffusion en distinguant les composants vérifiés à la source ou réanalysés des éléments nécessitant une prudence ou une confirmation supplémentaire. Cette couche finale de vérification empêche la présentation de produits analytiques non résolus ou non reconstituables comme des résultats validés.
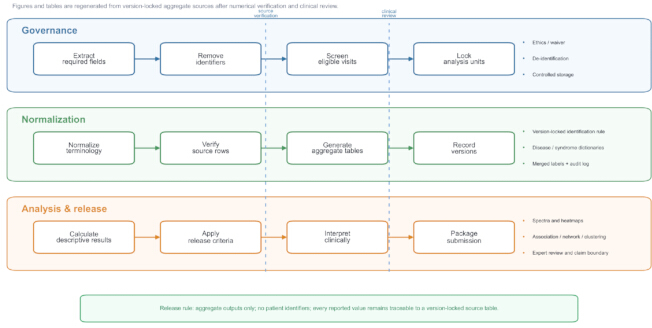
Figure 1 : Flux de travail de l'extraction de données médicales validées par la source. La gouvernance, la normalisation terminologique, l'analyse agrégée, la revue clinique et l'emballage pour diffusion sont représentées comme des étapes séquentielles du flux de travail. Les bandes bleue, verte et orange distinguent les domaines du flux de travail, et les lignes verticales en pointillés indiquent les points de contrôle. Les flèches indiquent la séquence du flux de travail et ne suggèrent aucune causalité biologique. La règle de diffusion précise que seules les sorties agrégées sont publiées, que les identifiants des patients sont exclus, et que chaque valeur rapportée reste traçable jusqu'à un tableau source verrouillé en version. Aucune barre d'erreur n'est applicable. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
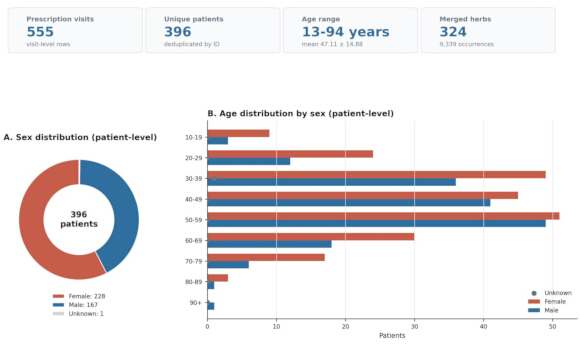
Figure 2 : Profil des données et démographie au niveau des patients. Les boîtes de synthèse indiquent 555 consultations pour prescriptions, 396 patients uniques, une tranche d'âge au niveau des patients comprise entre 13 et 94 ans avec un âge moyen de 47,11 ± 14,88 ans, et 324 étiquettes d'herbes fusionnées représentant 9 339 occurrences d'utilisation d'herbes. (A) Répartition par sexe au niveau des patients parmi les 396 patients uniques, incluant les catégories femmes, hommes et sexe inconnu. (B) Répartition par âge au niveau des patients selon le sexe parmi les mêmes 396 patients. Les boîtes de synthèse utilisent les dénominateurs au niveau des consultations ou des patients, selon le cas. Les couleurs permettent de distinguer les catégories de sexe et les éléments de synthèse, sans signification inférentielle. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
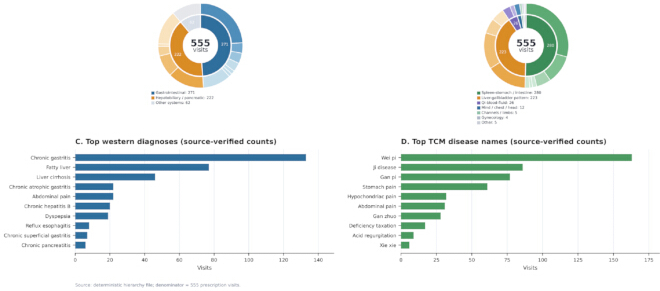
Figure 3 : Spectres de maladies obtenus à partir des consultations pour ordonnance. (A) Groupes hiérarchiques de maladies occidentales et (B) groupes hiérarchiques de maladies de la médecine traditionnelle chinoise (MTC) dérivés de 555 consultations éligibles pour ordonnance. (C) Principaux diagnostics occidentaux normalisés et (D) principaux noms normalisés de maladies de la MTC issus du même dénominateur au niveau des consultations. Les segments circulaires et les barres représentent le nombre de consultations ; les couleurs distinguent les systèmes ou catégories diagnostiques et ne reflètent pas les effets du traitement. Les libellés sources de la MTC conservés sont définis dans le tableau 3 : Wei pi (oppression ou inconfort épigastrique), Ji disease (affection d'accumulation, libellé source de la MTC), Gan pi (un libellé de maladie de la MTC utilisé pour les troubles du foie gras), Gan zhuo (littéralement, fixité du foie ; un ancien libellé de maladie de la MTC conservé), Bi disease (maladie d'obstruction), Xiao ke (amaigrissement avec soif), Xie xie (selles molles ou aqueuses) et Fu xie (diarrhée). Ces traductions explicatives ne transforment pas les libellés sources en diagnostics biomédicaux modernes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
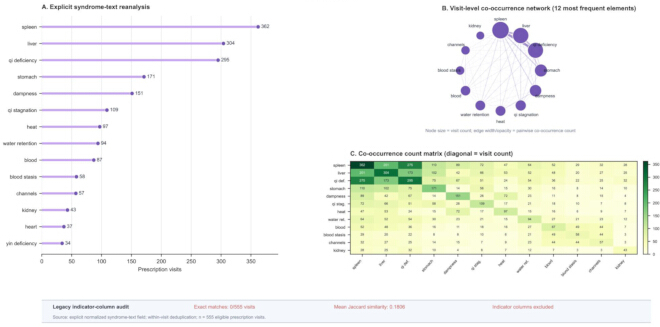
Figure 4 : Spectre explicite des syndromes-textes et structure de co-occurrence. (A) Fréquences au niveau des consultations pour 14 éléments de syndrome normalisés après déduplication intra-consultation, en utilisant 555 consultations prescriptibles comme dénominateur. (B) Réseau de co-occurrence des 12 éléments de syndrome les plus fréquents ; la taille des nœuds représente la fréquence des consultations, et l'épaisseur et l'opacité des arêtes représentent les effectifs de co-occurrence par paires. (C) Matrice symétrique correspondante des effectifs de co-occurrence ; les cellules diagonales représentent les fréquences individuelles par consultation, et les cellules hors diagonale représentent les effectifs de co-occurrence par paires. La bande d'audit indique 0 correspondance exacte entre les textes de syndrome et les indicateurs sur 555 lignes, ainsi qu'une similarité moyenne de Jaccard texte-indicateur de 0,1806 ; par conséquent, les anciennes colonnes d'indicateurs ont été exclues des rapports principaux. Dans la matrice, Qi def. désigne un déficit de qi, Qi stag. désigne une stagnation du qi, et Water ret. désigne une rétention d'eau. La palette de couleurs est descriptive. Aucune barre d'erreur n'est applicable. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
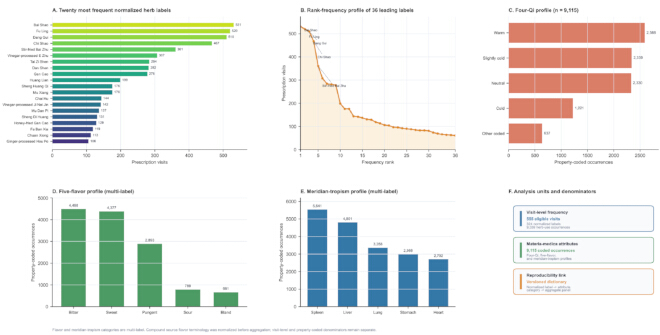
Figure 5 : Herbes à haute fréquence et profils normalisés des attributs de la matière médicale. (A) Les vingt étiquettes d'herbes normalisées les plus fréquentes parmi 555 consultations éligibles. (B) Profil de rang-fréquence des 36 principales étiquettes d'herbes normalisées. (C) Distribution des Quatre-Qi basée sur 9 115 occurrences d'utilisation d'herbes codées par propriété ; le Quatre-Qi possède une valeur unique pour chaque occurrence codée. (D) Distribution des Cinq-Goûts et (E) distribution de la tropisme des méridiens, basées sur le même dénominateur d'occurrences codées par propriété ; ces deux attributs comportent plusieurs étiquettes, et les effectifs par catégorie ne sont donc pas exclusifs. (F) Unités d'analyse au niveau de la consultation et au niveau des propriétés codées, ainsi que leur lien de reproductibilité. La longueur des barres représente les effectifs, et les couleurs permettent de distinguer les panneaux. Aucune barre d'erreur n'est applicable. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
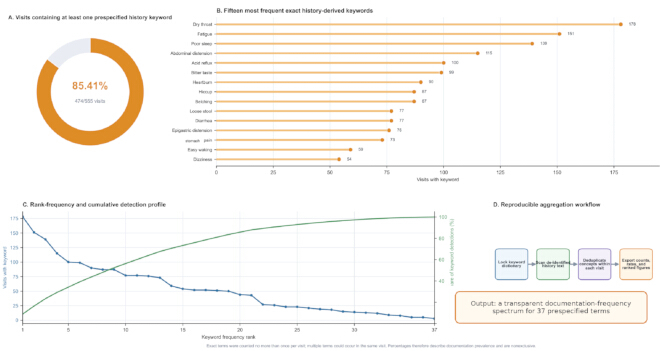
Figure 6 : Spectre de mots-clés symptomatiques dérivés de l’anamnèse et flux de travail reproductible d’agrégation. (A) Proportion des 555 consultations éligibles pour prescription contenant au moins un mot-clé prédéfini dans l’anamnèse ; 474 consultations (85,41 %) contenaient au moins un mot-clé. (B) Les quinze concepts symptomatiques exacts dérivés de l’anamnèse les plus fréquents. (C) Distribution complète de fréquence par rang sur 37 termes et part cumulative des détections de mots-clés. (D) Flux de travail figé en version, allant du dictionnaire prédéfini aux sorties agrégées. Chaque concept était compté au plus une fois par consultation, bien que plusieurs concepts puissent apparaître lors d’une même consultation. Les barres oranges représentent les effectifs de mots-clés, et les couleurs du flux de travail distinguent les étapes de traitement. Aucune barre d’erreur n’est applicable. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
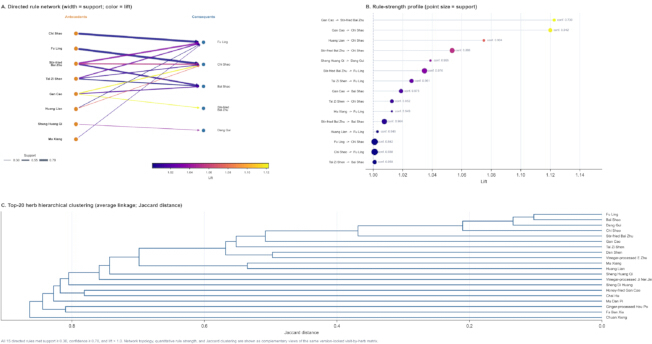
Figure 7 : Règles d'association dirigées entre herbes et regroupement hiérarchique. (A) Réseau bipartite dirigé de l'ensemble des 15 règles d'association à base d'une seule herbe satisfaisant aux seuils prédéfinis de support ≥ 0,30, de confiance ≥ 0,70 et de lift > 1,0. L'épaisseur des arêtes représente le support, et la couleur des arêtes représente le lift. (B) Profil d'intensité des règles pour les mêmes 15 règles classées par ordre décroissant de lift ; la taille des points représente le support, et les étiquettes adjacentes indiquent la confiance (conf.). (C) Regroupement hiérarchique en moyenne liée des 20 variables d'herbes les plus fréquentes, basé sur la distance de Jaccard. Tous les panneaux utilisent les consultations prescriptives comme unité d'analyse et décrivent des motifs de codétection, et non une efficacité, une synergie ou une association fixe recommandée. Aucune barre d'erreur n'est applicable. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
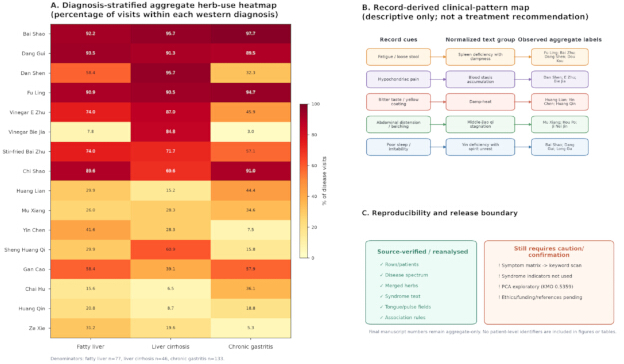
Figure 8 : Profils agrégés d'herbes stratifiés par diagnostic, carte des profils cliniques et limite de diffusion. (A) Carte thermique stratifiée par diagnostic montrant la prévalence au niveau des consultations de 16 étiquettes normalisées d'herbes dans la stéatose hépatique (n = 77), la cirrhose du foie (n = 46) et la gastrite chronique (n = 133). Chaque cellule représente le pourcentage de consultations éligibles au sein du strate de diagnostic occidental correspondant, à l’aide d’une échelle de couleurs fixe allant de 0 % à 100 %. (B) Carte des profils cliniques dérivée des dossiers, reliant les indices vérifiés des dossiers à des groupes de textes normalisés et aux étiquettes d’herbes agrégées observées. Des connecteurs en pointillés, non directionnels, distinguent cette couche interprétative descriptive de la prévalence calculée ; ce panneau ne constitue pas une recommandation thérapeutique. (C) Reproductibilité et limite de diffusion distinguant les composants vérifiés à la source ou réanalysés de ceux nécessitant une prudence ou une confirmation. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Métrique | Valeur | Unité/dénominateur | Statut |
| Visites avec ordonnance | 555 | 555 visites avec ordonnance | vérifié à partir du fichier XLSX récupéré |
| Patients uniques | 396 | 396 patients uniques | vérifié à partir du fichier XLSX récupéré |
| Plage d'âge par patient | 13-94 | années | vérifié |
| Âge moyen ± écart-type par patient | 47,11 ± 14,88 | années | vérifié |
| Âge moyen ± écart-type par visite | 48,22 ± 15,82 | années | vérifié |
| Sexe par patient | Femmes 228 ; hommes 167 ; inconnu 1 | 396 patients | vérifié |
| Sexe par visite | Femmes 327 ; hommes 227 ; inconnu 1 | 555 visites | vérifié |
| Plantes médicinales fusionnées | 324 | noms fusionnés distincts | vérifié |
| Occurrences d'utilisation des plantes médicinales fusionnées | 9339 | 555 visites avec ordonnance | vérifié |
Tableau 1 : Profil du jeu de données. Les caractéristiques démographiques au niveau des patients et les variables au niveau des consultations avec ordonnance sont indiquées en utilisant leurs dénominateurs respectifs. Les totaux normalisés des plantes sont également fournis.
| Nom de la maladie | Nombre | Pourcentage des visites |
| Gastrite chronique | 133 | 24 |
| Stéatose hépatique | 77 | 13,9 |
| Cirrhose du foie | 46 | 8,3 |
| Gastrite atrophique chronique | 22 | 4 |
| Douleur abdominale | 22 | 4 |
| Hépatite B chronique | 20 | 3,6 |
| Dyspepsie | 19 | 3,4 |
| Œsophagite par reflux | 8 | 1,4 |
| Gastrite superficielle chronique | 7 | 1,3 |
| Pancréatite chronique | 6 | 1,1 |
| Colite ulcéreuse | 6 | 1,1 |
| Polype de la vésicule biliaire | 6 | 1,1 |
| Syndrome post-cholecystectomie | 6 | 1,1 |
| Dysfonctionnement intestinal | 6 | 1,1 |
| Lithiase biliaire | 6 | 1,1 |
| Hépatite chronique | 5 | 0,9 |
| Fatigue | 5 | 0,9 |
| Dysfonctionnement gastro-intestinal (étiquette d'origine incertaine) | 5 | 0,9 |
| Gastrite chronique (étiquette d'origine incertaine) | 5 | 0,9 |
| Cirrhose hépatique auto-immune | 4 | 0,7 |
Tableau 2 : Principaux diagnostics occidentaux normalisés. Nombre et pourcentages des principaux diagnostics occidentaux normalisés enregistrés lors des 555 consultations éligibles pour une prescription. Les pourcentages utilisent les consultations éligibles pour une prescription comme dénominateur.
| Nom de la maladie en MTC | Nombre | Pourcentage des consultations |
| Wei pi (oppression ou gêne épigastrique) | 163 | 29,4 |
| Ji disease (affection d'accumulation, étiquette MTC de la source) | 86 | 15,5 |
| Gan pi (étiquette de maladie en MTC utilisée pour les troubles du foie gras) | 77 | 13,9 |
| Douleur d'estomac | 61 | 11 |
| Douleur hypochondriaque | 32 | 5,8 |
| Douleur abdominale | 31 | 5,6 |
| Gan zhuo (littéralement, fixation du foie ; une ancienne étiquette de maladie en MTC conservée) | 28 | 5 |
| Épuisement par déficience | 17 | 3,1 |
| Régurgitation acide | 9 | 1,6 |
| Xie xie (selles molles ou aqueuses) | 6 | 1,1 |
| Insomnie | 4 | 0,7 |
| Dysenterie | 4 | 0,7 |
| Céphalée | 4 | 0,7 |
| Bi disease (maladie d'obstruction) | 4 | 0,7 |
| Trouble menstruel | 3 | 0,5 |
| Oppression thoracique | 3 | 0,5 |
| Trouble de la transpiration | 3 | 0,5 |
| Constipation | 3 | 0,5 |
| Fu xie (diarrhée) | 2 | 0,4 |
| Xiao ke (amaigrissement avec soif) | 2 | 0,4 |
Tableau 3 : Noms normalisés des maladies en médecine traditionnelle chinoise (MTC) les plus fréquents. Nombre et pourcentages des noms normalisés des maladies en MTC les plus fréquents enregistrés lors des 555 consultations avec ordonnance éligibles. Les pourcentages utilisent les consultations avec ordonnance éligibles comme dénominateur. Les libellés sources conservés et les explications associées ne sous-entendent pas une équivalence avec les diagnostics biomédicaux modernes.
| Rang | Élément du syndrome | Visites pour prescription | Visites éligibles | Pourcentage de visites |
| 1 | rate | 362 | 555 | 65,23 % |
| 2 | foie | 304 | 555 | 54,77 % |
| 3 | déficience du Qi | 295 | 555 | 53,15 % |
| 4 | estomac | 171 | 555 | 30,81 % |
| 5 | humidité | 151 | 555 | 27,21 % |
| 6 | stagnation du Qi | 109 | 555 | 19,64 % |
| 7 | chaleur | 97 | 555 | 17,48 % |
| 8 | rétention d'eau | 94 | 555 | 16,94 % |
| 9 | Sang | 87 | 555 | 15,68 % |
| 10 | stase sanguine | 58 | 555 | 10,45 % |
| 11 | méridiens | 57 | 555 | 10,27 % |
| 12 | rein | 43 | 555 | 7,75 % |
| 13 | cœur | 37 | 555 | 6,67 % |
| 14 | déficience du Yin | 34 | 555 | 6,13 % |
Tableau 4 : Éléments dominants du syndrome normalisés. Les éléments du syndrome ont été extraits du texte explicite du syndrome normalisé et dédoublonnés pour chaque consultation prescriptive. Les effectifs utilisent les 555 consultations prescriptives éligibles comme dénominateur ; les pourcentages ne sont pas exclusifs, car plusieurs éléments du syndrome peuvent survenir au cours d'une même consultation.
| Intitulé fusionné de l'herbe | Nombre | Pourcentage de visites |
| Bai Shao | 531 | 95,7 |
| Fu Ling | 520 | 93,7 |
| Dang Gui | 510 | 91,9 |
| Chi Shao | 467 | 84,1 |
| Bai Zhu sauté à la poêle | 361 | 65 |
| E Zhu préparé au vinaigre | 307 | 55,3 |
| Tai Zi Shen | 284 | 51,2 |
| Dan Shen | 282 | 50,8 |
| Gan Cao | 278 | 50,1 |
| Huang Lian | 199 | 35,9 |
| Sheng Huang Qi | 176 | 31,7 |
| Mu Xiang | 176 | 31,7 |
| Chai Hu | 144 | 25,9 |
| Ji Nei Jin préparé au vinaigre | 142 | 25,6 |
| Mu Dan Pi | 137 | 24,7 |
| Sheng Di Huang | 131 | 23,6 |
| Gan Cao frit au miel | 129 | 23,2 |
| Fa Ban Xia | 119 | 21,4 |
| Chuan Xiong | 113 | 20,4 |
| Hou Po préparé au gingembre | 106 | 19,1 |
| Yin Chen | 104 | 18,7 |
| Sheng Bai Zhu | 97 | 17,5 |
| Dou Kou | 96 | 17,3 |
| Sheng Long Gu | 92 | 16,6 |
| Zhe Bei Mu | 90 | 16,2 |
| Huang Qin | 88 | 15,9 |
| Dang Shen | 85 | 15,3 |
| Bie Jia préparé au vinaigre | 83 | 15 |
| Gui Zhi | 83 | 15 |
| Sheng Mu Li | 81 | 14,6 |
| Jiao Zhi Zi | 74 | 13,3 |
| He Huan Hua | 69 | 12,4 |
| Huang Jing préparé au vin | 66 | 11,9 |
| Chen Pi | 64 | 11,5 |
| Ze Xie | 63 | 11,4 |
| Jin Qian Cao | 61 | 11 |
Tableau 5 : Principales étiquettes d'herbes normalisées selon la fréquence des consultations avec ordonnance. Chaque étiquette d'herbe normalisée a été comptée au plus une fois par consultation avec ordonnance. Les effectifs et les pourcentages utilisent 555 consultations avec ordonnance éligibles comme dénominateur, et les formes de préparation cliniquement significatives sont conservées comme étiquettes distinctes.
| Rang | Mot-clé dérivé de l'anamnèse | Visites avec ordonnance | Visites éligibles | Pourcentage de visites |
| 1 | Secousse de la gorge | 178 | 555 | 32,07 % |
| 2 | Fatigue | 151 | 555 | 27,21 % |
| 3 | Mauvais sommeil | 139 | 555 | 25,05 % |
| 4 | Distension abdominale | 115 | 555 | 20,72 % |
| 5 | Reflux acide | 100 | 555 | 18,02 % |
| 6 | Goût amer | 99 | 555 | 17,84 % |
| 7 | Brûlures d'estomac | 90 | 555 | 16,22 % |
| 8 | Hoquet | 87 | 555 | 15,68 % |
| 9 | Rot | 87 | 555 | 15,68 % |
| 10 | Stool lâche | 77 | 555 | 13,87 % |
| 11 | Diarrhée | 77 | 555 | 13,87 % |
| 12 | Distension épigastrique | 76 | 555 | 13,69 % |
| 13 | Douleur d'estomac | 73 | 555 | 13,15 % |
| 14 | Réveil facile | 59 | 555 | 10,63 % |
| 15 | Vertiges | 54 | 555 | 9,73 % |
| 16 | Vomissements | 52 | 555 | 9,37 % |
| 17 | Nausées | 52 | 555 | 9,37 % |
| 18 | Douleur sourde | 51 | 555 | 9,19 % |
| 19 | Douleur distendante | 50 | 555 | 9,01 % |
| 20 | Mauvais appétit | 44 | 555 | 7,93 % |
| 21 | Douleur abdominale | 43 | 555 | 7,75 % |
| 22 | Oppression thoracique | 27 | 555 | 4,86 % |
| 23 | Irritabilité | 26 | 555 | 4,68 % |
| 24 | Céphalées | 23 | 555 | 4,14 % |
| 25 | Borborygmes | 23 | 555 | 4,14 % |
| 26 | Inconfort épigastrique | 21 | 555 | 3,78 % |
| 27 | Palpitations | 19 | 555 | 3,42 % |
| 28 | Urine jaune | 18 | 555 | 3,24 % |
| 29 | Sensation de corps étranger | 15 | 555 | 2,70 % |
| 30 | Douleur aiguë | 14 | 555 | 2,52 % |
| 31 | Constipation | 13 | 555 | 2,34 % |
| 32 | Somnolence | 12 | 555 | 2,16 % |
| 33 | Sensation de corps étranger pharyngé | 9 | 555 | 1,62 % |
| 34 | Sueurs excessives | 8 | 555 | 1,44 % |
| 35 | Douleur hypochondriaque | 5 | 555 | 0,90 % |
| 36 | Ténèsmes | 5 | 555 | 0,90 % |
| 37 | Stool sec | 3 | 555 | 0,54 % |
Tableau 6 : Principaux mots-clés de symptômes issus des antécédents cliniques. Concepts exacts de symptômes détectés dans le texte des antécédents anonymisés. Chaque concept n’a été compté qu’une seule fois par consultation prescriptive, bien que plusieurs concepts puissent survenir au cours d’une même consultation. Les effectifs et pourcentages utilisent comme dénominateur les 555 consultations prescriptives éligibles.
| Antécédent | Conséquent | Visites co-occurentes | Support | Confiance | Lift |
| Chi Shao | Fu Ling | 438 | 0,7892 | 0,9379 | 1,0010 |
| Fu Ling | Chi Shao | 438 | 0,7892 | 0,8423 | 1,0010 |
| Stir-fried Bai Zhu | Fu Ling | 350 | 0,6306 | 0,9695 | 1,0348 |
| Stir-fried Bai Zhu | Bai Shao | 348 | 0,6270 | 0,9640 | 1,0076 |
| Stir-fried Bai Zhu | Chi Shao | 320 | 0,5766 | 0,8864 | 1,0535 |
| Tai Zi Shen | Fu Ling | 273 | 0,4919 | 0,9613 | 1,0260 |
| Tai Zi Shen | Bai Shao | 272 | 0,4901 | 0,9577 | 1,0010 |
| Gan Cao | Bai Shao | 271 | 0,4883 | 0,9748 | 1,0189 |
| Gan Cao | Chi Shao | 262 | 0,4721 | 0,9424 | 1,1200 |
| Tai Zi Shen | Chi Shao | 242 | 0,4360 | 0,8521 | 1,0127 |
| Gan Cao | Stir-fried Bai Zhu | 203 | 0,3658 | 0,7302 | 1,1226 |
| Huang Lian | Fu Ling | 187 | 0,3369 | 0,9397 | 1,0029 |
| Huang Lian | Chi Shao | 180 | 0,3243 | 0,9045 | 1,0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0,3027 | 0,9545 | 1,0388 |
| Mu Xiang | Fu Ling | 167 | 0,3009 | 0,9489 | 1,0127 |
Tableau 7 : Règles d'association dirigées entre herbes satisfaisant aux seuils prédéfinis. Les règles ont été générées à partir de 555 lignes binaires de consultations avec ordonnance en utilisant un support ≥ 0,30, une confiance ≥ 0,70 et un lift > 1,0. Le support utilise 555 consultations avec ordonnance comme dénominateur, et la direction de la règle est conservée car la confiance est directionnelle.
| Étiquette de l'herbe | Stéatose hépatique (n) | Stéatose hépatique (N) | Stéatose hépatique (%) | Cirrhose du foie (n) | Cirrhose du foie (N) | Cirrhose du foie (%) | Gastrite chronique (n) | Gastrite chronique (N) | Gastrite chronique (%) |
| Bai Shao | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| Dang Gui | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| Dan Shen | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| Fu Ling | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| Vinegar-processed E Zhu | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| Vinegar-processed Bie Jia | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| Stir-fried Bai Zhu | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| Chi Shao | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| Huang Lian | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| Mu Xiang | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| Yin Chen | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| Sheng Huang Qi | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| Gan Cao | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| Chai Hu | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| Huang Qin | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| Ze Xie | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
Tableau 8 : Prévalence de l'utilisation des herbes stratifiée par diagnostic. Numérateurs, dénominateurs et prévalence au niveau des consultations pour 16 étiquettes normalisées d'herbes utilisées dans les cas de foie gras (n = 77), de cirrhose hépatique (n = 46) et de gastrite chronique (n = 133). Chaque étiquette d'herbe a été comptée au plus une fois par consultation prescriptive éligible.
Tableau supplémentaire 1 : Transparence et registre de vérification assistées par l'intelligence artificielle. Documentation distinguant le registre d'analyse initial de l'examen de cohérence effectué lors de la révision le 21 août 2026. Le tableau indique l'outil/le modèle/la version, la portée des entrées, l'objectif, le désaccord identifié concernant la cardinalité des quatre Qi, la correction humaine, les limites d'utilisation, les informations sur le relecteur, la décision finale et le modèle de prompt. Aucune ligne brute au niveau des patients n'a été fournie au système d'intelligence artificielle. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2 : Résultats relatifs à la qualité des données issues de l'audit des sources. La complétude des champs récupérés, les constats de l'audit, les actions analytiques et les états publiés sont indiqués pour les champs cliniques sources et les structures analytiques anciennes. Ce tableau documente l'exclusion des indicateurs de syndrome anciens non conciliés, la correction des totaux antérieurs de plantes médicinales, l'absence de vecteurs de distribution reconstructibles avant nettoyage pour l'estimation de la stabilité inter-versions, ainsi que les quantités qui n'ont pas pu être reconstituées. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 3 : Correspondance de la nomenclature des herbes. Les libellés normalisés d'affichage des herbes sont associés à des descripteurs de traitement, à des noms normalisés de matières médicinales chinoises (MMC), à la terminologie source, à des sources botaniques, zoologiques ou minérales, à des versions de référence, à des repères de preuve et à des limites de preuve. Les libellés spécifiques au traitement sont conservés lorsqu'ils ont une signification clinique. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 4 : Analyses de sensibilité seuil et visite répétée. Les perturbations des seuils des règles d'association, les comparaisons des jeux de règles une visite par patient, les métriques de sensibilité Chi Shao > Fu Ling, ainsi que la comparaison des distances d'entrée pour le regroupement par paires de 190 sont présentées. Veuillez cliquer ici pour télécharger ce fichier.
Fichier supplémentaire 1 : Script déterministe de seuil et de sensibilité aux visites répétées. Script déterministe utilisé pour reproduire les métriques agrégées de seuil et de sensibilité aux visites répétées à partir du jeu de données source verrouillé en version. Le fichier ne contient aucune donnée au niveau des patients. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
La contribution principale de ce protocole est un parcours complet et vérifiable allant de dossiers cliniques anonymisés de médecine traditionnelle chinoise à des résultats agrégés destinés à la recherche. Les étapes les plus critiques consistent à figer la règle d'identification de la cohorte avant d'examiner les résultats analytiques, à distinguer les patients uniques des consultations prescriptives, à conserver chaque correspondance entre termes originaux et termes normalisés, et à vérifier chaque numérateur et dénominateur avant la visualisation. Ces contrôles transforment le nettoyage des données, auparavant une activité préliminaire invisible, en un élément documenté de la méthode. Ils alignent également le flux de travail sur les référentiels RECORD, STROBE, FAIR et sur les cadres établis de qualité des données issues des dossiers médicaux électroniques11,12,13,14,15. Un résultat n'est considéré comme prêt à être publié que lorsque son champ source, son unité d'analyse, sa version de dictionnaire, sa règle de calcul, son dénominateur, son tableau, sa figure et la décision du relecteur peuvent être retracés dans le registre de preuves.
La méthode est innovante car elle intègre la gouvernance, l'ingénierie terminologique, le calcul, la visualisation et l'examen clinique, au lieu de les traiter comme des tâches distinctes. Une seule matrice de syndrome explicite permet de générer le spectre de fréquence, le réseau de co-occurrence et la carte thermique. Une seule matrice ordonnance-visite-par-plante soutient les résumés de fréquence, les règles d'association dirigées et le regroupement hiérarchique19,20,21. Un seul tableau stratifié par diagnostic permet d'obtenir à la fois des pourcentages exacts et la carte thermique finale. Le flux analytique utilise des outils libres reproductibles pilotés par script36,37,38,39,40, ce qui permet à une correction apportée à un dictionnaire en amont ou à une décision concernant la cohorte de se propager à toutes les sorties dépendantes. Des travaux antérieurs sur les entrepôts de données cliniques ont également démontré l'importance du prétraitement lié aux sources et de la réutilisation de données structurées41,42. Cette architecture réduit la transcription manuelle, maintient l'alignement entre les codages graphiques et les tableaux sources, et facilite l'audit, l'enseignement et le transfert à d'autres équipes de recherche.
Trois études récentes de fouille de bases de données fournissent des principes de conception utiles, bien que leur unité d'analyse soit un article plutôt qu'une consultation clinique. L'étude sur la polyarthrite rhumatoïde et la dépression combine une stratégie de recherche prédéfinie avec des analyses par pays, institution, auteur, revue, mot-clé et chronologie26. L'étude sur la colite ulcéreuse et les inhibiteurs de la kinase Janus utilise une collaboration coordonnée, des analyses de co-citation, de regroupement et de détection de pics pour distinguer les thèmes persistants des fronts émergents de la recherche27. L'étude sur la polyarthrite rhumatoïde et la fibromyalgie étend la cartographie bibliométrique à l'analyse bioinformatique tout en maintenant une distinction entre les deux niveaux de preuve28. Le présent protocole applique le même principe de vues analytiques coordonnées mais non interchangeables. Un transfert vers la gynécologie, la pneumologie, la rhumatologie ou une autre spécialité nécessite la reconstruction de champs spécifiques à la spécialité, de dictionnaires terminologiques, de règles d'inclusion et d'exclusion, de critères de jugement et de procédures de revue clinique avant que l'ensemble de règles puisse être réutilisé. Les spectres de maladies, les réseaux de syndromes, les mots-clés des symptômes, les règles d'association, le regroupement et les profils stratifiés par diagnostic proviennent tous de sources verrouillées par version, mais chacun répond à une question distincte et conserve son propre dénominateur et sa propre limite d'interprétation.
L'intelligence artificielle supervisée par l'humain peut fournir une couche supplémentaire de contrôle qualité lorsqu'elle est limitée à des extraits anonymisés approuvés ou à des matériaux agrégés. Dans ce flux de travail, l'IA peut comparer la terminologie entre fichiers, signaler les incohérences entre légendes et tableaux, identifier les étiquettes qui dépassent les limites des figures, vérifier que chaque nœud de réseau affiché possède une arête valide, et suggérer des formulations plus claires. L'IA ne détermine pas l'éligibilité de la cohorte, n'invente pas de correspondances terminologiques, n'infère pas les effets du traitement, ni ne remplace l'examen des données sources. Cette répartition des responsabilités est conforme à la vision plus large selon laquelle l'IA médicale doit compléter le jugement humain plutôt que d'occulter la responsabilité33. Elle reflète également l'accent mis par DECIDE-AI sur la transparence des facteurs humains, la gestion des erreurs et l'évaluation responsable34. La finalité de chaque invite, le résultat examiné, la correction acceptée, le réviseur et la date doivent donc être conservés dans le journal d'audit chaque fois qu'une assistance par IA est utilisée.
Le dépannage est particulièrement important lorsqu'un résultat semble cliniquement plausible mais échoue à la réconciliation des sources. Dans de tels cas, l'interprétation ultérieure doit être suspendue jusqu'à ce que l'origine de la divergence soit identifiée, qu'il s'agisse de la détermination des critères d'éligibilité, de la suppression des doublons, du mappage terminologique, du choix des champs, du choix du dénominateur ou de l'assemblage des données. Tous les résultats dépendants doivent ensuite être régénérés après correction. L'exemple traité repose sur un jeu de données rétrospectif, monocentrique, de patients externes experts, dans lequel les visites répétées ne sont pas indépendantes les unes des autres. L'analyse de sensibilité d'une visite par patient a réduit l'ensemble de règles conservées de 15 à 12, tout en préservant l'appartenance à l'ensemble des 20 plantes médicinales les plus fréquentes. Parmi les 190 paires non ordonnées parmi ces 20 variables communes, la corrélation de Pearson était de 0,9944, le rho de Spearman de 0,9836, la variation moyenne absolue de la distance de Jaccard de 0,0146, et la variation maximale de 0,0528 (Supplementary Table 4). Par conséquent, un fort soutien au niveau des visites ne doit pas être interprété comme une validation au niveau des patients. Le spectre des mots-clés historiques reflète une documentation littérale plutôt qu'une échelle de symptômes validée. Les résumés de matière médicale sont pondérés par fréquence d'occurrence et non par dose. Les règles d'association décrivent une co-inscription plutôt qu'une causalité. Les cartes thermiques stratifiées par diagnostic sont descriptives et n'établissent ni l'efficacité comparative, ni la spécificité à une maladie, ni la nécessité du traitement.
Le protocole peut être appliqué à la recherche sur l'héritage de l'expérience clinique experte, à la description de cohortes spécialisées en consultation externe, à l'harmonisation terminologique multicentrique, à la revue de la qualité de la documentation, à la sélection de variables pour des registres prospectifs, ainsi qu'à la préparation respectueuse de la confidentialité de jeux de données agrégés destinés à des collaborations. Les travaux futurs pourront intégrer une collecte prospective et structurée des symptômes, des modèles regroupés par patient, des variables de dose explicites, des hypothèses comparatives prédéfinies, une validation externe, des services terminologiques versionnés, des calculs préservant la confidentialité et des registres interactifs de preuves. Le traitement du langage naturel et l'analyse assistée par intelligence artificielle pourraient réduire davantage la curation répétitive, à condition d'être encadrés par des règles figées par version et par une vérification humaine. De manière plus générale, le protocole permet de transformer l'expérience clinique dispersée en un objet de recherche transparent, pouvant être examiné, reproduit, remis en question et étendu. La méthode ne convertit pas la fréquence en efficacité ; elle convertit plutôt les décisions analytiques non documentées en preuves visibles, fournissant ainsi une base pour des questions cliniques plus rigoureuses et pour une recherche en MTC plus durable dans le monde réel.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun intérêt concurrent.
Remerciements
OpenAI Codex (gpt-5.6-luna et gpt-5.6-sol) a été utilisé exclusivement pendant la révision du manuscrit pour des vérifications de cohérence inter-fichiers au niveau agrégé et des suggestions de formulation. Aucun dossier au niveau du patient n’a été fourni au système d’intelligence artificielle. Tous les résultats assistés par l’IA ont été vérifiés indépendamment par rapport aux documents sources par Tian Xia le 21 août 2026. Les auteurs ont examiné et approuvé le contenu final et assument l’entière responsabilité du manuscrit. Ce projet a été soutenu par le Programme national clé de recherche et de développement de Chine, Projet spécial clé sur la modernisation de la médecine traditionnelle chinoise (n° 2025YFC3512800) ; le Projet majeur national de science et technologie de Chine (Projet n° 2026ZD0554100 ; Sous-projet n° 2026ZD0554101) ; le Projet d’amélioration des capacités de recherche clinique et de transfert des résultats scientifiques des hôpitaux centraux de haut niveau en médecine traditionnelle chinoise, Projet spécial sur la transmission de l’expérience académique des éminents experts seniors en médecine traditionnelle chinoise (n° HLCMHPP2023016) ; et la Fondation des sciences naturelles de la région autonome ouïgoure du Xinjiang (n° 2025D01C213).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Regrouper les feuilles de calcul de réanalyse | Fichiers locaux générés par l'auteur | Non applicable | Utilisé pour les décomptes agrégés, les tableaux et la génération de figures. |
| Exportation anonymisée des dossiers patients externes | Système institutionnel de dossier médical électronique | Non applicable | Utilisé uniquement dans l'environnement institutionnel contrôlé ; les dossiers au niveau du patient ne sont pas des éléments soumis. |
| lxml | Projet lxml | 6.1.1 | Version du logiciel utilisée pour la sérialisation préservant les espaces de noms lors de la régénération en phase de révision ; pas une version historique d'analyse initiale. |
| Matplotlib | Projet Matplotlib (matplotlib.org) | 3.11.1 | Version observée dans l'environnement de régénération en phase de révision et dans les métadonnées SVG de la figure 3 ; pas une version historique d'analyse initiale. |
| NetworkX | Projet NetworkX | Package PyPI : networkx | Identifiant du package enregistré ; la version exacte en phase de révision n'a pas été vérifiée dans l'environnement hérité. |
| NumPy | Projet NumPy | 2.3.5 | Version du logiciel utilisée pour régénérer les sorties agrégées révisées ; pas une version historique d'analyse initiale. |
| openpyxl | Projet openpyxl | 3.1.5 | Version du logiciel utilisée pour écrire les sorties XLSX agrégées révisées ; pas une version historique d'analyse initiale. |
| pandas | Projet pandas | 3.0.1 | Version du logiciel utilisée pour régénérer les sorties agrégées révisées ; pas une version historique d'analyse initiale. |
| PyMuPDF | Projet PyMuPDF | 1.28.2 | Version du logiciel utilisée pour la régénération en phase de révision des sorties de figures révisées ; pas une version historique d'analyse initiale. |
| Python | Fondation Python Software | 3.13.15 | Version du logiciel utilisée pour régénérer les sorties agrégées révisées ; pas une version historique d'analyse initiale. |
| SciPy | Projet SciPy | Package PyPI : scipy | Identifiant du package enregistré ; la version exacte en phase de révision n'a pas été vérifiée dans l'environnement hérité. |
Références
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.