Des analyses transcriptomiques intégrées, effectuées à partir d'échantillons massifs et de cellules uniques, ont identifié six biomarqueurs diagnostiques liés au métabolisme de l'hème pour les chéloïdes. Une validation expérimentale a confirmé une régulation anormale du récepteur 1 du virus de la leucémie féline du sous-groupe C (FLVCR1) dans les fibroblastes chéloïdiens, tandis qu'un accolement moléculaire a mis en évidence la (+)-gallocatéchine comme un composé susceptible d'interagir avec FLVCR1, justifiant des investigations fonctionnelles supplémentaires.
Article de recherche
Identification de biomarqueurs liés au métabolisme de l'hème dans les chéloïdes par analyse transcriptomique et culture de fibroblastes humains
Dans cet article
Résumé
Résumé
Le kélidoïde est un trouble fibroprolifératif caractérisé par une forte récurrence et une pathogenèse mal élucidée, pour lequel des cibles thérapeutiques efficaces font encore défaut. Des données récentes suggèrent que le reprogrammation métabolique, en particulier dans le métabolisme de l'hème, pourrait induire la fibrose. Cette étude examine le rôle du métabolisme de l'hème, en se concentrant sur le récepteur 1 du virus de la leucémie féline du sous-groupe C (FLVCR1), dans la pathogenèse du kélidoïde et explore son potentiel diagnostique et thérapeutique. Nous avons analysé des jeux de données de séquençage ARN en masse (bulk RNA-seq) et des données de séquençage ARN unicellulaire (scRNA-seq). Des modèles d'expression différentielle, de l'opérateur de sélection et de réduction absolue (LASSO) et de forêt aléatoire (RF) ont permis d'identifier des biomarqueurs diagnostiques liés au métabolisme de l'hème. Des analyses d'infiltration immunitaire, de cartographie unicellulaire, de construction de réseau de microARN (miARN) et de docking moléculaire avec des composés de médecine traditionnelle chinoise ont été réalisées. Six biomarqueurs liés au métabolisme de l'hème ont été identifiés, formant un nomogramme diagnostique à haute précision. FLVCR1, enrichi dans les cellules endothéliales et les mélanocytes, est négativement corrélé aux cellules T auxiliaires folliculaires, suggérant une interaction immunométabolique. L'analyse du réseau régulateur de miARN a révélé cinq miARN ciblant conjointement les six biomarqueurs. Le docking moléculaire a identifié la (+)-gallocatéchine comme ligand de FLVCR1 à forte affinité. Ces résultats suggèrent une association entre le métabolisme de l'hème lié à FLVCR1 et les altérations immunitaires dans la pathogenèse du kélidoïde. Le panel de biomarqueurs a montré un potentiel diagnostique exploratoire, et la (+)-gallocatéchine a été identifiée comme un composé candidat interagissant avec FLVCR1, nécessitant une validation ultérieure. Cette étude replace le kélidoïde dans le spectre métabo-fibrotique et propose une intervention métabolique-immunitaire comme stratégie thérapeutique novatrice.
Introduction
La chéloïde, un trouble fibroprolifératif caractérisé par un dépôt excessif de matrice extracellulaire s'étendant au-delà des limites de la lésion cutanée initiale, touche 4 à 16 % de la population mondiale, avec une prévalence nettement plus élevée chez les personnes d'ascendance africaine, asiatique et hispanique1,2. Malgré son caractère histologiquement bénin, la chéloïde entraîne des charges physiques et psychosociales importantes en raison de démangeaisons persistantes, de douleurs, de rétractions fonctionnelles et de défiguration esthétique. Les modalités thérapeutiques actuelles, notamment les corticostéroïdes intra-lésionnels, l'exérèse chirurgicale, la radiothérapie et la thérapie au laser, restent insuffisantes, avec des taux de récidive dépassant 50 % après un traitement monothérapeutique3,4,5. Cet impasse thérapeutique souligne un manque fondamental dans notre compréhension de la pathogenèse de la chéloïde, en particulier des facteurs initiateurs situés en amont qui déclenchent et maintiennent la cascade fibreuse au-delà des voies de signalisation profibrotiques canoniques.
Les recherches contemporaines se sont principalement concentrées sur les voies canoniques telles que la signalisation TGF-β/Smad et l'activation anormale des fibroblastes6,7,8. Bien que l'infiltration des cellules immunitaires—en particulier des macrophages polarisés en phénotype M2, des lymphocytes T régulateurs et des cellules dendritiques dysrégulées—ait été documentée dans les tissus de chéloïdes9,10, ces études considèrent largement les altérations immunitaires comme des conséquences en aval du dysfonctionnement des fibroblastes plutôt que comme des régulateurs en amont. De manière critique, les programmes métaboliques susceptibles de façonner activement cette interaction immunofibrotique restent totalement inexplorés dans la pathogenèse des chéloïdes11,12,13. Ce manque de connaissances est frappant, étant donné les paradigmes émergents dans les affections fibrotiques, où la réorganisation métabolique agit comme un régulateur maître du remodelage tissulaire.
Le reprogrammation métabolique s'est récemment imposée comme un nœud central de la fibrogenèse dans plusieurs systèmes organiques. Dans la fibrose pulmonaire et hépatique, une homéostasie altérée du hème—due à une expression modifiée de transporteurs, de molécules de piégeage ou d'enzymes biosynthétiques—provoque un stress oxydatif, une ferroptose et une inflammation stérile qui favorisent directement le dépôt de collagène14. L'accumulation de hème active l'inflammasome NLRP3, induisant ainsi l'activation des fibroblastes, tandis que le déficit du récepteur 1 du virus de la leucémie féline du sous-groupe C (FLVCR1) aggrave la fibrose tissulaire par une toxicité persistante du hème. Ces découvertes placent le métabolisme du hème non pas uniquement comme un processus d'entretien cellulaire, mais comme un centre de signalisation dynamique capable d'initier des cascades fibrotiques—un paradigme encore à explorer dans les troubles cutanés fibroprolifératifs.
La plausibilité d'une immunomodulation médiée par l'hème est renforcée par des preuves mécanistiques provenant de modèles de cancer et d'inflammation chronique. L'hème agit comme une molécule de signalisation qui module directement le destin des cellules immunitaires : il favorise la polarisation des macrophages de type M1 vers le phénotype M2 via la voie de signalisation TLR4/NF-κB15, influence la différenciation des lymphocytes T par une répression transcriptionnelle médiée par Bach216, et régule de manière critique la maturation des cellules dendritiques par l'exportation de l'hème dépendante de FLVCR117,18. Notamment, FLVCR1, un transporteur d'hème de la membrane plasmique essentiel à l'homéostasie cellulaire de l'hème, a récemment été impliqué dans le développement des cellules immunitaires et dans la dysfonction endothéliale19. L'ensemble de ces données convergentes place FLVCR1 comme un nœud moléculaire plausible reliant une dysrégulation du métabolisme de l'hème à une remodélisation immunitaire pathologique — une hypothèse aux implications profondes pour la pathogenèse des chéloïdes, au vu de leur microenvironnement riche en cellules immunitaires.
Malgré des progrès importants dans la compréhension de la communication entre l'hème et le système immunitaire dans d'autres contextes pathologiques, il n'a pas encore été exploré si un métabolisme de l'hème dysrégulé agit comme un facteur déclencheur en amont, amorçant ou amplifiant le paysage immunitaire pathologique des chéloïdes. Ce manque critique de connaissances justifie une investigation urgente pour plusieurs raisons interconnectées : les chéloïdes partagent des caractéristiques pathologiques marquantes — notamment une inflammation persistante et un stress oxydatif — avec des affections fibrotiques d'origine métabolique telles que la fibrose pulmonaire et la fibrose hépatique, suggérant une possible similitude dans les mécanismes régulateurs sous-jacents. Le système d'exportation de l'hème centré sur FLVCR1 a été validé mécanistiquement dans des tissus non cutanés comme régulateur direct de fonctions immunitaires clés telles que la polarisation des macrophages et la maturation des cellules dendritiques, fournissant ainsi une base théorique solide pour son extrapolation à l'immunopathologie des chéloïdes20. Plus important encore, cibler cet axe métabolique-immunitaire offre une opportunité révolutionnaire de dépasser les thérapies symptomatiques actuelles, qui ne font que supprimer les effets fibrotiques en aval, permettant potentiellement une intervention en amont à l'origine métabolique de la progression de la maladie21.
En nous appuyant sur ce raisonnement, nous avons émis l'hypothèse qu'une dysrégulation centrée sur FLVCR1 du métabolisme du hème remodèle activement le microenvironnement immunitaire et favorise la pathogenèse des chéloïdes. Afin de valider systématiquement cette hypothèse, nous avons combiné des analyses transcriptomiques en masse et à la résolution de la cellule unique selon une approche en plusieurs étapes : nous avons tout d'abord identifié et validé des biomarqueurs diagnostiques associés au métabolisme du hème dans les tissus chéloïdiens à l'aide d'algorithmes d'apprentissage automatique et d'une vérification sur un groupe témoin indépendant ; nous avons ensuite précisé les profils d'expression spatiale de ces biomarqueurs dans différents compartiments cellulaires — notamment les cellules endothéliales, les fibroblastes, les mélanocytes et les sous-populations immunitaires — par cartographie à la résolution de la cellule unique ; par la suite, nous avons établi leurs corrélations quantitatives avec des populations cellulaires immunitaires spécifiques afin de définir des liens fonctionnels entre immunité et métabolisme ; enfin, nous avons construit un réseau régulateur de microARN (miARN) centré sur FLVCR1 et réalisé un dockage moléculaire avec des composés de médecine traditionnelle chinoise afin d'identifier des cibles thérapeutiques exploitables. Cette étude approfondie met non seulement au jour un axe immunité-métabolisme du hème auparavant méconnu dans la pathogenèse des chéloïdes, mais fournit également un panel de biomarqueurs pertinent sur le plan translationnel, doté d'un potentiel diagnostique et thérapeutique double pour ce trouble fibroprolifératif récalcitrant.
Protocole
Une approbation éthique et un consentement éclairé n'étaient pas requis pour cette étude, car toutes les données ont été obtenues à partir de bases de données accessibles au public, notamment le Gene Expression Omnibus (GEO), et aucun participant humain identifiable ni sujet animal n'a été directement impliqué.
Acquisition et prétraitement des données
Les gènes associés au métabolisme de l'hème ont été obtenus à partir de la base de données Molecular Signatures Database (MSigDB ; voir la Table des Matériaux et la Table S1 Supplémentaire), incluant les jeux de gènes REACTOME_Heme_Biosynthesis, REACTOME_Heme_Degradation, Wikipathway_Heme_Biosynthesis, REACTOME_Scavenging_Heme_from_Plasma et HALLMARK_Heme_Metabolism. Tous les jeux de données analysés dans cette étude provenaient de sources publiques. Deux jeux de données d'expression génique en masse (microarrays) ont été récupérés à partir de la base de données Gene Expression Omnibus (GEO) : GSE44270, comprenant 18 échantillons de chéloïdes et 14 échantillons de peau normale, et GSE7890, comprenant 10 échantillons de chéloïdes et 9 échantillons de peau normale. GSE44270 et GSE7890 ont été générés respectivement sur les plateformes GPL6244 et GPL570. Les fichiers de matrices de séries ainsi que les informations correspondantes sur les échantillons ont été téléchargés et importés dans l'environnement R. Étant donné que les valeurs d'expression présentes dans les fichiers de matrices de séries avaient déjà été prétraitées et normalisées par les soumissionnaires initiaux des données, aucune transformation logarithmique additionnelle en base 2 ni aucune normalisation entre échantillons n'a été effectuée. Les deux jeux de données ont été traités indépendamment et n'ont pas été fusionnés, car ils ont été générés sur des plateformes de microarrays différentes. Les jeux de données ont été prétraités comme décrit ci-dessous (voir la Table des Matériaux). Les sondes génétiques ont été associées à leurs symboles génétiques correspondants, et les sondes dépourvues d'annotations génétiques ou correspondant à plusieurs gènes ont été exclues. Pour les gènes possédant plusieurs jeux de sondes, la valeur d'expression a été attribuée selon le niveau d'expression détecté le plus élevé. En outre, des données de séquençage de l'ARN monocellulaire (scRNA-seq) provenant de GSE163973, contenant trois échantillons de chéloïdes, ont été téléchargées et traitées conformément aux critères de contrôle qualité définis dans l'étude d'origine.
Recherche et validation de marqueurs diagnostiques liés au métabolisme de l'hème dans les kélidoïdes
Pour identifier les gènes associés au métabolisme de l'hème différentiellement exprimés dans les chéloïdes, le test de Wilcoxon a été appliqué à GSE44270 à l'aide de la fonction R wilcox.test, avec un seuil de significativité de P < 0,05. Afin d'identifier des marqueurs diagnostiques potentiels pour les chéloïdes, deux modèles d'apprentissage automatique ont été utilisés : la forêt aléatoire (RF) et la régression logistique LASSO (least absolute shrinkage and selection operator). L'analyse par forêt aléatoire a été réalisée avec une graine aléatoire fixée à 1 afin d'assurer la reproductibilité (voir le Tableau du matériel). Le modèle a été construit à l'aide de 500 arbres (ntree = 500), et l'importance des gènes a été évaluée selon la diminution moyenne de l'impureté des nœuds (IncNodePurity). Les gènes dont les valeurs d'importance étaient supérieures à 0,3 ont été sélectionnés comme biomarqueurs candidats issus de la forêt aléatoire. La régression logistique LASSO a été effectuée avec α = 1, et 50 valeurs de lambda ont été évaluées durant l'entraînement du modèle (voir le Tableau du matériel). Le paramètre de pénalité optimal a été déterminé à l'aide d'une validation croisée en cinq parties avec la fonction cv.glmnet, en utilisant une réponse binomiale. Les gènes présentant des coefficients de régression non nuls ont été conservés comme candidats sélectionnés par LASSO. Enfin, l'intersection des gènes identifiés par la forêt aléatoire et la régression LASSO a été considérée comme la signature génique diagnostique finale. La signature génique diagnostique finale a été évaluée à l'aide d'un modèle basé sur un nomogramme. Toute la sélection des caractéristiques et l'estimation des paramètres du modèle ont été effectuées exclusivement sur la cohorte de découverte (GSE44270), et la signature finale de six gènes a été ultérieurement évaluée sur une cohorte de validation indépendante (GSE7890). Les performances diagnostiques du nomogramme ont été évaluées en calculant l'aire sous la courbe caractéristique de fonctionnement du récepteur (AUC). Afin d'examiner la stabilité du modèle, l'analyse a inclus une validation croisée en cinq parties et 1 000 itérations de rééchantillonnage bootstrap, à partir desquelles une AUC corrigée pour l'optimisme a été obtenue. Une analyse de courbe décisionnelle (DCA) a ensuite été utilisée pour estimer le bénéfice net potentiel du nomogramme ; toutefois, ce résultat a été interprété avec prudence en raison de la petite taille de l'échantillon.
Infiltration des cellules immunitaires et analyse de corrélation
L'enrichissement des cellules immunitaires a été évalué par une analyse d'enrichissement de gènes à l'échelle d'un échantillon unique (ssGSEA) (voir la Table des matériels). La matrice de signatures des cellules immunitaires a été obtenue à partir d'une étude précédemment publiée par Charoentong et al.22. et contenait 782 gènes marqueurs représentant 28 populations de cellules immunitaires innées et adaptatives. L'analyse a été réalisée à l'aide d'un noyau gaussien sur les valeurs d'expression de puces à ADN normalisées et continues. Une taille minimale de jeu de gènes de 10 a été exigée après apparie des gènes marqueurs à la matrice d'expression, et les scores ssGSEA obtenus ont été normalisés. Tous les autres paramètres ont été conservés à leurs valeurs par défaut. Les coefficients de corrélation de Pearson ont ensuite été calculés pour évaluer les relations entre les scores d'enrichissement des cellules immunitaires et l'expression des gènes diagnostiques. La matrice de corrélation obtenue a été visualisée sous forme de graphique de corrélation, et certaines associations sélectionnées ont été représentées sous forme de graphiques en bonbons (voir la Table des matériels).
Traitement et analyse des données de séquençage de l'ARN au niveau de la cellule unique
Des données de séquençage de l'ARN à l'échelle unique ont été obtenues à partir de GSE163973, et seuls les trois échantillons de chéloïdes, KF1, KF2 et KF3, ont été inclus dans la présente analyse. Les données d'expression ont été importées et traitées comme décrit ci-dessous (voir le Tableau des matériaux). Les cellules présentant moins de 200 ou plus de 6 000 comptages totaux d'identifiants moléculaires uniques (UMI) ont été exclues, et les doublets prédits ont été éliminés. Les comptages d'expression génique pour chaque cellule ont été normalisés par rapport à l'expression cellulaire totale, multipliés par un facteur d'échelle de 10 000, puis transformés en logarithme. La variation associée aux lots a été éliminée par régression lors de la mise à l'échelle des données, et les résidus mis à l'échelle ainsi obtenus ont été utilisés pour les analyses ultérieures. Les 2 000 gènes les plus variables ont été sélectionnés en fonction de leur expression moyenne et de leur dispersion, et une analyse en composantes principales a été réalisée sur ces gènes. Les 15 premières composantes principales ont été utilisées pour construire un graphe de plus proches voisins (k-nearest-neighbor) basé sur les distances euclidiennes, qui a ensuite été converti en un graphe de voisins les plus proches partagés. Les cellules ont été regroupées à l'aide de l'algorithme de Louvain avec une résolution de 0,8, et l'approximation uniforme du variété (uniform manifold approximation and projection) a été effectuée en utilisant les mêmes 15 composantes principales. Les types cellulaires ont été annotés selon les définitions de types cellulaires rapportées dans l'étude initiale, et les annotations obtenues ont été enregistrées dans le champ de métadonnées. Les annotations des types cellulaires et les regroupements en clusters ont été visualisés sur les coordonnées de l'approximation uniforme du variété, et l'expression des gènes diagnostiques a été affichée à travers les populations cellulaires annotées.
Construction du réseau régulateur miARN–ARNm
Le réseau régulateur miARN–ARNm a été construit comme décrit ci-dessous (voir le Tableau des matériaux). Homo sapiens a été sélectionné comme organisme, et les identifiants génétiques ont été fournis sous forme de symboles génétiques officiels. Les gènes candidats ont été soumis au module Interactions gène–miARN, et TarBase v9.0 a été sélectionnée comme base de données d'interactions. TarBase contient des interactions régulatrices expérimentalement validées entre les miARN et les gènes. Seules les interactions miARN–ARNm étayées par des preuves expérimentales impliquant les gènes candidats en entrée ont été conservées pour la construction du réseau, tandis que les interactions prédites sans preuve expérimentale ont été exclues. Aucun seuil supplémentaire de score de confiance n’a été appliqué.
Analyse de criblage virtuel et de docking moléculaire basés sur la structure
Un criblage virtuel a été effectué afin de hiérarchiser les ligands candidats issus de la bibliothèque de composés dirigés contre la protéine humaine FLVCR1 (protéine apparentée au récepteur du virus de la leucémie féline, sous-groupe C 1 ; voir le Tableau des matériaux) en utilisant un flux de travail de criblage virtuel basé sur la structure (SBVS). La structure tridimensionnelle de la FLVCR1 humaine a été récupérée dans la Protein Data Bank (PDB ID : 8UBZ). Cette structure représente la FLVCR1 humaine liée à la choline, déterminée par microscopie électronique cryogénique en mode particule unique à une résolution globale de 3,02 Å (accès EMDB : EMD-42110). La structure expérimentalement déterminée a été choisie car elle contient la conformation de FLVCR1 liée au substrat, fournissant ainsi des informations structurales permettant de définir la cavité de liaison au ligand physiologiquement pertinente. Lors de la préparation du récepteur, les molécules de choline (CHT) et d'hémisuccinate de cholestérol (Y01) co-résolues ont été conservées afin de préserver l'environnement structural entourant la région d'entrée du substrat et de liaison du ligand. L'espace de recherche pour le docking a été défini autour de la cavité de liaison au substrat/ligand de FLVCR1, englobant la région de liaison à la choline co-résolue. La boîte de grille était centrée aux coordonnées x = 160,587 Å, y = 160,613 Å et z = 160,484 Å. Les dimensions de la boîte de docking ont été fixées à [X × Y × Z Å] afin d'assurer une couverture adéquate de la cavité de liaison au substrat et des résidus environnants. Les composés candidats ont ensuite été positionnés (docked) dans cette région de liaison prédéfinie. Les poses de docking ont été classées selon leurs affinités de liaison prédites, des scores de docking plus négatifs indiquant des interactions prévues plus favorables entre le ligand et FLVCR1. Les composés les mieux classés ont été sélectionnés pour des analyses ultérieures du mode de liaison et des interactions protéine-ligand.
Simulation de dynamique moléculaire et calcul de l'énergie libre de liaison par la méthode MM/GBSA
La simulation de dynamique moléculaire (MD) a été utilisée pour examiner plus en détail le complexe protéine–ligand prédit (voir la Table des matériels). La topologie du ligand a été préparée en attribuant les paramètres du champ de force General Amber Force Field (GAFF) et en intégrant des charges électrostatiques restreintes (RESP). Le complexe a ensuite été décrit à l'aide du champ de force Amber99SB-ILDN, placé dans un modèle d'eau transférable intermoléculaire à trois points, puis neutralisé avec trois ions Na⁺. Après une minimisation d'énergie par la méthode du gradient conjugué, le système a été équilibré pendant 100 ps dans un ensemble à nombre de particules, volume et température constants, puis pendant 100 ps supplémentaires dans un ensemble à nombre de particules, pression et température constants, avec 100 000 pas dans chaque phase. Une phase de production de 100 ns a ensuite été réalisée à 300 K et 1 bar en utilisant un pas de temps de 2 fs. La trajectoire obtenue a été analysée en termes d'écart quadratique moyen (RMSD), de fluctuation quadratique moyenne (RMSF), de rayon de giration (Rg), de surface accessible au solvant (SASA), de persistance des liaisons hydrogène et d'énergie libre de liaison par la méthode MM/GBSA (mécanique moléculaire/surface de Born généralisée).
Culture cellulaire
Les lignées cellulaires de fibroblastes normaux humains dermiques (NHDF) et de fibroblastes primaires de chéloïde (PKF) ont été cultivées dans un milieu de croissance pour fibroblastes enrichi avec 2 % de sérum de veau fœtal, du facteur de croissance fibroblastique basique humain recombinant (1 ng/mL) et de l'insuline (5 µg/mL). Les deux lignées cellulaires ont été maintenues dans un incubateur humidifié à 37 °C avec 5 % de CO₂ et ont été repiquées lorsqu'elles atteignaient une confluence de 80 à 90 %.
Analyse par immunotransfert
Des protéines totales ont été isolées à partir des cellules NHDF et PKF à l’aide d’un tampon de lyse composé de radioimmunoprécipitation, de phénylméthylsulfonylfluorure, d’un cocktail d’inhibiteurs de protéases et d’inhibiteurs de phosphatases. La concentration en protéines a été déterminée par un dosage à l’acide bicinchoninique, après quoi des quantités égales de protéines ont été séparées par électrophorèse sur gel de polyacrylamide en présence de dodécylsulfate de sodium et transférées sur une membrane de fluorure de polyvinylidène. La membrane a été bloquée pendant 90 min à température ambiante avec 5 % de lait écrémé en poudre préparé dans une solution saline tamponnée au Tris contenant du Tween, puis incubée toute la nuit à 4 °C avec des anticorps primaires dirigés contre FLVCR1 (polyclonal issu du lapin, 1:1 000) et GAPDH (monoclonal issu de la souris, 1:20 000). Le jour suivant, une incubation avec l’anticorps secondaire a été réalisée pendant 90 min à température ambiante. Les intensités des bandes ont été mesurées à l’aide d’ImageJ, et les niveaux relatifs de protéines ont été normalisés par rapport au témoin interne GAPDH. Un minimum de trois réplicats biologiques indépendants a été utilisé pour chaque analyse par immunotransfert.
Analyse par PCR en temps réel avec détection fluorescente de la transcription inverse quantitative (qRT-PCR)
L'ARN total a été préparé à partir des cellules NHDF et PKF à l'aide du kit de référence. L'ADNc a ensuite été généré à l'aide du mélange de synthèse d'ADNc de référence pour la qPCR (avec DNase double brin). La qRT-PCR a été réalisée sur un système de PCR en temps réel, et l'expression de FLVCR1 a été mesurée à l'aide du mélange rapide SYBR Green de référence. L'ARNm de GAPDH a servi de référence interne pour la normalisation. Chaque réaction de qRT-PCR a été effectuée en triplets techniques, et les niveaux relatifs d'ARNm ont été calculés selon la méthode 2−ΔΔCt. Chaque expérience a été réalisée indépendamment au moins trois fois, et les séquences des amorces sont indiquées dans le Tableau supplémentaire S2.
Analyse statistique
Les différences entre groupes ont été évaluées à l'aide du test de la somme des rangs de Wilcoxon, et les valeurs sont exprimées comme la moyenne ± l'écart type (SD). Les associations entre variables continues ont été examinées à l'aide du coefficient de corrélation de Pearson. Les résultats avec une valeur P < 0,05 ont été considérés comme statistiquement significatifs. Les niveaux de significativité ont été indiqués comme suit : ns, P > 0,05 ; *, P < 0,05 ; **, P < 0,01 ; ***, P < 0,001 ; et ****, P < 0,0001.
Résultats
Recherche de biomarqueurs diagnostiques candidats pour le kélidoïde à l'aide d'un algorithme d'apprentissage automatique
Un total de 283 gènes liés au métabolisme de l'hème ont été inclus dans cette étude. L'analyse de l'expression différentielle du jeu de données GSE44270, comparant les tissus de peau chéloïdiens et normaux, a identifié 25 gènes exprimés de manière significativement différente (Figure 1A et Tableau supplémentaire S3). Afin de sélectionner davantage des biomarqueurs associés à la maladie, la régression LASSO a identifié 9 gènes candidats (Figure 1B,C et Tableau supplémentaire S3), tandis que l'algorithme de forêt aléatoire (RF) a sélectionné 11 gènes présentant une importance prédictive élevée (Figure 1D et Tableau supplémentaire S3). L'intersection entre les résultats de LASSO et de RF a été visualisée à l'aide d'un diagramme de Venn, permettant d'obtenir six biomarqueurs centraux, à savoir FLVCR1, TMCC2, EIF2AK1, XK, HPX et KEL (Figure 1E et Tableau supplémentaire S3). Une analyse de la caractéristique de fonctionnement du récepteur (ROC) dans la cohorte GSE44270 a montré une performance diagnostique satisfaisante pour les six biomarqueurs, avec des valeurs d'AUC de 0,8016 pour FLVCR1, 0,7063 pour TMCC2, 0,7817 pour EIF2AK1, 0,7460 pour XK, 0,7500 pour HPX et 0,7857 pour KEL (Figure 1F). À partir de ces six biomarqueurs, un nomogramme diagnostique pour les chéloïdes a ensuite été construit à l'aide du package rms dans R (Figure 1G).
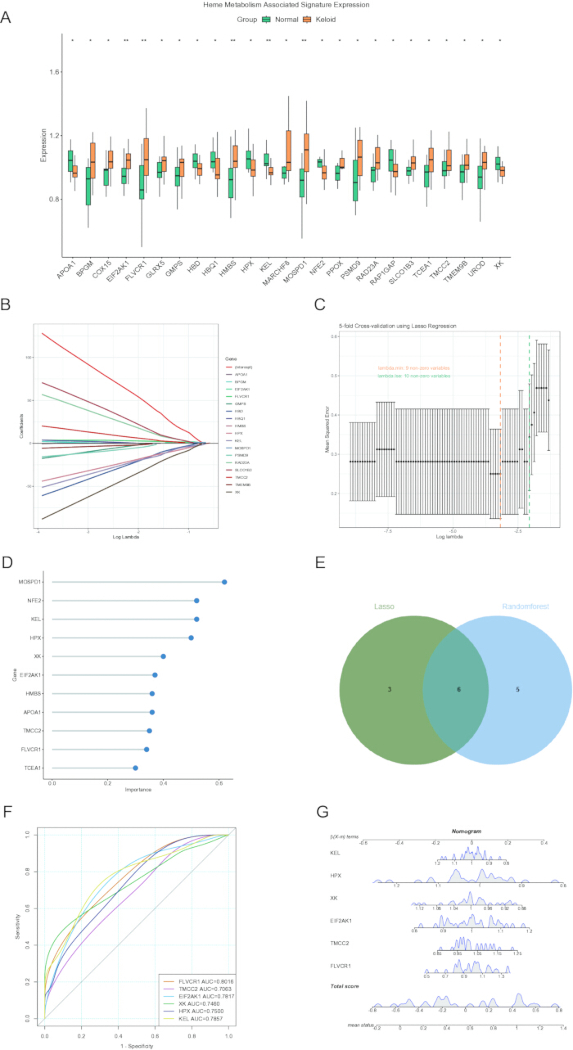
Figure 1 : Identification de gènes candidats liés au métabolisme de l'hème associés aux chéloïdes à l'aide d'algorithmes d'apprentissage automatique. (A) Graphique en boîte illustrant l'expression différentielle des gènes liés au métabolisme de l'hème entre les tissus chéloïdiens et normaux. (B,C) Analyse de régression logistique LASSO pour le criblage de marqueurs diagnostiques candidats. (D) Biomarqueurs candidats sélectionnés par l'algorithme RF. (E) Diagramme de Venn montrant les gènes communs identifiés par les deux algorithmes d'apprentissage automatique. (F) Analyse de la courbe ROC évaluant les performances diagnostiques des biomarqueurs candidats. (G) Nomogramme pour la prédiction des chéloïdes basé sur la signature à six gènes. Abréviations : LASSO, opérateur de sélection et de réduction absolue minimale ; RF, forêt aléatoire ; ROC, caractéristique de fonctionnement du récepteur. Signification statistique : ns, P > 0,05 ; *, P < 0,05 ; **, P < 0,01 ; ***, P < 0,001 ; et ****, P < 0,0001. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
Les performances prédictives du nomogramme diagnostique ont été évaluées dans la cohorte d'apprentissage (GSE44270) et dans la cohorte de validation (GSE7890). Le modèle a montré une excellente précision diagnostique, avec des valeurs d'AUC de 0,984 (IC à 95 % : 0,950–1,000) et de 0,922 (IC à 95 % : 0,806–1,000), respectivement (Figure 2A,D). Afin d'évaluer davantage la robustesse et le risque de surajustement de la signature diagnostique à six gènes, des analyses de validation interne supplémentaires ont été réalisées dans la cohorte de découverte (GSE44270). Une validation croisée en cinq parties a révélé des performances discriminantes cohérentes entre les sous-groupes, avec une AUC moyenne de 0,925, indiquant que le modèle conservait des performances de classification stables malgré les variations des échantillons d'apprentissage. De plus, une validation par bootstrap avec 1 000 rééchantillonnages a donné une AUC moyenne de 0,930 (IC à 95 % : 0,794–1,000). Après correction de l'optimisme potentiel dû à la taille limitée de l'échantillon, l'AUC corrigée restait à 0,930, suggérant que les performances diagnostiques de la signature à six gènes étaient relativement stables après validation interne. En outre, l'analyse de courbe décisionnelle (DCA) a indiqué que le nomogramme offrait un bénéfice net potentiel supérieur à celui d'autres stratégies diagnostiques sur une gamme de probabilités seuils, bien que ces résultats doivent être interprétés avec prudence en raison de la taille limitée de l'échantillon (Figure 2B,E). Par ailleurs, les échantillons de chéloïdes présentaient des scores de risque significativement plus élevés que les témoins sains dans les deux cohortes, d'apprentissage et de validation (Figure 2C,F), confirmant davantage la stabilité et la fiabilité du modèle diagnostique.
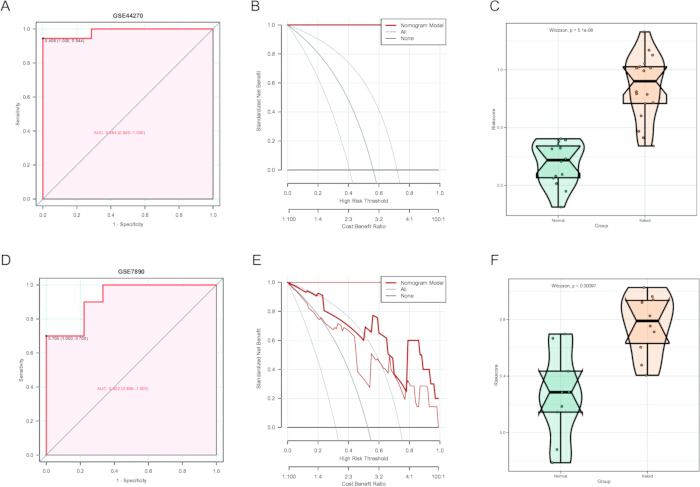
Figure 2 : Validation du nomogramme pour la prédiction des chéloïdes. (A) Courbe ROC évaluant les performances prédictives du nomogramme dans le jeu de données GSE44270. (B) ACD évaluant l'utilité clinique du nomogramme dans GSE44270. (C) Distribution des scores de risque comparant les échantillons chéloïdiens et sains dans GSE44270. (D) Courbe ROC évaluant les performances prédictives du nomogramme dans le jeu de données indépendant GSE7890. (E) ACD évaluant l'utilité clinique du nomogramme dans GSE7890. (F) Distribution des scores de risque comparant les échantillons chéloïdiens et sains dans GSE7890. Abréviations : ROC = caractéristique de fonctionnement du récepteur ; ACD = analyse de courbe de décision. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Les biomarqueurs diagnostiques sont associés aux caractéristiques immunitaires du kélidoïde
Afin d'explorer la relation entre les six biomarqueurs diagnostiques et le microenvironnement immunitaire, une analyse de corrélation a été réalisée pour évaluer les associations entre l'expression des biomarqueurs et l'infiltration des cellules immunitaires. Les résultats ont révélé que les six biomarqueurs étaient significativement associés à plusieurs populations de cellules immunitaires infiltrantes (Figure 3A). Plus précisément, l'expression de FLVCR1 était négativement associée aux cellules T auxiliaires folliculaires (Figure 3B). TMCC2 présentait des corrélations positives avec les cellules natural killer et les cellules dendritiques activées, tandis qu'elle était négativement corrélée aux cellules dendritiques immatures et aux cellules B immatures (Figure 3C–F). De plus, l'expression de EIF2AK1 était négativement associée aux cellules natural killer CD56dim (Figure 3G), tandis que XK était négativement associé aux éosinophiles (Figure 3H).
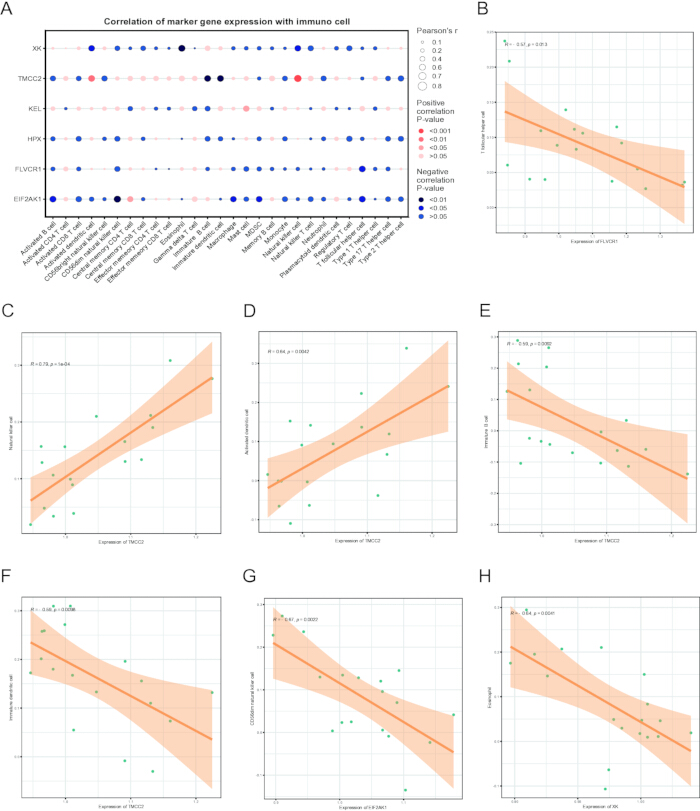
Figure 3: Corrélation entre les gènes candidats liés au métabolisme de l'hème et l'infiltration des cellules immunitaires. (ACarte thermique montrant les corrélations entre les gènes candidats et les populations de cellules immunitaires. Le rouge indique des corrélations positives, tandis que le bleu indique des corrélations négatives.B). Corrélation entre FLVCR1 expression et cellules T auxiliaires folliculaires.C-F) Corrélations entre TMCC2 expression et cellules Natural Killer, cellules dendritiques activées, cellules dendritiques immatures et cellules B immatures, respectivement. (G) Corrélation entre EIF2AK1 expression et cellules natural killer CD56dim.H). Corrélation entre XK expression et éosinophiles. Abréviations : FLVCR1 = récepteur du sous-groupe C du virus de la leucémie féline 1 ; TMCC2 = transmembrane et domaines en hélice alpha 2 ; EIF2AK1 = kinase 1 de l'initiation de la traduction du facteur 2 alpha chez les eucaryotes ; CD56dim = population pauvre en cluster de différenciation 56 Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Analyse des données de transcriptome unicellulaire
Afin de caractériser les profils d'expression des biomarqueurs diagnostiques identifiés au sein du microenvironnement des chéloïdes, nous avons analysé le jeu de données de séquençage de l'ARN monocellulaire GSE163973. Après contrôle de qualité et intégration des données, 21 488 cellules de haute qualité ont été conservées pour les analyses ultérieures. Les cellules présentant moins de 200 ou plus de 6 000 comptes totaux d'identifiants moléculaires uniques (UMI) ont été exclues, et les doubles potentiels ont été identifiés et éliminés à l'aide du package DoubletDetection. Les 2 000 gènes présentant la plus grande variabilité d'expression ont été sélectionnés, suivis d'une réduction de dimensionnalité et d'une visualisation par l'approximation uniforme des variétés et la projection (UMAP). Un total de 10 grandes populations cellulaires a été identifié, incluant les cellules endothéliales, les fibroblastes, les fibres musculaires, les kératinocytes, les cellules immunitaires, les cellules endothéliales lymphatiques, les cellules glandulaires, les cellules nerveuses, les mélanocytes et une population cellulaire non classée (Figure 4A,B). L'analyse d'expression a révélé des profils de distribution spécifiques à chaque type cellulaire pour les biomarqueurs diagnostiques. FLVCR1 était principalement exprimé dans les cellules endothéliales et les mélanocytes, tandis que EIF2AK1 montrait une expression relativement élevée dans les cellules nerveuses, les cellules glandulaires et les fibroblastes. HPX était principalement enrichi dans les mélanocytes, tandis que KEL présentait une expression prédominante dans les cellules glandulaires (Figure 4C,D).
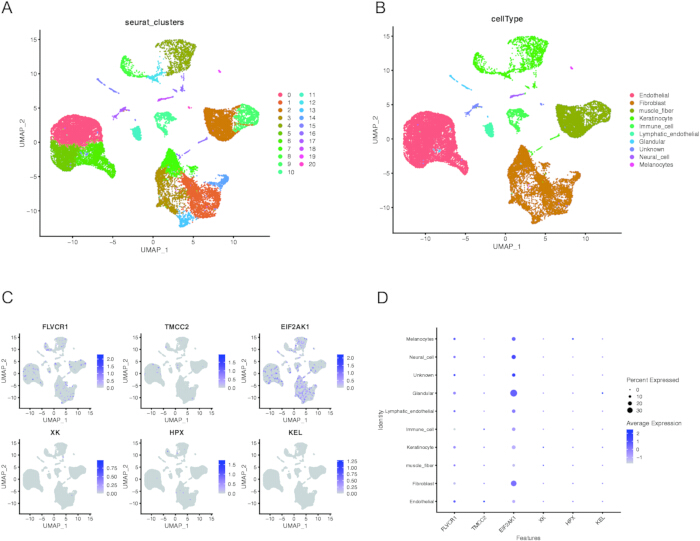
Figure 4 : Répartition des biomarqueurs diagnostiques liés au métabolisme de l'hème dans le transcriptome unicellulaire des cicatrices chéloïdiennes. (A) Graphique UMAP montrant 21 grappes cellulaires comprenant 21 488 cellules provenant d'échantillons de chéloïdes. (B) Annotations des types cellulaires basées sur les annotations rapportées dans l'étude initiale. (C) Graphiques d'expression montrant l'expression des biomarqueurs diagnostiques liés au métabolisme de l'hème dans différents types cellulaires. (D) Graphique en bulles montrant les niveaux d'expression moyens et les pourcentages de cellules exprimant les biomarqueurs diagnostiques liés au métabolisme de l'hème selon les différents types cellulaires. Abréviation : UMAP = approximation uniforme du collecteur et projection. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Identification et analyse du réseau d'interactions de biomarqueurs diagnostiques candidats
Afin d'explorer les mécanismes régulateurs sous-jacents aux biomarqueurs diagnostiques candidats, un réseau régulateur miARN–ARNm a été construit. Afin d'améliorer la fiabilité des interactions prédites, les miARN ciblant les biomarqueurs candidats ont été identifiés par recouvrement. Un total de 282 miARN interagissant avec les six biomarqueurs diagnostiques a été obtenu, et le réseau régulateur résultant est présenté dans la Figure 5. Notamment, il a été prédit que hsa-miR-34a-5p, hsa-let-7a-5p, hsa-let-7d-5p, hsa-let-7e-5p et hsa-miR-26b-5p régulent simultanément les six biomarqueurs candidats.
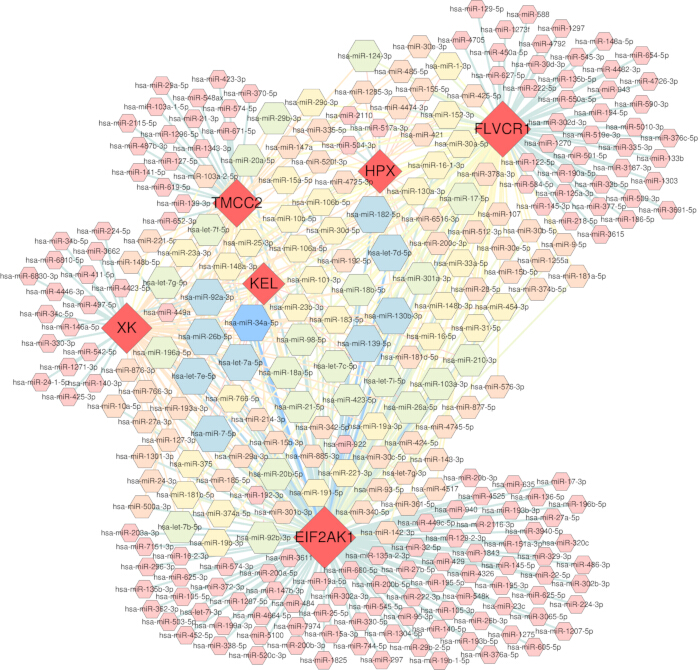
Figure 5 : réseau régulateur des miARN des biomarqueurs diagnostiques liés au métabolisme de l'hème. Le réseau illustre les relations régulatrices entre les six gènes biomarqueurs diagnostiques (FLVCR1, HPX, TMCC2, KEL, XK et EIF2AK1) et les miARN qui leur sont associés. Les nœuds géniques représentent les biomarqueurs diagnostiques, tandis que les nœuds environnants représentent les miARN. Les arêtes indiquent des interactions miARN–ARNm confirmées expérimentalement. Abréviations : FLVCR1 = récepteur 1 du sous-groupe C du virus de la leucémie féline ; HPX = hémopexine ; TMCC2 = domaines transmembranaires et en hélice enroulée 2 ; KEL = métallo-endopeptidase Kell ; XK = groupe sanguin X-lié Kx ; EIF2AK1 = kinase 1 de l'initiation de la traduction du facteur 2 alpha chez les eucaryotes ; miARN = ARN micro ; ARNm = ARN messager. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Validation expérimentale de l'expression de FLVCR1 et analyse de docking moléculaire de composés thérapeutiques potentiels
Afin de valider les résultats bioinformatiques et confirmer la pertinence fonctionnelle du gène central identifié, nous avons évalué expérimentalement l'expression de FLVCR1 dans les PKF et les NHDF. Les analyses par qRT-PCR et par immunotransfert ont systématiquement montré que FLVCR1 était significativement surexprimé dans les fibroblastes de chéloïde par rapport aux témoins normaux (Figure 6A–C, Figure supplémentaire S1 et Tableau supplémentaire S4). Cette surexpression cellulaire soutient l'implication potentielle d'une dysrégulation métabolique de l'hème associée à FLVCR1 dans la pathogenèse des chéloïdes.
Étant donné le rôle potentiel de FLVCR1 dans les modifications immunitaires associées au métabolisme du hème, nous avons ensuite cherché à identifier des composés thérapeutiques potentiels capables de cibler directement FLVCR1 afin d'interrompre cet axe pathogène. Un criblage virtuel à haut débit a été réalisé à l'aide d'une bibliothèque de composés de médecine traditionnelle chinoise (MTC) et de la structure protéique préparée. Les 20 composés présentant les scores de docking les plus favorables ont été sélectionnés pour une évaluation approfondie (Tableau supplémentaire S5). En général, une énergie de liaison plus faible indique une affinité de liaison plus forte, et des énergies de docking inférieures à −5 kcal/mol sont considérées comme indicatives d'interactions ligand–protéine stables. Parmi les composés criblés, la (+)-gallocatéchine, la (−)-épicatéchine, la (−)-gallocatéchine et la cyanidine (chlorure) ont montré des affinités de liaison favorables envers FLVCR1. Notamment, la (+)-gallocatéchine a présenté l'interaction la plus forte avec FLVCR1 en formant quatre liaisons hydrogène avec GLU214, ASN245, GLN246 et GLN471, suggérant un mode de liaison ligand–protéine stable (Figure 6D–G). Ces résultats mettent en évidence la (+)-gallocatéchine comme un candidat prometteur pour une intervention thérapeutique ciblée, basée sur le mécanisme, dirigée contre FLVCR1.
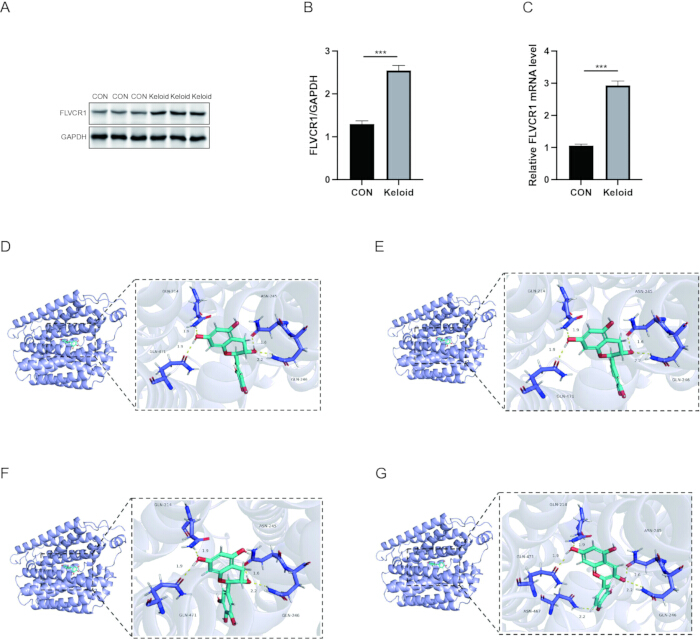
Figure 6 : Validation expérimentale de l'expression de FLVCR1 et modélisation moléculaire de composés ciblant FLVCR1. (A) Images représentatives de western blot montrant l'expression protéique de FLVCR1 dans les échantillons CON et les kélidoïdes. GAPDH a servi de contrôle de chargement. (B) Quantification des niveaux protéiques de FLVCR1 normalisés à GAPDH. (C) Les niveaux d'expression relative de l'ARNm de FLVCR1 dans les fibroblastes CON et kélidoïdes ont été déterminés par qRT-PCR. GAPDH a été utilisé comme référence interne. (D–G) Représentations tridimensionnelles des modes de liaison prédits entre FLVCR1 et des composés organiques sélectionnés : (D) (+)-Gallocatéchine. (E) (-)-Épicatéchine. (F) (-)-Gallocatéchine. (G) Cyanidine (chlorure). Abréviations : FLVCR1 = récepteur du sous-groupe C du virus de la leucémie féline 1 ; CON, témoin ; GAPDH, déshydrogénase du glyceraldéhyde-3-phosphate ; qRT-PCR, réaction de transcription inverse quantitative en chaîne par polymérase ; SD, écart type. Les données sont exprimées comme moyenne ± SD. Signification statistique : ns, P > 0,05 ; *, P < 0,05 ; **, P < 0,01 ; ***, P < 0,001 ; et ****, P < 0,0001. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
Confirmation de la stabilité du complexe FLVCR1–(+)-gallocatéchine par simulation de dynamique moléculaire
Afin d'évaluer la fiabilité du mode de liaison ligand–protéine prédit, une simulation de dynamique moléculaire (DM) a été réalisée pour le complexe FLVCR1–(+)-gallocatéchine. L'analyse s'est concentrée sur la stabilité structurale du complexe au cours du temps et sur l'impact de la liaison du ligand sur le comportement conformationnel de la protéine, en utilisant les calculs de RMSD, RMSF, du rayon de giration (Rg), de SASA, d'analyse des liaisons hydrogène et de MM/GBSA. L'analyse du RMSD (Figure 7A) a montré que la protéine apo et le complexe lié au ligand présentaient des fluctuations initiales durant les 20 premières ns, suivies d'une stabilisation progressive, indiquant que les systèmes avaient atteint un état d'équilibre au cours de la simulation. Après l'équilibration, la valeur de RMSD du complexe FLVCR1–(+)-gallocatéchine est restée inférieure à 0,2 nm, suggérant que la liaison du ligand contribuait au maintien de la stabilité structurale de FLVCR1. L'analyse du RMSF (Figure 7B) a révélé que la majorité des résidus présentaient des fluctuations limitées tout au long de la simulation, indiquant le maintien de l'intégrité globale de la protéine, tandis que plusieurs régions flexibles pourraient correspondre à des boucles impliquées dans l'accommodation du ligand. De plus, des profils stables de Rg et de SASA (Figure 7C,D) ont indiqué que le complexe conservait une conformation compacte, sans expansion structurale marquée ni changement notable d'exposition au solvant. L'analyse des liaisons hydrogène (Figure 7E) a révélé que le complexe FLVCR1–(+)-gallocatéchine maintenait des interactions intermoléculaires persistantes, avec environ 3 à 4 liaisons hydrogène formées durant la simulation, soutenant ainsi la stabilité de l'association ligand–protéine. L'analyse MM/GBSA a en outre montré que le complexe FLVCR1–(+)-gallocatéchine présentait une énergie libre de liaison favorable (ΔGtotal = −34,87 ± 4,13 kcal/mol) (Supplemental Table S6). L'analyse de décomposition énergétique a indiqué que les interactions de van der Waals (ΔVDWAALS = −46,34 ± 2,16 kcal/mol) et les interactions électrostatiques (ΔEelec = −14,09 ± 3,45 kcal/mol) étaient les principales contributions favorables à la liaison, malgré la contribution défavorable de l'énergie de solvatation polaire (ΔGsolvation = 25,55 ± 0,74 kcal/mol) (Supplemental Table S6). Dans leur ensemble, ces résultats de simulation de DM démontrent que la (+)-gallocatéchine forme un complexe stable avec FLVCR1 et confirment davantage la fiabilité du mode de liaison prédit par le docking.
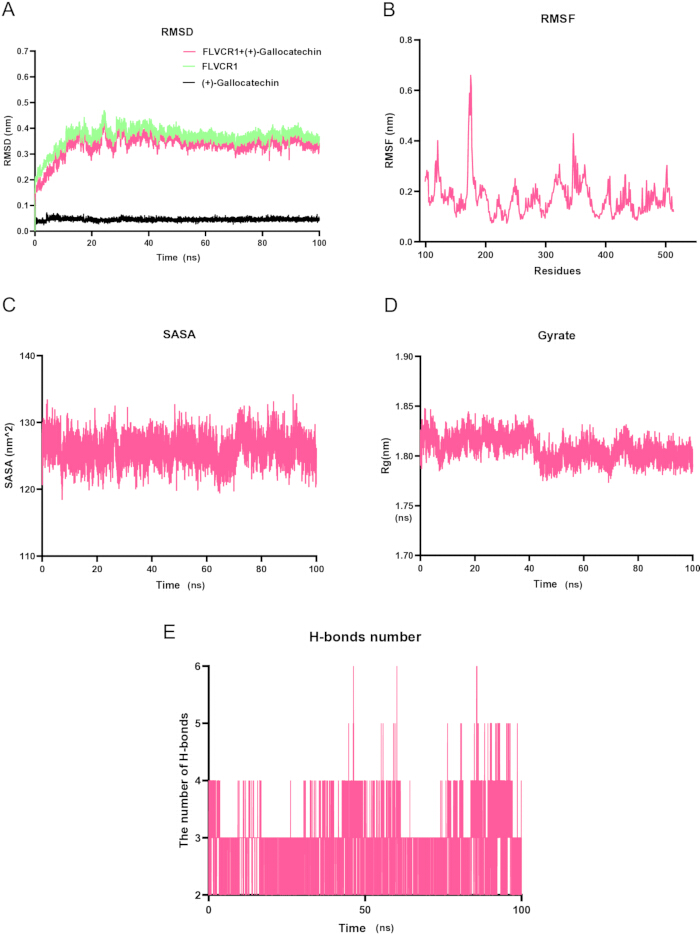
Figure 7 : Analyse par simulation de dynamique moléculaire du complexe FLVCR1–(+)-Gallocatéchine. (A) Profils de RMSD de la FLVCR1 apo et du complexe FLVCR1–(+)-Gallocatéchine au cours de la simulation de dynamique moléculaire de 100 ns. (B) Profil de RMSF montrant les fluctuations au niveau des résidus de la FLVCR1 durant la simulation. (C) Profil de SASA illustrant les variations de la surface accessible au solvant du complexe FLVCR1–(+)-Gallocatéchine. (D) Profil de Rg évaluant la compacité du complexe FLVCR1–(+)-Gallocatéchine au cours de la simulation. (E) Analyse des liaisons hydrogène montrant les interactions intermoléculaires dynamiques entre la FLVCR1 et la (+)-Gallocatéchine tout au long de la simulation. Abréviations : FLVCR1 = récepteur 1 du sous-groupe C du virus de la leucémie féline ; RMSD = écart quadratique moyen ; RMSF = fluctuation quadratique moyenne ; SASA = surface accessible au solvant ; Rg = rayon de giration. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Disponibilité des données :
Les jeux de données transcriptomiques accessibles au public analysés dans cette étude peuvent être consultés sur le Gene Expression Omnibus (GEO) sous les numéros d'accès GSE44270, GSE7890 et GSE163973. Les données brutes générées dans cette étude et sous-jacentes à la validation expérimentale, incluant les mesures de qRT-PCR, les images originales de western blot et les données de quantification de western blot, sont fournies sous forme de Figure Supplémentaire S1, Tableau Supplémentaire S1, Tableau Supplémentaire S2, Tableau Supplémentaire S3 et Tableau Supplémentaire S4. Les résultats de docking moléculaire et les données d'énergie libre de liaison MM/GBSA sont également fournis dans le Tableau Supplémentaire S5 et le Tableau Supplémentaire S6.
Figure supplémentaire S1 : Données brutes du western blot.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S1 : Gènes liés au métabolisme de l'hème.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S2 : Séquences des amorces des gènes sélectionnés. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S3 : Approches d'apprentissage automatique pour l'identification de biomarqueurs diagnostiques potentiels dans l'excès de cicatrisation chéloïdienne. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S4 : Données brutes soutenant la validation expérimentale de l'expression de FLVCR1. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S5 : Les 20 meilleurs composés candidats identifiés par le dockage moléculaire avec FLVCR1.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S6 : Analyse de l'énergie libre de liaison MM/GBSA du complexe FLVCR1–(+)-Gallocatéchine.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Cette étude met en évidence une association potentielle entre un métabolisme du hème dysrégulé, l'expression de FLVCR1 et des modifications de l'environnement immunitaire dans la formation des cicatrices chéloïdes. En combinant des analyses de transcriptomique en masse et en cellule unique, nous avons établi que FLVCR1 constitue un nœud moléculaire reliant le défaut d'exportation du hème à une réorganisation immunitaire pathologique, plaçant ainsi la chéloïde au sein du spectre émergent des troubles « métabo-fibrotiques »23,24,25. L'importance potentielle de FLVCR1 est étayée par des preuves convergentes provenant de plusieurs niveaux d'analyse. La transcriptomique en masse a révélé une surexpression significative de FLVCR1 dans les tissus chéloïdes, avec une capacité diagnostique robuste, tandis que la cartographie à résolution unicellulaire a localisé son expression principalement dans les cellules endothéliales et les mélanocytes — deux types cellulaires impliqués de manière critique dans la pathogenèse chéloïde par angiogenèse anormale et hyperpigmentation, respectivement26,27. De manière particulièrement convaincante, l'expression de FLVCR1 présentait une forte corrélation négative avec les cellules T auxiliaires folliculaires (Tfh), un sous-ensemble de lymphocytes de plus en plus reconnu pour favoriser une immunité polarisée vers le phénotype Th2 et le dépôt de collagène dans les microenvironnements fibrotiques28. Des études antérieures ont montré que l'exportation du hème médiée par FLVCR1 participe à la maturation des cellules dendritiques et à la présentation de l'antigène29, suggérant un lien potentiel entre l'homéostasie du hème associée à FLVCR1 et la régulation immunitaire. La surexpression observée de FLVCR1 et sa corrélation négative avec l'infiltration des cellules Tfh pourraient donc refléter des altérations de l'homéostasie immunitaire, impliquant potentiellement des cytokines profibrotiques associées aux cellules Tfh telles que l'IL-4 et l'IL-1329,30,31.
En outre, l'accumulation intracellulaire d'hème résultant d'un dysfonctionnement de FLVCR1 active probablement l'inflammasome NLRP3 — un mécanisme bien documenté dans la fibrose hépatique, où l'hème agit comme un motif moléculaire associé aux lésions (DAMP) déclenchant une inflammation stérile32,33,34. Une telle activation de l'inflammasome favoriserait la libération d'IL-1β/IL-18, induisant une polarisation des macrophages vers le phénotype M2 via la signalisation TLR4/NF-κB, et créant ainsi une boucle auto-entretenue de stress oxydatif et d'activation des fibroblastes35,36. Dans leur ensemble, ces données soutiennent l'implication de FLVCR1 comme biomarqueur candidat et contributeur potentiel aux interactions entre métabolisme de l'hème et réponse immunitaire dans le kyste; toutefois, la cascade mécanistique proposée nécessite une validation fonctionnelle directe. La rétention intracellulaire d'hème induit d'abord des dommages oxydatifs et active l'inflammasome, ce qui entraîne par la suite un dysfonctionnement des cellules dendritiques, favorisant ainsi une déviation vers les cellules T auxiliaires folliculaires et vers des réponses immunitaires de type Th2 ; cette déviation immunitaire amplifie ensuite la polarisation des macrophages vers le phénotype M2, aboutissant finalement à l'activation des fibroblastes et à la progression de la fibrogenèse.
Au-delà de l'action isolée de FLVCR1, la dysrégulation synergique des six biomarqueurs révèle un effondrement coordonné de l'homéostasie du hème à travers plusieurs nœuds régulateurs. TMCC2, corrélé positivement avec les cellules dendritiques activées mais associé négativement aux sous-ensembles immatures, pourrait représenter un mécanisme compensatoire tentant de restaurer la compétence immunitaire en contexte de stress lié au hème37,38. EIF2AK1, fortement exprimé dans les fibroblastes chéloïdiens et les cellules glandulaires, agit comme un capteur moléculaire direct de l'excès de hème qui phosphoryle eIF2α afin de supprimer globalement la synthèse protéique tout en régulant positivement de manière sélective les gènes de réponse au stress39,40,41. Cela place EIF2AK1 comme un élément central reliant l'accumulation de hème à la transition phénotypique des fibroblastes—ce qui pourrait expliquer pourquoi les fibroblastes chéloïdiens présentent une résistance accrue à l'apoptose et une production exagérée de collagène42,43,44. HPX, le principal capteur plasmatique du hème, montre une expression restreinte dans les mélanocytes, suggérant une tentative autonome de la cellule pour atténuer la toxicité du hème au sein des compartiments riches en pigments45,46,47. La dysrégulation concomitante de XK et de KEL implique davantage les mécanismes de gestion du hème propres à la lignée érythroïde dans la pathogenèse des chéloïdes—une découverte aux implications intéressantes pour comprendre pourquoi les chéloïdes apparaissent fréquemment sur des sites de traumatisme accompagnés d'hémorragies microscopiques. Plutôt que de considérer ces six gènes comme des marqueurs indépendants, nous interprétons leur dysrégulation collective comme la preuve d'un échec systémique de la compartimentation du hème, dans lequel l'exportation altérée (FLVCR1), la détection (EIF2AK1), la capture (HPX) et le trafic membranaire (XK, KEL) convergent pour créer un microenvironnement riche en hème et propice à la fibrose.
Ce modèle métabolique-immunitaire est renforcé par une couche épigénétique convaincante : nous avons identifié un réseau de ceRNA dans lequel la régulation à la baisse de certains ARN micro (par exemple, la famille let-7 et miR-34a-5p) pourrait simultanément déréprimer des voies liées au métabolisme de l'hème et des voies fibrotiques, bien que ce modèle régulateur nécessite une validation supplémentaire23. La résolution spatiale offerte par l'analyse à l'échelle cellulaire unique met en lumière la chorégraphie cellulaire sous-jacente à ce processus, montrant comment un dysfonctionnement métabolique dans les cellules structurelles sème activement un microenvironnement riche en cellules immunitaires par une signalisation paracrine de l'hème, transformant ainsi notre compréhension d'une perspective de « tissu global » vers un modèle d'écosystème cellulaire dynamique48,49,50. L'accumulation d'hème dans les cellules endothéliales pourrait favoriser les fuites vasculaires et l'extravasation des leucocytes par l'induction de l'hème oxygénase-1 et la surexpression des molécules d'adhésion, contribuant ainsi à l'établissement du microenvironnement riche en cellules immunitaires observé dans les kélidoïdes51,52,53. Parallèlement, l'expression de FLVCR1 dans les mélanocytes correspond aux observations cliniques d'hyperpigmentation kélidoïde et suggère des vulnérabilités métaboliques partagées entre les voies pigmentaires et fibrotiques — potentiellement médiées par des réponses au stress oxydatif54,55. Cette cartographie spatiale transforme notre compréhension d'une perspective de « tissu global » vers un modèle d'écosystème cellulaire dans lequel un dysfonctionnement métabolique dans les cellules structurelles (endothélium, mélanocytes) façonne activement le comportement des cellules immunitaires par une signalisation paracrine de l'hème.
Du point de vue translationnel, notre nomogramme intégrant les six biomarqueurs a atteint une précision diagnostique quasi parfaite, surpassant nettement n'importe quel marqueur unique et démontrant un bénéfice clinique net clair selon l'analyse de courbe de décision. De manière plus provocante, le dockage moléculaire a identifié la (+)-gallocatéchine — un polyphénol bioactif abondant dans le thé vert et les herbes médicinales chinoises traditionnelles — comme un ligand de FLVCR1 à forte affinité, formant des liaisons hydrogène stables avec GLU-214, ASN-245, GLN-246 et GLN-471. Cette découverte est particulièrement convaincante étant donné les preuves antérieures selon lesquelles les catéchines suppriment la synthèse du collagène, inhibent la sécrétion du facteur de croissance transformant bêta 1 et atténuent le stress oxydatif dans les fibroblastes de kéliodes56,57,58. Nous émettons l'hypothèse que la (+)-gallocatéchine pourrait stabiliser la conformation de FLVCR1 afin d'augmenter la capacité d'exportation de l'hème, interrompant ainsi le déclencheur métabolique de la fibrose à sa source — une stratégie fondamentalement différente des thérapies actuelles qui suppriment simplement la production de collagène en aval. Savoir si ce type d'intervention métabolique pourrait influencer la récidive des kéliodes nécessite une validation expérimentale et clinique supplémentaire.
Bien sûr, cette étude présente également des limites. Premièrement, nos analyses restent essentiellement computationnelles, et l'association observée entre l'expression de FLVCR1 et l'infiltration des cellules T folliculaires auxiliaires (Tfh) n'établit pas de relation causale directe. Une validation par cytométrie en flux des cellules Tfh et des études fonctionnelles impliquant une inhibition ou une surexpression de FLVCR1 dans les fibroblastes de kéliodes, associées à des tests d'interaction entre fibroblastes et cellules immunitaires ou à des tests utilisant des milieux conditionnés, sont nécessaires pour préciser le rôle potentiel de FLVCR1 dans la régulation immunitaire. Deuxièmement, la taille relativement restreinte de l'échantillon peut introduire une incertitude et un biais d'optimisme dans l'évaluation des performances de la signature à six gènes. Bien qu'une validation interne ait été réalisée, l'évaluation fiable de la performance diagnostique et de la calibration reste limitée. Par conséquent, le panel à six gènes doit être considéré comme une signature moléculaire exploratoire nécessitant une validation supplémentaire dans des cohortes plus larges et indépendantes. Troisièmement, le jeu de données en single-cell doit être élargi afin de mieux capturer l'hétérogénéité interindividuelle et les populations cellulaires rares. Quatrièmement, une validation au niveau protéique de l'expression des biomarqueurs et de leur localisation spatiale par immunohistochimie renforcerait la pertinence clinique de nos résultats. Enfin, bien que le docking moléculaire suggère une interaction potentielle entre la (+)-gallocatéchine et FLVCR1, des tests de liaison in vitro ainsi que des études d'efficacité in vivo sont nécessaires avant toute application clinique. Malgré ces limites, nos résultats fournissent un cadre multidimensionnel reliant le métabolisme du hème associé à FLVCR1 aux altérations immunitaires dans le kéliode, et identifient des biomarqueurs moléculaires et des candidats thérapeutiques potentiels à explorer davantage.
Déclarations de divulgation
Les auteurs n'ont aucune incompatibilité d'intérêts à déclarer.
Contributions des auteurs
Qiuyan Yang a contribué à la conception de l'étude. Jianping Zhang a contribué à la collecte des données. Qiuyan Yang et Xiaofang Sun ont contribué à l'analyse statistique. Qiuyan Yang et Jing Wang ont contribué à la réalisation des schémas et à la finalisation du manuscrit. Tous les auteurs ont lu et approuvé la version finale du manuscrit.
Remerciements
Nous remercions sincèrement les chercheurs ayant généré et partagé publiquement les jeux de données GSE44270, GSE7890 et GSE163973 via la base de données Gene Expression Omnibus (GEO).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| AmberTools | Amber Project | https://ambermd.org/AmberTools.php | Version 22 ; Génération de paramètres de ligand à l'aide du champ de force GAFF |
| Anti-FLVCR1 | Proteintech | 26841-1-AP | |
| Anti-GAPDH | Proteintech | 60004-1-Ig | |
| AutoDock Vina | The Scripps Research Institute | https://vina.scripps.edu/ | Version 1.2.3 ; Docking moléculaire et prédiction de l'affinité de liaison du ligand |
| AutoDockTools | The Scripps Research Institute | https://ccsb.scripps.edu/autodocksuite/adt/ | Version 1.5.6 ; Préparation du ligand et du récepteur pour le docking moléculaire |
| Kit d'essai de protéines BCA | Servicebio | G2026 | |
| Mélange de synthèse d'ADNc pour qPCR avec dsDNase | UnionScript | Transcription inverse pour qRT-PCR | |
| ChemBio3D | PerkinElmer | https://revvitysignals.com/products/research/chemdraw | Version 14.0 ; Optimisation conformationnelle 3D et minimisation de l'énergie des ligands |
| Système d'imagerie chimiluminescente | Visualisation des bandes de western blot | ||
| Pack DoubletDetection | GitHub / JonathanShor | https://github.com/JonathanShor/DoubletDetection | Détection et élimination des doublets prédits dans l'analyse scRNA-seq |
| Substrat chimiluminescent ECL | Détection du signal en western blot | ||
| Sérum de veau fœtal | Concentration finale de 2 % ; Supplément pour le milieu de culture des fibroblastes | ||
| Milieu de croissance des fibroblastes 2 | PromoCell | C-23020 | |
| Amorces FLVCR1 et GAPDH | Tableau supplémentaire S2 | Amplification par qRT-PCR des gènes cibles et de référence | |
| Gaussian | Gaussian, Inc. | https://gaussian.com/ | Gaussian 16W ; Calcul des charges atomiques RESP pour la paramétrisation du ligand |
| Appareil d'électrophorèse sur gel | Séparation des protéines par SDS-PAGE | ||
| Pack GEOquery | Bioconductor | https://bioconductor.org/packages/GEOquery/ | Version 2.68.0 ; Récupération de l'expression génique et des métadonnées à partir de la base de données GEO |
| Pack ggplot2 | CRAN | https://cran.r-project.org/package=ggplot2 | Version 4.0.2 ; Visualisation des données |
| Pack glmnet | CRAN | https://cran.r-project.org/package=glmnet | Version 4.1.10 ; Sélection de caractéristiques LASSO |
| GROMACS | GROMACS Development Team | https://www.gromacs.org/ | Version 2022.3 ; Simulations de dynamique moléculaire et analyse des trajectoires |
| GS AntiQ qPCR SYBR Green Fast Mix (Universal) | Genesand | SQ410 | |
| GSE163973 | Base de données GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE163973 | 3 échantillons de chéloïde ; Analyse d'expression unicellulaire |
| GSE44270 | Base de données GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE44270 | 18 échantillons de chéloïde et 14 échantillons normaux ; Expression différentielle et criblage de biomarqueurs |
| GSE7890 | Base de données GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE7890 | 10 échantillons de chéloïde et 9 échantillons normaux ; Validation indépendante de biomarqueurs diagnostiques |
| Pack GSVA | Bioconductor | https://bioconductor.org/packages/GSVA/ | Version 1.48.3 ; Analyse d'infiltration des cellules immunitaires basée sur ssGSEA |
| Anticorps secondaire caprin anti-IgG de souris conjugué à la HRP | Abcam | ab97040 | |
| Anticorps secondaire caprin anti-IgG de lapin conjugué à la HRP | Abcam | ab97051 | |
| Incubateur à CO2 humidifié | 37 °C, 5 % CO2 ; Maintien des cellules NHDF et PKF | ||
| ImageJ | National Institutes of Health | https://imagej.nih.gov/ij/ | Quantification de l'intensité des bandes de western blot |
| Insuline | Concentration finale de 5 μg/mL ; Supplément pour le milieu de culture des fibroblastes | ||
| Base de données des signatures moléculaires (MSigDB) | Broad Institute | https://www.gsea-msigdb.org/gsea/msigdb | Version 2024.1.Hs ; Source des jeux de gènes associés au métabolisme de l'hème |
| NetworkAnalyst | NetworkAnalyst | https://www.networkanalyst.ca/ | Version 3.0 ; Construction du réseau d'interaction miARN-mARN |
| NHDF | Procell | CP-H106 | |
| Lait écrémé en poudre | Solution à 5 % ; Blocage de la membrane pour l'analyse par western blot | ||
| Film ou capuchons d'étanchéité optique | Scellage des réactions de qRT-PCR | ||
| PBS | Procell | PB180327 | |
| PDB ID : 8UBZ | RCSB PDB | https://www.rcsb.org/structure/8UBZ | Structure humaine de FLVCR1 ; Source de la structure protéique FLVCR1 pour le criblage virtuel basé sur la structure |
| Inhibiteurs de phosphatase | Supplément pour le tampon de lyse protéique | ||
| PKF | Procell | GCP-H235 | |
| PMSF | Servicebio | G2008-1ML | |
| Pack pROC | CRAN | https://cran.r-project.org/package=pROC | Version 1.19.0.1 ; Analyse des courbes ROC et de l'AUC |
| Cocktail d'inhibiteurs de protéase | Roche | 4693124001 | |
| Appareil de transfert protéique | Transfert des protéines vers une membrane PVDF | ||
| Membrane PVDF | Millipore | IPVH08100 | |
| PyMOL | Schrödinger, LLC | https://pymol.org/ | Version 2.6.1 ; Visualisation et analyse des poses de docking protéine-ligand et des interactions moléculaires |
| Plaques ou tubes de qRT-PCR | Préparation des réactions de qRT-PCR | ||
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Version 4.3.1 ; Analyses statistiques et bioinformatiques |
| Pack randomForest | CRAN | https://cran.r-project.org/package=randomForest | Version 4.7.1.2 ; Sélection de caractéristiques par forêt aléatoire |
| REACTOME_HEME_BIOSYNTHESIS ; REACTOME_HEME_DEGRADATION ; WIKIPATHWAYS_HEME_BIOSYNTHESIS ; REACTOME_SCAVENGING_HEME_FROM_PLASMA ; HALLMARK_HEME_METABOLISM | Base de données des signatures moléculaires (MSigDB) | https://www.gsea-msigdb.org/gsea/msigdb | Version 2024.1.Hs ; 283 gènes uniques après fusion ; Définition des gènes associés au métabolisme de l'hème |
| Système de PCR en temps réel | Amplification et détection par qRT-PCR | ||
| Facteur de croissance fibroblastique humain recombinant de base | Concentration finale de 1 ng/mL ; Supplément pour le milieu de culture des fibroblastes | ||
| Tampon RIPA | Servicebio | G2002 | |
| Pack rms | CRAN | https://cran.r-project.org/package=rms | Version 6.7.1 ; Construction de nomogrammes |
| Réactifs ou gels préfabriqués pour SDS-PAGE | Séparation des protéines par SDS-PAGE | ||
| Pack Seurat | CRAN | https://satijalab.org/seurat/ | Version 5.4.0 ; Prétraitement, regroupement et visualisation des données scRNA-seq |
| TarBase | DIANA Tools | https://carolina.imis.athena-innovation.gr/diana_tools/ | Version 9.0 ; Source d'interactions miARN-mARN expérimentalement validées |
| Kit Total RNA II | Omega | R6934-01 | |
| Bibliothèque de composés actifs de médecine traditionnelle chinoise | Source de composés candidats pour le criblage virtuel | ||
| Solution saline tamponnée au Tween/Tris | Préparation du tampon de blocage et lavage de la membrane | ||
| Mélange UnionScript de synthèse de premier brin d'ADNc pour qPCR (avec dsDNase) | Genesand | SR511 |
Références
- Dirand Z, et al. Macrophage phenotype is determinant for fibrosis development in keloid disease. Matrix Biol. 2024;128:79-92.
- Fang X, et al. Hypertrophic scarring and keloids: epidemiology, molecular pathogenesis, and therapeutic interventions. MedComm (2020). 2025;6(10):e70381.
- Adler R, et al. Pentoxifylline and long-term risk of keloid formation: a real-world 10-year outcomes study using TriNetX. J Am Acad Dermatol. 2026;94(5):1561-3.
- Banerjee P, et al. Anti-fibrotic properties of a decellularized extracellular matrix scaffold from porcine small intestinal submucosa in normal human and keloid fibroblasts. Int J Mol Sci. 2025;26(24):11764.
- Chang YH, McGrath JA, Hsu CK. Regression of extensive keloids during imatinib therapy for gastrointestinal stromal tumor. JAMA Dermatol. 2025;161(12):1293-4.
- Wang QR, et al. CCL17 drives fibroblast activation in the progression of pulmonary fibrosis by enhancing the TGF-β/Smad signaling. Biochem Pharmacol. 2023;210:115475.
- Higuchi Y, et al. Cavin-2 promotes fibroblast-to-myofibroblast trans-differentiation and aggravates cardiac fibrosis. ESC Heart Fail. 2024;11(1):167-78.
- Zhang H, et al. Plasma apolipoprotein E protein attenuates pulmonary fibrosis through LRP1 and PLAU dual receptor-mediated TGF-β/Smad inhibition. J Adv Res. 2025. doi:10.1016/j.jare.2025.12.045.
- Chen Q, et al. Immune imbalance drives keloid pathogenesis: emerging targets for precision immunotherapy. Adv Wound Care (New Rochelle). 2026:21621918261417702.
- Deng CC, et al. Single-cell RNA-seq reveals immune cell heterogeneity and increased Th17 cells in human fibrotic skin diseases. Front Immunol. 2024;15:1522076.
- Wang Q, et al. Weighted gene co-expression network analysis and machine learning identified the lipid metabolism-related gene LGMN as a novel biomarker for keloid. Exp Dermatol. 2024;33(1):e14974.
- Zhang W, et al. New insights into keloid pathogenesis: biomarker potential for CDK7 and DDB2. Front Cell Dev Biol. 2025;13:1718189.
- Li W, et al. Altered arginine metabolism affects proliferation and radiosensitivity of keloids. Exp Dermatol. 2025;34(3):e70077.
- Jiang J, et al. Ambient fine particulate matter induces cardiac fibrosis through triggering ferroptosis by heme degradation induced-iron overload. Ecotoxicol Environ Saf. 2025;297:118227.
- Lin W, et al. Heme oxygenase-1 overexpression activates the IRF1/DRP1 signaling pathway to promote M2-type polarization of spinal cord microglia. Drug Dev Res. 2024;85(8):e70033.
- Knez J, Kovačič B, Goropevšek A. The role of regulatory T-cells in the development of endometriosis. Hum Reprod. 2024;39(7):1367-80.
- Voltarelli VA, et al. Heme: the lord of the iron ring. Antioxidants (Basel). 2023;12(5):1074.
- Wilks A, Egoshi R. Heme trafficking and the importance of handling nature's most versatile cofactor. Chem Rev. 2025;125(23):11358-78.
- Bertino F, et al. Dysregulation of FLVCR1a-dependent mitochondrial calcium handling in neural progenitors causes congenital hydrocephalus. Cell Rep Med. 2024;5(7):101647.
- Kumar A, et al. Iron regulates the quiescence of naive CD4 T cells by controlling mitochondria and cellular metabolism. Proc Natl Acad Sci U S A. 2024;121(17):e2318420121.
- Jiang H, et al. Gut microbiota dysbiosis in diabetic nephropathy: mechanisms and therapeutic targeting via the gut-kidney axis. Front Endocrinol (Lausanne). 2025;16:1661037.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-62.
- Chen Y, et al. 5-ALA photodynamic metabolite-powered zero-waste ferroptosis amplifier for enhanced hypertrophic scar therapy. Nat Commun. 2025;16(1):8321.
- Li X, et al. Hypericin-mediated photodynamic therapy promotes apoptosis and inhibits fibrosis by inducing HMOX1-mediated ferroptosis in hypertrophic scar fibroblasts. J Photochem Photobiol B. 2025;273:113303.
- Chen Y, et al. Functional transdermal nanoethosomes enhance photodynamic therapy of hypertrophic scars via self-generating oxygen. ACS Appl Mater Interfaces. 2021;13(7):7955-65.
- Oh S, et al. Revealing the pathogenesis of keloids based on the status: active vs inactive. Exp Dermatol. 2024;33(5):e15088.
- Zhao S, et al. New anti-fibrotic strategies for keloids: insights from single-cell multi-omics. Cell Prolif. 2025;58(6):e13818.
- Yasujima T, et al. The role of FLVCR1 and FLVCR2 in choline transport in the Caco-2 intestinal epithelial cell model and rat small intestine. Biochim Biophys Acta Mol Basis Dis. 2025;1871(6):167883.
- Zhang M, Chen H, Qian H, Wang C. Characterization of the skin keloid microenvironment. Cell Commun Signal. 2023;21(1):207.
- Wang Y, et al. FoxC1 activates Notch3 signaling to promote the inflammatory phenotype of keloid fibroblasts and aggravates keloid. Exp Cell Res. 2025;444(2):114402.
- Zhang J, et al. ERG transcriptionally activates SFRP1 to promote apoptosis of keloid fibroblasts and inhibit epithelial-mesenchymal transition and fibrosis through the Wnt3a/β-catenin pathway. Arch Dermatol Res. 2025;317(1):467.
- Ramos-Tovar E, Muriel P. NLRP3 inflammasome in hepatic diseases: a pharmacological target. Biochem Pharmacol. 2023;217:115861.
- Brahadeeswaran S, et al. NLRP3: a new therapeutic target in alcoholic liver disease. Front Immunol. 2023;14:1215333.
- Xiao Y, et al. STING mediates hepatocyte pyroptosis in liver fibrosis by epigenetically activating the NLRP3 inflammasome. Redox Biol. 2023;62:102691.
- Paolucci T, et al. Quantum molecular resonance inhibits NLRP3 inflammasome/nitrosative stress and promotes M1 to M2 macrophage polarization: potential therapeutic effect in osteoarthritis model in vitro. Antioxidants (Basel). 2023;12(7):1358.
- Wei J, et al. FERM domain containing kindlin 1 knockdown attenuates inflammation induced by intracerebral hemorrhage in rats via NLR family pyrin domain containing 3/nuclear factor kappa B pathway. Exp Anim. 2023;72(3):324-35.
- Tao L, Zhou Y, Wu L, Liu J. Comprehensive analysis of sialylation-related genes and construct the prognostic model in sepsis. Sci Rep. 2024;14(1):18110.
- Sun Q, et al. Identification of hub genes and key pathways associated with sepsis progression using weighted gene co-expression network analysis and machine learning. Int J Mol Sci. 2025;26(9):4433.
- Chen JJ. HRI protein kinase in cytoplasmic heme sensing and mitochondrial stress response: relevance to hematological and mitochondrial diseases. J Biol Chem. 2025;301(5):108494.
- Chakrabarty Y, Yang Z, Chen H, Chan DC. The HRI branch of the integrated stress response selectively triggers mitophagy. Mol Cell. 2024;84(6):1090-100.e6.
- Bora P, et al. Drug repurposing screen identifies an HRI activating compound that promotes adaptive mitochondrial remodeling in MFN2-deficient cells. Proc Natl Acad Sci U S A. 2025;122(48):e2517552122.
- Zhang C, et al. CaMKII suppresses proteotoxicity by phosphorylating BAG3 in response to proteasomal dysfunction. EMBO Rep. 2024;25(10):4488-514.
- Chaabani H, et al. Trifloxystrobin induces oxidative stress-dependent activation of the OMA1-DELE1-HRI integrated stress response leading to apoptosis in human neuroblastoma cells. Environ Pollut. 2026;390:127562.
- Das R, et al. CMT2A-linked MFN2 mutation, T206I promotes mitochondrial hyperfusion and predisposes cells towards mitophagy. Mitochondrion. 2024;74:101825.
- De Simone G, et al. Heme scavenging and delivery: the role of human serum albumin. Biomolecules. 2023;13(3):575.
- Turilli-Ghisolfi ES, Lualdi M, Fasano M. Ligand-based regulation of dynamics and reactivity of hemoproteins. Biomolecules. 2023;13(4):683.
- Zhang P, et al. Risk factors and prediction models for cardiotoxicity induced by anthracyclines in malignant chemotherapy. Cancer Chemother Pharmacol. 2025;95(1):73.
- Petrillo S, et al. Endothelial cells require functional FLVCR1a during developmental and adult angiogenesis. Angiogenesis. 2023;26(3):365-84.
- Fiorito V, Tolosano E. Unearthing FLVCR1a: tracing the path to a vital cellular transporter. Cell Mol Life Sci. 2024;81(1):166.
- Manco M, et al. FLVCR1a controls cellular cholesterol levels through the regulation of heme biosynthesis and tricarboxylic acid cycle flux in endothelial cells. Biomolecules. 2024;14(2):149.
- Shi X, et al. Increased melanin induces aberrant keratinocyte-melanocyte-basal-fibroblast cell communication and fibrogenesis by inducing iron overload and ferroptosis resistance in keloids. Cell Commun Signal. 2025;23(1):141.
- Khunger N, Dash A. Impact of air pollution on skin pigmentation: mechanisms and protective strategies. Int J Dermatol. 2025;64(10):1788-801.
- Ahuja K, Raju S, Dahiya S, Motiani RK. ROS and calcium signaling are critical determinant of skin pigmentation. Cell Calcium. 2025;125:102987.
- Dutta A, Chakraborty S, Roy A, Mittal A, et al. Tissue fibrosis in cardiorenal syndrome: crosstalk between heart and kidneys. Nephrol Dial Transplant. 2025;40(7):1273-83.
- Noah AA, et al. Reversal of fibrosis and portal hypertension by empagliflozin treatment of CCl4-induced liver fibrosis: emphasis on gal-1/NRP-1/TGF-β and gal-1/NRP-1/VEGFR2 pathways. Eur J Pharmacol. 2023;959:176066.
- Murakami T, Shigeki S. Pharmacotherapy for keloids and hypertrophic scars. Int J Mol Sci. 2024;25(9):4674.
- Jin J, Zheng Z. Gut microbiota-derived metabolites in keloid and hypertrophic scarring. Front Microbiol. 2025;16:1644758.
- Aubert A, et al. Potential implications of granzyme B in keloids and hypertrophic scars through extracellular matrix remodeling and latent TGF-β activation. Front Immunol. 2024;15:1484462.