Ce protocole intègre des analyses transcriptomiques en masse et à la cellule unique avec des tests préliminaires sur des tissus de patients afin de prioriser MMP1 dans l'ulcère du pied diabétique. MMP1 présentait un profil d'expression centré sur les fibroblastes et une abondance tissulaire plus élevée, soutenant une association avec le remodelage de la matrice, bien que la causalité et l'utilité clinique restent à préciser.
Article de recherche
Transcriptomique globale et unicellulaire intégrative avec validation tissulaire : identification prioritaire de MMP1 dans l'ulcère du pied diabétique
* These authors contributed equally
Dans cet article
Résumé
Résumé
Les sources cellulaires des modifications transcriptomiques reproductibles dans les ulcères du pied diabétique (UPD) restent incomplètement définies. Cette étude a combiné une analyse de l'expression différentielle, une analyse par réseau de co-expression génique pondérée (WGCNA), un criblage des gènes liés à la neuropathie périphérique diabétique (NPD), une sélection exploratoire de caractéristiques par apprentissage automatique, deux jeux de données transcriptomiques massifs externes, une analyse unicellulaire, une analyse par réseau de médecine traditionnelle chinoise (MTC), ainsi que des tests de réaction en chaîne par polymérase quantitative (qPCR) et de transfert western sur des tissus de patients. Dans GSE199939 (10 échantillons d'UPD et 11 témoins), 3 691 gènes différentiellement exprimés ont été identifiés, et le module bleu de la WGCNA était fortement associé à l'UPD (r = 0,97, p = 5 × 10-13). L'intersection des gènes différentiellement exprimés, des gènes centraux du module bleu et des 1 062 gènes liés à la NPD a permis d'obtenir 77 candidats. CCL7, CHEK1, MKI67, MMP1, MMP13 et TRPV2 étaient soutenus par au moins deux méthodes de sélection de caractéristiques ; une séparation complète dans l'élimination itérative de caractéristiques par machine à vecteurs de support a soulevé des inquiétudes quant à un surajustement dans le lot de découverte. MMP1 présentait le changement d'expression le plus élevé dans le lot de découverte (log2 du rapport d'expression = 9,854 ; p ajusté = 1,24 × 10⁻²⁹). Dans la matrice combinée GSE68183/GSE80178, MMP1 avait un p ajusté de 0,0159 et une aire sous la courbe caractéristique de fonctionnement du récepteur (AUC) de 0,981. Dans GSE134431, l'expression de MMP1 était nominalement plus élevée dans les tissus d'UPD que dans la peau diabétique non ulcérée (p = 0,0225 ; p ajusté = 0,135 ; AUC = 0,808). L'analyse de 69 944 cellules provenant de 24 échantillons a montré une expression moyenne de MMP1 la plus élevée dans les fibroblastes, avec une expression au niveau de l'échantillon plus importante dans les fibroblastes, les kératinocytes et les cellules endothéliales d'UPD. Les tests sur tissus de patients ont révélé une abondance plus élevée de l'ARNm de MMP1 dans quatre paires appariées (test apparié sur ΔCq, p = 3,04 × 10⁻⁵) et une abondance protéique plus élevée dans trois paires appariées (p apparié = 0,0107). La réplication statistique était incomplète. Ces résultats suggèrent une association centrée sur les fibroblastes dans le remodelage de la matrice extracellulaire, soumise à des limites dues à l'utilisation de valeurs de transcripts par million (TPM) comme entrée dans l'analyse de découverte basée sur les décomptes, à l'absence complète de données de prétraitement unicellulaire et à la petite taille des cohortes utilisées pour les tests sur tissus. La causalité et l'utilité clinique restent à démontrer.
Introduction
L'ulcère du pied diabétique est une complication grave et récurrente du diabète qui résulte de la convergence de la neuropathie, de la surcharge mécanique répétée, de la maladie artérielle périphérique, de la prédisposition aux infections et de la réparation tissulaire altérée. Selon des estimations récentes, des millions de personnes sont touchées dans le monde chaque année, et la cicatrisation est souvent prolongée, avec des risques importants de récidive, d'hospitalisation, d'amputation des membres inférieurs et de décès1. La prévention et la prise en charge dépendent donc non seulement des soins locaux de la plaie, mais aussi de l'identification de la perte de la sensibilité protectrice, de la réduction de la pression plantaire, du traitement de l'infection et de l'ischémie, ainsi que de la prise en compte des facteurs de risque systémiques1,2. La neuropathie périphérique diabétique est particulièrement importante, car une altération sensorielle progressive peut réduire la perception de la pression, des traumatismes et de la dégradation tissulaire, tandis que les anomalies motrices et autonomiques peuvent modifier davantage la biomécanique du pied et l'intégrité de la peau2,3. Au niveau tissulaire, les lésions neuropathiques peuvent coexister avec une neuroinflammation, un dysfonctionnement microvasculaire, un stress métabolique et une réparation déficiente, créant ainsi un environnement de plaie dans lequel les lésions persistent malgré les soins standards1,3.
Une cicatrisation cutanée réussie nécessite une inflammation coordonnée, une réépithélialisation, une angiogenèse, une activation des fibroblastes, un dépôt de matrice extracellulaire (ECM) et un remodelage matriciel ultérieur. Dans le diabète, ces processus peuvent devenir temporellement désorganisés : les signaux inflammatoires peuvent rester actifs, la migration des kératinocytes peut être altérée, les réponses endothéliales peuvent être insuffisantes, et les fibroblastes peuvent produire ou organiser une matrice anormale. Les fibroblastes jouent un rôle central dans la phase stromale de la réparation car ils synthétisent les protéines matricielles, régulent l'architecture du collagène, communiquent avec les cellules immunitaires et épithéliales, et contribuent à la contraction de la plaie. Des études utilisant des fibroblastes de patients atteints d'ulcères du pied diabétique (DFU) ont révélé des anomalies persistantes dans la transcription liée à la matrice extracellulaire et l'assemblage matriciel, ce qui conforte l'idée que l'état des fibroblastes constitue un élément important de la biologie des plaies chroniques4. Les métalloprotéinases matricielles (MMP) participent à ce processus en clivant les substrats de la matrice extracellulaire et en permettant la migration cellulaire, le renouvellement tissulaire et le remodelage ; toutefois, leurs effets dépendent de la localisation, du moment, de la disponibilité des substrats et de la régulation par les inhibiteurs tissulaires des métalloprotéinases (TIMP)5. Un déséquilibre entre la protéolyse et le remplacement matriciel peut donc être compatible avec une réparation altérée, mais une expression accrue d'une MMP individuelle n'établit pas en soi un rôle néfaste ou bénéfique. La métalloprotéinase matricielle 1 (MMP1), une collagénase interstitielle capable de participer au renouvellement du collagène fibrillaire, a été signalée comme modifiée dans les tissus d'ulcères du pied diabétique, et des études cliniques antérieures ont associé les profils MMP/TIMP au statut de la plaie ou aux trajectoires de cicatrisation6,7. Ces observations appuient une investigation plus approfondie de la MMP1 dans les ulcères du pied diabétique.
Le profilage transcriptomique offre une approche systématique pour identifier les programmes moléculaires associés aux ulcères du pied diabétique (DFU), mais plusieurs limitations méthodologiques compliquent l'interprétation. Les jeux de données provenant de tissus entiers moyennent les signaux provenant des kératinocytes, des fibroblastes, des cellules endothéliales, des cellules immunitaires et d'autres compartiments, ce qui rend difficile de déterminer si un candidat reflète une expression modifiée au sein d'un type cellulaire, des modifications dans la composition cellulaire, ou les deux. La comparabilité entre les jeux de données peut également être réduite par des différences liées aux plateformes, aux stratégies de normalisation, aux sites d'échantillonnage tissulaire, à la gravité de l'ulcère, à l'état d'infection, au stade de la maladie et au tissu de référence. Il est important de noter que la peau diabétique du pied non ulcérée constitue un comparateur tissulaire diabétique cliniquement pertinent, mais qu'elle n'est pas interchangeable avec une peau saine. Le séquençage de l'ARN à l'échelle de la cellule unique peut partiellement résoudre le problème d'origine cellulaire en distinguant les populations cellulaires hétérogènes et leurs états transcriptionnels. Une étude antérieure utilisant la transcriptomique à l'échelle de la cellule unique et la transcriptomique spatiale des DFU a identifié des populations distinctes de fibroblastes et a démontré que les programmes des fibroblastes varient selon le contexte de la plaie et l'état de cicatrisation8. Ces résultats appuient l'utilisation d'une analyse résolue au niveau cellulaire afin de compléter les données transcriptomiques obtenues à partir de tissus entiers.
Les méthodes de sélection de variables peuvent aider à hiérarchiser les candidats à partir de données d'expression à haute dimensionnalité, mais les études biomédicales sur de petits échantillons sont particulièrement sensibles aux estimations optimistes et à une sélection instable des gènes. Lorsque le nombre de variables mesurées dépasse largement celui des échantillons biologiques, une séparation apparemment parfaite peut survenir, même lorsque l'information prédictive généralisable est limitée. Le fait de réutiliser les mêmes observations pour la sélection des variables, l'ajustement des paramètres et l'évaluation des performances surestime davantage l'AUC, rendant ainsi la validation croisée imbriquée, les modèles verrouillés et des cohortes de test véritablement indépendantes essentielles pour évaluer la performance prédictive9,10. Ces préoccupations concernent les études sur les ulcères du pied diabétique (DFU), car les cohortes disponibles publiquement sont souvent petites et hétérogènes. Les bases de données d'ingrédients, cibles et herbes de médecine traditionnelle chinoise ont été utilisées en complément uniquement pour la génération d'hypothèses.
Cette étude a intégré la transcriptomique en masse, l'analyse WGCNA, le criblage de gènes liés au DPN, la sélection de caractéristiques par apprentissage machine, l'évaluation sur des jeux de données externes, l'analyse unicellulaire, l'analyse de réseau de médecine traditionnelle chinoise et la validation sur des tissus de patients. Les gènes candidats identifiés dans le groupe de découverte ont été évalués à l’aide de jeux de données transcriptomiques supplémentaires, et le meilleur candidat a été localisé dans des types cellulaires spécifiques à l’aide de données unicellulaires. L’expression de MMP1 a ensuite été examinée au niveau de l’ARNm et des protéines dans les tissus des patients par qPCR et immunobuvardage. Ce cadre a été conçu pour identifier un candidat reproductible associé aux ulcères du pied diabétique et caractériser son contexte cellulaire et biologique.
Protocole
Conception de l'étude et sources de données
L'étude, incluant la collecte et l'utilisation d'échantillons tissulaires humains pour la validation par qPCR et immunobuvardage, a été examinée et approuvée par le Comité d'éthique de l'Hôpital quatrième de Wuhan (numéro d'approbation : KY2024-161-01). Toutes les procédures impliquant des tissus humains ont été réalisées conformément au protocole approuvé et aux principes éthiques applicables. La composante transcriptomique de l'étude a utilisé des jeux de données accessibles au public et dépouillés d'identifiants. Un consentement éclairé écrit a été obtenu de la part de tous les participants dont les échantillons tissulaires ont été utilisés pour la validation expérimentale. Les jeux de données transcriptomiques accessibles au public ont été analysés sous forme dépouillée d'identifiants, et les procédures de consentement relatives aux études initiales ayant généré les données ont été gérées par les institutions respectives.
Cette étude a intégré la transcriptomique globale, l'analyse de réseaux, la sélection de caractéristiques, l'analyse unicellulaire, la prédiction de réseaux de médecine traditionnelle chinoise (MTC) et la validation sur tissus de patients. Le lot de découverte était constitué du jeu de données du Gene Expression Omnibus (GEO) GSE199939 (10 échantillons d'ulcères du pied diabétique [DFU] et 11 échantillons témoins). L'évaluation externe par transcriptomique globale comprenait une matrice fusionnée GSE68183/GSE80178 (9 échantillons DFU et 6 témoins) et GSE134431 (13 échantillons DFU et 8 échantillons de peau diabétique non ulcérée [DFS]). L'analyse unicellulaire a utilisé un objet Seurat prétraité et annoté par SingleR, dérivé de GSE165816, comprenant 69 944 cellules provenant de 24 échantillons (14 DFU et 10 témoins). L'évaluation sur tissus a inclus quatre paires appariées de patients (lésion DFU et tissu péri-lésionnel) pour la PCR quantitative et trois paires appariées pour le immunoblotting, selon les données d'essai récupérées et la confirmation des appariements par les auteurs. Tous les matériaux et équipements utilisés dans cette étude sont répertoriés dans le Tableau des matériaux.
Construction du jeu de gènes associés à la DPN
Les gènes associés à la neuropathie périphérique diabétique ont été récupérés à partir de la base de données Gene du National Center for Biotechnology Information (NCBI) à l’aide de rentrez. Les termes de recherche incluaient « neuropathie périphérique diabétique », « neuropathie diabétique », « polyneuropathie diabétique », « neuropathie diabétique douloureuse » et « polyneuropathie diabétique sensitivo-motrice », restreints à Homo sapiens. Les identifiants obtenus ont été associés aux symboles génétiques officiels, convertis en majuscules, nettoyés et dédoublonnés. Les gènes issus de la base de données ont été combinés à une liste de gènes DPN compilée à partir de la littérature, puis dédoublonnés, produisant un total de 1 062 gènes associés à la DPN. Les chaînes complètes de recherche et le code de nettoyage des identifiants sont inclus dans les scripts accompagnants ; ceux-ci incluent également les neuropathies diabétiques, le diabète associé à une polyneuropathie distale symétrique ou symétrique ou à une neuropathie périphérique, ainsi que le descripteur MeSH « Diabetic Neuropathies ». La composante issue de la littérature nécessite encore une traçabilité au niveau des références bibliographiques.
Prétraitement du lot de découverte et analyse de l'expression différentielle
La matrice d'expression GSE199939 a été alignée sur le tableau de phénotype selon l'identifiant de l'échantillon. Les identifiants de gènes en double ont été rendus uniques. L'analyse de découverte archivée a arrondi les valeurs d'expression et ajusté un modèle binomial négatif à l'aide de DESeq2 (version 1.48.2), en utilisant le groupe comme facteur de planification expérimentale et DFU par rapport au témoin comme contraste. Les gènes présentant des valeurs de p ajustées manquantes ont été exclus. Le contrôle du test multiple a été effectué selon la procédure de Benjamini–Hochberg (BH). La liste archivée des gènes différentiellement exprimés (DEG) utilisait une valeur absolue du log2 du rapport d'expression supérieure à 1 et une valeur de p ajustée selon BH < 0,05. La comparaison avec la source publique GEO a confirmé que les données d'entrée étaient en TPM, et non en nombre brut de lectures. L'arrondissement des valeurs TPM ne satisfait pas aux exigences de DESeq2 relatives aux données brutes. Les estimations initiales ont été conservées, mais la validité des statistiques de découverte et des résultats dépendants d'analyses WGCNA et de sélection de caractéristiques reste incertaine, en attendant une réanalyse appropriée. La comparaison avec la source est documentée dans l'archive complémentaire.
Pour la visualisation, la transformation stabilisant la variance (VST) de DESeq2 a été appliquée avec blind = FALSE. Une analyse en composantes principales (ACP) a été réalisée sur la matrice d'expression VST. La carte thermique utilisait les scores z par ligne pour les 50 gènes présentant les valeurs de p ajustées les plus faibles. L'implémentation de l'ACP a centré et normalisé les valeurs transformées par gène à l'aide de prcomp avec scale. = TRUE.
Analyse de réseau de co-expression génique pondérée
Pour l'analyse WGCNA, les gènes dont le nombre de lectures était supérieur à 5 dans au moins trois échantillons de la série GSE199939 ont été conservés. Les facteurs de taille ont été estimés à l'aide de DESeq2, la transformation variance-stabilisante (VST) a été appliquée avec l'option blind = TRUE, et les 5 000 gènes présentant la plus grande variance inter-échantillons ont été sélectionnés. La qualité des échantillons et des gènes a été évaluée à l'aide de la fonction goodSamplesGenes, et un regroupement hiérarchique de type liaison moyenne a été utilisé pour l'évaluation de qualité au niveau des échantillons.
Un réseau signé a été construit à l'aide de WGCNA (version 1.74). Les puissances candidates de 1 à 10 et de 12 à 30 par incréments de 2 ont été évaluées à l'aide de pickSoftThreshold ; un seuil cible d'ajustement à une topologie sans échelle de 0,85 a été utilisé, et la puissance de seuil doux sélectionnée était de 18. Les modules ont été identifiés à l'aide de blockwiseModules en utilisant une adjacence signée et une matrice de chevauchement topologique signée, une corrélation de Pearson, une taille minimale de module de 30, une hauteur de coupure de fusion de 0,25, un seuil de réaffectation de 1 × 10⁻⁶, pamRespectsDendro = FALSE, et une taille maximale de bloc de 10 000.
Les eigengènes de module ont été corrélées à un caractère binaire de DFU. Les modules non gris présentant un |r| > 0,5 et un p < 0,05 ont été considérés comme associés à la DFU. Pour chaque module associé, la significativité génique (GS) a été définie comme la corrélation de Pearson entre l'expression génique et le statut de DFU, et l'appartenance au module (MM) comme la corrélation de Pearson entre l'expression génique et l'eigengène correspondant du module. Les gènes centraux ont été définis par un |MM| > 0,8 et un |GS| > 0,5. Le module bleu, qui présentait la plus forte association positive avec la DFU, a été retenu. Ses gènes centraux ont été croisés avec les gènes différentiellement exprimés (DEGs) et le jeu de gènes liés à la DPN. Le seuil de centralité indiqué utilise donc les valeurs absolues de MM et de GS, indépendamment du signe de la corrélation.
Priorisation des caractéristiques fondée sur l'apprentissage automatique
Les 77 gènes partagés par les ensembles de gènes DEG, de gènes centraux du module bleu et de gènes associés au DPN ont été évalués dans GSE199939. Les symboles de gènes en double ont été regroupés par leur expression moyenne. La matrice de gènes candidats a été transformée selon log2, en supposant que la valeur maximale excède 50 ; les caractéristiques de variance nulle ont été supprimées, et les caractéristiques conservées ont été standardisées. Une graine aléatoire de 123 a été utilisée. La séquence mise en œuvre comprenait le criblage des candidats à l’échelle de la cohorte, le regroupement des symboles en double, la transformation logarithmique conditionnelle, le filtrage des variances nulles, le centrage et la mise à l’échelle sur l’ensemble de la cohorte, et la sélection spécifique aux algorithmes des caractéristiques. Le criblage des DEG et de la WGCNA a utilisé l’ensemble de la cohorte de découverte avant la validation croisée au niveau de l’algorithme. Le flux de travail rapporté n’établit donc pas une validation imbriquée exempte de fuites, et ses AUC internes ne peuvent pas être utilisées comme estimations non biaisées de la performance prédictive.
Trois procédures de sélection de caractéristiques ont été appliquées. Premièrement, une régression logistique par l'opérateur de contraction et de sélection des moindres valeurs absolues (LASSO) a été ajustée à l'aide de glmnet (version 5.0), famille binomiale, alpha = 1, erreur de classification comme mesure de validation croisée, sans standardisation supplémentaire, et validation croisée en cinq parties contrainte par la taille de la plus petite classe. Les caractéristiques situées à lambda.1se ont été sélectionnées ; lambda.min a été utilisée uniquement si lambda.1se ne sélectionnait aucun gène. Deuxièmement, une forêt aléatoire composée de 1 000 arbres a été ajustée à l'aide de randomForest (version 4.7-1.2) ; les gènes dont la diminution moyenne de l'indice de Gini était au moins aussi élevée que l'importance moyenne parmi les gènes candidats ont été conservés. Troisièmement, l'élimination récursive de caractéristiques par machine à vecteurs de support linéaire (SVM-RFE) a été mise en œuvre avec e1071 (version 1.7-17), en classant les caractéristiques selon le poids linéaire au carré sur la cohorte complète avant d'évaluer progressivement des sous-ensembles de caractéristiques de plus en plus petits par l'aire sous la courbe (AUC) de validation croisée leave-one-out (LOOCV). Le classement n'a pas été recalculé au sein de chaque pli d'apprentissage. L'ajustement du SVM linéaire a utilisé scale = FALSE et probability = TRUE, sans grille de réglage de coût explicite. La sélection de la pénalité LASSO a utilisé sa validation croisée interne sans boucle externe d'évaluation distincte, et l'importance de la forêt aléatoire a été calculée à partir de la cohorte complète.
Aucun gène n'a été sélectionné par les trois méthodes ; par conséquent, seuls les gènes soutenus par au moins deux méthodes ont été retenus. SVM-RFE a produit une AUC de 1,00 pour toutes les tailles de sous-ensembles évaluées, et le plus petit sous-ensemble ex-aequo a été sélectionné. Ce séparage complet ayant soulevé des inquiétudes quant à un surajustement et une évaluation trop optimiste dans la petite cohorte de découverte, l'AUC de SVM-RFE n'a pas été interprétée comme une estimation de la performance clinique. Aucun modèle multigénique figé n'a été testé dans une cohorte externe ; des analyses externes de la courbe ROC (caractéristique de fonctionnement du récepteur) ont évalué l'expression individuelle des gènes candidats. L'examen du script d'analyse a confirmé que le prétraitement et le classement des caractéristiques par SVM n'étaient pas limités aux plis d'apprentissage. Les mêmes résultats de validation croisée leave-one-out (LOOCV) ont été utilisés pour choisir la taille du sous-ensemble, sans boucle externe d'évaluation. Par conséquent, ce flux de travail présente une fuite d'information et ne permet qu'une priorisation exploratoire des caractéristiques.
Analyse d'enrichissement fonctionnel
Des analyses de surreprésentation ont été effectuées sur le panel de six gènes à l’aide de l’Ontologie génétique (GO) et de l’Encyclopédie de Kyoto des gènes et des génomes (KEGG). Les symboles génétiques ont été associés aux identifiants Entrez à l’aide de org.Hs.eg.db (version 3.21.0). L’analyse GO a été réalisée avec clusterProfiler (version 4.16.0) pour les trois catégories d’ontologies : processus biologique, composant cellulaire et fonction moléculaire. L’enrichissement KEGG a utilisé le code organisme humain (hsa). Les termes significatifs ont été définis par un p nominal < 0,05 et un p ajusté selon BH < 0,05. Étant donné que seuls six gènes étaient inclus, l’analyse d’enrichissement a été utilisée principalement pour l’annotation fonctionnelle. Le script KEGG a utilisé des annotations locales issues de KEGG.db avec enrichKEGG(use_internal_data = TRUE) ; la version de l’annotation doit être précisée. Les scripts GO et KEGG n’ont pas fourni d’univers personnalisé, de sorte que les bases de données d’annotation ont défini les fonds par défaut.
Évaluation externe par transcriptomique globale
Pour la matrice fusionnée GSE68183/GSE80178, les symboles génétiques ont été normalisés et les symboles en double regroupés par expression moyenne sur les lignes correspondantes. Les six gènes candidats ont été alignés sur le fichier de phénotype. Étant donné que les fichiers disponibles ne documentaient pas entièrement la procédure de fusion amont et de correction par lot, ce jeu de données a été analysé tel que fourni et interprété avec prudence. Par conséquent, ni l'élimination des effets de lot ni l'indépendance du signal de groupe par rapport aux effets d'étude ne peuvent être établies à partir du registre de traitement fourni. Cette matrice fournit un soutien exploratoire entre jeux de données plutôt qu'une réplication définitive.
Pour GSE134431, les six gènes candidats ont été extraits de la matrice de lectures par kilobase par million de lectures cartographiées (RPKM) et transformés selon log2(RPKM + 1). DFS a été utilisée comme groupe de référence et DFU comme groupe de comparaison. DFS représente la peau diabétique non ulcérée du pied. La Figure 4C initialement soumise représentait les valeurs RPKM brutes ; le panneau révisé utilise l'échelle log2(RPKM + 1) indiquée. Des tests de Wilcoxon bilatéraux avec approximation normale et correction de continuité, ainsi que des analyses ROC orientées automatiquement, ont été vérifiés sur les deux échelles et ont donné des valeurs p et des AUC identiques, car la transformation est strictement monotone.
Pour chaque jeu de données de validation globale, les différences d'expression entre les groupes ont été évaluées à l'aide de tests de somme de rangs de Wilcoxon bilatéraux, et une correction de Benjamini-Hochberg (BH) a été appliquée pour les six gènes. Les courbes ROC ont été calculées à l'aide du package pROC (version 1.19.0.1), en utilisant une direction sélectionnée automatiquement par le logiciel. Les AUC et leurs intervalles de confiance à 95 % (IC) correspondants ont été calculés afin de comparer les profils de discrimination entre les jeux de données. La sélection automatique de la direction de la courbe ROC à partir de chaque jeu de données d'évaluation peut conduire à une discrimination optimiste ; ces AUC unidimensionnels sont descriptifs et ne valident pas un modèle préétabli de prédiction clinique.
Localisation au niveau de la cellule unique et analyse au niveau de l'échantillon
L'analyse en cellule unique a utilisé l'objet Seurat enregistré biofsci_SingleR_annotated_MMP1_analyzed.rds provenant de GSE165816, contenant 22 889 gènes et 69 944 cellules dans le test RNA. Le test RNA conservait une couche de décomptes d'entiers non négatifs et une couche de données générée par la méthode LogNormalize avec un facteur d'échelle de 10 000, suivie d'une transformation log1p ; cette dernière n'était pas exprimée en TPM. L'objet contenait 2 000 gènes variables sélectionnés à l'aide de la méthode vst (loess.span = 0,3 ; 20 intervalles de largeur égale), l'expression normalisée pour tous les gènes conservés (centrage et mise à l'échelle activés ; scale.max = 10), et 50 composantes principales calculées à partir des caractéristiques variables avec une graine (seed) fixée à 42. L'historique des commandes enregistré utilisait les dimensions 1 à 20 de Harmony pour la construction des plus proches voisins et la projection uniforme par approximation de variété (UMAP). Les paramètres des voisins incluaient k = 20, Annoy avec 50 arbres et distance euclidienne, ainsi qu'un seuil d'élagage des voisins les plus proches partagés (SNN) de 1/15. Le regroupement (clustering) utilisait une résolution de 0,8, l'algorithme 1, n.start = 10, n.iter = 10, et random.seed = 0. UMAP utilisait l'implémentation uwot, 30 voisins, deux dimensions de sortie, une métrique de distance cosinus, min.dist = 0,3, spread = 1, learning.rate = 1, et une graine fixée à 42. L'objet conservait une réduction Harmony, mais les seuils de contrôle qualité d'origine, l'appel complet de RunHarmony incluant les covariables de lot, ainsi que les paramètres de référence et d'annotation de SingleR pour cet objet analysé n'ont pas pu être récupérés. Les étiquettes de type cellulaire, les étiquettes de groupe et les identifiants d'échantillon étaient stockés respectivement dans SingleR_label, Group et orig.ident. Dix types cellulaires annotés ont été conservés : lymphocytes B, lymphocytes T CD8+, cellules endothéliales, cellules épithéliales, fibroblastes, cellules souches hématopoïétiques, kératinocytes, macrophages, monocytes et neurones.
L'expression de MMP1 a été résumée par type cellulaire. Les cellules présentant une expression normalisée de MMP1 supérieure à zéro ont été classées comme positives pour MMP1. Pour l'analyse au niveau de l'échantillon, l'expression moyenne normalisée a été calculée pour chaque combinaison échantillon-type cellulaire. Les échantillons DFU et témoins ont été comparés au sein de chaque type cellulaire à l'aide de tests de Wilcoxon-Mann-Whitney bilatéraux, suivis d'une correction BH sur l'ensemble des types cellulaires testés. C'est l'identifiant d'échantillon GEO, et non la cellule individuelle, qui a été utilisé comme unité dans ces comparaisons rapportées. Les 24 identifiants n'ont pas été considérés comme la preuve de 24 donneurs indépendants. L'objet enregistré ne contenait pas d'identifiant de donneur vérifié, et les prélèvements répétés de tissus provenant d'un même donneur n'ont pas été modélisés ; les tests au niveau de l'échantillon sont donc interprétés comme exploratoires. Ces résumés correspondent à la moyenne de l'expression normalisée au sein de chaque échantillon et type cellulaire ; il ne s'agit pas de modèles différentiels de type pseudobulk fondés sur les comptages.
Dix ensembles fonctionnels de gènes ont été notés à l'aide de Seurat AddModuleScore. Les corrélations de Spearman entre l'expression de MMP1 par cellule et les scores de module ont été calculées et corrigées selon Benjamini-Hochberg (BH). Pour l'analyse exploratoire des cellules à forte expression de MMP1, les trois types cellulaires présentant la plus forte expression moyenne de MMP1 parmi les types cellulaires comprenant au moins 50 cellules ont été sélectionnés. Un seuil global a été défini comme la médiane de l'expression parmi les cellules positives pour MMP1 lorsque plus de 10 cellules positives étaient disponibles ; dans le cas contraire, le script a utilisé le 75e centile global. Les cellules dépassant ce seuil ont été affectées au groupe MMP1-haut, les autres cellules formant le groupe MMP1-bas. La fonction FindMarkers a utilisé un test de Wilcoxon, avec logfc.threshold = 0,25 et min.pct = 0,1. Les gènes surexprimés ayant une valeur p ajustée < 0,05 ont été soumis à une analyse d'enrichissement des processus biologiques de l'ontologie génique (GO). Étant donné que les groupes étaient définis par l'expression de MMP1, cette analyse a permis de décrire les voies associées à l'état MMP1-haut. Les corrélations par cellule, leurs valeurs p ajustées et l'enrichissement entre les groupes MMP1-haut et MMP1-bas sont descriptifs, car la dépendance intra-échantillon n'a pas été modélisée. Les cellules individuelles n'ont pas été considérées comme des répliques biologiques indépendantes.
Prédiction des ingrédients, cibles et plantes en médecine traditionnelle chinoise
Les six gènes prioritaires ont été appariés à la colonne 4 de la table locale d'interactions produit chimique-gène de la base de données Comparative Toxicogenomics Database (CTD). Les enregistrements ont été restreints à Homo sapiens dans la colonne 7. Les noms des ingrédients ont été tronqués et normalisés en minuscules pour l'appariement, et les appariements redondants ingrédient-cible et plante-ingrédient ont été supprimés. Les ingrédients ont été associés aux plantes à l'aide de la table de référence plante-ingrédient. L'enrichissement de la base de données a utilisé un p nominal < 0,05 et un p ajusté < 0,05. Les doublons d'enregistrements plante-ingrédient-cible ont été supprimés avant le résumé fondé sur la couverture. L'enrichissement des plantes a utilisé clusterProfiler::enricher avec l'appariement plante-ingrédient comme TERM2GENE, minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1 et qvalueCutoff = 1, avant d'appliquer les seuils de significativité nominale et ajustés par BH. Ces liens de base de données peuvent décrire des changements d'expression ou d'activité, mais n'établissent pas de liaison directe ni un effet uniforme dans un sens précis.
Les herbes ont été classées selon le score de couverture suivant :
S = 3R + 5L +2T + 3C + 2I + N (1)
Ici, R représente le nombre d'enregistrements MMP1, L le nombre d'ingrédients liés à MMP1, T le nombre de cibles couvertes, C le nombre d'ingrédients principaux, I l'indicateur de l'axe de la matrice, et N le nombre total d'ingrédients.
Les ingrédients principaux étaient la quercétine, la lutéoline et la berbérine. L'indicateur d'axe matriciel était fixé à 1 lorsqu'une plante couvrait à la fois MMP1 et MMP13, et à 0 dans les autres cas. Les plantes candidates devaient contenir au moins un enregistrement lié à MMP1, ainsi que soit au moins deux ingrédients liés à MMP1, soit au moins quatre cibles plus un ingrédient principal. Le score a été utilisé pour résumer la couverture de la base de données et n'a pas été considéré comme une mesure d'efficacité pharmacologique. Les coefficients définissent une règle personnalisée et heuristique de couverture qui met l'accent sur les enregistrements et ingrédients liés à MMP1, une couverture plus large des cibles, les trois ingrédients désignés et la couverture conjointe de MMP1/MMP13. Ces coefficients n'ont pas été ajustés selon des résultats cliniques ni validés expérimentalement, et des pondérations alternatives pourraient modifier le classement des plantes.
Prélèvement des tissus patients et évaluation préliminaire par qPCR et immunotransfert
Les patients ayant reçu un diagnostic clinique d'ulcères du pied diabétique et ayant subi une débridement ou une chirurgie indiquée cliniquement à l'Hôpital Quatrième de Wuhan étaient éligibles lorsque du tissu du pied était disponible et qu'un consentement éclairé écrit avait été obtenu. Les critères d'exclusion étaient la présence d'une lésion maligne au site d'échantillonnage, une cause non diabétique de l'ulcère, ou une quantité ou une qualité insuffisante de tissu pour les tests prévus. Des échantillons de tissu d'ulcère du pied diabétique (DFU) et de tissu non ulcéreux entourant la plaie ont été prélevés chez le même patient conformément au protocole d'étude approuvé. Ce dernier tissu servait de témoin apparié périplaie ; il ne s'agissait pas de peau saine non diabétique. L'évaluation par qPCR comprenait quatre paires appariées (quatre spécimens d'ulcère du pied diabétique et quatre spécimens périplaie correspondants), et le test de western blot comprenait trois paires appariées. L'appariement a été confirmé par les auteurs pour chaque test ; l'identité croisée entre les tests n'a pas été utilisée dans les comparaisons statistiques. Chaque patient constituait l'unité biologique, et les puits techniques de PCR représentaient des mesures répétées au sein d'un même spécimen. Ces tests préliminaires avaient pour objectif d'évaluer l'expression tissulaire de MMP1 et n'étaient pas conçus pour établir une performance diagnostique, une causalité ou une généralisation à travers les différents phénotypes d'ulcère du pied diabétique.
Pour la validation par qPCR, l'ARN total a été extrait d'échantillons tissulaires provenant de patients à l'aide d'un réactif d'extraction d'ARN total, conformément aux instructions du fabricant. La concentration et la pureté de l'ARN ont été évaluées par spectrophotométrie, et les échantillons présentant un A260/A280 rapport de 1,8 à 2,1 ont été utilisés pour les analyses ultérieures. ARN total (1 µg) a été transcrit inversement à l'aide d'un kit de transcription inverse provenant du virus de la leucémie murine de Moloney (M-MLV) dans un volume réactionnel final de 20 µL. Le projet d'instrument disponible identifie un système de PCR en temps réel. La PCR quantitative a été réalisée en utilisant un mélange maître PCR SYBR Green 2x dans un 20 µL réaction contenant 10 µL de 2x SYBR Green master mix, 0.4 µL chacun des amorces sens et antisens, 2 µL d'ADN complémentaire (ADNc), et 7.2 µL d'eau sans nucléase. Le programme d'amplification comprenait une dénaturation initiale à 95 °C pendant 30 s, suivis de 40 cycles de 95 °C pendant 5 s et 60 °C pendant 30 s. Une analyse de la courbe de fusion a été réalisée pour vérifier la spécificité de l'amplification. MMP1 l'abondance des transcrits a été mesurée avec β-actine (ACTB) comme gène de référence. Les séquences des amorces sont indiquées dans Tableau 1. Pour l'analyse appariée révisée, les cinq puits techniques par cible au sein de chaque échantillon ont été moyennés avant ΔCalcul du Cq et relatif MMP1 l'expression a été calculée en utilisant le 2-ΔΔCq méthode, le groupe de tissu péri-ulcéreux non ulcéré étant utilisé comme témoin de calibrage. Les paires d'échantillons appariés obtenues étaient NC–DFU, NC1–DFU1, NC2–DFU2 et NC3–DFU3, confirmées par les auteurs comme quatre paires appariées provenant de patients. Le graphique de qPCR précédent utilisait cinq valeurs issues de réplicats techniques provenant uniquement des échantillons NC et DFU ; le graphique révisé présente une seule valeur par spécimen, obtenue après moyenne des réplicats techniques pour chacune des quatre paires. L'inférence appariée a été effectuée en utilisant ΔCq = Cq moyen(MMP1) − Cq moyen(ACTB), plutôt que des valeurs de variation d'expression au niveau des puits. Le projet d'instrument archivé diffère également du volume de réaction et du programme de cyclage indiqués, et sa correspondance avec l'expérience tracée reste non résolue.
Pour la validation par immunoblot (WB), les échantillons de tissus ont été homogénéisés dans un tampon de lyse RIPA glacé complété par des inhibiteurs de protéases. Les lysats ont été incubés sur glace pendant 30 min puis centrifugés à 12 000 x g pendant 15 min à 4 °C. Les surnageants ont été récupérés, et les concentrations protéiques ont été déterminées à l’aide d’un dosage à l’acide bicinchoninique. Des quantités équivalentes de protéines (20 µg par piste) ont été séparées sur des gels de polyacrylamide en gradient 4 %–20 % contenant du dodécylsulfate de sodium, puis transférées sur des membranes de difluorure de polyvinylidène de 0,22 µm. Les membranes ont été bloquées pendant 1 h à température ambiante avec 5 % de lait écrémé dans une solution saline tamponnée au Tris contenant 0,1 % de Tween-20, puis incubées toute la nuit à 4 °C avec un anticorps polyclonal anti-MMP1 (1:1 000) et un anticorps polyclonal anti-cofiline (1:6 000). Après trois lavages avec la solution saline tamponnée au Tris contenant 0,1 % de Tween-20, les membranes ont été incubées pendant 1 h à température ambiante avec une immunoglobuline G (IgG) de chèvre anti-lapin conjuguée à la peroxydase de raifort (1:5 000). Les bandes protéiques ont été révélées à l’aide d’un substrat chimiluminescent amélioré et visualisées à l’aide d’un système d’imagerie chimiluminescente utilisant le logiciel de fonctionnement associé (version 1.2.0), tel qu’enregistré dans les métadonnées de l’image. Les bandes ont été quantifiées à l’aide du logiciel ImageJ. La cofiline a été utilisée comme témoin de chargement, et l’abondance protéique de MMP1 a été normalisée par rapport à la cofiline pour les comparaisons entre groupes.
Analyse statistique et logiciels
Tous les tests étaient bilatéraux, sauf indication contraire. Le seuil principal de correction pour les tests multiples était un p ajusté selon Benjamini-Hochberg < 0,05. Les tailles d'échantillons exactes variaient selon les jeux de données et, pour l'analyse au niveau des échantillons unicellulaires, selon la présence d'un type cellulaire donné dans chaque échantillon. Les résumés de l'expression continue sont présentés comme des observations individuelles, avec des boîtes à moustaches affichant la médiane et l'intervalle interquartile ; les moustaches s'étendent jusqu'à 1,5 fois l'intervalle interquartile. Pour le western blot, les six rapports MMP1 sur cofilin récupérés ont été analysés à l'aide d'un test t apparié bilatéral sur trois paires de patients confirmées par les auteurs (dl = 2 ; p = 0,0107). Pour la qPCR, cinq valeurs de Cq d'ACTB et cinq valeurs de Cq de MMP1 ont été moyennées séparément au sein de chaque spécimen avant le calcul du ΔCq. Un test t apparié bilatéral a comparé les valeurs de ΔCq des ulcères du pied diabétique (DFU) et des tissus péri-lésionnels appariés pour quatre paires de patients confirmées par les auteurs (dl = 3 ; p = 3,04 × 10⁻⁵). La moyenne des ΔCq péri-lésionnels a été utilisée comme calibrateur commun pour l'affichage de l'expression relative. Le changement moyen de l'expression intrapatient (fold change) et son intervalle de confiance à 95 % ont été obtenus par la transformation inverse de la différence moyenne appariée de ΔCq et de son intervalle de confiance basé sur t. Les observations biologiques individuelles sont représentées avec des lignes reliant les tissus appariés ; les puits techniques n'augmentent pas la taille de l'échantillon biologique. Les valeurs p associées aux tests sur tissus sont nominales et exploratoires. Avec trois ou quatre patients, la normalité des différences appariées ne peut être évaluée de façon fiable, et les tests restent préliminaires. Les analyses bioinformatiques et la génération des figures ont été réalisées sous R 4.5.2 sur Windows 11. Les versions des packages principaux incluaient DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4 et ggplot2 4.0.3. Un inventaire consolidé des logiciels, bases de données et paramètres est fourni dans le tableau supplémentaire 1.
Résultats
La transcriptomique de découverte identifie un vaste programme d'expression associé aux ulcères du pied diabétique
GSE199939 a servi de cohorte de découverte et comprenait 10 échantillons de DFU et 11 échantillons témoins (Figure 1A). L'analyse en composantes principales de l'expression normalisée par VST a montré une séparation nette entre les groupes ; les composantes principales 1 et 2 expliquaient respectivement 34,8 % et 15,1 % de la variance totale (Figure 1B).
À l'aide de |log2 du rapport d'expression| > 1 et d'une valeur p ajustée par BH < 0,05, l'analyse de l'expression différentielle a identifié 3 691 gènes différentiellement exprimés (GDE), dont 1 247 gènes surexprimés dans les ulcères du pied diabétique (DFU) et 2 444 gènes sous-exprimés dans les DFU (Figure 1C). Les 50 GDE principaux ont formé un patron d'expression fortement structuré par groupes (Figure 1D). Parmi les six gènes sélectionnés par la suite, MMP1 présentait la variation la plus importante dans le groupe de découverte (log2 du rapport d'expression = 9,854 ; valeur p ajustée = 1,24 × 10⁻²⁹).
Un module de co-expression associé aux UPD converge avec les gènes différentiellement exprimés et les gènes liés à la NPDD
Une analyse WGCNA a été réalisée sur les 5 000 gènes les plus variables transformés par VST. Une puissance de seuil doux de 18 a été choisie pour le réseau signé, équilibrant l'ajustement à la topologie sans échelle et la connectivité (Figure 2A). Le regroupement hiérarchique et la détection dynamique de modules ont identifié plusieurs modules de co-expression (Figure 2B). Le module bleu présentait la plus forte association positive avec l'UDF (coefficient de corrélation de Pearson r = 0,97, p = 5 × 10-13 ; Figure 2C). Les résumés correspondants du regroupement des échantillons et des contrôles qualité de la taille des modules sont fournis dans la Figure supplémentaire 1A,B.
Dans le module bleu, 689 gènes ont satisfait aux critères de centralité |MM| > 0,8 et |GS| > 0,5 (Figure 2D). L'intersection des 3 691 gènes différentiellement exprimés, des 689 gènes centraux du module bleu et des 1 062 gènes liés aux DPN a permis d'identifier 77 gènes candidats communs (Figure 2E). Une vue épurée du réseau des gènes centraux du module bleu ainsi que les statistiques les plus élevées des gènes centraux sont présentées dans la Figure supplémentaire 2A,B.
La sélection de caractéristiques par méthode multiple privilégie six gènes mais révèle un surajustement dans la cohorte de découverte
Les 77 gènes en intersection ont été analysés par LASSO, forêt aléatoire et SVM-RFE. LASSO a conservé sept gènes au seuil de pénalité sélectionné : MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67 et CHEK1 (Figure 3A). Le filtrage par forêt aléatoire a conservé 41 gènes dont l'importance était égale ou supérieure à la moyenne, incluant cinq membres du panel final parmi les caractéristiques les plus fortement classées (Figure 3B). SVM-RFE a produit une AUC de 1,00 pour chaque sous-ensemble imbriqué évalué ; selon la règle du sous-ensemble de taille minimale en cas d'égalité, CHEK1 a été sélectionné comme sous-ensemble à un gène (Figure 3C), soulevant des inquiétudes quant à un surajustement et à une évaluation trop optimiste dans la cohorte de découverte. Les profils d'expression correspondants, les cartes thermiques et les courbes ROC de la cohorte de découverte sont présentés dans la Figure supplémentaire 3A–C.
Aucun gène n'a été sélectionné par les trois méthodes. La rétention des gènes soutenus par au moins deux méthodes a permis d'obtenir CCL7, CHEK1, MKI67, MMP1, MMP13 et TRPV2 (Figure 3D). L'annotation GO de ces six gènes a mis en évidence la désassemblage de la matrice extracellulaire, les processus cataboliques et métaboliques du collagène, le chromosome condensé et les fonctions liées à la métalloendopeptidase (tous les p ajustés selon Benjamini-Hochberg < 0,05 ; Figure 3E). L'analyse KEGG a identifié la voie de signalisation de l'interleukine-17 (IL-17) (CCL7/MMP1/MMP13 ; p ajusté = 1,81 × 10⁻⁴) et la voie de signalisation de la relaxine (MMP1/MMP13 ; p ajusté = 0,0175 ; Figure 3F). Ces résultats d'enrichissement ont été utilisés pour caractériser les fonctions biologiques représentées par le panel de six gènes.
L'évaluation inter-données montre un soutien hétérogène pour MMP1
Dans la matrice fusionnée GSE68183/GSE80178 (9 UPD et 6 témoins), CCL7, MMP1, et MMP13 différaient entre les groupes après correction BH pour les six gènes (ajusté p = 0,0168, 0,0159 et 0,0431, respectivement ; Figure 4A). CHEK1, MKI67, et TRPV2 n'ont pas atteint le seuil de significativité ajusté (ajusté p = 0,259, 0,680 et 0,259). L'analyse ROC à un seul gène a produit des AUC de 0,944 pour CCL7 (95 % IC, 0,825–1,000), 0,704 pour CHEK1 (0,403–1,000), 0,574 pour MKI67 (0,243–0,905), 0,981 pour MMP1 (0,930–1,000), 0,870 pour MMP13 (0,686–1,000) et 0,722 pour TRPV2 (0.447–0.997; Figure 4BCes valeurs ROC ont été considérées comme exploratoires car la procédure de fusion en amont et de correction de biais technique n'avait pas été entièrement documentée.
Dans GSE134431 (13 échantillons de DPU et 8 échantillons de SPD non ulcérés), MMP1 l'expression était plus élevée dans les UPD que dans les UPS selon le test de Wilcoxon au seuil de significativité nominal (p = 0,0225), bien que cette association n'ait plus été significative après correction BH (ajusté) p = 0.135; Figure 4C). Les cinq autres gènes n'ont montré aucune différence significative entre les groupes. MMP1 a également montré la plus forte AUC descriptive, avec une AUC de 0,808 (IC à 95 %, 0,589–1,000), tandis que les AUC des autres candidats variaient entre 0,529 et 0,635 (Figure 4D). Dans l'ensemble, MMP1 a montré le modèle descriptif le plus cohérent parmi les six candidats, mais la réplication statistique était incomplète.
L'analyse en cellule unique localise MMP1 principalement dans les fibroblastes
Le jeu de données à cellule unique comprenait 69 944 cellules provenant de 24 échantillons (14 UPD et 10 témoins) et comprenait 10 types cellulaires annotés (Figure 5A). La visualisation des caractéristiques par UMAP a localisé l'expression de MMP1 dans des régions cellulaires restreintes, plutôt qu'une expression uniforme à travers l'atlas (Figure 5B). Au total, 3 799 cellules (5,43 %) présentaient une expression normalisée de MMP1 supérieure à zéro. Les fibroblastes présentaient la plus forte expression normalisée moyenne (0,181) et la plus grande proportion globale de cellules positives pour MMP1 (7,88 % ; Figure 5C).
Au niveau de l'échantillon, l'expression moyenne de MMP1 était plus élevée dans les échantillons de DFU que dans les échantillons témoins chez les kératinocytes, les fibroblastes et les cellules endothéliales. Après correction BH sur l'ensemble des types cellulaires testés, chacune de ces comparaisons présentait une valeur p ajustée de 0,0214 (kératinocytes : 9 échantillons témoins et 14 échantillons DFU ; fibroblastes : 10 et 14 ; cellules endothéliales : 10 et 14 ; Figure 5D). La fraction positive pour MMP1 est passée de 5,86 % à 9,29 % dans les fibroblastes, de 0,026 % à 6,68 % dans les kératinocytes, et de 0,29 % à 2,67 % dans les cellules endothéliales (Figure 5E).
Les corrélations entre les scores par module et par cellule étaient modérées. La plus forte corrélation positive a été observée pour le score du module sénescence/phénotype sécréteur associé à la sénescence (SASP) (rho de Spearman = 0,274), suivie par celle du remodelage de la matrice extracellulaire (rho = 0,240), de la ferroptose (rho = 0,197) et de l'activation des fibroblastes (rho = 0,170 ; Figure 5F). La comparaison entre les fibroblastes à forte expression de MMP1 et ceux à faible expression de MMP1 a révélé un enrichissement en termes liés à l'organisation de la matrice extracellulaire, à l'organisation de la structure extracellulaire, à l'organisation des fibrilles de collagène, au traitement des glycoprotéines et au repliement des protéines (Figure 5G). Ces observations descriptives associent l'état des fibroblastes à forte expression de MMP1 à des processus liés au remodelage de la matrice. Des analyses complémentaires au niveau des groupes, des résumés par échantillon incluant tous les types cellulaires et le contexte des scores fonctionnels sont fournis dans la Figure supplémentaire 4A–C. Les associations au niveau individuel n'ont pas été considérées comme une preuve indépendante du donneur.
La couverture du réseau privilégie les ingrédients associés à MMP1 et les herbes candidates
Le tableau filtré des relations ingrédient-plante-cible contenait 561 enregistrements uniques reliant 99 plantes, 14 ingrédients et cinq des six cibles candidates. MMP1 était la cible la plus fréquente, avec 156 enregistrements, suivie par CHEK1 (120), MMP13 (102), MKI67 (100) et TRPV2 (83 ; Figure 6A). Parmi les ingrédients, la quercétine et la lutéoline présentaient la couverture végétale la plus étendue et étaient associées respectivement à 83 et 62 plantes. La bérbérine était liée à 10 plantes ; ces trois ingrédients ont été utilisés comme ingrédients principaux dans la règle de priorisation (Figure 6B).
Le score de couverture classait Guanhuangbo, Mahuang et Niuxi ex aequo au rang le plus élevé (score = 38 chacun ; Figure 6C). Chacun couvrait les cinq cibles disponibles et contenait deux ingrédients liés à MMP1. La matrice ingrédient-cible a montré que la quercétine offrait la couverture la plus étendue parmi le panel de cibles, tandis que la lutéoline et la berbérine assuraient une connectivité supplémentaire centrée sur MMP1 (Figure 6D). Un réseau ciblé reliait les principales herbes à des ingrédients représentatifs et aux cinq cibles disponibles (Figure 6E). Ces résultats ont permis d'identifier des combinaisons herbe-ingrédient-cible présentant une forte couverture dans la base de données, pour une évaluation ultérieure. Les matrices de couverture complémentaires herbe-cible et ingrédient-clé sont présentées dans la Figure supplémentaire 5A,B.
Des dosages préliminaires sur tissus appariés montrent une abondance plus élevée de l'ARNm et de la protéine MMP1
L'évaluation par immunoblotting a révélé une abondance plus élevée de MMP1 dans les échantillons de DUC par rapport aux échantillons appariés de tissu périulcéreux non ulcéreux correspondants (Figure 7A,B). Les trois paires appariées présentaient une différence moyenne de 0,3553 dans le rapport MMP1/cofiline (DFU moins périwound) (IC à 95 %, 0,1959–0,5147 ; test t apparié bilatéral, t(2) = 9,592, p = 0,0107). Les mesures appariées de chaque patient sont présentées dans la Figure 7B. Après moyennage de cinq puits techniques par gène et par échantillon, la qPCR a montré une abondance normalisée plus élevée du ARNm de MMP1 dans chacun des quatre échantillons de DUC par rapport à l'échantillon périulcéreux apparié correspondant (Figure 7C). La différence moyenne intrapatient appariée DFU moins périwound en ΔCq était de −2,6035 (IC à 95 %, −2,8024 à −2,4046 ; test t apparié bilatéral, t(3) = −41,663, p = 3,04 × 10⁻⁵), ce qui correspond à une augmentation moyenne géométrique de 6,08 fois (IC à 95 %, 5,30–6,98). Ces observations préliminaires, basées sur de petits échantillons, ne permettent pas d'établir un effet fonctionnel.
Dans les jeux de données de découverte et externes en volume, MMP1 présentait le modèle descriptif le plus cohérent parmi les six gènes prioritaires, bien que la réplication statistique n'ait pas été complète. Les résumés au niveau cellulaire unique ont montré une expression moyenne la plus élevée dans les fibroblastes, et les mesures appariées de western blot provenant de trois patients ainsi que les mesures appariées de qPCR provenant de quatre patients ont révélé une abondance accrue de MMP1. Ces observations confirment MMP1 comme un candidat associé aux ulcères du pied diabétique, justifiant des investigations supplémentaires. L'ensemble du flux de travail allant de l'analyse computationnelle à l'évaluation tissulaire est résumé dans la Figure supplémentaire 6.
DISPONIBILITÉ DES DONNÉES :
Les jeux de données transcriptomiques publiques sont disponibles dans le NCBI Gene Expression Omnibus sous les numéros d'accès GSE199939, GSE68183, GSE80178, GSE134431 et GSE165816. Les scripts d'analyse et de génération de figures, les tableaux d'expression et de résultats traités, les tableaux sources des figures quantitatives, les tableaux de résultats statistiques, le classeur original de qPCR et le projet d'instrument, ainsi que les images brutes non recadrées de western blot fournies, sont inclus dans le fichier supplémentaire 1. L'archive contient également les métadonnées cellulaires extraites, l'historique des commandes provenant de l'objet unicellulaire récupéré, les rapports de vérification du type de matrice et un manifeste de fichiers. Le fichier supplémentaire 1 conserve les fichiers sources historiques et inclut un dossier R2_Updates contenant les tableaux sources révisés pour les tests appariés, les résultats statistiques, le code de génération des figures et l'inventaire corrigé des paramètres. Le fichier RDS Seurat entièrement analysé est identifié dans la documentation de l'archive, mais n'est pas intégré dans ce fichier ZIP supplémentaire. L'historique complet de la fusion en masse, les paramètres d'origine de filtrage et d'annotation unicellulaires, ainsi que les détails complets sur la soustraction du fond des western blots et la quantification par bande ne sont pas entièrement disponibles ; ces limitations sont décrites dans le protocole et la discussion. Le fichier RDS récupéré localement n'a pas été déposé dans un référentiel public.
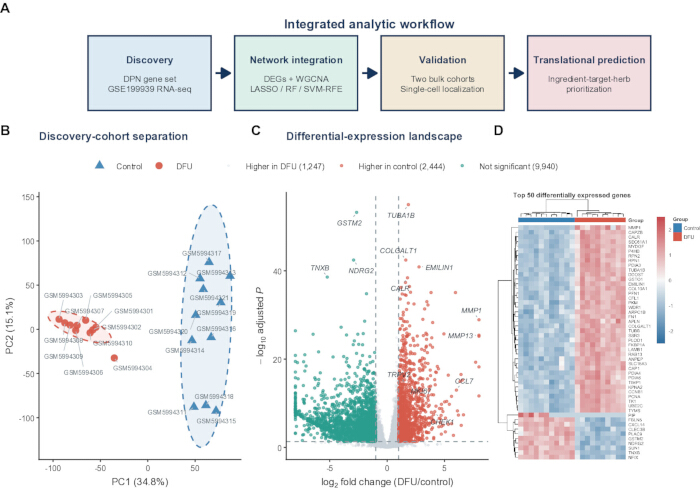
Figure 1 : La transcriptomique de découverte identifie un programme d'expression associé à l'ulcère du pied diabétique (DFU). (A) Aperçu du flux de travail computationnel, comprenant la construction du jeu de gènes DPN, l'analyse de découverte sur GSE199939, l'intégration de réseaux et d'apprentissage automatique, l'évaluation en masse et en cellule unique, ainsi que la prédiction des ingrédients, cibles et plantes de la médecine traditionnelle chinoise (TCM). (B) Analyse en composantes principales des profils d'expression transformés pour la stabilisation de la variance (VST) de GSE199939, provenant de 10 échantillons DFU et 11 témoins. Les ellipses indiquent les régions regroupant 90 % des données ; les pourcentages indiquent la variance expliquée par chaque composante. (C) Graphique volcan de l'analyse différentielle d'expression réalisée avec DESeq2, comparant DFU et témoin. Les points rouges et cyan représentent respectivement les gènes surexprimés dans le DFU et dans le témoin, selon un seuil de |log2 du rapport d'expression| > 1 et une valeur p ajustée par la méthode de Bonferroni (BH) < 0,05 ; les points gris ne remplissent pas les deux critères. (D) Carte thermique des scores z normalisés par ligne pour les 50 gènes présentant les valeurs ajustées de p les plus faibles. Les colonnes correspondent aux échantillons biologiques et la barre d'annotation indique le groupe. DEGs : gènes différentiellement exprimés ; DFU : ulcère du pied diabétique ; DPN : neuropathie périphérique diabétique ; VST : transformation stabilisant la variance. L'évaluation expérimentale finale est décrite dans le protocole et la Figure 7. qPCR : réaction en chaîne par polymérase en temps réel ; TCM : médecine traditionnelle chinoise ; RF : forêt aléatoire ; LASSO : opérateur de sélection et de rétrécissement absolu minimal ; SVM-RFE : élimination récursive des caractéristiques par machine à vecteurs de support. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
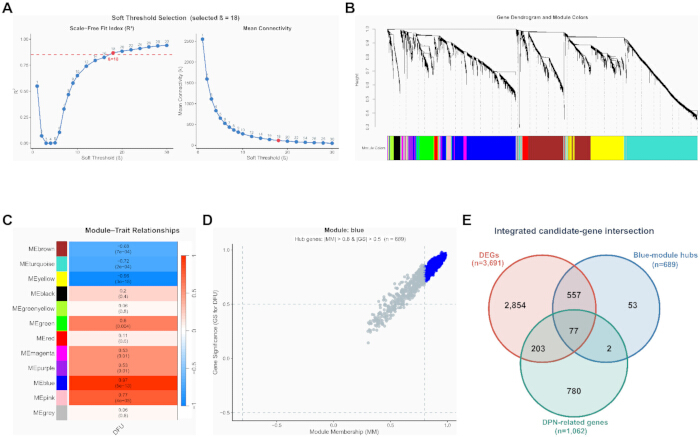
Figure 2 : L'analyse WGCNA et les connaissances antérieures sur la DPN convergent vers 77 gènes candidats. (A) Évaluation du seuil doux du réseau signé pour les 5 000 gènes les plus variables transformés par VST. La puissance sélectionnée était bêta = 18 ; la ligne en pointillés indique l'ajustement cible de topologie sans échelle à 0,85. (B) Dendrogramme génique avec affectation dynamique des couleurs par module selon la méthode d'average linkage. (C) Corrélations de Pearson entre les eigengènes des modules et le caractère binaire d'ulcère du pied diabétique (DFU). Chaque cellule indique le coefficient de corrélation et la valeur p bilatérale correspondante ; la couleur reflète la direction et l'ampleur. (D) Signification génique pour le DFU en fonction de l'appartenance au module bleu. Les points bleus remplissent les critères |appartenance au module| > 0,8 et |signification génique| > 0,5 ; n = 689 gènes centraux. (E) Intersection à trois ensembles comprenant 3 691 gènes différentiellement exprimés (DEG), 689 gènes centraux du module bleu et 1 062 gènes liés à la DPN, produisant 77 candidats communs. DFU, ulcère du pied diabétique ; DPN, neuropathie périphérique diabétique ; GS, signification génique ; MM, appartenance au module ; WGCNA, analyse de réseau de co-expression génique pondérée. La cohorte de découverte comprenait 21 échantillons (10 DFU et 11 témoins). L'annotation de la Figure 2D utilise |MM| > 0,8 et |GS| > 0,5, conformément au critère de valeur absolue validé dans le code initial de sélection. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
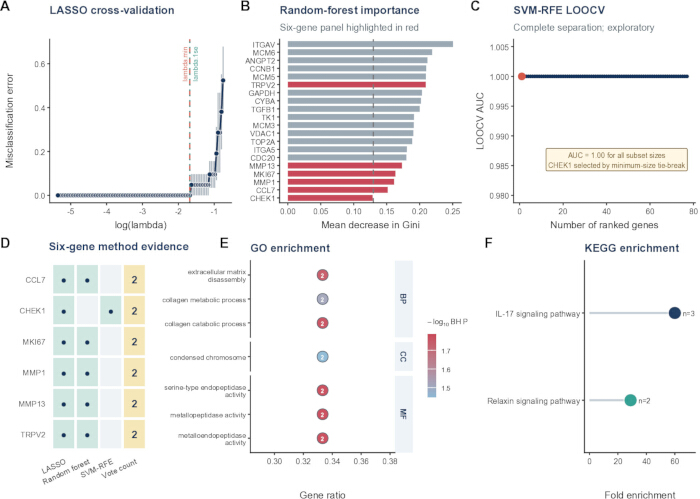
Figure 3 : La priorisation des caractéristiques par méthode multiple donne un panel de six gènes. (A) Courbe de validation croisée à cinq plis pour la régression LASSO binomiale. Les lignes verticales en pointillés indiquent lambda.min et lambda.1se ; les caractéristiques non nulles sélectionnées ont été prises à lambda.1se, sauf si cette pénalité ne produisait aucune caractéristique. (B) Diminution moyenne de l'indice de Gini dans la forêt aléatoire pour les 20 gènes les mieux classés d'un modèle de 1 000 arbres. Les barres rouges identifient les membres du panel final de six gènes ; la ligne en pointillés marque l'importance moyenne utilisée comme seuil de rétention sur l'ensemble complet des candidats. (C) AUC de la validation croisée LOOCV par SVM linéaire avec élimination récursive des caractéristiques (SVM-RFE) sur des sous-ensembles imbriqués. Toutes les tailles de sous-ensembles ont produit un AUC = 1,00 ; CHEK1 a été sélectionné selon la règle du sous-ensemble de taille minimale en cas d'égalité, indiquant un surajustement dans la cohorte de découverte. (D) Matrice de soutien des méthodes pour CCL7, CHEK1, MKI67, MMP1, MMP13 et TRPV2. Les points indiquent la sélection par LASSO, forêt aléatoire ou SVM-RFE ; la dernière colonne indique le nombre de méthodes de soutien. (E) Termes sélectionnés de l'ontologie des gènes enrichis parmi les six gènes. La position des points montre le ratio de gènes, les étiquettes des points indiquent le nombre de gènes mappés, la couleur représente -log10 de la valeur p ajustée BH, et la bande latérale indique l'ontologie. (F) Voies KEGG enrichies parmi les gènes mappés. La position des points montre l'enrichissement par facteur, la taille des points indique le nombre de gènes mappés, et la couleur distingue les voies. L'enrichissement exigeait une valeur p nominale < 0,05 et une valeur p ajustée BH < 0,05. AUC, aire sous la courbe ROC ; BH, Benjamini-Hochberg ; BP, processus biologique ; CC, composant cellulaire ; KEGG, Encyclopédie de Kyoto des gènes et des génomes ; LOOCV, validation croisée leave-one-out ; MF, fonction moléculaire ; SVM-RFE, élimination récursive des caractéristiques par machine à vecteurs de support. LASSO, opérateur de réduction et de sélection par norme L1. Les panneaux A–D utilisent les 21 échantillons de découverte (10 DFU et 11 témoins). Dans le panneau A, les barres d'erreur indiquent l'erreur-type de l'erreur de validation croisée. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
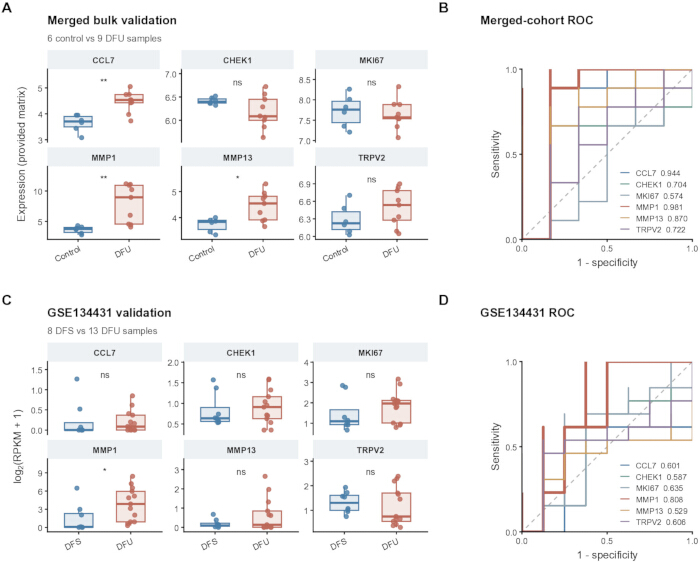
Figure 4 : Évaluation transcriptomique globale croisée entre jeux de données du panel de six gènes. (A) Expression des six gènes dans la matrice fusionnée GSE68183/GSE80178 (6 échantillons témoins et 9 échantillons DFU). (B) Courbes ROC individuelles correspondantes avec valeurs d'AUC ; les intervalles de confiance à 95 % sont fournis dans le tableau de données source. Étant donné que la fusion amont et la correction par lot n'ont pas été entièrement documentées, ces résultats ont été interprétés comme exploratoires. (C) Expression log2(RPKM + 1) dans GSE134431 (8 échantillons DFS non ulcérés et 13 échantillons DFU). (D) Courbes ROC et valeurs d'AUC correspondantes. Dans (A) et (C), les boîtes montrent la médiane et l'intervalle interquartile, les moustaches s'étendent jusqu'à 1,5 fois l'intervalle interquartile, et les points représentent les échantillons biologiques. Les astérisques indiquent la significativité nominale issue des tests de Wilcoxon à deux échantillons indépendants bilatéraux (*p < 0,05, **p < 0,01) ; les valeurs de p ajustées selon Benjamini-Hochberg pour les six gènes sont indiquées dans le texte et le tableau de données source. Le sens de la courbe ROC a été sélectionné automatiquement par pROC. AUC, aire sous la courbe caractéristique de fonctionnement du récepteur ; DFS, peau diabétique du pied non ulcérée ; DFU, ulcère du pied diabétique ; RPKM, lectures par kilobase par million de lectures cartographiées ; ROC, caractéristique de fonctionnement du récepteur. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
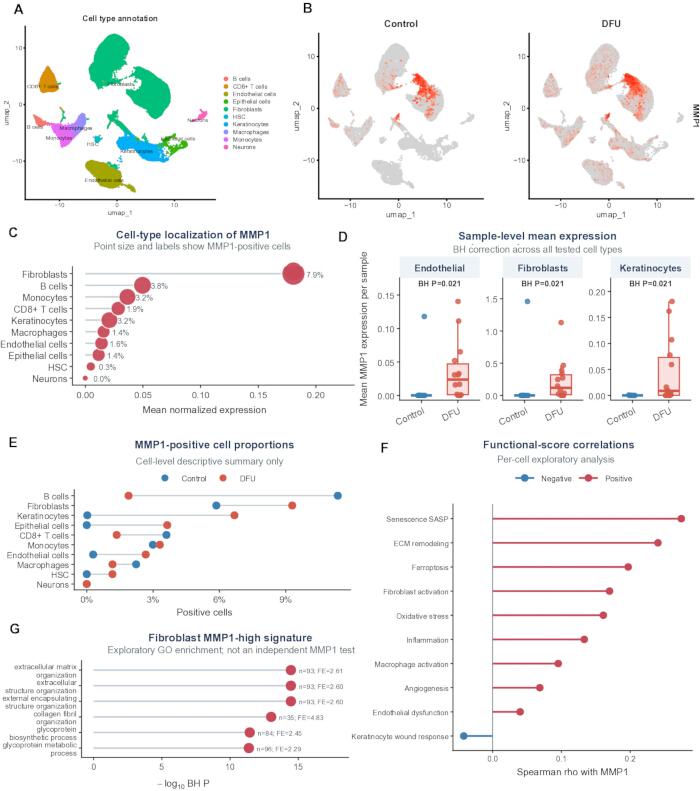
Figure 5 : La localisation au niveau monocellulaire relie MMP1 aux signaux de remodelage des fibroblastes et de la matrice. (A) UMAP de 69 944 cellules issues de 24 échantillons (10 témoins et 14 échantillons DFU), colorés selon les 10 annotations de types cellulaires obtenues par SingleR. (B) Graphiques caractéristiques UMAP montrant l’expression normalisée de MMP1 dans les cellules témoins et DFU. (C) Résumé par type cellulaire de l’expression moyenne normalisée de MMP1 ; la taille des points et les étiquettes indiquent la fraction globale de cellules positives pour MMP1, définie comme une expression normalisée > 0. (D) Expression moyenne de MMP1 au niveau des échantillons dans les cellules endothéliales, les fibroblastes et les kératinocytes. Les boîtes montrent la médiane et l’intervalle interquartile ; les points représentent les échantillons biologiques. Des tests bilatéraux de Wilcoxon ont été appliqués, suivis d’une correction BH pour tous les types cellulaires testés. Les effectifs disponibles étaient de 10 témoins et 14 DFU pour les cellules endothéliales et les fibroblastes, et de 9 témoins et 14 DFU pour les kératinocytes. (E) Fractions de cellules positives pour MMP1 selon le groupe et le type cellulaire. (F) Corrélations de Spearman par cellule entre l’expression de MMP1 et les scores des modules fonctionnels. (G) Enrichissement en processus biologiques selon l’ontologie génique (GO) parmi les gènes surexprimés dans les fibroblastes MMP1-forts par rapport aux fibroblastes MMP1-faibles. BH, Benjamini-Hochberg ; DFU, ulcère du pied diabétique ; ECM, matrice extracellulaire ; GO, Gene Ontology ; HSC, cellules souches hématopoïétiques ; UMAP, uniform manifold approximation and projection. Les corrélations par cellule et l’enrichissement conditionné à l’expression dans les panneaux F et G constituent des descriptions exploratoires, sans inférence confirmatoire tenant compte des donneurs. L’indépendance au niveau des échantillons nécessite une vérification des identifiants des donneurs. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
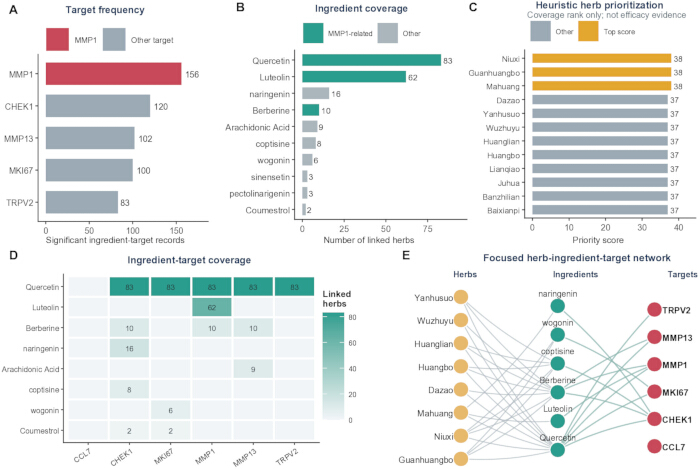
Figure 6 : Prédiction fondée sur la couverture des ingrédients, cibles et plantes de la MTC centrée sur MMP1. (A) Nombre d'enregistrements filtrés de plantes-ingrédients-cibles de la base de données pour chaque cible candidate disponible. (B) Nombre de plantes associées aux ingrédients les plus fréquents ; les ingrédients liés à MMP1 sont en turquoise. (C) Plantes principales classées par score de couverture ; les barres dorées indiquent les trois scores conjoints les plus élevés. (D) Matrice ingrédient-cible pour les ingrédients à forte couverture représentatifs. Les valeurs des cellules indiquent le nombre de plantes associées ; les cellules vides indiquent l'absence d'enregistrement dans le tableau de relations filtré. (E) Réseau ciblé reliant les plantes, ingrédients et cibles candidates les mieux classés. La couleur des nœuds indique le type d'entité ; les liens plante-ingrédient en gris représentent la présence, et les liens ingrédient-cible en turquoise représentent des liens issus de la base de données. Le tableau de relations filtré contenait 561 enregistrements uniques, 99 plantes, 14 ingrédients et cinq cibles avec des liens qualifiants ; CCL7 est affiché comme un sixième nœud candidat isolé. MTC, médecine traditionnelle chinoise. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
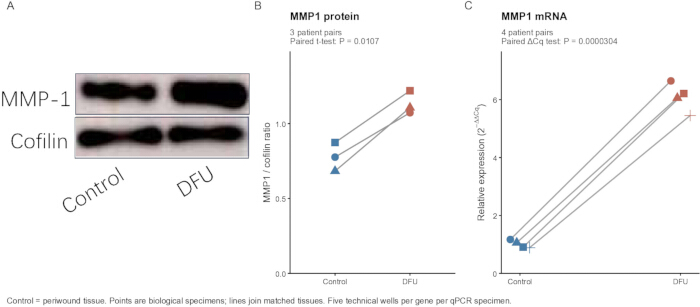
Figure 7 : Évaluation préliminaire par qPCR et immunoblot de l'expression de MMP1 dans des tissus de patients atteints d'ulcères du pied diabétique (DFU). (A) Immunoblot représentatif fourni précédemment, montrant l'abondance de la protéine MMP1 dans des tissus péri-lésionnels non ulcérés et dans des tissus DFU, avec la cofiline comme témoin de chargement. (B) Rapports MMP1/cofiline récupérés à partir du projet de tracé initial. Les symboles indiquent des mesures biologiques individuelles provenant de trois paires de patients ; des lignes relient les échantillons appariés de tissus péri-lésionnels et DFU. Le test t apparié bilatéral a donné t(2) = 9,592 et p = 0,0107. (C) Abondance relative de l'ARNm MMP1 dans quatre paires de patients appariées confirmées par les auteurs : NC–DFU, NC1–DFU1, NC2–DFU2 et NC3–DFU3. Cinq puits techniques pour ACTB et cinq puits techniques pour MMP1 ont été moyennés séparément au sein de chaque échantillon avant le calcul de ΔCq. L'expression relative a été calculée selon la méthode 2−ΔΔCq, en utilisant la moyenne des ΔCq des tissus péri-lésionnels comme calibrateur commun. Chaque symbole représente un échantillon biologique ; des lignes relient les tissus appariés. Le test t apparié bilatéral a utilisé les valeurs de ΔCq au niveau des échantillons (t(3) = −41,663 ; p = 3,04 × 10⁻⁵), et non les variations d'expression des puits techniques. Aucune étoile de significativité n'est utilisée. Les puits techniques ne sont pas des réplicats biologiques. « Control » désigne le tissu péri-lésionnel non ulcéré. Cq : cycle de quantification. Les valeurs p pour les tests tissu-assay sont nominales et exploratoires. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Gène | Numéro d'accès RefSeq | Amorce sens 5' à 3' | Amorce antisens 5' à 3' |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
Tableau 1 : Séquences des amorces pour la validation par PCR quantitative de MMP1. Les séquences oligonucléotidiques (5′–3′) sens et antisens ainsi que les numéros d'accès des transcrits NCBI RefSeq sont indiqués pour MMP1 humain (NM_002421) et ACTB (NM_001101.5). ACTB (β-actine) a été utilisé comme gène de référence pour l'expression relative de MMP1.
Figure supplémentaire 1 : Résumés du contrôle qualité de l'analyse WGCNA. (A) Clustering hiérarchique de liaison moyenne des échantillons de GSE199939 basé sur les 5 000 gènes les plus variables ayant subi une transformation stabilisant la variance. Les étiquettes des échantillons sont colorées par groupe ; la ligne horizontale en pointillés indique le seuil à 95 % de la hauteur du dendrogramme, utilisé pour l'évaluation visuelle des valeurs aberrantes. (B) Nombre de gènes attribués à chaque module WGCNA. Les barres turquoise indiquent les huit modules non gris satisfaisant au critère d'association avec les ulcères du pied diabétique (DFU) ; les barres grises indiquent les autres modules. DFU, ulcère du pied diabétique ; VST, transformation stabilisant la variance ; WGCNA, analyse de réseau de co-expression génique pondérée. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 2 : Appui de la co-expression du module bleu. (A) Réseau simplifié de co-expression des 25 gènes centraux du module bleu ayant les rangs les plus élevés. Parmi les corrélations par paires ayant |r| > 0,70, le réseau affiché contient l'union des deux liens les plus forts de chaque gène. La taille des nœuds indique le degré dans ce réseau affiché et élagué, et la couleur de remplissage des nœuds indique la signification du gène pour l'ulcère du pied diabétique (DFU). (B) Signification des gènes et appartenance au module bleu pour les 15 gènes centraux ayant les rangs les plus élevés. Le sous-ensemble d'arêtes a été sélectionné pour améliorer la lisibilité et ne représente pas toutes les corrélations éligibles. DFU, ulcère du pied diabétique ; GS, signification du gène ; MM, appartenance au module. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 3 : Résultats du machine learning appliqué à la cohorte de découverte interne. (A) Expression normalisée de CCL7, CHEK1, MKI67, MMP1, MMP13 et TRPV2 dans la cohorte de découverte GSE199939. Les boîtes montrent la médiane et l'intervalle interquartile, et les points représentent les échantillons biologiques. (B) Carte thermique des scores z par ligne au niveau des échantillons pour les six mêmes gènes. Les étiquettes courtes des échantillons sont associées aux identifiants GEO dans la clé des données sources. (C) Courbe ROC du modèle multigénique ajusté sur la cohorte de découverte. Une AUC de 1,00 a été obtenue en ajustant et en évaluant le modèle sur les mêmes 21 échantillons, indiquant un surajustement (overfitting) dans la cohorte de découverte. AUC, aire sous la courbe caractéristique de fonctionnement du récepteur ; ROC, caractéristique de fonctionnement du récepteur. La cohorte de découverte comprenait 21 échantillons (10 DFU et 11 témoins). Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 4 : Contexte d'expression au niveau cellulaire unique. (A) UMAP de 69 944 cellules colorées selon le groupe témoin et le groupe DFU. (B) Expression moyenne de MMP1 au niveau des échantillons biologiques, pour l'ensemble des 10 annotations de types cellulaires ; les points représentent les échantillons, et l'axe des abscisses utilise une transformation en racine carrée pour l'affichage. (C) Carte thermique des scores de modules fonctionnels résumés sur l'ensemble des cellules appartenant à chaque type cellulaire annoté, et normalisés pour chaque module. DFU, ulcère du pied diabétique ; UMAP, projection et approximation de variété uniforme. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 5 : Matrices de couverture des MTC soutenant. (A) Nombre d'enregistrements plante-médicament cible issus de la base de données pour les 18 plantes les mieux classées ayant une couverture liée à MMP1 et les cinq cibles candidates présentes dans le tableau de relations filtré. (B) Nombre d'enregistrements de la base de données reliant les mêmes plantes aux principes actifs principaux quercétine, lutéoline et bérbérine. Les valeurs des cellules indiquent le nombre d'enregistrements uniques dans la base de données après suppression des doublons. MTC, médecine traditionnelle chinoise. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 6 : Schéma du flux de travail de l'analyse computationnelle et tissulaire. Le schéma résume les données d'entrée de la découverte, l'intersection DEG/WGCNA, la sélection exploratoire de caractéristiques, l'évaluation externe en masse, le contexte monocellulaire, l'extension TCM et l'évaluation appariée de l'expression tissulaire. La qPCR a utilisé quatre paires de patients appariés et le western blotting a utilisé trois paires de patients appariés. Les nombres de candidats et les résultats computationnels rapportés sont conservés de l'analyse initiale. L'utilisation de données TPM dans le flux de travail de découverte basé sur les comptages, les enregistrements incomplets du prétraitement initial des données monocellulaires et les petits effectifs des cohortes d'essais tissulaires restent des limites. Le schéma n'implique pas que les analyses de découverte ont été revalidées. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 1 : Inventaire des logiciels d'analyse, bases de données, paramètres et limitations. Ce classeur recense 26 étapes d'analyse, indiquant pour chacune l'étape d'analyse, l'outil ou la base de données utilisée, la version indiquée, les entrées, les principaux paramètres, les sorties, ainsi que les informations manquantes ou les limitations. Il couvre la transcriptomique exploratoire, l'analyse WGCNA, le criblage génique et la sélection de caractéristiques, l'enrichissement, les analyses externes en mode massif et en cellule unique, l'analyse de réseau de médecine traditionnelle chinoise (TCM), ainsi que la restitution des données par tissu et test. Ce tableau consigne les informations méthodologiques disponibles sans garantir à lui seul la reproductibilité indépendante. Veuillez cliquer ici pour télécharger ce fichier.
Fichier supplémentaire 1 : Archive des données, du code d'analyse, des sources des figures et des tests. Cette archive contient les scripts disponibles pour l'analyse et la génération des figures, les tableaux de résultats et d'expression traités, les données brutes des figures quantitatives et des analyses statistiques, le classeur original de qPCR et le projet instrument, les images brutes non recadrées de western blot fournies, les métadonnées et l'historique des commandes issues de l'analyse en cellule unique, les rapports de vérification au format matrice, ainsi qu'un manifeste des fichiers. Les fichiers historiques sont conservés ; le dossier R2_Updates contient l'analyse corrigée des tests appariés, les sources mises à jour des figures et l'inventaire révisé des paramètres. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Ce flux de travail intégré a priorisé MMP1 à partir de la transcriptomique globale, de l'analyse WGCNA, du criblage des gènes liés aux DPN et d'une sélection exploratoire de caractéristiques, puis a examiné le contexte cellulaire et l'expression tissulaire. Six gènes étaient soutenus par au moins deux méthodes de sélection, et MMP1 a montré la plus grande variation d'expression dans le groupe de découverte. Les preuves externes étaient hétérogènes : MMP1 est restée significative dans la matrice fusionnée GSE68183/GSE80178, tandis que son association dans GSE134431 était nominale (p = 0,0225) et n'ont pas résisté à la correction de BH (ajusté p = 0,135). La valeur AUC de 0,808 dans GSE134431 est descriptive, particulièrement parce que la direction de la CRO a été choisie au sein du jeu de données d'évaluation. Par conséquent, « le plus cohérent » décrit le profil observé parmi les six candidats et n'implique pas une réplication statistique complète ni un biomarqueur diagnostique validé.
Le panel de candidats a été annoté en fonction du remodelage du collagène, de la désassemblage de la matrice extracellulaire, de l'activité de métalloendopeptidase, ainsi que des voies de signalisation de l'IL-17 et de la relaxine. Ces annotations sont compatibles avec la biologie des plaies chroniques, mais ne concernent qu'un petit nombre de gènes. De précédentes études humaines ont signalé des profils modifiés de MMP et de leurs inhibiteurs dans les plaies diabétiques6, tandis qu'une étude prospective sur les ulcères du pied diabétique (UPD) a associé un rapport plus élevé entre MMP1 et l'inhibiteur tissulaire des métalloprotéinases 1 (TIMP1) à une meilleure cicatrisation7. Ainsi, une expression accrue de MMP1 ne doit pas nécessairement indiquer un effet uniformément néfaste ; sa pertinence pourrait dépendre de l'étape de réparation, de la disponibilité du substrat et de l'équilibre avec les inhibiteurs. Des observations expérimentales concernant MMP13, CCL7 et l'IL-17 apportent un contexte supplémentaire11,12,13,14, mais on ne peut pas supposer que leurs fonctions soient équivalentes chez l'humain en cas d'UPD.
Résumés au niveau cellulaire unique localisés la moyenne la plus élevée MMP1 expression dans les fibroblastes, avec une expression au niveau de l'échantillon plus élevée dans les fibroblastes, les kératinocytes et les cellules endothéliales provenant d'ulcères du pied diabétique (DFU). Ce profil correspond aux rapports sur l'organisation altérée de la matrice extracellulaire (ECM) dans les fibroblastes issus d'ulcères du pied diabétique4, états hétérogènes des fibroblastes dans les études unicellulaires et spatiales8et les programmes de fibroblastes associés à la cicatrisation par les macrophages15. Toutefois, les identifiants des échantillons nécessitent une vérification au niveau du donneur, et les corrélations entre les scores modulaires au niveau cellulaire ainsi que l'enrichissement conditionnel à l'expression restent descriptifs, car la dépendance intra-donneur n'a pas été modélisée. La contribution de populations épithéliales et endothéliales plaide également contre un mécanisme exclusivement autonome aux fibroblastes. Transcriptomique spatiale, ARN in situ hybridation ou immunomarquage offrirait une localisation complémentaire16.
La valeur méthodologique réside dans la combinaison de l'expression différentielle, de la co-expression, des connaissances préalables sur les gènes, des résumés résolus au niveau cellulaire et des modalités d'essais indépendantes afin de hiérarchiser les candidats. Elle ne réside pas dans la précision prédictive obtenue sur le groupe de découverte. Un dépistage effectué sur l'ensemble de la cohorte a précédé la validation croisée au niveau de l'algorithme, et la valeur uniforme de la CUS de 1,00 pour le SVM-RFE soulève des inquiétudes quant à une fuite de données, un surajustement et une évaluation trop optimiste. Le panel devrait donc rester un résultat de hiérarchisation de caractéristiques. Une préparation entièrement imbriquée, comprenant la sélection et l'ajustement des paramètres, suivie d'un test indépendant figé, serait nécessaire pour une évaluation prédictive9,10. L'entrée utilisée pour la découverte a été vérifiée comme étant en TPM, malgré son utilisation dans un modèle basé sur les décomptes ; les statistiques de découverte et la sélection ultérieure restent donc non vérifiées en l'attente d'une réanalyse appropriée. La matrice globale fusionnée ne dispose pas de l'historique complet de son prétraitement. L'objet Seurat récupéré fournit les paramètres de normalisation, de sélection des caractéristiques variables, d'ACP, de voisins, de regroupement en clusters et de représentation UMAP, bien que son filtrage initial, l'appel complet de Harmony et sa référence d'annotation restent documentés de façon incomplète. Le retraitement harmonisé à partir des données brutes, l'évaluation documentée des effets de lot et les analyses de pseudobulk ou de modèles mixtes tenant compte du donneur constituent des approches alternatives pour une évaluation complémentaire.
Les tests sur tissus provenant de patients fournissent des preuves préliminaires indépendantes d'une abondance plus élevée de MMP1. Le tissu de comparaison était constitué de tissu péri-lésionnel non ulcéreux provenant des mêmes patients, de sorte que le contraste reflète des différences locales associées à l'ulcère au sein du tissu diabétique, plutôt qu'une comparaison avec une peau saine. Les mesures de western blot issues de trois paires appariées de patients et les mesures de qPCR issues de quatre paires appariées confirmées par les auteurs ont été analysées à l'aide de tests appariés, les observations biologiques individuelles étant affichées. Pour la qPCR, les puits techniques ont été moyennés au sein de chaque échantillon, et l'inférence s'est appuyée sur la valeur ΔCq ; les puits techniques n'ont pas augmenté la taille de l'échantillon biologique. Le sens constant des observations appariées soutient une comparaison préliminaire d'expression, mais les petites tailles d'échantillons ne permettent pas d'établir la généralisabilité ni d'évaluer de façon fiable les hypothèses de distribution. L'abondance dans le tissu global ne permet pas d'établir la localisation cellulaire de la protéine, son activité enzymatique ou un effet causal sur la cicatrisation. Des cohortes plus importantes, cliniquement bien caractérisées, sont nécessaires. D'autres limites incluent des covariables cliniques incomplètes, des tissus comparateurs distincts, un ensemble de gènes DPN issu de la littérature mais documenté de façon incomplète, et des enregistrements incomplets de soustraction du fond original des immunoblot. Le tissu sain, le tissu témoin défini par l'étude et la peau diabétique non ulcéreuse ne doivent pas être considérés comme interchangeables.
Le réseau de médecine traditionnelle chinoise est une extension générant des hypothèses. Ses poids personnalisés résument la couverture des bases de données plutôt que l'engagement des cibles ou l'efficacité, et les classements peuvent varier selon le contenu des bases de données et les choix de pondération. La quercétine et la berbérine présentent également une exposition systémique variable ou limitée17,18. Les ingrédients et plantes candidats nécessitent donc des tests directs sur les cibles, les relations dose-réponse, la pharmacocinétique, la toxicité et les fonctions. Les travaux futurs devraient combiner des cohortes indépendantes bien documentées avec une localisation spatiale et une perturbation de MMP1 dans des fibroblastes primaires ou des modèles multicellulaires de plaie. Les résultats actuels soutiennent MMP1 comme une cible candidate associée aux ulcères du pied diabétique dans un contexte de remodelage matriciel centré sur les fibroblastes, sans établir de lien de causalité ni d'utilité clinique.
Déclarations de divulgation
Les auteurs déclarent qu'ils n'ont aucun conflit d'intérêts.
Remerciements
Cette recherche a été soutenue par le projet municipal de recherche scientifique médicale de Wuhan (projet d'orientation, n° de subvention WX23Z77), géré par la Commission municipale de la santé de Wuhan.
Les auteurs remercient les participants ayant fourni les échantillons de tissus pour cette étude ainsi que les chercheurs ayant produit et déposé les jeux de données accessibles au public dans le Gene Expression Omnibus du NCBI.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Bandes de tubes PCR transparents à paroi mince de 0,2 mL | Axygen / Corning | PCR-0208-C | URL : https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| Pointes de pipette filtrantes stériles de 1 000 μL | Axygen / Corning | TF-1000-R-S | URL : https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| Tubes microcentrifuges stériles de 1,5 mL, sans DNase/ARNase | Solarbio Life Sciences | YA0430 | URL : https://www.solarbio.com/goodsInfo?id=305429 |
| Pointes de pipette filtrantes stériles de 10 μL | Axygen / Corning | TF-300-L-R-S | URL : https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| 2× SYBR Green PCR Mastermix | Solarbio Life Sciences | SR1110 | URL : https://www.solarbio.com/goodsInfo?id=994 |
| Solution tampon Tris-Tween 20× | Solarbio Life Sciences | T1080 | URL : https://www.solarbio.com/goodsInfo?id=1309 |
| Pointes de pipette filtrantes stériles de 200 μL | Axygen / Corning | TF-200-R-S | URL : https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| Paire d'amorces qPCR ACTB | Solarbio Life Sciences (synthèse d'oligonucléotides sur mesure) | Sur commande | RefSeq NM_001101.5 ; F : CACCATTGGCAATGAGCGGTTC ; R : AGGTCTTTGCGGATGTCCACGT ; URL : https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Suède | Amersham Imager 600 | Modèle enregistré dans les 22 fichiers TIFF fournis ; logiciel de fonctionnement version 1.2.0 ; URL : https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Kit d'analyse protéique par acide bicinchoninique | Solarbio Life Sciences | PC0020 | URL : https://www.solarbio.com/goodsInfo?id=64504 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | Version 4.16.0 |
| Anticorps polyclonal contre la cofiline (lapin anti-cofiline) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Chine) | 10960-1-AP | Dilution utilisée en immunobuvardage dans cette étude : 1:6 000 ; URL : https://www.ptgcn.com/ ; RRID : AB_2291830 |
| Base de données Comparative Toxicogenomics Database | CTD | https://ctdbase.org/ | Ressource ingrédient-cible |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | Version 1.48.2 |
| Eau sans DNase/ARNase | Solarbio Life Sciences | R1600 | URL : https://www.solarbio.com/goods.php?id=1085 |
| e1071 | CRAN / auteurs e1071 | https://cran.r-project.org/package=e1071 | Version 1.7-17 |
| Substrat chimiluminescent ECL Plus | Solarbio Life Sciences | PE0010 | URL : https://www.solarbio.com/pdf/2-DBYMY/1-ZW/PE0010.pdf |
| Gene Expression Omnibus : GSE134431 | Centre national d'information sur la biotechnologie | GSE134431 | URL : https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus : GSE165816 | Centre national d'information sur la biotechnologie | GSE165816 | URL : https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus : GSE199939 | Centre national d'information sur la biotechnologie | GSE199939 | URL : https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus : GSE68183 | Centre national d'information sur la biotechnologie | GSE68183 | URL : https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus : GSE80178 | Centre national d'information sur la biotechnologie | GSE80178 | URL : https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gene Ontology | Consortium Gene Ontology | https://geneontology.org/ | GO |
| ggplot2 | Développeurs ggplot2 | https://ggplot2.tidyverse.org/ | Version 4.0.3 |
| glmnet | CRAN / auteurs glmnet | https://cran.r-project.org/package=glmnet | Version 5.0 |
| Tableau de référence herbe-ingrédient | Source non indiquée dans le manuscrit | Non indiqué | Non documenté : nom exact de la base de données/fichier, version/date et URL d'accès public |
| Immunoglobuline secondaire anti-lapin IgG (H+L) conjuguée à la peroxydase de raifort (HRP) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Chine) | SA00001-2 | Dilution utilisée en immunobuvardage dans cette étude : 1:5 000 ; URL : https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm ; RRID : AB_2722564 |
| Échantillons de tissus humains d'ulcère du pied diabétique | Hôpital de Wuhan Quatrième, Wuhan, Chine | N/A | Échantillons appariés aux patients ; qPCR n=4 échantillons ; immunobuvardage n=3 échantillons ; protocole approuvé KY2024-161-01 |
| Échantillons de tissus humains péri-lésionnels non ulcérés | Hôpital de Wuhan Quatrième, Wuhan, Chine | N/A | Échantillons témoins péri-lésionnels appariés aux patients ; qPCR n=4 échantillons ; immunobuvardage n=3 échantillons ; protocole approuvé KY2024-161-01 |
| ImageJ | Instituts nationaux de la santé | https://imagej.net/ij/ | Version non documentée |
| Encyclopédie de Kyoto des gènes et des génomes (KEGG) | KEGG | https://www.genome.jp/kegg/ | Code organisme humain hsa |
| Liste de gènes DPN issue de la littérature | Composant issu de la littérature ; tableau source au niveau des gènes non entièrement documenté | Non indiqué | Provenance au niveau des gènes non entièrement documentée |
| Spectrophotomètre UV-visible microvolume | Marque/modèle non indiqués dans le manuscrit | Non indiqué | Non documenté : fabricant exact, modèle et URL du produit ; utilisation indiquée : concentration en ARN et évaluation du rapport A260/A280 |
| Anticorps polyclonal contre la MMP1 (lapin anti-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Chine) | 10371-2-AP | Dilution utilisée en immunobuvardage dans cette étude : 1:1 000 ; URL : https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm ; RRID : AB_2297741 |
| Paire d'amorces qPCR MMP1 | Solarbio Life Sciences (synthèse d'oligonucléotides sur mesure) | Sur commande | RefSeq NM_002421 ; F : ATGAAGCAGCCCAGATGTGGAG ; R : TGGTCCACATCTGCTCTTGGCA ; URL : https://www.solarbio.com/ |
| NCBI Gene | Centre national d'information sur la biotechnologie | https://www.ncbi.nlm.nih.gov/gene/ | Base de données des gènes humains |
| Lait écrémé en poudre, réactif de blocage | Solarbio Life Sciences | D8340 | URL : https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | Version 3.21.0 |
| Gel SDS-PAGE préfabriqué, gradient 4 %–20 % | Solarbio Life Sciences | PG42010-S | URL : https://www.solarbio.com/goodsInfo?id=12646 |
| pROC | CRAN / auteurs pROC | https://cran.r-project.org/package=pROC | Version 1.19.0.1 |
| Mélange d'inhibiteurs de protéase, 100× | Solarbio Life Sciences | P6730 | URL : https://www.solarbio.com/goodsInfo?id=25748 |
| Système de transfert protéique | Marque/modèle non indiqués dans le manuscrit | Non indiqué | Non documenté : fabricant exact, modèle et URL du produit ; utilisation indiquée : transfert sur membrane PVDF de 0,22 μm |
| Membrane PVDF, 0,22 μm | Solarbio Life Sciences | YA1690 | URL : https://www.solarbio.com/goodsInfo?id=228106 |
| R | Fondation R pour l'informatique statistique | https://www.r-project.org/ | Version 4.5.2 |
| randomForest | CRAN / auteurs randomForest | https://cran.r-project.org/package=randomForest | Version 4.7-1.2 |
| Appareil de PCR en temps réel | Roche Diagnostics | LightCycler 96 | version du logiciel non confirmée. Le volume/profil de cyclage du projet diffère du protocole rapporté ; le lien exact avec l'expérience reste à vérifier. |
| Microcentrifugeuse réfrigérée | Marque/modèle non indiqués dans le manuscrit | Non indiqué | Non documenté : fabricant exact, modèle et URL du produit ; utilisation indiquée : 12 000 × g pendant 15 min à 4 °C |
| rentrez | CRAN / auteurs rentrez | https://cran.r-project.org/package=rentrez | Version 1.2.4 |
| Buffer de lyse RIPA, haute concentration | Solarbio Life Sciences | R0010 | URL : https://www.solarbio.com/goodsInfo?id=1163 |
| Système d'électrophorèse SDS-PAGE | Marque/modèle non indiqués dans le manuscrit | Non indiqué | Non documenté : fabricant exact, modèle et URL du produit ; utilisation indiquée : séparation des protéines sur gels en gradient 4 %–20 % |
| Seurat | Laboratoire Satija / développeurs Seurat | https://satijalab.org/seurat/ | Version 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | Version 2.10.0 |
| Homogénéisateur de tissus | Marque/modèle non indiqués dans le manuscrit | Non indiqué | Non documenté : fabricant exact, modèle et URL du produit ; utilisation indiquée : homogénéisation des tissus dans un tampon de lyse glacé |
| Réactif TriQuick pour l'extraction d'ARN total | Solarbio Life Sciences | R1100 | URL : https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | URL : https://www.solarbio.com/goodsInfo?id=102 |
| Bouchons plats ultra-transparents pour bandes de tubes PCR de 0,2 mL | Axygen / Corning | PCR-2CP-RT-C | URL : https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| Kit RT-PCR universel (M-MLV) | Solarbio Life Sciences | RP1100 | URL : https://www.solarbio.com/goodsInfo?id=992 |
| WGCNA | CRAN / auteurs WGCNA | https://cran.r-project.org/package=WGCNA | Version 1.74 |
| Windows | Microsoft | https://www.microsoft.com/windows/windows-11 | Windows 11 |
Références
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.