מחקר זה נועד לערוך השוואה בין L1-L2-אנגלית ל-L1-L2 פורטוגזית כדי לבדוק עד כמה ההשפעה של מבטא זר אחראית הן למדדים והן לפרמטרים פרוזודיים-אקוסטיים, כמו גם לבחירת קול היעד במערך הקול.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר שיטה
מבטא זר וזיהוי רמקולים משפטיים במערכי קול: השפעת מאפיינים אקוסטיים המבוססים על פרוזודיה
במאמר זה
סיכום
תקציר
מחקר זה נועד לבחון הן את המאפיינים הפרוזודיים-אקוסטיים והן את המתאמים התפיסתיים של אנגלית במבטא זר ופורטוגזית ברזילאית במבטא זר ולבדוק כיצד הפקות המבטא הזר והמקומי של הדוברים קשורות לתפיסת המאזינים. במתודולוגיה ביצענו הליך הפקת דיבור עם קבוצה של דוברי פורטוגזית ברזילאית L2 וקבוצה של דוברי אנגלית ברזילאית L2, והליך תפיסת דיבור בו ביצענו מערכים קוליים לשתי השפות. עבור הניתוח הסטטיסטי של הפקת הדיבור, הרצנו מודלים תוספים כלליים כדי להעריך את ההשפעה של קבוצות השפה על כל מחלקה (מטרית או פרוזודית-אקוסטית) של תכונות הנשלטות לאפקט ההחלקה של המשתנים של המחלקה הנגדית. לצורך הניתוח הסטטיסטי של תפיסת הדיבור, הרצנו מבחן קרוסקאל-וואליס ומבחן דאן פוסט-הוק כדי להעריך את השפעת הקולות של ההרכבים על הציונים שנשפטו על ידי המאזינים. עם זאת, ערכנו מבחני דמיון אקוסטיים (קוליים) המבוססים על מרחקים קוסינוסיים ואוקלידיים. התוצאות הראו הבדלים אקוסטיים משמעותיים בין קבוצות השפה מבחינת שונות ה-f0, משך הזמן ואיכות הקול. עבור ההרכבים, התוצאות הצביעו על כך שמאפיינים פרוזודיים של f0, עוצמה ואיכות קול היו בקורלציה לשיפוט הנתפס של המאזינים.
מבוא
המבטא הוא היבט בולט ודינמי של תקשורת ושטף, הן בשפת האם (L1) והן בשפה זרה (L2)1. מבטא זר מייצג את המאפיינים הפונטיים של L2 של שפת יעד, והוא יכול להשתנות (עם הזמן) בתגובה לחוויית ה-L2 של הדובר, סגנון הדיבור, איכות הקלט, האקספוזיציה, בין משתנים אחרים. ניתן לכמת מבטא זר כדרגה (סקלרית) של הבדל בין דיבור L2 המופק על ידי דובר זר לבין מבטא מקומי או ייחוס של שפת היעד2,3,4,5.
מחקר זה נועד לבחון הן את המאפיינים הפרוזודיים-אקוסטיים והן את המתאמים התפיסתיים של אנגלית במבטא זר ופורטוגזית ברזילאית במבטא זר (BP), כמו גם לבדוק באיזו מידה הפקות המבטא הזר והמקומי של הדוברים קשורות לתפיסת המאזינים. מחקר קודם בתחום הפורנזי הוכיח את החוסן של תנועות ועיצורים בזיהוי מבטא זר כיציב לניתוח ארוך טווח של אדם (The Lo Case6) או מתייחס לדיוק הזיהוי הגבוה של דובר (The Lindbergh Case7). עם זאת, חקירת מאפיינים פרוזודיים-אקוסטיים המבוססים על משך, תדר בסיסי (f0, כלומר, המתאם האקוסטי של גובה הצליל), עוצמה ואיכות קול (VQ) זכתה לתשומת לב הולכת וגוברת8,9. לפיכך, הבחירה בתכונות פרוזודיות-אקוסטיות במחקר זה מייצגת אפיק מבטיח בתחום הפונטיקה המשפטית8,10,11,12,13.
המחקר הנוכחי נתמך על ידי מחקרים המוקדשים למבטאים זרים כצורה של הסוואת קול במקרים משפטיים14,15, כמו גם בהכנת מערכי קול לזיהוי דוברים16,17. לדוגמה, קצב הדיבור שיחק תפקיד חשוב בזיהוי דוברי גרמנית, איטלקית, יפנית וברזילאית של אנגלית18,19,20,21,22. מלבד קצב הדיבור, תכונות ספקטרליות ו-f0 לטווח ארוך מאתגרות דוברי L2 מיומנים בהיכרות עם שפת היעד מכיוון שהמוח והבסיסים הקוגניטיביים סובלים ממחסור בזיכרון, קשב ורגש, המשתקף בביצועים הפונטיים של הדובר במהלך תורי דיבור ארוכים23. ההשקפה של מבטאים זרים בתחום הזיהוי הפלילי היא שההגדרה של מה באמת נשמע כמו מבטא זר תלויה במידה רבה בחוסר ההיכרות של המאזין ולא בדרגה לא קיצונית של דיבור24.
בתחום התפיסתי, כלי פורנזי נפוץ ששימש מאז אמצע שנות ה-90 לזיהוי פושעים הוא ה-Voice Lineup (זיהוי שמיעתי), המקביל לזיהוי חזותי המשמש לזיהוי פושע בזירת פשע16,25. במערך קולות, קולו של החשוד מוצג לצד רדידים - קולות דומים בהיבטים סוציולינגוויסטיים כגון גיל, מין, מיקום גיאוגרפי, ניב ומעמד תרבותי - לזיהוי על ידי עד שמיעה. ההצלחה או הכישלון של מערך קולי יהיו תלויים במספר דגימות הקול ומשך הדגימה25,26. יתר על כן, עבור דגימות מהעולם האמיתי, נחשב שאיכות השמע משפיעה באופן עקבי על דיוק הזיהוי הקולי. איכות שמע ירודה עלולה לעוות את המאפיינים הייחודיים של קול27. במקרה של דמיון קולי, פירוט פונטי עדין המבוסס על f0 יכול לבלבל את המאזין במהלך זיהוי קולי28,29. תכונות אקוסטיות כאלה משתרעות מעבר ל-f0 וכוללות אלמנטים של משך, ותכונות ספקטרליות של עוצמה ו-VQ30. השקפה זו של מאפיינים פרוזודיים מרובים היא חיונית בהקשר של השוואת קול משפטית כדי להבטיח זיהוי מדויק של דובר9,14,15,29,31.
לסיכום, מחקרים בפונטיקה משפטית הראו שונות מסוימת בנוגע לזיהוי מבטא זר במהלך העשורים האחרונים. מצד אחד, נראה כי מבטא זר אינו משפיע על תהליך זיהוי הדובר32,33 (במיוחד אם הדובר אינו מכיר את המבטא הזר היעד34). מצד שני, ישנם ממצאים בכיוון ההפוך12,34,35.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
עבודה זו קיבלה אישור מוועדת אתיקה למחקר בבני אדם. בנוסף, התקבלה הסכמה מדעת מכל המשתתפים המעורבים במחקר זה לשימוש בנתוניהם ולפרסומם.
1. הפקת דיבור
הערה: אספנו דיבור ממשימת קריאה של 'L1 English-L2 BP' שהופקו על ידי קבוצה 1ה- אמבסדור (Am)אמריקאי ה_אנגלית (מארה"ב) Sדוברים (AmE-S), ובשני סרטוני 'L1 BP-L2 English' שהופקו על ידי קבוצה 2ה- מוחזילייאן Sרמקולים (Bra-S). ראה איור 1 עבור תרשים זרימה של הפקת דיבור.

איור 1תרשים זרימה סכמטי של הפקת דיבור. אנא לחצו כאן כדי להציג גרסה גדולה יותר של איור זה.
- משתפים
- קבע את ה- מספר המשתתפים, ה- שפה (שפה ראשונה אנגלית, שפה שנייה פורטוגזית ברזילאית; שפה ראשונה פורטוגזית ברזילאית, שפה שנייה אנגלית), ה- מין (נקבה או זכר), ה- גיל (ממוצע, סטיית תקן), ה- מאפייני קבוצה (אנשי מקצוע או סטודנטים לתואר ראשון), ו- רמת מיומנות בשפה שנייה (L2) (מתקדם או מתקדם מאוד) עבור כל קבוצה.
הערה: לצורך המחקר הנוכחי, הן קבוצת AmE-S והן קבוצת Bra-S נחשבו לשולטות בשפה כשפה שנייה (L2) (שתי הקבוצות סווגו כבעלות רמה של B2-C1)36ה-AmE-S התגוררו בברזיל במשך שנתיים בעת ביצוע הפרוצדורות. ה-Bra-S התגוררו בארה"ב יותר משנתיים בעת ביצוע הפרוצדורות. במהלך מגוריהם בחו"ל, שתי הקבוצות נהגו לדבר בשפתם השנייה (L2) למטרות לימוד ועבודה לפחות 6 ימים בשבוע, למשך כ-4-5 שעות ביום. - הקציאו למשתתפים חדר שקט ונוח והציגו בפניהם את חומרי הקריאה עבור כל קבוצה.
- קבע את ה- מספר המשתתפים, ה- שפה (שפה ראשונה אנגלית, שפה שנייה פורטוגזית ברזילאית; שפה ראשונה פורטוגזית ברזילאית, שפה שנייה אנגלית), ה- מין (נקבה או זכר), ה- גיל (ממוצע, סטיית תקן), ה- מאפייני קבוצה (אנשי מקצוע או סטודנטים לתואר ראשון), ו- רמת מיומנות בשפה שנייה (L2) (מתקדם או מתקדם מאוד) עבור כל קבוצה.
- איסוף נתונים
הערה: יש לאסוף נתוני דיבור ממשימת קריאה בשפות הבאות: שפת אם (L1) באנגלית ושפה שנייה (L2) בבניו-פורטוגזית (BP); שפת אם (L1) בבניו-פורטוגזית (BP) ושפה שנייה (L2) באנגלית. יש לאפשר למשתתפים לקרוא את הטקסטים מראש במידת הצורך.- נהלי הקלטה
- הקליטו את נתוני הדיבור במקום שקט עם תנאי אקוסטיקה מתאימים.
- השתמש במקליט קול דיגיטלי (ראה את ה- טבלת חומרים)37 ומיקרופון קרדיואידי חד-כיווני מבודד אלקטרומגנטית (ראה את ה- טבלת חומרים)38.
- הקליטו את נתוני השמע ב-.wavטופס.
- הגדירו את קצב הדגימה ל-48 kHz ואת רזולוציית הכמת (quantization rate) ל-16 ביטים.
הערה: פורמט השמע והתצורה עבור קצבי הדגימה והקוונטיזציה המתוארים בשלבים 1.2.1.3 ו-1.2.1.4 יושמו כדי להבטיח איכות גבוהה והפחתת רעשים, במטרה לשמר את המאפיינים הספקטרליים המשמשים לניתוח אקוסטי מאוחר יותר.
- נהלי הקלטה
- ניתוח אקוסטי
הערה: חלק את נהלי הניתוח האקוסטי לשלושה שלבים: יישור כפוי (forced-alignment), יישור מחדש והפקת תכונות אקוסטיות.- כתוב את התמלול הלשוני (ב-'.אנא ספק את הטקסט באנגלית שברצונך לתרגם.קובץ) עבור כל קובץ שמע.
- תייג את הזוג של 'אנא ספק את הטקסט באנגלית שברצונך לתרגם.'/'.wavקבצים בעלי שם זהה (כלומר, 'my_file.wav'/ 'my_file.נא לספק את הטקסט שברצונך לתרגם.').
הערה: כדי לשפר את ביצועי הפרוצדורה המתוארת בסעיף 1.3.7, מומלץ מאוד ששלוש התווים הראשונות של התגיות בקובץ '.txt/.wav' יסמלו את ה- שפה, ניבאו, או שמא דגשבעוד שהתווים הרביעון עד השישי מציינים את ה- מין (למשל, EL1FEM עבור הנראה שהקלדת "nglish" במקום "English". אנא ספק את הטקסט באנגלית שברצונך לתרגם לעברית. L1 נקבהאלה). החל מהתו השביעי ואילך, על המשתמש לציין את מספר הדובר (למשל, 001 עבור הדובר הראשון). כתוצאה מכך, זוג ה-'.txt/.wav' הראשון הוא EL1FEM001. - צרו תיקייה עבור כל שפת L1-L2.
הערה: תיקייה עבור אנגלית L1-L2 ותיקייה עבור BP L1-L2. - אשר שכל זוגות הקבצים באותה שפה נמצאים באותה תיקייה.
- בצע את הסנכרון הכפוי (forced alignment).
- גש לממשק האינטרנט של כלי הסנכרון הכפוי (forced aligner) Munich Automatic Segmentation (MAUS) (רשתעכברים)39 ב- https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/Pipeline
- גרור ושחרר כל זוג של .wav / .אנא ספק את הטקסט באנגלית שברצונך לתרגם. קבצים מה- תיקייה למלבן המקווקו ב- קבצים (או לחצו בתוך המלבן, איור 2A).
- לחץ על ה העלאה כפתור להעלאת הקבצים אל התוכנה ליישור רצפים (ראו את החץ האדום ב- איור 2A).
- בחר את האפשרויות הבאות ב- אפשרויות שירות תפריט (איור 2B): G2P-MAUS-PHO2SYL עבור שם הצינור; אנגלית (ארה"ב) (עבור שפה) אם נתוני L1-L2 באנגלית; איטלקית (IT) (עבור שפה) אם נתוני לחץ תוך-גית (BP) ב-L1-L2.
הערה: בחרנו ב'איטלקית' עבור נתוני ה-BP מכיוון ש-webMAUS אינו מספק מודלים אקוסטיים מאומנים מראש עבור יישור כפוי (forced alignment) של BP. הספרות הפונטית גורסת כי לפונולוגיה האיטלקית יש מלאי תנועות סימטרי בן שבעה, הדומה במידה מסוימת לזה של BP40וכן דמיון אקוסטי עיצורי41,42. - שמור על אפשרויות ברירת המחדל עבור 'פורמט פלט' ו'שמור הכל'.
- בדוק את ה- הפעלה תיבת בחירה לאישור תנאי השימוש (ראו חץ ירוק ב- איור 2C).
- לחצו על ה- הפעלת שירות רשת כפתור להרצת הקבצים שהועלו בתוכנת ההשוואה (aligner).
הערה: עבור כל קובץ שמע, המקשר האוטומטי (forced aligner) MAUS מחזיר קובץ Praat TextGrid אובייקט (קובץ '.txt' בפורמט מוקדם של Praat המכיל את האנוטציה של מילים, הברות פונולוגיות ופונמות, בהתבס על התמלול הלשוני שהופק מקובץ ה-'.txt' המתואר בשלב 1.3.1). - לחץ על ה- הורדה כקובץ ZIP לחצן להורדת קבצי ה-TextGrid כקובץ דחוס (zipped)איור 2C).
הערה: ודאו שקבצי ה-TextGrid הדחוסים (zipped) יורדו לאותה תיקייה שבה נמצאים קבצי השמע. - חלץ את קבצי ה-TextGrid עבור יישור מחדש מאוחר יותר בתוכנה לניתוח פונטי43.
- בצע את היישור מחדש.
- גש להורדה של הסקריפט עבור Praat VVUnitAligner44 מתוך https://github.com/leonidasjr/VVunitAlignerCode_webMAUS/blob/main/VVunitAligner.praat.
- אשרו שכל זוגות הקבצים מאותה שפה ו-VVUnitAligneר הסקריפטים נמצאים באותה תיקייה.
הערה: תיקייה עבור קבצי האנגלית L1-L2 ועבור ה-VVunitAligner, ותיקייה עבור קבצי ה-BP L1-L2 ועבור ה-VVunitAligner. - פתח את התוכנה לניתוח פונטי.
- לחץ Praat | פתיחת סקריפט Praat… להפעלת הסקריפט מתוך ה- חלון אובייקטים.
- לחץ על ה- הפעלה לחץ על הכפתור פעם אחת.
הערה: טופס הנקרא סנכרון הברות פונטי (Phonetic syllable alignment) החלון המכיל את ההגדרות לשימוש בסקריפט יופיע על המסך (איור 3A). - לחץ על ה- שפה כפתור לבחירה בין השפות 'English (US)', 'Portuguese (BR)', 'French (FR)' או 'Spanish (ES)'.
- לחצו על ה- סגמנטציית מקטעים כפתור לבחירה בין הליכי סגמנטציה מסוג 'Automatic' (אוטומטית), 'Forced (manual)' (כפויה (ידנית)) או 'None' (ללא).
- בדוק את ה- שמירת קבצי TextGrid אפשרות לשמירה אוטומטית של קובצי ה-TextGrid החדשים.
- לחץ אישור | הרץ כפתורים ליישור מחדש של היחידות הפונטיות משלב 1.3.5.7.
הערה: עבור כל קובץ שמע, VVUnitAligner ייצור קובץ TextGrid חדש עבור סעיף 1.3.7 (איור 3B).
- בצע חילוץ אוטומטי של המאפיינים האקוסטיים.
- גשו והורידו את הסקריפט SpeechRhythmExtractor45 מתוך https://github.com/leonidasjr/SpeechRhythmCode/blob/main/SpeechRhythmExtractor.praat להוצאה אוטומטית של מאפיינים פרוסודיים-אקוסטיים.
- צרו תיקייה חדשה והניחו בה את SpeechRhythmExtractor יחד עם כל זוגות קובצי ה-audio/TextGrid של כל השפות.
- פתח את התוכנה לניתוח פונטי.
- לחץ Praat | פתיחת סקריפט ב-Praat… להפעלת הסקריפט מתוך ה- חלון אובייקטים.
- לחץ על ה- הפעלה לחץ על הכפתור פעם אחת בלבד.
הערה: טופס המכיל את הגדרות הסקריפט יופיע על המסך. בתיבות של שמות קבצי הפלט מסוג '.txt', שנה את שמות הקבצים בהתאם או השאר את השמות המוגדרים כברירת מחדל. - בדוק את ה- פרמטרי איכות הקול אפשרות לשמירת ה- קובץ פלט VQ עבור איכות הקול (איור 3C).
הערה: קובץ פלט שני זה (ה- קובץ פלט VQ( מכיל את הפרמטרים של ההבדל בין ה-1נא לספק את טקסט המקור לאנגלית לצורך התרגום. ו-2נד הרמוניות (H1-H2) ושיא הבליטות הצפסטרלית (CPP)9. - בדוק את ה- יעד לשוני אפשרות לבחור מבין התוויות 'שפה', 'ניב' או 'מבטא' (איור 3C).
- בדוק את ה- יחידה אפשרות לבחירה של מאפייני ה-f0 בהרץ (Hz) או בחצאי טונים (Semitones)איור 3C).
- הגדר את הערכים עבור סף F0, ספי thresholds המינימום והמקסימום של f0 (איור 3C).
הערה: אלא אם למחקר יש מטרות ספציפיות או מאפייני שמע ספציפיים שנקבעו מראש, מומלץ מאוד להשאיר את הפרמטרים שלב 1.3.7.9 בערכי ברירת המחדל. - לחץ אישור | הפעל עבור חילוץ אוטומטי של המאפיינים האקוסטים.
הערה: התסריט מחלץ קצב דיבור (SpeechRhythmExtractor) מחזיר קובץ '.txt' המופרד בטאבים (קובץ פלט/ קובץ פלט VQ) המכיל את המאפיינים האקוסטיים שהופקו מהדוברים.
- ניתוח סטטיסטי
- העלה את גיליון הנתונים המכיל את המאפיינים האקוסטים לתוך R46 סביבה (או כל תוכנה/סביבה סטטיסטית מכל בחירה).
- בצע סטטיסטיקה לא-פרמטרית באמצעות מודלים אדיטיביים כלליים (GAMs).
- ביצוע מודלים אדיטיביים כלליים (GAMs) ב-R.
- הקלידו את הפקודות הבאות ולחצו על הכנס.
library(mgcv)
model = gam(the מאפיין אקוסטית-פרוזודי/מטרי בניתוח ~ ה- שפה + s(הנבחרים מאפיין מדידהעל ידי ה- שפה) + אחרים מאפיינים מטריים/פרוסודיים-אקוסטיים, נתונים = ה מסגרת נתונים)
הערה: החלטנו לבצע את הסטטיסטיקה של הפרוטוקול בשפת התכנות R, בשל הפופולריות הגוברת שלה בקרב פונטיקאים (ובלשנים) בקהילה האקדמית. R נמצאה בשימוש נרחב במחקרי שטח פונטיים.47יש לזכור ששלב 1.4.2.2 מכיל פסאודו-קוד. כתבו את הקוד בהתאם למשתני המחקר.

איור 2צילום מסך של יישור פונטי באמצעות כלי היישור הכפוי MAUS. (Aהמלבן המקווקו מיועד לגרירה והשמה של 'my_file.wav'/' my_fileהקובץ ריק. נא לספק את הטקסט למסמך ה-txt לצורך תרגום.קבצים או לחיצה בתוך התיקייה לחיפוש קבצים אלה; כפתור ההעלאה מסומן בחץ האדום. (Bהקבצים שהועלו מהפאנל A (ראו חץ כחול), את ה-pipeline שבו יש להשתמש, את השפה עבור זוגות הקבצים, את פורמט הקבצים להחזרה, וכפתור 'true/false' להשארת כל הקבצים.Cתיבת הסימון של תנאי השימוש (ראה חץ ירוק), ה- הפעלת שירותי רשת (Web Services) לחצן, והתוצאות (קבצי TextGrid להורדה). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
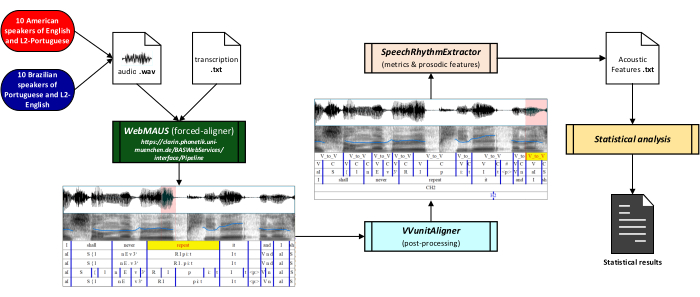
איור 3צילום מסך של הליך היישור מחדש. (A) טופס הגדרות קלט להליך היישור מחדש. (B) צורת גל חלקית, ספקטרוגרמה רחבת פס עם קו מתאר של ה-f0 (בכחול), ושש שכבות המחולקות למקטעים (ומסומנות) כ- דרגה 1יחידות מתחילת תנועה עד לתחילת התנועה הבאה (V_to_V); תחילת תנועה (V_to_V); דרג 2יחידות של תנועה (V), עיצור (C) והפסקה (#); דרגה 3ייצוגים פוניים V_to_V; דרגה 4מספר מילים מהטקסט; דרגה 5: מקטעי (CH) דיבור מהטקסט; שכבה 6: שכבת טונליות המכילה את הטון הגבוה ביותר (H) ואת הטון הנמוך ביותר (L) של כל מקטע דיבור שהופק על ידי דוברת אנגלית אמריקאית סטנדרטית (AmE-S).C) הגדרות קלט לחילוץ אוטומטי של המאפיינים האקוסטיים. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
2. תפיסת דיבור
הערה: ביצענו ארבעה זיהויי קול באנגלית עם מאזינים אמריקאים וארבעה זיהויים ב-BP עם מאזינים ברזילאים. ראו איור 4 לתרשים זרימה של תפיסת דיבור.
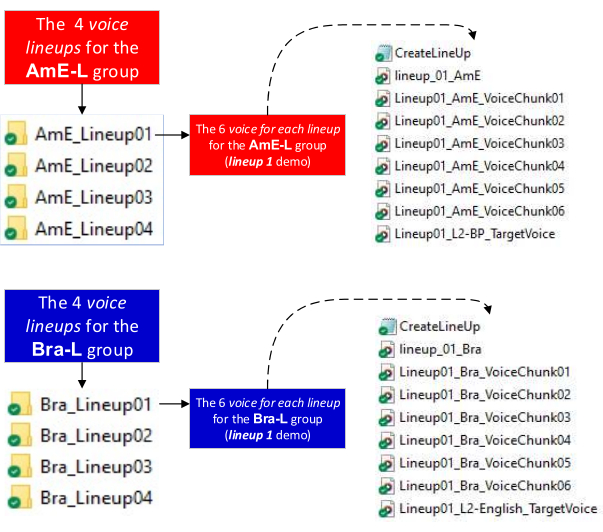
איור 4תרשים זרימה סכמטי לתפיסת דיבור. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
- משתפים
- בחרו משתתפים שונים עבור כל קבוצה, מתוך אלו שלא השתפו בפרוטוקול הפקת הדיבור.
הערה: לשלב זה של הפרוטוקול נבחרו שתי קבוצות של משתפים: קבוצה 1ה- Amאמריקאי האנגלית (מארה"ב) Lמאזינים (AmE-L), ו- קבוצה 2ה- מוחברזילאי Lמאזינים (Bra-L). במחקר הנוכחי, הן קבוצת AmE-L והן קבוצת Bra-L נחשבו למיומנות בשפה שנייה (L2) (שתי הקבוצות סווגו כרמה B2-C1)36 בזמן ביצוע ההליכים, קבוצת ה-AmE-L התגוררה בברזיל במשך שנתיים. קבוצת ה-Bra-L התגוררה בארה"ב במשך יותר משנתיים בעת ביצוע ההליכים. במהלך שהייתם בחו"ל, שתי הקבוצות נהגו להשתמש בשפת המטרה שלהן (L2) למטרות לימודים ועבודה (לפחות שישה ימים בשבוע, למשך כ-4 עד 5 שעות ביום). - קבע את ה- מספר המשתתפיםה, ה שפה (שפה ראשונה אנגלית, שפה שנייה פורטוגזית ברזילאית; שפה ראשונה פורטוגזית ברזילאית, שפה שנייה אנגלית), ה- מין (נקבה או זכר), ה- גיל (ממוצע, סטיית תקן), ה- מאפייני קבוצה (אנשי מקצוע או סטודנטים לתואר ראשון) וה- רמת השליטה בשפה שנייה (L2) עבור כל קבוצה.
- בחרו משתתפים שונים עבור כל קבוצה, מתוך אלו שלא השתפו בפרוטוקול הפקת הדיבור.
- סידורי הקולות
הערה: חלק את הפרוצדורות של מערכי ההכרייה הקוליים לשני שלבים שונים: הכנת מערכי ההכרייה הקוליים והרצתם.- הכינו ארבעה מערכי קול (voice lineups) לאנגלית וארבעה ל-BP.
- קבלו קבצי שמע מהדוברים של סעיף 1: הפקת דיבור.
- יש לוודא שקבצי השמע של כל גורם שפה נמצאים בתיקיות נפרדות.
- בחרו באופן אקראי שישה מקטעי קול בשפה האנגלית כשפת אם (L1) או בשפה הפורטוגזית הברזילאית כשפת אם (L1 BP).
הערה: שישה קולות במערך מייצגים קול מטרה אחד ו- חמש רשמיות. - בחרו מקטע קולי באנגלית כשפה שנייה (L2 English) או בפורטוגזית ברזילאית כשפה שנייה (L2 BP) מאחד הדוברים שנכללו בשלב 2.2.1.3.
הערה: מקטע הקול בשלב 2.2.1.4 הוא ה- קול ייחוס8. המקטעים חייבים להיות באורך של כ-20 שניות. - גשו והורידו את הסקריפט עבור Praat CreateLineup48 מ- https://github.com/pabarbosa/prosody-scripts-CreateLineUp
- יש לוודא כי קול הייחוס ב-L2, המגבים (foils) ב-L1 וקול המטרה ב-L1 נמצאים באותה תיקייה לפני הרצת הסקריפט CreateLineup (איור 5).
- פתח את התוכנה לניתוח פונטי.
- מתוך ה- חלון אובייקטיםלחץ/י Praat | פתיחת סקריפט Praat… להפעלת הסקריפט.
- לחץ הפעלה | הפעלה.
הערה: הסקריפט מחזיר קובץ בסדר הבא: (קול הייחוס של L2) + (קול היעד של L1 והמסיחים המפוזרים באופן אקראי)איור 5).
- הרצת זיהויי קול (voice lineups)
- צרו מרחב מקוון לאירוח של רשימות השמות (lineups) בכל פלטפורמה לבחירתכם (למשל, SurveyMonkey. ראו את ה טבלת חומרים) לעריכת זיהויים קוליים מרחוק.
- גש לקישור למרחב המקוון.
- העלה את הקבצים שהוחזרו מסקריפט ה-CreateLineup לפלטפורמה.
- בצעו את הפרוצדורה לפני הגעת המשתתפים כדי לבחון כל שלב.
הערה: מומלץ לגשת לקישור מראש ולהריץ את סדרות הבדיקה (lineups) כדי לוודא שהכל פועל כסדרו.
- הכינו ארבעה מערכי קול (voice lineups) לאנגלית וארבעה ל-BP.
- ניתוח סטטיסטי
- העלו את גיליון הנתונים המכיל את ציוני שיפוטי המאזינים לסביבת R (או לכל תוכנה או סביבה סטטיסטית אחרת לבחירתכם).
- בצעו את מבחן קרوسקל-וואליס (Kruskal-Wallis test) ב-R.
- הקלידו את הפקודות הבאות ולחצו על הזן.
model = kruskal.test(פסקי דין כל אחת זיהוי קולי (Voice Lineup), נתונים = ה מסגרת נתונים)
- בצע מבחן דאן (Dunn's test) פוסט-הוק.
- בצעו את מבחן דאן (Dunn's test) ב-R.
- הקלידו את הפקודות הבאות ולחצו על הכנס.
library(FSA)
model = dunnTest(פסקי דין כל אחד זיהוי קולי (Voice Lineup), data = data, method = "בונפרוני")
הערה: הקודים בשלבים 2.3.1.2 ו-2.3.2.2 הם פסאודו-קודים (ראו הערה 1.4.2.2).
- העלו את גיליון הנתונים המכיל את ציוני שיפוטי המאזינים לסביבת R (או לכל תוכנה או סביבה סטטיסטית אחרת לבחירתכם).
- ניתוח דמיון אקוסטי
- בחרו את מערכי הגרויים (ראו הערה בשלב 2.2.1.3) שהציגו הבדלים לא מובהקים בין הגריי target לבין מי מהגרויים המסיחים (foils).
- חזור על הפרוצדורות שלבים 1.3.1 עד 1.3.7.5, ושלבים 1.3.7.8 עד 1.3.7.10.
- גש והורד את הסקריפט עבור Python49, דמיון_אקוסטי_קוסינוס_אוקלידיס50 מ- https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py.
הערה: הסקריפט מחזיר שלוש מטריצות (בפורמט '.txt' ו-'.csv'): אחת עבור דמיות קוסינוס (Cosine similarity)51,52, אחד עבור מרחק אוקלידי52,53, ואחד עבור ערכי מרחק אוקלידי שונה (Transformed Euclidean distance), כמו גם השוואה זוגית בין קול המטרה לבין כל דגימת השוואה (foil). - וודאו שהסקריפט הורד לאותה תיקייה שבה נמצא מערך הנתונים של השורות (lineup dataset).
- לחץ על פתח קובץ… כפתור להפעלת הסקריפט.
- לחץ הפעל | הפעל ללא ניפוי שגיאות לחצנים
הערה: השני הרצה ייתכן שסימון הכפתור יהיה כ- הרץ או הרץ ללא ניקוי שגיאות או הפעל סקריפט. כולם מבצעים את אותן הפקודות. הדבר תלוי פשוט בסביבת ה-Python שבה נעשה שימוש. - בצעו בדיקות דמיון קולי בהתבס על מאפיינים אקוסטיים.
הערה: דמיות קוסינוס (או מרחק קוסינוס) היא טכניקה המיושמת בבינה מלאכותית (AI), ובמיוחד בלמידת מכונה במערכות לזיהוי אוטומטי של דיבור (ASR). זהו מדד דמיות שערכו נע בין אפס לאחד. דמיות קוסינוס הקרובה לאחד מעידה כי שני קולות הם ככל הנראה דומים. דמיות קוסינוס הקרובה לאפס מעידה כי הקולות הם ככל הנראה שונים.52מרחק אוקלידי, המכונה לעיתים קרובות דמיון אוקלידי, נפוץ מאוד גם בבינה מלאכותית (AI), בלמידה חישובית (machine learning) ובזיהוי אוטומטי של דיבור (ASR). הוא מייצג את המרחק בקו ישר בין שתי נקודות במרחב אוקלידי.53כלומר, ככל שהנקודות קרובות יותר (ערכי מרחק קצרים יותר), כך הקולות דומים יותר. כדי להשיג הבנה ברורה יותר של התוצאות המדווחות עבור שתי הטכניקות, ביצענו טרנספורמציה של ציוני הגלם של המרחק האוקלידי לערכים שבין אפס (דמיון קול נמוך יותר) לאחד (דמיון קול גבוה יותר).54.

איור 5הגדרת ספריות עבור תפיסת דיבור. סדרו את התיקיות. כל תיקייה מכילה שישה קולות L1, את קול היעד L2, את ה- "יצירת מערך" התסריט, וקובץ השמע של מערך הקולות (שמוחזר לאחר הרצת התסריט). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
תוצאות עבור הפקת דיבור
בסעיף זה, תיארנו את הביצועים של המאפיינים הפרוזודיים-אקוסטים והמדדים הקצביים בעלי מובהקות סטטיסטית. מאפיינים פרוזודיים אלו היו קצבי הדיבור, הפיצול וההפסקה, הקשורים למשך זמן, וכן Shimmer, הקשור לאיכות הקול. המדדים הקצביים היו סטיית התקן (SD) של משך ההברה, SD של עיצורים, SD של משך תנועות או עיצורים, ומקדם השונות של משך ההברה (ראו את הטבלה המשלימה S1).
ה- קצב דיבור (איור 6A) פוחת במהירות ...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
הפרוטוקול הנוכחי מציג חידוש בתחום הפונטיקה (המשפטית). הוא מחולק לשני שלבים: אחד מבוסס על ייצור (ניתוח אקוסטי) ואחד מבוסס על תפיסה (ניתוח שיפוט). שלב ניתוח הייצור כולל את הכנת הנתונים ויישור מאולץ, יישור מחדש וחילוץ אוטומטי של תכונות פרוזודיות-אקוסטיות מלבד הסטטיסטיקה. פרוטוקול זה מחבר את שלב איסוף הנתונים לניתוח הנתונים בצורה מהירה ויעילה יותר מהפרוטוקולים המסורתיים המבוססים על פילוח ידני בעיקר.
עם זאת, תהליך היישור מחדש, המוצג בשלבי הפרוטוקול 1.3.6 עד 1.3.6.9, עובד בעצם על יחידות הטלפון והמיל...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
למחברים אין ניגודי אינטרסים להצהיר עליהם.
תודות
מחקר זה נתמך על ידי המועצה הלאומית לפיתוח מדעי וטכנולוגי - CNPq, מענק מס' 307010/2022-8 למחבר הראשון, ומענק מס' 302194/2019-3 למחבר השני. המחברים מבקשים להביע את תודתם הכנה למשתתפי מחקר זה על שיתוף הפעולה הנדיב ותרומתם שלא תסולא בפז.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| CreateLineup | אוסף אישי | # | סקריפט לפראט להכנת מערכי קול |
| I3 של Dell (עם כונן Solid-State - SSD) | Dell | # | מחשב נייד |
| Praat | Paul Boersma & דיוויד וינינק | # | תוכנה לניתוח פונטי |
| Python 3 | Python Software Foundation | # | שפת תכנות מתורגמת, ברמה גבוהה, לשימוש כללי |
| R | פרויקט R למחשוב סטטיסטי | שפת תכנות לחישוב סטטיסטי | |
| Shure Beta SM7B | Shure | # | Microphone |
| SpeechRhythmExtractor | אוסף אישי | # | סקריפט לפראט לחילוץ אוטומטי של תכונות אקוסטיות |
| SurveyMonkey | SurveyMonkey Inc. | # | הרכיבו סקרים חינמיים הניתנים להתאמה אישית, כמו גם חבילה של תוכניות עורפיות הכוללות ניתוח נתונים, בחירת מדגם, הטיה וייצוג נתונים. |
| Tascam DR-100 MKII | Tascam | # | מקליט קול דיגיטלי |
| מערכת הפילוח האוטומטית של מינכן MAUS | אוניברסיטת מינכן | # | יישור מאולץ של קבצי אודיו (.wav) ומידע לשוני (.txt) |
| VVUnitAligner | אוסף אישי | # | סקריפט לפראט ליישור מחדש אוטומטי ועיבוד לאחר של יחידות פונטיות |
מקורות
- Moyer, A. Foreign Accent: The Phenomenon of Non-native Speech. , Cambridge University Press. (2013).
- Munro, M., Derwing, T. Foreign accent, comprehensibility and intelligibility, redux. J Second Lang Pronunciation. 6 (3), 283-309 (2020).
- Levis, J. Intelligibility, Oral Communication, and the Teaching of Pronunciation. , Cambridge University Press. (2018).
- Munro, M. Applying Phonetics: Speech Science in Everyday Life. , Wiley-Blackwell. (2022).
- Gut, U. Speaker Classification. Muller, C. , Springer-Verlag. 75-87 (2007).
- Rogers, H. Foreign accent in voice discrimination: a case study. Forensic Linguistics. 5 (2), 203-208 (1998).
- Solan, L., Tiersma, P. Hearing Voices: Speaker Identification in Court. Hastings Law Journal. 54, 373-436 (2003).
- Alcaraz, J. The long-term average spectrum in forensic phonetics: From collation to discrimination of speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 87-110 (2023).
- Silva, L. Jr, Barbosa, P. A. Voice disguise and foreign accent: Prosodic aspects of English produced by Brazilian Portuguese speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 195-226 (2023).
- Munro, M., Derwing, T. Modeling perceptions of the accentedness and comprehensibility of L2 speech. Studies in Second Language Acquisition. 23 (4), 451-468 (2001).
- Keating, P., Esposito, C. Linguistic Voice Quality. Working Papers in Phonetics. , 85-91 (2007).
- Niebuhr, O., Skarnitzl, R., Tylečková, L. The acoustic fingerprint of a charismatic voice -Initial evidence from correlations between long-term spectral features and listener ratings. Proceedings of Speech Prosody. , 359-363 (2018).
- Segundo San, E. International survey on voice quality: Forensic practitioners versus voice therapists. Estudios de Fonética Experimental. 29, 8-34 (2021).
- Farrús, M. Fusing prosodic and acoustic information for speaker recognition. International Journal of Speech, Language and the Law. 16 (1), 169(2009).
- Farrús, M. Voice disguise in automatic speaker recognition. ACM Computing Surveys. 51 (4), 1-2 (2018).
- Nolan, F. A recent voice parade. The International Journal of Speech, Language and the Law. 10 (2), 277-291 (2003).
- McDougall, K. Ear-catching versus eye-catching? Some developments and current challenges in earwitness identification evidence. Speaker Individuality in Phonetics and Speech Sciences. Bernardasci, C., Dipino, D., Garassino, D., Negrinelli, S., Pellegrino, E., Schmid, S. , Officinaventuno. 33-56 (2021).
- Gut, U. Rhythm in L2 speech. Speech and Language Technology. 14 (15), 83-94 (2012).
- Urbani, M. Pitch Range in L1/L2 English. An Analysis of F0 using LTD and Linguistic Measures. Coop. , Libraria Editrice Università di Padova. (2012).
- Gonzales, A., Ishihara, S., Tsurutani, C. Perception modeling of native and foreign-accented Japanese speech based on prosodic features of pitch accent. J Acoust Soc Am. 133 (5), 3572(2013).
- Silva, L. Jr, Barbosa, P. A. Speech rhythm of English as L2: an investigation of prosodic variables on the production of Brazilian Portuguese speakers. J Speech Sci. 8 (2), 37-57 (2019).
- Foreign accent and L2 speech rhythm of English a pilot study based on metric and prosodic parameters. Silva, L. Jr, Barbosa, P. A. Proceedings of the II Brazilian Conference on Prosody (Anais II Congresso Brasileiro de Prosódia), 1, 41-50 (2023).
- Costa, A. El cerebro bilingüe: La neurociencia del lenguaje. , Penguin Randon House. (2017).
- Eriksson, A. Tutorial on forensic speech science: Part I. Forensic Phonetics. , (2005).
- Harvey, M., Giroux, M., Price, H. Lineup size influences voice identification accuracy. Applied Cognitive Psychology. 37 (5), 42-89 (2023).
- Pautz, N., et al. Identifying unfamiliar voices: Examining the system variables of sample duration and parade size. Q J Exp Psychol (Hove). 76 (12), 2804-2822 (2023).
- McDougall, K., Nolan, F., Hudson, T. Telephone transmission and earwitnesses: Performance on voice parades controlled for voice similarity. Phonetica. 72 (4), 257-272 (2015).
- Nolan, F., McDougall, K., Hudson, T. Some acoustic correlates of perceived (dis) similarity between same-accent voices. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2011). , 1506-1509 (2011).
- Sheoran, S., Mahna, D. Voice identification and speech recognition: an arena of voice acoustics. Eur Chem Bull. 12 (5), 50-60 (2023).
- Hudson, T., McDougall, K., Hughes, V. Forensic phonetics. The Cambridge Handbook of Phonetics. Knight, R. -A., Setter, J. , Cambridge University Press. 631-656 (2021).
- Eriksson, A. The disguised voice: Imitating accents or speech styles and impersonating individuals. Language and identities. Llamas, C., Watt, D. , Edinburgh University Press. 86-96 (2010).
- Köster, O., Schiller, N. Different influences of the native language of a listener on speaker recognition. Forensic Linguistics. 4 (1), 18-27 (1997).
- The influence of native-language background on speaker recognition. Köster, O., Schiller, N., Künzel, H. Proceedings of the International Congress of Phonetic Sciences (ICPhS 1995), , 306-309 (1995).
- Thompson, C. P. A language effect in voice identification. Applied Cognitive Psychology. 1, 121-131 (1987).
- San Segundo, E., Univaso, P., Gurlekian, J. Sistema multiparamétrico para la comparación forense de hablantes. Estudios de Fonética Experimental. 28, 13-45 (2019).
- Council of Europe. Common European Framework of Reference for Languages: Learning, Teaching, Assessment. , Press Syndicate of the University of Cambridge. (2001).
- How to use Tascam DR-100 MKII: Getting started. , https://www.youtube.com/watch?v=O2E72uV9fWc (2018).
- Getting the most from your Shure SM58 microphone. , https://www.youtube.com/watch?v=wweNufW7EXA (2020).
- Kisler, T., Reichel, U. D., Schiel, F. Multilingual processing of speech via web services. Computer Speech & Language. 45, https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/WebMAUSBasic 326-347 (2017).
- Escudero, P., Boersma, P., Rauber, A., Bion, R. A cross-dialect acoustic description of vowels: Brazilian and European Portuguese. J Acoust Soc Am. 126 (3), 1379-1393 (2009).
- Post-aspiration in standard Italian: some first cross-regional acoustic evidence. Stevens, M., Hajek, J. Proceedings 11th Conference of the International Speech Communication Association (INTERSPEECH 2010), , 1557-1560 (2011).
- Barbosa, P., Madureira, S. Manual de Fonética Acústica Experimental: aplicações a dados do português. , Cortez. (2015).
- Boersma, P., Weenink, D. Praat: Doing phonetics by computer. (Version 6.1.38) [Computer program]. , https://www.praat.org/ (1992-2021).
- Silva, L. Jr VVUnitAligner. [Computer program]. , https://github.com/leonidasjr/VVunitAlignerCode_webMAUS (2022).
- Silva, L. Jr, Barbosa, P. A. SpeechRhythmExtractor [Computer program]. , https://github.com/leonidasjr/VowelCode (2019-2023).
- R Core Team. A language and environment for statistical computing. R Foundation for Statistical Computing. , https://www.R-project.org/ (2023).
- Pigoli, D., Hadjipantelis, P. Z., Coleman, J. Z., Aston, J. The statistical analysis of acoustic phonetic data. Journal of the Royal Statistical Society. 67 (5), 1103-1145 (2018).
- Barbosa, P. A. CreateLineup [Computer program]. , https://github.com/pabarbosa/prosody-scripts-CreateLineUp (2021).
- Van Rossum, G., Drake, F. L. Python 3 Reference Manual. , CreateSpace. (2009).
- Silva, L. Jr AcousticSimilarity_cosine_euclidean. [Computer program]. , https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py (2024).
- Automatic assessment of voice similarity within and across speaker groups with different accents. Gerlach, L., McDougall, K., Kelly, F., Alexander, A. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023), , 3785-3789 (2023).
- Gahman, N., Elangovan, V. A comparison of document similarity algorithms. International Journal of Artificial Intelligence and Applications. 14 (2), 41-50 (2023).
- San Segundo, E., Tsanas, A., Gómez-Vilda, P. Euclidean distances as measures of speaker similarity including identical twin pairs: A forensic investigation using source and Filter voice characteristics. Forensic Science International. 270, 25-38 (2017).
- Speaker's voice characteristics and similarity measurement using Euclidean distances. Singh, M. K., Singh, N., Singh, A. K. Proceedings of the International Conference on Signal Processing and Communication (ICSC 2019), , 317-322 (2019).
- Darling-White, M., Banks, W. Speech rate varies with sentence length in typically developing children. J Speech Lang Hear Res. 64 (6), 2385-2391 (2021).
- Barbosa, P. A. Incursões em torno do ritmo da Fala. , Pontes Editores. (2006).
- Golestani, N., Pallier, C. Anatomical correlates of foreign speech sound production. Cereb Cortex. 17 (4), 929-934 (2007).
- Trouvain, J., Fauth, C., Möbius, B. Breath and non-breath pauses in fluent and disfluent phases of German and French L1 and L2 read speech. Proceedings of Speech Prosody. , 31-35 (2016).
- Waaning, J. The Lombard effect: the effects of noise exposure and being instructed to speak clearly on speech acoustic parameters. [Master's thesis]. , Radboud University. (2021).
- Villegas, J., Perkins, J., Wilson, I. Effects of task and language nativeness on the Lombard effect and on its onset and offset timing. J Acoust Soc Am. 149 (3), 1855(2021).
- Differences between native and non-native Lombard speech in terms of pitch range. Proceedings of the 23rd International Congress on Acoustics(ICA 2019). Marcoux, K., Ernestus, M. , 5713-5720 (2019).
- Marcoux, K., Ernestus, M. Pitch in native and non-native Lombard speech. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2019). , 2605-2609 (2019).
- Marcoux, K., Ernestus, M. Acoustic characteristics of non-native Lombard speech in the DELNN corpus. Journal of Phonetics. 102, 1-25 (2024).
- Gil, J., San Segundo, E. La cualidad de voz en fonética judicial [Voice quality in judicial phonetics]. Lingüística Forense: la Lingüística en el ámbito legal y policial. Garayzábal, M., Jiménez, M., Reigosa, M. , Euphonía Ediciones. 154-199 (2014).
- Gil, J., San Segundo, E. El disimulo de la cualidad de voz en fonética judicial: Estudio perceptivo de la hiponasalidad [Voice quality disguise in judicial phonetics: A perceptual study of hyponasality. Panorama de la fonética española actual. Penas-báñez, M. A. , Arco Libros. 321-366 (2013).
- Passeti, R., Madureira, S., Barbosa, P. What can voice line-ups tell us about voice similarity. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 3765-3769 (2023).
- Nolan, F. The DyViS database: Style-controlled recordings of 100 homogeneous speakers for forensic phonetic research. International Journal of Speech Language and the Law. 16 (1), 31-57 (2009).
- Caroll, D. Psychology of Language. , Wadsworth. (1994).
- Ortega-Llebaria, M., Silva, L. Jr, Nagao, J. Macro- and micro-rhythm in L2 English: Exploration and Refinement of Measures. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 1582-1586 (2023).
- Fernández-Trinidad, M. Hacia la aplicabilidad de la cualidad de la voz en fonética judicial. Loquens. 9 (1-2), 1-11 (2022).
- Brouwer, S. The role of foreign accent and short-term exposure in speech-in-speech recognition. Atten Percep Psychophys. 81, 2053-2062 (2019).
- Love, R., Wright, D. Specifying challenges in transcribing covert recordings: Implications for forensic transcription. Front Commun. 6, 1-14 (2021).
- Meer, P. Automatic alignment for New Englishes: Applying state-of-the-art aligners to Trinidadian English. J Acoust Soc Am. 147 (4), 2283-2294 (2020).
- Montreal Forced Aligner: trainable text-speech alignment using Kaldi. McAuliffe, M., Socolof, M., Mihuc, S., Wagner, M., Sonderegger, M. Proceedings 18th Conference of the International Speech Communication Association (INTERSPEECH 2017), , 498-502 (2017).
- Chodroff, E. Montreal Forced Aligner: MFA Tutorial. , https://zenodo.org/records/7591607 (2023).
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
הדפסות חוזרות והרשאות
גלה מאמרים נוספים
