מחקר זה בוחן האם גורמי שיווק זוגיים משפרים את מערכות המלצות הספורט לאוהדי ליגת העל הסינית. שילוב של שביעות רצון, אמון, מחויבות והדדיות משפר משמעותית את דיוק ההמלצות ב-Top-N, במיוחד בתנאים דלילות וזנב ארוך. התוצאות מראות שמחויבות והדדיות מניעות התנהגות חוזרת של מעורבות גבוהה, בעוד שביעות רצון ואמון תומכים בעיקר במעורבות מוקדמת.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
מערכות המלצה חכמות לחיזוי התנהגות צריכת אוהדים בליגת העל הסינית
במאמר זה
סיכום
תקציר
הבנה וחיזוי התנהגות צריכה של האוהדים היא אתגר מרכזי בספורט מקצועני, אך רוב מערכות ההמלצה מסתמכות בעיקר על אינטראקציות היסטוריות ומתמקדות בתשומת לב מוגבלת לגורמים שיווקיים במערכות יחסים שמעצבים את מעורבות האוהדים. כדי להתמודד עם הפער הזה, מחקר זה מפתח את MLP-PA (Perceptron רב-שכבתי עם Pyramid Attention) ובוחן האם שילוב מצבי היחסים של האוהדים — כגון שביעות רצון, אמון, מחויבות והדדיות — יכול לשפר את יעילות ההמלצות במגוון תרחישי צריכה בקרב אוהדי ליגת העל הסינית (CSL). באמצעות מאגר נתונים רב-תרחישי הכולל כרטיסים, מרצ'נדייז, חברות ותוכן דיגיטלי, תוצאות אמפיריות מראות שההמלצות שנוצרות על ידי MLP-PA משיגות דיוק גבוה משמעותית בדירוג Top-N מאשר שיטות סינון שיתופיות מסורתיות, עם שיפורים בולטים במיוחד בהגדרות דלילות וארוכות זנב. הניתוח מגלה עוד כי גורמי יחסים שונים קשורים לדפוסי צריכה שונים: מחויבות והדדיות קשורים חזק יותר להתנהגויות חוזרות ומעורבות גבוהה, בעוד שביעות רצון ואמון משפיעים בעיקר על תגובות ראשוניות וקצרות טווח. ממצאים אלו מראים כי גורמי שיווק במערכות יחסים ממלאים תפקיד מהותי ומובחן בהתנהגות צריכת האוהדים, ומציעים תובנות מעשיות לאסטרטגיות מעורבות מותאמות אישית ותפעול דיגיטלי בכדורגל מקצועני.
מבוא
בשנים האחרונות, מערכות המלצה הפכו לרכיב מרכזי בפלטפורמות דיגיטליות, המאפשרות יישור בין משתמשים, מוצרים והקשרי צריכה באמצעות התאמה אישית מונחית נתונים. בעוד שטכנולוגיות המלצה מבוססות היטב בתחומים כמו מסחר אלקטרוני ומדיה מקוונת, היישום שלהן בספורט מקצועני נותר פחות מפותחיחסית 1. בליגות כמו ליגת העל הסינית (CSL), התנהגות צריכת האוהדים היא תלויה מאוד להקשר ומתפתחת בין שלבי לפני המשחק, יום המשחק ואחריו, כאשר החלטות הרכישה משולבות באופן הדוק עם נוכחות לא מקוונת, היקשרות רגשית וזהות חברתית. עם זאת, רוב המחקרים הקיימים על ממליצי ספורט מאמצים בעיקר סינון שיתופי או טכניקות מבוססות תוכן מתחומים אחרים ומתמקדים באותות אינטראקציה קצרי טווח, כגון קליקים או רכישות. גישות אלו מתעלמות במידה רבה מהדינמיקות הקשורות בין אוהדים למועדונים — כגון אמון, מחויבות או הדדיות — שידועות במחקר שיווק ספורט כמעצבות מעורבות ארוכת טווח וצריכה חוזרת2. כתוצאה מכך, המודלים הנוכחיים מתקשים להסביר מדוע היסטוריות התנהגותיות דומות עשויות להוביל לתוצאות צריכה שונות במצבים יחסיים שונים. פער זה מדגיש את הצורך במסגרות ממליצות שמתרחבות מעבר לתדירות האינטראקציה ומתחשבות במפורש במנגנונים מונחי מערכות יחסים בקבלת החלטות של מעריצים3.
מנקודת מבט של שיווק מערכות יחסים, שביעות רצון, אמון, מחויבות והדדיות מהווים יחד איכות מערכת יחסים ומבוססים היטב כמניעים לתוצאות מפתח בקרב האוהדים, כולל נוכחות במשחקים, רכישות מוצרים, חידוש חברות ותמיכה מפה לאוזן 4,5,6. לעומת זאת, רוב מערכות המלצות הספורט הקיימות ממשיכות למודל אינטראקציות בין אוהד לפריט כאותות התנהגות הומוגניים ברובם, תוך מתן מעט תשומת לב להקשר היחסי שמאחורי אותן אינטראקציות. פישוט זה מגביל את יכולתם ללכוד כיצד גורמי יחסים שונים משפיעים באופן מובחן על שלבי צריכה ועוצמות מעורבות, ומסייע להסביר מדוע מודלים המבוססים אך ורק על היסטוריית אינטראקציה אינם מצליחים להבדיל בין תגובות קצרות טווח לבין התנהגות מעריצים מתמשכת ובעלת מעורבות גבוהה.
מבחינה הנדסית, מערכות ממליצי ספורט מתמודדות עם אתגרים נוספים, כולל משוב סמוי אסימטרי, דלילות חמורה בזנב ארוך, והקשרים הטרוגניים של אינטראקציה מרובת מגע7. גישות סינון שיתופיות מסורתיות ומודלים עמוקים חד-נתיביים לעיתים מציגים הכללה מוגבלת בהקשרים בהקשרים כאלה ומציעים מעט פרשנות לתמיכה בהחלטות בפעולות שיווק.
מבחינה מתודולוגית, מחקרי מערכות ממליצים קודמים הציעו מגוון פתרונות לטיפול בדלילות, הטרוגניות ואופטימיזציה ארוכת טווח. מודלים מבוססי גרף ומודלים מונעי קשב שיפרו את ביצועי הלמידה והדירוג הייצוגי על ידי שינוי משקל חשיבות השכנים ולכידת אינטראקציות מסדר גבוה 8,9. ארכיטקטורות היברידיות שמשלבות אותות שיתופיים עם למידה עמוקה הראו הישגים במשימות המלצה בקנה מידה גדול10. גישות מבוססות חיזוק-למידה מרחיבות עוד יותר את האופטימיזציה לעבר מטרות ארוכות טווח במקום דיוק קצר ראייה11. התקדמויות אלו מספקות יסודות מתודולוגיים חשובים למידול אינטראקציות מורכבות תחת משוב דל.
עם זאת, רוב הגישות הללו נשארות אגנוסטיות למבני שיווק מערכות יחסים ואינן משלבות במפורש משתנים כמו שביעות רצון, אמון, מחויבות או הדדיות בתהליך ההמלצה. מגבלה זו בולטת במיוחד בהקשרים של כדורגל מקצועני, שבהם מתפתחות מערכות יחסים בין אוהדים למועדון וידוע כי ממדים יחסים שונים שולטים בתוצאות התנהגותיות שונות (למשל, רכישה בפעם הראשונה לעומת נוכחות חוזרת) 12,13,14,15.
כדי להשלים את הפער הזה, אנו מציעים את MLP-PA (Multi-Layer Perceptron with Pyramid Attention), מסגרת המליצה מודעת לקשרים המותאמת לתרחיש הסופר ליג הסיני (CSL). בהתבסס על ארכיטקטורת סינון שיתופי עצבי (NCF) עם עמוד שדרה של Perceptron רב-שכבתי (MLP), המודל המוצע מתייחס לשביעות רצון, אמון, מחויבות והדדיות כתכונות יחסיות מהשורה הראשונה ומשלב אותם בערוץ מוקדם מבוסס קשב. מודול קשב תכונות פירמידה משמש למיזוג מאוחר כדי להגביר באופן סלקטיבי דפוסי אינטראקציה בולטים בקנה מידה מרובים תוך שילוב ייצוגים של מאוורר, פריט והקשר. על ידי מידול מפורש של משתני קשר לצד מאפייני אינטראקציה לא ליניארית, MLP-PA שואף לשפר הן את דיוק החיזוי והן את יכולת הפרשנות בהמלצות ספורט.
הערכה אמפירית על מאגר נתונים CSL שנבנה בעצמו מראה שהגישה המוצעת עולה בעקביות על קווי בסיס קלאסיים, כולל UserCF, ItemCF ו-MF-BPR, במדדי דירוג Top-N. ניתוח נוסף של וריאנטים של מודל מצביע על כך ששילוב תשומת לב מודעת למערכות יחסים מסייע להפחתת דלילות זנב ארוך והטרוגניות הקשרית. התוצאות גם חושפות תפקידים מובחנים של גורמים יחסיים. מחויבות והדדיות קשורים יותר להתנהגויות חזרתיות ובעלות מעורבות גבוהה, בעוד שביעות רצון ואמון תומכים בעיקר בתגובות ראשונות וקצרות טווח.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
מחקר זה עושה שימוש ביומני אינטראקציה בין מעריצים-פריטים שלא זוהו ונתוני שאלונים אנונימיים שנאספו למטרות מחקר בלבד. לא ניגשו, נשמרו או עובדו מידע אישי מזהה. לפי הנחיות מוסדיות וארציות, מחקר זה לא דרש אישור פורמלי של ועדת אתיקה או הסכמה מדעת אישית.
הכנת מערך נתונים ונהלי ניסוי
שלב 1. הכנת נתונים ועיבוד מוקדם
הכנת מערכי נתונים ונהלי ניסוי תוכננו כדי להפוך יומני התנהגות גולמיים ותגובות סקר למאגר ניסויי מאוחד וניתן לשחזור, המתאים לאימון והערכה של מודלים. התהליך מתמקד בניקוי נתונים, אנונימיזציה, בניית תכונות, נרמול ויישור רשומות אינטראקציה עם משתנים הקשורים ליחסים. יומני אינטראקציה גולמיים נבדקו תחילה כדי להסיר רשומות לא שלמות ואירועים כפולים כדי להבטיח עקביות בנתונים. מזהי האוורר ומזהי הפריטים הוסמרו לאחר מכן באמצעות גיבוב כדי להגן על פרטיות המשתמש. צורות שונות של אינטראקציה, כולל גלישה, קליקים, רכישה ואימות נוכחות, מופו לאותות משוב מרומזים, כאשר כל אינטראקציה נצפתה טופלה כמקרה חיובי. משתנים הקשורים למערכת יחסים—שביעות רצון, אמון, מחויבות והדדיות—נאספו מתשובות לשאלונים וקושרו למזהי האוהדים המתאימים. ערכי שאלון חסרים טופלו באמצעות הקצאה ממוצעת באותה שכבת חברות כדי לשמור על מאפיינים ברמת הקבוצה. תכונות רציפות נורמליזציה באמצעות קנה מידה מינימלי-מקסי לטווח [0, 1] כדי להבטיח השוואה בין משתנים. לאחר עיבוד מוקדם, מערך הנתונים הסופי נשמר בקבצים מובנים שכללו מזהי מאווררים אנונימיים, מזהי פריטים, חותמות זמן, תגיות הקשריות ומשתני יחסים מנורמלים, אשר שימשו בעקביות בכל ההגדרות הניסיוניות.
תפוקה צפויה:
כתוצאה מתהליך זה, הפלטים כוללים טבלת אינטראקציה מנוקה, טבלה מנורמלת של משתני יחסים המיושרים למזהי מאווררים, וסיכום סטטיסטי המפרט את מספר המאווררים, הפריטים והאינטראקציות במאגר הנתונים הסופי.
שלב 2. חלוקת אימון/אימות/מבחן ודגימה שלילית
הנתונים מחולקים כרונולוגית ברמת המשתמש כדי למנוע דליפת מידע. לכל אוהד, האינטראקציה האחרונה שמורה לבדיקות, השנייה האחרונה לאימות, והאינטראקציות הנותרות לאימון. דגימות שליליות נוצרות על ידי דגימה אחידה של פריטים שאינם אינטראקטיביים מתוך קבוצת הפריטים. לכל אינטראקציה חיובית נלקח מספר קבוע של דגימות שליליות (יחס דגימה שלילי = 1:5) במהלך האימון. אותה בנייה של קבוצת מועמדים מיושמת בעקביות בכל המודלים.
תפוקה צפויה:
כתוצאה משלב זה, הפלטים כוללים מערכי נתונים של אימון, אימות ובדיקות מחולקים כרונולוגית, יחד עם רשימות דגימות שליליות שנוצרו מראש בהתאם ליחס הדגימה שנקבע.
שלב 3. סביבת תוכנה ויישום
כל הניסויים מיושמים בפייתון. אימון והערכת מודלים מתבצעים באמצעות PyTorch (גרסה ≥ 1.12). אופטימיזציה של היפרפרמטרים בייסיאניים מתבצעת באמצעות Optuna (גרסה ≥ 3.0). סקריפטים של אימון מתבצעים על תחנת עבודה המצוידת בכרטיס מסך NVIDIA יחיד (≥ זיכרון 8GB). קבצי הקונפיגורציה מציינים מסלולי מאגר נתונים, פרמטרי מודל והגדרות אופטימיזציה כדי להבטיח שחזוריות.
שלב 4. מבנה הדגם ומפרט פרמטרים
מודל MLP-PA מורכב משכבת הטמעה, עמוד שדרה פרספטרון רב-שכבתי, ערוץ יחס-קשב, ומודול מיזוג פירמידה לתשומת לב. הפרמטרים המרכזיים מוגדרים כך: ממד הטמעה = 32; שכבות נסתרות MLP = [64, 32]; פונקציית הפעלה = ReLU; אופטימייזר = אדם עם קצב למידה 0.001 ודעיכת משקל 1e-5. מודול תשומת הלב הפירמידה משתמש בשלושה סולמות איגוד עם גדלי גרעין {1, 2, 4} וצעד השווה לגודל הליבה. יחס הפחתת הקשב מוגדר ל-4. Dropout בקצב 0.3 מיושם כדי למנוע התאמת יתר. הפסקה מוקדמת מופעלת אם NDCG@10 האימות לא משתפר במשך 10 תקופות רצופות.
שלב 5. אימון ואופטימיזציה של היפרפרמטרים
המודל מאומן באמצעות הפסד דירוג בייסיאני מותאם אישית (BPR) זוגי. במהלך האימון, ביצועי האימות מנוטרים בסוף כל תקופה. חיפושי אופטימיזציה של היפרפרמטרים בייסיאניים על קצב למידה, גודל הטמעה, שיעור הנשירה, יחס דגימה שלילי ופרמטרים הקשורים לקשב. מטרת האופטימיזציה היא אימות NDCG@10. כל תצורה מועמדת מאומנת בעצירה מוקדמת כדי להפחית עלויות חישוביות.
תפוקה צפויה:
כתוצאה מתהליך זה, הפלטים כוללים נקודות ביקורת מודליות מיומנות, יומני ביצועי אימות, ותצורת ההיפרמטר האופטימלית שזוהתה באמצעות אופטימיזציה בייסיאנית.
שלב 6. הערכה ויצירת תוצאות
לאחר האימון, המודל הביצועי הטוב ביותר (המבוסס על NDCG@10 אימות ) מוערך על קבוצת הבדיקות. רשימות המלצות של Top N נוצרות לכל מאוורר, והביצועים נמדדים באמצעות HR@K ו-NDCG@K. ניתוחים נוספים, כולל מחקרי אבלציה ופרופיל קשב מותנה פאזה, מתבצעים באותו פרוטוקול הערכה כדי להבטיח השוואה.
קריטריוני השלמה
הפרוטוקול נחשב שלם כאשר מתקבלים הפלטים הבאים: 1) מודל MLP-PA מאומן במלואו עם היפרפרמטרים אופטימליים; 2) תוצאות HR@K ותוצאות NDCG@K של סט הבדיקות לכל מודלי הבסיס והאבלציה; 3) נקודות ביקורת של מודל, מדדי הערכה וקבצי קונפיגורציה שניתנים לשחזור. פלטים אלו מאפשרים יחד שכפול עצמאי של פרוטוקול מערכת הממליץ המוצע.
תיאוריית שיווק יחסי מחויבות-אמון
תורת המחויבות–אמון מזהה מחויבות ואמון כגורמים המרכזיים לאיכות מערכת היחסים. על ידי הפחתת אי-הוודאות העסקית וטיפוח אוריינטציה ארוכת טווח וכוונה שיתופית, גורמים אלה מקדמים המשכיות יחסית ויצירת ערך16. אמון משקף את אמונות האוהדים ביכולת, יושרה וטוב לב של המועדון, מה שמפחית סיכון נתפס ואסימטריית מידע. כתוצאה מכך, אמון גבוה יותר מאפשר מעורבות עם חיכוך נמוך עם המלצות מותאמות אישית, הרשאת נתונים ותהליכי תשלום, ובכך תומך בהתנהגויות בשלבים מוקדמים ובהתחייבות נמוכה לאורך משפך הקליק לרכישה. מחויבות, לעומת זאת, לוכדת את נכונות המעריצים להשקיע זמן, משאבים כספיים והיקשרות רגשית לשמירת הקשר למרות חלופות מתחרות או חוסר שביעות רצון זמנית17. מכיוון שהמחויבות קשורה קשר הדוק ליישור זהות, עלויות שקועות והשקעות ייעודיות, היא מספקת כוח הסבר יציב יותר להתנהגויות יקרות ומעורבות גבוהה, כגון רכישות חזרות, חידוש חברות, נוכחות באצטדיון והסברה מפה לאוזן18.
בהתבסס על הבחנות אלו, נגזר את ההשערות הבאות.
H1 (אמון → התנהגות תומכת): אמון גבוה יותר מפחית חיכוך בהחלטות וסיכון נתפס, ובכך מעלה את הסיכוי להתנהגויות שטחיות כמו קליקים, פעולות הרחבה לעגלה ורכישות ראשוניות.
H2 (יתרון יחסי של מחויבות): מבין ארבעת ממדי היחסים, המחויבות מציגה את כוח ההסבר השולי החזק ביותר להתנהגויות יקרות וארוכות טווח, כולל רכישות חוזרות, חידושים ונוכחות לא מקוונת, ותרומתה לביצועים חיזויים עולה על זו של שביעות רצון ואמון.
תורת ההחלפה החברתית
תיאוריית ההחלפה החברתית מדגישה שאנשים פועלים לפי נורמות של הדדיות והוגנות באינטראקציות חוזרות19. הדדיות נתפסת גורמת לאוהדים להרגיש שיש נתינה וקיחה מהמועדון בוויתורי ערך, תגובות רגשיות והקצאת משאבים. כאשר הדדיות נתפסת כאותנטית וברת קיימא, המעריצים נוטים יותר להחזיר דרך צריכה ונוכחות, ויוצרים לולאת משוב חיובית20. סיפוק הוא פונקציה של חוויות מצטברות ביחס לציפיות. באמצעות מנגנון ציפיות-אישור, היא מקדמת ציות קצר טווח והמלצה חיובית מפה לאוזן, ומספקת קרקע פורייה לפיתוח אמון ומחויבות21.
בהתאם לכך, אנו מסיקים:
H3 (שביעות רצון → התנהגות תומכת): שביעות רצון גבוהה מפחיתה חרטה ומגבירה את התגובה המיידית, ומגבירה רכישה והשתתפות לטווח קצר.
H4 (הדדיות → המרה ורכישה מחדש): במסגרת משחק חוזר, אותות הדדיות מגבירים את עוצמת החליפין של "אני מרוויח → אני מחזיר", ומשפרים משמעותית את שיעורי ההמרה והרכישה מחדש — במיוחד בהקשרים רגישים למחיר או מחסור.
בשילוב שתי התיאוריות, ארבעת הממדים מציגים הטרוגניות ברורה בהקשרים במסלולי ההשפעה שלהם:
בהקשרים של אי-ודאות או סיכון נתפס גבוה — מוצרים חדשים, תמחור דינמי, אישור/תשלום בהימור גבוה — האמון מפעיל השפעות שוליות חזקות יותר (תומך ב-H1).
בהקשרים ארוכי טווח/דביקים לזהות—כרטיסי עונה, משחקי בית רצופים, חידוש חברות—המחויבות שולטת (תומכת ב-H2).
בצמתים של התאמה עיקרית או מתחת לתמריצים/מחסור—הטבות מוגבלות, קידומים—הדדיות מעלה חזק יותר את ההמרה והרכישה מחדש (תומך ב-H4).
הסיפוק משמש כ"קרקע הבסיס", שמניע באופן חיובי התנהגויות קצרות טווח כמעט בכל ההקשרים (תומך ב-H3) ומחזק בעקיפין אמון ומחויבות על ידי שיפור איכות החוויה. במקום לבדוק את ההשערות הללו באמצעות מידול משוואות מבניות, אנו מזריקים את ארבעת הממדים לשכבת תשומת לב, מה שמאפשר למודל ללמוד משקלים הקונטקסטואליים ולאשר את המנגנונים בניסויים באבלציה.
MLP
הפרספטרון הרב-שכבתי (MLP) משמש כלומד העמוד השדרה לייצוג במסגרת שלנו.
(1) שכבת מיפוי קלט.
וקטור התכונה המקורי מורחב ליניארית פעם אחת על ידי מטריצת 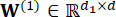 משקל והטיה b(1), ומניב
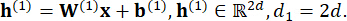 (1)
(2) שכבת לא-ליניאריות עמוקה.
אנחנו מערימים שכבות ליניאריות, הפעלה ונרמול. המיפוי הליניארי משתמש בטרנספורמציה אפינית מחוברת לחלוטין:
z = Wx + b, (2)
כאשר 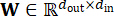 היא מטריצת המשקל,
 הוא וקטור ההטיה, x הוא פלט השכבה הקודמת, ו-z הוא הפלט הליניארי. כדי להתאים לתכונות ההפעלה של ReLU ולשמור על יציבות גרדיאנטים במהלך האימון, אנו מאמצים אתחול He עבור W:
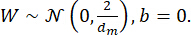 (3)
פונקציית ההפעלה היא ReLU, שמתאימה במיוחד לארכיטקטורות עמוקות22. כאשר x>0, הנגזרת של ReLU היא קבועה, מה שמקל ביעילות על בעיית הגרדיאנט האבוד הקשורה להפעלה של סיגמואידים וכך מאיץ התפשטות אחורית והתכנסות23. ReLU הוא גם פשוט חישובית (ללא מעריכיים) ודליל באופן טבעי (מפיק אפס עבור x<0), מה שמפחית תגובות נוירון מיותרות ומשפר את ההכללה. ההגדרה שלו היא24
σ(x) = מקסימום(0,x), (4)
בהחלה מבחינת אלמנט על הפלט הליניארי, מתקבלים:
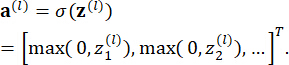 (5)
לאחר כל פעולת "הפעלה ליניארית →", אנו מציגים את נורמליזציה באצווה (BN) כדי לייצב גרדיאנטים ולהאיץ את ההתכנסות. BN מתקן באופן דינמי תכונות בכל מנה קטנה, מפחית שינוי משתנים פנימי, משפר יציבות אימון ומפחית את הרגישות לקצב הלמידה. ל-BN יש גם אפקט רגולריזציה קל בדומה להזרקת רעש, שמסייע למנוע התאמת יתר מבלי לפגוע בקיבולת הדגם.
יהי פלט המיני-אצווה הנוכחי , 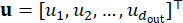 הטרנספורם BN עבור התכונה ה-j הוא
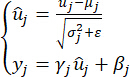 (6)
כאשר μ j ו-σj2 הם ממוצע האצווה והשונות של התכונה ה-j, ε הוא קבוע קטן ליציבות נומרית, ו-γj, βj הם פרמטרים ניתנים ללמידה בקנה מידה והזזה שמחזירים את ההבעה הלא-ליניארית של הרשת.
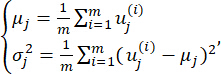 (7)
כאן m הוא גודל המיני-אצ', ε הוא קבוע קטן ליציבות נומרית, ו-γ j, βj הם פרמטרים ללמידה בקנה מידה/הזזה המשמשים לשחזור ההבעה הלא-ליניארית של הרשת לאחר הנרמליזציה.
(3) שכבת דחיסת תכונות
לאחר חילוץ תכונות עמוק, אנו מוסיפים שכבת דחיסת תכונות בסוף בלוק MLP כדי לשמור על מידע בולט תוך דיכוי כפילות, להפחית את העומס החישובי של המודולים הבאים ולספק רגולריזציה מתונה. יהי וקטור הקלט .  הפלט הדחוס הוא
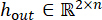 , עם פרמטרים
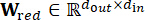 ,
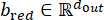 . הפעולה היא:
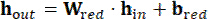 (8)
מנגנון תשומת לב פירמידה (PA)
יהי פלט שכבת MLP האחרונה . כדי לאפשר ברירה מפורשת על פני אינטראקציות לא ליניאריות מסדר גבוה יותר, אנו מסדרים
 מחדש תחילה לפי שדה/ערוץ למטריצה25:

 (9)
כאשר C הוא מספר הערוצים ו-L הוא האורך לכל ערוץ.
(1) בניית תכונות רב-קניות.
לאורך ציר התכונה L, יש להחיל איגוד חד-ממדי עם מספר סולמות כדי לקבל26
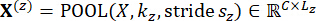 (10)
כאשר k וצעד מגדירים את סולם ה-S.
(2) ערוץ תשומת לב לפי סולם.
לכל סולם, בנה תיאור ערוץ ומשקלי קשב27:
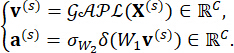 (11)
כאשר δ(⋅) הוא ReLU, σ(⋅) הוא סיגמואיד,
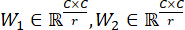 , r הוא יחס ההפחתתה.
החלו את המשקולות לפי ערוץ:
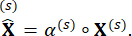 (12)
(3) מיזוג וכתיבת תגובה.
להקרין כל סולם עם GAPL למרחב חד-ממדי מאוחד ולמזג אותם:
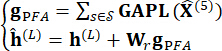 (13)
כאשר Ps הם משקלי מיזוג ו-Wr הוא הקרנה ללמידה המשמשת בכתיבה שאריתית.
ניקוד סופי:
 (14)
כאשר ⊙ מציין את מכפלת האדמארד (מבחינת איברים) ומציין  שרשור וקטורי.
פורמליזציה ולמידה של משימות ב-Top N
(1) הגדרת בעיות.
תן לערכת המעריצים להיות F וסט הפריטים I (כרטיסים, סחורה, הטבות חברות ותוכן). משוב  מרומז מציין אם המעריץ
 יצר אינטראקציה עם פריט
 (קליק, רכישה, נוכחות/אימות וכו'). הדגימות החיוביות בסט האימון הן
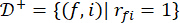 ,
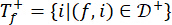 .
אנו מזריקים את ארבעת משתני שיווק היחסים — שביעות רצון, אמון, מחויבות, הדדיות — כוקטור: 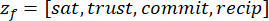 לשכבת הקשב כדי לקבל ייצוג
 מערכת יחסים מודע להקשר, אשר משולב עם הטמעות/
 פריטים ליצירת הציון
 . עבור כל זוג
 חיובי , אנו מציירים מספר שליליים ביחס קבוע מ-
 ל- לצורה
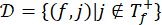 .
(2) מטרה זוגית.
כדי לאופטימיזציה ישירה של דירוג יחסי, אנו משתמשים ב-BPR (דירוג בייסיאני מותאם אישית)28:
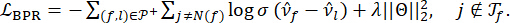 (15)
כאן 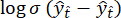 מבטא את הסבירות ש"הציון החיובי עולה על הציון השלילי";
 הוא רגולרייזר L2 לשליטה בהתאמת יתר;
 מציין את כל הפרמטרים הניתנים ללמידה.
(3) הסקה ודירוג.
בזמן המבחן, קבוצת המועמדים היא 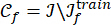 . אנו מחשבים ציונים , ומחזירים את רשימת ה-Top-N29:
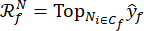 (16)
עיצוב אלגוריתם המלצות
סעיף זה מתאר את תהליך ההמלצה המלא ששימש במחקר זה, ומכסה את הצינור מקצה לקצה מהעיבוד המוקדם של הנתונים ועד להכשרת מודלים והסקה מקוונת. תהליך העבודה מסביר כיצד נתוני אינטראקציה גולמיים בין אוהד לפריט ומשתני קשר הופכים לציוני דירוג מותאמים אישית באמצעות למידת ייצוג ומודלים מבוססי קשב. ההליך המפורט מתואר כך.
שלב 1: הכנת נתונים ונרמול.
יומני אינטראקציה בין מאוורר לפריט CSL הופכים לאותות משוב מרומזים. ערכים חסרים מטופלים, וארבעת משתני הקשר — שביעות רצון, אמון, מחויבות והדדיות — מנורמלים. הנתונים מחולקים כרונולוגית לקבוצות אימון, אימות ובדיקות, ונוצרות מספר דגימות שליליות בכל אינטראקציה חיובית.
שלב 2: קידוד קשב במערכת יחסים.
ארבעת משתני היחסים מוזנים למודול קשב כדי ללמוד משקלי חשיבות מודעים להקשר, ויוצרים ייצוג קומפקטי של יחסי מאוורר למידול במורד הזרם.
שלב 3: בניית קלט אינטראקציה.
הטמעות-מאוורר ופריט נלמדות ומשולבות עם ייצוג היחסים ליצירת וקטור התכונה המלא לכל אינטראקציה בין מאוורר-פריט.
שלב 4: למידת ייצוג.
תכונות האינטראקציה מועברות דרך ענף MLP כדי ללכוד דפוסים לא ליניאריים מסדר גבוה וליצור ייצוג סמוי מאוחד.
שלב 5: תשומת לב לתכונות פירמידה.
פירמידת תכונות רב-קנה מידה נבנית מעל פלט ה-MLP. מיושמים תשומת לב לפי ערוץ ומיזוג במגוון קנה מידה, ותכונות משודרגות משולבות באמצעות חיבורים שאריתיים להגברת ערוצים בולטים תוך דיכוי ערוצים מיותרים.
שלב 6: ניקוד ותפוקה.
הענף הליניארי מחובר לייצוג הלא-ליניארי המשופר ומוזן לשכבת הפלט כדי לחשב ציון העדפה לכל זוג מאוורר-פריט.
שלב 7: אימון ואופטימיזציה.
המודל מותאם באמצעות יעד דירוג זוגי. אופטימייזר אדפטיבי משמש יחד עם ירידה במשקל, ירידה והפסקה מוקדמת כדי לשפר הכללה ולהפחית התאמת יתר.
שלב 8: אופטימיזציה של היפרמטר בייסיאני.
מדדי דירוג אימות משמשים כמטרה לחיפוש אוטומטי של היפרפרמטרים מרכזיים, כולל ממדי הטמעה, עומק ורוחב הרשת, קצב למידה, יחס דגימה שלילי, שיעור נשירה ופרמטרים הקשורים לפירמידה ותשומת לב.
שלב 9: הסקה ודירוג.
במהלך הסקה מקוונת, מחושבים ציוני העדפה לכל מעריץ על פני פריט המועמד כדי לייצר המלצות ל-Top-N, כאשר אסטרטגיות דירוג אופציונליות מיושמות כדי להתחשב ברעננות, גיוון ומגבלות עסקיות.
אימות ניסויי
מערך נתונים וסכימת תכונות
אנו מעריכים על בסיס מאגר נתונים שנבנה בעצמנו שמחבר (באמצעות מזהי אוהדים מגובבים) ללוגי מערכת מידע של מועדון CSL שדה-זהה של אינטראקציות מרומזות בין אוהדים לפריט לסקר יחסים עכשווי. הנתונים מכסים ארבעה תחומי עסק — כרטיסים, מרצ'נדייז, חברות ותכנים — וכוללים גלישה, קליק, הוספה לעגלה/מועדפים, רכישה/כרטיסים, ואירועי אימות באצטדיון, עם חותמות זמן, ערוץ מגע, תגי הקשר ודגלי קידום. התקופה היא ≥ עונה מלאה אחת; הקנה מידה הוא בסדר גודל של מאווררים, פריטים ואירועים שמספקים למידול עמוק.
סכמת תכונות וקידודים: Items-ItemID, ItemType, TeamTag, PriceBand (הטמעות/קטגוריות); מעריצים—FanID, אזור, דרגת חברות, קביעות (FanID נלמד כהטמעה; תחומים קטגוריים/מספריים אחרים סטנדרטיים); תכונות RQ — שביעות רצון, אמון, מחויבות, הדדיות שהוגדלו ל-[0,1] והוזנו לערוץ תשומת הלב, ואז התמזגו עם ייצוגים של MLP דרך PA; הקשר—PhaseTag, ערוץ, דגל קידום, שעה, ימי חול (קטגוריות כהטמעות; תכונות זמן עם קידוד סינוסואידלי/cos).
אופטימיזציה של היפרפרמטרים
היפרפרמטרים המרכזיים של MLP-PA מכוונים באמצעות אופטימיזציה בייסיאנית במרחב חיפוש מוגדר מראש, תוך שימוש ב-NDCG@10 בסט האימות כמטרה ראשית (עם HR@10 כהתייחסות) ועצירות מוקדמות כדי לצמצם התאמת יתר. כל תצורת מועמדים מתבצעת תחת מספר זרעים אקראיים וממוצעת. ההגדרות הסופיות המופעלות מדווחות בטבלה 1.
| היפרפרמטר | תיאור | טווח החיפוש | ערך נבחר |
| ממד הטמעה | גודל הטמעת מאוורר/פריט | {32, 64, 128} | 64 |
| שכבות נסתרות MLP | מספר שכבות MLP | {2, 3, 4} | 3 |
| יחידות נסתרות MLP | יחידות לכל שכבה נסתרת | {64, 128, 256} | 128 |
| שיעור הנשירה | הסתברות לנשירה | [0.1, 0.5] | 0.3 |
| קצב למידה | קצב הלמידה ההתחלתי | [1e-4, 1e-2] | 1.00E-03 |
| יחס דגימה שלילי | שליליים לכל מדגם חיובי | {1, 3, 5, 10} | 5 |
טבלה 1: הגדרות ההיפרמטר הסופיות של מודל MLP-PA
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
התכנסות ויציבות
כדי להעריך את התנהגות ההתכנסות ויציבות האימון של המודל המוצע, אנו משווים את ביצועי האימות שלו מול ממליץ סטנדרטי מבוסס MLP ללא קשב תכונות פירמידה או תשומת לב מודעת לקשרים, המשמש כמודל הבקרה. כל המודלים מאומנים תחת חלוקות נתונים זהות, הגדרות אופטימיזציה וקריטריוני עצירה זהים כדי להבטיח השוואה הוגנת.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
תרומות מושגיות ומתודולוגיות
מחקר זה תורם מבחינה מושגית על ידי מסגור מחדש של ממדי מערכת יחסים—שביעות רצון, אמון, מחויבות והדדיות—לא כתכונות עזר סטטיות, אלא כאותות יחסים רגישים להקשר, שהשפעתם משתנה בין שלבי המעורבות. המסגרת המוצעת מממשת את הרעיון הזה באמצעות מנגנון מבוסס קשב שמשקלל מחדש באופן דינמי רמזים יחסיים בשילוב עם ייצוגים התנהגותיים. בכך, היא מתקדמת מעבר להעשרת תכונות ומציגה דרך עקרונית להטמיע מבני שיווק מערכות יחסים בארכיטקטורות המלצות מ...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
למחבר אין ניגודי עניינים להצהיר עליהם.
תודות
המחבר רוצה להודות למבקרים האנונימיים על הערותיהם וההצעות הבונות שלהם, שסייעו לשפר את הבהירות והאיכות של כתב היד. הוא גם מודה לתמיכת הארגון המשתף פעולה במתן גישה לנתונים בהם השתמשו במחקר זה. כל דעות, ממצאים ומסקנות המובעות במאמר זה הן של המחבר ואינן משקפות בהכרח את עמדות המוסדות המסונפים.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Python | https://www.python.org | 3.9.10 | |
| מסגרת למידת עומק | PyTorch | https://pytorch.org | >= 1.12 |
| ספריית אופטימיזציה של היפר-פרמטרים | Optuna | https://optuna.org | >= 3.0 |
| חומרה | מעבד גרפי של NVIDIA | https://www.nvidia.com | GPU בודד, >= 8 GB זיכרון |
| מאגר נתונים | מאגר מאוורר CSL שנבנה בעצמו | N/A | עונה מלאה אחת או יותר; קנה מידה מספק לדוגמנות עמוקה |
| נתוני אינטראקציה | יומני אינטראקציה משתמעים בין מעריץ לפריט | N/A | לא ממוין בנפרד |
| נתוני סקר | נתוני שאלון על יחסים | N/A | לא ממוין בנפרד |
| שיטת עיבוד נתונים מוקדמת | אי-זיהוי מבוסס Hash | N/A | הוחל על מזהים של מעריץ ופריט |
| שיטת עיבוד נתונים מוקדמת | חיסום ממוצע בתוך דרגת חברות | N/A | הוחל על תגובות שאלון חסרות |
| שיטת עיבוד נתונים מוקדמת | נורמליזציה מינימלית-מקסימלית | N/A | טווח [0, 1] |
| אסטרטגיית פיצול נתונים | פיצול ברמת משתמש כרונולוגית | N/A | העדכני ביותר = בדיקה; השנייה העדכנית ביותר = אימות; השאר = אימון |
| דגימה שלילית | דגימה שלילית אחידה | N/A | יחס חיובי:שלילי = 1:5 |
| גב המודל | MLP (תפיסה רב שכבתית) | https://pytorch.org/docs/stable/nn.html | שכבות נסתרות [128, 64, 32] (מותאם) |
| מודול תשומת לב | ערוץ תשומת לב יחסים | N/A | מודול מותאם אישית |
| מודול מיזוג | תשומת לב פירמידה (PA) | N/A | קנה מידה של איחוי {1, 2, 4}, צעד = גודל גרעין, יחס הפחתה = 4 |
| אופטימייזר | Adam | https://pytorch.org/docs/stable/generated/torch.optim.Adam.html | שיעור למידה 0.001, פיחות משקל 1e-5 |
| רגולציה | Dropout | https://pytorch.org/docs/stable/generated/torch.nn.Dropout.html | קצב 0.3 |
מקורות
- Wang, L., et al. Drug combination recommendation model for systemic lupus erythematosus and antiphospholipid syndrome. Pharmaceutics. 18 (8), 1224(2025).
- Hu, X., Yuan, Z., Ma, Z. A robot control knowledge recommendation model PKGAT based on multimodal knowledge graph. Int J Softw Eng Knowl Eng. 35 (8), (2025).
- Ji, S. An intelligent recommendation model for disclosure of electricity market entities based on association rule mining algorithm. Electr Eng. , In press (2025).
- Xie, F., et al. Differential weighting and flexible residual GCN-based contrastive learning for recommendation. Symmetry. 17 (8), 1320(2025).
- Duan, J., et al. A deep recommendation model based on semantic information and correlation between items. J Intell Inf Syst. , In press (2025).
- Malakhatka, E., et al. Optimal time recommendation model for home appliances: HSB Living Lab dishwasher study. Energy Effic. 18 (1), 3(2024).
- Yuan, Q., Cong, G., Ma, Z., Sun, A., Magnenat-Thalmann, N. Time-aware point-of-interest recommendation. Proc Int ACM SIGIR Conf Res Dev Inf Retr, 36, 363-372 (2013).
- Alaoui, E. D., et al. Comparative study of filtering methods for scientific research article recommendations. Big Data Cogn Comput. 8 (12), 190(2024).
- Li, X., Hu, G. Design and implementation of an electronic journal resource recommendation system integrating user profile and knowledge graph. Front Comput Intell Syst. 10 (2), 74-78 (2024).
- Sami, A., et al. A deep learning-based hybrid recommendation model for internet users. Sci Rep. 14 (1), 29390(2024).
- Zhonghua, W. Intelligent recommendation model of tourist places based on collaborative filtering and user preferences. Appl Artif Intell. 37 (1), (2023).
- Wang, Q., Esquivel, A. J. Personalized movie recommendation system based on DDPG: Application and analysis of reinforcement learning in user preferences. Front Soc Sci Technol. 5 (18), (2023).
- Miao, L., et al. Study on two-tier EV charging station recommendation strategy under multi-factor influence. J Artif Intell. 5, 181-193 (2023).
- Yunni, X., et al. A quasi-Newton matrix factorization-based model for recommendation. Int J Web Serv Res. 20 (1), 1-15 (2023).
- Mourad, J., et al. Personalized PV system recommendation for enhanced solar energy harvesting using deep learning and collaborative filtering. Sustain Energy Technol Assess. 60, 103456(2023).
- Pfajfar, G., et al. Value of corporate social responsibility for multiple stakeholders and social impact: A relationship marketing perspective. J Bus Res. 143, 46-61 (2022).
- Khan, R. U., et al. The impact of customer relationship management and company reputation on customer loyalty: The mediating role of customer satisfaction. J Relatsh Mark. 21 (1), 1-26 (2022).
- Sheth, J. New areas of research in marketing strategy, consumer behavior, and marketing analytics: The future is bright. J Mark Theory Pract. 29 (1), 3-12 (2021).
- Mishra, M., Mund, P. Fifty-two years of consumer research based on social exchange theory: A review and research agenda using topic modeling. Int J Consum Stud. 48 (4), e13074(2024).
- Cook, K. S., Hahn, M. Social exchange theory: Current status and future directions. Theor Sociol. 50, 179-205 (2021).
- Naseer, A., Jalal, A. Multimodal objects categorization by fusing GMM and multilayer perceptron. Proc 5th Int Conf Adv Comput Sci (ICACS), , 1-7 (2024).
- Hussain, K., et al. Analyzing LULC transformations using remote sensing data: Insights from a multilayer perceptron neural network approach. Ann GIS. 30, 1-28 (2024).
- Mfetoum, I. M., et al. A multilayer perceptron neural network approach for optimizing solar irradiance forecasting in Central Africa with meteorological insights. Sci Rep. 14 (1), 3572(2024).
- Yu, Y., et al. Multi-scale spatial pyramid attention mechanism for image recognition: An effective approach. Eng Appl Artif Intell. 133, 108261(2024).
- Liu, H., et al. A deep convolutional neural network for the automatic segmentation of glioblastoma brain tumor: Joint spatial pyramid module and attention mechanism network. Artif Intell Med. 148, 102776(2024).
- Liu, M., et al. Vehicle object counting network based on feature pyramid split attention mechanism. Vis Comput. 40 (2), 663-680 (2024).
- Alvarado, O., et al. A systematic review of interaction design strategies for group recommendation systems. Proc ACM Hum-Comput Interact, 6 (CSCW2), 1-51 (2022).
- Zhao, Y. Design of garment style recommendation system based on interactive genetic algorithm. Comput Intell Neurosci. 2022, 9132165(2022).
- Nazer, L. H., et al. Bias in artificial intelligence algorithms and recommendations for mitigation. PLOS Digit Health. 2 (6), e0000278(2023).
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.