מתן משוב בצורת שני תכונות מבוססות סמנטיקה של NLP דרך מערכת המחשב והמשוב הכתוב של המורה שימש לשיפור שטף ונכונות הכתיבה באנגלית של התלמידים. התוצאות הראו תוצאות חיוביות לגבי הראשון.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
חקירת השפעת הערכת כתיבה אוטומטית באמצעות רשת עצבית עמוקה והערכה כתובה של מורים על ביצועי כתיבה באנגלית
במאמר זה
סיכום
תקציר
טכנולוגיות למידת שפה בסיוע מחשב השיגו את ההישגים הגדולים ביותר בלמידת שפה, במיוחד בהקשר של בינה מלאכותית (AI), בשנים האחרונות. ישנן טכנולוגיות שונות, כגון הערכת כתיבה אוטומטית (AWE להלן) וניקוד אוטומטי למאמרים (AES), הנחשבות לעמודי תווך בלמידת שפה, לא רק בתחום המחשב אלא גם בחינוך. ההערכה יכולה להתבצע רק בצורת ציונים הוליסטיים באמצעות טכנולוגיית AWE, שהייתה יעילה מאוד בשיפור למידת השפה ולכן אינה מספקת משוב מפורט או מעמיק. כדי לספק משוב כתיבה מפורט על שני מרכיבים עיקריים בשפה (כלומר, דקדוק ושטף), נבחנו מערכת יישום בעזרת מחשב הכוללת מודלים של רשת עצבית, ושתי שיטות עיבוד שפה טבעית מבוססות סמנטיקה (NLP להלן). לשם כך, 90 סטודנטים באוניברסיטאות פקיסטנים שלומדי אנגלית שנייה (ESL) הוקצו באקראי לקבוצות הביקורת, משוב המרצים וקבוצות הניסוי. ההערכה בסיוע מחשב כללה רשת עצבית. תוצאות מבחן ההשוואה בין מודל הבסיס של AWE לבין המדריכים שדרגו הראו מתאם בין המשוב בעזרת מחשב שהשתמש ברשתות עצביות אלו. ההשלכות של תוצאות כאלה טמונות בפדגוגיית כתיבת ESL, במיוחד במצבים שבהם דיוק לשוני ושטף מהווים אתגר.
מבוא
המשוב בכתיבה מתייחס לתכונות שונות של השפה, כגון ארגון, דקדוק, שטף, תוכן ומכניקה, ומאפשר ללומדים לכתוב מחדש או ליצור טקסט כתוב חדש 1,2,3. כיום, מורי כתיבה באנגלית הם מרוויחים משמעותיים בזכות השינויים וההתקדמות המהירים בלמידת שפה בעזרת מחשב (CALL להלן) והערכת כתיבה בעזרת מחשב בצורת AWE או AES ודירוג מאמרים כתובים4. בנוסף, הערכה ממוחשבת של כתיבת אנגלית מספקת משוב אבחוני על מרכיבים לשוניים כמו תוכן, דקדוק, אוצר מילים ועוד, ומספקת תגובות עדכניות, אישיות ואובייקטיביות לטקסט הכתוב של התלמידים. מערכת ה-AWE גם מסוגלת לתת תשובות כתובות ברורות לתלמידים כדי שיספוגו את הידע שנרכש מהתגובות הכתובות ויגדיל את היכולת הקוגניטיביתשל 6תלמידים.
המחקר הנוכחי התבסס על מחקר4, שהציע את הרעיון של למידת כתיבה אנגלית מבוססת מחשב רב-אסטרטגית, עם פרספקטיבה של תיאוריית משוב הכתיבה באנגלית ותהליך הניקוד האנליטי בראש. זה כלל מודלים נוספים מבוססי סמנטיקה של NLP ששילבו למידה עמוקה במשוב כתוב כדי להציע ניקוד משוב כתוב מורכב. היא מתייחסת למגבלות של טכנולוגיית AWE קודמת, שמדגישה רק את הניקוד ההוליסטי אך לא את הניקוד האנליטי והספציפי. כתוצאה מכך, זה קשור יותר להערכה מדויקת ומיידית עם ציונים תת-וכוללים בסדרת מרכיבים של מדדים לשוניים, כדי לשפר את למידת הכתיבה באנגלית בקרב תלמידים. מבין המאפיינים השונים של הבלשנות (כגון תוכן, מורכבות, נכונות, שוטפות), המחקר הנוכחי יבחן רק את השטף ואת ההיבט הדקדוקי של לומדי ESL בפקיסטן. לשם כך, המחקר הנוכחי מציע אסטרטגיה של טכנולוגיית NLP הכוללת שימוש ברשתות עצביות בליווי הערכת מורים.
בהקשר של לימוד השפה הפקיסטנית, תלמידים פקיסטנים נתקלים בקשיים בלמידת כתיבה באנגלית, אף על פי שהם רואים בלימוד אנגלית מקצוע חובה החל מכיתה א' ועד כיתה י"ד. כאן נכנסים לתמונה גורמים רבים, כמו קורסים שגויים ושימוש בשיטות ישנות להסברת הדקדוק. ברמת האוניברסיטה, מספר התלמידים שהמורים נדרשים ללמד הוא משמעותי למדי, שכן לסטודנטים יש מגוון רקעים הכולל מכללות ובתי ספר שונים. זה מאלץ את המורים להשקיע רוב הזמן בתיקון טעויות כתיבה של התלמידים, וזה מעלה את עומס העבודה לגדול מדי. מצד שני, התלמידים לקחו כמובן מאליו את המשוב הכתוב של המורים ולא השקיעו מאמצים לזהות את הטעויות ולתקןאותן 8.
מחקר טען כי שטף השפה מושפעת בעיקר מהעובדה שמכיוון שהתלמידים מפחדים לטעות, היא הופכת למחסום לכתיבה שוטפת, ולכן התלמידים מעדיפים להימנע מטעויות תכופות יותר מאשר לעסוק במחשבות. לעיתים יש התערבות של השפה האורדו בכתיבה האנגלית, בנוסף לגורמים הקשקיים נוספים. יתרה מזאת, השפה האורדו היא השפה הלאומית. כתוצאה מהגורמים ההקשריים הללו, המורים מתקשים לספק משוב מדויק, בזמן ועקבי לכל תלמיד כאשר התלמידים מייצרים תוצרים כתובים או עורכים את כתבי היד. בהתחשב בתיאוריה של הערכת הכתיבה, מחקר זה יוכל לעקוב אחרי המחקר המשתמש באסטרטגיית משוב אוטומטית לכתיבה מכנית במהלך השוואת הערכת המורה המסורתית, ולוקח את הניקוד האנליטי במקום ההוליסטי כדי להבטיח שהתלמידים יקבלו משוב מיידי על שני הממדים הלשניים המשמעותיים (כלומר דקדוק ושטף).
מוצרים תעשייתיים שונים של AWE ו-AES הופיעו, ביניהם Pigai.org, בינגו אנגלית, My Access, E-rater, I-write, Criterion ועוד. AES/AWE בשלב מוקדם של התפתחותו מאופיין בעיקר במערכת למידת מכונה מסורתית המבוססת על משפט בייס10, רגרסיה ליניארית11 ועוד. כיום, הפיתוח המורחב של למידה עמוקה, במיוחד טכנולוגיית רשתות עצביות, תרם רבות גם לתחום המשוב הכתיבה, כגון רשתות עצביות חוזרות או RNN12, זיכרון ארוך-טווחקצר 13, רשתות עצביות קונבולוציוניות (CNN)14, גישת BERT15. AWE גם נהנתה מאסטרטגיות קדם-הכשרה שהופעלו בתחילת NLP16. מחקרים רבים לקחו בחשבון פתרונות שונים המתמקדים ברשתות עצביות, כגון יצירת דגימות יריבות למטרת למידה, למידה באמצעות Multitask17, למידה באמצעות Self-Supervisor18, ו-Graph Algorithms19. חלקם הציעו טכניקות שונות להתמודדות עם בעיית המחסור בנתוני הכשרה לכתיבת משוב20. ישנם גם מודלים של ניקוד התורמים למודלים רבים של רשתות עצביות21.
תיקון שגיאות דקדוק (להלן GEC) הוא דרך עצמאית למשימות NLP, שיש לה יכולת לזהות ואז לתקן אוטומטית את שגיאות ההרכבה. תוכן המשימה של GEC קשור לזה של היבטי AWE. משימות AWE נחשבות כמתייחסות לאבחון שגיאות דקדוקיות, שרובן נדרשות להיות מודגשות בצורה הנכונה. עם זאת, מחקרי AWE נתנו פחות תשומת לב ל-GEC, ורק מעט מחקרים שילבו את מודל ה-GEC המוקדם בטכנולוגיית ה-AWE. בהתחלה, המחקר על GEC בוחר רוב הזמן ב-N-גרם22, ובמודלשפה 23 כולל BERT24 כדי לזהות ולתקן שגיאות דקדוקיות. עם זאת, הפתרונות הנ"ל לא הצליחו לפתור לחלוטין בעיות כמו אי-סדר והשמטת רכיבים. הארכיטקטורה של מקודד-מפענח25 השיגה את אותה הצלחה ב-GEC על ידי טיפול בבעיות שמודלים אחרים לא יכלו לטפל בהן בעבר. חשוב לציין שארכיטקטורות GEC מתקדמות השתמשו במודלים מרובים לפתרון בעיות, כולל גישות מבוססות טרנספורמר26.
מחקרים אחרים אישרו את היעילות של AES בהשוואה לדירוגים אנושיים בכל הנוגע להערכת כתיבת מאמרים27,28. מחקר29 הראה את השפעת ההערכה האוטומטית על שפת האנגלית של הלומדים. הממצאים הצביעו על כך שהערכה אוטומטית השפיעה לטובה על שטף הכתיבה באנגלית. לעומת זאת, מחקריםאחרים מתעלמים משיעור גילוי השגיאות הגבוה על ידי AES לעומת דירוגים אנושיים. מחקרים עדכניים מדגישים את היעילות הגוברת של כלים בסיוע בינה מלאכותית להערכת כתיבה בחינוך לשפות. אחד מהמחקרים הללו,31, ערך השוואה בין דירוג אוטומטי למשוב המורה בהקשר הלמידה של סטודנטים סינים.
התפקיד המהפכני של כלים מבוססי בינה מלאכותית בכתיבה אקדמית דווח באופן פעיל בספרות האחרונה. מחקר על יישום כלי כתיבה מונעים בינה מלאכותית כהשלמה לחינוך הכתיבה המסורתי של EFL מדגיש את החשיבות העליונה של שוויון הזדמנויות ותמיכה פרואקטיבית של מורים ביישום מוצלח של טכנולוגיה32. המחקרים שחקרו את AWE, כמו Pigai, הצביעו על מתאם חזק בין המשוב בתמיכת מחשבים לבין שיפור הכתיבה, התיקונים והכתיבה החדשה באנגלית כשפה שנייה33. מחקר נוסף הדגיש את היתרונות של אוטואנקודרים וריאציוניים (VAEs) המשפיעים לטובה על ההיבט של הכשרת כתיבה באנגלית אצל הלומדים ומקבלים משוב על רמות גבוהות יותר של למידה עמוקה, תוך התמחות בתכונות לשוניות שונות34. מחקר נוסף הציע שמערכות AWE עצביות יהיו יעילות לשימוש עם GEC מבוסס NLP, המשתמש בלמידה עמוקה כדי להציע הערכה מיידית35.
שיפור מערכות רב-סוכניות הוא שלב חשוב בפיתוח טכנולוגיות המסייעות בכתיבה. דוגמה לכך ש-AcademyCraft, המבוסס על למידה עמוקה, הוכיח יכולת לכתוב ולתת משוב מפורט, ובכך מאפשר תמיכה בכתיבה מבוססת בינה מלאכותית של EFL/ESL, על סכמות אנליטיות מורכבות36. למעשה, מחקרי למידת שפה מבוססי טכנולוגיה זיהו גם דפוסים מתפתחים מגוונים כמו למידה עמוקה, הערכה אוטומטית ומשוב סמנטי, עם ניתוח ביצועים שהראה עלייה הדרגתית ועקבית בדיוק הכתיבה, וכן מעורבות הלומדים37.
מודלים של טרנספורמר-LSTM הראו נטייה מסוימת לדירוגים אוטומטיים ומשוב על כתיבה באנגלית. ארכיטקטורות היברידיות אלו לקחו יחד את ההבנה הקונטקסטואלית של הטרנספורמרים יחד עם העיבוד הסדרתי של מערכות LSTM, והסיקו כי הן מראות דיוק משופר בדקדוק ובדירוגי קוהרנטיות ומספקות משוב מעודן יותר לדור38. התפיסה של מורי EFL לגבי כלי כתיבה בינה מלאכותית מדווחת בעקביות על שיפורים מדידים בארגון התוכן ובאיכות הכתיבה, תוך התמקדות בתפקיד הקריטי של עזרה פדגוגית בהפעלת התועלת של שילוב טכנולוגי39. יש פחות מחקרים שמשווים בין משוב ממורים למשוב הנתמך במחשב, ומרמזים על מודלים של למידה עמוקה לבחינת ההשפעה על כתיבת אנגלית של לומדי ESL מבחינת שטף ודקדוק.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
כל התוכנות והכלים ששימשו במחקר מופיעים בטבלת החומרים.
קריטריוני דירוג
הסיווג של ההערכה שאומץ במחקר הנוכחי עוסק בשני תחומים עיקריים: שטף ונכון, הכוללים את כל הדרישות להערכה מקיפה של כתיבה באנגלית כשפה זרה (EFL). ממדים אלו נועדו למדוד את הנקודות המרכזיות באיכות הכתיבה המסייעות בתקשורת יעילה ובהדגמת מיומנות בשליטה בשפה. מודול השטף מודד טבעיות, הבעה וקוהרנטיות בכתיבה על ידי מדידת חלקות הרעיונות וכן עד כמה מילים ומבנה משפטים משתמשים בהם. מודול הנכונות מתמקד בדיוק דקדוקי מדויק, שלמות מכנית ועמידה במוסכמות האנגלית הסטנדרטיות, ובאופן היפותטי מודד וסופר את שגיאות השפה בכמה רמות. (ראו טבלה 1)
הגדרת משימה
בהתאם לתנאי הערכת כתיבה אוטומטית של תלמידים הלומדים את השפה האנגלית, המחקר הנוכחי מציע מודל חדש של מערכת הערכת כתיבה אנגלית בסיוע מחשב של EG. בהשוואה למחקרים הקודמים, שהוגבלו על ידי היקף מערכות הערכת כתיבה אוטומטיות, המערכת המוצעת תסייע לפתור מגבלות אלו באמצעות הכנסת טכניקות למידה עמוקה חדשניות שיאפשרו למשתמשים רמת ניתוח לשוני, היקף שינוי וניתוח משוב מערכתי המבוסס על עיבוד נתונים נרחב. לפי שניים מהמדדים המשמעותיים ביותר של יצירה, כלומר, שטף (עד כמה היצירה טבעית, קוהרנטית ובעלת הבעה בטבעה), או נכונות (עד כמה נכון הטקסט, המלא בשגיאות דקדוקיות, מכניות ולשוניות), עם הרכיבים הנפרדים של רשתות העצביות, מערכת המודל הכפול צריכה לבצע מספר הערכות. בנוסף, הוא מזהה טעויות ברמות לשוניות שונות, ממליץ על אמצעי תיקון, ומספק משוב ברשימה כדי לאפשר למשתמשים לשפר את לימוד השפה של התלמידים בצורה שיטתית. כדי לתאר את תהליך חישוב מערכת ההערכה האוטומטית בעזרת מחשב, אנו מציעים את המודל המתמטי הבא בנוסחאות (1)–(4) (ראו טבלה 2).
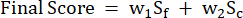 (1)
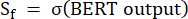 (2)
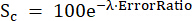 (3)
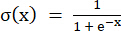 (4)
כאשר: ציון סופי = ציון הערכת הכתיבה המשולב; W1 = משקל שהוקצה לציון שטף; w2 = משקל שהוקצה לציון נכונות; Sf = ציון שטף מבוסס BERT (מנורמל ל-[0, 1]); Sc = ציון נכונות דעיכה מעריכית; λ = עונש שגיאה קבוע לדעיכה; σ(x) = פונקציית הפעלה לוגיסטית של סיגמואיד; ErrorRatio = יחס השגיאות לסך הטוקנים בטקסט. ציוני השטף מנורמלים ל-[0, 1] על ידי פונקציית הסיגמואיד הלוגיסטית σ(x) בעוד שפונקציית הדעיכה האקספוננציאלית משמשת לניקוד נכונות כדי להטיל עונש מתאים על תדירות השגיאות.
ארכיטקטורת מערכת ועיצוב
ארכיטקטורת המערכת שלו משתמשת במערכת דו-מודלית עם ארכיטקטורת עיבוד מקבילית, שבה ניתוח מאמרי קלט מתבצע במקביל דרך מסלולי הערכה מקבילים. מודולי השטף והנכון, בתורם, מניבים ציונים מתאימים, והציון המשולב הסופי הוא הממוצע המשוקלל של שני תת-הציונים. מודול הנכונות מציע גם הצעה לזיהוי ותיקון שגיאות, בנוסף לניקוד (ראו איור 1).
מודול השטף
שטף כתיבה ניתן להגדיר כאופי או דפוס השימוש בשפה מבחינת בחירה נכונה של אוצר מילים, מגוון מבנה המשפט, מורכבות תחבירית, קוהרנטיות ועוד. מודלים של הערכת שטף לוכדים רעיונות שמועברים ללא גמגום או מבוכה, ונשמעים קרובים למגמות התקשורת המקומיות. מדידת שטף מסורתית מבוססת על סולמות, המדגישה חששות אמינות בין המערכים. המערכת המוצעת מתגברת על חיסרון זה בכך שהיא כוללת רשת עצבית מבוססת BERT שמעוררת קוהרנטיות סמנטית וטבעיות לשונית אוטומטית באמצעות הבנה סיטואציונית עמוקה. החלטה אדריכלית זו התקבלה בהתחשב בחוזקות של BERT, שנמצא כיעיל בזיהוי קשרים קונטקסטואליים ודפוסים סמנטיים הנדרשים למדידת שטף. רצפי קלט מוזנים למערכת ומועברים דרך 12 שכבות שנאי עם תשומת לב עצמית מרובת ראשים לזיהוי תלות ארוכת טווח ויחסים קונטקסטואליים (ראו איור 2).
מנגנון תשומת הלב יהיה כדלקמן:
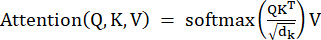 (5)
יהי Q, K ו-V המטריצות שמייצגות שאילתה, מפתח וערך, בהתאמה, ו-d ו-k הם הממדים של וקטורי המפתח. הטמעת אסימון CLS היא הסיכום, שמתעד את הקוהרנטיות הסמנטית הכוללת של רצף הקלט כולו.
חישוב ציון השטף הוא כדלקמן:
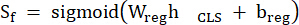 (6)
כאשר hCLS הוא הטמעת הטוקן של BERT [CLS], ו-Wreg הם bרגול הפרמטרים של ראש הרגרסיה, ו-σ היא פונקציית ההפעלה הסיגמואידי שמנרמל את הפלט ל-[0, 1].
מודול הנכונות
הערכת נכונות מתמקדת בדיוק דקדוקי, דיוק מכני והיצמדות למוסכמות האנגלית הסטנדרטיות. ממד זה עוסק בהיבטים הטכניים של הכתיבה, כולל תחביר, מורפולוגיה, פיסוק ודיוק איות. רכיב הנכונות לא רק מעריך את מספר השגיאות הלשוניות, אלא גם בוחן את ההשפעה על איכות הטקסט הכוללת. בניגוד להערכת שטף, המדגישה קוהרנטיות סמנטית וזרימה טבעית, מודול הערכת נכונות דורש זיהוי מדויק של שגיאות ותיקון שיטתי. המודול מבחין בין סוגי שגיאות שונים, מעריך את חומרת השגיאות ומספק תיקונים ממוקדים לתמיכה בשיפור הלמידה. אובדן הנכונות עושה שימוש במודל FLAN-T5, שעובר התאמה עדינה לזיהוי ותיקון שגיאות דקדוקיות. בחירה זו מבוססת על יכולת הטרנספורמציה של טקסט לטקסט ב-T5, שמאפשרת למערכת לא רק למצוא תקלות אלא גם להציג תיקונים רלוונטיים בתוך מערכת אחת. המערכת היא צורת מקודד-מפענח, והטקסט מוזן בצורת הטרנספורמציה הזו: (ראו איור 3)
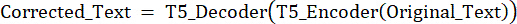 (7)
רכיב המקודד מייצר ייצוגים רגישי הקשר שלא רק לוכדים את הנטיות הדקדוקיות אלא גם אזורים פוטנציאליים של כישלון:
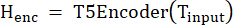 (8)
בעזרת יצירת וריאציות דקדוקיות מתאימות לטעויות שזוהו בטעות, המפענח מייצר רצפים מתוקנים:
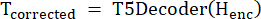 (9)
סוג זה של עיבוד דו-כיווני מאפשר למערכת להיות מודעת להקשרים של שגיאות, ואיך יש לתקן את ההקשרים, כך שהרמזים יהיו קוהרנטיים סמנטית, אך מתמקדים בכל תיקון דקדוק.
כימות שגיאה ואלגוריתם ניקוד
ציון הדיוק השווה את הכתיבה המקורית לגרסה הנכונה של הכתיבה, תוך התחשבות בשגיאות הלשוניות ובחומרה בהתאם למיקום בתוך הטקסט ולהפרעה למשמעות. שיטה זו לוכדת את ההבחנה בין סוגי השגיאות בהשוואה להשפעה על ההבנה הטקסטואלית של הטקסט. הקשר בין תדירות השגיאות לאיכות הטקסט הירודה הודגש בצורה לוגריתמית במערכת הדירוג. שלב יסודי בהשוואת אסימונים בין הטקסט המקורי לטקסט המתוקן הוא שתי דרגות השוואה המבוססות על טכניקת יישור מחרוזות לפי ביט. השלב השני כולל זיהוי וסיווג סוגי טעויות בהתבסס על כמה טקסונומיות לשוניות ידועות שמבדילות בין שגיאות דקדוקיות (הסכמה בין נושא לפועל, עקביות בזמן ואמינות מבנה תחביר), טעויות מכניות (אותיות גדולות, פיסוק ואיות), ושגיאות שימוש (בחירת מילים, ביטוי אידיומטי והתאמת רישום). השלב השלישי הוא חישוב יחס השגיאה בהתבסס על אורך הטקסט הכולל. השלב הרביעי מנצל את אלגוריתם ניקוד הדעיכה האקספוננציאלי, שהופך את יחס השגיאות לציוני נכונות ניתנים לפירוש ישיר כדי להתקרב לתלות הלא-חיבובית והלא-ליניארית בין תדירות הטעויות לאיכות הטקסט.
הטיפול המתמטי בתהליך כימות השגיאות מתחיל בחישוב יחס השגיאות המותקן, שמספק קצב התקנת שגיאות מנורמל, מה שמאפשר השוואה הוגנת של טקסטים באורכים שונים:
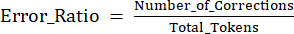 (10)
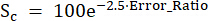 (11)
נקבע פרמטר כיול של 2.5 על בסיס אמפירי על ידי אימות מלא באמצעות שיפוטי מומחים אנושיים, כך שפונקציית הניקוד תוכל להציע תוצאות בהתאם להבנת האדם ביחס לירידה באיכות הטקסט ככל שתדירות השגיאות עולה. קביעת ערך פרמטר זה בדרך זו מבטיחה שכל טקסט עם שיעור שגיאה נמוך (Error_Ratio < 0.1) יקבל ציון נכון גבוה, שכן הוא עוקב בקפדות אחרי כללי האנגלית התקנית; כל טקסט עם שיעור שגיאה בינוני (0.1 < Error_Ratio ≤ 0.3) מקבל ציון ביניים של נכונות המצביע על כך שיש חששות לשוניים שעדיין אינם הרסניים לחלוטין, וכל טקסט עם שיעור שגיאות גבוה (Error_Ratio > 0.3) קיבל ציון נכון נמוך בגלל חששות לשוניים קריטיים שמשפיעים משמעותית על אפשרות ההבנה.
אלגוריתם דירוג הנכונות להערכת נכונות לוקח בחשבון באופן שיטתי את כל השגיאות שאותרו ותוקנו על ידי מערכת מבוססת T5 כפריטי עונש בחישוב יחס השגיאה הסופי. מנגנון הקנס המשמש לשגיאות דקדוקיות מיוצג על ידי הירידה האקספוננציאלית בצמיחת יחס השגיאה לערכים גבוהים, מה שאומר שאיכות הטקסט ירודה מאוד, והיא הופכת ל-100 כאשר יחס השגיאה שווה ל-0, כלומר אין שגיאות בכלל. זהו שימוש מושלם בקונבנציות תקן באנגלית. קשר מתמטי כזה מבטיח שקוד הנכונות מציע הבחנה משמעותית בכל ספקטרום רמות המיומנות הלשונית ומגיב להתקדמויות קטנות עוקבות, המצביעות על רכישות אמיתיות.
מערכי נתונים: קורפוס הכשרה והערכה
נתוני הכשרה באיכות והיקף מספקים הם קריטיים לביצועי מערכת המודלים הדו-מודליים. המחקר הנוכחי השתמש במאגר נתונים מתוכנן היטב של טקסטים שנכתבו על ידי תלמידים כדי לפתח ולהעריך את המודל, שנוצר באמצעות משימות כתיבה שונות. המדגם כלל 45 סטודנטים באוניברסיטאות פקיסטניות גברים ו-45 נשים בגיל ממוצע של 19, שלמדו 'אנגלית פונקציונלית' כקורס חובה. כל תלמיד כתב שמונה חיבורים במשך שמונה שבועות, כולל מבחן מקדים, חיבורי התערבות ואירועים לאחר המבחן. התלמידים הורשו להפיק 400–450 מילים לכל משימת כתיבה. הסטטיסטיקות של מערכי הנתונים מספקות את המאפיינים הבאים:
70,500 מילים
אורך משפט ממוצע: 15.7 מילים (SD = 3.2)
טווח אוצר המילים (יחס סוג-טוקן): 0.64 (SD 0.08) צפיפות שגיאות דקדוקיות: 2.3 ל-100 מילים (SD = 1.1)
ההצדקה והבטחת איכות הנתונים של הנתונים שנבחרו
מאגר הנתונים שנבחר נבע מכמה שיקולים חשובים שאפשרו את העושר והרלוונטיות למחקר על הערכת כתיבה אוטומטית. ראשית, אוכלוסיית הסטודנטים לכלכלה נבחרה בשל אופיו, בדומה ללומדים EFL בהשכלה הגבוהה בפקיסטן, מה שאפשר להציג דוגמאות כתיבה אותנטיות יותר המשקפות מצבים מהעולם האמיתי. שנית, קביעת טווח המילים הפוטנציאלי המקסימלי והמינימלי, 400–450 מילים, התבססה על נתוני מחקרי פיילוט שהטווח הזה מורכב לשונית מספיק כדי לנתח אותו באופן אמין על ידי מכונה, והוא נשאר בעל גודל שניתן לנהל מבחינת הערכות אנושיות עקביות. כל אחת מהחיבורים הוערכה על ידי שלושה מורים מיומנים לאנגלית (מהימנות בין-מדרגת κ = 0.847, ממד שטף, ו-0.823, ממד נכונות) על סולמות סטנדרטיים של 10 נקודות לשטף ודירוג נכון. ההכשרה של המעריכים האנושיים הייתה קפדנית ותלויה בכללי ניקוד מפותחים בנוגע למבחני כתיבה IELTS ו-TOEFL. הנתונים מורכבים ממאגר נתונים עם הערות אנושיות, שניתן להשתמש בו באימון ואימות מודלים לצורך אימון על נתונים עם הערות אנושיות.
נהלי קדם-עיבוד ואימות נתונים
מערך הנתונים עובד מראש באופן שיטתי וכלל נרמול טקסט, טוקניזציה של הטקסט עם טוקנייזר BERT WordPiece, ובדיקות אימות איכות. אלו שהגישו עבודה לא שלמה ויצרו טקסט מועתק לא נכללו כדי לקבוע את שלמות הנתונים. הנתונים האחרונים חולקו באקראי לאימון (70%, n = 189), אימות (15%, n = 41) ומערכות מבחן (15%, n = 40) באמצעות דגימה שכבתית כדי לאזן את האיזון בין רמות המיומנות וסוגי המשימות. ניתוח לשוני של קורפוס מקורות גדול הכולל טקסטים אקדמיים ערוכים מקצועית, מאמרים מעיתונים ומאמרים שפורסמו, ויוצר כ-50 מיליון מילים. קורפוס זה מספק דפוסי שפה הנדרשים לביצוע בדיקות שטף ועוזר בהליכים לזיהוי שגיאות על ידי השוואה שלהם לשימוש הסטנדרטי. בקורפוס ההתייחסות, השלבים לפני עיבוד מוקדם ואינדוקס הם טוקניזציה, תיוג חלקי דיבור, ניתוח תחביר ותיווג סמנטי כדי להקל על גישה יעילה במהלך הערכה בזמן אמת.
אסטרטגיית אימון מודל שטף
מוצעת מערכת אופטימיזציה סדרתית שתאמן את הנתונים להשגת שטף. ההכשרה השתמשה בתכונות מתקדמות, כולל תזמון קצב למידה אדפטיבי, גודל אצווה מתקדם ושיטות רגולריזציה מתקדמות שמונעות התאמת יתר ככל שההכשרה מתקדמת, ובכך שומרות על יעילות המודל בזיהוי דפוסים לשוניים המעידים על שטף שפה. קצב הלמידה הוא 5 × 10⁻⁴ עם לוח זמנים ליניארי של דעיכה, המוגדר להבטיח שההתכנסות תישאר יציבה ולא תתנדנד סביב ערכי הפרמטרים האופטימליים. קצב הלמידה הזה נבחר באמצעות חיפוש רשת ב-[1 x 10⁻⁶, 1 x 10⁻⁴] כאשר 5 x 10⁻⁵ הוא הפשרה הנכונה ביותר בין מהירות ההתכנסות ליציבות. ההכשרה האמיתית תוגבל ל-3 תקופות בלבד, תצורה שאופטימיזציה על בסיס יתרונות אמפיריים באמצעות מעקב אחרי אובדן האימות כדי למנוע התאמת יתר מבלי למנוע עדכוני פרמטרים מספקים כדי להפוך את הלמידה ליעילה. נעשתה עצירת מנגנונים מוקדמת עם סבלנות של 2 תקופות ודל מינימלי של 0.001 כדי למנוע התדרדרות.
האופטימיזציה מתבצעת על ידי אופטימייזר AdamW, עם בחירות פשוטות יותר כמו β₁ = 0.9 (תנע, ששולט בהתדרדרות הערכות המומנט הראשון באופן מעריכי), β₂ = 0.999 (הערכת מומנט שני, השולטת בהתדרדרות מעריכי של הערכות המומנט השני), ו-ε = 1 × 10⁻8 (מונח יציבות נומרית). רגולריזציה של דעיכת משקל (λ = 0.01) מונעת גדילה מופרמטית של גודל הפרמטרים, כאשר ערך זה נבחר באמצעות ניתוח ביצועי אימות בטווח [0.001, 0.1]. ניטור מורכב מסוגל לנטר מדדים שונים באימון כדי להבטיח ביצועים מיטביים של המודל ולמנוע התאמת יתר. במסגרת המעקב נכללים:
מעקב אחרי אובדן: אובדן אימון ואימות נמדדים בכל תקופה, וההפסקה המוקדמת מתרחשת אוטומטית כאשר אובדן האימות כבר לא משתפר בשתי תקופות רצופות.
מדדי ביצועים: נתוני האימות משמשים לחישוב מקדמי המתאם של פירסון בין ציונים חזויים למציאותיים כל 100 שלבי אימון.
חישה גרדיאנטית: נורמות גרדיאנט מנוטרות כדי לזהות גרדיאנטים מתאפסים ומתפוצצים, ובנורמה גרדיאנטית של 1.0 מופעלת חיתוך גרדיאנט.
תזמון קצב למידה: ירידה בקצב הלמידה מבוסס אימות (גורם = 0.5) במקרה של יותר מישור אפוק אחד.
קשור לרגולריזציה: שיעורי נשירה (0.1 ל-BERT, 0.3 לראש רגרסיה) נמצאו באבלציה שיטתית. מספר שיטות רגולריזציה המבוססות על מניעת התאמת יתר משמשות במהלך תהליך האימון: (1) רגולריזציה של נפילת הכדור באמצעות שיעורי נפילת אופטימליים לכל סוג שכבה ברשת, (2) ירידה במשקל כפי שהוסבר לעיל, (3) עצירה מוקדמת, שנקבעת על ידי ביצועי הוולידציה, ו-(4) הרחבת נתונים המבוססת על פרפרזה של 15 אחוז מדוגמאות האימון באמצעות שיטות תרגום חוזר. נקודות הביקורת של המודל בעל הביצועים הטובים ביותר נשמרו לאחר כל תקופה, והמודלים בעלי הניקוד הגבוה ביותר נבחרו בהתבסס על ציוני קורלציה של אימות. פונקציית האובדן המשמשת בחלק הערכת השטף היא שגיאת ריבוע ממוצעת (MSE), שהיא פונקציית המטרה העיקרית של משימת הרגרסיה לחיזוי ציוני השטף הרציפים. נוסחת האובדן מתמטית ניתנת כך:
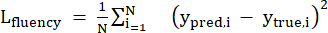 (12)
N הוא גודל המדגם הכולל של האימון, y_pred, i הוא ציון השטף החזוי של מדגם i, ו-y_true, i הוא ציון האמת הקרקעית המקביל כפי שניתן על ידי מעריכים מומחים אנושיים. הפסד זה מאוד שימושי במניעת שגיאת חיזוי בפועל ריבועי, כך ששגיאות גדולות יותר גורמות לעונש גדול יותר, והוא גם ניתן להגזרה. מנגנון תזמון קצב הלמידה מתקדם מאוד עם תהליך דו-שלבי, והוא מתחיל בשלב חימום ליניארי, ואחריו תהליך דעיכה שיטתי כדי ליצור מאפייני התכנסות אופטימליים. זה נעשה בשלב החימום, שבו קצב הלמידה מתחיל מאפס ומשתנה בהדרגה לקצב המקסימלי, ולאחר מכן פרמטרי המודל מותאמים ביחס למערך הנתונים של האימון. הביטוי המתמטי של שלב החימום הוא:
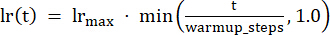 (13)
לאחר שלב החימום, קצב הלמידה מתדרדר בצורה ליניארית שיטתית כדי למנוע חריגה מערכי הפרמטרים האופטימליים וכתוצאה מכך התכנסות יציבה. מתמטית, שלב הדעיכה נקרא כך:
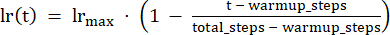 (14)
כאשר t הוא שלב האימון הנוכחי, lr max הוא קצב הלמידה המקסימלי שהושג במהלך החימום, חימום הוא מספר השלבים שהוקצו לשלב החימום, וסך הכל הוא סך צעדי האימון בכל התקופות. הליך התזמון שהוזכר מבטיח למידה אגרסיבית של המודל ברמות הנמוכות ויציבות ברמות ההתכנסות.
אסטרטגיית אימון מודל נכונות
מודל הדיוק התבסס על אסטרטגיית למידת ההעברה באמצעות מודל FLAN-T5 מאומן מראש כדי לנצל את כל הידע הדקדוקי הזמין לפי הצורך. המטרה הייתה לבחון את ההבנה הכללית של השפה וכן את המידע הספציפי לגבי הטעויות שביצעו לומדי ESL. שיטת למידת ההעברה שהשתמשה בה קוראת לנקודת ביקורת pszemraj/flan-t5-large-grammar-synthesis כמודל הבסיס, עם מספר יתרונות בולטים מבחינת נכונות. מכיוון שהמודל כבר מאומן ובעל יכולת הבנת שפה גבוהה שעברה הכשרה בתחומים שונים של טקסט, הוא יתאים את עצמו לסגנונות כתיבה ונושאים רבים בכתיבה. במיוחד, בוצעה כיוונון דקדוקי ייחודי על מאגרי תיקון גדולים המכסים סוגים שונים של שגיאות דקדוקיות, כפי שניתן להיתקל בכתיבה בשפה שנייה. יתרה מזאת, נקודת הביקורת מורכבת ממערכות זיהוי שגיאות עוצמתיות שנבדקות מול סוגי השגיאות השונים (כלומר, שגיאות מורפולוגיות, שגיאות תחביריות וסמנטיות), ויוצרות סטנדרט מושלם להשוואה לפרמטרי בדיקת התיקון המולדות של המחקר.
תהליך התאמת התחום משקף את השינויים השיטתיים בפרמטרים שאינם משנים את היכולות הכלליות של הבנת השפה של המודל המוכשר מראש, אלא מציגים את התכונות הספציפיות של פתרון משימת הערכת הכתיבה. תהליך ההסתגלות הזה נגזר במתמטיקה כך:
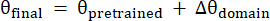 (15)
כאן θpretrained מייצג את הפרמטרים של המודל המאומן מראש המקודד הבנה כללית של שפה וידע דקדוקי,ותחום Δθ מייצג את עדכוני הפרמטרים הספציפיים שנלמדו ממשימת הערכת כתיבת היעד. העדכונים הספציפיים לתחום מחושבים באמצעות אופטימיזציה מבוססת גרדיאנט על מאגר הנתונים היעד, כדי להבטיח שהמודל יפתח רגישות ספציפית למשימה לסוגי שגיאות נפוצים בכתיבת EFL מבלי לפגוע ביכולות הלשוניות הרחבות יותר שלו.
ניסויים בהשוואות
כדי להוכיח את פונקציונליות ה-EG, מקדם המתאם של פירסון מוצע כערך המרכזי של המדידה, שקובע את הקשר הליניארי בין ציונים אוטומטיים לבין המומחיות של בני אדם. מקדם המתאם נמצא על ידי הנוסחה:
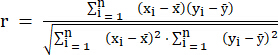 (16)
כאשר xi מייצג את הציונים האוטומטיים, מייצג את הדירוגים האנושיים, ו  -
 ו- הם הממוצעים המתאימים. מקדם המתאם נע בין −1 ל-1, כאשר ערכים קרובים ל-1 מצביעים על קשר חיובי חזק בין הערכה אוטומטית להערכה אנושית.
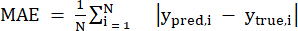 (17)
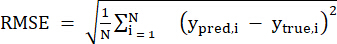 (18)
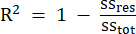 (19)
השוואות מודלים בסיסיים
כדי להעריך את ביצועי ה-EG ולהדגים את עליונותה על פני השיטות הקיימות, מתבצעות השוואות מעמיקות עם שיטות AWE מבוססות ושיטות מסורתיות של מטר יחיד. השוואות בסיס אלו חיוניות לאימות הערך המוסף של ארכיטקטורת EG ולהוכחה ששילוב הערכת שטף ונכונות מספק שיפורים מדידים לעומת גישות המתמקדות בממדים בודדים בנפרד. בחירת מודלי הבסיס כוללת ארבע קטגוריות של AWE, שכל אחת משקפת כיוון ייחודי לאופן שבו יש להעריך כתיבה. הראשון כולל מודל יחיד המבוסס על BERT להערכת שטף. מודלים אלו משתמשים בארכיטקטורות טרנספורמרים כדי להעריך את דפוסי הטקסט של חלקות וקוהרנטיות. הקטגוריה השנייה, המשולבת במתודולוגיות לשוניות מסורתיות, מתמקדת במערכות מבוססות כללים לזיהוי שגיאות דקדוקיות. לכן, הדגש נשאר על נכונות, תוך התעלמות מהיבטים אחרים הקשורים לאיכות הכתיבה, כמו לכידות ותוכן. הקטגוריה השלישית היא מערכות AWE מבוססות תכונות, הכוללות מדדים למורכבות לשונית — כמו אורך משפט וריאציוני, גיוון הלקסיס ומורכבות תחבירית ליצירת ציוני איכות כלליים. הרביעית מתחשבת במערכות היברידיות על ידי שילוב תכונות לשוניות שונות ברמת פני השטח, לעיתים באמצעות שיטות אנסמבל או ממוצעים משוקללים. מודלים אלה אינם מגיעים לרמת המורכבות המשולבת שמושגת על ידי ארכיטקטורות עצביות EG. ביצועי המודל הבסיסי מוערכים בשלושה ממדים עיקריים. הראשון מודד התאמה בין ציונים שנוצרו על ידי המערכת לבין דירוגי מומחים אנושיים מיומנים (מדריכי אנגלית) באמצעות רובריקות סטנדרטיות. השני קובע הכללה, ומזהה האם הביצועים נשארים עקביים בין שלושה מאמרים עם נושאים ומורכבות משתנים. הממד השלישי מתבסס על אמינות חיזויית, ומעריך את הדיוק והיציבות של הניקוד באמצעות כלים סטטיסטיים כגון שגיאה מוחלטת ממוצעת, שגיאת שורש ממוצע ריבועי, וניתוח רווחי אמון. ביחד, ממדים אלו יוצרים מסגרת איתנה להשוואה ומדגישים את עליונות מערכות EG, במיוחד בהשגת דיוק ויציבות גבוהים יותר מהגישות המסורתיות.
קבוצות ניסוי וקבוצת ביקורת
מחקר זה כלל 90 סטודנטים לתואר ראשון בכלכלה שלמדו קורס אנגלית פונקציונלית בשני קורסים שלמים. הנתונים נאספו בשלוש הזדמנויות: מבחן מקדים, התערבות ופוסט-מבחן כדי לעקוב אחר ההתקדמות בדיוק ושטף הכתיבה לאורך זמן. מחקר זה אושר על ידי מועצת הייעוץ המחלקתית, אוניברסיטת COMSATS באיסלאמאבאד, קמפוס לאהור, פקיסטן. המשתתפים נחשפו לשני מצבים: משוב אנושי מסורתי ומשוב נתמך על ידי מחשב. קבוצת הביקורת כללה 45 תלמידים, שקיבלו את המשוב הכתוב המסורתי ממורה לאנגלית מיומן. המשתתפים קיבלו משוב כתוב על חיבורי הסטודנטים בצורת ציונים הוליסטיים, זיהוי טעויות והמלצות בצורת הערות מהמדריך כיצד לשפר את העבודה. הקבוצה הניסויית, בתורה, כללה 45 תלמידים שקיבלו הדרכה דומה בכיתה, אך הכתיבה של התלמידים הושלמה בעזרת משוב אוטומטי מהיר שסיפק ה-EG, שסיפק להם את המידע האבחוני, הן מבחינת שטף והן מבחינת דיוק, בתוך כ-30 שניות מההגשה.
מחקר זה נערך במשך 8 שבועות, כאשר נערך מבחן מקדים (שבוע 1) כדי לקבוע את ביצועי הכתיבה הראשוניים של הנבדקים לפני שהתלמידים קיבלו התערבות. משוב מבוסס מחשב עם סמנים סמנטיים של NLP בקבוצת הניסוי והערכת מורים בקבוצת הביקורת ניתן למשתתפים במשך שישה שבועות. בסופו של דבר, המבחן לאחר המבחן (בשבוע 8) בוצע כדי להבין את ההבדל בין מדדי דיוק לפני ואחרי המבחן וציוני שטף. כדי להשיג תוצאות דומות בהשוואתיות, התבקשו המשיבים לבצע משימות דומות בכתב בכל תקופת הערכה, ובכך לצמצם משתנים מבלבלים פוטנציאליים של קושי המשימה והיכרות עם התוכן בכתיבה. כדי להבטיח שההנחיות בכתיבה תואמות לרמת הקושי, וכן לקבוע תוקף לתוכן, נבחרו ההנחיות בכתיבה באופן תואמ. נושאי החיבור נבחרו על בסיס כך שהתלמידים מכסים תחומי תוכן שונים כדי למנוע מהמשתתפים לבצע משימה דומה לאורך זמן.
בשלב הקדם-מבחן, המשתתפים התבקשו לכתוב חיבור באורך 400–450 מילים ולכתוב על המטרות האקדמיות והקרייריסטיות. המשימה התיאורית הזו התבססה על ניסיון אישי ותחזיות עתידיות, מה שמרמז על הצורך לארגן את הכתיבה, לספק דוגמאות ברורות ולהציג הצהרה הגיונית על מטרות ומוטיבציה אישיות. משימת כתיבת ההתערבות התבססה על נושאים שונים, כמו כתיבה על שגרת היומיום של החיים, תחביבים, טיולים, היום הראשון באוניברסיטה, ימים בלתי נשכחים בחיים ורגעי חברים הכי טובים. הנושא שלאחר המבחן היה קשור לנושא 'השפעת הטכנולוגיה על התקשורת', ואורך המאמר הנדרש היה 400–450 מילים.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
תוקף ואמינות הגישה הסטטיסטית
המערכת נבדקה על שיטות סטטיסטיות משלימות שונות, שכולן מספקות ראיות מקיפות להשפעות ה-EG על התפתחות הכתיבה. זוהי שיטה אנליטית רב-ממדית שמכירה בכך שהתערבויות חינוכיות כפופות לניתוח סטטיסטי מורכב שלא ניתן לצמצם להשוואות בלבד של קבוצות, אלא לניתוח דפוסי שינוי, עוצמת ההשפעות והקורלציה של אסטרטגיות מדידה שונות (טבלה 1, טבלה 3 וטבלה 4).
ניתוח השוואתי של ש...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
תוצאות הניסוי מראות מספר הישגים משמעותיים. ראשית, מערכת המודל הכפול השיגה קורלציה חזקה עם שיפוטי מומחים אנושיים (r = 0.923), והביצעה ביצועים טובים משמעותית בגישות מודל יחיד ומערכות AWE עכשוויות. שנית, מחקר ההתערבות המבוקרת חשף שיפורים משמעותיים בביצועי הכתיבה של תלמידי ESL, עם גודל אפקט גדול (d = 1.28) שעלה על אלו שדווחו בספרות עדכנית. שלישית, המערכת הראתה ביצועים מעולים במדדי הערכה שונים, כולל הפחתת השגיאה הממוצעת המוחלטת (0.149) ושיפור בעקביות במשימות כתיבה מגוונות.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
אין ניגודי עניינים בין כל המחברים.
תודות
אנו מודים לתמיכה של אוניברסיטת COMSATS באיסלאמאבאד, קמפוס לאהור, הפקולטה לאנגלית, בסיוע באיסוף נתונים מהסטודנטים.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| <חזק>תוכנות / ספריות ששימשו במחקר | |||
| מסגרת למידה עמוקה | פייטורץ' | 1.13.1 | מסגרת למידה עמוקה ליישום רשתות עצביות |
| מודלים מאומנים מראש | טרנספורמרס (חיבוק פייס) | 4.21.3 | טעינת מודלים מאומנים מראש, מימושי מודלים מסוג BERT ו-T5 |
| מודל שפה | BERT (ייצוגי מקודדים דו-כיווניים מטרנספורמרים) | ברט-בסיס-ללא מעטפת | הערכת שטף, הערכת קוהרנטיות סמנטית, הבנה קונטקסטואלית |
| מודל שפה | FLAN-T5 (Fine Tuned Language Net T5) | pszemraj/flan-t5-large-grammar-synthesis | תיקון שגיאות דקדוקיות, טרנספורמציה מטקסט לטקסט, זיהוי שגיאות |
| מחשוב נומרי | NumPy | 1.23.5 | חישובים נומריים, פעולות מערך עבור פונקציות מתמטיות |
| ניתוח נתונים | פנדות | 1.5.2 | מניפולציה של נתונים, ניתוח סטטיסטי ועיבוד מוקדם |
| למידת מכונה | Scikit-learn | 1.1.3 | חישוב מדדים סטטיסטיים, ניתוח קורלציה, מדדי הערכה |
| ויזואליזציה | Matplotlib | 3.6.2 | המחשת נתונים, גרפים של התקדמות האימון, גרפים של ביצועים |
| ויזואליזציה | סיבורן | 0.12.1 | ויזואליזציה סטטיסטית של נתונים, מפות חום של קורלציה |
| ערכת כלים ל-NLP | NLTK (ערכת כלים לשפה טבעית) | 3.7 | עיבוד טקסט מוקדם, טוקניזציה, ניתוח לשוני |
| עיבוד NLP | ספייסי | 3.4.4 | עיבוד מוקדם מתקדם של NLP, תיוג POS, ניתוח תחבירי |
| טוקניזציה | טוקנייזרים | 0.13.2 | טוקניזציה מהירה עבור BERT WordPiece ו-T5 טוקניזציה |
| <תוכנה חזקה>סטטיסטית וניתוח | |||
| תוכנה סטטיסטית | תוכנה סטטיסטית של SPSS | גרסה 26.0 | ניתוח סטטיסטי, בדיקות t לדגימות עצמאיות, ANOVA, ניתוח קורלציה |
| מאגר נתוני אימון | מערך הנתונים של Kaggle ASAP | גרסת 2012 | התייחסות לקורפוס האימון (90% ממודלי AWE משתמשים במאגר נתונים זה) |
| <ספריות אופטימיזציה ואימון של STRONG>PYTHON | |||
| אופטימייזר | torch.optim.AdamW | PyTorch 1.13.1 | אופטימיזציה של מודל עם רגולריזציה של דעיכת משקל (λ=0.01), &בטא; 1=0.9, &בטא; 2=0.999, ε=1&פעמים; 10-8< ל-sup> |
| אובדן / הפעלה | torch.nn.פונקציונלי | PyTorch 1.13.1 | הפעלה של סיגמואידים, אובדן פונקציות, רגולריזציה של נשירה |
| טעינת נתונים | torch.utils.data.DataLoader | PyTorch 1.13.1 | גודל אצווה פרוגרסיבי (4→ 16), טעינת נתונים ואצווה |
| טוקניזציה | טרנספורמרס. אוטוטוקנייזר | טרנספורמרס 4.21.3 | טוקניזציה של BERT WordPiece, עיבוד מוקדם של טקסט |
| טעינת דגמים | טרנספורמרס. אוטומודל | טרנספורמרס 4.21.3 | טעינת מודלים מאומנת מראש לארכיטקטורות BERT ו-T5 |
| בקרת גרדיאנט | torch.nn.utils.clip_grad_norm_ | PyTorch 1.13.1 | חיתוך גרדיאנט (סף: 1.0) ליציבות אימון |
| לוח זמנים של LR | torch.optim.lr_scheduler | PyTorch 1.13.1 | לימוד תזמון קצב עם דעיכה ליניארית וחימום |
| מדדים | sklearn.metrics | Scikit-learn 1.1.3 | קורלציה של פירסון, MAE, חישוב RMSE להערכה |
| <מימוש רשת עצבית בפייתון חזק>פייתון | |||
| מחלקת בסיס | torch.nn.module | PyTorch 1.13.1 | מחלקת בסיס לארכיטקטורות רשתות עצביות מותאמות אישית (Fluency & מודולי נכונות) |
| שכבות ליניאריות | torch.nn.ליניארי | PyTorch 1.13.1 | מימוש ראש רגרסיה ליניארית (768→ 512→ 256→ 128→ 1 נוירון) |
| רגולריזציה | torch.nn.Dropout | PyTorch 1.13.1 | רגולריזציה של נפילת (0.1 ל-BERT, 0.3 לראש רגרסיה) |
| הפעלה | torch.nn.functional.sigmoid | PyTorch 1.13.1 | הפעלת סיגמואידים לנרמול ציוני שטף [0,1] |
| הפעלה | torch.nn.functional.relu | PyTorch 1.13.1 | הפעלת ReLU בשכבות רגרסיה עבור טרנספורמציות לא ליניאריות |
| טרנספורמר | טרנספורמרס. ברט מודל | טרנספורמרס 4.21.3 | 12 שכבות שנאי עם תשומת לב עצמית מרובת ראשים להערכת שטף |
| Seq2Seq | טרנספורמרס. T5For ConditionalGeneration | טרנספורמרס 4.21.3 | ארכיטקטורת מקודד-מפענח לתיקון שגיאות דקדוקיות |
| פונקציית אובדן | torch.nn.MSELoss | PyTorch 1.13.1 | פונקציית אובדן השגיאה בריבוע ממוצע לאימון רגרסיית שטף |
| <ספריות הערכה ומדדים של STRONG>PYTHON | |||
| קורלציה | scipy.stats.pearsonr | SciPy 1.9.3 | מקדם קורלציה פירסון להסכמה בין מודל לאדם |
| מדד השגיאה | sklearn.metrics.mean_absolute_error | Scikit-learn 1.1.3 | חישוב שגיאת ממוצעת מוחלטת (MAE) לדיוק חיזוי |
| מדד השגיאה | sklearn.metrics.mean_squared_error | Scikit-learn 1.1.3 | שגיאת ממוצע ריבועי שורש (RMSE) להערכת גודל השגיאה |
| מבחן סטטיסטי | scipy.stats.ttest_ind | SciPy 1.9.3 | מבחן t לדגימות בלתי תלויות לבדיקת מובהקות סטטיסטית |
| מטריצת קורלציה | numpy.corrcoef | NumPy 1.23.5 | חישוב מטריצת קורלציה לאמינות בין מעריכים |
| קורלציה של נתונים | פנדות. DataFrame.corr | פנדות 1.5.2 | ניתוח קורלציה של נתונים ודיווח סטטיסטי |
| ויזואליזציה | matplotlib.pyplot | Matplotlib 3.6.2 | המחשת ביצועים, גרפים של קורלציה, טבלאות התקדמות באימון |
| מפת חום | seaborn.heatmap | סיבורן 0.12.1 | ויזואליזציה של מטריצת קורלציה והצגת נתונים סטטיסטיים |
| PYTHON לעיבוד טקסט וספריות NLP | |||
| עיבוד טקסט | re (ביטויים רגולריים) | פייתון 3.9+ מובנה | התאמת דפוסי טקסט, ניקוי נתונים ועיבוד מוקדם |
| טיפול בקונפיגורציה | json | פייתון 3.9+ מובנה | טיפול בקבצי קונפיגורציה, אחסון פרמטרי מודל |
| סיריאליזציה | מלפפון חמוץ | פייתון 3.9+ מובנה | סדרת מודלים ושמירה/טעינה בנקודות ביקורת |
| מעקב התקדמות | TQDM | 4.64.1 | סרגל התקדמות ללולאות אימון ועיבוד נתונים |
| כריתת עצים | כריתת עצים | פייתון 3.9+ מובנה | רישום התקדמות באימון, מעקב אחרי שגיאות וניפוי שגיאות |
| שכפול | אקראי | פייתון 3.9+ מובנה | הגדרת זרע אקראית לניסויים שניתנים לשחזור |
| מערכת קבצים | os | פייתון 3.9+ מובנה | פעולות מערכת קבצים, ניהול נתיב מודל |
| ניתוח CLI | ארגפרסה | פייתון 3.9+ מובנה | ניתוח ארגומנטים בשורת פקודה עבור תצורות אימון |
| <חזקות>פרסומות Awe / AES (מקורא) | |||
| פלטפורמה מסחרית | Pigai.org | פלטפורמת AWE מסחרית | הערכת כתיבה בשפה האנגלית הסינית, מערכות משוב אוטומטיות |
| פלטפורמה מסחרית | בינגו אנגלית | מערכת AWE מסחרית | תמיכה בלמידת שפה אנגלית, פיתוח מיומנויות כתיבה |
| פלטפורמה חינוכית | הגישה שלי | פלטפורמת כתיבה חינוכית | הערכת כתיבה לסטודנטים והעברת משוב |
| מנוע ניקוד | מדרג אלקטרוני | מנוע ניקוד אוטומטי של ETS | ציון מאמרים סטנדרטיים במבחן, הערכה הוליסטית |
| כלי הערכה | אני-כותב | כלי הערכת כתיבה | הערכת כתיבה אקדמית ומשוב אבחוני |
| שירות תרגול | קריטריון | שירות תרגול כתיבה ב-ETS | פיתוח מיומנויות כתיבה ומשוב אוטומטי |
| מודל שפה של בינה מלאכותית | ChatGPT | מודל השפה של OpenAI | משוב והערכה בכתיבה בעזרת בינה מלאכותית (מוזכר בספרות) |
| <חזק>ארכיטקטורות למידה עמוקה (מוזכרת בספרות) | |||
| אדריכלות | רשתות עצביות חוזרות (RNN) | קאי, 2019 | עיבוד טקסט רציף ו-mdash; כתיבת מערכות משוב והערכה אוטומטית |
| אדריכלות | זיכרון קצר טווח ארוך (LSTM) | ג'ין ואח', 2018 | מידול תלות לטווח ארוך ו-mdash; ניקוד חיבורים אוטומטי וניתוח רצפים |
| אדריכלות | רשתות עצביות קונבולוציוניות (CNN) | דונג ואח', 2017 | זיהוי דפוסים מקומיים ו-mdash; סיווג טקסט וחילוץ תכונות לצורך ניקוד |
| אדריכלות | טרנספורמר-LSTM היברידי | שואן, 2025 | עיבוד הקשרי וסדרתי משולב ו-mdash; ניקוד אוטומטי ויצירת משוב |
| אדריכלות | מקודדים אוטומטיים וריאציוניים (VAEs) | קומאר ואחרים, 2024 | מידול גנרטיבי ו-mdash; פיתוח מיומנויות כתיבה משופר ומשוב מותאם אישית |
| אדריכלות | מערכות רב-סוכניות | תומפסון ואח', 2024 | עיבוד בינה מלאכותית שיתופי ו-mdash; סיוע כתיבה מתקדם (פלטפורמת AcademiCraft) |
| מנגנון | מנגנוני קשב | דונג ואח', 2017 | תשומת לב עצמית ותשומת לב מרובת ראשים ו-mdash; שיפור ביצועי AES והבנה הקונטקסטואלית |
| <חזקות>טכניקות למידת מכונה מסורתיות (הפניה) | |||
| שיטה סטטיסטית | משפט בייס | רודנר & ליאנג, 2002 | גישה מסורתית של למידת מכונה ו-mdash; פיתוח AES/AWE מוקדם וניקוד הסתברותי |
| שיטה סטטיסטית | רגרסיה ליניארית | פאנדי ואח', 2015 | מידול סטטיסטי ו-mdash; הערכת כתיבה מבוססת תכונה וחיזוי ציונים |
| שיטת הלמידה | למידת העדפת דרגה | צ'ן & הוא, 2013 | מתודולוגיה מבוססת דירוג ו-mdash; ניקוד השוואתי למאמרים ומידול העדפות |
| מודל שפה | דגמי N-גרם | שיה ואח', 2015 | מודלים סטטיסטיים של שפה ו-mdash; תיקון שגיאות דקדוקיות וזיהוי דפוסים |
| אדריכלות | ארכיטקטורת מקודד-מפענח | Ge ואחרים, 2018 | מידול רצף לרצף ו-mdash; תיקון שגיאות דקדוקיות והמרת טקסט |
| <תקני ומסגרות הערכה חזקים> | |||
| תקן הערכה | הערכת כתיבה ב-IELTS | התאמת רובריקת הניקוד | קריטריוני הערכה סטנדרטיים לשטף ולנכונות |
| תקן הערכה | הערכת כתיבה ב-TOEFL | סטנדרטים לכתיבה אקדמית | הערכת מיומנות וניקוד סטנדרטי |
| מדד סטטיסטי | גודל אפקט D של כהן | 0.2=קטן, 0.5=בינוני, 0.8=גדול | הערכת מובהקות מעשית ליעילות התערבות |
| מדד אמינות | אמינות בין מערכים (κ) | שטף: 0.847 / נכונות: 0.823 | מקדם קאפה ו-mdash; עקביות ומעריך אנושי ואימות הסכמה |
מקורות
- Bitchener, J. Evidence in support of written corrective feedback. J Second Lang Writ. 17 (2), 102-118 (2008).
- Nusrat, A., Ashraf, F., Narcy-Combes, M. F. Effect of direct and indirect teacher feedback on accuracy of English writing: A quasi-experimental study among Pakistani undergraduate students. 3L Lang Linguist Lit. 25 (4), 84-98 (2019).
- Nusrat, A., Khan, S., Kashif, F., Fawad, R. Effect of teachers’ asynchronous e-feedback and synchronous oral feedback on English language learners’ writing accuracy. Front Educ. 7, 783684 (2022).
- Chen, B., Bao, L., Zhang, R., Zhang, J., Liu, F., Wang, S., et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: A writing feedback perspective. J Educ Comput Res. 61 (8), 60-102 (2024).
- Li, J., Link, S., Hegelheimer, V. Rethinking the role of automated writing evaluation (AWE) feedback in ESL writing instruction. J Second Lang Writ. 27, 1-18 (2015).
- Ellis, R. Explicit form-focused instruction and second language acquisition. The handbook of educational linguistics. , 437-455 (2008).
- Shamim, F. Trends, issues and challenges in English language education in Pakistan. Asia Pac J Educ. 28 (3), 235-249 (2008).
- Haider, G. An insight into difficulties faced by Pakistani student writers: Implications for teaching of writing. J Educ Soc Res. 2 (3), 17-27 (2012).
- Nawaz, M., Hussain, S. A., Bughio, F. A. Exploring the preferred corrective feedback and practiced corrective feedback among Pakistani ESL secondary school students and teachers in writing class: Matches and mismatches. Int J Lang Lit Transl. 6 (1), 31-45 (2023).
- Rudner, L. M., Liang, T. Automated essay scoring using Bayes theorem. J Technol Learn Assess. 1 (2), 1-22 (2002).
- Phandi, P., Chai, K. M. A., Ng, H. T. Flexible domain adaptation for automated essay scoring using correlated linear regression. , 431-439 (2015).
- Cai, C. Automatic essay scoring with recurrent neural network. , 1-7 (2019).
- Jin, C., He, B., Hui, K., Sun, L. TDNN: A two-stage deep neural network for prompt-independent automated essay scoring. 1, 1088-1097 (2018).
- Dong, F., Zhang, Y., Yang, J. Attention-based recurrent convolutional neural network for automatic essay scoring. CoNLL. , 153-162 (2017).
- Sharma, A., Kabra, A., Kapoor, R. Feature enhanced capsule networks for robust automatic essay scoring. , 365-380 (2021).
- Mim, F. S., Inoue, N., Reisert, P., Ouchi, H., Inui, K. Corruption is not all bad: Incorporating discourse structure into pre-training via corruption for essay scoring. IEEE ACM Trans Audio Speech Lang Process. 29, 2202-2215 (2021).
- Cummins, R., Rei, M. Neural multi-task learning in automated assessment. arXiv. , 1-9 (2018).
- Cao, Y., Jin, H., Wan, X., Yu, Z. Domain-adaptive neural automated essay scoring. , 1011-1020 (2020).
- Jiang, Z., Liu, M., Yin, Y., Yu, H., Cheng, Z., Gu, Q., et al. Learning from graph propagation via ordinal distillation for one-shot automated essay scoring. , 2347-2356 (2021).
- Li, X., Chen, M., Nie, J. Y. SEDNN: Shared and enhanced deep neural network model for cross-prompt automated essay scoring. Knowl Based Syst. 210, 106491 (2020).
- Beseiso, M., Alzubi, O. A., Rashaideh, H. A novel automated essay scoring approach for reliable higher educational assessments. J Comput High Educ. 33 (3), 727-746 (2021).
- Xie, W., Huang, P., Zhang, X., Hong, K., Huang, Q., Chen, B., et al. Chinese spelling check system based on an n-gram model. , 128-136 (2015).
- Brockett, C., Dolan, W. B., Gamon, M. Correcting ESL errors using phrasal SMT techniques. , 249 (2006).
- Zhang, S., Huang, H., Liu, J., Li, H. Spelling error correction with soft-masked BERT. , 882-890 (2020).
- Ge, T., Wei, F., Zhou, M. Reaching human-level performance in automatic grammatical error correction: An empirical study. arXiv. , 1-15 (2018).
- Zhao, W., Wang, L., Shen, K., Jia, R., Liu, J. Improving grammatical error correction via pre-training a copy-augmented architecture with unlabeled data. 1, 156-165 (2019).
- Shermis, M. D., Koch, C. M., Page, E. B., Keith, T. Z., Harrington, S. Trait ratings for automated essay grading. Educ Psychol Meas. 62 (1), 5-18 (2002).
- Mizumoto, A., Shintani, N., Sasaki, M., Teng, M. F. Testing the viability of ChatGPT as a companion in L2 writing accuracy assessment. Res Methods Appl Linguist. 3 (2), 100116 (2024).
- Ajabshir, Z. F., Ebadi, S. The effects of automatic writing evaluation and teacher-focused feedback on CALF measures and overall quality of L2 writing across different genres. Asian Pac J Second Foreign Lang Educ. 8 (1), 26 (2023).
- Almusharraf, N., Alotaibi, H. An error-analysis study from an EFL writing context: Human and automated essay scoring approaches. Tech Knowl Learn. 28 (3), 1015-1031 (2023).
- Chen, H., Pan, J. Computer or human: A comparative study of automated evaluation scoring and instructors' feedback on Chinese college students' English writing. Asian Pac J Second Foreign Lang Educ. 7 (1), 34 (2022).
- Liu, X., Zhang, Y., Chen, L. The transformative impact of AI-powered tools on academic writing: Perspectives of EFL university students. Lang Learn Technol. 28 (2), 78-95 (2024).
- Zhang, Q., Li, F. From process to product: Writing engagement and performance of EFL learners under computer-generated feedback instruction. System. 115, 102998 (2023).
- Kumar, S., Patel, R., Williams, T. Automated deep learning approaches in variational autoencoders (VAEs) for enhancing English writing skills. J Educ Technol Res. 45 (3), 234-251 (2024).
- Martinez, A., Rodriguez, P., Thompson, K. Neural automated writing evaluation with corrective feedback. Comput Linguist. 50 (1), 123-145 (2024).
- Thompson, J., Anderson, C., Davis, R. AcademiCraft: Transforming writing assistance for English for academic purposes with multi-agent system innovations. Artif Intell Educ. 12 (4), 445-462 (2024).
- Rodriguez, M., Kim, S., Brown, D. Technology-enhanced language learning in English language education: Performance analysis, core publications, and emerging trends. Appl Linguist Rev. 15 (2), 201-225 (2024).
- Xuan, Y. Transformer-LSTM models for automatic scoring and feedback in English writing assessment. IEEE Access. 13, 82084-82096 (2025).
- Anderson, R., Smith, K., Johnson, M. The impact of AI writing tools on the content and organization of students' writing: EFL teachers' perspective. Comput Educ. 195, 104712 (2023).
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.