מאמר זה מציע שיטה לניטור בטיחות בקו ייצור המשלבת את You Only Look Once גרסה 11 (YOLOv11) עם רשתות נוירונים קונבולוציוניות. השיטה השיגה דיוק ממוצע (mAP@0.5) של 0.91 בסף intersection-over-union של 0.5, mAP@0.5:0.95 של 0.82, וקצב של 120 פריימים לשנייה ביחידה לעיבוד גרפי, תוצאות העולות על מודלי הבסיס שנבחנו.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר שיטה
ניטור בטיחות של קו ייצור בזמן אמת באמצעות זיהוי אובייקטים מבוסס למידה עמוקה והגברת מאפיינים
במאמר זה
סיכום
תקציר
עם העמקתה של מהפכת התעשייה 4.0, רמות האוטומציה והבינה של קווי ייצור השתפרו משמעותית, דבר המגביר את הדרישות לביצועים בזמן אמת, לדיוק ולבטיחות של הניטור. מערכות ניטור מסורתיות, הנשענות על בדיקות ידניות או על החלטות פשוטות המבוססות על סף (threshold), סובלות בדרך כלל מזמני תגובה איטיים, משיעורי התראות שגויות גבוהים ומאינטליגנציה מוגבלת. לפיכך, מאמר זה מציע מערכת לניטור בטיחות בקו ייצור המשלבת את You Only Look Once גרסה 11 (YOLOv11) עם רשת עצבית קונבולוציונית (CNN). ראשית, התמונות שנרכשו עברו עיבוד מקדים. לאחר מכן, נעשה שימוש ב-YOLOv11 כדי לזהות עובדים, ציוד וסיכונים פוטנציאליים בזמן אמת. בהמשך, הוצגה רשת CNN משופרת עם היתוך מאפיינים רב-קנה מידה (multi-scale feature fusion) ומנגנוני קשב (attention mechanisms) כדי לשפר את יכולות חילוץ המאפיינים עבור יעדים קטנים או מוסתרים. לבסוף, תוצאות הזיהוי הותכו עם המאפיינים המשופרים של ה-CNN כדי להעריך את מצב הבטיחות. ניסויים נערכו באמצעות סט נתונים לבטיחות בקו ייצור שנבנה באופן עצמאי, תוך שימוש באופטימיזציה של stochastic gradient descent (SGD) עם מומנטום של 0.9, קצב למידה ראשוני של 0.01, weight decay של 0.0005, התאמת קצב למידה בשיטת cosine-annealed, גודל batch של 32, ואימון למשך 200 epochs. מדדי mAP@0.5 ומהירות זיהוי בפריימים לשנייה (FPS) שימשו כמדדי הערכה להשוואה עם אלגוריתמי הבסיס שנבדקו. התוצאות מראות כי המערכת המוצעת השיגה mAP@0.5 של 0.91 ומהירות זיהוי של 120 FPS. כמו כן, היא הדגימה ביצועים חסונים תחת תנאים מורכבים כגון הצללה ותאורה משתנה, מה שמסייע לאימות יעילותה ופוטנציאל היישום המעשי שלה בניטור בטיחות בקווי ייצור.
מבוא
בייצור תעשייתי מודרני, הבטיחות היא אבן היסוד להבטחת יעילות הייצור ורווחת כח האדם. סביבת קו הייצור כוללת בדרך כלל ציוד מכני במהירות גבוהה, תהליכים טכנולוגיים מורכבים ופעולות שיתופיות הכוללות משימות מרובות. כל סיכון בטיחותי פוטנציאלי, אפילו קטן, עלול להוביל לתאונות ייצור חמורות, שיגרמו להפסדים כלכליים משמעותיים ואפילו למקרי מוות. לפיכך, קריטי להקים מערכת ניטור בטיחות יעילה, חכמה ובזמן אמת כדי לשפר את הבטיחות בייצור התעשייתי1,2.
שיטות מסורתיות לניטור בטיחות מסתמכות בעיקר על מעקב וידאו ידני וחיישנים שונים (כגון חיישני אינפרא-אדום, עשן ורעידות)3. ניטור ידני אינו יעיל בלבד, אלא גם נוטה להשמטות של זיהויים עקב עייפות של אנשי הניטור, ואינו יכול לספק כיסוי רציף ומקיף. למרות שחיישנים יכולים לספק פונקציית התראה מוקדמת מסוימת, טווח הגילוי שלהם מוגבל והם רגישים להפרעות סביבתיות, מה שמוביל לבעיות בולטות של התראות שווא4. מערכות ניטור חכמות הפכו למוקד מחקר גובר. ניתוח בזמן אמת של זרם וידאו באמצעות אלגוריתם למידה עמוקה יכול לזהות באופן אוטומטי אירועים חריגים, התנהגויות לא בטוחות וסיכונים פוטנציאליים, ובכך לשפר משמעותית את רמת האינטליגנציה של מערכת הניטור4,5.
זיהוי אובייקטים הוא טכנולוגיה מרכזית בניטור חכם. כנציגים של גלאי אובייקטים בעלי שלב אחד, אלגוריתמי סדרת You Only Look Once (YOLO) מציגים יתרונות משמעותיים. מ-YOLOv1 ועד YOLOv8, אוסף אלגוריתמים זה עבר פיתוח מתמשך, עם שיפורים בארכיטקטורת הרשת, בפונקציית ההפסד ובמתודולוגיית האימון, בין היתר6,7. YOLOv1, בפרט, השיג דיוק זיהוי גבוה יותר תוך שמירה על קצב פריימים גבוה, במיוחד כאשר הוא מתמודד עם רקעים מורכבים ומטרות צפופות8.
עם זאת, למרות ביצועיו המצוינים במשימות כלליות של זיהוי אובייקטים, YOLOv1 עדיין מתמודד עם אתגרים בתרחישים ספציפיים של ניטור בטיחות בקווי ייצור9. לדוגמה, דיוק הזיהוי של YOLOv1 עלול לרדת כאשר עובדים מוסתרים חלקית על ידי ציוד, או כאשר תמרורי בטיחות הם קטנים ודומים מאוד לצבע הרקע. דבר זה מחייב את המודל להיות בעל יכולות חזקות יותר של חילוץ מאפיינים והבנה סמנטית10.
רשתות עצביות קונבולוציוניות (CNNs) בעלות יכולות עוצמתיות בחילוץ מאפייני תמונה1. באמצעות תכנון ארכיטקטורות רשת עמוקות ומורכבות יותר, CNNs יכולות ללמוד מאפייני תמונה עשירים ומופשטים יותר. שילוב של CNN עם YOLOv1 ממנף את יכולות הזיהוי המהירות של YOLOv1 ואת חילוץ המאפיינים העמוק של ה-CNN, ובכך בונה מערכת ניטור בטיחות חסונה ואינטליגנטית יותר.
על בסיס זה, מאמר זה מציע מערכת לניטור בטיחות בקו ייצור המשתמשת ב-YOLOv1 וב-CNN. ההיבטים החדשניים של מחקר זה כוללים: (1) הצעה לארכיטקטורת היתוך עמוק של YOLOv1 ו-CNN משופר; (2) הצגת היתוך תכונות רב-קנה מידה ומנגנון קשב מורכב כדי לשפר את הזיהוי של מאפייני בטיחות מרכזיים; ו-(3) אימות יתרונות הביצועים של המודל על גבי מערך נתונים של סביבה מורכבת שנבנה באופן עצמאי.
פיתוח אלגוריתמי סדרת YOLO
מאז הצגתו הראשונה על ידי Redmon et al. בשנת 201512, עורר אלגוריתם You Only Look Once (YOLO) עניין רב. בניגוד לגלאים בעלי שני שלבים המסתמכים על הצעות אזורים (region proposals), YOLO מתייחס לזיהוי אובייקטים כמשימת רגרסיה. על ידי חיזוי ישיר של המחלקות והמיקומים של אובייקטים בתמונה, YOLO משפר משמעותית את מהירות הזיהוי, מה שהופך אותו למתאים לשימוש בזמן אמת13.
כעבודה פורצת דרך בסדרה זו, YOLOv1 משיגה זיהוי יעדים מקצה לקצה לראשונה14. YOLOv1 כוללת חלוקה של תמונת הקלט למבנה של רשת, שבה כל תא רשת, המסודר בדרך כלל בפורמט של S × S, מופקד על זיהוי אובייקטים הנופלים בתוך גבולותיו.
באופן ספציפי, הפלט של YOLOv1 הוא טנזור. בין ה- S × S × (B × 5 + C), החיזוי של כל תיבת חסום (bounding box) מכיל 5 איברים: קואורדינטת נקודת המרכז (x,y), רוחב ו', גובה הוביטחון ג'תהליך החישוב מוצג במשוואה (1):
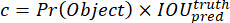 (1)
ביניהם, Pr(אובייקט() מייצג את ההסתברות שקיים מטרה בסריג, ו- IOU מייצג את היחס בין החיתוך לאיחוד (Intersection over Union) בין תיבת החסום החזויה לתיבת האמת (ground-truth box). כל רשת חוזה גם קבוצה של הסתברויות למחלקה, פרוטוקול המייצגת את ההסתברות שהמטרה שייכת ל- i-מחלקה בנוכחות יעד. פונקציית ההפסד של YOLOv1 מורכבת משלושה מרכיבים עיקריים: ההפסד עבור חיזוי קואורדינטות, ההפסד עבור אומדן ביטחון (confidence estimation) וההפסד עבור חיזוי קטגוריה15.
YOLOv2 מציגה Batch Normalization, מסווג ברזולוציה גבוהה ואסטרטגיית אימון רב-קנה מידה, המשפרים את היציבות והדיוק16. YOLOv3 משתמשת ב-Darknet-53 כרשת הבסיס (backbone network) שלה ושואבת השראה מקונספט ה-Feature Pyramid Network (FPN) כדי לשפר את זיהוי המטרה17.
YOLOv4 ביצעה אופטימיזציות רבות המבוסות על YOLOv3, והכניסה טכנולוגיות כגון Cross Stage Partial Network (CSPNet)18, Path Aggregation Network (PANet)19, ושיפור נתונים בשיטת Mosaic כדי לשפר עוד יותר את ביצועי המודל. YOLOv5 תרמה תרומה משמעותית להיבטים ההנדסיים, והציעה מימוש יעיל וקל יותר לשימוש20.
בשנים האחרונות המשיכה סדרת YOLO להתפתח, כאשר גרסאות כגון YOLOv6, YOLOv7 ו-YOLOv8 שוחררו אחת אחרי השנייה. באמצעות הצגת מבנה ה-Extended Efficient Layer Aggregation Network (E-ELAN) וטכניקות של רה-פרמטריזציה של המודל, YOLOv7 משיגה פריצות דרך חדשות הן במהירות והן בדיוק. שיפורים אלו לא רק משפרים את יעילות למידת המאפיינים אלא גם מייעלים את ביצועי ההסקה של הרשת, מה שמאפשר ל-YOLOv7 לעקוף גרסאות קודמות וגלאים מרכזיים רבים במגוון משימות של זיהוי אובייקטים בזמן אמת. YOLOv8 מייעלת עוד יותר את מבנה הרשת, מאמצת תכנון ללא עגנים (anchor-free), מפשטת את המודל ומשפרת את יכולת ההכללה שלו21.
בהתבסס על היתרונות של גרסאות קודמות, YOLOv1, ששימש במחקר זה, עבר אופטימיזציה עבור תרחישים תעשייתיים מורכבים. השיפורים המרכזיים שבו כוללים רשת חילוץ מאפיינים, מודול מיזוג מאפיינים יעיל יותר ועיצוב חסון יותר של פונקציית ההפסד. שיפורים אלו מאפשרים ל-YOLOv1 להפגין ביצועים טובים יותר בטיפול בחסימות, מטרות קטנות ורקעים מורכבים בסביבות ייצור. YOLOv1 הוא גרסה של סדרת YOLO ששוחררה על ידי Ultralytics. בהשוואה ל-YOLOv8, הוא משפר את מודול ה-C3K2 ואת נתיב מיזוג המאפיינים, ומציג אסטרטגיית תיבת עיגון (anchor box) אדפטיבית, ובכך מספק חסינות גבוהה יותר בזיהוי בתרחישים תעשייתיים.
הבסיס וההתקדמות של רשתות נוירונים קונבולוציוניות (CNN)
רשת נוירונים קונבולוציונית (CNN) היא מודל מרכזי שהשפיע עמוקות על הצלחתו של הלמידה העמוקה בתחום הראייה הממוחשבת. היא פועלת על ידי חילוץ מאפיינים מקומיים של התמונה באמצעות פעולות קונבולוציה, ולאחר מכן הפחתת ממדיות המאפיינים באמצעות פעולות pooling, ובכך משיגה הפשטה היררכית של התמונה2.
רשת CNN טיפוסית מורכבת ממספר שכבות קונבולוציה (convolutional), שכבות דגימה (pooling) ושכבות מחוברות במלואן (fully connected). שכבת הקונבולוציה סורקת את תמונת הקלט באמצעות גרעין קונבולוציה, מחשבת מכפלות סקלריות על פני אזורים מקומיים ומייצרת מפת מאפיינים. תהליך החישוב מוצג במשוואה (2):
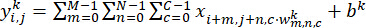 (2)
היכן נראה ששלחת רק את האות "x". אנא ספק את הטקסט המדעי שברצונך לתרגם מאנגלית לעברית, ואשמח לבצע את התרגום המקצועי עבורך בהתאם להנחיות. היא התמונה הקלטית, וק ו bק הם המשקל וההטיה של גרעין הקונבולוציה, בהתאמה, ו-  האם הערכים של מפת התכונות של הפלט במיקום (i,j). שכבת האיסוף (pooling layer) משתמשת בדרך כלל ב-Max Pooling או ב-Average Pooling. השכבה המחוברת במלואה (fully connected layer) אחראית על חילוץ מאפיינים וניבוי הסתברויות סיווג.
על בסיס זה, מאמר זה מתכנן מודול להגברת תכונות CNN עבור YOLOv11, המורכב משני ענפים מקבילים: ענף קונבולוציה רב-קנה-מידה המשתמש בגרעיני קונבולוציה של 3 × 3 ו-5 × 5 כדי לחלץ תכונות רב-קנה-מידה; וענף קשב (attention) המחבר באופן סדרתי את מודולי קשב הערוץ (Squeeze-and-Excitation) וקשב מרחבי כדי להגביר את התכונות המבדילות של יעדים מרכזיים. הפלטים של שני הענפים ממוזגים באמצעות חיבור אלמנטים (element-wise addition), ופונקציית ההפסד המתאימה להגברת התכונות מוצגת בנוסחה (3):
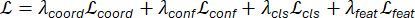 (3)
Lcoord הוא הפסד רגרסיית קואורדינטות של תיבת התוחם; Lconf הוא הפסד הביטחון של היעד; Lcls הוא הפסד סיווג הקטגוריה; Lfeat הוא הפסד שיפור המאפיינים, המשמש להגבלת המאפיינים המבדילים של יעדים קטנים ויעדים מוסתרים שהוצאו על ידי מודול השיפור של ה-CNN; λcoord, λconf, λcls, λfeat הם מקדמי המשקל של פונקציות ההפסד המתאימות. עבור משימה זו, נקבע λfeat = 0.05, והמשקלים הנותרים אוזנו בהתאם לדרישות משימת הזיהוי.
מבני CNN קלאסיים, כגון VGGNet23 ו-ResNet24, השיגו הצלחה רבה במשימות סיווג תמונות. בין ארכיטקטורות אלו, ResNet מפחית באופן יעיל את בעיית הגרדיאנט הנעלם באימון רשתות עמוקות, ובכך מקל על בניית מבני רשת עמוקים ומורכבים יותר.
במשימות של זיהוי אובייקטים, CNN משמשת בדרך כלל כמחלץ תכונות (backbone). לדוגמה, Darknet, CSPDarknet (cross-stage partial Darknet) ואחרים בסדרת אלגוריתמי YOLO, מבוססים כולם על CNN25. כדי לשפר את יכולות חילוץ התכונות, חוקרים הציעו מבני CNN משופרים רבים. לדוגמה, מודול ה-Inception מחלץ תכונות במקביל באמצעות גרעיני קונבולוציה רב-קנה מידה. DenseNet משפרת את שימוש החוזר בתכונות באמצעות חיבורים צפופים. רשת ה-Squeeze-and-Excitation מתאימה באופן אדפטיבי את חשיבותם של ערוצי התכונות באמצעות מנגנוני קשב (attention mechanisms)26.
במחקר זה, תכננו מודול CNN משופר כדי להגביר את יכולות חילוץ המאפיינים של YOLOv11. מודול זה משלב מיזוג מאפיינים רב-קנה מידה עם מנגנון קשב (attention mechanism) כדי ללכוד באופן יעיל יותר מידע בטיחותי מרכזי בתרחישים של קווי ייצור.
מצב היישום של למידה עמוקה בניטור בטיחות תעשייתית
למידה עמוקה זכתה לתאוצה משמעותית בניטור בטיחות תעשייתית. אלגוריתמים המבוססים על CNN משמשים כדי לקבוע אם עובדים חובשים קסדות בטיחות כראוי, לזיהוי חדירות בלתי מורשות לאזורי סיכון, ולניטור מצבם של ציודים עם תקלות27.
בכל הנוגע לזיהוי התנהגות, רשתות נוירונים קונבולוציוניות תלת-מדיות (3D CNNs) ורשתות נוירונים רקורסיביות משמשות לניתוח ההתנהגות התפעולית של עובדים ולזיהוי פעולות שעלולות להיות לא בטוחות. כך למשל, באמצעות ניתוח רצפי תנוחות של עובדים, ניתן לקבוע האם הם מפרים נהלי תפעול בטיחותיים28.
YOLO ו-Faster R-CNN נמצאים בשימוש נרחב לזיהוי כוח אדם וציוד בסרטוני מעקב בזמן אמת. לדוגמה, בספרות הוצעה מערכת לזיהוי קסדות בזמן אמת המבוססת על YOLOv5, אשר שיפרה ביעילות את האינטליגנציה של ניהול הבטיחות באתרי בנייה29.
אף על פי שנעשה התקדמות מסוימת במחקרים קיימים, נותרו מספר אתגרים. ראשית, סביבות תעשייתיות מאופיינות בדרך כלל בתאורה מורכבת, הסתרה והפרעות רקע, המטילות דרישות מחמירות על החוסן של האלגוריתם. שנית, ביצועים בזמן אמת הם דרישה מרכזית, והאלגוריתם חייב להשיג הסקה במהירות גבוהה תוך שמירה על הדיוק. לבסוף, מחקרים קיימים מתמקדים בעיקר בזיהוי של משימה בודדת וחסרים בהם חקירות של היתוך מידע ממקורות מרובים וניתוח מקיף30.
במחקר זה, מודל מיזוג ה-YOLOv1 וה-CNN המוצע נועד להתמודד עם האתגרים שהוזכרו לעיל ולהשיג ניטור מקיף ובזמן אמת של סיכוני בטיחות בקו הייצור, על ידי שיפור יכולות חילוץ המאפיינים והמיזוג שלהן.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
אלגוריתמי YOLOv1 ו-CNN
ארכיטקטורה כוללת של המערכת
מערכת הניטור לבטיחות בקו הייצור המוצעת במאמר זה מאמצת ארכיטקטורה היברידית המשלבת את YOLOv1 עם CNN משופר, כדי להשיג ניטור בטיחות בזמן אמת ברמת דיוק גבוהה ובמהירות גבוהה. כפי שמוצג ב- איור 1המערכת מורכבת בעיקר ממודול עיבוד מקדים של הקלט, מודול זיהוי אובייקטים מסוג YOLOv1, מודול העצמה של מאפיינים מבוס CNN ומודול קבלת החלטות ממוזג. התמונה הקלטתית עוברת תחילה נורמליזציה והרחבה (augmentation) על ידי מודול העיבוד המקדים כדי לשפר את יכולת ההכללה של המודל. לאחר מכן, מאפיינים מופקים על ידי רשת הבסיס (backbone) מסוג CSPDarknet, ושדה התפיסה (receptive field) מורחב על ידי מודול spatial pyramid pooling-fast (SPPF). מאפיינים רב-קנה-מידה (multi-scale) ממוזגים לאחר דגימה כלפי מעלה (upsampling), ותשומת ערוץ (channel attention) ותשומת מרחב (spatial attention) מיושמות באופן רצופי על המאפיינים הממוזגים כדי להגביר עוד יותר את הייצוג המבדיל של יעדים מרכזיים. מודול ההעצמה של מאפיינים מבוס CNN מושמע אחרי הפלטים של השכבות C3, C4 ו-C5 של רשת הבסיס של YOLOv1, ומקבל מפות מאפיינים רב-קנה-מידה בגדלים של 80 × 80 × 256, 40 × 40 × 512 ו-20 × 20 × 1,024, בהתאמה. מודול ההעצמה של מאפיינים מבוס CNN משפר עוד יותר את הפקת המאפיינים עבור יעדים קטנים או מוסתרים. לבסוף, מודול קבלת ההחלטות הממוזג משלב את תוצאות הזיהוי של YOLOv1 עם המאפיינים המועצמים על ידי ה-CNN ומבצע להם אופטימיזציה משותפת באמצעות פונקציית הפסד (loss function) מתוכננת, כדי להוציא את המיקום המדויק, הקטגוריה וציון הביטחון (confidence score) של היעד.
מסגרת הזיהוי YOLOv1
YOLOv1 הציגה מספר שיפורים קריטיים המנצלים את חוזקותיה של מסגרת הזיהוי החד-שלבית של סדרת YOLO. הארכיטקטורה שלה מחולקת לשלושה רכיבים עיקריים: רשת שלד (backbone network), רשת היתוך תכונות (feature fusion network) וראש זיהוי (detection head). רשת השלד משתמשת במבנה CSPDarknet משופר. רשת היתוך התכונות משלבת קשרים מקומיים חוצי-שלבים וקונבולוציות ניתנות להפרדה בעומק (depthwise separable convolutions), בהשראת רשתות פירמידת תכונות (feature pyramid networks) ורשתות אגרגציה של נתיבים (path aggregation networks), כדי למזג ביעילות תכונות ברב-קנה מידה.
מודול לשיפור מאפיינים
מודול שיפור המאפיינים נועד לשפר את הרגישות של המודל למאפייני בטיחות מרכזיים. הוא מעבד את מפות המאפיינים המופקות מכל שכבה של רשת ה-backbone של YOLOv1, תוך מיזוג מידע מקני מישק (scales) שונים באמצעות פעולות דגימה מחדש כלפי מעלה (upsampling) וכלפי מטה (downsampling). באופן ספציפי, הענף הרב-קני לוכד גיוון של קני מישק מרחביים, בעוד שענף הקשב (attention branch) מחזק באופן דינמי ערוצים מרכזיים ותגובות מיקומיות. שני ענפים אלו אינם פועלים באופן עצמאי, אלא הם משלימים זה את זה וממוזגים באמצעות חיבורים שאריתיים (residual connections) וכיוונון מחדש של המאפיינים. מפת המאפיינים המעובדת על ידי מודול השיפור בכל קני מישק מותאמת למספר הערוצים של מפת המאפיינים המקורית באמצעות קונבולוציה של 1 × 1, ולאחר מכן ממוזגת עם מפת המאפיינים המקורית של YOLOv1 באמצעות חיבור איבר-איבר (element-wise addition). מפת המאפיינים הממוזגת מוזנת לאחר מכן לרשת פירמידת המאפיינים (FPN) העוקבת למיזוג רב-קני, ובכך נוצר ייצוג היררכי של מאפייני בטיחות. כדי להבטיח אינטגרציה חלקה בין המודולים, מאומץt אסטרטגיית אימון משותפת מקצה לקצה (end-to-end), כאשר פונקציית ההפסד מורכבת מהפסד הזיהוי של YOLOv1 והפסד שיפור המאפיינים של מודול ה-CNN.
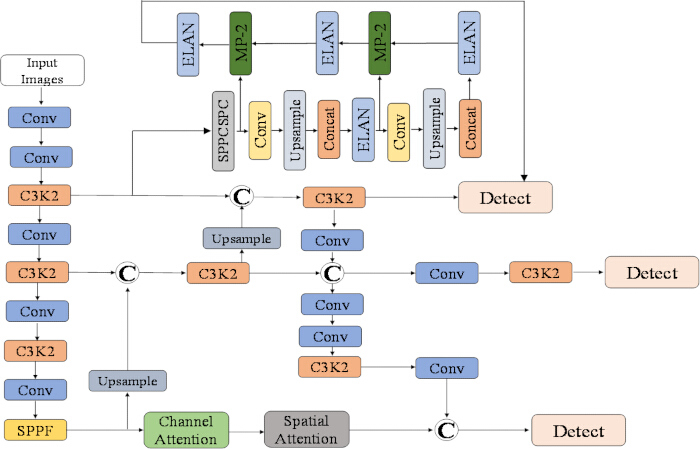
איור 1אלגוריתם YOLOv1-CNN. מודול שיפור המאפיינים נועד להגביר את הרגישות של המודל למאפייני בטיחות קריטיים. הוא מעבד מפות מאפיינים (feature maps) משכבות שונות של ה-backbone של YOLOv1, תוך מיזוג מאפיינים בקני מידה שונים באמצעות פעולות dampled-downsampling ו-upsampling. בנוסף, הוא משלב מנגנוני קשב מרחביים וערוציים (channel- and spatial-attention mechanisms). כדי להבטיח שילוב חלק בין מודולי YOLOv1 ו-CNN, נעשה שימוש באסטרטגיית אימון משותפת. במהלך האימון, הפרמטרים של שני המודולים מותאמים באופן מקצה לקצה (end-to-end). פונקציית ההפסד משלבת את הפסד הזיהוי של YOLOv1 עם הפסד שיפור המאפיינים של מודול ה-CNN. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
כדי לאמת את יעילותם של מודל ה-YOLOv1 ומודל ה-CNN המוצעים במיזוג לניטור בטיחות בקו ייצור, נבנה מאגר נתונים המכסה תרחישי סיכון בטיחותיים שונים. מאגר נתונים זה מכיל 12,0 תמונות של סצנות מקו ייצור, המחולקות למערכי אימון, תיקוף ובדיקה ביחס של 7:1.5:1.5, עם גרעין אקראי (random seed) קבוע של 42. הוא מכסה תנאי עבודה מגוונים, כולל תאורה סטנדרטית, תאורה חלשה, הסתרה חלקית, הסתרה כבדה, טשטוש תנועה ורקעים מורכבים. סף הביטחון (confidence threshold) להסקה נקבע ל-0.5, וסף הדיכוי הלא-מקסימלי (NMS) נקבע ל-0.45. כל הניסויים חזרו שלוש פעמים...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
תוצאות ניסיוניות מראות כי מודל היתוך ה-YOLOv11–CNN המוצע משפר את דיוק הזיהוי ואת הביצועים בזמן אמת לצורך ניטור בטיחות בקו ייצור. תוך ניצול זיהוי השלב הבודד היעיל של YOLOv11 והגברת המאפיינים של מודול ה-CNN, המערכת זיהתה עובדים, ציוד ואזורים מסוכנים בתנאי תאורה מורכבים ותנאי הסתרה. היתוך מאפיינים רב-קנה-מידה ומנגנוני קשב שיפרו את היכולת להתמקד באלמנטים מרכזיים של בטיחות, ובכך סיפקו ראיות ויזואליות ניתנות לפירוש לצורך התרעה מוקדמת.
למערכת יש ערך מעשי עבור קווי ייצור בסביבות כגון ייצור רכבים והרכב...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
למחברים אין ניגודי אינטרסים להצהיר עליהם.
תודות
עבודה זו נתמכה בחלקה על ידי הקרן למחקר מדעי של אוניברסיטת Taizhou לכישרונות מתקדמים "מחקר על טכנולוגיות מפתח של זיהוי מדויק לייצור חכם" (TZXY2020QDJJ006).
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| COCO API | N/A | כלי הערכה ששימש להערכת דיוק זיהוי המטרות ולניתוח סטטיסטי. | |
| CUDA 11.4 | NVIDIA | N/A | פלטפורמת מחשוב מקבילי ששימשה יחד עם מסגרת PyTorch 1.12. |
| Edge TPU | N/A | פלטפורמת פריסה ששימשה לבדיקת השהיה וצריכת חשמל; ההשהיה המדווחת הייתה 18 ms וצריכת החשמל הייתה 15 W. | |
| התקן מחשוב קצה Jetson Xavier | NVIDIA | התקן מחשוב קצה ששימש לבדיקת תפוקה; מהירות העיבוד המדווחת הייתה 70 FPS עם השהיה באחוזון ה-99 בטווח של 50 ms. | |
| NVIDIA Tesla V100 GPU | NVIDIA | GPU ששימש בשרת האימון/הערכה. | |
| PyTorch 1.12 | N/A | מסגרת למידה עמוקה ששימשה לאימון והערכת המודל. | |
| scikit-learn | N/A | כלי להערכה/ניתוח סטטיסטי ששימש להערכת המודל. | |
| סט נתונים לבטיחות בקו ייצור שנבנה באופן עצמאי | N/A | N/A | סט נתונים של 12,000 תמונות של סצנות בקו ייצור בפורמט VOC, המכסה תאורה סטנדרטית, תאורה נמוכה, הסתרה חלקית, הסתרה כבדה, טשטוש תנועה ורקעים מורכבים; שש קטגוריות של תוויות: עובדים, קסדות בטיחות, זרועות רובוטיות, אזורי סיכון, כלים ורכבים. |
| שרת אימון | שרת המצויד ב-NVIDIA Tesla V100 GPU ובמערכת ההפעלה Ubuntu 20.04. | ||
| מערכת ההפעלה Ubuntu 20.04 | N/A | מערכת ההפעלה ששימשה בשרת האימון/הערכה. | |
| פורמט תיוג VOC | N/A | N/A | פורמט התיוג ששימש עבור סט הנתונים לבטיחות בקו ייצור שנבנה באופן עצמאי. |
| מודל זיהוי אובייקטים YOLOv11 | Ultralytics | N/A | מודל לזיהוי אובייקטים ששימש לזיהוי עובדים, ציוד וסכנות פוטנציאליות בזמן אמת. |
מקורות
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.