מחקר זה מציג מסגרת עבודה לאב-טיפוס אוטומטי של ממשק משתמש, המשלבת עקרונות תכנון קוגניטיביים, מידול צבע תפיסתי ולמידה עמוקה. המערכת משפרת את הנגישות, את בהירות הפריסה, את הרמוניית הצבעים ואת העקביות בין מסכים שונים, ובכך מביאה לעיצובי ממשק קוהרנטיים וממוקדי-משתמש.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
מסגרת עבודה לאב-טיפוס אוטומטי של ממשקי משתמש, המשלבת עקרונות עיצוב קוגניטיביים וויזואליים לשיפור השמישות ובהירות הפריסה
במאמר זה
סיכום
תקציר
עיצוב ממשק משתמש (UI) אפקטיבי דורש איזון הרמוני בין משיכה ויזואלית, שמישות קוגניטיבית ועקביות של הפריסה. עם זאת, גישות נוכחיות ליצירה אוטומטית של UI מתמקדות בעיקר במראה הוויזואלי או בזיהוי רכיבים, וחסרות מסגרת מאוחדת המשלבת עקרונות קוגניטיביים, בינה של צבעים והסקה מבנית. יתרה מכך, שיטות קיימות סובלות מהכללה מוגבלת של פריסות, יכולת פרשנות נמוכה, בחירת צבעים סטטית והתנהגות לא עקבית בין מסכים שונים. בהקשר זה, עבודה זו מציעה מסגרת לאב-טיפוס אוטומטי של UI המשלבת זיהוי רכיבים המבוסס על רשת נוירונים קונבולוציונית מבוססת אזורים מהירה (Faster R-CNN) ומידול צבע תפיסתי המונהג על ידי מרחב צבע אחיד CIECAM02 (CAM02-UCS), המועשרים בעקרונות עיצוב קוגניטיביים וויזואליים. ה-Faster R-CNN משמש לזיהוי רכיבי UI ולהסקת מבנים היררכיים מתוך מאגרי נתונים של ממשקים בקנה מידה רחב. מודול משופר ליצירת צבעים מנתח תמונות מותג או תמונות ייחוס כדי להבטיח ערכות נושא של צבעים הרמוניות, אחידות תפיסית ותואמות לשמישות באמצעות CAM02-UCS. פלטים אלו עוברים אופטימיזציה נוספת באמצעות כללי עיצוב קוגניטיביים, כולל קיבוץ גשטלט, חוקי פיטס והיק, ריווח מבוסס קשב ומידול הירכיה ויזואלית, כדי ליצור באופן אוטומטי פריסות UI מזוקקות ומכוונות-משימה. ניסויים שנערכו על מאגרי הנתונים RICO, ENRICO ו-Guo’s UI Color מראים כי המערכת המוצעת משיגה דיוק של 92.4% בזיהוי רכיבים, משפרת את בהירות הפריסה ואת דיוק סדר הקריאה ב-18.7%, ומייצרת פלטות צבעים שדורגו כהרמוניות יותר ב-24.5% על ידי מעצבים בהשוואה לשיטות בסיס. הערכות משתמשים מצביעות גם על הפחתה של 31% בעומס הקוגניטיבי הנתפס ועל עלייה של 28% בעקביות העיצובית בין מסכים. ממצאים אלו מוכיחים כי שילוב של הבנה מבנית מבוססת למידה עמוקה עם מידול צבע מבוסס תפיסה ועקרונות עיצוב קוגניטיביים יוצר אבות-טיפוס של UI שהם יעילים ביותר, קוהרנטיים אסתטית וידידותיים למשתמש. מסגרת זו מבססת גישה חדשנית מקצה לקצה לאב-טיפוס אוטומטי של UI חכם וממוקד-אדם.
מבוא
ממשקי משתמש גרפיים (GUIs) משמשים כתווים מרכזיים לתקשורת בין בני אדם למערכות מחשוב, ומשפיעים באופן משמעותי על השמישות, הנגישות וחוויית המשתמש הכללית (UX)1,2. מערכות תוכנה מודרניות נסמכות על ממשקים אינטואיטיביים ומושכי לב מבחינה חזותית כדי למשוך משתמשים ולשמר אותם. באופן מסורתי, עיצוב ממשק משתמש כולל יצירת פריסות גרפיות שמתורגמות לאחר מכן לקוד front-end על ידי מהנדסים. עם זאת, הבדלים בפרוטוקולים ספציפיים לפלטפורמות שונות בין מערכות הפעלה מחייבים התאמה חוזרת, מה שמעלה את מורכבות הפיתוח ואת המאמץ הנדרש. כתוצאה מכך, יצירת קוד ממשק משתמש אוטומטית הפכה לכיוון מחקר חשוב, המפחית את המאמץ הידני ומשפר את יעילות הפיתוח.
גישות מוקדמות ליצירה אוטומטית של ממשקי משתמש (UI) משלבות טכניקות מסורתיות של עיבוד תמונה עם מודלי למידה עמוקה לזיהוי וסיווג אזורים3,4. כיום, אסטרטגיות דומיננטיות ליצירת קוד של ממשקי משתמש גרפיים (GUI) מיישמות טכניקות של ראייה ממוחשבת כדי לנתח תמונות UI ולהמיר אותן לייצוגים מובנים של צד-לקוח (front-end)5,6,7. בעוד ששיטות עיבוד תמונה מסתמכות על מאפיינים המוגדרים ידנית, גישות של למידה עמוקה מחלצות ייצוגים היררכיים ממאגרי נתונים רחבי היקף. כתוצאה מכך, חוקרים בחנו גישות היברידיות המשלבות למידה עמוקה עם טכניקות עיבוד תמונה ספציפיות לתחום כדי לשפר את החוסן ואת הדיוק.
צבע הוא גורם קריטי נוסף בעיצוב ממשק משתמש (UI), המשפיע על תפיסת המשתמש, על השמישות ועל המשיכה האסתטית1. שמירה על עקביות בין תוכן התמונה לבין סכימות הצבע של ממשק המשתמש הופכת למאתגרת כאשר קלטים חזותיים משתנים בגוון ובהקשר8,9,10. כתוצאה מכך, מחקר משמעותי התמקד ביצירה אוטומטית של פלטות צבעים ובמידול צבע תפיסתי. שיטות קיימות ליצירת צבע כוללות טכניקות המבוססות על מרחב הצבע CIELAB11. גישות אחרות משתמשות באלגוריתמי אשכול (clustering), כגון k-means, כדי לחלץ צבעים דומיננטיים מתמונות12. כתוצאה מכך, עבודות אחרונות אימצו יותר ויותר גישות מונחות-נתונים המבוססות על למידה חישובית לצורך מידול צבע.
במקביל, גישות של למידה עמוקה שיפרו משמעותית את זיהוי רכיבי ממשק המשתמש (UI) ואת הבנת הפריסה. רשתות נוירונים אפשרו ניתוח מבני מדויק יותר של ממשקים בנייד13. עם זאת, שיטות אלו מתמקדות בעיקר בדיוק הזיהוי ולעתים קרובות מזניחות היבטים ברמה גבוהה יותר, כגון שמישות קוגניטיבית, היררכיית פריסה ויעילות אינטראקציה. הוצעו גם מודלים גנרטיביים עבור סינתזה של פריסות UI14,15, אך הם ניצבים בפני אתגרים בשמירה על עקביות בין מסכים ובמתן החלטות עיצוביות ניתנות לפירוש16. גישות אחרות מתמקדות בדמיון ויזואלי או באיכות הרינדור, אך חסרות מסגרת מאוחדת המשלבת סמנטיקה של רכיבים, הרמוניה של צבעים ומגבלות שמישות17. זיהוי טקסט הוא חשוב אף הוא להבנת תוכן ה-UI. טכניקות כגון רשתות נוירונים רקורסיביות קונבולוציוניות (CRNNs) מאפשרות זיהוי מדויק של תבניות טקסט מורכבות במסכי ממשק18,19,20.
הוצעו מספר מערכות ליצירת קוד UI מתוך סקיצות או תמונות. Sketch2Code משתמשת בזיהוי אובייקטים כדי להמיר סקיצות לייצוגי קוד21,22, אך היא רגישה לאיכות התמונה. REDRAW מספקת תהליך (pipeline) אוטומטי לאיסוף נתונים ואימון מודלים, המשלב רשתות נוירונים קונבולוציוניות ורשתות נוירונים רקורסיביות כדי ליצור ייצוגי UI מובנים23,24. עבודות מאוחרות יותר הציגו מדדי הערכה משופרים לבחינת איכות ה-UI שנוצר25. גישות עדכניות יותר כוללות מודלים מבוססי דיפוזיה ומודלים מבוססי טרנספורמר ליצירת פריסה (layout), כגון diffusion layout transformers ללא שיטות autoencoder, יצירת פריסות GUI באמצעות גרפי סידור GUI מבוססי טרנספורמר, ויצירת פריסות UI המונחית על ידי מודלי שפה גדולים26,27,28. סקירה השוואית של גישות אלו מוצגת ב-טבלה 1.
| מקורות ושיטה(ות) מרכזית(יות) | מטרה | יתרונות | חסרונות |
| יצירה אוטומטית של ערכת צבעים לממשק משתמש מבוססת תמונה: חילוץ צבעים דומיננטיים + מידול צבעים תפיסתי CAM02-UCS¹ | יצירה אוטומטית של ערכות צבעים לממשק משתמש (UI) מתוך תמונות ייחוס, תוך אופטימיזציה של הרמוניה ויכולת שימוש. | ביסוס תפיסתי חזק (CAM02-UCS); מאזן באופן מפורש בין הרמוניה לשמישות (ניגודיות וגיוון); כולל יישום מבוסס רשת והערכה של מעצבים. | מתמקד אך ורק בצבע/בתמה (ולא בפריסה או במבנה הרכיבים); סינתזת ממשק משתמש (UI) המבוססת על כללים/היוריסטיקות ולא על למידה מקצה לקצה. |
| איחוד של יצירת פריסות באמצעות מודל דיפוזיה מופרד (LDGM)²⁵ | יצירת פריסה מאוחדת וגמישה עבור סצנות גרפיות וממשקי משתמש. | גיוון ויכולת בקרה בחזית הטכנולוגיה עבור יצירת פריסות (layout generation); תומך ביצירה מותנית ובסוגים מרובים של מאפיינים. | תוצרי דיפוזיה עשויים להפגין בעיות יישור או בעיות בסידור המבני (layout) ברמת פירוט גבוהה אלא אם יוטלו עליהם אילוצים; מורכבות מודל ועלות הסקה גבוהות יותר. |
| טרנספורמרים של פריסת דיפוזיה ללא שיטות אוטו-אנקודר: טרנספורמר + דיפוזיה ליצירת פריסה (ללא אוטו-אנקודר)²⁶ | שיפור הנאמנות וההלימה עבור מדדי ייחוס (benchmarks) של יצירת פריסה (מדדי FID, הלימה וחפיפה). | לכידה טובה יותר של מתאמים סמנטיים בין אובייקטים סמוכים; ביצועים חזקים במדדי FID ובמדדי יישור (alignment). | מתמקד בעיקר בגיאומטריית הפריסה (מיקומים, גדלים, קטגוריות) ולא בסמנטיקה של ממשק המשתמש (UI). |
| יצירת פריסות ממשק משתמש גרפי (GUI) באמצעות מודלים מבוססי Transformer מתוך גרפים של סידורי ממשק משתמש גרפי (GUI-AGs)²⁷ | יצירת פריסות של ממשק משתמש גרפי (GUI) מאילוצים מיקומיים/גרפיים כדי לסייע למעצבים. | ייצוגים גרפיים לוכדים אילוצים רלציוניים; טרנספורמר מאפשר יצירה גמישה המותנית באילוצים. | עשוי לדרוש גרפים של אילוצים מפורשים מהמעצבים; דגש מוגבל על צבע ומדדי שמישות. |
| יצירת פריסת ממשק משתמש (UI) באמצעות מודלי שפה גדולים (LLMs) בהנחיית דקדוק ממשק משתמש: מודלי שפה גדולים (LLMs) + דקדוק ממשק משתמש היררכי²⁸ | בחינת מודלי שפה גדולים (LLMs) ליצירת פריסות (layout generation) ושיפור הניתנות להסבר והשליטה באמצעות ייצוגי דקדוק. | בקרת יכולת גבוהה ויכולת הסבר; יכול להפיק תועה מלמידה בהקשר (in-context learning) ממודלי שפה גדולים (LLMs מסוג GPT). | עבודה בשלב מוקדם עם תיקוף אמפירי מוגבל; עיצוב דקדוק ועמידות בממשקי משתמש (UI) שונים |
טבלה 1: השוואה בין שיטות קיימות למידול צבעים וליצירת פריסות בממשק משתמש (UI). הטבלה מסכמת גישות מייצגות לעיצוב ממשקי משתמש, כולל יצירת ערכות נושאי צבע, יצירת פריסות מבוססת דיפוזיה, שיטות מבוססות טרנספורמר ויצירת פריסות מונחית מודלי שפה גדולים. עבור כל שיטה מוצגים הטכניקה הבסיסית, המטרה, היתרונות והמגבלות, תוך הדגשת ההבדלים במידול תפיסתי, ביכולת יצירת הפריסה, בשליטה ובשיקולי שמישות.
למרות התקדמות זו, נותרה מגבלה מרכזית: שום מערכת קיימת אינה משלבת באופן משותף זיהוי רכיבים, מידול צבע תפיסתי, עקרונות עיצוב קוגניטיביים ועקביות של פריסה במסכים מרובים בתוך מסגרת אחת מקצה לקצה1. גישות נוכחיות מבצעות בדרך כלל אופטימיזציה רק להיבט אחד או שניים — כגון זיהוי, פריסה או צבע — מבלי להתחשב בתלויות ההדדיות ביניהם. פיצול זה מדגיש פער מחקרי קריטי בפיתוח מערכות אוטומטיות מאוחדות וממוקדות-משתמש לבניית אבות-טיפוס של ממשקי משתמש (UI). בפרט, עקרונות עיצוב קוגניטיביים כגון חוקי הגשטאלט, חוק פיטס (Fitts’ law) וחוק היק (Hick’s law) נתפסים לעיתים קרובות באופן מושגי בלבד, במקום להיות משולבים באופן פורמלי במודלים חישוביים.
כדי להתגבר על מגבלות אלו, מחקר זה מציע מסגרת עבודה (framework) אוטומטית מקצה לקצה לאב-טיפוס של ממשק משתמש (UI), המשלבת זיהוי רכיבים, מידול צבע תפיסתי ועקרונות עיצוב קוגניטיביים בתוך מערכת מאוחדת. מסגרת העבודה תוכננה לשפר את איכות הפריסה, להפחית את העומס הקוגניטיבי, לשפר את ההרמוניה הצבעונית ולהגביר את השמישות הכוללת. שיפורים אלו תוקפו באמצעות ניסויים על מאגרי הנתונים RICO, ENRICO ו-Guo’s UI Color, המדגימים את היעילות של שילוב היבטים מבניים, תפיסתיים וקוגניטיביים בתוך צינור עיבוד (pipeline) אחד ואוטומטי לאב-טיפוס של UI. ההשערה היא ששילוב של זיהוי רכיבים מבוסס למידה עמוקה, מידול צבע תפיסתי ועקרונות עיצוב קוגניטיביים בתוך מסגרת עבודה מאוחדת ישפר באופן משמעותי את איכות אב-הטיפוס של ה-UI בהשוואה לגישות קיימות. באופן ספציפי, H1 מציעה כי מסגרת העבודה משפרת את איכות הפריסה, כולל יישור, קיבוץ וסדר קריאה. H2 גורסת כי מסגרת העבודה מפחיתה את העומס הקוגניטיבי של המשתמש. H3 מציעה כי מידול צבע תפיסתי משפר את תיאום הצבעים ואת ההרמוניה הוויזואלית. H4 קובעת כי השמישות הכללית והאיכות האסתטית של אבות-הטיפוס של ה-UI משתפרות.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
מחקר זה משתמש במאגרי נתונים הזמינים לציבור ואינו כולל נבדקים בבני אדם או בבעלי חיים.
מסגרת אב-הטיפוס האוטומטית המוצעת לממשקי משתמש (UI) משלבת הבנה מבנית מבוססת למידה עמוקה, מידול צבעים אחיד תפיסתי ועקרונות עיצוב קוגניטיביים כדי להפיק אבות-טיפוס של ממשקים קוהרנטיים וממוקדי-משתמש. המתודולוגיה מתחילה בארכיטקטורת Faster R-CNN שאומנה על מאגרי הנתונים RICO ו-ENRICO כדי לזהות רכיבי UI ולחלץ את היחסים ההיררכיים ביניהם, מה שמאפשר פרשנות מדויקת של פריסות מסך מגוונות. הרכיבים שזוהו מעובדים לאחר מכן על ידי מודול אינטליגנציית צבע, אשר מחלץ רמזי צבע המבוססים על מותג או תמונה, ממדל דמיון תפיסתי באמצעות CAM02-UCS, ומייצר פלטות צבעים הרמוניות, מודעות לניגודיות ועומדות בתקני נגישות. לאחר מכן, עקרונות עיצוב קוגניטיביים — כולל חוקי הקיבוץ של Gestalt, חוק פיטס (Fitts' law), חוק היק (Hick's law), ריווח מבוסס קשב ומגבלות היררכיה חזותית — מיושמים באמצעות מנוע אופטימיזציה קוגניטיבית כדי לזקק את הארגון המרחבי ואת יישור הרכיבים. לבסוף, שכבת הסקת מסקנות על הפריסה משלבת מגבלות מבניות, תפיסתיות וקוגניטיביות כדי להפיק אבות-טיפוס של UI עקביים בין מסכים שונים, המאזנים בין שמישות, אסתטיקה ובהירות פונקציונלית. צינור עיבוד משולב זה מבטיח קוהרנטיות תפיסית, מפחית עומס קוגניטיבי ועומד בעקרונות עיצוב ממוקד-אדם. זרימת העבודה המלאה של השיטה המוצעת מומחשת ב-איור 1.
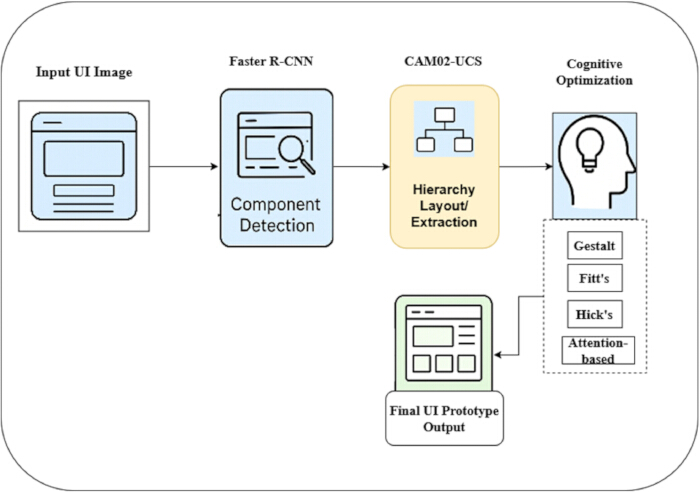
איור 1. ארכיטקטורה כללית של מסגרת העבודה המוצעת ליצירת אב-טיפוס אוטומטי של ממשקי משתמש. התרשים ממחיש את תהליך העבודה המלא, החל מתמונת ממשק משתמש כקלט. זיהוי רכיבים מבוצע באמצעות Faster R-CNN כדי לזהות את אלמנטי הממשק. הרכיבים שזוהו מעובדים לאחר מכן באמצעות מידול תפיסתי מבוסס CAM02-UCS לצורך חילוץ ההיררכיה והפריסה. לאחר מכן מיושמת אופטימיזציה קוגניטיבית המבוססת על עקרונות Gestalt, חוק פיטס (Fitts’ law), חוק היק (Hick’s law) והתאמות מבוססות קשב. החיצים מצביעים על זרימת הנתונים בין המודולים, המביאה לתוצר הסופי של אב-טיפוס ממשק המשתמש. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
סקירה כללית של המסגרת
איור 1 ממחיש את זרימת העבודה מקצה לקצה של מסגרת אב-טיפוס ממשק משתמש (UI) אוטומטית מוצעת, אשר הופכת צילום מסך גולמי של ממשק משתמש לאב-טיפוס מזוקק מבחינה קוגניטיבית. התהליך מתחיל בתמונת ממשק המשתמש הקלטית, המועברת למודול זיהוי רכיבים המבוסס על Faster R-CNN. מודול זה מזהה אלמנטים של ממשק כגון כפתורים, סמלים, שדות טקסט ומכלים, ומוציא את תיבות התחום ותוויות הסיווג התואמות להם. הרכיבים שזוהו מעובדים לאחר מכן בשלב חילוץ ההיררכיה והפריסה. בהתבסס על יחסים מרחביים ותבניות מבניות, המערכת בונה עץ פריסה היררכי המשקף את האופן שבו משתמשים תופסים באופן טבעי את ארגון המסך. ייצוג זה לוכד קיבוץ ויזואלי ותלויות מבניות בין אלמנטים של ממשק המשתמש. הפריסה שחולצה עוברת לאחר מכן זיקוק באמצעות אופטימיזציה קוגניטיבית על ידי יישום עקרונות עיצוב ממוקדי-משתמש. אלו כוללים קיבוץ Gestalt לצורך צבירה ויזואלית, חוק פיטס (Fitts’ law) לאופטימיזציה של גודל מטרת המגע והנגישות, חוק היק (Hick’s law) להפחתת מורכבות קבלת ההחלטות, וריווח מבוסס קשב לשיפור ההיררכיה הוויזואלית. כתוצאה מכך, הפריסה הופכת לאינטואיטיבית, קריאה ויעילה יותר לאינטראקציית משתמש. לבסוף, הפריסה האופטימלית משולבת עם מידול צבע תפיסתי ליצירת אב-טיפוס ממשק משתמש קוהרנטי. הממשק המתקבל הוא מדויק מבנית, הרמוני ויזואלית ותואם לציפיות שמישות אנושיות.
המסגרת יושמה באמצעות PyTorch 2.0 על Ubuntu 22.04. הניסויים נערכו במערכת המצוידת ב-GPU מדגם NVIDIA RTX 4090 (זיכרון VRAM של 24 GB). מודל Faster R-CNN השתמש ב-backbone מסוג ResNet-50 שאומן מראש על מאגר הנתונים ImageNet. האימון בוצע באמצעות אופטימייזר SGD (stochastic gradient descent) עם קצב למידה של 0.001, גודל אצווה (batch size) של 16, ועד 60 תקופות (epochs). כדי למנוע התאמת יתר (overfitting), הוחל מנגנון עצירה מוקדמת (early stopping) באמצעות קבוצת תיקוף שהכילה 20% מהנתונים. למרות שהאימון בוצע עד ל-60 תקופות, התכנסות הושגה בדרך כלל מוקדם יותר באמצעות עצירה מוקדמת בהתבסס על הפסד התיקוף (validation loss). ערכי ה-Momentum וה-weight decay נקבעו ל-0.9 ו-0.0005, בהתאמה. הרחבת הנתונים (Data augmentation) כללה נורמליזציה, היפוך אופקי אקראי, וכן חיתוך ושינוי גודל אקראיים.
הכנת מערך הנתונים
כדי לתמוך במסגרת המוצעת לאב-טיפוס אוטומטי של ממשק משתמש (UI), נעשה שימוש בשלושה סטים משלימים של נתונים: ENRICO29, RICO30, ומערך נתוני הצבעים של Guo's UI Color Dataset1. מערך הנתונים RICO מכיל 66,261 מסכי UI של אנדרואיד שנאספו מ-9,700 אפליקציות, ומספק גיוון רחב לזיהוי רכיבים והפקת פריסה היררכית. ENRICO כולל 1,464 צילומי מסך איכותיים של UI שסווגו ידנית ל-20 תבניות עיצוב, מה שמאפשר הכללה משופרת עבור הסקה מבנית ומידול עקביות של הפריסה. מערך הנתונים Guo’s UI Color Dataset מורכב מ-128 תמונות UI נבחרות עם ערכות נושא צבעוניות רשומות, המשמשות למידול צבע תפיסתי ולהערכת פלטת צבעים. עם זאת, בשל גודלו הקטן יחסית, מערך נתונים זה עשוי להכניס שונות מסוימת במאפייני הפריסה. עבור מחקר זה, הוכנה מערכת נתונים משולבת של 5,128 מסכים לאימון ולהערכה. באופן ספציפי, כ-4,000 תמונות מ-RICO שימשו לאימון מודל ה-Faster R-CNN לזיהוי רכיבים, 1,000 תמונות מ-ENRICO שימשו ללמידת תבניות פריסה ומידול עקביות מבנית, ו-128 תמונות ממערך הנתונים של Guo שימשו למשימות הערכת צבע. כל התמונות נורמלו לרזולוציה של 480 × 800 pixels, הומרו למרחב צבע sRGB אחיד, ועברו סימון מחדש עם תיבות תוחמות (bounding boxes) סטנדרטיות ומטא-נתונים היררכיים כדי להבטיח תאימות בין מערכי הנתונים. סקירה כללית של מערכי הנתונים ששימשו במחקר זה מוצגת ב-Table 2. מערך הנתונים RICO תומך בזיהוי רחב-היקף של רכיבי UI ובניתוח מבני, בעוד ש-ENRICO משפר את יכולת המודל לזהות תבניות פריסה ולאכוף עקביות בין מסכים. מערך הנתונים Guo’s UI Color Dataset, למרות גודלו הקטן, ממלא תפקיד קריטי בהערכת הרמוניה צבעונית תפיסית ומידול ניגודיות. יחד, מערכי נתונים אלו מספקים בסיס מקיף ומאוזן לאימון, תיקוף והערכה של המסגרת המוצעת לאב-טיפוס אוטומטי של UI.
| ערכה של נתונים | סך התמונות הזמינות | תמונות ששימשו במחקר | המטרה במסגרת המוצעת |
| מאגר הנתונים RICO30 | 66,261 | 4,000 | זיהוי רכיבי ממשק משתמש, חילוץ פריסה מבנית |
| מאגר הנתונים ENRICO29 | 1,464 | 1,000 | למידת תבניות עיצוב, מידול עקביות פריסה |
| סט הנתונים של צבעי ממשק משתמש של Guo1 | 128 | 128 | הפקת תבנית צבעים, הערכת צבע תפיסית |
| סך הכל משולב | 67,853 | 5,128 | מערך נתונים מקיף לזיהוי, פריסה ומידול צבע |
טבלה 2: סיכום מערכי הנתונים ששימשו במסגרת המוצעת. הטבלה מציגה את מערכי הנתונים ששימשו לאימון ולהערכה, כולל מערכי הנתונים RICO, ENRICO ו-Guo’s UI Color. היא מדווחת על המספר הכולל של התמונות הזמינות, תת-המערכה ששימשה במחקר זה, והתפקיד הספציפי של כל מערך נתונים בזיהוי רכיבים, מידול פריסה וניתוח צבע תפיסתי במסגרת המוצעת.
אסטרטגיית דגימה מרובדת יושמה כדי לשמר את הגיוון ברכיבי ממשק משתמש (UI), במבני פריסה ובפיזור הצבעים במאגרי הנתונים RICO, ENRICO ו-Guo. מאגר הנתונים פוצל לתתי-קבוצות של אימון (70%), תיקוף (15%) ובדיקה (15%) באמצעות דגימה מרובדת. התמונות נורמלו באמצעות ממוצע (0.485, 0.456, ו-0.406) וסטיית תקן (0.229, 0.224, ו-0.225). הרחבת נתונים (Data augmentation) כללה הפיכה אופקית אקראית (הסתברות = 0.5) וחיתוך אקראי (טווח קנה מידה: 0.8–1.0), ולאחריהם שינוי גודל ל-224 × 224 pixels שיושם במהלך האימון.
הערת רכיבים ועיבוד מקדים
מאגרי הנתונים RICO, ENRICO ו-UI Color Dataset של Guo תומכים יחד בשלושת הרכיבים הפונקציונליים המרכזיים של מסגרת אב-הטיפוס האוטומטית לממשקי משתמש (UI) המוצעת: זיהוי רכיבים, מידול פריסה ואופטימיזציה תפיסתית של צבעים. מאגר הנתונים RICO מכיל אוסף רחב של יותר מ-66,000 מסכי UI למובייל ומשמש בעיקר לאימון מודול זיהוי הרכיבים. הגיוון שבו מאפשר למודל Faster R-CNN ללמוד ייצוגים חסונים של אלמנטי UI נפוצים, כגון כפתורים, תמונות ושדות טקסט, במגוון רחב של יישומים. דבר זה מבטיח זיהוי ומיקום מדויקים של רכיבי UI תחת תנאי עיצוב משתנים. מאגר הנתונים ENRICO מספק מסכי UI באיכות גבוהה עם תיוג תבניות לצורך למידת קשרים מבניים ותבניות פריסה. הוא מאפשר למערכת להבין קשרים בין-רכיביים, ארגון היררכי ותבניות עיצוב נפוצות. מאגר נתונים זה ממלא תפקיד קריטי במידול מבני פריסה ואכיפת עקביות בין מסכים, ובכך מאפשר למסגרת לייצר פריסות התואמות למוסכמות עיצוב מקובלות. לעומת זאת, ה-UI Color Dataset של Guo משמש ספציפית למידול צבע תפיסתי וקוגניטיבי. בניגוד ל-RICO ו-ENRICO, המתמקדים בהיבטים מבניים, מאגר נתונים זה מכיל תמונות UI נבחרות עם תבניות צבע מתויגות. תיוגים אלו משמשים לאימון מודולים לחילוץ צבעים ולהערכת הרמוניה. באמצעות מיפוי קשרי צבע למרחבי צבע תפיסתיים כגון CAM02-UCS, המסגרת לומדת לייצר פלטות צבעים המאזנות בין ניגודיות, נגישות וקוהרנטיות אסתטית. יחד, מאגרי נתונים אלו יוצרים תהליך עבודה (pipeline) משולב: RICO תומך בזיהוי רכיבים, ENRICO מאפשר הבנת תבניות פריסה ועקביות מבנית, ומאגר הנתונים של Guo מסייע באופטימיזציה תפיסתית של צבעים. שילוב זה מבטיח שאב-הטיפוסים של ה-UI שנוצרו הם מדויקים מבנית, הרמוניים ויזואלית ואופטימליים מבחינה קוגניטיבית.
נורמליזציה בוצעה באמצעות ממוצע של [0.485, 0.456, 0.406] וסטיית תקנית של [0.229, 0.224, 0.225]. טכניקות של הגדלת נתונים (data augmentation), כולל חיתוך אקראי, היפוך אופקי וסיבוב, יושמו כדי לשפר את ההכללה של המודל. בנוסף, ערכי הפיקסלים הותאמו לטווח [0, 1], וכל התמונות שונו לרזולוציה של 480 × 800 פיקסלים כדי להבטיח עקביות בין סתי מאספי הנתונים. תמונות שגודלן שונה ל-224 × 224 פיקסלים משמשות להגדלה במהלך האימון, בעוד הרזולוציה המקורית של 480 × 800 פיקסלים נשמרת עבור ניתוח הפריסה (layout analysis). תיבות תוחמות (bounding boxes) הותאמו כדי לסנן הערות לא רלוונטיות באמצעות ספים שהוגדרו מראש. כדי להשיג אחידות בין סתי מאספי הנתונים, כל אלמנטי ממשק המשתמש (UI) סומנו ידנית באמצעות כלי הסימון LabelImg. סכימה שהוגדרה מראש נקבעה לפני הסימון כדי לסווג את אלמנטי ממשק המשתמש לקטגוריות כגון כפתור, טקסט, תמונה, אייקון ומכל (container). לייצוג תיבות התוחמות הוחלה מערכת קואורדינטות אחידה, ומידע היררכי נבנה על בסיס יחסים מרחביים בין האלמנטים והקשרים של הורה-ילד בתוך עץ הפריסה. בנוסף, נקבעו הנחיות להבטחת סימון עקבי של אלמנטים, טיפול נכון ברכיבים חופפים ואכיפת ספי גודל מינימליים במאספי הנתונים RICO, ENRICO ו-Guo.
ניסוחים מתמטיים מפורטים עבור אימון לזיהוי רכיבים והפקת תבנית פריסה מופיעים בקובץ משלים 1.
מודל ה-Faster R-CNN אומן באמצעות SGD עם momentum של 0.9 ו-weight decay של 0.0005. קצב הלמידה הראשוני נקבע ל-0.001 והותאם באמצעות מדיניות step decay המבוססת על ביצועי התיקוף. האימון בוצע עד ל-60 epochs עם batch size של 16. הוחל עצירה מוקדמת (Early stopping) כדי למנוע overfitting, תוך שימוש במערכת תיקוף המהווה 20% מנתוני האימון.
פונקציית המיפוי f(.) מקבלת כקלט אלמנטים מזוהים של ממשק המשתמש (UI) ומפיקה כפלט ייצוג פריסה היררכי. היא מחשבת יחסי סמיכות בין אלמנטים של ממשק המשתמש על בסיס מרחק מרחבי וקריטריוני יישור, ובונה מטריצת סמיכות כדי לייצג יחסים אלה. לאחר מכן, מיושם אלגוריתם קיבוץ (clustering), כגון DBSCAN, כדי לקבץ רכיבים קשורים. לבסוף, האלמנטים המקובצים מאורגנים למבנים היררכיים המבוססים על יחסי הורה-ילד, ובכך נוצר ייצוג פריסה מובנה.
ניסוחים מפורטים עבור מידול הרמוניה של צבעים ויעד האופטימיזציה המאוחד מופיעים בקובץ משלים 1.
פונקציית מטרה זו ממסגדת מתמטית את השילוב של זיהוי מבני, הסקת מסקנות לגבי פריסה ומידול צבע תפיסתי, ובכך מבטיחה שכל מרכיבי המסגרת יתרמו במשותף ליצירת אבות-טיפוס של ממשקי משתמש (UI) קוהרנטיים וממוקדי-משתמש. האופטימיזציה מבוצעת באופן מודולרי עבור כל מרכיב במסגרת. SGD משמש לאימון מודול זיהוי הרכיבים, בעוד שאופטימייזר Adam משמש במהלך האופטימיזציה המשותפת של פונקציית המטרה המאוחדת. המטרה המשולבת משמשת להנחיית ביצועי המערכת הכוללים. בשלבי האופטימיזציה המשותפת, פונקציית המטרה ממוזערת באמצעות אופטימייזר Adam עם קצב למידה של 0.001 וגודל אצווה (batch size) של 16. האימון מבוצע עד ל-60 epochs, כאשר מיושם עצירה מוקדמת (early stopping) כאשר השינוי בהפסד האימות (validation loss) הוא פחות מ-10−4 במשך חמישה epochs רצופים.
זיהוי רכיבים באמצעות Faster R-CNN
המסגרת המוצעת משתמשת ב-Faster R-CNN לזיהוי אוטומטי של רכיבי ממשק משתמש (UI), כולל כפתורים, סמלים, שדות טקסט, תמונות ומכלים. Faster R-CNN מתאים למשימה זו כיוון שהוא משלב דיוק גבוה בזיהוי אובייקטים עם יצירה יעילה של הצעות לאזורים (region proposal generation), דבר החיוני לטיפול בפריסות ממשק משתמש מורכבות המכילות אלמנטים צפופים. המודל משתמש בתשתית ResNet-50 שאומנה מראש על מאגר הנתונים ImageNet כדי להוציא מפות מאפיינים קונבולוציוניות מכל מסך ממשק משתמש. במהלך האימון, השכבות המוקדמות הוקפאו כדי לשמר מאפיינים חזותיים כלליים, בעוד שהשכבות הגבוהות יותר (conv4_x ו-conv5_x) עברו כיוונון עדין (fine-tuning) לזיהוי רכיבי ממשק משתמש ספציפיים. מפות מאפיינים אלו לוכדות מבנים חזותיים, קצוות, טקסטורות וגבולות של רכיבים. במהלך הזיהוי, רשת הצעת האזורים (RPN) מזהה אזורי מועמדים (anchors) שסביר שיכילו רכיבי ממשק משתמש. ה-anchors מוגדרים באמצעות סולמות מרובים (128, 256, ו-512) ויחסי גובה-רוחב (1:1, 1:2, ו-2:1) כדי להתאים לאלמנטי ממשק משתמש בגדלים שונים. במהלך האימון, anchors עם ערך intersection-over-union (IoU) הגבוה מ-0.7 ביחס לתיבות האמת (ground truth boxes) מסומנים כחיוביים, בעוד שאלו עם IoU נמוך מ-0.3 מסומנים כשליליים; anchors עם ערכי IoU ביניים נסוגים מההתחשבויות. לכל anchor מוקצית הסתברות המצביעה על נוכחות של רכיב. לאחר מכן מיושם דיכוי מקסימום לא (NMS) כדי להסיר הצעות עודפות וחופפות, מה שמבטיח מיקום יעיל של אלמנטי ממשק משתמש משמעותיים גם בממשקים עמוסים. לאחר יצירת אזורי המועמדים, כל הצעה מסווגת לקטגוריות רכיבים שהוגדרו מראש, וקואורדינטות תיבת החסם (bounding-box) שלה מעודכנות. פעולת ROI Align מוציאה ייצוגי מאפיינים בגודל קבוע עבור כל הצעה, אשר מעובדים לאחר מכן על ידי שכבות מחוברות באופן מלא (fully connected layers) לצורך סיווג ורגרסיה. ענף הסיווג פולט הסתברויות של מחלקות, בעוד שענף הרגרסיה חוזה קואורדינטות מדויקות של תיבת החסם. מודל ה-Faster R-CNN כולו מאומן מקצה לקצה על ידי אופטימיזציה של פונקציית הפסד משותפת המשלבת את הפסד ה-RPN עם הפסד הזיהוי הסופי. דבר זה מאפשר למערכת לא רק לזהות במדויק רכיבי ממשק משתמש, אלא גם למקם אותם בדיוק במבני ממשק מגוונים. תיאור מפורט של זיהוי רכיבים באמצעות Faster R-CNN, כולל שלב ה-RPN, סיווג ROI, עידון תיבת החסם ומטרת האופטימיזציה הסופית, מופיע ב-Supplementary File 1.
אלגוריתם S1 מספק את זרימת העבודה המפורטת לזיהוי רכיבים והפקה מבנית (קובץ משלים 1). הוא מתאר את התהליך המלא של זיהוי אוטומטי של רכיבי ממשק משתמש (UI) והפקה מבנית מתמונת מסך גולמית. תמונת הקלט עוברת תחילה עיבוד מקדים ומועברת דרך רשת CNN (backbone) כדי להפיק מאפיינים חזותיים עמוקים. מאפיינים אלו משמשים את ה-RPN ליצירת תיבות חסם (bounding boxes) מועמדות, אשר עוברות לאחר מכן עידון באמצעות סיווג ורגרסיה. NMS מסירה זיהויים עודפים כדי להבטיח מיקום מדויק. לאחר הזיהוי, הרכיבים מקובצים על בסיס קרבה מרחבית באמצעות קיבוץ מרחבי מבוסס צפיפות עם רעש (DBSCAN). שלב קיבוץ זה מאפשר בנייה של עץ UI היררכי הלוכד קשרי הורה-ילד וקיבוצים לוגיים בין רכיבים. ייצוג היררכי זה מהווה את הבסיס לניתוח פריסה (layout) והבנת UI בהמשך. איור 2 ממחיש את תהליך זיהוי הרכיבים של Faster R-CNN במסך UI של מכשיר נייד. ממשק הקלט (משמאל) מכיל אלמנטים של UI כגון כפתורים ובלוקים של טקסט, אשר נסגרים באופן אוטומטי בתוך תיבות חסם. אזורים מזוהים אלו מסווגים לאחר מכן לקטגוריות של רכיבים (למשל, Button ו-Text), כפי שמוצג על ידי חיבורים מסומנים. מודול הזיהוי Faster R-CNN (מימין) מעדן את קואורדינטות תיבות החסם, מקצה תוויות סמנטיות, ומפיק מידע מבני ברמת הרכיב. שלב זה משמש כבסיס קריטי לתהליכים עוקבים, כולל הפקת פריסה, אופטימיזציה קוגניטיבית ויצירת אב-טיפוס של UI, על ידי אספקת ייצוגים מדויקים בעלי משמעות סמנטית של רכיבי UI.
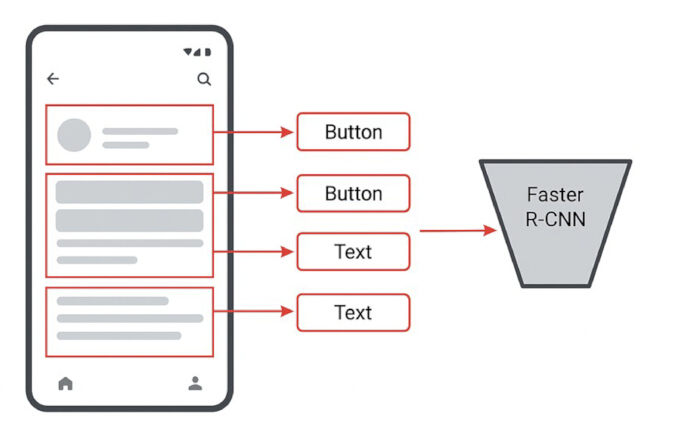
איור 2זיהוי רכיבים של אלמנטים בממשק משתמש באמצעות Faster R-CNN. האיור ממחיש את הזיהוי של רכיבי ממשק משתמש (UI) מתוך צילום מסך של ממשק קלט. אזורי עניין מזוהים באמצעות תיבות תוחמות, ואלמנטים כגון כפתורים ושדות טקסט מסווגים באמצעות Faster R-CNN. חצים מצביעים על המיפוי של הרכיבים המזוהים לתויות הסמנטיות המתאימות להם. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
חילוץ תבניות פריסה ומידול היררכי
בעקבות זיהוי רכיבים באמצעות Faster R-CNN, כל אלמנט בממשק המשתמש (UI) מיוצג על ידי תיבת תחום (bounding box). עם זאת, תיבות תחום אלו לבד אינן מעבירות את האופן שבו האלמנטים מאורגנים מבנית בתוך הממשק, למשל, אילו אלמנטים שייכים לכותרות, לסרגים של ניווט או לאזורי תוכן מקובצים. כדי לטפל במגבלה זו, הרכיבים שזוהו מומרים לעץ UI לוגי, שבו כל רכיב נחשב לצומת (node) ורכיבים הקשורים פונקציונלית או ויזואלית מקובצים תחת צמתים הורים משותפים. כדי לזהות קבוצות פריסה משמעותיות, מיושמות טכניקות קיבוץ (clustering) כגון DBSCAN או קיבוץ היררכי אגלומרטיבי. שיטות אלו מנתחות קרבה מרחבית ותבניות יישור בין הרכיבים כדי לזהות קשרים בין אלמנטים ב-UI. באופן המקביל לשיטות עיצוב אנושיות, המערכת לומדת לזהות תבניות מבניות נפוצות כגון כותרות (headers), כותרות תחתיות (footers), רשתות ובלוקים של תוכן. לאחר קביעת הקיבוץ, מנותחים מאפיינים מבניים נוספים — כולל יישור, ארגון רשתי וסדר קריאה — כדי לבנות ייצוג פריסה מקיף. לדוגמה, רכיבים המיושרים בעמודות בעלות רוחב שווה עשויים להעיד על פריסה מבוססת כרטיסים, בעוד שאלמנטים המסודרים בערימה אנכית עשויים להעיד על ממשק מבוסס טופס או פיד. באמצעות שילוב של קיבוץ, הסקת מסקנות מרחבית וכללי יישור, המסגרת בונה עץ UI היררכי הלוכד הן קיבוץ ויזואלי והן קשרים פונקציונליים. ייצוג היררכי זה משמש כבסיס לזיקוק הפריסה בהמשך ולמידול עקביות רב-מסכי, מה שמאפשר למערכת להפיק עיצובי ממשק מובנים, קוהרנטיים וממוקדי-משתמש.
נוסחאות מפורטות למרחק מרחבי ולדמיון יישור מופיעות בקובץ נלווה 1.
קיבץ (Clustering) עבור קיבוץ פריסה (DBSCAN)
לזיהוי קבוצות פריסה, מיושם אלגוריתם DBSCAN. DBSCAN משתמש בשני פרמטרים: (1) ε = המרחק המקסימלי בין רכיבים שכנים ו-(2) = המספר המינימלי של רכיבים הדרושים להיווצרות צביר. עבור ניתוח זה, פרמטרי ה-DBSCAN נבחרו באופן אמפירי בהתבסס על רזולוציית ממשק המשתמש (UI) הנורמליזית (480 × 800 pixels). פרמטר מרחק השכנות נקבע ל-ε = 50 pixels כדי ללכוד קרבה מרחבית בין רכיבי UI סמוכים. המספר המינימלי של נקודות הדרוש להיווצרות צביר נקבע ל-MinPts = 3 כדי למנוע היווצרות של קבוצות לא משמעותיות או שגויות של רכיבי UI.
הניסוח המפורט לבניית עץ ממשק המשתמש (UI) הלוגי מופיע בקובץ השלמה 1.
מידול צבע תפיסתי באמצעות CAM02-UCS
מידול צבע תפיסתי מבטיח כי הצבעים המשמשים בממשק המשתמש (UI) הנוצר יהיו הרמוניים, קריאים ויעילים מבחינה קוגניטיבית. צבעים דומיננטיים מחולצים ממקורי קלט, כגון תמונות של ממשקי משתמש, באמצעות טכניקות של קיבוץ (clustering). באופן ספציפי, מיושם קיבוב K-means עם אתחול K-means++ למשך 300 איטרציות כדי לקבל פלטות צבעים מייצגות. עם זאת, מרחב הצבע RGB אינו משקף במדויק את התפיסה החזותית האנושית, מה שאומר שצבעים דומים מספרית עשויים להיראות שונים מבחינה תפיסית. כדי לטפל במגבלה זו, כל הצבעים שחולצו מומרים ל-CAM02-UCS, שהוא אחיד תפיסית. במרחב זה, מרחקים שווים תואמים להבדלי צבע תפיסתיים שווים, מה שהופך אותו למתאים למידול הרמוניית צבעים וניגודיות. לאחר המיפוי ל-CAM02-UCS, הפרשי צבע תפיסתיים מחושבים באמצעות מרחק אוקלידי, מה שמאפשר למערכת לכמת ניגודיות, הרמוניה ושונות בין צבעים. צבעים הדומים מדי מופרדים כדי לשפר את הקריאות, בעוד שצבעים בעלי ניגודיות מופרזת ממתנים כדי למנוע אי-נוחות חזותית. הפלטה הנוצרת עומדת גם בתקני נגישות כגון WCAG AA ו-AAA, ומבטיחה ניגודיות מספקת בין אלמנטים של קדמה ורקע. יתרה מכך, הרמוניית צבעים נאכפת על ידי הגבלת הקשרי הפלטה לסכמות משלימות, אנלוגיות או טריאדיות, בהתאם לנושא הממשק המתוכנן. דבר זה מבטיח שפלטת הצבעים שתתקבל לא תהיה רק מושכת מבחינה חזותית, אלא גם נגישה פונקציונלית ואופטימלית מבחינה קוגניטיבית. כדי ללטש את הפלטה עוד יותר, מיושם תהליך אופטימיזציה תחת מגבלות של דמיון תפיסתי, ניגודיות, הרמוניה ועקביות מיתוגית. צבע עיקרי נבחר (למשל, מזהות המותג), וצבעים משניים מותאמים במונחים של לומיננסה וכרומה כדי לשמור על ההיררכיה החזותית. מנגנון הערכה מבוסס-כללים בוחן פלטות מועמדות על בסיס מרחקים תפיסתיים ומדדי נגישות, תוך מזעור המאמץ הקוגניטיבי ושמירה על איזון אסתטי. כתוצאה מכך, המסגרת מייצרת סכמות צבעים לממשק משתמש המפגינות לכידות, קריאות ועקביות תפיסית ברמה מקצועית.
ביטויים מתמטיים מפורטים עבור מידול צבע תפיסתי המבוסס על CAM02-UCS מופיעים בקובץ משלים 1.
אלגוריתם S2 (קובץ משלים 1) מתאר את זרימת העבודה להוצאה ואופטימיזציה של צבעים תפיסתיים המבוססת על CAM02-UCS תחת מגבלות של הרמוניה ונגישות. בתחילה, צבעים דומיננטיים מופקים מתמונת הקלט ועוברים טרנספורמציה ל-CAM02-UCS כדי להבטיח שהבדלי צבע תואמים לתפיסה אנושית. לאחר מכן, מרחקים תפיסתיים בין צבעים מחושבים ומוגבלים לטווחים שהוגדרו מראש כדי לשמור על בהירות והרמוניה כאחד. בהמשך, נגישות נאכפת על ידי הערכת יחסי ניגודיות של לומיננס (luminance contrast ratios) בהתאם להנחיות WCAG. הפלטה הסופית מתקבלת על ידי אופטימיזציה של פונקציית מטרה משולבת המאזנת בין ריווח תפיסתי, דרישות ניגודיות ומגבלות הרמוניה של צבעים. דבר זה מבטיח שסכמות הצבעים של ממשק המשתמש (UI) הנוצרות אינן רק מושכות ויזואלית, אלא גם קריאות, נגישות ועקביות מבחינה תפיסית.
אופטימיזציה של עיצוב קוגניטיבי
אופטימיזציה של עיצוב קוגניטיבי מבטיחה שפרוטוטיפי ממשק המשתמש (UI) הנוצרים באופן אוטומטי יהיו לא רק עקביים מבחינה חזותית, אלא גם קלים להבנה ואינטראקציה. מודול זה משלב עקרונות מפתח של עיצוב קוגניטיבי, כולל עקרונות הגשטלט, חוק פיטס וחוק היק, כדי להנחות את הסידור, הקיבוץ והריווח של רכיבי ממשק המשתמש. ניסוחים מתמטיים מפורטים עבור אופטימיזציה של עיצוב קוגניטיבי מופיעים ב-קובץ משלים 1.
מטרה משולבת לאופטימיזציה קוגניטיבית
הביטוי המתמטי למטרת האופטימיזציה הקוגניטיבית המשולבת מופיע ב-Supplementary File 1. מקדמים המייצגים את החשיבות של קיבוץ חזותי, יעילות אינטראקציה ומורכבות קבלת החלטות מסומנים באמצעות alpha, beta ו-gamma, בהתאמה. במחקר זה, ערכיהם של alpha, beta ו-gamma נקבעו באופן אמפירי באמצעות מערך נתוני התיקוף. עבור הניסוי הנוכחי, המקדמים נקבעו באופן הבא: α = 0.5, β = 0.3, ו-γ = 0.2. תצורה זו מספקת איזון יעיל בין קיבוץ חזותי, יעילות אינטראקציה ופשטות קבלת החלטות.
עקביות רב-מסמכיים ויצירת ממשק משתמש (UI)
מידול עקביות רב-מסכיים מבטיח שמסכים שונים בתוך אפליקציה יחלקו זהות ויזואלית, פריסה מבנית ותבנית אינטראקציה קוהרנטית. כאשר משתמשים מנווטים בין מסכים, הם מפתחים ציפיות לגבי מיקום אלמנטים, טיפוגרפיה, ריווח והיררכיה ויזואלית. כדי לענות על ציפיות אלו, המערכת מנתחת תבניות חוצות-מסכים באמצעות תבניות שנגזרו ממאגרי הנתונים RICO ו-ENRICO. תבניות אלו לוכדות מבני UI נפוצים כגון פריסות של "בית–פירוט" (home–detail), תבניות של "רשימה–פירוט" (list–detail), טפסים רב-שלביים ותזרימי לוח בקרה (dashboard). באמצעות השוואה של מיקום רכיבים והתנהגות קיבוץ, המערכת בונה פרופיל מבני חוצה-מסכים המזהה אילו אלמנטים צריכים להישאר עקביים ואילו עשויים להשתנות. לאחר זיהוי התבניות המבניות, המסגרת אוכפת עקביות בסולמות טיפוגרפיים, יחסי ריווח, פריסות רשת ועגינות ניווט. לדוגמה, סרגלי כותרת שומרים על גובה עקבי, כפתורי ראשיים שומרים על גודל ויישור אחידים, ובלוקים של תוכן עוקבים אחר סדר ויזואלי צפוי. דבר זה מושג באמצעות תהליך רגולריזציה של פריסה המעריך כל מסך אל מול אילוצים מבניים גלובליים. אם מסך חורג מהתבניות שנלמדו — כגון ריווח (padding) לא עקבי או כותרות שאינן מיושרות — המערכת מתאימה אוטומטית את הפריסה כדי להשיב את הקוהרנטיות. תיקונים אלו מסייעים בהבטחת חוויית משתמש (UX) חלקה ומפחיתים את עלויות ההחלפה הקוגניטיבית בין מסכים. המסגרת מנתחת בנוסף את גרף הניווט בין המסכים כדי לשמור על עקביות בזרימת האינטראקציה. תבניות ניווט נפוצות, כולל מעברים קדימה/אחורה, ניווט מבוסס לשוניות ותהליכי עבודה רב-שלביים, מזוהות ונאכפות. כל מעבר עובר אימות כדי להבטיח התאמה למודל המנטלי של המשתמש, ובכך לשפר את השמישות ולהפחית בלבול. כתוצאה מכך, מודל העקביות הרב-מסכיים ממזער רעש ויזואלי, מגביר את תחושת המוכרות ומקדם חוויית אינטראקציה מאוחדת.
ניסוחים מתמטיים מפורטים עבור עקביות רב-מסכית ויצירת ממשק משתמש (UI) מסופקים ב- קובץ משלים 1.
לבסוף, מנוע הרינדור מייצר פלטים חזותיים בפורמטים כגון wireframes ב-SVG, אבות-טיפוס ב-HTML/CSS, או דגמי UI מבוססי פיקסלים. מסכי ה-UI שהתקבלו מציגים סדר קריאה נכון, קשרים צבעוניים הרמוניים, יישור רשת מדויק והיררכיה חזותית עקבית לאורך מספר מסכים.
אלגוריתם S3 מספק את זרימת העבודה לאופטימיזציה של הפריסה הקוגניטיבית-חזותית ועקביות רב-מסמכית (קובץ משלים 1). אלגוריתם S3 מתאר את תהליך האופטימיזציה הקוגניטיבי והמבני המשולב המשמש ליצירת פריסות ממשק משתמש (UI) ידידותיות למשתמש. הוא משלב קיבוץ תפיסתי (עקרונות הגשטלט), יעילות אינטראקציה (חוק פיטס) ופשטות קבלת החלטות (חוק היק) בתוך מסגרת אופטימיזציה מאוחדת. תחילה, נקשרים יחסים מרחביים בין רכיבים כדי לבסס קיבוצים תפיסתיים. לאחר מכן, יעילות האינטראקציה מותאמת על ידי כיוונון גודל הרכיבים ומיקומם, בעוד שמורכבות קבלת ההחלטות נשלטת על ידי הגבלת מספר הבחירות המוצגות למשתמשים. בנוסף, האלגוריתם אוכף עקביות רב-מסמכית על ידי התאמת כל מסך לתבניות פריסה נלמדות, ובכך מבטיח אחידות בטיפוגרפיה, בריווח ובארגון המבני. פונקציית אופטימיזציה רב-מטרתית מזככת לאחר מכן את הפריסה על ידי איזון בין יישור, ריווח ועלות קוגניטיבית, מה שמוביל לממשק שהוא גם קוהרנטי חזותית וגם יעיל קוגניטיבית. באופן כללי, אלגוריתם זה מבטיח שפריסות רב-מסמכיות שנוצרו ישמרו על רמות גבוהות של עקביות חזותית, שמישות ובהירות תפיסתית.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
מסגרת אב-טיפוס ממשק המשתמש (UI) האוטומטית המוצעת הוערכה באמצעות מערך נתונים משולב של 5,128 מסכי UI משלושה מקורות: 4,000 תמונות RICO, 1,000 מסכי ENRICO, ו-128 דגימות UI עם הערות צבע מתוך ה-UI Color Dataset של Guo. מערך נתונים מעורב זה מספק מדד ייחוס (benchmark) מאוזן להערכת דיוק זיהוי הרכיבים, בהירות מבנית של הפריסה, עקביות בין מסכים והרמוניה צבעונית תפיסית.
תוצאות ניסיוניות מדגימות כי מודל הזיהוי המבוסס על Faster R-CNN משיג דיוק של 92.4% בזיהוי רכיבים ומכליל ביעילות סגנונות ממשק משתמש (UI) ניי...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
הממצאים מדגימים שיפורים בעלי מובהקות סטטיסטית בישימות, בארגון המבני ובאיכות התפיסית (p < 0.05), ומאששים את היעילות של שילוב עקרונות עיצוב קוגניטיביים באבטיפוסים אוטומטיים של ממשקי משתמש (UI). בניגוד למערכות מסורתיות ליצירת ממשקי משתמש המסתמכות בעיקר על זיהוי חזותי או על היוריסטיקות מבוססות-כללים, המסגרת המוצעת משלבת קיבוץ גשטאלט, מידול היררכי, מגבלות ריווח וקריאות תפיסית לאורך כל תהליך השחזור של ממשק המשתמש. שיפורים שנצפו ב-NASA-TLX, SUS ו-SET מאשרים עוד הפחתה בעלת מובהקות סטטיסטית בעומס הקוגניטיבי (NASA-TLX, p.<...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
למחברים אין ניגודי עניינים.
תודות
המחברים מודים על התמיכה האקדמית והמוסדית שניתנה על ידי Wuhan College of Foreign Languages & Foreign Affairs, Keimyung University, ו-Shanghai Institute of Commerce and Foreign Languages במהלך השלמת מחקר זה.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| מעבד (CPU) | AMD Ryzen 9 7950X (16 ליבות, 32 תהליכים, 4.5–5.7 GHz) | Advanced Micro Devices (AMD), ארה"ב | Ryzen 9 7950X |
| ערכת הכלים CUDA (CUDA Toolkit) | גרסה 11.8 | NVIDIA Corporation, ארה"ב | CUDA Toolkit 11.8 |
| cuDNN | גרסה 8.9 | NVIDIA Corporation, USA | cuDNN v8.9 |
| Faster R-CNN | מודל לזיהוי אובייקטים (עם רשת להצעת אזורים - Region Proposal Network) | Meta AI Research / Detectron2 | מסגרת העבודה Detectron2 |
| Matplotlib | גרסה 3.7 | צוות הפיתוח של Matplotlib | v3.7.0 |
| NVIDIA RTX 4090 GPU | כרטיס גרפי 24 GB GDDR6X | NVIDIA Corporation, סנטה קלרה, קליפורניה, ארה"ב | RTX 4090 |
| NumPy | גרסה 1.24 | מפתחי NumPy | v1.24.0 |
| OpenCV | גרסה 4.8 | קרן OpenCV | v4.8.0 |
| PyTorch | גרסה 2.0 | PyTorch Foundation (Meta AI) | v2.0.0 |
| ResNet-50 עם FPN | רשת CNN בסיסית (Backbone) עם רשת פירמידת מאפיינים (Feature Pyramid Network) | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | גרסה 1.3 | מפתחי Scikit-learn | v1.3.0 |
| SciPy | גרסה 1.10 | קהילת SciPy | v1.10.0 |
| זיכרון מערכת (RAM) | 64 GB DDR5 | Corsair / Kingston (או מקבילה להם) | ערכה של DDR5 בנפח 64GB |
| מערכת ההפעלה Ubuntu | גרסה 22.04 LTS | Canonical Ltd., UK | Ubuntu 22.04 LTS |
מקורות
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.