פרוטוקול זה מתאר את פיתוח והערכתו של צ'אטבוט מבוסס הנחיות, מבוסס הנחיות, שאוסף ומסכם תוכן מהנחיות פרקטיקה קלינית מבוססת רשת לסרטן כדי ליצור תגובות מבוססות התייחסות לשאילתות משתמשים.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר שיטה
פיתוח צ'אטבוט מבוסס הנחיה מבוסס הנחיה לדור שאיבה מוגבר, המתייחס לקווי מנחים לפרקטיקה קלינית מבוססת רשת לסרטן
במאמר זה
סיכום
תקציר
הזמינות הנרחבת של מידע רפואי באינטרנט שיפרה את הגישה לידע הקשור לבריאות עבור המטופלים; עם זאת, היא גם הגבירה את החשיפה למידע רפואי שגוי. טיפול בסרטן כולל מידע מורכב, מה שמקשה על המטופלים לזהות מקורות מדויקים ומבוססי ראיות. מודלים גדולים מאפשרים אינטראקציה עם שפה טבעית אך לעיתים קרובות יוצרים הזיות, מה שמגביל את יישמתן בהעברת מידע רפואי. ייצור משודרג בשחזור (RAG) יכול להפחית סיכונים אלו על ידי עיגון תגובות במקורות ייחוס חיצוניים. מחקר זה מתאר את פיתוח והערכתו של צ'אטבוט RAG המבוסס על הנחיות, המשתמש בהנחיות קליניות מבוססות רשת לציבור. המערכת מחלקת כתובות URL מדפי תוכן העניינים של המנחה, מעבדת טקסט עמוד באמצעות ניתוח מורפולוגי ודמיון קוסינוסי בהתבסס על תדירות מונחים ותדירות הפוכה של מסמך, ובונה מידע הפניה מדפים רלוונטיים מאוד. מודל שפה גדול משתמש בהפניות אלו כדי לייצר תגובות המוגבלות לתוכן המנחה. מדריך JLCS לחולי סרטן ריאות ומשפחותיהם שימש כהנחיה עיקרית. מערכי השאלות כללו גם סוגי סרטן בתוך ההיקף המכוסים בהנחיה וגם סוגי סרטן מחוץ לתחום להערכת ביקורת תגובה. מידע רפואי חולץ בהצלחה מדפי תוכן העניינים, כאשר 98% מהכתובות שהופקו הכילו תוכן רפואי שניתן להתייחס. בשאלות בתוך היקף, הצ'אטבוט יצר תגובות על ידי סיכום תוכן ההנחיות, ולא זוהו הזיות במהלך הבדיקה הידנית תחת תנאי הבדיקה שהוגדרו. בשאלות מחוץ לתחום, הצ'אטבוט סירב בעקביות לענות והציין שהמידע הזמין אינו מספיק. מבנה האינטרנט של המדריך אפשר גירוד יעיל וארגון של תוכן ההפניה ברמת ה-URL. פרוטוקול זה מספק הנחיות מעשיות לבניית מערכות בינה מלאכותית המספקות מידע רפואי באמצעות הנחיות קליניות מבוססות רשת.
מבוא
השימוש הנרחב באינטרנט וברשתות החברתיות הקל על המטופלים לגשת למידע רפואי 1,2. מידע על טיפול בסרטן הוא לעיתים קרובות מורכב ונרחב, מה שמקשה במיוחד על המטופלים לזהות מקורות מדויקים, רלוונטיים ומבוססים על ראיות מדעיות3. בעוד שמשאבים מקוונים יכולים לתמוך בהבנת המטופל, הם גם מכילים כמויות משמעותיות של מידע רפואי שגוי3, מה שעלול להשפיע לרעה על החלטות המטופלים לגבי הטיפול שלהם4. מכיוון שמידע שגוי הקשור לסרטן יכול להשפיע על תוצאות המטופלים5, יש צורך גובר במערכות בינה מלאכותית (AI) שיכולות לסייע למשתמשים בודדים לחפש, לסכם ולפרש מידע רפואי6.
מודלים לשוניים גדולים (LLMs) מאפשרים למשתמשים לגשת למידע דרך שיחה בשפה טבעית7; עם זאת, יצירת מידע שגוי (כלומר, הזיות) נותרה דאגה רצינית בתחום הרפואה 8,9,10,11. מקור מרכזי למידע שגוי הוא איכות ודיוק נתוני האימון ששימשו לפיתוח הצ'אטבוט. בנוסף, האופי הסטטי של אימון מודלים גורם לכך שהידע עלול להפוך למיושן עם הזמן, מה שמגביל את יכולתם של מודלים גדולים גדולים לספק מידע עדכני ורלוונטי להקשר12,13. מגבלות אלו מדגישות את החשיבות של אסטרטגיות ניהול ידע יעילות כדי להבטיח שתגובות הצ'אטבוטים יישארו מדויקות, רלוונטיות ומעודכנות. במיוחד, מערכות שיכולות לגשת בקלות ולהתייחסות למשאבים מבוססי ראיות עדכניים, כגון הנחיות לפרקטיקה קלינית, רצויות בסביבות רפואיות, שבהן ההמלצות והסטנדרטים של הטיפול משתנים כל הזמן. כדי להתמודד עם אתגר זה, יצירת שליפה-מוגברת (RAG), שמייצרת תגובות על ידי שילוב מידע ממקורות ידע חיצוניים, זכתה לתשומת לב גוברת 10,13,14,15,16,17.
למרות ש-RAG מיושם יותר ויותר בצ'אטבוטים רפואיים, הושם דגש מוגבל על האופן שבו יש לשלב באופן שיטתי הנחיות פרקטיקה קלינית כמקורות מידע עיקריים18. הנחיות רבות לפרקטיקה קלינית זמינות לציבור באינטרנט; עם זאת, עדיין לא ברור אם מבנה האינטרנט הקיים שלהם יכול לשמש ישירות כמסגרת שליפת למערכות RAG18. בנוסף, שיטות מעשיות לבניית מידע ייחוס ללא פיתוח מבוסס ידע ידני לא הוכחו היטב.
במחקר זה, מטרתנו לקבוע עקרונות עיצוב למערכות בינה מלאכותית המתייחסות להנחיות בתחום הרפואה על ידי פיתוח והערכה של צ'אטבוט RAG מבוסס הנחיות, המשתמש בהנחיות קליניות מבוססות רשת הזמינות לציבור, ובכך לאפשר גישה פשוטה ובזמן למידע מבוסס הנחיות. כהוכחת מושג, הערכנו את ההיתכנות הטכנית של שליפת הנחיות, יצירת תגובות והגבלת תגובה באמצעות מבנה האינטרנט הקיים של הנחיות לפרקטיקה קלינית זמינה לציבור, במטרה להציע פרוטוקול פיתוח שניתן לשחזר למערכות RAG המונחות על פי הנחיות.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
מחקר זה אינו כולל נבדקים אנושיים הזקוקים להגנה מפני סיכונים הכרוכים במחקר. לכן, אין צורך בבדיקה של ועדת ביקורת מוסדית בהתאם להנחיות האתיקה היפניות למחקר רפואי הכולל נבדקיםאנושיים 19. מחקר זה מדווח בהתאם לדיווח שקוף של מודל רב-משתני לפוגנוזה או אבחון אישי (TRIPOD)-LLM20.
עיין באיור 1 לסקירה סכמטית של פרוטוקול הצ'אטבוט RAG המבוסס על הנחיות.
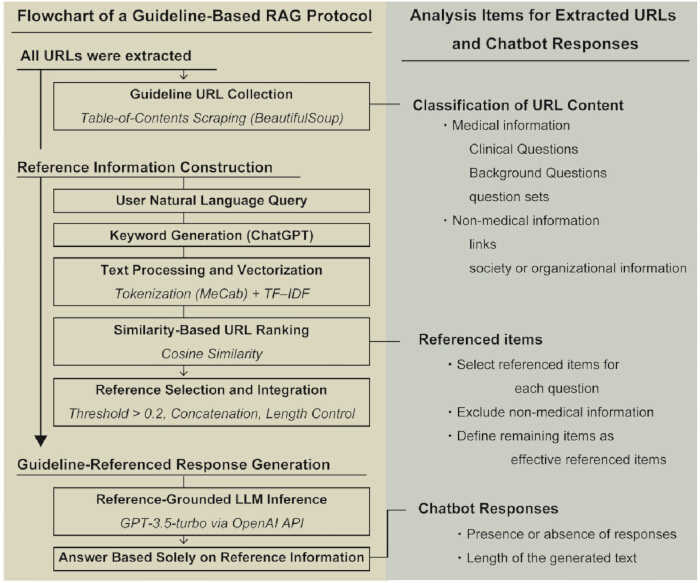
איור 1. זרימת העבודה של פרוטוקול הצ'אטבוט RAG מבוסס הנחיות. סקירה סכמטית של זרימת העבודה בצ'אטבוט RAG המבוססת על הנחיות. כתובות URL מופקות מדף תוכן העניינים של הנחיות קליניות מבוססות רשת ומשמשות לבניית מידע הפניות. שאילתות משתמשים מומרת למילות מפתח, ותוכן דף האינטרנט מעובד באמצעות טוקניזציה, וקטוריזציה של תדירות מונחים–הפוך לתדירות מסמכים, וניתוח דמיון קוסינוסי לזיהוי דפי הנחיות רלוונטיים. מידע ייחוס נבחר משולב ומסופק למודל שפה גדול כדי לייצר תגובות המבוססות אך ורק על תוכן ההנחיה המוזכר. הפאנל הימני מסכם את פריטי ההערכה ששימשו לכתובות URL שחולצו, מידע הפניה ותגובות לצ'אטבוט. אנא לחצו כאן כדי לצפות בגרסה מוגדלת של הדמות הזו.
1. הכנת מידע מקובע מהנחיות מבוססות רשת
- חלצו את כל כתובות ה-URL מדפי תוכן העניינים של הנחיות הפרקטיקה הקלינית מבוססת האינטרנט באמצעות BeautifulSoup 4 (ספריית ניתוח HTML) המיושמת בשפת התכנות Python (גרסה 3.12).
הערה: מימוש סקריפט חילוץ ה-URL באמצעות שפת התכנות עם החבילות הבאות: ספריית ניתוח HTML (גרסה 4.12.3) ובקשות (ספריית שליפת דפי אינטרנט; גרסה 2.32.3). התקן חבילות באמצעות pip. קוד המקור המלא לחילוץ כתובות מסופק בקובץ משלים 1. ראו את טבלת החומרים לפרטי תוכנה. - בדוק ידנית את כל כתובות ה-URL שחולצו כדי לאשר גישה מוצלחת ורלוונטיות להנחיות הפרקטיקה הקלינית היעד.
- סווג כל כתובת URL כמכילה מידע רפואי או לא-רפואי. בצע סיווג כתובת URL לפי מחבר אחד (S.N.).
הערה: מידע רפואי הוגדר כתוכן הנחיות שניתן להתייחס, כולל שאלות קליניות (CQs), שאלות רקע וסטים של שאלות. מידע לא רפואי כלל קישורים, דפי חברה או ארגונים, ותוכן נלווה נוסף שלא היה מתאים לעיון. - הרכיבו את כתובות ה-URL המאומתות לתוך חוברת עבודה של Microsoft Excel (פורמט .xlsx), כאשר כתובת URL אחת נרשמת בכל שורה. שמרו את רשימת ה-URL שהתקבלה כמאגר קלט לניתוח שליפת טקסט, עיבוד מוקדם וניתוחי דמיון נוספים.
2. יצירת מילות מפתח משאילתות משתמשים
- הזן את שאילתת השפה הטבעית ל-ChatGPT (Generative Pretrained Transformer, גרסה 4o; מודל יצירת מילות מפתח).
- בדוק את המודל לחלץ שתי מילות מפתח המתאימות לשאילתת המשתמש.
- השתמשו בהנחיה הבאה, שנכתבה ביפנית, ליצירת מילות מפתח:
"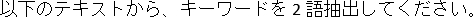 "
(תרגום לאנגלית: "חלץ שתי מילות מפתח מהטקסט הבא.") - צרף את שאילתת השפה הטבעית של המשתמש לפקודה זו והגיש אותה למודל יצירת מילות מפתח ליצירת מילות מפתח.
- אל תשנה ידנית אף פרמטרי מודל. בצע יצירת מילות מפתח באמצעות הגדרות ברירת המחדל של מודל יצירת מילות מפתח.
- יצר שתי מילות מפתח לכל שאילתת משתמש. שמרו על שתי מילות המפתח ללא שינוי, סינון או בחירה ידנית נוספת, והשתמשו בהן לחישובי דמיון נוספים.
- אחסן את מילות המפתח שנוצרו בחוברת עבודה של Microsoft Excel (בפורמט .xlsx). לכל רשומה, שמרו את שאילתת המשתמש המקורית ואת מילות המפתח שנוצרו בהתאם לשליפת המשך המבוססת על דמיון.
3. עיבוד טקסט וחישוב דמיון
- שלפו את תוכן הטקסט המלא מכל כתובת URL שחולצה באמצעות ספריית שליפת הדפים וספריית ניתוח ה-HTML. חילוץ תוכן טקסט ממקור ה-HTML באמצעות פונקציית BeautifulSoup get_text().
- עבדו מראש את טקסט דף האינטרנט והמילות מפתח שנוצרו על ידי הסרת תגיות HTML ותווים שאינם יפניים.
- בצע ניתוח מורפולוגי יפני באמצעות MeCab (גרסה 0.996; מנתח מורפולוגי יפני) עם מילון ברירת מחדל. שמור רק שמות עצם ומחבר אותם למחרוזת טקסט מוגבלת למרחב.
- משלבים את מילות המפתח שנוצרו למחרוזת טקסט אחת והחלו את אותם פרה-עיבוד וטוקניזציה שמשמשים לטקסט דף אינטרנט.
- יצירת וקטורי תדירות מונחים–תדר מסמך הפוך (TF–IDF) מתוך טקסט דף האינטרנט המעובד וטקסט מילות מפתח באמצעות מימוש TfidfVectorizer בספריית scikit-learn (גרסה 1.6.1) עם הגדרות פרמטרים ברירת מחדל.
הערה: כל פרמטרי TfidfVectorizer נותרו בערכיהם המוגדרים כברירת מחדל, ולא הוחלו הגדרות פרמטרים מותאמות אישית. - חשב את דמיון הקוסינוס בין כל וקטור דף אינטרנט לווקטור מילות המפתח באמצעות פונקציית הדמיון של הקוסינוס.
- דרגו כתובות URL בסדר יורד לפי ציוני דמיון קוסינוס. אין להחיל קריטריונים נוספים לשבירת שוויון.
- בחרו עמודים עם ציון דמיון קוסינוס של ≥0.2 כמידע על המועמדות.
הערה: סף הדמיון הקוסינוסי (0.2) נבחר אמפירית במהלך פיתוח המערכת כדי לתת עדיפות לשליפת שליפה ולהימנע מהחרגת תוכן הנחיות רלוונטי פוטנציאלי. - שמור את כל דפי המועמדים שעומדים בסף הדמיון.
4. בניית מידע רפרנס
- חלץ ברצף את תוכן הטקסט של הדפים הנבחרים מראש הרשימה המדורגת.
- לאחד את הטקסטים שהופקו ליצירת מסמך ייחוס אחד.
- לפני ההגשה למודל הגדול, החלף תווים חדשים ותווי רווח לבן עוקבים בטקסט ההתייחסות בריבוע יחיד.
- קיצוץ את טקסט ההתייחסות המקושר ל-4,096 התווים הראשונים לפני שמספקים אותו ל-LLM.
הערה: מגבלת הקיצור התבססה על תווים ולא על טוקנים. נבחרה מגבלה של 4,096 תווים באופן אמפירי כדי להבטיח שהמידע המשולב של ההנחיות וההפניה יישאר במסגרת קיבולת הקלט של מודל GPT-3.5-turbo-16k ליצירת תגובה.
5. יצירת תגובה מבוססת בינה מלאכותית
- ספק את מידע ההתייחסות שנבנה ואת שאילתת המשתמש המקורית למודל יצירת התגובה דרך ממשק תכנות היישומים (API).
- הנחו את הבינה המלאכותית באמצעות ההנחיה הבאה (שנכתבה כולה ביפנית) כדי לוודא שהתשובות נוצרות אך ורק על בסיס מידע ההפניה שסופק:
"אתה עוזר מידע רפואי שמספק הדרכה לחולי סרטן. יצר תגובות בהתבסס אך ורק על המידע הבא, ואל תשתמש בידע או בהיגיון הכללי שלך. התשובות צריכות להיות מפורטות וקלות להבנה, באורך של כ-500 תווים. אם המידע המקורי אינו מכיל מספיק מידע כדי לענות על השאלה, השיב: 'אין מספיק מידע בטקסט,' מבלי להשתמש בספקולציה או בידע כללי." - ספק את מידע ההפניה ושאילתת המשתמש יחד בתוך הודעת משתמש אחת. מבנה את הקלט כך: "מידע הפניה: [טקסט הפניה]" ואחריו "שאלה: [שאילתת משתמש]".
- יצר תגובות באמצעות מודל יצירת תגובות עם ההגדרות הבאות: טמפרטורה = 0.1, אורך פלט מקסימלי = 1,024 טוקנים, n = 1, ועצירה = אין.
- קבלו את התגובה שנוצרה על ידי הבינה המלאכותית להערכה נוספת.
הערה: שלחו את פרטי ההפניה ושאילתת המשתמש כהודעה של משתמש יחיד. ספק את הוראות יצירת התגובה בנפרד כהודעה מערכתית.
6. הנחיות מקורות וניסוח שאלות
- בחרו במדריך JLCS לחולי סרטן ריאות ומשפחותיהם (מדריך ריאות)21, הזמין בחינם באינטרנט, כמידע עיוני למערכת הצ'אטבוטים המבוססת על ההנחיות RAG.
- צרו שתי קטגוריות של שאלות הערכה בהתבסס על סוג הסרטן: גידולי תימיים, שנמצאים בתחום ההנחיה, וגליומה ילדים, שאינה בתחום המידע המוזכר.
- נסחו ארבע שאלות הכוללות אבחון וטיפול בכל סוג סרטן:
"אילו שיטות אבחון זמינות לגידולים XX (למשל, טימיים או גליומה ילדים)?"
"מהן הגישות האבחנתיות הפתולוגיות לגידולים XX?"
"אילו אפשרויות טיפול זמינות לגידולים XX?"
"מהן אפשרויות הטיפול הכירורגי לגידולים XX?" - שלח שאלות הקשורות לסוגי סרטן המכוסים על ידי ההנחיות המקוונות המוזכרות לצ'אטבוט. לדוגמה, הגישו שאלה בנוגע לאבחון גידול תימי תוך שימוש במדריך הריאות כמידע מקור.
- שלחו שאלות מחוץ להיקף ההנחיות של ההפניה לצ'אטבוט כדי להעריך את יכולתו להימנע משימוש במידע חיצוני או לא קשור. לדוגמה, הגישו שאלה בנוגע לגליומה ילדים תוך שימוש במדריך הריאות כמידע מקור.
- העריכו כל שאלה במפגש צ'אט עצמאי. אל תעביר היסטוריית שיחה בין שאלות.
- רשמו את התגובות שנוצרו על ידי הבינה המלאכותית להערכה הבאה.
7. הערכת תגובה
- בצע סקירה ידנית של כל התגובות שנוצרו.
- העריך האם כל תגובה מכילה הזיות.
- העריך האם כל תגובה נתמכת במידע הכלול בהנחיות המקור.
הערה: הזיות הוגדרו כתגובות המכילות אירועים, שמות או מונחים שלא קיימים שעלולים לגרום לנזק רפואי14. כל התגובות שנוצרו נבדקו לדיוק ולהיעדר הזיות על ידי מחבר אחד עם 8 שנות ניסיון בבית חולים אוניברסיטאי, כולל תמיכה במטופלים ותקשורת רפואית עבור חולי סרטן. כל אי-ודאות לגבי סיווג התגובה נפתרה באמצעות שיחה עם רופא שותף בעל ניסיון של למעלה מ-20 שנה בשירותי מידע לסרטן במרכז הלאומי לסרטן ביפן. - יש לשקול שתגובה נתמכת רק כאשר כל ההצהרות הרלוונטיות קלינית ניתנות לאישור ישיר מההנחיות המקוריות שנאספו מבלי לדרוש ידע נוסף או הסקה לא מגובה.
- סווג כל תגובה באמצעות תוויות תוצאה מוגדרות מראש. סווג תגובות המכילות רק מידע הנתמך בהנחיית ההפניה כ"חסרה הזיה". סווג תגובות המכילות מידע לא נתמך או מזויף כ"הזיה נוכחת".
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
אחזור תוכן רפואי דרך דפי תוכן העניינים
ארכיטקטורת גרידת האתרים אספה כתובות URL מדף תוכן העניינים של ההנחיה. מתוך מדריך הריאות נלקחו 106 כתובות URL מדף תוכן העניינים, מתוכם 104 (98%) הכילו מידע רפואי (טבלה משלימה 1). היעילות של תגובות הצ'אטבוטים בהתבסס על דפי תוכן ההנחיה מסוכמת בטבלה 1. הצ'אטבוט יצר תשובות לכל ארבע מילות המפתח הקליניות כאשר השאלות היו בתחום ההנחיה. לצורך "אבחון גידול תימי" ו"אבחון פתולוגי", הוצ...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
במחקר זה בחנו את התועלת של צ'אטבוט RAG מבוסס הנחיה שהשתמש במדריך קליני מבוסס רשת — מדריך JLCS לחולי סרטן ריאות ומשפחותיהם — כמקור מידע עיווני. הצ'אטבוט יצר תגובות מבוססות על תוכן ההנחיות על ידי ניצול מבנה האינטרנט של המדריך ושליפת דפים בהתבסס על הדמיון לשאילתות המשתמשים. גישה זו הראתה כי שליפה מבוססת דמיון בשילוב עם יצירת תגובות מבוססות הנחיה יכולה לתמוך בהעברת מידע רפואי אמין ויעיל. מחקרים עדכניים הדגישו הן את הפוטנציאל והן את המגבלות של צ'אטבוטים רפואיים מבוססי LLM, במיוחד בנוגע להזיות...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
המחברים מצהירים שאין להם אינטרסים מתחרים.
תודות
המחברים מודים לד"ר קניצ'י אינואה, דוקטור (מרכז השד בבית החולים שונאן ממוריאל), על תמיכתו הטכנית הנרחבת בפיתוח הצ'אטבוט המבוסס על הנחיות, מבוסס הנחיות. המחברים גם מודים לד"ר צ'יקקו ימאקי, ולכל חברי צוות המחקר במכון לבקרת סרטן, המרכז הלאומי לסרטן יפן (טוקיו, יפן), על מתן עצות חשובות בנושא שנדון במאמר זה. בנוסף, המחברים מודים ל-Editage על העריכה באנגלית. עבודה זו נתמכה במענק מחקר למדעי הבריאות והעבודה (R6–Cancer Control–23EA1026).
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
```html
```
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Beautiful Soup 4 (version 4.12.3) | פרויקט Beautiful Soup | לא חל | ספריית Python המשמשת לחילוץ URL ולניתוח HTML |
| ChatGPT version 4o | OpenAI | לא חל | משמש לייצור מילות מפתח |
| GPT-3.5-turbo | OpenAI | לא חל | משמש לייצור תגובות |
| JLCS Guidebook for Lung Cancer Patients and Families | Japan Lung Cancer Society | לא חל | הנחיה קלינית מבוססת אינטרנט המשמשת כמידע עזר |
| MeCab (version 0.996) | MeCab Project | לא חל | מנתח מורפולוגי יפני |
| OpenAI API | OpenAI | לא חל | משמש לייצור תגובות מבוססות AI |
| Python (version 3.12) | Python Software Foundation | לא חל | סביבת תכנות |
| Requests (version 2.32.3) | Requests Project | לא חל | ספריית Python המשמשת לשליפת דפי אינטרנט |
| scikit-learn (version 1.6.1) | מפתחי scikit-learn | לא חל | משמש לווקטוריזציה של TF–IDF וחישוב דמיון קוסינוס. |
| urllib.parse | Python Software Foundation | לא חל | ספריית Python המשמשת לנורמליזציה וחיבור URL |
מקורות
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.