העבודה מציעה מסגרת מקצה לקצה לניתוח רגשות רב-מודאלי, המנצלת מקודדי transformer, ייצוגי רגשות מופרדים (disentangled) ותשומת לב חוצת-מודאליות מבוססת גרפים עם מיפוי חזותי, במטרה לשפר את דיוק זיהוי הרגשות בשני מאגרי נתונים.
מאמר מחקר
מיפוי חזותי של מאפייני רגש רב-מודאליים לעיצוב אינטראקציה חכמה
במאמר זה
סיכום
תקציר
מיפוי חזותי של מאפייני רגש רב-מודאליים הוא חיוני לתכנון ממשקים חכמים, שכן הוא מאפשר למכונות להבין, לפרש ולהגיב למצבים רגשיים אנושיים. עם זאת, אלגוריתמים נוכחיים לזיהוי רגשות רב-מודאליים מתמקדים בעיקר בביצועים חיזויים, ומספקים תובנות מועטות לגבי יכולת הפרשנות, מודעות לאינטראקציה או אינטראקציות בין-מודאליות ברמת המאפיינים. עבודה זו הציגה מסגרת למיפוי חזותי של היבטי רגש רב-מודאליים המשלבת ויזואליזציה מכוונת-אינטראקציה, למידת ייצוג ניתנת לפרשנות וחיזוי רגשות. ללא שימוש במאפיינים שנוצרו ידנית, נעשה שימוש במקודדים מבוססי transformer כדי לחלץ שימועים (embeddings) רגשיים ברמה גבוהה ממודליות טקסטואליות, קוליות וחזותיות. כדי לשפר את החסינות, מידע ספציפי לרגש ומידע ספציפי למודליות הופרדו באמצעות טכניקה של למידת ייצוג מופרדת (disentangled representation learning). בנוסף, פותחה רשת קשב בין-מודאלית מבוססת גרף כדי להשתמש בשקלול קשב אדפטיבי לצורך סימולציה של קשרים רגשיים עדינים בין המודליות. מודול מיפוי חזותי רב-מבטי פותח כדי לתאר מסלולי רגש זמניים, התפלגויות קשב בין-מודאליות ושימועים רגשיים חבויים במטרה לשפר את השקיפות. מאגר הנתונים Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) של אוניברסיטת קרנגי מלון ומאגר הנתונים הסיני לניתוח סנטימנט רב-מודאלי (CH-SIMS) שימשו להערכת המסגרת המוצעת. על פי תוצאות ניסיוניות, המסגרת המוצעת סיפקה יכולת פרשנות משופרת ברמת המאפיינים וויזואליזציה מודעת-אינטראקציה, תוך שהיא עולה בעקביות בביצועיה על טכניקות בסיס מייצגות במונחים של דיוק, F1-score, מתאם וטעות מוחלטת ממוצעת. בנוסף, מודול המיפוי החזותי סייע בפרשנות איכותנית של ייצוגי רגש רב-מודאליים, אינטראקציות בין-מודאליות ודינמיקה רגשית זמנית, ובכך תמך בויזואליזציה ובניתוח מודעים-אינטראקציה.
מבוא
היכולת לזהות ולהבין נכונה רגשות אנושיים הפכה למכריעה לשיפור האינטראקציה בין בני אדם למכונות. בנוסף להיותו חיוני לשיפור האינטראקציה בין אדם למחשב, לניתוח רגשות יש פוטנציאל לחולל מהפכה במספר תחומים, כולל אבחון רפואי טרום-דיאגנוסטי1, ניתוח התנהגותי בכיתות לימוד2, מעקב פסיכולוגי אחר מטופלים3, זיהוי עייפות בכלי רכב4, וניהול חכם בסביבות בית חכם5. התפתחויות אחרונות במחשוב רגשי (affective computing) ובלמידה עמוקה6 הגבירו את העניין ביצירת מערכות בזמן אמת המסוגלות ללכוד את המורכבות של הרגש האנושי.
שיטות רבות כיום מסתמכות בעיקר על נתונים חד-מודאליים (unimodal), כגון סימנים טקסטואליים, גרפיים או שמיעתיים7,8,9. גישות אלו נכשלות שוב ושוב בזיהוי אותות מעודנים, כגון סרקזם או ניואנסים תלויי-הקשר. המחקר עבר להערכת רגשות רב-מודאלית (multimodal), המשלבת נתונים משלימים ממקורות מרובים כדי להתגבר על מגבלות אלו10,11,12. היתרונות של מיזוג מודאליות מרובות הודגמו על ידי מודלי בסיס כגון early fusion-long short-term memory (EF-LSTM)13, רשתות עצביות עמוקות מסוג light and FM (LF-DNN)14, רשתות tensor fusion (TFN), וגישות מיזוג רב-מודאליות בדרגה נמוכה (low-rank). עם זאת, רוב הגישות הללו מסתמכות על יצירת מאפיינים במצב לא מקוון (offline) ואינן מתאימות למצבים דינמיים בעולם האמיתי.
על מנת להכיל מצבים רגשיים, מחקרי ויישומי זיהוי רגשות רב-מודאליים גדלו במהלך עשר השנים האחרונות15. אחד מתחומי המחקר המאתגרים והמשמעותיים ביותר כיום הוא ניטור רציף של מצבים רגשיים באמצעות מגוון מקורות נתונים16. הרעיון של רב-מודאליות הופיע באופן טבעי למדי עם עלייתם של מערכות ידע מגוונות שכאלה, והוא הוביל להתקדמויות רבות ביישום רגשות בתחומים כגון מחשוב רגשי, אינטראקציית אדם-מחשב (HCI), למידה, משחקי וידאו, שירות לקוחות, טיפול רפואי, הערכת חווית משתמש (UX) ועוד. עם זאת, לא תמיד היה פשוט ליישם טכניקות לזיהוי רגשות בהערכת UX.
אחת הסיבות העיקריות להתמקדות בזיהוי רב-מודאלי (multimodal) במקום בשיטות חד-מודאליות היא החסרונות המובנים בהסתמכות על מקור מידע יחיד. מערכות לזיהוי רגשות חד-מודאליות עלולות לסבול מדיוק נמוך יותר עקב נתונים חסרים או לא ברורים, בעוד שסכמות MER הן אמינות יותר ומציעות הבנה מקיפה ומעמיקה יותר של מצבים הבעתיים על ידי שילוב של מספר מקורות נתונים17. לדוגמה, שפת פנים לבדה עשויה שלא להספיק כדי לסווג רגשות בצורה מדויקת, במיוחד כאשר המחוות מורכבות או לא ברורות. עם זאת, שילוב של הבעות פנים עם צורות תקשורת אחרות, כגון שפה או רמזים פיזיים, עשוי להעלות את רמת הדיוק בזיהוי הרגשות.
מחקרים נרחבים על זיהוי רגשות נערכו במספר מודליות. מחקרים מוקדמים התמקדו בזיהוי מאפיינים מבדילים ממודליות שונות, כגון קלט גרפי, אקוסטי או מבוסס טקסט. עם זאת, הולך ומתברר ששילוב של מודליות שונות יכול לספק מידע רגשי מאוזן, המוביל לזיהוי סנטימנט מהימן ומדויק יותר. חלק זה סוקר התקדמויות מרכזיות בניתוח רגשות במודליות בודדות ובניתוח רב-מודלי, תוך התמקדות בגישות הבסיס, בחסרונותיהן ובנימוקים לשיטה שלנו.
המחקר הראשוני על זיהוי רגשות התמקד בעיקר במודאליות אחת. בתחום הראייתי, מחקר פורץ דרך הוביל לסיווג של תנועות פנים פרוטוטיפיות20. התקדמויות מאוחרות יותר כללו טכניקות ללכידת דינמיקה זמנית, כגון תנועה חזותית21 ומודלי מרקוב חבויים22, בעוד שתגובות פנים חולקו ליחידות פעולה באמצעות מערכת קידוד פעולות פנים (FACS)23. רשתות LSTM ורשתות נוירונים קונבולוציוניות (CNNs) שימשו בהצלחה להפקת מאפיינים משמעותיים ישירות מאותות שמע גולמיים; מתודולוגיות לזיהוי רגשות מבוסס שמע התקדמו מעיבוד אותות קונבנציונלי ללמידה עמוקה24. הפקת אותות סנטימנטים הקשריים בניתוח רגשות מבוסס טקסט שופרה משמעותית על ידי רשתות נוירונים רקורסיביות (RNNs) המשלבות מנגנוני קשב, ולאחרונה, על ידי מודלים מבוססי Transformer. למרות הישגיהן, טכניקות של מודאליות אחת אינן מסוגלות מטבען לייצג במדויק את המורכבויות שבני האדם חווים, כיוון שחסר להן המידע המשלים שנמצא במודאליות אחרות.
מספר מודלים המבוססים על מנגנוני קשב (attention mechanism), כגון מודל DialogXL25, הוצעו בשנת 2021 כדי לאסוף נתונים סביבתיים לטווח ארוך יותר בתחום זיהוי סנטימנט בשיחות. Kim et al.26 הציגו בשנת 2021 את מודל EmoBERTa במטרה להגביר את הדיוק של ERC. מודל זה משתמש בנתוני הדוברים כדי לשפר את מאפייני הדוברים בשיחות ואת האינטראקציות שלהם זה עם זה. בשנת 2022, Li et al.27 הציגו את שיטת CoG-BART. שיטה זו משתמשת בלמידה ניגודית מונחית (supervised contrastive learning) כדי לשפר את יכולתו של המודל לפרש נתונים רלוונטיים. יש לציין כי למידה מונחית דורשת כמות ניכרת של נתונים מתויגים.
דוגמה טיפוסית לעבודה מסוג זה היא מסגרת ה-Multimodal Interaction-Aware Representation (MIAR)28, המשתמשת בטוקנים של אינטראקציית מאפיינים וביישור ניגודי (contrastive alignment) כדי לשפר את ההכללה בין מודליות שונות. MIAR משפרת את יישור המודליות ומשיגה ביצועים חזקים במספר מערכי נתונים; עם זאת, היא מתמקדת בעיקר בדיוק חיזוי מבלי להתייחס למיפוי חזותי. באופן דומה, מודל ה-Cross-Attentional Audio-Visual Fusion29 לוכד ביעילות אינטראקציות אודיו-ויזואליות ברזולוציה גבוהה לצורך חיזוי ערות (arousal) וולנס (valence), אך הוא מוגבל לשתי מודליות וחסר יכולות ויזואליזציה. גישות למידול זמני המבוססות על רשתות LSTM ומיזוג אוטואנקודר לוכדות בהצלחה את הדינמיקה הזמנית של רגשות, אך מספקות תובנה מוגבלת לגבי אינטראקציות בין מודליות והייצוגים הרגשיים שנלמדו. לאחרונה, שיטות מבוססות טרנספורמר, כגון ה-Transformer-based Multimodal Fusion Network (TMFN)30, הדגימו ביצועים חזקים ב-CMU-MOSI וב-CMU-MOSEI באמצעות מיזוג רב-מודלי משופר ולמידה ניגודית. עם זאת, גישות אלו נותרות בעיקר מונעות ביצועים ומספקות תמיכה מוגבלת ביכולת הסבר (explainability), פרשנות ברמת המאפיין וויזואליזציה מוכוונת-אינטראקציה.
כדי לשפר את השילוב של נתונים טקסטואליים, אקוסטיים וויזואליים, הוצעו מספר טכניקות לזיהוי רגשות רב-מודאלי (multimodal). למרות שלא הצליחו ללכוד אינטראקציות מורכבות בין מודאליות שונות, טכניקות מיזוג מוקדם כגון EF-LSTM ו-LF-DNN הדגימו את היתרונות של שימוש במידע רב-מודאלי לצורך ניתוח סנטימנט ורגשות. אף על פי שה-TFN שיפר את הביצועים במאגרי נתונים סטנדרטיים כגון CMU-MOSI ו-CMU-MOSEI והציג מידול מפורש של אינטראקציות בין-מודאליות, הפרשנות המוגבלת שלו והמורכבות החישובית הגבוהה עיכבו את יעילותו. כדי לשפר את היישור בין המודאליות (modality alignment) ואת מיזוג התכונות הדינמי, טכניקות מודרניות יותר כגון MIAR, מודלי מיזוג בעלי תשומת לב צולבת (cross-attentional fusion), TMFN וטרנספורמרים רב-מודאליים אדפטיביים השתמשו בטופולוגיות של טרנספורמר ובמנגנוני קשב (attention mechanisms). שיטות אלו התמקדו בעיקר בביצועים חיזויים, והעניקו תובנות מועטות לגבי ייצוגים רגשיים ברמת התכונה ותלויות בין-מודאליות, וזאת למרות השגתן תוצאות תחרותיות במדדי הערכה נפוצים כגון accuracy, F1-score ו-mean absolute error. יתרה מכך, מחקרים מעטים ביססו טכניקות ויזואליזציה שיכולות לחשוף קידודי רגש חבויים (latent emotion embeddings), התפלגויות קשב ודינמיקה רגשית זמנית, או שילבו מידול מבוסס גרפים של אינטראקציות בין-מודאליות. הגישה המוצעת משלבת מיפוי ויזואלי רב-מבטי, מיזוג קשב צולב מבוסס גרפים ולמידת ייצוג מופרדת (disentangled representation learning) כדי להתגבר על חסרונות אלו ולשפר את ביצועי זיהוי הרגשות הרב-מודאלי.
בדומה לכך, ה-Adaptive Multimodal Transformer32 מציע מיזוג מבוסס-החלפה כדי למתן באופן אדפטיבי מידע מודאלי רועש או חסר, ובכך לשפר את ביצועי סיווג הסנטימנט. למרות שגישה זו יכולה לטפל ביעילות בפערים בהפצה של המידע המודאלי, תכנונה ספציפי למשימה של ניתוח סנטימנט והיא מספקת תובנה מוגבלת לגבי הייצוגים הרגשיים שנלמדו. תרומה משמעותית נוספת היא ה-Multimodal Fusion Model33, המשלב רשתות CNN, רשתות LSTM כפליות ומנגנוני קשב מבוססי-טרנספורמר לזיהוי רגשות מולטי-מודאלי בזמן אמת. המודל מבצע מיזוג מלא של מודליות וידאו, אודיו וטקסט ומראה ביצועי זיהוי חסונים. עם זאת, בדומה למודלים קיימים אחרים, הוא מתמקד בעיקר בדיוק החיזוי וחסר מאפיינים מפורשים לוויזואליזציה וליכולת פירוש המכוונת לאינטראקציה.
לסיכום, בעוד שגישות עדכניות לזיהוי רגשות רב-מודאלי השיגו הצלחה ניכרת בלכידת אינטראקציות בין-מודאליות ובשיפור דיוק התחזיות, רובן מתמקדות במשימות מונחות-זיהוי. תחומים כגון פרשנות ברמת המאפיינים, ויזואליזציה של ייצוגים רגשיים במרחב התמונה, ושילוב המסגרת המוצעת לעיצוב אינטראקציה חכמה קיבלו תשומת לב מועטה. עם אתגרים אלו לנגד עינינו, מוצגת המסגרת המוצעת.
מרבית השיטות הנוכחיות מתמקדות בעיקר בשיפור ביצועי החיזוי תוך שהן מציעות יכולת פרשנות מוגבלת של ייצוגים רגשיים נלמדים ואינטראקציות בין-מודאליות, וזאת למרות התקדמויות בולטות בזיהוי רגשות רב-מודאלי28,29. לעיתים קרובות קשה לאסטרטגיות היתוך נוכחיות למדל אינטראקציות מורכבות בין מודאליות טקסטואליות, אקוסטיות וויזואליות, במיוחד כאשר מתרחשים פערים בין המודאליות ומחסור במידע 28,31. בעוד שעיצובים מבוססי-transformer ומנגנוני קשב שיפרו את למידת הייצוג, השקיפות והפרשנות שלהם נפגעות לעיתים קרובות בשל היעדר הפרדה מפורשת בין מידע ספציפי לרגש למידע ספציפי למודאליות31,32,33. בנוסף, רק מספר קטן של מחקרים בחנו מידול מבוסס-גרף של אינטראקציות בין-מודאליות או יצרו מסגרות ויזואליזציה שיכולות לחשוף דינמיקה רגשית זמנית, התפלגויות קשב ושיבוצים רגשיים (emotion embeddings). חסרונות אלו מדגישים את הצורך במסגרת רב-מודאלית הניתנת לפרשנות עבור אינטראקציה חכמה בין אדם למכונה, המשלבת מיפוי ויזואלי מוכוון-אינטראקציה עם למידה בין-מודאלית חזקה.
עבודה זו מציגה מסגרת ניתנת לפירוש למיפוי חזותי של היבטי רגש רב-מודאליים בעיצוב ממשקים חכמים. ללא צורך במאפיינים שנוצרו ידנית, המערכת משתמשת בלמידה עמוקה מקצה לקצה (end-to-end) כדי לחלץ ייצוגים רגשיים ברמה גבוהה ממודליות טקסטואליות, קוליות וחזותיות. אינטראקציות רגשיות חוצות-מודאליות ממודלות באמצעות מנגנון היתוך תשומת לב (attention fusion) מבוסס גרף המפריד בין מידע ספציפי לרגש לבין מידע ספציפי למודאליות, מה שמאפשר למידה של ייצוגים מופרדים ומשפר את יכולת הפירוש ואת החוסן של המערכת. בנוסף, פותח מודול ויזואליזציה רב-מבטים להצגת דינמיקה רגשית זמנית, דפוסי תשומת לב חוצי-מודאליות ושיבוצי רגש (emotion embeddings). היעילות וההתאמה של המסגרת המוצעת במערכות אינטראקציה חכמות בין אדם למכונה נבחנות באמצעות תיקוף על מאגרי נתונים סטנדרטיים לזיהוי רגשות רב-מודאליים.
עבודה זו מציעה מסגרת ייחודית למיפוי חזותי של היבטי רגש רב-מודאליים, החורגת מגישות מסורתיות מוכוונות-חיזוי כדי להתגבר על מידול לקוי של אינטראקציות בין-מודאליות ועל הפרשנות המוגבלת במערכות נוכחיות לזיהוי רגשות רב-מודאליים. בתוך ארכיטקטורה אחת, הגישה המוצעת משלבת למידת ייצוג רב-מודאלית מבוססת transformer, מידול תכונות מופרד (disentangled) מודע-רגש, מיזוג קשב בין-מודאלי מבוסס גרף, וויזואליזציה מוכוונת-אינטראקציה. המסגרת מפרידה בבירור בין ייצוגים ספציפיים לרגש לבין ייצוגים ספציפיים למודאליות כדי לשפר את הפרשנות, החסינות והעקביות הבין-מודאלית, בניגוד לגישות נוכחיות המתמקדות בעיקר בביצועי הסיווג. בנוסף, מוצג מנגנון קשב מבוסס גרף המאפשר מידול אדפטיבי של אינטראקציות בין-מודאליות על ידי לכידה של תלות רגשית ברמת פירוט גבוהה בין מודאליות טקסטואלית, קולית וחזותית. מודול מיפוי חזותי רב-מבטים נוצר כדי להגביר את השקיפות באמצעות חשיפת מסלולי רגש זמניים, דפוסי קשב בין-מודאליים והטמעות (embeddings) רגשיות חבויות, המספקים תובנות אינטואיטיביות לגבי תהליך קבלת ההחלטות של המודל. בנוסף לאספקת ויזואליזציה ופרשנות משופרות של דינמיקה רגשית רב-מודאלית, הערכה ניסיונית על מאגרי הבקרת CH-SIMS ו-CMU-MOSEI הראתה ביצועים תחרותיים במונחים של דיוק, F1-score, שגיאה מוחלטת ממוצעת ומתאם.
פרוטוקול
העבודה המוצעת שואפת לשפר את עיצוב האינטראקציה החכמה על ידי הגשת מסגרת ניתנת לפירוש למיפוי חזותי של מאפייני רגש רב-מודאליים. בעבודה זו נעשה שימוש במאגרי הנתונים CH-SIMS ו-CMU-MOSEI, הזמינים לציבור. שני מאדרי הנתונים נרכשו מהמקורות הרשמיים שלהם ונוצלו בהתאם להנחיות השימוש, תקני המחקר ותנאי הרישוי שנקבעו על ידי יוצריהם. התוכן הרב-מודאלי של מאדרי הנתונים, הכולל נתוני טקסט, אודיו ווידאו, נאסף ותויג תחילה על ידי ספקי מאדרי הנתונים בהתאם להסכמות המשתתפים המאושרות ופרוטוקולי איסוף הנתונים שלהם. במחקר זה לא התקיימה אינטראקציה אנושית ישירה, לא גויסו משתפים חדשים ולא נאסף מידע המאפשר זיהוי אישי. כל ניתוח בוצע באמצעות מאדרי נתונים מחקריים הזמינים לציבור. כתוצאה מכך, ניתוח הנתונים המשני שלנו לא הצריך אישור אתי נוסף או סקירה של ועדת הלסינקי (IRB). המחקר בוצע בהתאם לנורמות מוסדיות מתאימות השולטות בשימוש במאדרי נתונים הזמינים לציבור, נהלי מחקר אתיים ומדיניות שימוש בנתונים רלוונטית.
מנגנון קשב צלב-מודאלי (cross-modal attention) מבוס גרפים הועסיק כדי ללמוד אפיוני רגש על פני מודאליות שונות, תוך שימוש במאפיינים ספציפיים לרגש או למודאליות כדי לשפר את ההבנה. רכיב מיפוי חזותי רב-מבט משמש לשיפור עיצוב אינטראקטיבי מודע-רגש בזמן אמת, ויעילותו מוערכת עבור זיהוי רגשות. הממצאים מראים כי השיטה המוצעת משפרת הן את יכולת הפירוש והן את היעילות עבור ממשקי משתמש חכמים מודעים-רגש בעולם האמיתי. איור 1 מציג את זרימת העבודה הארכיטקטונית של העבודה המוצעת. איור 1 מציג את זרימת העבודה המלאה של מסגרת המיפוי החזותי המוצעת ללמידת מאפייני רגש מולטי-מודאליים בהקשר של מערכות אינטראקציה חכמות. זרימת העבודה מתחילה בשלוש מודאליות קלט מסונכרנות, דהיינו טקסט, אודיו ווידאו, הלוכדות מידע רגשי משלים ממודאליות בלשבית, פרוזודית והבעות פנים, בהתאמה. מקודד טרנספורמר ספציפי למודאליות מעבד כל מודאליות כדי להשיג ייצוגים ברמה גבוהה של נתוני הקלט הגולמיים. הייצוגים מוזנים לאחר מכן למודול למידת ייצוגים מופרדים (disentangled representation learning), שבו ההטמעות הספציפיות לרגש מופרדות מהמאפיינים הספציפיים למודאליות כדי להבטיח עקביות ברגשות הנלמדים על פני מקורות נתונים הטרוגניים. ההטמעות הספציפיות לרגש מכל מודאליות מרוכזות לאחר מכן על ידי רשת קשב צלב-מודאלית מבוססת גרפים, הממדלת את התלויות הרגשיות הבין-מודאליות ומקצה משקולות חשיבות דינמיות לכל מודאליות בהתבס על הקשר האינטראקציה. לבסוף, המסגרת מספקת הן פלטי סיווג רגשות והן תובנות אינטראקטיביות, המקלות על קבלת החלטות שקופה מודעת-רגש ועל עיצוב אינטראקציה חכם ואדפטיבי.
רכישת נתונים רב-מודאלית
מאגרי הנתונים CH-SIMS ו-CMU-MOSEI הם שני מאגרי נתונים מולטי-מודאליים קיימים בנחלת הכלל, אשר אספו מידע מולטי-מודאלי, כגון וידאו, אודיו וטקסט מסונכרונים. מאגר הנתונים CH-SIMS כולל בחינות מולטי-מודאליות של סינים, הכוללות 2,281 מקטעי וידאו, שנגזרו ממספר מקטעי וידאו מסרטים, דרמות טלוויזיוניות ותוכניות בידור. מחקרים על ניתוח מולטי-מודאלי של רגשות באמצעות נתונים מולטי-מודאליים הופכים למעניינים וישימים יותר על ידי הוספת אודיו וטקסט תואמים למקטעי וידאו אלו. עם זאת, אחד מאגרי הנתונים המולטי-מודאליים הגדולים ביותר לבחינת דעה, תחושות ורגש הוא מאגר הנתונים CMU-MOSEI, שנאסף ממעל 23,0 קליפי וידאו של ביטויים שנאמרו על ידי למעלה מ-1,0 דוברים במגוון נושאים. מאגר הנתונים חולק באופן אקראי לתתי-קבוצות של אימון (70%), תיקוף (15%) ובדיקה (15%) תוך שמירה על התפלגות המחלקות.
תמלילים טקסטואליים, אותות שמע ופריימים של וידאו נרכשים ומסונכרנים לפי חותמת זמן כדי להתאימהם ברמה זמנית מדויקת. אינטגרציה ברמת הפריימ הוא מבטיחה שלמנגנוני למידת הייצוג והמיזוג מבוס הגרף המוצעים תהיה יכולת למדל ולנצל באופן משותף תוכן רגשי הנובע מהבעות חזותיות, טוני שמע ותוכן לשוני. סוג זה של טכניקת רכישה רב-מודאלית מאפשר חילוץ יעיל של דינמיקות רגשיות בין-מודאליות, דבר החיוני לעיצוב אינטראקציה חכמה ולמיפוי חזותי מובן.
טבלה 1 מציגה את המבנים המרכזיים של מערכי הנתונים של רגשות רב-מודאליים המשמשים בשיטה המוצעת. כדי להשיג טווח רחב יותר של רגשות קשורים, כגון מילים מדוברות, אינטונציות קוליות והבעות פנים, CH-SIMS ו-CMU-MOSEI משלבים מודליות של וידאו, אודיו וטקסט ממערכי נתונים אלו. יתרה מכך, מספר מוגבל של דגימות נתונים זמינות ב-CH-SIMS, מה שמאפשר בחינה מעמיקה של אינטראקציות בין מודליות ושונות רגשית בסין. מצד שני, מערך הנתונים CMU-MOSEI חשוב יותר להערכת העמידות של למידת הייצוג ואלגוריתמי הוויזואליזציה הקשורים הנידונים בעבודה זו, שכן הוא מכיל כמות גדולה של נתונים על פני שפות שונות, נושאים שונים ורמות רגש מוערות. בנוסף, בהשוואה למחקרים קודמים, הוא מפחית קשיים בבחירת מידע בעת בדיקת המודלים.
עיבוד מקדים וסנכרון רב-מודאלי
הערות חותמות הזמן ממאגרי הנתונים CH-SIMS ו-CMU-MOSEI שימשו לסנכרון המודליות הטקסטואלית, השמעית והחזותית, כדי להבטיח למידה עקבית של ייצוג רב-מודלי. כל ביטוי שימש כיחידת הניתוח הבסיסית וקושר למקטעי אודיו ווידאו תואמים בתוך אותו פרק זמן. היישור בוצע ברמת הביטוי. התמלול חולק למקטעים על בסיס חותמות הזמן של ההתחלה והסיום של כל ביטוי. הקשר בין התמלול לאודיו ולוידאו נקבע על ידי חילוץ פרמי הווידאו ואות האודיו התואמים שנפלו בתוך אותו פרק זמן. בעוד שמקטעי אודיו עובדו באמצעות Wav2Vec 2.0 להפקת ייצוגים אקוסטיים, פרמים חזותיים ממקטע הווידאו נדגמו בקצב שנקבע מראש והקודדו באמצעות Vision Transformer (ViT). מקודד RoBERTa שימש ליצירת שיכנונים (embeddings) טקסטואליים מתמלולי הביטויים. סנכרון זמני הושג על ידי יישור כל מאפייני המודליות לגבול ביטוי יחיד, מכיוון ששלוש המודליות הפיקו רצפי מאפיינים באורכים שונים. פורמט באורך קבוע שימש לנרמול של רצפים באורכים משתנים. רצפים ארוכים יותר קוצרו לאורך הרצף המקסימלי המותר, בעוד שרצפים קצרים יותר קיבלו ריפוד של אפסים (zero-padded). במהלך האימון, מסכות קשב (attention masks) שימשו להפרדה בין אלמנטים מרופדים לבין מיקומי מאפיינים לגיטימיים. שיכנונים ספציפיים למודליות הוקרנו למרחב חבוי (latent space) משותף לפני ההיתוך, כדי להתגבר על אורכי רצפים שונים בין המודליות. הדבר הבטיח עקביות ממדית ואפשר למנגנון הקשב מבוס הגרפים להקל על למידה מוצלחת של אינטראקציה בין-מודלית. כדי לשמור על איכות הנתונים ועל שלמות הסנכרון, דגימות עם קבצים פגומים, הערות חסרות או מידע מודלי חלקי הוחרגו מהמחקרים.
חילוץ מאפיינים מבוס Transformer
שיטת למידה עמוקה משמשת ללמידה של ייצוגי תכונות ברמה גבוהה המודעים לרגשות ממידע על פני מספר מודליות, כגון ראייה, שמע וטקסט, באופן מקצה לקצה לאחר סנכרון הנתונים הרב-מודאליים וביצוע כל עיבוד מקדמי נדרש. באמצעות שימוש במקודד transformer ללמידה של ייצוגי תכונות מבדילים באופן מהותי מנתונים רב-מודאליים גולמיים, השיטה המוצעת מבטלת את הצורך בהנדסת תכונות. כדי להקל על העקביות בין מאגרי הנתונים המשמשים בגישה המוצעת, נלמד embedding בגודל קבוע עבור כל מודליות. לדוגמה, נלמדים embedding של תכונות ב-768 ממדים עבור כל אחת מהמודליות הבודדות, כולל מודליות של תמונה, שמע וטקסט, המגבשים יחד מרחב תכונות מאוחד המשמש לאורך כל הגישה, ובמיוחד בגישת חילוץ תכונות המשמשת עבור מאגר הנתונים CH-SIMS המוצע ומאגר הנתונים CMU-MOSEI, כדי ללמוד תכונות ברמה גבוהה על פני נתונים בגדלים שונים.
מודאליות חזותית: Vision transformer עבור קידודים (embeddings) של פריימים מודעי-רגש
מודל Vision Transformer (ViT-Base) שימש לחילוץ מידע חזותי מפרימי וידאו על מנת להשיג ייצוגים מרחביים רלוונטיים לרגשות. לפני חילוץ המאפיינים, פרמי כל מקטע וידאו הותאמו לגודל של (24 × 24) פיקסלים ונדגמו במרווחי זמן קבועים. באמצעות גודל פאץ' (patch) של 16 × 16 פיקסלים, ארכיטקטורת ViT-Base מייצרת סדרה של טוקנים חזותיים המעובדים על ידי 12 שכבות מקודד-טרנספורמר. הייצוגים שהופקו ברמת הפריים הוקרינו למרחב שיכון (embedding space) בעל 768 ממדים, תוך שימוש במודל ViT מאומן מראש כשלד חזותי (visual backbone). השכונות ברמת הפריים אוגדו באמצעות מיצוע (mean pooling) כדי ליצור את הייצוג החזותי הסופי עבור כל מקטע. במהלך האימון, נעשה שימוש בנורמליזציה של תמונות ובשיטות הרחבה (augmentation) נפוצות, כגון חיתוך אקראי והפיכה אופקית, כדי לשפר את ההכללה. לאחר מכן, מסגרת היתוך רב-מודלית (multimodal fusion) המוצעת שימשה לשילוב השכונות החזותיות הללו עם ייצוגים טקסטואליים וקווליים.
כדי לשמר את הדינמיקה הזמנית ברגשות, דגימות וידאו ממאגרי הנתונים CH-SIMS ו-CMU-MOSEI יידגמו באופן אחיד עבור המודאליות החזותית. פרשמיו של כל סרטון, 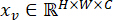 ניתן לחלק ל-N מקטעים בגודל קבוע, אשר לאחר מכן עוברים השטחה והעברה הפוכה למרחב שיכון חבוי (latent embedding space) בעל ממד
 סדרה נוצרת על ידי הוספת שיבוצים מיקומיים (positional embeddings) ואסימון קיבוץ (grouping token) הניתן ללמידה:
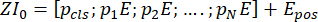 (1)
איפה  מסמל קידוד מיקומי (positional encoding) ו-
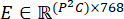 היא מטריצת השילוב של הרכיבים (patch embedding matrix).
שכבות מקודד טרנספורמר (transformer encoder) נערמות, המורכבות מרשתות הזנה קדימה (feed-forward networks) ומנגנוני קשב עצמי רב-ראשי (multi-head self-attention), כדי לעבד את רצף הפסגות (patches) המשובצים. הטרנספורמציה בשכבה l מתוארת כך:
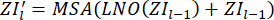 (2)
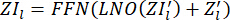 (3)
כדי להשיג את וקטור המאפיינים החזותי המודע לרגש, מוציאים את הפלט השקול ל-class token כוקטור המאפיינים.  כדי להתמודד עם ייצוגים חזותיים עקביים של רגשות, למרות הבדלים בשפה ובתוכן בין מאגרי נתונים שונים, שילבו שימושים (embeddings) ברמת הפריים מכל מקטע וידאו כדי ללכוד הבעות פנים ואת התפתחות הרגש.
מודאליות שמע באמצעות Wav2Vec 2.0 עבור פרוזודיה והטמעות אקוסטיות סמנטיות הטמעות דיבור הקשריות הופקו באמצעות מקודד Wav2Vec 2.0 מאומן מראש כשלד אקוסטי. וקטור מאפיינים אקוסטיים באורך קבוע עבור כל ביטוי התקבל על ידי אגרגציה של ייצוגי הנסתרים (hidden representations) באמצעות mean pooling. מודל ה-Wav2Vec 2.0 שימש לחילוץ ייצוגים אקוסטים מאות שמע כדי ללכוד מאפייני דיבור הקשריים ורלוונטיים לרגש. לפני חילוץ המאפיינים, הקלטות השמע נורמלו ודגמו מחדש ל-16 kHz. כדי להבטיח סנכרון בין המודאליות הטקסטואלית לוויזואלית, כל מקטע שמע ברמת ההגייה בודד באמצעות גבולות חותמות הזמן שסופקו באנוטציות של מערך הנתונים. המקודד האקוסטי המאומן מראש הותאם במהלך אימון המודל כדי לשפר את ההתאמה למשימה הספציפית, מה שאיפשר לייצוגים הנגזרים לייצג בצורה מדויקת יותר את ההיבטים הרגשיים של אותות הדיבור. לאחר מכן, בוצעו מיזוג קשב צמוד-מודאליות מבוס גרף ולמידת ייצוגים מופרדים (disentangled representation learning) באמצעות הטמעות השמע הסופיות.
במודאליות השמע, נעשה שימוש ב-Wav2Vec-2.0 כדי למדל אותות דיבור הנגזרים ממידע דיבור ראשוני במאגרי הנתונים CH-SIMS ו-CMU-MOSEI, תוך חילוץ ישיר של מאפייני שמע הקשורים לרגש. עבור כל אות דיבור קלט קיים קידוד מאפיינים קונבולוציוני (convolutional feature encoding).  :
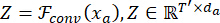 (4)
כאשר Z מייצג תכונות פרוסודיות ברמה נמוכה, כגון מלודיה, טון ואנרגיה. רשת הקשר מבוססת-טרנספורמר (transformer-based context network) מועילה למבנים שהוזכרו לעיל, ומייצגת תלויות מבוסות-זמן לטווח ארוך:
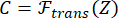 (5)
נתונים אקוסטיים פרוזודיים וסמנטיים, החיוניים להבעת רגש, נכללים בייצוגים אקוסטיים תלויי-הקשר אלו. יישום (embedding) שמע באורך ספציפי נוצר על ידי ביצוע הליך איסוף זמני (temporal pooling):
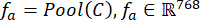 (6)
התכנון נמנע משימוש במאפיינים אקוסטיים כגון MFCCs ומשיג עמידות באמצעות נתוני דיבור באנגלית מ-CMU-MOSEI ונתוני דיבור בסינית מ-CH-SIMS, וזאת על ידי חילוץ ייצוגים מצורות גל באופן פשוט.
מודליות טקסט באמצעות RoBERTa להטמעות רגשיות קונטקסטואליות
עבור המודאליות הטקסטואלית, נעשה שימוש בטרנספורמר דו-כיווני עמוק, RoBERTa, על תמלי הדיבור משני מערכי הנתונים כדי להפיק סמנטיקה קונטקסטואלית ומשמעות רגשית. מקודדי טרנספורמר מבוססי RoBERTa שימשו לחילוץ ייצוגים טקסטואליים מנתוני התמלילים כדי ללכוד מידע סמנטי ורגשי קונטקסטואלי. מודל RoBERTa מאומן מראש שימש עבור מערך הנתונים CMU-MOSEI בשפה האנגלית, בעוד שגרסת RoBERTa סינית שימשה עבור מערך הנתונים הסיני CH-SIMS כדי להתחשב טוב יותר במאפיינים לשוניים ספציפיים לשפה. עיבוד מקדים של הטקסט כלל טוקניזציה באמצעות ה-tokenizer של RoBERTa המתאים לכל שפה ונורמליזציה של הטקסט. כדי להבטיח עיבוד אצוות (batch processing) עקבי, רצפי הקלט הומרו להטמעות טוקנים (token embeddings) ונpadded או נקטמעו לאורך רצף מקסימלי שנקבע מראש. בהתאם לפורמט הקלט של RoBERTa, הוכנסו טוקנים מיוחדים לסיווג ולהפרדה. הטמעה טקסטואלית באורך קבוע התקבלה על ידי אגרגציה של ייצוגי הטוקנים הקונטקסטואליים שהופקו על ידי מקודד הטרנספורמר, תוך שימוש בייצוג המשפט הסופי המקביל ל-[CLS]. כדי להתאים את הייצוגים הנלמדים למשימת זיהוי הרגשות, מקודדי RoBERTa המאומנים מראש עברו כוונון (refinement) באמצעות אימון מולטי-מודאלי. מסגרת ההיתוך המולטי-מודאלית המוצעת שימשה לאחר מכן למיזוג ההטמעות הטקסטואליות עם המאפיינים האודיו-ויזואליים.
ניתן לשלב את השכבלים (embeddings) של האסימונים ואת קידודי המיקום עבור כל קלט שעבר אסימוניזציה, 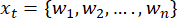 כדי ליצור את ייצוג הקלט בטכניקת השתנויות דו-כיוונית עמוקה המכונה
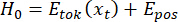 (7)
צורה זו מיוצגת דרך השכבות של ה-L transformer, המשתמש במנגנון self-attention כדי לגלות את התלויות ההקשריות בין מילים:
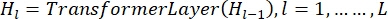 (8)
השיכון הרגשי ההקשרי (contextual emotion embedding) מתקבל באמצעות המצב החבוי הסופי של אסימון הסיווג:
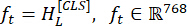 (9)
קיטוב רגשי, רגשות עזים והשלכות נלוות הם דוגמאות למאפיינים לשוניים הקשורים לרגשות אשר ייצגו על ידי שיכון (embedding) זה. RoBERTa מקלה על מידול שאינו תלוי בשפה. הדבר מאפשר למערכת להשתמש באותו גודל שיכון הן עבור טקסטים באנגלית מתוך מאגר הנתונים CMU-MOSEI והן עבור טקסטים בסינית מתוך מאגר הנתונים CH-SIMS.
שלושה וקטורי מאפיינים ספציפיים למודליות בעלי 768 ממדים, עבור המודליות הוויזואלית fv, השמעית fa והטקסטואלית ft , מופקים באמצעות שלב למידת ייצוג המאפיינים העמוק המוצע. בעיצוב האינטראקציה האינטליגנטית, ייצוגים נלמדים אלו יוצרים מרחב מאפיינים מולטי-מודאלי מאוחד המשמש כבסיס למיפוי ויזואלי ברמת המאפיינים, היתוך חוצה-מודליות מבוס גרף ולמידת ייצוג מופרד (disentangled representation learning).
למידת ייצוגים מופרדים
לאחר למידה של ייצוג תכונות עמוק, עיבוד נוסף של וקטורי התכונות הרב-מודאליים מהמודאליות החזותית, השמעית והטקסטואלית עשד להניב תיאור רגשות מנותק. אם יישובי התכונות (feature embeddings) הספציפיים למודאליות של המודאליות השמעית, החזותית והטקסטואלית ששימשו בשלב הקודם מיוצגים על ידי fv, fa ו- fתבהתאם לכך, כך ש-  ו-
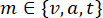 מטרת שלב זה היא לבצע פירוק (factorization) של כל מאפייני המודאליות לשני תיאורי לטנט (latent depictions) נפרדים, הכוללים את תיאורי הרגש לאחר התחשבות בסמנטיקה הקודמת של כל אחת מהמודאליות השונות.
דבר זה מושג על ידי הזנת מאפיין של כל מודאליות, פמ' לשתי רשתות הקרנה מקבילות: מקודד רגשות  ומקודד מודאליות (modality encoder)
 , שם מופקים שני הקידודים.
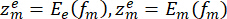 (10)
איפה  המאפיין החבוי הקשור לרגש מיוצג על ידי
 מייצג מאפיין חבוי (latent feature) הספציפי לאופן ביטוי (modality) מסוים. הדבר מאפשר להטמעות (embeddings) ספציפיות לרגש לתקשר עם מרחב שחוזר על עצמו על פני קלטים מרובים, כולל שמע, חזותי וטקסט, תוך שמירה על הנתונים המבניים הייחודיים הקשורים לכל אופן ביטוי.
הפרדה יעילה מושגת על ידי שחזור עם אילוצי עצמאות. השחזור של מאפיין המודליות המקורי ניתן על ידי:
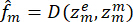 (11)
איפה  היא רשת מפענח (decoder network). הפסד השחזור (reconstruction loss) משמר את הנתונים הבאים:
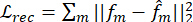 (12)
בנוסף, אורתוגונליות, או חוסר מתאם (decorrelation), בין רגש לבין תיאורים ספציפיים למודליות מגבילים לעיתים קרובות את חפיפת המידע:
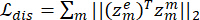 (13)
על ידי השגתו של יעדים אלו, המודל עשוי ללמוד ייצוגי רגשות שהם אמינים, מובנים ועמידים לשונות במודליות. מיזוג בין-מודאלי מבוס גרפים ומאפייני מיפוי חזותי מאוחרים יותר, במיוחד עבור עיצוב אינטראקציה חכמה, נשענים במידה רבה על ייצוגי רגשות מובנים וניתנים לפירוש.
עקביות רגשית בין מודליות
הוספת עקביות רגשית משפרת בבירור את יעילות המיזוג בין המודליות. זאת משום שאסטרטגיות מיזוג אינן צריכות להתחשב בפערים גדולים בין שני הייצוגים, מכיוון שהשיכבול רגשי הספציפי למודליות חולק מרחב חבוי (latent space). הייצוג המשולב של שני הרגשות מתואר כדלקמן:  מיזוג משוקל יהיה יציב יותר כאשר ייצוגים ספציפיים לרגש יהיו עקביים, מכיוון ששינויים בין אותות ממודליות שונות לא ישפיעו יותר על התוצאה.
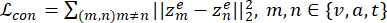 (14)
על ידי אכיפת יישור סמנטי של מידע רגשי, מטרה זו ממזערת פערים בין מודליות שונות ומבטיחה שתפיסת הרגש תישאר עקבית ללא קשר למודליות המשמשת לביטויו. כתוצאה מכך, נוצר מרחב ייצוג רגשי ומגובש באמצעות השלכת רמזים רגשיים שהתקבלו מאות דיבור, הבעות פנים ותוכן לשוני.
השפעה על מיזוג חוצה-מודאלי
מיזוג רב-מודאלי (Cross-modal fusion) הופך ליעיל יותר כאשר מושגגת עקביות רגשית בין המודאליות השונות. מנגנוני המיזוג אינם נדרשים עוד לפצות על פערים משמעותיים בייצוגים הבין-מודאליים, כיוון שהשיכובים (embeddings) הספציפיים לרגש מיושרים במרחב לטנטי משותף. ייצוג הרגש הממוזג מוגדר באופן הבא:
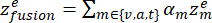 (15)
כאשר αm מייצג את משקל הקשב שניתן למודאליות m. המיזוג המשוקלל הופך ליציב ומובן יותר כאשר ייצוגים ספציפיים לרגש הם עקביים, שכן תוצאת המיזוג מראה ראיות רגשיות משלימות במקום אותות מודאליות סותרים.
מבחינה מתמטית, הורדה  השונות בין סוגי ייצוגים שונים הספציפיים לרגשות ביחס ל- שקול ל:
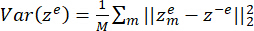 (16)
איפה  מייצג את ממוצע ביטוי הרגש. שונות מופחתת גורמת לכך שמרכיבי הקלט ישוקללו על פי משמעותם הרגשית המדויקת ולא על פי רעש המרכיב, מה שמבטיח התכנסות משופרת של הרשת והערכת קשב מדויקת יותר.
מטרת הלמידה הסופית של ויזואליזציות רגשות מופרדות (disentangled) היא לשלב פרגמנטציה, רקונסטרוקציה ואחידות רגשית:
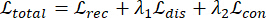 (17)
שני ההיפר-פרמטרים, λ1 ו-λ2, שולטים במערכת היחסים בין מהימנות רגשית חוצת-מודליות לבין דיסוציאציה. המודל המוצע רוכש ייצוגים רגשיים בלתי תלויים במודליות, ניתנים לפירוש וניתנים למיזוג כדי להשיג זאת, תוך דגש על מתן בסיס איתן למיזוג מבוס גרפים וייצוג ברמת המאפיינים בעיצוב ממשקים חכמים.
היתוך קשב רב-מודאלי מבוס גרף
רשת קשב צולבת-מודאלית מבוססת גרף שימשה לסימולציה של קשרים רגשיים מפורטים בין מודאליות שונות. כדי להקל על זרימת המידע בין המודאליות, נבנה גרף רב-מודאלי עם קישוריות מלאה, שבו כל שיכון (embedding) ספציפי למודאליות (טקסט, אודיו וויזואליה) מיוצג כצומת בגרף. קשרי המודאליות שימשו להקמת מטריצת הסמיכות של הגרף, אשר שופרה לאחר מכן באמצעות שיטת קשב למידה (learnable attention). מרחב חבוי משותף נוצר על ידי שרשור והקרנה של הפלטים ממספר ראשי קשב. ייצוג רגשי רב-מודאלי מאוחד הופק לאחר מכן על ידי אגרגציה של ייצוגי הצמתים באמצעות בריכה המשוקללת בקשב (attention-weighted pooling). מודולי הניבוי והוויזואליזציה לניתוח מודע-אינטראקציה וזיהוי רגשות קיבלו לאחר מכן ייצוג מותך זה. למודול היתוך הגרף היה ממד ייצוג חבוי של 256 ושתי שכבות קשב גרפי, כאשר לכל אחת שמונה ראשי קשב. כדי לקבוע את החשיבות היחסית של מודאליות סמוכות, חושבו מקדמי קשב בין צמתים מחוברים והם נורמלו באמצעות פונקציית softmax. לאחר כל שכבת קשב גרפי הוחלו נורמליזציה של שכבה, קישורי שארית (residual connections) וקצב dropout של 0.2 כדי להגביר את יציבות האימון ולהפחית התאמת-יתר (overfitting). לאחר שרשור והקרנה של פלטי מספר ראשי קשב אל מרחב חבוי משותף, שולבו ייצוגי הצמתים לכדי שיכון רגשי רב-מודאלי יחיד באמצעות בריכה המשוקללת בקשב. לאחר מכן, הייצוג המותך שימש למיפוי ויזואלי רב-מבט ולניבוי רגשות.
אינטראקציות בין-מודאליות מגוונות נלכדו באמצעות תשומת גרף רב-ראשית (multi-head graph attention). פונקציית softmax שימשה לנורמליזציה של מקדמי התשומת בין צמתים מחוברים עבור כל צומת. כדי להגביר את יציבות האימון ולמנוע התאמת-יתר (overfitting), השכבות של תשומת הגרף המעורמות במודול היתוך הגרפים לוועו חיבורים שאריתיים (residual connections), נורמליזציה של שכבות ורגולריזציית dropout.
בואו נבחן את המונחים בנפרד, הן מייצגות את הייצוגים המתאימים לרגשות הספציפיים שנאספו מהמודליות החזותית, השמעית והטקסטואלית; כל רכיב נמצא בתוך המרחב הלטנטי המשותף  המודלים עבור צמתי המודאליות משתמשים בסימון עבור הגרף
 עם צמתי האוסף
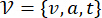 המקבילים לשלושת צומתי המודליות עצמם, כדי לחזק במפורש את התלויות הרגשיות המשותפות בין ייצוגי המודליות השונות.
לאחר הקצאת וקטור מאפיינים ספציפי לרגש לכל צומת בגרף, נקבל:
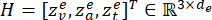 (18)
בניגוד לשיטות היתוך מסורתיות, המשתמשות במשקולות היתוך קבועות או נקבעות מראש, השיטה המוצעת לומדת משקולות קצה אדפטיביות המבוסות על חשיבותן ותלותיהן ההדדית, הן בין ערוצים והן בין מצבים רגשיים.
רשת קשב גרפית (GAT) משמשת למיזוג רב-מודאלי (cross-modal fusion). מקדם קשב מחושב עבור כל צומת i והצמתים השכנים לו, כלומר צומת j:
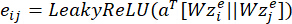 (19)
השפעה הרגשית של מעבר ממצב j למודאליות i נמדדת על ידי המשקלים הנורמליים αij.
בשלב הבא, המראה המאוחד (fused appearance) של כל צומת מודליות מחושב כקיבוץ משוקל של השכנים שלו:
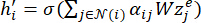 (20)
היכן פונקציית ההפעלה  הוא אי-ליניארי. בסופו של דבר, המאפיינים המעודכנים של כל צומת משולבים כדי להשיג ייצוג רגשי ממוזג גלובלי:
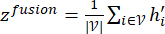 (21)
זוהי טכניקה שימושית למידול רגשות ניתן לפירוש ולמיפוי חזותי עוקב, מכיוון שהיא לוכדת מידע משלים ממודליות שונות תוך שימור מערכות יחסים בין-מודליות מורכבות.
אלגוריתם 1 (קובץ משלים 1) מספק את התרשים הכללי לביצוע מיזוג חוצה-מודאליות מבוס גרף. תחילה, נוצר גרף שבו מאפיינים ספציפיים לרגש מקושרים לכל אחת מהמודאליות החזותית, הקולית והטקסטואלית. לאחר מכן, מחושבים מדדי הקשב (attention scores) עבור זוגות צמתים בכל גרף, המייצגים את השילוב של התלות הרגשית. מדדי הקשב מנורמלים לאחר מכן כדי לציין את התרומה היחסית של כל מודאליות להקשר הרגשי המוגדר, מה שמאפשר למידה של משקלי הקשב. בשלב האחרון, נוצר ייצוג הרגש הכללי (emotion embedding) על ידי אגרגציה של המאפיינים הקשורים לצמתי הגרף. במובן זה, המיזוג הכללי של האלגוריתם עבור המאפיינים הרב-מודאליים המקושרים לרגשות המוגדרים מבטיח יכולות הסתגלות, פרשנות ואינטליגנציה הקשרית.
איור 2 מציג את המבנה ואת אופן הפעולה של רשת הקשב הרב-מודאלית (cross-modal attention network) המוצעת למיזוג רגשות רב-מודאלי. הייצוגים (embeddings) הספציפיים לרגשות, המופקים באופן עצמאי עבור המודליות של טקסט, שמע ווידאו, מועברים תחילה דרך מנגנוני קשב ברמת המודאליות הלומדים את החשיבות היחסית של מידע לשוני, קולי והבעתי עבור הקשר רגשי נתון. הייצוגים של המודליות, המשוקללים לפי הקשב, משולבים לאחר מכן כדי ליצור ייצוג רגשי מאוחד, שבו מטריצת הקשב לוכדת את התלויות הבין-מודאליות ואת עוצמות האינטראקציה. מטריצת הקשב הנלמדת על ידי הרשת מווסת באופן דינמי את התרומות של המודליות, ובכך מאפשרת לה להתמקד במודאליות ההוראתית החזקה ביותר תוך התעלמות ממודליות רועשות ופחות אינפורמטיביות. ייצוג הרגש הממוזג מאפשר זיהוי מדויק של רגשות וניתוח דק של מצבים רגשיים כגון ניטרליות, חיבוק ודאגה.
מודול מיפוי חזותי
בעזרת סעיף המיפוי הוויזואלי, שנוצר במיוחד למטרה זו, מעצב אינטראקציה חכם יכול להמיר את הייצוג המאוחד של המצב הרגשי לצורה ויזואלית מובנת וזמינה לצריכה לאחר תהליך ההיתוך הרב-מודאלי, בהתבס על הגרף.
כדי להקל על הבנת הייצוגים הרגשיים החבויים (latent emotional representations), נעשה שימוש בטכניקות להפחתת ממדיות על מנת להציג ויזואלית את השכבלים (embeddings) הרגשיים הרב-מודאליים שנלמדו. לאחר הפחתת ממדיות התכונות תוך שמירה על מרבית השונות באמצעות ניתוח רכיבים ראשיים (PCA), השכבלים הוקרינו למרחב דו-מדי לתצוגה באמצעות t-distributed Stochastic Neighbor Embedding (t-SNE). עבור t-SNE נעשה שימוש בערך perplexity של 30, קצב למידה של 20 ו-1,0 איטרציות אופטימיזציה. אשכולות ספציפיים לרגשות ומערכות יחסים בין מודאליות הוצגו ויזואלית באמצעות ההקרנות שהתקבלו. משקולות קשב חוצות-מודאליות מנורמלות שהתקבלו מרשת הקשב מבוססת הגרף שימשו ליצירת מפות חום של קשב. התרומות היחסיות של המודאליות הטקסטואלית, השמעית והחזותית במהלך חיזוי הרגש מוצגות במפות חום אלו. מקדמי הקשב שנלמדו שימשו כמשקולות קצוות ליצירת גרפים של אינטראקציה חוצת-מודאליות, אשר אפשרו בחינה ויזואלית של קשרים בין-מודאליים וזרימת מידע בתוך מסגרת המיזוג (fusion framework). תרשימי מסלול רגשי נוצרו על ידי ניטור התפתחות השכבלים הרגשיים החבויים לאורך wyputterances עוקבים כדי לבחון דינמיקה רגשית זמנית. מסלולים אלו שופכים אור על האופן שבו מצבים רגשיים ותרומות מודאליות מתפתחים לאורך זמן. Matplotlib ו-Scikit-learn הן שתי חבילות Python ששימשו ליצירת כל הוויזואליזציות. כדי להעריך את יכולת הפירוש (interpretability), את היווצרות האשכולות, את תרומות המודאליות ואת הדינמיקה הרגשית הזמנית, נערכו ניתוחים איכותניים של ויזואליזציות השכבלים, גרפי האינטראקציה ומפות החום של הקשב.
יה המשתנה 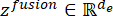 ייצג את הייצוג המאוחד של המצב הרגשי באמצעות פונקציית רשת תשומת גרפית (graph attention network). בניגוד להדמיה ברמת הפלט של גרפי המצב הרגשי, מטרתו העיקרית של המודול היא להמיר את ייצוגי המצב הרגשי ואת המשקלות התואמים של מנגנון התשומת לפורמט חזותי מובן.
באמצעות ה-αji שנלמד, נוצר מפת חום של קשב (attention heatmap) כדי לבחון באופן חזותי את תרומתה של כל מודאליות. לאחר מכן, משקלי הקשב הנכנסים מסוכמים יחד כדי לקבוע ציון חשיבות מרוכב עבור כל מודאליות:
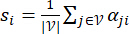 (22)
כאשר si מייצג את התרומה הרגשית היחסית של מודאליות I. כדי לסייע ביצירת מפת חום של קשב (attention heatmap), הערכים שהתקבלו מנורמלים ומופכים למפת צבעים המקלה על המשתמש לזהות את המודאליות הדומיננטית בנקודות זמן שונות או במצבים אינטראקטיביים. באמצעות מודאליות קלט חזותיות, שמיעתיות או טקסטואליות שונות, ממשק כזה עוזר למשתמש להבין כיצד פועל מנגנון הקשב של המערכת.
הגרף הנלמד ממודל באופן ספציפי כ"גרף אינטראקציה משוקל" כדי לייצג את התלות הבין-מודלית של רגשות אנושיים. המודליות עצמה מיוצגת על ידי כל צומת בגרף, ועוצמת האינטראקציות המערבות רגשות אנושיים מיוצגת על ידי משקולות בצורה של αji על הקשתות המחברות ביניהם. הגרף המשוקל לעיל ממחיש את עוצמת האינטראקציות הרגשיות האנושיות. הגדרת i ו-j היא:
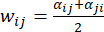 (23)
עובי הקו או השקיפות של ויזואליזציית הגרף מוצגים כראוי הודות למשקלים אלו. דבר זה מקל על הבנת האופן שבו המודליות מקיימות אינטראקציה. בעזרת גרפי אינטראקציה בין-מודלית, המעצב יכול להבין טוב יותר כיצד מדדי רגש מקיימים אינטראקציה במהלך תהליך ההיתוך.
הטמעות הרגש הממוזגות  בנקודות זמן שונות מועmדות למרחב ממד נמוך יותר באמצעות אלגוריתם להפחתת ממדים, כגון PCA או t-SNE, וזאת כדי להציג את ההתפתחות של רגשות לאורך זמן:
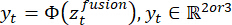 (24)
שבה פונקציית ההטלה מיוצגת על ידי  הופעתן של מסלולי רגשות בדו-ממד/תלת-ממד (2D/3D), המציגים מעברים רגשיים, עוצמות ויציבות באינטראקציות, יכולה להתפרש כתיאור אינטואיטיבי של התפתחותם של מצבים רגשיים לאורך זמן. היבטים אלו יכולים לשמש לאינטראקציה חכמה, לקבלת החלטות ולניטור בזמן אמת.
בניגוד למערכות רגשות קונבנציונליות המספקות רק מיפויים למחלקות או ציונים מסוימים, מערכת זו מתמקדת בהדגמה של האופן שבו רגשות אנושיים נוצרים בתוכה. היא חושפת את תהליך קבלת ההחלטות שלה באמצעות הצגת ויזואליזציות של מאפיינים ביניים, כולל גורמי שקלול, אינטראקציות בין מודלים והנתיבים התואמים להם. דבר זה מאפשר למשתמש להבין כיצד כל גורם — ויזואלי, קולי או לשוני — משפיע על המערכת ביצירת תגובותיה לרגש אנושי.
מיפוי רגשות לצורות מובנות באמצעות ייצוגים חזותיים יכול לגשר על הפער שבין ניתוח רגשות באמצעות שיטות למידה עמוקה לבין השילוב שלהן בתכנון ממשקים חכמים. ניתן להשתמש בנתונים שנאספו משתי הגישות כדי ליצור ממשקי משתמש מדויקים יותר. לפיכך, הגישה המוצעת יכולה לספק למעצבי אינטראקציה מידע חיוני ליצירת ממשקי משתמש מדויקים יותר. במילים אחרות, הבנת הרגשות הופכת לחלק פעיל מאוד מעיצוב האינטראקציה. הדיוק יכול לגדול רק כאשר הבנת הרגשות מוטמעת באופן פעיל בעיצוב האינטראקציה.
מודול המיפוי הוויזואלי מאפשר הסבירות במספר דרכים מקושרות אך שונות: הסבירות ברמת המאפיינים חושפת ייצוגים בסיים של רגש שנוצרו על ידי ה-DNN, ובכך מאפשרת לנו להבין את הסמנטיקה המשמשת לתיאור כל מאפיין הקשור לרגש; הסבירות ברמת המודאליות משתמשת בנתונים מגרפי האינטראקציה וממפות חום של קשב ויזואלי כדי לתאר כיצד כל מודאליות — ויזואלית, קולית או טקסטואלית — תורמת להחלטות שהתקבלו להבעת רגשות; ולבסוף, המסלולים הנובעים מהטמעת הרגש (emotion embedding) מאפשרים לנו להבין כיצד כל מודאליות ויזואלית וטקסטואלית משתנה לאורך זמן מנקודת מבט של אינטראקציה דינמית. אנא עיינו באלגוריתם 2 (Supplementary File 1).
המאפיינים הרגשיים הרב-מודאליים הממוזגים ממופים לייצוגים בעלי משמעות חזותית עבור עיצוב אינטראקציה חכמה, תוך שימוש באלגוריתם המיפוי החזותי המוצע (Algorithm 2). משקולות קשב רב-מודאליות מבוסות-גרף משמשות לכימות ההבדלים בין האלמנטים החזותיים, הקוליים והטקסטואליים של הקלט בכל שלב של הזמן. הבדלים אלו ממופים לאחר מכן לייצוגים חזותיים כדי להדגיש את המקורות העיקריים המשפיעים על הרגשות באמצעות אלמנטים חזותיים של מפות חום. כדי לספק מבט מעמיק על האינטראקציה בין אלמנטים של הקלט ולהעביר את האבולוציה הרגשית הנוצרת על ידי האלמנטים הרב-מודאליים, המערכת מחשבת עוצמות אינטראקציה זוגיות ליצירת משקולות האינטראקציה הרב-מודאליות. במקביל, נוצר מבט על האבולוציה הרגשית על ידי מיפוי האלמנטים הרגשיים הממוזגים שנאספו לאורך זמן למרחב בעל ממדים נמוכים, כדי להפיק אבולוציה רציפה של אלמנטים רגשיים.
חיזוי רגשות ומשוב אינטראקציה
תוצאת ייצוג הרגש הממוזג, המיוצגת כ- מש לאחר מכן כפונקציה הן למשוב אינטראקציה והן לניבוי רגשות. יתרה מכך, ניבוי רגשות מתואר כמודל רב-משימתי הכולל משימת רגרסיה לזיהוי רציף של עוצמת הרגש ומשימת סיווג לזיהוי רגשות בדידים. לצורך זיהוי רגשות בדידים נעשה שימוש במודל הסיווג הבא, המבוס על softmax:
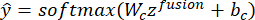 (25)
איפה  מייצג את ההסתברויות הצפויות עבור מחלקות הרגש ו- ו'נראה כי לא סיפקת טקסט לתרגום. אנא שלח את התוכן באנגלית שברצונך לתרגם לעברית. וְ bנראה שסיפקת רק את האות "c". אנא שלח את הטקסט המלא שברצונך לתרגם, ואשמח לבצע את התרגום המקצועי עבורך בהתאם להנחיות. הם אילוצים הניתנים ללמידה. פונקציית ההפסד של הצלבה-אנטרופיה (cross-entropy loss) מנוצלת כדי לשפר את מטרת הסיווג:
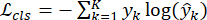 (26)
כאשר yk הוא תגית האמת (ground-truth), ו-K הוא מספר מחלקות הרגש. ענף רגרסיה משמש להערכת עוצמת הרגש במקביל, ומפיק תחזית של מאפיינים רגשיים רציפים שונים, כולל ערכיות (valence) ועוררות (arousal). תן לו את ההגדרה הבאה:
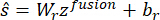 (27)
שבו ציון עוצמת הרגש הצפוי מצוין על ידי  השתמשו בפונקציית אובדן של טעות ריבועית ממוצעת (Mean-squared error loss) כדי לשפר את משימת הרגרסיה:
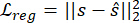 (28)
באופן כללי, שתי המטלות משולבות ביעד הניבוי:
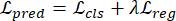 (29)
שבה המטרות של רגרסיה וסיווג מאוזנות על ידי λ. הדבר מרמז על שינוי דינמי של מודול הוויזואליזציה בהתבס על מצב הרגש שזוהה, כדי לאפשר סוג זה של משוב המודע לאינטראקציה. ההקשר של האינטראקציה בזמן t נתון מיוצג על ידי ct. תגובתו של מודול הוויזואליזציה מסופקת על ידי:
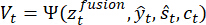 (30)
שבה פונקציית התאמת הוויזואליזציה מיוצגת על ידי  דבר זה מאפשר התאמה של מפות חום של מודליות (modalities), גרפי אינטראקציה ומסלולי רגשות בזמן אמת, בהתבס על שינויים ורגשות צפויים. הדבר מעיד כי המערכת מספקת תמיכה משמעותית למשוב, בנוסף לביצועים טובים בחיזוי מצב רגשי.
תוצאות
עבודה זו מתקפת את מסגרת המיפוי הוויזואלי המוצעת למאפייני רגש רב-מודאליים, הן במונחים של פרשנות מודעת-אינטראקציה והן במונחים של ביצועים חזויים, תוך שימוש בשני מאגרי נתונים בנצ'מרק, CH-SIMS ו-CMU-MOSEI. על פי תוצאות הניסויים, הגישה המוצעת מציגה ביצועים טובים יותר באופן עקבי מטכניקות נוכחיות לזיהוי רגש רב-מודאלי במגוון מדדים, כולל קורלציה, דיוק (accuracy), מדד F1 וטעות מוחלטת ממוצעת (MAE). ייצוג הרגש המופרד (disentangled), מנגנון היתוך צלב-מודאלי מבוס גרפים ואסטרטגיית למידת הייצוג העמוקה מקצה לקצה תורמים כולם לשיפור זה על ידי אפשור מידול רגשי יציב ומיושר סמנטית יותר. הגישה המוצעת מספקת תובנות עשירות יותר ברמת המאפיינים באמצעות מיפוי ויזואלי, אשר חורג מעבר לרווחים כמותיים ומקל על הבנת התרומות של המודאליות השונות והדינמיקה הרגשית. למרות הבדלים בשפה, בביטוי תרבותי ובגודל מאגרי הנתונים, העלייה בביצועים שצוינה נצפתה באופן עקבי בשני מאגרי הנתונים, מה שמדגים את יכולת ההכללה החזקה של המסגרת המוצעת.
בשלב העבודה המוצע נעשה שימוש במאגרי הנתונים הציבוריים CH-SIMS ו-CMU-MOSEI עבור רגשות רב-מודאליים. מאגר הנתונים CH-SIMS כולל 2,281 קטעי וידאו מסרטים, דרמות טלוויזיוניות ותוכניות בידור. ב-CH-SIMS זמינים נתוני טקסט, שמע ווידאו מסונכרנים. תוויות סנטימנט חד-מודאליות ורב-מודאליות מסווגות לקטגוריות חיוביות, ניטרליות ושליות. מאגר נתונים רב-מודאלי גדול בשפה האנגלית המוכר בשם CMU-MOSEI מכיל כ-23,453 קטעי וידאו מתויגים הכוללים למעלה מ-1,0 דוברים הדנים במגוון רחב של נושאים. מאגר נתונים זה מכיל הן הערות רציפות של עוצמת רגש, כגון valence ו-arousal, והן תוויות רגשיות קטגוריאליות. על ידי תמיכה במגוון תנאים לשוניים, תרבותיים ורגשיים, ניסויים בשני מאגרי נתונים אלו באמצעות המסגרת המוצעת מחזקים את החסינות והאמינות. טבלה 2 מציגה את פרטי סביבת הסימולציה.
הגדרות הניסוי והיישום העיקריות ששימשו להערכת המסגרת המוצעת מסוכמות בסביבת סימולציה זו. כדי להבטיח ממדיות תכונות אחידה בין המודליות הטקסטואלית, השמעית והחזותית, מיושמים מקודדים מבוססי transformer באופן אחיד. המערכת עושה שימוש במנגנון קשב מבוס גרף עבור היתוך בין-מודלי, המאפשר למידה אדפטיבית של תלויות בין-מודליות הנוגעות למצבים רגשיים.
המסגרת המוצעת מחלצת ייצוגים טקסטואליים, קוליים וחזותיים באמצעות מקודדי מודאליות מבוססי transformer. שכבות מחוברות באופן מלא עם הפעלת ReLU מקרינות את השכבלים (embeddings) הספציפיים למודאליות לתוך מרחב לטנטי משותף. מקודדים נפרדים, ספציפיים לרגש וספציפיים למודאליות, שכל אחד מהם כולל שתי שכבות מחוברות באופן מלא והפעלה לא ליניארית ונורמליזציה, משמשים לאחר מכן ללמידת ייצוגים מופרדים (disentangled). הייצוגים הלטנטיים מקורנים לתוך מרחב תכונות בעל 256 ממדים, שבו מידע עבור כל מודאליות ורגש נלמד בנפרד. כדי לשמר את מידע המודאליות ולקדם הפרדה יעילה, נעשה שימוש במפענחי שחזור. לפני היתוך רב-מודאלי וחיזוי, מודול קשב חוצה-מודאלי מבוס גרפים ממדל תלויות רגשיות בין המודאליות באמצעות הייצוגים הלטנטיים. הרשת אומנה באמצעות אופטימיזטור Adam עם קצב למידה ראשוני של 1 × 10⁻4 וגודל אצווה (batch size) של 32. נעשה שימוש בעצירה מוקדמת (Early stopping) על בסיס הפסד האימות כדי למנוע התאמת יתר (overfitting). פונקציית המטרה הכוללת כללה הפסדי סיווג, שחזור ועקביות ייצוגים, כאשר כל אחד מהם שוקלל על ידי היפר-פרמטרים הניתנים לכוונון. אימון המודל הרץ עד ל-100 תקופות (epochs), והמודל בעל הביצועים הטובים ביותר על קבוצת האימות נשמר לצורך הבדיקה.
המסגרת המוצעת הוערכה באמצעות מדדי סיווג, כולל Accuracy, Precision, Recall ו-F1-score, יחד עם מדדי רגרסיה כגון Mean Absolute Error (MAE). Precision, Recall ו-F1-score חושבו באמצעות macro-averaging כדי לתת מענה לחוסר איזון במחלקות בין קטגוריות הרגש. עבור ניסויי סיווג, תוויות הרגש/סנטימנט שהוגדרו מראש במאגרי הנתונים CH-SIMS ו-CMU-MOSEI שימשו כמחלקות האמת (ground-truth). עבור חיזוי סנטימנט מבוס רגרסיה, ציוני עוצמת הסנטימנט הרציפים של מאגרי הנתונים שימשו כמשתני המטרה. מטריצות בלבול (Confusion matrices) הופקו כדי לנתח את ביצועי החיזוי לפי מחלקה ואת דפוסי הסיווג השגוי עם רווח סמך של 95%. כדי להבטיח חוסן, כל ניסוי חזר 5 פעמים תוך שימוש באתחולים אקראיים שונים, והתוצאות המדווחות תואמות את הממוצע ± סטיית התקן של הביצועים בכל ההרצות. מובהקות סטטיסטית נבחנה באמצעות הליכי בדיקת השערות מתאימים, ורווחי סמך חושבו במידת הצורך. זמן האימון נמדד כסך כל הזמן שחלף עד להתכנסות המודל על פלטפורמת החומרה שצוינה.
ניתן להשוות מספר מודלי בסיס מייצגים, כולל מיזוג מוקדם (early fusion) ומיזוג מאוחר (late fusion), עם השיטה המוצעת: TFN, שיטות מבוסות LSTM, מודלי מיזוג מולטימודאליים בעלי דרגה נמוכה, טרנספורמרים מולטימודאליים אדפטיביים ואדריכליות חדשות מבוסות קשב חוצה-מודאליות (cross-modal attention). מודלי בסיס אלו משקפים טכניקות חדישות המתמקדות בעיקר בשיפור דיוק זיהוי הרגשות באמצעות שיטות מיזוג שונות. בניגוד לשיטות אלו, המתמקדות בעיקר בחיזוי ברמת הפלט, הלמידה של ייצוגים מופרדים (disentangled representation learning) והמיזוג מבוס הגרפים של המסגרת המוצעת משפרים את יכולת הפירוש (interpretability) ואת המודעות לאינטראקציות. דוגמאות למודלי בסיס שיושמו באמצעות המאגרים הרשמיים שלהם או מימושי ייחוס הזמינים לציבור כוללות את LSTM Fusion, TFN, Low-Rank Multimodal Fusion (LMF), Adaptive-Graph וטכניקות מבוסות טרנספורמרים. כאשר הגדרות היפר-פרמטרים מקוריות של המחברים היו זמינות, נעשה בהן שימוש. כל מודלי הבסיס שאומנו מחדש הוערכו באמצעות אותם חלוקי מערכי נתונים, טכניקות עיבוד מקדמי, פרמטרי אופטימיזציה ומדדי הערכה, כדי להבטיח השוואה הוגנת. טבלאות ההשוואה מזהות בבירור את המקורות הרלוונטיים עבור נתונים שנלקחו ישירות מפרסומים קודמים.
דיוק
דיוק סיווג הרגשות הבדידים נמדד הן עבור CH-SIMS והן עבור CMU-MOSEI; עם זאת, מגמת הדיוק משתנה בהתאם למאפיינים של שני מאגרי הנתונים. מכיוון ש-CH-SIMS הוא מאגר נתונים בגודל בינוני עם מספר שווה של קטגוריות סנטימנט וסרטוני וידאו שעברו עיבוד מקדים קפדני, רמת הדיוק שלו גבוהה, מה שמרמז על כך שהמודל מסוגל ללכוד מידע רגשי מולטי-מודלי עדין עם רעש מועט. לעומת זאת, סיווג מדויק של רגשות הוא מאתגר במקרה של CMU-MOSEI, היות שהוא מאגר נתונים רחב-היקף הכולל דוברים מרקעים מגוונים. לכן, בנוסף ליכולתו של המודל לזהות סנטימנט, הדיוק במאגר הנתונים CMU-MOSEI מעיד על יכולתו להכליל ולעמוד במגוון תרחישי אינטראקציה. השיפור בדיוק בשני מאגרי הנתונים מראה כי הגישה המוצעת מכלילה היטב על פני מאגרי נתונים בשפות שונות, בגדלים שונים וברמות שונות של מורכבות רגשית.
דיוקי הסיווג של הגישה המוצעת ושל בסיסי השוואה נפוצים אחרים במערכי הנתונים CH-SIMS ו-CMU-MOSEI מוצגים בטבלה 3. כפי שמוצג בטבלה 3, המסגרת המוצעת השיגה את הדיוק הגבוה ביותר בשני מערכי הנתונים, CH-SIMS ו-CMU-MOSEI, ועקפה את בסיס ההשוואה החזק ביותר (Adaptive-Graph) בכ-3.3% ו-3.1 נקודות אחוז, בהתאמה. ערכי סטיית תקן נמוכים יותר מעידים גם על יציבות רבה יותר לאורך הרצות ניסוייות חוזרות. לגישות מסורתיות של LSTM-fusion דיוק נמוך יותר בשל יכולתם המוגבלת ללכוד קשרים מורכבים בין מודליות (cross-modal). TFN ו-LMF משפרים את דיוק הסיווג על ידי מידול של קשרים בין מודליות.
מדד F1 (F1-Score)
בבעיות של סיווג רגשות, האיזון בין הרגישות (recall) לדיוק (precision) נמדד באמצעות מדד ה-F1-score. עבור מאגרי נתונים של סיווג רגשות רב-מודאלי, אשר נוטים להכיל מספר לא שווה של דגימות בכל מחלקה, מדד זה מתאים יותר. במשימות של סיווג רגשות, האיזון בין הרגישות לדיוק נמדד באמצעות ה-F1-score. מכיוון שמאגרי נתונים לסיווג רגשות רב-מודאלי צפויים להיות לא מאוזנים, ה-F1-score הוא המד המתאים יותר. ככל שהמודל מסוגל לזהות מחלקות רגש בצורה טובה יותר, כך ה-F1-score יהיה גבוה יותר.
איור 3 ממחיש את הערכת מדד ה-F1-score של הטכניקה המוצעת אל מול קווי הבסיס (baselines) במערך הנתונים CH-SIMS. היכולת של קו הבסיס המבוס על LSTM למדל קשרים רגשיים מורכבים בין מודליות נחשפת על ידי מדד ה-F1-score הנמוך ביותר שלו. מדדי ה-F1-score שהושגו על ידי הטכניקות שנבחנו במערך הנתונים CH-SIMS מוצגים בהשוואה באיור 3. כפי שהודגש, מבנים מתוחכמים יותר מבוססי גרפים ומבוססי Transformer עולים באופן עקבי בביצועיהם על שיטות מסורתיות יותר מבוססות היתוך (fusion). מודל ה-LSTM הציג את התוצאה הנמוכה ביותר עם F1-score של 0.71, ואחריו TFN (0.74) ו-LMF (0.76). מדד ה-F1-score עלה ל-0.79 בשימוש ב-Adaptive-Graph, מה שמעיד על החשיבות של מידול קשרים בין-מודליים. עם F1-score של 0.82, המסגרת המוצעת עלתה בביצועיה על Adaptive-Graph ב-3.8%, על LMF ב-7.9%, על TFN ב-10.8% ועל LSTM ב-15.5%. ממצאים אלה מראים כי מנגנון קשב צלב-מודלי (cross-modal attention) מבוס גרפים ולמידת ייצוג מופרד (disentangled representation learning) המוצעים לוכדים ביעילות רבה יותר מידע רגשי משלים על פני מודליות טקסטואליות, קוליות וחזותיות, מה שמוביל לביצועי סיווג טובים יותר.
המגמות היחסיות עקביות, על אף שכל השיטות מראות ירידה קלה ב-F1-score בהשוואה ל-CH-SIMS, כפי שמוצג ב-איור 4. הממצאים מראים שיפור עקבי בביצועים משיטות היתוך (fusion) מסורתיות לאסטרטגיות למידה מולטימודאליות מבוסות גרפים. המודלים עם ה-F1-score הנמוך ביותר היו LSTM (0.69), TFN (0.72) ו-LMF (0.74). ביצועי מודל ה-Adaptive-Graph עלו ל-0.7, מה שמדגים עד כמה ניתן למדל קשרים חוצי-מודאליות (cross-modal) היטב. המסגרת המוצעת עלתה בביצועיה על כל שאר הגישות והשיגה את ה-F1-score הגבוה ביותר, 0.80. התרומה של למידת ייצוג רגשות מופרד (disentangled) ומנגנון קשב חוצי-מודאליות מבוס גרפים ללכידת רמזים רגשיים משלימים בין מודאליות טקסטואלית, אקוסטית וויזואלית, מודגמת על ידי השיפור לעומת baseline החזק ביותר, Adaptive-Graph. תוצאות אלו מראות כי המסגרת המוצעת לזיהוי רגשות מולטימודאלי היא מהימנה ויעילה. הגישה המוצעת מראה שיפור משמעותי הן לעומת הגישה מבוססת הגרפים והן לעומת שיטת ההיתוך הקונבנציונלית, מה שמאשר עוד יותר את יכולת ההכללה החזקה של השיטה. השיפור ב-F1-score במערך הנתונים CMU-MOSEI מדגים כי הגישה המוצעת יכולה להשיג ביצועי סיווג רגשות מאוזנים גם בסביבות רועשות ומגוונות.
דיוק
במערכות תקשורת חכמות, הדיוק (precision) הוא קריטי מכיוון שאות רגשי שגוי עלול להפחית את חווית המשתמש. היחס בין מקרים שנחזו במדויק עבור רגש מסוים לבין המספר הכולל של המקרים שחזו שיהיו באותו רגש מוגדר כדיוק. מכיוון שייצוגי הרגשות המופרדים (disentangled) הם בעלי רעש נמוך יותר ופחות נוטים לסיווג שגוי בניגוד למודליות, המודל המוצע משיג ביצועים טובים יותר ממודלי הבסיס על מערך הנתונים CH-SIMS ב-איור 5.
באיור 5 מושווה הדיוק שהושג על ידי מספר טכניקות לזיהוי רגשות רב-מודאלי במאגרי הנתונים CH-SIMS ו-CMU-MOSEI. ככל שהמודלים עוברים מטכניקות מסורתיות מבוסות היתוך (fusion) לארכיטקטורות מתוחכמות יותר מבוססות גרפים, הדיוק עולה בהתמדה. המסגרה המוצעת השיגה את הדיוק המקסימלי של 0.82 במאגר הנתונים CH-SIMS, כאשר הדיוק עלה מ-0.71 עבור LSTM ל-0.74, 0.76 ו-0.79 עבור TFN, LMF ו-Adaptive-Graph, בהתאמה. במאגר הנתונים CMU-MOSEI, הדיוק עלה מ-0.69 עבור LSTM ל-0.72, 0.74 ו-0.7 עבור TFN, LMF ו-Adaptive-Graph, בהתאמה. הגישה המוצעת השיגה את הדיוק הגבוה ביותר של 0.80. המסגרת המוצעת העלתה את הדיוק בכ-3.8% ב-CH-SIMS וב-3.9% ב-CMU-MOSEI בהשוואה לקו הבסיס החזק ביותר (Adaptive-Graph). ממצאים אלו מראים כי על ידי לכידה של מידע רגשי משלים על פני מודליות טקסטואליות, אקוסטיות וויזואליות, למידת הייצוג המופרד (disentangled representation learning) המוצעת ומנגנון הקשב הרב-מודאלי מבוס הגרפים מפחיתים בהצלחה תחזיות חיוביות שגויות (false-positive). השפעתו של מודאליות לא רלוונטית מומטת עוד יותר על ידי הקשב הרב-מודאלי מבוס הגרפים. הגיוון המוגבר של הדוברים והביטויים הלשוניים בקורפוס CMU-MOSEI גורם לירידה קלה בדיוק עבור כל המודלים.
הסתמכות על ידע קודם
במשימות של זיהוי רגשות, recall (חזרה), המהווה מדד ליכולתו של מודל לסווג באופן נכון מקרים רגשיים השייכים למחלקה מסוימת, הוא קריטי מכיוון שחוסר במידע רגשי עלול להשפיע לרעה על איכות האינטראקציה. ערך recall גבוה יותר מעיד על כך שהמודל מזהה פחות שליליים שגויים ויותר ביטויים רגשיים ממשיים. ניתן לראות ב-recall מדד ליעילות שבה מופק מידע רגשי מטקסט, מאודיו וממודליות חזותיות בהקשר של ניתוח רגשות רב-מודאלי.
היתרון של הטכניקה המוצעת על פני גישות הבסיס במאגרי הנתונים CH-SIMS ו-CMU-MOSEI מוצג בהשוואת ה-recall באיור 6. ככל שהמודלים מתפתחים משיטות מבוסות מיזוג (fusion) קונבנציונליות למבנים מולטי-מודאליים מתוחכמים יותר המבוססים על גרפים, התוצאות מראות באופן עקבי שיפורים ב-recall. ה-recall במאגר הנתונים CH-SIMS עלה מ-0.70 עבור LSTM ל-0.73, 0.75 ו-0.78 עבור TFN, LMF ו-Adaptive-Graph, בהתאמה; recall מרבי של 0.82 הושג על ידי המסגרת המוצעת. הגישה המוצעת השיגה את ה-recall הטוב ביותר, 0.80, במאגר הנתונים CMU-MOSEI, שבו ה-recall עלה מ-0.68 עבור LSTM ל-0.71, 0.73 ו-0.76 עבור TFN, LMF ו-Adaptive-Graph, בהתאמה. המסגרת המוצעת הניבה שיפורים יחסיים של כ-5.1% ב-CH-SIMS ו-5.3% ב-CMU-MOSEI בהשוואה לגישת הבסיס החזקה ביותר (Adaptive-Graph). תוצאות אלו מראות כי באמצעות לכידה של רמזים רגשיים משלימים על פני מודאליות טקסטואלית, אקוסטית וויזואלית, למידת הייצוג המופרד (disentangled representation learning) ומנגנון התשומת צמוד-מודאליות המבוס על גרפים שהוצעו, מצליחים להפחית תחזיות שגויות מסוג false-negative, ובכך לשפר את הזיהוי של מחלקות רגש בשני מאגרי הנתונים. מכיוון שלשיטות מסורתיות יש יכולת מוגבלת למדל מערכות יחסים מורכבות בין מודאליות, הן נוטות להציג ערכי recall נמוכים יותר. על ידי מידול מפורש יותר של מערכות היחסים בין המודאליות, TFN ו-LMF משיגים שיפורים מתונים. על ידי סימולציה של מערכות היחסים המבניות בין המודאליות, שיטת ה-Adaptive-Graph שיפרה עוד יותר את ה-recall. עבור שני מאגרי הנתונים, השיטה המוצעת משיגה את ה-recall הגבוה ביותר, מה שמעיד על יכולתה המיטבית לזהות מופעים רגשיים בתרחישי אינטראקציה שונים. השיפור בולט יותר במאגר הנתונים הגדול CMU-MOSEI, דבר המדגים את החוסן וההכללה של המסגרת המוצעת.
טעות מוחלטת ממוצעת (MAE)
טעות מוחלטת ממוצעת (MAE) משמשת להערכת ביצועים של משימות חיזוי רציפות של עוצמת רגש, כגון חיזוי וולנס (valence) או עירור (arousal). בניגוד לדיוק (accuracy), MAE משקפת טוב יותר את הקרבה של עוצמת הרגש החזויה למצב הרגשי בפועל. זו הסיבה ש-MAE מתאימה יותר למערכי נתונים כגון CH-SIMS ו-CMU-MOSEI, הכוללים תוויות רגשיות רציפות. ערך MAE נמוך יותר מעיד על דיוק גבוה יותר בחיזוי עוצמת הרגש.
השוואת ה-MAE בין המסגרת המוצעת לבין גישות הבסיס במאגרי הנתונים CH-SIMS ו-CMU-MOSEI מוצגת ב-טבלה 4. שיטות היתוך מסורתיות המבוסות על LSTM נוטות להציג ערכי MAE גבוהים יותר בשל יכולתן המוגבלת למדל תלויות רגשיות מולטי-מודאליות מורכבות. TFN ו-LMF יכולים להפחית את ה-MAE על ידי מידול אינטראקציות מולטי-מודאליות, וגישת ה-Adaptive-Graph מפחיתה אותו עוד יותר על ידי למידת יחסי גרף בין המודליות. המסגרת המוצעת משיגה את ה-MAE הנמוך ביותר בשני מאגרי הנתונים, מה שמעיד על הערכה מדויקת יותר של עוצמת הרגש. ראוי לציין כי השיפור משמעותי יותר במאגר הנתונים CMU-MOSEI, שבו השונות הרחבה בנתונים ותנאי הדוברים הופכים את משימת הניבוי למאתגרת יותר.
מטריצת בלבול עבור מערך הנתונים CH-SIMS
שיטות הבסיס של early fusion LSTM ו-TFN מראות בלבול משמעותי בין מחלקות של רגשות ניטרליים וחיוביים, על פי מטריצות הבלבול עבור מערך הנתונים CH-SIMS. דבר זה מרמז כי שיטות אלו אינן יעילות מספיק בזיהוי ביטויים רגשיים מולטי-מודאליים דቂקים. מנגד, השיטה המוצעת מראה בבירור דומיננטיות אלכסונית חזקה, עם מעט מאוד אלמנטים מחוץ לאלכסון, ובכך משפרת את יכולת ההפרדה בין המחלקות. מנגנון למידת הרגשות המופרד (disentangled emotion learning) של השיטה המוצעת מבטיח ייצוג עקבי של רגשות בין מודאליות שונות, וגישת היתוך הגרפים (graph fusion) שלה משפרת את ההבחנה בין מחלקות סנטימנט דומות. איור 7A–E מציג את מטריצת הבלבול עבור מערך הנתונים CH-SIMS עם שיטות בסיס שונות.
מטריצת בלבול עבור מערך הנתונים CMU-MOSEI
המסגרת המוצעת משתמשת בקידודי רגש (emotion embeddings) שאינם תלויים באופן ההצגה (modality-invariant) ובמשקלי קשב אדפטיביים כדי להפחית משמעותית את שיעור הסיווג השגוי, במיוחד עבור קלטים מעורפלי רגש. הדבר מאש כי המסגרת המוצעת פועלת היטב במגוון תרחישים של אינטראקציה מולטי-מודאלית בקנה מידה גדול. בשל גודל מערך הנתונים, השונות בין הדוברים והטבע הרציף של תוויות הסנטימנט, מטריצות הבלבול של CMU-MOSEI מראות שיעור סיווג שגוי כולל גבוה יותר. שיטות הבסיס (baseline methods) מראות מידה ניכרת של בלבול בין קטגוריות רגש שונות. איור 8A–E מציגה את מטריצת בלבול (confusion matrix) עבור מערך הנתונים CMU-MOSEI עם שיטות בסיס (baseline) שונות.
זמן אימון לכל תקופה (epoch)
הפשרות החישוביות של טכניקות היתוך רב-מודליות מתקדמות מודגשות על ידי השוואת זמן האימון לכל epoch. בשל מקודדי ה-transformer ומנגנוני תשומת לב גרפיים (graph attention), המודל המוצע דורש זמן אימון מעט רב יותר מאשר גישות היתוך פשוטות, אך עלייה זו אינה בלתי סבירה. המסגרת המוצעת הדגימה ביצועים חזקים במערכי נתונים בנצ'מרק של ניתוח רגשות רב-מודלי ומראה פוטנציאל לשילוב במערכות אינטליגנטיות של אינטראקציה אדם-מכונה. עם זאת, התאמת הפריסה לזמן אמת לא נבחנה במחקר הנוכחי ומצריכה חקירה נוספת באמצעות ניתוחים של השהיה (latency), תפוקה (throughput), זיכרון ופריסה. ראוי לציין כי יציבות ההסגירה (convergence) המשופרת והביצועים העדיפים בחיזוי ובפרשנות הופכים את העלות החישובית הנוספת לכדאית. איור 9 מציג את תוצאת זמן האימון לכל epoch עבור השיטה המוצעת.
ניסוי השהיה (Ablation study)
כדי לקבוע את השפעתו של כל מרכיב מרכזי במסגרת המוצעת, כגון מודול המיפוי החזותי, היתוך בין-מודאלי מבוס גרפים וייצוג רגשי מופרד (disentangled), נערך מחקר אבלציה (ablation study). כדי להבין את ההשפעה, כל מרכיב הוסר בנפרד. על פי תוצאות הניסוי, אסטרטגיית היתוך הגרפים משפרת את מידול התלות הבין-מודאלית, ותרומתו של הייצוג הרגשי המופרד היא החשובה ביותר ליציבות הביצועים. תפקידו העזר של מודול המיפוי החזותי הוכח על ידי ההשפעה המזערית שלו על הביצועים בעת הסרתו. תוצאות מחקר האבלציה תחת אותם תנאי אימון והערכה מוצגות ב-Table 5. הידרדרות הביצועים הגדולה ביותר נצפתה לאחר הסרת מודול התשומת (attention) הבין-מודאלי מבוס הגרפים, אשר הפחית את הדיוק מ-81.72% ל-7.8% ואת מדד ה-F1-score מ-0.823 ל-0.76. הדבר מדגיש את חשיבותו של מידול אינטראקציות מורכבות בין-מודאליות. תפקידו של מודול למידת הייצוג המופרד בלמידת ייצוגים חסונים ספציפיים לרגש הוכח על ידי העובדה שהסרתו הפחיתה את הדיוק ב-2.78 נקודות אחוז ואת ה-F1-score ב-0.032. היתרון העיקרי של מודול המיפוי החזותי הוא יכולת הפרשנות (interpretability) ולא דיוק הסיווג, כפי שמעידה הירידה המתונה יותר בביצועי הניבוי עם הסרתו. תצורת היתוך הבסי (Basic Fusion) הציגה את הביצועים הגרועים ביותר, מה שמוכיח כי ביצועי זיהוי רגשות רב-מודאליים מיטביים דורשים את השפעתם המשותפת של כל המודולים המוצעים.
זמינות נתונים:
מערכי הנתונים ששימשו במחקר זה הם מערכי נתונים להשוואה (benchmark) הזמינים לציבור. מערך הנתונים CMU-MOSEI מסופק על ידי ה-Multimodal SDK של אוניברסיטת קרנגי מלון ומתואר ב-Zadeh et al. (2018) (https://doi.org/10.18653/v1/P18-1208), כאשר הגישה אליו זמינה בכתובת https://multicomp.cs.cmu.edu/multimodal-language-analysis-in-the-wild-cmu-mosei-dataset-and-interpretable-dynamic-fusion-graph/. מערך הנתונים CH-SIMS מתואר ב-Yu et al. (2020) (https://doi.org/10.18653/v1/2020.acl-main.343) וניתן לגשת אליו באופן ציבורי באמצעות המשאבים שסיפקו המחברים, כולל https://github.com/thuiar/MMSA. כל הניסויים נערכו באמצעות הגרסאות הרשמיות של מערכי נתונים אלה. הנתונים הגולמיים שחולצו, קבצי הנתונים המעובדים, תוצרי עיבוד מקדמי (preprocessing), חלוקות לאימון/תיקוף/בדיקה, ייצוגי מאפיינים נגזרים ופרטי המימוש התומכים בממצאי מחקר זה זמינים לציבור במאגר Zenodo בכתובת https://doi.org/10.5281/zenodo.2124921.
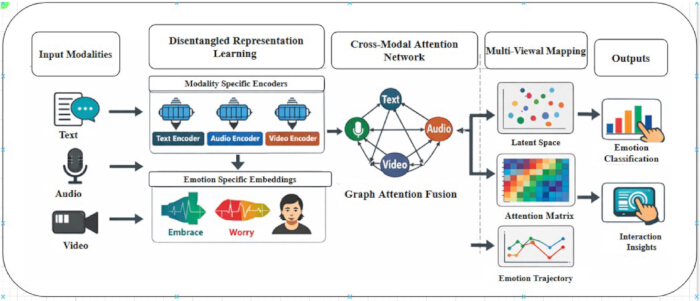
איור 1תרשים סכימתי של מסגרת המיפוי הוויזואלי המוצעת למאפייני רגש רב-מודאליים. איור מושגי של הארכיטקטורה הכוללת, המציג רכיבים של חילוץ תכונות רב-מודאלי (multimodal), למידת ייצוג מופרד (disentangled representation learning), היתוך קשב צמוד-מודאלי מבוס גרפים ומיפוי חזותי לניתוח רגשות רב-מודאלי ניתן לפירוש. אנא לחץ כאן כדי להציג גרסה מורחבת של איור זה.
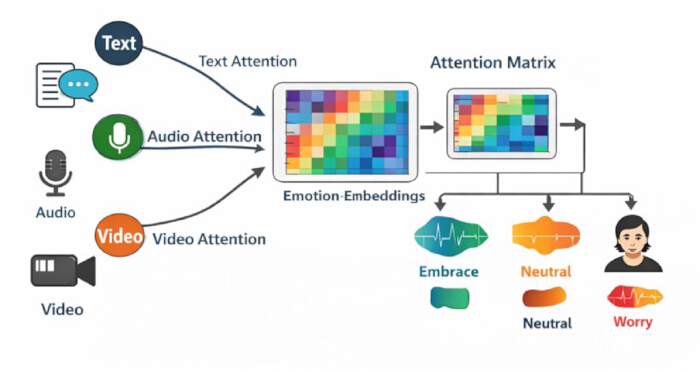
איור 2תרשים זרימה סכימטי של הפרוטוקול החישובי המוצע.
ייצוג מושגי של צינור העיבוד מקצה לקצה, הכולל את שלבי רכישת מערך הנתונים, עיבוד מקדים, מיצוי מאפיינים ספציפיים למודליות, היתוך רב-מודאלי, ויזואליזציה וניבוי רגשות אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
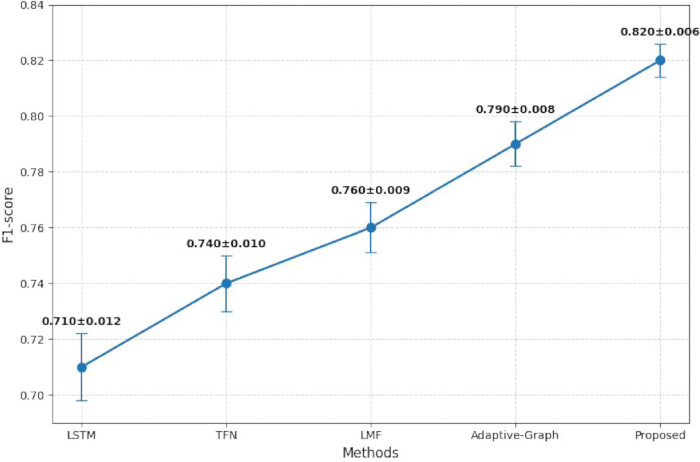
איור 3השוואה של ביצועי מדד F1 על מערך הנתונים CH-SIMSערכי F1-score ממוצעים שהתקבלו מחמישה ריצים ניסיוניים עצמאיים (n = 5) תוך שימוש באתחולים שונים של זרעי אקראיות (random seed). פסי השגיאה מייצגים ± סטיית תקן (SD) אחתערכי F1-score גבוהים יותר מעידים על ביצועי סיווג רגשות טובים יותר. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
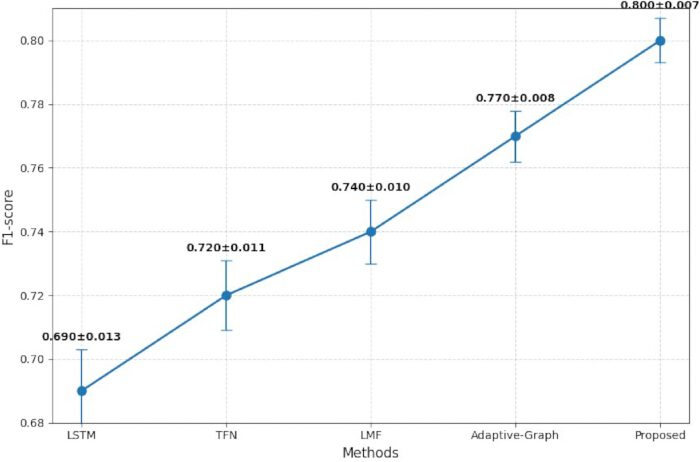
איור 4השוואה של ביצועי מדד F1 במערך הנתונים CMU-MOSEIערכי F1-score ממוצעים שהתקבלו מחמישה הרצות ניסויים עצמאיות (n = 5) באמצעות אתחולים שונים של זרעים אקראיים (random seed). פסי השגיאה מייצגים ± סטיית תקן (SD) אחתוהמתאימים לו ממוצע ± SD הערכים מוצגים מעל לכל נקודת נתונים. ערכי F1-score גבוהים יותר מעידים על ביצועי סיווג רגשות טובים יותר. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
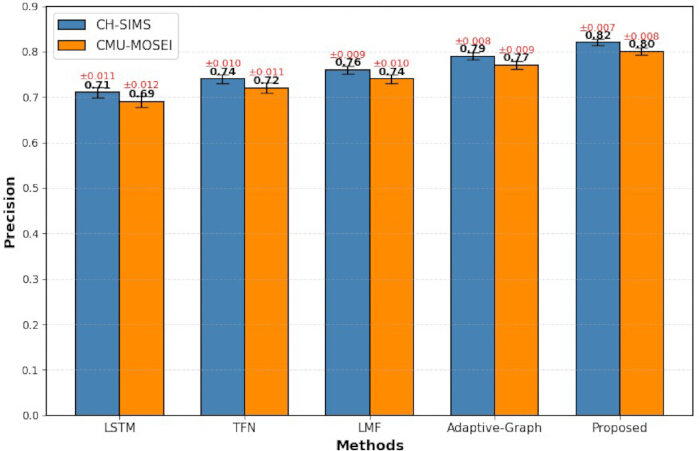
איור 5השוואת דיוק במאגרי הנתונים CH-SIMS ו-CMU-MOSEI. ציוני דיוק ממוצעים שהתקבלו באמצעות LSTM, TFN, LMF, Adaptive-Graph והמסגרה המוצעת לאורך חמישה הרצות ניסיוניות עצמאיות (n = 5)סטיות התקן (Error bars) מייצגות ± סטיית תקן (SD) אחת חושב מתוך הרצות חוזרות עם אתחולים שונים של זרעי אקראיות (random seed). המסגרת המוצעת משיגה את הדיוק הגבוה ביותר בשני מערכי הנתונים, ובכך מדגימה הבחנה משופרת בין מחלקות רגש באמצעות למידת מאפיינים מולטי-מודאלית יעילה והיתוך חוצה-מודאלי מבוס גרף. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
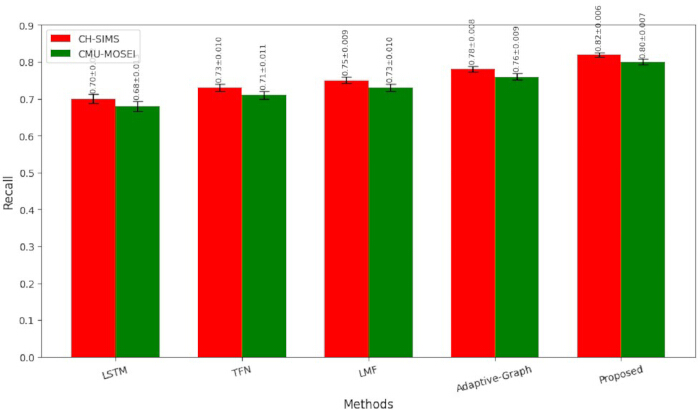
איור 6: השוואת recall במאגרי הנתונים CH-SIMS ו-CMU-MOSEI. ציוני Recall ממוצעים שהושגו על ידי LSTM, TFN, LMF, Adaptive-Graph והמסגרה המוצעת לאורך חמישה הרצות ניסוייות בלתי תלויות (n = 5). סטיות התקן מציינות ± סטיית תקן (SD) אחת נגזר מניסויים חוזרים. המסגרת המוצעת משיגה בעקביות את ה-recall הגבוה ביותר בשני מאגרי הנתונים, מה שמעיד על יכולת עדיפה בלכידת מידע רגשי רב-מודאלי ובצמצום תחזיות שגויות מסוג false-negative. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
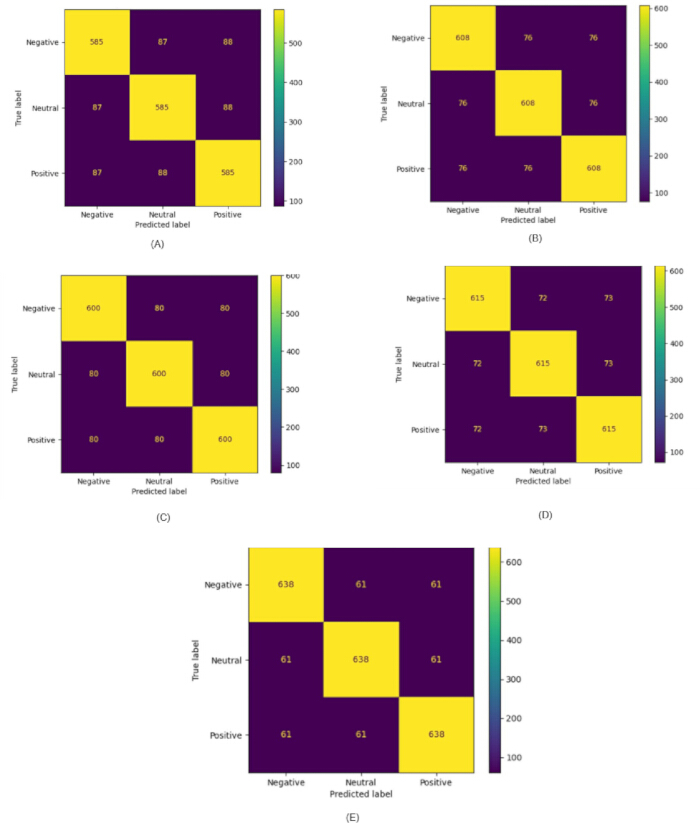
איור 7מטריצת בלבול עבור מערך הנתונים CH-SIMS עם שיטות בסיס שונותהשורות תואמות למחלקות הרגש של ה-ground-truth, והעמודות תואמות למחלקות שנחזו. ערכי התאים מייצגים את אחוז הדגימות שנורמלו ביחס לכל מחלקה אמית. מטריצת הבלבול חושבה באמצעות מחיצת הבדיקה המופרדת של CH-SIMS. אחוזים גבוהים יותר באלכסון מעידים על דיוק זיהוי טוב יותר עבור קטגוריית הרגש התואמת. מטריצות בלבול של (A(LSTM עם מיזוג מוקדם, (B(TFN, (C) LMF, (ד') גרף אדפטיבי, ו- (ההשיטה המוצעת על מערך הנתונים CH-SIMS. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
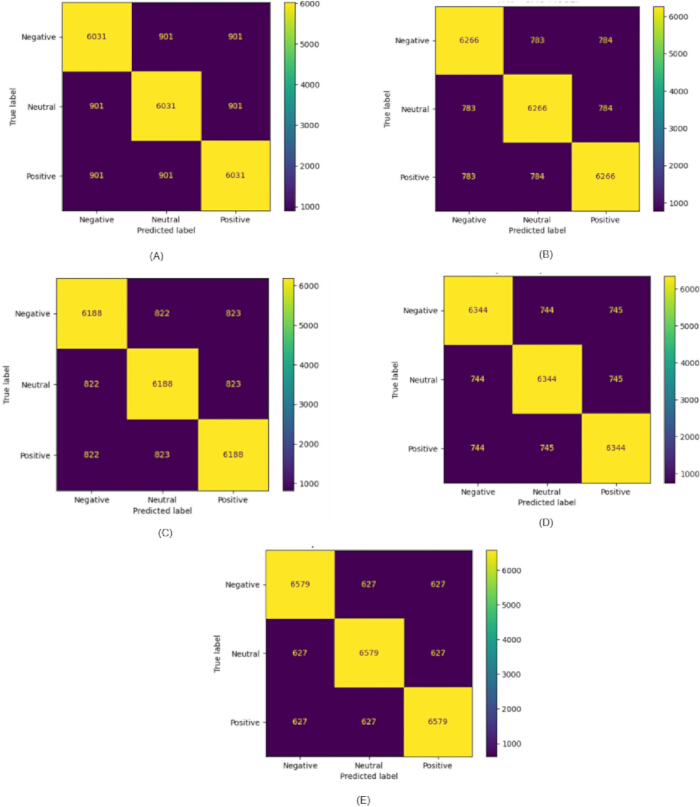
איור 8מטריצת בלבול עבור מערך הנתונים CMU-MOSEI עם שיטות בסיס שונותשורות מייצגות תוויות רגש ממשיות ועמודות מייצגות תוויות חזויות. הערכים מדווחים כאחוזים מנורמלים לפי מחלקה על סט הבדיקה של CMU-MOSEI. המטריצה ממחישה הן דגימות שסווגו נכון (ערכי האלכסון) והן בלבול בין קטגוריות רגש (ערכים מחוץ לאלכסון). מטריצת בלבול עבור CMU-MOSEI (A( LSTM עם היתוך מוקדם, (B(TFN, (C) LMF, (ד') גרף אדפטיבי, ו-(ה) השיטה המוצעת על מערך הנתונים CMU-MOSEI. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
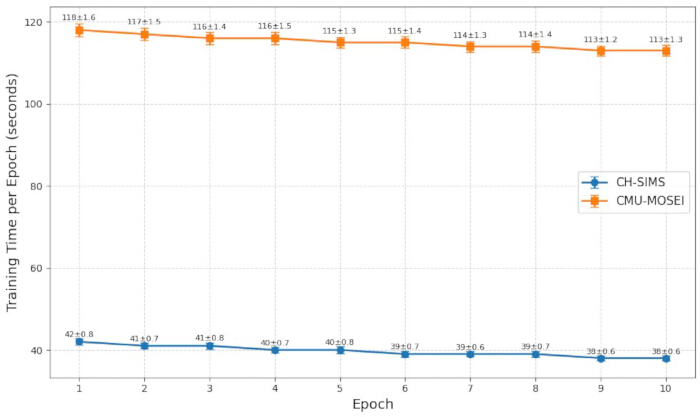
איור 9השוואה של זמן האימון לכל תקופה (epoch) במאגרי נתונים רב-מודאליים של רגשות המשמשים כבנצ'מרק.
זמן אימון ממוצע לכל תקופה (epoch) שהתקבל מ- חמשה הרצות ניסיוניות עצמאיות (n = 5) עבור מאגרי הנתונים CH-SIMS ו-CMU-MOSEI תחת הגדרות חומרה ותוכנה זהות. פס השגיאה מייצגים ± סטיית תקן אחת (SD) חושב מניסויים חוזרים תוך שימוש באתחולים שונים של זרעי אקראיות (random seeds). ערכים נמוכים יותר מעידים על יעילות חישובית גבוהה יותר, בעוד שזמני אימון יציבים בין הרצות מעידים על שיפור בשחזוריות ובעקביות האימון. אנא לחץ כאן כדי להציג גרסה מוגדלת של איור זה.
| מערך נתונים | מודליות | מספר דגימות | שפה | תוויות רגש/סנטימנט |
| CH-SIMS34 | וידאו, אודיו, טקסט | 2,281 מקטעי וידאו | סינית | תוויות סנטימנט רב-מודאליות וחד-מודאליות (שלי, ניטרלי, חיובי) |
| CMU-MOSEI35 | וידאו, אודיו, טקסט | ~23,453 קליפים מתויגים | אנגלית | תוויות סנטימנט ועוצמת רגש (רציפות וקטגוריאליות) |
טבלה 1: תיאור מערכי הנתונים. סיכום של מערכי הנתונים ששימשו במחקר זה, המודליות, מספר הדגימות, השפה, ותוויות הרגש/סנטימנט עבור מערכי הנתונים CH-SIMS ו-CMU-MOSEI.
| רכיב | מפרט |
| מסגרת תכנות | Python עם PyTorch |
| מחלץ מאפיינים חזותיים | Vision Transformer (ViT) |
| מחלץ מאפיינים קוליים | Wav2Vec 2.0 |
| מחלץ מאפייני טקסט | RoBERTa |
| אסטרטגיית היתוך | רשת קשב רב-מודלית מבוססת גרף (Graph-based Cross-Modal Attention Network) |
| ממד מאפיינים | 768 לכל מודליות |
| אופטימייזר אימון | Adam |
| קצב למידה | 1.0E-04 |
| גודל אצווה (Batch Size) | 16 |
| חומרה | NVIDIA GPU (למשל, סדרת RTX) |
| מאגרי נתונים להערכה | CH-SIMS, CMU-MOSEI |
| ממד לטנטי | 2.56E+02 |
| ממד שיכון (Embedding Dimension) | 768 |
| פונקציית הפעלה | ReLU |
| אופטימייזר | Adam |
| קצב למידה | 1.0E-04 |
| גודל אצווה (Batch Size) | 32 |
| איטרציות (Epochs) | 10 |
| עצירה מוקדמת | מופעל |
| פונקציית הפסד | סיווג + שחזור + עקביות |
טבלה 2: סביבת הסימולציה. הגדרה ניסיונית ופרטי מימוש של סביבת הסימולציה, כגון מפרטי המודל, מאפיינים, אופטימיזציה וחומרה שבה נעשה שימוש.
| שיטה | דיוק CH-SIMS (%) | דיוק CMU-MOSEI (%) |
| LSTM (מיזוג מוקדם/מאוחר) | 72.84 ± 1.12 | 70.35 ± 1.26 |
| TFN | 74.91 ± 0.98 | 72.68 ± 1.10 |
| LMF | 76.23 ± 0.85 | 74.12 ± 0.94 |
| גרף-אדפטיבי | 78.46 ± 0.73 | 76.89 ± 0.81 |
| השיטה המוצעת | 81.72 ± 0.61 | 79.94 ± 0.69 |
טבלה 3: הערכת דיוק השיטה המוצעת אל מול טכניקות בסיס במאגרי הנתונים CH-SIMS ו-CMU-MOSEI. התוצאות מדווחות כממוצע ±± סטיית תקן שהתקבלו מחמש הרצות ניסוייות עצמאיות (n = 5) תוך שימוש באתחולים שונים של זרעי אקראיות (random seed). כל השיטות הוערכו באמצעות חלוקות זהות של נתוני אימון, תיקוף ובדיקה במאגרי הנתונים שלהן כדי להבטיח השוואה הוגנת.
| שיטה | MAE של CH-SIMS ↓ | CMU-MOSEI MAE ↓ |
| LSTM (מיזוג מוקדם/מאוחר) | 0.412 ± 0.014 | 0.465 ± 0.016 |
| TFN | 0.387 ± 0.012 | 0.439 ± 0.014 |
| LMF | 0.361 ± 0.010 | 0.412 ± 0.012 |
| גרף-אדפטיבי | 0.334 ± 0.009 | 0.379 ± 0.010 |
| השיטה המוצעת | 0.298 ± 0.007 | 0.341 ± 0.008 |
טבלה 4: תוצאות השגיאה המוחלטת הממוצעת. התוצאות מדווחות כממוצע ± סטיית תקן שהתקבלו מחמישה הרצות ניסיוניות עצמאיות (n = 5) תוך שימוש באתחולים שונים של זרעים אקראיים. כל השיטות הוערכו באמצעות חלוקות זהות של אימון, תיקוף ובדיקה עבור מערכי הנתונים שלהן כדי להבטיח השוואה הוגנת. השוואה של ה-MAE לחיזוי רציף של עוצמת רגש באמצעות המסגרה המוצעת וגישות בסיס (baseline) בשני מערכי הנתונים.
| גרסת מודל | דיוק (%) | F1-score |
| מודל מלא | 81.72 ± 0.61 | 0.823 ± 0.08 |
| ללא הפרדה (Disentanglement) | 78.94 ± 0.74 | 0.791 ± 0.010 |
| ללא מיזוג גרפים | 7.8 ± 0.81 | 0.76 ± 0.01 |
| ללא מיפוי חזותי | 80.1 ± 0.66 | 0.807 ± 0.09 |
| מיזוג בסי | 74.91 ± 0.98 | 0.742 ± 0.013 |
טבלה 5: תוצאות מחקר אבלציה (Ablation study) עם שיטות בייסליין. התוצאות מדווחות כ- ממוצע ± סטיית תקן התקבל מ- חמשה הרצות ניסיוניות בלתי תלויות (n = 5) באמצעות אתחולים שונים של זרעי אקראיות (random seed). כל השיטות הוערכו באמצעות חלוקות זהות של קבוצות אימון, תיקוף ובדיקה במאגרי הנתונים הרלוונטיים להן, על מנת להבטיח השוואה הוגנת. השוואת ביצועים בין גרסאות שונות של המודל, המצביעה על היעילות של למידה מייצוגים מופרדים (disentangled representations), מיזוג מבוס גרפים ומודול המיפוי החזותי.
קובץ משלים 1: אלגוריתם 1 ואלגוריתם 2.אנא לחצו כאן כדי להוריד קובץ זה.
דיון
הממצאים הניסיוניים מדגימים כי במאגרי הנתונים CH-SIMS ו-CMU-MOSEI, מסגרת המיפוי הוויזואלי המוצעת למאפייני רגש רב-מודאליים עולה בביצועיה על טכניקות נוכחיות לזיהוי רגשות רב-מודאלי. בהשוואה למודלים של מיזוג מוקדם ומאוחר, כגון EF-LSTM ו-TFN, הטכניקה המוצעת משיגה דיוק גבוה יותר ומדדי F1 Scores גבוהים יותר, דבר המעיד על חסינותה בטיפול במידע רגשי מגוון. ניתן לייחס את השיפור בשיטה לייצוג הרגש המופרד (disentangled), המדכא רעש ספציפי למודאליות ומבטיח עקביות רגשית בין המודאליות הוויזואלית, השמעית והטקסטואלית36.
לאחרונה, מודלים מולטי-מודאליים מבוססי transformer, כגון Adaptive Multimodal Transformers37 ו-MIAR38, הראו תוצאות מרשימות במידול תלויות חוצות-מודאליות. עם זאת, מודלים אלה עוסקים בעיקר בחיזוי וחסרים מנגנונים התומכים בפרשנות ברמת המאפיינים. לעומת זאת, המערכת המוצעת משלבת קשב חוצה-מודאלי מבוסס גרף עם מודול מיפוי ויזואלי, מה שמאפשר ניתוח שקוף של האינטראקציות בין המודאליות לרגשות. זהו היבט קריטי החסר כעת בספרות, שבה הסקת מסקנות רגשית נתפסת כתהליך של "קופסה שחורה".
המסגרת המוצעת הדגימה ביצועים עקביים על פני מערכי הנתונים של CH-SIMS ו-CMU-MOSEI. בעוד שלמסגרת עשויות להיות יישומים פוטנציאליים באינטראקציה חכמה בין אדם למכונה, ניטור רפואי, סביבות למידה אדפטיביות ומערכות אחרות המודעות לרגשות, המחקר הנוכחי העריך את השיטה רק תחת תנאי benchmark מבוקרים. לא בוצע פריסה בעולם האמיתי, הערכת ממשק משתמש, מחקר שמישות או הערכה של נבדקים אנושיים. לכן, היעילות המעשית של המסגרת בסביבות תפעוליות עדיין דורשת בדיקה. עבודה עתידית תתמקד בהערכות מכוונות-פריסה, מחקרים ממוקדי-משתמש, ניתוח השהיה (latency), הערכת צריכת זיכרון וביצועי אינטראקציה בזמן אמת.
יתרה מכך, השיפורים בביצועים על פני מאגרי נתונים מגוונים מבחינה תרבותית ולשונית מדגימים את תקפות המסגרת המוצעת. בניגוד לעבודות קודמות שתוקפו בוצע על מאגר נתונים בודד או תרחיש אינטראקציה ספציפי, המסגרת המוצעת מראה ביצועים חסונים על פני שפות, דוברים וביטויים רגשיים שונים. לפיכך, המסגרת המוצעת מתאימה מאוד למערכות אינטראקציה חכמות מעשיות הדורשות זיהוי רגשות מדויק וקבלת החלטות ניתנת לפירוש.
הפרשנות של המסגרת המוצעת הוערכה באמצעות ניתוח מבוסס ויזואליזציה של הייצוגים הרב-מודאליים שנלמדו. באופן ספציפי, נבחנו שיבוצי רגשות חבויים (latent emotion embeddings), מפות קשב חוצות-מודאליות, גרפים של אינטראקציה בין מודאליות ומסלולי רגש זמניים, כדי לספק תובנות לגבי תהליך קבלת ההחלטות של המודל ותרומת המודאליות השונות. מטרתו של מודול המיפוי הוויזואלי היא להגביר את השקיפות על ידי מתן אפשרות לצפייה באינטראקציות ברמת המאפיינים ובדינמיקה רגשית. עם זאת, מדדי פרשנות פורמליים, הערכות נאמנות לקשב (attention-faithfulness) ומחקרי משתמשים לא נכללו בעבודה הנוכחית. לפיכך, יש לפרש את יתרונות הפרשנות המדווחים כראיות מבוססות ויזואליזציה ולא כמדדי הסבריות שתוקפו הוכח כמותית.
מנקודת מבט תיאורטית, מחקר זה תורם את הדברים הבאים למחשוב רגשי מולטי-מודאלי: הוא מציע דרך שיטתית למידול רגשות המבדילה בבירור בין ייצוגים ספציפיים לרגש לבין ייצוגים ספציפיים למודאליות. על ידי הבטחת עקביות רגשית בין מודאליות שונות במרחב חבוי משותף, המסגרת המוצעת מקדמת את התיאוריה של למידת ייצוגים במערכות מולטי-מודאליות. השילוב של מנגנוני קשב מבוססי גרף מעגן באופן פורמלי יותר את התלויות בין המודאליות השונות בביטוי רגשות.
מנקודת מבט מעשית, המסגרת המוצעת מועילה מאוד לעיצוב אינטראקציה חכמה ולממשקי משתמש מודעי-רגש. מודול המיפוי הוויזואלי במסגרת המוצעת מאפשר למתכנני מערכות להבין את ההשפעה של מודליות שונות על חיזוי רגשות, דבר החשוב מאוד עבורם. המסגרת המוצעת מועילה מאוד ליישומים כגון סוכני שיחה רגשיים, מערכות למידה אדפטיביות, ממשקי ניטור רפואיים ופלטפורמות להערכת חווית משתמש.
עם זאת, למסגרת המוצעת ישנן מספר מגבלות. השימוש במנגנוני תשומת לב גרפיים (graph attention mechanisms) ובמקודדי טרנספורמר (transformer encoders) מוסיף מורכבות, שעלולה להיות בעייתית עבור מכשירים בעלי יכולות מוגבלות. יתרה מכך, המחקר הנוכחי מתעלם מאותות פיזיולוגיים אחרים, כגון EEG ומעקב עיניים, לטובת התמקדות במודליות חזותית, קולית וטקסטואלית. היעילות החישובית של המסגרת המוצעת לצורך פריסה בזמן אמת לא הוערכה באופן ספציפי, למרות העובדה שהיא השיגה ביצועי ניבוי תחרותיים ויכולת ויזואליזציה משופרת. מחקרים עתידיים יבחנו ביצועי פריסה בהקשרי אינטראקציה חכמה בעולם האמיתי, עיכוב בהסקה (inference delay), קיבולת עיבוד (throughput), צריכת זיכרון וטכניקות לדחיסת מודלים. כדי לשפר עוד יותר את דיוק מידול הרגשות ואת התגובתיות של האינטראקציה, מחקרים עתידיים יתמקדו בפיתוח מודלים קלילים, טכניקות אופטימיזציה לזמן אמת ושילוב של מודליות נוספות. ביצועי פריסה בזמן אמת לא הוערכו, והשילוב של מקודדי טרנספורמר ושיטות תשומת לב מבוססות גרפים מעלה את המורכבות החישובית. רק מערכי הנתונים הבנצ'מרק CH-SIMS ו-CMU-MOSEI שימשו לתיקוף המתודולוגיה, דבר שעלול להוביל להטיות ספציפיות למערכי הנתונים ולהגביל את היכולת להכליל את התוצאות לדומיינים, שפות ואוכלוסיות משתמשים אחרים. בנוסף, המחקר הנוכחי אינו כולל אותות פיזיולוגיים כמו נתוני EEG או מעקב עיניים; תחת זאת, הוא מתמקד במודליות חזותית, קולית וטקסטואלית. למרות שתיאורים מפורטים של המימוש ושל סביבת הסימולציה שיפרו את יכולת השחזור, קוד המקור ומודלים מאומנים מראש אינם זמינים כעת לציבור.
בעבודה זו נעשה שימוש במסגרת מיפוי חזותית חדשנית ללמידת מאפייני רגש רב-מודאליים עבור עיצוב אינטראקציה חכמה. השיטה המוצעת משלבת למידת ייצוג מבוססת transformer מקצה לקצה, מידול רגשות מופרד (disentangled emotion modeling) ותשומת לב חוצת-מודאליות מבוססת גרף, וזאת כדי להשיג דיוק חיזוי ופרשנות גבוהים. ניסויים על מאגרי הנתונים CH-SIMS ו-CMU-MOSEI מראים כי המסגרת המוצעת עולה בביצועיה על מודלים קיימים של זיהוי רגשות רב-מודאליים מבחינת דיוק ומדד F1-score. חשוב מכך, פתרון המיפוי החזותי המוצע מגשר על הפער שבין זיהוי רגשות לבין אסטרטגיית אינטראקציה, ומציע כיוון חדש לעיצוב של מערכות מחשוב רגשי רב-מודאליות המודעות לאינטראקציה וניתנות לפרשנות.
כדי להקל על עיצוב אינטראקציה חכם וניתן לפירוש, מחקר זה הציג מסגרת מיפוי ויזואלית חדשנית ללמידה של מאפייני רגש רב-מודאליים. המערכת המוצעת משלבת בהצלחה זיהוי רגשות ויכולת פירוש בתוך ארכיטקטורה אחת, על ידי שילוב של חילוץ מאפיינים רב-מודאליים מבוסס-transformer, למידה של ייצוג רגשי מופרד (disentangled), היתוך קשב חוצה-מודאליות מבוסס-גרף, ושיטות מיפוי ויזואלי. בנוסף למתן ייצוגים ויזואליים ברורים של תרומות המודאליות, אינטראקציות חוצות-מודאליות ודינמיקה רגשית זמנית, הערכה ניסיונית על מאגרי הנתונים CH-SIMS ו-CMU-MOSEI הראתה ביצועים משופרים לעומת שיטות בסיס מייצגות במספר מדדים, כולל Accuracy, Precision, Recall, F1-score ו-Mean Absolute Error (MAE). עם זאת, מחקרי פריסה בעולם האמיתי, הערכות ממוקדות-משתמש, הערכות כמותיות של יכולת ההסבר ושילוב של מודאליות פיזיולוגיות אינם כלולים במחקר זה, המוגבל להערכות על שני מאגרי נתוני ייחוס. יתרה מכך, סביבות עם משאבים מוגבלים עלולות להיתקל בקשיים בשל העלות החישובית של מקודדי transformer ותהליכי קשב מבוססי-גרף. בעוד שעבודות עתידיות יתמקדו בתיקוף נרחב יותר על מאגרי נתונים שונים, שילוב של מודאליות נוספות, מחקרי שמישות, שחרור משאבים ניתנים לשחזור ואופטימיזציה לתרחישי פריסה בזמן אמת, המסגרת המוצעת מראה באופן כללי את הפוטנציאל של ניתוח רגשות רב-מודאלי וניתן לפירוש עבור מחשוב רגשי (affective computing) ויישומי אינטראקציה חכמה.
גילויים
למחברים אין ניגודי עניינים.
תודות
המחברים מעוניינים להודות על התמיכה שניתנה על ידי בית הספר לדיור, בנייה ותכנון, Universiti Sains Malaysia, פנאנג, מלזיה, ובית הספר לאמנות העיצוב, Changsha University of Science & Technology, צ'אנגשה, סין. כמו כן, המחברים מביעים את הערכתם ל-Xiamen Academy of Arts and Design, Fuzhou University, שיאמן, סין, על תמיכתם האקדמית והמחקרית לאורך עבודה זו.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Adam | ספריית PyTorch Optimizer | https://pytorch-optimizers.readthedocs.io/en/latest/ (Learning Rate = 1 × 10⁻⁴) | אופטימיזציה של פרמטרים במהלך אימון המודל |
| CH-SIMS | מאגר הנתונים המקורי | הגרסה הציבורית האחרונה | סט נתוני ייחוס (Benchmark) לניתוח רגשות/סנטימנטים רב-מודאלי בסינית |
| CMU-MOSEI | מאגר CMU Multimodal SDK | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (הגרסה הציבורית האחרונה) | סט נתוני ייחוס (Benchmark) לזיהוי סנטימנטים ורגשות רב-מודאליים |
| Disentangled Emotion Encoder | מימוש מותאם אישית | https://pytorch-geometric.readthedocs.io/en/latest/(ארכיטקטורת Dual Encoder) | הפרדה בין ייצוגים חבויים (latent representations) ספציפיים לרגש וספציפיים למודאליות |
| Graph Attention Network (GAT) | PyTorch Geometric | Multi-head GAT (https://pytorch-geometric.readthedocs.io/en/latest/) | מידול קשרים רגשיים חוצי-מודאליות ומיזוג מאפיינים אדפטיבי |
| Graph-Based Cross-Modal Attention Layer | מימוש מותאם אישית | מיזוג Multi-Head Attention | למידה של תלויות רגשיות ברזולוציה גבוהה בין מודאליות |
| Matplotlib | פרויקט Matplotlib | 3.7+ | יצירת תרשימים ואנליזה ויזואלית |
| NetworkX | פרויקט NetworkX | 3.0+ | בנייה וויזואליזציה של גרפים של אינטראקציות חוצות-מודאליות |
| NVIDIA GPU | תאגיד NVIDIA | GPU תומך CUDA | האצה של אימון רשתות טרנספורמר ורשתות עצביות גרפיות |
| Principal Component Analysis (PCA) | Scikit-learn | sklearn.decomposition.PCA | הפחתה ראשונית של ממד השכבות (embeddings) הרגשיות רב-ממדיות |
| Python | Python Software Foundation | 3.8+ | שפת התכנות המרכזית להטמעת מסגרת ניתוח הרגשות הרב-מודאלית |
| PyTorch | PyTorch Foundation | 2.0+ | פיתוח, אימון ואופטימיזציה של רשתות עצביות עמוקות |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, 768-dim embeddings) | חילוץ ייצוגי רגשות לשוניים וסמנטיים בהקשר |
| Seaborn | פרויקט Seaborn | 0.12+ | יצירת מפות חום של קשב (attention heatmaps) וויזואליזציות סטטיסטיות |
| t-distributed Stochastic Neighbor Embedding (t-SNE) | Scikit-learn | scikit-learn.org (Perplexity = 30, Iterations = 1000) | ויזואליזציה של אשכולות רגשיים חבויים ומסלולים |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS או גרסה מאוחרת יותר | סביבת הרצה ניסויית |
| Vision Transformer (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, 768-dim embeddings | חילוץ ייצוגים ויזואליים מודעי-רגש מתוך פריימים של וידאו |
| Wav2Vec 2.0 | Meta AI Research | Base Model, 768-dim embeddings | חילוץ מאפייני רגש אקוסטים וקוליים בהקשר |
מקורות
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.