מחקר זה בוחן התנהגויות קבלת החלטות ותיקון של סטודנטים למסלול אנגלית המתרגמים נרטיבים הממוקדים בסין, תוך שילוב רשומות של רישום הקשות (keystroke-logging) וקורפוס danmu כדי לחשוף כיצד בולטות טקסטואלית משפיעה על מאמץ העיבוד ועל איכות התרגום.
מאמר מחקר
התנהגות קבלת החלטות ותיקון בתרגום מסינית לאנגלית: ראיות מסטודנטים למקצוע האנגלית המתרגמים נרטיבים המתמקדים בסין
במאמר זה
סיכום
תקציר
ככל שנרטיבים המתמקדים בסין נכנסים יותר ויותר למסבב בינלאומי, התרגום מסינית לאנגלית הפך לזירה של נגישות ומשא ומתן על משמעות, ולא להעברה לשונית פשוטה. עבור סטודנטים למקצוע התרגום, האתגר העיקרי חורג מבחירה לקסיקלית; הוא כולל את ההחלטה כיצד להעביר רפרנסים רוויים תרבותית, עמדות הערכתיות ומיצוב נרטיבי עבור קוראים מחוץ להקשר המקור. מחקר זה בוחן את קבלת ההחלטות בזמן אמת ואת התנהגויות העריכה של 72 סטודנטים למגמה באנגלית המתרגמים נרטיבים המתמקדים בסין. באמצעות תכנון מסוג תהליך-תוצר (process-product), המחקר משלב נתוני רישום הקשות (keystroke-logging) שנאספו באמצעות Translog-II, הערכות של תוצרי התרגום, וקורפוס עזר של danmu (פרשנויות מסונכרנות בזמן) ששימש כשכבה של בולטות עבור הקהל ולא כמדד ישיר לקושי לשוני ברמת המקטע. תהליכי התרגום נותחו על פי משך ההפסקות, תדירות העריכות, מיקום העריכות והתפלגות השלבים, בעוד שאיכות התוצר הוערכה באמצעות דירוג מומחים וקידוד ממוקד של מקטעים הקשורים לתרבות. קורפוס של 18,642 תגובות danmu מ-24 סרטוני Bilibili שימש לזיהוי תמות נרטיביות בולטות בציבור וביטויים רגישים תרבותית. התוצאות מראות כי מקטעים בעלי מטען תרבותי וצפיפות הערכית עוררו הפסקות ארוכות יותר, עלייה בעריכות רקורסיביות וניסוחים מחדש צפופים יותר במהלך התהליך. תרגומים באיכות גבוהה יותר נקשרו לעריכות סלקטיביות ובזמנים אסטרטגיים ברמת השיח וברמת ההתאמה התרבותית, ולא למספר כולל גבוה יותר של עריכות. החפיפה בין טריגרים נרטיביים בולטים ב-danmu לבין מקטעי תרגום שדרשו מאמץ רב מפורשת כראיה מתכנסת לבולטות בקרב הקהל וללחץ עיבוד אצל המתרגם, ולא כראיה לסיבתיות. המחקר מקדם את המחקר על תהליך התרגום על ידי קישור התנהגות העריכה לתרגום נרטיבי המוטמע תרבותית, ומציע השלכות להכשרת מתרגמים בתקשורת בין-תרבותית.
מבוא
בשנים האחרונות, תרגום של שיח הקשור לסין עבר מלהיות עניין מקצועי יחסי לסוגיה מרכזית בתקשורת בינלאומית1. מה שעומד על הפרק בתרגום כזה אינו רק העברה של תוכן פרופוזיציונלי, אלא ניסוח מחדש של נרטיבים ציבוריים הנושאים מיצוב פוליטי, מסגור תרבותי ותכנון קהל יעד. עבודות על תרגום של שיח פוליטי סיני הבהירו נקודה זו יותר ויותר: כאשר טקסטים מתורגמים לקוראים מחוץ לסין, בחירות לגבי ניסוח, מודאליות ודגשים טקסטואליים הופכות גם לבחירות לגבי האופן שבו סין מוסברת ומפורשת בחו"ל2. ברגע שהבעיה ממוסגרת באופן זה, גישה המתמקדת בתוצר בלבד הופכת לבלתי מספקת. תרגום סופי יכול להראות מה נבחר, אך הוא אינו יכול להראות מתי עלה ספק, היכן התחיל ניסוח מחדש, או כיצד פתרונות מתחרים נבחנו ונפסלו3.
מגבלות אלו מסייעות להסביר מדוע מחקר אמפירי של תהליך התרגום הפך לזרם חשוב בתוך לימודי תרגום, תוך שימוש בכלי מעקב אחר תהליכים כדי ללכוד הפסקות, מחיקות, הוספות והצורה הזמנית של קבלת ההחלטות, במקום להסיק אותם באופן עקיף מהטקסט הסופי4. גישה זו אינה מחליפה גישות מבוססות תוצר, סוציולוגיות, תרבותיות או מבוססות קורפוס; תחת זאת, היא מוסיפה ראיות לגבי הגוייתם של החלטות תרגום מרגע לרגע. עבודות אחרונות עברו מתיאור של הפסקות מבודדות למידול התרגום כפעילות בעלת מבנה זמני. טקסונומיית "הסס-הכוונה-זרימה", למשל, מתייחסת להתנהגות תרגום כאל חילופין דפוסיים בין אי-ודאות, חיפוש והפקה שוטפת, ומסבירה מדוע קטעים מסוימים במשימה הופכים לבלתי יציבים ומעוררים ניסוח מחדש5. שינוי זה רלוונטי במיוחד בתרגום של סטודנטים, שבו השליטה השפתית, הידע בנושא והשליטה האסטרטגית עדיין מתפתחים במקביל6.
ראיות משילוב של מעקב עיניים ורישום הקשות מקלדת מראות כי מתרגמים מתחילים אינם מחלקים את הקשב באופן שווה, וכי הפקת טקסט היעד הופכת לעיתים קרובות למוקד מרכזי של עומס קוגניטיבי במהלך תרגום מסינית לאנגלית7. כתוצאה מכך, מה שנראה כבעיה מקומית בניסוח בתוצר עשוי למעשה לשקף ארגון מחדש רחב יותר של הקשב והמאמץ במהלך התהליך בזמן אמת8. ראיות מהעת האחרונה מצביעות עוד על כך שמתרגילים עשויים להפיק טקסטים בעלי הלימות שטחית דומה, בעודם נבדלים באופן משמעותי בכמות המאמץ, חוסר הוודאות והניטור העצמי הנדרשים. עיבוד סופי מספק עשוי עדיין להישען על נתיב החלטות שברירי או לא יעיל שניתן ללכוד רק באמצעות מדדים רגישים לתהליך9. יתרה מכך, עבודות השוואתיות מעידות כי מומחיות בתרגום כוללת בקרה מט认知טיבית יציבה על מועדי העצירה, החיפוש, המשך השחזור או החזרה לצורך עריכה10.
עריכה היא הנקודה המדויקת שבה תהליך קוגניטיבי נסתר זה הופך לנראה ביותר. זהו השלב שבו מתרגמים חוזרים לניסוחים קודמים, בוחנים חלופות, ומכריעים אם הבעיה היא לקסיקלית, תחבירית, שיחית או תרבותית. כתוצאה מכך, אין להתייחס לעריכה כאל שלב ליטוש סופי, אלא כאל מדד מרכזי להתפתחות המתרגם. תוצאות טובות יותר קשורות לאופן שבו חלופות מconsolidated במהלך ההפקה, מה שמעיד על כך שעריכה יעילה היא סלקטיבית, מתוזמנת אסטרטגית ומגיבה לדרישות טקסטואליות רחבות יותר, ולא מהווה פשוט צבירה של תיקונים11,12,13.
מורכבות קבלת ההחלטות והעריכה הופכת חדה יותר כאשר טקסט המקור הוא נרטיב המתמקד בסין ולא קטע מידע ניטרלי. טקסטים כאלו מסתמכים לעיתים קרובות על הנחות רוויית תרבות, ביטויים המושרשים בהקשר היסטורי ורמזים הערכתיים שמשמעותם תלויה ברקע משותף ולא בהסבר מפורש14,15,16. רמת קושי של הטקסט משנה את עצם רמת הפירוט של העיבוד; טקסטים נרטיביים בעלי צפיפות תרבותית או הערכית מאלצים מתרגמים לעבוד ביחידות קטנות יותר, לבצע פעולות לא ליניאריות ולעסוק בארגון מחדש מקומי חוזר8. עבור סטודנטים לתרגום, הבעיה המרכזית היא להחליט כמה מהרקע הגנוז הזה יש לפרוס או לארגן מחדש עבור קוראים מחוץ לקהילת השיח המקורית, מבלי למחוק את הספציפיות התרבותית.
שלושה פערים ספציפיים מהווים את המניע למחקר הנוכחי. ראשית, מדדי תהליך תרגום כגון משך השתיקה, תדירות השתיקות הממושכות, הפסקות סמן העכבר והתייעצות עם מילון נבחנים לעיתים קרובות בנפרד מטיפולוגיות של תיקון, מה שמקשה על הבנת האופן שבו לחץ קבלת החלטות בא לידי ביטוי כניסוח מחדש מאוחר יותר. שנית, קטגוריות נרטיביות ספציפיות תרבותית זכו לפחות תשומת לב מבוססת-תהליך מאשר טקסטים אקדמיים או חשיפתיים כלליים, למרות שנרטיבים המתמקדים בסין דורשים מהמתרגמים לעיתים קרובות להתמודד עם עומס תרבותי, צפיפות הערכתית והשלכות רקע דחוסות בו-זמנית14,15,16. במחקר זה, עומס תרבותי מתייחס לצפיפות של התייחסויות תלויות-תרבות והנחות מוקדמות משותפות; צפיפות הערכתית מתייחסת לנקיטת עמדה גלויה או סמויה, עצימות רגשית ומסגור טעון ערכים; ודחיסות נרטיבית מתייחסת למידה שבה מידע רקע, קשרים סיבתיים או מיקום חברתי מעובים למקטעים טקסטואליים קצרים. שלישית, משימות תרגום מתוכננות בדרך כלל אך ורק על בסיס ניתוח פנימי של הטקסט, תוך התחשבות מועטה בשאלה האם מקטעים שזוהו כקשים תואמים לנקודות המושכות תשומת לב ציבורית בתפוצה דיגיטלית. Danmu (תגובות וידאו מסונכרנות בזמן) יכולים לתפקד כטקסט נלווה (paratext) וכשיח השתתפותי, המדגישים את מה שהקהל מבחין בו, עליו הוא חולק או אותו הוא מפרש מחדש17,18; עם זאת, יש להתייחס לבולטות ה-danmu כאינדיקטור ברמת הסמנטיקה למעורבות הקהל, ולא כתחליף ישיר לקושי לשוני ברמת המקטע.
במטרה לתת מענה לפערים אלו, המחקר הנוכחי בוחן כיצד סטודנטים למסלולי לימודי אנגלית מקבלים החלטות ומבצעים תיקונים בעת תרגום נרטיבים המתמקדים בסין מסינית לאנגלית. באמצעות שילוב של נתוני תהליך התרגום ושיח של קהל דיגיטלי במסגרת אנליטית אחת, המחקר שואף להסביר לא רק היכן מתקשים סטודנטים מתרגמים, אלא גם מדוע קשיים אלו מתרכזים סביב סוגים מסוימים של משמעות נרטיבית.
באופן ספציפי, מחקר זה עוסק בארבע שאלות מחקר: (1) אילו דפוסי קבלת החלטות מאפיינים את התרגום מסינית לאנגלית של נרטיבים ממוקדי סין על ידי סטודנטים למגמת אנגלית? (2) כיצד משתנה התנהגות העריכה במקטעים בעלי רמות שונות של עומס תרבותי וצפיפות נרטיבית? (3) אילו ממדים של התנהגות העריכה קשורים לאיכות תרגום גבוהה יותר? ו-(4) האם נקודות בעלות בולטות תרבותית שזוהו בשיח ה-danmu חופפות למקטעים המייצרים את מאמץ העיבוד הגבוה ביותר במהלך התרגום?
בהתאם לכך, המחקר בוחן ארבע היפותזות קשורות ברצף אנליטי אחד: H1 מניחה כי מקטעים בעלי עומס תרבותי גבוה יותר יגרמו להפסקות ארוכות יותר, לאי-ודאות רבה יותר בקבלת ההחלטות ולתיקונים תכופים יותר מאשר מקטעים בעלי עומס תרבותי נמוך; H2 מבחינה בין שני נתיבים, וחוזה כי צפיפות הערכתית תגביר תיקונים מושהים בעוד שדחיסה נרטיבית תגביר ניסוח מחדש ברמת השיח; H3 חוזה כי איכות התרגום תוסבר באופן חזק יותר על ידי הסלקטיביות ותזמון התיקון מאשר על ידי סך מספר התיקונים לבדו; ו-H4 חוזה כי מקטעים בולטים ב-danmu יחפפו למקטעי תרגום הדורשים מאמץ גבוה, כהתכנסות אסוציאטיבית בין בולטות עבור הקהל לבין לחץ עיבוד עבור המתרגם.
פרוטוקול
כל השיטות הכוללות נבדקים בני אדם בוצעו בהתאם להנחיות המוסדיות ואושרו על ידי ועדת הבקרה המוסדית (IRB) או ועדת אתיקה למחקר בבני אדם של אוניברסיטת הנורמלית של האנשאן (Hanshan Normal University). הסכמה מדעת התקבלה מכל המשתתפים לפני הניסוי.
מסגרת מושגית ומערך מחקר
מחקר זה השתמש במערך מחקר מסוג תהליך-תוצר (process–product) עם שכבת שיח עזר, כדי לבחון כיצד תגובות דנמו (danmu) שנוצרו על ידי הקהל משפיעות על תרגום כתוביות. המסגרת האנליטית שילבה מאפיינים טקסטואליים, מדדים של תהליך התרגום ותוצרי איכות התרגום. באופן ספציפי, המחקר בחן האם תשומת לב של הקהל, כפי שמשתקפת בצפיפות הדנמו, כיוונה את המשאבים הקוגניטיביים של המתרגמים לעבר מאפיינים טקסטואליים מסוימים, והאם הקצאה זו של תשומת הלב השפיעה לאחר מכן על איכות התרגום.
כדי להוציא למעשה מסגרת עבודה זו, המחקר קבע תחילה מאפיינים טקסטואליים ברמת המקטע המבוססים על ארבעה ממדים: עומס תרבותי, צפיפות הערכתית, דחיסה נרטיבית ובולטות דנמו (danmu). עומס תרבותי התייחס לנוכחות של התייחסויות ספציפיות תרבותית שדרשו התאמה או הסבר. צפיפות הערכתית מדדה את הריכוז של שפה טעונה רגשית או עמדתית בתוך מקטע. דחיסה נרטיבית תפסה את המידה שבה תוכן סמנטי דחוס תחת מגבלות הכתוביות. בולטות דנמו ייצגה את מידת תשומת הלב של הקהל המופנית לכל מקטע כתוביות, כפי שנמדדה על ידי נפח תגובות הדנמו המסונכרנות. בניגוד למדדים קונבנציונליים של קשיי תרגום, בולטות דנמו שיקפה קשב מפוזר חברתית ולא מורכבות טקסטואלית פנימית. מקטע שזכה למעורבות רבה של הקהל לא היה בהכרח קשה יותר לתרגום; תחת זאת, הוא ייצג נקודה בעלת משמעות תקשורית מוגברת בתוך חווית הצפייה.
המסגרת האנליטית כללה שלושה מאגרי נתונים מקושרים. מאגר הנתונים ברמת המשתתף כלל מאפיינים דמוגרפיים אישיים ומומחיות בתרגום. מאגר נתוני התהליך-תוצר קישר כל מקטע כתוביות למדדי התנהגות שהופקו מרישום לחיצות מקלדת (keystroke logging), יחד עם דירוגי איכות תרגום של מומחים. מאגר נתוני ה-danmu הכיל תגובות קהל מסונכרנות עם תזמון הכתוביות, שמהן חושבו ערכי בולטות (salience) של ה-danmu. מאגרי נתונים אלו קושרים באמצעות מזהי משתתפים ומקטעים, מה שאפשר ניתוח סימולטני של כל מקטע כתוביות מתורגם ביחס למאפייני המתרגם, התנהגות עיבוד קוגניטיבי, קשב הקהל ותוצרי התרגום. בסיס הנתונים המשולב הסופי כלל 216 מפגשי תרגום מלאים ו-3,168 תצפיות של משתתף-טקסט-מקטע, אשר סיפקו את הבסיס האמפירי לניתוחי התהליך-תוצר העוקבים.
סינון משתתפים ובניית פרופיל רקע
המדגם כלל 72 סטודנטים למגמת אנגלית שגויסו מאוניברסיטה ציבורית בדרום סין, שהתפלגו באופן שווה בין השנה השנייה, השלישית והרביעית ללימודי תואר ראשון (24 משתתפים לכל שנתון). כל המשתתפים היו דוברי סינית כשפת אם המקבלים הדרכה פורמלית בכתיבה ובתרגום באנגלית. כדי להבטיח השוואה הוגנת בקרב אוכלוסיית המתרגילים, הם excluded אנשים שהתגוררו במדינה דוברת אנגלית במשך יותר מ-6 חודשים או החזיקו בהסמכה מקצועית כמתרגמים. המשתתפים לא חולקו לקבוצות ניסוי נפרדות לפי ניסיון בתרגום, היכרות תרבותית או רמת שליטה בשפה השנייה. במקום זאת, נרשמו שנת הלימודים, ציונים במבחני רמת אנגלית עדכניים, קורסי תרגום קודמים, הערכה עצמית של מידת ההיכרות עם נושאים תרבותיים הקשורים לסין, ומידה ממוצעת של עיסוק שבועי בתרגול דו-לשוני, ונתונים אלו נכללו כמשתנים מלווים (covariates) ברמת המשתתף במודלים הסטטיסטיים. הבהרה זו פותרת גם את חוסר העקביות במספר המשתתפים שעלה במהלך ביקורת העמיתים: הן בכתב היד והן במערך הנתונים לשחזור מופיעים 72 משתתפים, 216 מפגשי משימה ו-3,168 תצפיות ברמת המקטע.
בחירת טקסט מקור ובניית משימות
חומרי התרגום כללו שלושה טקסטים נרטיביים עכשוויים המתמקדים בסין, אשר פותחו במיוחד למחקר זה כדי לשקף שיח ציבורי אותנטי ולהימנע משכפול של חומרים המוגנים בזכויות יוצרים. כל טקסט הכיל 205–225 תווים סיניים, אך נחלקו באופן שיטתי במאפייניהם הפנימיים. טקסט A מציג נרטיב של שיבה הביתה לחג האביב, בעל עומס תרבותי בינוני ותחביר פשוט יחסית. טקסט B מתאר זיכרון מחג סירות הדרקון ומכיל צפיפות גבוהה יותר של ביטויים ספציפיים לתרבות וידע רקע מרומז. טקסט C מתאר נרטיב של שידור חי ומסחר אלקטרוני בכפר, המאופיין בשפה הערכתית דחוסה ובמיקום נרטיבי דחוס.
הטקסטים פולחו באופן שיטתי באמצעות גבולות פסוקים, ולאחריהם גבולות יחידות משמעות, מה שהניב 44 יחידות ניתנות לניתוח בשלוש משימות התרגום (טבלה 1). לפני הקידוד הפורמלי, הוגדר במדריך קידוד המושגים "עומס תרבותי", "צפיפות הערכתית" ו"דחיסה נרטיבית" באמצעות סולמות סודרים של 1–5. מחקר פיילוט שכלל 12 סטודנטים שלא השתתפו בניסוי המרכזי אישר את כיול הקושי המיועד, את בהירות הוראות המשימה ואת יציבות גבולות הפלחים לצורך סנכרון לחיצות המקשים.
בניית קורפוס עזר ומיפוי בולטות
על מנת לזהות רמזים נרטיביים בולטים במישור הציבורי, נערך קורפוס danmu עזר מ-24 סרטונים ב-Bilibili שהועלו בין ינואר 2023 לדצמבר 2025. סרטונים נכללו רק אם תאמו את אחד משלושת התחומים הסמנטיים המיוצגים בטקסטים המקור, צברו יותר מ-50,000 צפיות, הכילו אינטראקציית danmu דחופה, ואפשרו ייצוא ומיפוי תמטי של תגובות מסונכרנות בזמן. לאחר הסרת כפילויות וסינון של אימוג'ים, מילות מילוי אונומטופאיות ומקטעים לא רלוונטיים, הקורפוס הסופי כלל 18,642 תגובות.
מילות תוכן סטנדרטו וקובצו באמצעות עוגני מילות-מפתח הקשורות לטקסט המקור. לאחר מכן, לכל מקטע בטקסט המקור הוקצה ציון בולטות (salience score) רציף של danmu, המבוסס על תמהיל משוקלל של תדירות מקבצי מילות-מפתח מנורמלת, ריכוז תגובות בתוך המקבץ התמטי התואם, ועוצמה הערכתית ממוצעת. הליך זה מאפשר השוואות בין מאמץ העיבוד של המתרגם לבין הבולטות עבור הקהל ברמת מקבצי התוכן הסמנטיים, במקום באמצעות התאמה לקסית ישירה. מכיוון ש-danmu משקף תגובות של הקהל לסרטונים מקוונים ולא למשימת התרגום הניסויית עצמה, בולטות ה-danmu מפורשת כאינדיקטור חיצוני למעורבות הקהל ולא כראיה ישירה לקושי הלשוני של מקטע מהמקור.
הליך ניסויי ותפיסת נתונים
מפגשי התרגום נערכו באופן פרטני במעבדת מחשבים מבוקרת, תחת תנאים סטנדרטיים של חומרה, תוכנה וגישה לאינטרנט (איור 2). לאחר הדרכה של חמש דקות שהדגישה את הפקתה של אנגלית קריאה עבור קהל בינלאומי, השלימו המשתתפים חימום הקלדה באנגלית במשך שלוש דקות כדי לצמצם את השפעות ההסתגלות למקלדת. שלוש משימות התרגום הועברו ברצף באמצעות Translog-II, כאשר סדר המשימות נשמר באיזון באמצעות תכנון ריבוע לטיני כדי לחלק את השפעות העייפות והסדר הפוטנציאליות באופן שווה בין המשתתפים. למשתתפים הוקצבו מקסימום 20 דקות לכל טקסט, עם הפסקות מנוחה של חמש דקות בין המשימות.
אף על פי שהשימוש במילון דו-לשוני מובנה הותר, השימוש במערכות תרגום מכונה ובמנועי חיפוש חיצוניים נאסר. כל הלחיצות על המקלדת, ההפסקות ותנועות הסמן תועדו באופן אוטומטי והושלמו על ידי הקלטות מסך סינכרוניות כדי לאמת אירועי תיקון לא-לינאריים. לאחר השלמת כל משימה, המשתתפים מילאו הערכה עצמית של רמת הקושי, ששימשה אך ורק כדי לסייע בפירוש מקרים גבוליים של קידוד.
מדידת תהליך וקידוד משתנים
רישומי ההקלדה הותאמו למבנה המקטעים שהוגדר מראש. פרק התאמה החל עם הקשקת המקש הראשונה בשפת היעד המתאימה למקטע, והסתיים כאשר המשתתף התקדם באופן סופי למקטע הבא. תיקונים חופפים הוקצו מחדש באמצעות רישומי מעקב אחר הסמן בעלי חותמת זמן.
התנהגות קבלת ההחלטות כוונתה באמצעות חמישה מדדים: משך ההפסקה הראשונה לפני תרגום המקטע הראשוני, משך ההפסקה הממוצע בתוך המקטע, תדירות ההפסקות העולות על שתי שניות, מספר הפניות למילון, ומספר ההפרעות המבוססות על סמן העכבר המעידות על סטיות מכתיבה ליניארית (Table 2). התנהגות העריכה סווגה לפי שני ממדים: תזמון ותפקיד. התזמון הבחין בין עריכות מקומיות מיידיות לבין עריכות מושהות שבוצעו לאחר שהכתיבה התקדמה מעבר למקטע הנוכחי. הקידוד התפקודי סיווג את העריכות כעריכות שטח (תיקוני צורה ללא שינוי סמנטי), עריכות משמעות (שינויים לקסיקליים או תחביריים), עריכות ברמת השיח (התאמות של קשרי פסוקים או קוהרנטיות), ועריכות התאמה תרבותית (ניסוחים מחדש המכוונים לקהל היעד). שני מקודדים מיומנים ניתחו באופן עצמאי כל אירוע עריכה לפני הכרעה, והקצו קטגוריה תפקודית ראשית אחת לכל אירוע. המהימנות הבין-שופטים הייתה חזקה בכל המדדים המקודדים. מדד Cohen’s ĸ העיד על הסכמה משמעותית עבור הקידוד הקטגוריאלי של תפקודי העריכה (ĸ = 0.84, p < 0.001). עבור המשתנים הסודריים ברמת הטקסט, מקדמי מתאם תוך-מעמדיים (ICC, מודל אפקטים מעורבים דו-כיווני, הסכמה מוחלטת) הדגימו מהימנות גבוהה עבור עומס תרבותי (ICC = 0.86), צפיפות הערכתית (ICC = 0.78), ודחיסה נרטיבית (ICC = 0.82). כל אי-הסכמה ראשונית בקידוד נפתרה לאחר מכן באמצעות הכרעה משותפת.
הערכת איכות התרגום
איכות התרגום הוערכה באופן בלתי תלוי בנתוני התהליך על ידי שני מעריכים בעלי השכלה דוקטורלית וניסיון רב בהוראת תרגום. תוך עיוורון לזהות המשתתפים ולמדדי התהליך, יישמו המעריכים רובריקה של 100 נקודות, שהתחלקו באופן שווה בין חמישה ממדים: דיוק סמנטי, שטף לשוני, קוהרנטיות נרטיבית, עיבוד תרבותי והתאמת המשלב הלשוני (טבלה 3). פערים בציונים הגדולים משמונה נקודות הובילו לבדיקה משותפת ולקביעת ציון מחדש בהסכמה, כאשר הממוצע שנקבע בבוררות שימש כציון הסופי לאיכות התרגום. רישומי הדירוג שלפני הבוררות נשמרו כדי לאפשר דיווח שקוף על מהימנות בין-שופטים בחומרי השחזור.
מידול סטטיסטי
הניתוחים בוצעו בשלושה שלבים עוקבים. ראשית, חושבו סטטיסטיקות תיאוריות כדי לסכם את כל המשתנים על פני קבוצות השנה וסוגי הטקסטים. שנית, מאמץ העיבוד ברמת המקטע נותח באמצעות מודלי רגרסיה עם השפעות מעורבות (mixed-effects regression models) כדי להתחשב במבנה המקונן של מקטעים בתוך טקסטים ובבדיקות חוזרות של משתתפים בודדים. משתנים תלויים, כולל משך ההפסקה הראשונה ותדירות התיקונים, מודלו כפונקציות של עומס תרבותי, צפיפות הערכתית, דחיסה נרטיבית ובולטות danmu, תוך בקרה על רמת המיומנות של המשתתף. כדי לשפר את השקיפות הסטטיסטית, נכללו מתאמי המנבאים, אבחוני ניפוח שונות (variance inflation), רווחי סמך של 95%, הערכות גודל אפקט ומדדי התאמת מודל.
לבסוף, איכות התרגום מודלה כדי להעריך את התרומות החיזויות של עיתוי התיקון ותפקוד התיקון ביחס לתדירות התיקונים הכוללת. החפיפה בין מקטעים בולטים ב-danmu לבין מקטעי תרגום בעלי מאמץ גבוה הוערכה באמצעות החמיש העליון של כל התפלגות, מדד מאמץ מורכב וסטנדרטי, וניתוח חפיפה אקראית. לא בוצעו ניתוחי גורמים חוקרים (exploratory factor analysis) או מידול משוואות מבניות (structural equation modeling). בהתאם לכך, האיורים הנלווים מוצגים אך ורק כסיכומים מושגיים, תיאוריים או מבוססי רגרסיה.
תוצאות
פרופיל כללי של מפגשי התרגום
כל 72 המשתתפים השלימו את שלוש משימות התרגום תחת תנאים ניסויים סטנדרטיים, מה שהניב 216 מפגשי תרגום מלאים. לאחר יישור המקטעים, מאגר הנתונים האנליטי הסופי כלל 3,168 תצפיות של משתתף-טקסט-מקטע. זמן ההשלמה הממוצע של המשימה במדגם היה 998.4 s לטקסט, עם הבדלים ברורים בין קבוצות השנים ובין טקסטים המקור (Table 4; Figure 3). בהתאם לכך, הן כתב היד והן הנתונים הנלווים תומכים בעקביות בגודל מדגם של n = 72 משתתפים; כל איור המסכם תתי-קבוצות חייב לזהות במפורש תתי-קבוצות אלו.
סטודנטים בשנה רביעית השלימו את משימות התרגום במהירות רבה יותר ובפחות הפרעות מאשר סטודנטים בשנה שנייה. הבדל זה חרג ממהירות העיבוד בלבד. קבוצת הסטודנטים מהשנה הרביעית הפגינה גם משכי זמן ממוצעים קצרים יותר עד להפסקה הראשונה, פחות הפסקות ארוכות ומספר כולל נמוך יותר של תיקונים, וזאת תוך השגת ציוני האיכות הגבוהים ביותר בתרגום. לעומת זאת, סטודנטים בשנה שנייה ביצעו את מספר התיקונים הרב ביותר, שרובו היו שינויים שטחיים ותיקונים מקומיים מיידיים. סטודנטים מתקדמים הפגינו שיעור גבוה יותר של תיקונים דחויים ותיקוני התאמה תרבותית, מה שמעיד על כך שביצועי תרגום מעולים היו קשורים לאסטרטגיות תיקון סלקטיביות ולא לנפח תיקונים גדול יותר.
ההבדלים בין שלושת טקסטים המקור היו בולטים באופן דומה. טקסט A הניב את זמני ההשלמה הקצרים ביותר, את מספר ההפסקות הארוכות המעט ביותר ואת צפיפות התיקונים הנמוכה ביותר. טקסטים B ו-C הציבו שניהם דרישות עיבוד גבוהות יותר, אם כי באמצעות מנגנונים שונים. טקסט B עורר את המספר הגבוה ביותר של אירועי תיקון הקשורים לתרבות, בעוד שטקסט C הניב את התדירות הגבוהה ביותר של תיקונים ברמת השיח ואת משך ההפסקה הממוצע הארוך ביותר בתוך מקטע. לפיכך, מקור קושי העיבוד היה שונה בין הטקסטים. בטקסט B, הקושי התרכז סביב התייחסויות תלויות-תרבות והנחות רקע משתמעות, בעוד שבטקסט C, הוא היה קשור בעיקר לדחיסה נרטיבית ולמיקום הערכתי.
ניתוח שונות חד-כיווני (one-way analysis of variance) אישר הבדלים מובהקים בין קבוצות השכבות השנתיות באיכות התרגום הכוללת, F (2, 69) = 31.84, p < 0.001, עם גודל אפקט גדול (η2 ≈ 0.48 בהתבסס על ציוני ממוצע ברמת המשתתף). השוואות post hoc הראו כי סטודנטים בשנה הרביעית השיגו ציונים גבוהים באופן מובהק מאלו שבשנה השלישית, אשר בתורם עלו בביצועיהם על הסטודנטים בשנה השנייה. דפוס זה נצפה גם לגבי משך ההפסקה הראשונה, תדירות ההפסקות הארוכות ויחס התיקון המאוחר. יחד, ממצאי בסיס אלה מבססים שתי נקודות חשובות עבור הניתוחים הבאים. ראשית, שלושת טקסטים המקור השתנו בקושי העיבוד ולא רק בתוכן הנושאי. שנית, איכות תרגום גבוהה יותר הייתה קשורה לארגון מחדש של תהליכי התרגום ולא להפחתה פשוטה במאמץ העיבוד.
השפעות של בולטות טקסטואלית על קבלת החלטות והתנהגות תיקון
כדי לקבוע האם מאפיינים טקסטואליים ברמת המקטע ניבאו את מאמץ העיבוד, נאמדו מודלים של אפקטים מעורבים (mixed-effects models) עבור משך ההפסקה הראשונה, תדירות הפסקות ארוכות, צפיפות תיקונים כוללת וצפיפות תיקונים מושהיתים. עומס תרבותי, צפיפות הערכתית, דחיסה נרטיבית ובולטות דנמו (danmu salience) הוזנו כאפקטים קבועים, כאשר משתתף ומקטע נכללו כחיתוכים אקראיים (טבלה 5; איור 4). סינון המנבאים אישר את היעדרם של בעיות מולטיקוליניאריות, כאשר כל ערכי מקדם ניפוח השונות (VIF) היו נמוכים משמעותית מהסף השמרני של 2.5 (VIF מקסימלי = 1.45). כדי להעריך את התאמת המודל ואת חלק השונות שהוסברה, חושבו ערכי R2 שוליים ומותנים עבור כל מודלי האפקטים המעורבים (R2 שולי נע בין 0.08 ל-0.19; R2 מותנה נע בין 0.46 ל-0.64). רכיבי השונות המלאים עבור אפקטים אקראיים (חיתוכי משתתף ומקטע) ומדדי התאמת המודל התואמים מפורטים בטבלה 5. אומדני המקדמים פורשו יחד עם רווחי הסמך של 95% שלהם ולא על סמך ערכי p בלבד.
עומס תרבותי הראה את ההשפעה החזקה והעקבית ביותר בכל המודלים. במודל ההפסקה הראשונה, כל עלייה של יחידה אחת במדד העומס התרבותי הייתה קשורה לעלייה של 0.91 s במשך ההפסקה הראשונה (b = 0.91, SE = 0.12, 95% CI [0.67, 1.15], p < 0.001). עומס תרבותי הגביר באופן משמעותי גם את תדירות ההפסקות הארוכות (b = 0.19, SE = 0.04, 95% CI [0.11, 0.27], p < .001) ואת צפיפות התיקונים הכוללת (b = 0.27, SE = 0.06, 95% CI [0.15, 0.39], p < .001). לפיכך, מקטעים בעומס תרבותי לא רק עיכבו את העיבוד הראשוני, אלא גם הגבירו את הסבירות לניסוח מחדש לאחר מכן.
דחיסה נרטיבית הפגינה דפוס השפעות חסון באותה מידה אך שונה. היא הייתה מנבא חזק של תיקון ברמת השיח (b = 0.31, SE = 0.07, 95% CI [0.17, 0.45], p < .001) והגבירה באופן משמעותי את משך ההפסקה הממוצע בתוך המקטע (b = 0.58, SE = 0.14, 95% CI [0.31, 0.85], p < .001). במונחים מעשיים, מקטעים שדחסו מידע רקע רב למקטעי טקסט קצרים היו בעלי סבירות נמוכה יותר לעורר החלפה לקסיקלית מיידית, וסבירות גבוהה יותר לדרוש בחינה מבנית רחבה יותר.
גם לצפיפות ההערכתית הייתה תרומה משמעותית, אם כי השפעתה העיקרית הייתה על תיקון מושהה ולא על השהיית ההחלטה הראשונית. במודל התיקון המושהה, צפיפות הערכתית הניבה מקדם חיובי (b = 0.23, SE = 0.05, 95% CI [0.13, 0.33], p < .001). השפעתה על משך ההפסקה הראשונה הייתה צנועה יחסית (b = 0.34, SE = 0.13, 95% CI [0.09, 0.59], p = 0.010). ממצאים אלה מרמזים כי רמזים הערכתיים לא תמיד נתפסו כצווארי בקבוק בעיבוד במהלך התרגום הראשוני. במקום זאת, הם הפכו לבעייתיים לעיתים קרובות רק לאחר שהופקה טיוטה ראשונית, מה שהניע את המתרגמים לבחון מחדש סוגיות של עמדה, טון או הלימה נרטיבית.
בולטות ה-Danmu נותרה מנבא משמעותי לאחר בקרה על משתנים פנימיים של הטקסט. היא ניבאה באופן משמעותי הן את משך ההפסקה הראשונה (b = 0.36, SE = 0.14, 95% CI [0.09, 0.63], p = 0.011) והן את צפיפות התיקונים הכוללת (b = 0.17, SE = 0.06, 95% CI [0.05, 0.29], p = 0.006). למרות שגודל האפקט שלה היה קטן יותר מאלו של העומס התרבותי והדחיסה הנרטיבית, תרומתה העקבית מצביעה על כך שקטעים המושכים תשומת לב ציבורית רבה יותר במאגר ה-danmu נוטים לדרוש גם מאמץ עיבוד רב יותר במהלך התרגום. ממצא זה מפורש כראיה מתכנסת לבולטות סמנטית, ולא כראיה לכך שתדירות ה-danmu גורמת באופן ישיר לקשיי תרגום.
התנהגות בדיקה ואיכות תרגום
בניתוחים הבאים נבדק האם איכות התרגום הוסברה טוב יותר על ידי הכמות הכוללת של התיקונים או על ידי מאפייניהם הזמניים והפונקציונליים. מודל האיכות (Table 5) הניב דפוס ברור של תוצאות. המספר הכולל של התיקונים לא ניבא באופן מובהק את איכות התרגום (b = 0.04, 95% CI [-0.06, 0.14], p = 0.412), בעוד שגם תזמון התיקונים וגם תפקיד התיקונים היו מנבאים מובהקים. באופן ספציפי, יחס התיקונים המאוחרים (b = 1.12, 95% CI [0.39, 1.85], p = 0.003), תיקונים ברמת השיח (b = 1.76, 95% CI [0.96, 2.56], p < 0.001), ותיקוני התאמה תרבותית (b = 2.04, 95% CI [1.14, 2.94], p < 0.001) היו כולם קשורים באופן חיובי לאיכות התרגום. לעומת זאת, תיקונים שטחיים הראו קשר שלילי קטן אך מובהק סטטיסטית (b = -0.63, 95% CI [-1.18, -0.08], p = 0.028).
ממצאים אלו מעידים כי כמות התיקונים לבדה אינה יכולה להבחין בין ניסוח מחדש פרודוקטיבי לבין טיוטה לא יציבה (איור 5). בדיקה איכותנית של תסריטי התרגום תמכה בפרשנות זו. בתרגומים שקיבלו ציונים נמוכים יותר, התיקונים נטו להתרכז סביב החלפות לקסיקליות מקומיות ותיקונים דקדוקיים, ללא פתרון של אי-התאמות עמוקות יותר בין רמזים נרטיביים בסינית לבין מסגור רטורי באנגלית. בתרגומים שקיבלו ציונים גבוהים יותר, תיקונים מאוחרים כללו לעיתים קרובות ארגון מחדש של מבנה המידע, הכנסת בירוור (explicitation) סלקטיבי, או התאמה של שפה הערכתית כדי לשפר את הנגישות עבור קהל קוראים בינלאומי. דוגמאות מייצגות של תגובות danmu מתורגמות—כולל "ביטוי זה הוא סיני מאוד", "יש להסביר את הרקע", ו"קהלים זרים עשויים שלא להבין התייחסות זו"—ממחישות את סוגי החששות מהקהל בעלי רלוונטיות תרבותית הקשורים לצבירי המקטעים המתאימים. דוגמאות אלו מוצגות אך ורק כדי להקל על הפרשנות ואין לראות בהן ראיה לכוונות המשתתפים.
חפיפה בין בולטות של danmu לבין צווארי בקבוק של תרגום
בניתוח הסופי נבדק האם מקטעים בעלי בולטות ציבורית במאגר ה-danmu חופפים למקטעים שדרשו את מאמץ העיבוד הגדול ביותר במהלך התרגום. עבור כל מקטע חושב מדד מאמץ משולב, באמצעות סטנדרטיזציה וסיכום של משך ההפסקה הראשונה, תדירות ההפסקות הארוכות וצפיפות התיקונים. לאחר מכן, 20% העליונים של המקטעים על בסיס מדד מאמץ משולב זה הושוו ל-20% העליונים המדורגים לפי בולטות ה-danmu.
החפיפה הייתה משמעותית: שישה מתוך תשעת המקטעים בעלי המאמץ הגבוה ביותר הופיעו גם בין תשעת המקטעים הבולטים ביותר ב-danmu, מה שמתרגם לשיעור חפיפה של 66.7%. מכיוון שההשוואה של החמישון העליון כללה תשעה מקטעים בלבד, רווח הסמך של וילסון (Wilson confidence interval) היה רחב יחסית (95% CI בערך 35.4%–87.9%). עם זאת, ניתוח חפיפה מקרי מדויק הצביע על כך שחפיפה של שישה מקטעים או יותר לא הייתה סבירה תחת הקצאה אקראית (p ≈ .001). ברמת המקטע, הבולטות ב-danmu הייתה במתאם חיובי עם מדד המאמץ המשולב (Spearman's ρ = 0.41, p = 0.006). מרבית המקטעים החופפים הופיעו בטקסטים B ו-C והתמקדו בהתייחסויות מוטמעות תרבותית, יזמות דיגיטלית ומיצוב הערכתי. ממצאים אלו מרמזים כי השיח הציבורי משמש כסמן חיצוני למקומות שבהם המשמעות הנרטיבית הופכת לבולטת במיוחד, אם כי הקשר נותר מתאמי ולא סיבתי.
בסיכומה של התמונה, ממצאים אלו מדגימים כי מאמץ העיבוד בתרגום נרטיבים הממוקדים בסין הוא ספציפי למקטע ומעוצב בעיקר על ידי עומס תרבותי, דחיסה נרטיבית וצפיפות הערכתית. איכות התרגום אינה תלויה בנפח התיקונים הכולל, אלא באסטרטגיות תיקון דחויות, רגישות לשיח ומכוונות תרבותית. לבסוף, ההלימה שנצפתה בין מקטעי תרגום הדורשים מאמץ רב לבין נקודות נרטיביות בולטות ב-danmu תומכת בקשר אסוציאטיבי בין בולטות עבור הקהל לבין מאמץ העיבוד של המתרגם, מבלי לרמוז כי הבולטות ב-danmu עצמה היא הגורם לקשיי התרגום.
זמינות נתונים:
כל הנתונים הגולמיים, קבצי רישום הקשות המקלדת, תצפיות מעובדות ברמת המקטע, תצפיות ברמת הסשן, מטא-נתוני danmu-video ו-5,000 תגובות ה-danmu הראשונות שהוצגו, מסופקים בחוברת נתוני השחזור. קובץ תגובות ה-danmu המלא מכיל 18,642 תגובות והוא הופקד כחלק מחבילת הנתונים. ניתן לגשת למערך הנתונים דרך מאגר Zenodo בכתובת https://doi.org/10.5281/zenodo.19289665.
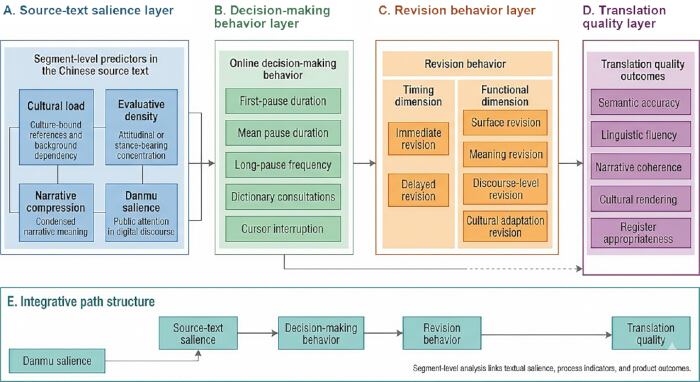
איור 1: מסגרת מושגית של המחקר. (A) מנבאים טקסטואליים ברמת המקטע, כולל עומס תרבותי, צפיפות הערכתית, דחיסה נרטיבית ובולטות danmu. (B) מדדי תהליך ששימשו להפעלה אופרציונלית של התנהגות קבלת החלטות מקוונת, כולל משך ההפסקה הראשונה, משך הפסקה ממוצע, תדירות הפסקות ארוכות, התייעצויות במילון והפרעות סמן. (C) סיווג דו-ממדי של התנהגות תיקון לפי תזמון התיקון ותפקוד התיקון. (D) חמישה ממדים המשמשים להערכת איכות התרגום: דיוק סמנטי, שטף לשוני, קוהרנטיות נרטיבית, עיבוד תרבותי והתאמה מרשומית. (E) מסגרת אנליטית כוללת המראה את הקשרים בין בולטות טקסט המקור, התנהגות קבלת החלטות, התנהגות תיקון ואיכות התרגום, כאשר בולטות danmu משמשת כמדד חיצוני לבולטות סמנטית בקרב הקהל. לא בוצע ולא מוצג במחקר זה ניתוח גורמים גשש (EFA) או מידול משוואות מבניות (SEM). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
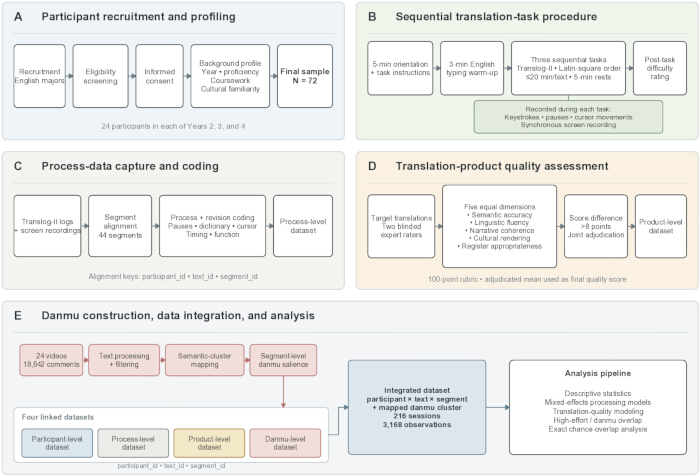
איור 2: זרימת עבודה של איסוף נתונים והלימת נתונים. (A) גיוס משתתפים, סינון התאמה, הסכמה מדעת ואיסוף מידע רקע. (B) ביצוע שלושת משימות התרגום ב-Translog-II תחת תנאים ניסיוניים סטנדרטיים. (C) איסוף נתוני תהליך, כולל לחיצות מקשים, הפסקות, תנועות סמן, אירועי תיקון והקלטות מסך מסונכרנות. (D) הערכה עיוורת של מומחים לתוצרי התרגום, ולאחריה פתרון סתירות בדירוג. (E) בניית קורפוס ה-danmu העזר והלימתו עם מערכי נתונים ברמת המשתתף, הטקסט, המקטע, התהליך והתוצר, כדי לייצר את מערך הנתונים המשולב הסופי המשמש לניתוחים הסקתים. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
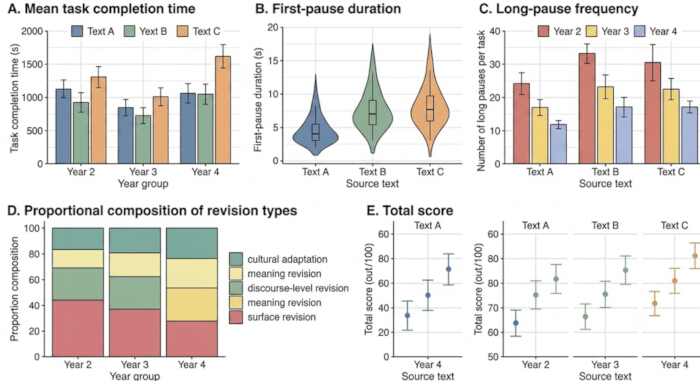
איור 3: התפלגות של מדדי תהליך ותוצר בין שכבות הגילים וטקסטים מקור שונים. (A) זמן ממוצע להשלמת המשימה לפי טקסט מקור ושכבת גיל. (B) התפלגות משך ההפסקה הראשונה בשלושת טקסטים המקור. (C) תדירות הפסקות ארוכות לפי טקסט מקור ושכבת גיל. (D) התפלגות פרופורציונלית של קטגוריות תיקון בין שכבות הגילים, כולל תיקוני שטח, תיקוני משמעות, תיקונים ברמת השיח ותיקוני התאמה תרבותית. (E) ציוני איכות תרגום כוללים לפי שכבת גיל עבור כל טקסט מקור. יחד, הפנלים מראים כי רמות גיל גבוהות יותר קשורות לפחות הפרעות בעיבוד, לאסטרטגיות תיקון סלקטיביות יותר ולאיכות תרגום גבוהה יותר, בעוד שטקסטים B ו-C מטילים דרישות עיבוד גבוהות יותר מאשר טקסט A. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
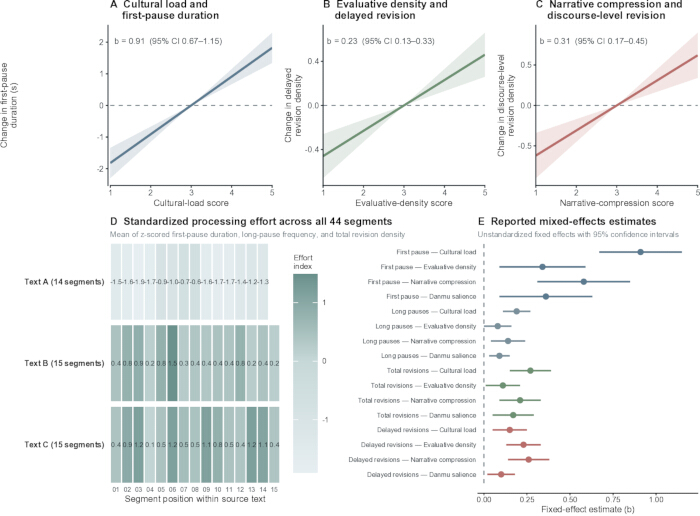
איור 4: השפעות של בולטות טקסטואלית ברמת המקטע על התנהגות תהליך התרגום. (A) אפקט שולי מותאם של עומס תרבותי על משך הפסקה ראשונה. (B) אפקט שולי מותאם של צפיפות הערכתית על צפיפות תיקונים מושהים. (C) אפקט שולי מותאם של דחיסה נרטיבית על צפיפות תיקונים ברמת השיח. (D) מפת חום של מדד מאמץ העיבוד הסטנדרטי בכל מקטעי טקסט המקור, מקובצים לפי טקסט מקור. (E) מקדמי אפקט קבוע סטנדרטיים שנאמדו ממודלי רגרסיה של אפקטים מעורבים. האיור מדגים כי מאפיינים טקסטואליים שונים מפעילים נתיבי עיבוד נפרדים, כאשר עומס תרבותי, צפיפות הערכתית ודחיסה נרטיבית תורמים להססות ולתיקונים באמצעות מנגנונים שונים חלקית. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
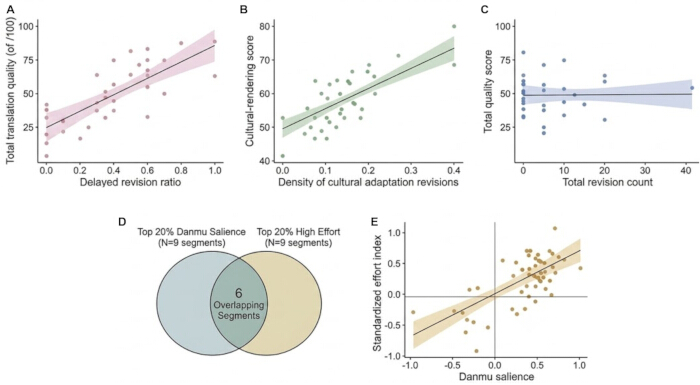
איור 5: קשרים בין תהליך התרגום, איכות התרגום ובולטות ה-danmu. (A) הקשר בין יחס העריכה המאוחרת לבין ציון איכות התרגום הכולל. (B) הקשר בין עריכות של התאמה תרבותית לבין ציון הרינדור התרבותי. (C) הקשר בין מספר העריכות הכולל לבין איכות התרגום הכללית, המדגים את הערך הניבוי המוגבל של כמות העריכות לבדה. (D) חפיפה בין 20% העליונים של מקטעים בולטים ב-danmu לבין 20% העליונים של מקטעי תרגום שדרשו מאמץ גבוה. (E) קשר ברמת המקטע בין בולטות ה-danmu לבין מדד מאמץ העיבוד הסטנדרטי. יחד, הפאנלים מראים שביצועי תרגום מוצלחים קשורים לעריכה המתוזמנת באופן אסטרטגי ומכוונת תפקודית, ולא לנפח העריכות לבדו, וכי מקטעי נרטיב בולטים לציבור נוטים לחפוף גם לצווארי בקבוק בתרגום. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
| מזהה טקסט | נושא נרטיבי | תווים סיניים | מספר המקטעים | ציון עומס תרבותי (1–5) | ציון צפיפות הערכתית (1–5) | ציון דחיסת נרטיב (1–5) | קושי חזוי | הערת תיקוף |
| טקסט א' | נרטיב השבה הביתה לרגל פסטיבל האביב | 212 | 14 | 3 | 2 | 3 | בינוני | נבדק בבדיקת פיילוט עם 12 סטודנטים שלא השתתפו במחקר |
| טקסט ב׳ | נרטיב זיכרון של פסטיבל סירות הדרקון | 219 | 15 | 5 | 3 | 4 | גבוה | נבדק בגרסת פיילוט עם 12 סטודנטים שלא השתתפו במחקר |
| טקסט ג | נרטיב של שידור חי כפרי ופיתוח מולדת | 223 | 15 | 4 | 5 | 4 | גבוה | נבדק בבדיקת פיילוט עם 12 סטודנטים שלא השתתפו במחקר |
טבלה 1: פרופיל טקסט המקור ומבנה המקטעים.
| משתנה | רמה | הגדרה אופרטיבית | יחידת מידה |
| משך ההפסקה הראשונה | מקטע | הזמן מתחילת המקטע ועד להקשה הראשונה הרלוונטית במקלדת בשפת היעד | שניות |
| משך הפסקה ממוצע בתוך מקטע | מקטע | משך זמן ממוצע של כל ההפסקות בתוך המקטע | שניות |
| שכיחות הפסקות ארוכות | מקטע | מספר ההפסקות הארוכות מ-2 שניות | ספירה |
| התייעצויות במילון | מקטע | מספר הפעילויות של חלון המילון במהלך עיבוד המקטע | ספירה |
| הפסקות סמן | מקטע | מספר הפעמים שבהן הסמן סטה מהכתיבה הליניארית לפני השלמה יציבה | ספירה |
| תיקון מיידי | מקטע | תיקון שבוצע לפני שהכתיבה התקדמה אל מעבר לאזור הטקסט המקומי הנוכחי | ספירה / צפיפות |
| תיקון מושהה | מקטע | תיקון שבוצע לאחר שהכתיבה התקדמה לאזור טקסט מאוחר יותר | ספירה / צפיפות |
| תיקון שפתאי | תפקיד התיקון | תיקון ברמת הצורה ללא שינוי סמנטי | ספירה / צפיפות |
| תיקון משמעות | תפקיד התיקון | שינוי לקסיקלי או תחבירי המשפיע על ביטוי המשמעות | ספירה / צפיפות |
| תיקון ברמת השיח | תפקיד התיקון | התאמה של קשרי פסוקים, קוהרנטיות או סדר המידע | ספירה / צפיפות |
| תיקון התאמה תרבותית | תפקיד התיקון | ניסוח מחדש או הבהרה של משמעות תלוית-תרבות המכוונת לקהל היעד | ספירה / צפיפות |
| מדד מאמץ משולב | מקטע | שקלול סטנדרטי של משך ההפסקה הראשונה, שכיחות הפסקות ארוכות וצפיפות תיקונים | z-score |
| בולטות Danmu | מקטע / מקבץ סמנטי | מדד עקיף משוקלל של מקבץ סמנטי המבוסס על שכיחות מנורמלת של מקבץ מילות מפתח, ריכוז תגובות ועצימות הערכה | ציון רציף |
טבלה 2: הגדרות תפעוליות של משתני תהליך.
| ממד | טווח ציונים | מיקוד הניקוד |
| דיוק סמנטי | 1-20 | נאמנות למשמעות המקור, דיוק של התוכן המועבר והיעדר עיוותים משמעותיים |
| שטף לשוני | 1-20 | תקינות דקדוקית, טבעיות, אידיומטיות וקריאות ברמת המשפט |
| קוהרנטיות נרטיבית | 1-20 | זרימת מידע, קישור בין פסוקיות, התקדמות ויציבות טקסטואלית |
| עיבוד תרבותי | 1-20 | טיפול בהפניות תלויות-תרבות, אקספליקיטציה (הבהרה), מסגור ונגישות פרשנית |
| התאמה למשלב לשוני | 1-20 | התאמה לקהל היעד, הלימה סגנונית ושליטה בטון |
טבלה 3: מחוון לדירוג איכות התרגום.
| סעיף | משתנה | שנה 2 (n = 24), ממוצע ± סטיית תקן | שנה 3 (n = 24), ממוצע ± סטיית תקן (SD) | שנה 4 (n = 24), ממוצע ± SD |
| פרופיל מפגש ברמת המשתתף | זמן השלמת המשימה (שניות) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| פרופיל סשן ברמת המשתתף | משך זמן ההפסקה הראשונה הממוצע (שניות) | 7.09 ± 0.50 | 6.65 ± 0.40 | 6.38 ± 0.41 |
| פרופיל סשן ברמת המשתתף | תדירות הפסקות ארוכות למשימה | 21.04 ± 0.32 | 18.47 ± 0.30 | 16.31 ± 0.19 |
| פרופיל מפגש ברמת המשתתף | סה"כ סבבי תיקונים למשימה | 28.65 ± 2.87 | 26.24 ± 2.63 | 24.59 ± 2.42 |
| תצורת עריכה | יחס ניתוחי תיקון מאוחרים | 0.45 ± 0.01 | 0.54 ± 0.01 | 0.63 ± 0.01 |
| תצורת עדכון | יחס תיקון ברמת השיח | 0.37 ± 0.01 | 0.40 ± 0.01 | 0.45 ± 0.01 |
| תצורת גרסה | יחס תיקון של התאמה תרבותית | 0.38 ± 0.01 | 0.42 ± 0.00 | 0.48 ± 0.01 |
| תצורת עדכון | יחס תיקון פני השטח | 0.04 ± 0.00 | 0.02 ± 0.00 | 0.00 ± 0.00 |
| איכות המוצר | ציון איכות כולל | 77.82 ± 4.65 | 84.03 ± 4.44 | 88.27 ± 4.56 |
| איכות המוצר | ציון התאמה תרבותית | 77.73 ± 4.49 | 83.95 ± 4.85 | 88.18 ± 4.86 |
טבלה 4: סטטיסטיקה תיאורית עבור משתני תהליך ומוצר.
| משתנה תוצאה | משתנה ניבוי | b | שגיאה סטנדרטית | רווח ברתק 95% | t/z | p |
| משך ההפסקה הראשונה | עומס תרבותי | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| משך ההפסקה הראשונה | צפיפות הערכתית | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| משך ההפסקה הראשונה | דחיסה נרטיבית | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| משך ההפסקה הראשונה | בולטות דנמו (Danmu salience) | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| שכיחות הפסקות ארוכות | עומס תרבותי | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| תדירות השהיות ממושכות | צפיפות הערכתית | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| שכיחות הפסקות ארוכות | דחיסת נרטיב | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| שכיחות השהיות ממושכות | בולטות דנמו (Danmu salience) | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| צפיפות חזרה כוללת | עומס תרבותי | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| צפיפות חזרה כוללת | צפיפות הערכתית | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| צפיפות רבויה כוללת | דחיסה נרטיבית | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| צפיפות רכיבים כוללת | בולטות דנמו (Danmu salience) | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| צפיפות תיקון מושהית | עומס תרבותי | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| צפיפות תיקון מאוחרת | צפיפות הערכתית | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| צפיפות תיקון מושהית | דחיסת נרטיב | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| צפיפות תיקון מאוחרת | בולטות דנמו (Danmu salience) | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| ציון איכות כולל | סך הכל תיקונים | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| ציון איכות כולל | יחס תיקון מאוחר | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| ציון איכות כולל | תיקונים ברמת השיח | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| ציון איכות כולל | תיקוני התאמה תרבותית | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| ציון איכות כולל | תיקוני שטח | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| ציון איכות כולל | שנתון | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
טבלה 5: מודלים של השפעות מעורבות החוזים התנהגות תהליך ברמת המקטע ואיכות תרגום.
דיון
הממצאים הנוכחיים מדגימים כי הקושי בתרגום של נרטיבים ממוקדי-סין מסינית לאנגלית אינו מפוזר באופן אחיד לאורך הטקסט. תחת זאת, הוא מתרכז במקטעים שבהם מתלכדים הפניות תרבותיות, עמדות הערכתיות ומשמעויות נרטיביות דחוסות. דבר זה תומך בתפיסה של קשיי תרגום המבוססת על תהליך, ולא על חסר באוצר מילים. מחקר אמפירי על תהליכי תרגום מדגיש כי תרגום הוא פעילות מאורגנת זמנית שבה היסית, התמצאות והפקה מפוזרים באופן לא אחיד19. ריכוז המאמץ שנצפה במחקר זה משקף כיצד מקטעים ספציפיים מטילים לחץ פרשני רב יותר, ובכך משבשים את כתיבת הטיוטה הליניארית באופן עמוק יותר מאשר מקטעים אחרים. ניתן לסכם את בדיקת ההשערות באופן הבא: H1 נתמכה כיוון שנטייה תרבותית הגבירה היסית מוקדמת וצפיפות של תיקונים; H2 דויקה כיוון שצפיפות הערכתית ודחיסה נרטיבית פעלו דרך נתיבי תיקון שונים; H3 נתמכה כיוון שתזמון ותפקוד התיקונים ניבאו את האיכות בצורה חזקה יותר מאשר סך מספר התיקונים; ו-H4 נתמכה כחפיפה אסוציאטיבית בין בולטות של danmu לבין מקטעים הדורשים מאמץ גבוה, ולא כקשר סיבתי.
בנוגע להתנהגות העריכה, הנתונים מעידים כי סך מספר העריכות אינו מנבא את איכות התרגום; במקום זאת, עריכות מאוחרות, עריכות ברמת השיח ועריכות של התאמה תרבותית הן הגורמים העיקריים לביצועים טובים יותר. הבחנה זו מרמזת כי העריכה היא פרודוקטיבית רק כאשר היא מבוצעת כהערכה מחדש מובנית ולא כתיקון מקומי חוזר. בדומה למחקרי מעקב עיניים ורישום הקשות המעידים כי מתרגילים מקצים מאמץ באופן שונה כאשר משימות הופכות לקשות, סטודנטים חזקים יותר במחקר זה לא היו פשוט פעילים יותר7. הם קטעו באופן סלקטיבי פתרונות זמניים, העריכו אותם מחדש בשלבים מאוחרים יותר, וכיוונו את העריכות לעבר התאמה נרטיבית או תרבותית. כתוצאה מכך, ציוני התוצר לבדם אינם מספיקים להסברת ביצועי המתרגם, שכן ציוני סיום דומים נובעים לעיתים קרובות ממסלולי תהליך שונים בתכלית9.
ניתן להבין תופעה זו בצורה הטובה ביותר דרך נקודת המבט של המרת מאמץ. בתרגומים שקיבלו ציונים נמוכים יותר, המאמץ הקוגניטיבי נשאר כלוא ברמה המקומית — סטודנטים עשו הפסקות, החליפו פריטים לקסיקליים או התאימו ה"א הידיעה, אך נכשלו בפתרון אי-התאמות עמוקות יותר בין המשמעויות של טקסט המקור לבין המסגור של טקסט היעד. לעומת זאת, בטקסטים שקיבלו ציונים גבוהים יותר, נראה כי המאמץ הומר להחלטות מבניות שמיגש את הטקסט עבור קורא היעד. בדומה למחקרים על ביצועי עריכה לאחר-תרגום של סטודנטים, תוצאות אלו מאשרות כי מאמץ תהליכי אינו מביא תועלת באופן אוטומטי; ערכו תלוי בהמרתו לשיפור טקסטואלי הניתן לפירוש20.
יתרה מכך, תכונות טקסטואליות שונות מפעילות מנגנוני עיבוד מובחנים. עומס תרבותי הוביל לעלייה עקבית בהססויות מוקדמות ובצפיפות תיקונים, בעוד שדחיסה נרטיבית ניבאה באופן חזק תיקונים ברמת השיח. הבחנה זו מבהירה מדוע מקטעים קשים באים לידי ביטוי בצורה שונה במהלך תהליך התרגום: חלקם משבשים את הגישה הקוגניטיבית כבר בשלב הניסוח הראשוני, בעוד שאחרים הופכים לבעייתיים רק במהלך שמירה על קוהרנטיות לאורך קטעי שיח רחבים יותר. בדומה למחקרים המראים כי טקסטים קשים מניבים יחידות עיבוד קטנות יותר והפסקות צפופות יותר, ממצאים אלו מדגישים כיצד משמעויות תרבותיות והערכתיות דחוסות מאלצות מתרגמים לנוע בין ביטוי מקומי לבין מסגור נרטיבי גלובלי8.
תרומה מתודולוגית משמעותית של מחקר זה היא השילוב של בולטות ה-danmu כשכבה של שיח קהלי. החפיפה המשמעותית בין מקטעי תרגום שדרשו מאמץ גבוה לבין מקטעים בולטים ב-danmu מעידה על כך שהצווארי בקבוק שעימם נתקלים הסטודנטים חופפים לעיתים קרובות לנקודות המושכות תשומת לב מוגברת של הקהל בתפוצה דיגיטלית. דבר זה מקשר בין קושי בתרגום לבין שיח השתתפותי מבלי למזג את שני המושגים. תגובות ה-danmu חושפות מה הקהל מבחין בו או עליו הוא חולק בתפוצה המתווכת בווידאו, בעוד שרישומי הקשות ומקרי תיקון חושפים כיצד מתרגילים סטודנטים מעבדים מקטעים הקשוריים סמנטית בטקסט המקור. הפרשנות הסבירה ביותר היא, לפיכך, הסבר המבוסס על רמזים משותפים: התייחסויות טעונות תרבותית, הנחות רקע דחוסות ומיצוב הערכתי יכולים בו-זמנית למשוך את תשומת לב הקהל ולהגביר את לחץ העיבוד של המתרגם21.
מבחינה פדגוגית, חפיסה זו מרמזת שנרטיבים המתמקדים בסין מופצים בהקשרים שבהם המשמעות מנוהלת באופן פומבי ומהיר, וכפופה לסדרי עדיפויות מתחרים כגון מיידיות, מובנות והתאמה לקהל היעד22. כתוצאה מכך, הכשרת מתרגמים חייבת לעבור מתפיסה של סגירת טיוטות כשלב כללי של הגהה, להדגשה של התערבויות פונקציונליות ואסטרטגיות זמניות. צווארי הבקבוק שנצפו נוצרו לעיתים רחוקות על ידי טרמינולוגיה לבדה; הם הופיעו במקומות שבהם משמעות הנרטיב הייתה תלויה בהנחות מוקדמות המעוגנות תרבותית, במסגור רלציוני ובגישה סלקטיבית של קהל היעד. בדומה להפצה של ספרות נרטיבית אתנית סינית, העברת נרטיבים אלו דורשת מעבר מעבר לדיוק לקסיקלי, כדי לקבוע כיצד יש להבנות מחדש את המשמעות התרבותית המקומית לצורך הפצה גלובלית רחבה יותר23. ניתן ליישם שיטה זו בהכשרת מתרגמים באמצעות שימוש ביומני הקשות, הקלטות מסך ודוגמאות של שיח קהלי, כדי לסייע לסטודנטים לזהות מתי מקטע דורש פירוט (explicitation), ארגון מחדש, מסגור תרבותי או התאמת מרשב (register), במקום החלפה לקסיקלית פשוטה.
מספר מגבלות מעכבות את פרשנות הממצאים הללו. ראשית, בולטות ה-danmu מהווה מדד עקיף (proxy) של אשכול סמנטי למעורבות הקהל, ולא מדד ישיר לקושי לשוני, והעיצוב המתאמי הנוכחי אינו יכול לבסס קשר סיבתי בין בולטות ציבורית לבין מאמץ התרגום. עבודות עתידיות יוכלו להפעיל מניפולציה ניסוית על העומס התרבותי, הצפיפות ההערכתית והדחיסה הנרטיבית כדי לבחון מסלולים סיבתיים. שנית, המדגם מוגבל למתרגמים בהכשרה מאוניברסיטה אחת, וניסיון המשתתפים, ההכרות התרבותית והשליטה בשפה השנייה נשלטו סטטיסטית ולא באמצעות דגימה מרובדת באופן מלא. שכפול של המחקר עם מתרגמים מקצועיים, סטודנטים ממספר מוסדות וטווחי שליטה רחבים יותר בשפה יחזק את היכולת להכליל את הממצאים. שלישית, טקסטים המקור הוכנו על ידי החוקרים ועברו בדיקת פיילוט כדי לכייל את המשימה, אך מחקרים עתידיים צריכים לכלול תיקוף נוסף באמצעות טקסטים ציבוריים אותנטיים ופאנלים עצמאיים לפיתוח חומרים. רביעית, קידוד העומס התרבותי, הצפיפות ההערכתית, הדחיסה הנרטיבית ותפקודי העריכה תלויים בהגדרות אופרציונליות שקופות, ברישומים של מקודדים עצמאיים ובמהימנות בין-שופטים שניתן לאמת לצד קובץ הקידוד שנפסק. מחקרים עתידיים עשויים לשלב רישום הקשות מקלדת עם מעקב עיניים, ראיונות רטרוספקטיביים, פרוטוקולי "חשיבה בקול" או משימות עריכה לאחר תרגום (post-editing), כדי לבצע טריאנגולציה של המנגנונים הקוגניטיביים העומדים בבסיס החלטות העריכה.
בסופו של דבר, מחקר זה מבהיר את הבסיס התהליכי של ביצועי סטודנטים בתרגום סיפורים המתמקדים בסין מסינית לאנגלית. באמצעות קישור בין נתוני תיעוד הקשות (keystroke-logging), הערכת התוצר ושיח קהל דיגיטלי, הממצאים מדגימים כי צווארי בקבוק בתרגום מופיעים בנקודות של משמעות נרטיבית בעלת מטען ציבורי. הגורם המכריע בתרגום בין-תרבותי אינו נפח העריכה הגולמי, אלא יכולתו של המתרגם לזהות מקטעים הדורשים ארגון מחדש פרשני ולדחות באופן אסטרטגי את סגירת הניסוח עד שנוסח פתרון יציב ומתאים לקהל היעד.
גילויים
למחברים אין ניגשויות להצהיר עליהן.
תרומות המחברים
Weijia Chen: קונספטואליזציה, מתודולוגיה, ניתוח פורמלי, חקירה, כתיבת טיוטה ראשונית.
Chunming Wu: תכנון המחקר, הנחיה בנוגע לניתוח הפורמלי ונהלי טיפול בנתונים, וסקירה ומשוב על תיקונים במענה להערות הבודקים.
תודות
מחקר זה נתמך פננסית על ידי שתי מענקים מאוניברסיטת Hanshan Normal. באופן ספציפי, הוא מהווה תוצר מחקר מדורג של תוכנית הקורס לב undergraduate של דרג ראשון לשנת 2023 (קורס דרג ראשון במתכונת פרונטלית) עבור "Theory and Practice of Chinese–English Translation II" (מספר אישור YHS [2023] 172). בנוסף, המחקר נתמך על ידי פרויקט איכות ההוראה ורפורמה בהוראה לשנת 2025, שהוגדר כקורס מודל לחינוך אידיאולוגי ופוליטי מבוסס תוכנית לימודים עבור "Chinese–English Translation" (מספר אישור YHSJ〔2025〕126). המחברים מודים על התמיכה המוסדית שניתנה להשלמת מחקר זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| קורפוס דנמו (danmu) של Bilibili | Bilibili | 24 סרטונים; 18,642 תגובות; https://www.bilibili.com | בניית קורפוס דנמו (danmu) עזר וחישוב בולטות דנמו ברמת המקטע |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | ניקוי נתונים, ארגון קידוד וניהול נתונים ראשוני |
| R | R Foundation for Statistical Computing | R 4.3.1;https://www.r-project.org | מידול אפקטים מעורבים, אנליזת מתאם ויצירת איורים |
| תוכנה להקלטת מסך | עמדת עבודה במעבדה | כלי עזר לתחנת עבודה מקומית; ללא מספר קטלוגי | אימות של פרקי עדכון לא-ליניאריים וגיבוי של נתוני תהליך |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | סטטיסטיקה תיאורית, ANOVA וניתוחים סטטיסטיים בסיסיים |
| Translog-II | בית הספר למשק Copenhagen / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | רישום הקשות מקלדת והקלטה של הפסקות, תנועות סמן ואירועי תיקון במהלך משימות תרגום |
מקורות
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.