מחקר זה מפתח מסגרת אופטימיזציה של הנחיות (prompts) רב-שכבתית המבוססת על DeepSeek, במטרה לשפר את מיומנויות העברת הכתיבה באנגלית בהקשרים בין-תרבותיים. באמצעות שרשרת הנחיות תלת-שלבית וניסוי מעין-ניסויי עם 60 סטודנטים למגמת אנגלית, התוצאות מראות שיפור משמעותי בקבוצת הניסוי בהשוואה לקבוצת הביקורת.
מאמר מחקר
אופטימיזציה של הנחיות (Prompts) ב-DeepSeek להוראת כתיבה באנגלית בין-תרבותית: מחקר מעשי של כשירות העברה
במאמר זה
סיכום
תקציר
כדי להתגבר על המגבלה שבה הוראת כתיבה מסורתית באנגלית מזניחה טיפוח שיטתי של העברה לשונית (language transfer), ומסגרות הנחיה (prompt frameworks) קיימות אינן מתאימות להוראה בכיתה, מחקר זה בונה מערכת אימון להעברה היררכית המבוססת על מודל DeepSeek, המכסה ארבע רמות משימה הדרגתיות: משפט, פסקה, שיח ותרבות, כאשר כל המשימות מוגדרות בצורה של שלשייה (triple form). הוקמה ספריית משימות חומש המכסה תחביר, מבנה, תרבות, רגישטר (register) ולוגיקה, והנחיות ממוקדות מיוצרות באופן אוטומטי מטיוטות כתיבה אותנטיות של סטודנטים. בשילוב עם ארכיטקטורת Mixture of Experts (MoE) של המודל, פותח שרשרת הנחיות מקוננת כדי לפצל מטלות מורכבות לשלושה שלבים רצופים: ארגון מחדש סמנטי, תיקון לשוני והתאמה תרבותית. תוך אימוץ מערך מחקר קוסי-ניסויי, מחקר זה גייס 60 סטודנטים שנה ב' למגמה לאנגלית מאוניברסיטה אחת, שחולקו לקבוצת ניסוי ולקבוצת ביקורת של 30 סטודנטים כל אחת, למשך שלושה שבועות של התערבות מדורגת לאורך שלושה סבבי אימון. תוצאות לאחר הניסוי מעידות כי ציון ההעברה התרבותית של קבוצת הניסוי עלה מ-2.8 ל-4.5, בהשוואה לעלייה של 0.3 בלבד בקבוצת הביקורת; הציון הממוצע בהערכת מורים השתפר מ-59.1 ל-74.4, לעומת עלייה של קבוצת הביקורת מ-60.1 ל-64.9. רוב מקדמי המתאם בין הניקוד של ה-AI להערכת המורים עולים על 0.8, ומעל 90% מהמשתתפים הביעו שביעות רצון מפונקציות השכתוב והאופטימיזציה המבנית של ה-AI. בשל גודל המדגם הקטן בניסוי זה, גישת אופטימיזציה זו היא ישימה ליישום בשיעורי כתיבה באנגלית באוניברסיטה.
מבוא
בלימוד כתיבה באנגלית בהקשר בין-תרבותי, לומדים שאינם דוברי אנגלית כשפת אם מתמודדים לעיתים קרובות עם אתגר של יכולת העברה (transfer ability) לא מספקת במעבר מידע לשוני ליישום מעשי1,2. למרות שלסטודנטים יש בסיס דקדוקי ואוצר מילים מסוים, הם מתקשים להמיר ביעילות תבניות משפטים, מבנים וביטויים תרבותיים לכתיבה ממשית, מה שמוביל לפלט לשוני פורמלי ומחשבה מוגבלת, אשר בתורם משפיעים על איכות הכתיבה הכוללת3. בנוסף, הבדלים בין-תרבותיים במבנה השפה, בארגון הלוגי ובנורמות פרגמטיות מחריפים עוד יותר את מורכבות העברת הכתיבה4. בשנים האחרונות, מודלי שפה גדולים (LLMs) סיפקו תמיכה טכנולוגית חדשה להוראת כתיבה5. כלי כתיבה אינטליגנטיים, כגון DeepSeek, הדגימו יכולות חזקות ביצירה ובבנייה מחדש של שפה. עם זאת, בפרקטיקה ההוראתית, הם מוגבלים לרוב לתיקון לשוני ברמה השטחית וטרם שולבו באופן עמוק בתהליך ההוראה, הממוקד בטיפוח יכולת ההעברה. חסרים בהם אוריינטציה למטרות הוראה ויכולת בקרה על התנהגות היצירה6,7. יישומי כתיבה מבוססי בינה מלאכותית נפוצים מגבילים ברובם את תפקודיהם לתיקון שגיאות דקדוקיות שטחיות, במקום להתמקד בטיפוח כשירות העברה סיסטמטית, מה שמוביל לשליטה הוראתית דלה בפלטי המודל.
מחקרים קיימים בנושא סיוע בכתיבה עבור לומדי ESL (אנגלית כשפה שנייה) מתחלקים לשלוש קטגוריות מרכזיות: משוב כתיבה מונחה-הנחיות (prompts) קונבנציונלי, התערבות גנרית של AI לליטוש טקסט, ואימון העברה ממוקד-ביצוע ידני. ראשית, מחקרים כלליים בתחום הנדסת ההנחיות (prompt engineering) מתמקדים באופטימיזציה טכנית של מענה לשאלות ושכתוב טקסט, ללא התאמה למטרות הוראה היררכיות של העברה8,9. שנית, חניכה טיפוסית ל-ESL המבוססת על ChatGPT מתמקדת בשיפור הדיוק הכללי של הכתיבה, ולא בטיפוח העברה שכבתית בתחומי התחביר, המבנה וההקשרים הבין-תרבותיים10. שלישית, פדגוגיה מסורתית של העברה, הנשענת על חיקוי וכתיבה ניגודית, חסרה משוב בלולאה סגורה הנתמך על ידי כלים אינטליגנטיים11. בניגוד למחקרים קודמים, מחקר זה מפתח הנחיות היררכיות מכוונות-העברה המותאמות למטרות הוראה רב-שכבתיות, ובונה תהליך עבודה לייצור אוטומטי של הנחיות מונחה-דוגמאות, ובכך יוצר מנגנון אימון ייחודי בלולאה סגורה המשלב יצירת מודל, משוב של מורה ותיקון של התלמיד.
ספרות קודמת מעלה השערה על קשר פוטנציאלי המשלב בין שונות תרבותית-לשונית, מגבלות מבניות מובנות של המודל ופרקטיקה לא עקבית בכיתה, אך שרשרת סיבבית כזו נותרה ללא אישוש אמפירי מספיק במחקרים קיימים, והיא הופכת להשערת המחקר המרכזית שתיבחן במאמר זה12,13. באשר למאפיינים המובנים של DeepSeek המוזכרים במאמר זה, ממשק ההוראות הפתוח שלו ותכנון ניתוב המומחים המבוסס על MoE תועדו בדוחות טכניים קיימים של המודל ובמחקרים יישומיים על שפה. בהתבסס על מאפייני מודל מתועדים אלו, מחקר זה מתאים שרשראות פרומפטים מקוננות כדי לפרק משימות מורכבות של העברה בין-תרבותית, ומפתח כללי תזמון דינמיים של תתי-מודלים עבור השמות משימות העברה מובחנות. תוך התמקדות בפיתוח יכולת העברה מובנית, עבודה זו בוחנת אופטימיזציה ממוקדת של פרומפטים ב-DeepSeek, במטרה להפוך מודלי שפה גדולים מכלי עריכת טקסט אוניברסליים למערכות ייעודיות לאימון בהעברה עבור הוראת כתיבה באנגלית במכללות.
בתחום המחקר של כתיבה בשפה שנייה, תופעת ההעברה (transfer) מהווה נושא מרכזי מזה זמן רב14,15. תיאוריית העברת השפה המסורתית מתמקדת בעיקר בהשפעות ההעברה החיוביות והשליליות של שפת האם על תהליך רכישת שפת היעד, תוך דגש מיוחד על פונטיקה, אוצר מילים ותחביר16. Mirzayev E ציין כי בהוראת כתיבה באנגלית כשפה שנייה (ESL), העברה שלילית מהשפה הראשונה נותרת גורם מפתח המגביל את התפתחות יכולות הכתיבה של התלמידים17. ככל שהיקף המחקר התרחב, הקהילה האקדמית הרחיבה בהדרגה את מוקד תשומת הלב שלה להעברת מבנה הכתיבה18. כתיבה בשפת ביניים (Interlanguage) סובלת לעיתים קרובות משגיאות לשוניות ומאתיליזציה (fossilization) עקב גורמים מרובים19. במקביל, תיאוריית ההעברה הקוגניטיבית זכתה אף היא לתשומת לב גוברת20. תיאוריה זו מדגישה את ההבדלים בארגון הקוגניטיבי ובדפוסי הביטוי בתהליך הכתיבה. לדוגמה, כתיבה מערבית שמה דגש על הסקה ליניארית ולוגיקה מפורשת, בעוד שהמסורת הסינית מעדיפה גישה ספירלית ועמימות סמנטית. קיים מתח משמעותי בין השתיים. לפיכך, העברת שפה אינה כוללת רק המרה של יחידות לשוניות, אלא גם התאמה וטרנספורמציה של מבני חשיבה ונורמות ביטוי תרבותיות ברמה עמוקה יותר, המהווים אתגר חשוב בהוראת כתיבה באנגלית כיום21.
בתרגול של פיתוח יכולת העברה, מחקרים קיימים משתמשים לעיתים קרובות באסטרטגיות כגון כתיבה חיקויית22, כתיבה השוואתית23 ואימון בתרגום24 כדי לשפר את הבנת הלומדים ואת היישום של מנגנון ההעברה לשפת היעד. כתיבה חיקויית מסייעת בבניית יכולת שיח בסיסית, אך היא עלולה להוביל בקלות לנוקשות מבנית; כתיבה השוואתית יכולה לשפר את הסגנון הלשוני ואת המודעות התרבותית, אך היא חסרה רבדיות סיסטמטית של משימות ומשוב מותאם אישית; אימון בתרגום יכול לקדם זיהוי של מטאפורות תרבותיות, אך ללא הדרכה, הוא עלול להוביל בקלות לסטיות סמנטיות או לחוסר התאמה פרגמטית. האסטרטגיות שלעיל נשענות בעיקר על הדגמה ידנית והדרכה חווייתית25, חסרות בנייה מפורשת של אסטרטגיות העברה ומנגנוני משוב סיסטמטיים, ומאתגר להתאימן להבדלים אינדיבידואליים ברמת השליטה בשפה ובסגנונות קוגניטיביים. למרות שחלק מהמחקרים ניסו להרחיב את אימון ההעברה באמצעות משימות כתיבה מגוונות26,27, תהליך ההוראה עדיין לא יצר לולאה סגורה של "מטרת העברה-יצירת שפה-משוב אסטרטגי"; השפעת הפנמת אסטרטגיות ההעברה היא מוגבלת, ופיתוח יכולת ההעברה של סטודנטים במשימות כתיבה ממשיות עדיין אינו מספיק28.
עם פיתוחן של טכנולוגיות מודלי שפה גדולים, הפוטנציאל שלהם ככלי עזר בהוראת שפות זכה לתשומת לב גוברת29. כלי בינה מלאכותית גנרטיבית, המיוצגים על ידי ChatGPT (Chat Generative Pre-trained Transformer)30 ו-DeepSeek31, נמצאים בשימוש נרחב בתרחישים כגון ליטוש טקסטים, שכתוב שפתי והתאמת שפה. Diasamidze ואח' מצאו כי סטודנטים ל-ESL המשתמשים ב-ChatGPT הראו ביצועים טובים יותר מקבוצת ההוראה המסורתית מבחינת דיוק דקדוקי, עשירות אוצר מילים ויכולת ארגון טקסט32. עם זאת, היישומים הקיימים מוגבלים ברובם לעיבוד שפה ברמה שטחית וחסרה בהם הדרכה שיטתית בנוגע למטרות ההעברה. Ranade ציין כי פרויקטים מבוססי-פרומפט בתרחישים חינוכיים עכשוויים מתבססים ברובם על תבניות כלליות, והתוכן המיוצר חסר סתגלנות הקשרית וספציפיות למשימה33. בנוסף, אימון מודלים מרכזיים מסתמך על קורפוס פתוח וחסר מידול מעמיק של ההבדלים בביטויים תרבותיים בסינית ובאנגלית. בטקסט המיוצר נוטים להופיע חוסר התאמה תרבותית ופרגמטיקה לא טבעית34,35, דבר המגביל את יישומם המעמיק בהוראת העברת כתיבה בין-תרבותית.
פרוטוקול
אישור אתי
לפני הניסוי, קיבלו המחברים אישור (מספר אישור: NBCC-ETH-2026-037) מהמכללה והפיצו מסמכי הסכמה מדעת לכל הסטודנטים שהשתתפו. כל הסטודנטים עודכנו בבירור לגבי מטרות המחקר, ההליכים הניסויים ותקנות השימוש בנתונים. ההשתתפות הייתה וולונטרית, והמשתתפים יכלו לפרוש מהמחקר בכל עת. כל הנתונים האישיים והעבודות הכתובות עברו אנונימיזציה כדי להגן על הפרטיות ושימשו לניתוח אקדמי בלבד. כל 60 המשתתפים חתמו על טופס ההסכמה לפני השתתפותם במחקר. המשתתפים נבחרו משני כיתות כתיבה באנגלית מקבילות לשנה ב' באותה מכללה מקצועית גבוהה, וגויסו באמצעות דגימת נוחות. קריטריוני ההכללה כללו: מעבר מבחן CET-6 עם ציון > 425, ללא היעדרויות בסמסטר זה, וציונים ממוצעים בשני מבחני הכתיבה האחרונים של היחידה. קריטריוני ההחרגה כללו: שימוש ארוך טווח בתוכנות כתיבה באנגלית מבוססות AI מסחריות מחוץ לכיתה ודיסלקסיה חמורה.
השונות עבור כל משתני התוצאה הרציפים דווחה כממוצע ± סטיית תקן (SD). כל הניתוחים בוצעו עם גודל מדגם של n = 30 משתתפים לכל קבוצה (קבוצת ניסוי לעומת קבוצת ביקורת), סך הכל N = 60. עבור נתונים אורכיים של מדידות חוזרות, נעשה שימוש בניתוח שונות למדידות חוזרות (RM-ANOVA) כדי לבחון השפעות עיקריות של הקבוצה והזמן, ואת האינטראקציה בין הקבוצה לזמן. מבחני t למדגמים בלתי תלויים שימשו להשוואות זוגיות post-hoc בנקודות זמן בודדות. קבוצת הביקורת קיבלה הוראת כתיבה מסורתית בתוספת כלי כתיבה גנרי, חינמי ולא מותאם אישית מבוסס AI (ללא הנחיות מדורגות, ללא תבניות מכוונות להעברה). שעות ההוראה, משימות הכתיבה, תדירות המשוב וטקסטים האימון היו זהים לאלו של קבוצת הניסוי, למעט היעדר ההתערבות של שרשרת הנחיות מקננת מותאמת אישית וספריית משימות בעלת חמישה רמות ששימשה במחקר זה. קבוצת הניסוי השתמשה בהוראות המבוססות על מודל DeepSeek כדי למקסם את הוראת הכתיבה, כולל הנחיה של שרשרת הנחיות מקננת, פלט של התאמה בין-תרבותית ומנגנון של "יצירה-רפלקסיה-יצירה מחדש". קבוצת הביקורת, לעומת זאת, השתמשה בשיטות הוראה מסורתיות או בכלים מבוססי AI לא אופטימליים. באמצעות השוואת אפקטיביות ההוראה בין שתי הקבוצות, אומתה היעילות של שיטת אימון ההעברה המבוססת על מודל שפה גדול בשיפור יכולת העברת הכתיבה של התלמידים.
רעיון המחקר הכללי
מחקר זה נועד לשפר את יכולת ההעברה (transfer) של סטודנטים בכתיבה בשפה האנגלית ולפתח שיטות עיצוב לימודי אפקטיביות, תוך התמקדות מיוחדת בהתאמת DeepSeek לשימוש חינוכי. ראשית, הוצעה אסטרטגיה לאופטימיזציה של הוראות לצורך עיצוב מחדש של הפרומפטים (prompts) במודל. הדבר שיפר את התאמת הפלט המופק למספר מטרות העברה בהוראת כתיבה, כולל מבנה תחבירי, לוגיקה של פסקאות וביטוי תרבותי. שנית, מטלות הכתיבה של המורים הומרו לתבניות פרומפטים מובנות ומכוונות מטרה. לאחר מכן נקבע קשר מיפוי בין מטלות ההוראה להתנהגויות המודל. דבר זה שיפר את יכולת השליטה במודל והבטיח שהתוכן המופק רלוונטי מבחינה פדגוגית. לבסוף, פיתח המחקר תהליך אימון העברה בלולאה סגורה: "הפקה–רפלקסיה–שכתוב–הפקה מחדש". תהליך זה עודד סטודנטים לזהות אסטרטגיות העברה וללטש באופן פעיל את הביטוי הלשוני שלהם בתמיכת המודל. באמצעות חזרות חוזרות, יכולות ההעברה של הסטודנטים בכתיבה בין-לשונית ובין-תרבותית התחזקו באופן מתמיד. השלבים לטרנספורמציה של מבנה המשפט מוצגים ב-איור 1A–D.
כדי להבהיר את לוגיקת הפעולה המלאה של מערכת האימון לכתיבה בסיוע AI ולשפר את יכולת השחזור, זרימת העבודה הכוללת של היישום מסוכמת בטבלה 1, המכסה מקשרי ליבה הכוללים קלט גולמי, התערבויות מורה, יישום פרומפטים, פעילויות סטודנטים, תוצרים סופיים ומדדי הערכה תואמים.
אסטרטגיית בניית משימות מכוונת-העברה
מחקר זה התמקד בפיתוח יכולת העברה בכתיבה באנגלית. במסגרתו נבנה נתיב של משימות העברה המתקדם מרמה שטחית לעומק, המנחה את הסטודנטים באופן שיטתי ברכישה ותרגול של אסטרטגיות העברה לשוניות רב-שכבתיות. כדי לתאר את מבנה הנתיב ככלל, הוא הוגדר כמערך משימות בן ארבע רמות:
T = {T1,T2,T3,T4} (1)
T1 מייצג את משימת ההעברה ברמת המשפט, המתמקדת בפעולות מבנה דקדוקיות בסיסיות, כגון הרחבת משפטים קצרים, שינוי סביל/פעיל (voice change) והחלפת פסוקיות, כדי לסייע לתלמידים לשלוט בשיטות מגוונות של מבנה משפט. T2 היא משימת ההעברה ברמת הפסקה, המנחה את התלמידים להקדיש תשומת לב לארגון ולקישור של המידע בתוך הפסקה, ומאמנת אותם לשפר את הבהירות המבנית ואת קוהרנטיות הביטוי של הפסקה באמצעות חילוץ משפט המפתח והתאמת הלוגיקה בין המשפטים. T3 מייצגת את המשימה ברמת השיח (discourse), המתרחבת עוד יותר לפריסה הלוגית הכוללת ולקצב הטיעונים של הפרק, ומנחה את התלמידים לבנות מאמר באנגלית עם מערכת טיעונים שלמה על ידי התאמת סדר הפסקאות ואופטימיזציה של יחסי הסמיכות המבניים. T4 היא משימת ההעברה ברמה התרבותית, הדורשת מהתלמידים לזהות מאפייני ביטוי תרבותיים משתמעים בכתיבה בשפת האם, כגון ניסוחים עקיפים ורמזים סמנטיים, ולהמיר אותם לביטויים ישירים או לצורות לוגיות מפורשות התואמות את תרבות שפת היעד. תהליך ההתפתחות שלה מוצג ב-איור 2. כדי להגביר את הישימות וההערכה של עיצוב המשימות, מחקר זה הגדיר עוד כל רמת משימה כצורה של שלשייה:
Ti = (Si,Gi,Ei) (2)
Sj מייצג את דגימת הקלט של המשימה, Gi מייצג את פעולת ההעברה המיועדת, ו-Ei מייצג את קריטריוני ההערכה התומכים. באמצעות ביטוי מובנה זה, הובטח שכל רמה של המשימה נבנתה על בסיס השליטה באסטרטגיה מהרמה הקודמת, וצויידה בדגימות תואמות, בתיאורי יעד ובקריטריוני ביצוע, ובכך סופק מנגנון להתקדמות עקבית של נתיב ההעברה. בתהליך בניית מערכת אימון ההעברה, כדי להשיג כיסוי סיסטמטי של סוגי משימות וניהול יעיל של קריאות ההוראה, מחקר זה בנה ספריית משימות מובנית המכסה חמישה סוגים של יעדי העברה, בהתבסס על ממדי המרה לשוניים נפוצים בהעברה של כתיבה. ספריית המשימות בוטאה באופן פורמלי כך:
M = {(Dj,TDj)∣j = 1,2,3,4,5} (3)
Dj מתייחס לחמישה ממדי העברה: העברה תחבירית, העברה מבנית, העברה תרבותית, העברת רגיסטר והעברה לוגית; קבוצת המשימות TDj הקשורה לכל ממד מייצגת את תת-קבוצת הפעולות שלו. בתהליך פיתוח ספריית המשימות, ראשית, הכותבים סיכמו וסיווגו קשיים נפוצים בהעברה וסוגי שגיאות לשוניות על בסיס מספר רב של דגימות כתיבה אמיתיות של סטודנטים, ובשילוב עם צרכי ההוראה וסטנדרטי ההערכה בפועל, חילקו את סוגי ההעברה השונים לתחומים פונקציונליים, וקבעו את יעדי האימון המרכזיים ואת דפוסי הפעולה של כל משימה. כל משימה יוצגה באופן מופשט כמבנה של שלשייה כדלקמן:
Ti,j = (Si,j,Gi,j,Ci,j) (4)
Si,j מייצג את דגימת קלט המשימה, Gi,j הוא תיאור יעד ההעברה של המשימה, ו-Ci,j הוא ממד ההערכה והבקרה של המשימה. במשימת ההעברה התחבירית, מחקר זה תכנן רצף ארגון משפטים שהתקדם מפשוט למורכב, וכיסה חיבור משפטים, קינון פסוקיות, המרה לסביל ומושגים קשורים, במטרה לשפר את יכולותי הסטודנטים בהרחבת משפטים וטרנספורמציה דקדוקית. משימת ההעברה המבנית התמקדה באופטימיזציה של לוגיקת הפסקה, חיזוק ארגון המידע ושיפור היכולת לבנייה לוגית באמצעות כתיבה מחדש של המשפט המרכזי, מיון משפטי תמיכה ובנייה מחדש של קשרי סיבה-תוצאה ודוגמאות. משימת ההעברה התרבותית התבססה על קורפוס בין-תרבותי ומטרתה סטיות פרגמטיות, כגון ביטויים משתמעים והפליאציות (euphemisms). היא תכננה המרות ביטוי הקרובות להקשר הממשי כדי לקדם את פיתוח ההסתגלות התרבותית. משימת העברת המשלב (register) הנחתה את הסטודנטים להמיר ביטויים מדוברים לשפה אקדמית ולשלוט באסטרטגיות למעבר בין משלבים. משימת ההעברה הלוגית התמקדה בבניית שרשראות הסקה והבטחת בהירות הביטוי, תוך ביצוע אימון בשימוש במילות קישור, הבהרה של קשרים לוגיים ומעברים בין פסקאות.
על בסיס דוגמאות כתיבה ממשיות של תלמידים, פיתח מחקר זה תהליך להפקת הנחיות (prompts) הקשור באופן הדוק למשימות הוראה, במטרה לשפר את הרלוונטיות של ההנחיות ואת המעשיות של התוכן המופק. התהליך הובל על ידי מורים, שבחרו קטעי טקסט מייצגים של תלמידים במהלך תהליך ההוראה, תוך התמקדות בבעיות העברה טיפוסיות כגון משפטים עודפים, מבנים מבולגנים וביטויים תרבותיים שאינם הולמים. לאחר מכן הם תייגו את הדוגמאות עם סוגי העברה באמצעות ממשק המערכת כדי להבהיר את מטרות האימון. לאחר קבלת מידע התיוג, הפעילה המערכת באופן אוטומטי את מודול זיהוי משימת ההעברה. לאחר מכן היא התאימה את הקלט לספריית המשימות וספריית תבניות ההנחיות שהוגדרו מראש. תהליך ההתאמה שקלל גורמים כגון סוג ההעברה, מאפיינים לשוניים ומבנה הטקסט. על בסיס גורמים אלו, בחרה המערכת בתבנית המתאימה ביותר והפיקה הנחיה ראשונית. המערכת תמכה גם בעיבוד שיפור מובנה. תיוגי המורים הומרו לפורמט סטנדרטי שניתן לפירוש קל על ידי המודל. רמזים הדרכתיים רלוונטיים הוטמעו בהנחיה כדי לסייע למודל להבין במדויק הן את כוונות המורה והן את שאלות התלמיד. כדי לשפר את הגמישות והשליטה בהנחיות, כללה המערכת מודול סיוע למורה. מודול זה אפשר למורים לדייק את ההנחיות על ידי שינוי ההדרכה, התאמת הגדרות ההקשר והתאמה אישית של הטון והסגנון. כתוצאה מכך, המורים זכו לשליטה רבה יותר בתהליך ההפקה והתאימו אותו טוב יותר לתרחישי הוראה שונים.
מנגנון אופטימיזציה של פקודות ב-Deepseek
בהתבסס על הצרכים המעשיים של אימון להעברה (transfer) בכתיבה באנגלית, פיתרה מחקר זה חמישה סוגים של תבניות הנחיה (prompt templates) מוכוונות-העברה. תבניות אלו תוכננו להנחות ולבקר את התנהגות היצירה של מודל השפה הגדול. תבנית ההעברה המבנית התמקדה בארגון הפסקאות ובמבנה השיח. היא סייעה לסטודנטים לארגן מחדש טקסטים באמצעות אימוץ מבנים כגון פתיחה–גוף–סיכום, ועל ידי שיפור הזרימה הלוגית של הרעיונות. תבנית ההעברה התחבירית הדגישה מורכבות ברמת המשפט. היא עודדה שימוש במבנים דקדוקיים מגוונים, כולל סביל, מבנים מקבילים ופסוקיות מורכבות, כדי להגביר את רמת התחככמות של הביטוי הכתוב. תבנית ההעברה התרבותית עסקה בהתאמה תרבותית בכתיבה. היא הנחתה סטודנטים להתאים ביטויים המושפעים משפתם ומתרבותם האם לצורות טבעיות ומקובלות יותר בהקשרים דוברי אנגלית. תבנית העברת המשלב (register) התמקדה בהתאמת סגנון ובבקרת משלב. היא סייעה לסטודנטים להתאים את השימוש בשפה בהתאם למטרות כתיבה, קהלי יעד וסוגי ז'אנרים שונים. תבנית ההעברה הלוגית נועדה לחזק את הארגון הלוגי. היא קידמה שימוש יעיל בקשרים כגון סיבה ותוצאה, השוואה וניגוד, ופיתוח מקבילי, ובכך שיפרה את הלכידות ואת הדיוק הטיעוני. יחד, חמש התבניות הללו כיסו את הממדים העיקריים של העברת הכתיבה. הן סיפקו תמיכה הדרכתית מובנית הן לעיצוב משימות הוראה והן ליצירת טקסט מבוססת-מודל.
כל סוג של תבנית עקב אחר פורמט מאוחד כדי להבטיח את אוניברסליותה ויכולת ההתאמה שלה למצבים לימודיים שונים. התבנית הכילה ארבעה אלמנטים מרכזיים: הראשון היה יעד ההוראה, שציין בבירור את משימת ההעברה הנדרשת; השני היה קלט לדוגמה, שסיפק לסטודנטים מקטעי שפה ממשיים כבסיס למסד הנתונים (corpus) עבור יעילות ההוראה; השלישי היה הפלט המיועד, שהציג את הסגנון הסטנדרטי של פלט שפה אידיאלי לאחר ההעברה, כדי שהסטודנטים יוכלו להשוות ולהשתמש בו לצורך כיוונון המודל; הרביעי היה הצעה לשימוש, שהסבירה את רמת השפה, סוג הטקסט ואסטרטגיית השימוש החלה על התבנית, וסיפקה רמזים לפרמטרים ניתנים לכיוונון כדי לשפר את הבקרת היצירה ואת אפקט ההדרכה הלימודית.
כדי להמחיש עוד יותר את לוגיקת התכנון והיישום המעשי של תבניות ההנחיה (prompt templates), מוצגות להלן דוגמאות מייצגות של חמש הנחיות מוכוונות-העברה. כל התבניות עמדו במסגרת מאוחדת, שהורכבה מיעד להוראה, קלט לדוגמה, פלט יעד והמלצת שימוש. הסטודנטים הונחו להרחיב משפטים פשוטים, להמיר את סוגי הפעיל והסביל במשפטים, ולהטמיע פסוקיות כדי להעשיר את הגיוון התחבירי. לדוגמה, עבור טיוטת הסטודנט "I study English writing. It is very important for cross-cultural communication", הפלט המיטבי הוא "Learning English writing plays a vital role in improving learners’ ability of cross-cultural communication". הנחיה זו התאימה לאימון ברמת המשפט עבור סטודנטים לשנה שנייה למסלול אנגלית ברמת קושי בינונית, תוך התמקדות בשחזור תחבירי בסיסי ובשינוי קול המשפט. סוג אחר של הנחיה התמקד בהעברה תרבותית, במטרה לזהות ביטויי "צ'ינגליש" (Chinglish) המושפעים מחשיבה תרבותית מקומית ולנסח מחדש משפטים לביטויים פרגמטיים טבעיים באנגלית התואמים לנורמות תרבותיות מערביות. כדוגמה למשפט של סטודנט "Many people think you must work hard if you want to succeed", הגרסה המעודכנת הייתה "People generally believe that diligence is the key to success". הנחיה זו יושמה באימון העברה ברמה התרבותית, תוך התמקדות בביטול דפוסי חשיבה סיניים משתמעים וקידום ביטוי מפורש בהקשר של השפה האנגלית.
מחקר זה פיתח גם שרשרת הנחיות מקננת בעלת שלושה שלבים, אשר קיבלה את טיוטות הפסקאות של הסטודנטים כקלט מאוחד והורצה בשלבים עוקבים. השלב הראשון היה ארגון סמנטי, כאשר ההנחיה דרשה מהמשתתף לסדר מחדש את משפטי הפסקה הנתונה, למטב את הסדר הלוגי של הרעיונות, ולבנות פסקה שלמה עם משפטי מפתח ברורים. השלב השני היה תיקון לשוני, אשר ביקש לשכתב את הפסקה המתוקנת לאנגלית אקדמית רשמית, להחליף מילים סלנגיות, ולהשתמש באופן הולם במשפטים מורכבים ובמבני סביל. השלב השלישי היה התאמה תרבותית, שהנחייתו כיוונה את המשתמשים לבדוק ביטויים תרבותיים-פרגמטיים בטקסט, להסיר הפרעות תרבותיות מהשפה האם, וללטש את התוכן כדי שיתאים למוסכמות כתיבה בין-תרבותיות באנגלית. הדוגמאות לעיל הדגימו באופן מלא את מצבי הפעולה של תבניות הנחיה בודדות ושל שרשראות הנחיות מקננות. על בסיס זה, המחקר תכנן שרשרת הנחיות מדורגת ומלאה בשילוב עם ארכיטקטורת ה-MoE של DeepSeek.
כדי להתגבר על המגבלות של הנחיות (prompts) במחזור בודד מבחינת בקרת הייצור ועומק התגובה למשימה, מחקר זה תכנן מבנה של שרשרת הנחיות מקננת בעלת מאפיינים מדורגים ורציפים, המאפשרים הנחיה היררכית ויצירה הדרגתית של משימות תרגום מורכבות. מנגנון זה פירק משימת תרגום מלאה למספר תתי-מטרות ותכנן תבניות הנחיה תואמות לכל תת-מטרה, אשר חוברו בטור לפי הסדר הלוגי של שחזור סמנטי, התאמת סגנון לשוני והסתגלות פרגמטית תרבותית, ובכך נוצרה שרשרת ייצור בעלת תלות בהקשר. מחקר זה יישם אופטימיזציה של שרשרת הנחיות מקננת עבור DeepSeek באמצעות ה-API הפתוח הסטנדרטי שלו. מודל DeepSeek אימץ באופן טבעי ארכיטקטורת Mixture of Experts (MoE) המצוידת במערכת ניתוב מומחים אוטומטית בצד השרת (backend), הפועלת כמודול הסקה פנימי מובנה שאינו תלוי בהנחיות חיצוניות. ההנחיות הרב-שלביות המותאמות אישית שינו רק את מאפייני התוכן של קלטי המודל. בהתאם לדרישות הסמנטיות, הסגנוניות והתרבותיות המוטמעות בקלטים שעברו אופטימיזציה, מנגנון ניתוב ה-MoE המובנה של המודל הפעיל באופן עצמאי את מודולי המומחים המתאימים ביותר במהלך יצירת הטקסט. תכנון ההנחיות התלת-שלבי, המתמקד בארגון מחדש של הסמנטיקה, התאמת סגנון והסתגלות תרבותית, שיפר בלבד את טקסטים הקלט ולא התערב בלוגיקת הבחירה וההקצאה של המומחים הפנימיים במודל.
מבחינת התהליך התפעולי, המערכת קיבלה טקסטים של סטודנטים שהועלו על ידי מורים, העבירה הערות מטרה, וקבעה באופן אוטומטי האם להפעיל את מבנה השלשלת המקונן. אם הופעל, המערכת ביצעה שלושה שלבים ברצף: השלב הראשון היה ארגון סמנטי מחדש, שבו נקראה תבנית העברת המבנה כדי למטב את ארגון הפסקאות ואת הרמזים הלוגיים; השלב השני היה התאמת סגנון השפה, שבו נעשה שימוש בתבנית השפה כדי להמיר ביטויים מדוברים לשפה אקדמית כתובה; השלב השלישי היה התאמה תרבותית, שבו נקראה תבנית ההעברה התרבותית כדי לזהות ולהחליף ביטויים שאינם תואמים את התרבות של שפת המטרה, ובכך נוצר טקסט אותנטי יותר.
כל סבב של יצירה השתמש בפלט של הסבב הקודם כקלט ושמר את זיכרון המטמון של וקטור ההקשר (context vector cache) כדי להבטיח קוהרנטיות סמנטית. המורים התאימו אישית את מבנה שרשרת ההנחיות (prompt chain) בממשק המערכת, כולל בחירת תבנית, שינוי הוראות והתאמת הרצף. המערכת תמכה גם בפונקציית "חבילת שילוב תבניות", שהקל על המורים להשתמש שוב במשימות או להקציבן בקבוצות. בנוסף, המערכת כללה מנגנון מובנה של הפרעה ומשוב דינמיים שסיפק תוצאות ביניים לאחר כל יצירה. המורים ביצעו הערות או התאימו הוראות המשך בזמן אמת, ובכך יצרו לולאה פדגוגית סגורה של "יצירה-התאמה-יצירה מחדש".
יצירת מודל, הערכה
בתהליך יצירת הטקסט והערכתו המבוסס על מודל DeepSeek, מחקר זה בנה מנגנון ניקוד אוטומטי רב-ממדי כדי לנתח באופן שיטתי ולהעריך כמותית טקסטים שנוצרו בשלושה היבטים: מורכבות תחבירית, סטנדרטיזציה מבנית וקוהרנטיות של השיח. מחקר זה השתמש במנתח התלויות (dependency parser) של spaCy ובמודול התוסף לפתרון קו-רפרנס (coreference resolution) של Coreferee לצורך חילוץ מאפייני טקסט והערכה אוטומטית. מנתח התלויות של spaCy ניתח את המבנה התחבירי של הטקסט באנגלית, תוך חילוץ מדדי מפתח כגון אורך משפט ממוצע ומספר פסוקיות מקננות, מה שאיפשר ניתוח כמותי של המורכבות התחבירית. מודול התוסף לפתרון קו-רפרנס של Coreferee, הפועל במסגרת spaCy, זיהה בעיקר קשרי רפרנס פנימיים בטקסט והעריך את קוהרנטיות הרפרנס של השיח, ובכך סיפק תמיכה טכנית לניקוד אוטומטי של איכות הכתיבה. בשל מגבלות רשת, האתרים בקוד פתוח מהחו"ל שהוזכרו לעיל לא היו נגישים.
ראשית, המערכת העריכה את המורכבות התחבירית. היא חילצה מאפיינים כגון אורך משפט ממוצע, עומק של הטמעת פסוקיות ומגוון משפטים. מאפיינים אלה הושגו באמצעות ניתוח תלויות (dependency parsing) ומידול עצי תחביר עמוקים. בהתבסס על התוצאות, המערכת העריכה האם הסטודנטים התקדמו בהצלחה מדפוסי משפטים פשוטים למבנים מורכבים יותר. שנית, המערכת העריכה את ארגון הפסקאות. היא שילבה ייצוגי טקסט מבוססי BERT עם מודלי סיווג כדי לזהות רכיבי פסקה מרכזיים, כולל משפטי נושא, משפטים תומכים ומשפטי סיכום. לאחר מכן נבנה מפה של מבנה הפסקה כדי לקבוע האם הארגון תואם את המוסכמות של כתיבה אקדמית באנגלית. שלישית, המערכת העריכה את הלכידות הטקסטואלית. היא בחנה את השימוש במילות קישור לוגיות, עקביות סמנטית בין משפטים ואת איכות הקישורים הרפרנציאליים לאורך הטקסט. אינדיקטורים אלה שימשו להערכת הבהירות של הפיתוח הלוגי והמעבר החלק בין הרעיונות. כדי למדוד עקביות בנושא, המערכת חישבה דמיון סמנטי באמצעות ייצוגים מבוססי וקטורים. לכידות רפרנציאלית הוערכה באמצעות טכניקות של פתרון קו-רפרנציה (coreference resolution), שסייעו להפחית פערים סמנטיים והפניות מעומבנות. לבסוף, ציונים מכל הממדים שולבו לכדי וקטור ניקוד מאוחד. התוצאות עברו סטנדרטיזציה כדי ליצור מערכת הערכה מקיפה, המאפשרת השוואה מהימנה בין דגימות כתיבה שונות.
בשלב ההערכה הידנית, מחקר זה פיתח מערכת ניקוד תלת-ממדית לאימון בהעברת מיומנויות כתיבה, המקיפה את מידת הבולטות של התנהגות ההעברה, טבעיות הביטוי והסתגלות תרבותית, וזאת כדי להגביר את הרלוונטיות של הערכת המורה ואת האפקטיביות של המשוב ההוראתי. המערכת שילבה את פונקציות העזר שלה כדי להשיג שילוב אורגני בין ניקוד כמותי להערות איכותניות. בממד התנהגות ההעברה, המורים העריכו את השימוש של התלמידים באסטרטגיות העברה בכתיבה מחדש של טקסטים בהתבסס על יעדי משימה שהוגדרו מראש. המערכת סיפקה תצוגת השוואה ראש בראש של הטקסט המקורי לעומת הגרסה הנוצרת, כדי לסייע למורים לזהות אם פעולות כגון התאמת משפטים ושחזור מבני שיקפו ביעילות את סוג ההעברה הנדרש.
הערכת הביטוי הטבעי התמקדה בשטף ובאותנטיות של התוצר הלשוני. המורים השתמשו במדדי השפה שהופקו על ידי המערכת כדי להעריך האם המשפטים תואמים את הרגלי הביטוי של דוברי אנגלית כשפת אם, וכדי לשפוט האם המבנה הדקדוקי, צירופי המילים ומקצב המשפט היו טבעיים ומתאימים. כמו כן, הם הצביעו על בעיות והציעו ביטויים חלופיים באמצעות הערות. ממד ההסתגלות התרבותית התמקד בהתאמה של הפרגמטיקה הבין-תרבותית. המורים נדרשו לזהות האם הטקסט מכיל ביטויים לא הולמים הנובעים מהשפעה של תרבות שפת המקור, כגון עמימות סמנטית, קונפליקטים רטוריים או שיפוטים ערכיים מעורפלים. המערכת סיפקה דוגמאות נפוצות למילים המבטאות סטייה תרבותית ותמכה במורים בהסבר הבסיס לתיקון ודרישות ההקשר התרבותי בתוך ההערות, ובכך הנחתה את התלמידים לשפר את המודעות להעברה תרבותית ואת דיוק הביטוי. כל ממד דורג בסולם של 5 נקודות וכלל מודולים להערות חופשיות ולהצעות למילוי. תוצאות ההערכה הסופיות הוצגו כתרשים רדאר.
כדי לשפר את יעילות ההערכה ולתמוך בשימוש מעשי בכיתה, מחקר זה פיתח מנגנון הערכה שיתופי המשלב ניקוד מבוסס AI עם הערכת מורה. המערכת ביצעה תחילה הערכה רב-ממדית של הטקסט שהופק על ידי DeepSeek. היא העריכה היבטים מרכזיים כגון מורכבות תחבירית, ארגון פסקאות וקוהרנטיות טקסטואלית באמצעות מודול ניקוד אוטומטי. תוצאות הניקוד הוצגו לאחר מכן בזמן אמת בממשק המורה. המורים סקרו את הניקוד המפורט עבור כל ממד וביצעו התאמות במידת הצורך, בהתבסס על שיקול דעתם המקצועי והבנתם את ביצועי ההעברה של התלמידים. כמו כן, הם הוסיפו הערות ממוקדות ישירות לטקסט כדי לספק משוב והצעות להוראה שעשויות שלא להילכד על ידי הניקוד האוטומטי. כל ממד הערכה אימץ סולם דירוג של חמש נקודות. הממשק כלל גם מודולים להערות חופשיות ולהמלצות כדי להקל על מתן משוב מותאם אישית. תוצאות ההערכה הוצגו ויזואלית באמצעות תרשים רדאר, המאפשר למורים לזהות במהירות את נקודות החוזק והחולשה של התלמידים בממדי העברה שונים.
בנוסף, המערכת אפשרה למורים להתאים את השקלול של ממדים ספציפיים או את הציונים הכוללים כדי להביאם בהלימה עם המטרות הלימודיות. תכונה זו הבטיחה שההערכה הסופית תשקף באופן מדויק יותר את ביצועיהם בפועל של התלמידים ואת צרכי הלמידה שלהם. לאחר השלמת הבדיקה הידנית, המערכת שילבה באופן אוטומטי נתוני הערכה שהופקו על ידי המכונה ונתונים שהופקו על ידי המורה. לאחר מכן, היא הפיקה דוח משוב חזותי. הדוח כלל תרשים רדאר של ביצועי העברה (transfer-performance) ותרשים מעקב גרסאות. ויזואליזציות אלו הדגימו בבירור שינויים ביכולות ההעברה של התלמידים לאורך סבבים מרובים של יצירת טקסט ועריכתו, ובכך אפשרו ניטור רציף של התקדמות הלמידה.
תהליך אימון העברה
מחקר זה תכנן תהליך מלא של אימון בהעברה (transfer training). ראשית, המורה הקצה משימות כתיבה ספציפיות באנגלית בהתבסס על יעדי ההוראה והרמה בפועל של התלמידים, והבהיר את סוג ההעברה ואת מוקד האימון. לאחר מכן, המערכת יצרה באופן אוטומטי הנחיות הנחיה (prompt instructions) תואמות בהתבסס על המשימות שהגדיר המורה, והפעילה את מודל ה-DeepSeek כדי ליצור טיוטה ראשונה של הכתיבה, אשר שימשה כחומר הבסיס לשכתוב ולאימון ההעברה של התלמידים. לאחר קבלת הטיוטה הראשונה, התלמידים נדרשו לזהות באופן פעיל את מאפייני ההעברה המשתקפים בטקסט ולשכתב את התוכן באופן ממוקד, תוך שימוש באסטרטגיות ההעברה שלמדו כדי לשפר את ההתאמה של המבנה התחבירי, ארגון הפסקאות והביטוי התרבותי. עם השלמת השכתוב, המורה סיפק סקירה מפורטת של הטקסט שהגיש התלמיד, תוך הדגשת יעילות אסטרטגיית ההעברה והצעת הצעות ספציפיות לשיפור והדרכת כתיבה. בהתבסס על משוב המורה, מודל ה-DeepSeek הופעל מחדש כדי ליצור גרסה אופטימלית, ובכך תמך עוד יותר בתלמידים בליטוש הטקסטים שלהם ובהעמקת התרגול של אסטרטגיות ההעברה. לבסוף, התלמיד השלים את הגשת הטיוטה הסופית, מילא את טבלת הקוגניציה של ההעברה, ביצע הערכה עצמית וסיכם את שיטות ההעברה והשפעותיהן, ובכך קידם את שיפור היכולת המטא-קוגניטיבית ואת הפנמת מיומנויות ההעברה בכתיבה. טבלת הקוגניציה של ההעברה שתוכננה למחקר זה מוצגת ב-Table 2.
כל הפריטים העריכו בסולם דירוג של 1–5, החל מ-1 (חוסר שליטה) ועד 5 (שליטה מלאה). נתוני ההערכה העצמית נאספו לאחר שלושה סבבים של הכשרה רצופה; מדדי הניקוד מתייחסים לתקני פעולת העברה שהוגדרו מראש בספריית המשימות חמשית-הממדים.
תוצאות
הוראת תכנון ניסויים
מחקר זה השתמש בגרסת הקוד הפתוח הבסיסית של DeepSeek, תוך הסתמכות על ממשק ה-API הפתוח של הפלטפורמה עבור קריאות התוכנית. המערכה המלאה של חמישה טקסי תבנית להנחיה (prompt), ארבע רמות של רשומות דוגמה למשימות, תגי קטגוריות של הערות העברה וכללי מיפוי להתאמה בין תבניות שגיאות כתיבה נערכו בנספח המשלים. למערכת היו פרמטרי קריאה קבועים: מקדם טמפרטורה של 0.7, ואורך הפלט הוגבל באופן דינמי בהתבסס על סוג שאלת הכתיבה. המערכת פעלה בהקפדה לפי רצף קבוע של שחזור סמנטי > התאמה סגנונית > התאמה תרבותית, תוך ביצוע קריאות של שרשראות הנחיה מקננות. פלט המודל נבחר באופן ידני על ידי המדריך לצורך שימוש בטקסטים אפקטיביים בהוראה בכיתה.
במחקר זה הוזמנו שלושה מרצי כתיבה באנגלית במשרה מלאה ברמה אקדמית, בעלי ניסיון של למעלה מ-5 שנים, להשתתף בדירוג ידני. כל המדרגים עברו הכשרה סטנדרטית לפני הדירוג הרשמי, שכללה היכרות עם ממדי ההערכה, מערכת הניקוד של 5 נקודות, העברה תרבותית, תחביר, שיח ופרטי דירוג נוספים, והם השלימו כיול טרום-דירוג. כל החיבורים של הסטודנטים דורגו באופן עצמאי על ידי שני מרצים במודל דירוג סמיע וכפול (blind, double-blind). אם ההפרש בין ציוני שני המדרגים עלה על נקודה אחת (מתוך 5), מרצה בכיר שלישי פעל כבורר בדירוג, והממוצע של שני הציונים התקפים נקבע כציון הידני הסופי עבור אותה דגימה. שתי קבוצות של מדרגים היו מעורבות בשלב ההערכה למטרות מחקר שונות. שלושה מרצי כתיבה באנגלית במשרה מלאה באוניברסיטה עם ניסיון הוראה של למעלה מ-5 שנים ביצעו דירוג כפול וסמיע של כל דגימות הכתיבה של הסטודנטים בניסוי הפורמלי, ומרצה בכיר שלישי שימש כבורר כאשר פערים בדירוג עלו על נקודה אחת בסולם של 5 נקודות. לעומת זאת, חמישה מדרגים השתתפו במבחן מהימנות בין-שופטים באמצעות מקדם מתאם תוך-מחלקה (ICC), שנערך בנפרד כדי לאמת את העקביות של סטנדרטי ההערכה בין המעריכים. ההבדל במספר המדרגים נובע מדרישות תפקודיות שונות: שלושה מרצים מרכזיים הבטיחו את הדירוג המעשי של נתוני הניסוי, בעוד שפאנל מורחב של חמישה מדרגים סיפק ראיות חסונות יותר למהימנות של מערכת ההערכה כולה.
מורכבות תחבירית, ניקוד מבנה טקסט באמצעות BERT ודמיון סמנטי מדורגים כולם בטווח של 0–5 נקודות. המשקלות עבור כל ממד נקבעו בהתאם לתקני הוראה ומחקר של כתיבה בשפה זרה: תחביר 0.35, מבנה טקסט 0.35, ולוגיקה ותרבות 0.3. ערכי המשקלות התבססו על מערכות הערכה כמותיות מבוססות לכתיבה באותו תחום. מודול הניקוד האוטומטי של ה-AI כויל באמצעות ספים שהתבססו על 15 חיבורי מודל שסווגו מראש. הניקוד האנושי התבצע לפי סולם דירוג מאוחד של חמש נקודות. הניקוד הממוחשב והכיול האנושי שולבו לצורך אימות טרום-ניסויי לפני ההערכה הרשמית.
משימת ההוראה בוצעה סביב שלושה יעדי העברה ברמות שונות של "תחביר-מבנה-תרבות", עם שלושה סבבי אימון, שכל אחד מהם נמשך שבוע אחד. הסבב הראשון כלל שכתוב ברמת המשפט לשיפור הגיוון התחבירי ודיוק הביטוי; הסבב השני כלל בנייה מחדש של המבנה ברמת הפסקה לשיפור ארגון הפסקאות והקוהרנטיות הלוגית; הסבב השלישי כלל העברה ברמה התרבותית לחיזוק המודעות הפרגמטית הבין-תרבותית והסתגלות הביטוי. בהינתן מדידות חוזרות שנאספו מאותם משתתפים במבחן מקדים, בשלושה סבבי אימון עוקבים ובמבחן מסכם, נבחר ניתוח שונות למדידות חוזרות (RM-ANOVA) כגישה הסטטיסטית העיקרית לבחינת ההשפעות המרכזיות של הקבוצה (ניסוית לעומת ביקורת), השפעות מרכזיות של זמן הבדיקה, וכן אפקט האינטראקציה של קבוצה × זמן, אשר שיקף האם השינויים בציונים במהלך האימון היו שונים בין שתי הקבוצות. הנחת הספריות אומתה באמצעות מבחן Mauchly; תיקון Greenhouse–Geisser הוחל במקרה שהנחת הספריות הופרה. מבחני t למדגמים בלתי תלויים נשמרו אך ורק להשוואות זוגיות לאחר מכן (post-hoc) בין הקבוצות בנקודות זמן בודדות, בעוד שמתאם פירסון ו-Cohen’s d שימשו לבדיקת עקביות הניקוד וכימות גודל האפקט, בהתאמה.
כל הניתוחים הסטטיסטיים נקבעו מראש לפני איסוף הנתונים. מבחני t למדגמים בלתי תלויים (Independent-samples t-tests) אומצו כדי להשוות מדדי כתיבה לפני ואחרי ההתערבות בין שתי קבוצות, כאשר השערת האפס הראשית הניחה שאין הבדלים בין-קבוצתיים בביצועי העברת כישורי הכתיבה. ניתוח מתאם פירסון (Pearson correlation analysis) שימש לכימות הקשר הליניארי בין הניקוד האוטומטי של ה-AI לבין הדירוגים הידניים של המורה, וערך Cohen’s d חושב כגודל האפקט הסטנדרטי להשוואות בין-קבוצתיות. סף המובהקות נקבע על α = 0.05 עבור כל בדיקות ההשערות, ורווחי סמך של 95% חושבו לצד כל הסטטיסטיקות של המבחנים. תוכנת SPSS 26.0 שימשה לביצוע כל החישובים הסטטיסטיים. לא היו נתונים חסרים בציוני המבחנים של התלמידים ובמאגרי הנתונים של השאלונים, שכן כל המשתתפים השלימו את האימון המלא בן שלושת הסבבים ואת ההערכות הרלוונטיות; לפיכך, לא נדרש ביצוע השלמה (imputation) או מחיקת מקרים עבור ערכים חסרים.
בניית מערכת מדדי ההערכה
כדי להעריך באופן מקיף את ביצועי הסטודנטים באימון להעברת מיומנויות כתיבה באנגלית, מחקר זה בנה מערכת הערכה רב-ממדית שכיסתה את יעדי ההעברה בשלוש רמות של "תחביר-מבנה-תרבות", שילבה יכולת שפתית, תגובת מודל, משוב הוראתי והכרה עצמית, וקבעה שישה מדדים מרכזיים. ראשית, "מדד העברת הכתיבה" היה מדד הערכה מקיף שכיסה גיוון תחבירי, בהירות מבנית והסתגלות תרבותית, תוך שילוב של ניקוד אוטומטי של המערכת וניקוד ידני של המורה לצורך ניתוח כמותי. "ציון המורכבות התחבירית" עשה שימוש בטכנולוגיית עיבוד שפה טבעית כדי לחלץ מאפיינים כגון אורך משפט ממוצע, מספר רמות קינון של פסוקיות ותדירות השימוש בביטויי פועל, כדי להעריך את העושר והמורכבות של משפטי הסטודנטים. ניתוח "התאמה לסגנון אקדמי" בחן את שיעור השימוש בסביל ואת שיעור אוצר המילים הרשמי, בהתבסס על מודל NLP (עיבוד שפה טבעית), כדי לקבוע האם הטקסט עומד בנורמות הסגנוניות של כתיבה אקדמית באנגלית. בנוסף, המחקר הציג ממד הערכה סובייקטיבי, שאסף משוב על הקבלה והמעשיות של ההצעות שהופקו על ידי המודל באמצעות שאלונים למורים, כדי להעריך את ההשפעה הממשית של הוראה בסיוע בינה מלאכותית. "שינויים בציוני בדיקת המורים" שיקפו את השפעת ההוראה בסיוע בינה מלאכותית על שיפור איכות הכתיבה על ידי השוואת ציוני המורים על חיבורי הסטודנטים לפני ואחרי הניסוי. לבסוף, "הערכה עצמית של הסטודנט על יכולת ההעברה" השתמשה בטבלת קוגניציית העברה כדי להנחות את הסטודנטים להעריך עצמית את שליטתם במבנה, תחביר, תרבות וממדים אחרים, ובכך להגביר את המודעות המטא-קוגניטיבית ויכולות הרפלקסיה שלהם. התיאורים הספציפיים ומקורות הנתונים עבור כל מדד מוצגים בTable 3.
מדדים תחביריים וסגנוניים חושבו באופן אוטומטי באמצעות ניתוח תלויות (dependency parsing) וסיווג מבוסס BERT, כאשר הציונים הנורמליים נעים בין 0 ל-5; הערכה ידנית בוצעה במقياس של 5 נקודות. נוסחאות החישוב למורכבות תחבירית השתמשו בסך מספר המילים חלקי מספר הפסוקיות כמכנה המרכזי. מקור הנתונים הגולמיים: חיבורי כתיבה ממבחני קדם ומבחני סוף של כל 60 הסטודנטים שנרשמו.
תוצאות ניסיוניות וניתוח
כדי להציג באופן אינטואיטיבי את הבדלי הביצועים המקיפים של התלמידים בשלושת ממדי ההעברה הסינטקטית, ההעברה המבנית וההעברה התרבותית, איור 3 השווה את מדד העברת הכתיבה הממוצע של התלמידים בקבוצת הניסוי ובקבוצת הביקורת לפני הניסוי ואחריו: איור 3 הראה את ההבדל בציונים הממוצעים בין קבוצת הניסוי לקבוצת הביקורת בשלושת הממדים של העברה סינטקטית, העברה מבנית והעברה תרבותית. קבוצת הניסוי הראתה שיפור משמעותי ביכולת ההעברה בכל ממד לאחר הניסוי, והמעגל החיצוני של תרשים הרדאר גדול משמעותית מהמעגל הפנימי, מה שמעיד על כך שלשיטת אופטימיזציית ההוראה המבוססת על מודל DeepSeek יש השפעה חיובית בקידום פיתוח יכולת העברת הכתיבה באנגלית של התלמידים. לעומת זאת, מדדי יכולת ההעברה השונים של קבוצת הביקורת נותרו ללא שינוי יחסי לפני הניסוי ואחריו. השיפור הכולל היה מוגבל, מה שמעיד על כך שלשיטות הוראה מסורתיות או לכלים מסייעי AI שלא עברו אופטימיזציה של הוראות המערכת יש תפקיד מוגבל באימון העברה. היה קושי לגרום לגירוי יעיל של פוטנציאל הלמידה של התלמידים בהעברה שפתית רב-ממדית.
מדדי העברת הכתיבה הממוצעים של הקבוצה הניסויית בממדים של העברה תחבירית, העברה מבנית והעברה תרבותית לפני הניסוי היו 3.0, 2.9 ו-2.8, בהתאמה, ואלו עלו ל-4.3, 4.1 ו-4.5 לאחר הניסוי, עם עליות של 1.3, 1.2 ו-1.7, בהתאמה, מה שמעיד על כך שלשיטת ההוראה הייתה השפעת התערבות טובה ברמות העברה שונות. ציוני קבוצת הביקורת לפני הניסוי היו 3.0, 3.0 ו-2.9. לאחר הניסוי, הערכים עלו ל-3.4, 3.3 ו-3.2, בהתאמה, ערכים הנמוכים באופן משמעותי מאלו של הקבוצה הניסויית. ראוי לציין במיוחד כי בממד של העברה תרבותית, הקבוצה הניסויית הראתה את השיפור המשמעותי ביותר, עם עלייה מ-2.8 ל-4.5, כלומר עלייה של 1.7 נקודות, הגבוהה משמעותית מהעלייה של 0.3 נקודות בקבוצת הביקורת. תוצאה זו מצביעה על כך ששיטת ההוראה המוצעת ממלאת תפקיד משמעותי בסיוע לתלמידים לזהות ולהסתגל לנורמות הביטוי התרבותי באנגלית. הדבר בא לידי ביטוי לא רק בהתאמות של צורת השפה, אלא גם בשיפור המודעות הפרגמטית הבין-תרבותית של התלמידים ובעומק הבנתם את הרגלי הביטוי התרבותי של שפת היעד. העברת השפה באה לידי ביטוי בעיקר במורכבות תחבירית, התאמת סגנון השפה והיבטים נוספים. המחקר השתמש בטכנולוגיית NLP אוטומטית כדי לבצע ניתוח מעמיק של טקסטים שנכתבו על ידי התלמידים, חילץ מאפייני שפה מרכזיים, ושילב ציוני מורים כדי להעריך באופן שיטתי שינויים ביכולת העברת השפה של התלמידים לאורך שלושה סבבים של משימות.
מורכבות תחבירית וסגנון לשוני
מבחינת מורכבות תחבירית, המחקר תיעד את אורך המשפט הממוצע ואת מספר רמות קינון הפסוקיות של הטקסט שנוצר על ידי סטודנטים לאחר השלמת משימת הכתיבה הייעודית בכל סבב של משימות. שני מדדים אלו היו נפוצים למדית מורכבות הביטוי השפתי. הם שיקפו ביעילות את רמת ההתפתחות של הסטודנטים במגוון המשפטים וביכולת הארגון המבני, כפי שמוצג ב-איור 4.
במהלך האבולוציה האורכית של המורכבות התחבירית, קבוצת הניסוי הראתה מגמת עלייה ברורה בשלושת סבבי המשימות, מה שמעיד על קידום יעיל של אימון העברה (transfer training) ביכולתם של הסטודנטים לבטא את המבנה הלשוני שלהם. מבחינת אורך משפט ממוצע, קבוצת הניסוי עלתה מ-12.5 מילים במשימה 1 ל-16.1 מילים במשימה 3, עלייה של 3.6 מילים, שהייתה גבוהה משמעותית מהעלייה של קבוצת הביקורת שעמדה על 0.9 מילים בלבד באותה תקופה (מ-12.4 ל-13.3). באופן דומה, מהיבט המורכבות המבנית, שנמדדה לפי מספר שכבות קינון של פסוקיות, קבוצת הניסוי עלתה מ-1.8 שכבות ל-2.7 שכבות, בעוד שקבוצת הביקורת עלתה מ-1.7 ל-1.9 שכבות, עם עלייה איטית יחסית. כדי לוודא אם ההבדל במורכבות התחבירית בין שתי קבוצות הסטודנטים הוא מובהק סטטיסטית, המחקר השתמש במבחני t למדגמים בלתי תלויים כדי לנתח את אורך המשפט הממוצע ואת מספר רמות קינון הפסוקיות בשלושת שלבי המשימה. התוצאות הראו כי קיים הבדל מובהק בין קבוצת הניסוי לקבוצת הביקורת במונחים של אורך משפט ממוצע, t(58) = 4.23, p < 0.001, Cohen’s d = 0.98; כמו כן, היה הבדל מובהק במספר רמות קינון הפסוקיות, t(58) = 3.15, p = 0.002, Cohen’s d = 0.78. השוואה זו הראתה שאימון העברה שיטתי לא רק שיפר את יכולתם של הסטודנטים להבנות משפטים מורכבים, אלא גם חיזק את השליטה שלהם באסטרטגיות ארגון דקדוקיות. בפרט, במהלך השלב השלישי של המשימה, סטודנטים בקבוצת הניסוי הפגינו גמישות רבה יותר בשימוש בפסוקיות רב-שכבתיות ובמבני משפטים מורכבים. הדבר שיקף מעבר בולט בהעברה הלשונית שלהם מרמה "פונקציונלית" לרמה "אסטרטגית" יותר. נתיב האימון המכוון להעברה שיפר באופן רציף את מיומנויות ההעברה התחבירית של הסטודנטים, והתגבר ביעילות על המגבלות של כתיבת משפטים בודדים ועל דפוסי הביטוי הקבועים הנפוצים לעיתים קרובות בהוראה מסורתית. מבחינת התאמת סגנון השפה, המחקר חילץ את טקסטים הכתיבה של הסטודנטים לפני ואחרי הניסוי. נעשה שימוש במודל NLP כדי לקבוע את שיעור אוצר המילים הפורמלי ואת תדירות השימוש בסביל כאינדיקטורים מרכזיים להערכת התאמת סגנון השפה האקדמית. אינדיקטורים אלו שיקפו האם לסטודנטים יש את המודעות הלשונית ואת יכולת הביטוי כדי להסתגל לסגנון היעד בכתיבה באנגלית. התוצאות הרלוונטיות מוצגות באיור 5.
איור 5 מראה את השינויים בהתאמה לסגנון אקדמי של קבוצת הניסוי ושל קבוצת הביקורת לפני ואחרי המטלה, תוך התמקדות בעיקר בשני מדדי הליבה: שיעור אוצר המילים הפורמלי ותדירות השימוש בסביל. באופן כללי, לאחר השלמת אימון העברה המבוסס על מודל DeepSeek, יכולת ההסתגלות לסגנון אקדמי של קבוצת הניסוי השתפרה באופן משמעותי, מה שמעיד על יעילותה של שיטת הוראה זו בטיפוח המודעות של הסטודנטים לנורמות לשוניות ויכולתם להסתגל לסגנונות אקדמיים. בנוגע לשיעור אוצר המילים הפורמלי, בקבוצת הניסוי הוא עלה מ-0.42 לפני המטלה ל-0.56 אחריה, עלייה משמעותית יחסית. לעומת זאת, בקבוצת הביקורת חלה עלייה קלה בלבד, מ-0.43 ל-0.48, מה שמעיד על שיפור מוגבל. תוצאה זו הראתה כי לאחר קבלת הנחיית prompt שיטתית ומשוב מהמודל, הסטודנטים בקבוצת הניסוי נטו יותר להשתמש באוצר מילים פורמלי העומד בדרישות הסגנון האקדמי בתהליך הכתיבה, וסגנונם הלשוני התקרב בהדרגה לסטנדרטים של כתיבה אקדמית באנגלית. מבחינת תדירות השימוש בסביל, בקבוצת הניסוי חלה עלייה משמעותית מ-0.18 לפני המטלה ל-0.27 אחריה, המהווה עלייה של 0.09; לעומת זאת, בקבוצת הביקורת העלייה הייתה של 0.02 בלבד.
על מנת לוודא אם השינויים שלעיל הם מובהקים סטטיסטית, המחקר ביצע מבחן t למדגמים בלתי תלויים על הנתונים לפני המשימה ואחריה. התוצאות הראו כי בקבוצת הניסוי חל שיפור מובהק בשיעור אוצר המילים הפורמלי, t(58) = 3.89, p < 0.001, Cohen's d = 0.92; גם העלייה בתדירות השימוש בסביל הייתה מובהקת, t(58) = 4.56, p < 0.001, Cohen’s d = 1.05. הדבר העיד על כך שהסטודנטים בקבוצת הניסוי השיגו התקדמות משמעותית בהתאמת סגנון השפה, וכי התקדמות זו לא הייתה מקרית, אלא תוצאה של השפעה משולבת של הנחיית פרומפטים שיטתית ומשוב מודל.
אימות סטטיסטי
בנוסף, כדי לאמת עוד יותר את מהימנות התוכן שנוצר על ידי בינה מלאכותית (AI) בפרקטיקה ההוראתית, המחקר השווה גם את ציוני הממוצע של תוכן שנוצר על ידי AI לעומת תוכן שנוצר על ידי מורים תחת סוגי הנחיות (prompts) שונים. העקביות בין השניים הוערכה באמצעות חישוב מקדם המתאם של פירסון. תוצאות ההשוואה הרלוונטיות מוצגות ב טבלה 4. טבלה 4 מראה את העקביות בין התוכן שנוצר על ידי AI לבין ציוני המורים בחמישה סוגים של הנחיות מוכוונות העברה. מנקודת המבט של ציון הממוצע, ציון ה-AI היה נמוך מעט מציון המורה באופן כללי. עם זאת, הפער היה בטווח סביר ברוב סוגי המשימות, מה שמעיד על כך שלמודל DeepSeek יש יציבות גבוהה וערך רפרנסי בהערכת משימות העברה בכתיבה. תחת הנחיית העברה תחבירית, ציון המורה הממוצע היה 4.1 וציון ה-AI היה 4.0, עם הפרש של 0.1 בלבד ביניהם. בהנחיות העברה מבנית ולוגית, ציון ה-AI היה נמוך ב-0.1 נקודות בלבד מציון המורה, מה שמעיד על כך שהמודל יכול לדמות טוב יותר את קריטריוני ההערכה של המורה במשימות אלו, הכוללות רמה גבוהה של מבנה לשוני וכללים ברורים. לעומת זאת, סטיות הניקוד תחת הנחיות העברה תרבותית והעברת מרגש (register) בולטות יחסית, עם ציוני AI של 3.6 ו-3.7 בהתאמה, שהם נמוכים ב-0.2 מציוני המורים, מה שמשקף את העובדה של-AI עדיין היו מגבלות מסוימות בהתמודדות עם משימות בעלות סובייקטיביות גבוהה, כגון משמעויות סמנטיות ופרגמטיקה תרבותית. מהימנות בין מעריכים הוערכה באמצעות ICC (n = 5 מעריכים). ה-ICC הכללי עבור ניקוד ידני היה 0.86, וערכי ה-ICC עבור כל ממד נעו בין 0.82 ל-0.89, מה שמעיד על הסכמה מספקת בין המעריכים.
ניתוח נוסף של מקדם המתאם של פירסון העלה כי העקביות של הציונים תחת הנחיות שונות הייתה ברמה גבוהה, מה שמעיד על כך שציון ה-AI לא רק היה קרוב לשיפוט של המורה מבחינת הערך, אלא גם הפגין קשר ליניארי טוב במגמת הניקוד שלו. מבין אלו, מקדם העקביות של הנחיית ההעברה הסינטקטית היה הגבוה ביותר, 0.87, והנחיות ההעברה המבנית וההעברה הלוגית היו 0.83 ו-0.85, בהתאמה, מה שמעיד על כך שתוצאות ההערכה של ה-AI במונחים של מורכבות סינטקטית, ארגון פסקאות וקוהרנטיות לוגית עקביות מאוד עם שיפוט המורה. ייתכן שזה נובע מכך שלמשימות אלו יש יעדים ברורים ומאפייני שפה מדידים, אשר הקלו על זיהוי המודל ועל שיפוט יציב. מקדם המתאם של הנחיית ההעברה התחומית הוא 0.81. למרות ירידה קלה, הוא עדיין הפגין יכולת הערכה חזקה, מה שמעיד על כך של-AI יש דרגה מסוימת של שיפוט ברמת ההתאמה הסגנונית. עם זאת, מקדם העקביות של הנחיית ההעברה התרבותית היה רק 0.79, נמוך יותר מסוגים אחרים, אך עדיין בטווח מקובל.
על מנת לבחון את ישימותם של סוגים שונים של הנחיות (prompts) בפרקטיקה ההוראתית ואת מידת הקבלה שלהם על ידי מורים, תוכנן שאלון שביעות רצון מתגובות להנחיות. חמישה מורי אנגלית (שסומנו T1–T5) הוזמנו לדרג את הצעות היצירה של חמישה סוגי הנחיות באמצעות סולם של חמש רמות (מ"לא שביעות רצון גבוהה" ועד "שביעות רצון גבוהה מאוד"), כפי שמוצג ב-איור 6: ציוניהם של חמשת המורים על חמשת סוגי ההנחיות משתנים במידה מסוימת, אך באופן כללי רמת ההכרה הייתה גבוהה. מביניהם, ההנחיות ל"העברה תחבירית" (syntactic transfer) ו"העברה תרבותית" (cultural transfer) קיבלו את הציונים הגבוהים ביותר, עם ממוצע של 4.0, מה שמשקף פרקטיקה ויכולת הסתגלות חזקות בהוראה. לעומת זאת, ההנחיה ל"העברת רגיסטר" (register transfer) קיבלה ציונים נמוכים יחסית, עם ממוצע של 2.4 בלבד, וחלק מהמורים, כגון T4 ו-T5, נתנו את הציונים הנמוכים ביותר, מה שמעיד על כך שההכוונה ויכולת ההסתגלות שלה ביישומים הוראתיים עדיין דורשות שיפור.
ברמה האישית, נצפו הבדלים ברורים בנטיית הניקוד של המורים. הניקוד הכולל של T1 היה חיובי, מה שמעיד על דרגה גבוהה של קבלה של כתיבה בסיוע AI, בעוד שהניקודים של T5 היו נמוכים במספר ממדי פרומפט (Prompt), ובמיוחד ב"העברת רגיסטר" (register transfer) ו"העברת לוגיקה" (logic transfer). הבדל זה עשוי להיות קשור לניסיון ההוראה של המורים, להעדפת השפה או לרמת ההיכרות עם כלי AI, דבר המצביע על כך שעיצוב פרומפטים עתידי צריך לשקול מנגנוני התאמה אישיים כדי להגביר את הקבלה בקרב קבוצות מורים שונות. כדי לאמת עוד יותר את ההשפעה הממשית של הוראה בסיוע AI על שיפור איכות הכתיבה של התלמידים, המחקר השווה את השינויים בציונים הכוללים של קבוצת הניסוי וקבוצת הביקורת, כפי שהוערכו על ידי מורים, לפני ואחרי הניסוי. תוצאות ההשוואה מוצגות ב-איור 7.
כפי שמוצג ב-איור 7, הציונים הכוללים של קבוצת הניסוי ושל קבוצת הביקורת, כפי שהוערכו על ידי מורים לפני ואחרי הניסוי, הראו הבדלים משמעותיים. באופן כללי, לאחר התערבות הוראתית לאופטימיזציית ההוראה המבוססת על מודל DeepSeek, הציון הכולל של קבוצת הניסוי הראה מגמת עלייה משמעותית. לעומת זאת, השינוי בציון של קבוצת הביקורת היה מתון יחסית. ציון המורה הממוצע של קבוצת הניסוי לפני הניסוי היה 59.1 נקודות, והציון הממוצע לאחר הניסוי עלה באופן משמעותי ל-74.4 נקודות, המהווה עלייה של 15.3 נקודות. נתון זה מעיד על כך שלהוראה בסיוע בינה מלאכותית (AI) הייתה השפעה חיובית על איכות הכתיבה של התלמידים. מדיאגרמת הקופסה ניתן היה להבחין כי גם טווח ההתפלגות של ציוני קבוצת הניסוי התרחב. בפרט, קופסת הציונים לאחר הניסוי גבוהה משמעותית מזו שלפניו, וערכי המקסימום העליונים והמינימום התחתונים עלו, מה שמעיד על כך שהרמה הכללית של התלמידים השתפרה באופן משמעותי. לעומת זאת, השינויים בציונים של קבוצת הביקורת היו מוגבלים יחסית. לפני הניסוי, הציון הממוצע של קבוצת הביקורת היה 60.1 נקודות, ולאחר הניסוי הוא היה 64.9 נקודות, המהווה עלייה של 4.8 נקודות. עלייה זו הייתה נמוכה בהרבה מזו של קבוצת הניסוי, וקופסת הציונים של קבוצת הביקורת לא השתנתה הרבה לפני ואחרי הניסוי, מה שמעיד על כך שלשיטות הוראה מסורתיות או לכלים מבוססי AI שאינם אופטימליים יש השפעה מוגבלת על שיפור איכות הכתיבה.
בנוסף, מחקר זה השתמש בטבלת קוגניציה של העברה כדי להוביל את הסטודנטים דרך שלושה סבבים של הערכה עצמית על פיתוח יכולותיהם בהתאמה מבנית, טרנספורמציה של משפטים וביטוי תרבותי, בין היתר, כדי לשקף את מגמת השינוי במודעות המטא-קוגניטיבית של הסטודנטים ובשליטתם באסטרטגיות העברה. התוצאות מוצגות ב איור 8. על פי נתוני תרשים הרדאר של ההערכה העצמית של הסטודנטים ביכולת ההעברה המוצגים באיור 8, ההערכה העצמית של הסטודנטים בחמישה ממדים של העברה מבנית, העברה תחבירית, העברה תרבותית, העברת משלב (register) והעברה לוגית בשלושת סבבי המטלות הראתה מגמת עלייה מתמדת, מה שמעיד כי תחת התערבות הוראתית של אופטימיזציה של ההדרכה המבוססת על מודל DeepSeek, יכולתם של הסטודנטים להשתמש באסטרטגיות העברה השתפרה באופן משמעותי. בסבב המטלות הראשון, ציוני ההערכה העצמית של הסטודנטים היו נמוכים באופן כללי. מבין חמשת הממדים, "העברה מבנית" ו"העברה לוגית" קיבלו ציונים של 3.2 ו-3.0, בהתאמה, בעוד ש"העברה תרבותית" ו"העברת משלב" קיבלו ציונים של 2.5 ו-2.7, מה שמעיד על כך שהסטודנטים עדיין לא היו בשלים בזיהוי ובשימוש באסטרטגיות העברה. עד לסבב המטלות השני, הציונים של כל פריט השתפרו, כאשר "העברה מבנית" עלתה ל-3.8, "העברה תחבירית" ל-3.5, ו"העברה לוגית" ל-3.7. דבר זה הראה כי בהנחיית המורים ובסיוע של משוב מהמודל, הסטודנטים השתלטו בהדרגה על נקודות המפתח של פעולות העברה בסיסיות והחילו אותן לראשונה בכתיבה בפועל. בסבב המטלות השלישי, ציוני ההערכה העצמית של הסטודנטים עלו באופן משמעותי, כאשר "העברה מבנית" ו"העברה לוגית" הגיעו ל-4.5 ו-4.3, בהתאמה, ושאר הממדים התייצבו אף הם מעל 4.0 נקודות, מה שמעיד על ההשפעה המתמשכת של מספר סבבים של אימון בהעברה בשיפור השליטה של הסטודנטים בצורה הלשונית וביכולת בניית הטקסט. בשלב זה, הסטודנטים יצרו לולאה קוגניטיבית בסיסית סגורה בין הבנה, ביצוע ורפלקסיה של אסטרטגיות העברה. בנוסף למשוב מהמורים, המחקר הפץ גם שאלון סקר שביעות רצון לגבי פונקציית הכתיבה בסיוע בינה מלאכותית לכל הסטודנטים בקבוצת הניסוי, ונאספו בסך הכל 30 שאלונים תקפים. השאלון העריך את ביצועי הבינה המלאכותית בשלושה מודולים פונקציונליים: הצעות לשכתוב, אופטימיזציה מבנית ורמזים תרבותיים, ודרש מהסטודנטים לבחור אפשרויות בהתאם לחמישה רמות של סטנדרטים. התוצאות מוצגות בטבלה 5.
על פי תוצאות סקר שביעות הרצון של הסטודנטים מפונקציות הכתיבה בסיוע בינה מלאכותית (AI) המוצגות ב-טבלה 5, סטודנטים בקבוצת הניסוי נתנו באופן כללי הערות חיוביות על ביצועי ה-AI בשלושת המודולים הפונקציונליים של הצעות לשכתוב, אופטימיזציה מבנית והנחיות תרבותיות, מה שמעיד על סיכויי יישום טובים של מערכות כתיבה בסיוע AI לשיפור יעילות אימוני הכתיבה ואיכות התמיכה ההוראתית. באופן כללי, יותר מ-90% מהסטודנטים הביעו "שביעות רצון רבה" או "שביעות רצון" בשני הפריטים הפונקציונליים של "הצעות לשכתוב" ו"אופטימיזציה מבנית", כאשר "הצעות לשכתוב" זכתה לרמת השביעות הרצון הגבוהה ביותר, שהגיעה ל-91%, דבר המצביע על כך שהסטודנטים הכירו במידה רבה ביכולת של ה-AI בבנייה תחבירית מחדש ובליטוש שפתי. לשם השוואה, שביעות הרצון מפונקציית "הנחיות תרבותיות" הייתה נמוכה יחסית. עם זאת, היא הגיעה ל-83%, מה שמעיד על כך שלמרות של-AI יש מידה מסוימת של מורכבות וסובייקטיביות בהכוונת ביטויים בין-תרבותיים, תפקידו בסיוע לסטודנטים לזהות ולהתאים הפרעות תרבותיות של שפת האם עדיין זוהה על ידי רוב הסטודנטים. מבחינת חוסר שביעות רצון, אחוז הסטודנטים שבחרו ב"לא מרוצה" או "לא מרוצה כלל" בשלוש הפונקציות היה נמוך מ-5%, מה שמעיד על כך שלפונקציות בסיוע AI הייתה שמישות וקבלה טובה ברוב תרחישי היישום. ראוי לציין כי שיעור הסטודנטים שדירגו "ממוצע" בפריט "הנחיות תרבותיות" היה גבוה יחסית, מה שמרמז כי ה-AI הנוכחי עשוי שלא לענות באופן מלא על ציפיות הסטודנטים בעת התמודדות עם סוגיות של הסתגלות תרבותית, וכי עדיין קיים מקום לשיפור. ניתוח מקיף מגלה כי שיטת אופטימיזציית ההנחיות המבוססת על DeepSeek זכתה להכרה רחבה בקרב הסטודנטים, במיוחד עבור התמיכה בצורה השפתית.
ניתוח שונות למדידות חוזרות (RM-ANOVA)
ניתוח שונות עם מדידות חוזרות בשני גורמים (RM-ANOVA) בוצע כדי לבחון את ההשפעות של הקבוצה (גורם בין-נבדקים: קבוצת ניסוי לעומת קבוצת ביקורת) והזמן (גורם תוך-נבדקים: מבחן מקדים, משימה 1, משימה 2, משימה 3, מבחן מסכם), וכן את האינטראקציה ביניהם, על ביצועי העברת הכתיבה באנגלית של הסטודנטים. מבחן Mauchly העיד על הפרה של הנחת הספריות (p < 0.05), ולכן הוחל תיקון Greenhouse–Geisser כדי להתאים את דרגות החופש עבור השפעות תוך-נבדקים. כל הניתוחים התבססו על n = 30 משתתפים בכל קבוצה. התוצאות מוצגות בטבלה 6:
תוצאות ניתוח השונות (ANOVA) עם מדידות חוזרות ותיקון Greenhouse–Geisser הצביעו על השפעות עיקריות מובהקות של קבוצה, זמן, ואינטראקציית קבוצה × זמן בכל הממדים שנמדדו (p < 0.001). עבור מדד ההעברה הכללי (Overall Transfer Index), נצפתה השפעה מובהקת של קבוצה (F(1,58) = 76.32), לצד השפעה מובהקת של זמן (F(2.14,124.12) = 92.75) ואינטראקציה מובהקת של קבוצה × זמן (F(2.14,124.12) = 68.49), מה שמעיד על כך שהשינויים בביצועי ההעברה הכלליים לאורך זמן היו שונים באופן מובהק בין הקבוצות.
באופן דומה, העברה תחבירית (syntactic transfer) הראתה השפעות מובהקות של קבוצה (F(1,58) = 52.18), זמן (F(2.11,122.38) = 71.26), ואינטראקציה בין קבוצה לזמן (F(2.11,122.38) = 45.73), מה שמעיד על דפוסי התפתחות שונים ביכולת ההעברה התחבירית בין הקבוצות ובנקודות המדידה השונות. עבור העברה מבנית (Structural Transfer), זוהו גם השפעות מובהקות של קבוצה (F(1,58)=48.65), זמן (F(2.09,121.22) = 67.81), ואינטראקציה (F(2.09,121.22) = 41.36), המשקפות שיפורים עקביים עם מסלולי התפתחות התלויים בקבוצה. ראוי לציין כי העברה תרבותית (Cultural Transfer) הפגינה את ההשפעות החזקות ביותר, עם השפעת קבוצה מובהקת (F(1,58) = 81.44), השפעת זמן בולטת (F(2.07,119.96) = 98.52), ואינטראקציה חזקה בין קבוצה לזמן (F(2.07,119.96) = 79.27), מה שמרמז על דפוס הצמיחה המשמעותי והמובחן ביותר בממד זה. באופן כללי, כל המדדים מראים השפעות מובהקות סטטיסטית, מה שמאשר כי להתערבות הייתה השפעה יציבה ומובחנת על התפתחות ההעברה לאורך זמן.
זמינות נתונים:
כל הנתונים שהופקו או נותחו במהלך מחקר זה כלולים במאמר זה. נתוני ההערכה הגולמיים מסופקים ב- טבלה נלווית 1.
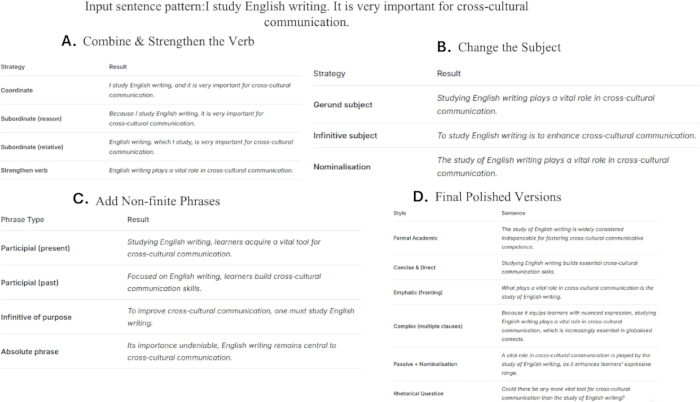
איור 1: שלבים לטרנספורמציה של מבנה המשפט. (A) אסטרטגיות לשילוב וחיזוק פעלים לשיפור מבנה המשפט. (B) טרנספורמציות חלופיות של הנושא, הכוללות שם פעולה (gerund), שם פועל (infinitive) ונושאים נומינליים. (C) שימוש בביטויים לא סופיים (non-finite phrases) להגברת הגיוון והתמציתיות של המשפט. (D) דוגמאות לגרסאות סופיות מלוטשות המדגימות סגנון אקדמי משופר וביטוי אנגלי בין-תרבותי. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
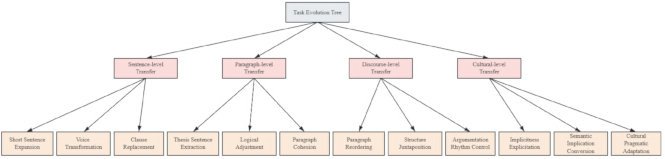
איור 2: דיאגרמת עץ של התפתחות משימות. היא מציגה את המבנה הדרגתי של משימות העברה בארבע רמות, החל מרמת המשפט, הפסקה, השיח ועד לרמה התרבותית. אנא לחץ כאן כדי לצפות בגרסה מורחבת של איור זה.
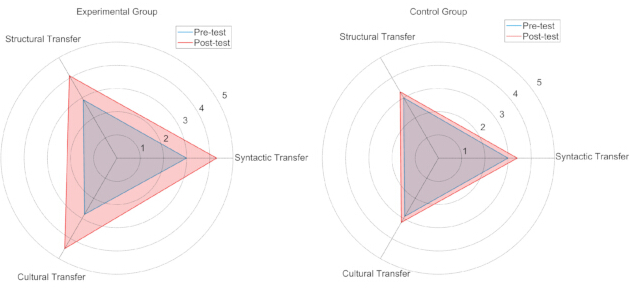
איור 3: השוואה של יכולת העברת הכתיבה לפני ואחרי הניסוי. תרשים הרדאר מציג את ציוני המבחן המקדים והמבחן המסכם של הקבוצה הניסויית וקבוצת הביקורת בממדי העברה תחביריים, מבניים ותרבותיים. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
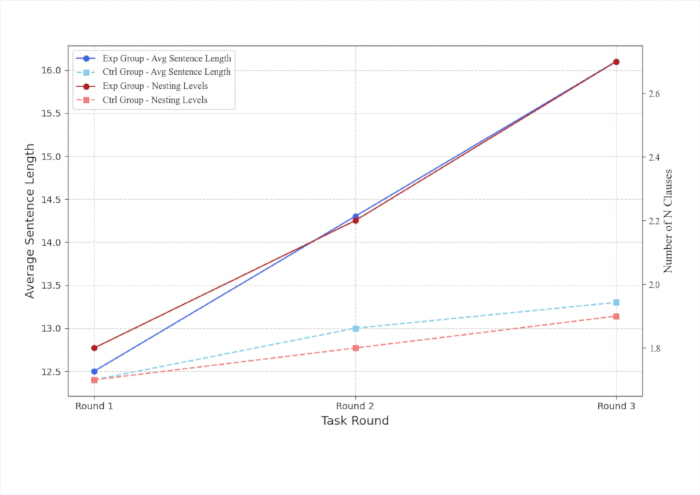
איור 4: תרשים קווי של מגמת המורכבות התחבירית. מוצגים שינויים באורך המשפט הממוצע ובשכבות קינון של פסוקיות לאורך שלוש משימות אימון. אנא לחצו כאן כדי להציג גרסה גדולה יותר של איור זה.
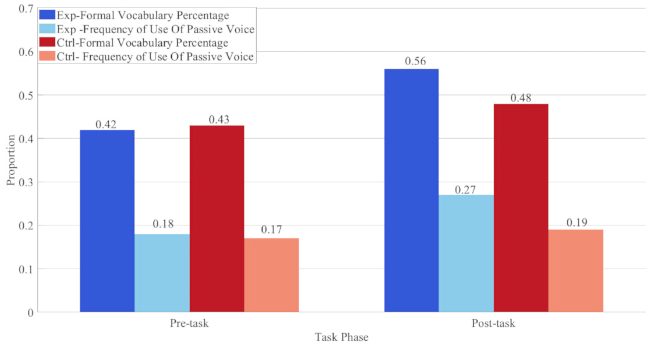
איור 5: התאמה לטרמינולוגיה אקדמית. איור זה מציג שינויים בשיעור אוצר המילים הרשמי ובתדירות השימוש בסביל לפני ואחרי ההתערבות. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
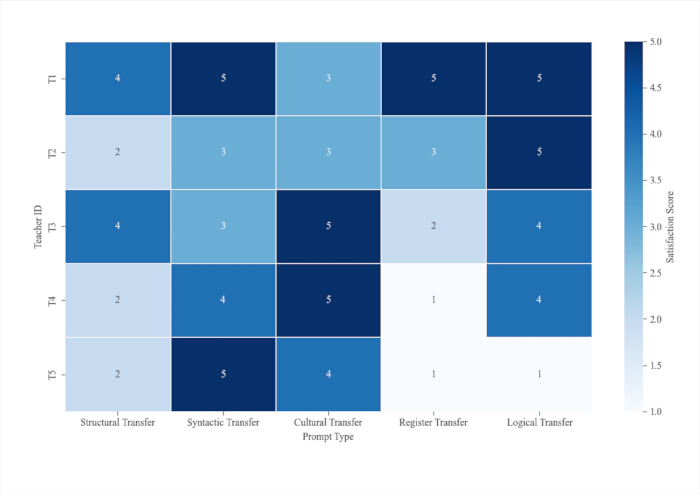
איור 6: מפת חום של שביעות רצון מתגובות להנחיות. כאן מסוכמים הדירוגים של חמישה סוגי תבניות הנחיה מהמורים המשתתפים. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
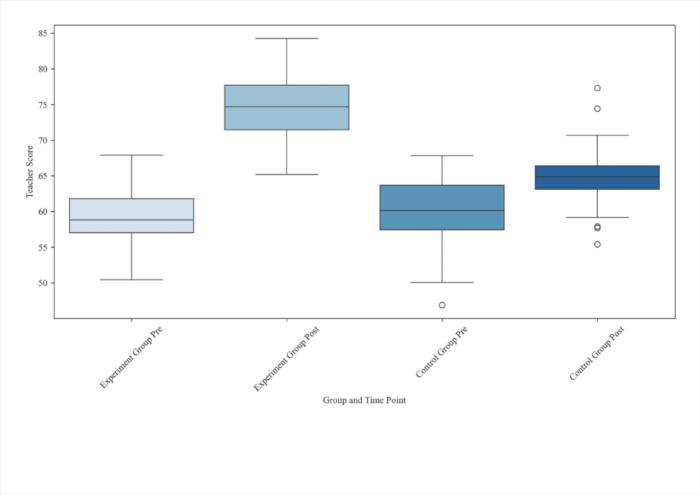
איור 7: תרשים קופסה של שינויים בדירוגי המורים. תרשים הקופסה מדגים את ההתפלגות והשינויים הכוללים בציוני כתיבה שהוערכו על ידי מורים עבור שתי קבוצות לפני ואחרי הניסוי. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
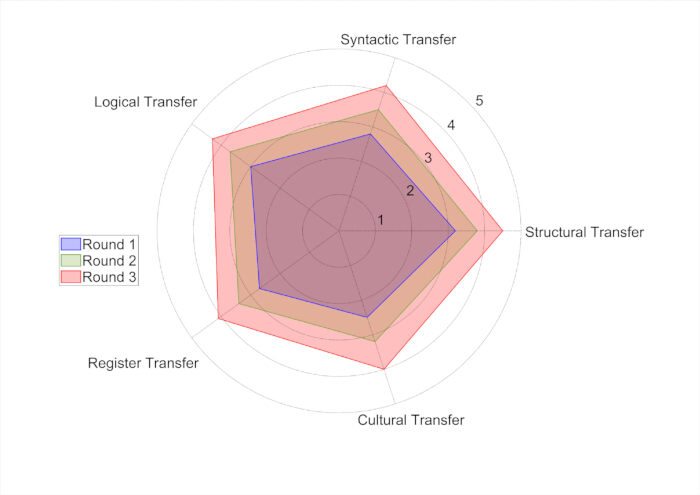
איור 8: תרשים רדאר של יכולת ההעברה כפי שהוערכה על ידי הסטודנטים. התרשים מציג את ציוני ההערכה העצמית של הסטודנטים בחמישה ממדי העברה לאורך שלושה סבבי אימון. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
| נא להזין את טקסט המקור לתרגום. | תפעול למורה | סוג ההנחיה | תפעול סטודנטים | פלט | קריטריוני הערכה |
| טיוטות הכתיבה המקוריות של סטודנטים (משפטים/פסקאות/חיבורים) | 1. סמן את סוגי ההעברה ואת רמות המשימה 2. התאם את פרמטרי ההנחיה במידת הצורך | הנחיית העברה בודדת / שרשרת הנחיות מקוננת תלת-שלבית | 1. לימוד אסטרטגיות העברה 2. שכתוב טיוטות על בסיס משוב מ-AI 3. השלמת הערכה עצמית | טקסט שעבר עריכה על ידי בינה מלאכותית + טיוטה סופית שעברה עריכה על ידי סטודנט | מורכבות תחבירית, רציונליות מבנית, התאמה תרבותית, קוהרנטיות לוגית, סטנדרטיזציה של מרשם (סולם 0–5) |
טבלה 1: טבלת סיכום זרימת העבודה. טבלה זו מסכמת את זרימת העבודה התפעולית המלאה של ההדרכה להעברת כתיבה באנגלית בסיוע בינה מלאכותית (AI), ומכסה את חומרי הקלט, פעולות המורה והסטודנט, סוגי הפרומפטים, התוצרים הסופיים וקריטריוני ההערכה המתאימים.
| קטגוריית הפרויקט | תוכן עניינים |
| הבנת יעדי המשימה | אנא תאר בקצרה את מטרות ההגירה של סבב משימות הכתיבה הנוכחי, כגון התאמה מבנית, התאמה תרבותית והמרה לשונית. |
| אסטרטגיית ההגירה שנעשה בה שימוש | אנא רשום את אסטרטגיות ההגירה שאימצת (ניתן לבחור מספר אפשרויות): |
| התאמה מבנית | |
| טרנספורמציה של משפטים | |
| החלפת שפות | |
| ביטוי תרבותי | |
| חיזוק הקשר הלוגי | |
| אחר: _______ | |
| כתוב מחדש דוגמאות והוראות | בחרו 1–2 משפטים שנכתבו מחדש, הציגו את הגרסאות לפני ואחרי הכתיבה מחדש, והסבירו את הסיבות לשינויים ואת יעדי ההעברה הרצויים. |
| קשיים וספקות שעלו | תארו את כל האתגרים שנתקלתם בהם במהלך ההגירה או שאלות שהיו לכם לגבי ביטוי ספציפי. |
| ציון הערכה עצמית (מתוך 5 נקודות) | אנא דרג את שכתוב הטקסט שלך בהתבסס על שלושת ההיבטים הבאים: |
| • דיוק ביישום האסטרטגיה (5/) | |
| • שטף טבעי של הביטוי (5/) | |
| • התאמה תרבותית (/5) | |
| מטרות לשיפור הכתיבה בעתיד | תאר בקצרה את יכולת ההעברה (transferability) שתרצה לחזק או למטב בסבב האימונים הבא |
טבלה 2: טבלת קוגניציית העברה. סולם דירוג של 1–5 (1 = ללא שליטה, 5 = שליטה מלאה) אומץ להערכה עצמית של סטודנטים לגבי אסטרטגיות העברת כתיבה.
| שם האינדיקטור | תיאור | מקור נתונים |
| מדד העברת כתיבה (0–5) | מדד כמותי המודד באופן מקיף את יכולת העברת השפה, המכסה שלושה רמות: תחביר, מבנה ותרבות. | דירוג אוטומטי על ידי המערכת + דירוג ידני על ידי מורים |
| מדד מורכבות תחבירית | כולל אורך משפט ממוצע, מספר השכבות של פסוקיות מוטמעות, עושר של ביטויי פועל וכדומה. | ניתוח אוטומטי באמצעות NLP |
| התאמה לסגנון אקדמי | האם הדבר תואם את סטנדרטי הכתיבה האקדמית באנגלית? | שיפוט של מודל עיבוד שפה טבעית |
| שביעות רצון מתגובת הפרומפט | קבלה והערכה מעשית של המלצות שהופקו על ידי מודל בקרב מורים | שאלון למורים |
| שינויים בדירוג של ביקורת מורה | השוואה בין ציוני המורים לפני ואחרי הניסוי כדי לשקף את השיפור באיכות הכתיבה | רישומי דירוג מורים |
| יכולת ההעברה של סטודנטים כפי שהוערכה על ידם | סטודנטים מעריכים עצמית את רמת השליטה שלהם בממדי העברה שונים | מלאו את טופס המודעות להגירה |
טבלה 3: סיכום של מדדי הערכה, תיאורים ומקורות נתונים. טבלה זו מבהירה את ההגדרות, שיטות המדידה ומקורות הנתונים המקוריים עבור כל מדד הערכה מרכזי במחקר זה.
| סוג הנחיה | דירוג ממוצע של מורים | ממוצע ציון בינה מלאכותית | מקדם המתאם של פירסון |
| העברה מבנית | 4 | 3.9 | 0.83 |
| העברה תחבירית | 4.1 | 4 | 0.87 |
| העברה תרבותית | 3.8 | 3.6 | 0.79 |
| העברת רגיסטרים | 3.9 | 3.7 | 0.81 |
| העברה לוגית | 4.2 | 4.1 | 0.85 |
טבלה 4: השוואת העקביות בין תכנים שנוצרו על ידי בינה מלאכותית לבין דירוגי מורים. התוצאות מדגימות את העקביות בין התכנים שנוצרו על ידי בינה מלאכותית לבין דירוגי המורים בסוגי פרומפטים שונים.
| פריטי תפקוד | שביעות רצון גבוהה מאוד | שביעות רצון | באופן כללי | לא מרוצה | לא מרוצה כלל |
| הצעה לשכתוב | 66% | 25% | 7% | 1.50% | 0.50% |
| אופטימיזציה מבנית | 60% | 30% | 7% | 2% | 1% |
| טיפים לתרבית | 55% | 28% | 12% | 3.50% | 1.50% |
טבלה 5: נתוני סקר על שביעות רצון סטודנטים מפונקציות מסייעות מבוססות AI. הנתונים מראים את התפלגות שביעות הרצון של הסטודנטים מפונקציות של שכתוב באמצעות AI, אופטימיזציה מבנית ופרומפטים תרבותיים.
| מדוד | קבוצת F(df) | זמן F(df)GG | קבוצה × זמן F(df)GG | p |
| מדד העברה כולל | 76.32 (1, 58) | 92.75 (2.14, 124.12) | 68.49 (2.14, 124.12) | <0.001 |
| העברה תחבירית | 52.18 (1, 58) | 71.26 (2.11, 122.38) | 45.73 (2.11, 122.38) | <0.001 |
| העברה מבנית | 48.65 (1, 58) | 67.81 (2.09, 121.22) | 41.36 (2.09, 121.22) | <0.001 |
| העברה תרבותית | 81.44 (1, 58) | 98.52 (2.07, 119.96) | 79.27 (2.07, 119.96) | <0.001 |
טבלה 6: סיכום תוצאות ANOVA למדידות חוזרות. הטבלה מציגה את תוצאות ANOVA דו-כיווני למדידות חוזרות עבור ביצועי העברת הכתיבה הכלליים ושלושת תתי-הממדים שלו, כולל השפעות עיקריות של קבוצה, זמן, והאינטראקציה בין קבוצה לזמן. קיצורים: GG = תיקון Greenhouse–Geisser.
טבלה נלווית 1: הערכת נתונים גולמיים. כוללת את הנתונים הגולמיים ששימשו בכל הניתוחים במחקר זה.אנא לחץ כאן להורדת קובץ זה.
דיון
מחקר זה בונה מסגרת אופטימיזציה רב-שכבתית להנחיות, המבוססת על ארכיטקטורת MoE של DeepSeek, עבור הוראת העברה של כתיבה באנגלית בין-תרבותית. המחקר, המתמקד במשימות פרוגרסיביות בעלות ארבע רמות הנעות מהרמה המשפטית ועד לממד התרבותי ובספריית משימות סטנדרטית בחמישה קטגוריות, מממש יצירה אוטומטית של פרומפטים המבוססת על דגימות כתיבה של סטודנטים ממשיים ומכונן שרשראות פרומפטים מקוננות בשלושה שלבים כדי לפרק משימות הסתגלות בין-תרבותיות מורכבות. בניגוד לתכנון פרומפטים גנרי קונבנציונלי המוגבל לליטוש טקסט, הפתרון המוצע קושר את הידור הפרומפטים באופן הדוק למטרות הוראת העברת שפה, ובונה זרימת הוראה במעגל סגור של יצירת מודל, הערה של מורה וסבבי תיקון של סטודנט. מנקודת מבט של התקדמות דיסציפלינרית, עבודה זו מרחיבה את הגבול המעשי של הנדסת פרומפטים ברכישת שפה שנייה, ומספקת נתיב בניית תבנית כמותי לשילוב מאפייני פרמטרים של מודלי שפה גדולים עם אימון ממוקד בכיתות EFL. היא גם מעשירה את הראיות האמפיריות למחקר העברה פרגמטית בין-תרבותית בסביבת סיוע של AI, ובכך משלימה ממצאי מחקר קיימים שהתמקדו אך ורק בשגיאות העברה שלילית תחבירית36,37.
נתונים מניסוי מעבר-ניסויי (quasi-experiment) אמפירי מאשרים כי הקבוצה הניסויית הראתה שיפור ניכר במדדי העברה תחבירית, מבנית ותרבותית, אך מספר מגבלות מובנות מצמצמות את יכולת ההכללה של תוצאות המחקר. בשל מגבלות תנאי המחקר, נעשה שימוש בחלוקה לא-אקראית של כיתות ללא הסתרת מידע מהמעריכים (blinding), וכל המדגמים נבחרו מקרב סטודנטים למגמה של אנגלית באוניברסיטה אחת; עובדה זו מקשה על שלילת השפעות של מוטיבציה ללמידה עצמאית של הלומדים והרגלי הוראה ארוכי טווח של המורים במהלך השינויים בציונים. בנוסף, התערבות זו נמשכה שלושה שבועות בלבד, מה שמהווה תוכנית הכשרה קצרת טווח. בשילוב עם מערך דגימה של מרכז יחיד, שבו כל המשתתפים גויסו ממכללה מקצועית אחת, ייתכן שההשפעות החיוביות שנצפו לא יהיו יציבות לחלוטין בפרקטיקה הוראתית ארוכת טווח. לפיכך, יש לפרש את ממצאי המחקר בזהירות, ואינו נכון להכליל את המסקנות באופן ישיר על סוגים שונים של מכללות, מחזורי הוראה ארוכים יותר, או קבוצות סטודנטים בעלות רמות מיומנות שונה בשפה.
בפריסה הוראתית מעשית, מערכת אופטימיזציית הפרומפטים הנוכחית בשילוב עם מודל DeepSeek מציגה מגבלות בולטות ומקרי כשל טיפוסיים. במשימות של העברה תרבותית ושינוי מרגש (register), המודל מייצר לעיתים ביטויים שאינם הולמים מבחינה פרגמטית או תוצאות המרה סגנוניות נוקשות בעת עיבוד טקסטים בעלי קונוטציות תרבותיות עדינות ודרישות סגנוניות התלויות בהקשר38,39; כמו כן, הוא אינו מצליח לזהות במדויק חשיבה תרבותית מקומית משתמעת בפסקאות ארוכות ומורכבות, מה שמוביל לעריכה חלקית בלבד של ביטויי Chinglish. בנימוק אוטומטי, עקביות ההערכה של ה-AI יורדת באופן משמעותי עבור פריטים פרגמטיים-תרבותיים סובייקטיביים מאוד, והוא אינו מסוגל להבחין ביעילות בין הבדלים דקים בביטוי רטורי ובמשמעויות בין-תרבותיות. בנוסף, שרשרת הפרומפטים המקננת התלת-שלבית נוטה לסטייה סמנטית ביצירה איטרטיבית רב-סבבית, שבה שגיאות מהשלב הראשון של הארגון הסמנטי יורשות ומוגברים בשלבי העריכה הלשונית וההסתגלות התרבותית הבאים40,41.
בכל הנוגע למגמות פיתוח להמשך, ניתן להוביל שיפור נוסף משלושה ממדים מעשיים. ראשית, להרחיב את היקף ספריית המשימות על ידי איסוף קורפוס כתיבה מסטודנטים שאינם מתמחים באנגלית ומסטודנטים בעלי רמות מיומנות שוניות בשפה, כדי לחזק את התאימות של התבניות לקבוצות לומדים מגוונות. שנית, לשלב כוונון עדין (fine-tuning) רציף של תתי-מודולים קלילים של DeepSeek כדי להפחית את הסטייה הקיימת בדירוג העברה תרבותית של בינה מלאכותית, אשר נמצא כבעל עקביות נמוכה יותר בהשוואה להערכת מורים בנתונים הנוכחיים. שלישית, להטמיע את מערכת אופטימיזציית הפרומפטים השלמה בתוך פלטפורמות מקוונות קונבנציונליות ללימוד שפות זרות, כדי להשיג צבירת נתונים אוטומטית לטווח ארוך לצורך אופטימיזציה איטרטיבית רציפה של כללי הפרומפטים. עם ההעשרה המתמשכת של משאבי קורפוס תרבותיים רב-לשוניים, המסגרת הטכנית המוצעת צפויה להרחיב את יישומה להוראת תרגום דו-לשונית ולקורסי תקשורת בין-תרבותית במחקרים עתידיים.
גילויים
המחברים מצהירים כי אין להם ניגודי אינטרסים פיננסיים.
תודות
עבודה זו נתמכה על ידי פרויקט תכנון החינוך של מחוז Zhejiang 2026: מחקר על בנייה מחדש של מסגרת כשירות הוראה ואסטרטגיות קידום של מרצים במוסדות להשכלה גבוהה מקצועית תחת העצמה דיגיטלית וחכמה (מספר פרויקט: ZWT26024; מספר אישור: 2026SCG360).
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| מודל השפה המאומן מראש BERT | https://github.com/google-research/bert | ייצוג טקסט, זיהוי מבנה פסקאות, חישוב דמיון סמנטי ותסניף טקסט תומכים בדירוג אוטומטי של תוכן הכתיבה. | |
| Coreferee | Explosion AI | https://github.com/explosion/coreferee | יחסי התייחסות בטקסט מזוהים, וקוהרנטיות רפרנציאלית של השיח מוערכת כדי לסייע בדירוג אוטומטי של איכות הכתיבה. |
| מודל השפה הגדול DeepSeek | DeepSeek AI | https://chat.deepseek.com/ | מבוסס על ארכיטקטורת מודל MoE, בוצעו אופטימיזציה של הוראות ותכנון שרשרת מילות הנחיה (prompt word chain). המודל משתמש בפרמטרים קבועים: מקדם טמפרטורה של 0.7, ואורך הפלט מוגבל דינמית בהתאם לסוג השאלה. |
| spaCy | Explosion AI | https://github.com/explosion/spaCy | מבנה התלויות התחבירי (dependency syntax structure) של טקסט באנגלית מנותח, ומדדים כגון אורך משפט ממוצע ומספר פסוקיות מקננות נחלצים כדי לכמת את המורכבות התחבירית. |
| SPSS 26.0 | IBM | https://www.ibm.com/products/spss-statistics | בוצעו ניתוחים סטטיסטיים כגון ANOVA למדידות חוזרות (RM-ANOVA), מבחן t למדגמים בלתי תלויים, ניתוח מתאם פירסון, חישוב גודל אפקט (Cohen’s d), ומבחן מהימנות (ICC). |
מקורות
- Maqsood M, Zahid A, Asghar T, et al. Issues in teaching English in a cultural context. Migr Lett. 2024; 21(4): 1020–1027.
- Tran NT, Nguyen TT, Pham HH. Exploring the challenges of L1 negative transfer among Vietnamese English language learners: a qualitative study. rEFLections. 2024; 31(2): 837–857.
- Zhu P. Cultural dimensions as guidelines in handling language problems for effective written communication across cultures. Int J Linguist Lit Transl. 2023; 6(12): 85–95.
- Zeng Z, Nair SM, Wider W. A comparative study of Chinese EFL undergraduates' pragmatic competence in English letter writing between urban and suburban universities. World J Engl Lang. 2022; 12(6): 377–388.
- Litvinova TA, Mikros GK, Dekhnich OV. Writing in the era of large language models: a bibliometric analysis of the research field. Nauchnyi Rezultat Voprosy Teoreticheskoi i Prikladnoi Lingvistiki. 2024; 10(4): 5–16.
- Long M. Cultivating interdisciplinary foreign language talents through interdisciplinary synergy of on-campus teaching and off-campus practices under the new liberal arts. Educ Rev USA. 2025; 9(5): 520–526.
- Voss E, Cushing ST, Ockey GJ, et al. The use of assistive technologies including generative AI by test takers in language assessment: a debate of theory and practice. Lang Assess Q. 2023; 20(4-5): 520-532.
- Manyasa J. When language transfer is negative: analysis of morpho-syntactic interference errors by learners of French in Tanzanian higher learning institutions. J Foreign Lang. 2021; 13(1): 165-190.
- Fikri N. The study of language transfer in EFL students' translation work. J Pendidik Nonformal. 2023; 1(1): 9.
- Ahmat A, Yang Y, Ma B, et al. Cross-lingual prompting method with semantic-based answer space clustering. Appl Intell. 2025; 55(2): 1-17.
- Maity S, Deroy A, Sarkar S. Investigating large language models for prompt-based open-ended question generation in the technical domain. SN Comput Sci. 2024; 5(8): 1-32.
- Wu W, Cao Y, Yi N, et al. Detecting and reducing the factual hallucinations of large language models with metamorphic testing. Proc ACM Softw Eng. 2025; 2(FSE): 1432-1453.
- Kaganovich P, Münz-Manor O, Ezra-Tsur E. Style transfer of modern Hebrew literature using text simplification and generative language modeling. CEUR Workshop Proc. 2023; 1613: 73-95.
- Yuan Y. Influence of native language transfer on senior high school English writing. Theory Pract Lang Stud. 2021; 11(2): 170-176.
- Jiamin M. The influence of cultural factors on language transfer in second language acquisition. Res J Engl Lang Lit. 2024; 12(1): 186-195.
- Zhang L. Native language transfer in vocabulary acquisition: an empirical study from connectionist perspective. J Lang Teach Res. 2023; 14(2): 446-458.
- Mirzayev E. The influence of first language interference on ESL writing skills. EuroGlob J Linguist Lang Educ. 2024; 1(1): 33-39.
- Fujiwara Y, Iwao T, Ito H, et al. Exploring the transfer of topic-comment structures called unagi-sentences in Asian L2 Englishes: cross-proficiency-level and cross-varietal studies. Asian Englishes. 2025; 27(1): 25-40.
- Guo Q. Interlanguage and its implications to second language teaching and learning. Pac Int J. 2022; 5(4): 8-14.
- Vereeck A, Janse M, De Herdt K, et al. Why Plato needs psychology: proposal for a theoretical framework underpinning research on the cognitive transfer effects of studying classical languages. Psiholoska Obzorja. 2023; 32: 121-130.
- Zhang W. Study on the negative transfer of mother tongue on college students. Int J Front Sociol. 2023; 5(16): 164-171.
- Li C. A review of theories, pedagogies and vocabulary learning tasks of English vocabulary learning apps for Chinese EFL learners. J China Comput Assist Lang Learn. 2024; 4(2): 346-375.
- Nsengimana I, Niyibizi E, Ngabonziza JDA. The impact of language transfers on learners' writing skills in English learning among students in Mahama Refugee Camp, Rwanda. Afr J Empir Res. 2024; 5(3): 605-613.
- Jovein S K, Sharifabad E D, Yazdani M. On the relationship between university translator training programs and the translation market requirements: The case of English translation graduates and postgraduates of Imam Reza International University. Journal of Critical Studies in Language and Literature. 2024; 5(6): 1-13.
- Qin X. Collaborative inquiry in action: a case study of lesson study for intercultural education. Asian Pac J Second Foreign Lang Educ. 2024; 9(1): 66-91.
- Sun L, Asmawi A. The effect of WeChat-based instruction on Chinese EFL undergraduates’ business English writing performance. International Journal of Instruction. 2023; 16(1): 43-60.
- Moro G, Piscaglia N, Ragazzi L, et al. Multi-language transfer learning for low-resource legal case summarization. Artificial Intelligence and Law. 2024; 32(4): 1111-1139.
- Sun Y. A study of college English writing teaching based on dynamic assessment. Pac Int J. 2023; 6(1): 83-88.
- Jeon J, Lee S. Large language models in education: a focus on the complementary relationship between human teachers and ChatGPT. Educ Inf Technol. 2023; 28(12): 15873-15892.
- Kostka I, Toncelli R. Exploring applications of ChatGPT to English language teaching: opportunities, challenges, and recommendations. TESL-EJ. 2023; 27(3): n3-n22.
- Antara IMAR, Anggreni NPY. Analyzing grammatical errors in EFL students' opinion essays using DeepSeek AI: patterns and pedagogical implications. Stilistika. 2025; 13(2): 210-218.
- Diasamidze L, Tedoradze T. Enhancing ESL students' writing skills through natural language processing model ChatGPT. Eurasia Proc Educ Soc Sci. 2024; 35: 230-238.
- Ranade N, Saravia M, Johri A. Using rhetorical strategies to design prompts: a human-in-the-loop approach to make AI useful. AI Soc. 2025; 40(2): 711-732.
- Zhou W, Gao B. Construction and application of English-Chinese multimodal emotional corpus based on artificial intelligence. Int J Hum Comput Interact. 2025; 41(3): 1782-1793.
- Chen B, Bao L, Zhang R, et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: a writing feedback perspective. J Educ Comput Res. 2024; 61(8): 60-102.
- Jeon H. Designing teaching for transfer in English for academic purposes. RELC Journal. 2024; 55(2): 567-577.
- Pei Y J. Construction of a" Feedback-Revision" Teaching Model for Senior High School English Continuation Writing Based on Generative AI. International Journal of Educational Development. 2026; 3(1): 16-25.
- Holubnycha L, Kuznetsova O, Shchokina T, et al. AI-Powered Teaching: Literature Review of ChatGPT's Impact on University Educators. International Journal of Interactive Mobile Technologies. 2025; 19(15): 41.
- Almuhanna M A. Teachers' perspectives of integrating AI-powered technologies in K-12 education for creating customized learning materials and resources. Education and Information Technologies. 2025; 30(8): 10343-10371.
- Hastomo T, Mandasari B, Widiati U. Scrutinizing Indonesian pre-service teachers’ technological knowledge in utilizing AI-powered tools. Journal of education and learning (EduLearn). 2024; 18(4): 1572-1581.
- Cai H, Lu L, Han B, et al. Exploring pre-service teachers’ reflection mediated by an AI-powered teacher dashboard in video-based professional learning: a pilot study. Educational technology research and development. 2025; 73(2): 1129-1154.