מסגרת ה-MSCNN-LSTM המוצעת משלבת מיצוי מאפיינים מרחביים רב-קנימיים עם מידול רצפים זמניים לצורך זיהוי פעולות בסרטוני ספורט, ובכך היא לוכדת מאפיינים מרחביים ברזולוציה גבוהה ותבניות תנועה זמניות, תוך השגת ביצועי סיווג תחרותיים במאגרי נתונים סטנדרטיים של פעולות ספורט.
מאמר מחקר
זיהוי פעולות בסרטוני ספורט באמצעות רשתות קונבולוציה רב-קנימיות עם מידול זמני המבוס על זיכרון לטווח קצר ארוך (LSTM)
במאמר זה
סיכום
תקציר
זיהוי פעולות בסרטוני ספורט נותר מאתגר בשל דינמיקה מורכבת של תנועה, הסתרה ושונות גבוהה בתוך המחלקה. למרות שגישות למידה עמוקה קיימות, כולל CNN-BiLSTM ומודלים המבוססים על למידה בהעברה (transfer learning), הדגימו יעילות בזיהוי פעילות אנושית, ביצועיהן עשויות להיות מוגבלים בתרחישי ספורט עם תנועות מהירות ומגוונות. שיטות רבות קיימות מסתמכות על מסנני קונבולוציה במقياس בודד, אשר עשויים שלא ללכוד ביעילות מאפייני תנועה עדינים וגסים בו-זמנית. כדי לטפל במגבלה זו, מחקר זה מציע רשת נוירונים קונבולוציונית רב-מقياسية (MSCNN) המשולבת עם רשת Long Short-Term Memory (LSTM) לזיהוי פעולות בסרטוני ספורט. ה-MSCNN מחלצת ייצוגים מרחביים במספר שדות קליטה באמצעות גרעיני קונבולוציה מקבילים, מה שמאפשר למידה של מאפייני תנועה מפורטים והקשריים כאחד. מאפיינים אלו מעובדים לאחר מכן על ידי ה-LSTM כדי ללכוד תלויות זמניות והמשכיות של התנועה לאורך פריימים עוקבים. הערכה ניסיונית נערכה על מאגרי הבדיקה UCF1, UCF Sports ו-JHMDB. מודל ה-MSCNN-LSTM המוצע השיג דיוקי סיווג של 98.3%, 95.4% ו-81.7%, בהתאמה, ובכך עלה בביצועיו על הגישות ההשוואתיות שנבחנו במחקר זה. ניתוח Ablation הדגים עוד את תרומתם של חילוץ מאפיינים רב-מقيשאי ומידול זמני לביצועים הכוללים. ממצאים אלו מדגימים את הפוטנציאל של המסגרת המוצעת לשלב מידע מרחבי וזמני לזיהוי פעולות בסרטוני ספורט.
מבוא
לזיהוי פעילות אנושית ישנם יישומים נרחבים במגוון תחומים בעולם האמיתי, כולל מעקב חכם, זיהוי חריגות, אחזור אודיו-ויזואלי מבוס-פעולה וניטור מטופלים במערכת הבריאות1,2. לזיהוי פעולות, במיוחד בזרמי וידאו ממערכות מעקב ומפלטפורמות של רשתות חברתיות, יש פוטנציאל משמעותי לזיהוי חריגות ולהבנת אירועים3. פעולות אנושיות מזוהות בניתוח וידאו באמצעות תצפית על חלקי גוף שונים, כגון הידיים והרגליים. בניגוד לתמונות סטטיות, פריים בודד לרוב אינו מספיק כדי לייצג פעולה4. לדוגמה, התנוחה הראשונית של פעולות כדורגל וקפיצה בחבל עשויה להיראות דומה בפריים בודד. ההבדלים בין פעולות אלו הופכים גלויים כאשר הן נצפות לאורך רצף של פריימים הלוכדים דפוסי תנועה ואינטראקציות של גוף האדם עם סביבתו5,6,7. קיצורי המילים המשמשים לאורך כתב יד זה מסוכמים בטבלה 1 כדי לשפר את קריאות הטקסט ולהבטיח עקביות בטרמינולוגיה.
| קיצור | פירוט מלא |
| AI | בינה מלאכותית (Artificial Intelligence) |
| AUC | השטח תחת העקום (Area Under the Curve) |
| BiLSTM | זיכרון לטווח קצר ארוך דו-כיווני (Bidirectional Long Short-Term Memory) |
| CNN | רשת נוירונים קונבולוציונית (Convolutional Neural Network) |
| CUDA | ארכיטקטורת התקן חישוב מאוחדת (Compute Unified Device Architecture) |
| F1-score | ממוצע הרמוני של דיוק ורגישות (Harmonic Mean of Precision and Recall) |
| GPU | מעבד גרפי (Graphics Processing Unit) |
| HAR | זיהוי פעילות אנושית (Human Activity Recognition) |
| JHMDB | מאגר נתונים של תנועה אנושית מרוכבת (Joint Human Motion DataBase) |
| LSTM | זיכרון לטווח קצר ארוך (Long Short-Term Memory) |
| mAP-T | דיוק ממוצע זמני (Temporal Mean Average Precision) |
| MCC | מקדם המתאם של מתיוס (Matthews Correlation Coefficient) |
| MSCNN | רשת נוירונים קונבולוציונית רב-קנימית (Multi-Scale Convolutional Neural Network) |
| ROC | מאפיין תפעול מקלט (Receiver Operating Characteristic) |
| TSI | מדד יציבות זמנית (Temporal Stability Index) |
| UCF | אוניברסיטת מרכז פלורידה (University of Central Florida) |
| VRAM | זיכרון גישה אקראית של וידאו (Video Random Access Memory) |
טבלה 1: רשימת קיצורים המשמשים בכתב היד. קיצורים נפוצים וראשי תיבות המשמשים לאורך המחקר והצורות המלאות התואמות להם.
סיווג מהיר ומדויק של סרטוני ספורט הוא חשוב למגוון רחב של יישומים8,9,10, כולל אנליטיקה של ספורט, זיהוי אירועים, אחזור מבוס תוכן ומערכות המלצה1,12,13. עם הצמיחה המהירה של תוכן וידאו הקשור לספורט, המגבלות של מסגרות אנליטיות מוקדמות הפכו לבולטות יותר ויותר14. כתוצאה מכך, קיים ביקוש גובר לגישות חסונות המסוגלות להתמודד עם המורכבות והטבע הדינמי של פעילויות ספורט. שיטות מסורתיות לסיווג סרטוני ספורט הסתמכו במידה רבה על תיאורים שנוצרו ידנית, כגון זרימה אופטית (optical flow) והיסטוגרמה של גרדיאנטים מכוונים (HOG), כדי לאפיין דפוסי תנועה ופעילויות בסרטוני ספורט15.
רשתות ConvNets, שהשיגו הצלחה יוצאת דופן בסיווג תמונות סטטיות, יושמו גם בניתוח וידאו. עם זאת, זיהוי פעולות נותר מאתגר יותר מכיוון שסרטוני וידאו מכילים מידע מרחבי-זמני (spatiotemporal) דינמי. גישות נוכחיות המבוסות על למידה עמוקה ניתן לחלק באופן כללי לשלוש קבוצות: רשתות דו-זרמיות (two-stream networks)16, רשתות קונבולוציה תלת-מדיות (3D convolutional networks), וארכיטקטורות יעילות חישובית. כדי ללמוד מידע זמני מזרימה אופטית (optical flow), רשתות דו-זרמיות משתמשות ב-ConvNet נוספת17,18, אם כי גישה זו דורשת משאבים חישוביים רבים. בעוד שארכיטקטורות קונבולוציה תלת-מדיות כגון C3D, I3D ו-R3D יכולות למדל מידע זמני באופן ישיר, הן מגדילות משמעותית את מספר הפרמטרים, מה שהופך את האופטימיזציה למאתגרת יותר. שיטות יעילות חישובית מנסות להפחית את מורכבות המודל באמצעות בחינת פעולות תלת-מדיות מפורקות (decomposed 3D operations).
יתרה מכך, מכיוון ש-CNNs מסוגלים לחלץ מאפיינים מרחביים מקומיים ו-LSTMs מסוגלים ללכוד מידע על הקשר זמני, מודלים היברידיים יכולים ללמוד ביעילות תבניות תנועה מרחביות-זמניות מקלטי חיישנים. מחקרים אחרונים המשלבים ארכיטקטורות של CNN ורשתות עצביות רקורסיביות הניבו תוצאות מעודדות18,19,20. עם זאת, מכיוון ש-LSTMs דוחסים מידע במהלך עיבוד הרצף, רעש שנוצר במהלך חילוץ המאפיינים עלול להשפיע על ביצועי הזיהוי. כדי לטפל בבעיה זו, מספר מחקרים שילבו מנגנוני קשב (attention mechanisms)21,2. מנגנוני קשב מאפשרים למודל להתמקד במאפיינים הרלוונטיים ביותר למשימת הזיהוי, ובכך לשפר את ביצועי הסיווג.
אף שדגמי LSTM דו-כיווניים עמוקים בשילוב עם חילוץ מאפיינים מבוס CNN השיגו תוצאות מבטיחות בזיהוי פעילות אנושית, נותרו מספר אתגרים בעת הרחבת מסגרות עבודה אלו לזיהוי פעולות בסרטוני ספורט. ראשית, ארכיטקטורות CNN-LSTM קיימות משתמשות לעיתים קרובות בחילוץ מאפיינים קונבולוציוני רב-קנה (single-scale), דבר שעלול להגביל את יכולתן ללכוד פעולות המתרחשות ברזולוציות מרחביות וזמניות מרובות, כגון תנועה סימולטנית של שחקן ואובייקט בסצנות ספורט. רשתות קונבולוציוניות רב-קנה, כולל 3D CNNs23 ו-two-stream CNNs, הדגימו את החשיבות של לכידת רמזים מרחביים ותנועתיים בקניינים שונים, אם כי קונספט זה נותר פחות נחקר במערכות היברידיות מבוסות LSTM. שנית, רוב דגמי ה-CNN-BiLSTM הקודמים24 מתמקדים בעיקר בתלות זמנית לטווח קצר, בעוד שרציפות תנועה לטווח ארוך ואינטראקציות בין אובייקטים הנפוצות בספורט קבוצתי עשויות שלא להיות מיוצגות באופן מספק. גישות רבות המבוסות על למידה בהעברה (transfer learning), כגון MobileNetV2 ו-ResNet, מסתמכות על מאפייני פריימים סטטיים ואינן מנצלות באופן מלא מנגנוני תשומת לב זמנית או מיזוג מאפיינים רב-קנה אדפטיבי25. יתרה מכך, רוב הדגמים הקיימים הוערכו בעיקר על מאגרי נתונים סטנדרטיים כגון UCF1 ו-JHMDB. מאגרי נתונים עדכניים יותר ייעודיים לספורט, הלוכדים תנועות מצלמה מורכבות ותבניות פעילות, כגון SoccerNet ו-FineGym, נותרו פחות נחקרים. מגבלות אלו מדגישות את הצורך במסגרת עבודה לחילוץ מאפיינים קונבולוציוניים רב-קנה המשולבת עם מודולי זיכרון זמני, כגון רשתות LSTM או BiLSTM, כדי ללכוד טוב יותר הן ייצוגים מרחביים ברזולוציה גבוהה והן תלויות זמניות לטווח ארוך בזיהוי פעולות בסרטוני ספורט.
בנוסף, רשתות CNN יכולות לחלץ מאפיינים מרחביים מקומיים, בעוד שרשתות LSTM יכולות למדל הקשר זמני. לפיכך, ארכיטקטורות היברידיות של CNN-RNN הראו ביצועים מבטיחים בזיהוי פעילות אנושית26,27. מחקרים אחרונים הרחיבו את מסגרות ה-CNN–LSTM הקונבנציונליות על ידי שילוב אסטרטגיות למידה משלימות לשיפור זיהוי הפעילות האנושית. לדוגמה, מנגנוני קשב (attention mechanisms) הוצגו כדי להדגיש מאפיינים רלוונטיים למשימה ולדכא ייצוגים פחות אינפורמטיביים, ובכך לשפר את ביצועי הזיהוי28. גישות אחרות אימצו למידה רב-משימתית (multi-task learning) כדי לבצע אופטימיזציה משותפת למשימות זיהוי פעולה וסגמנטציה זמנית, ובכך לשפר את יעילות הלמידה ואת ייצוג המאפיינים29. למרות התקדמויות אלו, לשיטות הקיימות עשויה להיות עדיין יכולת מוגבלת להבחין בין פעולות דומות ויזואלית, מכיוון שמאפיינים מרחביים וזמניים עדינים (fine-grained) לא תמיד נלכדים ביעילות. טבלה 2 מסכמת את נקודות החוזק והמגבלות של הגישות הקיימות30.
| סימוכין / שנה | השיטה שבה נעשה שימוש | סט(ים) של נתונים | מדדי ביצועים | נקודות חוזק מרכזיות | מגבלות |
| Hassan et al. (2024)1 | KFDI (תמונה דינמית של פריים מפתח) | UCF1 | דיוק: 85.3% | בחירה יעילה של פריימי מפתח וייצוג משופר של תמונות דינמיות. | רגיש לשגיאות בבחירת פריימים; מידול זמני מוגבל. |
| .Zhou et al (2023)24 | CNN מורחב + BiLSTM + בלוק שאריות (Residual Block) | UCF1, ספורט UCF | דיוק: UCF1: 89 ו-UCF Sports: 92.2% | משלב למידה מרחבית וזמנית; לוכד מידע רב-קנה מידה. | עתיר משאבים חישוביים; סיכון להתאמת-יתר (overfitting) במאגרי נתונים קטנים. |
| .Ullah et al (2025)34 | מאפיין מקומי-גלובלי + QSVM | UCF1 | דיוק: 82.6% | משלב מאפיינים מעובדים ידנית ומאפיינים עמוקים לזיהוי חסון. | דורש כיוונון ידני; יכולת הרחבה מוגבלת. |
| שין וחב' (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF1, UCF50, UCF101 ו-JHMDB | דיוק: UCF1: 97.73%; UCF50: 98.81%; UCF101: 98.46%; JHMDB: 83.38% | לוכד תלויות מרחביות וזמניות ארוכות טווח. | עלות חישובית גבוהה ודרישות נתונים רבות. |
| Su et al. (2024)23 | 3D-CNN | UCF1 | דיוק: 85.1% | למידת מאפיינים מרחביים-זמניים מקצה לקצה. | דרישות גבוהות לזיכרון ולמעבד גרפי (GPU). |
| Karuppannan et al. (2024)35 | אוטו-אנקודר עמוק + רשת נוירונים קונבולוציונית (CNN) | UCF1 | דיוק: 96.2% | לומד ייצוגי תכונות דחוסים. | מידול זמני מוגבל לטווח ארוך. |
| .Sahoo et al (2020)36 | HAR-Depth | KTH, UCF sports, JHMDB, UCF101, ו-HMDB51 | דיוק: KTH: 97.67%; UCF Sports: 95.0%; JHMDB: 73.13%; UCF101: 92.97%; HMDB51: 69.74% | למידה זמנית יעילה מבוססת עומק. | דורש הערכת עומק מדויקת ועיבוד מקדים נרחב. |
טבלה 2: השוואה בין שיטות למידה עמוקה קיימות לזיהוי פעולות בסרטוני ספורט.סיכום של גישות מייצגות של למידה עמוקה, כולל מערכי נתונים, מאפיינים מתודולוגיים, יתרונות ומגבלות, תוך הדגשת פערי המחקר שמענה להם מסגרת ה-MSCNN-LSTM המוצעת.
הוצעה מסגרת לעשיית אנימציית פנים המונחית על ידי סנכרון שמע, המשלבת מודל לניקוי רעשים פנימי (FDM) עם מודל דיפוזיה לטנט מקומי-אל-גלובלי (LG-LDM) ליצירת אנימציות פנים בעלות ביטוי רגשי. נעשה שימוש באוטו-אנקודר וריאציוני עם קוונטיזציית וקטורית ממוקד-רגש (EVQ-VAE) כדי לשחזר גיאומטריית פנים תלת-מדית מפורטת ושינויי הבעה עדינים31. כמו כן, פותחה מסגרת לאחיזה רובוטית המודעת להסתרות באמצעות ראייה סטריאוסקופית בינוקולרית, לצורך ביצוע סגמנטציה של המטרה, לוקליזציה, הסקת הסתרה והערכת תנוחת אחיזה של מטרות מרובות בתנאי הסתרה32. בנוסף, הוצגה מסגרת דו-שלבית להפקת קרקע מענני נקודות באמצעות הקרנת רשת וחלוקת סלילים אדפטיבית, שבה נעשה שימוש בהסתברויות גובה ועקמומיות כדי לדייק את הגבולות בין הקרקע למכשולים לאחר הפקה גסה באמצעות ניתוח מאפיינים מבוס רשת3.
למרות התקדמויות משמעותיות בזיהוי פעולות המבוס על למידה עמוקה, שיטות קיימות עדיין מתקשות להתמודד עם השונות הגבוהה והמורכבות של סרטוני ספורט, הכוללים תנועה מהירה, תנועת מצלמה ואינטראקציות בין מספר שחקנים. מודלים מסורתיים רבים המבוססים על CNN או LSTM פועלים בקנה מידה מרחבי יחיד, ולכן עשויים להתקשות בלכידה יעילה של דפוסי תנועה מקומיים וגלובליים כאחד. יתרה מכך, שמירה על קוהרנטיות זמנית ברצפים ארוכים או בפעולות חופפות נותרת מאתגרת. למרות ששיטות של למידה בהעברה (transfer learning) שיפרו את חילוץ המאפיינים, התאמתן למאגרי נתונים ספציפיים לספורט נותרה בלתי נחקרת יחסית.
מחקר זה שואף לפתח ולהעריך מסגרת של רשת נוירונים קונבולוציונית רב-קנימית בשילוב זיכרון לטווח קצר-ארוך (MSCNN-LSTM) לזיהוי פעולות בסרטוני ספורט, וזאת על ידי שילוב של מיצוי מאפיינים מרחביים רב-קנימיים עם מידול זמני מבוס LSTM כדי ללכוד הן מאפיינים מרחביים עדינים והן תלויות זמניות ארוכות טווח. המסגרת המוצעת עושה שימוש בגרעיני קונבולוציה משלימים ובמיזוג מאפיינים רב-שכבתי כדי לשפר את הייצוג של פעולות ספורט מורכבות תחת תנאים מאתגרים. ביצועיה הוערכו על גבי מאגרי הנתונים המקובלים UCF1, UCF Sports ו-JHMDB באמצעות מדדי דיוק (accuracy), דיוק חיובי (precision), רגישות (recall), מדד F1, ממוצע דיוק ממוצע לאורך זמן (mAP-T), מדד יציבות זמנית (TSI), מקדם קאפה של כוהן (κ), מקדם מתיוס (MCC) ושטח תחת עקומת ROC (AUC). תוצאות ניסיוניות הדגימו ביצועים תחרותיים בהשוואה לשיטות שנבחנו במחקר זה, ומדגישות את הפוטנציאל של המסגרת לניתוח ספורט, ניטור ביצועי ספורטאים, זיהוי אירועים אוטומטי והבנת סרטוני ספורט.
פרוטוקול
מחקר זה השתמש במסגרת למידה עמוקה דו-שלבית לזיהוי פעולות בסרטוני ספורט, המשלבת רשת נוירונים קונבולוציונית רב-קנה-מידה (MSCNN) עם רשת זיכרון לטווח קצר ארוך (LSTM). לצורך פיתוח והערכה של המודל נעשה שימוש במאגרי נתונים סטנדרטיים הזמינים לציבור, דהיינו UCF11, UCF Sports ו-JHMDB. לא נאספו נתונים חדשים ממשתתפים אנושיים, ולא נעשה שימוש או עיבוד במידע המאפשר זיהוי אישי. מכיוון שהמחקר כלל ניתוח משני של מאגרי נתונים אנונימיים הזמינים לציבור ולא כלל השתתפות אנושית ישירה, לא נדרשו אישור אתי ממוסד או הסכמה מדעת.
תהליך העבודה כלל דגימת פריימים ונורמליזציה זמנית, ולאחריהן חילוץ מאפיינים באמצעות מודול ה-MSCNN. המאפיינים שחולצו עובדו לאחר מכן באמצעות רשת LSTM למידול זמני, ולאחר מכן הועברו לשכבת סיווג רב-מחלקית. לבסוף, המודל אומן והוערך באמצעות מערכי נתוני הייחוס שנבחרו. איור 1 ממחיש את הארכיטקטורה הכוללת של המסגרת המוצעת.
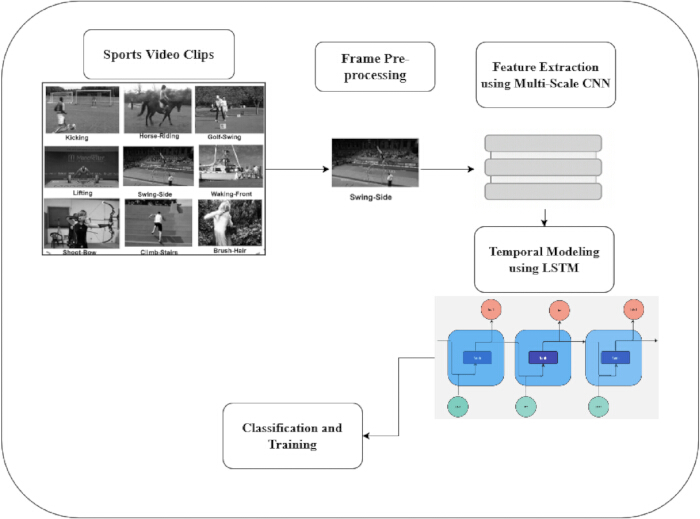
איור 1מסגרת MSCNN-LSTM מוצעת לזיהוי פעולות בסרטוני ספורט. זרימת עבודה כללית המדגימה עיבוד מקדים של וידאו, הפקת מאפיינים מרחביים רב-קנה-מידה, למידה של רצפים זמניים וסיווג פעולות. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
איור 1 ממחיש את זרימת העבודה של מסגרת מוצעת לזיהוי פעולות בסרטוני ספורט, המבוססת על ארכיטקטורת MSCNN-LSTM היברידית. התהליך מתחיל בסרטוני ספורט המכילים פעולות אתלטיות שונות, כולל בעיט, רכיבה על סוסים ותנופת גולף. הסרטונים הגולמיים פווקו לפריימים בודדים במהלך שלב עיבוד המקדם, שבו הפריימים נגזרו, סטנדרטיזו והוכנו כקלט למודל. הפריימים שעברו עיבוד מקדם הוכנסו לאחר מכן למודול ה-MSCNN לצורך חילוץ מאפיינים. הארכיטקטורה הקונבולוציונית רב-קנימית לוכדת מאפיינים מרחביים בשדות קליטה שונים, מה שמאפשר חילוץ של מידע מקומי והקשרי מתוך פריימי סרטוני הספורט. וקטורי המאפיינים שחולצו עובדו לאחר מכן על ידי רשת LSTM כדי למדל תלויות זמניות ואת התפתחות התנועה לאורך פריימים עוקבים. לבסוף, מודול הסיווג והאימון השתמש בייצוגים הספטיו-טמפורליים שנלמדו כדי לחזות את קטגוריית הפעולה עבור כל סרטון. המסגרת המוצעת כללה ארבעה שלבים רצופים, המתחילים באיסוף נתונים ועיבוד מקדם באמצעות מאגרי הנתונים המקובלים UCF1 (YouTube Actions), UCF Sports ו-JHMDB. כל סרטון ספורט הומר לרצף של פריימים, אשר שונו לגודל אחיד, נורמלו ועברו הרחבה (augmentation) באמצעות סיבוב, היפוך וגזירה כדי לשפר את העמידות לשינויים סביבתיים. הפריימים שעברו עיבוד מקדם עובדו לאחר מכן על ידי הרשת הנוירונית הקונבולוציונית רב-קנימית (MSCNN) המוצעת, שבה ענפים קונבולוציוניים מקבילים עם גרעינים (kernels) של 3 × 3, 5 × 5 ו-7 × 7 חילצו מאפיינים מרחביים מקומיים והקשריים משלימים. מאפיינים רב-קנימיים אלו שורשרו ועובדו באמצעות נורמליזציית אצוות (batch normalization) ו-max pooling כדי לייצר ייצוגי מאפיינים תמציתיים. המאפיינים שהתקבלו ברמת הפריימים סופקו לאחר מכן לרשת Long Short-Term Memory (LSTM) כדי למדל תלויות זמניות בין פריימים עוקבים. פלטי ה-LSTM הסופיים עברו השטחה (flattening) והועברו דרך שכבות מחוברות באופן מלא עם הפעלת ReLU, ולאחריהן מסווג Softmax לחיזוי קטגוריית הפעולה. הרשת אומנה באמצעות אופטימיזטור Adam עם פונקציית הפסד cross-entropy ורגולריזציית dropout להפחתת התאמת-יתר (overfitting). ביצועי המודל הוערכו לבסוף על מאגרי הנתונים UCF1, UCF Sports ו-JHMDB באמצעות מדדי דיוק (accuracy), precision, recall ו-F1-score.
1. איסוף נתונים ועיבוד מקדמי
במחקר זה נעשה שימוש בשלושה מאגרי נתונים השוואתיים (benchmark datasets) הזמינים לציבור עבור ספורט ופעולות אנושיות. מאגרי נתונים אלו מכילים צילומי סרטון של ספורט מהעולם האמיתי עם תנועות מצלמה, נקודות מבט ומורכבות רקע משתנות. באופן ספציפי, המחקר השתמש ב-UCF1 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php), המכיל 1 קטגוריות פעולה שנאספו מ-1,168 סרטוני YouTube שהוקלטו מכ-25 אנשים, עם מספר דגימות לכל פעולה. מאגר הנתונים Joint-Annotated Human Motion Database (JHMDB)34,35 מכיל 21 מחלקות פעולה ו-928 סרטונים מתויגים. מאגר הנתונים UCF Sports כולל 10 מחלקות פעולה ו-150 רצפי וידאו שנתפסו ממקורות שידור ברזולוציה של 720 × 480 pixels (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
במצטבר, מערכי נתונים אלו מכסים הן ספורט אישי והן ספורט קבוצתי ומספקים שונות במשך הזמן ובקנה המידה הוויזואלי לצורך הערכת מסגרת ה-MSCNN-LSTM המוצעת לזיהוי פעולות. כחלק מתהליך סינון איכות הנתונים, מערכי הנתונים UCF1, UCF Sports ו-JHMDB נבחנו לאיתור סרטונים פגומים, קבצים כפולים וקטעים עם הערות (annotations) חסרות. לא זוהו דגימות העומדות בקריטריונים של פסילה אלו; לפיכך, כל הסרטונים הזמינים נשמרו לניתוח המשכי. לאחר מכן, מערכי הנתונים חולקו לתתי-קבוצות של אימון (70%), תיקוף (15%) ובדיקה (15%) באמצעות אסטרטגיית פיצול אקראית עקבית. איור 2 מציג תמונות מייצגות ששימשו לאימון ולהערכה.
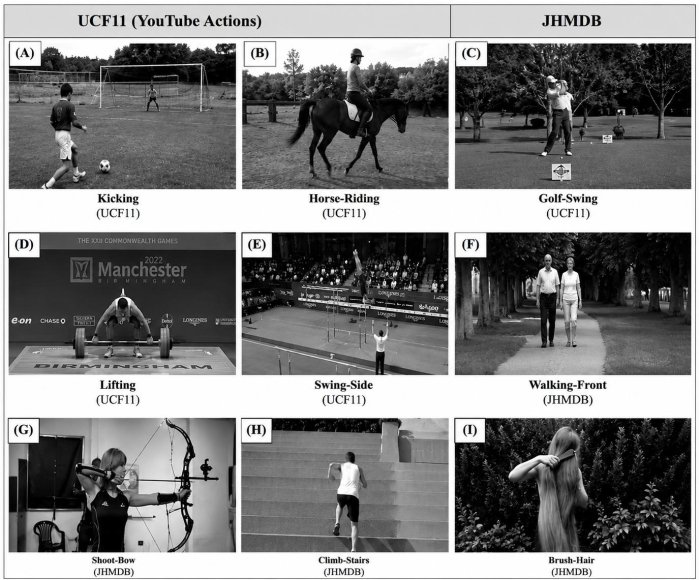
איור 2מסגרות מייצגות מתוך מאגרי נתונים סטנדרטיים לזיהוי פעולות ספורט. פאנלים (א–ד) מציגים דוגמאות מתוך מערך הנתונים UCF1 (YouTube Actions), פאנלים (ה–ח) מתוך מערך הנתונים UCF Sports, ולוחות (א–למתוך מאגר הנתונים JHMDB. הפריימים ממחישים וריאציות במחלקי פעולות, זוויות ראייה, רקעים, תנאי תאורה ומורכבות תנועה. נא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
מודל זיהוי הפעולות המוצע הוערך על מאגרי הנתונים המקובלים (benchmark) UCF1, UCF Sports ו-JHMDB, כפי שסוכם ב-Table 3. מאגרי נתונים אלו מייצגים דפוסי תנועה מגוונים ותנאי סביבה מאתגרים. מאגר הנתונים UCF1 (YouTube Actions) מכיל פעולות ספורט מ-1 מחלקות שנרכשו תחת תנאי תאורה, נקודות מבט ותנאי רקע משתנים. מאגר הנתונים UCF Sports כולל 150 סרטוני ספורט מהשטח משידורים מקצועיים, המציגים רצפי תנועה ריאליסטיים. מאגר הנתונים JHMDB מספק הערות (annotations) מפורטות של תנועת אדם עבור 21 קטגוריות פעולה בעלות רזולוציה גבוהה (fine-grained), ומש כמאגר נתונים מקובל לזיהוי פעולות מרחביות-זמניות (spatiotemporal). יחד, מאגרי נתונים אלו שימשו להערכת ביצועי המודל בתרחישים של ספורט ופעולות אנושיות. הרשת אומנה באמצעות אופטימייזר Adam למשך 10 epochs עם גודל batch של 32, קצב למידה ראשוני של 0.01, ופונקציית הפסד מסוג cross-entropy. המודל עם הפסד הוולידציה הנמוך ביותר נבחר להערכה הסופית. בכל הניסויים נעשה שימוש ב-seed אקראי קבוע של 42. כדי לשפר את ההתכנסות, יושמו מנגנוני עצירה מוקדמת (Early stopping) והפחתת קצב למידה בעת מישוריים (learning-rate reduction on plateau), ובמהלך אימון ה-LSTM נעשה שימוש בקיטוע גרדיאנטים (gradient clipping) עם סף של 5.0 כדי למנוע גרדיאנטים מתפוצצים. מודל ה-MSCNN-LSTM המוצע הכיל כ-15 מיליון פרמטרים הניתנים לאימון. תצורת החומרה והתוכנה ששימשה למימוש מסוכמת ב-Table 4. מכיוון שהתפלגויות המחלקות היו מאוזנות מספיק, לא יושמו הליכי שקלול מחלקות או דגימה מחדש (resampling) נוספים. מודלי השוואה יושמו תוך שימוש בהיפר-פרמטרים שדווחו במחקריהם המקוריים, כאשר הגדרות האימון תואמו במידת האפשר. ערכי הביצועים דווחו כממוצע ± סטיית תקן מחמש הרצות עצמאיות עם אתחולים אקראיים שונים. הבדלים בין המודל המוצע למודלי ההשוואה הוערכו באמצעות מבחני t-paired בסף מובהקות של p < 0.05.
| מערך נתונים | מספר המחלקות | מספר סרטונים | רזולוציה (px) | נא לספק את טקסט המקור לתרגום. | תיאור |
| UCF1 (פעולות YouTube) | 11 | 1168 | משתנה (≈ 320×240) | אוניברסיטת מרכז פלורידה | כולל 11 פעולות אנושיות מענפי ספורט (לדוגמה, קליעה לסל בכדורסל, צלילה, תנועת חבטה בגולף, הלהטוט בכדורגל). הסרטונים נאספו מ-YouTube וכוללים שונות גבוהה בתאורה, בזווית הצפייה וברקע. |
| ספורט UCF | 10 | 150 | 720×480 | מאגר נתוני פעולות ספורט של UCF | מכיל פעילויות ספורט כגון צלילה, רכיבה על סוסים, תנועת חבטה בגולף, ריצה והנפת משקולות, שהוקלטו מצילומי שידורי טלוויזיה אמיתיים (BBC, ESPN). |
| JHMDB | 21 | 928 | 320×240 | מכון מקס פלאנק למערכות חכמות | כולל פעילויות יומיומיות וספורטיביות כגון תפיסה, קפיצה, הברשת שיער, קליעה וריצה, עם אנוטציות של מפרקים לצורך ניתוח תנועה ותנוחה. |
טבלה 3: מאפיינים של מערכי הנתונים הייחוסים ששימשו לאימון ולהערכה. סקירה כללית של מערכי הנתונים UCF1, UCF Sports ו-JHMDB, כולל מספר מחלקות הפעולה, דגימות הווידאו, מאפייני מערכי הנתונים ותפקידם באימון, תיקוף ובחינה של המודל.
| פרמטרים שנעשה בהם שימוש | תיאור |
| שפת תכנות | Python 3.8.18 [4] |
| מסגרת למידה עמוקה | TensorFlow 2.15.0 [1] |
| מאיץ GPU | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| מעבד (CPU) | Intel Core i9 @ 3.5 GHz × 16 Cores |
| מערכת הפעלה | Windows 1 |
| זיכרון (RAM) | 64 GB DDR4 |
| אופטימייזר | Adam (learning rate = 0.01) |
| גודל אצווה (Batch Size) | 32 |
| מספר תקופות (Epochs) | 100 |
| פונקציות אקטיבציה | ReLU (שכבות CNN), Softmax (שכבת פלט) |
| שיעור Dropout | 0.5 |
טבלה 4: סביבת הסימולציה ותצורת ההיפר-פרמטרים של מודל ה-MSCNN-LSTM המוצע. מפרטי חומרה, סביבת תוכנה, הגדרות אופטימייזר, קצב למידה, גודל אצווה (batch size), מספר תקופות (epochs), ממדי קלט והיפר-פרמטרים אחרים ששימשו במהלך אימון והערכת המודל.
2. עיבוד מקדים
לפני האימון, כל סרטון גלם הומר לרצף של פריימים מסודרים לפי זמן ולאחר מכן עבר נורמליזציה, דגימה זמנית והעשרה. כל סרטון קלט V הומר תחילה לרצף של פריימים ויוצג כטנזור 4D V ∈ RT×H×W×C, כאשר T הוא מספר הפריימים, H × W i מציין את אינדקס הפריים, ו-C מציין את מספר ערוצי הצבע (3 עבור RGB). צינור העיבוד המקדים כלל חילוץ פריימים, שינוי גודל מרחבי ואחריו חיתוך מרכזי או אקראי לרזולוציה קבועה (H′, W′), נורמליזציה של עוצמה לכל פיקסל, והעשרת נתונים אופציונלית, כולל היפוך אקראי, קנה מידה ושינויים אקראיים בצבע (color jittering), לפני חילוץ המאפיינים. באופן קונקרטי, נורמליזציית העוצמה יושמה כנורמליזציית ציון סטנדרטית כבמשוואה (1).
 (1)
כאשר μ, σ הם ממוצעי הערוצים וסטיות התקן שחושבו על פני קבוצת האימון, או כסקאלינג min–max כפי שמופיע במשוואה (2).
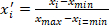 (2)
לאחר נורמליזציה, כל פריים יוצג כ-F̃t ∈ RH′×W′×C′ וטנזור הווידאו שהתקבל יוצג כ-V′ ∈ RT×H′×W′×C. ב-frontend קונבולוציוני רב-קנה-מידה (multi-scale), מפות מאפיינים מרחביות של שדות קליטה מרובים מתקבלות על ידי החלת מספר קונבולוציות דו-מדיות (או תלת-ממדיות עבור קונבולוציות מרחביות-זמניות מוקדמות) עם גדלי גרעין (kernel) שונים; לאחר מכן נוצר ייצוג מאפיינים זמני עבור כל פריים או קליפ וידאו קצר והועבר למודול ה-LSTM. המאמר המקורי מיישם MobileNetV2 ולאחר מכן Deep BiLSTM לצורך מידול זמני; צינור העיבוד המקדים (preprocessing pipeline) שלעיל תואם באופן מלא להחלפה של multi-scale conv + LSTM.
3. דגימה ונורמליזציה זמנית
מכיוון שאורכי הסרטונים T משתנים בין מערכי נתונים ובתוכם, אנו דוגמים באופן אחיד או מדגמים מחדש פריימים במישור הזמן כדי לספק לרשת הקונבולוציה רב-קנימית + LSTM אורך קלט קבוע N במונחים של פריימים או קטעים קצרים. ניתן לחשב אינדקסים אחידים של פריימים כפי שמוצג במשוואה (3),
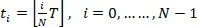 (3)
לפיכך, רצף הפריימים שנדגמו הוא Vs = {F̃t0, …, F̃tN−1}. כאשר נדרשת רמת דיוק זמנית גבוהה יותר, אנו מבצעים אינטרפולציה זמנית ליניארית: עבור כל זמן שברי כך שנדגם מחדש τ ∈ [0, T−1] שחושב כפי שמופיע במשוואה (4).
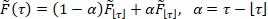 (4)
כך שהרצף שדוגם מחדש Vs יכיל בדיוק N פריימים וישמור על תנועה חלקה. לחלופין, דגימה באמצעות קטעים קצרים רציפים (אורך חלון זמני w עם פסיעה s) מניבה קבוצה של טנזורי קטעים שבהם כל קטע Cj ∈ RT×H′×W′×C ו-j = 0, …, ⌊(T − w)/s⌋. לצורך נורמליזציה זמנית בתוך הרשת, איגור (pooling) זמני פשוט במספר קני מידה הוא יעיל: בהינתן רצף מאפיינים זמני X = {x1, …, xN} שנוצר על ידי שכבות קונבולוציה רב-קנייות, יש להחיל מאפיינים מאוגרים כפי שמוצג במשוואה (5).
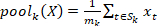 (5)
כאשר Sk הוא התמיכה הזמנית עבור קנה מידה k (למשל, Sk עשוי להיות בלוקים שאינם חופפים או אינדקסים מורחבים) ו- mk = |Sk|.
לפני חילוץ המאפיינים, כל הסרטונים הותאמו לגודל של 24 × 24 פיקסלים ונדגמו בקצב של 25 פריימים לשנייה. בכל ניסוי נעשה שימוש באורך רצף קבוע של 32 פריימים. טכניקות להעשרת הנתונים (data augmentation) שנעשה בהן שימוש כללו חיתוך אקראי (scale = 0.8–1.0), סיבוב אקראי (±15°), היפוך אופקי אקראי (probability = 0.5) ושינוי בהירות (±20%). ערכי הממוצע [0.485, 0.456, 0.406] וסטיות התקן [0.29, 0.24, 0.25] של ImageNet שימשו לסטנדרטיזציה של ערכי הפיקסלים. עבור כל רצף סרטונים, בוצע דגימה זמנית באמצעות בחירת פריימים אחידה. סרטונים ארוכים יותר קוצצו או נדגמו באופן אחיד כדי לשמור על אורך רצף עקבי, בעוד שסרטונים עם פחות מ-32 פריימים עברו ריפוד באפסים (zero-padded). הגדרות אלו יושמו באופן עקבי לאורך שלבי האימון וההערכה.
4. מיצוי מאפיינים באמצעות MSCNN
רשת עצבית קונבולוציונית רב-קנימית (MSCNN) הופעלה כדי לשפר את הייצוג המרחבי של פעולות בסרטוני ספורט. רשתות עצביות קונבולוציוניות קונבנציונליות המסתמכות על גודל גרעין (kernel) יחיד עשויות להיות בעלות יכולת מוגבלת ללכידת מאפיינים במספר קניינים מרחביים. מכיוון שחלק מפעולות הספורט מציגות מאפיינים חזותיים דומים, ייתכן כי ארכיטקטורה קונבולוציונית חד-קנימית תתקשה ללכוד בו-זמנית הן מאפיינים מקומיים והן מאפיינים גלובליים. כדי לטפל במגבלה זו, המסגרת המוצעת משתמשת בגרעיני קונבולוציה בגדלים שונים לביצוע חילוץ מאפיינים רב-קנימי ומיזוג מאפיינים.
בארכיטקטורת הרשת המוצעת, נעשה שימוש בגרעיני קונבולוציה של 1 × 1 כדי לארגן מידע בין הערוצים ולהפחית את הממדיות של מפות המאפיינים של הקלט. בנוסף, שכבות אלה מגבירות את יכולת הביטוי של הרשת על ידי הכנסת טרנספורמציות מאפיינים נוספות וייצוגים לא-ליניאריים. גרעיני קונבולוציה בגדלים שונים מאפשרים חילוץ של מידע מרחבי במספר קני מידה. נורמליזציה סדרתית מבוצעת בעקבות מיזוג מאפיינים רב-קני מידה משוקלל כדי לשפר את יציבות האימון. על מנת לצמצם בעיות של דעיכת גרדיאנט (gradient vanishing) ופיצוץ גרדיאנט (gradient explosion) במהלך אימון רשת עמוקה, הארכיטקטורה המוצעת משתמשת בחיבורים שאריתיים (residual connections) ובמידול זמני מבוס LSTM.
התכנון רב-הקנה (multi-scale) משפר את יכולתו של הרשת ללכוד מאפיינים ברזולוציות מרחביות שונות ומשפר את יכולת ייצוג המאפיינים. יתרה מכך, גרעין קונבולוציה קונבנציונלי של N × N מפורק לפעולות קונבולוציה של N × 1 ו-1 × N. קונבולוציות ה-N × 1 וה-1 × N המיושמות במודול ה-MSCNN תוכננו ללכוד מאפיינים מרחביים רב-קנה וכיווניים משלימים מתוך פריימים בודדים של הווידאו. פעולות קונבולוציה אלו משפרות את ייצוג המאפיינים המרחביים על ידי חילוץ תבניות בקני מידה שונים של שדה קליטה (receptive-field). קשרים זמניים בין פריימים עוקבים ממודלים לאחר מכן על ידי מודול ה-LSTM, המעבד את רצף המאפיינים שחולצו על ידי ה-MSCNN כדי ללמוד תלותיות זמניות ארוכות טווח לצורך זיהוי פעולות.
כל סרטון ספורט V = {F1, F2, …, FT} מפורק ל-T פריימים. כדי לקודד וריאציות מרחביות, למשל, תנוחת שחקן, טשטוש תנועה ומסלול הכדור, ענפים קונבולוציוניים בשלושה קנה מידה שונים פועלים ב- s ∈ {1, 2, 3}, המתאימים לגדלי קרנל של 3 × 3, 5 × 5 ו-7 × 7. כל ענף מחלץ מפות מאפיינים כבמשוואה (6):
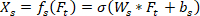 (6)
כאשר Ws ו-bs הם משקולות והטיות קונבולוציה (convolutional weights and biases) בקנה מידה s, ו-σ היא פונקציית ההפעלה ReLU. שכבת מיזוג רב-קנימית (multi-scale fusion layer) מאגדת תכונות כפי שמוצג במשוואה (7):
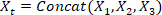 (7)
טנזור מאפיינים ממוזג זה משלב הן רמזי תנועה בעלי רזולוציה גבוהה והן מידע הקשרי של שטחים רחבים, כגון פעילויות קבוצתיות. איור 3 ממחיש רק את מודול חילוץ המאפיינים של ה-MSCNN. שכבת ה-LSTM (256 יחידות נסתרות), השכבה הצפופה (128 נוירונים) ושכבת ה-dropout (0.5) המשמשות למידול זמני ולסיווג מוצגות בנפרד ב-איור 4.
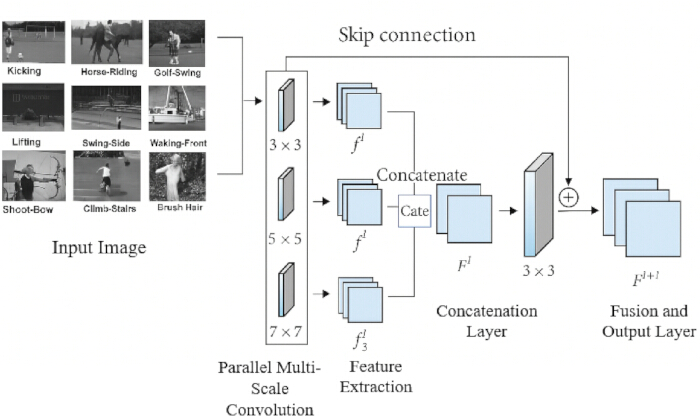
איור 3מודול חילוץ מאפיינים מוצע מבוס רשת עצבית קונבולוציונית רב-קנימית (MSCNN). שלושה ענפי קונבולוציה מקבילים עם גדלי גרעין של 3 × 3, 5 × 5 ו-7 × 7 מחלצים מאפיינים מרחביים משלימים ברב-קנה מידה, אשר ממוזגים לפני מידול זמני על ידי רשת LSTM. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
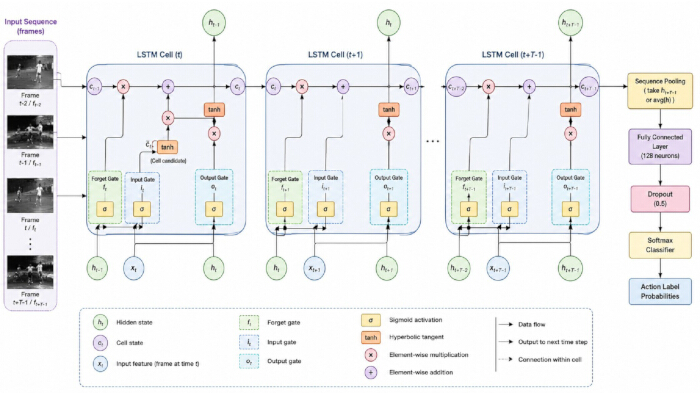
איור 4ארכיטקטורת LSTM מוצעת לזיהוי פעולות בסרטוני ספורט. מודול ה-LSTM ממדל תלויות זמניות באמצעות פעולות של שער קלט, שער שכחה ושער פלט לאורך פריימים רצופים של וידאו. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
איור 3 ממחיש את מודול חילוץ המאפיינים המוצע של רשת נוירונים קונבולוציונית רב-קנימית (MSCNN) לזיהוי פעולות בסרטוני ספורט. פריימי וידאו של הקלט עובדו במקביל דרך שלושה ענפים קונבולוציוניים עם גדלי גרעין (kernel) של 3 × 3, 5 × 5 ו-7 × 7, כאשר כל אחד מכיל 64 מסננים כדי ללכוד מאפיינים מרחביים משלימים ברזולוציות עדינות וגסות. הפלטים עובדו באמצעות נורמליזציית אצוות (Batch Normalization), הפעלת ReLU ו-max pooling של 2 × 2, ולאחר מכן שורשרו ואוחדו על ידי קונבולוציה של 1 × 1 עם 128 מסננים. חיבור דילוג שאריתי (residual skip connection) שימר מידע מרחבי ברמה נמוכה ושיפר את זרימת הגרדיאנט. מפות המאפיינים המאוחדות הופשטו (flattened) והועברו לשכבת LSTM עם 256 יחידות נסתרות לצורך מידול זמני, ולאחריה שכבה מחוברת במלואה (fully connected layer) עם 128 נוירונים, הפעלת ReLU ושיעור dropout של 0.5 לפני סיווג סופי באמצעות שכבת Softmax. מפות המאפיינים הרב-קנימיות (f1נראה שהטקסט שהזנת ריק או מכיל רק תו בודד. אנא ספק את הטקסט המדעי באנגלית שברצונך לתרגם לעברית, ואשמח לבצע את התרגום המקצועי עבורך., f2למרחבו- פ3לשורשרו כדי ליצור את הייצוג המאוחד (Fל׳), אשר עובד תגליד (convolution) של 3 × 3 נוסף כדי להפיק את מפת המאפיינים (feature map) של הפלט עבור השכבה הבאה. ארכיטקטורה היררכית זו אפשרה למידה של מאפיינים מרחביים משלימים במספר שדות קליטה (receptive fields), ובכך שיפרה את הביצועים בזיהוי פעולות ספורט.
5. מידול זמני באמצעות LSTM
על מנת למדל את האבולוציה מבוססת הזמן לאורך קצוות הווידאו, רצף המאפיינים המצטבר הועבר למערכת ה-LSTM כדי ללכוד תלויות דינמיות והמשכיות של תנועה. עבור כל סרטון קלט, חילצנו תחילה מאפייני CNN רב-קנימיים לכל פריים. נסמן את פריימי הווידאו כ-I1, …, IT. עבור כל פריים t וכל קנייִם s, המקודד הקונבולוציוני הרב-קנימי מייצר וקטור מאפיינים ft(s) ∈ Rd. לאחר מכן, נמזג את הקנייִים למתאר פריים יחיד באמצעות השלכה + שרשור (projection + concat) או סכום משוקל, כפי שמופיע במשוואה (8):
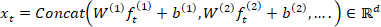 (8)
לאחר מכן, העבירו את הרצף {xt}tT=1 לתוך LSTM כדי למדל את הדינמיקה הזמנית. בסימון LSTM סטנדרטי, בזמן t השערים והמצבים מופיעים במשוואות (9) עד (13):
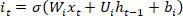 (9)
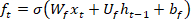 (10)
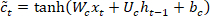 (11)
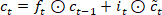 (12)
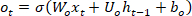 (13)
כאן σ היא הפעלת הסיגמואיד, ו-⊙ היא כפל איבר-איבר.) למרות שניתן להשתמש בארכיטקטורות LSTM דו-כיווניות כדי ללכוד הקשר זמני הן מהעבר והן מהעתיד, המסגרת המוצעת משתמשת ב-LSTM סטנדרטי כדי למדל תלויות זמניות לאורך פריימים רצופים של וידאו. בחירה עיצובית זו עקבית עם ארכיטקטורת ה-MSCNN-LSTM המוצגת במחקר זה. לאחר עיבוד הקליפ, התקבל ייצוג של הקליפ (למשל, המצב החבוי האחרון או איחוד זמני): z = Poolt(vt).
איור 4 ממחיש את זרימת העבודה של ארכיטקטורת ה-LSTM המוצעת לזיהוי פעולות ספורט. הרשת קיבלה רצף של פריימים מווידאו או מאפיינים שהופקו באמצעות CNN ועיבדה אותם לאורך צעדי זמן עוקבים (t−2, t−1, ו-t). כל תא LSTM כלל שער כניסה (input gate), שער שכחה (forget gate) ושער יציאה (output gate), שויסתו את זרימת המידע ברשת. שער הכניסה שילב מידע חדש במצב התא (cell state), שער השכחה השליך מידע זמני לא רלוונטי, ושער היציאה יצר את המצב החבוי (hidden state) שהועבר לצעד הזמן הבא. מצב התא שמר על תלויות זמניות ארוכות טווח, בעוד שהמצב החבוי לכד מידע זמני קצר טווח. לאחר עיבוד רצפי, פלטי ה-LSTM עברו איחוד (pooling) כדי ליצור ייצוג מאפיינים זמני, שהועבר לשכבה במחוברת באופן מלא (fully connected layer) ולמסווג Softmax כדי לחזות את פעולת הספורט המתאימה. הרשת אומנה באמצעות אופטימייזר Adam למשך 10 epochs עם גודל batch של 32, קצב למידה ראשוני של 0.01, ופונקציית הפסד cross-entropy. המודל עם הפסד האימות הנמוך ביותר נבחר להערכה סופית. כדי להבטיח שחזור, כל הניסויים בוצעו באמצעות seed אקראי קבוע של 42. נעשה שימוש בעצירה מוקדמת (early stopping) והפחתת קצב הלמידה בעת מישורה (plateau) כדי לשפר את ההתכנסות, ובוצע קיטוע גרדיאנטים (gradient clipping) עם סף של 5.0 במהלך אימון ה-LSTM כדי למנוע התפוצצות גרדיאנטים. מודל ה-MSCNN-LSTM המוצע הכיל כ-15 מיליון פרמטרים הניתנים לאימון.
ציוני המחלקה הסופיים וההסתברות משתמשים בשכבה ליניארית + softmax כבמשוואה (14):
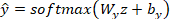 (14)
אמן על ידי מזעור הפסד האנטרופיה הצולבת (cross-entropy loss) על קטעי הווידאו המסומנים, כפי שמוצג במשוואה (15):
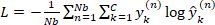 (15)
כאשר Nb הוא גודל האצווה (batch), C הוא מספר המחלקות, ו-y(n) הוא ה-one-hot ground truth. רגולריזציה (dropout על פלטי xt/LSTM, דעיכת משקולות) וקיטום גרדיאנטים (Gradient clipping) מיושמים כדי לסייע ביציבות עבור רצפי ספורט ארוכים.
תוצאות
מודל ה-MSCNN-LSTM המוצע אומן והוערך על מאגרי הנתונים UCF1 (YouTube Actions), UCF Sports ו-JHMDB, שכללו פעולות ספורט, נקודות מבט ותבניות תנועה מגוונות. מכיוון שההפצה בין המחלקות הייתה מאוזנת מספיק, לא הוחלו הליכי שקלול מחלקות או דגימה מחדש נוספים. מודלים להשוואה הוטמעו באמצעות ההיפר-פרמטרים שדווחו במחקריהם המקוריים, כאשר הגדרות האימון הותאמו במידת האפשר. התוצאות דווחו כממוצע ± סטיית תקן מחמישה הרצות עצמאיות עם אתחולים אקראיים שונים. הבדלים בין המודל המוצע למודלי ההשוואה הוערכו באמצעות מבחני t מזווגים בסף מובהקות של p < 0.05.
איור 5 משווה את דיוק הסיווג בין שלושת מאגרי הנתונים. מודל ה-MSCNN-LSTM השיג את הדיוק הגבוה ביותר, והגיע ל-98.3% ב-UCF1, ל-95.4% ב-UCF Sports ול-81.7% ב-JHMDB. ערכים אלו עלו מאלו שהושגו על ידי מודלי ה-Dilated CNN–BiLSTM, ה-Two-Stream LSTM וה-ViT-ReT. הדיוק הנמוך יותר ב-JHMDB שיקף את הקושי הגדול יותר בזיהוי פעולות בעלות רזולוציה עדינה (fine-grained) בסרטוני וידאו ברזולוציה נמוכה יותר.
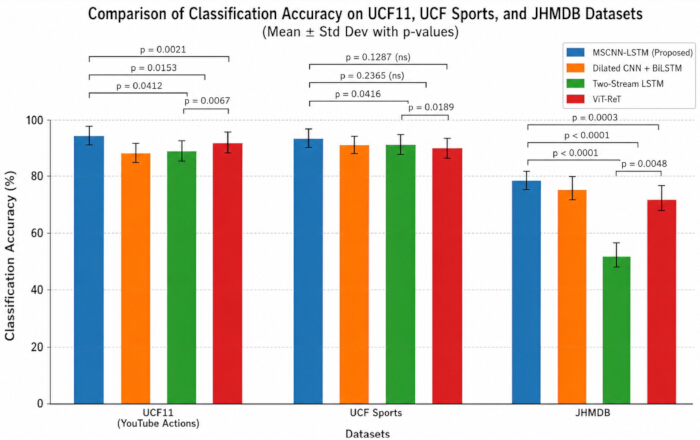
איור 5השוואה של דיוק הסיווג (%) של מודלי למידה עמוקה שונים על מאגרי נתונים של סרטוני ספורט. דיוק הסיווג של MSCNN-LSTM, ViT-ReT, Two-Stream LSTM ו-Dilated CNN + BiLSTM במאגרי הנתונים UCF1, UCF Sports ו-JHMDB. התוצאות מדווחות כממוצע ± סטיית תקן (SD) מחמש הרצות עצמאיות (n = 5). פסי השגיאה מייצגים סטיית תקן אחת. מובהקות סטטיסטית נבחנה באמצעות מבחן זוגי דו-זנבי ת.בדיקות (p < 0.05). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
המודל המוצע השיג גם את הדיוק (precision) הגבוה ביותר בכל מערכי הנתונים, עם ערכים של כ-96% ב-UCF1, 93% ב-UCF Sports ו-78% ב-JHMDB (איור 6). ערכי ה-Recall היו כ-95%, 94% ו-77%, בהתאמה (איור 7), בעוד שציוני ה-F1 התואמים היו כ-95.5%, 93.5% ו-7.5% (איור 8). ממצאים אלו העידו על כך שהמודל שמר על איזון חיובי בין זיהוי נכון של מחלקות פעולה לבין הגבלה של תחזיות חיוביות שגויות (false-positive).
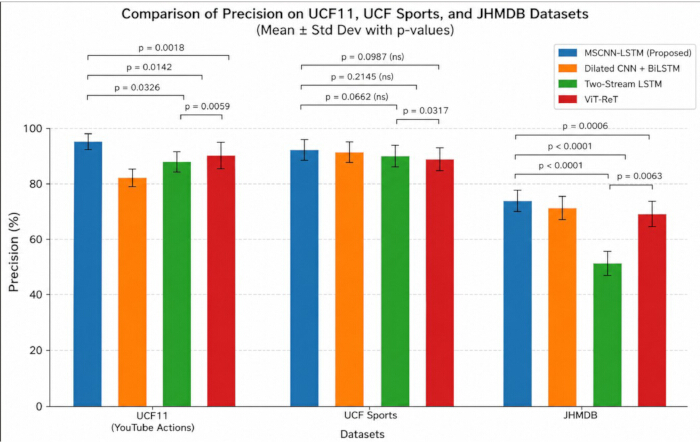
איור 6השוואה של הדיוק (%) של מודלים שונים של למידה עמוקה על מאגרי נתונים של סרטוני ספורט. ערכי הדיוק מדווחים כממוצע ± סטיית תקן (SD) מחמש הרצות עצמאיות (n = 5). פסי השגיאה מייצגים סטיית תקן אחת. מובהקות סטטיסטית נבחנה באמצעות מבחן t זוגי דו-זנבי ט-בדיקות (p < 0.05). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
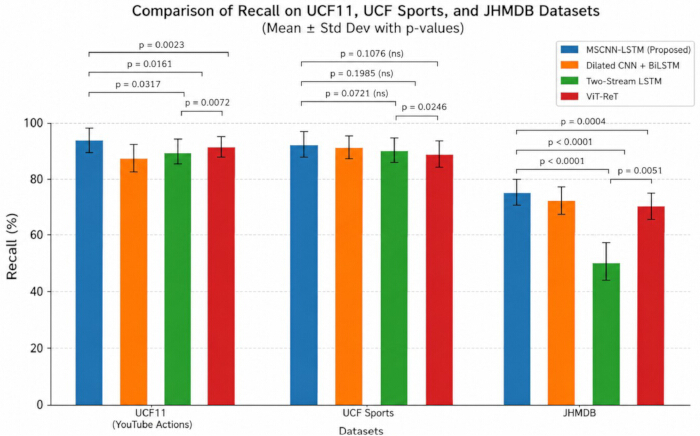
איור 7השוואה של ה-recall (%) של מודלי למידה עמוקה שונים על מאגרי נתוני סרטוני ספורט. ערכי recall מדווחים כממוצע ± SD מחמישה הרצות עצמאיות (n = 5). פסי השגיאה מייצגים סטיית תקן אחת. מובהקות סטטיסטית הוערכה באמצעות מבחן t מזווג דו-זנבי ת׳בדיקות (p < 0.05). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
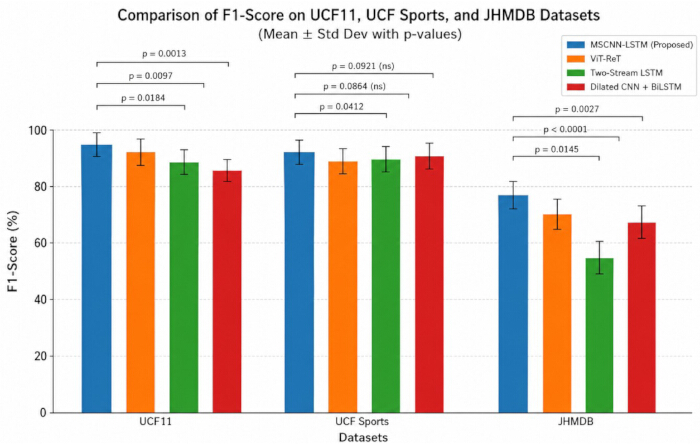
איור 8השוואה של מדד F1 (%) של מודלי למידה עמוקה שונים על מאגרי נתוני סרטוני ספורט. מדדי F1 מדווחים כממוצע ± סטיית תקן (SD) מחמש הרצות עצמאיות (n = 5). פסי השגיאה מייצגים סטיית תקן אחת. מובהקות סטטיסטית נבחנה באמצעות מבחן דו-זנבי מזווג ת'בדיקות (p < 0.05). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
טבלה 5 מציגה את תוצאות מדד הקאפה של כהן (Cohen’s kappa) ומקדם המתאם של מתיוס (Matthews correlation coefficient). במערך הנתונים UCF1, המודל המוצע השיג κ = 0.96 ו-MCC = 0.96, בהשוואה לערכי κ/MCC של 0.92/0.92 עבור ViT-ReT, 0.90/0.90 עבור Two-Stream LSTM, ו-0.87/0.87 עבור Dilated CNN–BiLSTM. במערך הנתונים UCF Sports, מודל ה-MSCNN-LSTM השיג κ = 0.95 ו-MCC = 0.94, תוצאות העולות על הערכים המקבילים שהושגו על ידי ViT-ReT (0.90/0.90), Two-Stream LSTM (0.88/0.89), ו-Dilated CNN–BiLSTM (0.84/0.85). במערך הנתונים JHMDB, המודל המוצע השיג κ = 0.83 ו-MCC = 0.84, בהשוואה ל-0.74/0.75 עבור ViT-ReT, 0.70/0.71 עבור Two-Stream LSTM, ו-0.71/0.72 עבור Dilated CNN–BiLSTM. תוצאות אלו הראו התאמה חזקה יותר בין התוויות שנחזו לתוויות האמת (ground-truth) עבור המודל המוצע.
| מודל | סט של נתונים | מדד קאפה של כהן (κ) | מקדם המתאם של מת'יוס (MCC) |
| CNN מורחב + BiLSTM [4] | UCF1 (פעולות YouTube) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| ספורט UCF | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| LSTM דו-זרמי [38] | UCF1 (פעולות YouTube) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| ספורט UCF | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer) [6] | UCF1 (פעולות YouTube) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| ספורט UCF | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| מודל ה-MSCNN–LSTM המוצע | UCF1 (פעולות YouTube) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| ספורט UCF | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
טבלה 5: השוואה של מדד Cohen's kappa (κ) ומקדם המתאם של Matthews (MCC) בין מודלי למידה עמוקה שונים. השוואת ביצועים של MSCNN-LSTM, ViT-ReT, Two-Stream LSTM, ו-Dilated CNN + BiLSTM על מאגרי הנתונים UCF1, UCF Sports, ו-JHMDB. ערכים גבוהים יותר מעידים על התאמה חזקה יותר בין התוויות החזויות לתוויות האמיתיות ועל אמינות סיווג גבוהה יותר. הערכים מדווחים כממוצע ± SD מחמש הרצות עצמאיות (n = 5).
איור 9 מציג את עקומות מאפייני תפקוד המקלט (receiver operating characteristic curves). מודל ה-MSCNN-LSTM המוצע השיג ערכי AUC של 0.975 ב-UCF1, 0.961 ב-UCF Sports ו-0.937 ב-JHMDB. ערכי ה-AUC הגבוהים באופן עקבי מעידים על יכולת הבחנה חזקה בין מחלקות פעולה במאגרי נתונים בעלי רמות מורכבות שונות.
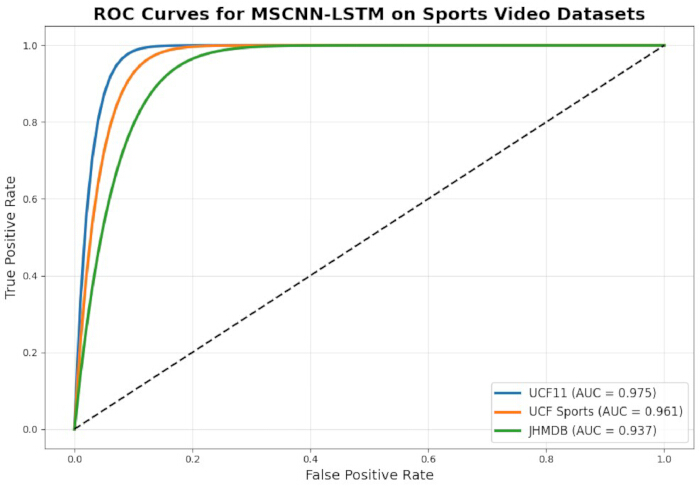
איור 9עקומות מאפיין תפעול מקלט (ROC) של מודל ה-MSCNN-LSTM המוצע. עקומות ROC עבור מערכי הנתונים UCF1, UCF Sports ו-JHMDB, הממחישות את הפשרה בין שיעור החיוביים האמיתיים (true positive rate) לבין שיעור החיוביים הכוזבים (false positive rate). השטח תחת העקומה (AUC) מסכם את ביצועי ההבחנה של המודל על פני ספי סיווג שונים. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
תוצאות הביצועים הזמניים מסוכמות ב- טבלה 6במאגר הנתונים UCF11, המודל המוצע השיג mAP-T של 98.3%, דיוק ברמת הפריימים (frame-level accuracy) של 96.5%, ו-TSI של 0.95. במאגר UCF Sports, הערכים המקבילים היו 95.4%, 94.0%, ו-0.93. במאגר JHMDB, המודל השיג mAP-T של 81.7%, דיוק ברמת הפריימים של 78.9%, ו-TSI של 0.8.טבלה 7ערכים אלו היו גבוהים מאלו שהתקבלו במודלי ההשוואה והצביעו על שיפור בקוהרנציה הטמפורלית וביציבות הניבוי הן ברצפי פעולות קצרים והן ברצפי פעולות ארוכים.
| שיטה | סט נתונים | mAP-T (%) | דיוק ברמת פריים (%) | מדד יציבות זמנית (TSI) |
| CNN מורחב + BiLSTM4 | UCF1 (פעולות YouTube) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| ספורט UCF | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| LSTM בעל שני זרמים38 | UCF1 (פעולות YouTube) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| ספורט UCF | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer)6 | UCF1 (פעולות YouTube) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| ספורט UCF | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF1 (פעולות יוטיוב) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| ספורט UCF | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
טבלה 6: השוואה של מדדי ביצועים זמניים לזיהוי פעולות בסרטוני ספורט. תוצאות ניסיוניות של דיוק ממוצע על פני מקטעים זמניים (mAP-T), דיוק ברמת הפריימים, ומד יציבות זמנית (TSI) עבור מודלי למידה עמוקה שונים במאגרי הנתונים של הבנצ'מרק. הערכים מדווחים כממוצע ± SD מחמישה הרצות עצמאיות (n = 5).
| תצורה | Multi-Scale CNN (MSCNN) | LSTM | דיוק (%) | ציון F1 (%) | mAP-T (%) |
| קו בסיס CNN בלבד | ✗ | ✗ | 90.4 ± 1.2 | 89.8 ± 1.3 | 8.9 ± 1.4 |
| CNN + LSTM | ✗ | ✓ | 93.1 ± 0.9 | 92.4 ± 1.0 | 91.7 ± 1.1 |
| MSCNN בלבד | ✓ | ✗ | 94.2 ± 0.8 | 93.6 ± 0.9 | 92.8 ± 1.0 |
| MSCNN-LSTM המוצע | ✓ | ✓ | 98.3 ± 0.5 | 97.8 ± 0.6 | 97.1 ± 0.6 |
טבלה 7: מחקר אבלציה (Ablation study) של מסגרת ה-MSCNN-LSTM המוצעת. תרומת הביצועים של רכיבי ה-MSCNN וה-LSTM תחת הגדרות אימון והערכה זהות. הערכים מדווחים כממוצע ± SD מחמישה הרצות עצמאיות (n = 5).
איור 10, איור 1, איור 12 מציגים את מטריצות הבלבול המנורמלות לפי שורות עבור UCF1, UCF Sports ו-JHMDB, בהתאמה. כל שלוש המטריצות הראו דומיננטיות אלכסונית ברורה, המעידה על כך שרוב מחלקות הפעולה זוהו נכונה. שגיאות מוגבלות מחוץ לאלכסון התרחשו בעיקר בין פעולות בעלות מאפיינים ויזואליים או תנועתיים דומים. מטריצת JHMDB הראתה בלבול רב יותר בין המחלקות באופן יחסי, דבר העולה בקנה אחד עם הביצועים הכמותיים הנמוכים יותר שנצפו במערך נתונים מאתגר זה.
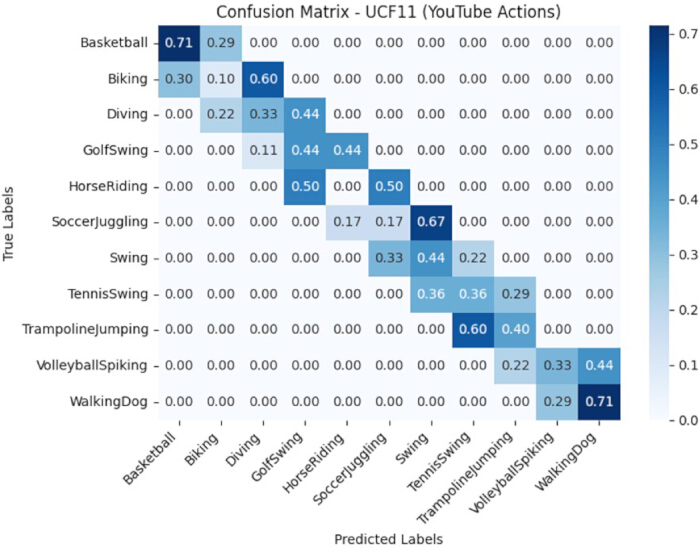
איור 10מטריצת בלבול מנורמלת לפי שורות של מודל ה-MSCNN-LSTM המוצע על מערך הנתונים UCF1. כל שורה מנורמלת לאחד, והערכים באלכסון מייצגים את ה-recall עבור כל מחלקה ולא את דיוק הסיווג הכולל, המדווח בנפרד. אנא לחצו כאן כדי להציג גרסה מורחבת של איור זה.
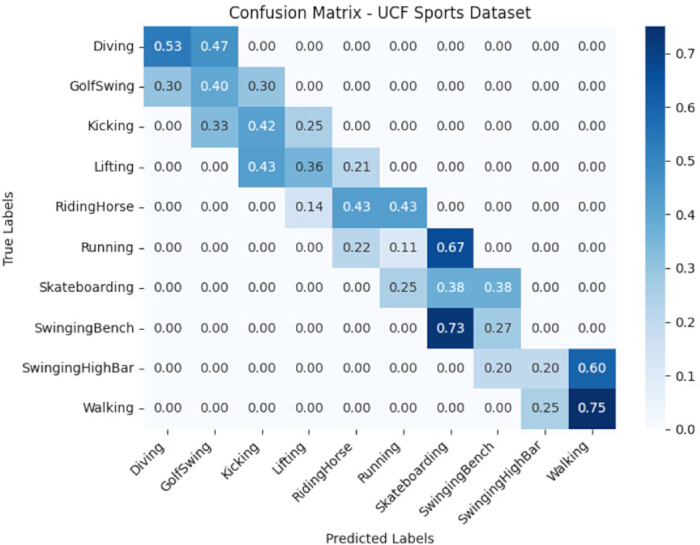
איור 1מטריצת בלבול מנורמלת לפי שורות של מודל ה-MSCNN-LSTM המוצע על מאגר הנתונים UCF Sports. כל שורה מנורמלת ליחידה, והערכים באלכסון מייצגים את ה-recall ( Recall) עבור כל מחלקה ולא את דיוק הסיווג הכללי, שדווח בנפרד. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
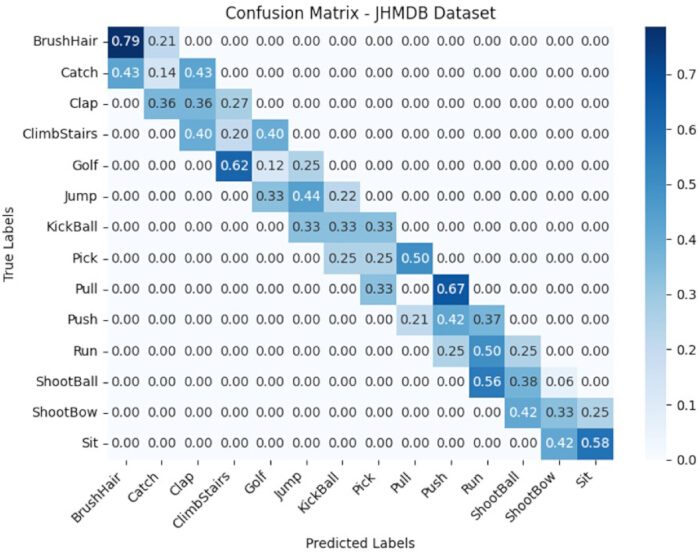
איור 12מטריצת בלבול מנורמלת לפי שורות של מודל ה-MSCNN-LSTM המוצע על מערך הנתונים JHMDB. כל שורה מנורמלת לאחד, והערכים באלכסון מייצגים את ה-recall עבור כל מחלקה ולא את דיוק הסיווג הכולל, המדווח בנפרד. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
באופן כללי, מסגרת ה-MSCNN-LSTM המוצעת הראתה ביצועים עקביים יותר מהמודלים להשוואה שנבחנו במדדי סיווג, הסכמה, הבחנה ויציבות זמנית. הממצאים תמכו בהשערה ששילוב של מיצוי מאפיינים מרחביים רב-קנימיים עם מידול זמני מבוס LSTM שיפר את זיהוי פעולות הספורט במאגרי נתונים בעלי מורכבות תנועה, איכות תמונה ותנאי נקודת מבט משתנים.
זמינות נתונים:
מערכי הנתונים שנותחו במהלך המחקר הנוכחי זמינים לציבור מהמקורות הבאים: מערך הנתונים UCF1 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) ומערך הנתונים UCF Sports (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). כדי לתמוך בשחזור המחקר, צינור העיבוד המקדים (preprocessing pipeline), חלוקת מערכי הנתונים (יצירת פיצול של אימון/תיקוף/בדיקה), קובצי המימוש, קובצי התצורה והתיעוד התומך ששימשו בניסויים הופקדו במאגר Zenodo והם זמינים לציבור בכתובת https://doi.org/10.5281/zenodo.21020947.
דיון
מסגרת ה-MSCNN-LSTM המוצעת הראתה ביצועים עקביים יותר מהגישות שנבחנו במאגרי הנתונים benchmark של UCF11, UCF Sports ו-JHMDB. שיטות קודמות המבוסות על Dilated CNN–BiLSTM, ארכיטקטורות Vision Transformer ו-3D CNNs הדגימו למידה יעילה של מאפיינים מרחביים-זמניים (spatiotemporal), אך הן עלולות להיות מוגבלות בשל סיבוכיות חישובית גבוהה, דרישות אימון משמעותיות או ייצוג לא מספיק של תבניות תנועה עדינות23,24,25. לעומת זאת, המסגרת המוצעת שילבה מיצוי מאפיינים מרחביים רב-קנימיים (multi-scale) עם מידול זמני מבוס LSTM, מה שאיפשר ללכוד הן פרטי תנועה מקומיים והן תלות זמנית לטווח רחוק. שילוב זה שיפר את הזיהוי של פעולות ספורט מורכבות, הפחית בלבול בין מחלקות (inter-class confusion) ושיפר את העקביות הזמנית, במיוחד במאגר הנתונים המאתגר יותר JHMDB. ממצאים אלו מעידים כי המסגרת המוצעת סיפקה ייצוג מאוזן של מידע מרחבי וזמני בהשוואה לגישות המבוסות על CNN, רשתות רקורסיביות ו-transformer שנבחנו.
מנקודת מבט תיאורטית, מסגרת ה-MSCNN-LSTM סיפקה גישה מאוחדת למיזוג מאפיינים רב-קנימי וללמידה רצפית-זמנית36,37. השימוש בשדות רספטיביים היררכיים אפשר את מיצוי המידע המרחבי בקניינים שונים, בעוד שה-LSTM מידל תלויות בין פריימים עוקבים בווידאו. תכנון זה הרחיב את תהליך ה-CNN-LSTM הקונבנציונלי על ידי שימור מידע מרחבי מקומי והקשרי לפני המידול הזמני. הביצועים העקביים במאגרי נתונים הכוללים מחלקות פעולה, תבניות תנועה ונקודות מבט של מצלמה מגוונות תמכו עוד יותר בחסון של הארכיטקטורה המוצעת.
מנקודת מבט מעשית, המסגרת הראתה פוטנציאל לניתוח ספורט אוטומטי, הערכת ביצועי ספורטאים, זיהוי אירועים והבנת סרטוני ספורט. עם זאת, נדרשת תיקוף נוסף בתנאי הפעלה של העולם האמיתי לפני הפריסה. למרות שהארכיטקטורה השיגה ביצועי זיהוי חזקים, יש לאשר את התאמתה למכשירים בעלי משאבים מוגבלים או לפלטפורמות ניתוח מבוסות ענן באמצעות הערכה נוספת של העלות החישובית, זמן ההסקה, דרישות הזיכרון וצריכת האנרגיה.
מחקר האבלציה (ablation study) הדגים את התרומות המשלימות של רכיבי ה-MSCNN וה-LSTM. ה-MSCNN שיפר את מיצוי המאפיינים המרחביים על ידי למידת ייצוגים במספר קשקי שדות רספטיביים (receptive-field scales), בעוד שה-LSTM שיפר את המידול הזמני באמצעות לכידת תלויות תנועה בין פריימים עוקבים. תצורת ה-MSCNN-LSTM המלאה השיגה את הביצועים הטובים ביותר, מה שמעיד על כך שמיצוי מאפיינים מרחביים רב-קשקי ומידול רצפים זמני תרמו במשותף לשיפור שנצפה בזיהוי הפעולות.
באופן כללי, מסגרת ה-MSCNN-LSTM המוצעת שילבה ביעילות למידה של ייצוגים מרחביים וזמניים לצורך זיהוי פעולות בסרטוני ספורט. הערכה על מאגרי הנתונים UCF1, UCF Sports ו-JHMDB הראתה ביצועים משופרים בהשוואה לגישות הלמידה העמוקה שנבחנו. תוצאות אלו תמכו בהשערה כי שילוב של מאפיינים קונבולוציוניים רב-קנימיים עם מידול זמני מבוס LSTM משפר את זיהוי פעולות ספורט מורכבות. עם זאת, נדרשת תיקוף על מאגרי נתונים גדולים, מגוונים יותר וחוצי-דומיינים כדי לבס את יכולת ההכללה והיישומיות בעולם האמיתי.
יש לשקול מספר מגבלות. ראשית, ההערכה הוגבלה למאגרי נתונים של benchmark הזמינים לציבור, וייתכן שהיא אינה מייצגת באופן מלא את הגיוון והמורכבות של סביבות ספורט בעולם האמיתי. שנית, למרות שנעשה שימוש בחלוקות קבועות לאימון, תיקוף ובדיקה, לא ניתן היה לשלול לחלוטין הטיות במאגר הנתונים ודליפה לא מכוונת של נתונים. שלישית, הביצועים המדווחים עשויים להשתנות בהתאם להרכב מאגר הנתונים, אתחול המודל, נהלי עיבוד מקדים והגדרות האימון. בנוסף, רכיבי המידול הקונבולוציוני והזמני רב-הקנה הגבירו את הדרישות החישוביות, דבר שעשוי להשפיע על הפריסה במכשירים עם משאבים מוגבלים. המסגרת לא נבחנה גם כן באמצעות מאגרי נתונים חיצוניים או תרחישי ייצור בזמן אמת.
מודלי וידאו מבוססי Transformer הראו ביצועים חזקים במאגרי נתונים רחבי-היקף לזיהוי פעולות, אך לעיתים קרובות הם דורשים משאבים חישוביים משמעותיים ונתוני אימון נרחבים. מסגרת ה-MSCNN-LSTM המוצעת מציעה גישה חלופית על ידי שילוב של מיצוי מאפיינים מרחביים רב-קנימיים (multi-scale) עם מידול זמני רקורסיבי. עבודות עתידיות צריכות לבחון תיקוף בין-מאגרי נתונים, הסקה בזמן אמת, אופטימיזציה חישובית, הערכת אי-ודאות, וארכיטקטורות היברידיות המשלבות מנגנוני קשב מבוססי transformer עם מסגרת ה-multi-scale CNN-LSTM המוצעת38.
גילויים
המחברים מצהירים כי אין ניגודי אינטרסים.
תודות
מחקר זה נערך במרכז לטכנולוגיית בינה מלאכותית (CAIT), הפקולטה למדעי המידע וטכנולוגיה, Universiti Kebangsaan Malaysia. המחברים מודים על התמיכה המוסדית ועל מתקני המחקר שסופקו. עבודה זו לא קיבלה מימון ספציפי מכל סוכנות מימון ציבורית, מסחרית או ללא מטרת רווח.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| מעבד גרפי GeForce RTX 3090 | NVIDIA Corporation | RTX 3090, 24 GB VRAM | מש לאימון ולהסקה של מודלי למידה עמוקה |
| מעבד Intel Core i9 | Intel Corporation | 16 ליבות, 3.5 GHz | מש לעיבוד מקדים של נתונים ולחישוב |
| זיכרון המערכת | גנרי | 64 GB DDR4 RAM | תומך בעיבוד וידאו רחב-היקף |
| שפת התכנות Python | Python Software Foundation | גרסה 3.8.18 | שפת התכנות העיקרית למימוש |
| TensorFlow | גוגל | גרסה 2.15 | מסגרת למידה עמוקה ששימשה לפיתוח המודל |
| מערכת הפעלה | Microsoft Corporation | Windows 1 | פיתוח מודלים וניסויים |
| ערכת הכלים CUDA (CUDA Toolkit) | NVIDIA Corporation | CUDA 1.8 | האצה באמצעות GPU לאימון מודלים |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | ספריית האצה לרשתות עצביות עמוקות |
| OpenCV | קוד פתוח | גרסה 4.8.1 | חילוץ פרימיות וידאו ועיבוד מקדים |
| NumPy | קוד פתוח | גרסה 1.24.4 | חישוב נומרי ועיבוד מערכים |
| Scikit-learn | קוד פתוח | גרסה 1.3.2 | הערכת ביצועים וניתוח סטטיסטי |
| Matplotlib | קוד פתוח | גרסה 3.7.5 | ויזואליזציה של תוצאות ניסוייות |
| סט הנתונים UCF1 | אוניברסיטת מרכז פלורידה | מאגר נתונים ציבורי | ערכת נתוני ייחוס לזיהוי פעולות ספורט |
| מאגר נתוני הספורט של UCF | אוניברסיטת מרכז פלורידה | מאגר נתונים ציבורי | סט רכיב נתונים (dataset) להערכה של זיהוי פעולות ספורט |
| מאגר הנתונים JHMDB | מכון מקס פלנק לאינפורמטיקה | מאגר נתונים ציבורי | סט רכיבי נתונים למד של זיהוי תנועה ופעולה אנושית |
מקורות
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543