פרוטוקול זה מתאר את היישום של פלטפורמת אינטרנט עם יכולת פעולה הדדית המשלבת נתונים קליניים מבוססי FHIR עם יצירה מועשרת באחזור (Retrieval-Augmented Generation) ומודלי שפה גדולים מרובי-סוכנים לתמיכה בהחלטות קליניות. זרימת העבודה מאפשרת פריסה ניתנת לשחזור, אינטגרציה סטנדרטית של נתונים והערכה של ניתוח נתונים רפואיים בסיוע בינה מלאכותית (AI).
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
פלטפורמת רשת עם יכולת פעולה הדדית המבוססת על מודלי שפה גדולים לניתוח נתונים רפואיים: פרוטוקול לתמיכה בקבלת החלטות קליניות
במאמר זה
סיכום
תקציר
קבלת החלטות קליניות נבלמת לעיתים קרובות על ידי רשומות בריאות אלקטרוניות מקוטעות ויכולת קישוריות (interoperability) מוגבלת בין מערכות מידע בריאותיות הטרוגניות. מאמר זה מציג פרוטוקול שלב-אחרי-שלב להטמעת פלטפורמת רשת בעלת יכולת קישוריות המשלבת נתונים קליניים באמצעות תקן Fast Healthcare Interoperability Resources (FHIR), לצד Retrieval-Augmented Generation (RAG), מודלי שפה גדולים (LLMs), ומסגרת הסקה קלינית רב-סוכנית (multi-agent) לתמיכה בניתוח נתונים רפואיים ותמיכה בקבלת החלטות קליניות. הפרוטוקול מתאר את זרימת העבודה המלאה, כולל הגדרת סביבת מחשוב, עיבוד מקדים של מערכי נתונים קליניים, אינטגרציית נתונים מבוססת FHIR, בניית בסיס נתונים וקטורי, הגדרת שליפה (retrieval), הנדסת פרומפטים, תזמור רב-סוכני והערכת המערכת. תוצאות מייצגות מדגימות את יכולתה של הפלטפורמה להפיק תגובות רלוונטיות קלינית ועקביות מבחינת ההקשר, תוך שיפור הקישוריות הסמנטית בין מקורות נתונים הטרוגניים. ביצועי המערכת הוערכו באמצעות מדדים כמותיים וסמנטיים משלימים, כולל BLEU, ROUGE, BERTScore ודמיון קוסינוס (cosine similarity). הערכה איכותית בוצעה באמצעות מערכי נתונים רפואיים של benchmark הזמינים לציבור ואנונימיים לחלוטין, כדי להעריך את השחזוריות של זרימת העבודה המתודולוגית המוצעת. הארכיטקטורה המוצעת משלבת קישוריות בריאותית סטנדרטית עם מודלי שפה משופרי-שליפה כדי לשפר הסקה הקשרית, להפחית הזיות (hallucinations) ולתמוך בתהליכי עבודה קליניים שחזירים הנעזרים ב-AI. פרוטוקול זה מספק מסגרת ניתנת להרחבה ושחזור עבור חוקרים ומפתחים השואפים להטמיע מערכות בריאות חכמות, מודעות לפרטיות ובעלות יכולת קישוריות לתמיכה בקבלת החלטות קליניות, ניתוח נתונים רפואיים ומחקר תרגומי עתידי.
מבוא
מידע בריאותי נוצר באופן שגרתי בבתי חולים, מרכזים לאבחון, מעבדות ומרפאות חוץ, ולעיתים קרובות הוא נשאר מפוזר בין מערכות מידע הטרוגניות. פרגמנטציה זו מגבילה את יכולת ההחלפה (interoperability) ומגבילה את הגישה המהירה לרשומות מטופלים מקיפות, דבר היוצר אתגרים מתמשכים בטיפול קליני, באינטגרציית נתונים ובניהול שירותי הבריאות1,2,3,4.
ההשלכות של פרגמנטציה זו הופכות לבולטות במיוחד בזרימות עבודה קליניות התלויות בגישה מהירה למידע על המטופל. כאשר אנשי מקצוע בתחום הבריאות אינם יכולים לשלוף רשומות רפואיות מלאות ואינטגרטיביות, ההערכה הקלינית הופכת לקשה יותר, מה שמעלה את הסיכון לקבלת החלטות חלקית ומפחית את יעילות מתן הטיפול, במיוחד במצבי חירום5,6.
התפתחויות אחרונות בבינה מלאכותית (AI), ובמיוחד במודלי שפה גדולים (LLMs), הרחיבו את מגוון הגישות החישוביות הזמינות ליישומים בתחום הבריאות. מודלים אלו נבחנו במשימות כגון סיוע באבחון, טריאז' קליני ותמיכה בקבלת החלטות. לדוגמה, Jahan et al.5 העריכו את השימוש ב-LLMs במשימות ביו-רפואיות, בעוד ש-Taylor et al.7 חקרו מודלים שעברו כוונון עדין (fine-tuned) לסריקת בריאות נפשית דיגיטלית, ודיווחו על תוצאות מעודדות במסגרות קליניות ייעודיות.
היישום של מודלי שפה גדולים (LLMs) התרחב גם לתחומים קליניים ייעודיים יותר. Song et al. 49 בחנו את השימוש בהם לאבחון פנוקוניוזיס (pneumoconiosis), בעוד ש-Chien et al.8 יישמו מודלים אלו כדי לנתח דפוסי עומס עבודה בקרב מטפלים לא פורמליים. ברפואת עיניים, Xue et al.9 הציעו מערכת למתן תשובות לצורך אבחון גלאוקומה, בעוד ש-Tan et al.3 ו-Wu et al.10 דיווחו על שימוש ב-LLMs במערכות אבחון היברידיות ובייעוץ של רפואה סינית מסורתית.
השימוש במודלי שפה גדולים (LLMs) אינו מוגבל ליישומים קליניים ישירים. Zhang et al.11 חקרו את יישומם לזיהוי רגשות בתרחישים של בריאות הנפש, בעוד ש-Sarzaeim et al.12 בחנו מערכות שיטור חכמות שעשויות לתרום גם לניתוחים הקשורים לבריאות הציבור. מחקרים אלה ממחישים את הישימות הרחבה של גישות מבוססות LLM בתחומים שונים הקשורים לשירותי בריאות.
אף על פי ש-LLMs הרחיבו את האפשרויות ליישומים בתחום הבריאות, שילובם בסביבות קליניות נותר קשור לאתגרים טכניים, ארגוניים ורגולטוריים משמעותיים. פריסה מעשית דורשת תשתית מחשוב מתאימה, ממשל נתונים אפקטיבי ועמידה במסגרות רגולטוריות כגון תקנת הגנת הנתונים הכללית (GDPR) וחוק הגנת הנתונים הכללי של ברזיל (LGPD). מסגרות אלו קובעות דרישות לעיבוד מאובטח ואתי של מידע בריאותי רגיש, תוך התייחסות לסוגיות הקשורות לפרטיות, אמינות והטיה אלגוריתמית במערכות בריאות מסייעות בבינה מלאכותית13,14.
יכולת פעולה הדדית בין מקורות נתונים הטרוגניים של שירותי בריאות, כולל רשומות בריאות אלקטרוניות (EHRs), מערכות דימות רפואיות ומכשירי האינטרנט של הדברים (IoT), ממשיכה להוות אתגר טכני מרכזי בפריסת פתרונות בריאות מבוססי בינה מלאכותית (AI). בהקשר זה, מסגרות עבודה סטנדרטיות ליכולת פעולה הדדית כגון HL7 FHIR מספקות מנגנון מובנה להחלפת מידע קליני בין מערכות שונות תוך שמירה על עקביות סמנטית ותמיכה באינטגרציה ניתנת להרחבה.
עבודה זו מציגה פלטפורמת רשת בעלת יכולת פעולה הדדית המשלבת מודלי שפה גדולים (Large Language Models) עם תקני קישוריות של מערכות בריאות כדי לתמוך בניתוח נתונים רפואיים בסביבות קליניות הטרוגניות. הארכיטקטורה המוצעת משלבת אינטגרציית נתונים מבוססת HL7 FHIR עם יצירה מוגברתת-אחזור (Retrieval-Augmented Generation - RAG) ומסגרת עיבוד רב-סוכנית כדי לספק ניתוח מונחה בינה מלאכותית המודע להקשר, תוך שמירה על הלימה עם דרישות הגנת הנתונים הרלוונטיות, כולל החוק הברזילאי להגנה על נתונים כלליים (LGPD).
פרוטוקול זה מתאר ארכיטקטורה בעלת יכולת פעולה הדדית (interoperable) לשילוב נתונים קליניים הטרוגניים תוך שימוש בתקני קישוריות מקובלים בתחום הבריאות. כמו כן, הוא מפרט את היישום של צינור עיבוד רב-סוכנים (multi-agent processing pipeline) המבוסס על מודלי שפה גדולים וקטנים (LLMs ו-SLMs), יחד עם מסגרת הערכה המשלבת מדדים כמותיים וניתוחים איכותיים להערכת התנהגות הפלטפורמה המוצעת.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
מחקר זה לא כלל גיוס של משתפים אנושיים, גישה לרשומות רפואיות מזוהות של מטופלים, או ניסויים הכוללים בעלי חיים. הפרוטוקול פותח והוערך באופן בלעדי באמצעות מאגרי נתונים זמינים לציבור ואנונימיים לחלוטין לצורך תיקוף מתודולוגי. לא בוצעו גישה או עיבוד של מידע בריאותי אישי. לפיכך, לא נדרש אישור מוועדה לביקורת מוסדית (IRB) או מוועדת אתיקה במחקר. הפרוטוקול פותח בהתאם לעקרונות הגנת הנתונים הרלוונטיים, כולל חוק הגנת הנתונים הכללי של ברזיל (LGPD), כדי לתמוך ביישומים עתידיים הכוללים נתונים קליניים.
בחירה ועיבוד מקדים של מערכי נתונים
הפרוטוקול המוצע הוערך באמצעות מאגרי נתונים קליניים זמינים לציבור ואנונימיים לחלוטין, הכוללים רשומות בריאות אלקטרוניות (EHRs) מובנות, נתוני מענה על שאלות קליניות ומאגרי נתונים של דימות רפואי לצורך תיקוף מתודולוגי. לפני השילוב בפלטפורמה, עברו מאגרי הנתונים הליכי עיבוד מקדמי סטנדרטיים, כולל נרמול נתונים, הסרת רשומות לא עקביות או חסרות, מיפוי למשאבי HL7 FHIR, ניקוי טקסט, פילוח למקטעי אחזור (retrieval chunks) ויצירת וקטורים (embedding) לצורך אינדוקס וקטורי. שלבי עיבוד מקדמי אלו הבטיחו עקביות סמנטית בין מקורות נתונים הטרוגניים, קידמו את יכולת השילוב (interoperability) ואפשרו את השחזור של זרימת העבודה המוצעת, תוך שמירה על עמידה בעקרונות הגנת הפרטיות החלים על הנתונים.
מסדי הנתונים הופקו ממאגרי ביצועים (benchmark) הזמינים לציבור ונהוגים במחקרים בתחומי בינה מלאכותית ובריאות דיגיטלית. הם נבחרו כדי לייצג מידע קליני הטרוגני, הכולל רשומות רפואיות אלקטרוניות (EHRs) מובנות, תיאורים קליניים בלתי מובנים, משימות של מענה על שאלות קליניות ומטא-נתונים של דימות רפואי. במקום להעריך קוהורט קליני ספציפי, הפרוטוקול מתמקד בהדגמת זרימת עבודה ליישום הניתנת לשחזור וניתנת להתאמה למסדי נתונים שונים בתחום הבריאות. הגיוון של מסדי נתונים אלו מאפשר תיקוף של צינור השוריינות (interoperability pipeline), מחולל מוגבר באחזור (RAG), ומסגרת הסקה מרובת סוכנים על פני מודליות שונות של נתונים קליניים.
הגדרת סביבת הניסוי
הסביבה הניסויית הוקמה כדי להעריך את הפלטפורמה בעלת יכולת ההסבה (interoperable platform) תחת תנאים מבוקרים וניתנים לשחזור. הארכיטקטורה מורכבת ממודולי קליטת נתונים, שכבות קישוריות, מודלי שפה גדולים (LLMs) ומרכיבי הערכה, המאורגנים בתוך צינור עיבוד יחיד לניתוח נתונים רפואיים. איור 1 ממחיש את זרימת העבודה המלאה, מקליטת הנתונים הקליניים ועד להפקת הפלטים האבחנתיים.
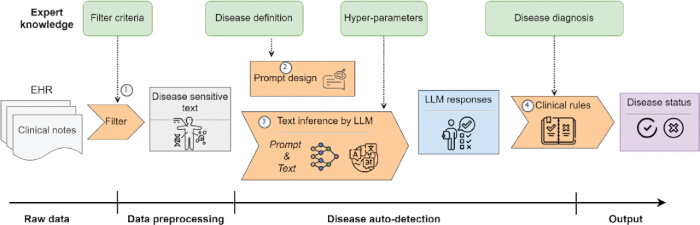
איור 1זרימת עבודה כוללת של המערכת, הממחישה את צינור העיבוד מנתונים קליניים גולמיים ועד לפלט של מצב המחלה. התהליך מתחיל בקליטה של רשומות בריאות אלקטרוניות (EHR), ולאחריה סינון נתונים ועיבוד מקדים להוצאת מידע הרגיש למחלה. שלב תכנון פרומפט מובנה משלב ידע של מומחים, הגדרות מחלה והיפר-פרמטרים, המאפשרים אינטראקציה יעילה עם מודל שפה גדול (LLM). ה-LLM מבצע הסקת מסקנות טקסטואלית כדי להפיק תגובות מודעות להקשר, אשר מוערכות לאחר מכן באמצעות כללים קליניים כדי לקבוע את סטטוס המחלה הסופי. זרימת העבודה מדגישה את השילוב של עיבוד מקדים של נתונים, פרומפטינג מונחה-ידע והסקה מבוססת בינה מלאכותית לתמיכה בקבלת החלטות קליניות. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
ארכיטקטורת קישוריות (interoperability) במערכות בריאות
תשתית ה-backend מאמצת ארכיטקטורה מודולרית המבוססת על RESTful APIs כדי לתמוך בתקשורת בין רכיבי הפלטפורמה (איור 2). ארכיטקטורה זו תואמת מידע קליני הטרוגני, כולל רשומות בריאות אלקטרוניות (EHRs) מובנות, הערות רופא ומטא-נתונים המופקים ממערכות דימות רפואיות. מכיוון שנתונים אלו מקורם במקורות ובפורמטים מרובים, הפיעילות ההדדית (interoperability) הושגה באמצעות מודלים סטנדרטיים של נתונים, ובמיוחד את מסגרת Fast Healthcare Interoperability Resources (FHIR)15,16,17..אימוץ FHIR תומך בחילוף מידע מובנה תוך שמירה על סקילביליות וגמישות בסביבות בריאות מבוזרות. מנגנוני תקשורת מבוססי HL7 שולבו גם הם כדי להקל על האינטגרציה עם מערכות קליניות ישנות, שעדיין נמצאות בשימוש נרחב במוסדות בריאות16,17.
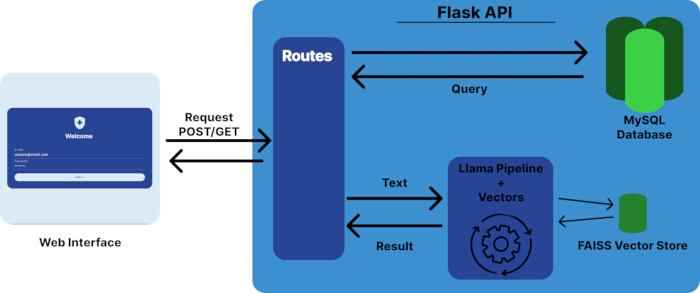
איור 2ארכיטקטורת המערכת של הפלטפורמה הבין-תפעולית המוצעתממשק האינטרנט מתקשר עם צד השרת (backend) באמצעות Flask API באמצעות בקשות HTTP POST/GET. ה-API מנהל את הניתוב, עיבוד השאילתות והאינטראקציה עם מקורות נתונים מובנים ובלתי מובנים כאחד. מסד נתונים מסוג MySQL מאחסן נתונים קליניים מובנים, בעוד שמאגר וקטורים המבוס על FAISS תומך בחיפוש דמיון לצורך פעולות שליפה. צינור העיבוד (pipeline) המבוסס על LLaMA מעבד קלטים טקסטואליים ומייצר תגובות באמצעות ייצוגים וקטוריים, מה שמאפשר יצירה מוגברת בשליפה (RAG). הארכיטקטורה מדגישה את השילוב של שירותי רשת, ניהול מסדי נתונים, שליפה וקטורית והסקה של מודל שפה גדול במערכת מאוחדת. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של דמות זו.
הגדרת זרימת עבודה רב-סוכנית
ארכיטקטורת הרב-סוכנים מאורגנת לסוכנים פונקציונליים מומחים האחראים על שלבים שונים של זרימת העבודה. סוכן עיבוד מקדמי מבצע נורמליזציה של נתונים ומיפוי FHIR, ולאחריו סוכן שליפה האחראי על חיפוש סמנטי בתוך בסיס הנתונים הווקטורי. סוכן הסקה משלב את ההקשר שנשלף עם ה-LLM כדי להפיק תגובות, בעוד שסוכן אימות בודק את עקביות הפלט ואת העיצוב לפני החזרת התגובה הסופית. תיאום הסוכנים פועל לפי אסטרטגיית ניהול רצפית שבה הפלט של כל סוכן משמש כקלט לשלב הבא, מה שמבטיח מימוש מודולרי וניתן לשחזור.
אינטגרציה של נתונים קליניים
שכבת אינטגרציית הנתונים מרכזת מידע ממספר מקורות קליניים ומכינה אותו לעיבוד המשכי. עיבוד מקדים כולל נורמליזציה של נתונים, טוקניזציה (tokenization) והתאמת ישויות כדי לשפר את העקביות הסמנטית בין מערכי נתונים הטרוגניים. מכיוון שמידע קליני משתנה במבנהו ובאיכותו, פעולות אלו מסייעות להפחית רעשים ולהקל על האינטראקציה עם מודלים של בינה מלאכותית (AI). כמו כן, הוחלו אסטרטגיות מיפוי מובנות כדי להאחיד פורמטים שונים של נתונים ולשמור על תאימות עם צינור העיבוד, כפי שמוצג ב-איור 315,16,17.
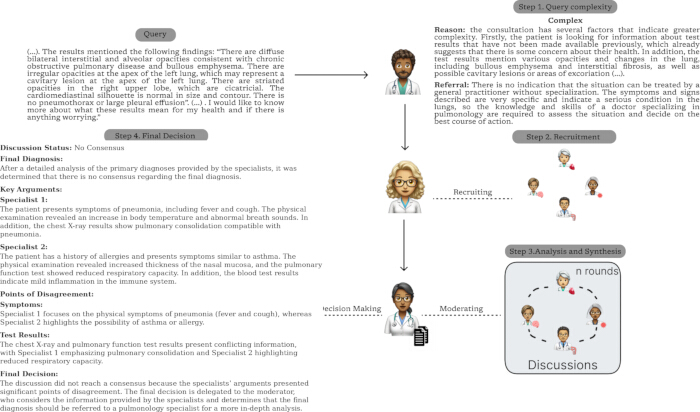
איור 3דוגמה מפורטת לתהליך הסקה קלינית מרובה-סוכניםהאיור ממחיש כיצד שאילתה קלינית מנותחת דרך מספר שלבים, הכוללים הערכת מורכבות, גיוס מומחים, דיון שיתופי וקבלת החלטה סופית. תהליך זה מדגים את יכולתו של המערכת להתאים באופן דינמי אסטרטגיות הסקה על בסיס מורכבות השאילתה, ובכך לשפר הן את היעילות והן את הדיוק האבחנתי בתרחישים של תמיכה בהחלטות קליניות. אנא לחצו כאן כדי להציג גרסה גדולה יותר של דמות זו.
הגדרת תוכנית העבודה (pipeline) של יצירה מוגברת באחזור (Retrieval-Augmented Generation)
יצירה מוגברתת שולף (Retrieval-Augmented Generation - RAG) משולבת כדי לספק ניתוח מודע להקשר על ידי שילוב של אחזור מידע עם היכולות הגנרטיביות של מודלי שפה גדולים. שאילתות משתמש מומרות לייצוגים וקטוריים באמצעות מודלי שיכון (embedding models) ומושוות למסד הנתונים הוקטורי באמצעות חיפוש דמיון סמנטי כדי לאחזר את קטעי ההקשר הרלוונטיים ביותר. המסמכים שנשלפו משולבים לאחר מכן עם השאילתה המקורית לפני ביצוע ההסקה על ידי ה-LLM. אסטרטגיה זו מסייעת לספק מידע הקשרי במהלך יצירת התגובה וקושרה לשיפור בעקביות עובדתית ולהפחתת הזיות (hallucinations) ביישומים עתירי ידע, כולל שירותי בריאות18,19. איור 1 ו-איור 3 ממחישים את זרימת העבודה הכוללת של השליפה ואת תהליך ההסקה התואם.
עבור כל בקשה של משתמש, הפרומפט הסופי נבנה באופן דינמי על ידי שילוב השאילתה המקורית עם הקטעים ההקשריים הרלוונטיים ביותר שנשלפו ממאגר הנתונים הווקטורי. המידע שנשלף משולב כראיה הקשרית לפני שלב ההסקה, מה שמאפשר למודל השפה להפיק תגובות המבוסות על ידע רפואי שנשלף, תוך שמירה על עקביות סמנטית וצמצום של תוצרי השלמה שאינם נתמכים בנתונים.
הנדסת פרומפטים והסקה רב-סוכנית
הפרוטוקול משלב אסטרטגיות של הנחיה מובנית (structured prompting) כדי לשפר את הפרשנות ההקשרית במהלך יצירת התגובה. טכניקות הנחיה אלו, יחד עם מנגנוני הסקה מתקדמים, מסייעות בהכוונת תהליך החשיבה בתרחישים קליניים מורכבים ועקביות עם התפתחויות אחרונות שדווחו בספרות20.
הארכיטקטורה כוללת מסגרת רב-סוכנים המורכבת ממודולים ייעודיים המבצעים פונקציות נפרדות בתוך צינור העיבוד, כולל אימות נתונים, סינון הקשר, תמיכה בחשיבה קלינית ואימות פלט. הארגון המודולרי מאפשר ביצוע משימות באופן סדרתי או במקביל, ובכך מספק גמישות לדרישות עיבוד שונות (איור 4). חלוקת פעילויות אלו בין מספר סוכנים מפחיתה את ההסתמכות על מודל שפה יחיד ותומכת בזרימת עיבוד חסונה יותר. אסטרטגיה ארכיטקטונית זו עולה בקנה אחד עם התפתחויות אחרונות בתחומי הבינה המלאכותית המבוזרת ועיצוב מערכות אינטליגנטיות21,2.
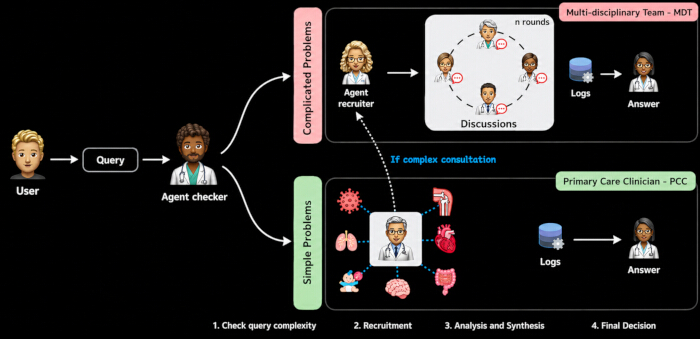
איור 4מסגרת קבלת החלטות רב-סוכנית לחשיבה קליניתהתהליך מתחיל בשאילתת משתמש, הנבדקת על ידי בודק-סוכן האחראי להערכת מורכבות השאילתה. במקרים מורכבים, המערכת מגייסת באופן דינמי צוות רב-תחומי (MDT) של סוכנים מומחים, המקיימים סבבי דיון איטרטיביים כדי לנתח את הבעיה ולסנתז ידע לפני קבלת החלטה סופית. במקרים פשוטים יותר, השאילתה מטופלת על ידי סוכן קלינאי רפואה ראשונית (PCC), מה שמאפשר יצירה מהירה יותר של תגובה. ארכיטקטורה אדפטיבית זו מאזנת בין יעילות לעומק אנליטי, ובכך משפרת את איכות ההחלטות ואת יכולת ההתרחבות של המערכת ביישומי בריאות. אנא לחץ כאן כדי להציג גרסה גדולה יותר של דמות זו.
הערכת ביצועים
ביצועי המערכת הוערכו באמצעות מדדים משלימים הלוכדים הן את האיכות הלשונית והן את העקביות הסמנטית של הפלטים הנוצרים. מדד ה-BLEU יושם למדידת דמיון תחבירי בהתבס על חפיפת n-grams23, בעוד שמד ROUGE העריך את הrecall ואת כיסוי התוכן, במיוחד במשימות סיכום והפקת מידע24. דמיון סמנטי הוערך באמצעות BERTScore, המשתמש בטמיעות (embeddings) קשריות הגזורות ממודלים מבוססי transformer כדי להשוות בין טקסטים נוצרים לטקסטים של ייחוס25. ניתוחים נוספים כללו perplexity ודמיון קוסינוס (cosine similarity) לבחינת ביטחון המודל והקוהרנטיות הסמנטית, בהתאמה26,27.
מדדי ההערכה שנבחרו מספקים נקודות מבט משלימות על ביצועי המערכת על ידי שילוב של ניתוחים לקסיקליים וסמנטיים. שילוב זה רלוונטי במיוחד ביישומים בתחום הבריאות, שבהם פרשנות הקשרית חשובה לא פחות מדמיון לקסיקלי. הפלטפורמה הוערכה בסביבה חישובית מבוקרת התומכת הן בפריסה מבוססת ענן והן בפריסה מקומית. הרצה מקומית של LLMs נכללה כאפשרות כדי לתמוך בדרישות פרטיות נתונים ולהפחית את ההסתמכות על שירותים חיצוניים בעת עיבוד מידע קליני רגיש. אסטרטגיית פריסה זו תואמת למסגרות הגנה על נתונים וניתנת להתאמה לסביבות תפעוליות שונות4.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
ביצועי המערכת הוערכו באמצעות מדדים כמותיים משלימים יחד עם ניתוח איכותי, כדי לבחון הן את הדיוק הלשוני והן את העקביות הסמנטית של הפלטים הנוצרים. אסטרטגיית הערכה זו משלבת מדדים לקסיקליים וסמנטיים כדי לספק אפיון רחב יותר של התנהגות המודל במשימות של יצירת שפה הקשורה לשירותי בריאות.
טבלה 1 מציגה את התוצאות הכמותיות שהתקבלו באמצעות BLEU, ROUGE ו-BERTScore. מדדים אלו נבחרו מכיוון שהם מעריכים היבטים משלימים של טקסט שנוצר, כולל דמיון לקסיקלי, כיסוי מידע והלימה סמנטית, והם נמצאים בשימוש ...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
ההערכה המוצגת במחקר זה מייצגת תיקוף מתודולוגי שבוצע באמצעות מאגרי נתונים של שירותי בריאות המהווים מדדי ייחוס (benchmarks) זמינים לציבור ואנונימיים לחלוטין. לא בוצע תיקוף קליני פרוספקטיבי הכולל אנשי מקצוע בתחום הבריאות או גיוס מטופלים, שכן מטרתו של מחקר זה היא להדגים פרוטוקול יישום הניתן לשחזור ולא את היעילות הקלינית.
ממצאי מחקר זה מצביעים על כך ששילוב של תקני קישוריות (interoperability) במערכות בריאות עם מודלי שפה גדולים מספק מסגרת מעשית לשילוב מידע קליני הטרוגני. הארכיטקטורה המוצעת מאגדת מנגנ...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
המחברים מצהירים כי אין ניגודי אינטרסים פיננסיים או מערכות יחסים אישיות שעלולים היו להשפיע על העבודה המדווחת במאמר זה. כלי בינה מלאכותית (AI) גנרטיבית שימשו אך ורק כדי לסייע בעריכה לשונית, תיקון דקדוקי ושיפור קריאות המאמר. כל התוכן המדעי, עיצוב המחקר, המתודולוגיה, ניתוח הנתונים, פרשנות התוצאות וההחלטות העריכתיות פותחו, אומתו ואושרו על ידי המחברים, הנושאים באחריות מלאה לתוכן מאמר זה.
תודות
המחברים מבקשים להודות למעבדת המערכות המשובצות והמבוזרות (LESC), באוניברסיטה הפדרלית של סארה (UFC), על אספקת סביבת המחקר והדיונים הטכניים שתמכו בפיתוח עבודה זו. המחברים מודים גם למפתחים ולמתחזקים של התוכנות בקוד פתוח, תקני קישוריות ומסדי הנתונים הזמינים לציבור ששימשו לאורך מחקר זה.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | גרסה 1.8.0 | בסיס נתונים וקטורי המשמש לחיפוש דמיון בצינור העיבוד של יצירה מועשרת באחזור (RAG). |
| תקן FHIR | HL7 International | גרסה 4 (R4) | תקן קישוריות למערכות בריאות שאומץ להחלפת נתונים קליניים מובנים. |
| בקבוק מעבדה | פרויקטי משטחים | גרסה 3.0.3 | מסגרת פיתוח אינטרנט (web framework) של Python המשמשת להטמעת ה-API של ה-backend מסוג RESTful. |
| תקן HL7 | HL7 International | גרסה 2.x | פרוטוקול העברת הודעות מיושן המשמש לצורך קישוריות (interoperability) עם מערכות מידע בית-חולים. |
| ממשק תכנות יישומים (API) מסוג HTTP REST | יישום מותאם אישית | לא רלוונטי | שכבת תקשורת RESTful בין צד לקוח (frontend), צד שרת (backend), בסיס נתונים ושירותי בינה מלאכותית (AI). |
| LangChain | LangChain Inc. | גרסה 0.3.x | מסגרת המשמשת לשילוב של מודלי שפה גדולים (LLMs), הנדסת פרומפטים ותהליכי עבודה של יצירה מוגברתת-שליפה (Retrieval-Augmented Generation). |
| LangGraph | LangChain Inc. | גרסה 0.2.x | מסגרת העבודה ששימשה לתיאום זרימת העבודה של הסקה קלינית רב-סוכנית. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | גרסה 3.1 | מודל שפה גדול (Large Language Model) המשמש להסקה קלינית וליצירת שפה טבעית. |
| MySQL Community Server | Oracle Corporation | גרסה 8.0 | מסד נתונים רלציוני המשמש לאחסון נתונים קליניים מובנים. |
| Ollama | Ollama Inc. | גרסה 0.9.x | מנוע הסקה מקומי המשמש להרצת מודלי שפה גדולים תוך שמירה על פרטיות המטופל. |
| Python | Python Software Foundation | גרסה 3.11 | שפת התכנות ששימשה למימוש הפלטפורמה המלאה. |
| PyTorch | Linux Foundation | גרסה 2.4 | מסגרת למידה עמוקה המשמשת להסקה של מודלי שפה גדולים. |
| תהליך יצירה מוגברת באחזור (RAG) | יישום מותאם אישית | לא רלוונטי | מסגרת בינה מלאכותית המשלבת אחזור סמנטי עם הסקה של מודל שפה גדול (LLM) לצורך יצירת תגובות מודעות-הקשר. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | מודל שיכון (Embedding model) המשמש ליצירת ייצוגי וקטורים צפופים עבור אחזור סמנטי של מסמכים. |
| Ubuntu Linux | Canonical Ltd. | גרסה 24.04 LTS | מערכת ההפעלה ששימשה לפיתוח ולהערכה ניסיונית. |
| Visual Studio Code | Microsoft Corporation | גרסה 1.100 | סביבת פיתוח משולבת המשמשת למימוש תוכנה ולניקוי שגיאות (debugging). |
מקורות
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.