מחקר זה מציג מסגרת דו-שלבית לסיווג כיסוי קרקע באמצעות היפספקטרלי ו-LiDAR, המשתמשת בחילוץ תכונות MetaFormer וב-bidirectional flow matching ליישור בין-מודאלי לפני מיזוג. הערכה על שלושה מאגרי נתונים ציבוריים של benchmark מדגימה ביצועי סיווג תחרותיים תחת פרוטוקולי benchmark קבועים.
מאמר מחקר
למידה רציפה של שדה וקטורים רב-מודאלי לסיווג כיסוי קרקע באמצעות היפר-ספקטרום ו-LiDAR
במאמר זה
סיכום
תקציר
סיווג באמצעות חישוש מרחוק רב-מודאלי ממלא תפקיד חשוב ביישומים כגון מיפוי עירוני וניטור סביבתי. עם זאת, התפלגויות תכונות הטרוגניות בין מודאליות החישוש עלולות להוביל לחוסר התאמה בתכונות (feature misalignment) וחוסר עקביות סמנטית, דבר המגביל את יעילותה של ההיתוך הרב-מודאלי. גישות קיימות להיתוך רב-מודאלי, כולל שיטות קונבולוציוניות, שיטות מבוססות גרפים, שיטות מבוססות קשב (attention), שיטות ניגודיות (contrastive), שיטות מוכוונות-הסעה (transport-oriented) ושיטות מבוססות רצפים, יכולות לנצל מידע משלים אך עשויות שלא ליישר באופן מספק את התפלגויות התכונות הספציפיות למודאליות. מחקר זה מציע את FlowErs, מסגרת סיווג רב-מודאלית דו-שלבית המטפלת באתגר זה באמצעות התאמת זרימה רב-מודאלית (multimodal flow matching). השערת העבודה היא שצמצום הפערים בהתפלגויות התכונות הזוגיות לפני היתוך התכונות משפר את סיווג כיסוי הקרקע תחת פרוטוקולי השוואה קבועים. בשלב הראשון, מקודדי MetaFormer ספציפיים למודאליות מחלצים ייצוגים היררכיים מנתוני דימות היפר-ספקטרלי (HSI) ונתוני LiDAR. לאחר מכן, מודול התאמת זרימה רב-מודאלית לומד שדות מהירות מותנים בזמן כדי להסעה התפלגויות תכונות זוגיות לעבר ייצוג חבוי (latent representation) משותף, תוך שימוש במטרה של שגיאה ריבועית ממוצעת דו-כיוונית. בשלב השני, מודול היישור שהוכשר מראש משמש שוב כדי ליישר ייצוגים רב-מודאליים לפני שראש היתוך קל משקל מבצע סיווג ברמת הפיקסל. הערכה על שלושה מאגרי נתונים ציבוריים להשוואה הדגימה דיוק כולל (OA) מקסימלי של 97.56% תחת חלוקות השוואה קבועות. הביצועים השתנו בין מחלקות כיסוי קרקע בודדות, והמחקר דן במגבלות ספציפיות למחלקות ובהשפעת חוסר איזון בין המחלקות על מדדי הסיכום. ההערכה הנוכחית מוגבלת לניסויי חלוקה קבועה ללא ניתוח סטטיסטי של הרצות חוזרות או פרופיל חישובי. עבודה עתידית תחקור חסינות סטטיסטית, יעילות חישובית והכללה בין אזורים שונים.
מבוא
סיווג מדויק של שימושי קרקע וכיסוי קרקע (LULC) באמצעות הדמיה בחשחול הוא חיוני למגוון רחב של יישומים בעולם האמיתי, כולל פיתוח עירוני, ניטור סביבתי, ניהול אסונות ופיתוח בר-קיימא1. נתונים רב-מודאליים של חישחול, כולל הדמיה היפר-ספקטרלית (HSI), סריקה באמצעות לייזר (LiDAR) ורדאר בעל מפתח סינתטי (SAR), הפכו לזמינים יותר בשנים האחרונות. זמינות מוגברת זו הרחיבה משמעותית את יכולות החישחול לסיווג כיסוי קרקע ברזולוציה גבוהה2. אמצעי חישחול אלו לוכדים מאפיינים שונים אך משלימים של פני השטח של כדור הארץ. HSI מספק מידע ספקטרלי עשיר לאפיון הרכב החומרים, בעוד ש-LiDAR מספק מידע מדויק על מבנה וגובה3. שילוב של מקורות נתונים הטרוגניים אלו יכול להפיק ייצוגי תכונות מבדלים יותר, עמידים יותר לרעשים ומקיפים יותר מבחינה סמנטית מאשר כל מודאליות לבדה4.
על אף זאת, ניצול יעיל של נתונים מולטי-מודאליים (רב-אופנאיים) נותר אתגר מתמשך5. קושי מרכזי נובע מההטרוגניות האינהרנטית של אופנאי החישה, הנבדלים ברזולוציה מרחבית, במאפייני רעש, בהתפלגויות סטטיסטיות ובסמנטיקה של מאפיינים6. לדוגמה, אותו אובייקט כיסוי קרקע עשוי להיות מיוצג כחתימה ספקטרלית רב-ממדית ב-HSI וכמבנים גיאומטריים דלילים ב-LiDAR7. כתוצאה מכך, מאפיינים ספציפיים לאופנאי נמצאים לרוב במגווני מאפיינים (feature manifolds) שונים, מה שהופך מיזוג מאפיינים ישיר לבלתי יעיל או למטעה פוטנציאלית. יתרה מכך, גישות רבות קיימות למיזוג מולטי-מודאלי, כולל שיטות מבוססות קונבולוציה, תשומת לב (attention) ו-Transformer, מניחות במשתמע כי מאפיינים שהופקו מחיישנים שונים כבר מיושרים מרחבית וסמנטית8. עם זאת, הנחה זו לרוב אינה תקפה ביישומים מעשיים. שרשור פשוט של מאפיינים או מיזוג ברמת הפיקסל אינם יכולים ללכוד באופן מספק פערים בין-מודאליים, מה שעלול להוביל לאופטימיזציה לא יציבה ולביצועי הכללה מופחתים. בנוסף, למרות ששיטות מיזוג מבוססות תשומת לב משפרות את האינטראקציה בין מאפיינים, הן עשויות לספק מידול מוגבל של תלות בין-מודאלית לטווח רחוק, הנחוצה לסיווג כיסוי קרקע בקנה מידה גדול או ברזולוציה גבוהה9. כתוצאה מכך, יישור יעיל של ייצוגי מאפיינים הטרוגניים נותר אתגר מרכזי בחישה מרחוק מולטי-מודאלית, כיוון ששיבוצים (embeddings) שאינם תואמים עלולים להגביל את השילוב של מידע משלים.
כדי להתמודד עם אתגר זה, יישור חוצה-מודאלי (cross-modal alignment) מנוסח כבעיה של הובלת מאפיינים מותנית. התאמת זרימה (Flow matching) מספקת מסגרת מבוססת מתמטית ללמידה של מיפויים רציפים והפיכים בין התפלגויות מאפיינים הטרוגניות10. היא מובילה התפלגות אחת לעבר אחרת באמצעות שדה מהירות תלוי-זמן המוגדר על ידי משוואה דיפרנציאלית רגילה (ODE), ובכך מקדמת טרנספורמציות רציפות בין סעפות (manifolds) של מאפיינים11. בניגוד למודלים מבוססי דיפוזיה, המסתמכים על הפרעות רעש סטוכסטיות או התאמת התפלגות משתמעת באמצעות אימון אדברסרי, התאמת זרימה לומדת טרנספורמציות דטרמיניסטיות וביייקטיביות בין מרחבי מאפיינים מובנים12. מאפיינים אלו הופכים את התאמת הזרימה למתאימה לחישוש מרחוק רב-מודאלי, שבו HSI, LiDAR ו-SAR מייצגים כל אחד סעפות מאפיינים רב-ממדיות הלוכדות תכונות משלימות של פני כדור הארץ13. בהתאם לכך, התאמת זרימה מספקת גישה עקרונית לביסוס התאמה חוצה-מודאלית באמצעות הובלת מאפיינים רציפה, תוך קידום עקביות גיאומטרית במהלך יישור המאפיינים. תחת הנחות רגולריות מתאימות, זרימת ODE יכולה לספק מיפוי הפיך; עם זאת, הפיכות מדויקת ופרשנות פיזיקלית לא הוערכו באופן אמפירי במחקר הנוכחי. היפותזת העבודה היא שהפחתת השוני בין התפלגויות מאפיינים מזווגות לפני היתוך המאפיינים משפרת את סיווג כיסוי הקרקע המצטבר תחת חלוקות ייחוס (benchmark splits) קבועות.
כתוצאה משיקולים אלו, המסגרת המוצעת, FlowErs, משלבת שלב יישור מבוסס זרימה (flow-based alignment) בתוך ארכיטקטורה דו-שלבית. בשלב הראשון, רשת זרימה דו-כיוונית מאומנת כדי ליישר את סילוני המאפיינים (feature manifolds) של כל מודאליות. באופן ספציפי, שלדי MetaFormer ייחודיים למודאליות מחלצים קידודים של מאפיינים היררכיים, ומטרת התאמת זרימה (flow-matching objective) מותאמת כדי להעביר דגימות בין התפלגויות מאפיינים ספציפיות למודאליות. תהליך זה מספק טרנספורמציה חלקה והפיכה בין מרחבי מאפיינים, ובכך מעודד ייצוגים השייכים לאותה מחלקה סמנטית להיות מיושרים יותר בתוך מישור חבוי (latent domain) משותף. בשלב השני, מיישר הזרימה שאומן מראש מושבת (frozen), וקלטים רב-מודאליים חדשים עוברים טרנספורמציה לפני שהם ממוזגים על ידי מסווג קל משקל. אסטרטגיית אימון מופרדת זו מפרידה בין יישור גיאומטרי לבין סיווג סמנטי, מה שמאפשר לשני השלבים להבטיע מטרות משלימות. מודול היישור נועד להפחית פערים בהתפלגות המאפיינים לפני מיזוג המאפיינים, ואינו טוען להבטחה מוכחת של שימור נפח. יתרה מכך, FlowErs מספקת ניסוח מפורש של העברת מאפיינים עבור מיזוג רב-מודאלי, אם כי עמידות לשגיאות רישום (registration errors) לא הוערכה בנפרד במחקר הנוכחי.
התרומות העיקריות של מחקר זה מסוכמות כדלקמן. FlowErs מוצגת כמסגרת עבודה (framework) דו-שלבית לסיווג רב-מודאלי של כיסוי קרקע. במסגרת המוצעת, מאפיינים ספציפיים למודאליות מופקים תחילה באמצעות מקודדי MetaFormer ולאחר מכן מיושרים באמצעות מודול מבוסס-זרימה (flow-based module) לפני מיזוג מאפיינים קל-משקל. תכנון מופרד זה תומך באופטימיזציה יעילה תוך שמירה על גמישות בין מודאליות חישה שונות. בנוסף, מחקר זה בוחן התאמת זרימה מותנית (conditional flow matching) כמנגנון להעברת מאפיינים עבור יישור מאפיינים חוצה-מודאליות מזווג ברחשות חישייה מרחוק רב-מודאליות. מודול הזרימה הדו-כיווני חוזה יעדי מהירות מנוגדים עבור ייצוגי מאפיינים מזווגים לפני מיזוג המאפיינים, ובכך מספק אסטרטגיית יישור מפורשת לפני אינטגרציה רב-מודאלית. יתרה מכך, מסגרת העבודה המוצעת נבחנה על שלושה מאגרי נתונים ציבוריים של benchmark, והשיגה דיוק כולל (OA) מקסימלי של 97.56% תחת חלוקות ה-benchmark הקבועות שסופקו. מגבלות ברמת המחלקה והיקף ההערכה הנוכחית מתועדים אף הם באופן מפורש.
התקדמויות אחרונות ב-flow matching ביססו אותו כסביבת מידול גנרטיבית עוצמתית המאחדת מודלים מבוססי דיפוזיה, אנרגיה ותובלה. בניגוד לסימולציה של מסלולים סטוכסטיים, כפי שנעשה במודלי דיפוזיה, flow matching לומד ODE דטרמיניסטי המעביר התפלגות קדם פשוטה, כגון רעש גאוסי, להתפלגות הנתונים של המטרה באמצעות שדה מהירות למידה15. ניסוח זה קושר באופן ישיר בין הערכת ניקוד (score estimation) לבין התפתחות צפיפות, מה שמוביל למסלולי הסתברות חלקים יותר ולדינמיקת אימון יציבה יותר. יתרון מרכזי של flow matching הוא הניסוח הדטרמיניסטי והיעיל חישובית שלו. מודלי rectified flow16 מפשטים עוד יותר את מסלולי התובלה לנתיבים כמעט ישרים, מה שמשפר את היציבות הנומרית ומאפשר יצירת דגימות באיכות גבוהה במספר קטן יחסית של שלבי אינטגרציה. מחקרים מאוחרים יותר, כולל מודלי עקביות (consistency models)17, שילבו יעדים בהשראת דיפוזיה בתוך מסגרות מבוססות זרימה קומפקטיות כדי להשיג איכות דגימה דומה או משופרת עם הסקה יעילה. בנוסף, אימון מבוסס זרימה יכול לנצל שלדי דיפוזיה (diffusion backbones) שאומנו מראש, דבר המקל על השימוש בפריורים גנרטיביים רחבי היקף תוך הפחתת עלויות הדגימה. מחקרים אחרונים הרחיבו את ה-flow matching למגוון רחב של יישומים. לדוגמה, Hu et al.18 חקרו שלדי transformer ומניפולציות במרחב חבוי (latent-space) לעריכת תמונות נשלטת וניתנת להרכבה באמצעות flow matching. יישומים אחרים כוללים סינתזת תמונות19, אבחון תקלות במיסבים20, וריתוך רובוטי רב-מטרה ורב-תפר21. יחד, מחקרים אלו מדגימים כי flow matching ישים מעבר לסינתזה מותנית של תמונות ברזולוציה גבוהה, תוך אספקת בסיס תיאורטי מבוסס עם פוטנציאל להכללה בין דומיינים. על ידי למידת מיפויי תובלה רציפים ודטרמיניסטיים, flow matching מספק איזון בין יעילות, יכולת שליטה ונאמנות גנרטיבית. הניסוח שלו המבוסס על ODE מציע נקודת מבט מאוחדת על מידול גנרטיבי מודרני ומספק בסיס תיאורטי ליישומים הכוללים ייצוג נתונים מולטי-מודאלי ויישור מאפיינים.
סיווג חישוש מרחוק רב-מודאלי שואף להתגבר על המגבלות של מודאליות חישוש בודדות על ידי שילוב של מידע משלים מ-HSI, הדמיה מולטיספקטרלית, LiDAR ו-SAR. גישות של היתוך מוקדם התבססו על מאפיינים שנוצרו ידנית או על אלגוריתמים מבוססי גרעין, כגון מכונות וקטורים תומכים (SVMs), אך היו מוגבלות בשל ממדיות גבוהה ואינטראקציה בין-מודאלית לא מספיקה22. התקדמות בלמידה עמוקה אפשרה אסטרטגיות היתוך מובנות, כולל היתוך מוקדם, ביניים ומאוחר, כאשר היתוך ברמת המאפיינים מספק איזון מעשי בין שילוב מידע לבין מורכבות חישובית23. רשתות נוירונים קונבולוציוניות (CNNs) לוכדות ביעילות מידע מרחבי-ספקטרלי מקומי, בעוד שארכיטקטורות מבוססות Transformer ממדלות תלויות טווח רחוק בעלות חישובית גבוהה יותר24. כתוצאה מכך, ארכיטקטורות היברידיות של CNN–Transformer הפכו לפופולריות יותר מכיוון שהן משלבות את נקודות החוזק המשלימות של שתי הגישות. דוגמאות מייצגות כוללות שיטות היתוך בקנה מידה סמוך המשפרות מידע קונטקסטואלי באמצעות אינטראקציות חוצות-קנה מידה25 ומסגרות רב-שכבתיות המשלבות מאפייני CNN רדודים עם ייצוגי Transformer עמוקים באמצעות מנגנוני קשב אדפטיביים26. יחד, מחקרים אלה מדגישים את החשיבות של אינטראקציה אפקטיבית חוצת-קנה מידה וחוצת-מודאליות להפחתת כפילות מאפיינים ולשיפור הייצוג הסמנטי.
פיתוחים אחרונים בחנו גם אסטרטגיות משלימות ללמידה רב-מודלית (multimodal learning). לדוגמה, שיטות של ייצוג בדרגה נמוכה (low-rank representation), כגון המסגרת המונחית על ידי עקומת אבנינגהוס, מפחיתות התאמת-יתר (overfitting) על ידי שימור מבנה הסבך (manifold structure) תוך דיכוי מידע מיותר27. במקביל, נחקרה למידה רב-מודלית מבוזרת כדי להתמודד עם מגבלות פרטיות ותקשורת ביישומים מעשיים. לדוגמה, FedFusion מקרינה תכונות רדודות למרחבי תת-מרחבים בדרגה נמוכה כדי לאפשר למידה רב-מודלית פדרטיבית28. יחד, מחקרים אלה ממחישים שלושה כיווני מחקר משלימים: ארכיטקטורות היברידיות של CNN–Transformer לאיזון בין מידול תכונות מקומי וגלובלי, למידה בדרגה נמוכה להפחתת כפילויות ורעש, ולמידה מבוזרת לפריסה ניתנת להרחבה השומרת על הפרטיות. עם זאת, נותרו אתגרים משמעותיים, כולל חוסר איזון בין מודליות, זמינות מוגבלת של נתונים מתויגים, והטרייד-אוף בין דחיסת מודלים לדיוק הסיווג. אתגרים אלו הניעו מחקר מתמשך של מסגרות מיזוג רב-מודליות קלות ובעלות יכולת הכללה. גישות עדכניות ליישור רב-מודלי שילבו גם קשב חוצה-מודליות (cross-modal attention), למידה ניגודית (contrastive learning), מיזוג מבוסס גרפים, התאמת דומיין (domain adaptation) ואסטרטגיות להתאמת התבצעות. בניגוד לכך, FlowErs מנסח את היישור הרב-מודלי כהסעה של תכונות מזווגות המותנות בזמן, ומוצג כאסטרטגיית יישור משלימה ולא כתחליף אוניברסלי לגישות קיימות.
פרוטוקול
מחקר זה השתמש באופן בלעדי במערכי נתוני ייחוס הזמינים לציבור (Houston2013, Augsburg, ו-MUUFL) לצורך סיווג כיסוי קרקע באמצעות חישוש מרחוק. לא היו מעורבים בניסויים משתתפים אנושיים, ניסויי בעלי חיים או דגימות ביולוגיות שנאספו מחדש. לפיכך, לא נדרש אישור אתי ממוסד.
סקירת המחקר
מסגרת העבודה המוצעת, FlowErs, מבצעת סיווג רב-מודאלי של כיסוי קרקע באמצעות אסטרטגיית למידה דו-שלבית. זרימת העבודה הכללית שלה מוצגת ב-איור 1A–C. מסגרת העבודה מורכבת משלושה רכיבים עיקריים: (i) מקודדים מבוססי MetaFormer המפיקים ייצוגי תכונות היררכיים ממודאליות חישוב שונות, (ii) מודול התאמת זרימה רב-מודאלית (MFM) המיישר באופן מפורש התפלגויות תכונות חוצות-מודאליות, ו-(iii) ראש סיווג קל המשבץ קטגוריות של כיסוי קרקע מייצוגי התכונות המאוחדים. זרימת העבודה הכללית מפיקה תחילה תכונות ספציפיות למודאליות, מיישרת לאחר מכן תכונות אלו בתוך מרחב חבוי משותף באמצעות התאמת זרימה מותנית, ולבסוף מבצעת סיווג של כיסוי קרקע ברמת הפיקסל באמצעות הייצוגים הרב-מודאליים המיושרים.
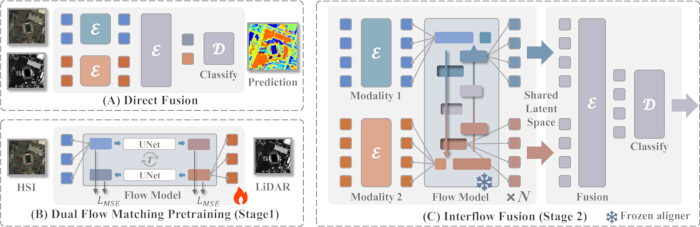
איור 1: סקירה כללית של מסגרת ה-FlowErs המוצעת לסיווג רב-מודאלי של כיסויי קרקע. (A) מיזוג תכונות ישיר קונבנציונלי, שבו תכונות ספציפיות למודאליות שהוצאו מדמיון היפר-ספקטרלי (HSI) ונתוני LiDAR (זיהוי ומיקום באמצעות לייזר) משורשרות ישירות לפני הסיווג. (B) שלב 1: אימון מקדים של התאמת זרימה (flow-matching) רב-מודאלית דו-כיוונית. רשת U-Net מותנית בזמן לומדת הובלה רציפה ודו-כיוונית של תכונות בין ייצוגי תכונות ספציפיים למודאליות, תוך שימוש בהפסד של ריבוע השגיאה הממוצע (mean-squared-error loss) כדי להשרות התאמה בין התפלגויות תכונות הטרוגניות. (C) שלב 2: מיזוג בין-זרימתי (Interflow fusion). מודול התאמת הזרימה שאומן מראש מושבת (frozen) ונעשה בו שימוש חוזר כדי להתאים ייצוגי תכונות ספציפיים למודאליות לפני מיזוג תכונות קל וסיווג כיסוי קרקע ברמת הפיקסל. E, מקודד (encoder); D, מפענח (decoder); T, השכבת זמן (time embedding); , הפסד של ריבוע השגיאה הממוצע (mean-squared-error loss); S, ייצוג חבוי משותף (shared latent representation). אנא לחץ כאן כדי להציג גרסה גדולה יותר של איור זה.
המסגרת המוצעת מפרידה בין יישור מאפיינים (feature alignment) לבין סיווג סמנטי באמצעות אסטרטגיית אימון דו-שלבית. במהלך השלב הראשון, מודול ה-MFM מאומן ללמוד הובלה דו-כיוונית של מאפיינים בין סבבים (manifolds) של מאפיינים ספציפיים למודאליות. במהלך השלב השני, מודול יישור הזרימה שאומן מראש מוקפא ונעשה בו שימוש חוזר כדי ליישר ייצוגי מאפיינים רב-מודאליים לפני היתוך מאפיינים קל וסיווג. תכנון מופרד זה מאפשר למודול היישור ולרשת הסיווג למטב (optimize) יעדים משלימים, תוך הפחתת פערים בהתפלגות המאפיינים לפני היתוך רב-מודאלי.
סקירה תיאורטית
התאמת זרימה (Flow matching) היא פרדיגמה של מידול גנרטיבי שהוצעה לאחרונה, הלומדת טרנספורמציה דטרמיניסטית רציפה בין שתי התפלגויות הסתברותיות. בניגוד למודלים מבוססי דיפוזיה, המכניסים סטוכסטיות באמצעות הפרעות רעש, התאמת זרימה מגדירה באופן ישיר שדה מהירות למידה שמעביר באופן רציף התפלגות הסתברותית אחת לעבר אחרת. ניסוח הובלה רציפה זה מאפשר יישור מאפיינים באמצעות ODE, ובכך מאפשר לייצוגי מאפיינים מזווגים ממודליות חישה שונות להתפתח לאורך מסלול משותף לפני מיזוג המאפיינים. במחקר הנוכחי, נעשה שימוש בהתאמת זרימה מותנית כדי ללמוד הובלת מאפיינים דו-כיוונית בין שיבוצים (embeddings) ספציפיים למודליות שחולצו על ידי מקודדי MetaFormer. המודל מאומן באמצעות יעד של התאמת זרימה מותנית הממזער את הפער בין שדות המהירות החזויים למטרות על פני ייצוגי מאפיינים משורטטים (interpolated). הניסוח המתמטי המלא, הגזירה התיאורטית, המשוואות השולטות ויעד האימון מופיעים ב-קובץ משלים 1.
ניסוח הבעיה
סיווג כיסוי קרקע מנתוני חישוש מרחוק מולטי-מודאליים כרוך בלמידה של ייצוגים סמנטיים ממודאליות חישוש הטרוגניות, כגון HSI ו-LiDAR. מודאליות אלו מציגות מאפייני חישוש מובחנים. HSI רוכש מידע ספקטרלי עשיר עם מאות ערוצים ( ), בעוד ש-LiDAR מספק מידע מבני ברזולוציה גבוהה עם מספר ערוצים קטן יחסית (
 ). חוסר איזון זה בין העושר הספקטרלי לדלילות המבנית יוצר פער דומיין משמעותי בהתפלגויות התכונות, מה שהופך מיזוג תכונות ישיר ללא אופטימלי ובעל פוטנציאל לחוסר יציבות.
באופן פורמלי, בהינתן זוג קלטים רב-מודאליים, 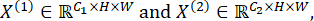 המטרה היא לחזות מפה סמנטית ברמת הפיקסל בהתאם ל- משוואה 1:
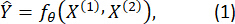
כאן, 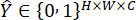 הוא טנזור התיוגים בקידוד one-hot, C מציין את המספר הכולל של קטגוריות כיסוי הקרקע, ו-θ מייצג את כל פרמטרי המודל הניתנים ללמידה. למערך הנתונים Houston2013 יש גודל תמונה של 349 × 1905 פיקסלים עם 144 ערוצים היפרספקטרליים (HSI) וערוץ LiDAR אחד. למערך הנתונים Augsburg יש גודל תמונה של 1152 × 480 פיקסלים עם 224 ערוצי HSI וערוץ LiDAR אחד. למערך הנתונים MUUFL יש גודל תמונה של 325 × 220 פיקסלים עם 64 ערוצי HSI ושני ערוצי LiDAR. עבור כל מערכי הנתונים, טלאי תמונת הקלט שונו לגודל של 32 × 32 פיקסלים לפני האימון.
גישות מולטי-מודאליות קונבנציונליות ממזגות מאפיינים ספציפיים למודאליות באמצעות שרשור (concatenation) או מנגנוני קשב (attention), תוך הנחה משתמעת כי מודאליות שונות נמצאות במרחב מאפיינים תואם. עם זאת, הנחה זו כמעט ואינה מתקיימת עבור נתוני חישה מרחוק, מאחר שההתפלגויות הסטטיסטיות והמאפיינים המרחביים-ספקטרליים הספציפיים לכל מודאליות שונים באופן מהותי.
כדי לגשר באופן מפורש על פער זה, מודול התאמת זרימה (flow matching),  מוצג. המודול מוגדר באמצעות פרמטרים של
 ולומד טרנספורמציות דו-כיווניות רציפות בין סייפנים (manifolds) של מאפיינים ספציפיים למודליות. באופן ספציפי (משוואה 2),
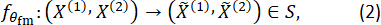
כאן, S מייצג את המרחב הלטנטי המשותף שבו ייצוגי התכונות הספציפיים למודאליות מיושרים גיאומטרית. לאחר מכן, ייצוגי התכונות המיושרים ממוזגים ומסווגים בהתאם למשוואה 3 באופן הבא:
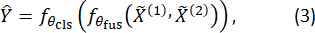
כאן,  ו-
 מייצגים את מודולי מיזוג התכונות (feature-fusion) והסיווג, בהתאמה. ניסוח זה מגדיר את מסגרת ה-FlowErs הכוללת. במקום להסתמך אך ורק על מיזוג תכונות סטטיסטי סמוי, המסגרת המוצעת מציגה מנגנון יישור מפורש מבוסס-זרימה (flow-based alignment mechanism) המעביר באופן רציף ייצוגי תכונות ספציפיים למודליות אל תוך מרחב חבוי (latent space) משותף, לפני מיזוג התכונות הרב-מודאלי והניבוי הסמנטי.
מקודד MetaFormer
FlowErs מבצעת יישור מאפיינים בין-מודאלי (cross-modal feature alignment) באמצעות מקודדים קלי משקל ספציפיים למודאליות, הלומדים ייצוגי מאפיינים אינפורמטיביים ועקביים מבחינה גיאומטרית מכל מודאליות חישוש. כפי שמוצג ב-איור 2, כל מודאליות מעובדת על ידי מקודד עצמאי המבוסס על ארכיטקטורת MetaFormer. MetaFormer מכלילה את עיצוב ה-Transformer הבסיסי על ידי הפרדת ערבוב הטוקנים (token mixing) מהטרנספורמציה של הערוצים, ללא חישוב מפורש של קשב עצמי (self-attention). עיצוב זה מאפשר עיבוד יעיל של HSI בעל ממד גבוה, תוך שמירה על יכולת התאמה למודאליות בעלות מספר ערוצים נמוך, כגון LiDAR.
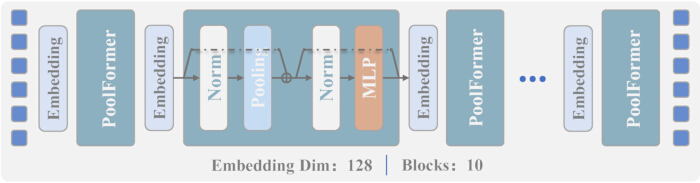
איור 2: ארכיטקטורת מקודד ה-MetaFormer הספציפי למודאליות המשמש במסגרת ה-FlowErs המוצעת. המקודד הופך קלטים ספציפיים למודאליות לייצוגי תכונות היררכיים באמצעות בלוקים חוזרים של embedding ו-PoolFormer. כל בלוק PoolFormer מורכב מנורמליזציה, ערבוב טוקנים מבוסס pooling, הוספה שיורית (residual addition), נורמליזציה ופרספטרון רב-שכבתי (MLP). ייצוגי התכונות ההיררכיים שנוצרו מועברים למודול ה-flow-matching הרב-מודאלי לצורך יישור תכונות חוצה-מודאליות. Norm, נורמליזציה; MLP, פרספטרון רב-שכבתי. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
עבור כל מודאליות  , מקודד ה-MetaFormer
 , הופך את הקלט
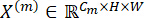 להיררכיה של ייצוגי תכונות חבויים (משוואה 4):
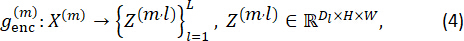
כאן, L מייצגת את המספר הכולל של שלבי המקודד, ו-Dl מייצגת את ממד השקיעה (embedding dimension) בשלב l. המקודד של ה-MetaFormer מורכב משלושה שלבים (N = 3) עם ממדי שקיעה של 64, 128 ו-256, בהתאמה. מספר הבלוקים של PoolFormer המתאימים בכל שלב הם 2, 6 ו-2, בהתאם לארכיטקטורה ההיררכית הפרוגרסיבית המתוארת במאמר.
כל מקודד מתחיל ב-1 × שכבת קונבולוציה (convolution) אחת הממפה את ערוצי הקלט למרחב שיכון (embedding space) משותף (משוואה 5):
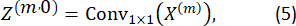
שכבת היטלה זו מלווה ב- L בלוקי MetaFormer נערמים. כל בלוק מורכב משתי פעולות שארית (residual operations): (i) ערבוב טוקנים (token mixing) באמצעות איסוף מרחבי (spatial pooling) כדי לצבור מידע הקשרי, ו-(ii) טרנספורמציה של ערוצים באמצעות פרספטרון רב-שכבתי (MLP) כדי לזקק ייצוגי מאפיינים ספקטרליים-מרחביים. פעולות אלו מבוטאות באמצעות משוואות 6 ו-7 כדלקמן:
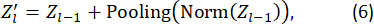

כאן, Pooling(·) מציין אגרגציה של הקשר מרחבי המבוססת על average-pooling, ו-MLP(·) מציין רשת feed-forward קונבולוציונית בעלת שתי שכבות המשלבת אקטיבציית GELU ורגולריזציית dropout.
המקודד (encoder) עוקב אחר ארכיטקטורה היררכית שבה ממד השקיעה (embedding dimension) גדל בהדרגה לאורך השלבים העוקבים (למשל, 64  128 256). תכנון פרוגרסיבי זה מאפשר לשכבות עמוקות יותר לקודד מידע מרחבי-ספקטרלי עשיר יותר, תוך שיפור קיבולת הייצוג של המאפיינים שנלמדו. המימוש משתמש בגרעין איחוד (pooling kernel) בגודל 3 × 3, בממד נסתר של MLP של 128, ובשיעור dropout של 0.1. כל השכבות הקונבולוציוניות בתוך מקודד ה-MetaFormer משתמשות בגרעיני 1 × 1 עם stride של 1 וללא padding. אופרטור האיחוד משתמש ב-average pooling של 3 × 3 עם stride של 1 ו-padding של 1. נורמליזציה של אצווה (BatchNorm2d) מיושמת לאורך כל המקודד. ל-MLP יש ממד נסתר של 128, הוא עושה שימוש בפונקציית ההפעלה GELU ומשתמש בשיעור dropout של 0.1. שלושת שלבי המקודד מכילים 2, 6 ו-2 בלוקי PoolFormer, בהתאמה, והגדרות ארכיטקטוניות אלו מיושמות באופן עקבי בכל השלבים.
בהשוואה למקודדים המבוססים על Transformer, מקודד ה-MetaFormer מבטל את העלות החישובית הריבועית הקשורה לתשומת לב עצמית (self-attention), תוך הפחתת הטיות ספציפיות למודליות במהלך חילוץ תכונות. ערבב האסימונים (token mixer) שלו, המבוסס על איגור (pooling), מרכז ביעילות הקשר מרחבי מקומי, בעוד שיישור בין-מודאלי מבוצע לאחר מכן על ידי מודול התאמת הזרימה (flow matching). כתוצאה מכך, ייצוגי התכונות ברמה הגבוהה ביותר המופקים על ידי המקודד מספקים קלטים בעלי מידע סמנטי ועקביות גיאומטרית עבור יישור תכונות רב-מודאלי.
התאמת זרימה רב-מודלית (Multimodal Flow Matching)
האתגר המרכזי לאחר חילוץ מאפיינים הוא היישור של ייצוגי מאפיינים הטרוגניים המקוריים ממודליות חישה שונות השוכנות על סעפות מאפיינים (feature manifolds) שונות. שרשור ישיר של  ו-
 מניב לרוב תוצאות דלות בשל התפלגויות מאפיינים שאינן עקביות והטיות ספציפיות למודליות. FlowErs נותן מענה מפורש לאתגר זה על ידי הצגת מודול MFM הלומד טרנספורמציות רציפות ודו-כיווניות בין שני מרחבי המאפיינים, כפי שמוצג באופן מושגי ב-איור 1B.
תן 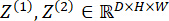 מסמנים את ייצוגי המאפיינים שהופקו על ידי מקודדי ה-MetaFormer. שדה זרימה רציף המוגדר על ידי זמן האינטרפולציה
 מוגדר באמצעות משוואה 8 כדלקמן:
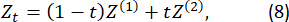
כאן, t = 0 מתייחס למודאליות המקור ו-t = 1 מתייחס למודאליות היעד.
מודל התאמת הזרימה (flow matching), , מומש כ-U-Net מותנה-זמן המנבא את שדה המהירות המיידי השולט בטרנספורמציה לאורך מסלול אינטרפולציה זה. כל חוזה זרימה מורכב משלושה בלוקים של דגימה מורדת (64 128 256 512) ושלושה בלוקים תואמים של דגימה עולה (512 256 128 64) המשתמשים בקוולוציות 3 × 3, נורמליזציה של אצוות (batch normalization), והפעלת יחידה ליניארית ממוטבת (ReLU). להטמעות זמן ביניים יש ממדים של 128, 256, 512, 256, ו-128, בהתאמה. הטמעת הזמן משתמשת בקידוד מיקום סינוסואידלי קבוע. אינטגרציה של ODE מבוצעת באמצעות שיטת אוילר קדמית עם גודל צעד קבוע. במהלך האימון, מספר שלבי האינטגרציה נקבע ל-6, בעוד שבמהלך ההסקה (inference) נעשה שימוש ב-5 שלבי אינטגרציה כברירת מחדל. מספר החזרות בפועל של לולאת האינטגרציה מחושב כ-
שדה המהירות החזוי ניתן על ידי משוואה 9 להלן:
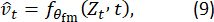
כאן,  מסמן את המהירות הרגעית החזויה. המודל לומד לקרב את ההעתקה
 ובכך הוא מעודד טרנספורמציות רציפות בין מרחבי תכונות ספציפיים למודליות. מטרת האימון מנוסחת כפונקציית הפסד של טעות ריבועית ממוצעת (MSE) דו-כיוונית המותנית בזמן באופן הבא (משוואה 10):
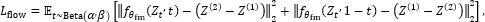 (10)
דגימה של t מהתפלגות בטא (Beta distribution) המוגדרת חושפת את המודל למצבי אינטרפולציה ביניים, אך אינה מבססת עקביות מחזורית (cycle consistency) מדויקת. בניגוד לשיטות יישור מבוססות דיפוזיה, ניסוח התאמת הזרימה (flow matching) המוצע הוא דטרמיניסטי, אינו דורש דגימה סטוכסטית במהלך ההסקה, וניתן לאמן אותו באמצעות נתונים מתויגים ובלתי מתויגים כאחד.
מודל זרימה (flow model) מאומן משמש לאחר מכן כמפעיל יישור דטרמיניניסטי המקרין ייצוגי מאפיינים ספציפיים למודליות אל מרחב חבוי משותף S. הייצוגים המיושרים מתקבלים באופן הבא (משוואה 11):
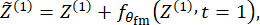
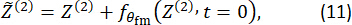
כאן,  ו-
 מייצגים את ייצוגי המאפיינים המיושרים. יישור מבוסס-זרימה (Flow-based alignment) מיושם על ייצוגי המאפיינים הביניים משני שלבי המקודד הראשונים (שלב 1 ושלב 2), עם ממדי שיכון (embedding dimensions) של 64 ו-128, בהתאמה. מאפייני המקודד ברמה הגבוהה ביותר (שלב 3, ממד שיכון 256) אינם מעובדים על ידי מודול התאמת הזרימה (flow-matching module). במקום זאת, מאפיינים אלו שורשרו ישירות והועברו למסווג לצורך ניבוי רב-מודאלי.
מנגנון יישור דו-כיווני זה מעביר באופן הדרגתי ייצוגי מאפיינים ספציפיים למודאליות לעבר מרחב חבוי משותף באמצעות שדה זרימה רציף. כתוצאה מכך, הם הופכים למיושרים יותר לפני מיזוג מאפיינים רב-מודאלי, ובכך מספקים ייצוגי מאפיינים עקביים סמנטית ותואמים גאומטרית לצורך הסיווג הבא.
תהליך האימון
FlowErs מנצלת נתונים מסומנים ולא מסומנים בעוד היא שומרת על יישור בין-מודאלי יציב באמצעות אסטרטגיית אימון דו-שלבית, כפי שמוצג באיור 1(B,C). במהלך השלב הראשון, מודול יישור בלתי תלוי במודאליות נלמד באמצעות התאמת זרימה (flow matching) לא מפוקחת. במהלך השלב השני, מבוצע סיווג מפוקח תוך שימוש בייצוגים חבויים מיושרים, תוך שימוש חוזר במודול יישור הזרימה שאומן מראש.
שלב 1: אימון מקדים לא פוקח של זרימה (Unsupervised Flow Pretraining)
בהינתן זוגות תמונות רב-מודאליים,  ייצוגי מאפיינים ספציפיים למודליות,
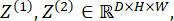 מופקים באמצעות מקודדי MetaFormer. ייצוגי תכונות ביניים נוצרים באמצעות האינטרפולציה המוגדרת ב- משוואה 8, כאשר
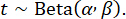 מודול התאמת הזרימה (flow matching),
 , מופתח על ידי מזעור הפונקציה למטרה דו-כיוונית מותנית בזמן המוגדרת ב- משוואה 10 ללא שימוש בתוויות מחלקה. בשלב זה, רק פרמטרי ה-flow-matching,
 , מעודכנים, ובכך מאפשרים למודל ללמוד התאמות מודעות גיאומטריה מדגמים מתויגים ולא מתויגים כאחד לפני הסיווג המפוקח. שלב 1 (אימון מקדים של התאמת זרימה - flow-matching) בוצע באמצעות האופטימייזר AdamW עם קצב למידה של 1 × 10⁻4, דעיכת משקל של 1 × 10⁻2, ולוח זמנים של קצב למידה בשיטת cosine annealing. עבור מאגרי הנתונים Houston2013 ו-Trento נעשה שימוש בגודל אצווה (batch size) של 16, בעוד שעבור מאגרי הנתונים Augsburg ו-MUUFL נעשה שימוש בגודל אצווה של 32. מודול ה-flow-matching עבר אימון מקדים למשך 2,000 תקופות (epochs) תוך שימוש בדגימות מתויגות ולא מתויגות כאחד. ה-seed האקראי נקבע על 3407. כל הניסויים בוצעו באמצעות PyTorch על מעבד גרפי NVIDIA A100 בודד (זיכרון של 80 GB).
שלב 2: סיווג מודרך עם מיישר משותף
מודול ה-flow matching שעבר אימון מוקדם נעשה בו שימוש חוזר במהלך האימון בפיקוח, והוא מיושם על שני שלבי המקודד הראשונים במקום על כל רמות התכונות. ייצוגי התכונות המיושרים ממוזגים לאחר מכן באמצעות ראש הסיווג כדי להפיק תחזיות ברמת הפיקסל. אופטימיזציה בפיקוח ממזערת את הפסד ה-cross-entropy המסוכך (משוואה 12):
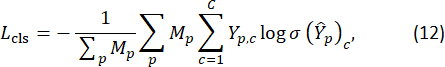
כאן, M מייצג את מסכת התיוג, Y מייצג את תיוגי האמת (ground-truth) בקידוד one-hot, ו- σ(·) מייצג את פונקציית ה-softmax. במהלך שלב 2 (אימון מודרך), מודול ה-flow-matching שאומן מראש נותר קפוא לחלוטין ושמש כאופרטור קבוע ליישור בין-מודאלי (cross-modal alignment). המשקולות שאומנו מראש נטענו בתחילת שלב 2 ולא עודכנו במהלך האימון המודרך. רק הפרמטרים של מקודד ה-MetaFormer והמסווג עברו אופטימיזציה. האימון המודרך בוצע באמצעות אופטימייזר AdamW עם קצבי למידה ספציפיים למסדי נתונים של 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL), ו-1 × 10⁻5 (Trento). דעיכת המשקולות (Weight decay) נקבעה ל-1 × 10⁻2 עבור כל מסדי הנתונים למעט MUUFL, שעבורו נעשה שימוש בערך של 5 × 10⁻2. גדלי אצווה (Batch sizes) של 16 או 32 היו בשימוש בהתאם למסד הנתונים. המודלים אומנו למשך 100 תקופות (epochs) (עבור Houston2013 ו-MUUFL), 200 תקופות (עבור Augsburg), ו-20 תקופות (עבור Trento) תוך שימוש בלוח זמנים של קצב למידה עם cosine annealing. פונקציית ההפסד ששימשה היא CrossEntropyLoss עם mean reduction. לא הופעל מנגנון עצירה מוקדמת (early stopping); תחת זאת, נקודת השמירה (checkpoint) של המודל שהשיגה את הדיוק הכולל (OA) הגבוה ביותר על סט הבדיקה נבחרה כמודל הסופי. זרימת העבודה המלאה של יישום הליך האימון הדו-שלבי מסוכמת ב-קובץ משלים S1 (אלגוריתם S1).
אסטרטגיית אימון מופרדת זו מפרידה בין יישור גיאומטרי לבין הבחנה סמנטית. במהלך שלב 1, המודל לומד מיפויי תכונות דו-כיווניים רציפים באמצעות יעד flow-matching. במהלך שלב 2, מודול היישור שאימן מראש מספק פעולת העברת תכונות משותפת לפני היתוך תכונות רב-מודאלי, בעוד שרשת הסיווג לומדת ייצוגים מבחינים בין מחלקות מתוך המרחב החבוי המיושר. שימוש חוזר במיישר שאומן מראש מקדם יישור תכונות עקבי לפני היתוך, אך אינו מוצג כערבות עצמאית לשיפור ההכללה.
מאגרי נתונים ניסיוניים
המסגרת המוצעת הוערכה באמצעות שלושה מערכי נתונים מייצגים של השוואה עבור חישוש מרחוק רב-מודיאלי: Houston201329, Augsburg30, ו-MUUFL31.
סט הנתונים Houston2013 שוחרר כחלק מתחרות ה-IEEE GRSS Data Fusion. הוא מייצג נוף עירוני מגוון ביוסטון, ארה"ב, ומכיל 15 מחלקות של כיסוי קרקע, כולל אזורי מגורים, כבישים, צמחייה ומקווי מים. סט הנתונים כולל HSI עם 144 פסים ספקטרליים המשתרעים על פני הספקטרום מהאור הנראה ועד לאינפרא-אדום הקרוב, יחד עם מודל שטח דיגיטלי (DSM) נגזר-LiDAR בעל פס בודד ברזולוציה מרחבית של 2.5 m. המרקמים העירוניים המורכבים והשונות הספקטרלית המשמעותית בתוך המחלקות הופכים את סט הנתונים הזה למאתגר עבור סיווג מדויק של כיסוי קרקע.
סט הנתונים של Augsburg נרכש מעל אזור עירוני בנוי בצפיפות בגרמניה. הוא כולל הדמיות היפר-ספקטרליות עם 224 ערוצים ספקטרליים המכסים את טווח אורכי הגל 400–1000 nm, יחד עם נתוני גובה LiDAR רשומים (co-registered). סט הנתונים כולל 17 מחלקות כיסוי קרקע מסומנות, ביניהן מבנים, קרקע חשופה, אספלט, צמחייה וצל, ברזולוציה מרחבית של 2 m. בהשוואה ל-Houston2013, ה-Augsburg מציג קורלציות ספקטרליות חזקות יותר יחד עם מגוון מחלקות רב יותר, ובכך מספק מדד (benchmark) מאתגר להערכת יישור תכונות בין-מודאלי (cross-modal feature alignment) והכללה.
מאגר הנתונים MUUFL Gulfport נאסף מעל קמפוס אוניברסיטאי ומייצג סביבה חצי-עירונית המכילה צמחייה שופעת לצד מבנים קטנים מעשה ידי אדם. מאגר הנתונים כולל דימויים היפר-ספקטרליים של 64 ערוצים שעברו סינון רעשים, יחד עם מדידות LiDAR דו-ערוציות הכוללות מידע על גובה ועוצמה. הוא מכיל 11 מחלקות של כיסוי קרקע ומציג פירוט מרחבי עדין, פיקסלים מעורבים ותנאי תאורה משתנים, דבר ההופך אותו למתאים מאוד להערכת מיזוג מאפיינים רב-מודאלי עבור סיווג אובייקטים קטנים.
ביחד, שלושת מאגרי הנתונים הייחוסים הללו מקיפים שונות משמעותית ברזולוציה מרחבית (1–2.5 m), בממדיות ספקטרלית (64–224 bands), במורכבות הסצנה ובהרכב כיסוי הקרקע. כתוצאה מכך, הם מספקים מדד ייחוס מגוון להערכת היעילות והיכולת להכללה של שיטות לסיווג רב-מודאלי של כיסוי קרקע. המאפיינים העיקריים של מאגרי הנתונים מסוכמים ב-טבלה 1. חלוקת האימון/בדיקה עבור כל שלושת מאגרי הנתונים תואמת לחלוקות הייחוס הרשמיות שסופקו על ידי ספקי הנתונים המקוריים. באופן ספציפי, מאגר הנתונים Houston2013 משתמש בחלוקה הרשמית מתחרות ה-IEEE GRSS Data Fusion Contest לשנת 2013, הכוללת 2,832 דגימות אימון ו-12,197 דגימות בדיקה. מאגר הנתונים Augsburg משתמש באנוטציות mask_train ו-mask_test שסופקו רשמית, מה שמעניק 4,538 דגימות אימון ו-47,896 דגימות בדיקה. מאגר הנתונים MUUFL משתמש בחלוקה הרשמית train_test_gt.mat, המכילה 28,645 דגימות אימון ו-24,283 דגימות בדיקה. עבור כל מאגר נתונים, חלקי תמונה (patch) בגודל 32 × 32-pixel הממורכזים על כל פיקסל מסומן הופקו כדגימת אימון או בדיקה בודדת. לא בוצעו פיצול נתונים או דגימה מחדש נוספים.
| מאפיין | Houston2013 | Augsburg | MUUFL |
| גודל תמונת HSI (פיקסלים) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| גודל תמונת LiDAR (פיקסלים) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| ערוצים ספקטרליים של HSI | 144 | 224 | 64 |
| ערוצי LiDAR | 1 | 1 | 2 |
| טווח אורכי גל של HSI | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 nm |
| טווח אורכי גל של LiDAR | לא רלוונטי | לא רלוונטי | לא רלוונטי |
| רזולוציה מרחבית (HSI) | 2.5 m | 2.0 m | 0.54 m × 1.00 m |
| רזולוציה מרחבית (LiDAR) | 2.5 m | 2.0 m | 0.60 m × 0.78 m |
| מספר מחלקות כיסוי קרקע | 15 | 17 | 11 |
טבלה 1: מאפיינים של שלושת מאגרי הנתונים של מדדי השפה (benchmark) לחשיפה רחוקה רב-מודאלית ששימשו להערכה. הטבלה מסכמת את ממדי התמונה, המאפיינים הספקטרליים, הרזולוציות המרחביות ומספר מחלקות כיסוי הקרקע עבור מאגרי המדדים Houston2013, Augsburg ו-MUUFL ששימשו להערכת מסגרת ה-FlowErs המוצעת.
פרטי היישום
מסגרת FlowErs הוטמעה ב-PyTorch ואומנה והוערכה באמצעות יחידה לעיבוד גרפי (GPU) עם 80 GB של זיכרון. האימון בוצע למשך 100 epochs תוך שימוש ב-batch size של 16. נעשה שימוש באופטימייזר AdamW עם קצב למידה ראשוני של 1 × 10⁻⁴ ו-weight decay של 1 × 10⁻². תזמון קצב למידה מסוג cosine annealing שימש לעדכון קצב הלמידה לאורך האימון. קצב dropout של 0.1 הוחל כדי לשפר את ההכללה של המודל ולהפחית overfitting. פונקציית ההפסד cross-entropy שימשה לאופטימיזציה בפיקוח (supervised optimization). לצורך שחזור התוצאות, כל הניסויים אותחלו באמצעות גרעין אקראי (random seed) קבוע של 3407. חלוקות האימון/בדיקה (train/test) שסופקו שימשו ללא יצירת חלוקת תיקוף (validation split) נוספת. כל patch קלט שונה לגודל של 32 × 32 pixels לפני האימון. לא הוחלו הגברה של נתונים (data augmentation), תיקון רישום תמונות (image-registration) מפורש, או נרמול נוסף של טוען הנתונים (data-loader). פיקסלים הקשורים לתיוגים שליליים הוצאו מחישוב ההפסד בפיקוח. טיפול בפיקסלים חסרים או רועשים לא הוערך בנפרד.
מדדי הערכה
שלושה מדדי הערכה נפוצים שימשו לבחינת ביצועי הסיווג: OA, דיוק ממוצע (AA), ומקדם קאפה (k). OA מודדת את שיעור הדגימות שסווגו נכון מתוך כלל הדגימות, AA מייצגת את דיוק הסיווג הממוצע על פני כל מחלקות כיסוי הקרקע, ומקדם קפה (Kappa coefficient) מכמת את ההסכמה בין הסיווגים החזויים לסיווגי הייחוס לאחר התחשבות בהסכמה מקרית. ערכים גבוהים יותר בכל שלושת המדדים מעידים על ביצועי סיווג טובים יותר. כל הערכים המדווחים ב- טבלאות 2–6 הן הערכות נקודתיות של פיצול קבוע (fixed-split point estimates) שהתקבלו באמצעות זרע אקראי (random seed) 3407. לא חושבו רווחי סמך, מבחני מובהקות סטטיסטית, או pהערכי-p מדווחים.
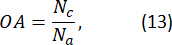
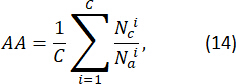
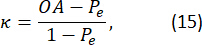
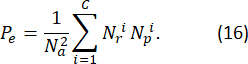
כאן, Nc ו- Na מציינים את המספר הכולל של הדגימות שסווגו נכונה ואת מספר הדגימות שנבחנו, בהתאמה.  ו-
 מציינים את מספר הדגימות שסווגו נכונה ואת סך הדגימות עבור המחלקה ה- i, בהתאמה. בחישוב מקדם הקאפה (Kappa), Pe מציין את ההסתברות להסכמה המתרחשת במקרה, ו-
 ו-
 מציינים את מספר דגימות הייחוס ומספר דגימות החיזוי עבור המחלקה ה- i, בהתאמה.
תוצאות
זרימת העבודה הכללית של תהליך ההערכה במסגרת ה-FlowErs המוצעת מומחשת ב- איור 1, המסכם את אסטרטגיית הסיווג הרב-מודאליתית הדו-שלבית. תהליך חילוץ המאפיינים הספציפי למודאליות, המבוסס על מקודד MetaFormer, מוצג ב- איור 2, והמאפיינים העיקריים של שלושת ה-benchmark datasets ששימשו להערכה מסוכמים ב- טבלה 1ביצועי הסיווג הוערכו לאחר מכן במאגרי הנתונים המהווים נקודת ייחוס (benchmark) של MUUFL, Houston2013 ו-Augsburg, תוך שימוש ב-OA, AA ובמקדם קאפה (κ) המוגדרים בסעיף הפרוטוקול.
השוואה לשיטות אחרות
מספר רשתות סיווג רב-מודאליות (multimodal) משמשות כנקודות ייחוס (benchmarks) כדי לספק השוואה מקיפה של המסגרת המוצעת. DFINet32 משלבת מידע היפר-ספקטרלי ומולטי-ספקטרלי באמצעות מודול cross-attention מסוג depth-wise כדי לשפר את האינטראקציה בין תכונות באמצעות מספר יעדי אובדן (loss objectives). DSHFNet33 מציגה אסטרטגיית מיזוג היררכית דינמית המשלבת באופן הדרגתי ייצוגים בקנה מידה עדין (fine-scale) ובקנה מידה גס (coarse-scale). MDL-Middle34 מעסיקה אסטרטגיית מיזוג תכונות בשכבה בינונית כדי לאזן מידע ממספר מודליות חישה. CMCL35 מתייחסת לנתוני HSI ו-LiDAR כהשקפות משלימות של אותה סצנה ומיישמת למידה ניגודית (contrastive learning) יחד עם כיוונון עדין כפול (dual fine-tuning) כדי לשפר את יישור התכונות. Two-Branch36 משתמשת בארכיטקטורה קונבולוציונית בעלת נתיב כפול המעבדת באופן עצמאי כל מודאליות לפני מיזוג התכונות. ExViT37 מבצעת עיבוד טלאים (patch processing) רב-מודאלי באמצעות ענפי Transformer מקבילים עם מודולי cross-modal attention. DSymFuse38 מרחיבה את ארכיטקטורת ה-Transformer בעלת הענפים הכפולים באמצעות מיזוג תכונות היררכי של מקומי-גלובלי. CTPMSN39 משלבת ארכיטקטורות קונבולוציוניות ו-Transformer עם יישור פרומפטים טקסט-ויזואליים כדי לשפר את העקביות הסמנטית ואת ההבחנה בין מחלקות. ערכי ההשוואה הופקו מהפרסומים המצוטטים או מפרוטוקולי ההערכה שדווחו בהם, ולא נוצרו באמצעות מימוש מאוחד או מסגרת ניסויית משותפת. לכן, יש לפרש השוואות אלו כהשוואות ייחוס תיאוריות ולא כהערכות מבוקרות של פנים אל פנים.
מאגר הנתונים MUUFL
תוצאות הסיווג שהתקבלו עבור מערך הנתונים MUUFL Gulfport מסוכמות בטבלה 2, ומפות סיווג מייצגות מוצגות באיור 3A–J. בפיצול הבנצ'מרק הקבוע שדווח, המסגרת המוצעת השיגה OA של 95.24% ומקדם Kappa של 93.69%, בהשוואה ל-93.99% ו-92.03%, בהתאמה, עבור CTPMSN. הביצועים ברמת המחלקה השתנו בין קטגוריות כיסוי הקרקע. בהשוואה ל-CTPMSN, המסגרת המוצעת השיגה דיוקי סיווג גבוהים יותר עבור מחלקות העצים (Trees), בעיקר דשא (Mostly Grass), ומשטחים מעורבים (Mixed Surface) ב-2.73%, 3.16% ו-1.86%, בהתאמה. לעומת זאת, מחלקת המדרכה הצהובה (Yellow Curb) נותרה מאתגרת בשל מספר הדגימות המוגבל הזמין, והדיוק המדווח שלה היה נמוך מזה של מספר שיטות השוואה. בהתאם לכך, אין לפרש את השיפור הנצפה בביצועים המצרפיים כמעיד על ביצועים עדיפים עבור כל מחלקת כיסוי קרקע בנפרד. ההשוואה האיכותית באיור 3A–I מראה את מפות הסיווג שהופקו על ידי השיטות שנבחנו, בעוד שאיור 3J מציג את מפת הייחוס של האמת בשטח (ground-truth) התואמת, הממחישה את ההתפלגות המרחבית של מחלקות כיסוי הקרקע לאורך מערך הנתונים MUUFL Gulfport.
| סיווג | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| עצים | 89.2 | 74.91 | 87.31 | 84.86 | 91.32 | 92.64 | 91.24 | 95.55 | 98.28 |
| בעיקר דשא | 72.98 | 84.63 | 76.38 | 86.54 | 80.65 | 77.48 | 79.57 | 88.92 | 92.08 |
| משטח מעורב | 69.22 | 34.77 | 68.33 | 54.75 | 67.92 | 82.07 | 82.23 | 87.92 | 89.78 |
| עפר/חול | 76.68 | 87.06 | 78.74 | 84.45 | 78.32 | 93.74 | 89.17 | 97.27 | 93.55 |
| כביש | 86.68 | 81.09 | 83.76 | 86.25 | 84.34 | 90.35 | 85.6 | 94.52 | 95.94 |
| מים | 100 | 99.25 | 88.52 | 98.53 | 100 | 99.38 | 100 | 100 | 97.56 |
| צל | 83.29 | 90.65 | 92.12 | 97.72 | 84.89 | 91.47 | 91 | 95.98 | 90.54 |
| בניין | 93.26 | 90.22 | 89.69 | 97.54 | 93.76 | 89.27 | 96.29 | 96.29 | 98.26 |
| מדרכה | 57.34 | 53.09 | 77.06 | 77.98 | 71.32 | 73.54 | 79.62 | 88.07 | 79.61 |
| שפה צהובה | 84.28 | 1.03 | 96.75 | 80.62 | 81.41 | 93.72 | 91.57 | 97.37 | 48.91 |
| לוחות בד | 97.92 | 92.79 | 99.41 | 98.41 | 99.21 | 99.41 | 100 | 99.41 | 93.13 |
| דיוק כולל (OA) | 83.87 | 74.29 | 83.54 | 82.45 | 85.61 | 89.94 | 88.78 | 93.99 | 95.24 |
| דיוק ממוצע (AA) | 82.76 | 73.23 | 84.37 | 85.9 | 85.1 | 90.12 | 89.54 | 94.68 | 88.88 |
| מקדם קאפה (κ × 100) | 79.82 | 67.92 | 78.84 | 78.37 | 81.22 | 85.37 | 85.37 | 92.03 | 93.69 |
טבלה 2: ביצועי סיווג (%) של שיטות שונות על מערך הנתונים הייחוס MUUFL. ביצועי סיווג לכל מחלקה יחד עם הדיוק הכולל (OA), הדיוק הממוצע (AA), ומקדם קאפה (κ) שהושגו על ידי מסגרת FlowErs המוצעת ושיטות מתחרות על מערך הנתונים הייחוס MUUFL.
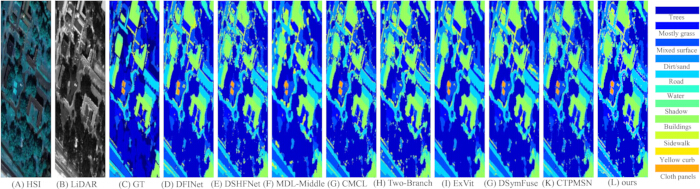
איור 3: תוצאות מייצגות של סיווג כיסוי קרקע עבור מערך נתוני הבנצ'מרק MUUFL. (A) דימוי היפר-ספקטרלי (HSI). (B) תמונת LiDAR (מדידת מרחק באמצעות לייזר). (C) מפת ייחוס של אמת קרקע (GT). (D–L) מפות סיווג שהופקו על ידי DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN, ומסגרת FlowErs המוצעת, בהתאמה. מקרא הצבעים מזהה את מחלקות כיסוי הקרקע המיוצגות בכל מפת סיווג.אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
ערכה של נתונים Houston2013
תוצאות הסיווג שהתקבלו עבור מערך הנתונים Houston2013 מוצגות ב-טבלה 3, ומפות סיווג מייצגות מוצגות ב-איור 4A–J. בחלוקת הבנצ'מרק הקבועה המדווחת, המסגרת המוצעת השיגה OA של 97.56% ומקדם Kappa של 97.39%. בהשוואה לתוצאות ה-CTPMSN המדווחות, המסגרת המוצעת הדגימה OA גבוה בכ-3.8 נקודות אחוז. שיפורים נצפו גם עבור מחלקות המגורים (Residential) והכבישים המהירים (Highway), עם עליות מדווחות של כ-2.4 ו-0.5 נקודות אחוז, בהתאמה. עם זאת, מחלקת המסחר (Commercial) נותרה מאתגרת יחסית והציגה דיוק סיווג נמוך יותר ממספר שיטות מתחרות, מה שעשוי לשקף דמיון ספקטרלי ומרחבי עם קטגוריות כיסוי קרקע עירוניות אחרות. באופן כללי, התוצאות המצטברות מעידות על ביצועי סיווג משופרים בבנצ'מרק זה, תוךما שהן מדגימות כי הביצועים השתנו בין המחלקות השונות. ההשוואה האיכותית ב-איור 4A–I מראה את מפות הסיווג שנוצרו על ידי השיטות שנבחנו, בעוד ש-איור 4J מציג את מפת הייחוס של האמת הקרקעית (ground-truth) התואמת, הממחישה את ההתפלגות המרחבית של מחלקות כיסוי הקרקע במערך הנתונים Houston2013.
| סוג | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| דשא בריא | 82.39 | 85.58 | 83.1 | 82.91 | 80.31 | 81.67 | 80.06 | 96.96 | 100 |
| דשא במצב עקה | 100 | 94.65 | 85.06 | 95.68 | 92.44 | 100 | 78.67 | 94.27 | 96.94 |
| דשא סינתטי | 100 | 98.12 | 99.6 | 94.93 | 99.23 | 99.01 | 99.41 | 99.41 | 99.84 |
| עץ | 100 | 93.09 | 91.57 | 93.37 | 98.75 | 98.96 | 95.55 | 96.21 | 99.6 |
| קרקע | 98.76 | 99.91 | 98.86 | 99.43 | 99.2 | 99.91 | 98.67 | 99.43 | 100 |
| מים | 94.5 | 93.1 | 100 | 97.3 | 95.32 | 100 | 95.8 | 100 | 97.6 |
| מגורים | 87.5 | 66.65 | 97.64 | 92.58 | 90.87 | 93.28 | 87.22 | 86.86 | 99.29 |
| מסחרי | 91.53 | 76.29 | 88.13 | 87.96 | 95.31 | 89.27 | 85.85 | 94.61 | 84.07 |
| כביש | 84.19 | 36.29 | 85.93 | 80.76 | 82.63 | 89.42 | 93.29 | 88.07 | 92.73 |
| כביש מהיר | 69.32 | 89 | 74.42 | 57.41 | 66.69 | 71.33 | 67.95 | 81.66 | 99.74 |
| מסילת רכבת | 96.76 | 94.78 | 84.54 | 79.57 | 93.44 | 92.88 | 79.13 | 97.7 | 99.72 |
| חניון 1 | 83.27 | 88.39 | 95.39 | 52.83 | 85.67 | 89.63 | 91.07 | 93.28 | 95.42 |
| חניון 2 | 85.36 | 96.46 | 87.37 | 92.42 | 86.17 | 89.47 | 84.21 | 95.09 | 99.18 |
| מגרש טניס | 100 | 97.3 | 95.14 | 83.04 | 98.72 | 97.89 | 100 | 100 | 99.72 |
| מסלול ריצה | 99.21 | 100 | 100 | 97.02 | 100 | 97.97 | 100 | 100 | 99.83 |
| דיוק כולל (OA) | 91.21 | 85.02 | 89.55 | 83.87 | 90.01 | 91.57 | 87.57 | 93.74 | 97.56 |
| דיוק ממוצע (AA) | 92.42 | 87.55 | 91.05 | 85.76 | 90.98 | 92.32 | 89.09 | 94.9 | 97.58 |
| מקדם קפה (κ × 100) | 91.09 | 83.59 | 87.59 | 82.76 | 89.1 | 90.85 | 85.29 | 93.21 | 97.39 |
טבלה 3: ביצועי סיווג (%) של שיטות שונות על מערך הנתונים Houston2013. ביצועי סיווג לכל מחלקה יחד עם הדיוק הכללי (OA), הדיוק הממוצע (AA), ומקדם קאפה (κ) שהושגו על ידי מסגרת FlowErs המוצעת ושיטות מתחרות על מערך הנתונים Houston2013.
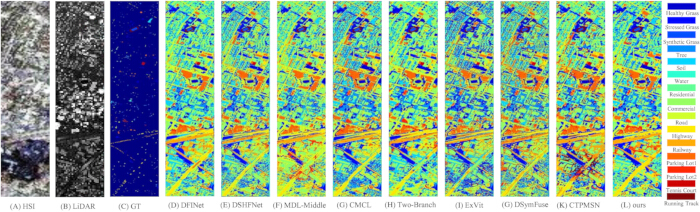
איור 4: תוצאות מייצגות של סיווג כיסוי קרקע עבור מערך הנתונים של Houston2013. (A) דימוי היפר-ספקטרלי (HSI). (B) דימוי LiDAR (זיהוי ומיקום באמצעות לייזר). (C) מפת ייחוס של אמת קרקע (GT). (D–L) מפות סיווג שהופקו על ידי DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN, ומסגרת FlowErs המוצעת, בהתאמה. מקרא הצבעים מזהה את מחלקות כיסוי הקרקע המיוצגות בכל מפת סיווג. אנא לחצו כאן כדי לצפות בגרסה מוגדלת של איור זה.
סט הנתונים של Augsburg
תוצאות הסיווג שהתקבלו עבור מערך הנתונים של Augsburg מסוכמות בטבלה 4, ומפות סיווג מייצגות מוצגות באיור 5A–J. מערך נתונים זה מאופיין בשונות תוך-מחלקה משמעותית ובמבנה רקע מורכב. בחלוקת benchmark קבועה שדווחה, המסגרת המוצעת השיגה OA של 97.56% ו-AA של 89.21%. בהשוואה לשיטות ה-benchmark המפורטות, המסגרת המוצעת דיווחה על דיוקי סיווג גבוהים יותר עבור המחלקות Industrial ו-Commercial בכ-14 ו-45 נקודות אחוזים, בהתאמה. ההבדל בין OA ל-AA מעיד על כך שהביצועים הכלליים הושפעו מתדירות המחלקות, בעוד ש-AA משקף את הביצועים הממוצעים בכל המחלקות. בהתאם לכך, יש לפרש את ה-OA המדווח יחד עם התוצאות עבור כל מחלקה, מכיוון שביצועי הסיווג השתנו בין קטגוריות כיסוי קרקע בודדות. ההשוואה האיכותית באיור 5A–I מציגה את מפות הסיווג שהופקו על ידי השיטות שנבחנו, בעוד שאיור 5J מציג את מפת הייחוס (ground-truth) המתאימה, הממחישה את ההתפלגות המרחבית של מחלקות כיסוי הקרקע במערך הנתונים של Augsburg.
| סוג | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| עצים | 96.41 | 98.21 | 91.72 | 94.27 | 95.85 | 93.64 | 90.58 | 93.36 | 99.57 |
| מגורים | 96.88 | 42.08 | 95.19 | 69.84 | 92.75 | 97.71 | 96.32 | 97.37 | 98.97 |
| תעשייה | 58.2 | 47.29 | 62.61 | 35.22 | 72.66 | 65.82 | 72.45 | 64.6 | 86.41 |
| צמחייה נמוכה | 92.22 | 51.75 | 87.76 | 80.27 | 88.9 | 84.88 | 89.65 | 96.72 | 99.58 |
| גינות חלקות | 55.87 | 95.94 | 50.86 | 89.33 | 72.86 | 46.85 | 62.91 | 58.69 | 91.22 |
| מסחר | 10.98 | 50.91 | 24.24 | 45.59 | 20.32 | 24.49 | 17.22 | 29.73 | 74.3 |
| מים | 22.87 | 67.78 | 29.04 | 54.87 | 36.82 | 24.49 | 13.27 | 15.53 | 74.39 |
| דיוק כולל (OA) | 88.78 | 56.59 | 87.74 | 75.94 | 87.29 | 87.72 | 88.35 | 91.56 | 97.56 |
| דיוק ממוצע (AA) | 62.29 | 65.47 | 63.06 | 67.61 | 67.78 | 62.56 | 63.2 | 65.14 | 89.21 |
| מקדם קאפה (κ × 100) | 84.32 | 46.78 | 82.69 | 67.83 | 82.58 | 82.49 | 83.36 | 87.88 | 96.48 |
טבלה 4: ביצועי סיווג (%) של שיטות שונות על מערך נתוני הייחוס (benchmark) של Augsburg. ביצועי סיווג לכל מחלקה יחד עם הדיוק הכולל (OA), הדיוק הממוצע (AA) ומקדם קאפה (κ) שהושגו על ידי מסגרת FlowErs המוצעת ושיטות מתחרות על מערך נתוני הייחוס של Augsburg.
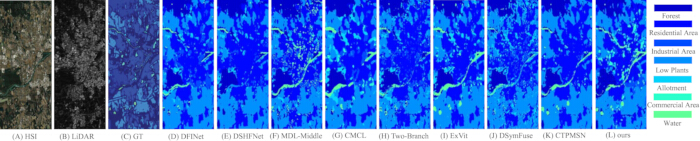
איור 5: תוצאות מייצגות של סיווג כיסוי קרקע עבור מערך הנתונים של Augsburg. (A) דימוי היפר-ספקטרלי (HSI). (B) דימוי LiDAR. (C) מפת ייחוס של אמת קרקע (GT). (D–L) מפות סיווג שהופקו על ידי DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN, ומסגרת FlowErs המוצעת, בהתאמה. מקרא הצבעים מזהה את מחלקות כיסוי הקרקע המיוצגות בכל מפת סיווג. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
כדי להקל על השוואה חזותית מעמיקה יותר של אזורים מאתגרים, מוצגות בתמונות מוגדלות של אזורי עניין (ROIs) מייצגים מתוך מאגרי הנתונים MUUFL, Houston2013 ו-Augsburg ב-איור 6. תמונות מוגדלות אלו מדגישות את גבולות האובייקטים ומבנים מרחביים בקנה מידה קטן, הפחות בולטים במפות הסיווג של הסצנה המלאה המוצגות ב-איורים 3–5, ובכך הן מספקות ראיות איכותיות נוספות לביצועי הסיווג בשלושת מאגרי הנתונים המשמשים כבנצ'מרק.
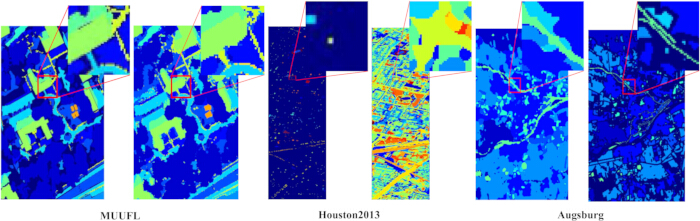
איור 6: תצוגות מוגדלות של אזורי עניין (ROIs) מייצגים ממאגרי הנתונים MUUFL, Houston2013 ו-Augsburg. אזורי עניין מייצגים ממאגרי הנתונים MUUFL, Houston2013 ו-Augsburg הוצגו בתצוגה מוגדלת כדי להקל על השוואה חזותית של פרטי סיווג בקנה מידה קטן. תיבות אדומות מציינות את האזורים שנבחרו, והתצוגות המוגדלות התואמות מדגישות גבולות של אובייקטים, מבנים קטנים ואזורים מאתגרים אחרים שקשה להבחין בהם במפות הסיווג של הסצנה המלאה המוצגות באיורים 3–5. תצוגות מוגדלות אלו מספקות הערכה איכותנית נוספת של תוצאות הסיווג. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
ניתוח השפעת רכיבי המודל (Ablation Study)
השפעת מודול התאמת הזרימה הרב-מודאלי (multimodal flow matching):
כדי להעריך את תרומתו של מודול ה-MFM, בוצעו ניסויי אבלציה (ablation experiments) באמצעות שלוש תצורות מודל: מסגרת ה-FlowErs המלאה (Baseline), מודל ללא מודול ה-MFM (w/o MFM), ומודל מפושט המשתמש ביישור זרימה חד-כיווני (Single Flow). התוצאות הכמותיות המתאימות מסוכמות ב- טבלה 5.
| שיטה | MUUFL | יוסטון2013 | אוגסבורג | ||||||
| OA (%) | חומצות אמינו (%) | κ × 100 | OA (%) | חומצות אמינו (%) | κ × 100 | OA (%) | חומצות אמינו (%) | κ × 100 | |
| קו בסיס | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| ללא MFM | 92.87 | 86.02 | 91.05 | 95.31 | 95.28 | 94.97 | 95.12 | 87.06 | 93.98 |
| זרימה בודדת | 94.38 | 87.43 | 92.72 | 96.58 | 96.47 | 96.22 | 96.47 | 88.36 | 95.47 |
טבלה 5: מחקר אבלציה (Ablation study) של מסגרת ה-FlowErs המוצעת על גבי מערכי נתוני הבנצ'מרק MUUFL, Houston2013 ו-Augsburg. ביצועי הסיווג מדווחים עבור המודל המלא (Baseline) ושתי גרסאות אבלציה באמצעות דיוק כולל (OA), דיוק ממוצע (AA) ומקדם קאפה (κ).
בהשוואה למודל הבסיס (Baseline), הסרת מודול ה-MFM הובילה לערכי OA, AA ו-Kappa נמוכים יותר בכל שלושת מערכי נתוני הבקרים. תצורת ה-Single Flow הניבה ביצועים ביניים בין המודל המלא לבין המודל ללא MFM, דבר המצביע על כך שיישור תכונות חד-כיווני שימר חלק מהשיפור בביצועים שנצפה, אך לא הגיע לביצועים המצטברים של היישום הדו-כיווני. תצפיות אלו מרמזות כי מודול יישור הזרימה הדו-כיווני תרם לביצועים המדווחים תחת הגדרות הבקרים שנבדקו. ההבדלים המדווחים מייצגים הערכות נקודתיות של פיצול קבוע שהתקבלו באמצעות גרעין אקראי (random seed) בודד, ולכן יש לפרשם באופן תיאורי ולא כראיה למשמעות סטטיסטית.
בשלושת מערכי הנתונים המשמשים כנקודת ייחוס, נצפו הפרשי הביצועים המצטברים הגדולים ביותר בין מודל הבסיס (Baseline) למודלי האבלציה במערך הנתונים MUUFL, בעוד שבמערך הנתונים Houston2013 נצפו הבדלים קטנים יותר יחסית. שיפורים הן ב-OA והן ב-AA נצפו עבור המודל המלא ביחס לתצורות האבלציה, מה שמעיד על ביצועי סיווג מצטברים גבוהים יותר יחד עם ביצועי מחלקה ממוצעים משופרים תחת חלוקות הייחוס שהוערכו. ממצאים אלו עקביים עם היפותזת המחקר לפיה יישור מאפיינים (feature alignment) לפני היתוך רב-מודאלי עשוי לשפר את ביצועי הסיווג; עם זאת, בניסוי הנוכחי לא בוצעו ניסויים חוזרים או ניתוחים סטטיסטיים.
השפעת מספר שלבי אינטגרציית הזרימה:
כדי להעריך עוד יותר את השפעת מספר שלבי אינטגרציית הזרימה בתוך מודול ה-MFM, שונו מספר שלבי האינטגרציה בטווח שבין 2 ל-10. תוצאות הסיווג המתאימות מסוכמות ב-טבלה 6. פרמטר שלב האינטגרציה שולט בדיסקרטיזציה של תהליך הובלת התכונות הרציף במהלך יישור רב-מודאלי, כאשר ערכים קטנים יותר מייצגים דיסקרטיזציה גסה יותר וערכים גדולים יותר מייצגים דיסקרטיזציה עדינה יותר. כפי שמוצג ב-טבלה 6, הערכות נקודת הפיצול הקבועה הגבוהות ביותר על פני המדדים שנבדקו התקבלו כאשר מספר שלבי האינטגרציה היה 6. הביצועים השתפרו בדרך כלל ככל שמספר שלבי האינטגרציה עלה מ-2 ל-6, ולאחר מכן הביצועים המדווחים נותרו יציבים יחסית או ירדו מעט בשלושת מערכי נתוני הייחוס. תצפיות אלו מעידות כי ההגדרה הנומינלית של שישה שלבי אינטגרציה סיפקה את הביצועים המצטברים הגבוהים ביותר תחת תנאי הייחוס שנבדקו. כיוון שהתוצאות המדווחות מבוססות על זרע אקראי (random seed) בודד ועל פיצולי ייחוס קבועים, יש לפרש הבדלים אלו באופן תיאורי ולא כראיה להבדלי ביצועים מובהקים סטטיסטית.
| שלבי אינטגרציית זרימה | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| 2 | 92.37 | 84.63 | 90.12 | 95.73 | 96.12 | 95.64 | 94.86 | 85.73 | 92.76 |
| 3 | 93.58 | 85.47 | 90.98 | 96.32 | 96.48 | 96.01 | 95.61 | 86.48 | 93.51 |
| 4 | 94.31 | 86.51 | 91.76 | 96.88 | 96.92 | 96.57 | 96.18 | 87.34 | 94.12 |
| 5 | 94.92 | 87.62 | 92.54 | 97.18 | 97.22 | 97.05 | 96.89 | 88.02 | 95.07 |
| 6 | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| 7 | 95.12 | 88.56 | 93.5 | 97.49 | 97.44 | 97.31 | 97.34 | 88.84 | 96.21 |
| 8 | 94.95 | 88.22 | 93.2 | 97.31 | 97.29 | 97.17 | 96.98 | 88.46 | 95.82 |
| 9 | 94.63 | 87.75 | 92.85 | 97.09 | 97.03 | 96.88 | 96.45 | 87.92 | 95.28 |
| 10 | 94.21 | 86.97 | 92.18 | 96.77 | 96.81 | 96.61 | 95.87 | 87.03 | 94.61 |
טבלה 6: השפעת מספר שלבי אינטגרציית הזרימה על ביצועי הסיווג עבור מאגרי הנתונים המהוות נקודות ייחוס MUUFL, Houston2013 ו-Augsburg. ביצועי הסיווג מדווחים כדיוק כולל (OA), דיוק ממוצע (AA) ומקדם קפא (κ) עבור מספרים שונים של שלבי אינטגרציית זרימה. שישה שלבי אינטגרציה תואמים לתצורה שנעשה בה שימוש במסגרת FlowErs הסופית.
מבין מערכי הנתונים שהוערכו, מערך הנתונים MUUFL הפגין את השונות הגדולה ביותר בביצועים עם שינוי מספר שלבי האינטגרציה, בעוד שמערך הנתונים Houston2013 הראה שינויים קטנים יותר באופן יחסי, ובמקביל השיג את הביצועים הגבוהים ביותר שדווחו בשישה שלבי אינטגרציה. מערך הנתונים Augsburg הדגים מגמה דומה עם שונות ביצועים צנועה יחסית בין הגדרות שלבים שונות. יחד, תצפיות אלו מצביעות על כך שמספר בינוני של שלבי אינטגרציית זרימה סיפק את ביצועי הסיווג הגבוהים ביותר שדווחו עבור מערכי הנתונים שהוערכו. הניתוח הנוכחי אינו כולל ניסויים חוזרים, הערכות אי-ודאות, פרופיל חישובי, עמידות למודליות חסרות או קלטים רועשים, או הכללה בין אזורים, ולכן לא הוסקו מסקנות בנוגע להיבטים אלה.
ההערכה לאורך שלושת מאגרי נתוני הייחוס הדגימה ביצועי סיווג מצטברים תחרותיים תחת חלוקות הייחוס הקבועות שדווחו, עם OA מקסימלי של 97.56%. ניסויי הבלע (ablation) הראו כי תצורת ה-flow-matching הדו-כיוונית המלאה השיגה בעקביות ביצועים מצטברים גבוהים יותר מאשר מודלי הבלע המקבילים בכל מאגרי הנתונים שנבחנו. ניתוחים לפי מחלקה הצביעו על כך שביצועי הסיווג השתנו בין קטגוריות כיסוי הקרקע, כאשר מחלקות מיעוט וקטגוריות דומות ספקטרלית נותרו מאתגרות יחסית ותרמו להבדל שנצפה בין OA לבין AA במאגרי נתונים לא מאוזנים. ההערכה הנוכחית מבוססת על אומדני נקודה בחלוקה קבועה שהושגו באמצעות גרעין אקראי (random seed) יחיד, ואינה כוללת אומדני אי-ודאות של הרצות חוזרות, בדיקות מובהקות סטטיסטית, פרופיל חישובי, רגישות לאי-רישום מרחבי (spatial misregistration), עמידות למודאליות חסרה או רועשת, או הכללה בין אזורים. היבטים אלו מצדיקים חקירה נוספת במחקרים עתידיים.
זמינות נתונים:
מערכי הנתונים הציבוריים המשמשים כבנצ'מרק במחקר זה זמינים מהספקים המקוריים שלהם. חומרי המימוש, מפות הניבוי ותוצאות ההערכה זמינים לציבור דרך מאגר Zenodo בכתובת https://doi.org/10.5281/zenodo.21395701.
קובץ משלים 1: ניסוח מתמטי ואלגוריתם אימון של מסגרת ה-FlowErs.קובץ משלים זה מספק את הניסוח המתמטי המלא העומד בבסיס מסגרת ה-FlowErs המוצעת, כולל ניסוח הזרימה הרציפה (משוואות S1–S2), משוואת זרימת ההסתברות (משוואה S3), נתיב הזרימה האופטימלי (משוואות S4–S5), מטרת האימון של התאמת זרימה מותנית (משוואה S6), והתכונות התאורטיות הנלוות. הקובץ כולל גם את אלגוריתם S1, המסכם את זרימת העבודה של האימון הדו-שלבי המלא, המורכב מאימון מקדימה (pretraining) של התאמת זרימה ללא פיקוח, ולאחריו סיווג מולטימודלי תחת פיקוח.
דיון
המחקר הנוכחי מציג את FlowErs, מסגרת חישובית לרשמיות רחוקה רב-מודאלית המפרידה בין יישור מאפיינים בין-מודאלי לבין סיווג סמנטי באמצעות אסטרטגיית למידה דו-שלבית. במקום מיזוג ישיר של מאפיינים הטרוגניים הספציפיים לכל מודאליות, המסגרת המוצעת מיישרת תחילה את ייצוגי המאפיינים באמצעות התאמת זרימה מותנית (conditional flow matching) לפני המיזוג הרב-מודאלי והסיווג. תכנון זה נותן מענה לאתגר רב-שנתי של התפלגויות מאפיינים הטרוגניות בין HSI ל-LiDAR, שבהן הבדלים במנגנוני החישה מגבילים לעיתים קרובות את יעילותן של אסטרטגיות מיזוג קונבנציונליות המבוססות על שרשור או תשומת לב (attention)23,26,35,36,37,38,39. על ידי הגדרת יישור רב-מודאלי כהעברה רציפה של מאפיינים, FlowErs מרחיב פיתוחים אחרונים בהתאמת זרימה ממודלים גנרטיביים לעבר למידת ייצוגים ברשמיות רחוקה רב-מודאלית15,16,17,18,19,20,21. תחת תנאי הבנצ'מרק שנבחנו, המסגרת המוצעת השיגה ביצועי סיווג מצטברים תחרותיים במאגרי הנתונים Houston2013, Augsburg ו-MUUFL, בעוד שמחקר האבלאציה הנלווה תמך עוד יותר בתרומתו של מודול יישור הזרימה הדו-כיווני לביצועי הפיצול הקבוע שדווחו.
הממצאים המדווחים מצביעים על כך שיישור מאפיינים מפורש לפני היתוך רב-מודאלי עשוי לשפר את התאימות של ייצוגי מאפיינים הטרוגניים שהופקו ממודליות חישייה שונות. שיטות קודמות לחישייה מרחוק רב-מודאלית הסתמכו בעיקר על רשתות קונבולוציה, ארכיטקטורות מבוססות Transformer, מנגנוני קשב, למידה ניגודית או היתוך מונחה-פרומפט כדי לחזק את האינטראקציה בין המאפיינים23,26,35,36,37,38,39. למרות שגישות אלו הדגימו ביצועי סיווג חזקים, רובן מניחות שניתן למזג ישירות שיבודי (embeddings) ספציפיים למודאליות לאחר חילוץ המאפיינים. בניגוד לכך, FlowErs מציגה שלב ביניים של יישור גיאומטרי המעביר באופן רציף מאפיינים ספציפיים למודאליות אל תוך מרחב חבוי משותף לפני הסיווג. ההערכה לפי מחלקות מדגימה כי השיפורים בביצועים המצטברים לא היו מפוזרים באופן אחיד על פני כל קטגוריות כיסוי הקרקע. לדוגמה, מספר מחלקות מיעוט וקטגוריות עירוניות דומות ספקטרלית נותרו קשות יחסית לסיווג, וההבדל שנצפה בין ה-OA ל-AA, במיוחד עבור מערך הנתונים של Augsburg, משקף את השפעת חוסר האיזון בין המחלקות לצד ביצועים משתנים ברמת המחלקה. בהתאם לכך, יש לפרש את המדדים המצטברים המדווחים לצד התוצאות לפי מחלקות, ולא כראיה לשיפורים אחידים בכל קטגוריה.
ניסויי האבלציה תומכים עוד יותר בעיצוב המוצע. הסרת מודול התאמת הזרימה הרב-מודאלית (multimodal flow matching module) הפחיתה את ביצועי הסיווג המצטברים בשלושת מאגרי הנתונים הייחוסים, בעוד שגרסת הזרימה החד-כיוונית הציגה באופן עקבי ביצועים שבין המודל המלא לבין המודל ללא התאמת זרימה. תצפיות אלו עולות בקנה אחד עם השערת העבודה לפיה הובלה דו-כיוונית של תכונות עשויה לשפר את ההתאמה בין המודליים לפני מיזוג התכונות תחת תנאי הייחוס שנבדקו. באופן דומה, ניתוח אינטגרציית הזרימה הדגים כי דיסקרטיזציה בינונית של מסלול ההובלה הנלמד הניבה את הביצועים המצטברים הגבוהים ביותר, כאשר שישה שלבי אינטגרציה ייצגו את נקודת העבודה הנומינלית במימוש הנוכחי. השיפורים בביצועים הפכו שוליים או ירדו מעט עם שלבי אינטגרציה נוספים, מה שמרמז כי דיסקרטיזציה דקה יותר עשויה להניב תשואה פוחתת תחת התנאים הניסויים שנבדקו. השאלה האם נקודת עבודה זו ניתנת להכללה למאגרי נתונים אחרים, למודליות חישה אחרות או לארכיטקטורות רשת שונות, נותרה למחקר.
יש לשקול מספר מגבלות בעת פירוש הממצאים הנוכחיים. ראשית, ההערכה הוגבלה לשלושה מערכי נתונים ייחוס (benchmark) הזמינים לציבור, תוך שימוש בחלוקות קבועות של אימון/בדיקה ובגרעין רנדומלי (random seed) יחיד. כתוצאה מכך, לא נבחנו אי-ודאות הנובעת מהרצות חוזרות, רווחי סמך, בדיקות מובהקות סטטיסטית ושונות בין הרצות. שנית, שיטות ההשוואה נלקחו מהפרסומים המקוריים שלהן ולא מומשו מחדש בתוך מסגרת ניסויית משותפת; לפיכך, יש לפרש את ההשוואות המדווחות באופן תיאורי ולא כשחזורים מבוקרים של השוואה ישירה (head-to-head). שלישית, לא נחקרה העמידות (robustness) למודליות חסרות, תצפיות רועשות, חוסר התאמה מרחבית (spatial misregistration) והכללה בין אזורים שונים. בנוסף, למרות ש-flow matching מספק מסגרת תיאורטית להעברת מאפיינים רציפה ופוטנציאלית הפיכה15,16,17, הפיכות מדויקת, שימור טופולוגיה ופרשנות פיזיקלית של הטרנספורמציות שנלמדו לא אומתו אמפירית במחקר הנוכחי. כמו כן, מאפיינים חישוביים, הכוללים זמן הסקה (inference time), צריכת זיכרון ומורכבות פעולות נקודה צפה (floating-point operation complexity), לא נבדקו בנפרד.
גישות חלופיות לחקר יישור רב-מודאלי (multimodal alignment) ממשיכות להתפתח. מחקרים אחרונים בחנו למידה ניגודית (contrastive learning), מיזוג מבוסס גרפים, למידת ייצוג בדרגה נמוכה (low-rank representation learning), למידה רב-מודאלית מונחית-פרומפט, למידה פדרטיבית, וארכיטקטורות היברידיות של קונבולוציה ו-Transformer כדי לשפר את השילוב של מאפיינים רב-מודאליים23,26,27,28,35,36,37,38,39. אסטרטגיות אלו נותרות משלימות ולאו דווקא שוללות זו את זו, ועבודות עתידיות עשויות לבחון שילובים של העברת מאפיינים מפורשת מבוססת-זרימה עם פרדיגמות יישור קיימות אלו. מעבר לסיווג כיסוי קרקע, יישור מאפיינים רציף עשוי להיות ישיים גם למשימות קשורות של חישה רחוקה רב-מודאלית, כולל סגמנטציה סמנטית, זיהוי שינויים, זיהוי עצמים, ניטור סביבתי, הערכת אסונות, חקלאות מדייקת ומיפוי עירוני, שבהן מודליות חישייה משלימות זמינות יותר ויותר2,3,4,5,6,7,8,9,23.
במחקרים עתידיים יש להעריך את המסגרת המוצעת תחת תנאים ניסיוניים מגוונים יותר, על ידי שילוב של ניתוחים סטטיסטיים של הרצות חוזרות, פרופילינג חישובי, עמידות בפני מודליות חסרות או רועשות, רגישות לשגיאות רישום מרחבי והערכת העברה בין אזורים. מחקרים נוספים שיבחנו פרמטריזציות זרימה חלופיות, ארכיטקטורות מקודד שונות ומערכי נתונים בנצ'מרק מולטי-מודאליים גדולים יותר, יעמיקו את ההבנה לגבי היכולת להכליל ואת היישומיות המעשית של המתודולוגיה המוצעת. יחד, התוצאות הנוכחיות מצביעות על כך שיישור מאפיינים מפורש באמצעות התאמת זרימה מותנית מהווה אסטרטגיה משלימה מבטיחה לסיווג חישוש מרחוק מולטי-מודאלי, תוך הדגשת מספר הזדמנויות לפיתוח מתודולוגי נוסף ולהערכה מקיפה.
גילויים
ניגוד עניינים:
המחברים מצהירים כי אין להם ניגודי עניינים.
תודות
העבודה הזו נתמכת כלכלית על ידי פרויקט קרן המחקר המדעי של אוניברסיטת Shaanxi A&F (מנסרה מס' ZK25-38) ומחלקת החינוך של מחוז Shaanxi (מנסרה מס' 24JK0734).
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| אופטימייזר AdamW | PyTorch Foundation | כלול ב-PyTorch | משמש לאופטימיזציה של המודל. נעשה שימוש ב-PyTorch 2.5.0. |
| סט נתוני הבנצ'מרק Augsburg | Hu J et al. (Earth System Science Data, 2022); Remote Sensing Technology, LMU Munich | https://doi.org/10.5281/zenodo.7185498 | סט נתוני בנצ'מרק ציבורי רב-מודאלי של חישוף מרחוק המשמש להערכת המודל. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | משמש לאימון והסקה של מודל מואץ-GPU. |
| מעבד גרפי (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | משמש לאימון והערכה של המודל. |
| סט נתוני הבנצ'מרק Houston2013 | IEEE Geoscience and Remote Sensing Society Data Fusion Contest | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | סט נתוני בנצ'מרק ציבורי של דימויים היפר-ספקטרליים ו-LiDAR המשמש להערכת המודל. |
| סט נתוני הבנצ'מרק MUUFL Gulfport | University of Florida (Gader P et al., Technical Report REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | סט נתוני בנצ'מרק ציבורי של דימויים היפר-ספקטרליים ו-LiDAR המשמש להערכת המודל. |
| מערכת הפעלה | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | סביבה חישובית ששימשה לפיתוח, אימון והערכה של המודל. |
| PyTorch | PyTorch Foundation | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | מסגרת למידה עמוקה ששימשה להמימוש, אימון והערכה של מודל ה-FlowErs. |
| Python | Python Software Foundation | Python 3.11; https://www.python.org/downloads/release/python-3110/ | שפת תכנות ששימשה להמימוש ולהרצה של זרימת העבודה החישובית. |
מקורות
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.