פרוטוקול זה משלב נתונים טרנסקריפטומיים רב-ממדיים עם למידת מכונה כדי לזהות גנים הקשורים להזדקנות ולמיטוכונדריה בקרדיומיופתיה מדורגית (dilated cardiomyopathy), לצורך גילוי סמנים ביולוגיים וסיווג לתת-סוגים מולקולריים.
מאמר מחקר
זיהוי גנים מרכזיים (Hub Genes) הקשורים להזדקנות ולמיטוכונדריה בקרדיומיופתיה מדורגית (Dilated Cardiomyopathy)
במאמר זה
סיכום
תקציר
קרדיומיופתיה מורחבת (DCM) מאופיינת בהרחבה של החדר השמאלי ובתפקוד סיסטולי לקוי, והיא קשורה לתפקוד מיטוכונדריאלי לקוי ולהפעלה אימונו-דלקתית. עם זאת, חתימות מולקולריות הקשורות להזדקנות ומסלולי בקרה מיטוכונדריאליים ב-DCM עדיין אינם מובנים במלואם. מחקר זה ניתח שישה מאגרי נתונים טרנסקריפטומיים (bulk transcriptomic) ומאגר נתונים אחד של ריצוף RNA של תא בודד (single-cell RNA sequencing) מתוך מאגר הנתונים Gene Expression Omnibus. לאחר נורמליזציה של הנתונים, תיקון אפקטים של סדרות (batch correction) ואנוטציה של סוגי תאים, זוהו גנים מועמדים הקשורים להזדקנות ולמיטוכונדריה באמצעות ניתוח ביטוי דיפרנציאלי, ניתוח רשתות ביטוי משותף משוקלל של גנים (WGCNA) ובניית רשת אינטראקציות חלבון-חלבון. גנים מרכזיים סוננו עוד יותר באמצעות רגרסיית LASSO (least absolute shrinkage and selection operator), יער אקראי (random forest) וביטול תכונות רקורסיבי של מכונת וקטורים תומכים (SVM-RFE). ניתוחים של חדירת תאי חיסון, תקשורת בין-תאית ותתי-סוגים מולקולריים בוצעו כדי לאפיין את המיקרו-סביבה החיסונית של הלב ב-DCM. סך של 66 גנים הקשורים להזדקנות ו-16 גנים הקשורים למיטוכונדריה נמצאו קשורים ל-DCM, והם היו מועשרים בעיקר במסלולי סיגנל של hypoxia-inducible factor-1, פוספורילציה חמצונית ומסלולים הקשורים ל-nitric oxide synthase. ניתוחי למידת מכונה וריצוף RNA של תא בודד זיהו את SERPINE1, TGFB2, CYBB ו-TLR2 כגנים מרכזיים. CYBB ו-TLR2 ביטו ביטוי גבוה במונוציטים ובמקרופגים, בעוד ש-SERPINE1 ו-TGFB2 ביטאו ביטוי בעיקר בתאי סטורמה. ניתוח של נוף החיסון הראה עלייה בהפעלת מקרופגים פרו-דלקתיים ותקשורת בין-תאית משתנה בדגימות DCM. בהתבסס על ביטוי הגנים המרכזיים, דגימות DCM חולקו לשני תתי-סוגים מולקולריים הקשורים לסיגנל של vascular endothelial growth factor ולביו-סינתזה של חומצות מרה ראשוניות, בהתאמה. פרוטוקול זה מספק מסגרת אינטגרטיבית לזיהוי סמנים ביולוגיים מועמדים ותתי-סוגים מולקולריים ב-DCM.
מבוא
קרדיומיופתיה מורחבת (DCM) היא הפרעה של השריר הלבבי המאופיינת בהרחבה של החדר השמאלי ובליקוי בתפקוד הסיסטולי. זוהי הסיבה השלישית בשכיחותה לאי-ספיקת לב והאינדיקציה המובילה להשתלת לב ברחבי העולם1. מחקרים מבוססי אוכלוסייה מעריכים שכיחות של כ-1 מתוך 250 מבוגרים, עם שכיחות גבוהה יותר בגברים ושיעור ניכר של מקרים המיוחסים לווריאנטים מונוגניים2. ממצאים אלו מעידים כי הן רגישות גנטית והן גורמים סביבתיים תורמים להיווצרותה ולהחמרתה של DCM.
הפתוגנזה של DCM כוללת תהליכים השזורים זה בזה, הכוללים הפעלה דלקתית, עקה חמצונית, אפופטוזיס של קרדיומיוציטים ואותות פרו-פיברוטיים לא מווסתים. פולימורפיזמים גנטיים דלקתיים, כולל וריאנטים של מקדם tumor necrosis factor-α, נקשרו לרגישות ל-DCM ויראלי3. עקה חמצונית מוגברת נקשרה אף היא למות קרדיומיוציטים ולליקוי בתפקוד החדר השמאלי בסוגי DCM אנושיים4. בנוסף, הפעלה חריגה של אותות Wnt/β-catenin ו-calcineurin/nuclear factor of activated T cells מקדמת היפרטרופיה של השריר הלבבי ופיברוזיס אינטרסטיציאלי, ובכך תורמת להתקדמות המחלה5,6. תפקוד מיטוכונדריאלי לקוי הוא מרכיב חשוב נוסף ב-DCM כיוון שלקרדיומיוציטים יש דרישות אנרגיה גבוהות. שיבוש בביוגנזה מיטוכונדריאלית, בהומאוסטזיס של סידן, במיטופאגיה ובשלמות ה-DNA המיטוכונדריאלי עלול לפגוע בפוספורילציה חמצונית ולתרום לליקוי תפקודי לב הדרגתי7,8,9,10.
למרות ממצאים מכניסטיים אלה, נותרו פערי ידע משמעותיים. בפרט, הקשרים הזמניים והסיבתיים בין עיצוב מחדש של המבנה המיטוכונדריאלי לבין תפקוד ביואנרגטי לקוי במהלך התחלה והתקדמות של DCM טרם הוגדרו במלואם11. מספר אסטרטגיות טיפוליות נבחנו. טיפול בתאי גזע הראה פוטנציאל רגנרטיבי באמצעות השפעות פראקריניות, ציטופרוטקטיביות ואימונו-מודולטוריות, אך נדרשת אופטימיזציה של מקורות התאים, נתיבי ההחדרה והישרדות לאחר השתלה12. גישות של טיפול גנטי, הכוללות החדרה מבוססת נגיף adeno-associated ועריכה גנומית מבוססת clustered regularly interspaced short palindromic repeats, מציעות גם הן אסטרטגיות לטיפול מדויק. עם זאת, מגבלות הקשורות לטרופיזם קרדיאלי, אימונוגניות של הווקטור ובטיחות לטווח ארוך נותרו ללא פתרון13.
מאגרי נתונים טרנסקריפטומיים ציבוריים ממאגרים כגון ה-Gene Expression Omnibus (GEO) נמצאים בשימוש נרחב לגילוי סמנים ביולוגיים ב-DCM. משאבים אלו מספקים גישה לקוהורטות קליניות רב-מרכזיות, תומכים במחקרים חסכוניים וניתנים לשחזור, ויכולים לשפר את העוצמה הסטטיסטית באמצעות אינטגרציה של מספר מאגרי נתונים14. פרופיל טרנסקריפטומי מאפשר גם סריקה של גנים מועמדים ברמה הגנומית, סיווג לתת-סוגים מולקולריים וניתוח ברמת מסלולים ביולוגיים15. עם זאת, למאגרי נתונים ציבוריים יש מגבלות מובנות, הכוללות השפעות של אצוות טכניות (batch effects), הטרוגניות קלינית ואטיולוגית, יכולת מוגבלת להסקה סיבתית, ומידע לונגיטודיני או פרוגנוסטי חסר16. לכן, ממצאים המופקים ממאגרי נתונים טרנסקריפטומיים ציבוריים מתאימים ביותר להצבת היפותזות ולתיעדוף סמנים ביולוגיים מועמדים, ודורשים תיקוף בקוהורטות עצמאיות ובמודלים ניסיוניים.
מחקרים ביואינפורמטיים רבים של DCM מסתמכים בעיקר על ניתוח ביטוי דיפרנציאלי, שעלול להניב ממצאים של חיוביים שגויים ואינו מאפיין באופן מלא רשתות של ביטוי גנים משותף או הטרוגניות תאית בתוך רקמת הלב. כדי להתגבר על מגבלות אלו, המחקר הנוכחי השתמש באסטרטגיה אנליטית אינטגרטיבית המשלבת שיטות משלימות. ניתוח טרנסקריפטומי של אוכלוסיית תאים (Bulk transcriptomic analysis) מספק פרופילים של ביטוי ברמת הרקמה המתאימים להשוואות בין קבוצת ביקורת לקבוצת מחלה. ניתוח רשת של ביטוי גנים משותף משוקלל (WGCNA) מזהה מודולים של גנים הקשורים למאפיינים פנוטיפיים ומאפשר תיעדוף של קבוצות גנים הקשורות תפקודית, במקום גנים בודדים בעלי ביטוי דיפרנציאלי. ניתוח רשת של אינטראקציית חלבון-חלבון (PPI) מזהה גנים בעלי קישוריות גבוהה על בסיס טופולוגיית הרשת. שלושה אלגוריתמים של למידת מכונה—רגרסיית LASSO (least absolute shrinkage and selection operator), יער אקראי (random forest), ומכונת וקטורים תומכים עם סילוק תכונות רקורסיבי (support vector machine-recursive feature elimination)—שימשו לזיהוי ביומרקרים מועמדים על פני מערכי הנתונים המשולבים¹⁷. לאחר מכן, נעשה שימוש בריצוף RNA של תא בודד (scRNA-seq) כדי לבחון דפוסי ביטוי ספציפיים לסוג התא ורשתות תקשורת בין-תאיות18.
למרות שדיספונקציה מיטוכונדריאלית ושינויים מולקולריים הקשורים להזדקנות נחקרו כל אחד בנפרד ב-DCM, הקשרים המשולבים שלהם עם שינויים תעתוקיים הקשורים למחלה נותרו בלתי נחקרים דיו. המחקר הנוכחי שילב מספר מערכי נתונים של bulk transcriptomic ו-scRNA-seq כדי לזהות גני-צומת (hub genes) הקשורים להזדקנות ולמיטוכונדריה ב-DCM, לאפיין את המיקרו-סביבה החיסונית של הלב, ולבחון תת-סוגים מולקולריים על בסיס הגנים שזוהו. גישה משולבת זו שימשה לתיעדוף של ביומרקרים מועמדים ולספק בסיס למחקרי מנגנונים ותיקוף עוקבים.
פרוטוקול
כל ההליכים בבעלי חיים נסקרו ואושרו על ידי ועדת האתיקה לבעלי חיים במעבדה של בית החולים המסופח השני של אוניברסיטת הרפואה הסינית בהנאן (מספר אישור HNSZYYYJS2023011150). כל ההליכים בוצעו בהתאם להנחיות לבדיקה אתית של רווחת בעלי חיים במעבדה (GB/T 35892-2018) ובהתאם לעקרונות ה-3R של Replacement (החלפה), Reduction (צמצום) ו-Refinement (שיפור). הרכיבים, מאגרי המידע, התוכנות והציוד ששימשו במחקר זה מפורטים ב- טבלת חומרים.
1. משאבי נתונים וחומרים ניסיוניים
עכברי CTNTR141W טרנסגניים זכרים בדרגת SPF, בעלי פנוטיפ של קרדיומיופתיה התרחבותית (DCM) ספונטנית ומשקל גוף של 25 ± 2 g, שימשו כקבוצת המודל. עכברי C57BL/6J זכרים בדרגת SPF, בעלי גיל תואם ומשקל גוף של 25 ± 2 g, שימשו כקבוצת הביקורת. כל קבוצה כללה 12 עכברים. כל בעלי החיים הושגו ממוסדות המחזיקים ברישיונות תקפים להפקת חיות מעבדה, ושוכנו בסביבת מחסום בדרגת SPF בטמפרטורה של 22 ± 2 °C ובלחות יחסית של 40%–60% תחת מחזור אור/חושך של 12 שעות, עם גישה חופשית למזון ומים סטריליים. לאחר שבוע אחד של אקלימטציה, כל העכברים הוחזקו תחת אותם תנאים למשך 4 שבועות נוספים לפני הערכת תפקוד הלב ואיסוף דגימות. כל העכברים היו בני 6–8 שבועות בתחילת הניסוי. העכברים הורדמו עמוקות והורגו באמצעות פריקה צווארית.
שבעה מאגרי נתונים טרנסקריפטומיים ציבוריים של רקמת שריר לב מהחדר השמאלי של חולים עם DCM נשלפו ממאגר הנתונים Gene Expression Omnibus (GEO)19. מאגרי נתונים אלו כללו שישה מאגרי נתונים טרנסקריפטומיים מסוג bulk ומאגר נתונים אחד של ריצוף RNA של תא בודד (scRNA-seq), GSE145154. הן פרקציות חיוביות ל-CD45 והן פרקציות שליליות ל-CD45 נכללו בניתוח. שתי פרקציות התאים, החיוביות והשליליות ל-CD45, אוחדו לפני ביצוע ה-clustering. זהות הדגימה שימשה כמשתנה ה-batch העיקרי עבור אינטגרציית Harmony. דגימות של חדר שמאלי נורמלי וחדר שמאלי עם DCM מתוך GSE145154 נכללו, ובמיוחד GSM4307515, GSM4307516, GSM4307520 ו-GSM4307521. מאגרי הנתונים ששימשו במחקר זה היו GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 ו-GSE141910. כל הדגימות שאינן DCM הוצאו, ורק דגימות ביקורת (קבוצת Control) ודגימות DCM (קבוצת DCM) נשמרו. אף דגימה לא הוסרה לאחר בקרת איכות. מידע על הדגימות ממאגרי ה-GEO שנכללו מסוכם כך: GSE5406 הכיל 102 דגימות (16 ביקורת ו-86 דגימות DCM); GSE42955 הכיל 17 דגימות (5 ביקורת ו-12 דגימות DCM); GSE57338 הכיל 231 דגימות (136 ביקורת ו-95 דגימות DCM); GSE79962 הכיל 20 דגימות (11 ביקורת ו-9 דגימות DCM); GSE116250 הכיל 51 דגימות (14 ביקורת ו-37 דגימות DCM); ו-GSE141910 הכיל 322 דגימות (161 ביקורת ו-161 דגימות DCM).
2. עיבוד מקדים של נתוני טרנסקריפטום מסוג bulk
מטריצות ביטוי גולמיות וקבצי אנוטציה קלינית עבור ששת מאגרי הנתונים מסוג bulk הורדו באמצעות חבילת GEOquery20. קבצי CEL גולמיים נשלפו עבור מאגרי נתוני המיקרו-מערך (microarray) של Affymetrix, ומטריצות ספירה גולמיות נשלפו עבור מאגרי נתוני ה-RNA-seq. תיקון רקע, נורמליזציית קוונטילים וחישוב ביטוי עבור נתוני המיקרו-מערך בוצעו באמצעות אלגוריתם ה-robust multi-array average המיושם בחבילת affy21.
נתוני הספירה של RNA-seq נורמלו באמצעות שיטת trimmed mean of M-values בחבילת edgeR22 והומרו לערכי counts per million שעברו טרנספורמציית log₂. מזהי הגששים (probes) הומרו לסמלי גנים רשמיים באמצעות קובצי אנוטציה ספציפיים לפלטפורמה. כאשר מספר גששים מופו לאותו גן, חושב ערך הביטוי הממוצע.
השפעות אלומה (batch effects) טכניות בין מערכי נתונים הוסרו באמצעות אלגוריתם ComBat בחבילת sva23. מקור מערך הנתונים ופלטפורמת הזיהוי הוגדרו כגורמי אלומה (batch factors). ניתוח רכיבים ראשיים (PCA) בוצע לפני ואחרי תיקון האלומה כדי להעריך את יעילות ההסרה של השפעות האלומה.
3. עיבוד מקדים של נתוני טרנסקריפטום של תא בודד ואנוטציה של תאים
מטריצת ביטוי הגנים מ-GSE145154 יובאה ל-Seurat כדי לבנות אובייקט Seurat באמצעות Seurat גרסה 524. תאים באיכות נמוכה הוצאו מהניתוח על פי הסף הבא: 200–6,000 גנים מזוהים לתא, ספירה כוללת של מזהים מולקולריים ייחודיים (UMI) הגבוהה מ-500, ואחוז גנים מיטוכונדריאליים נמוך מ-25%. תאים שחרגו מספי סף בקרת האיכות הללו הוצאו כמרכיבים באיכות נמוכה או כתאים קרועים. הסרנו תאים באיכות נמוכה אך ורק על בסיס ספי בקרת האיכות שתיארו לעיל.
נורמליזציה לוגריתמית בוצעה באמצעות פונקציית NormalizeData עם מקדם קנה מידה של 10,000. 3,000 הגנים בעלי השונות הגבוהה ביותר נבחרו באמצעות פונקציית FindVariableFeatures עם שיטת vst. הנתונים עברו סקלינג באמצעות ScaleData, ולאחריו בוצע ניתוח רכיבים ראשיים (PCA) להפחתת מימדיות ליניארית.
אפקטים של סדרות (Batch effects) תוקנו באמצעות אלגוריתם Harmony25 דרך הפונקציה RunHarmony, כאשר זהות הדגימה הוגדרה כמשתנה הקיבוץ. 15 הרכיבים הראשיים הראשונים שימשו למקבץ תאים באמצעות הפונקציות FindNeighbors ו-FindClusters. המקבץ בוצע באמצעות אלגוריתם Leiden ברזולוציה של 0.15. הפחתת ממדים לא ליניארית וויזואליזציה בוצעו באמצעות שיטת uniform manifold approximation and projection.
סוגי התאים סווגו באמצעות גני סימון קנוניים יחד עם סיווג אוטומטי באמצעות חבילת SingleR26. גני הסימון היו כדלקמן: לתאי B, הגנים IGKC, MS4A1 ו-CD79A; לתאי שריר לב (cardiomyocytes), הגנים TNNI3, MYL2 ו-ACTC1; לתאי אנדותל, הגנים VWF, PECAM1 ו-EGFL7; למקרופאגים, הגנים C1QC, C1QB ו-C1QA; למונוציטים, הגנים S100A8, S100A9 ו-G0S2; לתאי NK (natural killer cells), הגנים NKG7, GNLY ו-CCL5; לתאי שריר חלק, הגנים MYL9, TAGLN ו-ACTA2; לתאי סטרומה, הגנים FBLN1, LUM ו-DCN; ולתאי T, הגנים CD3E, CD3G ו-CD3D.
4. ניתוח ביטוי דיפרנציאלי ודירוג העשרה של קבוצות גנים
מודל ליניארי נבנה באמצעות חבילת limma27 כדי להשוות את ביטוי הגנים בין קבוצת ה-DCM לקבוצת הביקורת הבריאה. גנים עם P value < 0.05 ושינוי מקפלת (fold change) מוחלט הגדול מ-1.5, המקביל ל-log₂ fold change מוחלט הגדול מ-0.58, הוגדרו כבעלי ביטוי דיפרנציאלי מובהק.
ניתוח העשרה של קבוצות גנים עבור דגימה בודדת (Single-sample gene set enrichment analysis) בוצע כדי לחשב ציוני העשרה עבור קבוצות גנים הקשורות להזדקנות ולקטבונים בכל דגימה28. הבדלים בציוני ההעשרה בין קבוצת ה-DCM לקבוצת הביקורת הבריאה הוערכו באמצעות מבחן Wilcoxon rank-sum, כאשר ערך P value < 0.05 נחשב למשמעותי מבחינה סטטיסטית.
ברמת התא הבודד, חישובי ציוני מודול הקשור להזדקנות ומודול מיטוכונדריאלי בוצעו באמצעות פונקציית AddModuleScore ב-Seurat. הבדלים בציוני המודולים בין הקבוצות הוערכו באמצעות מבחן Wilcoxon rank-sum.
חתימות גנים הקשורות להזדקנות נשלפו ממאגר הנתונים CellAge (https://genomics.senescence.info/cells/), ומערכי גנים הקשורים למיטוכונדריה התקבלו מ-GeneCards (https://www.genecards.org/). רשימות הגנים המלאות ששימשו לדירוג מופיעות ב- קובץ משלים 1.
5. בניית רשת ביטוי גנים משותף משוקללת
עבור בניית הרשת, נשמרו 5000 הגנים המקודדים לחלבון עם שונות הביטוי הגבוהה ביותר בנתוני הטרנסקריפטומיקה הגולמיים (bulk transcriptomic data). פונקציית pickSoftThreshold הופעלה כדי לחשב את מדד התאמה לטופולוגיה נטולת-סולם (scale-free topology fit index) תחת מספר הספקים של חזקות סף-רכות (soft-thresholding powers). הסף האופטימלי נקבע כחזקה המינימלית המניבה רשת נטולת-סולם עם ערך R2 הגבוה מ-0.9. בהתאם לכך, נבחרה חזקת סף-רכה של β = 5 עבור ניתוח הרשת בהמשך.
רשת ביטוי-משותף שקולה בעלת סימן (signed weighted co-expression network) נבנתה באמצעות הפונקציה blockwiseModules עם גודל מודול מינימלי של 30. מקדמי מתאם פירסון חושבו בין כל eigengene של מודול לבין מדד העשירה הקשור להזדקנות או למיטוכונדריה. מודולים בעלי מקדם מתאם מוחלט הגבוה מ-0.4 ו-P < 0.001 נחשבו כמודולים בעלי קשר מובהק.
ביצעו חיתוך בין גנים בתוך מודולים בעלי קשר מובהק לבין גנים עם ביטוי Differentially Expressed, במטרה לזהות גנים מועמדים להזדקנות הקשורה ל-DCM וגנים מועמדים למיטוכונדריה הקשורה ל-DCM.
6. ניתוח העשרה תפקודי
ניתוחים של העשרה תפקודית, כולל ניתוחי Gene Ontology (GO) ומסלולי Kyoto Encyclopedia of Genes and Genomes (KEGG), בוצעו עבור הגנים המועמדים באמצעות חבילת clusterProfiler29. העשרת GO כיסתה שלוש קטגוריות סטנדרטיות: תהליך ביולוגי, רכיב תאי ותפקוד מולקולרי.
כל הניתוחים בוצעו עם אנוטציה של מין אדם, שימוש בשיעור התגליות השגויות (FDR) לצורך תיקון של ערכי P, וסף q-value של 0.05. קבוצות הגנים הוגבלו לטווח גודל של 10–500 גנים, ומונחים עם FDR < 0.05 הוגדרו כבעלי מובהקות סטטיסטית. לבסוף, תוצאות העשרה של GO הוצגו באמצעות תרשימי עמודות מקובצים, בעוד שתוצאות העשרה של KEGG הוצגו באמצעות תרשימי בועות.
7. בניית רשת PPI וסריקת גני מפתח (hub genes)
גנים מועמדים הוכנסו למסד הנתונים STRING גרסה 11.530, כאשר האורגניזם הוגדר כ-Homo sapiens וסף הביטחון לאינטראקציה הוגדר כציון משולב הגבוה מ-0.7. צמתים מנותקים הוסתרו, ונתוני האינטראקציה יוצאו בפורמט של ערכים מופרדים בטאבים (TSV).
נתוני האינטראקציה יובאו לתוכנת Cytoscape גרסה 3.9.1 לצורך ויזואליזציה31. ציונים טופולוגיים של צמתים חושבו באמצעות תוסף CytoHubba32 עם שלושה אלגוריתמים: Degree, maximum neighborhood component, ו-maximal clique centrality.
מודולים פונקציונליים מרכזיים בתוך הרשת זוהו באמצעות תוסף ה-MCODE33 עם פרמטרי ברירת המחדל הבאים: סף דרגה (degree cutoff), 2; k-core, 2; סף ציון צומת (node score cutoff), 0.2; ועומק מרבי, 100. גנים שדורגו בין 10 המובילים על ידי שלושת האלגוריתמים הטופולוגיים הועברו להצלבה עם גנים בתת-הרשת הליבתית של MCODE כדי לזהות את הגנים המהווים את מוקדי (hubs) האינטראקציה הסופיים בין חלבונים.
8. בחירת גנים מרכזיים ובניית מודל אבחנתי מבוססי למידת מכונה
כדי להבטיח הדירות וייצוג מאוזן, מאגר הנתונים המשולב של הטרנסקריפטומיקה ב-bulk פולח באופן אקראי למערכות אימון ותיקוף ביחס של 7:3 באמצעות גרעין אקראי קבוע (seed = 123456). פילוח זה בוצע באופן שכובתי לפי קבוצת המחלה (DCM לעומת ביקורת) כדי לשמור על פרופורציות מחלקות עקביות בשתי המערכות. לפני הפילוח, תוקנו אפקטים של אצוות (batch effects) ממקורות נתונים שונים באמצעות חבילת ה-sva, והדגימות המשולבות טופלו כקוהורט מאוחד במהלך ההקצאה האקראית.
שלושה אלגוריתמים של למידת מכונה יושמו לסריקת גנים מועמדים. ראשית, בוצעה רגרסיה לוגיסטית מסוג LASSO באמצעות הפונקציה cv.glmnet בחבילת glmnet34נבנה מודל סיווג בינארי בשיטת אימות צולב של 5 קיפולים (5-fold cross-validation), כאשר מדד ה-AUC אומץ כמדד ההערכה. גנים בעלי מקדמים שאינם אפס בערך lambda.min נשמרו כגנים מועמדים.
שנית, נבנה מודל סיווג של יער אקראי (random forest) עם 500 עצי החלטה באמצעות חבילת randomForest35. מספר המשתנים שנדגמו עבור כל פיצול נקבע לשורש הריבועי של מספר המאפיינים הכולל. חשיבות הגנים כומתה על בסיס מקדם ג'יני (Gini coefficient), ועשרת הגנים בעלי ציוני החשיבות הגבוהים ביותר נשמרו.
שלישית, ניתוח SVM-RFE בוצע באמצעות פונקציית rfe בחבילת caret36. מספר התכונות נקבע בטווח של 1–10, ולאימון המודל אומצה וולידציה צולבת של 5-fold. לבסוף נבחרה תת-קבוצת הגנים בעלת הדיוק האופטימלי בוולידציה הצולבת.
גנים שזוהו על ידי כל שלושת האלגוריתמים הוגדרו כגני הליבה הסופיים הקשורים להזדקנות ולמיטוכונדריה ב-DCM. לאחר מכן נבנו מודלים אבחנתיים באמצעות 10 אלגוריתמי סיווג: עץ החלטה (decision tree), gradient boosting machine, boosted generalized linear model, k-nearest neighbors, רגרסיה לוגיסטית, רשת עצבית, ריבועים פחותים חלקיים (partial least squares), יער אקראי (random forest), support vector machine ו-extreme gradient boosting.
עקומות מאפייני תפעול של מקלט (Receiver operating characteristic curves) הופקו באמצעות חבילת pROC37. השטח תחת העקומה, הדיוק, הרגישות והסגוליות חושבו כדי להעריך את הביצועים האבחנתיים בקבוצות האימון והתיקוף.
ניתוח SHapley Additive exPlanations בוצע כדי לחשב את התרומה של כל גן ליבה לתחזיות המודל38. נוצרו תרשימי סיכום ותרשימי מפל (waterfall plots) לכל דגימה. מודל אבחוני סופי עם שטח תחת העקומה הגבוה מ-0.8 בסט validaion נחשב בעל ביצועי אבחון טובים.
9. הסקת תקשורת בין-תאית
רשתות תקשורת בין-תאית במיקרו-סביבה הלבבית הוסקו באמצעות חבילת התוכנה CellChat39. אובייקט CellChat נבנה באמצעות מסד הנתונים CellChatDB.human. ליגנדים וקולטנים בעלי ביטוי דיפרנציאלי זוהו באמצעות identifyOverExpressedGenes, וזוגות אינטראקציה משמעותיים סוננו באמצעות identifyOverExpressedInteractions.
הסתברויות תקשורת בין סוגי תאים חושבו באמצעות computeCommunProb. רשת התקשורת הגלובלית ברמת סוג התא רוכזה באמצעות aggregateNet. מספר האינטראקציות ועוצמת התקשורת בין כל זוג של סוגי תאים נמדדו והוצגו חזותית באמצעות מפות חום (heatmaps) ותרשימי עמודות.
10. כימות חדירת תאי מערכת החיסון
ציוני העשרה עבור 28 סוגי תאי מערכת החיסון חושבו עבור כל דגימת bulk באמצעות ניתוח העשרת קבוצות גנים של דגימה בודדת (single-sample gene set enrichment analysis)28 ומערכת גנים המהווה חתימה של תאי מערכת החיסון40. מבחן Wilcoxon rank-sum שימש להשוואת ציוני העשרת תאי מערכת החיסון בין קבוצת ה-DCM לקבוצת הביקורת הבריאה. ערך של P < 0.05 נחשב למשמעותי סטטיסטית.
ניתוח מתאם פירסון בוצע כדי להעריך את הקשר בין רמות הביטוי של הגנים המרכזיים לבין ציוני העשרה של תאי מערכת החיסון. כל המתאמים עם P < 0.05 נחשבו למשמעותיים מבחינה סטטיסטית.
11. קיבץ קונסנזוס (Consensus clustering) עבור סיווג סוב-טיפים מולקולריים
ביצוע קיבץ קונסנזוס לא מודרך של דגימות DCM בוצע באמצעות פרופילי ביטוי של גנים מרכזיים באמצעות חבילת ConsensusClusterPlus41. פרמטרי הקיבץ נקבעו למספר מקסימלי של 6 אשכולות, 1000 איטרציות של דגימה חוזרת (resampling), ופרופורציית דגימה חוזרת של 0.8. לצורך הקיבץ אומצה שיטת Partitioning around medoids עם מרחק אוקלידי, ונעשה שימוש ב-seed אקראי קבוע כדי להבטיח שחזוריות.
מספר תתי-הסוגים האופטימלי נקבע בהתאם לתרשים delta area ולציוני יציבות של אשכולות קונסנזוס (consensus cluster stability scores), כאשר בסופו של דבר זוהה K = 2. בנוסף, בוצע ניתוח רכיבים ראשיים (Principal component analysis) כדי לאמת את ההפרדה המובחנת בין שני תתי-הסוגים המולקולריים.
ניתוח שונות של קבוצות גנים (Gene set variation analysis)42 הוחל כדי לחשב מדדי העשרה של נתיבי KEGG ספציפיים לדגימה. חבילת ה-limma27 שימשה לזיהוי הפעלת נתיבים דיפרנציאלית בין תתי-סוגים, וערך P נמוך מ-0.05 הוגדר כבעל מובהקות סטטיסטית.
12. הערכה אקו-קרדיוגרפית של תפקוד הלב
העכברים הורדמו באמצעות הזרקה תוך-peritoneאלית (intraperitoneal) של סודיום פנטוברביטאל 1% (30 מ"ג/ק"ג), וקיבוע בתנוחת שכיבה על הגב על שולחן ניתוחים תרמוסטטי. לאחר הסרת שיער מהחזה, נמרח באופן אחיד ג'ל צימוד לאולטרסאונד באזור הפרקורדיאלי (precordial).
בדיקת אקו-קרדיוגרפיה במצב M בהנחיה דו-ממדית בוצעה בגובה השרירים הפפילריים של החדר השמאלי באמצעות מערכת אולטרסאונד לבעלי חיים קטנים. נרשמו שלושה מחזורי לב רציפים ויציבים כדי למדוד את הקוטר הדיאסטולי הסופי של החדר השמאלי, הקוטר הסיסטולי הסופי, מקדם הפליטה (ejection fraction) והקיצור הפרקציונלי (fractional shortening). כל הערכות האקו-קרדיוגרפיה בוצעו באופן סמיים על ידי טכנאי אולטרסאונד מוסמך.
שלושה עכברים נבחרו באופן אקראי מכל קבוצה לבדיקת אקו-לב, ו-6 בעלי חיים אלו בסך הכל נשחטו לאחר מכן לצורך איסוף רקמת שריר לב ומדידת ELISA. שאר בעלי החיים הניסויים עברו בדיקות מעבדה מקבילות נוספות, ונתוניהם לא נכללו במחקר הנוכחי.
13. איסוף רקמת שריר הלב, מיצוי חלבון ובדיקת ELISA (ספיחה חיסונית מקושרת לאנזים)
לאחר הערכה אקו-קרדיוגרפית, העכברים הורדמו עמוק והורגו בהמתה הומנית. רקמות הלב נשלו במהירות באמצעות thoracotomy חציונית, ושריר הלב של החדר השמאלי נחתך על קרח. הרקמות המבודדות נשטפו ביסודיות בתמיסת phosphate‑buffered saline קרה כדי להסיר דם תוך-לבי שנותר. לאחר ספיגת עודפי נוזלים בעזרת נייר סינון סטרילי, הדגימות הוקפאו מיד בהקפאה מהירה (snap‑frozen) בחנקן נוזלי ואוחסנו בטמפרטורה של −80 °C לצורך מיצוי חלבון בהמשך, תוך הימנעות קפדנית ממחזורי הפשרה והקפאה חוזרים.
רקמות שריר לב קפואות נשקלו ונחתכו על קרח למקטעים של כ-1 mm3. הרקמות עברו ליזיס בבופר ליזיס RIPA קר, המכיל מעכבי פרוטאז ופוספטאז, ביחס סטנדרטי של 100 µL בופר ל-10 mg רקמה. הדגימות עברו הומוגניזציה מכנית מלאה על קרח והובאו לדגירה למשך 30 min להשגת ליזיס תאי מלא.
את הליזטים סבבנו בצנטריפוגה במהירות של 12,000 × g למשך 15 min בטמפרטורה של 4 °C. את העליונות שהתקבלו אספנו למבחנות נקיות מאנזימים, ואת ריכוז החלבון הכולל כימתנו באמצעות ערכה לבדיקת חלבון מסוג bicinchoninic acid, בהתאם לפרוטוקולי היצרן. את כל הדגימות נורמלנו לריכוז חלבון זהה באמצעות באפר ליזיס.
רמות הביטוי של החלבונים של ארבעת הגנים המרכזיים (hub genes) בליזאטים של שריר הלב נמדדו באמצעות ערכות ELISA (enzyme‑linked immunosorbent assay) המתאימות. סטנדרטים בדילול סדרתי וליזאטים של רקמה מנורמלים הוספו בשכפולים (100 µL לבאר) למיקרו-פלטות מצופות מראש. הפלטות דגרו במשך 2 h בטמפרטורת החדר ונשטפו ביסודיות עם בופר השטיפה שסופק בערכה.
לכל באער הוסף נוגדן מצומד לאנזים והוא דגר במשך 1 h בטמפרטורת החדר, ולאחר מכן בוצע שטיפה יסודית. לאחר מכן הוסף תמיסת כרומוגן של סובסטרט, והפלטות דגרו במשך 20 min בטמפרטורת החדר בחושך. תגובת הצבע הופסקה באמצעות תמיסת עצירה, וערכי הבליעה נמדדו ב-450 nm (אורך גל ייחוס: 570 nm) באמצעות קורא מיקרו-פלטות רב-אורכי גל.
14. ניתוח סטטיסטי
כל הניתוחים הסטטיסטיים והדמיונים הוויזואליים של הנתונים בוצעו באמצעות R גרסה 4.2.3. עבור מדידות ריכוז ב-ELISA של כל גן מטרה (TGFB2, SERPINE1, CYBB, TLR2), הוחל תחילה מבחן Shapiro-Wilk כדי להעריך את נורמליות הנתונים בקבוצת הביקורת ובקבוצת ה-DCM בנפרד. לאחר מכן, נעשה שימוש במבחן F כדי להעריך את הומוגניות השונויות בין שתי הקבוצות. שיטת ההשוואה בין הקבוצות נקבעה בהתאם לתוצאות מבחן הומוגניות השונות: אם השונויות היו הומוגניות (P ≥ 0.05), נבחר מבחן t של Student למדגמים בלתי תלויים להשוואת ערכי הממוצע בין הקבוצות; אם השונויות היו הטרוגניות (P < 0.05), נעשה שימוש במבחן t של Welch המתוקן לצורך הניתוח. כל המבחנים היו דו-זנביים, וסף המובהקות הסטטיסטית נקבע על P < 0.05. הנתונים הוצגו כתרשימי קופסה (boxplots) עליהם ה superimposed נקודות נתונים אינדיבידואליות מפוזרות (jittered). ערכי ה-P של כל המבחנים וסוג מבחן ה-t שיושם צוינו בפירוט על כל תרשים.
תוצאות
עיבוד מקדמי של נתונים וניתוח ביטוי דיפרנציאלי
כל ששת מערכי הנתונים הטרנסקריפטומיים (bulk transcriptomic datasets) עברו עיבוד מקדמי סטנדרטי ותיקון השפעות של אצוות (batch-effect correction) לפני הניתוחים הבאים. נתוני המערכים הזרקריים (Microarray) נורמלו באמצעות אלגוריתם ה-robust multi-array average, בעוד שנתוני הספירה של RNA-seq נורמלו בשיטת ה-trimmed mean of M-values. אלגוריתם ה-ComBat יושם כדי להסיר השפעות אצוות טכניות הקשורות למקור מערכי הנתונים ולפלטפורמת הגילוי. ניתוח רכיבים ראשיים (Principal component analysis) הראה כי הדגימות התקבצו לפי מקור מערכי הנתונים לפני התיקון, אך היו מפוזרות באופן אחיד יותר לאחר התיקון, ללא הפרדה נראית לעין לפי אצוות.
ניתוח ביטוי דיפרנציאלי בין קבוצת קרדיומיופתיה דילטנטית (DCM) לקבוצת הביקורת הבריאה (HC) בוצע באמצעות חבילת ה-limma. מפת החום של 20 הגנים בעלי הביטוי הדיפרנציאלי המשמעותי ביותר הראתה הפרדה בפרופילי הביטוי בין שתי הקבוצות (איור 1A). סך הכל 1,473 גנים בעלי ביטוי דיפרנציאלי זוהו באמצעות ספי הביטוי P value < 0.05 ו- |log₂ fold change| > 0.58. מתוכם, 819 גנים הראו ביטוי מוגבר (upregulated), ו-654 גנים הראו ביטוי מופחת (downregulated) בדגימות שריר לב של DCM (איור 1B).
לאחר מכן נעשה שימוש בניתוח העשרה של קבוצות גנים לדגימה בודדת (Single-sample gene set enrichment analysis) כדי לחשב מדדי העשרה עבור קבוצות גנים הקשורות להזדקנות ולקריטריונים מיטוכונדריאליים בכל דגימה. שני המדדים היו שונים באופן מובהק בין קבוצת ה-DCM לקבוצת ה-HC (איור 1C).
ניתוח רשת ביטוי גנים משותף משוקלל
ניתוח רשת ביטוי גנים משותף משוקלל (Weighted gene co-expression network analysis) בוצע כדי לזהות מודולים של גנים הקשורים למדדי העשרה של הזדקנות ומיטוכונדריה. 5,00 הגנים המקודדים לחלבון בעלי שונות הביטוי הגבוהה ביותר במערך הנתונים הכולל (bulk dataset) שימשו לבניית הרשת. בעוצמת סף רכה של β = 5, מדד התאמה של טופולוגיה חסרת קנה מידה עלה על R2 = 0.9, ובכך עמד בקריטריון של רשת חסרת קנה מידה (איור 1D).
ה clustering היררכי ומיזוג מודולים זיהו שלושה מודולי גנים. כל שלושת המודולים היו במתאם מובהק עם מדד ההזדקנות. המודול בצבע טורקיז הראה את המתאם החזק ביותר עם מדד ההזדקנות (r = 0.69, P < 0.01). עבור מדד המיטוכונדריה, המודולים הכחול והאפור היו במתאם מובהק, כאשר המודול הכחול הראה את הקשר החזק ביותר (r = 0.56, P < 0.01; איור 1E). לפיכך, נבחר המודול בצבע טורקיז לסריקת גנים הקשורים להזדקנות, והמודול הכחול נבחר לסריקת גנים הקשורים למיטוכונדריה.
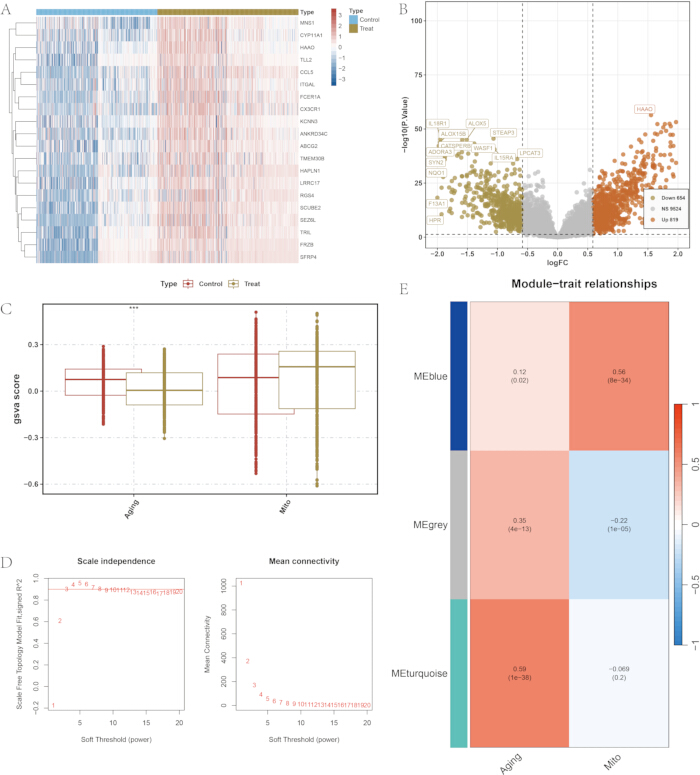
איור 1ניתוח ביטוי דיפרנציאלי ובניית רשת שיתוף-ביטוי גנים משוקללת. (A) מפת חום (Heatmap) של 20 הגנים עם הביטוי הדיפרנציאלי המשמעותי ביותר בין קבוצת הקרדיומיופתיה הדילטטיבית (DCM) לקבוצת הביקורת הבריאה (HC). (Bתרשים הภูקנו (Volcano plot) של כל הגנים בעלי ביטוי דיפרנציאלי. צבע אדום מציין גנים עם ביטוי מוגבר (upregulated), צבע ירוק מציין גנים עם ביטוי מופחת (downregulated), וצבע אפור מציין גנים שאינם מובהקים. הספים היו ערך P < 0.05 ו- |log₂ fold change| > 0.58. (C) תרשימי קופסה של ציוני ניתוח העשרה של קבוצות גנים (GSEA) עבור דגימה בודדת עבור קבוצות גנים הקשורות להזדקנות וקבוצות גנים הקשורות למיטוכונדריה. (ד'בחירת סף רך (Soft-threshold) עבור ניתוח רשתות ביטוי גנים משותף משוקל, המציגה את מדד ההתאמה לטופולוגיה חסרת סולם (scale-free topology fit index) ואת הקישוריות הממוצעת עבור חזקות סף רך שונות.המפת חום (Heatmap) של מתאמים בין גנים מרכזיים של מודולים (module eigengenes) לבין מדדי הזדקנות ומדדים מיטוכונדריאליים. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
זיהוי גנים מועמדים הקשורים להזדקנות ולמיטוכונדריה
גנים מועמדים זוהו על ידי חיתוך של הגנים בעלי הביטוי השונה, גנים במודולים שנבחרו של ניתוח רשתות ביטוי גנים משותף משוקל (WGCNA), ומערכי הגנים הייחסיים התואמים. ניתוח זה זיהה 6 גנים מועמדים להזדקנות הקשורים ל-DCM (איור 2A) ו-16 גנים מועמדים למיטוכונדריה הקשורים ל-DCM (איור 2B).
ניתוח העשרה של Gene Ontology הראה כי הגנים המועמדים הקשורים להזדקנות היו מועשרים בתהליכים ביולוגיים, כולל ביוסינתזה של nitric oxide synthase וארגון המטריקס extracellulare המכיל קולגן (איור 2C). הגנים המועמדים הקשורים למיטוכונדריה היו מועשרים במונחים הקשורים למטבוליזם אנרגטי מיטוכונדריאלי, כולל ממברנה פנימית של המיטוכונדריה וקומפלקס של שרשרת הנשימה (איור 2D).
ניתוח באמצעות מאגר ה-Kyoto Encyclopedia of Genes and Genomes הראה כי הגנים המועמדים הקשורים להזדקנות היו מועשרים במסלולי השמעות של hypoxia-inducible factor-1, phosphoinositide 3-kinase-protein kinase B, ו-advanced glycation end product-receptor for advanced glycation end product (איור 2E). הגנים המועמדים הקשורים למיטוכונדריה היו מועשרים במסלולים הכוללים oxidative phosphorylation (איור 2F).
דפוסי הביטוי הדיפרנציאלי של 6 הגנים המועמדים הקשורים להזדקנות בין קבוצות ה-DCM וה-HC הוצגו באמצעות מפת חום של הביטוי (איור 2G). דפוסי הביטוי של 16 הגנים המועמדים הקשורים למיטוכונדריה הוצגו באמצעות תרשימי קופסה (איור 2H).
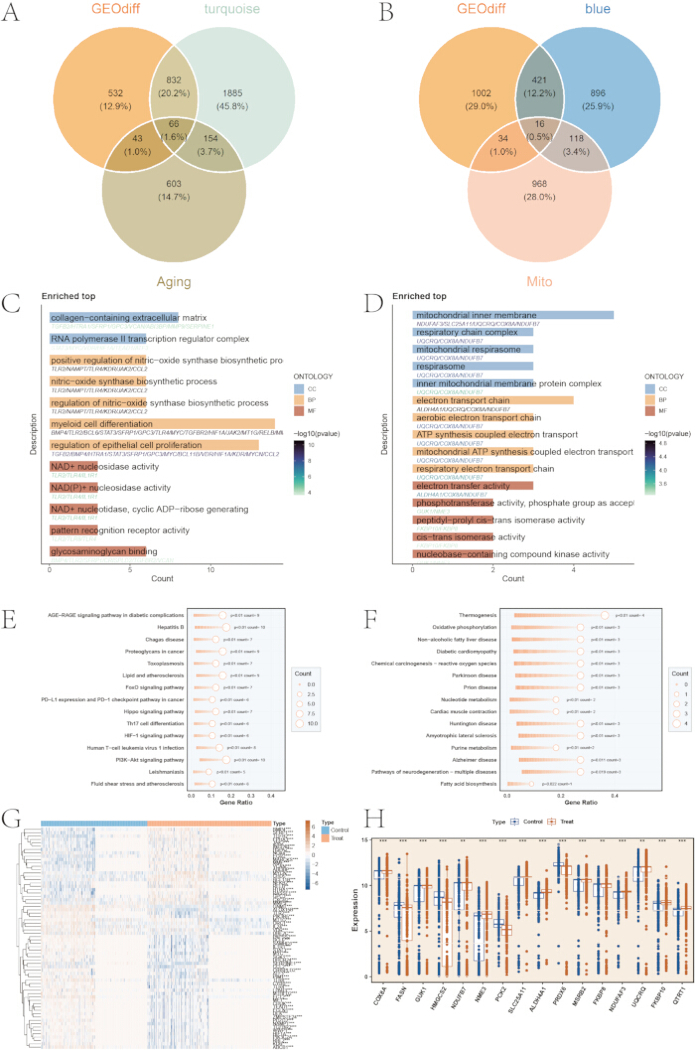
איור 2סריקה והעשרה תפקודית של גנים מועמדים. (Aדיאגרמת ון המראה את החפיפה בין גנים בעלי ביטוי דיפרנציאלי, גנים של מודול מניתוח רשת ביטוי משותף משוקלל של גנים (WGCNA), ומערך גני ייחוס הקשורים להזדקנות.B(דיאגרמת ונ המראה את החפיפה בין גנים בעלי ביטוי שונה, גנים ממודולים של ניתוח רשת ביטוי משותף משוקל של גנים (WGCNA), ומערכת הגנים הייחוס הקשורה למיטוכונדריה. (C(ניתוח העשרה של אונטולוגיית גנים (Gene Ontology) עבור גנים מועמדים הקשורים להזדקנות. (ד') ניתוח העשרה של אונטולוגיית גנים (Gene Ontology) עבור גנים מועמדים הקשורים למיטוכונדריה. (הניתוח העשרה של נתיבים באמצעות Kyoto Encyclopedia of Genes and Genomes עבור גנים מועמדים הקשורים להזדקנות.Fניתוח העשרה של נתיבים ב-Kyoto Encyclopedia of Genes and Genomes עבור גנים מועמדים הקשורים למיטוכונדריה.ג') מפת חום (Heatmap) של ביטוי 6 הגנים המועמדים הקשורים להזדקנות בקבוצות ה-DCM וה-HC. (H) תרשימי קופסה (box plots) של ביטוי 16 הגנים המועמדים הקשורים למיטוכונדריה בקבוצות ה-DCM וה-HC. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
אנוטציה של סוגי תאים במערך הנתונים של ריצוף RNA של תא בודד
מערך הנתונים של ריצוף RNA של תא בודד GSE145154 שימש לאימות ברזולוציה של תא בודד. לאחר סינון בקרת איכות, נורמליזציה לוגריתמית ותיקון אצוות באמצעות Harmony, התאים מדגימות שונות התפלגו במרחב ה-uniform manifold approximation and projection ללא הפרדה נראית לעין המזוה עם דגימות ספציפיות. באמצעות 15 הרכיבים הראשיים הראשונים ורזולוציית צבירה של 0.15, חולקו התאים ל-9 צבירים (איור 3A).
גנים מסמנים קנוניים ואנוטציה אוטומטית באמצעות SingleR זיהו 9 סוגי תאים עיקריים: מקרופאגים, תאי NK (natural killer cells), תאי T, תאי B, תאים אנדותליאליים, תאי שריר חלק, מונוציטים, תאי סטרומה וקרדיומיוציטים (איור 3B). דפוסי הביטוי של גנים מסמנים ספציפיים לסוגי תאים תמכו באנוטציות אלה (איור 3C).
ציוני מודול מיטוכונדריאלי חושבו עבור כל תא באמצעות פונקציית AddModuleScore והבדילו באופן מובהק בין קבוצת הקרדיומיופתיה הדילטטיבית לקבוצת הביקורת הבריאה (P < 2.22 × 10⁻16; איור 3D). גם ציוני מודולים הקשורים להזדקנות הבדילו באופן מובהק בין שתי הקבוצות (P < 2.2 × 10⁻16; איור 3E). השלכה של הציונים המיטוכונדריאליים על מרחב ה-uniform manifold approximation and projection הראתה כי ציונים גבוהים נצפו בעיקר בתאי שריר הלב (cardiomyocytes) (איור 3F). לעומת זאת, ציונים גבוהים הקשורים להזדקנות נצפו בעיקר במקרופאגים (איור 3G).
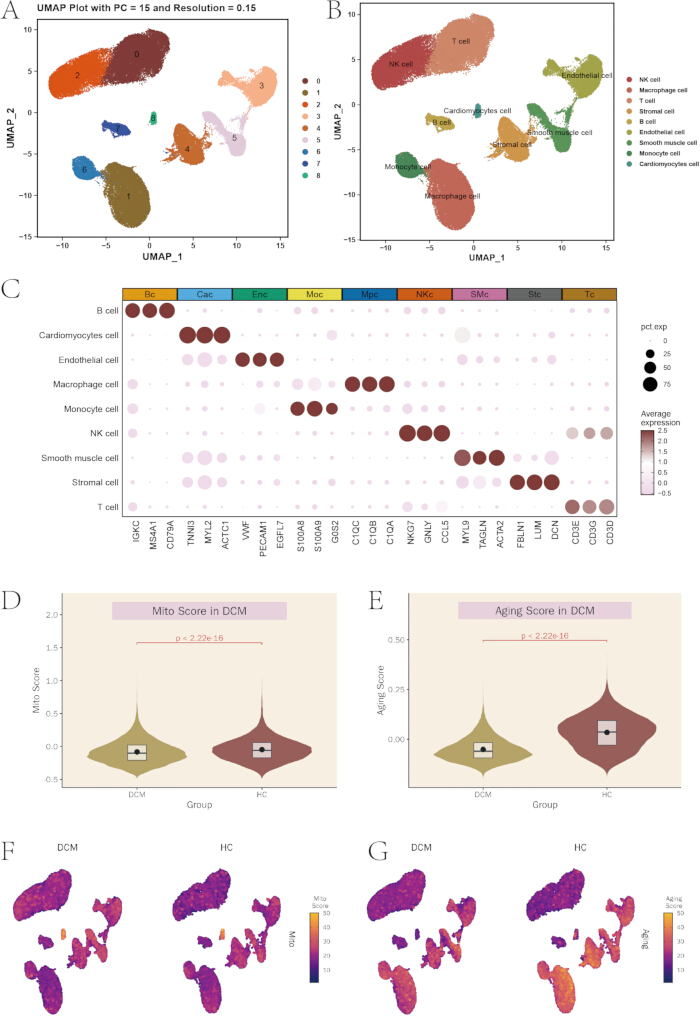
איור 3אנוטציה של טרנסקריפטום של תא בודד וניתוח מדד-מודול (module-score). (A(תרשים קירוב והקרנה של סבחים רב-ממדיים (UMAP) של מקבצי תאים שנוצרו באמצעות 15 הרכיבים הראשיים הראשונים ורזולוציית מקבץ של 0.15. (B) תרשים קירוב והקרנה של רבני מניפולציה אחידה (UMAP) של סוגי התאים המאannotated. (C) תרשים בועות (Bubble plot) המציג את הביטוי של גנים מסמנים קנוניים לאורך סוגי תאים. (ד') תרשים כינור (Violin plot) של ציוני המודול המיטוכונדריאלי בקבוצות ה-DCM וה-HC. (ה.) תרשים כינור (Violin plot) של ציוני מודולים הקשורים להזדקנות בקבוצות DCM ו-HC. (F) תרשים Uniform Manifold Approximation and Projection המראה את התפלגות ציוני המודול המיטוכונדריאלי בין התאים. (ג'תרשים Uniform Manifold Approximation and Projection (UMAP) המראה את התהלוכיות של מדדי מודולים הקשורים להזדקנות בין תאים. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של דמות זו.
בניית רשת אינטראקציות בין חלבונים
הסט המשולב של 6 גנים מועמדים הקשורים להזדקנות ו-16 גנים מועמדים הקשורים למיטוכונדריה הוכנס למסד הנתונים STRING גרסה 11.5 כדי לבנות רשת אינטראקציות בין חלבונים, תוך שימוש בסף ביטחון גבוה של combined score > 0.7. הרשת יוותרה ל-Cytoscape לצורך ויזואליזציה ואנליזה טופולוגית (איור 4A).
נעשה שימוש בניתוחי דרגה (Degree), מרכזיות קליקה מקסימלית (maximal clique centrality), רכיב שכנות מקסימלי (maximum neighborhood component) ו-MCODE כדי לזהות צמתים בעלי קישוריות גבוהה ותתי-רשתות ליבה. תתי-הרשתות שזוהו בשיטות אלו מוצגות ב-איור 4B–E.
10 הגנים המובילים שדורגו לפי Degree, מרכזיות קליקה מקסימלית (maximal clique centrality) ומרכיב שכנות מקסימלי (maximum neighborhood component) הושוו עם הגנים בתת-רשת הליבה של MCODE. ניתוח זה זיהה 10 גנים מועמדים: TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9, ו-CXCR2.
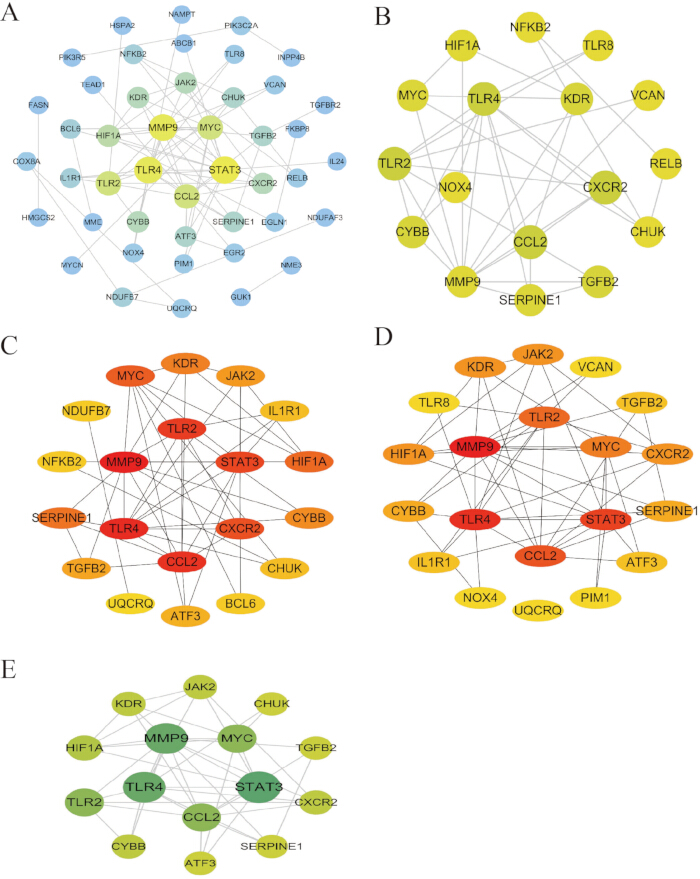
איור 4בניית רשת אינטראקציות בין חלבונים וסריקת גנים מרכזיים (hub genes).
(A( רשת אינטראקציות כוללת בין חלבונים של הגנים המועמדים. (B) תת-רשת ליבה שזוהתה באמצעות MCODE. (פחמן(ג) תת-רשת ליבה שזוהתה באמצעות מרכזיות קליקה מקסימלית (maximal clique centrality). (ד) תת-רשת ליבה שזוהתה באמצעות רכיב השכנות המקסימלי (maximum neighborhood component). (ה) תת-רשת ליבה שזוהתה באמצעות דרגה (Degree). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של דמות זו.
סריקת גנים מרכזיים (hub genes) מבוססת למידת מכונה
שלושה אלגוריתמים של למידת מכונה — רגרסיה לוגיסטית מסוג LASSO (least absolute shrinkage and selection operator), יער אקראי (random forest), ו-SVM-RFE (support vector machine-recursive feature elimination) — הוחלו כדי לסרוק גנים מרכזיים מתוך 10 המועמדים לאינטראקציות בין חלבונים. כל הניתוחים בוצעו באמצעות זרע אקראי קבוע (set.seed(12345)) וולידציה צולבת של 5-fold. במודל ה-LASSO, גנים עם מקדמים שאינם אפס בערך ה-lambda האופטימלי (lambda.min) נשמרו כמועמדים (איור 5A).
במודל של מכונת וקטורים תומכים עם סילוק מאפיינים רקורסיבי (SVM-RFE), הושגה דיוק הצלבה מרבי של 0.859 כאשר נכללו 10 מאפיינים (איור 5B), עם שיעור שגיאה מינימלי תואם של 0.141 (איור 5C). מודל היער האקראי (random forest) עם 50 עצי החלטה הראה התכנסות יציבה של שיעור שגיאת ה-out-of-bag (איור 5D). דירוג חשיבות הגנים המבוס על מקדם ג'יני מיקם את TGFB2, TLR2, SERPINE1 ו-CYBB בין הגנים בעלי הדירוג הגבוה ביותר (איור 5E). החיתוך של הגנים שנבחרו על ידי שלושת האלגוריתמים הניב ארבעה גני מפתח (hub genes) סופיים: CYBB, SERPINE1, TGFB2 ו-TLR2 (איור 5F).
ניתוח SHapley Additive exPlanations בוצע כדי להעריך את התרומה של כל גן מרכזי (hub gene) לתחזיות המודל. ל-TGFB2 היה ערך ה-SHapley Additive exPlanations המוחלט הממוצע הגבוה ביותר, 0.249, ואחריו SERPINE1 עם 0.103, CYBB עם 0.083, ו-TLR2 עם 0.078 (איור 6A). תרשים הסיכום הציג את ההתפלגות וכיוון התרומה של הגנים על פני הדגימות (איור 6B). תרשימי תלות ממחישים את הקשר בין ערכי הגנים האינדיבידואליים לתרומתם למודל (איור 6C), בעוד שתרשימי מפל (waterfall plots) לכל דגימה הראו את התרומה של כל גן לתחזיות פרטניות (איור 6D).
בשלב הבא נבנו מודלים לסיווג אבחנתי המבוססים על ארבעת הגנים המרכזיים (hub genes) באמצעות 10 אלגוריתמי סיווג. בקבוצת האימון, רוב האלגוריתמים השיגו ערכי שטח תחת העקומת (AUC) הגבוהים מ-0.85 (איור 6E). בקבוצת תיקוף פנימית, רוב האלגוריתמים השיגו ערכי שטח תחת העקומת הגבוהים מ-0.78 (איור 6F).
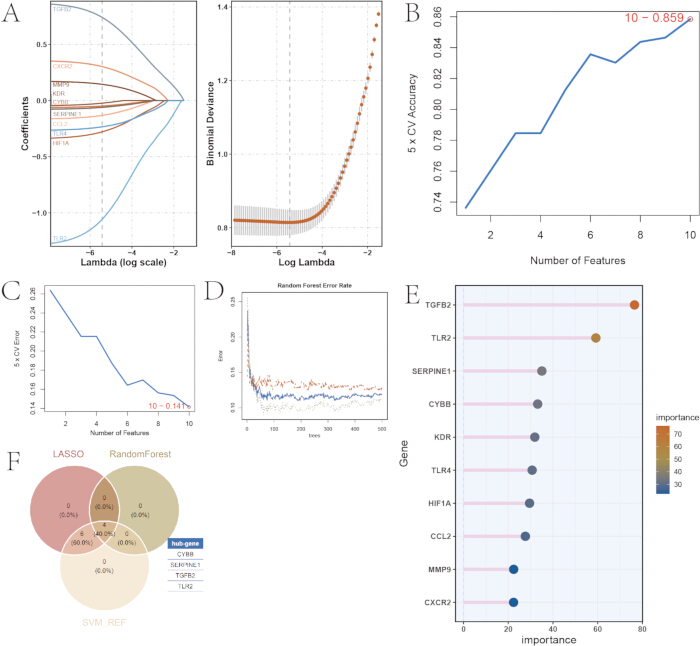
איור 5סריקה של גנים מרכזיים (hub genes) מבוססת למידת מכונה. (Aמסלול מקדמי רגרסיה של LASSO (Least Absolute Shrinkage and Selection Operator) ובחירת למבדה (lambda) אופטימלית.Bעקומת דיוק של 검증 צולבת (Cross-validation) עבור מודל של מכונת וקטורים תומכים עם סילוק תכונות רקורסיבי (support vector machine-recursive feature elimination).C(עקומת שגיאת 검יקום-צולב (Cross-validation) עבור מודל מכונת וקטורים תומכים-סילוק תכונות רקורסיבי (SVM-RFE). (ד׳) עקומת שיעור השגיאה מחוץ לשקיות (Out-of-bag) עבור מודל היער האקראי (random forest). (הופעת הגב (E)) דירוג חשיבות גנים על בסיס מקדם גיני במודל היער האקראי (Random Forest). (זכר) תרשים ון המציג את הגנים המרכזיים (hub genes) שזוהו על ידי שלושת אלגוריתמי למידת המכונה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
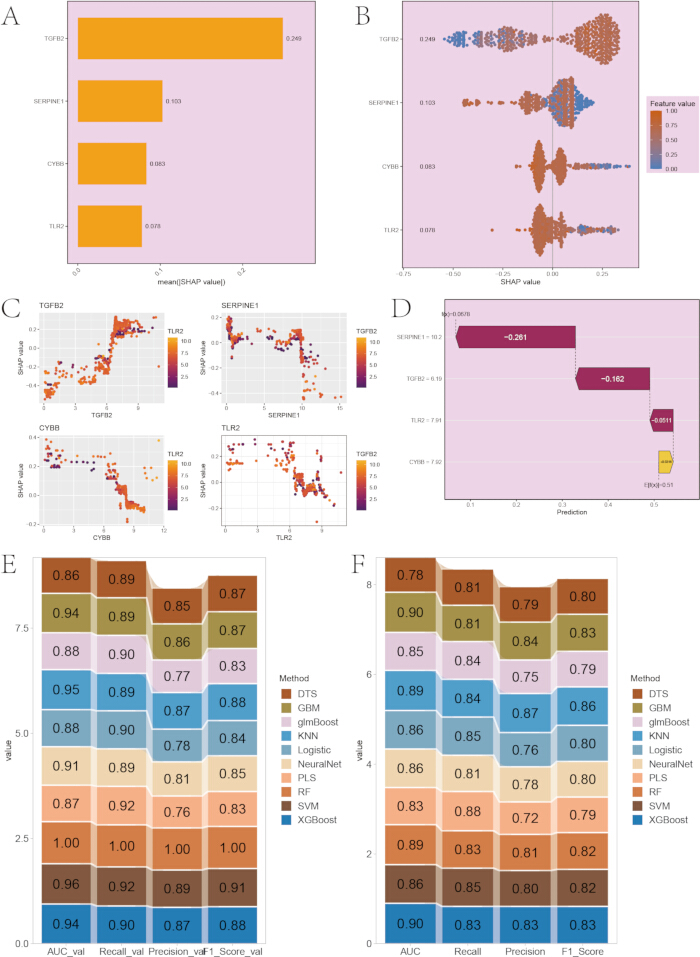
איור 6הערכת מודל אבחנתי ואנליזת SHapley Additive exPlanations. (A) ערכי SHapley Additive exPlanations (SHAP) מוחלטים ממוצעים עבור ארבעת הגנים המרכזיים (hub genes). (B(תרשים סיכום של SHapley Additive exPlanations המראה את ההתפלגות וכיוון התרומה של הגנים. (C) תרשימי תלות של SHapley Additive exPlanations עבור כל גן מרכזי (hub gene). (Dתרשים מפל (waterfall plot) של SHapley Additive exPlanations עבור מדגם מייצג.המפת חום של ביצועי האבחנה עבור 10 אלגוריתמי סיווג במערך האימון.F) מפת חום של ביצועים אבחנאיים עבור 10 אלגוריתמי סיווג במערך האימות. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של דמות זו.
תיקוף ברמת התא הבודד וניתוח תקשורת בין תאים
דפוסי הביטוי של ארבעת הגנים המרכזיים (hub genes) נבחנו ברמת התא הבודד. ניתוח התפלגות סוגי התאים הראה כי CYBB ו-TLR2 בוטו ברמה גבוהה במונוציטים ובמקפגים, בעוד ש-SERPINE1 ו-TGFB2 בוטו בעיקר בתאי סטורמה (איור 7A).
תרשימי כינור (Violin plots) הראו כי ביטוי ה-CYBB היה שונה באופן מובהק בין קבוצת הקרדיומיופתיה הדילטנטית לבין קבוצת הביקורת הבריאה (איור 7B). גם SERPINE1 (איור 7C), TGFB2 (איור 7D) ו-TLR2 (איור 7E) היו שונים באופן מובהק בין הקבוצות. כל ארבעת הגנים הראו עלייה מובהקת בביטוי (upregulated) בקבוצת הקרדיומיופתיה הדילטנטית ביחס לביקורות הבריאות, עם P < 0.01 לכל השוואה.
רשתות תקשורת בין תאים במיקרו-סביבה של הלב הוסקו באמצעות CellChat ומסד נתונים של ליגנדים וקולטנים. מספרם והעוצמה הכוללת של האינטראקציות בין התאים היו שונים בין קבוצת הקרדיומיופתיה הדילטטית לקבוצת הביקורת (איור 7F). נצפתה גם עוצמת תקשורת דיפרנציאלית בין סוגי תאים שונים (איור 7G). מונוציטים, מקרופאגים, קרדיומיוציטים ותאי סטרומה היו המשתתפים העיקריים ברשת התקשורת.
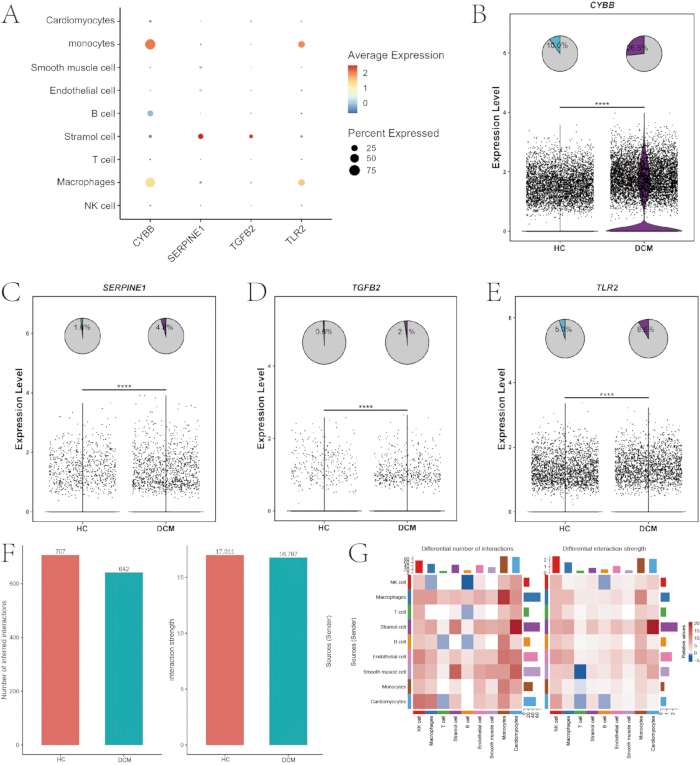
איור 7תיקוף של גנים מרכזיים (hub genes) ברמה של תא בודד ואנליזה של תקשורת בין-תאית. (Aתרשים בועות המראה את הביטוי של ארבעת הגנים המרכזיים (hub genes) על פני סוגי התאים.B) תרשים כינור (Violin plot) של ביטוי CYBB בקבוצות ה-DCM וה-HC. (C) תרשים כינור (Violin plot) של ביטוי SERPINE1 בקבוצות ה-DCM וה-HC. (ד'(תרשים כינור של ביטוי TGFB2 בקבוצות ה-DCM וה-HC. (ה) תרשים כינור (Violin plot) של ביטוי TLR2 בקבוצות ה-DCM וה-HC. (F) תרשים עמודות המראה את מספר ועוצמתן הכוללת של אינטראקציות בין תאים. (ג׳) מפת חום (Heatmap) המציגה את עוצמת התקשורת הדיפרנציאלית בין תאים בין קבוצות. אנא לחצו כאן כדי לצפות בגרסה מורחבת של דמות זו.
ניתוח חדירת תאי מערכת החיסון
ציוני העשרה עבור 28 תתי-סוגים של תאי מערכת החיסון חושבו עבור כל דגימת bulk באמצעות ניתוח העשרה של קבוצות גנים לדגימה בודדת (single-sample gene set enrichment analysis). השפעות של רוב סוגי תאי מערכת החיסון היו שונות באופן מובהק בין קבוצת הקרדיומיופתיה הדילטנטית לבין קבוצת הביקורת הבריאה (איור 8A).
לאחר מכן בוצע ניתוח מתאם פירסון כדי להעריך את הקשר בין הביטוי של הגנים המרכזיים (hub genes) לבין מדדי העשירה של תאי מערכת החיסון. ביטוי של CYBB נמצא במתאם מובהק עם השכיחות של סוגי תאי חיסון מרובים (איור 8B). מתאמים דומים נצפו עבור SERPINE1 (איור 8C), TGFB2 (איור 8D), ו-TLR2 (איור 8E). CYBB, SERPINE1 ו-TLR2 הראו מתאמים חיוביים עם מספר אוכלוסיות של תאי חיסון מולדיים, כולל מונוציטים ומקרופאגים.
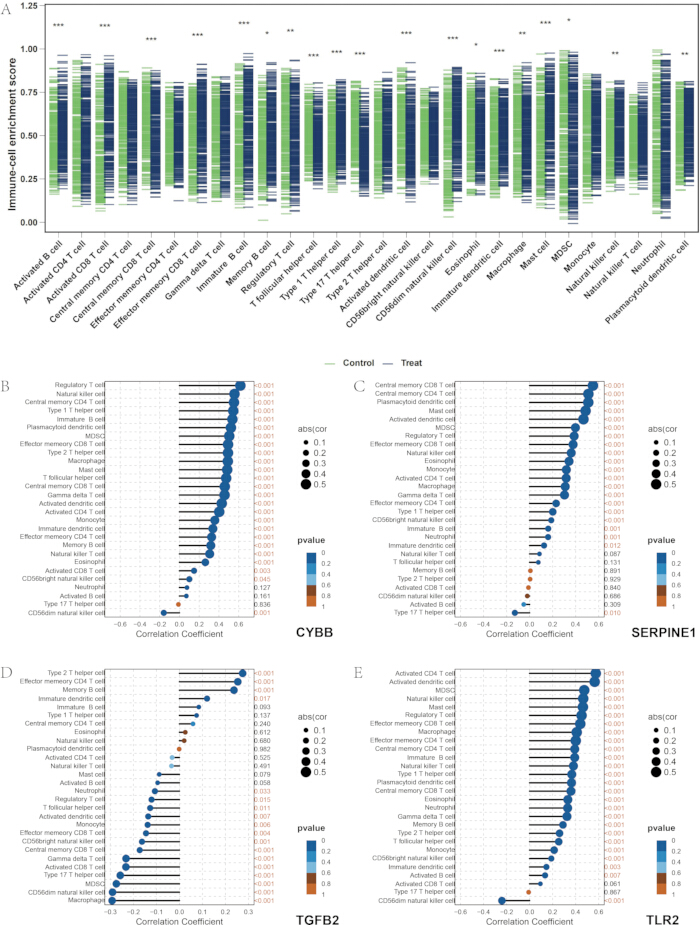
איור 8חדירה של תאי מערכת החיסון וניתוח קורלציה. (A) תרשימי קופסה של מדדי העשירה עבור 28 סוגי תאי חיסון בקבוצות ה-DCM וה-HC. (B) תרשים לוליפופ (Lollipop plot) המציג מתאמים בין ביטוי של CYBB לבין שכיחות של תאי מערכת החיסון. (Cתרשים לוליפופ (Lollipop plot) המראה מתאם בין ביטוי של SERPINE1 לבין שכיחות תאי מערכת החיסון.ד'תרשים לוליפופ (Lollipop plot) המציג מתאמים בין ביטוי TGFB2 לבין שכיחות תאי מערכת החיסון.התרשים לוליפופ (Lollipop plot) המציג מתאמים בין ביטוי TLR2 לבין שפע תאי חיסון. אנא לחצו כאן כדי להציג גרסה מורחבת של איור זה.
סיווג תת-מולקולרי של קרדיומיופתיה מורחבת
בוצע צבירה (clustering) של קונסנזוס ללא פיקוח על דגימות של קרדיומיופתיה מורחבת, בהתבס על פרופילי הביטוי של ארבעת הגנים המרכזיים (hub genes). מטריצת צבירת הקונסנזוס תמכה בהפרדה עבור K = 2 (איור 9A). גרף delta area תמך עוד ב-K = 2 כמספר הצבירות האופטימלי, המקריב את הדגימות לשני תתי-סוגים מולקולריים, C1 ו-C2 (איור 9B).
רמות הביטוי של CYBB, SERPINE1 ו-TLR2 נבדלו באופן משמעותי בין שני תתי-הסוגים (איור 9C). גם השכיחות של תתי-אוכלוסיות רבות של תאי מערכת החיסון נבדלה בין תתי-הסוגים (איור 9D). ניתוח וריאציה של קבוצות גנים (GSVA) הראה הפעלה יחסית של מסלול השיגנל של הגורם לצמיחה של תאי אנדו grows לועי (vascular endothelial growth factor signaling pathway) בתת-סוג C1, בעוד שבסנתזה של חומצות מרה ראשוניות ובסנתזה של גליקוספינגוליפידים נרשמה העשרה בתת-סוג C2 (איור 9E). ניתוח רכיבים ראשיים (PCA) הראה הפרדה בין הדגימות שהוקצו לשני תתי-הסוגים (איור 9F).
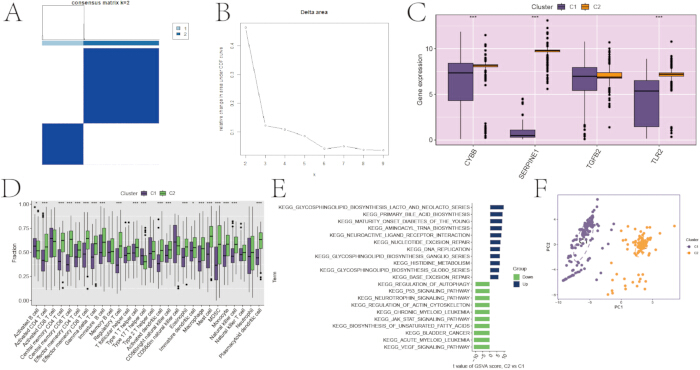
איור 9צבירה מconsensus (Consensus clustering) לצורך סיווג תת-סוגים מולקולריים של קרדיומיופתיה מורחבת. (A) מטריצת אשכולים של קונסנסוס (Consensus clustering matrix) עבור K = 2. (Bתרשים שטחי דלתא המשמש לקביעת מספר הצבירים האופטימלי.C) תרשימי קופסה של ביטוי גנים מרכזיים (hub genes) בשני הסוגים המולקולריים. (ד') תרשימי קופסה של שכיחות תאי מערכת החיסון בשני הסוגים המולקולריים. (המפת חום של מסלולי Kyoto Encyclopedia of Genes and Genomes המועשירים באופן דיפרנציאלי בין שני הסוגים המולקולריים.F) תרשים ניתוח רכיבים ראשיים (PCA) המראה הפרדה בין שני הסוגים המולקולריים. אנא לחצו כאן כדי להציג גרסה מורחבת של איור זה.
In vivo תיקוף במודל עכברים עם קרדיומיופתיה דילטבית
עכברים טרנסגניים מסוג CTNTR141W עם פנוטיפ ספונטני של קרדיומיופתיה דילטבית שימשו לתיקוף in vivo. בהשוואה לעכברי ביקורת C57BL/6J מסוג wild-type תואמי גיל, העכברים הטרנסגניים הראו עלייה משמעותית בקוטר הדיאסטולי הסופי של החדר השמאלי וירידה בסינוק (ejection fraction) של החדר השמאלי, ממצאים העולה בקנה אחד עם התרחבות החדרים ודיספונקציה סיסטולית (איור 10A).
חלבון כולל הופק מרקמת שריר הלב של החדר השמאלי, וריכוזיהם של ארבעת החלבונים המקודדים על ידי גנים מרכזיים (hub genes) נמדדו באמצעות מבחן ספיחה חיסונית מקושרת לאנזים (ELISA) לאחר נורמליזציה של חלבון כולל מבוססת חומצה ביצינכונינית. כל המדידות בוצעו בשכפולים. לעקומות הסטנדרט היו מקדמי מתאם (R2) ≥ 0.9, ומקדמי השונות בין בארות משוכפלות היו נמוכים מ-10%. מובהקות סטטיסטית בין קבוצת הביקורת לקבוצת ה-DCM הוערכה באמצעות מבחן t של Student או מבחן t של Welch, בהתאם לשוויון השונויות שהוערך במבחן F (נורמליות אושרה באמצעות מבחן Shapiro-Wilk). רמות חלבון בשריר הלב התואמות לכל ארבעת הגנים המרכזיים היו גבוהות באופן מובהק בעכברי קרדיומיופתיה מדורדרית (DCM) בהשוואה לביקורות (איור 10B). לצורך תיקוף ה-ELISA, נכללו 3 שכפולים ביולוגיים (עכברים בודדים) בכל קבוצה. לצורך תיקוף ה-ELISA, נכללו שלושה שכפולים ביולוגיים עצמאיים לכל קבוצה. ממצאים אלו צריכים להיחשב כראשוניים ומצריכים אישור בקוהורט גדול יותר.
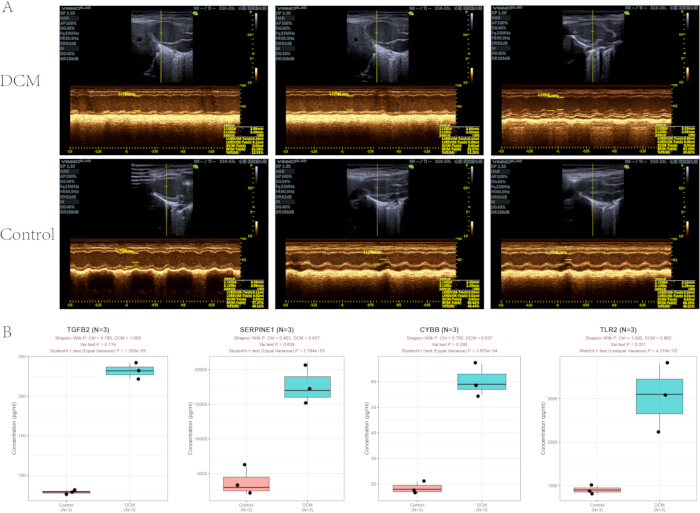
איור 10: בתוך הגוף (In vivo) תיקוף במודל העכבר הטרנסגני CTNTR141W לקרדיומיופתיה דילטנית. (A) תמונות אקו-קרדיוגרפיות מייצגות במצב M (M-mode) של עכברי DCM טרנסגניים CTNTR141W ועכברי ביקורת מסוג פראי (wild-type). (Bכימות באמצעות ELISA של ארבעה חלבונים המופקים מגנים מרכזיים (hub genes) ברקמות שריר הלב של חדר שמאלי בעכברים. תרשימי קופסה ופשמים (Box-and-whisker plots) מציגים את ריכוזי החלבון עבור קבוצת הביקורת (Control) וקבוצת ה-DCM (n = 3 חזרות ביולוגיות לכל קבוצה). בכל תרשים קופסה: הקו האופקי המלא בתוך הקופסה מציין את ערך החציון; הגבולות העליון והתחתון של הקופסה מייצגים את האחוזון ה-75 וה-25 (טווח בין-רבעוני, IQR); הפשמים העליון והתחתון נמתחים עד לנקודות הנתונים המקסימליות והמינימליות שאינן נחשבות לערכים חריגים בטווח של 1.5 × IQR; נקודות שחורות בודדות מתאימות לחזרות ביולוגיות בלתי תלויות מבעלי חיים בודדים. ציר ה-y מציין ריכוז חלבון מוחלט: pg/mL עבור TGFB2 ו-CYBB, ו-ng/mL עבור TLR2 ו-SERPINE1. השוואות סטטיסטיות בין שתי קבוצות בוצעו באמצעות מבחן t של Student (שונות שווה) או מבחן t של Welch (שונות לא שווה), כאשר נורמליות אומתה באמצעות מבחן Shapiro-Wilk והומוגניות השונות נבדקה באמצעות מבחן F. הצהרת הגבלה: תוצאות ה-ELISA שהתקבלו מ-n = 3 חזרות הן ממצאים גששיים ראשוניים, ויש צורך בתיקוף עתידי עם גודל מדגם מורחב. אנא לחצו כאן כדי להציג גרסה גדולה יותר של איור זה.
זמינות נתונים:
ששת מאגרי הנתונים של התמלול המאסיבי (bulk transcriptomic) ומאגר נתונים אחד של ריצוף RNA מתאי-בודד (single-cell RNA sequencing) שנותחו במחקר זה זמינים לציבור במאגר הנתונים Gene Expression Omnibus תחת מספרי הגישה GSE5406, GSE4295, GSE5738, GSE7962, GSE16250, GSE141910, ו-GSE145154. הניתוח של תאי הבודד כלל את הדגימות GSM4307515, GSM4307516, GSM4307520, ו-GSM4307521 מתוך GSE145154. כל שאר הנתונים שהופקו או נותחו במהלך מחקר זה, יחד עם הקוד המחשוב, כלולים במאמר גבוי זה ובקבצי המידע המשלים שלו. באופן ספציפי, קובץ משלים 1 כולל את רשימות הגנים המלאות הקשורות להזדקנות ולמיטוכונדריה, את חתימת החסינות של 28 התאים, סקריפטים אנליטיים מותאמים אישית, מטריצות נתונים טרנסקריפטומיים מנורמלים, נתוני מקור לבדיקות ELISA ואת נתוני המקור הגולמיים שעליהם מבוסים כל האיורים במאמר.
קובץ משלים 1: מערכי גנים הקשורים להזדקנות ולמיטוכונדריה, חתימות חיסוניות, סקריפטים של ניתוח, נתונים טרנסקריפטומיים מנורמלים ונתוני מקור של האיורים. אנא לחצו כאן להורדת קובץ זה.
דיון
תהליך העבודה הרב-שכבתי המשולב שילב מטה-אנליזה טרנסקריפטומית של דגימות bulk, בניית רשת ביטוי גנים משותף משוקללת (WGCNA), למידת מכונה מסוג ensemble, תיקוף טרנסקריפטומי ברמת התא הבודד ואימות במודל בעלי חיים in vivo. ארבעה גני מפתח (hub genes) הקשורים להזדקנות ולמיטוכונדריה, CYBB, SERPINE1, TGFB2 ו-TLR2, זוהו כביומארקרים אבחנתיים פוטנציאליים לקריודילטציה של החדר השמאלי (DCM). שילוב של שישה מאגרי נתונים טרנסקריפטומיים עצמאיים של החדר השמאלי ממאגר ה-Gene Expression Omnibus, כולל פלטפורמות של microarray וריצוף RNA, הפחית את ההטיה של מאגר נתונים בודד והגביר את הבסיס הסטטיסטי של האנליזה43,44,45. אנליזה של רשת ביטוי גנים משותף משוקללת, בשילוב עם סטים מוגדרים מראש של גנים הקשורים להזדקנות ולמיטוכונדריה, אפשרה זיהוי של מודולים פונקציונליים הקשורים לתכונה, במקום להסתמך על אנליזה של ביטוי Differentially Expressed בלבד46. למידת מכונה מסוג ensemble הפחיתה את ההטיה הספציפית לאלגוריתם הקשורה לשיטות בחירת מאפיינים בודדות47,48, בעוד שאנליזת SHapley Additive exPlanations כימתה את תרומתו של כל גן מפתח לתחזיות המודל49. תיקוף על פני טרנסקריפטומים של שריר הלב ב-bulk, טרנסקריפטומים של תאים בודדים ומודל עכבר טרנסגני אפיין עוד יותר את ההתפלגות התאית ואת רמות החלבון בשריר הלב של הגנים שנבחרו50.
תיקון אפקטים של סדרות (Batch correction) היה שלב קריטי בניתוח המשולב, מכיוון ששונות שיורית הספציפית למסד נתונים עלולה להשפיע על ניתוח ביטוי דיפרנציאלי ועל קשרי מודול-תכונה. לכן, מקור מסד הנתונים ופלטפורמת הגילוי נכללו כגורמי סדרה (batch factors) במודל ComBat. מקבץ תלוי-מסד נתונים שיורי בגרפי ניתוח רכיבים ראשיים (PCA) היה מעיד על תיקון חלקי ועל הטיה סיסטמטית פוטנציאלית44. הסף הרך (soft-thresholding power) היה חשוב גם הוא לבניית רשת ביטוי משותף של גנים משוקללת. נבחר הערך המינימלי שהניב מדד התאמה של טופולוגיה נטולת-קנה-מידה (scale-free topology fit index) של R2 > 0.9, מה שהוביל ל-β = 5. ערך נמוך יותר עלול להוביל למודולים מקוטעים או חסרי מידע תפקודי, בעוד שערך גבוה יותר עלול להחליש את הקישוריות בין הגנים ולהפחית את העוצמה הסטטיסטית של ניתוח המתאם בין מודול לתכונה46. ספי תבקרת האיכות של תאים בודדים הותאמו לרקמת לב, כיוון שלתאי שריר הלב (cardiomyocytes) יש פעילות מטבולית גבוהה. אסטרטגיית סינון מחמירה, עם רף אחוז גנים מיטוכונדריאליים נמוך מ-25% וטווח של 200–6,000 גנים מזוהים, יושמה כדי להסיר תאים פגומים או באיכות נמוכה תוך שימור תאי שריר הלב50. גרעין אקראי קבוע, set.seed(12345), שימש לפיצול מסד הנתונים, לאימון המודל ולתיקוף צולב (cross-validation) כדי להפחית את השונות בניתוחי למידת מכונה חוזרים47.
אישור הגנוטיפ, תנאי דיור סטנדרטיים ומדידות אקו-קרדיוגרפיות עקביות היו חשובים לשמירה על יציבות פנוטיפית בניסויי החיות. עכברים טרנסגניים מסוג CTNTR141W מפתחים הרחבה של החדר השמאלי ודיספונקציה סיסטולית לאחר תקופת ההסתגלות וההזנה המוגדרת51. אימות הגנוטיפ לפני החלוקה לקבוצות הכרחי כדי להוציא בעלי חיים שאינם טרנסגניים ולמנוע סיווג שגוי של הפנוטיפ. יש לבצע את המדידות האקו-קרדיוגרפיות באופן עקבי בגובה השרירים הפפילריים של החדר השמאלי, כאשר המדידות מחושבות כממוצע של שלושה מחזורי לב יציבים רצופים. שינוי במיקום הדימות או בעומק ההרדמה עלול להגביר את השונות במדידות של מקדם הפליטה של החדר השמאלי51. איכות בדיקת ה-Enzyme-linked immunosorbent assay הוערכה באמצעות מקדמי מתאם של עקומת סטנדרט, R2 ≥ 0.99, ומקדמי וריאציה < 10% בין בארות כפולות. ליניאריות לקויה של עקומת הסטנדרט או מדידות כפולות שאינן עקביות עלולות להכניס שגיאה שיטתית להערכות ריכוז החלבון.
מספר בעיות אנליטיות עלולות להופיע במהלך יישום זרימת העבודה. הפרדה מתמשכת בין סדרות (batch separation) לאחר תיקון ComBat עשויה לשקף קוליניאריות בין משתני הסדרה לגורמים קליניים, סינון לא מספיק של גנים בעלי ביטוי נמוך, או שונות טכנית שלא נכללה במודל. ניתן לכלול משתנים קליניים משתנים (covariates), כגון גיל ומין, כמשתנים מוגנים (protected variables) כאשר הם זמינים, וניתן להסיר גנים עם ביטוי אפס ביותר מ-70% מהדגימות כדי להפחית רעש44. ניתן לשקול תיקון משלים באמצעות removeBatchEffect כאשר נותרת הפרדה שיורית. מספר גבוה או נמוך באופן בלתי צפוי של גנים המבטאים ביטוי דיפרנציאלי עשוי להצריך הערכה של הטרוגניות הדגימות, נורמליזציה, ערכים חריגים (outliers) ובחירת סף27. ניתן לטפל במתאמים נמוכים בין מודול לתכונה (module-trait correlations) על ידי הערכה מחדש של סף השונות, הספק של הסף הרך (soft-thresholding power) וערכי תכונה קיצוניים. הרחבה מ-5,000 ל-7,500 הגנים בעלי השונות הגבוהה ביותר, או החלפה של ניתוח העשراء של קבוצת גנים לדגימה בודדת (single-sample gene set enrichment analysis) בניתוח שונות של קבוצות גנים (gene set variation analysis), עשויה לשפר את זיהוי המודולים46. מספר מופרז של צמתים מבודדים ברשת אינטראקציית חלבון-חלבון עשוי להצריך התאמה של סף האמינות של STRING או הרחבה של קבוצת הגנים המועמדת30. ביצועים נמוכים של למידת מכונה עשויים לשקף הבדלים בהתפלגות בין קבוצת האימון לקבוצת התיקוף, יתירות של מאפיינים או חוסר איזון בין הקבוצות. דגימה מרובדת (stratified sampling), הפחתת מאפיינים יתירים או דגימת-יתר (oversampling) של מחלקת המיעוט עשויות להפחית השפעות אלו47. אשכולות (clustering) מעומבנים של תאים בודדים עשויים להצריך הערכה מחדש של תיקון Harmony, בחירת רכיבים ראשיים ואנוטציה של גני סימון50.
יש לשקול מספר מגבלות. מערכי הנתונים הטרנסקריפטומיים הושגו רטרוספקטיבית ממאגרי מידע ציבוריים, ולא ניתן היה לשלוט על עיצובי המחקר המקוריים ועל משתנים קליניים מבלבלים. ההערות הקליניות היו חלקיות במערכי הנתונים השונים, ובמרביתם היה חסר מידע מפורט על האטיולוגיה, היסטוריית תרופות, גיל המטופלים ותוצאים ארוכי טווח. מגבלות אלו מנעו הערכה של הקשרים בין הגנים שנבחרו לבין הפרוגנוזה, התגובה לטיפול או הזדקנות כרונולוגית52. ייתכן שנותרה שונות טכנית שיורית למרות תיקון האצוות (batch correction). הניתוח התבסס בעיקר על ביטוי messenger RNA ולא כלל נתונים אפיגנומיים, פרוטאומיים או מטבולומיים משולבים. כתוצאה מכך, לא ניתן היה לקבוע את הפעילות החלבונית, את הרגולציה הפוסט-טרנסלציונית ואת המנגנונים שמעלה. רק מערך נתונים אחד של תא בודד נכלל, מה שהגביל את הערכת ההטרוגניות התאית בין אטיולוגיות שונות של DCM50. המודל הטרנסגני CTNTR141W מייצג בעיקר DCM תורשתי הקשור למוטציה ב-cardiac troponin T וייתכן שאינו משחזר צורות אידיופתיות, ויראליות או איסכמיות של המחלה51. הבדלים בין מינים, בין עכברים לבני אדם, מגבילים אף הם את התרגום הקליני הישיר. תיקוף ברמת החלבון הוגבל לרקמת שריר לב של עכברים, ולא בוצעו השוואות עם ביומרקרים מבוססים או ניתוחים של קהל מטופלים קליני רחב. ארבעת גני המפתח (hub genes) אינם ספציפיים ל-DCM ועשויים להשתנות גם במצבים קרדיווסקולריים או דלקתיים אחרים. בנוסף, בחירת המועמדים התבססה על סטים של גנים שהוגדרו מראש כקשורים להזדקנות ולמיטוכונדריה. אסטרטגיה מונחית-היפותזה זו עשויה להוביל להשמטת גנים שאינם כלולים בסטים של הייחוס שנבחרו, בעוד שחיתוך בין שלושה אלגוריתמים של למידת מכונה עשוי להשמיט גנים שזוהו על ידי שיטה אחת בלבד48.
המסגרת האנליטית עשויה לתמוך בתתי-סיווגים מולקולריים עתידיים, תיקוף של סמנים ביולוגיים ומחקרי מולטי-אומיקה ב-DCM. ניתן להעריך את פאנל ארבעת הגנים בקוהורטות עצמאיות של דם פריפרי או שריר הלב לפני הערכתם ככלי לאבחון או לתתי-סיווג. תתי-הסוגים C1 ו-C2 הראו פרופילים שונים של מסלולי חיסון ומטבוליזם, דבר המספק בסיס לתיקוף עתידי של מאפיינים ביולוגיים ספציפיים לתת-הסוג15. הגנים הנבחרים עשויים להיבחן גם במחקרי דוקינג מולקולרי, מחקרים תאיים ומחקרי תפקוד. TLR2 ו-CYBB קשורים לאיתות דלקתי ולהפקה של רדיקלים חופשיים של חמצן (ROS), בעוד ש-TGFB2 ו-SERPINE1 קשורים לפיברוזיס ולremodeling של הלב53. שילוב עם נתונים פרוטאומיים, מטבולומיים, אפיגנומיים, נתוני GWAS ונתוני רנדומיזציה מנדלית עשוי לסייע בהערכת קשרי בקרה וקשרים סיבתיים פוטנציאליים54. ניתן להתאים את זרימת העבודה גם למחקרי טרנסקריפטומיקה של קרדיומיופתיה היפרטרופית, קרדיומיופתיה איסכמית ואי-ספיקת לב, על ידי החלפת מערכי הנתונים הספציפיים למחלה ומערכי הגנים הייחוס45. שילוב עתידי של בדיקות תא בודד עבור ריצוף כרומטין נגיש לטרנספוזז (ATAC-seq) וטרנסקריפטומיקה מרחבית עשוי לספק מידע נוסף על בקרה תאית וביטוי מרחבי. ההעשרה שנצפתה של חתימות הקשורות להזדקנות במקרופאגים וחתימות מיטוכונדריאליות בקרדיומיוציטים הייתה עקבית עם דיווחים קודמים על תהליכים דלקתיים ומיטוכונדריאליים במחלות לב55,56,57.
למחקר זה מספר מגבלות שיש להכיר בהן. בפרט, ערכות ה-ELISA המסחריות ששימשו לכימות החלבונים תוקפו באופן רשמי לזיהוי חלבונים מטרים בדגימות סרום. במחקר הנוכחי, נעשה שימוש בליזאטים של רקמת שריר הלב כמעטריקה לזיהוי במקום סרום. למרות שיושמו בקפידה הליכי טיפול מקדים בדגימות ופרוטוקולים ניסיוניים עקביים לאורך הבדיקה כדי להבטיח את מהימנותם ואת היכולת להשוות את הנתונים הניסיוניים, היעדר תיקוף רשמי של היצרן לערכות ELISA אלו עבור דגימות ליזאט של רקמת שריר הלב עלול להוביל לסטיות קלות פוטנציאליות בתוצאות הכימות של החלבונים. לפיכך, השימוש בערכות ELISA ספציפיות לסרום עבור ליזאטים של רקמת שריר הלב מהווה מגבלה מתודולוגית של מחקר זה.
גילויים
המחבר מצהיר כי אין לו ניגודי אינטרסים.
תודות
החוקרים מודים על הנתונים הזמינים לציבור שסופקו באמצעות מאגר הנתונים Gene Expression Omnibus. תודה מודעת גם למבקרים ולעורכים על הערותיהם הבונות לגבי כתב היד. עבודה זו נתמכה על ידי פרויקט המחקר המדעי ברמת המחלקה המחוזית (מענק מס' 2021JDZX2026), "מנגנון של פורמולת Yiqi Huoxue בהפחתת עיצוב מחדש של כלי דם טרשתיים via בקרת דלקת המתווכת על ידי KLF2-Nrf2".
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Aquasonic Clear Ultrasound Gel | Parker Laboratories, Inc. | Mar-34 | משמש לדמיונאקוקרדיוגרפיה של בעלי חיים קטנים. |
| BCA Protein Assay Kit | Thermo Fisher Scientific | 23227 | גילוי ב-562 nm; טווח, 20–2,000 µg/mL; משמש לכימות חלבון כולל של ליזאטים של לב עכבר. |
| CellAge database | Human Ageing Genomic Resources | https://genomics.senescence.info/cells/ | מקור לחתימות גנים הקשורות להזדקנות. |
| CytoHubba, Cytoscape plugin | Cytoscape App Store | Version 0.1 | משמש לדירוג טופולוגיית צמתים ברשתות אינטראקציה של חלבון-חלבון. |
| Cytoscape | Cytoscape Consortium | Version 3.9.1 | משמש לוויזואליזציה של רשתות אינטראקציה של חלבון-חלבון. |
| Full-wavelength microplate reader | Thermo Fisher Scientific | Multiskan FC | משמש למדידת בליעה בבדיקות ELISA. |
| Gene Expression Omnibus | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/geo/ | מאגר ציבורי המשמש להשגת מערכי נתוני טרנסקריפטומיקה. |
| GeneCards | Weizmann Institute of Science | https://www.genecards.org/ | מקור למערכי גנים הקשורים למיטוכונדריה. |
| Halt Protease and Phosphatase Inhibitor Cocktail, 100×, EDTA-free | Thermo Fisher Scientific | 78441 | נשמר ב-4 °C; מתווסף לבאפר RIPA בריכוז של 10 µL/mL מיד לפני השימוש. |
| Liquid nitrogen | Local laboratory gas supplier | Not applicable | משמש להקפאה מהירה (snap-freezing) של רקמת שריר לב. |
| Male SPF-grade C57BL/6J mice, 6–8 weeks old, 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | Not applicable | רישיון ייצור בעלי חיים מס' SCXK (Jing) 2021-0006; שימשו כביקרות נורמליות. |
| Male SPF-grade CTNTR141W transgenic DCM mice, 6–8 weeks old, 25 ± 2 g | Institute of Laboratory Animal Science, Chinese Academy of Medical Sciences | Not applicable | רישיון ייצור בעלי חיים מס' SCXK (Jing) 2021-0065; שימשו כמודל DCM ספונטני. |
| MCODE, Cytoscape plugin | Cytoscape App Store | Version 2.0.2 | משמש לזיהוי תת-רשתות תפקודיות מרכזיות ברשתות אינטראקציה של חלבון-חלבון. |
| Mouse CYBB ELISA Kit | Biogradetech | A-QEK09250-96wells | שימש במחקר זה למדידת CYBB בליזאטים של רקמת שריר לב של עכבר. |
| Mouse PAI-1 ELISA Kit | EK-BIO | ML30970 | שימש במחקר זה למדידת PAI-1, החלבון המקודד על ידי SERPINE1, בליזאטים של רקמת שריר לב של עכבר. |
| Mouse TGF-β2 ELISA Kit | ElaBoX | SEKM-0036 | שימש במחקר זה למדידת TGF-β2 בליזאטים של רקמת שריר לב של עכבר. |
| Mouse TLR-2 ELISA Kit | Solarbio | SEKM-0163 | שימש במחקר זה למדידת TLR-2 בליזאטים של רקמת שריר לב של עכבר. |
| Phosphate-buffered saline, pH 7.4, calcium- and magnesium-free | Biological Industries | 02-024-1ACS | תמיסה סטרילית 1×; נשמרת ב-4 °C; משמשת לשטיפת רקמה ולדילול. |
| R package: caret | CRAN | Version 6.0-94 | משמש לביצוע recursive feature elimination באמצעות support vector machine. |
| R package: CellChat | CellChat developers | Version 1.6.1 | משמש להסקת תקשורת בין-תאית מנתוני רצף RNA של תא בודד. |
| R package: clusterProfiler | Bioconductor | Version 4.8.3 | משמש לניתוח העשרה תפקודית. |
| R package: ConsensusClusterPlus | Bioconductor | Version 1.64.0 | משמש לביצוע consensus clustering לא מפוקח. |
| R package: edgeR | Bioconductor | Version 3.42.4 | משמש לנורמליזציה של נתוני רצף RNA בשיטת trimmed mean of M-values. |
| R package: GEOquery | Bioconductor | Version 2.68.0 | משמש להורדת נתונים מ-Gene Expression Omnibus. |
| R package: glmnet | CRAN | Version 4.1-8 | משמש לביצוע רגרסיה לוגיסטית בשיטת least absolute shrinkage and selection operator. |
| R package: limma | Bioconductor | Version 3.56.2 | משמש לניתוח ביטוי דיפרנציאלי ומידול סטטיסטי. |
| R package: pROC | CRAN | Version 1.18.5 | משמש לניתוח עקומי receiver operating characteristic. |
| R package: randomForest | CRAN | Version 4.7-1.2 | משמש ללמידת מכונה בשיטת random forest. |
| R package: Seurat | CRAN | Version 5.0.1 | משמש לניתוח נתוני רצף RNA של תא בודד. |
| R package: SingleR | Bioconductor | Version 2.2.0 | משמש לאנוטציה אוטומטית של סוגי תאים. |
| R package: sva | Bioconductor | Version 3.48.0 | משמש לתיקון אפקט-אצווה (batch-effect) באמצעות ComBat. |
| Refrigerated centrifuge | Sigma-Aldrich | SIGMA 3-K | משמש לסנטריפוגציה של ליזאטים של רקמת שריר לב. |
| RIPA Lysis and Extraction Buffer | Thermo Fisher Scientific | 89900 | תמיסה 1× מוכנה לשימוש; נשמרת ב-4 °C; מתווספים לה מעכבי פרוטאז ופוספטאז לפני השימוש. |
| Small-animal ultrasound imaging system | VINNO Technology Co., Ltd. | VINN06LAB | משמש להערכה אקוקרדיוגרפית של תפקוד הלב. |
| Sodium pentobarbital | Sinopharm Chemical Reagent Co. | 20040428 | הוכן כתמיסה של 1%, 10 mg/mL, בסליין סטרילי; משמש להרדמה תוך-peritoneal במינון של 30 mg/kg. |
| STRING database | STRING Consortium | Version 11.5 | משמש לבניית רשתות אינטראקציה של חלבון-חלבון. |
| TGrinder H24 Tissue Homogenizer | TIANGEN | OSE-TH-01 | משמש להומוגניזציה של רקמת שריר לב של עכבר בבאפר RIPA במהירות של 6.0 m/s למשך 30–60 s לאורך 2–3 מחזורים. |
| Thermostatic animal platform/heated operating table for small animals | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | משמש לשמירה על טמפרטורה של 37 °C של העכברים במהלך אקוקרדיוגרפיה; טווח פעולה, מטמפרטורת החדר ועד 50 °C. |
מקורות
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740