מחקר זה מציג את RareCode, מסגרת למידה עמוקה ללא פיקוח המזהה חריגות בתמונות היסטופתולוגיות של סרטן המעי הגס על ידי ניתוח נדירות הפעלת ספר קודים (CAR), עם פוטנציאל לסייע בסינון ראשוני ללא נתוני אימון מתויגים.
מאמר מחקר
RareCode: מסגרת למידה עמוקה בלתי מונחית לזיהוי חריגות בתמונות היסטופתולוגיות של סרטן המעי הגס והפישס (Colorectal Cancer)
במאמר זה
סיכום
תקציר
זיהוי חריגות ללא פיקוח בתמונות היסטופתולוגיות נחקר רבות באמצעות גישות מבוסות שחזור המודדות שגיאות שחזור, אך שיטות אלו נכשלות לעיתים קרובות בלכידת וריאציות פתולוגיות עדינות ברמה הסמנטית בשל ההטרוגניות האינהרנטית של מרקמי הרקמות. כדי לטפל במגבלה זו, מחקר זה מציג את RareCode, מסגרת מבוססת קוונטיזציה של וקטורים המרחיבה את פרדיגמת הזיהוי מעבר לשחזור ברמת הפיקסל כדי לשלב ניתוח הפעלת ספריית קודים (codebook) ברמה הסמנטית. החדשנות המרכזית היא דירוג נדירות הפעלת ספריית קודים (CAR), המאפיין את תדירות ההפעלה של כל רשומה בספריית הקודים במהלך אימון על דגימות נורמליות בלבד, ומסמן הפעלות לא שכיחות כאינדיקטורים לחריגות בזמן ההסקה, ובכך משלים את שגיאות השחזור באמצעות הבחנה ברמה הסמנטית. בהתבס על מנגנון CAR זה בעל קנה מידה יחיד, מוצג בנוסף מודול ספריית קודים היררכית רב-קנימית (MHC), המשתמש בספריות קודים בגדלים שונים עם משקלי מיזוג למידים כדי ללכוד תבניות פתולוגיות הנעות ממבני רקמה גסים ועד לפרטים עדינים ברמה התאית. תוך ניצול התכנון הרב-קנימי, נוצרות מפות חום של חריגות היררכיות בכל רמת פירוט של ספריית הקודים, המספקות לפתולוגים רמזי לוקליזציה חזותיים, רב-מדיים וניתנים לפירוש, המצביעים הן על המיקום והן על הרמה המבנית שבה מתרחשות החריגות. אימות צולב של חמישה קיפולים (Five-fold cross-validation) על מאגר נתונים של תמונות היסטופתולוגיות של סרטן מעי גס עם הערות קליניות שהתקבלו מבית החולים Shenzhen People's Hospital מדגים כי RareCode משיג שטח תחת העקומה (AUC) של 96.82%, תוך ביצועים העולים על שיטות הבסיס. ניתוח לפי מחלקה הראה ביצועים חזקים יותר לזיהוי סרטן (AUC = 9.4%, specificity = 94.21%) מאשר לזיהוי דלקת (AUC = 94.30%, specificity = 60.4%). ממצאים אלו מצביעים על כך שניתוח CAR עשוי להציע גישה מבטיחה ללא פיקוח לזיהוי חריגות היסטופתולוגיות, אשר עשויה לסייע בסינון קליני מקדים באבחון סרטן מעי גס.
מבוא
סריקה היסטופתולוגית מהימנה לסרטן המעי הגס נותרת מוגבלת בשל הצורך באנוטציה של מומחים ובבדיקה ידנית, במיוחד כאשר נגעים דלקתיים וממאירות מראים מורפולוגיה חופפת1,2. מגבלות אלו מהוות מניע לגישות חישוביות לא מונחות (unsupervised) הלומדות מרקמה נורמלית ללא צורך באנוטציות מקיפות של מקרים חריגים3,4.
הדחיפות הקלינית של סריקה היסטופתולוגית אוטומטית מודגשת על ידי חוסר האיזון הגובר בין הדרישה לאבחון לבין המומחיות הפתולוגית הזמינה, כאשר עומס האבחון לכל פתולוג בארה"ב עלה ביותר מ-40% במהלך עשור אחד, בעוד שכוח האדם של הפתולוגים המשיך להצטמצם5. בסרטן המעי הגס והחלחולת (CRC), תוכניות סריקה מאורגנות נקשרו להפחתה של 29-68% בתמותה6, אך היכולת לבצע סקירה פתולוגית ידנית נותרה מוגבלת בשל זמינות כוח האדם. מערכת סריקה מוקדמת אוטומטית המזהה באופן מהימן מקרים חשודים לבדיקה בעדיפות גבוהה עשויה לסייע בהפגת נטל זה ולשפר את זמני התשובה האבחנתיים. עם זאת, פריסת מערכות כאלה דורשת הן רגישות גבוהה כדי למנוע החמצת מקרים חיוביים אמיתיים והן סגוליות מספקת כדי למנוע התראות שווא מרובות7.
זיהוי חריגות ללא פיקוח (UAD) הפך לרלוונטי יותר ויותר בניתוח תמונות רפואיות8 מכיוון שניתן באמצעותו למדל התפלגויות של רקמות נורמליות ללא צורך בתוויות אימון של מקרים חריגים3,9,10. מודלים מבוססי שחזור, הכוללים autoencoders, variational autoencoders, רשתות Adversarial Generative ווריאציות מועשרות בזיכרון, מזהים חריגות באמצעות שגיאות שחזור, אך דקודרים בעלי קיבולת גבוהה עשויים עדיין לשחזר אזורים חריגים בנאמנות גבוהה1,12,13,14,15,16,17. שיטות מבוסות מאפיינים כגון PatchCore ו-PaDiM משתמשות בייצוגים שאומנו מראש, אם כי מאפיינים שנלמדו מתמונות טבעיות עשויים שלא ללכוד באופן מלא אטיפיה מיקרוסקופית בהיסטופתולוגיה18,19,20,21. מודלי יסוד ייעודיים לפתולוגיה ומגלי חריגות מבוססי דיפוזיה מספקים חלופות עוצמתיות, אך דרישות הנתונים או העלויות החישוביות שלהם עשויות להגביל את השימוש הישיר בהם בסינון בתפוקה גבוהה2,23. שיטות אוטומטיות ואבולוציוניות מהזמן האחרון, כגון EvoAAE24 ו-MoARNN-AM25, מדגימות עוד יותר את הערך של אופטימיזציה אדפטיבית של מודלים לזיהוי חריגות, אם כי הקשרי היישום שלהם שונים מניתוח תמונות היסטופתולוגיות. בניגוד לכך, שיטות המבוסות על קוונטיזציית וקטורים (VQ) מטילות אילוצי ספריית קודים (codebook) בדידים שיכולים להפחית מיפוי זהות; עם זאת, גישות קיימות מבוסות VQ עדיין מסתמכות בעיקר על שגיאות שחזור מרחביות ומנצלות באופן חסר את המידע הסמנטי הכלול בתבניות הפעלת ספריית הקודים26,27.
על אף שהשיטות שהוזכרו לעיל מראות ביצועים מבטיחים בתחומים כלליים, יישומן בתרחישים היסטופתולוגיים מורכבים ניצב בפני אתגרים ספציפיים. תמונות היסטופתולוגיות מאופיינות בהטרוגניות רקמתי מורכבת על פני מספר רמות מבניות28. בפועל, ניתוח תמונות מתבצע בדרך כלל על פיסות תמונה מקומיות המופקות מחתכי רקמה, והאבחנה הפתולוגית היא מטבעה רב-קנה מידה: פתולוגים מעריכים מורפולוגיה של בלוטות ורקמות בהגדלה נמוכה, בעודם בוחנים פליאומורפיזם גרעיני ודמויות מיטוטיות בהגדלה גבוהה29. זיהינו שלוש מגבלות מרכזיות של הגישות הנוכחיות: ראשית, חריגות פתולוגיות ורקמות נורמליות מראות דמיון גבוה במאפיינים חזותיים ברמה נמוכה, כגון סגנונות צביעה ומרקמים מקומיים, מה שגורם לשיטות מבוסות שחזור להיכשל בזיהוי חריגות עדינות, שכן דגימות נורמליות וחריגות עשויות להניב איכות שחזור דומה ברמה הסמנטית. שנית, מרבית השיטות הקיימות משתמשות בחילוץ מאפיינים בקנה מידה יחיד, מה שמקשה על לכידה סימולטנית של מאפיינים חריגים הן ברמת הרקמה והן ברמה התאית30,31. שלישית, למרות ששיטות מרכזיות יכולות להפיק מפות חום ברמת פיקסלים, הן נכשלות לעיתים קרובות בלכידה אינטואיטיבית של התכונות ההיררכיות של החריגות, מה שמגביל את התועלת של מודלים אלו כעזרים לאבחון קליני.
כדי להתמודד עם האתגרים שלעיל, אנו מציעים את RareCode, מסגרת UAD הבוחנת דפוסי הפעלה של ספריית קודים (codebook) וייצוג תכונות היררכי במספר רמות של הפשטה. המסגרת מציגה שלושה מרכיבים עיקריים: (1) מנגנון לדירוג נדירות הפעלת ספריית קודים (CAR), המחשב ציוני נדירות בהתבס על תדרי הפעלת רשומות שאומנו בלעדית על דגימות נורמליות, ובכך מבדיל בין דגימות נורמליות לאנומליות ברמה הסמנטית ומספק אותות מבחינים המשלימים את שגיאות השחזור המרחביות המסורתיות. (2) ארכיטקטורת מיזוג ספריית קודים היררכית רב-קנימית (MHC), הלוכדת תכונות פתולוגיות ברמות פירוט שונות — מדפוסי מבנה גסים ועד לפרטים תאיים עדינים — באמצעות שימוש בספריות קודים בעלות קיבולות משתנות, כאשר מיזוג אדפטיבי מושג באמצעות משקולות למידה. (3) מודול לוקליזציה היררכי ניתן לפירוש, המנצל את הארכיטקטורה הרב-קנימית כדי להפיק מפות חום של אנומליות ברמות פירוט שונות, ובכך מספק לפתולוגים רשמי אבחנה רב-קנימיים וניתנים לפירוש סמנטי.
השערה המרכזית של מחקר זה הייתה שפרופילי תדירות-הפעלה של ספר קודים (codebook), שנגזרו מספרי קודים שאומנו אך ורק על תמונות היסטופתולוגיות נורמליות של המעי הגס והרקטום, יקודדו מידע סמנטי הרלוונטי לאנומליות מעבר לשגיאת שחזור ברמת הפיקסל, וכי אינטגרציה רב-קנימית (multi-scale) של אותות משלימים אלו תשפר את ההבחנה בין תמונות המכילות רקמה סרטנית או דלקתית לבין תמונות נורמליות בהשוואה לשיטות UAD מייצגות, כפי שיימדד בעיקר באמצעות AUC. כדי לבחון השערה זו, הערכנו את RareCode באמצעות תיקוף צולב של 5 קיפולים (5-fold cross-validation) על סט נתונים של CRC עם התייחסויות קליניות, וביצענו ניתוחי אבלציה (ablation) ומיקום כדי לבחון את התרומה והפרשנות של מרכיבי הליבה שלו.
פרוטוקול
המחקר אושר על ידי ועדת האתיקה לחקר מחקר קליני של מרפאת שנזן'סוקרן של בית החולים (אישור מס' LL-KY-2025300-01). פוטר הדרישה להסכמה מדעת על ידי הוועדה האתית, dado שהמחקר הרטרוספקטיבי הזה השתמש בתמונות היסטופתולוגיות וחומרים קליניים קיימים, ללא קשר ישיר למטופלים או התערבות בהם. כל הנתונים הקליניים והתמונות היסטופתולוגיות חולצו מהזדהותם לפני הניתוח, ולא נעשה שימוש במידע זיהוי אישי במחקר זה. כל הנתונים שנעשה בהם שימוש במחקר הזה טופלו בהתאם לסטנדרטים האתיים של הוועדות המוסדיות והלאומית למחקר.
סקירת מסגרת
המבנה הכולל של מסגרת ה-UAD המוצעת, RareCode, מוצג ב- איור 1המסגרת משתמשת בארכיטקטורה מקבילה דו-ענפית. עבור כל תמונה בגודל 512 × 512, מופרדים פצ'ים לא חופפים בגודל 32 × 32 ו-64 × 64 כקלטים בקנה מידה דק ובר-קנה מידה גס, בהתאמה. הפצ'ים בגודל 64 × 64 מתארים מחדש ל-32 × 32 לפני העברתם לרשת, כדי ששני הענפים ישתמשו באותו גודל קלט של מקודד-מפענח, תוך שמירה על שדות קליטה שונים. המקודדים בכל ענף ממפים את התכונות הנCogרות למרחב נסתר, שבו מודול MHC מטיל אילוצי דיסקרטיזציה. לאחר מכן, המפענחים משחזרים את התמונה מהתכונות המוקוונטטות כדי לחשב שגיאות שחזור בתחום המרחבי. מנגנון CAR מודד אז את רמת החריגה ברמת המשמעות על ידי ניתוח תדירויות הפעלת ספר הקודים. לבסוף, המודל מאחד את ציוני השחזור וציוני CAR באמצעות שילוב משוקלל, כדי לקבל ציוני חריגה ברמת התמונה. מסגרת RareCode מתואמת מקצה לקצה באמצעות דוגמאות נורמליות בלבד, ללא צורך בהערות הבהרה על חריגות. העיצוב הדו-ענפי שימש ללכידת תכונות תאיות מקומיות ומבנים בלוטתיים רחבים יותר. מודול MHC שימש ליצירת מודל של תכונות אלו באמצעות ספרי קודים בקיבולת שונה.
ארכיטקטורת מקודד-מפענח
RareCode בונה מקודדים ומפענחים מבניים עצמאיים לזרועות של סcales עדינים וגרוסים. כל זרוע משתמשת באותו עיצוב מקודד-מפענח אך ללא שיתוף פרמטרים. המקודד כולל ארבעה בלוקי קונבולוציה, שכל אחד מהם כולל קונבולוציה של 3×3, נורמליזציית קבוצה, פונקציית הפעלה מסוג ReLU, ו-_dropout. רוחב הערוץ עולה מ-64 ל-128, לאחר מכן ל-256, והמפה הסופית של התכונות מוצגת כמישורית ומשודרת לשקופית סמויה ממימד 64. המפענח משקף את המקודד באמצעות שכבת הצגה מלאה, ולאחריה ארבע שכבת קונבולוציה טרנספוניות, המחזירות כל פצירה לגודל הקלט המקורי של הרשת. שגיאת השחזור מחושבת כטעות ריבועית ממוצעת בין הקלט לפצירות שהושזרו. על ידי שילוב מבנה מקודד-מפענח זה עם אילוצי ספריית קוד דיסקרטית, RareCode לומד ייצוגים קומפקטיים של רקמה תקינה ומודד סטיות במהלך ההסקה.
סִפְרִיַּת קוד היררכית רב-סקאלית
לכידת תכונות פתולוגיות ברמות שונות של הפשטה—ממדדי רקמה כלליים עד הבדלים תאיים מקומיים—מודול ה-MHC משתמש ב-K ספריות קוד דיסקרטיות  בכשירותים משתנים נ1, נ2, ..., נKבסידור FourScales הסופי, כל ענף כולל ארבעה ספרי קוד עם 64, 128, 256 ו-512 ערכים, בהתאמה, וכל ערך בספר קוד כולל שיכבוץ ממימד 64. עבור כל תכונת פציעה מקודדת, נבחר ערך ספר הקוד הקרוב ביותר לפי מרחק אוקלידי. הפלטים הממוספרים מספרי קוד שונים ממוזגים לאחר מכן באמצעות משקלים הניתנים ללמוד, המנורמלים לאורך ספרי הקוד. צפוי שספרי קוד קטנים יותר, בעקבות מגבלות דחיסה חזקות יותר, יקודדו תבניות פרוטוטיפיות ברמות גסות שמשמיטות וריאציות מקומיות, בעוד שספרי קוד גדולים יותר שומרים על תכונות ברמות עדינות יותר אשר תופסות מאפיינים מבניים ספציפיים יותר. עבור כל ספר קוד
 , כאשר ek(א)
 Rד מסמן את וקטור השיכפול ה-i בספר הקוד ה-k, מאפיינים רציפים ממופים למרחב ספר הקוד הבדיד באמצעות חיפוש שכנם הקרוב ביותר (משוואה 1 ו-2):
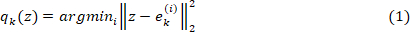

כדי להשיג שילוב מותאם של תכונות בקנה מידה מרובה, אנו מציגים משקולות שאפשר ללמוד. לאחר נורמליזציה באמצעות פונקציית סופטמקס, מתבצע סכימה משוקללת על הפלטים המספרתיים ממכס כל קוד (משוואה 3):
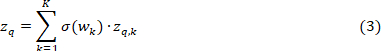
כאשר σ(·) מציין את פונקציית הסופטמקס, שמבטיחה שהמשקלים מקיימים Σk σ(wk) = 1. ערכת עיצוב זו מאפשרת למודל להתאים אוטומטית את יחסי寄יבוץ של ספריות הקוד ברמות דקדוק שונות, בהתאם לתוכן הסמנטי של התכונות הקלט.
כדי למקסם את למידת ספר הקודים, אנו מאמצים את פונקציית האובדן הסטנדרטית של VQ (משוואה 4):
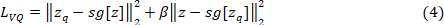
כאשר sg[·] מציין את פעולת גרדיינט העצירה, ו- β = 0.25 הוא מקדם משקל אובדן ההתחייבות. האיבר הראשון מעודד את וקטורי מאגר הקוד להזוז לכיוון פלטיה של היחידה המפענחת, בעוד שהאיבר השני מעודד את פלטיה של היחידה המפענחת להישאר עקביים עם וקטורי מאגר הקוד המתאימים להם. המנגנון השלם של VQ בקנה מידה מרובה מוצג באיור איור 2.
ניקוד נדירות הפעלה של ספר קודים
CAR מודד חריגות ברמה הסמנטית בהתבסס על סטטיסטיקות הפעלה של קודבוק, המחושבות ממדגמי אימון נורמליים. לאחר אימון המודל, כל תמונות אימון נורמליות עברו דרך המוצפן ומודול MHC ללא הגברת נתונים. עבור כל ענף ולכל קודבוק, נרשם אינדקס ההשמה של כל תכונת פצ'ה, וסוכם מספר ההשמות לכל ערך בקודבוק. הספירות נורמלות לאחר מכן כדי לקבל את התפלגות תדר ההפעלה עבור הקודבוק הזה (משוואה 5):

במהלך ההסקה, כל תמונה נבדקת עברה את אותה תהליך של חילוץ פצ'ים, קידוד והשמה למילון הקודים של השכן הקרוב ביותר. עבור כל ערך ממילון הקודים שהושם, מחושב ציון הנדירות כלוגריתם השלילי של תדירות ההפעלה שלו בקבוצת האימון הרגילה (משוואה 6):

כאשר ε הוא קבוע קטן המשמש לצורך יציבות מספרית. כתוצאה מכך, רכיב ספריית קוד בתדירות נמוכה מקבל ציון נדירות גבוה יותר, מה שמעיד על כך שהתכונה המתאימה של התחום פחות עקיבה עם ההתפלגות הלומדת של רקמות תקינות. ציוני הנדירות ברמת התחום ממוצעים בתוך כל תמונה ובין ענפי הסקאלה המורכבת והסקאלה הגסה כדי לקבל תגובה ברמת התמונה לנדירות.
כדי להשלים את נדירות התדירות של הפעלה, אנו גם מחשבים ציון מרחק של רמת כימות על בסיס פרcntl (משוואה 7):
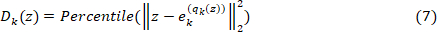
הציון הזה נגזר מהמרחק האוקלידי בין כל וקטור תכונות מוצפן לבין ערך קודבוק הקרובה אליו. הפצה של המרחק מוערכת מדגמי אימון נורמליים, ומרחקי דגימות המבחן מומרות לציוני אחוזון. ציוני אחוזון גדולים יותר מצביעים על כך שתכונת המיזוג קשה יותר לייצוג באמצעות הפורוטוטיפים של קודבוק הנורמה שלמדו.
הציון הסופי של CAR משלב את נדירות האקטיבציה ואת מרחק הכימות בכל ספרי הקודים, תוך שימוש במשקלות ספרי הקודים הניתנים ללמוד (משוואה 8):
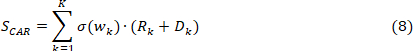
משקלים מנורמלים זהים של קודבוק, המשמשים לשלב תכונות מרובה קנה מידה, מופעלים גם לשלב ברמת הניקוד, תוך שמירה על עקביות בין למידת הייצוג לניקוד החריגות. ניקוד CAR המתקבל מחושב ברמת התמונה, ואז ממוזג עם ניקוד השחזור כדי לקבל את ניקוד החריגות הסופי. מנגנון הניקוד הכולל של CAR מוצג ב איור 3.
חישוב ציון הסטייה הסופי
אנו מאחדים שגיאות שחזור בתחום המרחבי עם ציוני CAR ברמה הסמנטית. לפני האיחוד, שני הציונים מאופנים בנפרד באמצעות נורמליזציה של מינימום-מקסימום מבוססת פרcntl כדי להפחית את השפעת החריגים הקיצוניים. ציון החריגות הסופי ברמת התמונה מוגדר אז כ-(משוואה 9):
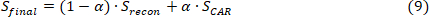
כאשר Sריכוך מציין את שגיאת השחזור הממוצעת המורחבת הנורמלית, המבטאת את איכות שיחזור הדגימה במרחב הפיקסלים; SCAR הינו ציון ה-CAR שמתואר לעיל, הש capturing מעלות של חריגות ברמה הסמנטית. הפרמטר ההיפרני α [0,1] מגדיר את המשקל היחסי בין שני הרכיבים, כאשר הערכים האופטימליים נקבעים באמצעות ערכות אימות.
מטרת האימון
המסגרת RareCode מתואמת מקצה לקצה באמצעות דוגמאות נורמליות בלבד. איבוד האימון הכולל כולל את הרכיבים הבאים (משוואה 10):

כל מונח מוגדר באופן הבא: איבוד השחזור: 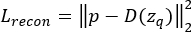 , מדידת שגיאת הריבוע הממוצעת בין הפצאות הקלט p ופתות משוחזרות ד(זq) לאחר קוונטיזציה. אובדן זה מופעל בנפרד ל-32 × 32 ענף פצ'ים (
 ) ו-64 × 64 ענף פצ'ט (
 כדי להבטיח למידה יעילה של תכונות בשני הקני מרחביים.
תיאור הקובץ
כדי להעריך את RareCode, נערך ניסויים על סט נתוני תמונות היסטופתולוגיות של CRC עם הערות קליניות, הכולל תמונות של مقטי רקמות קולורקטליות נטושות בהמיטוקסילין ואאוזין (H&E)&ה), שהושג מ- Shenzhen People'ס של בית חולים. כל התמונות בסט הנתונים הזה מקורן ממקרי קליניקאים אמיתיים. התמונות הודגמו בהגדלה של 40x עם רזולוציה מקורית של 1024 × 1024 פיקסלים. כדי להבטיח אמינות ואיכות של ההגדרות, נבדקו וודאגו כל תווי הקטגוריות של הדגימות על ידי שני פטולוגים מקצועיים בכירים או יותר, בהתאם לפרוטוקול של עיוור כפול.
בהתבסס על מאפיינים היסטופתולוגיים, סווגו הנתונים לשלושה תחומים: רקמה נורמלית (1,226 תמונות), סרטן (1,215 תמונות) ודלקת (1,214 תמונות). בהקשר של הגדרת UAD דו-קרית, דגימות של סרטן ודלקת טופלו כחריגות, בעוד שדגימות נורמליות שימשו כהתפלגות ייחוס. תיאור זה משקף את משימת המיון המיועדת – הפרדת מקרים הדורשים סקירה פתולוגית נוספת ממקרים הנראים נורמליים מבחינה מורפולוגית.
כל ה- H&המראות המוכתמים ב-E יוצרו מחדש בגודל 512 × 512 פיקסלים לפני שהופכים לקלט לרשת. נעשה שימוש בפונדק חלוקה חותך 5-겹 עם דגימה מאורבת לצורך הערכה. בכל פונדק, דגימות ה"נורמלי" חולקו תחילה לקבוצות אימון, אימות ובדיקה נבדלת. RareCode אומן רק על דגימות האימון הנורמליות. קבוצת האימות, שמכילה אף היא רק דגימות נורמליות, שימשה לבחירת מודל, איזון פרמטרים על ובחירת משקל ההיתוך. αהקבוצה המבודדת לבדיקה, שכוללת דוגמיות נורמליות שלא נראו קודם לכן ודוגמיות חריגות הכוללות סרטן ודלקת, שימשה אך ורק להערכת הביצועים הסופית ולא שימשה לאימון המודל, לבחירת פרמטרים על, או α בחירה.Shown in מוצגות הקטגוריות הנציגות, מבנה ערכת הנתונים, ופרוטוקול האימות ב איור 4.
פרטי יישום
המסגרת RareCode שהוצעה והשיטות להשוואה יושמו באמצעות PyTorch. כל הניסויים בוצעו על גבי תחנת עבודה שצוידה בכרטיס גרפיקה יחיד מסוג NVIDIA GeForce RTX 4060 Ti (16 ג"ב). להגדרת מבנה הרשת, על מנת ללכוד תכונות בטווחים מרחביים שונים, מבנה הרשת הדו-ענף מעבד פצאות לא חופפות בשני קני מידה: 32 × 32 פיקסלים (שדה קבלה קטן יותר, שצובר דפוסי kếtext מקומיים) ו-64 × 64 פיקסלים (שדה קולט גדול יותר, שצובר הקשר מרחבי רחב יותר), בהתאמה. ממד השיכפול של התכונה הרציפה שנוצר על ידי שני מקודדי הענפים מוגדר באופן אחיד ל-64. במודול MHC, אנו מגדירים ארבעה ספרי קוד עם קיבולת שונה לכל ענף, בכמויות פרוטוטייפיות דיסקרטיות של 64, 128, 256 ו-512, בהתאמה.
במהלך האופטימיזציה, רשת ה-Deep נ_entrened ב-50 אפוקים, עם גודל קבוצה של 8. אנו משתמשים באופטימיזר AdamW לעדכון המשקלים, עם קצב למידה התחלתי של 5 × ופחיתת משקל של כדי למנוע התאמה יתר. בנוסף, כדי להבטיח התכנסות חלקה של האימון, השתמשו בלוח זמנים של קצב למידה עם הפסקות קוסינוס, המאפשר אופטימיזציה מדויקת יותר בשלבים מאוחרים של האימון. בחרו בגודלי פッチים וגודלי ספריות קוד כדי לאזן בין ייצוג רב-קויית לבין עלות חישובית. תצורת FourScales הסופית נתמכה בניתוח איבול, ו α נבחר על פי קבוצת האימות לפני הערכת קבוצת המבחן.
לניפוי עקמת המפענח, יושמה גרסה של מפענח מורכב על סמך תצורת FourScales. הגרסה הזו השתמשה באותה חלוקת נתונים, גודלי ספרי קוד, מחזורי אימון, אופטימיזר, קצב למידה, ומבוססת אימות α סלקציה, והערכה של מדדים כמודל FourScales. דקודר הבסיסי הוחלף בדקודר בסגנון EMCAD שמכיל בלוקי קונבולוציה מרובת קנה מידה מסוג depthwise ומודולי תשומת לב של בלוקי הקונבולוציה (CBAM). לאחר כל אחד משלושת שלבי ההגדלה הראשונים באמצעות קונבולוציה טרנספונדית, מופעלים באופן מקבילי 3 × 3, 5 × 5, ו-7 × הוחלו 7 הקונבולוציות העומקות, ולאחריהן 1 × 1 שילוב נקודתי, נורמליזציית מקבץ, הפעלה של ReLU, חיבור שאריתי, ותשומת לב מסוג CBAM. CBAM כלל תשומת לב של ערוץ בהתבסס על תיאורי ממוצע ומקסימום של פולינג, ותשומת לב מרחבית באמצעות 7 × 7 הקונבולוציה. השלב הסופי השתמש בהיפוך הקונבולוציה ופעולה סיגמואידית לשחזור 32 × 32 פצ'ים.
תוצאות
השוואה לשיטות בסיס
כדי להעריך את מסגרת RareCode, נבחרו מספר שיטות UAD מייצגות כשיטות בסיס, המקיפות שיטות מבוסות שחזור (CAE32, VAE12, SAE33, MAE34, PatchSAE35), שחזור מוגבר בזיכרון (MemAE36), זיקוק ידע (STFPM37), יצירת אנומליות סינתטיות (DRAEM38), וחילוץ מאפיינים מאומן מראש (PatchCore18). בחירת שיטות הבסיס התמקדה בשיטות שניתן לאמן או ליישם תחת תקציבי מחשוב והנחות נתונים דומות (גישה לדגימות אימון נורמליות לא מתויגות בלבד), ובכך להבטיח שהבדלי הביצועים משקפים תרומות מתודולוגיות ולא פערים בהיקף נתוני האימון המקדים. כדי להבטיח השוואה הוגנת, כל השיטות הוערכו באמצעות אותם פילולי נתונים של 5-fold, צינור עיבוד מקדים, מדדי הערכה וסביבת מחשוב. המודלים אומנו תחת פרוטוקול UAD זהה תוך שימוש בדגימות אימון נורמליות בלבד, כאשר ההיפר-פרמטרים והספים נבחרו על סט הוולידציה והביצועים הסופיים הוערכו רק על סט הבדיקה המופרש. טבלה 1 מסכמת את תוצאות ה-5-fold cross-validation, ואיור 5 מציג השוואות באמצעות תרשימי רדאר רב-מדדיים.
כפי שמוצג בטבלה 1 ובאיור 5, RareCode משיג ביצועי זיהוי חיוביים ויציבות סטטיסטית במאגר הנתונים של CRC. מבחינת AUC, RareCode (96.82 ± 0.23%) עולה בביצועיו על מספר מודלי בסיס מבוססי שחזור, כולל MemAE (94.97 ± 0.81%). ניתוח סטטיסטי מאשר כי RareCode עולה בביצועיו על כל מודלי הבסיס המבוססים על שחזור (paired t-tests, p < 0.05), כאשר השיפור לעומת MemAE מגיע למשמעות סטטיסטית (p < 0.01). RareCode מראה שונות ביצועים נמוכה (סטיית תקן של 0.23%), דבר המעיד על יציבות עקבית בין הקיפולים (cross-fold stability). היעילות המוגבלת של DRAEM, המבוס על אנומליות סינתטיות, משקפת ככל הנראה את העובדה שאסטרטגיות פשוטות של הבלטת מרקמים אינן יכולות לדמות באופן הולם אטיפיה פתולוגית מורכבת.
בכל הנוגע לספציפיות, RareCode משיג 58.24 ± 5.9%, ובכך עולה על כל שיטות ההשוואה בהפחתת שיעורי החיוביים השגויים. נתון זה מייצג שיפור של כ-25 נקודות אחוז לעומת קו הבסיס של שחזור בלבד (NoCAR, 3.76%), מה שמעיד על תרומתו של מנגנון ה-CAR להפחתת חיוביים שגויים. הספציפיות הנמוכה יותר של STFPM ו-PatchCore, הנשענות על מאפיינים שאומנו מראש על תמונות טבעיות, עשויה לשקף חלקית את פער הדומיין בין תמונות טבעיות לתמונות היסטופתולוגיות. ראוי לציין כי STFPM ו-DRAEM מראים שונות גבוהה בספציפיות (±3.53% ו-±7.09%), כאשר הספציפיות לכל קיפול (per-fold) נעה בין רמות קרובות לאפס לרמות בינוניות, דבר המעלה חששות לגבי מהימנות הפריסה שלהן.
ביצועי זיהוי לפי מחלקה
ניתוח לפי מחלקה בוצע על ידי השוואה נפרדת של דגימות סרטן ודגימות דלקת מול דגימות נורמליות (טבלה 2). RareCode השיג ביצועים גבוהים יותר בזיהוי סרטן (AUC = 9.4 ± 0.12%, recall = 98.13 ± 0.29%, specificity = 94.21 ± 2.2%) מאשר בזיהוי דלקת (AUC = 94.30 ± 0.4%, recall = 96.5 ± 0.78%, specificity = 60.4 ± 4.34%). ממצאים אלו מצביעים על כך ש-RareCode עשוי להפגין יכולת הבחנה חזקה יותר עבור חריגות ממאירות מאשר עבור שינויים דלקתיים, בעוד שנראה כי הגבול שבין דלקת לנורמלי תורם משמעותית לירידה בספציפיות הכוללת.
ניתוח השפעת רכיבים (Ablation study)
כדי לבחון את תרומתם של רכיבי מפתח בתוך מסגרת ה-RareCode, נערכו ניסויי ablation להערכת ההשפעה של מנגנון ה-CAR ומודול ה-MHC על ביצועי הזיהוי. התוצאות מפורטות ב-טבלה 3. כפי שמוצג ב-איור 6A, הוספת CAR לבסיס ההשוואה (baseline) המבוס על שחזור בלבד שיפרה את ה-AUC מ-92.81% ל-95.92%, ומיזוג ספרי קוד רב-קנימי (multi-scale codebook fusion) העלה את ה-AUC עוד יותר ל-96.82%. איור 6B מראה כי ה-CAR שיפר גם את הספציפיות, כשהיא עלתה מ-3.76% בבסיס ההשוואה NoCAR ל-58.24% במודל ה-FourScales המלא. תוצאות אלו תומכות בערכם המשליים של נדירות הפעלת ספר הקוד והמיזוג רב-הקנימי.
בנוסף, נערכה בדיקת אבלציה של מורכבות המפענח (decoder-complexity ablation) באמצעות תצורת FourScales. כפי שמוצג ב- טבלה 3גרסת ה-complex-decoder, הכוללת בלוקים של קונבולוציה עומקית (depthwise convolution) רב-קנימית ומודולי תשומת לב של בלוק קונבולוציוני (CBAM), הראתה AUC נמוך יותר מאשר מודל ה-FourScales הבסי (95.17 ± 0.4% לעומת 96.82 ± (0.23%). תוצאה זו מרמזת כי, במסגרת הגדרות ה-RareCode המבוסות על VQ-AE הנוכחיות, הגדלת קיבולת המפענח (decoder) לא שיפרה את ביצועי זיהוי האנומליות ועשויה להפחית את יעילות הייצוג המוגבל על ידי ספר הקודים (codebook).
ניתוח תגובה מרחבית היררכית
כדי לבחון את התגובות המרחביות שנוצרו על ידי RareCode, שגיאות שחזור ברמת הפסיפס (patch-level) ומפות נדירות של ספריית הקודים (codebook rarity maps) aggregated ברמת התמונה והושוו בין דגימות נורמליות לאנומליות. יחס אנרגיה, Cohen's d ו-AUC שימשו לכימות ההפרדה בתגובה ברמת התמונה. תוצאות מפורטות מוצגות בטבלה 4, באיור 7 ובאיור 8.
התוצאות מראות כי מדדי נדירות של ספר קודים (codebook rarity scores) בכל הסקאלות מציגים עלייה בתגובה עבור דגימות חריגות (energy ratios > 1). ספרי קודים בעלי קיבולת נמוכה יותר (Codebook 64) משיגים הבחנה חזקה יותר ברמת הלוקליזציה (78.79% AUC), באופן העולה עם הציפייה ששיעורי דחיסה גבוהים יותר מעודדים למידה של תבניות פרוטוטיפיות מופשטות יותר, אשר רגישות יותר לסטיות מארכיטיפים של רקמה נורמלית. שגיאת השחזור כשלעצמה מספקת יכולת משמעותית לזיהוי חריגות (93.31% AUC), בעוד שמדדי CAR מספקים אותים משלימים מממד התדירות הסמנטית.
בדיקה איכותנית של איור 7 הראתה כי תגובות מוגברות בדגימות סרטן חפפו לבלוטות לא סדירות וצפופות, הגדלה גרעינית, היפרכרומזיה, פסאודו-סטראטיפיקציה ואובדן של פולריות אפיתליאלית. בדגימות דלקתיות, נצפו תגובות חזקות יותר סביב קריפטות מעוות וחלחולי תאי דלקת צפופים. ספרי קודים (codebooks) בעלי קיבולת נמוכה נטו ללכוד סטיות ארכיטקטוניות רחבות יותר, בעוד שספרי קודים בעלי קיבולת גבוהה ייצרו תגובות ממוקדות יותר ברמה התאית. ממצאים אלו מספקים פרשנות מורפולוגית איכותנית אך לא תיקוף ברמת הפיקסל.
ניתוח פרמטרי מיזוג
משקל המיזוג α מאזן את התרומות של שגיאת השחזור המרחבית ושל מדד ה-CAR לניקוד האנומליה הסופי. ערכי α אופטימליים עבור כל fold נקבעו באמצעות חיפוש רשת (grid search) (בצעד של 0.05) על קבוצות האימות, והתוצאות מוצגות בטבלה 5 וב איור 9. ערכי α אופטימליים מתרכזים בעיקר בטווח שבין 0.85 ל-0.95, עם ממוצע של 0.90 ± 0.05. תחת תצורות אופטימליות, המודל משיג AUC ממוצע של 96.82 ± 0.23% על קבוצות הבדיקה. משקלים אופטימליים גבוהים יותר (בסביבות 0.90) מצביעים על כך שמדדי CAR תורמים יותר לזיהוי הסופי מאשר שגיאת השחזור, בעוד ששגיאת השחזור מספקת אילוצים מקומיים עזריים. בהשוואה להגדרת α = 0 בניתוח הרגישות (AUC = 93.29%), הגדרת המיזוג שנבחרה באימות שיפרה את ה-AUC בכ-3.53 נקודות אחוז.
לסיכום, עבודה זו מציגה את מסגרת RareCode לזיהוי חריגות בלתי מונחה בתמונות היסטופתולוגיות, במטרה להפחית את בעיית מיפוי הזהות (identity-mapping) הנתקלת במודלים גנרטיביים מסורתיים. מנגנון ה-CAR מפחית את ההסתמכות המוגברת על שגיאות שחזור ברמת הפיקסל, בעוד שמודול ה-MHC מספק ייצוגי מאפיינים היררכיים ברמות גרנולריות מרובות, מה שמאפשר הבחנה משלימה של חריגות ברמות שונות של הפשטה. ניסויים על מאגר הנתונים CRC מדגימים כי RareCode משיג 96.82% AUC, כאשר ניתוח לפי מחלקה מראה זיהוי סרטן יעיל (AUC = 9.4%) והבחנה חזקה יותר עבור סרטן מאשר עבור דלקת, מה שמרמז כי החפיפה בין דלקת לרקמה נורמלית נותרת אתגר מרכזי. מחקרי אבלציה מאשרים כי שילוב של מאפיינים סמנטיים בדידים מ-VQ עם ייצוגים מורפולוגיים של רקמה ברב-קנה מידה משפר את ביצועי הזיהוי. רגישות גבוהה (Recall = 98.40%) וסגוליות מתונה (Specificity = 58.24%) של RareCode מצביעות על פוטנציאל ככלי לסריקה ראשונית לתיעדוף תמונות היסטופתולוגיות חשודות; עם זאת, השפעתו הממשית על עומס העבודה של הפתולוגים תדרוש הערכה פרוספקטיבית של זרימת העבודה.
זמינות נתונים:
מאגר התמונות ההיסטופתולוגיות של CRC ששימש במחקר זה התקבל מבית החולים של העם שנזן (Shenzhen People's Hospital) תחת אישור אתי מוסדי (מספר אישור LL-KY-2025300-01). בשל פרטיות המטופלים ומדיניות שיתוף הנתונים המוסדית, מאגר הנתונים אינו זמין לציבור. ניתן לבקש גישה מהמחבר המקבל, בכפוף לבקשה סבירה, אישור מוסדי והסכמי שימוש בנתונים. קוד המקור של מסגרת ה-RareCode זמין לציבור בכתובת https://github.com/XL-alg/RareCode.
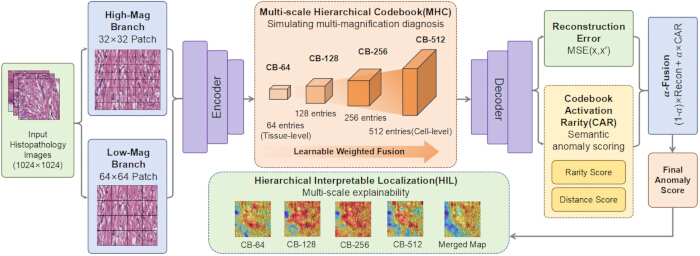
איור 1הארכיטקטורה הכללית וזרימת הנתונים של מסגרת ה-RareCode. A 512 × 512 H&תמונה היסטופתולוגית שנצבעה ב-H&E מחולקת ל-32 חלקים שאינם חופפים × 32 ו-64 × 64 טלאים (patches) כקלטים בקנה מידה עדין וגס. שני הענפים מקודדים את הטלאים להטמעות לטנטיות (latent embeddings), מחילים דיסקרטיזציה של ספריית קודים היררכית רב-קנימית (MHC), ומשחזרים את הטלאים כדי לחשב ציוני שגיאת שחזור. במקביל, מנגנון נדירות הפעלת ספריית הקודים (CAR) מעריך נדירות סמנטית מתוך פרופילי תדירות הפעלה של ספריית הקודים שנלמדו מדגימות אימון נורמליות. ציוני השחזור וה-CAR הנורמליים ממוזגים לאחר מכן כדי להפיק את ציון האנומליה הסופי ברמת התמונה, בעוד שהתגובות ברמת הטלאים מוקרנות חזרה למישור התמונה לצורך לוקליזציה היררכית. אנא לחץ כאן כדי לצפות בגרסה מורחבת של איור זה.
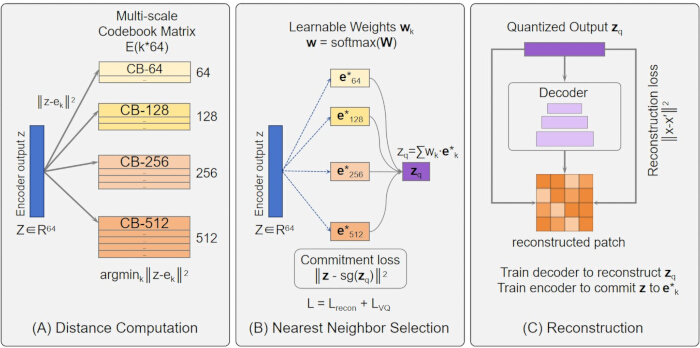
איור 2: מנגנון קוונטיזציית וקטורים רב-קנה מידה. (A) חישוב מרחק בין מאפייני פלט המקודד לבין וקטורי ההטמעה של ספר הקודים. (B) בחירת השכן הקרוב ביותר ומיזוג משוקל בין ספרי קודים בעלי קיבולים של 64, 128, 256 ו-512. (C) שחזור ממאפיינים שעברו קוונטיזציה באמצעות מפענח קונבולוציוני טרנספוזיציוני. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
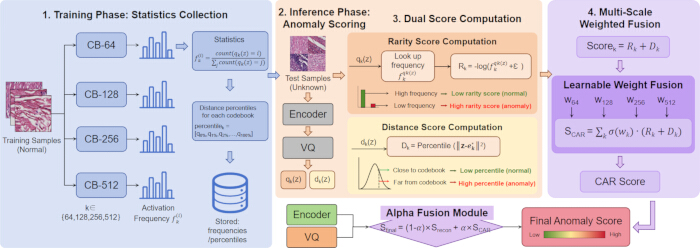
איור 3: מנגנון ניקוד ה-CAR. איור זה מדגים ארבעה שלבים: שלב 1: סטטיסטיקות תדירות ההפעלה מחושבות אך ורק על דגימות אימון נורמליות. שלב 2: דגימות בדיקה מקבלות אינדקסי הפעלה ומרחקים באמצעות מקודד וקוונטיזציית וקטורים. שלב 3: ציוני נדירות וציוני מרחק מחושבים בהתבסס על פרופילי תדירות של קבוצת האימון. שלב 4: ציונים מכל קנה מידה של ספריית קודים (codebook) ממוזגים באמצעות משקולות למידה כדי להפיק את ציון ה-CAR הסופי. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
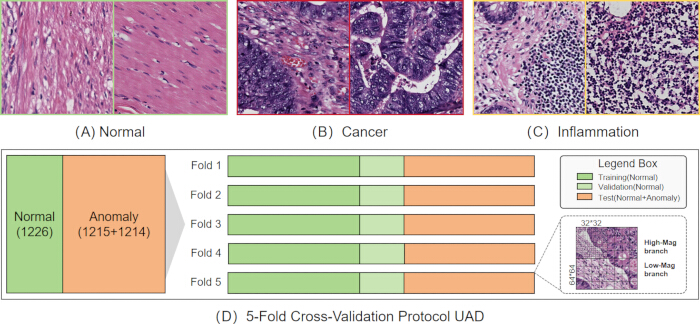
איור 4הרכב סט הנתונים של CRC ופרוטוקול ניסיוני. (א–ג) H מייצגת&תמונות היסטופתולוגיות שנצבעו ב-H&E של רקמת מעי גס ונשירה נורמלית, סרטן המעי הגס ודלקת של המעי הגס. (ד'פרוטוקול אימות צולב (cross-validation) של 5 קיפולים עבור UAD, שבו דגימות נורמליות שימשו לאימון ולאימות, בעוד שדגימות נורמליות ואנומליות שהושארו בצד שימשו לבדיקה. התמונות עוברו לדיגיטציה בהגדלה של 40x וחולקו לטלאים (patches) בגדלים של 32x32 ו-64x64. צבעים ירוק, ירוק בהיר וכתום מציינים את מערכי האימון, האימות והבדיקה, בהתאמה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
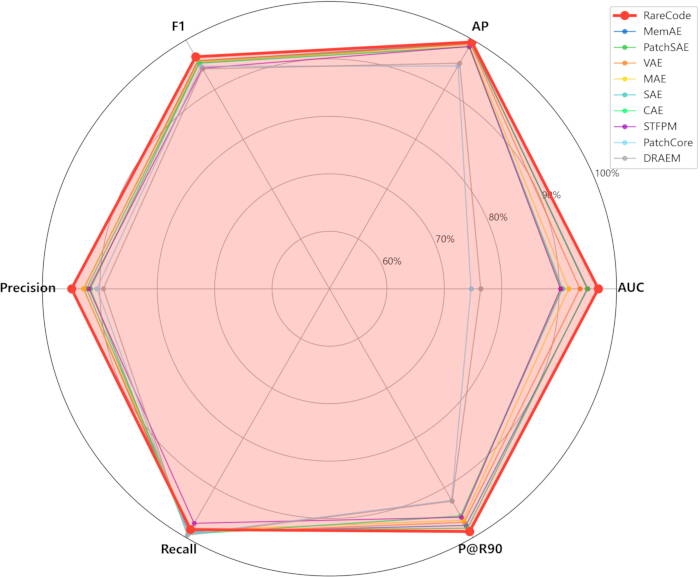
איור 5: תרשים רדאר להשוואה רב-מדדית של שיטות לזיהוי חריגות.תרשים רדאר המשווה את RareCode מול שיטות בסיס (baseline) על פני AUC, דיוק ממוצע (AP), F1-score, דיוק (precision), רגישות (recall), ודיוק ברגישות של 90% (P@R90). כל הערכים מייצגים ביצועים ממוצעים על פני תיקוף צולב של 5-fold. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
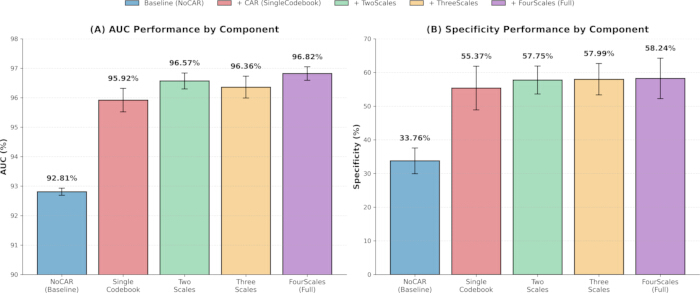
איור 6: ניתוח תרומה מצטברת של רכיבי מחקר האבלאציה (ablation study). (A) השוואת ביצועי AUC המראה שיפור הדרגתי מקו הבסיס של שחזור בלבד (NoCAR), דרך תצורת ספריית קודים בודדת ועד לתצורות רב-קנה-מידה. (B) השוואת ביצועי ספציפיות המדגימה את השפעת מנגנון ה-CAR על הפחתת תוצאות חיוביות שגויות. כל סטיות התקן (error bars) מייצגות סטיית תקן (SD) על פני תיקוף צולב של 5 קיפולים (5-fold cross-validation). אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
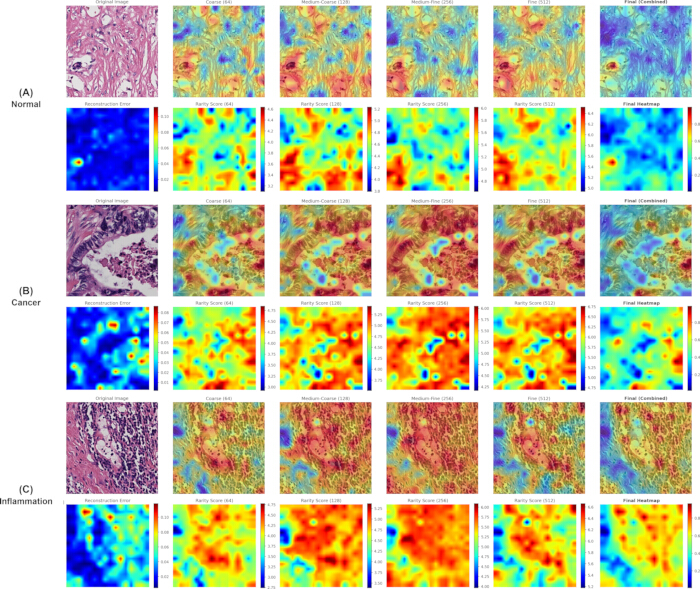
איור 7: מפות חום של לוקליזציה היררכית באמצעות ספריית קודים רב-סקאלית. דוגמאות מייצגות מוצגות עבור דגימות של (A) נורמליות, (B) סרטניות, ו(C) דלקתיות. כל שורה כוללת את התמונה המקורית, שכבת מיסוך (overlay), מפת שגיאות שחזור, מפות ציון נדירות מספריות קודים בקיבולים שונים (64, 128, 256 ו-512), ומפת הלוקליזציה הממוזגת הסופית. ספריות קודים בעלות קיבול נמוך יותר מדגישות תבניות גסות באמצעות הפשטת דחיסה חזקה יותר, בעוד שספריות קודים בעלות קיבול גבוה יותר משמרות פרטים מבניים עדינים יותר. אזורים בעלי תגובה גבוהה תואמים איכותית למאפיינים היסטופתולוגיים הקשורים לסרטן או לדלקת, אך לא תוקפו באמצעות אנוטציות של מומחים ברמת הפיקסל. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
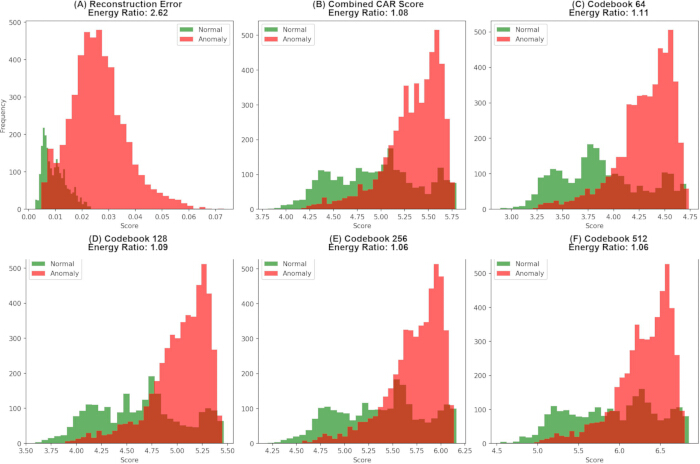
איור 8: היסטוגרמות התפלגות של סוגי ציונים שונים. היסטוגרמות המשוות התפלגויות ציונים בין דגימות נורמליות לדגימות חריגות עבור (A) שגיאת שחזור, (B) ציון CAR משולב, (C) Codebook 64, (D) Codebook 128, (E) Codebook 256, ו-(F) Codebook 512. היסטוגרמות בירוק ובאדום מציינות דגימות נורמליות וחריגות, בהתאמה. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
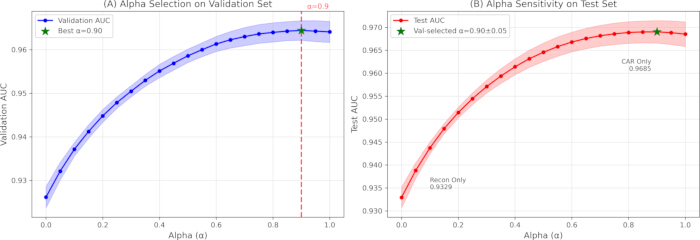
איור 9: ניתוח רגישות של פרמטר אלפא. (A) ערכי AUC של קבוצת התיקוף ששימשו לבחירת α. (B) ערכי AUC של קבוצת הבדיקה תחת ערכי α שונים. ערכי α שנבחרו מקבוצת התיקוף נעו בין 0.85 ל-0.95, עם ממוצע של 0.90 ± 0.05, בדומה לטבלה 5. השונות ב-AUC נותרה מתחת ל-0.5% כאשר α השתנה בטווח שבין [0.70, 1.0], מה שמעיד על ביצועים יציבים על פני טווח פרמטרים רחב. אנא לחצו כאן כדי להציג גרסה גדולה יותר של איור זה.
| שיטה | AUC (%) | AP (%) | F1 (%) | דיוק (%) | רגישות (%) | סגוליות (%) | P@R90 (%) |
| הנדסת מחשב בשירות האוטומציה (CAE) | 90.37 ± 0.94 | 98.62 ± 0.18 | 95.34 ± 0.15 | 91.64 ± 0.40 | 99.35 ± 0.22 | 28.14 ± 3.88 | 95.66 ± 0.32 |
| אירוע חמור (SAE) | 90.58 ± 0.94 | 98.66 ± 0.18 | 95.34 ± 0.15 | 91.67 ± 0.40 | 99.32 ± 0.24 | 28.46 ± 3.97 | 95.71 ± 0.30 |
| מקודד אוטומטי וריאציוני (VAE) | 93.60 ± 0.82 | 99.13 ± 0.12 | 95.86 ± 0.19 | 92.81 ± 0.49 | 99.12 ± 0.29 | 39.07 ± 4.70 | 96.94 ± 0.43 |
| MAE | 91.65 ± 2.75 | 98.76 ± 0.50 | 95.61 ± 0.60 | 92.87 ± 1.56 | 98.55 ± 0.55 | 39.74 ± 14.32 | 96.55 ± 0.97 |
| MemAE | 94.97 ± 0.81 | 99.35 ± 0.11 | 95.78 ± 0.33 | 92.82 ± 1.07 | 98.95 ± 0.60 | 39.15 ± 9.99 | 97.57 ± 0.33 |
| PatchSAE | 94.86 ± 0.36 | 99.34 ± 0.05 | 95.39 ± 0.13 | 92.32 ± 0.27 | 98.67 ± 0.12 | 34.91 ± 2.57 | 98.13 ± 0.24 |
| STFPM | 90.23 ± 3.05 | 98.70 ± 0.44 | 94.32 ± 0.21 | 91.90 ± 3.51 | 97.14 ± 3.38 | 29.82 ± 33.53 | 95.93 ± 1.96 |
| DRAEM | 76.34 ± 2.82 | 95.34 ± 0.90 | 94.19 ± 0.07 | 89.39 ± 0.65 | 99.56 ± 0.65 | 6.19 ± 7.09 | 92.69 ± 0.57 |
| PatchCore | 74.64 ± 1.82 | 94.76 ± 0.55 | 94.73 ± 0.05 | 90.52 ± 0.15 | 99.36 ± 0.12 | 17.49 ± 1.54 | 92.54 ± 0.15 |
| RareCode | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 94.93 ± 0.67 | 98.40 ± 0.48 | 58.24 ± 5.99 | 98.80 ± 0.10 |
טבלה 1: תוצאות השוואה מול שיטות בסיס (ולידציה צולבת של 5 קיפולים). ביצועי גילוי של RareCode ותשע שיטות בסיס ל-UAD על מערך נתוני ה-CRC. המדדים כוללים AUC, דיוק ממוצע (AP), רגישות (recall), סגוליות (specificity), מדד F1, דיוק ברגישות של 90% (P@R90), ודיוק (precision). כל הערכים מייצגים ממוצע ± SD על פני ולידציה צולבת של 5 קיפולים. ערכים מודגשים מציינים את הביצועים הטובים ביותר עבור כל מדד.
| קטגוריה | AUC (%) | AP (%) | F1 (%) | רגישות (%) | סגוליות (%) |
| סרטן | 99.44 ± 0.12 | 99.86 ± 0.03 | 98.34 ± 0.17 | 98.13 ± 0.29 | 94.21 ± 2.22 |
| דלקת | 94.30 ± 0.44 | 98.48 ± 0.12 | 93.44 ± 0.29 | 96.55 ± 0.78 | 60.44 ± 4.34 |
טבלה 2: ביצועי זיהוי לפי מחלקה על פני תתי-סוגי חריגות. הערכה נפרדת של ביצועי הזיהוי של RareCode עבור דגימות סרטן ודלקת אל מול דגימות נורמליות. מדדים למחלקה, כולל AUC, AP, F1-score, recall וסגוליות (specificity), חושבו באמצעות ספי ביצוע אופטימליים ספציפיים למחלקה.
| גרסה | תצורת ספר הקודים | CAR | AUC (%) | AP (%) | F1 (%) | ספציפיות (%) | P@R90 (%) |
| NoCAR |  | | 92.81 ± 0.12 | 99.05 ± 0.02 | 95.30 ± 0.08 | 33.76 ± 3.82 | 96.72 ± 0.12 |
| ספר קודים יחיד | [256] |  | 95.92 ± 0.40 | 99.47 ± 0.05 | 96.25 ± 0.14 | 55.37 ± 6.51 | 98.31 ± 0.43 |
| שני קנה מידה | [128, 512] | | 96.57 ± 0.27 | 99.56 ± 0.04 | 96.45 ± 0.12 | 57.75 ± 4.14 | 98.75 ± 0.12 |
| ThreeScales | [128, 256, 512] | | 96.36 ± 0.37 | 99.53 ± 0.05 | 96.52 ± 0.17 | 57.99 ± 4.65 | 98.60 ± 0.23 |
| FourScales | [64, 128, 256, 512] | | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 58.24 ± 5.99 | 98.80 ± 0.10 |
| FourScales + מפענח מורכב | [64, 128, 256, 512] | | 95.17 ± 0.44 | 99.39 ± 0.06 | 95.32 ± 0.20 | 53.83 ± 21.45 | 98.40 ± 0.37 |
טבלה 3: תוצאות מחקר אבלציה (Ablation study). השוואת ביצועים של תצורות RareCode עם הוספה הדרגתית של רכיבים: בסיס של שחזור בלבד (NoCAR), CAR עם ספריית קודים אחת (SingleCodebook), ותצורות רב-קנה-מידה (TwoScales, ThreeScales, FourScales). כלולה גם אבלציה נוספת של מורכבות המפענח (decoder-complexity) תוך שימוש בתצורת FourScales. המדדים כוללים AUC, דיוק ממוצע (AP), F1-score, ספציפיות ודיוק ב-90% recall (P@R90).
| סוג הניקוד | יחס אנרגיה | Cohen's d | AUC (%) |
| שגיאת שחזור | 2.623 | 2.06 | 93.31 |
| Combined CAR | 1.078 | 1.02 | 74.85 |
| Codebook 64 | 1.109 | 1.207 | 78.79 |
| Codebook 128 | 1.085 | 1.067 | 76.19 |
| Codebook 256 | 1.065 | 0.916 | 72.80 |
| Codebook 512 | 1.064 | 0.83 | 70.38 |
טבלה 4: ניתוח ברמת התמונה של תגובות נגזרות-לוקליזציה. שגיאת השחזור הממוצעת לתמונה ותגובות נדירותות של ספריית הקוד (codebook rarity) הושוו בין דגימות נורמליות לאנומליות באמצעות יחס האנרגיה, Cohen's d ו-AUC.
| קיפול | אופטימלי α | AUC של תיקוף (%) | AUC של הבדיקה (%) |
| 1 | 0.95 | 96.22 | 96.91 |
| 2 | 0.9 | 96.38 | 96.39 |
| 3 | 0.85 | 96.71 | 96.82 |
| 4 | 0.85 | 96.22 | 96.93 |
| 5 | 0.95 | 96.72 | 97.05 |
| ממוצע | 0.90 ± 0.05 | 96.45 ± 0.23 | 96.82 ± 0.23 |
טבלה 5: ערכי אלפא אופטימליים לאורך הקיפולים. משקל מיזוג אופטימלי אלפא שנקבע באמצעות חיפוש רשת (grid search) (גודל צעד 0.05) על קבוצות תיקוף עבור כל קיפול של 검증 צולב (cross-validation), עם נתוני ממוצע וסטיית תקן (SD).
דיון
התוצאות מרמזות כי תבניות הפעלת ספר-הקודים (codebook) עשויות לספק מידע משלים לשגיאות השחזור המרחביות. השיפור מ-NoCAR למודל FourScales המלא תומך בתרומה הפוטנציאלית של ניקוד CAR, בעוד שמשקלי המיזוג שנבחרו מצביעים על כך שנדירות סמנטית עשויה למלא תפקיד חשוב בציון האנומליה הסופי. הסבר אפשרי הוא שחריגויות הקשורות ל-CRC יכולות להשתרע על פני קנה מידה מורפולוגי שונה, מאטיפיה גרעינית ועד לשיבוש ארכיטקטוני של בלוטות, ולכן עשויות להפיק תועלת מייצוגי מאפיינים ברמות פירוט מרובות14. המודל הנוכחי לוכד היקפים מרחביים שונים באמצעות פאצ'ים של 32 × 32 ו-64 × 64 באותה רמת הגדלה; שילוב עתידי עם מסגרות עיבוד של תמונות-סלייד מלאות (WSI) עשוי לתמוך עוד יותר בניתוח היררכי ברמת הסלייד39.
מבחינה קלינית, ניתן להחשיב את RareCode ככלי מיון למסננת ראשונית (pre-screening triage tool) ולא כמערכת אבחנתית אוטונומית. רמת ה-recall הגבוהה שלו (98.40%) מעידה על סיכון נמוך יחסית להחמצת מקרים חריגים40, בעוד שהספציפיות המתונה שלו (58.24%) משקפת ככל הנראה את הקושי להבחין בין שינויים דלקתיים לרקמה נורמלית בסביבה לא מונחית (unsupervised setting). הספציפיות הגבוהה יותר עבור סרטן (94.21%) מרמזת עוד כי התראות שווא עשויות להיות פחות שכיחות עבור תת-הסוג הקריטי ביותר מבחינה קלינית. מאפייני ביצועים אלו תומכים בשימוש פוטנציאלי ב-RareCode ככלי למסננת ראשונית לצורך תעדוף מקרים הדורשים הערכה של מומחה וייעול של סקירת הפתולוגיה5,6.
ממצאים לפי קטגוריה עשויים לתמוך עוד יותר בתפקידו הפוטנציאלי של RareCode במיון. הביצועים החזקים יחסית עבור סרטן בהשוואה לדלקת עשויים לשקף את הסטיות הארכיטקטוניות והציטולוגיות הבולטות יותר הנראות לעיתים קרובות ברקמה ממאירה, כולל אובדן פולריות, פלאומורפיזם גרעיני ודסמופלזיה סטורמלית14,39. לעומת זאת, שינויים דלקתיים עשויים לחפוף באופן הדוק יותר לשונות של רקמה שפירה, מה שעשוי להסביר חלקית את הספציפיות הנמוכה יותר עבור דלקת. לכן, יש לפרש את הספציפיות הכוללת בזהירות, כאשר זיהוי סרטן משמש כמקרה בוחן בעל חשיבות קלינית ולא כאבחנה אוטונומית סופית.
יש לפרש את מצבי הכשל הפוטנציאליים של RareCode בהקשר של מטרת הלמידה שלו כסיווג של מחלקה אחת (one-class learning). מכיוון שהמודל לומד תבניות של רקמה נורמלית ולא קטגוריות ספציפיות של מחלות, שינויים שאינם נאופלסטיים, כגון אפיתל רגנרטיבי, פיברוזיס, נמק או דלקת בולטת, עשויים גם הם לקבל ציוני אנומליה גבוהים. לעומת זאת, דיספלזיה עדינה או קרצינומה מובחנת היטב עם ארכיטקטורה בלוטית כמעט נורמלית עשויות להניב תגובות חלשות יותר. גורמים טכניים, כולל וריאציות בצביעה, קיפולי רקמה, ארטיפקטים של חיתוך, חוסר מיקוד ודחיסת תמונות, עשויים גם הם להשפיע על שגיאות השחזור ועל תדרי הפעלה של ספר הקודים (codebook). שיקולים אלו מצביעים על כך שתרגום קליני ידרוש בקרת איכות של התמונות, הרמוניזציה של הצביעות, כיול מותאם לסורק ותיקוף רב-מרכזי39,41.
היקף השוואות הבסיס. ההערכה הניסויית במחקר זה מתמקדת בשיטות הפועלות תחת הנחות נתונים וחישוב דומות — ובפרט, שיטות שניתן לאמן מקצה לקצה באמצעות דגימות נורמליות קטנות ללא תוויות בלבד, ללא צורך במאגרי נתונים חיצוניים לאימון מקדים. היקף זה כולל את הפרדיגמות המרכזיות בזיהוי חריגות בלתי מונחה: שיטות מבוסות שחזור (CAE, VAE, SAE, MAE, PatchSAE), שיטות מועשרות בזיכרון (MemAE), זיקוק ידע (STFPM), הרחבה סינתטית (DRAEM) והתאמת תכונות מאומנות מראש (PatchCore). אנו מציינים כי שתי קטגוריות של שיטות לא נכללו כבסיסי השוואה ישירים. ראשית, מודלי יסוד ייעודיים לפתולוגיה (UNI, CONCH, CTransPath) מנצלים אימון מקדים על מיליוני תמונות פתולוגיות נבחרות, והיתרונות בביצועיהם נובעים בעיקר מקנה המידה ומגיוון של נתוני האימון המקדים ולא ממנגנון זיהוי החריגות; לכן, השוואה ישירה תערב בין התרומה של נתוני האימון המקדים לבין התרומה של מתודולוגיית הזיהוי. הביצועים התת-אופטימליים של STFPM ו-PatchCore — ששניהם משתמשים בשלדים (backbones) מאומנים מראש על ImageNet — ממחישים באופן אמפירי את השפעת פער הדומיין כאשר תכונות מאומנות מראש למטרות כלליות מיושמות בתרחישים היסטופתולוגיים, ומצביעים על כך שאימון מקדים ספציפי לפתולוגיה עשוי לגשר על פער זה. שנית, שיטות לזיהוי חריגות מבוסות דיפוזיה, למרות היותן מבטיחות, כרוכות בעומס חישובי גבוה משמעותית במהלך ההסקה (בדרך כלל נדרשים מאות שלבי הסרת רעשים איטרטיביים), מה שמגביל את יישומן בזרימות עבודה של סריקה קלינית בתפוקה גבוהה שבהן יעילות העיבוד היא דרישה מעשית. עבודות עתידיות יבחנו האם שילוב של מקודדים מאומנים מראש וספציפיים לפתולוגיה בארכיטקטורת RareCode — במקום המקודד הנוכחי המאומן מקצה לקצה — יכול לשפר עוד יותר את ביצועי הזיהוי תוך שימור יתרונות הפרשנות של מנגנון ה-CAR.
יש להכיר במספר מגבלות. ראשית, התיקוף הוגבל למסד נתונים של CRC ממרכז רפואי בודד, ונדרשת הערכה רב-מרכזית נוספת על פני מוסדות, סורקים ופרוטוקולי צביעה שונים. שנית, למרות שהסגוליות (specificity) הספציפית לסרטן הייתה מעודדת, הסגוליות הכללית נותרה מושפעת מהגבול שבין דלקת לרקמה נורמלית. שלישית, לא היו זמינות הערות מומחה ברמת פיקסל; לכן, לא ניתן היה לחשב את מדדי Dice ו-IoU, והערכת הלוקליזציה הוגבלה לוויזואליזציה איכותנית ולניתוח ברמת התמונה של תגובות מרחביות מצטברות. רביעית, עדיין נדרשים מחקרי קוראים פורמליים כדי לקבוע האם מפות חום היררכיות יכולות לשפר את הדיוק האבחנתי או את יעילות הבדיקה. לבסוף, RareCode מבצע כיום ניתוח ברמת ה-patch וברמת התמונה, ופריסה ברמת WSI תדרוש שילוב עם מסגרות עיבוד נוספות39,41,42.
עבודות עתידיות צריכות להעריך את RareCode על בנצ'מרקים ציבוריים וקוהורטות רב-מרכזיים לאחר אינטגרציה עם מסגרות עיבוד של WSI. מחקרי קוראים פרוספקטיביים עשויים לסייע בהערכת ההשפעה הפוטנציאלית שלו על הדיוק האבחנתי, זמן הבדיקה וההסכמה בין בוחנים42. כיוונים נוספים כוללים שיפור היעילות החישובית, הרחבת המודל לעבר סיווג תתי-סוגים של אנומליות רב-מחלקתיות, ושילוב למידה מרובת-דוגמאות (multiple-instance learning) לאבחנה ברמת השקף28,39.
גילויים
המחברים מצהירים כי אין להם ניגודי אינטרסים פינסיים ידועים או מערכות יחסים אישיות שעלולות היו להיראות כמשפיעות על העבודה המדווחת במאמר זה. במהלך הכנת עבודה זו, השתמשנו ב-ChatGPT כדי לשפר את השפה ואת קריאות כתב היד וכדי לסייע ביצירת קוד להדמיית נתונים. לאחר השימוש בכלי זה, סקרנו וערוכנו את התוכן לפי הצורך ואנו לוקחים אחריות מלאה על המאמר שפורסם.
תודות
מחקר זה נתמך על ידי תחנת העבודה של האקדמאי Yong Dai (טכנולוגיה אבחנתית למחלות אוטואימוניות) (Wan Ke Science and Technology [2023] No. 317), פרויקט קרן החדשנות של תלמידי מוסמכים של מרכז המחקר הלאומי של Hefei למדעי הבריאות וטכנולוגיה, מרכז מחקר משותף לרפואה ובריאות תעסוקתית, קרן פתוחה (No.OMH-2023-04), ופרויקט המחקר הקליני והתרגומי של מחוז Anhui (No.20242761020132).
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| מעבד גרפי GeForce RTX 4060 Ti | NVIDIA | לא רלוונטי | זיכרון VRAM בנפח 16 GB; נעשה שימוש ב-GPU בודד לכל הניסויים (RRID:SCR_02858) |
| Matplotlib | צוות הפיתוח של Matplotlib | גרסה 3.8.4 | ויזואליזציה של נתונים ויצירת איורים (RRID:SCR_08624) |
| NumPy | מפתחי NumPy | גרסה 1.26.4 | חישובים מספריים ופעולות על מערכים (RRID:SCR_00863) |
| pandas | צוות הפיתוח של pandas | גרסה 2.2.3 | ארגון נתונים ועיבוד תוצאות טבלאי (RRID:SCR_018214) |
| כרית | התורמים של Python Imaging Library / Pillow | גרסה 10.3.0 | טעינת תמונות ועיבוד מקדמי |
| פייתון | Python Software Foundation | גרסה 3.12.3 | שפת תכנות המשמשת לפיתוח מודלים וניתוח נתונים (RRID:SCR_08394) |
| PyTorch | Meta Platforms, Inc. | גרסה 2.7.0+cu18 | מסגרת למידה עמוקה ששימשה למימוש ואימון המודל (RRID:SCR_018536) |
| scikit-learn | מפתחי scikit-learn | גרסה 1.4.2 | תיקוף צולב (Cross-validation), פיצול לאימון ובדיקה ומדדי הערכה (RRID:SCR_0257) |
| SciPy | מפתחי SciPy | גרסה 1.13.1 | ניתוח סטטיסטי (RRID:SCR_08058) |
| torchvision | פרויקט PyTorch | גרסה 0.2.0+cu18 | עיבוד מקדים של תמונות והמרת נתונים |
| tqdm | מפתחי tqdm | גרסה 4.6.4 | ניטור התקדמות האימון וההערכה |
מקורות
- Fan J, Sun Q, Di Y, et al. DIPathMamba: A domain-incremental weakly supervised state space model for pathology image segmentation. Med Image Anal. 2025;103:103563.
- Nan T, Zheng S, Qiao S, et al. Deep learning quantifies pathologists' visual patterns for whole slide image diagnosis. Nat Commun. 2025;16(1):5493.
- Lagogiannis I, Meissen F, Kaissis G, et al. Unsupervised pathology detection: a deep dive into the state of the art. IEEE Trans Med Imaging. 2024;43(1):241-252.
- Tian Y, Liu F, Pang G, et al. Self-supervised pseudo multiclass pre-training for unsupervised anomaly detection and segmentation in medical images. Med Image Anal. 2023;90:102930.
- Metter DM, Colgan TJ, Leung ST, et al. Trends in the US and Canadian pathologist workforces from 2007 to 2017. JAMA Netw Open. 2019;2(5):e194337.
- Shaukat A, Levin TR. Current and future colorectal cancer screening strategies. Nat Rev Gastroenterol Hepatol. 2022;19(8):521-531.
- Ancker JS, Edwards A, Nosal S, et al. Effects of workload, work complexity, and repeated alerts on alert fatigue in a clinical decision support system. BMC Med Inform Decis Mak. 2017;17(1):36.
- Litjens G, Kooi T, Ehteshami Bejnordi B, et al. A survey on deep learning in medical image analysis. Med Image Anal. 2017;42:60-88.
- Stepec D, Skocaj D. Unsupervised detection of cancerous regions in histology imagery using image-to-image translation. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops. 2021:3785-3792.
- Li Y, Lao Q, Kang Q, et al. Self-supervised anomaly detection, staging and segmentation for retinal images. Med Image Anal. 2023;87:102805.
- Hinton GE, Salakhutdinov RR. Reducing the dimensionality of data with neural networks. Science. 2006;313(5786):504-507.
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: Proceedings of the 2nd International Conference on Learning Representations (ICLR). 2014.
- Goodfellow IJ, Pouget-Abadie J, Mirza M, et al. Generative adversarial nets. In: Advances in Neural Information Processing Systems. 2014;27:2672-2680.
- Lu S, Zhang W, Zhao H, et al. Anomaly detection for medical images using heterogeneous auto-encoder. IEEE Trans Image Process. 2024;33:2770-2782.
- Yang Z, Zhang T, Soltani Bozchalooi I, et al. Memory-augmented generative adversarial networks for anomaly detection. IEEE Trans Neural Netw Learn Syst. 2022;33(6):2324-2334.
- Huyan N, Quan D, Zhang X, et al. Unsupervised outlier detection using memory and contrastive learning. IEEE Trans Image Process. 2022;31:6440-6454.
- Jézéquel L, Beaudet J, Histace A, et al. Unified anomaly detection via multi-scale contrasted memory. IEEE Trans Image Process. 2026;35:2802-2815.
- Roth K, Pemula L, Zepeda J, et al. Towards total recall in industrial anomaly detection. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:14298-14308.
- Defard T, Setkov A, Loesch A, et al. PaDiM: a patch distribution modeling framework for anomaly detection and localization. In: International Conference on Pattern Recognition. Cham: Springer; 2021:475-489.
- Zingman I, Stierstorfer B, Lempp C, et al. Learning image representations for anomaly detection: application to discovery of histological alterations in drug development. Med Image Anal. 2024;92:103067.
- Jiang Y, Cao Y, Shen W. Prototypical learning guided context-aware segmentation network for few-shot anomaly detection. IEEE Trans Neural Netw Learn Syst. 2025;36(7):12016-12026.
- Wang X, Zhao J, Marostica E, et al. A pathology foundation model for cancer diagnosis and prognosis prediction. Nature. 2024;634(8035):970-978.
- Frotscher A, Kapoor J, Wolfers T, et al. Unsupervised anomaly detection in medical imaging using aggregated normative diffusion. Med Image Anal. 2026;109:103895.
- Zeng GQ, Yang YW, Lu KD, et al. Evolutionary adversarial autoencoder for unsupervised anomaly detection of industrial Internet of Things. IEEE Trans Reliab. 2025;74(3):3454-3468.
- Lu KD, Zhang BX, Xu Y, et al. MoARNN-AM: multi-objective automated recurrent neural network with attention mechanism for cyber-attack detection of UAV. IEEE Trans Consum Electron. 2026;72(1):1738-1749.
- van den Oord A, Vinyals O, Kavukcuoglu K. Neural discrete representation learning. In: Advances in Neural Information Processing Systems. 2017;30:6306-6315.
- Ghafourian A, Shui H, Upadhyay D, et al. Targeted collapse regularized autoencoder for anomaly detection: black hole at the center. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10348-10358.
- Gao Z, Mao A, Dong Y, et al. SMMILe enables accurate spatial quantification in digital pathology using multiple-instance learning. Nat Cancer. 2025;6(12):2025-2041.
- Wang X, Liu H, Zhang Y, et al. Joint modeling histology and molecular markers for cancer classification. Med Image Anal. 2025;102:103505.
- Jin H, Shen J, Cui L, et al. Dynamic graph based weakly supervised deep hashing for whole slide image classification and retrieval. Med Image Anal. 2025;101:103468.
- Schmitz R, Madesta F, Nielsen M, et al. Multi-scale fully convolutional neural networks for histopathology image segmentation: from nuclear aberrations to the global tissue architecture. Med Image Anal. 2021;70:101996.
- Masci J, Meier U, Ciresan D, et al. Stacked convolutional auto-encoders for hierarchical feature extraction. In: International Conference on Artificial Neural Networks. Berlin: Springer; 2011:52-59.
- Ng A. Sparse autoencoder. CS294A Lecture Notes. 2011;72:1-19.
- He K, Chen X, Xie S, et al. Masked autoencoders are scalable vision learners. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:16000-16009.
- Lim H, Choi J, Choo J, et al. Sparse autoencoders reveal selective remapping of visual concepts during adaptation. In: Proceedings of the 13th International Conference on Learning Representations (ICLR). 2025.
- Gong D, Liu L, Le V, et al. Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2019:1705-1714.
- Wang G, Han S, Ding E, et al. Student-teacher feature pyramid matching for anomaly detection. In: Proceedings of the 32nd British Machine Vision Conference (BMVC). 2021.
- Zavrtanik V, Kristan M, Skocaj D. DRAEM: a discriminatively trained reconstruction embedding for surface anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2021:8330-8339.
- Niazi MKK, Parwani AV, Gurcan MN. Digital pathology and artificial intelligence. Lancet Oncol. 2019;20(5):e253-e261.
- Raab SS, Grzybicki DM, Janosky JE, et al. Clinical impact and frequency of anatomic pathology errors in cancer diagnoses. Cancer. 2005;104(10):2205-2213.
- Schömig-Markiefka B, Pryalukhin A, Hulla W, et al. Quality control stress test for deep learning-based diagnostic model in digital pathology. Mod Pathol. 2021;34(12):2098-2108.
- Steiner DF, MacDonald R, Liu Y, et al. Impact of deep learning assistance on the histopathologic review of lymph nodes for metastatic breast cancer. Am J Surg Pathol. 2018;42(12):1636-1646.