פרוטוקול זה מדגים זרימת עבודה מובנית וניתנת לביקורת לעיבוד נתונים אנונימיים משאלוני רווחה נפשית של סטודנטים לתואר ראשון, החל מהייצוא הגולמי וסינון התגובות, דרך חישוב ציוני סולמות, בדיקת מהימנות, דיאגנוסטיקה של רגרסיה, אימות מקורות האיורים, ועד לפלט אנליטי המוכן להצגה חזותית.
מאמר שיטה
תהליך עבודה מובנה לסריקה, דירוג והדמיה של נתוני שאלון רווחה נפשית בקרב סטודנטים לתואר ראשון
במאמר זה
סיכום
תקציר
מחקרים המבוססים על שאלונים משמשים באופן נרחב לבחינת רווחת סטודנטים, אך המסלול הפרוצדורלי מתגובות גולמיות למשתנים הניתנים לניתוח, טבלאות סטטיסטיות ופלט ויזואלי אינו מתועד לעיתים קרובות מספיק. פרוטוקול זה מדגים זרימת עבודה מובנית וניתנת לביקורת לעיבוד נתונים אנונימיים משאלוני רווחה של סטודנטים לתואר ראשון, שנאספו באמצעות מספר סעיפי סולם מסוג Likert. זרימת העבודה מתחילה באישור אתי, תיעוד הסכמה, הגדרת השאלון וייצוא נתונים גולמיים, וממשיכה דרך סינון תגובות, סקירה של תגובות כפולות, טיפול בנתונים חסרים, קידוד פריטים, ניקוד הפוך, הערכת מהימנות, ניתוח תיאורי, ניתוח מתבם, השוואה ניגודית בין קבוצות, מידול רגרסיה, בדיקה דיאגנוסטית והכנת מקורות לוויזואליזציה. השאלון לדוגמה משתמש בסעיפי סולם מתועדים ומותאמים למחקר, המבוססים על Depression Anxiety Stress Scales-21, Tuckman Procrastination Scale, Psychological Sense of School Membership Scale, ספרות על מדידת חשיבה מסדר גבוה ותיעוד של סולמי רווחה סובייקטיבית. רגשות שליליים, דחיינות אקדמית, תחושת שייכות למוסד הלימודים, חשיבה מסדר גבוה ורווחה סובייקטיבית משמשים כמשתנים לדוגמה ברמת הסולם, כדי להראות כיצד ניתן להמיר תגובות ברמת הפריט לפלטים אנליטיים שניתן לעקוב אחריהם. פלטים מייצגים כוללים טבלת זרימת סינון, סיכום דמוגרפי, סטטיסטיקות תיאוריות ואימות טווחים, אומדני עקביות פנימית, מטריצת מתבם, תוצאות השוואה ניגודית, מקדמי רגרסיה, דיאגנוסטיקה של שאריות והשפעה, וקבצי מקור לאיורים. הפרוטוקול מדגיש כללי החלטה שנקבעו מראש, מפת סולם מקושרת, יומן סינון טרום-ניתוח, אימות ניקוד הפוך ואימות מקורות מספריים לאיורים. במקום להציע סולם פסיכומטרי חדש, לתקף מודל מדידה או לבסס קשרים סיבתיים, שיטה זו מספקת פרוצדורה מעשית וניתנת לביקורת עבור חוקרים שצריכים לסנן, לנקד, לנתח ולהציג ויזואלית נתונים של רווחת סטודנטים לתואר ראשון המבוססים על שאלונים. ניתן להתאים את זרימת העבודה למחקרים דומים המבוססים על שאלונים כאשר מפת הסולם, האישור האתי, כללי הניקוד, ספי סינון התגובות וקבצי המקור לוויזואליזציה מוגדרים לפני הניתוח.
מבוא
רווחה סובייקטיבית היא תוצאה חשובה במחקרים על סטודנטים, שכן היא משקפת את האופן שבו סטודנטים מעריכים את חייהם, את חוויותיהם הרגשיות, את מערכותיהם החברתיות ואת התפקוד היומיומי שלהם בתוך סביבות למידה. בהשכלה הגבוהה, רווחת הסטודנטים היא רב-ממדית ואינה מוגבלת רק לשביעות רצון מהחיים או למצוקה פסיכולוגית בלבד1. לפיכך, נתונים משאלונים נותרה שימושיים כאשר חוקרים צריכים לבחון חוויות רגשיות, התנהגותיות, חברתיות, קוגניטיביות וחוויות הקשורות לרווחה בתוך אותו מסגרת אנליטית.
הערכם של נתוני שאלונים תלוי לא רק במבנים הנבחרים, אלא גם באופן שבו תגובות גולמיות מומרות למשתנים אנליטיים. מחקרים רבים מדווחים על ציוני סולם, מטריצות מתאם, השוואות קבוצות או מודלים של רגרסיה מבלי להציג את ההחלטות הביניים המקשרות בין הרשומות הגולמיות לטבלאות ולאיורים הסופיים. תגובות חסרות עשויות להיות מטופלות באופן לא עקבי, פריטים עם דירוג הפוך עלולים להיות מקודדים באופן שגוי, הגשות כפולות עלולות להישאר במערך הנתונים, ותגובות לא קשובות עשויות להיות מטופלות כתצפיות תקפות. לכן, החלטות לגבי נתונים חסרים צריכות להיות מתוכננות, מתועדות ומדווחות, במקום להתייחס אליהן כאל שלב בלתי נראה שבוצע בדיעבד2. נתוני שאלונים מקוונים דורשים גם כללים מפורשים לאיכות התגובה, מכיוון שמענה מהיר מדי, תבניות של סימון קו ישר (straight-lining), תשובות לא עקביות ודפוסי מאמץ נמוך אחרים עלולים לעוות סטטיסטיקה תיאורית, הערכות מהימנות וקשרים שנצפו3.
החידוש בפרוטוקול זה טמון בנתיב הביקורת (audit trail) המקושר שלו, מהייצוא הגולמי של השאלון ועד לפלטים הסטטיסטיים והחזותיים הסופיים. באופן ספציפי, זרימת העבודה מוסיפה מפת סולם השלמה, יומן סינון טרום-ניתוח, נקודת ביקורת לדירוג הפוך, יומן אימות דירוג, אימות מקור נומרי עבור איורים, ועקבות ביקורת המקשרים כל טבלה או איור לקובץ המקור שלהם. הדבר מבדיל את השיטה מפרקטיקות סטנדרטיות של ניקוי סקרים, דירוג סולמות, בדיקת מהימנות או ויזואליזציה. במקום להצהיר בלבד כי נתוני השאלון נוקו ונותחו, הפרוטוקול מגדיר איזה קובץ נעול, איזה קובץ מסונן, אילו כללים מיושמים, אילו ציוני סולם נוצרים, ואיזו טבלה נומרית מאומתת משמשת ליצירת כל פלט חזותי.
תהליך העבודה מודגם באמצעות נתונים אנונימיים משאלונים של סטודנטים במכללה, הכוללים חמישה משתנים ברמת סקאלה (scale-level): רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית. מבנים אלה נבחרו כדי לספק דוגמאות רגשיות, התנהגותיות, הקשריות (במסגרת בית הספר), קוגניטיביות ומכוונות-תוצאה בתוך תהליך עבודה מובנה הניתן לביקורת. דחיינות אקדמית נקשרה לקשיי בריאות נפש מאוחרים יותר בקרב סטודנטים באוניברסיטה, כולל דיכאון, חרדה ותוצאות הקשורות ללחץ4. תחושת שייכות לבית הספר ורווחה סובייקטיבית קשורות אף הן קשר הדוק בקרב אוכלוסיות סטודנטים, מה שתומך בשילוב של מדדי שייכות ורווחה בתוך אותה מסגרת עיבוד שאלונים5. עם זאת, בפרוטוקול זה, מבנים אלו משמשים להדגמת תהליך העבודה ולא כדי לבסס מודל פסיכולוגי סיבתי.
מאפיין מרכזי של הפרוטוקול הוא ההפרדה בין החלטות עיבוד הנתונים לבין הפרשנות המהותית. מפת הסולם מוכנה לפני הניתוח, קריטריוני איכות התגובה נקבעים לפני דירוג הסולם, אימות הדירוג ההפוך (reverse-scoring) מושלם לפני הבדיקה הסטטיסטית, ואיורים מופקים רק לאחר שטבלאות המקור המספריות שלהם נבדקו. רצף זה חשוב מכיוון שסולמי תגובה מסוג Likert דורשים התאמה מדויקת בין ניסוח הפריטים, עגני התגובה, כיוון הדירוג והטיפול הסטטיסטי6. הפרוטוקול גם מתעדף עיבוד מקדים שקוף ואימות דירוג על פני מורכבות של מודלים. מודלים ניבויים או רב-משתנים עשויים להיות שימושיים במחקרי סטודנטים7, וסיכומים גרפיים יכולים לשפר את הפרשנות כאשר הם נשארים קשורים למטריצות מספריות מאומתות8, אך שניהם תלויים בהכנה שקופה של משתני הקלט. מסיבה זו, זרימת העבודה משתמשת בניתוח קורלציה, השוואת קבוצות ניגודית, מידול רגרסיה, בדיקה דיאגנוסטית וויזואליזציה כמודולים לדוגמה ולא כטענות מהותיות מחייבות.
פרוטוקול זה מיועד לחוקרים הזקוקים לזרימת עבודה מעשית לעיבוד שאלונים עבור נתונים אנונימיים על רווחת סטודנטים. הוא מתאים למקרים שבהם תגובות לשאלון ברמת הפריט מיוצאות מפלטפורמה מקוונת, כאשר יש לחשב משתנים ברמת סולם מפריטי סולם ליקרט (Likert), והמטרה היא להפיק פלטים שקופים לצורך ניתוח תיאורי, מתאמי, השוואת קבוצות, רגרסיה, אבחון וויזואליזציה. הפרוטוקול אינו מיועד לביסוס קשרים סיבתיים, תיקוף סולמות חדשים, תחליף לניתוח גורמים מאשר (CFA), תחליף לבדיקת ש अपरת מדידה (measurement invariance), או תחליף למודלים של תגובה לפריט (IRT) או מודלים של משתנים חבויים. תרומתו היא פרוצדורלית: הוא הופך את הנתיב מרשומות השאלון לטבלאות ואיורים המדווחים לנראה, הניתן לשחזור ובדיקה. מיקוד זה עולה בקנה אחד עם דאגות נוכחיתות לגבי איכות נתוני סקרים מקוונים9, בדיקת רגרסיה והשפעה10, וזרימות עבודה בדיקות עבור ניתוחים מבוססי שאלונים11.
פרוטוקול
מחקר זה, שכלל משתתפים אנושיים, נבחן ואושר על ידי ועדת האתיקה של המכללה לאווירונאוטיקה, אוניברסיטת גואיג'ו הפתוחה (מספר אישור GZOU-EDU-2024-015). הוועדה קבעה כי המחקר זכאי לפטור אתי מכיוון שנעשה בו שימוש בהליכי שאלונים אנונימיים והתנדבותיים, והוא הצב את המשתתפים לסיכון מינימלי בלבד. כל המשתתפים סיפקו הסכמה מושכלת אלקטרונית לפני מילוי השאלון ויכלו להפסיק את מעניתם בכל עת ללא קנס. מכיוון שמספר סעיפים עסקו ברגשות שליליים, סטרס, בדידות, חוסר אונים, חוסר שביעות רצון או חוויות רווחה נפשית דומות, דף ההסכמה ודף השאלון הסופי סיפקו פרטי קשר של החוקר והמוסד עבור משתתפים שחוו אי-נוחות. מערך הנתונים ששימש בפרוטוקול זה עבר אנונימיזציה לפני הסינון, הניקוד, הניתוח וההדמיה. השאלון המלא מסופק כקובץ משלים 1.
1. הכנת השאלון, חומרי האתיקה ותוצרי זרימת העבודה
- הגדירו את האוכלוסייה הזכאית, את מסגרת המחקר, את מבני השאלון ואת התוצרי האנליטיים המתוכננים לפני תכנות השאלון.
- הכינו בקשה לאישור אתי הכוללת את אוכלוסיית היעד, ערוץ הגיוס, תוכן השאלון, זמן השלמה משוער, הגנה על אנונימיות, אחסון נתונים, הליך נסיגה, מידע לתמיכה במשתתפים וניתוחים מתוכננים.
- שמרו את מסמך האישור האתי או הפטור מהוועדה, את ניסוח הטופס להסכמה, את טקסט הגיוס, את גרסת השאלון, את המידע לתמיכה במשתתפים ואת זרימת העבודה המתוכננת בתיקיית הפרויקט לפני תחילת איסוף הנתונים.
- הגדירו את אוכלוסיית המטרה כסטודנטים לתואר ראשון במשרה מלאה, בני 18 לפחות, הרשומים כעת להשכלה גבוהה, המסוגלים להבין את השאלון ומסוגלים לספק הסכמה מדעת.
- הגדירו קריטריוני החרגה לפני הגיוס. הדריגו החוצה משימים שסירבו לתת הסכמה, אינם עומדים בהגדרת אוכלוסיית היעד, שלחו תגובות כפולות, חורגים מסף הנתונים החסרים, או עומדים בקריטריונים המשולבים לתגובה לא תקפה המתוארים בשלב 1.4.
- מקם את הצהרת ההסכמה המדעית בתחילת השאלון. ציין את מטרת המחקר, את העובדה שההשתתפות היא רצונית, זמן השלמה משוער של 12 דקות, הגנה על אנונימיות, את הזכות לנסיגה, תוכנית לשימוש בנתונים, פרטי התקשרות עם החוקר ופרטי התקשרות לקבלת תמיכה.
- אין לאסוף מידע המאפשר זיהוי ישיר, כולל מספרי זיהוי של סטודנטים, מספרי זיהוי לאומיים, מספרי טלפונים ניידים, כתובות דוא"ל אישיות, כתובות מעונות או מזהים אישיים אחרים.
- סדרו את השאלון לפי הסדר הבא: הסכמה מושכלת, מידע דמוגרפי, פריטי רגשות שליליים, פריטי דחיינות אקדמית, פריטי תחושת שייכות לבית הספר, פריטי חשיבה מסדר גבוה ופריטי רווחה סובייקטיבית.
- בחרו את כלי המדידה לפני תכנות השאלון. בפרוטוקול זה, רגשות שליליים הוערכו באמצעות סולם הדיכאון, החרדה והמתח בן 21 הפריטים (Depression Anxiety Stress Scales-21), דחיינות אקדמית באמצעות סולם הדחיינות של טקמן (Tuckman Procrastination Scale) בן 16 הפריטים, תחושת שייכות לבית הספר באמצעות סולם תחושת השייכות הפסיכולוגית לבית הספר בן 18 הפריטים, חשיבה מסדר גבוה באמצעות מערך של 20 פריטי חשיבה מסדר גבוה שהותאם מספרות published העוסקת במדידת חשיבה מסדר גבוה, ורווחה סובייקטיבית באמצעות סולם רווחה סובייקטיבית בן 20 פריטים למחקר בקרב סטודנטים במכללה.12,13,14,15,16.
- הכינו מפת סולם נעולה לפני תכנות השאלון. כלולו את שם המבנה, שם הסולם המקורי, ציטוט מקורי, גרסת השפה, סטטוס הרשאה או אישור, הליך התרגום או ההתאמה, קוד הפריט, ניסוח הפריט, טווח התגובות, עגני תגובה, כיוון הניקוד, סטטוס פריט עם ניקוד הפוך, משתנה סופי ברמת הסולם וכלל ניקוד.
- הגדר קבוצת פריטים כסולם מהודק אך ורק כאשר המכשיר המקורי, הציטוט, הראיות לתיקוף ומצב ההתאמה או התרגום מתועדים. זהה כל קבוצת פריטים שפותחה על ידי המחברים או שספציפית למחקר ב- טבלה 1 ו- קובץ משלים 1.
- יש לנעול את מסגרת המדידה לפני איסוף הנתונים. עבור כלים מתורגמים או מותאמים, יש להשלים את התרגום, הסקירה, התאמת הנוסח ובדיקת הפיילוט לפני תחילת הגיוס.
- הכינו חבילת ביקורת של זרימת העבודה הכוללת את קובץ השאלון הנעול, מפת סולמות, רשימת תיוג לייצוא נתונים גולמיים, יומן סינון, יומן אימות ניקוד, יומן ניתוח, תבנית לטבלת מקור-איור, וקובץ תחביר או סקריפט של הניתוח.
- השתמשו בשמות קבצים עם גרסאות עבור כל תוצרי זרימת העבודה.
- הגדירו את העמודות הנדרשות עבור כל קובץ ביקורת.
- יומן הסינון כולל את מזהה הרשומה, קריטריון הסינון, סטטוס סימון, סטטוס החרגה, סיבת ההחרגה, תאריך ההחלטה וראשי תיבות של הבודק.
- מפת הסולם כוללת את שם המבנה, מקור הסולם, קוד הפריט, ניסוח הפריט, טווח התגובות, עגני התגובה, סטטוס דירוג הפוך, שם המשתנה הסופי, כלל הדירוג וסטטוס הרשאה או התאמה.
- יומן אימות הניקוד כולל את קוד הפריט, טווח הערכים המקורי, טווח הערכים המקודדים מחדש, נוסחת ניקוד הפוך, תוצאת בדיקת הטווח, סטטוס אי-התאמה, התיקון שבוצע ותאריך התיקון.
- טבלת מקור-האיור כוללת את מספר האיור, מספר הלוח, טבלת המקור, המשתנים המוצגים, הסטטיסטיקה המוצגת, גודל המדגם וסטטוס האימות.
- הגדירו את זרימת העבודה האנליטית לפני תכנות השאלון: ניהול הסקר, ייצוא נתונים גולמיים, סינון תגובות, חישוב ציוני סקאלה, הערכת מהימנות, ניתוח תיאורי, ניתוח מתאם, השוואת קבוצות גבוהות-נמוכות, מידול רגרסיה, בדיקות דיאגנוסטיות והכנה להצגה חזותית של הנתונים17.
- בנה את הפרוטוקול סביב החלטות, פעולות ותוצרי אימות, במקום סביב נתיבי תפריטים בתוכנה.
- ספקו משאבי זרימת עבודה כאשר הדבר מותר על פי מדיניות המוסד והכתב העת, כולל את קובץ השאלון, מפת הסוללה, תבנית יומן סינון, תבנית יומן ניקוד, קובץ סינטקס או סקריפט של הניתוח, וטבלאות מקור של איורים.
הערה: איור 1 מציג את המסלול מהכנת השאלון ועד לייצוא נתונים גולמיים, סינון תגובות, חישוב ציוני סולם, ניתוח סטטיסטי, בדיקות אבחנתיות ופלט של ויזואליזציה. טבלה 1 מדווח על המכשיר המקור, מספר הפריטים, טווח התגובות, מסגרת הניקוד, כלל הניקוד ההפוך, סטטוס ההיתר או ההתאמה, והמשתנה הסופי ברמת הסקאלה עבור כל מבנה.
2. הגדרה והפצה של השאלון
- וודאו שפלטפורמת השאלון תומכת במנגנון סינון הסכמה (consent gating), פריטים חובה, בחינת הגשות כפולות, לכידת חותמות זמן והקלטת משך זמן התגובה.
- צרו את השאלון באמצעות פלטפורמת הסקר המקוונת המפורטת בטבלת החומרים. תכננו את השאלון בהתאם למפת הסולם הסגורה.
- השוו את השאלון המתכנן למפת הסולם הסגורה, פריט אחר פריט, לפני שחרור קישור הסקר. רשמו כל תיקון ביומן המחקר.
- הגדירו את פריט ההסכמה המדעית כפריט החובה הראשון. הגדירו עצירה אוטומטית של השאלון כאשר משתתף בוחר באפשרות "אינני מסכים להשתתף".
- תכננו את סעיפי הדמוגרפיה והסולם הפסיכולוגי לפי הסדר שנקבע בשלב 1.8. השתמשו בקודי פריטים התואמים למפת הסולם.
- הגדירו את פריטי הסולם הפסיכולוגי כחובה רק כאשר הדבר מותר על פי אישור האתיקה או הפטור, וכאשר המשתתפים יכולים לפרוש ללא סנקציה. אם תגובות כפויות אינן מותרות, רשמו את כלל הטיפול בנתונים חסרים לפני איסוף הנתונים.
- הציגו את עגני התגובה (response anchors) לפני כל סעיף בסולם ושמרו על עגנים עקביים בתוך כל סולם18.
- בטלו הגשות חוזרות כאשר פלטפורמת הסקר מספקת פונקציה זו. שמרו כל מזהה אנונימי של מכשיר, דפדפן, פלטפורמה או הגשה הדרוש לבחינת תגובות כפולות.
- הפעילו הקלטה אוטומטית של זמן ההגשה ומשך זמן ההשלמה.
- הגדירו את תקופת פתיחת השאלון ל-7 ימי לוח, או השתמשו בחלון האיסוף שאושר על ידי ועדת האתיקה.
- שלחו את קישור השאלון דרך ערוץ הגיוס המוסדי המאושר. ספקו את אותן הוראות כתובות לכל המשתתפים.
- סגרו את השאלון לאחר סיום חלון האיסוף שנקבע מראש.
הערה: שמרו את ניסוח הגיוס, קישור השאלון, תאריכי הפתיחה והסגירה, הגדרות הפלטפורמה, ניסוח ההסכמה, גרסת השאלון הסופית והגדרות הייצוא מהפלטפורמה ביומן המחקר.
3. ייצוא ואבטחת הנתונים הגולמיים
- ייצאו את תגובות השאלון שהושלמו כקובץ גיליון אלקטרוני מיד לאחר סגירת חלון האיסוף.
- שמרו את הקובץ המיוצא הראשון כסט הנתונים הגולמי הנעול. אין לערוך קובץ זה.
- צרו עותק עבודה אחד לצורך סינון, ניקוד וניתוח. נקבו את שם הקובץ לפי התאריך, מספר הגרסה ומזהה הפרויקט.
- ודאו שהקובץ המיוצא מכיל שורה אחת עבור כל נשאל ועמודה אחת עבור כל משתנה דמוגרפי, פריט שאלון, משתנה חותמת זמן, משתנה פלטפורמה או שדה פלטפורמה נגזר.
- אחסנו את סט הנתונים הגולמי הנעול, עותק העבודה, מפת הסולם, קובץ השאלון, יומן המחקר, יומן הסינון, יומן אימות הניקוד, יומן הניתוח, טבלאות מקור-איור וקובץ הסינטקס או הסקריפט בתיקיית פרויקט המוגנת בסיסמה.
- בדקו שסט הנתונים אינו מכיל מידע מזוהה באופן ישיר. הסירו כל שדה מזהה בלתי צפוי מעותק העבודה לפני הניתוח, ורשמו ביומן המחקר את שם השדה, הסיבה להסרה, תאריך ההסרה ואת הסוקר האחראי.
- בדקו זיהוי עקיף לפני שיתוף או פרסום נתונים ברמת המשתתף. סקרו תאים דמוגרפיים קטנים שנוצרו משילובי מין, גיל, שנת לימוד, קטגוריית מוסד וקטגוריית התמחות אקדמית. אם תא מכיל פחות מחמישה נשאלים, שלבו קטגוריות, השתיקו את התא או ספקו נתונים מצברים בלבד.
- רשמו את סטטוס זמינות הנתונים ביומן המחקר, כולל האם נתונים ברמת המשתתף זמינים, מוגבלים בשל דרישות אתיקה או פרטיות, או הוחלפו בסט נתונים של זרימת עבודה מצברת.
- צרו יומן סינון לפני ניקוי הנתונים. רשמו את גודל המדגם הגולמי, קריטריון הסינון, מספר הרשומות שסומנו, מספר הרשומות שהוסרו, מספר הרשומות שנשמרו, הסיבה להדרה, תאריך ההחלטה וראשי התיבות של הסוקר.
- צרו קובץ מעקב ניתוח לפני ביצוע הניתוח הסטטיסטי. רשמו את שם התוכנה, גרסת התוכנה, מערכת ההפעלה, שמות הקבצים, גרסת הנתונים, גרסת הסקריפט או הסינטקס ואת התאריך של כל הרצת ניתוח.
הערה: השתמשו בסט הנתונים הגולמי הנעול לצורכי אימות בלבד. בצעו את כל פעולות הסינון, הניקוד והניתוח באמצעות עותק העבודה.
4. סריקת תגובות ובניית מערך הנתונים האנליטי
- יש להחיל כללי החרגה ובקרת איכות שנקבעו מראש לפני חישוב כל ציון ברמת הסקאלה.
- יש להחיל את כללי הסינון על העתק העבודה בסדר הבא: סטטוס הסכמה, זכאות, הגשות כפולות, נתונים חסרים, משך התגובה, תגובות בשורה ישרה (straight-line responding), ערכים מחוץ לטווח ומדדי איכות תגובה משולבים.
- לאחר כל פעולת סינון, רשום ביומן הסינון את מספר הרשומות שסומנו, הוסרו ונשמרו. אין לדרוס גרסאות קודמות של קובץ העבודה.
- הסר את כל הרשומות שבהן פריט ההסכמה המודעת מסומן כ-"לא" או נותר ללא מענה.
- הסר את כל הרשומות שאינן עומדות בקריטריוני ההכללה שהוגדרו בשלב 1.4.
- בצע סינון להגשות כפולות באמצעות מזהי תגובה אנונימיים, זמן ההגשה, דגלי הגשות כפולות של הפלטפורמה ותבניות תגובה חוזרות.
- שמור את ההגשה המלאה הראשונה כאשר מזוהים נתונים כפולים, אלא אם קיימת סיבה מתועדת התומכת בשמירת תגובה מלאה מאוחרת יותר.
- תקן את כל כללי איכות התגובה לפני חישוב ציוני הסקאלה. טבלה 2 מסכמת את ספי החרגה, ספי הסימון, הרציונל, התמיכה הספרותית ותוכנית ניתוח הרגישות ששימשו את זרימת העבודה.
- בצע סינון לנתונים חסרים. הסר נבדק כאשר יותר מ-20% מכל פריטי הסקאלה חסרים. החלף פריט חסר בודד בציון הממוצע של הנבדק עבור אותה סקאלה רק כאשר לפחות 80% מאותה סקאלה הושלמה. אין לבצע השלמה (imputation) למשתנים דמוגרפיים אלא אם המשתנה אינו משמש באף ניתוח.
- רשום את מספר הנבדקים שהוחרגו בשל יותר מ-20% פריטי סקאלה חסרים ואת מספר הנבדקים שקיבלו השלמה לפי ממוצע בתוך הסקאלה. במערך הנתונים הנוכחי, 4 נבדקים הוחרגו בשל יותר מ-20% פריטי סקאלה חסרים, ו-21 נבדקים קיבלו השלמה לפי ממוצע בתוך הסקאלה עבור 37 פריטים חסרים בודדים.
- בצע סינון למשך התגובה. סמן תגובות שהושלמו בפחות מ-180 s. התייחס לערך זה כאל דגל מהירות (speeding flag) ולא ככלל החרגה אוטומטי.
- בצע סינון לתגובות בשורה ישרה. סמן תגובה כאשר אותה אפשרות נבחרה עבור יותר מ-90% מכל פריטי סקאלת הליקרט (Likert-scale). התייחס לערך זה כאל דגל תבנית תגובה ולא ככלל החרגה אוטומטי.
- בצע סינון למדדי מאמץ נמוך נוספים, כולל ראיות להגשות כפולות, חותמות זמן בלתי אפשריות, מחרוזות תגובה חוזרות על פני הגשות נפרדות, או סתירות בין מטא-נתוני הפלטפורמה לתוכן השאלון.
- הסר תגובה מסומנת רק כאשר לפחות שני מדדי בקרת איכות מצביעים על תגובה לא תקפה, כגון זמן השלמה קצר במיוחד בשילוב עם תגובות בשורה ישרה, ראיות להגשה כפולה או מטא-נתוני פלטפורמה בלתי אפשריים19.
- רשום את כל הרשומות שסומנו, גם כאשר הן נשמרות. במערך הנתונים הנוכחי, 19 תגובות סומנו בשל משך השלמה < 180 s, 8 תגובות סומנו בשל >90% תגובות בשורה ישרה, ו-13 רשומות הוחרגו מאחר שעמדו בשני מדדי איכות תגובה או יותר.
- בצע סינון לערכים מחוץ לטווח. ודא שפריטי רגש שלילי נמצאים בטווח 1–4; פריטי דחיינות אקדמית, שייכות בית-ספרית וחשיבה מסדר גבוה נמצאים בטווח 1–5; ופריטי רווחה סובייקטיבית נמצאים בטווח 1–6.
- תקן ערך רק כאשר הייצוא המקורי מראה בבירור שגיאת עיצוב. אין לשנות ציונים פסיכולוגיים תקפים רק משום שהם נראים גבוהים או נמוכים באופן חריג.
- צור טבלת זרימת סינון המדווחת על שאלונים שהוגשו, החרגות בגין הסכמה וזכאות, החרגות של כפילויות, החרגות בשל נתונים חסרים, דגלי איכות תגובה, החרגות בקרת איכות משולבות, השלמות פריטים בודדים, מקרים אנליטיים שנשמרו וגודל מדגם האנליזה הסופי.
- השלם את טבלת זרימת הסינון באמצעות יומן הסינון הנעול ושמור רשומת ביקורת מיוצאת של החלטות הסינון. במערך הנתונים הנוכחי, זרימת הסינון הייתה כדלקמן: שאלונים שהוגשו, n = 448; החרגות בגין הסכמה או זכאות, n = 6; הגשות כפולות שהוסרו, n = 5; רשומות שהוחרגו בשל >20% פריטי סקאלה חסרים, n = 4; רשומות שהוחרגו בשל שני מדדי איכות תגובה או יותר, n = 13; מערך נתונים אנליטי סופי, n = 420.
- שמור את הרשומות שנשמרו כמערך הנתונים האנליטי. השתמש בשם קובץ חדש עם מספר גרסה ושמור את יומן הסינון יחד עם מערך הנתונים האנליטי.
הערה: שמור ציוני קיצון תקפים אלא אם קיימת בעיית איכות תגובה מתועדת.
5. דירוג הסולמות הפסיכולוגיים
- המירו תגובות ברמת הפריט למשתנים ברמת הסקאלה רק לאחר השלמת סינון התגובות ושמירת מערך הנתונים האנליטי.
- קודדו את כל הפריטים מסוג Likert בהתאם לעגני התגובה בשאלון הנעול ולכללי הניקוד במפת הסקאלה.
- השאירו את משתני הפריטים המקוריים ללא שינוי. צרו משתנים נגזרים נפרדים עבור פריטים שקודדו מחדש או קיבלו ניקוד הפוך.
- נקדו כל סקאלה בהתאם למפת הסקאלה הנעולה ולכלי המקור התואם או למדריך הניקוד.
- בצעו ניקוד הפוך לפריטי הרווחה הסובייקטיבית הייעודיים לפני חישוב מדד הרווחה הסובייקטיבית. עבור סקאלת תגובה של 1–6, חשבו כל פריט הפוך כ-7 פחות הניקוד המקורי, והוסיפו _R לשם המשתנה הנגזר.
- השתמשו במשתנים בעלי הניקוד ההפוך, ולא במשתנים המקוריים, בעת חישוב הרווחה הסובייקטיבית.
- חשבו כל ניקוד ברמת הסקאלה כממוצע של הפריטים שנשמרו בה: רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית.
- נקבו את המשתנים הסופיים ברמת הסקאלה כ-Negative emotion, Academic procrastination, School belongingness, Higher-order thinking ו-Subjective well-being.
- אמתו את הערך המינימלי והמקסימלי של כל משתנה ברמת הסקאלה אל מול טווח התגובות התאורטי שלו. בדקו שוב את הקידוד, הניקוד ההפוך ואת הטיפול בערכים חסרים אם ניקוד כלשהו חורג מהטווח הצפוי.
- אמתו את כיוון כל סקאלה אל מול מפת הסקאלה לפני ביצוע ניתוח הסקתי. ניקודים גבוהים יותר צריכים לשקף את הכיוון המיועד של המבנה (construct).
- בצעו ביקורת על הניקוד ההפוך לפני הניתוח. חשבו מחדש את הפריטים בעלי הניקוד ההפוך עבור תת-קבוצה אקראית של רשומות, או עבור כל הפריטים בעלי הניקוד ההפוך במידת האפשר, ורשמו את תוצאת הביקורת ביומן אימות הניקוד.
- אם זוהתה שגיאת ניקוד, תקנו את המשתנה הנגזר, ייצרו מחדש את ניקוד הסקאלה המושפע, עדכנו את יומן אימות הניקוד והריצו מחדש את כל הניתוחים הבאים ואת טבלאות מקור האיורים על בסיס מערך הנתונים האנליטי המתוקן.
הערה: התייחסו לניקוד הפוך ולאימות טווחים כנקודות בקרה נדרשות לפני ניתוח מתאמים, השוואת קבוצות, מודלי רגרסיה או ויזואליזציה.
6. הערכת עקביות פנימית ותכונות תיאוריות
- חשבו עקביות פנימית, מתאמי פריט-סך מתוקנים וסטטיסטיקה תיאורית עבור כל סקאלה באמצעות משתני הפריטים שהוגדרו במפת הסקאלה הנעולה.
- רשמו את ערכי אלפא של קרונבך (Cronbach’s alpha), מספר הפריט, גודל מדגם תקף, מתאמי פריט-סך מתוקנים וערכי אלפא במקרה של הסרת פריט עבור כל סקאלה.
- השתמשו בערך אלפא של קרונבך של 0.70 כסף המינימלי המקובל לסף מהימנות במסלול עבודה זה. לפני הסרת פריט כלשהו, בדקו את ניסוח הפריט, כיוון הניקוד, ניקוד הפוך, התאמה למבנה המושגי ואת תיעוד כלי המדידה המקורי20.
- חשבו את אומגה של מקדונלד (McDonald’s omega) כהערכת מהימנות משלימה כאשר סביבת הניתוח תומכת בכך. דווחו על אומגה יחד עם אלפא של קרונבך כאשר שתי ההערכות מובילות לפרשנויות שונות של המהימנות.
- בחנו כל פריט עם מתאם פריט-סך מתוקן שלילי או נמוך מאוד לפני ששקולתם את הסרתו. התייחסו לכך תחילה כבעיה אפשרית של קידוד, ניקוד הפוך או התאמה למבנה המושגי.
- אל תסירו פריט רק כדי להעלות את אלפא של קרונבך. הסרת פריט חייבת להיות מוצדקת על ידי מדריך הניקוד, ניסוח הפריט, מתאם פריט-סך מתוקן, התאמה מושגית ואימות ניקוד מתועד.
- חשבו סטטיסטיקה תיאורית עבור כל חמשת המשתנים ברמת הסקאלה, כולל ממוצע, סטיית תקן, מינימום, מקסימום, התאמה (skewness) וגבנוניות (kurtosis).
- בדקו ריכוז רצפה או תקרה על ידי רישום הפרופורציה של המשיבים בציון המינימלי והמקסימלי האפשריים עבור כל סקאלה.
- רשמו את הערכות המהימנות, אבחוני פריט-סך, הסטטיסטיקה התיאורית וכל החלטות ניקוד ביומן הניתוח.
הערה: אלפא של קרונבך משמשת כנקודת בקרה של מהימנות, ולא כהליך תיקוף פסיכומטרי מלא. כאשר נדרשת הערכת מדידה פורמלית, שלבו במסלול עבודה זה את אומגה של מקדונלד, ניתוח גורמים מאשש (CFA), בדיקת אי-שינוי מדידה (measurement invariance), מידול תגובת פריט או שיטות אחרות של משתנים חבויים.
7. ביצוע ניתוח קורלציה
- השתמשו בחמישה משתנים מאומתים ברמת סולם: רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית.
- לפני חישוב מתאמי פירסון, בחנו את ההתפלגויות ואת תרשימי הפיזור הדו-משתניים עבור כל זוג של משתנים ברמת סולם.
- העריכו האם המשתנים מראים שונות ציונים רציפה בקירוב, שיפוע (skewness) חמור, קשרים לא ליניאריים או דפוסי ערכים חריגים משפיעים.
- חשבו את מקדמי מתאם פירסון וערכי p דו-זנביים עבור כל הזוגות של משתנים ברמת סולם, כאשר ההנחות מקובלות לצורך ניתוח קשר תיאורי.
- רשמו את מקדם המתאם, את ערך ה-p, את גודל המדגם ואת כיוון הקשר עבור כל זוג משתנים.
- דווחו על מקדמי המתאם עד שלוש ספרות אחרי הנקודה.
- השוו את הכיוון של כל מקדם למפת הסולם. בדקו שוב את דירוג הפריטים אם מקדם מסוים סותר את כיוון המבנה המתוכנן.
- שמרו את מטריצת המתאמים המאומתת כטבלת המקור המספרית עבור מפת החום של המתאמים בסעיף תוצאות מייצגות.
- כאשר ההתפלגויות בעלות שיפוע ניכר, כאשר נדרשת רגישות לסולם סודרי, או כאשר תרשימי הפיזור מרמזים על קשרים מונוטוניים אך לא ליניאריים, חזרו על הניתוח באמצעות מתאם ספירמן והשוו את הכיוון ואת העוצמה היחסית של הקשרים.
- רשמו האם תוצאות פירסון וספירמן הובילו לאותה פרשנות מהותית.
הערה: השתמשו בניתוח המתאמים הן כבדיקה של קשר תיאורי והן כביקורת על כיוון הדירוג.
8. יצירת קבוצות של רווחה נפשית סובייקטיבית גבוהה ונמוכה
- השתמשו במערך הנתונים האנליטי המנוקה והמדורג. אין לחזור לייצוא הגולמי לצורך בניית הקבוצות.
- השתמשו במדד הרווחה הסובייקטיבית הרציף כתוצאה העיקרית למודל הרגרסיה. השתמשו בחלוקה לקבוצות גבוהה-נמוכה אך ורק לצורך השוואת פרופילים ניגודית.
- מיינו את המשיבים לפי מדד הרווחה הסובייקטיבית, מהגבוה לנמוך.
- החילו את כלל קבוצות הקיצון (extreme-group rule) שנקבע מראש של 27% כדי להגדיר את קבוצות הרווחה הסובייקטיבית הגבוהה והנמוכה. תיעדו את הרציונל לסף זה בטבלה 2 וביומן הניתוח.
- שייכו את המשיבים ב-27% העליונים לקבוצת הרווחה הסובייקטיבית הגבוהה ואת המשיבים ב-27% התחתונים לקבוצת הרווחה הסובייקטיבית הנמוכה.
- שמרו את 46% האמצעיים במערך הנתונים האנליטי המלא לצורך סטטיסטיקה תיאורית, ניתוח מתאמים, השוואת מין ומודל רגרסיה, אך השמיגו מקרים אלה מהניגוד גבוה-נמוך.
- צרו משתנה קיבוץ בשם Subjective well-being group. קודדו את הקבוצה העליונה כ-High, את הקבוצה התחתונה כ-Low ואת שאר המשיבים כ-Middle.
- וודאו שהקבוצות הגבוהה והנמוכה מכילות את מספר המקרים המיועד. במקרה של ציונים זהים בגבול ה-27%, החילו את כלל הטיפול בציונים זהים שנקבע מראש ורשמו את ההחלטה ביומן הניתוח.
- בצעו בדיקת רגישות כאשר גבול ה-27% יוצר חברות קבוצה לא יציבה עקב ציונים זהים או גודל מדגם קטן. השתמשו בכלל חלופי שנקבע מראש, כגון חלוקה לשליש (tertile grouping), ודווחו האם הפרשנות נותרה ללא שינוי.
הערה: החלוקה לקבוצות גבוהה-נמוכה היא הליך ניגוד תיאורי. היא לא אמורה להחליף את מדד הרווחה הסובייקטיבית הרציף במודל הרגרסיה הראשי.
9. השוואה בין קבוצות עם רווחה סובייקטיבית גבוהה ונמוכה
- סננו את מערך הנתונים האנליטי כדי להשאיר רק נשאלים שסווגו כ"גבוה" (High) או "נמוך" (Low) במשתנה הקיבוץ של הרווחה הסובייקטיבית.
- השוו את הקבוצות הגבוהה והנמוכה במדדי רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר וחשיבה מסדר גבוה.
- לפני השוואה בין קבוצות, בחן את ההתפלגויות הספציפיות לקבוצה, את גדלי המדגמים ואת שוויון השונות עבור כל משתנה.
- השתמש במבחן מדגמים בלתי תלויים ת-בדיקה כאשר הנחות ההתפלגות והשונות מקובלות. השתמשו בבדיקת Welch’s נראה כי לא סיפקת טקסט לתרגום. אנא הזן את הטקסט באנגלית שברצונך לתרגם לעברית.-בדיקה כאשר הנחת השוויון של השונויות אינה נתמכת.
- יש לרשום את ממוצעי הקבוצות, את סטיות התקן ואת ההבדלים בין הממוצעים, tערכי-p, דרגות חופש, pערכי p ורווחי סמך של 95%.
- חשבו את ה-d של קוהן (Cohen’s d) עבור כל הפרש בין קבוצות, ופרשו את גודל האפקט יחד עם ערך ה-p.
- בדוק האם כיוון ההבדלים בין הקבוצות עולה בקנה אחד עם הגדרות המבנה (construct definitions) ומטריצת המתאם.
- שמרו את טבלת השוואת הקבוצות המאומתת כמקור הנומרי עבור כל ויזואליזציה של השוואת קבוצות.
- דווחו על ניתוח זה כהשוואה בין פרופילי רווחה סובייקטיבית קיצוניים.
הערה: אין לפרש את ההשוואה בין ערכים גבוהים לנמוכים כראיה סיבתית.
10. בחינת הבדלים בין המינים
- הסיר את מסנן קבוצות הגבוה-נמוך (high-low) וחזור למערך הנתונים האנליטי המלא.
- השתמשו במין כמשתנה קיבוץ תיאורי ולא כחשיפה סיבתית.
- השוו בין המשיבים הנשים למשיבים הגברים במדדי רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית.
- לפני ההשוואה, יש לבחון את גודלי המדגמים הספציפיים לקבוצה, את רמת השמיטות (missingness), את ההתפלגויות ואת שוויון השונות.
- השתמש במבחן מדגמים בלתי תלויים t-מבחן כאשר ההנחות מקובלות. השתמש ב-Welch’s t-בדיקה כאשר הנחת השוויון של השונויות אינה נתמכת.
- רשמו ממוצעי קבוצות, סטיות תקן, הפרשי ממוצעים, tערכי-p, דרגות חופש, pערכי-p, רווחי סמך של 95%, וערכי d של כוהן (Cohen’s d).
- פרשו הבדלים בין המינים באופן תיאורי ודווחו על גדלי אפקט באמצעות pערכי-p.
- אין להשתמש בתוצאות השוואת המין כדי להצדיק החרגה בדיעבד (post hoc), שינוי סולם או פרשנות סיבתית.
הערה: השוואות בין מינים נכללו כבדיקות תיאוריות של תת-קבוצות במסגרת תהליך העבודה של שאלון חתך זה.
11. הערכת מודל הרגרסיה
- השתמשו ברווחה סובייקטיבית (subjective well-being) כמשתנה התלוי.
- השתמשו ברגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר וחשיבה מסדר גבוה כמנבאים סימולטניים ברמת סולם21.
- השתמשו במשתנים הרציפים ברמת הסולם שנוצרו במהלך ניקוד הסולם. אין להחליף את הניקוד הרציף של הרווחה הסובייקטיבית במשתנה חלוקה לגבוה-נמוך.
- התאימו את המודל הראשי באמצעות רגרסיה ליניארית מרובה עם כניסה סימולטנית.
- רשמו מקדמים לא מתוקננים, מקדמים מתוקננים, טעויות תקן, ערכי t, ערכי p, רווחי סמך של 95%, R2, R2 מתוקנן, סובלנות (tolerance) וגורם ניפוח שונות (variance inflation factor).
- השתמשו בערכי גורם ניפוח שונות הנמוכים מ-5.00 כסף המגבלה להוכחת היעדר מולטיקוליניאריות חמורה.
- בחנו תרשימי פיזור דו-משתנים, תרשימי רגרסיה חלקית או תרשימי רכיב-בתוספת-שאריות כדי להעריך אם הקשרים בין המנבאים לרווחה הסובייקטיבית הם ליניאריים בקירוב.
- העריכו את אי-תלות השאריות באמצעות סטטיסטיקת Durbin-Watson.
- העריכו את נורמליות השאריות באמצעות תרשים Q-Q של השאריות ומבחן נורמליות פורמלי כאשר הדבר מתאים לגודל המדגם.
- העריכו הומוסקדסטיות באמצעות תרשים של שאריות מתוקננות מול ערכים חזויים מתוקננים.
- שמרו שאריות מתוקננות, ערכים חזויים מתוקננים, ערכי מינוף (leverage values) ומרחק קוק (Cook’s distance) לצורך בדיקות אבחון.
- העריכו מודל מתוקנן משלים הכולל את ארבעת המנבאים הפסיכולוגיים ואת המשתנים הדמוגרפיים שדווחו בתיאור המדגם, כולל מין, גיל, שנת לימוד, קטגוריית מוסד וקטגוריית תחום לימוד אקדמי, כאשר משתנים אלו זמינים ומפוזרים באופן הולם.
- השוו את המודל הראשי למודל המתוקנן המשלים. רשמו האם הכיוון, העוצמה והפרשנות הסטטיסטית של ארבעת המנבאים הפסיכולוגיים נשארים יציבים לאחר התאמה דמוגרפית.
- שמרו את המקדמים המתוקננים המאומתים ורווחי הסמך של 95% מהמודל הראשי כטבלת המקור המספרית עבור תרשים המקדמים בסעיף התוצאות המייצגות22.
הערה: פרשו מקדמי רגרסיה כקשרים מותנים ולא כהשפעות סיבתיות. המודל המתוקנן דמוגרפית משמש בניתוח רגישות כדי להעריך אם מסקנות זרימת העבודה נשארות יציבות לאחר התחשבות במשתני רקע זמינים.
12. אבחון מודל הרגרסיה
- בדוק את השאריות הסטנדרטיות ממודל הרגרסיה שהותאם. סמן מקרים עם שאריות סטנדרטיות מוחלטות הגדולות מ-3.00.
- בדוק את ערכי המינוף (leverage) ואת מרחק קוק (Cook’s distance) עבור תצפיות משפיעות.
- סמן תצפיות שמרחק קוק שלהן גדול מ-4/n כבעלות פוטנציאל להשפיע, כאשר n הוא גודל המדגם האנליטי. התייחס למרחק קוק הגדול מ-1.00 כסף רפרנס להשפעה חמורה ולא כגבול הסינון היחיד.
- בדוק את תרשים השאריות מול הערכים החזויים (residual-versus-predicted plot) כדי לזהות אי-ליניאריות, שונות לא שווה והקבצות חריגות.
- בדוק את תרשים ה-Q-Q של השאריות ואת תוצאת מבחן הנורמליות של השאריות. רשום האם הערכת הנורמליות תומכת בשימוש במודל הליניארי לצורך ניתוח קשר תיאורי.
- רשום את סטטיסטיקת דרבין-וואטסון (Durbin-Watson) וקבע האם אי-התלות של השאריות מקובלת.
- סקור את כל המקרים המסומנים אל מול יומן הסינון, יומן אימות הניקוד וקריטריוני ההסמיכות.
- שמור על מקרים מסומנים כאשר הם מייצגים תצפיות תקפות ואינם משקפים שגיאות בהזנת נתונים, שגיאות ניקוד, הגשות כפולות, הפרות של קריטריוני הסמיכות או בעיות מתועדות באיכות התגובה.
- תקן או הסר מקרה מסומן רק כאשר נתיב הביקורת (audit trail) מזהה שגיאה פרוצדורלית, שגיאת סמיכות, קידוד, ניקוד או הזנת נתונים מתועדת.
- הרץ שוב את מודל הרגרסיה לאחר כל תיקון מתועד והשווה את המקדמים, רווחי הסמך, R2, R2 מתוקנן ותוצרי האבחון מול המודל המקורי.
- בצע בדיקת רגישות להשפעה על ידי התאמה מחדש של המודל לאחר ה exclusion של מקרים עם מרחק קוק הגדול מ-4/n. דווח האם הפרשנות המהותית משתנה.
- רשום את החלטת האבחון הסופית ביומן הניתוח, כולל מספר המקרים שסומנו על ידי שאריות סטנדרטיות, מספר המקרים שסומנו על ידי מרחק קוק הגדול מ-4/n, מרחק קוק מקסימלי, סטטיסטיקת דרבין-וואטסון והמסקנה מבדיקות הנורמליות והליניאריות של השאריות.
הערה: אין להסיר מקרים משפיעים רק כדי לשפר את התאמת המודל. הסרה או תיקון חייבים להתבסס על סיבה מתועדת בנתיב הביקורת.
תוצאות
מערך נתונים אנליטי שהופק לאחר סינון תגובות
סבב סינון התגובות הניב מערך נתונים אנליטי של 420 רשומות סטודנטים אנונימיות מתוך 448 שאלונים שהוגשו. יומן הסינון תיעד כל נקודת הכרעה. שש רשומות הוסרו מכיוון שדרישות ההסכמה או הזכאות לא התממשו, חמש הגשות כפולות הוסרו, ארבע רשומות הוצאו מהמחקר מכיוון שיותר מ-20% מכל פריטי הסולם היו חסרים, ו-13 רשומות הוצאו מהמחקר מכיוון שעמדו בשניים או יותר ממדדי איכות התגובה. תשע עשרה תגובות סומנו בשל משך זמן ההשלמה. <180 שניות, שמונה תגובות סומנו כ- >תגובה בקו ישר בשיעור של 90%, ועבור 37 פריטים חסרים בודדים בוצע השלמת ערכים חסרים באמצעות ממוצע בתוך הסולם עבור 21 נשאלים. מערך הנתונים האנליטי הסופי לא הכיל מידע המאפשר זיהוי ישיר של המשתתפים, אף מקרה שנשאר לא חרג מסף ההדרה עבור נתונים חסרים, וכל התגובות לפריטים שנשמרו היו בתוך טווחי התגובה שהוגדרו מראש. תהליך הסינון מסוכם ב- טבלה 3.
המדגם שנשמר כלל 275 משיבות ו-145 משיבים, המהווים 65.5% ו-34.5% ממאגר הנתונים האנליטי, בהתאמה. הגיל הממוצע היה 20.1 ± 1.2 שנים. המשיבים התפלגו על פני ארבע שנות לימוד לתואר ראשון, כאשר שנה א' עד שנה ד' היוו 27.1%, 27.4%, 25.5% ו-20.0% מהמדגם. מאגר הנתונים כלל גם שלוש קטגוריות מוסדיות וחמש קטגוריות של מסלולי לימוד אקדמיים. לאחר סקירת הקטגוריות, אף תא דמוגרפי שפורסם לא הכיל פחות מחמישה משיבים. המאפיינים הדמוגרפיים של מאגר הנתונים האנליטי מסוכמים ב- טבלה 4.
בניית סולמות, אימות טווחים ודוגמאות לתהליכי עבודה שאינם אופטימליים
לאחר קידוד הפריטים וביצוע ניקוד הפוך, חושבו חמישה משתנים ברמת הסולם: רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית. כל ציון נותר בתוך טווח התגובה התיאורטי שלו. ציוני הרגש השלילי נעו בין 1.048 ל-3.143 בסולם של 1-4. דחיינות אקדמית, תחושת שייכות לבית הספר וחשיבה מסדר גבוה נעו בין 1.312 ל-4.250, בין 2.333 ל-4.444, ובין 2.350 ל-4.850 בסולמות ה-1–5 שלהם, בהתאמה. רווחה סובייקטיבית נעה בין 2.000 ל-5.300 בסולם של 1–6. אימות הניקוד ההפוך לא העלה אי-התאמה בין המשתנים שנוקדו באופן הפוך לבין כלל הניקוד הנעול במערך הנתונים האנליטי הסופי. בדיקות אלו אישרו כי קידוד הפריטים, הניקוד ההפוך, הטיפול בפריטים חסרים וסיכום הציונים הושלמו ללא שגיאות טווח גלויות.
תהליך העבודה יצר גם דוגמאות ביקורת לא אופטימליות הממחישות כיצד שגיאות או פלטים מפוקפקים מזוהים לפני הניתוח הסופי. במהלך הרצת ביקורת, זוהה ערך שגוי של ניקוד הפוך עבור רווחה סובייקטיבית, מכיוון שיומן אימות הניקוד השווה בין הערך המקורי, הנוסחה הצפויה "reversed score = 7-original score", הערך הנגזר וטווח הסולם הסופי. המשתנה הנגזר תוקן, ניקוד הרווחה הסובייקטיבית הופק מחדש, וכל הפלטים התיאוריים, פלטי המתאם, ההשוואה, הרגרסיה, האבחון ומקורות האיורים שבאו לאחר מכן הורצו מחדש. בקובץ עבודה ביניים אחר, זוהה ערך פריט מחוץ לטווח במהלך אימות הטווח, והוא הובלה לטיפול בגיליון האלקטרוני ולא לייצוא הגולמי הננעל. עותק העבודה תוקן ותועד מבלי לשנות תגובה קיצונית תקפה כלשהי. כמו כן, נבחנת אזהרת מהימנות כאשר פריט אחד הראה מתאם פריט-סך מתוקן נמוך יותר מפריטים אחרים באותו סולם; מכיוון שניסוח הפריט, כיוון הניקוד וההלימה למבנה היו נכונים, הפריט נשמר. אי-התאמה בוויזואליזציה של טיוטה זוהתה כאשר איור לא תאם את טבלת המקור המספרית המאומתת שלו; האיור הופק מחדש מהטבלה המאומתת, ורישום מקור האיור עודכן. דוגמאות אלו מדגימות כי תהליך העבודה לא רק מייצר פלטים מוצלחים, אלא גם מזהה שגיאות קידוד, בעיות טווח, אזהרות מהימנות, אי-התאמות בין איור למקור וסוגיות של איכות תגובות באמצעות נתיב הביקורת.
מאפיינים תיאוריים ועקביות פנימית
חמישה משתני רמת הסולם הראו שונות ניתנת לשימוש. ציון הרגש השלילי הממוצע היה 2.099 ± 0.391, וציון דחיינות אקדמית הממוצע היה 2.639 ± 0.484. תחושת שייכות לבית הספר וחשיבה מסדר גבוה הראו ערכים ממוצעים גבוהים באופן בינוני, 3.343 ± 0.390 ו-3.627 ± 0.418, בהתאמה. ציון הרווחה הסובייקטיבית הממוצע היה 3.784 ± 0.543. אף סולם לא הראה דפוס ברור של אפקט רצפה או תקרה, ושיעור המשיבים במינימום או במקסימום התיאורטי היה נמוך מ-2.0% עבור כל סולם.
העקביות הפנימית הייתה מקובלת עבור כל חמשת הסולמות. ערכי אלפא של קרונבך (Cronbach’s alpha) נעו בין 0.834 ל-0.899, ובכך עלו על הסף שנקבע מראש של 0.70. רגש שלילי הראה את העקביות הפנימית הגבוהה ביותר, עם אלפא של קרונבך של 0.899, ואחריו רווחה נפשית סובייקטיבית עם 0.895. ערכי אומגה של מקדונלד (McDonald’s omega) נעו בין 0.842 ל-0.906, ואומדני האומגה לא שינו את פרשנות המהימנות. סקירת המתאם המתוקן בין פריט לסך הכל לא זיהתה אף פריט הדורש הסרה. הסטטיסטיקה התיאורית ואומדני המהימנות מדווחים בטבלה 5.
מבנה המתאם בין משתני רמת הסולם
מטריצת המתאמים שימשה כמדד תיאורי לקשרי גומלין וכבדיקה לכיוון הניקוד. לפני חישוב מתאמי פירסון (Pearson), נבחנו התפלגויות הסולמות ותרשימי פיזור דו-משתנים. אף משתנה לא הפגין הטיה (skewness) או קורטוזיס (kurtosis) חמורים, ואף תרשים פיזור לא הראה דפוס לא-ליניארי חזק שעלול לבטל את תקינות ניתוח מתאמי פירסון התיאורי. רווחה נפשית סובייקטיבית נמצאה במתאם שלילי עם רגש שלילי (r = -0.496) ודחיינות אקדמית (r = -0.294), ובמתאם חיובי עם תחושת שייכות לבית הספר (r = 0.481) וחשיבה מסדר גבוה (r = 0.386). שאר הקשרים תאמו את אותה לוגיקת ניקוד: רגש שלילי נמצא בקשר חיובי עם דחיינות אקדמית (r = 0.270) ובקשר שלילי עם תחושת שייכות לבית הספר (r = -0.346) וחשיבה מסדר גבוה (r =-0.205); דחיינות אקדמית נמצאה בקשר שלילי עם תחושת שייכות לבית הספר (r = -0.222) וחשיבה מסדר גבוה (r = -0.134); ותחושת שייכות לבית הספר נמצאה בקשר חיובי עם חשיבה מסדר גבוה (r = 0.310). מטריצת מתאמי פירסון המלאה מוצגת בטבלה 6.
בדיקת רגישות באמצעות מתאם Spearman הניבה את אותה פרשנות כיוונית עבור כל זוגות המשתנים. מתאמי Spearman בין הרווחה הסובייקטיבית לבין ארבעת המנבאים היו ρ = -0.502 עבור רגש שלילי, ρ = -0.301 עבור דחיינות אקדמית, ρ = 0.477 עבור תחושת שייכות לבית הספר, ו-ρ = 0.392 עבור חשיבה מסדר גבוה. מטריצת Pearson המאומתת שימשה כטבלת המקור המספרית לצורך ההדמיה. איור 2A מציג את מפת החום המלאה של המתאמים בין חמשת המשתנים ברמת הסקאלה. איור 2B מציג את ארבעת המתאמים עם הרווחה הסובייקטיבית.
הדגמה ניגודית באמצעות קבוצות של רווחה סובייקטיבית גבוהה ונמוכה
כלל החלוקה של 27% שימש כהדגמה של זרימת עבודה ניגודית ולא כסיווג מהותי של פרופילי רווחה בעולם האמיתי. הכלל הניב שתי קבוצות בגודש שווה: 113 נשאלים בקבוצת הרווחה הסובייקטיבית הגבוהה ו-113 בקבוצת הרווחה הסובייקטיבית הנמוכה. 194 הנשאלים המרכזיים נשמרו במערך הנתונים האנליטי המלא אך הוצאו מההשוואה ניגודית זו. שום תיקו בגבולות לא שינה את השיוך לקבוצה.
מודול זה הראה כי זרימת העבודה יכולה להפיק משתנה חלוקה שהוגדר מראש, לסנן את מערך הנתונים האנליטי, לחשב סטטיסטיקה תיאורית ספציפית לקבוצות, להריץ השוואות קבוצתיות בהתאם להנחות הנתונים, ולייצא טבלת מקור מאומתת לצורך ויזואליזציה. קבוצת הרווחה הסובייקטיבית הגבוהה הראתה רגש שלילי נמוך יותר מקבוצת הרווחה הסובייקטיבית הנמוכה (1.864 ± 0.358 לעומת 2.335 ± 0.343; הפרש ממוצעים = -0.472) ודחיינות אקדמית נמוכה יותר (2.455 ± 0.476 לעומת 2.801 ± 0.483; הפרש ממוצעים = -0.346). תחושת שייכות לבית הספר וחשיבה מסדר גבוה היו גבוהות יותר בקבוצת הרווחה הסובייקטיבית הגבוהה, עם הפרשי ממוצעים של 0.454 ו-0.351, בהתאמה. כל ארבע ההשוואות היו מובהקות (p < 0.001), עם ערכי Cohen’s d של -1.346 עבור רגש שלילי, -0.722 עבור דחיינות אקדמית, 1.279 עבור תחושת שייכות לבית הספר, ו-0.860 עבור חשיבה מסדר גבוה. מבחן Welch’s t-test שימש כאשר הנחת שוויון השונויות לא נתמכה; אחרת, נשמר מבחן t-test סטנדרטי למדגמים בלתי תלויים. אין לפרש פלטים אלו כראיה לכך שהמשתנים המנבאים שנבחרו מגדירים פרופילי רווחה של תלמידים בעולם האמיתי, מכיוון שהקבוצות נוצרו ממשתנה התוצאה ולאחר מכן הושוו על בסיס משתנים מתואמים. השוואת קבוצות הגבוה-נמוך מסוכמת בTable 7.
השוואה תיאורית לפי מין
המין נבחן כמשתנה חלוקה תיאורי. רספונדנטים מהמין הנשי הראו ציון ממוצע של רגשות שליליים גבוה מעט מאשר רספונדנטים מהמין הגברי (2.129 ± 0.380 לעומת 2.042 ± 0.407). הבדל זה היה מובהק סטטיסטית אך קטן בעוצמתו (p = 0.033; Cohen’s d = 0.224). דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית לא הראו הבדלים משמעותיים מבוססי מין. הממוצעים של רווחה סובייקטיבית היו כמעט זהים בין רספונדנטים מהמין הנשי לבין רספונדנטים מהמין הגברי (3.781 ± 0.521 לעומת 3.789 ± 0.583; p = 0.887; Cohen’s d = -0.015). בדיקות רגישות באמצעות Welch’s t-test לא שינו את פרשנות תוצאות ההשוואה לפי מין. תוצאות ההבדלים בין המינים מוצגות בטבלה 8.
מודל רגרסיה כדוגמה ליצירת מודל ובדיקה דיאגנוסטית
מודל רגרסיה ליניארית מרובה שימש כדוגמה ליצירה, לאבחון ולאימות של מודל המבוסס על נתוני שאלונים מדורגים. רווחה נפשית סובייקטיבית הוזנה כמשתנה התלוי, בעוד שרגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר וחשיבה מסדר גבוה הוזנו בו-זמנית כמשתנים מנבאים ברמת סולם. מטרת מודול זה הייתה להדגים חילוץ מקדמים, בדיקות למולטיקוליניאריות, אבחון שאריות, הערכת השפעה, ניתוח רגישות מותאם לדמוגרפיה והכנת איורים ומקורות.
המודל הסביר חלק בינוני מהשונות ברווחה סובייקטיבית, עם R2 = 0.411 ו-R2 מתוקנן = 0.406. רגש שלילי הראה את המקדם הסטנדרטי השלילי הגבוה ביותר (B = -0.450, β סטנדרטי = -0.324). דחיינות אקדמית הראתה אף היא מקדם שלילי (B = -0.130, β סטנדרטי = -0.116). תחושת שייכות לבית הספר וחשיבה מסדר גבוה הראו מקדמים סטנדרטיים חיוביים של β = 0.275 ו-β = 0.218, בהתאמה. כל ארבעת המנבאים היו מובהקים סטטיסטית במודל המתואם: רגש שלילי, תחושת שייכות לבית הספר וחשיבה מסדר גבוה ב-p < 0.001, ודחיינות אקדמית ב-p = 0.004. לא נמצאה מולטיקוליניאריות, שכן כל ערכי גורם הגדלת השונות (VIF) היו נמוכים מ-1.24. פלטי רגרסיה אלו הם פלטים מייצגים של בדיקת מודל, ולא הסבר פסיכולוגי סופי לרווחת התלמידים. טבלה 9 מציגה את פלט הרגרסיה המלא.
מודל משלים מותאם לדמוגרפיה נאמד על ידי הוספת מין, גיל, שנת לימוד, קטגוריית מוסד וקטגוריית תחום לימודים אקדמי לארבעת המנבאים הפסיכולוגיים. המודל המותאם הסביר פרופורציה דומה של שונות, כאשר R2 = 0.427 ו-R2 מותאם = 0.414. הכיוון והפרשנות הסטטיסטית של ארבעת המנבאים הפסיכולוגיים נותרו ללא שינוי לאחר ההתאמה הדמוגרפית. מודל הרגישות המותאם לדמוגרפיה מסוכם ב-טבלה 10. איור 3A מציג את המקדמים הסטנדרטיים ומרווחי סמך של 95% עבור ארבעת המנבאים. איור 3B מציג את תצוגת האבחון המבוססת על ערכים נבואים סטנדרטיים, שאריות סטנדרטיות ומרחק קוק (Cook’s distance).
דיאגנוסטיקה של רגרסיה ושימור המודל
הדיאגנוסטיקה של הרגרסיה לא הצביעה על כך שהמודל שהותאם הונע על ידי רשומה משפיעה בודדת. תרשימי הרגרסיה הדו-משתנית והחלקית לא הראו אי-ליניאריות חזקה. תרשים השאריות מול הערכים החזויים לא הראה הטרוסקדסטיות חמורה או קיבץ (clustering) חריג. סטטיסטיקת Durbin-Watson הייתה 1.93, מה שתומך בעצמאות קבילה של השאריות. תרשים Q-Q של השאריות לא הראה סטייה חמורה מהתפלגות נורמלית. מבחן נורמליות רשמי לשאריות היה מובהק סטטיסטית, W = 0.992, p = 0.031, אך תרשים ה-Q-Q וגודל המדגם תמכו בשימור המודל הליניארי לצורך ניתוח קשר תיאורי.
לשני רשומות היו שאריות סטנדרטיות מוחלטות הגבוהות מ-3.00. לאף רשומה לא היה מרחק קוק (Cook's distance) הגבוה מ-1.00. תוך שימוש בסף הרגיש יותר של מרחק קוק >4/נּ, שבו נ = 420 ו-4/נ" = 0.0095, 17 רשומות סומנו כבעלות השפעה פוטנציאלית. מרחק קוק (Cook’s distance) הגדול ביותר היה 0.037. מקרי השארית וההשפעה שסומנו נבחנו אל מול יומן הסינון, יומן אימות הניקוד וקריטריוני ההכשירות. באף אחד מהם לא נמצאו ראיות לשגיאות בהזנת נתונים, ניקוד שגוי, תגובות כפולות, אי-עמידה בקריטריוני הכשירות או בעיות מתועדות באיכות התגובות; לפיכך, מקרים אלה נשמרו במודל הסופי. בדיקת רגישות להשפעה, תוך החרגת מקרים עם מרחק קוק >4/n, הניב את אותה פרשנות של זרימת העבודה (workflow) כמו המודל הראשי. השינוי המוחלט המקסימלי במקדמים הסטנדרטיים היה 0.026, והערך המתוקנן R2 השתנה מ-0.406 ל-0.405. תוצאות האבחון והרגישות מסוכמות ב- טבלה 11.
אימות פנימי של צינור העיבוד האנליטי
תהליך העבודה חזר על עצמו באמצעות מערך הנתונים האנליטי שנוקה ודורג, תוך שימוש באותם כללי דירוג, ספי סף להחלטה וקובץ מעקב של הניתוח. בוצעו שוב ניתוח עקביות פנימית, סטטיסטיקה תיאורית, ניתוח מתאם, השוואות בין קבוצות גבוהות-נמוכות, השוואות בין מינים, מידול רגרסיה, בדיקה דיאגנוסטית והכנת מקורות לוויזואליזציה. התוצאים החוזרים תאמו את הסטטיסטיקה התיאורית המקורית, את מטריצת המתאם, את ערכי השוואת הקבוצות, את מקדמי הרגרסיה, את התוצאים הדיאגנוסטיים ואת קובצי המקור לוויזואליזציה. הדבר אישש את היציבות החישובית של צינור העיבוד האנליטי כאשר הוא מיושם על אותו מערך נתונים אנליטי נעול. בדיקה זו אינה מהווה שחזור פרוצדורלי עצמאי, אשר ידרוש מאנליסט עצמאי ליישם את תהליך העבודה המלא מתוך הייצוא הגולמי הנעול ולהגיע לאותם תוצאים מתועדים.
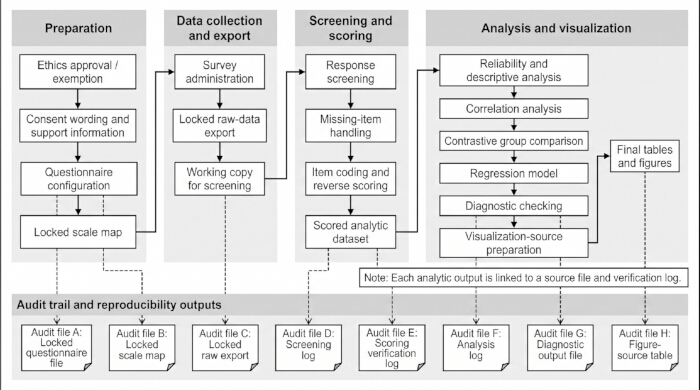
איור 1: זרימת עבודה לעיבוד נתונים של רווחה סובייקטיבית המבוססת על שאלונים. התרשים מציג את רצף הפרוטוקול ותוצרי ביקורת מרכזיים, כולל הכנה אתית, הגדרת השאלון, ניהול הסקר, ייצוא נתונים גולמיים, מפת סקלה, יומן סינון, סט נתונים אנליטי מנוקד, טבלאות ניתוח מאומתות, אבחונים של רגרסיה, קבצי מקור של איורים ותוצרי ויזואליזציה. אנא לחץ כאן להצגת גרסה גדולה יותר של איור זה.
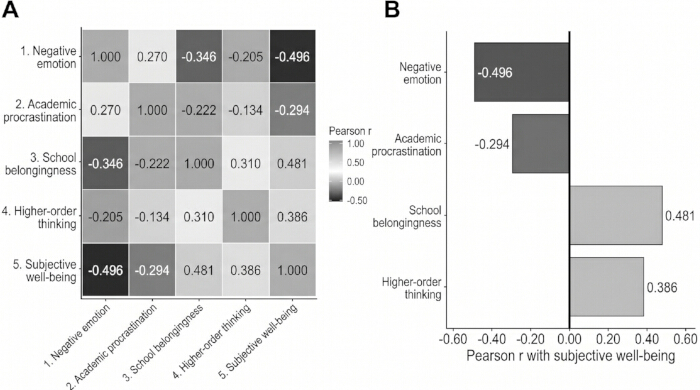
איור 2מבנה המתאם בין משתנים ברמת הסולם. (A) מפת חום של מתאם פירסון שהופקה ממטריצת המתאם המאושרת ב- טבלה 6. (Bפרופיל מתאמים ממוקד רווחה סובייקטיבית שהופק מאותה טבלת מקור מאומתת. חמישה משתנים ברמת סולם מוצגים: רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית. אנא לחצו כאן כדי להציג גרסה גדולה יותר של דמות זו.
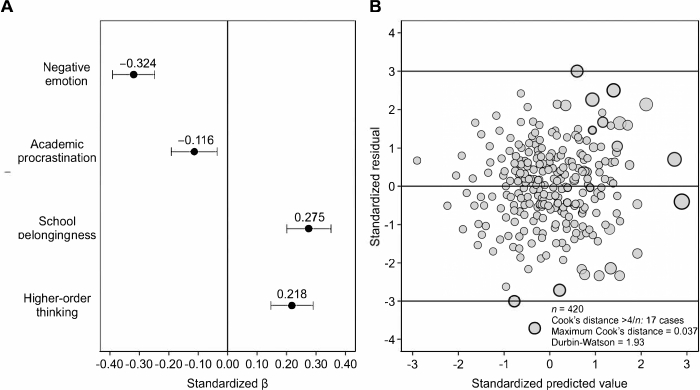
איור 3מקדם רגרסיה והדמיה אבחנתית. (A) מקדמי רגרסיה סטנדרטיים ומרווחי בר סמך של 95% שהופקו מפלט הרגרסיה הראשוני ב- טבלה 9. (Bתצוגת אבחון רגרסיה שהופקה מערכים של ערכים חזויים סטנדרטיים, שאריות סטנדרטיות וערכי מרחק קוק (Cook’s distance) המסוכמים ב- טבלה 11ערכי מרחק קוק (Cook’s distance) גדולים יותר מעידים על תצפיות בעלות פוטנציאל השפעה רב יותר על המודל המותאם. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
טבלה 1: מבנה השאלון ומסגרת ניקוד הסולם. טבלה זו מסכמת את מסגרת המדידה, כולל שם המבנה, כלי המקור, ציטוט המקור, סטטוס התאמה או תיעוד, מספר הפריט, טווח התגובות, כיוון הניקוד, דרישה לניקוד הפוך, שיטת הניקוד, המשתנה הסופי ברמת הסולם ותפקידו בפרוטוקול. אנא לחצו כאן להורדת טבלה זו.
טבלה 2: סינון תגובות וקריטריונים להחלטות אנליטיות. טבלה זו מפרטת את הקריטריונים שהוגדרו מראש עבור סינון הסכמה, סינון התאמה, סקירת תגובות כפולות, טיפול בנתונים חסרים, סימון משך תגובה, זיהוי תגובות קו-ישר (straight-line response), טווחי תגובה תקפים, הערכת מהימנות, סיווג קבוצות גבוהות-נמוכות, דיאגנוסטיקת רגרסיה ובדיקות רגישות. אנא לחצו כאן כדי להוריד טבלה זו.
טבלה 3: תהליך הסינון משאלונים שהוגשו למערך הנתונים האנליטי הסופי. טבלה זו מדווחת על מספר השאלונים שהוגשו, רשומות שסומנו, רשומות שהוסרו, רשומות שנשמרו ומקורות אימות בכל שלב של הסינון. משך זמן ההשלמה ותשובות במבנה של קו ישר (straight-line responding) נחשבו כסימני איכות תגובה ולא כקריטריונים להדרה אוטומטית. אנא לחצו כאן להורדת טבלה זו.
טבלה 4: מאפיינים דמוגרפיים של מערך הנתונים האנליטי. טבלה זו מסכמת את רשומות הסטודנטים האנונימיות שנשמרו לאחר סינון התגובות, כולל מין, גיל, שנת לימוד לתואר ראשון, קטגוריית מוסד וקטגוריית תחום לימודים אקדמי. תאי הדמוגרפיה נבחנו לבדיקת סיכון לזיהוי עקיף לפני הדיווח. אנא לחצו כאן להורדת טבלה זו.
טבלה 5: סטטיסטיקה תיאורית, אימות טווח ועקביות פנימית של חמישה משתנים ברמת סקאלה. טבלה זו מדווחת על מספר פריט, טווח תיאורטי, טווח נצפה, ממוצע, סטיית תקן, אלפא של כרונבך, אומגה של מקדונלד וריכוז רצפה/תקרה עבור רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית. אנא לחצו כאן להורדת טבלה זו.
טבלה 6: מטריצת מתאמי פירסון של משתני רמת סולם. טבלה זו מציגה את מקדמי המתאם של פירסון בין רגשות שליליים, דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית. המטריצה שימשה כפלט של קשר תיאורי וכשלב לאימות כיוון הניקוד. אנא לחצו כאן כדי להוריד טבלה זו.
טבלה 7: השוואה ניגודית בין קבוצות בעלות רווחה סובייקטיבית גבוהה ונמוכה. טבלה זו משווה בין רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר וחשיבה מסדר גבוה בין משיבים שנמצאו ב-27% העליונים וב-27% התחתונים של ציוני הרווחה הסובייקטיבית. ההשוואה מדגימה את תהליך העבודה של הקיבוץ וההשוואה, ולא סיווג מהותי של פרופילי רווחה. אנא לחצו כאן להורדת טבלה זו.
טבלה 8: השוואה תיאורית לפי מין. טבלה זו מציגה השוואות תיאוריות של רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר, חשיבה מסדר גבוה ורווחה סובייקטיבית לפי מין. המין טופל כמשתנה קיבוץ תיאורי. אנא לחצו כאן כדי להוריד טבלה זו.
טבלה 9: מודל רגרסיה ליניארית מרובה ראשוני לניבוי רווחה סובייקטיבית. טבלה זו מציגה את מודל הרגרסיה הראשוני שבו רווחה סובייקטיבית הייתה המשתנה התלוי, ורגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר וחשיבה מסדר גבוה הוזנו בו-זמנית כמנבאים ברמת סולם. ערכי טעות סטנדרטית, רווח בר סמך ומקדם ניפוח שונות כלולים בטבלה. אנא לחצו כאן כדי להוריד טבלה זו.
טבלה 10: מודל רגישות של רגרסיה מותאם לדמוגרפיה המנבא רווחה סובייקטיבית. טבלה זו מציגה ארבעה מנבאים פסיכולוגיים לאחר התאמה למין, גיל, שנת לימוד לתואר ראשון, קטגוריית מוסד וקטגוריית מגמה אקדמית. משתנים דמוגרפיים קטגוריאליים הוזנו באמצעות קידוד דמי (dummy coding). ערכי טעות סטנדרטית, רווח בר-סמך וגורם ניפוח שונות (VIF) כלולים בטבלה. אנא לחצו כאן להורדת טבלה זו.
טבלה 11: אבחוני רגרסיה ובדיקות רגישות להשפעה. טבלה זו מסכמת פלטי שאריות, השפעה ואבחון מודל, כולל שאריות סטנדרטיות, מרחק קוק (Cook’s distance) > 1.00, מרחק קוק > 4/n, מרחק קוק מקסימלי, סטטיסטיקת דורבין-ו类似的ון (Durbin-Watson), תרשים Q-Q של השאריות, מבחן נורמליות של השאריות, תרשים שאריות לעומת ערכים חזויים, בדיקת ליניאריות ואנליזת רגישות להשפעה. אנא לחצו כאן להורדת טבלה זו.
קובץ משלים 1: מבנה השאלון, מקור הסולמות ותיעוד הניקוד. קובץ משלים זה מספק את סדר הגשת השאלון, ניסוח ההסכמה המודעת, משתנים דמוגרפיים, תיעוד של כלי המקור, קודי פריטים, עגני תגובה, מידע על התאמה וסטטוס תיעוד, כיוון הניקוד, כללי ניקוד הפוך, בניית משתני רמת סולם סופיים, כללי טיפול בפריטים חסרים, שדות קישור לאיכות התגובה, כללי אימות טווח וקישורי סימוכין לחמישה מבני שאלון. הוא משמש כתוספת השאלון/ספר הקודים לתיעוד תכנות הסולמות, הניקוד והאימות בזרם העבודה. אנא לחץ כאן כדי להוריד קובץ זה.
דיון
פרוטוקול זה סטנדרטיז את תהליך נפוץ אך לעיתים קרובות לא מדווח במלואו במחקרי רווחה נפשית (well-being) המבוססים על שאלונים: המעבר מרשומות תגובה גולמיות לנתונים מסוננים, משתני סולם מחוקים, פלטים סטטיסטיים וקבצים המוכנים לוויזואליזציה. תרומתו אינה פיתוח של תיאוריה חדשה על רווחה סובייקטיבית או הצעה של מודל סיבתי. במקום זאת, זרימת העבודה מספקת נתיב הניתן לביקורת עבור הגדרת השאלון, סינון תגובות, חישוב ציוני סולם, בדיקת מהימנות, ניתוח תיאורי, ניתוח קשרים, דיאגנוסטיקה של רגרסיה ואימות מקורות של איורים. הבחנה זו חשובה מכיוון שניתן ביקורת במחקרי שאלונים מבוססי סקרים תלויה בהחלטות פרוצדורליות שמתקבלות לעיתים קרובות לפני תחילת הפרשנות הסטטיסטית, כולל אילו רשומות נשמרות, כיצד מטפלים בפריטים חסרים, כיצ nào מעבדים פריטים עם ניקוד הפוך, וכיצון טבלאות מקור מספריות מקושרות לפלטים חזותיים. הפיכת החלטות אלו למפורשות מפחיתה פרקטיקות מדידה מוטלות בספק במחקרי סולם23 ותומכת בתרבות מחקר שקופה יותר24.
מאפיין מרכזי של הפרוטוקול הוא השימוש בארטפקטים של ביקורת קונקרטיים במקום תיאור מילולי בלבד. זרימת העבודה המעודכנת מקשרת כל מבנה (construct) למכשיר המקור שלו, לטווח הפריטים, לעגיני התגובה, לכיוון הניקוד, לכלל ניקוד הפוך, למשתנה הסופי ברמת הסקלה, ולמידע על התאמה או סטטוס תיעוד. נתיב הביקורת כולל את קובץ השאלון הננעל, את מפת הסקלה הננעלה, את הייצוא הגולמי הננעל, יומן סינון, יומן אימות ניקוד, יומן ניתוח, קובץ פלט דיאגנוסטי וטבלת מקור לדמויות. קבצים אלו מבהירים איזו גרסה של השאלון הוחלה, אילו רשומות הוחרגו או נשמרו, כיצד הופקו הציונים, ואיזו טבלה מאומתת שימשה ליצירת כל דמות. כאשר לא ניתן לשתף באופן פומבי נתונים ברמת המשתתף, מערך נתונים סינתטי בעל מבנה משתנים זהה ויומני סינון וניקוד מלאים יכולים לאפשר לקוראים לבחון את זרימת העבודה החישובית ללא גישה לרשומות מזוהות או מזוהות באופן עקיף. מבנה מבוסס-ארטפקטים זה עולה בקנה אחד עם עקרון ה-FAIR, לפיו תוצרי מחקר שניתן להשתמש בהם שוב דורשים מקור ברור, מבנה ותנאי גישה25.
יש לפרש את התוצאות המייצגות כפלט של זרימת העבודה ולא כראיה מהותית לגבי הגורמים הפסיכולוגיים של רווחת התלמיד. השוואת הרווחה הסובייקטיבית הגבוהה-נמוכה נכללה כדי להדגים כיצד ניתן ליישם, לבדוק ולדווח על כלל חלוקה שנקבע מראש; אין לפרש זאת כסיווג של פרופילי רווחה בעולם האמיתי. באופן דומה, מודל הרגרסיה מדגים כיצד ניתן למדל נתונים מציוני שאלונים, לבדוק אותם למולטיקוליניאריות, להעריך אותם באמצעות דיאגנוסטיקה של שאריות והשפעה, ולקשר אותם לטבלת מקור-איור מאומתת. המודל אינו קובע כי רגש שלילי, דחיינות אקדמית, תחושת שייכות לבית הספר או חשיבה מסדר גבוה קובעים באופן סיבתי את הרווחה הסובייקטיבית. מכיוון שכל המשתנים העיקריים נאספו באמצעות אותו שאלון דיווח עצמי בנקודת זמן אחת, לא ניתן לשלול הטיית שיטה משותפת, השפעות של סגנון מענה והקשר מדידה משותף26.
תהליך עבודה זה אינו מחליף תיקוף פסיכומטרי מלא. אלפא של קרונבך (Cronbach’s alpha), אומגה של מקדונלד (McDonald’s omega), בדיקות טווח נצפה, סקירה של פריט-סך הכל ואימות ניקוד הפוך הם שלבי בקרת איכות מועילים עבור תהליך ניקוד שניתן לביקורת, אך הם אינם קובעים תוקף גורמי, שוויון מדידה, תכונות תגובה של פריטים או השוואתיות בין קבוצות. מחקרים המשתמשים בשאלון לבדיקה מהותית של תיאוריות צריכים לבצע ניתוח גורמים מאשש, בדיקת שוויון מדידה בין קבוצות דמוגרפיות או מוסדיות רלוונטיות, ובדיקות תוקף נוספות בעת הצורך27. לפיכך, יש להבין את הפרוטוקול הנוכחי כמסגרת לעיבוד נתונים ודיווח שניתנת לביקורת, ולא כמחקר תיקוף מלא עבור המבנים הכלולים בו.
תהליך העבודה הודגם על מדגם של סטודנט אחד לתואר ראשון, תוך שימוש בנתוני שאלון בדיווח עצמי שנאספו בנקודת זמן אחת, ללא תיקוף חיצוני. אין להניח כי תהליך זה ניתן להעברה לאוכלוסיות, דיסציפלינות, מוסדות, שפות והקשרים תרבותיים אחרים. אם תהליך העבודה יחזור וישמש בהקשר אחר, יש לבנות מחדש את מפת הסולם במקום להעתיקה באופן מכני. על חוקרים לבחון את מקור הפריטים, את סטטוס התרגום או ההתאמה, את התלות התרבותית וההקשרית של פריטי הרווחה הנפשית, את עגני התגובה, את כללי הניקוד ההפוך, את פרשנות הציונים ואת הדרישות האתיות המקומיות. נהלי תרגום והתאמה דורשים תיעוד מפורש ולא שינויי ניסוח בלתי רשמיים28, ופרשנות של ציוני מבחנים חינוכיים ופסיכולוגיים צריכה להישאר קשורה לראיות התומכות בשימוש ובאוכלוסייה המיועדים29.
בפועל, הפרוטוקול שימושי ביותר כמסגרת הניתנת לביקורת עבור עיבוד נתונים ודיווח במחקרי רווחה (well-being) המבוססים על שאלונים. הוא מסייע לחוקרים להפוך את ההחלטות לגבי ניקוי נתונים, ניקוד, דיאגנוסטיקה וויזואליזציה לנראות לפני תחילת הפרשנות. יישומים עתידיים צריכים לבחון את זרימת העבודה על מדגמים בלתי תלויים, הגדרות מוסדיות שונות, עיצובים אורךים (longitudinal designs) וצוותי אנליסטים ששחזרו את התהליך באופן בלתי תלוי. תיקוף חיצוני, כללי החלטה רשומים מראש, מערכי נתונים סינתטיים משותפים, יומני סינון/ניקוד מלאים כדוגמה ושחזור על ידי אנליסטים בלתי תלויים יחזקו עוד יותר את יכולת הנייד ואת אמינות זרימת העבודה.
גילויים
למחברים אין ניגודי עניינים להצהיר עליהם.
תודות
המחברים מודים לסטודנטים במכללה שהשתתפו בסקר השאלון על תמיכתם במהלך איסוף הנתונים. המחברים מודים גם למדריכים הרלוונטיים ולעוזרי המחקר על סיועם בהפצת השאלונים, בארגון הנתונים, באימות התוצאות ובהכנת הטבלאות והאיורים. עבודה זו לא קיבלה מימון ספציפי.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| חבילת ה-R broom | CRAN | חבילת R | משמש להמרת פלטי רגרסיה לטבלאות מקדמים וסיכומי מודל מובנים. |
| חבילת ה-R בשם car | CRAN | חבילת R | משמש לאימות מקדם ניפוח השונות (variance inflation factor) ולתמיכה באבחון רגרסיה. |
| תיעוד המקור של סולמות דיכאון, חרדה ועקה-21 (Depression Anxiety Stress Scales-21) | הקרן לפסיכולוגיה של אוסטרליה | Lovibond ו-Lovibond, 1995 | תיעוד המקור עבור סעיף הרגשות השליליים. זרימת העבודה השתמשה בניסוחים מותאמים למחקר, התואמים להערכות עדכניות של מצבים רגשיים שליליים. |
| חבילת ה-R dplyr | CRAN | חבילת R | משמש לסינון נתונים, קידוד מחדש, קיבוץ, סיכומי זרימת סינון והכנת טבלאות אנליטיות. |
| חבילת ה-R ggplot2 | CRAN | חבילת R | שמש להפקת מפת חום (heatmap) של המתאמים, תרשים מתאמים של רווחה סובייקטיבית, תרשים מקדמי רגרסיה ותצוגה אבחנתית. |
| תיעוד מקור למדידת חשיבה מסדר גבוה | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | תיעוד המקור עבור סעיף חשיבה מסדר גבוה. זרימת העבודה השתמשה בסט פריטים המותאם למחקר, אשר מיושר עם חשיבה אנליטית, הערכתית, רפלקטיבית, אינטגרטיבית ומבוססת ראיות. |
| IBM SPSS Statistics | IBM Corp. | גרסה 29.0.2.0 | משמש לסטטיסטיקה תיאורית, קרונבך’אלפא של קרונבך, מתאם פירסון, מדגמים בלתי תלויים ומבחן וולש (Welch)’מבחני t, רגרסיה ליניארית מרובה, סטטיסטי Durbin-Watson, שאריות סטנדרטיות, ערכי מינוף, Cook’מרחק, ומקדמי ניפוח שונות (variance inflation factors). |
| חבילת ה-psych ב-R | CRAN | חבילת R | משמש לסיכומים פסיכומטריים, Cronbach’אימות אלפא של קרונבך (Cronbach's alpha verification), ומקדונלד (McDonald)’ס-אומגה. |
| תיעוד המקור של סולם תחושת השייכות הפסיכולוגית לבית הספר | Wiley | Psychol Sch. 1993;30(1):79-90 | תיעוד מקור עבור סעיף השייכות לבית הספר. זרימת העבודה השתמשה בניסוחים המותאמים למחקר, אשר תואמים תחושות של קבלה, חיבור, תמיכה ושייכות בסביבת בית הספר. |
| סביבת הסטטיסטיקה R | R Foundation for Statistical Computing | גרסה 4.4.2 | המשמש לאימות אנליטי משני, McDonald’$\omega$ (אומגה), בדיקות רגישות של Spearman, הכנת פלט רגרסיה, הכנת פלט דיאגנוסטי והכנת מקור ויזואליזציה. |
| חבילת ה-R readxl | CRAN | חבילת R | משמש לייבוא ייצואים של שאלונים מגיליונות אלקטרוניים אל זרימת העבודה של האימות ב-R. |
| תיעוד המקור של סולם רווחה סובייקטיבית לאזרחים סיניים | מדעי & פרסום אקדמי | DOI: 10.5923/j.ijap.20190905.01 | תיעוד המקור עבור סעיף הרווחה הסובייקטיבית (subjective well-being). זרימת העבודה השתמשה בניסוחים המותאמים למחקר ובפריטים עם ניקוד הפוך, אשר תואמו עם חוויות רווחה הקשורות לשביעות רצון מהחיים, משמעות, תמיכה, התקדמות, חוסר שביעות רצון, חוסר אונים ולחץ. |
| קובץ משלים 1: מבנה השאלון ותיעוד סולמות המדידה | מחברים | קובץ משלים 1 | מספק את מבנה השאלון שהועבר, את סדר המבנים (constructs), את מקור הסולמות, קודי פריטים, נקודות עיגון לתגובות, כיוון ניקוד, כללי ניקוד הפוך, בניית ניקוד ברמת הסולם ומידע על סטטוס התיעוד. |
| תיעוד מקור עבור סולם הדחיינות של טקמן (Tuckman Procrastination Scale) | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | תיעוד מקור עבור סעיף הדחיינות אקדמית. זרימת העבודה השתמשה בניסוחים מותאמי-מחקר התואמים התנהגות של עיכוב אקדמי ודחיית משימות. |
| פלטפורמת השאלונים המקוונת Wenjuanxing | Changsha Ranxing Information Technology Co., Ltd. | פלטפורמה מבוססת רשת | משמש להסכמה אלקטרונית, תכנות שאלונים, איסוף תשובות לפריטים, תיעוד חותמות זמן, רישום משך ההשלמה, סקירת הגשות כפולות וייצוא תשובות גולמיות. |
מקורות
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.