מאמר זה בוחן אלגוריתם לאופטימיזציה של תזמון דינמי המשלב Transformer ולמידת חיזוק מסוג PPO, תוך התמקדות בקונפליקטים תכופים במשאבים ובעיכובים בתגובה בתזמון פעילויות איגודים.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
אלגוריתם לתזמון דינמי ואופטימיזציה של משאבים עבור פעילויות איגוד באמצעות שילוב של Transformer ולמידה עם חיזוק
במאמר זה
סיכום
תקציר
כדי לפתור את בעיית הירידה ביעילות הארגונית הנגרמת מקונפליקטים תכופים בהקצאת משאבים ומתגובות תזמון מושהות בניהול פעילויות של איגודי עובדים, מאמר זה מציע אלגוריתם תזמון דינמי המשלב Transformer ו-PPO (Proximal Policy Optimization). ביישום הספציפי, ראשית תוכננה מבנה מידול מאחד לתרחישי תזמון כדי להמיר מצבי פעילות, כוח אדם ומשאבים לקלטי טנזור, ובכך להשיג אינטגרציה של אילוצים רב-ממדיים. לאחר מכן, נעשה שימוש במנגנון הקשב הרב-ראשי (multi-head attention) של ה-Transformer כדי לקודד את סדרת הזמן של בקשות פעילות היסטוריות ומצב המשאבים, לחלץ מאפיינים מרחביים-זמניים רב-ממדיים ולהגביר את התפיסה של סיכוני קונפליקט. בהמשך, בהתבסס על תוצאות הקידוד ורשת האסטרטגיה של PPO, נוצרות פעולות תזמון מהמצב הנוכחי כדי לשפר את יכולת ההסתגלות של האסטרטגיה לסביבות מורכבות. לבסוף, באמצעות עדכון גיזום (pruning) ומנגנון תיקון פונקציית היתרון, מובטחים היציבות של האסטרטגיה במהלך האיטרציות וביצועי תזמון משופרים. ניסויים הראו כי כאשר צפיפות המשימות היא 1000, זמן ההחלטה הממוצע של אלגוריתם התזמון הוא 0.72s ועיכוב התגובה הממוצע שלו הוא 1.59s, מה שמעיד על מהירות תגובה גבוהה ויעילות קבלת החלטות. לאורך שבעה סוגי פעילות ורמות מורכבות, שיעור קונפליקטי המשאבים הוא 0.05–0.12; שיעור ניצול המשאבים הממוצע הוא 0.75–0.86; ומדד יציבות התזמון הוא 0.8–0.91, מה שמפחית ביעילות קונפליקטים תכופים בהקצאת משאבים ומשיג יציבות תזמון גבוהה. בתנאים של עומס מקבילי גבוה, מדד איזון המשאבים ומדד חסנות העברת האסטרטגיה הם 0.88 ו-0.85 בהתאמה, מה שמעיד על יכולת הסתגלות טובה לעומסי משימות מקביליים.
מבוא
פעילויות של איגודים כרוכות בתזמון מורכב של משימות ומשאבים מרובים, דבר הדורש מהמערכת יכולות תגובה דינמיות יעילות1,2. דרישות הפעילות משתנות בתדירות גבוהה, והבאת כוח האדם ומשאבי המקום היא מורכבת, דבר שעלול להוביל בקלות לקונפליקטים של תזמון ולבזבז משאבים3,4. תיעוד מדויק של היסטוריית הפעילויות ומצב המשאבים בזמן אמת, לצד שיפור היכולת לזהות ולהגיב לקונפליקטים פוטנציאליים, הם המפתח להגברת היעילות התפעולית הארגונית5,6. שילוב של טכנולוגיית מידול סדרות עיתים מתקדמת ואלגוריתמים של למידת חיזוק יכול להוביל להבנה מעמיקה ולאופטימיזציה חכמה בסביבות תזמון מורכבות, ובכך לסייע במיקסום ניצול המשאבים, האצת התגובה לתזמון וקידום השדרוג האינטליגנטי של ניהול פעילויות האיגוד.
עם זאת, גישות תזמון קיימות בפועל הן במידה רבה מבוססות כללים וסטטיות, ואינן מסוגלות להסתגל לשינויים תכופים במשימות ולתנודות במשאבים, מה שמוביל לעיתים קרובות לזמני תגובה ממושכים ולקונפליקטים חמורים במשאבים. בתזמון פעילויות של איגודים, סוגי המשימות מגוונים מאוד; השימוש במשאבים מוגבל מאוד ומשתנה לעיתים קרובות; והתלויות בין הפעילויות והתחרותיות בין המשאבים מהוות מפת תזמון מורכבת7,8. בפועל, לא ניתן להתאים ביעילות את לוח הזמנים של הפעילות לחלונות הזמן הזמינים של משאבים כגון כוח אדם ואתרים9,10, וקונפליקטים מתרחשים לעיתים קרובות, מה שמעמיד בסכנה את הלכידות הכללית של הפעולות הארגוניות11,12. מערכת התזמון אינה עומדת בפני מטרה אחת של אופטימיזציה, אלא בפני איזון בין מדדים רב-ממדיים, כגון מזעור קונפליקטים במשאבים, מקסימום מהירות תגובה, יציבות אסטרטגיית התזמון ושיעור השלמת המשימות13,14, המציגים מאפיינים טיפוסיים של אופטימיזציה רב-מטרתית. בנוסף, פעילויות של איגודי עובדים מציגות שלבים ומחזורים מובחנים, ואסטרטגיות תזמון חייבות להסתגל באופן דינמי למבני דרישת המשאבים המשתנים בשלבי משימה שונים. תוכניות סטטיות הנוצרות פעם אחת אינן יכולות לתמוך בסביבת ביצוע עם שינויים בתדירות גבוהה15,16. הלוגיקה של התזמון הקיימת חסרה חקירה מעמיקה של התנהגות משימות היסטורית ודפוסי שינויים במצב המשאבים. היא אינה מסוגלת לספק תחזיות מדויקות והסקת אסטרטגיות לעתיד17,18. אסטרטגיית התזמון של המערכת מגיבה באיטיות למשימות פתאומיות ולשינויים זמניים במשאבים, מה שמשפיע על הקיימות הכללית של התפעול19,20. בניית מערכת תזמון בעלת יכולת ניבוי, גמישות ויציבות הפכה לדרישה טכנית מרכזית ביישומים מעשיים. הדבר דורש מהמודל להיות בעל תפיסת מידע רב-ממדית, זיכרון רצפי ויכולות הגירה של אסטרטגיות, ולשמור על קבלת החלטות חסונה ואיזון משאבים בסביבת ריבוי-משימות, ובכך לאפשר תיאום חכם ואופטימלי של תזמון פעילויות האיגוד.
מחקרים רבים הציעו פתרונות שונים לבעיית התזמון הדינמי. ביניהם, השילוב של למידה עמוקה (deep learning) ולמידה בחיזוק (reinforcement learning) הראה יכולות התאמה ואופטימיזציה חזקות. חלק מהחוקרים משתמשים ב-LSTM (Long Short-Term Memory)21,22 כדי למדל נתוני סדרות זמן ומשלבים אסטרטגיות של למידה בחיזוק כדי למטב את התנהגות התזמון, ובכך השיגו תוצאות מסוימות. סוג אחר של מחקר משתמש בשיטה היוריסטית המבוססת על אלגוריתם גרידי (greedy algorithm), תוך דגש על פשטות ויעילות של החלטות התזמון, מה שמתאים לתרחישים עם כללים ברורים23,24. מחקרים אחרים בחנו את היישום של רשת Q עמוקה (DQN) לתזמון, והשיגו אסטרטגיות משופרות באמצעות קירוב פונקציית ערך25,26. עם זאת, לשיטות אלו ישנן בעיות כגון לכידה לא מספקת של תלויות ארוכות טווח, עדכוני אסטרטגיה לא יציבים ועיכובי תגובה משמעותיים כאשר הן ניצבות בפני תרחישים מורכבים ומשתנים של פעילות איגודית, מה שמקשה על עמידה בצרכי התזמון של משימות צפופות ומגוונות. לכן, השאלה כיצד לבנות אלגוריתם תזמון בעל יכולות חילוץ מאפיינים יעילות ועדכון אסטרטגיה יציב הפכה לצוואר בקבוק שיש לפרוץ במחקר הנוכחי.
במחקרים על תזמון רב-תחומי, ארכיטקטורת ה-Transformer יושמה במשימות שונות של חיזוי סדרות זמן ואופטימיזציה של תזמון הודות למנגנון הקשב העצמי רב-הראשים (multi-head self-attention) שלה, אשר לוכד ביעילות תלותיות זמניות ארוכות-טווח27,28. כאשר היא משולבת עם אלגוריתם PPO בלמידת חיזוק, האסטרטגיה מעודכנת באופן יציב ויעיל על ידי קיטום פונקציית המטרה, וגישה זו הראתה ביצועים טובים בתחומים כגון בקרת רובוטים ויצור חכם29,30,31. מספר מחקרים ניסו לשלב את ה-Transformer עם למידת חיזוק עבור תזמון משאבים מורכב32. עם זאת, בתזמון דינמי של פעילויות איגוד, מחקרים מעטים עוסקים בשילוב של סוגי פעילויות מגוונים ואילוצי משאבים מורכבים. חלק מהמחקרים השתמשו ברשתות עצביות גרפיות (graph neural networks) כדי למדל את הקשר בין משאבים למשימות, ובכך שיפרו את דיוק זיהוי הקונפליקטים33,34. חוקרים מסוימים ביצעו אופטימיזציה לתזמון משאבים המבוסס על מחשוב קצה (edge computing) כדי להגביר את היעילות והביצועים של המודל35,36. עם זאת, לשיטות אלו עדיין יש יכולות מידול מוגבלות עבור הקשר זמני. על בסיס זה, מאמר זה מציע להשתמש ב-Transformer כדי לקודד רצפי פעילות היסטוריים ורצפי מצבי משאבים, בשילוב עם רשת מדיניות PPO, כדי להשיג תפיסה גבוהה של סיכוני קונפליקט ועדכון יציב של אסטרטגיות תזמון, במטרה להתמודד עם צרכי התזמון המשתנים והמורכבים של פעילויות איגוד.
מחקרים עדכניים יותר בחנו אופטימיזציה של תזמון משאבים מנקודות מבט שונות, כגון קונסולידציה של VM ליעילות אנרגטית במחשוב ענן37, אלגוריתמי אימות ברשתות סלולריות38, קונסולידציה משופרת של VM באמצעות הגירה חיה (live migration) למחשוב ענן בר-קיימא39, אופטימיזציה של תנועה באמצעות חיזוי המתנה ואלגוריתמים אבולוציוניים40, ואחסון ענן מבוסס בלוקצ'יין עם אופטימיזציה משופרת ושמירה על שלמות הנתונים41. בעוד שעבודות אלו מספקות תובנות רבות לגבי הקצאת משאבים ואלגוריתמי אופטימיזציה, הן מתמקדות בעיקר בתשתיות ענן, טלקומוניקציה או מערכות אחסון, ואינן עוסקות באופן ספציפי במגבלות של פעילויות רב-סוגיות, קונפליקטים דינמיים של משאבי כוח אדם ומקום, ודרישות תזמון בזמן אמת הגלומות בניהול פעילויות איגוד. הבחנה זו מדגישה עוד יותר את הצורך במסגרת תזמון ייעודית המותאמת להקשר הארגוני של פעילויות איגוד.
שיטות תזמון קיימות עבור פעילויות של איגודים נכשלות לעיתים קרובות בלכידה של תלויות מרחביות-זמניות ארוכות טווח ובשמירה על יציבות המדיניות בצל שינויים דינמיים, מה שמוביל לזמני תגובה איטיים ולהתנגשויות משאבים גבוהות. כדי למלא פערים מחקריים אלו, מחקר זה מציע מודל אופטימיזציה של תזמון המבוסס על העיקרון שמיקוד קשב רב-ראשי (multi-head attention) של Transformer יכול לקודד ביעילות רצפים היסטוריים לניבוי התנגשויות, וש-Proximal Policy Optimization (PPO) עם יעד קטוע (clipped objective) מבטיח עדכוני מדיניות יציבים ואדפטיביים. באופן ספציפי, Transformer מיושם כדי לקודד רצפי מצבי פעילות ומשאבים, תוך חילוץ מאפיינים מרחביים-זמניים מרכזיים להגברת צפיית ההתנגשויות, ו-PPO משולב ליצירת פעולות תזמון יעילות ועדכונים יציבים. מטריצת אילוצים מאוחדת תוכננה למיפוי פעילויות, כוח אדם ואתרים, ובכך לשפר את הזיהוי של תלויות מורכבות. החדשנויות המרכזיות של עבודה זו כוללות: (1) שילוב של קידוד זמני ולמידה חיזוקית המותאמים ספציפית לתזמון פעילויות של איגודים; (2) מנגנון קשב מודע להתנגשויות המתעדף תפיסת סיכונים; ו-(3) עדכון גיזום עם תיקון פונקציית יתרון להבטחת חסינות האסטרטגיה תחת עומס גבוה של פעולות מקבילות. ניסויים נרחבים תחת צפיפויות ומורכבויות משימה שונות מאששים את עליונות המודל על פני שיטות קיימות במהירות התגובה, בניצול המשאבים וביציבות, ומספקים פתרון תזמון חכם, מעשי וניתן להרחבה לניהול פעילויות של איגודים.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
איור 1 מציג את המבנה של מערכת לתזמון פעילויות איגוד המשלבת מידול סדרות עתיות ולמידה עם חיזוק. שכבת הקלט משלבת לוחות זמנים של פעילויות, זמינות משאבים ומידע על חלונות זמן של כוח אדם, ובונה מטריצת יחסי קונפליקט רב-ממדית בין משימות למשאבים באמצעות מודול גרף האילוצים. ה-transformer מבצע קידוד של קשב רב-ראשי (multi-head attention) על הרצף ההיסטורי של מצבי הפעילות והמשאבים, ומפיק מצבים נסתרים עם תלויות זמניות. מודול המדיניות משתמש בתוצאות הקידוד כדי להפיק התפלגויות פעולות והערכת מצב, ומבצע החלטות תזמון לאחר דגימת פעולות. תוצאות הביצוע מועברות חזרה לסביבה, מעדכנות את מצב המשאבים ומייצרות תגמולים מיידיים. על בסיס זה, מודול האופטימיזציה בונה פונקציית מטרה עם קיטום (clipping), מעריך את פונקציית היתרון ומתקן את ההערכה של רשת הערכים כדי להגביל את סטיות המדיניות ולהבטיח עדכונים יציבים של התנהגויות התזמון. לולאת נתונים סגורה נוצרת בין המודולים כדי להשיג תפיסה רגישה מאוד של קונפליקטי משאבים ועדכוני אסטרטגיה אדפטיביים בסביבות דינמיות, ובכך לשפר את יכולת התגובה האינטליגנטית ואת יעילות הקצאת המשאבים של מערכת תזמון פעילויות האיגוד בתרחישים של משימות מרובות ואילוצים גבוהים.
מידול תרחישים של תזמון פעילות איגוד
כל בקשות הפעילות במערכת התזמון מאורגנות לרצפי תזמון בדידים המבוססים על צעדי זמן. כל פעילות מוגדרת עם זמני התחלה וסיום ברורים, קטגוריות משאבים, שלבים ורמות עדיפות. סטטוס השימוש באתר ממודל כמטריצת חלונות זמן דו-ממדית, שבה הציר האופקי מייצג את יחידת הזמן הסטנדרטית והציר האנכי מייצג את מספר המשאב המרחבי. סטטוס המשאב מסומן כזמין או כתפוס, ובכך נוצרת מפת התפלגות משאבים ראשונית בעלת מבנה סטטי. מידע תזמון כוח האדם מורחב בממד הזמן-זהות כדי לבנות וקטור חלון זמן רציף, כאשר כל אחד מהם מתעד את סטטוס המשימה-פנאי של איש הצוות ואת מספר המחלקה. כל מידע הקלט משולב למבנה טנזור תלת-ממדי, שבו denotes את צעד הזמן הבדיד, denotes את מספר ישויות המשאבים, ו-denotes את קוד תכונת השימוש במשאב המתאימה (כגון האם הוא תפוס, מספר הפעילות, עדיפות השימוש וכו'). מבנה זה מאפשר למערכת התזמון לקרוא את תצורת המשאבים בכל רגע נתון, ובכך להבטיח ייצוג מאוחד של סוגי סטטוס משאבים שונים.
לאחר קישור מידע המשימה למודל, וקטור עוצמת המשימה נקבע על בסיס עדיפות הפעילות ותקופת השימוש במשאב. שילובי משימות שעלולים לגרום לקונפליקט מסומנים באמצעות שיטת זיהוי חפיפת חלונות זמן. שילובי קונפליקט מומרים לקבוצות צמתים, וקבוצות קשתות נבנות על בסיס סוגי משאבים ותקופות משותפות כדי לייצג באופן מפורש תלויות משתמעות. גרף המשימות הסופי שנבנה מכיל מידע על גבולות רצף הזמן, חפיפת משאבים או קונפליקט במגבלות, ובכך מספק בסיס מבני לזיהוי קונפליקטים להמשך ולהפקת אסטרטגיות תזמון. מבנה זה שומר על הטבע הדינמי של תזמון המשימות ועל השינויים הרציפים במצב המשאבים, ותומך בתפיסה בזמן אמת של שינויים במגבלות התזמון.
זיהוי קונפליקטים משתמש באזורים הדלילים החופפים של ממדי הזמן והמשאבים במבנה הטנזור כתנאים ראשוניים לשיפוט. הוא מיישם עיבוד קידוד של קשרים סטטיים עבור זוגות משימות עם יעדי תזמון חופפים. הוא בונה מבנה גרף G=(V,E,C), שבו V מייצג את קבוצת הצמתים הפעילים, E מייצג את הקשתות שנוצרו על בסיס קונפליקטים במשאבים, ו-C היא מטריצת קידוד משקלי הקונפליקט עבור הקשתות. פונקציית משקל הקונפליקט מוגדרת בצורה הבאה:
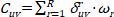 (1)
מתוכם, Cuv הוא משקל הקונפליקט בין פעילויות u ו-v; u, v הם אינדקסים של פעילויות; R הוא המספר הכולל של סוגי המשאבים; δuvr ∈ {0,1} מציין האם חלונות הזמן של פעילויות u ו-v חופפים במשאב r; ωr הוא משקל רגישות הקונפליקט של המשאב r. פונקציה זו מבצעת סכום משוקלל של עוצמות הקונפליקט, תוך התחשבות בהבדלים בחשיבותם של קונפליקטי משאבים לתוצאות התזמון, ובעוד היא שומרת על ביטוי כמותי של התפלגות עוצמת הקונפליקט.
מבנה גרף הקונפליקט שלעיל מומר למטריצת גבול אילוצים באמצעות ייצוג מטריצה דלילה. כל פריט במטריצה מכיל את מידת קונפליקט המשאבים. המטריצה מוטמעת בתהליך קבלת החלטות התזמון כדי לקבוע אם ניתן לתזמן משימות במקביל, בעוד שלוגיקת מיגון הפעולות (action-shielding) נמצאת ברשת המדיניות. כדי להתמודד עם אגרגציה של פעילויות מחזוריות ופרצי משימות בצפיפות גבוהה, יושם מנגנון עדכון דינמי למעקב אחר שינויים בסטטוס המשימות ולשינוי תוכן המטריצה בזמן אמת ככל שמשאבים משוחררים או נוספים, ובכך להבטיח את הרציפות והעקביות של גבול התזמון לאורך התפתחות המשימות.
היישום של מבנה גרף קונפליקט זה מאפשר למערכת התזמון למדל באופן חזותי צווארי בקבוק פוטנציאליים של משאבים ותבניות של חפיפת משימות, ובכך לשפר את היעילות של ניתוח הניתוק (decoupling analysis) של רשת ההחלטות בתרחישי אילוצים מורכבים. התנהגות התזמון אינה נשענת עוד על התאמה לוגית מבוססת כללים; במקום זאת, היא מחפשת את המסלול האופטימלי במרחב האילוצים, דבר המשפר את היכולת לאזן באופן דינמי בין קונפליקטים מקומיים של משאבים לבין מפת המשימות הגלובלית. המערכת יכולה לשמור על יציבות התזמון ועל קוהרנטיות המשימות בסביבה שבה המשאבים תנודתיים, ומשימות מתווספות או מוסרות בתדירות גבוהה.
איור 2 מציג תרשים מבנה רשת המבוסס על יחסי משקלי קונפליקט המשימות. כל צומת באיור מייצג משימה לתיזמון, והקווים בין הצמתים מציינים קונפליקטים בשימוש במשאבים. עובי הקשת משקף את משקל הקונפליקט; ככל שהקונפליקט חמור יותר, כך הקו עבה יותר. חישוב המשקל משלב חפיפת משאבים ומשלב את רגישות הקונפליקט של משאבים שונים כדי ליצור עוצמת קונפליקט מרוכבת בין משימות. מבנה הגרף חושף כי חלק מהמשימות יוצרות אזורים מחוברים בצפיפות, מה שמעיד על תחרות משמעותית על ניצול המשאבים. תופעה זו של צבירת קונפליקטים מקומית היא המקור העיקרי לבקבוקי צוואר במשאבים ולעיכובים במשימות בתהליך התיזמון, ועל פיה יכול אלגוריתם התיזמון להגדיר יעדי תיווך בעדיפויות. סידור הצמתים עושה שימוש באסטרטגיית פריסה מונחית-כוח (force-directed layout) כדי לאגד באופן אוטומטי משימות בעלות קונפליקט גבוה, מה שמאפשר למערכת התיזמון לזהות קבוצות משימות מרכזיות ולבצע אופטימיזציה של חלוקת האסטרטגיה, ובכך לשפר את העקביות הכללית של התיזמון ואת תיאום המשאבים.
קידוד רצף מצבים היסטורי
בהתבסס על גרף הקונפליקטים ומטריצת האילוצים שנבנו, השלב הבא הוא קידוד הרצפים ההיסטוריים של הפעילויות ומצבי המשאבים, כדי שניתן יהיה לחלץ את התבניות הזמניות העומדות בבסיס אילוצים אלו לצורך קבלת החלטות בהמשך. המידע המרכזי בתרחיש התזמון מורכב מבקשות לפעילויות, שינויים בסטטוס המשאבים ורשומות משוב של משימות. מידע זה מהווה סדרות זמן הטרוגניות מרובות, התואמות למאפיינים כגון נקודות זמן של אירועים, מזהי שימוש במשאבים וסטטוס ביצוע של פעילויות. כדי לאחד את מבנה העיבוד, כל סוג קלט מקודד כרצף וקטורים באורך שווה, ונקבע אינדקס זמן מאוחד כדי להבטיח סנכרון של המצבים תחת סנכרון זמנים. יחידת הקלט בכל רגע נתון מיוצגת על ידי שרשור של שלוש קבוצות של וקטורי מאפיינים: וקטור מאפייני הפעילות מייצג את סוג המשימה, העדיפות ומספר השלב; וקטור מאפייני המשאב מתעד את התפיסה הנוכחית של המשאב, הקיבולת שנותרה ומיקום חלון הזמינות; וקטור מאפייני המשוב מתאר האם המשימה בוצעה בצורה חלקה ברגע הקודם, והאם התרחש אירוע של קונפליקט במשאבים או עיכוב.
כל המאפיינים עוברים טרנספורמציה ליניארית וממופים לאותו מרחב ממדי כדי לקבל מטריצת שיכון (embedding matrix) סטנדרטית X ∈ ℝT×d, כאשר T מייצג את מספר שלבי הזמן ו-d הוא ממד השיכון המאוחד. כדי לשמר את המבנה הזמני, מטריצת הקלט מתווספת איבר אחר איבר למטריצת קידוד המיקום P ליצירת קלט מודע-מיקום:
Z = X + P (2)
Z היא רצף הקלט הסופי, המשמש כקלט למנגנון ה-attention העוקב. תכנון קידוד המיקום משתמש בתבנית קבועה של פונקציות סינוס וקוסינוס כדי למנוע דליפה של מידע עתידי ולהבטיח כי אילוצים סיבתיים נשמרים בקפידה במהלך הקידוד. המבנה לעיל מאפשר למודל לתפוס בו-זמנית מאפייני משימה, מצב משאבים ומיקום זמן. הוא מהווה בסיס זיכרון מצב מלא, המספק מבנה מאוחד ברזולוציה גבוהה עבור מנגנון ה-attention העוקב.
מודול הקשב מעבד את רצף הקלט כדי ללכוד קשרים פוטנציאליים בין מספר שלבי זמן. קבוצות מרובות של ראשי קשב משמשות לעיבוד נפרד של הרצף, ובכך הן מגבירות את רגישות המודל לסוגים שונים של נתיבי התפתחות מצב. כל ראש קשב מייצר מטריצת שאילתה Q, מטריצת מפתח K ומטריצת ערך V מרצף הקלט, מחשב את מטריצת התפלגות המשקלים ומייצר ייצוג משוקלל. הפלט של קשב בעל ראש בודד הוא:
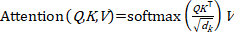 (3)
דק' הוא מספר ממדי המאפיינים לכל ראש. בנוסחה זו, שאלוןK⊤ מייצג את הדמיון בין מומנטים, √דק משמשת ליציבות נומרית, ופונקציית ה-softmax מבטיחה נורמליזציה של המשקלות. ראשי קשב (attention heads) שונים מתמקדים בשילובים שונים של שלבי זמן, והתלויות הדינמיות שהם לוכדים הן גמישות ומגוונות, מה שמסייע בחשיפת כללים מרומזים כגון מבשרי קונפליקטים במשימות, דפוסי צריכת משאבים ומגמות של משוב חריג.
כל פלטי ראשי תשומת הלב (attention heads) משרשרים ועוברים דרך שכבת טרנספורמציה ליניארית כדי לייצר רצף קידוד מאוחד, המשמש כקלט המצב עבור רשת יצירת אסטרטגיית התזמון. רצף זה מקודד את מסלול התנהגות המשימה, את מאפייני שינוי המשאבים ואת ההשפעה של סטיות ביצוע קודמות בחלון התזמון הנוכחי, ובכך נותן מענה יעיל לבעיה של תלות היסטורית גבוהה בהתנהגות התזמון וביטוי תכונות דליל. מודולים של חיבור שאריות (Residual connection) ונורמליזציה של שכבות (layer normalization) שולבו בשכבת פלט הקידוד כדי לשפר את יציבות האימון ואת יכולות שימור הביטוי של הרשת העמוקה.
רצף מצבי המצב הנסתרים (hidden state) של הפלט אינו שומר רק מידע על התפתחות בזמן, אלא מגיב גם לשינויים הנובעים ממשימות פתאומיות או מחוסר התאמה זמני במשאבים, ובכך מדגים סתגלנות גבוהה. תכנון מבני זה נמנע מהגדרה מפורשת של כללים, מאפשר מידול מובנה של סביבות תזמון דינמיות, ותומך במודולי מדיניות עוקבים ביצירת פתרונות תזמון בעלי עקביות גלובלית וסתגלנות מקומית תחת תנאים רב-מטרתיים.
יצירת אסטרטגיית תזמון דינמית
רצפי המצבים החבויים המקודדים, המטמיעים הן תלויות זמניות והן מידע על קונפליקטים במשאבים, מוזנים לאחר מכן לרשת המדיניות כדי ליצור פעולות תזמון המסתגלות לסביבה הנוכחית. רצף המצבים החבויים המוצא מהמודול המקודד משמש כקלט לרשת אסטרטגיית התזמון. קבוצת וקטורי המצב בכל רגע נתון מהווה את ביטוי התצפית של הסביבה הנוכחית, המכסה את התפתחות מאפייני המשימה, מגמות השימוש במשאבים ומסלולי משוב היסטוריים. ממד ייצוג המצב ואורך חלון הזמן הם קבועים, והרציפות של שינויי המצב נלכדת באמצעות מנגנון עדכון מחליק (sliding-update mechanism). לפני שווקטור המצב נשלח לרשת המדיניות, הוא עובר נורמליזציה וארגון מחדש של מאפיינים כדי להבטיח שהקלט ישמור על התפלגות מספרית יציבה במרחב רב-ממדי, ובכך להפחית התפוצצות גרדיאנטים ותנודות בהתכנסות.
מבנה רשת המדיניות עושה שימוש במודול פלט בעל שני ענפים, כאשר ענף אחד יוצר את התפלגות הפעולות והשני מוציא את הערכת פונקציית ערך המצב. מרחב הפעולות כולל את כל המשימות הניתנות לתזמון ואת המשאבים הניתנים להקצאה. מנגנון סינון המועמדים מסנן שילובי פעולות לא חוקיים או מיותרים כדי ליצור קבוצה מוגבלת וחוקית של פעולות. ענף המדיניות מוציא התפלגות הסתברותית π(at|st), כאשר at מייצגת את פעולת התזמון בצעד הזמן, ו-st הוא קלט המצב הנוכחי. אסטרטגיית דגימה גאוסיאנית סטנדרטית או דגימת softmax משמשות לבחירת פעולות מההתפלגות לצורך תזמון בפועל. הפלט השני הוא הערכת פונקציית ערך המצב, המייצגת את ציפיית התגמול לטווח ארוך במצב הנתון ומשמשת להערכה ולעדכון של המדיניות.
ברשת המדיניות, השכבה הנסתרת מחילה פונקציות אקטיבציה ונורמליזציה של אצוות (batch normalization) כדי לשפר את יכולת הביטוי הלא-לינארית ולהאיץ את התכנסות הרשת. בתהליך קבלת ההחלטות, עדיפות הביצוע, עלות תזמון המשאבים והביצועים ההיסטוריים של משימות שונות נחשבים כגורמי קשב (attention factors) ומיושמים על מנגנון בחירת הפעולה באמצעות מטריצת משקלות ספציפית, כדי ליצור מסגרת פלט-מדיניות הניתנת לכיוונון אדפטיבי. תכנון זה מונע הסתמכות על כללים קבועים, ובכך משפר את גמישות האסטרטגיה בטיפול בקונפליקטים פתאומיים ובצווארי בקבוק מבניים.
אסטרטגיית התזמון משתמשת במנגנון דגימה אקראית כדי להפיק את רצף הפעולות בפועל. בכל מחזור תזמון, נדגמת פעולה ניתנת לביצוע מהתפלגות הפעולות הנוכחית, ומצב המשאבים וסימון צומת המשימה מעודכנים. לאחר ביצוע הפעולה, המערכת מחשבת את תגמול המשוב המיידי בהתבסס על שינויים במשאבים ותוצאות התקדמות המשימה, כדי למדוד את השפעת סבב התזמון הזה על המטרה הכוללת. תכנון התגמול לוקח בחשבון ממדים מרובים, כולל שיעור השלמת המשימות, יעילות ניצול המשאבים ומידת דיכוי הקונפליקטים. הוא מספק משוב למודול עדכון האסטרטגיה באמצעות מדדים מקיפים.
תהליך התזמון כולו בונה שרשרת החלטות מרקוב ומשתמש בשיטת דגימת מסלול אמפירית כדי לתעד את רצף המצב-פעולה-תגמול, המסומן כ-(st, at, rt, st+1). אופטימיזציה של האסטרטגיה נשענת על בניית פונקציית היתרון (advantage function), כאשר הערכת היתרון מוגדרת בצורה הבאה:
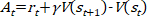 (4)
At מייצג את ערך היתרון, rt הוא התגמול המיידי הנוכחי, γ הוא מקדם ניכוי התגמול, ו-V(st) ו-V(st+1) הם פלטי פונקציית ערך המצב במצב הנוכחי ובמצב הבא, בהתאמה. פונקציית היתרון משקפת את מידת העליונות של הפעולה הנוכחית ביחס לביצועים הממוצעים של האסטרטגיה. היא משמשת להנחיית שיפור האסטרטגיה בהמשך. אם At > 0, המשמעות היא שהפעולה הנוכחית טובה יותר מהציפייה הממוצעת, ויש להעלות את ההסתברות שלה; אחרת, יש להפחית את נטיית הבחירה בה.
במהלך תהליך עדכון האסטרטגיה, כדי למנוע תנודות באסטרטגיה הנגרמות מאמפליטודות עדכון מוגזמות, מיושם מנגנון קיטוע של התפלגות המטרה כדי להגביל את טווח השינוי בין האסטרטגיה החדשה לישנה, ובכך לשמור על הרציפות והיציבות של פלט הרשת. קישור הדוק מוקם בין התפלגות הפעולות לבין תגמול המשוב, מה שמאפשר לאסטרטגיה להגיב באופן מיידי לשינויים באילוצים מורכבים. מנגנון זה שומר על יציבות קבלת ההחלטות ועל תזמון משאבים רציונלי במצבים שבהם משימות משתנות בתדירות גבוהה או כאשר חוסר התאמה פתאומי במשאבים מתרחש, ובכך מונעות ביעילות בעיות כגון הקצאה כפולה, גודש במשאבים או הצטברות של תורי משימות. מערכת התזמון יכולה לשמור על מצב תפעולי טוב יותר בטווח של צפיפויות משימה משתנות ומחסור במשאבים, מה שמעיד על יכולות הסתגלות חזקות.
איטרציה של אסטרטגיות ומנגנון עדכון יציב
כדי להבטיח שאסטרטגיות התזמון הנוצרות יישארו יציבות ולא ידרדרו לאורך סבבי אימון חוזרים, בתת-סעיף זה מוצג מנגנון עדכון איטרטיבי הכולל קיטום (clipping) ותיקון יתרון (advantage correction). מרווח עדכון הקיטום (truncation) בין האסטרטגיות הישנה והחדשה נקבע, ופונקציית מטרה של קיטום (clipping) משמשת להגבלת הסחיפה של האסטרטגיה כדי למנוע זעזוע בתזמון במהלך תהליך עדכון האסטרטגיה. רשת הערכת השווי מתוקנת בשילוב עם פונקציית היתרון כדי לשפר את דיוק התזמון לטווח ארוך.
התפלגות ההסתברות של פלט הפעולה של רשת המדיניות נוטה לתנודות חריפות במהלך איטרציות תזמון רציפות, דבר שעלול להוביל להתנהגות לא יציבה או להקצאת משאבים לא מסודרת. כדי למתן את זעזוע התזמון הנגרם מסטיות במדיניות (policy drift), תוכנן מרווח עדכון קטוע כדי לשלוט בטווח השינוי בין המדיניות החדשה לישנה, ונבנה איבר הגבלה כדי לדייק את פונקציית המטרה. הסתברות המדיניות ההיסטורית נרשמת בסבב הדגימה, ואיבר היחס נבנה עם הסתברות המדיניות הנוכחית. יעד עדכון המדיניות נקבע כ:
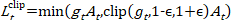 (5)
כאן, gt = πθ(at|st)/πθold(at|st) מייצג את יחס ההסתברות בין המדיניות החדשה לישנה; ε הוא סף הקיטום (clipping threshold) המגביל את טווח עדכון המדיניות. כאשר היחס חורג מהגבול, נעשה שימוש בערך הקיטום במקום זאת כדי למנוע מהאסטרטגיה לייצר גרדיאנטים מופרזים מדגימות קיצוניות, ובכך להבטיח שהתאמת פרמטרי הרשת תישאר בתוך הטווח שהוגדר מראש. מבנה זה מגביל באופן דינמי את טווח השינויים באסטרטגיית הפלט עבור כל סבב תזמון, ושומר על החלקות ועקביות של פלט האסטרטגיה תחת התפלגויות משימות צפופות, תוך הפחתה משמעותית של שיעור הרעידות (jitter rate) בהתנהגות התזמון.
פונקציית המטרה של המדיניות מועשרת באיברי רגולריזציה ותגמול אנטרופיה במהלך תהליך העדכון כדי להגביר את הגיוון של התפלגות הפעולות ולדכא התכנסות מוקדמת. כל סבב של עדכוני מדיניות משתמש במספר קבוצות (batches) של דגימות מסלולי ניסיון לאימון מתגלגל, ובכך שומר על רוחב כיסוי במרחב המצבים. כאשר משווים את התפלגות ההסתברות של רצף הפעולות הפלט לפני העדכון ואחריו, מחושב שיעור הסטייה של ההתפלגות, וסף קשיח מסנן את טווח ההפרעה המקובל של המדיניות. מנגנון זה מספק בקרת גבולות להגירת מדיניות תזמון בין מחזורים, ובכך מדכא התאמת יתר (overfitting) הנובעת משינויים קיצוניים במצב המשאבים.
עדכוני אסטרטגיה נשענים על הערכת המצב המסופקת על ידי פונקציית הערך. סטיות בהערכת ערך המצב עלולות להשפיע ישירות על נכונותה של פונקציית היתרון, ובכך לשנות את כיוון האיטרציה של האסטרטגיה. כדי לשפר את דיוק ההערכה, נבנה מנגנון נסיגה (backtracking) רב-סדרות זמן, וערכן המצטבר המהוון של תגמולים עתידיים משמש לתיקון ערך המצב הנוכחי. תגמול הנסיגה מאמץ את מבנה ה-Generalized Advantage Estimation (GAE), המוגדר כך:
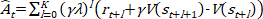 (6)
Ât הוא ערך היתרון המתוקן; λ הוא מקדם איזון הנסיגה (backtracking); rt+l מייצג את התגמול המיידי של הצעד ה-(t+l); V(st+l) הוא ערך המצב שמופק על ידי רשת ההערכה. מבנה זה משלב משוב מיידי לטווח קצר וציפיות מצב לטווח ארוך כדי לתקן סטיות בחיזוי התגובות של האסטרטגיה עבור קונפליקטים עתידיים במשאבים, עומסי שיא והצטברות משימות. λ שולט בעומק הנסיגה ומתעדכן באופן אוטומטי במהלך תקופות של תנודות דינמיות חריפות במשאבים, כדי להגביר את החסינות של תגובת רשת ההערכה לאירועים פתאומיים.
המבנה התלוי-זמן רב-קנה-מידה המוטמע בפונקציית היתרון מאפשר לרשת ההערכה למדל מגמות משאבים לטווח ארוך. לצורך זיהוי סטייה בפלט המדיניות, נעשה שימוש במדד עקביות התנהגות המדיניות כדי להעריך האם הרשת מגיבה תגובה מופרזת לשגיאת ההערכה. איברי שארית של הפרש-משוב מנטרים את התנהגות עדכון המדיניות, כאשר יעד האימון ואמפליטוד עדכון המשקולות של פונקציית הערך מתוקנים באופן דינמי. רשת הערך ורשת המדיניות עוברות אופטימיזציה משותפת כדי להבטיח כי הערכת הערך לא תסטה ממטרת השלמת המשימה, תוך מניעה ממתיגה תדירה של תזמון שתשגה בשיפוט מצב קונפליקט המשאבים.
מנגנון עדכון מדיניות יציב זה יכול לשמר ביעילות את יכולת השליטה והעקביות של עדכוני התנהגות המדיניות בסביבת משימות דינמית רב-ממדית, לשפר את יעילות כיסוי המשימות ואת הגמישות בניצול משאבים, וליצור מבנה תזמון אינטליגנטי איטרטיבי ומתמשך. התנהגות התזמון מונעת נפילה לאופטימיזציה מקומית באבולוציה ארוכת טווח ומגבירה את יכולת ההסתגלות הכוללת לשינויים בדפוסי המשימות ולתנודות במחקורי המשאבים.
איור 3A מציג את המגמה בערך פונקציית המטרה כפונקציה של מספר איטרציות האימון תחת תנאים שונים של סף קיטוע (truncation threshold). הציר האופקי מייצג את מספר איטרציות האימון, והציר האנכי מייצג את הערך המספרי של פונקציית המטרה הקטועה. ε נקבע ל-0.1, 0.2 ו-0.3, המייצגים דרגות שונות של עוצמת בקרת סחף המדיניות (policy drift control). העקומה המתאימה לערך ε קטן יותר נתונה לתנודתיות פחותה, ופונקציית המטרה נותרת יציבה. כאשר ε = 0.1, ערך פונקציית המטרה הכללי הוא בין 0.8 ל-1, דבר המעיד על ההדרגתיות והיציבות של עדכון האסטרטגיה. עם זאת, ערך ε גדול יותר מוביל לתנודות בולטות. כאשר ε = 0.3, ערך פונקציית המטרה הכללי הוא בין 0.65 ל-0.95, ועקומת פונקציית המטרה מראה אמפליטודת תנודה גדולה יותר, מה שמשקף את הסיכון לסטייה חמורה בתהליך עדכון האסטרטגיה. ככל שהסף נמוך יותר, כך האסטרטגיה יציבה יותר, דבר המתאים לסביבות תזמון עם אילוצים גבוהים. איור 3B מציג את השינויים בהערכת היתרון המוכללת (generalized advantage estimate) תחת מקדמי איזון נסיגה (backtracking balance coefficients) שונים. λ נקבע ל-0.8, 0.9 ו-1.0 בהתאמה, כדי לשלוט בעומק הנסיגה של תגמולים עתידיים. העקומה מראה שככל ש-λ גבוה יותר, כך תנודות ה-GAE קטנות יותר, המגמה ארוכת הטווח חלקה יותר, והיא לוכדת באופן מדויק יותר את ההשפעה הפוטנציאלית של התנהגות התזמון לאחר מספר שלבים. העקומה עם λ של 0.8 מראה תנודות מחזוריות בולטות, מה שמעיד על כך שהיא רגישה יותר לתגמולים מיידיים ומתאימה יותר למשימות קצרות ופתאומיות. לעומת זאת, λ של 1.0 מתמקד יותר במידול מגמות ארוכות טווח ומתאים לתרחישים של משימות מחזוריות.
ניתוח סיבוכיות חישובית ויכולת הרחבה
הסיבוכיות החישובית של מסגרת ה-Transformer-PPO המוצעת נקבעת על ידי שני רכיבים עיקריים: מקודד ה-Transformer ואופטימיזציית המדיניות של ה-PPO.
עבור מקודד Transformer בעל L שכבות, H ראשי קשב (attention heads), ממד שיכון d ואורך רצף קלט T (חלון הזמן ההיסטורי), הסיבוכיות בזמן עבור מעבר קדימה (forward pass) היא O(L·T2·d + L·T·d2), כאשר האיבר T2 נובע ממנגנון הקשב העצמי (self-attention). במימוש, L = 3, H = 4, d = 128, ו-T מקובע ל-100 צעדי זמן, מה שמוביל למאמץ חישובי סביר. עבור חלונות היסטוריים ארוכים יותר, האיבר הריבועי T2 הופך לגורם הדומיננטי; עם זאת, בפועל, תזמון פעילות איגודית כרוך בדרך כלל באופקים היסטוריים סופיים (למשל, חלונות נעים של רבעון אחד או שנה אחת), וניתן להתאים את רזולוציית צעדי הזמן כדי לאזן בין דיוק ליעילות.
עבור רכיב ה-PPO, רשת המדיניות (policy network) ורשת הערך (value network) הן MLP קלות משקל (256 ו-128 נוירונים לכל שכבה נסתרת), שסיבוכיות ההסקה שלהן היא O(d·m), כאשר m הוא מספר היחידות הנסתרות, נתון הזניח בהשוואה למקודד ה-Transformer. עדכון המדיניות במהלך האימון כולל מספר תקופות (epochs) של עדכוני גרדיאנט במיני-באצ'ים (mini-batch), עם סיבוכיות של O(B·E·d2), כאשר B הוא גודל הבאצ' ו-E הוא מספר תקופות העדכון.
מבחינת יכולת הרחבה (scalability), המסגרת מציגה שלושה מאפיינים חיוביים. ראשית, ניתן לבצע מקביליות של מנגנון התשומת לב (attention mechanism) על פני שלבי הזמן, מה שמאפשר האצה יעילה באמצעות GPU. שנית, גודל המודל אינו תלוי במספר הפעילויות או המשאבים, מכיוון שמטריצת האילוצים נבנית באופן דינמי בכל שלב של התזמון ולא מוטמעת כפרמטרים קבועים. דבר זה מאפשר לפרוס את אותו מודל מאומן בבתי איגודים בקנה מידה שונה ללא צורך באימון מחדש. שלישית, עבור תרחישים בקנה מידה גדול במיוחד, ניתן להקטין את אורך חלון ההיסטוריה T ואת ממד ההטמעה (embedding dimension) d כפשרה, או לאמץ את גרסת התשומת לב הדלילה (sparse attention) כדי להפחית את הסיבוכיות מ-O(T2) ל-O(T log T) או O(T).
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
נתונים ניסיוניים
כדי להעריך באופן מקיף את ביצועיו של אלגוריתם התזמון הדינמי Transformer-PPO המוצג במאמר זה, הניסוי משתמש בנתוני ניהול פעילויות מאיגוד ארגוני גדול במהלך שלוש השנים האחרונות כסט נתונים למשווה (benchmark). סט נתונים זה מכיל למעלה מ-5,000 רשומות של פעילויות, המקיפות סוגים שונים, כולל פגישות, הדרכות ובידור, עם מידע תזמון עבור מספר משאבים, כגון מקומות, ציוד וכוח אדם. כל רשומה מפרטת את זמן ההתחלה והסיום של הפעילות, דרישות המשאבים, העדיפות וסטטוס הביצוע בפועל (כולל אירועי קונפליקט וניצול משאב...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
התוצאות הניסיוניות מדגימות כי אלגוריתם ה-Transformer-PPO המוצע עולה בעקביות בביצועיו על שיטות הבסיס (LSTM-PPO, חיפוש חמדני ו-DQN) בכל מדדי ההערכה. את הביצועים העדיפים ניתן לייחס לשני גורמים מרכזיים. ראשית, מנגנון תשומת הלב העצמית רב-הראשים (multi-head self-attention) של ה-Transformer לוכד ביעילות תלויות זמניות ארוכות-טווח ברצפי פעילויות ומצבי משאבים, מה שמאפשר זיהוי פרואקטיבי של קונפליקטים פוטנציאליים. דבר זה מסביר מדוע שיעור הקונפליקטים נותר נמוך גם בתנאי מורכבות גבוהה (למשל, שיתוף פעולה בין-מחלקתי והכנסה זמנית של משימו...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
המחברים מצהירים כי אין להם ניגודי עניינים כספיים.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | שפת תכנות ליבית |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | מסגרת למידה עמוקה (מימוש Transformer/PPO) |
| NumPy 1.23 | מפתחי NumPy | הערות גרסה 1.23.0 הגרסה הזו כוללת מספר שינויים משמעותיים, כולל תמיכה ב-SIMD, שיפורים בביצועים ומספר תיקוני באגים. שינויים משמעותיים - נוספה תמיכה ב-SIMD (Single Instruction, Multiple Data), המאפשרת האצה של פעולות רבות על גבי מעבדים תומכים. - הוכנסו שיפורים בביצועי האינדקסים (indexing) והסריחה (slicing). - מספר פונקציות שהיו מסומנות כ-deprecated הוסרו או שונו. תכונות חדשות - נוספה תמיכה ב-`numpy.typing`, המאפשרת הגדרת טיפוסים סטטית עבור מערכי NumPy. - פונקציות חדשות לטיפול במערכים רב-ממדיים. שינויים שדורשים תשומת לב (Breaking Changes) - שינויים בהתנהגות של מספר פונקציות בשימוש נרחב כדי להבטיח עקביות מתמטית. - שינויים בטיפוסי ההחזרה של חלק מהפונקציות במקרים של קלט ריק. תיקוני באגים - תיקון בעיות של זליגות זיכרון במספר פעולות. - תיקון שגיאות חישוב במקרים של מספרים צפים (floating point) קיצוניים. ספריות ותלויות - עדכון דרישות הגרסה של Python לגרסה 3.8 ומעלה. - שיפור התאימות עם ספריות scipy ו-pandas. | ספריית חישובים מספריים |
| Matplotlib 3.5 | צוות הפיתוח של Matplotlib | התקנה המדריך הזה יסייע לכם להתקין את Matplotlib. המלצות לפני ההתקנה לפני שתתקינו את Matplotlib, מומלץ מאוד להוסיף למסמך ההתקנה שלכם את חבילות התוכנה הבאות: - NumPy - Pandas (אופציונלי) הדרך המומלצת ביותר להתקין את Matplotlib היא באמצעות מנהל החבילות pip. התקנה באמצעות pip ניתן להתקין את Matplotlib באמצעות הפקודה הבאה בטרמינל: pip install matplotlib אם אתם משתמשים בגרסת פייתון ספציפית, ייתכן שתצטרכו להשתמש ב-pip3: pip3 install matplotlib התקנה באמצעות Conda אם אתם משתמשים ב-Anaconda או Miniconda, ניתן להתקין את Matplotlib באמצעות הפקודה הבאה: conda install matplotlib בדיקת ההתקנה כדי לוודא שההתקנה הושלמה בהצלחה, תוכלו להריץ את הקוד הבא בפייתון: import matplotlib print(matplotlib.__version__) אם הגרסה מודפסת ללא שגיאות, Matplotlib הותקנה בהצלחה. הערות למערכות הפעלה שונות Windows במערכת ההפעלה Windows, מומלץ להשתמש בסביבה וירטואלית (virtual environment) כדי למנוע התנגשויות בין חבילות. macOS במערכת ההפעלה macOS, ניתן להתקין את Matplotlib באמצעות pip או conda. אם אתם נתקלים בבעיות עם התצוגה הגרפית, ודאו שמותקן גרסת Xcode עדכנית. Linux ברוב הפצות הלינוקס, ניתן להתקין את Matplotlib דרך מנהל החבילות של ההפצה (למשל apt ב-Ubuntu): sudo apt-get install python3-matplotlib עם זאת, התקנה באמצעות pip נשארת הדרך המומלצת לקבלת הגרסה העדכנית ביותר. | ויזואליזציה של תוצאות |
| סט נתונים של תזמון פעילות איגודים מקצועיים | מאגר נתונים פנימי של ארגון שותף (אנונימי) | אינו זמין לציבור עקב הסכם סודיות; חוקרים רשאים לפנות למחבר המקשר לצורך קבלת גישה | מעל 5,000 רשומות פעילות (פגישות, הדרכות, בידור) מאיגוד עובדים של ארגון גדול לאורך שלוש שנים |
| NVIDIA A100 GPU | |||
| PyTorch |
מקורות
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.