מחקר זה בוחן סמנים ביולוגיים של אלקטרואנצפלוגרפיה (EEG) להבחנה בין מחלת אלצהיימר, דמנציה פרונטוטמפורלית וביקורות בריאות. מודלי Random Forest המשתמשים במאפייני שורש ממוצע הריבועים (root mean square), צפיפות ספקטרלית של הספק (power spectral density) ואנטרופיה, פוענחו באמצעות בינה מלאכותית ניתנת להסבר (explainable AI) וניתוח גודל אפקט. הסרת מאפייני אנטרופיה בעלי השפעה נמוכה שיפרה את ביצועי הסיווג, והובילה לדיוק של 94% במבחן.
מאמר מחקר
מיזוג סמנים ביולוגיים של אלקטרואנצפלוגרפיה (EEG) מרוב-תחומי לסיווג דמנציה מבוסס למידת מכונה
במאמר זה
סיכום
תקציר
אלקטרואנצפלוגרפיה (EEG) נחקרה כגישה לא פולשנית לאפיון פעילות מוחית במצבים נוירודגנרטיביים. מחקר זה בחן האם סמנים ביולוגיים של EEG רב-תחומיים יכולים להבדיל בין מחלת אלצהיימר (AD), דמנציה פרונטו-טמפורלית (FTD) וביקורות בריאות (HC). מערך הנתונים הזמין לציבור הכיל הקלטות EEG ממצב מנוחה, בעיניים עצומות, של 88 משתתפים, הכוללים 36 חולי AD, 23 חולי FTD ו-29 ביקורות בריאות. סמנים ביולוגיים של EEG רב-תחומיים ומאפיינים דמוגרפיים הופקו לצורך סיווג באמצעות למידת מכונה. המאפיינים שהופקו מה-EEG כללו שורש ממוצע ריבועים (RMS), צפיפות ספקטרלית של הספק (PSD) ומדדי אנטרופיה. מסווג Random Forest אומן באמצעות סט המאפיינים המשולב ופורש באמצעות בינה מלאכותית ניתנת להסבר. ניתוחי יציבות מאפיינים וגודל אפקט של Cohen’s d בוצעו כדי להעריך את תרומת המאפיינים, ולאחריהם בוצע ניתוח אבלציה. מאפיינים מבוססי אנטרופיה הראו את התרומה הנמוכה ביותר לסיווג. המודל הרב-תחומי המלא השיג דיוק אימון של 96% ודיוק בדיקה של 92%. לאחר הסרת מאפייני האנטרופיה, דיוק הבדיקה עלה ל-94%. תוצאות אלו מתארות את ביצועי הסיווג של מאפייני ה-EEG הרב-תחומיים והמאפיינים הדמוגרפיים שנבחרו במסגרת Random Forest.
מבוא
מחלת אלצהיימר (AD) היא מצב נוירולוגי פרוגרסיבי הקשור להידרדרות בתפקוד הקוגניטיבי והמוטורי. שכיחותה עולה באופן משמעותי עם הגיל, ודמנציה היא גורם מרכזי לתחלואה ותמותה בקרב מבוגרים1,2,3,4,5. מכיוון שהאבחנה וסיווג המחלה נותרו מאתגרים, נחקר ניתוח של אותות מוחיים כאמצעי לאפיון שינויים נוירופיזיולוגיים הקשורים לדמנציה.
אלקטרואנצפלוגרפיה (EEG) היא שיטה לא פולשנית להקלטת הפעילות החשמלית של המוח, והיא נחקרה במחלת אלצהיימר ובהפרעות נוירולוגיות אחרות6,7,8,9,10,11. אותות EEG משקפים פוטנציאלים חשמליים הנוצרים כתוצאה מפעילות נוירונלית, והם מוקלטים באופן לא פולשני ממספר מיקומים על קרקפת הראש12,13,14. פעילות מוחית מאופיינת בדרך כלל באמצעות פסי תדרים של דלתא, תטא, אלפא, בטא וגמא15. מחלת אלצהיימר נקשרה להאטה ב-EEG, להפחתה במורכבות האות ולסנכרון משתנה16. ניתוחים ספקטרליים דיווחו על עלייה בפעילות דלתא ותטא לצד ירידה בפעילות אלפא ובטא בקרב אנשים עם AD בהשוואה לקבוצות ביקורת בריאות17,18,19. מחקרי סיווג EEG קודמים דיווחו על ביצועים גבוהים בהבחנה בין AD לביקורות בריאות (HC) ובין דמנציה פרונטוטמפורלית (FTD) ל-HC. לעומת זאת, הבחנה בין AD ל-FTD הייתה בדרך כלל מאתגרת יותר10,11.
שיטות של למידת מכונה שימשו לזיהוי דפוסים באותות EEG הקשורים למחלות נוירולוגיות20,21. לפיכך, חילוץ מאפיינים הוא רכיב חשוב בסיווג המבוסס על EEG. מחקרים קודמים בחנו מאפיינים ספקטרליים, זמניים, של מורכבות ושל קישוריות תפקודית בשילוב עם מודלים של למידת מכונה3,15,22,23. מאפיינים ספקטרליים רלוונטיים במיוחד מכיוון שהם מכמתים שינויים בפעילות המוח התלויים בתדר, כולל ירידה בפעילות alpha ועלייה בפעילות theta שדווחו במצב של AD23,24,25,26.
מספר מחקרים המבוססים על EEG העריכו שילובים שונים של מאפיינים, מסווגים ואסטרטגיות תיקוף. ניתוח מבוסס קישוריות (Connectivity) שימש להבחנה בין AD, FTD ו-HC, כאשר ביצועי הסיווג שדווחו השתנו בהתאם להשוואה ולפרוצדורת בחירת המאפיינים27. מאפיינים מבוססי פורייה (Fourier) הוערכו אף הם לצורך הבחנה בין AD, ליקוי קוגניטיבי קל (MCI) וביקורות בריאות, אם כי המגבלות כללו עיבוד מקדים מוגבל והסתברות להתאמת יתר (overfitting) הקשורה לאסטרטגיית התיקוף28. מדדי מורכבות לא-ליניאריים של EEG הראו פוטנציאל מבחין לסיווג AD, כאשר חלקם השיגו דיוק, רגישות וסגוליות גבוהים, אם כי יישומם עבור MCI והבחנה בין שלבי המחלה נותר מוגבל21.
שיטות למידה עמוקה המבוססות על ייצוגי זמן-תדר של EEG נחקרו גם הן עבור סיווג רב-מחלקתי של AD, MCI ו-HC29. למרות שדווח על ביצועי סיווג גבוהים, המגבלות כוללות קבוצות נחקרים קטנות או נבחרות, חוסר איזון בין המחלקות, חומרה הטרוגנית של המחלה, היעדר תיקוף חיצוני ויכולת פרשנות מופחתת של המודלים29. אסטרטגיית התיקוף היא גם שיקול מתודולוגי חשוב. גישות בלתי תלויות-משתתף הראו כי תיקוף צולב (cross-validation) קונבנציונלי ברמת האפוקה (epoch) עלול להוביל להערכת יתר של הביצועים כאשר אפוקות מאותו משתתף מופיעות הן בסט האימון והן בסט הבדיקה30. מגבלה זו רלוונטית במיוחד כאשר משווים תוצאות סיווג בין מחקרים המשתמשים בסכמות תיקוף שונות.
מדדי מורכבות וקישוריות הוערכו גם באמצעות מסווגי מכונת וקטורים תומכים (support vector machine), כאשר קישוריות מבוססת-מופע ואנטרופיה רב-קנימית הראו רמות משתנות של ביצועי הבחנה31,32. עבודות אחרות שהשתמשו במאפיינים המופקים מ-Fourier ומ-wavelet דיווחו על ביצועים משתנים בהשוואות בין AD, MCI ו-HC, כאשר סיווג רב-מחלקתי נותר בדרך כלל קשה יותר מסיווג בינארי14. גישות המבוססות על אנטרופיה וסנכרון הדגימו בנוסף הבחנה בין קבוצות AD לקבוצות ביקורת, אם כי מאפייני אוכלוסיית הביקורת עשויים להשפיע על גודל האפקט שנצפה2.
המחקר הנוכחי מעריך סט מאפיינים רב-ממדי הכולל מדדי שורש ממוצע ריבועים (RMS), צפיפות ספקטרלית של הספק (PSD) ואנטרופיה שהופקו מפסים של תדרי EEG, יחד עם הגיל כמשתנה דמוגרפי. RMS מייצג את אמפליטודת האות בתוך כל פס תדר, בעוד ש-PSD מייצג את ההספק במישור התדר. אנטרופיה נכללה כמדד למורכבות האות. מאפיינים אלו מספקים תיאורים משלימים של פעילות ה-EEG ומוערכים באמצעות מסווג Random Forest. המחקר בוחן בנוסף את חשיבות המאפיינים, יציבות המאפיינים, בינה מלאכותית ניתנת להסבר וניתוח גודל אפקט כדי להעריך את התרומה היחסית של המאפיינים שהופקו. המחקר הנוכחי בוחן את היעילות של מאפייני EEG רב-ממדיים, כולל מדדים ספקטרליים, זמניים ומבוססי מורכבות, להבחנה בין מחלת אלצהיימר (AD), דמנציה פרונטו-טמפורלית (FTD) וביקרות בריאות (HC) באמצעות למידת מכונה. כמו כן, הוא בוחן אילו מאפיינים של פסי תדרי EEG תורמים בצורה החזקה ביותר לסיווג כאשר משתמשים במדדי צפיפות ספקטרלית של הספק (PSD), שורש ממוצע ריבועים (RMS) ואנטרופיה. בנוסף, המחקר משווה בין התרומות של מאפיינים מבוססי הספק, כולל PSD ו-RMS, לבין אלו של מאפיינים מבוססי אנטרופיה, ומעריך את תרומתו של הגיל למודל הסיווג.
פרוטוקול
סכימה סכמטית של זרימת העבודה של עיבוד מקדים של EEG, חילוץ מאפיינים וסיווג מוצגת ב- איור 1. החומרים והתוכנות ששימשו במחקר מפורטים ב- טבלת חומרים.
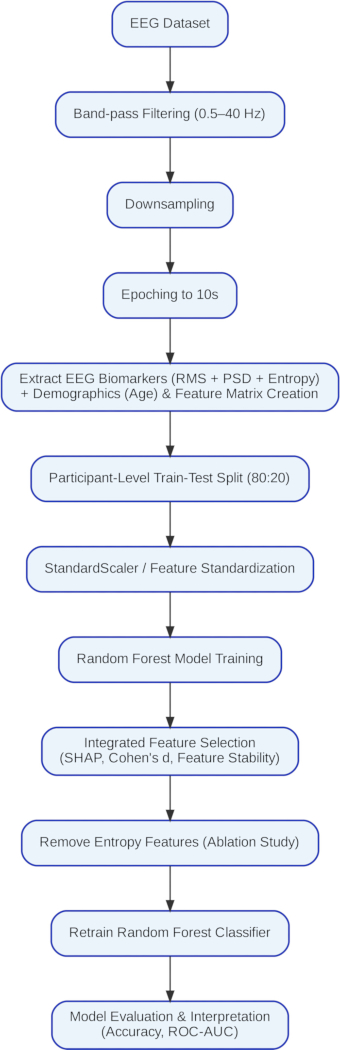
איור 1: זרימת העבודה של צינור העיבוד המקדים, חילוץ המאפיינים והסיווג של ה-EEG. סקירה סכמטית של זרימת העבודה במחקר, הכוללת אימות נתוני EEG, סינון מעבר-פס (band-pass) והגדרה מחדש של נקודת הייחוס (re-referencing), חילוץ מאפייני שורש ממוצע ריבועי (RMS), צפיפות הספק ספקטרלית (PSD) ואנטרופיה, הוספת גיל, חלוקה למערכות אימון ובדיקה, פיתוח מודל Random Forest, ניתוח יציבות מאפיינים, ניתוח SHAP, ניתוח גודל אפקט של Cohen’s d, בחירת מאפיינים משולבת, אבלציה (ablation) של מאפייני אנטרופיה, אימון מחדש של המודל והערכת ביצועים. אנא לחצו כאן כדי להציג גרסה מוגדלת של איור זה.
1. איסוף נתונים
מערך נתוני EEG במצב מנוחה הזמין לציבור הושג ממאגר OpenNeuro (מערך נתונים ds004504, גרסה 1.0.9)33. תוויות המשתתפים והמידע הדמוגרפי אומתו. מערך הנתונים כלל 88 משתתפים, ביניהם 36 משתתפים עם מחלת אלצהיימר (AD), 23 עם דמנציה פרונטו-טמפורלית (FTD), ו-29 ביקורות בריאות (HC).
2. ייבוא הקלטות EEG
עבור כל משתתף, הקלטת ה-EEG נטענה באמצעות ספריית MNE-Python. כל קובץ EEG נבדק כדי לוודא שהוא נגיש, שניתן לייבא אותו בהצלחה ושהוא כולל מזהה משתתף תקף. הקלטות עם קבצים חסרים או פגומים הוצאו מהמחקר. תדר הדגימה המקורי של ה-EEG, 500 Hz, נשמר בשלב זה. האותים עברו דגימה מחדש (downsampled) כדי להפחית את העומס החישובי תוך שמירה על כל המידע הקליני הרלוונטי של ה-EEG למחקר זה.
3. סינון פס-מעבר
הקלטות ה-EEG הרציפות סוננו באמצעות מסנן פס-מעבר מסדר רביעי עם תדר חיתוך נמוך של 0.5 Hz ותדר חיתוך גבוה של 40 Hz.
4. ייחוס ממוצע משותף וחלוקה לתקופות (Epoching)
ייחוס ממוצע משותף (CAR) הוחל על הקלטות ה-EEG המסוננות. עבור כל דגימת זמן, חושב ממוצע האות בכל ערוצי ה-EEG הזמינים והוא הופחת מכל ערוץ. אותי ה-EEG המיוחסים נשמרו לצורך ניתוחים המשכיים. כל הקלטת EEG מיוחסת חולקה לתקופות (epochs) באורך קבוע באמצעות הפונקציה make_fixed_length_epochs() ב-MNE-Python. נעשה שימוש במשך תקופה של 10 s ללא חפיפה (0 s overlap).
5. תיקוף תקופות (Epoch validation)
עבור כל משתתף, נשמרו רק תקופות שלמות באורך 10s. כל מקטע EEG שנותר באורך של פחות מ-10 s בסוף ההקלטה נשלף. כל תקופה שנשמרה שימשה לאחר מכן כדגימה בודדת לצורך חילוץ מאפיינים.
6. הכנת מאפיינים
למרות שנתוני מבחן המצב המנטלי המקוצר (MMSE) היו זמינים במערך הנתונים המקורי, הם הוצאו מהניתוח הנוכחי. המאפיינים שהופקו מה-EEG מוזגו עם מידע דמוגרפי של המשתתפים, כולל גיל ותוויות אבחנה, אשר הושגו מקובץ המטא-נתונים participants.csv. מזהה המשתתף שימש כמפתח המשותף, ורק משתתפים עם רשומות מאפייני EEG ומידע דמוגרפי תואם נשמרו.
מטריצת מאפייני הרב-מישור כללה חמישה מאפייני שורש ממוצע ריבועים (RMS) (delta_rms, theta_rms, alpha_rms, beta_rms, ו-gamma_rms), חמישה מאפייני צפיפות ספקטרלית של הספק (PSD) (delta_psd, theta_psd, alpha_psd, beta_psd, ו-gamma_psd), וחמישה מאפייני אנטרופיה (delta_entropy, theta_entropy, alpha_entropy, beta_entropy, ו-gamma_entropy). גיל נכלל כמשתנה דמוגרפי משלים. מכיוון שפילוגי הגיל עשויים להשתנות בין קבוצות אבחנה שונות, לא ניתן היה לשלול לחלוטין השפעה דמוגרפית מתערבת. קבוצת האבחנה, שהוגדרה כ-AD, HC או FTD, הוקצתה כתגית היעד.
7. עיבוד מקדמי של הנתונים וחלוקה למערכי אימון ובדיקה
במהלך העיבוד המקדמי, קצב הדגימה של ההקלטות הופחת מ-500 Hz ל-250 Hz כדי להפחית את הדרישות החישובתיות תוך שמירה על מידע התדרים של ה-EEG הרלוונטי.
מערך הנתונים חולק לתתי-קבוצות של אימון (80%) ובדיקה (20%) ברמת הנבדק, תוך שימוש באסטרטגיית פיצול מקובצת (grouped splitting). תחזיות ברמת הנבדק הושגו לאחר מכן באמצעות הצבעת רוב בין התקופות (epochs) שנחזו עבור כל משתתף. ההערכה העיקרית השתמשה בפיצול אימון-בדיקה מקובץ ברמת הנבדק כדי למנוע מצב שבו תקופות מאותו משתתף יופיעו בשתי תתי-הקבוצות. תחזיות ברמת הנבדק הושגו באמצעות הצבעת רוב בין התקופות שנחזו עבור כל משתתף. מערך הנתונים נסקר לאיתור ערכים חסרים, ותצפיות חסרות הוסרו או הושלמו (imputed) בהתאם לצורך. תוויות אבחנתיות קודדו. StandardScaler הותאם על נתוני האימון ולאחר מכן הוחל הן על מערך נתוני האימון והן על מערך נתוני הבדיקה.
8. פיתוח מודל Random forest
מסווג Random Forest אותחל באמצעות 80 עצים, עומק מקסימלי של 10 עבור העץ, מקסימום של ארבעה מאפיינים, מינימום של חמישה דגימות לכל עלה, ומצב רנדומלי (random state) של 42. המסווג אומן באמצעות מערך הנתונים המנורמל לאימון.
9. הערכת מודל
תוויות סיווג נחזו הן עבור מערך הנתונים לאימון והן עבור מערך הנתונים לבדיקה. נבנתה מטריצת בלבול (confusion matrix), וחושבו הדיוק (accuracy), הדיוק החזוי (precision), הרגישות (recall) ומדד F1-score יחד עם דוח הסיווג. רמות הדיוק באימון ובבדיקה תועדו.
עבור ההערכה ברמת המשתתף, ודאו שכל התקופות (epochs) של משתתף נתון הוקצו באופן בלעדי למערך האימון או למערך הבדיקה. מסווג ה-Random Forest אומן באמצעות אותם היפר-פרמטרים ששימשו בניתוח הראשוני.
10. תיקוף צולב (Cross-validation)
כהליך נוסף להערכת המודל, בוצע תיקוף צולב מרובד בעל חמישה קיפולים (five-fold stratified cross-validation) תוך שימוש ב-shuffle = True ו-random_state = 30. חושבו הדיוק הממוצע וסטיית התקן על פני חמשת הקיפולים. ניתוח זה נבחן בנפרד מהערכת ההשמטה (holdout) העיקרית ברמת הנבדק.
11. ניתוח יציבות תכונות
יציבות התכונות הוערכה על ידי חזרה על אימון ה-Random Forest 10 פעמים תוך שימוש בגרעינים אקראיים (random seeds) מ-0 עד 9. עבור כל הרצה, תועדו דיוק הבדיקה וציוני חשיבות התכונות. הממוצע וסטיית התקן של ציון חשיבות התכונה עבור כל Predictor חושבו על פני 10 ההרצות, וה-Predictors דורגו לפי יציבותם. ניתוח זה שימש להערכת העקביות של דירוג התכונות ולא כדי להחליף את ההערכה הראשונית ברמת הנבדק.
12. ניתוח בינה מלאכותית ניתנת להסבר (Explainable AI)
כלי ה-SHAP TreeExplainer הוחל על מודל ה-Random Forest המאומן. ערכי SHAP חושבו כדי להעריך את תרומתו של כל מאפיין לתחזיות המודל. עבור כל מאפיין חושב ערך ה-SHAP המוחלט הממוצע, והמאפיינים דורגו בהתאם לתרומות ה-SHAP שלהם. מאפיינים עם ערכי SHAP נמוכים באופן עקבי זוהו והושוו לתוצאות ניתוחי יציבות המאפיינים וניתוחי Cohen’s d. מאפיינים שהפגינו תרומות נמוכות באופן עקבי נבחרו לשלב הבא של ablation ולאימון מחדש של המודל.
13. ניתוח סטטיסטי של גודל האפקט
חישוב של d של כוהן (Cohen’s d) בוצע עבור כל סמן ביולוגי (biomarker) של EEG עבור AD מול ביקורת בריאה, מחלה של אלצ하이מר לעומת דמנציה פרונטו-טמפורלית, ודמנציה פרונטו-טמפורלית לעומת השוואות לבקרי בריאות (HC). גדלי גודל-השפעה (effect-size) פושטו באמצעות ספי סף של 0.20 להשפעה קטנה, 0.50 להשפעה בינונית ו-0.80 להשפעה גדולה.
14. בחירת מאפיינים משולבת
התוצאות של ניתוח חשיבות המאפיינים ב-Random Forest, ניתוח SHAP וניתוח Cohen’s d הושוו. משתנים מנבאים שהפגינו באופן עקבי חשיבות מאפיין נמוכה, תרומת SHAP נמוכה וגדלי אפקט קטנים זוהו כמועמדים להסרה.
15. השמטת מאפיינים (Feature ablation)
מאפייני אנטרופיה הוערכו בניתוח השמטה גשש, ונבנתה מטריצת מאפיינים מצומצמת הכוללת RMS, PSD וגיל. מסווג ה-Random Forest אומן מחדש תוך שימוש באותם היפר-פרמטרים. אימון המודל, הבדיקה, התיקוף הצולב (cross-validation) וניתוח עקומת ROC (receiver operating characteristic) חזרו על עצמם באמצעות סט המאפיינים המצומצם.
16. ניתוח ROC
הסתברויות המחלקה הופקו ממסווג Random Forest שעבר אופטימיזציה. עקומות ROC רב-מחלקיות הופקו באמצעות שיטת one-לעומת-אסטרטגיית מנוחה. חושבו ערכי השטח תחת העקומה (AUC) ספציפיים למחלקה וה-AUC הממוצע.
17. השוואת ביצועים
ביצועי מודל התכונות המלא הושוו לביצועי מודל התכונות המצומצם שהתקבל לאחר השמטת תכונות האנטרופיה (entropy-feature ablation).
תוצאות
מודל ה-Random Forest השיג דיוק של 96% באימון ודיוק של 92% בבדיקה. מדד ה-F1-score בממוצע מאקרו (macro-average) היה 92%, בעוד שמדד ה-F1-score בממוצע משוקלל (weighted-average) היה גם הוא 92%, מה שמעיד על ביצועים דומים בשלושת הסוגים (classes). ביצועי הסיווג היו הגבוהים ביותר עבור סוג מחלת האלצהיימר (AD), בעוד שסוג הדמנציה הפרונטו-טמפורלית (FTD) הראה ביצועים נמוכים יותר יחסית, כפי שמוצג ב-טבלה 1.
ניתוח עקומת מאפייני תגובה של מקלט (ROC) שימש להערכת הפרדה בין מחלקות על פני ספי סיווג שונים. כפי שמוצג ב-איור 2, השטח תחת עקומת ה-ROC (AUC) עלה על 0.98 עבור כל שלוש המחלקות, מה שמעיד על יכולת הפרדה גבוהה בין קבוצות ה-AD, ה-FTD וביקורת הבריאה (HC).
ניתוח SHAP באמצעות TreeExplainer בוצע כדי להעריך את תרומת המאפיינים למודל הסיווג של Random Forest. תרשים המיליונים ב-איור 3 הראה את התרומה היחסית של צפיפות הספק ספקטרלית (PSD), שורש ממוצע הריבוע (RMS), אנטרופיה ומאפיינים דמוגרפיים. מאפיינים עם ערכי SHAP מוחלטים גבוהים יותר תרמו בצורה חזקה יותר לתחזיות המודל, בעוד שמאפיינים הקשורים לאנטרופיה הראו תרומות נמוכות יחסית.
ניתוח יציבות המאפיינים בוצע על ידי חזרה על אימון Random Forest על פני זרעי אקראיות (random seeds) שהוגדרו. דיוק הבדיקה וציוני חשיבות המאפיינים נרשמו עבור כל הרצה, וחושבו הממוצע וסטיית התקן של חשיבות המאפיינים. המודל השיג דיוק סיווג ממוצע של 95% בניתוח זה, עם סטיית תקן של 0.17%. הרצות חוזרות אלו שימשו בעיקר להערכת העקביות של דירוג המאפיינים ונבחנו בנפרד מהערכת ה-holdout העיקרית ברמת הנבדק. הגיל דורג גבוה בניתוח יציבות המאפיינים, כפי שמוצג ב-טבלה 2. המאפיינים theta_psd ו-theta_rms דורגו אף הם גבוה, בעוד ש-alpha_psd, alpha_rms, beta_psd ו-beta_rms הראו חשיבות מאפיינים מתונה.
חישוב Cohen’s d בוצע כדי להעריך את גודל ההבדלים בין הקבוצות, כפי שמוצג ב-טבלה 3. הנחתה של פס אלפא (alpha_rms, d = 0.97; alpha_psd, d = 0.87) ועלייה בפעילות תטא (theta_rms, d = 0.72) הראו את ההבדלים הגדולים ביותר שדווחו בין משתתפים עם AD לבקרות בריאות. ממצאים אלו היו עקביים עם ההאטה הקורטיקלית שדווחה במחקרי EEG של דמנציה34. מאפיינים מבוססי אנטרופיה הראו גדלי אפקט קטנים יותר באופן יחסי. השוואות בין AD ל-FTD הניבו גדלי אפקט קטנים עד בינוניים ברובם.
מאפייני פס אלפא הראו גודלי אפקט גדולים עבור קבוצת ה-AD-מול-HC ו-FTD-מולהשוואות לקבוצת ביקורת בריאה (HC). עבור מחלת אלצהיימר (AD) לעומת בקרים בריאים (HC), גודלי האפקט שדווחו היו 0.87- עבור alpha_psd ו-0.97- עבור alpha_rms. עבור FTD לעומת בקרב בקרי ביקורת בריאים (HC), ניחות פס alpha היה 0.73−. מאפיין ה-theta_psd הראה גודל אפקט של 0.61 עבור AD. לעומת HC, בעוד ש-theta_rms הראה גודל אפקט של 0.72. הבדלים קטנים יותר נצפו עבור AD לעומת דמנציה פרונטו-טמפורלית (FTD).
מאפייני פס בטא הראו גדלי אפקט קבוצתיים קטנים עד בינוניים בעיקר. גדלי האפקט של beta_psd היו −0.35 עבור AD לעומת HC ו-−0.41 עבור AD לעומת FTD, בעוד ש-beta_rms הראה אפקטים קטנים לרוב. מאפייני פס גמא הראו אפקטים בינוניים בחלק מההשוואות. גודל האפקט של gamma_psd היה 0.47 עבור FTD לעומת HC ו-0.20 עבור AD לעומת HC, בעוד ש-gamma_rms הראה גודל אפקט של 0.50 עבור FTD לעומת HC.
Delta PSD ו-RMS הראו גדלי אפקט חיוביים קטנים עבור AD לעומת HC (0.29 ו-0.34, בהתאמה) ו-FTD לעומת HC (0.25 ו-0.25, בהתאמה). גדלי האפקט עבור AD לעומת FTD היו קרובים לאפס. Delta entropy הראתה גדלי אפקט קטנים בכל שלוש ההשוואות (0.08, 0.20 ו-−0.11).
ניתוחי יציבות-מאפיינים (Feature-stability), SHAP וגודל-אפקט הצביעו על תרומה נמוכה יחסית של מאפייני האנטרופיה. כתוצאה מכך, בוצע ניתוח אבלציה (ablation analysis) על ידי השמטת מאפייני האנטרופיה והשארת RMS, PSD וגיל. בעקבות אבלציית המאפיינים, מודל ה-Random Forest השיג דיוק אימון של 96% ודיוק בדיקה של 94%. תוצאה זו פורשה כהשוואה גישושית במסגרת בחירת המאפיינים שנבדקה. הדיוק (Precision), הרגישות (recall), מדד F1 והתמיכה (support) עבור המחלקות AD, HC ו-FTD מוצגים בטבלה 4.
הביצועים לפני ואחרי השבתת מאפייני האנטרופיה מושווים בטבלה 5. דיוק הבדיקה עלה מ-92% ל-94% לאחר הסרת האנטרופיה. שינויים לפי מחלקה מוצגים בטבלה 6. עבור FTD, הדיוק (precision) עלה ב-4%, ומדד ה-F1 עלה ב-2%. הרגישות (recall) עבור קבוצת ה-HC עלתה ב-4%, בעוד שהדיוק ירד ב-2%. מדדי ביצוע של ממוצע מאקרו (macro-average) וממוצע משוקלל (weighted-average) עלו בכ-1%–2% בעקבות השבתת המאפיינים.
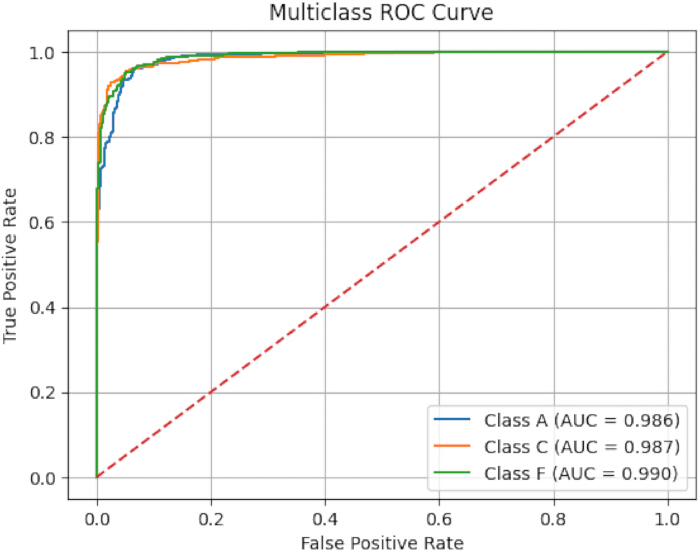
איור 2: עקומות מאפייני תפעול של מקלט (ROC) עבור מחלת אלצהיימר, דמנציה פרונטוטמפורלית ובקרות בריאות. עקומות מאפייני תפעול של מקלט (ROC) רב-מחלקתיות שנוצרו באמצעות אסטרטגיית one-versus-rest עבור מחלת אלצהיימר (מחלקה A), דמנציה פרונטוטמפורלית (מחלקה F) ובקרות בריאות (מחלקה C). השטח תחת העקומה (AUC) חושב עבור כל מחלקה. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
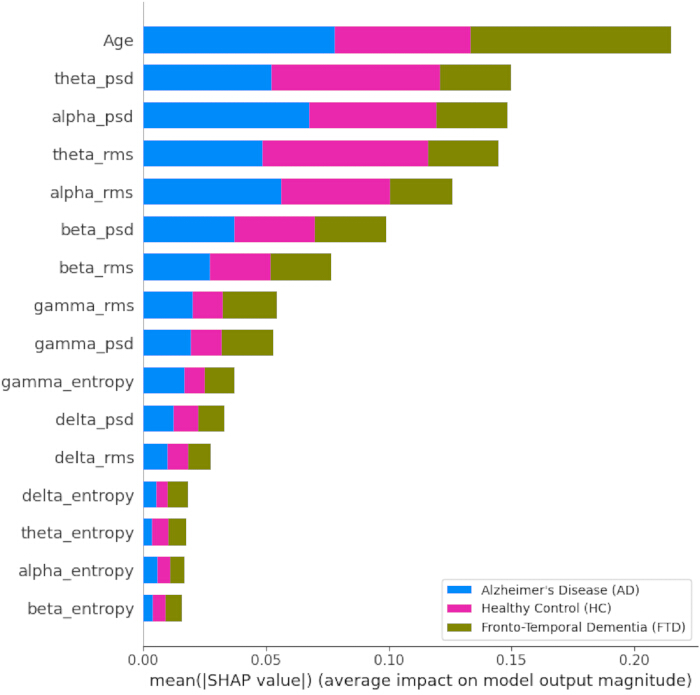
איור 3: ניתוח סיכום SHAP של מודל Random Forest המאומן. תרשים עמודות מסכם המציג את התרומה היחסית של מאפיינים דמוגרפיים ומאפיינים נגזרים מ-EEG למודל הסיווג של Random Forest. ערכי SHAP מוחלטים ממוצעים שימשו לדירוג התרומות של מאפייני root mean square (RMS), צפיפות ספקטרלית של הספק (PSD), אנטרופיה וגיל. אנא לחצו כאן כדי להציג גרסה גדולה יותר של איור זה.
| דיוק (Precision) | רגישות (Recall) | מדד F1 (F1-Score) | תמיכה (Support) | |
| אלצהיימר | 0.92 | 0.95 | 0.94 | 579 |
| ביקורת | 0.93 | 0.92 | 0.93 | 480 |
| דמנציה פרונטו-טמפורלית | 0.93 | 0.87 | 0.9 | 314 |
| ממוצע מאקרו | 0.93 | 0.92 | 0.92 | 1373 |
| ממוצע משוקלל | 0.93 | 0.92 | 0.92 | 1373 |
טבלה 1: דוח סיווג על נתוני הבדיקה. דיוק (Precision), רגישות (recall), מדד F1-score ותמיכה (support) עבור מחלקות מחלת האלצהיימר, ביקורת בריאה ודמנציה פרונטו-טמפורלית במערך נתוני הבדיקה, יחד עם מדדי ביצועים של ממוצע-מאקרו וממוצע משוקלל.
| מאפיין | ממוצע | סטיית תקן |
| גיל | 0.1966 | 0.0017 |
| צפיפות הספק ספקטרלית של תטא (theta_psd) | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| דלתא_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| אנטרופיית גמא | 0.0326 | 0.0008 |
| אלפא-אנטרופיה | 0.0325 | 0.0006 |
| בטא_אנטרופיה | 0.0283 | 0.0009 |
| אנטרופיית תטא | 0.0258 | 0.0004 |
| דלתא אנטרופיה | 0.0255 | 0.0005 |
טבלה 2: דירוג יציבות המאפיינים של מודל ה-Random Forest. ערכי חשיבות-מאפיין ממוצעים והשונות התואמת שהתקבלו מאימון חוזר של Random Forest תוך שימוש בזרעים אקראיים (random seeds) מ-0 עד 9. המאפיינים דורגו על פי יציבותם לאורך ההרצות.
| מאפיין | אלצהיימר לעומת HC | אלצהיימר מול דמנציה פרונטוטמפורלית | דמנציה פרונטו-טמפורלית מול HC |
| דלתא PSD | 0.293 | -0.069 | 0.253 |
| צפיפות הספק ספקטרלית (PSD) של תטא | 0.612 | 0.23 | 0.355 |
| Alpha PSD | -0.869 | -0.219 | -0.64 |
| Beta PSD | -0.352 | -0.408 | 0.201 |
| Gamma PSD | 0.201 | -0.326 | 0.468 |
| דלתא אנטרופיה | 0.081 | 0.199 | -0.111 |
| אנטרופיית תטא | 0.208 | 0.033 | 0.163 |
| אלפא אנטרופיה | -0.061 | 0.071 | -0.137 |
| בטא אנטרופיה | -0.37 | -0.042 | -0.332 |
| אנטרופיית גמא | -0.338 | 0.047 | -0.391 |
| דלתא RMS | 0.342 | 0.041 | 0.251 |
| RMS של תטא | 0.718 | 0.354 | 0.318 |
| Alpha RMS | -0.977 | -0.205 | -0.73 |
| Beta RMS | -0.494 | -0.365 | 0.015 |
| Gamma RMS | 0.187 | -0.33 | 0.5 |
טבלה 3: השוואת גודל אפקט (Cohen’s d) בין קבוצות אבחנה. ערכי Cohen’s d עבור סמנים ביולוגיים של EEG בהשוואות בין מחלת אלצהיימר לעומת קבוצת ביקורת בריאה, מחלת אלצהיימר לעומת דמנציה פרונטוטמפורלית, ודמנציה פרונטוטמפורלית לעומת קבוצת ביקורת בריאה.
| דיוק | הסרה מהשוק (Recall) | מדד F1 (F1-Score) | תמיכה | |
| אלצהיימר | 0.94 | 0.95 | 0.94 | 579 |
| בקרה | 0.91 | 0.96 | 0.94 | 480 |
| דמנציה פרונטו-טמפורלית | 0.97 | 0.89 | 0.92 | 314 |
| ממוצע מאקרו | 0.94 | 0.93 | 0.93 | 1373 |
| ממוצע משוקלל | 0.94 | 0.94 | 0.94 | 1373 |
טבלה 4: דוח סיווג לאחר השמטת מאפיינים. דיוק (Precision), רגישות (recall), מדד F1 (F1-score) ותמיכה (support) עבור מחלקות מחלת האלצהיימר, ביקורת בריאה ודמנציה פרונטוטמפורלית לאחר הסרת מאפייני האנטרופיה ואימון מחדש של מודל Random Forest.
| מדד | לפני אבלציה | אחרי אבלציה | שינוי |
| דיוק אימון | 0.96 | 0.96 | 0% שינוי |
| דיוק בדיקה | 0.92 | 0.94 | +2% שיפור |
| דיוק (Precision) מאקרו | 0.93 | 0.94 | +1% שיפור |
| חזרת (Recall) מאקרו | 0.92 | 0.93 | +1% שיפור |
| ציון F1 מאקרו | 0.92 | 0.93 | +1% שיפור |
| דיוק (Precision) משוקלל | 0.93 | 0.94 | +1% שיפור |
| חזרת (Recall) משוקללת | 0.92 | 0.94 | +2% שיפור |
| ציון F1 משוקלל | 0.92 | 0.94 | +2% שיפור |
טבלה 5: השוואת ביצועים לפני ואחרי השבתה של מאפיינים. השוואה של מדדי ביצועי מודל עבור סט המאפיינים הרב-תחומי המלא ועבור סט המאפיינים המצומצם שהתקבל לאחר הסרת מאפייני אנטרופיה.
זמינות נתונים:
מערך הנתונים המעובד בפורמט CSV ששימש לפיתוח המודל ולניתוח מסופק כ-קובץ משלים 1. קוד עיבוד המקור זמין במחברת Python בכתובת https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing, והקוד לבניית המודל ולניתוח זמין בכתובת https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing. ניתן להנפיק מחדש את מערך הנתונים המעובד ב-CSV באמצעות קוד עיבוד המקור שסופק
| סוג | מדד | לפני | אחרי | שינוי |
| אלצהיימר | דיוק (Precision) | 0.92 | 0.94 | 0.02 |
| רגישות (Recall) | 0.95 | 0.95 | אין שינוי | |
| ציון F1 | 0.94 | 0.94 | אין שינוי | |
| ביקורת | דיוק (Precision) | 0.93 | 0.91 | −2% |
| רגישות (Recall) | 0.92 | 0.96 | 0.04 | |
| ציון F1 | 0.93 | 0.94 | 0.01 | |
| FTD | דיוק (Precision) | 0.93 | 0.97 | 0.04 |
| רגישות (Recall) | 0.87 | 0.89 | 0.02 | |
| ציון F1 | 0.9 | 0.92 | 0.02 |
טבלה 6: שינויים בביצועים לפי מחלקה לפני ואחרי השחתת מאפיינים. שינויים במדדי הדיוק (precision), הרגישות (recall) ומדד F1 עבור המחלקות של מחלת אלצהיימר, ביקורת בריאה ודמנציה פרונטו-טמפורלית בעקבות הסרת מאפייני אנטרופיה.
קובץ משלים 1: סט נתונים של מאפייני EEG ברמת epoch מעובדים המשמשים לפיתוח המודל ולניתוח. אנא לחצו כאן להורדת קובץ זה.
דיון
מסווג Random Forest שימש לסיווג דגימות אלקטרואנצפלוגרפיה (EEG) לקבוצות של מחלת אלצהיימר (AD), דמנציה פרונטו-טמפורלית (FTD) וביקורת בריאה (HC) באמצעות מאפיינים מרובי-מישורים, כולל צפיפות הספק ספקטרלית (PSD), שורש ממוצע הריבועים (RMS) ומדדי אנטרופיה. גיל נכלל כמשתנה דמוגרפי משלים. כיוון שהתפלגויות הגיל היו עשויות להשתנות בין הקבוצות האבחנתיות, לא ניתן היה לשלול לחלוטין השפעות דמוגרפיות מתערבות, ולכן הביצועים המדווחים שיקפו את התרומה המשותפת של מידע דמוגרפי ואלקטרופיזיולוגי. הניתוח בחן את יכולתם של מאפייני EEG מרובי-מישורים להבחין בין קבוצות ה-AD, FTD ו-HC, והעריך את תרומתם של מאפייני פס דלתא, תטא, אלפא, בטא וגמא לסיווג35. ניתוחי יציבות מאפיינים וגודל אפקט הצביעו על כך שמאפיינים מבוססי הספק, כולל PSD ו-RMS, תרמו באופן חזק יותר מאשר מאפיינים מבוססי אנטרופיה. הביומרקרים שהופקו מה-EEG שיקפו גם דפוסים הקשורים להאטה של מקצבים ולירידה בפעילות אלפא.
מחקרים קודמים העריכו מאפייני EEG המבוססים על אנטרופיה, PSD ו-RMS באמצעות גישות שונות של למידה חישובית (machine learning)2,14,27,28,36,37. אנטרופיה שימשה לאפיין את המורכבות והחוסר בסדירות של ה-EEG, בעוד ש-PSD שימש לכימות מאפיינים ספקטרליים2,14,27,28,36. גם RMS הוערך כמאפיין של פס תדרים37. בעבודה קודמת, תוך שימוש באותו סט נתונים בסיסי, הוחלה סיווג בינארי מבוסס PSD עם תיקוף מסוג leave-one-subject-out33. הניתוח הנוכחי, לעומת זאת, שילב RMS, אנטרופיה ו-PSD על פני פסי alpha, beta, gamma, theta ו-delta במסגרת של סיווג רב-מחלקות (multiclass classification). טרנספורמר EEG קל משקל הוערך על אותו סט נתונים תוך שימוש באסטרטגיית סיווג בינארי מסוג leave-one-subject-out. טרנספורמר EEG קל משקל שהוערך על אותו סט נתונים באמצעות אסטרטגיית סיווג בינארי מסוג leave-one-subject-out דיווח על דיוק של 83.28%. יש לפרש השוואה מספרית ישירה עם התוצאות הנוכחיות בזהירות, מכיוון שמשימת הסיווג ונהלי התיקוף היו שונים38.
מאפייני פס ה-Alpha הראו את גודלי האפקט הגדולים ביותר להבחנה בין AD ל-HC ובין FTD ל-HC, ופעילות theta מוגברת תרמה אף היא להבחנה בין AD ל-HC. מאפייני פס ה-Beta הראו השפעות קטנות יותר בין הקבוצות, בעוד שמאפיינים מבוססי אנטרופיה הראו תועלת מבדילה מוגבלת יחסית. מאפייני פס ה-Gamma הראו השפעות בינוניות בחלק מההשוואות, כולל FTD לעומת HC. מחקרים קודמים דיווחו על הספק alpha נמוך יותר ועל פעילות theta משתנה ב-AD ובהשוואות אבחנתיות קשורות23,25,39. אנטרופיה תוארה גם היא כביומארקר בעל פוטנציאל ייחודי במחלה נוירודגנרטיבית36, מה שמעיד על כך שתרומתה עשויה להשתנות בהתאם למערך הנתונים, להגדרת המאפיין ולגישת הניתוח.
מכונות וקטורים תומכים שימשו רבות במחקרי סיווג EEG קודמים3,21,24,37. מסווג ה-Random Forest ששימש בניתוח הנוכחי סיפק הערכות של חשיבות מאפיינים והיה רלוונטי לקבוצת המאפיינים המובנית ששימשה במחקר זה40,41. דיוקי אימון ובדיקה של 96% ו-94%, בהתאמה, התקבלו לאחר הסרה (ablation) של מאפייני אנטרופיה. הסרת מאפייני האנטרופיה הייתה קשורה לשיפור בביצועי המודל, מה שמחזק את התרומה היחסית הנמוכה שנצפתה עבור מאפיינים אלה בניתוחי היציבות, SHAP וגודל האפקט. גישות של למידה עמוקה וגישות מבוססות-טרנספורמר יושמו אף הן על סיווג EEG, אם כי גישות כאלה דורשות בדרך כלל מערכי נתונים גדולים יותר ומיועדות לייצוגים רב-ממדיים או סדרתיים27,39,42,43,44,45.
אותות EEG הם רועשים ואינם סטציונריים, ומודלים מבוססי עצי-ensemble יכולים לספק חוסן בעת ניתוח ייצוגים מובנים של מאפיינים. במחקר הנוכחי, RMS, PSD, אנטרופיה וגיל הוערכו כקלטים משלימים למודל Random Forest. RMS ייצג את אמפליטודת האות בתוך פסי תדרים, PSD ייצג את ההספק הספקטרלי, ואנטרופיה ייצגה את מורכבות האות. הממצאים הצביעו על כך ש-PSD ו-RMS תרמו באופן חזק יותר מאנטרופיה לסיווג במסגרת שנבחנה. הגיל תרם אף הוא למודל, אם כי הכללתו העלתה את האפשרות של בלבול דמוגרפי (demographic confounding). מחקרים עתידיים יוכלו להעריך משתנים דמוגרפיים נוספים וגישות חלופיות של למידת מכונה או למידה עמוקה במאגרי נתונים גדולים יותר, כדי להעריך באופן מעמיק יותר את יכולת ההכללה ואת ביצועי הסיווג.
גילויים
לא הצהרו על ניגודי אינטרסים כספיים ידועים, מערכות יחסים אישיות, קשרים פיננסיים או פעילויות אחרות שעלולות היו להשפיע על העבודה המדווחת במחקר זה.
תודות
ניתנת הכרה למסד נתוני ה-EEG הזמין לציבור ששימש במחקר זה, וכן לתרומותיהם של החוקרים שהפכו את מסד הנתונים לנגיש למטרות מחקר. לא התקבל מימון ספציפי מסוכנויות מימון ציבוריות, מסחריות או ללא מטרת רווח.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Google Colab | [confirm environment]colab runtime | סביבת מחשוב מבוססת ענן המשמשת להרצת מחברות הניתוח | |
| MNE-Python | MNE-Python project | 1.12.1 | משמש לעיבוד מקדים של EEG, ייחוס (referencing), סינון ופילוח למקטעים (epoch segmentation) |
| NumPy | NumPy project | (2.0.2) | משמש לחישובים מספריים ומבוססי מערכים |
| OpenNeuro EEG dataset | OpenNeuro | ds004504, (1.0.9) | מערך נתוני EEG במצב מנוחה הזמין לציבור ומכיל הקלטות של AD, FTD ו-HC |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | סביבת תכנות המשמשת לעיבוד נתונים ופיתוח מודלים |
| scikit-learn | scikit-learn project | 1.6.1 | משמש לעיבוד מקדים, פיצול נתונים מקובץ, סיווג באמצעות Random Forest והערכת ביצועים |
| SciPy | SciPy project | (1.16.3) | משמש לעיבוד אותות וחישובים סטטיסטיים |
| SHAP | SHAP project | 0.52.0 | משמש לניתוח בינה מלאכותית ניתנת להסבר באמצעות TreeExplainer |
מקורות
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379