פלטפורמת האוטומציה המוצעת לקבלת מערכות מתח נמוך משלבת את האינטרנט של הדברים (IoT), ניהול זרימת עבודה חזותית, מחשוב קצה וענן, הנדסת תכונות ולמידת מכונה, כדי להפוך את בדיקות הקבלה של מערכות מתח נמוך (LV) לאוטומטיות. הפלטפורמה מאפשרת זיהוי תקלות חכם, קבלת החלטות בזמן אמת, קבלה אוטומטית, דיוק גבוה, השהיית תפעול נמוכה ופריסה ניתנת להרחבה.
מאמר מחקר
פלטפורמת אוטומיזציה מונחית-תהליך לבדיקות קבלה במתח נמוך עם תזמור זרימת עבודה חזותית ותיקוף באמצעות למידת מכונה
במאמר זה
סיכום
תקציר
ההתרחבות המהירה של רשתות מתח נמוך (LV) והשילוב שלהן עם משאבי אנרגיה מבוזרים דורשים פתרונות ניהול חכמיים ואוטומטיים. פלטפורמות האינטרנט של הדברים (IoT) בשיתוף פעולה בין ענן לקצה (Cloud-edge) תומכות בניטור, בקרה ואיסוף נתונים בזמן אמת. עם זאת, בפלטפורמות קיימות חסרים בדרך כלל אוטומציה של זרימת עבודה, תזמור ויזואלי של תהליכים, תמיכה בקבלת החלטות מונחית-משתמש ותיקוף מקיף. כתוצאה מכך, הן אינן מספקות פתרונות מונחי-תהליך עבור בדיקות קבלה אוטומטיות של רשתות LV. מחקר זה מציג את התכנון וההערכה של פלטפורמה לאוטומציה של קבלת רשתות מתח נמוך, המבוססת על קנבס תהליכים ויזואלי. הפלטפורמה המוצעת מאמצת ארכיטקטורה מונחית-תהליך שבה זרימות עבודה של קבלה נוצרות, מנוהלות ומבוצעות באופן ויזואלי. קנבס התהליכים הוויזואלי הופך ניטור סטטי קונבנציונלי לאוטומציה דינמית של זרימת עבודה על ידי אפשור ביצוע, תיקוף וקבלת החלטות של זרימת העבודה בזמן אמת. המסגרת משלבת את מערך הנתונים Open LV Network & Smart Meter כדי לתמוך במידול ריאליסטי של התנהגות עומס חשמלי. זרימת העבודה כוללת איסוף נתונים מבוסס IoT, עיבוד מקדמי של נתונים, הנדסת תכונות, תזמור זרימת עבודה באמצעות קנבס תהליכים ויזואלי, תיקוף מבוסס למידת מכונה והצגה ויזואלית בלוח בקרה (dashboard) בזמן אמת. המסגרת המוצעת השיגה שיעור זיהוי תקלות של 98.4%, שטח מתחת לעקומת מאפייני תפעול המקלט (ROC-AUC) של 0.968, ושיהוי בקבלת החלטות תפעולית של 31 ms, ובכך עלתה בביצועיה על גישות בסיס מסורתיות מבוססות-ענן ומבוססות-IoT בכ-30%–40%.
מבוא
מהפכת התעשייה 4.0 (I4.0)1 מתאפשרת על ידי מספר טכנולוגיות מתפתחות, שביניהן האינטרנט התעשייתי של הדברים (IIoT) הוא אחד החשובים ביותר. ה-IIoT מתייחס ליישום של טכנולוגיות האינטרנט של הדברים (IoT) בסביבות תעשייתיות, שבהן מכשירים ומכונות מקושרים מתקשרים בעיקר באמצעות אינטראקציות של מכונה-למכונה. מכיוון שכשלים במערכות תעשייתיות עלולים להוביל להפסדים תפעוליים משמעותיים, יישומי IIoT דורשים תקשורת אמינה ביותר תוך יצירת נפחי נתונים גדולים בהרבה מאלו של מערכות IoT קונבנציונליות2. בנוסף, מחקרים מסוימים רואים ב-IIoT מושג הקשור קשר הדוק לתעשייה 4.03. טכנולוגיות IoT משנות ארכיטקטורות היררכיות מסורתיות על ידי אפשור מערכות גמישות יותר עם חילוף נתונים רציף4. מחקרים רבם לאחרונה סקרו ארכיטקטורות IIoT קיימות והציעו עיצובי מסגרות עבודה חדשים5,6,7,8,9. למרות התפתחויות אלה, נותרות שתי מגבלות עיקריות. ראשית, מסגרות עבודה חדשות מוצעות לעיתים קרובות כדי להתגבר על חסרונות של ארכיטקטורות קודמות, מה שמוביל למספר הולך וגדל של מודלים חלופיים המגבירים את הגיוון הארכיטקטוני ואת מורכבות היישום. שנית, רמת ההפשטרה הגבוהה הקשורה לארכיטקטורות מוצעות רבות מגבילה את אימוצן המעשי בסביבות תעשייתיות10.
מספר ארכיטקטורות IIoT דווחו בספרות. ארכיטקטורת IIoT המבוססת על תקן ה-Open Platform Communications (OPC) הוצגה ב11, יחד עם תוכנת ביניים (middleware) ב-Python לניהול תקשורי OPC. ארכיטקטורת IIoT בעלת שבע שכבות הוצעה ב12; עם זאת, פרטי היישום וניסויי התיקוף לא סופקו. מסגרת המשלבת טכנולוגיות 5G ו-IIoT תוארה ב13 יחד עם מקרה בוחן מייצג, אם כי התיקוף הניסיוני היה מוגבל. מסגרת עיצוב רגשי עבור Industry 4.0 הוצגה, והשלכותיה הפוטנציאליות נדנו ללא אישור ניסיוני14. פלטפורמת IIoT רב-שכבתית הוערכה ב15 בתוך סביבת בדיקה (testbed) בעולם האמיתי, תוך דגש על שיקולי טלקומוניקציה. באופן דומה, מסגרת IoT מודולרית לניטור איכות אוויר פנימי הוצגה ב16 וביצועיה הוערכו באמצעות נתונים שנאספו מ-84 משקי בית עם ילדים.
האינטרנט של הדברים (IoT) הפך לטכנולוגיה המתפתחת במהירות עם פוטנציאל ניכר ליישום במגזר ההספק החשמלי17,18. שילוב טכנולוגיות IoT בצמתי מערכת חשמל מאפשר ייצור, שינוע, חלוקה, תפעול וניצול חכמים ויעילים יותר של חשמל, באמצעות קבלת החלטות אוטונומית הנתמכת על ידי ניטור רציף בזמן אמת של זרימת החשמל ברשת החשמל החכמה. כתוצאה מכך, צמתים חכמים אלו משפרים את ביצועי התפעול הכלליים של הרשת החשמלית19. טכנולוגיית תקשורת מהווה מרכיב בסיסי בהטמעת רשת חכמה, מכיוון ששתי קטגוריות עיקריות של מידע חייבות להיות מועברות באופן אמין: מדידות מחיישנים ואותות בקרה. בנוסף לשיהיית תקשורת נמוכה, יישומים של רשתות חכמות דורשים איכות שירות (QoS) הולמה ואבטחת נתונים נאותה כדי להבטיח תפעול אמין20.
בחירת טכנולוגיית תקשורת מתאימה ליישומים של רשתות חשמל חכמות (smart grid) מחייבת התחשבות במרווחי תקשורת, בקצבי העברת נתונים ובעלויות תקשורת21. רשתות תקשורת של IoT מורכבות בדרך כלל משכבות תוכנה, אבטחה, שירות, מערכת וקישוריות. בתוך שכבת הקישוריות, פרוטוקולי תקשורת מסווגים בדרך כלל לשלוש קטגוריות. פרוטוקולים לטווח רחוק כוללים את LoRa (Long Range) ו-NB-IoT (Narrowband-IoT); פרוטוקולים לטווח בינוני כוללים Wi-Fi, 4G/LTE ו-5G; ופרוטוקולים לטווח קצר כוללים את Bluetooth ו-ZigBee. ככל ששווקי החשמל הפכו למרוגלים (deregulated) יותר, חשיבותו של חיזוי העומס עלתה לצורך הערכת ההשפעות של תנאי מזג האוויר, כשלים בציוד, שינויים רגולטוריים וגורמים תפעוליים אחרים על עלות שירותי החשמל. כתוצאה מכך, חיזוי מדויק של עומס ביתי הפך לחיוני להפעלה ולפיקוח על רשתות חכמות, מיקרו-רשתות (microgrids) ובניינים חכמים22.
פעולה אמינה של רשתות מתח נמוך (LV) תלויה בשמירה על איכות חשמל גבוהה23. איכות החשמל נקבעת על ידי היעילות של ויסות המתח, איזון הזרם וצמצום הפרעות טכניות תחת תנאי הפעלה לא מאוזנים24. מבין גורמים אלה, איזון פאזות הוא חשוב במיוחד מכיוון שהוא קובע את הפריסה האחידה של מתחים וזרמים בין הפאזות25. איזון פאזות לקוי עלול להגביר את חימום המוליכים, סטיות במתח וזרמי אפס, ובכך להפחית את יעילות המערכת ואת אמינות התפעול26. כ consequently, יש לשקול איזון פאזות במהלך תהליך התכנון כדי לשפר את ביצועי המערכת, את היציבות התפעולית ואת האמינות לטווח ארוך. עם זאת, היבט זה כמעט ואינו משולב במתודולוגיות המקובלות לתכנון רשתות מיני-grid.
התקדמויות אחרונות במערכות לניהול תהליכי עבודה (workflow orchestration) הדגימו את היתרונות של אוטומציה מונחית אירועים וניהול תהליכים חזותי בסביבות IoT תעשייתיות. עם זאת, יישומן לאישור רשתות הפצה ובדיקות קבלה למתח נמוך נותר מוגבל. רוב מערכות האוטומציה הקיימות למתח נמוך מתמקדות בעיקר בניטור ובקרה פיקודית, בעוד שמספר מועט יחסית של מחקרים בוחנים ניהול קבלה מונחה תהליכי עבודה או אימות תאימות אוטומטי. באופן דומה, אף שטכניקות של למידת מכונה זכו לתשומת לב ניכרת לזיהוי חריגות במוני חשמל חכמים ולהערכת איכות חשמל, גישות אלו פותחו בדרך כלל כמודלים אנליטיים עצמאיים ולא כמרכיבים של מסגרת אינטגרטיבית לניהול תהליכי עבודה.
בשנים האחרונות הוצעו פתרונות שונים של מוני אנרגיה חכמים לניהול בניינים חכמים ואוטומציה ביתית27. אב-טיפוס של מונה חכם הוצג במקור27 כדי להדגים את השילוב של מושגים חינוכיים ברמת האוניברסיטה בתוך טכנולוגיות של מדידה חכמה. המונה החכם שפותח הפגין פוטנציאל משמעותי לניהול ובקרת אנרגיה, להפחתת צריכת האנרגיה ולהטבה עבור חברות השבקה והצרכנים כאחד באמצעות תקשורת IoT דו-כיוונית. לאחר מכן הוצגה מערכת של שקעים חכמים המבוססת על בקר מיקרו (microcontroller) כדי לתמוך בניטור אנרגיה אינטליגנטי28.
מערכת השקע החכם המוצעת מציגה את צריכת החשמל בזמן אמת באמצעות ממשק משתמש גרפי מבוסס Android. בנוסף, המכשיר יכול לזהות נוכחות של מכשירים חשמליים מחוברים, יכולת המכונה מדידת עומס פולשנית (invasive load measurement)28. לצורך היישום נעשה שימוש בשקע חכם מסחרי בעלות נמוכה. שיפורים עתידיים כוללים ניטור של זרם השורש הממוצע הריבועי (RMS), הספק ממשי, הספק ריאקטיבי וזווית הפאזה בין המתח לזרם. כפי שתואר במחקרינו הקודמים, מיקרו-רשת פוטו-וולטאיות המחוברת חלקית לרשת משתמשת בפרוטוקולי תקשורת ZigBee ו-LoRa להחלפת מידע עם מכשירים של מונה חכם, מה שמוכיח את ההיתכנות של תקשורת מבוססת IoT עבור מערכות אנרגיה מבוזרות29,30.
כדי להתגבר על המגבלות של תכנון מערכות הפצה קונבנציונליות, הפרקטיקה ההנדסית והמחקר המדעי התקדמו במספר כיוונים משלימים. כיוון מחקר אחד התמקד בתכנון ברמה גבוהה באמצעות מערכות מידע גיאוגרפיות (GIS) לבחירת אתרים ולהערכה ראשונית של משאבים31,32. כיוון אחר התרכז בשיפור רכיבים ותתי-מערכות בודדים, כולל בחירת מוליכים, מימדי ייצור ואגירת אנרגיה אופטימליים, והערכות השוואתיות של מערכות הפצה בזרם חילופין (AC) ובזרם ישר (DC)33,34,35,36. כיוון מחקר שלישי יישם אלגוריתמי אופטימיזציה לתכנון רשתות הפצה, ניתוב מזינים ותכנון טופולוגיית רשת. פיתוחים אחרונים כוללים מסגרות עבודה כגון פלטפורמת uGrid של החוקרים, המשלבת מיקום התקנים וקונפיגורציית רשת, אך חסרה בה ניתוח זרימת הספק סטנדרטי לצורך אימות ואופטימיזציה. גישות אחרות מסתמכות על כיוון פרמטרים ידני ליצירת טופולוגיה או מתמקדות ביישומים ייעודיים כגון מיקרו-רשתות DC בהספק נמוך37,38,39. למרות שגישות אלו מייצגות התקדמות משמעותית, נדרשת עבודה נוספת כדי לבסס מתודולוגיה משולבת לתכנון מקצה לקצה של מערכות הפצה במתח נמוך. יתרה מכך, הערכות טכנו-כלכליות מקיפות של מערכות מתח נמוך חד-פאזיות, תלת-פאזיות והיברידיות נותרו מוגבלות.
התפתחויות אחרונות בבינה מלאכותית (AI) ולמידת מכונה הרחיבו עוד יותר את היכולות של מערכות חשמל חכמות. סקירה מקיפה הציגה סיכום של יישומים של בינה מלאכותית ולמידת מכונה ברשתות חשמל חכמות, כולל טכנולוגיות מתפתחות כגון Federated Learning, Generative AI, מודלי שפה גדולים (LLMs), בינה מלאכותית של הדברים (AIoT) ותאומים דיגיטליים40. הסקירה הדגישה יישומים בחיזוי עומסים, תחזוקה חזויה, זיהוי חריגות, ניהול בצד הביקוש ושילוב רכבים חשמליים, תוך הדגשת אתגרים מתמשכים הקשורים לתאימות, פרטיות, סקביליות, חסינות ושיקולים אתיים. סקירה אחרונה אחרת העריכה שיטות AI לניהול אנרגיה מבוזר בתוך תשתיות IoT-edge-cloud, תוך התמקדות בלמידת מכונה, למידת חיזוק ומערכות רב-סוכנים לבקרה מבוזרת של אנרגיה41.
בסך הכל, מחקרים קודמים קידמו ניטור מבוסס IoT, מדידה חכמה, מחשוב ענן-קצה (cloud-edge computing), בינה מלאכותית וניהול אנרגיה חכם עבור מערכות הפצה במתח נמוך (LV). עם זאת, טכנולוגיות אלו פותחו במידה רבה באופן עצמאי. תזמור זרימת עבודה (workflow orchestration), ניהול קבלה אוטומטי, תיקוף מונחה-תהליכים ותמיכה משולבת בקבלת החלטות נותרו מוגבלים, מה שמדגיש את הצורך במסגרת אוטומציה מאוחדת ומכוונת-זרימת עבודה.
בהתאם לכך, מחקר זה מציג פלטפורמה לאוטומציה של קבלת רשתות במתח נמוך (LV) המבוססת על קנבס תהליכי ויזואלי. המסגרת המוצעת משלבת רכישת נתונים מבוססת IoT, עיבוד מקדמי של נתונים, הנדסת מאפיינים, תזמור זרימת עבודה, תיקוף מבוסס למידת מכונה, מחשוב ענן-קצה (cloud-edge computing) וויזואליזציה בזמן אמת בתוך ארכיטקטורה מאוחדת, כדי לתמוך בבדיקות קבלה אוטומטיות ואמינות של רשתות LV באמצעות נתוני מוני חכמים מהעולם האמיתי. איור 1 מספק סקירה כללית של הארכיטקטורה המכוונת-זרימה של הפלטפורמה המוצעת. זרימת העבודה כוללת רכישת נתונים, עיבוד מקדמי, הנדסת מאפיינים, תזמור זרימת עבודה, קבלת החלטות אינטליגנטית ושילוב ענן-קצה, המאפשרים תיקוף אוטומטי של רשתות חלוקת LV באמצעות מסגרת מכוונת-תהליכים. הפלטפורמה הראתה דיוק תיקוף גבוה תוך הפחתת השהיית קבלת החלטות תפעולית וזמן ביצוע של זרימת העבודה בהשוואה לגישות קונבנציונליות.
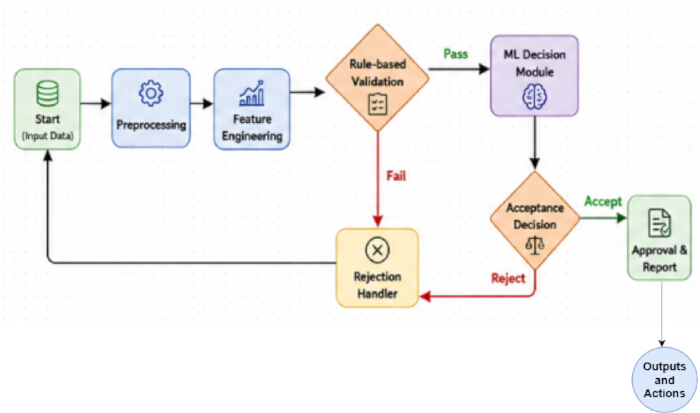
איור 1. ארכיטקטורה מכוונת-זרימת-עבודה של פלטפורמת האוטומציה המוצעת לבדיקות קבלה למתח נמוך. ארכיטקטורה ברמה גבוהה של הפלטפורמה המוצעת לאוטומציה של קבלת מתח נמוך (LV) מונחית-תהליך. המסגרת ממחישה את האינטגרציה הרצפית של רכישת נתונים מבוססת IoT, עיבוד מקדימה של נתונים, הנדסת מאפיינים, תזמור זרימת עבודה, קבלת החלטות חכמה, שיתוף פעולה בין ענן לקצה (cloud-edge) וקבלה אוטומטית לצורך תיקוף רשת הפצה של מתח נמוך. IoT = האינטרנט של הדברים; LV = מתח נמוך; ML = למידת מכונה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של דמות זו.
פרוטוקול
This study did not involve human participants, animals, or identifiable personal data. The analyses were performed using a publicly available dataset (UK Power Networks Open LV Network & Smart Meter dataset) together with synthetically generated data for validation; therefore, ethics committee approval and informed consent were not required. The research tools used in the protocol are listed in the Table of Materials.
1. רכישת נתונים
The Low-Voltage (LV) Acceptance Automation Platform was developed using electrical measurements acquired from smart meters, IoT sensors, and the Open LV Network & Smart Meter Dataset. Electrical parameters, including voltage, current, active power, reactive power, and energy consumption, were collected through Wi-Fi-, PLC-, and RS-485-based communication protocols. Real-time measurements were used for live system monitoring, whereas historical data supported model development and validation.
The proposed framework used the Open LV Network & Smart Meter Dataset provided by UK Power Networks42. The dataset comprises household smart meter consumption, feeder-level load profiles, and feeder voltage measurements. Time-series subsets containing load consumption and voltage data were selected for model training and evaluation. In addition, a simulated smart meter dataset was generated to represent operational conditions and fault scenarios required for workflow validation and machine learning model evaluation. The simulated dataset included timestamped measurements of voltage, current, active power, reactive power, energy consumption, total harmonic distortion (THD), and voltage imbalance. Fault samples were generated by simulating undervoltage, overvoltage, excessive harmonic distortion, and voltage imbalance based on established low-voltage operational thresholds. The dataset characteristics are summarized in Table 1.
| Attribute | Description |
| Dataset Name | Open LV Network & Smart Meter Dataset |
| Simulated Smart Meter Dataset | Geneated 1000 smaples for Fault simulation and workflow validation |
| Data Type | Time-series (historical smart meter data) |
| Data Granularity | Household-level and feeder-level measurements |
| Key Features | Voltage, current, active power, reactive power, energy consumption, timestamps |
| Data Frequency | High-resolution (e.g., half-hourly / minute-level depending on subset) |
| Coverage | Residential low-voltage distribution networks |
| Usage in Proposed Work | Model training, validation, load behavior analysis, and acceptance workflow evaluation |
Table 1: Dataset description. Summary of the Open LV Network & Smart Meter dataset used for model development and performance evaluation. The table presents the dataset components, measured electrical variables, sampling characteristics, and dataset partitioning for training, validation, and testing.
בשל רשת ה-Open LV &מכיוון שסט הנתונים של המונה החכם (Smart Meter Dataset) אינו מכיל תוויות תקלות מוגדרות מראש, הוחלה אסטרטגיית תיוג מבוססת כללים הן על סט הנתונים האמיתי והן על סט הנתונים הסימולטיבי. דגימות שעמדו בגבולות התפעול הנורמליים קיבלו את התווית 0 (נורמלי), בעוד שדגימות שחרגו מספי תפעול (למשל, סטיות מתח הגדולות מ- ±10% מהמתח הנקוב, THD > 5%, או חוסר איזון במתח > (2%) הוקצתה להם תווית 1 (תקלה). תוויות אלה שימשו כאמת קרקע (ground truth) במהלך אימון המודל, התיקוף והבדיקה. מנוע החוקים המוצע מאפשר גם להגדיר ערכי סף בהתאם לתקנים אזוריים או לקריטריוני קבלה ספציפיים של חברת התשתיות.
מערך הנתונים חולק לתתי-קבוצות של אימון (70%), תיקוף (15%) ובדיקה (15%). ערכים חסרים טופלו באמצעות אינטרפולציה ליניארית, השלמה לפי ממוצע וטכניקות של מילוי קדימה (forward-fill), כפי שמתואר בשלב עיבוד המקדמים. כדי להבטיח חסון סטטיסטי ויכולת שחזור, כל הניסויים חזרו חמש פעמים תוך שימוש בזרעי אקראיות (random seeds) שונים.
2. עיבוד מקדמי של נתונים
Raw data from the Open LV Network & Smart Meter Dataset and IoT sensor measurements were preprocessed to improve data quality prior to feature extraction and model development. Missing values, noise, and inconsistencies caused by communication interruptions and sensor malfunctions were identified and corrected using interpolation, mean imputation, and forward-fill techniques. The detailed mathematical derivations are provided in Supplementary File 1 (Section S1).
נתוני סדרות הזמן שעברו עיבוד מקדמי חולקו למקטעי פעולה מייצגים (S₁–S₅ ו-Sk). מכל מקטע הופקו מאפיינים סטטיסטיים וחשמליים, כולל עומס ממוצע, עומס שיא, עומס מינימלי, סטיית תקן, סטיית מתח וצריכת חשמל. המאפיינים שהופקו מסוכמים ב-טבלה 2 ושימשו כקלטים לשלב הנדסת המאפיינים הבא.
| מזהה פלח | עומס ממוצע (kW) | עומס שיא (kW) | עומס מינימלי (kW) | סטיית תקן (kW) | סטיות מתח (p.u.) | צריכת חשמל (kWh) | מרווח זמן |
| S₁ | 2.45 | 3.8 | 1.2 | 0.65 | 0.032 | 58.4 | 00:00–01:00 |
| S₂ | 2.9 | 4.1 | 1.5 | 0.72 | 0.028 | 64.2 | 01:00–02:00 |
| S₃ | 3.25 | 4.85 | 1.8 | 0.81 | 0.035 | 71.6 | 02:00–03:00 |
| S₄ | 3.8 | 5.2 | 2.1 | 0.9 | 0.041 | 78.9 | 03:00–04:00 |
| S₅ | 4.1 | 5.75 | 2.4 | 0.95 | 0.045 | 85.3 | 04:00–05:00 |
| Sק' | 3.6 | 5.1 | 2 | 0.88 | 0.038 | 76.5 | תגובת ה-t (t-response)ק |
טבלה 2: ייצוג מאפיינים מייצג שהוצאו ממקטעי סדרות זמנים. מאפיינים סטטיסטיים, חשמליים, התנהגות עומס, יציבות מתח ואיכות חשמל מייצגים שהוצאו מנתוני סדרות זמנים של LV מקוטעים במהלך הנדסת מאפיינים. הערכים ממחישים את ייצוג המאפיינים המהונדסים ואינם תוצאות ביצועים ניסיוניות. LF = Load Factor; PAR = Peak-to-Average Ratio; VSI = Voltage Stability Index; PF = Power Factor; THD = Total Harmonic Distortion.
3. הנדסת מאפיינים
הנדסת תכונות (Feature engineering) בוצעה כדי לשפר את ייצוג הנתונים שעברו עיבוד מקדמי עבור תזמור זרימת עבודה (workflow orchestration) וקבלת החלטות חכמה. ניתוח רכיבים עיקריים (PCA)^43 יושם כדי להפחית את ממדיות הנתונים על ידי הסרת משתנים עודפים ומשתנים בעלי מתאם גבוה, תוך שימור רכיבי התכונות המידעיים ביותר. הגזרות המתמטיות מוצגות ב- קובץ משלים 1 (סעיף S2).
מדדים סטטיסטיים, אינדיקטורים להתנהגות עומס, מדדי יציבות מתח ומדדי איכות חשמל נגזרו מנתוני סדרות הזמן המקוטעות. תכונות מהונדסות אלו כללו את מקדם העומס (LF), יחס שיא לממוצע (PAR), מדד יציבות מתח (VSI), מדד חוסר איזון מתח, מקדם הספק (PF) ועיוות הרמוני כולל (THD). קבוצת התכונות שהתקבלה שימשה כקלט עבור מודולי ניהול זרימת העבודה (workflow orchestration) ומודולי קבלת ההחלטות האינטליגנטיים.
תהליך העבודה של הנדסת המאפיינים מסוכם ב- קובץ משלים 1 (אלגוריתם משלים 1)ההליך כלל פילוח של הנתונים שעברו עיבוד מקדים, חילוץ מאפיינים סטטיסטיים וחשמליים, חישוב של התנהגות העומס, יציבות המתח ומדדי איכות ההספק, ויישום PCA ליצירת וקטור המאפיינים הסופי ששימש לאימון ולתיקוף המודל.
4. עיצוב קנבס של תהליך ויזואלי
פלטפורמת ה-Visualized Process Canvas פותחה כמסגרת לניהול זרימות עבודה (workflow) מבוססת גרף לאוטומציה של הליכי קבלה למתח נמוך (LV). זרימת העבודה יוצגה כגרף מכוון, G = (N, E), כאשר N = {n1, n2, …, nm} מציין את צמתי זרימת העבודה התואמים לשלבי עיבוד בודדים (למשל, קלט נתונים, עיבוד מקדים, תיקוף וקבלת החלטות), ו-E = {eij} מייצג את הקשתות המכוונות המגדירות את רצף הביצוע בין הצמתים. ייצוג זה מבוסס הגרף אפשר יצירת זרימות עבודה ניתנות להגדרה וביצוע אוטומטי שלהן ללא צורך בכתיבת קוד ידנית.
כל צומת בזרימת העבודה ביצעה משימת עיבוד ספציפית על ידי קבלת נתוני קלט, ביצוע פעולות שהגדירו מראש והעברת הפלט המעובד לצמתים הבאים. קריטריוני קבלה, כולל ספי ממתח ועומס, הוטמעו ככללי אימות ניתנים להגדרה שניתן היה לעדכן מבלי לשנות את מבנה זרימת העבודה. זרימת העבודה תמכה both בביצוע רציף ובביצוע מקבילי כדי לשפר את היעילות החישובית. מודלים של למידת מכונה שולבו בצמתים ייעודיים של זרימת העבודה לצורך זיהוי חריגות ואימות קבלה אוטומטי (איור 2).
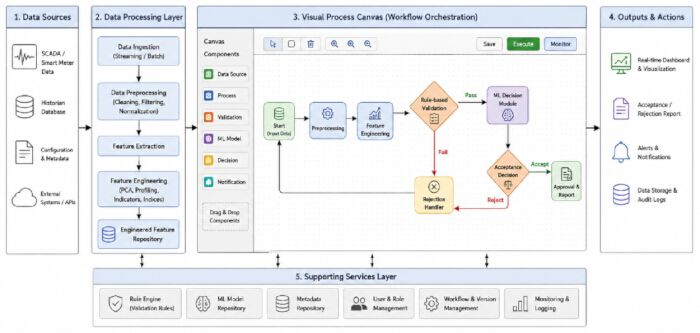
איור 2: ארכיטקטורת קנבס של תהליך ויזואלי עבור אוטומיזציה של קבלת LV. סקירה כללית של מסגרת תזמור זרימת העבודה הוויזואלית המשמשת לאוטומציה של קבלת LV. קנבס התהליך ממחיש את הארגון הגרפי של צמתי זרימת העבודה עבור עיבוד נתונים, הנדסת מאפיינים, תיקוף מבוסס כללים, קבלת החלטות אינטליגנטית והפקת פלט, זאת כדי לתמוך בתכנון, ביצוע ובניטור של זרימת העבודה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של דמות זו.
הניסוח המתמטי המתאר את זרימת המידע דרך גרף זרימת העבודה מופיע ב-קובץ משלים 1 (סעיף S3). קובץ משלים 1 (אלגוריתם משלים 2) מתאר את הליך ניהול זרימת העבודה, כולל מעבר בגרף זרימת העבודה, ביצוע צמתים, אימות כללים, יצירת החלטות ואגירת פלטים.
לוח התהליכים הוויזואלי (Visualized Process Canvas) הוטמע באמצעות ארכיטקטורת תוכנה מונחית מיקרו-שירותים כדי לתמוך ביכולת הרחבה ובפריסה מודולרית. ממשק זרימת העבודה הגרפי פותח באמצעות React.js כדי לאפשר הגדרת זרימת עבודה באמצעות גרירה והשלכה (drag-and-drop). שירותי התזמור של ה-Backend הוטמעו באמצעות Flask/FastAPI, בעוד ש-Eclipse Mosquitto שימש כמתווך ההודעות MQTT לתקשורת בין מודולי זרימת העבודה. EdgeX Foundry סיפק ניהול מכשירי קצה ואינטגרציית IoT. שירותי למידה ממוחשבת הוטמעו באמצעות Scikit-learn, TensorFlow ו-PyTorch, והועברו למכולות (containerized) באמצעות Docker ו-Kubernetes.
5. מנוע לניהול תהליכי עבודה (Workflow orchestration engine)
מנוע ניהול זרימת העבודה (workflow orchestration engine) תיאם את הביצוע של זרימת עבודת הקבלה המוגדרת. תיאור מפורט מסופק ב- קובץ משלים 1 (סעיף S4), ורצף הביצוע מסוכם ב- איור משלים 1.
תהליך ביצוע זרימת העבודה כלל אימות של הגדרת זרימת העבודה, אתחול סביבת הביצוע, תזמון צמתי זרימת העבודה בהתאם לתלויות שלהם, ביצוע צמתים באופן סדרתי או במקביל, החלת אימות מבוסס כללים, אגרגציה של פלטי ביניים, והפקת החלטת קבלה או דחייה סופית בהתבסס על הערכה מבוססת כללים ולמידת מכונה. תוצאות הביצוע פורסמו באמצעות לוחות בקרה (dashboards), דוחות, ממשקי תכנות של יישומים (APIs) ושירותי אחסון נתונים. תהליך ניצוח זרימת העבודה הכולל מוצג ב-איור 3.
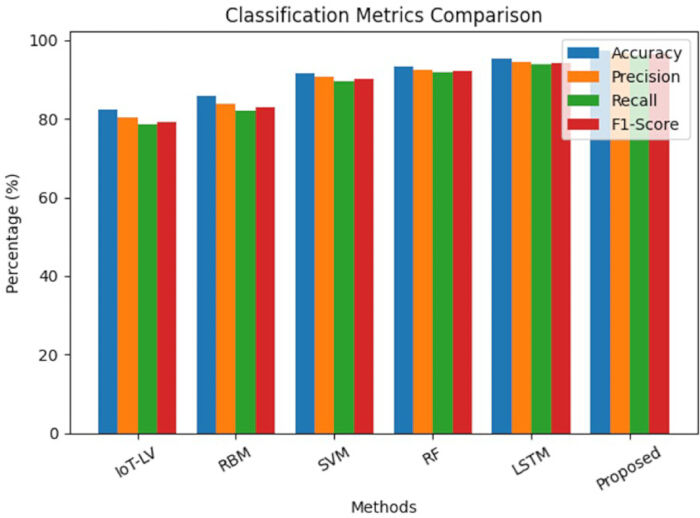
Figure 3: Comparison of classification performance metrics across different methods. Comparison of the classification performance of IoT-LV, RBM, Support Vector Machine (SVM), Random Forest (RF), Long Short-Term Memory (LSTM), and the proposed framework using the Open LV Network & Smart Meter dataset. Performance is evaluated using Accuracy, Precision, Recall, and F1-score. Results are presented as mean ± standard deviation (SD) from five independent experimental runs using a 70%/15%/15% training/validation/testing split. Error bars represent one standard deviation. Please click here to view a larger version of this figure.
6. מודול קבלת החלטות חכמה
מודול ההחלטה האינטליגנטי פותח כדי להפוך לאוטומטיים את תהליכי קבלת ההחלטות לאישור מתח נמוך (LV) באמצעות מודלים של למידת מכונה עם פיקוח. אלגוריתמים של סיווג ורגרסיה הוחלו על וקטורי מאפיינים מהונדסים כדי לתמוך בקבלת החלטות תפעולית. מודלי הסיווג זיהו תנאי הפעלה נורמליים ואנומליים, בעוד שמודלי רגרסיה העריכו צריכת אנרגיה עתידית ומגמות תפעוליות.
ווקטור תכונות הקלט, X ∈ ℝd, כלל את התכונות הסטטיסטיות, יציבות המתח, התנהגות העומס ואיכות ההספק שחולצו במהלך שלב הנדסת התכונות. מודלי Standalone Support Vector Machine (SVM)44, Random Forest (RF)45, ו-Long Short-Term Memory (LSTM)46 הוטמעו כמסווגי בסיס לצורך הערכה השוואתית. הניסוח המתמטי של מודלי הלמידה מופיע ב-קובץ משלים 1 (סעיף S5).
לצורך סיווג, משתנה הפלט y ∈ {0,1} ייצג תנאי הפעלה נורמליים (0) ותנאי הפעלה חריגים (1). כאשר זוהו תנאי הפעלה חריגים או אירועי עומס יתר, זרימת העבודה ייצרה התראת תקלה וסימנה את תהליך הקבלה כבלתי תקין; אחרת, התהליך סווג כקבול.
מנוע ניהול זרימת העבודה שילב תחזיות של למידת מכונה עם תיקוף מבוסס כללים, תוך שימוש באסטרטגיית פתרון קונפליקטים מבוססת סדרי עדיפויות. כללי תפעול קריטיים לבטיחות וקריטריונים רגולטוריים לקבלה הוגדרו כסייגים קשיחים, ולכן הם קיבלו קדימות על פני תחזיות למידת המכונה במקרה של קונפליקטים. החלטות קבלה סופיות הופקו באמצעות השילוב של פלטי מודול התיקוף המבוסס כללים ומודול קבלת ההחלטות האינטליגנטי.
7. אינטגרציית ענן-קצה ולוח בקרה להדמיה
ארכיטקטורת מחשוב ענן-קצה (cloud-edge computing) הוטמעה כדי לתמוך בעיבוד נתונים, אחסון והדמיה בעלי יכולת הרחבה עבור פלטפורמת האוטומציה של קבלת המערכות במתח נמוך (LV). מדי מים חכמים, מערכות SCADA ומכשירי IoT אוספים באופן רציף מדידות חשמליות, המעובדות בשכבת הקצה. באמצעות סינון, נורמליזציה, חילוץ תכונות והסקה בזמן אמת כדי להפחית את עומס התקשורת ולאפשר קבלת החלטות בשהיה נמוכה. הגזרות המתמטיות מפורטות ב- קובץ משלים 1 (סעיף S6).
נתונים מעובדים הועברו לשכבת הענן לצורך אחסון לטווח ארוך, אנליזה מתקדמת, הנדסת תכונות, אימון מודלים וניהול מודלים. לוחות בקרה (dashboards) אינטראקטיביים סיפקו ניטור מערכת בזמן אמת, התראות, דיווח ותמיכה בקבלת החלטות תפעוליות. ארכיטקטורת הענן-קצה (cloud-edge) מוצגת ב- איור משלים 2, ופרטי היישום מסוכמים ב- טבלה 3.
| Layer | Component | Hardware / Software | Specification / Version | Purpose / Description |
| Edge Layer | Edge Device | Raspberry Pi 4 / NVIDIA Jetson Nano | Quad-core CPU, 4–8 GB RAM | Real-time data acquisition and local processing |
| IoT Gateway | Industrial IoT Gateway | MQTT / Modbus / OPC-UA support | Communication between sensors and edge/cloud | |
| Sensors / Smart Meters | Digital Smart Meters | Voltage, Current, Power Measurement | Data collection from LV network | |
| Edge Software | Python, EdgeX Foundry, MQTT Broker | Python 3.x | Data preprocessing, filtering, local inference | |
| Communication Protocols | Wi-Fi / PLC / RS-485 | Standard protocols | Data transmission to cloud layer | |
| Cloud Layer | Cloud Platform | AWS / Microsoft Azure / Google Cloud | Scalable cloud services | Data storage, analytics, and model training |
| Storage | AWS S3 / Azure Blob / InfluxDB | Time-series database | Storing historical and real-time data | |
| Compute & ML | Python, TensorFlow, PyTorch, Scikit-learn | ML libraries (latest versions) | Model training, evaluation, deployment | |
| Containerization | Docker, Kubernetes | Latest stable versions | Workflow orchestration and scalability | |
| Data Processing | Apache Spark / Pandas | Distributed processing | Large-scale data analytics | |
| Visualization Layer | Dashboard Tools | Grafana / Apache Superset / Plotly Dash | Web-based tools | Real-time monitoring and visualization |
| Web Framework | React.js / Angular / Flask / FastAPI | Modern web stack | UI development and API integration | |
| Notification System | Email / SMS Gateway / Push Notifications | Twilio / Firebase | Alert generation and communication | |
| API Services | REST APIs | JSON-based communication | Integration between modules |
טבלה 3: פרטי יישום המערכת. סיכום של תצורת החומרה, סביבת התוכנה, פרוטוקולי התקשורת ומרכיבי מחשוב הענן-קצה ששימשו ליישום פלטפורמת האוטומציה המוצעת לקבלת LV.
תוצאות
The performance of the proposed Low-Voltage (LV) Acceptance Automation Platform was evaluated using the Open LV Network & Smart Meter Dataset together with a synthetic smart meter dataset generated to represent additional operating conditions and fault scenarios. The synthetic dataset enabled controlled evaluation of workflow orchestration, intelligent decision-making, and fault detection under abnormal operating conditions. The Open LV Network & Smart Meter Dataset comprised household smart meter measurements, feeder-level load profiles, and voltage measurements. Time-series segments corresponding to load consumption and voltage variations were extracted for model development and evaluation.
המאum חולק לתתי-קבוצות של אימון (70%), תיקוף (15%) ובדיקה (15%). פלטפורמת האוטומציה המוצעת לאישור LV השיגה דיוק סיווג גבוה (בקירוב 96%–98%), יכולת גילוי תקלות יעילה וקיצור של השהיית קבלת ההחלטות התפעולית. כדי להבטיח חוסן סטטיסטי והדירות, כל הניסויים חזרו חמישה פעמים באופן עצמאי תוך שימוש בזרעים אקראיים (random seeds) שונים. התפלגויות הביצועים שהתקבלו נותחו לאחר מכן באמצעות מבחן זוגי נראה כי הטקסט למסירה ריק או מכיל רק את האות "t". אנא ספק את הטקסט המלא באנגלית המיועד לתרגום, ואשמח לבצע את התרגום המקצועי לעברית בהתאם להנחיות שסיפקת.בדיקות, ניתוח שונות חד-כיווני (ANOVA), ניתוח פוסט-הוק של Tukey's honestly significant difference (HSD), ומרווחי סמך של 95%. סביבת הסימולציה ששימשה ליישום המסגרת המוצעת מסוכמת ב- טבלה 4.
| Parameter | Value | Description |
| Dataset | Open LV Network & Smart Meter Dataset + Synthetic Smart Meter Dataset | Real-world and simulated LV network data |
| Total Samples | 1000 synthetic samples + selected Open LV subsets | Data used for validation and testing |
| Data Split | 70% Training / 15% Validation / 15% Testing | Model development and evaluation |
| Number of Independent Runs | 5 | Statistical reliability analysis |
| Random Seeds | 42, 52, 62, 72, 82 | Reproducible experimental setup |
| Total Statistical Observations | 30 observations (6 models × 5 runs) | Used for t-test, ANOVA, and Tukey HSD |
| Sampling Rate | 30-min / 1-min intervals | Time-series resolution |
| Features | Load, Voltage, Current, Active Power, Reactive Power, THD, Voltage Unbalance, Derived Features | Input features for ML models |
| ML Models | Random Forest, SVM, XGBoost, LSTM | Intelligent decision module |
| Hardware | NVIDIA RTX 3090 GPU, Intel Core i9 CPU, 64 GB RAM | Training and simulation environment |
| Edge Device | Raspberry Pi 4 / Jetson Nano | Edge inference and real-time processing |
| Software | Python 3.10, TensorFlow 2.12+, Scikit-learn 1.3+, PyTorch 2.0+ | Model implementation |
| Communication Protocols | MQTT / HTTP / RS-485 | Data transmission |
| Threshold Values | Voltage ±10%, THD > 5%, Voltage Unbalance > 2%, Feeder Load > 90% capacity | Fault labeling and validation rules |
| Statistical Tests | Paired t-test, One-way ANOVA, Tukey HSD, 95% Confidence Interval | Performance significance evaluation |
טבלה 4: סביבת הסימולציה. תצורת הסביבה הניסויית, הכוללת חלוקת מערך הנתונים, מודלים של למידת מכונה, מפרטי חומרה, סביבת תוכנה ופרוטוקול תיקוף. הניסויים בוצעו באמצעות חלוקה של 70% לאימון, 15% לתיקוף ו-15% לבדיקה, וחזרו על הפעולה חמש פעמים תוך שימוש בגרעיני אקראיות (random seeds) שונים.
ביצועי סיווג
המסגרת המוצעת הוערכה באמצעות מספר מדדי ביצועים, הכוללים דיוק (accuracy), דיוק חיובי (precision), רגישות (recall), מדד F1, השהיה (latency) ושיעור זיהוי תקלות. הדיוק שימש להערכת ביצועי הסיווג הכלליים, בעוד שהדיוק החיובי, הרגישות ומדד F1 העריכו את יעילות זיהוי התקלות. ההשהיה מדדה את זמן התגובה לקבלת החלטות תפעוליות של זרימת העבודה, ושיעור זיהוי התקלות כימת את יכולתה של המסגרת לזהות תנאי הפעלה חריגים ברשת ההפצה של המתח הנמוך (LV). יכולת ההתרחבות (scalability) הוערכה בהמשך באמצעות הגדלה הדרגתית של מספר דגימות נתוני הקלט.
פלטפורמת האוטומציה המוצעת למקבלי LV הושוותה לחמש גישות ייחוס, בעניינן IoT-LV, ניטור מבוסס כללים (RBM), מכונת וקטורים תומכים (SVM), יער אקראי (RF), וזיכרון לטווח קצר ארוך (LSTM). מסגרת ה-IoT-LV תומכת בעיקר ברכישת נתונים ובניטור בסיסי באמצעות קריטריונים של סף שנקבעו מראש, ללא יכולות קבלת החלטות חכמות. באופן דומה, גישת ה-RBM מסתמכת על ספי תפעול קבועים ולכן חסרה למידה אדפטיבית. למרות ש-SVM ו-RF מסווגים נתונים תפעוליים ביעילות באמצעות למידה מונחית, הם אינם משלבים תזמור זרימת עבודה או ניהול קבלה משולב. LSTM מספק למידה זמנית משופרת עבור ניתוח סדרות זמנים אך אינו תומך בביצוע אוטומטי של זרימת עבודה. לעומת זאת, המסגרת המוצעת משלבת תזמור זרימת עבודה, קבלת החלטות היברידית מבוססת כללים ולמידת מכונה, הנדסת מאפיינים, ומחשוב ענן-קצה בתוך ארכיטקטורת אוטומציה מאוחדת.
כדי להבטיח השוואה הוגנת, כל שיטות הבסיס הוערכו באמצעות אותן חלוקות של אימון, תיקוף ובדיקה (70%, 15% ו-15%, בהתאמה). אופטימיזציה של היפר-פרמטרים עבור שיטות הבסיס של למידת המכונה בוצעה באמצעות מערך נתוני התיקוף, וכל המודלים השתמשו בהליכי עיבוד מקדמי ונרמול מאפיינים זהים. בניגוד למסווגי ה-SVM44, RF45, ו-LSTM46 העומדים בפני עצמם, שאומנו ישירות על מרחב המאפיינים המקורי, המסגרה המוצעת שילבה הנדסת מאפיינים מתקדמת, תיקוף של זרימת העבודה ותזמור של כללי קבלה לפני שלב הסיווג.
ביצועי הסיווג של כל השיטות מסוכמים ב- טבלה 5מבין הגישות השגרתיות, IoT-LV השיגה את דיוק הסיווג הנמוך ביותר (82.4%) בשל הסתמכותה על ניטור קונבנציונלי ללא קבלת החלטות חכמה. RBM שיפרה במעט את הביצועים והגיעה לדיוק של 85.7%; עם זאת, ספי הסתמכות (validation thresholds) קבועים הגבילו את יכולת ההסתגלות שלה. גישות של למידת מכונה הדגימו ביצועים משתפרים באופן פרוגרסיבי, כאשר SVM ו-RF השיגו דיוקים של 91.6% ו-93.4% בהתאמה, הודות ליכולתן ללמוד תבניות מבדילות מתוך הנתונים. LSTM שיפרה עוד יותר את דיוק הסיווג ל-95.2% על ידי לכידה יעילה של תלויות זמניות (temporal dependencies) בתוך נתוני סדרות הזמן של המונה החכם.
פלטפורמת האוטומציה המוצעת לקבלת LV השיגה את ביצועי הסיווג הכוללים הטובים ביותר, עם דיוק (accuracy) של 97.3%, רגישות (precision) של 96.8%, recall של 96.1%, ומדד F1-score של 96.4%. שיפורים אלו מיוחסים לשילוב של עיבוד מקדים מתקדם, הנדסת תכונות (feature engineering), ניהול זרימת עבודה (workflow orchestration), קבלת החלטות היברידית המבוססת על כללים ולמידת מכונה, ועיבוד שיתופי בענן ובקצה (cloud-edge), ולא רק ליישום אלגוריתמי למידת המכונה בלבד. יחד, רכיבים אלו שיפרו את היכולת להבחין בין תנאי הפעלה נורמליים לאבנורמליים, תוך שיפור היעילות של תיקוף הקבלה האוטומטי.
ביצועי הסיווג ההשוואתיים של כל השיטות שנבחנו מוצגים ב-איור 3.
| שיטה | דיוק (%) | דיוק חוזר (%) | רגישות (%) | מדד F1 (%) |
| IoT-LV | 82.4 | 80.2 | 78.5 | 79.3 |
| RBM | 85.7 | 83.9 | 82.1 | 83 |
| SVM | 91.6 | 90.8 | 89.7 | 90.2 |
| RF | 93.4 | 92.6 | 91.8 | 92.2 |
| LSTM | 95.2 | 94.5 | 93.8 | 94.1 |
| השיטה המוצעת | 97.3 | 96.8 | 96.1 | 96.4 |
טבלה 5: השוואה של מדדי סיווג. השוואה של ביצועי הסיווג של IoT-LV, RBM, SVM, RF, LSTM והמסגרת המוצעת באמצעות Accuracy, Precision, Recall ו-F1-score. התוצאות מדווחות כממוצע ± סטיית תקן (SD) שהתקבלו מחמישה ריצות ניסיוניות עצמאיות.
ניתוח מובהקות סטטיסטית
To further evaluate the reliability of the proposed LV Acceptance Automation Platform, statistical significance testing was performed to compare its performance with the benchmark methods, including IoT-LV, RBM, SVM, RF, and LSTM. Multiple experimental runs were conducted using different train-validation-test partitions of the Open LV Network & Smart Meter Dataset. The resulting classification accuracies were used to calculate the mean and standard deviation for each method, followed by paired t-tests to determine whether the observed performance differences were statistically significant. The mathematical formulation of the paired t-test is provided in Supplementary File 1 (Section S7).
רמת מובהקות של 0.05 אומצה עבור כל האנליזות הסטטיסטיות. כדי להבטיח שחזור, כל ניסוי חזר חמש פעמים באופן בלתי תלוי, תוך שימוש בזרעים אקראיים ובחלוקות נתונים שונות. מדדי הביצועים שהתקבלו מכל הרצה שימשו לאחר מכן להערכה סטטיסטית.
תוצאות מבחן ה- t המזוודוגים מסוכמות ב-טבלה 6. המסגרה המוצעת הראתה ביצועים טובים משמעותית מכל שיטות הייחוס (p < 0.05), והפגינה שיפורים מובהקים סטטיסטית בדיוק (accuracy), ברגישות (precision), בזיכרון (recall) ובמדד F1. שיפורי ביצועים משמעותיים נצפו לא רק לעומת גישות קונבנציונליות כגון IoT-LV ו-RBM, אלא גם לעומת מודלים מתקדמים יותר של למידה מכונה, כולל SVM, RF ו-LSTM. ממצאים אלו מעידים כי השיפורים שנצפו לא נבעו משונות מקרית, אלא נבעו ממסגרת האוטומציה המשולבת המכוונת-זרימה (workflow-oriented).
| השוואה | p-value | מובהקות |
| המוצע המוצע מול IoT-LV | 0.0008 | מובהק |
| המוצע המוצע מול RBM | 0.0015 | מובהק |
| המוצע המוצע מול SVM | 0.012 | מובהק |
| המוצע המוצע מול RF | 0.021 | מובהק |
| המוצע המוצע מול LSTM | 0.034 | מובהק |
טבלה 6: ניתוח מובהקות סטטיסטית זוגית (ערכי p). השוואה סטטיסטית זוגית בין המסגרת המוצעת לבין שיטות הייחוס. הטבלה מציגה ערכי p שהתקבלו מבדיקת מובהקות סטטיסטית, כאשר p < 0.05 מעיד על הפרש מובהק סטטיסטית.
ניתוח עקומת מאפייני מקלט (ROC)
ניתוח עקומת מאפייני תגובה של מקלט (ROC) בוצע כדי להעריך באופן מעמיק את יכולת הסיווג של פלטפורמת אוטומציית קבלת ה-LV המוצעת בהשוואה ל-IoT-LV, RBM, SVM, RF ו-LSTM. השטח תחת עקומת ה-ROC (AUC) שימש לכימות יכולת ההבחנה של כל מסווג באמצעות הערכת השיווי (trade-off) בין שיעור החיוביים האמיתיים (TPR) לבין שיעור החיוביים השגויים (FPR).
מסגרת ה-IoT-LV השיגה את ה-AUC הנמוך ביותר (בקירוב 0.690), מה שמשקף את הסמיכות שלה לניטור קונבנציונלי ללא קבלת החלטות חכמה. RBM הניב AUC בינוני של בקירוב 0.738 בשל התבססותו על כללי אימות המבוססים על סף קבוע. מסווגי למידת המכונה הראו ביצועים משתפרים באופן הדרגתי, כאשר SVM ו-RF השיגו ערכי AUC של בקירוב 0.833 ו-0.861, בהתאמה, הודות ליכולתם ללמוד תבניות מבדילות מנתוני תפעול. LSTM שיפר עוד יותר את ביצועי הסיווג, והשיג AUC של בקירוב 0.885 על ידי מידול יעיל של תלויות זמניות בנתוני סדרות זמן של מונה חכם.
פלטפורמת האוטומציה המוצעת לקבלת ה-LV השיגה את ה-AUC הגבוה ביותר (בערך 0.910), דבר המעיד על יכולת הבחנה עליונה בין תנאי הפעלה נורמליים לבלתי נורמליים. שיפור זה מיוחס להשפעות המשולבות של הנדסת תכונות מתקדמת, תזמור זרימת עבודה (workflow orchestration), קבלת החלטות היברידית המבוססת על כללים ולמידת מכונה, ועיבוד שיתופי בענן ובקצה (cloud-edge). עקומות ה-ROC ההשוואתיות עבור כל השיטות שנבחנו מוצגות ב- איור 4.
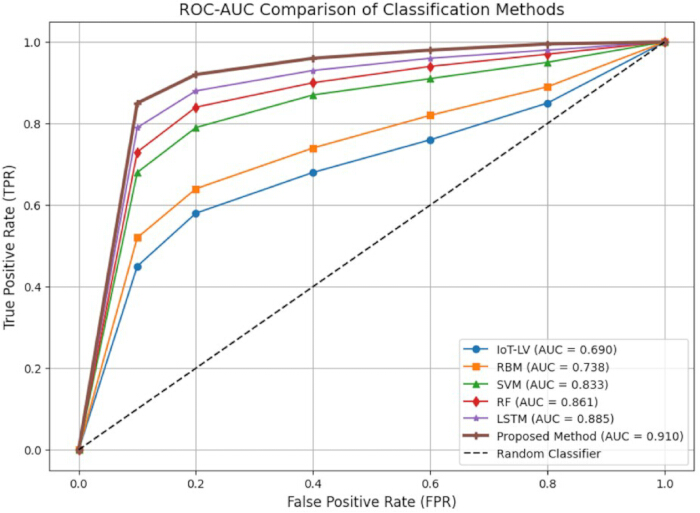
איור 4: השוואת עקומות מאפייני תגובה (ROC) עבור אוטומציה של קבלת LV. השוואה של עקומות מאפייני תגובה (ROC) עבור IoT-LV, RBM, SVM, RF, LSTM והמסגרת המוצעת. השטח תחת עקומת ה-ROC (ROC-AUC) מעריך את ביצועי הסיווג על פני ספי thresholds (ספי תגובה) שונים. TPR מייצג את שיעור החיוביים האמיתיים (True Positive Rate), ו-FPR מייצג את שיעור החיוביים השגויים (False Positive Rate). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
ניתוח מובהקות סטטיסטית מבוסס ANOVA
To further validate the experimental results, a one-way analysis of variance (ANOVA) was performed to compare the performance of the proposed framework with IoT-LV, RBM, SVM, RF, and LSTM. Whereas the paired t-test evaluates differences between two methods, ANOVA determines whether statistically significant differences exist among multiple groups simultaneously. The ANOVA analysis was conducted using repeated experiments with different train-validation-test partitions of the Open LV Network & Smart Meter Dataset. The mathematical derivations are presented in Supplementary File 1 (Section S8).
תוצאות ה-ANOVA מוצגות בטבלה 7. סטטיסטי F גבוה (בקירוב 18.7) עם p < 0.001, שהתקבל מ-30 תצפיות בחמש הרצות ניסויים בלתי תלויות, הדגימו הבדלים מובהקים סטטיסטית בין השיטות שנבחנו.
| מקור השונות | SS | df | טרשת נפיקה | ערך F (F-value) | ערך p |
| בין קבוצות | 412.6 | 5 | 82.52 | 18.7 | < 0.001 |
| בתוך קבוצות | 132.4 | 30 | 4.41 | — | — |
| סך הכל | 545 | 35 | — | — | — |
טבלה 7: תוצאות ניתוח שונות חד-כיווני (ANOVA). תוצאות מבחן ANOVA חד-כיווני שבוצע כדי להעריך הבדלים סטטיסטיים בין השיטות המושוות. הטבלה מציגה את ה-F-statistic, את דרגות החופש (df) ואת ה- pערכים-p.
על מנת לזהות את השיטות הספציפיות האחראיות להבדלים אלו, בוצע לאחר מכן ניתוח פוסט-הוק (post-hoc) בשיטת ה-HSD (Honestly Significant Difference) של Tukey. התוצאות מסוכמות ב- טבלה 8 והראו כי פלטפורמת אוטומציית קבלת ה-LV המוצעת עלתה בביצועיה באופן משמעותי על IoT-LV, RBM, SVM ו-RF, וכן השיגה שיפורים מובהקים סטטיסטית לעומת LSTM. ממצאים אלו מאשרים עוד יותר את היעילות של שילוב תזמור זרימת עבודה (workflow orchestration), הנדסת תכונות, קבלת החלטות היברידית המבוססת על כללים ולמידה מכונה, ומחשוב ענן-קצה (cloud-edge computing) במסגרת מאוחדת לאוטומציית קבלה.
| השוואה | ערך p | חשיבות |
| השיטה המוצעת לעומת IoT-LV | < 0.001 | משמעותי |
| המוצע לעומת RBM | < 0.001 | משמעותי |
| השיטה המוצעת לעומת SVM | 0.009 | משמעותי |
| השיטה המוצעת לעומת RF | 0.018 | משמעותי |
| השיטה המוצעת לעומת LSTM | 0.041 | משמעותי |
טבלה 8: ניתוח פוסט-הוק של מבחן Tukey HSD (הפרש משמעותי כנה). השוואות זוגיות בין השיטות שנבחנו באמצעות מבחן Tukey HSD פוסט-הוק לאחר ANOVA. הטבלה מציגה הפרשי ממוצעים, רווחי סמך (CI), ערכי p מתוקננים ומובהקות סטטיסטית.
ניתוח רווח סמך
המהימנות והעקביות של המסגרת המוצעת הוערכו בהמשך על ידי חישוב רווחי סמך (CI) של 95% עבור דיוק הסיווג שהתקבל מניסויים חוזרים. ההליך החישוביםי מתואר ב- קובץ משלים 1 (סעיף S8).
ניתוח רווח הביטחון מסוכם ב- טבלה 9גישות קונבנציונליות, כולל IoT-LV ו-RBM, הראו רווחי סמך רחבים יחסית, המעידים על שונות רבה יותר בביצועי הסיווג. לעומת זאת, השיטות המבוססות על למידת מכונה (SVM, RF ו-LSTM) הראו רווחי סמך צרים יותר, דבר המשקף יציבות משופרת לאורך ניסויים חוזרים.
| שיטה | דיוק ממוצע (%) | סטיית תקן (%) | רווח סמך 95% (%) |
| IoT-LV | 82.4 | 1.8 | [81.0, 83.8] |
| RBM | 85.7 | 1.6 | [84.5, 86.9] |
| SVM | 91.6 | 1.3 | [90.6, 92.6] |
| RF | 93.4 | 1.2 | [92.5, 94.3] |
| LSTM | 95.2 | 1 | [94.5, 95.9] |
| השיטה המוצעת | 97.3 | 0.8 | [96.7, 97.9] |
טבלה 9: רווחי סמך עבור דיוק סיווג. דיוק סיווג ממוצע, סטיית תקן (SD) ומרווח בר-סמך (CI) של 95% עבור כל שיטה שנבחנה, בהסתמכות על חמישה הרצות ניסוייות עצמאיות. הטבלה מסכמת את השונות הסטטיסטית ואת מהימנות ביצועי הסיווג.
פלטפורמת האוטומציה המוצעת לקבלת LV השיגה את דיוק הסיווג הממוצע הגבוה ביותר (97.3%) יחד עם רווח ברבטחון של 95% הצר ביותר (96.7%–97.9%), מה שמעיד על עקביות וחוסן מצוינים. יתרה מכך, היעדר חפיפה בין רווח ברבטחון של המסגרת המוצעת לבין אלו של שיטות הייחוס מספקת ראיה נוספת לביצועיה העליונים מבחינה סטטיסטית.
ביצועי חיזוי
בנוסף לביצועי הסיווג, הוערכה יכולת החיזוי של פלטפורמת האוטומציה המוצעת לקבלת LV באמצעות שורש ממוצע הריבועים (RMSE) וטעות מוחלטת ממוצעת (MAE). מדדים אלו מכמתים את דיוק תחזית צריכת האנרגיה על ידי מדידת הסטייה בין הערכים החזויים לערכים שנצפו.
ביצועי החיזוי של המסגרת המוצעת ושל שיטות הייחוס מסוכמים ב- טבלה 10מפות החום של מטריצות הבלבול התואמות עבור שיטות הסיווג שהוערכו מוצגות ב- איור 5, הממחישה את התפלגויות התחזיות של חיוביים אמיתיים, שליליים אמיתיים, חיוביים שגויים ושליליים שגויים. המסגרה המוצעת השיגה את שגיאות התחזית הנמוכות ביותר, עם RMSE של 2.1 ו-MAE של 1.6, מה שמעיד על ביצועי חיזוי עליונים בהשוואה ל-IoT-LV, RBM, SVM, RF ו-LSTM. שגיאות התחזית פחתו בהדרגה מהגישות הקונבנציונליות של IoT-LV ו-RBM אל מודלי ה-SVM, RF ו-LSTM המבוססים על למידת מכונה, דבר המדגיש את היתרונות של טכניקות למידה חכמות. המסגרה המוצעת הפחיתה עוד יותר את שגיאות התחזית על ידי שילוב של הנדסת תכונות מתקדמת, תזמור זרימת עבודה (workflow orchestration), קבלת החלטות היברידית המבוססת על כללים ולמידת מכונה, ועיבוד שיתופי של ענן-קצה, ובכך שיפרה את הדיוק והאמינות של תחזית צריכת האנרגיה. השהיית קבלת ההחלטות התפעולית עבור השיטות שנבחנו מושווה ב- איור 6המסגרת המוצעת השיגה את השהיית ההחלטה הקצרה ביותר, ובכך הדגימה את יעילותם של תזמור זרימת עבודה ועיבוד שיתופי בין הענן למקצה (cloud-edge).
| שיטה | שורש ממוצע הריבועים של השגיאה (RMSE) | MAE |
| IoT-LV | 8.9 | 7.2 |
| RBM | 7.6 | 6.1 |
| מכונת וקטורים תומכים (SVM) | 5.1 | 4.3 |
| RF | 4.2 | 3.5 |
| LSTM (זיכרון לטווח ארוך קצר - Long Short-Term Memory) | 3.4 | 2.8 |
| השיטה המוצעת | 2.1 | 1.6 |
טבלה 10: השוואה של מדדי שגיאת חיזוי (RMSE ו-MAE). השוואה של ביצועי החיזוי של IoT-LV, RBM, SVM, RF, LSTM והמסגרה המוצעת באמצעות שורש ממוצע ריבועי השגיאה (RMSE) ושגיאה מוחלטת ממוצעת (MAE). ערכי RMSE ו-MAE נמוכים יותר מעידים על שגיאות חיזוי קטנות יותר.
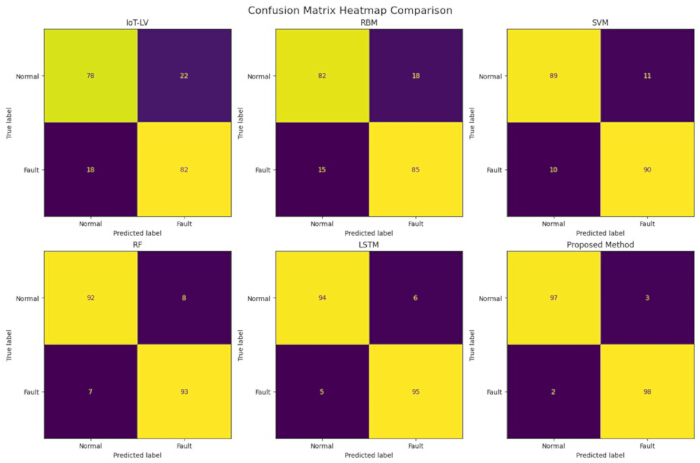
איור 5: השוואה של מפות חום של מטריצות בלבול. מטריצות בלבול עבור IoT-LV, RBM, SVM, RF, LSTM והמסגרת המוצעת, המראות תוצאות סיווג במונחים של חיובי אמיתי (TP), שלילי אמיתי (TN), חיובי שגוי (FP) ושלילי שגוי (FN). מפות החום ממחישות את התפלגות הדגימות שסווגו נכון ושגוי עבור כל שיטה. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
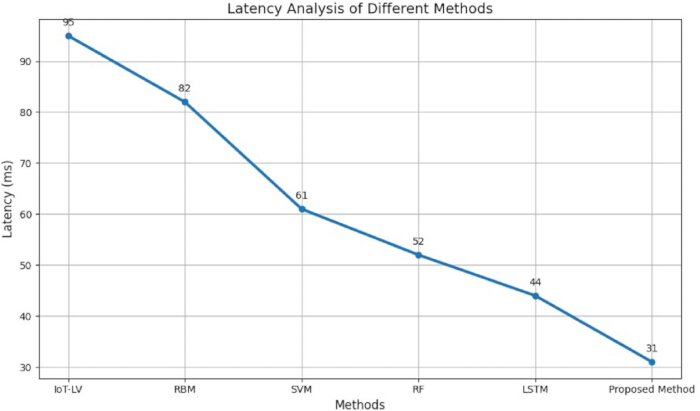
איור 6: השוואה של השהיית קבלת החלטות תפעולית בין שיטות שונות. השוואה של השהיית קבלת החלטות תפעולית של IoT-LV, RBM, SVM, RF, LSTM והמסגרה המוצעת במהלך אוטומציה של קבלת LV. ההשהיה נמדדת במילישניות (ms) ומייצגת את זמן קבלת ההחלטה התפעולי הדרוש לביצוע זרימת העבודה, אימות כללים ויצירת החלטת קבלה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
ניתוח השפעת רכיבים (Ablation study)
התרומה של כל רכיב מרכזי בפלטפורמת האוטומציה המוצעת לקבלת LV הוערכה באמצעות מחקר אבלציה (ablation study). המסגרת נבנתה באופן הדרגתי על ידי הפעלת הנדסת תכונות (feature engineering), קבלת החלטות חכמה מבוססת למידת מכונה, ניהול זרימת עבודה (workflow orchestration) ואינטגרציית ענן-קצה. תצורת הבסיס, שבה אף אחד מהמודולים הללו לא היה פעיל, השיגה דיוק של 82.6%, ציון F1 של 80.4%, RMSE של 8.7 ושיהוי תפעולי של 96 ms, דבר המדגים את המגבלות של עיבוד קונבנציונלי ללא אוטומציה חכמה.
תוצאות האבלציה מסוכמות ב-Table 11. שילוב הדרגתי של הנדסת מאפיינים שיפר באופן משמעותי את ביצועי הסיווג על ידי הגברת הייצוג של המאפיינים התפעוליים שהופקו מנתוני המונה החכם. הוספת מודול ההחלטה האינטליגנטי הגבירה עוד יותר את דיוק הסיווג והפחיתה שגיאות חיזוי באמצעות קבלת החלטות מונחית נתונים. שילוב של תזמור זרימת העבודה שיפר את יעילות האוטומציה על ידי תיאום תהליכי האימות, הביצוע וההחלטה, בעוד ששיתוף פעולה בין הענן למקצה (cloud-edge) הפחית את השהיית קבלת ההחלטות התפעולית באמצעות עיבוד מבוזר. יחד, מודולים אלו הניבו שיפורים עקביים בדיוק ובמדד F1, ובמקביל הפחיתו את ה-RMSE ואת השהיית הביצוע.
פלטפורמת האוטומציה המלאה לקבלת LV השיגה את הביצועים הכוללים הטובים ביותר, עם דיוק סיווג של 97.3%, מדד F1 של 96.4%, RMSE של 2.1, ושיהוי תפעולי של 31 ms. ממצאים אלו מוכיחים כי השיפורים שנצפו בביצועים נובעים מהשילוב של תזמור זרימת עבודה (workflow orchestration), הנדסת מאפיינים מתקדמת, קבלת החלטות היברידית המבוססת על כללים ולמידת מכונה, ושיתוף פעולה בין ענן לקצה (cloud-edge collaboration), ולא ממרכיב בודד בלבד. ביצועי זיהוי התקלות של השיטות שנבחנו מוצגים ב-איור 7, שבו המסגרת המוצעת השיגה את שיעור זיהוי התקלות הגבוה ביותר. איור 8 ממחיש את ניתוח ניתנות ההרחבה (scalability), ומראה כי המסגרת המוצעת שמרה על זמן העיבוד הנמוך ביותר עם הגדלת נפח מערך הנתונים, מה שמאשש את התאמתה לאוטומציה של קבלת LV בקנה מידה רחב.
| תצורה | סנכרון זרימות עבודה | הנדסת מאפיינים | עיבוד בענן ובקצה (Cloud–Edge Processing) | מודול קבלת החלטות חכם מבוסס למידה מכונה (ML) | דיוק (%) | מדד F1 (%) | שורש ממוצע הריבואים בריבוע (RMSE) | זמן השהיה (ms) |
| מערכת בסיס | ✗ | ✗ | ✗ | ✗ | 82.6 | 80.4 | 8.7 | 96 |
| + הנדסת תכונות | ✗ | ✓ | ✗ | ✗ | 88.9 | 87.5 | 6.2 | 84 |
| + מודול קבלת החלטות מבוסס למידת מכונה (ML) | ✗ | ✓ | ✗ | ✓ | 92.8 | 91.6 | 4.5 | 63 |
| + תזמור זרימת עבודה | ✓ | ✓ | ✗ | ✓ | 95.1 | 94.2 | 3.3 | 48 |
| + אינטגרציית ענן-קצה (Cloud–Edge Integration) | ✓ | ✓ | ✓ | ✓ | 97.3 | 96.4 | 2.1 | 31 |
טבלה 11: ניתוח אבליציה (Ablation study) של המסגרת המוצעת. הערכה ניסונית של התרומה של הנדסת תכונות, קבלת החלטות חכמה, תזמור זרימת עבודה ואינטגרציית ענן-קצה לביצועים הכוללים של המסגרת המוצעת. הביצועים מדווחים עבור כל תצורה רב-שלבית באמצעות Accuracy, F1-score, RMSE ו-Operational Decision Latency.
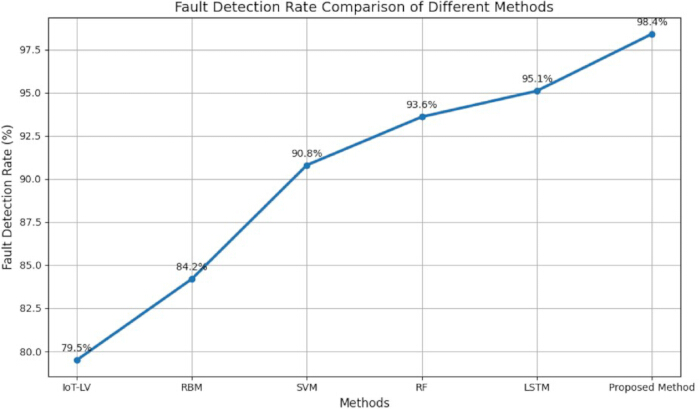
Figure 7. Comparison of fault detection rate across different methods. Comparison of the fault detection performance of IoT-LV, RBM, SVM, RF, LSTM, and the proposed framework using the Open LV Network & Smart Meter dataset. Fault Detection Rate (%) represents the proportion of correctly identified fault conditions. Please click here to view a larger version of this figure.
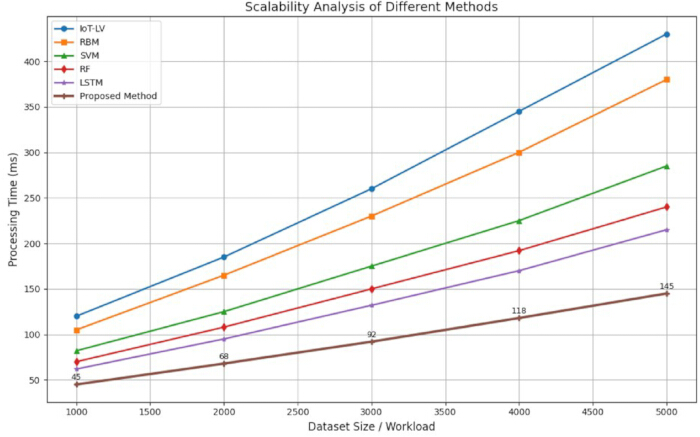
איור 8. ניתוח סקילביליות (יכולת הרחבה) של שיטות שונות. השוואה של הסקילביליות של IoT-LV, RBM, SVM, RF, LSTM והמסגרת המוצעת תחת גדלי מאגרי נתונים גדלים. הסקילביליות מוערכת באמצעות זמן עיבוד (ms) ככל שעומס החישוב עולה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
זמינות נתונים:
The Open LV Network & Smart Meter dataset used in this study is publicly available through the UK Power Networks Open Data Portal42 at: https://ukpowernetworks.opendatasoft.com/explore/assets/ukpn-smart-meter-consumption-lv-feeder/. All study-generated resources, including the simulated smart meter dataset, example workflow configurations, deployment artifacts, research prototype implementation, source code, and evaluation scripts, are publicly available through the Zenodo repository at: https://zenodo.org/records/21187749.
איור משלים 1: תרשים זרימה של מנוע ניהול זרימת העבודה. התרשים מדגים את רצף הפעולות המבוצעות על ידי מנוע ניהול זרימת העבודה (workflow orchestration engine), הכוללות רכישת נתונים, עיבוד מקדים, ביצוע זרימת העבודה, תיקוף מבוסס למידת מכונה, יצירת החלטה ודיווח תוצאות עבור בדיקת קבלה אוטומטית למתח נמוך.אנא לחצו כאן להורדת קובץ זה.
איור משלים 2: ארכיטקטורת ענן-קצה (Cloud–edge) לאוטומציה של קבלה במתח נמוך. הארכיטקטורה ממחישה את האינטראקציה בין התקני קצה לבין שירותי ענן. מדידות חשמליות שנאספו ממדחקים חכמים, מערכות SCADA והתקני IoT מעובדות בקצה לצורך עיבוד מקדים והסקה בזמן אמת, ולאחר מכן מועברות לענן לצורך אחסון, אנליזה, ניהול מודלים וויזואליזציה באמצעות לוח בקרה אינטראקטיבי לניטור.אנא לחץ כאן להורדת קובץ זה.
דיון
ההערכה הניסויית הוכיחה כי פלטפורמת אוטומציית הקבלה למתח נמוך (LV) המוצעת, המכוונת לתהליכי עבודה, עלתה בעקביות בביצועיה על גישות הייחוס בסיווג, חיזוי, זיהוי תקלות, השהיית קבלת החלטאות תפעולית ויכולת גידול (scalability). שיפורים אלו בביצועים נבעו משילוב של הנדסת תכונות מתקדמת, תזמור תהליכי עבודה, שיתוף פעולה בין ענן לקצה (cloud-edge), וקבלת החלטות היברידית המבוססת על כללים ולמידת מכונה, ולא משימוש במודל למידת מכונה בודד. הממצאים עולים בקנה אחד עם מחקרים קודמים שהראו כי אוטומציה המכוונת לתהליכי עבודה וארכיטקטורות IoT חכמות משפרות את היעילות התפעולית, את יכולת השילוב (interoperability) ואת תמיכת קבלת ההחלטות ביישומים תעשייתיים וביישומים של רשתות חשמל חכמות2,3,9,10,18.
הניתוחים הסטטיסטיים חיזקו עוד יותר את מהימנותם של הממצאים הניסיוניים. בדיקות מובהקות זוגיות, ניתוח שונות חד-כיווני (ANOVA), ניתוח רווח סמך וניתוח עקום מאפיין תגובה (ROC) אישרו כי המסגרת המוצעת השיגה שיפורים מובהקים סטטיסטית לעומת שיטות הייחוס, תוך שמירה על יכולת סיווג מצוינת על פני ספי סריקה שונים47,48,49. הערכות סטטיסטיות אלו מספקות ראיות נוספות לכך שהשיפורים שנצפו בביצועים לא נבעו משונות מקרית.
בדיקות השקיפות (scalability) והאבלציה (ablation) הוכיחו עוד יותר את יעילות הארכיטקטורה המוצעת תחת עומסי מחשוב גדלים ותצורות מערכת שונות. ניתוח השקיפות הראה כי המסגרת שמרה על זמני עיבוד נמוכים יותר מאשר שיטות הייחוס (benchmark) כאשר גודל מערך הנתונים גדל מ-1,000 ל-5,000 דגימות. באופן דומה, מחקר האבלציה אישר כי כל רכיב מרכזי תרם לביצועי המערכת הכוללים. הנדסת מאפיינים שיפרה את הייצוג של מאפיינים תפעוליים שהוצאו מנתוני מדי-חשמל חכמים, מודול ההחלטה האינטליגנטי שיפר את חיזוי התקלות והאימות האוטומטי, תזמור זרימת העבודה (workflow orchestration) ביצע אופטימיזציה לתזמון ולביצוע המשימות, ושיתוף פעולה בין הענן לקצה (cloud-edge collaboration) הפחית את תקורה של התקשורת ואת השהיית ההחלטות התפעוליות. תצפיות אלו תואמות לדוחות קודמים המדגישים את היתרונות של ארכיטקטורות ענן-קצה ותזמור תהליכים להשגת מערכות IoT תעשייתיות בעלות שקיפות גבוהה והשהיה נמוכה9,15,19,20,21.
מכיוון שהמסגרת המוצעת פועלת בסביבת LV המאפשרת IoT, אבטחת סייבר ופרטיות נתונים הם שיקולים חשובים עבור פריסה מעשית. תקשורת מאובטחת בין מדי חשמל חכמים, התקני קצה, שערים (gateways) ושירותי ענן יכולה להיות מושגת באמצעות פרוטוקולי MQTT ו-HTTPS המאפשרים TLS (Transport Layer Security). בקרת גישה מבוססת תפקידים (RBAC) מספקת אימות והרשאה לניהול זרימת העבודה ומשאבי המערכת, בעוד שהצפנה מסוג AES-256 (Advanced Encryption Standard) מגינה על נתונים תפעוליים במהלך ההעברה והאחסון. רישום ביקורת (Audit logging) וסנכרון מאובטח בין הענן לקצה תומכים עוד יותר ביושרה, בסודיות ובניתבות של הנתונים לאורך זרימת העבודה של האישור. מנגנוני אבטחה אלה תואמים את ההמלצות הנוכחיות לתשתיות תקשורת מאובטחות של האינטרנט התעשייתי של הדברים (IIoT) ורשתות חשמל חכמות6,7,19,20,21.
המסגרת המוצעת תורמת גם לפיתוח מערכות חלוקת חשמל חכמות על ידי הצגת ארכיטקטורה מאוחדת מכוונת-זרימת-עבודה (workflow-oriented), המשלבת שיתוף פעולה בין הענן למסוף (cloud-edge collaboration), תזמור זרימת עבודה, הנדסת מאפיינים וקבלת החלטות מבוססת למידה מכונה בתוך פלטפורמה אחת של אוטומציה. בניגוד לגישות ניטור קונבנציונליות מבוססות IoT המתמקדות בעיקר ברכישת נתונים ועיבוד ריכוזי1,10,11,12, המסגרת המוצעת תומכת באימות אוטומטי, זיהוי תקלות חכם וקבלת החלטות מונחית-תהליכים. מחקרי השקיפות (ablation studies) והבדיקות למספריות (scalability) מדגימים עוד את היתרונות של ארכיטקטורות חכמות מודולריות עבור ניהול אנרגיה חכם עתידי ויישומי תעשייה 4.03,9,14,15.
מנקודת מבט מעשית, פלטפורמת האוטומציה המוצעת לקבלת LV מאפשרת ניטור בזמן אמת, תיקוף אוטומטי, זיהוי תקלות חכם וקבלת החלטות קבלה עם מינימום התערבות אנושית. השהיית ההחלטה התפעולית שהושגה, שעומדת על 31 ms, ושיעור זיהוי התקלות של 98.4% מדגימים את יכולתו של המסגרת לתמוך ביישומים תעשייתיים בזמן אמת. יתרה מכך, ארכיטקטורת שיתוף הפעולה בין הענן לקצה (cloud-edge) מפחיתה את עומס התקשורת תוך אספקת השקיפות (scalability) הנדרשת לעיבוד נתונים שנרכשו ממדחנים חכמים, מקורות אנרגיה מבוזרים ומכשירים מבוססי IoT. יכולות אלו עולות בקנה אחד עם המגמות הנוכחיות באוטומציה של רשתות חשמל חכמות ובמערכות ניהול אנרגיה אינטליגנטיות18,19,20,21,27,29,30.
Despite the promising results, several limitations should be acknowledged. The experimental evaluation was conducted using the Open LV Network & Smart Meter Dataset together with synthetic fault data because publicly available LV datasets do not provide comprehensive fault annotations. Consequently, the simulated fault scenarios and rule-based labels may not fully represent the diversity of real-world operating conditions. Furthermore, validation was performed using a single dataset, and practical deployment may be affected by communication constraints, sensor errors, and the computational limitations of edge devices operating under heterogeneous network conditions. Although cybersecurity mechanisms were considered within the proposed architecture, their implementation and evaluation were beyond the scope of this study. Future work will therefore focus on validating the framework using independent real-world datasets, diverse LV network topologies, and field deployment scenarios. Additional research will investigate adaptive intelligent energy management, explainable artificial intelligence, digital twin-assisted monitoring, and enhanced cloud-edge collaboration to further improve the robustness, scalability, and interpretability of intelligent LV acceptance automation systems40,41.
גילויים
המחברים מצהירים כי אין להם ניגודי עניינים פיננסיים או בלתי פיננסיים.
תודות
המחברים מודים לפורטל הנתונים הפתוחים של UK Power Networks על אספקת מערך הנתונים הזמין לציבור Open LV Network & Smart Meter ששימש במחקר זה. מחקר זה לא קיבל מימון חיצוני.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Apache Spark | Apache Software Foundation | גרסה 3.4+ | ניתוח נתונים בקנה מידה רחב |
| Apache Superset | Apache Software Foundation | גרסה 3.x | לוח בקרה של אנליטיקה |
| Docker Engine | Docker Inc. | גרסה 24.x | פריסת אפליקציה |
| מתווך MQTT של Eclipse Mosquitto | Eclipse Foundation | גרסה 2.x | חילופי נתונים |
| EdgeX Foundry (גרסת Jakarta או מאוחרת יותר) | LF Edge (Linux Foundation) | גרסה ג'קרטה / ז'נבה | ניהול התקני קצה |
| Flask / FastAPI | פרויקטי משטחים / סבסטיאניáבמרכיב Ramíרזולוציה | Flask 2.3+ / FastAPI 0.100+ | אינטגרציה של ממשק תכנות יישומים (API) של צד-שרת |
| Grafana | Grafana Labs | גרסה 10.x | ויזואליזציה וניטור |
| שער (Gateway) ל-IoT תעשייתי | Advantech / Siemens | ECU-1251 / SIMATIC IOT2040 | תקשורת מחיישן לענן |
| חששני IoT (חששני מתח/זרם) | Texas Instruments / Analog Devices | INA219 / ACS712 | ניטור רשת בזמן אמת |
| ערכת פיתוח Jetson Nano | NVIDIA Corporation | 945-13450-0000-100 | הסקת מסקנות של בינה מלאכותית בקצה (Edge AI inference) |
| Kubernetes | Cloud Native Computing Foundation (CNCF) | גרסה 1.27+ | סקלאביליות של זרימת העבודה |
| מודל LSTM (Keras/TensorFlow) | Google (TensorFlow/Keras) | כלול ב-TF 2.12+ | חיזוי ותחזית עומס |
| מודול PLC (תקשורת קווי חשמל - Power Line Communication) | STMicroelectronics | ST7580 | תקשורת רשת חשמל חכמה |
| Plotly Dash | Plotly Inc. | גרסה 2.x | ויזואליזציה אינטראקטיבית |
| Python 3.10 | Python Software Foundation | גרסה 3.10.x | עיבוד וניתוח נתונים |
| PyTorch | Meta AI | גרסה 2.0+ | יישום למידה עמוקה |
| אלגוריתם Random Forest (יער אקראי) | Scikit-learn | כלול בגרסה 1.3 ומעלה | סיווג תקלות |
| Raspberry Pi 4 Model B (4GB RAM) | Raspberry Pi Foundation | RPI4-MODBP-4GB | עיבוד קצה |
| React.js / Angular | מטא / גוגל | React 18.x / Angular 16+ | פיתוח ממשק משתמש |
| מודול משדר-מקלט (Transceiver) RS-485 | Maxim Integrated (Analog Devices) | MAX485 | קישוריות מכשירים תעשייתיים |
| Scikit-learn | מפתחי Scikit-learn | גרסה 1.3+ | מודלים של למידת מכונה |
| מכונת וקטורים תומכים (SVM) | Scikit-learn | כלול בגרסה 1.3+ | סיווג ותיקוף |
| TensorFlow | Google LLC | גרסה 2.12+ | אימון מודל |
| Twilio / Firebase Cloud Messaging | Twilio Inc. / Google | לא רלוונטי | התראות והודעות |
| מודול Wi-Fi | Espressif Systems | ESP8266 / ESP32 | העברת נתונים |
| XGBoost | DMLC (קהילת למידה חישובית מבוזרת - Distributed ML Community) | גרסה 1.7+ | תמיכה חכמה בקבלת החלטות |
מקורות
- Tong L, Zhou J, Li J. IoT-based low-voltage power distribution system management and control platform. Front Energy Res. 2022;10:902715. https://doi.org/10.3389/fenrg.2022.902715
- Babayigit B, Abubaker M. Industrial Internet of Things: A review of improvements over traditional SCADA systems for industrial automation. IEEE Syst J. 2023;18:120–133.
- Nakagawa EY, et al. Industry 4.0 reference architectures: State of the art and future trends. Comput Ind Eng. 2021;156:107241. https://doi.org/10.1016/j.cie.2021.107241
- Ladegourdie M, Kua J. Performance analysis of OPC UA for industrial interoperability towards Industry 4.0. Internet Things. 2022;3:507–525.
- Bader SR, Maleshkova M, Lohmann S. Structuring reference architectures for the industrial Internet of Things. Future Internet. 2019;11:151. https://doi.org/10.3390/fi11070151
- Fun TS, Samsudin A. Recent technologies, security countermeasure and ongoing challenges of industrial Internet of Things (IIoT): A survey. Sensors (Basel). 2021;21:6647. https://doi.org/10.3390/s21196647
- Mirani AA, et al. Key challenges and emerging technologies in industrial IoT architectures: A review. Sensors (Basel). 2022;22:5836. https://doi.org/10.3390/s22155836
- Fraile F, et al. Reference models for digital manufacturing platforms. Appl Sci. 2019;9:4433. https://doi.org/10.3390/app9204433
- Serôdio C, et al. Software and architecture orchestration for process control in Industry 4.0 enabled by cyber-physical systems technologies. Appl Sci. 2024;14:2160. https://doi.org/10.3390/app14052160
- Ungurean I, Gaitan NC. A software architecture for the industrial Internet of Things—A conceptual model. Sensors (Basel). 2020;20:5603. https://doi.org/10.3390/s20195603
- Hsiao CH, Lee WP. OPIIoT: Design and implementation of an open communication protocol platform for industrial Internet of Things. Internet Things. 2021;16:100441. https://doi.org/10.1016/j.iot.2021.100441
- Domínguez-Bolaño T, et al. An overview of IoT architectures, technologies, and existing open-source projects. Internet Things. 2022;20:100626. https://doi.org/10.1016/j.iot.2022.100626
- Sasiain J, et al. Towards flexible integration of 5G and IIoT technologies in Industry 4.0: A practical use case. Appl Sci. 2020;10:7670. https://doi.org/10.3390/app10217670
- Cañas H, et al. A conceptual framework for smart production planning and control in Industry 4.0. Comput Ind Eng. 2022;173:108659. https://doi.org/10.1016/j.cie.2022.108659
- Cabrini FH, et al. Enabling the industrial Internet of Things to cloud continuum in a real city environment. Sensors (Basel). 2021;21:7707. https://doi.org/10.3390/s21227707
- Gabriel MF, et al. Implementation of an IoT architecture for promoting healthy air quality in 84 homes of families with children. Build Environ. 2024;266:112040. https://doi.org/10.1016/j.buildenv.2024.112040
- Silva BN, Khan M, Han K. Internet of Things: A comprehensive review of enabling technologies, architecture, and challenges. IETE Tech Rev. 2018;35:205–220.
- Dhaou ISB, et al. Internet of Things technologies for smart grid. In: Research Anthology on Smart Grid and Microgrid Development. IGI Global; Hershey; 2022. p. 805–832.
- Kondoro A, et al. A low latency secure communication architecture for microgrid control. Energies. 2021;14:6262. https://doi.org/10.3390/en14196262
- Tightiz L, Yang H. A comprehensive review on IoT protocols' features in smart grid communication. Energies. 2020;13:2762. https://doi.org/10.3390/en13112762
- Kondoro A, et al. Real-time performance analysis of secure IoT protocols for microgrid communication. Future Gener Comput Syst. 2021;116:1–12.
- Rodrigues R, et al. A review of solid-state circuit breakers. IEEE Trans Power Electron. 2020;36:364–377.
- IEEE. IEEE Std 1159-2019: IEEE recommended practice for monitoring electric power quality. IEEE; Piscataway (NJ); 2019. https://doi.org/10.1109/IEEESTD.2019.8800097
- Otcenasova A, et al. The influence of power quality indices on active power losses in a local distribution grid. Energies. 2019;12:1389. https://doi.org/10.3390/en12071389
- Ma K, et al. Review of distribution network phase unbalance: Scale, causes, consequences, solutions, and future research direction. CSEE J Power Energy Syst. 2020;6:479–488.
- Peppanen J, et al. Modeling power electronic equipment to improve distribution feeder current and voltage balance [Presentation]. Presented at: IEEE PES Transmission and Distribution Conference and Exposition (T&D); Denver, CO; 2018. Available from: https://ieeexplore.ieee.org/ https://doi.org/10.1109/TDC.2018.8440261
- Sayed S, et al. Design and realization of an open-source and modular smart meter. Energy Sci Eng. 2019;7:1405–1422.
- Satapathy LM, et al. Arduino based home automation using Internet of Things (IoT). Int J Pure Appl Math. 2018;118:769–778.
- Shaban M, et al. Design of a partially grid-connected photovoltaic microgrid using IoT technology. Appl Sci. 2021;11:11651. https://doi.org/10.3390/app112411651
- Shaban M, Dhaou IB. Design of an IoT-enabled microgrid architecture for a partial grid-connected mode [Presentation]. Presented at: 18th International Multi-Conference on Systems, Signals and Devices (SSD); Virtual; 2021. Available from: https://ieeexplore.ieee.org/ https://doi.org/10.1109/SSD52085.2021.9429443
- Taye BZ, et al. Rural electrification planning using geographic information system (GIS). Cogent Eng. 2020;7:1836730. https://doi.org/10.1080/23311916.2020.1836730
- Huld T, et al. Geospatial analysis of photovoltaic mini-grid system performance. Energies. 2017;10:218. https://doi.org/10.3390/en10020218
- Domínguez J, et al. IntiGIS-Local: A geospatial approach to assessing rural electrification alternatives for sustainable socio-economic development in isolated communities—A case study of Guasasa, Cuba. Energies. 2024;17:3835. https://doi.org/10.3390/en17153835
- Tafula JE, et al. Multicriteria decision-making approach for optimum site selection for off-grid solar photovoltaic microgrids in Mozambique. Energies. 2023;16:2894. https://doi.org/10.3390/en16062894
- Isihak S, et al. Evolution of GIS-based rural electrification planning models and an application of OnSSET in Nigeria. Renew Sustain Energy Transit. 2022;2:100019. https://doi.org/10.1016/j.rset.2022.100019
- Korkovelos A, et al. The role of open access data in geospatial electrification planning and the achievement of SDG7: An OnSSET-based case study for Malawi. Energies. 2019;12:1395. https://doi.org/10.3390/en12071395
- Cicilio P, et al. uGrid: Reliable minigrid design and planning toolset for rural electrification. IEEE Access. 2019;7:163988–163999.
- Nasir M, et al. Optimal planning and design of low-voltage low-power solar DC microgrids. IEEE Trans Power Syst. 2018;33:2919–2928.
- Vai V, et al. Optimal low-voltage distribution topology with integration of PV and storage for rural electrification in developing countries: A case study of Cambodia. J Mod Power Syst Clean Energy. 2020;8:531–539.
- Banad Y, Sharif S, Rezaei Z. Artificial intelligence and machine learning for smart grids: from foundational paradigms to emerging technologies with digital twin and large language model-driven intelligence. Energy Convers Manag X. 2025;28:101329. https://doi.org/10.1016/j.ecmx.2025.101329
- Álvarez-López C, González-Briones A, Li T. Explainable AI and multi-agent systems for energy management in IoT-edge environments: a state-of-the-art review. Electronics. 2026;15(2):385. https://doi.org/10.3390/electronics15020385
- UK Power Networks. Open data portal [Online]. Available from: https://www.ukpowernetworks.co.uk/our-company/open-data-portal (Accessed June 2026).
- Jolliffe IT. Principal Component Analysis. 2nd ed. Springer; New York; 2002. https://doi.org/10.1007/b98835
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273–297.
- Breiman L. Random forests. Mach Learn. 2001;45:5–32.
- Hochreiter S, Schmidhuber J. Long short-term memory. Neural Comput. 1997;9:1735–1780.
- Fawcett T. An introduction to ROC analysis. Pattern Recognit Lett. 2006;27:861–874.
- Montgomery DC, Runger GC. Applied Statistics and Probability for Engineers. 8th ed. John Wiley & Sons; Hoboken (NJ); 2020.
- Montgomery DC. Design and Analysis of Experiments. 10th ed. John Wiley & Sons; Hoboken (NJ); 2020.