פרוטוקול זה מתאר כיצד לבנות, לאמן ולהעריך מסגרת רשת U-Shape של Vision Mamba רב-תצפית לחלוקת תמונות רפואיות, המאפשרת סגמנטציה שחזורית של נגעי עור ואיברי בטן באמצעות הכנת מערכי נתונים סטנדרטיים, יישום מודלים והערכת ביצועים.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר שיטה
מסגרת רשת בצורת U של ממבה עם ראייה מרובת תצוגה לסגמנטציה של תמונות רפואיות
במאמר זה
סיכום
תקציר
סגמנטציה של תמונות רפואיות דורשת שיטות חישוביות שתופסות במדויק הקשר גלובלי, גבולות מקומיים ומבנים אנטומיים רב-סקאליים, תוך שמירה על שחזור ביישומים שונים. מאמר זה מציג פרוטוקול לבניה, הדרכה והערכה של מסגרת רשת U-Shape של Vision Mamba רב-תצוגה לחלוקת תמונות רפואיות דו-ממדיות. הפרוטוקול מספק תהליך עבודה שניתן לשחזר הכולל רכישת מערכי נתונים ציבוריים, עיבוד מוקדם של תמונות ומסכה, בניית רשת, הדרכת מודלים, בחירת נקודות ביקורת, והערכת ביצועים כמותית ואיכותית. המסגרת משלבת סריקת תכונות מרובת תצוגה ללכידת מידע משלים על מרחב, קווי מתאר, קנה מידה וגבולות, ומיישמת מיזוג תכונות רב-שלבי בתוך ארכיטקטורת מקודד-מפענח בצורת U לשיפור האינטגרציה של תכונות במהלך סגמנטציה. הפרוטוקול מודגם באמצעות מאגרי נתונים זמינים לציבור על נגעי עור וחלוקת איברי בטן. במסגרת זרימת היישום המתוארת, המסגרת משיגה ביצועי סגמנטציה תחרותיים באמצעות מדדי הערכה סטנדרטיים. על ידי מעקב אחר הנהלים המוצגים בפרוטוקול זה, חוקרים יכולים לשחזר את מימוש המודל, לאמן את הרשת באמצעות הגדרות ניסוי מוגדרות, להעריך את ביצועי הסגמנטציה ולהתאים את זרימת העבודה למשימות סגמנטציה רפואיות קשורות הדורשות ניתנת לשחזור ניתנת לניתוח מבוסס למידה עמוקה.
מבוא
סגמנטציה של תמונות רפואיות היא משימה יסודית בתחומי ראיית המחשב וניתוח תמונות רפואיות 1,2,3. זה כולל חלוקת תמונה לאזורים או אובייקטים מרובים לניתוח ועיבוד נוספים. טכנולוגיה זו חשובה במיוחד בהדמיה רפואית משום שהיא מסייעת לרופאים לזהות ולאתר אזורים פתולוגיים, ובכך משפרת את הדיוק האבחוני ותכנון הטיפול. עם התקדמות טכנולוגיות הדמיה רפואית, כגון הדמיית תהודה מגנטית (MRI), טומוגרפיה ממוחשבת (CT) וטומוגרפיית פליטת פוזיטרונים (PET), הביקוש לטכניקות סגמנטציה מדויקות של תמונות רפואיות המשיך לעלות. השיטות הנוכחיות לסגמנטציה של תמונות רפואיות ניתנות לסיווג כללי לשלוש גישות עיקריות: שיטות מבוססות רשת עצבית קונבולוציונית (CNN)4, שיטות מבוססות טרנספורמר5, ושיטות מבוססות מודל-מרחב מצבים (SSM) 6,7. שיטות מבוססות CNN משתמשות בדרך כלל בארכיטקטורות רשת בצורת U לחלוקת תמונות רפואיות. הארכיטקטורה הנפוצה ביותר בקטגוריה זו היא U-Net8, שהדגימה את היעילות של ארכיטקטורת מקודד-מפענח בצורת U לסגמנטציה של תמונות ביו-רפואיות. U-Net3+ משלבת חיבורי דילוגים צפופים מ-UNet++9 עם חיבורי דילוג בקנה מידה מלא כדי לשפר את אגרגציית התכונות הרב-קניות. עם זאת, לשיטות מבוססות CNN יש יכולת מוגבלת ללכוד תלויות לטווח ארוך, ולכן ייתכן שאינן מודלים ביעילות מידע הקשרי לטווח ארוך.
שיטות מבוססות טרנספורמרים לוכדות ביעילות תלות לטווח ארוך באמצעות מנגנון תשומת הלב העצמית, שמאפשר חישוב מקבילי ומקצה משקלי תשומת לב שונים לאזורים שונים של עניין. UNETR++10 מציג את מודול תשומת לב זוגית יעילה (EPA) כדי להפחית את מספר הפרמטרים והעלות החישובית. nnFormer11 משלבת פעולות קונבולוציונליות משולבות וריכוז עצמי ומציגה מנגנון תשומת לב עצמי מבוסס נפח מקומי-גלובלי ללמידת ייצוגים וולומטריים בסגמנטציה תלת-ממדית (תלת-ממדית) של תמונות רפואיות. H2Former12 מציע משמר ראייה היברידי היררכי יעיל המשלב מנגנוני קשב עם חילוץ תכונות מבוסס CNN במקודד. עם זאת, שיטות מבוססות טרנספורמר מציגות מורכבות חישובית ריבועית עם עלייה באורך הרצף, מה שמוביל לעלות חישובית גבוהה משמעותית. איור 1 ממחיש את המוטיבציה ל-MVM-UNet ומשווה את אסטרטגיית הסריקה הרב-תצוגה המוצעת למסגרות סגמנטציה קיימות מבוססות SSM.
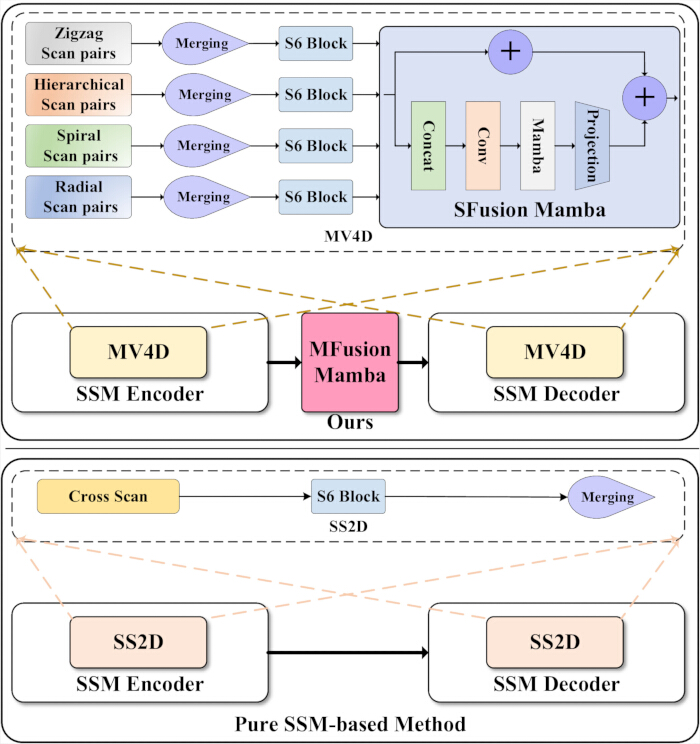
איור 1. השוואה בין MVM-UNet לבין ארכיטקטורות סגמנטציה מבוססות מודל מצב-מרחב טהור (SSM) קיימות. השוואה בין מסגרת סגמנטציה קונבנציונלית המבוססת על מודל מצב טהור (SSM) לבין ארכיטקטורת Multi-View Mamba U-Net (MVM-UNet) המוצעת. הפאנל העליון ממחיש את MVM-UNet, שבו מודול Multi-View 4-Directional (MV4D) מפיק תכונות משלימות באמצעות זוגות סריקה זיגזג, היררכיים, ספירליים ורדיאליים, המשולבים על ידי Spatial Fusion Mamba (SFusion Mamba), בעוד ש-Multi-stage Fusion Mamba (MFusion Mamba) מאגד תכונות מקודד רב-סקאלה לפני הפענוח. הפאנל התחתון מציג ארכיטקטורה מייצגת מבוססת SSM טהורה המשתמשת במודולי סריקה סלקטיבית דו-ממדית (SS2D) עם סריקה צולבת. התרשים מדגיש את ההבדלים האדריכליים בין רשתות סגמנטציה מבוססות SSM קונבנציונליות לבין ה-MVM-UNet המוצע. אנא לחצו כאן כדי לצפות בגרסה מוגדלת של הדמות הזו.
שיטות מבוססות SSM משלבות את יכולת המידול הגלובלית של טרנספורמרים עם מורכבות חישובית ליניארית. ארכיטקטורת הממבה מעבדת באופן סלקטיבי מידע קלט באמצעות מודל מרחב מצבים סלקטיבי (Selective-SSM), המאפשר למודל להתאים את הפרמטרים שלו באופן דינמי בהתאם לקלט, תוך סינון מידע לא רלוונטי והדגשת תכונות אינפורמטיביות. Vim13 ו-VMamba14 מתאימים את ארכיטקטורת הממבה למשימות ראייה ממוחשבת. U-Mamba15 עושה שימוש בארכיטקטורת CNN–SSM היברידית כדי לחקור את יישום SSMs בחלוקת תמונות רפואיות, בעוד שמאמבה-UNet16 מאמץ ארכיטקטורת מקודד-מפענח מבוססת SSM לחלוטין לפיצול תמונות רפואיות. שיטות אלו משיגות ביצועים תחרותיים תוך שימוש בפרמטרים קטנים בהרבה. עם זאת, שיטות מבוססות SSM/Mamba כיום בעיקר מפיקות תכונות תמונה באמצעות פאצ'ים פשוטים של תמונה ואסטרטגיות סריקה SS2D, אשר מציבות מספר מגבלות לסגמנטציה רפואית של תמונות. ראשית, SS2D וטכניקות מבוססות פאץ' מיועדות בעיקר למשימות ראייה ממוחשבת כלליות. Local Mamba17 ו-MotionMamba 18 הציעו כי אסטרטגיית הסריקה SS2D אינה מספקת לכל המשימות הוויזואליות, משום שאסטרטגיות סריקה שונות לוכדות סוגים שונים של מידע חזותי. שנית, אסטרטגיית הסריקה של SS2D פשוטה יחסית, ומתבססת רק על כיווני סריקה אופקיים ואנכיים. כתוצאה מכך, ייתכן שהוא לא מצליח ללכוד כראוי יחסים מרחביים מורכבים ופרטים מבניים עדינים. סגמנטציה רפואית של תמונות דורשת מידול סימולטני של הקשר מרחבי גלובלי ושל תכונות אנטומיות מקומיות מדויקות. יתרה מזאת, שיטות קיימות מבוססות SSM/Mamba מאפשרות מיזוג תכונות מוגבל בין המקודד למפענח. ארכיטקטורות כמו UNet++ ו-FATNet משפרות את דיוק הסגמנטציה באמצעות מיזוג תכונות משופר, ומדגישות את חשיבות האינטגרציה היעילה של תכונות לסגמנטציה של תמונות רפואיות.
כדי להתמודד עם מגבלות אלו, מאמר זה מציע מסגרת חדשה לחלוקת תמונות רפואיות מבוססת ממבה, הנקראת MVM-UNet. כפי שמוצג באיור 1, מודול MV4D המוצע ל-Multi-View Four-Directional משמש כרכיב הליבה לחילוץ תכונות ב-MVM-UNet ותוכנן במיוחד לחלוקת תמונות רפואיות על ידי שילוב מידע מארבע אסטרטגיות סריקה שונות. כל אסטרטגיית סריקה מפיקה תכונות תמונה משלימות ומייצגת תצוגה שונה של התמונה הנכנסת. סריקת זיגזג19 מחליפה את כיוון המעבר בסוף כל שורה או עמודה, ובכך מאזנת בין מידע מרחבי מקומי וגלובלי. לעומת זאת, סכמות הסריקה הספירליתוהרדיאלית 20 מספקות כיסוי מקיף על ידי התפשטות החוצה מהמרכז או פנימה מהפריפריה. סריקההיררכית 18 לוכדת תכונות מקומיות וגלובליות בקני מידה שונים. כדי לשפר את עמידות כל אסטרטגיית סריקה, זוגות סריקה ממזגים לפני ההזנה לבלוק S6. מודול Scan-view Fusion Mamba (SFusion Mamba) משלב לאחר מכן את התכונות שהופקו מארבעת מודאליות הסריקה. כדי לנצל בצורה יעילה תכונות מקודד רב-קניות, מאמר זה מציע בנוסף מודול מיזוג ממבה רב-קנה מידה (MFusion Mamba), שאוסף וממזג את הפלטים מכל שלב מקודד לפני שהוא מעביר את התכונות הממוזגות למפענח. MVM-UNet הוערך על פי מערכי הנתונים ISIC 2017, ISIC 2018 ו-Synapse. תוצאות ניסוי מראות ש-MVM-UNet משיג ביצועי סגמנטציה תחרותיים במאגרי הנתונים ISIC 2017, ISIC 2018 ו-Synapse.
ארכיטקטורות סגמנטציה מייצגות כוללות סגמנטציה רפואית מתקדמת עוד יותר. U-Net יושמה בהצלחה גם במשימות ניתוח תמונות ביו-רפואיות כגון ספירת תאים, זיהוי ומורפומטריה21. ארכיטקטורות CNN משודרגות על ידי תשומת לב, כמו CA-Net22, משפרות ייצוג תכונות באמצעות מנגנוני קשב מקיפים. מסגרות סגמנטציה מייצגות מבוססות טרנספורמר, כולל TransUNet23, Pyramid Medical Transformer24, Swin U-Net25, TransAttUNet26 ו-TransCUNet27, מדגימות עוד יותר את היעילות של מידול תכונות גלובלי מבוסס תשומת לב לסגמנטציה של תמונות רפואיות.
עיצוב MVM-UNet מונע משתי מגבלות של שיטות סגמנטציה קיימות מבוססות SSM/Mamba. ראשית, רבים מהמודלים הנוכחיים של Vision Mamba מסתמכים על אסטרטגיות סריקה דו-ממדיות פשוטות, שעשויות להיות בלתי מספקות לתמונות רפואיות המכילות גבולות נגעים לא סדירים, אזורי מטרה קטנים ומבנים אנטומיים רב-קנפיים. שנית, ארכיטקטורות מקודד-מפענח בצורת U קונבנציונליות מעבירות בעיקר תכונות דרך חיבורי דילוג מתאימים, מה שמגביל את השימוש הישיר במידע מקודד רב-שלבי במהלך הפענוח. לכן, MVM-UNet מציגה את MV4D לשיפור מידול מרחבי רב-תצוגה ואת MFusion Mamba לאגרגציה מפורשת של תכונות מקודד רב-שלבי. עיצוב זה נועד להתאים את המידול ארוך הטווח המבוסס ממבה לדרישות הספציפיות של סגמנטציה של תמונות רפואיות.
למרות ש-MVM-UNet בנוי על פרדיגמת המקודד-מקודד הכללית ומידול רצפים מבוסס ממבה, החידוש שלו טמון באופן שבו רכיבים אלו מותאמים ומשולבים לסגמנטציה רפואית של תמונות. במקום פשוט לשלב בלוק ממבה סטנדרטי בתוך עמוד שדרה בצורת U, המסגרת המוצעת מעצבת מחדש את תהליך המידול המרחבי באמצעות מספר ענפי זוג סריקה ממוקדי משימות, מציגה את SFusion Mamba לשילוב ייצוגים ספציפיים לסריקה, משפרת את בלוק MVV עם מסלולי שאריות והקרנה, ומכניסה את MFusion Mamba בין המקודד למפענח כדי לאגד תכונות מקודד רב-שלבי לפני הפענוח. עיצוב ברמת ארכיטקטורה זה שואף להתמודד עם גבולות לא סדירים, אזורי מטרה קטנים ומבנים אנטומיים רב-קנה מידה הנצפים בדרך כלל בתמונות רפואיות.
פרוטוקול זה מתאים במיוחד למשימות סגמנטציה הדורשות מידול סימולטני של מידע הקשרי לטווח ארוך, גבולות אובייקטים לא סדירים ומבנים אנטומיים רב-קנה מידה בתמונות רפואיות דו-ממדיות. בהשוואה לשיטות סגמנטציה מבוססות CNN, עיצוב המקודד-מפענח מבוסס ממבה מספק מנגנון יעיל למידול הקשר תוך שמירה על זרימת עבודה בצורת U המוכרת לחוקרי סגמנטציה רפואית. בהשוואה לשיטות מבוססות טרנספורמר, המסגרת המוצעת נמנעת משימוש ישיר בתשומת לב עצמית ריבועית ומיועדת לחוקרים המחפשים מידול הקשר גלובלי באמצעות מנגנון מידול רצף יעיל יחסית. בהתאם לכך, פרוטוקול זה מתאים לסגמנטציה של נגעי עור, חלוקת איברים בטניים ומשימות דו-ממדיות דומות של חלוקת תמונות רפואיות, שבהן חשוב גם מידע מבני גלובלי וגם פרטי גבול מקומיים.
לפרוטוקול זה יש גם מגבלות שיש לקחת בחשבון לפני השימוש. ייתכן שהוא לא נחוץ למשימות סגמנטציה פשוטות יחסית שבהן CNN קל משקל כבר מספק ביצועים מספקים. בנוסף, הוא אינו מתוכנן ישירות לסגמנטציה נפחית תלת-ממדית מלאה ללא התאמה אדריכלית. חוקרים עם נתונים מוגבלים מאוד עם הערות, משאבי יחידת עיבוד גרפיקה (GPU) מוגבלים, או דרישה למודלים קלאסיים ניתנים לפרשנות גבוהה, צריכים גם הם לשקול את המגבלות הללו לפני יישום הפרוטוקול. בסך הכול, שיטה זו מיועדת לחוקרים המעוניינים לשחזר ולהעריך מסגרת סגמנטציה בצורת U מבוססת ממבה, המאזנת בין מידול הקשר ארוך טווח, ייצוג גבולות מקומיים ומיזוג תכונות רב-שלביות.
התרומות המרכזיות הן כדלקמן:
1. מאמר זה מציג מסגרת חלוקה רפואית חדשנית מבוססת ממבה, הנקראת MVM-UNet. בניגוד לגישות שמשלבות ישירות בלוקי ממבה מבוססי SS2D או סטנדרטיים, MVM-UNet מציגה את MV4D למודלים של תכונות תמונה רפואיות מארבע תצוגות זוג סריקה משלימות, כולל זיגזג, היררכי, ספירלי ורדיאלי.
2. מאמר זה מעצב את SFusion Mamba ואת בלוק ה-MVV כדי לשלב ייצוגים ספציפיים לסריקה ולשפר את טרנספורמציית התכונות. SFusion Mamba מאחד את התכונות שהופקו מענפי זוגות סריקה שונים, בעוד שהענפים השאריים וההקרנה למעלה-למטה בתוך בלוק MVV מספקים מסלולי תכונות משלימים שמייצבים ומעשירים ייצוגים של תכונות.
3. מאמר זה מציג את MFusion Mamba כמודול מיזוג רב-שלבי ביניים בין המקודד למפענח. בניגוד לחיבורי דילוג קונבנציונליים שמעבירים בעיקר תכונות של שלבים תואמים, MFusion Mamba מאגד במפורש תכונות מקודד רב-שלבי באמצעות מיזוג גס לדק ומספק מידע מועשר לפענוח.
4. תוצאות ניסוי נרחבות מראות כי ה-MVM-UNet המוצע משיג ביצועי סגמנטציה תחרותית במאגרי ISIC 2017 ו-ISIC 2018 וביצועים חזקים במאגר הסגמנטציה הרב-איברי של Synapse. יתרה מזאת, מחקרי אבלציה מקיפים מאמתים את תרומתו של כל רכיב בתוך MVM-UNet.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
מחקר זה השתמש רק במאגרי תמונות רפואיות זמינים לציבור ולא מזוהים, כולל ISIC 2017, ISIC 2018 ו-Synapse. לא נאספו משתתפים אנושיים חדשים, נבדקים בעלי חיים או רשומות רפואיות פרטיות מזוהות במחקר זה. מאגר הנתונים של ISIC 2017 ששימש במחקר זה היה מאגר הסגמנטציה של פצעי העור ISIC 2017 Challenge, שהושג ממאגר הנתונים הרשמי של International Skin Imaging Collaboration Challenge (https://challenge.isic-archive.com/data/#2017). גרסת מערך הנתונים ששימשה במחקר זה תואמת למשימת חלוקת הנגעים של ISIC 2017, הכוללת את המחיצות הרשמיות של ההדרכה, האימות והבדיקה. מערך הנתונים הורד ב-15 במרץ 2024. מאגר הנתונים של ISIC 2018 ששימש במחקר זה היה מאגר הסגמנטציה של משימת 1 של ISIC Challenge Task 1, שהתקבל ממאגר הנתונים הרשמי של International Skin Imaging Collaboration (https://challenge.isic-archive.com/data/#2018). גרסת מערך הנתונים ששימשה במחקר זה תואמת למשימה 1 של ISIC 2018: סגמנטציה של גבול הנגעים. מערך הנתונים הורד ב-8 ביולי 2024.
מאגר הנתונים של סינפס ששימש במחקר זה היה Multi-Atlas Labeling Beyond the Cranial Vault הבטני CT, שהושג ממאגר הסינפס תחת מזהה accession syn3193805 (https://www.synapse.org/Synapse:syn3193805). מאגר הנתונים ששימש במחקר זה תואם למאגר הנתונים הנפוץ ל-30 מקרי CT בבטן עם סגמנטציה רב-איברית. הארכיון שהורד היה Abdomen/RawData.zip, שהיה זמין תחת סינת accession syn3193805. לא סופקו מספר גרסה נפרד, תווית שחרור או תג שחרור מתוארך על ידי המאגר בזמן ההורדה. בהתאם לחלוקה התקנית שאומצה במחקרים קודמים, 18 מקרים שימשו להכשרה ו-12 מקרים לבדיקה. חלוקת הנתונים התבצעה לפי רשימת המקרים שבה השתמשה TransUNet23. בפרט, תיקי ההכשרה היו case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028, ו-case0037, בעוד שהמקרים היו case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025, ו-case0035. מערך הנתונים הורד ב-9 ביולי 2024. מכיוון שמחקר זה השתמש רק במאגרי נתונים ציבוריים שלא מזוהים ולא כלל איסוף נתונים חדשים של נבדקים אנושיים או מידע פרטי מזוהה, לא נדרשה אישור ועדת ביקורת מוסדית לניסויים החישוביים המתוארים בפרוטוקול זה. לא התקבלה קביעת פטור מוסדית רשמית בכתב. אם נדרש על פי מדיניות מוסדית מקומית, על החוקרים לקבל קביעת פטור מוסדי לפני ביצוע ניתוחים משניים של מאגרי נתונים זמינים לציבור. לא היה זמין מספר הפניה לפטור אתי מוסדי או מסמכי פטור רשמיים למחקר זה.
1. הכנת מערכי נתונים
- הורידו את מאגר הנתונים של סגמנטציה של נגעי עור ISIC לשנת 2017 מהמאגר הרשמי של שיתוף הפעולה הבינלאומי להדמיית עור. השתמש במחלקות הרשמיות של ההדרכה, האימות והבדיקה. ודאו שהמאגר מכיל 2,000 תמונות אימון, 150 תמונות אימות ו-600 תמונות בדיקה.
- הורד את מאגר הנתונים של חלוקת נגעי העור ISIC לשנת 2018 מהמאגר הרשמי של שיתוף הפעולה הבינלאומי להדמיית עור. השתמש במחלקות הרשמיות של ההדרכה, האימות והבדיקה. ודאו שמאגר הסגמנטציה מכיל 2,594 תמונות אימון, 100 תמונות אימות ו-1,000 תמונות בדיקה.
- הורד את מאגר הנתונים של סגמנטציה רב-אורגנית של Synapse. השתמשו בחלוקה הסטנדרטית הכוללת 18 מקרים (2,212 פרוסות אקסיאליות) לאימון ו-12 מקרים (1,567 פרוסות אקסיאליות) לבדיקה. אל תכניס סט אימות נפרד.
- שמרו את 12 מקרי הבדיקה באופן בלעדי להערכה סופית. אין להשתמש במקרי הבדיקה לאימון מודלים, כוונון היפרפרמטרים או בחירת מודל. משימת החלוקה כוללת שמונה איברים בטניים: אאורטה, כיס המרה, טחול, כליה שמאלית, כליה ימין, כבד, לבלב וקיבה.
- השתמש בחלוקת מערך הנתונים של סינפס הבא. 18 תיקי ההכשרה היו case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028, ו-case0037. 12 המקרים שנבדקו היו case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025, ו-case0035.
- ארגן כל מערך נתונים לתיקיות תמונה ומסכה נפרדות. ודא שלכל תמונה יש מסכת סגמנטציה מתאימה עם אותו מזהה מקרה.
- המור כל מסכת נגע עור למפת סגמנטציה בינארית של קדמת הרקע. שמור את תוויות האורגנים הרב-מחלקתיות המקוריות עבור מערך הנתונים Synapse.
- עבור מערכי הנתונים של ISIC 2017 ו-ISIC 2018, יש להקצות ערך תווית של 0 לפיקסלים ברקע ו-1 לפיקסלים של נגע (קדמתי) לאחר המרת מסכה בינארית. פיקסלים עם ערכי מסכה מקוריים גבוהים מ-0 מטופלים כקדמת הקדמית ומומרים ל-1, בעוד פיקסלים עם ערכי מסכה מקוריים 0 מטופלים כרקע ונשמרים כ-0. עבור מערך הנתונים של סינפסה, שמרו על ערכי התווית השלמים המקוריים, כאשר 0 מייצג את מחלקת הרקע ו-1–8 מייצג את שמונה מחלקות האיברים הקדמיים.
- שנו את גודל התמונות והמסכות של ISIC 2017 ו-ISIC 2018 ל-256 × 256 פיקסלים מבלי לשמור על יחס הגובה-רוחב המקורי. אל תמרחו חיתוך או ריפוד.
- שנו את גודל כל פרוסת CT של סינפס ואת מפת התווית המתאימה ל-224 × 224 פיקסלים. השתמש באינטרפולציה ביליניארית לתמונות RGB, באינטרפולציה של ספליין מסדר שלישי לפרוסות CT, ובאינטרפולציה של השכן הקרוב ביותר למסכות סגמנטציה.
- שינוי גודל תמונות בפייתון.
- עבור מערכי הנתונים ISIC 2017 ו-ISIC 2018, השתמשו בטרנספורמציית myResize מותאמת אישית שמיומשת ב-utils.py, שקוראת ל-torchvision.transforms.functional.resize כדי לשנות את גודל טנזורי התמונה והמסכה ל-256 × 256 פיקסלים. אין לציין מצב אינטרפולציה מפורש או טיעון אנטי-אליאסינג בטרנספורמציה זו.
- למערך הנתונים Synapse, השתמש ב-scipy.ndimage.zoom במערכי נתונים/dataset.py. שינוי גודל חיתוך תמונת CT ל-224 × 224 פיקסלים באמצעות אינטרפולציה של ספליין מסדר שלישי (סדר = 3), ומפות תוויות בגודל מחדש באמצעות אינטרפולציה של השכן הקרוב ביותר (סדר = 0). אל תפעיל פעולה נפרדת של אנטי-אליאסינג או הגדרה anti_aliasing=True במהלך שינוי הגודל.
- נרמול כל תמונת ISIC RGB לפני המרת טנזור באמצעות ממוצע ספציפי וסטיית תקן (SD) לפי מערך הנתונים באמצעות משוואה 1 כך:
 (1)
לאחר מכן משנה את קנה המידה של התמונה המנורמלת לטווח של 0–255 באמצעות נירמול מינימום–מקסימלי.- השתמש ב-μ = 159.922 ו-σ = 28.871 עבור ערכת ההכשרה של ISIC 2017 ו-μ = 148.429 ו-σ = 25.748 עבור ערכות האימות והבדיקה של ISIC 2017. השתמש ב-μ = 157.561 ו-σ = 26.706 עבור ערכת האימון ISIC 2018 ו-μ = 149.034 ו-σ = 32.022 עבור ערכות האימות והבדיקה של ISIC 2018.
- המרו כל תמונה מנורמלת לטנזור בצורת 3 × 256 × 256. המרו כל מסכה בינארית לטנזור בצורת 1 × 256 × 256.
- בצע נרמול מינימום–מקסימום באופן עצמאי עבור כל תמונה לאחר נרמול ממוצע וסטיית תקן ספציפית למאגר נתונים. באופן ספציפי, מחסר את הממוצע הספציפי למאגר הנתונים מכל תמונה וחלק בסטיית התקן המתאימה.
- חשב את ערכי העוצמה המינימליים והמקסימליים מהתמונה המנורמלת ושנו את גודל התמונה לטווח 0–255 באמצעות ערכי המינימום והמקסימום לכל תמונה אלו. אל תשתמש בערכים מינימליים ומקסימליים של כל מערך הנתונים עבור שלב שינוי המינימום-מקסימלי הזה.
- הכן כל פרוסת CT של Synapse כתמונה דו-ממדית בגווני אפור. המור כל פרוסת CT ל-float32 והוסף ממד ערוץ יחיד כדי לקבל טנזור קלט בצורות 1 × 224 × 224.
- שמור על כל מפה של תווית Synapse כמסכת מספר שלם חד-ערוצי, בצורות 224 × 224. אין להחיל נרמול ממוצע SD נוסף ברמת מערך הנתונים בטוען הנתונים.
- השתמש בקבצי Synapse המעובדים מראש בפורמט .npz עבור slice האימון ובפורמט .npy.h5 לבדיקות נפחים. טען את מערכי התמונה והתוויות ישירות מכל קובץ .npz במהלך האימון וישירות מכל קובץ .npy.h5 במהלך הבדיקה. אין להחיל חיתוך אינטנסיבי נוסף, חלונות CT, נרמול ברמת מערך הנתונים או דגימה מחדש בנפח גולמי בטוען הנתונים ששוחרר.
- במהלך אימון המודלים, המרו כל פרוסה דו-ממדית טעונה ל-float32, שנו את גודלה לגודל המרחב היעד באמצעות scipy.ndimage.zoom עם סדר = 3 עבור פרוסות תמונה וסדר = 0 למפות תוויות, ואז המרו את המערכים המוגדלים מחדש לטנזורים עם ממד ערוץ יחיד.
- יישם הגדלת נתונים רק על מערך האימונים. עבור ISIC 2017 ו-ISIC 2018, יש ליישם היפוך אופקי אקראי (p = 0.5), היפוך אנכי אקראי (p = 0.5), וסיבוב אקראי (p = 0.5) עם זווית מדגימה מ-0° עד 360°.
- החלו את אותה טרנספורמציה גאומטרית על כל זוג תמונה-מסכה. במהלך האימות והבדיקות, יש להחיל רק שינוי גודל, נרמול והמרת טנזור.
- לגבי מערך הנתונים של סינפסה, יש להחיל סיבוב אקראי והפיכת אקראית במהלך האימון. סובבו באקראי כל זוג תמונה-תווית ב-k × 90°, כאשר k ∈ {0,1,2,3}, הפכו באקראי את זוג התמונה-תווית לאורך ציר מרחבי אחד, או סובבו באקראי את זוג התמונה-תווית בזווית שנמדגם בין −20° ל-20°.
- אין להחיל הגדלה סטוכסטית במהלך הבדיקות.
- החלו הגדלת נתונים על מערך הנתונים של Synapse באמצעות הענפים הבלעדיים המיושמים בטרנספורמציית RandomGenerator.
- עבור כל מדגם אימון, הערך תחילה את המצב random.random() > 0.5. אם תנאי זה מתקיים, יש להחיל random_rot_flip, הכולל סיבוב אקראי של 90° (k = 0, 1, 2 או 3) ואחריו היפוך אקראי לאורך ציר מרחבי אחד.
- אם הענף הראשון לא נבחר, יש להעריך תנאי שני, random.random() > 0.5. אם תנאי זה מתקיים, יש להחיל random_rotate באמצעות זווית סיבוב נבחרת באקראי בין −20° ל-20°. אם אף אחד מהתנאים אינו מתקיימ, אין להחיל הרחבה סטוכסטית על הדגימה.
- החלו את אותה טרנספורמציה גם על תמונת הקלט וגם על מפת התווית המתאימה.
- הגדר את הזרע האקראי לפני טעינת מערכי נתונים, עיבוד מוקדם ואימון. השתמשו בזרעים אקראיים 1, 52 ו-100 לניסויים המרכזיים בהשוואה והשתמשו בזרעים 100 למחקרי אבלציה אלא אם צוין אחרת.
- אתחול את המעבד Python, NumPy, PyTorch, PyTorch CUDA ו-cuDNN לפני בניית ה-data loader. שמרו על מחיצות מערכי הנתונים, נהלי העיבוד המוקדם, הגדרות השדרוג, פרמטרי הנרמליזציה, אסטרטגיית שינוי גודל ועיבוד הערכה ללא שינוי בכל ריצות הזרע.
- הגדר num_workers = 0 עבור ניסויי ISIC ו-Synapse לביצוע טעינת נתונים בתהליך הראשי. לפני בניית מערך הנתונים ויצירת ה-DataLoader, אתחל את זרע האקראי הגלובלי באמצעות פונקציית set_seed כדי לזרוע את מחוללי המספרים האקראיים של Python, NumPy, PyTorch, PyTorch CUDA ו-cuDNN. אל תגדיר worker_init_fn נפרד או מחולל אקראי ספציפי ל-DataLoader, שכן אלו אינם בשימוש במימוש שפורסם.
2. בניית ארכיטקטורת MVM-UNet
- לבנות את ה-Multi-view Vision Mamba UNet (MVM-UNet) המוצע באמצעות ארכיטקטורת מקודד-מפענח בצורת U.
- הגדר את מימד התמונה הקלט ל-H × W × 3. העבר את תמונת הקלט דרך שכבת הטמעת הפאץ'.
- מימוש שכבת ההטמעה באמצעות קונבולוציה דו-ממדית עם גודל ליבה של 4 × 4, צעד של 4, שלושה ערוצי קלט ו-96 ערוצי יציאה.
- המרת מפת תכונת הקלט לרזולוציה מרחבית של H/4 × W/4 עם C = 96 ערוצי יציאה.
- בנה ארבעה שלבי מקודד וארבעה שלבי מפענח. הפחתת הרזולוציה המרחבית בחצי והכפלת ממד הערוץ לאחר כל שלב מקודד.
- השתמש בתצורת מקודד-מפענח סימטרית. הגדר את מספר בלוקי ה-MVV גם במקודד וגם במפענח ל-{2, 2, 2, 2}.
- הנח שני בלוקי MVV בכל שלב מקודד ושני בלוקי MVV בכל שלב מפענח.
- הכנס בלוק MVV לכל שלב מקודד ומפענח. השתמש במודול MV4D כמודול חילוץ תכונות מרכזי בתוך כל בלוק MVV.
- הכנס את מודול MFusion Mamba בין המקודד למפענח. השתמש במודול זה כדי למזג תכונות מקודד רב-שלבי לפני הפענוח.
- הגדר את זרימת העבודה הכוללת של MVM-UNet. השתמש ב-MV4D לחילוץ תכונות בכל המקודד.
- שמור על יציאות המקודד כחיבורים מדלגים. העבר את פלטי המקודד לשלבי המפענח המתאימים.
- העבר את תכונות המקודד ל-MFusion Mamba לפני הפענוח. העלו בהדרגה את הייצוג הממוזג דרך המפענח ויצרו את מפת הסגמנטציה הסופית באמצעות ראש הסגמנטציה.
- העבר את תמונת הקלט I ∈ RB×H×W×3 דרך שכבת ההטמעה כדי לקבל
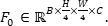 את Here, C = 96.
- יצירת מפות תכונות מקודד: E1 ∈ RB×H/4×W/4×C, E2 ∈ RB×H/8×W/8×2 C, E3 ∈ RB×H/16×W/16×4C, ו-E4 ∈ RB×H/32×W/32×8C. השתמש בלוקי MVV המכילים MV4D בכל שלב מקודד.
- שמור כל תכונת מקודד עבור חיבור הדילוג המתאימה. העבר את כל תכונות המקודד ל-MFusion Mamba למיזוג תכונות רב-שלביות.
- יישר תכונות מקודד למרחב תכונות משותף לפני מיזוג גס ועדין בתוך MFusion Mamba. העבר את הייצוג הממוזג למפענח.
- העלו בהדרגה את ייצוג המפענח. ממזג את תכונות המפענח עם E3 ב-H/16 × W/16, E2 ב-H/8 × W/8, ו-E1 ב-H/4 × W/4.
- הגדל את תכונת המפענח הסופית לרזולוציה המקורית של התמונה. יצר את מפת
 החיזוי ∈ RB×H×W×K. כאן, K = 1 עבור סגמנטציה בינארית של נגעים ו-K = 8 עבור סגמנטציה מרובת איברים בסינפסה.
- עיין באיור 2 לארכיטקטורת הרשת הכוללת ובטבלה משלימה 1 למפרט הארכיטקטורה המלאה שכבה-שכבה, כולל פעולות, פרמטרים עיקריים וממדי תכונות פלט לכל שלב
- שכבות מעבר מקודד–מפענח
- תכונות מקודד מדגם נמוך באמצעות שכבות מעבר של מיזוג פאצ'ים. לכל מעבר, יש לדגום ארבע קבוצות תכונות משולבות במרחב משכונה של 2 × 2, לאחד אותן לאורך ממד הערוץ, ליישם נורמליזציה שכבתית (LayerNorm), ולהקרין את התכונה 4C-ממדית המתקבלת לערוצי 2C באמצעות שכבה ליניארית ללא הטיה. פעולה זו מפחיתה את הרזולוציה המרחבית פי 2 תוך הכפלת ממד הערוץ.
- תכונות מפענח דגימות באמצעות שכבות מעבר שמרחיבות פאץ'. מיישמים היטל ליניארי ללא הטיה, מסדר מחדש את התכונות המורחבות במרחב כדי להגדיל את הרזולוציה פי 2, ומיישם את LayerNorm לאחר ההרחבה המרחבית. חזרו על פעולה זו כדי לשחזר בהדרגה את מפות התכונות מ-H/32 ×W/32 ל-H/16 × W/16, H/8 × W/8, ו-H/4 × W/4.
- יישר תכונות מקודד בתוך מודול MFusion Mamba על ידי שינוי גודלן לרזולוציה המרחבית היעד באמצעות אינטרפולציה ביליניארית (align_corners = False) ואז יישום הקרנת ערוץ ליניארית ללמידה לפני מיזוג תכונות.
- ראש סגמנטציה
- העלו את מיפוי תכונות המפענח הסופי מ-H/4 × W/4 לרזולוציה המקורית של התמונה (H × W) באמצעות שכבת הרחבת הפאץ' הסופית. החלו היטל ליניארי, מבצעים סידור מחדש מרחבי עם גורם התרחבות של 4, והחלו את LayerNorm.
- הקרנה את מפת הפיצ'ר המשוחזרת ל-K ערוצי פלט באמצעות קונבולוציה של 1 × 1 לאחר המרת הטנזור לפורמט ערוץ ראשון.
- יצירת התחזית הסופית במהלך ההערכה על ידי יישום פונקציית הפעלה סיגמואידי לסגמנטציה בינארית של נגעים או הפעלה סופטמקס ואחריה ארגמקס לסגמנטציה מרובת איברים של סינפסה. אל תפעיל פונקציית הפעלה בתוך ראש הסגמנטציה עצמו.
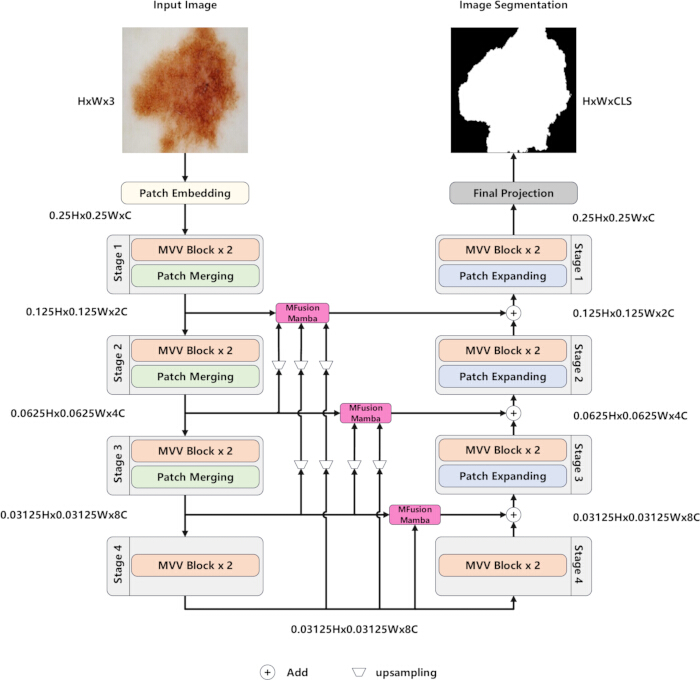
איור 2. הארכיטקטורה הכוללת של Mamba U-Net רב-תצוגה (MVM-UNet). סקירה של ארכיטקטורת ה-Mamba U-Net (MVM-UNet) המוצעת ב-Multi-View. תמונת הקלט מומרת להטמעות פאץ' ומעובדת דרך ארבעה שלבי מקודד המורכבים מבלוקי Multi-View Vision (MVV) המופרדים על ידי פעולות מיזוג פאצ'ים. תכונות המקודד מאוגדות על ידי ממבה מיזוג רב-שלבית (MFusion Mamba) ומועברות למפענח דרך חיבורי דילוג. המפענח משחזר בהדרגה את הרזולוציה המרחבית באמצעות פעולות הרחבת פאץ' ומייצר את מפת הסגמנטציה הסופית דרך שכבת ההקרנה. אנא לחצו כאן כדי לצפות בגרסה מוגדלת של הדמות הזו.
3. בניית מודול MV4D
- השתמש במודול MV4D כיחידת חילוץ תכונות בסיסית ב-MVV Block. הזן את פאצ'י תכונות הקלט לארבעה ענפי זוג סריקה. עיין באלגוריתם 1, קובץ משלים 1 לקוד הפסאודו-קוד המלא של שטח מרחבי, בניית אינדקס זוגות סריקה, איסוף רצפים, עיבוד S6/Mamba, סידור מרחבי הפוך, מיזוג זוגות סריקה, מיזוג ממבה SFusion, הקרנה ועיצוב פלט מחדש.
- השתמש בפרוצדורות יצירת אינדקס סריקה זיגזג, היררכי, ספירלי ורדיאלי שמיושמות במודלים/mvmunet/core.py. לכל אסטרטגיית סריקה, השתמשו בסדר הסריקה קדימה ובסדר ההפוך שלו כזוג סריקה דו-כיווני אחד.
- בנה את זוג הסריקה הזיגזגית. עברו על תכונות התמונה בכיוונים מתחלפים בסוף כל שורה או עמודה. השתמש בדפוס הסריקה הזה כדי לאזן בין מידע מרחבי מקומי וגלובלי.
- בנו את זוג הסריקה ההיררכי. לכידת תכונות בקני מידה מרחביים שונים. השתמשו בדפוס סריקה זה כדי לחזק את ההפקה של ייצוגים מקומיים וגלובליים.
- בנה את זוג הסריקה הספירלית. סרקו את תכונות התמונה מהמרכז לכיוון הגבול או מהגבול למרכז. השתמש בדפוס סריקה זה כדי לשפר את הפקת מידע קווי המתאר הגלובליים.
- בנה את זוג הסריקה הרדיאלית. סרוק תכונות תמונה לאורך כיוונים רדיאליים מרובים. השתמשו בדפוס סריקה זה כדי לשפר את חילוץ פרטי הגבול והקצוות המקומיים.
- ממזגים כל זוג סריקה לפני שמזינים את הרצף הממוזג לבלוק S6. השתמש בעיצוב הזוגי לשיפור עמידות כל אסטרטגיית סריקה תוך שמירה על יעילות חישובית.
- הזן את רצף הפלט של כל ענף זוג סריקה לבלוק S6. קבל ארבעה ייצוגי תכונות התואמים לתצוגות הסריקה הזיגזגית, ההיררכית, הספירלית והרדיאלית.
- מיזוג ארבעת הייצוגים של התכונות שהופקו באמצעות מודול SFusion Mamba. השתמש בשני מסלולי מיזוג מקבילים. בנתיב הראשון, יש לשלב את ארבעת התכונות על ידי חיבור לפי אלמנט.
- במסלול השני של SFusion Mamba, מחברים את ארבעת התכונות. עבד את הייצוג המקושר באמצעות Conv1d ו-Mamba. הקטן את ממד הערוץ באמצעות שכבת הקרנה כדי להתאים לממד פלט בלוק S6.
- הגדר את בלוק S6/Mamba תוך שימוש במימד התכונה C כממד המודל. השתמש בשכבת הקרנה כדי למפות כל תכונת זוג סריקה מאוחד חזרה לממד הערוץ C לפני המיזוג.
- ב-SFusion Mamba, בצע חיבור לפי אלמנט במסלול הראשון. לאחד את ארבעת תכונות תצוגת הסריקה במסלול השני לפני Conv1d, Mamba והקרנה ליניארית. השתמש בפעולות הנירמליזציה, ההיטל הליניארי, קונבולוציה מופרדת לפי עומק ופעולות הפעלה סביב MV4D כפי שמתואר בשלב 4.
- הוסף את הפלטים של שני מסלולי ההיתוך כדי קבלת הפלט הסופי של מודול MV4D.
- בנה ארבעה ענפי זוג סריקה משלימים במקום להשתמש רק בכיווני סריקה אופקיים ואנכיים. השתמש בסריקת זיגזג להדגשת מעבר מרחבי רציף, בסריקה היררכית לחיזוק ייצוג רב-קנה מידה, בסריקה ספירלית ללכידת מידע על קווי מתאר ממרכז לגבול, וסריקה רדיאלית לשיפור חילוץ פרטים מקומיים ממוקד גבולות.
- עבד כל ענף זוג סריקה באופן עצמאי. ממזג את הפיצ'רים המתקבלים באמצעות SFusion Mamba. מפה כל רצף מעובד חזרה לסדר המרחבי המקורי שלו לפני המיזוג.
- בהינתן מפת תכונת קלט X ∈ RB×H×W×C, שטחו אותה ל-Xseq ∈ RB×L×C, כאשר L = H × W.
- סדר מחדש את הרצף השטוח לפי אינדקסי הסריקה עבור כל ענף זוג סריקה. עבדו כל רצף מסודר מחדש באמצעות בלוק S6. השחזר את הרצף המעובד לסדר המרחבי המקורי.
- למזג את ארבעת תכונות תצוגת הסריקה דרך מסלול החיבור ומסלול SFusion Mamba כדי לקבל את הפלט הסופי של MV4D. עיין באיור 3 לארכיטקטורת MV4D ולאלגוריתם 1, קובץ משלים 1 לתהליך היישום המלא ברמת טנזור.
- השתמש ביישום התוכנה המלא במודלים/mvmunet/core.py. קובץ זה מכיל את מחוללי הסריקה, PairwiseScanMamba, SequenceS6, SFusion Mamba ומודול העטיפה MV4D.
- יצירת מדדי סריקה מרובי תצוגות
- יצר את אינדקסי הסריקה על ידי מעקב אחרי המימוש שפורסם ב-model/mvmunet/core.py. למפת תכונות קלט בגודל מרחבי H × W, שטח כל מיקום פיקסל לאינדקס חד-ממדי באמצעות: index = r × W + c, כאשר are ו-c מסמנים את קואורדינטות השורה והעמודה, בהתאמה.
- יצירת סריקת זיגזג על ידי חציית אלכסוני תמונה עם קבוע r + c. אספו את אינדקסי הפיקסלים התקפים לכל אלכסון והחליפו את כיוון המעבר על ידי הפיכת הסדר של כל אלכסון זוגי.
- יצר את הסריקה ההיררכית על ידי חלוקה רקורסיבית של התמונה לארבעה רבעים. בקרו ברבעים העליונים-שמאליים, העליונים-ימין, התחתונים-שמאל והתחתון-ימין ברצף עד שהגובה או הרוחב של תת-האזור לא יעלו על 2 פיקסלים, ואז עברו על שאר הפיקסלים בסדר שורה ראשית.
- יצר את הסריקה הספירלית על ידי חציית הגבול החיצוני של התמונה משמאל לימין לאורך השורה העליונה, מטה לאורך העמודה הימנית, ימין לשמאל לאורך השורה התחתונה, ומעלה לאורך העמודה השמאלית תוך הקטנת הגבול בהדרגה לכיוון מרכז התמונה.
- יצר את הסריקה הרדיאלית על ידי מיון כל פיקסל לפי המרחק הריבועי שלו ממרכז התמונה ואז לפי הזווית הפולרית שלו שמחושבת באמצעות פונקציית atan2.
- יצר סריקה הפוכה לכל אסטרטגיית סריקה על ידי הפיכת סדר הסריקה הקדמי המתאים. משלבים את רצפי הסריקה הקדמית והאחורה ליצירת זוג סריקה אחד לכל אסטרטגיית סריקה לפני העברת זוגות הסריקה למודול MV4D.
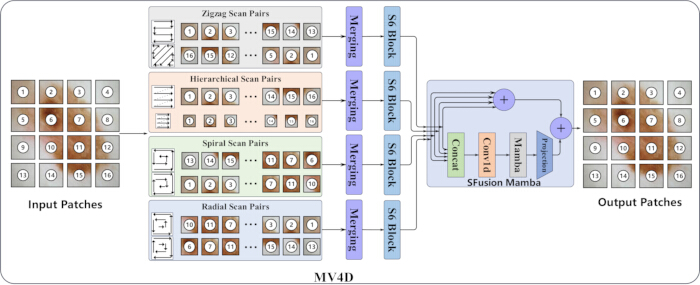
איור 3. ארכיטקטורת המודול הרב-תצוגה 4-כיוונית (MV4D). מבנה מודול חילוץ תכונות רב-תצוגה 4-כיוונית (MV4D). טלאי קלט מעובדים דרך ארבעה ענפי זוג סריקה משלימים הכוללים זיגזג, היררכי, ספירלי וסריקה רדיאלית. תכונות שמופקות מארבעת הענפים מאוחדות, מעובדות באמצעות בלוקי מרחב מצבים, ומשולבות על ידי Spatial Fusion Mamba (SFusion Mamba) ליצירת ייצוג תכונות הפלט. אנא לחצו כאן כדי לצפות בגרסה מוגדלת של הדמות הזו.
4. בניית בלוק MVV
- בנה את בלוק MVV באמצעות ענף ראשי אחד ושני סניפים עזריים. השתמשו במבנה הכולל המוצג באיור 4.
- החלו נרמול שכבה על תכונת הקלט בסניף הראשי. הזן את התכונה המנורמלת לשכבה ליניארית. העבר את התכונה המומרת לקונבולוציה הניתנת להפרדה בעומק.
- עבד את המאפיין הטרנספורמטיבי באמצעות קונבולוציה מופרדת בעומק. הפעל את פונקציית ההפעלה של GLU. הזן את הפיצ'ר המופעל למודול MV4D.
- בנה את הענף המסייע הראשון כקשר שאריתי זהות. חבר את תכונת הקלט ישירות לפלט הסופי. השתמשו בענף זה כדי לשמר את הייצוג המקורי ולייצב את ההכשרה.
- בנה את הענף השני כענף הקרנה למטה למעלה. דחסו את תכונת הקלט באמצעות שכבת הקרנה מטה. שחזר את ממד התכונה באמצעות שכבת הקרנה כלפי מעלה.
- למזג את התפוקות של הסניף הראשי ושני הענפים המשניים. קבל את פלט הבלוק הסופי של MVV. עיין באיור 4 לארכיטקטורה המלאה.
- הגדר את הממד הנסתר של הענף הראשי שווה לממד ערוץ הקלט Cs. החלו את LayerNorm(Cs) לפני ההיטל הליניארי הראשי והשתמשו בשכבה ליניארית עם ממדים Cs→Cs. השתמשו בקונבולוציה מופרדת בעומק הכוללת קונבולוציה 3×3 עומק עם ריפוד 1, קבוצות = Cs, וללא הטיה, ואחריה קונבולוציה נקודתית של 1×1 ללא הטיה.
- הפעילו את פונקציית ההפעלה של GELU לאחר הקונבולוציה הניתנת להפרדה בעומק. הזנת התכונה המופעלת ל-MV4D והחלה הקרנה ליניארית בממדים Cs→Cs. הגדר את ענף ההקרנה למטה למעלה באמצעות LayerNorm(Cs), יחס הקרנה של 4, הקרנה למטה Cs→C s/4, הפעלת GLU, והקרנה מעלה Cs/4→Cs.
- משלבים את ענף הזהות, ענף ההקרנה למטה-למעלה, והענף הראשי המעובד בנתיב השחרור באמצעות חיבור אלמנט לצורך הפלט הסופי של בלוק MVV.
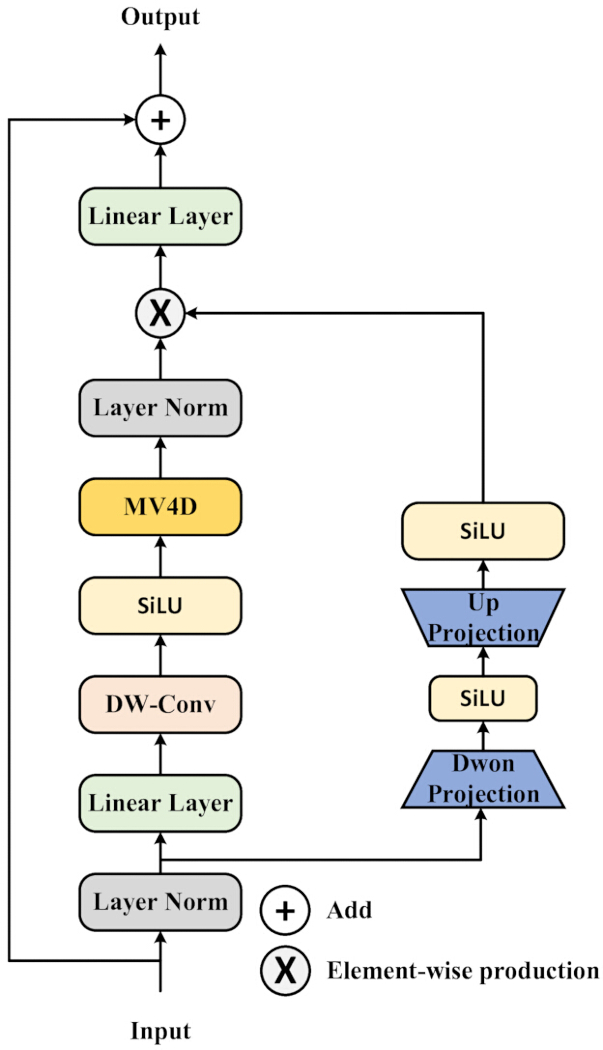
איור 4. ארכיטקטורה של בלוק Multi-View Vision (MVV). מבנה בלוק החזון הרב-תצוגה (MVV). הבלוק מורכב מענף חילוץ תכונות עיקרי הכולל את מודול Multi-View 4-Directional (MV4D) יחד עם שכבות קונבולוציה עומקית, נרמול והקרנה ליניארית. ענף הקרנה עזרי למעלה למטה מספק מודולציה של תכונות עם שער באמצעות כפל לפי אלמנט לפני חיבור שאריתי ליצירת ייצוג תכונת הפלט. אנא לחצו כאן כדי לצפות בגרסה מוגדלת של הדמות הזו.
5. בניית MFusion Mamba
- אסוף את מפות התכונות מכל שלבי המקודדים. יישר את תכונות המקודד למרחב ייצוג מאוחד על ידי שינוי גודל או הקרנה בעת הצורך. עיין באלגוריתם 2, קובץ משלים 1 עבור תהליך היישום המלא ברמת טנזור.
- שינוי גודל תכונות המקודד לרזולוציה המרחבית היעד בעת הצורך. תכונות פרויקט עם ממדים שונים של ערוץ לאותו ממד ערוץ. יישר את כל תכונות המקודד לפני מיזוג רב-שלבי.
- הזן את תכונות המקודד המיושר לרכיב Coarse Fusion. בצע היתוך גס באמצעות מוצר Hadamard. יצר את הייצוג המאוחד הגס.
- הזן את הייצוג המאוחד הגס לרכיב ההיתוך העדין. בנה שני מסלולי היתוך עדין מקבילים. עבד את שני המסלולים באופן עצמאי.
- עבדו את מסלול ההיתוך הדק הראשון באמצעות שכבה ליניארית. עבדו את מסלול ההיתוך הדק השני באמצעות הקרנה למעלה, Conv1d, ממבה והקרנה למטה. השחזר את ממד התכונה לאחר ההקרנה כלפי מטה.
- למזג את הפלטים של שני מסלולי ההיתוך העדין באמצעות מוצר האדמארד. מרח את השכבה הליניארית הסופית. קבל את פלט MFusion Mamba.
- הזן את פלט MFusion Mamba למפענח. פענח את הייצוג הרב-שלבי הממוזג יחד עם תכונות הדילוג של מקודד-מפענח. יצר את מפת הסגמנטציה הסופית.
- יישר תכונות מקודד משלבים שונים למרחב תכונות מאוחד לפני מיזוג גס. עבד את ייצוגי התכונות המיושרים באמצעות שלבי המיזוג הגס והעדין. עיין באיור 5 עבור ארכיטקטורת MFusion Mamba ואלגוריתם משלים 2 עבור זרימת העבודה המלאה ברמת טנזור.
- השתמש בפרמטרי היישום של MFusion Mamba כדלקמן. לכל תכונת מקודד Ei, הקרינו את ממד הערוץ מ-Ci ל-Ct. שינוי גודל תכונות מוקרנות לגודל המרחב היעד באמצעות אינטרפולציה ביליניארית עם align_corners=False בעת הצורך.
- החלו את מכפלת Hadamard לביצוע Coarse Fusion על פני תכונות המקודד המיושרים. הגדר את מסלול ההיתוך העדין הראשון באמצעות שכבה ליניארית עם ממדים Ct → Ct. הגדר את מסלול ההיתוך הדק השני באמצעות הקרנה מעלה Ct → 2Ct, Conv1d, בלוק Mamba/S6 עם ממד מודל 2Ct, כיוון סריקה אחד, מימד מצב 16, והקרנה כלפי מטה2Ct → Ct.
- למזג את יציאות מסלולי ההיתוך העדין באמצעות מוצר Hadamard. מיישמים הקרנה ליניארית סופית בממדים Ct ל-Ct. הזן את הייצוג הרב-שלבי הממוזג אל המפענח.
- פיוז תכונות מקודד רב-שלבי באמצעות MFusion Mamba
- אסוף את תכונות המקודד מכל ארבעת שלבי המקודד (E1,E 2, E3 ו-E4) והשתמש בהן כקלט למודול MFusion Mamba. אל תבחר רק את תכונת המקודד בשלב המתאים למיזוג המפענח.
- יישר את כל תכונות המקודד לרזולוציה המרחבית הנדרשת לשלב המפענח הנוכחי. שינוי גודל תכונות המקודד לרזולוציה היעד והקרינה לממד הערוץ הנדרש לפני מיזוג התכונות.
- חזור על הליך יישור התכונות עבור כל שלב מפענח. כאשר המפענח פועל ב-H/16 × W/16, H/8 × W/8, ו-H/4 × W/4, משנים את הגודל והקרינה E1,E 2,E 3 ו-E4 למרחב המאפיינים המתאים.
- למזג את תכונות המקודד הרב-שלבי המיושרים באמצעות פעולות Coarse Fusion ו-Fine Fusion של מודול MFusion Mamba, ולשלב את הייצוג הממוזג עם תכונות המפענח בקנה מידה מתאים.
- בצע את הקרנת הפיצ'רים, שינוי גודל ופעולות מיזוג בהתאם למימוש שפורסם ב-models/mvmunet/core.py.
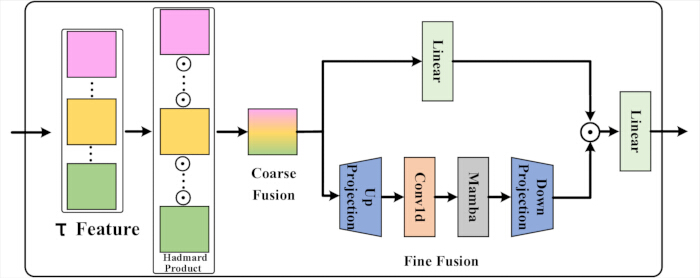
איור 5. ארכיטקטורת מודול ה-Multi-stage Fusion Mamba (MFusion Mamba). מבנה מודול ה-Multi-שלבי Fusion Mamba (MFusion Mamba). תכונות מקודד רב-קנה מידה משולבות תחילה באמצעות מיזוג גס ובהמשך מעודנות באמצעות מודול Fine Fusion הכולל הקרנה ליניארית, קונבולוציה חד-ממדית (Conv1d), בלוק ממבה ושכבות הקרנת תכונות לפני יצירת ייצוג התכונות הממוזגות של המפענח. אנא לחצו כאן כדי לצפות בגרסה מוגדלת של הדמות הזו.
6. אימון מודלים
- למד MVM-UNet על אובונטו 22.04.1 עם גרסת ליבת לינוקס 6.8.0. השתמש בתחנת עבודה המצוידת במעבד Intel Core i9-13900K דור 13 ובכרטיס גרפי NVIDIA A800. השתמש באותה תצורת חומרה לאורך כל האימון וההערכה.
- מימוש ואמן את המודל באמצעות PyTorch 2.0.1 עם CUDA 11.8. התקן את כל התלות הנדרשת בתוכנה לפני ההדרכה.
- השתמש באופטימייזר AdamW עם קצב למידה התחלתי של 3 × 10⁻⁵, β1 = 0.9, β2 = 0.999, ε = 1 × 10⁻⁸, ודעיכת משקל של 0.01. הגדר את גודל האצווה ל-32 אלא אם צוין אחרת.
- תאמן כל דגם ל-300 תקופות. השתמש בלוח זמנים לקצב למידה עם חימוש קוסינוס עםη דקות = 1 × 10⁻⁵. הגדר את גודל התמונה ל-256 × 256 עבור ISIC 2017 ו-ISIC 2018 ול-224 × 224 עבור Synapse.
- השתמשו בשלושה זרעים אקראיים עצמאיים (1, 52 ו-100) לניסויים המרכזיים בהשוואה המרכזית. חזור על תהליך האימון וההערכה המלא לכל זרע. דווח על התוצאות הכמותיות הסופיות כממוצע ± ה-SD בשלוש הריצונות.
- השתמש בזרע אקראי קבוע של 100 לכל מחקרי אבלציה אלא אם צוין אחרת. שמרו על חלוקות מערך הנתונים, אסטרטגיית העיבוד המוקדם, ארכיטקטורת הרשת, האופטימיזטור, קצב הלמידה, גודל האצווה ומספר תקופות האימון ללא שינוי בכל ניסויי האבלציה.
- השתמש באובדן BCE-Dice לסגמנטציה בינארית של נגעים ב-ISIC 2017 ו-ISIC 2018. הגדר את משקל הירידה של BCE ו-Dice ל-1.0. השתמשו באובדן CE-Dice ל-Synapse והגדרו גם את משקלי הירידה באנטרופיה צולבת וגם בקוביות ל-1.0.
- שינוי גודל, נרמול והרחבה של תמונות האימון של ISIC 2017 ו-ISIC 2018 באמצעות הליך העיבוד המוקדם המתואר בשלב 1. הפעיל שינוי גודל, סיבוב אקראי והפיכת אקראית על תמונות אימון Synapse כפי שמתואר בשלב 1. השתמש בהגדרות קדם-עיבוד זהות בכל ריצות האימון.
- בחרו נקודות ביקורת של המודל בהתאם לפרוטוקול האימות הספציפי למאגר נתונים. שמור את נקודת הביקורת עם ביצועי האימות הטובים ביותר ל-ISIC 2017 ו-ISIC 2018, ובצע אימות כל 30 אפוקים. לאמן את Synapse במשך 300 אפוקים ללא סט אימות ולהשתמש בנקודת הבדיקה הסופית של האימון לבדיקה.
- השתמש בסט האימות הרשמי רק לבחירת דגם ב-ISIC 2017 ו-ISIC 2018. אל תשתמש בערכת הבדיקה של Synapse לאימון, כיוון היפרפרמטרים או בחירת נקודות ביקורת. שמור את כל נתוני הבדיקה אך ורק להערכה סופית.
- השתמש בפרמטרי האימון הבאים לשחזוריות. הגדר את גודל האצווה ל-32 עבור כל מערכי הנתונים. השתמש ב-AdamW עם קצב למידה התחלתי של 3 × 10⁻⁵, β1 = 0.9, β2 = 0.999, ε = 1 × 10⁻⁸, ודעיכת משקל של 1 × 10⁻².
- הגדר את מתזמן קצב הלמידה עם אנילינג קוסינוס עם T max = 50 ו-ηmin = 1×10⁻⁵ עבור ISIC 2017 ו-ISIC 2018. הגדר את המתזמן עם Tmax = 100 ו-ηmin = 1×10⁻⁵ עבור Synapse. שמור על תצורת המתזמן ללא שינוי בכל הניסויים החוזרים על עצמם.
- לאמן את כל הדגמים באמצעות אריתמטיקה FP32 מדויקת במלואה. כבה אימון דיוק מעורב אוטומטי. אל תפעיל חיתוך גרדיאנט במהלך האופטימיזציה.
- שמרו על הגדרות הדיוק, אסטרטגיית עדכון הגרדיאנט, קונפיגורציית האופטימיזציה, לוח הזמנים לקצב הלמידה ופרוטוקול הזרעה האקראית ללא שינוי בכל ניסויי ההשוואה, מחקרי אבלציה וריצות השחזור.
- בחר את נקודת הביקורת הטובה ביותר לדגם
- העריכו את המודל על מערך האימות לאחר כל תקופת אימון עבור מערכי הנתונים ISIC 2017 ו-ISIC 2018.
- חשב את אובדן ה-Binary Cross-Entropy (BCE)-Dice עבור כל אצווה של אימות וחשב את ממוצע אובדן האימות על פני כל מערך הוולידציה.
- שמור את המודל הנוכחי כנקודת ביקורת הטובה ביותר כאשר אובדן האימות הממוצע נמוך מההפסד המינימלי שנרשם קודם.
- רשמו את החיתוך הממוצע מעל איחוד (mIoU), מקדם דמיון קוביות (DSC), דיוק (Acc), ספציפיות (Spe) ורגישות (Sen) במהלך האימות לצורך ניטור ביצועים בלבד. אל תשתמש במדדים אלה כקריטריון לבחירת נקודות ביקורת.
7. הערכת מודלים
- הערך את המודל המאומן באמצעות מערך הבדיקות הרשמי לכל מאגר נתונים. השתמש בסט המבחנים רק להערכת ביצועים סופית.
- עבור ISIC 2017 ו-ISIC 2018, חשב את mIoU, DSC, Acc, Sen ו-Spe. השתמשו בחיוביים אמיתיים ברמת פיקסל (TP), חיוביים שגויות (FP), שליליות אמיתיות (TN) ושליליות שגויה (FN) לכל החישובים.
- החלו פונקציית הפעלה סיגמואידי על פלט המודל עבור ISIC 2017 ו-ISIC 2018. המור את מפת ההסתברות למסכת סגמנטציה בינארית באמצעות סף של 0.5. חשב את מדדי ההערכה באמצעות משוואות 2–6:
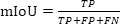 (2)
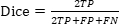 (3)
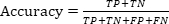 (4)
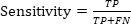 (5)
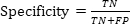 (6)
- עבור Synapse, יישם את פונקציית ההפעלה של softmax על פלט המודל. הקצה כל פיקסל או ווקסל למחלקה עם ההסתברות הגבוהה ביותר באמצעות פעולת argmax. חשב את ה-DSC ואת מרחק האוסדורף באחוזון ה-95 (HD95) עבור כל איבר קדמי ודווח על הערכים הממוצעים בכל מקרי הבדיקה.
- השווה MVM-UNet עם שיטות סגמנטציה מבוססות CNN, מבוססות טרנספורמר, ומודל מצב (SSM). השתמש במחיצות זהות למערכי נתונים, פרוצדורות עיבוד מקדים, רזולוציות קלט ומדדי הערכה לכל המתודות.
- השתמש במחיצות ההדרכה, האימות והבדיקות הרשמיות ל-ISIC 2017 ו-ISIC 2018. השתמש בחלוקה הסטנדרטית של 18 מקרי אימון ו-12 מקרי בדיקה עבור Synapse. הגדר את רזולוציית הקלט ל- עבור מערכי הנתונים של ISIC ול-Synapse.
- שכפל שיטות בסיסיות באמצעות היישומים הרשמיים שלהן כאשר זמינים. דיווח שיחזר תוצאות כממוצע ± ה-SD לאורך ריצות חזרות. שמור על ערכים מדווחים בספרות כפי שפורסם במקור והבחין ביניהם בהערות הטבלה המתאימות.
- בצע בדיקות אבלציה באמצעות זרע אקראי קבוע של 100 אלא אם צוין אחרת. שמרו על חלוקות מערכי הנתונים, הליך העיבוד המוקדם, רזולוציית קלט, אופטימייזר, לוח זמנים לקצב למידה, גודל האצווה, מספר התקנים, פונקציית האובדן ומדדי ההערכה ללא שינוי בכל ניסויי האבלציה.
- העריך את התרומות של MV4D, SFusion Mamba, ענף ההקרנה למעלה ולמטה בבלוק MVV, MFusion Mamba, גודל התמונה הקלט, ערך dropout, ותצורת שכבת המקודד-מפענח. שנו רק את הרכיב או הפרמטר היעד בכל ניסוי אבלציה.
- בצע את מבחן הדירוג החתום של וילקוקסון באמצעות תוצאות זוגיות לכל תמונה עבור ISIC 2017 ו-ISIC 2018 ותוצאות זוגיות לכל מקרה עבור Synapse. נבחן ערך p קטן מ-0.05 כדי להצביע על מובהקות סטטיסטית.
- העריך יעילות חישובית באמצעות אותה סביבת חומרה ורזולוציית קלט לכל השיטות. מדדו את זמן האימון לכל תקופה, זמן הסקה לכל תמונה, שיא השימוש בזיכרון GPU במהלך האימון, מספר פרמטרי המודל, ופעולות נקודה צפה (FLOPs). חשב FLOPs באמצעות מסירה קדימה אחת.
- בחרו דוגמאות איכותיות מייצגות רק מתוך קבוצת הבדיקות לאחר סיום הערכת המודל. השווה את התמונה המקורית, מסכת האמת הקרקעית והמסכה החזויה באמצעות מקרי בדיקה זהים בכל השיטות. בחר דוגמאות מייצגות הכוללות מטרות קטנות, גבולות לא סדירים, גבולות מעורפלים ומבנים מולטיאורגניים מייצגים.
- חשב מדדי הערכה וביצוע ניתוח סטטיסטי
- חשב את מדדי הסגמנטציה של מערכי הנתונים ISIC 2017 ו-ISIC 2018 בפייתון באמצעות NumPy ו-sklearn.metrics.confusion_matrix. הסף למפת ההסתברות החזויה ב-0.5, קבל את TP, FP, TN ו-FN ברמת הפיקסל, וחשב את mIoU, DSC, Acc, Sen ו-Spe מתוך ערכים אלו.
- חשב את ה-DSC וה-HD95 עבור מאגר הנתונים Synapse באמצעות medpy.metric.binary.dc ו-medpy.metric.binary.hd95, בהתאמה. מיישמים softmax ואחריהם argmax על פלט המודל לפני חישוב מדדי ההערכה.
- חשב את מספר ה-FLOPs והפרמטרים הניתנים לאימון באמצעות thop.profile במעבר קדימה אחד.
- בצע את מבחן הדירוג החתום של Wilcoxon בפייתון באמצעות scipy.stats.wilcoxon. השתמש בערכי מדדים מזווגים לכל תמונה עבור מערכי הנתונים ISIC 2017 ו-ISIC 2018 וערכי מדדים זוגיים לכל מקרה עבור מערך הנתונים Synapse.
8. הגדרת פונקציית אובדן
- השתמש באובדן הסטנדרטי Cross-Entropy (CE) לסגמנטציה רב-מחלקתית ובהפסד BCE סטנדרטי לסגמנטציה בינארית. השתמש בנוסחת הפסד קוביות סטנדרטית לסגמנטציה. משוואות 7–11 מגדירות את פונקציות האובדן המשמשות בפרוטוקול זה.
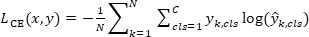 (7)
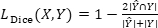 (8)
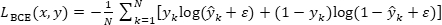 (9)
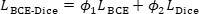 (10)
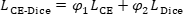 (11)
- הגדר את משקלי הירידה BCE ו-Dice ל-1.0 עבור ISIC 2017 ו-ISIC 2018, כך
 ש-1 = 1.0 ו-2 = 1.0. הגדר את משקלי הירידה של CE ו-Dice ל-1.0 עבור Synapse, כך φ1 = 1.0 ש ו-φ2 = 1.0.
- מיישם את פונקציות האובדן ב-utils.py. השתמש ב-nn. BCELoss לסמסטר BCE ו-nn. CrossEntropyLoss למונח CE. חשב את אובדן הקוביות הבינארי על ידי השטחת כל מסכה חזויה ומסכת אמת יסודית, חישוב אובדן הקוביות לכל מדגם, וממוצע האובדן לאורך האצווה. חשב את אובדן הקוביות הרב-מחלקות על ידי המרת מפת התווית היעד לפורמט one-hot, יישום softmax על פלט המודל, חישוב אובדן הקוביות לכל מחלקה, וממוצע האובדן בין כל המחלקות.
- הגדר את קבוע החלקה ל-1 עבור אובדן קוביות בינארי ו-1×10⁻⁵ עבור הפסד קוביות מרובי-מחלקות. מימוש הפסד BCE-Dice באמצעות מחלקת BceDiceLoss כאשר wb = 1 ו-wd = 1. מיישם את אובדן ה-CE-Dice באמצעות מחלקת CeDiceLoss עם loss_weight = [1, 1]. שמור על קבועי החלקה, אסטרטגיית הפחתת המשחק ויישום התוכנה ללא שינוי עבור כל מערכי הנתונים, הזרעים האקראיים והניסויים.
- הגדרת הפחתת ההפסדים
- למומש, נני. BCELoss() ו-nn. CrossEntropyLoss() מבלי לציין במפורש את טיעון ההפחתתה.
- השתמש בהגדרת ברירת המחדל של הפחתת הפסד PyTorch (reduction = "ממוצע") עבור שתי פונקציות האובדן. אל תשתמש בצמצום = "סכום" או בפלט אובדן לא מצומצם.
9. הגדרות שחזוריות וביצוע
- הורד את המימוש שפורסם מ-https://github.com/LIXUEGUANG002/MVM-UNet. השתמש במאגר יחד עם חבילות התוכנה, מערכי הנתונים, מפרטי החומרה והמשאבים החישוביים המפורטים בטבלת החומרים.
- שכפל את המאגר ונכנס לתיקיית הפרויקט על ידי הרצת git clone https://github.com/LIXUEGUANG002/MVM-UNet.git, ואחריו CD MVM-Unet.
- הגדר את ניסוי ISIC 2017 או ISIC 2018 על ידי הגדרת שם מערך הנתונים, נתיב מאגר נתונים, גודל קלט, גודל אצווה, מספר אפוקים, פונקציית אובדן, אופטימיזטור, מתזמן קצב למידה וזרע אקראי בקונפיגורציות/config_setting.py. הרץ את סקריפט האימון מהשורש של המאגר באמצעות פייתון train.py.
- הגדר את ניסוי Synapse על ידי הגדרת שם מערך הנתונים, נתיב נתוני האימון, נתיב נפח הבדיקה, תיקיית הרשימה, גודל הקלט, מספר מחלקות, גודל אצווה, מספר אפוקים, פונקציית אובדן, אופטימיזטור, מתזמן קצב למידה וזרע אקראי ב-configs/config_setting_synapse.py. הרץ את סקריפט האימון מהשורש של המאגר באמצעות פייתון train_synapse.py.
- בצע הערכה מבוססת הסקה בלבד על ידי הגדרת only_test_and_save_figs = True, best_ckpt_path לנקודת הביקורת המאומנת, ו-img_save_path לתיקיית הפלט בקובץ התצורה המתאים. הרץ train.py פייתון עבור ISIC 2017 או ISIC 2018, או הרץ train_synapse.py פייתון עבור Synapse ליצירת תוצאות חיזוי ומספרים איכותיים.
- השתמש בגרסת קוד המקור שפורסמה
- שכפול את מאגר GitHub שיצא ובדקו commit ee891b42c2f083c4990eed72f1d4463adc5e103e בסניף הראשי לפני הגדרת מערכי הנתונים, סקריפטי האימון והגדרות ההערכה.
- השתמש בהתחייבות זו כדי לשחזר את הניסויים שדווחו במחקר זה. לא הייתה גרסת שחרור מתויגת זמינה למאגר בזמן עדכון כתב היד.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
תוצאות צפויות ופרשנות
כאשר פרוטוקול זה מיושם נכון, מודל MVM-UNet המאומן צפוי לייצר ביצועי סגמנטציה יציבים לאורך ריצות חזרות, עם שינויים קטנים בלבד בין זרעים אקראיים שונים ברוב מדדי ההערכה. עבור ISIC 2017 ו-ISIC 2018, תוצאות מוצלחות משתקפות בערכי DSC, mIoU, Acc, Sen ו-Spe גבוהים, יחד עם מסכות נגע חזויות העוקבות מקרוב אחרי גבולות הנגעים בין אמת קרקע (איורים 6 ו-7). עבור סינפסה, תוצאות מוצלחות משתקפות בערכי DSC ממוצעים גבוהים וערכי HD95 נמוכים ברחבי האיב...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
פרוטוקול זה מתאר את MVM-UNet, מסגרת סגמנטציה רפואית מבוססת ממבה. השיטה תוכננה כדי להתמודד עם שתי מגבלות של מודלים קיימים של סגמנטציה. ראשית, שיטות מבוססות CNN קונבנציונליות מוגבלות ביכולת למודל תלות לטווח ארוך ומידע היררכי הקשרי בתמונות רפואיות מורכבות43. שנית, שיטות מבוססות טרנספורמר יכולות למודל הקשר גלובלי אך בדרך כלל דורשות עלות חישובית גבוההיותר 23,25. MVM-UNet משתמשת בארכיטקטורת Mamba 13,14,15,16,17,...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
המחברים מצהירים שאין להם אינטרסים פיננסיים מתחרים.
תודות
מחקר זה לא קיבל מימון חיצוני.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
```html
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 with Linux kernel 6.8.0; Intel Core i9-13900K CPU; NVIDIA A800 GPU; 128 GB RAM; 512 GB local storage. | Computational platform for training, validation, testing, ablation, and inference-only experiments. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | NVIDIA A800 GPU (80 GB memory). | GPU-accelerated model training and inference. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | 13th Gen Intel Core i9-13900K CPU. | Host processor for data loading, preprocessing, and experiment execution. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB system RAM | Memory for dataset loading, preprocessing, and training. |
| Hardware - Storage | Institutional computing platform / local workstation | 2 TB NVMe solid-state drive. | Storage for datasets, checkpoints, logs, and generated prediction figures. |
| Software environment - Operating system | Canonical Ltd. | Recommended: Ubuntu 22.04.1 LTS | Operating system for the computational environment. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Environment name: mvmunet | Python environment used to install and isolate dependencies. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Programming language used for implementation and experiment execution. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | GPU computing backend required by PyTorch and Mamba-related packages. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | GPU-accelerated deep-learning primitives used through PyTorch. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Deep-learning framework for model training, loss calculation, optimization, and inference. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Image transform utilities used in preprocessing and augmentation. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Installed with the recommended PyTorch environment. |
| Python package - timm | timm developers | timm == 0.4.12 | Model-component or utility dependency listed in the repository environment instructions. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | Dependency used by GPU-accelerated sequence modeling components. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Efficient causal convolution dependency required by the Mamba implementation. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | State-space sequence modeling package used for Mamba/S6-related components. |
| Python package - NumPy | NumPy developers | NumPy version 1.24.3. | Numerical computation and array operations. |
| Python package - SciPy | SciPy developers | SciPy version 1.10.1. | Scientific computation; scipy.ndimage.zoom is imported in utils.py. |
| Python package - SimpleITK | Insight Software Consortium | SimpleITK version 2.2.1. | Medical image input/output and preprocessing utility imported in utils.py. |
| Python package - MedPy | MedPy developers | MedPy version 0.4.0. | Medical image metric calculation package imported in utils.py. |
| Python package - scikit-image | scikit-image developers | scikit-image version 0.21.0. | Image-processing dependency listed in README. |
| Python package - scikit-learn | scikit-learn developers | scikit-learn version 1.3.2. | Machine-learning utility package listed in README. |
| Python package - matplotlib | Matplotlib developers | Matplotlib version 3.7.2. | Used for saving qualitative visualization figures. |
| Python package - h5py | h5py developers | h5py version 3.9.0. | HDF5 file support for Synapse test volumes. |
| Python package - thop | THOP developers | THOP version 0.1.1.post2209072238. | Used when calculating FLOPs and parameter-related computational cost. |
| Python package - packaging | Python Packaging Authority | packaging version 23.1. | Dependency listed in README. |
| Python package - pytest | pytest developers | pytest version 7.4.0. | Dependency listed in README. |
| Python package - chardet | chardet developers | chardet version 5.2.0. | Dependency listed in README. |
| Python package - yacs | YACS developers | yacs version 0.1.8. | Configuration utility dependency listed in README. |
| Python package - termcolor | termcolor developers | termcolor version 2.3.0. | Logging/terminal utility dependency listed in README. |
| Python package - submitit | submitit developers | submitit version 1.4.5. | Experiment/job utility dependency listed in README. |
| Python package - tensorboardX | tensorboardX developers | tensorboardX version 2.6.2.2. | Training log visualization utility listed in README. |
| Python package - ml-collections | ml_collections developers | ml-collections version 0.1.1. | Imported by configs/config_setting_synapse.py. |
| Dataset - ISIC 2017 Challenge dataset | International Skin Imaging Collaboration | ISIC 2017 skin lesion segmentation dataset | Public de-identified dermoscopic skin lesion images and masks used for binary segmentation. |
| Dataset - ISIC 2018 Challenge Task 1 dataset | International Skin Imaging Collaboration | ISIC 2018 Task 1: Lesion Boundary Segmentation | Public de-identified dermoscopic skin lesion images and masks used for binary segmentation. |
| Dataset - Synapse Multi-Atlas Labeling Beyond the Cranial Vault dataset | Synapse / Sage Bionetworks | Accession identifier: syn3193805 | Public abdominal CT multi-organ segmentation dataset. |
| Data organization - ISIC 2017 data folder | Authors / repository layout | data/isic2017/ | Expected local folder containing train and validation images/masks. |
| Data organization - ISIC 2018 data folder | Authors / repository layout | data/isic2018/ | Expected local folder containing train and validation images/masks. |
| Data organization - Synapse data folder | Authors / repository layout | data/Synapse/ | Expected local folder for Synapse lists, train_npz, and test_vol_h |
מקורות
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.