מחקר זה מציג מסגרת קלה להפחתת הזיות במודלי שפה גדולים באמצעות אימות ברמת הטענה וסף סטטיסטי אדפטיבי. על ידי תיקון סלקטיבי של טענות שאינן נתמכות באמצעות הסקת מסקנות בשפה טבעית (Natural Language Inference), גישה זו משפרת את הדיוק העובדתי תוך שמירה על השהיית תגובה נמוכה ויעילות פריסה מעשית.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
אימות טענות מונחה NLI אדפטיבי עם מודל החלטה סטטיסטי להפחתת הזיות בשהיה נמוכה במודלי שפה גדולים
במאמר זה
סיכום
תקציר
מודלי שפה גדולים (LLMs) מראים נטייה קריטית לייצר פלטים שגויים עובדתית אך רהוטים מבחינה לשונית - תופעה המכונה הזיה (hallucination) - המהווה סיכון חמור ביישומים הדורשים דיוק מרבי. אסטרטגיות הפחתה קיימות, כולל יצירה מוגברתת-שליפה (retrieval-augmented generation) ודגימת עקביות-עצמית (self-consistency sampling), גורמות או לעיכוב משמעותי בזמן ההסקה (inference latency) או תלויות בתשתיות ידע חיצוניות, מה שמגביל את יכולת היישום שלהן בפריסות בזמן אמת. מאמר זה מציע מסגרת קלה לבדיקת טענות בשני שלבים, המפרקת תגובות של LLM לטענות עובדתיות אטומיות ומאמתת באופן עצמאי כל טענה שחולצה אל מול מקור ייחוס שנוצר בנפרד באמצעות הנחיית ייחוס עובדתי מבודדת. אף על פי שהמחולל והמאמת חולקים את אותו מודל שפה בסיסי, הפרדת יצירת התגובה מהייחוס העובדתי מפחיתה את ההתנייה הישירה של התגובה וממזערת הטיות אישור במהלך האימות, תוך שימוש בהסקת שפה טבעית (Natural Language Inference, NLI), ומיישמת סף סטטיסטי אדפטיבי - המוגדר כ-τ = µ + kσ על פני התפלגות ציוני הביטחון של ה-NLI - כדי לתקן באופן סלקטיבי רק טענות שסותרות את המקור. בניגוד לשיטות קודמות המבוססות על NLI הנשענות על גבולי החלטה קבועים, המסגרת המוצעת מתאימה באופן דינמי את סף האימות להתפלגות הביטחון של כל תגובה, ומראה ביצועים עקביים במדדי הייחוס שנבחנו ללא צורך באימון מחדש של המודל. בבדיקה על TruthfulQA ו-FEVER, המסגרת הפחיתה את שיעור ההזיות מ-28% ל-9% ב-TruthfulQA - הפחתה יחסית של 67.9% - תוך הוספה של 160 ms בלבד של שיהוי לעומת ה-LLM הבסיסי, והביאה לביצועים טובים יותר מ-SelfCheckGPT ו-FActScore בדיוק זיהוי ההזיות. תוצאות אלו מעידות כי המסגרת יכולה לספק איזון מיטבי בין מהימנות עובדתית לבין שיהוי תגובה במדדי הייחוס שנבחנו, בעוד שנדרש תיקוף נוסף על פני תחומים והגדרות פריסה שונות.
מבוא
מודלים של שפה רחבה (LLMs) הפכו לרכיבים בסיסיים במערכות בינה מלאכותית מודרניות, והם מפגינים יכולת מרשימה במגוון רחב של משימות שפה טבעית, כולל יצירת טקסט, מענה על שאלות, סיכום והסקה מורכבת1. יכולתם להפיק תגובות שוטפות וקוהרנטיות מבחינה הקשרית האיצה את אימוצם בתחומים בעלי השפעה רבה, כגון תמיכה בהחלטות קליניות, ניתוח משפטי, הנדסת תוכנה וטכנולוגיה חינוכית2. עם זאת, מגבלה קריטית ומתמשכת פוגעת באמינותם בהקשרים אלו: הזיות (hallucinations), שבהן המודלים יוצרים תגובות שוטפות מבחינה לשונית אך שגויות עובדתית, חסרות ביסוס או מומצאות לחלוטין 3. מחקרים אמפיריים מדווחים על שיעורי הזיות הנעים בין 15% ליותר מ-40% בהתאם למשימה ולמודל, כאשר אפילו מערכות מתקדמות כיום כמו GPT-4 מראות חוסר עקביות עובדתי מדיד תחת הערכה ספציפית לתחום2,3. מגבלה זו מהווה סיכון חמור ביישומים הדורשים דיוק גבוה, שבהם פלטים שגויים עלולים להוביל למידע מוטעה, לאבחנה שגויה או לקבלת החלטות פגומות4. הזיות נובעות באופן יסודי מהטבע הפרובביליסטי של מידול שפה - מודלי LLMs מייצרים טוקנים על ידי חיזוי המשכים סבירים סטטיסטית של רצפי קלט, במקום לשלוף או להסיק מידע מתוך ידע עובדתי מאומת5. כתוצאה מכך, פלטים שנוצרו עשויים להטמיע טענות שנשמעות סבירות אך אינן מדויקות, להציג קביעות חסרות ביסוס, או לבלבל בין מושגים הקשוריים סמנטית אך נבדלים עובדתית6.
אסטרטגיות הפחתה קיימות מתמודדות עם בעיה זו באמצעות מספר פרדיגמות, שלכל אחת מהן מגבלות בולטות. יצירה מוגברת באמצעות אחזור (RAG) מפחיתה הזיות על ידי ביסוס התשובות במסמכים שאוחזרו באופן חיצוני, אך היא גורמת לעיכוב משמעותי בזמן התגובה (latency), דורשת גישה למאגרי ידע מתוחזקים, ונותרת פגיעה כשלי-אחזור בתחומים מתמחים או בתחומים בעלי משאבים מוגבלים7,8,9.
למרות שמחולל התגובה ומחולל המקורות מופעלים באמצעות אותו מודל GPT-3.5 Turbo בבסיסם, הם פועלים תחת יעדי הנחיה (prompting) והקשרי ביצוע שונים. מחולל התגובה מייצר תשובה ללא הגבלה לשאילתת המשתמש, בעוד שמחולל המקורות מבצע משימת שליפת עובדות מבודדת ללא גישה לתגובה שנוצרה קודם לכן. הפרדה זו מפחיתה השפעות ישירות של התניית התגובה ומגבילה את הטיית האישור במהלך אימות הטענות. לפיכך, המסגרת מתייחסת למקור שנוצר כבלתי תלוי מבחינה פרוצדורלית ולא כבלתי תלוי מבחינה סטטיסטית.
מחקרים אחרונים בחנו גם אסטרטגיות פענוח קלילות להפחתת הזיות (hallucinations) ביצירת טקסט, מבלי להסתמך על אחזור חיצוני או אימות חוזר. גישה מייצגת אחת היא פענוח באמצעות השוואת שכבות (Decoding by Contrasting Layers - DoLA), המשפרת את העובדתיות על ידי השוואת ייצוגים משכבות ביניים ושכבות סופיות של הטרנספורמר במהלך הפענוח. בניגוד למסגרות אימות שלאחר היצירה, שיטות אלו מתערבות ישירות במהלך יצירת האסימונים (tokens), ולכן הן מבצעות אופטימיזציה לשלב שונה בתהליך יצירת השפה. אסטרטגיות משלימות אלו מוכיחות כי ניתן להפחית הזיות הן במהלך הפענוח והן באמצעות אימות שלאחר היצירה, כאשר כל גישה מציעה פשרות שונות בכל הנוגע למאמץ חישובי, מורכבות יישום ואמינות עובדתית.
שיטות עקביות-עצמית (Self-consistency) משפרות את המהימנות העובדתית על ידי דגימת תגובות מרובות ובחירת הפלט השכיח או הקוהרנטי ביותר, אך העלות החישובית שלהן עולה באופן ליניארי עם מספר הדגימות, מה שהופך אותן לבלתי מתאימות לפריסות הרגישות לשהיית זמן (latency).8גישות של זיכוך איטרטיבי, המעדכנות שוב ושוב את הפלטים באמצעות לולאות של משוב עצמי, מפחיתות באופן הדרגתי את שיעורי השגיאה אך מאריכות באופן משמעותי את זמן ההסקה עם כל מעבר נוסף.9שיטות אימות מבוססות NLI (הסקה לוגית טבעית) מציעות חלופה ממוקדת יותר על ידי הערכת גרירה סמנטית בין טענות שנוצרו לבין טקסטים של ייחוס, אך יישומים קיימים מסתמכים על ספי סגירה קבועים שאינם מסוגלים להסתגל להתפלגויות ביטחון, תחומים או התנהגויות מודל משתנים.10,11בסיכום, גישות אלו מטילות עומס חישובי בלתי קביל, תלויות בתשתית חיצונית, או שחסרה להן הסתגלות הנדרשת לפריסה כללית. השוואה של המאפיינים העיקריים של גישות אלו לאימות הזיות מוצגת ב- טבלה משלימה 1.
מאמר זה מציע מסגרת קלת משקל לאימות טענות בשני שלבים, שנועדה להפחית הזיות (hallucinations) בפלטי LLM תוך שמירה על השהיית תגובה נמוכה. בשלב הראשון, ה-LLM מייצר תגובה ראשונית, אשר מופרקת לאחר מכן לטענות עובדתיות אטומיות. בשלב השני, כל טענה מאומתת באמצעות הסקת מסקנות בשפה טבעית (Natural Language Inference) אל מול ייחוס עובדתי שנוצר בנפרד דרך מעבר הסקה מבודד שאינו ניגש לתגובה המקורית שנוצרה, וסף ביטחון שנגזר סטטיסטית קובע את החלטת ה"קבלה או תיקון" ברמת הטענה. התרומות המרכזיות של עבודה זו הן כדלקמן: (1) צינור אימות דו-שלבי ברמת הטענה המפריד בין יצירת התגובה לבין התיקוף העובדתי, ובכך מאפשר הערכה עצמאית וממוקדת של כל טענה אטומית ללא צורך בשליפה חיצונית או ביצירה מחדש של התגובה המלאה; (2) מנגנון סף סטטיסטי אדפטיבי המבוסס על התפלגות ציוני הביטחון של NLI (τ = µ + kσ), אשר קובע באופן דינמי את גבולות הקבלה והתיקון במקום להסתמך על כללי החלטה קבועים, מה שמשפר את העמידות על פני התפלגויות ביטחון משתנות; (3) אסטרטגיית תיקון סלקטיבית המגבילה את היצירה מחדש רק לאותן טענות שסווגו כסותרות, ובכך מפחיתה משמעותית את העומס החישובים בהשוואה לגישות של דגימה מחדש של התגובה המלאה או זיכוך איטרטיבי; (4) הערכה אמפירית על מדד ממוקד-הזיות המדגימה כי המסגרת המוצעת מפחיתה את שיעורי ההזיות מ-28% ל-9% תוך שמירה על השהיית התגובה בתוך גבולות פריסה מעשיים.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
מחקר זה לא כלל משתתפים אנושיים, בעלי חיים, דגימות ביולוגיות או נתוני מטופלים. לפיכך, לא נדרשו אישור אתי מוסדי והסכמה מדעת.
סקירת מערך המחקר
מסגרת אימות דו-שלבית הוטמעה כדי לשפר את המהימנות העובדתית של פלטים ממודלי שפה גדולים (LLM). הפרוצדורה כללה יצירת תגובה, חילוץ טענות, בניית סימוכין מבודדים (Isolated Reference Construction), אימות המבוסס על הסקת מסקנות בשפה טבעית (NLI), קבלת החלטות סטטיסטית אדפטיבית, תיקון סלקטיבי והרכבת התגובה הסופית. המסגרת הוערכה באמצעות מערכי נתוני הבנצ'מרק TruthfulQA ו-FEVER.
זרימת עבודה כללית
שאילתת משתמש ← יצירת תגובה ראשונית ← חילוץ טענות ← יצירת מקורות רפרנס עצמאיים ← אימות NLI ← חישוב סף סטטיסטי ← תיקון טענות ← תגובה מאומתת סופית. זרימת העבודה הכוללת של מסגרת אימות הטענות האדפטיבית מוצגת באיור 1.
הכנת מערך הנתונים
מערך הנתונים TruthfulQA12, המכיל 817 שאלות מבוססות עובדות, הורד והוכן להערכה. מערך הנתונים FEVER13 כולל 185,445 טענות מתויגות המסומנות כנתמכות (Supported), מופרכות (Refuted) או כמי שאין לגביהן מידע מספיק (Not Enough Information); ההערכה השתמשה בנתוני הפיתוח המתויגים עם שדות הטענה, הראיה והתווית של האמת (ground-truth label). כל טענה נערכה אל מול הראיות שסופקו עבורה, בעוד שתווית FEVER המקורית נשמרה כתוצאת הייחוס לצורך אימות. מערך הנתונים FEVER, המכיל זוגות של טענה-ראיה לאימות עובדות, הושג ועבר עיבוד מקדים. שאלות וטענות קלט הומרו לפורמט טקסט סטנדרטי. רשומות כפולות ודגימות חסרות הוסרו לפני הניסויים. TruthfulQA חולק לתתי-קבוצות של תיקוף ובדיקה. כ-20% מהדגימות של TruthfulQA (164 שאלות) שימשו לכוונון סף, בעוד ש-653 השאלות הנותרות נשמרו להערכת ביצועים. עבור FEVER, הטענות שסופקו בבנצ'מרק שימשו ישירות כיחידות אימות ולא עברו את תהליך יצירת התגובה ומיצוי הטענות שיושם על TruthfulQA. מאפייני מערכי נתוני הבנצ'מרק ששימשו לפיתוח ולהערכת המסגרת מסוכמים בTable 1.
יצירת תגובה ראשונית
כל שאילתה הוגשה למודל השפה הבסיסי. התגובות הופקו באמצעות nucleus sampling עם temperature של 0.7 ו-top-p של 0.9. אורך הפלט המקסימלי הוגבל ל-256 tokens. התגובות שהופקו נשמרו ללא עיבוד נוסף או שינוי ידני. הטקסט שהופק הועבר ישירות לשלב חילוץ הטענות.
חילוץ טענות
כל תגובה שהופקה פוּרקה להצהרות עובדתיות הניתנות לאימות עצמאי. נעשה שימוש בהנחיית פירוק מובנית כדי לזהות טענות אטומיות. הצהרות מורכבות הופרדו ליחידות עובדתיות מינימליות. דעות סובייקטיביות, ביטויים סגנוניים ומילות קישור שיחתיות הוסרו. כל טענה שהופקה נשמרה כיחידת אימות עצמאית.
דוגמה:
תגובה מקורית:
"מרי קירי הייתה פיזיקאית וכימיהי בשורשיה פולנית, שביצעה מחקרים חלוציים בתחום הרדיואקטיביות."
טענות שהופקו: (1) מארי קירי נולדה בפולין; (2) מארי קירי הייתה פיזיקאית וכימיה; (3) מארי קירי ערכה מחקרים על רדיואקטיביות.
בניית רצף ייחוס מבודד:
עבור כל טענה שהופקה, נוצר סימוכין עובדתי עצמאי. מודל האימות קיבל אך ורק את שאילתת המשתמש המקורית. הגישה לתשובה המקורית שהופקה הוגבלה כדי למנוע הטיות אישור. נעשה שימוש בהנחיית שליפה עובדתית כדי לעודד תשובות תמציתיות ומבוססות ראיות. הסימוכינים שהופקו נשמרו לצורך אימות עוקב.
אימות הסקה בשפה טבעית
כל זוג של טענה-מקור הוגש למודל NLI שאומן מראש. מודל ה-NLI סיווג את הקשר כ: גרירה (Entailment), ניטרלי (Neutral), או סתירה (Contradiction). הסתברויות הביטחון עבור שלושת הסיווגים נרשמו. הוקצה ציון אימות חתום: ערך חיובי עבור גרירה, אפס עבור ניטרלי, או ערך שלילי עבור סתירה. כל ציוני האימות נאספו לצורך חישוב הסף.
חישוב סף סטטיסטי אדפטיבי
ביטחון האימות המופק על ידי מודל ה-NLI משתנה באופן משמעותי בין תגובות שונות, מכיוון ששאילתות שונות מייצרות מספרים שונים של טענות, רמות שונות של מורכבות סמנטית והתפלגויות ביטחון שונות. סף גלובלי קבוע מניח שכל התגובות עוקבות אחר פרופיל ביטחון דומה, דבר שרק לעיתים רחוקות נצפה בפועל. כדי להתאימה לשונות זו, המסגרת המוצעת מעריכה את גבול ההחלטה באופן פרטני עבור כל תגובה, תוך שימוש בממוצע ובסטיית התקן של ציוני האימות שלה. הממוצע משקף את רמת הביטחון הכללית של התגובה, בעוד שסטיית התקן לוכדת את פיזור ערכי הביטחון בין הטענות שהופקו. ניסוח אדפטיבי זה מאפשר לקריטריון הקבלה להסתגל לאי-ודאות הספציפית לתגובה, במקום להסתמך על סף יחיד עבור כל הקלטים.
חושבו הממוצע (µ) וסטיית התקן (σ) של כל ציוני האימות החתומים.
סף ההחלטה האדפטיבי חושב באופן הבא:

כאשר τ מייצג את הסף האדפטיבי, µ מציין את ציון האימות הממוצע, σ מציין את סטיית התקן, ו-k מייצג את פרמטר הרגישות.
פרמטר הרגישות אותחל ב-0.7. טענות שסווגו כגרירה (Entailment) עם ציונים הגבוהים או השווים ל-τ+ התקבלו. טענות שסווגו כסתירה (Contradiction) עם ציונים הנמוכים או השווים ל-τ- סומנו לתיקון. טענות עם ציונים בטווח (τ+, τ-) נשמרו כניטרליות.
תיקון סלקטיבי של תביעות
טענה הועברה לתיקון רק כאשר מודל ה-NLI סיווג את זוג הטענה-מקור כסתירה (Contradiction), כאשר ציון האימות החתום התואם לה עמד בקריטריון הסף האדפטיבי si ≤ -τ. לפיכך, החלטת התיקון נקבעה באופן משותף על ידי תוויות הסיווג של ה-NLI והסף הסטטיסטי הספציפי לתגובה. טענות שסווגו כגרירה (Entailment) עם si ≥ τ התקבלו, בעוד שטענות שנפלו בטווח -τ < si < τ נחשבו לניטרליות ונשמרו ללא תיקון. קריטריון משולב זה הבטיח שהתיקון יוחל רק על טענות המפגינות הן סתירה סמנטית והן ראיות אימות שליליות חזקות מספיק.
שחזור התגובה
טענות שהתקבלו ותוקנו סודרו ברצפן המקורי שלהן. גבולות המשפטים הוחזרו כדי לשמור על קריאות. התאמות דקדוקיות מינוריות בוצעו במידת הצורך. הפלט המורכב נשמר כתגובה המאומתת הסופית.
הערכת ביצועים
המסגרת הוערכה באמצעות ארבעה מדדים: (1) דיוק (Accuracy): שיעור התגובות שנותרו נכונות עובדתית לאחר האימות; (2) מדד F1 (F1 Score): הממוצע ההרמוני של הדיוק (precision) והרגישות (recall) בזיהוי הזיות; (3) השהיית תגובה (Response Latency): זמן העיבוד הכולל מהגשת השאילתה ועד ליצירת התגובה המאומתת; (4) שיעור הזיות (Hallucination Rate)
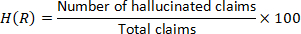
השהיה (Latency) דווחה כזמן הביצוע הממוצע על פני מדידות חוזרות. מכיוון שערכי השהיה פרטניים לכל הרצה לא נשמרו, לא חושבו סטיות תקן ומרווחי סמך.
הערכת נכונות ספציפית לבנצ'מרק
עבור TruthfulQA, התגובה המאומתת הסופית הושוותה מול רפרנסים של תשובות מאושרות על ידי בני אדם ומול רשימות של תשובות שגויות השייכות לבנצ'מרק. תגובה נספרה כנכונה כאשר הטענות העובדתיות שלה היו עקביות עם המידע בתשובה המקובלת ולא הכילה תוכן התואם לדפוסי תגובה שגויים שזוהו. עבור FEVER, כל טענה בפלט הסופי הוערכה אל מול הראיות המשויכות אליה והאנוטציה המקורית של FEVER; טענות נתמכות (Supported) נחשבו למאומתות עובדתית, בעוד שטענות שהופרכו (Refuted) נספרו כשגויות. מקרים של "אין מספיק מידע" (Not Enough Information) נשמרו כבלתי ניתנים להכרעה ולא נחשבו כראיה עובדתית חיובית. ההחלטות ברמת הטענה שהתקבלו רוכבו עבור כל בנצ'מרק כדי לחשב את הדיוק (Accuracy) ואת שיעור ההזיות (Hallucination Rate) שדווחו.
סביבה ניסיונית
המסגרת יושמה באמצעות Python 3.9. פעולות עיבוד הנתונים בוצעו באמצעות ספריות ניתוח מספריות וטבלאיות. מודל ה-NLI פעל במצב הסקת מסקנות (inference mode) ללא כוונון עדין (fine-tuning) נוסף. הניסויים בוצעו בתחנת עבודה המצוידת במעבד Intel Core i5, זיכרון RAM בנפח 16 GB ומערכת הפעלה של 64-bit. כל ההערכות בוצעו בהגדרת הסקת מסקנות של מעבר יחיד כדי להבטיח פעולה בעיכוב נמוך (low-latency). כל הניסויים נערכו באמצעות תצורות חומרה ותוכנה זהות כדי להבטיח הערכה עקבית בין מערכי הנתונים לשיטות הבסיס (baseline methods).
תוצאה צפויה
הפרוטוקול תוכנן להפיק החלטות אימות ברמת הטענה על ידי זיהוי טענות שייתכן שאינן נתמכות, והעברה סלקטיבית של טענות עם סתירה חריפה לצורך תיקון. הפלט הצפוי הוא תגובה מאומתת עם פחות אי-עקביות עובדתיות ומעמס עיבוד נוסף מוגבל, בכפוף לביצועים שנצפו במהלך ההערכה הניסויית.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
יצירת תגובה ראשונית
מודל השפה הבסיסי ייצר תשובות שוטפות ורלוונטיות מבחינה הקשרית עבור שאלות משני מאגרי נתוני הבנצ'מרק. עם זאת, בדיקה מפורטת חשפה הצהרות לא נתמכות ולא מדויקות עובדתית במספר תשובות. במאגר הנתונים TruthfulQA, המערכת הבסיסית הראתה שיעור הזיות של 28%, בעוד ששיעור הזיות של 26% נצפה במאגר הנתונים FEVER. ממצאים אלו אישרו כי יצירת שפה ישירה לבדה אינה מספיקה עבור יישומים הדורשים אמינות עובדתית גבוהה, וביססו את מצב הבסיס שביחס אליו הושוו כל הליכי האימות הבאים.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
המסגרת המוצעת שיפרה את ביצועי האימות העובדתי תוך הימנעות מדגימה חוזרת ושליפה חיצונית. ב-TruthfulQA, שיעור ההזיות ירד מ-28% עבור ה-LLM הבסיסי ל-9% עם המסגרת המלאה, בעוד שהדיוק עלה מ-0.72 ל-0.87. ב-FEVER, שיעור ההזיות ירד מ-26% ל-10%, והדיוק עלה מ-0.74 ל-0.89. יש לפרש השוואות אלו במסגרת ההגדרות הניסיוניות והמימושים ששימשו במחקר זה, ולא כראיה לעליונות אוניברסלית בכל תנאי פריסה. המסגרת מבצעת אימות ברמת הטענה לאחר היצירה באמצעות ייחוס עובדתי מבודד ותיקון סלקטיבי, ובכך מספקת פשרה בין ביסוס על ידע חיצוני, הסקה חוזרת ואימות קל ל...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
המחברים מצהירים כי אין להם ניגודי עניינים.
תודות
המחברים מבקשים להביע את תודתם הכנה למוסדם על אספקת הסביבה האקדמית והמשאבים החישובים שהיו נחוצים לביצוע מחקר זה. המחברים מודים גם למפתחים ולמחזיקים של מערכי נתוני הייחוס הזמינים לציבור ששימשו במחקר זה, ואשר אפשרו הערכה מקיפה של המסגרה המוצעת. תודה מ 특별ת מופנית לעמיתים ולבודקים על משובם הבונה, אשר סייע בשיפור האיכות והבהירות של עבודה זו. כמו כן, המחברים מודים לקהילת המחקר של הקוד הפתוח על אספקת ספריות התוכנה והכלים שהקלש על הניסויים, ניתוח הנתונים והצגת התוצאות. מאמציהם המתמשכים קידמו באופן משמעותי את המחקר בתחום עיבוד השפה הטבעית ובינה מלאכותית מהימנה. המחברים מצהירים כי לא התקבל תמיכה כספית חיצונית או מימון למחקר זה.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| ערכת נתוני הבנצ'מרק FEVER | משימה משותפת FEVER (Thorne et al.) | https://fever.ai/dataset/fever.html | מאגר נתונים לאימות עובדות הזמין לציבור, המכיל זוגות של טענה-ראיה המשמשים להערכה |
| GPT-3.5 Turbo (מודל שפה גדול B10+2:12:12 | OpenAI | מזהה מודל: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | שמש גם כמחולל התגובות וגם כמחולל הייחוס העצמאי, הגישה אליו התבצעה באמצעות ה-OpenAI API |
| NumPy | מפתחי NumPy (קוד פתוח) | https://numpy.org/ | ספריית חישוב נומרי המשמשת לחישובים סטטיסטיים, כולל ממוצע וסטיית תקן של ציוני אימות NLI |
| Openai (ספריית לקוח Python API) | OpenAI | https://github.com/openai/openai-python | ספריית לקוח ב-Python המשמשת להגשת פרומפטים ולקבלת השלמות מ-GPT-3.5 Turbo |
| פנדות | צוות הפיתוח של pandas (קוד פתוח) | https://pandas.pydata.org/ | ספריית ניתוח נתונים טבלאית המשמשת לעיבוד מקדים של מערכי נתונים ולטיפול בתוצאות |
| מודל סיווג מאומן מראש להסקה בשפה טבעית (NLI) | מרכז המודלים של Hugging Face (מודל שנבנה על ארכיטקטורת DeBERTa-v3-large של Microsoft) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | נעשה בו שימוש במצב הסקה (inference mode), ללא כיוונון עדין (fine-tuning), כדי לסווג כל זוג של טענה-מקור כאסמכתא (entailment), ניטרלי (neutral) או סתירה (contradiction) |
| פייתון | Python Software Foundation | גרסה 3.9; https://www.python.org/downloads/release/python-390/ | שפת התכנות המרכזית ששימשה ליישום מסגרת האימות |
| SciPy | מפתחי SciPy (קוד פתוח) | https://scipy.org/ | ספריית מחשוב מדעי המשמשת לתמיכה בניתוח סטטיסטי של תוצאות ניסיוניות |
| Transformers (ספריית Hugging Face Transformers) | Hugging Face | https://github.com/huggingface/transformers | ספריית Python המשמשת לטעינה ולהרצה של מודל NLI שאומן מראש |
| סט המערך של מדד TruthfulQA | פורסם במקור על ידי Lin, Hilton, and Evans | https://github.com/sylinrl/TruthfulQA | מדד ייחוס (benchmark) הזמין לציבור הכולל 817 שאלות מונחות-עובדות המשמשות לכוונון סף ולהערכה |
| מחשב תחנה (Workstation) | לא צוין בכתב היד (נא לאשר יצרן/דגם) | מעבד Intel Core i5; זיכרון RAM בנפח 16 GB; מערכת הפעלה של 64 סיביות | חומרה ששימשה לביצוע כל הניסויים תחת תצורות זהות |
| הערה: כל כתובות ה-URL המופיעות לעיל נבדקו ואושרו כפעילות נכון לתאריך של טבלה זו. |
מקורות
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
הדפסות חוזרות והרשאות
מאמר זה פורסם
הסרטון יגיע בקרוב