מאמר זה מציג מסגרת מבוססת CNN הניתנת להסבר לסיווג נגעים בעור, המשלבת דיוק אבחנתי גבוה עם יכולת פירוש של המודל. המסגרת מסווגת תמונות של נגעים ומייצרת הסברים ויזואליים לתחזיותיה. התוצאות מדגימות ביצועים חזקים ושקיפות משופרת, התומכות בקבלת החלטות קלינית ומסייעות לרופאי עור בגילוי מוקדם של מחלות עור.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
מסגרת ממוחשבת ניתנת להסבר לסיווג נגעים בעור באמצעות למידה עמוקה
במאמר זה
סיכום
תקציר
השימוש ברשתות נוירונים קונבולוציוניות עמוקות למטרת אבחון מחלות בעור הוכח במחקרים שונים כמי שמניב רמות דיוק דומות לאלו המושגות על ידי רופאי עור. עם זאת, עדיין קיימים אתגרים רבים, כולל ביצועים נמוכים והכללה לקויה במקרים מסוימים, וכן יכולת פרשנות נמוכה הקשורה לשימוש במודלים של "קופסה שחורה". מצב זה יוצר מכשולים משמעותיים ליישום מעשי, שכן הוא דורש יכולת הסבר בנוסף לאבחון מדויק, מה שמחייב מציאת פתרון. כדי להתגבר על הקשיים שהוזכרו, פותחה במחקר זה מסגרת למידה עמוקה ניתנת להסבר לסיווג נגעי עור (EDLF-SLC). המסגרת משתמשת בגישות שונות בלמידת מכונה ובבינה מלאכותית ניתנת להסבר (XAI) כדי להבטיח שיפורים הן בדיוק והן בפרשנות באופן תלת-שלבי. בשלב הראשוני, ייצוגים עמוקים שהופקו ממספר ארכיטקטורות CNN מאומנות מראש ממוזגים כדי לשמר מידע מבחין משלים שנלמד על ידי ארכיטקטורות רשת שונות לפני הסיווג באמצעות SVM עם גרעין פונקציית בסיס רדיאלית. לאחר מכן, מסווגי Support Vector Machine (SVM) עם גרעין פונקציית בסיס רדיאלית משמשים לסיווג המאפיינים שהתקבלו. לבסוף, התחזיות של המודל מפורשות באמצעות הסברים מקומיים ניתנים לפרשנות ללא תלות במודל (LIME). תוצאות ניסיוניות מראות כי EDLF-SLC מגיע ל-88.0% בדיוק (accuracy), 89.0% בדיוק חזוי (precision), 87.0% ברגישות (recall) ו-88.0% במדד F1, מה שמעיד על ביצועים תחרותיים בהשוואה למספר שיטות שדווחו לאחרונה תחת התנאים הניסיוניים שנבחנו במחקר זה.
מבוא
נגעים בעור מהווים דאגה מרכזית בדרמטולוגיה ובאונקולוגיה, כיוון שהם נעים בין חריגות שפירות לסרטנים ממאירים כגון מלנומה, הצורה הקטלנית ביותר של סרטן העור. בשנת 2020, המלנומה הייתה אחראית לכ-325,000 מקרים חדשים ומעל ל-57,000 מקרי מוות ברחבי העולם1. למרות שהתקדמות בסינונים ובטיפולים שיפרה את תוצאות המטופלים, אבחון מאוחר וגישה מוגבלת לשירותי בריאות ממשיכים לתרום לשיעורי תמותה גבוהים ולאובדן שנות חיים, במיוחד בקרב אוכלוסיות צעירות2,3.
האבחנה המסורתית מסתמכת בעיקר על בדיקה חזותית ודרמוסקופיה, מה שהופך את התהליך לתלוי במומחיות של הקלינאים וחשוף לסובייקטיביות, לשונות בין בודקים, לביופסיות מיותרות ולזמני בדיקה ממושכים4,5,6. כדי להתגבר על מגבלות אלה, למידה עמוקה, ובמיוחד CNNs, הגיחה כפתרון יעיל לסיווג אוטומטי של נגעים בעור. מודלים המבוססים על CNN, כולל DDCNN-F7, YOLOv7-XAI8 ומספר ארכיטקטורות אחרות9,10,11,12,13, הדגימו דיוק אבחנתי גבוה על ידי למידה אוטומטית של מאפייני תמונה מבדילים. למרות הצלחתם, רוב מודלי הלמידה העמוקה פועלים כ"קופסאות שחורות", מה שמגביל את אמון הקלינאים ומעכב את אימוצם בפרקטיקה רפואית שגרתית. לכן, הוצגו טכניקות של בינה מלאכותית ניתנת להסבר כדי לשפר את שקיפות המודל על ידי אספקת הסברים חזותיים לתחזיות. בין שיטות אלו, Local Interpretable Model-Agnostic Explanations מייצרת הסברים מקומיים ניתנים לפירוש על ידי זיהוי אזורי התמונה המשפיעים ביותר על החלטות המודל14.
סיווג נגעים בעור התפתח מהערכה קלינית מסורתית למערכות אבחון מתקדמות מבוססות בינה מלאכותית (AI), מתוך צורך בזיהוי מדויק, אמין ומוקדם של סרטן העור. התפתחות זו התקדמה דרך חמישה שלבים מרכזיים — שיטות אבחון מסורתיות, אבחון מסייע במחשב (CAD), למידה מכונה (ML), למידה עמוקה (DL), ולאחרונה, בינה מלאכותית ניתנת להסבר (XAI) ולמידה פדרטיבית (FL) — המשקפים מאמצים מתמידים לשיפור דיוק האבחון, העקביות, יכולת ההרחבה והאמינות הקלינית, תוך התגברות על מגבלות הבדיקה הקונבנציונלית. שיטות חישוביות מוקדמות ניסו לחקות חשיבה קלינית באמצעות מתארי תמונה שהוגדרו ידנית ונגזרו מכלל ה-ABCD, כולל אסימטריה, אי-סדירות של הגבול, שונות בצבע וקוטר הנגע. מאפיינים אלה שולבו עם רשתות בייזיאניות, עצי החלטה, מערכות מומחים ומודלים של הסקת מסקנות עמומה (fuzzy inference) כדי לתמוך באבחון מלנומה, כאשר מספר מחקרים דיווחו על דיוקי סיווג העולים על 90%15,16,17. למרות ששיטות אלו סיפקו בסיס חשוב לאבחון מסייע במחשב, הן היו תלויות לחלוטין במאפיינים שהונדסו ידנית ובכללי אבחון שהוגדרו מראש. כתוצאה מכך, הן הפגינו חוסן מוגבל מול שינויים באיכות התמונה, מורפולוגיית הנגע, התאורה ותנאי הרכישה.
כדי לטפל בחסרונות אלה, הופיעו מערכות CAD קלאסיות כשלב ביניים בין ניתוח תמונות קונבנציונלי לבין מסגרות מודרניות המבוססות על AI. מערכות CAD שילבו מיצוי מאפיינים ידני עם מסווגים קונבנציונליים כדי לשפר את העקביות האבחנתית ולסייע בקבלת החלטות קליניות. מספר גישות היברידיות שילבו קיבץ היררכי (hierarchical clustering) עם רשתות עצביות רקורסיביות וארכיטקטורות של זיכרון לטווח קצר ארוך (long short-term memory), והשיגו דיוקי סיווג המתקרבים ל-99.5%18. מסגרות CAD אחרות שילבו מסווגי gradient boosting עם הסברים מבוססי SHAP, והפגינו דיוק אבחנתי תחרותי תוך שיפור השקיפות של המודל19. למרות שמערכות אלה ייצגו שיפור משמעותי לעומת גישות המבוססות על כללים בלבד, הן המשיכו להסתמך במידה רבה על מיצוי מאפיינים ידני, עיבוד מקדים נרחב, מערכי נתונים מתויגים בקפידה וצינורות עיבוד רב-שלביים.
טכניקות של למידת מכונה קידמו עוד יותר את הסיווג האוטומטי של נגעי עור על ידי הפיכת הלמידה למבוססת נתונים במקום תכנון כללים מפורשים. מסגרות היברידיות המשלבות רשתות נוירונים קונבולוציוניות (CNN) עם מסווגי למידת מכונה קונבנציונליים, כולל רגרסיה לוגיסטית ו-k-nearest neighbors, הדגימו ביצועי סיווג חזקים במאגרי נתונים סטנדרטיים, והשיגו רמות דיוק העולות על 95%9. למידה רב-מודלית בפיקוח עצמי (Self-supervised multimodal learning) שיפרה עוד יותר את ייצוג המאפיינים על ידי ניצול משותף של תמונות דרמוסקופיות וקליניות, ובכך הפחיתה את התלות באנוטציה ידנית נרחבת תוך שיפור ביצועי הסיווג20. מחקרים נוספים שילבו CNNs עם ניתוח מבדיל מוכלל (generalized discriminant analysis), דסקריפטורי SURF ואלגוריתמי אופטימיזציה כדי לשפר אתBהבחנה בין מאפיינים ואת דיוק הסיווג21. טכניקות לבחירת מאפיינים אוטומטית המשתמשות ב-DenseNet-201, InceptionV3 ואלגוריתמי אופטימיזציה של עצי בינאריים שיפרו עוד יותר את ייצוג המאפיינים תוך שמירה על ביצועים דיאגנוסטיים תחרותיים22. גישות של למידה בהעברה (Transfer learning) המשתמשות בארכיטקטורות מאומנות מראש כגון AlexNet ו-GoogLeNet הדגימו גם הן יכולת סיווג מבטיחה למרות נתוני אימון מוגבלים23. עם זאת, רוב שיטות ה-ML המשיכו להישען על נהלי עיבוד מקדים שתוכננו בקפידה, אסטרטגיות אופטימיזציה ידניות, מאגרי נתונים מאוזנים וכיוונון נרחב של היפר-פרמטרים. התיקוף החיצוני המוגבל שלהן והרגישות לחוסר איזון בין מחלקות הגבילו עוד יותר את יישומן המעשי בסביבות קליניות מגוונות.
הכנסת ה-DL שינתה באופן מהותי את הסיווג האוטומטי של נגעי עור על ידי מתן אפשרות ללמידה מקצה לקצה ישירות מנתוני תמונות גולמיים. רשתות CNN ביטלו את הצורך בהנדסת מאפיינים ידנית תוך שיפור משמעותי של הביצועים האבחנתיים במספר מערכי נתונים של benchmark. רוב הגישות המבוססות על CNN הדגימו שיפורים משמעותיים בסיווג נגעים באמצעות ארכיטקטורות מתוחכמות יותר ויותר. מודלי CNN מודעי-סימטריה בחנו מאפייני נגעים בעלי משמעות קלינית אך השיגו דיוק מאוזן בינוני בלבד24. גישות אחרות שילבו ארכיטקטורות EfficientNet עם הסברי LIME ו-SHAP כדי לשפר את יכולת הפרשנות תוך הצגת מדדים כמותיים של מהימנות25. מערכות DL היברידיות המשלבות סגמנטציה של נגעים, למידת אנסמבל ו-CNN השיגו ביצועים מצוינים במספר מערכי נתונים של ISIC, אך נותרו רגישות לאיכות הסגמנטציה ולאיזון בין המחלקות26.
לאחרונה, ארכיטקטורות היברידיות מתוחכמות יותר שיפרו עוד יותר את דיוק הסיווג באמצעות שילוב של טכניקות DL משלימות. רשתות Adversarial Generative מותניות בשילוב עם YOLOv5 וניתוח רכיבים בלתי תלויים (ICA) השיגו דיוקי סיווג העולים על 99%, אם כי המורכבות החישובית שלהם הגבילה את הפריסה המעשית שלהן 27. באופן דומה, ארכיטקטורות היברידיות של LSTM–ResNet למדו ביעילות ייצוגים מרחביים-זמניים, אך דרשו משאבים חישוביים גדולים משמעותית28. מודלים מבוססי Transformer, כולל Sap-Former, ניצלו מידע הקשרי גלובלי כדי לשפר את ייצוג התכונות, אך דרשו עיבוד מקדים נרחב, מערכי נתונים רחבי היקף עם תוויות והספק חישובי משמעותי29. חלופות קלות יותר כגון S-MobileNet ניסו לאזן בין יעילות חישובית לדיוק אבחנתי30, בעוד ששיטות של התאמת דומיין ללא פיקוח (unsupervised domain adaptation) שיפרו את ההכללה בין דומיינים למרות יעילות מופחתת כאשר היו זמינים דגימות אימון מוגבלות בלבד31. רשתות היברידיות עם מנגנוני קשב (Attention), המשלבות מודולי קשב קונבולוציוניים שונו ולמידת ensemble של snapshots, הדגימו גם הן ביצועים מבטיחים לסיווג נגעי עור של אבעבועות קוף, אם כי אתגרים הקשורים לחוסר איזון בין מחלקות, גיוון בתמונות ויכולת הסבר מוגבלת נותרו ללא פתרון32. ארכיטקטורות שאריות (residual) מותאמות אישית, המשתמשות בתכנוני רשת עמוקים יותר ובפונקציות הפסד היברידיות, שיפרו עוד יותר את דיוק הסיווג מעבר ל-99%, אך גררו עומס חישובי וזמן אימון גדולים במידה ניכרת33. מחקרי סקירה מקיפים הגיעו למסקנה עקבית כי DL עולה באופן משמעותי על גישות מסורתיות של תכונות ידניות (handcrafted) על ידי למידה אוטומטית של ייצוגי תמונות מבחנים, תוך זיהוי סימולטני של אתגרים מתמשכים הקשורים לארטיפקטים של דימות, שונות בתאורה, מורכבות חישובית והכללה קלינית מוגבלת34.
אף על פי שלמידה עמוקה (DL) שיפרה באופן דרמטי את הדיוק האבחנתי, חששות בנוגע לשקיפות המודל, הערכת אי-ודאות ופריסה קלינית מהימנה עוררו עניין גובר בבינה מלאכותית ניתנת להסבר (XAI) ובלמידה פדרטיבית. מספר מחקרים בחנו טכניקות לכימות אי-ודאות, כולל conformal prediction, Monte Carlo dropout ו-evidential deep learning, והראו כי הערכת ביטחון מהימנה יכולה לשפר משמעותית את התמיכה בקבלת החלטות, למרות שהיא מטילה מגבלות חישוביות ומגבלות הקשורות לנתונים35. מסגרות למידה הדדית מבוססות Transformer הוצעו גם הן כדי לטפל בחוסר איזון בין מחלקות תוך שיפור יעילות למידת התכונות36. גישות אחרות שילבו רשתות CNN ברזולוציה מלאה עם טכניקות אופטימיזציה מבוססות גרף כדי לשפר את סגמנטציית וסיווג הנגעים37, בעוד שמסגרות למידה עמוקה היברידיות המשלבות מספר ייצוגי תכונות משלימים השיגו דיוקי סיווג המתקרבים ל-99.5%, למרות הדרישה לעיבוד מקדים נרחב38.
מחקרים עדכניים מתמקדים יותר ויותר בשילוב של יכולת הסבר (explainability) ישירות בתוך מסגרות של DL כדי להגביר את אמון הקלינאים ולהקל על האימוץ הקליני המעשי. מערכות ניתנות להסבר המשתמשות במספר ארכיטקטורות של רשתות נוירונים קונבולוציוניות (CNN) יחד עם Grad-CAM ו-Score-CAM הצליחו למקם אזורי נגעים רלוונטיים לאבחנה תוך שמירה על ביצועי סיווג תחרותיים הן במאגרי נתונים פנימיים והן בחיצוניים39. מסגרות היברידיות של CNN–Transformer המשלבות תמונות דרמוסקופיות עם מטא-נתונים קליניים שיפרו עוד יותר את ביצועי הניבוי, תוך שימוש ב-SHAP וב-Grad-CAM ליצירת הסברים חזותיים בעלי משמעות קלינית40. ארכיטקטורות היברידיות נוספות מבוססות-transformer המשלבות EfficientNetV2S, Swin Transformers, רשתות Xception שונו ומנגנוני תשומת לב גרפיים (graph attention), לכדו ביעילות מאפייני נגעים גלובליים ומקומיים משלימים, אם כי מספר הפרמטרים הגבוה שלהן והביצועים המוגבלים במחלקות מיעוט הגבילו את הפריסה המעשית שלהן41. באופן דומה, מסגרות היברידיות של YOLOv8–Vision Transformer הדגימו שיפור במיקום נגעים, בסיווג רב-מחלקתי ובפרשנות חזותית באמצעות הרחבה אדפטיבית (adaptive augmentation) יחד עם הסברי SHAP ו-Grad-CAM; עם זאת, שיטות אלו המשיכו להסתמך בעיקר על מאגרי נתוני ייחוס והפגינו חוסן מוגבל עבור קטגוריות נגעים של מיעוט42. מספר מאמרי סקירה סיכמו פיתוחים אלו, תוך הדגשה הן של ההתקדמות המרשימה שהושגה על ידי טכניקות למידה עמוקה מודרניות והן של האתגרים המתמידים הקשורים ליעילות חישובית, יכולת הסבר, תלות במאגרי נתונים ותיקוף קליני43,44,45. טבלה 1 מסכמת מספר עבודות שפורסמו לאחרונה המשתמשות באלגוריתמים של למידה עמוקה לסיווג נגעים בעור.
למרות ההתקדמות המרשימה שהושגה על ידי שיטות DL אחרונות בסיווג נגעי עור, רוב הגישות הקיימות נותרות מוגבלות בשל מורכבות חישובית גבוהה, תלות במאגרי נתונים גדולים ומתוייגים, יכולת פרשנות מוגבלת של המודל ותיקוף לא מספיק בסביבות קליניות מגוונות בעולם האמיתי. כדי להתגבר על מגבלות אלו, מאמר זה מציע את מסגרת ה-EDLF-SLC, המשלבת מאפיינים משלימים שהופקו ממספר ארכיטקטורות CNN יחד עם מסווג SVM לסיווג חסון ומדויק. המסגרת עושה שימוש נוסף בעיבוד מקדים משופר לשיפור איכות התמונה ולטיפול בחוסר איזון במחלקות, תוך שילוב טכניקת LIME כדי לספק הסברים ויזואליים לחיזויים בודדים, ובכך להגביר את שקיפות המודל ואת האמינות הקלינית שלו.
לתרומות של מחקר זה יש שלושה היבטים. ראשית, המחברים מציעים מסגרת עבודה חסונה, EDLF-SLC, המשלבת רשתות נוירונים קונבולוציוניות (CNNs) מתקדמות עם מסווג של מכונה וקטורית תומכת (SVM) כדי להשיג סיווג מדויק ואמין של נגעים בעור. שנית, המחברים מיישמים טכניקות עיבוד מקדים משופרות כדי לטפל בחוסר איזון בין המחלקות ולהפחית רעשים בתמונות, ובכך משפרים את איכות תמונות הקלט ואת הביצועים הכוללים של מודל הסיווג. שלישית, המחברים משלבים את שיטת LIME (Local Interpretable Model-agnostic Explanations) כדי להציג באופן ויזואלי ולפרש תחזיות בודדות של המודל על ידי הדגשת אזורי התמונה המשפיעים ביותר על החלטות הסיווג, ובכך משפרים את השקיפות והיכולת לפרש את מסגרת העבודה המוצעת.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
מחקר זה לא כלל גיוס משתתפים אנושיים או איסוף נתונים מזהים של מטופלים. כל הניסויים בוצעו באמצעות מערך נתוני נגעי העור ISIC 2020 הזמין לציבור, אשר הושג ממאגר Kaggle; לפיכך, לא נדרשו אישור של ועדת אתיקה מוסדית והסכמה מדעת. כל החומרים ששימשו במחקר זה נמצאים ב- טבלת חומרים.
חילוץ ומיזוג מאפיינים
תמונות של נגעי עור עובדו באמצעות מספר מודלי CNN מאומנים מראש. וקטורי מאפיינים עמוקים שחולצו מארכיטקטורות ה-CNN הנבחרות שורשרו כדי לבנות ייצוג מאפיינים מאוחד עבור כל תמונת נגע עור. אסטרטגיית המיזוג שנבחרה משמרת מידע חזותי משלים שנלמד על ידי ארכיטקטורות CNN שונות, מה שמאפשר למסווג ה-SVM העוקב לנצל הן מאפייני מרקם ברמה נמוכה והן ייצוגים סמנטיים ברמה גבוהה יותר. למרות שטכניקות להורדת ממדיות, כגון ניתוח רכיבים ראשיים (PCA) או בחירת מאפיינים מבוססת מידע הדדי, עשויות להפחית את ממדיות המאפיינים, הייצוג הממוזג המלא נשמר במכוון כיוון שמרחב המאפיינים הממוזג נותר ניתן לניהול חישובי עבור מסווג ה-RBF-SVM שנעשה בו שימוש, תוך שימור מידע אבחנתי משלים שחולץ ממבני ה-CNN ההטרוגניים.
סיווג
וקטורי התכונות המאוחדים שימשו לאימון מסווג SVM עם גרעין RBF. נעשה שימוש בטכניקות לאופטימיזציה של היפר-פרמטרים כדי לקבוע את הגדרות הסיווג האופטימליות. לאחר מכן, המסווג קטל את נגעי העור למחלקות המתאימות להם.
ניתנות להסבר
כדי לשפר את יכולת הפרשנות, נעשה שימוש ב-LIME ליצירת הסברים ויזואליים המדגישים את אזורי התמונה שתורמים באופן המשמעותי ביותר לתוצאות הסיווג. הסברים אלו יסייעו לקליניקאים להבין ולתקף את החלטות המודל.
תוכנית הערכה
המסגרה המוצעת הוערכה באמצעות מערך נתונים סטנדרטי (benchmark) של נגעי עור. הביצועים נבחנו באמצעות Accuracy, Precision, Recall ו-F1-Score. ניסויים השוואתיים נערכו מול גישות קיימות של למידת מכונה ולמידה עמוקה כדי להדגים את יעילותה של המסגרת המוצעת.
תוצאות צפויות
המחקר היה צפוי להניב מערכת מדויקת וניתנת לפירוש לסיווג נגעי עור. תוצאות ניסיוניות ראשוניות מעידות כי EDLF-SLC משיג דיוק של 88.0%, רגישות (precision) של 89.0%, recall של 87.0% ומדד F1-score של 88.0%, ובכך עולה בביצועיו על מספר שיטות מתחרות. שילוב הסברים באמצעות LIME היה צפוי להגביר את רמת האמון ולהקל על אימוץ מערכות אבחון מבוססות בינה מלאכותית בפרקטיקה הקלינית.
חשיבות
מחקר זה תורם לתחום הגדל של בינה מלאכותית ניתנת להסבר (Explainable AI) בתחום הבריאות, על ידי התייחסות לאתגרי ביצועים ושקיפות באבחון נגעים בעור. למסגרת המוצעת יש פוטנציאל לסייע לרופאי עור בקבלת החלטות אבחנתיות אמינות וניתנות לפירוש יותר, ובסופו של דבר לשפר את הטיפול במטופלים. יתרה מכך, בחלק זה, סיפקו המחברים מידע בנוגע לחומרים ולמתודולוגיה שיושמה במחקר זה. באופן ספציפי, המחברים פתחו בתיאור מערך הנתונים ששימש לניסויים והמשיכו לדיון מפורט במסגרת הלמידה העמוקה הניתנת להסבר לסיווג נגעים בעור.
ערכת נתונים
העבודה המוצגת מתבססת על ערכת הנתונים ISIC 2020 הזמינה לציבור (International Skin Imaging Collaboration), אליה ניתן לגשת באתר Kaggle (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). מאגר ה-ISIC מוכר כאחד המשאבים הטובים ביותר בתחום ההדמיה הדרמטולוגית, מאחר שהוא מספק מגוון רחב של תמונות דרמוסקופיות של סוגים שונים של נגעים בעור, כפי שמוצג ב-איור 1. באופן משמעותי, ערכת הנתונים כוללת תמונות של מצבים שפירים וממאירים כאחד, מה שהופך אותה למועילה לביצוע משימות סיווג בינארי של סרטן העור 46. בערכת הנתונים הנוכחית ישנן 3,297 תמונות, מתוכן 1,800 שפירות ו-1,497 ממאירות. לצורך ניסויים יעילים יותר, היה צורך לחלק את הנתונים למערכת אימון ומערכת בדיקה. בפרט, ישנן 2,637 תמונות אימון, הכוללות 1,440 שפירות ו-1,197 ממאירות, בעוד שמערכת הבדיקה מורכבת מ-660 תמונות, מתוכן 360 שפירות ו-300 ממאירות. סיכום של ערכת הנתונים מוצג ב-טבלה 2.
מודל ה-EDLF-SLC המוצע
במאמר זה הוצע פתרון יעיל ומובן לסיווג נגעי עור לקטגוריות שפירות וממאירות, תוך שימוש בטכניקה חדשנית של למידה עמוקה הניתנת להסבר, המבוססת על גישה היברידית המשלבת את היתרונות של מספר מודלים של רשתות נוירונים קונבולוציוניות (CNN) שאומנו מראש. רשתות נוירונים קונבולוציוניות הוכחו כיעילות ביותר בחילוץ מאפיינים סמנטיים ברמה גבוהה מתמונות רפואיות. תוך שימוש ביכולת זו, מסגרת הלמידה העמוקה הניתנת להסבר לסיווג נגעי עור המוצעת (EDLF-SLC) מנצלת מספר מודלי CNN שאומנו מראש כדי להשיג ביצועים מעולים. כדי להבטיח את השקיפות הדרושה בתהליך קבלת ההחלטות הרפואיות, הוטמעה בגישה המוצעת שיטת LIME ליצירת הסברים מקומיים קריאים לבני אדם עבור תוצאות הפלט. ניתן לחלק את המסגרת השלמה לשלושה שלבים עיקריים, כפי שמוצג ב-איור 2>, והם: (1) עיבוד מקדים של נתונים, (2) חילוץ מאפיינים וסיווג, ו-(3) יכולת פרשנות.
ארכיטקטורת מודל ואינטגרציה
כשלב מקדימ, נבחרו שבעה מודלים פופולריים של למידה עמוקה (MobileNetV2, ResNet50, EfficientNetB0, Xception, InceptionResNetV2, NASNetLarge, ו-MobileNet) והוערכו בנפרד על סט נתוני האימות, וארבעת המודלים היעילים ביותר (ResNet50, EfficientNetB0, MobileNet, ו-Xception) נבחרו לשלב חילוץ התכונות. במסגרת המוצעת, כל תמונת קלט x הועברה באופן עצמאי דרך המודלים המאומנים מראש שנבחרו. השכבה האחרונה עם חיבור מלא (fully connected layer) הוסרה מכל אחד מהמודלים הללו, ווקטורי תכונות הופקו מהשכבות הקודמות. fResNet50(x), fEfficientNetB0(x), fMobileNet(x), ו-fXception(x) מתייחסים לווקטורי התכונות הפלט מכל אחד מהמודלים שהוזכרו לעיל. באמצעות שרשור וקטורי תכונות אלה, מתקבל וקטור תכונות מאוחד חדש F(xi):
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
לאחר מכן, F(xiהועבר דרך מסווג SVM עם גרעין פונקציית בסיס רדיאלית (RBF) כדי לקבל את תוצאת הסיווג. האלגוריתם המלא עבור המסגרת המוצעת מוצג ב- קובץ משלים 1.
המסגרת המוצעת מאמצת מיזוג ישיר ברמת המאפיינים (feature-level fusion), מכיוון שכל ארכיטקטורת CNN מאומנת לומדת מאפיינים מבחינים שונים של נגעי עור באמצעות ארכיטקטורת הרשת הייחודית שלה וההיררכיה של המאפיינים שנלמדו. כתוצאה מכך, שרשור ייצוגי מאפיינים הטרוגניים אלו משמר מידע משלים התורם לאפיון מקיף יותר של הנגע לפני השלב של הסיווג. למרות ששיטות להפחתת ממדיות, כגון ניתוח רכיבים ראשיים (PCA) או בחירת מאפיינים מבוססת מידע הדדי (mutual information), יכולות להפחית את ממדיות הייצוג הממוזג, וקטור המאפיינים הממוזג המלא נשמר במכוון מאחר שממדיותו נשארת ניתנת לניהול חישובי עבור מסווג ה-RBF-SVM שנבחר, ובו בזמן שהיא משמרת מידע אבחנתי משלים שהוצא על ידי רשתות ה-CNN השונות. עיצוב זה, לפיכך, נותן עדיפות לשימור ייצוגים עמוקים משלימים על פני הסרת מאפיינים שעשויים להיות אינפורמטיביים לפני הסיווג.
הכנת נתונים
הכנת הנתונים כללה עיבוד מקדמי ופיצול של מערך הנתונים למערכי אימון ובדיקה. העיבוד המקדמי נועד לשפר את איכות הנתונים על ידי ביטול אי-עקביות, מחיקת רכיבים כפולים, עיצוב תמונות הקלט וביצוע נרמול תכונות (feature scaling) לצורך אימון יציב של מודל איכותי. כל התמונות נורמלו לטווח של [−1, 1] באמצעות נרמול Z-score:
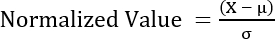 (2)
כאשר µ ו-σ מייצגים את ערך הממוצע ואת סטיית התקן של התמונה המתאימה, בהתאמה. מערך הנתונים חולק לשתי תתי-קבוצות, כלומר, קבוצת אימון (70.0%) וקבוצת בדיקה (30.0%).
הגדלת נתונים (Data augmentation)
כדי למנוע התאמת יתר (overfitting) ולהגביר את יכולת ההכללה של המודל, נעשה שימוש במספר טכניקות הגדלה עבור קבוצת האימון. הגדלת תמונות כוללת שינוי של התמונות במטרה להרחיב באופן מלאכותי את מערך הנתונים מבלי לשנות מאפיינים חיוניים של המצבים הרפואיים. צינור העיבוד להגדלה נבנה באמצעות ה-Keras Sequential API. נעשה שינוי באמצעות טרנספורמציות כגון היפוך אופקי אקראי, סיבוב בזווית קטנה, שינוי גודל (resizing), קנה מידה (scaling), התאמת בהירות/ניגודיות, זום ותנועות מינוריות. דוגמאות מייצגות של תמונות מוגדלות מוצגות ב-איור 3.
מודלים מאומנים מראש
מספר מודלים של למידה עמוקה מאומנים מראש אומצו במסגרת המוצעת לצורך חילוץ מאפיינים מתמונות הקלט. מודלים אלו כוללים את MobileNet, ResNet50, EfficientNetB0, Xception, NASNetLarge, Inception-ResNet-v2 ו-MobileNetV2. MobileNet ו-MobileNetV2 הם מודלים קלילים של למידה עמוקה לביצועי חישוב יעילים באמצעות קונבולוציות ניתנות להפרדה לפי עומק (depth-wise separable convolutions). ResNet50 משתמש במנגנון של חיבורים שיוריים (residual connections) לאימון המודל, ובכך נמנע מבעיית הגרדיאנטים הנעלמים במהלך האימון. EfficientNetB0 יוצר איזון בין יעילות לדיוק באמצעות גישה של סקאלינג מורכב (compound scaling). Xception מרחיב את רשת Inception באמצעות קונבולוציות ניתנות להפרדה לפי עומק. NASNetLarge כולל שימוש בחיפוש ארכיטקטורה עצבית (neural architecture search) לבניית מבני רשת עצבית עמוקה אופטימליים, ו-Inception-ResNet-v2 בונה היבריד של מודל Inception ומנגנון החיבורים השיוריים. וקטורי מאפיינים שחולצו מ-ResNet50 (1,024 מאפיינים), EfficientNetB0 (1,280 מאפיינים), MobileNet (1,024 מאפיינים) ו-Xception (2,048 מאפיינים) שורשרו יחד כדי להפיק ייצוג מאוחד במימדיות של 5,376. אסטרטגיית מיזוג זו נבחרה כדי לשמר ייצוגים משלימים שנלמדו על ידי ארכיטקטורות CNN שונות, במקום לצמצם את הייצוג לפני הסיווג. וקטור המאפיינים שנוצר מועבר לאחר מכן למסווג RBF-SVM, הקובע את גבול ההחלטה הבלתי-ליניארי האופטימלי בתוך מרחב המאפיינים הממוזג.
מודל בינה מלאכותית הניתן להסבר (LIME)
על מנת לספק פרשנות מקומית מסוימת של תחזיות המודל, המחברים מאמצים את השיטה של יצירת הסברים מקומיים קריאים לבני אדם עבור כל תחזית ספציפית של המודל, שיטה הנקראת LIME47. עבור כל תמונת קלט, LIME מחלק אותה תחילה ליחידות קטנות יותר הנקראות superpixels. לאחר מכן נוצרים שיבושים (perturbations) מהתמונה המקורית, ותחזיות ממודל הרשת העמוקה נאמדות עבור כל אחד מהשיבושים. לאחר מכן, מותאם מודל ליניארי משוקלל על השיבושים תוך שימוש במשקולות התלויות בקרבתם למופת הקלט המקורי. לאחר התאמת המודל הליניארי, נאמדים מדדי חשיבות המאפיינים, המצביעים על תפקידו של כל superpixel בתחזית התגית הסופית. מדדי חשיבות אלו מודגשים חזותית בתמונת ההסבר הסופית. אלגוריתם LIME מוצג בקובץ משלים 2.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
הערכת הביצועים של מסגרת הסיווג שפותחה מבוססת על מדדי הערכה מסורתיים הנגזרים ממטריצת בלבול (confusion matrix). מטריצת בלבול מאפשרת קבלת הבנה מלאה של ביצועי המסווג באמצעות ייצוג מספר הסיווגים הנכונים והשגויים שבוצעו עבור כל מחלקה שהוגדרה. באופן זה, ניתן לנתח את כל סוגי השגיאות. לדוגמה, הן תוביות חיוביות (false positives) והן תוביות שליליות (false negatives) הן חשובות במיוחד באבחון מחלות. ערכים גבוהים של תוביות חיוביות עשויים להעיד על רגישות גבוהה של המסווג, אך במקביל, כמויות גדולות של תוביות שליליות מעידות על רגישות נמוכה ...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
מסגרת הלמידה העמוקה ההסברית המוצעת לסיווג נגעים בעור (EDLF-SLC) מדגימה כי שילוב של ייצוגי מאפיינים עמוקים משלימים עם בינה מלאכותית הסברית יכול לשפר הן את ביצועי הסיווג והן את שקיפות המודל. על ידי שילוב של מספר ארכיטקטורות CNN מאומנות מראש (ResNet50, EfficientNetB0, MobileNet ו-Xception) לחילוץ מאפיינים ושימוש במכונת וקטורים תומכים (SVM) לסיווג סופי, המסגרת מנצלת את היתרונות של מחלצי מאפיינים שונים כדי להפיק ייצוגי נגעים עשירים ומבחינים יותר מאלו המתקבלים מרשת שלד אחת. יתרה מכך, שילוב של הסברים מקומיים הניתנים לפירוש ללא ...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
המחברים מצהירים כי אין ניגוד עניינים.
תודות
המחברים מבקשים להביע את תודתם הכנה לאוניברסיטת טאיף על אספקת סביבת המחקר והתמיכה המוסדית שסייעו להשלמת עבודה זו.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| ISIC 2020 Skin Lesion Dataset | International Skin Imaging Collaboration (ISIC) | ISIC 2020 Challenge Dataset | מאגר תמונות דרמוסקופיות המשמש לפיתוח והערכה של מודלים. |
| Keras | Keras Team | אינטגרציה עם TensorFlow | בנייה ואימון של מודלי למידה עמוקה. |
| LIME (Local Interpretable Model-Agnostic Explanations) | Ribeiro et al. | חבילת Python | יצירת הסברים ויזואליים מקומיים לתחזיות המודל. |
| Matplotlib | Matplotlib Developers | הגרסה התואמת העדכנית ביותר | ויזואליזציה של עקומות למידה, מטריצות בלבול (confusion matrices) וגרפי הערכה. |
| NumPy | NumPy Developers | הגרסה התואמת העדכנית ביותר | חישובים מספריים ומניפולציה של מערכים. |
| NVIDIA Tesla T4 GPU | NVIDIA Corporation | 16 GB VRAM | האצת אימון המודל והסקה (inference). |
| Pandas | Pandas Development Team | הגרסה התואמת העדכנית ביותר | עיבוד נתונים וניהול תוצאות ניסויים. |
| Pretrained CNN Models | TensorFlow/Keras Applications | ResNet50, EfficientNetB0, MobileNet, Xception | חילוץ מאפיינים עמוקים מתמונות דרמוסקופיות. |
| Python | Python Software Foundation | גרסה 3.9 | שפת התכנות המשמשת למימוש. |
| PyTorch | PyTorch Foundation | גרסה 2.3.1 | מסגרת למידה עמוקה המשמשת לחילוץ מאפיינים ומימוש מודלים. |
| Scikit-learn | Scikit-learn Developers | הגרסה התואמת העדכנית ביותר | Support Vector Machine (SVM), מדדי הערכה ועיבוד מקדמי של נתונים. |
| Support Vector Machine (RBF Kernel) | Scikit-learn | SVC | סיווג של ייצוגי מאפיינים עמוקים ממוזגים. |
| TensorFlow | Google LLC | גרסה 2.x | מסגרת למידה עמוקה לאימון מודלים והסקה. |
| Ubuntu Operating System | Canonical Ltd. | Ubuntu 20.04 | סביבת ההפעלה הניסויית. |
מקורות
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.