מאמר זה מציע מודל חדש, רשתות עצביות גרפיות עם תשומת לב לינארית של gated-slot עבור המלצות מבוססות סשן, המאמץ תשומת לב לינארית של gated-slot המבוססת על גרף סשן שנבנה באופן דואלי. המודל משפר את דיוק ויעילות ההמלצות ועולה בביצועיו על SOTA בשלושה מאגרי נתונים ציבוריים.
מאמר מחקר
רשתות עצביות גרפיות עם תשומת לב ליניארית בעלת חריץ שער עבור המלצות מבוססות סשן
במאמר זה
סיכום
תקציר
מערכות המלצה מבוססות-סשן (Session-based Recommendation - SBR) שואפות לחזות את הפריט הבא שהמשתמש צפוי לבצע איתו אינטראקציה, בהתבסס על רצף ההתנהגות בתוך הסשן הנוכחי. גישות אחרונות המנצלות את מנגנון התשומת לב (attention) של ה-Transformer (למשל, GC-SAN) הראו ביצועים עדיפים על פני שיטות מסורתיות; עם זאת, הן סובלות מעומס חישובי רב ומסיבוכיות מקום בשל העלות הריבועית של התשומת-לב העצמית (self-attention). כדי להתגבר על מגבלות אלו, מוצע מודל חדש בשם GSLA4Rec (gated‑slot linear attention graph neural networks for session‑based recommendation), המשלב תשומת-לב ליניארית עם מנגנון שערים (gating) למידי ואסטרטגיית עדכון זיכרון מבוססת-סלוטים (slot‑based) בהשראת gated‑slot attention. באופן ספציפי, GSLA4Rec בונה תחילה שני גרפים: גרף סשן ללכידת מעברי פריטים בתוך הסשן, וגרף גלובלי של שכנים לקידוד אותות שיתופיים בין סשנים, ובכך ממדל מידע הקשרי מקומי וגלובלי כאחד. הגישה המוצעת מתמקדת במנגנון ה-gated-slot linear attention, אשר (1) עושה שימוש ביחידות שערים כדי לדכא רעשים מאינטראקציות לא רלוונטיות או כפולות בסשנים ארוכים, (2) משתמש ביחידות סלוטים כדי לאחסן ולעדכן באופן דינמי ייצוגי סשן תמציתיים — ובכך מפחית את עומס הזיכרון, ו-(3) מחליף את התשומת-לב העצמית בתשומת-לב ליניארית כדי להשיג סיבוכיות זמן ליניארית. יחד, רכיבים אלו משפרים משמעותית את דיוק הניבוי של המודל ואת היעילות בלכידת תחומי העניין המשתנים של המשתמשים. ניסויים נרחבים על מספר מאגרי נתונים ציבוריים להשוואה, כולל Diginetica, Tmall ו-NowPlaying, מדגימים כי GSLA4Rec עולה בעקביות בביצועיו על שיטות SBR מהמצב המכניס (SOTA) בביצועי ההמלצה, דבר המאמת את יעילותו של מנגנון ה-GSLA.
מבוא
עם הפיתוח המהיר של שירותים מקוונים (כגון מסחר אלקטרוני, פלטפורמות לסרטונים קצרים ופידי נייד של חדשות), סוגיית העומס המידעתי הפכה לבולטת וחמורה יותר ויותר. מערכות המלצה1,2 מספקות שירותי דחיפת מידע מותאמים אישית ומדויקים באמצעות ניתוח מעמיק של נתוני ההתנהגות של המשתמשים. עם זאת, ביישומים מעשיים רבים המתאפיינים בגישה אנונימית, משתמשים שאינם מחוברים, הגנת פרטיות ומשכי אינטראקציה קצרים, שיטות המלצה מסורתיות כגון סינון שיתופי3 ופירוק מטריצות4,5 מגבילות במידה רבה את כושר היישום של אלגוריתמי ההמלצה. כדי להתמודד עם אתגרים אלו, צצה גישת ה-SBR6,7,8,9. SBR מתמקדת בנתוני רצף האינטראקציות בתוך הסשן הנוכחי של המשתמש כדי לחזות את נקודת העניין הפוטנציאלית הבאה. פרדיגמה זו לא רק נמנעת מהסתמכות על נתוני היסטוריה ארוכי טווח של משתמשים, אלא גם לוכדת בדייקנות שינויי עניין דינמיים בטווח קצר, ובכך מדגימה ערך יישומי ייחודי בתרחישים כגון מסחר אלקטרוני, סרטונים קצרים, המלצות מוזיקה וכדומה.
שיטות מוקדמות הסתמכו בעיקר על שרשראות מרקוב5,10,11,12 כדי למדל הסתברויות מעבר בין פריטים ברצפי סשנים. למרות ששיטות אלו יכלו ללכוד תלויות רצף מסדר ראשון, האפיון של תלויות מורכבות מסדר גבוה ודינמיקה לא ליניארית של תחומי עניין של משתמשים נותר מוגבל, מה שהגביל את יעילות המודלים בתרחישים מורכבים. עם פיתוח טכנולוגיית למידה עמוקה13,14, שיטות המבוססות על רשתות נוירונים יושמו באופן נרחב ב-SBR. GRU4REC15 הייתה הראשונה ליישם רשתות נוירונים רקורסיביות14 (RNNs) להמלצות מבוססות סשנים, ובכך לכדה ביעילות תלויות זמניות ברצפים; NARM16 שיפרה עוד יותר את היכולת לחלץ תחומי עניין של משתמשי ליבה על ידי שילוב מנגנוני קשב (attention mechanisms) עם RNNs; STAMP17 השתמשה בפרספטרונים רב-שכבתיים (MLPs) בשילוב עם מנגנוני קשב כדי להתמקד בלכידת תחומי עניין קצרי טווח של משתמשים. בעוד ששיטות אלו השיגו התקדמות מסוימת במידול רצפים, הן עדיין התמודדו עם אתגרים כגון קושי בטיפול בתלויות ארוכות טווח ורגישות לרעש.
בשנים האחרונות, רשתות עצביות גרפיות (GNNs)18,19,20,21 הביאו נקודת מבט חדשה למשימת ה-SBR. מודלים כגון SR-GNN22 ממדלים באופן מפורש קשרי מעבר מורכבים על ידי בניית גרף סשן (SG), ובכך השיגו שיפורים משמעותיים בדיוק ההמלצות. עם זאת, מרבית השיטות הקיימות המבוססות על GNN מבצעות בניית גרף והעברת הודעות בתוך סשנים בודדים, ובכך חסרות ניצול יעיל של מידע על קורלציה גלובלית של פריטים. כדי לפתור בעיה זו, GCE-GNN23 משלבת סמנטיקה גלובלית וגרפי סשן באמצעות מנגנון תשומת לב עצמית (self-attention) כדי לשקול באופן אדפטיבי את חשיבות הפריטים על ידי בניית גרף גלובלי של שכנים (NGG), ובכך השיגה שיפורים ניכרים בביצועים. למרות זאת, שיטות קיימות המבוססות על GNN עדיין מתמודדות עם שני צווארי בקבוק מרכזיים: ראשית, מורכבות מנגנון תשומת הלב העצמית גדלה באופן ריבועי עם אורך הסשן, מה שמוביל למסה חישובית ניכרת בעת עיבוד סשנים ארוכים; שנית, ל-GNNs מסורתיות חסרה היכולת לווסת באופן דינמי את חשיבות הפריטים במהלך אגרגציית מידע, מה שמקשה על ההבחנה בין רעש לבין התנהגויות קריטיות, דבר המשפיע על איכות הייצוג.
כדי להתמודד עם אתגרים אלה, מאמר זה מציע רשת עצבית גרפית של קשב לינארי עם חריצי-שער להמלצות מבוססות-סשן (GSLA4Rec): (1) תכנון מנגנון חריצי-שער המסנן רעשים באמצעות שערים ומאחסן מידע סמנטי מרכזי בחריצי סשן, ובכך משפר את חסינות המודל ומפחית את עומס האחסון; (2) הצגת מנגנון קשב לינארי המפחית את הסיבוכיות החישובית מ-O(N2) ל-O(N) כאשר N הוא אורך הסשן), תוך שמירה על היכולת למדל תלויות למרחקים ארוכים; (3) ביצוע ניסויים נרחבים בשלושה מאגרי נתונים ציבוריים (Diginetica, Tmall, ו-NowPlaying), המראים כי GSLA4Rec עולה בביצועיו באופן משמעותי על שיטות SOTA קיימות, ובמיוחד מדגים יתרונות ברורים בתרחישים של סשנים ארוכים ונתונים דלילים.
פרוטוקול
חוויית המלצות מבוססות-סשן
ניתן לבחון המלצות מבוססות-סשן (Session-based recommendation) משלו נקודות מבט: SBR, למידת הקשר גלובלית ו-GSLA (ראו טבלת חומרים). במחקר זה לא השתתפו בני אדם או בעלי חיים. כל מערכי הנתונים הניסיוניים ששימשו בעבודה זו זמינים לציבור והוגשו כ-קובץ משלים: GSLA4Rec.zip.
המלצה מבוססת סשן
מערכת המלצות מבוססת-סשן (SBR) הייתה מערכת בינה מלאכותית שהתקשרה עם משתמשים באמצעות דיאלוגים של שפה טבעית במספר סבבים כדי להבין באופן דינמי את העדפות המשתמשים ולספק המלצות מותאמות אישית. SBR התפתחה משיטות מסורתיות לגישות מבוססות למידה עמוקה וגישות היברידיות, ולאחר מכן התקדמה לעבר פתרונות מבוססי מודלי שפה גדולים (LLM).
המלצה מסורתית מבוססת-סשן
SBR מסורתי יוצג בדרך כלל על ידי שיטות מבוססות שרשראות מרקוב וסינון שיתופי (Collaborative Filtering). הראשונות הפיקו המלצות על ידי פירוק של מטריצות מעברים הסתברותיות ספציפיות למשתמש. לדוגמה, Guy Shani24 הציע שיטת המלצה המבוססת על תהליך החלטה מרקובי (Markov Decision Process) שהפיקה המלצות על ידי פירוק של המטריצות המתאימות; Wanrong Gu25 שיפרה את ביצועי ההמלצות על ידי שילוב של שרשראות מרקוב עם מרווחי זמני רכישה. האחרונות הפיקו המלצות על ידי חילוץ קשרים רצפיים חבויים בין פריטים אינטראקטיביים סמוכים באמצעות פירוק מטריצות (matrix factorization). לדוגמה, Sarwar B1 חישב דמיון בין פריטים על בסיס התנהגויות היסטוריות של משתמשים (כגון ציונים ולחיצות) כדי להמליץ על פריטים התואמים להעדפות העבר של המשתמשים. אם משתמש A אהב את פריט a, ופריט c היה דומה מאוד ל-a, המערכת תמליץ על c ל-A; Rendle S5 הציע את FPMC, מודל המלצות רצפי המשלב פירוק מטריצות עם שרשראות מרקוב, כדי ללכוד קשרים רצפיים חבויים בין פריטים אינטראקטיביים סמוכים. עם זאת, SBR מסורתי זה התמקד בקשרים רצפיים בין פריטים סמוכים, מה שהקשה על מידול של יחסי תלות מורכבים.
המלצה מבוססת-סשן באמצעות למידה עמוקה
מערכות המלצה מבוססות-סשן (session-based recommendation) המשתמשות בלמידה עמוקה התפתחו דרך שלבים שכללו רשתות עצביות קונבולוציוניות (CNNs)26,27,28,29, RNNs ו-GNNs. SBR מבוסס-CNN ניצל פעולות כגון קונבולוציה ו-pooling כדי ללמוד ייצוגים של הקשר כל סשן, אשר שימשו לאחר מכן להמלצות עוקבות. Caser30 המיר את L הפריטים האחרונים שהמשתמש הגיב אליהם לווקטורים במימד d באמצעות שכבת embedding, ובכך יצר מטריצת embedding שהתייחסה כ"תמונה" הממופה במרחב הזמן והמרחב החבוי (latent space). לאחר מכן, נעשה שימוש בשלושה מסנני קונבולוציה של תבניות רצף — ברמת נקודה (point-level), ברמת איחוד ללא דילוג (union-level with no skip), וברמת איחוד עם דילוג אחד (union-level with skip once) — כדי ללמוד תבניות סדרתיות לשיפור ביצועי ה-SBR. Tuan et al.31 מידלו באופן אחיד זרמי לחיצות של סשנים ומאפייני תוכן באמצעות גרעיני קונבולוציה תלת-ממדיים כדי ליצור ייצוגים משותפים של מרחב-זמן-תוכן.
רשתות RNN היו מחלקה של ארכיטקטורות רשתות עצביות שתוכננו במיוחד לעיבוד נתונים סדרתיים. הרעיון המרכזי היה ללכוד תלות זמנית באמצעות מבנים רקורסיביים כגון רשתות זיכרון לטווח קצר ארוך (LSTM)13 ויחידות רקורסיביות שעריות (GRUs)32, והן היו נפוצות בשימוש בתחומים כגון עיבוד שפה טבעית (NLP)33, זיהוי דיבור34, תרגום טקסט35, נסיעות36,37, פשיעה38, וחיזוי מגמות עתידיות39 (למשל, תנועה40, שוקי מניות41,42, ומטאורולוגיה43). GRU4Rec, שהוצעה על ידי Hidasi וחב', הייתה אבן דרך במחקר בתחום SBR, והיא הייתה הראשונה להכניס רשתות RNN ל-SBR וללכוד דפוסי התנהגות סדרתיים של משתמשים באמצעות GRU כדי להשיג המלצות מותאמות אישית.
רשתות עצביות גרפיות (GNNs)44 הפגינו כושר ביטוי חזק במידול מערכות יחסים מורכבות בתוך נתונים במבנה של גרף, וחלק מהחוקרים הציגו GNNs למידול מעברים מורכבים בתוך סשנים או ביניהם. בהתאם לארכיטקטורות שונות של מודלי GNNs, שיטות מבוססות GNNs עבור המלצות מבוססות סשנים (SBR) סווגו באופן כללי לרשתות עצביות גרפיות עם שערים (GGNNs)45, רשתות קונבולוציה גרפיות (GCNs)46, ורשתות תשומת לב גרפיות (GATs)47. מודל ה-SR-GNN היה הראשון ליישם GNNs ב-SBR על ידי ייצוג רצפי סשנים כגרפים מכוונים ושימוש ב-GGNNs כדי ללכוד מערכות יחסים מורכבות של מעברי פריטים בתוך סשנים, בשילוב עם מנגנוני תשומת לב להשגת הייצוג (embedding) הסופי של הסשן, ובכך שיפר את ביצועי ההמלצות. Chen L48 הציע מסגרת GNNs רב-מבטית (multi-view) המשלבת תכונות מובנות ומילות מפתח לא מובנות כדי למדל אסוציאציות רב-ממדיות של מוצרים, מה ששיפר את הדיוק של ה-SBR. Driss E49 תכנן מערכת המלצות סשנים חדשנית המאמצת רשתות עצביות גרפיות מסוג קפסולה (capsule graph neural networks) כדי ללכוד מאפייני פריטים מורכבים ולהגביר את דיוק התחזית עבור SBR.
טכניקות הלמידה העמוקה שהוזכרו לעיל העשירה את היקף המחקר של SBR ושיפרו ביעילות את הביצועים, אך הן עדיין סבלו ממגבלות מסוימות, שבאו לידי ביטוי בעיקר ב: 1) עבור פריטים חדשים או סשנים דלילים מאוד, היה קשה למודלים לבצע תחזיות מדויקות בשל היעדר הקשר גלובלי; 2) הם לא יכלו לנצל את התבניות הגלובליות הכלולות בכל הסשנים ההיסטוריים.
המלצה היברידית מבוססת-סשן
מערכות המלצה היברידיות מבוססות-סשן שילבו את החוזקות של טכניקות שונות, כגון סינון שיתופי (collaborative filtering), למידה עמוקה (Deep-Learning) ומנגנוני קשב (attention mechanisms), כדי לשפר את ביצועי ה-SBR. מודל GC-SAN50 שילב מנגנון קשב עצמי המבוסס על SR-GNN כדי ללכוד טוב יותר מידע על אינטראקציות של פריטים חשובים בתוך סשן. מודל FGNN51 ביצע אגרגציה נוספת של מידע מפריטים שכנים באמצעות מנגנון קשב רב-ראשי (multi-head attention) כדי ללמוד מערכות יחסים מרובות של פריט המטרה. SR-HetGNN52 השתייך ל-SBR עם גרפים הטרוגניים; באמצעות הצגת פריטים מסוגים שונים (משתמש, פריט, סשן) וקשתות רב-יחסיות (לחיצה, רכישה, התרחשות משותפת, אסוציאציית תכונות), הוא בנה רשת ידע גלובלית שפרצה את מגבלת רצפי הפריטים הבודדים, והיהה שיטה חשובה למידול התנהגות של משתמשים אנונימיים ואסוציאציות של עניין בין סשנים בשנים האחרונות. KGSR-SAP53 בנה גרף ידע על ידי חיבור פריטים עם קשתות של מערכות יחסים מרובות כדי לתאר אינטראקציות מגוונות בין משתמש לפריט, ובכך פתר את בעיית אובדן המידע שבה הגרף הגלובלי מכיל רק קשתות מסוג אחד (אינטראקציית משתמש-פריט). Wang ZH54 הציע את DiffSBR, מודל המלצות לסשנים המבוסס על דיפוזיה. הוא מייצר העדפות אמינות לפריט הבא על ידי סימולציה של הסרת רעשים (denoising), ובכך משפר את המידול של רצפי לחיצות דינמיים של משתמשים. Qiao ST55 בנה מסגרת SBR המשלבת למידת כוונה רב-מבטית (multi-view intent learning) וסנכרון עם LLM. מסגרת זו כרתה כוונות משתמש משתמעות מפרספקטיבות מגוונות וניצלה מודלי שפה כדי לסנכרן מאפיינים סמנטיים לצורך שיפור ביצועי ההמלצות.
הקשר גלובלי
כדי להתגבר על החסרון של "צפייה במפגשים בבידוד", חוקרים הבינו שניתן להשתמש במידע גלובלי כדי לשפר את יכולת הייצוג של המפגש הנוכחי, ובכך לפתור בעיות כגון דלילות נתונים, בעיית ההתחלה הקרה (cold start) ופער סמנטי ב-SBR מסורתי. במקביל, בעת בניית הקשר גלובלי, נדרשה שילוב של מידע גלובלי למבנה של מפגש בודד תוך מזעור הפרעות רעש. CSRM56 ביצע אופטימיזציה לייצוג ברמת המפגש על ידי שילוב מידע שיתופי בין המפגש הנוכחי למפגשים שכנים, תוך שימוש במקודד זיכרון חיצוני (OME) כדי לחלץ כוונות שיתופיות מתוך המידע השיתופי. CA-TCN57 הציע מודל רשת קונבולוצית זמנית מודעת למספר מפגשים (cross-session aware), שבנה גרפים גלובליים וגרפי הקשר של מפגשים כדי לדמות את ההשפעה של מעבר בין מפגשים על פריטים ומפגשים, בעוד שהרשת הקונבולוצית הזמנית (TCN) מרחיבה את שדה הרסיפטיביות באמצעות קונבולוציות מורחבות (dilated convolutions), כאשר מספר השכבות מכסה רצפים באורך מעריכי (receptive field = ), ובכך פותר את בעיית היעלמות הגרדיאנט של RNNs. Chen58 הציע שיטת SBR המבוססת על רשתות עצביות של היפר-גרפים (SR-HGNNs), המשלבת מנגנוני התפשטות ותשומת לב מסדרים מעורבים (סדר נמוך וסדר גבוה) כדי לפתור את בעיית ההחלקה המוגזמת (over-smoothing) של GNNs מסורתיים במפגשים קצרים ולהבדיל בין החשיבות של סדרי התפשטות שונים, ובכך להשיג לכידה מדויקת יותר של תלויות ומניעת הפרעות רעש. GCE-GNN השתמש בזוגות פריטים המופיעים יחד במספר סדרי התרחשות כדי לבנות גרף משוקלל לא מכוון, תוך ספירת תדרי ההופעה המשותפת של פריטים כדי לשקף את חשיבות הפריטים במפגש; AGNN-GC59 השתמש ביחסי מעבר של פריטים בין מפגשים כדי לבנות גרף שיתופי גלובלי, תוך חישוב הסתברויות מעבר של פריטים בגרף הגלובלי כדי לשקף שינויי עניין במפגש; DA-GCN60 השתמש במסלול הקצר ביותר לעדכון מטריצת הסמיכות כדי לבנות גרף משוקלל דינמי, תוך חישוב תדירות הופעה משותפת בגרף הגלובלי ומרחק מסלול בין פריטים. בהשראת הספרות לעיל, מאמר זה הציע לבנות גרף גלובלי באמצעות שיטה מבוססת שכנים, כלומר, שימוש במקדם דמיון ג'קארד (Jaccard similarity coefficient) לחישוב מפגשים דומים, מה שלא רק ניצל מידע גלובלי אלא גם סינן רעשים (סינון פריטים לא רלוונטיים), ובכך השיג את מטרת הבנייה המדויקת של הקשר גלובלי והניח תשתית איתנה לאלגוריתם ה-SBR העוקב.
קשב לינארי עם חריצים מוגבלים (Gated-slot linear attention)
טרנספורמרים מסורתיים61 גרמו למורכבות מרחבית-זמנית גבוהה בשל הצורך בפעולות קשב (attention) מחוברות באופן מלא לאורך הרצף כולו, כדלקמן:
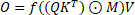 (1)
כאשר Q, K, V ∈ RN×d היו טרנספורמציות ליניאריות של פריטי הקלט, M = {Mij = 1 אם i ≥ j, אחרת −∞ } הייתה המסכה הסיבבית (causal mask) למניעת דליפת מידע עתידי, ⊙ סימן מכפלה איבר-איבר, ו-f סימנה את פונקציית האקטיבציה softmax.
כדי להשיג קשב ליניארי (linear attention)62, הרעיון הישיר ביותר היה להסיר את פונקציית ההפעלה softmax. עם זאת, לו פונקציית ההפעלה softmax הייתה מוסרת באופן ישיר, קשב ליניארי היה מוביל בוודאות למספר בעיות פוטנציאליות: אובדן כושר הביטוי העוצמתי של רשתות נוירונים וחוסר יכולת לפתור בעיות מורכבות בעולם האמיתי.
קשב לינארי מסוג Slot עם בקרת זיכרון חסומה
בהנחה שיש לשמר את פונקציית ההפעלה softmax, K ו-V דחסו בנפרד ל-K̃, Ṽ ∈ Rm×d. מנקודת המבט של רשת זיכרון, ל-K̃ ו-Ṽ היו תאי זיכרון שאורכם גדל עם הרצף, כלומר, מספר התאים m = N. אם m היה קבוע, ליניאריזציה הייתה אפשרית באופן ברור. בהשראת Bounded-memory Control63, נדרש שכל טוקן בפריטי הקלט באורך N ייכתב באופן תחרותי לתוך m תאים.
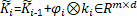 ,
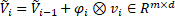 ,
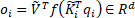 (2)
כאשר f הייתה פונקציית ההפעלה softmax ו-φi היה וקטור לשליטה בקלט האפקטיבי לצורך בקרה על ערך המפתח ki באופן הבא.
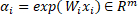 ,
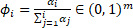 (3)
כאן, (φi)j מייצג את עוצמת הכתיבה של הטוקן ה-i למשבצת ה-j, והתקבל באמצעות פונקציית softmax מצטברת.
כדי להשיג חישוב ליניארי יעיל, נוסחה (2) נכתבה מחדש כנוסחה (4), אשר חישבה את οi מתוך qi, ki, ו-vi (משוואה 4) על ידי {οi|i=1T, qi, ki, vi)|i=1T} ואימצה חישוב סדרתי בשני מעברים:
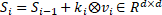 ,
 (4)
לפיכך, ניתן להסיק את פעולות ה-SLA:
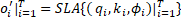 ,
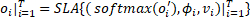 (5)
כאשר oi′ ∈ ℝm, οi ∈ ℝd. לפיכך, SLA יכולה להשיג אימון לפי מקטעים (chunk-wise) בזמן לינארי ויעילות חומרתית64.
קשב לינארי בעל חריצים שערים (Gated-slot linear attention)
מנגנון attention ליניארי בעל חריצים (Slot linear attention) עם בקרת זיכרון חסומה עשוי להפחית את הסיבוכיות החישובית והמרחבית. עם זאת, הצטברות של מידע עלולה להחדיר רעש לאינטראקציות של הסשן, ולכן דעיכה תלוית-נתונים הייתה חשובה מאוד לצורך שימור ושכחה סלקטיביים של מידע; מנגנון סלקטיבי זה נבחן מחדש במודלים עדכניים של מרחב מצבים סלקטיבי (selective state-space models)65. GSLA עם דעיכה תלוית-נתונים יכול להיות מבוטא כך:
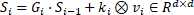 ,
 (6)
כאן שערי הדעיכה הוגדרו באמצעות צורה של מכפלה חיצונית Gi = αi ⊗ βi, αi, βi ∈ [0,1]d. בהמשך, ניתן לכתוב את GSLA גם בצורה שקולה הבאה, כאשר בדרך כלל קובעים βt = 1 והכפלה של מטריצות כפי שמוצג ב64:
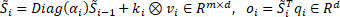 (7)
כאשר αi ו-ki מייצגים בנפרד את שער השכחה ואת שער הקלט, ניתן להקשיר את שני השערים כך ש-ki = 1 − αi, בהשראת הספרות על RNNs עם שערים (gated RNNs). היה ברור שניתן לנסח את GSLA באמצעות חישוב סדרתי בשני מעברים, כפי שמוצג במשוואה (8). המבנה מסדר שני תמך באימון מקבילי בבלוקים לשיפור יעילות האימון, והכנסת פעולת softmax למרכז המבנה מסדר שני שיפרה את יכולת המידול של זיכרון בעל חריצים מוגבלים (finite slot memory).
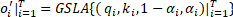 ,
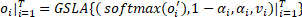 (8)
המרה של נתוני סשן
הגדרת הבעיה
תהי רצף הסשן הנתון S = {v1s, v2s, ⋯, vns}, כאשר vis מייצג את הפריט ה-i שנלחץ. על ידי ניתוח התנהגות הלחיצות של המשתמש ברצף זה, המערכת חזתה את הפריט הבא שבו המשתמש עשוי להיות מעוניין vn+1s.
בניית גרף
בניית גרף סשן
עבור סשן S = {v1s, v2s, ⋯, vns}, נבנה גרף מכוון Gs = (Vs, εs), כאשר Vs היה קבוצת הפריטים של הסשן הנתון S, ו-εs = {eijlocal|vi, vj, vi, vj ∈ Vs} הייתה קבוצת הקשתות של הסשן הנתון S. ε(vi-1s, vis) ייצג את הפריטים שנלחצו ברצף בסשן זה. ניתן היה לחלק את הקשת eijlocal לארבעה סוגים: ein, eout, ein-out, eself. מכיוון שפריט זהה עשוי להופיע שוב ושוב ברצף, נספר הערך המשוקלל עבור כל קשת.
הסשן הנוכחי s = [v1, v2, v4, v2, v3] הומר ל-SG, כפי שמוצג ב-איור 1A.
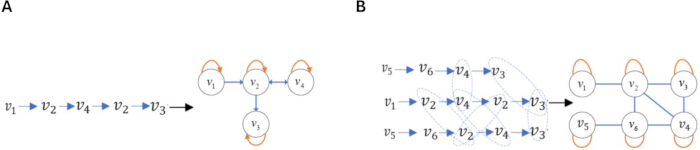
איור 1: הפיכת פריטים אינטראקטיביים למבני גרף. (A) איור של בניית גרף סשן (SG) על ידי הפיכת סשן לגרף. (B) איור של בניית גרף גלובלי של שכנים (NGG) על ידי שילוב של סשנים רבים לגרף אחד. איור זה נערך באופן עצמאי באמצעות Visio עם אלמנטים מותאמים אישית באופן מלא. לא נעשה שימוש במשאבי גרפיקה חיצוניים המוגנים בזכויות יוצרים, ולכן לא נדרש רישוי זכויות יוצרים נוסף מצד שלישי. זכויות היוצרים של האיור שייכות למחברים ויעמדו בכללי זכויות היוצרים של כתב העת עם קבלת המאמר. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
בניית גרף שכנים גלובלי
בהתבסס על הסשן הנוכחי S, נבנה ה-NGG המתאים Gg = (Vg, εg) כדי להעשיר את למידת הייצוג של הסשן הנוכחי באופן חוצה-סשנים. Vg היה קבוצת הפריטים המכילה את כל הפריטים ב-Gg, ו-εg = {eijglobal|vi, vj, vi, vj ∈ Vg} הייתה קבוצת הקשתות של Gg. ε(vi-1g, vig) ייצג את הפריטים בעלי האינטראקציה הישירה vi-1g ו-vig ב-NGG Gg. תהליך זה היה מורכב משני שלבים: רכישת סשנים שכנים ובניית NGG.
רכישת מפגשי שכנים
בכלל מערך הנתונים, נחפשו הסשנים עם המספר המקסימלי של פריטים המופיעים יחד עם הסשן הנוכחי. ה- N סשנים המובילים עם ספירות ההופעה המשותפת הגבוהות ביותר נבחרו כדי לבנות קבוצת סשנים שכנים מועמדים S. לאחר מכן, נעשה שימוש במקדם דמיון ג'קארד (Jaccard similarity coefficient) כדי לחשב את הדמיון בין הסשן הנוכחי cu לבין סשן Sr ∈ S מקבוצת המועמדים S, כפי שמוצג במשוואה (9).
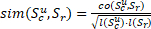 (9)
כאן, co(Scu, Sr) סימן את מספר הפריטים המופיעים יחד הן ב-Scu והן ב-Sr, בעוד ש-l(Scu) ו-l(Sr) ייצגו בהתאמה את אורכיהם של Scu ו-Sr, כאשר Scu ו-Sr סימנו את הסשן הנוכחי ואת סשן שכנה. סשנים עם דמיון נמוך מסף מסוים (שניתן להגדירו כהיפר-פרמטר) סוננו החוצה, והסשנים שנותרו הרכיבו את קבוצת סשני השכנים Ns עבור הסשן הנוכחי.
בניית גרף גלובלי של שכנים
על בסיס קבוצת מפגשי השכנים Ns, נבנה ה-NGG, כפי שמוצג ב-איור 1B. במהלך בניית מטריצת הסמיכות, אם בין שני פריטים (vi, vj) התקיים אינטראקציה, הערך התואם Aij נקבע ל-1, ואחרת הוא נקבע ל-0. בנוסף, האינטראקציות בין הפריטים עובדו כבלתי מכוונות ולוו בלולאות עצמיות (self-loops), ולאחר מכן בוצעה נורמליזציה, כפי שמוצג ב-טבלה 1.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
טבלה 1: מטריצת סמיכות מנורמלת של הגרף הגלובלי של השכנים. הטבלה מציגה את מטריצת הסמיכות המנורמלת המתארת את הקשרים המשוקללים בין הצמתים בגרף הגלובלי של השכנים שנבנה.
תכנון אלגוריתם המלצות מבוסס-סשן
סעיף זה מרחיב על המודל החדשני המוצע GSLA4Rec, אשר שיפר את ביצועי ה-SBR על ידי הכנסת מנגנון ה-GSLA על גבי ייצוג מאפיינים משותף של SG ו-NGG.
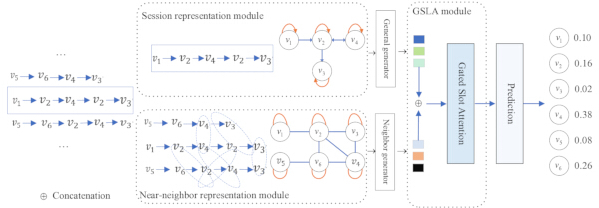
איור 2: מסגרת העבודה GSLA4Rec.מסגרת עבודה זו שילבה למידה של מבנה גרף של סשנים ומבנה גרף גלובלי של שכנים, סיננה רעשי אינטראקציה באמצעות מנגנון שער (gating mechanism), איזנה בין אחסון ליעילות באמצעות מנגנון חריצי זיכרון (memory slots mechanism), ולכדה רלוונטיות של פריטים באמצעות מנגנון קשב ליניארי (linear attention mechanism) כדי לחזות את העדפת הלחיצה הבאה של המשתמש. איור זה שורטט באופן עצמאי באמצעות Visio עם אלמנטים בהתאמה אישית מלאה. לא נעשה שימוש במשאבי גרפיקה חיצוניים המוגנים בזכויות יוצרים, ולכן לא נדרש רישוי זכויות יוצרים נוסף מצד שלישי. זכויות היוצרים של האיור שייכות למחברים ויעמדו בכללי זכויות היוצרים של כתב העת עם קבלת המאמר. GSLA4Rec מייצג רשתות עצביות גרפיות בעלות קשב ליניארי וחריצים עם שער (gated-slot linear attention graph neural networks) עבור SBR. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
איור 2 מציג את המסגרת של GSLA4Rec, המורכבת מארבעה רכיבים עיקריים: 1) ייצוג פריטים ברמת הסשן (Session-level item representation). רכיב זה השתמש במודל GNNs על גבי SG כדי ללמוד שיבוצי פריטים (embeddings) ברמת הסשן בתוך הסשן הנוכחי; 2) ייצוג פריטים ברמה גלובלית של שכנים (Neighbor global-level item representation). רכיב זה למד שיבוצי פריטים ברמה גלובלית על פני כל הסשנים על ידי שימוש ב-GRU כדי לשלב באופן רקורסיבי את שיבוצי השכנים של כל פריט בהתבסס על ה-NGG; 3) GSLA. רכיב זה מידל את העדפות המשתמשים בסשן הנוכחי על ידי אגרגציה של ייצוגי הפריטים שנלמדו הן ברמת הסשן והן ברמה הגלובלית; 4) שכבת חיזוי (Prediction layer). רכיב זה פלט את ההסתברויות החזויות עבור הפריטים המועמדים. ארבעת הרכיבים מוצגים בפירוט בהמשך.
ייצוג הסשן
ב-SBR, הבנת דפוסי האינטראקציה של המשתמשים הייתה קריטית. לשם כך, נבנו SG ו-NGG לצורך למידת ייצוג של סשנים, במטרה להבין באופן מקיף את דפוסי האינטראקציה של המשתמשים ובכך ללכוד את הכוונות האותנטיות יותר של המשתמשים.
ייצוג פריטים ברמת הסשן
בהתבסס על ה-SG ב-איור 1A, נעשה שימוש בשיטת Weighted Bidirectional Graph Attention (WBGAT) כדי לחלץ מאפיינים של ה-SG. שיטה זו הציגה משקולות קשתים וכיווניות פריטים (In-neighbor ו-Out-neighbor) בהתבסס על מנגנון GAT סטנדרטי, והשיגה את האפקט של חיזוק קשתים חשובים ולכידה של תלויות דו-כיווניות, ובכך נתנה מענה לחסרונות של GAT מסורתי בנוגע למערכות יחסים אסימטריות בין פריטים ולעוצמת האינטראקציה. תהליך החישוב היה כדלקמן:
ראשית, חישוב משקלי נורמליזציה של דרגת הכניסה של הפריטים.
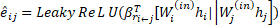 (10)
כאשר eij מציין את משקל השכנים הקרובים מסדר ראשון של מאפייני פריט j ביחס לפריט i,  היה הקשר בין פריט i לפריט j, β* ∈ ℝd היו וקטורי משקלות, hi ו-hj היו הייצוגים של פריט i ופריט j בהתאמה, Wi(in) ∈ ℝd*d ו-Wj(in) ∈ ℝd*d היו פרמטרים הניתנים לאימון, ו-|| ייצג פעולת שרשור (concatenation). כדי להבדיל בין קשרי דרגה נכנסת (in-degree) שונים, אומנו שני וקטורי משקלות, rin ו-rin-self. פונקציית ההפעלה שנוצלה הייתה LeakyReLU.
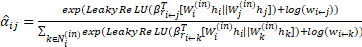 (11)
כדי להפוך את המקדמים לניתנים להשוואה בין פריטים שונים, משקולות הקשב נורמלו באמצעות פונקציית softmax. כאשר Ni(in) הייתה קבוצת השכנים הפנימיים מסדר ראשון של פריט i,  היה משקל השכן הפנימי של קשת מכוונת (i←j) ב-SG, שיטה זו אפשרה למודל ללמוד קורלציות של מאפייני פריט תוך שמירה על מידע על חוזק הקשר האינהרנטי של מבנה הגרף, וזאת על ידי נטילת הלוגריתם של משקולות הקשת והוספתן לציון הקשב המקורי eij.
שנית, חישוב משקלי נורמליזציה של דרגת היציאה (out-degree) של הפריט.
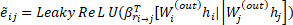 (12)
כאשר ẽij מציין את משקל השכנה החוצה (out-neighbor weight) מסדר ראשון של מאפייני פריט j כלפי פריט i,  היה הקשר בין פריט i ל-j, ואומנו שני וקטורי משקל, כלומר rout ו-rout-self.
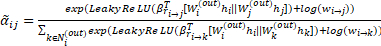 (13)
כאשר Ni(out) הייתה קבוצת השכנים היוצאים מסדר ראשון של פריט i,  היה משקל השכן היוצא של הקשת המכוונת (i→j) ב-SG.
שלישית, אגרגציית מידע. ניתן לקבל את ההטמעה המעודכנת של הפריט לאחר שקלול וסכימה של הטמעות הדרגה הנכנסת (in-degree) והדרגה היוצאת (out-degree) מסדר ראשון של פריט i.
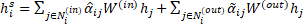 (14)
כאשר  ו-α̃ij מייצגים בהתאמה את משקלי ה-in-degree וה-out-degree של פריט i, ו-
 מייצג את הייצוג המעודכן של פריט i.
ייצוג פריטים ברמה גלובלית של שכנים
מחקרים אחרונים הסכימו בעקביות כי בניית גרף גלובלי עשויה לשפר את ייצוג הנתונים ובכך להביא לשיפור בביצועי ה-SBR, דבר זה היה מעבר לספק. עם זאת, שיפור גלובלי של נתונים עלול להחדיר גם מידע לא רלוונטי, כגון רעש. במודל המוצע, כדי להשיג העשרה גלובלית של נתונים תוך מזעור הרעש ככל האפשר, נבנה גרף גלובלי של שכנים קרובים.
בהתבסס על ה-NGG ב-איור 1B ועל מטריצת הסמיכות הנורמלית ב-טבלה 1, הסשן הנוכחי והסשנים השכנים לו הומרו ל-NGG, ושיטת GGNNs45 יושמה כדי לחלץ מאפיינים של ה-NGG. תהליך הלמידה של וקטורי הפריטים ב-NGG הוצג במשוואה (15).
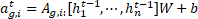
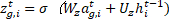
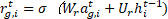
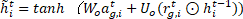
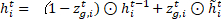 (15)
W ∈ ℝd×2d מייצג את משקלי הבקרה, zg,i ו-rg,i מייצגים את שער העדכון ושער האיפוס, בהתאמה. [h1t-1, ⋯, hnt-1] מייצג את רשימת כל וקטורי הפריטים בסשן s. σ(x) = 1/(1 + e-x) הייתה פונקציית הסיגמואיד הלוגיסטית, ⊙ סימן כפל איבר-איבר, ו-hi ∈ ℝd מייצג את הווקטור לאחר עדכון עם שערים. מטריצת הסמיכות As ∈ ℝn×n הצביעה על הקישוריות בין פריטים בסשנים שכנים, ו-As,i: ∈ ℝ1×n ייצג בלוק עמודות של As המתאים לפריט vs,i במטריצת הסמיכות. עבור הסשן הנוכחי s = [v1, v2, v4, v2, v3], ה-NGG ומטריצת הסמיכות הנורמלית מוצגים ב-איור 1B וב-טבלה 1, בהתאמה.
ייצוג פריט
הייצוג של הפריט התקבל על ידי סכימה של וקטור הפריט ברמת הסשן ושל וקטור הפריט השכני ברמה הגלובלית, כפי שמוצג במשוואה (16):
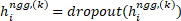
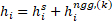 (16)
שם נעשה שימוש ב-dropout על ייצוגי פריטי השכנים ברמה הגלובלית כדי להפחית overfitting.
קשב לינארי עם חריצים שערים (Gated-slot linear attention)
מנגנון תשומת הלב הליניארית בעלת החריצים השערים (GSLA) במאמר זה שילב תשומת לב ליניארית עם בקרת זיכרון חסומה ומנגנון שערים תלוי-נתונים. מצד אחד, הוא ירש את מנגנון חריצי הזיכרון הסופי של מודל הבקר מבוסס תשומת הלב (ABC), דחס זוגות מפתח-ערך שגדלו במקור עם אורך הרצף למספר קבוע של חריצים, וכל חריץ עודכן באמצעות כתיבה תחרותית, ובכך פתר את בעיית הסיבוכיות החישובית של תשומת לב גלובלית בטרנספורמר. מצד שני, הוא הציג מנגנון שערים עדין הדומה ל-GLA, שבו נתוני הקלט התאימו באופן דינמי את יחס השימור של מידע היסטורי באמצעות שער שכחה αi, ובכך פתר את בעיית הרעש שנגרמה מחסרונו של מנגנון שכחה ב-ABC.
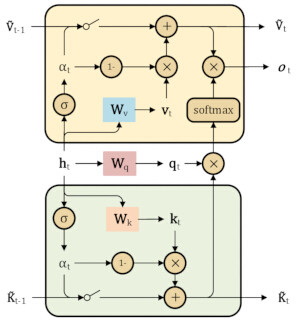
איור 3: תרשים סכמטי של GSLA. וקטור הקלט מופנה לווקטור השאילתה (query), לווקטור מילת המפתח (keyword) ולווקטור הערך (value), בהתאמה, ולאחר מכן מעובד על ידי קשב ליניארי (linear attention) עם בקרת זיכרון מוגבלת ומנגנון שערים תלוי-נתונים כדי לקבל את ווקטור השאילתה המעודכן, ווקטור מילת המפתח, ווקטור הערך ווקטור הפלט. איור זה שורטט באופן עצמאי באמצעות Visio עם אלמנטים מותאמים אישית באופן מלא. לא נעשה שימוש במשאבי גרפיקה חיצוניים המוגנים בזכויות יוצרים, ולכן לא נדרש רישוי נוסף של זכויות יוצרים מצד שלישי. זכויות היוצרים של האיור שייכות למחברים ויהיו תואמות לכללי זכויות היוצרים של כתב העת עם קבלת המאמר. GSLA מייצג gated-slot linear attention. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
כפי שיושם באופן ספציפי ב-איור 3, וקטור הקלט מופה בנפרד לווקטור השאילתה (query vector), לווקטור המפתח (key vector) ולווקטור הערך (value vector)64:
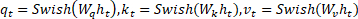 (17)
כאשר Wq, Wk, Wv ∈ ℝd×d מייצגים את מטריצות משקלי הטרנספורמציה המתאימות בהתאמה לשאילתה (query), למפתח (key) ולערך (value), ו-ht מציין את וקטור ההטמעה (embedding vector) בצעד הזמן ה-t ברצף הקלט של הסשן. פונקציית Swish הוגדרה כ-Swish(x) = x · σ(x) והיא פונקציית אקטיבציה בעלת שער עצמי (self-gated activation function), כאשר σ היא פונקציית הסיגמואיד (Sigmoid); פונקציה זו הניבה ביצועים טובים יותר מפונקציית האקטיבציה המסורתית ReLU במספר משימות של למידה עמוקה (Deep-Learning).
GSLA השתמשה בשער שכחה αi ובשער קלט 1 − αi, בהתאם לנתוני הקלט, כדי לעדכן באופן דינמי את המידע בתא הזיכרון ה-i. התהליך היה כדלקמן64:
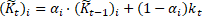 (18)
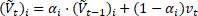 (19)
כאן, K̃t ו-Ṽt ייצגו את חריצי וקטור המפתחות (key vector slots) וחריצי וקטור הערכים (value vector slots) בצעד הזמן t, בעוד ש-K̃t-1 ו-Ṽt-1 ייצגו את חריצי וקטור המפתחות וחריצי וקטור הערכים בצעד הזמן t−1. שער השכיחה הוא αi = σ(Wαht)1/τ, כאשר Wα ∈ ℝd הייתה מטריצת משקלי הטרנספורמציה, σ הייתה פונקציית הסיגמואיד (Sigmoid), ו-τ היה מקדם הריסון (בדרך כלל מוגדר כ-8), המשמש לשליטה ברמת הרכות של שער השכיחה. דבר זה אפשר ל-GSLA להתאים בצורה חלקה את קצב השכיחה של מידע היסטורי: ככל ש-αi גדול יותר, כך ה-GSLA הסתמך יותר על מידע היסטורי, וככל ש-αi קטן יותר, כך ה-GSLA התמקד יותר בקלט הנוכחי.
חריצי וקטור המפתח K̃t וחריצי וקטור הערך Ṽt של החריצים בשלב ה-t נכתבו בצורה של מטריצה, כפי שמוצג65 במשוואות (20) ו-(21):
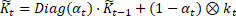 (20)
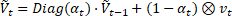 (21)
לאחר מכן, נעשה שימוש ב-GSLA בעל תכונות מסדר שני (ראו משוואה (8)) כדי לחשב את הפלט oi |i=1T עבור כל שלב זמן i ∈ [1, …, T]. טרנספורמציה ליניארית הוחלה על הפלט של כל שלב זמן כדי לקבל את התוצאה h̃t. לבסוף, חושב ערך הממוצע של הייצוגים של כל הפריטים ברצף הסשן כדי להפיק את ה-session embedding S̃e עם עדכוני זיכרון דינמיים:
 (22)
 (23)
כאן, ot מייצג את הפלט של Gated-Slot בצעד זמן t, ו-h̃t מציין את התוצאה של ביצוע טרנספורמציה ליניארית על ot. S̃e מציין את ערך הממוצע של h̃t בכל צעדי הזמן.
שכבת חיזוי
על בסיס ייצוג הסשן שהתקבל S̃e והשיכון (embedding) הראשוני של פריט i, בוצעו פעולות מכפלה סקלארית כדי לחשב את הניקוד עבור כל פריט מועמד hi. לאחר מכן, נעשה שימוש בפונקציית softmax כדי לקבל את הסבירויות להמלצה עבור הפריט המועמד i:
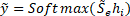 (24)
כאן, ỹ מייצג את הסטירואידים של הסבירות להמלצה על הפריט המועמד, hi מסמן את הווקטור של הפריט המועמד, ולצורך אימון המודל נעשה שימוש בפונקציית הפסד של cross-entropy.
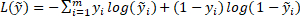 (25)
כאן, y היה הייצוג של ה-one-hot encoding עבור ה-ground truth.
תוצאות
מאגרי נתונים ועיבוד מקדים
בניסויים, נבחרו שלושה מאגרי נתונים ציבוריים של SBR המבוססים על נתוני עסקאות אמיתיים בתרחישי יישום מעשיים כדי להעריך את ביצועי המודל: Diginetica, שהופק מתחרות CIKM Cup 2016 ומכיל רשומות עסקאות והקלקות של משתמשים; Tmall, העוסק ביומני משתמשים מפלטפורמת Tmall ומתעד התנהגויות גלישה ורכישה של משתמשים; ו-Nowplaying, שהכיל רשומות מוזיקה על היסטוריית ההשמעה של משתמשים בפלטפורמות מוזיקה. מאגרי נתונים אלו נמצאים בשימוש נרחב במחקרי SBR ויכולים להעריך באופן מקיף את היעילות והישימות של המודל.
בשלב עיבוד המקדימה של הנתונים, מערכי הנתונים עברו סטנדרטיזציה כדי להבטיח עקביות באיכות הנתונים. באופן ספציפי, כל הסשנים שאורכם היה פחות מ-2 סוננו החוצה, ופריטים שהופיעו פחות מ-5 פעמים הוסרו. יתרה מכך, עבור כל סשן S = {v1, v2, ..., vn}, נוצרו תתי-סדרות מרובות לצורך אימון ובדיקה של המודל. תתי-סדרות אלו היו במבנה: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). לאחר השלמת עיבוד המקדימה הנ"ל, בוצעו ניתוחים סטטיסטיים על מערכי הנתונים, ומידע מפורט הוצג ב-טבלה 2.
| ערכה של נתונים | Diginetica | Tmall | Nowplaying |
| לחיצות | 982961 | 818479 | 1367963 |
| אימון | 719470 | 351268 | 825304 |
| בדיקה | 60858 | 25898 | 60417 |
| פריטים | 43097 | 40728 | 60417 |
| אורך ממוצע | 5.12 | 6.69 | 7.42 |
טבלה 2: תיאור מערכי הנתונים. הטבלה מסכמת את הסטטיסטיקות של מערכי הנתונים Diginetica, Tmall ו-Nowplaying, כולל מספר הלחיצות, דגימות האימון והבדיקה, הפריטים ואורך הסשן הממוצע.
הגדרות ניסיוניות
הגדרת פרמטרים
כדי להבטיח את הוגנות הניסוי, אומצו שיטות עיבוד מקדים לעיבוד שלושה מאגרי נתונים, תוך הגדרה מראש של הפרמטרים של מודל ה-GSLA4Rec. עבור מאגרי הנתונים Diginetica ו-Nowlaying, גודל האצווה (batch size) נקבע ל-150, ועבור מאגר הנתונים Tmall נקבע ל-300. הפרמטרים של מודל זה אותחלו באמצעות התפלגות גאוסיאנית עם ממוצע 0 וסטיית תקן 0.1, והממד נקבע ל-100. האופטימייזר שבו נעשה שימוש היה Adam עם קצב למידה ראשוני שנקבע ל-0.001, כאשר קצב הלמידה הוכפל ב-0.1 בכל 3 תקופות (epochs). האימון בוצע למשך סה"כ 30 תקופות על מעבד גרפי NVIDIA TITAN V ובסביבת PyTorch 1.11.0 עם cu113 (ראו טבלת חומרים) כדי לקבל את הערך המיטבי, סף הסינון של סשנים שכנים נקבע ל-0.5, ל'2 בניסוי הוחל רגולריזציה (regularization). עבור כל סט נתונים, נבחרו 10% האחרונים של הנתונים, הממוינים לפי זמן המסחר, כסט הבדיקה (test set), ו-10% ו-80% הנותרים נבחרו באופן אקראי כסט האימות (validation set) וסט האימון (training set), בהתאמה. מספר חריצי הזיכרון (memory slots) ב-GSLA נקבע לערך מתוך הקבוצה {0, 1, 2, 3, 4, 5}.
מדדי הערכה
במאמר זה נעשה שימוש ב- P@N (Precision@N, N = 10/20) וב- MRR@N (Mean Reciprocal Rank@N, N = 10/20). מדד P@N שימש למדידת הפרופורציה של המלצות נכונות מבין N תוצאות ההמלצה הראשונות, ומדד MRR@N שימש לחישוב הדירוג ההו Reciprocal הממוצע של פרויקטים נכונים; ככל שערך ה-MRR גבוה יותר, כך ביצועי המיון טובים יותר.
ניתוח ביצועים
היעילות של מודל GSLA4Rec הוערכה אל מול קווי בסיס (baselines) המייצגים שלבים שונים של פיתוח טכנולוגי. בשלב מוקדם, נעשה שימוש בשיטות למידת מכונה עבור SBR, לדוגמה FPMC5 ששימש לניבוי השפעה רצפית המבוססת על שרשרת מרקוב. לאחר מכן, עם פיתוחה של הבינה המלאכותית, הוחלה למידה עמוקה באופן נרחב עבור SBR; כך למשל, GRU4Rec10 התבסס על RNNs המודלים את ה-SBR באמצעות ערימה של מספר שכבות של GRUs ועיצוב פונקציות הפסד ייעודיות לאופטימיזציה של SBR; NARM16 הציג AM כדי ללכוד את האינטרסים המרכזיים של המשתמשים, והפיק ייצוג embedding סופי של פריט ההמלצה הבא האפשרי; STAMP17 השתמש בפרספטרונים רב-שכבתיים משופרי AM לצורך לכידה סימולטנית של העניין הכללי והעניין המיידי של המשתמשים. בשנים האחרונות, רשתות עצביות גרפיות (GNNs) נמצאו בשימוש נרחב גם הן ב-SBR הודות ליכולת הלמידה החזקה שלהן של נתונים לא-אוקלידיים. לדוגמה, SR-GNN22 יישם GNNs עבור SBR לראשונה, והפיק קשרי מעבר מורכבים בין פריטים באמצעות GGNNs תוך התמקדות באינטרסים המיידיים של המשתמשים בשילוב עם AM; GCE-GNN23 השתמש ב-GATs כדי להשיג קשרי העברת פריטים בהקשרים מקומיים וגלובליים, והפיק ייצוגי סשן באמצעות RPE ו-soft-AM; S2-DHCN66 המיר את נתוני הסשן להיפר-גרף (hypergraph) וגרף-קו (line-graph) והשתמש בלמידה עם פיקוח עצמי כדי לשפר את ה-SBR.
לאחרונה, אומצה גישה מקיפה לשיפור ביצועי SBR. לדוגמה, GC-SAN50 שילב GNNs עם רשתות self-attention רב-שכבתיות לקידום ביצועי ההמלצה על ידי מידול תלותיות לטווח קצר ולטווח ארוך, TASRec67 שילב מידע זמני באמצעות בניית רצף של תצלומי גרף דינמיים בנקודות זמן שונות, CT-GNN68 אימץ GNNs עם מידע זמני משולב כדי ללמוד מידע על קשרים זמניים נוספים בין פריטים, CORE69 מיזג מידע על הופעה משותפת (co-occurrence) ומידע זמני של הפריטים כדי לקבל ייצוג סשן סופי, RESTC70 הציע דפוסי אינטראקציה מרחביים-זמניים בהשראת תכונות האחידות והיישור של למידה ניגודית (contrastive learning), COTRec66,71 אימץ למידה בפיקוח עצמי על שתי תצפיות של גרף סשן ואימון משותף (co-training) כדי לפתור את בעיית דלילות הנתונים של SBR, ו-RAIN71 ניצל מיסוך קשתות (edge masking) ושחזור מבני, ואימן במקביל מחוון קשתות כדי לזהות ולהסיר במפורש קשתות רועשות, מה ששיפר משמעותית את הדיוק והחוסן של SBR.
| מאגרי נתונים | דיגנטיקה (Diginetica) | Tmall | מנוגן כעת | ||||||||||
| סוג שיטה- אימות | מדדים | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| למידת מכונה | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| למידה עמוקה | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| למידה עמוקה | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| למידה עמוקה | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| רשתות עצביות גרפיות (GNNs) | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| רשתות עצביות גרפיות (GNNs) | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| רשתות עצביות גרפיות (GNNs) | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNNs+Att | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| רשתות עצביות גרפיות (GNNs) עם מנגנון קשב (Att) | GC-SAN | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| רשתות עצביות גרפיות (GNNs) + טמפרטורה (Tem) | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| RRNs+Tem | ליבה | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| רשתות עצביות גרפיות (GNNs)+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| רשתות עצביות גרפיות (GNNs) + שרשרת מחשבה (COT) | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNNs+ReStr | גשם | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNNs+Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| סטיית תקן | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| ערך p | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| טהסקה | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
טבלה 3: השוואת ביצועים על שלושה סטים של נתונים. הטבלה משווה בין GSLA4Rec לבין שיטות המלצה המבוססות על למידת מכונה, למידה עמוקה, GNN, מנגנוני קשב (attention), שיטות זמניות ושיטות המלצה אחרות על סטי הנתונים Diginetica, Tmall ו-Nowplaying באמצעות P@10, P@20, MRR@10 ו-MRR@20. עבור GSLA4Rec מדווחים גם ערכי SD וערכי p.
על מנת לאמת את ביצועי מודל ה-GSLA4Rec ולשלול שיפור בביצועים הנובע מגורמים אקראיים, נערכו ניסויי חלוקה לקבוצות וניתוחים סטטיסטיים מרובים על קבוצת הבדיקה. באופן ספציפי, קבוצת הבדיקה חולקה לקבוצות של 150 session-ים לכל סבב, והתהליך חזר על עצמו 30 פעמים באמצעות שיטת ה-random seed. התוצאות הממוצעות וזמן החישוב של כל ניסויי החלוקה חושבו כביצועי מודל ה-GSLA4Rec וכזמן ההסקה (inference time) שלו, בהתאמה. סטיית התקן (SD) ומבחן t למשמעות סטטיסטית של מודל ה-GSLA4Rec חושבו כדי לאמת עוד יותר את היציבות והוודאות של השיפור בביצועי מודל ה-GSLA4Rec. Table 3 מציג את הביצועים, את ה-SD, את ערך ה-p ואת ה-Tinference של מודל ההמלצות המוצע, GSLA4Rec, בהשוואה למודלי הבסיס (baselines) בשלושת מאגרי הנתונים. המספרים עם הקו התחתון מציינים את שיטת הבסיס הטובה ביותר, והמודל בעל הביצועים הטובים ביותר עבור כל מדד הערכה סומן בכתב מודגש שחור.
שיטות המלצה מבוססות למידת מכונה: במשימות SBR, שיטת FPMC המסורתית הראתה את הביצועים הגרועים ביותר, בעיקר מכיוון שדגמי שרשראות מרקוב לא הצליחו ללכוד דפוסי מעבר מורכבים בין פריטים. 2) שיטות המלצה מבוססות למידה עמוקה: דגמים כגון GRU4REC, NARM ו-STAMP השתמשו בגישות של מידול רצפים והשיגו שיפורים מסוימים בביצועים. מביניהם, NARM ו-STAMP הראו תוצאות המלצה טובות יותר מ-GRU4REC, בעיקר מכיוון ש-NARM הציג מנגנון קשב (attention mechanism) כדי ללכוד את האינטרסים העיקריים של המשתמשים. 3) שיטות המלצה מבוססות GNNs: אימוץ GNNs ב-SBR הביא לשיפורים בולטים בביצועים. לדוגמה, SR-GNN, שהוביל את המעבר של רצפי סשנים למבני גרף כדי ללכוד מידע מבני מרחבי של פריטים, עלה בביצועיו על שיטות למידה עמוקה המיוצגות על ידי STAMP בשיפור של 0.36–4.64%, ובכך הדגים את היתרון המרחבי של מבני גרף בעיבוד נתונים סדרתיים. S2-DHCN אימץ קונבולוציית היפר-גרף בעלת שני ערוצים כדי ללכוד תלויות מסדר גבוה בין פריטים ושילב למידה ניגודית בפיקוח עצמי (self-supervised contrastive learning) לשיפור הייצוגים, ובכך נתן מענה למגבלה של GNNs מסורתיים הממדלים רק יחסים זוגיים וסובלים ממידע לא מספיק; ביצועיו עלו על שיטות למידה עמוקה המיוצגות על ידי STAMP ב-1.30–7.04%. GCE-GNN, באמצעות שילוב יעיל של מידע מסשן בודד ומידע סשנים גלובלי, עלה בביצועיו על שיטות למידה עמוקה המיוצגות על ידי STAMP ב-1.46–7.60% ועלה על SR-GNN ב-0.88–5.85%, מה שמעיד על כך ששיטות מבנה גרף המשלבות מידע הקשרי גלובלי יכולות לשפר משמעותית את ביצועי ה-SBR. 4) שיטות המלצה מבוססות GNNs + מנגנון קשב: TASRec שאף ללכוד בצורה מדויקת יותר העדפות קצרות טווח וארוכות טווח ברצפי ההתנהגות של משתמשים על ידי הצגת מנגנון מודע-זמן (time-aware mechanism); ביצועיו עלו על שיטות למידה עמוקה ב-0.73–5.91% ועל דגם SR-GNN ב-0.30–2.31%, אך היו נמוכים מדגם GCE-GNN ב-0.59–3.84%. GC-SAN שילב מבני גרף שהומרו מרצפי סשנים עם מנגנוני קשב עצמי רב-ראשיים (multi-head self-attention) כדי ללכוד בהצלחה תלויות מקומיות וארוכות טווח בתוך סשנים; ביצועיו היו דומים או חזקים מעט מדגם SR-GNN, אך נחלו מפני דגמי TASRec ו-GCE-GNN. הדבר מרמז כי שילוב מנגנוני קשב יכול לשפר ביעילות את ביצועי SBR, אך השיפור היה פחות משמעותי מזה שהושג באמצעות מידע גלובלי, ובכך אישר מחדש את חשיבותו של מידע הקשרי גלובלי. 5) שיטות המלצה מבוססות GNNs + קידוד זמן: CT-GNN היה הראשון לשלב מבני גרף עם קידוד זמני כדי ללכוד בו-זמנית "מבנה מרחבי" ו"דינמיקה זמנית", ועלה בביצועיו על דגם GC-SAN ב-0.55–3.82%. CORE לכד העדפות ארוכות טווח וכוונות קצרות טווח על ידי ניתוח סטטיסטי של תדירויות הופעה משותפת של פריטים מסשנים גלובליים ותכנון שקלול מיקום זמני לסשנים נוכחיים, בהתאמה, ומיזג את מידע ההופעה המשותפת והמידע הזמני כדי לקבל את ייצוג הסשן הסופי; ביצועיו עלו על דגם TASRec ב-0.25–9.58% ועל דגם GC-SAN ב-0.67–11.56%, והראו שיפור משמעותי של 3.64–5.74% לעומת דגם GCE-GNN במערך הנתונים של Tmall. RESTC הציג דגם למידה ניגודית המבוסס על GNNs מרחביים-זמניים כדי לפתור בעיות ב-GNNs מסורתיים, כגון התמקדות בלעדית במבני גרף מרחביים, התעלמות ממידע זמני ומיזוג מרחבי-זמני לא מספיק; ביצועיו עלו על דגם CORE ב-0.39–3.31% ועל דגם GCE-GNN ב-0.28–7.56%, מה שמעיד על כך שגם קידוד זמני וגם למידה ניגודית משפרים ביעילות את ביצועי SBR. RAIN השתמש בטכניקות של מיסוך קשתות (edge masking) ושחזור מבני כדי לאמן במשותף אינדיקטור קשתות לזיהוי והסרה מפורשת של קשתות רועשות, והשיג ביצועים קרובים לאלה של דגם RESTC.
המודל המוצע, GSLA4Rec, שילב מידע הקשרי גלובלי ומנגנון gated-slot linear attention כדי ללכוד ביעילות את המידע ההקשרי של המשתמשים תוך סינון רעשים והפחתת המורכבות החישובית. הוא הראה שיפורים בביצועים בכל מערכי הנתונים, ועלה על שני מודלי הבסיס בעלי הביצועים הטובים ביותר — מודל ה-RESTC ב-0.54–2.31% ומודל ה-GCE-GNN ב-0.83–10.18%. דבר זה בלט במיוחד בטיפול בתלויות רצפיות בתרחישי סשנים ארוכים ב-SBR (ספציפית, שיפורים של 10.18% ו-4.73% בהשוואה ל-GCE-GNN ושל 1.44% ו-2.31% בהשוואה ל-RESTC במערכי הנתונים Tmall ו-Nowplaying, בהתאמה). בקצרה, מודל ה-GSLA4Rec המוצע שילב בנייה יעילה של גרפים כדי ללכוד הקשרי משתמשים ולסנן רעשים; ביצועיו עלו באופן עקבי על ה-SOTA בכל מערכי הנתונים.
ניתוח יעילות
כפי שמוצג ב-איור 4, תוצאות ניסיוניות על מערך הנתונים Diginetica הראו כי מודל ה-GSLA4Rec המוצע השיג מהירות אימון גבוהה יותר מאשר מודלי הבסיס במונחים של זמן אימון ל-epoch, כאשר כל הניסויים הופעלו על GPU מסוג NVIDIA TITAN V וצרכו כ-9300MB של זיכרון. מודלים המבוססים על למידה עמוקה, כולל STAMP, NARM ו-GRU4Rec, רצו ביעילות אך הציגו את הביצועים החלשים ביותר; מודלי TASRec ו-GC-SAN המבוססים על GNNs ומנגנון Self-Attention שיפרו את הביצועים, אך סבלו מזמן הרצה ממושך באופן משמעותי. למרות ש-S2-DHCN ו-CORE המבוססים על GNNs גרמו לעלייה קלה בזמן החישוב, הביצועים הכוללים הראו שיפור ניכר, ובמיוחד מודל ה-GSLA4Rec המוצע, שהפגין שיפור משמעותי בביצועים. הסיבה העיקרית לכך הייתה שמודל ה-GSLA4Rec השקיע פחות זמן בבניית הגרף מאשר מודלי הבסיס, ויתרה מכך, הוא השתמש במנגנון gated linear attention דו-מעברי עם חריצי זיכרון קבועים m, מה שהוביל לסיבוכיות זמן לינארית של O(Ldm). תכנון זה היה יעיל משמעותית מאשר self-attention סטנדרטי O(L2d) תוך שמירה על קיבולת זיכרון חזקה באמצעות קריאת חריצים מחוזקת ב-softmax. ביצוע ניסויי בדיקת ביצועים על סט הבדיקה לסנכרון זמן ההסקה הסטטיסטי, כפי שמוצג בשורה האחרונה של טבלה 3, הדגימו את יתרון היעילות של מודל ה-GSLA4Rec, תוך הימנעות מ-"דיוק גבוה מזויף אך לא זמין" והשגה אמיתית של איזון בין אפקטיביות ליעילות.
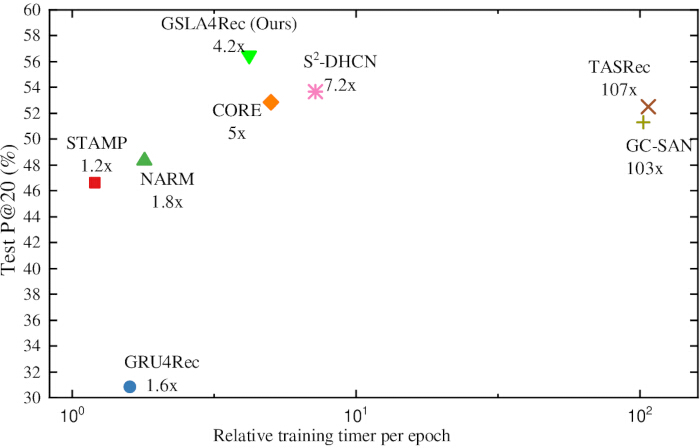
איור 4: ביצועים לאורך זמן ההרצה של GSLA4Rec ב-Diginetica. האיור מראה את זמן האימון היחסי לכל epoch עבור GSLA4Rec המוצע ומודלי הבסיס (baseline), שהורצו על NVIDIA TITAN V GPU באמצעות Diginetica, כאשר GSLA4Rec השיג מהירות אימון גבוהה יותר ממודלי הבסיס. איור זה צויר באופן עצמאי באמצעות OriginPro עם אלמנטים מותאמים אישית. לא נעשה שימוש במשאבי גרפיקה חיצוניים המוגנים בזכויות יוצרים, ולפיכך לא נדרש רישוי זכויות יוצרים נוסף מצד שלישי. זכויות היוצרים של האיור שייכות למחברים ויהיו תואמות לכללי זכויות היוצרים של כתב העת עם קבלת המאמר. GSLA4Rec מייצג gated-slot linear attention graph neural networks עבור SBR. אנא לחץ כאן כדי להציג גרסה גדולה יותר של איור זה.
לסיכום, היעילות של מודל ה-GSLA4Rec המוצע, הכולל מנגנון gated-slot attention בעל סיבוכיות ליניארית, עלתה באופן עקבי על רמות ה-SOTA בכל מערכי הנתונים. בפרט, GSLA4Rec השיג שיפורים משמעותיים בביצועים בתרחישי המלצה עבור סשנים ארוכים במערכי הנתונים Tmall ו-Nowplaying, והפגין יכולת מידול עליונה של תלויות סדרתיות.
ניתוח ניסויי אבלציה
השפעת SG ו-NGG ו-GSLA
כדי להעריך את ההשפעה של ה-SG, ה-NGG, מנגנון השערים (gating mechanism), חריצי הזיכרון (memory slots) והקשב הליניארי (linear attention) על ה-SBR הנוכחי, בוצעו ניסויי אבלציה (ablation studies) על מערכי הנתונים Diginetica, Tmall ו-Nowplaying. בגרסת GSLA4Rec‑NotSG הושמט קידוד תכונת ה-SG תוך שימור קידוד ה-NGG, בגרסת GSLA4Rec‑NotNGG הושמט קידוד ה-NGG וביצוע חילוץ התכונות התבסס אך ורק על SG, בגרסת GSLA4Rec‑NotGM הוסר רק מנגנון השערים בתוך ה-GSLA, בגרסת GSLA4Rec‑NotMS הוסרו אך ורק חריצי הזיכרון של ה-GSLA, ובגרסת GSLA4Rec‑NotLA הושמט רק מודול הקשב הליניארי ב-GSLA.
| Dataset | Diginetica | Tmall | Nowplaying | |||
| Measures | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
טבלה 4: ביצועי ניסויי אבלציה של GSLA4Rec. הטבלה מציגה את ביצועי האבלציה של GSLA4Rec לאחר הסרת רכיבי מודל בודדים במאגרי הנתונים Diginetica, Tmall ו-Nowplaying, כפי שהוערכו באמצעות P@20 ו-MRR@20.
טבלה 4 הציגה את תוצאות מחקר האבלאציה (ablation study) על מאגרי נתונים שונים, כאשר כל מדדי הביצועים ירדו בהשוואה למודל המלא. הירידה בביצועים בעקבות הסרת קידוד גרף הסשן הגלובלי של השכנים הקרובים (GSLA4Rec-NotNGG) הייתה חזקה יותר מאשר בעת הסרת קידוד מאפייני גרף הסשן (GSLA4Rec-NotSG). מחיקה של כל תת-מודול ב-GSLA תביא לירידה בביצועים, כאשר דרגת הירידה בביצועים דורגה מהגבוהה לנמוכה כך: קשב לינארי (linear attention), חריצי זיכרון (memory slots) ומנגנון שערים (gating mechanism). הסיבה לכך היא שחשיבותו של כל פריט ב-SBR הייתה שונה בהחלט, והיה צורך בזיכרון אסוציאטיבי בין הפריטים. ניתן לראות כי GSLA היה חלק מרכזי במודל המוצג במאמר זה.
השפעה של שיטות אגרגציה שונות
כדי להעריך את השפעתן של שיטות שונות לאגרגציית מידע על ביצועי מודל ה-GSLA4Rec, נבחנו שלוש שיטות קלאסיות לאגרגציית מידע: 1) Average Pooling: ביצוע פעולת מימוצע (average pooling) על הווקטורים שנוצרו על ידי ה-SG וה-NGG; 2) שרשור וקטורים (Vector Concatenation): שרשור הווקטורים שנוצרו על ידי ה-SG וה-NGG; 3) סכימת וקטורים (Vector Summation): סכימה של הווקטורים שנוצרו על ידי ה-SG וה-NGG. התוצאות מוצגות ב- טבלה 5GSLA4Rec עם Vec-Sum השיג את הביצועים הטובים ביותר ב-Diginetica, Tmall ו-Nowplaying. לעומת זאת, Mean-pooling הניב תוצאות דלות בכל מערכי הנתונים. הביצועים הנחותים של אגרגציית ממוצע (mean aggregation) ואגרגציית שרשור (concatenation aggregation) עשויים לנבוע מהתאמת יתר (overfitting) שנגרמה מעודף פרמטרים, דבר שפגע בביצועי המודל הכוללים.
| ערכה של נתונים | Diginetica | Tmall | מתנגן כעת | |||
| מדדים | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| מיצוע-בריכה (Mean-Pooling) | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| שרשור וקטורים | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| Vec-Sum | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
טבלה 5: השפעות של שיטות אגרגציה שונות. הטבלה משווה את ההשפעות של mean pooling, שרשור וקטורים (vector concatenation) וסכימת וקטורים (vector summation) על ביצועי GSLA4Rec במאגרי הנתונים Diginetica, Tmall ו-Nowplaying תוך שימוש ב-P@20 ו-MRR@20.
ניתוח הגדרות היפר-פרמטרים
השפעות של גדלי חריצי זיכרון שונים
חריצי זיכרון שמרו מידע מצעדי זמן קודמים, דבר שהיה חשוב במיוחד עבור משימות עם תלויות זמניות. סעיף זה בחן את השפעת גדלי חריצי הזיכרון m = [0, 1, 2, 3, 4, 5] על ביצועי ה-SBR. תוצאות ניסיוניות, המוצגות ב-טבלה 6, הצביעו על כך שכאשר גודל חריצי הזיכרון m נקבע ל-3, המדדים P@20 ו-MRR@20 הניבו ביצועים אופטימליים בשלושת מערכי הנתונים. הדבר מרמז כי גודל מתון של חריצי זיכרון שיפר ביעילות את דיוק ההמלצות ואיכות הדירוג של המודל; חריצי זיכרון קטנים יותר מתקשים לזכור מידע היסטורי מספיק ומתמקדים יותר בתחומי העניין קצרי-הטווח של המשתמשים, בעוד שכאשר גודל חריצי הזיכרון עלה ל-4 או יותר, המודל שומר מידע היסטורי מרובה מדי, מה שגורם לו להסתמך יתר על המידה על תחומי עניין היסטוריים תוך הזנחת מידע קלט עדכני וקריטי יותר, ובכך פוגע בביצועי ההמלצות.
| Dataset | Diginetica | Tmall | Nowplaying | |||
| Measures | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-m1 | 55.43 | 18.92 | 41.55 | 17.12 | 25.60 | 8.43 |
| GSLA4Rec-m2 | 56.02 | 19.35 | 42.90 | 18.25 | 26.62 | 8.95 |
| GSLA4Rec-m3 | 56.47 | 19.98 | 43.60 | 19.96 | 27.10 | 9.32 |
| GSLA4Rec-m4 | 53.96 | 19.25 | 43.06 | 19.09 | 26.34 | 8.35 |
| GSLA4Rec-m5 | 52.18 | 18.03 | 42.12 | 17.56 | 24.86 | 8.85 |
טבלה 6: השפעות של גדלי חריצי זיכרון שונים. הטבלה מציגה את ביצועי GSLA4Rec עם תצורות שונות של חריצי זיכרון (m0–m5) במאגרי הנתונים Diginetica, Tmall ו-Nowplaying באמצעות P@20 ו-MRR@20.
השפעות של יחסי dropout שונים
כדי למנוע התאמת יתר (overfitting), הוכנסה רגולריזציית dropout. לפני סכימת וקטור הפריט ברמת הסשן ווקטור הפריט ברמת השכנים הגלובלית, פלטי הנוירונים הושמטו באופן אקראי בווקטור הפריט ברמת השכנים הגלובלית hingg,(k) כדי לשפר את החסינות ואת יכולת ההכללה של מודל ה-GSLA4Rec.
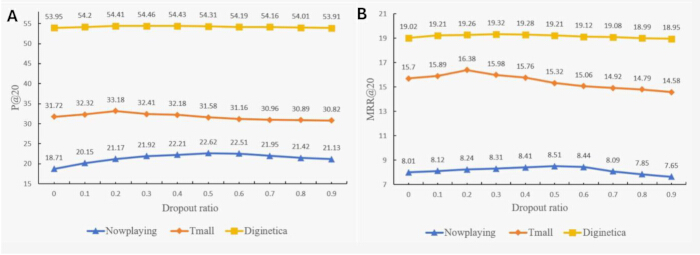
איור 5: ביצועי GSLA4Rec תחת יחסי dropout שונים. (A) P@20 ו-(B) MRR@20 של GSLA4Rec תחת יחסי dropout שונים במאגרי הנתונים Nowplaying, Tmall ו-Diginetica. הביצועים עלו תחילה ולאחר מכן ירדו ככל שיחס ה-dropout עלה, מה שמעיד על החסינות ויכולת ההכללה של המודל. GSLA4Rec, רשתות עצביות גרפיות של gated-slot linear attention להמלצות מבוססות סשן (SBR). איור זה שורטט באופן עצמאי באמצעות OriginPro עם אלמנטים מותאמים אישית באופן מלא. לא נעשה שימוש במשאבי גרפיקה חיצוניים המוגנים בזכויות יוצרים; לפיכך, לא נדרש רישוי זכויות יוצרים נוסף מצד שלישי. זכויות היוצרים של האיור שייכות למחברים ויהיו תואמות לכללי זכויות היוצרים של כתב העת עם קבלת המאמר. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
איור 5A–B מראה את ההשפעה של יחסי dropout שונים במשוואה (16) על ביצועי המודל. תוצאות ניסיוניות הצביעו על כך שהמודל מציג ביצועים נמוכים כאשר יחס ה-dropout היה נמוך, אולם עם עליית יחס ה-dropout, ביצועי המודל השתפרו בהדרגה עד שהגיעו לרמה אופטימלית. באופן ספציפי, יחס ה-dropout האופטימלי היה 0.3 במערך הנתונים Diginetica, 0.2 במערך הנתונים Tmall, ו-0.5 במערך הנתונים Nowplaying. כאשר יחס ה-dropout חרג מערכים אופטימליים אלו, ביצועי המודל החלו לרדת, בעיקר מכיוון ש-dropout מוגבר של נוירונים מנע מהמודל ללמוד ביעילות תכונות חשובות מנתוני הסשן.
השפעות של גודלי שיכון שונים
כדי לצמצם את העומס החישובים ככל האפשר תוך שמירה על ביצועי מודל אופטימליים, נבחנה ההשפעה של ממדי שיכון (embedding dimensions) שונים d על ביצועי מודל ה-GSLA4Rec. כפי שמוצג ב-איור 6A–B, בשלושה מאגרי נתונים ציבוריים, Diginetica, Tmall ו-Nowplaying, מודל ה-GSLA4Rec הציג ביצועים נמוכים כאשר ממד השיכון d היה 10–40; עם זאת, ביצועי המודל עלו במהירות ככל שערכו של d גדל, ומדדי הביצועים נטו להתייצב כאשר ערכו של d היה בטווח שבין 80 ל-120. לאחר מכן, הביצועים למעשה ירדו ככל ש-d המשיך לגדול, ככל הנראה עקב התאמת יתר (overfitting) שנגרמה מממד שיכון גדול מדי. לפיכך, ממד וקטור השיכון של הפריט נקבע בסופו של דבר ל-100.
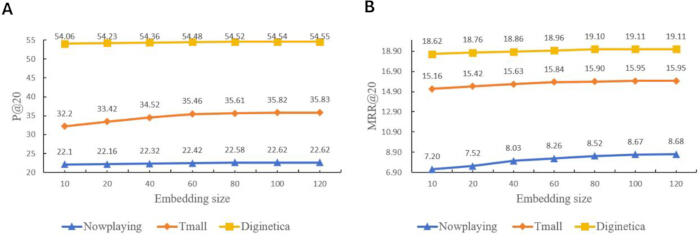
איור 6: ביצועי GSLA4Rec תחת גדלי embedding שונים. (A) P@20 ו-(B) MRR@20 של GSLA4Rec תחת גדלי embedding שונים במאגרי הנתונים Nowplaying, Tmall ו-Diginetica. ביצועי המודל עלו בהדרגה עם הגדלת ה-embedding ובסופו של דבר הגיעו לרמת מישוריזציה (plateau). GSLA4Rec, רשתות נוירונים גרפיות של gated-slot linear attention להמלצות מבוססות סשן (SBR). איור זה שורטט באופן עצמאי באמצעות OriginPro עם אלמנטים מותאמים אישית באופן מלא. לא נעשה שימוש במשאבי גרפיקה חיצוניים המוגנים בזכויות יוצרים; לפיכך, לא נדרש רישוי זכויות יוצרים נוסף מצד שלישי. זכויות היוצרים של האיור שייכות למחברים ויעמדו בכללי זכויות היוצרים של כתב העת עם קבלת המאמר. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
השפעות של אורכי מפגשים שונים
היה ידוע כי אורך כל סשן משתנה בשלושת מאגרי הנתונים של SBR מהעולם האמיתי (Diginetica, Tmall ו-Nowplaying). כדי לוודא את החוסן של מודל GSLA4Rec בהשוואה למודלי בסיס (baselines) באורכים שונים של סשנים, כל הסשנים ב-Diginetica וב-Tmall חולקו לשלוש קבוצות: קבוצה קצרה (S), קבוצה בינונית (M) וקבוצה ארוכה (L), בהתאמה מ-1 עד 6, 7 עד 12, ומעל 12. מדד MRR@20 אומץ כדי לוודא את ביצועי השיטות במקום P@20, מאחר ש-MRR יכול לשקף טוב יותר את איכות הדירוג של תוצאות נכונות. איור 7A–B הראה כי מודל GSLA4Rec הגיע לביצועים טובים יותר ממודל הבסיס המבוסס על רצפים NARM, ממודל הבסיס המבוסס על GNNs שנקרא SR-GNN, ממודל הבסיס GNNs המוגבר בלמידה ניגודית S2-DHCN, וממודל הבסיס המרחבי-זמני RESTC באורכים שונים של סשנים. במקביל, נצפה כי ביצועיהם של כל השיטות פחתו עם הגברת אורך הרצף, מאחר שמעברים ארוכי-טווח בין פריטים הקשו על לכידת העדפות המשתמשים, אך מודל GSLA4Rec המוצע הראה את קצב הירידה האיטי ביותר בהשוואה למודלי הבסיס, כיוון שמנגנון Gated-slot יכול לסנן פריטים לא רלוונטיים; ביצועיו של GSLA4Rec עלו על אלו של מודל NARM ב-6.3 ו-8.85 בהתאמה בקבוצות הארוכות של Diginetica ו-Tmall.
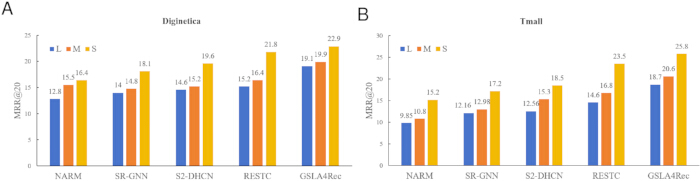
איור 7: ביצועי GSLA4Rec תחת אורכי סשן שונים. ביצועי GSLA4Rec ומודלי הבסיס תחת קבוצות שונות של אורכי סשן במאגרי הנתונים (A) Diginetica ו-(B) Tmall, כפי שהוערכו באמצעות MRR@20. קבוצות אורך הסשן מסומנות כ-L, M ו-S. GSLA4Rec, רשתות עצביות גרפיות בעלות קשב ליניארי עם חריצי שער (gated-slot linear attention) להמלצות מבוססות סשן (SBR). איור זה שורטט באופן עצמאי באמצעות OriginPro עם אלמנטים מותאמים אישית באופן מלא. לא נעשה שימוש במשאבי גרפיקה חיצוניים המוגנים בזכויות יוצרים; לכן, לא נדרש רישוי נוסף של זכויות יוצרים מצד שלישי. זכויות היוצרים של האיור שייכות למחברים ויעמדו בכללי זכויות היוצרים של כתב העת עם קבלת המאמר. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
סיכום
מאמר זה מציע רשת קשב לינארית עם חריצי-שערים בהקשר גלובלי (global context gated-slot linear attention network) עבור SBR. באמצעות שילוב של SG ו-NGG, והצגת מנגנון קשב לינארי של חריצי-שערים, שיטה זו מאפשרת התמקדות בפריטים מרכזיים ברצף הסשן, לכידה של תלויות ארוכות וקצרות טווח, הפחתה יעילה של רעשים והורדה של הסיבוכיות החישובית. תוצאות ניסיוניות מאשרות כי שיטה זו מציגה דיוק ויעילות המלצה מעולים בשלושה מאגרי נתונים ציבוריים, ובמיוחד מצטיינת במשימות של מידול תלויות ארוכות טווח.
זמינות נתונים:
שלושה מאגרי נתונים ציבוריים נפוצים (Diginetica, Tmall ו-Nowplaying, אתרים ניתן למצוא ב- טבלת חומריםשבתמכו בממצאי מחקר זה זמינים באופן פתוח באינטרנט. במקביל, שלושה מאגרי נתונים ציבוריים נפוצים וקוד המקור של עבודה זו הוגשו כ- תיקיית נספחים: GSLA4Rec.zip. אנא לחצו כאן להורדת קובץ זה.
דיון
ביחס לערכים הבסיסיים, המודל GSLA4Rec משיג שיפור כפול בביצועים וביעילות בשלושה סיבות עיקריות. ראשית, יישום מנגנוני שסתום ל-NGG מקל על דלילות הנתונים ומסנן רעש באופן יעיל. שנית, מנגנון תאי הזיכרון מאזן בין קיבולת האחסון ליעילות באמצעות פרמטר על מ התאמה. שלישית, מנגנון הקשבה ליניארי מחשב מתאמים בין פריטים ב- או(נ) מורכבות, נמוכה בהרבה מה- או(N2)61מודל ה-GSLA4Rec מסתמך במידה מוגזמת על המשתמשים' רצפי אינטראקציה מתעלמים מהמאפיינים הרב-מודליים של פריטים48בינתיים, הבנייה של NGG משתמשת בסף ג'קארד קבוע ללא פונקציית התאמה דינמית, ובתאי הזיכרון מ אינו יכול להשיג התאמה מותאמת65.
מודל ה-GSLA4Rec, אשר בונה את ה-SG&NGG ומקבל את attention הליניארי של סлот עם שסתום, מתאים במיוחד להמלצה על סשן אנונימי39 בפלטפורמות מסחר אלקטרוני ושידור באינטרנט. בפלטפורמות מסחר אלקטרוני, המודל הזה ממליץ על מוצרים מתאימים למשתמשים על ידי זיהוי תבניות של התנהגות דפדוף, לחיצה או הוספה לעגלת הקניות, ללא תלות במאפייני המשתמש. קבצי הנתונים Diginetica ו-Tmall שנשתמשו במאמר זה הם קבצי נתונים של המלצות בפלטפורמות מסחר אלקטרוני. בפלטפורמות של סרטונים קצרים ושידור מוזיקה, השיטה הזו מנתחת את המשתמשים' רצפי השמעה כדי להסיק את העדפותיהם הסמויות, מעדכנים סיכומי תוכן כדי לשמור על המשתמשים, ומרחיבים את זמן הצפייה. קבוצת הנתונים Nowplaying שנעשה בה שימוש במאמר זה היא קבוצת הנתונים להמלצת מוזיקה.
קיימות חלופות שיכולות להחליף את מבנה הקשבון הליניארי עם חריץ שמאוור. הממבא הח emerging65 מודל מרחב מצבים מבוסס, כחלופה, מאפיין את עצמו באחסון בורר של מרחב המצבים ובסיבוכיות חישוב ליניארית, תוך שיווי משקל בין סיבוכיות ליניארית לבין יכולת התאמה לרצפים ארוכים, בשילוב עם מודל שפה גדול (LLM)55 מסגרת שיפור, היא מחלצת את המשתמשים' הכוונה הנסתרת מיומן האינטראקציה המקורי, ובכך להשיג ביצועי המלצה ויעילות טובים. עבודות עתידיות יכולות למטב את GSLA4Rec ממספר נקודות מבט: בניית NGG דינמית כדי להחליף את הסינון הקבוע לפי יקרד, יישום של חריצי זיכרון משתנים כדי להתאים אוטומטית להפעלות באורכים שונים, והכללת מידע רב-מודאלי של המשתמש כדי לשפר את דיוק ההמלצה. בנוסף, בעזרת מודלים שמשולבים LLM55,משתמשים' ניתן לחקות כוונות סמויות מרצפי אינטראקציה, וניתן לסנן נתונים של שיחות רועשות במדויק יותר72.
גילויים
המחברים מצהירים כי אין להם ניגודי אינטרסים פיננסיים ידועים או מערכות יחסים אישיות שעלולים היו להשפיע על העבודה המדווחת במאמר זה.
תודות
המחבר מודה למבקרים על המשוב וההצעות המחשבתיים במהלך תהליך הביקורת, ולפרופסור Jiang Nan, המנחה לדוקטורט שלי, על הדרכתו המסורה. מחקר זה נתמך בחלקו על ידי הקרן הלאומית למדע של סין תחת מענק מס' 6217072713 ומענק מס' 62061019, ובחלקו על ידי נושאי מחקר פתוחים במערכות חישש בלתי מאוישות וטכנולוגיית בינה מלאכותית של מחוז Jiangxi בשנת 2025, ובחלקו על ידי המעבדה המחוזית המרכזית של Jiangxi לחומרים ומכשירים אלקטרוניים מתקדמים (מס' 2024SSY03012).
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | אין | CUDA 11.3 היא גרסה של פלטפורמת מחשוב מקבילי ומודל תכנות ששוחררה על ידי NVIDIA בשנת 2021, במטרה לשפר את הביצועים ואת גמישות הפיתוח של יישומים מואצים באמצעות GPU. |
| Diginetica | Diginetica | אין | Diginetica הוא מאגר הנתונים הרשמי של תחרות ה-CIKM (International Information Retrieval Conference) Cup לשנת 2016, אשר שימש בתחרות אלגוריתמים של CIKM לפתרון בעיית אחזור מוצרים מותאם אישית במסחר אלקטרוני עם הקשר חיפוש. כיום הוא הפך למאגר נתוני הייחוס הסטנדרטי והנפוץ ביותר בתחום המלצות מבוססות סשן (SBR). |
| Nowplaying | Zenodo | אין | זהו מאגר נתונים רחב היקף של התנהגות האזנה למוזיקה שנבנה על בסיס כריית ציוצים עם התג "# nowplaying", כאשר עיקרו משמש למחקרים בתחומי המלצות לשיחות מוזיקה, המלצות מודעות להקשר וניתוח מתאם רגשי. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | אין | OriginPro היא תוכנה מסחרית מקצועית לשרטוט מדעי וניתוח נתונים שפותחה על ידי OriginLab Corporation, והיא משמשת בדרך כלל ליצירת תרשימים ברמה של מאמרים מדעיים, סטטיסטיקה של נתונים, התאמת עקומות, עיבוד אותות ועוד. מאמר זה משתמש ב-OriginPro ליצירת תרשימי השוואה ניסיוניים, תרשימי קו ותרשימי עמודות. |
| PyTorch 1.11.0 | PyTorch Foundation | אין | PyTorch היא מסגרת עבודה (framework) לקוד פתוח ללמידה עמוקה ולמידת מכונה, ששוחררה על ידי Facebook בשנת 2016. היא מיישמת בעיקר גזירה אוטומטית ומציגה גרפי חישוב דינמיים כדי להפוך את בניית המודלים לגמישה יותר. |
| TITAN V GPU | NVIDIA | אין | NVIDIA TITAN V הוא כרטיס גרפי דגל שהושק על ידי NVIDIA בסוף שנת 2017, ומיועד בעיקר לתחומי המחשוב בעוצמה גבוהה ובינה מלאכותית. |
| Tmall | Tmall | אין | מתחרות ההמלצות של Alibaba Tmall ב-IJCAI 2015, פרסמה Alibaba Tianchi לציבור לוגים מקוונים אמיתיים של Tmall שעברו דה-סנסיטיזציה. זהו אחד משלושת מאגרי הנתונים הסטנדרטיים בתחום ה-SBR (Diginetica, Yoocoose, Tmall) ומערכת ההערכה המועדפת עבור תרחישי מסחר אלקטרוני סיניים. |
| visio 2021 | Microsoft | אין | Visio היא תוכנה לשרטוט וקטורי שפותחה על ידי Microsoft, המשמשת לשרטוט דיאגרמות מבנה של מודלים, תרשימי זרימה, דיאגרמות מסגרת ודיאגרמות טופולוגיה של רשת במאמרים למחקר מדעי, ולהפקת תרשימי וקטורים לאיורים של מאמרים. |
מקורות
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.