פרוטוקול זה מתאר את יצירת מערך נתונים המבוסס על מזג האוויר והערכה שיטתית של מודלים של למידה חישובית (machine learning), למידה עמוקה (deep learning) ומודלים היברידיים לניבוי ניחות אטמוספרי בתקשורת אופטית במרחב חופשי (free-space optical communications) תחת תנאים סביבתיים עיראקיים מגוונים, הכוללים סופות אבק, ערפל, גשם ושלג.
מאמר מחקר
למידת מכונה עולה בביצועיה על למידה עמוקה לניבוי ניחות אטמוספרי בתקשוב אופטי במרחב חופשי תחת תנאי מזג האוויר בעיראק
במאמר זה
סיכום
תקציר
מערכות תקשורת אופטית במרחב חופשי (Free-space optical communications) מציעות רוחב פס גבוה, אבטחה מוגברת ופעולה ללא צורך ברישוי, אך הן מושפעות מאוד מירידה בביצועים עקב ניחות אטמוספירי הנגרם מפיזור ובליעה. חיזוי מדויק של הניחות חשוב עוד יותר בעיראק, שבה הסביבה חמה, מאובקת, ערפילית וגשומית באופן רנדומלי. מטרת מחקר זה היא להעריך את הביצועים של טכניקות למידה חישובית (machine learning), למידה עמוקה (deep learning) ומידול היברידי לחיזוי ניחות אטמוספירי במערכות תקשורת אופטית במרחב חופשי בתנאי מזג אוויר עיראקיים שונים. מאגר נתונים סינתטי של 1500 דגימות נוצר באמצעות מודלים פיזיקליים של התפשטות המוכרים היטב עבור חמישה משטרי מזג אוויר: שמיים בהירים, ערפל, גשם, סופות אבק ושלג. חמישה עשר מודלים לחיזוי הוערכו באופן שיטתי, שכללו שש טכניקות של למידה חישובית (Random Forest [RF], Extreme Gradient Boosting, Light Gradient Boosting Machine, Support Vector Regression, Linear Regression, ו-K-Nearest Neighbors), שש ארכיטקטורות של למידה עמוקה (Multilayer Perceptron, Deep Neural Network, Long Short-Term Memory [LSTM], One-Dimensional Convolutional Neural Network [CNN], CNN–LSTM, ו-Attention-based Network) ושלוש גישות היברידיות. התוצאות הראו כי RF הניב את הביצועים הטובים ביותר (R2 = 0.9654, root mean square error = 1.324 dB/km) בהשוואה לגישות למידה עמוקה (R2 מיטבי = 0.7766) ושיטות היברידיות (R2 מיטבי = 0.9571). חשיבות המאפיינים נותחה באמצעות Shapley Additive exPlanations ונמצא כי ריכוז האבק (67.3%) והראות (21.2%) היו הגורמים המשפיעים ביותר. בעוד ש-RF הוביל לאימון ולהסקה מהירים משמעותית, בדיקה סטטיסטית לא גילתה הבדל משמעותי בין RF לבין הגישה ההיברידית בעלת הביצועים הטובים ביותר (p = 0.083). הוכח כי ביצועי טכניקות הלמידה החישובית הקונבנציונליות יעילים ביותר להערכת ניחות אטמוספירי במערכות תקשורת FSO בתנאי סביבה קשים, בהתאם לתאוריות פיזיקליות ידועות של התפשטות. עם זאת, אנו מדגישים כי מסקנות אלו מבוססות על נתונים סינתטיים, ויש לתקפן באמצעות מדידות אטמוספריות ממשיות לפני שניתן יהיה להשתמש בהן במערכות FSO מבצעיות.
מבוא
רשתות תקשורת אופטית במרחב חופשי (FSO) מציעות בדרך כלל קיבולת גבוהה יותר ואבטחה טובה יותר, אך ניחות אטמוספרי עקב פיזור ובליעה מהווה גורם מגביל מרכזי למרחק התקשורת1. בעבודה זו אנו מספקים ניתוח מפורט של גישות למידת מכונה, למידה עמוקה וגישות היברידיות2 להערכת ניחות אות FSO בסביבה המאתגרת של עיראק, המתאפיינת בטמפרטורות גבוהות, סופות אבק ומשקעים לא סדירים.
מערכות תקשורת FSO התגלו כאחד הפתרונות המבטיחים לקישוריות אלחוטית ברוחב פס גבוה3, עם קצבי נתונים העולים על 100 Gbps למרחקים של מאות מטרים עד למספר קילומטרים4. קישורי FSO פועלים בספקטרום הנראה ובספקטרום האינפרא-אדום, בניגוד למערכות רדיו-תדר (RF) קונבנציונליות, ומציעים יתרונות כגון פעולה ללא צורך ברישוי, חסינות להפרעות אלקטרומגנטיות, אבטחה משופרת הודות לפיזור קרן צר וקיבולת רוחב פס גדולה5. תכונות אלו הופכות את ה-FSO לטכנולוגיה אטרקטיבית עבור יישומי backhaul, קישורים בין בניינים, רשתות להתאוששות מאסונות וקישוריות "מייל אחרון" במקומות שבהם פריסת סיבים היא יקרה מדי6. עם זאת, תקשורת דרך פיזור, סטיות קרן ובליעה7,8 תלויה רבות בתנאי הסביבה מבחינת זמינות וביצועים. אתגר זה הוא אחד המגבלות העיקריות של מערכות תקשורת אופטית במרחב חופשי. תנאי מזג האוויר גורמים לווריאציות רחבות ברמות הנחיתה (dB/km). בתנאי שמיים בהירים, הנחיתה עשויה להיות נמוכה מ-0.5 dB/km, בעוד שערפל כבד עלול לגרום לנחיתה להגיע ל-≥50 dB/km ב-1550 nm (על פי מודל הערפל של Kim, החוזה ערכי נחיתה של עד 50 dB/km עבור ראות נמוכה מ-50 m ב-1550 nm)9,10, וגשם כבד עלול לגרום לנחיתה להגיע עד ל-20–30 dB/km, תלוי בקצב הגשם (תחזית מודל Carbonneau)11. לכן, נדרש חיזוי מדויק של הנחיתה לצורך תכנון קישור אמין, תכנון רשת ואסטרטגיות שידור אדפטיביות. השיטות הקונבנציונליות מבוססות על מודלים פיזיקליים של התפשטות, כגון מודל Kim עבור ערפל12, מודל Carbonneau עבור גשם13, ותאוריית פיזור Mie עבור חלקיקי אירוסול14. עם זאת, בעוד שמודלים אלו מספקים בסיס תיאורטי טוב, הם מסתמכים לעיתים קרובות על פרמטרים אטמוספריים מדויקים שאינם זמינים תמיד בפועל, ולעיתים קרובות אינם לוקחים בחשבון את האינטראקציות המורכבות בין מספר תופעות מטאורולוגיות המתרחשות במקביל15.
השונות הסביבתית הקיצונית בעיראק מציבה אתגרים משמעותיים להפריסה של מערכות תקשורת אופטית במרחב חופשי (FSO). תנאי השידור מסתבכים עוד יותר עקב מיעוט משקעים ואירועי ערפל מבודדים, בעוד שטמפרטורות החורף עלולות לרדת מתחת לנקודת הקיפאון וטמפרטורות הקיץ עלולות לעלות מעל 50 °C16. בספקטרום הנמצא בשימוש רב כגון 1550 nm באורכי גל רגילים, סופות אבק, המכונה מקומית "al-haboob", עלולות להגביל את הראות לפחות מ-100 מטרים, מה שמוביל לערכי ניחות העולים על 20dB/km17. כדי שמערכות FSO יופרסו בהצלחה בעיראק ובמדינות אחרות במזרח התיכון, יש צורך בפיתוח מודלים של חיזוי מהימנים שיכולים להעריך במדויק את ביצועי המערכת תחת תנאים סביבתיים שונים אלו18.
פיתוחים חדשים בלמידת מכונה מציגים תחליפים מעשיים לטכניקות מידול קונבנציונליות המבוססות על פיזיקה. היכולת של טכניקות למידת מכונה ללמוד ישירות קורלציות לא-ליניאריות מורכבות בין ניחות לבין גורמים אטמוספריים מאפשרת זיהוי של אינטראקציות זעירות שדגמים אנליטיים מסורתיים עלולים להחמיץ19. במגוון משימות של חיזוי אקלימי, אסטרטגיות של Random Forest (RF) והגברת גרדיאנט (gradient-boosting) הדגימו ביצועים חזקים20. באופן דומה, טכניקות למידה עמוקה זכו להצלחה ניכרת בעיבוד שפה טבעית, ראייה ממוחשבת וחיזוי סדרות עתיות21. עם זאת, גישות אלו לא נחקרו מספיק עבור חיזוי ניחות ב-FSO, במיוחד עם מערכי נתונים מוגבלים ותנאי מזג אוויר משתנים מאוד22. כדי למלא פער זה, עבודה זו מציגה חקירה מעמיקה של למידת מכונה, למידה עמוקה וגישות היברידיות לחיזוי ניחות אות FSO בתנאי האטמוספירה של עיראק. דבר זה מושג על ידי בניית מערך נתונים סינתטי המתוכנן היטב ומבוסס על מודלים פיזיקליים מוכרים של התפשטות23. אנו משערים כי עבור מערכי נתונים סביבתיים טבלאיים בגודל בינוני עם מספר קטן של משתנים מנבאים דומיננטיים, ביצועי החיזוי של שיטות אנסמבל מבוססות עץ יעלו על ארכיטקטורות למידה עמוקה מורכבות. המטרות העיקריות הן (1) ביסוס מתודולוגיית בסיס להשוואת שיטות חיזוי בסביבת סימולציה מבוקרת, (2) זיהוי האסטרטגיות האלגוריתמיות הטובות ביותר לחיזוי ניחות אטמוספרי, ו-(3) הערכת חשיבות המאפיינים ויכולת הפרשנות של המודל כדי להשיג תובנה לגבי הגורמים הסביבתיים המשפיעים ביותר על הניחות. בעבודה זו נעשה שימוש בנתונים סינתטיים, אך מונח היסוד להמשך תיקוף באמצעות מדידות ניסיוניות מהעולם האמיתי כבר הונח, כפי שצפוי בעבודות עתידיות. יתרה מכך, ניתוחי חשיבות מאפיינים ויכולת הפרשנות שולבו כדי לקבוע את הגורמים הסביבתיים החשובים ביותר המשפיעים על הניחות.
פרוטוקול
מחקר זה לא כלל משתתפים אנושיים או בעלי חיים בעלי חוליות, ולא נדגמו רקמות. כל הנתונים ששימשו למחקר זה נוצרו באופן סינתטי באמצעות מודלים של התפשטות פיזיקלית ופרמטרים מטאורולוגיים הזמינים לציבור. לפיכך, לא נדרש אישור אתי מוועדה לביקורת מוסדית (IRB) או מוועדה מוסדית לטיפול ובקרת בעלי חיים (IACUC).
יצירת מערך נתונים המבוססת על תאוריית ההתפשטות הפיזיקלית. מערך הנתונים נבנה כדי לדמות תנאים אטמוספריים שעתיים עבור מערכת תקשורת אופטית במרחב חופשי למשך שנה קלנדרית שלמה (2024) עבור תנאים אטמוספריים עיראקיים. יצרנו מאגר נתונים סינתטי עם 1,500 דגימות לשעה.
ראשית, תנאי מזג האוויר הוקצו באופן אקראי בהתבסס על מגמות אזוריות: שמיים בהירים (54.3%), אבק (24.9%), ערפל (10.5%), גשם (7.4%) ושלג (2.8%). שנית, מודל הנח attenuation פיזיקלי תואם הוחל על כל דגימה בהתבסס על תנאי מזג האוויר, כלומר חוק ביר-למברט (Beer-Lambert law) עבור שמיים בהירים, מודל קים (Kim model) עבור ערפל, תיאוריית קרבונו (Carbonneau theory) עבור גשם ותיאוריית פיזור מי (Mie scattering theory) עבור סופות אבק. שלישית, פרמטרי מערכת ה-FSO נקבעו באופן הבא: הספק שידור של 20 dBm, אורך גל של 1550 nm, מרחק שידור של 3 km, מפתח שידור של 2.5 cm ומפתח קליטה של 20 cm. רביעית, הנח attenuation חושבה ב-dB/km עבור כל דגימה. לבסוף, מערך הנתונים המלא חולק באופן אקראי ל-1,200 דגימות אימון (80%) ו-300 דגימות בדיקה (20%). התנאים המסומולקים כוללים ריכוזי אבק גבוהים הקשורים לסופות חול, סופות גשם ושינויי טמפרטורה מ-−4.89°C עד 47.99°C. תנאי מזג האוויר והתפלגויות הפרמטרים נבחרו בהתבסס על רשומות האקלים של עיראק לתקופה 2020–2024. חמישה משטרי מזג אוויר (שמיים בהירים, ערפל, גשם, סופות אבק ושלג) נבחרו כיוון שהם מכסים את מלוא הספקטרום של תנאי האטמוספירה המשפיעים על הנח attenuation ב-FSO בעיראק, כאשר סופות אבק נפוצות במיוחד במזרח התיכון. נתונים היסטוריים על מטאורולוגיה שנאספו ברחבי אזורי עיראק שימשו ליצירת התפלגות ההסתברות עבור כל תנאי מזג אוויר. ההתפלגות שהתקבלה הייתה כדלקמן: 54.3% מהשמיים בהירים (המצב הדומיננטי), 24.9% אבק (המייצג את בעיית סופות החול של עיראק), 10.5% ערפל (שכיח בחורפים בצפון עיראק), 7.4% גשם (כמויות משקעים נמוכות האופייניות לעיראק), ו-2.8% שלג (לעיתים באזורים הרריים בצפון). הפרמטרים המטאורולוגיים הרלוונטיים מודלו באמצעות התפלגויות הסתברות עבור כל תנאי מזג אוויר באופן הבא: הטמפרטורה מודלה באמצעות התפלגות נורמלית (ממוצע 28.55±11.18°C) בין −4.89°C ל-47.99°C בהתבסס על קיצוניים עונתיים בעיראק; הלחות מודלה באמצעות התפלגות אחידה (ממוצע 42.01±25.56%) מ-0% עד 100%; הנראות מודלה באמצעות התפלגות לוג-נורמלית בין 0.05 km ל-29.99 km (ממוצע 13.10±10.91 km) כדי להביא בחשבון אירועי נראות נמוכה שכיחים במהלך סופות אבק; ריכוז האבק מודל באמצעות התפלגות מעריכית בין 0 ל-4.96 mg/m3 (ממוצע 0.74±1.30 mg/m3) עם הסתברויות גבוהות יותר עבור ריכוזים נמוכים וזנבות ארוכים עבור אירועי אבק קיצוניים.
מערכת התקשורת תוכננה עם הספק שידור של 20 dBm, אורך גל של 1550 nm, מרחק שידור של עד 3 km, מפתח שידור של 2.5 cm, ומפתח קליטה של 20 cm כדי לפצות על הפסדי הפיזור. הפרמטרים של מערכת ה-FSO חולקו לשתי קבוצות: פרמטרים קבועים שלא השתנו עבור כל הדגימות, ופרמטרים משתנים ששונו במהלך יצירת מערך הנתונים. עבור כל 1,500 הדגימות, הפרמטרים הבאים היו קבועים: הספק שידור (20 dBm), אורך גל תפעולי (1550 nm), מפתח שידור (קוטר 2.5 cm, נצילות 0.7) ומפתח קליטה (קוטר 20 cm, נצילות 0.7). פרמטרים אלו היו קבועים מכיוון שהם המפרטים הפיזיים של חומרת מערכת ה-FSO והם אינם משתנים בהתאם לתנאי מזג האוויר. מערך הנתונים נוצר עם 1,500 דגימות שבהן השתנו הפרמטרים הבאים: טמפרטורה (−4.89°C עד 47.99°C), לחות (0% עד 100%), ראות (0.05 km עד 29.99 km), ריכוז אבק (0 עד 4.96 mg/m3) ותנאי מזג אוויר (שמיים בהירים, ערפל, גשם, אבק, שלג). פרמטרים אלו שונו בהתאם להתפלגויות הסתברותיות שנגזרו מנתוני האקלים של עיראק לשנים 2020–2024. עבור כל דגימה, ערך הניחות (dB/km) חושב באמצעות מודל הניחות הפיזי המתאים, בהתאם לשילוב הספציפי של תנאי מזג האוויר והפרמטרים המשתנים.
ניחות פיזיקלי מודל באמצעות מודל Carbonneau עבור גשם, חוק Beer–Lambert עבור שמיים בהירים, תאוריית פיזור Mie עבור אבק, ומודל Kim עבור ערפל24. חוק Beer-Lambert תקף לתנאי שמיים בהירים שבהם הניחות נשלט על ידי פיזור מולקולרי ובליעה, אשר פוחתים באופן מעריכי עם המרחק25. מקדם ההכחדה α באורך גל של 1550 nm נובע מפיזור Rayleigh על ידי מולקולות אוויר ומבליעה על ידי גזים אטמוספריים26. מודל Kim הוא מודל ייעודי לערפל הקושר בין הניחות לנראות באמצעות מקדמים אמפיריים הנגזרים מהתפלגות גודל טיפות הערפל. המעריך q, התלוי באורך הגל, מייצג את פיזור Mie27. הפרמטר המרכזי במודל Carbonneau הוא קצב הגשם R, שכן ניחות הגשם תלוי בגודל ובצפיפות טיפות הגשם, והמקדמים נגזרים באופן אמפירי ב-1550 nm ומכויילים ספציפית עבור אורכי גל אופטיים28. תאוריית פיזור Mie ישימה לתנאי אבק, מכיוון שגודל חלקיקי האבק (רדיוס של 0.1–100 μm) בר השוואה לאורך הגל (1550 nm), ומדד השבירה המורכב m = 1.55–0.005i עבור אבק מהמזרח התיכון כולל הן פיזור והן בליעה29. מודלי הניחות הפיזיקלי הבאים הוטמעו עם המשוואות והגדרות הפרמטרים המתאימות להם.
עבור תנאי שמיים בהירים, נעשה שימוש בחוק ביר-למברט:
Aclear = 10×log₁₀(e(α×d)) (1)
כאשר α הוא מקדם ההכחדה (שהשתנה באמצעות התפלגות נורמלית המרוכזת ב-0.02 dB/km עם סטייה של ±0.005 dB/km ב-1550 nm בתנאי ראות צלולה), ו-d הוא מרחק השידור (שנקבע על 3 km). עבור תנאי ערפל, מודל Kim יושם באמצעות המשוואה:
Afog = 10×ln(10)/V×(λ/550)−q (2)
כאשר V היא הנראות בקילומטרים (שנויה בין 0.05km ל-10km), λ הוא אורך הגל בננומטרים (קבוע על 1550nm), ו-q הוא מקדם התפלגות גודל החלקיקים המחושב כך: q=1.6 עבור V>50 km, q=1.3 עבור 6<V<50 km, q=0.585×V(1/3) עבור 1 <V<6km, q=0 עבור 0.5<V<1km, ו-q=0.5 עבור V<0.5km. עבור תנאי גשם, נעשה שימוש במודל Carbonneau:
Arain=0.023×R0.93 (3)
כאשר R הוא קצב הגשם ב-mm/h (שנע בין 0.25 ל-50mm/h בהתאם לרישומי הגשמים בעיראק). קשר יעילות ההכחדה שימש עבור נסיבות של סערת אבק באמצעות פיזור Mie:
Adust=10×log₁₀(e(τ×L)) (4)
כאשר τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr, r הוא רדיוס החלקיק (0.1–100μm בהתאם להרכב אבק עיראקי), Qext הוא נצילות הכיליון שחושבה באמצעות תאוריית Mie, λ=1550nm, m=1.55–0.005i הוא מקדם השבירה המרוכב עבור אבק ממזרח התיכון, ו-N(r) הוא התפלגות גודל החלקיקים שמודלה באמצעות התפלגות לוג-נורמלית עם רדיוס ממוצע גיאומטרי של 2.5 μm וסטיית תקן של 2.0. מודל הניחות הוטמע עבור תנאי שלג באופן הבא:
Asnow = 0.1×S0.75 (5)
כאשר S הוא קצבe שלג ב-mm/h (0.5–15 mm/h). משוואה אמפירית זו נבחרה בהתבסס על עבודות בספרות30, שבהן פותחו מודלים של ניחות להגברה אופטית דרך שלג באמצעות תאוריית פיזור Mie המיושמת על התפלגויות גודל של פתיתי שלג. המשוואה תקפה לקצבי שלג שבין 0.5 ל-15 mm/h ומניחה תנאי שלג יבש עם קטרי פתיתי שלג טיפוסיים של 1–10 mm. המקדם 0.1 והמעריך 0.75 התקבלו מהתאמת עקומה לחישובי פיזור Mie30 עבור שלג ב-1550 nm. המשוואה אינה מתאימה לשלג רטוב או למשקעים משולבים, שעשויים להיות בעלי תכונות ניחות משתנות, למרות שהיא מספקת הערכה סבירה עבור שלג יבש. מכיוון שהגישה יעילה מבחינה חישובית, מצוטטת לעיתים קרובות בפרסומי FSO, ומתאימה לנסיבות השלג החזויות בצפון עיראק (חבל כורדיסטן בינואר ובפברואר), היא נבחרה למחקר זה. כל המודלים הוטמעו ב-Python 3.9 תוך שימוש ב-Numpy לחישובים מספריים. המודל התואם הוחל על תנאי מזג האוויר שנבחרו באופן אקראי ועל נתוני סביבה נדגמים כדי לחשב את ערך הניחות עבור כל דגימה. התפלגות מזג האוויר שהתקבלה כללה 814 תנאי שמיים בהירים (54.27%), 375 אירועי אבק (25.00%), 157 אירועי ערפל (10.47%), 111 אירועי גשם (7.40%) ו-43 אירועי שלג (2.87%).
בחינה של מידע מטאורולוגי היסטורי שנאסף מתחנות מטאורולוגיות עיראקיות במספר אזורים (בגדאד, בצרה, מוסול ורמדי) בין 2020 ל-2024 שימשה לקביעת הפרופורציות של מצבי מזג האוויר. משרד התחבורה העיראקי והארגון המטאורולוגי והסייסמולוגי של עיראק (IMOS) סיפקו את הנתונים המקוריים. בנתונים נכללו רשומות מזג אוויר יומיות שתיעדו את התנאים האטמוספריים השוטפים עבור כל יום. טמפרטורה (מינימום, מקסימום וממוצע יומי), לחות יחסית, ראות, כמות משקעים והתרחשויות של סערות אבק היו בין המאפיינים הספציפיים שהופקו מרשומות אלו. פורטל הנתונים הפתוחים של ממשלת עיראק (https://www.motrans.gov.iq/) מספק גישה לחלק מנתוני IMOS; עם זאת, הרשומות הספציפיות ששימשו במחקר זה אינן מאוחסנות באופן ציבורי במאגר מרכזי. מידע האקלים ששימש לחישוב האחוזים של תנאי מזג האוויר וערכי הפרמטרים מסוכם בטבלה 1. ימי שמיים בהירים הוגדרו כימים ללא משקעים, ראות הגדולה מ-10 km וללא פעילות אבק, והם היוו 54.27% מתוך 1,825 הימים שתועדו. ימי סערת אבק (כולל סערת אבק מלאה (ראות < 1 km) ואבק רחף (ראות 1–5 km)) היוו 25.00% מהימים, מה שמעיד על השכיחות הגבוהה של אירועי סערות חול באקלים הצחיח והחצי-צחיח של עיראק. ימים שבהם הראות הייתה נמוכה מ-1 km עקב רחף של טיפות מים (למעט ירידה בראות הנגרמת מאבק) סווגו כימי ערפל. אחוז ימי הערפל היה 10.47%, וימי ערפל התרחשו בעיקר בחורף באזורי צפון עיראק. ימי גשם, ימים עם משקעים מדידים של >0.1 mm, היוו 7.40%, נתון העולה בקנה אחד עם הממוצע הנמוך של משקעים שנתיים בעיראק של 150–200 mm לשנה. ימי שלג (ימים עם הצטברות של משקעים קפואים) היוו 2.87% מהימים והתרכזו באזורים הרריים בצפון (חבל כורדיסטן) בינואר ובפברואר. פרופורציות אלו שימשו מאוחר יותר כמשקולות הסתברות לדגימה אקראית ביצירת מערך הנתונים. לפיכך, מערך הנתונים הסינתטי משקף את השכיחות בעולם האמיתי של כל תנאי מזג אוויר בסביבה העיראקית.
שיקולי הטיות ביצירת נתונים סינתטיים
כדי לצמצם הטיות אפשריות, ננקטו מספר צעדים:
(1) בחירת ההתפלגות: התכונות הסטטיסטיות של נתוני האקלים מהמקור שימשו לבחירת התפלגויות ההסתברות. הטמפרטורה הייתה בעלת התפלגות נורמלית עם ממוצע וסטיית תקן כפי שתועדו על ידי ה-IMOS. הלחות הייתה בעלת התפלגות אחידה על פני כל הטווח שנצפה (0-100%). לגבי הראות, הונח כי היא עוקבת אחר התפלגות לוג-נורמלית כדי להביא בחשבון את השכיחות הגבוהה של אירועי ראות נמוכה במהלך סופות אבק. ריכוז האבק עקב אחר התפלגות מעריכית, שבה היו הסתברויות גבוהות יותר בריכוזים נמוכים וזנבות ארוכים באירועי אבק קיצוניים31. ממצא זה היה עקבי עם השכיחות שנצפתה של אירועי אבק בעיראק32.
(2) פרופורציות של תנאי מזג אוויר: ניתוח של רשומות IMOS לשנים 2020–2024, הכולל 1,825 תצפיות יומיות בארבעת האזורים, הניב את הפרופורציות הבאות: 54.3% שמיים בהירים, 24.9% אבק, 10.5% ערפל, 7.4% גשם ו-2.8% שלג. ימים ללא משקעים, עם ראות >10 km וללא פעילות אבק הוגדרו כימים של שמיים בהירים. ימים עם סופות אבק כללו הן סופות אבק מלאות (ראות <1 km) והן אבק תלוי (ראות 1–5 km). יום ערפל הוגדר כיום שבו הראות הייתה פחות מ-1 km והגורם היה תלייה של טיפות מים (לא אבק). ימי גשם הוגדרו כימים עם משקעים מדידים >0.1 mm. ימי שלג הוגדרו כימים עם הצטברות של משקעים קפואים33.
(3) טווחים של פרמטרים: טווחי הפרמטרים התבססו על ערכי הקיצון שנצפו ברישומי ה-IMOS: הטמפרטורה נעה בין −4.89 °C (מוסול, חורף) ל-47.99 °C (בצרה, קיץ), הנראות נעה בין 0.05 km (סופות אבק חמורות) ל-29.99 km (תנאים צלולים), וריכוז האבק נע בין 0 ל-4.96 mg/m3 (על בסיס ריכוז האבק המקסימלי שנצפה במהלך אירועי חבוּב חמורים)34.
(4) הנחות עצמאות: הנחנו כי הפרמטרים הסביבתיים נדגמו באופן עצמאי, דבר המהווה פישוט של תנאי העולם האמיתי שבהם משתנים אטמוספריים נמצאים במתאם (למשל, ריכוז אבק גבוה נמצא לעיתים קרובות במתאם עם ראות נמוכה). על מנת לספק סביבת סימולציה מבוקרת להשוואה שיטתית של מודלים, אומצה הנחת עצמאות זו 35. השלכות הנחות אלו נסקרות בפרק הדיון.
(5) פיצול שכובתי: הפיצול למערכות אימון ובדיקה בוצע באופן שכובתי על בסיס קטגוריית תנאי מזג האוויר (שמיים בהירים, ערפל, גשם, אבק, שלג) כדי להבטיח שהפרופורציה של כל תנאי מזג אוויר במערכי האימון והבדיקה תואמת את ההתפלגות של מערך הנתונים המקורי. בדרך זו, מערך הבדיקה אינו איסונסיבי ביחס לתנאי מזג אוויר נדירים (במיוחד שלג, העומד על 2.87%)36.
אישור על יצירה דטרמיניסטית של מטרה
חשוב לציין כי ביצועי החיזוי הטובים שנצפו כאן עשויים לנבוע בחלקם מכך שהמודל למד או קירב את המשוואות הפיזיקליות הדטרמיניסטיות ששימשו ליצירת ערכי המטרה הסינתטיים37. בניגוד למדידות ניסיוניות בעולם האמיתי, המכילות רעשי מדידה, שגיאות מכשירים ותופעות פיזיקליות שלא נכללו במודל, מערך הנתונים הסינתטי מספק קשר נקי וללא רעשים בין מאפייני הקלט לבין מטרה הניחות. זאת משום שערכי הניחות חושבו ישירות ממודלים פיזיקליים של התפשטות (חוק ביר-למברט, מודל Kim, מודל Carbonneau ותאוריית פיזור Mie) בהתבסס על פרמטרי הקלט. לפיכך, מדדי הביצועים הכמותיים (R2, RMSE, MAE) מייצגים ביצועים על נתונים סינתטיים המופקים ממשוואות, ואין לפרשם כביצועים צפויים על נתונים תצפיתיים או ניסיוניים רועשים. יש להתבונן בתוצאות בעיקר כהערכה השוואית של מתודולוגיות מידול בסביבת סימולציה מבוקרת38.
סט מאפיינים מלא לאימון מודל
סט הנתונים לאימון הכיל 10 מאפייני קלט לאימון המודל:
1. טמפרטורה (°C)
2. לחות (%)
3. ראות (km)
4. ריכוז אבק (mg/m3)
5. קצב משקעים (mm/h)
6. קצב הצטברות השלג (mm/h)
7. מהירות רוח (m/s)
8. לחץ ברומטרי (hPa)
9. חודש (מספרי, 1–12)
10. עונה (קידוד one-hot: אביב, קיץ, סתיו, חורף)
הבהרה חשובה: תנאי מזג האוויר (שמיים בהירים, ערפל, גשם, אבק, שלג) שימשו כמשתנה קטגוריאלי לצורך שכיבה (stratification) במהלך פיצול מערך הנתונים, ולא נכללו כמאפייני קלט עבור אף מודל. ניתוח ה-SHAP כולל רק את 10 המאפיינים המפורטים לעיל. משתנה העונה עבר קידוד one-hot (4 קטגוריות: אביב, קיץ, סתיו, חורף), ועבור ניתוח ה-SHAP, התרומות של משתני העונה שקודדו ב-one-hot סוכמו על פני כל העונות כדי להפיק ערך תרומה יחיד עבור העונה. ערך משולב זה מייצג את התרומה הכוללת של כל המשתנים הקשורים לעונה לחיזוי הנחיתה (attenuation). לפני יצירת דמות הסיכום, זוהו ארבעת עמודי העונה שקודדו ב-one-hot, וערכי ה-SHAP שלהם סוכמו עבור כל דגימה. שיטה זו מבטיחה שהשימוש של המודל בעונה כמשתנה קטגוריאלי מורכב עקבי עם ניתוח ה-SHAP.
הגורמים הסביבתיים העיקריים שהשפיעו באופן ישיר על הניחות האופטי באמצעות מנגנונים פיזיקליים היו מאפיינים 1–6. להוספת מאפיינים 7 ו-8 (מהירות רוח ולחץ) כגורמים מטאורולוגיים משלימים עשויה להיות השפעה עקיפה על הניחות על ידי השפעה על יציבות האוויר ופיזור אירוסולים. כדי להתחשב בשינויים עונתיים בתנאי האטמוספירה, מאפיינים 9–10 (חודש ועונה) נכללו כמתארי זמן. ערך הניחות (dB/km) שימש כמשתנה המטרה עבור כל המודלים. נתוני מפתח סטטיסטיים של מערך הנתונים כללו טמפרטורה (28.55°C ± 11.18°C), לחות (42.01% ± 25.56%), ראות (13.10 ± 10.91 km; טווח: 0.05–29.99 km), ריכוז אבק (0.74 ± 1.30 mg/m3; מקסימום: 4.96 mg/m3), ניחות (4.80 ± 7.20 dB/km; טווח: 0.09–50.93 dB/km), טווח פעולה (5.74 ± 1.97 km), ויחס אות לרעש (64.88 ± 15.07 dB). טווח הפעולה וה-SNR חושבו מערכי הניחות באמצעות משוואות תקציב קישור FSO סטנדרטיות.
חישוב טווח העבודה
טווח הפעולה (ב-km) חושב באמצעות משוואת תקציב הקישור (link budget):
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
שם: Pמרשם = הספק התקבל (הוגדר לרגישות מינימלית של −30 dBm); Pתרגום = הספק שידור (קבוע על 20 dBm); Gת = הבחנה של המשדר (מחושבת ממימדי המפתח); Gנא לספק את הטקסט המקור באנגלית לתרגום. = הגבר מקלט (מחושב על סמך גדלי המפתח); λ = אורך גל (1550 ננומטר); R = טווח בק"מ; A = בלימה אטמוספרית ב-dB/km (חושבה על סמך המודלים הפיזיקליים).
הגברים של המשדר והמקלט: הגבר המשדר (Gt) חושב באופן הבא: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi. הגבר המקלט (Gr) חושב באופן הבא: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi. מפתח השידור היה בקוטר 2.5 cm, עם נצילות של 0.7. מפתח הקליטה היה בקוטר 20 cm, עם נצילות של 0.7. המשוואה נפתרה באופן איטרטיבי עבור R כדי לקבוע את מרחק הקישור המקסימלי שניתן להשיג עבור כל ערך ניחות.
חישוב יחס אות לרעש
ה-SNR (יחס אות לרעש) ב-dB חושב באמצעות המשוואה:
SNR=Prx−10×log₁₀(kTB)−NF (7)
כאשר: Prx = ההספק שהתקבל ב-dBm (חושב מתוך תקציב הקישור); k = 1.38×10⁻23 J/K (קבוע בולצמן); T = 290 K (טמפרטורת המקלט); B = 109 Hz (רוחב פס של המקלט, 1 GHz); NF = 3 dB (מספר הרעש של המקלט). רצפת הרעש חושבה כך:
10 × log10(kTB) ≈ −84 dBm (8)
עבור כל דגימה, לאחר חישוב הניחות A באמצעות המודל הפיזי המתאים, נגזר טווח הפעולה (Operating Range) על ידי פתרון תקציב הקישור עבור R, וה-SNR חושב מההספק שהתקבל Prx באותו טווח.
ערכי טווח פעולה תלויי מזג אוויר: טווח הפעולה השתנה בהתאם לתנאי מזג האוויר: שמיים בהירים (7.12 ± 1.85 km), ערפל (5.81 ± 1.92 km), שלג (5.42 ± 1.56 km), גשם (3.81 ± 0.98 km), ואבק (3.72 ± 1.08 km). שולי ביטחון של 3 dB לא יושמו בחישובים הנוכחיים; טווח הפעולה מייצג את הטווח המקסימלי התאורטי ללא שולי ביטחון של המערכת. טווח הפעולה המדווח (5.74 ± 1.97 km) הוא הממוצע הכללי על פני כל תנאי מזג האוויר39.
מרחק שידור קבוע: מרחק השידור במודלים של ניחות פיזיקלי נקבע ל-3 km. זהו מרחק התקשורת שעבורו בוצעו חישובי הניחות. טווח הפעולה המדווח הוא המרחק המקסימלי התאורטי שחושב באמצעות משוואת תקציב התקשורת (link budget equation), אשר עשוי להיות שונה ממרחק השידור הקבוע של 3 km. ערכי ניחות ספציפיים למזג האוויר נרשמו עבור תנאי שקיפות (0.27±0.06 dB/km), ערפל (1.88±1.92 dB/km), שלג (6.45±2.54 dB/km), גשם (13.58±6.32 dB/km), ואבק (13.10±7.32 dB/km). כל הערכים הכמותיים המדווחים בכתב יד זה מוצגים כממוצע ± סטיית תקן (SD), אלא אם צוין אחרת40.
ערך ה-R2 של תיקוף צולב (Cross-validation) עבור Random Forest דווח כ-0.960±0.007. במקרים מסוימים, כגון טמפרטורה (−4.89 עד 47.99°C), ראות (0.05 עד 29.99km), ריכוז אבק (0 עד 4.96 mg/m3) ונחיתה (0.09 עד 50.93dB/km), הטווח (מהנמוך לגבוה) מצוין במילים. מערך הנתונים פולח לתתי-קבוצות עבור בדיקה (300 דגימות; 20%) ואימון (1,200 דגימות; 80%). כדי לבצע את פיצול האימון-בדיקה, נעשה שימוש בדגימה אקראית מרובדת (Stratified random sampling). כדי להבטיח שהאחוז של כל תנאי מזג אוויר במערכת האימון (80%) ובמערכת הבדיקה (20%) תואם את התפלגות מערך הנתונים המקורי, נעשה שימוש בריבוד על בסיס קטגוריית תנאי מזג האוויר (שמיים בהירים, ערפל, גשם, אבק ושלג). באופן ספציפי, 1,200 (80%) מתוך 1,500 הדגימות הוקצו למערכת הלמידה ו-300 (20%) למערכת הבדיקה. דגימות נבחרו באופן אקראי עבור כל קטגוריה של תנאים מטאורולוגיים תוך שמירה על הפרופורציות המקוריות: מתוך 814 דגימות של שמיים בהירים (54.27%), 651 הוקצו לאימון ו-163 לבדיקה; מתוך 375 דגימות אבק (25.00%), 300 לאימון ו-75 לבדיקה; מתוך 157 דגימות ערפל (10.47%), 126 לאימון ו-31 לבדיקה; מתוך 111 דגימות גשם (7.40%), 89 לאימון ו-22 לבדיקה; מתוך 43 דגימות שלג (2.87%), 34 לאימון ו-9 לבדיקה. דגימה אקראית בתוך כל רבדה בוצעה באמצעות גרעין אקראי (random seed) של 42 כדי להבטיח שחזוריות. גישה מרובדת זו נבחרה כדי למנוע ייצוג לא מאוזן של תנאי מזג אוויר נדירים (במיוחד שלג ב-2.87%) במערכת הבדיקה, מה שעלול היה להוביל להערכת ביצועים לא אמינה עבור תנאים אלו.
הערכת מודל למידת מכונה
שש שיטות למידת מכונה נבחנו, כולל רגרסיית וקטורים תומכים (SVR) עם גרעין פונקציית בסיס רדיאלית (C = 100), K-שכנים קרובים (KNN; k = 10, שקלול מרחקים), RF (200 עצים, עומק מקסימלי = 20), Extreme Gradient Boosting (XGBoost; 200 אומדנים, עומק מקסימלי = 10, קצב למידה = 0.1), Light Gradient Boosting Machine (LightGBM; 200 אומדנים, עומק מקסימלי = 10, קצב למידה = 0.1), ורגרסיה ליניארית כבסיס להשוואה. עבור כל מודלי הלמידה של מכונות ולמידה עמוקה, בוצע כוונון היפר-פרמטרים עבור הפרמטרים הקריטיים ביותר, בעוד שערכי ברירת המחדל נשמרו עבור פרמטרים שלא צוינו. עבור מודלי למידת מכונה, הפרמטרים הבאים כווננו במפורש באמצעות חיפוש רשת (grid search) עם תיקוף צולב של 5 קיפולים (5-fold cross-validation) על קבוצת האימון: 1) יער אקראי (Random Forest): מספר עצים (נבדקו: 50, 100, 150, 200, 250) ועומק מקסימלי (נבדקו: 10, 15, 20, 25, ללא הגבלה), כאשר נבחרו ערכים אופטימליים של 200 עצים ועומק 20. 2) XGBoost: מספר אומדנים (נבדקו: 100, 150, 200, 250), עומק מקסימלי (נבדקו: 6, 8, 10, 12), וקצב למידה (נבדקו: 0.05, 0.1, 0.2), כאשר נבחרו ערכים אופטימליים של 200 אומדנים, עומק 10, וקצב למידה 0.1. 3) LightGBM: נעשה שימוש בטווחי כוונון זהים, מה שהוביל ל-200 אומדנים, עומק 10, וקצב למידה 0.1. 4) SVR: פרמטר הרגולריזציה C (נבדקו: 1, 10, 50, 100) ומקדם הגרעין gamma (נבדקו: ‘scale’, ‘auto’, 0.1, 0.01) כווננו, כאשר נבחרו C = 100 אופטימלי וגרעין RBF. 5) KNN: מספר השכנים k (נבדקו: 3, 5, 7, 10, 15) כוונן, כאשר נבחר k = 10 אופטימלי והופעלה הצבעה משוקללת מרחקים.
כל שאר הפרמטרים עבור מודלים אלה הושארו בערכי ברירת המחדל שלהם כפי שהוגדרו ב-scikit-learn (ראה טבלת חומרים עבור הגרסה; לדוגמה, Random Forest: bootstrap=True, min_samples_split=2, min_samples_leaf=1; XGBoost: subsample=1.0, colsample_bytree=1.0, gamma=0). עבור מודלים של למידה עמוקה, הארכיטקטורה (מספר השכבות ומספר היחידות בכל שכבה) ושיעור הנשירה (dropout rate; 20%) כווננו ידנית באמצעות ניסויים חזרתיים על קבוצת האימות, בעוד שהאופטימייזר (Adam), קצב הלמידה הראשוני (0.001), סבילות העצירה המוקדמת (early stopping patience; 20 תקופות/epochs), ופרמטרי הפחתת קצב הלמידה (מקדם 0.5, סבילות 10) נקבעו על פי פרקטיקות סטנדרטיות בספרות ונשמרו קבועים בכל ניסויי הלמידה העמוקה.
מקורות נתונים אקלימיים
מידע מטאורולוגי היסטורי שנאסף מתחנות מזג אוויר עיראקיות במספר מקומות (בגדאד, בצרה, מוסול ורמדי) בין השנים 2020 ל-2024 שימש לחישוב הפרופורציות של מצבי מזג האוויר והתפלגויות המשתנים. הנתונים הגולמיים סופקו על ידי משרד התחבורה העיראקי והארגון המטאורולוגי והסייסמולוגי של עיראק (IMOS). רשומות מזג אוויר יומיות המפרטות את המצב האטמוספרי השולט בכל יום נכללו בנתונים. משתנים ספציפיים שהושגו מרשומות אלו כללו טמפרטורה (מינימום, מקסימום וממוצע יומי), לחות יחסית, ראות, כמות משקעים והתרחשויות של סופות אבק. נתוני ה-IMOS זמינים חלקית דרך פורטל הנתונים הפתוחים של ממשלת עיראק (https://www.motrans.gov.iq/), אם כי הרשומות הספציפיות ששימשו במחקר זה אינן מאורכבות באופן ציבורי במאגר מרכזי. סיכום של נתוני האקלים ששימשו לקביעת הפרופורציות של תנאי מזג האוויר וטווח הפרמטרים מוצג ב-טבלה 1.
נעשה שימוש באימות צולב חמיש-מגלה (Fivefold cross-validation) על קבוצת האימון (1,200 דגימות) כדי לכייל היפר-פרמטרים ולהעריך ביצועים עבור כל מודלי הלמידה המכונה. כל משתני הקלט (טמפרטורה, לחות, נראות, ריכוז אבק, קצב משקעים של גשם, קצב משקעים של שלג, מהירות רוח, לחץ) עברו נרמול מאפיינים באמצעות סטנדרטיזציה (נרמול Z-score): x_scaled = (x − μ)/σ, כאשר μ ו-σ הם הממוצע וסטיית התקן של קבוצת האימון. ביצענו סטנדרטיזציה בתוך כל קיפול של האימות הצולב תוך שימוש בסטטיסטיקות מקיפול האימון בלבד כדי למנוע זליגת נתונים. מודלים מבוססי עץ (Random Forest, XGBoost, LightGBM) הם חסינים לשינויי קנה מידה (scale-invariant), אך אותה סטנדרטיזציה הוחלה לצורך עקביות בין כל מודלי הלמידה המכונה. נרמול Min-max שימש עבור מודלי למידה עמוקה: x_scaled = (x−x_min)/(x_max−x_min), אשר מנרמל מאפיינים לטווח [0, 1] בהתבסס על ערכי המינימום והמקסימום מקבוצת האימון. קלטים חסומים מובילים להתכנסות מהירה יותר של רשתות נוירונים, וזו הסיבה שנבחרו. קבוצת הבדיקה נורמלה באמצעות הפרמטרים שהתקבלו מקבוצת האימון, ולא שימשה לבחירת מודל או לכיוונון היפר-פרמטרים.
מדדי ביצועים מלאים נרשמו, כולל מקדם דטרמינציה של הבדיקה (R2), שגיאת השורש הממוצעת של הריבועים (RMSE), השגיאה המוחלטת הממוצעת (MAE), R2 של תיקוף צולב (cross-validation) וזמן אימון. זמני האימון עבור כל מודלי הלמידה המכונה והלמידה העמוקה דווחו בשניות (s) עבור המודלים המהירים יותר (Linear Regression, KNN, SVR, Random Forest, XGBoost, LightGBM) ובדקות (min) עבור המודלים האיטיים יותר (ארכיטקטורות למידה עמוקה). כל המודלים אומנו בסביבה חישובית זהה כדי להבטיח השוואה הוגנת41.
זמן האימון נמדד באמצעות מודול time של Python, כלומר, זמן השעון שחלף מתחילת פונקציית התאמת המודל ועד לסיומה, ללא הזמן הנדרש לטעינת נתונים ולעיבוד מקדמי. זמן האימון עבור מודל למידה עמוקה הוא הזמן שלקח להשלים את כל האיפוכים (epochs) עד לעצירה מוקדמת. זה כולל הפצה קדימה (forward propagation), הפצה לאחור (backward propagation) ובדיקות תיקוף. כל הניסויים בוצעו כאשר במערכת לא רצו תהליכים אינטנסיביים אחרים מבחינה חישובית, וזאת כדי להשיג מדידות זמן עקביות. הזמנים הם ממוצע של 5 הרצות עצמאיות (סטיות תקן)42.
הערכת מודל למידה עמוקה
שש ארכיטקטורות של למידה עמוקה הוערכו באמצעות האצה של GPU, כולל פרספטרון רב-שכבתי (MLP; 64-32-16), רשת עצבית עמוקה (DNN) עם נורמליזציית אצוות (batch normalization) (128-64-32-16), רשת זיכרון לטווח קצר ארוך (LSTM; 64-32 יחידות, אורך רצף = 10), רשת עצבית קונבולוציונית חד-ממדית (1D-CNN), מודל היברידי של CNN–LSTM, ורשת מבוססת קשב (attention-based network). כל מודלי הלמידה העמוקה הוטמעו באמצעות TensorFlow עם ה-API של Keras והורצו עם האצת GPU (ראה טבלת חומרים עבור גרסאות חומרה/תוכנה). ארכיטקטורת ה-1D-CNN כללה שלוש שכבות קונבולוציה (64, 128 ו-256 מסננים, גודל גרעין 3, אקטיבציית ReLU, padding='same'), שתי שכבות MaxPooling1D (גודל בריכה 2), שכבת GlobalAveragePooling1D, שכבת Dense עם 128 יחידות ואקטיבציית ReLU, שכבת Dropout (0.2), ושכבת Dense פלט (יחידה אחת, אקטיבציה ליניארית), ובסך הכל כ-245,000 פרמטרים הניתנים לאימון. הארכיטקטורה ההיברידית של CNN-LSTM קיבלה רצפי קלט של 10 שלבי זמן עם 5 מאפיינים, תוך שימוש בשתי שכבות Conv1D (64 ו-128 מסננים, גודל גרעין 3, ReLU, padding='same'), שכבת MaxPooling1D (גודל בריכה 2), שתי שכבות LSTM (64 ו-32 יחידות, return_sequences=False), שכבות Dropout (0.2), שכבת Dense (32 יחידות, ReLU), ושכבת Dense פלט (יחידה אחת, אקטיבציה ליניארית), ובסך הכל כ-198,000 פרמטרים הניתנים לאימון. הרשת מבוססת הקשב השתמשה במנגנון קשב רב-ראשי (multi-head attention) עם 4 ראשים (מימדי מפתח וערך של 64), שבו הקלט הוקרן ל-64 מימדים, ולאחריו קשב של מכפלה סקלרית רשומית (נוסחה: Attention(Q, K, V) = softmax(QKT/√d_k)V), חיבורים שאריתיים (residual connections), נורמליזציית שכבות, רשת הזנה קדימה (128→64 יחידות), איסוף ממוצע גלובלי (global average pooling), Dropout (0.2), שכבת Dense (32 יחידות, ReLU), ושכבת Dense פלט (יחידה אחת, אקטיבציה ליניארית), ובסך הכל כ-167,000 פרמטרים הניתנים לאימון43.
כל המודלים השתמשו בעצירה מוקדמת (patience = 20), הפחתת קצב למידה (factor = 0.5, patience = 10), dropout (20%), ואופטימייזר Adam (learning rate = 0.001). עבור כל מודלי הלמידה העמוקה, גודל האצווה (batch size) נקבע ל-32 דגימות, מספר תקופות האימון (epochs) המקסימלי היה 200 עם עצירה מוקדמת (patience = 20, שחזור המשקולות הטובות ביותר), ופונקציית ההפסד הייתה טעות ריבועית ממוצעת (MSE). הפיצול בין אימון לוולידציה היה כדלקמן: מתוך 1,200 דגימות האימון המקוריות (לאחר פיצול אימון-בדיקה של 80/20), 80% (960 דגימות) שימשו לאימון ו-20% (240 דגימות) לוולידציה. ביצענו שכיבה (stratification) של פיצול האימון-וולידציה לפי תנאי מזג האוויר כדי לשמר את ההתפלגות. קבוצת הוולידציה שימשה אך ורק לעצירה מוקדמת, דעיכת קצב הלמידה וניטור התאמת-יתר (overfitting); היא לא שימשה לבחירת מודל או לכיוונון היפר-פרמטרים מעבר להליכים אוטומטיים אלו. לא שמרנו קבוצת וולידציה נפרדת עבור מודלי הלמידה המכונה; במקום זאת, השתמשנו בוולידציה צולבת של חמישה קיפולים (five-fold cross-validation) על 1,200 דגימות האימון כדי לכוונן היפר-פרמטרים ולהעריך ביצועים44.
הצדקה להערכת ארכיטקטורת LSTM ו-CNN–LSTM
מערך הנתונים המרכזי מורכב מדגימות מזג אוויר שנוצרו באופן בלתי תלוי, אך בחנו גם ארכיטקטורות LSTM ו-CNN–LSTM מהסיבות הבאות: (1) תנאים אטמוספריים בעולם האמיתי הם בעלי מתאם עצמי זמני (temporally autocorrelated), ובחינת מודלים מבוססי רצפים מאפשרת לנו לקבוע האם לכידה של תלויות כאלה עשויה לשפר את דיוק התחזית; (2) מחקרים עדכניים בתחום התחזיות האטמוספריות הדגימו את הערך הפוטנציאלי של ארכיטקטורות רצפיות למידול האבולוציה הזמנית של פרמטרים מטאורולוגיים34; (3) בחינה של מגוון רחב של ארכיטקטורות מבטיחה השוואה מקיפה של גישות מתודולוגיות, המהווה תרומה מרכזית של מחקר זה; ו-(4) ארכיטקטורת ההיבריד CNN–LSTM משלבת חילוץ מאפיינים מרחביים עם מידול זמני, דבר שעשוי להועיל ללכידת האינטראקציות המורכבות בין משתנים אטמוספריים מרובים45.
עיצוב נתונים עבור קלט של מודל סדרתי
עבור הארכיטקטורות הסקוונציאליות (LSTM ו-CNN–LSTM), נתוני הקלט אורגנו מחדש מדגימות עצמאיות לרצפים פסאודו-סקוונציאליים באמצעות גישת חלון נחלק (sliding-window). באופן ספציפי, 1,200 דגימות האימון קובצו תחילה לקטגוריות של תנאי מזג אוויר כדי לשמר עקביות פיזיקלית. בתוך כל קטגוריית מזג אוויר, הדגימות סודרו לפי חותמות הזמן שנוצרו עבורן (תצפיות שעתיות סימולטיביות לשנת לוח 2024). לאחר מכן, הוחל חלון נחלק באורך 10 כדי להפיק רצפי קלט של 10 שלבי זמן רצופים (כל אחד עם 5 מאפיינים: טמפרטורה, לחות, ראות, ריכוז אבק וקצב משקעים) לצורך חיזוי הנחלישה בשלב הזמן ה-11th. שיטה זו שומרת על הסדר הכרונולוגי של התצפיות הסימולטיביות, תוך שהיא מאפשרת למודלים סקוונציאליים ללמוד תלויות זמניות. מבנה מערכת הבדיקה היה זהה, למעט שימוש באותו גודל חלון ומערכת מאפיינים. אנו מכירים בכך שמבנה פסאודו-סקוונציאלי זה הוא פישוט מתודולוגי ואינו משקף דינמיקה זמנית מהעולם האמיתי. ציינו זאת כמגבלה בפרק הדיון.
הערכת גישות היברידיות
נבחנו שלוש גישות היברידיות. הגישה הראשונה הייתה Voting Ensemble שביצע ממוצע של תחזיות ממודלי Random Forest, XGBoost ו-Deep Neural Network תוך שימוש במשקל שווה (לכל מודל הוקצה משקל של 1/3), כאשר התחזית הסופית חושבה באופן הבא:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
נבחר שקלול שווה כדי להימנע מהחדרת היפר-פרמטרים נוספים וכדי להעריך את ביצועי הבסיס של האנסמבל ללא הטיה כלפי מודל בודד. הגישה השנייה השתמשה בערמה (stacking) של מטא-לומד מסוג Ridge. הלומדים הבסיסיים היו Random Forest, XGBoost, ורשת עצבית עמוקה (המבוססת על Attention). תהליך הערמה כלל שני שלבים: ראשית, כל לומד בסיסי אומן על סט האימון המלא של 1,200 דגימות באמצעות 5-fold cross-validation כדי לייצר תחזיות מחוץ-לקיפול (out-of-fold), ובכך נוצרה מטריצת מטא-מאפיינים חדשה בגודל 1,200×3 (תחזית אחת לכל מודל בסיס עבור כל דגימה). שנית, מטא-לומד של רגרסיית Ridge (פרמטר רגולריזציית L2 alpha=1.0) אומן על מטא-מאפיינים אלו, תוך שימוש בערכי הניחות המקוריים כמטרה, כדי ללמוד את משקולות השילוב האופטימליות עבור הלומדים הבסיסיים. תחזית הערמה הסופית הייתה:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
כאשר המשקלות w נלמדו על ידי ה-Ridge meta-learner. הגישה השלישית הייתה רשת נוירונים מודרכת פיזיקה (Physics-Informed Neural Network) ששילבה 70% מהתחזיות של הרשת הנוירונית עם 30% ממודל Kim עבור דגימות בתנאי ערפל. השילוב בוצע באמצעות ממוצע משוקלל קבוע לפי הנוסחה הבאה:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
כאשר ŷneural הוא הפלט של הרשת העצבית מבוססת ה-Attention, ו-ŷKim הוא הניחות שחושב ממודל הערפל של Kim על בסיס קלט של נראות. עבור דגימות ללא ערפל, החלק הפיזיקלי נקבע כ-0, והמודל הופעל כרשת עצבית טהורה. המשקולות (70% רשת עצבית ו-30% פיזיקה) נקבעו על בסיס ניסויים מקדימים בסט הוולידציה (לא בסט הבדיקה), שבהם בחנו שילובי משקלות של 90:10, 80:20, 70:30, 60:40 ו-50:50. חלוקה של 70/30 נבחרה כיוון שהיא סיפקה את ה-R2 הטוב ביותר בוולידציה ועדיין שמרה על אילוץ פיזיקלי מספיק ממודל Kim כדי לבצע רגולריזציה לתחזיות ולמנוע פלטים שאינם סבירים פיזיקלית, במיוחד במצבי ערפל שבהם מודל Kim מספק גבולות ניחות תיאורטיים מבוססים.
ניתוח חשיבות תכונות ופרשנות
מודל Random Forest עם חשיבות מאפיינים מבוססת אי-ניקיון (הפחתת שונות) שימש להפקת דירוגי חשיבות עבור כל 10 מאפייני הקלט. הניתוח הראה כי ריכוז האבק (67.3%) והראות (21.2%) היו החזאים החשובים ביותר, המסבירים יחד 88.5% מסך החשיבות החיזויית. המאפיין החשוב השלישי היה קצב הגשם (6.0%), ואחריו מהירות הרוח (2.1%), טמפרטורה (1.5%), לחות (0.9%), חודש (0.5%), עונה (0.3%), קצב הצטברות שלג (0.1%) ולחץ אטמוספרי (0.1%). ציוני החשיבות הנמוכים עבור המאפיינים הזמניים (חודש ועונה) מעידים כי השונות העונתית בניחות אטמוספרי נלכדת בעיקר על ידי פרמטרים סביבתיים בסיסיים ולא על ידי דפוסים מבוססי זמן בלבד.
ניתוח SHAP (Shapley Additive exPlanations) בוצע כדי להעריך את הקשרים בין גורמים סביבתיים לבין הנחתה. מימוש ה-SHAP שנעשה בו שימוש היה מודול ה-TreeExplainer מספריית SHAP, המותאם במיוחד למודלים מבוססי עצים, כולל Random Forest, XGBoost ו-LightGBM (ראו טבלת חומרים עבור גרסה). הגדרות ניתוח ה-SHAP היו כדלקמן: מודל ה-Random Forest המאומן הועבר ל-TreeExplainer, שחישב ערכי SHAP באמצעות גישת ייחוס מאפיינים התערבותית (שולית) המבוססת על התוחלת המותנית של פלט המודל. ערכי SHAP חושבו עבור כל 300 דגימות קבוצת הבדיקה, מה שיצר מטריצה בגודל 300 × 10 (ערך SHAP אחד לכל מאפיין לכל דגימה). עבור כל מאפיין, ערך ה-SHAP ייצג את תרומתו לתחזית ביחס לבסיס (ממוצע התחזיות של המודל). ערכי SHAP שליליים הצביעו על סטייה כלפי מטה, בעוד שערכי SHAP חיוביים הראו כי המאפיין העלה את תחזית ההנחתה. עוצמת התרומה הובאה לידי ביטוי בגודל ערך ה-SHAP. התפלגות ערכי ה-SHAP עבור כל מאפיין (באמצעות beeswarm plots), כיוון ההשפעה (המתאם בין ערכי המאפיין לערכי ה-SHAP) ודירוגי חשיבות המאפיינים הוצגו ויזואלית באמצעות תרשימי סיכום (summary plots). פונקציות השרטוט המובנות של ספריית SHAP — הפונקציה shap.summary_plot() עבור ה-beeswarm plot והפונקציה shap.bar_plot() עבור חשיבות מאפיינים גלובלית — שימשו ליצירת כל ויזואליזציות ה-SHAP.
טיפול במשתנים בקידוד One-Hot: ארבעה עמודות בינאריות (אביב, קיץ, סתיו וחורף) שימשו תחילה לקידוד של משתנה העונה. כדי ליצור ערך תרומה יחיד של "עונה" עבור כל דגימה לצורך ניתוח SHAP, שולבו התרומות של ארבעת המשתנים המקודדים ב-one-hot על ידי חיבור ערכי ה-SHAP עבור כל קטגוריית עונה. כדי לבצע קיבוץ זה, אותרו כל העמודות שהתאימו לקבוצות העונה בקידוד one-hot, חולצו ערכי ה-SHAP שלהן עבור כל דגימה, ולאחר מכן הם סוכמו ברמה האיברית. ערכי ה-SHAP המשולבים שמתקבלים מייצגים את התרומה הכוללת של העונה לחיזוי הניחות. שיטה זו מאפשרת הצגת שורה אחת של "עונה" בתרשים סיכום ה-SHAP ומבטיחה עקביות עם השימוש של המודל בעונה כמשתנה קטגורי מורכב. מכיוון שהמספר המשולב מספק תיאור מובן יותר של התרומה הכוללת של העונה, ערכי ה-SHAP של העונה לא הוצגו בנפרד עבור כל קטגוריית עונה.
תוצאות
מאפייני מערך הנתונים הסינתטי מסוכמים באיור 1A–F. מערך הנתונים כלל תנאים של שמיים בהירים, אבק, ערפל, גשם ושלג (איור 1A), כאשר הדגימות פזרו על פני עונות חמות-יבשות ועונות קרות-לחות (איור 1B) ותקופות של יום ולילה (איור 1C). ההתפלגויות של טמפרטורה, לחות וראות תחת תנאי מזג אוויר שונים מוצגות באיור 1D–F.
מודלי הלמידה המכונהית הפגינו ביצועי ניבוי חזקים בהערכת הנחתה אטמוספרית (איור 2A–D; טבלה 3). RF השיג את הביצועים הכוללים החזקים ביותר מבין המודלים שנבחנו, עם R2 של 0.9654 בבדיקה ו-RMSE של 1.324 dB/km (איור 2A; טבלה 3). RF הסביר 96.54% מהשונות שנצפתה תוך שמירה על שגיאת ניבוי נמוכה מ-1.5 dB/km. גם XGBoost הציג ביצועים טובים (איור 2C), ואחריו LightGBM (איור 2B). חוסנו של המודל נתמך על ידי תיקוף צולב של חמישה קיפולים (five-fold cross-validation), כאשר RF השיג R2 בתיקוף צולב של 0.960 ± 0.007 (איור 2D). לעומת זאת, K-Nearest Neighbors הפגין סימנים של התאמת יתר (overfitting), עם R2 של 1.000 באימון ו-R2 של 0.7341 בבדיקה, בעוד שרגרסיה ליניארית השיגה ביצועי ניבוי בינוניים (איור 2A; טבלה 3).
ניתוח חשיבות המאפיינים של 10 מאפייני הקלט שהוזכרו לעיל מוצג ב-איור 3A. ציוני החשיבות היחסיים מדורגים באופן הבא: ריכוז אבק (67.3%), ראות (21.2%), קצב גשם (6.0%), מהירות רוח (2.1%), טמפרטורה (1.5%), לחות (0.9%), חודש (0.5%), עונה (0.3%), קצב שלג (0.1%), ולחץ (0.1%). המשתנה 'מצב מזג האוויר' משמש לריבוד מערך הנתונים אך אינו נכלל בניתוח חשיבות המאפיינים, כיוון שהוא משתנה קטגורי מורכב המייצג מספר פרמטרים פיזיקליים בסיסיים, והשפעתו נלכדת על ידי המאפיינים הסביבתיים הבודדים. ניתוחי חשיבות מאפיינים ופרשנות זיהו את המשתנים הסביבתיים הקשורים בעוצמה החזקה ביותר לנחיתה (איור 3A,B). ריכוז אבק (67.3%), ראות (21.2%) וקצב גשם (6.0%) היומרו יחד ל-94.4% מסך החשיבות החיזויית (איור 3A). ניתוח SHAP הדגימה עוד כי עלייה בריכוז האבק וירידה בראות היו קשורות לתחזיות של עלייה בנחיתה (איור 3B).
מודלים של למידה עמוקה הפגינו ביצועי ניבוי נמוכים יותר מאשר גישות למידה משיננית (איור 4A–D). מודל הלמידה העמוקה בעל הביצועים הטובים ביותר, רשת מבוססת Attention, השיג R2 של 0.7766 ו-RMSE של 3.362 dB/km (איור 4A). ארכיטקטורות רקורסיביות הראו ביצועים נמוכים במיוחד, כאשר הן מודלי LSTM והן מודלי CNN–LSTM הניבו ערכי R2 קרובים לאפס וערכי RMSE העולים על 7.19 dB/km (איור 4B). ניתן להסביר חלקית את הביצועים הנמוכים יחסית של ארכיטקטורות ה-LSTM וה-CNN-LSTM (ערכי R2 = 0.0110 ו-0.0109, בהתאמה; RMSE = 7.193 dB/km ו-7.196 dB/km) על ידי הטבעם הפסאודו-סקוונציאלית של נתוני הקלט, שאינה לוכדת באופן מלא את הדינמיקה הזמנית האמיתית של תנאי האטמוספירה.
בניגוד ליישומי סדרות בזמן אמת, שבהם התלויות הרצפיות הן חזקות ומוגדרות היטב, מערך הנתונים שלנו consisted בעיקר מדגימות עצמאיות עם סדר כרונולוגי שהוטל באופן מלאכותי. ביצועי הניבוי הדלים של ארכיטקטורות אלו מרמזים כי המידע הזמני שהופק באמצעות גישת החלון הנחלק (sliding-window) היה אינו מספיק או לא מייצג את ההתפתחות האטמוספרית האמיתית (איור 4C). נתון זה תומך במסקנתנו כי עבור מערכי נתונים מסוג זה, גישות למידה מכונה פשוטות יותר מתאימות יותר מאשר מודלים מורכבים של למידה עמוקה מבוססי רצף. ביצועי התיקוף עבור כל ארכיטקטורות הלמידה העמוקה מסוכמים באיור 4D.
הביצועים של למידת מכונה, למידה עמוקה וגישות היברידיות מסוכמים באיור 5A,B, ובטבלה 3. בין השיטות ההיברידיות, Voting Ensemble השיג R2 של 0.9340 ו-RMSE של 1.827 dB/km (איור 5A,B; טבלה 3). Ridge meta-learner stacking השיג R2 של 0.9571 ו-RMSE של 1.473 dB/km (איור 5A,B; טבלה 3), ביצועים המתקרבים לאלו של RF אך דורשים זמני אימון ארוכים משמעותית. ה-Physics-Informed Neural Network השיג R2 = 0.8269 ו-RMSE = 2.960 dB/km (איור 5A,B; טבלה 3) והפגין ביצועים טובים יותר ממודלי הלמידה העמוקה, אך פחות טובים מגישות למידת המכונה הטובות ביותר. השוואה סטטיסטית בין מודלי RF ל-Stacking Ensemble הצביעה על כך שאין הבדל מובהק בביצועי הניבוי (טבלה 3; paired t-test: t = −1.74, p = 0.083). לפיכך, למרות ש-RF השיג את ה-R2 המספרי הגבוה ביותר, ההבדל מהגישה ההיברידית הטובה ביותר לא היה מובהק סטטיסטית.
באופן כללי, התוצאות תומכות בהשערה שגישות של למידת מכונה יכולות לחזות במדויק את הנחית האטמוספרית בתנאי מזג האוויר בעיראק. RF השיג באופן עקבי את ביצועי הניבוי הגבוהים ביותר (איור 2A,B; טבלה 3), בעוד שניתוחי חשיבות מאפיינים ו-SHAP זיהו את ריכוז האבק והראות כגורמים הסביבתיים הדומיננטיים המשפיעים על הנחית (איור 3A,B).
הצהרת נתוני תיקוף: כל הערכות המודל בוצעו על מערך הנתונים הסינתטי המפורט בסעיף השיטות. לא נעשה שימוש בנתונים ניסיוניים או תצפיתיים על ניחות אטמוספרי בתיקוף המודל. מערך הנתונים הסינתטי נוצר באמצעות מודלים פיזיקליים ידועים של התפשטות (חוק ביר-למברט, מודל Kim, מודל Carbonneau ותאוריית פיזור Mie), כאשר פרמטרים מטאורולוגיים נבחרו מהתפלגויות הסתברותיות המבוססות על רשומות אקלים מעיראק. כפי שצוין בסעיף השיטות, ביצועי הניבוי החזקים עשויים לשקף בחלקם את למידת המודל או את הקירוב שלו למשוואות הפיזיקליות הדטרמיניסטיות ששימשו ליצירת ערכי המטרה. לפיכך, מדדי ביצועים כמותיים (R2, RMSE, MAE) מייצגים ביצועים על נתונים סינתטיים שנגזרו ממשוואות, ויש לפרשם כהשוואות יחסיות בין מתודולוגיות מידול בסביבת סימולציה מבוקרת, ולא כהבטחות ביצועים מוחלטות עבור מערכות FSO תפעוליות. גישה זו מספקת סביבה מבוקרת להערכה השוואתית של מתודולוגיות מידול ניבוי (כפי שמופיע ב-טבלה 2), אך אינה מחליפה תיקוף באמצעות מדידות ניחות FSO בעולם האמיתי תחת תנאי מזג אוויר עיראקיים ממשיים.
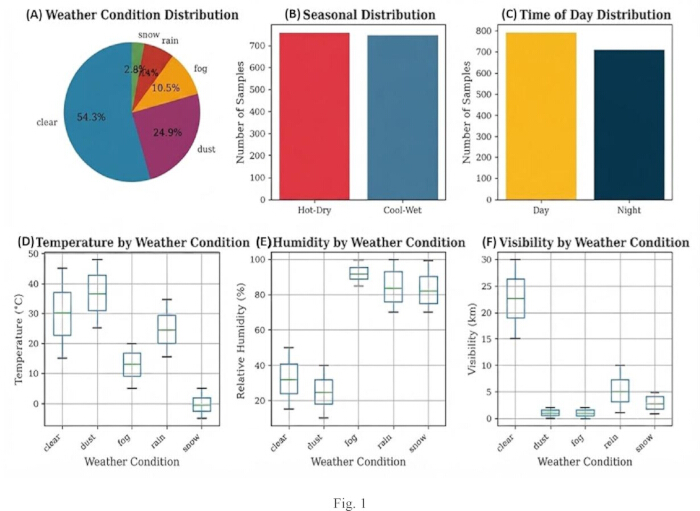
איור 1: מאפייני מערך הנתונים הסינתטי והמשתנים הסביבתיים ששימשו למידול ניחות אטמוספרי. (A) התפלגות התנאים המטאורולוגיים המיוצגים במערך הנתונים, כולל מצבים של שמיים בהירים, אבק, ערפל, גשם ושלג. (B) התפלגות עונתית של הדגימות לאורך תקופות חמות-יבשות וקרות-לחות. (C) התפלגות דגימות שנאספו בתנאי יום ולילה. (D) התפלגויות טמפרטורה עבור כל מצב מזג אוויר. (E) התפלגויות לחות עבור כל מצב מזג אוויר. (F) התפלגויות נראות עבור כל מצב מזג אוויר. תרשימי קופסה מציגים את החציון (קו מרכזי), את הטווח הבין-רבעוני (קופסה), ואת ערכי המינימום והמקסימום (שפם). טמפרטורה מדווחת ב-°C, לחות ב-% ונראות ב-km. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
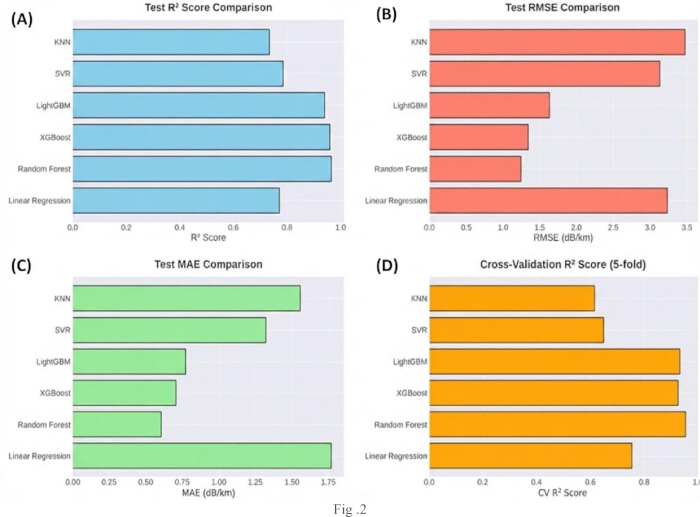
איור 2: השוואת ביצועים של מודלים של למידת מכונה לחיזוי ניחות אטמוספרי. (A) ציוני מקדם דטרמינציה (R2) בבדיקה עבור מודלי למידת המכונה שנבחנו, כולל רגרסיה ליניארית, Random Forest, Extreme Gradient Boosting (XGBoost), Light Gradient Boosting Machine (LightGBM), רגרסיית וקטורים תומכים (SVR) ו-K-Nearest Neighbors (KNN). (B) ערכי שורש ממוצע הריבועים (RMSE) בבדיקה עבור כל מודל של למידת מכונה. (C) ערכי טעות מוחלטת ממוצעת (MAE) בבדיקה עבור כל מודל של למידת מכונה. (D) ציוני מקדם דטרמינציה (R2) של תיקוף צולב שהושגו באמצעות תיקוף צולב של חמישה קיפולים (five-fold cross-validation). ערכי R2 גבוהים יותר וערכי RMSE ו-MAE נמוכים יותר מעידים על ביצועי חיזוי משופרים. RMSE ו-MAE מדווחים ב-dB/km. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
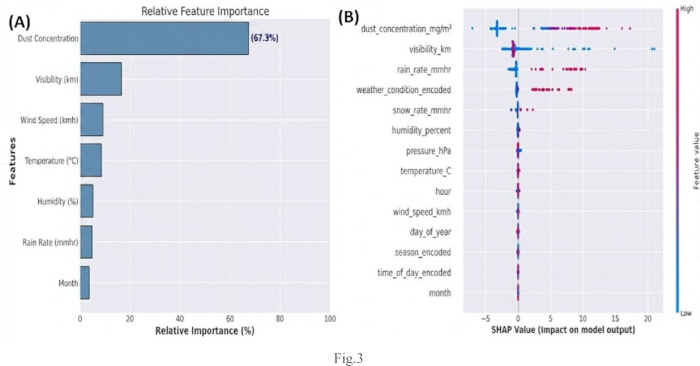
איור 3: ניתוח חשיבות מאפיינים ופרשנות מודל לחיזוי ניחות אטמוספרי. (A) דירוג חשיבות מאפיינים מבוסס זיהום יחסי (relative impurity) ממודל Random Forest, המראה את תרומתן של כל 10 המשתנים הסביבתיים והזמניים לחיזוי הניחות. המאפיין המשפיע ביותר היה ריכוז האבק (67.3%), ואחריו הראות (21.2%), קצב הגשם (6.0%), מהירות הרוח (2.1%), טמפרטורה (1.5%), לחות (0.9%), חודש (0.5%), עונה (0.3%), קצב השלג (0.1%) ולחץ אטמוספרי (0.1%). החשיבות היחסית היא אחוז מחשיבות המודל הכוללת. (B) תרשים סיכום SHapley Additive exPlanations (SHAP) הממחיש את השפעתם של מאפיינים בודדים על תחזיות המודל. מטריצת ה-SHAP חושבה עבור 300 דגימות מקבוצת הבדיקה (300 × 10 מאפיינים). עבור משתנה העונה שקודד בשיטת one-hot (במקור ארבעה עמודות בינאריות: אביב, קיץ, סתיו, חורף), ערכי ה-SHAP שולבו על ידי סיכום על פני ארבע הקטגוריות כדי להפיק ערך תרומה בודד של 'עונה' לכל דגימה. כל נקודה מייצגת דגימה, וסולם הצבעים מציין את ערך המאפיין, מנמוך (כחול) ועד גבוה (אדום). ערכי SHAP חיוביים מעידים על עלייה בניחות החזוי, בעוד שערכי SHAP שליליים מעידים על ירידה בניחות החזוי. אנא לחצו כאן להצגת גרסה מוגדלת של איור זה.
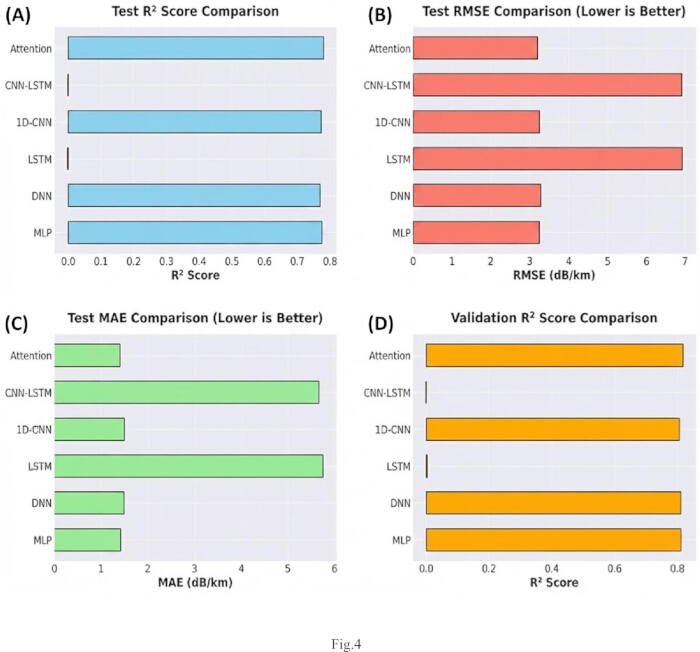
איור 4: השוואת ביצועים של מודלי למידה עמוקה לניבוי ניחות אטמוספרי. (A) ציוני מקדם דטרמינציה (R2) של הבדיקה עבור ארכיטקטורות הלמידה העמוקה שנבחנו, כולל Multilayer Perceptron (MLP), Deep Neural Network (DNN), Long Short-Term Memory (LSTM), רשת עצבית קונבולוציונית חד-ממדית (1D-CNN), Convolutional Neural Network–Long Short-Term Memory (CNN–LSTM), ומודלים מבוססי Attention. (B) ערכי שגיאת השורש הממוצעת של הריבועים (RMSE) של הבדיקה עבור כל מודל למידה עמוקה. (C) ערכי השגיאה המוחלטת הממוצעת (MAE) של הבדיקה עבור כל מודל למידה עמוקה. (D) ציוני מקדם דטרמינציה (R2) של האימות עבור מודלי הלמידה העמוקה שנבחנו. ערכי R2 גבוהים יותר וערכי RMSE ו-MAE נמוכים יותר מעידים על ביצועי ניבוי משופרים. RMSE ו-MAE מדווחים ביחידות של dB/km. אנא לחץ כאן כדי לצפות בגרסה מורחבת של איור זה.
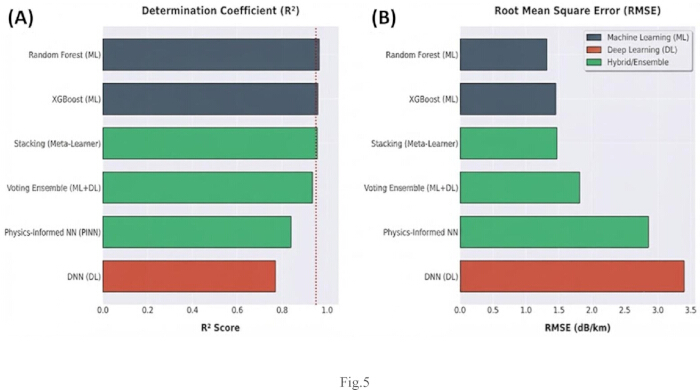
איור 5: ביצועים השוואתיים של מודלים של למידת מכונה, למידה עמוקה ומודלים היברידיים לניבוי ניחות אטמוספרי. (A) ערכי מקדם הדטרמינציה (R2) עבור גישות מייצגות של למידת מכונה, למידה עמוקה וגישות היברידיות, כולל מודלים של Random Forest, Extreme Gradient Boosting (XGBoost), רשת עצבית עמוקה (DNN), Voting Ensemble, Stacking ו-Physics-Informed Neural Network. (B) ערכי שגיאת השורש הממוצעת של הריבועים (RMSE) עבור אותם מודלים. למידת מכונה (ML), למידה עמוקה (DL) וטכניקות היברידיות/אנסמבל הן שלוש הקטגוריות שעל פיהן המודלים מקודדים בצבעים. ביצועי ניבוי משופרים מצוינים על ידי ערכי R2 גבוהים יותר וערכי RMSE נמוכים יותר. RMSE מבוטא ביחידות של dB/km. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
| תנאי מזג אוויר | פרופורציה | טווח טמפרטורות | טווח לחות | טווח נראות | טווח הפרמטרים העיקריים |
| שמיים בהירים | 54.27% (814 דגימות) | עד −4.89 47.99°C | 0–100% | >10 ק"מ | — |
| אבק | 25.00% (375 דגימות) | 10–45°C | 10–60% | 0.05–5 ק"מ | אבק: 0–4.96 mg/m³3 |
| ערפל | 10.47% (157 דגימות) | מ-5- עד 20°C | 70–100% | 0.05–1 ק"מ | — |
| גשם | 7.40% (111 דגימות) | 5–30°C | 60–100% | 1–10 ק"מ | גשם: 0.25–50 מ"מ/שעה |
| שלג | 2.87% (43 דגימות) | 10- עד 5°C | 50–100% | 0.5–5 ק"מ | שלג: 0.5–15 מ"מ/שעה |
טבלה 1: מדדי ביצועים של מודלי למידת מכונה לניבוי ניחות אטמוספרי.
| מודל | בדיקת R2 | RMSE (dB/km) | MAE (דציבל/ק"מ) | CV R2 | זמן אימון (שניות) |
| יער אקראי (Random Forest) | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| רגרסיית וקטורים תומכים (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| רגרסיה ליניארית | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| K-שכנים קרובים (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
טבלה 2: הערכה השוואתית של מודלי למידה עמוקה, מודלים היברידיים ומודלי למידת מכונה ספציפיים.
| מודל | קטגוריה | בדיקת R2 | RMSE (dB/km) | דירוג |
| יער אקראי | למידה מכונה | 0.9654 | 1.324 | 1 |
| XGBoost | למידת מכונה | 0.9582 | 1.455 | 2 |
| מכלול ערימה (Stacking Ensemble) | היברידי | 0.9571 | 1.473 | 3 |
| LightGBM | למידת מכונה | 0.9507 | 1.581 | 4 |
| מכלול הצבעה | היברידי | 0.934 | 1.827 | 5 |
| רשת עצבית מונחית פיזיקה | היברידי | 0.8269 | 2.96 | 6 |
| תשומת לב | למידה עמוקה | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
טבלה 3: השוואה של יעילות החישוב (אימון והסקה) של כל מודל שנבדק.
נתונים זמינות:
סט הנתונים הסינתטי המלא הכולל 1,500 דגימות עם כל מאפייני הקלט (טמפרטורה, לחות, נראות, ריכוז אבק, קצב גשם, קצב שלג, מהירות רוח, לחץ אטמוספרי, חודש, עונה ומצב מזג האוויר) והמשתנה המטרה (ניחות ב-dB/km) מסופק כקובץ נלווה למאמר זה בכתובת https://doi.org/10.5281/zenodo.21792999. סט הנתונים מעוצב כך שכל דגימה מופיעה בשורה אחת, הכוללת את כל המשתנים המחושבים (טווח פעולה ו-SNR).
קוד המימוש המלא, הכולל: סקריפטים ליצירת נתונים (מימושים של מודלים פיזיקליים); פונקציות לעיבוד מקדימה ונרמול תכונות (feature scaling); את כל מימושי מודלי הלמידה המכונה; את כל מימושי מודלי הלמידה העמוקה; סקריפטים להערכה וויזואליזציה; ונהלי כוונון היפר-פרמטרים וולידציה צולבת (cross-validation), אמור להיספק גם הוא כקובץ נלווה.
נתוני אקלים ממקור: נתוני האקלים ששימשו להגדרת התפלגויות הנתונים הסינתטיים התקבלו מהארגון המטאורולוגי והסייסמולוגי העיראקי (IMOS) וממשרד התחבורה העיראקי, ומכסים את התקופה 2020–2024. סיכום של נתוני האקלים ששימשו לקביעת הפרופורציות של תנאי מזג האוויר וטוהי הפרמטרים מופיע ב-טבלה נספחת 1. רשומות ה-IMOS הספציפיות ששימשו במחקר זה אינן מאורכבות באופן ציבורי במאגר מרכזי, אך ניתן לבקשן ישירות מ-IMOS. הסטטיסטיקות המסכמות והתפלגויות ההסתברות הנגזרות מסופקות בחומרי העזר כדי לאפשר שחזור של המחקר.
מידע על המאגר: קוד המקור ומערך הנתונים הופקדו במאגר ציבורי (Zenodo) בכתובת https://doi.org/10.5281/zenodo.21792999.
דיון
על מנת לחזות את הנחטת האוויר במערכות תקשורת FSO הפועלות תחת תנאי מזג האוויר של עיראק, המחקר הנוכחי העריך טכניקות של למידת מכונה, למידה עמוקה ושיטות היברידיות. מכיוון שהשפעות אטמוספריות ממשיכות להיות אחת מהבעיות המרכזיות המשפיעות על ביצועי הקישור וזמינותו, הערכות אחרונות הדגישו את החשיבות הגוברת של מידול חיזוי עבור מערכות FSO21. התוצאות הראו כי גישות קלאסיות של למידת מכונה, ובמיוחד RF ו-XGBoost, סיפקו דיוק חיזוי גבוה ובמקרים מסוימים עלו באופן מספרי על שיטות למידה עמוקה ושיטות היברידיות. עם זאת, מבחנים סטטיסטיים לא הראו הבדל משמעותי (p=0.083) בין RF לבין האנסמבל ההיברידי הטוב ביותר (Stacking), מה שאומר ששתי הגישות יכולות להגיע לתוצאות דומות במערך נתונים זה. הממצאים שלנו מצביעים על כך ששיטות אנסמבל מבוססות-עצים עדיין בעלות ביצועים גבוהים עבור נתונים סביבתיים טבלאיים עם גדלי מדגם בינוניים ומספר קטן של משתני ניבוי דומיננטיים. ניתוח של חשיבות המאפיינים הראה כי ריכוז האבק והראות היו הגורמים המרכזיים להנחתה, ויחד הסבירו את רוב כוח הניבוי. ממצא זה תואם למחקרים קודמים שהראו את ההשפעה החשובה של ערפל, אבק, אירוסולים וזיהום אטמוספרי על התפשטות האות האופטי22,23,24,25. ממצאים דומים דווחו ביישומי ניטור סביבתי, שבהם מודלים של למידת מכונה מפיקים לעיתים קרובות תועלת ממערכי נתונים המכילים מספר קטן של משתנים בעלי ערך אינפורמטיבי גבוה26,27,28,29,30,31,32. ניתוח SHAP שיפר עוד יותר את יכולת הפרשנות של המודל על ידי כימות ההשפעה של פרמטרים סביבתיים בודדים על תחזיות ההנחתה.
ניתן לייחס את הביצועים הנמוכים יותר של מודלי למידה עמוקה למספר גורמים. גודל מערך הנתונים היה צנוע יחסית לאימון ארכיטקטורות עצביות מורכבות (ב-https://doi.org/10.5281/zenodo.21792999), והמשתנים הסביבתיים הראו חשיבות תכונות מרוכזת מאוד. מחקרים קודמים הראו כי שיטות למידה עמוקה מפיקות תועלת בדרך כלל ממערכי נתונים גדולים, מבני תכונות היררכיים וייצוגים לא-ליניאריים מורכבים33,34,35,36,37. לעומת זאת, מערך נתוני הנחטות ששימש במחקר זה הכיל מספר מוגבל של מנבאים דומיננטיים והיה חסר את התלויות הזמניות הנדרשות לארכיטקטורות רקורסיביות. הביצועים הדלים של מודלי LSTM ו-CNN–LSTM מרמזים כי מנגנוני למידה סדרתיים עשויים שלא לספק יתרונות משמעותיים עבור יישום זה.
ניתן לייחס את הדומיננטיות של ריכוז האבק (67.3%) והנראות (21.2%) כמנבאים של ניחות אטמוספרי למספר גורמים. ראשית, הפיזור והבליעה המולקולריים ב-1550 nm נדחקים לצל על ידי פיזור Mie מחלקיקי אבק. בתאוריית Mie, יעילות ההכחדה Q_ext רגישה מאוד לריכוז החלקיקים, והניחות משתנה כמעט ליניארית עם ריכוז האבק במשטר של ריכוז בינוני עד גבוה. שנית, עיראק חשופה לסופות אבק תכופות (25.00% מהימים ברישומי האקלים שלנו), הגורמות לערכי ניחות של 4–30 dB/km. זאת בניגוד לערפל (10.47%, 0.5–10 dB/km) וגשם (7.40%, 2–25 dB/km). השונות הגבוהה יותר בניחות של אבק מספקת אותות חזקים יותר עבור המודלים ללמידה. שלישית, ההתפלגות האקספוננציאלית של ריכוז האבק (0.4–4.96 mg/m3) מייצרת טווח רחב של ערכי ניחות. הזנב הארוך של אירועי אבק קיצוניים מניב ערכי ניחות גבוהים, החיוניים לניבוי מדויק. רביעית, למודל פיזור Mie יש תלות פשוטה יותר (בערך ליניארית) בריכוז האבק, אשר קלה יותר לקירוב עבור מודלים מבוססי עצים בהשוואה לקשר המורכב יותר בין נראות לניחות ערפל במודל Kim. חמישית, לממצא זה יש משמעות מעשית מכיוון שסופות אבק הן אחד התנאים הסביבתיים המאתגרים ביותר עבור FSO במזרח התיכון. ניבוי מדויק במהלך אירועי אבק הוא חיוני להפעלה אמינה של המערכת.
הממצאים מקדמים את המחקר בתחום תקשורת FSO על ידי מתן הנחיה מעשית לבחירת אלגוריתמים לחיזוי ניחות אטמוספרי. חיזוי מדויק של הניחות חיוני לתכנון רשתות, ניהול קישוריות אדפטיבי ופריסה אמינה של מערכות תקשורת אופטית בסביבות מאתגרות כגון המזרח התיכון23,28,30,36. בנוסף, ייתכן שהמתודולוגיה תהיה ישימה לבעיות חיזוי סביבתיות אחרות הכוללות התפשטות באוויר, ניטור אטמוספרי והערכת ביצועים של רשתות אופטיות38,39,40. שימוש במאגרי נתונים גדולים יותר מהעולם האמיתי, טכניקות למידה מרוכבת (ensemble learning) מתוחכמות, מסגרות למידה בהעברה (transfer learning), או ארכיטקטורות מורכבות יותר מבוססות פיזיקה (physics-informed) הן דוגמאות לשיטות נוספות לבחינת רעיון זה41,42,43,44,45.
היקף המסקנות וסוגיות של הכללה
מסקנות עבודה זו מבוססות בעיקר על מערך נתונים סינתטי שנוצר ממודלים פיזיקליים מבוססים של התפשטות (חוק ביר-למברט, מודל Kim, מודל Carbonneau ותאוריית פיזור Mie). לגישה מתודולוגית זו ישנן השלכות מסוימות על היקף הממצאים שלנו והכללה שלהם:
מסקנות מנתונים מסומולצים: (1) דירוג ביצועים השוואתי של למידה מכונה, למידה עמוקה וגישות היברידיות לניבוי ניחות אטמוספרי. (2) זיהוי ריכוז אבק ונראות כגורמי הניבוי הסביבתיים הדומיננטיים של ניחות אופטי תחת התנאים הממודלים. (3) יתרון ביעילות חישובית של שיטות אנסמבל מבוססות עץ על פני ארכיטקטורות של למידה עמוקה. (4) יכולת פרשנות של חשיבות מאפיינים וניתוחי SHAP להסברת תחזיות המודל.
מסקנות הדורשות אישור בעולם האמיתי: (1) הערכים המוחלטים של R2 ו-RMSE שהתקבלו מהמודלים שנבחנו תלויים במאפיינים הספציפיים של מערך הנתונים הסינתטי, וייתכן שהם משקפים את למידת המשוואות הפיזיקליות הדטרמיניסטיות ששימשו ליצירת יעדי המודל. (2) טרם הוכח כי ניתן להחיל את המודל הטוב ביותר, Random Forest, על תנאי אטמוספירה לא ידועים בעולם האמיתי. (3) תיקוף שטח הוא הכרחי כדי שהממצאים יהיו ישימים ליחידות FSO מבצעיות המותקנות בעיראק. (4) יש לאשר כי דירוגי חשיבות המאפיינים שזוהו הם עמידים בתנאי מדידה בשטח.
חשוב להבחין בין ביצועים על נתונים סינתטיים הנגזרים ממשוואות לבין ביצועים על נתונים תצפיתיים או ניסויים רועשים. מערך הנתונים הסינתטי מספק קשר נקי וללא רעש בין מאפייני הקלט ליעד הניחות, דבר שעשוי להוביל למדדי ביצועים חיזויים גבוהים יותר מאלו שניתן להשיג עם נתונים מהעולם האמיתי הכוללים רעשי מדידה, שגיאות מכשירים ותופעות פיזיקליות שלא מודלו. אנו ממליצים כי עבודות עתידיות יופנו להשגת מדידות ניחות FSO מהעולם האמיתי תחת תנאי מזג האוויר בעיראק, כדי לתקף את התוצאות המוצגות במחקר זה ולהעריך את יכולת ההכללה האמיתית של המתודולוגיות המוצעות.
השלכות של נתונים סינתטיים על יכולת ההכללה של המודל
יש לשקול בקפידה את ההשלכות של השימוש בנתונים סינתטיים במחקר זה לצורך הכללת המודלים:
יתרונות הגישה הסינתטית: מערך הנתונים עקבי מבחינה פיזיקלית ומבוסס על מסגרות תיאורטיות מקובלות, תוך שימוש במודלים פיזיקליים מבוססים של התפשטות גלים. פרמטרים מטאורולוגיים הופקו מרשומות מטאורולוגיות של עיראק, כדי שמערך הנתונים ישקף את התכונות הסטטיסטיות של תנאי מזג האוויר האמיתיים בעיראק. בנוסף להימנעות ממשתנים מתערבים של מדידות שטח (כגון שגיאות מדידה, כיול ציוד או רשומות נתונים לא מספיקות), הגדרה מבוקרת זו מאפשרת בחינה שיטתית של מתודולוגיות מידול.
מגבלות ההכללה: למערך הנתונים הסינתטי יש מגבלות בייצוג המורכבות המלאה של ניחות אטמוספרי ממשי, הכוללות: (1) אינטראקציה בין תופעות אטמוספריות מרובות המתרחשות בו-זמנית; (2) התנהגות לא ליניארית ולא סטציונרית של פרמטרים אטמוספריים; (3) שונות אקלימית ארוכת טווח שאינה נלכדת על ידי התפלגויות הדגימה; (4) השפעות מיקרו-אקלימיות מקומיות שעשויות להשפיע באופן משמעותי על התפשטות FSO; ו-(5) רעש ואי-ודאות הגנונים לאיסוף נתונים בעולם האמיתי.
שיקולי הטיות ביצירת נתונים סינתטיים הנחת הדגימה הבלתי תלויה של פרמטרים סביבתיים (ראו שיטות) היא פישוט יתר של תנאי העולם האמיתי, שבהם משתנים אטמוספריים נוטים להיות במתאם (למשל, ריכוזי אבק גבוהים נוטים להיות במתאם עם ראות נמוכה). הנחת אי-תלות נקבעה עבור סביבת סימולציה מבוקרת לצורך השוואה שיטתית של מודלים. עם זאת, שיטה זו עשויה שלא ללכוד את מלוא המורכבות של האינטראקציות בין הפרמטרים האטמוספריים. אנו משתמשים בשיטת פיצול מותיר (stratified splitting), השומרת על היחסים של תנאי מזג האוויר בקבוצות האימון והבדיקה, כדי לצמצם את הסיכוי לייצוג לא מאוזן של תנאים נדירים בקבוצת הבדיקה (במיוחד שלג ב-2.87%).
יצירת מטרות דטרמיניסטית: הביצועים החיזויים הגבוהים שנצפו במחקר זה עשויים להיות מוסברים בחלקם על ידי למידת המודלים של המשוואות הפיזיקליות הדטרמיניסטיות ששימשו ליצירת ערכי המטרה. לעומת זאת, נתונים ניסיוניים מהעולם האמיתי מכילים רעשי מדידה, שגיאות מכשירים ותופעות פיזיקליות שלא מודלו, ההופכים את החיזוי למאתגר יותר. לפיכך, יש לפרש את מדדי הביצועים הכמותיים (R2, RMSE, MAE) כהשוואות יחסיות בין מתודולוגיות בסביבת סימולציה מבוקרת, ולא כהבטחות ביצועים מוחלטות עבור מערכות FSO מבצעיות.
לפיכך, בעוד שהתוצאות ההשוואתיות בדירוגי ביצועי המודלים הן ככל הנראה חסונות (בשל העקביות הפיזיקלית של הנתונים הסינתטיים), אין לראות במדדי הביצועים המוחלטים (R2, RMSE, MAE) כאינדיקציה לביצועים הצפויים במערכות FSO מבצעיות. יש צורך לבחון את יכולת ההכללה של המודל לתנאי העולם האמיתי באמצעות מדידות ניסיוניות של ניחות אוויר שהתקבלו תחת תנאי מזג אוויר שונים בעיראק.
ישנן מספר מגבלות שיש להיות מודעים להן. ראשית, במקום להשתמש בתצפיות שטח, המחקר התבסס על מערך נתונים סינתטי שהופק באמצעות מודלים פיזיקליים מוכרים של התפשטות. כפי שנאמר קודם לכן, במקום לספק ערבויות ביצועים מוחלטות למערכות FSO מבצעיות, יש לראות במדדי הביצועים הכמותיים (R2, RMSE, MAE) השוואות יחסיות של גישות בסביבת סימולציה מבוקרת. שנית, ייתכן שמודלים סטנדרטיים לעומת מודלים של למידה עמוקה לא הצליחו ללמוד ייצוגי מאפיינים חסונים בשל גודל מערך הנתונים. שלישית, מדדי ביצועים אחרים של FSO, כגון זמינות קישור, שגיאות כיוון ונשיגה הנגרמת מטurbulence, לא נלקחו בחשבון לטובת חיזוי הניחות. רביעית, רשומות היסטוריות מהשנים 2020 עד 2024 שימשו לחישוב הפרופורציות של תנאי מזג האוויר, אשר עשויות שלא לשקף במדויק וריאציות בדפוסי האקלים העיראקי משנה לשנה. חמישית, מבנה נתוני הקלט הפסאודו-סקוונציאלי של מודלי CNN–LSTM ו-LSTM הוא פישוט מתודולוגי שעשוי שלא ללכוד כראוי את הדינמיקה הזמנית של יישומים בעולם האמיתי. בעת הערכת התוצאות, יש לקחת בחשבון מגבלות אלו שכן עשויות להיות להן השפעה על יכולת ההכללה של הממצאים.
עדיפות מומלצת: אימות בעולם האמיתי. איסוף וניתוח של מדידות ניחות FSO בפועל תחת תנאי מזג האוויר בעיראק הוא נתיב העבודה העתידי הקריטי ביותר. זה צריך לכלול: (1) הקמת מעמדי בדיקה של FSO בחלקים שונים של עיראק (למשל, בגדאד, בסרה, מוסול, רמדי) כדי לתעד וריאציות אקלימיות אזוריות; (2) שימוש במכשירים מכויילים במיקומי FSO למדידה סימולטנית של פרמטרים אטמוספריים (טמפרטורה, לחות, ראות, ריכוז אבק); (4) תיעוד הניחות במהלך אירועי מזג אוויר קיצוניים (סופות אבק, ערפל כבד, גשם כבד); (5) הנגשת הנתונים שנאספו לציבור כדי לאפשר שחזור ומחקר השוואתי; ו-(3) המשך ניטור למשך מחזור שנתי מלא אחד לפחות כדי ללכוד את התנודות העונתיות. תיקוף מעשי כזה יספק הזדמנות להעריך את יכולת ההכללה של המודל ולשפר את טכניקות החיזוי שפותחו במחקר זה.
כדי לתקף ולשפר את המודלים שנוצרו, מחקרים עתידיים צריכים להתמקד בשילוב של מדידות FSO בפועל שהתקבלו בתנאי מזג האוויר בעיראק. מחקרים נוספים עשויים לבחון אסטרטגיות של למידה בהעברה (transfer learning) המנצלות מאגרי נתונים אטמוספריים רלוונטיים, תוכניות למידה מקוונת המתאימות את עצמן לתנאי סביבה משתנים, ואסטרטגיות היברידיות של ניסוי-סימולציה המשלבות נתונים נמדדים עם מודלים פיזיקליים. מחקרים נוספים בתחומי ה-AI ההסברי (explainable AI) וגישות למידה מתוחכמות מבוססות פיזיקה עשויים לשפוך אור רב יותר על המנגנונים העומדים בבסיס הניחות של האוויר ולחזק את העמידות של מערכות ניבוי עתידיות.
גילויים
ניגוד עניינים: המחברים מצהירים כי אין ניגודי עניינים.
תודות
המחברים מצהירים כי לא התקבל מימון חיצוני למחקר זה. אנו מודים למרכז הבינלאומי למחקר יישומי ותיאורטי (IATRC), רובע בגדד, עיראק.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| CUDA Toolkit | NVIDIA Corporation | 11.8 | ספריית האצה של GPU לאימון למידה עמוקה |
| cuDNN | NVIDIA Corporation | 8.6.0 | ספריית רשתות עצביות עמוקות מואצת GPU |
| GPU (יחידת עיבוד גרפי) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | משמש לאימון למידה עמוקה מואץ GPU |
| CPU (יחידת עיבוד מרכזית) | Intel Corporation | Core i9-13900K, 24 cores/32 threads | מעבד תחנה לאימון והערכה של כל המודלים |
| זיכרון מערכת (RAM) | n/a | 64 GB DDR5, 5200 MHz | זיכרון תחנה |
| Keras API | Open source (part of TensorFlow) | bundled with TensorFlow 2.11.0 | API ברמה גבוהה ללמידה עמוקה המשמש לכל ארכיטקטורות ה-DL |
| LightGBM | Open source (Microsoft) | 3.3.5 | מסגרת עבודה ל-Gradient boosting |
| NumPy | Open source (NumFOCUS) | 1.23.5 | ספריית חישובים נומריים |
| מערכת הפעלה | Canonical Ltd. | Ubuntu 22.04 LTS | מערכת הפעלה של תחנת העבודה |
| Python | Python Software Foundation | 3.9 | שפת תכנות המשמשת לכל תהליכי יצירת הנתונים והמידול |
| scikit-learn | Open source | 1.2.2 | ספריית למידה מכונה (RF, SVR, KNN, Linear Regression, cross-validation, scaling) |
| SHAP (SHapley Additive exPlanations) | Open source | 0.41.0 | ספרייה לפרשנות מודלים, מודול TreeExplainer |
| TensorFlow | Open source (Google) | 2.11.0 | מסגרת עבודה ללמידה עמוקה המשמשת לכל שש ארכיטקטורות ה-DL |
| XGBoost | Open source | 1.7.5 | ספריית Extreme Gradient Boosting |
מקורות
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.