פרוטוקול זה מציע את FedMediFormer-XAI, מסגרת בינה רב-מודאלית לסוכרת השומרת על הפרטיות באמצעות למידה מבוזרת (federated learning), טרנספורמרים רב-מודאליים, הרחבת נתונים מבוססת דיפוזיה, המלצה מותאמת אישית לתרופות מבוססת גרפים ובינה מלאכותית ניתנת להסבר, לצורך חיזוי מדויק, קבלת החלטות שקופה וניהול מותאם אישית של מחלת הסוכרת.
מאמר שיטה
FedMediFormer-XAI: טרנספורמרים רב-מודאליים פדרטיביים עם הגברה באמצעות דיפוזיה והמלצה על תרופות מבוססת גרפים לסוכרת
במאמר זה
סיכום
תקציר
ניהול מחלת הסוכרת ניצב בפני מספר מכשולים, כגון נתוני בריאות מקוטעים, חששות הנוגעים לפרטיות, יכולת הסבר נמוכה ומחסור בהנחיה טיפולית מותאמת אישית. עבודת מחקר זו מציגה את FedMediFormer-XAI, מסגרת מאוחדת ומתאימה המשלבת למידה פדרטיבית (federated learning), טרנספורמרים מולטי-מודאליים, הרחבת נתונים מבוססת דיפוזיה (diffusion-based data augmentation), רשתות נוירונים גרפיות (GNNs) להמלצה על תרופות, ובינה מלאכותית ניתנת להסבר (XAI) לצורך בינה בתחום הסוכרת. המערכת משתמשת בסוגים מגוונים של נתוני בריאות, כגון רשומות קליניות, מדדי בריאות אוכלוסייה, נתוני ניטור רציף של גלוקוז, תמונות קרקית העין, מדידות מחיישנים לבישים ומידע פרמקולוגי. כדי לייצר דגימות סינתטיות ולטפל בחוסר איזון בין מחלקות, נעשה שימוש במודלי דיפוזיה, וארכיטקטורות של טרנספורמרים מולטי-מודאליים מיושמות כדי ללמוד קשרים בין מקורות נתונים שונים מאוד. למידה פדרטיבית מאפשרת אימון שיתופי של מודלים באופן השומר על פרטיות ללא שיתוף נתוני מטופלים גולמיים. רכיב ה-GNN לוכד אינטראקציות בין מטופל לתרופה ובין תרופה לתרופה לצורך המלצות תרופתיות מותאמות אישית. שיטות הסבר כגון SHapley Additive exPlanations (SHAP), ויזואליזציה של תשומת לב (attention visualization), גרדיאנטים אינטגרליים (Integrated Gradients) והסקה נגדית (counterfactual reasoning) מספקות פרשנויות שקופות של תוצאות החיזוי וההמלצה. במימוש המייצג, המסגרת המוצעת השיגה דיוק (accuracy) של 94.2%, ערך ניבוי חיובי (precision) של 93.1%, רגישות (recall) של 92.8%, מדד F1 של 92.9%, מקדם מתאם של מטיוס (MCC) של 0.88, ושטח תחת העקומה של מאפייני תפעול מקבל (AUC-ROC) של 0.96. מודול ההמלצות מבוסס הגרף השיג precision = 0.89, recall = 0.84, ו-Normalized Discounted Cumulative Gain (NDCG) = 0.91. הפרוטוקול מספק גישה מובנית לשילוב נתוני בריאות הטרוגניים באמצעות טרנספורמרים מולטי-מודאליים, למידה פדרטיבית, הרחבה מבוססת דיפוזיה, המלצות מבוססות גרף ובינה מלאכותית ניתנת להסבר. התוצאות החישוביות המדווחות מדגימות את הפוטנציאל של המסגרת לחיזוי סוכרת ולהמלצה על תרופות מותאמות אישית, בעוד שהתכנון הפדרטי תומך בטיפול מבוזר בנתונים. נדרשת הערכה קלינית פרוספקטיבית רב-מרכזית כדי לבסס את התועלת הקלינית, את יכולת ההכללה ואת הישימות בעולם האמיתי.
מבוא
סוכרת (Diabetes mellitus) היא אחת מהמחלות המטבוליות הכרוניות השכיחות ביותר הפוגעות בבני אדם ומהווה בעיה מרכזית של בריאות הציבור בשל התפשטותה, השפעותיה ארוכות הטווח והעלויות העצומות של טיפול בחולים1,2. על פי דוח, כיום חיים ברחבי העולם למעלה מ-537 מיליון מבוגרים עם סוכרת, ומספר זה צפוי לעלות באופן משמעותי במהלך העשורים הבאים3. אם רמות הסוכר הגבוהות בדם אינן נשלטות, האדם יסבול מהסיבוכים החמורים ביותר, כגון מחלה כלילית של הלב4, נזקי כליות5, נזקי עצבים6, אובדן ראייה7 ושבץ מוחי8. לכן, זיהוי המחלה בשלב מוקדם, ניטור קבוע של מצב המטופל והקניית הכשרה באמצעות גישות רפואיות מתקדמות הם צעדים הכרחיים כדי לסייע לחולים לחיות חיים בריאים יותר, ובכך לצמצם את הוצאות מערכת הבריאות של המדינה9,10.
כיום, השימוש ברשומות רפואיות אלקטרוניות (EHRs), מכשירים לבישים, מערכות לניטור רציף של גלוקוז (CGM), טכנולוגיות לדימות רשתית ואפליקציות לבריאות ניידת מתפשט במהירות, ומייצר נפחים גדולים של נתוני בריאות הטרוגניים שניתן לנתח11. כלי איסוף נתונים מגוונים אלו יכולים לספק מידע רב על גוף האדם, על יכולת התפקוד שלו בשלבים שונים של מחלה, על האופן שבו המטופל מגיב לסוגים שונים של טיפול ועל התנהגותו בחיי היומיום12. בינה מלאכותית (AI) הוכחה כפתרון הטוב ביותר לעיבוד נתונים מורכבים ביותר, לחיזוי סוכרת, לניטור המחלה ולסיוע לרופאים בקבלת החלטות קליניות13. יתרה מכך, אלגוריתמים של למידת מכונה, כולל יערות אקראיים (random forests), מכונות וקטור תמיכה (support vector machines) ושיטות gradient boosting, הניבו תוצאות מצוינות בהערכת סיכון לסוכרת14. לאחרונה, ארכיטקטורות של למידה עמוקה אפשרו חילוץ אוטומטי של מאפיינים ושיפרו את ביצועי הניבוי במגוון יישומים של שירותי בריאות15.
באמצעות שיטות למידה מולטי-מודאליות, הבינה של מערכות לניבוי סוכרת שופרה משמעותית על ידי מיזוג רשומות קליניות מובנות, מדידות פיזיולוגיות, תמונות רשתית ומדדים התנהגותיים למסגרת חיזוי אחת16. באמצעות מקורות מידע מרובים, מודלים מולטי-מודאליים יכולים לזהות דפוסים שאינם נראים כאשר כל מודאליות נבחנת בנפרד17. מודלים מבוססי Transformer למדו לאחרונה תלויות ארוכות-טווח ומערכות יחסים הקשריות מסוגים שונים של נתוני בריאות בצורה יעילה מאוד18. עם זאת, בעיות כגון מחלקות לא מאוזנות (unbalanced classes), נתונים חסרים, הטרוגניות של נתונים ויכולת הכללה מוגבלת עדיין מונעות את השימוש הנרחב במערכות AI מולטי-מודאליות בסביבות קליניות19.
על אף התפתחויות אלו, מערכות בינה רבות קיימות לסוכרת עדיין מסתמכות על מסגרות למידה מרכזיות, הדורשות מטבען איחוד של נתוני מטופלים ממוסדות שונים למאגר יחיד20. שיטות מעין אלו מובילות כבר כעת למחלוקות בנושאי פרטיות מטופלים, משמורת נתונים, אבטחת סייבר ועמידה ברגולציה21. למעשה, בשל שיקולים משפטיים ואתיים, ספקי שירותי בריאות מוגבלים לעיתים קרובות ביכולתם לשתף נתונים רגישים של מטופלים22. בהקשר זה, למידה פדרטיבית (federated learning) הופכת לפתרון בר-ביצוע, שכן היא מאפשרת אימון של מודל שיתופי ללא שיתוף נתוני המטופלים בפועל23. באמצעות אופטימיזציה מבוזרת ואגרגציה מאובטחת של פרמטרים, למידה פדרטיבית מאפשרת ניתוח בריאותי תוך הגנה על הפרטיות, על ידי ניצול ידע ממאגרי נתונים המפוזרים גיאוגרפית24. עם זאת, עומס תקשורתי, הטרוגניות של לקוחות ויציבות התכנסות עדיין מהווים בעיות מרכזיות בתרחישי בריאות פדרטיביים25.
חיסרון נוסף של מערכות הבינה המלאכותית לסוכרת שבשימוש כיום הוא חסרונם של שקיפות ותמיכה בטיפול מותאם אישית. מודלים רבים של למידה עמוקה מתנהגים כ"קופסאות שחורות", דבר המהווה בעיה עבור קלינאים המעוניינים להבין את הנימוקים העומדים בבסיס התחזיות וההמלצות26. שיטות של בינה מלאכותית ניתנת להסבר (XAI), כגון SHAP, Integrated Gradients, ויזואליזציה של קשב (attention visualization) והסקה נגדית (counterfactual reasoning), מוכיחות פוטנציאל רב לשיפור שקיפות המודל ואמון הקלינאים27. בנוסף לכך, רשתות עצביות גרפיות (GNNs) הפכו לכלים המתקדמים ביותר ללכידת אינטראקציות בין מטופל לתרופה ובין תרופה לתרופה, מה שמוביל להמלצות תרופתיות מותאמות אישית ולהערכת בטיחות של תרופות28. מודלי דיפוזיה חדשים הציגו גם פתרונות ליצירת נתוני בריאות סינתטיים אותנטיים ולטיפול בחוסר איזון בין מחלקות (class imbalance)29.
טרנספורמרים, למידה פדרטיבית (federated learning), יצירת נתונים סינתטיים מבוססת דיפוזיה, רשתות נוירונים גרפיות ובינה מלאכותית ניתנת להסבר הראו כולם תוצאות מבטיחות ביישומים בתחום הבריאות; עם זאת, שילובם במסגרת אחת ניתנת לשחזור של בינה לסוכרת נותר מוגבל. גישות קיימות מטפלות בדרך כלל ברכיבים אלה באופן עצמאי, תוך התמקדות בלמידה השומרת על פרטיות ללא המלצות לטיפול מותאם אישית, בחיזוי רב-מודלי ללא אימון מבוזר, או ביכולת הסבר ללא תמיכה בקבלת החלטות קליניות מבוססת גרפים. למרות שמודלי דיפוזיה יכולים לתמוך באיזון מחלקות וארכיטקטורות טרנספורמרים יכולות ללמוד קשרים בין מודליות בריאות הטרוגניות, פרוטוקולים סטנדרטיים לשילוב טכנולוגיות משלימות אלו נותרים מוגבלים. לפיכך, עבודה זו מציגה פרוטוקול מתודולוגי מאוחד המשלב חיזוי רב-מודלי, הרחבת נתונים מבוססת דיפוזיה, אופטימיזציה פדרטיבית, המלצה מותאמת אישית לתרופות מבוססת גרפים ובינה מלאכותית ניתנת להסבר בתוך זרימת עבודה ניתנת לשחזור, תוך מתן בסיס לתיקוף קליני ותרגום ליישום עתידי.
בניגוד למחקרים המניחים זמינות של מערכי נתונים מולטי-מודאליים ברמת המטופל, פרוטוקול זה משלב מערכי נתונים ציבוריים הטרוגניים ללא ביצוע התאמה ישירה בין מטופלים. מודלים עצמאיים ספציפיים למודאליות מאומנים עבור כל מקור נתונים, והטמעות של מאפיינים חבויים (latent feature embeddings) משולבות באמצעות מנגנון קשב חוצה-מודאליות (cross-modal attention mechanism). תכנון זה שומר על קפדנות מתודולוגית תוך שכלול אינטגרציה של ידע מולטי-מודאלי על פני מאגרי בריאות מגוונים.
הפרוטוקול המוצע מיועד בעיקר לפיתוח מתודולוגי ולסביבות בינה מלאכותית (AI) בשירותי בריאות מבוזרים, שבהן מקורות נתונים הטרוגניים זמינים במאגרים או במוסדות נפרדים והריכוז הישיר של הנתונים מוגבל. ביישום הנוכחי, מערכי הנתונים הספציפיים למודליות הם עצמאיים ואינם תואמים לרמת המטופל; לכן, אינטגרציה מולטי-מודלית מבוצעת ברמת הייצוג הנלמד ולא באמצעות התאמה ישירה ברמת המטופל. יישום מעשי ידרוש נתוני מטופלים מולטי-מודליים מקושרים כראוי, עיבוד מקדים והגדרות תוצאה עקביות בין האתרים המשתתפים, תשתית חישובית מתאימה, ועמידה בדרישות האתיקה, הפרטיות והרגולציה הרלוונטיות.
מאמר זה מציג את FedMediFormer-XAI, מסגרת טרנספורמר רב-מודאלית פדרטיבית המאפשרת בינה של סוכרת תוך שמירה על פרטיות, באמצעות תכונות של חיזוי, המלצה והסבר תחת קורת גג אחת. מסגרת זו משלבת הרחבת נתונים מבוססת דיפוזיה (diffusion-based data augmentation) כדי לטפל בחוסר איזון בין מחלקות, למידת טרנספורמר רב-מודאלית לחיזוי סוכרת, למידה פדרטיבית לפיתוח מודלים שיתופי, המלצה אישית על תרופות המבוססת על רשתות עצביות גרפיות (graph neural networks), ושיטות בינה מלאכותית הניתנת להסבר (explainable artificial intelligence) לתמיכה בהחלטות קליניות באופן שקוף. הארכיטקטורה הכללית וזרימת העבודה של מסגרת ה-FedMediFormer-XAI המוצעת מוצגות ב-איור 1.
התרומות המרכזיות של מסגרת ה-FedMediFormer-XAI המוצעת מסוכמות כדלקמן: (1) מוצג פרוטוקול מאוחד המשלב למידה פדרטיבית (federated learning), טרנספורמרים מולטי-מודאליים, הגברת נתונים מבוססת דיפוזיה (diffusion-based data augmentation), המלצה מותאמת אישית על תרופות המבוססת על רשתות עצביות גרפיות, ובינה מלאכותית הניתנת להסבר (explainable artificial intelligence) בתוך זרימת עבודה אחת הניתנת לשחזור עבור בינה של סוכרת. (2) פותחה אסטרטגיית למידה פדרטיבית השומרת על פרטיות כדי לאפשר אימון שיתופי של מודלים בין לקוחות בריאות מבוזרים מדומים ללא שיתוף נתוני מטופלים גולמיים. (3) מוצגת ארכיטקטורת טרנספורמר מולטי-מודאלית ללמידה משותפת של ייצוגים משלימים מרשומות קליניות מובנות, נתוני ניטור רצף גלוקוז, תמונות של קרקית הרשתית ומדדי בריאות אוכלוסייה. (4) שולבה יצירת נתונים סינתטיים מבוססת דיפוזיה כדי להפחית חוסר איזון בין מחלקות ולשפר את חוסנו של המודל תוך שימור המאפיינים הסטטיסטיים של נתוני האימון המקוריים. (5) מודול למידה גרפית הטרוגנית מבוסס GraphSAGE מיושם כדי למדל קשרי מטופל-תרופה ותרופה-תרופה עבור המלצת תרופות מותאמת אישית ודירוג טיפולים המודע לאינטראקציות. (6) טכניקות מרובות של בינה מלאכותית הניתנת להסבר, הכוללות SHapley Additive exPlanations (SHAP), גרדיאנטים משולבים (Integrated Gradients), ויזואליזציה של קשב (attention visualization) והסברים קונטר-פקטואליים (counterfactual explanations), שולבו כדי לשפר את שקיפות המודל ולספק פלט של תחזיות והמלצות הניתן לפירוש. (7) סופק פרוטוקול תיקוף מקיף, הכולל הערכה חיזויית, הערכת למידה פדרטיבית, הערכת המלצות, ניתוח יכולת הסבר, הערכה ממוקדת-קלינאי, תיקוף חיצוני והערכת יכולת שחזור.
פרוטוקול
כל מערכי הנתונים ששימשו במחקר זה הושגו ממאגרי מידע זמינים לציבור והכילו מידע מזוהה על מטופלים. אלו כללו את Pima Indians Diabetes Dataset, CDC Diabetes Health Indicators Dataset, OhioT1DM Dataset, APTOS 2019 Blindness Detection Dataset, Drug Review Dataset ו-Drug-Drug Interaction Dataset. לא נערך גיוס ישיר של מטופלים, לא בוצעו התערבויות, לא נאספו דגימות ולא הייתה גישה למידע בריאותי אישי מזוהה. המחקר הוגבל לניתוח משני של מערכי נתונים אנונימיים הזמינים לציבור לצורך פיתוח ותיקוף מתודולוגיים, ונערך בהתאם לדרישות המוסדיות לשימוש בנתונים אלו. ההערכה הממוקדת בבני אדם המתוארת בפרוטוקול זה מיועדת ליישום עתידי ולא בוצעה במחקר הנוכחי. חוקרים שיבצעו הערכה זו צריכים לקבל את האישור המתאים מוועדת האתיקה המוסדית, להשיג הסכמה מדעת בכתב מכל המשתתפים, ולציית לדרישות המוסדיות הרלוונטיות, להסכמי השימוש בנתונים ולתקנות הלאומיות.
1. הגדרת סביבת החישוב
- התקינו את Python 3.11 כסביבת התכנות הראשית. התקינו את PyTorch 2.3 ו-TensorFlow 2.15 לפיתוח ואימון של מודלים ללמידה עמוקה. התקינו את ספריית Transformers (גרסה 4.45) להטמעת ארכיטקטורות מבוססות transformer.
- התקינו את PyTorch Geometric (גרסה 2.5) לתמיכה בבנייה ובאימון של רשתות עצביות גרפיות (graph neural networks). התקינו את SHAP (גרסה 0.47) ו-Captum (גרסה 0.8) לביצוע ניתוחי הסבירות (explainability) ושיוך תכונות (feature attribution).
- התקינו את NumPy, Pandas ו-Scikit-learn לחישובים נומריים, עיבוד מקדים של נתונים וכלי עזר ללמידת מכונה. התקינו את OpenCV ו-Matplotlib למשימות עיבוד תמונה וויזואליזציה. התקינו את NetworkX לבנייה וניתוח של גרפי אינטראקציות בין תרופות.
- התקינו את CUDA Toolkit ומנהלי התקנים (drivers) תואמים של NVIDIA GPU כדי לאפשר חישוב מואץ בחומרה. הגדירו מעבד גרפי NVIDIA RTX 4090 עם לפחות 32 GB של זיכרון מערכת. הגדירו את ה-random seed ל-42 עבור האימון, התיקוף והבדיקה כדי להבטיח תוצאות הניתנות לשחזור. בדקו את ההתקנות ואת התאימות של ספריות התוכנה שבשימוש. רשמו את גרסאות התוכנה, מפרטי החומרה ופרמטרי קונפיגורציית המודל ששימשו לניתוח.
2. הכנה ועיבוד מקדים של מערכי נתונים
- הורד וארגן את מערכי הנתונים הקליניים, הפיזיולוגיים, הדימות והפרמקולוגיים הנדרשים למאגרים ספציפיים לפי מודאליות, ואמת את תקינותם. אשר את מאפייני מערכי הנתונים, יעדי הניבוי ורמות האינטגרציה כפי שפורט ב- טבלאות 1 ו-2תהליך העבודה מוצג ב- איור 2.
- הסר רשומות כפולות, לא תקפות או לא עקביות, וכן רשומות שחסרים בהן משתנים חיוניים. חלק כל מערך נתונים רלוונטי לתתי-קבוצות של אימון (70%), תיקוף (15%) ובדיקה (15%) שאינן תלויות בחולה. בצע התאמה (Fit) של השלמת ערכים חסרים באמצעות חציון (median imputation), נרמול Min-Max וקידוד קטגורי על בסיס תת-קבוצת האימון בלבד, והחל את התמורות המותאמות ללא שינוי על תתי-קבוצות התיקוף והבדיקה. בצע יצירת נתונים סינתטיים על תת-קבוצת האימון בלבד. ודא את החלוקה ואת מניעת זליגת נתונים (leakage) בהתאם ל- טבלה נלווית 1.
- ייבאו נתוני גלוקוז, צריכת מזון, מינוני אינסולין, פעילות גופנית ושינה. בצעו סטנדרטיזציה של חותמות הזמן, יישרו אירועים למרווחי זמן קבועים, בצעו אינטרפולציה לינארית לערכי גלוקוז שלא תועדו, חלקו רשומות רציפות לחלונות באורך קבוע, והחילו נורמליזציית z-score כדי ליצור קלטים עבור transformer זמני.
- טענו את תמונות קרקית הרשתית והסירו קבצים פגומים או שאינם קריאים, כפילויות, תמונות ללא תוויות, ותמונות עם ארטיפקטים חמורים או נראות לא מספקת של שדה הרשתית.
- שנו את גודל התמונות שנשמרו ל-224 × 224 פיקסלים, נרמול עצימות הפיקסלים לטווח [0, 1], ויישום השוואת היסטוגרמה אדפטיבית עם הגבלת ניגודיות (CLAHE).
- הגדל את מספר תמונות האימון באמצעות סיבוב אקראי בטווח של ±15°, היפוך אופקי בהסתברות של 0.5, זום אקראי בטווח של 0.9–1.1×, וכיוונון בהירות בתוך ±20%. אין להחיל הגברה סטוכסטית (stochastic augmentation) על תמונות האימות או הבדיקה. יש לאחסן את התמונות המעובדות לצורך אימון ה-Vision Transformer.
- שלב את הייצוגים הספציפיים למודאליות בהתאם לאסטרטגיית שילוב מערכי הנתונים המסוכמת ב- טבלה 2אין לבצע התאמה ישירה ברמת המטופל בין מאגרי מידע עצמאיים כאשר מזהי מטופלים משותפים אינם זמינים.
- יש לאחסן כל מערך נתונים ציבורי כמאגר נתונים נפרד הספציפי למודליות, כיוון שמזהי מטופלים אינם משותפים בין המאגרים.
- אמן מחלצי מאפיינים ספציפיים למודליות באופן עצמאי באמצעות מערכי הנתונים המתאימים: (א) רשומות קליניות → מקודד TabTransformer; (ב) מדדי בריאות האוכלוסייה → מקודד TabTransformer; (ג) ניטור רציף של גלוקוז → טרנספורמר זמני; (d) תמונות קרקית הרשתית → Vision Transformer; (ה) נתונים פרמקולוגיים → מודול GraphSAGE
- חלץ שיבוצי תכונות חבויות (latent feature embeddings) באופן עצמאי מכל מודליות. בצע מיזוג של השיבוצים החבויות שנלמדו בלבד באמצעות מודול מיזוג קשב חוצה-מודליות (cross-modal attention fusion module) המוצע, במקום למזג רשומות מטופלים גולמיות.
- יש לוודא כי לא מבוצע התאמה מלאכותית של חולים בין מאגרי נתונים ציבוריים עצמאיים. יש לשמור על חלוקות נפרדות של קבוצות אימון, תיקוף ובדיקה עבור כל מאגר נתונים לאורך תהליכי העיבוד המקדים, ההעשרה (augmentation) ופיתוח המודל.
- שמור את ייצוגי המאפיינים הרב-מודאליים המאוחדים לצורך חיזוי במורד הזרם, למידה פדרטיבית, יכולת הסבר והמלצה מותאמת אישית על תרופות (איור 2).
3. ביצוע הרחבת נתונים מבוססת דיפוזיה (diffusion-based data augmentation)
- יש להחיל הרחבת נתונים (augmentation) מבוססת דיפוזיה על מערכי הנתונים הטבלאיים המובנים של נתונים קליניים ובריאות האוכלוסייה באמצעות TabDDPM. יש להפיק דגימות סינתטיות אך ורק ממחיצת האימון שעברה עיבוד מקדים, וזאת כדי למנוע זליגת מידע. הגדירו את המודל בהתאם ל- טבלה נלווית 2.
- אמנו את TabDDPM למשך מקסימום 500 תקופות (epochs) באמצעות אופטימייזר Adam (קצב למידה = 1 × 10⁻4; גודל אצווה = 256). החילו עצירה מוקדמת (early stopping) אם הפסד האימות (validation loss) אינו משתפר בלפחות 0.001 במשך 20 תקופות (epochs) רצופות. צרו דגימות סינתטיות עבור מחלקות עם ייצוג חסר.
- הערך את איכות הנתונים הסינתטיים באמצעות סטטיסטיקת Kolmogorov–Smirnov (KS), דיברגנציית Jensen–Shannon, מרחק Wasserstein, ניתוח קורלציה לפי מאפיינים וביצועי סיווג במורד הזרם (downstream). השווה בין התפלגויות המאפיינים המקוריות לסינתטיות באמצעות חפיפת היסטוגרמות, אמידת צפיפות גרעין (kernel density estimation) ומקדמי קורלציה זוגיים.
- קבל דגימות סינתטיות רק כאשר התפלגויות המאפיינים לפי מחלקה נותרות עקביות עם נתוני האימון המקוריים (מבחן KS, p > 0.05; סטיית ג'נסן-שנון < (0.10)) ואינם מכילים ערכים קליניים לא מציאותיים. שלב את הדגימות המאושרות עם מערך נתוני האימון המקורי כדי ליצור מערך נתונים מאוזן מבחינת מחלקות. תזרים העבודה של ההעשרה מוצג ב- איור 3.
- יש לתקף את הנתונים הסינתטיים על ידי אימון מחדש של מודל לחיזוי סוכרת תוך שימוש במערכי הנתונים המקוריים ובמערכי הנתונים המועשרים. השוו את ה-Accuracy, ה-F1-score, ה-MCC וה-AUC-ROC כדי להעריך שינויים בהכללה של המודל ובהטיה התפלגותית.
4. פיתוח מודל הטרנספורמר הרב-מודאלי
הגדירו את הטרנספורמר הרב-מודאלי באמצעות מקודדים ספציפיים למודליות עבור נתונים קליניים מובנים, רצפי CGM ותמונות קרקית רשתית, כפי שמוצג ב-איור 4. שלבו את הייצוגים המתוצאים באמצעות תשומת לב חוצת-מודליות (cross-modal attention) לטובת חיזוי סוכרת והמלצה מותאמת אישית על תרופות המבוססת על גרפים.
- פיתוח המקודד הקליני (Clinical Encoder)
- אתחול ארכיטקטורת מקודד TabTransformer. הזנת משתנים קליניים מנורמלים ומדדי בריאות אוכלוסייה. יצירת ייצוגי מאפיינים הקשריים באמצעות מנגנוני קשב (attention) של transformer.
- הגדרת מקודד ה-TabTransformer עם 32 משתני קלט קליניים מובנים, ממד שיכון (embedding dimension) של 128, ארבע שכבות transformer, שמונה ראשי קשב, ממד feed-forward של 512, קצב dropout של 0.20, והפעלת Gaussian Error Linear Unit (GELU).
- למידת שיכונים קליניים חבויים (latent embeddings) הלוכדים קשרים בין מאפייני מטופלים. אחסון השיכונים הקליניים המתקבלים לצורך אינטגרציה רב-מודאלית.
- פיתוח מקודד ניטור גלוקוז רציף (CGM Encoder)
- אתחול מקודד transformer זמני (temporal transformer encoder). הזנת רצפי ניטור גלוקוז רציף ומדידות פיזיולוגיות למקודד. שימוש במנגנוני קשב עצמי (self-attention) לקידוד תלויות זמניות.
- הגדרת ה-temporal transformer עם אורך רצף של 96 צעדי זמן, מרווח דגימה של 15 min, ממד שיכון של 128, ארבע שכבות transformer, שמונה ראשי קשב, קידוד מיקומי סינוסואידלי, וקצב dropout של 0.20.
- יצירת שיכונים רצפיים המשקפים את דינמיקת הגלוקוז של המטופל. השארת השיכונים הזמניים מוכנים לתהליך מיזוג (fusion) הבא.
- פיתוח מקודד Vision Transformer
- אתחול ארכיטקטורת Vision Transformer. הזנת תמונות קרקית רשת יעברו עיבוד מקדים. חלוקת התמונות לטלאים (patches) בגודל קבוע.
- הגדרת ה-Vision Transformer עם רזולוציית תמונת קלט של 224 × 224 pixels, גודל טלאים של 16 × 16 pixels, ממד שיכון של 768, 12 בלוקי transformer, 12 ראשי קשב, וקצב dropout של 0.10.
- יצירת ייצוגי מאפיינים ברמת הטלאים. הפקת מאפיינים חזותיים המעידים על פתולוגיות ברשתית וסממנים ביולוגיים הקשורים למחלה. שמירת שיכוני התמונות למיזוג רב-מודאלי.
- ביצוע מיזוג בין-מודאלי (Cross-Modal Fusion)
- חילוץ הייצוגים החבויים ממקודדי ה-Clinical, ה-CGM וה-Vision Transformer והקרנתם של כולם למרחב חבוי משותף בן 256 ממדים באמצעות הקרנות ליניאריות עצמאיות ולאחריהן נורמליזציה של שכבות (Layer Normalization).
- שרשור (Concatenate) של אסימוני המודאליות המוקרנים, הוספת שיכוני סוג-מודאליות למידים, והחלת קשב בין-מודאלי רב-ראשי (multi-head cross-modal attention) כדי לאפשר חילופי מידע בין הייצוגים הקליניים, ה-CGM והרשתית. הגדרת בלוק הקשב עם שמונה ראשים, מרחב מודל בן 256 ממדים, שכבת feed-forward בת 1,024 ממדים, הפעלת GELU, dropout של 0.10, חיבורים שאריתיים (residual connections) ונורמליזציה של שכבות.
- ביצוע מיצוע (Mean-pooling) לכל קבוצת אסימונים ספציפית למודאליות ושרשור הייצוגים המתקבלים. הקרנת הווקטור המשורשר בן 768 הממדים לייצוג רב-מודאלי מאוחד בן 512 ממדים, ושמירת משקלי הקשב והייצוגים הממוזגים לצורך ניתוחי הסביריות (explainability) ואבלאציה (ablation) עוקבים.
- העברת הייצוג המאוחד למודולים לחיזוי סוכרת ולהמלצת תרופות מבוססות GraphSAGE. שמירה על חלוקות האימון, התיקוף והבדיקה המקוריות של כל מודאליות לאורך תהליך המיזוג, ללא התאמה מלאכותית ברמת המטופל בין מאגרי הנתונים העצמאיים.
- הגדרת ה-multimodal transformer בהתאם לפרמטרי המודל המסוכמים ב-Supplementary Table 3.
5. הגדרת למידה פדרטיבית (federated learning)
- הגדירו את מסגרת הלמידה הפדרטיבית (federated learning) כדי לאפשר אימון שיתופי של מודלים בין מוסדות בריאות מבוזרים גיאוגרפית ללא החלפת נתונים ברמת המטופל. בצעו אופטימיזציה של המודל המקומי בכל מוסד משתתף באמצעות הנתונים הזמינים מקומית. שתפו רק פרמטרי מודל מוגנים עם שרת האגרגציה המרכזי. שמרו על פרטיות המטופלים תוך כדי אפשור פיתוח שיתופי של מודלים מולטי-מודאליים.
- הפרידו את מערכי הנתונים המולטי-מודאליים והפיצו אותם בין מספר לקוחות פדרטיביים כדי לדמות תרחיש שבו מוסדות בריאות שונים משתפים פעולה ללא שיתוף הנתונים שלהם.
- הגדירו את רשת הלמידה הפדרטיבית עם 10 לקוחות בתי חולים משתתפים, שרת אגרגציה מרכזי אחד, חמישה תקופות אימון (epochs) מקומיות לכל סבב תקשורת, 100 סבבי תקשורת, שברי השתתפות לקוחות של 80%, בחירת לקוחות אקראית בכל סבב תקשורת, ומעטפת מינימלית של שמונה לקוחות משתתפים לסבב.
- הקצו לכל לקוח מערך נתונים השייך למוסד מסוים כדי שהנתונים יישארו מקומיים וסודיים. חלקו את נתוני האימון המולטי-מודאליים בין 10 לקוחות בתי חולים סימולטיביים באמצעות אסטרטגיית Dirichlet-based non-independent and identically distributed (non-IID) כדי לייצר התפלגויות מחלקות, הרכבים דמוגרפיים וגדלי מערכי נתונים של לקוחות הטרוגניים.
- השתמשו בזרע אקראי (random seed) קבוע כדי להבטיח הדירות (reproducibility). אמתו את ההתפלגויות שהתקבלו ברמת הלקוח ושמרו על חלוקות אלו לאורך כל האימון הפדרטיבי. שמרו על מערכי נתוני האימות והבדיקה באופן בלתי תלוי מחלוקות הלקוחות.
- אתחלו כל לקוח מקומי עם פרמטרי המודל הגלובלי שהתקבלו משרת האגרגציה המרכזי.אמנו את הטרנספורמר המולטי-מודאלי המקומי למשך חמישה epochs באמצעות נתוני האימון המקומיים של הלקוח. בצעו אופטימיזציה למודל המקומי באמצעות אופטימייזר AdamW עם קצב למידה (learning rate) של 1 × 10⁻4.
- חשבו את עדכוני פרמטרי המודל המקומי לאחר השלמת האימון המקומי. הגנו על פרמטרי המודל המקומיים לפני העברתם לשרת האגרגציה המרכזי. העבירו את פרמטרי המודל המקומיים המוגנים לשרת האגרגציה המרכזי לצורך אגרגציה גלובלית.
- קבלו את פרמטרי המודל המוגנים מכל לקוחות בתי החולים המשתתפים. אמתו את תקינות עדכוני המודל שהתקבלו לפני האגרגציה. בצעו אגרגציה למשקולות המודל המקומיות באמצעות אלגוריתם Federated Averaging (FedAvg). עדכנו את הטרנספורמר המולטי-מודאלי הגלובלי באמצעות פרמטרי המודל המאוגרגים.
- הפיצו מחדש את פרמטרי המודל הגלובלי המעודכנים ללקוחות בתי החולים המשתתפים. חזרו על נהלי האימון המקומי והאגרגציה הגלובלית עד להשלמת 100 סבבי תקשורת או עד להשגת קריטריון ההתכנסות שהוגדר מראש.
- הגנו על פרמטרי המודל המועברים באמצעות מנגנון האגרגציה המאובטח המצוין והצפנת AES-256. בצעו אימות של הלקוחות המשתתפים באמצעות תעודות דיגיטליות.
- הקימו ערוצי תקשורת מוצפנים באמצעות Transport Layer Security (TLS) 1.3. שמרו רק את פרמטרי המודל הגלובלי המאוגרגים לאחר השלמת כל סבב תקשורת.
- העריכו את הפרטיות והאבטחה באמצעות הערכות של חשיפת נתונים גולמיים, שיתוף בלתי מורשה, הסקת השתתפות (membership inference) והיפוך מודל (model inversion). עבור הסקת השתתפות, השוו את ה-AUC-ROC של התקיפה לקו הבסיס האקראי (0.50); העריכו היפוך באמצעות מדד דמיון מבני (SSIM) ויחס אות לרעש שיא (PSNR) עבור תמונות רשתית, ושגיאת שחזור מנורמלת עבור מאפיינים מספריים.
- אמתו אגרגציה מאובטחת על ידי אישור שהשרת אינו יכול לגשת לעדכוני לקוחות בודדים שאינם מאוגרגים. אמתו הגנה של AES-256/TLS 1.3 ואשרו כי לא התבצעו העברות של עדכוני מודל שאינן מוצפנות.
- השוו מדדי פרטיות בין תצורות פדרטיביות למרכזיות במידת הרלוונטיות ודווחו על המדדים המפורטים ב-Supplementary Table 4.
- העריכו את הסיבוכיות החישובית של אימון טרנספורמר מקומי כ-O(N × L × d2), כאשר N מייצג את מספר הדגימות, L מייצג את מספר שכבות הטרנספורמר, ו-d מייצג את ממד השכיבה (embedding dimension).
- העריכו את הסיבוכיות החישובית של אגרגציה פדרטיבית כ-O(K × P) לכל סבב תקשורת, כאשר K מייצג את מספר הלקוחות המשתתפים ו-P מייצג את מספר פרמטרי המודל הניתנים לאימון.
- החליפו רק פרמטרי מודל מוגנים בין הלקוחות המשתתפים לבין שרת האגרגציה המרכזי במהלך כל סבב תקשורת. חשבו את נטל התקשורת (communication overhead) בהתבסס על גודל המודל, מספר הלקוחות המשתתפים ומספר סבבי התקשורת.
- השוו את נטל חילופי הפרמטרים לעלות המוערכת של העברת מערכי הנתונים המולטי-מודאליים המקבילים של שירותי הבריאות. הגדירו את מסגרת הלמידה הפדרטיבית בהתאם לפרמטרים המסוכמים ב-Supplementary Table 4. תהליך העבודה של הלמידה הפדרטיבית ותהליך אגרגציית הפרמטרים מוצגים ב-Figure 5.
6. בניית מודול ההמלצה המותאמת אישית לתרופות
- ייבאו את הנתונים הפארמקולוגיים, נתוני התרופות, הטיפול במטופלים ונתוני אינטראקציות בין תרופות לסביבת המחשוב. בנו גרף בריאות הטרוגני הכולל צמתים של מטופלים, תרופות, מחלות, בדיקות מעבדה וגורמי סיכון קליניים.
- הגדירו את הקשרים בין מטופל למחלה, מטופל לתרופה, מחלה לתרופה, אינטראקציה בין תרופות ומטופל לבדיקת מעבדה כקשתות בגרף. אמתו את מבנה הגרף והסירו קשרים כפולים, לא תקינים או מנותקים לפני אימון המודל.
- ייצגו את צמתי המטופלים באמצעות גיל, מין, מדד מסת גוף (BMI), HbA1c, גלוקוז בדם, לחץ דם ומשך מחלת הסוכרת. ייצגו את צמתי התרופות באמצעות סוג התרופה, מנגנון הפעולה, מינון, תדירות מתן ותופעות לוואי ידועות.
- ייצגו את צמתי המחלות באמצעות חומרת המחלה, שלב המחלה וסיבוכים נלווים. קודדו תכונות קטגוריאליות ונרמלו תכונות צמתים רציפות לפני אימון ה-GraphSAGE.
- אתחלו את שיבודי הצמתים (node embeddings) באמצעות תכונות הצמתים שעברו עיבוד מקדים. דגמו עד 25 צמתים שכנים עבור כל צומת מטרה במהלך אגרגציית השכנות. אגרגו את ייצוגי הצמתים השכנים באמצעות אגרגציית ממוצע (mean aggregation). עדכנו את שיבודי צומת המטרה באמצעות ייצוגי השכנות המאוגרגים.
- החילו את פונקציית ההפעלה rectified linear unit (ReLU) לאחר כל שכבת GraphSAGE. נרמלו את שיבודי הצמתים שהתקבלו. חזרו על הליך אגרגציית השכנות לאורך שלוש שכבות GraphSAGE.
- הגדירו את מודל ה-GraphSAGE עם ממד נסתר של 256, ממד שיבוד של 128, שלוש שכבות GraphSAGE, גודל דגימת שכנים של 25, קצב dropout של 0.30, קצב למידה של 1 × 10⁻4, גודל אצווה (batch size) של 512 ומקסימום של 100 תקופות אימון (epochs). בצעו אופטימיזציה למודל באמצעות אופטימייזר Adam.
- חשבו את השיבוד הספציפי למטופל ממודל ה-GraphSAGE המאומן. חשבו שיבודים עבור תרופות מועמדות. חשבו ציוני התאמה בין ייצוג המטופל לייצוגי התרופות המועמדות. דרגו את התרופות המועמדות בהתאם לציוני ההתאמה החזויים שלהן.
- זהו והסירו תרופות החולות ב przeci-indications (התוויות נגד) או תרופות שאינן בטוחות פוטנציאלית באמצעות מידע זמין על אינטראקציות בין תרופות. החזירו את חמש התרופות הזכאיות בעלות הדירוג הגבוה ביותר כהמלצות ה-Top-5 המותאמות אישית.
- אמנו את מודל ההמלצות באמצעות הפסד Bayesian Personalized Ranking (BPR). בצעו אופטימיזציה למטרת הדירוג כדי להקצות ציונים גבוהים יותר לתרופות המתאימות קלינית מאשר לתרופות מועמדות פחות מתאימות.
- זהו צמתים שכנים משפיעים וקשרים בגרף הרלוונטיים קלינית התורמים לכל המלצה לתרופה. חשבו ציוני שיוך תכונות (feature-attribution scores) עבור מאפייני מטופל, מחלה, מעבדה ומאפיינים הקשורים לתרופה התורמים להמלצה.
- הפיקו הסברים ויזואליים מבוססי גרף המראים את הקשרים התורמים לכל המלצה אישית לתרופה. הגדירו את מודל ההמלצות GraphSAGE בהתאם לפרמטרים המסוכמים ב-Supplementary Table 5. תהליך העבודה להמלצה מותאמת אישית על תרופות מבוססת גרף מוצג ב-Figure 6.
7. ביצוע הערכת יכולת הסבר (explainability assessment)
- ביצוע ניתוח SHAP
- טען את הטרנספורמר הרב-מודאלי (multimodal transformer) המאומן ואת מערך נתוני הבדיקה המופרש (held-out test dataset) לסביבת החישוב.
- אתחל את מסביר ה-SHAP באמצעות מודל הניבוי המאומן ומדגם רקע של 100 דגימות אימון, שנבחרו אך ורק ממערך נתוני האימון באמצעות דגימה אקראית מרובדת (stratified random sampling) בהתאם למחלקה של תוצאת הסוכרת. שמור על התפלגות מחלקות מקורבת של מחיצת האימון המלאה במדגם הרקע, והשתמש בזרע אקראי (random seed) קבוע של 42 כדי להבטיח בחירת מדגם הדירה. חשב ערכי SHAP עבור דגימות הבדיקה שנבחרו.
- חשב את חשיבות התכונות הגלובלית מתוך ערכי ה-SHAP המוחלטים, צור ויזואליזציות SHAP גלובליות ומקומיות, ושמור את הערכים שחושבו לצורך ניתוחים כמותיים וסטטיסטיים בהמשך.
- ביצוע ניתוח גרדיאנטים משולבים (Integrated Gradients)
- בחר דגימות מייצגות שסווגו נכונה ודגימות שסווגו שגויים מתוך מערך נתוני הבדיקה המופרש. הגדר קלטים בסיסיים (baseline) ספציפיים למודאליות לפני חישוב הגרדיאנטים המשולבים. השתמש בבסיס אפס עבור תכונות מספריות קליניות ונתוני CGM מנורמלים, המייצג תרומה אפסית של תכונה מנורמלת, והשתמש בתמונת בסיס בעלת ערכי אפס עבור קלט תמונת הרשתית המנורמלת.
- חשב ציוני שיוך (attribution scores) של גרדיאנטים משולבים באמצעות 100 שלבי אינטרפולציה בין הבסיס לקלט המקורי. נרמל את ציוני השיוך שהתקבלו כדי לאפשר השוואה בין תכונות ומודאליות שונות. צור ויזואליזציות שיוך כדי לזהות תכונות קליניות, זמניות ותכונות דימות משפיעות התורמות לניבויים אינדיבידואליים של המודל.
- ביצוע ויזואליזציית קשב (Attention Visualization)
- חלץ מטריצות קשב משכבות הטרנספורמר המאומנות עבור דגימות בדיקה מייצגות. חשב את משקלי הקשב הממוצעים על פני ראשי הקשב (attention heads) המתאימים. צור מפות חום של קשב כדי להמחיש אינטראקציות חוצות-מודאליות בין ייצוגים קליניים, זמניים וייצוגי דימות רשתית. זהה את התכונות הקליניות, הזמניות ותכונות הרשתית הדומיננטיות המקבלות משקלי קשב גבוהים במהלך הניבוי.
- חלץ את משקלי הקשב מהטרנספורמר הרב-מודאלי המאומן עבור דגימת בדיקה מופרשת שנבחרה באופן אקראי, והמחש את התפלגויות הקשב התואמות עבור תכונות קליניות, נתוני CGM זמניים, מיקום מרחבי ברשתית וקשב חוצה-מודאליות.
- יצירת הסברים קונטרפקטואליים (Counterfactual Explanations)
- בחר רשומות מטופלים מייצגות מתוך מערך נתוני הבדיקה המופרש. הגדר טווחים ומגבלות קליניות מותרות עבור תכונות מטופל שניתן לשנותן לפני יצירת דגימות קונטרפקטואליות. הגבל תכונות רציפות לטווח שנצפה בנתוני האימון, והגבל תכונות קטגוריאליות לקטגוריות תקפות שנצפו בנתוני האימון. אין לשנות מאפיינים דמוגרפיים בלתי משתנים, כולל גיל ומין.
- צור דגימות קונטרפקטואליות על ידי שינוי מינימלי אך ורק של התכונות הניתנות לשינוי המותרות, תוך שמירה על המגבלות הקליניות ומגבלות תחום התכונות שהוגדרו מראש. פסול דגימות קונטרפקטואליות המכילות ערכים מחוץ לטווח שנצפה בנתוני האימון, מצבים קטגוריאליים לא תקפים, או שינויים בתכונות בלתי משתנות. זהה את שינויי התכונות הקטנים ביותר שסבירים מבחינה קלינית הנדרשים כדי לשנות את התוצאה הנחזית.
- דווח על התכונות ששונו, הערכים המקוריים, הערכים הקונטרפקטואליים והשינויים התואמים בניבויי המודל. תהליך הערכת יכולת ההסבר (explainability assessment) מומחש ב-איור 7, בעוד שתוצרי ויזואליזציית קשב והסברים קונטרפקטואליים מייצגים מוצגים ב-איור משלים 1.
- הערכת איכות ההסבר
- חשב נאמנות (fidelity) כדי לכמת את ההסכמה בין ההסברים שנוצרו לבין התנהגות מודל הניבוי. חשב יציבות (stability) על ידי יצירה חוזרת של הסברים תחת הפרעות קטנות לקלט והשוואת דפוסי השיוך שהתקבלו. העरक עקביות (consistency) על ידי השוואת הסברים שנוצרו עבור דגימות בדיקה דומות מבחינה קלינית.
- חשב דלילות (sparsity) על ידי קביעת מספר התכונות או פרופורציית התכונות התורמות באופן משמעותי לכל הסבר. העरक שלמות (completeness) כדי לקבוע האם התכונות המשויכות מסבירות באופן מספק את פלט המודל התואם. העरक רגישות (sensitivity) על ידי מדידת שינויים בציוני השיוך בעקבות הפרעות מבוקרות של תכונות הקלט.
- חשב חוסר נאמנות (infidelity) כדי לכמת את חוסר ההסכמה בין שיוכי התכונות לבין השינויים שנצפו בניבויי המודל. רשום את כל מדדי יכולת ההסבר הכמותיים לצורך ניתוח סטטיסטי בהמשך.
- ביצוע תיקוף קלינאי פרוספקטיבי
- עבור תיקוף קליני פרוספקטיבי עתידי, השג אישור מוועדת האתיקה המוסדית המתאימה לפני גיוס מומחים קליניים. לאחר קבלת האישור האתי, גייס 12 קלינאים הכוללים שישה אנדוקרינולוגים, שלושה מומחים לסוכרת ושלושה פרמקולוגים קליניים, והשג הסכמה מדעת מכל המשתתפים לפני תחילת ההערכה.
- בחר באופן אקראי ניבויי מודל מייצגים והסברים תואמים להם לצורך הערכה על ידי הקלינאים. הצג את ההסברים שנבחרו באופן עצמאי לכל קלינאי משתתף באמצעות פורמט הערכה סטנדרטי.
- בקש מכל קלינאי להעריך את תועלת ההסבר, הרלוונטיות הקלינית, יכולת הפרשנות (interpretability) והמהימנות שלו באמצעות סולם ליקרט בן חמש נקודות. רשום דירוגי קלינאים אנונימיים וחשב הסכמה בין מעריכים (inter-rater agreement) ומדדים סטטיסטיים תואמים כפי שפורט בשלב 7.7.
- ביצוע ניתוח סטטיסטי
- הערך את התפלגות ציוני ההערכה הכמותיים לפני בחירת מבחן ההשוואה הסטטיסטי. החל מבחן t מזווג (paired t-test) על מדידות מזווגות בעלות התפלגות נורמלית, או את מבחן הסימנים של וילקוקסון (Wilcoxon signed-rank test) על מדידות מזווגות שאינן בעלות התפלגות נורמלית, לפי העניין.
- חשב את מקדם הקאפה של פלייס (Fleiss' kappa) כדי לכמת את ההסכמה בין המעריכים בקרב הקלינאים המשתתפים. חשב רווחי סמך של 95% עבור מדדי יכולת ההסבר ומדדי הערכת הקלינאים העיקריים. קבע את סף המובהקות הסטטיסטית ב- p < 0.05.
- דווח על הסטטיסטיקות של המבחנים שחושבו, רווחי הסמך וערכי ה-p עם תוצאות ההערכה התואמות. הערק ודווח על מדדי יכולת ההסבר בהתאם לקריטריונים המסוכמים ב-טבלה משלימה 6.
8. הערכת ביצועי המודל
- השווה בין FedMediFormer-XAI לבין Logistic Regression, Random Forest, XGBoost, TabTransformer, Vision Transformer, Temporal Transformer, והטרנספורמר הרב-מודאלי המרוכז באמצעות מדדי דיוק (accuracy), דיוק (precision), רגישות (recall), F1-score, MCC ו-AUC-ROC.
- בצע כל הערכת בסיס (baseline) באמצעות אותה אסטרטגיית אימון, תיקוף ובדיקה שהוגדרה מראש כדי להבטיח השוואה עקבית עם המסגרת המוצעת.
- חזור על הערכת המודל לאורך הרצות ניסוייות עצמאיות ורשום את מדדי הביצועים שהתקבלו בכל הרצה. חשב את הממוצע, סטיית התקן (SD), ורווח ברת-סמך (CI) של 95% עבור Accuracy, Precision, Recall, F1-score, MCC ו-AUC-ROC. דווח על תוצאות הביצועים כממוצע ± SD יחד עם ה-95% CI המתאים.
- הערך את הנורמליות של הפרשי הביצועים הזוגיים בין FedMediFormer-XAI לבין כל מודל בסיס. החל t-test זוגי על מדידות זוגיות בעלות התפלגות נורמלית, ואת מבחן הדירוג המסומן של וילקוקסון (Wilcoxon signed-rank test) על מדידות זוגיות שאינן בעלות התפלגות נורמלית. קבע את סף המובהקות הסטטיסטית ל- p < 0.05.
- דווח על סטטיסטיקות המבחן המתאימות, ערכי p ורווחי ברת-סמך של 95% כדי לכמת את המובהקות הסטטיסטית ואת אי-הוודאות של הפרשי הביצועים שנצפו.
- ספור את כל סבבי התקשורת עד שהמודלים מתכנסים סופית. עקוב אחר ביצועי המודל הגלובלי במהלך האימון הפדרטי. בחן כיצד ההתכנסות משתנה לאורך זמן בסבבי התקשורת.
- בדוק את יעילות אגרגציית הפרמטרים. בחן כיצד למידה מבוזרת משפיעה על ביצועי הניבוי. בצע השוואה בין התוצאות של למידה פדרטית לבין למידה מרוכזת.
- הערך התכנסות פדרטית לאורך סבבי תקשורת והשווה בין ביצועי ניבוי פדרטיים למרוכזים. הערך המלצות לתרופות באמצעות Precision@5, Recall@5 ו-NDCG@5.
- צור דגימות שליליות – דגימות תרופות ממאגר תרופות המועמדות כשמישות – על ידי בחירת תרופות שאינן נצפות כאינטראקציות חיוביות בין מטופל לתרופה עבור המטופל הרלוונטי. הסר את כל האינטראקציות החיוביות הידועות ואת כל התרופות המהוות התווית-contraindicated ממאגר הדגימה השלילי. שמור על יחס דגימה קבוע של 1:1 בין דגימות שליליות לחיוביות עבור אימון ההמלצות, והשתמש בגרעין אקראי (random seed) קבוע של 42 לבחירה הדירה של דגימות שליליות.
- הגדר את קבוצת הפריטים הרלוונטית עבור כל מטופל אך ורק מתוך נתוני ההערכה המופרשים (held-out). הגדר את קבוצת הפריטים הרלוונטיים Ru עבור מטופל u כקבוצת התרופות העומדות בקריטריונים חיוביים של אינטראקציה בין מטופל לתרופה ברשומות האמת (ground-truth) המופרשות. אין להשתמש בניבויי מודל כדי לבנות את Ru. הסר תרופות עם התווית-contraindicated מקבוצת ההמלצות המועמדות לפני הדירוג.
- צור את חמש התרופות השמישות בעלות הדירוג הגבוה ביותר עבור כל מטופל הערכה. חשב את Precision@5 כשיעורן של חמש התרופות המומלצות השייכות לקבוצת הפריטים הרלוונטית Ru של המטופל. חשב את Recall@5 כשיעור התרופות הרלוונטיות של המטופל שנשלפו מבין חמש ההמלצות. חשב NDCG@5 באמצעות הרלוונטיות המדורגת של התרופות המומלצות, תוך הקצאת רלוונטיות גבוהה יותר לתרופות המתאימות קלינית ורלוונטיות אפס לתרופות שאינן רלוונטיות. אגד את המדדים על פני כל מטופלי ההערכה ודווח על הממוצעים של Precision@5, Recall@5 ו-NDCG@5.
- בנה את האמת של ההמלצות (recommendation ground truth) לפני הערכת המודל ושמור על אינטראקציות מטופל-תרופה מופרשות בנפרד מנתוני אימון ההמלצות. אין להשתמש באינטראקציות תרופות מסט הבדיקה, בתוויות מסט הבדיקה או במידע על טיפולים עתידיים במהלך אימון GraphSAGE, דגימה שלילית או דירוג מועמדים.
- מדוד נאמנות (Fidelity) כדי לבדוק באיזו מידה ההסברים תואמים את התנהגות המודל. הערך את יציבות ההסבר באמצעות בדיקות מרובות. שפוט את יכולת ההבנה (Comprehensibility) על בסיס קריטריונים המכוונים לרופאים.
- בחן עד כמה ההסברים עקביים בין סוגי נתונים שונים. אשר את הערך הקליני של ההסברים שהופקו. מדדי ההערכה ששימשו לאורך המחקר מסוכמים ב-Supplementary Table 7.
9. ביצוע תיקוף קליני פרוספקטיבי
- בצעו תיקוף קליני פרוספקטיבי לאחר קבלת אישור אתי מתאים והסכמה מדעת, בהתאם להליכי הגיוס, ההערכה, איסוף הנתונים והניתוח הסטטיסטי המתוארים בשלבים 7.6–7.8. תכנון התיקוף הקליני הפרוספקטיבי, הכולל את הרכב המשתתפים, קריטריוני ההערכה, תנאי ההשוואה והניתוחים הסטטיסטיים המתוכננים, מסוכם ב- טבלה נלווית 8.
10. ביצוע תיקוף והערכת שחזור
- בצעו מחקרי אבלציה (ablation studies) באמצעות הסרה שיטתית של רכיבים בודדים ממסגרת ה-FedMediFormer-XAI המלאה, תוך שמירה על אותם חלוקי נתונים, הליכי עיבוד מקדים, הגדרות אימון ומדדי הערכה. העריכו את המודל המלא ואת התצורות ללא הגברה באמצעות דיפוזיה (diffusion augmentation), למידה פדרטיבית (federated learning), המלצת תרופות מבוססת GraphSAGE ומיזוג רב-מודאלי (multimodal fusion).
- השוו את התצורות המנוכרות (ablated configurations) למסגרת ה-FedMediFormer-XAI המלאה באמצעות Accuracy, Precision, Recall, F1-score, MCC ו-AUC-ROC. כמתו את השינוי בכל מדד ביצועים כדי לקבוע את תרומתו של כל רכיב במסגרת. השוו את תוצאות התיקוף (validation) לתוצאות הבדיקה הפנימית כדי להעריך את יכולת ההכללה (generalizability). בצעו בדיקות מובהקות סטטיסטית כדי לקבוע את מהימנותם של הבדלי הביצועים שנצפו.
- העריכו את יכולת ההכללה של המסגרת באמצעות מערך נתונים חיצוני בלתי תלוי, במידה ומערך נתונים כזה עם משתני קלט והגדרות תוצאה תואמות זמין. החילו את אותם הליכי עיבוד מקדים והערכה שנעשה בהם שימוש עבור מערך נתוני הבדיקה הפנימי, והשוו את מדדי הביצועים שהתקבלו לתוצאות הבדיקה הפנימיות.
- בצעו ניתוח מובהקות סטטיסטית לאורך הרצות ניסיוניות חוזרות. העריכו את נורמליות ההפרשים הזוגיים בביצועים לפני הבדיקה הסטטיסטית. השתמשו במבחן t למדגמים מזווגים עבור מדידות זוגיות בעלות התפלגות נורמלית, ובמבחן הדרגות המסומנות של וילקוקסון (Wilcoxon signed-rank test) עבור מדידות זוגיות שאינן בעלות התפלגות נורמלית. קבעו את סף המובהקות הסטטיסטית ב-p < 0.05.
- חשבו את הממוצע ואת רווח הסמך של 95% עבור Accuracy, Precision, Recall, F1-score, MCC ו-AUC-ROC. דווחו על הסטטיסטיקות של המבחן, ערכי ה-p ורווחי הסמך המתאימים עבור השוואות המודלים העיקריות. תיעדו את כל פרמטרי המודל, הליכי עיבוד המקדמים, תצורות האימון ופרוטוקולי ההערכה הנדרשים לשחזור הניסויים המדווחים.
- שמרו את קוד המקור, קבצי התצורה, סקריפטי ההערכה ומפרטי המודלים המאומנים ששימשו בניסויים המדווחים. תחזקו רשומות מפורטות של אימון המודלים, הגדרות ניסיוניות, זרעי אקראיות (random seeds) ותוצאות הערכה.
- יש לאמת את השלמות והעקביות של חומרי השחזור הזמינים. ודא כי השיטות והחומרים המתועדים מספקים מידע מספיק לשחזור עצמאי של זרימת העבודה הניסויית.
- סכם את משאבי השחזור ונהלי התיקוף ששימשו במחקר ב טבלה נלווית 9תעד את הליך מחקר האבליציה (ablation study) ואת קריטריוני ההערכה לבחינת תרומתם של מרכיבי המסגרת העיקריים.
תוצאות
ניתוח ביצועים חיזואיים
FedMediFormer-XAI הפגין ביצועי חיזוי משופרים בהשוואה למודלים החד-מודאליים (unimodal) ולמודלי הבסיס הקונבנציונליים שנבחנו. הרחבה מבוססת דיפוזיה (Diffusion-based augmentation) שיפרה את הייצוג של מחלקת המיעוט, וביצועי החיזוי שהתקבלו מסוכמים ב- טבלה 3הערכת ההרצות החוזרות הדגימה ביצועי ניבוי יציבים בכל המודלים שנבחנו. FedMediFormer-XAI השיג את הביצועים הכוללים הגבוהים ביותר, עם דיוק (accuracy) של 94.20 ± 0.34% (רווח בר-סמך של 95%: 93.78–94.62), דיוק חיובי (precision) של 93.10 ± 0.30% (רווח בר-סמך של 95%: 92.73–93.47), רגישות (recall) של 92.80 ± 0.28% (רווח בר-סמך של 95%: 92.45–93.15), ומדד F1 של 92.90 ± 0.28% (רווח בר-סמך של 95%: 92.55–93.25). המודל השיג MCC של 0.88 ± 0.02 (רווח בר-סמך של 95%: 0.86–0.90) ו-AUC-ROC של 0.96 ± 0.01 (רווח בר-סמך של 95%: 0.95–0.97). הטרנספורמר הרב-מודאלי המרוכז סיפק את הביצועים הכוללים הטובים הבאים, בעוד שהמודלים החד-מודאליים ומודלי הלמידה המכונה הקונבנציונליים הראו ביצועי ניבוי נמוכים יותר באופן יחסי. תוצאות אלו מצביעות על כך שלמידת ייצוג רב-מודאלית, בשילוב עם אופטימיזציה פדרטיבית, מניבה ביצועי סיווג של סוכרת משופרים ויציבים יותר.
ניתוח אבלה (Ablation study)
הסרה מדורגת של רכיבים (Component-wise ablation) שימשה להערכת התרומה של הגברה באמצעות דיפוזיה (diffusion augmentation), למידה פדרטיבית (federated learning), המלצת תרופות מבוססת GraphSAGE ומיזוג רב-מודאלי (multimodal fusion). מסגרת ה-FedMediFormer-XAI המלאה השיגה דיוק (accuracy) של 94.20 ± 0.34%, דיוק חזוי (precision) של 93.10 ± 0.30%, רגישות (recall) של 92.80 ± 0.28%, ציון F1 של 92.90 ± 0.28%, MCC של 0.88 ± 0.02 ו-AUC-ROC של 0.96 ± 0.01 על פני חמש הרצות עצמאיות. הסרת ההגברה באמצעות דיפוזיה הפחיתה את הדיוק ל-91.80 ± 0.42%, המקבילה לירידה של 2.40 נקודות אחוז, בעוד שציון ה-F1 וה-AUC-ROC ירדו ל-90.30 ± 0.38% ו-0.94 ± 0.01, בהתאמה. הפחיתה זו מעידה על תרומת ההגברה מבוססת הדיפוזיה לייצוג מחלקות מיעוט ולחוסן החזוי.
הסרת הלמידה הפדרטיבית (federated learning) הביאה לדיוק של 93.10 ± 0.37%, המהווה ירידה של 1.10 נקודות אחוז ביחס למסגרת המלאה. הדיוק (Precision), הרגישות (recall), מדד F1, מדד MCC ו-AUC-ROC פחתו אף הם ל-92.20 ± 0.34%, 91.80 ± 0.32%, 92.00 ± 0.33%, 0.86 ± 0.02 ו-0.95 ± 0.01, בהתאמה. השוואה זו מדגימה את תרומת התבניות הפדרטיביות לביצועים החזויים.
הסרת רכיב ההמלצה המותאמת אישית על תרופות המבוסס על GraphSAGE הובילה לשינוי קטן יחסית בביצועי חיזוי הסוכרת, כאשר הדיוק ירד ל-93.80 ± 0.35% ומדד ה-F1-score ירד ל-92.60 ± 0.30%. ערכי ה-MCC וה-AUC-ROC התואמים היו 0.87 ± 0.02 ו-0.96 ± 0.01, בהתאמה. תוצאה זו מעידה על כך ש-GraphSAGE תורם בעיקר להמלצה מותאמת אישית על תרופות ולא לקביעת ביצועי סיווג הסוכרת באופן ישיר.
ההפחתה הגדולה ביותר נצפתה כאשר הוסר מיזוג רב-מודאלי (multimodal fusion). הדיוק (Accuracy) ירד ל-87.60 ± 0.55%, המהווה ירידה של 6.60 נקודות אחוז, בעוד שהדיוק החזוי (precision), הרגישות (recall), מדד F1, מדד MCC ו-AUC-ROC ירדו ל-86.80 ± 0.51%, 85.90 ± 0.54%, 86.30 ± 0.52%, 0.76 ± 0.03, ו-0.91 ± 0.01, בהתאמה. ממצא זה מדגיש את החשיבות של מידול משותף של מידע משלים ממודליות קליניות, CGM ורשתית.
ניתוח למידה פדרטיבית
מסגרת הלמידה הפדרטיבית אפשרה אימון שיתופי של המודל על פני לקוחות מבוזרים, תוך שמירה על טיפול מבוזר בנתוני המטופלים הגולמיים. במהלך האימון, המודל המקומי של כל לקוח עבר כוונון עדין (fine-tuning) באופן פרטני ושולב באמצעות שיטת הממוצע הפדרטיבי (Federated Averaging). לאחר 100 סבבי תקשורת, המודל הגלובלי התכנס, וביצועיו החזויים נותרו עקביים עם למידה מרכזית. מסגרת הלמידה הפדרטיבית הפגינה התכנסות יציבה לאורך סבבי התקשורת למרות התפלגויות נתונים הטרוגניות של הלקוחות. חילופי פרמטרים מוגנים שימרו על טיפול מבוזר בנתונים, בעוד שהמודל הגלובלי שמר על ביצועי חיזוי תחרותיים ביחס לקו הבסיס המרכזי. טבלה 4 משווה בין המימושים המרכזיים והפדרטיביים. למידה פדרטיבית דרשה זמן אימון נוסף עקב עומסי תקשורת, תוך שמירה על ביצועי חיזוי המשתווים ללמידה מרכזית.
ניתוח ביצועים ברמת מערך הנתונים
כדי להעריך את יכולת ההכללה בין מודליות שונות של שירותי בריאות, הערכנו את הביצועים עבור כל מערך נתונים בנפרד. מודל ה-FedMediFormer-XAI הרב-מודאלי הפגין ביצועים חזקים ותחרותיים באופן כללי בכל מערכי הנתונים שנבחנו. הוא השיג דיוק של 91.8%, 93.1%, 92.4% ו-94.2% במערכי הנתונים Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM ו-APTOS 2019, בהתאמה. למרות שמערך הנתונים APTOS 2019 השיג דיוק (94.7%) ודיוק חיובי (precision) (93.9%) גבוהים מעט יותר מהמודל הרב-מודאלי, הגישה הרב-מודאלית המוצעת שמרה על ביצועים תחרותיים בכל מערכי הנתונים והשיגה AUC-ROC של 0.96, ערך שדומה ל-AUC-ROC הגבוה ביותר ברמת מערך הנתונים. התוצאות הכוללות ברמת מערך הנתונים מוצגות ב-טבלה 5. עבור מערכי נתונים בודדים, ניתוח תמונות רשתית השיג את הביצועים הטובים ביותר כאשר נעשה בו שימוש לבדו, בעוד שמיזוג רב-מודאלי הניב את התחזיות היציבות והמאוזנות ביותר.
ניתוח המלצות תרופות מותאמות אישית
רכיב ההמלצות המבוסס על רשת גרפית עצבית הוערך באמצעות מידע על יעילות תרופות ונתוני אינטראקציות בין תרופות, כאשר תרופות מועמדות דורגו לפי ציוני התאמה של מטופל-תרופה שנלמדו, ושילובי תרופות המהווים התוויית נגד הוצאו מהתהליך במהלך יצירת ההמלצות. השימוש בפורמט גרף הטרוגני ומידול האינטראקציות בין מטופל לתרופה ובין תרופה לתרופה בוצעו באופן יסודי, ובכך נתמכו בחירות תרופות מותאמות אישית והערכת בטיחות. מודל ההמלצות GraphSAGE לכד באופן יעיל קשרים מורכבים בין מטופלים, מחלות, ממצאים מעבדתיים ותרופות. המלצות מותאמות אישית הראו ביצועי דירוג גבוהים תוך שמירה על הסברים בעלי משמעות קלינית באמצעות ניתוח סביבת הגרף ושיוך מאפיינים.
בהתאם לטבלה 6, מודול ההמלצה המותאמת אישית לתרופות הוערך באמצעות Precision@5, Recall@5 ו-NDCG@5. מדדים אלו מכמתים את הרלוונטיות ואת איכות הדירוג של חמש ההמלצות המובילות לתרופות מותאמות אישית שנוצרו על ידי מודול ההמלצות המבוסס על GraphSAGE. מערכת ההמלצות השיגה ביצועי דירוג חזקים, עם precision = 0.89, recall = 0.84 ו-NDCG = 0.91.
ניתוח יכולת הסבר (Explainability analysis)
המסגרת משלבת את SHAP, Integrated Gradients, ויזואליזציה של קשב (attention visualization) והסברים קונטרפקטואליים (counterfactual explanations) כדי לתמוך בפירוש של תחזיות רב-מודאליות. SHAP שימש לכימות תרומות ברמת התכונה, Integrated Gradients לייחוס תחזיות לתכונות הקלט, ויזואליזציה של קשב לבחינת מיקוד המודל בין המודאליות השונות, והסברים קונטרפקטואליים לזיהוי שינויים בתכונות הקשורים לתחזיות חלופיות. איור 8 מציג תרשים סיכום SHAP מייצג שהופק ממודל FedMediFormer-XAI המאומן, בעוד שאיור 9 מציג ויזואליזציות קשב מייצגות שהופקו מהטרנספורמר המאומן. איורים אלה מייצגים פלטים שהתקבלו מהערכת המודל ולא איורים סכמתיים של הארכיטקטורה המוצעת.
באיור 8, מוצגים הדירוגים של חשיבות המאפיינים ברמת המקביץ. למאפיינים בעלי ערכי SHAP מוחלטים גבוהים יותר הייתה השפעה רבה יותר על תחזיות המודל, והם תאמו היטב את הידע הקליני הקיים.
איור 9 מציג ויזואליזציות תשומת לב (attention) מייצגות שהופקו ישירות ממודל FedMediFormer-XAI המאומן עבור דגימת מבחן אקראית שנשמרה בנפרד. הוויזואליזציות כוללות תשומת לב למאפיינים קליניים, תשומת לב זמנית ל-CGM, תשומת לב מרחבית לרשתית, ותשומת לב חוצת-מודליות (cross-modal) בין שלוש המודליות. ויזואליזציית תשומת הלב הדגימה עוד את הקצאת תשומת הלב שנלמדה על ידי המודל על פני מודליות מרובות. הדגימה שנבחרה הראתה תשומת לב קרובה יותר יחסית ל-HbA1c, למשך מחלת הסוכרת ולגיל בין המאפיינים הקליניים, בעוד שמפת תשומת הלב של ה-CGM הדגישה מספר תקופות עם שונות גלוקוז בולטת. מפת תשומת הלב של הרשתית זיהתה אזורי תמונה ספציפיים התורמים לייצוג של המודל, ומטריצת התשומת לב חוצת-המודליות הדגימה דפוסי תשומת לב תוך-מודליים וחוצי-מודליות. כפי שמוצג ב-איור 9, מפות תשומת הלב המייצגות שנגזרו מהמודל מדגישות דפוסי גלוקוז זמניים נבחרים, משתנים קליניים משפיעים ואזורי תמונת רשתית רלוונטיים לאבחנה בדגימת מבחן שנשמרה בנפרד.
תוצאות הערכה ממוקדת-אדם
פרוטוקול הערכה פרוספקטיבי ממוקד-אדם תוכנן כדי להעריך את רמת האמון של הקלינאי, את יכולת הפרשנות, את השמישות, את התועלת הקלינית ואת הרלוונטיות של ההסבר תחת תנאים של חיזוי בלבד לעומת חיזוי בתוספת הסבר. ההערכה המוצעת תכלול אנדוקרינולוגים, מומחים לסוכרת ופארמקולוגים קליניים, באישור מתאים מוועדת האתיקה המוסדית ובהסכמה מדעת. מכיוון שהערכה זו מיועדת ליישום פרוספקטיבי עתידי, ציוני התוצאות ברמת הקלינאי אינם מדווחים בפרוטוקול הנוכחי.
טבלה 7 מסכמת את תכנון ההערכה הפרוספקטיבית המוצע על ידי קלינאים ואת הקריטריונים שנקבעו מראש להערכת השפעות ההסברים על אמון הקלינאי, יכולת הפירוש והתועלת הנתפסת. ההערכה הפרוספקטיבית תשווה בין הערכות קלינאיות של תחזיות המודל עם ובלי הסברים נלווים, באמצעות קריטריונים מוגדרים מראש בסולם ליקרט (Likert-scale). מסגרת הערכת הפירושיות הממוקדת-באדם המוצעת מוצגת באיור 10
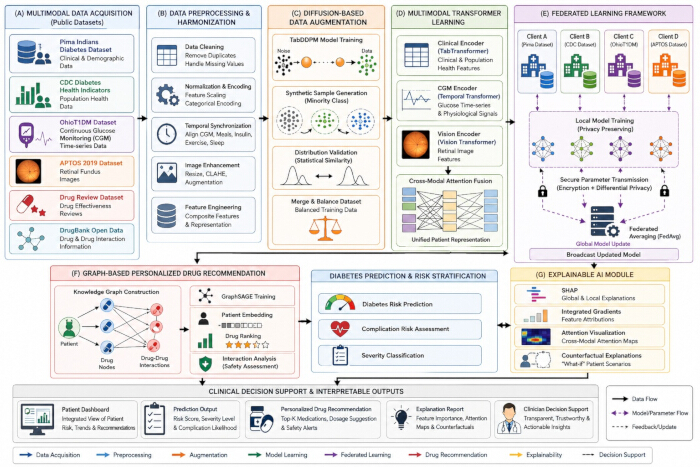
איור 1: ארכיטקטורת המסגרת הכוללת של FedMediFormer-XAI. סקירה סכמטית של מסגרת FedMediFormer-XAI, המציגה רכישה ועיבוד מקדימ של נתונים רב-מודאליים, הגברה מבוססת דיפוזיה (diffusion), למידת טרנספורמר ספציפית למודאליות, אימון מודל פדרטיבי, המלצת תרופות מותאמת אישית מבוססת GraphSAGE, וניתוח יכולת הסבר (explainability). המסגרת מייצרת תחזית לסוכרת, המלצות לתרופות מותאמות אישית ופלטי מודל ניתנים לפירוש. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
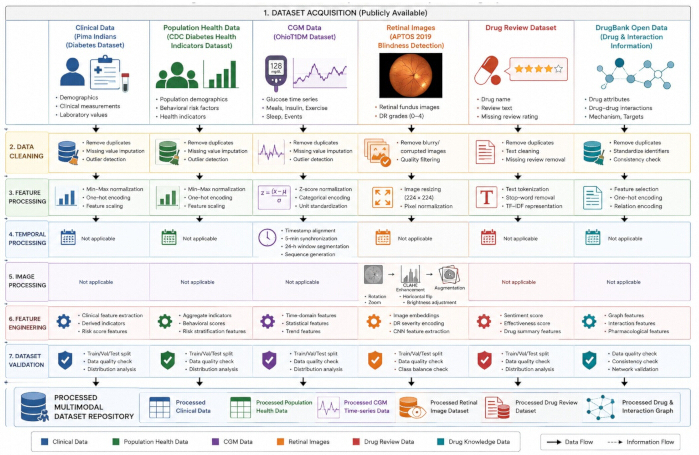
איור 2: צינור רכישה ועיבוד מקדים של מערכי נתונים רב-מודליים. תרשים זרימה של תהליך הרכישה והעיבוד המקדים של מערכי הנתונים הרב-מודליים המשמשים ב-FedMediFormer-XAI. נתונים קליניים ונתוני בריאות אוכלוסייה, רישומי CGM, תמונות רשתית ומידע פרמקולוגי עוברים בקרת איכות ספציפית למודאליות, עיבוד מקדים, נורמליזציה, קידוד והגדלה (augmentation) לפני שהם מומרים לייצוגים מוכנים למודל לצורך ניתוח המשכי. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
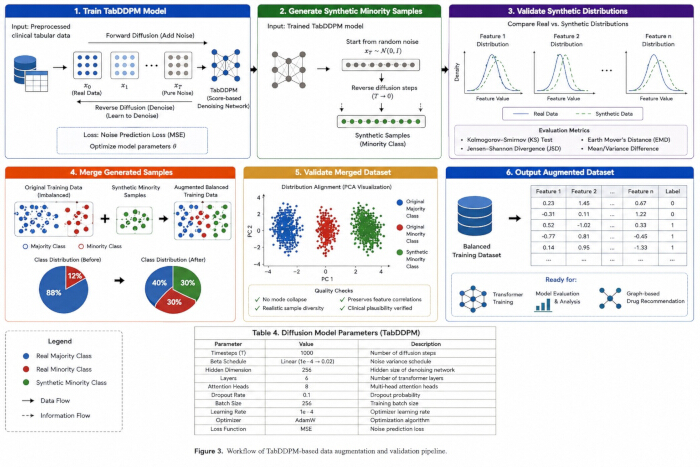
איור 3: זרימת עבודה להעשרת נתונים מבוססת דיפוזיה. תרשים זרימה להעשרה מבוססת דיפוזיה של נתוני אימון טבלאיים מובנים באמצעות TabDDPM. דגימות שנוצרו עוברות הערכות איכות ודמיון בהתפלגות לפני שילובן עם נתוני האימון המקוריים לשיפור האיזון בין המחלקות. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
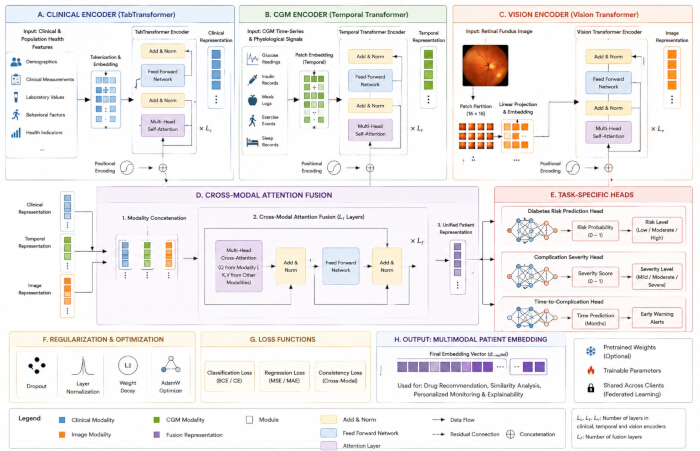
איור 4: ארכיטקטורה של מסגרת הטרנספורמר המולטי-מודלית המוצעת. ארכיטקטורה סכמטית הכוללת (A) מקודד TabTransformer עבור נתונים קליניים, (B) מקודד טרנספורמר זמני עבור נתוני CGM, ו(C) מקודד Vision Transformer עבור תמונות רשתית. (D) ייצוגים ספציפיים למודליות משולבים באמצעות תשומת לב חוצת-מודליות (cross-modal attention) כדי להפיק ייצוג מולטי-מודלי מאוחד. (E) ראשי חיזוי ספציפיים למשימה מפיקים את פלטי המודל. (F) רכיבי רגולריזציה ואופטימיזציה תומכים באימון המודל, ו (G) הפסדי סיווג, רגרסיה ועקביות חוצת-מודליות מנחים את תהליך האופטימיזציה. הייצוג המולטי-מודלי המתקבל תומך במשימות חיזוי, המלצה והסבירות (explainability) במורד הזרם. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
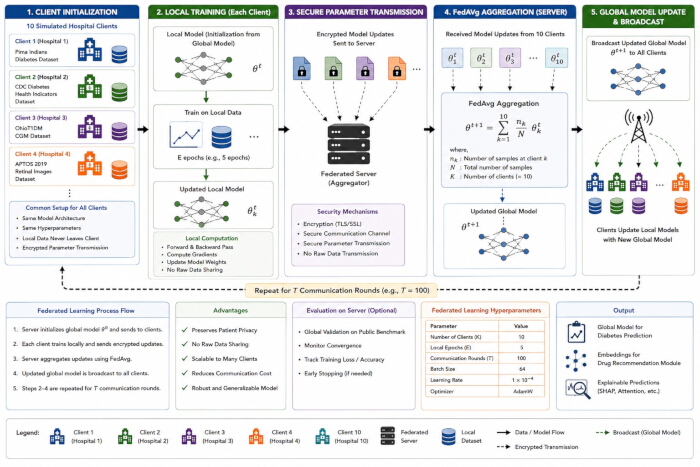
איור 5: מסגרת תקשורת ללמידה פדרטיבית. סכימה של זרימת העבודה לאימון פדרטיבי על פני לקוחות בבתי חולים מבוזרים. מודלים מולטי-מודאליים מקומיים מאומנים באמצעות נתונים ספציפיים ללקוח, ועדכוני מודל מוגנים מועברים לשרת מרכזי לצורך ביצוע Federated Averaging. המודל הגלובלי המאוחד מופץ מחדש בין הלקוחות לסבבי תקשורת עוקבים. המסגרת מדגימה גם חילוף פרמטרים מאובטח והערכה של דרישות הפרטיות, התקשורת והחישוב. נא ללחוץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
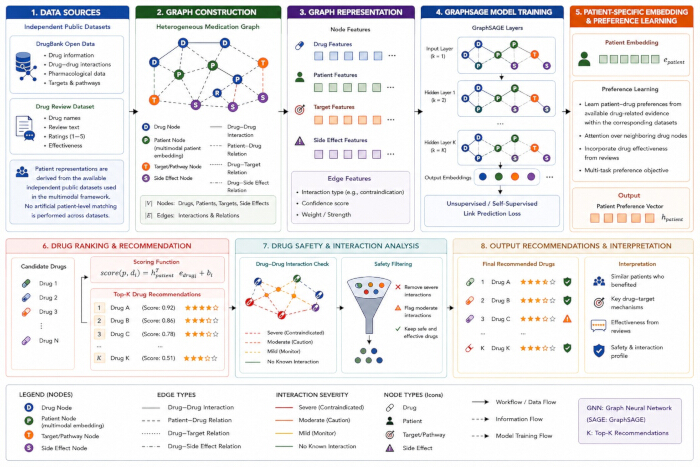
איור 6תהליך עבודה להמלצה מותאמת אישית על תרופות מבוסס גרפים. תרשים זרימה סכמטי להמלצה מותאמת אישית על תרופות מבוססת GraphSAGE. נתוני ייצוג פרמקולוגיים ונתוני מטופלים מאורגנים בגרף הטרוגני הכולל ישויות וקשרי בריאות רלוונטיים. GraphSAGE לומד ייצוגים של מטופלים ותרופות, המשמשים לחישוב מדדי התאמה בין מטופל לתרופה ולדירוג תרופות מועמדות. שילובי תרופות אסורים (Contraindicated) או לא בטוחים מסוננים לפני יצירת K ההמלצות המובילות (Top-K), כאשר מידע מבוסס גרף תומך בפירוש ההמלצות. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
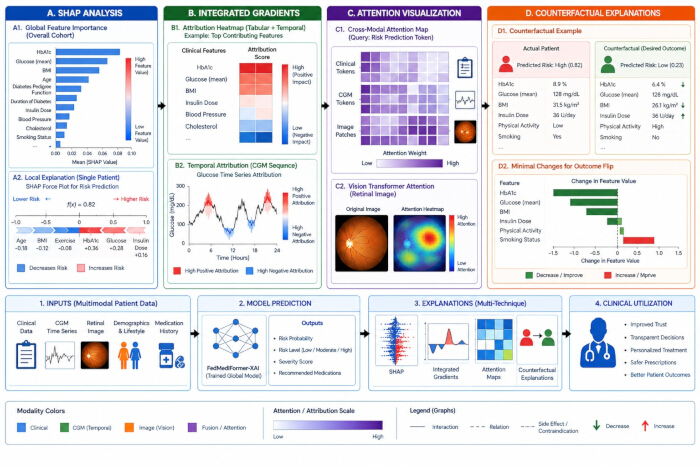
איור 7: מסגרת להערכת יכולת הסבר. סקירה סכמטית של זרימת העבודה של יכולת ההסבר. (A) ניתוח SHAP מעריך תרומות גלובליות ומקומיות של מאפיינים; (B) גרדיאנטים משולבים (Integrated Gradients) מספקים הסברים מבוססי שיוך (attribution); (C) ויזואליזציה של קשב (attention) מזהה מאפיינים משפיעים ואינטראקציות בין מודליות; ו (D) ניתוח נגדי (counterfactual analysis) מזהה שינויים במאפיינים הקשורים לשינויים בתחזיות. פלטי ההסבר הנובעים מכך תומכים בפירוש תחזיות המודל ובהמלצות מותאמות אישית. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
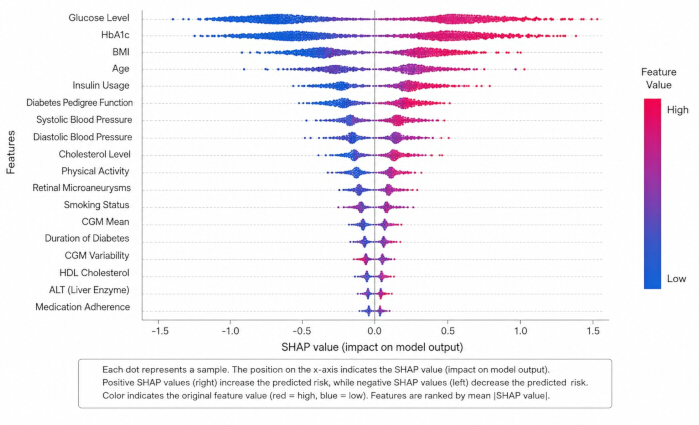
איור 8: ניתוח חשיבות מאפיינים באמצעות SHAP המופק מהמודל, כסימון למודל FedMediFormer-XAI המאומן. תרשים הסיכום של SHAP מציג את התפלגות ערכי ה-SHAP על פני הדגימות שנבחנו, כאשר המאפיינים מדורגים לפי תרומת ה-SHAP המוחלטת הממוצעת שלהם. ערכי SHAP חיוביים מעידים על תרומה לסיכון גבוה יותר לסוכרת לפי התחזית, בעוד שערכים שליליים מעידים על תרומה לסיכון נמוך יותר. הצבע מייצג את ערך המאפיין התואם, כאשר ערכים גבוהים יותר מוצגים באדום וערכים נמוכים יותר מוצגים בכחול. התרשים מייצג פלט הסברי ממשי המופק מהמודל ולא איור סכמטי. אנא לחץ כאן כדי להציג גרסה גדולה יותר של איור זה.
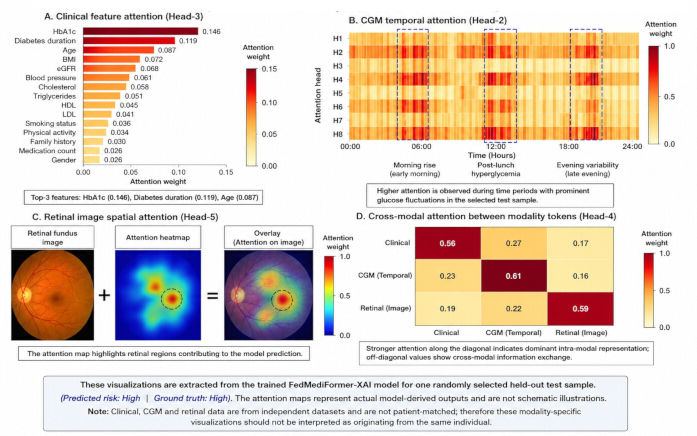
איור 9: פלטי קשב מייצגים שהופקו על ידי מודל FedMediFormer-XAI המאומן עבור דגימת מבחן אחת שנבחרה באופן אקראי מקבוצת הבדיקה. (A) קשב למאפיינים קליניים שהתקבל מרأس קשב של הטרנספורמר הרב-מודאלי, המראה את משקלי הקשב היחסיים שהוקצו למאפיינים קליניים. (B) קשב זמני לאורך רצף ה-CGM, הממחיש את פרקי הזמן שקיבלו קשב גבוה יותר מהמודל. (C) קשב מרחבי עבור תמונת קרקית הרשתית, כולל התמונה המקורית, מפת חום של הקשב והחלה של מפת הקשב על התמונה. (D) קשב חוצה-מודליות בין טוקנים של מודליות קליניות, CGM ורשתית, המראה שקלול מידע תוך-מודאלי וחוצה-מודליות. הוויזואליזציות המוצגות הן פלטים שנגזרו מהמודל המאומן. משקלי הקשב מוצגים עבור דגימת המבחן הנבחרת ויש לפרשם כדפוסי קשב של המודל ולא כמדדים עצמאיים של סיבתיות קלינית. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
| סט נתונים | סוג נתונים | דגימות/רשומות | מאפיינים/תוכן | מטרה | זמינות לציבור |
| ערכת נתוני סוכרת של אינדיאנים מפומא | טבלה קלינית | 768 חולים | 8 משתנים קליניים | ניבוי סיכון לסוכרת | ציבורי |
| מדדי בריאות לסוכרת של ה-CDC | בריאות האוכלוסייה | 253,680 רשומות | דמוגרפיה, אורח חיים, מדדי בריאות | ניתוח סיכוני אוכלוסייה | ציבורי |
| מאגר הנתונים OhioT1DM | סדרות זמן של CGM | 12 נבדקים | גלוקוז, אינסולין, ארוחות, פעילות גופנית, שינה | מידול סוכרת זמני | ציבורי |
| זיהוי עיוורון APTOS 2019 | דימויי רשתית | 3,662 תמונות | צילומי קרקית העין עם תוויות חומרה | ניתוח רטינופתיה סוכרתית | ציבורי |
| מאגר נתונים של ביקורות על תרופות | פרמקולוגי | 215,063 ביקורות | יעילות תרופות, דירוגים, ביקורות | המלצה על תרופה | ציבורי |
| נתוני פתוחים של DrugBank | גרף ידע של תרופות | אלפי תרופות | אינטראקציות בין תרופות, מטרות, מסלולים | בניית גרף | גישה ציבורית/אקדמית |
טבלה 1: מאפייני מערכי הנתונים. סיכום של מערכי נתונים הזמינים לציבור ששימשו במחקר זה, כולל סוג מערך הנתונים, גודל המדגם, מודאליות הנתונים, תוכן המאפיינים, המטרה המיועדת והזמינות.
| סט של נתונים | מודליות | מטרת החיזוי | רמת מיזוג |
| Pima Indians Diabetes | קלינית | סיווג סוכרת | שיכון מאפיינים (Feature embedding) |
| CDC Diabetes Health Indicators | בריאות אוכלוסייה | חיזוי סיכון לסוכרת | שיכון מאפיינים (Feature embedding) |
| OhioT1DM | ניטור גלוקוז רציף | חיזוי מגמת גלוקוז | שיכון מאפיינים (Feature embedding) |
| APTOS 2019 | תמונות קרקית הרשתית | ניתוח רטינופתיה סוכרתית | שיכון מאפיינים (Feature embedding) |
| Drug Review + DrugBank | פרמקולוגית | המלצה על תרופות | שיכון גרף (Graph embedding) |
טבלה 2: אסטרטגיית אינטגרציה של מערכי נתונים רב-מודאליים. סיכום של מערכי הנתונים ששימשו לבינה מלאכותית רב-מודאלית לסוכרת, כולל מודליות הנתונים, יעד הניבוי, והרמה שבה משולבים הייצוגים הספציפיים למודליות. נתונים קליניים, נתוני בריאות אוכלוסייה, ניטור גלוקוז רציף ונתוני תמונות רשת מיוצגים כשיבוצי מאפיינים (feature embeddings), בעוד שמידע פרמקולוגי משולב באמצעות שיבוצי גרפים (graph embeddings) לצורך המלצה מותאמת אישית על תרופות.
| מודל | דיוק, ממוצע ± סטיית תקן (רווח בר סמך של 95%) | דיוק, ממוצע ± סטיית תקנית (רווח בר סמך של 95%) | הסחב (Recall), ממוצע ± סטיית תקן (רווח ברחב של 95%) | מדד F1, ממוצע ± סטיית תקן (רווח ברካה של 95%) | MCC, ממוצע ± סטיית תקן (רווח בר-סמיכות 95%) | AUC-ROC, ממוצע ± סטיית תקן (95% CI) |
| יער אקראי (Random Forest) | 83.60 ± 0.74 (82.68–84.52) | 82.70 ± 0.60 (81.96–83.44) | 81.90 ± 0.56 (81.21–82.59) | 82.30 ± 0.56 (81.61–82.99) | 0.67 ± 0.03 (0.63–0.71) | 0.88 ± 0.01 (0.87–0.89) |
| XGBoost | 85.30 ± 0.71 (84.42–86.18) | 84.70 ± 0.60 (83.96–85.44) | 83.80 ± 0.56 (83.11–84.49) | 84.20 ± 0.56 (83.51–84.89) | 0.70 ± 0.03 (0.66–0.74) | 0.90 ± 0.01 (0.89–0.91) |
| TabTransformer | 87.50 ± 0.52 (86.85–88.15) | 87.00 ± 0.60 (86.26–87.74) | 86.20 ± 0.56 (85.51–86.89) | 86.60 ± 0.56 (85.91–87.29) | 0.75 ± 0.03 (0.71–0.79) | 0.92 ± 0.01 (0.91–0.93) |
| Vision Transformer | 88.80 ± 0.50 (88.18–89.42) | 88.20 ± 0.60 (87.46–88.94) | 87.60 ± 0.56 (86.91–88.29) | 87.90 ± 0.56 (87.21–88.59) | 0.78 ± 0.03 (0.74–0.82) | 0.93 ± 0.01 (0.92–0.94) |
| טרנספורמר זמני | 87.20 ± 0.51 (86.57–87.83) | 86.60 ± 0.60 (85.86–87.34) | 85.90 ± 0.56 (85.21–86.59) | 86.20 ± 0.56 (85.51–86.89) | 0.74 ± 0.03 (0.70–0.78) | 0.91 ± 0.01 (0.90–0.92) |
| CNN-LSTM | 86.90 ± 0.58 (86.18–87.62) | 86.30 ± 0.60 (85.56–87.04) | 85.60 ± 0.55 (84.92–86.28) | 85.90 ± 0.56 (85.21–86.59) | 0.73 ± 0.03 (0.69–0.77) | 0.91 ± 0.01 (0.90–0.92) |
| טרנספורמר רב-מודאלי מרכזי | 91.30 ± 0.12 (91.15–91.45) | 90.70 ± 0.60 (89.96–91.44) | 90.10 ± 0.56 (89.41–90.79) | 90.40 ± 0.56 (89.71–91.09) | 0.83 ± 0.03 (0.79–0.87) | 0.95 ± 0.01 (0.94–0.96) |
| FedMediFormer-XAI | 94.20 ± 0.34 (93.78–94.62) | 93.10 ± 0.30 (92.73–93.47) | 92.80 ± 0.28 (92.45–93.15) | 92.90 ± 0.28 (92.55–93.25) | 0.88 ± 0.02 (0.86–0.90) | 0.96 ± 0.01 (0.95–0.97) |
טבלה 3: ביצועי חיזוי לסוכרת. ביצועי חיזוי השוואתיים של FedMediFormer-XAI לעומת מודלי בסיס של למידה חישובית (machine learning) ולמידה עמוקה (deep learning) באמצעות מדדי דיוק (accuracy), רגישות (precision), recall, F1-score, MCC ו-AUC-ROC.
| מדד | למידה ריכוזית | למידה פדרטיבית (Federated Learning) |
| דיוק (%) | 94.7 | 94.2 |
| AUC-ROC | 0.97 | 0.96 |
| שימור פרטיות | לא | כן |
| נדרשת שיתוף נתוני גלם | כן | לא |
| סבבי תקשורת | לא רלוונטי | 100 |
| זמן אימון (שעות) | 4.8 | 5.6 |
| ציות רגולטורי | בינוני | גבוה |
טבלה 4: ביצועי למידה פדרטיבית לעומת למידה מרכזית. השוואה בין מימושי למידה מרכזית ולמידה פדרטיבית ביחס לביצועים חיזויים, דרישות לשיתוף נתוני גלם, סבבי תקשורת וזמן אימון.
| סט נתונים | דיוק (%) | דיוק (%) | רגישות (%) | AUC-ROC |
| מערך נתוני סוכרת של אינדיאנים מפאימה | 91.8 | 90.5 | 89.8 | 0.93 |
| מדדי בריאות לסוכרת של ה-CDC | 93.1 | 92.2 | 91.6 | 0.95 |
| מאגר הנתונים OhioT1DM | 92.4 | 91.8 | 91.1 | 0.94 |
| זיהוי עיוורון APTOS 2019 | 94.7 | 93.9 | 93.5 | 0.96 |
| היתוך רב-מודאלי (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
טבלה 5: תוצאות ברמת מערך הנתונים. ניתוח ביצועים על פני מערכי נתונים בודדים והגדרות מיזוג רב-מודאליות. התוצאות ממחישות את התרומה של מודליות נתונים שונות לביצועי הניבוי הכוללים.
| מדד | ערך |
| דיוק@5 | 0.89 |
| Recall@5 | 0.84 |
| NDCG@5 | 0.91 |
| דיוק בזיהוי אינטראקציות בין תרופות | 0.95 |
| כיסוי המלצות | 0.88 |
| דירוג הדדי ממוצע (Mean Reciprocal Rank - MRR) | 0.86 |
| מדד ציות לבטיחות | 0.94 |
טבלה 6: ביצועי המלצות תרופות מותאמות אישית. הערכה של המלצות תרופות מותאמות אישית מבוססות גרף באמצעות מדדי דירוג, דיוק זיהוי אינטראקציות, כיסוי המלצות והערכת בטיחות תרופתית.
| קריטריון הערכה | מערך ההערכה המוצע |
| אמון קלינאיים | הערכה באמצעות סולם ליקרט בן חמש נקודות |
| פרשנות (Interpretability) | הערכה באמצעות סולם ליקרט בעל חמישה נקודות |
| רלוונטיות קלינית | הערכה באמצעות סולם ליקרט בן חמש נקודות |
| תועלת ההסבר | הערכה באמצעות סולם ליקרט בן חמש נקודות |
| תועלת נתפסת | הערכה באמצעות סולם ליקרט בעל חמש נקודות |
| הסכמה בין מעריכים | מדד קאפה של פלייס (Fleiss' kappa), שיחושב לאחר הערכה פרוספקטיבית |
| השוואה סטטיסטית | מבחן סטטיסטי מזווג, בהתאם לצורך לאחר איסוף הנתונים |
| משתתפים | 12 קליניקאים, בכפוף לאישור ועדת אתיקה והסכמה מדעת |
| סטטוס הערכה | הערכה פרוספקטיבית/עתידית |
טבלה 7: קריטריוני הערכה מוצעים ממוקדי-אדם. מסגרת הערכה פרוספקטיבית מוצעת ממוקדת-קלינאי להערכת התועלת, הרלוונטיות הקלינית, יכולת הפירוש, המהימנות ויכולת השמישות של הסברים מ-FedMediFormer-XAI. ההערכה כוללת הערכה סטנדרטית במדד ליקרט (Likert) של חמש נקודות, הסכמה בין מעריכים באמצעות Fleiss' kappa, השוואה סטטיסטית בין תנאי של חיזוי בלבד לתנאי של חיזוי בתוספת הסבר, ומרווחי סמך של 95%. יש לבצע את הערכת הקלינאי רק לאחר קבלת אישור מוועדת האתיקה המוסדית המתאימה והסכמה מדעת.
טבלה נלווית 1: אסטרטגיית תיקוף מערך הנתונים. חלוקת מערך הנתונים, נהלי תיקוף, אסטרטגיות לאיזון מחלקות ואמצעי בקרת איכות הוטמעו כדי להבטיח שחזור והערכה מהימנה של המודל. אנא לחצו כאן להורדת הקובץ.
טבלה משלימה 2: פרמטרים של מודל הדיפוזיה. הגדרות תצורה עבור מודל הדיפוזיה TabDDPM, כולל פרמטרי אימון, הגדרות אופטימיזציה, ממדי מרחב חבוי (latent dimensions), אסטרטגיית תזמון רעש ומפרטי יצירת דגימות סינתטיות. אנא לחצו כאן להורדת קובץ זה.
טבלה משלימה 3: הגדרות הטרנספורמר הרב-מודאלי. הגדרות של ארכיטקטורת הטרנספורמר הרב-מודאלית, הכוללות את מקודדי הנתונים הקליניים, הזמניים והתמונה, ממדי השקיול (embedding) והמיזוג, ראשי קשב (attention heads), האופטימייזר, קצב הלמידה, גודל אצווה (batch size), תקופות אימון (epochs), קריטריון עצירה מוקדמת, והפסד אימון משולב. אנא לחצו כאן להורדת הקובץ.
טבלה משלימה 4: הגדרת למידה פדרטיבית. פרמטרים ששימשו לאימון פדרטיבי השומר על פרטיות, כולל מספר בתי החולים המשתתפים, סבבי תקשורת, עידני (epochs) אימון מקומיים, שיעור השתתפות לקוחות, אלגוריתם אגרגציה, אופטימייזר, קצב למידה, שיטת הצפנה, פרוטוקול תקשורת ומדיניות שיתוף נתונים גולמיים. אנא לחצו כאן להורדת קובץ זה.
טבלה משלימה 5: הגדרות GraphSAGE. הגדרות של מודול המלצות תרופות מותאמות אישית המבוסס על GraphSAGE הטרוגני, כולל סוג הגרף, ממדי השכבות הנסתרות והשיכון (embedding), מספר שכבות הגרף, גודל דגימת השכנות, האופטימייזר, קצב הלמידה, גודל אצווה (batch size), מספר תקופות אימון (epochs), הפסד Bayesian Personalized Ranking, ומספר המלצות התרופות המובילות. אנא לחצו כאן להורדת קובץ זה.
טבלה משלימה 6: מדדי הערכה של יכולת ההסבר. מדדים כמותיים וממוקדי-אדם המשמשים להערכת יכולת ההסבר של מסגרת ה-FedMediFormer-XAI. המדדים בוחנים את נאמנות ההסבר, יציבות, עקביות, דלילות, שלמות, רגישות, חוסר נאמנות, הסכמה בין מעריכים ואיכות ההסבר כפי שנתפסת על ידי קלינאיים. אנא לחצו כאן להורדת הקובץ.
טבלה נלווית 7: מדדי הערכה. מדדי חיזוי, למידה פדרטיבית, המלצה והסבירות (explainability) משמשים להערכת ביצועי המסגרת, החסינות, איכות הדירוג והיכולת לניתוח פרשני (interpretability). אנא לחצו כאן להורדת קובץ זה.
טבלה משלימה 8: תכנון הערכה ממוקדת-אדם. תכנון מחקר ההערכה הממוקד-קלינאי, הכולל קבוצות משתתפים, תנאי הערכה, קריטריונים להערכה והליכי ניתוח סטטיסטי. אנא לחץ כאן להורדת קובץ זה.
טבלה משלימה 9: נכס שחזוריותסיכום של מערכי הנתונים, מפרטי המימוש, קבצי התצורה, נהלי ההערכה, התיעוד והרישומים הניסויים הנדרשים כדי לתמוך בחזרתיות של מסגרת ה-FedMediFormer-XAI המוצעת. אנא לחצו כאן כדי להוריד קובץ זה.
דיון
פירוש הממצאים המרכזיים
התוצאות המייצגות מראות כי ניתן לשלב למידת טרנספורמר רב-מודאלית (multimodal transformer learning), למידה מבוזרת (federated learning), הרחבת נתונים מבוססת דיפוזיה (diffusion-based augmentation), המלצת תרופות מבוססת רשת עצבית גרפית (graph neural network-based drug recommendation) ובינה מלאכותית ניתנת להסבר (explainable artificial intelligence) לכדי מסגרת אחודה של בינה לסוכרת. על ידי שילוב של רשומות קליניות, מדדי בריאות אוכלוסייה, נתוני ניטור גלוקוז רציף, תמונות קרקית של הרשתית ומידע פרמקולוגי, מסגרת ה-FedMediFormer-XAI המוצעת הדגימה ביצועי ניבוי חזקים תוך תמיכה בפיתוח מודלים מבוזרים וניתנים לפירוש. שיטת הלמידה הרב-מודאלית מיצתה מאפיינים אינפורמטיביים ממודליות שונות של שירותי בריאות, מה שהוביל לניבוי טוב יותר של סוכרת ולהמלצות לטיפול מותאם אישית.
יתרונות הלמידה הפדרטיבית
תרומה מרכזית אחת של המסגרת המוצעת היא השילוב של למידה פדרטיבית (Federated learning) כדי לאפשר בנייה שיתופית ומבוזרת של מודלים. למידה פדרטיבית נבדלת משיטות למידה מרכזיות מסורתיות בכך שהיא מאפשרת למספר מוסדות להשתתף באימון המודל מבלי לשתף ישירות נתוני מטופלים גולמיים. הממצאים העיקריים הראו כי הלמידה הפדרטיבית שמרה על דיוק חיזוי ברמה דומה לזו של למידה מרכזית, תוך תמיכה בטיפול מבוזר בנתונים. תכונה זו רלוונטית במיוחד בתרחישים של שירותי בריאות, שבהם שיתוף נתונים מוגבל על ידי מדיניות מוסדית ודרישות פרטיות.
ניתוח יכולת ההסבר (Explainability analysis)
הערכת יכולת ההסבר מצאה כי ניתוח SHAP, גרדיאנטים משולבים (Integrated Gradients), ויזואליזציה של תשומת לב (attention visualization) והסברים קונטרפקטואליים (counterfactual explanations) יכולים כולם להניב תובנות בעלות משמעות קלינית לגבי התנהגות המודל. הסברים גלובליים ומקומיים הסכימו במידה רבה על המנבאים המובילים מנקודת מבט קלינית (כלומר, מדידות גלוקוז, מדד מסת הגוף, גיל, דפוסי מתן אינסולין ומומות רשתית). ויזואליזציות של תשומת לב הראו גם שארכיטקטורת ה-transformer התמקדה במאפייני דימוי ומאפיינים זמניים רלוונטיים מבחינה קלינית. גישות אלו משפרות את השקיפות על ידי אספקת פרשנויות משלימות של תחזיות המודל ותרומות המאפיינים.
ניתוח המלצות לתרופות בהתאמה אישית
אנו מציעים מודל המלצות המבוסס על GNN אשר, לצד מידול קשרי מטופל-תרופה וקשרי תרופה-תרופה, מספק המלצות לתרופות בהתאמה אישית. למעשה, הטופולוגיה של הגרף ההטרוגני סייעה הן בשליטה בדפוסי יעילות הטיפול והן בהתחשבות בבטיחות התרופות. תוצאות ההמלצה המצוינות לתרופות שהושגו במחקר זה ממחישות את יכולותיהם של שיטות למידה מבוססות גרף לפיתוח מערכות בינה לסוכרת, מעבר לחיזוי מחלות, לעבר תשתית לתמיכה טיפולית מותאמת אישית.
הערכה ממוקדת-אדם
המסגרת כוללת פרוטוקול הערכה פרוספקטיבי ממוקד-אדם להערכת ההשפעות של יכולת ההסבר (explainability) על אמון הקלינאי, יכולת הפרשנות, השמישות והתועלת הקלינית הנתפסת. ההערכה המוצעת תשווה בין תנאים של חיזוי בלבד לבין תנאים של חיזוי בתוספת הסבר, תוך שימוש בקריטריונים סטנדרטיים להערכה. יישום עתידי של הערכה זו, לאחר קבלת האישור המתאים מוועדת האתיקה המוסדית והסכמה מדעת, יספק ראיות אמפיריות לגבי קבלת המערכת על ידי קלינאים והתועלת המעשית של ההסברים שיוצרו.
שלבים קריטיים ליישום מוצלח וניתן לשחזור
מספר שלבים בפרוטוקול המוצע דורשים תשומת לב מיוחדת כדי להבטיח שחזור. עיבוד מקדים של מערך הנתונים וחלוקתו צריכים לשמור על הפרדה ברמת המטופל ולמנוע זליגת נתונים, בעוד שההפצות של לקוחות non-IID שהוגדרו צריכות להישמר במהלך הלמידה הפדרטיבית. מיזוג חוצה-מודליות (Cross-modal fusion) צריך לשמר את ממדי המרחב החבוי, את הגדרות התשומת לב (attention), את ההטמעות של סוגי המודליות (modality-type embeddings), את הנורמליזציה ואת ההשלכה הסופית. הרחבת נתונים מבוססת דיפוזיה (Diffusion-based augmentation) צריכה להשתמש בפרמטרי עיבוד מקדים ואימון עקביים, בעוד שהמלצה מבוססת GraphSAGE צריכה לשמור על ייצוגי מטופל-תרופה עקביים, סינון אינטראקציות, הגדרות של פריטים רלוונטיים וקריטריוני דירוג Top-K. ניתוח הניתנות להסבר (Explainability analysis) צריך להשתמש בדגימות רקע קבועות של SHAP, בקווי בסיס של Integrated Gradients, בהליכי חילוץ תשומת לב ובמגבלות קונטרפקטואליות מותרות מבחינה קלינית. יש לתעד את גרסאות התוכנה, את ה-random seeds, את הגדרות המודל, את חלוקות מערכי הנתונים ואת פרמטרי ההערכה כדי למזער שונות התלויה ביישום.
מגבלות
יש לקחת בחשבון מספר מגבלות בעת פרשנות הממצאים של מחקר זה. ראשית, המסגרת פותחה והוערכה באמצעות מערכי נתונים הזמינים לציבור, אשר עשויים שלא לייצג באופן מלא את הגיוון של אוכלוסיות שירותי בריאות וסביבות קליניות בעולם האמיתי. שנית, למרות שלמידה פדרטיבית (federated learning) הוערכה באמצעות לקוחות בתי חולים מדומים, לא בוצע תיקוף רחב היקף הכולל מוסדות בריאות עצמאיים. שלישית, למידה פדרטיבית מחייבת תקורה תקשורתית וחישובית נוספת שעשויה להשפיע על היכולת להרחבה (scalability) בסביבות עם משאבים מוגבלים. לבסוף, טכניקות ההסבר שיושמו במחקר זה הן בעיקר שיטות פרשנות לאחר מעשה (post hoc) ועשויות שלא לשקף באופן מלא את התנהגותו של המודל המורכב.
פרוטוקול התיקוף המוצע, הממוקד בבן אנוש, בוחן פאנל ראשוני של 12 מומחים קליניים הכולל אנדוקרינולוגים, מומחים לסוכרת ופרמקולוגים קליניים. גודל מדגם זה נועד להערכה ראשונית של שמישות וניתנות לפירוש, ולא לתיקוף קליני סופי. הפאנל המצומצם יחסית של המומחים עשוי להגביל את העוצמה הסטטיסטית ואת יכולת ההכללה. על כן, מחקרים פרוספקטיביים עתידיים צריכים לכלול קבוצות גדולות יותר של קלינאים ממספר מרכזים, המייצגים הגדרות קליניות והתמחות שונות.
מגבלה מרכזית של המסגרת המוצעת היא שהנתונים הקליניים, נתוני ה-CGM, הדמיות הרשתית והנתונים הקשורים לתרופות נגזרים ממאגרי נתונים ציבוריים עצמאיים ולא מרשומות מולטי-מודאליות תואמות למטופל. כתוצאה מכך, יש לפרש את רכיב ההיתוך הבין-מודאלי (cross-modal fusion) כמסגרת מתודולוגית לשילוב ייצוגים מודאליים משלימים, ולא כראיה הנגזרת ממדידות מולטי-מודאליות סימולטניות באותם מטופלים. הבדלים במאפייני האוכלוסייה, בפרוטוקולי הרכישה, בהתפלגויות התכונות ובהגדרות המחלה בין מאגרי המקור עשויים להוביל לאי-התאמות התפלגותיות ואולי להגביל את המידה שבה הקשרים הבין-מודאליים שנלמדו מייצגים קשרים אמיתיים ברמת המטופל. למרות שהפרוטוקול נמנע במפורש מהתאמה מלאכותית של מטופלים בין מאגרי נתונים עצמאיים, עיצוב זה מגביל הערכה ישירה של אינטראקציות מולטי-מודאליות ספציפיות למטופל ועשוי להשפיע על ההכללה הקלינית. לכן, אין לפרש את הביצועים המולטי-מודאליים המדווחים כשקולים לתיקוף על קוהורט מולטי-מודאלי שנאסף באופן פרוספקטיבי ותואם למטופל. מחקרים עתידיים צריכים לתקף את המסגרת באמצעות מאגרי נתונים גדולים יותר שנאספו באופן עצמאי ומכילים מידע קליני, CGM, רשתית וטיפולי מסונכרן מאותם מטופלים.
פתרון בעיות ושינויים בפרוטוקול
מספר שיקולים מעשיים עשויים להשפיע על יישום הפרוטוקול המוצע. חוסר איזון במחלקה (Class imbalance) עלול להפחית את ביצועי הניבוי כאשר מחלקות מיעוט אינן מיוצגות מספיק; ניתן למתן את אתגר זה באמצעות אסטרטגיות של דגימה מחדש והעשרה מבוססת דיפוזיה. ערכים חסרים ופורמט נתונים לא עקבי עלולים להשפיע על יציבות המודל ויש לטפל בהם באמצעות הליכי עיבוד מקדמי קפדניים. התכנסות של למידה פדרטיבית (Federated learning) עלולה להיות לא יציבה כאשר מערכי הנתונים של הלקוחות מראים הטרוגניות משמעותית; התאמה של תקופות אימון מקומיות (epochs), קצבי למידה ותדרי צבירה עשויה לשפר את היציבות. מגבלות חומרה עלולות להשפיע גם הן על יעילות האימון, במיוחד בעת עיבוד מערכי נתונים רב-מודליים גדולים וארכיטקטורות transformer. במקרים אלו, הפחתת גודל האצווה (batch size) או מורכבות המודל עשויה לשפר את ההיתכנות החישובית תוך שמירה על יכולת השחזור.
כיוונים עתידיים
מחקרים עתידיים עשויים להתמקד בשילוב טכנולוגיות של תאום דיגיטלי (digital twin) לצורך סימולציה מותאמת אישית של מחלות ותכנון טיפול. מודלי בסיס (Foundation models) המאומנים על מאגרי נתוני בריאות רב-מודאליים בקנה מידה גדול עשויים לשפר עוד יותר את למידת הייצוג ואת ההכללה של המודלים. טכניקות של הסבירות סיבתית (Causal explainability) עשויות לספק תובנה עמוקה יותר לגבי מנגנוני המחלה והשפעות הטיפול, מעבר להסברים המבוססים על מתאם (correlation). בנוסף, גישות של למידה חיזוקית (reinforcement learning) עשויות לתמוך באופטימיזציה של טיפול אדפטיבי ובאסטרטגיות דינמיות להמלצה על תרופות. התקדמויות אלו עשויות לשפר עוד יותר את התועלת הקלינית ואת יכולות ההתאמה האישית של מערכות בינה לסוכרת. יתרה מכך, תחזיות והמלצות לתרופות הנוצרות על ידי בינה מלאכותית צריכות להיחשב ככלים לתמיכה בהחלטות ולא כתחליפים לשיקול דעת קליני מקצועי. פיקוח אנושי הולם נותר חיוני לצורך פריסה אחראית ואתית של מערכות בינה מלאכותית בתחום הבריאות.
סיכום
FedMediFormer-XAI מספק מסגרת ניתנת לשחזור המשלבת למידה מולטי-מודאלית, אימון פדרטיבי, המלצה מותאמת אישית לתרופות ויכולת הסבר עבור בינה רפואית לסוכרת. תוצאות מייצגות תומכות בהיתכנות של זרימת העבודה המוצעת, בעוד שנדרשת תיקוף נוסף באמצעות מערכי נתונים מולטי-מודאליים התואמים למטופלים, סביבות קליניות רחבות יותר והערכה פרוספקטיבית של קלינאים לפני פריסה קלינית.
גילויים
המחברים מצהירים כי אין להם אינטרסים פיננסיים מתחרים, ניגודי עניינים או מערכות יחסים אישיות שעלולים היו להשפיע על העבודה המדווחת במחקר זה. כלי בינה מלאכותית שימשו אך ורק לסיוע בליטוש השפה, ארגון כתב היד, עיצוב ועריכה במהלך הכנת מאמר זה. כל התוכן המדעי, מערך המחקר, המתודולוגיה, ניתוח הנתונים, פרשנות התוצאות והמסקנות פותחו, אומתו ואושרו על ידי המחברים. המחברים נושאים באחריות מלאה לדיוק, ליושרה ולמקוריות של העבודה המוצגת בכתב יד זה.
תודות
המחברים מודים למפתחים ולמנהלים של מאגרי הנתונים הזמינים לציבור ושל משאבי התוכנה בקוד פתוח ששימשו במחקר זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| הצפנת AES | NIST | AES-256 | נתונים במצב מנוחה / הצפנת פרמטרי מודל מוגנת בלמידה פדרטיבית |
| APTOS 2019 Blindness Detection Dataset | Kaggle/APTOS | מהדורת 2019 | מאגר נתוני תמונות רשתית; זמין לציבור ומזוהה באופן אנונימי; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | גרסה 0.8 | ניתוח ייחוס ופרשנות של מודלים |
| CUDA Toolkit | NVIDIA | גרסה 12.2 | חישוב מואץ באמצעות GPU |
| Diabetes Health Indicators Dataset (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | מהדורת 2015 | מדדי בריאות אוכלוסייה; זמין לציבור ומזוהה באופן אנונימי; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Diabetic Retinopathy Detection Dataset | Kaggle | מהדורה ציבורית | מאגר נתוני תמונות רשתית; זמין לציבור ומזוהה באופן אנונימי; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| תעודות דיגיטליות | - | - | אימות לקוחות בלמידה פדרטיבית |
| Drug Interaction Dataset | Kaggle | מהדורה ציבורית | נתוני גרף של אינטראקציות בין תרופות; זמין לציבור ומזוהה באופן אנונימי; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Drug Review Dataset | UCI Machine Learning Repository | Dataset 462 | מאגר נתוני ביקורות ויעילות של תרופות; זמין לציבור ומזוהה באופן אנונימי; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib Developers | גרסה 3.9 | ויזואליזציה |
| MTS Diabetes Dataset | Kaggle | מהדורה ציבורית | מאגר נתוני חיישנים לבישים / חיזוי סוכרת; זמין לציבור ומזוהה באופן אנונימי; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX Developers | גרסה 3.3 | בנייה וניתוח של גרף אינטראקציות תרופתיות |
| NumPy | NumPy Developers | גרסה 1.26 | חישוב מספרי |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | אימון והסקה של מודלים; לפחות 32 GB זיכרון מערכת |
| OhioT1DM Dataset | Ohio University | מהדורה ציבורית | מאגר נתוני ניטור גלוקוז רציף; זמין לציבור ומזוהה באופן אנונימי; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV Foundation | גרסה 4.10 | עיבוד תמונה |
| Pandas | PyData | גרסה 2.2 | עיבוד נתונים ועיבוד מקדמי |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Dataset 34 | מאגר נתוני חיזוי סוכרת קליני; זמין לציבור ומזוהה באופן אנונימי; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | גרסה 3.11 | סביבת התכנות העיקרית |
| PyTorch | Meta AI | גרסה 2.3 | פיתוח ואימון מודלי למידה עמוקה |
| PyTorch Geometric | PyG Team | גרסה 2.5 | בנייה ואימון של רשתות עצביות גרפיות |
| Scikit-learn | Scikit-learn Developers | גרסה 1.5 | כלי עזר והערכה ללמידה חישובית |
| מנגנון אגרגציה מאובטח | - | - | אגרגציה מוגנת של פרמטרי מודל מקומיים בלמידה פדרטיבית |
| SHAP | SHAP Developers | גרסה 0.47 | בינה מלאכותית ניתנת להסבר וניתוח ייחוס מאפיינים |
| TensorFlow | גרסה 2.15 | פיתוח ואימון מודלי למידה עמוקה | |
| Transformers | Hugging Face | גרסה 4.45 | מימוש ארכיטקטורה מבוססת Transformer |
| אבטחת שכבת התעבורה | IETF | TLS 1.3 | ערוץ תקשורת מוצפן להחלפת פרמטרים פדרטיביים |
| תחנת עבודה | Generic | - | סביבת חישוב; לפחות 32 GB זיכרון מערכת |
מקורות
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.