מחקר זה משלב ניסוי תרחישים ובדיקות EEG כדי לבחון כיצד מסגור של תפקידי מומחה ומלווה קשור לאמון בהקשרים שונים של משימות רפואיות.
מאמר שיטה
מסגור תפקידים ואמון בבינה מלאכותית רפואית: ראיות מניסוי תרחישים ומ-EEG
במאמר זה
סיכום
תקציר
בינה מלאכותית רפואית מקוונת התפתחה מכלים אנליטיים של צד-שרת לממשקי שירות הפונים למטופלים, מה שהופך את נושא האמון המכויל (calibrated trust) לבעיה חשובה יותר ויותר של עיצוב וממשל. בהתבסס על תיאוריית התאמת התפקידים (role congruity theory), מחקר זה בחן כיצד מסגור של תפקיד מומחה לעומת תפקיד מלווה קשור לאמון בהקשרי משימות רפואיות שונות. במחקר 1 נעשה שימוש בניסוי תרחישים של 2 (תפקיד: מומחה לעומת מלווה) × 2 (משימה: ייעוץ למחלה לעומת ייעוץ בריאותי) (N = 300). מסגור כמומחה הגביר את המקצועיות הנתפסת, בעוד שמסגור כמלווה הגביר את הנוכחות החברתית; שתי התפיסות היו קשורות באופן עצמאי לאמון הכללי כאשר הן הוזנו בו-זמנית. הקשר העקיף דרך המקצועיות הותנה על ידי הקשר המשימה, אך השוואת bootstrap ישירה לא הראתה ששני מדדי התיווך הממותן (moderated-mediation) היו שונים עבור האמון הכללי. דיאגנוסטיקה של המדידות הצביעה על חפיפה משמעותית בין מקצועיות נתפסת לאמון קוגניטיבי, ובין נוכחות חברתית לאמון רגשי, מה שדורש פרשנות זהירה. מחקר 2 השווה בין הצהרות הממוסגרות כמומחה וכמלווה באמצעות EEG ב-39 תצפיות זוגיות. מסגור כמומחה לווה ב-ERS תטא פרונטלי-מרכזי גבוה יותר וב-ΔPLV תטא FCz-F6 פחות שלילי מתוקנן לבסיס, בעוד שההתנהגות ברמת התנאי לא הראתה הבדל מהימן בשיעור האמון, בזמן התגובה או בשיעור התגובות החסרות. ממצאי EEG אלו הם מתאמים חקרים ברמת התהליך ולא תיקוף עצבי של המודל העקיף המותנה. באופן כללי, נראה כי רמזי תפקיד מעצבים הערכות שאינן בלעדיות, המכוונות למסוגלות ומכוונות למערכת היחסים. עיצוב התפקיד צריך לתמוך בהסתמכות מכוילת באמצעות הגדרת גבולות יכולת, תקשור של אי-ודאות, אזהרות מבוססות סיכון והסלמה נאותה, במקום פשוט למקסם את האמון.
מבוא
בינה מלאכותית (AI) רפואית מקיפה כיום יישומים של צד-שרת (back-end) כגון זיהוי תמונות, ניתוח פתולוגי וגילוי תרופות, וכן ממשקי שירות הפונים למטופל. ניתוחים תעשייתיים צופים צמיחה מתמשכת של שוק ה-AI בתחום הבריאות עד שנת 20331. מודלי שפה גדולים מאפשרים למערכות AI רפואיות לענות על שאלות בריאותיות, לפרש תוצאות בדיקות, לסכם מידע ולספק המלצות בשפה טבעית2. שינוי זה משנה את מערכת היחסים של המשתמש עם הטכנולוגיה. כלי אנליטי של צד-שרת מוערך על ידי קלינאים וארגונים, בעוד שממשק הפונה למטופל חייב לתקשר למשתמשים את תפקידו, את הראיות, את מידת האי-ודאות ואת מגבלותיו. AI רפואית עשויה להופיע כעוזר אבחנתי, כממשק של רופא משפחה או כליווי לניהול הבריאות, וכל אחד מאלה יכול לעצב את האופן שבו המשתמשים תופסים את זהות השירות של המערכת. ככל שמערכות אלו משתתפות יותר בייעוץ למחלות ובניהול בריאות יומיומי, האמון הופך ליותר מאשר גישה כללית כלפי טכנולוגיה. הוא משפיע על השאלה האם משתמשים יחשפו מידע, האם יראו בהמלצות אמינות, האם יקימו אינטראקציה עם המערכת והאם יפעלו על פי הנחיות בריאותיות. לפיכך, אמון הוא שיקול מרכזי בתכנון ובממשל של פלטפורמות בריאות דיגיטליות.
יכולת טכנית לבדה אינה קובעת אם משתמשים יראו בבינה מלאכותית (AI) רפואית כמcredible ומקובלת. סקירות של סוכנים שיחתיים בתחום הבריאות מראות כי ההטמעה תלויה באיכות האינטראקציה, ברלוונטיות הקלינית, בשקיפות ובתנאי הפריסה3. עבודות אחרונות בנושא ראיות אמינות לבינה מלאכותית רפואית טוענות באופן דומה כי ביצועי המודל אינם מספיקים, אלא אם כן הטענות נתמכות בראיות המתאימות לשימוש המיועד4. שקיפות היא חיונית משום שמטופלים חייבים להיות מסוגלים לזהות את גבולות היכולת, את אי-הוודאות ואת הבסיס להמלצה, במקום להסיק מהימנות רק משפה רהוטה5. מחקר במערכות מידע ממסגר באופן דומה את האימוץ של אבחון מסייע-AI כבעיה של תצורת אמון, שבה יכולת הפרשנות, הגנת הפרטיות ורמזי הממשק מעצבים יחד את הקבלה6. שיקולים אלו חשובים עבור ממשקים של מודלי שפה. רהיטות יכולה להפוך תשובה לקלה להבנה, בעוד שהיא מותירה ללא מענה את השאלה האם למערכת יש ידע קליני, האם ההמלצה שלה רלוונטית לנסיבות המשתמש, ומתי נדרשת העברה לקלינאי מוסמך. השאלה הרלוונטית אינה רק האם בינה מלאכותית רפואית יכולה לספק תשובה, אלא האם משתמשים יכולים להעריך אותה ברמת הסתמכות הולמת.
האמון בבינה מלאכותית (AI) רפואית רגיש להקשר של המשימה. מחקרים על התנגדות ל-AI רפואית מראים כי משתמשים עשויים לדחות המלצות אלגוריתמיות בהחלטות בעלות סיכון גבוה, בשל אמונתם שאלגוריתם אינו יכול להתחשב בייחודיותם7. ההתנגדות אינה אוניברסלית. מחקרים על הערכת אלגוריתמים (Algorithm-appreciation) מצביעים על כך שאנשים עשויים להעדיף שיפוט אלגוריתמי כאשר המשימות הן אובייקטיביות והכללים ברורים יותר8. בייעוץ בריאות מקוון, רמת הפרסונליזציה והזהירות בעצות המיוצרות על ידי AI משפיעות על האמון והאימוץ9. מחקר של בחירה בדיסקרטיות (Discrete-choice research) המשווה בין ייעוצים קונבנציונליים, דיגיטליים ואלו המבוססים על AI, מצא באופן דומה כי ההעדפות וציפיות האמון משתנות בין הפורמטים השונים10. עבודת צוות בין בני אדם ל-AI יכולה גם היא להפחית התנגדות באמצעות העברת אמון ממומחיות אנושית למסגרת שירות נתמכת AI11. לפיכך, אמון ב-AI רפואית מתפתח דרך האינטראקציה בין סיכון נתפס, דרישות המשימה, סגנון התקשורת והערכת המערכת. ייעוץ בנושאי מחלה הופך את אי-הוודאות, ההפסד הפוטנציאלי, ההשלכות האבחנתיות ועלויות הטעות לבולטים. ייעוץ בריאות עוסק לעיתים קרובות יותר בתזונה, פעילות גופנית, שינה, היענות לטיפול וניהול מונע, שבהם אינטראקציה מתמשכת ונגישות רגשית עשויות לשאת משקל רב יותר. כתוצאה מכך, אותו רמז בממשק עשוי להתפרש באופן שונה כאשר משתמש מחפש עזרה במחלה אפשרית לעומת ניהול בריאות לטווח ארוך יותר.
מסגור תפקיד הוא מאפיין ממשק אחד שדרכו ניתן להעביר ציפיות אלו. בינה מלאכותית רפואית עשויה להיות ממוסגרת כמומחה המדגיש סמכות מקצועית, חשיבה מובנית, גבולות קליניים וראיות ליכולת, או כבן לוויה המדגיש אמפתיה, הרגעה, תמיכה חברתית והמשכיות. הבחנה זו קשורה למסוגלות וחמימות, שני הממדים של תפיסה חברתית, אך אינה מהווה פשוט בחירה בין מערכת מסוגלת למערכת חמימה12. סגנון התקשורת ומסגור הסוכנות משפיעים על הערכות של סוכני שיחה13. באפליקציות רפואיות לנייד, רמזים חברתיים וחששות פרטיות משפיעים במשותף על אמון ועל כוונה התנהגותית14. רמזים אנתרופומורפיים בסוכני שיחה בתחום הבריאות יכולים להגביר את הנוכחות החברתית, האמון והקבלה, אם כי הם עשויים גם ליצור ציפיות החורגות מיכולות המערכת15. מחקר על צוותי אדם-בינה מלאכותית מראה עוד כי חמימות ומסוגלות מנבאות צורות שונות של קבלה16. במשימות בסיכון גבוה, האמון תלוי בהתאמה בין תפקיד הצוות, הקשר המשימה והפרה של הביצועים17. עקביות בין התפקיד החברתי של צ'אטבוט לבין ביצועיו משפיעה גם היא על בנייה ותיקון של אמון18. לפיכך, רמזים של מומחה ובן לוויה הופכים סטנדרטים הערכתיים שונים לבולטים, במקום לשנות אך ורק את טון השיחה.
שני פערים נותרו. ראשית, המחקר לא הסביר כיצד הרלוונטיות של רמזים המכוונים לכשירות ולמערכות יחסים משתנה בהתאם לדרישות המשימה הרפואית. סקירות על אמון אנושי ב-AI מדגישות את התלות בהקשר אך אינן מבהירות כיצד רמזי מומחה ורמזי מלווה פועלים לאורך התייעצויות רפואיות למחלה לעומת התייעצויות לבריאות19. שנית, מחקרים על אמון ב-AI רפואי מסתמכים על דיווחים עצמיים, ובכך מספקים ראיות מוגבלות לגבי העיבוד הקוגניטיבי הקשור להערכה במסגרת תפקיד. פרטיות, שקיפות, אחריות והטיה מגבילים אף הם את הפרשנות של רמזי תפקיד בממשק המשתמש (front-end)20,21. כדי להתגבר על פערים אלו, מחקר זה נשען על תיאוריית ההלימה לתפקיד (role congruity theory), המסבירה הערכה באמצעות התאמה בין רמזי תפקיד לדרישות הבולטות בהקשר22. מחקר 1 משתמש בניסוי תרחישים אקראי של 2 (תפקיד: מומחה לעומת מלווה) x 2 (משימה: התייעצות למחלה לעומת התייעצות לבריאות) (N = 300) כדי לבחון מסגור תפקיד, הקשר משימה, וקשרי עקיפין מקבילים באמצעות מקצועיות נתפסת ונוכחות חברתית. מחקר 2 משתמש בניסוי EEG נפרד בתוך-נבדקים (N = 39) כדי להשוות פעילות בפס התטא בתגובה להיגדים הממוסגרים כמומחה וכמלווה. מחקר 1 מעריך קשרים התנהגותיים ומיתון הקשרי; מחקר 2 מספק השוואה גישושית ברמת התהליך ולא תיקוף עצבי של המודל העקיף המותנה.
מסגרת תיאורטית ופיתוח השערות
מסגור תפקידים בבינה מלאכותית רפואית
בינה מלאכותית רפואית פועלת בסביבות בעלות סיכון גבוה הכוללות סיכון למחלות, המלצות לטיפול, אחריות משפטית וגבולות אתיים23. לכן, הגדרת התפקיד היא משמעותית, שכן השפה בממשק המשתמש יכולה להפוך את גבולות היכולת, הראיות והאחריות לבולטים יותר או פחות עבור המשתמשים. באופן דומה, מחקרים על שקיפות מדגישים כי מערכות בינה מלאכותית רפואיות צריכות לתקשר את מגבלות היכולת ואת בסיסי הראיות שלהן5. תגובות בסגנון מומחה משדרות מיומנות באמצעות טרמינולוגיה פורמלית, נימוק מובנה, הצהרות על גבולות היכולת והמלצות לפעולה, בעוד שתגובות בסגנון מלווה משדרות תמיכה רגשית באמצעות אמפתיה, הרגעה וניסוח שיתופי. רמזים אלו אינם רק קישוט של הממשק: הם מעצבים את הסטנדרטים שהמשתמשים מחילים בעת הערכת המערכת24,25. אנתרופומורפיזם עשוי לעורר תגובות חברתיות, אך הוא עלול גם ליצור ציפיות לא מציאותיות ולטשטש את גבולות האחריות המשפטית26,27. מחקרים על צוותים של בני אדם ובינה מלאכותית ועל צ'אטבוטים מצביעים עוד על כך שחמימות, מיומנות, התאמה בין התפקיד להקשר ועקביות בין התפקיד החברתי לביצועים משפיעים על הקבלה ואמון16,17,18. במחקר זה, תואמות תפקידים מתייחסת להלימה בין הרמזים המועברים בתגובת הבינה המלאכותית לבין הדרישות ההערכתיות הבולטות במשימת הייעוץ22.
אמון בשני נתיבים: מקצועיות נתפסת ונוכחות חברתית
התאמה תפקידית (Role congruity) נגזרת מאינטראקציית התפקיד-מול-המשימה שנצפתה, ולא נמדדת כמבנה סובייקטיבי נפרד. לכן, הפרשנות קשורה לאינטראקציה הניסויית ואינה מרמזת על כך שהמשתתפים דיווחו באופן מודע על תחושה של התאמה לתפקיד. אמון כולל שיפוטים קוגניטיביים לגבי כשירות ואמינות, ושיפוטים רגשיים לגבי ביטחון ונוחות במערכת היחסים28,29,30. בשימוש ב-AI רפואי, המשתמשים מעריכים הן אם המערכת יכולה לתמוך בהחלטה בריאותית והן אם האינטראקציה איתה מרגישה בטוחה ונגישה מספיק. מסגור של מומחיות אמור להפוך את ההערכה המכוונת-כשירות לבולטת יותר. ראיות ממחקרים על תמיכה בהחלטות קליניות מעידות כי הסברים ומידע על הנימוקים של המערכת משפיעים על האמון וההסתמכות31. בייעוצים בריאותיים מקוונים, פרסונליזציה וטיפול קשורים אף הם לאמון ולקבלה9. מקצועיות נתפסת (Perceived professionalism) משקפת הערכה מכוונת-כשירות הרלוונטית לאמון25. מחקר על ייעוץ בריאותי מקוון מזהה באופן דומה את אמינות המקור כגורם הרלוונטי לקבלת המלצות בריאותיות על ידי משתמשים32. לכן, המחקר הנוכחי בודק האם מסגור של מומחיות קשור למקצועיות נתפסת גבוהה יותר.
H1: תפקידי ליווי (Companion roles) מייצרים תפיסה נמוכה יותר של מקצועיות בהשוואה למודלי בינה מלאכותית רפואית בסגנון מומחה.
מסגור של "בן לוויה" אמור להפוך את ההערכה הזוגית/בינאישית לבולטת יותר. נוכחות חברתית מתייחסת לאיכות הבינאישית הנתפסת של אינטראקציה מתווכת, ולא לאמונה שהמערכת היא אנושית33. היא קשורה לאיכות האינטראקציה, לאמון ולקבלה של שירותים מקוונים וסוכני שיחה בתחום הבריאות15,34.
נוכחות חברתית עשויה להפחית את העלות הפסיכולוגית של חשיפה עצמית ולתמוך בחליפין של מידע במהלך ייעוץ מקוון32. לפיכך, המחקר הנוכחי בוחן האם מסגור של ליווי (companion framing) קשור לנוכחות חברתית גבוהה יותר.
H2: תפקידי מומחה מייצרים נוכחות חברתית נמוכה יותר בהשוואה ל-Medical AIs בסגנון מלווה.
מקצועיות נתפסת ונוכחות חברתית נחשבות כהקשרים מקבילים שאינם מוצלבים עם אמון. הסתמכות נכונה על אוטומציה בעלת סיכון גבוה תלויה ביכולות המערכת, בגבולותיה ובדרישות המשימה, ולא רק במקסום האמון לבדו35.
H3: תפיסת מקצועיות ונוכחות חברתית חוזים באופן חיובי אמון כאשר הם מומדלים בו-זמנית.
השפעה ממתנת של הקשר המטלה
אותם רמזי תפקיד עשויים לשאת משקל פסיכולוגי שונה במשימות רפואיות שונות. התאמה בין משימה לטכנולוגיה (Task-technology fit) מספקת רציונל הקשרי לבחינה אם רמזי התפקיד תואמים את דרישות המשימה36. התייעצות רפואית כרוכה באי-ודאות גבוהה יותר, בסיכון להפסד ובעלויות של טעויות, מה שהופך את המקצועיות, הדיוק והגבולות הברורים לבולטים במיוחד7,37. לפיכך, רמזי מומחיות צריכים להיות תואמים יותר לדרישות אלו מאשר רמזי ליווי. ייעוץ בריאותי מתמקד בניהול בריאות לטווח ארוך, התמדה התנהגותית והמשכיות של האינטראקציה. סקירות של מערכות תומכות החלטה קלינית מבוססות AI וסוכני שיחה בריאותיים מדגישות את החשיבות של מידע הקשרי, יכולת ביצוע, אינטראקציה ותנאי יישום3,38,39.
מחקר זה חוזה כי ההבדל בין המומחה למלווה בתפיסת המקצועיות יהיה גדול יותר בייעוץ בנושא מחלה מאשר בייעוץ בנושא בריאות. הוא אינו מתייחס לאינטראקציה לא משמעותית בנוגע לנוכחות חברתית כראיה לאי-שינוי. ההשערה מוצעת באופן הבא:
H4: הקשר של המשימה ממתן באופן משמעותי את השפעת תפקידי המומחה על התפיסה של מקצועיות. ההשפעה חזקה יותר בייעוץ למחלה מאשר בייעוץ לבריאות.
פרוטוקול
סקירת המחקר
המחקר נערך בהתאם להצהרת הלסינקי ואושר על ידי ועדת האתיקה של אוניברסיטת Huaqiao (M2025021), אשר כיסתה הן את ניסוי התרחיש המקוון והן את ניסוי ה-EEG. כל המשתתפים נתנו הסכמה מדעת וקיבלו פיצוי עם הסיום.
מאמר זה כולל שני מחקרים משלימים (ראו איור 1). מחקר 1 הוא ניסוי תסריט אקראי של 2 × 2 המעריך השפעות של מסגור תפקיד והקשר משימה, בוחן את מבנה המדידה, ובודק קשרים עקיפים מותנים מקבילים באמצעות תפיסת מקצועיות ונוכחות חברתית. מחקר 2 הוא ניסוי EEG בתוך-נבדקים המשווה פעילות בפס התטא תחת הצהרות במסגור של מומחה לעומת מסגור של בן לוויה, ומפורש כהשוואה גששית ברמת התהליך. המחקרים מספקים ראיות התנהגותיות ועצביות ברמות שונות; הם אינם נתפסים כמנגנון רציף אחד.
מחקר 1: ניסוי תרחישים
משתתפים ומערך המחקר
במחקר 1 נעשה שימוש במערך בין-נבדקים מאוזן של 2 × 2 עם מסגור תפקיד (מומחה לעומת מלווה) והקשר משימה (ייעוץ רפואי לעומת ייעוץ בריאותי). חישוב G*Power המקורי הניח אפקט ANOVA כולל בינוני (f = 0.25), α = .05, ועוצמה של .80, והצביע על מינימום של 128 משתתפים40. מכיוון שחישוב זה לא הותאם לאפקטים עקיפים מותנים, הוא מדווח כבסיס הגיוס המקורי ולא כראיה לעוצמה עבור תיווך ממתן. עם N = 300 וארבעה תאים מאוזנים, ניתוח רגישות הראה עוצמה של 80% לזיהוי אינטראקציה של f = 0.162 (partial η2 = .026) ב-α = .05.
בנוסף, ביצענו ניתוח עוצמה מבוסס סימולציה בדיעבד (post hoc) עבור מדדי התיווך הממתן (moderated-mediation indices) באמצעות מערך נתוני השאלונים של SPSS שכלל 300 מקרים. הסימולציה יצרה 1,000 מקרי 2 מאוזנים × 2 דגימות ממודל המתווך-המקבילי המתואם באמצעות דגימה חוזרת של שאריות אמפיריות; עבור כל מערך נתונים סימולטיבי נעשה שימוש ברווחי סמך מסוג bootstrap-percentile עם 500 דגימות חוזרות של מקרים (case-resampled). ההסתברויות המוערכות לכך שרווח הסמך אינו כולל את הערך אפס היו .698 עבור מדד המקצועיות, .157 עבור מדד הנוכחות החברתית, ו-.279 עבור ההפרש הישיר בין שני המדדים. ניתוח זה מותנה במקדמים שנצפו, בהתפלגויות השאריות ובמפרט המודל, ואינו מהווה הצדקה מראש (a priori) לגודל המדגם. ניתוח העוצמה המלא המבוסס על סימולציית post hoc מוצג ב- טבלה משלימה S1.
שלוש מאות משתתפים גויסו באמצעות Credamo וחולקו באופן אקראי לארבעה תנאים (n = 75 לכל תא). המדגם כלל 109 גברים (36.3%) ו-191 נשים (63.7%); 43.7% היו בגילאי 21-30 שנים, 41.3% היו בגילאי 31-40 שנים, ו-69.7% החזיקו בתואר ראשון. כל פריטי השאלון הנדרשים הושלמו. לא נעשה שימוש בפריט ייעודי לבדיקת קשב או בהחרגה מוקדמת של זמן השלמה, ואף משתתף לא הוחרג. זמן ההשלמה החציוני היה 268 s (טווח = 67-1,894 s). ניתוח עמידות (robustness analysis) בדיעבד, שהוחרגו ממנו תשובות שזמן השלמתן היה נמוך מהאחוזון החמישי (<125 s; n שנותר = 285), העריך את הרגישות למענה מהיר באופן חריג. נתונים מפורטים של בדיקת המניפולציה וניתוחי רגישות של זמן ההשלמה מופיעים ב-Supplementary Table S2.
גירויים ניסיוניים והליך
חומרי הגירוי כללו מבוא לתרחיש המשימה ותגובת דיאלוג של רופא-AI, אשר יצרו ארבעה סטים ניסיוניים מלאים. בתרחיש הייעוץ הרפואי התבקשו המשתתפים לדמיין תחושת לחץ חוזרת בחזה ודפיקות לב במהלך הלילה, וחשש לגבי הצורך בטיפול דחוף בבית החולים. בתרחיש הייעוץ הבריאותי התבקשו המשתתפים לדמיין שהם במצב בריאותי טוב באופן כללי ומבקשים תוכנית תזונה ופעילות גופנית מותאמת אישית. כל קטגוריית משימה יוצגה על ידי תרחיש אחד; לפיכך, המסקנות מוגבלות לשני תרחישים אלה ולא מוכללות על כלל הייעוצים הרפואיים והבריאותיים.
בכל ארבעת צילומי המסך של השאלון נעשה שימוש באותו אייקון והוצג שם המערכת, Medical AI (DiagnosPro), ובכך נשמרה זהות תצוגה קבועה בין התנאים השונים. תשובות בניסוח של מומחה השתמשו בניתוח מובנה, הצהרות סיכון או ראיות, שפה מכוונת והמלצות מפורשות לפעולה. תשובות בניסוח של מלווה השתמשו באמפתיה, הרגעה, ניסוח שיתופי והצעות גמישות. לפיכך, המניפולציה ייצגה חבילה של רמזים מידעיים ותקשורת התואמת לתפקיד; היא לא בידלה בין ניסוח התפקיד לבין ספציפיות, יכולת ביצוע, ודאות, פירוט רפואי או תמיכה רגשית. ייתכן שהשם המשותף DiagnosPro העביר רמז של מומחיות בכל התנאים. מערך הגירויים המלא מופיע ב-Supplementary File 1.
המשתתפים קראו תחילה את טופס ההסכמה המדעית ולאחר מכן הוקצו באופן אקראי לאחד מארבעה תנאים ניסויים. לאחר קריאת התרחיש וגירוי הדיאלוג, הם מילאו את השאלון בהתבסס על תגובותיהם. השאלון נפתח בבדיקות מניפולציה, ולאחריהן מדדים של מקצועיות נתפסת, נוכחות חברתית, אמון ונתונים דמוגרפיים. ההליך ארך כ-15 min.
בכל הסולמות נעשה שימוש בדירוג Likert של 7 נקודות, כאשר 1 מייצג הסכמה חלשה מאוד ו-7 מייצג הסכמה חזקה מאוד. מקצועיות נתפסת נמדדה באמצעות שלושה פריטים: 'בינה מלאכותית רפואית זו מסוגלת לספק ייעוץ רפואי', 'בינה מלאכותית רפואית זו נראית מקצועית מאוד', ו-'בינה מלאכותית רפואית זו היא מומחית בתחום הרפואה' (α = .883)41. נוכחות חברתית נמדדה באמצעות שלושה פריטים: 'באינטראקציה עם בינה מלאכותית רפואית זו, הרגשתי מגע אנושי', 'האינטראקציה עם בינה מלאכותית רפואית זו גרמה לי להרגיש קרבה', ו-'בינה מלאכותית רפואית זו נראתה חברותית במהלך האינטראקציה' (α = .932)42. אמון קוגניטיבי כלל שלושה פריטים: 'אני יכול להסתמך על בינה מלאכותית רפואית זו מכיוון שיש לה את המיומנויות הדרושות למתן ייעוץ', 'אני בטוח בדיוק של הייעוץ המסופק על ידי בינה מלאכותית רפואית זו', ו-'לבינה מלאכותית רפואית זו יש יכולת מספקת לטפל בבעייתי הבריאותית' (α = .837). אמון רגשי כלל שלושה פריטים: 'בינה מלאכותית רפואית זו גורמת לי להרגיש חמימות ודאגה', 'ההסתמכות על בינה מלאכותית רפואית זו גורמת לי להרגיש בטוח מכיוון שנראה לה אכפת מהבריאות שלי', ו-'אני מאמין שבינה מלאכותית רפואית זו לא תעשה לי דבר מזיק במכוון' (α = .700). אמון כללי היה הממוצע של כל ששת פריטי האמון (α = .784). מדדים אלו נותחו כתוצאים של מומחיות, בין-אישיות, אמון קוגניטיבי, אמון רגשי ואמון כללי, ולא כמבנים מוהדרים זה מזה.
הניתוח התבצע בארבעה שלבים. ראשית, ניתוח גורמים מאשש (confirmatory factor analysis) השווה בין המודל המוצע בעל ארבעה גורמים לבין חלופות של שני גורמים וגורם אחד; נבחנו מהימנות מורכבת (composite reliability), שונות ממוצעת שהופקה (average variance extracted), מתאמים חבויים (latent correlations) ויחסי heterotrait-monotrait. שנית, מודלים פקטוריאליים מלאים של 2 x 2 העריכו השפעות עיקריות והשפעות אינטראקציה עבור מקצועיות נתפסת, נוכחות חברתית, אמון קוגניטיבי, אמון רגשי ואמון כללי, כולל ממוצעי תאים, רווחי סמך ו-η2 חלקי. הממוצעים השוליים המוערכים ורווחי סמך של 95% מוצגים ב-איור 2. שלישית, ב-PROCESS 4.2 beta Model 7 הוזנו מקצועיות נתפסת ונוכחות חברתית בו-זמנית כמתווכים מקבילים, עם 5,000 דגימות percentile-bootstrap43. מסגור התפקיד קודד כ-1 = מומחה ו-2 = מלווה, והקשר המשימה קודד כ-1 = ייעוץ למחלה ו-2 = ייעוץ לבריאות. bootstrap של דגימה חוזרת משותפת השווה ישירות את שני המדדים של תיווך ממותן (moderated mediation). רביעית, אמון קוגניטיבי ואמון רגשי נותחו בנפרד כתוצאות גששיות (exploratory outcomes). מכיוון שהמתווכים והתוצאות נמדדו בו-זמנית, ההערכות מפורשות כקשרים עקיפים העקביים עם תיווך ולא כמנגנונים פסיכולוגיים סיבתיים.
מחקר 2: ניסוי EEG
משתתפים
במחקר 2 גויסו 40 משתתפים. משתתף אחד הוצא מהמחקר כיוון שמספר הניסיונות שזוהמו בארטיפקטים עלה על 30% בלפחות תנאי ניסוי אחד, מה שהותיר 39 משתתפים בניתוחי ה-EEG הסופיים. קריטריון זה הבטיח שכל משתתף שנשאר תרם לפחות 70% מהניסיונות בכל תנאי. כל המשתתפים חתמו על הסכמה מדעת בכתב וקיבלו פיצוי לאחר הניסוי. מידע דמוגרפי לא ניתן היה לקשר לכל רשומות ה-EEG שנשמרו, ולכן הוא אינו מסוכם עבור מדגם ה-EEG הסופי.
גירויים ניסיוניים והליך
הניסוי נערך במעבדת EEG סטנדרטית תוך שימוש במערך תוך-נבדקים (within-subjects design), כאשר הגירויים הוצגו באמצעות E-Prime 2.1. המשתתפים התבקשו לדמיין אינטראקציה עם מערכת בינה מלאכותית (AI) רפואית ולהעריך את רמת האמון שלהם במערכת עבור כל תרחיש של ייעוץ רפואי. בניסוי בוצע מניפולציה על התפקיד הנתפס של מערכת ה-AI הרפואית, כולל גרסאות של סוג "מומחה" וסוג "ליווי".
בסך הכל נבנו 40 גירויי משפטים בסינית. תנאי סוג-המומחה הכיל 20 גירויים המתחילים ב"Medical AI expert", בעוד שתנאי סוג-הבן-זוג הכיל 20 גירויים מקבילים המתחילים ב"Medical AI companion". התרחישים הרפואיים כיסו הן פונקציות אבחנה מקצועיות, כגון שאילתות על היסטוריה רפואית, ניתוח דוחות בדיקה, הערכת נתוני קצב לב, פירוש בדיקות גנטיות, קביעת סיכון למחלה והמלצה על תוכניות טיפול, והן פונקציות תמיכה בניהול בריאות, כגון הבעת דאגה למצב הגופני, שאילתות על איכות השינה, הפגת חרדה, תיעוד נתוני בריאות, עידוד היצמדות לטיפול ומתן טיפים בריאותיים יומיומיים. לפיכך, התנאים נבדלו גם בתוכן הסמנטי ובמורכבות; לא בוצעו התאמה של גירויים עצמאיים או מבחן מקדים.
לפני הניסוי הפורמלי, המשתתפים השלימו בלוק תרגול קצר. כל ניסוי החל עם צלב קיבוע למשך 500 ms, ואחריו מרווח ריק משתנה (jittered) של 300–500 ms והצהרה של בינה מלאכותית רפואית שהוצגה למשך 1,600 ms. לאחר מכן, המשתתפים ביצעו שיפוט אמון בינארי בקצב עצמי על ידי לחיצה על מקש F לציון אמון או מקש J לציון חוסר אמון (ראו איור 3). הצהרות בניסוח של מומחה ובניסוח של בן לוויה הוצגו בסדר אקראי. יומני המשימות של E-Prime הצביעו על 80 ניסויים פורמליים לכל רשומת משימה: 40 ניסויי מומחה ו-40 ניסויי בן לוויה, כאשר כל אחת מ-20 ההצהרות הייחודיות לכל תפקיד הוצגה פעמיים.
נתוני משימה התנהגותית
נתוני המטלה ההתנהגותית היו שמישים עבור 38 מתוך 39 המשתתפים במדגם ה-EEG הסופי; רישום המטלה של משתתף אחד ב-E-Prime לא היה שמיש. לפיכך, ניתוחים התנהגותיים בוצעו עבור N = 38. תוצאות התנהגותיות מפורטות ופירוט המדגם מופיעים ב-Supplementary Table S3. אמון קודד כתגובה במקש F; תגובות במקש J העידו על אי-אמון. תגובות ריקות או זמן תגובה רשום של 0 ms קודדו כנתונים חסרים. שיעור האמון חושב בקרב הניסיונות שנענו, וזמן התגובה סוכם על פני הניסיונות שנענו. הנתונים העצביים שהיו זמינים לניתוח הכילו מדדים מצוברים לפי תנאי, אך לא מדדי EEG ברמת הניסוי או מזהה מאומת המקשר בין כל רישום התנהגותי לרישום ה-EEG שלו; לפיכך, לא הוערך מודל מעורב ברמת הניסוי עבור EEG ושיפוטי אמון.
הקלטה וניתוח EEG
נעשה שימוש בג'ל אלקטרוליט מוליך מסוג Quik-Gel כדי לשמור על עכבה (impedance) בין האלקטרודה לעור מתחת ל-5 kOhm. FCz שימש כרפרנס המקוון (online reference) כברירת מחדל של המכשיר, וקצב הדגימה היה 1,000 Hz. רפרנס לאחור (offline referencing) של הממוצע של ה-mastoids הדו-צדדיים בוצע באמצעות פונקציית ה-rereferencing המובנית של CURRY; FCz נשמר ושוחזר באופן אוטומטי ביחס לרפרנס החדש, ולא נעשה שימוש בפקודת שחזור מותאמת אישית או בסקריפט. עיבוד לאחור (offline processing) עוקב בוצע ב-MATLAB R2020b עם EEGLAB44 ו-ICLabel45. הנתונים עברו דגימה מחדש (downsampled) ל-500 Hz וסינון מעביר-פס (band-pass filtered) מ-0.1 עד 40 Hz. ערוצים פגומים ומקטעי נתונים מזוהמים באופן גס זוהו והוסרו באמצעות בדיקה ויזואלית; לא הוחל סף אינטרפולציה אוטומטי או סף דחייה אוטומטי של מקטעים. לאחר מכן נעשה שימוש במימוש ברירת המחדל של EEGLAB runica (אלגוריתם Infomax ICA), ורכיבים הוסרו כאשר ICLabel הקצה הסתברות של לפחות .70 למחלקה של ארטיפקט (למשל, פעילות עינית, שרירית, לבבית, רעש קו או רעש ערוץ). משתתפים עם יותר מ-30% ניסיונות מזוהמי ארטיפקטים באחד התנאים הוצאו מהמחקר, כדי להבטיח שימור של לפחות 70% מהניסיונות בכל תנאי. תקופות הזמן (Epochs) נפרשו מ-1,000- עד 1,996 ms. לצורך ניתוח קישוריות פונקציונלית, הנתונים שעברו עיבוד מקדיים עברו דגימה מחדש נוספת ל-250 Hz, ואלקטרודות פריפריאליות, כולל P7, P8, F7 ו-F8, הוצאו לפני הערכת סנכרון הפאזה (phase-synchrony).
פעילות תטא (Theta) שנרשמה באתרים בקרקפת באזור המצח-קו האמצעי נקשרה לחישובים המופעלים על ידי דרישות של בקרה קוגניטיבית46. סנכרון פאזה בפס תטא בין אתרי אלקטרודות פרונטליים מדיאליים ולטרליים נקשר גם הוא לתיאום במהלך עיבוד הקשור לבקרה47. בפרט, סנכרון פאזה מוגבר בפס תטא בין אתרים כגון FCz ו-F6 נצפה בעקבות זיהוי קונפליקט או שגיאה48. מכיוון שמדדים אלו של הקרקפת אינם ספציפיים באופן בלעדי לבקרה קוגניטיבית, הם נחשבים כאן כמדדי תהליך מתכנסים ולא כקריאות ישירות של מנגנון קוגניטיבי יחיד.
ראשית, בוצע כימות של סנכרון תלוי-אירוע (ERS) בתדר תטא בקו האמצע הפרונטלי בטווח של 4–8 Hz בתוך חלון זמן של 800–1,000 ms לאחר הגירוי. ה-ERS חושב באמצעות ניתוח זמן-תדר, כאשר השינוי בעוצמה היחסית חושב ביחס לקו הבסיס של 500–200- ms לפני הגירוי. ערכים חיוביים מעידים על הגברה של העוצמה (סנכרון), בעוד שערכים שליליים מעידים על דיכוי של העוצמה (דה-סנכרון). שנית, הקישוריות התפקודית נאמדה לאחר דגימה מחדש (downsampling) של הנתונים שעברו עיבוד מקדמי ל-250 Hz והסרה של אלקטרודות פריפריאליות, כולל P7, P8, F7 ו-F8. הוחל שינוי פורייה לזמן קצר (STFT) לפני חישוב ערך נעילת הפאזה (PLV) בתדר תטא בין FCz ל-F6. השינוי ב-PLV המתוקנן לקו הבסיס (ΔPLV) חושב ביחס לקו הבסיס של 600–200- ms לפני הגירוי. ערכי PLV גולמיים חסומים בין 0 ל-1; לכן, ערכי ΔPLV שליליים מעידים על ירידה ביחס לקו הבסיס ולא על נעילת פאזה שלילית. מדדי קרקפת אלו מפורשים כדפוסים גששים הקשורים לעיבוד הקשור לבקרה ותיאום פרה-פרונטלי; הם אינם מזהים באופן ישיר תהליך קוגניטיבי ספציפי או מקור עצבי.
תוצאות
מחקר 1: תוצאות ניסוי-תרחיש
מודל המדידה. המודל בעל ארבעת הגורמים התאים טוב יותר מהחלופות של שני גורמים או גורם אחד, אך ההתאמה המוחלטת הייתה מעורבת: χ2(48) = 223.93, p < .001; CFI = .935; TLI = .911; RMSEA = .111; SRMR = .140. המטענים המתוקננים נעו בין .382 ל-.937. המהימנות המורכבת הייתה .886 עבור מקצועיות נתפסת, .932 עבור נוכחות חברתית, .840 עבור אמון קוגניטיבי, ו-.709 עבור אמון רגשי; ערכי ה-AVE התואמים היו .722, .821, .636, ו-.474. התוקף המבדיל היה מוגבל: ערכי HTMT היו .935 בין מקצועיות נתפסת לאמון קוגניטיבי, ו-.926 בין נוכחות חברתית לאמון רגשי. לכן, ממצאי התהליך המותנה מפורשים בזהירות, וניתוחי אמון ספציפיים לממד הם גששים (טבלה 1).
בדיקות מניפולציה. משתתפים במסגור מומחה (n = 150, M = 5.57, SD = 1.18) דירגו את ה-AI הרפואי כדומה יותר למומחה מאשר משתתפים במסגור בן לוויה (n = 150, M = 3.21, SD = 1.76). מכיוון שהשוניות היו שונות, F = 47.42, p < .001, נעשה שימוש במבחן וולש (Welch’s test), t(259.90) = 13.63, p < .001, הפרש ממוצעים = 2.36, 95% CI [2.02, 2.70]. משתתפים במצב מחלה (n = 150, M = 2.51, SD = 1.53) נתנו דירוגים נמוכים יותר של נטייה לבריאות מניעתית מאשר משתתפים במצב בריאות (n = 150, M = 5.98, SD = 1.22), F = 10.96, p = .001; Welch’s t(284.11) = −21.70, p < .001, הפרש ממוצעים = −3.47, 95% CI [−3.79, −3.16]. דרגות חופש של וולש אינן שוות ל-N − 2 כאשר השוניות אינן שוות; בכל הניתוחים נעשה שימוש ב-N = 300.
סטטיסטיקה תיאורית לפי תנאי ניסוי. עבור מסגור של מומחה (expert framing), ייעוץ בנושאי מחלה ובריאות הניב ממוצעים של מקצועיות נתפסת של 5.69 (SD = 0.83) ו-5.85 (SD = 0.63), ממוצעים של נוכחות חברתית של 4.28 (SD = 1.54) ו-4.25 (SD = 1.64), וממוצעים של אמון כולל של 5.45 (SD = 0.86) ו-5.28 (SD = 0.87), בהתאמה. עבור מסגור של מלווה (companion framing), הממוצעים המקבילים למחלה ובריאות היו 4.52 (SD = 1.47) ו-5.25 (SD = 0.94) עבור מקצועיות נתפסת, 5.68 (SD = 1.07) ו-5.93 (SD = 0.74) עבור נוכחות חברתית, ו-5.30 (SD = 1.02) ו-5.61 (SD = 0.64) עבור אמון כולל. טבלה 2 מציגה את כל רווחי הסמך הספציפיים לתנאים ואת הבדיקות הפקטוריאליות המלאות.
תוצאות פקטוריאליות מלאות. מקצועיות נתפסת הראתה אפקט עיקרי של מסגור תפקיד (role-framing), F(1, 296) = 56.92, p < .001, partial η2 = .161, אפקט עיקרי של הקשר המשימה (task-context), F(1, 296) = 14.37, p < .001, partial η2 = .046, ואינטראקציה בין תפקיד למשימה (role × task), F(1, 296) = 5.89, p = .016, partial η2 = .020. נוכחות חברתית הראתה אפקט עיקרי של מסגור תפקיד, F(1, 296) = 105.57, p < .001, partial η2 = .263, אך לא האפקט העיקרי של המשימה, F(1, 296) = 0.59, p = .442, ולא האינטראקציה, F(1, 296) = 0.84, p = .359, היו סיגניפיקנטיים. תוצאה אחרונה זו מעידה כי לא זוהתה מיתון (moderation); היא אינה קובעת שוויון בין המשימות. עבור אמון קוגניטיבי, האינטראקציה בין תפקיד למשימה הייתה סיגניפיקנטית, F(1, 296) = 5.60, p = .019, partial η2 = .019; האינטראקציה המקבילה לא הייתה סיגניפיקנטית עבור אמון רגשי (affective trust), F(1, 296) = 3.48, p = .063, partial η2 = .012. אמון כללי לא הראה אפקט עיקרי של מסגור תפקיד, F(1, 296) = 0.81, p = .369, או אפקט עיקרי של משימה, F(1, 296) = 0.55, p = .459, אך האינטראקציה בין תפקיד למשימה הייתה סיגניפיקנטית, F(1, 296) = 5.78, p = .017, partial η2 = .019. בייעוץ בנושא מחלה, האמון הכללי לא היה שונה בין מסגור כבן לוויה (companion) למסגור כמומחה (expert), mean difference = −0.15, SE = 0.14, t(296) = −1.06, p = .288, 95% CI [−0.42, 0.13]. בייעוץ בנושא בריאות, האמון הכללי היה גבוה יותר תחת מסגור כבן לוויה, mean difference = 0.33, SE = 0.14, t(296) = 2.34, p = .020, 95% CI [0.05, 0.60].
קשרי עקיף מותנים מקביליים. כאשר מקצועיות נתפסת ונוכחות חברתית הוזנו בו-זמנית, שתיהן נמצאו בקשר חיובי עם אמון כללי: b = 0.4872, SE = 0.0258, p < .001, 95% CI [0.4294, 0.5460], ו- b = 0.3293, SE = 0.0208, p < .001, 95% CI [0.2762, 0.3829], בהתאמה. הקשר הישיר של מסגור התפקיד לא היה מובהק, b = 0.0119, SE = 0.0680, p = .861, 95% CI [−0.1071, 0.1361]. קשרי עקיף של מקצועיות היו −0.5695 בהתייעצות בנושא מחלה, 95% bootstrap CI [−0.7687, −0.3851], ו- −0.2923 בהתייעצות בנושא בריאות, 95% bootstrap CI [−0.4288, −0.1634]. קשרי עקיף של נוכחות חברתית היו 0.4625 בהתייעצות בנושא מחלה, 95% bootstrap CI [0.3165, 0.6091], ו- 0.5532 בהתייעצות בנושא בריאות, 95% bootstrap CI [0.3855, 0.7383] (Table 3). מדד התיווך הממותן דרך מקצועיות נתפסת היה 0.2772, 95% bootstrap CI [0.0594, 0.5035], בעוד שהמדד דרך נוכחות חברתית היה 0.0907, 95% bootstrap CI [−0.0984, 0.3008]. השוואת ה-bootstrap הישירה בין המדדים לא הייתה מובהקת, difference = 0.1864, 95% bootstrap CI [−0.0856, 0.4447]. לפיכך, התוצאות תומכות במיתון הקשרי של הקשר העקיף עם מקצועיות, אך אינן מבססות מיתון הקשרי שונה באופן סטטיסטי בין שני הקשרים.
ניתוחים גששיים של ממדי האמון. עבור אמון קוגניטיבי, הניגוד בין מדדי התיווך-ממתן של מקצועיות ונוכחות חברתית היה חיובי, difference = 0.3707, 95% bootstrap CI [0.0493, 0.6996]. עבור אמון רגשי, הניגוד המקביל לא נתמך, difference = 0.0022, 95% bootstrap CI [−0.3421, 0.3127]. שני המתווכים שמרו על קשרים חיוביים עם שני ממדי האמון, מה שמעיד על השפעות חוצות-נתיבים ולא על השפעות בלעדיות. בהתחשב בערכי HTMT הגבוהים, אין לפרש תוצאות אלו כהפרדה מוחלטת בין מנגנונים קוגניטיביים ורגשיים.
עוצמה של תיווך-ממתן (moderated-mediation) בדיעבד. תחת המודל המותאם והנחות של דגימה חוזרת של השאריות, ההסתברות המוערכת לכך שרווח הסמך של ה-percentile-bootstrap לא יכלול את הערך אפס הייתה .698 עבור מדד המקצועיות, .157 עבור מדד הנוכחות החברתית, ו-.279 עבור ההפרש הישיר ביניהם (1,000 סימולציות; 500 דגימות bootstrap חוזרות לכל סימולציה). הערכות אלו של עיצוב התצפית מסבירות מדוע מדד המקצועיות הנתמך והניגוד הישיר שאינו מובהק אינם צריכים להתפרש כראיה מכריעה למיתון הקשרי שונה.
חסינות זמן ההשלמה. לאחר החרגת 15 התגובות שהיו נמוכות מ-125 s, נותרו 285 מקרים. האינטראקציה של אמון כללי נותרה מובהקת, p = .029; מדד המקצועיות נותר נתמך, 95% bootstrap CI [0.0242, 0.4827]; והניגודיות בין מדדי התיווך הממתן נותרה לא מובהקת, 95% bootstrap CI [−0.1027, 0.4506]. המסקנות העיקריות לא היו תלויות ב-5% המהירים ביותר של התגובות.
מחקר 2: תוצאות EEG
ERS של גלי תטא בקו האמצע הפרונטלי. במדגם האנליטי הסופי (N = 39), ה-ERS של גלי תטא בחלון של 4–8 Hz, 800–1,000 ms היה גבוה יותר תחת מסגור של מומחה (M = 0.2948, SD = 0.8218) מאשר תחת מסגור של בן-לוויה (M = −0.0422, SD = 1.2155), הפרש ממוצע = 0.3369, 95% CI [0.0125, 0.6614], t(38) = 2.10, p = .042, Cohen’s dz = 0.337, partial η2 = .104. ערך ה-p המתוקנן לפי שיטת Holm עבור שתי תוצאות ה-EEG הזוגיות שדווחו היה .042. הפרש זה מעיד על עיבוד דיפרנציאלי של פס תטא בחלון זמן זה של המטלה; ERS של גלי תטא לבדו אינו מזהה תהליך פסיכולוגי ספציפי.
שינוי ב-PLV של תטא ב-FCz-F6 עם תיקון baseline (ΔPLV). במדגם האנליטי הסופי (N = 39), ה-ΔPLV של תטא היה פחות שלילי תחת מסגור של מומחה (M = −0.0111, SD = 0.0546) מאשר תחת מסגור של בן לוויה (M = −0.0350, SD = 0.0473), הפרש ממוצע = 0.0239, 95% CI [0.0058, 0.0420], t(38) = 2.68, p = .011, Cohen’s dz = 0.429, partial η2 = .159. ערך ה-p המתוקנן לפי שיטת Holm עבור שתי תוצאות ה-EEG הזוגיות שדווחו היה .022. דפוס זה מייצג ירידה קטנה יותר בעקביות הפאזה של תטא ביחס ל-baseline תחת מסגור של מומחה; הדבר אינו מבסס כשלעצמו בקרה פרה-פרונטלית חזקה יותר או מנגנון קוגניטיבי ספציפי (ראה איור 4 ו-טבלה 4).
תוצאות המטלה ההתנהגותית. ב-38 רשומות המטלה שנותחו, שיעור תגובת האמון היה 83.1% (SD = 15.8%) תחת מסגור של מומחה ו-82.4% (SD = 17.5%) תחת מסגור של בן לוויה, הפרש ממוצע = 0.7 נקודות אחוז, 95% CI [−0.9, 2.4], t(37) = 0.91, p = .371, dz = 0.147. זמני תגובה ממוצעים היו 828.7 ms (SD = 204.6) ו-826.1 ms (SD = 208.9), בהתאמה, הפרש ממוצע = 2.5 ms, 95% CI [−14.0, 19.1], t(37) = 0.31, p = .758, dz = 0.050. שיעורי תגובה חסרה היו 6.3% (SD = 7.4%) ו-5.2% (SD = 6.3%), בהתאמה, הפרש ממוצע = 1.1 נקודות אחוז, 95% CI [−1.0, 3.1], t(37) = 1.05, p = .302, dz = 0.170.
הצהרת זמינות נתונים:
נתוני השאלונים ממחקר 1 לאחר הסרת פרטים מזהים, קבצי EEG שעברו עיבוד מקדמי, וקבצי פלט EEG מצברים התומכים במחקר 2, זמינים לציבור ב-Open Science Framework (OSF) בכתובת https://doi.org/10.17605/OSF.IO/JKSP7. חומרי השלמה כוללים את גירויי הניסוי המלאים (קובץ משלים 1), בדיקות מניפולציה, ניתוחים התנהגותיים נוספים, ניתוחי עוצמה רטרוספקטיביים (post hoc) ומידע מתודולוגי תומך.
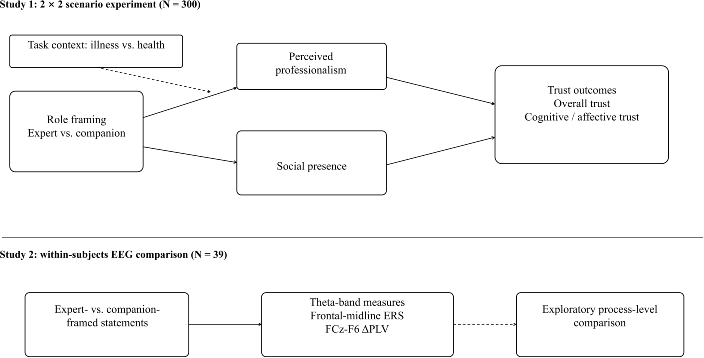
איור 1. מסגרת המחקר. מחקר 1 הוא ניסוי תרחישים מסוג 2 × 2 (N = 300) הבוחן מסגור תפקידים, הקשר המטלה וקשרים עקיפים מקבילים באמצעות מקצועיות נתפסת ונוכחות חברתית. מחקר 2 מספק השוואת EEG (אלקטרואנצפלוגרמה) גששית של הצהרות במסגור מומחה לעומת מסגור בן לוויה (N = 39); הוא אינו בוחן באופן ישיר את המודל העקיף המותנה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
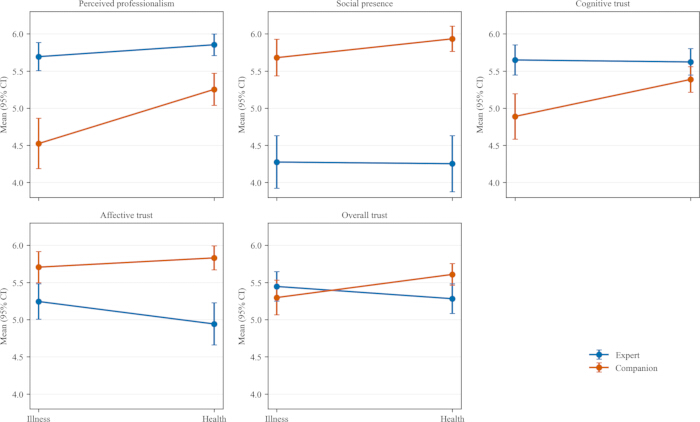
איור 2תרשימי פיזור של מסגור תפקיד × הקשר משימה עבור מקצועיות נתפסת, נוכחות חברתית, אמון קוגניטיבי, אמון רגשי ואמון כולל. הנקודות מייצגות את ממוצעי התאים, וסטיות התקן (error bars) מייצגות רווחי סמך של 95% (n = 75 לכל תא). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
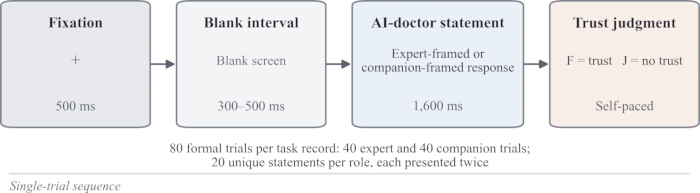
איור 3. רצף של ניסוי בודד במחקר 2. כל ניסוי כלל קיבוע של 500 ms, מרווח ריק משתנה (jittered) של 300–500 ms, הצהרת רופא-AI בניסוח של מומחה או של בן-לוויה למשך 1,600 ms, ושיפוט אמון בינארי בקצב אישי. רישומי המשימה ב-E-Prime הצביעו על 80 ניסויים פורמליים לכל רשומת משימה, עם 40 ניסויים לכל תנאי ניסוח תפקיד, ושתי הצגות של כל אחת מ-20 ההצהרות הייחודיות לכל תנאי. נא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
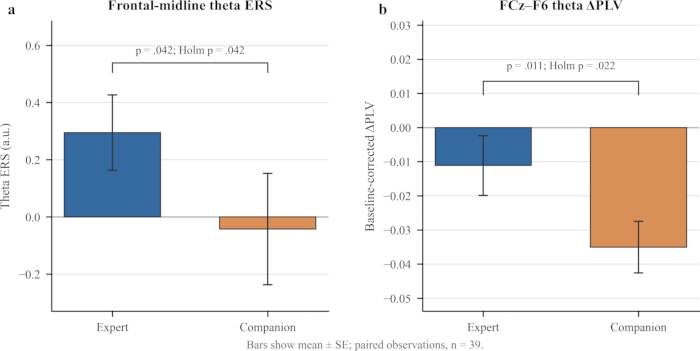
איור 4. השפעות של מסגור תפקיד ה-AI הרפואי על frontal-midline theta ERS ועל FCz-F6 theta delta PLV. (A) סנכרון הקשור לאירוע (ERS) של theta בקו האמצע הפרונטלי. (B) שינוי בערך נעילת הפאזה (ΔPLV) של theta ב-FCz-F6, מתוקן לבסיס; ערכים שליליים מציינים ירידה לעומת קו הבסיס לפני הגירוי. העמודות מציגות ממוצע ± SE עבור n = 39. מבחני t מזווגים הניבו p = .042 עבור theta ERS ו-p = .011 עבור ΔPLV; ערכי p המתוקנים לפי Holm עבור שתי התוצאים המדווחות היו .042 ו-.022, בהתאמה. קיצורים: אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
טבלה 1: דיאגנוסטיקה של מודל המדידה עבור מחקר 1. הטבלה מציגה עמוסים סטנדרטיים, α של קרונבך, מהימנות מורכבת, שונות ממוצעת מופקת, מתאמים חבויים וערכי HTMT עבור מקצועיות נתפסת, נוכחות חברתית, אמון קוגניטיבי ואמון רגשי. N = 300. המודל בעל ארבעת הגורמים התאים טוב יותר מהחלופות, אך RMSEA ו-SRMR הצביעו על התאמה מוחלטת חלשה ושני ערכי HTMT עלו על .90. קיצורים: CR = מהימנות מורכבת; AVE = שונות ממוצעת מופקת; HTMT = יחס heterotrait-monotrait. אנא לחץ כאן להורדת טבלה זו.
טבלה 2: סטטיסטיקה תיאורית לארבעה תנאים ומבחנים פקטוריאליים מלאים של 2 × 2 עבור מחקר 1. נתוני התאים מדווחים n, ממוצע, סטיית תקן ומרווח ברחבConfidence Interval של 95%; מבחנים פקטוריאליים מדווחים F, p ו-partial η2. N = 300; n = 75 לכל תא. מסגור התפקיד קודד כ-1 = מומחה ו-2 = בן לוויה; הקשר המשימה קודד כ-1 = מחלה ו-2 = ייעוץ בריאותי. המקדמים ומרווחי הביטחון אינם סטנדרטיים. אנא לחץ כאן להורדת טבלה זו.
טבלה 3: קשרים עקיפים מותנים ומקבילים במחקר 1. N = 300. מסגור התפקיד קודד כ-1 = מומחה ו-2 = בן לוויה; הקשר המשימה קודד כ-1 = ייעוץ למחלה ו-2 = ייעוץ לבריאות. מקצועיות נתפסת ונוכחות חברתית הוזנו בו-זמנית. האומדנים אינם סטנדרטיים, ורווחי סמך בשיטת bootstrap-percentile השתמשו ב-5,000 דגימות חוזרות. הטבלה כוללת קשרים עקיפים מותנים, את שני המדדים של תיווך ממתן, ואת השוואת ה-bootstrap הישירה ביניהם. ההשוואה הישירה בין שני מדדי התיווך הממותן עבור אמון כללי הייתה 0.1864, 95% CI [-0.0856, 0.4447]. אנא לחצו כאן להורדת טבלה זו.
טבלה 4: תוצאות EEG מזווגות במחקר 2. N = 39 תצפיות מזווגות במדגם האנליטי הסופי. הטבלה מציגה ממוצעי תנאים, הפרשי ממוצעים מזווגים, רווחי סמך של 95%, מבחני t מזווגים, Cohen’s dz, partial η2, וערכי p מתוקננים לפי Holm עבור frontal-midline theta ERS ו-baseline-corrected FCz-F6 theta ΔPLV. תיקון Holm חל רק על שתי תוצאות ה-EEG המזווגות המדווחות ואינו משחזר כל חיפוש רחב יותר שלא תועד על פני אלקטרודות, פסים או חלונות זמן. אנא לחצו כאן להורדת טבלה זו.
קובץ משלים 1: גירויים ניסויים ששימשו במחקר 1. הקובץ מכיל את הטקסט המלא של תגובות ה-AI הרפואיות בניסוח של מומחה ובניסוח של בן לוויה, ששימשו בתרחישים של התייעצות במקרה של מחלה והתייעצות בנושאי בריאות. מסופקים הן הטקסט המקורי בסינית והן התרגום לאנגלית.אנא לחצו כאן כדי להוריד קובץ זה.
טבלה נלווית S1. ניתוח עוצמה מבוסס סימולציה לאחר בדיקה (Post hoc) עבור מודל תיווך ממתן. אנא לחץ כאן להורדת קובץ זה.
טבלה משלימה S2. סטטיסטיקות לבדיקת מניפולציה וניתוחי רגישות לזמן השלמה עבור מחקר 1. אנא לחצו כאן להורדת קובץ זה.
טבלה משלימה S3. תוצאות משימה התנהגותית, פירוט מדגמים וסטטיסטיקה תיאורית עבור מחקר 2. אנא לחץ כאן להורדת הקובץ.
דיון
השלכות תיאורטיות
שני המחקרים מספקים ראיות ברמות שונות. מחקר 1 מזהה קשרים בין תפקיד למשימה וקשרים עקיפים מקבילים בניסוי תרחישים אקראי, בעוד שמחקר 2 מספק השוואת EEG גששית ברמת התהליך. לפיכך, המחקרים תומכים בגישה מוגבלת של הערכה ממוסגרת-תפקיד ולא במנגנון הדרגתי יחיד. הממצאים מרחיבים את תאוריית התיאום התפקידי (role congruity theory) לתחום ה-AI הרפואי על ידי התייחסות לתיאום כהלימה בין רמזי תפקיד לבין דרישות הערכתיות בולטות למשימה22. פרשנות זו נבדלת מתוכני כשירות-חמימות (competence-warmth) וממיתום בין המשימה לטכנולוגיה (task-technology fit). ניתן להבין את הממצאים הנוגעים לסלידה מאלגוריתמים (Algorithm-aversion) והערכה חיובית של אלגוריתמים (algorithm-appreciation) כהערכות רגישות-הקשר לגבי השאלה האם רמזי התפקיד והיכולת מתאימים למשימה49,50.
התוצאות תומכות גם בקשרים מקבילים ולא בלעדיים בין הגדרת התפקיד (role framing), מקצועיות נתפסת, נוכחות חברתית ואמון. מכיוון שמקצועיות חופפת לאמון קוגניטיבי ונוכחות חברתית חופפת לאמון רגשי, הראיות תומכות בתוכן הערכתי מובחן אך לא בשני מנגנונים נפרדים באופן מוחלט. האינטראקציה בין התפקיד למשימה בנוגע למקצועיות נתפסת עקבית עם הסבר התאימות לתפקיד (role-congruity account) המוצע. הראיות תומכות במיתון הקשרי של הקשר עם המקצועיות, אך הן אינן מבססות מנגנונים הקשריים אסימטריים מבחינה סטטיסטית או אי-שינוי (invariance) בנתיב הנוכחות החברתית.
ממצאי ה-EEG מספקים נקודת מבט גששית ברמת התהליך. הצהרות שנמסגרו על ידי מומחים לוו בתבניות מובחנות של פס התטא, אך התנאים נבדלו גם בתוכן הסמנטי ובמורכבות, וההתנהגות ברמת התנאי לא הראתה הבדל מהימן באמון. לכן, מדדי ה-EEG אינם מבססים מנגנון נפרד של בקרה קוגניטיבית או אמון. יש להתייחס לממצאים העצביים ככאלה המייצרים השערות. מחקר 2 לא ביצע מניפולציה על הקשר המטלה, לא מדד תפיסת מקצועיות או נוכחות חברתית, ולא קישר מדדי EEG ברמת הניסוי לשיפוטי אמון; לפיכך, תוצאות ה-EEG משלימות את המודל העקיף המותנה ולאו דווקא מתקפות אותו.
הממצאים עולים בקנה אחד עם הסתמכות הולמת, ולא מקסימלית. יש לכייל את ההסתמכות על מערכות אוטומטיות בהתאם ליכולות המערכת, לגבולותיה ולדרישות המשימה35. עבודות קשורות מתארות מנגנונים קוגניטיביים אדפטיביים שעשויים לתמוך באמון ובהסתמכות מכויילים51. נקודת המבט של ה-NeuroIS תומכת בשימוש במדדים עצביים כהשלמה לראיות התנהגותיות בעת בחינת תהליכים בעלי רזולוציה זמנית52. עבודות קודמות ב-fMRI מראות גם כי פעילות עצבית במהלך שיפוטי אמון בזמן אמת משתנה בין יעדים והקשרים שונים53.
השלכות ניהוליות
עבור פלטפורמות רפואיות מקוונות, ההשלכה המעשית היא הסתמכות מכויילת ולא מקסימום של אמון פשוט. יש להתאים את רמזי התפקיד לדרישות המשימה ולשלבם עם תקשורת של אי-ודאות, הגדרות מפורשות של מגבלות יכולת, אזהרות מבוססות סיכון והסלמה לרופאים מוסמכים.
במודולים בעלי סיכון גבוה הכוללים אבחנה, פרשנות של תוצאות חריגות, ייעוץ רפואי או תעדוף טיפולי (triage), רמזים מוכווני-כשירות עשויים לסייע למשתמשים לזהות את גבולות הראיות והפעולה מבלי להעניק סמכות שאינה מוצדקת. במודולים בעלי דחיפות נמוכה יותר, כגון תזונה, פעילות גופנית, שינה, היענות לטיפול ותמיכה רגשית, רמזים מוכווני-מערכת יחסים עשויים לתמוך במעורבות המשתמש מבלי ליצור הרגעה שגויה או אנתרופומורפיזם בלתי הולם.
עיצוב התפקיד צריך להיות מודולרי ומבוסס תרחישים, במקום הגדרה קבועה של אישיות. הגדרת התפקיד צריכה להיות משולבת עם הסברים, הנחיות פרטיות, תוויות סיכון ומנגנוני הסלמה. מחקר בתחום הממשל מדגיש כי שקיפות, אחריות, ניהול הטיות ופרטיות חייבים להיות מעוצבים יחד, כדי שרמזים אמינים לתפקיד בממשק המשתמש (front-end) לא יסתירו סיכונים במערכת האחורית (back-end)6,20,21.
מגבלות המחקר וכיוונים עתידיים
מחקר 1 הוא ניסוי המבוסס על תרחיש ולא על ייעוץ אמיתי. התנאים לא נבדקו מראש באופן בלתי תלוי מבחינת אורך, תדירות מילים, קריאות, דיוק, יכולת יישום, ערכיות רגשית, עוררות, סיכון, מוכרות או מורכבות. מחקרים עתידיים צריכים להשתמש במספר תרחישים, בשמות מערכת ניטרליים, בגירויים תואמים מבחינת תוכן, במניפולציה בלתי תלויה או במדידה מופרדת בזמן, ובאפקטים אקראיים ברמת המשתתף והגירוי.
מחקר 2 סיפק ראיות EEG ברמת התהליך, אך הקישור הדמוגרפי הסופי של 39 הנבדקים היה חסר, היגרוני של ה-EEG לא הותאמו באופן עצמאי או נבדקו מראש מבחינת אורך משפט, תדירות מילים, קריאות, ערכיות רגשית, עוררות, סיכון נתפס, מוכרות ומורכבות, וייתכן שתוויות תפקיד מפורשות יצרו מאפייני דרישה (demand characteristics). במחקר הנוכחי נעשה שימוש בערך נעילה פאזית מתוקנן לבסיס (ΔPLV) כמדד שהוגדר מראש לקישוריות תפקודית. למרות שאינדקס השהיית הפאזה המשוקלל (wPLI) פחות רגיש להולכה נפחית (volume conduction), הוא לא נכלל בצינור הניתוח המקורי. מחקרים עתידיים צריכים לבחון האם הממצאים הנוכחיים משתחזרים באמצעות wPLI או מדדי קישוריות משלימים אחרים. הפלטים העצביים הזמינים הם מרוכזים לפי תנאי (condition-aggregated) ולא ניתן לקשר אותם לשיפוטי אמון ברמת הניסוי; לכן, לא נאמד מודל מעורב של EEG-התנהגות ברמת הניסוי. PLV של הקרקפת רגיש גם להשפעות של רפרנס משותף והולכה נפחית. מגבלות אלו פירושן שיש להשאיר את הממצאים העצביים כחקרים ראשוניים (exploratory) ולא יש לפרשם כראיה למנגנון ייחודי של בקרה קוגניטיבית או אמון.
גילויים
למחברים אין ניגודי עניינים להצהיר עליהם.
במהלך הכנת עבודה זו, השתמשו המחברים ב-ChatGPT לשיפור השפה. לאחר השימוש בכלי/שירות זה, סקרו וערוכו המחברים את התוכן לפי הצורך והם נושאים באחריות מלאה לתוכן הפרסום.
תודות
פרויקט מחקר זה נתמך על ידי ה-National Social Sciences Funded General Projects, PRC (מענק מספר 22BGL006).
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| פלטפורמת סקרי Credamo מקוונת | Credamo (Jianshu), China | לא רלוונטי | פלטפורמה לשאלונים מקוונים, הקצאה אקראית וגיוס משתתפים ששימשה במחקר 1. |
| פונקציית rereferencing של CURRY | Compumedics Neuroscan, USA | גרסה לא צוינה | ביצוע rereferencing לא מקוון מובנה מרפרנס FCz מקוון לממוצע mastoid דו-צדדי; FCz שוחזר אוטומטית ביחס לרפרנס החדש. |
| כיפת אלקטרודות EEG, 64 ערוצים | Compumedics Neuroscan (Compumedics Limited), Australia | דגם/מספר קטלוג לא צוינו | כיפת אלקטרודות Ag/AgCl בעלת 64 ערוצים ששימשה להקלטת EEG רציפה. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, USA | גרסה 2023.0 | ארגז כלים של MATLAB ששימש לעיבוד מקדים של EEG ולניתוח רכיבים בלתי תלויים (ICA). |
| E-Prime | Psychology Software Tools, Inc., USA | גרסה 2.1 | הצגת גירויים ואיסוף תגובות במחקר 2. |
| G*Power | Heinrich Heine University Dusseldorf, Germany | גרסה 3.1.9.7 | חישוב גודל מדגם a priori מקורי, ניתוח רגישות לאינטראקציה וניתוח עוצמה (power analysis) מבוסס מודל post hoc עבור מחקר 1. |
| IBM SPSS Statistics | IBM Corp., USA | גרסה 27 | סביבה סטטיסטית ששימשה להרצת מאקרו PROCESS. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, USA | גרסה 1.7 | תוסף של EEGLAB ששימש לסיווג רכיבים בלתי תלויים המהווים ארטיפקטים. |
| MATLAB | The MathWorks, Inc., USA | גרסה R2020b | סביבת מחשוב ששימשה לעיבוד וניתוח EEG. |
| מאקרו PROCESS עבור SPSS | Andrew F. Hayes, Canada | גרסה 4.2 beta | מודל 7 כאשר מקצועיות נתפסת ונוכחות חברתית הוזנו בו-זמנית כמתווכים מקבילים, תוך שימוש ב-5,000 דגימות bootstrap percentile במחקר 1. |
| ג'ל אלקטרוליט מוליך Quik-Gel | Compumedics Neuroscan (Compumedics Limited), Australia | מספר קטלוג לא צוין; 32 oz | ג'ל מוליך ששימש להפחתת עכבת אלקטרודה-עור במהלך הקלטת EEG. |
| מגבר EEG מסוג SynAmps2 | Compumedics Neuroscan (Compumedics Limited), Australia | SynAmps2; מספר קטלוג לא צוין | מגבר EEG בעל 64-256 ערוצים שהוגדר להקלטה של 64 ערוצים. |
מקורות
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.