פרוטוקול אורכי זה משלב הערכות חוזרות באמצעות סולם תלות בטיפול (Care Dependency Scale) עם מודל תערובת גדילה (growth mixture modeling), במטרה לזהות מסלולי תלות סיעודית מובחנים לאחר אוטם שרירי לב חריף ולהעריך גורמים דמוגרפיים, קליניים ופסיכו-סוציאליים הקשורים לשיוך למחלקות במסלולים אלה.
מאמר מחקר
מעמדות חבויים של מסלולי תלות בסיעוד וגורמים קשורים בחולים עם אווטם שריר הלב החריף
* These authors contributed equally
במאמר זה
סיכום
תקציר
מחקר זה נועד לזהות מחלקות 잠נטיות של מסלולי תלות בסיעוד בקרב חולים עם אוטם שריר הלב החריב (AMI) ולבחון גורמים הקשורים לשיוך למחלקות מסלול אלו. מחקר תצפיתי אורך חד-מרכזי זה כלל 260 חולים עם AMI שאושפזו בבית החולים הציבורי של מחוז Linquan בין ינואר 2024 לינואר 2026. נקודת הבסיס של המחקר הוגדרה כנקודת הזמן לאחר טיפול חירום מוצלח והסתייעות של ההכרה. תלות בסיעוד הוערכה באמצעות סולם תלות בטיפול (CDS) בנקודת הבסיס (T1), ביום השלישי לאחר האשפוז (T2), בשחרור (T3), וחודש אחד לאחר השחרור (T4). מודל תערובת צמיחה (Growth mixture modeling) שימש לזיהוי מחלקות מסלול אורך נבדלות. מאפיינים קליניים ופסיכו-סוציאליים הוערכו לאחר מכן באמצעות רגרסיה לוגיסטית מולטינומיאלית כדי לזהות גורמים הקשורים באופן בלתי תלוי לשיוך למחלקת מסלול. זוהו ארבעה מסלולי תלות בסיעודיים נבדלים: סוג עצמאות גבוהה-שיפור איטי (C1, n = 66, 25.4%), סוג תלות מתונה-הידרדרות מהירה (C2, n = 54, 20.8%), סוג תלות גבוהה-שיפור משמעותי (C3, n = 90, 34.6%), וסוג תלות גבוהה-החמרה איטית (C4, n = 50, 19.2%). גיל, מצב משפחתי, תסמיני דיכאון וחרדה, תמיכה חברתית והיסטוריה של מחלות רקע הראו קשרים בלתי תלויים ספציפיים למחלקה עם השיוך למסלול. תלות בסיעוד הראתה הטרוגניות בין-אישית משמעותית בקרב חולים עם AMI, כאשר זוהו ארבעה מסלולי אורך נבדלים. גורמים הקשורים לשיוך למחלקת מסלול עשויים לסייע בזיהוי חולים הזקוקים להערכה סיעודית הדוקה יותר ולמעקב מותאם אישית; עם זאת, יעילותן של התערבויות המכוונות לגורמים אלה דורשת הערכה פרוספקטיבית.
מבוא
הסתלקות שריר הלב חריפה (AMI) נגרמת בדרך כלל מחסימה פתאומית של עורק כלילי, מה שמוביל להפחתה ניכרת או להפסקת זרימת הדם לשריר הלב ולנמק של שריר הלב בעקבות זאת. AMI נשאר מצב קרדיווסקולרי מסכן חיים מרכזי, מכיוון שפגיעה בתפקוד שריר הלב וסיבוכים חריפים עלולים להשפיע באופן משמעותי על התוצאות בטווח הקצר והארוך1. אסטרטגיות של פרפוזיה מחדש, הכוללות התערבות כלילית דרך העור (PCI) וטיפול תרומבוליטי, יכולות לשחזר את זרימת הדם הכלילית ושיפרו באופן משמעותי את הטיפול החריף ב-AMI. עם זאת, גם לאחר טיפול חריף מוצלח, חלק מהמטופלים ממשיכים לחוות מגבלות בטיפול העצמי ובפעולות היומיום, וכתוצאה מכך זקוקים לרמות משתנות של תמיכה סיעודית2.
תלות בטיפול סיעודי עלולה להשפיע על איכות חייהם של מטופלים, על השתתפותם החברתית, על ההחלמה התפקודית ועל תהליך השיקום הכללי3. מחקרים קודמים בנושא AMI התמקדו בעיקר באסטרטגיות אבחון וטיפול, במניעה ובניהול של סיבוכים, ובגורמים פרוגנוסטיים. מחקר חתך קודם בקרב מטופלים עם מחלה כלילית לאחר התערבות כלילית דרך העור זיהה שכישות (frailty), מסוגלות עצמית ומצב פסיכולוגי כגורמים הקשורים לתלות בטיפול; עם זאת, הערכה בנקודת זמן בודדת אינה יכולה לאפיין שינויים בתלות בתוך אותו מטופל או להבחין בין דפוסי החלמה הטרוגניים לאורך זמן4. באמצעות הערכה חוזרת של התלות בטיפול סיעודי בארבע נקודות זמן ויישום של מודל תערובת צמיחה (growth mixture modeling), המחקר הנוכחי מרחיב את הניתוחים הסטטיים הקודמים על ידי זיהוי תתי-קבוצות חבויות של מטופלים עם מסלולים אורכיים מובחנים. זיהוי דפוסים הטרוגניים אלו עשוי לסייע לקליניקאים לזהות מטופלים בעלי פרופילי שיקום שונים ולהוות בסיס להערכה סיעודית, למעקב ולטיפול תומך מותאמים אישית.
בהתאם לכך, מחקר זה נועד לזהות מחלקות אורך מובחנות של תלות בסיעוד, החל מנקודת הבסיס לאחר הטיפול הדחוף ועד לחודש אחד לאחר השחרור בקרב מטופלים עם AMI, ולבחון גורמים דמוגרפיים, קליניים ופסיכו-סוציאליים הקשורים להשתייכות למחלקות מסלול אלו. לאור אופיו הגשש של המחקר, לא הוגדרו מראש היפותזות כיווניות לגבי מחלקות מסלול ספציפיות.
פרוטוקול
המחקר נערך במחלקה לרפואת דחוף, בבית החולים הציבורי של מחוז לינקואן (Linquan County People’s Hospital), פוייאנג, אנחוי, סין. פרוטוקול המחקר נסקר ואושר על ידי ועדת האתיקה של בית החולים הציבורי של מחוז לינקואן (מספר אישור 24XNLC-HL1015). הסכמה מדעת בכתב התקבלה מכל המשתתפים לפני גיוסם. כל ההליכים שכללו משתתפים אנושיים בוצעו בהתאם לדרישות האתיקה המוסדיות ולעקרונות האתיקה הרלוונטיים.
מסגרת המחקר וזיהוי המשתתפים
המחקר נערך כחקירה תצפיתית אורך רב-מרכזית במחלקה לרפואה דחופה בבית החולים המרכזי של מחוז Linquan, פויאנג, אנהוי, סין. המשתתפים גויסו בין ינואר 2024 לינואר 2026 ונמעקבו החל מקו הבסיס לאחר הטיפול הדחוף ועד חודש אחד לאחר השחרור.
נעשה שימוש בדגימה נוחות כדי לזהות חולים מתאימים שאשפזו עם אוטם שריר הלב חריף (AMI). אותם קריטריוני התאמה והליכי סינון הוחלו על כל המשתתפים הפוטנציאליים. מכיוון שדגימת נוחות עלולה להוביל להטיית בחירה, מקור פוטנציאלי זה להטיה נלקח בחשבון בעת פרשנות היכולת להכליל את הממצאים.
סך הכל נסרקו 287 חולים, מתוכם 27 לא גויסו. שמונה חולים חוו אוטם שריר הלב בעבר, שישה לא היו מסוגלים להשלים את הערכות המחקר עקב הפרעה בהכרה או בתפקוד הקוגניטיבי, חמישה סבלו ממחלות לב אורגניות אחרות, ארבעה סבלו מגידולים ממאירים, כשל רב-מערכתי או מחלות סיסטמיות חמורות אחרות, וארבעה סירבו להשתתף. 260 החולים הנותרים גויסו למחקר.
קריטריוני התאמה והגדרת בסיס (baseline)
מטופלים נכללו במחקר אם הייתה להם אבחנה קלינית מובהקת של AMI, אם חוו את אירועהם הראשון של אוטם שריר הלב, אם גילם היה ≥18 שנים, אם היו בעלי הכרה תקינה ותפקוד קוגניטיבי מספיק כדי להבין ולהשלים את הערכות המחקר, ואם סיפקו הסכמה מדעת בכתב. מטופלים עם מחלות לב אורגניות אחרות, גידולים ממאירים, כשל רב-מערכתי או מחלות אורגניות מערכתיות חמורות אחרות הוצאו מהמחקר.
הגיוס הוגבל למטופלים עם אוטם שריר הלב ראשוני כדי להפחית את ההטרוגניות הקשורה לאוטם קודם, רבסוולריזציה קודמת, ליקוי תפקודי כרוני לאחר אוטם, והסתגלויות קודמות בטיפול עצמי או בשיקום, שכל אלה עשויים להשפיע באופן בלתי תלוי על התלות בסיעות בתחילת המעקב ועל דפוסי המסלול העוקבים.
T1 הוגדר כנקודת הזמן לאחר טיפול חירום מוצלח והתאוששות של ההכרה, כאשר המשתתף היה מסוגל להשלים את ההערכות הנדרשות באופן מהימן.
איסוף נתונים דמוגרפיים ונתונים קליניים הקשורים למערכת קרדיווסקולרית
שאלון מידע כללי ספציפי למחקר שימש לאיסוף נתונים על גיל, מין, מדד מסת גוף (BMI), מצב משפחתי, סיווג תפקוד לבבי, סוג אוטם השריר הלבבי, אסטרטגיית טיפול בפרפוזיה מחדש והיסטוריה של מחלות רקע. מידע דמוגרפי ופסיכו-סוציאלי הושג באמצעות הערכת שאלון וסקירת רשומות רפואיות, לפי הצורך. מאפיינים קליניים הקשורים למערכת קרדיווסקולרית, כולל סיווג תפקוד לבבי, סוג אוטם השריר הלבבי, אסטרטגיית פרפוזיה מחדש והיסטוריה של מחלות רקע, הופקו מהרשומות הרפואיות של האשפוז הנוכחי בהתאם להגדרות קבועות מראש. סיווג תפקוד לבבי הופק מרשומות האשפוז הנוכחי וחולק לקבוצות Class I–II או Class III–IV לצורך הניתוח. סוג אוטם השריר הלבבי סווג כאוטם שריר הלב עם העלאה של מקטע ST (STEMI) או אוטם שריר הלב ללא העלאה של מקטע ST (NSTEMI) בהתבסס על האבחנה שנרשמה במהלך האשפוז הנוכחי. היסטוריה של מחלות רקע קודדה באופן דיכוטומי כ"לא" (0) או "כן" (1), כאשר "כן" מציין שלפחות מצב תחלואה כרוני אחד שהוגדר מראש תועד בהיסטוריה הרפואית.
התערבות כלילית דפיקתית (PCI) וטיפול תרומבוליטי תועדו בהתאם לטיפול שניתן בפועל במהלך האשפוז המדד, ולא על פי תוכנית הטיפול המתוכננת. הערכים הרציפים המקוריים של הגיל ושל ה-BMI נשמרו לצורך ניתוח סטטיסטי.
הערכה חוזרת של תלות בסיעוד
את סולם תלות בטיפול (CDS5) הגישו ב-T1. הסולם כולל 15 פריטים. כל פריט דורג מ-1 (תלות מלאה) עד 5 (כמעט עצמאי), מה שהניב ציון כולל שנע בין 15 ל-75. ציונים גבוהים יותר העידו על עצמאות רבה יותר ותלות נמוכה יותר בסיעוד. על פי סיווג ה-CDS המקובל, ציונים של 60–69 מעידים על דרגה מוגבלת של תלות בטיפול, בעוד שציונים של 70–75 מעידים על כמעט עצמאות; לפיכך, ציון CDS כולל <70 נחשב במחקר הנוכחי כמורה על תלות בסיעוד4,5.
הערכת ה-CDS חזרה על עצמה ביום השלישי לאחר הקבלה (T2), בעת השחרור (T3), וחודש אחד לאחר השחרור (T4). אותן הנחיות, סדר פריטים, כללי ניקוד והליכי סיוע שימשו בכל ההערכות כדי למזער חוסר עקביות במדידה. הערכת T4 נערכה במהלך מעקב תקופתי שנקבע לחודש לאחר השחרור, באופן פרונטלי במרפאת חוץ או טלפונית כאשר ביקור פרונטלי לא היה בר ביצוע. בשני המקרים, חבר מיומן מצוות המחקר הגיש את כל פריטי ה-CDS תוך שימוש באותן הנחיות סטנדרטיות, סדר פריטים וקריטריוני ניקוד.
כל 260 המשתתפים שנרשמו השלימו את ה-CDS בכל ארבע נקודות הזמן, ולא היו משתתפים שאבדו למעקב במהלך תקופת התצפית של חודש אחד.
הערכה פסיכו-סוציאלית בסיסית
סולם דירוג הדיכאון של המילטון הכולל 17 פריטים (HAMD-17)6 הועבר פעם אחת בנקודת הזמן T1. פריטים 1–3, 7–11, 15 ו-17 דורגו מ-0 עד 4, בעוד שפריטים 4–6, 12–14 ו-16 דורגו מ-0 עד 2. ציוני הפריטים סוכמו כדי לקבל ציון כולל שנע בין 0 ל-54, כאשר ציונים גבוהים יותר מעידים על תסמיני דיכאון חמורים יותר.
שאלון החרדה הכללית-7 (GAD-7)7 הוענק פעם אחת ב-T1. כל אחד משבעת הפריטים דורג מ-0 (כלל לא) עד 3 (כמעט בכל יום), מה שהביא לציון כולל שנע בין 0 ל-21. ציונים גבוהים יותרת העידו על תסמיני חרדה חמורים יותר.
סולם דירוג התמיכה החברתית (SSRS)8 הועבר פעם אחת בנקודת הזמן T1. הסולם כלל 10 פריטים. פריטים 1–4 ו-8–10 דורגו במقياس בן 4 נקודות מ-1 עד 4; פריט 5 נספר מ-1 עד 4 בהתאם לרמת התמיכה שדווחה; ופריטים 6 ו-7 נספרו בהתאם למספר מקורות התמיכה הזמינים. הניקוד הכולל נע בין 12 ל-66, כאשר ציונים גבוהים יותר מעידים על תמיכה חברתית רבה יותר.
כל הערכות ה-CDS וההערכות הפסיכו-סוציאליות הועברו או הופקחו על ידי חברים מיומנים בצוות המחקר. לפני גיוס המשתתפים, המעריכים עברו הכשרה סטנדרטית על הגשת השאלונים, פרשנות הסעיפים, סיוע מותר ונהלי ניקוד. אותן הוראות סטנדרטיות, סדר סעיפים וקריטריוני ניקוד שימשו לאורך כל המחקר. לא נדרש אותו מעריך להעריך משתתף בודד בכל נקודת זמן; העקביות בין המעריכים נשמרה באמצעות הכשרה סטנדרטית ונהלי הערכה אחידים. המשתתפים התבקשו להשלים את השאלונים באופן עצמאי במידת האפשר. כאשר משתתפים חוו קשיים בקריאה, בהבנה או בכתיבה, ניתן סיוע סטנדרטי של אחד-על-אחד מבלי להציע תשובות, לפרש סעיפים בשם המשתתף או לשנות את תשובות המשתתף.
בקרת איכות נתונים וטיפול בנתונים חסרים
לפני מילוי השאלון, המשתתפים עודכנו במטרת המחקר, בהליכי ההשלמה ובדרישות הסודיות. עבור כל המשתתפים נעשה שימוש בהוראות סטנדרטיות ובהליכי הערכה זהים. השאלונים המולאים נבדקו באופן מיידי לאיתור תשובות שהושמטו או רשומות שאינן תקפות בבירור. כאשר פריט נותר ללא מענה, התבקש המשתתף לבחון שוב את הפריט שהושמט, ובמידה והסכים, לספק תשובה. כאשר נדרש סיוע במילוי השאלון, צוות המחקר לא הציע, פירש או סיפק תשובות בשמו של המשתתף. משתנים קליניים הופקו באמצעות הגדרות שנקבעו מראש, וטפסים מלאים אומתו לפני הזנת הנתונים.
כל 260 המשתתפים השלימו את הערכות ה-CDS בנקודות הזמן T1–T4, ללא איבוד משתתפים במעקב. נתוני ה-CDS האורכיים והמשתנים הדמוגרפיים, הקליניים והפסיכו-סוציאליים שנכללו באנליזות המדווחות היו מלאים. לפיכך, כל 260 המשתתפים נכללו באנליזות, ולא נדרש השלמה של נתונים חסרים (imputation).
מידול תערובת גדילה של ציוני CDS לאורכיים
מידול תערובת גדילה (GMM) בוצע באמצעות Mplus גרסה 8.3. הותאם GMM ללא תנאי (unconditional GMM) ללא משתנים נלווים, כאשר CDS_T1, CDS_T2, CDS_T3 ו-CDS_T4 הוזנו כמשתנים גלויים רציפים.
פתרונות בעלי מחלקה אחת עד חמש מחלקות הותאמו באופן רציף באמצעות אמידת נראות מרבית חסונה (MLR). כדי להפחית את הסיכון להתכנסות למקסימום מקומי, נוצרו 1,000 סטים אקראיים של ערכי התחלה, ו-200 הטובים שבהם נשמרו לשלב האופטימיזציה הסופי. עבור כל פתרון, אומתו סיום תקין של התהליך, שכפול של הלוג-נראות הטובה ביותר על פני ההתחלות האקראיות, והיעדר הערכות פרמטרים שאינן קבילות.
עבור כל פתרון נרשמו מדד האינפורמציה של אקאיקה (AIC), מדד האינפורמציה הבייסיאני (BIC), BIC מותאם לגודל המדגם (aBIC), אנטרופיה, מבחן יחס נסיון מותאם של Lo-Mendell-Rubin (LMR-LRT), ומבחן יחס נסיון בשיטת bootstrap (BLRT). ערכי AIC, BIC ו-aBIC נמוכים יותר פורשו כמעידים על התאמה יחסית טובה יותר של המודל, בעוד שערכי אנטרופיה הקרובים יותר ל-1 העידו על הפרדה ברורה יותר בין המחלקות.
כל פתרון מסוג k הושווה לפתרון k − 1 התואם לו באמצעות LMR-LRT ו-BLRT. המודל הסופי לא נבחר אך ורק על בסיס ירידה במדדי המידע; נשקלו גם יציבות ההתכנסות, גודל המחלקות, הסתברויות חברות פוסטריוריות, פארסומוניה ופרשנות קלינית. כל משתתף שויך למחלקה עם הסתברות החברות הפוסטריורית הגבוהה ביותר, והסתברויות פוסטריוריות ממוצעות ספציפיות למחלקה חושבו כמדד נוסף לאיכות הסיווג.
ניתוח של מדידות CDS חוזרות
כדי להעריך שינויים תוך-נבדקיים במדדי CDS לאורך T1, T2, T3 ו-T4 בקבוצה הכוללת, בוצע ניתוח שונות למדידות חוזרות חד-כיווני (RM-ANOVA), כאשר זמן ההערכה שימש כגורם התוך-נבדקי. הנחות של נורמליות מקורבת וספריות (sphericity) נבחנו. הספריות הוערכה באמצעות מבחן Mauchly, ותוצאות מתוקנות לפי Greenhouse–Geisser שימשו כאשר הנחת הספריות הופרה. כל המבחנים היו דו-צדדיים, וערך P < 0.05 נחשב למשמעותי סטטיסטית.
השוואות חד-משתניות בין מחלקות מסלול
ניתוחים שאינם GMM בוצעו באמצעות IBM SPSS Statistics גרסה 26.0. מדדי גיל, BMI, HAMD-17, SSRS ו-GAD-7 נותחו כמשתנים רציפים ללא קטגוריזציה.
משתנים רציפים בעלי התפלגות נורמלית בקירוב הוצגו כממוצע ± סטיית תקן והושוו בין ארבעת מחלקות המסלול באמצעות ניתוח שונות חד-כיווני (one-way analysis of variance). משתנים קטגוריאליים הוצגו כמספרי משתתפים והושוו באמצעות מבחן חי-ריבוע של פירסון. כל ערכי ה-P היו דו-צדדיים, ו-P < 0.05 שימש כסף למשכנתה לזיהוי משתנים להכללה במודל הרב-משתנה הראשוני.
בניתוח החד-משתני, גיל, מצב משפחתי, סיווג תפקוד לבבי, סוג אוטם שריר הלב, PCI, טיפול תרומבוליטי, מדד HAMD-17, מדד SSRS, מדד GAD-7 והיסטוריה של מחלות רקע עמדו בקריטריון P < 0.05 ולכן הוכנסו למודל הרב-משתני הראשוני. מין ו-BMI לא עמדו בקריטריון זה.
רגרסיה לוגיסטית מולטינומיאלית ואבחון מודלים
ארבעת סוגי המסלולים טופלו כתוצאה נומינלית, ובוצע ניתוח רגרסיה לוגיסטית מולטינומיאלית במקום רגרסיה לוגיסטית בינארית. C1 (עצמאות גבוהה-שיפור איטי) הוגדר כקטגוריית התוצאה המשמשת כקטגוריית ייחוס.
כל המשתנים עם P < 0.05 בניתוחים החד-משתניים נכללו במודל הראשוני. לאחר מכן הוחל תהליך בחירה לאחור של יחס הסבירות (Backward likelihood-ratio selection), כאשר משתנים שהראו P > 0.10 הוסרו באופן סדרתי. השפעות עיקריות בעלות משמעות סטטיסטית נשמרו במודל הסופי.
בדיקת מולטי-קוליניאריות (Multicollinearity) בוצעה באמצעות ערכי סבילות (tolerance) ומקדם הגברה של השונות (VIF). בניתוח הסופי, ערכי הסבילות נעו בין בערך 0.81 ל-0.97, וערכי ה-VIF נעו בין 1.03 ל-1.24, מה שמעיד על היעדר מולטי-קוליניאריות משמעותית.
בדיקת האינטראקציות הוגבלה למונחים שנקבעו מראש והיו סבירים מבחינה קלינית כדי להפחית את הסיכון להתאמת-יתר (overfitting). שלוש אינטראקציות שנקבעו מראש — גיל × היסטוריה של מחלות רקע, מצב משפחתי × ציון SSRS, וציון HAMD-17 × ציון GAD-7 — הוערכו באופן פרטני באמצעות מבחני יחס נסיון (likelihood-ratio tests). ערכי ה-P המתאימים היו 0.655, 0.301 ו-0.908, בהתאמה; לפיכך, אף אחד ממונחי האינטראקציה לא נשמר במודל.
ביצועי המודל הכוללים הוערכו באמצעות מבחן יחס הנחייתי (likelihood-ratio test) מול מודל עם נקודת חיתוך בלבד (intercept-only model); מבחני טיב התאמה (goodness-of-fit) של פירסון ושל סטיית ה-deviance; סטטיסטיקות pseudo-R2 של Cox-Snell, Nagelkerke ו-McFadden; דיוק סיווג; התכנסות; והערכה של הפרדה מלאה או כמעט מלאה (complete or quasi-complete separation).
דווחו יחסי סיכויים (ORs) מתוקננים עם רווחי סמך (CIs) של 95% עבור כל המנבאים הסופיים בהשוואות בין C2 ל-C1, C3 ל-C1, ו-C4 ל-C1. רווחי סמך רחבים פורשו כמעידים על דיוק מוגבל ולא כראיה מכרעת לגדלי אפקט גדולים.
שיקולי גודל מדגם ודיווח
לא הוחל סף גודל-מדגם אוניברסלי יחיד על ה-GMM. הלימות המדגם נבחנה ביחס למורכבות המודל, פרופורציות המחלקות, הפרדה בין מחלקות, דפוסי נתונים חסרים, אנטרופיה, הסתברויות פוסטריוריות והתכנסות9.
לא בוצע חישוב הספק (power calculation) פורמלי מראש המבוסס על סימולציה, מכיוון שהמחקר היה חקירה אורכית גששית שהתבססה על האוכלוסייה הזכאית שהייתה זמינה במהלך תקופת הגיוס שהוגדרה מראש. הפתרון הסופי בעל ארבעת הסיווגים כלל 66, 54, 90 ו-50 משתתפים והניב ערך אנטרופיה של 0.879, עם הסתברויות אחוריות (posterior probabilities) ממוצעות שנעו בין 0.871 ל-0.927.
עבור רגרסיה לוגיסטית רב-נומית, הערכה של הלימות המדגם בוצעה ביחס למספר המשתתפים בכל קטגוריית תוצאה ולמספר פרמטרי הנבואים המועמדים10. מכיוון שחלק ממחלקות המסלול היו קטנות יחסית, ניתוח הרגרסיה פורש כניתוח קשרים גשש ולא כפיתוח של מודל ניבוי סופי.
המחקר התצפיתי דווח בהתאם למסגרת Strengthening the Reporting of Observational Studies in Epidemiology (STROBE), כולל עיצובי המחקר, המסגרת, זרימת המשתתפים, מקורות הנתונים, מקורות פוטנציאליים להטיה, גודל המחקר, שיטות סטטיסטיות, טיפול בנתונים חסרים, תוצאות עיקריות, מגבלות ויכולת הכללה.
תוצאות
זרימת משתתפים ושלמות הנתונים
במהלך תקופת הגיוס, נבחנו 287 חולים עם AMI לצורך קביעת התאמתם למחקר. עשרים ושבעה חולים לא גויסו: שמונה חוו אוטם שריר הלב בעבר, שישה לא יכלו להשלים את הערכות המחקר בשל הפרעה בהכרה או בתפקוד הקוגניטיבי, לחמישה היו מחלות לב אורגניות אחרות, לארבעה היו גידולים ממאירים, כשל רב-איברי או מחלות סיסטמיות חמורות אחרות, וארבעה סירבו להשתתף. 260 המשתתפים הנותרים נכנסו למחקר, השלימו את ארבעת מדדי ה-CDS עד חודש לאחר השחרור, ונכללו ב-GMM הסופי ובניתוחים הבאים. לא היו ערכי CDS אורכיים חסרים, לא היו איבודים במעקב, ולא היו נתונים דמוגרפיים, קליניים או פסיכו-סוציאליים חסרים שדרשו השלמה (imputation) בניתוחים שדווחו.
בחירה של GMM בעל ארבעה מחלקות
מדדי ההתאמה השתפרו בהדרגה מהפתרון של מחלקה אחת לפתרון של ארבע מחלקות (Table 1). הפתרון של ארבע מחלקות הניב AIC = 6978.826, BIC = 7047.822, aBIC = 6978.741, entropy = 0.879, LMR-LRT P = 0.027, ו-BLRT P < 0.001. פרופורציות המחלקות כפי שהוערכו במודל היו 25.8%, 21.0%, 34.1%, ו-19.1%. כאשר נוספה מחלקה חמישית, ערכי AIC, BIC ו-aBIC ירדו במעט ל-6963.213, 7038.208 ו-6962.613, בהתאמה, וה-entropy עלה ל-0.912. עם זאת, לא ה-LMR-LRT (P = 0.128) ולא ה-BLRT (P = 0.063) העידו על שיפור מובהק סטטיסטית. בנוסף, המחלקה החמישית הכילה רק 6.4% מהמדגם. לפיכך, מודל ארבע המחלקות נשמר כיוון שהוא סיפק את האיזון המועדף בין התאמת המודל, יציבות, פשטות, גודל מחלקה ופרשנות קלינית.
התכנסות ואיכות הסיווג
הפתרון בעל ארבעת המחלקות הסתיים בצורה תקינה, והסבירות המקסימלית (log-likelihood) האופטימלית שוחזרה 18 פעמים לאורך התנעים האקראיים. לא נצפו אומדני פרמטרים שאינם קבילים. ההסתברויות הפוסטריוריות הממוצעות לשיוך למחלקה הסבירה ביותר היו 0.914 עבור C1, 0.889 עבור C2, 0.927 עבור C3, ו-0.871 עבור C4, דבר המעיד על הפרדה מקובלת בין המחלקות.
תלות סיעודית כוללת לאורך זמן
ציוני ה-CDS הממוצעים הכוללים היו 48.28 ± 10.25 ב-T1, 54.16 ± 14.33 ב-T2, 52.82 ± 12.17 ב-T3, ו-56.58 ± 15.15 ב-T4. מבחן ANOVA למדידות חוזרות חד-כיווני הראה הבדל כולל מובהק בציוני ה-CDS לאורך ארבע נקודות הזמן של ההערכה (F = 13.692, P < 0.001). ברמת הקבוצה, ציוני ה-CDS עלו עד היום השלישי, ירדו במעט במועד השחרור, ועלו שוב חודש לאחר השחרור. השונות הגבוהה יותר שנצפתה בנקודות זמן מאוחרות יותר העידה על כך שדפוסי הממוצע הכלליים הסתירו הטרוגניות משמעותית בין המשתתפים.
דפוסי מסלול
סביר להניח שסיווג המחלקות זיהה ארבעה מסלולים: C1, עצמאות גבוהה-שיפור איטי (n = 66, 25.4%); C2, תלות מתונה-הידרדרות מהירה (n = 54, 20.8%); C3, תלות גבוהה-שיפור משמעותי (n = 90, 34.6%); ו-C4, תלות גבוהה-החמרה איטית (n = 50, 19.2%; איור 1). ציוני CDS ממוצעים עבור C1 היו 55.50, 59.00, 60.00 ו-64.00 בנקודות הזמן T1–T4, בהתאמה; עבור C2 הם היו 50.00, 49.00, 39.00 ו-39.00; עבור C3 הם היו 43.22, 59.35, 61.86 ו-70.90; ועבור C4 הם היו 46.00, 44.00, 42.00 ו-40.00.
השוואות מחלקות חד-משתניות
הגיל היה שונה באופן מובהק בין C1–C4 (58.20 ± 7.80, 61.50 ± 7.40, 55.80 ± 7.60, ו-63.10 ± 7.20 שנים, בהתאמה; F = 12.572, P < 0.001; Table 2). BMI לא היה שונה באופן מובהק בין הקבוצות (23.60 ± 2.70, 23.40 ± 2.80, 23.80 ± 2.90, ו-23.50 ± 2.60 kg/m2, בהתאמה; F = 0.270, P = 0.847), וגם התפלגות המין הייתה דומה (χ2 = 0.142, P = 0.986). הבדלים מובהקים נצפו במצב המשפחתי (χ2 = 14.749, P = 0.002), בסיווג תפקוד הלב (χ2 = 15.283, P = 0.002), בסוג האוטם בשריר הלב (χ2 = 15.035, P = 0.002), ב-PCI (χ2 = 12.863, P = 0.005), בטיפול תרומבוליטי (χ2 = 15.622, P = 0.001), ובהיסטוריה של מחלות רקע (χ2 = 27.903, P < 0.001).
ציוני HAMD-17 הממוצעים היו 10.80 ± 2.70, 13.10 ± 2.90, 11.20 ± 2.60, ו-14.10 ± 3.00 עבור C1–C4, בהתאמה (F = 19.040, P < 0.001). ציוני SSRS הממוצעים היו 43.00 ± 4.80, 38.50 ± 5.00, 42.00 ± 4.90, ו-36.80 ± 5.10, בהתאמה (F = 20.742, P < 0.001), וציוני GAD-7 הממוצעים היו 9.50 ± 2.50, 12.10 ± 2.80, 10.00 ± 2.60, ו-13.70 ± 3.00, בהתאמה (F = 30.585, P < 0.001).
רגרסיה מולטינומיאלית סופית
המשתנים המנבאים המועמדים קודדו כפי שמוצג בTable 3. בחירה לאחור (backward selection) של יחס סבירות השאירה את הגיל, המצב המשפחתי, HAMD-17, SSRS, GAD-7 והיסטוריה של מחלות רקע במודל הרגרסיה הלוגיסטית מולטינומיאלית הסופי (Table 4). עבור C2 לעומת C1, מצב נשוי היה קשור לסיכויים נמוכים יותר לחברות ב-C2 (OR מותאם = 0.241, 95% CI = 0.095–0.612, P = 0.003), בעוד שציוני HAMD-17 גבוהים יותר (OR = 1.324, 95% CI = 1.121–1.564), ציוני GAD-7 גבוהים יותר (OR = 1.374, 95% CI = 1.160–1.626), ציוני SSRS נמוכים יותר (OR = 0.787, 95% CI = 0.711–0.871) והיסטוריה של מחלות רקע (OR = 3.107, 95% CI = 1.212–7.968) היו קשורים לחברות ב-C2. הגיל לא היה סיגניפיקנטי סטטיסטית בהשוואה זו (P = 0.089). עבור C3 לעומת C1, הגיל היה המנבא היחיד שנשאר סיגניפיקנטי סטטיסטית (OR = 0.954, 95% CI = 0.912–0.997, P = 0.036).
עבור C4 לעומת C1, גיל מבוגר יותר (OR = 1.077, 95% CI = 1.005–1.154), מצב לא נשוי (נשוי: OR = 0.248, 95% CI = 0.085–0.720), ציוני HAMD-17 גבוהים יותר (OR = 1.466, 95% CI = 1.214–1.772), ציוני SSRS נמוכים יותר (OR = 0.727, 95% CI = 0.646–0.819), ציוני GAD-7 גבוהים יותר (OR = 1.605, 95% CI = 1.318–1.955), והיסטוריה של מחלות רקע (OR = 4.454, 95% CI = 1.511–13.134) היו קשורים לחברות ב-C4.
דיאגנוסטיקה של המודל
המודל המולטינומי הסופי סיפק שיפור משמעותי לעומת המודל עם נקודת החיתוך בלבד (likelihood-ratio χ2 = 190.966, df = 18, P < 0.001). מבחני טיב ההתאמה של Pearson (χ2 = 745.020, df = 759, P = 0.635) והסטיות (deviance) (χ2 = 515.576, df = 759, P > 0.999) לא הצביעו על התאמה דלה של המודל. ערכי ה-pseudo-R2 של Cox-Snell, Nagelkerke ו-McFadden היו 0.520, 0.557 ו-0.270, בהתאמה, ודיוק הסיווג היה 53.1%. המודל התכנס לאחר שבע איטרציות, ללא עדות להפרדה מלאה או כמעט-מלאה (complete or quasi-complete separation). חלק מהאומדנים עבור היסטוריה של מחלות רקע הראו רווחי סמך (CIs) של 95% רחבים יחסית, דבר המעיד על דיוק מוגבל ותומך בפרשנות זהירה של קשרים אלו.
זמינות נתונים:
הנתונים הגולמיים התומכים בממצאי מחקר זה מסופקים עם המאמר כ- קובץ משלים 1.
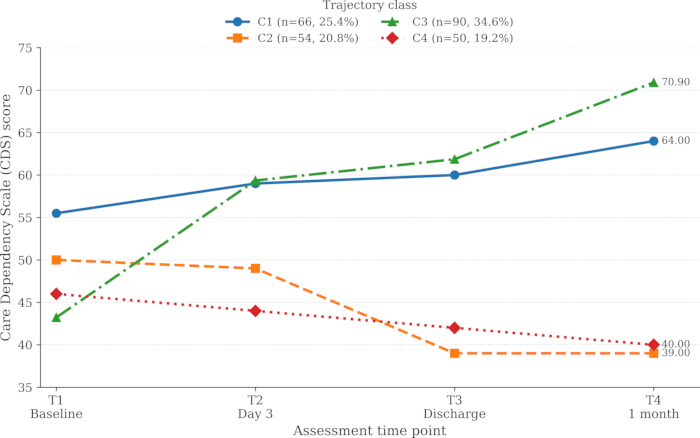
איור 1: מסלולים ארוכי טווח של תלות בסיעותי בקרב חולים עם אוטם שריר הלב חריף (AMI). ארבע מחלקות המסלול החבויות שזוהו על ידי GMM היו: עצמאות גבוהה-שיפור איטי (C1, n = 66, 25.4%), תלות בינונית-הידרדרות מהירה (C2, n = 54, 20.8%), תלות גבוהה-שיפור משמעותי (C3, n = 90, 34.6%), ותלות גבוהה-החמרה איטית (C4, n = 50, 19.2%). T1 מייצג את נקודת הבסיס לאחר טיפול חירום מוצלח והחזרת ההכרה; T2 מייצג את היום השלישי לאחר האשפז; T3 מייצג את השחרור; ו-T4 מייצג חודש אחד לאחר השחרור. ציר ה-y מייצג את ציון ה-CDS הממוצע הספציפי למחלקה, כאשר ציונים גבוהים יותר מעידים על עצמאות רבה יותר ותלות נמוכה יותר בסיעותי. קיצורים: AMI = acute myocardial infarction; CDS = Care Dependency Scale; GMM = growth mixture modeling. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
| מודל | AIC | BIC | aBIC | אנטרופיה | ערך P של LMR-LRT | ערך P של BLRT | פרופורציית מחלקות (%) |
| 1 | 7353.11 | 7384.108 | 7355.567 | — | — | — | — |
| 2 | 7141.412 | 7184.409 | 7156.355 | 0.726 | 0.002 | <0.001 | 48.2/51.8 |
| 3 | 7032.275 | 7086.271 | 7049.704 | 0.813 | 0.015 | <0.001 | 35.1/42.7/22.2 |
| 4 | 6978.826 | 7047.822 | 6978.741 | 0.879 | 0.027 | <0.001 | 25.8/21.0/34.1/19.1 |
| 5 | 6963.213 | 7038.208 | 6962.613 | 0.912 | 0.128 | 0.063 | 29.7/31.2/20.4/12.3/6.4 |
טבלה 1: מדדי התאמה עבור מודלי תערובת צמיחה של אחת עד חמש מחלקות של מסלולי תלות בסיעוד. ערכים נמוכים יותר של קריטריון המידע מעידים על התאמת מודל יחסי טובה יותר, בעוד שערכי אנטרופיה הקרובים יותר ל-1 מעידים על הפרדה ברורה יותר בין המחלקות. מבחני ה-LMR-LRT וה-BLRT משווים מודל של k מחלקות למודל התואם של k − 1 מחלקות. פרופורציות המחלקות הן פרופורציות המוערכות על ידי המודל; מספר המשתתפים הסופי והאחוזים מבוססים על השמה לסבירות הפוסטריורית הגבוהה ביותר למחלקה. קיצורים: AIC = Akaike Information Criterion; BIC = Bayesian Information Criterion; aBIC = sample-size-adjusted Bayesian Information Criterion; LMR-LRT = Lo-Mendell-Rubin adjusted likelihood-ratio test; BLRT = bootstrap likelihood-ratio test.
| פריט | סיווג | עצמאות גבוהה-שיפור איטי (C1) (n = 66) | תלות בינונית-הידרדרות מהירה (C2) (n = 54) | תלות גבוהה-שיפור משמעותי (C3) (n = 90) | תלות גבוהה-החמרה איטית (C4) (n = 50) | סטטיסטיקה | P ערך |
| גיל (שנים) | − | 58.20 ± 7.80 | 61.50 ± 7.40 | 55.80 ± 7.60 | 63.10 ± 7.20 | 12.572 | <0.001 |
| מין | זכר | 43 | 35 | 58 | 31 | 0.142 | 0.986 |
| נקבה | 23 | 19 | 32 | 19 | |||
| BMI (קג/מ²) | — | 23.60 ± 2.70 | 23.40 ± 2.80 | 23.80 ± 2.90 | 23.50 ± 2.60 | 0.27 | 0.847 |
| מצב משפחתי | נשוי/נשואה | 46 | 24 | 64 | 25 | 14.749 | 0.002 |
| לא נשוא/נשואה / גרוש/גרושה / אלמן/אלמנה | 20 | 30 | 26 | 25 | |||
| סיווג תפקוד לבבי | סוג I–II | 41 | 22 | 60 | 20 | 15.283 | 0.002 |
| דרגה III–IV | 25 | 32 | 30 | 30 | |||
| סוג אוטם שריר הלב | העתקה של מקטע ST | 50 | 35 | 44 | 37 | 15.035 | 0.002 |
| ללא הרמת מקטע ST | 16 | 19 | 46 | 13 | |||
| התערבות כלילית בעורקים כליליים (PCI) | כן | 45 | 38 | 62 | 21 | 12.863 | 0.005 |
| לא | 21 | 16 | 28 | 29 | |||
| טיפול תרומבוליטי | כן | 52 | 49 | 66 | 29 | 15.622 | 0.001 |
| לא | 14 | 5 | 24 | 21 | |||
| מדד HAMD | − | 10.80 ± 2.70 | 13.10 ± 2.90 | 11.20 ± 2.60 | 14.10 ± 3.00 | 19.04 | <0.001 |
| ציון SSRS | − | 43.00 ± 4.80 | 38.50 ± 5.00 | 42.00 ± 4.90 | 36.80 ± 5.10 | 20.742 | <0.001 |
| ציון GAD-7 | - | 9.50 ± 2.50 | 12.10 ± 2.80 | 10.00 ± 2.60 | 13.70 ± 3.00 | 30.585 | <0.001 |
| היסטוריה של מחלות רקע | כן | 20 | 32 | 28 | 34 | 27.903 | <0.001 |
| לא | 46 | 22 | 62 | 16 |
טבלה 2: ניתוח חד-משתני של מאפיינים על פני מחלקות של מסלול תלות בסיעוד. משתנים רציפים מוצגים כממוצע ± סטיית תקן והושוו באמצעות ניתוח שונות חד-כיווני (one-way analysis of variance). משתנים קטגוריאליים מוצגים כמספר משתתפים והושוו באמצעות מבחני חי-ריבוע של פירסון. כל ערכי ה- P הם השוואות כלליות דו-צדדיות בין ארבע מחלקות המסלול. קיצורים: BMI = מדד מסת הגוף; HAMD-17 = סולם דירוג הדיכאון של המילטון בן 17 פריטים; SSRS = סולם דירוג תמיכה חברתית; GAD-7 = סולם הפרעת חרדה מוכללת-7; PCI = התערבות כלילית בעורקים כליליים.
| משתנה | תיאור המטלה |
| גיל | הוזן כערך מקורי |
| מצב משפחתי | לא נשוי/גרוש/אלמן = 0; נשוי = 1 |
| סיווג תפקוד לבבי | סוג Ⅰ, Ⅱ = 0; סוג Ⅲ, Ⅳ = 1 |
| סוג השבץ (Infarction) | ללא הרמת מקטע ST = 0; הרמת מקטע ST = 1 |
| טיפול פולשני | לא = 0; כן = 1 |
| טיפול תרומבוליטי | לא = 0; כן = 1 |
| מדד HAMD | הוזן כערך מקורי |
| מדד SSRS | הוזן כערך מקורי |
| ציון GAD-7 | הוזן כערך מקורי |
| היסטוריה של מחלות רקע | לא = 0; כן = 1 |
טבלה 3: קידוד של משתנים מנבאים מועמדים עבור רגרסיה לוגיסטית מולטינומיאלית. גיל, HAMD-17, SSRS ו-GAD-7 הוזנו באמצעות ערכיהם הרציפים המקוריים. עבור משתנים דיכוטומיים, הקטגוריה שקודדה כ-0 שימשה כקטגוריית הייחוס: לא נשוי/גרוש/אלמן עבור מצב משפחתי; תפקוד לבבי Class I–II; NSTEMI; ללא PCI; ללא טיפול בתרופות thrombolytic; וללא היסטוריה של מחלות רקע. קיצורים: HAMD-17 = סולם דירוג הדיכאון של המילטון בעל 17 פריטים; SSRS = סולם דירוג תמיכה חברתית; GAD-7 = שאלון הפרעת חרדה מוכללת-7; NSTEMI = אוטם שריר הלב ללא עליית מקטע ST; PCI = התערבות כלילית בעורקים הכליליים.
| השוואת קבוצות | משתנה | β | SE | Wald χ² | P | OR מתוקנן (95% CI) |
| C2 לעומת C1 | גיל | 0.052 | 0.03 | 2.885 | 0.089 | 1.053 (0.992–1.118) |
| נשוי/ה | −1.422 | 0.475 | 8.951 | 0.003 | 0.241 (0.095–0.612) | |
| HAMD-17 | 0.281 | 0.085 | 10.893 | <0.001 | 1.324 (1.121–1.564) | |
| SSRS | −0.240 | 0.052 | 21.236 | <0.001 | 0.787 (0.711–0.871) | |
| GAD-7 | 0.317 | 0.086 | 13.607 | <0.001 | 1.374 (1.160–1.626) | |
| מחלות רקע | 1.134 | 0.48 | 5.567 | 0.018 | 3.107 (1.212–7.968) | |
| C3 לעומת C1 | גיל | −0.047 | 0.023 | 4.389 | 0.036 | 0.954 (0.912–0.997) |
| נשוי/ה | 0.085 | 0.367 | 0.054 | 0.817 | 1.088 (0.531–2.233) | |
| HAMD-17 | 0.053 | 0.064 | 0.682 | 0.409 | 1.054 (0.930–1.195) | |
| SSRS | −0.048 | 0.034 | 1.982 | 0.159 | 0.953 (0.891–1.019) | |
| GAD-7 | 0.078 | 0.066 | 1.375 | 0.241 | 1.081 (0.949–1.231) | |
| מחלות רקע | 0.019 | 0.374 | 0.003 | 0.959 | 1.020 (0.490–2.123) | |
| C4 לעומת C1 | גיל | 0.074 | 0.035 | 4.438 | 0.035 | 1.077 (1.005–1.154) |
| נשוי/ה | −1.394 | 0.544 | 6.574 | 0.01 | 0.248 (0.085–0.720) | |
| HAMD-17 | 0.383 | 0.097 | 15.733 | <0.001 | 1.466 (1.214–1.772) | |
| SSRS | −0.318 | 0.06 | 27.91 | <0.001 | 0.727 (0.646–0.819) | |
| GAD-7 | 0.473 | 0.101 | 22.111 | <0.001 | 1.605 (1.318–1.955) | |
| מחלות רקע | 1.494 | 0.552 | 7.332 | 0.007 | 4.454 (1.511–13.134) |
טבלה 4: ניתוח רגרסיה לוגיסטית רב-נומינלית של גורמים הקשורים לחברות במסלול תלות בסיעוד. C1, עצמאות גבוהה-שיפור איטי, הוגדר כקטגוריית התוצאה של קבוצת הייחוס. ORs מתוקננים ו-95% CIs מדווחים עבור C2 לעומת C1, C3 לעומת C1, ו-C4 לעומת C1. מודל ההשפעות הראשיות הסופי התקבל באמצעות בחירת יחס נראות לאחור (backward likelihood-ratio selection). המודל הסופי שיפר באופן מובהק את המודל הכולל רק את נקודת החיתוך (likelihood ratio χ2 = 190.966, df = 18, P < 0.001), עם Nagelkerke pseudo-R2 של 0.557 ודיוק סיווג כללי של 53.1%. קיצורים: OR = odds ratio; CI = confidence interval; HAMD-17 = 17-item Hamilton Depression Rating Scale; SSRS = Social Support Rating Scale; GAD-7 = Generalized Anxiety Disorder-7.
קובץ משלים 1: נתונים גולמיים התומכים בממצאי מחקר זה.אנא לחצו כאן כדי להוריד קובץ זה.
דיון
את השינויים האורכיים בתלות בסיעות סיעודיות יש לפרש באופן תיאורי. ברמת הקוהורט המלאה, ציון ה-CDS הממוצע היה 48.28 ± 10.25 ב-T1, מה שמעיד על צורך משמעותי בטיפול סיעודי בשלב המוקדם לאחר AMI11. ציון ה-CDS עלה ל-54.16 ± 14.33 ב-T2 במהלך הטיפול האקוטי וההחלמה המוקדמת12, ירד במעט ל-52.82 ± 12.17 בעת השחרור, ועלה שוב ל-56.58 ± 15.15 חודש אחד לאחר השחרור. מחקרים קודמים הדגישו את האתגרים הקשורים להשתתפות בשיקום לבבי לאחר AMI13; עם זאת, המחקר הנוכחי לא בחן באופן ישיר האם השתתפות בשיקום או גורמים ספציפיים אחרים הסבירו את השינויים הזמניים שנצפו. ניתוח מחלקות חבויות (Latent-class analysis) הדגים עוד כי דפוס הממוצע הכללי הסתיר ארבעה מסלולים שונים באופן מהותי. הטרוגניות זו תואמת באופן רחב למחקרים קודמים על מסלולים קרדיווסקולריים, כולל מסלולי איכות חיים הקשורה לבריאות לאחר AMI14 ומסלולי טיפול עצמי במטופלים עם מחלת לב כלילית15. הבדלים במספר ובצורה של המחלקות בין מחקרים עשויים לשקף הבדלים במבנים הנמדדים, בלוחות הזמנים של ההערכה, באוכלוסיות המטופלים, במשך המעקב ובגישות למידול מחלקות חבויות.
מספר שלבי פרוטוקול הם קריטיים לצורך שחזור התוצאות. ראשית, יש להגדיר את T1 באופן עקבי. הערכת בסיס צריכה להתבצע לאחר טיפול חירום מוצלח והתאוששות של ההכרה, מכיוון שהערכה מוקדמת יותר עלולה לשקף חוסר יציבות קלינית חולפת במקום מצב תפקודי מהימן. שנית, יש להנחית את ה-CDS באופן סטנדרטי בכל ארבע נקודות הזמן, שכן שינויים בהוראות או בהליכי הסיוע עלולים להוביל להבדלים לרוחביים מלאכותיים. שלישית, יש להבחין בבירור בין הערכות פסיכו-סוציאליות של הבסיס לבין הערכות CDS חוזרות. את השאלונים HAMD-17, GAD-7 ו-SSRS הגישו פעם אחת ב-T1, בעוד שה-CDS הוגש באופן חוזר ב-T1–T4. לבסוף, יש להתאים את ה-GMM עם מספיק התחלות אקראיות ולהעריכו על ידי שכפול של הלוג-סבירות (log-likelihood) האופטימלית, הערכות פרמטרים קבילות, הסתברויות אחוריות וגדלי מחלקות בעלי משמעות קלינית, במקום לבחור אותו אך ורק על בסיס ערכי AIC או BIC פוחתים.
בחירה בפתרון בעל ארבע מחלקות ממחישה שיקול חשוב במידול תערובות. הוספת מחלקה חמישית הפחיתה באופן מתון את קריטריוני המידע והגבירה את האנטרופיה; עם זאת, הפתרון בעל חמש המחלקות לא הדגימה שיפור מובהק סטטיסטית על פי LMR-LRT (P = 0.128) או BLRT (P = 0.063), והוסיף תת-קבוצה קטנה הכוללת רק 6.4% מהמדגם עם בידול קליני נוסף מוגבל. ביישומים דומים, לכן, אין לפרש כל מחלקה נוספת באופן אוטומטי כתת-קבוצה ביולוגית או קלינית משמעותית. יש לשקול מחדש פתרון פשוט יותר כאשר מודל מייצר מחלקה קטנה מאוד, מראה התכנסות לא יציבה, מניב log-likelihood אופטימלי שאינו ניתן לשחזור, מייצר מסלולים לא סבירים, או מראה שינויים משמעותיים בהרכב המחלקות בתגובה לשינויים מינוריים בערכי ההתחלה. לעומת זאת, מודל פשוט יותר מבחינה סטטיסטית עשוי להיות לא מתאים אם הוא ממזג דפוסים אורכיים מובחנים קלינית ומופרדים היטב.
את ניתוח הגורמים הקשורים יש לפרש כחקרני ולא כניבוי או כקשר סיבתי. גיל הראה קשרים ספציפיים למחלקה עם השיוך למסלול. מחקרים פרוספקטיביים קודמים בחולים עם AMI זיהו גיל מבוגר כמתאם חשוב לירידה עתידית במצב הבריאותי ובפעולות היומיום16,17. מצב משפחתי היה קשור גם הוא להשיוך למסלול, וסקירה שיטתית ומטא-אנליזה דיווחו על קשרים בין מצב נישואין או זוגיות לבין תוצאות המדווחות על ידי המטופל לאחר אוטם שריר הלב18. תמיכה חברתית נתפסת נמוכה נקשרה למצב בריאותי גרוע יותר ולתסמיני דיכאון לאחר AMI19, בעוד שמצוקה פסיכולוגית לאחר אוטם שריר הלב היא רלוונטית קלינית אף היא20. ראיות פרוספקטיביות קשרו עוד יותר תמיכה חברתית נתפסת נמוכה לתוצאות בריאותיות פיזיות ומנטליות גרועות יותר לאחר AMI21. היסטוריה של מחלות רקע הייתה קשורה למספר השוואות מסלולים במחקר הנוכחי, וראיות קודמות קשרו תחלואה מרובה (multimorbidity) לפגיעה תפקודית בחולים עם היסטוריה של AMI22. עם זאת, הניתוח הנוכחי לא העריך את המנגנונים הפיזיולוגיים, ההתנהגותיים או הפסיכו-סוציאליים העומדים בבסיס קשרים אלו. לפיכך, אין לפרש את הממצאים כראיה לכך ששינוי של גורמים אלו ישנה בהכרח את השיוך למחלקת המסלול.
לשיטה זו מספר מגבלות. המחקר נערך במרכז אחד תוך שימוש בדגימה נוחות, דבר שעלול היה להביא להטיית בחירה ולהגביל את התוקף החיצוני. רק חולים שחוו אוטם שריר לב ראשון נכללו במחקר; לפיכך, מבנה המסלול שזוהה עשוי שלא להיות תקף עבור חולים עם אירועים חוזרים. המעקב הסתיים חודש אחד לאחר השחרור, דבר שמנע הערכה של השאלה האם ארבע מחלקות המסלול נותרות יציבות לאורך תקופות ארוכות יותר. משתנים קרדיווסקולריים חשובים, הכוללים את מקדם הפליטה של החדר השמאלי, סיווג Killip, מאפייני כלי הדם האחראי לאוטם, הצלחת הפרוצדורה, סיבוכים תוך-בית חולים, טיפול תרופתי מפורט, B-type natriuretic peptide, סבילות למאמץ והשתתפות בשיקום לבבי מובנה, לא שולבו באופן שיטתי. לפיכך, לא ניתן לשלול השפעה של משתנים מתערבים שנותרו בנוגע לחומרת המחלה, עוצמת הטיפול ומצב השיקום.
מגבלה נוספת נוגעת לדיוק של חלק מהערכות הרגרסיה הספציפיות למחלקה. לא בוצע חישוב גודל מדגם רשמי המבוסס על סימולציה a priori. למרות שמודל ה-GMM בעל ארבע המחלקות הדגים התכנסות יציבה ואיכות סיווג מספקת, חלק מקבוצות המסלול היו קטנות יחסית. לכן, יש לפרש בזהירות רווחי סמך רחבים עבור הערכות נבחרות, ובמיוחד אלו הנוגעות להיסטוריה של מחלות רקע. דרושים קוהורט פרוספקטיביים רב-מרכזיים גדולים יותר עם תקופות מעקב ארוכות יותר, טיפוס פנוטיפי קרדיווסקולרי מקיף יותר ושחזור עצמאי כדי לאשר את מבנה המחלקות שזוהה ואת הגורמים הקשורים אליו. למרות מגבלות אלו, המסגרת המשולבת של repeated-CDS ו-GMM מספקת גישה מעשית לזיהוי דפוסי התאוששות מוקדמים הטרוגניים ועשויה להקל על הערכה סיעודית ומעקב אינדיבידואליים יותר באוכלוסיות עם AMI.
גילויים
המחברים מצהירים כי אין ניגודי אינטרסים. לא נעשה שימוש בכלי בינה מלאכותית (AI) בהכנה, בכתיבה, בעריכה או ביצירת האיורים עבור כתב יד זה.
תרומת המחברים:
כל המחברים תרמו לתכנון ועיצוב המחקר, לאיסוף הנתונים ולפרשנום, ולהכנת כתב היד ולעריכתו. כל המחברים סקרו ואישרו את הגרסה הסופית של כתב היד ומסכימים להיות אחראים לכל היבטי העבודה
תודות
המחברים מודים למטופלים שהשתתפו במחקר ולצוות הקליני שסייע בהפצת השאלונים, באיסוף הנתונים ובמעקב. מחקר זה לא קיבל מענק ספציפי מכל סוכנות מימון במגזר הציבורי, המסחרי או ללא מטרות רווח.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| מדד תלות בטיפול (Care Dependency Scale - CDS) | Dijkstra A, Buist G, Dassen T | לא רלוונטי | סולם הערכת תלות בטיפול סיעודי מקורי בן 15 פריטים; ציונים גבוהים יותר מעידים על עצמאות רבה יותר. |
| סולם תלות בטיפול, גרסה סינית | .Zhang SQ, Zhu YM, Li L, et al | לא רלוונטי | הגרסה הסינית/מקור התיקוף שצוטטו בכתב היד ושימשו לתמיכה ביישום ה-CDS במחקר זה. |
| שאלון מידע כללי | צוות המחקר, בית החולים הציבורי של מחוז לינקוואן (Linquan County People's Hospital)’בית החולים | פותח במסגרת המחקר; ללא מספר קטלוגי | טופס ספציפי למחקר המשמש לאיסוף נתונים על גיל, מין, BMI, מצב משפחתי, סיווג תפקוד לבבי, סוג אוטם השריר (MI), אסטרטגיית reperfusion והיסטוריה של מחלות רקע. |
| שאלון הערכת הפרעת חרדה מוכללת-7 (GAD-7) | Spitzer RL, Kroenke K, Williams JBW, Löאנחנו B | לא רלוונטי | סולם חרדה גלוי בן 7 פריטים, שהועבר פעם אחת בנקודת הבסס (T1). |
| סולם דירוג הדיכאון של המילטון, 17 פריטים (HAMD-17) | Hamilton M | לא רלוונטי | סולם דיכאון רשמי המוערך על ידי קלינאי; נעשה שימוש בשיטת הניקוד של 17 הפריטים בנקודת הבסיס (T1). |
| IBM SPSS Statistics | IBM Corp. | גרסה 26.0 | תוכנה סטטיסטית המשמשת לסטטיסטיקה תיאורית, ניתוח שונות חד-כיווני (one-way ANOVA), מבחני קאי-ריבוע ורגרסיה לוגיסטית רב-נומינלית. |
| תיעוד IBM SPSS Statistics 26 | IBM Corp. | תיעוד גרסה 26 | משאב תיעוד רשמי עבור IBM SPSS Statistics 26. |
| Mplus | מות׳éנּ & מוט' (Muth)éנ | גרסה 8.3 | תוכנה סטטיסטית המשמשת להתאמה של מודלי תערובת צמיחה (growth mixture models) בעלי מחלקה אחת עד חמש מחלקות; גרסה 8.3 שוחררה ב-30 באפריל 2019. |
| מדריך המשתמש של Mplus | מות'éנא לספק את הטקסט באנגלית שברצונך לתרגם. & מותוéנ | מהדורה שמינית / גרסה 8 | תיעוד המשתמש הרשמי של Mplus גרסה 8, המשמש כמשאב תוכנה מתודולוגי. |
| סולם דירוג תמיכה חברתית (SSRS) | Xiao SY | לא רלוונטי | סולם תמיכה חברתית סיני גבש, המורכב מ-10 פריטים, שהועבר פעם אחת בנקודת הבסיס (T1). |
| רשימת הבדיקה של STROBE למחקרי עוקבה (Cohort Study) | יוזמת STROBE | רשימת ביקורת למחקר עוקבה | רשימת בדיקה לדיווח המשמשת לבחינת השלמות של דוח מחקר תצפיתי אורך. |
| הצהרת STROBE | יוזמת STROBE | הנחיה משנת 2007 | הנחיית דיווח למחקרי תצפית; משמשת כמשאב דיווח לתכנון המחקר, משתתפים, הטיות, שיטות סטטיסטיות, תוצאות ומגבלות. |
מקורות
- Cai D, et al. Sex differences in outcomes in patients with acute myocardial infarction. BMC Cardiovasc Disord. 2025;25(1):272.
- Liu M, et al. A patient with acute myocardial infarction with electrocardiogram Aslanger's pattern. BMC Cardiovasc Disord. 2024;24(1):3.
- Yu F, Yuan X, Fu S. Optimizing emergency nursing protocols to enhance outcomes in patients with acute myocardial infarction: a retrospective study. Medicine (Baltimore). 2025;104(23):e41412.
- Guo J, Chen Y, Dai Y, Chen Q, Wang X. Influencing factors of care dependence in patients with coronary heart disease after percutaneous coronary intervention: a cross-sectional study. Nurs Open. 2023;10(1):241-251.
- Zhang SQ, Zhu YS, Li L, Ye WQ. Reliability and validity analysis of the Chinese version of the Care Dependency Scale for elderly patients. J Nurs Sci. 2014;29(3):7-9. [in Chinese].
- Li CQ, Zhong GK. Application of several commonly used mental health rating scales in psychiatry. Chin J Clin Rehabil. 2005;(12):34. [in Chinese].
- Spitzer RL, Kroenke K, Williams JBW, Löwe B. A brief measure for assessing generalized anxiety disorder: the GAD-7. Arch Intern Med. 2006;166(10):1092-1097.
- Xiao SY. The theoretical basis and research application of the Social Support Rating Scale. J Clin Psychiatry. 1994;4(2):98-100. [in Chinese].
- Muthén LK, Muthén BO. How to use a Monte Carlo study to decide on sample size and determine power. Struct Equ Modeling. 2002;9(4):599-620.
- Pate A, et al. Minimum sample size for developing a multivariable prediction model using multinomial logistic regression. Stat Methods Med Res. 2023;32(3):555-571.
- Shen Y, et al. Observation on the application effect of stressor perception and response meticulous nursing in the perioperative period of acute myocardial infarction. Altern Ther Health Med. 2024;30(1):63-67.
- Nakamura K, Ohbe H, Uda K, Fushimi K, Yasunaga H. Early rehabilitation after acute myocardial infarction: a nationwide inpatient database study. J Cardiol. 2021;78(5):456-462.
- Wang L, Liu J, Fang H, Wang X. Factors associated with participation in cardiac rehabilitation in patients with acute myocardial infarction: a systematic review and meta-analysis. Clin Cardiol. 2023;46(11):1450-1457.
- Munyombwe T, et al. Quality of life trajectories in survivors of acute myocardial infarction: a national longitudinal study. Heart. 2020;106(1):33-39.
- Ingadóttir B, Svavarsdóttir MH, Jurgens CY, Lee CS. Self-care trajectories of patients with coronary heart disease: a longitudinal, observational study. Eur J Cardiovasc Nurs. 2024;23(7):780-788.
- Hajduk AM, Dodson JA, Murphy TE, Chaudhry SI. A risk model for decline in health status after acute myocardial infarction among older adults. J Am Geriatr Soc. 2023;71(4):1228-1235.
- Hajduk AM, et al. Risk model for decline in activities of daily living among older adults hospitalized with acute myocardial infarction: the SILVER-AMI study. J Am Heart Assoc. 2020;9(19):e015555.
- Zhu C, Tran PM, Leifheit EC. Association of marital/partner status and patient-reported outcomes following myocardial infarction: a systematic review and meta-analysis. Eur Heart J Open. 2023;3(2):oead018.
- Leifheit-Limson EC, et al. The role of social support in health status and depressive symptoms after acute myocardial infarction: evidence for a stronger relationship among women. Circ Cardiovasc Qual Outcomes. 2010;3(2):143-150.
- Levine GN, et al. Post-myocardial infarction psychological distress: a scientific statement from the American Heart Association. Circulation. 2025;152(16):e298-e310.
- Bucholz EM, et al. Effect of low perceived social support on health outcomes in young patients with acute myocardial infarction: results from the VIRGO (Variation in Recovery: Role of Gender on Outcomes of Young AMI Patients) study. J Am Heart Assoc. 2014;3(5):e001252.
- Bagai A, et al. Multimorbidity, functional impairment, and mortality in older patients stable after prior acute myocardial infarction: insights from the TIGRIS registry. Clin Cardiol. 2022;45(12):1277-1286.