עבודת מחקר זו הציגה גישה, FusionNetX, המעשירה את יכולת מיזוג המאפיינים של DenseNet121 ו-EfficientNetB7 לצורך סיווג גידולי מוח בחמישה מאגרי נתונים הזמינים לציבור, תוך שימוש בהגדלת נתונים (data augmentation), עיבוד מקדים והתאמה של מודל היברידי (מיזוג ביניים), והשיגה תוצאות הנעות בין 98.77% ל-99.89%, תוך ביצועים עדיפים במספר פרמטרים של הערכה.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר שיטה
FusionNetX: מודל מיזוג מאפיינים עמוק הממנף MRI ולמידה עמוקה לזיהוי משופר של גידולי מוח
במאמר זה
סיכום
תקציר
גידולי מוח נחשבים לאחת המחלות הקטלניות ביותר בעולם, ואבחון שגוי שלהם מעמיד את חיי המטופלים בסכנה ומוריד את שיעור ההישרדות. דימות תהודה מגנטית (MRI) בשילוב טכניקות מבוססות למידה עמוקה, ובמיוחד רשתות נוירונים קונבולוציוניות, הוא חיוני להתגברות על מכשול זה, שכן הוא מאפשר בחינה מפורטת יותר של המבנה הפנימי של המוח ומציע יכולות למידה וניבוי יוצאות דופן. הצורך באבחון מדויק של גידול במוח הוא עדיין משמעותי. לכן, מוצע מודל DL משופר המבוסס על מיזוג תכונות (FusionNetX), המנצל את נקודות החוזק של שני מודלים מאומנים מראש, DenseNet121 ו-EfficientNetB7, תוך שימוש בפרמטרים של כוונון עדין (fine-tuning) מותאמים אישית, כולל שכבות הניתנות לאימון ושכבות שאינן ניתנות לאימון. מודל ה-FusionNetX המוצע יושם על חמישה מאגרי נתונים זמינים לציבור של גידולי מוח: Br35H, Figshare, Sartaj, Masoud ו-Balanced Brain Tumor. בוצעו מספר שלבי עיבוד מקדמי לשיפור איכות התמונות ולטיפול בבעיית התסמיכה (overfitting) באמצעות שינוי גודל והגדלת נתונים (data augmentation). באמצעות מגוון מדדי הערכת ביצועים, כגון accuracy, loss, positive predicted value, negative predictive value, true positive rate, true negative rate, F1-score, false negative rate ו-false positive rate, נמצא כי למודל FusionNetX המוצע רמת דיוק של 99.33% עבור Br35H, 99.13% עבור Figshare, 99.89% עבור Masoud, 99.19% עבור BBT-Dataset ו-98.77% עבור Sartaj. בנוסף, חמשת מאגרי הנתונים של גידולי המוח הוערכו באמצעות late fusion ו-attention-based fusion כדי להדגים את חשיבותו של מודל ה-FusionNetX המוצע, והתוצאות היו טובות משמעותית, עם שיפורים של 0.3% עד 1.9% בכל מאגרי הנתונים. יתרה מכך, חושבה עקומת מאפייני תגובת המקלט (receiver operating characteristic curve), ותוצאות ממדדי הערכת ביצועים שונים מעידות כי מודל FusionNetX המוצע יכול לזהות ולנבוא גידולי מוח במדויק ולסייע לאנשי מקצוע בתחום הבריאות לקבל החלטות בזמן.
מבוא
סרטן הוא המחלה הקטלנית ביותר בגוף האדם כיום בשל חומרתה וקצב התפשטותה, בעוד שסוגים מרובים של מחלות סרטניות, כגון גידולי מוח, סרטן השד, קשריות ריאה, סרטן הכליות ואחרים, נמצאים בגוף האם וגורמים לעלייה בשיעורי התמותה. סרטן מתפתח כאשר תאים או רקמות בגופו של אדם מתרבים באופן חריג. כאשר הסרטן עובר גרורות, הוא עלול לפגוע באיברים אחרים בגוף ולהפוך למסוכן יותר1. מכיוון שהמוח שולט בכל תפקודי הגוף, כל נזק לו עלול להוביל להשלכות מרחיקות לכת על הגוף כולו. זו הסיבה שגידולי מוח או סרטן המוח הם קטלניים כל כך לבני אדם2. בנוסף, גידולי מוח שפירים וממאירים הם שתי הקטגוריות העיקריות אליהן הם נחלקים. "שפיר" פירושו בעיקר שאינו סרטני; זוהי פשוט בעיה במוח שניתן לפתור על ידי שינוי הסביבה. אך במקרה של ממאירות, הדבר נחשב למסוכן בשל טבעו הגרורי, שכן תאים או רקמות חריגות נעים אל חלקי גוף אחרים או מהם, ובכך מפריעים גם לאיברים אחרים ומגבירים את סיכויי הסרטן בגוף3.
בנוסף, על פי איגוד גידולי המוח האמריקאי וארגון הבריאות העולמי (WHO), גידולי היפופיזה, מנינגיומות וגליומות הן שלוש הקטגוריות העיקריות של סרטני המוח4. גליומות מקורן בתאים גליאליים, המזינים את הנוירונים במוח. גידולי היפופיזה מתחילים בבלוטת ההיפופיזה, הממוקמת בבסיס המוח ואחראית על תפקודי גוף שונים; מנינגיומות, לעומתן, מתחילות בקרומי המוח (meninges), המגנים על הקרומים העוטפים את המוח ואת חוט השדרה. יתרה מכך, שיטות דימות רפואיות מרובות משמשות בדרך כלל לבחינת חלקים פנימיים של הגוף למטרות אבחנתיות, כולל צילומי רנטגן, בדיקות טומוגרפיה ממוחשבת (CT) ודימות תהודה מגנטית (MRI)5,6. לכל שיטת דימות יש יתרונות וחסרונות משלה. MRI היא שיטת דימות המספקת תמונות מפורטות של רקמות רכות ותאים בגוף, ובמיוחד במוח. סרטן כולל רקמות או תאים לא תקינים בגוף, ו-MRI מספקת תמונות מפורטות של חריגות אלו, מה שהופך אותה לשיטת דימות שימושית יותר לאבחון גידולי מוח או סרטן. בנוסף, MRI בטוחה יותר משיטות דימות אחרות כיוון שאינה מייצרת קרינה מזיקה במהלך בדיקות של האנטומיה הפנימית של הגוף.
בנוסף, נעשה שימוש במתודולוגיות חישוביות רבות כדי להתמודד עם האתגרים האבחנתיים הקשורים לגידולי מוח, כולל למידת מכונה (ML), עיבוד תמונה (IP) ולמידה עמוקה (DL), כאשר כל גישה מיושמת על תמונות שהופקו באמצעות שיטות דימות כדי לאבחן את הסרטן7. גישות אלו לומדות את התבניות והמבנים החבויים של עצמים שונים בתמונות כדי לאבחן סרטן באמצעות זיהוי תבניות באזור הפגוע. לכל גישה חישובית יש יתרונות וחסרונות משלה בתהליך האבחון. גישות המבוססות על ML ו-IP מחלצות מאפיינים שתוכננו ידנית (handcrafted features), מה שמוביל לרוב לתחזיות לא מדויקות ולאבחנה שגויה של התהליך, במיוחד במאגרי נתונים גדולים יותר8. כדי להתגבר על בעיות בחילוץ מאפיינים ידני, קיימת מגמה לעבר מודלים המבוססים על למידה עמוקה, המכונים בדרך כלל מודלים מבוססי רשת עצבית קונבולוציונית (CNN), הלומדים ומחלצים באופן אוטומטי את המאפיינים הטובים ביותר מהתמונות כדי לאבחן גידולים באופן מדויק. גישות מבוססות DL נפוצות כיום בדימות רפואי לאבחון מחלות בגוף האדם, במיוחד לזיהוי מוקדם ומדויק של גידולי מוח, סרטן השד, סרטן הריאות ומחלות אחרות, בשל יכולתן ללמוד ולחלץ תבניות מורכבות בנתונים רחבי היקף תוך הפקת תוצאות מדויקות יותר9. הבעיה העיקרית שבה נתקל מודל DL היא צריכת משאבים רבה ודגימת נתונים, בעיה שניתן לפתור באמצעות גישה אחרת המבוססת על למידה עמוקה הנקראת למידה בהעברה10 (TL), שבה נעשה שימוש במודלים מאומנים מראש (pretrained models) כדי לאבחן את המחלה, ובכך נחסכים זמן ומשאבים. אבחון מוקדם ומדויק של בעיות בריאותיות מתאפשר הודות למודלים מאומנים מראש, שכבר למדו מאגר נתונים גדול מאפיינים בסיסיים הקשורים למרקם, צבע, קצוות ועוד. מודלים אלו יכולים להיות מועברים למסד נתונים חדש שלא נחשף אליו בעבר, תוך מינוף המודל והוספת היפר-פרמטרים ושכבות הניתנות לאימון ושכבות שאינן ניתנות לאימון11. מחקר רב נערך על סיווג של גידולי מוח, וטבלה 112,13,14,15,16,17,18,19,20,21,22,23 מציגה את פרטי מחקרים אלו, כולל הגישות, מאגרי הנתונים והתוצאות. עם זאת, שום עבודת מחקר לא השתמשה במתודולוגיה המשלבת שני מודלים של למידה בהעברה לחילוץ מאפיינים חסון ומכוונת טכניקות רגולריזציה כדי להבטיח אימון ובדיקה חלקים. הערכה מקיפה של המתודולוגיה המוצעת מספקת תובנות לגבי ביצועי המודל על פני מאפיינים שונים של גידולי מוח.
| סימוכין | גישה | דגימות נתונים | תוצאות | מגבלות |
| 12 | CNN מותאם אישית | Br35H | Accuracy = 97.45%, | עדיין יש צורך בשיפורים בתוצאות; במקום להשתמש ב-CNN בהכנה עצמית, עדיף להשתמש במודל CNN קיים עם התאמות. |
| Loss = 0.1141%, | ||||
| Recall = 98.09%, | ||||
| F1-Score = 97.69%, | ||||
| Precision = 97.29%, | ||||
| Br35H מוגבר | Accuracy = 98.99%, | |||
| Precision = 98.90%, | ||||
| Loss = 0.0570%, | ||||
| Recall = 98.91%, | ||||
| F1-Score = 99.04% | ||||
| 13 | מודל DNN של מיזוג מאפיינים | Br35H | Accuracy = 98.22%, | עדיין יש צורך בשיפורים בתוצאות, ובמקום להשתמש במודל מותאם אישית, עדיין קיים צורך להשתמש במודל קיים עבור מיזוג מאפיינים. |
| FNR = 1.77%, | ||||
| Sensitivity = 98.2%, | ||||
| F1-Score = 98%, | ||||
| Specificity = 98%, | ||||
| Figshare | Accuracy = 98.01%, | |||
| Sensitivity = 96.03%, | ||||
| F1-Score = 96%, | ||||
| Specificity = 98.67%, | ||||
| FNR = 3.96% | ||||
| 14 | AlexNet עם SGD | Br35H | Accuracy = 98.79%, | עדיין יש צורך בכמה שיפורים בתוצאות, וכן עלינו לבחון מודלים מתקדמים יותר מבוססי CNN על דגימות נתונים שונות. |
| MCR = 1.20%, | ||||
| Sensitivity = 98.98%, | ||||
| Specificity = 98.58%, | ||||
| F1-Score = 98.82% | ||||
| 15 | InceptionV3 | Figshare | Accuracy = 98.89%, | המחברים השתמשו במאגר הנתונים Figshare, הכולל שלושה סוגי גידולים; במקום לסווג אותם, הם מסווגים האם קיים גידול או לא, ועדיין יש צורך בשיפורים בתוצאות וכן בסיווג של סוגי הגידולים. |
| SensitivityB = 95.28%, | ||||
| SensitivityM = 94.47% | ||||
| 16 | ResNet50 אופטימלי | Figshare | Accuracy = 99.03%, | יש צורך בחישוב פרמטרים נוספים להערכת ביצועים לצד שיפורים נוספים בתוצאות. |
| Recall = 99%, | ||||
| F1-Score = 99% | ||||
| 17 | Res-BRNet | Br35H | Accuracy = 98.22%, | עדיין קיים צורך בשיפורים בתוצאות. |
| Sensitivity = 98.11%, | ||||
| Precision = 98.22%, | ||||
| Figshare | F1-Score = 98.41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Accuracy = 99.18%, | ישנו שיפור קל בתוצאות ויש צורך לבחון מאגרי נתונים נוספים הקשורים לגידולי מוח. |
| Recall = 99.11%, | ||||
| F1-Score = 99.08, | ||||
| Precision = 99.07%, | ||||
| Sartaj | Accuracy = 97.24%, | |||
| Recall = 97.58%, | ||||
| F1-Score = 97.28%, | ||||
| Precision = 97.06%, | ||||
| 19 | CNN-SVM | Brats | Accuracy = 98.02%, | יש צורך להחיל מודלים קיימים עם SVM, ועדיין יש צורך בשיפורים בתוצאות. |
| F1-Score = 98.31%, | ||||
| Precision = 98.09%, | ||||
| Sensitivity = 98.53%, | ||||
| Specificity = 97.30%, | ||||
| Sartaj | Accuracy = 96.83%, | |||
| Precision = 95.36%, | ||||
| Sensitivity = 94.73%, | ||||
| Specificity = 97.56%, | ||||
| F1-Score = 95% | ||||
| 20 | EfficientNetB3 שעבר Fine-tuning | Figshare | Accuracy = 98.70% | יש צורך בוריאציות של EfficientNetB3 שהוזכרו לעיל כדי לשפר את התוצאות. |
| Sartaj | Accuracy = 97.50% | |||
| 21 | InceptionV4 | Masoud | Accuracy = 98.7%, | נדרשים שיפורים בתוצאות באמצעות שימוש במאגרי נתונים נוספים. |
| Precision = 99%, | ||||
| Sensitivity = 98%, | ||||
| Specificity = 99%, | ||||
| F1-Score = 99.1% | ||||
| 22 | VGG16 | Masoud | Accuracy = 98% | קיים צורך בשיפורים בתוצאות על ידי בדיקת מודלים נוספים של רשתות נוירונים עמוקות. |
| 23 | MFR-CNN | Masoud | Accuracy = 94%, | זוהי ארכיטקטורה מורכבת המשמשת בפתרון המוצע. |
| Recall = 96%, | ||||
| F1-Score = 96%, | ||||
| Precision = 96%, |
טבלה 1: בחינה השוואתית של עבודות המחקר העדכניות ביותר. הטבלה מסכמת מחקרים קיימים, יחד עם הגישות שלהם, מדגמי הנתונים, התוצאות והמגבלות. אנא לחצו כאן להורדת טבלה זו.
טבלה 1 סוקרת גישות קיימות, תוך הדגשת מגבלותיהן בשיפור התוצאות והצורך בשימוש במודלי DL קיימים תוך הערכת ביצועיהם אל מול פרמטרים סטטיסטיים שונים, וכל זאת בתוך מסגרת יעילה המציגה ביצועים טובים יותר במאגרי נתונים שונים של גידולי מוח.
מטרות המחקר והגדרת הבעיה
פירוש ידני הוא תהליך גוזל זמן וסובל משונות בין בוחנים; לכן, סיווג מהיר ומדויק של סוגי גידולי מוח באמצעות MRI הוא חיוני לקבלת החלטות קליניות. רוב גישות ה-DL לסיווג אוטומטי של גידולי מוח כיום מבוססות על רשת שלד (backbone) אחת או על מיזוג פשוט ברמת ההחלטה, מה שאינו מנצל באופן מלא את ייצוגי המאפיינים המשלימים ממספר ארכיטקטורות מאומנות מראש, ולעתים קרובות הן מאומתות על מערך נתונים בודד בלבד, דבר המגביל את הביטחון ביכולת ההכללה שלהן.
פרויקט מחקר זה שואף לפתח ולספק שיטה מלאה ומדויקת לאבחון סרטני מוח במוחות בני אדם באמצעות מסגרת DL בעלת עמוד שדרה כפול (EfficientNetB7 ו-DenseNet121), המנצלת ייצוגי מאפיינים משלימים כדי לאפשר סיווג חסון של גידולי מוח מ-MRI. כמו כן, הפרויקט מעריך את החסינות של המסגרת על פני מספר מאגרי נתונים ציבוריים עצמאיים. גישה זו יכולה לסייע לרדיולוגים ולפרמדיקים לאבחן גידולי מוח במהירות ובאופן יעיל, ובכך להציל חיי חולים על ידי מתן אפשרות לזיהוי וסיווג.
כדי לפתור בעיית מחקר ספציפית ולהשיג את המטרות של פרויקט מחקר זה, להלן שאלות המחקר והתרומה למענתן: 1) האם מיזוג ברמת המאפיינים (ביניים) של שתי רשתות backbone מאומנות מראש טוב יותר משיטות מיזוג ברמת ההחלטה (מאוחר) ומשיטות מיזוג מבוססות קשב (attention) לצורך סיווג גידולי מוח? 2) האם המערכת המוצעת תספק ביצועי סיווג עקביים במספר רב של מאגרי נתוני MRI של גידולי מוח שנרכשו באופן עצמאי?
היקף מחקר זה מוגבל לסיווג ברמת התמונה (פרוסת MRI דו-ממדית), תוך שימוש בחמישה מאגרי נתונים זמינים לציבור של תמונות MRI של גידולי מוח (Br35H, Figshare, Sartaj, Masoud, ו-BBT-Dataset); ההערכה בוצעה באופן עצמאי עבור כל מאגר, ולא באופן חוצה-מאגרים; ובאמצעות הארכיטקטורה הספציפית, תהליך עיבוד המקדימים (preprocessing pipeline) והתצורה הניסויית המתוארים בסעיף המתודולוגיה. המחקר אינו כולל תיקוף ברמת המטופל או בדיקות במסגרת של פריסה קלינית.
התרומות העיקריות של עבודת מחקר זו הן כדלקמן: 1) התרומה המרכזית של עבודת מחקר זו היא שימוש במודלים כפולים שהוכשרו מראש (pretrained) לחילוץ מאפיינים טוב יותר, כולל DenseNet121 ו-EfficientNetb7 עם היפר-פרמטרים אופטימליים. 2) ארכיטקטורת מודל חדשנית עם טכניקת רגולריזציה מתקדמת המשולבת עם מאפיינים משורשרים ממודל כפול שהוכשר מראש לביצועים חסונים. 3) יישום אסטרטגיית הרחבת נתונים (data augmentation) יעילה להגדלת הגיוון של דגימות האימון לצורך למידת מאפיינים גנריים וספציפיים יותר, ובכך להתגבר על בעיות של התסהוות (overfitting). 4) ביצועי המודל המוצע הוערכו על חמישה מאגרי נתונים נפרדים וזמינים לציבור של גידולי מוח, תוך התמקדות במדדי הערכה סטטיסטיים שונים, כולל accuracy, misclassification rate, precision, negative predictive value, sensitivity, specificity, F1-Score, false negative rate, ו-false positive rate.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
גידול מוחי הוא אחת המחלות המאיימות ביותר בעולם. אבחנה מדויקת יכולה להשפיע לטובה על הישרדותם של המטופלים. עם זאת, קיים צורך במערכת אבחון מדויקת המסוגלת לזהות גידולי מוח בשלב מוקדם. כדי לטפל בבעיה זו, הוצעה טכניקה מהימנה יותר לזיהוי מדויק של גידולי מוח בשלבים מוקדמים, באמצעות מנגנון למידה עמוקה כפול והיברידי עם היפר-פרמטרים מותאמים ושכבות מכוונות המבוססות על המודלים DenseNet121 ו-EfficientNetB7. הגישה המוצעת מקבלת תמונות MRI דו-ממדיות (2D) כקלט ומפיקה תחזית של קיום גידול או אי-קיום גידול עבור מערך הנתונים לסיווג בינארי Br35H, וסיווג סוג הגידול עבור ארבעה מערכי נתונים אחרים לסיווג רב-מחלקי. לפיכך, סעיף זה מדגים את השלבים המרכזיים של הגישה המוצעת, מרגע איסוף הנתונים ועד הפלט הסופי, כולל רכישת נתונים, עיבוד מקדים של נתונים, פיצול נתונים, בחירת מודל, חילוץ מאפיינים, חיזוי גידול והערכה של המודל המוצע, כפי שמוצג ב-איור 1.
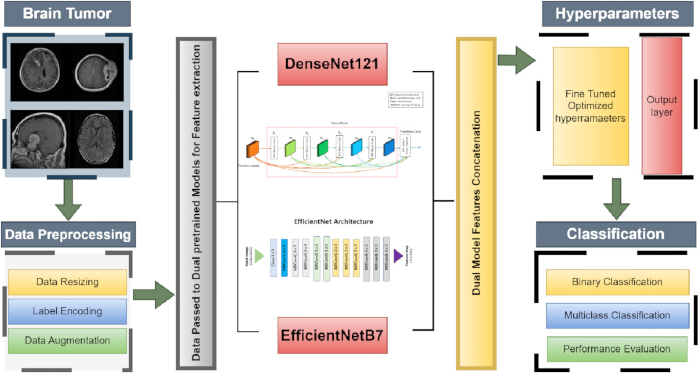
איור 1: זרימת העבודה של המתודולוגיה המוצעת. תרשים זה מציג את הארכיטקטורה הכוללת של המודל המוצע, הכוללת רכישת נתונים ועיבוד מקדימה; שני מודלים מאומנים מראש למיצוי מאפיינים; שרשור של המאפיינים שלהם; וכוונון היפר-פרמטרים לסיווג הגידול וסוגו. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
רכישת נתונים
בכל מחקר ניסויי, השלב הראשון הוא רכישת נתונים. לשם כך, נבחרו חמישה מאגרי נתונים שונים הזמינים לציבור, כולל Br35H24, Figshare25, Sartaj26, Masoud27, ומאגר נתונים המבוסס על תמונות MRI של גידולי מוח מהספרייה בקוד פתוח Kaggle28, אשר כבר שימשו חוקרים רבים לאבחון וזיהוי גידולי מוח. מאגר הנתונים Br35H מכיל 3,000 תמונות הכוללות שתי מחלקות: תמונות מוח בריא ותמונות מוח לא בריא (גידול), עם 1,500 תמונות בכל מחלקה, בעוד שמאגר הנתונים Figshare כולל 3,064 תמונות, המחולקות לשלוש קבוצות על סמך סוג הגידול: 1,426 תמונות של glioma, 708 תמונות של meningioma, ו-930 תמונות של גידולי היפופיזה. מאגר הנתונים Sartaj כולל 3,264 תמונות המסווגות לארבע מחלקות של גידולים: gliomas (926 תמונות), meningiomas (937 תמונות), גידולי היפופיזה (901 תמונות), ובריא או ללא גידול (500 תמונות). יתרה מכך, מאגר הנתונים Masoud כולל גם הוא ארבע מחלקות גידולים שונות, ותמונותיהן נלקחו משלושת מאגרי הנתונים שהוזכרו לעיל, עם סה"כ 7,023 תמונות, המסווגות להלן ל-glioma (עם 1,621 תמונות), meningioma (עם 1,645 תמונות), היפופיזה (עם 1,757 תמונות), ובריא או ללא גידול (עם 2,000 תמונות). מאגר הנתונים האחרון שנבחר הוא מאגר נתונים המבוסס על תמונות MRI, הכולל גם הוא ארבע מחלקות עם סה"כ 5,248 תמונות, המחולקות לסוגי גידולים, כולל 1,312 תמונות glioma, 1,312 תמונות meningioma, 1,312 תמונות היפופיזה, ו-1,312 תמונות בריאות או ללא גידול, אשר מחולקות באופן שווה לסוגי הגידולים ונחשבות למאגר נתונים מאוזן.
עיבוד מקדימה של נתונים
לאחר רכישת הנתונים, השלב הבא הוא עיבוד מקדמי (preprocessing), החיוני להשגת תוצאות טובות יותר ומועיל יותר עבור גישות חישוביות להפקה וללימוד של המאפיינים המיטביים מהנתונים, באופן המוביל לתוצאות מדויקות יותר. השלב הראשון שיושם היה שינוי גודל תמונות. נבחרו חמישה מאגרי נתונים הזמינים לציבור, הכוללים מחלקות וגדלי תמונות שונים, אפילו בתוך אותו מאגר נתונים עבור מחלקות גידולים שונות, והם שונו באופן אחיד לגודל של 224x224 לשיפור הפרשנות והלמידה של המודל. יתרה מכך, הוחל הגברה של נתונים (data augmentation) על כל מאגרי הנתונים על ידי יצירת דגימות נוספות מזוויות שונות, ובכך שופרו הפקת המאפיינים והלמידה על ידי מודלים של למידה עמוקה (DL). לשם כך, הוחל טווח סיבוב של 7% על כל התמונות, תוך סיבובן עד ל-7 מעלות. בנוסף, הוחלה הזזה אקראית של 5% על כל התמונות בצורה אופקית ואנכית, עם הזזה של 5% בגובה וברוחב ביחס לתמונות המקוריות. לאחר מכן, התמונות הוגדלו (zoom in) ב-10% ביחס לתמונות המקוריות, ולבסוף, כל התמונות הועתקו במראה (flipped) באופן אופקי ואנכי. הסיבה העיקרית לביצוע הגברת נתונים29 הוא להתגבר על התאמת-יתר (overfitting) ולשפר את יכולת ההכללה של המודלים על ידי אימון על גרסאות שונות ועבורו של מדגמי הנתונים המקוריים. לפני פיצול מערכי הנתונים לאימון ולאימות, הוחל קידוד תוויות (label encoding), המסייע יותר בחישוב ההפסד (loss) במהלך האימון והאימות, ובמקביל הופך את מדגמי הנתונים לחיוניים יותר עבור המודלים כדי לעבד את התוויות בצורה נכונה. בנוסף, מערך הנתונים חולק למערכי אימון ואימות, ביחס של 80% ל-20%.30 עבור כל אחד, ו- טבלה 2 מציג את ההתפלגות הכללית של דגימות הנתונים ואת יחסי האימון והתיקוף שלהן.
| סט נתונים | סוגי גידולים | סך הכל תמונות | תמונות אימון | תמונות תיקוף |
| Br35H | בריא | 1500 | 1200 | 300 |
| גידול | 1500 | 1200 | 300 | |
| סך התמונות | 3000 | 2400 | 600 | |
| Figshare | גליומה | 1426 | 1141 | 285 |
| מנינגיומה | 708 | 566 | 142 | |
| בלוטתיתהית | 930 | 744 | 186 | |
| סה"כ תמונות | 3064 | 2451 | 613 | |
| סרטאג׳ | גליומה | 926 | 741 | 185 |
| מנינגיומה | 937 | 749 | 188 | |
| ללא גידול | 500 | 400 | 100 | |
| בלוטת הפיתואיטרי (בלוטת היפופיזה) | 901 | 721 | 180 | |
| סך הכל תמונות | 3264 | 2611 | 653 | |
| מסעוד | גליומה | 1621 | 1297 | 324 |
| מנינגיומה | 1645 | 1316 | 329 | |
| ללא גידול | 2000 | 1600 | 400 | |
| בלוטת יותרת המוח | 1757 | 1405 | 352 | |
| סה"כ תמונות | 7023 | 5618 | 1405 | |
| מאגר נתונים מאוזן של גידולי מוח (BBT-Dataset) | גליומה | 1312 | 1050 | 262 |
| מנינגיומה | 1312 | 1050 | 262 | |
| ללא גידול | 1312 | 1050 | 262 | |
| בלוטת הפיתואיטרי (בלוטתיתהית) | 1312 | 1050 | 262 | |
| סה"כ תמונות | 5248 | 4200 | 1048 |
טבלה 2: התפלגות מערך הנתונים. הטבלה מציגה סטטיסטיקות לפי מחלקה של סך מספר התמונות, ומספר תמונות האימון והתיקוף במאגרי נתונים של גידולי מוח.
מערך הנתונים Br35H כולל 3000 תמונות, מתוכן נבחרו 2400 לאימון ו-600 לאימות. מערך הנתונים Figshare כולל 3064 תמונות; מכלל התמונות, 2451 נבחרו לאימון, וה-613 הנותרות לאימות. מערך הנתונים Sartaj כולל סך הכל 3264 תמונות, מתוכן 2611 שימשו לאימון וה-653 הנותרות לאימות. מערך הנתונים Masoud כולל סך הכל 7023 תמונות; מתוכן, 5618 שימשו לאימון, וה-1405 הנותרות לאימות. מערך הנתונים BBT כולל סך הכל 5248 תמונות. מתוך סך התמונות, 4200 נבחנו למטרות אימון, בעוד ששאר 1048 התמונות נבחנו למטרות אימות. בנוסף, איור 2 להלן ממחיש את תמונות גידולי המוח השונות.
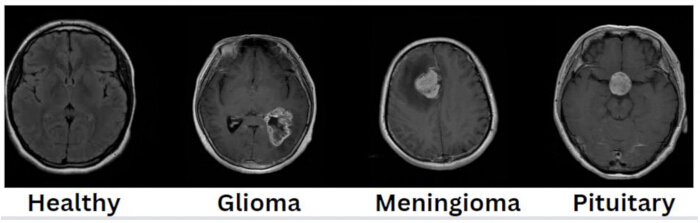
איור 2: תמונות של גידולי מוח, כולל סוגי הגידולים. מערך הנתונים כולל ארבע תמונות של רקמת מוח בריאה ושלוש תמונות של גידולים: גליומה, מנינגיומה וגידול בבלוטת יותרה. אנא לחץ כאן כדי להציג גרסה מוגדלת של איור זה.
המודל המוצע
בעקבות שלב עיבוד המקדמים, השלב הבא הוא להציע מודל אימון היעיל רק לסיווג גידולי מוח. לשם כך, הוצע מודל אימון יעיל, המיועד ספציפית לסיווג גידולי מוח. למטרה זו מוצע מודל מאומן-מראש (pretrained) חדש ויעיל המבוסס על מיזוג תכונות היברידי (hybrid feature fusion), הכולל את DenseNet12131,32 ו-EfficientNetB733, אשר שימשו לחילוץ התכונות מהתמונות; בהמשך, תכונות אלו שחולצו שורשרו והועברו להיפר-פרמטרים שונים שעברו כוונון עדין (fine-tuning), כולל שכבות הניתנות לאימון ושכבות שאינן ניתנות לאימון, כדי לאבחן גידולי מוח במדויק. המודל הוטמע על חמישה מאגרי נתונים שונים הזמינים לציבור, אשר נדונו בסעיפים קודמים רלוונטיים. יתרה מכך, מודל ה-DenseNet121 פותח על ידי Gao Huang ועמיתיו בשנת 2017 והוא כולל 121 שכבות. המטרה העיקרית של מודל זה הייתה להתמקד במקסום שימוש חוזר בתכונות ומניעת בעיית הגרדיאנט הנעלם (vanishing gradient problem)34. השכבות במודל זה מאורגנות בבלוקים צפופים (dense blocks), שכל אחד מהם מכיל מספר שכבות קונבולוציה (convolutional layers) המחלצות ולומדות תכונות. כל שכבה מקבלת כמבוא את מפת התכונות מכל השכבות הקודמות, והפלט שלה מחובר לפלטים של אותן שכבות ומועבר כמבוא לשכבות הבאות באותו בלוק באופן של הזנה קדימה (feed-forward). בנוסף, שכבות מעבר (transition layers) מתווספות בין הבלוקים הצפופים, כשכל אחת מהן מורכבת משכבת קונבולוציה של 1 × 1, שכבת BatchNormalization ושכבות average pooling של 2 × 2, המצמצמות את מפת התכונות כדי לשלוט במורכבות המודל. יתרה מכך, מתווספת שכבה סופית עם פונקציית אקטיבציה (AF) מסוג SoftMax לפני שכבת global average pooling לצורך הסיווג. התכנון הבסיסי של מודל ה-DenseNet121 מוצג ב-איור 334 להלן.
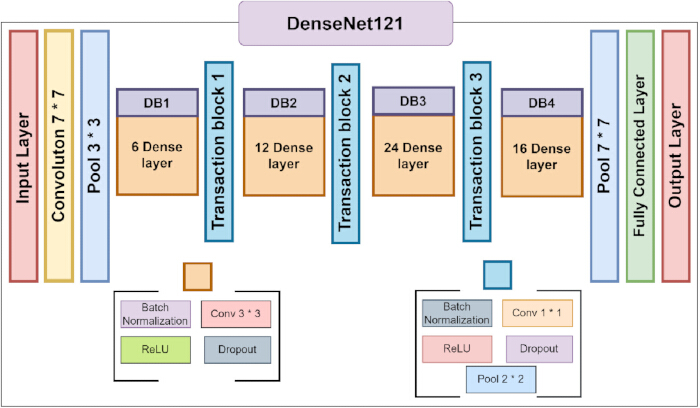
איור 3: פירוט ארכיטקטוני של DenseNet12134. איור זה מציג את הפירוט הארכיטקטוני של מודל ה-DenseNet121, כולל כל הבלוקים הדחוסים ובלוקי המעבר. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
בנוסף, מודל ה-EfficientNetB7 פותח על ידי Tan ו-Lee בשנת 2019. הוא שייך למשפחת ה-EfficientNet, עם וריאנטים מ-B0 עד B7, ומטרתו העיקרית היא להשיג ביצועים טובים יותר מאחרים תוך שימוש בפחות פרמטרים ובפחות כוח עיבוד. רוחב המודל (מספר הערוצים לשכבה), העומק (מספר השכבות) והרזולוציה ניתנים לכיוונון עדין באמצעות compound scaling, המהווה את תכונת הליבה של המודל. יתרה מכך, מודל זה מורכב מבלוקי MBConv (mobile inverted bottleneck convolutional), הכוללים שכבת הרחבה קונבולוציונית של 1 × 1 האחראית להרחבת הערוצים, depthwise separable convolution האחראית להחלת קונבולוציה על כל ערוץ בנפרד, ושכבת הקרנה קונבולוציונית של 1 × 1 המצמצמת את מספר הערוצים למספר המקורי. בנוסף, כל בלוק MBConv כולל בלוקי Squeeze and Excitation (SE)35, המבצעים כיול מחדש של מאפיינים ברמת הערוץ, ובכך מסייעים לרשת להתמקד במאפיינים החשובים ביותר. כמו כן, במקום sigmoid או כל AF אחר, נעשה שימוש בפונקציית Swish, המניבה ביצועים טובים יותר מ-ReLU על ידי מתן אפשרות לערכים שליליים, דבר המסייע בזרימת הגרדיאנט. מעבר לכך, נוספה שכבת פלט סופית עם AF מסוג SoftMax לפני שכבת global average pooling לצורכי סיווג. איור 435 מציג את התכנון הבסיסי של מודל ה-EfficientNetB7, בעוד שאיור 5 מציג את ארכיטקטורת המודל המומלצת.
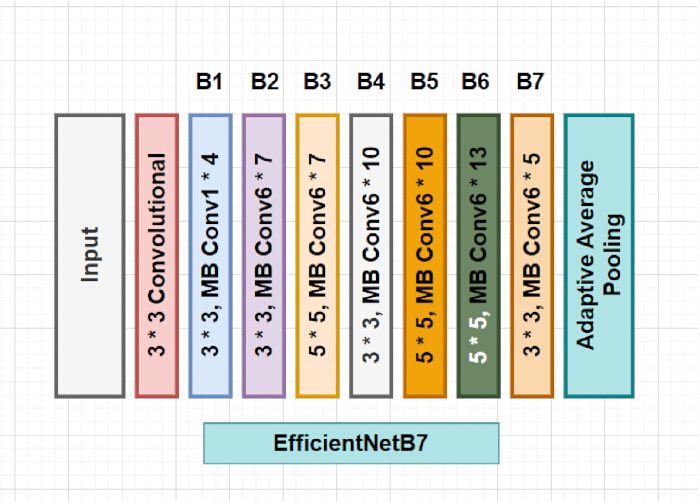
איור 4: פירוט ארכיטקטוני של EfficientNetB735. איור זה מציג את הפירוט הארכיטקטוני של מודל EfficientNetB7, כולל כל בלוקי הקונבולוציה מסוג mobile inverted bottleneck. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
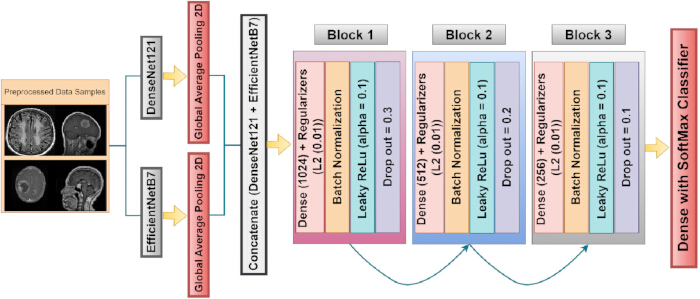
איור 5: ארכיטקטורת המודל המאוחה וההיברית המוצעת. הארכיטקטורה המוצעת ממחישה כיצד תמונות שעברו עיבוד מקדמי מועברות למחלץ התכונות, המורכב משלושה בלוקים מותאמים אישית עם היפר-פרמטרים שונים, ולאחריהם שכבת פלט. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
בנוסף, מאפיינים ראשוניים הופקו ממודלי DenseNet121 ו-EfficientNetB7 שסיימו אימון מוקדם (pretrained). המשקולות המעודכנות של המודלים שעברו אימון מוקדם נטענו אל המודלים המאומנים, והשכבות הבסיסיות שאינן ניתנות לאימון של המודלים הוקפאו כדי למנוע את אימון המודל מחדש. פעולה זו אמורה לסייע למודל לשמר את הידע המיטבי שרכש בעבר, להתאימו לאור דגימות נתונים חדשות כדי לשפר את ההתכנסות (convergence), ולהתמקד בשכבות נוספות לצורך אימון והפקה של מאפיינים מתקדמים. משוואות 1 ו-2 להלן מציגות את אופן הפעולה של מודלי DenseNet121 ו-EfficientNetB7.
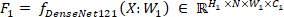 (1)
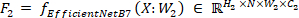 (2)
משוואות 1 ו-2 לעיל מראות את אופן הפעולה של המודל המאומן מראש בנוגע לחילוץ מאפיינים; F1 מציין את מפות המאפיינים של הפלט המופקות על ידי מודל DenseNet121 המאומן מראש, ו-F2 מציין את מפות המאפיינים של הפלט המופקות על ידי מודל EfficientNetB7 המאומן מראש באמצעות עיבוד תמונות הקלט, המיוצגות על ידי X. בנוסף, W1 ו-W2 הם הפרמטרים הלמידים או המשקולות הקשורים לבלוקים ולשכבות הראשונות של מודלי DenseNet121 ו-EfficientNetB7, בהתאמה. יתר על כן, ∈ RN ×H1×W1×C1 ו-∈ RN ×H2×W2×C2 מייצגים את ממדיה של מפות המאפיינים של הפלט של מודלי DenseNet121 ו-EfficientNetB7, בהתאמה, עם ממדים של H1 ×N×W1×C1 ו-H2 ×N×W2×C2, כאשר N מייצג את גודל האצווה (batch size) של התמונות, שנקבע כ-16. בנוסף, H1×W1 מייצג את הגובה והרוחב של התמונות עבור מודל DenseNet121, ו-H2×W2 מייצג את הגובה והרוחב של התמונות עבור מודל EfficientNetB7, אשר נבחרו בגדלי גובה ורוחב של 224 × 224. C1 ו-C2 מייצגים את ערוץ הצבע עבור מודלי DenseNet121 ו-EfficientNetB7, בהתאמה. לאחר קבלת מפות המאפיינים של הפלט מהמודל כ-2560 ערוצי פלט מ-EfficientNetB7 ו-1024 מ-DenseNet121, שכבת global average pooling 2D36 מיושמת על מפות המאפיינים של הפלט כדי להפחית את הממד המרחבי על ידי חישוב הממוצע של כל הממדים המרחביים לווקטור יחיד, דבר המקל על ההעברה לשכבה הבאה לצורך חילוץ מאפיינים וזיהוי תבניות טובים יותר במונחים של מאפיינים הניתנים לפירוש.
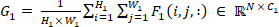 (3)
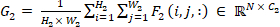 (4)
משוואות 3 ו-4 לעיל מראות את פעולת שכבת ה-global average pooling 2D המיושמת על מודלי DenseNet121 ו-EfficientNetB7, בהתאמה, כאשר  ו-
 מראות את תהליך הנורמליזציה של הסכום על ידי חלוקה במספר הכולל של המיקומים המרחביים עבור שני המודלים, כדי להבטיח שהפלט של ה-pooling יהיה ממוצע ולא סכום פשוט.
 ו-
 מייצגות את הסיכום על פני הממדים המרחביים של מפות המאפיינים (feature maps), בעוד ש-i ו-j משמשים למעבר על הגובה והרוחב, בהתאמה, לצורך סיכום מפות המאפיינים עבור שני המודלים. יתרה מכך, F1(i, j, :) ו-F2(i, j, :) מייצגים את ערכי מפות המאפיינים במיקומים מרחביים ספציפיים (i, j) על פני כל הערוצים עבור מודלי DenseNet121 ו-EfficientNetB7, בהתאמה. פעולת pooling זו מרכזת מידע מרחבי לייצוג דחוס ומדויק יותר, תוך שימור המאפיינים החשובים ביותר בכל תמונה. בנוסף, הפלטים של שכבות ה-global average pooling משורשרים (concatenated) כדי להפיק וקטור מאפיינים יחיד עבור כל דגימה; וקטור זה משמש לעיתים קרובות למיזוג מאפיינים ממודלים שונים כדי לשפר את הביצועים על ידי ניצול החוזקות של שני המודלים; משוואה 5 מראה כיצד הדבר מתבצע.
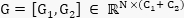 (5)
משוואה 5 לעיל מציגה את הליך השרשור של שני וקטורי מאפיינים של מודלים שונים [G1, G2], כאשר G1 מייצג את וקטור המאפיינים של מודל DenseNet121 ו-G2 מייצג את וקטור המאפיינים של מודל EfficientNetB7, בעוד שהצורה של וקטור המאפיינים המשורשר מיוצגת על ידי RN ×(C1+ C2), כאשר N הוא גודל האצווה (batch size), המייצג את מספר הדגימות המעובדות במקביל, ו-(C1+ C2) הוא המספר הכולל של המאפיינים המתקבלים ממודל 1 ו-2 בהתאמה, אשר מסתכם ב-3584 ומעובדים במקביל, ווקטור מאפייני הפלט המשורשר מיוצג על ידי G. יתרה מכך, שלושה בלוקים שונים נוספו כדי לשנות את המודל הממוזג לצורך חילוץ מאפיינים מורכבים יותר, שיפור ההכללה ומניעת התאמת יתר (overfitting), כדי להשיג תוצאות מדויקות ויעילות יותר. כל בלוק מורכב משכבה צפופה (dense layer) עם מספר שונה של נוירונים; הבלוק הראשון כולל 1024 נוירונים בשכבות הצפופות שלו, המתמקדים בלכידה של טווח רחב של מאפיינים ותבניות גנריות יותר בנתונים, בעוד שהבלוק השני כולל 512 נוירונים בשכבה הצפופה שלו, אשר מזקקים באופן ספציפי את המאפיינים על ידי הפחתת ממדיות והתמקדות בתבניות ספציפיות יותר. הבלוק השלישי מכיל 256 נוירונים בשכבה הצפופה שלו, המזקקים את המאפיינים באופן ספציפי יותר כדי להבטיח שרק המאפיינים והתבניות הרלוונטיים ביותר יעברו לשכבת הפלט לביצוע משימה רלוונטית יותר. בנוסף, גישות רגולריזציית L237 נוספו לכל שכבה צפופה בכל בלוק כדי למנוע התאמת יתר על ידי הענקת קנס למשקולות גדולות יותר, דבר שגורם למודל להיות מורכב יותר. שכבת dropout38 נכנסה לשימוש גם היא לאחר כל בלוק כדי להתעלם באופן אקראי מ-30%, 20% ו-10% מהנוירונים עבור בלוקים 1, 2 ו-3 בהתאמה, מה שמאלץ את הרשתות לפתח מאפיינים חסונים (robust) יותר שאינם תלויים בנוירון בודד. יתרה מכך, כדי לייצב את תהליך האימון, שכבת BatchNormalization39 מיושמת לאחר כל שכבה צפופה, מה שמבטיח שההפעלות (activations) יישארו בטווח יציב ועוזר למודל להימנע מבעיות כגון הגרדיאנטים הנעלמים (vanishing gradients) והגרדיאנטים המתפוצצים (exploding gradients) במהלך שלב האימון. בנוסף, שכבת BatchNormalization זו האאיצה את תהליך האימון, מה שאיפשר למודל להתכנס מהר יותר על ידי החלקת נוף ההפסד (loss landscape), דבר שהקל על האופטימייזרים להגיע למינימום גלובלי. להלבה, בכל בלוק, כדי לייצר אי-ליניאריות, נעשה שימוש בהפעלת leaky ReLU40, המאפשרת למודל ללמוד תבניות מורכבות; ל-leaky ReLU יש יתרונות על פני פונקציות הפעלה אחרות בכך שהיא מבטיחה שהנוירון לא יהיה לא פעיל על ידי התרת גרדיאנט קטן שאינו אפס עבור קלטים שליליים. לבסוף, משוואה 6 להלן מציגה את פעולתם של הבלוקים השונים המשולבים עם המודל הממוזג ההיברידי.
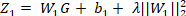 (6)
לאחר קבלת הווקטור המשורשר, G מועבר דרך השכבה הצפופה (fully connected) של בלוק 1 עם 1024 נוירונים, שבה מטריצת המשקולות W1 הופכת את ווקטור הקלט G לווקטור פלט בעל 1024 ממדים, כאשר כל איבר בווקטור הפלט הוא שילוב ליניארי של מאפייני הקלט. בנוסף, ווקטור ההטיה b1 מתווסף לכל אחד מ-1024 האיברים בפלט, מה שמאפשר למודל להסיט את הפלט של מאפייני הקלט באופן עצמאי. יתרה מכך, איבר רגולריזציית L2: λ||W1||22 מעניש משקולות גדולות, מה שמונע מהמודל להסתמך יתר על המידה על נוירון בודד ומסייע במניעת overfitting. כאשר מטריצת המשקולות של שכבה מסוימת ברשת הנוירונים היא W1, בעוד ש-||W1||22 מייצגת את ריבוע נורמת L2 של מטריצת המשקולות W1, ו-λ הוא פרמטר הרגולריזציה השולט במידת הרגולריזציה המיושמת, אשר נקבע ל-0.1 בכל הבלוקים. Z1 הופך לייצוג המאפיינים החדש לאחר החלת השכבה הצפופה וכן רגולריזציית L2 על הקלט שהועבר מהווקטור המשורשר G, כפי שמוצג במשוואה 6.
לאחר קבלת הפלט משכבת הצפיפות של בלוק 1 כ- Z1, הוחלה שכבת BatchNormalization, ששימשה להגברת מהירות תהליך האימון, ומשוואה 7 להלן מראה כיצד היא פועלת.
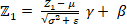 (7)
σ2 מייצג את השונות של הפלט של השכבה האחרונה Z1 לאורך ה-batch, בעוד ש-μ הוא הממוצע של הפלט Z1 המחושב בנפרד עבור כל נוירון, אשר היו 1024 בשכבה הצפופה (dense layer) הראשונה. מנגד, ε הוא קבוע זניח המוטמע כדי להבטיח יציבות נומרית ולמנוע חלוקה באפס. ניתן להתאים את הפלט הנורמלי על ידי המודל באמצעות כיוונון פרמטר קנה המידה הניתן ללמידה γ, בעוד שניתן להסיט את הפלט הנורמלי באמצעות פרמטר ההסטה הניתן ללמידה β. לבסוף, לאחר החלת שכבת ה-BatchNormalization על הפלט של השכבה הצפופה, הפלט הנורמלי Z1 מבטיח שלפעולות ההפעלה (activations) תהיה התפלגות עקבית על פני השכבות השונות, דבר המסייע לייצב ולהאיץ את האימון. לאחר ה-BatchNormalization, הפלט הנורמלי Z1 עובר דרך פונקציית ההפעלה leaky ReLu, אשר מייצרת אי-ליניאריות ברשת המסייעת בלמידת תבניות מורכבות בנתונים. במקום לבחור ב-ReLU או בפונקציית הפעלה אחרת, נבחרה leaky ReLU, שהיא גרסה שונה של פונקציית ReLU הלוקחת בחשבון גם ערכים שליליים קטנים במקום להפוך אותם ל-0 כפי שקורה בפונקציית ההפעלה ReLU, ובכך פותרת את בעיית ה-dying ReLU. משוואה 8 להלן מראה כיצד היא פועלת.
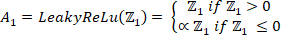 (8)
כאשר Z1 מייצג את הפלט של שכבת ה-BatchNormalization, אשר מועבר כקלט ל-Leaky ReLU לצורך ביצוע אי-ליניאריות, בעוד ש-∝ הוא קבוע קטן המשמש לקביעת השיפוע של החלק השלילי של הפונקציה. יתרה מכך, A1 מראה את הפלט המתקבל לאחר החלת האי-ליניאריות. לבסוף, שכבת dropout מוחלת על הפלט A1 שהתקבל כקלט מהפעלה של Leaky ReLu, כפי שמוצג במשוואה 9.
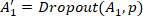 (9)
כאשר A1 הוא הפלט המקורי של פונקציית ההפעלה שהתקבל מפונקציית ההפעלה ReLu האחרונה, וכאשר p הוא שיעור ה-dropout, הנ🍸ה בין 0 ל-1 ונבחר כ-0.3, 0.2 ו-0.1 עבור שלוש שכבות בלוקים, בהתאמה, למטרת השמטת חלק מהנוירונים. יתרה מכך, A1′ מייצג את הפלט המעובד לאחר יישום שכבת ה-dropout, שבה חלק מהנוירונים הוגדרו כ-0. היתרון המרכזי בשימוש בשיטה זו הוא מניעת בעיות התאמת-יתר (overfitting) וכן הפחתת co-adaptation. בנוסף, הפלט מבלוק 1, A1′, מועבר שוב לבלוק הבא לצורך חילוץ תכונות מופשטות יותר, תוך יישום אותם פרמטרים שבלוק 1, עם הבחנה של 512 נוירונים בשכבה הצפופה (dense layer) במקום 1024 ושיעור dropout של 0.2 במקום 0.3; שאר רצפי הפעולות זהים, כפי שמתואר במשוואות 10 עד 13 להלן.
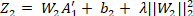 (10)
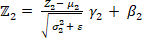 (11)
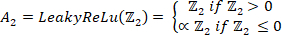 (12)
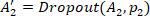 (13)
לאחר קבלת הפלט מבלוק 1 כ- A1′, הוא מועבר דרך השכבה הצפופה (dense layer, מקושרת באופן מלא) של בלוק 2 בעלת 512 נוירונים, כאשר מטריצת המשקולות W2 הופכת את וקטור הקלט A1′ לוקטור פלט בעל 512 ממדים, וכל איבר בוקטור הפלט הוא שילוב ליניארי של תכונות הקלט. בהמשך, וקטור ההטיה b2 מתווסף לכל אחד מ-512 האיברים בפלט, מה שמאפשר למודל להזיז את הפלט של תכונות הקלט באופן עצמאי. בנוסף, הוחלה רגולריזציית L2 שבה: λ||W2||22 הענישה משקולות גבוהות, דבר המשמש להפחתת התאמת-יתר (overfitting) על ידי מניעה מהמודל להסתמך באופן מופרז על נוירון ספציפי בבלוק זה. כאשר W2 היא מטריצת המשקולות של שכבה מסוימת ברשת העצבית, בעוד ש-λ הוא פרמטר הרגולריזציה השולט במידת הרגולריזציה המוחלת, אשר נקבע כ-0.1. Z2 הופך לייצוג התכונות החדש לאחר החלת השכבה הצפופה ורגולריזציית L2 על הקלט שהועבר מבלוק 1, כפי שמוצג במשוואה 10.
בנוסף, שכבת BatchNormalization הוחלה על המאפיין החדש Z2, אשר שימשה להגברת מהירות תהליך האימון; σ22 מייצג את השונות לאורך ה-batch, בעוד ש-μ2 הוא הממוצע של הפלט Z2. בעוד ש-ε הוא קבוע קטן המוטמע כדי להבטיח יציבות מספרית, γ הוא פרמטר קנה-מידה (scale) הניתן ללמידה המאפשר למודל לשנות את הפלט הנורמלי, ו-β הוא פרמטר הזזה (shift) הניתן ללמידה המאפשר למודל להזיז את הפלט הנורמלי. לבסוף, לאחר החלת שכבת ה-BatchNormalization, המוצגת במשוואה 11, הפלט הנורמלי Z2 עבר דרך פונקציית אקטיבציה מסוג leaky ReLU, שיצרה אי-ליניאריות ברשת, כפי שמוצג במשוואה 12. כאשר Z2 שייך לפלט של שכבת ה-BatchNormalization, העובר ל-Leaky ReLU כקלט לצורך ביצוע אי-ליניאריות. בעוד ש-A2 מראה את הפלט המתקבל לאחר החלת האי-ליניאריות.
לבסוף, שכבת dropout מוחלת על הפלט A2 המתקבל כקלט מהפעלת Leaky ReLU, כפי שמוצג במשוואה 13. כאשר A2 הוא הפלט המתקבל מפונקציית ההפעלה ReLU האחרונה, ו-p2 הוא שיעור ה-dropout, שנבחר להיות 0.2 עבור בלוק זה, וזאת לצורך השמטת חלק מהנוירונים. בהמשך, A2′ מייצג את הפלט המעובד לאחר החלת שכבת ה-dropout, שבה חלק מהנוירונים נקבעו ל-0. לאחר מכן, הפלט מבלוק 2, A2′, מועבר שוב לבלוק השלישי לצורך חילוץ של מאפיינים מופשטים יותר, תוך החלת אותם פרמטרים המופיעים בבלוק 2, עם הבחנה של 256 נוירונים בשכבה הצפופה (dense layer) במקום 512, ושיעור dropout של 0.1 במקום 0.2; שאר רצפי הפעולות נותרים זהים, כפי שמתואר במשוואות 14 עד 17 להלן.
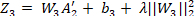 (14)
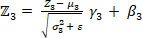 (15)
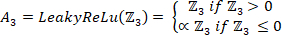 (16)
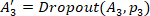 (17)
לאחר קבלת הפלט מבלוק 2 כ-A2′, הוא מועבר דרך השכבה הצפופה (fully connected) של בלוק 3 הכוללת 256 נוירונים, שבה מטריצת המשקולות W3 הופכת את וקטור הקלט A2′ לוקטור פלט בן 256 ממדים, כאשר כל איבר בווקטור הפלט הוא שילוב ליניארי של מאפייני הקלט. בהמשך, וקטור ההטיה b3 מתווסף לכל אחד מ-256 האיברים בפלט, מה שמאפשר למודל להזיז את הפלט של מאפייני הקלט באופן עצמאי. בנוסף, הוחלה רגולריזציית L2 שבה: λ||W3||22 מענשה משקולות גדולות, דבר המונע מהמודל להסתמך יתר על המידה על נוירון בודד ומסייע במניעת overfitting. כאשר, W3 היא מטריצת המשקולות של שכבה מסוימת ברשת העצבית, בעוד שדרגת הרגולריזציה המיושמת נשלטת על ידי פרמטר הרגולריזציה λ, אשר נקבע ל-0.01. Z3 הופך לייצוג המאפיינים החדש לאחר יישום השכבה הצפופה וכן רגולריזציית L2 על הקלט שעבר מבלוק 3, כפי שמוצג במשוואה 14.
בנוסף, שכבת ה-BatchNormalization הוחלה על המאפיין החדש Z3, אשר שימשה להאצת תהליך האימון; σ32 מייצג את השונות לאורך ה-batch, בעוד ש-μ3 הוא הממוצע של הפלט Z3. מאידך, ε הוא קבוע קטן שנוסף לצורך יציבות נומרית. ניתן להתאים את הפלט הנורמלי על ידי המודל באמצעות פרמטר קנה מידה למידה γ3, ולהסיטו באמצעות פרמטר הזזה למידה β3. לבסוף, לאחר החלת שכבת ה-BatchNormalization, המוצגת במשוואה 15, הפלט הנורמלי Z3 עבר דרך פונקציית האקטיבציה leaky ReLU, אשר יצרה אי-ליניאריות ברשת, כפי שמוצג במשוואה 16. כאשר Z3 שייך לפלט של שכבת ה-BatchNormalization, העובר ל-Leaky ReLU כקלט לביצוע אי-ליניאריות. בעוד ש-A3 מציג את הפלט המתקבל לאחר החלת האי-ליניאריות.
לבסוף, שכבת dropout מיושמת על הפלט A3 שהתקבל כקלט מהפעלת Leaky ReLU, כפי שמוצג במשוואה 17. כאשר A3 הוא הפלט שהתקבל מפונקציית ההפעלה ReLU האחרונה, ו-p3 הוא קצב ה-dropout, שנבחר להיות 0.1 עבור בלוק זה, לצורך השמטת חלק מהנוירונים. בנוסף, A3′ מייצג את הפלט המשונה לאחר יישום שכבת ה-dropout, שבה חלק מהנוירונים הוגדרו כ-0.
בנוסף, הפלט מבלוק 3 A3′ הועבר דרך השכבה הצפופה (dense layer) האחרונה לצורכי סיווג, עם מספר K של נוירונים המייצג את מספר המחלקות בפועל במערך הנתונים, כפי שמתואר במשוואה 18 להלן.
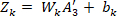 (18)
מטריצת המשקולות הקשורה לשכבה העבה היא Wk, האחראית להמרת הווקטור בן 256 הממדים A3′ לווקטור בן k ממדים, המייצג את המאפיינים שנלמדו מהבלוק הקודם ויוצא כפלט. בנוסף, bk מייצג את וקטור ההטיה (bias) המתאים את התחזית כדי להבטיח שלפונקציית ההפעלה יהיה פלט שאינו אפס כאשר הקלט הוא אפס, ו-Zk הוא הפלט של השכבה הסופית לפני הפעלת פונקציית ההפעלה, והוא מייצר את ה-logits עבור כל מחלקה; לבסוף, הוחל מסווג SoftMax41 הממיר את ה-logit Zk להסתברות של כל מחלקה, כפי שמוצג במשוואות 19 ו-20.
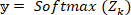 (19)
 (20)
כאשר ההסתברות החזויה עבור המחלקה ה-ith מיוצגת על ידי yi, K הוא מספר המחלקות, בעוד ש- Zk, i הוא ה-logit עבור המחלקה ה-ith, ו- eZk, i הוא האקספוננט של ה-logit של המחלקה ה-ith. y מראה את התפלגות ההסתברות של כל המחלקות האפשריות ומבטיח שסכום ההסתברויות יהיה 1. טבלה 3 להלן מספקת את פרטי ההיפר-פרמטרים ששימשו לאימון המודל ההיברידי המוצע, כולל הפרטים הארכיטקטוניים שאומצו לשיפור השחזור והביצועים.
| הפרמטרים ההיפר-למידתיים (Hyper Parameters) | המודל המוצע (FusionNetX) |
| גודל תמונה | 224 × 224 |
| ארכיטקטורת שלד | EfficientNetB7 ו-DenseNet121 מאומנים מראש כ-BBA1 ו-BBA2 |
| העשרת נתונים | טווח סיבוב = 7, |
| רוחב/גובה – טווח הזזה עד 0.05, | |
| טווח זום עד 0.01, | |
| היפוך אופקי/אנכי | |
| יחס פיצול הנתונים | 80% לאימון ו-20% לוולידציה באמצעות דגימה מרובדת (stratified sampling) עם randome_state קבוע = 42 |
| חילוץ ומיזוג מאפיינים | איחוד ממוצע גלובלי (Global average pooling) מיושם על הפלט של כל שלד (backbone): 2560 עבור BBA1 ו-1024 עבור BBA2, והם ממוזגים כדי לקבל 3584 וקטורי מאפיינים משותפים. |
| הרכב בלוק מחובר באופן מלא | 3 בלוקים מחוברים במלואם (fully connected) עם שכבת פלט אחת. כל בלוק מכיל רגולריזציית L2 (λ=0.01), נורמליזציה של אצווה (BatchNormalization), LeakyReLU (α=0.01), Dropout של (0.3, 0.2, ו-0.1) וממד נסתר של (1024, 512, 256) בהתאמה. לא הוכנסו חיבורי דילוג (Skip connection) נוספים בראש המיזוג (fusion head). |
| פונקציית אקטיבציה | Leaky ReLU & SoftMax |
| אופטימייזר וקצב למידה | Adam עם 0.00001 קבוע ללא מתזמן קצב למידה. |
| פונקציית הפסד | sparse_categorical_crossentropy |
| גודל סדרה | 16 |
| עידנים | 100 תקופות (epochs) קבועות עבור כל מערך נתונים |
| הפלטפורמה שבה נעשה שימוש | מחברת Kaggle בעלת GPU מסוג P100 ו-16GB VRAM עם פלטפורמות TensorFlow ו-Keras. |
טבלה 3: היפר-פרמטרים ששימשו לאימון המודל המוצע ופרטים אדריכליים מוצעים. טבלה זו מפרטת את הפרטים המבניים והאדריכליים של המודל המוצע, יחד עם פרמטרים שעברו כוונון עדין (fine-tuned) וסביבת המימוש.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
חלק זה מפרט את תוצאות הבדיקה של מודל מיזוג התכונות הכפול המוצע על חמישה מאגרי נתונים בקוד פתוח על סרטני מוח, הכוללים את מאגרי הנתונים Br35H, Figshare, Sartaj, Masoud ו-Balanced Brain tumor, וביצועיהם מוערכים ביחס לפרמטרים סטטיסטיים שונים להערכת ביצועים, הכוללים דיוק42,43,44, שיעור סיווג שגוי (MCR)45, דיוק (precision), המכונה גם PPV46, NPV, TPR המכונה גם רגישות (sensitivity)
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
לסיכום, המודל המוצע פעל באופן הבא: ראשית, גודל התמונה נבחר כ-224 × 224, שהוא גודל מתוּן עבור כל מודל למידה עמוקה כדי לחלץ וללמוד תכונות מתאימות מדגימות הנתונים תוך שמירה על כל המידע החשוב, ולאחר מכן בוצע הרחבת נתונים (data augmentation), המועילה יותר ליצירת דגימות נתונים בכיוונים מגוונים יותר, דבר המשחק תפקיד חשוב עבור מודלים בחילוץ תכונות ממישורים או זוויות שונות; טווח הסיבוב נבחר כ-7% עם טווח הזחה של הרוחב והגובה של 0.05 וטווח זום של 0.01. כמו כן הוחלו היפוכים אופקיים ואנכיים, המזיזים ומגדילים את הנתונים לזוויות שונות....
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
למחברים אין הצהרות לגבי ניגודי עניינים ואין להם ניגוד עניינים. יתרה מכך, לא נעשה שימוש בכלי בינה מלאכותית (AI) כדי להפיק את כתב היד או את האיורים.
תודות
המחברים אסירי תודה על התמיכה שניתנה על ידי הפרויקט לתמיכה בחוקרים של אוניברסיטת הנסיכה נורה בינת עבדולרחמן (PNURSP2026R192), אוניברסיטת הנסיכה נורה בינת עבדולרחמן, ריאד, ערב הסעודית. המחברים מודים גם למשתתפי המחקר ולמוסדות שתרמו למחקר זה.
מימון:
עבודה זו נתמכה על ידי מענק מהקרן הלאומית למחקר של קוריאה (NRF) במימון ממשלת קוריאה (MSIT) (מס' RS-2023-00218176) ועל ידי קרן המחקר של אוניברסיטת Soonchunhyang. פרויקט לתמיכה בחוקרים של אוניברסיטת הנסיכה נורה בינת עבדולרחמן, מספר (PNURSP2026R192), אוניברסיטת הנסיכה נורה בינת עבדולרחמן, ריאד, ערב הסעודית.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| מערך נתוני גידולי מוח Br35H | Kaggle (תורם מערך נתונים) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | מאגר נתונים ציבורי; סיווג בינארי (גידול / ללא גידול); 300 תמונות MRI |
| מאגר הנתונים של גידולי מוח מ-Figshare | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | מאגר נתונים ציבורי; רב-מחלקתי (גליומה, מנינגיומה, גידול בבלוטת הפיתוئیטרי) 3064 תמונות MRI |
| סט נתוני MRI לסיווג גידולי מוח של Sartaj | Kaggle (ערכה של נתונים מאת Sartaj Bhuvaji) | https://doi.org/10.34740/kaggle/dsv/12745533 | מאגר נתונים ציבורי; רב-מחלקתי (גליומה, מנינגיומה, ללא גידול, גידול בבלוטת הפיתוئیטרי) 3264 תמונות MRI |
| מאגר נתוני MRI של גידולי מוח של Masoud | Kaggle (מאגר נתונים מאת Masoud Nickparvar) | https://doi.org/10.34740/kaggle/dsv/14832123 | מאגר נתונים ציבורי; רב-מחלקתי (גליומה, מנינגיומה, ללא גידול, גידול בבלוטת הפיתוئیטרי) 7023 תמונות MRI |
| BBT-Dataset (מאגר נתונים של גידולי מוח) | Kaggle (תורם מערך נתונים) | https://doi.org/10.34740/kaggle/dsv/6758053 | מאגר נתונים ציבורי; 5,248 תמונות MRI של גידולי מוח במבנה רב-מחלקתי מאוזן |
| Python | Python Software Foundation | https://www.python.org | שפת תכנות, גרסה 3.10.13 |
| TensorFlow / Keras | מפתחי Google / TensorFlow | https://www.tensorflow.org | מסגרת למידה עמוקה; בניית מודל, אימון והערכה, גרסה 2.15.0 |
| EfficientNetB7 (מאומן מראש) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | שלד (backbone) שהוכשר מראש על ImageNet; חילוץ מאפיינים |
| DenseNet121 (מאומן מראש) | Keras Applications | https://keras.io/api/applications/densenet/ | שלד (backbone) שעבר אימון מוקדם על ImageNet; חילוץ מאפיינים |
| scikit-learn | מפתחי scikit-learn (NumFOCUS) | https://scikit-learn.org | קידוד תוויות (Label encoding), פיצול לאימון ובדיקה (train-test split), מדדי הערכה (דו"ח סיווג, מטריצת בלבול, ROC/AUC) |
| OpenCV (cv2) | צוות OpenCV | https://opencv.org | טעינת תמונות ושינוי גודלן |
| NumPy | מפתחי NumPy (NumFOCUS) | https://numpy.org | חישוב נומרי ופעולות על מערכים |
| pandas | צוות הפיתוח של pandas (NumFOCUS) | https://pandas.pydata.org | ארגון נתונים וטבלאות מדדים |
מקורות
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.