מאמר זה מציג תהליך עבודה חישובי בפיקוח אנושי לבחינת ייצוגים חוזרים של נשים ב-433 ציורי ייצוא סיניים מתקופת שושלת צ'ינג. שבע קטגוריות התייחסות אנושיות ורמזים חזותיים חוזרים מאפיינים את הדפוסים בתוך המאגר, בעוד שהממצאים מוגבלים לתמונות שנמדגנו ואינם מודדים את המציאות החברתית של תקופת צ'ינג או את התקבולות ההיסטוריות.
מאמר מחקר
זהות נשית ודמיון מעמדי בציורי ייצוא סיניים מתקופת צ'ינג: מחקר בסיוע בינה מלאכותית על פרשנות בין-תרבותית
במאמר זה
סיכום
תקציר
מחקר זה בחן ייצוגים חוזרים של זהות נשית ורמזים חזותיים המקודדים מעמד חברתי בקורפוס של 43 ציורי ייצוא סיניים מתקופת צ'ינג מהשנים 1757–191. זרימת העבודה שילבה את CLIP ViT-B/32 לסימון ראשוני, לוקליזציה בעזרת Segment Anything Model (SAM), הפחתת ממדיות ואשכול (clustering), וקידוד איקונוגרפי ידני על ידי שני מקודדים בלתי תלויים. תוויות CLIP שימשו לארגון ראשוני, SAM שימש כעזר ללוקליזציה, וקידוד אנושי שנשפט סיפק את קטגוריות הייחוס. התוצאות המצטברות זיהו שבע קטגוריות ייחוס אנושיות: עילית/יופי (n = 12), עובדת (n = 72), ביתית (n = 64), משרת (n = 58), טקס/חתונה (n = 45), שוק (n = 43), ומבצעת/אמנית (n = 39). תוויות חישוביות ראשוניות תאמו את תוויות הייחוס האנושיות ב-356 מתוך 43 ציורים (82.2%), כאשר ה-recall ברמת הקטגוריה נע בין 73.3% ל-8.4%. שילובים חוזרים של לבוש, הגדרה מרחבית, חפצים, תנוחה ויחסים חברתיים מתוארים שימשו לאפיון הפרופילים החזותיים של קטגוריות אלו. הערכה של 43 זוגות תוויות בינה מלאכותית-אדם ברמת המקרה הניבה מדדי דיוק (precision), recall ו-F1 מקיפים ברמת הקטגוריה, לצד מטריצת בלבול המפרטת את דפוסי הסיווג. תיקוף האשכולים תמך בפתרון האשכול שנבחר והדגים התאמה בין האשכולים שהופקו לבין קטגוריות הייחוס שהוגדרו על ידי בני אדם. באופן כללי, שילובים חוזרים של לבוש, הגדרה מרחבית, חפצים, תנוחה ויחסים חברתיים מעידים על טיפולוגיות ציוריות דפוסיות בתוך הקורפוס שנמדגם. ממצאים אלו מאפיינים את הייצוג החזותי בציורי ייצוא סיניים מתקופת צ'ינג, אך אין לפרשם כמדדים ישירים של מעמד משפטי, חוויה חיה, דרישת שוק או קבלה זרה היסטורית.
מבוא
ציורי ייצוא סיניים מתקופת שושלת צ'ינג היוו חלק מהרשתות המסחריות והתרבותיות שקישרו בין קנטון ומרכזי איסוף אחרים לבין קונים אירו-אמריקאיים החל מסוף המאה השמונה-עשרה1,2,3,4,5. סוחרים, מטיילים, דיפלומטים, מיסיונרים ואספנים רכשו ציורים אלה כסחורות ניידות, כמזכרות, כמקורות למידע חזותי וכייצוגים של מקומות, מקצועות, ייצור, מנהגים וסוגים חברתיים. לפיכך, תפוצתם שיקפה הן את שיטות העבודה בסדנאות הסיניות והן את ציפיותיהם של השווקים החיצוניים.
הביקוש הזר העדיף נושאים מוכרים, פורמטים סדרתיים, מוטיבים חוזרים וסצנות שניתן היה לאסוף ולהשוות ביניהן. סדנאות התאימו את המדיום, הקנה, הקומפוזיציה ואת נושאי היצירה לצורכי מכירה, בעוד שקונים העדיפו לעיתים קרובות תיאורים ברורים של מקצועות, טקסים, חללים פנימיים, גנים, רחובות וטיפוסים חברתיים ציוריים. גרסאות חוזרות של סצנות מסדנאות קנטון מדגימות עוד יותר כיצד אמנים ועוזריהם התאימו את האיקונוגרפיה ואת אמצעי התיאור המערביים עבור פטרונים מעבר לים1,2,3,4,5. אף על פי שייתכן שביקוש השוק השפיע על מה שהופק ונשמר, הקורפוס הנוכחי אינו מודד באופן ישיר את העדפותיהם או את תגובותיהם של קונים בודדים.
לפיכך, יש להתייחס לציורים אלו כמקורות סלקטיביים ומתווכים ולא כתיעודים מקיפים של חיי היומיום. הסצנות המוצגות בהם עשויות להעלות על נס, לפשט, לנרמל או להתאים פרקטיקות חברתיות באמצעות מוסכמות של בתי מלאכה, ברירה שיווקית, רכישה על ידי מוזיאונים, קטלוג ודיגיטציה1,2,3,4,5. פרשנות היסטורית חייבת להבחין בין מאפיינים הניתנים לצפייה ישירה בציורים לבין הסקות לגבי הפרטים המיוצגים, תנאי הייצור והמשמעויות שייחסו ליצירות צופים מאוחרים יותר.
דמויות נשיות מספקות אמצעי ממוקד לבחינת הבחנה זו. לבוש, תסרוקת, תנוחה, רקע מרחבי, חפצים, פעילויות ומערכות יחסים עם דמויות אחרות יכולים לסווג נשים לתפקידים חוזרים מבחינה חזותית, הכוללים קטגוריות של עילית/יופי, ביתיות, משרתות, עובדות, שוק, ביצועים וטקסים/חתונות. קטגוריות אלו הן תיאורים אנליטיים של דפוסים ציוריים ואינן קובעות, כשלעצמן, דרגה משפטית, עושר, מקצוע, אתניות, שיוך ל-Banner או ל-Han, אופי מוסרי או זהות חווית.
היסטוריה של אמנות דיגיטלית וראייה ממוחשבת יכולות להקל על ביצוע השוואות רחבות היקף של אוספים חזותיים שסורקו, ובמקביל לאפשר בחינה ביקורתית של ההנחות המוטמעות במודלים חישוביים6,7. מודלים של ראייה-שפה יכולים לסייע בזיהוי וארגון של מוטיבים חזותיים חוזרים, אם כי הטיות תרבותיות נותרות מגבלה משמעותית כאשר אוצרות מילים של מודלים עכשוויים מיושמים על תמונות היסטוריות שאינן מערביות8. מחקר חישובי דומה על ציור סיני מסורתי מדגים באופן דומה את הערך שבשילוב של זיהוי תבניות כמותי עם פרשנות מבוססת ידע היסטורי9.
מחקר זה עוסק בשלוש שאלות: (1) אילו קטגוריות של זהות נשית המקודדות על ידי בני אדם ומקובלות בשיפוט מוצגות במאגר? (2) אילו שילובים של לבוש, סביבה מרחבית, חפצים, תנוחה ויחסים חברתיים מאפיינים קטגוריות אלו? (3) כיצד משתנים הדיוק הכולל בהתאמה מדויקת והחזר (recall) ברמת הקטגוריה בין שבע הקטגוריות? זרימת העבודה מתבססת על גישות חישוביות לציור סיני מסורתי9, תוך הגבלת הטענות ההיסטוריות לתמונות שנמדגו ולניתוחים המתועדים.
התרומה המיועדת היא הן היסטוריוגרפית והן טכנית. השוואה בקנה מידה של קורפוס יכולה לזהות נוסחאות ציוריות חוזרות שניתן להקשיר לאחר מכן באמצעות ניתוח היסטורי מעמיק. גישה זו יכולה להעשיר מחקרים על מגדר, היררכיה, ייצוגים של חיי היומיום ומפגשים בין-תרבותיים, מבלי להתייחס לשכיחות של תמונה כראיה לשכיחות חברתית או לדמיון חזותי כהוכחה לזהות היסטורית.
פרוטוקול
מבנה המחקר ויחידה אנליטית
כל ציור או רשומת קטלוג נחשבו כיחידה אנליטית אחת. נעשה שימוש במערך תצפיתי מבוס-קורפוס, המשלב סקירת מטא-נתונים, ארגון חישובי ראשוני, קידוד ידני עצמאי ופרשנות של תולדות האמנות. תקופת המחקר הוגדרה כ-1757–1911, וקריטריונים להכללה ולהדרה הוחלו בתוך מסגרת זמן זו. יצירות אמנות היסטוריות ומטא-נתוני הקטלוג המשויכים אליהן נותחו. כאשר הושוו התפלגויות לאורך מרווחי תאריכים באורכים שונים, נורמלו הספירות לפי משך המרווח, בעוד שהטיות אפשריות של הישרדות ורכישה נלקחו בחשבון בפרשנות.
בנייה ובחירה של קורפוס
רשומות מועמדות נשלפו מקטלוגי המוזיאונים שצוינו, מארכיונים דיגיטליים ומקטלוגים שפורסמו. עבור כל רשומת מועמד, נשמרו המוסד, הכותרת, התאריך או טווח התאריכים, המדיום, מספר הרישום או הקטלוג, כתובת URL יציבה של המקור, תאריך השליפה והצהרת הזכויות. קישורי המקור נשמרו גם כאשר לא ניתן היה להפיץ באופן חוקי את קובץ התמונה התואם. הליך הסינון המדווח החל עם 612 תמונות מועמדות. מתוכן, 85 נפסלו מכיוון שנפלו מחוץ לתקופה של 1757–191 או מחוץ למסורת של ציורי ייצוא, 58 נפסלו מכיוון שהיו רפרודוקציות מודרניות, רשומות מטושטשות או תיארו נושאים שגויים, 29 נפסלו בשל חסרונה של דמות נשית הניתנת לזיהוי או רזולוציית תמונה לא מספקת, ו-7 נפסלו עקב מטא-דאטה לא מספיק. הקורפוס האנליטי הסופי כלל 433 רשומות.
סטנדרטיזציה של מטא-נתונים ועיבוד מקדים של תמונות
לכל ציור בקורפוס האנליטי הסופי הוקצה מזהה QEP יציב בטווח שבין QEP_01 ל-QEP_43. מטא-נתונים נלווים מהמוזיאונים נשמרו, כולל המוסד, מספר הרישום, הכותרת, התאריך, המדיום או החומרים, מקור המוצא, קישור למקור ותיאור קטלוגי זמין. לצורך ניתוח חזותי, תועדו התווית הראשונית של ה-AI, הקטגוריה האנושית שנקבעה, מספר הדמויות הנשיות, קבוצת גיל, תנוחה, לבוש, הגדרה מרחבית, חפצים נלווים ויחסים חברתיים. כל ציור סווג לאחת משבע קטגוריות עיקריות: עילית/יופי, ביתית, משרתת, עובדת, שוק, מופיעה, או טקס/חתונה. בסצנות המכילות מספר דמויות נשיות, זוהתה הדמות המרכזית על פי בולטות חזותית ומרכזיות נרטיבית. כאשר לא הייתה דמות נשית אחת דומיננטית, נקבעה הקטגוריה העיקרית על בסיס הפעילות המרכזית המתוארת וההקשר הכללי של הסצנה. חפיפות בין קטגוריות נפתרו על ידי מתן עדיפות לפעילות המתוארת ולהקשר הסצנה על פני הלבוש או המראה לבדם. מקרים מעומתים נסקרו באופן עצמאי על ידי שני המקודדים ונפתרו באמצעות הגעה לקונצנזוס. תמונות המקור נשמרו בפורמט JPEG או PNG. רק גבולות דפי אינטרנט, מסגרות קטלוג או שוליים שאינם חלק מהתמונה נגזרו. תוכן הציור לא שוחזר, לא נצבע מחדש, לא שופר ולא הוחזר למצבו המקורי.
סימון ראשוני מבוס CLIP
מקודד התמונות CLIP ViT-B/32 שימש לניתוח ראשוני של דמיון בין תמונות לטקסט9. מונחי זהות מועמדים כללו elite woman, domestic woman, female servant, working woman, market woman, female performer, bride, ו-ritual woman. מונחי סצנה כללו Chinese interior, garden, street market, workshop, tea production, textile work, ו-ceremonial scene. קבוצה מלאה של תבניות הנחיה (prompt templates), סדרן, כל שילוב הנחיות (prompt ensembling), נהלי נרמול טקסט, כללי החלטה, ציוני ביטחון ותיקונו נשמרה עבור כל תמונה.
רשימת ההנחיות המלאה הוחלה באופן עקבי על כל התמונות באמצעות מודל OpenAI CLIP ViT-B/32 שיושם ב-Python 3.10 עם PyTorch 2.0.1 וחבילת OpenAI CLIP. ההסקה בוצעה על GPU התומך ב-CUDA עם גודל אצווה (batch size) של 32 תוך שימוש בדיוק FP32. כל תמונה שונה בגודלה ונחתכה למרכז (center-cropped) ל-24 × 224 פיקסלים, וערוצי ה-RGB נורמלו באמצעות התמרת העיבוד המקדים המשויכת למודל ViT-B/32. הנחיית הטקסט (Text prompts) נבנו באמצעות מתארי הזהות והסצנה שהוגדרו לעיל וקודדו עם מקודד הטקסט של CLIP. דמיון קוסינוס (Cosine similarity) חושב בין וקטורי ההטמעה (embeddings) הנורמליים של התמונה והטקסט, וההנחיה בעלת ציון הדמיון הגבוה ביותר הוקצתה כתווית ה-AI הראשונית. ציוני הדמיון עבור כל התוויות המועמדות נשמרו לצורך סקירה אנושית מאוחרת יותר. נעשה שימוש ב-random seed קבוע של 42, ונהלי עיבוד מקדים, תבניות הנחיה וכללי החלטה זהים הוחלו על כל 43 הציורים.
מיקום באמצעות SAM
מודל Segment Anything (SAM) שימש באופן בלעדי לצורך מיקום של דמויות, בגדים, רהיטים, כלים, חפצי פולחן ואזורים אדריכליים לצורך בדיקה חזותית אנושית. יש להדגיש כי SAM לא לקח חלק בתהליך הסיווג; המסכות, החתכים והמאפיינים הנגזרים ממנו הופרדו מתהליכי התיוג והצמידה (clustering) של CLIP, ובכך הובטח שיישומו של SAM סיפק עזרי מיקום מבלי להשפיע על ביצועי הסיווג או לנפח אותם.
הנחיות נקודות ידניות או תיבות חסם הוחלו בעת הצורך כדי לדייק את המיקום של אלמנטים חזותיים. מסכות SAM נוצרו עבור דמויות נשיות, בגדים, רהיטים, כלים, חפצי פולחן ואלמנטים אדריכליים, וכל תוצאת סגמנטציה נבחנה חזותית כדי לוודא כי הכיסוי האזורי היה הולם. המסכות שהתקבלו תמכו בזיהוי ובבחינה של מאפיינים איקונוגרפיים רלוונטיים, אך לא שימשו לצורך תיוג CLIP או להקצאה לקטגוריות.
הפחתת ממדיות וצבירה (Clustering)
חושבו וקטורי שיכון (embeddings) של תמונות CLIP, ונעשה שימוש ב-UMAP עם מרחק קוסינוס לצורך ויזואליזציה דו-מדית10. הייצוג ששימש לצבירה, יחד עם הליך עיבוד המקדמים, הממדיות והגדרת המרחק שלו, תועדו.
אלגוריתמי K-means וצבירה היררכית (hierarchical clustering) הוחלו על ייצוגי מאפייני התמונה כדי לזהות קבוצות חזותיות חוזרות בתוך הקורפוס1. פתרונות K-means מועמדים עבור k = 5–9 הוערכו באמצעות מקדם הסילואט (silhouette coefficient) ומדד Davies–Bouldin. נעשה שימוש באתחול K-means++ עם n_init = 10, max_iter = 30, tol = 1 × 10⁻4, ו-random_state = 42. צבירה היררכית בוצעה באמצעות צבירה אגלומרטיבית (agglomerative clustering) עם קישור ממוצע (average linkage) ומרחק קוסינוס (cosine distance). פתרונות מועמדים הושוו באמצעות מדדי תיקוף כמותיים, יציבות הצבירה וניתנות לפירוש מבחינה היסטוריה-אמנותית, ופתרון הצבירה הסופי נבחר בשל הייצוג הקוהרנטי ביותר של תבניות חזותיות חוזרות. השיוך לצבירה שהתקבל עבור כל אחד מ-433 הציורים נשמר לצורך השוואה עוקבת עם הקטגוריות שקודדו על ידי בני אדם.
קידוד ידני, הדרכה ובוררות
שני מקודדים סקרו באופן עצמאי את כל 43 התמונות באמצעות ספר קודים בגרסה מוגדרת, שהכיל קטגוריה ראשית, מספר דמויות, קבוצת גיל, תנוחה, לבוש, סביבה מרחבית, חפצים ויחסים חברתיים. רשומות ספציפיות של כל מקודד נשמרו לפני שלב הבוררות. למקודדים היה רקע רלוונטי בתולדות האמנות ובניתוח ויזואלי, והם הוכשרו באמצעות מדריך קידוד סטנדרטי ודוגמאות מייצגות ממאגר הציורים. לפני תחילת הקידוד הרשמי, הם ביצעו תרגיל כיול שכלל 30 ציורים כדי לקדם פרשנות עקבית של שבע קטגוריות הזהות וחמש ממדי הרמזים הוויזואליים.
במהלך הקידוד הפורמלי, שני מקודדים העריכו באופן עצמאי את כל הציורים המתאימים, בעודם מסווגים (blinded) להחלטות הקידוד זה של זה, לתוויות ה-AI הראשוניות ולהקצאות לצבירים. מהימנות בין-מקודדים נבחנה באמצעות מדד Cohen’s kappa. ערך הקאפה שנצפה עבור קטגוריית הזהות העיקרית היה 0.8, והמשתנים הקטגוריים של הרמזים החזותיים נעו בין 0.79 ל-0.92, מה שמעיד על הסכמה חזקה בין המקודדים. מחלוקות נפתרו באמצעות דיון והסכמה, והקטגוריה והקודים של הרמזים החזותיים שנקבעו נרשמו לצורך ניתוח מאוחר יותר12. התוויות שלפני הבתירה נשמרו.
הסכמה בין בינה מלאכותית לבני אדם והערכת ביצועים
הקטגוריה האנושית שנקבעה בבוררות שימשה כנקודת ייחוס להשוואה תיאורית עם תווית בינה מלאכותית ראשונית אחת לכל ציור. דיוק ההתאמה המדויקת הכולל חושב כ-356/43 (82.2%). רגישות הקטגוריה (Recall) חושבה כמספר ההתאמות המדויקות בין הבינה המלאכותית לבני האדם חלקי התמיכה של הייחוס האנושי עבור כל קטגוריה. תמיכת הקטגוריה, התאמות מדויקות, אי-התאמות והמכנים המתאימים דווחו באופן מפורש.
על בסיס 43 תוויות זוגיות של בינה מלאכותית ובני אדם ברמת המקרה, חושבו נתוני כושלים חיוביים (false positives) במחלקה המטרה, רמת דיוק (precision), רגישות (recall) ומדדי F1 לכל קטגוריה. נבנתה מטריצת בלבול מלאה כדי לנתח דפוסי סיווג חוצי-אלכסון, אשר הנחו לאחר מכן את סקירת אי-התאמות, תיעוד טקסונומיית השגיאות וכללי הפסיקה.
חבילת שחזור וחומרים
תהליך העבודה החישובי וחומרי המחקר התומכים אורגנו במאגר עם בקרת גרסאות. חבילת השחזור תוכננה לכלול סקריפטים לעיבוד מקדימה, ניתוח CLIP, לוקליזציה של SAM, UMAP, אשכולים (clustering), ניתוח הסכמה ויצירת איורים, יחד עם ספר קודים לקידוד ידני, קבצי הגדרה, מידע על תלויות, פלטים נגזרים ברמת המקרה, ורשימה קריאה למכונה של מקורות תמונות ומידע על זכויות. למשאבי המחקר שנשמרו הוקצה מזהה קבוע כדי להקל על השחזור והשימוש החוזר.
לצורך ארגון וניהול של מטא-נתונים נעשה שימוש ב-Microsoft Excel 2021. עבור הניתוחים החישוביים נעשה שימוש ב-CLIP ViT-B/32 לסימון ראשוני של שפה-חזון (vision–language labeling), ב-SAM למיקום של אלמנטים חזותיים, ב-UMAP עם מרחק קוסינוס (cosine distance) להפחתת ממדיות, וב-K-means ואשכולה היררכית (hierarchical clustering) לניתוח תבניות גישושי. פתרונות האשכולה הוערכו באמצעות מקדם הסילואט (silhouette coefficient) ומדד Davies–Bouldin, והסכמה בין מקודדים נבדקה באמצעות קאפא של כהן (Cohen’s kappa). סביבת התוכנה, הגדרות המודלים, ההגדרות החישוביות והזרעים האקראיים (random seeds) ששימשו לאורך תהליך העבודה תועדו כדי לתמוך בשחזוריות.
תוצאות
בניית הקורפוס והרכב תיאורי
איור 1 מציג סקירה כללית של הקורפוס בארבעה לוחות. איור 1A מראה את תהליך הסינון המדווח מ-612 רשומות מועמדות ל-43 רשומות שנשמרו. איור 1B מציג דוגמאות מייצגות של מדיה ופורמטים. איור 1C מציג את הספירות לאורך ארבעה פרקי זמן, ואיור 1D מסכם את הרכב המקור והמדיה של הקורפוס. מכיוון שפרקי הזמן משתרעים על פני תקופות שאינן שוות, ספירות אלו מתארות את הרכב הקורפוס שנמדגם ואין לפרשן כשיעורי ייצור היסטוריים.
טבלה 1 מסכמת את המאפיינים המצטברים של הקורפוס. אוספי מוזיאונים כללו 302 רשומות, ארכיונים דיגיטליים 81, וקטלוגים מפורסמים 50. המדיה סווגה כצבעי מים לייצוא (n = 176), ציור על נייר פית' (n = 12), דף אלבום לייצוא (n = 83), ציור דמות (n = 41), ופורמט אחר (n = 21). המטא-נתונים סווגו כשלמים (n = 28), חלקיים (n = 118), או מינימליים (n = 27). דמויות נשיות סווגו כמרכזיות (n = 214), משניות (n = 102), או מרובות (n = 17). כל בלוק סיווג כלל את כל 43 הרשומות.
תוויות בינה מלאכותית ראשוניות וקטגוריות ייחוס אנושיות
טבלה 2 מסכמת את ההסכמה המצטברת בין התוויות הראשוניות שנוצרו על ידי בינה מלאכותית לבין קטגוריות הייחוס האנושיות ב-43 הציורים, בעוד שטבלה נלווית 1 מספקת את תוויות הבינה המלאכותית הראשוניות ברמת המקרה, את סיווגי המקודדים, את קטגוריות הייחוס האנושיות שנקבעו בבוררות, את סטטוס ההתאמה ואת השיוכים לאשכולות. באופן כללי, התוויות של הבינה המלאכותית ותוויות הייחוס האנושיות התאימו עבור 356 ציורים, מה שמתרגם לדיוק התאמה מדויקת של 82.2%. רגישות (recall) ברמת הקטגוריה חושבה כפרופורציה של התאמות מדויקות בין הבינה המלאכותית לבני אדם ביחס לתמיכת הייחוס האנושי עבור כל קטגוריה.
הrecall ברמת הקטגוריה נע בין 73.3% עבור סצנות של טקסים/חתונות (3/45) לבין 8.4% עבור עילית/יופי (9/12). הrecall היה 84.7% עבור עבודת כפיים (61/72), 82.1% עבור ביצועים (32/39), 79.7% עבור תפקידים ביתיים (51/64), 79.3% עבור משרתים (46/58), ו-79.1% עבור שוק (34/43). באופן כללי, ההסכמה המדויקת הייתה 356/433 (82.2%). הערכה של הזוגות ברמת המקרה אפשרה את חישוב מדדי הדיוק (precision) וציוני F1 עבור כל שבע הקטגוריות, כאשר מדדי הדיוק נעו בין 74.5% ל-89.2%, וציוני F1 נעו בין 0.75 ל-0.8. מטריצת בלבול מקיפה המפרטת תוצאות חיוביות שגויות (false positives) של מחלקת היעד ותבניות חוץ-אלכסוניות מוצגת ב-Supplementary Figure 1.
סיכומי תבניות חישוביות שדווחו
איור 2 מציג ארבעה תצוגות של ניתוחים חישוביים שדווחו. איור 2A מציג גלריה של תשע ציורים עם שכבות סגמנטציה צבעוניות המשמשות למיקום חזותי ולביקורת. איור 2B מציג תרשים פיזור UMAP של השכמות (embeddings) של תמונות CLIP שדווחו, עם קווי קונטור של צפיפות המסומנים כ-C1–C7. איור 2C משווה בין מספר הציורים שדווחו (נקודות מלאות) לבין recall ברמת קטגוריה (עיגולים ריקים), ואיור 2D מציג גלריה של ציורים מייצגים המקובצים לפי אותן תוויות. תיקוף האשכולות תמך בפתרון האשכול (clustering) שנבחר, אשר הניב silhouette score של 0.54 ומדד Davies–Bouldin של 0.92. המיפוי בין האשכולות לקטגוריות אנושיות הדגים התאמה חזקה, כאשר כל אשכול נגזר תאם בעיקר לקטגוריה נפרדת של ייחוס אנושי.
טבלה 3 מציגה שבעה פרופילים חישוביים שדווחו עם גדלי מדגם התואמים לשבעת התומכים של קטגוריית הייחוס האנושית. טבלת השכיחויות של הצבירים לפי קטגוריה מופיעה ב טבלה משלימה 2 ומראה את ההתפלגות של שבע קטגוריות הייחוס האנושיות שנפסקו על פני הצבירים C1–C7. ניתוח של הקצאות הצבירים ברמת המקרה הדגים כי הצבירה החישובית שחזרה על מבנים חזותיים שתאמו באופן הדוק את שבע קטגוריות הייחוס האנושיות.
הקשרים של רמזים חזותיים וסינתזה פרשנית
טבלה 4 מסכמת את פרופילי הרמזים החזותיים האיכותיים ששימשו לאפיון שבע הקטגוריות שקודדו על ידי בני אדם. פרופילים אלו מתארים הקשרים חוזרים בין לבוש, הגדרה מרחבית, תנוחה, חפצים ויחסים חברתיים. הם לא נגזרו מטבלה צולבת כמותית, ולכן לא ביסו מעמד משפטי, מוצא אתני, סיבתיות חברתית או תגובת קהל.
איור 3 משלב סיכומים כמותיים תיאוריים של המאפיינים הוויזואליים המקודדים עם מודל מושגי פרשני. איור 3A מציג את שבע הקטגוריות של ייחוס אנושי שנקבעו ואת גדלי המדגמים שלהן. איור 3B מראה את הקשרים היחסיים בין קטגוריות אלו לבין סמנים ויזואליים מקודדים בחמישה ממדים: לבוש, סביבה מרחבית, חפצים, תנוחה ויחסים חברתיים. עוצמות הקשר המוצגות חושבו מתוך ההערות ברמת המקרה בתוך כל קטגוריה של ייחוס אנושי. איור 3C מסכם את הקשרים בין קטגוריות ייחוס אנושי, ממדי סימון ויזואלי וארכיטיפים של השערות מחלקתיות, תוך שימוש בזרימות משוקללות הנגזרות מתצפיות מקודדות. קשרים כמותיים אלה מאפיינים דפוסי ייצוג חוזרים בתוך הציורים שנמדגמו ואין לפרשם כהערכות של התפלגויות דמוגרפיות או חברתיות היסטוריות. איור 3D מציג מודל פרשני מושגי חוצה-תרבויות ויש להבינו כמסגרת פרשנית מבוססת היסטוריה ולא כנתיב סיבתי שנבדק אמפירית.
פרשנות משולבת של תבניות חזותיות
לאורך כל המאגר, שבע קטגוריות הזהות הנשית אופיינו בשילובים חוזרים של לבוש, מסגרת מרחבית, חפצים, תנוחה ויחסים חברתיים. שילובים אלו סיפקו ראיות תיאוריות למוסכמות חזותיות תבניתיות בתוך הציורים שנדגמו. פרשנויות היסטוריות הנוגעות למגדר, היררכיה ותיווך בין-תרבותי נותרו ברמה ההסקית.
בסיכום הדברים, התוצאות המצטברות זיהו שבע קטגוריות זהות נשיות כנקודת ייחוס אנושית וחמישה ממדים חוזרים המשמשים לאפיון שלהן: לבוש, סביבה מרחבית, חפצים, תנוחה ויחסים חברתיים. תוויות בינה מלאכותית ראשוניות תאמו את הקטגוריות האנושיות שנקבעו עבור 356 מתוך 433 ציורים (82.2%), כאשר הrecall הנמוך ביותר ברמת הקטגוריה נצפה בסצנות של טקסים/חתונות (73.3%). ממצאים אלו תמכו בארגון תיאורי ובבהשוואה של הקורפוס. התוויות של בינה מלאכותית ובני אדם ברמת המקרה אפשרו הערכות של precision ו-F1 ברמת הקטגוריה. בנפרד, ניתוח השבצה (cluster analysis) זיהה מבנים התואמים לשבע קטגוריות הייחוס האנושיות. עם זאת, ממצאים חישוביים אלו מאפיינים מוסכמות של ייצוג חזותי ולא מבססים טענות סיבתיות לגבי מציאות חברתית היסטורית או קבלת הקהל.
זמינות נתונים:
הנתונים התומכים במחקר זה, כולל מטא-נתונים, מידע על המקור ורישומי סריקה, זמינים באמצעות Zenodo בכתובת https://doi.org/10.5281/zenodo.2130291.
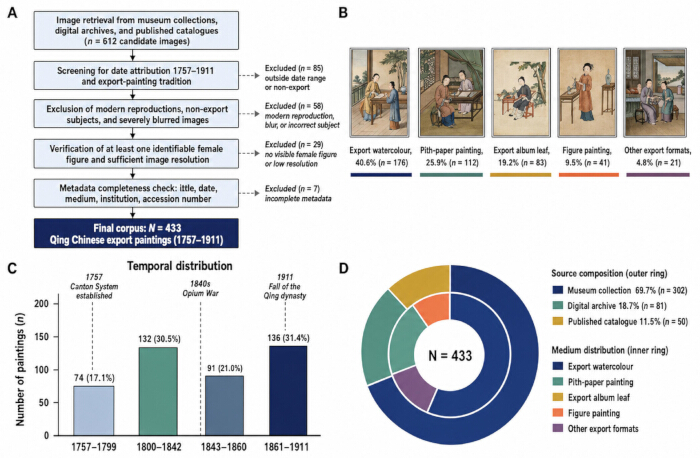
איור 1בניית קורפוס והרכב תיאורי של מדגם של 43 ציורים. (Aסריקה רצופית של 612 תמונות מועמדות, שהביאה ל-43 ציורים כשירים. ההחרגות כללו ציורים שאינם בתקופת המחקר או במסורת ציורי הייצוא (n = 85), רפרודוקציות מודרניות, תמונות מטושטשות או נושאים שגויים (n = 58), תמונות ללא דמות נשית ניתנת לזיהוי או בעלות רזולוציה לא מספקת (n = 29), ורישומים עם מטא-נתונים חסרים (n = 7).Bדוגמאות מייצגות של חמישה מדיומים ופורמטים: צבעי מים לייצוא (40.6%, n = 176), ציור על נייר ליבה (25.9%, n = 12), דף מאלבום לייצוא (19.2%, n = 83), ציור דמויות (9.5%, n = 41), ופורמטי ייצוא אחרים (4.8%, n = 21).C) התפלגות הציורים שנדגמו לאורך ארבעה פרקי זמן כרונולוגיים. (ד') התפלגות מקורות האיסוף (הטבעה חיצונית) ומדיה/פורמטים (הטבעה פנימית). האחוזים מבוססים על סך המדגם (N = 43) ומעוגלים לספרה אחת אחרי הנקודה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
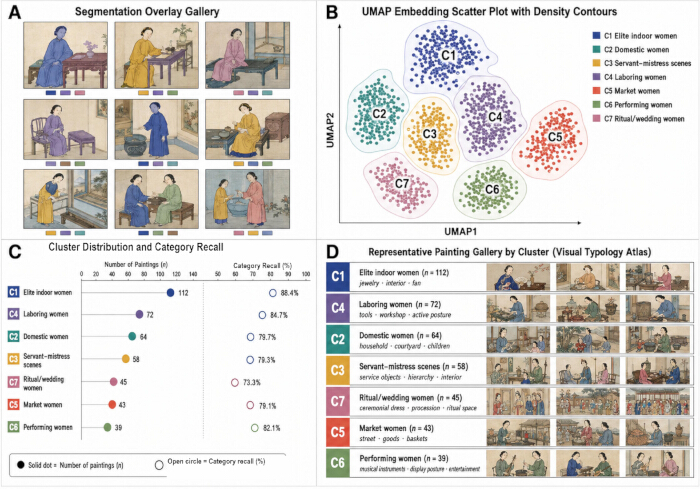
איור 2סגמנטציה מדווחת, ויזואליזציה של שיבוץ (embedding), התפלגות אשכולות, recall של קטגוריות וציורים מייצגים. (A) גלריה של תשעת ציורים עם שכבות סגמנטציה צבעוניות המשמשות לאיתור דמויות או אלמנטים חזותיים לצורך סקירה. (B) תרשים פיזור UMAP של קידודי תמונות ה-CLIP המדווחים, עם קווי קונטור של צפיפות ותיוגים C1–C7. (C) מספר הציורים שדווחו (נקודות מלאות, ציר עליון) ו recall של קטגוריה (עיגולים פתוחים, ציר תחתון); recall של קטגוריה שווה למספר ההתאמות המדויקות חלקי התמיכה של ייחוס אנושי. לא מוצגים רווחי סמך או פסי שגיאה. (ד'גלריית ציורים מייצגת המקובצת לפי תוויות C1–C7, עם תמונות שנבחרו על בסיס קרבתן למרכזי הצבירה (centroids) המתאימים. קיצורים: AI = בינה מלאכותית; CLIP = Contrastive Language–Image Pre-training; SAM = Segment Anything Model; UMAP = Uniform Manifold Approximation and Projection; C1–C7 = תוויות 1–7 המדווחות. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
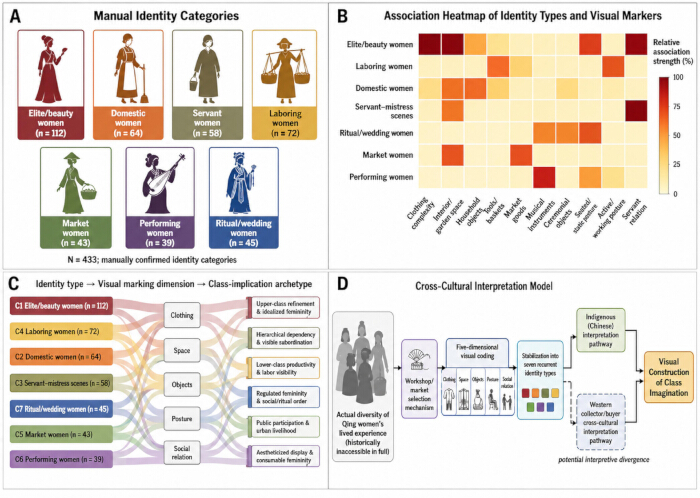
איור 3אסוציאציות של רמזים חזותיים ומסגרת פרשנית בין-תרבותית. (Aשבע קטגוריות זהות נשיות של ייחוס אנושי שנפסקו, וגדלי המדגמים שלהן בתוך קורפוס של 433 ציורים.Bמפת חום של קשרי אסוציאציה המציגה את העוצמה היחסית של הקשרים בין שבע קטגוריות הייחוס האנושיות לבין סממנים חזותיים מקודדים על פני לבוש, הגדרה מרחבית, חפצים, תנוחה ויחסים חברתיים. עוצמות האסוציאציה נגזרו מההערות ברמת המקרה בתוך כל קטגוריה.Cייצוג אלוביאלי (Alluvial representation) המסכם קשרי משקל בין קטגוריות ייחוס אנושיות, ממדי סימון חזותי ואב-טיפוסים של השמעת מחלקה (class-implication archetypes) על בסיס התצפיות המקודדות.ד') מודל פרשנות בין-תרבותי מושגי המקשר בין הפעילויות המתוארות, בחירת הסדנה והשוק, קידוד חזותי חמש-ממדי, סוגי זהות חוזרים ומסלולי פרשנות פוטנציאליים. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
טבלה 1: מאפייני הקורפוס והשלמות של המטא-נתונים (N = 433). ספירות ואחוזים מסכמים שישה בלוקים נפרדים: מרווח תאריכים, מקור, מדיום או פורמט, שלמות המטא-נתונים, ייצוג של דמויות נשיות וסוג הסצנה. כל בלוק משתמש ב-N = 43 כמכנה ומסכם ל-43; האחוזים הם פרופורציות של הקורפוס בתוך הבלוק, מעוגלות לספרה אחת אחרי הנקודה. אנא לחצו כאן להורדת קובץ זה.
טבלה 2: תוויות AI ראשוניות וקטגוריות ייחוס אנושיות (N = 43). תמיכה (Support) מייצגת את מספר הציורים שהוקצו לכל קטגוריית ייחוס אנושית. התאמות מדויקות (Exact matches) מציינות ציורים שבהם התווית הראשונית שנוצרה על ידי ה-AI תאמה לקטגוריית הייחוס האנושית. recall ברמת הקטגוריה מחושב כמספר ההתאמות המדויקות חלקי מספר התמיכות של הייחוס האנושי. אנא לחץ כאן כדי להוריד קובץ זה.
טבלה 3: סיכום פרופיל חישובי מדווח. C1–C7 משחזרים את גדלי הפרופילים המאומתים ואת התוויות הדומיננטיות. האינטגרציה של הקצאות אשכולות ברמת המקרה וטבלת השכיחות של אשכולות לפי קטגוריה מאשרת שקיבץ בלתי מודרך תפס ביעילות מבנים ויזואליים התואמים לשבע קטגוריות הייחוס האנושיות. אנא לחצו כאן להורדת קובץ זה.
טבלה 4: פרופילים איכותניים של קטגוריות זהות נשית ורמזים חזותיים הקשורים למעמד. ספירות ואחוזים מסכמים את קטגוריות הייחוס האנושיות, בעוד שלבוש, מרחב, חפצים, תנוחת גוף ויחסים חברתיים מאפיינים את הפרופילים החזותיים החוזרים הקשורים לכל קטגוריה. הפרשנויות הקשורות למעמד מייצגות קריאות איקונוגרפיות של דפוסים ציוריים ולא מדדים ישירים של מעמד חברתי היסטורי. אנא לחצו כאן להורדת הקובץ.
איור משלים 1: מטריצת בלבול המשווה בין תוויות AI ראשוניות לקטגוריות ייחוס אנושיות שנקבעו עבור מאגר של 43 ציורים. השורות מייצגות את קטגוריות ייחוס האדם שנקבעו (התוויות האמיתיות), והעמודות מייצגות את הקטגוריות הראשוניות שנוצרו על ידי CLIP (התוויות שנחזו). ערכי התאים מציינים את מספר הציורים עבור כל שילוב של תווית AI-אדם. תאי האלכסון מייצגים התאמות מדויקות בין ה-AI לאדם, כאשר ה-recall ברמת הקטגוריה המתאימה מוצג כאחוז. תאים מחוץ לאלכסון מייצגים אי-התאמות בין הסיווג הראשוני של ה-AI לבין קטגוריית ייחוס האדם שנקבעה. הדיוק הכולל של ההתאמות המדויקות היה 82.2% (356/43). אנא לחצו כאן להורדת קובץ זה.
טבלה נלווית 1: השוואה ברמת המקרה בין תוויות בינה מלאכותית ראשוניות, קטגוריות ייחוס אנושיות שנקבעו בבוררות, והקצאות לצבירי UMAP. כל שורה מייצגת את אחת מ-43 הציורים הסיניים שיוצאו בתקופת שושלת צ'ינג שנכללו במאגר האנליטי. הטבלה מדווחת את מזהה תמונת ה-QEP היציב, תווית CLIP ViT-B/32 ראשונית, סיווגים עצמאיים של מקודד אנושי 1 ומקודד אנושי 2, קטגוריה אנושית שנקבעה בבוררות, סטטוס התאמה בין בינה מלאכותית לבני אדם, והקצאה לצבירי UMAP. "Exact Match" (התאמה מדויקת) מציינת הסכמה בין תווית הבינה המלאכותית הראשונית לבין הקטגוריה האנושית שנקבעה בבוררות; "Mismatch" (אי-התאמה) מציינת חוסר הסכמה. הקטגוריה האנושית שנקבעה בבוררות שימשה כסיווג הייחוס לצורך ניתוחי הסכמה בין בינה מלאכותית לבני אדם. אנא לחצו כאן להורדת קובץ זה.
טבלה נלווית 2: טבלת שכיחות של קטגוריות ייחוס אנושיות והקצאות אשכולות חישוביות. השורות מייצגות את שבע קטגוריות הייחוס האנושיות שנקבעו, והעמודות מייצגות את האשכולות C1–C7 שהתקבלו מניתוח האשכולות החישובי. ערכי התאים מציינים את מספר הציורים שהוקצו לכל שילוב של קטגוריה-אשכול. התמיכה הכוללת מייצגת את מספר הציורים בכל קטגוריית ייחוס אנושית. ריכוז התצפיות על פני שילובי קטגוריה-אשכול מספק הערכה תיאורית של ההתאמה בין האשכולות החישוביים שהופקו באופן עצמאי לבין קטגוריות הייחוס האנושיות שנקבעו. אנא לחצו כאן כדי להוריד קובץ זה.
דיון
בתוך סיכומי הצבירה שסופקו, 43 רשומות אורגנו לשבע קטגוריות ייחוס אנושיות ותוארו באמצעות חמש משפחות של רמזים חזותיים. קטגוריית עילית/יופי הייתה הגדולה ביותר (12/43), ו-356 תוויות ראשוניות תאמו את ייחוס האנושי המדווח (82.2%). אלו הן תצפיות על הקורפוס. הן תומכות בבחינת נוסחאות ציוריות חוזרות, אך לא בטענה החזקה יותר כי הנוסחאות משחזרות באופן נאמן את חברת שושלת צ'ינג או גרמו לתגובה מסוימת בקרב קהלים זרים13.
שיח מגדרי נורמטיבי, מעמד בתוך משק הבית, עבודה והחוק של שושלת צ'ינג עיצבו את חייהן של נשים מבלי לקבוע אותם באופן אחיד. מחקרים על נשים בתקופת ה-High Qing מתעדים השתפות בעבודה, כתיבה, פולחן, דת ובידור, לצד משטרי משפחה וצניעות נורמטיביים. שמונת הדגלים (Eight Banners) היוו קבוצת מעמד תורשית ורב-אתנית שהוגדרה על ידי החוק והפרקטיקה המנהלית; לפיכך, אין להשוות באופן אוטומטי חברות בדגלים לאתניות מנצ'ו14,15,16,17. במחקר זה, לבוש, תנוחה, חפצים והסביבה הם רמזים חזותיים ולא ראיות לדרגה משפטית, שיוך לדגלים או להאן, אתניות, ציות מוסרי או זהות חוויה. ראיות ארכיוניות ומשפטיות יהיו נחוצות כדי לבס טענות אלו.
הממצאים החישוביים דורשים גם איפוק תרבותי וטכני. אין להניח שמודלים רב-תכליתיים של שפה וחזון (vision-language models) הם ניטרליים מבחינה תרבותית. תוצאות שפורסמו עבור CulturalVQA מראות ביצועים לא אחידים בין אזורים והיבטים תרבותיים שונים, אך מדד זה לא העריך את CLIP ViT-B/32 ולא השתמש באמנות היסטורית ממזרח אסיה8,18,19. לפיכך, הוא מהווה מניע, ולא תחליף, למד תואם-מקרים על קורפוס זה. עד שניסוי כזה יהיה זמין, CLIP משמש כעזר ארגוני ראשוני ולא כסמכות לגבי זהות או היררכיה של שושלת צ'ינג. צינור העיבוד החישובי איש כי SAM תפקד אך ורק כראיה עזר למיקום; שום מסכות או מאפיינים נגזרים ממסכות לא שימשו כקלטים לסיווג או להקבצה, ובכך הובטח שהקטגוריזציה החזותית התבססה אך ורק על ההטמעות הסמנטיות הגלובליות של התמונות הבלתי-מפולחות. מחקרים בתחום המורשת הדיגיטלית מדגישים גם רגישות תרבותית, פיקוח בין-תחומי, נגישות, הגנת נתונים ותהליכי עבודה שקופים20.
מבחינה היסטורית, הרלוונטיות של הדגמים טמונה בסחר בציורי ייצוא: סדנאות סיניות וביקוש זר בחרו וסימנדרו נושאים שהיו ניידים, קריאים וניתנים לאספקה; דימויים חוזרים מהסדנאות מעידים גם על העתקה עם וריאציה ולא על שכפול מכני גרידא1,2,3,4,5. לפיכך, הקורפוס יכול לתרום להיסטוריות של מגדר, היררכיה, דימויי חיי יומיום ומפגשים בין-תרבותיים על ידי הצגת הנוסחאות החוזרות על עצמן בקנה מידה רחב. הוא אינו מעיד על כך שהדימויים הם רשומות אתנוגרפיות מקיפות. השוואה חישובית יכולה להנחות קריאה מעמיקה והקשרה בין-תרבותית21, בעוד שרישומי ייצור, היסטוריות רכישה וראיות לקבלה חייבים לבס טענות לגבי כוונת השוק או משמעות עבור הקהל.
תגובה רגשית וקוגניטיבית נותרת ככיוון מחקר עתידי ולא כתוצאה של המחקר הנוכחי. Shi ועמיתיו שילבו דירוגי העדפה, ניתוח ממד חבוי ומעקב עיניים כדי להבחין בין נתיבים רגשיים, פורמליים-אסתטיים וקוגניטיביים בתגובות לתמונות Xiashi Pinprick Lantern2. עיצוב דומה יכול לבחון האם צופים מקדישים תשומת לב שונה לבגדים, חפצים, תנוחה או היררכיה בציורי ייצוא. מכיוון שמחקר זה לא אסף דירוגים, נתוני מעקב עיניים או נתוני קהל אחרים, לא ניתן להסיק ממנו עוררות רגשית, בולטות חזותית או קבלה רק מתוכן התמונה.
המגבלות הן תיאורטיות, מתודולוגיות ומעשיות. מבחינה תיאורטית, קטגוריות של רמזי-חומר מפשטות מגדר, יחסי משק בית, היררכיה משפטית, אתניות וניסיון חיים. מבחינה מתודולוגית, ההסקים מוגבלים על ידי הישרדות, איסוף, דיגיטציה, מטא-נתונים, מודלים של zero-shot, קידוד והטיות של תקופות לא אחידות. בעוד שקו התהליך האנליטי מדגים זיהוי דפוסים חסון, הטיות מבניות אלה מדגישות את הצורך להתייחס לפלטי מחשוב כניתוחים של מוסכמות חזותיות ולא כחלונות שקופים למציאות החברתית של תקופת שושלת צ'ינג (Qing). מבחינה מעשית, זכויות תמונה מגבילות הפצה מחדש, והממצאים עשויים שלא להכלל על פני מוסדות, תקופות, מדיה או סביבות מחשוב שונות. בכפוף למגבלות אלו, המחקר מציע מסגרת בפיקוח אנושי להפיכת תצפיות חזותיות חוזרות לשאלות היסטוריות הניתנות לבדיקה, במקום למסקנות אוטומטיות. כמאמר פרשני ולא כהתערבות, הוא לא העריך התקדמות לעבר יעד כלשהו מפסגות הפיתוח הבר-קיימא (SDG) או אינדיקטור כלשהו. עם זאת, נושא המחקר רלוונטי ליעד 5, והתיעוד המודע לזכויות והמסגור החינוכי הבין-תרבותי תואמים רעיונית למטרות 11.4 ו-4.7; לא נמדדה תוצאת SDG כלשהי. חבילת השחזור המסופקת מתאימה את המחקר לקריאות האחרונות לזרימות עבודה שקופות של מורשת דיגיטלית ולדרישות FAIR עבור מזהים קבועים, מטא-נתונים עשירים, רישיונות, מקורות (provenance), ונתונים, אלגוריתמים, כלים וזרימות עבודה הניתנים לשימוש חוזר20,23.
גילויים
למחברים אין ניגודי עניינים להצהיר עליהם.
תודות
המחברים מודים למוזיאון ויקטוריה ואלברט, למוזיאון הבריטי, למוזיאון האמנויות מטרופוליטן, למוזיאון הלאומי לאמנות אסייתית של הסמית'סוניאן, למוזיאון פיבודי אסקס, למוזיאון לאמנות של הונג קונג, לספרייה הבריטית, למכון המחקר גטי, ולמוסדות אחסון וצוותי קטלוג נוספים שרישומיהם המקוונים סייעו בגילוי הקורפוס. גישה לרישום מקוון אינה מהווה אישור להפצה מחדש של התמונה שלו; לפיכך, הזכויות ברמת הפאנל וקישורי המקור מתועדים בנפרד. המחברים מודים גם לקהילות המחקר הפתוח התומכות ב-CLIP וב-SAM, וכן לתמיכה המנהלית מאוניברסיטת סיטי של מקאו ומאוניברסיטת גואנגדונג פוליטכניק נורמל.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | מודל ראייה-שפה ששימש לניתוח ראשוני של דמיון בין תמונה–טקסט ולהקצאה של תוויות AI ראשוניות. |
| Computational workstation | תחנת העבודה החישובית של המחברים’ | CUDA-enabled GPU; תצורת חומרה מדויקת תדווח | תחנת עבודה ששימשה להסקת CLIP ו-SAM ולניתוחים חישוביים; יש לדווח על מפרטי ה-GPU, CPU, RAM, מערכת ההפעלה ו-CUDA מסביבת ההרצה המקורית. |
| Matplotlib | צוות הפיתוח של Matplotlib | חבילת Python; גרסה מדויקת תדווח | שימשה לוויזואליזציה חישובית וליצירת איורים וגרפים של הניתוח. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | שימש לארגון מטא-נתונים, רישומי סינון וניהול נתוני מחקר טבלאיים. |
| NumPy | מפתחי NumPy | חבילת Python; גרסה מדויקת תדווח | שימשה לחישובים מספריים ומניפולציה של מערכי מאפייני תמונה ומערכים אנליטיים. |
| pandas | צוות הפיתוח של pandas | חבילת Python; גרסה מדויקת תדווח | שימשה לטיפול בנתונים מובנים, עיבוד מטא-נתונים וארגון פלטי ניתוח ברמת המקרה. |
| Python 3.10 | Python Software Foundation | Python 3.10 | סביבת תכנות ששימשה ליישום זרימת העבודה של ניתוח תמונות חישובי. |
| PyTorch 2.0.1 | PyTorch Foundation | PyTorch 2.0.1 | מסגרת למידה עמוקה ששימשה להרצת קידוד תמונות וטקסט מבוס CLIP והסקה ב-GPU. |
| scikit-learn | מפתחי scikit-learn | חבילת Python; גרסה מדויקת תדווח | שימשה לחישובי K-means clustering, agglomerative clustering, silhouette coefficient, מדד Davies–Bouldin, ו-Cohen’s kappa. |
| Segment Anything Model (SAM) | Meta AI Research | SAM | מודל סגמנטציה ששימש לאיתור דמויות נשיות, בגדים, רהיטים, כלים, חפצי פולחן ואזורים ארכיטקטוניים לצורך בדיקה ויזואלית. |
| umap-learn | McInnes et al. | מימוש UMAP ב-Python | שימש להורדת ממדים ולוויזואליזציה דו-מדית של שיבוצי תמונות (embeddings) מ-CLIP עם מרחק קוסינוס. |
מקורות
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.