VoiceNet-RAI משלב מאפייני MFCC, ייצוגים (embeddings) רב-לשוניים של wav2vec 2.0 ו-EfficientNet-Lite לצורך סיווג מגדר וגיל מתוך נתוני קול. המסגרת משיגה דיוק של עד 97.87% בתת-הקבוצה בשפה האנגלית ותומכת ביישומים אחראים בזיהוי דיבור, אימות זהות ופורנזיקה דיגיטלית.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
VoiceNet: תשתית דיבור רב-לשונית של בינה מלאכותית אחראית לסיווג מגדר וגיל
127 צפיות
⸱
11 בספטמבר 2026
במאמר זה
סיכום
תקציר
סיווג מדויק של מגדר וגיל מנתוני קול הוא חיוני לאינטראקציה מותאמת אישית, מאובטחת ואתית בין אדם למחשב (HCI). עם השימוש הגובר במודלי דיבור גדולים ומאומנים מראש, כגון wav2vec 2.0, עולה הצורך לנצל ייצוגים אלו באופן אחראי עבור הסקת נתונים דמוגרפיים רב-לשונית ומודעת לפרטיות. מחקר זה מציע את VoiceNet-RAI, מסגרת למידה עמוקה (DL) המשלבת מקדמי MFCC (Mel-Frequency Cepstral Coefficients) עם שיבודי wav2vec 2.0 רב-לשוניים מבוססי transformer בתוך ארכיטקטורת EfficientNet-Lite, במטרה לתמוך בסיווג מדויק, הוגן ושקוף על פני הקשרים לשוניים מגוונים. המסגרת משלבת מידע קשרי (contextual) וספקטרלי כדי לשפר את החוסן תחת תנאי הקלטה משתנים. ניסויים על נתוני דיבור רב-לשוניים המקיפים 28 שפות מראים ביצועי סיווג חזקים, כאשר תת-הקבוצה בשפה האנגלית השיגה דיוק (accuracy) של 97.87%, דיוק (precision) של 98.61%, רגישות (recall) של 98.70% ומדד F1-score של 98.65%. תיקוף חיצוני באמצעות מערך הנתונים Mozilla Common Voice הניב דיוק של 98.27% לסיווג מגדר, מה שמעיד על יכולת הכללה למערך נתונים עצמאי. ניתוח אבלציה (ablation analysis) הראה עוד כי שילוב מאפייני MFCC ו-wav2vec 2.0 שיפר את הביצועים בהשוואה לייצוגים גולמיים או כאלה המבוססים על MFCC בלבד. ממצאים אלה מדגימים את הפוטנציאל של ייצוגי דיבור היברידיים, ספקטרליים-קשריים, לסיווג חסון ואחראי של מגדר וגיל.
מבוא
זיהוי קול הוא מרכיב מרכזי בתקשורת אנושית, שדרכו מבטאים אנשים את רגשותיהם, מחשבותיהם ומטרותיהם. קולות אנושיים מופקים באמצעות תהליך ביולוגי שבו אוויר נשף מהריאות ומעוצב לצליל על ידי איברי ההגייה, כגון השפתיים, הלשון והשיניים1. האוזן ממלאת תפקיד חיוני בזיהוי קול ויכולה להבחין בין קולות של גברים ונשים על בסיס מאפיינים כגון עוצמה וגובה צליל. מאפיין אחד התורם להבדלים משמעותיים בגובה הקול בין גברים לנשים הוא דימורפיזם מיני2. סיווג גיל ומגדר על פי קול רלוונטי ליישומים רבים, כולל אינטראקציה בין אדם למכונה, זיהוי מגדר אוטומטי, ברכות מותאמות אישית, סיווג מקדים של רגשות בדיבור וסיווג שיחות מבוסס מגדר3.
דיבור הוא חלק מהותי מהאינטראקציה האנושית. הקול האנושי מכיל מאפיינים מרובים המשתנים בין אנשים ויכולים לספק מידע על מצבים רגשיים ומנטליים, כמו גם על גיל ומין. מאפיינים רב-ממדיים אלו יכולים לשמש ביישומים כגון מערכות אבטחה מבוססות קול ועוזרים של בינה מלאכותית (AI) מכווני דיבור. תחומים נוספים שבהם ניתוח קול הוא חשוב כוללים מערכות אימות דוברים אוטומטי (ASV) ומערכות AI מבוססות רגש. מערכות קלט מבוססות קול יכולות גם לצמצם את מרחב החיפוש בתוך מאגרי נתונים4,5. בנוסף, מערכות אבטחה מבוססות AI יכולות להשתמש בנתוני קול ליישומים כגון חקירות פליליות והגנה על קורבנות. קולות של גברים ונשים מציגים מאפיינים שונים בשל הבדלים בתכונות התהודה של דרכי הקול. מאפיינים אלו ניתנים להוצאה מאותות דיבור בצורה המתאימה לעיבוד חישובי, מה שמאפשר סיווג מגדר מתוך נתוני קול6,7. לכן, נדרשים אלגוריתמי למידה יעילים לסיווג מגדר מבוסס קול. אלגוריתמי למידה עמוקה (DL) מתאימים במיוחד לסיווג הקשור לדיבור בשל יכולתם ללמוד תבניות מורכבות מנתוני שמע. מודלים כאלה עשויים להכיל שכבות קונבולוציוניות, רקורסיביות, קונבולוציוניות-זמניות או שכבות מחוברות באופן מלא, בהתאם לארכיטקטורה. שכבות אלו יכולות ללמוד מאפיינים אקוסטיים רלוונטיים, כולל גוון וגובה צליל. לאחר האימון, מודל יכול לסווג מגדר מהקלטות שמע שלא נראו בעבר8. תחום חשוב נוסף במחקר של למידת מכונה (ML) הוא סיווג גיל מהקלטות קול. אלגוריתמי ML יכולים להשתמש במאפיינים אקוסטיים כגון גובה צליל, גוון ואמפליטודה כדי לזהות תבניות הקשורות לגיל. טכניקות כגון ניתוח רכיבים ראשיים (PCA) יכולות גם הן להיות מיושמות כדי להוציא תבניות אינפורמטיביות מנתוני דיבור ופוטנציאלית לשפר את ביצועי הסיווג9.
למידה עמוקה (DL) הוכיחה ביצועים חזקים ביישומים כגון זיהוי תמונה, רגש ודיבור. רשתות נוירונים עמוקות (DNNs), בפרט, נמצאות בשימוש נרחב במשימות הקשורות לדיבור. במחקר זה, גישות מבוססות DL יושמו לסיווג קול בשילוב עם טכניקות מקובלות להפקת מאפיינים. מקדמי MFCC (Mel-Frequency Cepstral Coefficients) לוכדים מאפיינים ספקטרליים רלוונטיים של אותות דיבור ומספקים ייצוג יעיל לעיבוד המשכי. המאפיינים שהופקו שולבו לאחר מכן במסגרת של למידה בהעברה (transfer-learning) לסיווג מגדר וגיל המבוסס על קול10,11.
מחקרים אחרונים אימצו יותר ויותר ייצוגי דיבור מבוססי Transformer ולמידה בפיקוח עצמי (self-supervised) לצורך סיווג מאפייני דובר. חוקרים בחנו הטיות דמוגרפיות, כולל הטיות של מגדר וגיל, במודלים של דיבור בפיקוח עצמי כגון HuBERT ו-wav2vec 2.0, תוך הדגשת החשיבות של הערכה מודעת להגינות12. לאחרונה, גישות מבוססות Transformer שאינן תלויות שפה הדגימו את היעילות של ייצוגי דיבור הקשריים נלמדים לזיהוי מגדר בתנאים רב-לשוניים ורועשיים13. Sinha et al. חקרו לעומק ייצוגי wav2vec 2.0 ברמת השכבות עבור סיווג גיל ומגדר, והראו כי שכבות Transformer שונות לוכדות רמות משתנות של מידע הקשור לדובר14. פיתוחים אלו מהווים את המניע למסגרת VoiceNet-RAI המוצעת, המשלבת מידע ספקטרלי קונבנציונלי מבוסס MFCC עם ייצוגי wav2vec 2.0 הקשריים, תוך שילוב שיקולים רב-לשוניים והתחשבות ב-Responsible AI.
מחקרים אחרונים הדגימו כי ניתן לאפיין את גיל ומגדר הדובר באמצעות מאפיינים אקוסטים קונבנציונליים וייצוגים המבוססים על למידה עמוקה. גישות המשלבות מידע אקוסטים וטמפורלי הראו כי מאפייני דיבור משלימים יכולים לשפר את ביצועי הסיווג של גיל ומגדר15,16. מחקרים קשורים הדגימו גם כי מאפייני דיבור מעובדים שנוצרו באמצעות ייצוגי צוואר בקבוק עמוקים (deep bottleneck representations) יכולים לשפר את ביצועי הסיווג של גיל ומגדר הדובר17. ממצאים אלו תומכים בשימוש רחב יותר בייצוגים ספקטרליים, טמפורליים ונלמדים עבור משימות סיווג הכוללות דיבור ואותות נגזרים מדיבור.
מספר מחקרים בחנו זיהוי גיל ומגדר מתוך דיבור באמצעות גישות של למידה מכונה ולמידה עמוקה18,19,20,21,22,23,24,25,26,27,28,29,30. גישות עדכניות יותר בחנו ייצוגי MFCC שווניים ורשתות עצביות עמוקות לסיווג גיל ומגדר של הדובר31, בעוד ששונות רב-לשונית ותלות בשפה נותרות שיקולים חשובים בפיתוח מערכות חסונות לסיווג דמוגרפי מבוסס קול. הבדלים בהגייה, במבנה הפונטי, במאפייני הדובר ובתנאי ההקלטה עלולים להפחית את יכולת ההכללה של המודל בין שפות ואוכלוסיות שונות. בהתאם לכך, שימוש בייצוגי דיבור ספקטרליים והקשריים משלימים עשוי לשפר את החסינות בסביבות רב-לשוניות.
אף שגישות היברידיות שילבו בעבר מאפיינים אקוסטים מרובים או מסווגי אנסמבל לצורך זיהוי דמוגרפי מבוסס קול, VoiceNet-RAI נבדל מכך על ידי שילוב של שתי רמות משלימות של ייצוג דיבור בתוך מסגרת מאוחדת. באופן ספציפי, מאפייני MFCC קונבנציונליים משמרים מאפיינים ספקטרליים וקוליים מקומיים, בעוד ש-wav2vec 2.0 מספק ייצוגים קונטקסטואליים שנלמדו מדיבור גולמי באמצעות מקודד Transformer. במקום להסתמך אך ורק על תיאורים אקוסטים שתוכננו ידנית או על ייצוג עמוק בודד, VoiceNet-RAI מבצע היתוך ברמת המאפיינים של ייצוגי MFCC ו-wav2vec 2.0 המצברים באופן זמני, ולאחר מכן מזקק את הייצוג ההיברידי שהתקבל באמצעות EfficientNet-Lite. לפיכך, החידוש המדעי טמון בשילוב המתואם של ייצוגים ספקטרליים, קונטקסטואליים בפיקוח עצמי וייצוגים עמוקים קלי משקל לסיווג מגדר וגיל, יחד עם הערכה רב-לשונית, תיקוף באמצעות מאגרי נתונים עצמאיים וניתוח הוגנות של תתי-קבוצות. שילוב זה מרחיב את צינורות סיווג הדיבור ההיבריים הקונבנציונליים, מעבר להיתוך מאפיינים המכוון לדיוק בלבד, לעבר מסגרת השוקלת בו-זמנית השלמה של ייצוגים, עיצוב מודל קלי משקל, יכולת הכללה ו-Responsible AI.
התרומות המרכזיות של מחקר זה כוללות פיתוח של גישה לזיהוי מגדר וגיל מנתוני קול באמצעות שילוב של מאפייני MFCC ו-wav2vec 2.0 עם EfficientNet-Lite. נערכו ניסויים נרחבים על מערך נתונים של הקלטות קול מ-28 שפות, כאשר נבחנו מאפיינים מקוריים, מאפייני MFCC, מאפייני wav2vec 2.0 ושילוביים באמצעות מודלים של ML ו-DL. ביצועי המודלים הוערכו הן באמצעות מערך הנתונים הרב-לשוני המלא והן באמצעות תת-קבוצה של השפה האנגלית. המסגרת הוערכה בהמשך מנקודות מבט רב-לשוניות ומבחינת בינה מלאכותית אחראית (Responsible AI) באמצעות ניתוחי תתי-קבוצות ספציפיים למגדר ולשפה, הערכה בלתי תלויה בדובר, ותיקוף באמצעות מערך הנתונים Mozilla Common Voice. בנוסף, ביצועי המסגרת המוצעת הושוו לגישות חלוציות (state-of-the-art) שדווחו בספרות הקיימת, וסופקו תוצאות של 검증 צולבת (cross-validation). גוף משמעותי של מחקרים קשורים נערך, ו-Table 1 מסכם מחקרים אלה, כולל המודלים, מערכי הנתונים והתוצאות שדווחו19,20,21,22,23,24,25,26,27,28,29,30,31.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
במחקר זה נעשה שימוש במאגרי הנתונים BVC Challenging Voice Set ו-Mozilla Common Voice הזמינים לציבור, ללא מעורבות ישירה של משתתפים. לפיכך, לא נדרשו אישור אתי ממוסד או הסכמה מדעת נוספת. עובדו רק הנתונים הדרושים לסיווג מגדר וגיל, ולא נעשה ניסיון לזהות דוברים בודדים. מתודולוגיית זרימת העבודה המלאה של המסגרת המוצעת מוצגת ב-איור 1.
איסוף נתונים
מערך הנתונים ששימש בגישה המוצעת כלל קבצי אודיו בפורמט .wav שהשיגו מתוך BVC Challenging Voice Set, מערך נתונים קולי הזמין לציבור אשר פותח על ידי קבוצת Biometrics Vision and Computing (BVC) ומארח ב-GitHub32. מערך הנתונים הכיל הקלטות קוליות מ-526 אנשים, כולל 336 דוברים זכרים ו-190 דוברות נקבה. הוא כלל כ-3,964 הקלטות, הכוללות הקלטות של משפט בודד ושל מספר משפטים מכל דובר. טבלה 2 מסכמת את המאפיינים הדמוגרפיים, הכיסוי השפתי, תכונות ההקלטה, אסטרטגיית חלוקת הנתונים והגדרות עיבוד המקדם ששימשו עבור מערכי נתוני הדיבור במסגרת VoiceNet-RAI המוצעת.
חילוץ מאפיינים
קבצי שמע עובדו כדי להוציא תכונות חיוניות, אשר נשמרו לאחר מכן בקובץ CSV. מטא-נתונים, כולל גיל, מגדר והגייה של הדובר, הופקו מקובצי ה-README המתאימים. נעשה שימוש בשפת Python, יחד עם חבילת SciPy, לעיבוד קבצי ה-WAV ולהוצאת מאפיינים רלוונטיים. פונקציות התדר וה-Fast Fourier Transform (FFT) של NumPy שימשו להמרת אותות השמע מהמישור של הזמן למישור התדר. קבצי ה-WAV ייצגו את האמפליטודה כפונקציה של הזמן; עם זאת, מאפיינים הקשורים לתדר שיכולים להבדיל בין קולות גברים לנשים היו בעלי עניין רב יותר עבור משימת הסיווג33.
כדי להמיר את אותות השמע לייצוגים במישור התדר, הוטמעה התמרת פורייה בדידה (DFT) באמצעות אלגוריתם ה-FFT. התמרת פורייה ממירה אות במישור הזמן לספקטרום תדרים. מכיוון שספקטרום זה לא שימר מידע זמני, אות השמע חולק למקטעים חופפים, והתמרת פורייה הוחלה על כל מקטע באמצעות גישת התמרת פורייה לזמן קצר (STFT). הפונקציה np.fft.fft ייצרה את ספקטרום התדרים המרוכב, בעוד ש-np.fft.fftfreq סיפקה את תדרי הדגימה המתאימים. בספריית הדגימות היו זמינים 10 קבצי שמע עבור דובר יחיד. כל קובץ WAV עובד באמצעות חלונות גלישה של 200 ms כדי לחלץ את התדרים הדומיננטיים. לדוגמה, הקלטת שמע של 4 שניות הניבה רשימה של 20 ערכי תדר. עבור ספרייה המכילה 10 הקלטות, 10 הרשימות המתאימות, שכל אחת מהן הכילה 20 ערכי תדר, אוחדו לרשימה של רשימות. התדרים סוננו כדי לשמר ערכים שבין 20 Hz ל-280 Hz, בעוד שרעש פוטנציאלי סביב 50 Hz הוצא מהניתוח.
ייצוג מאפיינים היברידי של MFCC ו-wav2vec 2.0
כדי ללכוד הן ייצוגי דיבור הקשריים ברמה גבוהה והן מאפיינים אקוסטיים ברמה נמוכה, מחקר זה השתמש באסטרטגיית חילוץ מאפיינים היברידית ששילבה מאפייני MFCC עם השקהות (embeddings) של wav2vec 2.0 המבוססות על Transformer.
חילוץ מאפייני MFCC
מקדמי קפסטרליים בתדר-מל (MFCCs) הם מאפיינים הנמצאים בשימוש נרחב בעיבוד אותות קול ואודיו, במיוחד עבור יישומים כגון זיהוי דיבור וזיהוי דובר34,35. במחקר זה, מיצוי ה-MFCC הפך את אותות האודיו לווקטורי מאפיינים המייצגים תכונות רלוונטיות תפיסתיות של הדיבור. התהליך התחיל ב-pre-emphasis להגברת רכיבי תדר גבוה, ולאחריו framing ו-windowing כדי לחלק את האות למסגרות קצרות וחופפות. כל דגימת אודיו נדגמה מחדש תחילה ל-16 kHz וחולקה למסגרות של 25-ms עם חפיפה של 10-ms. לאחר מכן הוחלה התמרת פורייה מהירה (Fast Fourier Transform) על כל מסגרת כדי להמיר את האות מהמישור הזמן למישור התדר.
ספקטרום התדרים שהתקבל הועבר דרך סדרה של בנקי מסנני Mel שקירבו את תגובת התדר הבלתי ליניארית של התפיסה השמיעתית האנושית. בנקי מסננים אלה הדגישו תדרים רלוונטיים יותר מבחינה תפיסית תוך הפחתת התרומה של תדרים פחות אינפורמטיביים. לאחר מכן חושב הלוגריתם של הפלט מכל בנק מסננים כדי לקרב את הרגישות הלוגריתמית של השמיעה האנושית לעוצמת קול. לאחר מכן הוחלה התמרת קוסינוס בדידה (DCT) על האנרגיות הלוגריתמיות של בנקי המסננים כדי לבטל את המתאם בין המקדמים וליצור ייצוג דחוס של אות השמע. המקדמים שהתקבלו, המכונה MFCCs, לכדו מאפיינים ספקטרליים חשובים של הדיבור. MFCCs שימשו לסיווג מגדר וגיל מכיוון שהם לכדו מאפיינים אקוסטיים שהבדילו בין קולות על פי תכונות אלו.
חילוץ שיבוצים (embeddings) של wav2vec 2.0
מודל ה-wav2vec 2.0 Base עבר אימון מקדים על מאגרי דיבורים גדולים שאינם מתויגים. המודל כלל מקודד Transformer רב-שכבתי שעיבד קלטי גלי קול גולמיים והפיק שיבדים (embeddings) של דיבור בהקשר36.
בהינתן צורת גל קלט x ∈ RT, מודל wav2vec 2.0 ייצר רצף של ייצוגים חבויים:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
כאשר לכל וקטור שיכון (embedding vector) הייתה ממדיות של 768. כדי לקבל ייצוג באורך קבוע המתאים לסיווג, בוצע תהליך של temporal mean pooling על פני כל שלבי הזמן.
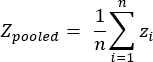 (2)
מנגנון היתוך מאפיינים
המאפיינים של MFCC ו-wav2vec 2.0 הוחברו באמצעות שרשור ברמת המאפיין. באופן ספציפי, מאפייני ה-MFCC אוגדו תחילה באמצעות ממוצע זמני כדי להפיק וקטור באורך קבוע.
m ∈ R40 (3)
וקטור המאפיינים ההיברידי הסופי התקבל באופן הבא:
h = [m || zpooled] ∈ R808 (4)
כאשר || מסמנת שרשור. מיזוג זה שילב שיכומים (embeddings) קשריים עמוקים עם מאפיינים ספקטרליים שנוצרו ידנית, מה שאפשר למודל ללכוד הן מידע סמנטי ברמה גבוהה והן תבניות אקוסטיות מפורטות.
כל דגימות השמע דוגמו מחדש תחילה ל-16 kHz. מאפייני MFCC חושבו עבור כל פריים (frame) והושגו עבורם ממוצעים זמניים כדי להפיק וקטור קבוע בעל 40 ממדים, בעוד ששיכמודי (embeddings) wav2vec 2.0 עברו מיעון ממוצע (mean-pooled) לאורך הזמן כדי להפיק ייצוג בעל 768 ממדים. מכיוון ששתי קבוצות המאפיינים הומרו לווקטורים באורך קבוע לפני האיחוד, לא נדרש סנכרון זמני ברמת הפריים. ייצוגי ה-MFCC וה-wav2vec שהתקבלו שורשרו לאחר מכן לווקטור מאפיינים היברידי בעל 808 ממדים לפני שהועברו למודל הסיווג.
שילוב עם EfficientNet-Lite
וקטור המאפיינים המאוחד, h, עוצב מחדש לפורמט המתאים ללמידת מאפיינים והוזן למודל EfficientNet-Lite לצורך אימון. שכבת היטל מחוברת באופן מלא מיפתה תחילה את הווקטור בן 808 הממדים למרחב לטנטי בעל ממדים גבוהים יותר, ולאחר מכן בלוקים של EfficientNet-Lite זיקקו מאפיינים היררכיים. שכבות של נורמליזציית אצוות (Batch normalization) וdropout שימשו להפחתת התאמת-יתר (overfitting) ולשיפור הכללה של המודל. פונקציית ההפעלה SoftMax שימשה להפקת ההסתברויות החזויות הסופיות עבור מחלקות המגדר והגיל. הייצוג המאוחד, h ∈ R808, טופל בתחילה כוקטור מאפיינים חד-ממדי והועבר דרך שכבת היטל מחוברת באופן מלא שמיפתה אותו ל-4,096 ממדים. הייצוג הממופה עוצב לאחר מכן מחדש לטנזור של 1 × 64 × 64 לפני שהוזן לארכיטקטורת EfficientNet-Lite.
כדי להתאים לייצוג תכונות של דיבור בערוץ יחיד, במקום קלט תמונה קונבנציונלי בעל שלושה ערוצים, שונו השכבה הקונבולוציונית של הקלט במודל EfficientNet-Lite המקורי משלושה ערוצי קלט לאחד. שאר בלוקי חילוץ התכונות של EfficientNet-Lite נשמרו ללא שינויים ארכיטקטוניים משמעותיים. שכבת average pooling גלובלית אדפטיבית הוחלה על מפות התכונות הסופיות כדי להפיק ייצוג באורך קבוע. ראש הסיווג המקורי הוחלף בשכבה מחוברת באופן מלא (fully connected) ספציפית למשימה, המכילה שתי יחידות פלט לסיווג מגדר ומספר היחידות המתאים לקבוצות הגילים שהוגדרו מראש. לבסוף, פונקציית ההפעלה SoftMax הוחלה כדי להפיק הסתברויות למחלקות. הייצוג ההיברידי המוצע שילב שיבוצי דיבור (embeddings) מודרניים בפיקוח עצמי עם תכונות מסורתיות של עיבוד אותות. שיבוצי wav2vec 2.0 לכדו מידע קונטקסטואלי ותלויות לטווח רחוק, בעוד שתכונות ה-MFCC סיפקו מידע אקוסטי משלים ברמה נמוכה. השילוב של ייצוגים אלו שיפר את ביצועי הסיווג, במיוחד בתנאי דיבור רועשים ורב-לשוניים.
מסווג ML
במחקר זה, נותח הביצועים של מספר אלגוריתמי ML לצורך סיווג מגדר וקבוצת גיל על בסיס קול.
יער אקראי (Random Forest)
Random Forest (RF) שימש כסיווג (classifier) חסון של למידת מכונה (ML), המשלב מספר עצי החלטה (DTs) כדי לשפר את דיוק התחזיות ולהפחית התאמת יתר (overfitting). RF פעל באמצעות הליך של למידה בהרכבה (ensemble-learning), שבו תחזיות ממספר עצים אוגרו כדי להפיק את התחזית הסופית37,38. גישה זו אפשרה ל-RF ללכוד דפוסים מגוונים בנתונים תוך הפחתת התאמת היתר הנלווית בדרך כלל לעצי החלטה בודדים. האקראיות שהוכנסה במהלך בניית העצים שיפרה את יכולת ההכללה של המודל, מה שהפך את RF למתאים למשימות סיווג כגון סיווג מגדר וגיל מתוך נתוני קול.
רגרסיה לוגיסטית
רגסיה לוגיסטית (LR) שימשה כמודל ML סטטיסטי לסיווג39. עבור סיווג בינארי, LR מעריכה את ההסתברות לתוצאה מסוימת על בסיס מאפייני הקלט באמצעות הפונקציה הלוגיסטית (סיגמואיד), וההסתברויות המתוּלדות משמשות ליצירת תחזיות מחלקה. LR הייתה ישימה גם לבעיות סיווג רב-מחלקי הכוללות יותר משתי מחלקות. עבור סיווג רב-מחלקי, LR השתמשה בגישות כגון one-vs-rest או רגרסיית SoftMax, בהתאם להגדרות הסיווג.
מסווג עצי אקסטרה (Extra Tree Classifier)
השתמשו במסווג עצי תמרור (ETC) כאלגוריתם למידה מתוך מקבץ (ensemble learning), אשר שילב מספר עצי החלטה (DTs) כדי להפיק תחזיות40,41. בניגוד ל-RF, ה-ETC מ einführt אקראיות נוספת על ידי בחירת מאפיינים מועמדים וספי סבחי פיצול באופן אקראי במהלך בניית העץ. הליך זה יצר עצים בעלי מתאם נמוך יותר והפחית את רגישות המודל למאפיינים בודדים, ובכך שיפר את העמידות לרעש. השתמשו במדד ג'יני (Gini index) כקריטריון פיצול להערכת חשיבות המאפיינים ולחלוקת הנתונים.
מכונת וקטור תומך
נעשה שימוש במכונת וקטורים תומכים (SVM) כמסווג ML כדי לזהות גבול החלטה אופטימלי במרחב מאפיינים רב-ממדי42. המטרה הייתה לקבוע היפרמישור שימקסם את השוליים בין המחלקות. שוליים רחבים יותר בין גבול ההחלטה לנקודות הנתונים הקרובות ביותר תמכו בדרך כלל בהפרדה טובה יותר בין המחלקות ובביכולת הכללה. SVM היה ישיים למספר משימות ML, כולל סיווג, רגרסיה וניתוח נתונים מבוסס מאפיינים.
רשתות נוירונים קונבולוציוניות
רשתות נוירונים קונבולוציוניות (CNNs) שימשו כמודלים של למידה עמוקה (DL) למשימות סיווג הכוללות ייצוגים מובנים של נתוני תמונה ואודיו. רשתות CNN חד-ממדיות (1D-CNNs) יושמו באופן נרחב גם על נתונים סקוונציאליים וטקסטואליים. ארכיטקטורות CNN השתמשו במסננים קונבולוציוניים ובפעולות בריכה (pooling) כדי לחלץ מאפיינים מבדילים מנתוני הקלט43,44. עבור סיווג מגדר וגיל מנתוני קול, הוחלו רשתות CNN על ייצוגים המופקים מדיבור כדי ללמוד דפוסים הקשורים לגובה הצליל, תדר, טון ומאפיינים קוליים אחרים הרלוונטיים להבחנה בין קבוצות גיל ומגדר.
VGG19
VGG19 שימשה כארכיטקטורת DL המאופיינת במבנה היררכי עמוק ואחיד יחסית לחילוץ תכונות45. הארכיטקטורה שלה השתמשה במסננים קונבולוציוניים קטנים בגודל 3 × 3 לאורך 19 שכבות, מה שאיפשר חילוץ הדרגתי של תכונות מבחינות. כאשר הוחלה על ייצוגים המופקים מדיבור, VGG19 לכדה הן דפוסים אקוסטיים ברמה נמוכה, כגון שינויים בגובה הצליל וב tầncy, והן תכונות מבחנות ברמה גבוהה יותר. הארכיטקטורה העמוקה שלה אפשרה הפשטה הדרגתית של תכונות לצורך מידול מאפיינים קוליים הקשורים למגדר ולגיל.
EfficientNet-Lite
EfficientNet-Lite שימשה כארכיטקטורת DL יעילה מבחינה חישובית46,47. המודל השתמש באסטרטגיית סקלה מאוזנת כדי להשיג ביצועי סיווג חזקים תוך דרישה למשאבים חישוביים מועטים יותר מאשר ארכיטקטורות DL כבדות יותר. גישת הסקלה המשולבת שלו שקללה יחד את עומק המודל, רוחבו ורזולוציית הקלט כדי להשיג חילוץ תכונות יעיל.
EfficientNet-Lite נבחר עבור מסגרת VoiceNet-RAI המוצעת בשל הארכיטקטורה הקלה שלו והאיזון המוטב בין ביצועי הסיווג למורכבות המודל. בהשוואה לארכיטקטורות כבדות יותר, הוא השתמש בבלוקים קונבולוציוניים יעילים ובסקלינג מורכב (compound scaling) כדי להשיג למידת מאפיינים אפקטיבית עם פחות פרמטרים ודרישות חישוב נמוכות יותר. מאפיינים אלו הפכו את EfficientNet-Lite למתאים עבור מסגרת סיווג הדיבור המוצעת, ואפשרו פוטנציאל לפריסה בסביבות עם משאבים מוגבלים.
MobileNet
MobileNet שימשה כארכיטקטורת DL קלה עבור יישומים עם משאבים חישוביים מוגבלים, כולל סביבות מחשוב ניידות ומחשוב קצה48. היעילות החישובית שלה הושגה בעיקר באמצעות קונבולוציות נפרדות לעומק (depthwise separable convolutions), אשר הפחיתו את מספר הפרמטרים ואת הפעולות החישוביות בהשוואה לארכיטקטורות קונבולוציוניות קונבנציונליות. מאפיינים אלו הפכו את MobileNet למתאימה להערכת סיווג מגדר וגיל מתוך נתוני קול, תוך שמירה על דרישות חישוביות נמוכות יחסית.
InceptionV3
InceptionV3 שימשה כארכיטקטורה עמוקה לחילוץ מאפיינים היררכיים מייצוגים המופקים מדיבור49. הארכיטקטורה שילבה פעולות קונבולוציה, איחוד (pooling) ופעולות מעורבות כדי לחלץ מאפיינים ברמות שונות של הפשטה. לצורך סיווג מגדר וגיל מנתוני קול, InceptionV3 שימשה ללמידה של תבניות אקוסטיות מורכבות וייצוגים היררכיים הקשורים לווריאציות במאפייני הקול.
פרמטרי הערכה
דיוק (Accuracy) היה אחד ממדדי ההערכה השכיחים ביותר למשימות סיווג50. על אף שהדיוק סיפק מדד שימושי לביצועי הסיווג הכלליים, הוא לא תמיד סיפק הערכה מקיפה, במיוחד עבור מערכי נתונים לא מאוזנים. לכן, נעשה שימוש במדדים נוספים, כולל דיוק חיזוי (precision), רגישות (recall) ומדד F1 (F1-score), כדי להעריך את ביצועי המודל. מדדים אלו סיפקו הערכה מקיפה יותר על ידי התחשבות בחיזויים נכונים ושגויים עבור כל מחלקה.
דיוק הוגדר כיחס בין תצפיות שסווגו נכון למספר התצפיות הכולל. למרות שדיוק הוא מדד אינפורמטיבי במיוחד עבור מערכי נתונים מאוזנים, מערך הנתונים ששימש במחקר זה היה לא מאוזן. לכן, כאשר חושבו ופורשו מדדי הסיווג, נלקחו בחשבון חיוביים אמיתיים (TP), חיוביים שגויים (FP), שליליים אמיתיים (TN) ושליליים שגויים (FN). המשוואה להלן מייצגת את ההגדרה הסטנדרטית של דיוק:
דיוק = (TP+TN)/(TP+TN+FP+FN)×100 (5)
דיוק (Precision) מעריך את יכולתו של המסווג להחזיר רק מקרים רלוונטיים:
דיוק= TP/(TP+FP) ×100 (6)
Recall, הידוע גם כרגישות (sensitivity), מודד את יכולתו של המסווג לזהות את כל המקרים הרלוונטיים:
רגישות (Recall)= TP/(FN+TP) × 100 (7)
מדד ה-F1-score משלב בין דיוק (precision) לרגישות (recall) למדד אחד, והוא שימושי במיוחד להערכת ביצועי סיווג במערכי נתונים לא מאוזנים:
F1-Score =2 ×(PPV ×TPR)/(TPR+PPV) × 100 (8)
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
תוצאות ניסיוניות לסיווג גיל ומגדר הוערכו באמצעות ייצוגי מאפיינים מבוססי MFCC וייצוגים היברידיים עם מודלים של ML ו-DL. מערך הנתונים חולק לקבוצות אימון ובדיקה ביחס של 80:20, כאשר 80% שימשו לאימון ו-20% לבדיקה. חלוקה ברמת הדובר יושמה כדי למנוע מהקלטות של אותו דובר להופיע בשתי הקבוצות.
ההיפר-פרמטרים ופרטי המימוש של המסגרת המוצעת מסוכמים ב-טבלה 3. הניסויים נערכו במערכת המצוידת במעבד Intel i7-8265U CPU, ב-16 GB של RAM ובמעבד גרפי NVIDIA Tesla K80 GPU המריץ Windows 11. Python וספריית...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
מחקר זה פיתח והעריך מסגרת אוטומטית לסיווג מגדר וגיל מנתוני קול על ידי שילוב מאפייני MFCC והטמעות wav2vec 2.0 עם EfficientNet-Lite. בניסויים הראשוניים, EfficientNet-Lite השיגה דיוק (accuracy) של 83.48%, דיוק חיזוי (precision) של 82.87%, רגישות (recall) של 84.28%, ומדד F1 של 83.54% תוך שימוש במאפיינים המקוריים. בעקבות שילוב מאפייני MFCC, הביצועים השתפרו באופן משמעותי, עם דיוק של 92.64%, דיוק חיזוי של 93.79%, רגישות של 94.92%, ומדד F1 של 94.84% על מערך נתונים הכולל 28 שפות. בשימוש בייצוג ההיברידי MFCC–wav2vec 2.0 על תת-קבוצ...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
למחברים אין ניגודי עניינים להצהיר עליהם.
תודות
המחברים מעוניינים להודות לפרויקט תמיכה בחוקרים של אוניברסיטת הנסיכה נורה בינת עבדולרחמן מספר (PNURSP2026R748), אוניברסיטת הנסיכה נורה בינת עבדולרחמן, ריאד, ערב הסעודית, על מימון מחקר זה.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| סט קולות מאתגרים של BVC | קבוצת חזון ומחשוב בביומטריה / OgeNI | מערך קולות מאתגר של BVC | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | גוגל | EfficientNet-Lite, הגרסה המדויקת שנעשה בה שימוש | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite |
| מעבד גרפי | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| מאגר הנתונים Mozilla Common Voice | Mozilla Foundation | Common Voice, הגרסה ששימשה בניסויים | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | מפתחי NumPy | הגרסה המדויקת שבה נעשה שימוש בניסויים | https://numpy.org/ |
| מעבד | אינטל | Intel Core i7-8265U | https://www.intel.com/ |
| פייתון | Python Software Foundation | הגרסה המדויקת שנעשה בה שימוש בניסויים | https://www.python.org/ |
| PyTorch | PyTorch Foundation | הגרסה המדויקת ששימשה בניסויים | https://pytorch.org/ |
| Scikit-learn | מפתחי Scikit-learn | הגרסה המדויקת ששימשה בניסויים | https://scikit-learn.org/ |
| SciPy | מפתחי SciPy | הגרסה המדויקת שבה נעשה שימוש בניסויים | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 11 | Microsoft | Windows 11, מהדורה/גרסה מדויקת אם זמינה | https://www.microsoft.com/windows/windows-11 |
מקורות
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.