פרוטוקול זה משלב רישומים התנהגותיים מולטי-מודאליים כדי להעריך מתאמים ניתנים לצפייה של מאמץ קוגניטיבי ואת היעילות התפקודית של תיקון בתרגום כתוב ובפירוש בראייה מאנגלית לסינית. הוא משלב רישום הקשות מקלדת, צילום מסך, ניתוח שמע, קידוד מבוסס תמלול והערכת איכות סטנדרטית.
מאמר שיטה
פרוטוקול התנהגותי להערכת מאמץ קוגניטיבי ועדכון אסטרטגי במשימות תרגום ופירוש במבט (Sight Interpreting) מאנגלית לסינית
במאמר זה
סיכום
תקציר
מאמר זה מציג פרוטוקול התנהגותי רב-מודאלי לבחינת מתאמים נצפים של מאמץ קוגניטיבי ותיקון אסטרטגי במהלך תרגום כתוב ותרגום סימולטני של טקסט (sight interpreting) מאנגלית לסינית. עבור התרגום הכתוב, סנכרנו לוגים של הקשות מקלדת והקלטות מסך, בעוד שעבור תרגום הסימולטני של הטקסט נעשה שימוש בהקלטות שמע ותמלילים מילה במילה. אירועי תיקון ותיקון עצמי מקודדים לפי סוג ולפי תוצאה תפקודית (יעילה, ניטרלית או מזיקה), באופן בלתי תלוי מדירוגי איכות פלט הוליסטיים. בהדגמה עם 62 משתתפים שחולקו לקבוצות של מתחילים ומיומנים, שתי הקבוצות השלימו את שני תנאי המטלה בסדר מאוזן (counterbalanced). למשתתפים המיומנים היו ציוני איכות פלט ממוצעים גבוהים יותר בתרגום כתוב (20.1 ± 2.1 לעומת 16.8 ± 2.3) ובתרגום סימולטני של טקסט (18.9 ± 2.4 לעומת 15.4 ± 2.6), ושיעור גבוה יותר של תיקונים או תיקונים עצמיים יעילים. מכיוון שהפסקות, מחיקות, השהיית תחילת דיבור וצפיפות תיקונים הם מדדים עקיפים ורגישים למטלה, הם מפורשים כמתאמים התנהגותיים הדורשים טריאנגולציה ולא כמדדים ישירים של מבנה תיאורטי אחיד. הפרוטוקול מיועד לטקסטים הסבריים מבוקרים וניתן להתאימו לזוגות שפות אחרים לאחר כיול מחדש של הטיפול בשיטת הקלט, ספי תגובה להפסקות, השוואת טקסטים ונהלי ניקוד.
מבוא
תרגום כתוב ופירוש במבט (sight interpreting) מאנגלית לסינית דורשים הבנה של טקסט המקור, העברה בין-לשונית וניסוח בשפת היעד, אך הם מציבים תנאי משימה שונים. תרגום כתוב מאפשר קריאה רקורסיבית ועריכה דחויה, בעוד שפירוש במבט דורש הפקה בעל פה תחת אילוצים זמניים הדוקים יותר. עומס קוגניטיבי, קושי בעיבוד ומאמץ קוגניטיבי הם מושגים קשורים אך לא ניתנים להחלפה: העומס נוגע לדרישות המשימה, בעוד שהמאמץ נוגע למשאבים שמשקיע המשתתף תחת דרישות אלו. מאמץ קוגניטיבי הוא סמוי ורב-ממדי; לכן, השהייה, הפסקות, מחיקות וצפיפות תיקונים נחשבים כאן כמתאמים התנהגותיים שעשויים לשקף תכנון, ניטור, תהליכים מוטוריים או קושי, ויש לפרש אותם באופן משותף ולא כמדידות ישירות של מאמץ1,2,3,4,5,6,7,8.
מחקר מוכוון-תהליך משלב ציוני מוצר עם רישומים התנהגותיים מסונכרני-זמן כדי לזהות מתי ובאיזה אופן מתקבלות החלטות תרגום. רישום לחיצות מקש (Keystroke logging) מספק מידע רב על רצפי הפקה וערכה, אך הרכבת טקסט בשיטות קלט בסינית עלולה להפריד בין אירועי לחיצה פיזיים לבין התווים שנרשמו; לכן, נדרשת הקלטת מסך מסונכרנת כדי לשחזר את מצב הטקסט הגלוי9,10,11. ספי treffen של הפסקות הן בחירות אנליטיות ולא גבולות קוגניטיביים אוניברסליים, וספים קצרים יותר עשויים לשנות באופן מהותי את המסקנות המבוססות על הפסקות8,12. כתוצאה מכך, הפרוטוקול דורש בדיקות סנכרון מפורשות, ניתוחי רגישות לספים והפרדה בין מדדים ספציפיים למשימה לבין מדדים משותפים.
תדירות התיקונים לבדה אינה מעידה על כך שניטור משפר את התוצר. תיקונים בכתב ותיקונים עצמיים בעל פה עשויים להתמקד בבחירה לקסית, בתחביר, במשמעות או בסגנון, אך יש להעריך את התוצאה התפקודית שלהם ביחס למשמעות המקור ולמקטע היעד שקדם להם באופן מיידי. מחקרי תרגום-ראייה (Sight-interpreting) על עיבוד בשפות אנגלית-סינית וסינית-אנגלית מראים שאימון, כיווניות, קואורדינציית עיניים-קול וגורמים המעוררים בעיות ספציפיות לשפה עשויים לשנות את דפוסי הביצוע13,14,15,16. מסיבה זו, סוג האפיזודה, תוצאת האפיזודה, איכות התוצר הסופי והתנהגות הקשורה להגשה מקודדים כמשתנים נפרדים.
הפרוטוקול מיועד ללומדים מבוגרים או למתרגמים/מתורגמנים מיומנים העובדים עם טקסטים הסבריים קצרים שאינם מקצועיים, במפגשים מבוקרי מחשב. הוא מתאים ביותר כאשר ניתן להקליט הקשות מקלדת ורישומי מסך עבור תפוקה כתובה, ולהקליט אודיו באיכות גבוהה עבור תפוקה בעל פה. ניתן להתאים את המסגרת לזוגות שפות אחרים, אך יש לתקף מחדש את התאמת הטקסט, החלוקה ליחידות מידע, התנהגות המקלדת או שיטת הקלט, ספי ההפסקה ועגיני הדירוג עבור כל זוג שפות ומערכת כתיבה17. ההדגמה משווה בין תנאי המשימה במקום לייחס את כל ההבדלים למודליות בלבד, מכיוון שגם אורך הטקסט, מגבלות הזמן, מצב הפלט וההזדמנויות לעריכה שונים.
פרוטוקול
כל השיטות הכוללות שימוש בנבדקים אנושיים בוצעו בהתאם להנחיות המוסדיות וקיבלו אישור מפורש מוועדת האתיקה למחקר בבני אדם של מכון גווילין לטכנולוגיית מידע (אישור מס׳ UYHAJ2025899). הסכמה מודעת בכתב התקבלה מכל המשתתפים לפני השתתפותם. נא לעיין ב- טבלת חומרים עבור רשימה מקיפה של הציוד והתוכנות ששימשו במחקר זה.
1. גיוס משתתפים והקצאה לקבוצות
- גייסו 62 משתתפים, הכוללים סטודנטים למסלולי לימוד באנגלית או בתרגום ומתמחים מקצועיים בפירוש סימולטני. ודאו כי כל המשתתפים הם דוברי סינית כשפת אם ובעלי ראייה ושמיעה תקינות או מתוקנות לרמה תקינה.
- שבצו את המשתתפים עם פחות מ-12 חודשים של הכשרה מובנית בתרגום לקבוצת הנוביסים (מתחילים), ושבצו את אלו עם לפחות 12 חודשי הכשרה לקבוצת המיומנים. דווחו באופן נפרד על ניסיון קודם בתרגום כתוב ובפירוש למסמכים עבור כל המשתתפים.
- סננו את המשתתפים לפני השבצה למשימות כדי להחריג את אלו שנחשפו בעבר לטקסטים המקור, בעלי ליקויים חושיים שאינם מתוקנים, או כאלו שאינם מסוגלים להשתמש בשיטת הקלט הסינית הסטנדרטית.
- החריגו משימות לאחר ההקלטה רק מסיבות שהוגדרו מראש, כגון שימוש אסור בכלים חיצוניים, ביצוע חסר, קבצים פגומים או הקלטות שמע שאינן ניתנות לשימוש.
- נהלו יומן החרגת משימות ללא מידע מזהה אישי. דווחו על המדגם הסופי שנותח באופן עקבי בטקסט וב-איור 1A–D.
2. בחירת חומרים והערכה ראשונית
- בחרו טקסטים הסבריים קצרים באנגלית מתחומים אקדמיים כלליים, חינוכיים, חברתיים או מתחומי תקשורת ציבורית. השתמשו בטקסטים לתרגום כתוב באורך של כ-180–220 מילים ובטקסטים לתרגום סימולטני (sight-interpreting) באורך של כ-120–160 מילים.
- בצעו התאמה או התאמה סטטיסטית לאורך הטקסט, לקושי לקסיקלי, למורכבות תחבירית, לצפיפות המידע ולמידת ההכרות עם הנושא בין תנאי המשימה השונים.
- הנחו שלושה מומחים דו-לשוניים לדרג באופן עצמאי את הקושי הלקסיקלי, המורכבות התחבירית, צפיפות המידע, ההכרות עם הנושא וההתאמה להעברה, על סולם של 1 עד 5 נקודות (1 = נמוך מאוד, 5 = גבוה מאוד).
- חשבו מקדם מתאם תוך-מעמדי (ICC) של השפעות אקראיות דו-כיוונית עם רווח סמך של 95% עבור הדירוגים הממוצעים. עדכנו פריטים שהראו הסכמה נמוכה (ICC < 0.75).
- שמרו על זוגות טקסטים רק כאשר משתני ההתאמה הסטנדרטיים נכנסים בטווח סטייה של ±10%.
- הגדירו יחידת מידע כטענה הקטנה ביותר בטקסט המקור המבטאת רעיון, קשר או אירוע אחד הניתנים לדירוג באופן עצמאי. פתרו מחלוקות לגבי גבולות היחידה לפני ביצוע המשימה.
- בצעו פיילוט להוראות, לשיטת הקלט, לסנכרון, לאיכות הסאונד ולמגבלות הזמן עם משתתפים שאינם נכללים בניתוח העיקרי. תיעדו את התפלגויות זמני ההשלמה ואת הפרופורציה של המשתתפים שהגיעו לכל מגבלת זמן.
- עדכנו טקסט או מגבלת זמן כאשר משתתפי הפיילוט מפגינים ביצועי תקרה/רצפה (ceiling/floor performance), עמימות מתמשכת או חוסר יציבות בהקלטה. תיעדו כל שינוי לפני השקת המחקר העיקרי.
3. הגדרת ניהול המטלה והקלטה
- בצעו את הבדיקה של המשתתפים באופן פרטני בחדר שקט ומבודד רעשים, תוך שימוש בתצורות חומרה ותוכנה סטנדרטיות.
- קראו תסריט הנחיות סטנדרטי ואפשרו פריט תרגול אחד שאינו חלק מהניסוי. אסרו שימוש במילונים, מנועי חיפוש, בינה מלאכותית גנרטיבית, תרגום מכונה ומאגרי טקסטים חיצוניים.
- בצעו איזון (Counterbalance) בין שני סדרי המטלות (תרגום כתוב תחילה לעומת תרגום תוך-ראייה תחילה) בתוך כל קבוצת אימון, ושמרו על הפסקה של 5 דקות בין המטלות.
- הכינו את רשימת ההקצאה לפני השלמת הגיוס והסתירו את השיוך עד לאישור ההתאמה. במקרה של שימוש במספר טקסטים מקור, בצעו איזון של זהות הטקסטים באופן בלתי תלוי בסדר המטלות ושמרו משתנה של מזהה טקסט (text-ID) לצורך הניתוח.
- הציגו את טקסט המקור באנגלית באופן רציף והנחו את המשתתף להפיק תרגום מדויק וטבעי לסינית בשדה הקלט הייעודי. אפשרו עריכה ללא הגבלה, אך אסרו באופן מוחלט הדבקת טקסט חיצוני.
- החילו את הגבלת הזמן של 20 דקות שנקבעה בניסוי הפיילוט ללא הצגת שעון ספירה לאחור, ורשמו האם הגיע המשתתף לתקרת הזמן.
- תעדו את מלוא תהליך התרגום הכתוב באופן רציף, באמצעות תוכנה לרישום לחיצות מקשים המסונכרנת עם הקלטת מסך רציפה. שמרו את תוצרי התרגום הסופיים לצד קבצי הלוג עם חותמות זמן לצורך חילוץ נתונים התנהגותיים בהמשך.
- הציגו את טקסט המקור לתרגום תוך-ראייה על המסך והנחו את המשתתף להתחיל בביצוע תרגום בעל פה לסינית ללא רשמי כתובים.
- החילו בעקביות את הגבלת הזמן של 6 דקות ורשמו האם הגיע המשתתף לתקרת הזמן. הבדילו בין תצפית שהוגבלה בזמן לבין תצפית שהושלמה באופן רגיל.
- הקליטו את הפלט הקולי באמצעות תוכנה ללכידה דיגיטלית של שמע. הפקו תמלילים מדויקים של מילה במילה מההקלטות הללו כדי להקל על הקידוד העתידי.
4. הפקת מדדי תהליכים התנהגותיים
- חלץ מדדי התנהגות של משימות כתיבה מקובצי הלוג, כאשר השהייה הראשונית מוגדרת כפרק הזמן מהופעת הגירוי ועד לתו הסינית הראשון שהוקלד.
- חלץ את זמן המשימה הכולל, את מספר ומשך ההפסקות, את קצב המחיקה, את צפיפות העריכה ואת קצב הייצור. שמור את חותמות הזמן הגולמיות ואת המכנה המדויק ששימש לכל מדד מנורמל.
- השתמש ב-2 s כסף המבצעי להפסקת כתיבה. דווח האם הפסקות במהלך ניווט בסמן, בחירת טקסט או בחירת מועמדים בשיטת הקלטה נכללות במדידה.
- חלץ מדדי התנהגות של משימות בעל פה מתוך צורת הגל והתמלול המאומת, כאשר השהיית התחלה מוגדרת כפרק הזמן מהצגת הגירוי ועד להגייה המשמעותית הראשונה בשפת היעד.
- ה excluded שאיפה, ניקוי גרון וצלילים לא לקסיקליים שהופסקו מחישוב השהיית ההתחלה. חלץ את זמן התרגום הכולל, הפסקות שקטות, הפסקות מלאות (filled pauses), חזרות, התחלות שגויות, תיקונים עצמיים וקצב דיבור.
- הגדר הפסקת שקט בעל פה כשתיקה בתוך הגייה שנמשכה לפחות 1.0 s. בדוק את גבולות ההפסקות אל מול צורת הגל והתמלול המאומת, והוצא שתיקות בתחילת ובסוף ההגייה מספירת ההפסקות בתוך ההגייה.
- השלם רישום בקרת איכות עבור כל משימה שבוצעה. תעד האם קובץ התהליך הרלוונטי קריא ומלא, האם התמלול אומת, והאם הקידוד הושלם או הוכרע. שמור את הרישום המקורי ועקב אחר כל התיקונים בנתיב הביקורת (audit trail).
5. קידוד של תיקון אסטרטגי ותיקון עצמי בעל פה
- שחזרו כל סבב תיקון כתוב על ידי סנכרון של יומן הלחיצות, סרטון המסך והטקסט הסופי.
- הגדירו פרק כרצף רציף של פעולות עריכה המופנות לאותו מקטע מטרה, וסגרו את הפרק כאשר הייצור נשאר במקום אחר למשך לפחות 2 s או כאשר עורכים מקטע שונה.
הערה: עבור קלט בסינית, הגדירו הבחנה בין שינויים בהרכבה לפני האישור (pre-commitment) לבין מחיקות של טקסט מטרה לאחר האישור, וקודדו רק את האחרונים כתיקונים טקסטואליים. - הקצו סוג תיקון ראשוני אחד בהתבסס על שינויים סמנטיים, תחביריים, לקסיקליים או סגנוניים. אפשרו תגית משנית למקרים חופפים, אך השתמשו בתגית הראשית לצורך ספירות המוהדרות אחת מהשנייה. יישמו את הדוגמאות המעשיות המסופקות ב-Supplementary File 1.
- הפיקו תמלול מדויק עם חותמות זמן לפני קידוד תיקון עצמי בעל פה. הנחו את התמלול הראשוני לסמן תוכן לקסיקלי, הפסקות מילוי, חזרות, התחלות שגויות, קטיעות ומקטעים שאינם מובנים.
- הביאו בודק מאומן שני שיבדוק את התמלול מול האודיו ויפתור אי-הסכמות תוך שמירה על חותמות הזמן המקוריות של האודיו.
- הגדירו תיקון עצמי בעל פה כניסוח מחדש גלוי שמחליף, משלים או מתקן מקטע בשפת המטרה שקדם לו באופן מיידי. אין להסיק על ניטור סמוי משתיקה לבדה. יישמו את אותם כללי החלטה לקסיקליים, תחביריים, סמנטיים וסגנוניים על תיקון עצמי בעל פה.
- קודדו חזרה מדויקת ללא שינוי מתקן כחוסר רצף (disfluency), התחלה נטושה שאחריה מופיע מבנה חדש כהתחלה שגויה בתוספת תיקון, והשמטה או תרגום שגוי ללא ניסוח מחדש גלוי כשגיאת פלט.
- כאשר האודיו אינו ברור או כאשר שתי קטגוריות נשארות סבירות באותה מידה, סמנו את הפרק כמעורפל. שמרו תגיות זמניות עבור פרקים מעורפלים והכריעו לגביהם לפני ניתוח המהימנות.
- שפטו את התוצאה התפקודית על ידי השוואת מקטעי המטרה לפני הפרק ואחריו אל מול יחידת מידע המקור וההקשר המקומי של המטרה. בצעו שיפוט זה לפני חשיפת הציון ההוליסטי הסופי. אין להשתמש בשינוי בציון ההוליסטי כהגדרה ליעילות.
- בצעו קידוד כפול לפחות ל-20% מהפלטים שנבחרו משתי הקבוצות ומסדר המשימות, וחשבו את המהימנות על סמך הקודים העצמאיים לפני הבת arbitration.
- הכשרי מחדש וקודד מחדש כאשר ההסכמה בין המדרגים יורדת מתחת למקדם Cohen’s kappa של 0.80. תעדו סף מדויק זה וכל פעולה מתקנת שננקטה.
6. הערכת איכות ומידול סטטיסטי
- דרגו כל תרגום כתוב סופי וכל ביצוע של תרגום תוך כדי קריאה (sight-interpreting) באמצעות המחוברת האנליטית בעלת 25 הנקודות בSupplementary File 1.
- דרגו את הדיוק, השלמות, ההתאמה הלקסית, הלכירויות והטבעיות של שפת היעד מ-0 עד 5 באמצעות נקודות הייחוס המצוינות. אין לבצע אינטרפולציה של קריטריוני הדירוג לאחר בדיקת השיוך לקבוצה.
- הנחו את המדרגים להשתמש הן באודיו והן בתמלול המאושר עבור מממדי התרגום תוך כדי קריאה. נתחו את מדדי ההפסקה וחוסר השטף בנפרד מציוני המחוברת.
- הכשירה שני מדרגים עצמאיים באמצעות ספר הקודים ולפחות 10 תוצרי תרגול, תוך הסתרת קבוצת המשתתפים וסדר המשימות מהמדרגים.
- לאחר דירוג עצמאי וקידוד של הפרקים, חשבו את המהימנות לפני הדיון. פתרו מחלוקות באמצעות קונצנזוס והתייעצו עם מדרג שלישי רק כאשר לא ניתן להגיע להסכמה.
- דווחו על מקדם מתאם תוך-מעמדי (intraclass correlation coefficient) של הסכמה מוחלטת עם השפעות אקראיות דו-כיווניות עבור ציוני איכות רציפים ממוצעים. דווחו על ערך Cohen's kappa עבור קוד התיקון הקטגורי הראשי, ועל ערך kappa נפרד עבור קוד התוצאה: יעילה/ניטרלית/מזיקה. ציינו את המספר המדויק ואת אחוז הפרקים שעברו קידוד כפול.
- וודאו שכל קובץ תהליך קריא ומלא לפני הניתוח, התאימו את יומני המשימות הכתובות להקלטות המסך התואמות, והשוו את התמלילים מול האודיו.
- תעדו כשלים בהתאמה, בעיות מובנות ופעולות מתקנות ביומן בקרת איכות. נרמלו מדדי תדירות באמצעות 100 יחידות מידע של טקסט המקור עבור תדירות הפסקות ו-100 תווים סיניים שיוצרו עבור צפיפות תיקונים בכתב.
- קודדו את התוצאה התפקודית באופן בלתי תלוי מציון האיכות ההוליסטי הסופי. קודדו פרק כ"יעיל" כאשר מקטע לאחר תיקון משפר את הטקסט מבלי להכניס בעיות חדשות, כ"ניטרלי" כאשר הוא אינו חולל שינוי מהותי, וכ"מזיק" כאשר הוא מכניס טעות.
- חשבו את שיעור היעילות כמספר הפרקים היעילים חלקי כל הפרקים שניתן לסווג, תוך החרגת פרקים מעורפלים מהמכנה.
- נתחו את ההדגמה כסט נתונים של מדידות חוזרות לצורך חקירה ראשונית (exploratory). הגדירו את מודל ההשפעות הקבועות לניבוי ציון איכות כולל באמצעות תנאי המשימה, קבוצת האימון, מדדי הפסקה, צפיפות תיקונים, שיעור יעילות, נטל חוסר שטף וקצב דיבור.
- כללו חיתוך אקראי (random intercept) עבור משתתף, וכללו השפעות אקראיות של טקסט המקור רק אם התכנון כולל מספיק טקסטים שנדגמו באופן עצמאי.
- מרכזו מנבאים רציפים, בחנו את השאריות ובדקו קוליניאריות. דווחו על שיטת ההערכה, גרסת התוכנה, β, SE, 95% CI, ערכי p מדויקים, רכיבי שונות, AIC, BIC ו-marginal/conditional R2. תארו את הניתוח כראשוני והימנעו מטענות סיבתיות מאששות.
- ייצאו חבילת ניתוח הניתנת לשחזור המכילה נתונים ללא פרטים מזהים, מילון, ספר קודים, מחוברת, פרטי תוכנה, סקריפטים ותוצרים. וודאו שניתן לעקוב אחרי כל ערך בטבלה או באיור עד למשתנה שם ושלב ניתוח לפני השחרור.
תוצאות
מאפייני בסיס של המשתתפים וזמינות נתונים
השאלון כלל 62 משתתפים (31 מתחילים ו-31 מיומנים), וגיליון המטלות הכיל 124 רשומות, המעידות על שני תיעודי מטלות שהושלמו לכל משתתף (טבלה 1). קבוצת המתחילים עברה פחות מ-12 חודשים של הכשרה מובנית בתרגום (מקסימום שנצפה, 8.6 חודשים), בעוד שהקבוצה המיומנת עברה לפחות 12 חודשים (מינימום שנצפה, 13.3 חודשים). ההתפלגויות של גיל, מין, משך למידת האנגלית, רמת מיומנות וסדר ביצוע המטלות היו דומות בין הקבוצות. איור 1 מציג את המדגם הסופי שנותח ומבחין נכונה בין נתונים ספציפיים למטלה: תיעודי הקשות מקלדת והקלטות מסך חלים על תרגום כתוב, הקלטות שמע ותמלילים מילה במילה חלים על תרגום סימולטני של טקסט (sight interpreting), ומדדי איכות חלים על שניהם.
פרופילים התנהגותיים לאורך תנאי המטלה
פרופילים התנהגותיים היו שונים בין שני תנאי המשימה ובין קבוצות האימון (טבלה 2; איור 2A–E). בתרגום כתוב נרשמו זמני השלמה ארוכים יותר והפסקות ממוצעות ארוכות יותר, בעוד שבפירוש בעין היו יותר הפסקות לכל 100 יחידות מידע מתחת לסף המדווח. בתוך כל תנאי משימה, הקבוצה שעברה אימון השלימה את המשימות מהר יותר והשיגה ציוני פלט ממוצעים גבוהים יותר. אין לפרש ניגודים אלה כהשפעות טהורות של המודליות, מכיוון שאורך הטקסט, הגבלת הזמן, אופן הפלט וההזדמנות לתיקון היו שונים אף הם. הפסקות אינן משבשות את הרצף באופן אחיד: הפסקה עשויה לשקף קושי שלא נפתר, תכנון מוצלח, ניטור או פעילות של שיטת הקלט, ולכן מדדי ההפסקה מפורשים יחד עם מדדי תיקון, הגשה ואיכות.
עדכון אסטרטגי, תיקון עצמי ומודל חיזוי
מסגרת הקידוד הפרידה בין סוג הפרק לבין התוצאה התפקודית (טבלה 3; איור 3A–D). משתתפים שעברו הכשרה הפיקו יותר פרקים של תיקון כתוב מאשר טירונים (12.4 ± 3.7 לעומת 8.9 ± 3.0 למשימה), בעוד שסך התיקונים העצמיים בעל פה לא השתנה באופן מובהק בין הקבוצות (4.9 ± 1.6 לעומת 4.4 ± 1.5 למשימה). למרות זאת, לקבוצה שעברה הכשרה היה פרופורציה גבוהה יותר של פרקים יעילים בשתי המשימות. סיכום ההשפעות המעורבות המדווח בטבלה 4 מציג קשרים ולא נתיבים סיבתיים; לכן, איור 3E מציג את הערכות ההשפעות הקבועות ומרווחי האמון המדווחים במקום דיאגרמה סיבתית.
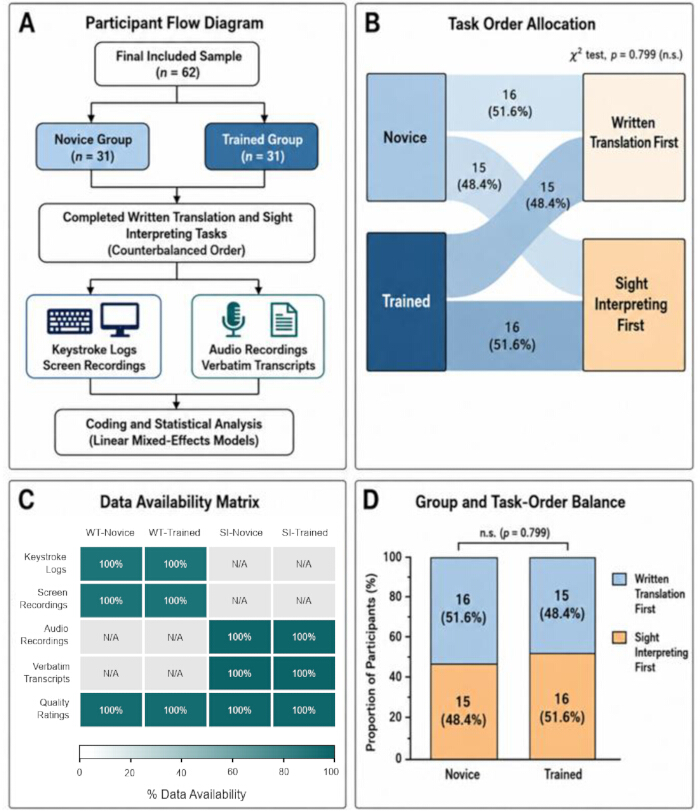
איור 1: זרימת משתתפים, הקצאת סדר מטלות וזמינות נתונים ספציפיים למטלה. (A) מדגם סופי מנותח של 62 משתתפים ו-124 רשומות מטלות. (B>) הקצאת סדר מטלות מאוזנת בתוך קבוצות של מתחילים ומיומנים. (C>) מטריצת זמינות שבה יומני הקשות ומקלדת והקלטות מסך רלוונטיים רק לתרגום כתוב, הקלטות שמע ותמלילי מילה במילה רק לתרגום סימולטני (sight interpreting), ודירוגי איכות לשתי המטלות. (D>) איזון קבוצה-סדר (מבחן chi-square, p = 0.799). n = 62 משתתפים (31 לכל קבוצה). אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
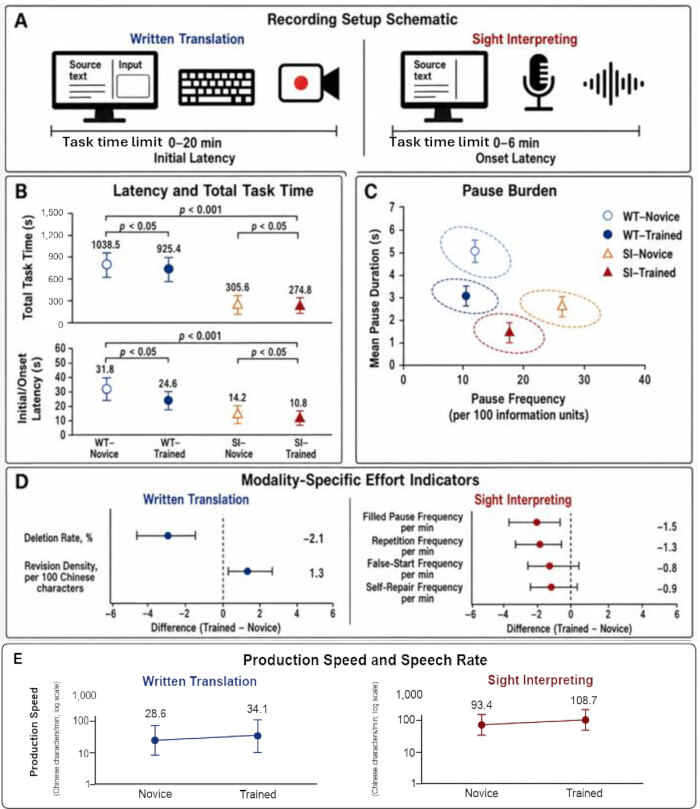
איור 2: פרופילים התנהגותיים בתנאי משימה של תרגום בכתב ותרגום simultaneous. (A) מערך הקלטה ספציפי למשימה. (B) השהיית התחלה/פתיחה וזמן משימה כולל. (C) התפלגות משותפת של תדירות הפסקות ומשך הפסקה ממוצע. (D) מדדי מחיקה, תיקון וחוסר רצף דיבור ספציפיים למשימה. (E) קצב הפקה בכתב וקצב דיבור בעל פה. בלוחות B, C ו-E, הנקודות וסטיות התקן מראות ממוצעי קבוצה ± SD; בלוח D, הנקודות מראות הפרשי ממוצעים בין מיומנים למתחילים וסטיות התקן מראות רווחי סמך של 95%. n = 31 משתתפים לכל קבוצה. בלוח E, ציר ה-y מוצג בסולם לוגריתמי. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
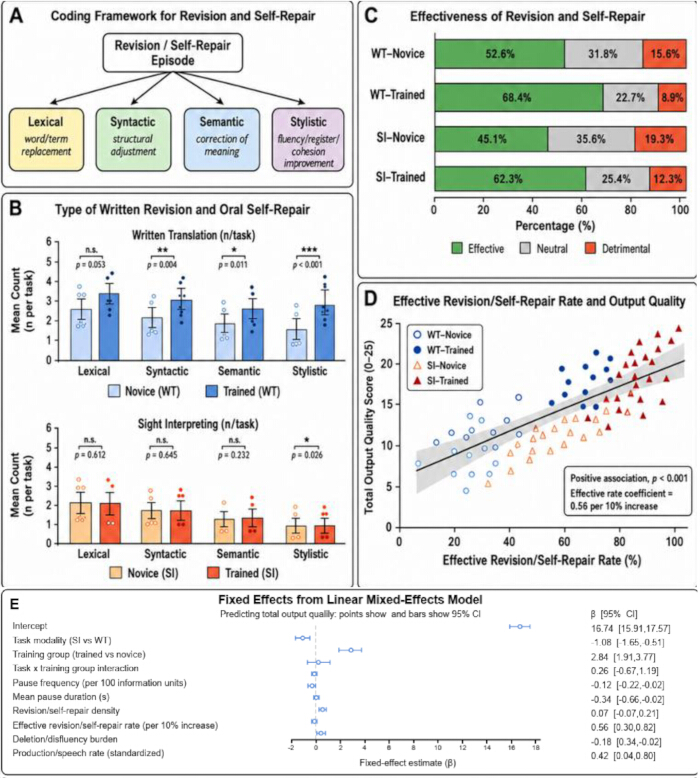
איור 3קידוד תיקון/תיקון עצמי, תוצאה תפקודית והקשרים לאיכות הפלט. (Aמסגרת קבלת החלטות להקצאה עצמאית של סוג האירוע ותוצאה תפקודית.B) ממוצעי הספירות של אירועים לקסיקליים, תחביריים, סמנטיים וסגנוניים בכל תנאי משימה. (C) פרופורציות ממוצעות של אירועים יעילים, ניטרליים ומזיקים. (D) קשר תיאורי בין שיעור פרקים יעילים לבין ניקוד כולל של איכות התוצר. (התרשים יער (forest plot) המציג השפעות קבועות ממודל אפקטים מעורבים ליניארי עם רווחי סמיכות של 95% (מפורט ב- טבלה 4); התרשים הוא אסוציאטיבי ואינו מייצג מודל של נתיב סיבתי. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
| משתנים | קבוצת מתחילים (n = 31) | קבוצת מיומנים (n = 31) | p value |
| גיל, שנים | 21.9 ± 1.7 | 22.4 ± 1.9 | 0.279 |
| נשים, n (%) | 22 (71.0) | 21 (67.7) | 0.779 |
| משך לימוד אנגלית, שנים | 12.4 ± 2.1 | 12.9 ± 2.2 | 0.36 |
| ציון רמת שליטה באנגלית | 548.6 ± 41.3 | 562.4 ± 45.8 | 0.216 |
| משך הכשרה בתרגום, חודשים | 5.6 ± 3.0 | 18.7 ± 5.4 | <0.001 |
| משך הכשרה בפירוש, חודשים | 2.3 ± 2.1 | 13.9 ± 5.7 | <0.001 |
| ניסיון קודם בתרגום בכתב ≥5 משימות, n (%) | 9 (29.0) | 24 (77.4) | <0.001 |
| ניסיון קודם בפירוש למראה ≥5 משימות, n (%) | 5 (16.1) | 20 (64.5) | <0.001 |
| תרגום בכתב תחילה, n (%) | 16 (51.6) | 15 (48.4) | 0.799 |
| פירוש למראה תחילה, n (%) | 15 (48.4) | 16 (51.6) | 0.799 |
טבלה 1: מאפייני המשתתפים ופרופילי אימון שפה בבסיס לפי קבוצה. משתנים מוצגים כממוצע ± סטיית תקן עבור נתונים רציפים וכספירות (אחוזים) עבור נתונים קטגוריאליים. ערכי ה-p המדווחים משקפים השוואות בין קבוצות כדי לאמת איזון דמוגרפי בבסיס ולאשר את ההבדלים המתוכננים במשך האימון.
| משתנים | תרגום כתוב: מתחילים (n = 31) | תרגום כתוב מאומן (n = 31) | מתרגמים חזותיים מתחילים (n = 31) | תרגום במבט (מאומנים) (n = 31) | השפעת המשימה p | אפקט קבוצתי p |
| חביון התחלה/הופעה, s | 31.8 ± 12.4 | 24.6 ± 9.7 | 14.2 ± 5.6 | 10.8 ± 4.2 | <0.001 | 0.003 |
| זמן משימה כולל, שניות | 1038.5 ± 168.2 | 925.4 ± 151.6 | 305.6 ± 59.3 | 274.8 ± 50.7 | <0.001 | 0.004 |
| תדירות הפסקות, לכל 100 יחידות מידע | 18.6 ± 6.1 | 14.2 ± 5.0 | 24.8 ± 7.4 | 19.6 ± 6.3 | <0.001 | 0.001 |
| משך השהיה ממוצע, s | 4.1 ± 1.2 | 3.3 ± 1.0 | 2.7 ± 0.8 | 2.3 ± 0.7 | 0.012 | 0.002 |
| קצב ייצור/דיבור, תווים סיניים לדקה | 28.6 ± 6.7 | 34.1 ± 7.5 | 93.4 ± 18.9 | 108.7 ± 20.4 | 0.001 | |
| שיעור מחיקה, % | 8.9 ± 3.4 | 6.8 ± 2.7 | 0.009 | |||
| צפיפות תיקונים, לכל 100 תווים סיניים | 7.6 ± 2.8 | 8.9 ± 3.1 | 0.087 | |||
| שכיחות הפסקות מלאות, לדקה | 5.7 ± 1.9 | 4.2 ± 1.6 | 0.002 | |||
| תדירות חזרות, לדקה | 4.9 ± 1.8 | 3.6 ± 1.4 | 0.004 | |||
| תדירות התנעה שגויה, לדקה | 2.8 ± 1.1 | 2.0 ± 0.9 | 0.006 | |||
| תדירות תיקון עצמי, לדקה | 4.8 ± 1.7 | 3.9 ± 1.4 | 0.031 | |||
| ציון איכות כולל, 0–25 | 16.8 ± 2.3 | 20.1 ± 2.1 | 15.4 ± 2.6 | 18.9 ± 2.4 | 0.002 | <0.001 |
| דיוק, 0–5 | 3.4 ± 0.7 | 4.1 ± 0.6 | 3.1 ± 0.8 | 3.8 ± 0.7 | 0.004 | <0.001 |
| שלמות, 0–5 | 3.3 ± 0.8 | 4.0 ± 0.6 | 3.0 ± 0.8 | 3.7 ± 0.7 | 0.006 | <0.001 |
| הלימה לקסיקלית, 0–5 | 3.2 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.041 | <0.001 |
| קוהרנטיות, 0–5 | 3.5 ± 0.6 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.003 | <0.001 |
| טבעיות בשפת היעד, 0–5 | 3.4 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.7 | 0.007 | <0.001 |
טבלה 2: מדדי תהליך התנהגותי ואיכות הפלט לאורך תנאי המשימה והקבוצות. הערכים מוצגים כממוצע ± סטיית תקן. ערכי ה-p המדווחים מצביעים על ההשפעות המרכזיות של אופן ביצוע המשימה (תרגום כתוב לעומת תרגום תוך-סיכום/Sight translation) ורקע ההכשרה (מתחילים לעומת מיומנים) על כל משתנה של תהליך ואיכות.
| משתנים | תרגום כתוב - מתחילים | תרגום כתוב - מיומנים | ערך p | תרגום תוך-זרימה (Sight interpreting) - מתחילים | תרגום תוך-זרימה (Sight interpreting) - מיומנים | ערך p |
| תיקון לקסיקלי/תיקון עצמי, n/task | 3.4 ± 1.5 | 4.2 ± 1.7 | 0.053 | 1.8 ± 0.8 | 1.7 ± 0.7 | 0.612 |
| תיקון תחבירי/תיקון עצמי, n/task | 2.1 ± 1.1 | 3.0 ± 1.2 | 0.004 | 1.1 ± 0.7 | 1.2 ± 0.8 | 0.645 |
| תיקון סמנטי/תיקון עצמי, n/task | 1.8 ± 1.0 | 2.5 ± 1.1 | 0.011 | 0.9 ± 0.6 | 1.1 ± 0.7 | 0.232 |
| תיקון סגנוני/תיקון עצמי, n/task | 1.6 ± 0.9 | 2.7 ± 1.2 | <0.001 | 0.6 ± 0.4 | 0.9 ± 0.6 | 0.026 |
| סך כל מקרי התיקון/תיקון עצמי, n/task | 8.9 ± 3.0 | 12.4 ± 3.7 | <0.001 | 4.4 ± 1.5 | 4.9 ± 1.6 | 0.209 |
| מקרים יעילים, % | 52.6 ± 13.5 | 68.4 ± 12.1 | <0.001 | 45.1 ± 14.2 | 62.3 ± 13.0 | <0.001 |
| מקרים ניטרליים, % | 31.8 ± 10.4 | 22.7 ± 8.8 | 0.001 | 35.6 ± 11.7 | 25.4 ± 9.6 | 0.001 |
| מקרים פוגעים, % | 15.6 ± 7.1 | 8.9 ± 5.6 | <0.001 | 19.3 ± 8.6 | 12.3 ± 6.8 | 0.001 |
טבלה 3: סוג ויעילות של תיקונים בכתב ותיקונים עצמיים בעל פה לאורך תנאי המטלה. סוגי הפרקים מדווחים כמספרים ממוצעים למטלה (± סטיית תקן), ותוצאות פונקציונליות מדווחות כאחוזי ממוצעים (± סטיית תקן). ערכי ה-p מצביעים על המובהקות של ההבדלים בין הקבוצות בתוך כל אופן ביצוע של המטלה.
| השפעות קבועות | β | SE | 95% CI | p value |
| נקודת חיתוך | 16.74 | 0.42 | 15.91 עד 17.57 | <0.001 |
| אופן המשימה: תרגום בעל פה לעומת תרגום בכתב | -1.08 | 0.29 | -1.65 עד -0.51 | <0.001 |
| קבוצת התנסות: מיומנים לעומת מתחילים | 2.84 | 0.47 | 1.91 עד 3.77 | <0.001 |
| אופן המשימה × קבוצת התנסות | 0.26 | 0.47 | -0.67 עד 1.19 | 0.581 |
| תדירות הפסקות, לכל 100 יחידות מידע | -0.12 | 0.05 | -0.22 עד -0.02 | 0.018 |
| משך הפסקה ממוצע, s | -0.34 | 0.16 | -0.66 עד -0.02 | 0.041 |
| צפיפות תיקונים/תיקון עצמי | 0.07 | 0.07 | -0.07 עד 0.21 | 0.334 |
| שיעור תיקונים/תיקון עצמי אפקטיבי, לכל עלייה של 10% | 0.56 | 0.13 | 0.30 עד 0.82 | <0.001 |
| נטל מחיקות/חוסר שטף | -0.18 | 0.08 | -0.34 עד -0.02 | 0.027 |
| קצב הפקה/דיבור, מתוקנן | 0.42 | 0.19 | 0.04 עד 0.80 | 0.032 |
טבלה 4: השפעות קבועות שדווחו ממודל התשמורת הליניארי המעורב החוזה את איכות התוצר הכוללת. הסיכום מפרט את המקדמים הבלתי-מתוקננים (β), שגיאות תקן (SE), רווחי סמך של 95% (CI), וערכי p מדויקים עבור כל המנבאים ההתנהגותיים ומנבאי המטלה שצוינו.
דיון
מחקר זה מדגים פרוטוקול רב-מודאלי למדידת אינדיקטורים תהליכיים ניתנים לצפייה וקידוד של תיקון אסטרטגי בתרגום כתוב ובתרגום סימולטני ממסמך (sight interpreting) מאנגלית לסינית. הפרוטוקול אינו מודד באופן ישיר משתנה אחיד של מאמץ קוגניטיבי. תגובתיות (latency), הפסקות, מחיקות ודפוסי תיקון מפורשים כמתאמים התנהגותיים הרגישים למשימה, שמשמעותם תלויה בטריאנגולציה עם רשומות מסונכרנות וראיות לאיכות הפלט1,2,3,4,5,6,7,8. שתי המשימות נבדלות גם בחומרים, בתזמון, במוד פלט ובהזדמנויות לתיקון; לפיכך, הניגודים המייצגים מתארים הבדלים בתנאי המשימה ולא השפעות מודאליות מבודדות. התרומה האנליטית העיקרית היא ההפרדה בין תדירות התיקון לבין התוצאה הפונקציונלית. בסיכומי הדיווח, משתתפים שעברו הכשרה ביצעו יותר תיקונים בכתב, ולא פחות, בעוד שסך תיקוני העצמי (self-repair) בעל פה לא נבדל באופן משמעותי בין הקבוצות. שיעור הפרקים האפקטיביים הגבוה יותר שלהם מרמז כי ניטור האיכות עשוי להיות אינפורמטיבי יותר מאשר תדירות גולמית, אך פרשנות זו תלויה בכללי החלטה שקופים, קידוד תוצאות עצמאי ודיווח על מהימנות. ספר הקוד והדוגמאות המעובדות ב-Supplementary File 1 נועדו להפוך הבחנה זו למשחזרת ולא למטרות קידומיות.
השלבים הקריטיים הם סנכרון בין הרשומות, איכות השמע, אימות התמלול ועקביות הקידוד. יש לבדוק את חותמות הזמן הזמינות ואת הרמזים לגבולות המשימה בעת סנכרון היומנים וההקלטות. יש לבחון את השמע כדי לוודא שאין גזירה (clipping) ושהוא ברור לפני התמלול, ויש לאמת את גבולות ההפסקות המוצעים אל מול צורת הגל והתמלול. עבור קלט בסינית, אין להשוות בין מקשי ההקלדה של הרכבת המילה לבין תיקונים של תווים שנכתבו סופית. יש לתעד בדיקות ופעולות מתקנות אלו ביומן בקרת איכות.
מספר מגבלות מעכבות את הפרשנות. ההדגמה משתמשת בקבוצות של סטודנטים ומתמחים, בטקסטים הסבריים כלליים קצרים, באורכי משימה ובמגבלות זמן שונות, ובמדגם המבוסס על זמינות. תנאי המשימה נבדלים גם באופן הפלט ובהזדמנויות לתיקון, ומערך הנתונים אינו כולל מזהים של טקסט מקור שנדגמו באופן עצמאי כדי להעריך שונות ברמת הטקסט. בנוסף, ספי סריקה של הפסקות (pause thresholds) הם בחירות אופרציונליות, והפסקות ארוכות יותר עשויות לשקף הן תכנון פרודוקטיבי והן קושי שלא נפתר. הכללה לאנשי מקצוע, לתחומים ייחודיים, לזוגות שפות אחרים או למערכות כתיבה אחרות דורשת תיקוף מחדש של החומרים, הטיפול בשיטת הקלט, הספים ועגני הניקוד.
עבודות עתידיות יכולות לשלב את הרישומים ההתנהגותיים עם מעקב עיניים, פופילוemetria (מדידת אישונים), או מדדים סובייקטיביים של עומס עבודה, כדי לבחון אילו הפסקות ותיקונים תואמים לקשב, למאמץ שנחווה או לתכנון מוצלח5,6,13,14,15,16. Shreve וחב' השתמשו במעקב עיניים בתרגום תוך כדי ראייה (sight translation) ואין לצטט אותם כבדיקת פופילוemetria18; פופילוemetria נידונה ישירות על ידי Seeber5. הרחבות רב-מודאליות כאלה צריכות לשמר את ההפרדה בין דרישת המשימה, המאמץ שהושקע, ההתנהגות שנצפתה והביצועים. לכן, הפרוטוקול הנוכחי משמש בצורה המיטבית כמסגרת שקופה להערכת תהליכים, שהאינדיקטורים שלה תומכים בטענות לגבי מאמץ קוגניטיבי חבוי, אך אינם מבססים אותן כשלעצמם.
גילויים
המחברים מדווחים על היעדר ניגודי עניינים מסחריים או פיננסיים. בנוגע לשימוש בבינה מלאכותית, המחברים מצהירים כי נעשה שימוש ב-OpenAI Codex במהלך תהליך העריכה אך ורק כדי לסייע בעריכת השפה, בבדיקות עקביות, בהכנת תיקוני מעקב ובבנייה מחדש של פריסות האיורים על בסיס נתונים שסיפקו המחברים. המחברים סקרו בקפידה את כל התוצרים בסיוע בינה מלאכותית והם נושאים באחריות מלאה לדיוק, ליושרה ולמקוריות של כתב היד הסופי. חוברת העבודה המובנית העומדת בבסיס הסיכומים המדווחים זמינה לציבור ב-Zenodo (https://doi.org/10.5281/zenodo.21189434). קובץ משלים 1 מכיל את מדריך הקידוד ואת מחוון האיכות המעוגן.
תודות
המחבר מודה למכון גווילין לטכנולוגיית מידע על התמיכה במעבדה, למומחים הדו-לשוניים שהעריכו את טקסטים המקור, למדרגים העצמאיים ולמשתתפים. מחקר זה לא קיבל מענק ספציפי מכל סוכנות מימון במגזר הציבורי, המסחרי או ללא מטרת רווח.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| תוכנה לניתוח אקוסטי (Praat) | Paul Boersma and David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| מחשב שולחני | Dell | OptiPlex | |
| תוכנה להקלטה דיגיטלית של אודיו (Audacity) | Audacity Team | https://www.audacityteam.org/ | |
| תוכנה לתיעוד הקשות מקלדת (Inputlog) | University of Antwerp | https://www.inputlog.net/ | |
| תוכנה להקלטת מסך (OBS Studio) | OBS Project | https://democreator.wondershare.com/ | |
| תוכנה לניתוח סטטיסטי (SPSS) | IBM | Version 27 |
מקורות
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
הדפסות חוזרות והרשאות
תגיות
מאמר זה פורסם
הסרטון יגיע בקרוב